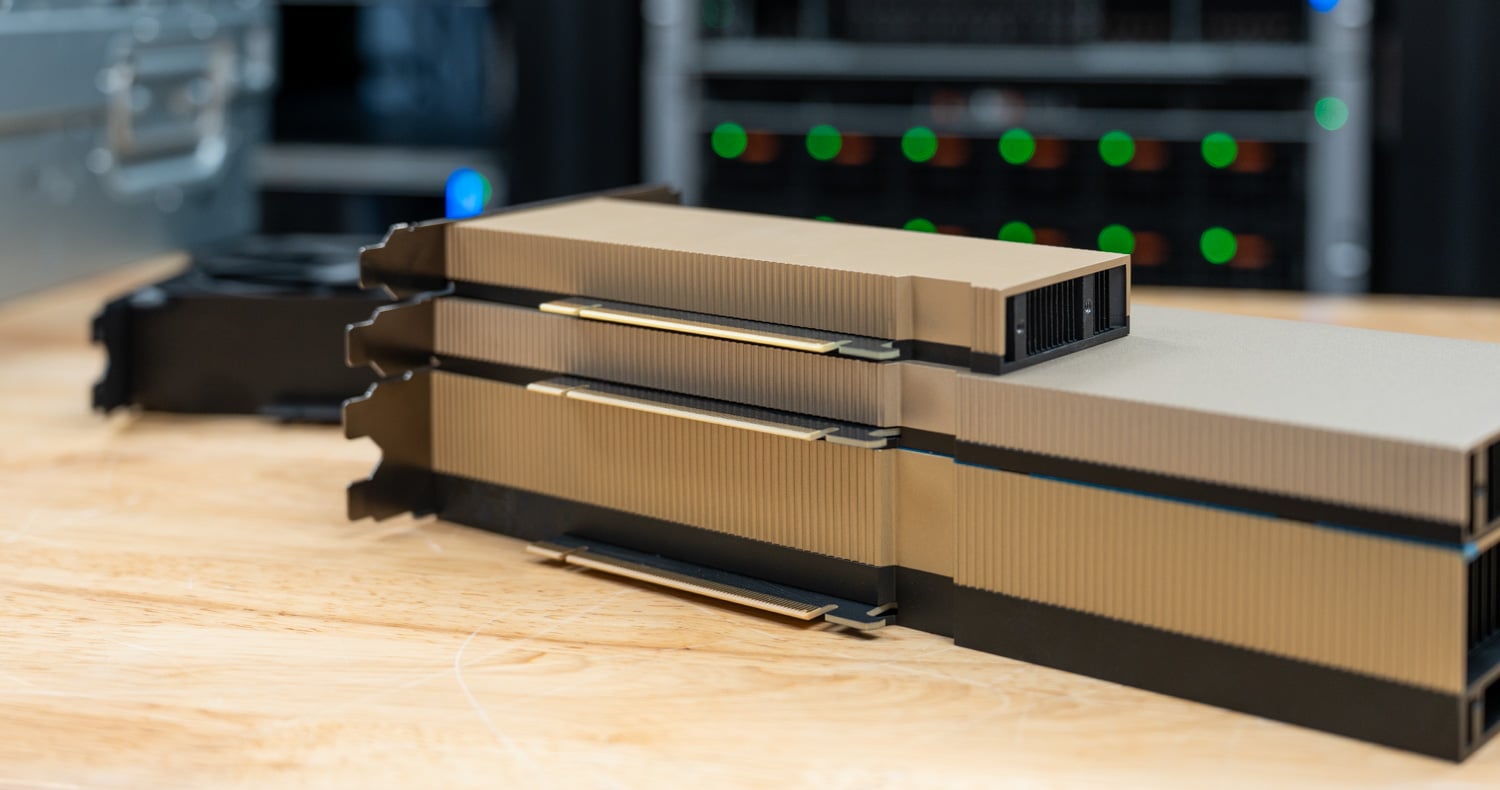
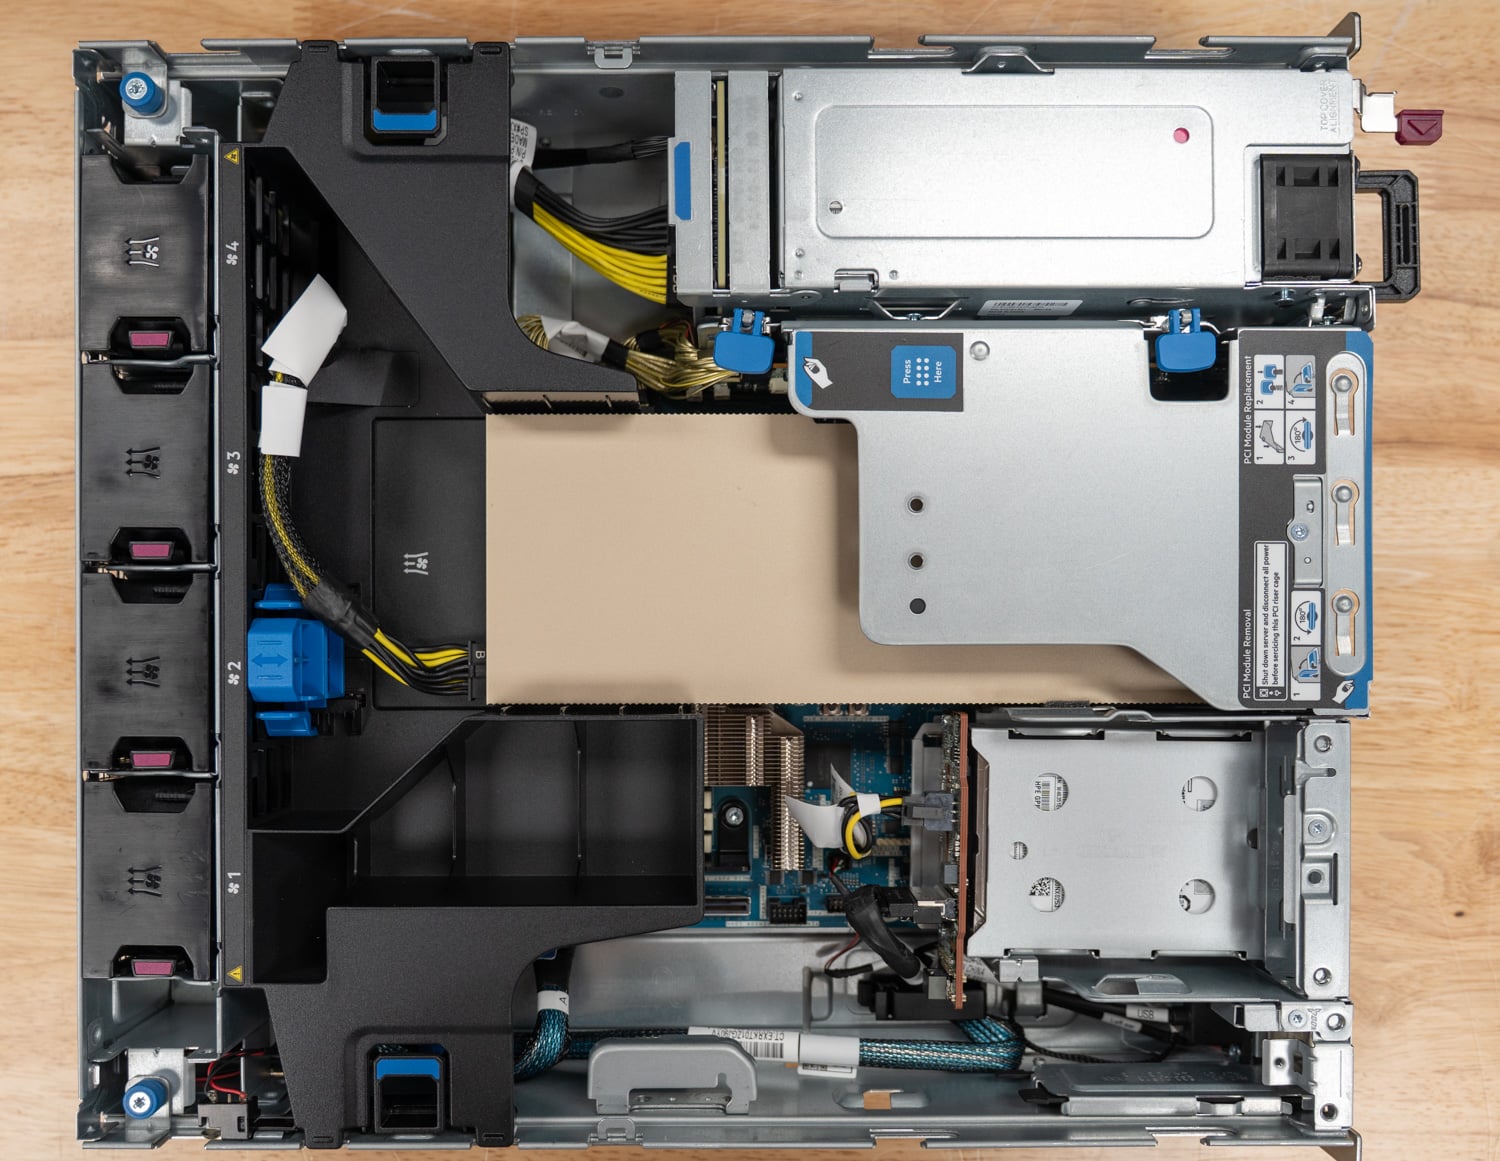
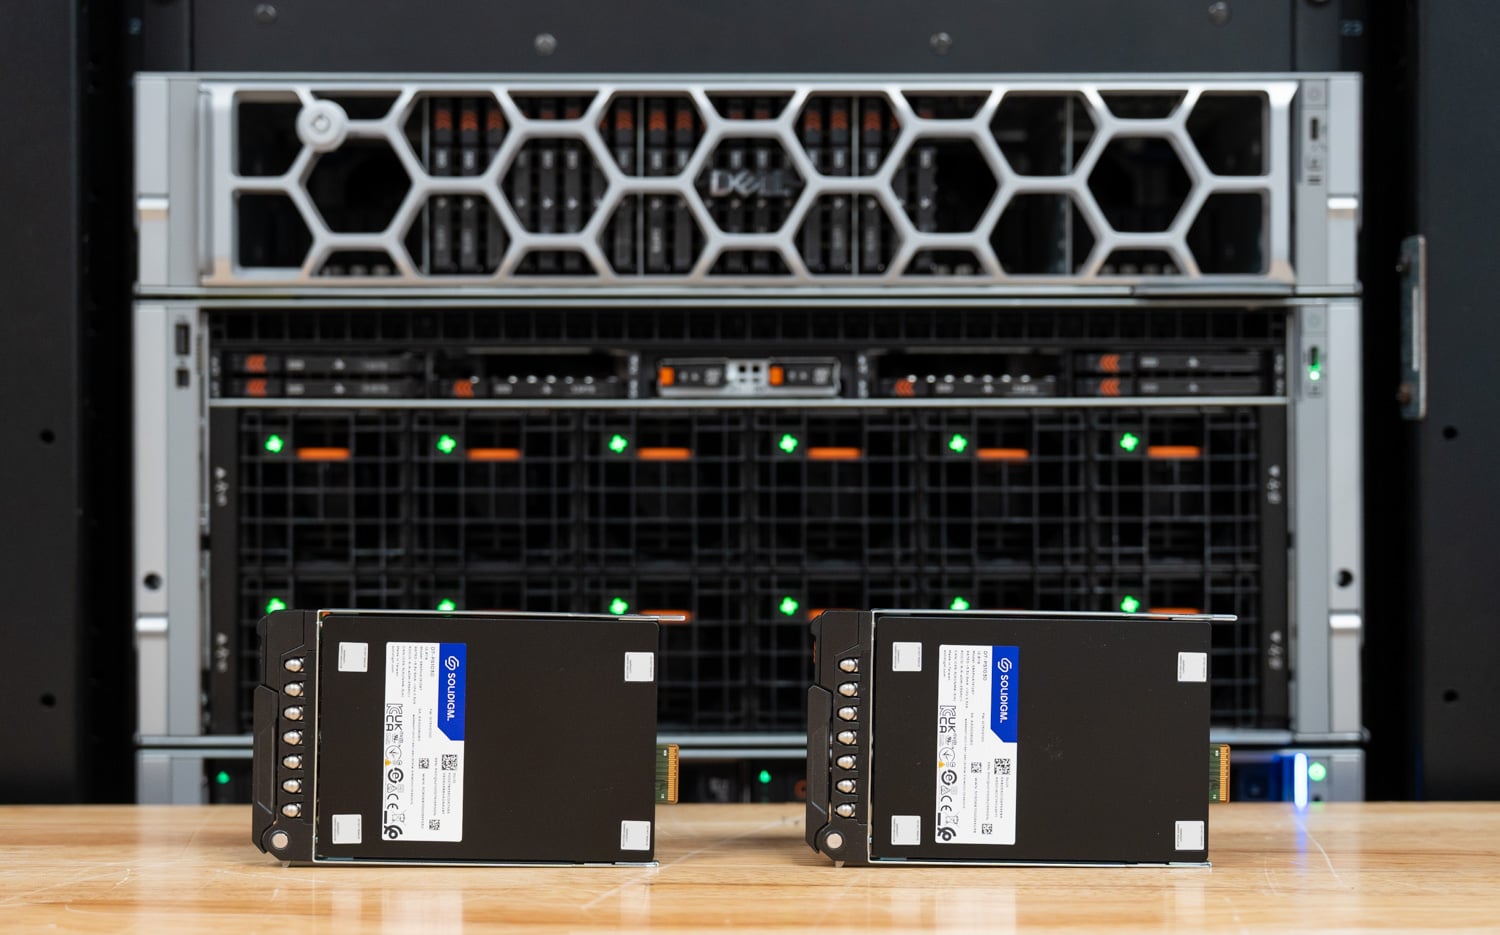
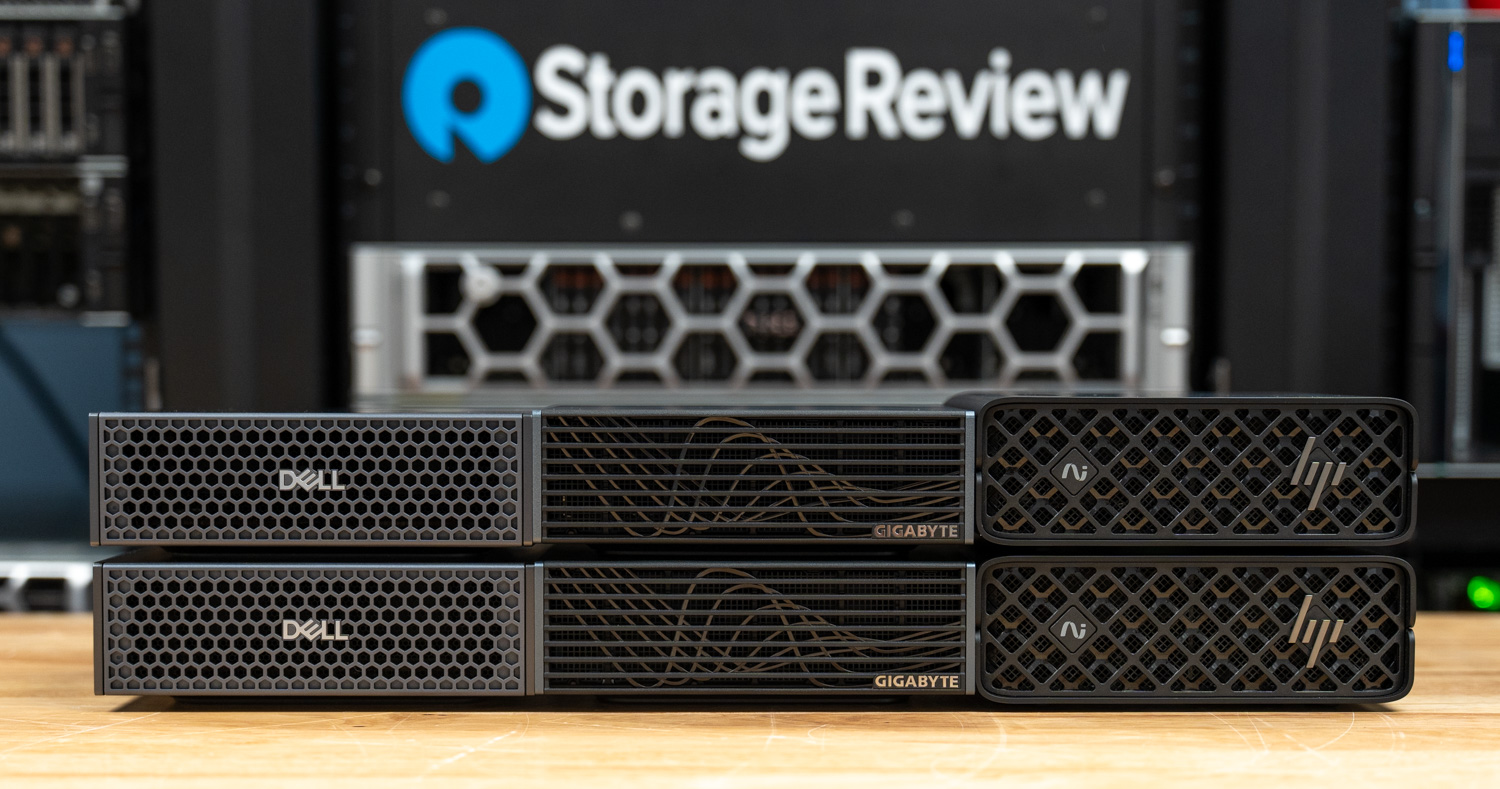
В наших текущих обзорах систем ИИ основное внимание уделяется выполнению инференции в лабораторных условиях с использованием моделей с открытыми весами из семейств Llama, Qwen, DeepSeek и gpt-oss, работающих через vLLM или SGLang, и измеряемых по пропускной способности и задержке первого токена. Обзор охватывает все уровни — от периферии до полного узла GPU: NVIDIA RTX PRO 4500 Server Edition обеспечила в среднем в 2.7 раза больше токенов в секунду, чем L4, который она была призвана заменить в HPE ProLiant DL145 Gen11, при этом потребление электроэнергии увеличилось примерно на 105 Вт; версии DGX Spark от Dell, GIGABYTE и HP выполняли распределенную инференцию в виде двух узловых кластеров по сети 200 Гбит/с; а Supermicro JumpStart предоставила нам возможность поработать с системами NVIDIA HGX B200 и AMD Instinct MI350X. К хранилищу применяется тот же подход, поскольку скорость передачи данных определяет загруженность этих графических процессоров, поэтому мы измеряем пропускную способность хранилища GPUDirect с помощью GDSIO и тестируем разгрузку кэша ключ-значение на флэш-память для рабочих нагрузок с длинным контекстом и агентных рабочих нагрузок.
Если вы занимаетесь подбором оборудования для ИИ, на странице «Лучшие серверы» представлены наши текущие рекомендации по выбору решений для вывода ИИ и периферийных вычислений на основе данных из этих обзоров; на странице «Лучшие корпоративные SSD- накопители» рассматриваются диски, обеспечивающие работу графических процессоров; а на странице « Лучшие массивы хранения данных» — платформы хранения данных для ИИ, используемые в обучающих кластерах и неооблачных средах.




 Amazon