

Компания Pliops находится на переднем крае ускорения обработки данных, специализируясь на аппаратных и программных решениях, разработанных для оптимизации и повышения производительности ресурсоемких рабочих нагрузок в облачных и корпоративных центрах обработки данных. Процессор Pliops Extreme Data Processor (XDP) создан для повышения производительности и эффективности современной инфраструктуры данных за счет управления потоком данных между приложениями и хранилищем, устранения узких мест и снижения задержки. XDP идеально подходит для требовательных сред, нуждающихся в высокой пропускной способности и минимальной задержке, таких как среды, лежащие в основе искусственного интеллекта, сложных баз данных, расширенной аналитики и масштабных систем хранения данных.

Поскольку искусственный интеллект все больше становится краеугольным камнем бизнес-операций и инноваций, требования к инфраструктуре центров обработки данных экспоненциально возросли, особенно для рабочих нагрузок, связанных с выводом данных ИИ. Эти рабочие нагрузки требуют быстрой и эффективной обработки огромных объемов данных, что создает огромную нагрузку на существующие вычислительные ресурсы и хранилище. Организации сталкиваются с растущими проблемами при развертывании масштабируемой, экономически эффективной и энергоэффективной инфраструктуры, способной стабильно соответствовать строгим требованиям к уровню производительности (SLA).
Pliops XDP LightningAI решает эти насущные проблемы напрямую. Это инновационное решение представляет собой универсальный механизм ускорения хранения данных, разработанный для бесшовной интеграции с ведущими серверными платформами , такими как системы Dell PowerEdge, и для совместной работы с передовыми решениями для вывода данных, такими как NVIDIA Dynamo , что гарантирует эффективную работу ИИ.
Почему кэширование ключ-значение имеет решающее значение для масштабируемого вывода LLM-функций
Механизмы и значение кэширования КВ
В основе оптимизации больших языковых моделей на основе трансформеров лежит кэширование ключ-значение (KV-кэширование) — фундаментальный метод, который снижает вычислительную избыточность во время авторегрессивного вывода. В трансформерных архитектурах генерация каждого нового токена требует вычисления механизма внимания между запросом текущего токена и ключами и значениями всех предыдущих токенов.
Без эффективного механизма кэширования этот процесс будет избыточно пересчитывать ключи и значения для каждого токена в последовательности на каждом шаге генерации. Это приводит к вычислительной сложности O(n²), или квадратичной сложности, для последовательности длиной n. Кэширование ключ-значение обходит эту проблему, сохраняя вычисленные матрицы ключей и значений предыдущих токенов непосредственно в памяти графического процессора; модель может повторно использовать эти предварительно вычисленные тензоры для последующих шагов. Это повторное использование значительно снижает вычислительную сложность до O(n) после первоначальной обработки токенов, что существенно ускоряет скорость вывода.
Повышение эффективности имеет первостепенное значение для приложений искусственного интеллекта, работающих в режиме реального времени, таких как интерактивные чат-боты, сервисы мгновенного перевода и динамическая генерация кода, где задержка является критическим фактором, напрямую влияющим на пользовательский опыт и жизнеспособность приложения.
Ограничения памяти графического процессора: скрытое узкое место.
Хотя кэширование ключ-значение существенно повышает скорость вывода, оно создает нагрузку на ресурсы памяти графического процессора. Размер кэша ключ-значение растет линейно как с длиной последовательности (контекстным окном), так и с размером пакета (количеством одновременных запросов).

В многопользовательских облачных средах или корпоративных системах, обрабатывающих сотни, если не тысячи, одновременных запросов, такое потребление памяти может быстро исчерпать даже самую высокопроизводительную инфраструктуру графических процессоров. Это исчерпание вынуждает принимать сложные компромиссные решения: уменьшить размеры пакетов (снижение пропускной способности), сократить длину контекста или инвестировать в большее количество графических процессоров (увеличение капитальных затрат).
Кроме того, распространенной практикой среди поставщиков услуг вывода данных является не сохранение кэша ключ-значение между действиями пользователя или сообщениями. Это означает, что квадратичная вычислительная сложность для ранее вычисленных токенов возникает заново при каждом последующем взаимодействии, что сводит на нет некоторые потенциальные преимущества в эффективности.
NVIDIA Dynamo: переосмысление вывода LLM в масштабе

Что такое NVIDIA Dynamo?
NVIDIA Dynamo — недавно выпущенная и революционная платформа с открытым исходным кодом, разработанная для решения сложных задач распределенного и дезагрегированного выполнения инференции LLM. Поддерживая различные бэкенды, включая PyTorch, SGLang, TensorRT-LLM и vLLM, Dynamo специально разработана для бесперебойного масштабирования операций инференции от развертывания с одним графическим процессором до кластеров с тысячами графических процессоров. Она внедряет значительные архитектурные инновации для борьбы с ограничениями памяти, вызванными кэшем ключ-значение, одновременно оптимизируя пропускную способность и минимизируя задержку.
Дезагрегированная архитектура обслуживания
Ключевым нововведением в NVIDIA Dynamo является подход к дезагрегированному предоставлению данных. Эта архитектура стратегически разделяет ресурсоемкий этап предварительного заполнения и этап декодирования, требующий больших объемов памяти (генерация последующих токенов). Благодаря интеллектуальному распределению этих отдельных этапов между специализированными пулами графических процессоров, Dynamo обеспечивает независимую оптимизацию каждого из них, что приводит к более эффективному использованию ресурсов и общему повышению производительности.
Усовершенствования кэша KV
NVIDIA Dynamo также включает в себя сложные возможности управления кэшем ключ-значение (KV Cache). Ее интеллектуальный маршрутизатор с поддержкой KV Cache отслеживает состояние и местоположение данных KV Cache по всему парку графических процессоров. Это позволяет интеллектуально направлять входящие запросы на вывод данных к графическим процессорам с соответствующими записями в кэше, минимизируя дорогостоящие перерасчеты и накладные расходы на передачу данных.
Кроме того, распределенный менеджер кэша ключ-значение Dynamo напрямую решает проблему ограничений объема памяти за счет реализации многоуровневой разгрузки. Эта функция позволяет перемещать менее часто используемые или менее приоритетные блоки кэша ключ-значение из дорогостоящей и быстрой памяти HBM в более экономичные решения для хранения данных, такие как общая память ЦП, локальные SSD-накопители или сетевое объектное хранилище. Такой иерархический подход к хранению данных позволяет организациям управлять и хранить значительно большие объемы данных кэша ключ-значение с минимальными затратами, повышая производительность и экономическую эффективность.
Важно уточнить, что на сегодняшний день описанные выше возможности разгрузки KV-кэша являются частью будущих планов развития Dynamo и пока недоступны в открытой версии. Таким образом, текущие развертывания Dynamo с открытым исходным кодом не поддерживают разгрузку KV-кэша в многоуровневое хранилище. Это означает, что на практике производительность Dynamo по-прежнему ограничена доступной памятью графического процессора.
Pliops XDP LightningAI: Решение проблемы кэширования ключ-значение в масштабе
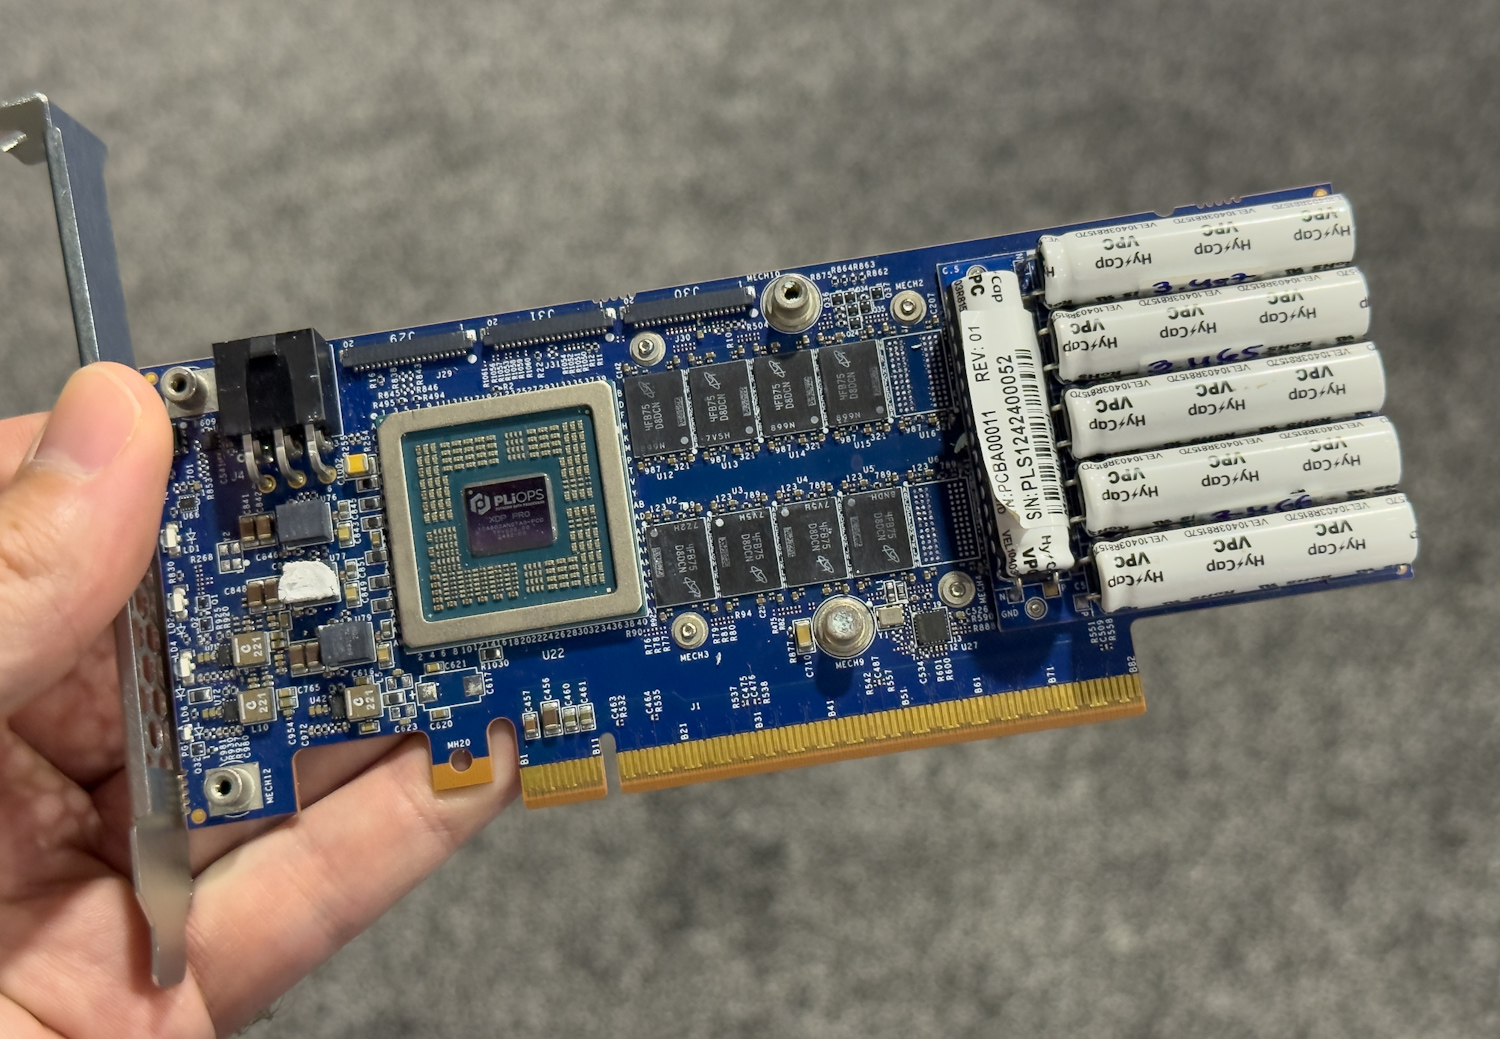
Представляем Pliops XDP LightningAI, которая создает сверхбыстрый, масштабируемый уровень памяти петабайтного размера, стратегически расположенный под HBM графического процессора. Это решает критически важные для организаций вопросы компромисса между размером пакета, длиной контекста, сложностью модели и растущими затратами на оборудование. Решение Pliops сочетает в себе передовой ASIC XDP-PRO и хранилище KVIO. Оно позволяет серверам на базе графических процессоров эффективно выгружать огромные объемы данных кэша ключ-значение на экономичные твердотельные накопители NVMe, сохраняя при этом исключительно низкую задержку доступа — менее миллисекунды.
На практике использование Pliops XDP LightningAI для разгрузки кэша ключ-значение практически не приводит к заметной разнице во времени до первого токена (TTFT) по сравнению со сценариями, где весь кэш ключ-значение хранится в дефицитной и дорогостоящей памяти HBM. Это позволяет организациям значительно расширить эффективную емкость памяти для кэширования ключ-значение без ущерба для критически важной низкой задержки, необходимой для приложений искусственного интеллекта реального времени.

Бесшовная интеграция благодаря проектированию на основе стандартов.
Преимуществом Pliops XDP LightningAI является использование открытых стандартов, что обеспечивает простоту внедрения. Архитектура решения, изначально использующая NVMe-oF, гарантирует широкую совместимость с существующими экосистемами серверов с графическими процессорами, не требуя модификации оборудования серверов для развертывания. Она использует стандартный NVMe-oF поверх RDMA для высокоскоростной синхронизации кэша с низкой задержкой между кластерами графических процессоров. Это позволяет использовать существующую сетевую инфраструктуру центров обработки данных, упрощая развертывание и снижая сложности интеграции.
Компания Pliops достигает этого с помощью целостного решения, построенного на основе двух взаимодополняющих технологий: XDP LightningAI и FusIOnX. Хотя эти компоненты работают вместе как часть общей архитектуры, они выполняют разные функции. Решение Pliops XDP LightningAI построено на базе специализированного аппаратного устройства, включающего в себя плату расширения PCIe, работающую на базе специализированного ASIC XDP и массива SSD-накопителей.
FusIOnX, с другой стороны, представляет собой дополнительную программную платформу, которая организует и управляет интеллектуальным использованием оборудования XDP LightningAI. Это дезагрегированная система разгрузки KV-кэша, которая исключает избыточные вычисления за счет хранения и повторного использования ранее вычисленных KV-кэшей. FusIOnX обеспечивает интеллектуальные возможности для идентификации, хранения и эффективного извлечения контекстных данных, которые в противном случае потребовали бы повторных вычислений, тем самым ускоряя вывод LLM. Программный стек предлагает множество конфигураций, адаптированных к различным сценариям развертывания, включая производственный стек vLLM с интеллектуальной маршрутизацией между несколькими узлами GPU и интеграцией с такими фреймворками, как Dynamo и SGLang.
Архитектура Pliops LightningAI FusIOnX
Архитектура системы построена на инициаторных узлах, в которых размещены графические процессоры, и целевых узлах LightningAI, отвечающих за перенос кэша ключ-значение в высокопроизводительное хранилище. Эти узлы взаимодействуют по высокоскоростной сети, используя протокол NVMe-oF и стандартные сетевые карты DPU.

Если углубиться в поток данных, то рабочий процесс Nvidia Dynamo взаимодействует с клиентским SDK FusIOnX внутри контейнера приложения на сервере с графическим процессором. Затем этот SDK обеспечивает связь через NVMe-oF с помощью DPU или стандартных сетевых карт с сервером хранения XDP LightningAI, на котором размещено хранилище FusIOnX KV Store и карта ускорения Pliops XDP Pro1.
LightningAI и NVIDIA Dynamo: тесты производительности
Тесты интеграции FusIOnX-Dynamo демонстрируют впечатляющий прирост производительности в различных конфигурациях. Тесты проводились с использованием модели Meta-Llama-3.1-70B-Instruct-FP8-dynamic, работающей с параллелизмом тензоров 2 (TP2).
Тестовая конфигурация
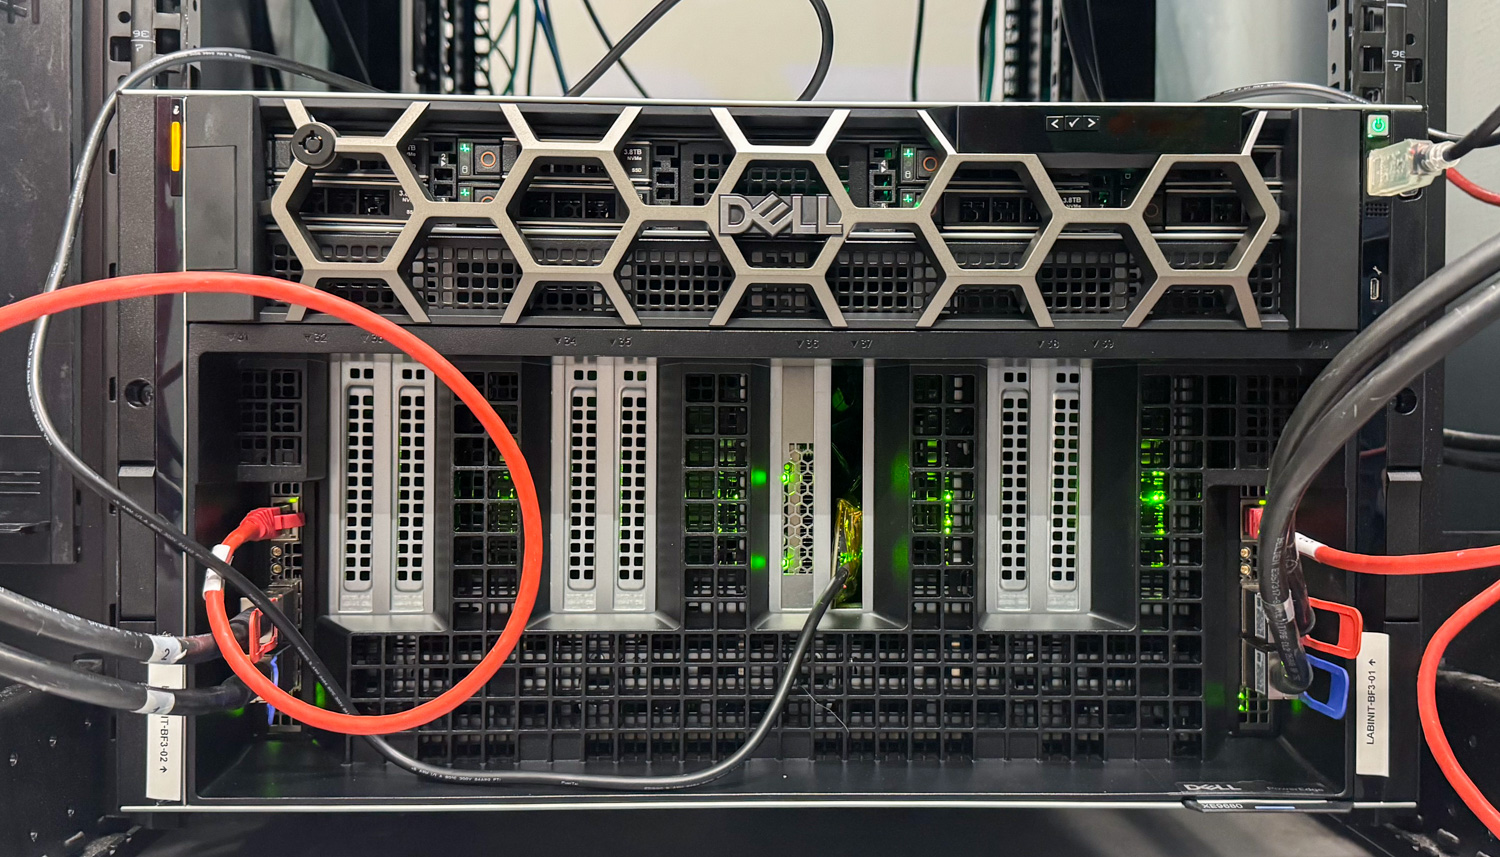
- Инициатор (GPU-сервер): Сервер Dell PowerEdge XE9680, сконфигурированный следующим образом:
- Графические процессоры: 8 видеокарт NVIDIA H100 SXM, каждая с 80 ГБ памяти HBM3.
- ДРАМ: 2TB
- процессоры: Двухсокетные процессоры Intel Xeon Platinum 8568Y+
- Сеть: 2 адаптера NVIDIA ConnectX-7 (400 Гбит/с)
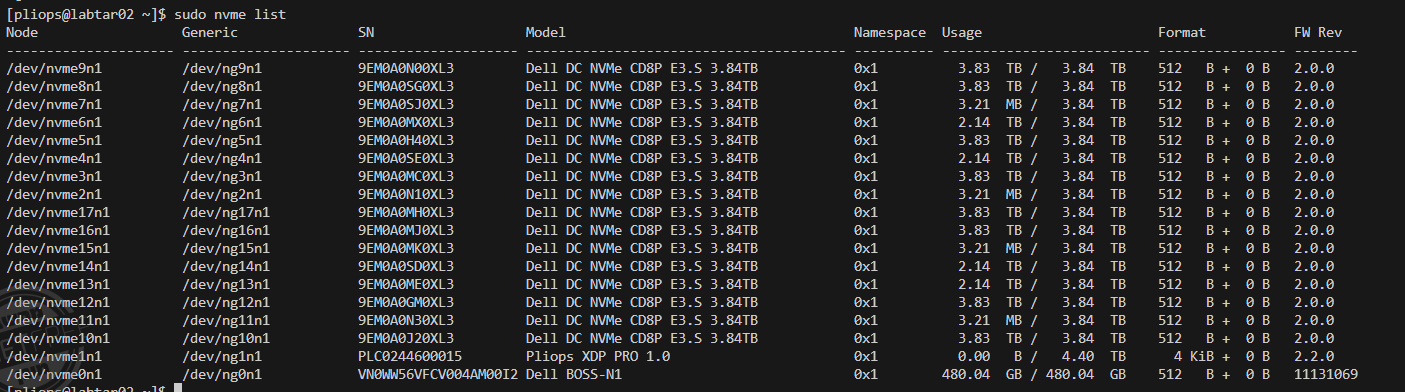
- Целевое устройство (сервер хранения Pliops): Узел Dell PowerEdge R860, сконфигурированный следующим образом:
- ДРАМ: 512GB
- процессоры: Четырехсокетные процессоры Intel Xeon Gold 6418H
- Ускорение Pliops: 1 карта Pliops XDP Pro1
- Хранение: 24 твердотельных накопителя Samsung PM1733a NVMe емкостью 3.84 ТБ каждый, обеспечивающие значительную емкость для разгрузки кэша типа "ключ-значение"
- Сеть: 1 x Адаптерная карта NVIDIA ConnectX-7 HHHL (400 Гбит/с, однопортовый OSFP, PCIe 5.0 x16)
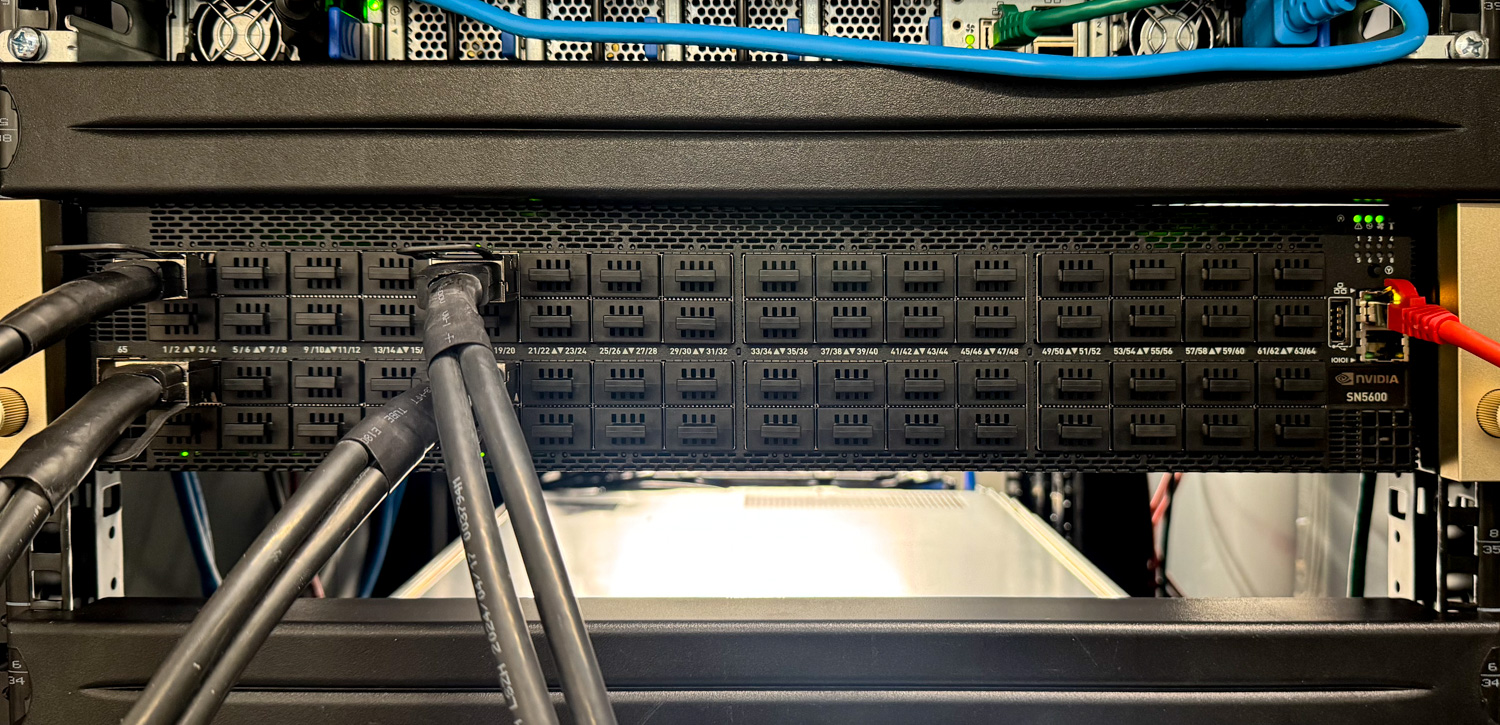
- Сетевое взаимодействие: Эти два сервера соединены через коммутатор NVIDIA SN5600 Spectrum-X 800 Гбит/с Ethernet, что обеспечивает высокоскоростную передачу данных с низкой задержкой для трафика NVMe-oF.
Измеряемые ключевые показатели:
- Время до получения первого токена (TTFT): Как быстро пользователи начинают видеть сгенерированный контент
- Время, затрачиваемое на вывод токена (TPOT): Время между генерацией токенов
- Запросов в секунду (RPS): Пропускная способность системы
- Токенов в секунду (TPS)Скорость генерации
В ходе тестирования имитировались многоходовые диалоги со средней длиной подсказок в 2,200 токенов и 100-230 выходными токенами за ход, при этом продолжительность диалогов составляла от 2 до 28 ходов.
Динамо-машина с одним рабочим
| Конфигурация | TTFT (мс) | TPOT (мс) | #клиенты | RPS |
|---|---|---|---|---|
| vLLM | 310 | 33 | 8 | 1.35 |
| Pliops FusIOnX | 111 | 30 | 16 | 3.03 |
| Gain | 2.79x | – | 2x | 2.24x |
Динамо-машина с двумя рабочими функциями
| Конфигурация | TTFT (мс) | TPOT (мс) | #клиенты | RPS |
|---|---|---|---|---|
| vLLM | 557 | 40 | 26 | 3.49 |
| vLLM 1P1D | 753 | 36 | 26 | 3.76 |
| Pliops FusIOnX | 166 | 38 | 56 | 8.43 |
| Gain | 3.3–4.5x | – | 2.15x | 2.24–2.4x |
Динамо-машина с четырьмя рабочими механизмами.
| Конфигурация | TTFT (мс) | TPOT (мс) | #клиенты | RPS |
|---|---|---|---|---|
| vLLM | 1192 | 41 | 60 | 7.32 |
| vLLM 2P2D | 719 | 39 | 60 | 7.99 |
| Pliops FusIOnX | 329 | 40 | 148 | 20.7 |
| Gain | 2.2–3.6x | – | 2.46x | 2.6–2.8x |
При типичном значении TPOT SLO 40 мс (что соответствует примерно 25 транзакциям в секунду на пользователя) FusIOnX демонстрирует в 2.8 раза более высокую эффективность, чем стандартный Dynamo, и в 2.24 раза более высокую эффективность, чем дезагрегированная конфигурация предварительного заполнения-декодирования Dynamo, с точки зрения количества повторных вычислений в секунду на GPU. А при менее строгом значении TPOT SLO, например, 60 мс (~17 транзакций в секунду на пользователя), эффективность возрастает более чем в 3 раза.

Кроме того, на следующем графике визуализируется средний прирост RPS, достигнутый Pliops по сравнению с обычным Dynamo в конфигурации с четырьмя рабочими процессами, измеренный в течение всего эксперимента. На протяжении всего тестового периода Pliops демонстрировал более чем двукратное улучшение по сравнению с Dynamo, что подтверждает способность решения поддерживать высокую производительность в реалистичных условиях нагрузки, приближенных к производственным. Этот устойчивый прирост пропускной способности напрямую приводит к увеличению параллельной обработки запросов пользователями и улучшению скорости отклика сервисов, подтверждая эффективность разгрузки кэша ключ-значение в масштабе предприятия.
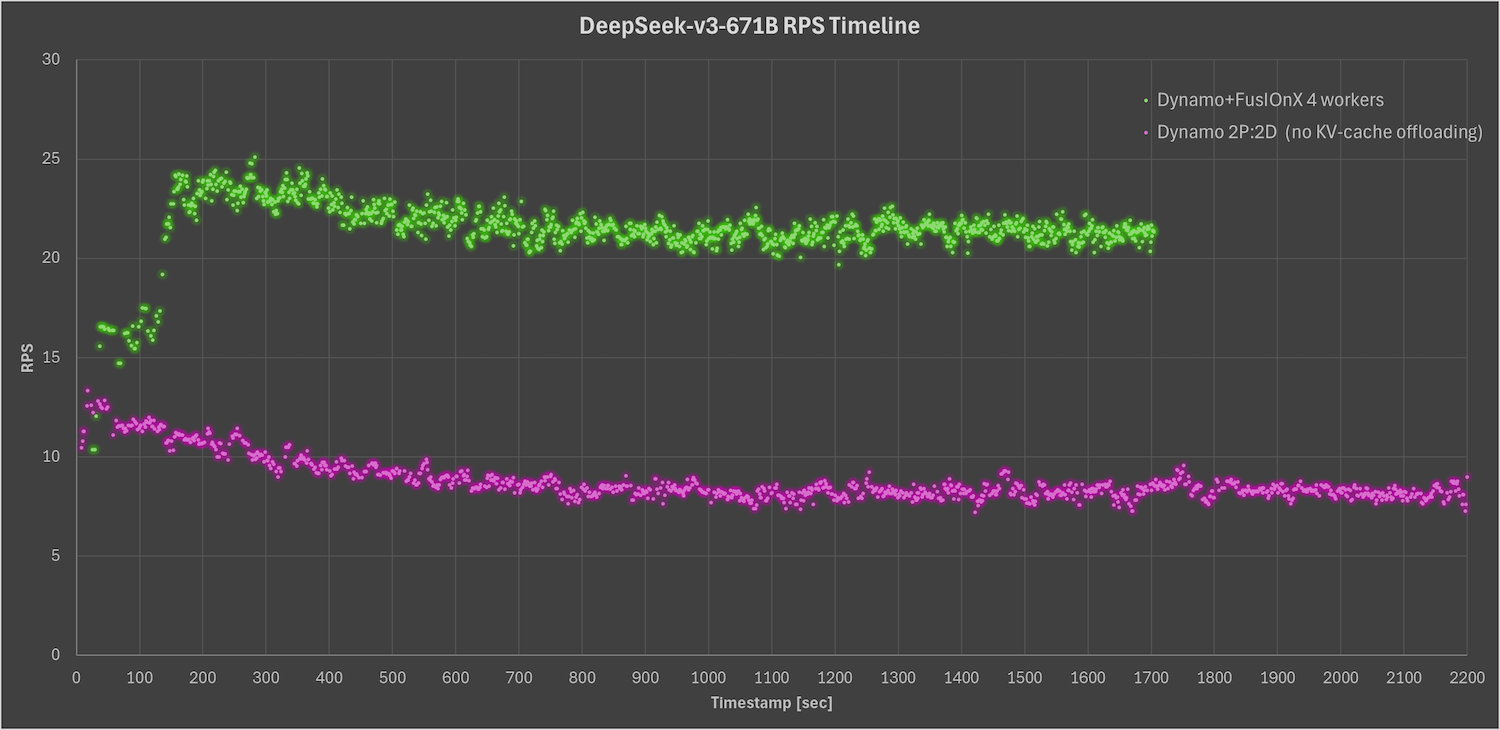
Количественная оценка преимуществ: реальные выгоды от разгрузки кэша ключ-значение.
Что это значит для бизнеса и всей экосистемы ИИ? Значительно сокращенное время до первого получения токена (TTFT) напрямую приводит к существенному улучшению пользовательского опыта, обеспечивая более быстрые и отзывчивые взаимодействия. Это особенно важно для интерактивных приложений, таких как чат-боты, виртуальные помощники и программы для совместной разработки в реальном времени, где задержка может существенно повлиять на удобство использования.
Помимо улучшения пользовательского опыта, возможность обрабатывать в два-три раза больше одновременных пользователей при строгом соблюдении целевых показателей уровня обслуживания (SLO) означает, что организации могут обслуживать значительно большую клиентскую базу, используя существующую аппаратную инфраструктуру. Эта расширенная мощность имеет решающее значение для развертывания облачных решений для вывода данных, где масштабирование для удовлетворения меняющегося спроса является первостепенной задачей.
Кроме того, практически неограниченная емкость кэша ключ-значение, обеспечиваемая Pliops XDP LightningAI, позволяет поддерживать гораздо более длительные контекстные окна и более высокую плотность одновременных пользователей, чем это возможно при использовании традиционных подходов, основанных только на HBM. Эта возможность больше не ограничивается крупнейшими исследовательскими лабораториями в области ИИ. Теперь поставщики решений для вывода данных всех размеров могут использовать решение Pliops для внедрения сложных механизмов кэширования ключ-значение, аналогичных тем, которые используются крупными компаниями в сфере ИИ, такими как OpenAI, Anthropic и Google.

Кроме того, эти поставщики могут снизить общее энергопотребление за счет устранения избыточных вычислений и оптимизации использования памяти, что способствует созданию более устойчивой инфраструктуры ИИ. В конечном итоге, эта эффективность может быть передана конечным пользователям в виде более конкурентоспособных по цене услуг ИИ, что одновременно позволит поставщикам максимизировать использование и отдачу от своих инвестиций в оборудование при минимальных дополнительных капитальных затратах.
Что это значит для инфраструктуры ИИ?
Pliops XDP LightningAI с архитектурой FusIOnX представляет собой значительный шаг вперед в оптимизации вывода LLM. Устранение критического узкого места в управлении кэшем ключ-значение за счет интеллектуальной разгрузки на экономичное хранилище обеспечивает существенное повышение производительности по всем ключевым показателям.
Бесшовная интеграция решения с NVIDIA Dynamo и vLLM сразу же применима к различным сценариям развертывания. Независимо от того, используется ли оно с расширенными возможностями распределенного обслуживания Dynamo или напрямую с vLLM, организации могут рассчитывать на значительное повышение пропускной способности, снижение задержки и повышение экономической эффективности.
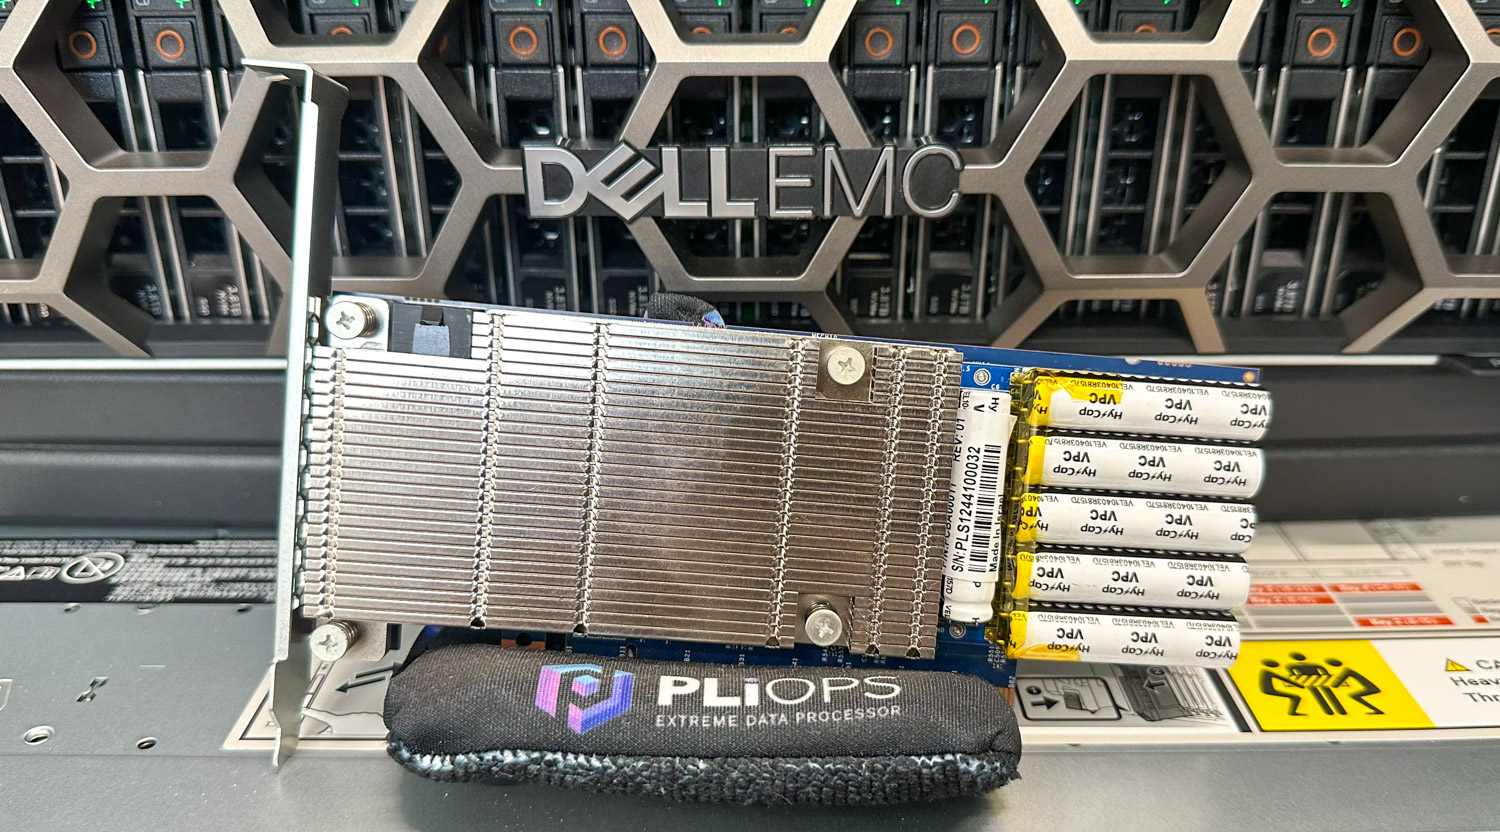
По мере роста размеров и возможностей LLM-систем, а также повышения их критически важной роли в решении задач, такие решения, как Pliops XDP LightningAI, станут незаменимым инструментом для организаций, стремящихся создать масштабируемую, эффективную и экономически выгодную инфраструктуру искусственного интеллекта.
Заключение
Pliops XDP LightningAI, дополненный архитектурой FusIOnX, обеспечивает значительный скачок в эффективности вывода LLM за счет решения проблемы узкого места в постоянно работающем кэше ключ-значение. Благодаря интеллектуальной выгрузке данных из кэша ключ-значение в высокопроизводительное и экономичное хранилище, Pliops позволяет организациям значительно расширять контекстные окна, поддерживать большее количество одновременных пользователей и соблюдать строгие стандарты SLO по задержке без дополнительных инвестиций в GPU. Бесшовная интеграция с такими фреймворками, как NVIDIA Dynamo и vLLM, обеспечивает широкую применимость в современных стеках обслуживания ИИ.
По мере усложнения LLM-систем и ускорения их внедрения в корпоративной среде, отделение масштабирования памяти от дорогостоящих ресурсов GPU станет критически важным. Pliops XDP LightningAI — это инструмент для создания инфраструктуры ИИ следующего поколения, позволяющий поставщикам предоставлять более быстрые, масштабируемые и экономически эффективные сервисы ИИ в больших масштабах. Для организаций, стремящихся обеспечить перспективность своих развертываний ИИ и максимизировать рентабельность инвестиций в оборудование, Pliops предлагает убедительное, готовое к производству решение одной из самых актуальных проблем в области крупномасштабного вывода данных сегодня.


 Amazon