

エンタープライズAIインフラストラクチャは、トレーニングモデルの最適化から、トレーニングモデルの提供へと移行しており、それによって経済構造も変化しています。トレーニングは、終了点のある設備投資プロジェクトです。推論は、サービスが稼働している限り実行される本番ワークロードであり、出力はトークンで測定されます。これが、現在AI事業者が直面しているトークノミクスの問題です。GPUがラックに設置され、電力予算が設定されると、ビジネスの成否はハードウェアが生成するトークンの数に左右されるようになります。
長時間のマルチターンワークロードでは、会話が長くなるにつれて、同じコンテキストがモデル内を繰り返し通過します。GPUは既にこれらのトークンを一度処理するためにコストを支払っていますが、KVキャッシュが削除されると、システムはそのコンテキストを再度プリフィルする必要があります。これにより、敵は再計算を行うことになります。どのような規模であっても、これは丸め誤差ではありません。電力、GPU時間、キューの増加、または追加のハードウェアとして返されるコストです。
反射的な解決策は、ラック内の最も高価なリソース、つまりGPUやDRAMをさらに購入することです。しかし、再計算によって既に再利用可能なものが生成されています。KVキャッシュは単なるデータであり、低コストで保存および取得できます。高コストな事前計算を回避する代わりに、わずかな再ロードコストが発生します。したがって、問題はキャッシュを保持するかどうかではなく、どこに保持するかであり、これはパフォーマンスの問題であると同時にコストの問題でもあります。VRAMは最速のティアであり、最も希少です。飽和すると、推論サーバーはキャッシュの削除を開始します。DRAMは、急激に上昇する価格で余裕を確保します。計算が変わる可能性があるのはフラッシュです。確かにDRAMよりは遅いですが、テラバイトあたりのコストははるかに低く、より高速なティアが破棄せざるを得ないコンテキストを保持するのに十分な容量があります。これは、会話全体を再処理するか、単に読み戻すかの違いです。
影響を測定するために、Dell PowerEdge XE7740 上にマルチターンエージェント テスト ワークロードを構築し、モデル、GPU、およびサービング スタックを一定に保ちました。システムをサイジングする人にとって重要な数値は、メモリ ティアが満杯になった後に何が起こるかです。その時点以降、フラッシュは、DRAM の 17,000 と比較して、合計で約 30,000 トークンを毎秒維持し、ピークの 94% を保持しましたが、DRAM ティアは 42% に低下しました。両方のオフロード ティアは、ピーク時に VRAM のみのベースラインを大幅に上回りました (DRAM で 2.9 倍、フラッシュで 2.2 倍) が、ピークはまさに DRAM ティアが枯渇しようとしているところです。最も高価なメモリがピークを購入し、コンテキストが拡大し続ける間、フラッシュがそれを保持します。
結果に入る前に、KVキャッシュとは何か、なぜそれがいっぱいになるのか、そしてシステムがより安価な保存場所を見つけられなくなったときに推論パフォーマンスが低下し始める理由について、正確に説明しておく価値がある。
主要なポイント(要点)
- フラッシュメモリはDRAMでは不可能なことを実現する。 メモリ負荷によってメモリが強制的に解放されるまでは、3つの構成すべてが同じように動作します。最初にVRAMが飽和し、512GBのDRAM層は実行開始から約45分後に満杯になり、メモリの解放が始まります。その後、フラッシュメモリはDRAMの17,000トークン/秒に対し、約30,000トークン/秒を維持し、ピーク時の94%を保持したのに対し、DRAMは42%まで低下しました。
- オフロードは再計算のために失われたスループットを回復します。 ピーク時には、KVキャッシュオフロードにより、DRAM層における総サービングスループットはVRAMのみのベースラインと比較して最大2.9倍、フラッシュ層では2.2倍に向上しました。この向上は、GPUが既に計算したコンテキストを再構築するのではなく、オフロード層から読み戻すことで、再プリフィル処理を省略できることによるものです。
- リピーターは最も違いを実感するでしょう。 再開されたセッションにおける最初のトークン取得までの最悪の遅延時間は、VRAMのみのベースラインでは13.9秒でしたが、フラッシュメモリでは3.2秒でした。オフロード機能によって、この遅延時間をインタラクティブなユーザーが許容できる範囲内に抑えることができます。
- エージェントによるトラフィックは立ち退き費用を高くする: 計測されたClaude Codeトラフィックの1週間分は、98.16%がキャッシュ読み取りであり、真のコールドインプットはわずか0.02%でした。
- KVオフロードは書き込み負荷の高いワークロードであり、高い耐久性を持つドライブが求められます。 モデルが生成するトークンごとに KV エントリが書き込まれ、TTL の入れ替えにより、ティアが 24 時間体制で書き換えられます。テストしたミラーリング RAID10 アレイでは、持続的な書き込みレートで、ドライブ 1 台あたり 1 日あたり約 3.2 回の書き込みとなり、RAID0 としてストライピングすると約 1.6 DWPD に低下し、D7-PS1030 の 3 DWPD 定格を挟む形になります。フラッシュ ティアの決定的な制約は容量や速度ではなく耐久性であり、キャッシュは使い捨てであるため、書き込み重視のドライブをこのように酷使することは許容できるトレードオフです。
推論の仕組み
大規模言語モデルは自己回帰的であり、各出力トークンはそれ以前のすべてのトークンに依存します。アテンション機構は、シーケンス内の各トークンについてクエリ(Q)ベクトルを計算し、それを先行するすべてのトークンのキー(K)ベクトルと値(V)ベクトルと照合することで、この条件付けを実現します。アテンションの出力は、これらの値の重み付き組み合わせであり、重みはQKの内積から得られます。
リクエストが到着すると、プロンプトに含まれるすべてのトークンに対応するKテンソルとVテンソルが存在するまで、プロンプトに応答することはできません。最初のステップはプリフィルです。エンジンはプロンプトをモデルに通して単一の並列処理を実行し、結果として得られるKテンソルとVテンソルをメモリに書き込みます。したがって、プリフィルは計算量に依存し、その遅延はプロンプトの長さに比例します。
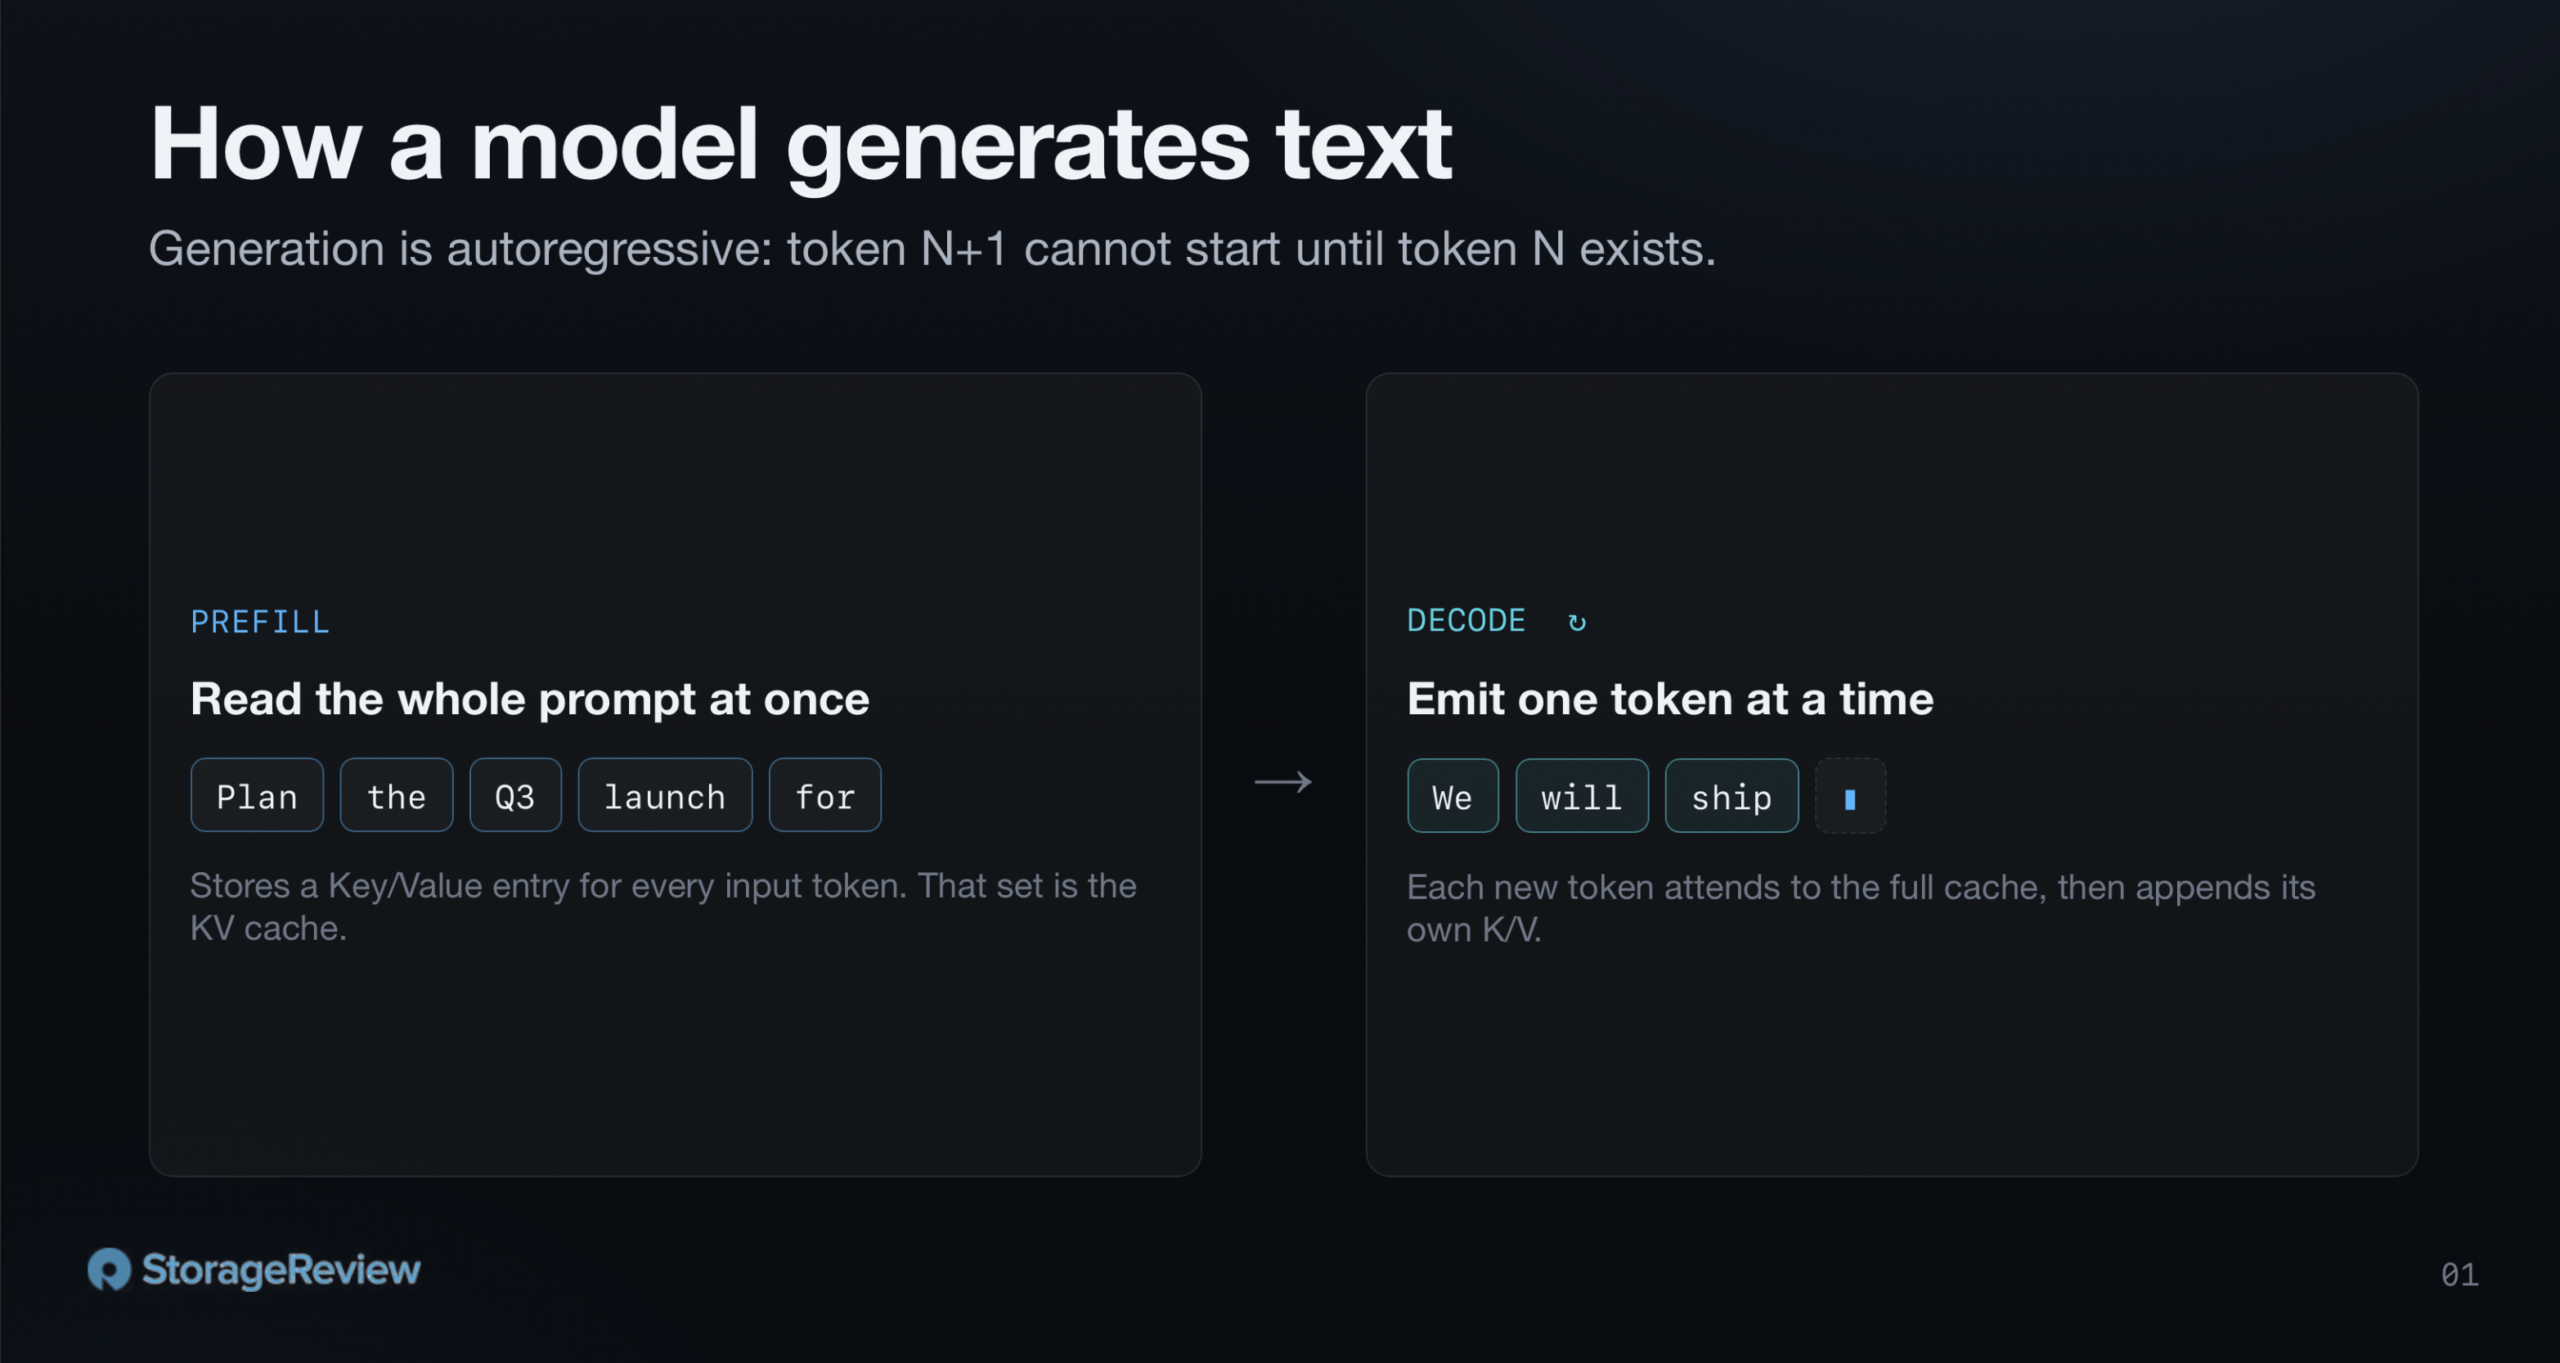
プリフィルが完了すると、エンジンは応答をトークンごとに1つずつ出力します。新しいトークンは、それ以前のすべてのトークンのKとVを読み取り、アテンション出力を計算し、次のステップのために自身のKとVをメモリに書き込みます。この第2フェーズはデコードです。各トークンを生成するには、メモリからキャッシュされたすべての以前のトークンのKとVテンソルをロードし、それらに対してアテンションを計算してから、新しいトークンのKとVテンソルを次のステップのために書き込む必要があるため、このフェーズはシーケンシャルであり、メモリ帯域幅に制限されます。
両フェーズで生成されるKテンソルとVテンソルはKVキャッシュです。これらがない場合、n+1番目のトークンを生成するたびに、n個前のトークンすべてのキーと値を再計算する必要があり、計算複雑度は2乗になります。キャッシュがあれば、新しいトークンはそれぞれ自身のKとVのみを計算し、残りはメモリから読み込むため、トークンあたりのコストは線形に維持されます。
エージェントトラフィックとはどのようなものか
推論は、応答のユーザーに見える部分の大部分をデコードが占めるため、メモリ帯域幅に依存するとよく言われます。しかし、この2つのフェーズの実際のバランスはワークロードに依存します。長いエッセイを要求する短いプロンプトはデコードに負荷がかかり、小さなJSON編集を要求する長いエージェントプロンプトはプリフィルに負荷がかかります。どちらのフェーズが優勢になるかによって、キャッシュ管理がうまくいかなかった場合にどの部分に負荷がかかるかが決まります。
再計算問題の形状は、そのバランスから導き出され、「エージェント」は幅広い使用パターンを網羅しています。エージェントコーディングは現在最も人気のあるパターンの 1 つであり、OpenRouter のリーダーボードでは、使用されているトークンのかなりの部分を占めています。代表的なケースを定量化するために、OpenTelemetry (OTEL) ロギングを使用して Claude Code を計測し、1 週間分のトレースを Grafana にエクスポートしました。トークン トラフィックのタイプ別の内訳を以下に示します。注: この Claude Code の使用は、コンテキスト長 1M の Claude Opus 4.8 モデルで、複数のコーディング プロジェクトを同時に実行しています。
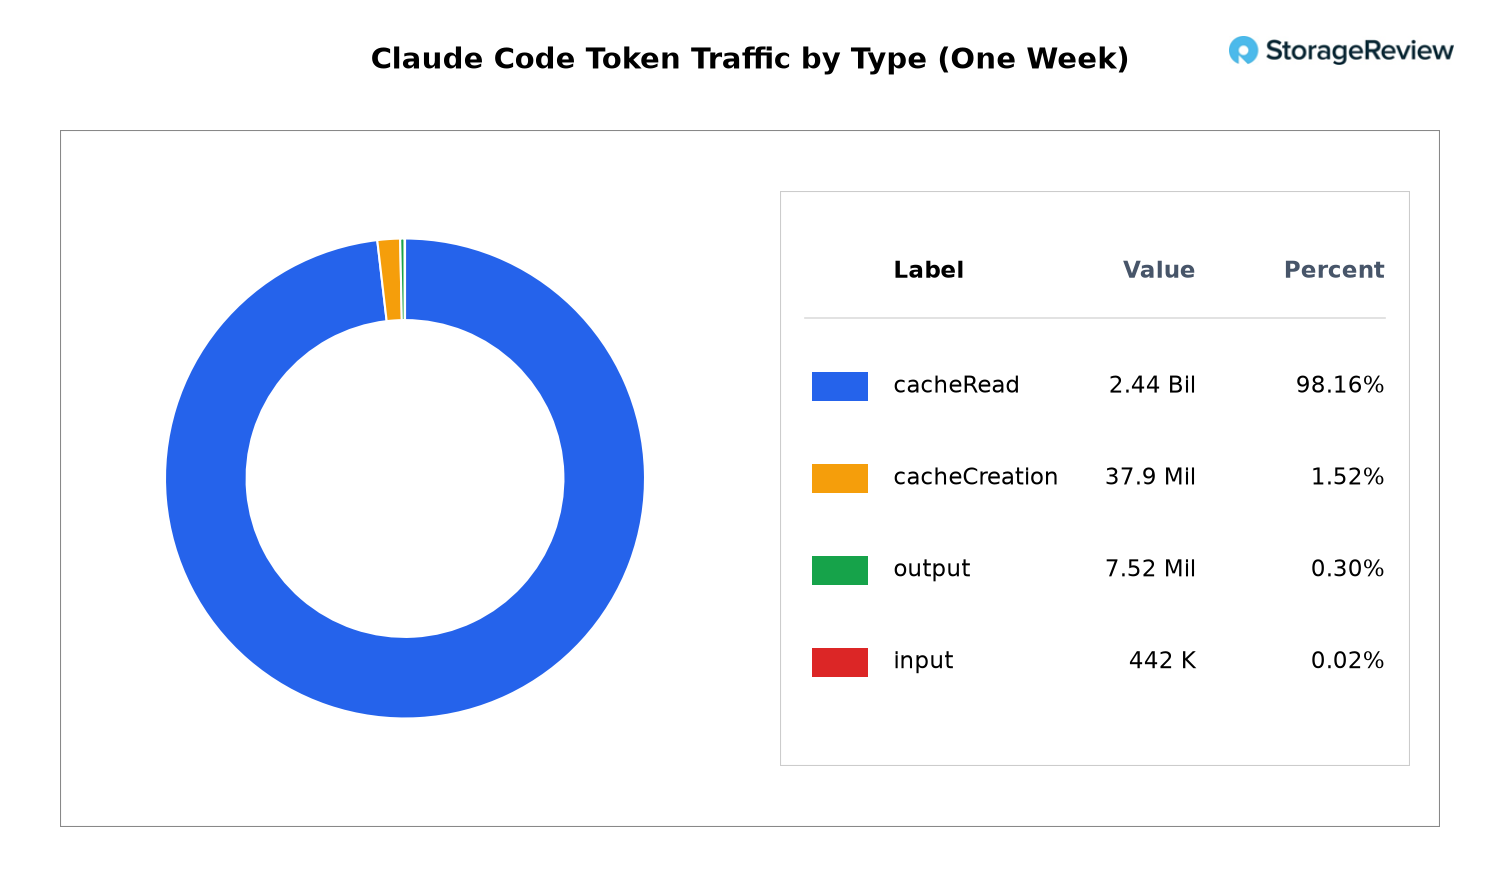
キャッシュ読み取りは、トークントラフィック全体の98.16%を占めました。キャッシュ作成(以前に確認されたプレフィックスがエントリの有効期限切れのため再入力される)は1.52%でした。出力トークンは0.30%でした。真にコールドな入力トークンは0.02%でした。
トラフィックの98%がキャッシュ読み取りであるワークロードでは、オフロードなしでキャッシュを削除すると、システムが実行しようとしていた作業の大部分を再度プリフィルすることになります。ボトルネックは、通常最適化されるフェーズであるデコード帯域幅から、GPUが以前のターンで既に実行したプリフィル計算へと移行します。実際、同じ理由で、大規模な分散型サービングアーキテクチャでは、デコードワーカーよりもプリフィルワーカーを多く実行していることがよくあります。プリフィルがゲートフェーズとなるためです。
98%という数値は、あるユーザーのトラフィック構成を示しています。短いやり取りのチャットワークロードでは、コールドトラフィックの割合が高くなります。ターンごとに異なるドキュメントを再挿入する検索機能強化型システムでも同様です。会話が長く、プレフィックスが安定しており、ユーザーが同じコンテキストに繰り返し戻る場合、この一般的な傾向は当てはまります。
キャッシュはどこに保存されるのか、そしてキャッシュがいっぱいになるとどうなるのか
このキャッシュは実際にはどこに存在し、容量が不足するとどうなるのでしょうか?モデルの重みがロードされた後、残りのVRAMはKVキャッシュ領域となり、固定サイズのブロックに分割されます。起動時にエンジンは、このキャッシュ領域が保持できるトークンの数を通知します。KVオフロードを使用しない標準的な設定では、このプールがキャッシュを配置できる唯一の場所です。
GPUサーバーは高価であり、トークンはその商品であるため、目標はGPUサーバーに常に処理を供給し続けることです。つまり、処理待ちのリクエストを少量キューに格納してGPUを常に稼働させ、コンピューティングリソースがアイドル状態にならないようにしつつ、キューのバランスを取り、応答レイテンシをサービスレベル目標(SLO)内に収める必要があります。すべてのリクエストがコンテキストウィンドウを完全に消費するわけではないため、完了したKVの多くはVRAMにキャッシュされます。しかし、負荷が継続するとキャッシュがいっぱいになり、いっぱいになると古いエントリが削除されて空き領域が確保されます。
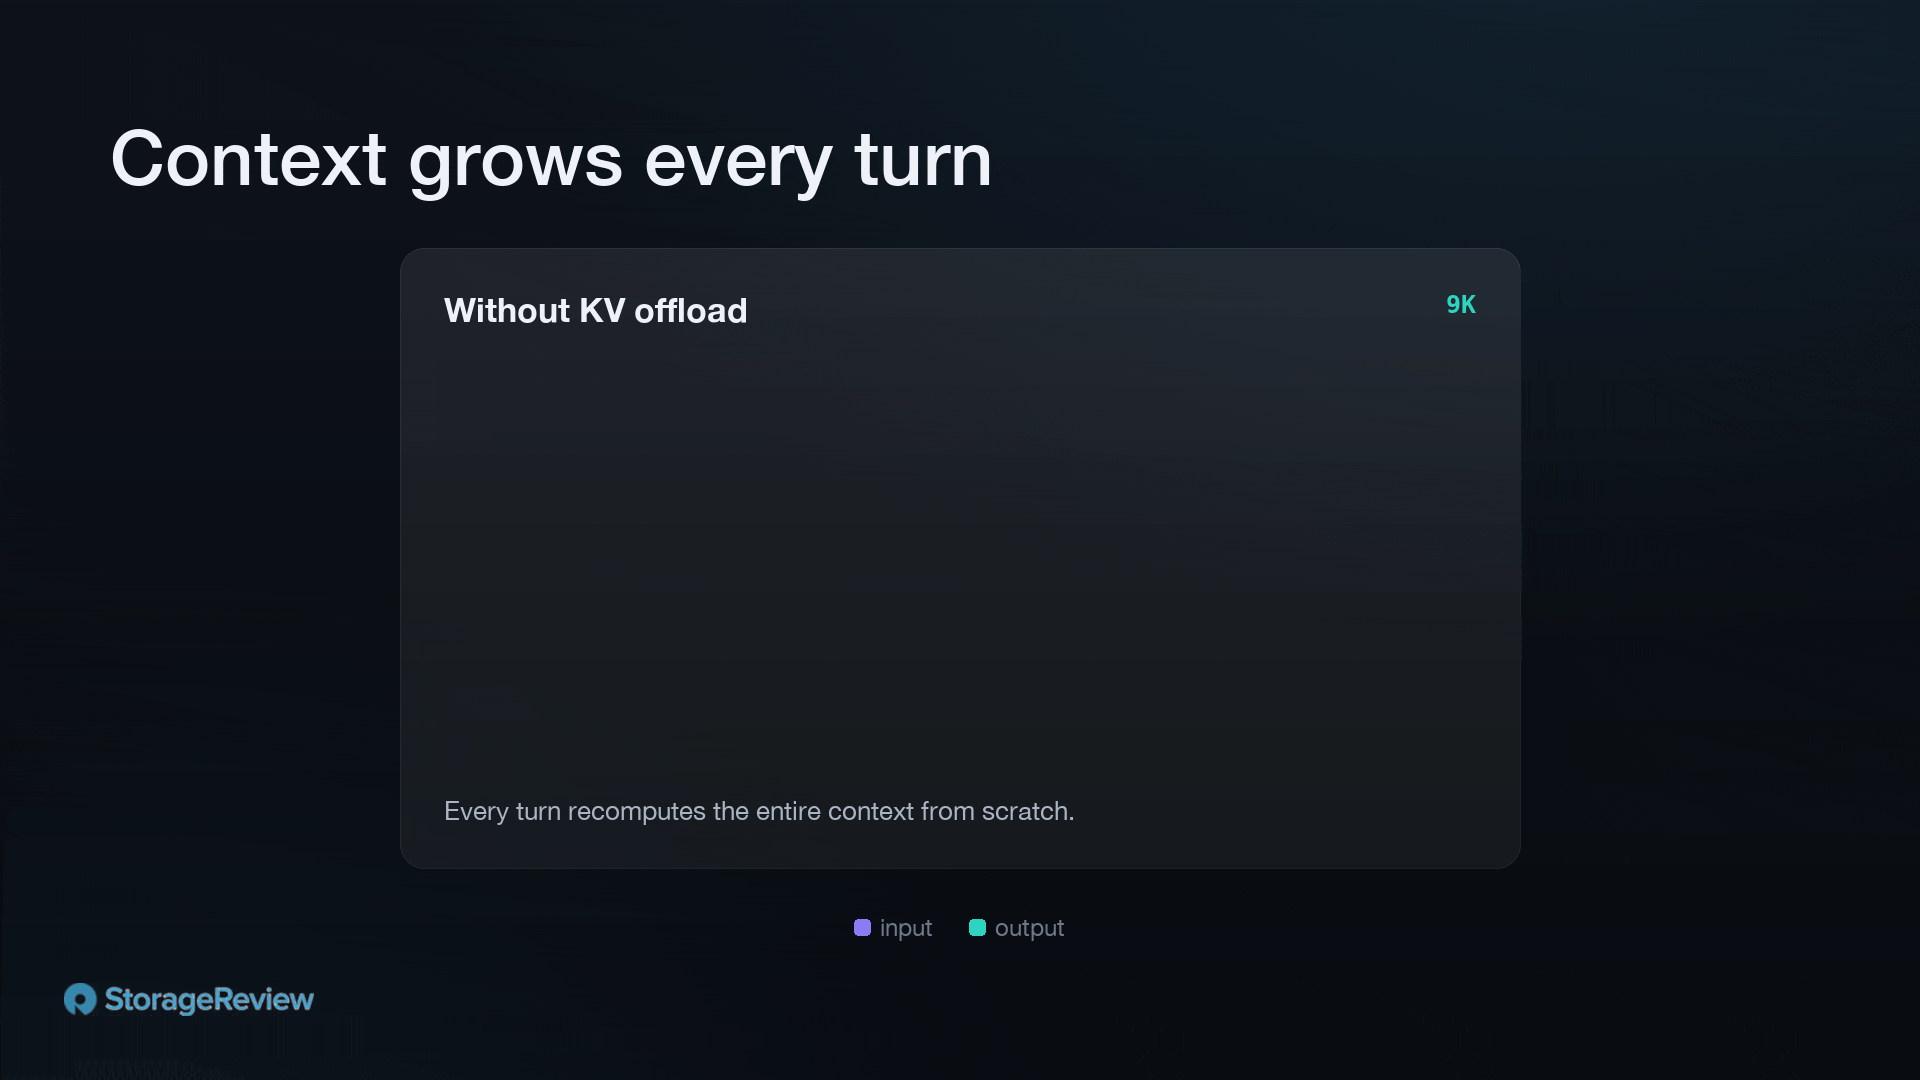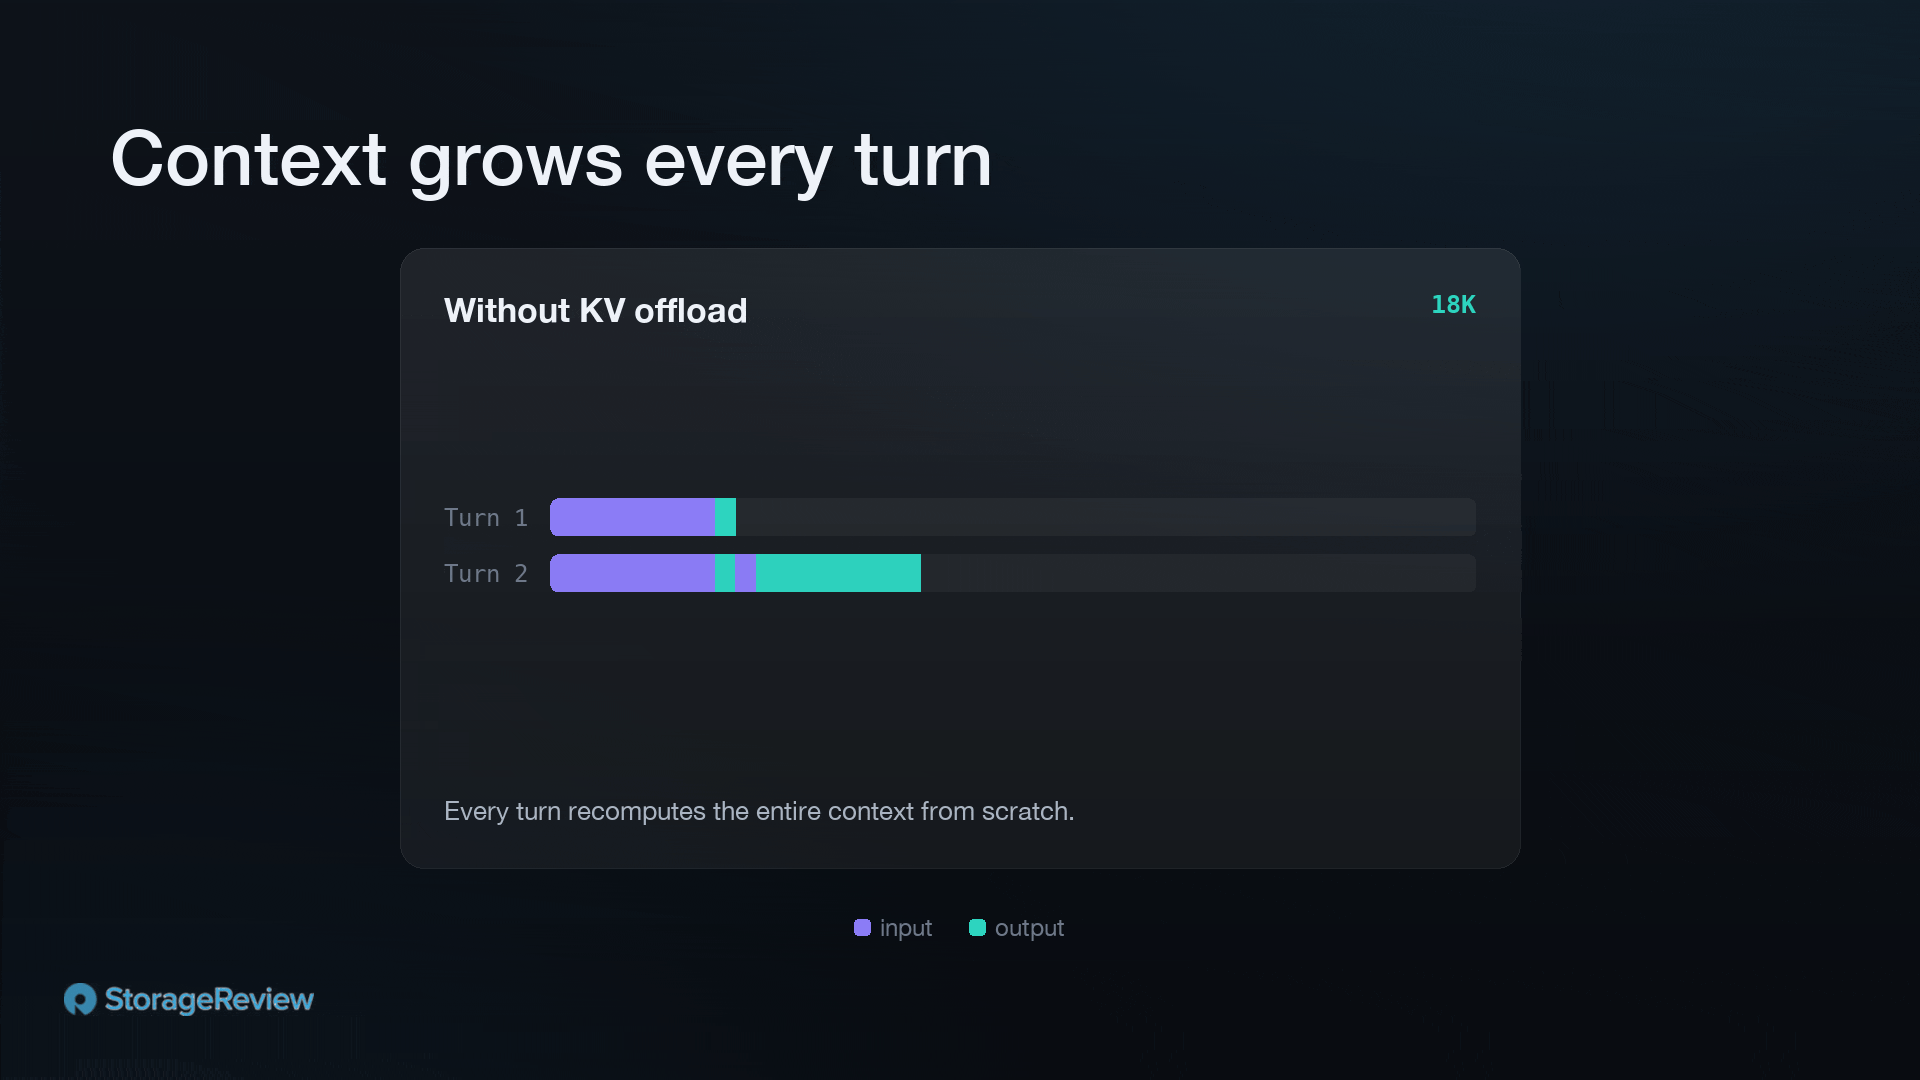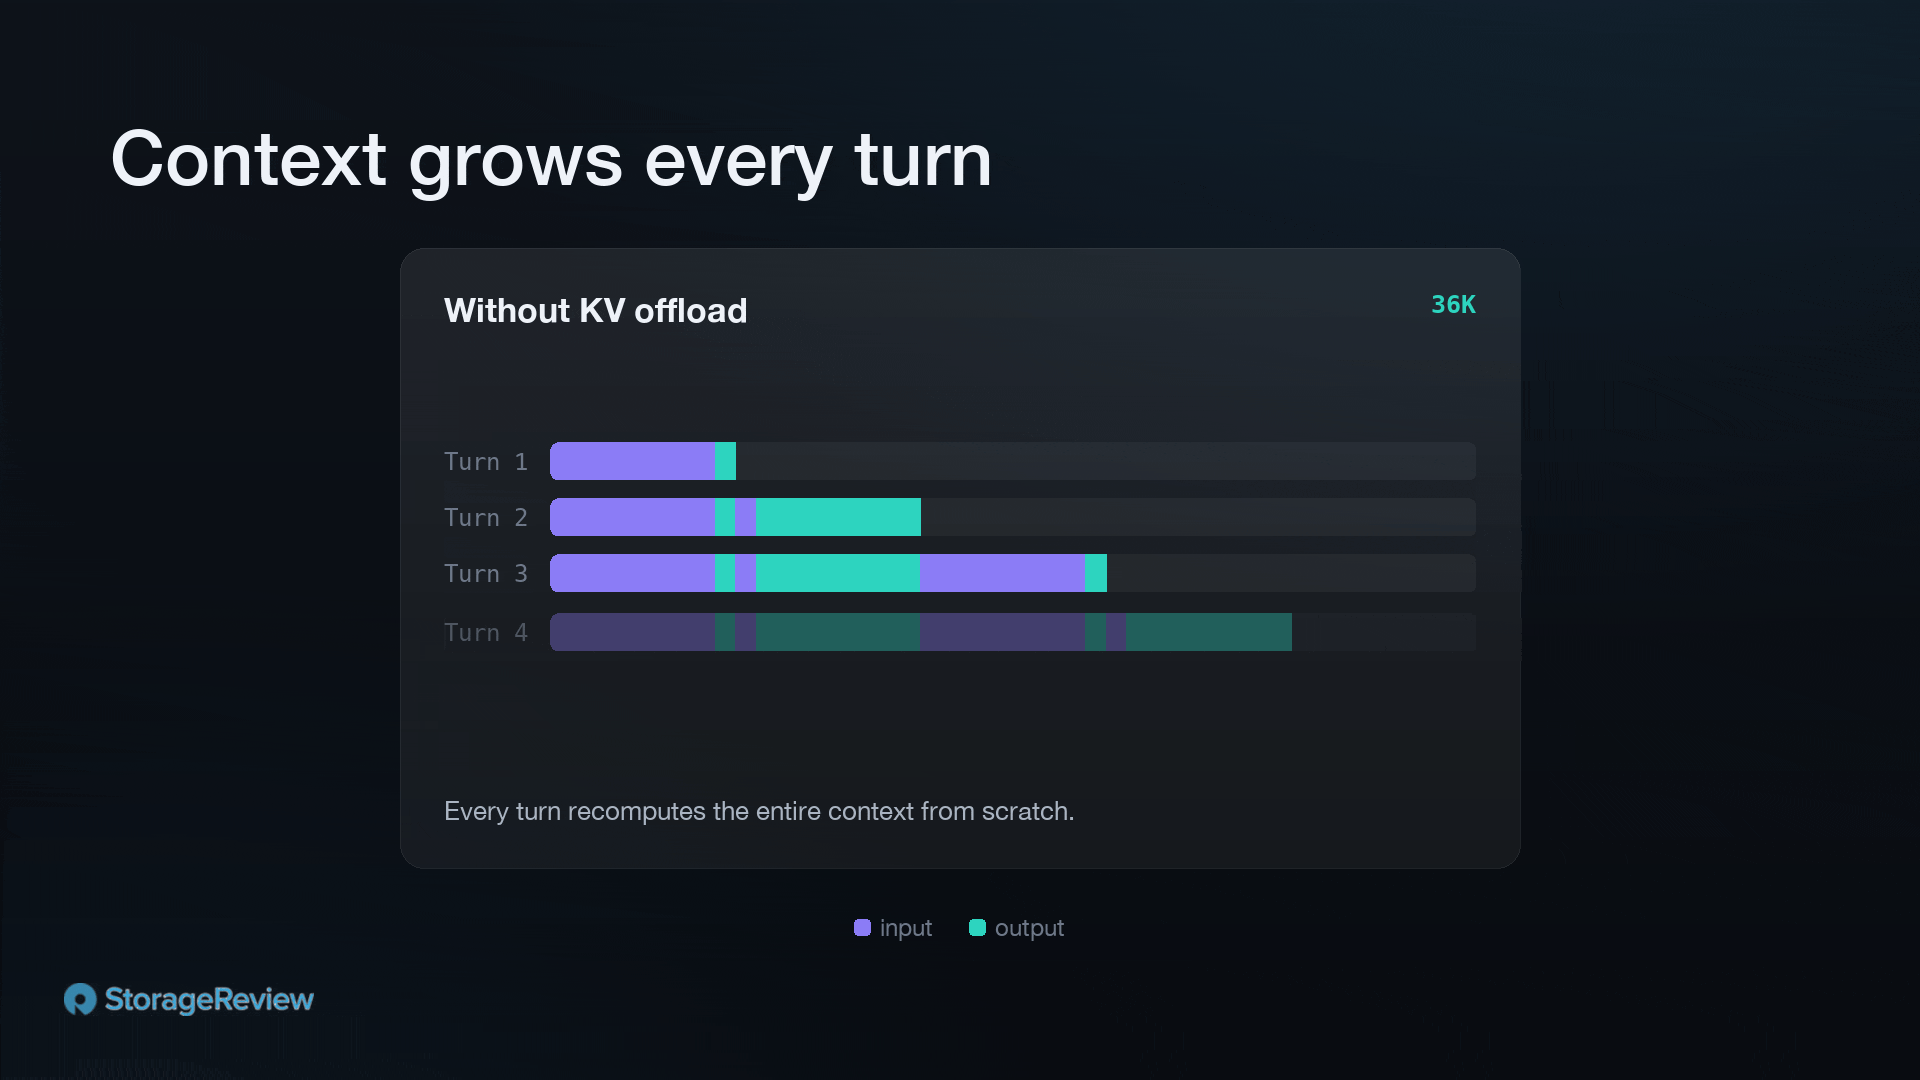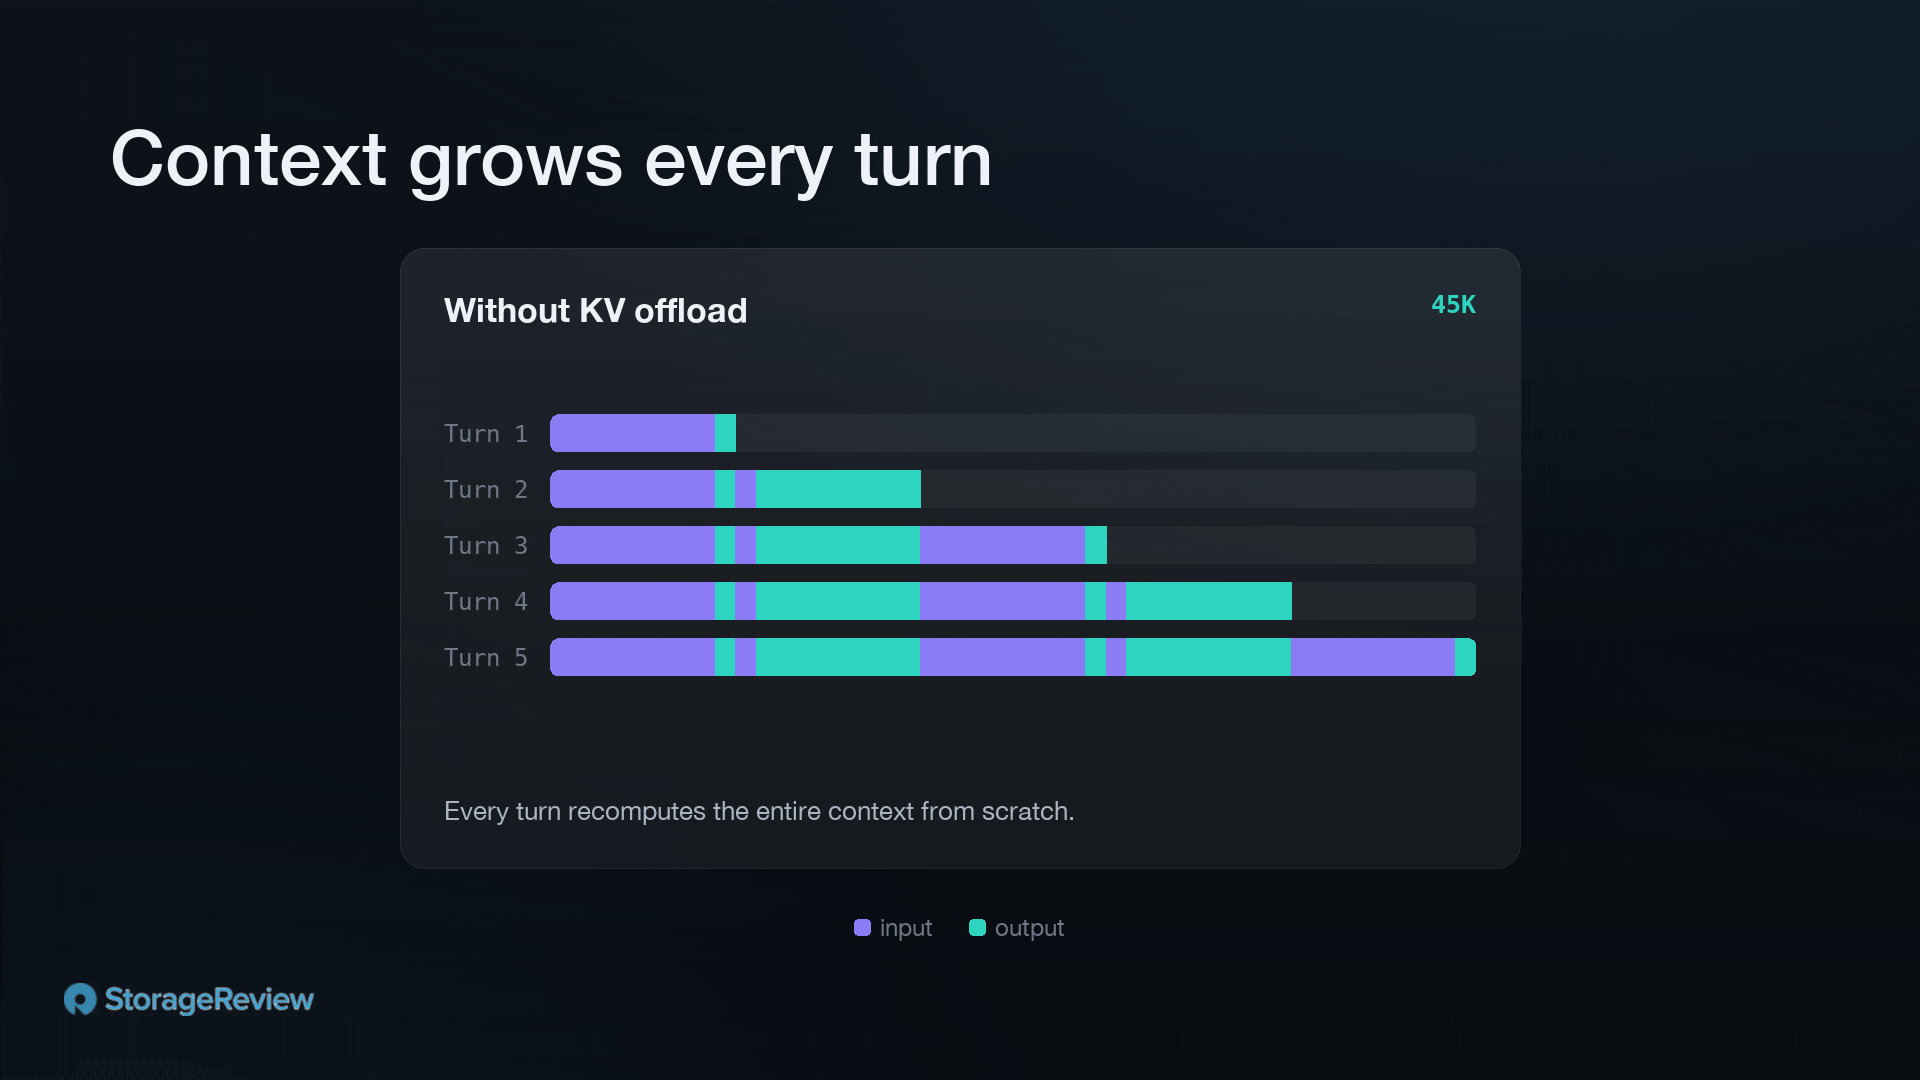
理想的な世界では、すべての回答を一度で済ませて終了するのが望ましいでしょう。しかし、モデルはまだそこまで優れていないため、エージェントループを実行し、ユーザーと、あるいはエージェント間でやり取りを繰り返します。次のターンが到来したとき、そのキーバリューがまだキャッシュされていない場合、エンジンはこれまでの会話全体と新しいトークンを再処理します。以前のすべてのターンのコンテキストがモデルに再度実行され、GPUが既にそれらのトークンに対して実行した計算に対して、その後のすべてのターンで2回目、3回目、そしてそれ以降の回数分の料金が支払われます。この部分は完全に無駄です。
KVキャッシュオフロードの変更点
VRAMがいっぱいになった瞬間にキャッシュを削除するのではなく、オフロードはキャッシュを階層的に段階的に移動させます。VRAMからシステムメモリ、そしてSSDへとキャッシュが移動していくのです。頻繁に使用されるキャッシュはVRAMに保持され、容量が足りなくなったエントリはシステムメモリにプッシュされます。システムメモリがいっぱいになると、それらのエントリはSSDまたはネットワークストレージ層にプッシュされます。実際のキャッシュ削除は、メモリの負荷ではなく、ユーザーが設定した有効期限(TTL)によって制御されるため、ほとんど発生しなくなります。
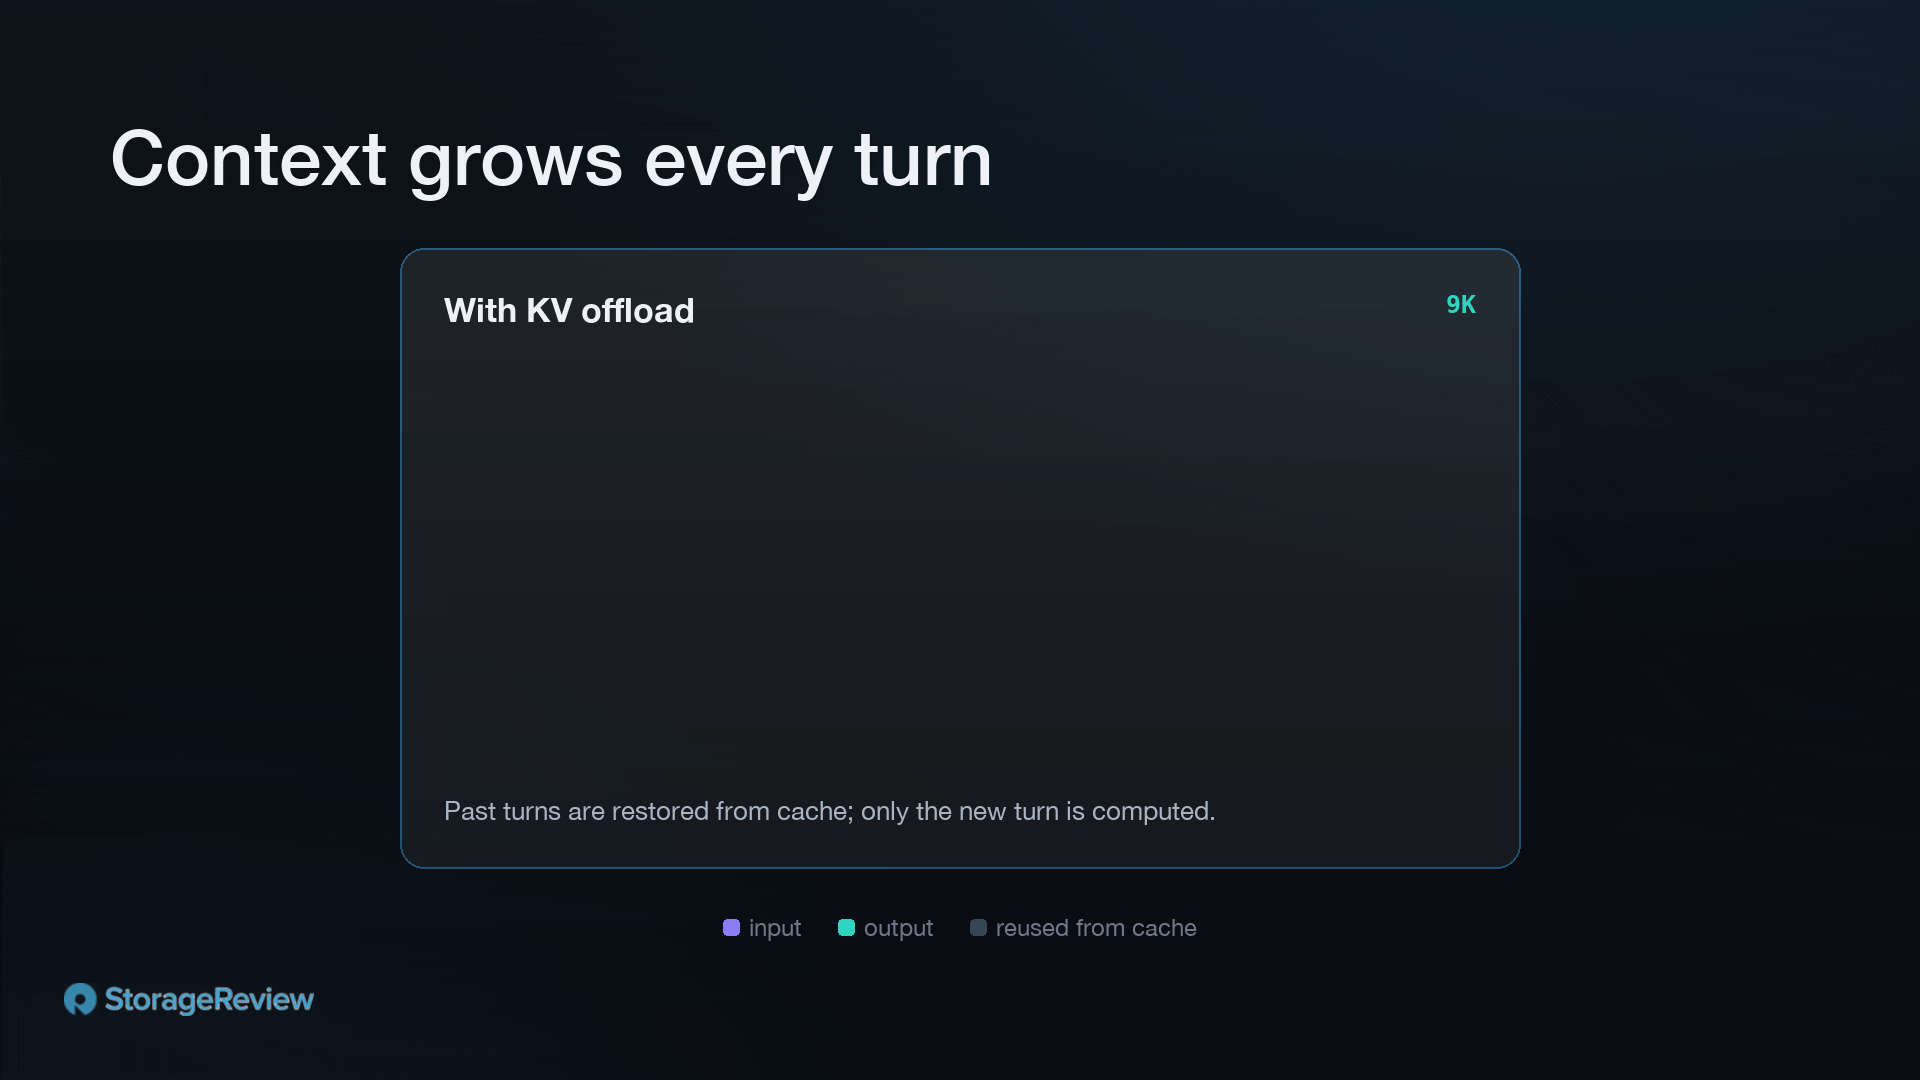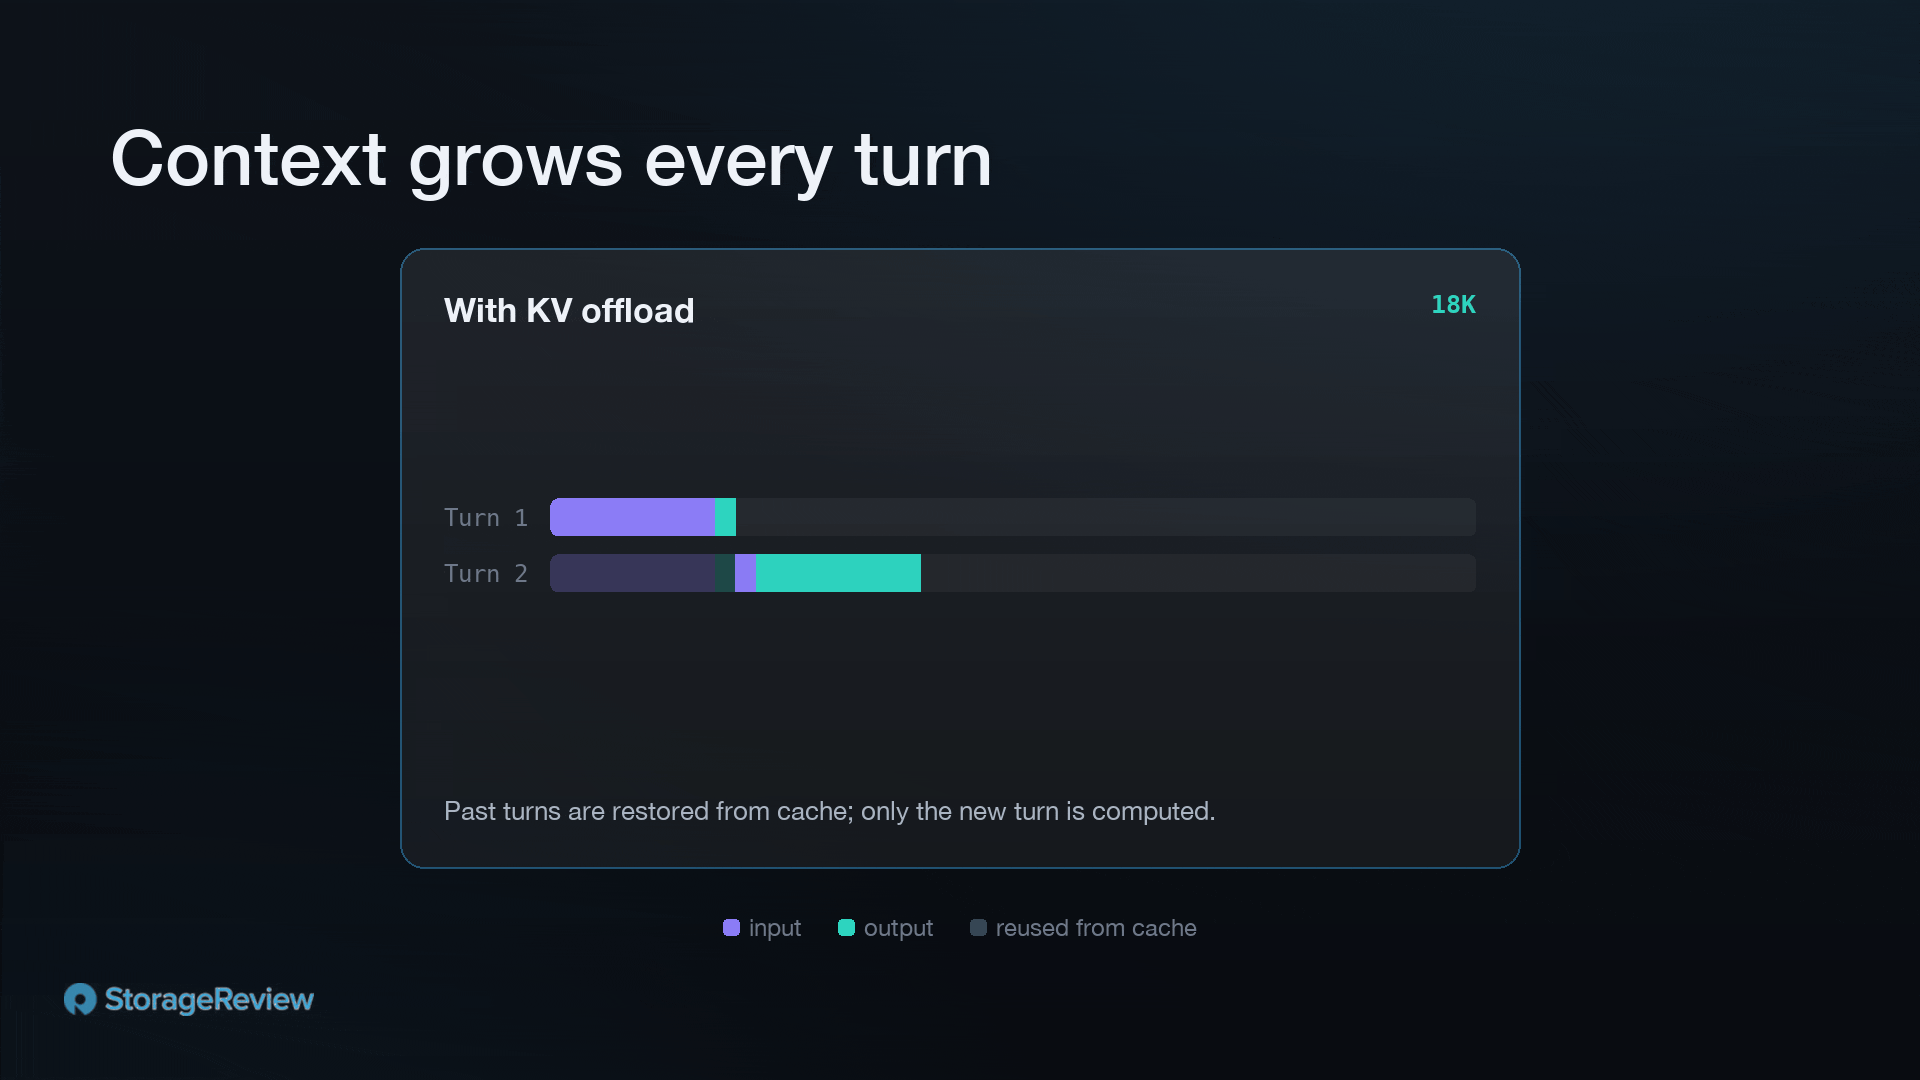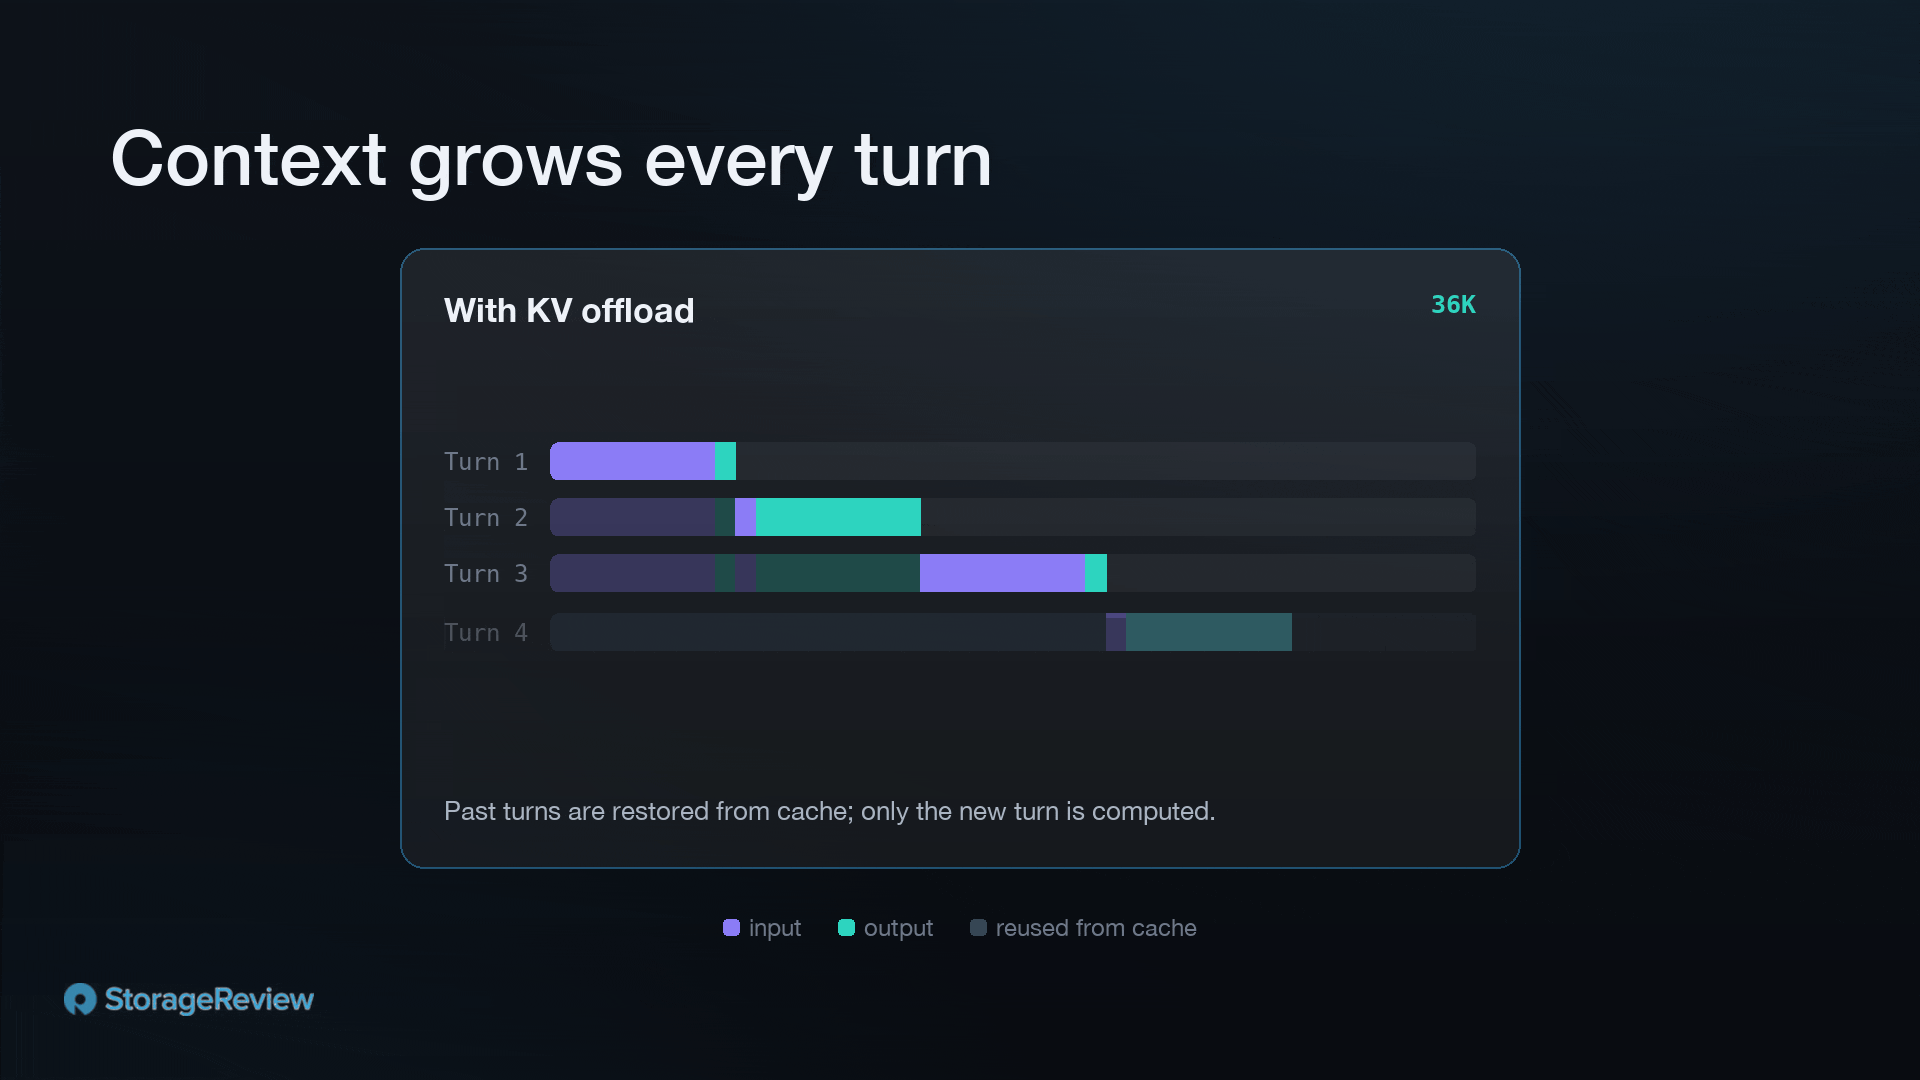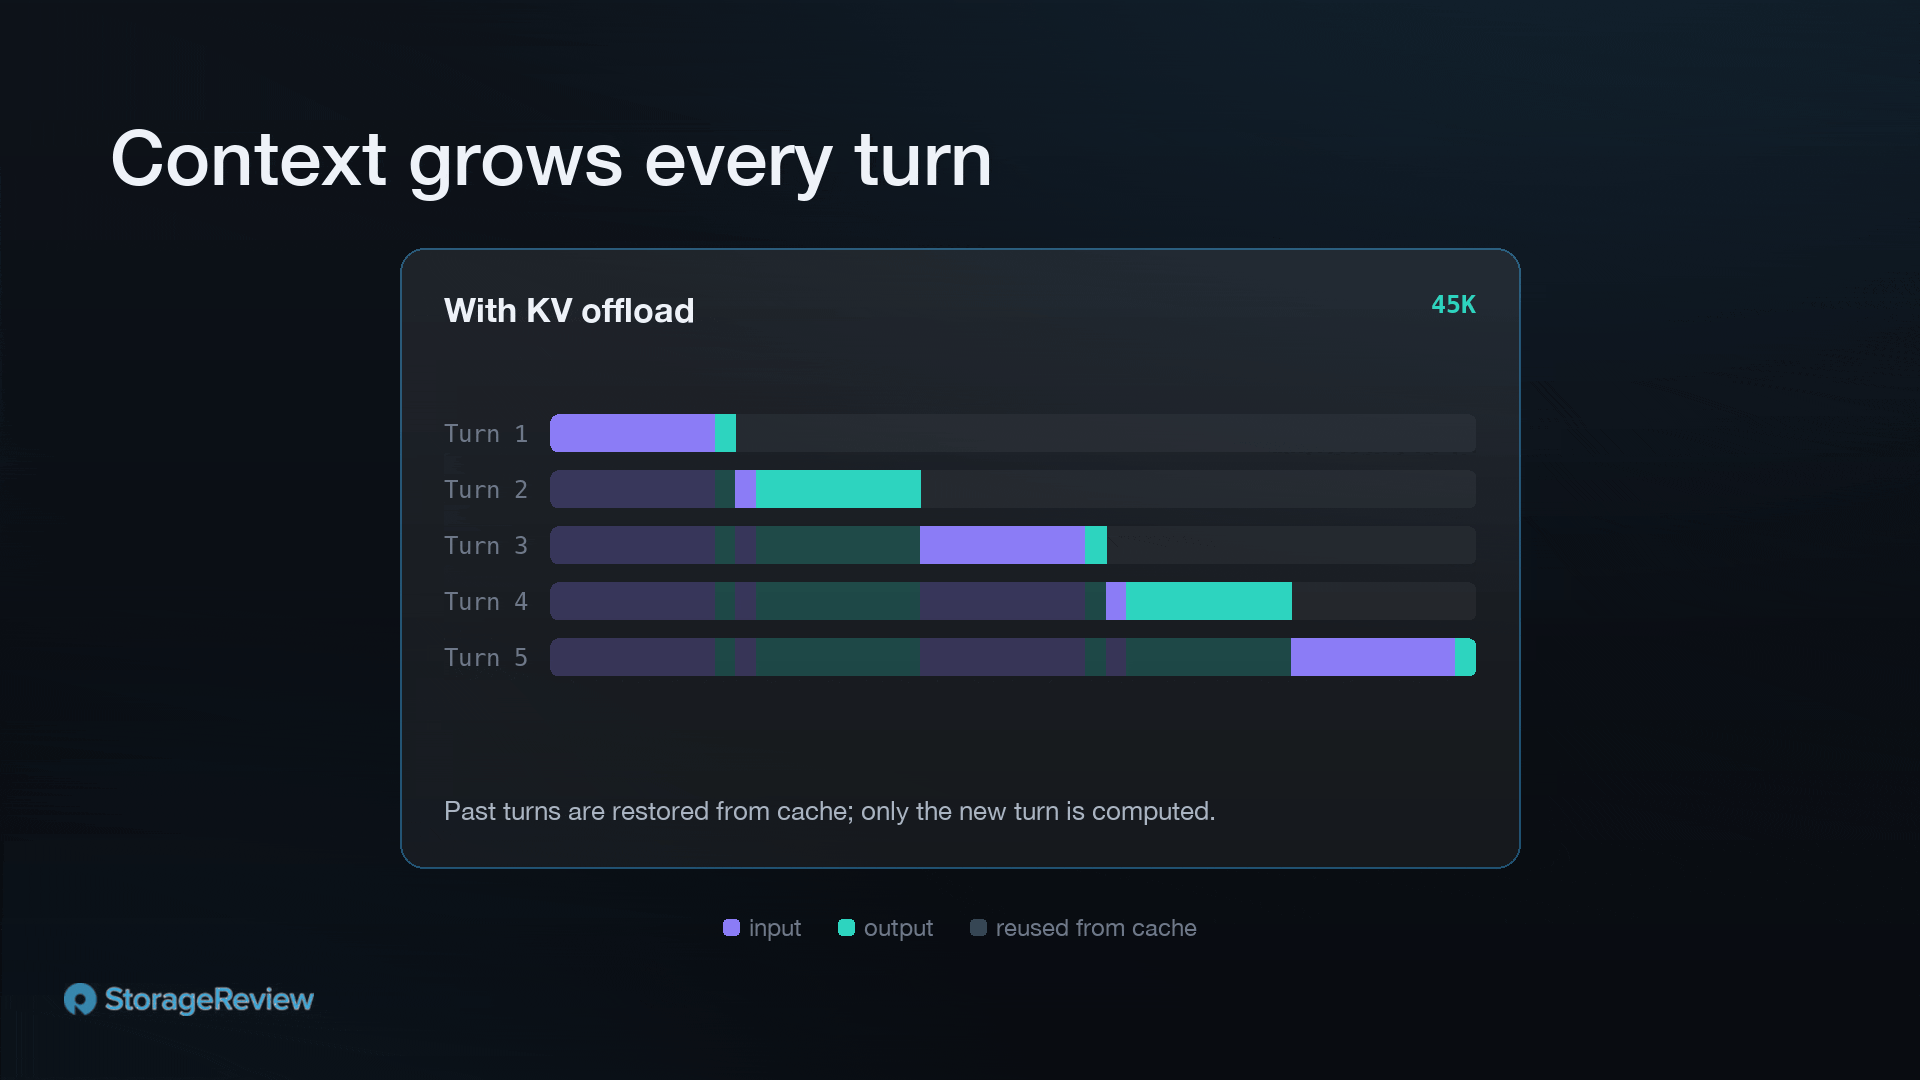
次のターンが到来すると、数万個のコンテキストトークンを再計算する代わりに、RAMまたはフラッシュストレージからキーバリュー(KV)を読み込みます。システムメモリからの再読み込みはわずかなレイテンシのペナルティを伴いますが、プリフィルをやり直すよりもはるかに安価で高速です。NVMeからの再読み込みはDRAMフェッチより若干遅いですが、それでも置き換える再計算よりははるかに高速です。ストレージ容量は比較的安価ですが、GPUコンピューティングはそうではないため、ターンの開始時にわずかな再読み込みレイテンシを犠牲にして数秒かかる再計算をスキップすることは、全体としてプラスになります。
テスト方法
私たちはこれを研究室で検証しました。システム構成は以下のとおりです。
- サーバー:Dell PowerEdge XE7740
- GPU:NVIDIA RTX PRO 6000 Blackwell Server Edition(96GB)×4
- システムメモリ:1TB DDR5(64GB×16枚、5200MT/s DDR5)
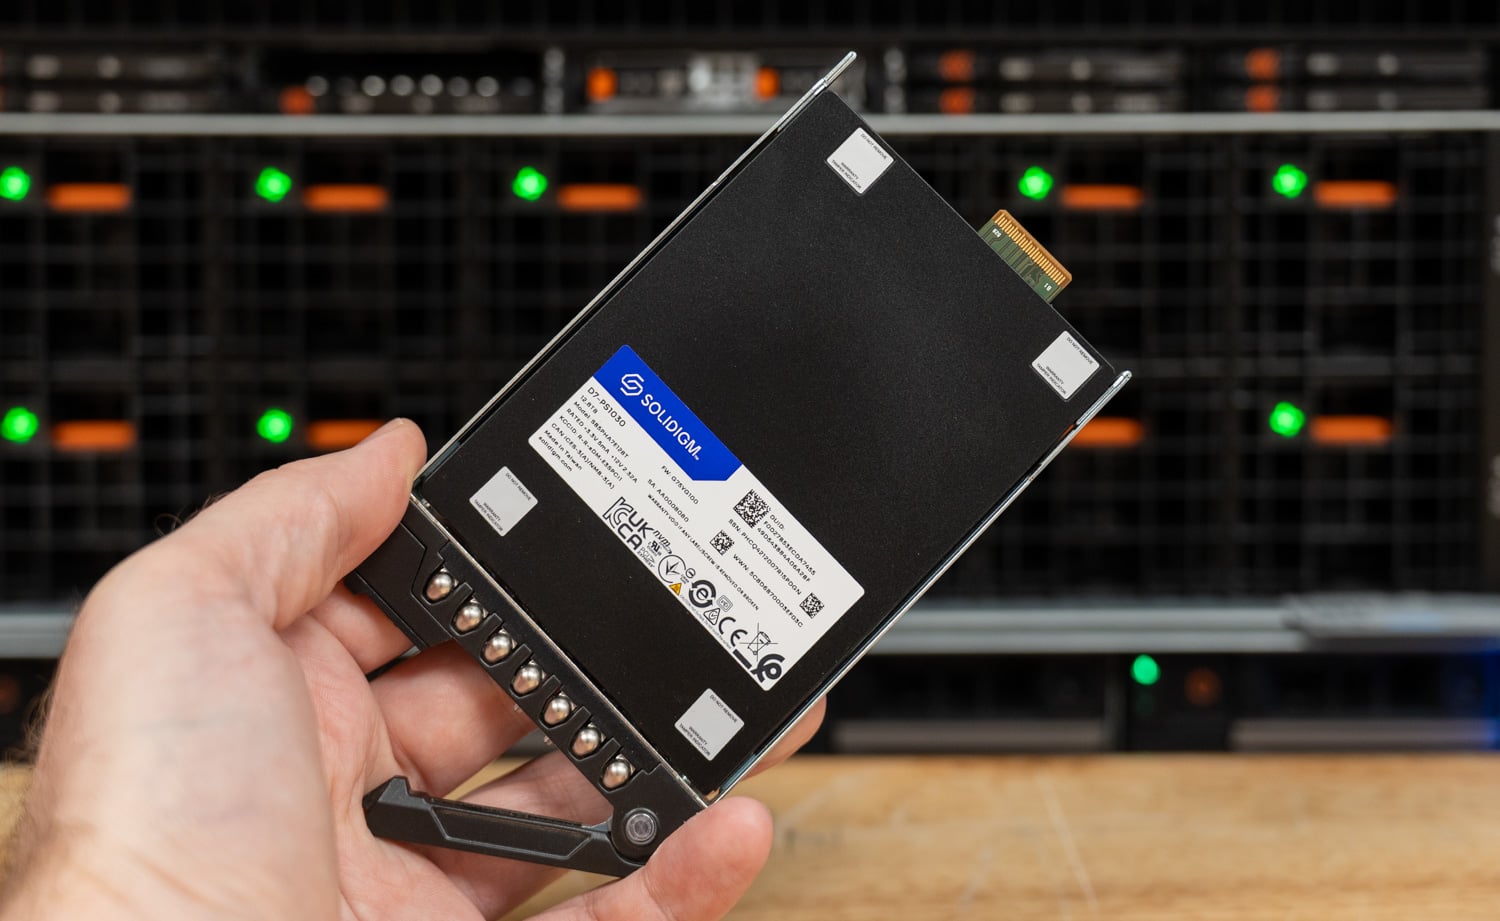
- ストレージ:Solidigm PS1030 12.8TB E3.Sドライブ×8台(RAID10構成)
- 提供スタック: vLLM 0.22.0 (LMCache 0.5.0)
- モデル:MiniMax-M2.7
このテストプラットフォームは、このワークロードに最適です。DellのPowerEdge XE7740は、エンタープライズAI推論専用に設計されたPCIe Gen5シャーシで、最大8つのダブルワイドGPUをサポートします。今回実行した4GPU構成は、最も人気のある構成の1つです。幅広い推論展開に十分なアクセラレータ容量を提供しながら、需要の増加に応じて同じ筐体内で8つまで拡張できる余地を残しています。各NVIDIA RTX PRO 6000 Blackwell Server Editionは96GBのGDDR7メモリを提供するため、4枚のカードで、キャッシュがGPUから離れる前に、かなりのVRAMプールを構築できます。その下には、8台の12.8TB Solidigm D7-PS1030ドライブをRAID10で構成したオフロード層があり、KVキャッシュ層が生成する継続的な書き込みに適したGen5高耐久性フラッシュです。そして最後に、今回選定したモデルであるMiniMax-M2.7は、テスト実施当時、当社の4GPU構成に適合する、最も優れたオープンコーディング対応モデルの1つでした。
我々は3つの構成をテストした。
- VRAMベースライン、オフロードなしの標準vLLM。VRAMに収まるものはすべてキャッシュされ、それ以外はすべて追い出される。
- LMCacheはシステムメモリにオフロードされ、オフロード用に512GBが割り当てられます。
- LMCacheはフラッシュメモリにオフロードされ、オフロード層としてローカルのRAID10 NVMeアレイが使用され、その前面には64GBのRAMステージングバッファが配置されます。
ワークロードは、固定された合成プレフィックススイープではなく、実際のエージェントコーディングトラフィックに基づいてモデル化しました。このトラフィックは、プレフィックスの再利用が広範囲に及ぶため、プリフィルが多く、デコードが少ないのが特徴です。セッションは、ポアソン過程に従って、1 分あたり λ = 2.5 セッションの割合で到着します。各セッションは、複数のターンにわたって実行されます。各ターンで、モデルは短い追加データ(通常は 250 ~ 600 トークンのツールまたはコマンドの結果)と、場合によっては 1,500 ~ 3,500 トークンのファイル読み取りデータを受け取ります。モデルは、短い応答(通常は 40 ~ 200 トークンのツール呼び出しまたは簡単な推論)と、場合によっては 400 ~ 900 トークンのコードブロックで応答します。ターンの長さは ±100 トークンで変動します。セッションは、64k トークンのコンテキスト上限に向かって単調に増加し、作業セットが VRAM を超えるディープコンテキスト領域に入ります。同じ初期負荷が3つの階層すべてを駆動し、それぞれに3分間のキャッシュウォームアップ時間が設けられている。
メモリ構成に関する簡単な注記:出荷時のXE7740には2TBのDDR5メモリが搭載されており、幅広いプロジェクトに対応できる最高スペック構成となっていました。この価格は、2026年のメモリ価格高騰以前に設定されたもので、当時としては大容量のDRAMが価格帯を大きく変えるものではありませんでした。元の構成は、現在企業が4つのGPUを注文する際のスペックと比較すると過剰だったため、より現実的な構成にするために、1TBのメモリを削除し、各チャネルに1つのDIMMを残してメモリスループットを最大化しました。
フラッシュ層に関する方法論上の注意点:今回の実行では、LMCacheのローカルディスクバックエンドを使用し、アレイの前に必要な64GBのRAMステージングバッファを配置しました。実行中にフラッシュ上に保持されるKVフットプリントはホストのDRAM容量をはるかに超えて増加したため、得られた結果はホストメモリではなくドライブサービスを反映したものとなっています。
パフォーマンス
負荷時のスループット
各階層が保持できる容量を超えてKVワーキングセットが拡大するにつれて、実行中の総サービス処理スループットは次のようになります。
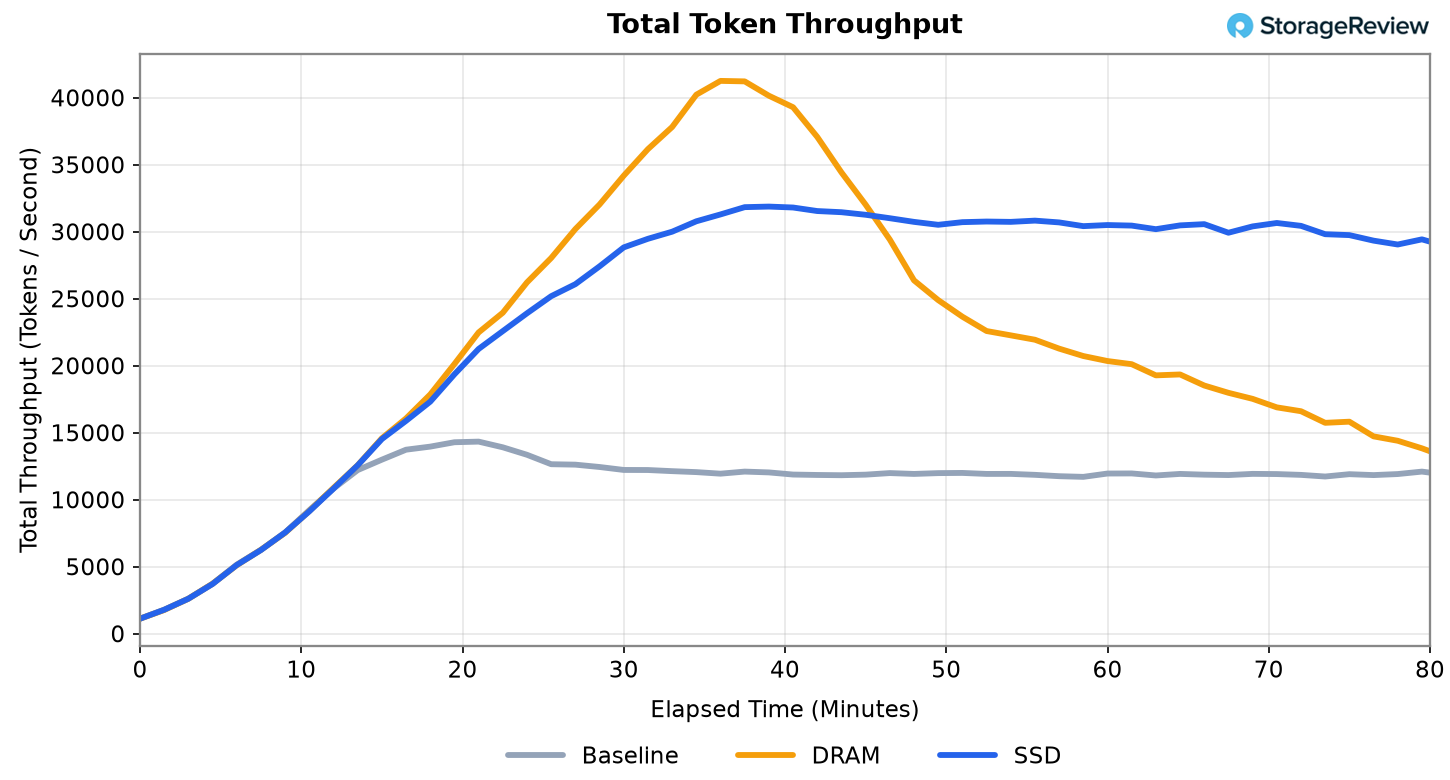
最初の10分間は、キャッシュがまだ満たされている間、すべての階層が同時に上昇し、パフォーマンスにほとんど差はありません。その後、メモリ階層が満たされるにつれて、それぞれが分離します。VRAMのみのベースラインが最初に停滞します。VRAMが飽和すると、1秒あたり約12,000トークンで横ばいになります。新しいセッションごとに古いセッションが追い出され、そのセッションが戻ってくると、追い出されたキャッシュを最初から再構築する必要があるため、毎秒のうち再プリフィルに費やす時間が増え、デコードに費やす時間は減ります。
DRAMとSSDの層は、キャッシュがいっぱいになるまでは、ほぼすべてのプレフィックスを再計算するのではなく、メモリまたはディスクから提供するため、そのプラトーをはるかに超えて上昇し続けています。ベースラインが再プリフィルに費やしていた時間は、代わりに新しいトークンの生成に費やされます。
ピーク時、オフロードによって、DRAM層ではベースラインの総処理スループットの最大2.9倍(+188%)、フラッシュ層では2.2倍(+122%)のスループットが実現しました。ワーキングセットがVRAM容量を超える前に、3つの構成すべてが1パーセント以内の差に収まります。メモリの強制的な解放は発生しないため、オフロードで回復すべきデータはありません。このメリットは、メモリ負荷によって強制的にメモリが解放された場合にのみ現れ、サーバーの負荷が高まるにつれてメリットも大きくなります。
より大きな階層の必要性は、DRAMが満杯になったときに明らかになります。この負荷では、512 GBのRAMキャッシュは実行開始から約45分で飽和し、そこからキャッシュの追い出しを開始する必要があります。返されるプレフィックスはミスして再プリフィルされますが、これはキャッシュが回避しようとしていたまさに再計算です。テラバイトの余裕を持つSSD階層は、この壁にぶつかることはありません。クロスオーバー後、フラッシュは毎秒約30,000トークンを維持しますが、DRAMは約17,000トークンで、RAMが不足するとSSDのスループットが75%向上します。言い換えれば、飽和後、DRAM階層はピークスループットのわずか42%しか提供しませんでしたが、SSD階層は94%を提供しました。この仕組み全体が依拠する容量階層は以下のとおりです。まずVRAMが枯渇し、次に512GBのDRAM層が枯渇し、ギガバイトではなくテラバイト単位で測定されるストレージ層は事実上枯渇することがないため、より高速な層がデータを破棄し始めた後も、ずっとコンテキストを提供し続けます。
その総スループットの数値を読む際の注意点として、報告されている毎秒数万トークンという数値は、GPUがトークンを計算する速度ではなく、大部分がオフロード層の処理速度であるということを覚えておいてください。総スループットは、各リクエストが運ぶ入力プリフィルトークンと出力デコードトークンをそれぞれカウントします。しかし、キャッシュが実装されている場合、ヒットが発生すると、プレフィックスのKVはGPU上で再プリフィルされるのではなく、DRAMまたはフラッシュからロードされます。
カウントを出力トークン、つまりユーザーが実際に待機するスループットの部分に限定すると、より明確な状況が把握できる。
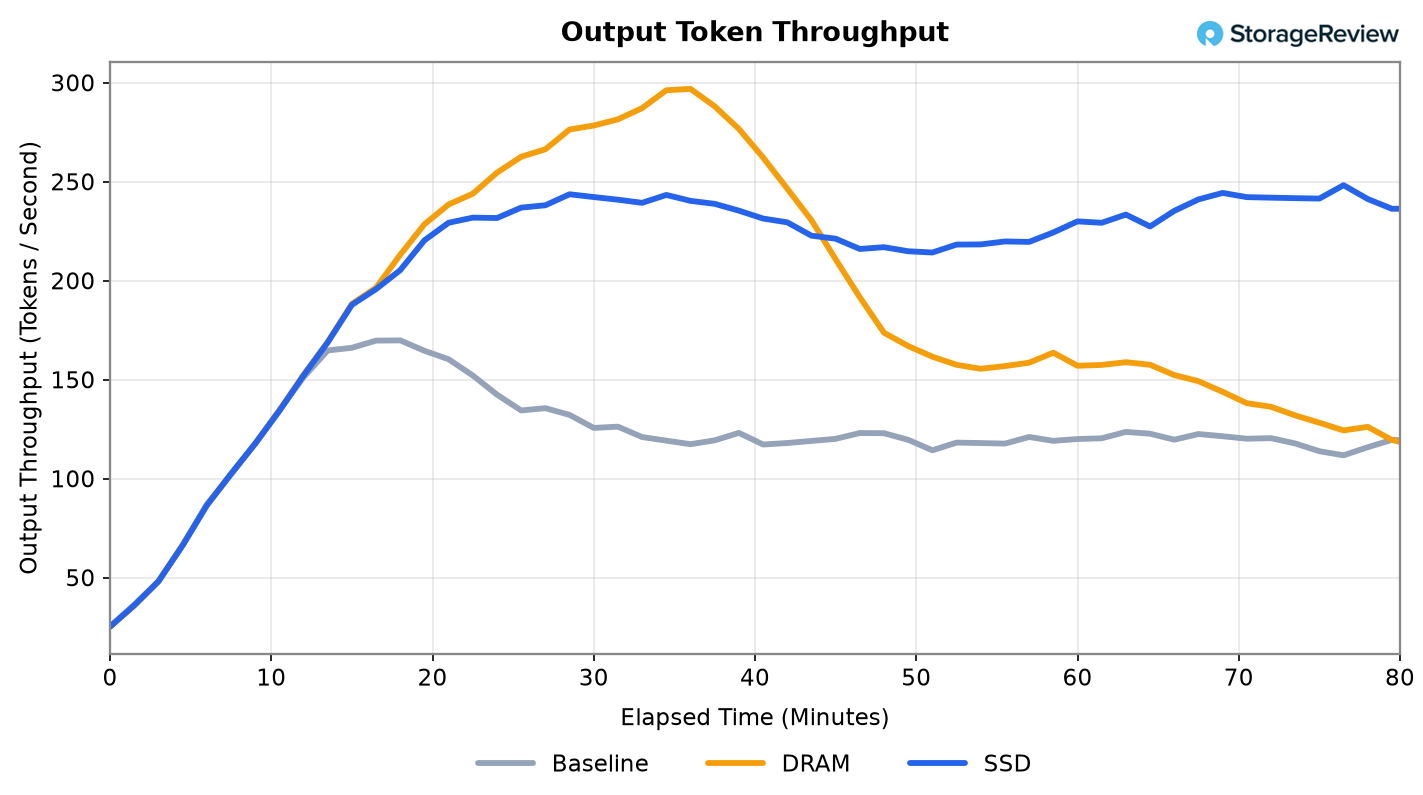
出力トークンでは、キャッシュが満たされる間は3つの階層が再び連動し、クロスオーバーで分岐します。DRAM階層は毎秒300トークン近くでピークに達し、ベースラインから75%増加し、その後、追い出しが始まると低下します。フラッシュは、残りの実行期間を通して毎秒250トークン近くを維持し、ベースラインから46%増加します。RAMとSSDのラインは、DRAMが飽和するまで互いに約10%以内の範囲に留まりますが、その後、差が広がります。
初回トークン遅延:ユーザーが待っているもの
スループットはトークンの総生成量を測定します。最初のトークンまでの時間は、個々のユーザーが目にする時間、つまり送信ボタンを押してから最初のトークンが返ってくるまでの待ち時間を測定します。作業セットが拡大し、各階層が満たされるにつれて、実行期間全体にわたって、中央値でこの値をプロットします。
キャッシュが保持されている間は、3つの階層すべてが約0.5秒で最初のトークンを返します。その後、スループットの順序と同じ順序で分岐します。ベースラインが最初に破綻し、実行の早い段階で10秒を超えますが、DRAM階層は512GBが45分頃にいっぱいになるまで、1秒未満のTTFTをはるかに長く維持します。その後、追い出しと再計算が始まると、レイテンシが急激に低下します。SSD階層は最も緩やかに劣化し、実行の後半全体にわたって3つの中で最も低いテールを維持します。
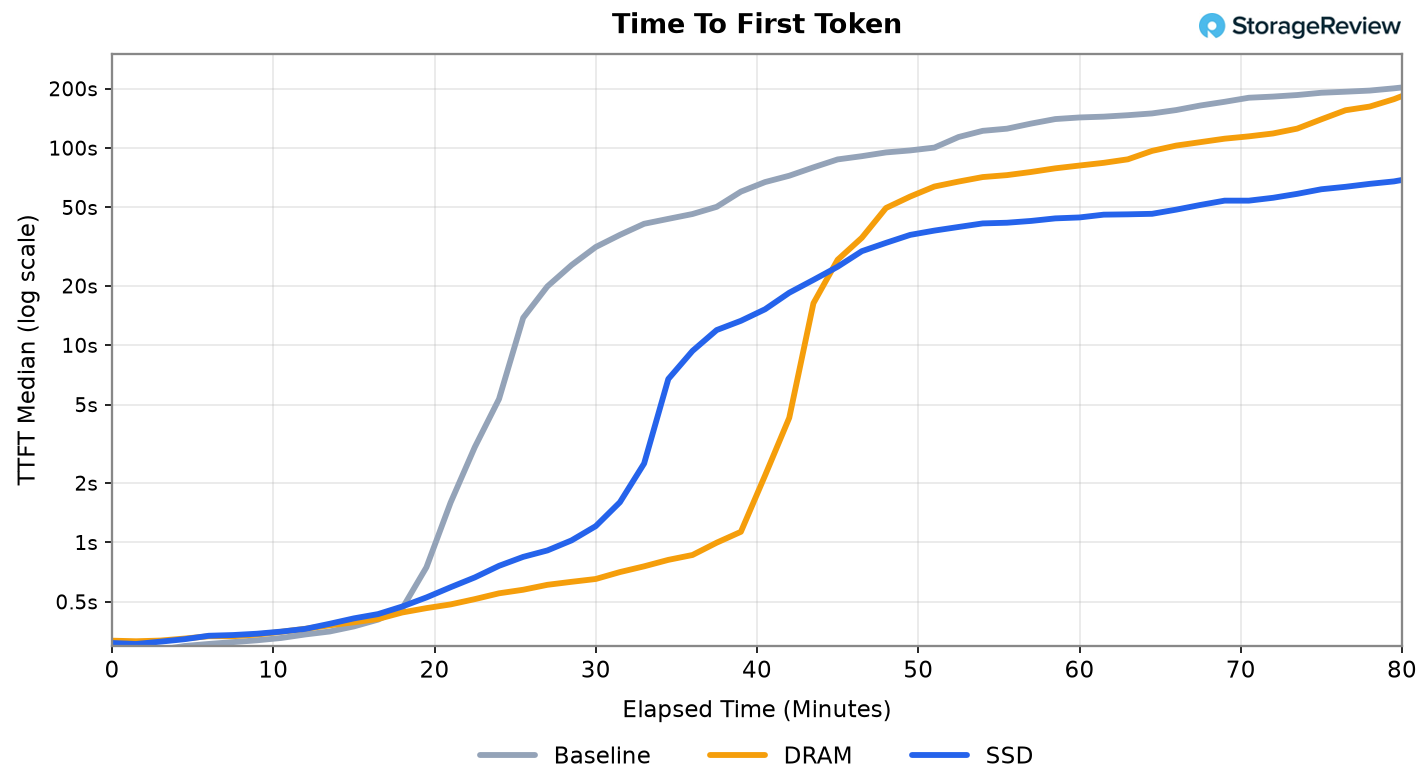
この逆転現象は、階層化に関する議論を簡潔に表したものです。ワーキングセットがDRAMの階層内に収まっている間は、DRAMがレイテンシーの面で優位に立ちます。しかし、ワーキングセットがDRAMの階層内に収まらなくなると、今度はフラッシュメモリがレイテンシーの面で優位に立ちます。なぜなら、フラッシュメモリはDRAMの階層が破棄し始めたコンテキストをまだ保持しているからです。
リピーター問題
上記のレイテンシの数値は、連続したセッション内のターンを対象としています。復帰ユーザーのケースは異なります。セッションは会話の途中で一時停止し、約 15 分間アイドル状態になり、その後中断したところから再開します。私たちは、約 20 ターン後に休止状態になり、15 分後に復活するコホートを使用してこれをモデル化しました。この時間は、ビジー状態のサーバーがその間にキャッシュを介して他のトラフィックを循環させるのに十分な時間です。このような復活が各ティアの測定ウィンドウ内に 11 回発生し、ワークロードはティア間で同一にシードされているため、同じ 11 セッションがすべての実行で復活し、再開ターンの同等の比較が可能になりました。下のグラフは、各ティアの通常のターンにおける最初のトークン時間の中央値を再開ターンに対してプロットしたもので、ひげはサンプルの中で最悪の再開を示しています。
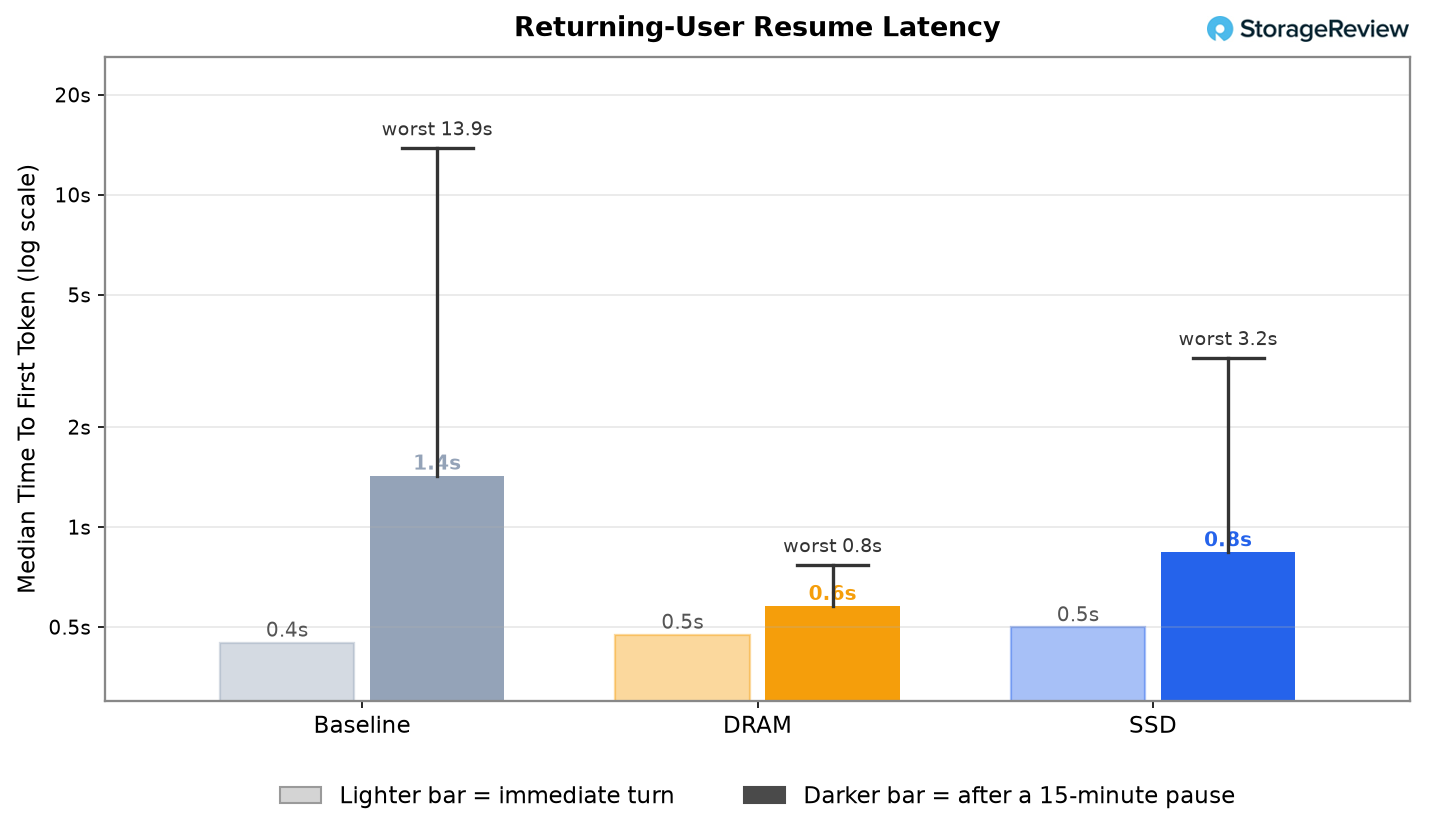
中央値では、数値はメカニズムの予測を裏付けるだけであり、階層は予想通りの順序で並んでいます。DRAMがリードしています。休止状態のセッションは0.6秒で再開し、通常のターンにかかる0.5秒をわずかに上回ります。SSDは0.8秒で2位です。NVMeフェッチはDRAMフェッチよりも遅いことは周知の事実であり、それがここでも表れています。VRAMのみのベースラインは1.4秒で最も遅くなっています。オフロードするものがないため、アイドル状態のセッションのプレフィックスはライブトラフィックのためにGPUメモリから追い出され、最初のターンバックでそれを再計算する必要があります。最良の場合でも、全体の差は約1秒程度です。
最良のケースは、選択が行われるケースではありません。各ティアの 11 回の復活のうち最悪のケースは、DRAM で 0.8 秒、SSD で 3.2 秒、ベースラインで 13.9 秒です。最初のトークンの 14 秒の待ち時間が許容範囲内か、ハード SLO 違反かはサービスによって異なりますが、インタラクティブなものについては後者であり、オフロード ティアのみが、ユーザーが我慢できる範囲内にそのテールを収めています。また、コンテキストによっても広がります。再計算コストは、戻ってきたユーザーが蓄積した履歴の量に応じてスケーリングされるためです。スループット テストのより深いコンテキストでは、ベースラインのテールは 14 秒をはるかに超えて実行されますが、DRAM と SSD では依然として制限されたリロードしか発生しません。
KVキャッシュの選択とサイジング
どちらのオフロード層も、VRAMのみのベースラインを大きく上回り、その性能差はごくわずかです。スループットの向上はVRAMの解放によるものであり、解放されるキャッシュがDRAMに配置されようとSSDに配置されようと、解放されるVRAMの量は同じであるため、差は小さいのです。スループットは、キャッシュがどの層から戻ってきたかには左右されません。レイテンシは、DRAMフェッチの方がNVMeフェッチよりも高速であるため、影響を受けますが、どちらも同じKVを最初から再計算するよりははるかに安価です。
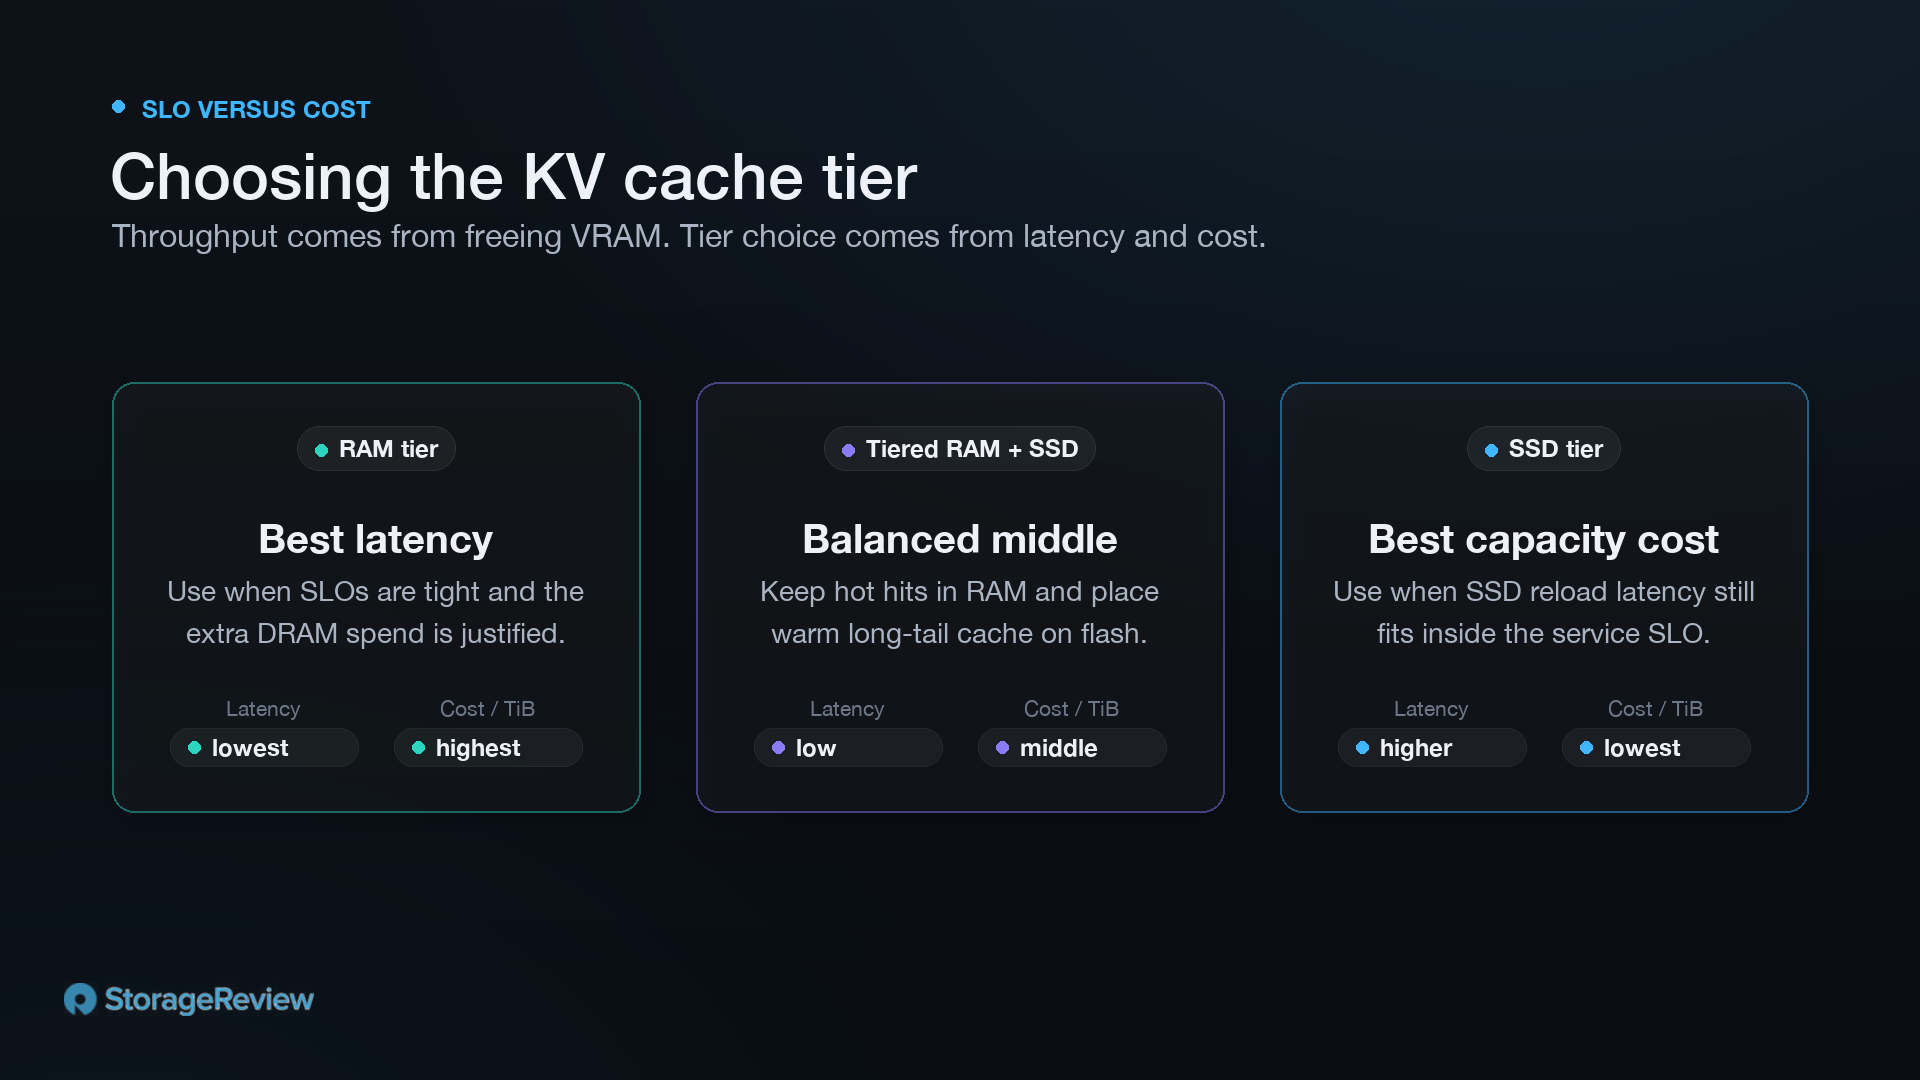
どちらを選択するかは、SLOとコストのトレードオフであり、オペレーターが何を最適化したいかによって異なります。オフロードされたキャッシュ全体をRAMに保持するとレイテンシは最も低くなりますが、フラッシュに比べてレイテンシの改善が比較的小さいため、設備投資(CAPEX)は高額になります。階層化はその中間的なアプローチです。レイテンシが重要な箇所でヒットを吸収する小規模なRAM階層と、数百ミリ秒以内に応答する必要のない、比較的負荷の高いロングテールキャッシュを保持するストレージ階層が背後に配置されます。
KVキャッシュを考えるもう一つの方法は、そのサイズです。ストレージ層のサイジングは、システムが維持できる最大トークンスループットによって決まります。システムが保持しなければならないKVフットプリントは、スループットにキャッシュエントリのTTLを掛けた値です。生成されたトークンはすべてKVエントリに書き込まれるため、計算式はトークンの到着レートに保持期間を掛けた値になります。本番環境におけるTTLのデフォルト値は、5分と1時間の2種類です。
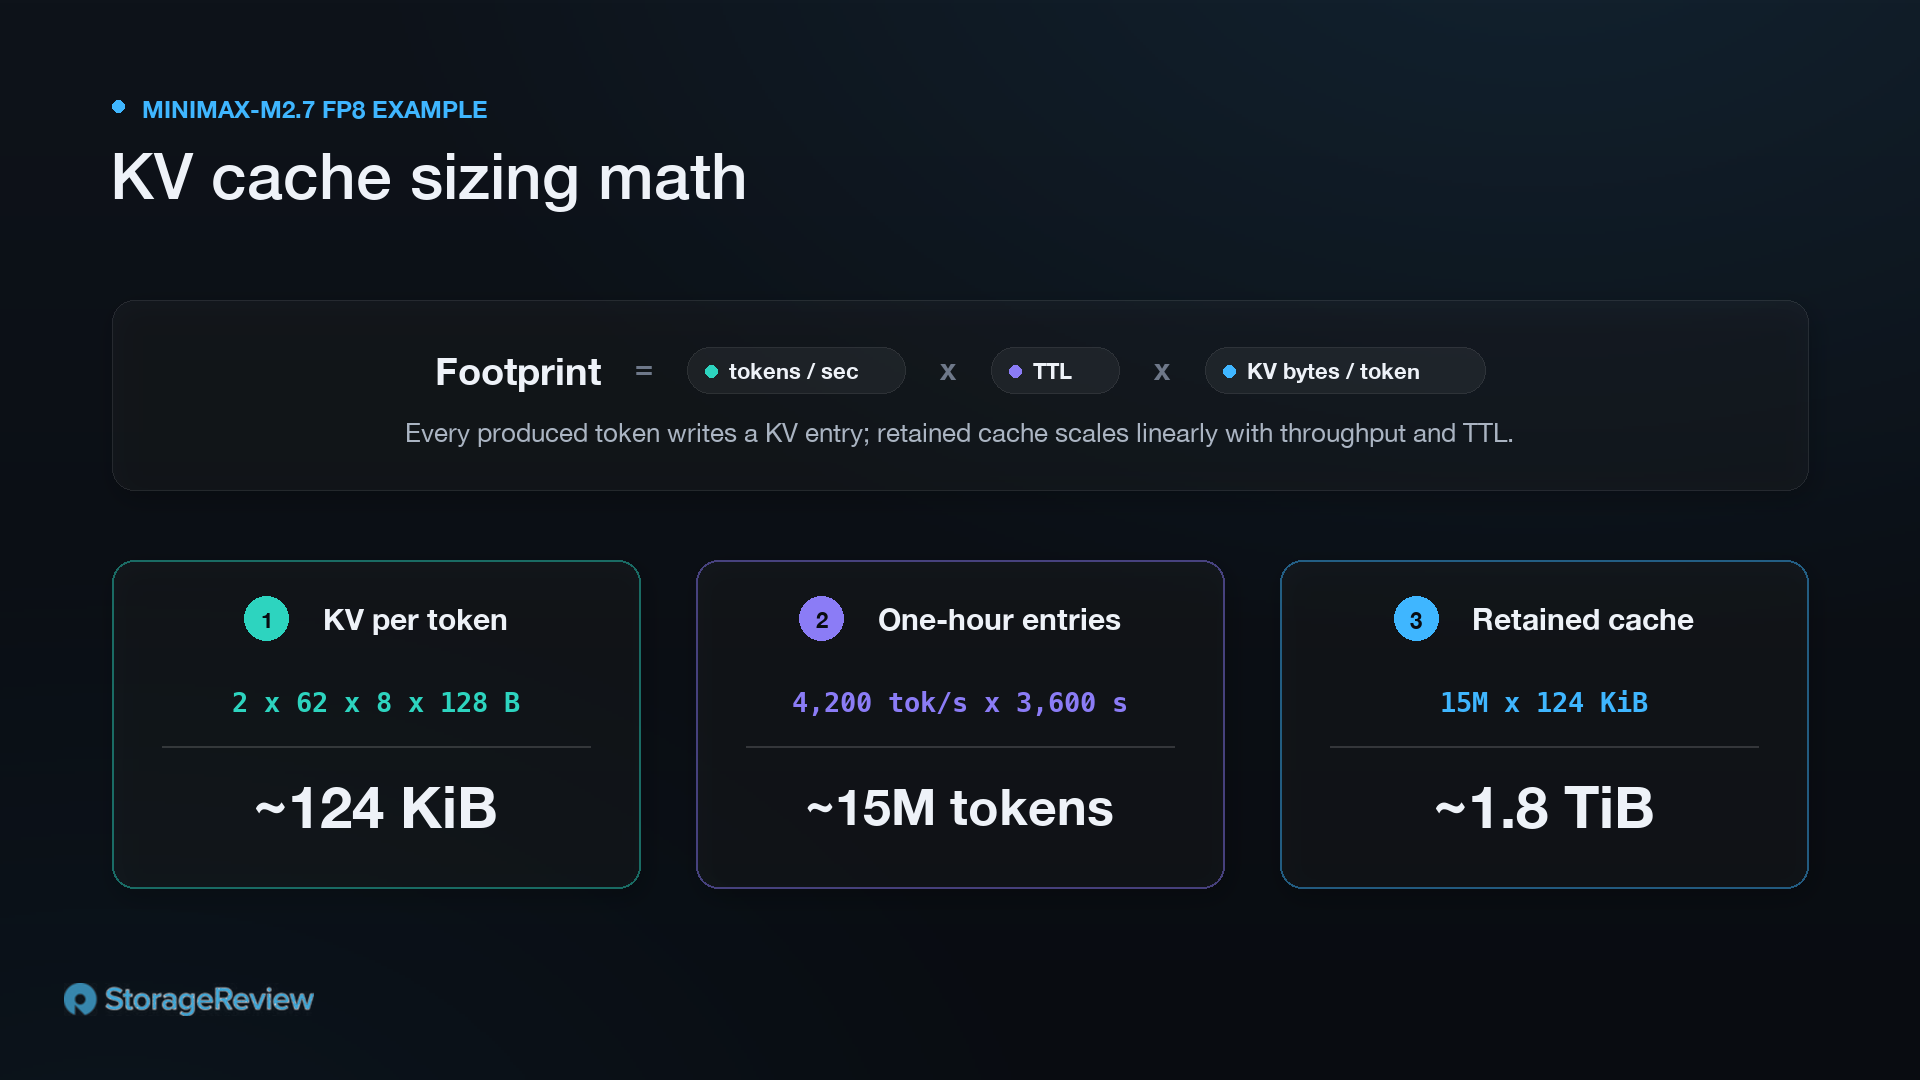
ここでテストしたFP8のMiniMax-M2.7のKVキャッシュサイズを計算してみましょう。KV要素1つあたり1バイトなので、トークンあたりのエントリは2 × 62 × 8 × 128バイト、つまり約124 KiBになります。これは、グループ化されたクエリアテンショントランスフォーマー全般に当てはまります。トークンあたりのKVは、レイヤー数 × KVヘッド数 × ヘッド次元数 × 2 (KとVの場合) × データ型バイト数なので、レイヤー数またはKVヘッド数が多いモデルほど、トークンあたりの書き込み量が比例して多くなります。ここでの適度な動作点 (RAM層で毎秒約4,200トークン) では、1時間の保持で約1,500万トークンのキャッシュが生成され、トークンあたり124 KiBなので、約1.8 TBになります。これは大量のDRAMであり、構築コストを押し上げます。
こうした点を踏まえ、SLO 要件と予算がティアの選択を左右します。SLO が十分に緩く、SSD ティアのリロード遅延が SLO 内に収まる場合、第 2 層の KV キャッシュはストレージのみ上に配置でき、コネクタに必要な薄い RAM ステージング バッファのみをその前に配置します。ストレージ コストは控えめです。テスト全体を通して、ピーク KV トラフィックは中程度の動作点で書き込みが 4.1 GB/s、読み取りが 1.1 GB/s であり、fio で測定した上限は約 114 GB/s でした。使用した RAID10 アレイには帯域幅に約 28 倍の余裕があったため、XE7740 が 8 個の GPU をフルに活用し、同時負荷が増加しても、フラッシュがボトルネックになることはありません。この余裕があるからこそ、オペレーターは速度ではなく容量を重視してティアをプロビジョニングできるのです。 D7-PS1030の容量が1テラバイト増えるごとに、TTLとシステムが常駐させるワーキングセットが拡張され、常駐キャッシュが大きくなればなるほど、再計算の回数が減り、より多くのトークンを処理できるようになります。
耐久性は、このティアを定義する制約です。KVオフロードキャッシュは非常に書き込み集中型です。モデルが生成するトークンごとにKVエントリが書き込まれ、TTLチャーンによってティアが24時間体制で書き換えられるため、ドライブは事実上書き込みを停止しません。8台のドライブアレイ全体で、持続的な書き込みは1.9GB/秒で実行され、テストしたRAID10構成では、ミラーリングによってメディアが吸収する量が2倍になり、12.8TBドライブ1台あたり1日あたり約3.2ドライブ書き込みとなり、D7-PS1030の持続定格3 DWPDをわずかに上回ります。プライマリストレージとしては不適格ですが、この場合は許容範囲内です。キャッシュは設計上使い捨てであり、摩耗したドライブの障害モードはデータ損失ではなく再計算です。RAID0は、8台のドライブすべてにストライピングして何も2回書き込まれないようにし、メディアレートを定格内に余裕で収まる約1.6 DWPDに下げるため、このティアにはおそらくより適しています。いずれにせよ、結論は変わりません。このワークロードは、他のどのワークロードよりも早く耐久性を消費し、専用の高耐久性ドライブは、この階層に必要な容量のごく一部しか搭載していません。そして、この組み合わせこそが、PS1030のような書き込み重視の大容量ドライブを最適な選択肢にする理由なのです。
1ドルあたりのトークン数
パフォーマンスのセクションでは、ワーキングセットがメモリ容量を上回った後でも、フラッシュメモリはDRAMでは維持できないスループットの大部分を維持し、ファーストトークンレイテンシも維持できることが示されました。商業的に重要なのは、データ保持を行う階層のコストです。再計算処理の簡単な解決策は、システム内の高価なDRAMを増設することです。オフロードの議論は、ストレージ階層の容量あたりのコストが大幅に低い場合にのみ有効です。
このギャップを最も明確に示しているのは、価格ではなく容量です。512GBのDRAMオフロード層は容量がいっぱいになり、キャッシュの解放を開始しましたが、テラバイト単位で計測されるフラッシュ層はそうではありませんでした。実用的なDRAM予算では、数十テラバイトものKVキャッシュをGPUの隣に配置することはできません。そのため、一定のコンテキスト長を超えると、高速なDRAMとフラッシュのどちらを選ぶかという選択ではなく、フラッシュとコンテキストの破棄(つまり、スループットとレイテンシを低下させるキャッシュの解放)のどちらを選ぶかという選択になります。
価格面では、エンタープライズ向けフラッシュメモリは長らくDRAMのテラバイト当たりのコストのほんの一部で販売されてきました。これは、NANDの多層構造の3D積層セルと、DRAMの1トランジスタ1コンデンサ構造という構造的な違いに起因するものです。2026年のメモリ需要の急増により、両方の価格が急騰し、NANDの契約価格は今年に入ってからDRAMと同等かそれ以上のペースで上昇しているため、DRAMが高騰する一方でフラッシュメモリが安くなっているという状況ではありません。しかし、現在の高騰した価格水準でも、テラバイト当たりの価格差は依然として存在し、テラバイト規模のキャッシュ容量をサービス予算に見合ったコストで利用できるのは、フラッシュメモリだけなのです。
スループットとコストは同じ方向性を示しています。フラッシュメモリが優位に立ったクロスオーバー点では、DRAM層よりも毎秒あたりのトークン数が多く、少なくはありませんでした。つまり、スループットを容量と引き換えにしているのではなく、テラバイトあたりのコストが低いメディアでより多くのスループットを実現しているのです。毎秒あたりのトークン数と1ドルあたりのコストで見ると、フラッシュメモリの優位性は大きく、保持する必要のあるコンテキストが長くなるほど、その差はさらに広がります。なぜなら、まさにその期間でDRAMは容量不足に陥るのに対し、フラッシュメモリは容量不足にならないからです。
ワーキングセットがDRAMに収まる限り、DRAMは適切な階層であり続け、コネクタが必要とする薄型のRAMステージングバッファはフラッシュメモリの前に配置されます。しかし、キャッシュがいっぱいになるまでワークロードに必要なピークパフォーマンスを得るために、GPUやDRAMを追加すると、テラバイトあたりのコストが最も高くなります。フラッシュメモリへのオフロードまたは階層化により、コンテキストを無期限に保持しながらパフォーマンスの大部分を維持でき、テラバイトあたりのコストも手頃になります。ただし、最終的な決定は、オペレーターが最適化するワークロードのSLO要件によって決まります。
結論
推論ワークロードの場合、トークノミクスが議論のすべてです。トークンは製品であり、再計算は無駄です。GPU はすでにそのコンテキストを一度生成しており、それを再構築するように指示されています。エージェントサービングは最もリスクが高い部分です。計測された Claude Code トラフィックの 1 週間のデータから、トークンの 98.16% がキャッシュ読み取りであり、GPU がすでに計算したコンテキストであり、そうでなければ、削除のたびに再構築されることがわかりました。KV キャッシュオフロードは、その履歴の再構築に使われるはずだった事前計算を新しいトークンに変換します。XE7740 では、モデル、GPU、エンジンを一定に保ったまま、高負荷時の VRAM のみのベースラインと比較して、合計サービング スループットが最大 2.9 倍になりました。DRAM 層が満杯になりフォールバックした場合でも、フラッシュは DRAM では匹敵できない容量でそのスループットを維持しました。
しかし、これによってDRAMの必要性がなくなるわけではありません。セッションが開いて短時間実行され、キャッシュがメモリ容量を超える前に閉じられるような、短時間でバースト的に発生するワークロードの場合、DRAMは適切な層であり、KVキャッシュのオフロードによるメリットはほとんどありません。ワーキングセットは適切に収まり、レイテンシは利用可能な最良の値であり、排除すべきものもありません。
しかし、私たちはそのようなプロファイルは例外であり、DRAM層だけで十分だと考えています。現在、ほとんどのプロダクション推論は長時間にわたり、継続的に実行されます。マルチターンエージェント、大規模なコンテキスト、安定した並行処理、同じセッションに繰り返し参加するユーザーなどがその例です。このような状況では、ワーキングセットがオペレーターがプロビジョニングできるメモリ層を超過し、キャッシュが追い出され、GPUは既に生成したコンテキストの再構築に再び取り組むことになります。これがコストのかかる障害モードであり、よくあるケースです。
これらのワークロードでは、KVキャッシュをフラッシュにオフロードすることで、2つの面でメリットが得られます。まず、GPUが古いトークンを再計算するのではなく、新しいトークンを生成し続けることができるため、この取り組み全体で測定されるトークノミクスの効率性が向上します。次に、それを可能にする容量を、システム内で最もコスト効率の高い耐久性のある階層に配置することができます。ビルドシート上で最も重要な結果は、何が削除されるかということです。キャッシュにフラッシュを使用するサーバーは、DRAMを大幅に削減でき、2026年のメモリ価格を考えると、これは見積もりで得られる最大の節約の1つです。トークンは製品であり、現在サービス提供を支配しているロングコンテキストワークロードの場合、トークン効率の良いパスは、同じトークンを2回生成するための費用を削減するパスであり、そのパスはフラッシュを経由します。
SolidigmのAI向けSSDストレージ
このレポートは Solidigm によって後援されています。このレポートで表明されているすべての見解や意見は、検討中の製品に対する当社の公平な見解に基づいています。


 Amazon