
AMDとIntelは、PyTorch向けのx86 CPU最適化作業をUnified Acceleration Foundation(UXL)が管理するオープンソースの深層学習ライブラリであるoneDNNに統合し、PyTorch内のx86アクセラレーションのデフォルトのオープンソースライブラリとして連携することを発表した。AMDはZenDNNの最適化をoneDNNに統合し、
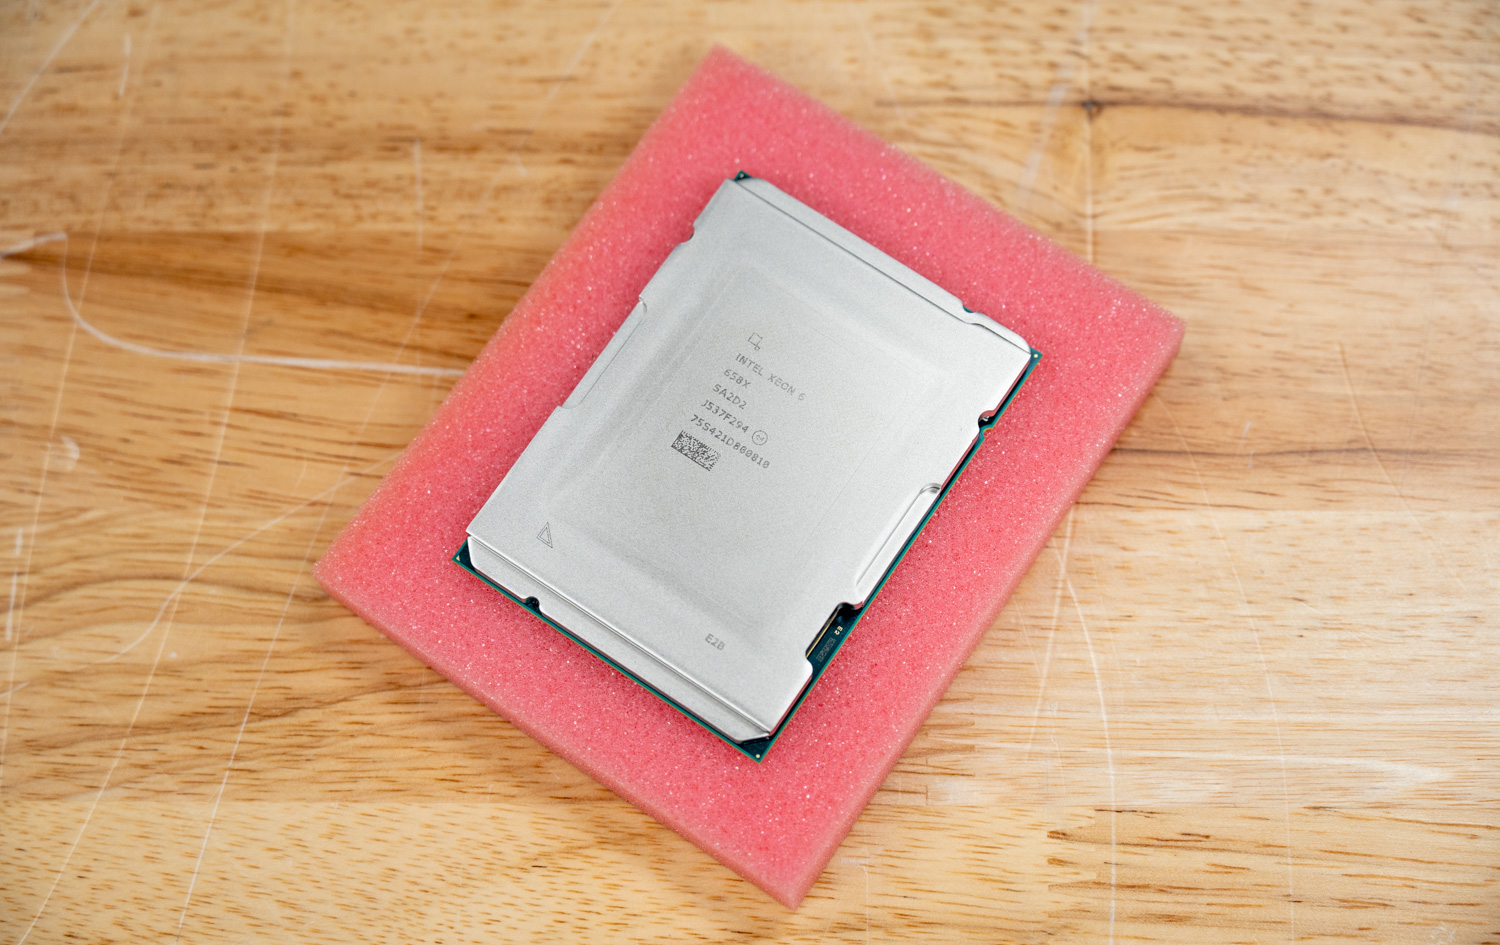

AMDとIntelは、PyTorch向けのx86 CPU最適化作業をUnified Acceleration Foundation(UXL)が管理するオープンソースの深層学習ライブラリであるoneDNNに統合し、PyTorch内のx86アクセラレーションのデフォルトのオープンソースライブラリとして連携することを発表した。AMDはZenDNNの最適化をoneDNNに統合し、
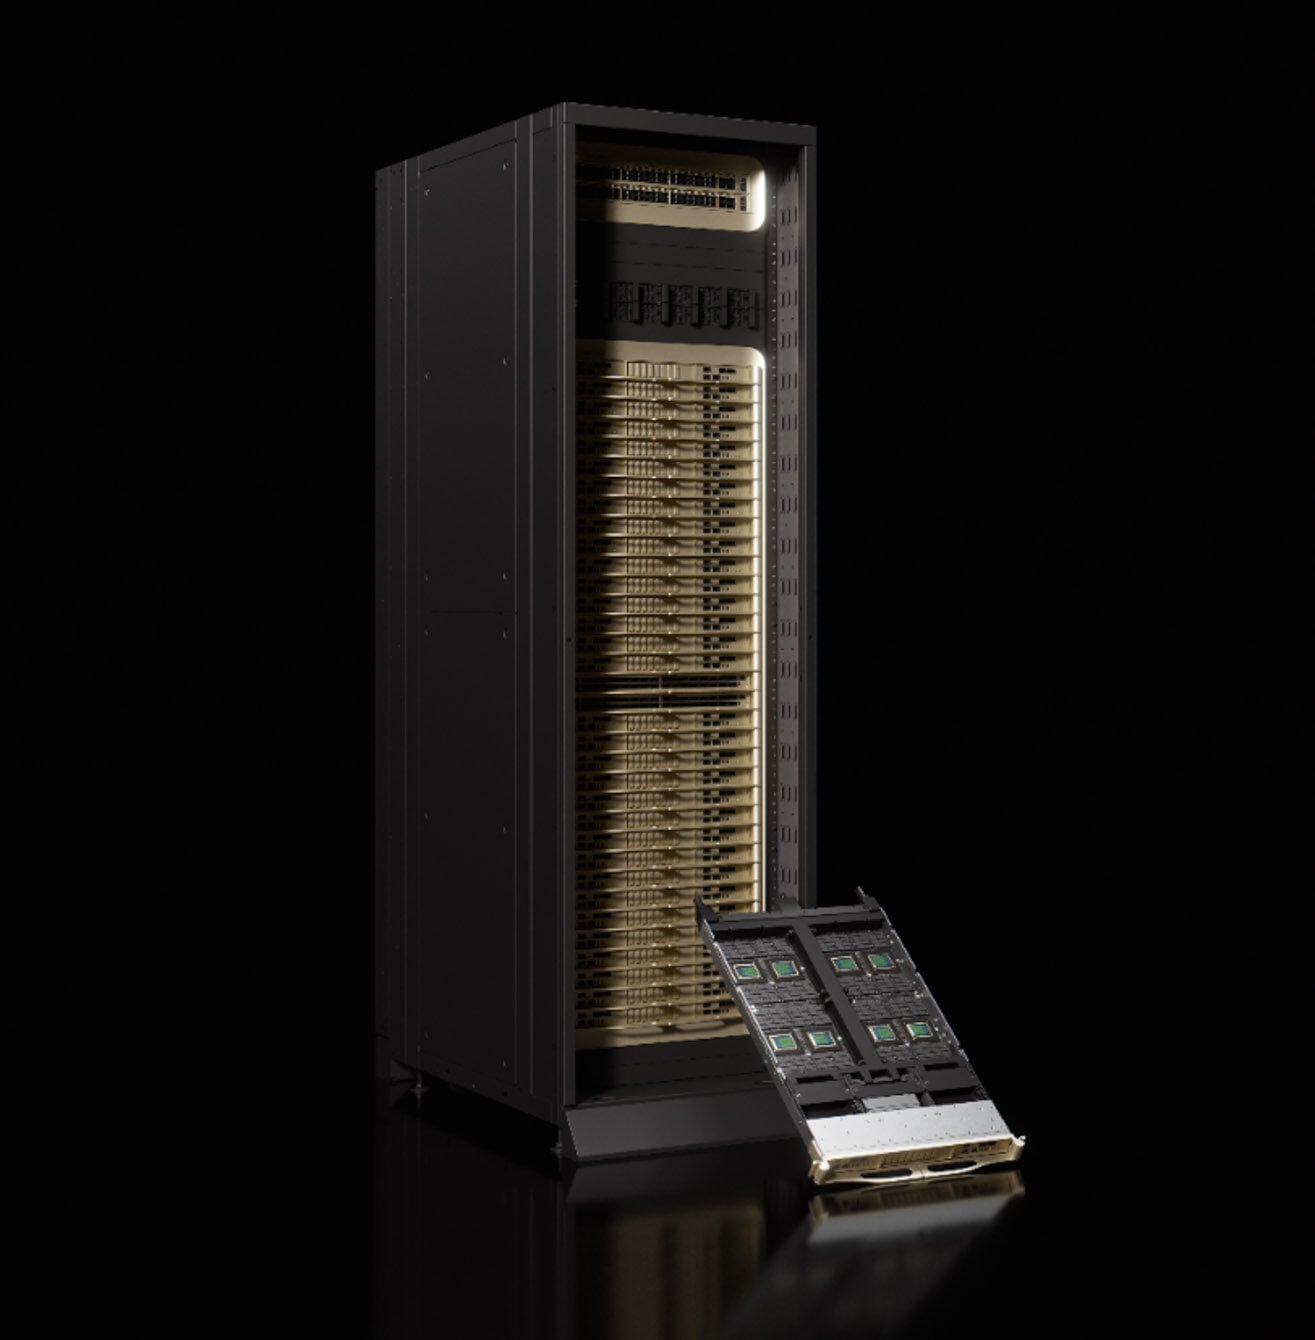
Supermicroは本日、NVIDIA Vera CPUラックを発表しました。これは48U、100%液冷式のラックで、256個のNVIDIA Vera CPU、22,528個のコア、45,056個のスレッドを搭載し、Supermicroは最大22,500個の同時エージェントサンドボックスに対応できると評価しています。これは、データセンタービルディングブロックソリューション(DCBBS)ポートフォリオの最新メンバーであり、
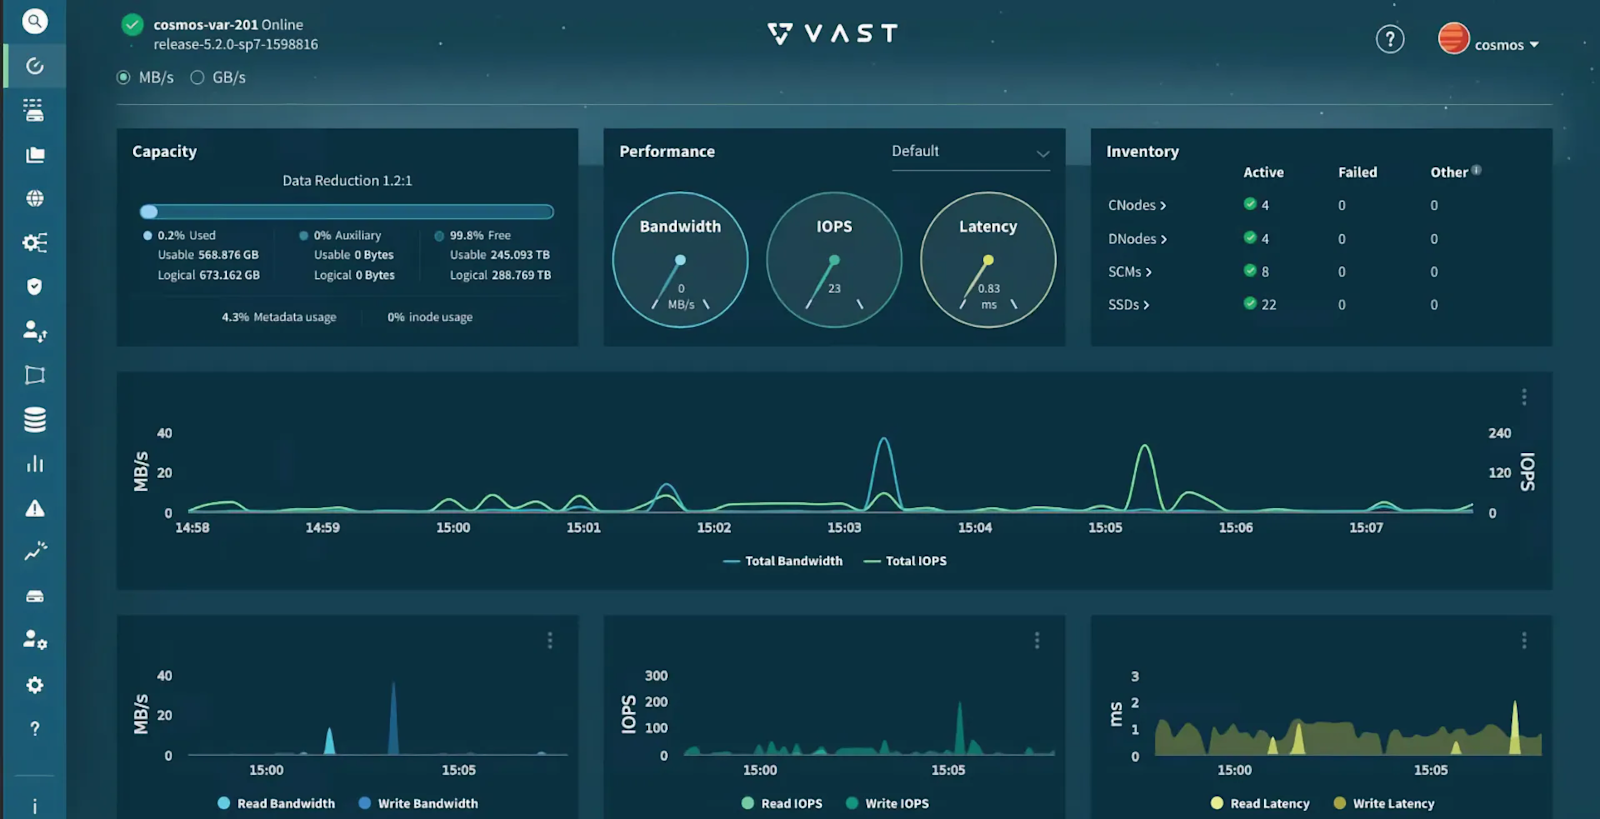
VAST Data は、NVIDIA GTC Berlin で NVIDIA と共同で Agent Sandbox Foundation Stack を発表しました。これは、VAST AI オペレーティングシステム上の NVIDIA OpenShell サンドボックス内で NVIDIA NemoClaw エージェントを実行するリファレンス アーキテクチャです。OpenShell は各エージェントの隔離された実行とポリシーの適用を処理し、VAST はサンドボックスを超えて存続する必要のある部分、つまりエージェントの
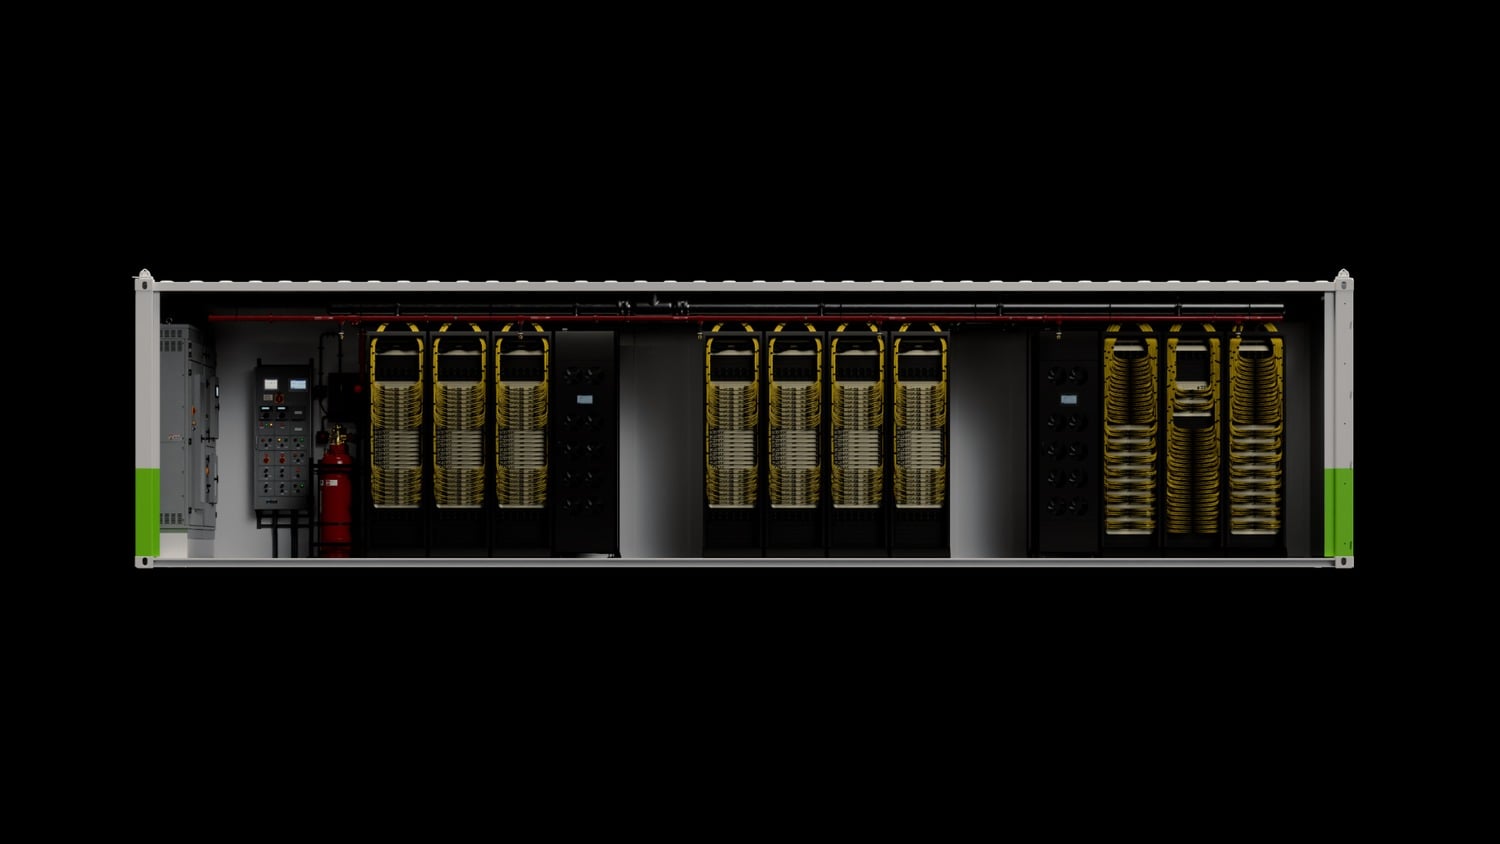
NVIDIA の GTC Berlin での今日の発表は、コンテナ化された Vera Rubin インフラストラクチャ、基板供給の 2.5 倍の拡張、AI ファクトリーの電力管理とエージェント セキュリティのためのソフトウェア、通信、自動運転車、ロボット工学、ヘルスケア プログラムに及ぶ。注目の数字は展開目標であり、NVIDIA は新しい DSX POD リファレンス デザインにより AI ファクトリーのコストを削減できると述べている。
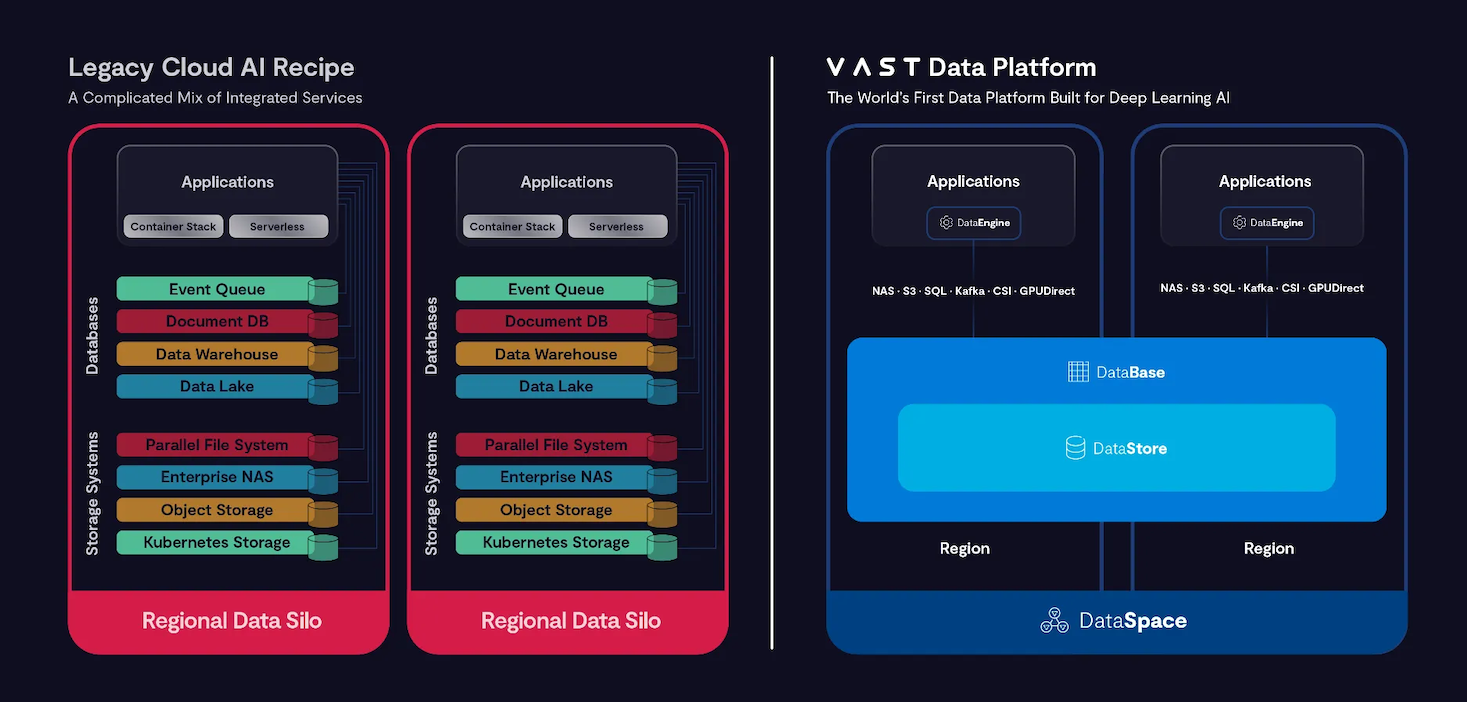
VAST Dataは、DeepLが、同社の文書翻訳およびリアルタイム音声翻訳の基盤となる研究環境のデータ基盤として、VAST AIオペレーティングシステムを導入すると発表した。現在の導入計画に基づくと、DeepLは既に運用しているNVMeハードウェアの約3倍のストレージ容量を見込んでおり、VASTのSyncEngineを使用して移行を行う予定だ。
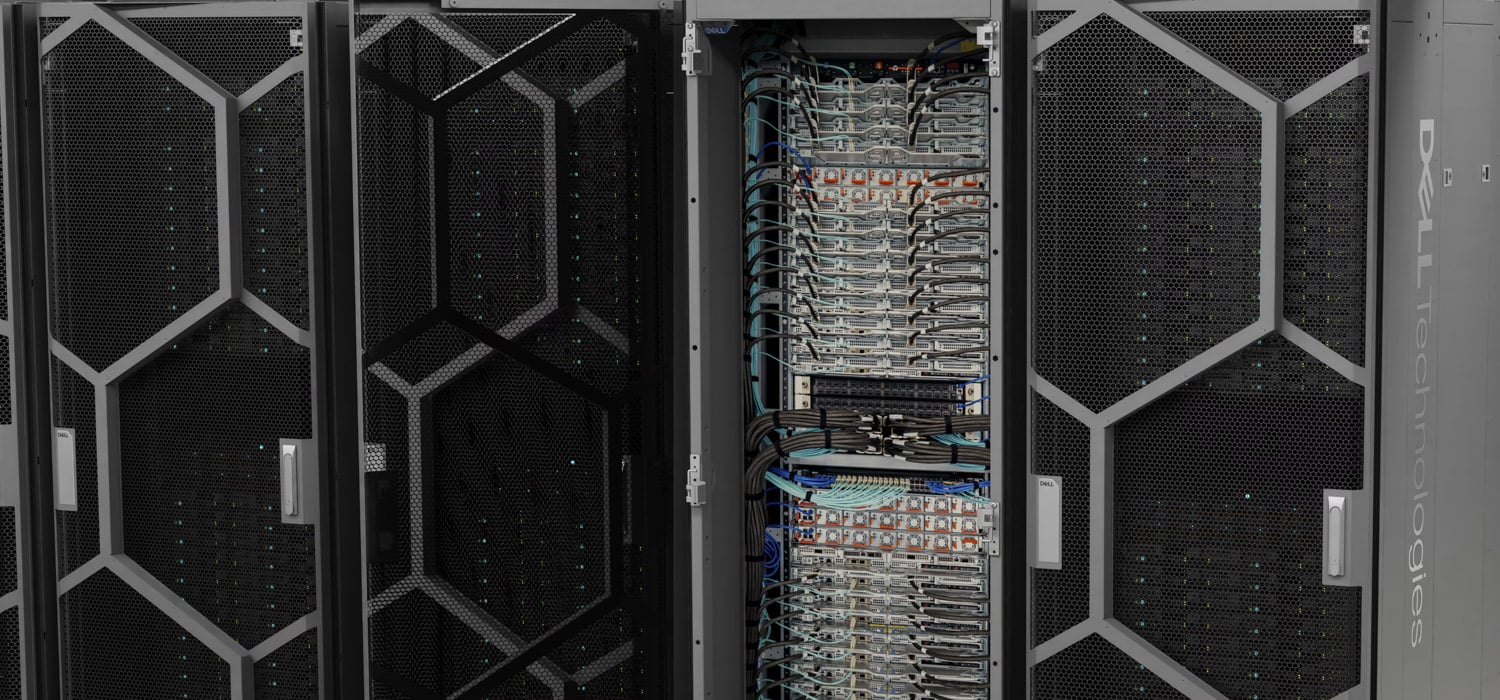
Dell Technologiesは本日、NVIDIA GTC BerlinでNVIDIAとのDell AI Factoryを拡張し、エージェントワークロード実行用の256個のNVIDIA Vera CPUを搭載した48U PowerEdge M9882ラック、Groq 3 LPUをベースにしたラック規模の推論システムPowerEdge XE9810、空冷式2ソケットVeraサーバー、GB10搭載の64GB Dell Pro Precision、およびセットを展示した。
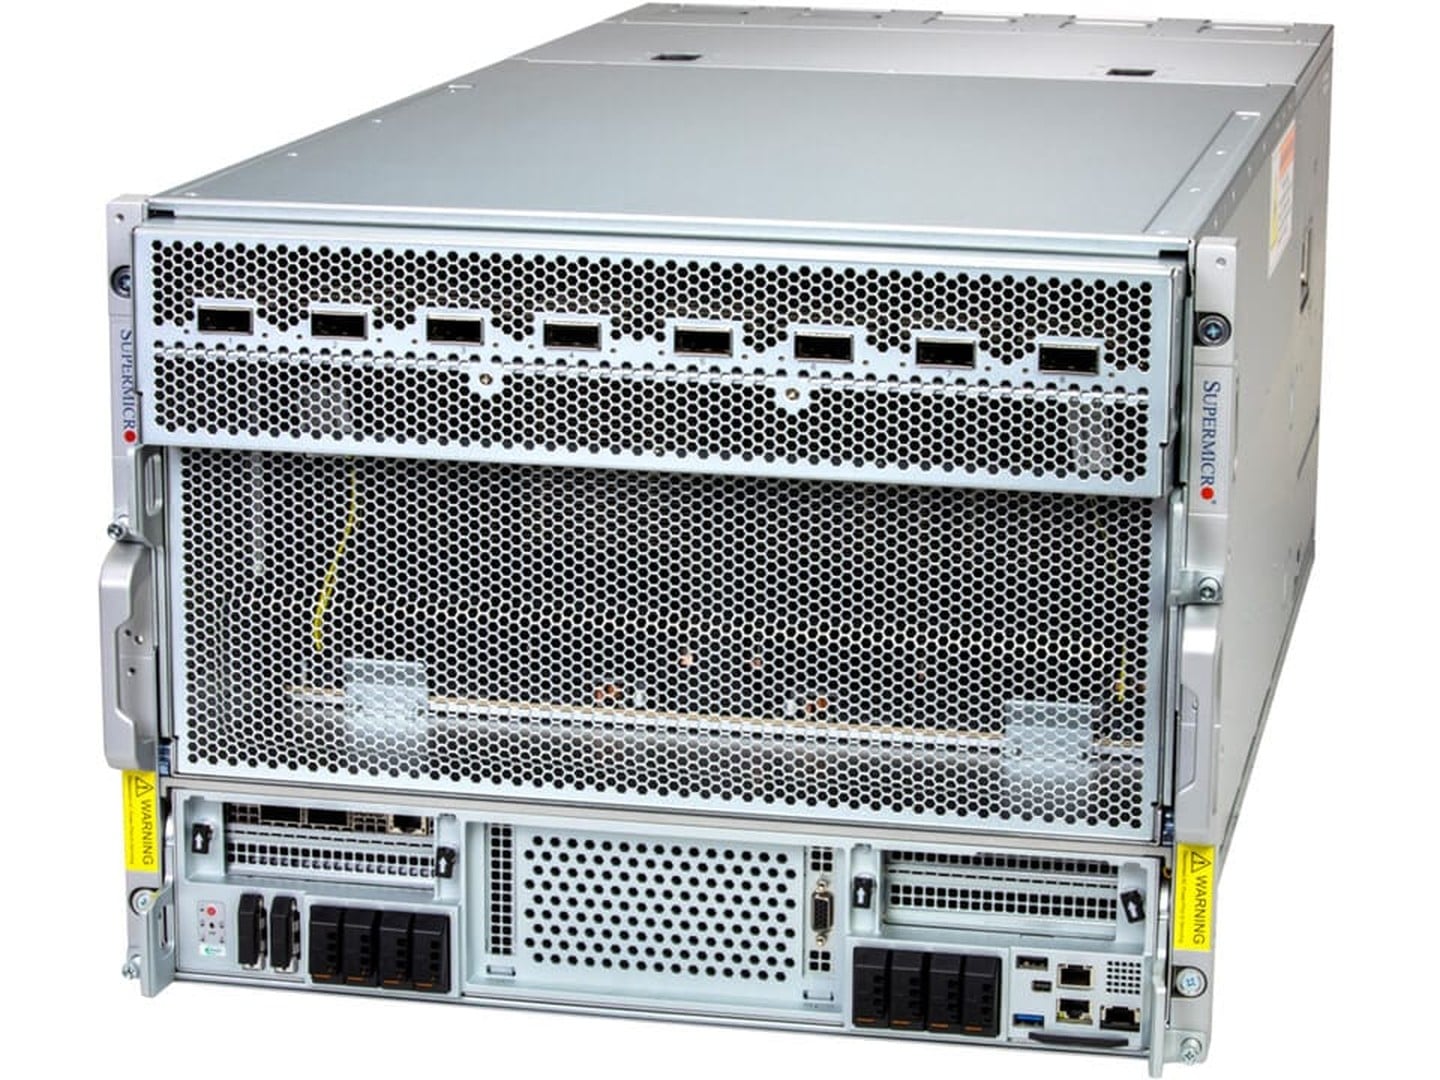
Nutanixは本日、NVIDIA GTC Berlinにおいて3つのコラボレーションを発表しました。1つ目は、Supermicroと共同開発した、ノードあたり8基のNVIDIA B300 Blackwell Ultra GPUを搭載したサーバーを基盤とするプライベート推論システム。2つ目は、NKP Bare Metalから始まるNVIDIA Vera CPUのDay Zeroサポート。3つ目は、Netrisとのマルチテナントスタックで、テナント分離を物理ネットワークにまで拡張するものです。
CoreWeaveは本日、NVIDIA GTC Berlinにて、Physical AI LaunchablesとCoreWeave Zero Trust AI Frameworkを発表しました。Launchablesは、ロボット工学および自律走行車ツール向けにテスト済みで実行可能なテンプレートのカタログであり、それぞれ1つのコマンドで起動できます。NVIDIA Isaac Sim、CARLA、MuJoCo、NVIDIA AlpaSim、NVIDIA Cosmos 3の環境と、調整済みのコーディングエージェントスキルを組み合わせたものです。
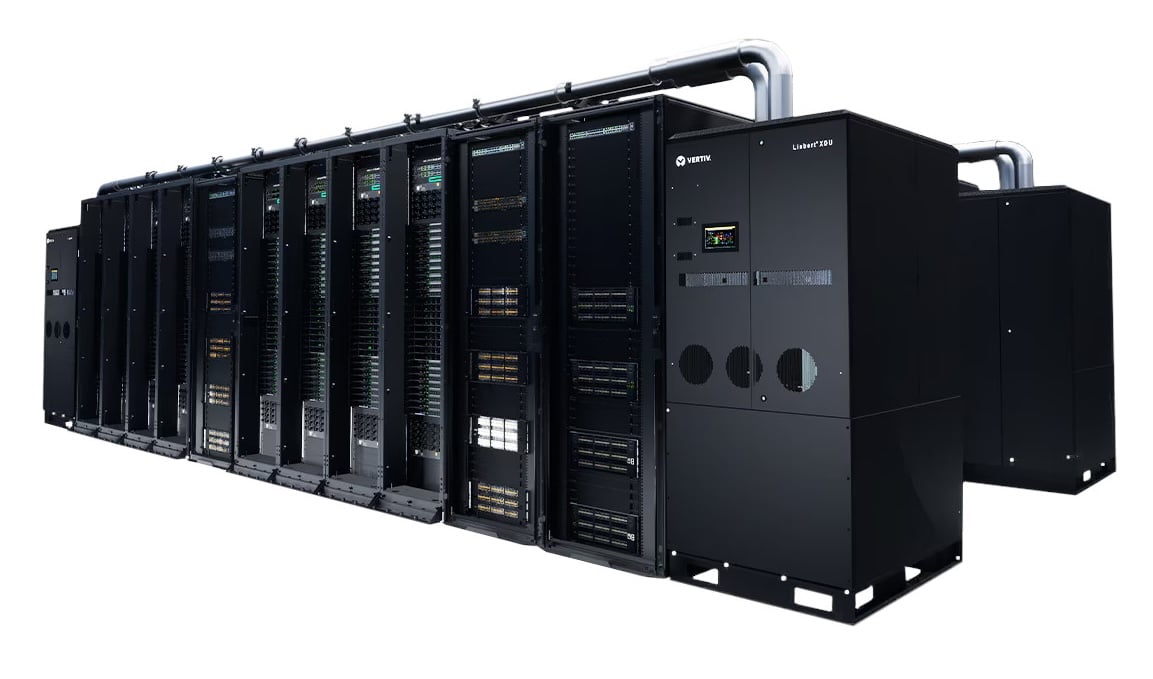
HPEは本日、NVIDIA GTCベルリンにてNVIDIAとの共同開発によるHPE AI Factoryのアップデートを発表し、その変更点のほとんどはHPEプライベートクラウドAIに反映される。開発者、独立系ソフトウェアベンダー、AIエージェントは、本番環境APIとモデルコンテキストプロトコル(MCP)サーバーを介してプラットフォームの推論、モデル、パイプラインへの統制されたアクセスが可能になり、クラスターは複数のAIエージェントを混在させることができるようになった。
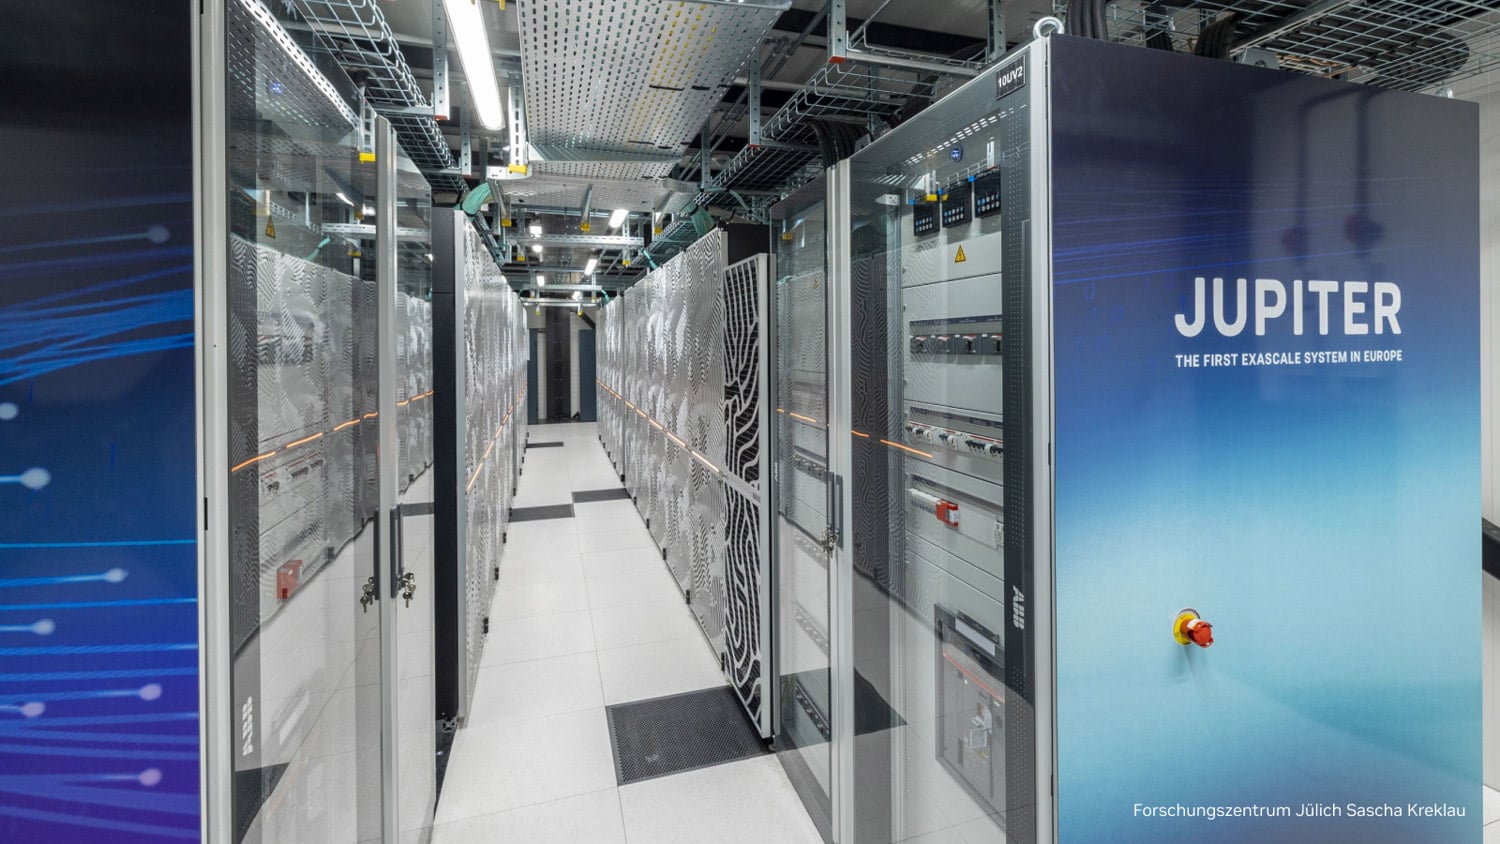
NVIDIAは、ユーリッヒ・スーパーコンピューティング・センターにある欧州初のエクサスケール・スーパーコンピュータ「JUPITER」上で、8,192個のGH200 GPUを用いて、耐障害性量子プロセッサの104量子ビット・シミュレーションを実行した。GTCベルリンに先駆けて発表されたこのシミュレーションは、現実的なハードウェアノイズの下で、耐障害性コンピュータが論理演算中に消費する非クリフォード状態を生成する手法であるマジックステート生成をモデル化している。


 Amazon