

カーネギーメロン大学の研究者らは、現場での SSD の信頼性に焦点を当てた研究を発表しました。この研究のタイトルは「現場でのフラッシュ メモリ障害に関する大規模研究」です。この調査は Facebook のデータセンターを使用して、4 年間と数百万の運用時間にわたって実施されました。この研究は、エラーがどのように現れるかを調査し、他の人が新しいフラッシュ信頼性ソリューションを開発できるようにすることを目的としています。
StorageReview で以前から述べてきたように、フラッシュにはパフォーマンス上の利点、密度上の利点、消費電力の削減がいくつかありますが、最大の欠点はコストです。多くの SSD は優れた寿命と信頼性を主張していますが、これまで大規模な現場での研究は行われていませんでした。
特定のサプライヤーと特定のドライブについては言及されていませんでしたが、Facebook はホット データ層で多くのドライブを使用しており、調査では SSD が使用されているプラットフォームの種類が記録されています(これは、システムで使用されるデバイス容量の組み合わせとして定義されています) 、使用されている PCIe テクノロジー、システム内の SSD の数)、これらはラベル プラットフォーム A ~ F でした。プラットフォームの容量は 720 GB から 3.2 TB で、1 世代の PCIe (バージョン 2 と XNUMX) があり、SSD を XNUMX つ使用するものと XNUMX つ使用するものがありました。稼働期間は半年から XNUMX 年以上に及びました。
研究者らは、SMART データと同様に、レジスタを使用して SSD の動作を追跡しました。生の値は 1 時間に 1 回収集され、Hive テーブルにキュレートできる形式に解析され、マシンのクラスターが MapReduce ジョブを使用して Hive に保存されたデータの並列集計を実行しました。これにより研究者らは、ビット エラー率、SSD の故障率とエラー数、異なる SSD 間の相関関係 (特に複数の SSD を備えたプラットフォーム)、および内部要因と外部要因の役割を監視することができました。
研究から得られた結論は次のとおりです。
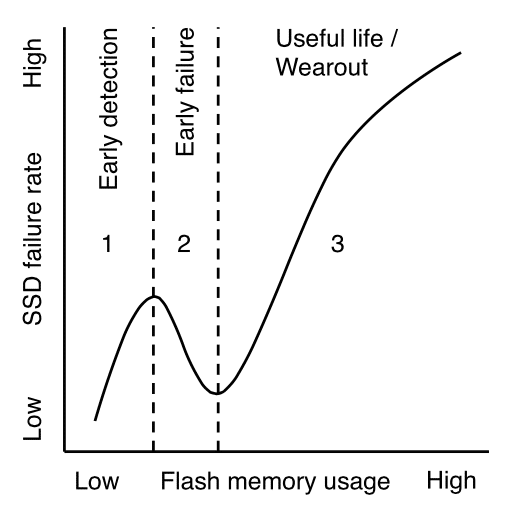
- SSD は、フラッシュ チップに書き込まれるデータ量に応じて、ライフサイクル中にいくつかの異なる故障期間 (早期検出、早期故障、耐用年数、摩耗) を経験します。
- 読み取り妨害エラーの影響は、調査した SSD の主なエラー原因ではありません。
- SSD の物理アドレス空間全体にまばらなデータ レイアウト (連続して割り当てられていないデータなど) があると、SSD の故障率が高くなります。高密度のデータ レイアウト (連続データなど) も、敵対的なアクセス パターンが原因で、特定の条件下で信頼性に悪影響を与える可能性があります。
- 温度が高くなると故障率が増加しますが、スロットリング技術を採用していない SSD で最も顕著に発生します。
- システム ソフトウェアによって書き込まれると報告されるデータ量は、システム レベルのバッファリングおよび摩耗低減技術により、フラッシュ チップに実際に書き込まれるデータ量よりも多くなる可能性があります。
この研究では、特定のドライブまたはドライブの種類が他のドライブより優れているとは述べていませんが、それでも、実際の頻繁な使用下で SSD がどのように動作するかについては興味深い結果となっています。この研究は、SSD の使用状況を調査する今後の研究と、SSD の信頼性をさらに高めたり、より長く使用できるようにする新技術の両方への扉を開きます。
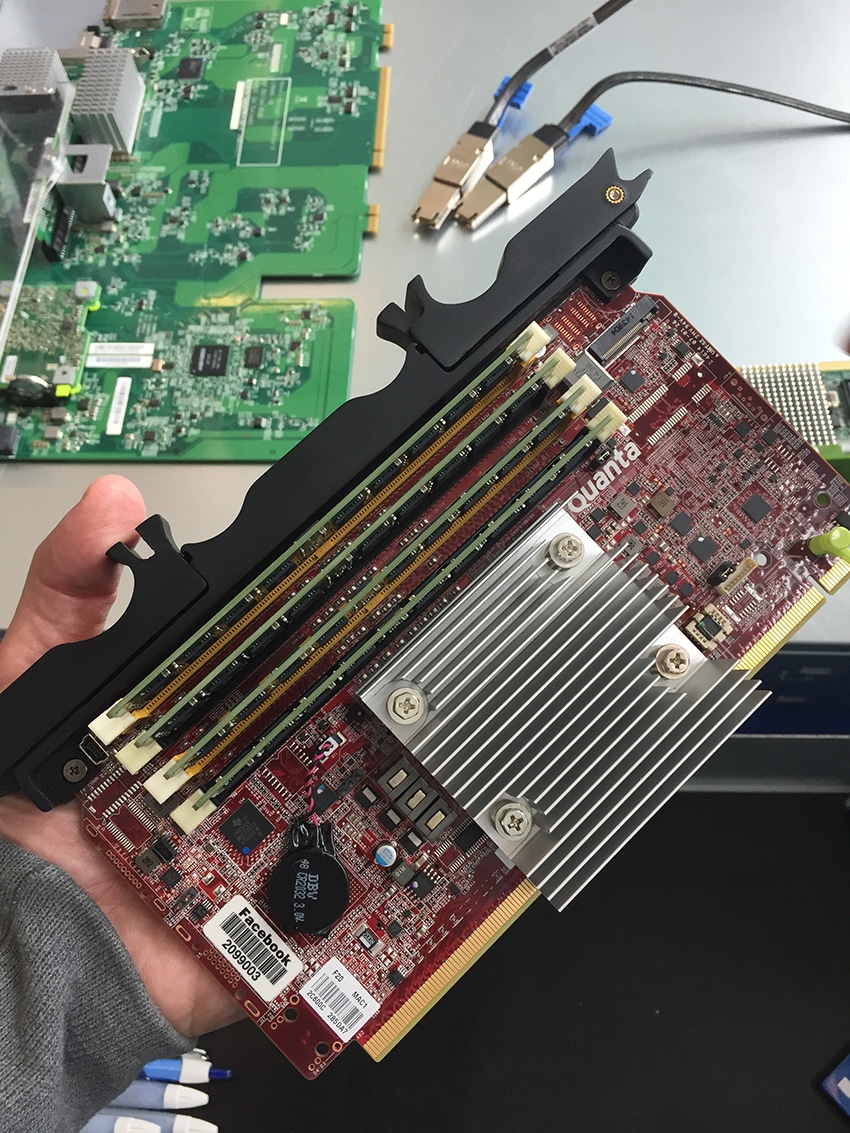
Facebookは、カーネギーメロン大学の研究から得られたようなデータポイントに対応するため、サーバー設計の進化を続けています。最近発表されたYosemiteプラットフォームは、Facebookがデータセンターにおいて、従来とは異なるフォームファクターでFlashを活用し、TCOを重視しながら最高のパフォーマンスを実現している好例と言えるでしょう。


 Amazon