

バックアップとリカバリはスノーボードに似ています。山腹をスピードを出して下るとき、または災害時に事業を継続しなければならないとき、少しの準備がスムーズに着陸できるか、雪の吹きだまりに顔面から落ちてしまうかの違いを生み出します。重大な失敗を避けるための 4 つの方法を紹介します。
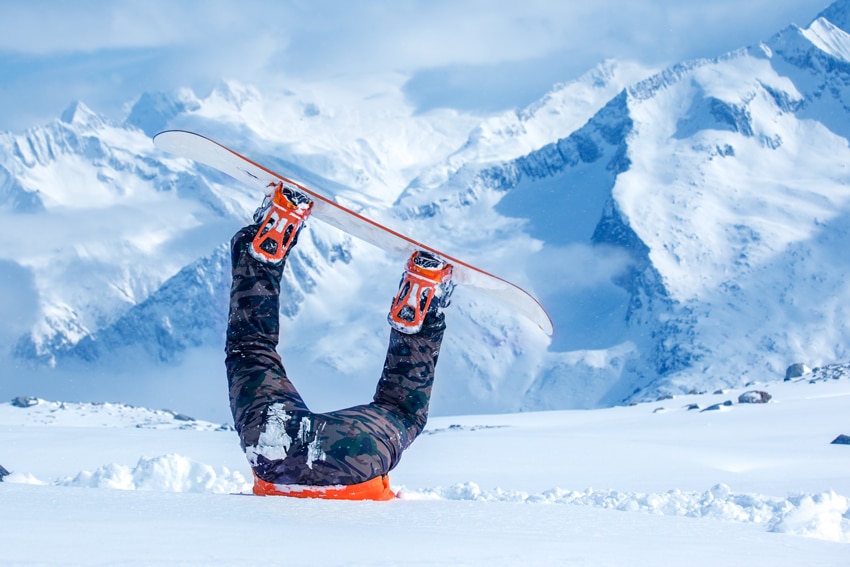
壮大な失敗 #1: ギアの欠陥
ゲレンデで初心者をどうやって見つけますか?高価でスタイリッシュなスキージャケットを着ているのに、薄いグローブと非防水ペイントを持っているスノーボーダーはどうでしょうか?それとも、ビンディングが正常に機能するかどうかを確認するのを忘れて、山の中腹でボードを紛失した人ですか?結局のところ、ギアが機能しなければ丘を駆け抜けることはできません。
同様に、データ損失が発生する前にバックアップが作成されていない場合、災害から回復することはできません。災害が発生するかなり前に、テクノロジーが正常に動作し、ビジネスに十分な堅牢な機能セットを備えていることを確認することが重要です。バックアップが自動で信頼性が高く、データの整合性がインラインおよびオフライン検証を通じて維持され、回復保証ソフトウェアによって回復テストが自動化され、バックアップが 2 番目の場所またはクラウドに正常にコピーされる実装が必要になります。簡単に言えば、データが実際にバックアップされ、オフサイトにコピーされていることを確認します。単純そうに聞こえますが、オンプレミスのサーバーがダウンした場合でもビジネスを継続できることを確認することが重要です。
壮大な失敗 #2: トレイルマップの無視
スキー場のリフトに乗るときは、グリーンのゲレンデに行くのか、黒いダイヤモンドに行くのかを確認せずに乗ることはできません。また、計画外にトレイルを外れて木々の間をスノーボードすることもありません。おそらく、土にぶつかったり、亀裂や渓谷に落ちるなど、さらに悪いことに遭遇する可能性が高いからです。山に登る前に、下山の計画を立てる必要があります。また、途中の標識をチェックして、コース上にいることを確認する必要があります。
スノーボード アドベンチャーにトレイル マップが必要なように、災害復旧を成功させるには書面による計画も必要です。これは、範囲が広く、段階的なガイドラインを含む文書を作成する必要があることを意味します。これは、次の 3 つの特有の領域を念頭に置いて行う必要があります。
- 人材: 主要な運用担当者を特定し、災害発生時に彼らがリモートまたは別の場所で作業できる方法を計画します。これは、所在地に関係なく、事業運営を維持するために必要な復旧システム、データ、その他のリソースに直接アクセスできることを意味します。組織の主要な通信インフラストラクチャ (企業の電子メールや電話システムなど) がダウンした場合に備えて、代替の通信手段 (従業員の携帯電話など) を設定することも重要です。
- インフラストラクチャ: 主要な運用インフラストラクチャ (これなしではビジネスを運営できないインフラストラクチャの部分) を特定し、それらが保護されていることを確認します。 IT インフラストラクチャが災害に耐えられるようにしたい理由は、最も重要な資産であるスタッフが、ビジネスの収益と収益性を継続的に向上させるために必要なツールを備えていることを忘れないでください。
- プロセス: 主要な運用プロセス (混乱が発生した場合に誰が何をするかを概説する段階的なガイドライン) を特定し、チーム メンバーが自分の役割を認識し、実践していることを確認します。 IT プロセスだけに焦点を当てるのではなく、ビジネスの日常業務に重要なあらゆるプロセスを考慮してください。
DR 計画とデータ保護ソリューションは、会社の目標復旧時点 (RPO)、つまり損失を許容できるデータの最大量 (時間単位)、および目標復旧時間も満たしている必要があります。 (RTO)、これは、データやシステムを使用しなくても許容できる最大時間です。最適な DR 計画は、復元されるデータの量と、その情報をどれだけ早くオンラインにする必要があるかに基づいています。
壮大な失敗 #3: 練習を怠った
初めての山を下るのが二重の黒いひし形のトレイルだったら、間違いなく顔から落ちるでしょう。ギアを買ってトレイルマップを調べただけで、雪の上に足を踏み入れずに魔法のようにスノーボードの方法を知ることはできません。テクニックを練習し、体力を鍛え、本能を磨くことが、下山を成功させる鍵となります。
災害時にビジネスを継続し、失われたデータを回復することは、ブラックダイヤモンドレベルの出来事です。 DR 戦略を一度もテストしたことがない場合は、全滅する可能性があります。 IT 管理者がバックアップ ソリューションをインストールしても、実際のリカバリのテストにほとんど着手しない (またはまったくしない) ことは珍しくありません。さらに、テストとなると、1 つや 2 つでは十分ではありません。今日のデジタル変革と IT の進化のペースは速いため、インフラストラクチャも急速に変化しています。最良の DR テストは反復的であり、一貫したスケジュールで実行されるため、バックアップが会社のインフラストラクチャの現在の状態を保護していることを確認できます。データの変更率は、災害復旧計画をテストする頻度を決定するための優れたベンチマークです。いくつかのバックアップ ベンダーは、自動化された DR テストを提供しており、時間と手間を大幅に節約できます。
また、さまざまな災害シナリオを考慮し、その結果として DR プロセスがどのように変化するかを評価する必要もあります。たとえば、あなたの戦略では、メディアをローテーションするためにチーム メンバーが 2 番目の場所まで車で移動する必要がありますか?洪水や吹雪などの大規模な自然災害により旅行ができなくなった場合はどうなりますか?クラウドでのバックアップは、物理的およびサイトベースの制限を克服するための優れたソリューションですが、クラウドからデータをどのくらいの速さで戻す必要があるかを計画する必要もあります。ハイパースケール クラウドは安価なストレージを提供できますが、WAN 経由でデータを復元するには数日かかる場合があります。プライマリ サイトから地理的に離れたセカンダリ サイト (多くの企業にとっては高価な提案) がない場合、サービスとしての DR を使用すると、クラウドで手頃な価格でスピンアップとビジネス継続性を実現できます。どちらを選択する場合でも、ベンダーの SLA について学び、RPO と RTO を理解し、そしてもちろんテストしてください。
壮大な失敗 #4: すべての雪が同じであると仮定する
パウダーが常に新鮮で、トレイルが混雑していなければ最高ですが、場合によってはぬかるみで苦労したり、春休みに観光客を避けたりすることもあるかもしれません。経験豊富なボーダーは、多様な地形やさまざまなスノーパークに挑戦できるスキルを身につけると、スノーボードが最も楽しくなる傾向があることを知っています。ほとんどの時間をお気に入りのゲレンデで過ごしたとしても、トレイルは日ごと、季節ごとに異なります。すべての雪は同じだと思っていると、坂を下る途中でトラブルに見舞われることになります。
IT インフラストラクチャでは、均一性を前提とすることはできません。可能な限り仮想化を望んでいるかもしれませんが、組織にはいくつかの物理サーバーが必要です。 IT チームがユーザーのニーズの変化やテクノロジーの進化に柔軟に対応できるよう、柔軟性を維持することが重要です。
最も一般的な例を挙げると、単一ベンダーのロックインを回避することは、現代の IT の技術的および経済的成功の両方にとって重要です。 DR の失敗は、管理者が DR 計画において 1 つのテクノロジーのみをサポートしているために発生することがよくあります。たとえば、SAN や NAS などのストレージ テクノロジはサポートされますが、直接接続されたストレージは無視されます。仮想化を採用しますが、物理サーバーは無視します。または物理アプライアンスをサポートしていますが、異なるモデルや世代のサーバー間での復元の必要性を考慮していません。ビジネスの継続に必要なテクノロジーの範囲を網羅するバックアップおよび DR 計画を作成してテストします。
スノーボードに慣れていない人が最初に知っておくべきことの 1 つは、転倒する可能性があるということです。 IT インフラストラクチャでも同様です。ユーザーによる軽微な削除、破壊的なマルウェアの侵入、サイト全体をダウンさせる大規模な自然災害など、データの損失は発生します。規模が何であれ、準備はできます。機器が機能していることを確認し、計画を完了し、DR をテストし、戦略の柔軟性を維持することで、重大な失敗を回避します。そうすることで、すぐに斜面を細断することができます。
著者について
ブルック・ブルマンは、エンタープライズレベルのクラウドを活用した事業継続ソリューションのリーディングカンパニーであるUnitrendsのプロダクトマーケティングマネージャーです。詳細については、info@unitrends.comまでお問い合わせいただくか、www.unitrends.comをご覧ください。


 Amazon