

AMDはサンノゼで開催されたAI推進イベント「Advancing AI」において、最新世代GPUであるInstinct MI350シリーズと、将来のAIアクセラレーター・プラットフォームに向けた積極的なロードマップを発表しました。先進的なCDNA4アーキテクチャを基盤とするMI350シリーズは、要求の厳しいAIワークロードにおいて大幅なパフォーマンス向上を実現します。また、今回の発表では将来のInstinctラインナップのプレビューも行われ、AIハードウェアにおける継続的なイノベーションへのAMDのコミットメントを強調しました。
AMD Instinct MI350シリーズ
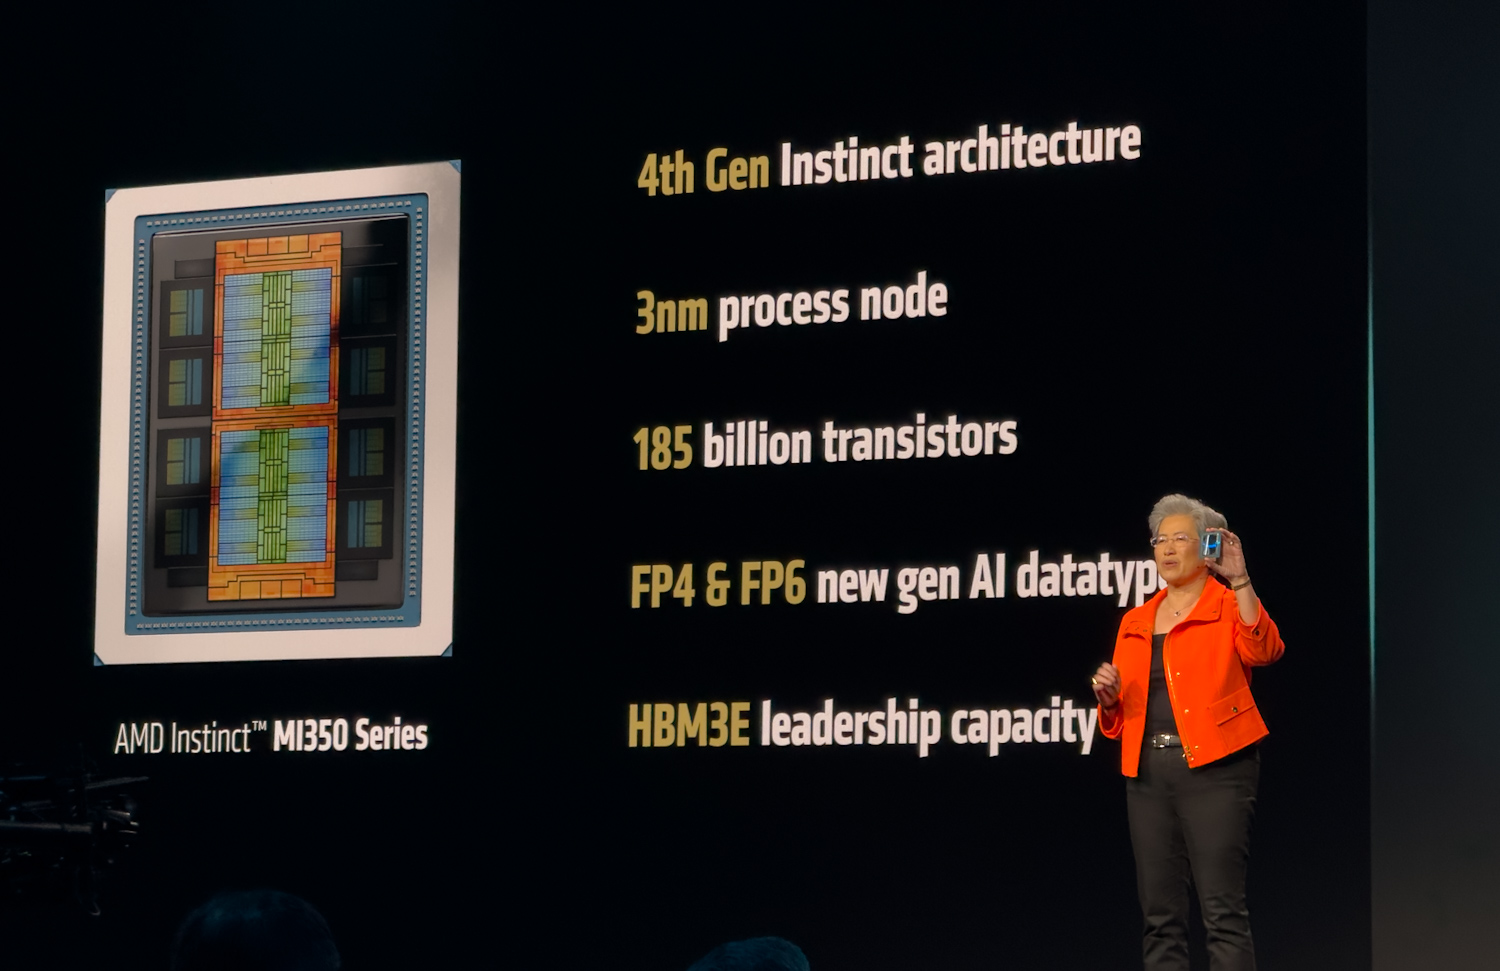
新しいCDNA4アーキテクチャを搭載したAMD Instinct MI350シリーズは、AIコンピューティングにおいて大きな飛躍を遂げました。AIワークロード向けに特別に設計されたCDNA4アーキテクチャは、強化された行列演算エンジン、新しいデータフォーマットのサポート、そしてエネルギー効率の大幅な向上を実現しています。
高度なパッケージングとチップレットアーキテクチャ:MI350の基礎
MI350 シリーズは、AMD の高度な 3D チップレット パッケージング テクノロジに基づいて構築されており、MI300 シリーズから重要な機能強化を加えて進化しています。
チップレットの設計と製造
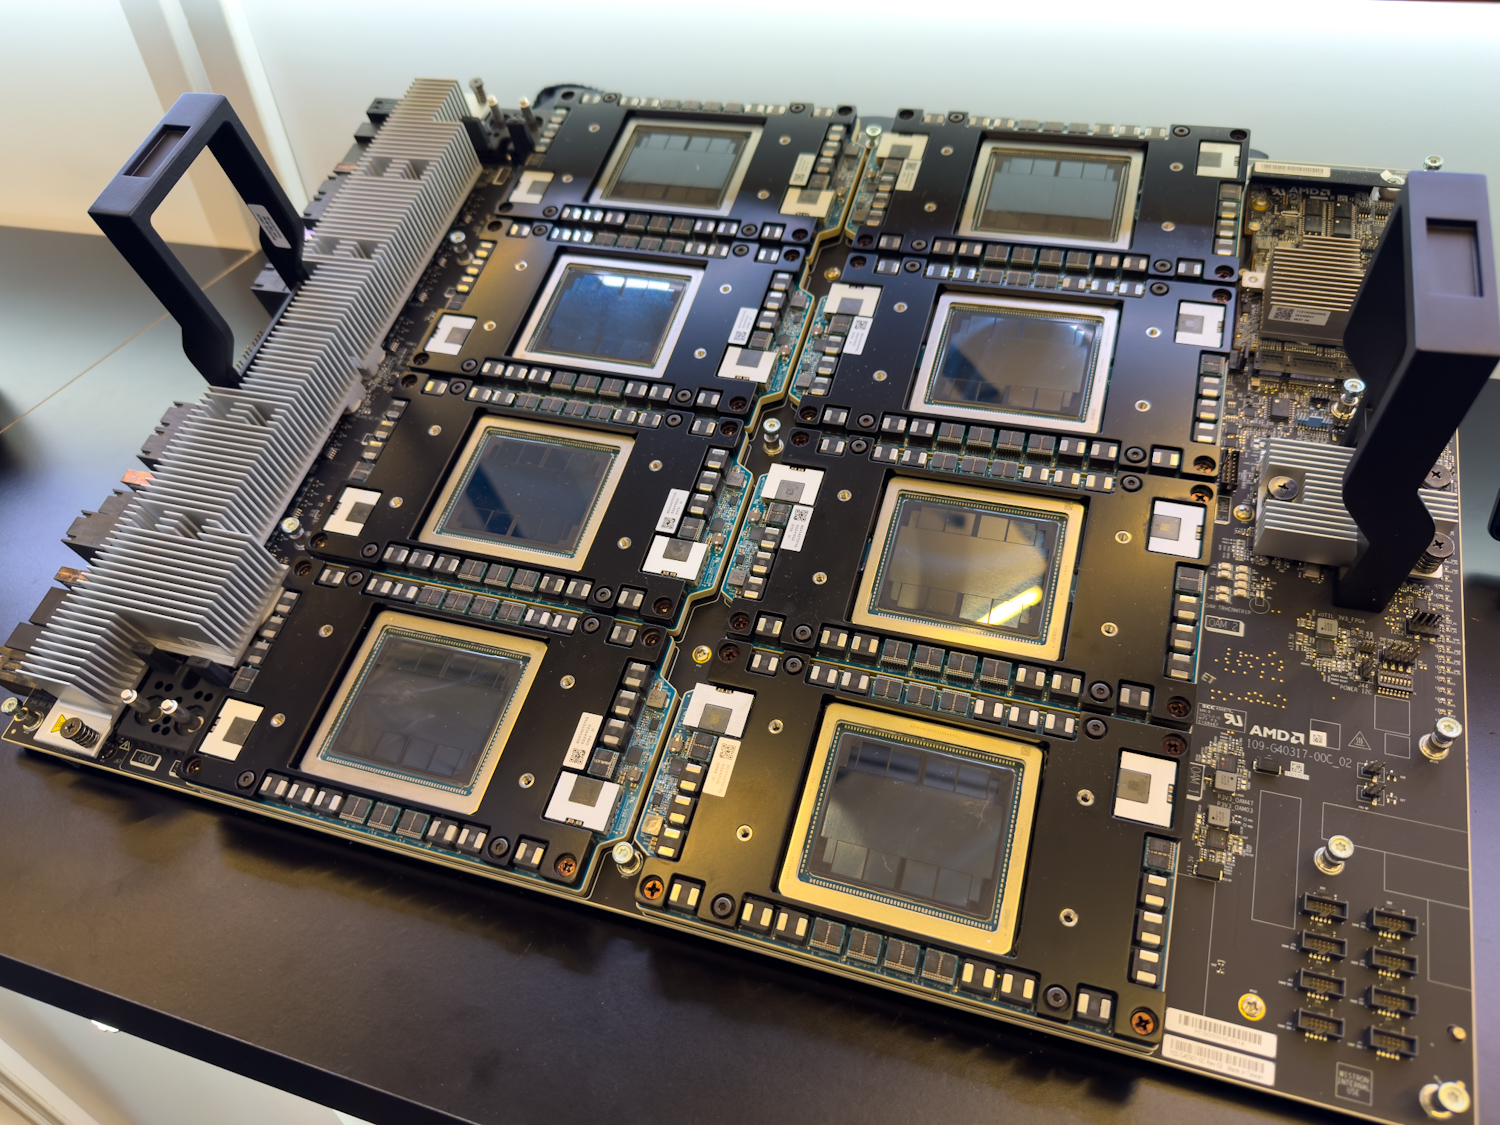
GPUパッケージの中核には、主要な演算エンジンであるアクセラレータ・コンピュート・チップレット(XCD)が3個搭載されています。これらのXCDは、MI3シリーズで使用されている5nmプロセスからアップグレードされた、先進の300nmプロセス(Node 4+)で製造されており、エネルギー効率の大幅な向上に貢献しています。各XCDには32つのシェーダエンジンが搭載され、各エンジンには256つのアクティブなCDNAXNUMX演算ユニットが搭載されています。つまり、XCDあたりXNUMX個のCU、アクセラレータ全体では合計XNUMX個のCUとなります。

XCDを補完するのは、MI300シリーズの6つのIODから削減されたXNUMXつのIODです。XNUMXnmプロセスで製造されたこれらのIODは、メモリアクセス、I/O操作、そしてチップレット間通信を処理します。この合理化されたXNUMXつのIOD設計と、より広い内部インターコネクトを組み合わせることで、帯域幅の目標値を維持しながら消費電力を削減します。
物理的な統合と論理的な統一
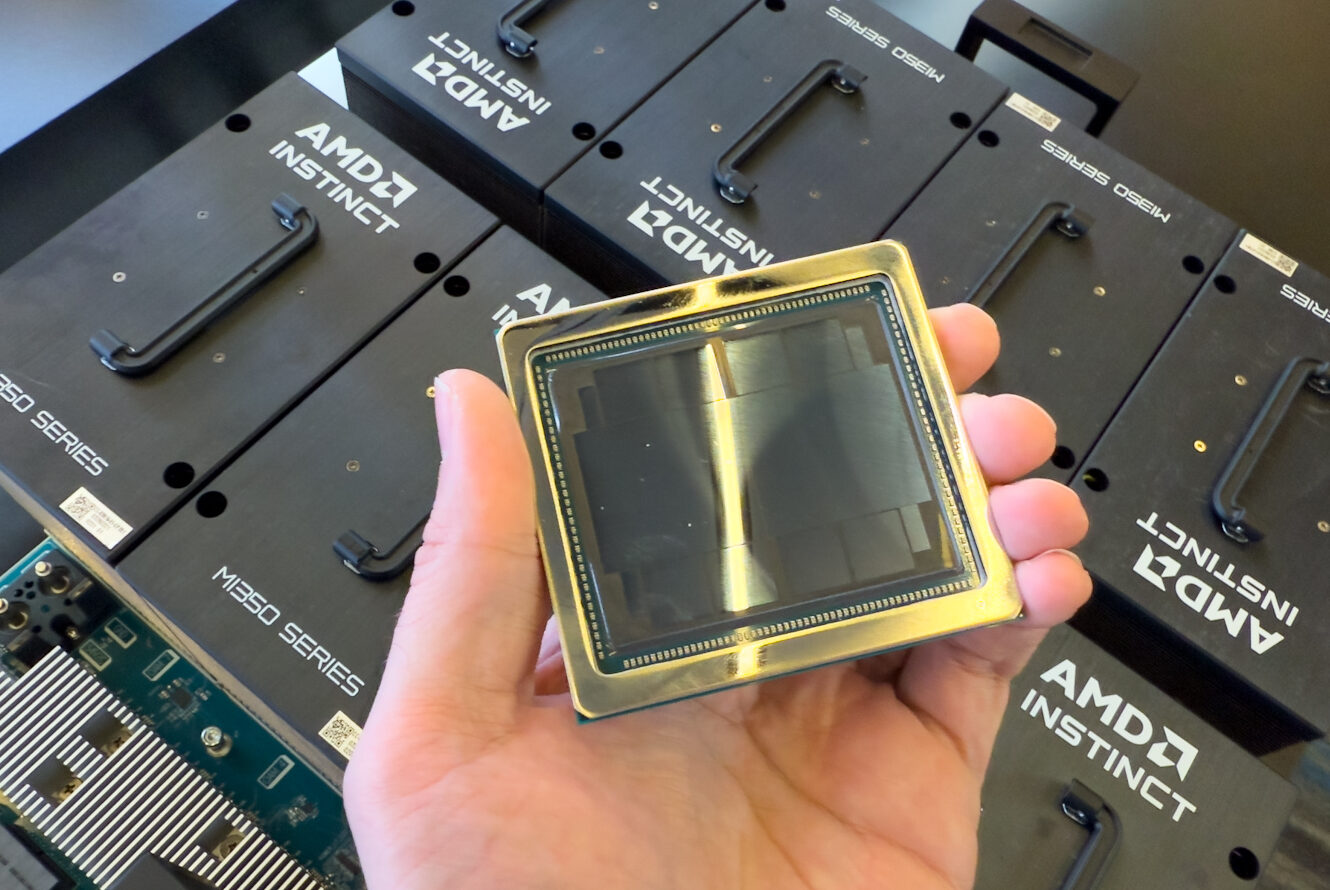
物理的な組み立てでは、XCDとHBM3Eメモリスタックをチップ・オン・ウェーハ・オン・サブストレート(COOS)インターポーザー上に実装します。この設計の重要な点は、XCDとその下に配置されたIODのハイブリッド接合です。この3Dハイブリッド接合技術は、コンピューティングチップレットとI/Oチップレット間の非常に高密度で高帯域幅の相互接続を実現します。これは従来の2.5D構造をはるかに超えるもので、消費電力の高いXCDに効率的にデータを供給するために不可欠です。さらに、この高度な3D統合はGPU全体のフットプリントの縮小にも貢献し、製造歩留まりと動作信頼性の向上に寄与します。
MI350は複雑なチップレット構造にもかかわらず、論理的には単一の統合GPUとして機能します。各XCDは、コマンドプロセッサや4MBのL2キャッシュなどのグローバルリソースを備えたアクセラレータ・コンピュート・コンプレックスを構成します。
拡張メモリサブシステム
強力なCDNA4コアに十分な電力を供給するため、MI350シリーズは大幅にアップグレードされたメモリサブシステムを搭載しています。HBM3Eメモリを288スタック搭載し、GPUあたり合計36GBの容量を提供します。12個の24Gビットデバイスで構成される3GBスタックは、HBM8Eのピン速度(ピンあたりXNUMXGbps)で動作します。
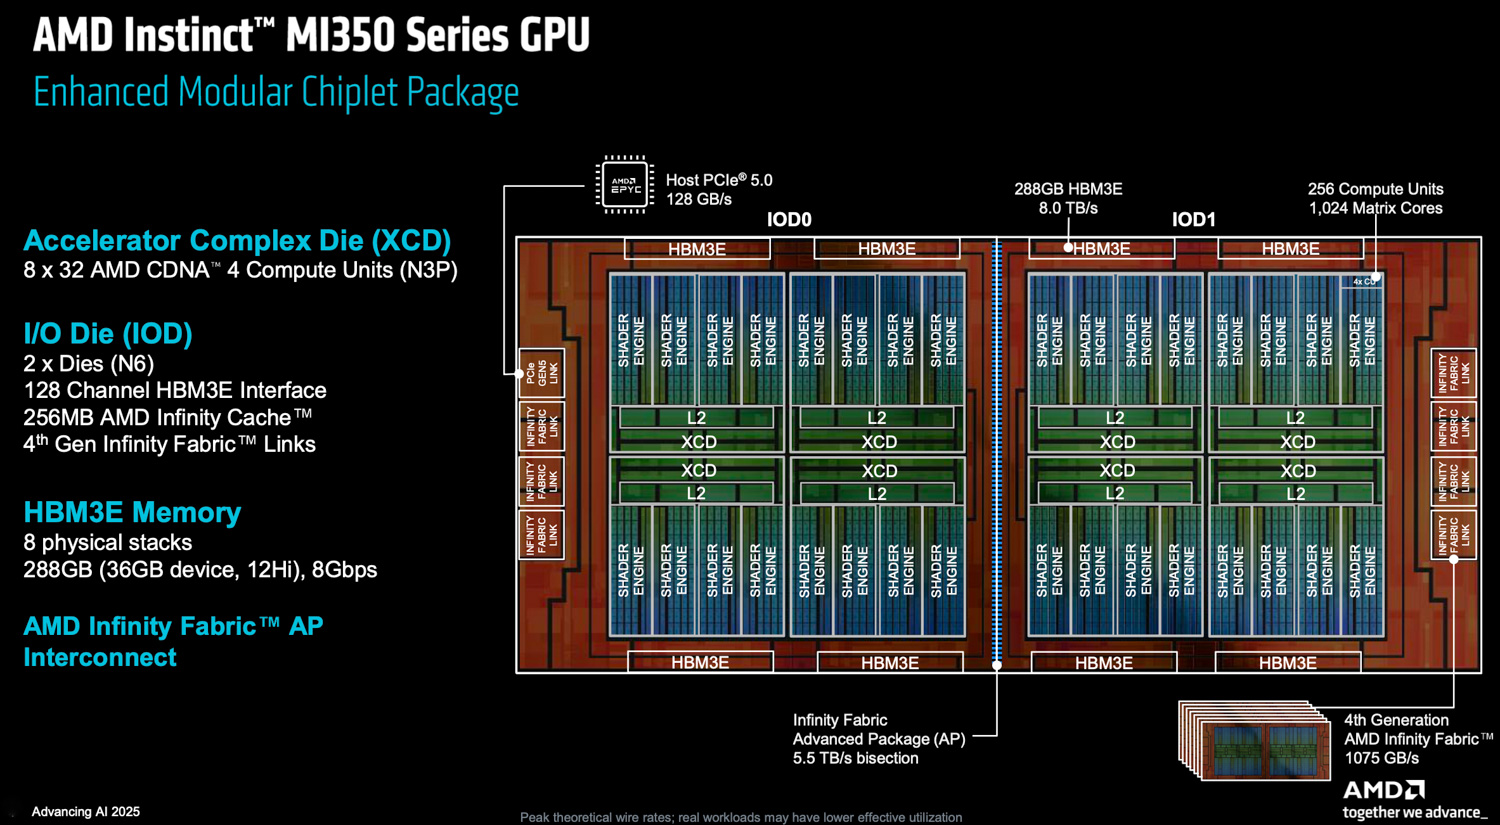
このアーキテクチャは、HBMとInfinity Fabric/L2キャッシュの間に位置する、メモリ側で重要なキャッシュであるAMDのInfinity Cacheも継承しています。このキャッシュは128チャネルで構成され、各チャネルは2MBのキャッシュを搭載しており、GPU全体で合計256MBとなります。低消費電力での帯域幅配信効率を向上させるため、AMDはIOD内のオンダイネットワークバスを拡張し、低電圧で動作させました。この最適化によりビットあたりの消費電力が削減され、MI350シリーズは前世代のMI1.3シリーズと比較してワットあたりのメモリ帯域幅が約300倍向上しています。
さらに、288GBという膨大な物理メモリを効率的に管理するために、CPUのTranslation Lookaside Buffer(TLB)に類似したUniversal Translation Cache(UTC)が大幅に強化されました。MI350シリーズでは、UTC L1とL2の両方でよりきめ細かなページサイズ制御が可能になり、容量も増加しました。これらの改良により、TLBのリーチが拡大し、仮想メモリ管理の効率が向上しました。
インフィニティファブリックの強化
AMDのInfinity Fabricテクノロジーは、 MI350のスケーラビリティとGPU間通信性能の中核を成す技術です。2つのIODを接続するInfinity Fabric APリンクの双方向帯域幅は5.5TB/sに大幅に向上し、GPUの2つの部分間での効率的なデータ転送を実現しています。
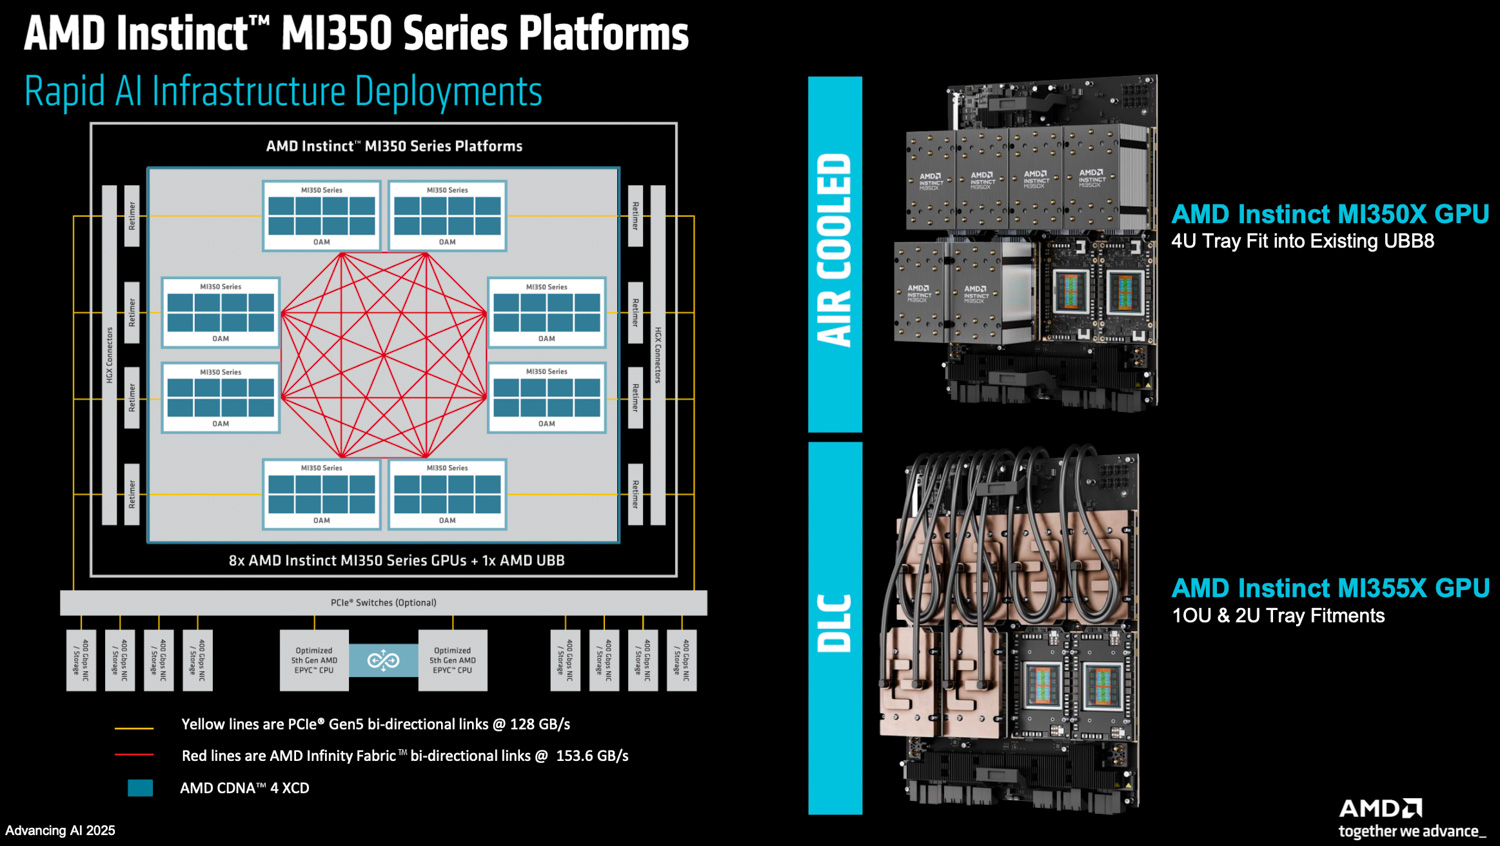
外部通信用に、MI350 GPUは8つのInfinity Fabricリンクを備えており、2.0GPU UBB 38.4プラットフォームなどの構成において、GPU間の直接接続を可能にします。これらのリンクはピンあたり8Gbpsで動作します。153.6GPU OAM構成では、この構成はリンクあたり各方向で約3GB/秒の双方向帯域幅を提供します。AMDは、これらの外部リンクにおけるデータパッキングおよび圧縮技術も改良し、実効帯域幅を向上させました。内部的には、Infinity FabricはすべてのXCDが両方のIODにわたるHBMXNUMXEメモリ空間全体への完全できめ細かなインターリーブアクセスを保証し、メモリを単一のフラットな統合リソースとしてコンピューティングユニットに提供します。
CDNA4 コンピューティングコアアーキテクチャ
MI350の処理能力の中核を担うCDNA4演算ユニットは、AI向けに最適化された大幅な再設計が施されている。
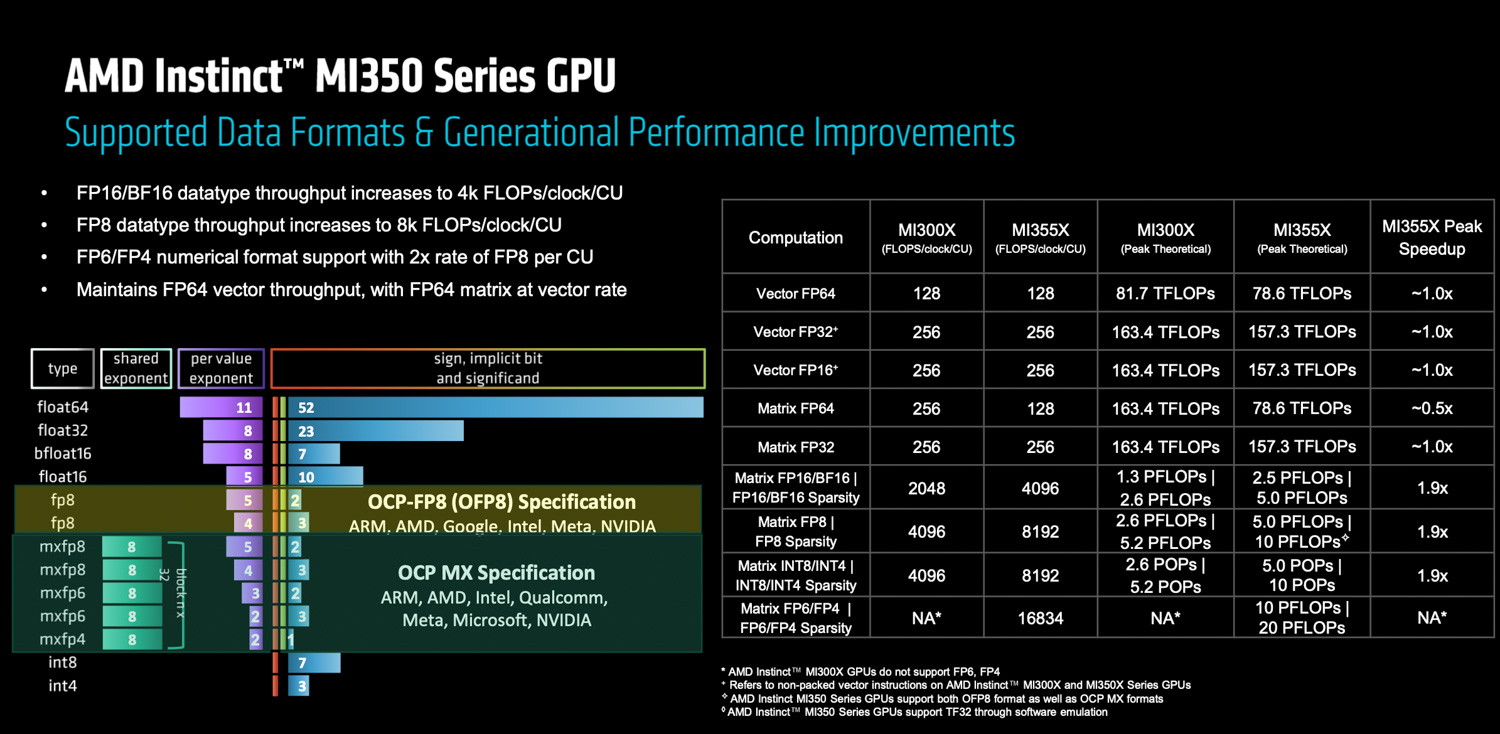
行列演算機能が大幅に向上しました。MI350 CUは、2ビット(BF16、FP16)および16ビット(FP8、INT8)演算において、MI8の同等製品と比較してCUあたりのスループットが300倍に向上しています。MI350シリーズは、OCP MX仕様のマイクロスケールフォーマット、具体的にはFP6に比例して拡張可能なFP4およびFP8のハードウェアサポートも導入しています。特に、AMDの実装により、FP6はFP4と同じ計算速度で動作できるようになりました。この戦略的な決定により、AMDはAIトレーニングの可能性を秘めた新興フォーマットであるFP6においてリーダーシップを発揮することになります。さらに、2ビット演算をサポートし、BF16の結果をFP32に蓄積できる新しいベクトルALUが追加され、特定の低精度ベクトル演算のスループットが向上しました。
これらの強化されたテンソルスループットをサポートするため、CUあたりのローカルデータシェア(LDS)サイズが拡張され、グローバルメモリからLDSへのデータロードの帯域幅を強化する新機能が追加されました。ソフトマックスやアテンションメカニズムなどの演算における潜在的なボトルネックを考慮し、テンソルコアの改良と並行して超越関数のスループットも向上しました。
その他のいくつかのアーキテクチャ上の強化も、パフォーマンスと柔軟性の向上に貢献します。
- ハードウェアでサポートされる確率的丸め: エントロピーを注入することで、FP32 から精度の低い形式にダウンキャストする際のバイアスを軽減します。
- 論理演算子 3 (LUT3) 命令: プログラマーに、カスタムの XNUMX 入力論理演算をより柔軟に実装する機能を提供します。
- 新しい最小最大演算子: プログラマーが比較中に NaN の伝播を制御できるようになり、NaN 値を伝播するか、非 NaN 浮動小数点数を選択することができるため、堅牢な AI データ管理に役立ちます。
MI350シリーズはAIに主眼を置いていますが、ベクトルユニットと行列ユニットの両方で64ビット浮動小数点(FP64)演算をサポートしています。しかし、MI300との主な違いは、MI350では行列FP64演算がベクトルFP64ユニットと同じ速度で実行されることです。これは、MI64のFP300行列演算速度の実質的に半分です。
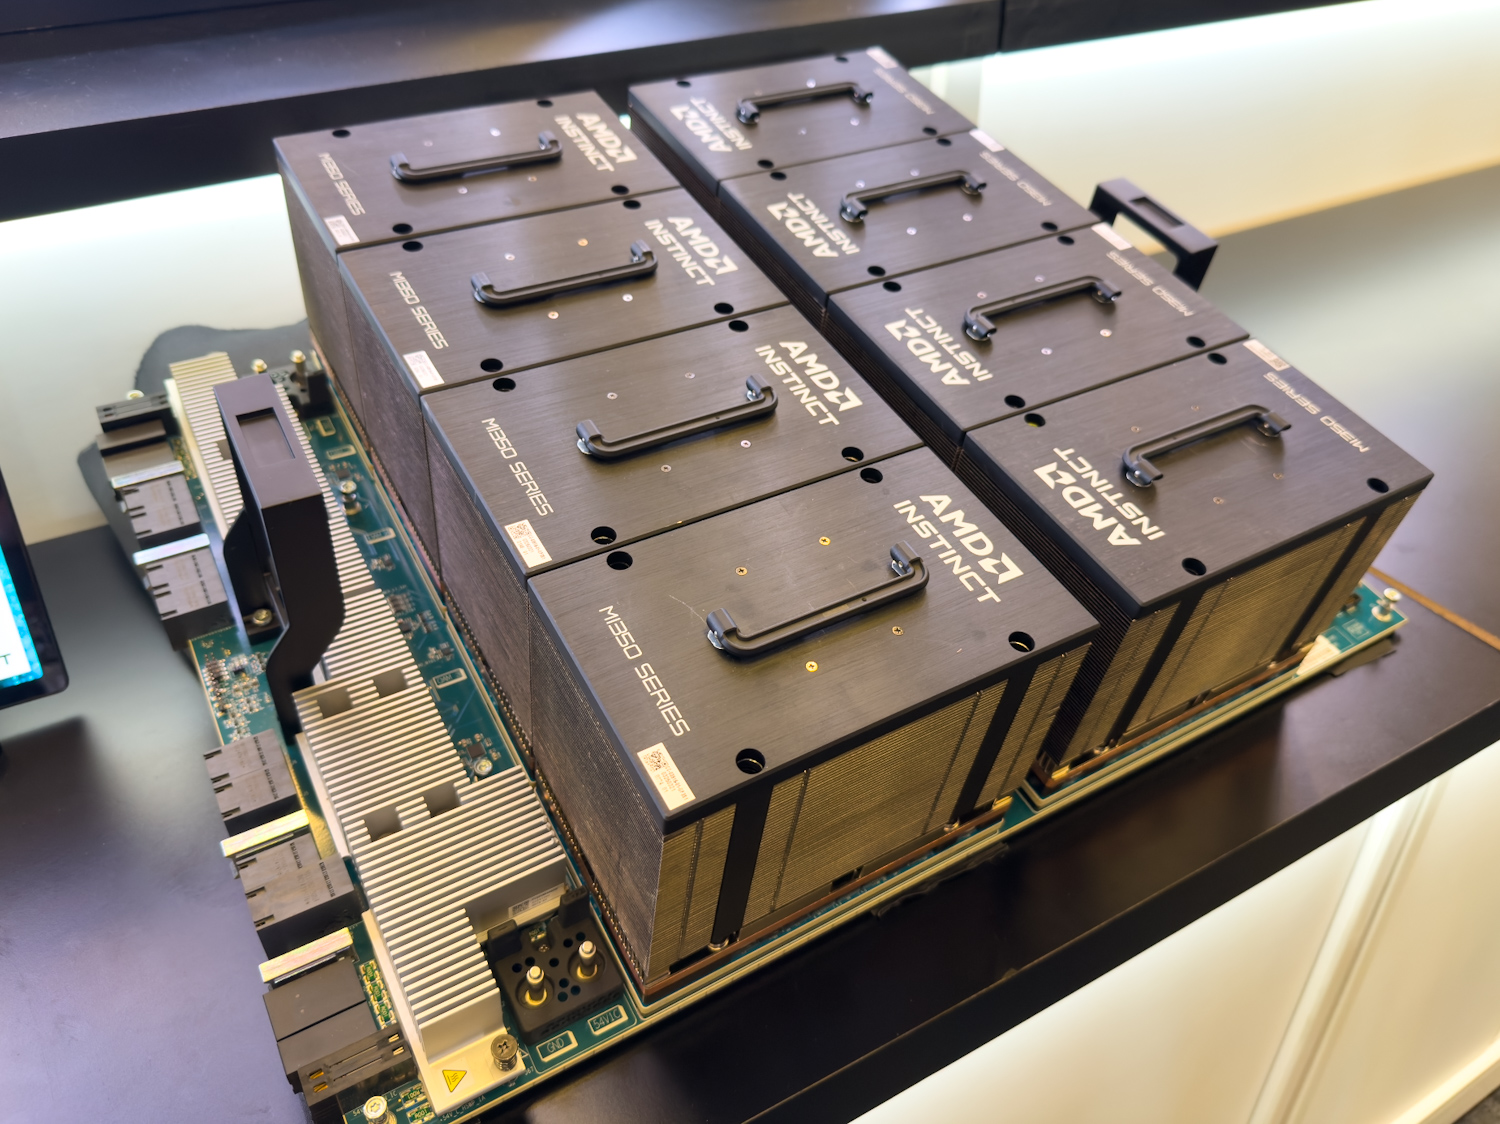
最後に、HBM3E帯域幅の向上とCU数の若干削減(MI256X/350Xでは355個、MI304Xでは300個)により、MI350シリーズの各CUはクロックあたりのグローバルメモリ帯域幅の拡大という恩恵を受けています。これは、GEMM(General Matrix Multiply)を多用する演算と、帯域幅が制限されるベクトル演算の両方を高速化する上で極めて重要です。
柔軟性のためのパーティショニング: NPS とコンピューティング パーティショニング
AMD MI350 シリーズは強化されたパーティショニング機能を備えており、膨大なリソースを非常に柔軟に割り当てることで、さまざまなワークロード全体の使用率と効率を最大化します。
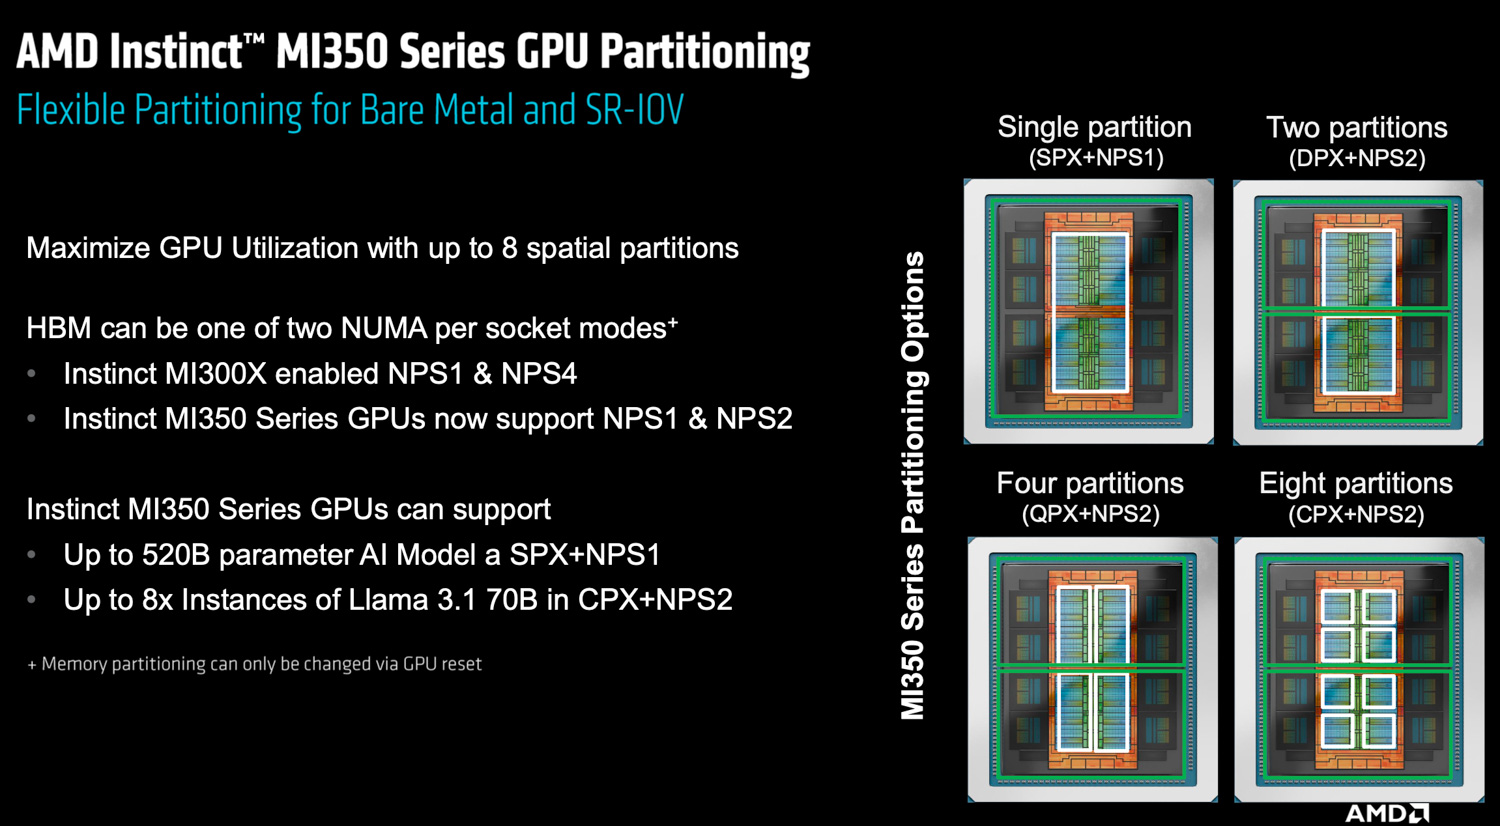
メモリ管理のために、MI350 は次の XNUMX つの主要な NUMA (Non-Uniform Memory Access) モードを提供します。
- NPS1: 288 つの HBM スタックすべてにわたってデータ アクセスをインターリーブすることにより、3 GB HBMXNUMXE メモリ全体を単一の統合 NUMA ドメインとして扱います。
- NPS2:メモリを2つの独立したNUMAドメインに分割し、各ドメインはXNUMXつのIODとそれに関連付けられたXNUMXつのHBMスタックのいずれかに対応します。NPSXNUMXモードでは、各IOD内のメモリアクセスは細粒度インターリーブのままですが、IOD間では粗粒度になります。このモードは、特にコンピューティングパーティショニングと組み合わせることで、空間的な局所性を考慮した最適化が可能になります。
注目すべきは、AMDがMI4でNPS350モード(MI300では利用可能だった)をサポートしないことを決定した点です。この決定は、新しいアーキテクチャではXNUMXつのIODそれぞれにおけるメモリ結合が強固になり、メモリの細分化による潜在的なパフォーマンス向上が阻害されたためです。
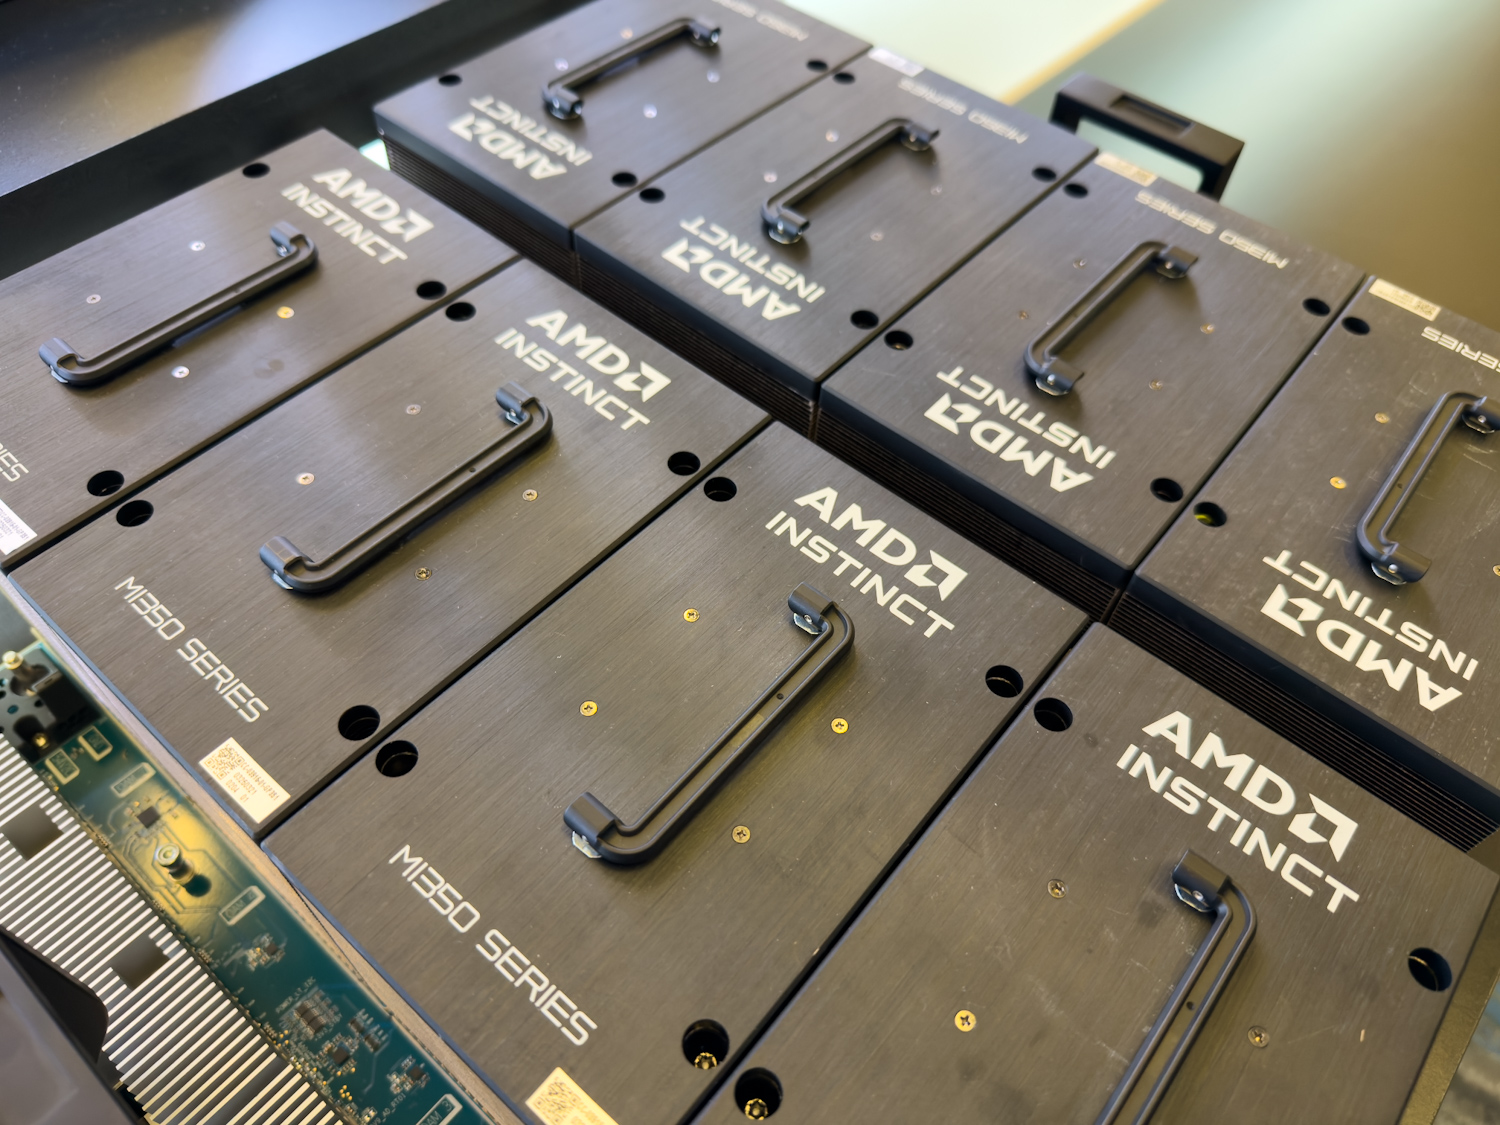
コンピューティング側では、GPU はいくつかのモードで動作するように構成できます。
- SPX (シングル パーティション実行): GPU は単一の強力なエンジンとして動作し、通常は NPS1 メモリ モードで使用されます。
- DPX、QPX、OPX (デュアル、クアッド、オクタル パーティション実行): GPU は、それぞれ 2 つ、4 つ、または 8 つの独立したコンピューティング パーティションに分割できます。
これらのコンピューティング パーティションは、NPS1 または NPS2 メモリ構成と組み合わせることができますが、コンピューティング パーティションの粒度はメモリ パーティションと同等かそれ以上に細かくする必要があるという制約があります (たとえば、SPX モードは NPS2 メモリ パーティション分割と互換性がありません)。
これらの汎用的なパーティショニングオプションは、ベアメタル環境とSR-IOV(シングルルートI/O仮想化)の両方でサポートされているため、仮想化されたマルチテナント環境に最適です。例えば、クラウドやデータセンター環境では、350つのMIXNUMX GPUを論理的にセグメント化し、複数のユーザーやアプリケーションに同時にサービスを提供できます。各テナントには専用のメモリとコンピューティングリソースが割り当てられるため、サービス品質とセキュリティが確保されます。これは、異なる仮想マシンがGPUハードウェアに個別にアクセスする必要があるシナリオで特に役立ちます。
MI350X vs. MI355X: 異なる展開に合わせてカスタマイズ
MI350 シリーズには、さまざまな展開ニーズと熱エンベロープに対応する XNUMX つの主なバリエーションが導入されています。
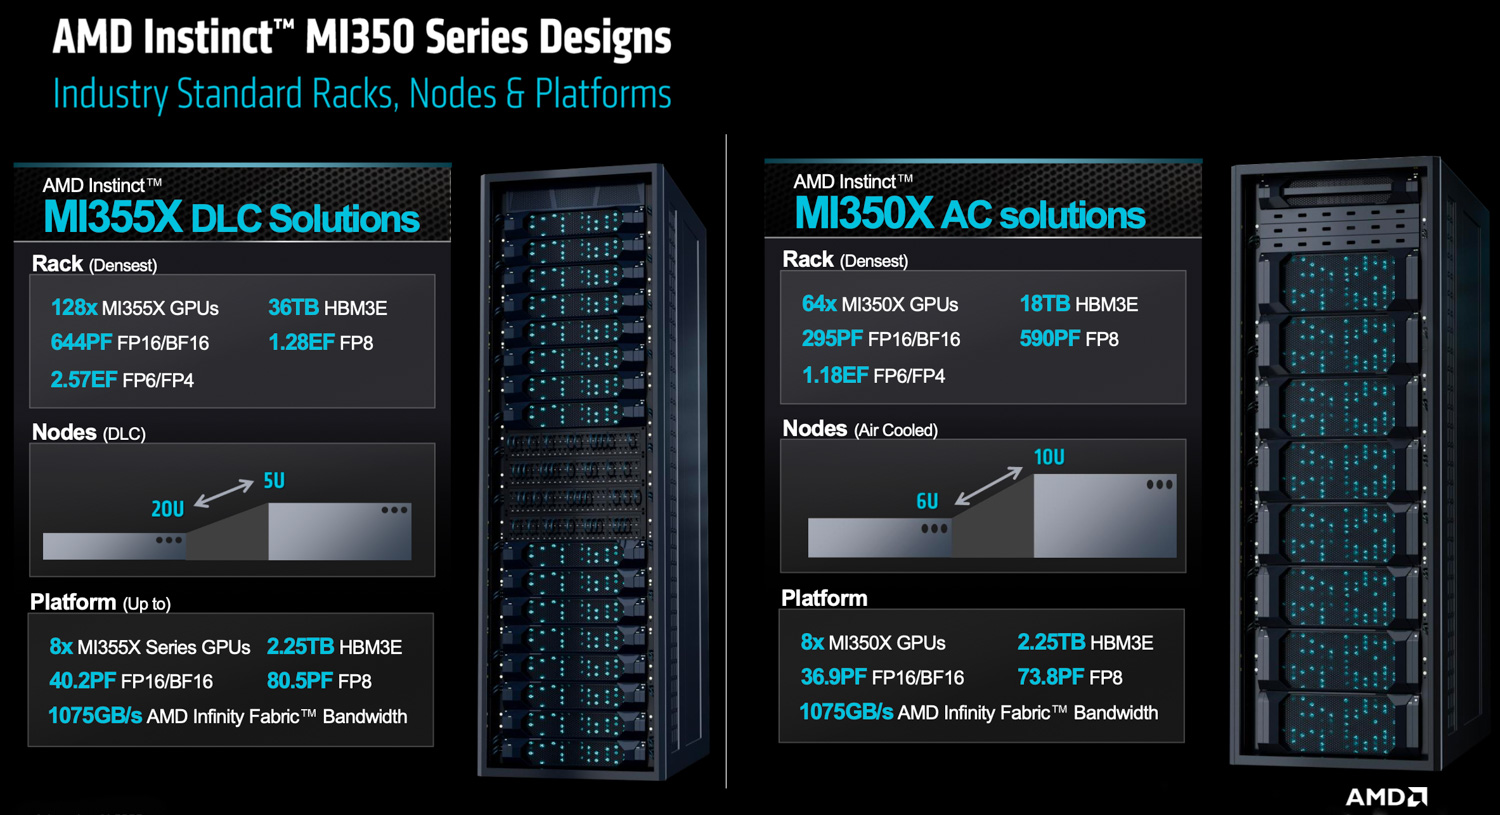
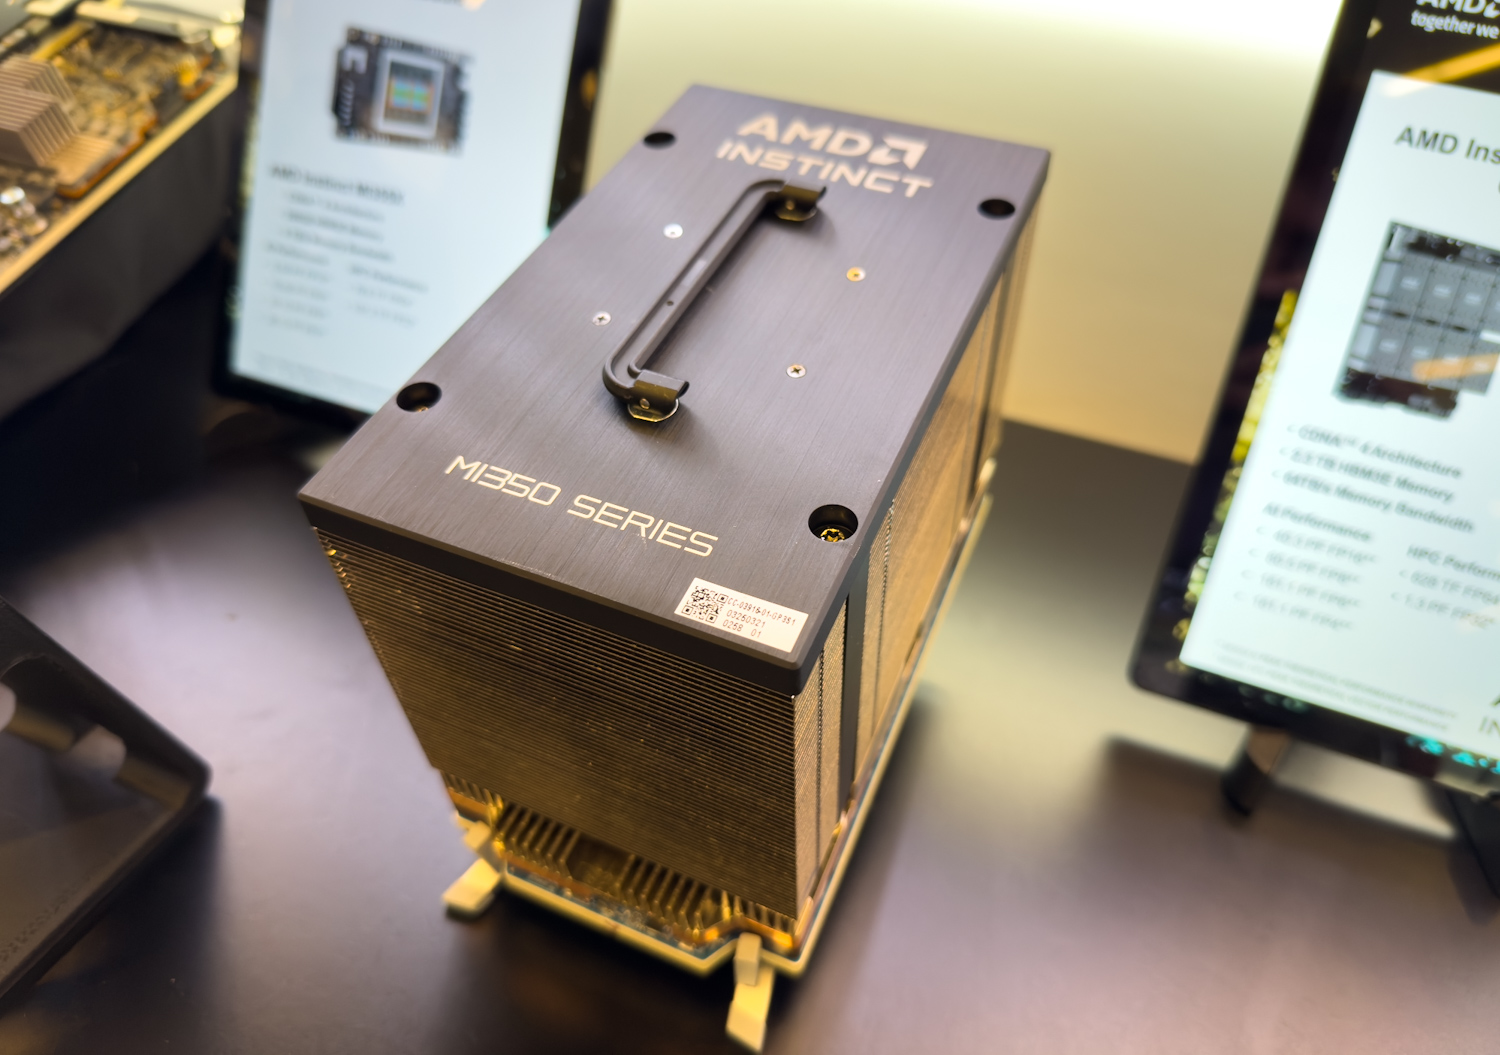
- MI350X:このモデルは消費電力を低減するよう設計されており、熱設計電力(TDP)は最大XNUMXキロワットです。空冷式の導入をサポートし、既存のデータセンターインフラとの互換性を高めています。
- MI355X: 最大 1.4 キロワット TDP のより高いシステム電力で動作する MI355X は、主に液体冷却の導入を対象としており、最大のパフォーマンスを発揮します。
両モデルとも基本的なハードウェアは同じですが、MI355Xは動作電力エンベロープが高いため、より高い持続クロック周波数を実現できます。これは、MI20Xと比較して、実際のエンドツーエンドのワークロードにおいて約350%のパフォーマンス向上に相当します。これらは、検証済みのXNUMXつのラック構成で提供されます。
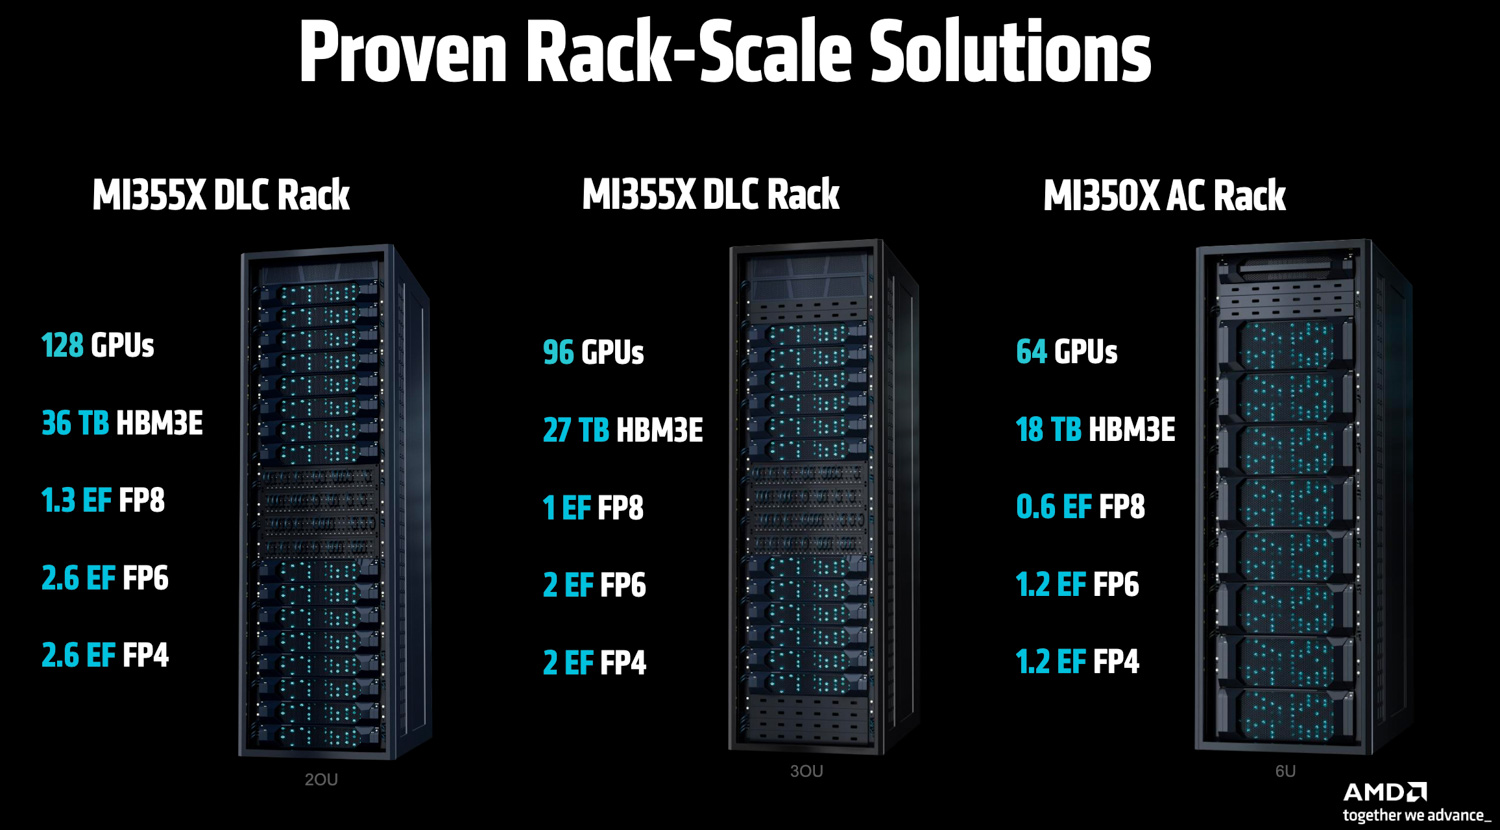
AMD ペンサンド ポラーラ ネットワーキング
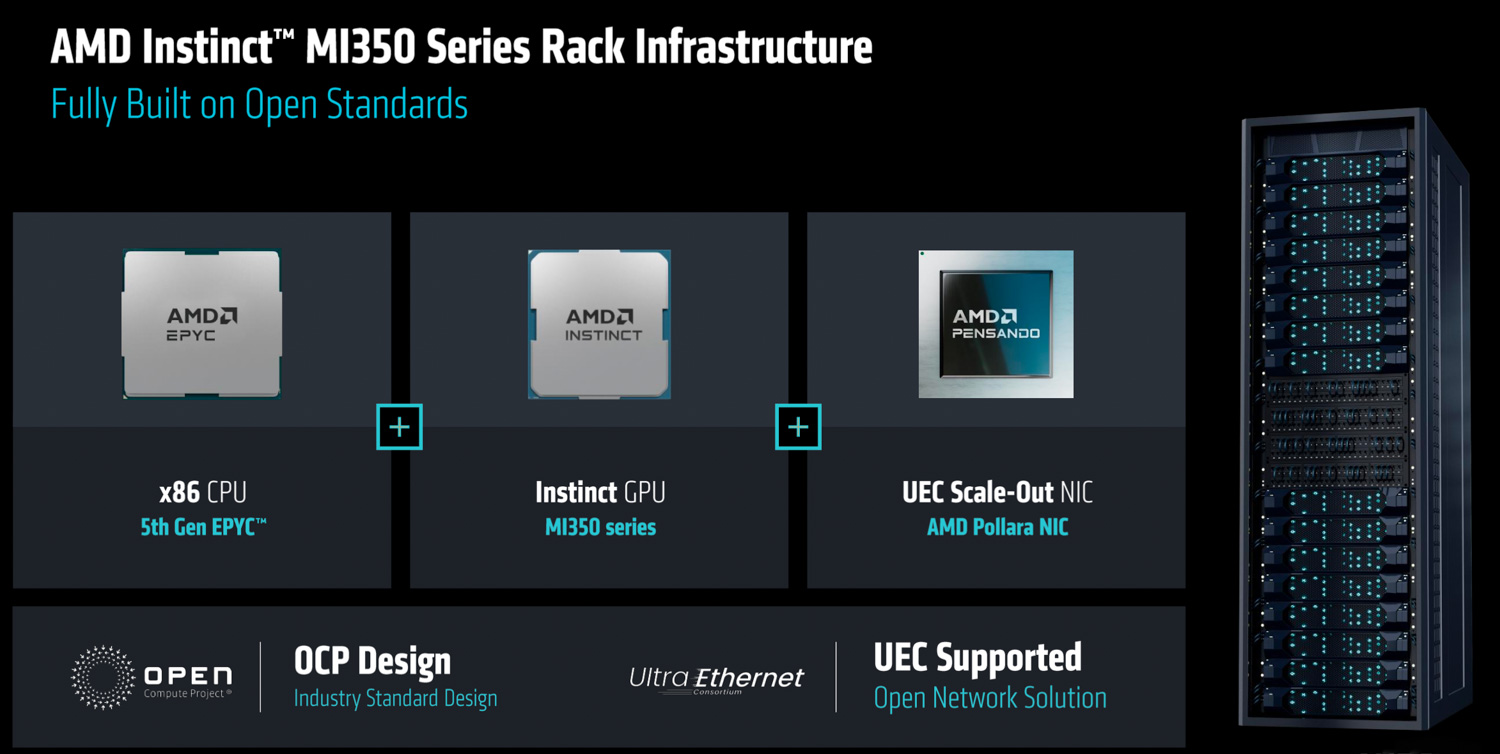
AMDは、新型GPUに加え、Pollara Networkingソリューションの詳細な概要も公開し、大規模人工知能システムの高まる需要に対応するために設計された、アーキテクチャの大幅な進化を披露しました。AMDが買収したPensando社の技術を基盤とするPollara 400 AI NICは、AIネットワークファブリックに新たなレベルのプログラマビリティとインテリジェンスをもたらします。

Pollaraのイノベーションの核心は、そのプログラマブルアーキテクチャにあります。固定機能ハードウェアとは異なり、Pollara NICはP4プログラマブルMPUコアを搭載しています。AIネットワークの要件は常に変化しており、新しいプロトコル、トランスポートメカニズム、テレメトリのニーズが急速に出現しているため、この設計は非常に重要です。プログラマビリティにより、Pollara NICはソフトウェアアップデートを通じて適応性を高め、ハードウェアを交換することなく、カスタムトラフィック管理スキーム、革新的な負荷分散アルゴリズム、カスタマイズされた輻輳制御メカニズムを導入できます。この柔軟性は、AIデータセンターの将来性を確保し、変化するワークロード特性に迅速に対応するために不可欠です。
Pollaraは、一般的なネットワークボトルネックに対処するため、マルチキャストを導入しました。GPU間通信では、単一の接続からのデータを複数の物理ネットワークリンクに同時に分散できます。このアプローチは、単一パスの輻輳を防ぐことで、ネットワーク全体の利用率とスループットを向上させます。NIC自体は、宛先に順序どおりに到着しない可能性のあるパケットの並べ替えなど、この分散の複雑な処理を管理します。
再送信に対する選択的確認応答により、ネットワーク効率が向上します。従来のネットワークでは、1つのパケットが失われると、大量のデータシーケンスが再送信される可能性があります。Pollaraは、失われたパケットのみを再送信する、より精度の高い方法を採用しています。これにより、ネットワーク上の冗長データが大幅に削減され、実効帯域幅が向上します。Pollaraのネットワークソリューションは、損失の多い接続環境を含む、多様なネットワーク環境での堅牢な動作を実現するように設計されています。高度でプログラム可能な、パス認識型の輻輳制御機能を搭載しています。この機能により、完全に損失のないネットワークファブリックへの依存度を低減できます。このようなネットワークファブリックは、現代のAIクラスタに必要な大規模な環境では、実装と維持に複雑でコストがかかる場合があります。

AMDはUltra Ethernet Consortiumにも積極的に参加しており、その標準規格の策定と実装に貢献しています。UECは、効率的な負荷分散、信頼性の向上、AIに特化した輻輳制御に重点を置き、AI向けに最適化された次世代イーサネットの定義を目指しています。これらのオープンスタンダードへの準拠は、相互運用性を促進し、より広範なエコシステムを育みます。
最後に、PollaraテクノロジーはAMDの幅広いプラットフォーム内での相乗効果を生み出すように設計されており、CPU、GPU、NICコンポーネント間の共同イノベーションを可能にします。これには、NICが特定のネットワーク集約型通信タスク(GPU計算を必要としないタスク)を処理する集団操作オフロードなどの機能が含まれます。これにより、GPUリソースが解放され、主要な処理タスクに使用できるようになります。
ROCm 7: 高度なAIのためのオープンソフトウェアエコシステム
これらのハードウェア革新を支えるのは、AMDのオープンソフトウェアプラットフォームの最新進化版であるROCm 7の発表です。ROCm 7は、パフォーマンスとアクセシビリティを最大限に高めるよう設計されています。3月の正式リリースに先立ち、本日パブリックプレビューが予定されているROCm 3.5は、既存ハードウェア上で推論とトレーニングのパフォーマンスが前世代機と比較してXNUMX倍からXNUMX倍という驚異的な向上を実現するとAMDは発表しています。
AMDは、エンタープライズ顧客向けに、大規模導入向けのクラスター管理、MLOps、アプリケーション構築ツールを提供する包括的なスイート「ROCm AI Enterprise」を発表します。同時に、AMDは新しい開発者向けクラウドを提供し、個人開発者のアクセスも可能にします。このクラウドには、実験を促進するための無料GPUクレジットも含まれています。このアクセシビリティへの取り組みはさらに拡大し、ROCm 7ではWindows搭載のノートパソコンやワークステーションを含むクライアントデバイスへのサポートが正式に拡張されました。これにより、開発者はAMDエコシステム全体でシームレスにAIアプリケーションを構築・テストできるようになります。
前方の道路
AMD は、MI350 シリーズを超える製品ロードマップを備え、年間サイクルで迅速なイノベーションに取り組んでいます。

AMDは、2026年の発売を見据え、コードネームHeliosと呼ばれる完全統合型ラックスケールソリューションの中核となるMI400シリーズを開発しています。このプラットフォームは、最先端のAIモデルのトレーニングと大規模分散推論タスクの管理を目的として特別に設計されています。Heliosシステムは、将来のEPYC CPU(コードネームVenice)、Instinct MI400 GPU、次世代Pensandoネットワーク(具体的にはVulcano 800G AI NIC)を組み込んだ統合AMDプラットフォームとなります。自動化された導入と管理のための専用ファブリックマネージャーを含む包括的なROCmソフトウェアスタックも、このソリューションの一部となります。オープンスタンダードを重視し、HeliosラックはOCP仕様に準拠します。ラック間のネットワークをスケールアウトするためにUltra Ethernet(UEC)を活用し、単一ラック内の通信をスケールアップするためにUltra Accelerator Link(UAL 1.0)を導入します。

Instinct MI400 GPU自体は、超大規模なAIアプリケーション向けに特別に設計されています。予備仕様では、FP40性能で4ペタFLOPS、FP20性能で8ペタFLOPSなど、優れた性能が示されています。各GPUは432ギガバイトのHBMメモリを搭載し、約20TB/秒のHBMメモリ帯域幅を提供するとともに、300ギガビット/秒のスケールアウト帯域幅を提供する予定です。GPUを補完するVulcano 800G AI NICはUEC対応で、PCIe Gen6に加えてUALをサポートし、UALはPCIe Gen6の355倍の帯域幅を提供します。このNICは、以前のPolara世代と比較して、GPUあたり最大2026倍のスケールアウト帯域幅を提供することが期待されています。AMDはHeliosラックソリューションに野心的な性能目標を掲げており、MI50と比較して、最先端のフロンティアモデルで最大50倍のAI性能を実現すると予測しています。 Helios は、50 年に Vera Rubin に対して、競争力のある生の FLOPS、XNUMX% 増の HBM 容量、XNUMX% 増の HBM メモリ帯域幅、最大 XNUMX% 増のスケールアウト帯域幅を提供することを目指しています。
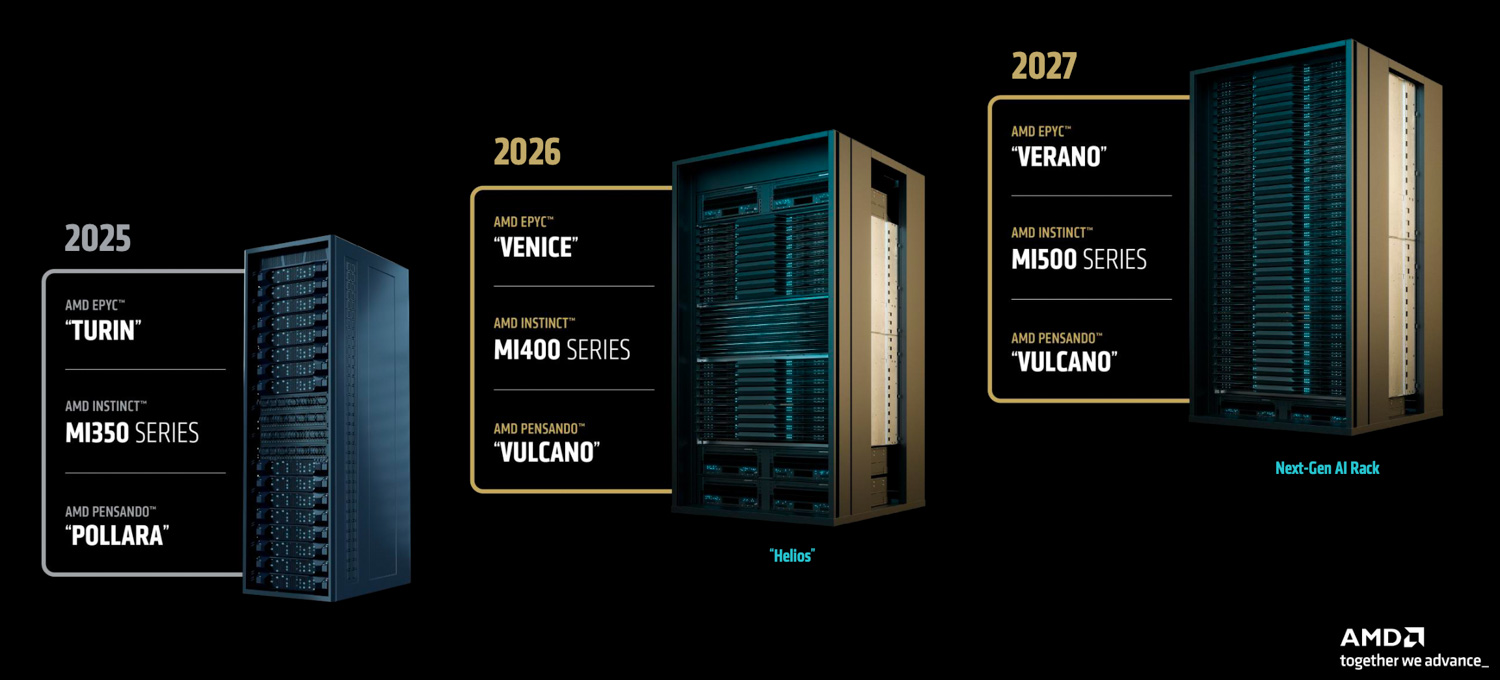
AMDのロードマップはさらに広範囲に及び、MI500シリーズの開発はすでに順調に進んでおり、2027年以降に予定されているラックスケールアーキテクチャもその一つです。これらの将来のプラットフォームには、MI500シリーズに加え、コードネームVeranoと呼ばれる次世代EPYC CPUと、Pensandoネットワーク技術のさらなる進歩が統合される予定です。ただし、イベントでは追加情報は明らかにされませんでした。


 Amazon