

今年初め、インテルは、インテル Habana Gaudi2 と GPU 市場リーダーである NVIDIA とのパフォーマンス結果を発表しました。これは、インテルの AI への取り組みを示し、AI が画一的なカテゴリーではないことを証明しました。同時に、Intel AI 研究者と Microsoft Research との共同開発により、最先端のビジョン言語タスクを提供する事前トレーニング済みマルチモーダル トランスフォーマーである BridgeTower が作成されました。 Hugging Face は、このモデルを機械学習用のオープンソース ライブラリに統合しました。
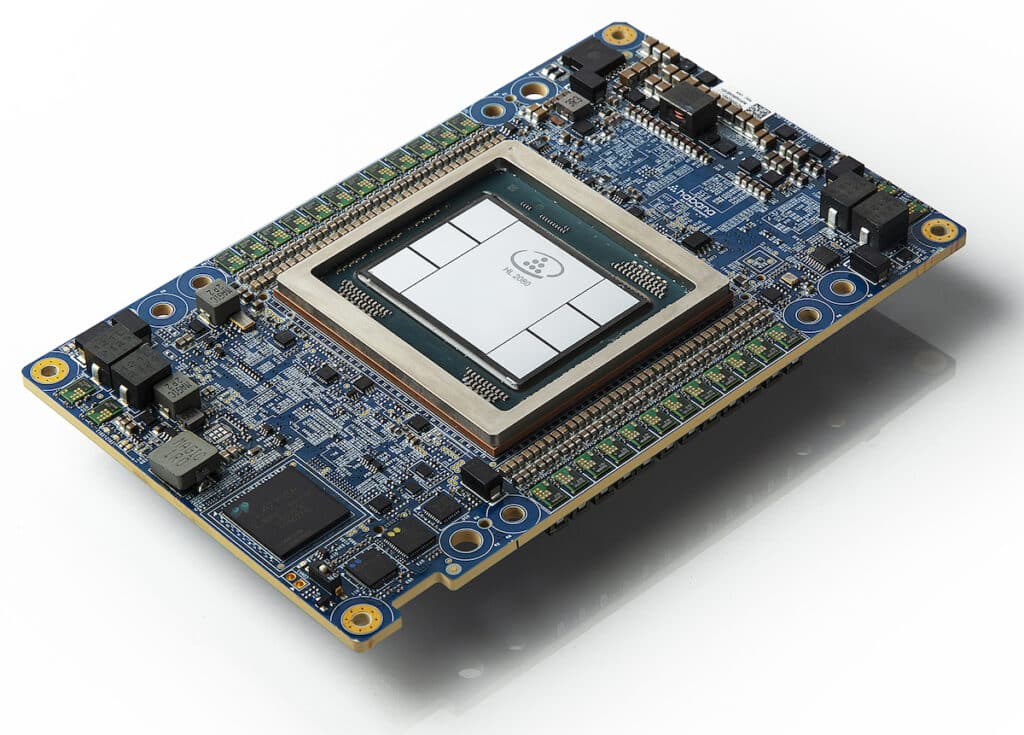
Habana Gaudi2 メザニン カード (クレジット: Intel Corporation)
Hugging Faceは、自社ウェブサイトのブログ記事でオリジナルのベンチマーク結果を公開し、Habana Gaudi2とNVIDIAのH100 GPUのAIトレーニング性能ベンチマーク結果を更新しました。これらのベンチマーク結果によると、マルチモーダルトランスフォーマーBridgeTowerモデルの獲得においてGaudi2はH100を上回りましたが、Optimum Habanaを使用したGaudi2はA100の2.5倍の性能を達成しました。これらの結果は、AI分野だけでなく、Vision-LanguageトレーニングにおいてもGaudi2の地位を確固たるものにしました。
Optimum Habana は、Transformers および Diffuser ライブラリと Habana の Gaudi プロセッサ (HPU) の間のインターフェイスです。さまざまなダウンストリーム タスクのシングルおよびマルチ HPU 設定でのモデルの読み込み、トレーニング、推論を簡単に実行できるツールを提供します。
ブリッジタワーの背景
ビジョン言語モデルは、ユニモーダル エンコーダーを使用してデータ表現を取得します。次に、データは結合されるか、クロスモーダル エンコーダーに入力されます。 BridgeTower は、ユニモーダル エンコーダーの最上位レイヤーをクロスモーダル エンコーダーのすべてのレイヤーにリンクする独自のブリッジ レイヤーで際立っており、さまざまなレベルでビジュアル データとテキスト データを効率的に組み合わせることができます。
BridgeTower は、わずか 4 万枚の画像でトレーニングされ、新しいパフォーマンス基準を設定し、Visual Question Answering (VQAv78.73) テストで 2% の精度を実現しました。これは、これまでの最高モデルを 1.09% 上回っています。スケールアップすると、モデルの精度は 81.15% とさらに高くなり、より大規模なデータセットでトレーニングされたモデルを上回りました。
最上位のビジョン言語モデルとしての BridgeTower のパフォーマンスは、特別なハードウェアを使用してデータを迅速にロードする機能によるものです。これらの迅速なデータ読み込み方法は、データ読み込みの課題に直面することが多いビジョン モデルにとって有益です。
ハードウェアに関する洞察
更新されたベンチマーク テストは、NVIDIA と Habana Labs の最新のハードウェアとソフトウェアに基づいています。 NVIDIA H100 Tensor Core GPU は、特殊な実行のための Transformer Engine と 80 GB のメモリを備えた、INVIDIA の最新かつ最速の GPU です。 Tensor Core テクノロジーの 100 回目の反復を使用する Nvidia A80 Tensor Core GPU は、クラウド プロバイダー全体で広く利用可能であり、40 GB メモリを搭載し、XNUMX GB の同等品よりも優れた速度を実現します。
Habana Labs Habana Gaudi2 は、Habana Labs の第 8 世代 AI ハードウェアで、それぞれ 96 GB のメモリを搭載した最大 XNUMX つの HPU を収容できます。ユーザーフレンドリーな機能を備えていると宣伝されており、Optimum Habana と組み合わせることで、Transformers ベースのコードを Gaudi に簡単に転送できるようになります。
ベンチマークの詳細
このテストには、866 億 48 万のパラメーターを使用した BridgeTower モデルの微調整が含まれ、いくつかのデータセットに対してさまざまなテクニックを使用して英語でトレーニングされました。次のステップでは、ニューヨーカー キャプション コンテスト データセットを使用してさらに微調整を行いました。すべてのプラットフォームで同じ設定を使用し、一貫した結果を得るためにそれぞれ XNUMX 個のサンプルのバッチを処理しました。
このような実験における課題は、画像データの読み込みに時間がかかることです。最適には、生データをデコードのためにデバイスに直接送信する必要があります。今後は、このデータ読み込みプロセスの最適化に焦点が移ります。
データ読み込みの最適化
CPU へのイメージの読み込みを高速化するには、サブプロセスを増やすと効果的です。 Transformers の TrainingArguments を使用すると、dataloader_num_workers=N 引数でデータ読み込み用の CPU サブプロセスの数を設定できます。デフォルト設定は 0 で、データがメインプロセスによってロードされることを意味しますが、これは効率的ではない可能性があります。値を増やすと速度が向上しますが、RAM の消費量も増加します。推奨設定は CPU コアの数です。ただし、最初に実験して最適な構成を決定することが最善です。
このベンチマークには 3 つの異なる実行がありました。
- 0 つのデバイス間で混合精度が実行され、データの読み込みが他のタスクと同じプロセスを共有します (dataloader_num_workers=XNUMX)。
- 同様の実行ですが、データ読み込み専用のサブプロセス (dataloader_num_workers=1) が使用されます。
- 同じセットアップですが、2 つの専用サブプロセス (dataloader_num_workers=XNUMX) があります。
Optimum Habana によるハードウェア アクセラレーションによるデータ読み込み
さらに速度を向上させるには、Habana のメディア パイプラインを使用して、データ読み込みタスクを CPU からアクセラレータ デバイス (Gaudi2 の HPU や A100/H100 の GPU など) に移します。 CPU 上で画像を完全に処理する代わりに、エンコードされた画像をデバイスに直接送信してデコードおよび拡張を行うことができます。このアプローチではデバイスのコンピューティング能力が最大化されますが、デバイスのメモリ消費量が増加する可能性があります。
画像を使用したトレーニング ワークフローを強化する 2 つの効果的な方法は、より多くのデータローダー リソースを割り当てることと、画像処理にアクセラレータ デバイスを使用することです。 BridgeTower のような高度なビジョン言語モデルをトレーニングする場合、これらの最適化により、Optimum Habana を備えた Habana Gaudi2 は NVIDIA の同等モデルよりも大幅に高速になります。 Habana GaudiXNUMX はユーザーフレンドリーで、追加のトレーニング引数がいくつか必要なだけです。


 Amazon