

NVIDIAとGoogle Cloudは、ラスベガスで開催されたGoogle Cloud Nextにおいて、長年にわたる両社のエンジニアリングパートナーシップの新たな段階を発表し、本番環境におけるエージェント型AIと物理AIのスケーリングを可能にするGoogle Cloud AI Hypercomputerプラットフォームのアップデートを紹介した。両社は、自律型エージェント、ロボット工学、デジタルツインなど、ますます複雑化するAIワークロードをサポートするため、シリコン、システム、ネットワーク、ソフトウェアにわたるインフラストラクチャの共同設計を継続している。
Vera Rubin氏によるA5Xインフラストラクチャは、大規模AIファクトリーをターゲットとしている。
Google Cloudは、NVIDIA Vera Rubin NVL72ラックスケールシステムをベースとしたA5Xベアメタルインスタンスを発表しました。これらのシステムは、推論の経済性と効率性を大幅に向上させるように設計されており、トークンあたりのコストを前世代比で最大10分の1に、メガワットあたりのトークンスループットを最大10倍に高めています。
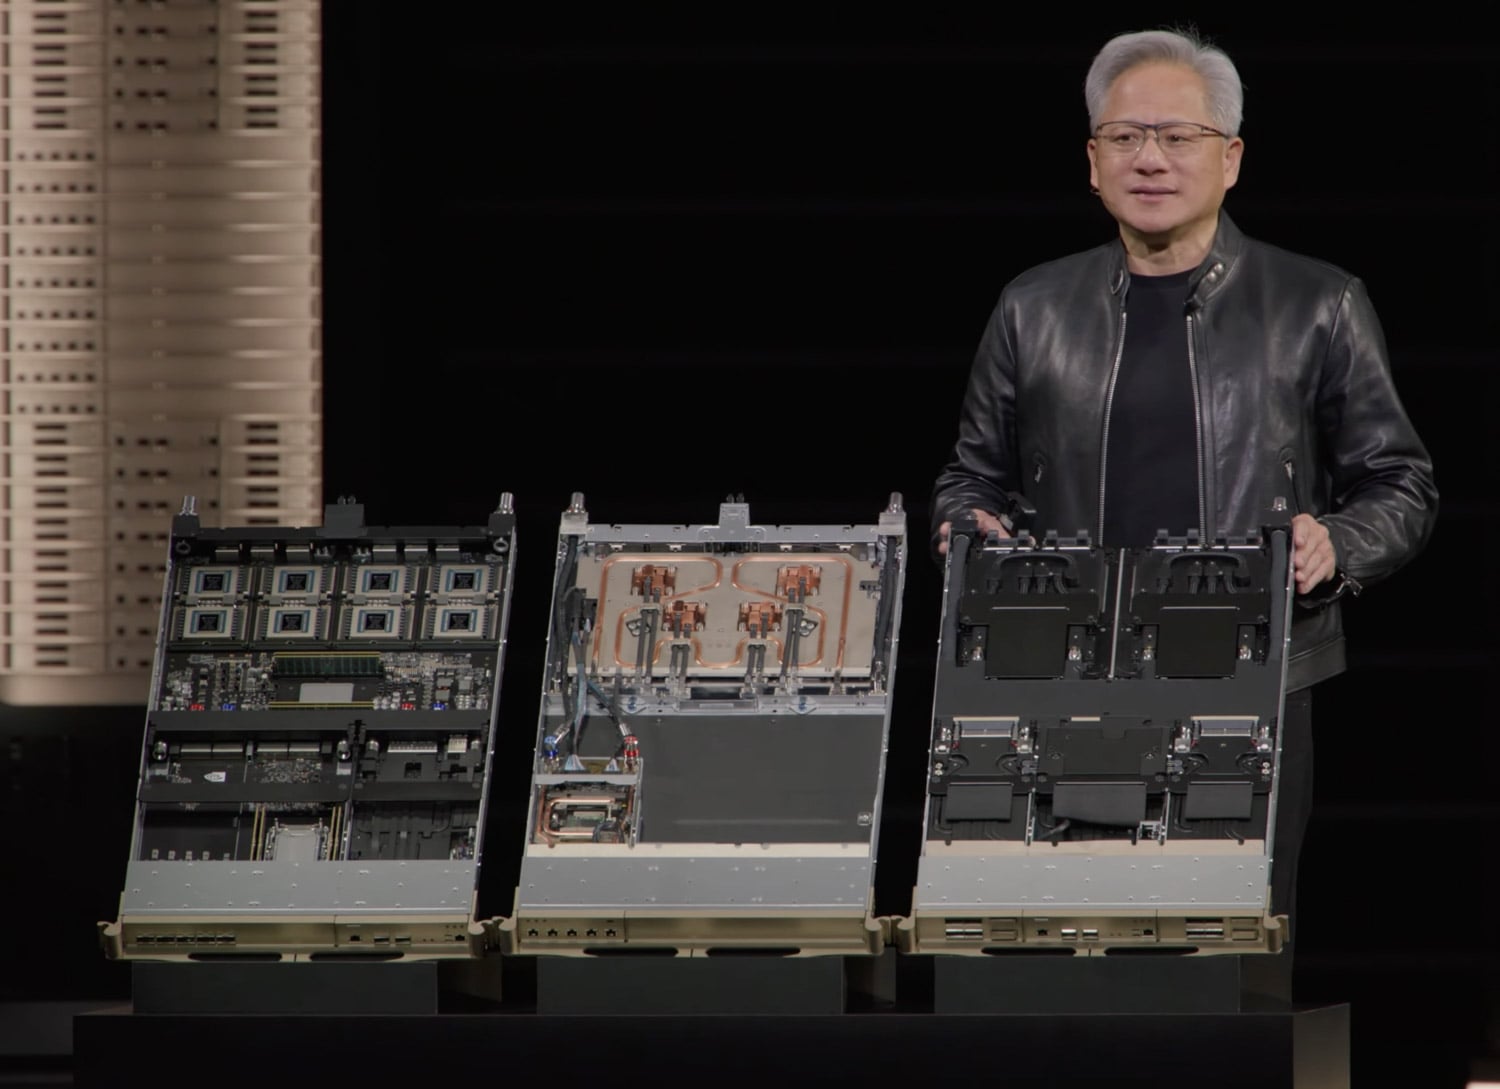
A5Xプラットフォームは、NVIDIA ConnectX-9 SuperNICとGoogleの次世代ネットワークスタックVirgoを統合しています。このアーキテクチャにより、単一サイト内で最大80,000個のRubin GPU、複数サイト展開では最大960,000個のGPUまでクラスタを拡張できます。この設計は、ネットワーク性能とシステムレベルの最適化が極めて重要な、ハイパースケールAIのトレーニングおよび推論環境を対象としています。
Google Cloudは、次世代のAIワークロードを支えるには、緊密に統合されたインフラストラクチャとマネージドAIサービスが必要であると強調した。この統合されたスタックにより、顧客はパフォーマンス、効率性、運用上の拡張性を重視しながら、モデルのトレーニング、微調整、デプロイを行うことができる。
ブラックウェルの幅広いポートフォリオにより、適切な規模の加速が可能になる
Google Cloudは、幅広い展開規模とパフォーマンスプロファイルに対応する、NVIDIA Blackwellベースのインスタンスのポートフォリオも発表しました。提供されるインスタンスには、NVIDIA HGX B200システムをベースとしたA4 VM、GB200およびGB300 NVL72プラットフォーム上に構築されたA4XおよびA4X Max構成、そしてRTX PRO 6000 Blackwell Server Edition GPUを搭載したG4インスタンスによる部分的なGPUアクセスが含まれます。
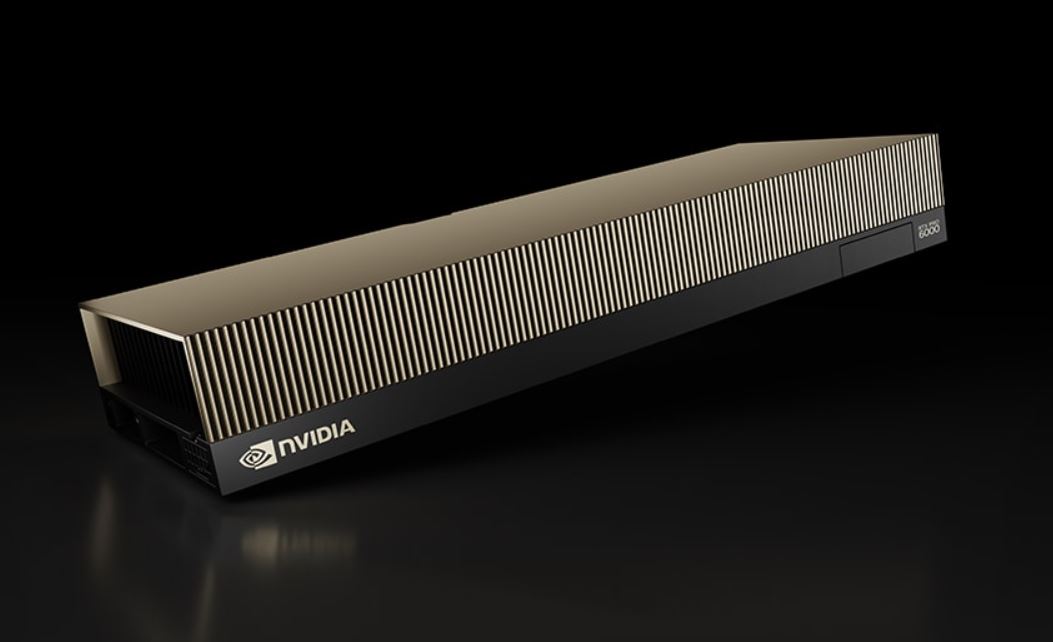
この幅広い構成により、組織はワークロード要件に合わせてインフラストラクチャを調整できます。構成は、軽度の推論タスク向けの部分的なGPUから、第5世代NVLinkおよびNVLink Switchテクノロジーで相互接続された72個のGPUを搭載したフルNVL72ラックまで多岐にわたります。ハイエンド構成では、大規模モデルのトレーニングや分散推論のために、数万個のGPUまで拡張可能です。
これらのシステムは、混合エキスパート(MoE)モデル、マルチモーダル推論、大規模データ処理、ロボット工学および物理AI向けのシミュレーションワークロードなど、幅広いAIワークロードをサポートするように設計されています。
早期導入企業は既にこのプラットフォームを活用している。Thinking Machines Labは、 Tinker APIのトレーニングを拡張するために、 GB300 NVL72ベースのA4X Maxインスタンスを使用している。一方、OpenAIは、Google Cloud上のGB200およびGB300ベースのインスタンスで、ChatGPTを含む大規模な推論ワークロードを実行している。
機密性の高いAI技術がBlackwell GPUにも適用範囲を拡大
Google Cloudは、AIインフラストラクチャに機密性の高いコンピューティング機能を拡張します。NVIDIA BlackwellおよびBlackwell Ultra GPU上で動作するGeminiモデルが、Google Distributed Cloudでプレビュー版として利用可能になり、組織は機密性の高いデータソースにより近い場所にモデルをデプロイできるようになります。
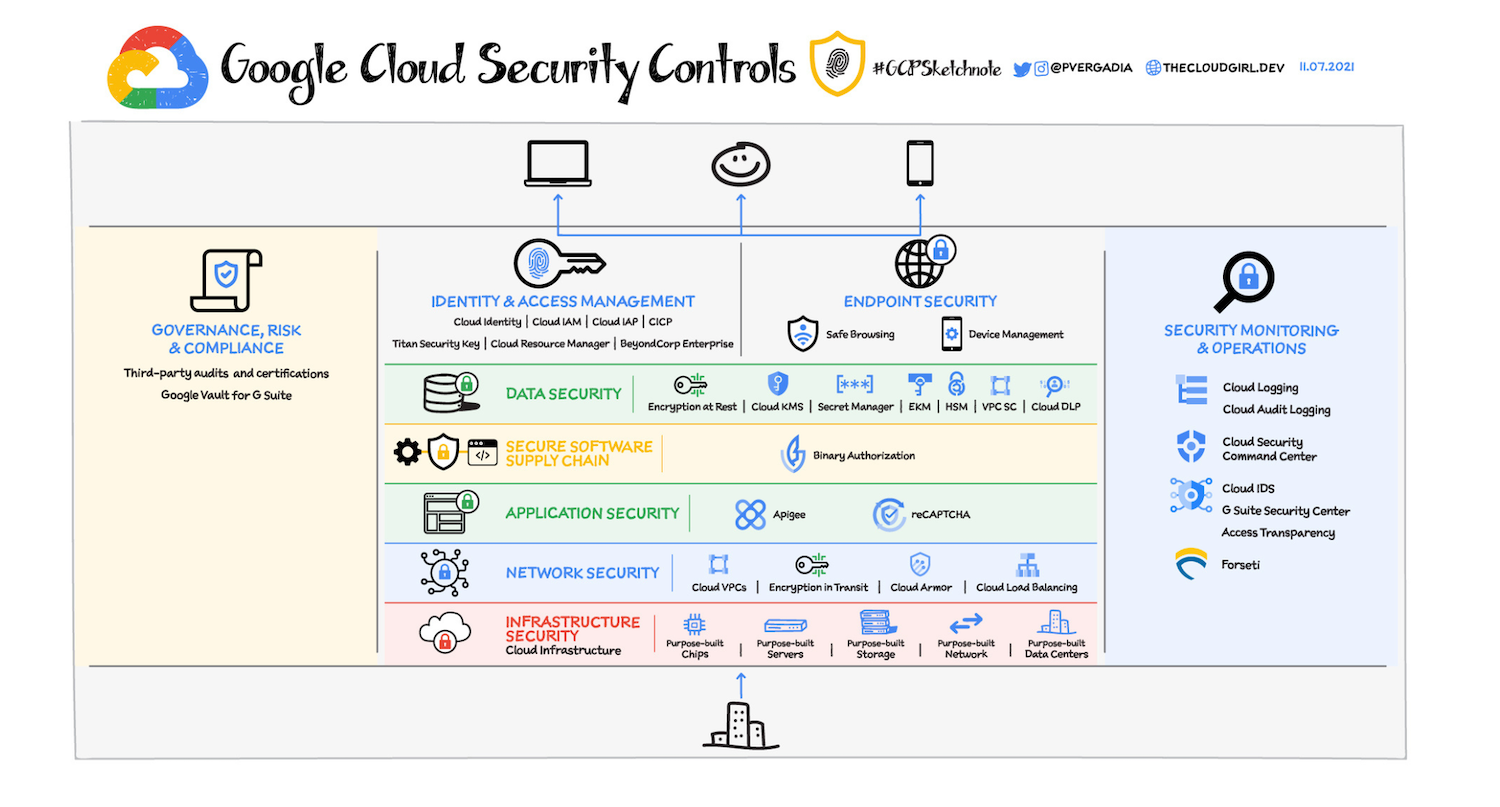
NVIDIA Confidential Computingは、暗号化された実行環境を実現し、プロンプトや微調整データをクラウド事業者を含む不正アクセスから保護します。この機能は、RTX PRO 6000 Blackwell GPUを搭載したConfidential G4 VMを通じて、マルチテナント環境にも提供される予定です。
これは、Blackwell GPUをパブリッククラウド上で機密コンピューティングに活用する初の事例であり、高性能AIインフラストラクチャへのアクセスを維持しながら、厳格なデータ保護を必要とする規制対象業界を対象としています。
エージェント型AIのためのオープンモデルとマネージドRLパイプライン
このプラットフォームは、GoogleのGeminiおよびGemmaモデル、NVIDIAのNemotronオープンモデルなど、幅広いモデルエコシステムをサポートしています。NVIDIA Nemotron 3 SuperはGemini Enterprise Agent Platformに統合され、開発者は推論駆動型のエージェントワークフローを構築および展開できるようになりました。
Google Cloudは、NVIDIA NeMoを基盤とした強化学習APIを備えたマネージドトレーニングクラスタも導入しました。このサービスは、クラスタのプロビジョニング、ジョブのオーケストレーション、障害処理を自動化し、大規模な強化学習トレーニングを可能にします。その目的は、運用上の複雑さを軽減し、チームがモデルの動作と最適化に集中できるようにすることです。
CrowdStrikeは、NVIDIA NeMoツール(Data Designer、Automodel、Megatron Bridgeなど)を使用して合成データを生成し、ドメイン固有のサイバーセキュリティモデルを微調整します。これらのワークフローはBlackwellベースのインフラストラクチャ上で実行され、脅威の検出と対応のパイプラインを高速化します。
産業および物理分野におけるAIワークロードの拡大
この共同プラットフォームは、産業および物理AIのユースケースにも対応しています。CadenceとSiemens Digital Industries Softwareのアプリケーションは、NVIDIAのアクセラレーションによりGoogle Cloud上で利用可能となり、半導体、自動車、航空宇宙、重機などの業界における設計、シミュレーション、製造ワークフローをサポートします。
NVIDIA OmniverseライブラリとIsaac SimはGoogle Cloud Marketplaceで入手可能で、物理的に正確なデジタルツインやロボットシミュレーションパイプラインの開発を可能にします。これらのツールを使用することで、組織はシステムを実運用前にシミュレーションおよび検証できます。
さらに、NVIDIA NIMマイクロサービスは、Vertex AIおよびGoogle Kubernetes Engineにデプロイすることで、ビジョンAIやロボット関連のワークロードをサポートできます。これらのサービスにより、リアルタイムビデオ分析、ロボットプランニング、自動データ処理などの機能が実現します。
プラットフォームの焦点:実験から製品化へ
今回のアップデートにより、Google Cloud AI Hypercomputerは、AIワークロードを研究段階から実運用段階へと移行させるためのフルスタックプラットフォームとしての地位を確立しました。コンピューティング、ネットワーク、ソフトウェア、セキュリティ機能が緊密に統合されたこのプラットフォームは、大規模なエージェントシステム、産業オートメーション、リアルタイムAIアプリケーションをサポートするように設計されています。


 Amazon