

サンノゼで開催されたGTC 2026で、NVIDIAのCEOであるジェンセン・フアン氏は、同社の次世代AIインフラストラクチャプラットフォームの概要と、シリコン、システム、ソフトウェア、エコシステムパートナーシップにわたる包括的な発表を行う基調講演を行いました。190か国以上から3万人を超える参加者が集まったGTC 2026は、Blackwellの導入以来、NVIDIAにとって最も包括的なプラットフォーム刷新の舞台となり、Vera Rubinアーキテクチャの本格的な量産展開と、Groq 30,000 LPUテクノロジーのNVIDIAデータセンターエコシステムへの統合が中心となりました。フアン氏がステージ上で述べたように、エージェントAIの転換点が到来し、Vera RubinはNVIDIAが史上最大のインフラストラクチャ構築と呼ぶものの幕開けとなります。
基調講演の中心テーマは、AIスケーリングの第4法則であるエージェントスケーリングの出現でした。エージェントスケーリングとは、AIシステムが人間だけでなく他のAIエージェントとも通信し、低遅延かつ大規模なコンテキスト推論に対する需要が前例のない規模で指数関数的に増加するというものです。NVIDIAは、この新たなフロンティアを支えるインフラストラクチャ基盤としてVera Rubinプラットフォームを位置付けました。このプラットフォームは、AIファクトリー向けに特別に設計された5つの新しいラックスケールシステムにわたって、共同設計された7つのチップを組み合わせています。このプラットフォームは、最先端AIラボからも支持を得ています。AnthropicのCEO兼共同創設者であるダリオ・アモデイ氏は、「企業や開発者は、ますます複雑化する推論、エージェントワークフロー、そしてミッションクリティカルな意思決定にClaudeを使用しています。そのためには、そのペースに追いつけるインフラストラクチャが必要です。NVIDIAのVera Rubinプラットフォームは、お客様が頼りにしている安全性と信頼性を向上させながら、継続的にサービスを提供するためのコンピューティング、ネットワーク、システム設計を提供してくれます」と述べています。 OpenAIのCEO、サム・アルトマン氏は次のように述べています。「NVIDIAのインフラストラクチャは、私たちがAIの最先端を切り拓き続けるための基盤です。NVIDIA Vera Rubinを活用することで、より強力なモデルやエージェントを大規模に実行し、より高速で信頼性の高いシステムを数億人のユーザーに提供できるようになります。」
ヴェラ・ルービン・プラットフォーム:エージェント型AIのフロンティアを切り拓く
CES 2026で初めて発表されたVera Rubin NVL72アーキテクチャをベースに、GTC 2026ではプラットフォームを包括的なPODスケールAIファクトリーエコシステムに拡張しました。NVIDIAはこれを、ディスクリートチップとスタンドアロンサーバーから、完全に統合されたラックスケールシステム、ポッドスケール展開、およびソブリンAIファクトリーへの移行として位置付けています。Vera Rubinプラットフォームは、NVIDIA Vera CPU、Rubin GPU、NVLink 6スイッチ、ConnectX-9 SuperNIC、BlueField-4 DPU、Spectrum-6 Ethernetスイッチ、および新たに統合されたNVIDIA Groq 3 LPUを統合し、コンピューティング、ネットワーキング、ストレージにわたるディープコデザインを備えた単一の統合AIスーパーコンピュータとして動作するように設計されており、グローバルサプライチェーンを持つ80以上のMGXパートナーのエコシステムによってサポートされています。

NVIDIAは、このプラットフォームが、あらゆるAIワークロードにおいて、Blackwell世代と比較してワットあたりの推論スループットを最大10倍向上させ、トークンあたりのコストを10分の1に削減できると主張しています。大規模なMixture-of-Expertsモデルのトレーニングでは、Vera Rubinは同等のパフォーマンスを達成するために必要なGPU数をわずか4分の1に削減できます。NVL72は、NVIDIA Quantum-X800 InfiniBandおよびSpectrum-X Ethernetとシームレスに連携し、大規模なGPUクラスタ全体で高い利用率を維持しながら、トレーニング時間と総所有コストを削減します。
世代比較:ブラックウェル ウルトラ vs. ヴェラ ルビン NVL72
| 製品仕様 | GB300 NVL72(ブラックウェル ウルトラ) | VR NVL72(ヴェラ・ルービン) |
|---|---|---|
| コンピューティングアーキテクチャ | ||
| GPU 数 | 72 個の Blackwell Ultra GPU | 72 個の Rubin GPU |
| CPU数 | 36 個の Grace CPU | 36個のVera CPU |
| CPUコア | CPUあたり72個のARMコア | CPUあたり88個のOlympus ARMコア |
| AIパフォーマンス | ||
| FP4推論パフォーマンス | 1.44エクサフロップス | 3.6エクサフロップス |
| GPU あたりの NVFP4 (推論) | 20PFLOPS | 50PFLOPS |
| GPU あたりの NVFP4 (トレーニング) | 10PFLOPS | 35PFLOPS |
| メモリ | ||
| GPUメモリタイプ | HBM3e | HBM4 |
| GPU メモリ帯域幅 | 約8 TB/秒 | 約22 TB/秒 |
| インターコネクト | ||
| NVLink生成 | NVLink5 | NVLink6 |
| NVLink帯域幅(GPUあたり) | 1.8 TB /秒 | 3.6 TB /秒 |
| ラックスケールNVLink帯域幅 | 130 TB /秒 | 260 TB /秒 |
| Networking | ||
| スケールアウト NIC | ConnectX-8(800 Gb/s) | ConnectX-9(1.6 TB/秒) |
| CPU-GPU インターコネクト | NVLink-C2C(900 GB/秒) | NVLink-C2C(1.8 TB/秒) |
Vera Rubinベースの製品は、2026年後半からパートナー企業を通じて提供開始される予定です。主なパートナー企業には、大手クラウドプロバイダーであるAmazon Web Services、Google Cloud、Microsoft Azure、Oracle Cloud Infrastructureに加え、NVIDIA Cloud PartnersのCoreWeave、Crusoe、Lambda、Nebius、Nscale、Together AIなどが含まれます。また、グローバルシステムメーカーであるDell Technologies、HPE、Lenovo、Supermicro、ASUS、Foxconn、GIGABYTE、Inventec、Pegatron、QCT、Wistron、Wiwynnも、Vera Rubin製品をベースにしたサーバーを提供する予定です。
CPXからLPXへ:NVIDIAのGroq買収がDecodeアクセラレーションをどのように変革したか
昨年開催されたAIインフラサミットで、NVIDIAは長コンテキスト推論クエリの高速化を目的とした構成のCPXラックを発表しました。この発表を取材した際、CPXの実際の機能についていくつかの疑問が生じました。一見すると、興味深いアーキテクチャコンセプトではあったものの、CPXは、おそらくアテンション処理の高速化を除けば、Rubin GPU自体を超える実質的な機能を提供しているようには見えませんでした。
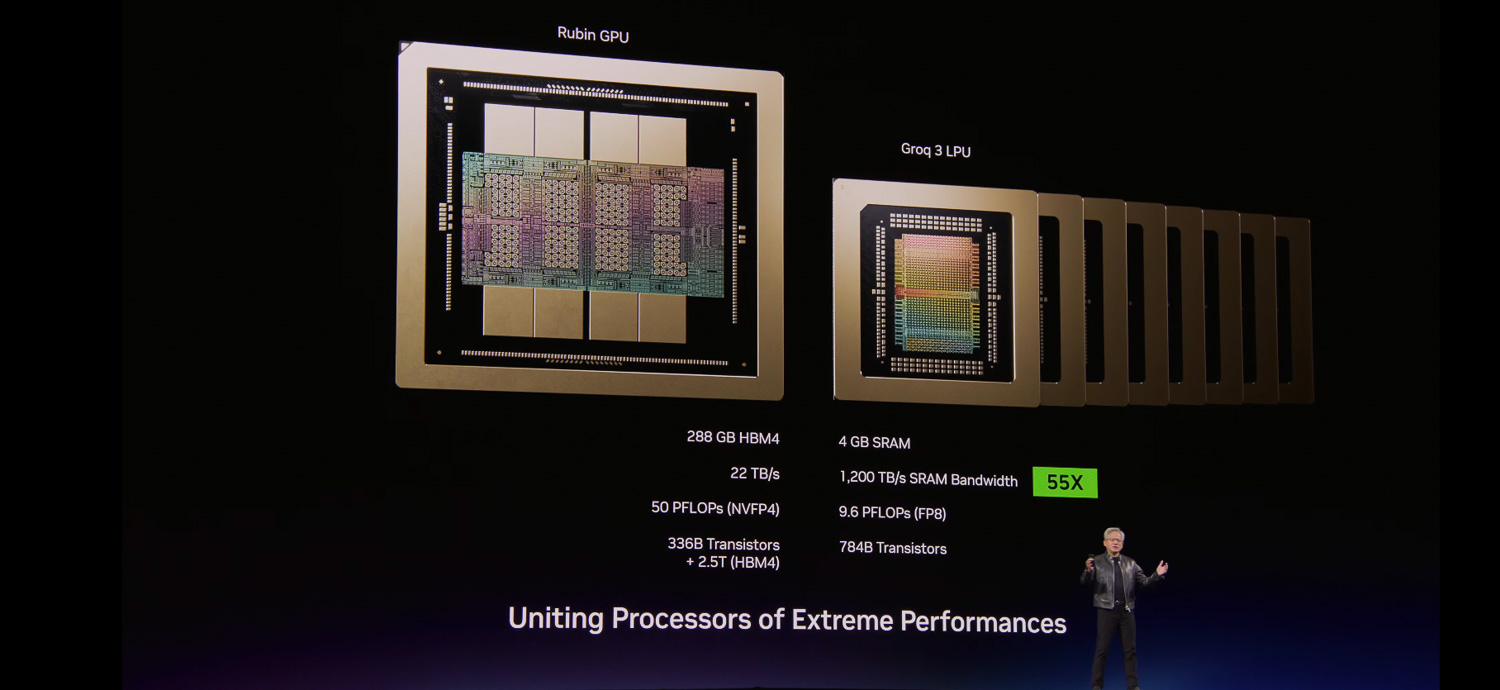
そして、業界で非常に人気を博したGroqの買収があり、NVIDIAがGroqのLPU技術をより広範なVera Rubinプラットフォームにどのように統合するのかという憶測が飛び交いました。そして、NVIDIAはGTC 2026でLPXを発表し、その疑問を解消しました。発表された内容から判断すると、CPXラックのコンセプトはGroq 3 LPXラックへと進化し、オリジナルのCPXのコンテキスト処理重視のアプローチは、Groqのシリコンを基盤とした根本的に異なるデコードアクセラレーションアーキテクチャへと置き換えられたようです。
Rubin GPUとGroq 3 LPU:相補的なアーキテクチャ
| 製品仕様 | ルービンGPU | Groq 3 LPU (LP30) |
|---|---|---|
| メモリタイプ | HBM4 | スタック型SRAM |
| メモリ容量(チップあたり) | 288 GB | 500 MB |
| メモリ帯域幅 | 22 TB /秒 | 150 TB /秒 |
| 第3章:濃度 | 高スループットトレーニングと事前充填 | 超低遅延トークンデコード |
| 展開 | VR NVL72(1ラックあたり72台) | LPXラック(1ラックあたり256個) |
| 集約ラックメモリ | 約20.7 TB HBM4 | 128GB SRAM |
| 帯域幅の拡張(ラック単位) | 260 TB/s NVLink 6 | 640 TB /秒 |
1 つの LPX ラックには 256 個の Groq 3 LPU が搭載されています。各 LPU には約 500 MB のスタック型 SRAM が搭載されており、ラック全体で約 128 GB のオンチップ SRAM と 640 TB/s のスケールアップ帯域幅が実現され、超低遅延のデコード アクセラレーション専用に設計されています。 2 つのプロセッサ タイプのコントラストは顕著です。Rubin GPU は 22 TB/s の帯域幅で 288 GB の HBM4 を提供しますが、LPU は容量を犠牲にして生の帯域幅を採用し、チップあたり SRAM プールから 150 TB/s を提供します。カスタム Spectrum X ベースの相互接続を介して VR NVL72 と共存する場合、2 つのラックは、Rubin に存在するアテンション デコードとフィード フォワード レイヤーが LPU にオフロードされることで、すべてのデコード トークンを協調して処理するように設計されています。数兆個のパラメータを持つモデルと数百万個のトークンからなるコンテキストに最適化された、共同設計されたLPXアーキテクチャは、Vera Rubinと連携することで、電力、メモリ、コンピューティングにおける効率を最大化します。LPXラックは完全液冷式で、MGXインフラストラクチャ上に構築されており、Vera Rubinの本格的な展開と同時期の2026年後半に提供開始予定です。

重要な点として、NVIDIA は CUDA に変更を加える必要がないことを確認しました。LPU は Vera および NVL72 プラットフォームで実行されている既存の CUDA スタックのアクセラレータとして機能し、計算はトークン単位で透過的にオフロードされます。GTC の質疑応答で、NVIDIA は LPU を「デコード モデル ブースター」と表現し、次世代のプレミアムおよびウルトラプレミアム モデル サービングを実現するために、「これらの兆パラメータ モデルを展開している AI ラボや AI フロンティア モデル ビルダーと緊密に協力していく」と説明しました。Groq の創設者やエンジニアの多くが NVIDIA に加わっており、両チーム間の協力は、Groq のロードマップを MGX インフラストラクチャに組み込むために推進する上で非常に良好であると報告されています。LPX の展開は、当初は幅広い OEM での提供ではなく、モデル ビルダーやサービス プロバイダーに重点を置きます。NVIDIA と Groq の統合による実際のパフォーマンスの向上を見るのが楽しみです。
Vera CPUラック:強化学習およびエージェントワークロード向けに専用設計されたコンピューティング環境
エージェント型AIが新たなクラスのCPUを必要とする理由
NVIDIAが専用のCPUラックを開発した理由を理解するには、現代のAI開発における強化学習(RL)のポストトレーニング段階の仕組みを理解することが役立ちます。ポストトレーニングとは、大規模なデータセットでモデルが事前学習された後の段階で、モデルを特定のユースケースに合わせて改良・特化させる段階のことです。
強化学習の仕組みでは、トレーニングループは3つの主要な構成要素から成ります。すなわち、ポリシーモデル(トレーニング対象のモデル)、モデルが行動を起こしフィードバックを受け取る環境、そしてそれらの行動の質を評価する報酬信号です。ポリシーモデルは候補となる出力を生成し、それらは環境内で実行され、報酬モデルによってスコアリングされ、得られた勾配を用いてポリシーが更新されます。
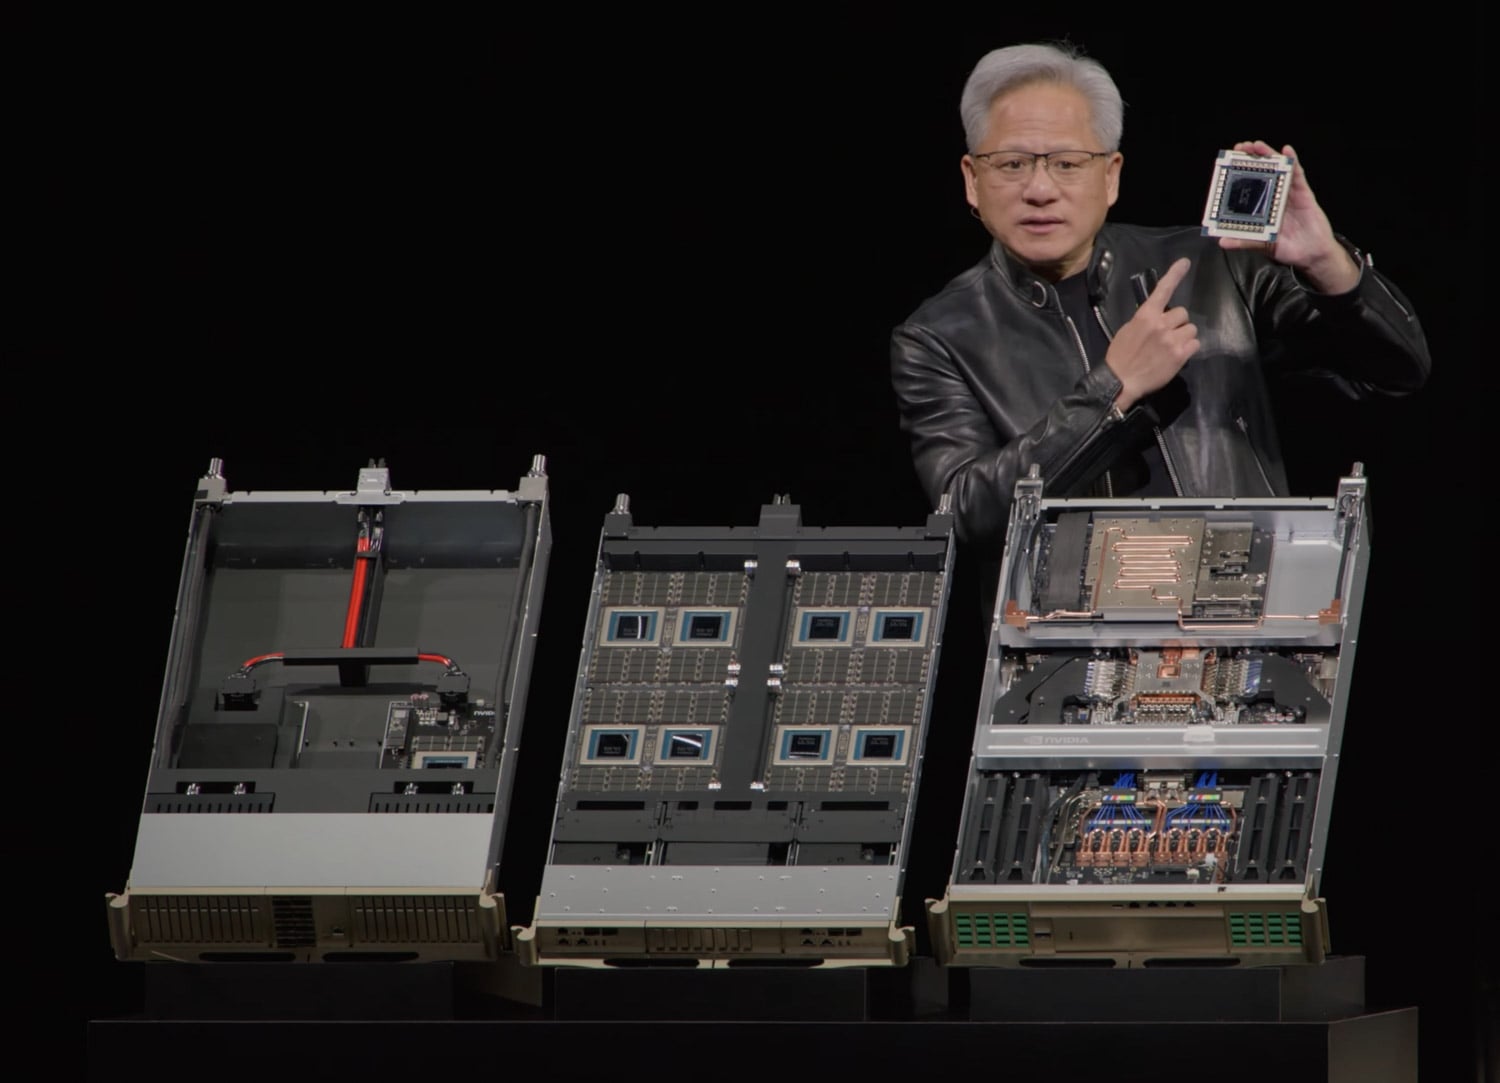
エージェント型AIワークロードの場合、この強化学習環境は抽象的なシミュレーションではなく、実際の計算サンドボックスです。たとえば、Claude Codeなどのツールや同様の自律型コーディングエージェントを使用して、エージェント型コーディングモデルを事後学習する場合を考えてみましょう。この環境では、3つの異なる計算プールが同時に動作する必要があります。まず、ポリシーモデルの重みを更新するGPUアクセラレータのトレーニングプールがあります。次に、推論アクセラレータが現在のポリシーモデルのチェックポイントを実行して、候補となるアクション(コード編集、ツール呼び出し、ファイル操作)を大規模に生成します。そして、最も重要なのは、実際の強化学習環境が実行される、従来のCPU計算の大規模なプールです。これらの環境では、エージェントが生成されたコードを実行し、テストスイートを実行し、ツール呼び出しを実行し、SQLクエリを発行し、バイナリをコンパイルし、ファイルシステムとやり取りし、トレーニングループにフィードバックされる報酬信号を生成するすべてのサンドボックス操作を実行します。
この従来の計算要件の規模は相当なものです。ポリシーモデルからの各実行は、数十個のツール呼び出しを順次トリガーする可能性があり、次のステップに進む前に、それぞれのツール呼び出しを実行、評価、および返さなければなりません。トレーニング実行全体で数千のデータポイントを並列に生成する場合、GPUトレーニングクラスタが環境実行で停止しないようにするには、膨大な数の高速CPUが必要になります。CPUサンドボックスプールでの遅延は、GPUサイクルのアイドル状態とトレーニング計算の無駄に直接つながります。デプロイされたエージェントシステムの推論時にも、同様のダイナミクスが適用されます。エージェントが実行するすべてのツール呼び出し、コードコンパイル、およびサンドボックス実行はCPU作業であり、エンドツーエンドのエージェントパイプラインの応答性を維持するために、十分な速さで完了する必要があります。NVIDIAのプレス資料にあるように、CPUはもはや単にモデルをサポートするだけでなく、モデルを駆動しているのです。
Vera CPUラック:NVIDIAの回答
この要件を満たすため、NVIDIAはVera CPUを発表しました。同社はこれを、エージェント型AIと強化学習の時代向けに特別に設計された世界初のプロセッサと呼んでいます。Vera CPUラックは、256個の液冷式Veraプロセッサを搭載した専用のラック規模システムで、それぞれが独立してフルパフォーマンスで動作する22,500を超える同時CPU環境を維持できます。AIファクトリーは、1つのラックで数万の同時インスタンスとエージェントツールを迅速に展開および拡張できます。このラックは、合計400TBのメモリ、300TB/秒の集約メモリ帯域幅、および64個のBlueField-4 DPUを提供し、これらはすべてVera RubinおよびDGXエコシステムと互換性があり、NVIDIA MGXモジュラーリファレンスアーキテクチャに基づいて構築されています。
Vera CPU自体は、NVIDIAが独自に設計した88個のOlympusコアをベースとしており、Armv9.2との完全な互換性を備えています。各コアは、NVIDIA Spatial Multithreadingを使用して2つのタスクを同時に処理できます。第2世代の低消費電力メモリサブシステムはLPDDR5Xをベースとしており、汎用CPUと比較して、最大1.2TB/sの帯域幅を実現し、消費電力は半分で2倍の帯域幅を提供します。
Vera Rackは、性能特性だけでなく、サプライチェーンにおける実務上の課題にも対応しています。数万個のGPUを擁するAIファクトリーを運営する組織は、環境実行のために同様に膨大な数のCPUを必要としますが、必要な規模と納期でAMDやIntelからこれだけの高性能x86プロセッサを調達するには、調達と供給面で大きな課題が生じる可能性があります。垂直統合型のNVIDIA CPUラックは、こうした依存関係を簡素化します。
Vera CPUの導入にNVIDIAと提携している顧客には、Alibaba、ByteDance、Meta、Oracle Cloud Infrastructureのほか、CoreWeave、Crusoe、Lambda、Nebius、Nscale、Cloudflare、Together AI、Vultrなどが含まれます。製造パートナーには、Dell Technologies、HPE、Lenovo、Supermicro、ASUS、Cisco、Foxconn、GIGABYTE、QCTなどが名を連ねています。
BlueField-4 STXとNVIDIA CMX:推論コンテキストメモリストレージの基盤となるリファレンスアーキテクチャ
CES 2026で、NVIDIAは、大規模なLLM推論におけるKVキャッシュ管理専用に構築された、AIネイティブなストレージインフラストラクチャの新クラスであるInference Context Memory Storage(ICMS)プラットフォームを発表しました。GTC 2026では、NVIDIAは、その基盤となるリファレンスアーキテクチャであるBlueField-4 STXを発表しました。これは、エージェントコンテキストとKVキャッシュデータ用にGPUメモリをポッド全体にシームレスに拡張するモジュール設計です。STXの最初のラック規模実装は、新しいNVIDIA CMXコンテキストメモリストレージプラットフォームです。これは、スケーラブルな推論システムとエージェントシステム向けに、高性能なコンテキストレイヤーでGPUメモリを拡張します。
トランスフォーマーベースの推論のスケーリング方法を検討すると、専用のストレージ層が必要であることが明らかになります。生成されたトークンはすべて、アテンションメカニズムを介して以前のすべてのトークンに注意を払う必要があり、キーバリュー(KV)キャッシュは、再計算を回避するために再利用できるように、事前に計算されたアテンション行列を保存します。問題は、KVキャッシュのサイズがシーケンスの長さとバッチサイズとともに増加することです。数百万トークンのコンテキストウィンドウにわたって数千の同時リクエストを処理するマルチテナント環境では、GPU HBMが枯渇します。オペレーターは、バッチサイズを小さくするか、コンテキストウィンドウを短くするか、GPUを追加するかのいずれかを行う必要がありますが、いずれも経済性または機能が低下します。
BlueField-4 STXは、GPU HBMと従来のストレージの間に位置づけられる、KVキャッシュアクセスパターン専用に設計された高帯域幅の共有ストレージレイヤーを提供することで、この課題に対処します。これはVera Rubinプラットフォームによって高速化され、Vera CPUとConnectX-9 SuperNIC、Spectrum-X Ethernetネットワーク、NVIDIA DOCA、およびNVIDIA AI Enterpriseソフトウェアを組み合わせたストレージ最適化BlueField-4プロセッサを活用します。NVIDIAは、CMXプラットフォームが従来のストレージと比較して1秒あたり最大5倍のトークン、高性能ストレージ向けの従来のCPUアーキテクチャと比較して4倍のエネルギー効率、エンタープライズAIデータの2倍の高速なデータ取り込みを実現すると主張しています。
NVIDIAは、DOCA Memosという新しいDOCAフレームワークも発表しました。これは、専用のKVキャッシュ処理によってBlueField-4ストレージを強化し、推論スループットを向上させると同時に、電力効率を大幅に改善します。その結果、POD全体にわたるコンテキストが実現し、AIエージェントとのマルチターンインタラクションの高速化、AIサービスの拡張性の向上、インフラストラクチャ全体の利用率の向上につながります。これは、分散型プリフィル/デコードフェーズ、スマートルーティング、階層型ストレージオフロードのためのソフトウェアフレームワークを提供するオープンソースのNVIDIA Dynamoプロジェクトと連携しています。
STXはNVIDIAが直接販売するのではなく、ストレージエコシステムのパートナーに提供するリファレンスアーキテクチャです。STX上で次世代インフラストラクチャを共同設計しているストレージプロバイダーには、Cloudian、DDN、Dell Technologies、Everpure、Hitachi Vantara、HPE、IBM、MinIO、NetApp、Nutanix、VAST Data、WEKAなどがあります。STXベースのシステムを構築している製造パートナーには、AIC、Supermicro、QCTなどがあります。コンテキストメモリストレージにSTXを採用する予定の大手AIラボやクラウドプロバイダーには、CoreWeave、Crusoe、IREN、Lambda、Mistral AI、Nebius、Oracle Cloud Infrastructure、Vultrなどがあります。STXベースのプラットフォームは、2026年後半にパートナーから提供される予定です。
Vera Rubin DSX AIファクトリーリファレンスデザインとOmniverse DSXブループリント
NVIDIAは、個々のラックやポッドに加え、Vera Rubin DSX AI FactoryリファレンスデザインとNVIDIA Omniverse DSX Blueprintの一般提供開始を発表しました。これらを組み合わせることで、1ワットあたりのトークン数を最大化し、最初の製品化までの時間を短縮する、共同設計されたAIインフラストラクチャの設計、構築、運用に関する包括的なフレームワークが提供されます。このアーキテクチャは、コンピューティング、ネットワーク、ストレージ、電力、冷却を緊密に統合することで、エネルギー効率を高め、AIファクトリーが継続的な高負荷ワークロード下でも確実に拡張でき、稼働時間を最大限に維持することを保証します。
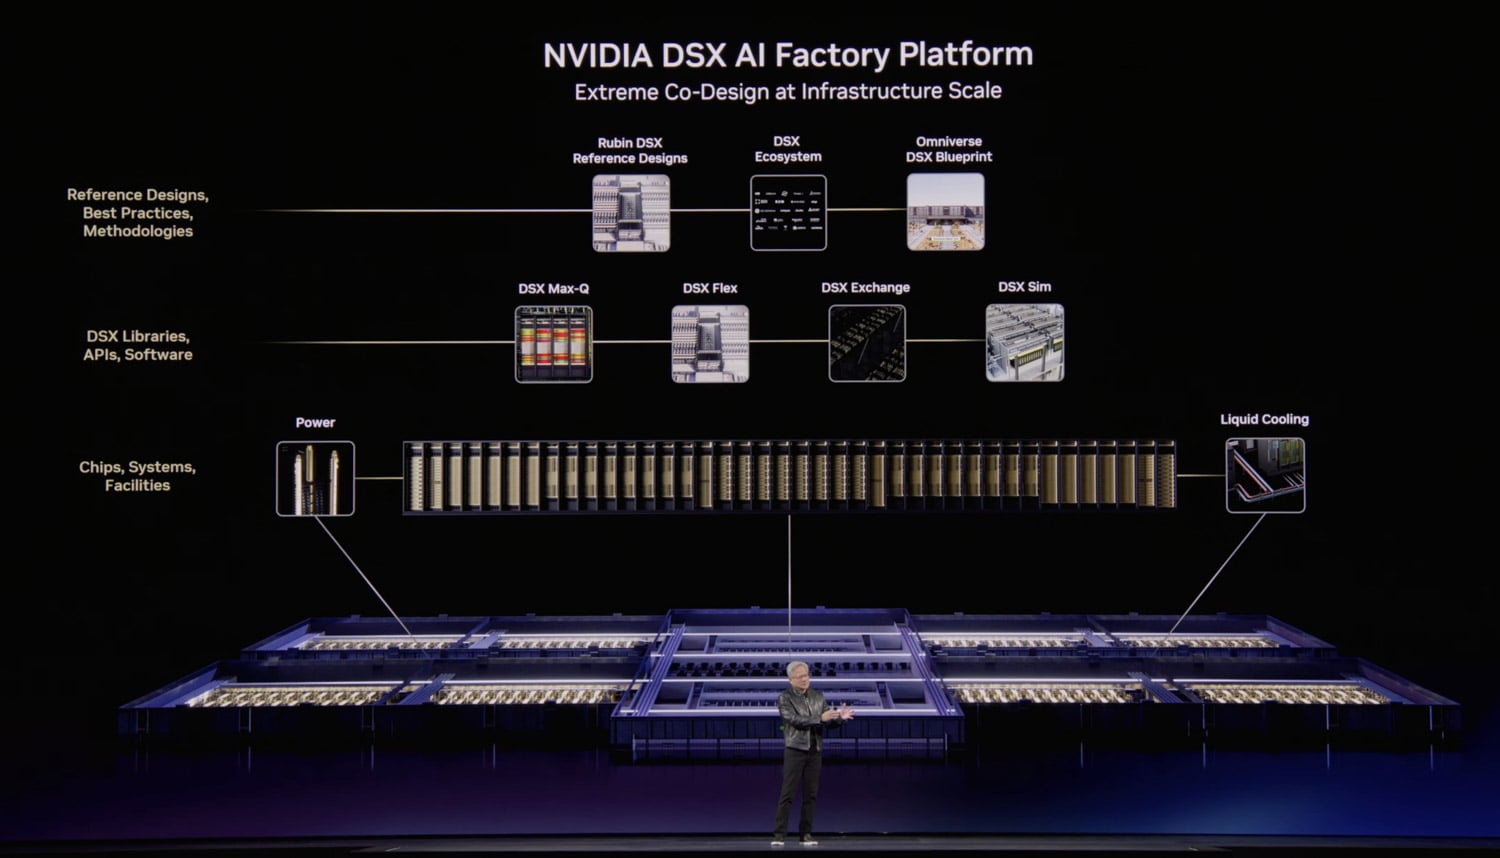
Rubin DSX ソフトウェアスタックは、オープンでモジュール式かつ構成可能であり、クラスタハードウェアと電源および冷却システムを接続します。これには、いくつかのコンポーネントライブラリが含まれています。DSX Max-Q は、AI ファクトリー全体にわたる動的な電力供給を可能にし、固定電力データセンター内で AI インフラストラクチャを 30% 多く展開できるようにします。DSX Flex は、AI ファクトリーをグリッドに柔軟に対応できる資産にし、NVIDIA が推定する 100 ギガワットの未使用グリッド電力を解放します。これは、現在、エネルギーが AI インフラストラクチャ構築の最大のボトルネックとなっており、300 億ドルを超える機器のバックログと、200 GW を超えるプロジェクトが米国の相互接続待ち行列に並んでいることを考えると、非常に重要な機能です。DSX Exchange は、IT、運用技術、および運用エージェント間で、コンピューティング、ネットワーク、エネルギー、電力、および冷却信号のスケーラブルで安全な統合を可能にします。DSX Sim モデルは、NVIDIA DSX Air プラットフォームを使用して、AI ファクトリーを高忠実度のデジタル ツインとして検証します。
Omniverse DSX Blueprintは、build.nvidia.comで一般提供が開始され、Vera Rubin氏のDSXリファレンスデザインと完全に互換性があります。開発者は、このブループリントを使用することで、AIファクトリーの物理的に正確なデジタルツインを構築し、リアルタイムで運用をシミュレーションし、構築や展開を開始する前にパフォーマンスを最適化できます。これにより、電力、冷却、ネットワーク、運用が単一の環境に統合され、収益化までの時間とAIの効率が加速されます。
DSXアーキテクチャとブループリントに貢献している業界リーダーには、Cadence、Dassault Systèmes、Eaton、Jacobs、Nscale、Phaidra、Procore Technologies、PTC、Schneider Electric、Siemens、Switch、Trane Technologies、Vertivなどが含まれます。特に、NscaleとCaterpillarは、世界最大級のAIファクトリーの一つとされるマルチギガワット規模の施設で、DSX Vera Rubinリファレンスデザインをウェストバージニア州で実現しています。エネルギー分野では、Emerald AI、GE Vernova、Hitachi、Siemens EnergyがDSXリファレンスアーキテクチャを使用して、グリッド容量を解放し、新しいAIファクトリーの構築に必要な電力を供給しています。Phaidraは、DSX Max-Qを自己学習型AIエージェントに統合し、安全性を維持しながら冷却スパイクを低減することで、約10%高い演算能力を実現しています。
NVIDIA Agent ToolkitとOpenCLAW:自律型エージェントのためのソフトウェアスタック
TC 2026では、エージェント型AIワークロードの急速な台頭にも注目が集まり、NVIDIAは自律型エージェントを同社がこれまで見てきた中で最も急速に成長しているワークロードだと説明しました。ソフトウェア発表の中心となったのはOpenCLAWで、これはおそらく史上最も重要なソフトウェアリリースであり、CLAWと呼ばれる長期実行型で自己進化するエージェントのオーケストレーションフレームワークです。CLAWは、個々のタスクではなく、ミッション全体を計画、実行、実行できる自律システムです。NVIDIAはCLAWをAIの新しいアプリケーションレイヤーと位置づけ、「何を、どのように、なぜ」という問いかけから、「構築、作成、製造」という問いかけへと移行したと指摘しました。
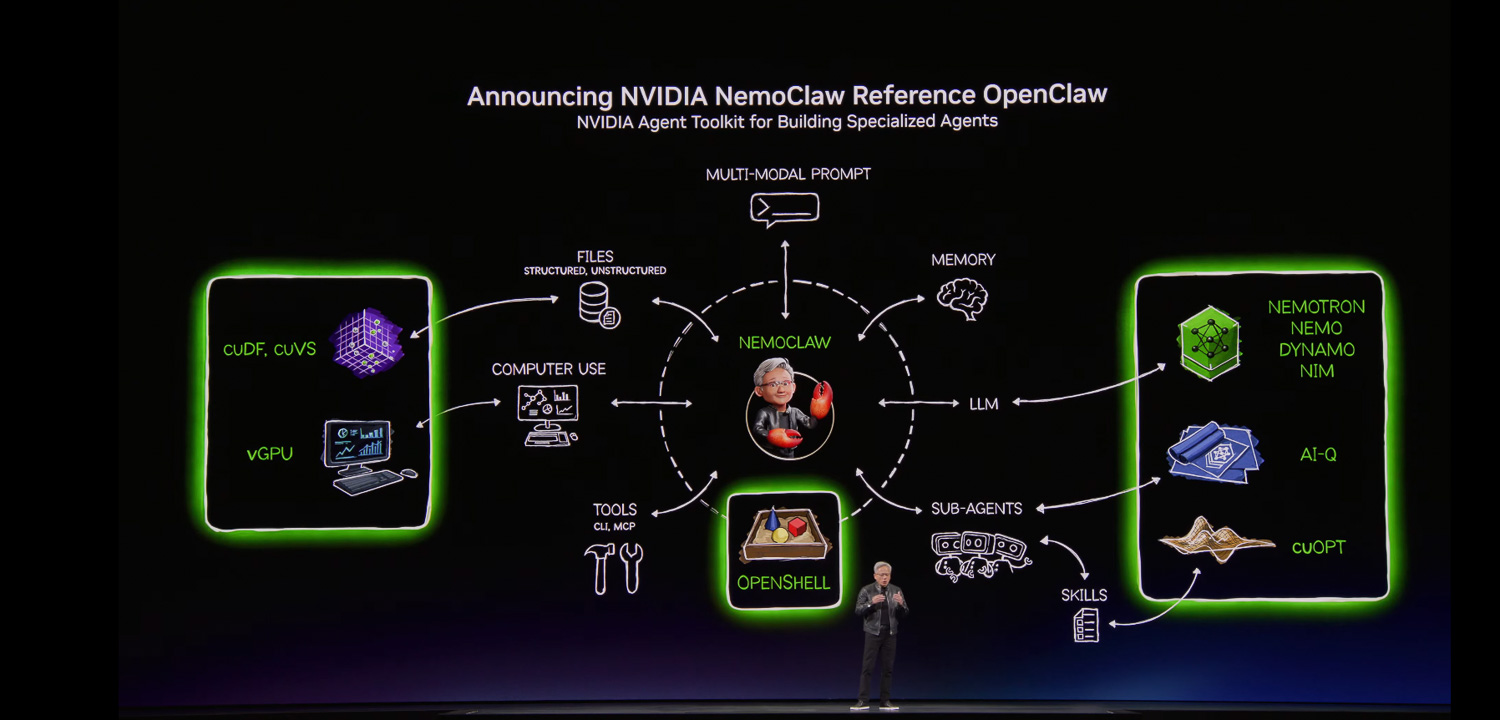
NVIDIA は、長時間実行される自律エージェントの構築、評価、最適化のためのモデル、ランタイム、ブループリントの完全オープンソースコレクションである NVIDIA Agent Toolkit を発表しました。主なコンポーネントには、推論、コーディング、音声のための Nemotron オープンモデル、エージェントのプロファイリングとカスタマイズのための Nemo、モデル推論のための NIM、スケールアウト サービングのための Dynamo 1.0 が含まれます。新たに追加されたものには、エージェント実行のためのポリシーベースのネットワーク、プライバシー、セキュリティ ガードレールを提供するオープンソースの安全性とセキュリティ ランタイムである NVIDIA OpenShell、ディープ リサーチ エージェント向けに最先端およびオープン モデル インテリジェンスを組み合わせたオープンソースのブループリントである IQ があります。IQ は、Deep Research Bench 1 と Complex Deep Research Bench 2 の両方のベンチマークでトップとなった最初の研究システムです。新しい cuOPT スキルは、自然言語で記述された最適化問題に関する専門知識を提供します。
NVIDIAはまた、OpenCLAWコミュニティへの貢献として、OpenCLAW開発者のピーター・スタインバーガー氏と共同開発したNemo CLAWを発表しました。Nemo CLAWは、OpenCLAW、Nemotronモデル、OpenShellランタイムを単一のコマンドでインストールし、エージェントが定義されたプライバシーとセキュリティの制約内で動作しながら、新しいスキルを開発・学習するための基盤を提供します。クラウドインフラストラクチャからオンプレミスのRTX PC、DGX Station、DGX Sparkまで、あらゆるプラットフォームで実行可能です。
DGX SparkおよびDGX Station:ローカルCLAW開発プラットフォーム
多くの開発者がコンピューティングリソースを完全に制御できるローカル開発環境を好むことを認識し、NVIDIAはCLAWエージェント開発専用に設計された2つの新しいプラットフォームを発表しました。DGX Sparkは、安全で常時稼働する自律型エージェントを実行するための高性能かつ電力効率の高いプラットフォームで、DGX SparkとGB10ベースのOEMパートナーシステムは現在世界中で利用可能です。究極のローカルCLAW開発プラットフォームとして位置づけられているDGX Stationは、開発者がクラウド接続なしで完全にオンプレミスで最先端レベルのインテリジェンスを備えたモデルを実行できるようにします。これは、完全な制御とセキュリティのためにすべてがローカルに保持される開発において非常に重要です。DGX Stationシステムは、2026年3月16日からOEMパートナーを通じて注文可能です。
ヴェラ・ルービン宇宙モジュール:地球外AIインフラ
NVIDIAは、最新の高速コンピューティングプラットフォームが宇宙イノベーションの新時代を切り開き、軌道データセンター(ODC)、地理空間インテリジェンス、自律型宇宙運用にAIコンピューティングをもたらすと発表しました。NVIDIA Vera Rubin Space Moduleは、NVIDIA H100 GPUと比較して最大25倍のAIコンピューティング能力を宇宙ベースの推論に提供し、大規模な言語モデルや高度な基盤モデルを軌道上で直接動作させることができます。緊密に統合されたCPU-GPUアーキテクチャにより、宇宙搭載機器からの膨大なデータストリームをリアルタイムで処理するために必要なパフォーマンスとメモリが提供されます。
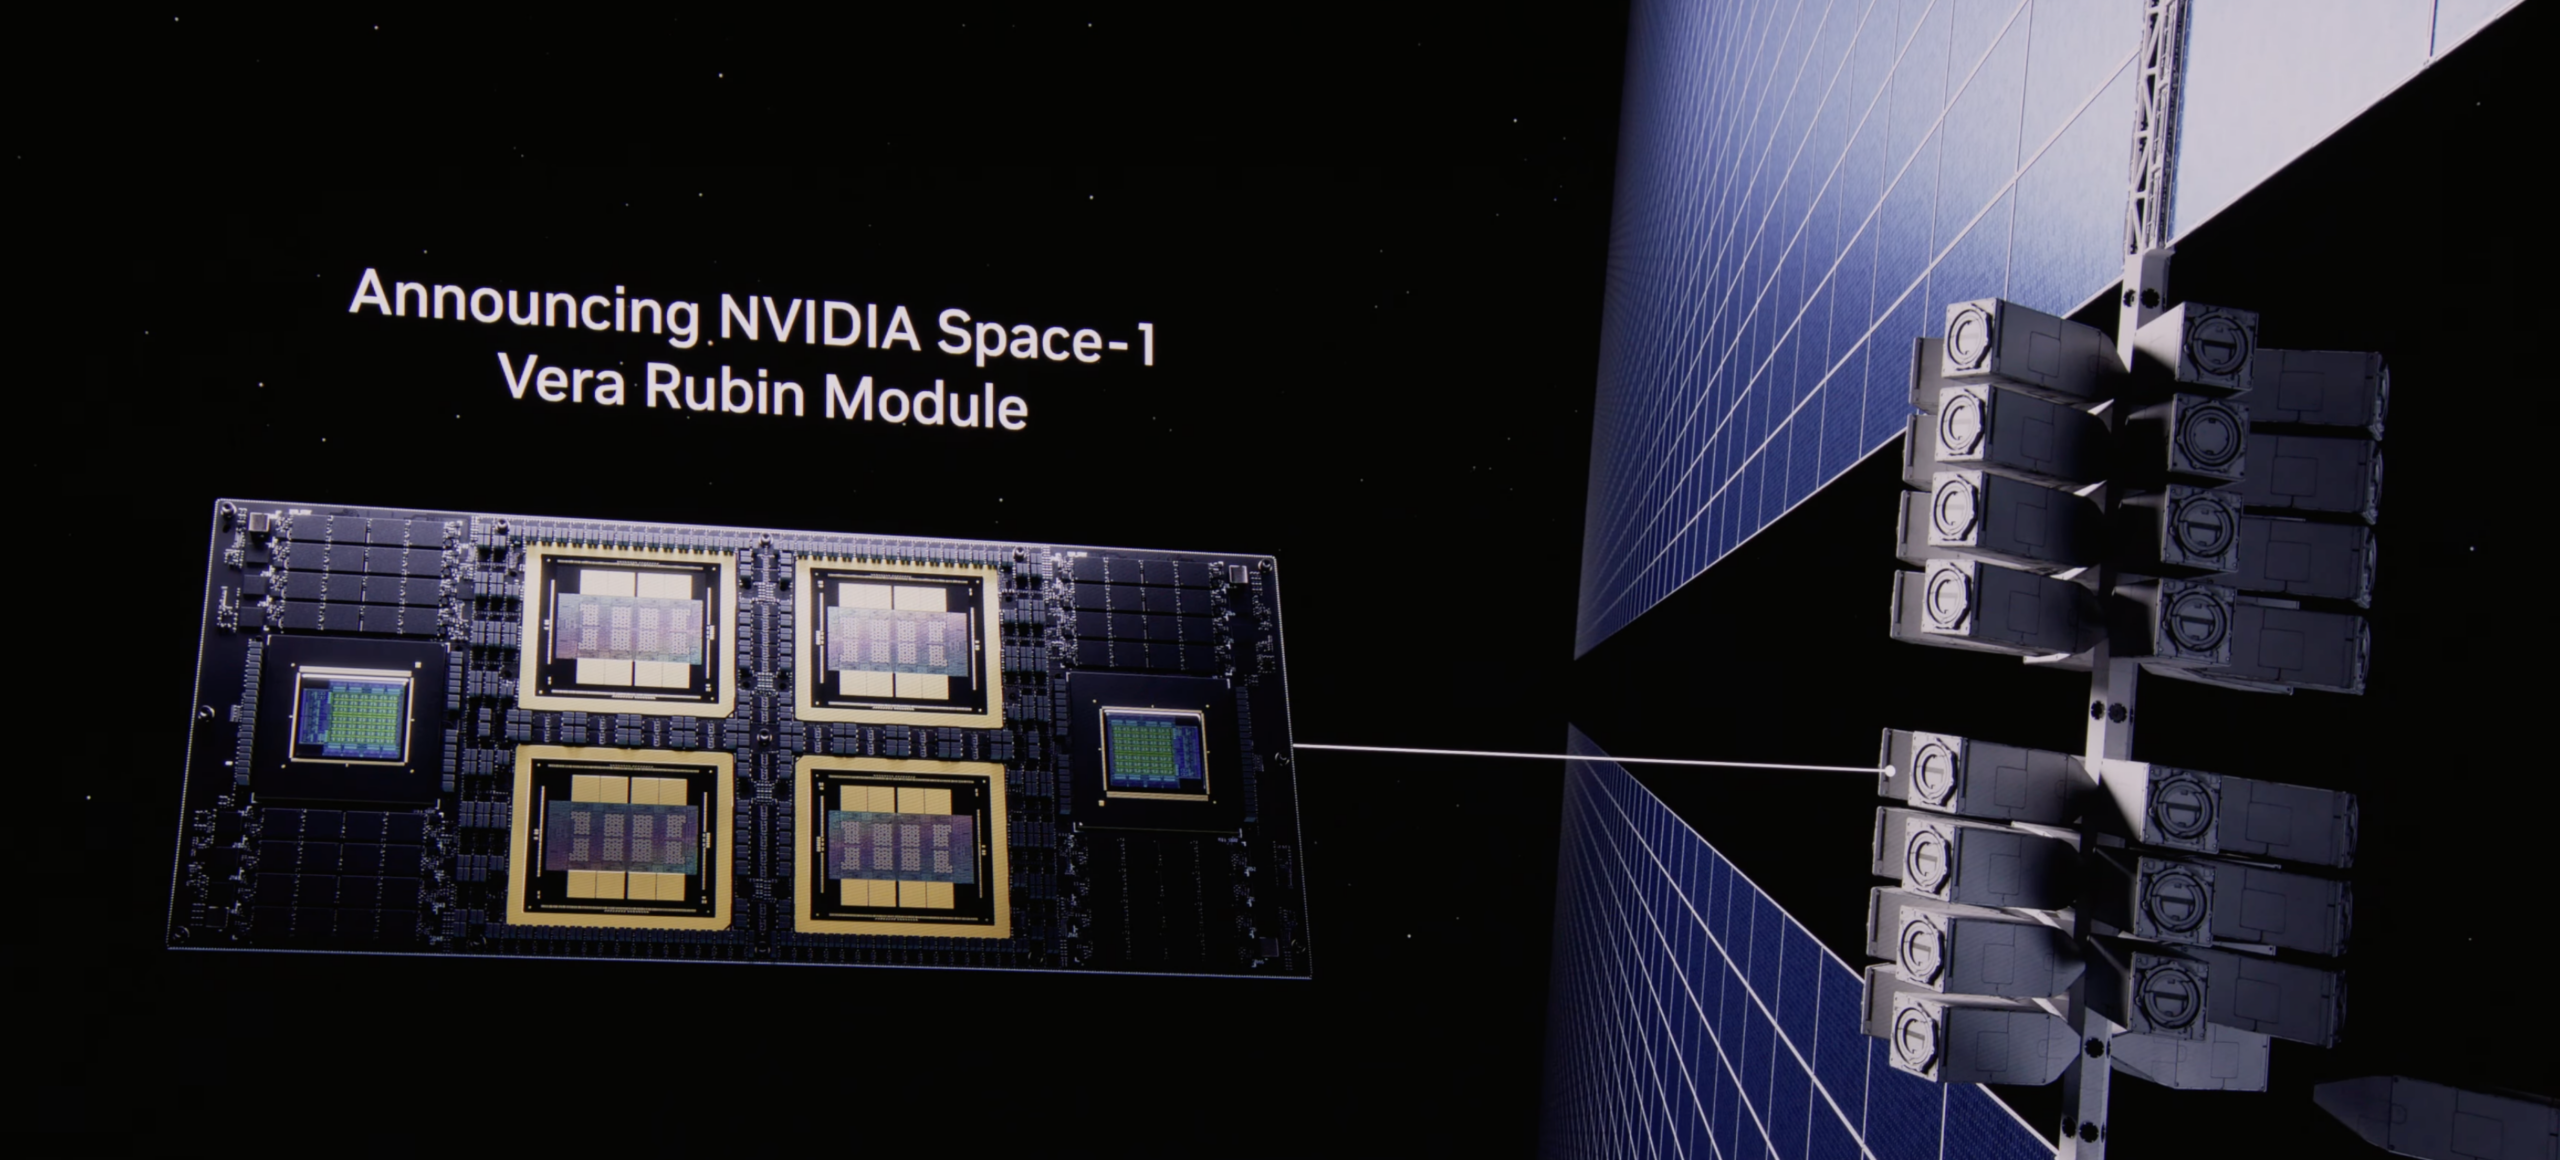
Vera Rubin宇宙モジュールと並んで、NVIDIA IGX Thorは軌道上のミッションクリティカルなエッジ環境に産業グレードの耐久性を提供し、Jetson OrinはSWaP制約のある宇宙船向けに最適化された超小型モジュールで高性能なAI推論を実現します。地上では、RTX PRO 6000 Blackwell Server Edition GPUが、地理空間情報処理において従来のCPUベースのバッチシステムと比較して最大100倍高速なパフォーマンスを提供します。Aetherflux、Axiom Space、Kepler Communications、Planet Labs、Sophia Space、Starcloudなどのパートナー企業は、これらのプラットフォームを基盤として、軌道上のデータセンター、自律的な宇宙運用、リアルタイムの地球観測など、次世代の宇宙ミッションを構築しています。
NVIDIA Dynamo 1.0:AIファクトリー向け推論オペレーティングシステム
GTC 2026の発表の締めくくりとして、NVIDIAはAIファクトリー推論のための初の分散型オペレーティングシステムとして位置づけるオープンソースソフトウェア「Dynamo 1.0」の製品化を開始しました。コンピュータのオペレーティングシステムがハードウェアとアプリケーションを調整するのと同様に、Dynamo 1.0はAIファクトリーの分散型オーケストレーションレイヤーとして機能し、クラスタ全体でGPUとメモリのリソースをシームレスに管理することで、複雑で多様なAIワークロードを大規模に処理します。
Dynamo 1.0 は、インテリジェントなルーティングと、GPU と低コストのストレージ層間でデータを移動できる機能により、推論処理を複数の GPU に分散させ、無駄な計算を削減し、メモリの制約を緩和します。エージェント型 AI やロングコンテキストワークロードの場合、Dynamo は、以前のステップで最も関連性の高い KV キャッシュデータを既に保持している GPU にリクエストをルーティングし、不要になったメモリをオフロードできます。この機能は、BlueField-4 STX/ICMS ストレージアーキテクチャと直接連携します。最近の業界ベンチマークでは、Dynamo は NVIDIA Blackwell GPU の推論パフォーマンスを最大 7 倍向上させ、トークンコストを削減し、数百万台の展開済み GPU の収益機会を拡大しました。これらはすべて、無料のオープンソースソフトウェアによって実現されています。
NVIDIAは、DynamoとTensorRT-LLMの最適化機能をLangChain、llm-d、LMCache、SGLang、vLLMといった人気の推論フレームワークに統合することで、オープンソースのエコシステムを加速させています。コアとなるDynamoの構成要素、メモリ管理のためのKVBM、GPU間高速データ転送のためのNIXL、そしてスケーリングを簡素化するGroveは、スタンドアロンモジュールとしても利用可能です。また、NVIDIAはTensorRT-LLMのCUDAカーネルをFlashInferプロジェクトに提供し、オープンソースフレームワークへのネイティブ統合を支援しています。
採用範囲の広さは特筆すべきものです。NVIDIA推論プラットフォームは、AWS、Microsoft Azure、Google Cloud、Oracle Cloud Infrastructureなどのクラウドプロバイダーに加え、NVIDIAのクラウドパートナーであるAlibaba Cloud、CoreWeave、Crusoe、DigitalOcean、Nebius、Nscale、Together AIと統合されています。AIネイティブ企業のCursor、Hebbia、Perplexityもこのプラットフォームを採用しており、推論エンドポイントプロバイダーのBaseten、Deep Infra、Fireworksも同様です。Amazon、AstraZeneca、BlackRock、ByteDance、Coupang、Instacart、Meituan、PayPal、Pinterest、Shopee、SoftBank Corp.などのグローバル企業もNVIDIA推論スタックを採用しています。Dynamo 1.0は本日より世界中の開発者にご利用いただけます。


 Amazon