

本日、シリコン バレーで開催された GPU テクノロジ カンファレンス 2018 で、NVIDIA はディープ ラーニングに関するいくつかの発表を行いました。これらの発表には、数十億の IoT デバイスにディープラーニング推論を導入するための Arm との提携が含まれます。 NVIDIA はまた、ディープ ラーニングのパフォーマンスが向上し、10 か月前と比べて XNUMX 倍になったと発表しています。
このパートナーシップは、オープンソースの NVIDIA Deep Learning Accelerator (NVDLA) アーキテクチャを ARM の機械学習用 Project Trillium プラットフォームに統合するものです。両社は、この提携により、IoT チップメーカーが AI を自社の設計に統合したり、数十億の IoT デバイスに AI を組み込んだりできるようになると述べています。この提携により、深層学習開発者は Arm の柔軟性と拡張性を活用して、より高いレベルのパフォーマンスを実現できるようになります。
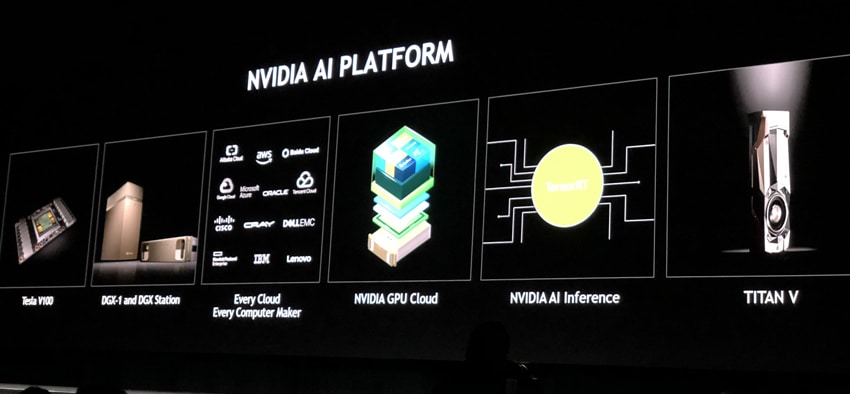
NVIDIA は、NVIDIA Tesla V2 への 100 倍のメモリ ブート (GPU あたり最大 32 GB のメモリ) や、最大 16 個の Tesla GPU の通信を可能にする GPU インターコネクト ファブリック NVSwitch などの進歩により、クラウド サービス プロバイダーとサーバー メーカーのパフォーマンスを強化しました。 2.4TB/秒の速度で。同社は、単体サーバーである NVIDIA DGX-2 もリリースしました。 DGX-2 は、300 ペタフロップスの計算能力、または 15 ラック分のスペースを占める XNUMX 台のサーバーを提供できます。
上で述べたように、新しい Tesla V100 には 32 GB ではなく 16 GB のメモリが搭載されており、メモリの増加によるすべての利点が得られます。これについては、いくつかのコンピューター メーカーが将来これを提供する予定であること以外に、これ以上言うことはありません。 Oracle Cloud Infrastructureは、新しいTesla V100をクラウドでも提供する予定です。
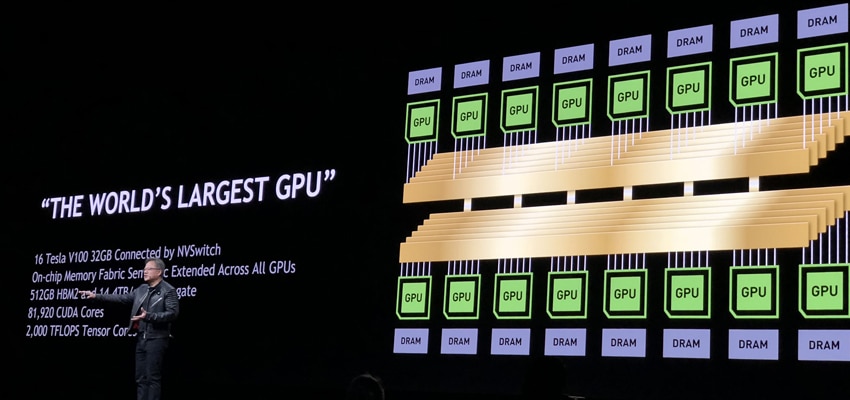
新しい相互接続ファブリック NVSwitch は、大規模なデータセットの制限を克服するように設計されています。 NVIDIA は、このインターコネクトは最高の PCIe スイッチよりも 5 倍高い帯域幅を備えていると述べています。 NVSwitch は、NVIDIA NVLink から得られたイノベーションを取り入れてさらに拡張し、さらに高度で複雑なシステムの構築を支援します。
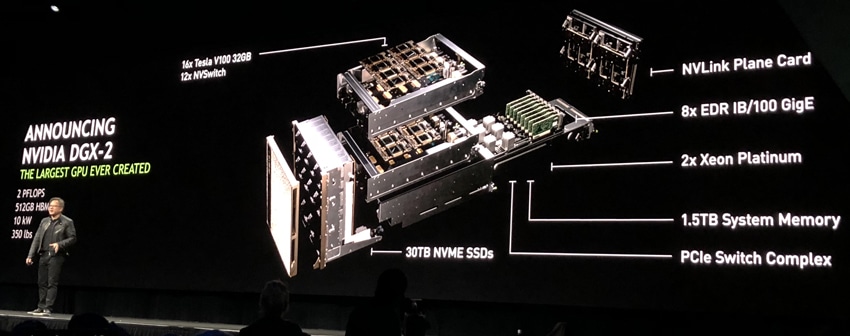
上で述べたように、DGX-2 は世界初の 16 ペタフロップスを実現できます。このシステムは、統合メモリ空間内の NVSwitch と 2 個の GPU すべてを活用して、このマイルストーンを達成しました。 DGX-2 には、NVIDIA ディープ ラーニング ソフトウェア スイートが付属しており、ディープ ラーニングの研究の最先端にいるデータ サイエンティストにとって理想的です。同社は、DGX-10 は 1 日以内に FAIRSeq (最先端のニューラル機械翻訳モデル) をトレーニングできると述べています。これは DGX-XNUMX から XNUMX 倍の改善です。


 Amazon