

AIインフラストラクチャはリソースを大量に消費することで知られており、企業は常にGPU利用率の最適化という課題に直面しています。デル・テクノロジーズは、AIファクトリープラットフォームを通じて、NVIDIAが最近買収したオーケストレーションソリューションであるRun:aiを統合することで、この課題に取り組んでいます。デルは最近のブログで、Run:aiがいかにリソース利用率を最大化し、AIの成果を加速させ、企業が大規模なGPUリソースを展開・管理する方法を変革するかを強調しました。
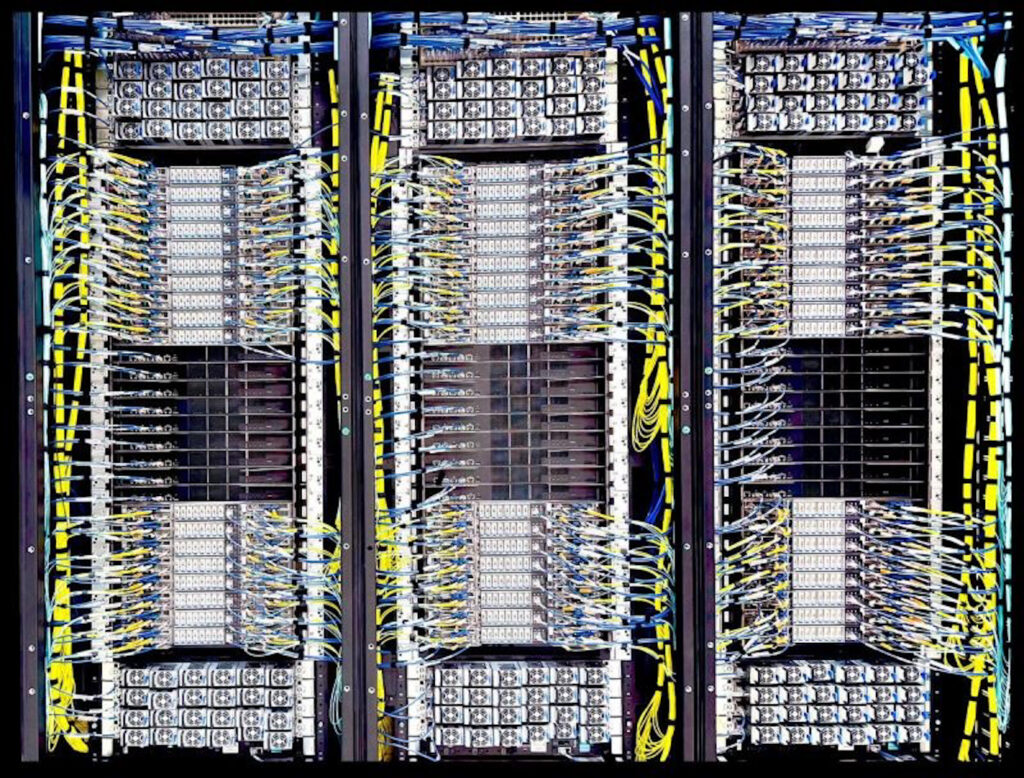
Dell NVL72 クラスタ
Run:ai とは何でしょうか?
Run:aiはKubernetes上に構築され、GPU中心のワークロード向けに特別に設計されたオーケストレーションプラットフォームです。2018年に設立されたRun:aiは、業界に蔓延する課題であるGPUの非効率的な使用を解決することで、高い評価を得ています。従来、AIワークロードに割り当てられたGPUは、アイドル状態のまま、あるいは十分に活用されていない状態になることが多くありました。Run:aiは、GPUリソースを動的にプールし、インテリジェントにスケジューリングすることでこの問題を解決します。これにより、GPUの部分的な割り当て、効率的なマルチGPUデプロイメント、そしてハイブリッド、クラウド、オンプレミス環境にわたるシームレスな管理が可能になります。
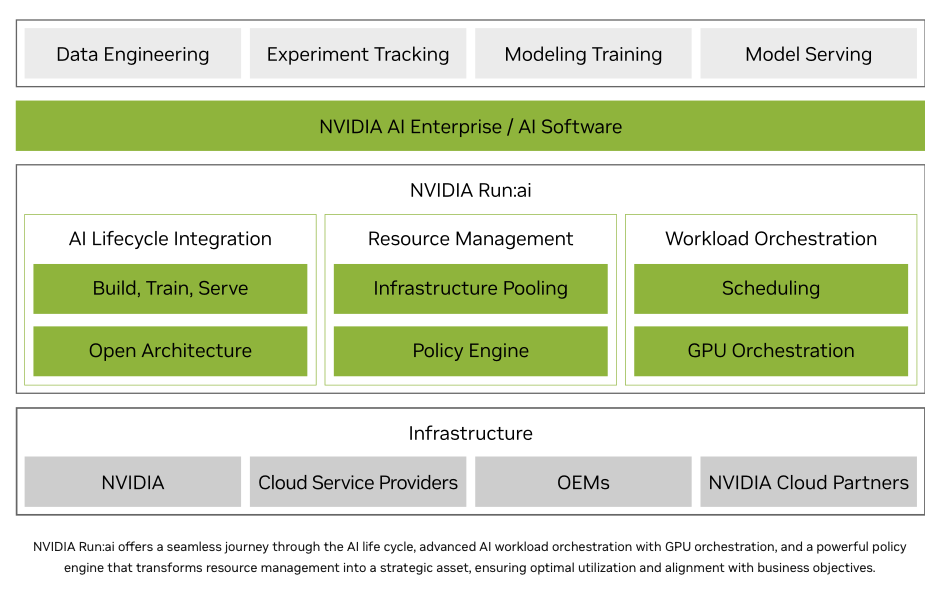
Run:aiがAIインフラを劇的に変革する可能性を認識したNVIDIAは、2024年12月に約7億ドルで同社を買収しました。興味深いことに、NVIDIAは最終的にRun:aiをオープンソース化することを約束しており、これは自社のハードウェアプラットフォームにとどまらず、幅広いエコシステムへの普及を促進する意向を示しています。この動きは、業界全体のイノベーションと効率性をさらに加速させることが期待されています。
リソース管理に関するより深い技術的視点を求めるユーザー向けに、NVIDIAのドキュメントでは、GB200 NVL72システム上でワークロードをオーケストレーションする上でRun:aiがいかに不可欠であるかを詳しく説明しています。このドキュメントでは、重要なギャップが指摘されています。KubernetesはNVIDIAのMNNVLアーキテクチャをネイティブに認識しないため、これらの高性能ドメイン間でワークロードを管理およびスケジューリングすることがより複雑になります。Run:aiは、NVLinkドメインを自動的に検出し、分散ワークロードの送信を簡素化することで、この複雑さを抽象化します。これにより、ポッドがNVLinkインターコネクトを備えたノードに正しく配置されることが保証され、各ジョブに対する高度なハードウェア知識や手動構成が不要になります。これらの機能は、プラットフォームが高密度トレーニング環境での運用を効率化し、組織がGB200 NVL72などの高度なハードウェア構成のパワーを最大限に活用できるようにすることを示しています。
これが企業にとってなぜ重要なのか
GPUを多用するワークロード、特に生成AIや大規模言語モデルを扱うワークロードを実行する組織にとって、GPUの利用率が低いことは大きなリスク、つまり投資の無駄につながります。Run:aiはこうした非効率性を直接的に解消し、NVIDIAによると、このプラットフォームを活用する組織はGPU利用率を最大5倍向上させることができるとのことです。
このレベルの最適化は、ROIを向上させるだけでなく、運用効率を根本的に変革します。これまで限られたリソースと複雑なスケジューリングプロセスに制約されていたチームは、ハードウェアへの追加投資なしに、より多くのモデルを同時にデプロイし、迅速に拡張し、より積極的に実験を行うためのツールを手に入れることができます。こうした手法は大規模なHPC導入では一般的ですが、GPU利用率を最大化するために必要なレベルの効率性は、エンタープライズではあまり一般的ではありません。
幅広い業界の勢い
いくつかの大手インフラストラクチャ プロバイダーがこのプラットフォームを採用しており、エンタープライズ IT 環境全体で勢いが高まっていることを示しています。
デルは、NVIDIAのRun:aiをはじめとするテクノロジーを中核としたAIファクトリー・フレームワークの拡張を続けています。デルによるRun:aiの活用事例は、企業が分断された手動のリソース割り当てから、マルチテナント環境全体で効率性を向上させる、より動的で自動化されたスケジューリングへと移行できることを示しています。
HPEは、GreenLake Marketplaceの一部としてRun:aiを提供し、Ezmeralプラットフォームと統合することで、高度なGPUスケジューリング、部分割り当て、ハイブリッドインフラストラクチャのオーケストレーションを可能にします。これにより、顧客はAIワークロードをより高い精度と拡張性で展開および管理できるようになります。
Ciscoは、Run:aiをUCS XシリーズサーバーおよびIntersightクラウド運用プラットフォームと統合しました。このソリューションは、クォータ管理、GPUの分割共有、リアルタイム監視といった機能を特長とし、オンプレミス環境での大規模AI導入をサポートします。
Run:aiのパートナー企業を一部ご紹介しました。NVIDIAは、上記の通り、多数のロゴを保有しています。大手OEMやクラウドプラットフォームプロバイダーは、より革新的で効率的なAIインフラストラクチャソリューションの提供を目指し、Run:aiと連携しています。



 Amazon