

Pliopsは、大規模言語モデル(LLM)推論ワークロードの最適化を目的としたオープンソースのクラスタ全体にわたるリファレンス実装であるvLLM Production Stackとの戦略的パートナーシップを発表しました。このパートナーシップは、AIコミュニティがGTC 2025カンファレンスに集結する準備を進める中で、極めて重要な意味を持ちます。Pliopsの高度なキーバリュー(KV)ストレージバックエンドとvLLM Production Stackの堅牢なアーキテクチャを組み合わせることで、このコラボレーションはAIのパフォーマンス、効率性、スケーラビリティにおける新たなベンチマークを確立します。
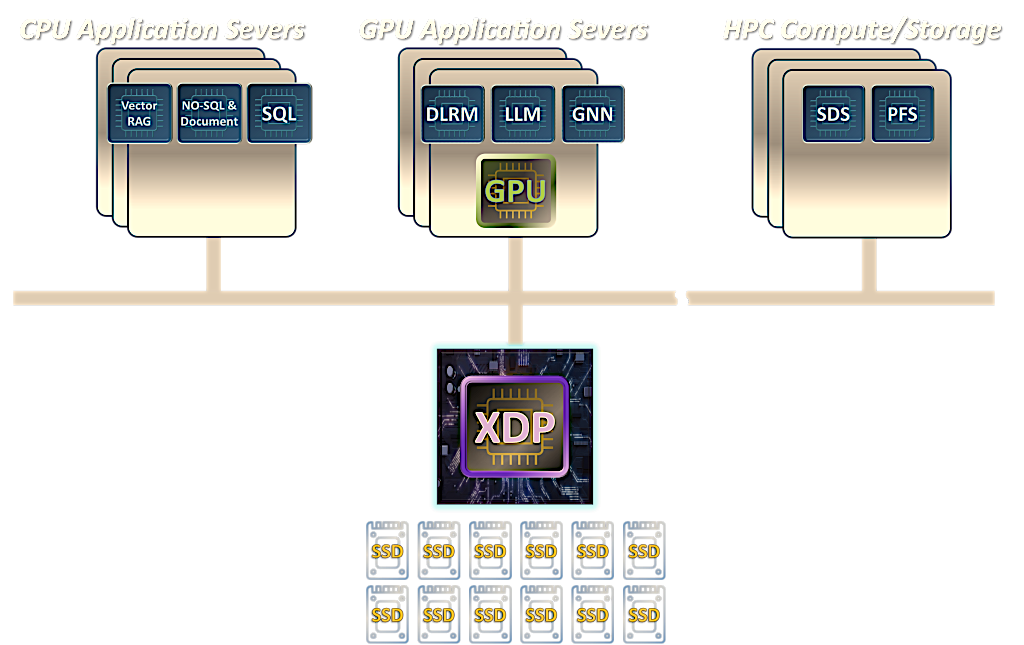
シカゴ大学の LMCache ラボの責任者である Junchen Jiang 氏は、このコラボレーションの可能性を強調し、LLM 推論の効率とパフォーマンスを向上させる能力を強調しました。この共同ソリューションは、高帯域幅メモリ (HBM) の下に新しいペタバイト規模のメモリ層を導入することで、高度なベクトル検索および取得機能を実現します。計算された KV キャッシュは、分散型スマート ストレージを使用して効率的に保持および取得され、vLLM 推論を加速します。
プリオプスに関する入門的な情報については、詳細解説記事をご覧ください。
KVCacheについて
大規模な言語モデルのほとんどは、クエリ、キー、および値のマトリックスを含むアテンション メカニズムに依存するトランスフォーマー アーキテクチャを使用します。トークンを順番に生成する場合、トランスフォーマーはアテンションを繰り返し計算するため、以前のキーと値 (KV) マトリックスの再計算が必要になり、計算コストが増加します。KV キャッシュは、以前に計算された KV マトリックスを保存することでこの問題に対処し、後続のトークン予測で再利用できるようにして、生成効率とスループットを大幅に向上させます。
しかし、これにより新たな課題が生じます。特に長い世代や、一般的なバッチ サイズが 32 であるバッチ推論では、KV キャッシュが非常に大きくなり、最終的に使用可能なメモリを超えてしまう可能性があります。この制限に対処するには、KV キャッシュ ストレージ バックエンドが不可欠になります。
Pliops XDP ライトニングAI
Pliops の XDP LightningAI をデータ センターに導入することは、コスト効率のパラダイム シフトを意味し、従来のアーキテクチャと比較して大幅なコスト削減を実現します。既存のインフラストラクチャに専用の XDP LightningAI サーバーを追加することで、組織はラック スペースの 67% の最適化、電力消費の 66% の削減、年間 OpEx の 58% の節約、初期投資コストの 69% の削減など、大幅な節約を実現できます。
Pliops は、包括的な AI ソフトウェア スタックと分散ノードによって補完された、エクストリーム データ プロセッサ (XDP)、XDP-PRO ASIC で進歩を続けています。GPU で開始されるキー値 I/O インターフェイスを利用するこのソリューションは、前例のないスケーラビリティとパフォーマンスを実現します。Pliops の XDP LightningAI は、エンドツーエンドのパフォーマンスを大幅に向上させ、vLLM 推論で最大 8 倍のゲインを達成し、Generative AI (GenAI) ワークロードを大幅に加速します。DeepSeek などの最先端の業界トレンドを統合することで、Pliops は将来の AI 開発に対する堅牢な適応性を保証します。
Pliops は AI DevWorld でこれらの進歩を披露し、XDP LightningAI が計算能力とコストを大幅に削減することで LLM のパフォーマンスに革命をもたらす様子を強調しました。このデモンストレーションは、エンタープライズ規模の持続可能な AI イノベーションを実現するという Pliops の取り組みを示しました。
継続的なコラボレーション
Pliops は、実用的なデータへの即時アクセスを提供し、シームレスな統合パスを確保することで、組織が AI 主導の洞察の可能性を最大限に引き出し、急速に進化するテクノロジー環境において競争上の優位性を維持できるようにします。
コラボレーションの今後のロードマップには、Pliops の KV-IO スタックをプロダクション スタックに統合し、マルチターン会話全体にわたる迅速なキャッシュ、スケーラブルな KV キャッシュのオフロード、合理化されたルーティング戦略などの高度な機能を実現することが含まれています。


 Amazon