

Supermicroは、近日発売予定のNVIDIA Vera Rubin NVL72およびNVIDIA HGX Rubin NVL8プラットフォームをサポートするため、ラックスケールの製造能力を拡張し、直接液冷機能をアップグレードしたことを発表しました。同社は、米国を拠点とする自社設計・製造体制と、自社のデータセンター・ビルディング・ブロック・ソリューション(DCBBS)アプローチ、そしてエンドツーエンドの液冷技術スタックを組み合わせることで、高密度AIインフラの導入期間を短縮することを目指しています。
SupermicroのCEO、チャールズ・リアン氏は、NVIDIAとの協業と同社のビルディングブロック設計手法が、高度なAIプラットフォームの提供を加速することを目指していると強調しました。また、Supermicroの広範な製造拠点と液冷技術の専門知識が、ハイパースケール環境およびエンタープライズ環境全体にわたるVera RubinおよびRubinシステムの効率的で信頼性の高い大規模導入の鍵となると強調しました。
ラックスケールフラッグシップ:NVIDIA Vera Rubin NVL72 SuperCluster
Supermicroは、最上位モデルとしてNVIDIA Vera Rubin NVL72 SuperClusterをサポートします。このラックスケールシステムは、72基のNVIDIA Rubin GPUと36基のNVIDIA Vera CPUに加え、NVIDIA ConnectX-9 SuperNICとNVIDIA BlueField-4 DPUを統合しています。このプラットフォームは、ラック内コヒーレンスのためにNVIDIA NVLink 6を採用しています。NVIDIA Quantum-X800 InfiniBandとNVIDIA Spectrum-X Ethernetを介してスケールアウトするように設計されており、大規模なトレーニング、推論、エージェントAIのためのラック・アズ・ア・システム設計への業界の動向と一致しています。
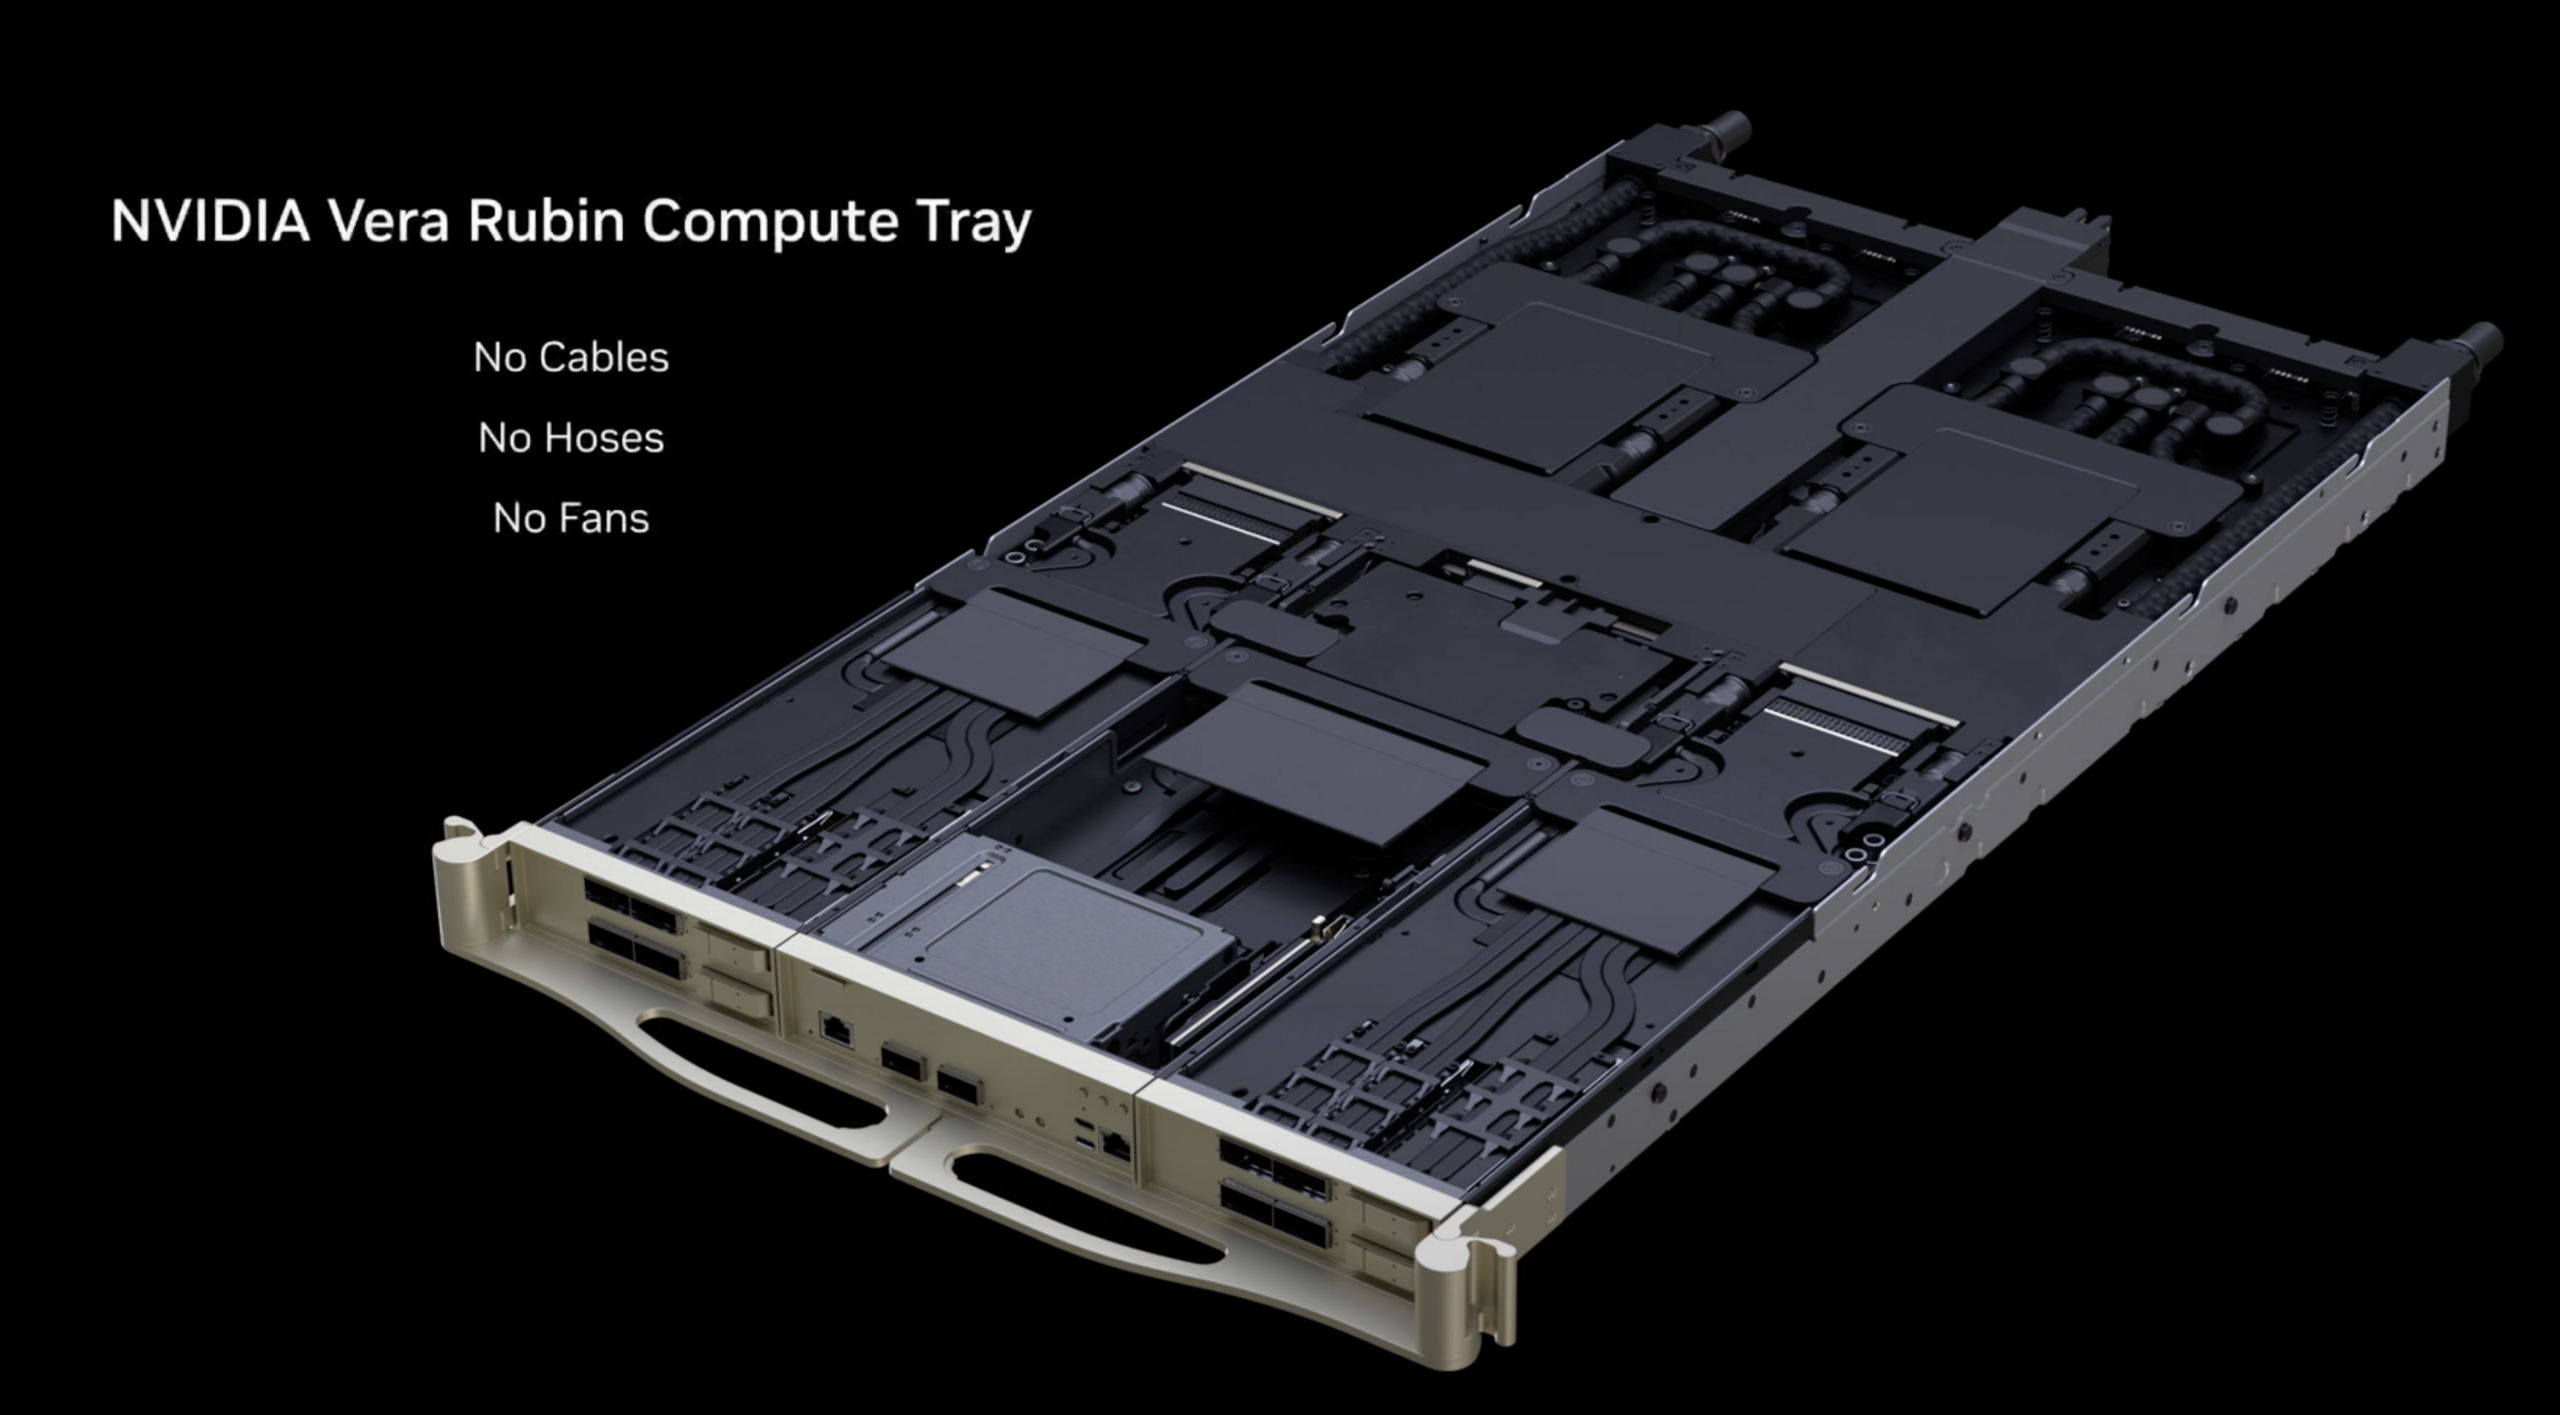
NVIDIAは、NVL72構成を3.6エクサフロップスのNVFP4性能と評価しています。これは、1.4PB/sのHBM4帯域幅と75TBの高速メモリによって支えられています。Supermicroの実装は、第3世代NVIDIA MGXラックアーキテクチャを基盤としており、保守性、信頼性、可用性を重視し、継続的なクラスタ運用をサポートしています。
冷却は設計の中核を成しています。Supermicroは、インローCDU(冷却剤分配ユニット)を備えた、強化されたデータセンター規模の液体冷却スタックを組み込んでいます。その目標は、スケーラブルな温水冷却を実現し、エネルギーと水の使用量を削減しながら、高負荷のAIワークロード下でも密度と予測可能なパフォーマンスを維持することです。
コンパクトで高密度なコンピューティング:2U 液冷式 NVIDIA HGX Rubin NVL8
Supermicroは、よりモジュール化されたビルディングブロックを求める企業やサービスプロバイダー向けに、2U液冷NVIDIA HGX Rubin NVL8システムも発表しました。この8GPUプラットフォームはAIおよびHPCワークロードを対象としており、NVIDIAは400ペタフロップスのNVFP4性能を謳っています。このプラットフォームは、176TB/sのHBM4帯域幅と28.8TB/sのNVLink帯域幅を誇り、SuperNICを介して1600Gb/sのNVIDIA ConnectX-9ネットワークを提供します。
Supermicroは、導入の柔軟性を維持するラックスケール設計を提供し、次世代Intel XeonおよびAMD EPYCプロセッサーを含む主力x86 CPUを搭載した構成オプションを提供しています。また、ラック統合のための高密度2Uバスバー設計と、Supermicroの直接液体冷却(DLC)テクノロジーを組み合わせることで、保守性を犠牲にすることなく、より高い持続電力エンベロープを実現します。
ヴェラ・ルビンのプラットフォーム機能
Supermicro のプラットフォーム サポートは、クラスターの設計と運用計画に直接影響を与える、次のような Vera Rubin 時代のいくつかの主要な機能と一致しています。
- NVIDIA NVLink 6は、GPU間およびCPUとGPU間の通信において、より高い帯域幅とより低いレイテンシを実現する高速インターコネクトファブリックです。これは、大規模な通信パターンがパフォーマンスを左右する可能性のある、非常に大規模なMixture-of-Expertsモデルのトレーニングと推論に特に有効です。
- NVIDIA Vera CPUは、NVIDIA設計のArmコアを搭載し、前世代と比べて2倍のパフォーマンス向上を実現しています。CPUは88コア、176スレッドによる空間マルチスレッドをサポートし、1.2TB/秒のLPDDR5Xメモリ帯域幅と大容量メモリを備えています。また、VeraはCPUとGPUの連携を強化し、GPUへのNVLink-C2C帯域幅は1.8TB/秒に達し、前世代の2倍とされています。
- NVIDIAの第3世代Transformer Engineは、長コンテキストかつ狭精度の高速化をターゲットとしています。これは、現代の推論が永続セッション、マルチエージェントパイプライン、そしてより高い同時実行性へと移行する中で、非常に重要になっています。このプラットフォームには、モデル、データ、プロンプトを保護・分離する統合GPUレベルの信頼できる実行環境を備えたラックスケールの機密コンピューティングである、第3世代の機密コンピューティングも組み込まれています。規制対象のワークフローにAIを導入するオペレーターにとって、機密コンピューティングとGPU実行境界の分離は、プラットフォーム選択の基準としてますます重要になっています。
- 信頼性の向上は、高度なヘルスモニタリングとリアルタイムチェック機能を備えた第2世代RASエンジンによって実現され、ダウンタイムを削減します。高密度の水冷環境では、メンテナンスにかかるコストが高く、運用上の不安定性に対する許容度が低いため、障害検出と保守性が不可欠です。
ネットワーキング: Spectrum-X イーサネットフォトニクスとラックスケールのスループット
Supermicroはまた、Rubinプラットフォームのサポートを、Spectrum-6 Ethernet ASICをベースとしたNVIDIAのSpectrum-X Ethernet Photonicsと連携させました。NVIDIAは、200G SerDesの共存パッケージ光学系と完全共有バッファを備え、TSMC 3nmプロセスで102.4 Tb/sのスイッチング性能を実現しています。
NVIDIAが掲げる目標は、従来のプラガブル光スイッチと比較して効率性と運用安定性を向上させることであり、電力効率は5倍、信頼性は10倍、アプリケーション稼働時間は5倍向上するとNVIDIAは述べています。NVIDIAは、液冷式のSN6800(409.6 Tb/s CPO、512x 800Gポート)、SN6810(102.4 Tb/s CPO、128x 800Gポート)、SN6600(プラガブル光スイッチ、128x 800Gポート、空冷または液冷構成)など、複数のスイッチモデルを挙げています。データセンター事業者にとって、これらの設計は、電力特性と熱特性が改善された高密度800Gイーサネットファブリックへの期待を高めており、フロントエンドネットワークの電力がラック予算の重要な部分を占めるようになるにつれて、その重要性はますます高まっています。
AIファクトリー向けストレージ統合
ストレージ面では、SupermicroはペタスケールのオールフラッシュストレージサーバーとJBOFシステムを基盤とした補完的なソリューションを披露しました。これらのプラットフォームは、NVIDIA BlueField-4 DPUと幅広いデータ管理ソリューションをサポートし、コンピューティング層で使用されるラックスケールの高速化アーキテクチャと同じアーキテクチャでストレージとネットワークを統合します。
Supermicro は今回の発表でストレージ プラットフォームのパフォーマンス数値を明らかにしていませんが、統合に重点が置かれていることは、コンピューティング、ネットワーク、ストレージが AI ファクトリーの導入に適合した、検証済みのフルスタック設計への継続的な移行を示しています。
製造規模とオンライン化までの時間
今回の発表の運用面のテーマは、製造スループットと導入速度です。Supermicroの拡張された施設と液冷スタックは、完全液冷式のVera RubinおよびRubinプラットフォームの製造と納入を効率化するように設計されています。同時に、モジュール式のDCBBSアーキテクチャは、迅速な構成、検証、そして拡張を可能にします。エンタープライズの技術系バイヤーにとって、差別化要因は単一のシャーシ仕様ではなく、予測可能な納入、繰り返し可能なラック構築、そして機器受領から安定した生産サービスまでの時間の短縮です。
Supermicro は、液体冷却がトップレベルの AI 密度のデフォルトになるにつれて、ラック スケールの製造と検証を産業化できるベンダーが、統合サイクルを延長せずに大規模な展開をサポートするのに最適な立場になると考えています。


 Amazon