

私たちは計算の限界を押し広げることに慣れていますが、今回はπ(e)の限界に挑戦します。昨年の100兆桁のベンチマークに続いて、私たちはさらにレベルアップし、πの既知の桁数を105兆桁まで伸ばすことにしました。これは3の後に105,000,000,000,000個の数字があることを意味します。昨年の取り組みからプラットフォームをいくつか更新し、その過程でいくつかの驚くべき発見があり、πの105兆桁目である6など、いくつかのことを学びました。
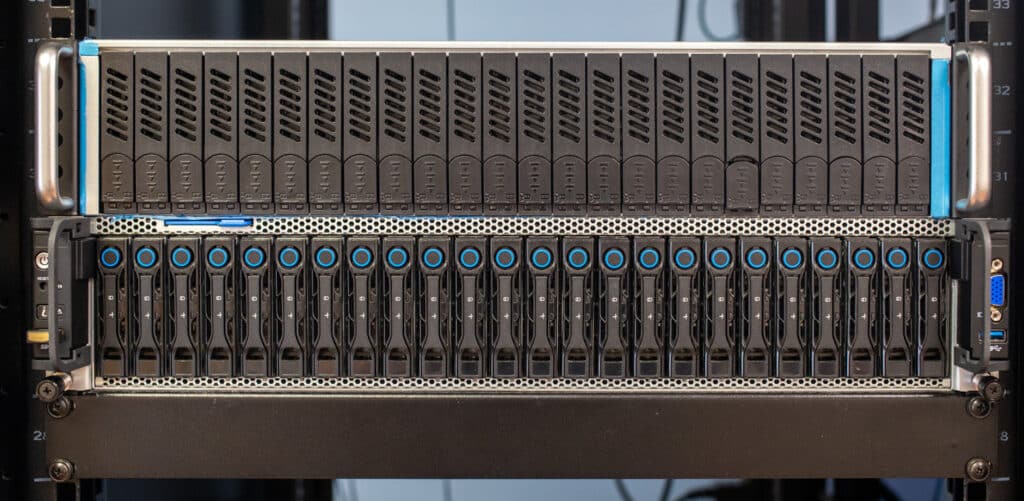
StorageReview ラボは、Pi を 105 兆桁まで計算するという世界記録を達成し、最新のハードウェアの驚異的な機能を強調しました。この取り組みは、2 TB の DRAM とほぼペタバイトの Solidigm QLC SSD を搭載した最先端の 128P 1.5 コア AMD EPYC Bergamo システムを活用しており、コンピューティングおよびストレージ テクノロジにおける画期的な成果を表しています。
課題
100 兆のデジタル処理の中で、私たちはいくつかの技術的な限界に遭遇しました。たとえば、サーバー プラットフォームは、前面スロットで 16 台の NVMe SSD のみをサポートしていました。十分な CPU パワーがありましたが、この計算には、プロセス中および最終的な TXT ファイルが出力されるバックエンドで大規模なストレージが必要でした。
前回、ストレージの問題を解決するために、PCIe NVME アダプター スレッドに頼って、さらに 0 つの SSD を押し込みました。次に、出力として、計算ボックスに iSCSI 共有を備えた RAIDXNUMX の HDD ストレージ サーバーがありました。今回は、このサーバーをもう少し「エンタープライズ」にしたいと考えたので、手伝ってくれる友人を数人連れてきました。興味深いことに、多数の NVMe SSD をサーバーに追加するのは、見た目ほど簡単ではありません。
ハードウェア
この壮大なプロジェクトの中核を担ったのは、それぞれ128コアを搭載したデュアルプロセッサAMD EPYC 9754 Bergamoシステムでした。高度な計算処理(AI、HPC、ビッグデータ分析)において卓越した性能を発揮することで知られるAMDのプロセッサが、必要な処理能力を提供しました。さらに、1.5TBのDRAMが高速なデータ処理と転送速度を実現。同時に、約1ペタバイトのSolidigm QLCストレージが、比類のない容量と信頼性を提供しました。
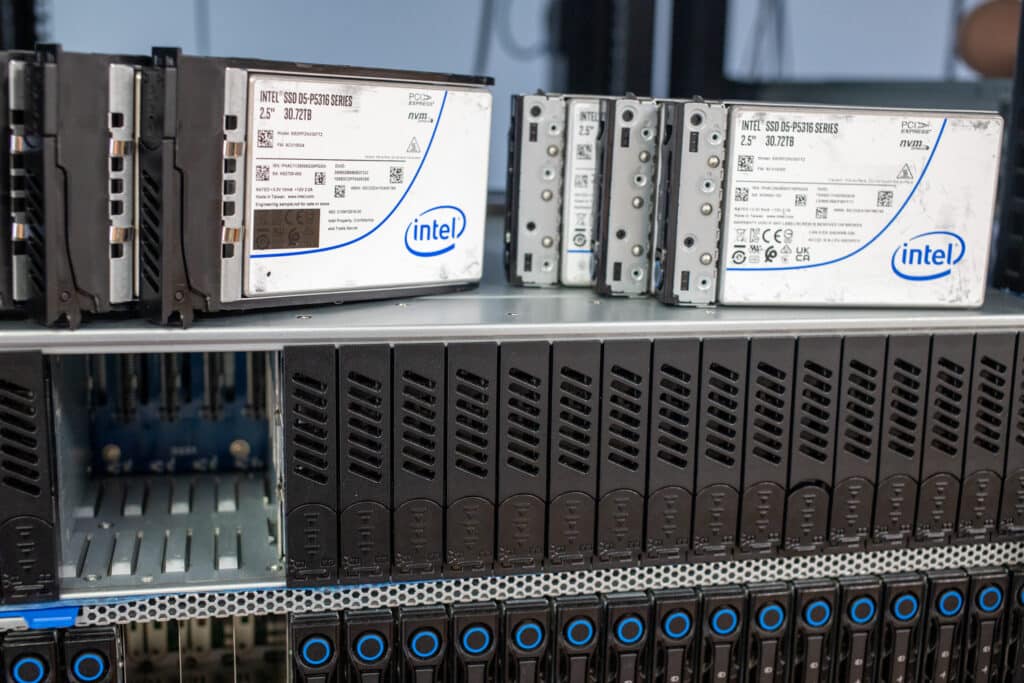
基本シャーシ プラットフォームは昨年と同じ (QCT ボックス) ですが、CPU を AMD EPYC 9754 Bergamo チップにアップグレードしました。私たちは、計算にストレージを使用することを避けながら、速度と小数点以下の改善を追求したいと考えていました。つまり、JBOF を提供するために SerialCables を呼び出す必要がありました。これにはそれ自体がいくつかの課題がありましたが、それについては以下で詳しく説明します。
| 値 | |
|---|---|
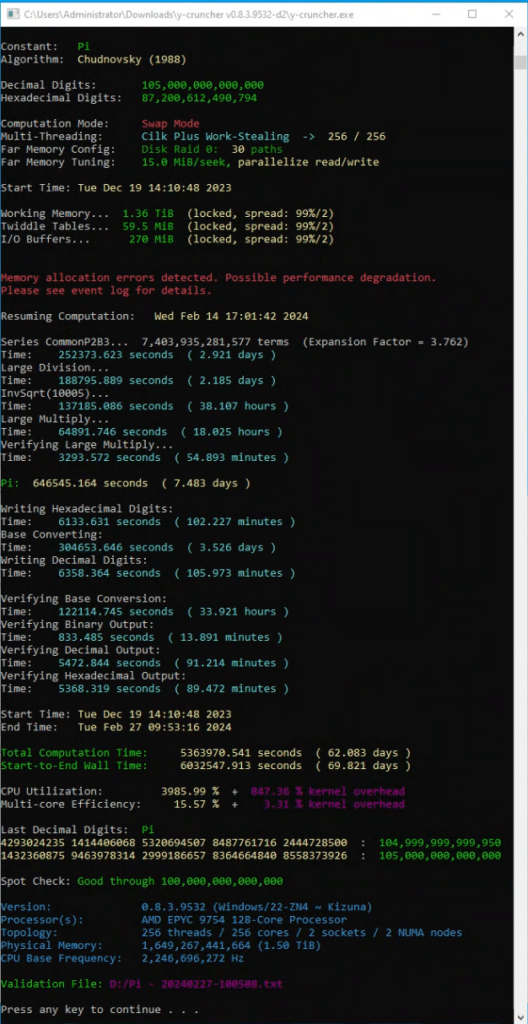
| 開戦日 | 19年14月10日(火)48:2023:XNUMX |
| 終了日 | 27年09月53日(火)16:2024:XNUMX |
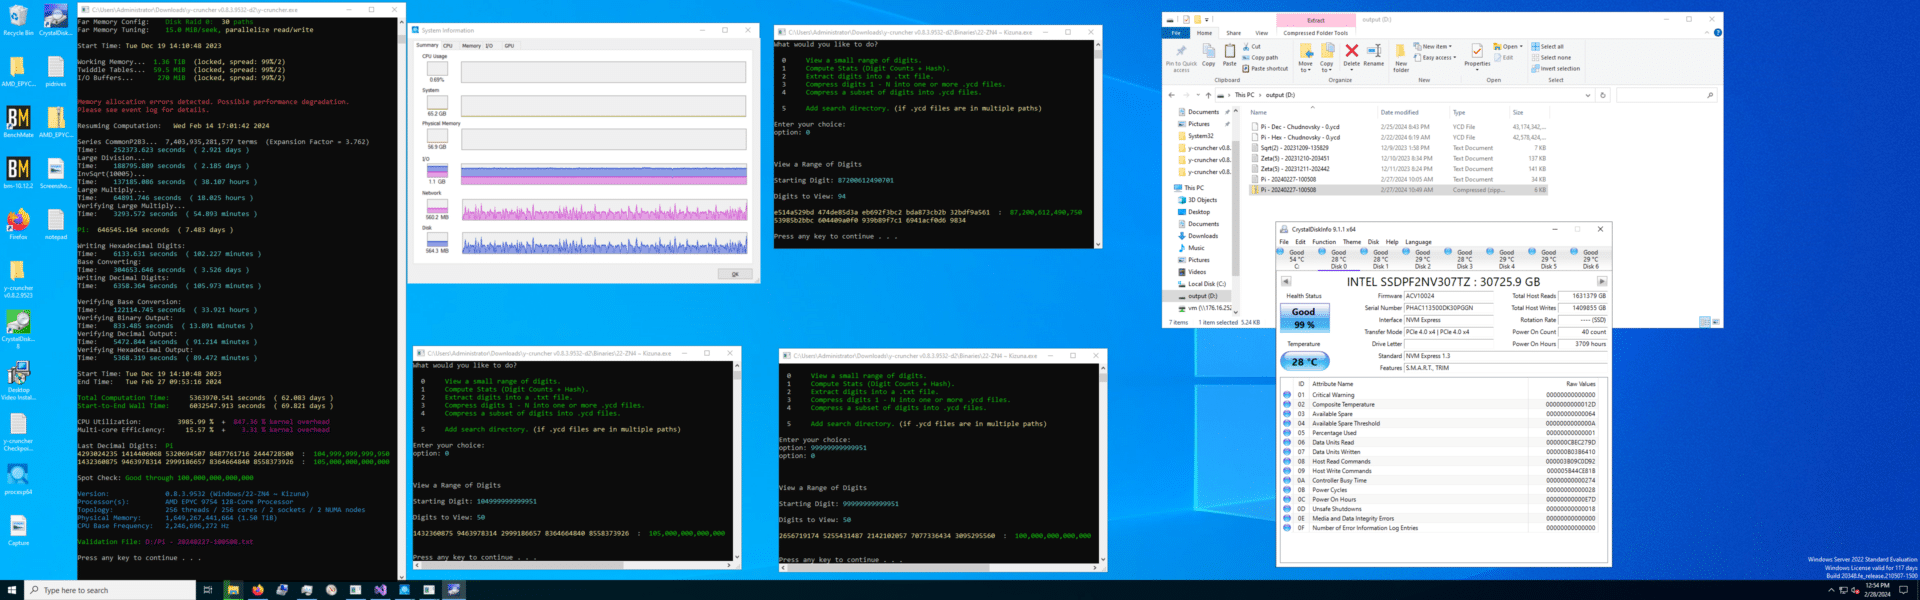
| 合計計算時間 | 5,363,970.541 秒 / 62.08 日 |
| 開始から終了までの所要時間 | 6,032,547.913 秒 / 69.82 日 |
計算期間:2023年12月14日~2024年2月27日(75日間)。
- CPU: デュアル AMD Epyc 9754 Bergamo プロセッサ、256 コア、BIOS で同時マルチスレッド (SMT) が無効になっています。
- メモリ: 1.5TBのDDR5 RAM。
- ストレージ: 36x 30.72TB Solidigm D5-P5316 SSD。
- SerialCables JBOF 内の 24x 30.72TB Solidigm D5-P5316 SSD
- サーバーに直接接続された 12 台の 30.72TB Solidigm D5-P5316 SSD。
- オペレーティング·システム: Windows Server 2022 (21H2)。
105兆への道
| 値 | |
|---|---|
| 定数 | Pi |
| アルゴリズム | チュドノフスキー (1988) |
| XNUMX 進数 | 105,000,000,000,000 |
| 16 進数 | 87,200,612,490,794 |
| スレッドモード | Cilk Plus ワークスティール -> 256 / 256 |
| ワーキングメモリ | 1,492,670,259,968 (1.36 TiB) |
| 合計メモリ | 1,492,984,298,368 (1.36 TiB) |
| 論理的に最大のチェックポイント | 157,783,654,587,576 (144 TiB) |
| 論理ピークディスク使用量 | 534,615,969,510,896 (486 TiB) |
| 論理ディスクの読み取りバイト数 | 44,823,456,487,834,568 (39.8 PiB) |
| 論理ディスクに書き込まれたバイト数 | 38,717,269,572,788,080 (34.4 PiB) |
直面した課題
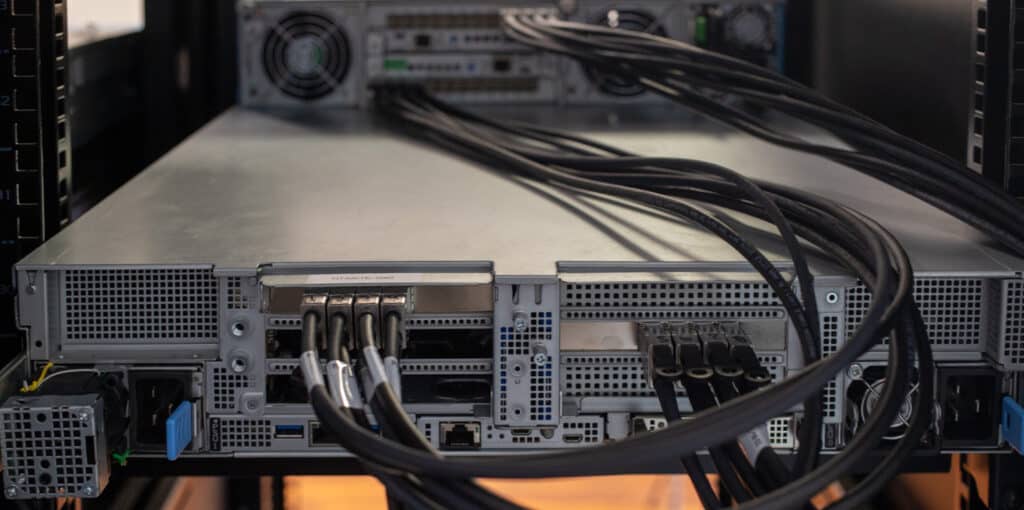
今回のテスト実行でプロセッサに利用可能なストレージを拡張するために必要だった新しいコンポーネントは、NVMe JBOFの追加でした。テストプラットフォームには16個のNVMeベイがあり、残りの8個はSATA専用でした。100兆回のテスト実行では、3つの内部PCIe U.2アダプタを使用してNVMeドライブ数を19に拡張しましたが、最適ではありませんでした。今回の再実行では、Serial Cables製の24ベイU.2 JBOFを追加しました。これにより、演算スワップストレージと内部出力ファイルストレージの2つの点で大幅に改善されました。もうRAID0構成のHDDストレージサーバーは必要ありません。
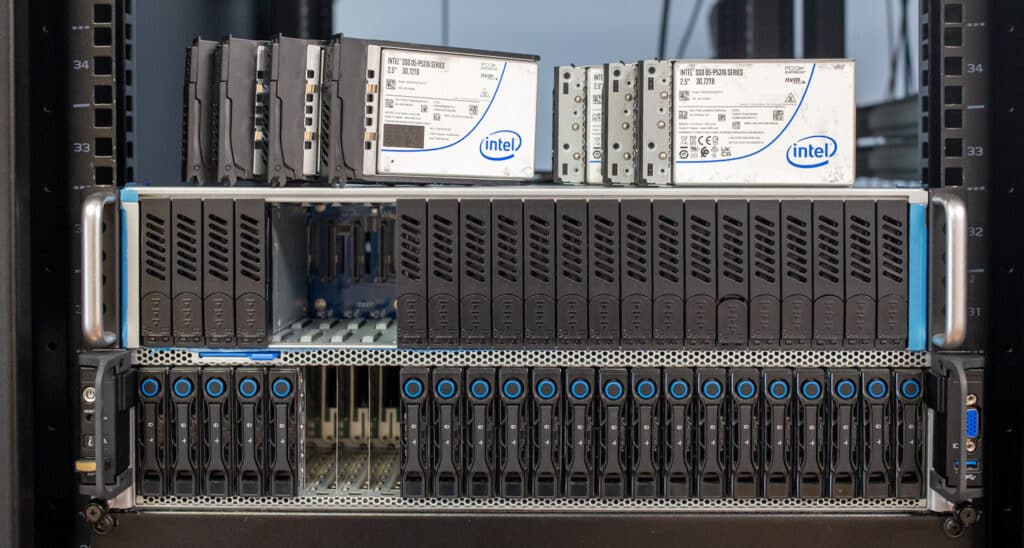
シリアル ケーブル 24 ベイ JBOF により、ドライブ数を当初の実行からほぼ 30 倍にすることができました。 6 台のドライブを y-cruncher スワップ スペースに割り当て、記憶域スペース RAID5 出力ボリューム用に 10 台の SSD を残しました。このアプローチの大きな利点は、最初の 100T Pi の反復のように、単一の XNUMXGb 接続の速度によって妨げられることがなかった出力段階で実現しました。 JBOF は総ドライブ数の問題に対処しましたが、個々のドライブのパフォーマンスという XNUMX つの制限が生じました。
直接接続された U.2 SSD を備えたサーバーには、ドライブごとに 96 つの PCIe レーンがあります。各ドライブがマザーボードに直接配線されている場合、24 台の SSD に対して XNUMX 個の PCIe レーンになります。 JBOF の合計帯域幅は、ホストに接続できる PCIe レーンの数によって制限されます。
この場合、12 枚の PCIe スイッチ ホスト カードを使用し、JBOF を 12 個の SSD からなる 16 つのグループに分割しました。 XNUMX 個の SSD の各グループは XNUMX 個の PCIe レーンを共有しました。 SSD をホストに接続する際には依然として大きな利点がありますが、JBOF を介して実行されるスワップ ドライブがサーバーに直接接続されているドライブよりも遅れてしまうシナリオがありました。これはJBOFのせいではありません。これは単なる技術的な制限、またはサーバーが動作できる PCIe レーンの数の制限です。
賢明な読者は、なぜ今回の実行では SSD を 36 個まで増やさずに 40 個に止めたのか疑問に思うかもしれません。これは面白い話です。多くのサーバーでは、アドレス指定可能な PCIe スペースに制限があります。私たちの場合、ドライブ数 38 の時点で、最後の SSD が USB チップセットの PCIe アドレスを奪い、サーバーの制御を失いました。安全策として、BIOS にアクセスしたりサーバーにログインしたりできるように、36 SSD にバックアップしました。限界を押し広げると、驚くべき発見が得られます。
診断の洞察と解決策
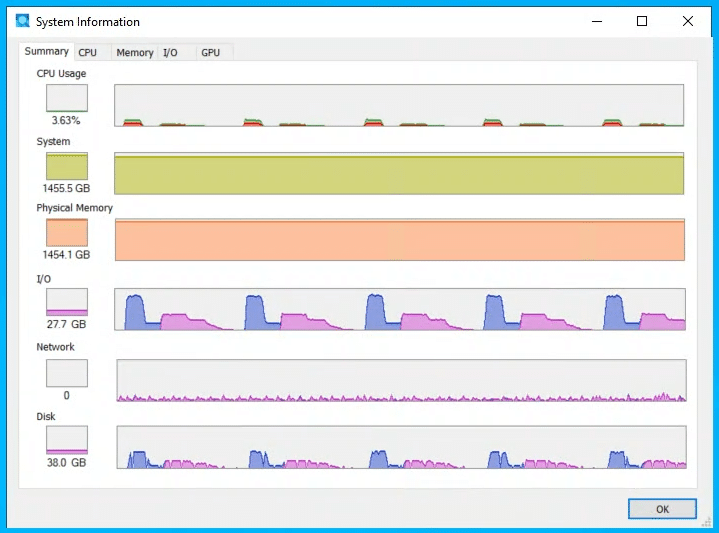
私たちが直面した2つの主要な課題のうち、最初の課題はパフォーマンスに関するものでした。そこで発見したのは、まさにアムダールの法則が働いているということでした。256コアのAMD Bergamoシステムで、大規模なスワップモード操作中にy-cruncherが「ハングアップ」する奇妙な問題が発生したのです。CPUとディスクI/Oアクティビティがほとんど見られないこのハングアップは、従来のソフトウェアの動作に関する想定を覆すものでした。このことから、並列コンピューティングとハードウェアの相互作用の複雑な仕組みを深く掘り下げる必要が生じました。
発見プロセスにより、プログラムは実際にハングアップしているわけではなく、非常に限られた容量で動作し、256 コアの広大なセットアップ全体でシングルスレッドで実行されていることが明らかになりました。この異常な動作は、特に関係する操作が計算集約的ではなく、1.5 TB の RAM を搭載したシステムで重大な遅延を引き起こすはずがないため、アムダールの法則の潜在的な影響に関する疑問を引き起こしました。
調査は、一般消費者向けデスクトップPCで同様の問題が再現されたことで予期せぬ展開を見せ、規模の小さいシステムでもアムダールの法則が深刻な影響を及ぼすことが明らかになった。これにより、根本原因のより詳細な調査が行われ、Zen4アーキテクチャ特有のCPUハザード、すなわちスーパーアライメントとそれがメモリアクセスパターンに及ぼす影響が判明した。
AMD プロセッサでは、その単純な性質により、観測よりもはるかに高速に実行されるはずのコード内のループによって、この問題がさらに悪化しました。根本的な原因は、AMD のロード/ストア ユニットによるメモリ エイリアシングの非効率的な処理にあるようです。この複雑な問題を解決するには、AVX512 を使用したループのベクトル化によってスーパーアライメントの危険性を軽減することと、並列処理を強化してアムダールの法則によって引き起こされる速度低下に対処することの両方が必要でした。この包括的なアプローチは当面の問題を解決しただけでなく、y-cruncher の計算プロセスの大幅な最適化にもつながり、高性能コンピューティング環境で同様の課題に取り組む先例となりました。
次の問題は、計算の最終ステップで発生しました。計算は予期せず停止し、クラッシュの原因に関する情報が提供されませんでした。 Alexander Yee にはリモート アクセスが許可され、10 年以上で初めて、Pi レコードを完成するには開発者からの直接介入が必要になりました。
私たちはこの診断プロセスには関与していませんでしたが、N63乗算アルゴリズムのAVX512コードパス内に重大な浮動小数点演算エラーが発生していました。アレクサンダーはリモートで診断を行い、修正済みのバイナリを提供し、チェックポイントから処理を再開することで、重要なソフトウェア修正を適用した後、最終的に計算を成功させることができました。
反省と前進
この取り組みは、ハイパフォーマンス コンピューティングの複雑さと予測不可能性を示しています。これらの課題を解決することで、Pi 計算の新たな記録が樹立され、ソフトウェア開発およびテスト方法論に対する貴重な洞察が得られました。最新の y-cruncher リリース v0.8.4 には、特定された問題の修正が組み込まれており、将来の計算の安定性が向上することが約束されています。
円周率を 105 兆桁まで計算するのは簡単な作業ではありませんでした。それには、綿密な計画、最適化、実行が必要でした。 StorageReview のチームは、オープンソース ソフトウェアと独自ソフトウェアを組み合わせてアルゴリズム プロセスを最適化し、ハードウェアの機能を最大限に活用し、計算時間を短縮し、効率を向上させました。
PCIe Gen4 の飽和読み取りパフォーマンスと最大 61.44TB の業界をリードする容量を備えた Solidigm QLC SSD は、信じられないほどの結果をもたらします。 「これらのドライブが高性能コンピューティングや AI 集約型アプリケーションで何を実現できるか想像してみてください」と Solidigm の戦略計画およびマーケティング担当副社長の Greg Matson 氏は述べています。 Solidigm の SSD が、Storagereview の pi 計算の XNUMX 回目の記録破りの試みを強化できることに私たちは興奮しています。彼らの取り組みは、Solidigm のストレージ ドライブの真の能力を証明し、データ集約型 AI アプリケーションの可能性の世界を開きます。」
結論
105 兆桁の円周率に到達する作業は、私たちが予想していたよりもはるかに複雑でした。よく考えてみると、新たな問題に遭遇することは予想されていたはずです。結局のところ、これまでに行われたことのない計算を完了しているのです。しかし、100 兆の計算が、はるかに「ダクトテープと金網」の構成で完了したため、私たちはそれができたと思いました。最終的に、このリグをゴールラインに到達させるには協力的な努力が必要でした。
私たちはパートナーとともにこの記録破りの達成を喜びますが、「これは一体何を意味するのでしょうか?」と自問しなければなりません。円周率がさらに 5 兆桁増えても、おそらく数学に大きな違いは生じないだろう。それでも、計算ワークロードと、それをサポートする最新の基盤となるハードウェアの必要性の間には、ある程度の線引きをすることができます。基本的に、この演習は、エンタープライズ データ センター クラスターであろうと大規模な HPC 設置であろうと、適切なハードウェアがすべての違いを生むことを反映しています。
円周率の計算においては、ストレージ容量が大きな制約となっていました。CPUの高速化は計算速度の向上に役立ちますが、多くの世界新記録の達成を阻む要因は、システム内のローカルストレージ容量です。今回の計算では、Solidigm D5-P5316 30.72TB SSDを再び活用し、システムに1.1PBを超えるフラッシュメモリ容量を確保しました。これらのSSDのおかげで、これまでの記録を塗り替え、円周率の105兆桁に到達することができました。
しかし、これは興味深い疑問を提起します。多くのフォロワーは、SolidigmがD5-P5336で61.44TB 、 D5-P5430 SSDで最大30.72TBのSSDを、複数のフォームファクタと容量で提供していることをご存知でしょう。私たちはこれらのドライブをレビューし、これらの驚異的な高密度ドライブを紹介するソーシャルメディア投稿を多数行っています。これらのSSDを32個使用してストレージ容量が2PBに迫るとなると、円周率の105兆桁が世界最大の記録としてどれくらいの期間保持されるのか疑問に思うかもしれません。私たちは、それほど長くは続かないだろうと考えています。
円周率の既知の最大の 10 進数の桁
1432360875 9463978314 2999186657 8364664840 8558373926: 105,000,000,000,000 までの桁


 Amazon