

現在、市場にはストレージ用のオプションがいくつかあります。ほとんどの差別化要因には、速度の違い、可用性の 9 の多さ、または GUI サポートの違いが含まれます。全体として、配列は非常に似ています。それらは、特定の顧客グループを対象とした異なる価格設定とサポートまたは機能を提供するだけです。 DataGravity は、真に異なるものを提供する分野に参入しました。 DataGravity が重視しているのは、データをどれだけ速く保存または取得できるかということではなく、2U フォーム ファクターにどれだけのドライブを搭載できるかということでもありません。いずれにしても少なくともまだです。 DataGravity は、データを理解し、顧客がデータを簡単に見つけてレポートし、業界または内部ポリシーへのコンプライアンスを確保できるようにすることを目的としています。
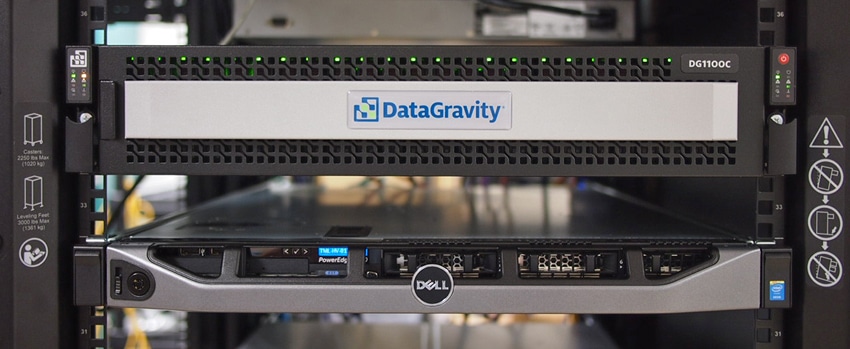
DataGravity がどこに適合するかというニュアンスを理解することが重要です。企業内には、データの検索と保護を担当するビッグデータ分析チームとセキュリティ チームが存在することがよくありますが、DataGravity が追求している市場はそこではありません。 DataGravity は、ほとんどの場合 IT スタッフが限られているものの、大企業と同じデータの課題を抱えているミッドレンジ市場を対象としています。 DataGravity は、なぜこのような複雑なプロセスを、それを使用する準備が整っていないと思われるユーザーに集中させるのでしょうか? DataGravity の創設者 Paula Long が述べているように、ウェブ サーフィンができればこの製品を使用できるからです。これらの問題を解決するには自動化が鍵となります。
DataGravity Discovery シリーズ ファミリは、ファイル内のデータを理解することで機能します。 DataGravity アレイは、たとえば社会保障番号をチェックするために Word ドキュメントを調査できるため、企業が保存しているファイルを即座に確認できるようになります。 DataGravity は、このデータを理解してレポートし、機密情報が不適切な関係者と共有されないようにすることができます。アレイに保存されているデータを理解することに加えて、すべてのファイル アクセスとユーザー アクティビティが監査され、企業がコンプライアンスとセキュリティの要件を満たすのに役立ちます。これは、DataGravity とは何か、そうでないものを理解する上で重要な違いです。 DataGravity は、NAS などの一般的な分野であるこの非構造化データのユースケースに重点を置いています。 DataGravity は iSCSI、NFS、SMB をサポートしていますが、DataGravity の主な使用例は、電子メールやトランザクション データベースなどの主流のビジネス アプリケーションの使用例ではありません。プラットフォームは最終的にはそこに到達する可能性があり、おそらくそうなるでしょうが、現在、その目標は非常に明確に定義されています。
社会保障番号、患者 ID、電話番号、クレジット カード番号などのデータは、簡単に定義して理解できます。実際、DataGravity は多くの一般的なコンプライアンス タグをそのままサポートしています。ただし、これらに限定されません。多くの企業と同様に、独自のニーズを持つ組織のために、DataGravity は組織が独自のタグを確立できるエディターを提供します。これにより、プラットフォームのユーザーは、業界固有のセキュリティ、コンプライアンス、電子情報開示の要件に迅速に対応できるようになります。もちろん、アクセス ルールに基づいてすべてを検索可能にすることで、保存されたデータの可視性も向上し、ビジネス価値が向上します。
DataGravity は、容量としてニアライン HDD を利用し、読み取りキャッシュとしてフラッシュを利用するいくつかの構成のアレイを提供します。これらのユニットはデュアル コントローラーであり、各コントローラーが「アクティブ」で、以下で詳しく説明する特定のジョブを実行します。 DG1100 の raw ディスク容量は 18 TB、DG1200 の raw ディスク容量は 36 TB です。 DG2200 は 48 TB、DG2400 は 96 TB を提供します。現在、これらは拡張可能ではありませんが、DataGravity はこれに対処する必要があることを明らかに認識しています。おそらく、拡張シェルフや複数のシステムを単一の管理ビューに統合する管理インターフェイスが使用されます。このレビューのテストは完全にユーザビリティに重点を置いています。私たちはニューハンプシャー州ナシュアのオフィスで DataGravity と 1100 日間過ごし、リモートでフォローアップ作業を完了しました。これにより、DGXNUMX ユニットを実際に使用する時間が得られました。
アーキテクチャ
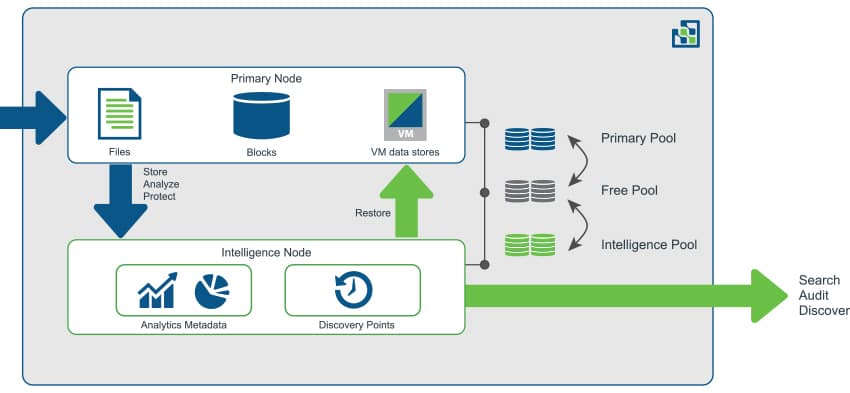
DataGravity には、ひねりを加えたデュアル アクティブ/アクティブ コントローラーがあります。通常、アクティブ/アクティブ デュアル コントローラーは、両方のコントローラーが I/O 処理でアクティブであることを意味します。ただし、DataGravity では、アーキテクチャはアクティブ/パッシブを模倣しており、プライマリ ノードがデータを提供し、インテリジェンス ノードがデータ分析を処理します。 DataGravity はこれを「アクティブ-プロアクティブ」と呼んでいます。基本的なセットアップは次のようになります。数 GB の DRAM、バッテリー バックアップの NVRAM、メタデータとキャッシュ用の SSD、そしてニアライン HDD。
DRAM およびバッテリ バックアップ式 NVRAM を流れるそれほど重要な量のデータを使用して、DataGravity はプライマリ ノードとインテリジェンス ノード間の書き込みを最優先業務としてミラーリングします。これは内部 PCIe ブリッジを通じて行われ、高帯域幅と低遅延の通信を提供します。この高速リンクは、継続的なデータ保護とデータ分析のために DataGravity アーキテクチャで活用されています。飛行中のデータは、プライマリ ノードがディスクにコミットできるようになるまでミラーリングされます。両方のコントローラーを機能させることで、Discovery シリーズは本番 I/O にプライマリ ストレージ ノードを利用し、通常アイドル状態のセカンダリ ノードをインテリジェンス ノードとして機能させます。インテリジェンス ノードは、このコントローラーにミラーリングされたメタデータと細粒度の書き込みを利用して、継続的な保護とデータを意識した分析処理を実現します。
アクティブ-アクティブ (この場合はアクティブ-プロアクティブ) には、支払われたものを使用できるという利点があります (アクティブ-パッシブではプライマリに障害が発生するまで 2 番目のノードが休止状態になるのに対して) が、常に発生する傾向にある 1 つの疑問は次のとおりです。ノードに障害が発生するとパフォーマンスに影響が出ますか? DataGravity が魔法を発揮するには 2 つのノードが必要で、そのうちの 1 つが失われると、顧客はどうなるでしょうか?ノードに障害が発生した場合、残りのノードが運用の基本を引き継ぎます。ユーザーは、通常の日常業務と同様にファイルにアクセスして使用することができます。ただし、障害が発生したノードが復旧するまで、分析の大部分は一時停止されます。言い換えれば、可用性は維持されますが、ノードが復元されるまでメタデータ中心の機能は低下します。
使いやすさ
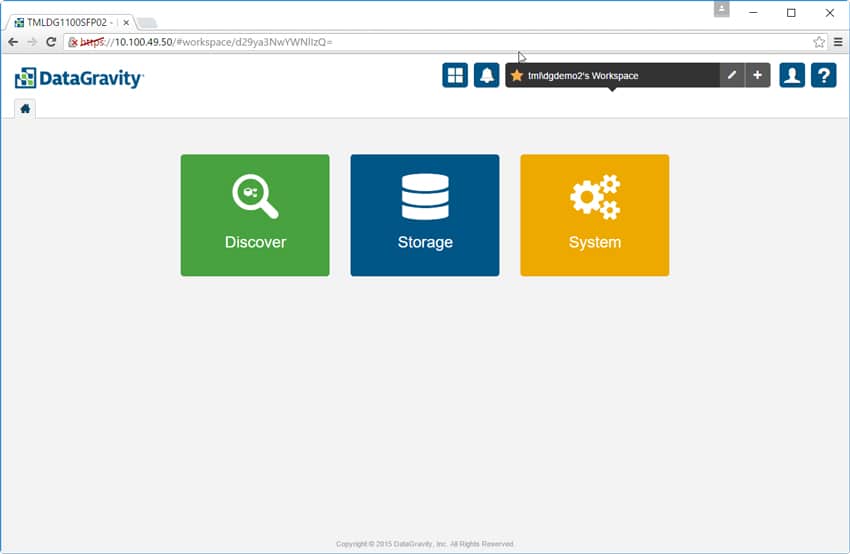
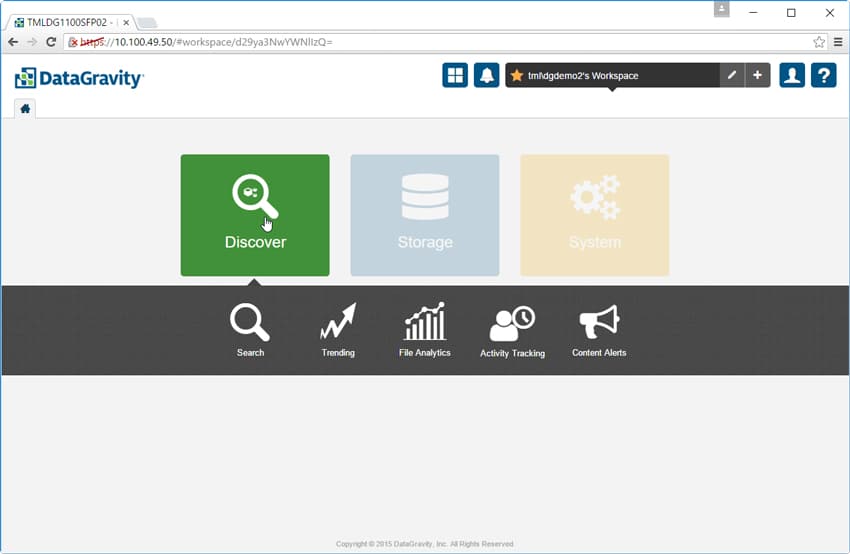
DataGravity GUI は HTML 5 ベースで、非常にシンプルで使いやすいレイアウトが特徴です。 [ホーム] タブには、[検出]、[ストレージ]、または [システム] の XNUMX つのオプションから選択できます。右上に沿って実行すると、システム ダッシュボードとアラート、ワークスペース、プロファイル、オンライン ヘルプのアイコンが含まれるグローバル アクセス パネルが表示されます。
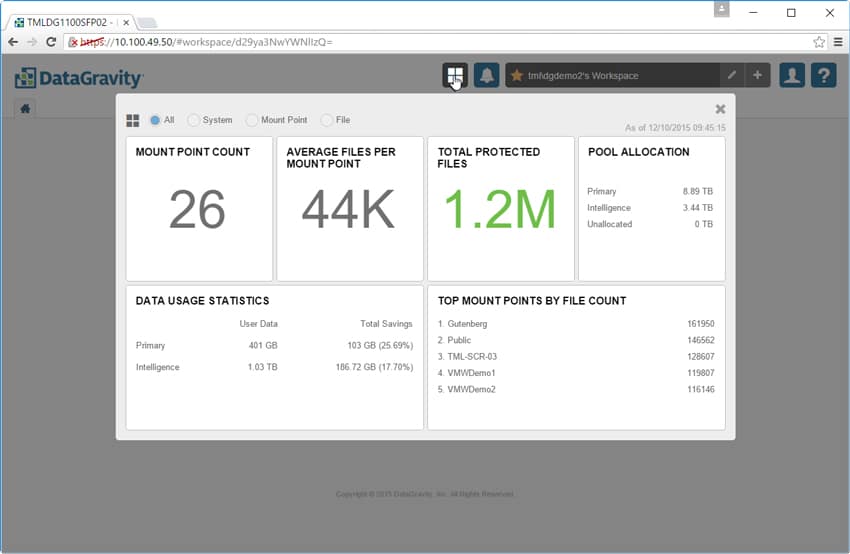
システム ダッシュボードでは、マウント ポイントの数、保護されているファイルの合計、プールの割り当て、データ使用量の統計などの統計を一目で確認できます。
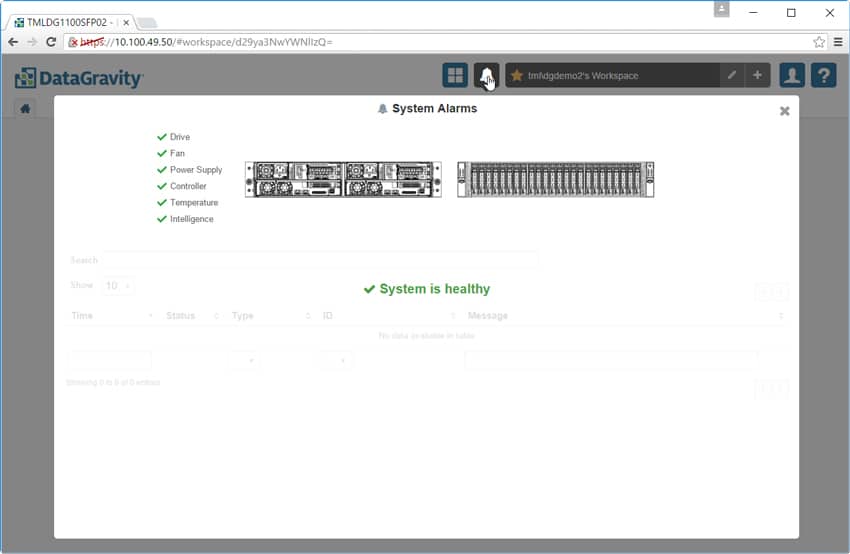
システム アラーム タブはその名の通り、アラームのリストとシステム内のどこで発生したかをユーザーに提供します。
アラーム タブの右側には、ワークスペース タブがあります。ここでユーザーはワークスペースの名前を変更したり、ワークスペースを追加したりできます。ワークスペースを使用すると、ユーザーはシステムのプライベート ビューを構成および管理できます。ユーザーは、ニーズに応じて複数のワークスペースを構成できます。

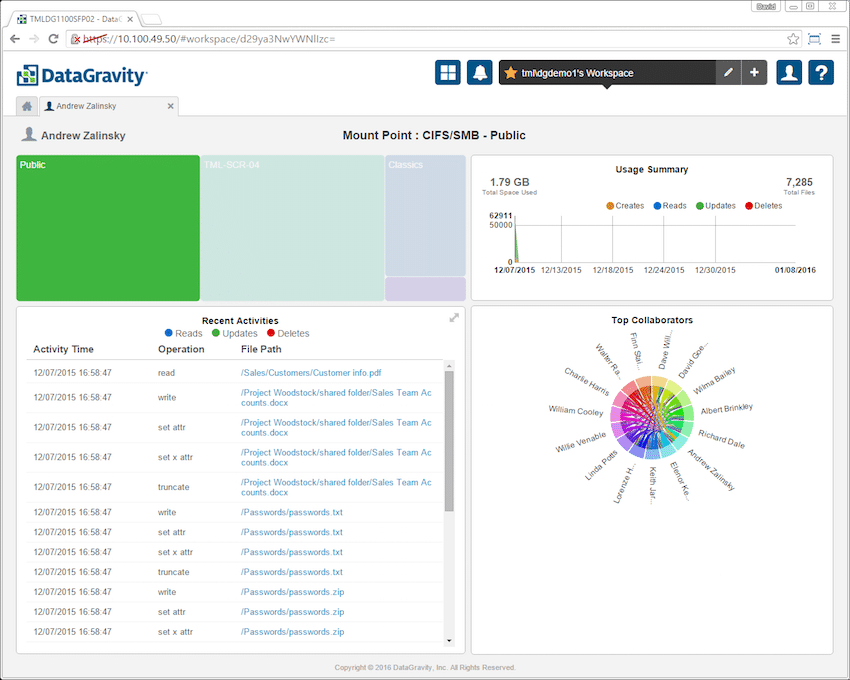
次のアイコンは「プロファイル」アイコンです。 「プロファイル」アイコンをクリックすると、承認されたユーザーは自分のプロファイルを管理できるようになります。保存された検索の電子メール サブスクリプションが可能になり、システムからログアウトできます。ログインすると、GUI には、経時的な使用状況の概要や最近のアクティビティ(読み取り、更新、削除、使用状況の場合は作成ごとに分類)などの情報が表示されるいくつかのタイルが表示されます。また、各ユーザーが誰であるかを示すコード ダイアグラムもあります。とどのような立場で協力しているのか。
[ホーム] タブに戻ると、一番左のアイコンが DataGravity の基本となる [Discover] タブです。このタブをクリックすると、検索、トレンド、ファイル分析、アクティビティ追跡、コンテンツ アラートなどのオプションがユーザーに表示されます。
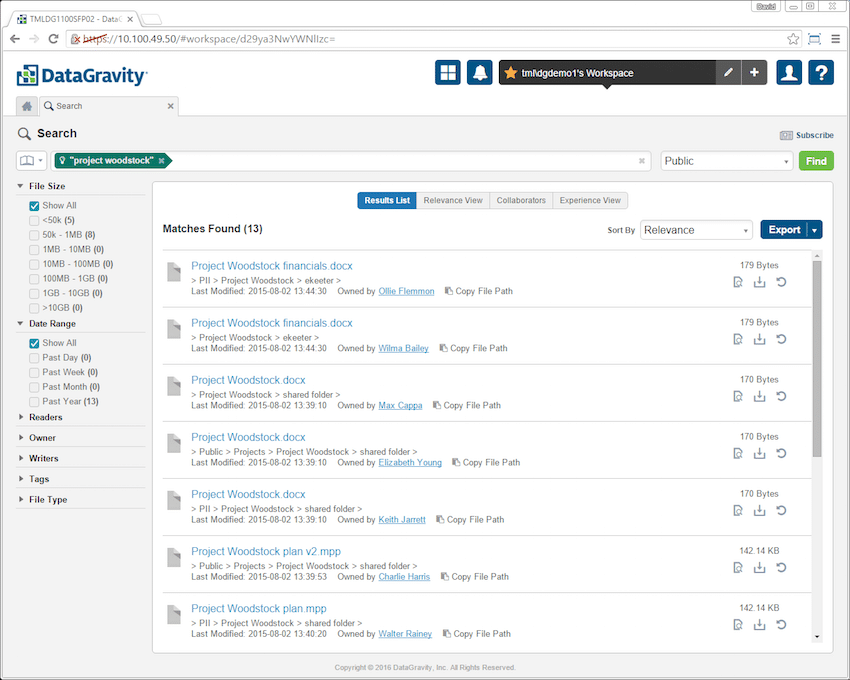
検索は文字通りです。検索バーが表示されるので、ユーザーは検索するキーワードまたはファイル名を入力するだけです。検索する前に、ユーザーは検索するマウント ポイントを選択する必要があります。下の画像では、「project woodstock」を検索しています。これにより、それらの用語を含むパブリック マウント ポイント内のすべてのファイルが返されました。左側のフィルターを使用すると、結果をさらに絞り込むことができます。
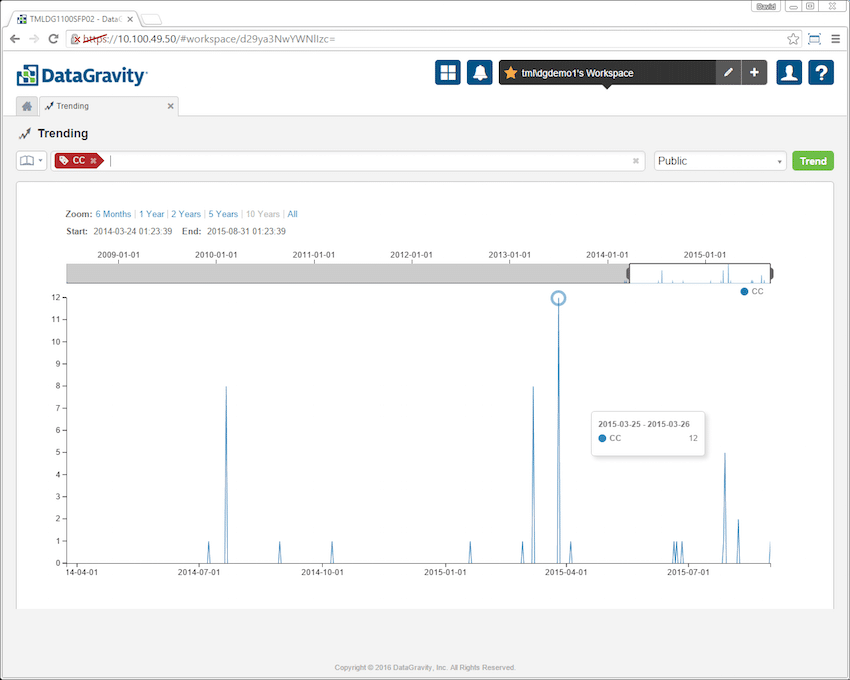
トレンドは検索に似ていますが、ここではユーザーが探しているキーワードまたはタグを入力するだけで、ソリューションによってデータがグラフィカルに表示されます。これにより、企業は、ライブ ファイルと削除されたファイルの両方でデータが時間の経過とともにどのようにアクセスされているかを確認できます。下の画面キャップでは、クレジット カード タグ (CC) がトレンド入りしました。結果は、パブリック マウント ポイントにおけるクレジット カード番号の長期的な傾向を示しています。
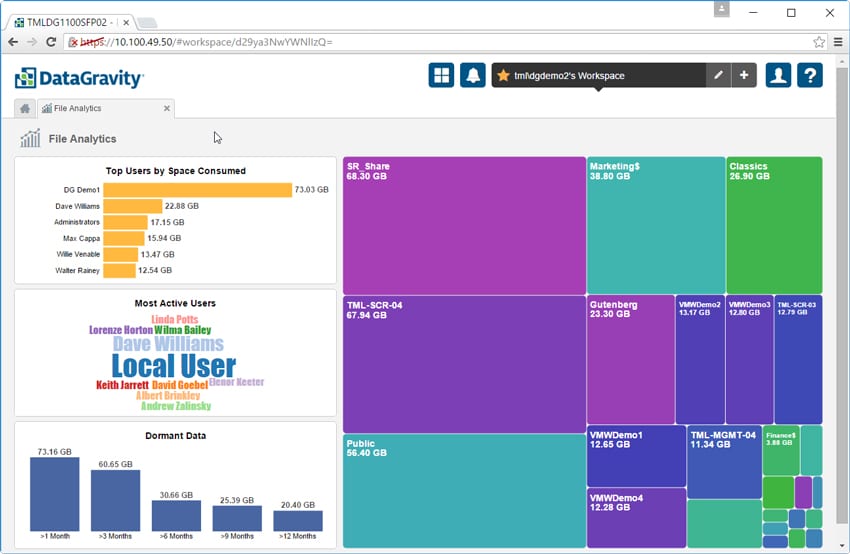
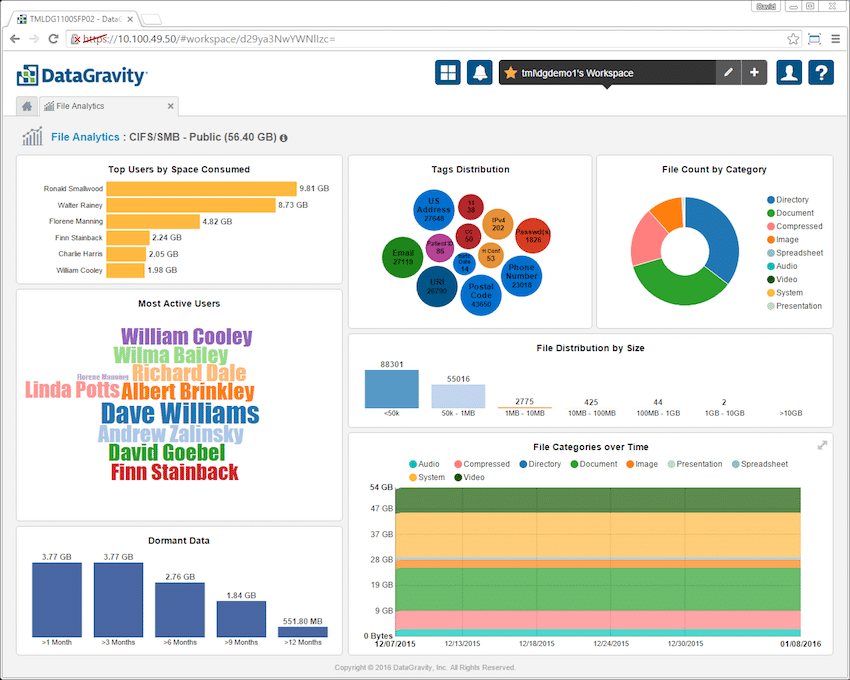
File Analytics は、DataGravity が他のストレージ ベンダーから独立しているもう 10 つの場所です。このダッシュボードを通じて、ユーザーは右側の色付きのブロックで表されるファイル共有と仮想マシンを簡単に確認できます。消費される容量の割合が大きいほど、色の付いたブロックも大きくなります。ユーザーは、消費スペース別の上位 1 人のユーザーを棒グラフで表示することもでき、最もアクティブなユーザー (アクティブなユーザーほど名前が大きく表示されます)、休止データとデータが非アクティブであった期間を 3、6、9 でグループ化して表示することもできます。 、12か月とXNUMXか月のカテゴリ。
個々のファイル共有または VM をクリックすると、この情報がさらに詳しく表示されます。左側には、最もアクティブなユーザー(読み取り / 書き込み / 削除操作によって測定)と、共有または VM 内のスペース別の上位ユーザーに関する情報が表示されます。休眠中のデータのリストもあります。右側には、タグ分布、カテゴリ別のファイル数、サイズ別のファイル分布、および時間の経過に伴うファイル カテゴリの 4 つの追加タイルがあります。各タイルをクリックすると、詳細が表示されます。
検出セクションの次のタブはアクティビティ追跡です。名前が示すように、管理者とセキュリティ ユーザーは、特定の期間にどのユーザーがどのようなアクティビティを実行したかをすぐに確認できます。管理者は、検索するマウント ポイントとユーザーと日付範囲を選択するだけで済みます。

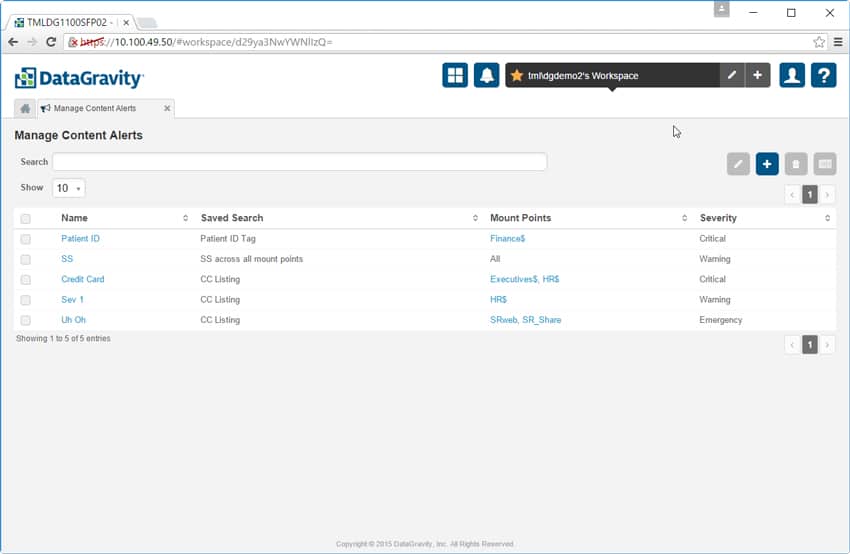
[検出] セクションの最後のタブでは、管理者がコンテンツ アラートを管理できます。以下の例では、管理者は、社会保障番号やクレジット カード番号がオープン テキスト、暗号化されていない形式、および本来の場所ではない場所で見つかったときに通知されるようにアラートを設定しています。これにより、企業は安全でない場所に置かれた重要なデータを迅速に見つけて移動できるようになります。
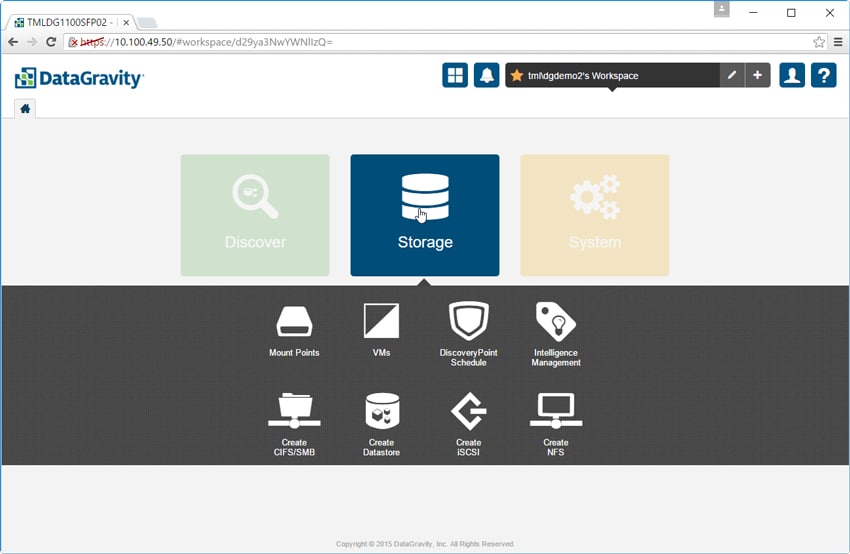
次のメインタブは「ストレージ」タブです。ここには、マウント ポイント、VM、DiscoveryPoint スケジュール、インテリジェンス管理、CIFS/SMB の作成、データストアの作成、iSCSI の作成、および NFS の作成の 8 つのサブタブがあります。
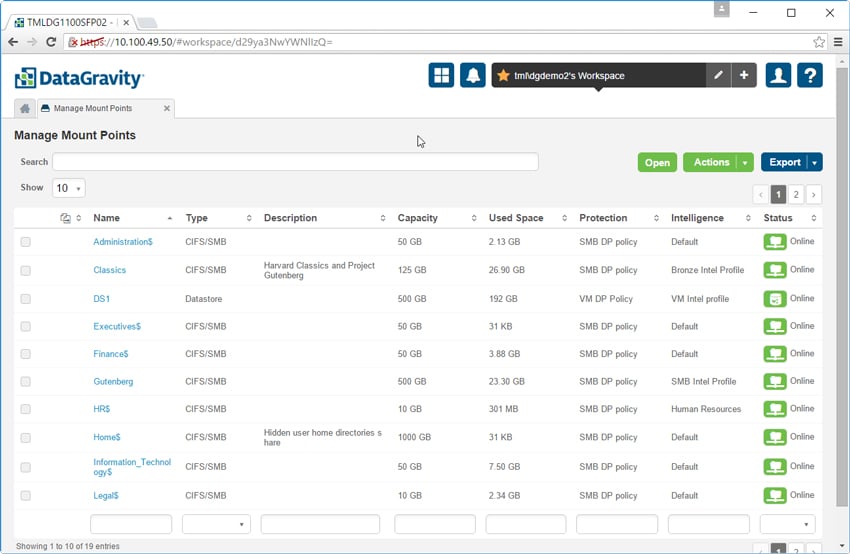
[マウント ポイントの管理] タブを使用すると、ユーザーは各マウント ポイントの設定を確認したり、新しいマウント ポイントを作成したりできます。ここでユーザーは、各マウント ポイントの容量 (および使用量)、それぞれの簡単な説明、その保護ポリシー、およびそのステータスを確認できます。ここで作成された新しいマウント ポイントはそれぞれ、必要に応じてこれらの設定を調整できます。
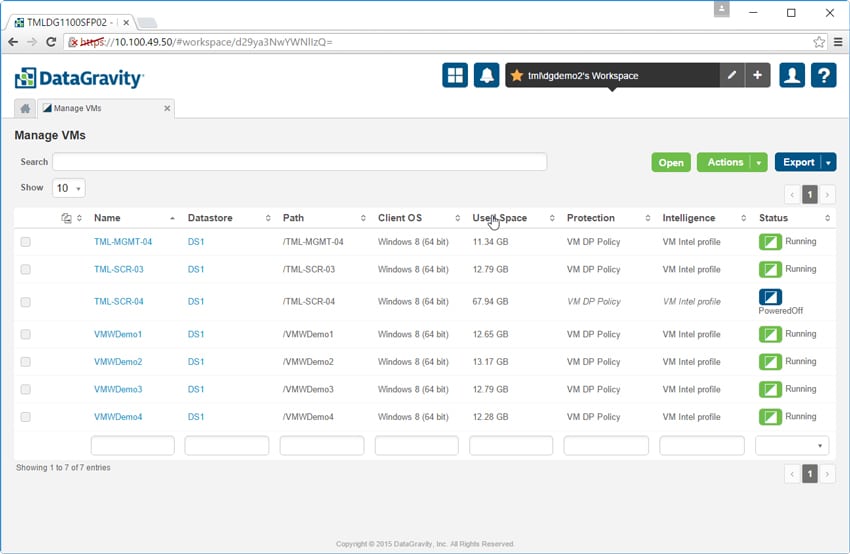
[VM の管理] タブは上記と似ています。ここでは、VM に関する情報を表示および構成できます。 VM 名、その場所、OS、使用容量、保護ポリシー、インテリジェンス プロファイル、VM が実行中か電源オフかが一覧表示されます。 VM をクリックすると、追加の詳細が表示されます。
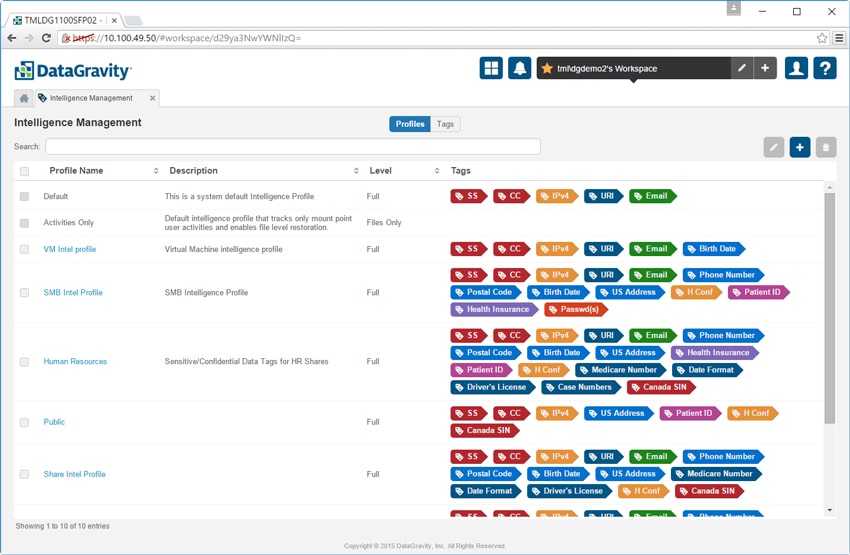
[インテリジェンス管理] タブを使用すると、管理者は特定のユースケースに合わせてインテリジェンス プロファイルを構成し、マウント ポイントと VM に適用できます。 [タグ] ボタンを使用すると、管理者は組み込みの正規表現エディタを使用して、機密データを含むコンテンツのパターンやフレーズを定義できます。
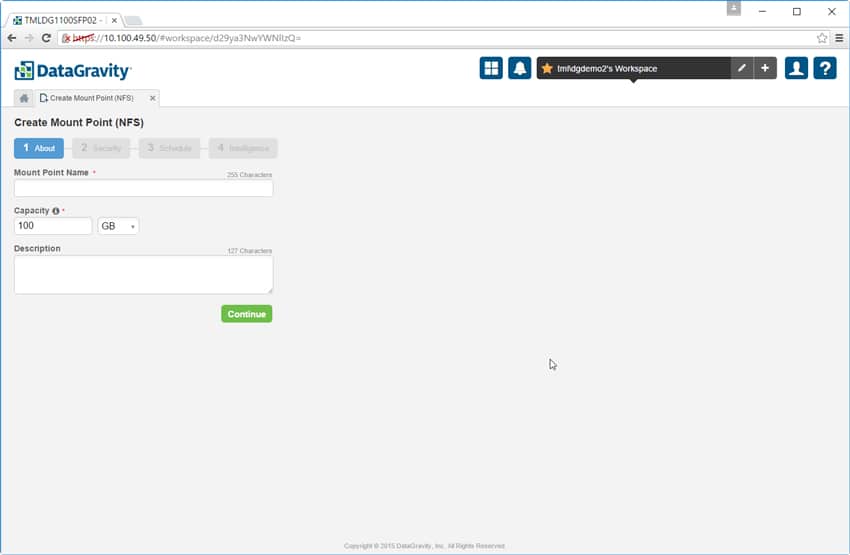
次の 4 つのタブはすべて、マウント ポイントとそのアクセス プロトコル (CIFS/SMB、VM 対応 NFS データストア、iSCSI、または NFS) の作成を扱います (下図)。管理者は、マウント ポイントの名前を追加し、必要に応じて説明を追加し、容量を選択し、セキュリティ ポリシーを設定し、DiscoveryPoint スケジュールを定義し、インテリジェンス プロファイルを選択します。
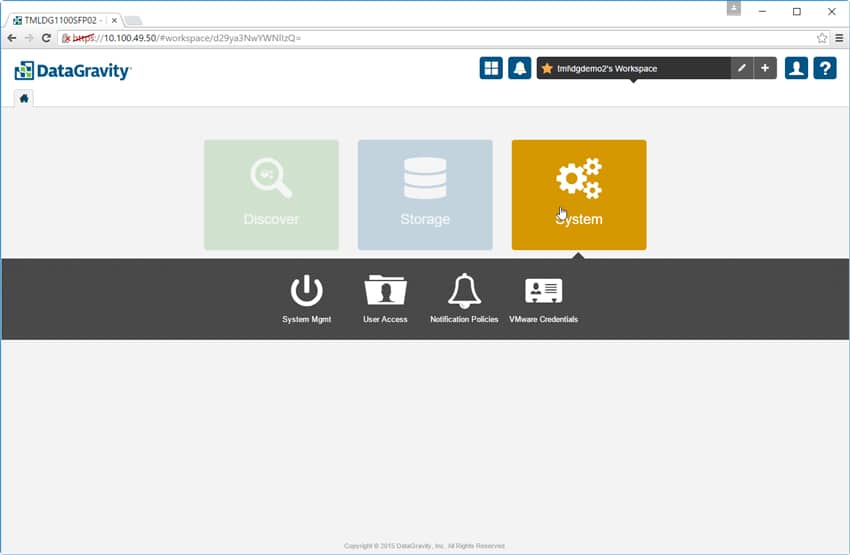
最後のメインセクションは「システム」タブです。これをクリックすると、[システム管理]、[ユーザー アクセス]、[通知ポリシー]、および [VMware 認証情報] の 4 つのサブタブが表示されます。
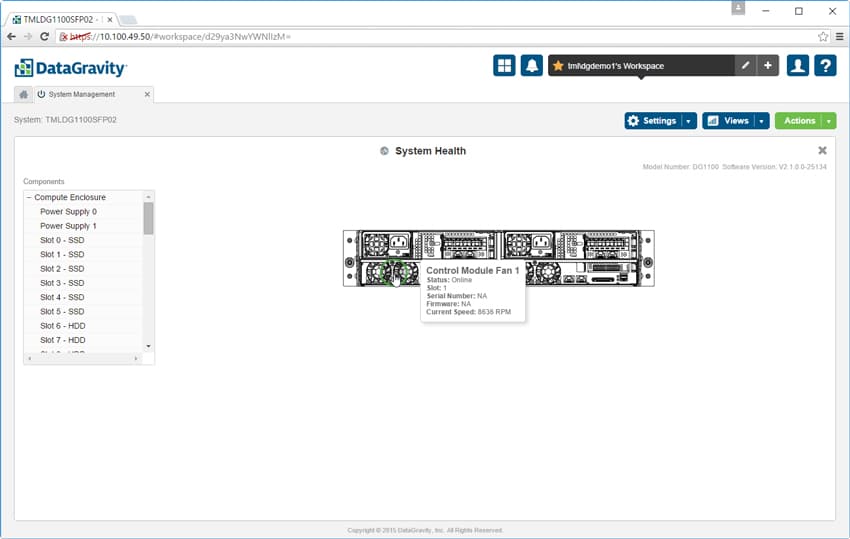
[System Mgmt] タブには、物理システムの健全性を表示する [System Health] など、複数のオプションがあります。左側には、ソリューション内のすべてのコンポーネントのリストが表示されます。右側にはグラフィック表現があり、マウスをカーソルを置くと詳細情報が表示されます。
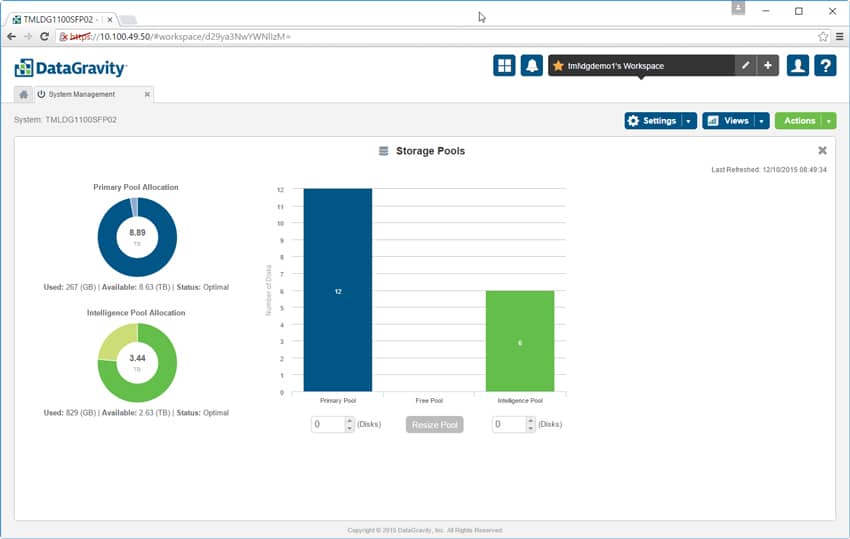
また、システム管理内にはストレージ プール セクションがあり、DataGravity システム内の 3 つの異なるプールが表示されます。プライマリ プールまたは日常使用に割り当てられたプール、インテリジェンス プール、およびストレージ用の空きプールです。まだ割り当てられていません。この画面から、ユーザーは必要に応じてプールのサイズを変更できます。
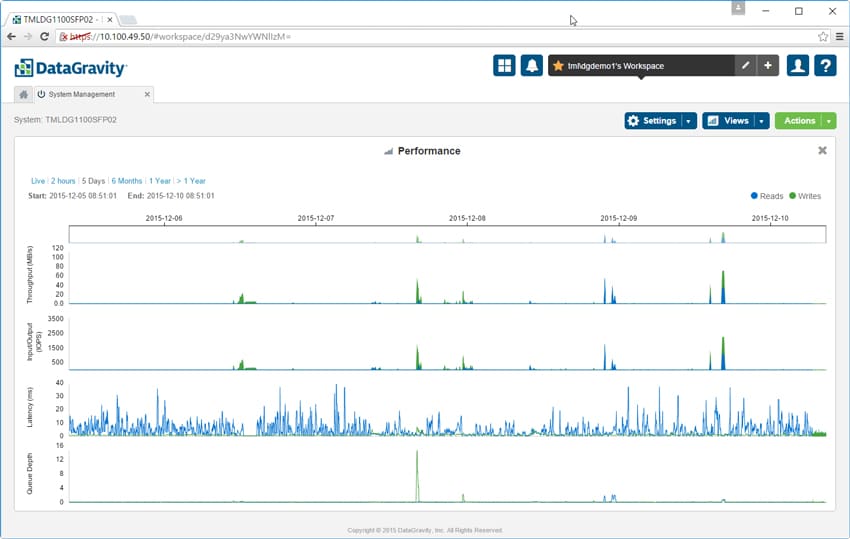
システムのパフォーマンスを確認するオプションもあります。パフォーマンス ビューには、読み取り I/O と書き込み I/O の両方が表示され、MB/秒単位のスループット、IOPS、レイテンシ、キューの深さなどの詳細が表示されます。ユーザーは、一定期間にわたるパフォーマンスを確認したり、パフォーマンスのリアルタイムの読み取りを確認したりできます。
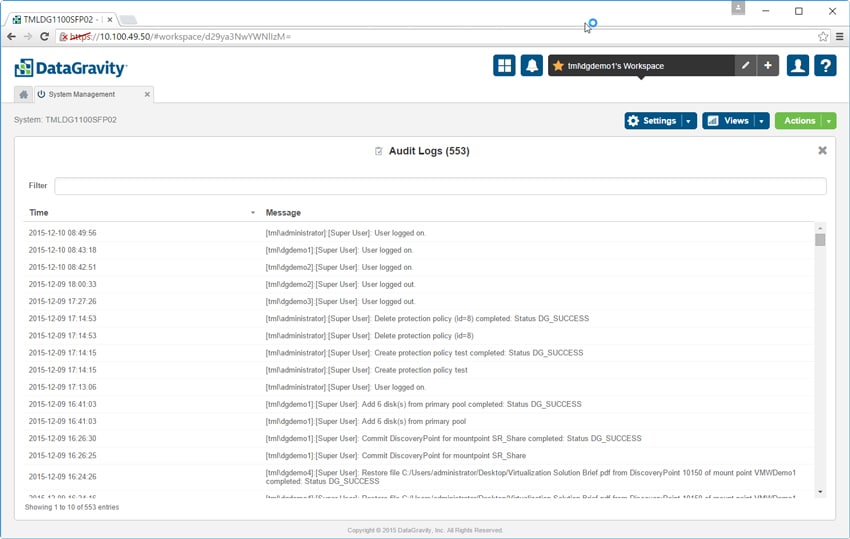
最後に、システム管理で、管理者は監査ログを表示できます。誰がログオンし、何をしていたかを確認できるだけでなく、アクセスを容易にするためにログをフィルタリングしたり、さらに処理するために別のシステムに転送したりすることもできます。
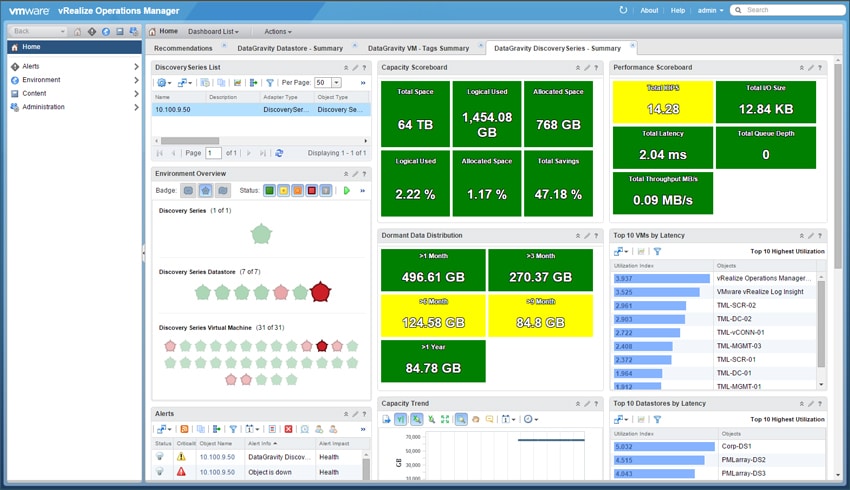
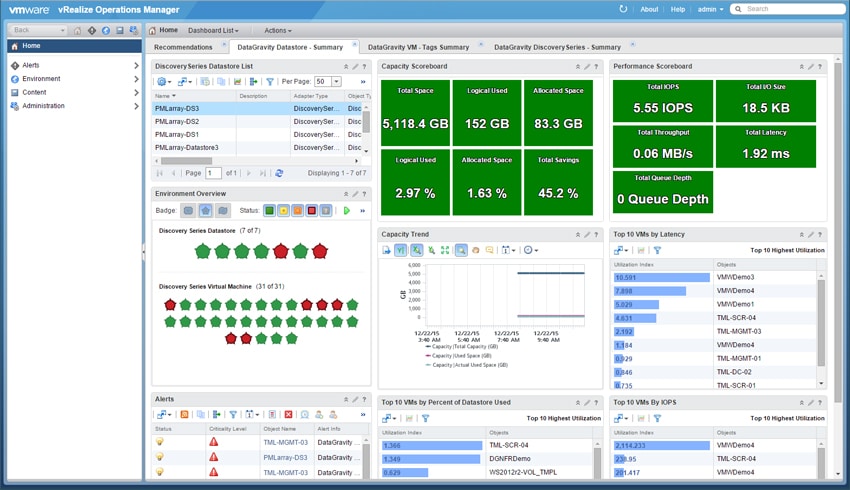
また、DataGravity は VMware vRealize Operations Manager (vROPS) と統合し、DataGravity システムの分析を vROPS が提供する集中コンソールに表示します。 DataGravity 自体には仮想的な存在がないため、この統合により、仮想化管理者は DataGravity ユーザー インターフェイスにログインせずにシステムを表示できるようになります。すべての情報が存在しますが、DataGravity GUI と比較してデータの視覚化は制限されています。
vROPS 統合では、Discovery シリーズ、データストア、または VM の概要ビューが表示されます。以下は、Discovery Series サマリー ダッシュボードのビューで、システムの全体的な容量とパフォーマンス、およびシステムに保存されているデータストアと VM の遅延とそれぞれのリスク スコアが表示されます。
DataGravity Datastore Summary ダッシュボードを表示すると、DataGravity データ対応の NFS データストアに対して同様のメトリクスが表示されます。
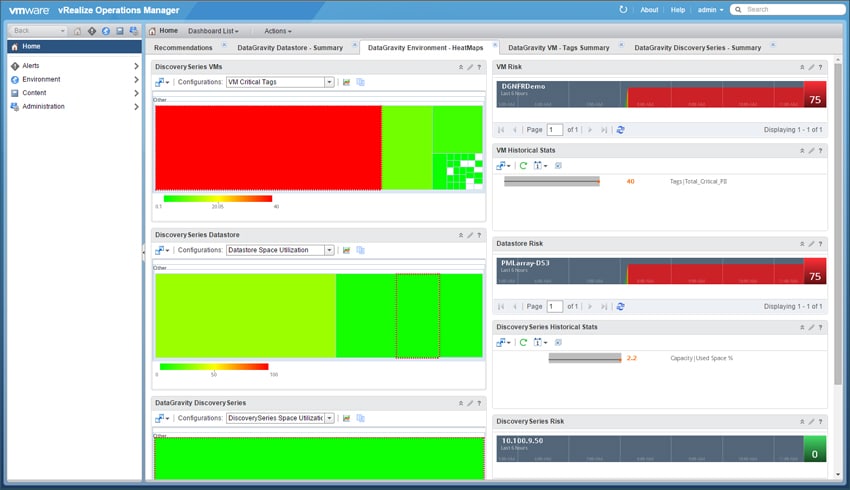
vROPS 統合では、スペース使用率の事前定義値と、VM、データストア、Discovery シリーズ システム内で見つかった重要なインテリジェンス タグに基づいて、潜在的な問題領域を示す「ヒート」マップも表示されます。
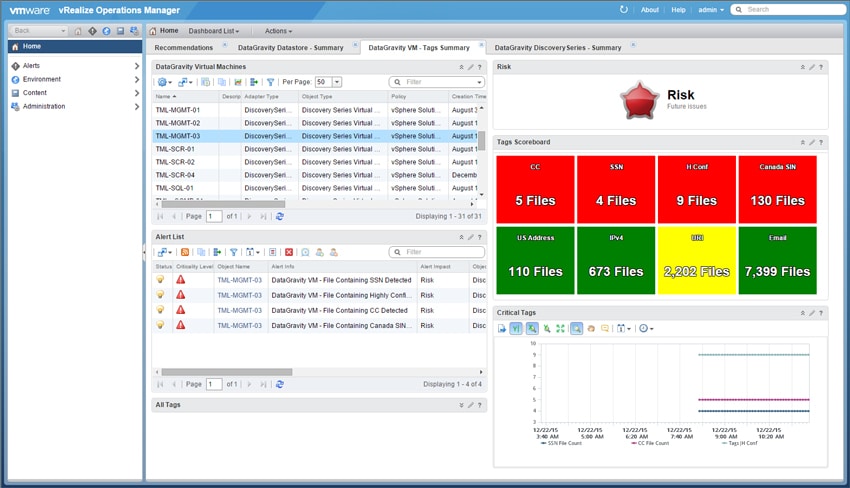
また、仮想化管理者は、どの VM 内のどのデータがリスクにさらされているかを確認できます。タグ付けシステムを通じて、リスクにさらされているデータの種類をより具体的に確認することもできます。
結論
DataGravity の Discovery シリーズは、純粋なパフォーマンスやバックアップとリカバリの時間枠からデータ認識に重点を移すストレージ アレイです。言い換えれば、DataGravity は、使いやすい GUI を通じてユーザーがすべてのデータを確認できるシステムを構築しました。これにより、ユーザーは自分のデータがシステム内のどこにあるかを確認できるだけでなく、データ、誰がアクセスしているか、機密データが公開される可能性があるかどうかを追跡する詳細な方法が提供されます。 DataGravity を使用すると、ユーザーはほとんどのファイル タイプにタグを付けることができ、特定のデータ ファイルをすばやく見つけて監視するのに役立ちます。これにより、(意図的でないか悪意があるかにかかわらず)問題を発見して企業のデータの安全性が高まるだけでなく、データの局所性、アクセス、保持のニーズ、コンプライアンスを理解することで、企業が保存されているすべてのデータを完全に活用できるようになります。
通常、StorageReview では基盤となるハードウェアを調査し、一連のベンチマークを通じてそのパフォーマンスをテストします。 DataGravity の場合、ソフトウェアが最大のセールスポイントです。同社は 18 TB から 96 TB までの複数の容量を提供しており、ソリューションには RAM、NVRAM、SSD、ニアライン HDD を組み合わせていますが、基盤となるハードウェアは DataGravity 分析プラットフォームをサポートするために存在します。もちろん、すべてのハードウェアはソフトウェアをサポートするために存在しますが、ほとんどのベンダーは、従来のストレージ機能を提供するために XNUMX つを並行して使用しています。 DataGravity は、最高のパフォーマンスや最低の遅延については主張しません。代わりに、DataGravity はデータの認識と使いやすさに重点を置いています。この点において、同社は明らかに優れています。
StorageReview チームはソリューションをテストするために現場に行きました。今回は使いやすさに焦点を当てていたため、パフォーマンス テストを実行するためにラボに物理デバイスは必要ありませんでした。私たちが到着する前に、DataGravity はウェブサイト コンテンツの大部分を配列に取り込み、私たちがよく知っている検索用のデータを提供してくれました。システムの基本的な概要を理解するだけで、さまざまな種類のファイル内のキーワードの検索、共有の作成、データ プールの再割り当てを行うソリューションを直感的に使い始めることができ、さらにソリューションの使用状況がどのように追跡されているかを確認することができました。
結局のところ、DataGravity が行っていることは、他のストレージ業界とは著しく異なります。ベテラン チームは、ストレージ コンプライアンスの可視性をフックとして、ビジネス上の正当な問題を解決することにまず取り組むことにしました。このインテリジェンスの重視は、容量やスループットのニーズに基づいて購入される従来のストレージとは大きく異なる DataGravity の基本です。 DataGravity のアプローチは規制された業界では非常に理にかなっていますが、当社の小規模ビジネスのユースケースでも、社外向けコンテンツの一部であっても詳細に把握できるようになると、すぐにメリットが得られました。その分析情報を、ユーザーのホーム ディレクトリ、ワークグループの共有フォルダ、その他のビジネス資産に関するものと組み合わせると、メリットが急速に増大します。また、DataGravity は非常に直感的に使用できるため、小規模または過負荷の IT ショップに適しています。
ボトムライン
DataGravity の Discovery シリーズを使用すると、企業はすべてのデータを安全に保ちながら、使いやすいインターフェースを通じて実用的に活用できるようになります。データの分析と可視化に重点を置いているのはストレージ業界では実にユニークであり、創造性が欠如していることが多い業界において DataGravity に大きな差別化ポイントを与えています。


 Amazon