

PERC975シリーズのRAIDコントローラのDell H13iは、同社がハードウェアRAID分野で過去975年以上にわたって成し遂げてきた最も飛躍的な進歩です。DellはPERCラインを定期的にアップデートしてきましたが、これらは主に漸進的なもので、PCIe世代の進化に合わせてコントローラのチューニングと帯域幅の向上に重点を置いていました。しかし、基盤となるアーキテクチャは、長年エンタープライズRAIDを定義してきたSATAとSASのレガシーに縛られていました。PERC H51iは、この悪循環を決定的に打破します。BroadcomのSAS975xxラインのチップセットをベースに構築されたこのコントローラは、フラッシュファーストでNVMeネイティブな設計への明確な移行を示しています。NVMeドライブのみをサポートし、従来のHDDおよびSATAテクノロジーのサポートを排除することで、HXNUMXiは、現代のデータ集約型およびAIファーストのワークロードの高性能、低レイテンシの需要に合わせて最適化された、ストレージインフラストラクチャへの先進的なアプローチを取り入れています。
主要なポイント(要点)
- フラッシュファースト NVMe RAID: PERC13 H975i は SAS/SATA から完全に移行し、NVMe ネイティブの AI 対応アーキテクチャを実現する Broadcom SAS51xx をベースに構築されています。
- 世代間の大きな飛躍: コントローラあたり最大 5 台の NVMe ドライブ (16 台で 16 台) を搭載した PCIe Gen32 x52.5 は、テストでコントローラあたり 12.5 GB/秒、12M IOPS を実現し、PERC88 と比較したパフォーマンス向上には、読み取り帯域幅の 318% 増加、書き込み帯域幅の 31% 増加、4K 読み取り IOPS の 466% 増加、4K 書き込み IOPS の XNUMX% 増加が含まれます。
- AIサーバーの適合性: フロント統合設計により、背面の PCIe スロットが GPU 用に解放され、MCIO の実行時間が短縮され、アクセラレータごとに専用のストレージ パイプが有効になり、CPU オーバーヘッドなしでより安定した確定的なスループットが得られます。
- ストレス下での回復力: スーパーキャパシタ保護キャッシュと高速再構築により、再構築中も高いパフォーマンスを維持しながら、時間を 10 分/TiB まで短縮します (最大 53.7 GB/秒の読み取り、68 GB/秒の書き込み、17.3M/5.33M 4K IOPS)。
- エンドツーエンドのセキュリティ: ハードウェアの信頼のルート、SPDM デバイス ID、およびドライブ、転送中のデータ、コントローラー キャッシュをカバーするフルスペクトル暗号化。
PERC H975iは、比類のないパフォーマンスと革新的なアーキテクチャを提供します。PCIe Gen 5 x16ホストインターフェイスを活用し、最大16台のNVMeドライブ(32台のコントローラでシステムあたり975台のNVMeドライブ)をサポートするH52.5iは、当社のテストで最大12.5GB/秒のスループットとコントローラあたり2万IOPSという驚異的なパフォーマンスを実現しました。これは、最大12万IOPSと6.9GB/秒のスループットを達成したPERC27と比較して、すべての主要カテゴリでほぼ13倍のパフォーマンス向上に相当します。PERC975は、純粋なパフォーマンスにとどまらず、従来のバッテリバックアップシステムに代わるスーパーキャパシタベースのキャッシュ保護メカニズムを導入し、運用の信頼性を損なうことなくデータの整合性を確保しています。前モデルのセキュリティ機能を基に構築されたHXNUMXiは、フルスペクトルの暗号化機能を拡張し、キャッシュ内のデータを暗号化し、転送中と保管中の両方で包括的な保護を提供します。
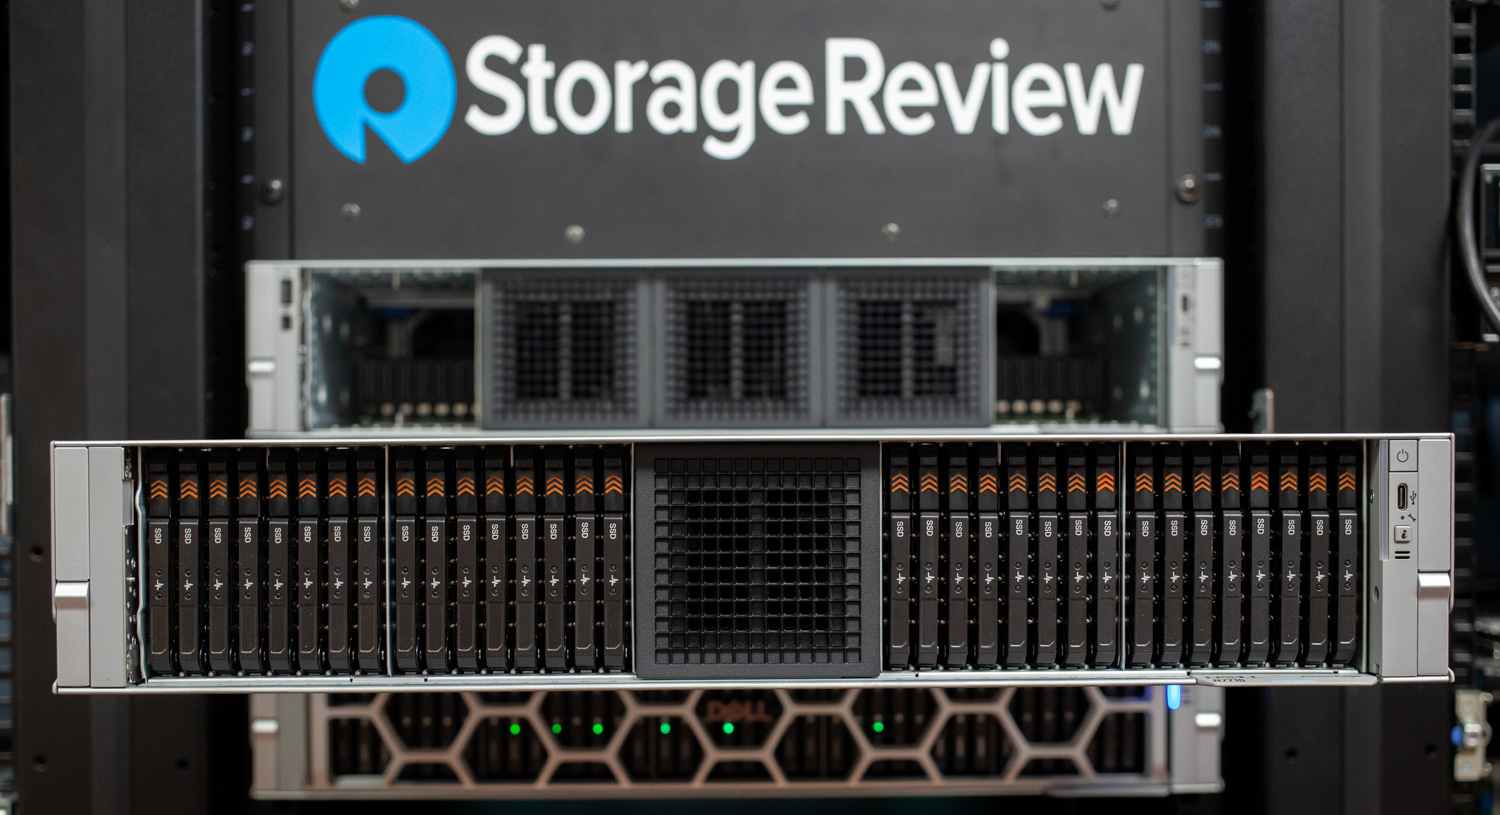
PERC H975iは、AIワークロードのかつてないほどの計算需要に応えるために設計された専用ストレージアクセラレータです。高密度と高性能を両立し、CPUオーバーヘッドのない低レイテンシストレージを提供します。実際には、x5インターフェースを飽和させる可能性のあるPCIe Gen16 RAIDカードとGen5 GPUを組み合わせることで、各アクセラレータに専用のストレージパイプラインが提供されます。これによりPCIe/NUMAトポロジが簡素化され、ノイジーネイバー効果(Noisy-Neighbor effect)が防止され、リビルドやバックグラウンドタスクがGPUのI/Oドメインに分離されます。
これをデュアルRAIDカードに拡張し、GPUを2基搭載することで、共有レーンやキャッシュの競合を回避しながら線形パフォーマンスを維持できます。その結果、大量のデータを必要とする学習・推論(大規模バッチ、高速シャッフル、高速チェックポイント読み取り)において、入力帯域幅が安定し、負荷時およびリビルド時のレイテンシ分散が改善します。このアーキテクチャは、ピーク時の数値を向上させるだけでなく、スループットをより決定論的にします。これはまさに、マルチGPU AIサーバーが高稼働率を維持するために必要な要素です。
Dell PERC12 H965i および PERC13 H975i の仕様
| 機能 | PERC12 H965i フロント | PERC13 H975i フロント |
|---|---|---|
| RAIDレベル | 0、1、5、6、10、50、60 | 0、1、5、6、10、50、60 |
| 非RAID(JBOD) | はい | はい |
| ホストバスタイプ | PCIe Gen4 x16 | PCIe Gen5 x16 |
| サイドバンド管理 | I2C、PCIe VDM | I2C、PCIe VDM |
| ポートあたりのエンクロージャ数 | 適用されない | 適用されない |
| プロセッサ/チップセット | Broadcom RAIDオンチップ、SAS4116W | Broadcom RAIDオンチップ、SAS5132W |
| エネルギーパック/電源バックアップ | 電池 | スーパーキャパシタ |
| ローカルキー管理セキュリティ | はい | はい |
| セキュアエンタープライズキーマネージャー | はい | はい |
| コントローラキューの深さ | 8,192 | 8,192 |
| 不揮発性キャッシュ | はい | はい |
| キャッシュメモリ | 8 GB DDR4 3200 MT/s | 統合RAIDキャッシュ |
| キャッシュ関数 | ライトバック、リードアヘッド、ライトスルー、常にライトバック、リードアヘッドなし | ライトバック、ライトスルー、常にライトバック、先読みなし |
| 最大複合仮想ディスク数 | 64 | 16 |
| 最大シンプル仮想ディスク数 | 240 | 64 |
| 最大ディスクグループ数 | 64 | 32 |
| ディスクグループあたりの最大 VD 数 | 16 | 8 |
| 最大ホットスペアデバイス数 | 64 | 8 |
| ホットスワップデバイスをサポート | はい | はい |
| 自動構成(プライマリ&1回実行) | はい | はい |
| ハードウェアXORエンジン | はい | はい |
| オンライン容量拡張 | はい | はい |
| 専用およびグローバルホットスペア | はい | はい |
| サポートされているドライブの種類 | NVMe Gen3およびGen4 | NVMe Gen3、Gen4、Gen5 |
| VDストリップ要素サイズ | 64KB | 64KB |
| NVMe PCIe サポート | Gen4 | Gen5 |
| 構成最大NVMeドライブ | コントローラあたり8台のドライブ | コントローラあたり16台のドライブ |
| サポートされているセクターサイズ | 512B、512e、4Kn | 512B、512e、4Kn |
| ストレージブートサポート | UEFIのみ | UEFIのみ |
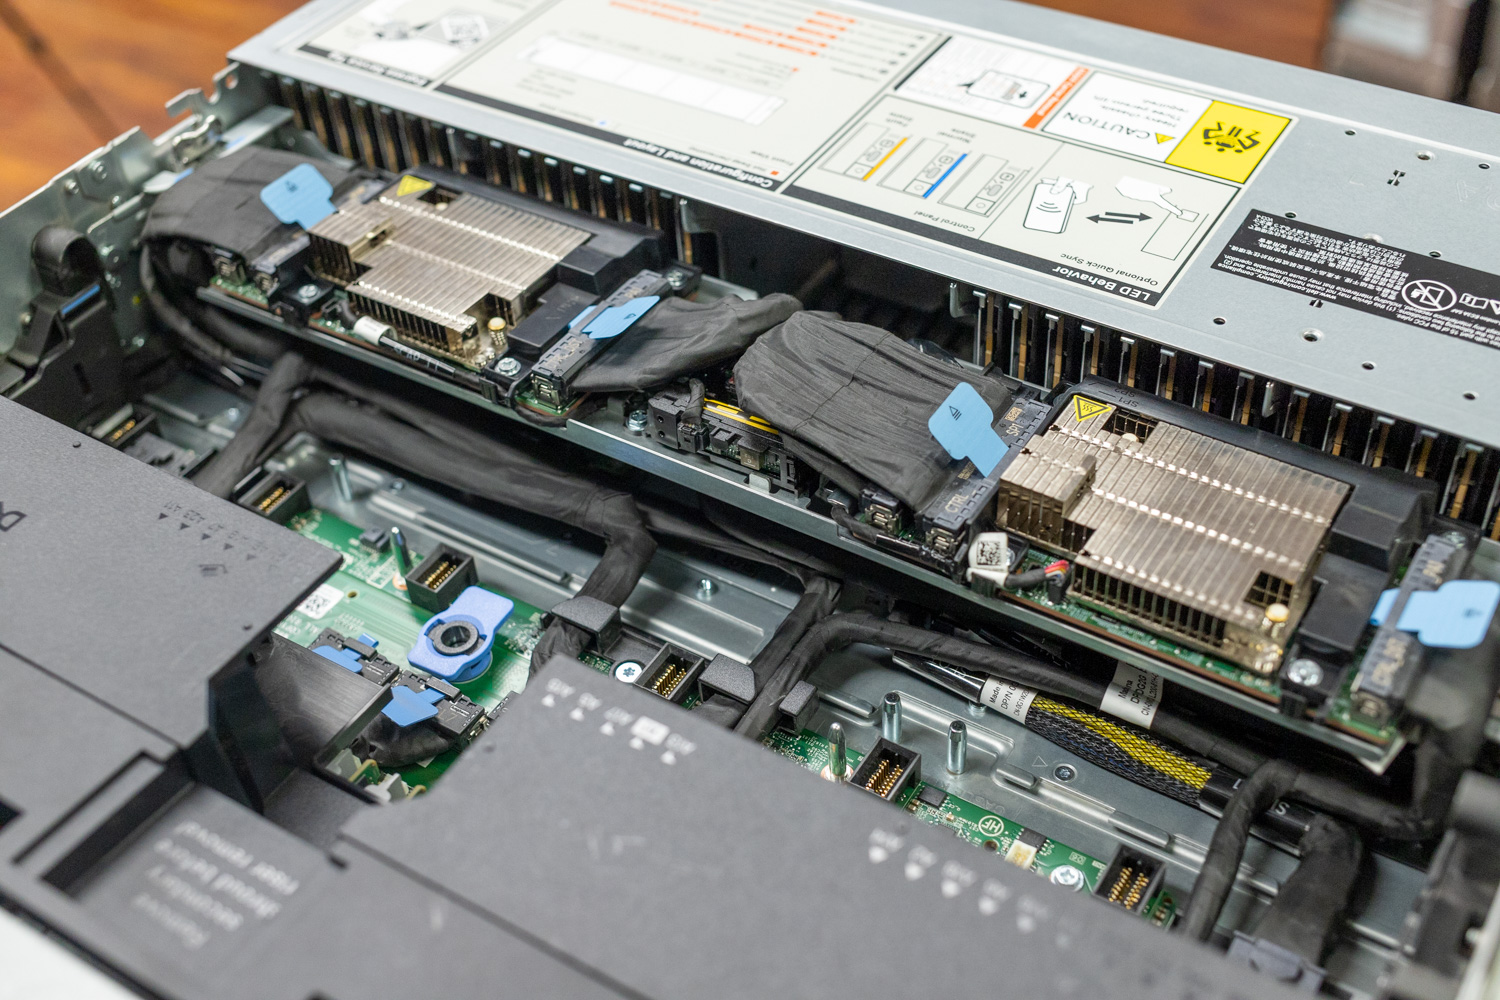
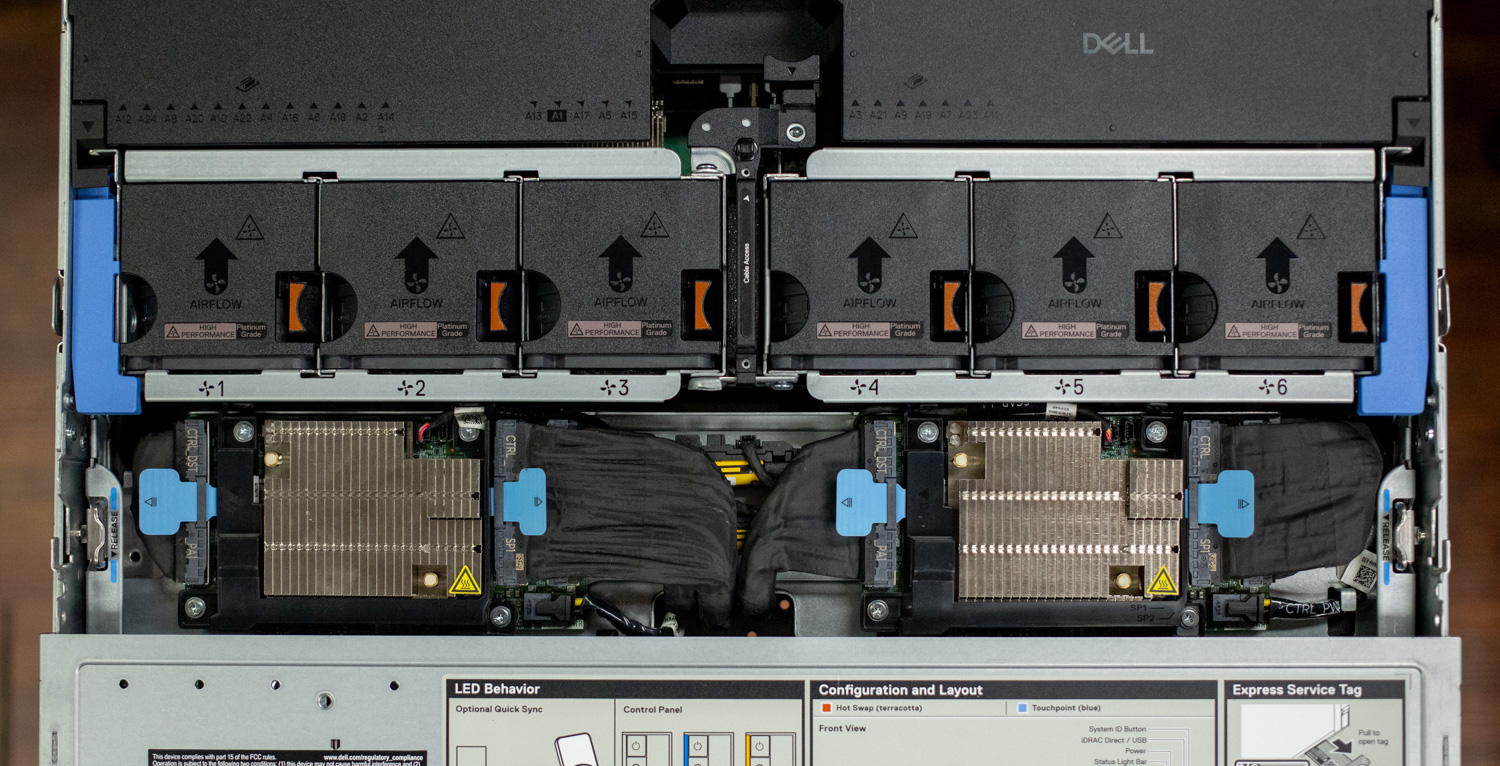
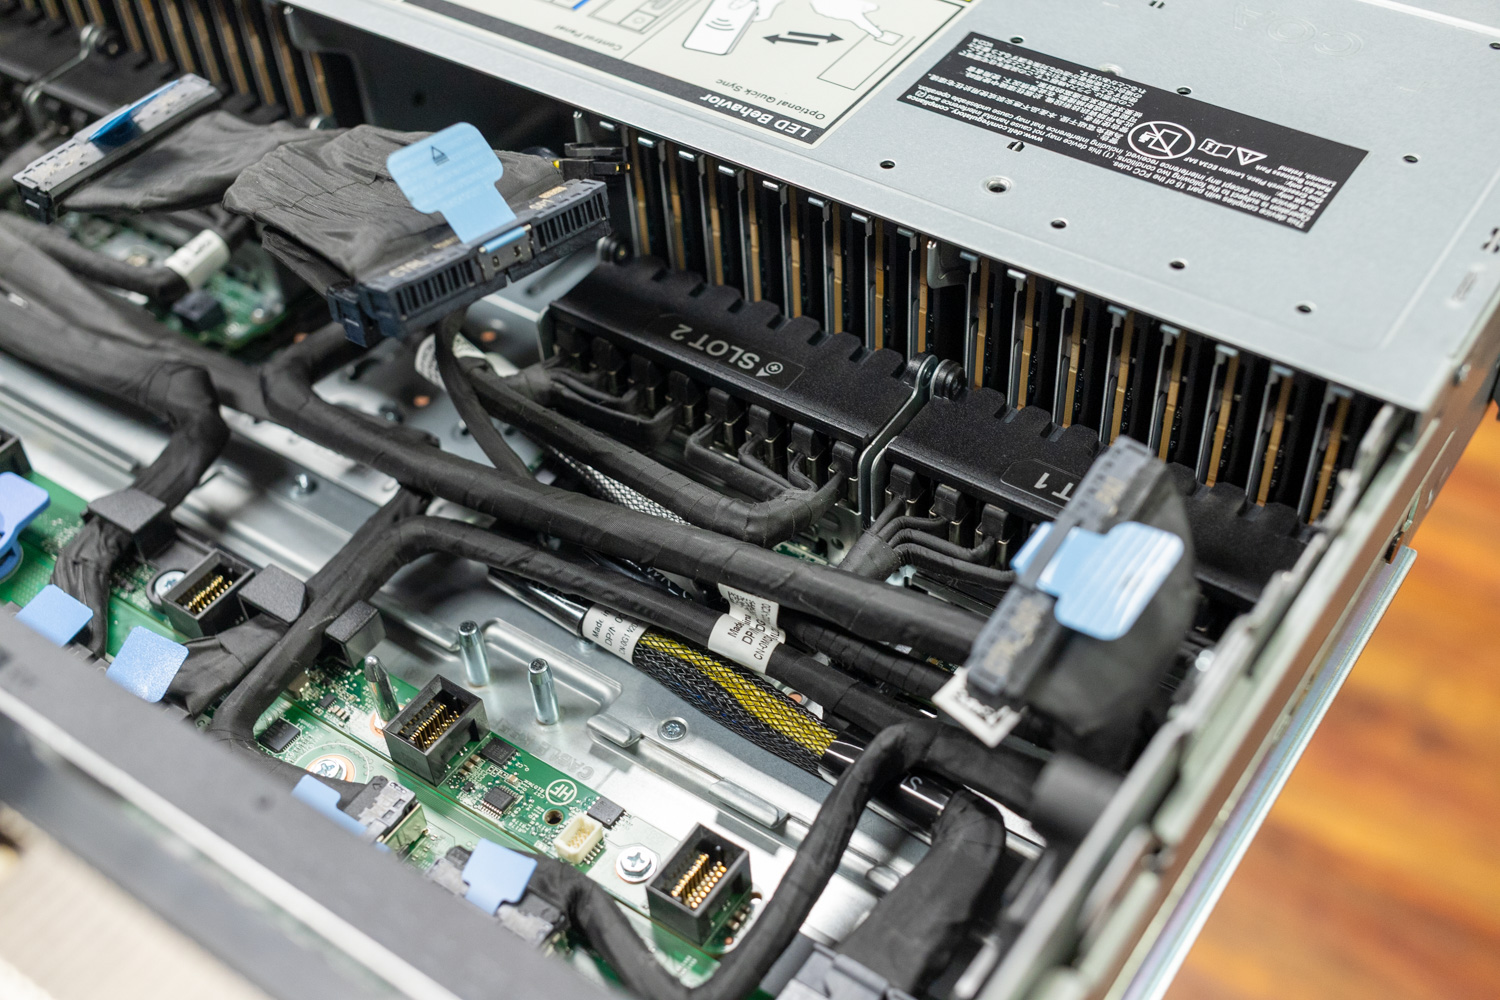
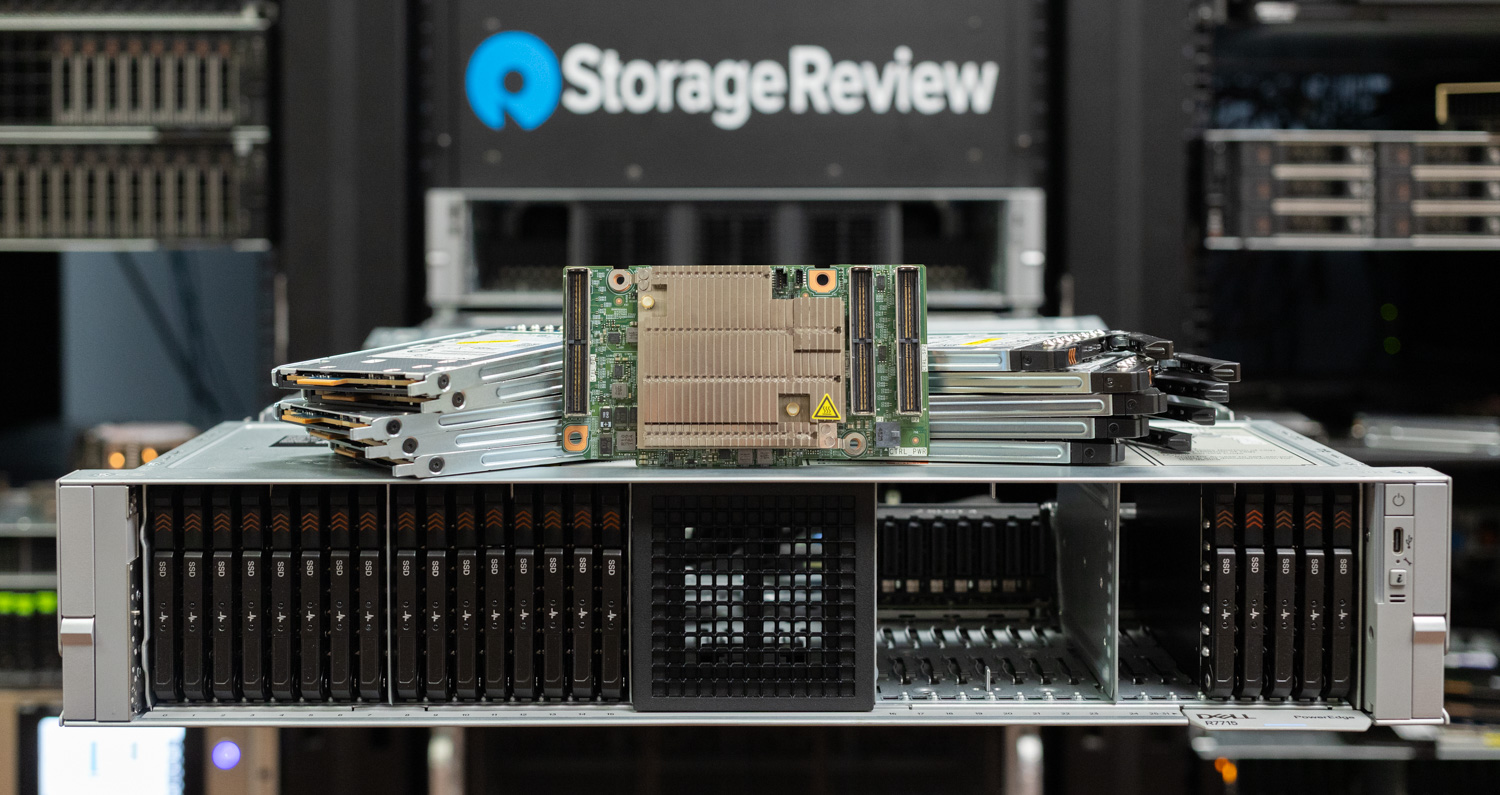
Dell PowerEdgeサーバに搭載されたPERC13 H975iフロントコントローラは、システムアーキテクチャへのシームレスな統合を実現するように設計されています。従来の背面PCIeスロットを占有するアドインカードとは異なり、H975iはフロントドライブバックプレーンに直接接続し、専用のPCIe 5.0インターフェースを介してマザーボードのフロントMCIOコネクタと接続します。この統合設計により、高性能GPUや追加のPCIe拡張用に背面PCIeスロットを確保しながら、ケーブル長を大幅に短縮できます。これにより信号の整合性が維持され、システムの信頼性と保守性が向上します。その結果、内部レイアウトがすっきりし、エアフローが改善され、高密度でコンピューティング負荷の高い環境でも優れたパフォーマンスを発揮します。
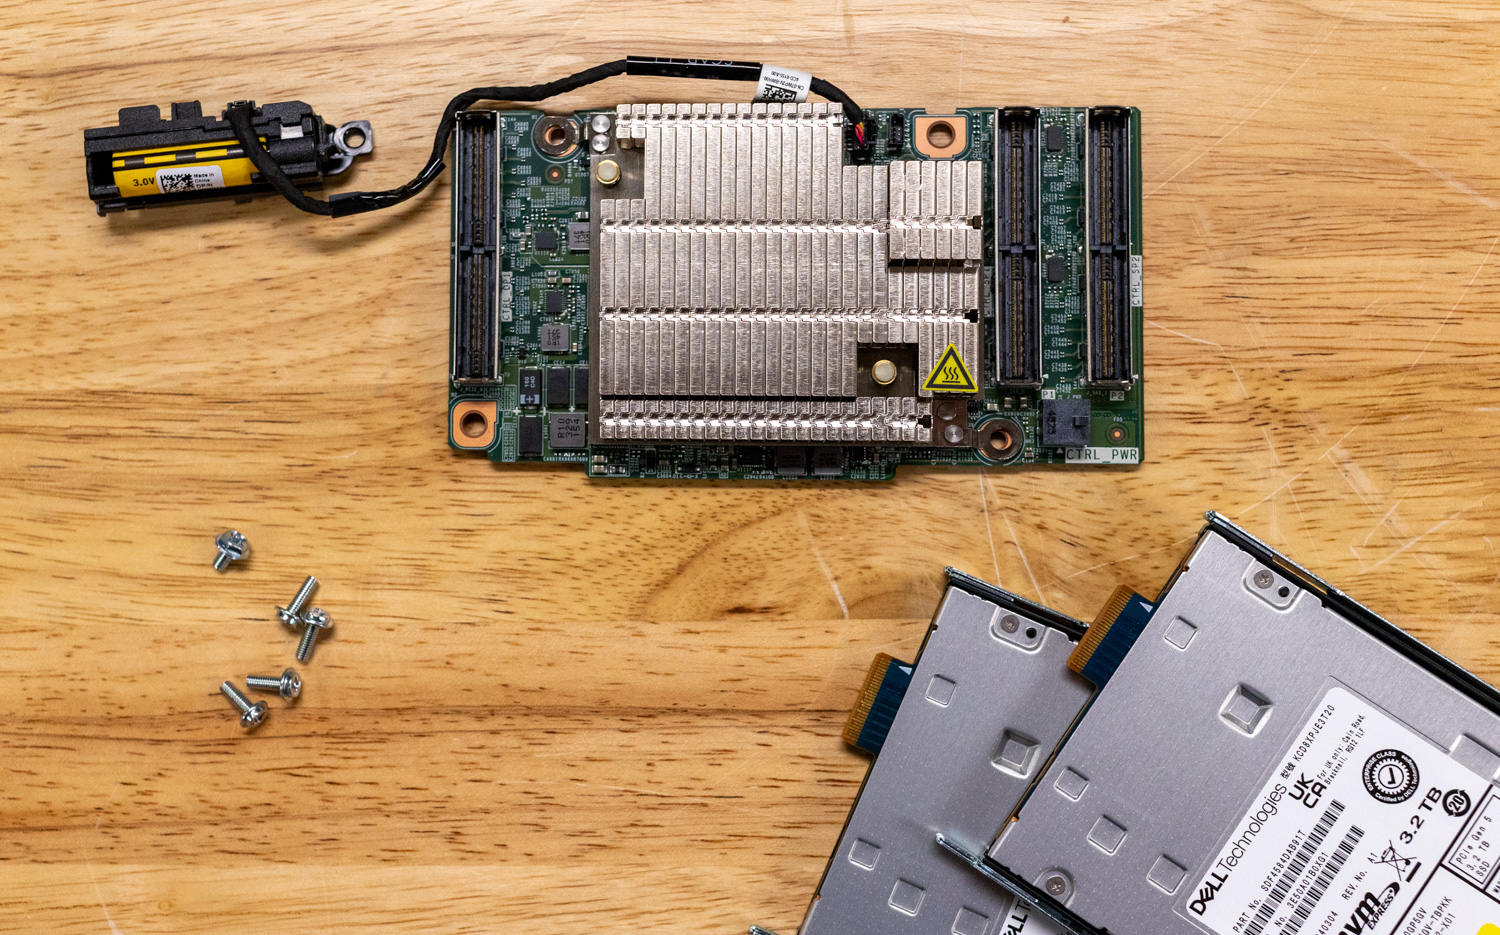
H975iは、シリコンレベルのハードウェア認証からSEDドライブにおけるデータのフルスペクトル暗号化まで、包括的なセキュリティアーキテクチャを実装しています。その基盤となるハードウェアルートオブトラストは、内部ブートROMから各ファームウェアコンポーネントに至るまで、暗号化検証の不変チェーンを確立し、認証されたデル認定ファームウェアのみがコントローラ上で実行できるようにします。このハードウェアベースのセキュリティは、セキュリティプロトコルおよびデータモデル(SPDM)実装を通じて拡張され、各コントローラには固有のデバイスID証明書が含まれており、iDRACはリアルタイムの認証検証を実行できます。コントローラは、従来の保存データシナリオを超えて、キャッシュメモリを含むように暗号化保護を拡張します。暗号化キーは、不正なファームウェアがアクセスできない安全なメモリ領域に保持されます。その結果、機密データは、ドライブ上に保存されているか、キャッシュでアクティブに処理されているかに関係なく、保護された状態を維持します。
H975iの電源保護機能は、スーパーキャパシタの統合により、従来のバッテリーバックアップシステムから大きく進化しました。スーパーキャパシタは、予期せぬ電源喪失時に瞬時に電力を供給し、暗号化されたキャッシュデータを不揮発性ストレージに完全にフラッシュすることで、データを無期限に保護します。さらに、学習サイクルに4~8時間を要するバッテリーベースのシステムとは異なり、H975iのスーパーキャパシタは、キャリブレーション中にパフォーマンスを低下させることなく、透過的学習サイクルを5~10分で完了します。この設計により、バッテリーソリューションに固有のメンテナンスのオーバーヘッドや劣化の懸念が解消され、ミッションクリティカルなデータ保護において優れた信頼性を提供します。
統合監視と管理
Dell の PERC13 RAID コントローラは、Dell の多くの RAID ソリューションと同様に、BIOS のシステム セットアップによるプラットフォームの起動中、iDRAC Web GUI、PERC12 ユーティリティ、さらには Dell OpenManage UI および CLI など、さまざまな方法で管理および監視できます。
iDRAC コントローラ管理
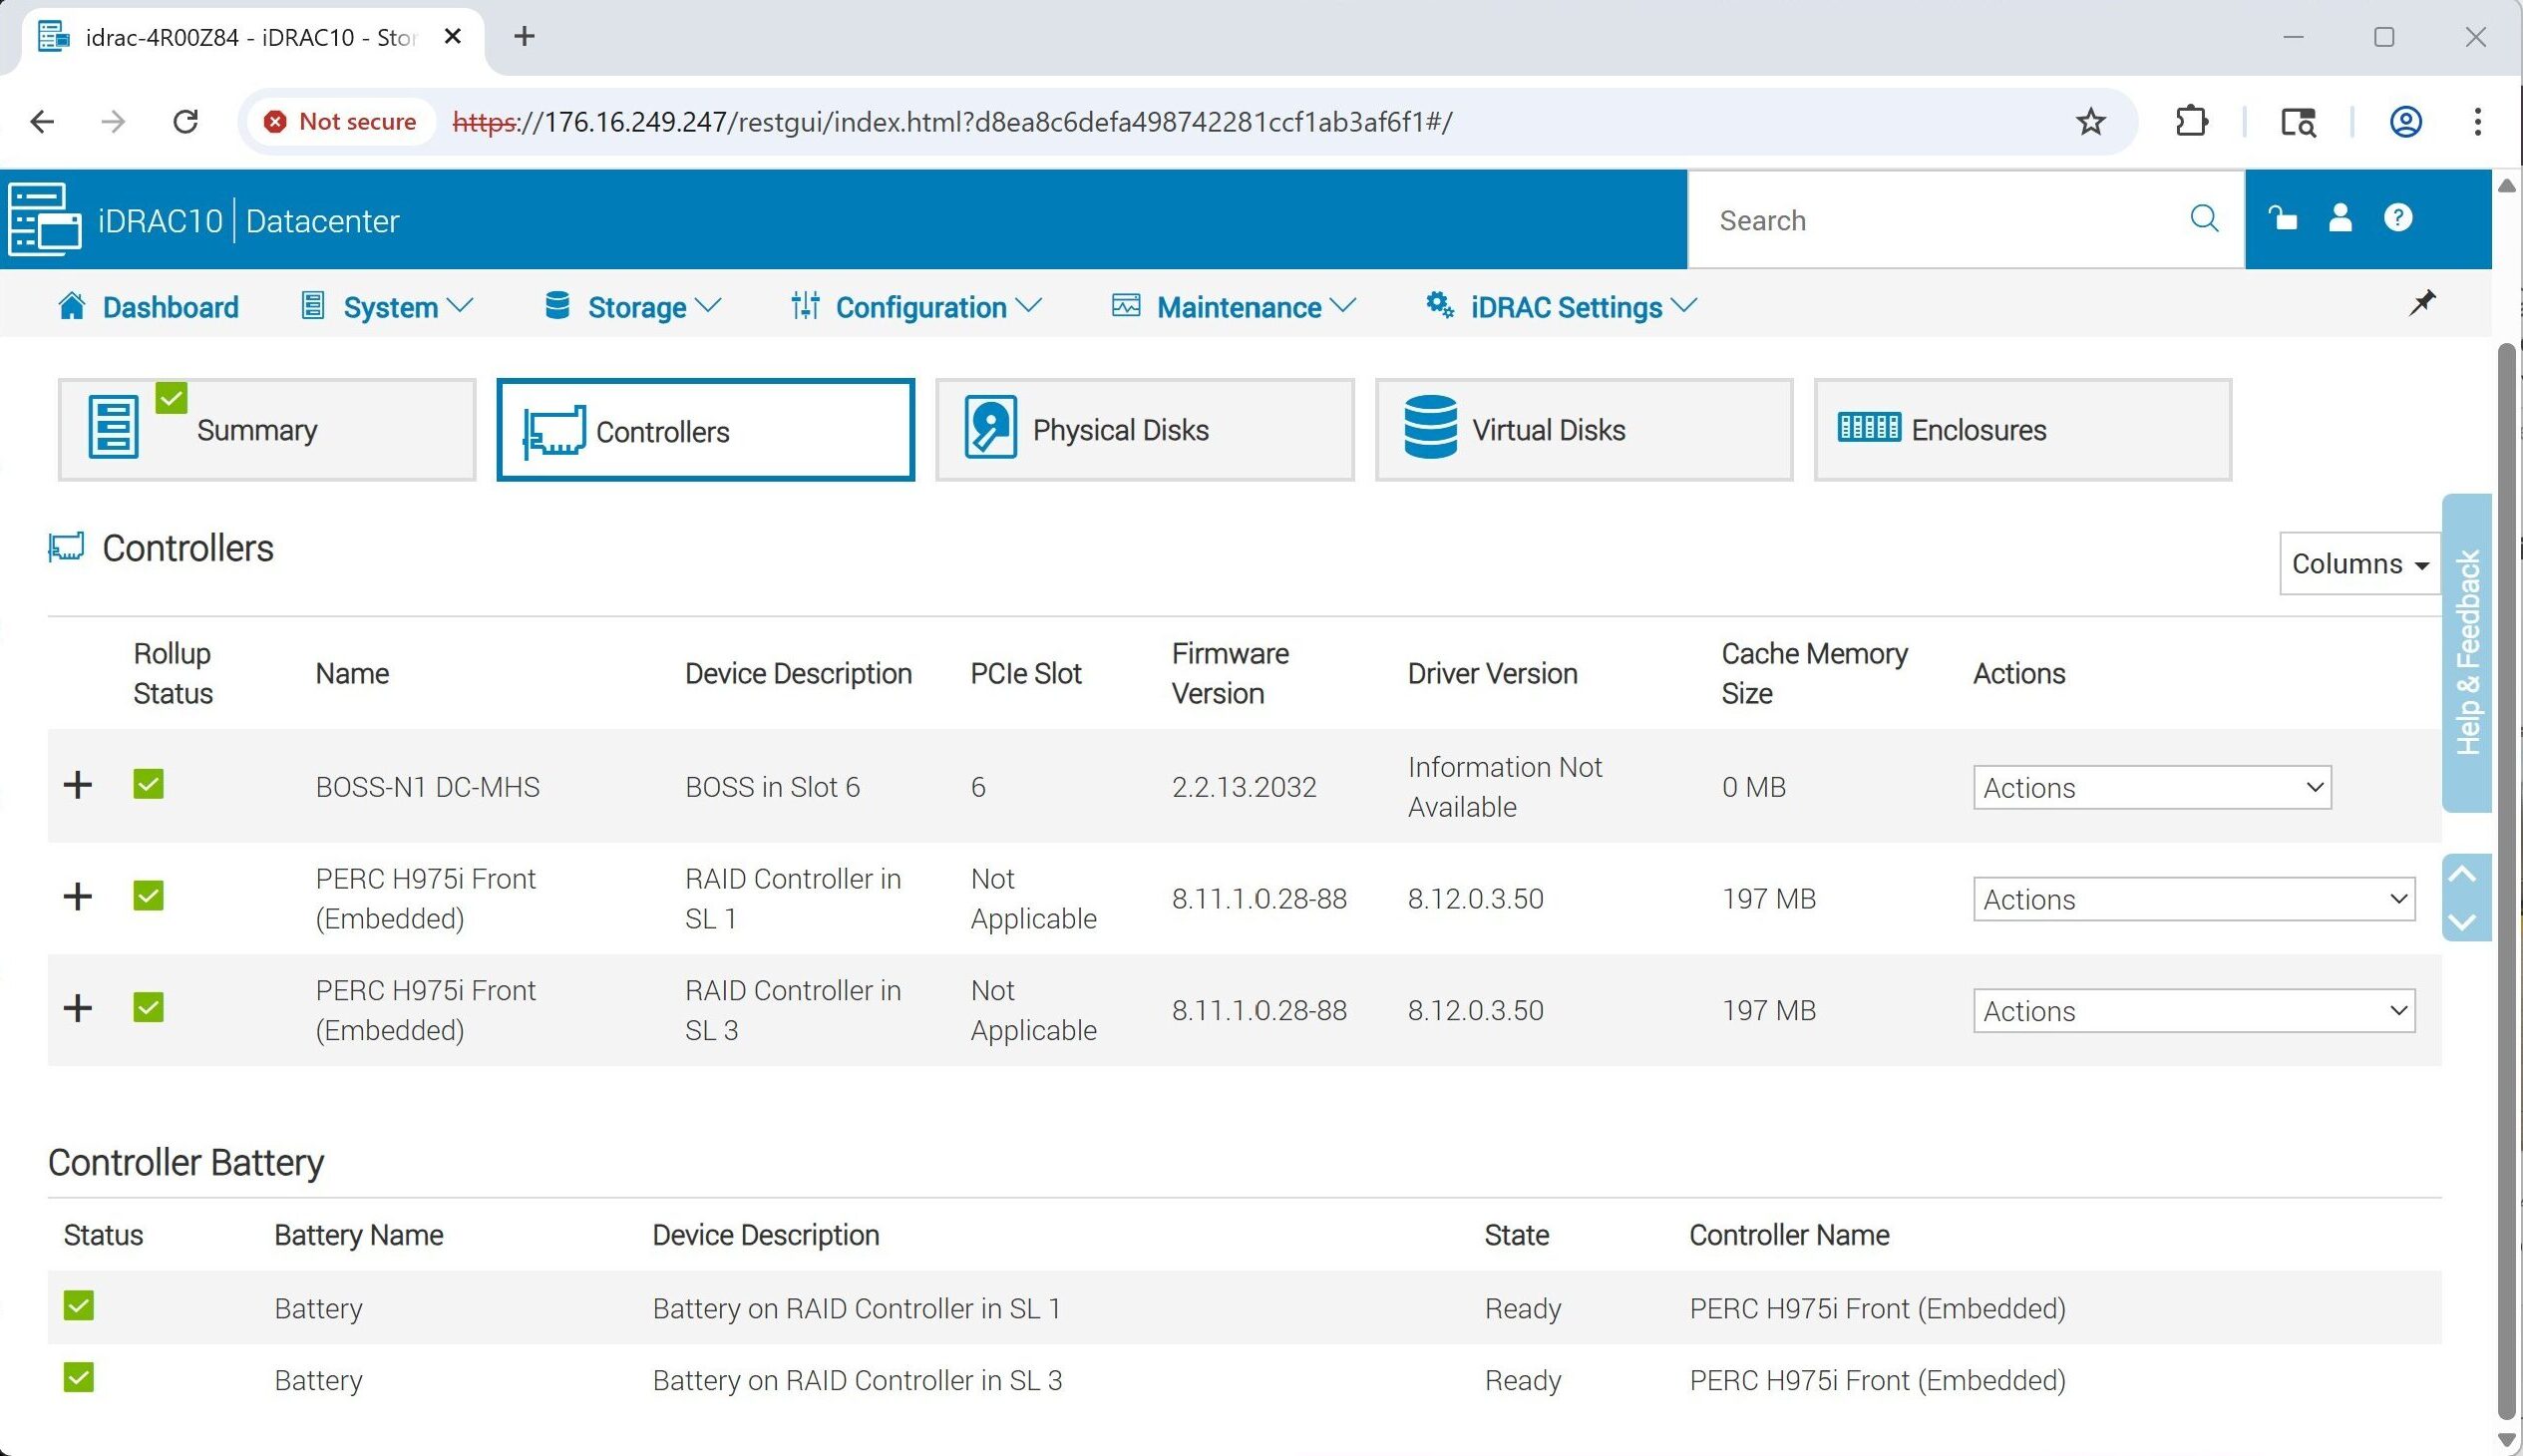
iDRAC管理インターフェースの「コントローラ」タブでは、サーバーのストレージハードウェアの概要が表示されます。BOSSカードの横には、デュアルPERC H975iコントローラが表示され、ファームウェアバージョン、キャッシュメモリ、バッテリーの状態に関する情報も表示されます。このサマリーにより、BIOSにアクセスしたりCLIツールを使用したりすることなく、コントローラの準備状況と構成を迅速に確認できます。
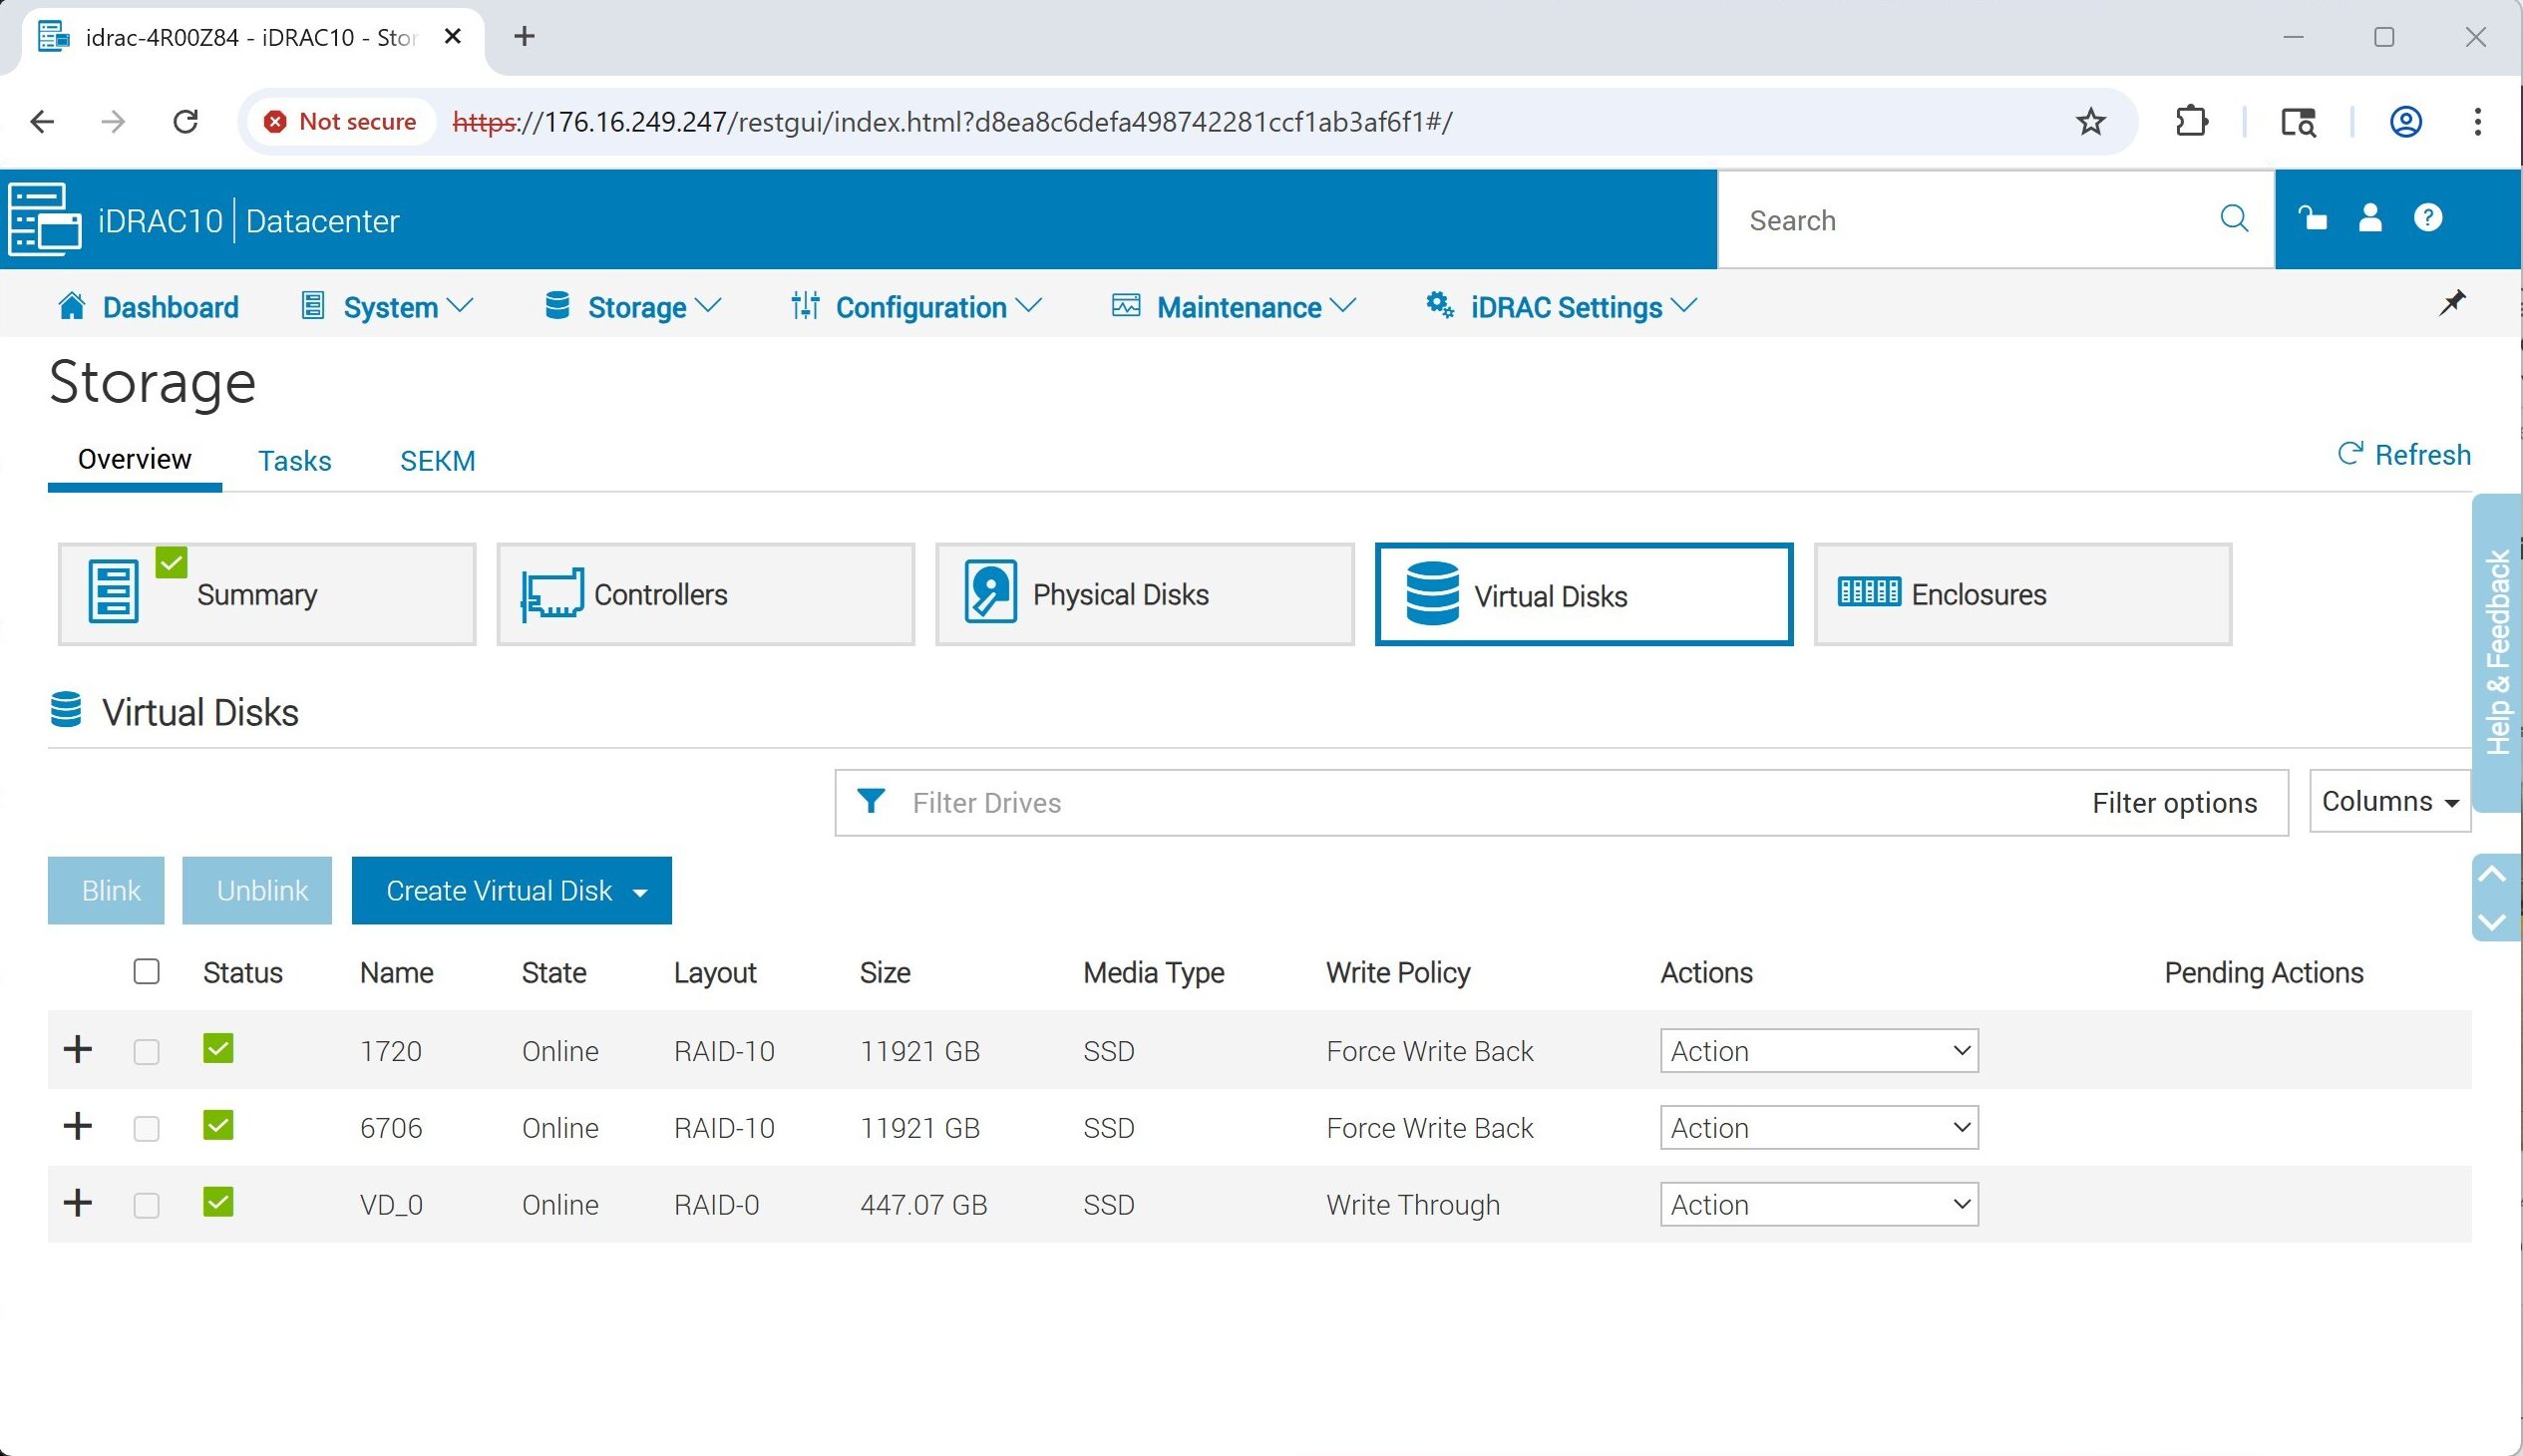
iDRACの「仮想ディスク」タブには、作成されたストレージアレイ(RAIDレベル、サイズ、キャッシュポリシーを含む)が表示されます。このシステムでは、10つのRAID-XNUMXグループがリストされており、いずれもSSD上に構築されています。このビューから、管理者はボリュームがオンラインになっていることを確認したり、新しい仮想ディスクを作成したり、「アクション」メニューを使用して既存の設定を調整または削除したりできます。
RAID コントローラ構成ユーティリティ
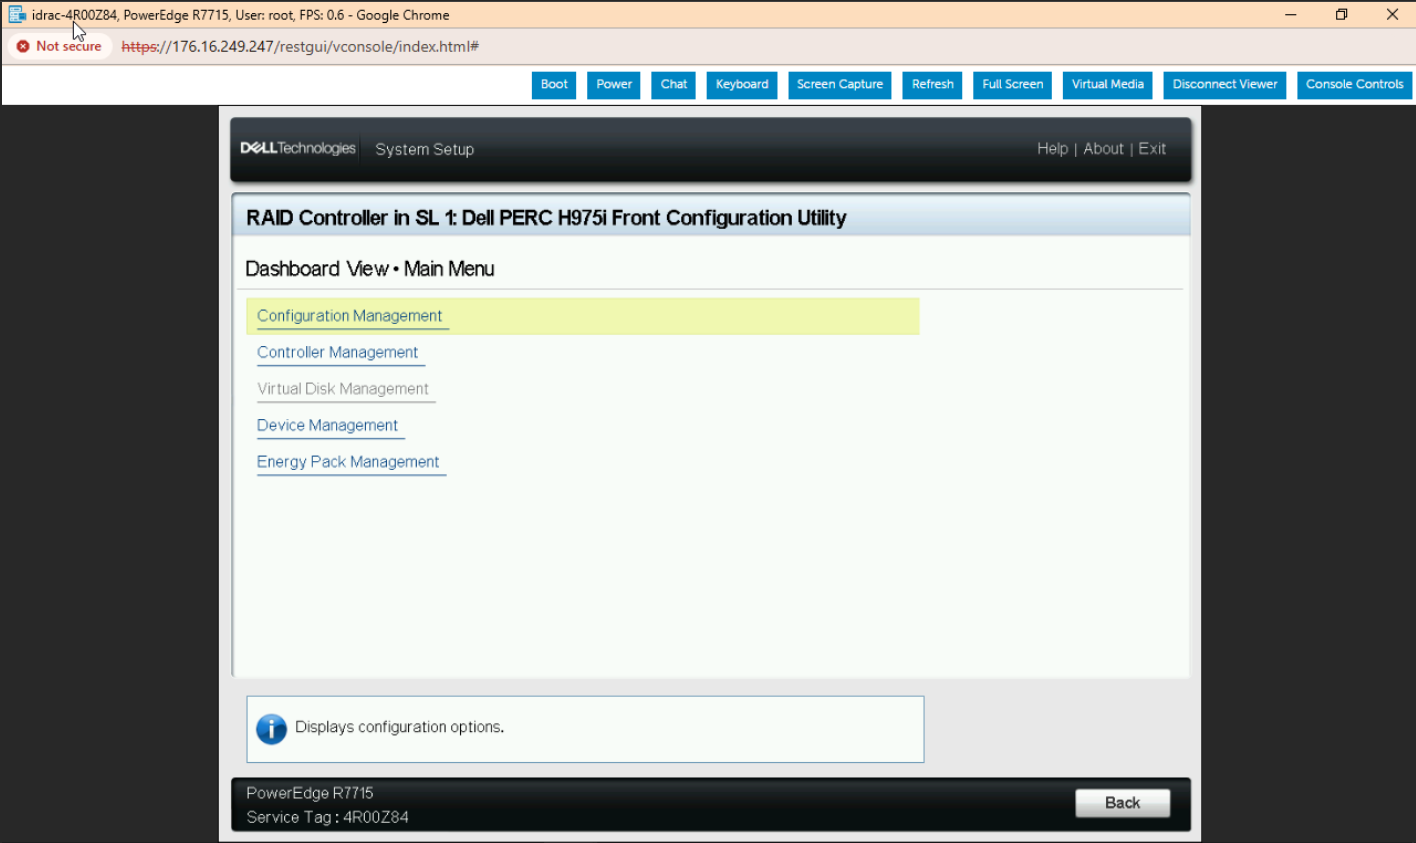
上の画像は、PowerEdge R975プラットフォームでPERC H7715iフロント構成ユーティリティのシステムセットアップを起動する例を示しています。このインターフェースから、構成管理、コントローラ管理、デバイス管理など、RAIDコントローラの主要な設定をすべて管理できます。このユーティリティは、プラットフォームの起動プロセス中に仮想ディスクの設定やハードウェアコンポーネントの直接監視を効率的に行う方法を提供します。
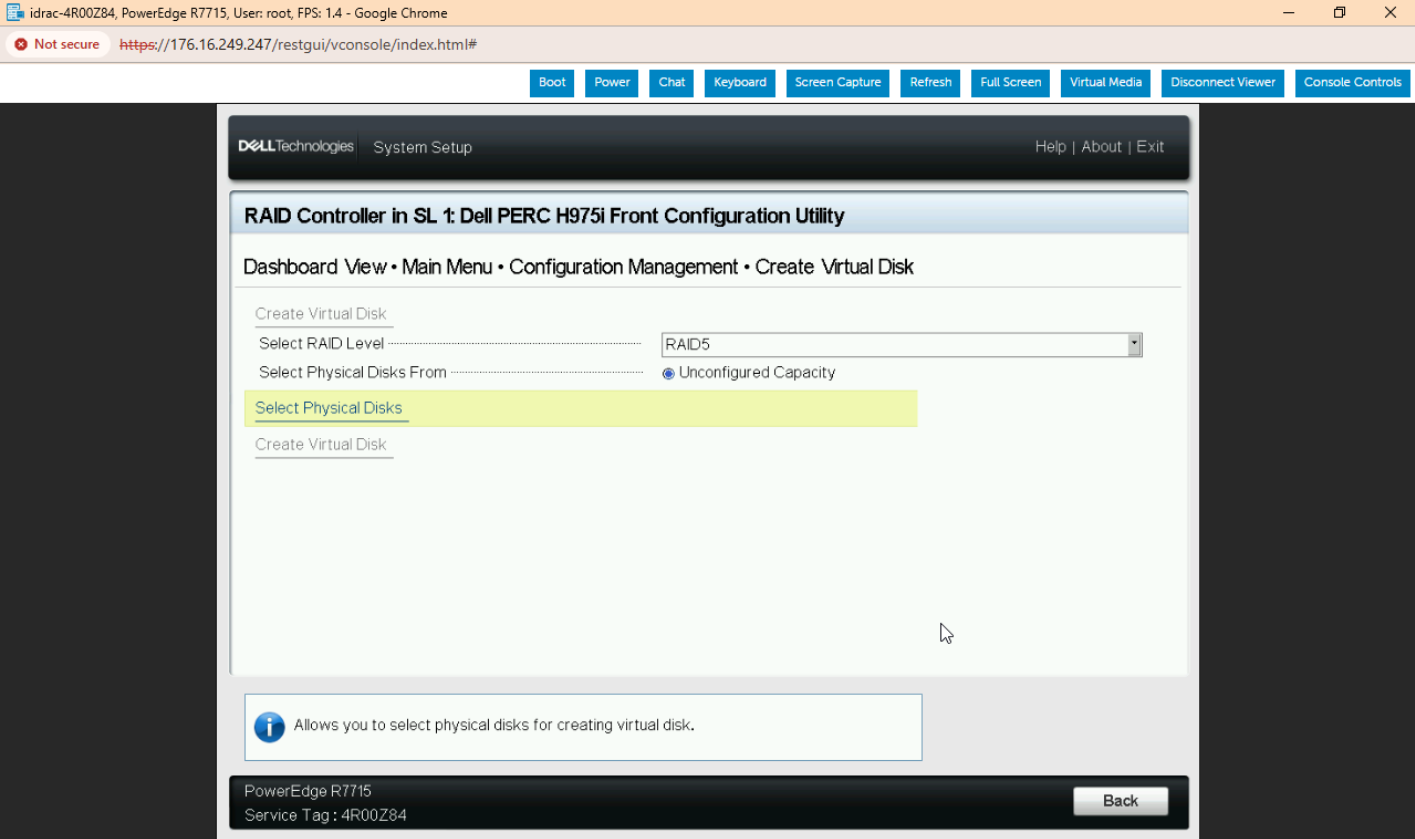
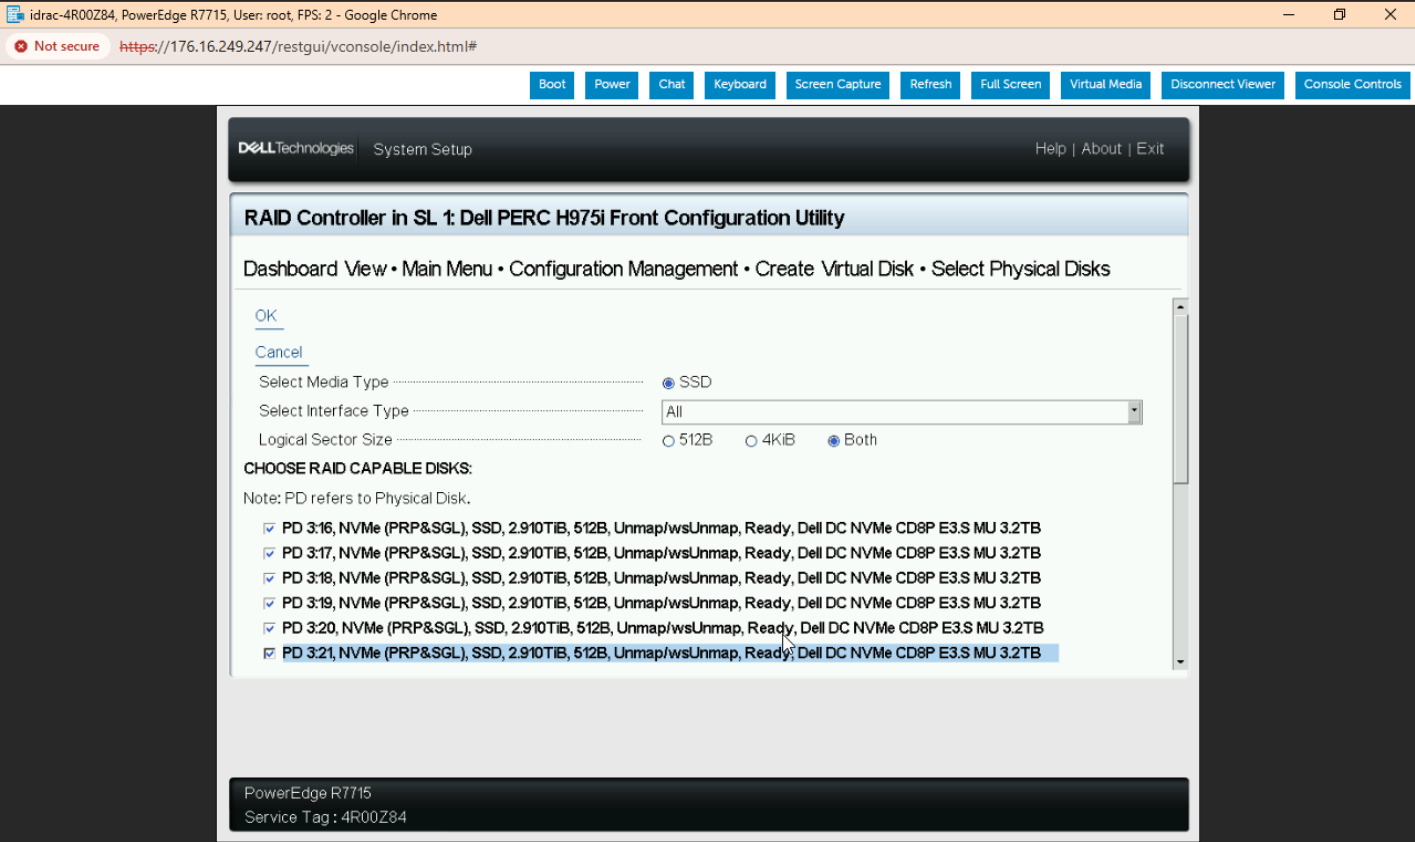
RAIDレベルを選択したら、アレイの物理ディスクの選択に進みます。この例では、利用可能なすべてのNVMe SSDがリストされ、RAID対応としてマークされています。未構成の容量プールから、3.2 TiBのDell DC NVMeドライブを複数選択します。メディアタイプ、インターフェース、論理セクターサイズなどのフィルターを使用して、選択範囲を絞り込みます。必要なドライブにチェックを入れたら、「OK」をクリックしてディスクの選択を確定し、仮想ディスクの作成を続行します。
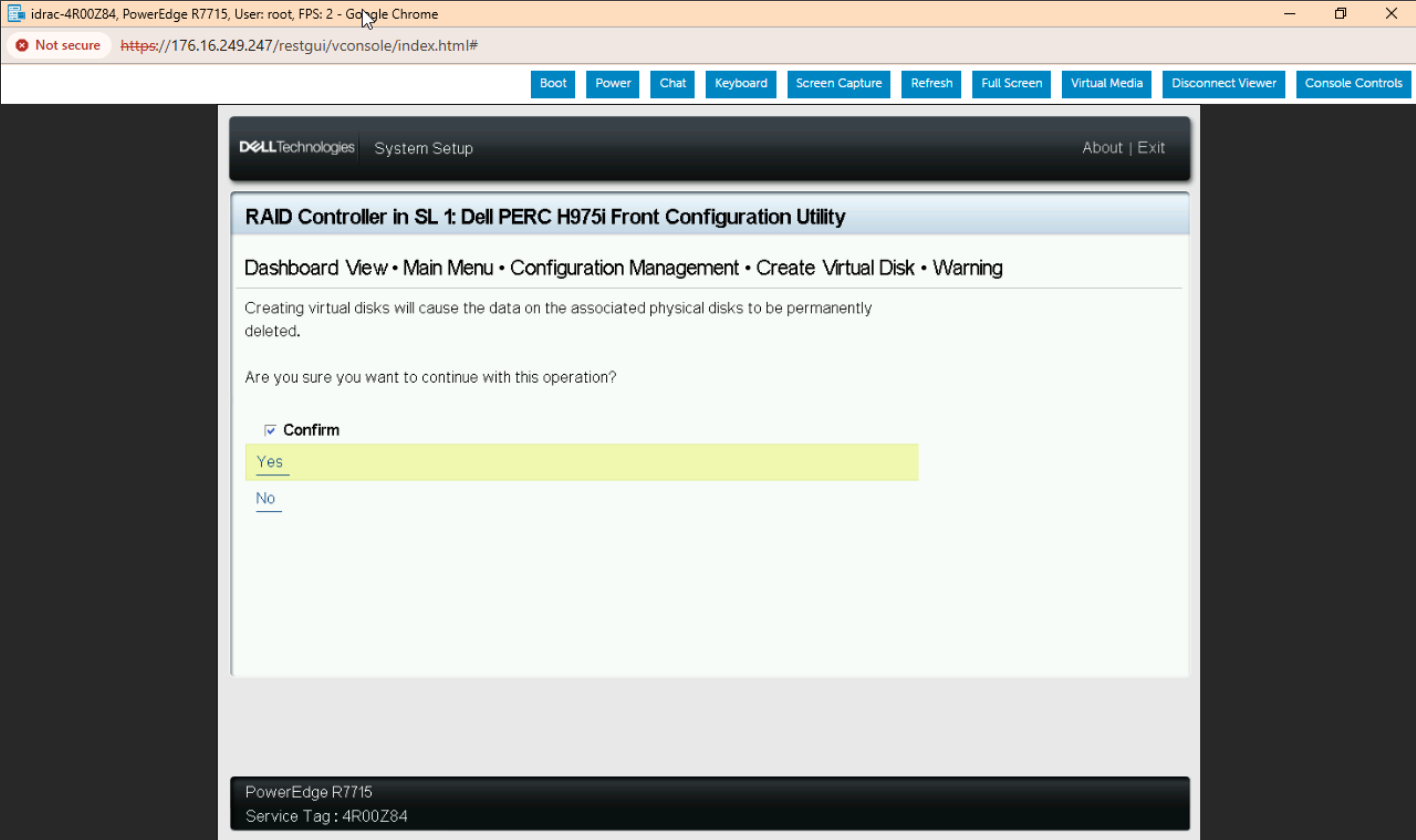
仮想ディスクの作成を完了する前に、選択した物理ディスク上のすべてのデータが完全に削除されることを確認する警告が表示されます。続行するには、「確認」ボックスにチェックを入れ、「はい」を選択して操作を承認します。この安全策により、RAID作成プロセス中の偶発的なデータ損失を防止できます。
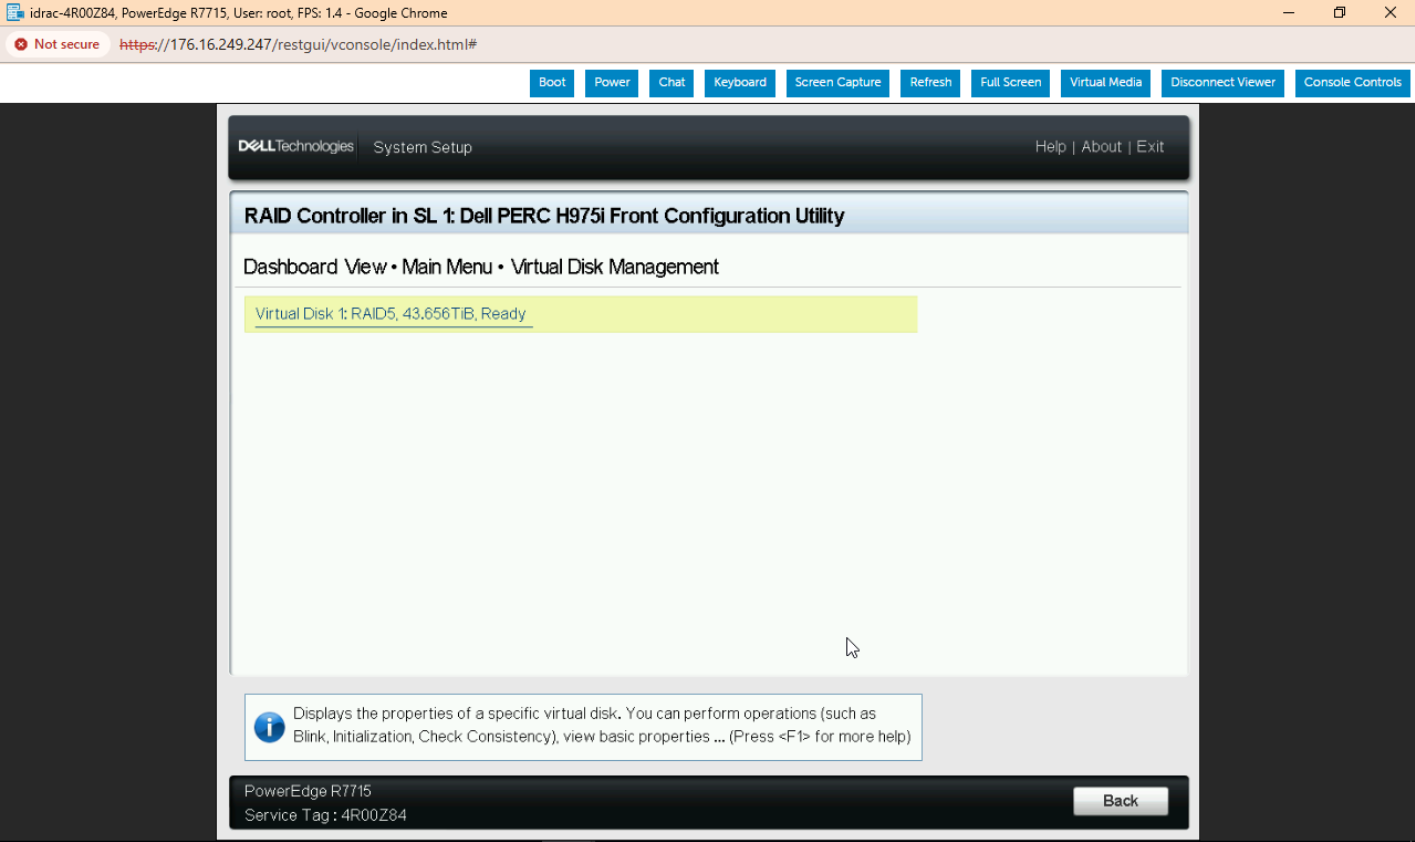
仮想ディスクが作成されると、「仮想ディスク管理」メニューに表示されます。この例では、新しいRAID 5仮想ディスクの容量が43.656TiB、ステータスが「準備完了」となっています。簡単な手順でストレージが設定され、使用できるようになります。
PERC BIOS構成ユーティリティとiDRACインターフェースは、ローカルおよびリモート管理のための直感的なオプションを提供しますが、DellはPERC CLI(perccli2)と呼ばれる強力なコマンドラインツールも提供しています。このユーティリティはWindows、Linux、VMwareをサポートしており、スクリプト作成、自動化、またはヘッドレス環境でのPERCコントローラの管理に最適です。Dellは、サポートサイトでPERC CLIのインストールとコマンドの使用方法に関する詳細なドキュメントも提供しています。
Dell PERC13 パフォーマンステスト
パフォーマンステストに着手する前に、PERC H7715iフロントコントローラをデュアル構成にしたDell PowerEdge R975プラットフォームを使用して環境を準備しました。これらのプラットフォームには、3.2KiBブロックサイズで最大12,000MB/秒のシーケンシャルリードと5,500MB/秒のシーケンシャルライトを実現する128TBのDell NVMeドライブ13台が接続されています。この高性能な基盤により、PERCXNUMXコントローラのスループットの限界を押し広げ、RAIDの挙動を大規模に評価することが可能になります。
- プラットフォーム: デル PowerEdge R7715
- CPU: AMD EPYC 9655P 96コアプロセッサ
- RAM: 768GB (12 x 64GB) DDR5-5200 ECC
- レイドコントローラー: PERC2 H13i x 975
- ストレージ: 32 x 3.2TB Dell CD8P NVMeドライブ
- PCIe アクセラレータ: NVIDIA H2 GPU 100基
NVIDIA Magnum IO GPU ダイレクトストレージ: AI とストレージの融合
現代のAIパイプラインは、多くの場合、コンピューティング能力ではなくI/O能力に依存しています。データバッチ、埋め込み、チェックポイントは、アクセラレータを常にビジー状態に維持するために、ストレージからGPUメモリへ十分な速度で転送する必要があります。NVIDIAのMagnum IO GDS(cuFile経由)は、従来の「SSD → CPU DRAM → GPU」というパスを短縮し、NVMeからGPUメモリへのデータDMA転送を可能にします。これにより、CPUのバウンスバッファのオーバーヘッドが排除され、レイテンシが低減し、負荷時のスループットがより予測可能になります。これらはすべて、GPU使用率の向上、エポックタイムの短縮、チェックポイントの保存/読み込みサイクルの高速化につながります。
当社の GDSIO テストは、ストレージから GPU へのデータ パス自体を測定するように調整されており、ブロック サイズとスレッド数をスキャンして、PERC13 を搭載した NVMe セットがどれだけ速く H100 メモリにストリーミングできるかを示しています。各 H975i を PCIe 5.0 x16 リンク (理論上、コントローラーあたり約 64 GB/秒、一方向) に接続すると、112 つのコントローラーで合計の上限が約 XNUMX GB/秒になります。曲線が平坦になる位置から、リンク制限かメディア制限かがわかります。実践者の方は、これらのチャートを実際のワークロードのプロキシとして読んでください。大規模なシーケンシャル読み取りは、データセットのストリーミングとチェックポイントの復元にマップされ、大規模なシーケンシャル書き込みはチェックポイントの保存にマップされ、同時実行による小規模な転送は、データローダーのシャッフルとプリフェッチを反映しています。つまり、強力な GDSIO スケーリングは、トレーニングと高スループット推論の両方で、GPU ストールが少なくなり、パフォーマンスがより安定することを意味します。
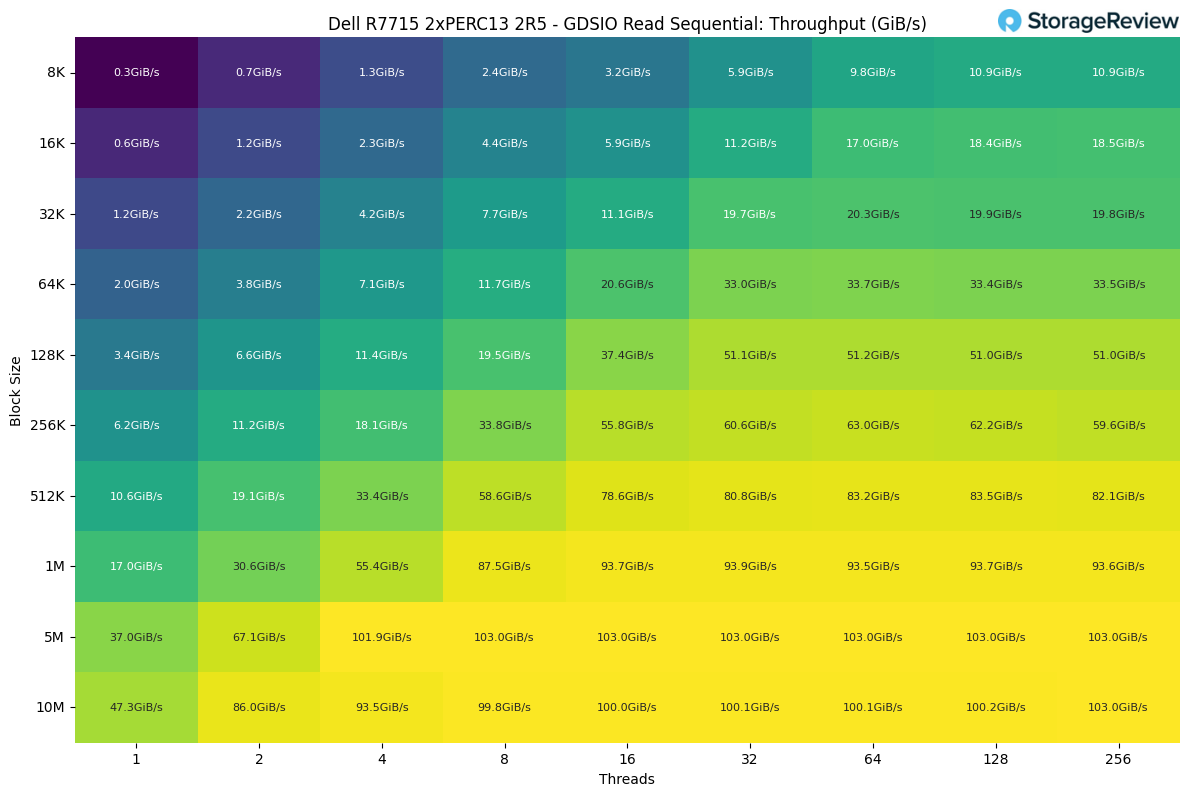
GDSIO 読み取りシーケンシャルスループット
シーケンシャルリードから始めると、ブロックサイズとスレッド数が少ない場合、スループットは緩やかに向上し、0.3Kブロック、シングルスレッドで約8 GiB/秒から始まりました。16Kブロックから512Kブロックの間では、特にスレッド数を4から16に増やすとパフォーマンスが急激に向上しました。最も顕著な向上は1M、5M、10Mブロックサイズで発生し、スループットが劇的に向上し、103Mブロックサイズ、10スレッドで256 GiB/秒に達しました。この推移から、PERC13アレイはより大きなブロックサイズとマルチスレッド並列処理の恩恵を受けており、64~128スレッドで最適な飽和状態に達し、それを超えるとパフォーマンスは頭打ちになることがわかります。
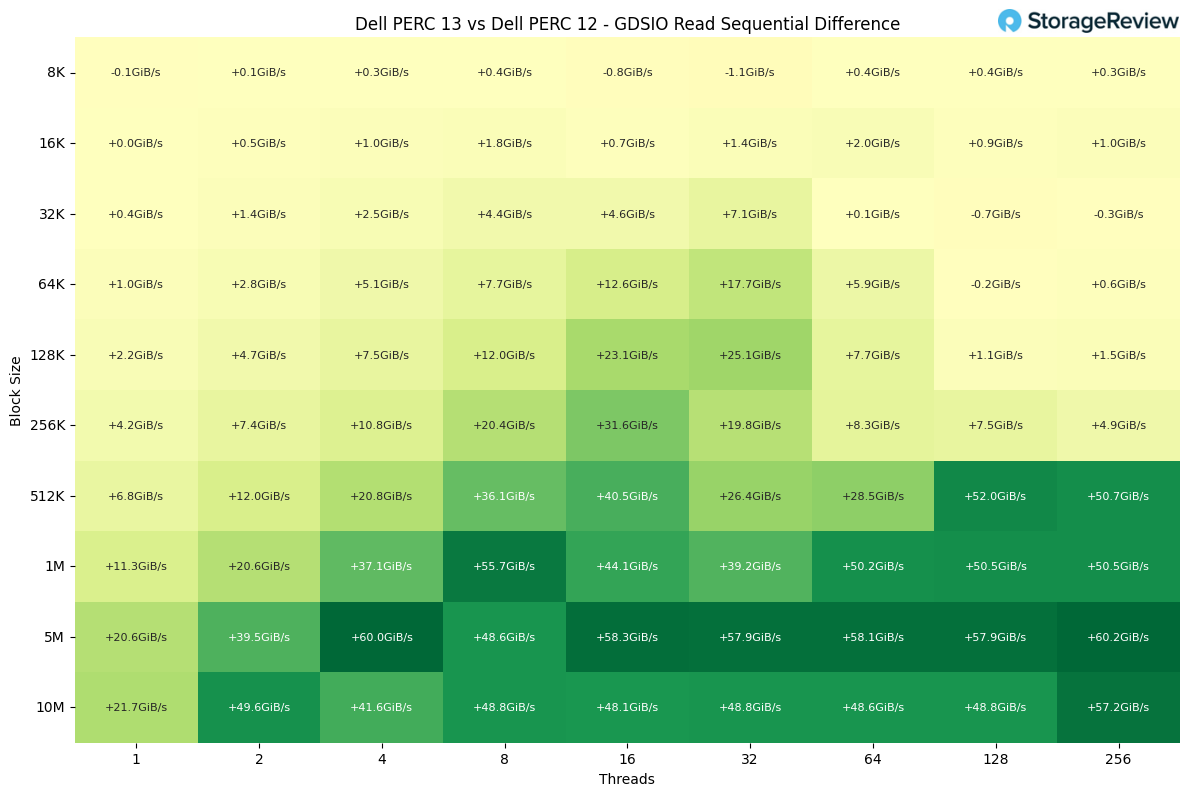
GDSIO 読み取りシーケンシャルスループット差
8K から 10M までのブロック サイズにわたるシーケンシャル読み取りテストでは、PERC13 (H975i) が一貫して PERC12 (H965i) を上回り、ブロック サイズが大きく、スレッド数が多いほどパーセンテージの向上が劇的に向上しました。
ブロックサイズが小さい場合(8K~16K)は、改善率は控えめ(通常0~20%)で、キュー深度が低い場合のテストのばらつきにより、H975iはわずかに遅れをとるケースもありました。ブロックサイズが32K~64Kになると、優位性はより安定し、H975iはほとんどのスレッド数で30~50%高いスループットを実現しました。
最も顕著な違いは、PERC128コントローラがシステムのシーケンシャルリード性能を最大限に引き出した、より大きなブロックサイズ(10KB~13MB)で確認されました。この性能向上において、H975iはH50iと比較して120~965%のパフォーマンス向上を示しました。例えば、ブロックサイズ1MB、スレッド数8~16の場合、スループットは55GiB/s以上向上し、約90%の向上に相当します。ブロックサイズ5MBおよび10MBでは、パフォーマンス向上率は100%を超え、一部の構成では前世代と比較してほぼXNUMX倍のパフォーマンスを実現しました。
全体的に見て、PERC13 (H975i) はシーケンシャルリードワークロードにおいて圧倒的なリードを確立しました。特にブロックサイズとスレッド数が増加するにつれて、その傾向は顕著になりました。ブロックサイズが小さいほど性能は徐々に向上しましたが、256KB以上のブロックサイズでは、新しいコントローラは一貫して50~100%以上の高いパフォーマンスを実現し、Dellの最新RAIDプラットフォームにおけるアーキテクチャの進歩を明確に示しました。
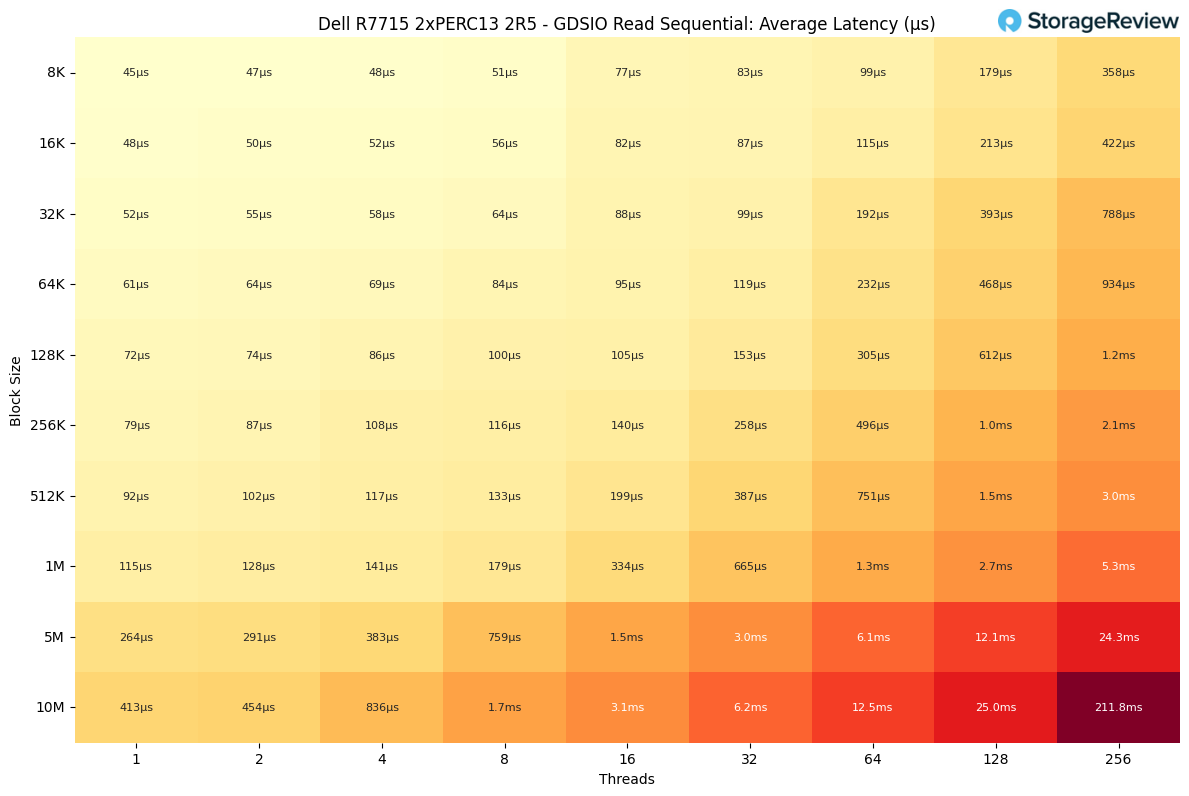
GDSIO 読み取りシーケンシャルレイテンシ
シーケンシャルリードのスループットが向上するにつれて、ブロックサイズが小さく、スレッド数が少ない場合でもレイテンシは管理可能な範囲に留まりました。例えば、100Kブロック、64スレッドまではレイテンシは16マイクロ秒未満に留まり、この範囲では読み取り処理が効率的に行われていることが示されました。ブロックサイズとスレッド数が増加すると、特に5MBおよび10MBで64スレッド以上の場合、レイテンシは急激に増加し、211.8MBブロック、10スレッドでは256ミリ秒に達しました。これは、スループットが高く維持されているにもかかわらず、極端なワークロードではコントローラーやキューイングのボトルネックが発生することを示しています。
パフォーマンスと効率の最適なバランスは、1~8スレッドで16MBのブロックサイズで観測されました。この条件では、アレイは87.5~93.7GiB/秒のスループットを維持しながら、レイテンシを179~334マイクロ秒の範囲に抑えました。この領域は、帯域幅を最大化し、遅延をXNUMXミリ秒未満に抑えるスイートスポットを表しています。
GDSIO 書き込みシーケンシャルスループット
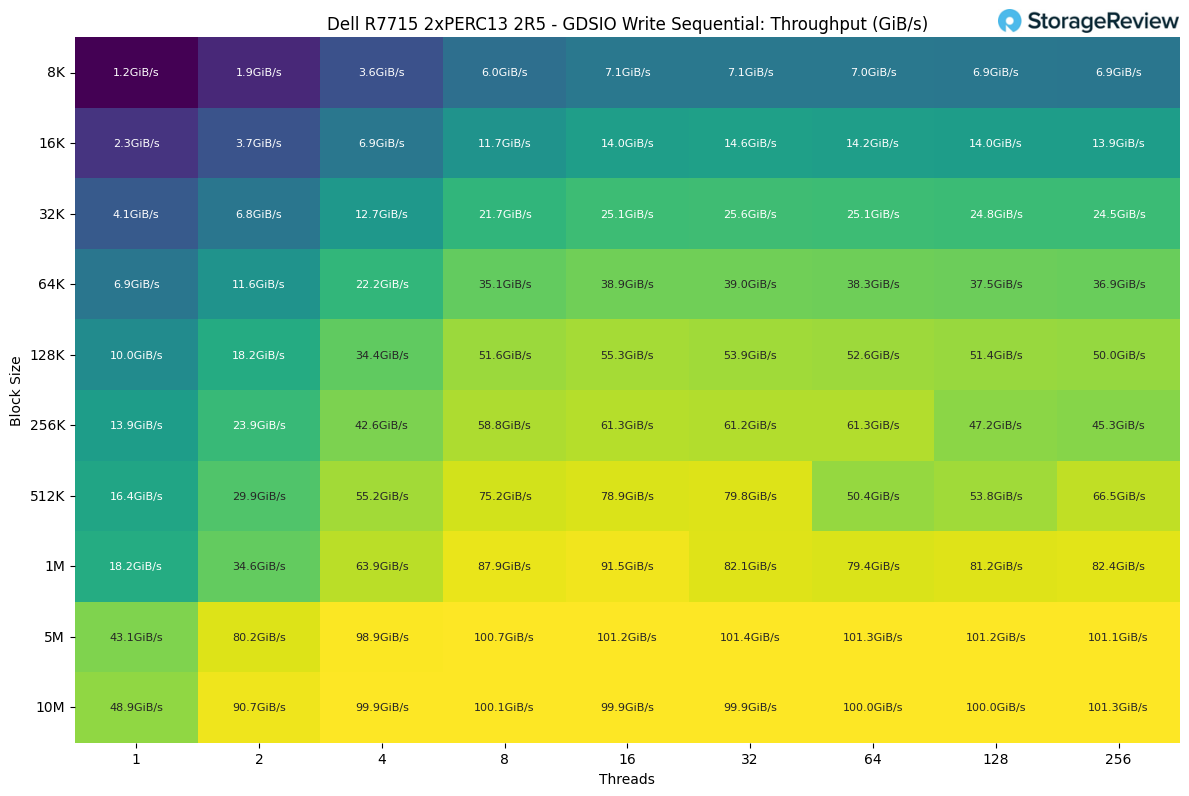
書き込みパフォーマンスは、ブロックサイズの増加に伴い初期段階から力強いスケーリングを示し、1.2K、8スレッド時の1GiB/秒から13.9Kでは256GiB/秒へとスループットが向上しました。最も顕著な向上はブロックサイズ128Kから1Mの間で見られ、80~8スレッドで16GiB/秒を超えるスループットを達成しました。ピークパフォーマンスはブロックサイズ5Mと10Mで達成され、100スレッド以降は101~8GiB/秒を維持しました。
これらの大規模ブロックでは、8~64スレッドでパフォーマンスが横ばいになり、コントローラがスケーリング曲線の早い段階で飽和状態に達したことを示しています。特に128スレッドと256スレッドといった高スレッド数では、スループットの安定性は変動し、5MBおよび10MBの大規模ブロックでは101GiB/秒で安定していましたが、256KBなどの中規模ブロックサイズでは低下し、61.2スレッドでは32GiB/秒、45.3スレッドでは256GiB/秒となりました。
GDSIO書き込みシーケンシャルスループット差
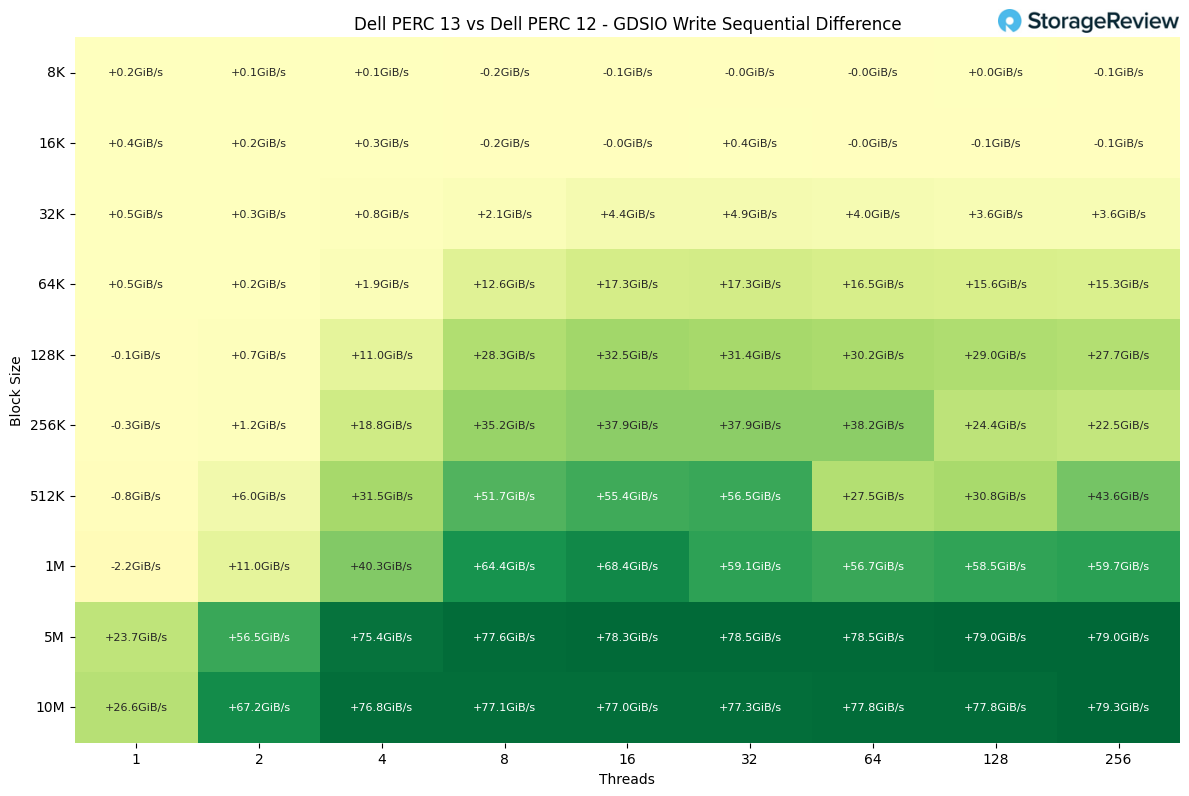
シーケンシャルライトテストでは、PERC13 (H975i) は PERC12 (H965i) と比較して、特にブロックサイズとスレッド数の増加に伴い、大幅なパフォーマンス向上を達成しました。ブロックサイズが小さい場合 (8K~32K) は、パフォーマンス向上は概ね0~10% 程度で、テストノイズによる差はごくわずかでした。
64KからH975iの優位性はより顕著になりました。64Kブロックサイズでは、H40iと比較してスループットが70~12GiB/s以上向上し、17~965%の向上が見られました。128K~256Kでは、その向上幅はさらに大きくなり、H975iは中~高スレッド数において、一貫して50~70%高いスループットを実現しました。
最も劇的なパフォーマンス差は、ブロックサイズが大きい場合(512K~10M)に現れました。512Kでは、H975iはH31iと比較して+56~+60 GiB/sのスループット向上を達成し、80~965%の向上に相当します。1Mブロックサイズでは、その差はさらに広がり、+40~+68 GiB/sのスループット向上を達成し、70~90%の向上に相当します。最後に、5Mおよび10Mブロックサイズでは、PERC 13はPERC 12と比較してほぼ75倍のスループット向上を達成し、+79~+100 GiB/sのスループット向上を達成しました。これは、スレッド数の多い一部のシナリオではXNUMX%の向上に相当します。
全体的に見て、PERC 13コントローラはシーケンシャルライト性能において世代間の明確な飛躍を示しました。最小ブロックサイズでは差はわずかですが、ワークロードが64Kを超えると、H975iは一貫して50~100%高いスループットを提供し、書き込み集中型のシーケンシャルワークロードにおいてH965iに対する優位性を確立しました。
GDSIO 書き込みシーケンシャルレイテンシ
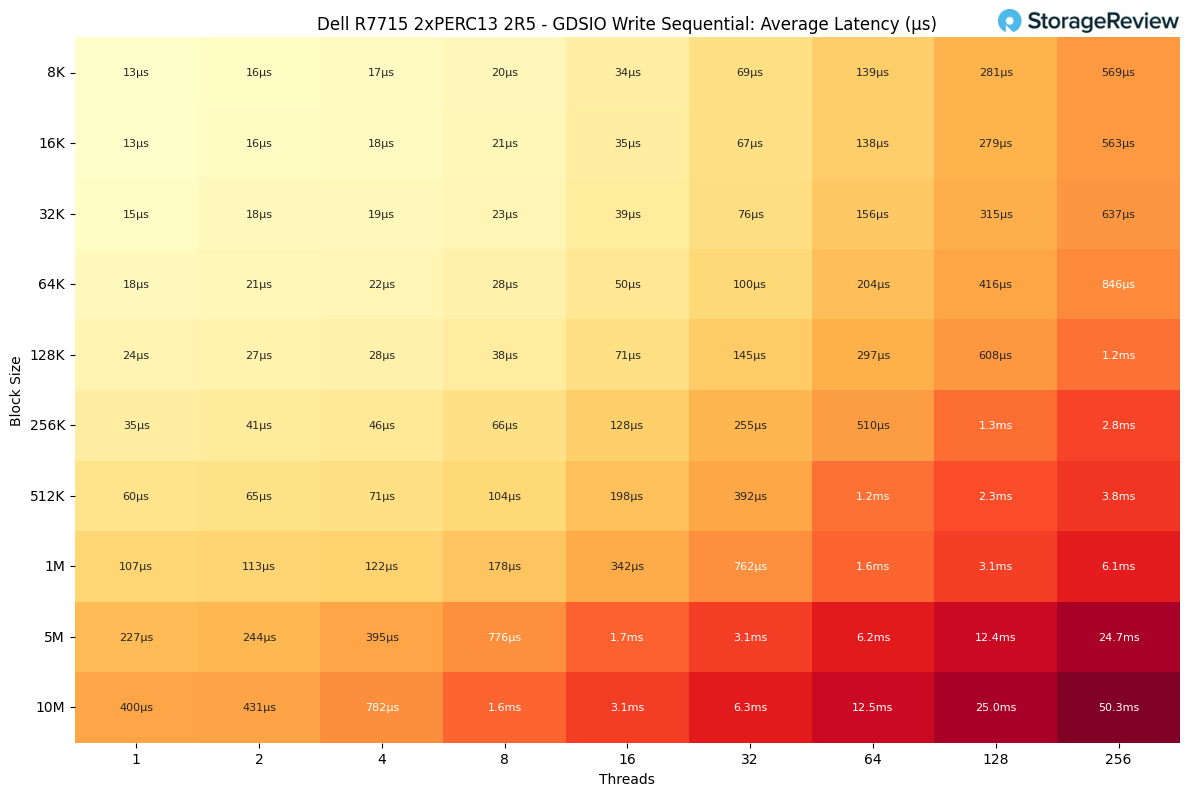
シーケンシャル書き込み時のレイテンシは、ブロックサイズが小さくスレッド数が少ない場合、非常に低い値を維持しました。50Kブロック、最大128スレッドでは、8マイクロ秒未満に抑えられることが多くありました。スレッド数が増加すると、レイテンシはより顕著に増加しました。例えば、392Kブロック、512スレッドではレイテンシは32マイクロ秒に達し、1MBブロック、1スレッドでは64ミリ秒を超えました。
飽和効果は、ブロックサイズが最大で同時実行レベルが最高になるとより顕著になりました。レイテンシは、12.4M、スレッド数5で128ミリ秒に上昇し、50.3M、スレッド数10では256ミリ秒に達しました。
シーケンシャル書き込みワークロードの最も効率的な動作ポイントは、1 ~ 5 スレッドで 8M または 16M のブロック サイズで発生しました。このとき、スループットは 87.9 ~ 101.2 GiB/秒に達し、レイテンシは 178 µs ~ 1.7 ms 以内に抑えられ、過度の書き込みキューの遅延を引き起こすことなく、強力な持続的なパフォーマンスが得られました。
MLPerf ストレージ 2.0 パフォーマンス
AIトレーニング環境における実際のパフォーマンスを評価するために、MLPerf Storage 2.0テストスイートを活用しました。MLPerf Storageは、実際のディープラーニングワークロードをシミュレートしたI/Oパターンをテストするために特別に設計されており、チェックポイント作成やモデルトレーニングといった課題をストレージシステムがどのように処理するかについての洞察を提供します。
チェックポイントベンチマーク
機械学習モデルを学習させる際には、モデルの状態を定期的に保存するためのチェックポイントが不可欠です。これにより、ハードウェア障害などの中断による学習の進行状況の損失を防ぎ、学習中の早期停止を可能にし、研究者が様々なチェックポイントから分岐して実験やアブレーションを行うことが可能になります。
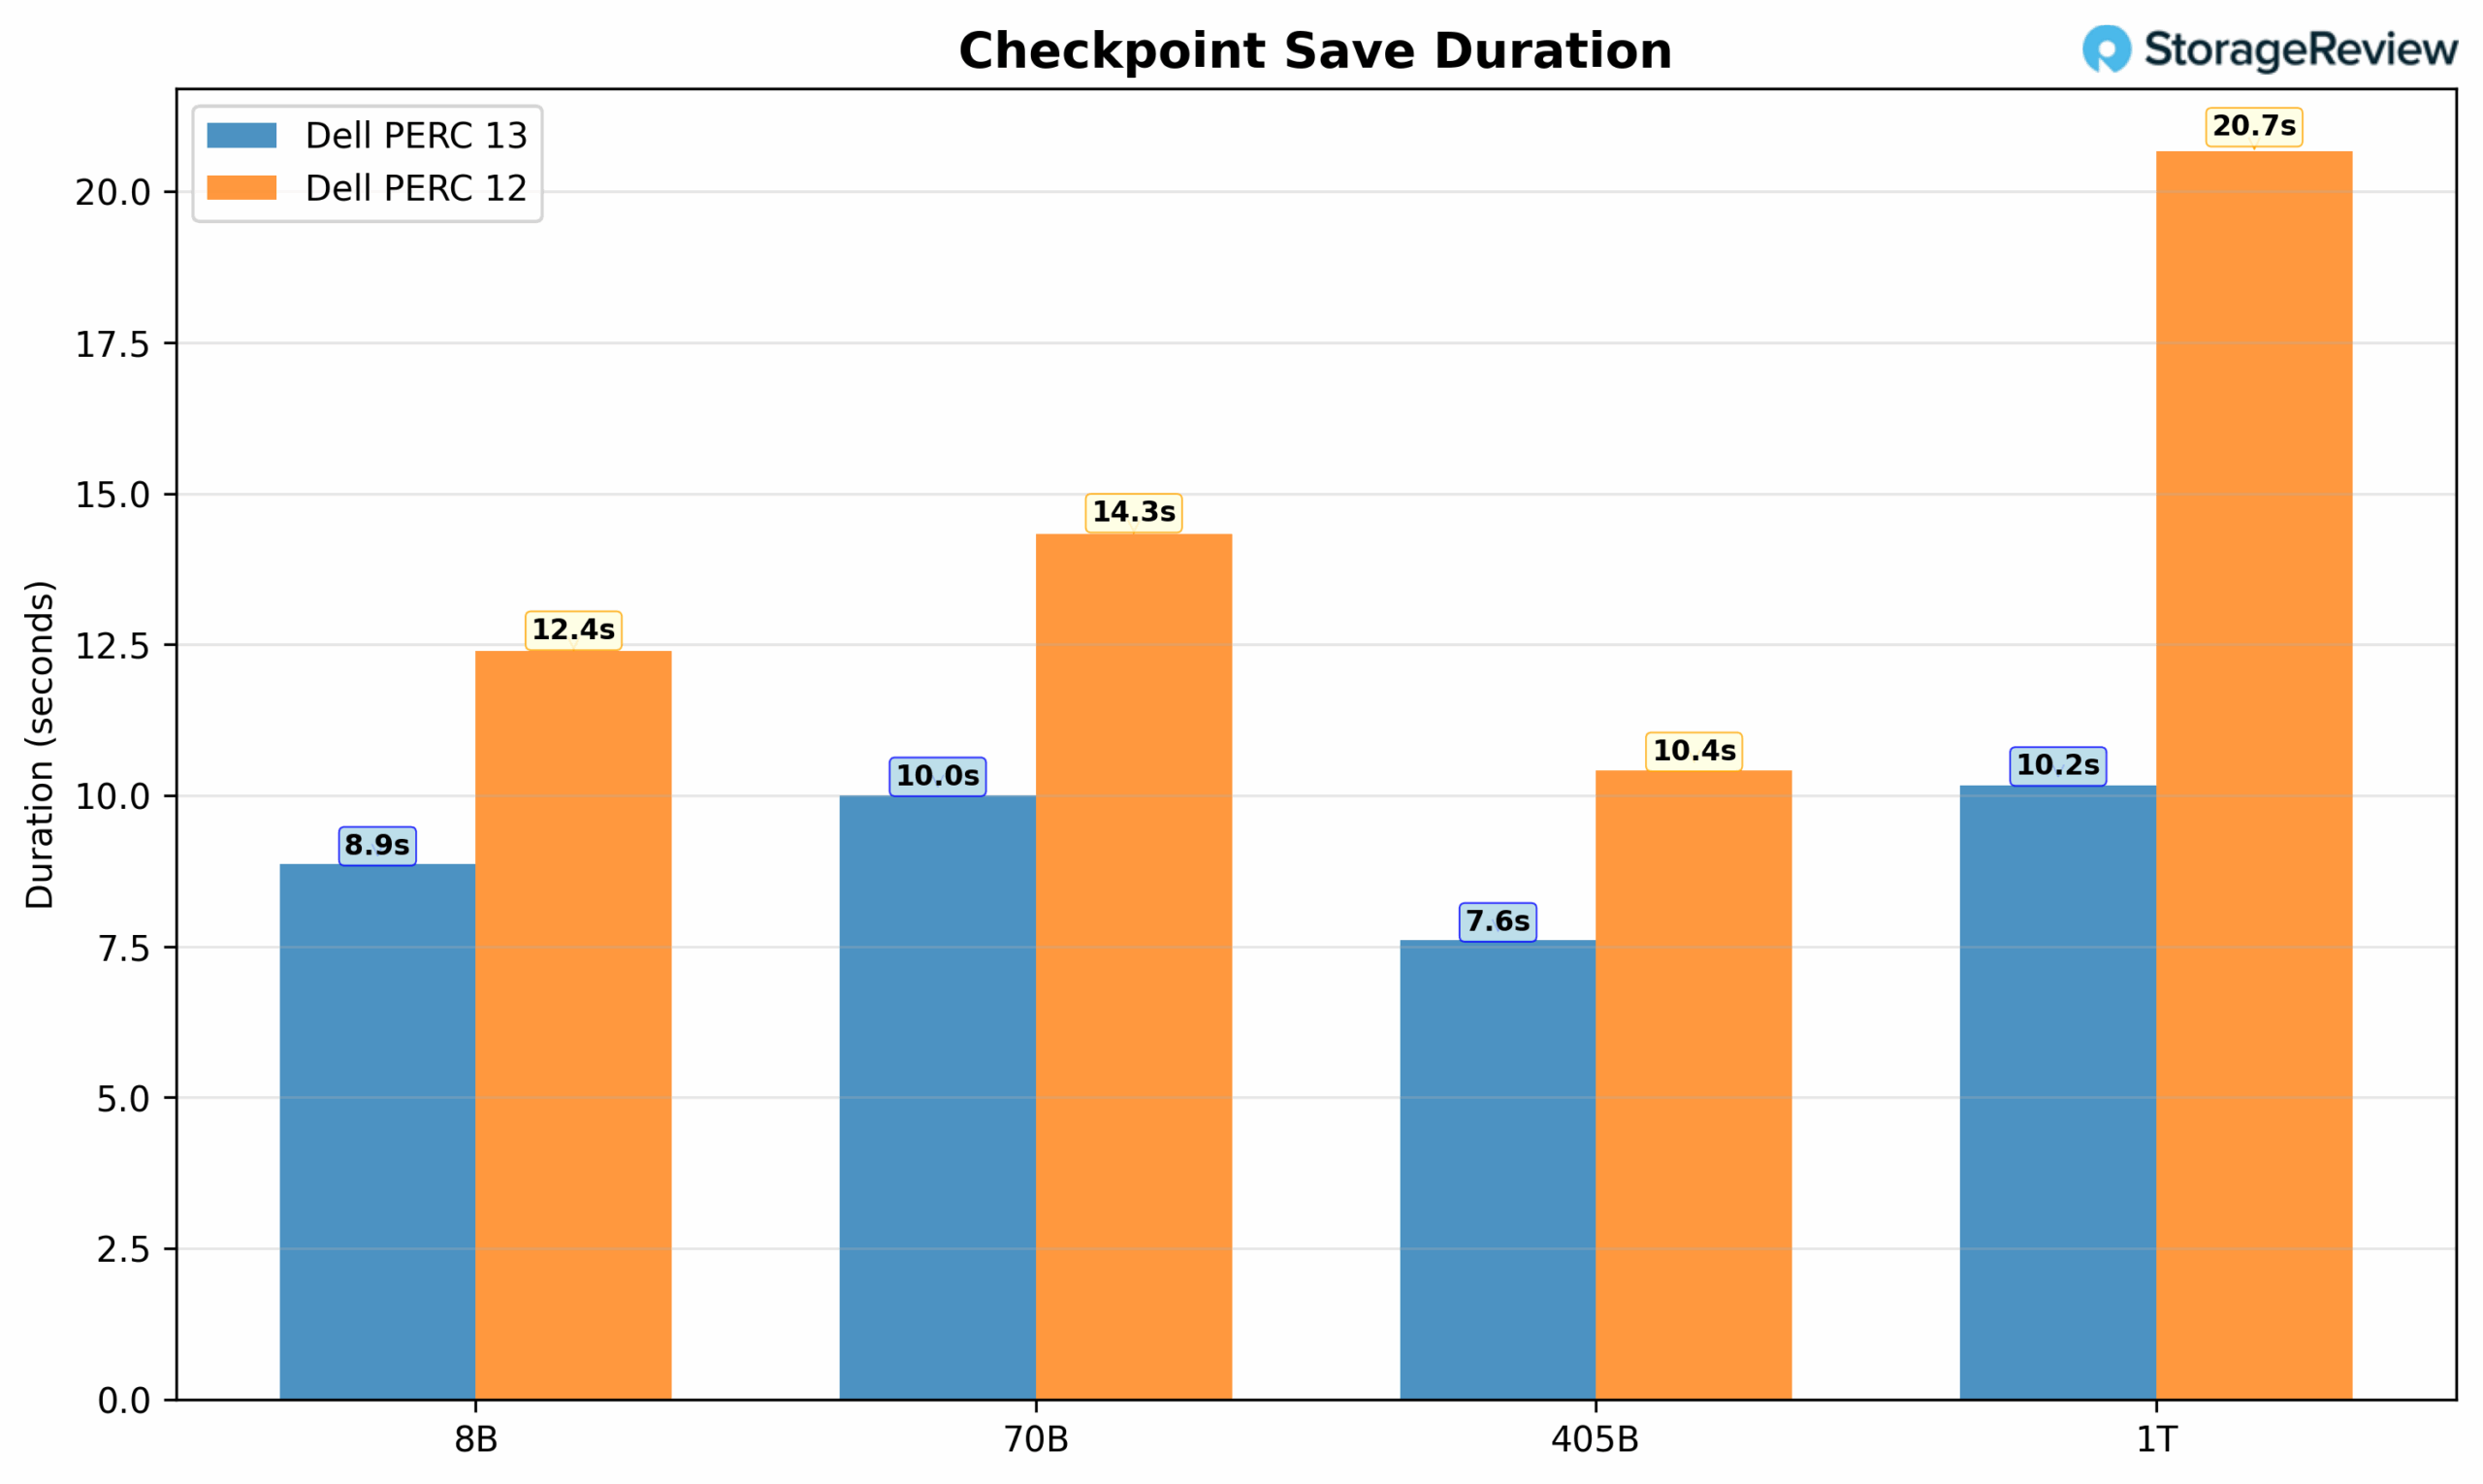
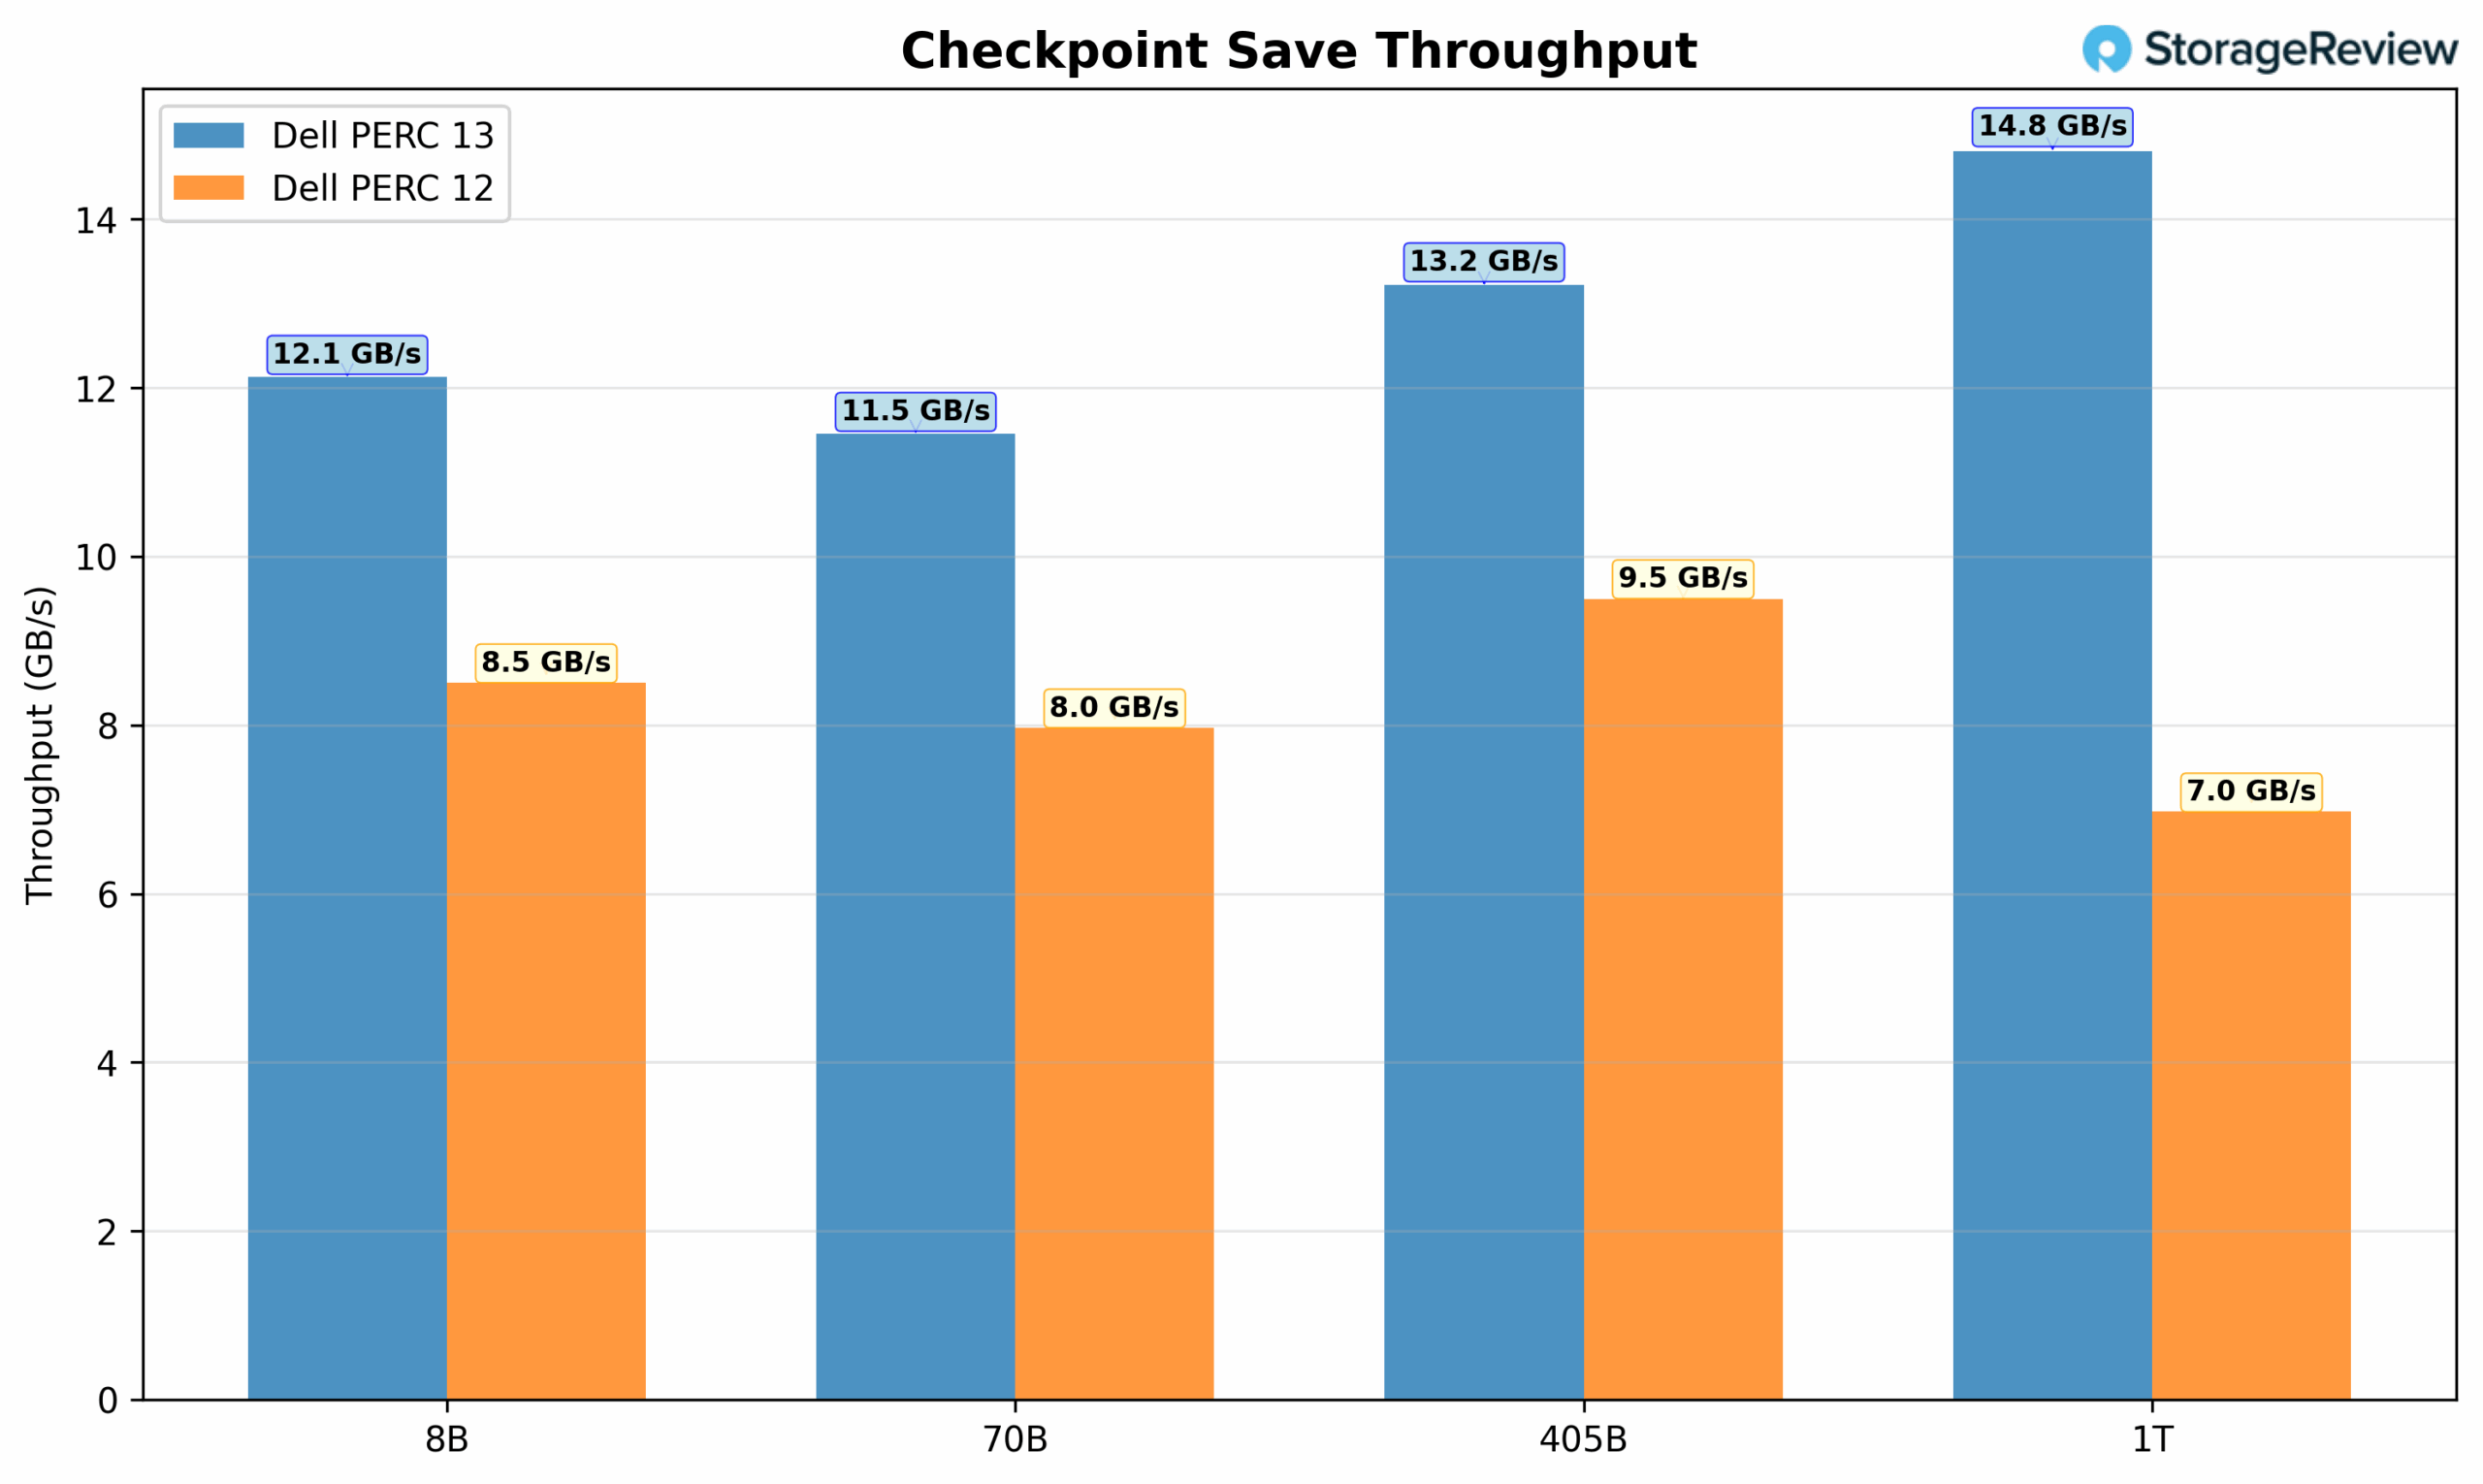
チェックポイント保存時間の比較では、Dell PERC13はすべてのモデル構成において一貫してPERC12を上回るパフォーマンスを示しました。PERC13の保存時間は7.61秒から10.17秒であったのに対し、PERC12では同じ操作に10.41秒から20.67秒を要しました。パフォーマンスの差は1Tパラメータモデルで最も顕著で、PERC13は10秒強で保存を完了したのに対し、PERC12は20秒以上を要しました。これは、最大モデルにおいて保存時間が約50%短縮されたことを意味します。
保存スループットの結果を見ると、PERC13の優れた帯域幅利用率と、一貫して高いデータ転送速度が実証されています。PERC13は11.46Tモデルでピークパフォーマンスを発揮し、14.81~1GB/秒のスループットを達成しています。一方、PERC12は最高9.49GB/秒で、最大構成では6.98GB/秒まで低下します。新しいコントローラは、モデルサイズを問わずより安定したパフォーマンスを維持しており、チェックポイント操作に典型的な大規模なシーケンシャル書き込みの処理に対する最適化が優れていることを示しています。
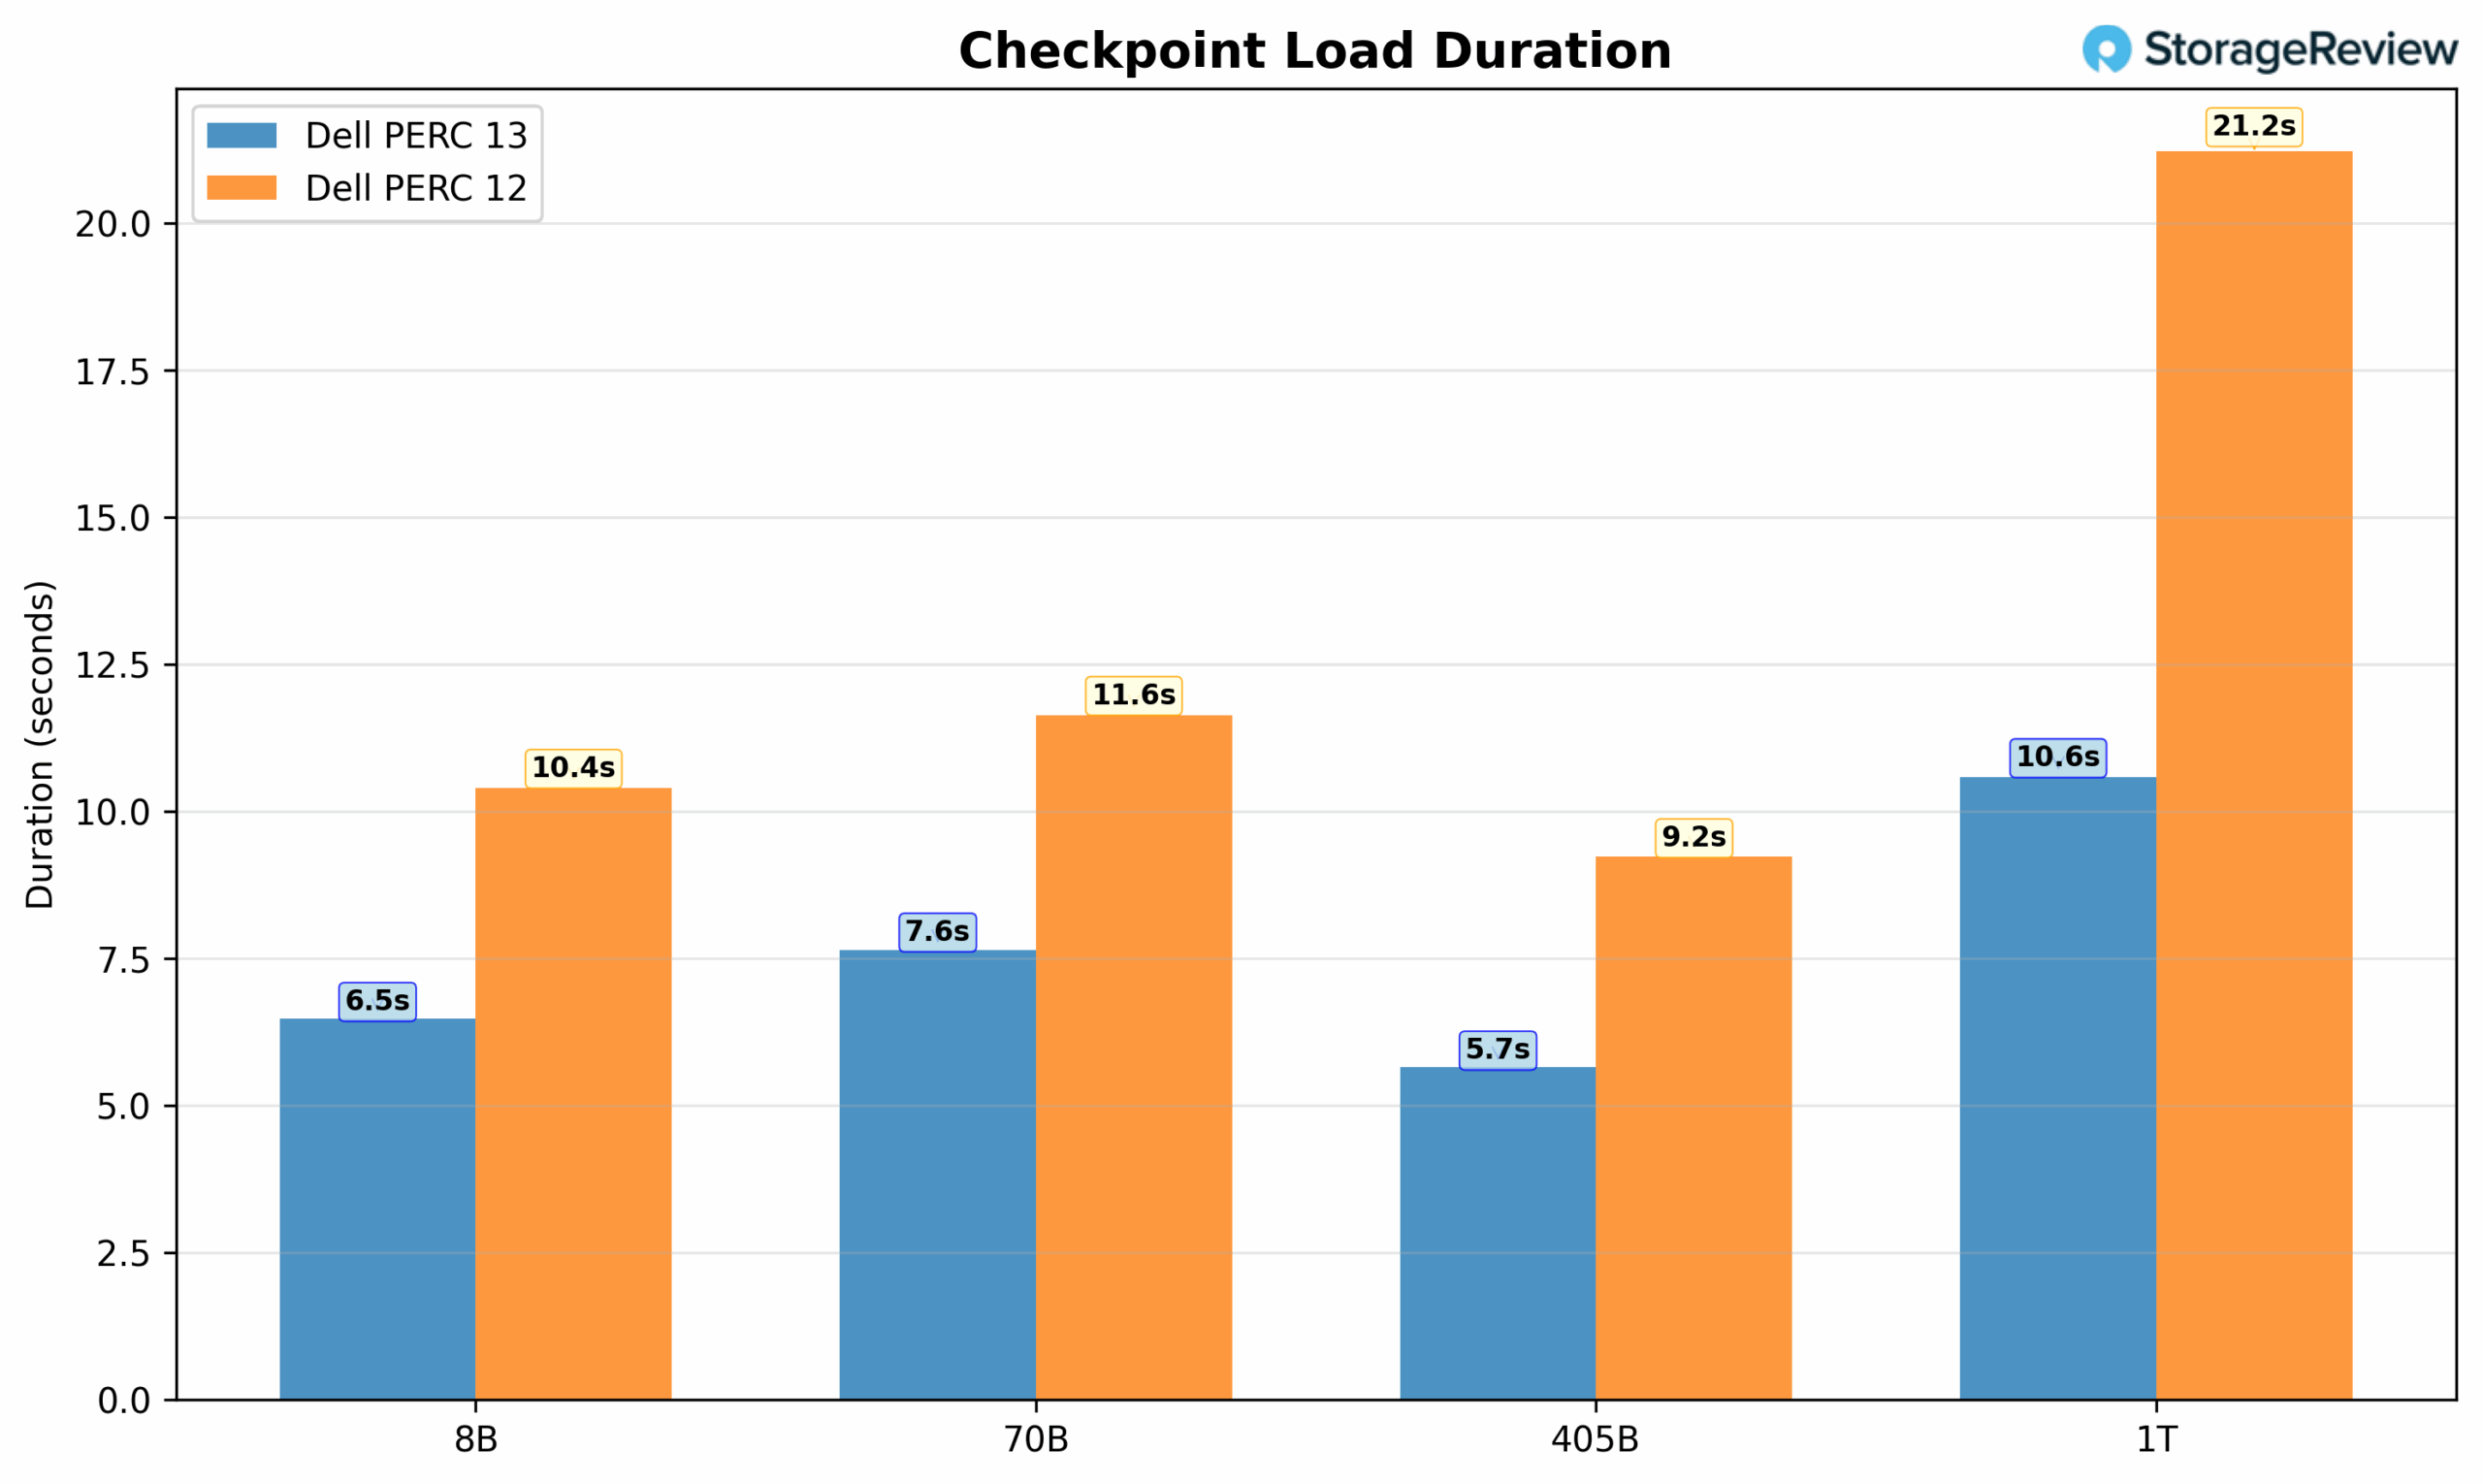
ロード時間の比較では、PERC13でも同様の優位性を示していますが、パフォーマンスの差はモデルサイズによって異なります。小型モデル(8B、70B)では、PERC 13はPERC35よりもチェックポイントのロード時間が約40~12%速くなりました。しかし、最も劇的な改善が見られたのは1Tモデルで、PERC13のロード時間は10.58秒だったのに対し、PERC12は21.22秒と、約50%の短縮となりました。この高速なリカバリ時間は、中断後にチェックポイントからトレーニングを再開する際のダウンタイムを最小限に抑えるために不可欠です。
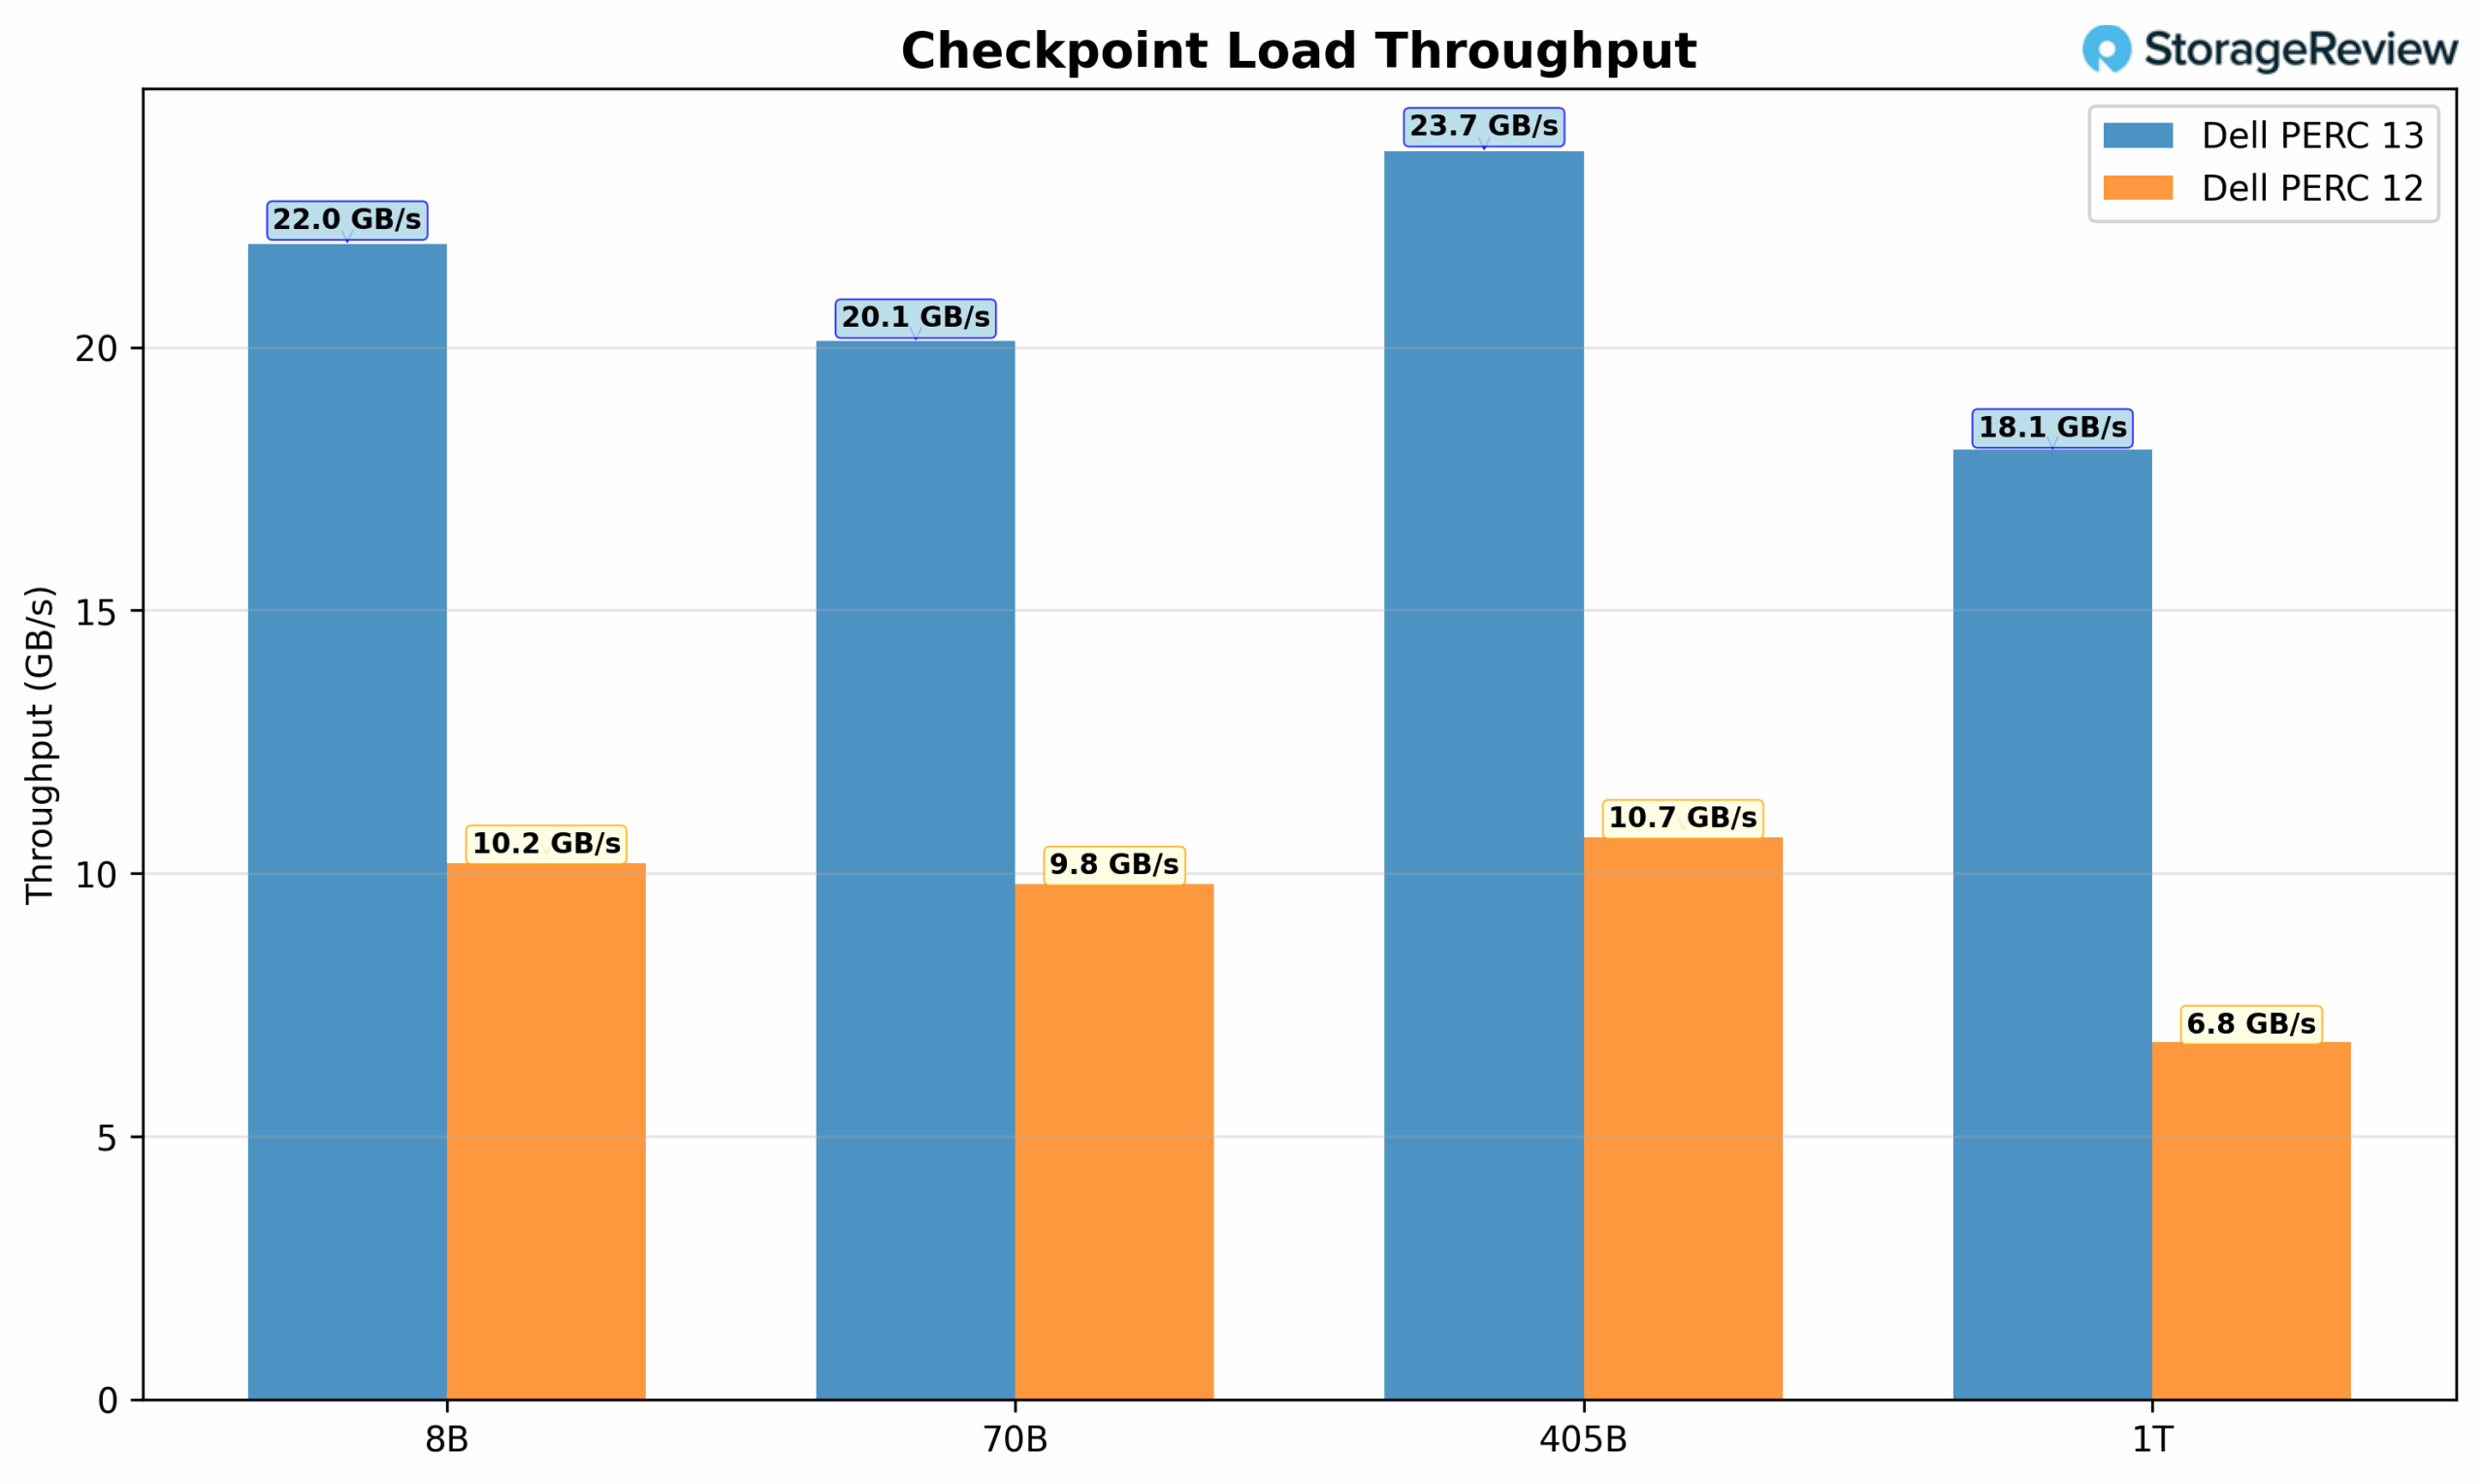
最後に、ロードスループットの指標を検証すると、PERC13は明確なパフォーマンス優位性を示し、すべての構成において18GB/秒以上のスループットを一貫して維持し、23.73Bモデルではピーク時で405GB/秒に達しました。一方、PERC12は6.8GB/秒から10.68GB/秒と低いパフォーマンスを示しました。
FIO パフォーマンスベンチマーク
今回のレビューでは新たなテスト手法を取り入れましたが、改善点を強調するために、前回のDell PERC12コントローラーに関する記事から一部のデータを引用し、ピーク帯域幅とピークスループットの違いを示しました。
PERC13 が性能向上をもたらすと言うのは控えめな表現です。各コントローラに単一の RAID5 ボリュームを配置した状態で、読み取り帯域幅が 88%、書き込み帯域幅が 318%、31K ランダム読み取りパフォーマンスが 4%、そして 466K ランダム書き込みパフォーマンスが驚異的な 4% 向上しました。これは PERC 13 コントローラの絶対的なピークパフォーマンスではありません。仮想ディスクの数を増やすことで、さらに高速化が可能です。ただし、この結果は、総容量を最大化した場合の単一名前空間のパフォーマンスを反映しています。
| ワークロード | デュアル PERC 12 (2 x RAID5) | デュアル PERC 13 (2 x RAID5) | パフォーマンスの向上 |
|---|---|---|---|
| 128K シーケンシャルリード | 56,107 (MB/秒) | 105,227 (MB/秒) | 88% |
| 128K シーケンシャル書き込み | 24,351 (MB/秒) | 101,723 (MB/秒) | 318% |
| 4KBランダム読み取り | 13,205,656 (IOP) | 17,342,057 (IOP) | 31% |
| 4KBランダム書き込み | 1,725,198 (IOP) | 9,758,677 (IOP) | 466% |
Dell PERC H975iおよびPERC H965iコントローラのパフォーマンスに焦点を当て、容量とパリティ保護の優れた組み合わせを提供するRAID 5を活用しました。Dell PERC H975iでは、複数の仮想ディスク(VD)構成(RAID 8(5R8)で5 VD、RAID 4(5R4)で5 VD、RAID 2(5R2)で5 VD)を検証しました。また、Dell PERC H965iでは、RAID 4(5R4)で5 VD、RAID 2(5R2)で5 VDの13つの構成もテストしました。これらの構成は、各コントローラが管理できるSSDの数に基づいて選択されました。最新のPERC 16コントローラは最大4台のSSDを管理でき、これらは5台のSSDからなる最大4つのRAID 12グループに簡単に分割できます。旧型のPERC8は2台のSSDしか管理できなかったため、テストできるRAID5 SSDグループは最大8つに制限されていました。この構成では、5R4システムの場合、各PERC RAIDコントローラに5台のドライブを搭載したRAIDXNUMXがXNUMXつ存在することになります。
各構成は同一のベンチマークプロセスで実行され、シーケンシャルワークロードを用いた2回のデバイス全体書き込みからなるプリコンディショニングフェーズから開始されました。定常状態に達した後、様々なアクセスパターンでパフォーマンスを測定しました。新しいワークロードテストを行う前に、対応する転送サイズを使用してプリコンディショニングサイクルを再実行し、結果の一貫性を確保しました。
128K シーケンシャル書き込み帯域幅
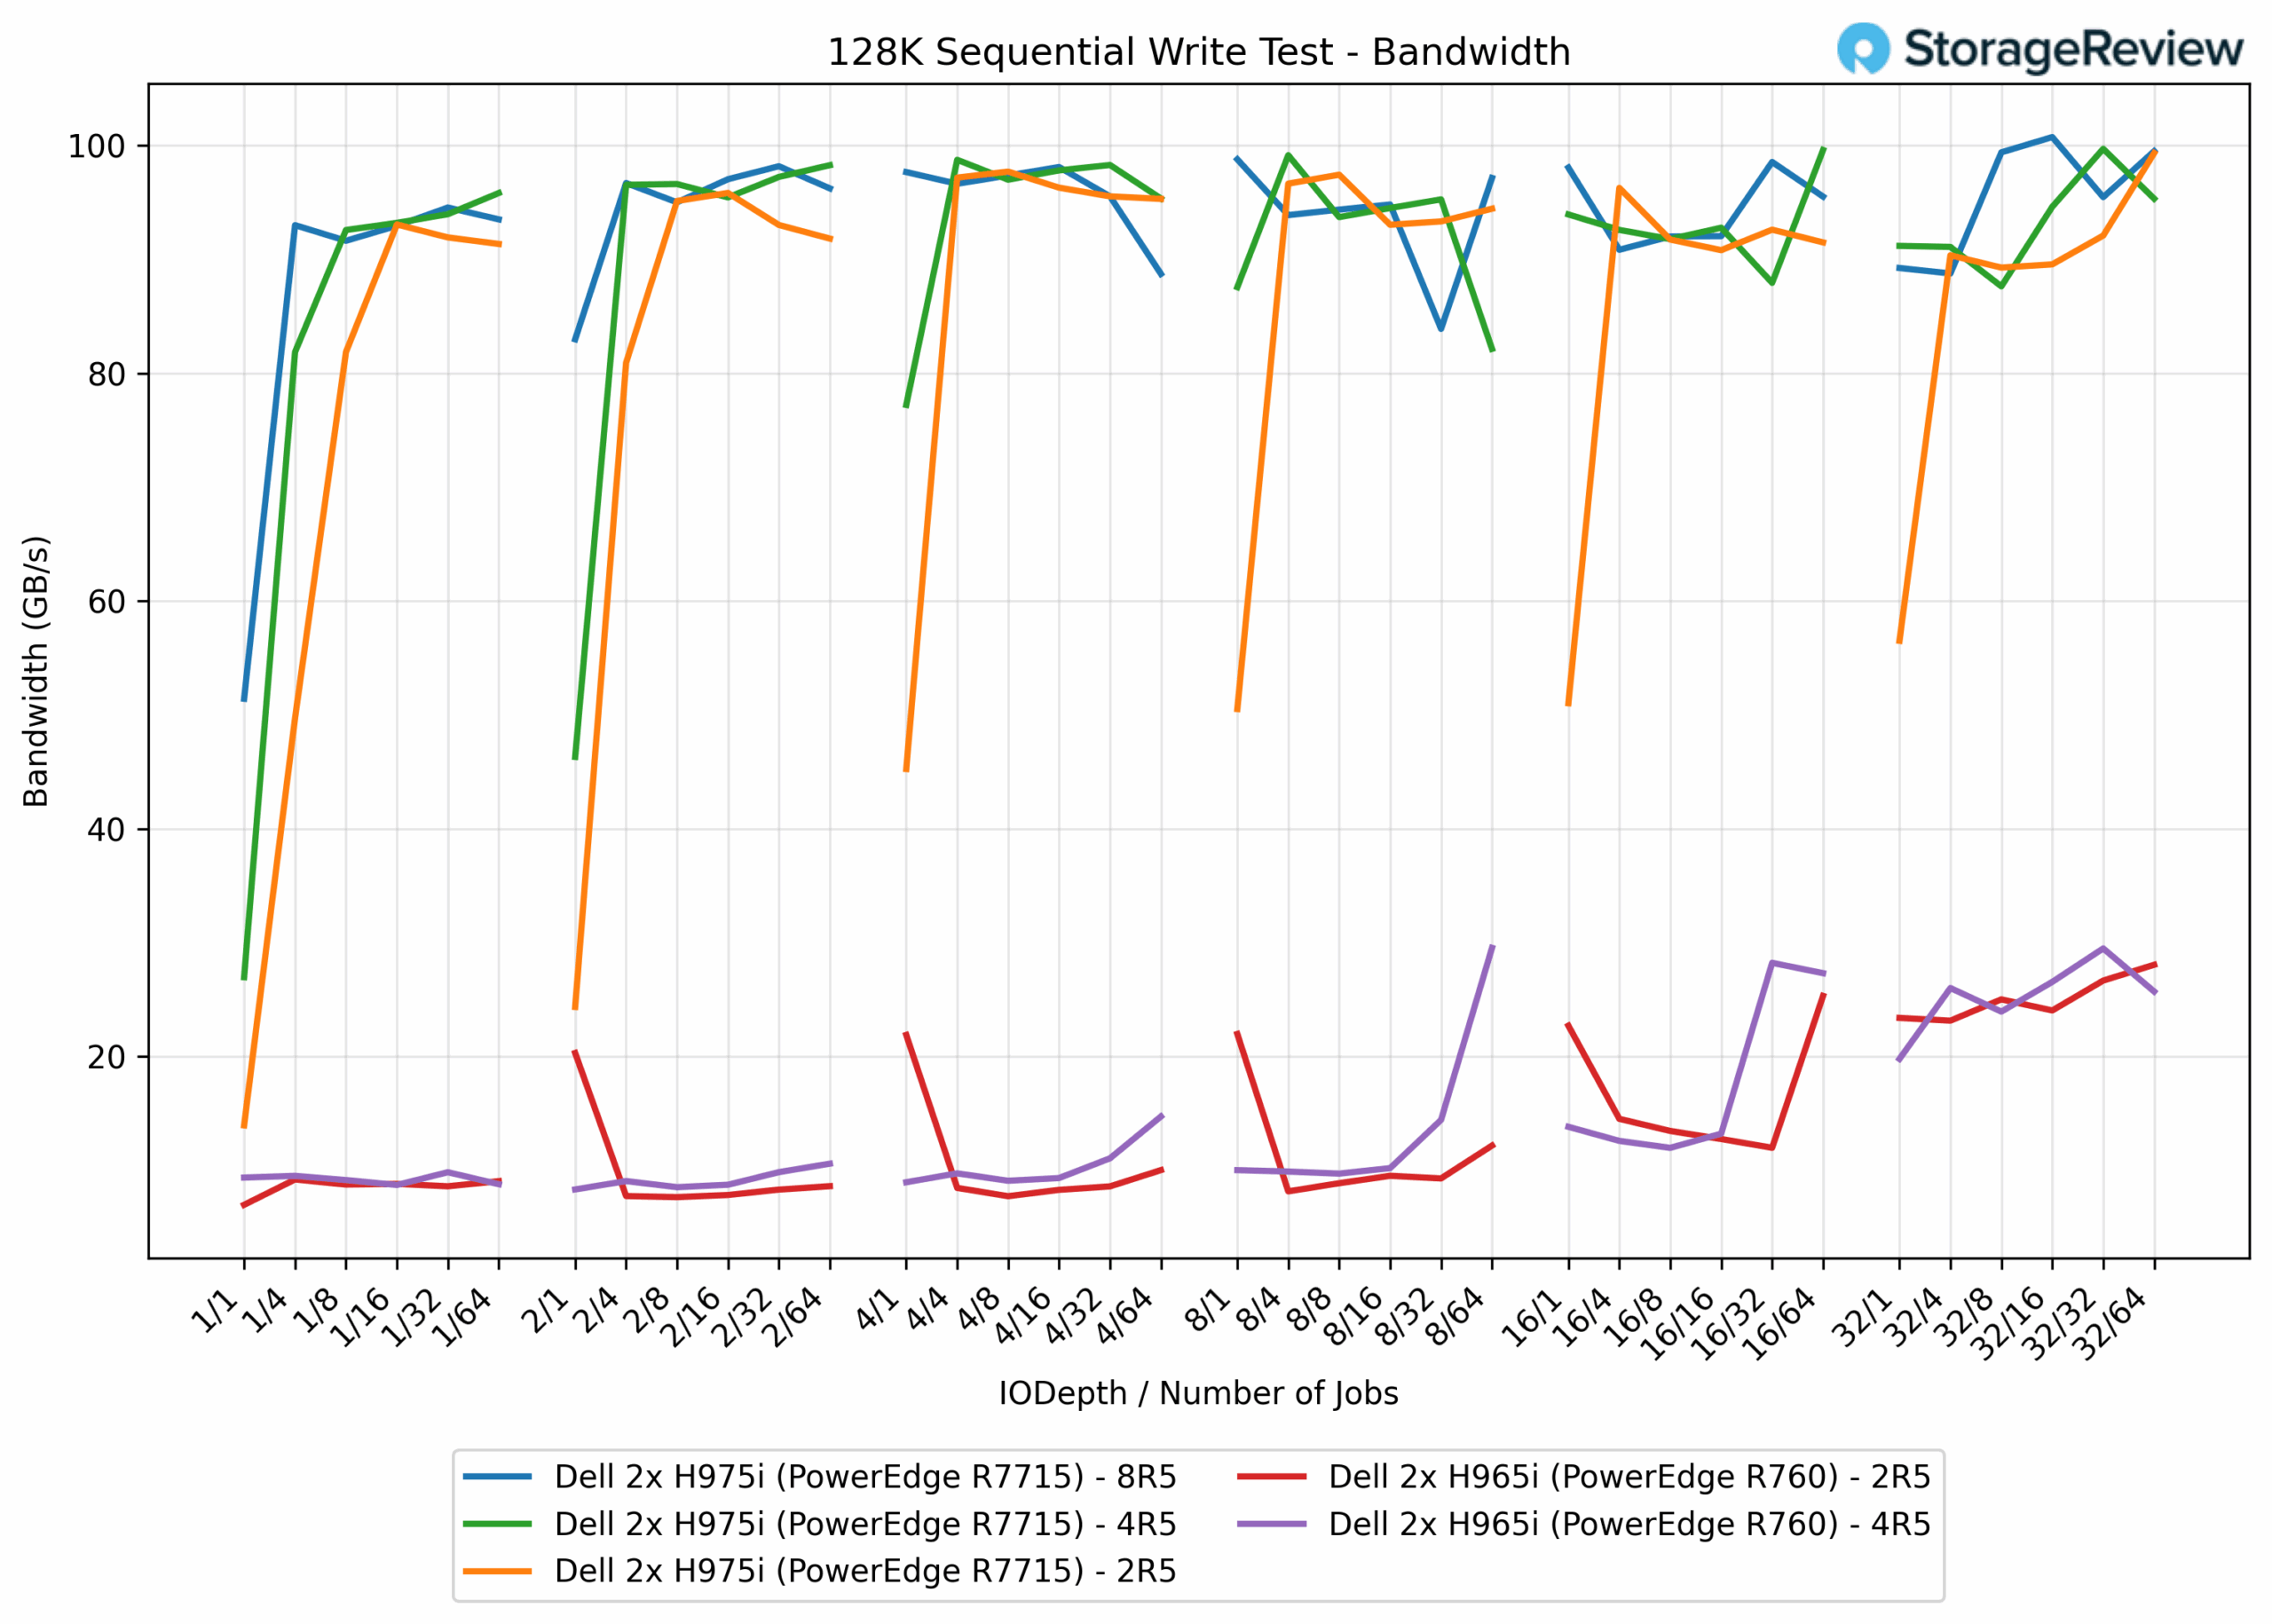
128Kシーケンシャル書き込みテストでは、コントローラ世代間で劇的なパフォーマンス差が見られました。PERC H965iアレイのスループットは控えめで、2R5構成では28.1 GB/秒、4R5構成では29.5 GB/秒に達し、RAIDディスクの追加によるスケーリングは最小限にとどまりました。対照的に、PERC H975iコントローラはすべての構成で優れたパフォーマンスを発揮しました。2R5アレイでは99.3 GB/秒(253%)、4R5構成では99.7 GB/秒(238%)、8R5構成では101.3 GB/秒(H243i 965R4比5%)に達しました。全体的に、H975iはディスク数に関わらず100 GB/秒前後で推移しており、128Kシーケンシャル書き込みにおけるコントローラの帯域幅の上限に達しつつあることを示しています。
128K シーケンシャル書き込みレイテンシ
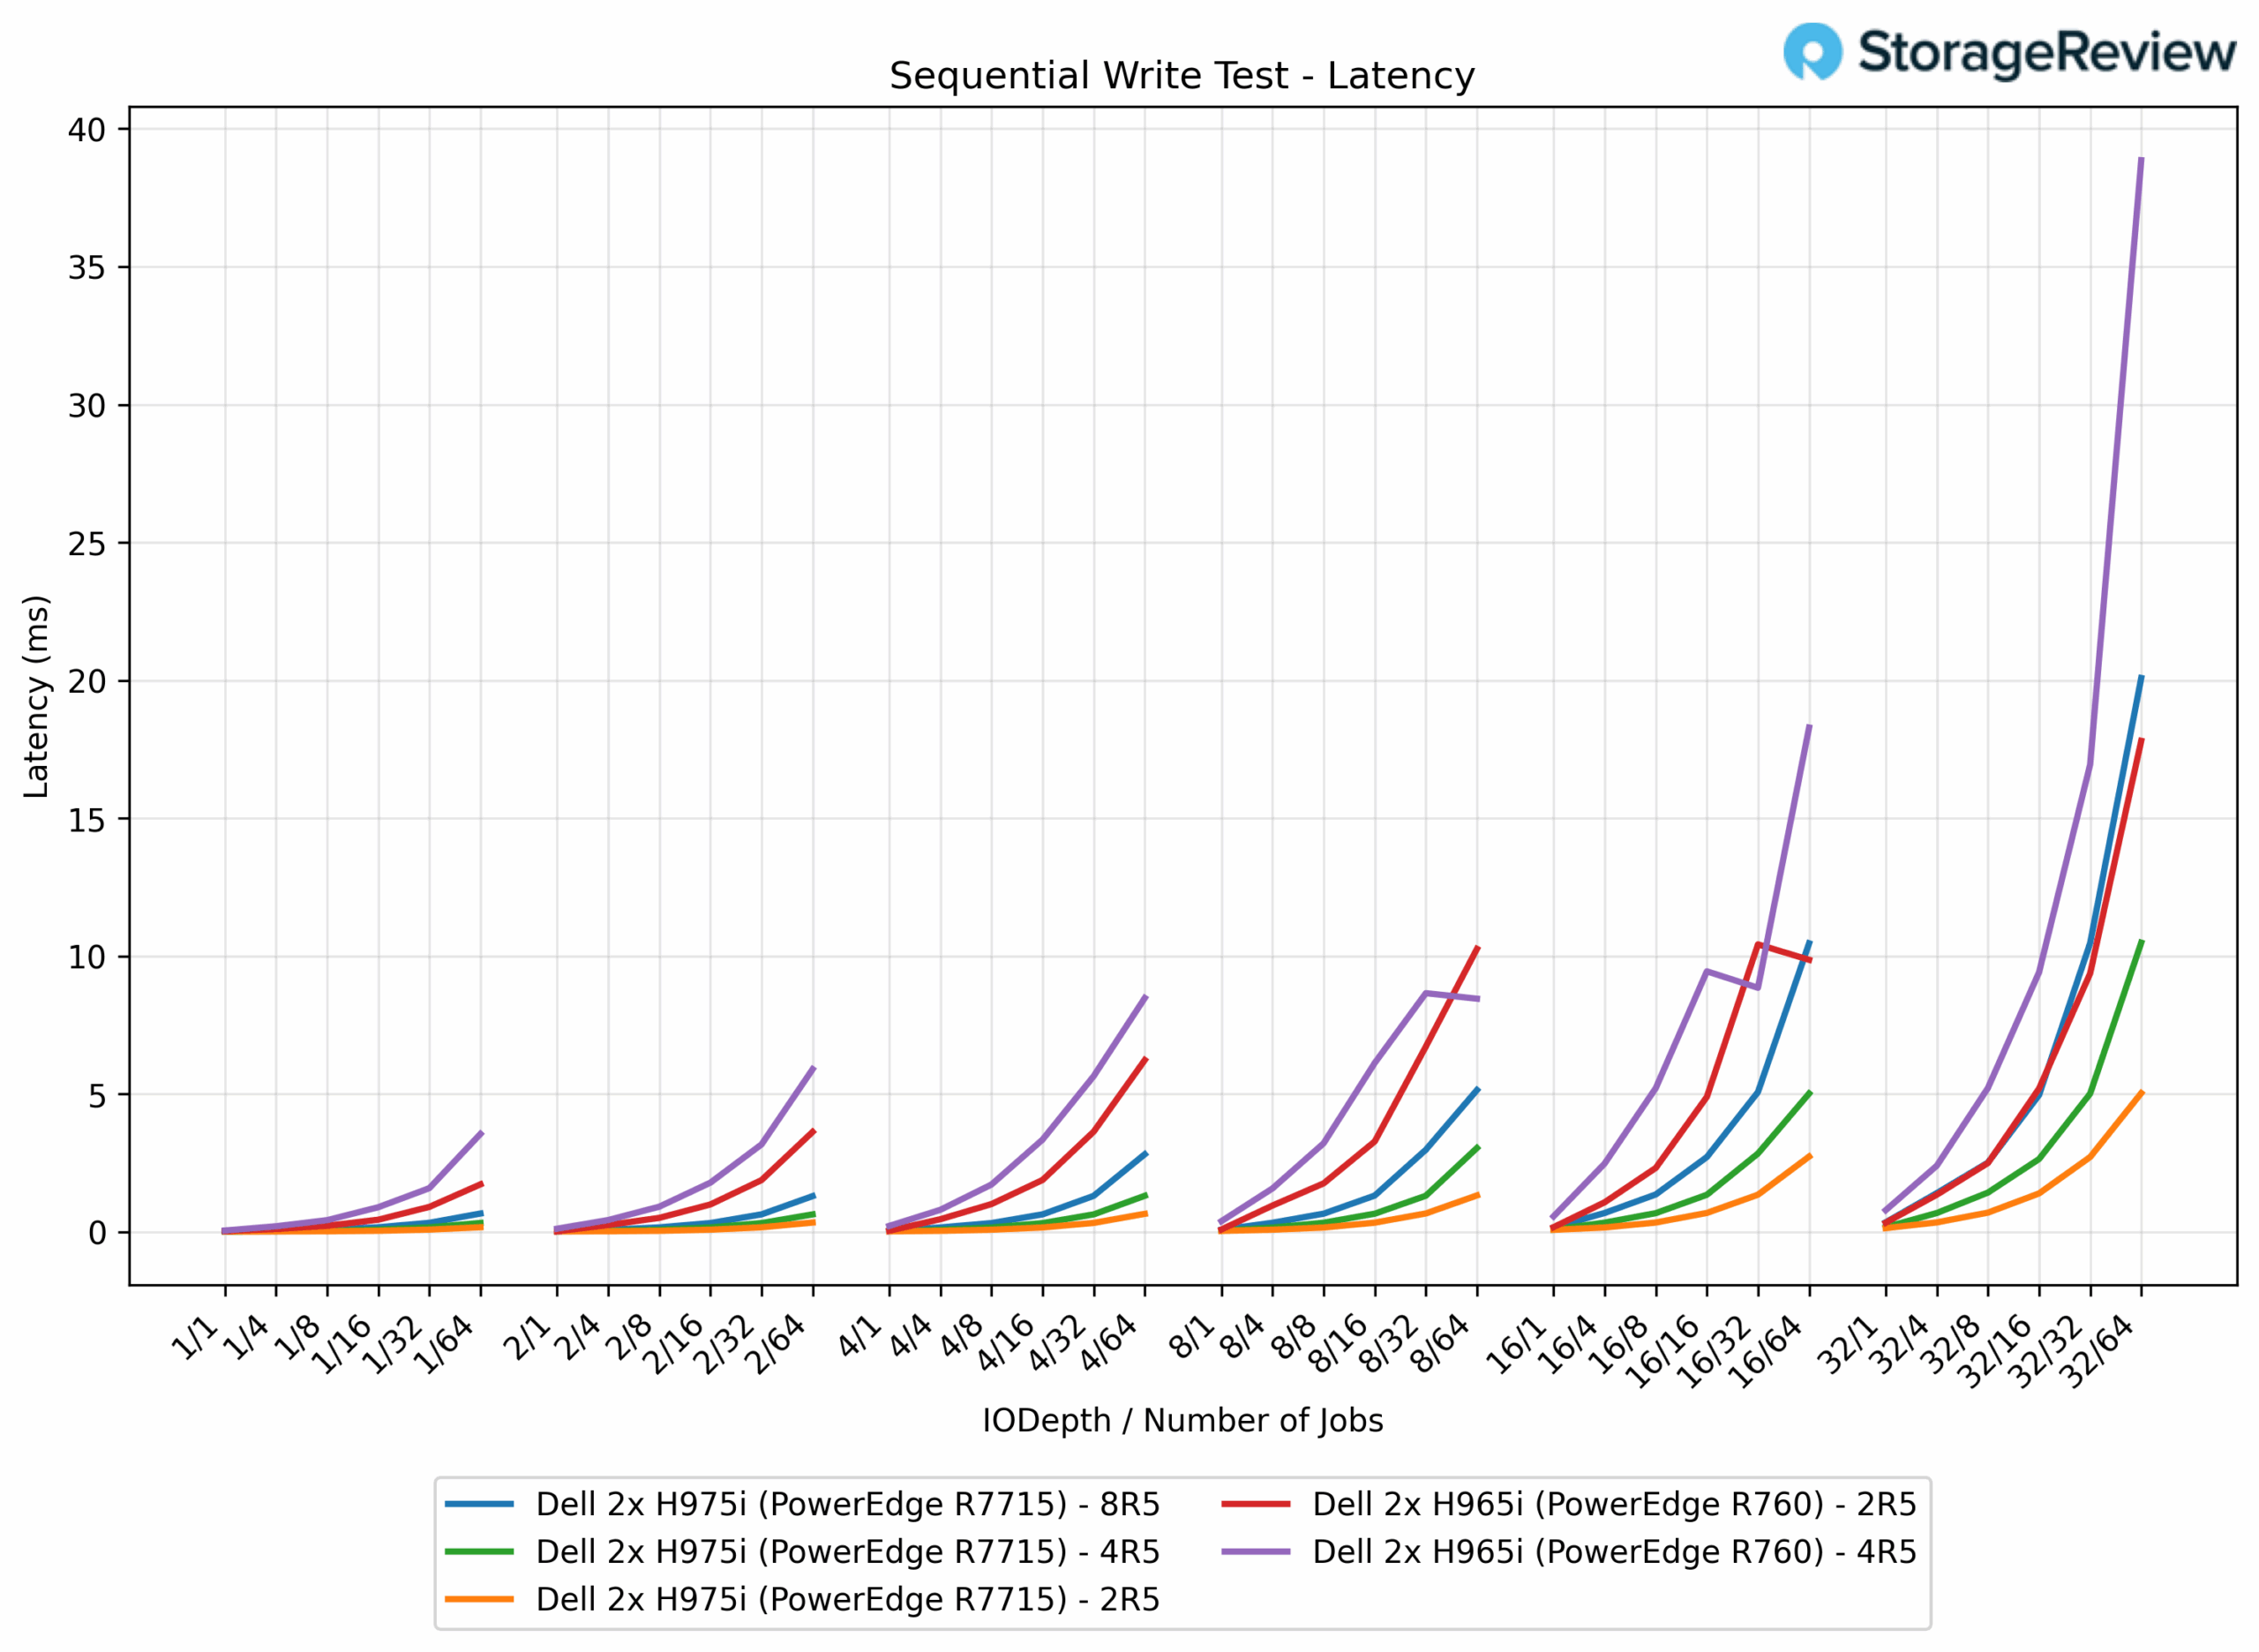
128Kシーケンシャル書き込みレイテンシテストでは、コントローラ世代間で明確な違いが見られました。PERC H965iアレイのレイテンシは高く、2R5構成では0.0238msから17.8ms、4R5構成では38.9msにまで上昇し、RAIDディスク追加によるメリットは最小限にとどまりました。一方、PERC H975iコントローラは、すべての構成においてレイテンシが大幅に低減しました。2R5アレイでは0.0173msから5.0ms(ピークレイテンシ72%低減)、4R5構成では0.0179msから10.5ms(73%低減)、8R5構成では0.0188msから20.1ms(H48i 965R4と比較して5%低減)となりました。
128K シーケンシャルリード帯域幅
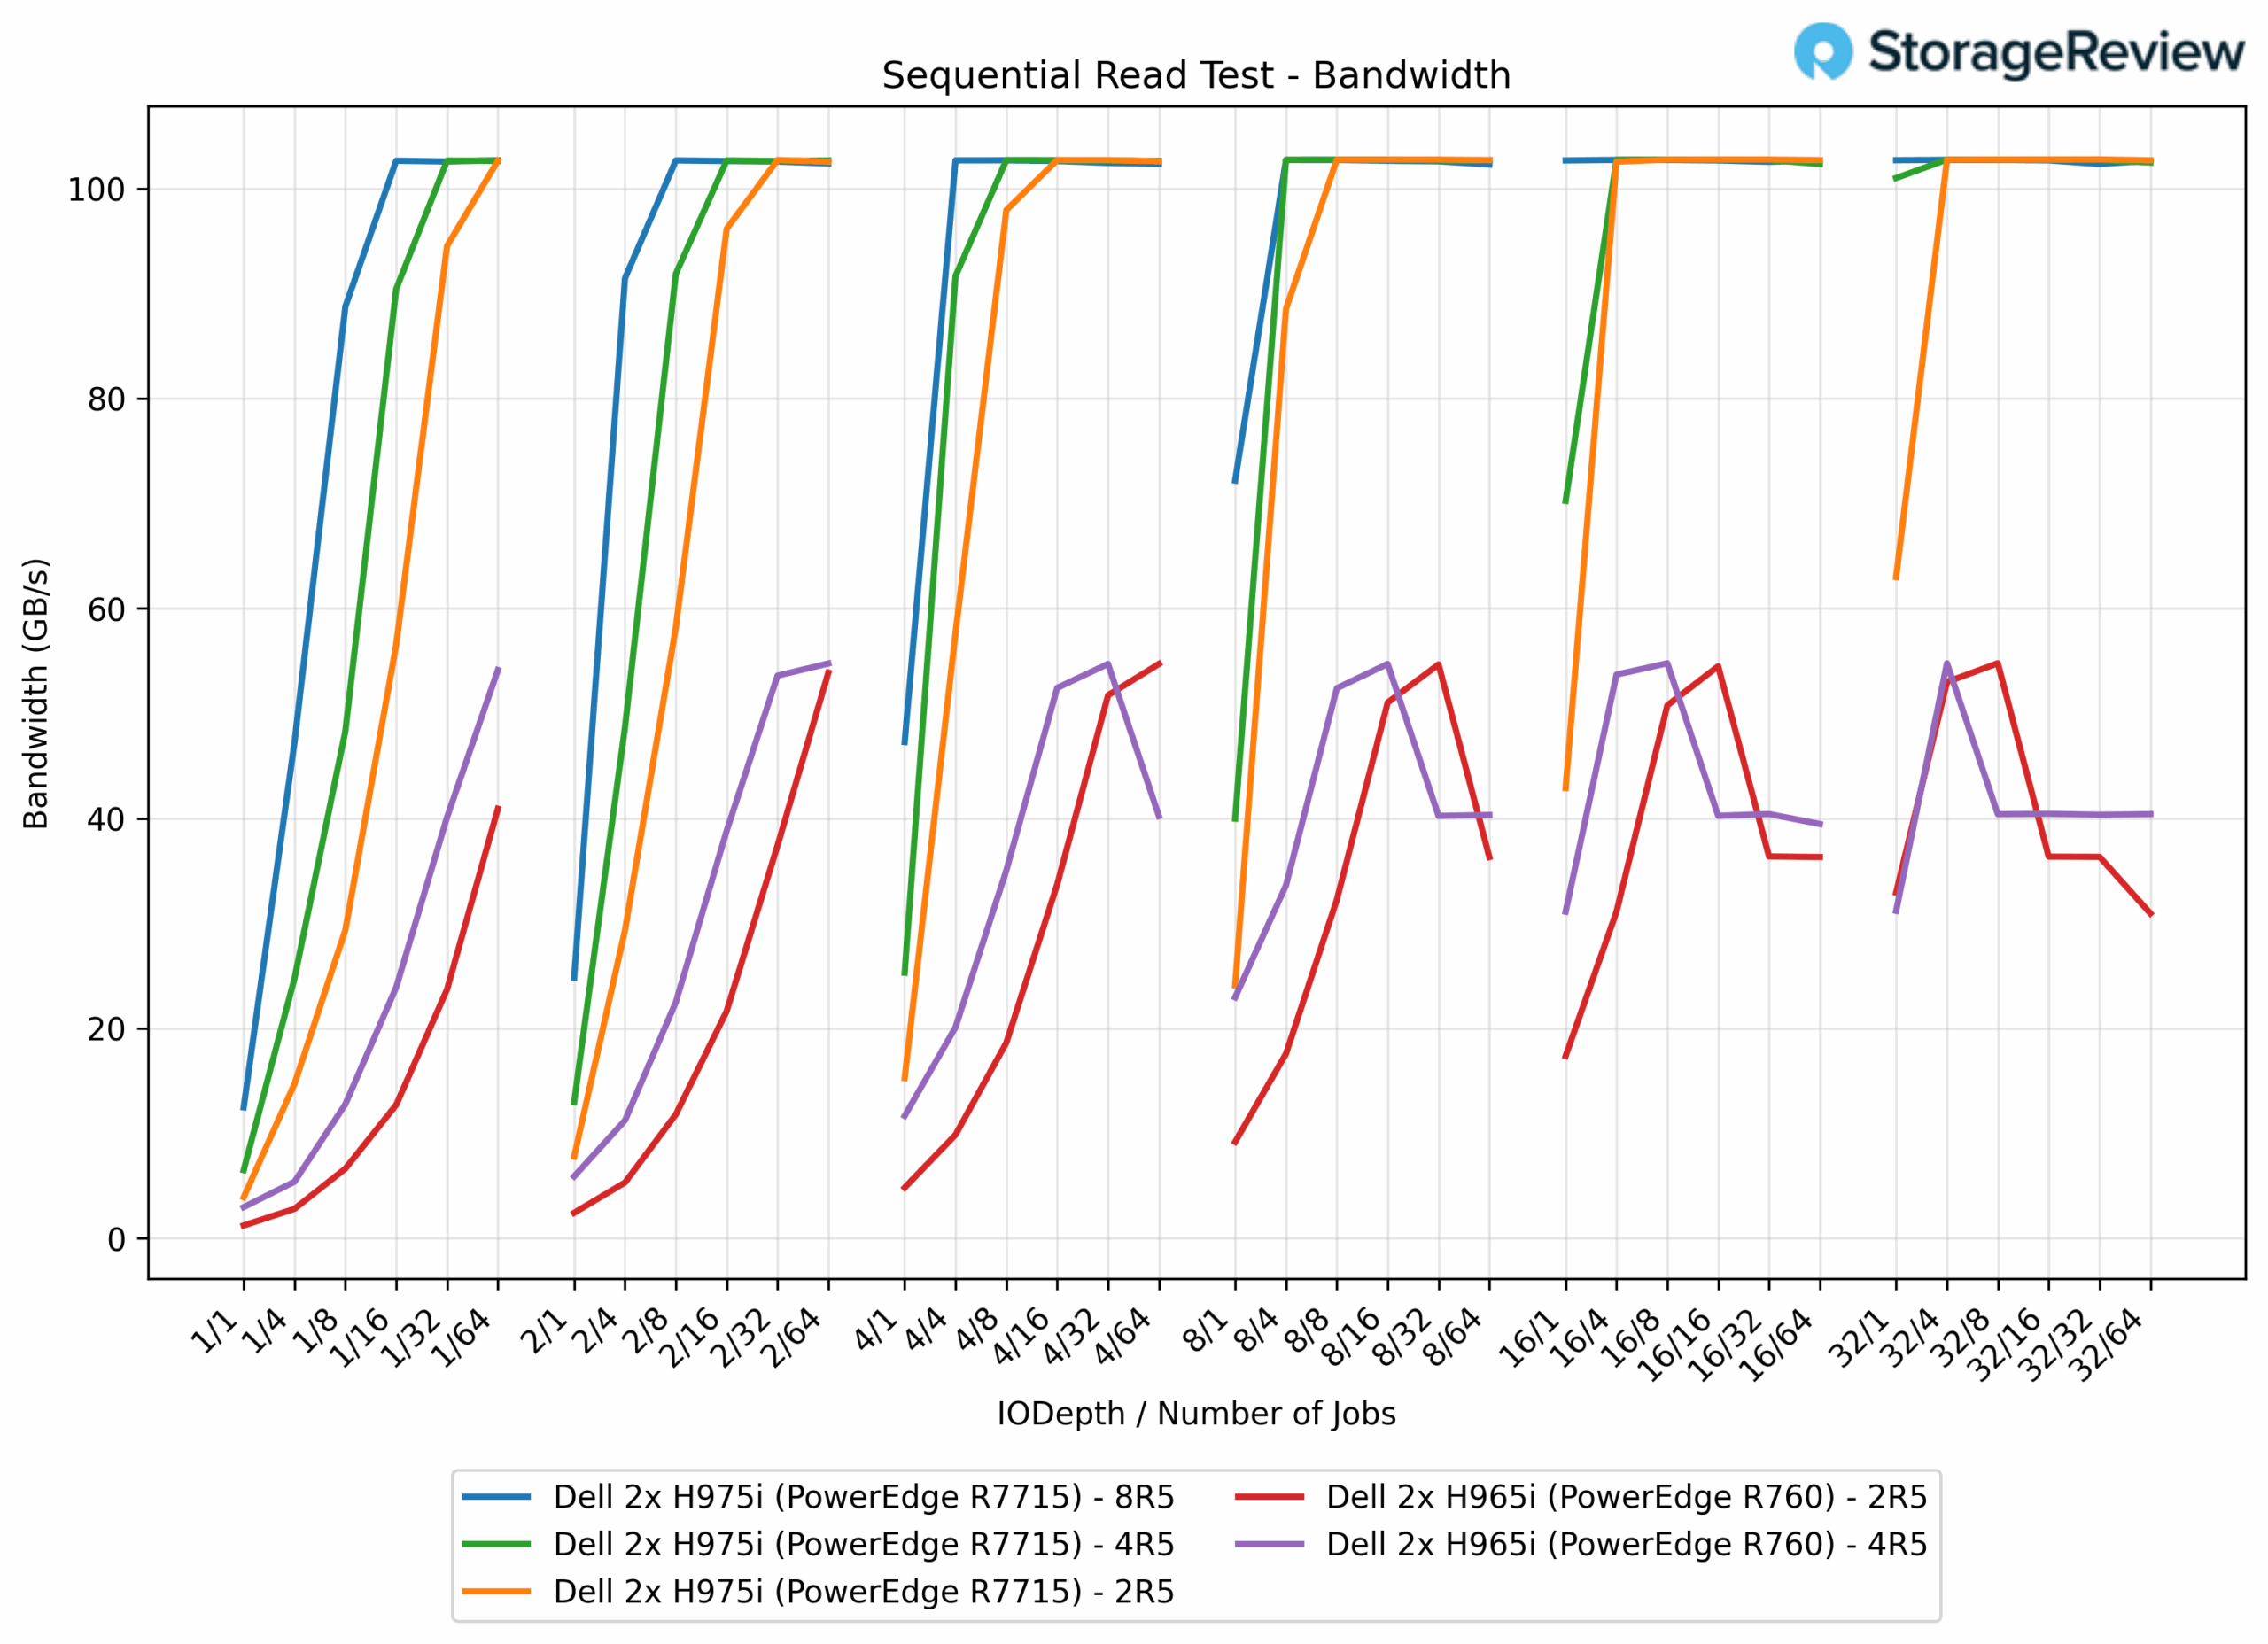
Dellシステムにおける128Kシーケンシャルリードテストにおいて、PERC H965iコントローラは両構成で一貫したパフォーマンスを示しました。2R5アレイは最大帯域幅54.8GB/秒、4R5構成も54.8GB/秒を達成しました。一方、PERC H975iコントローラは102.7つの構成全てで約102.8~975GB/秒のピーク帯域幅を達成し、大幅に優れたパフォーマンスを示しました。H2i 5R102.8アレイは87GB/秒(4%向上)、5R102.7構成は87GB/秒(8%向上)、5R102.7構成は87GB/秒(965%向上)を達成しました。特に、H2i コントローラは 5R4 構成と 5R975 構成間で有意なパフォーマンスのスケーリングを示さなかったのに対し、H5i コントローラはすべての RAID XNUMX 構成にわたって一貫して高いパフォーマンスを維持し、アレイ内のドライブ数に関係なく帯域幅の上限に達したように見えました。
128K シーケンシャルリードレイテンシ
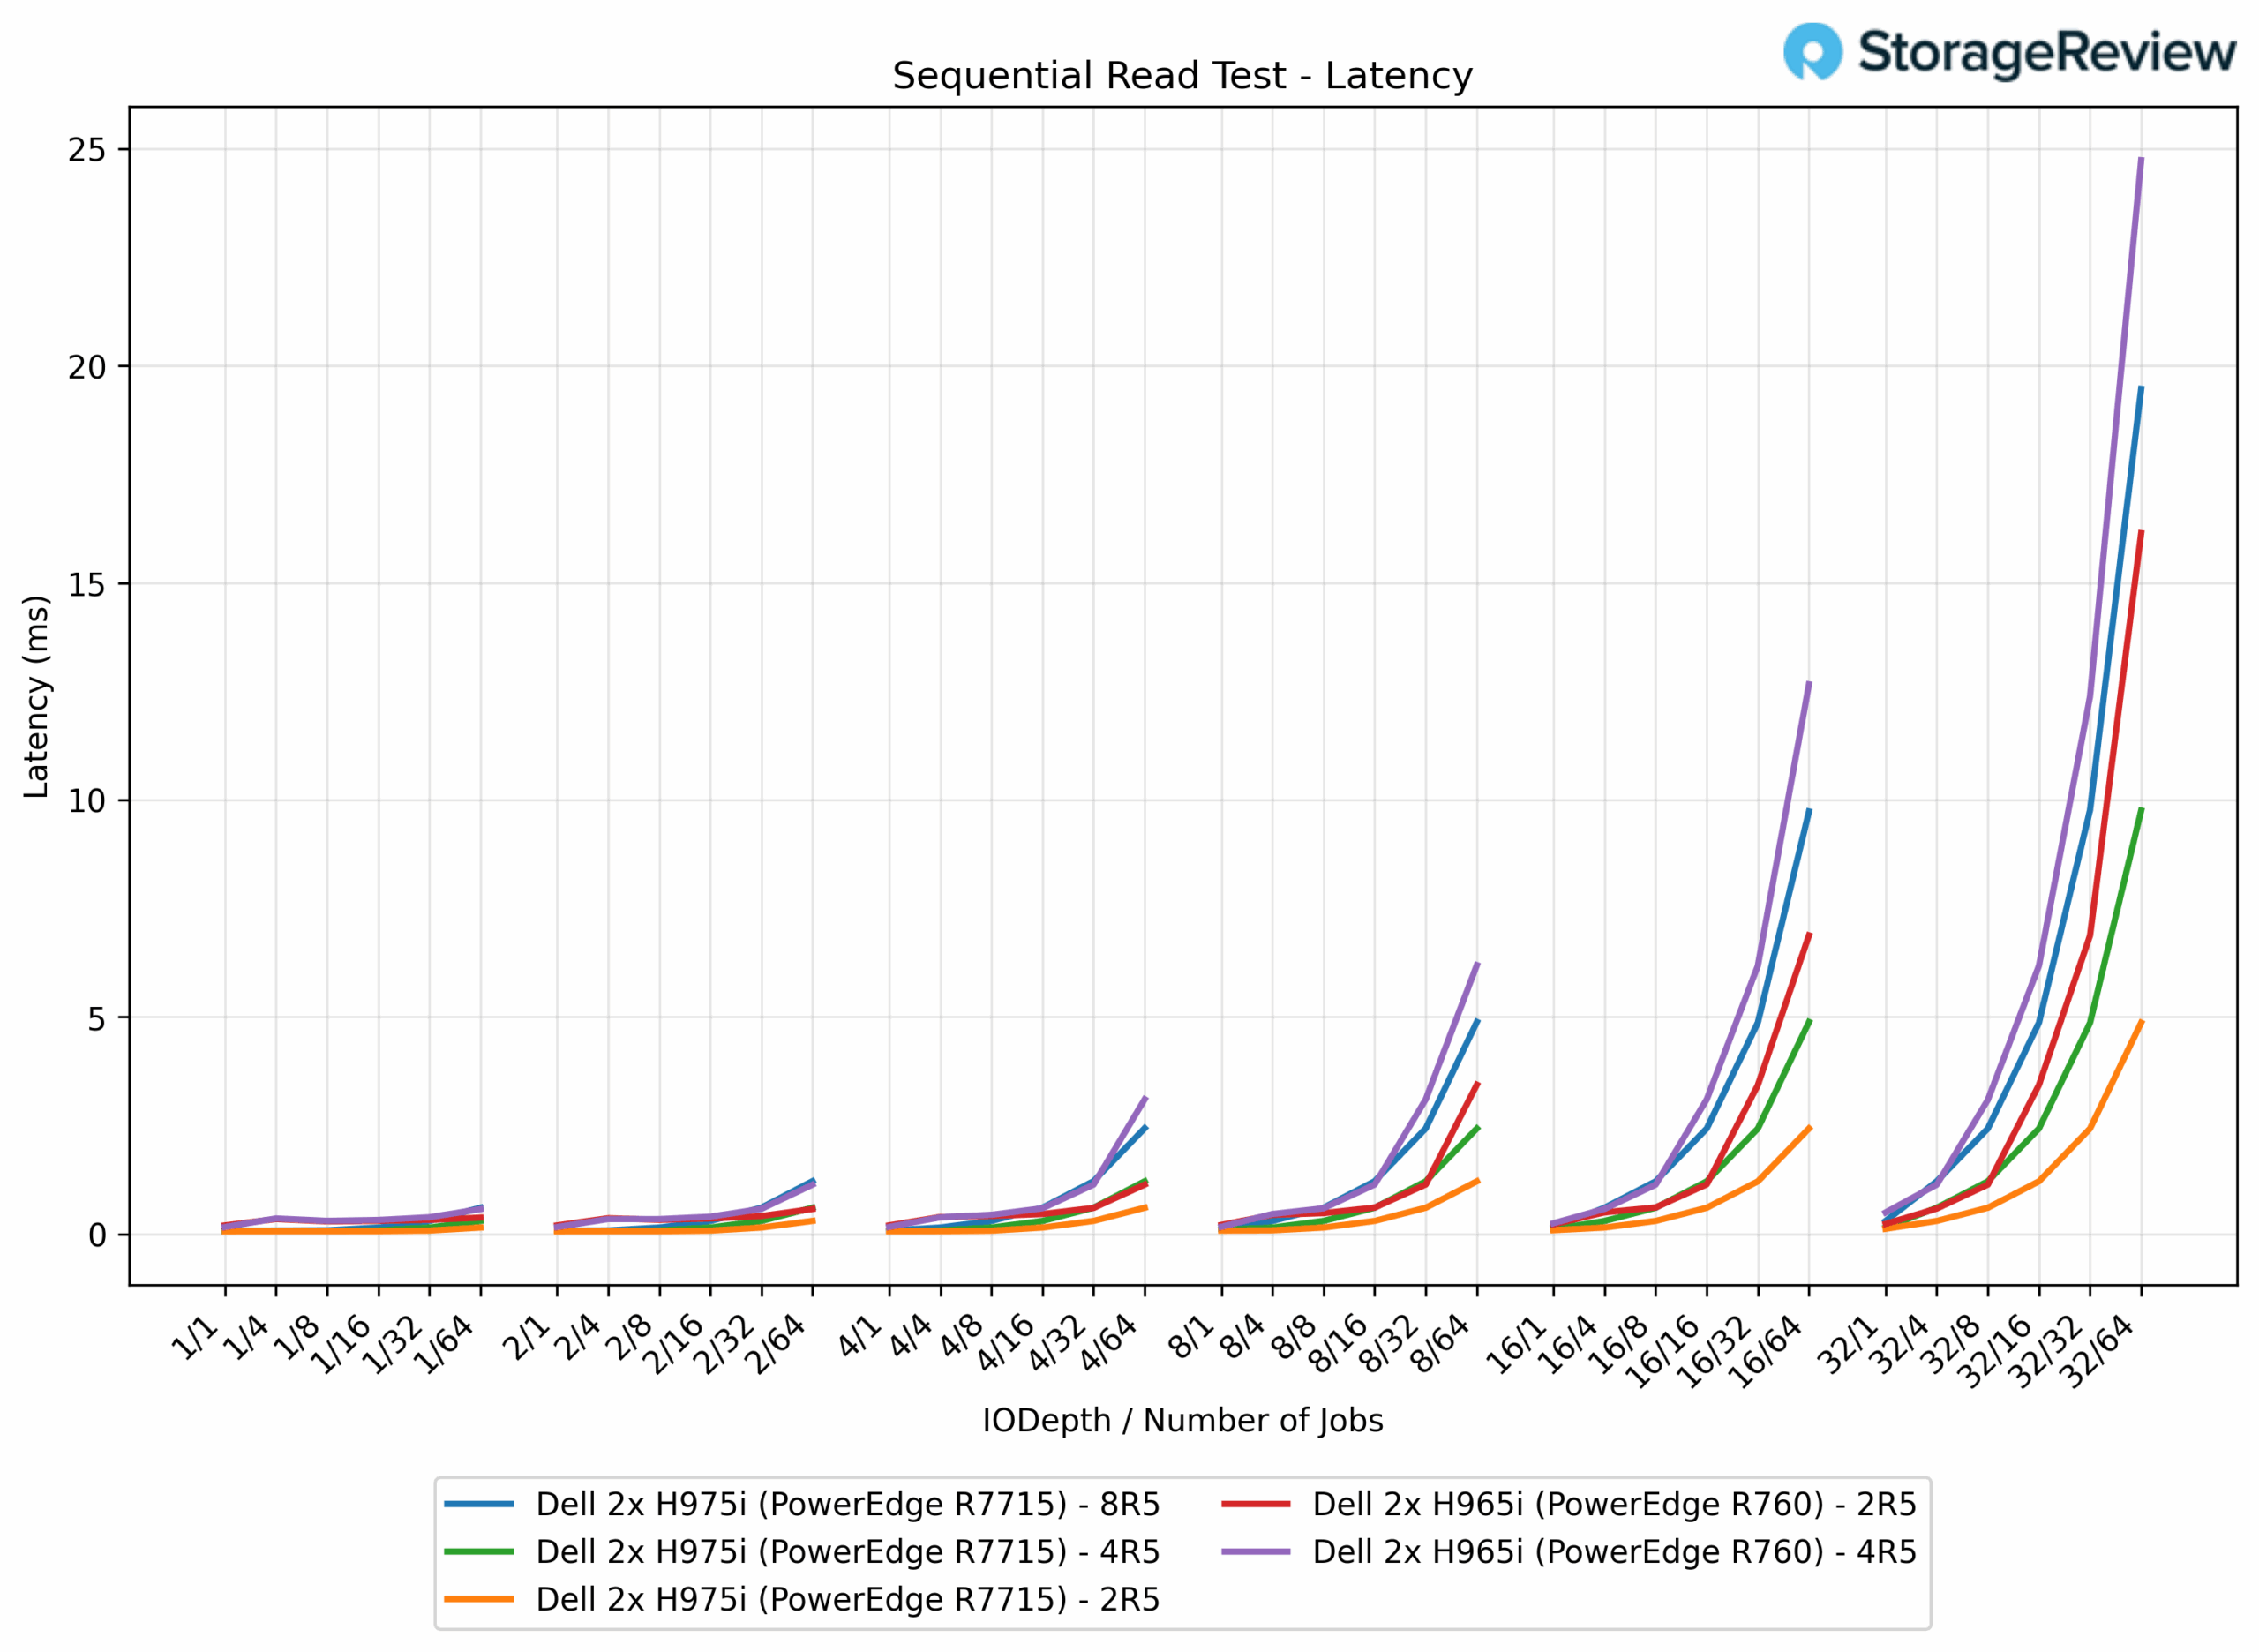
128Kシーケンシャルリードレイテンシテストにおいて、PERC H965iは0.2006R16.1構成で2ms~5ms、0.1644R24.7構成で4ms~5msのレイテンシを記録し、ドライブのスケールアップに伴いレイテンシの変動が拡大しました。一方、PERC H975iははるかに効率が高く、2R5構成では0.062ms~4.9ms(ピークレイテンシが80%低減)、4R5構成では0.075ms~9.8ms(60%低減)、8R5構成では19.5ms(H21i 965R4構成比で5%低減)と、レイテンシが大幅に向上しました。
64kランダム書き込み帯域幅
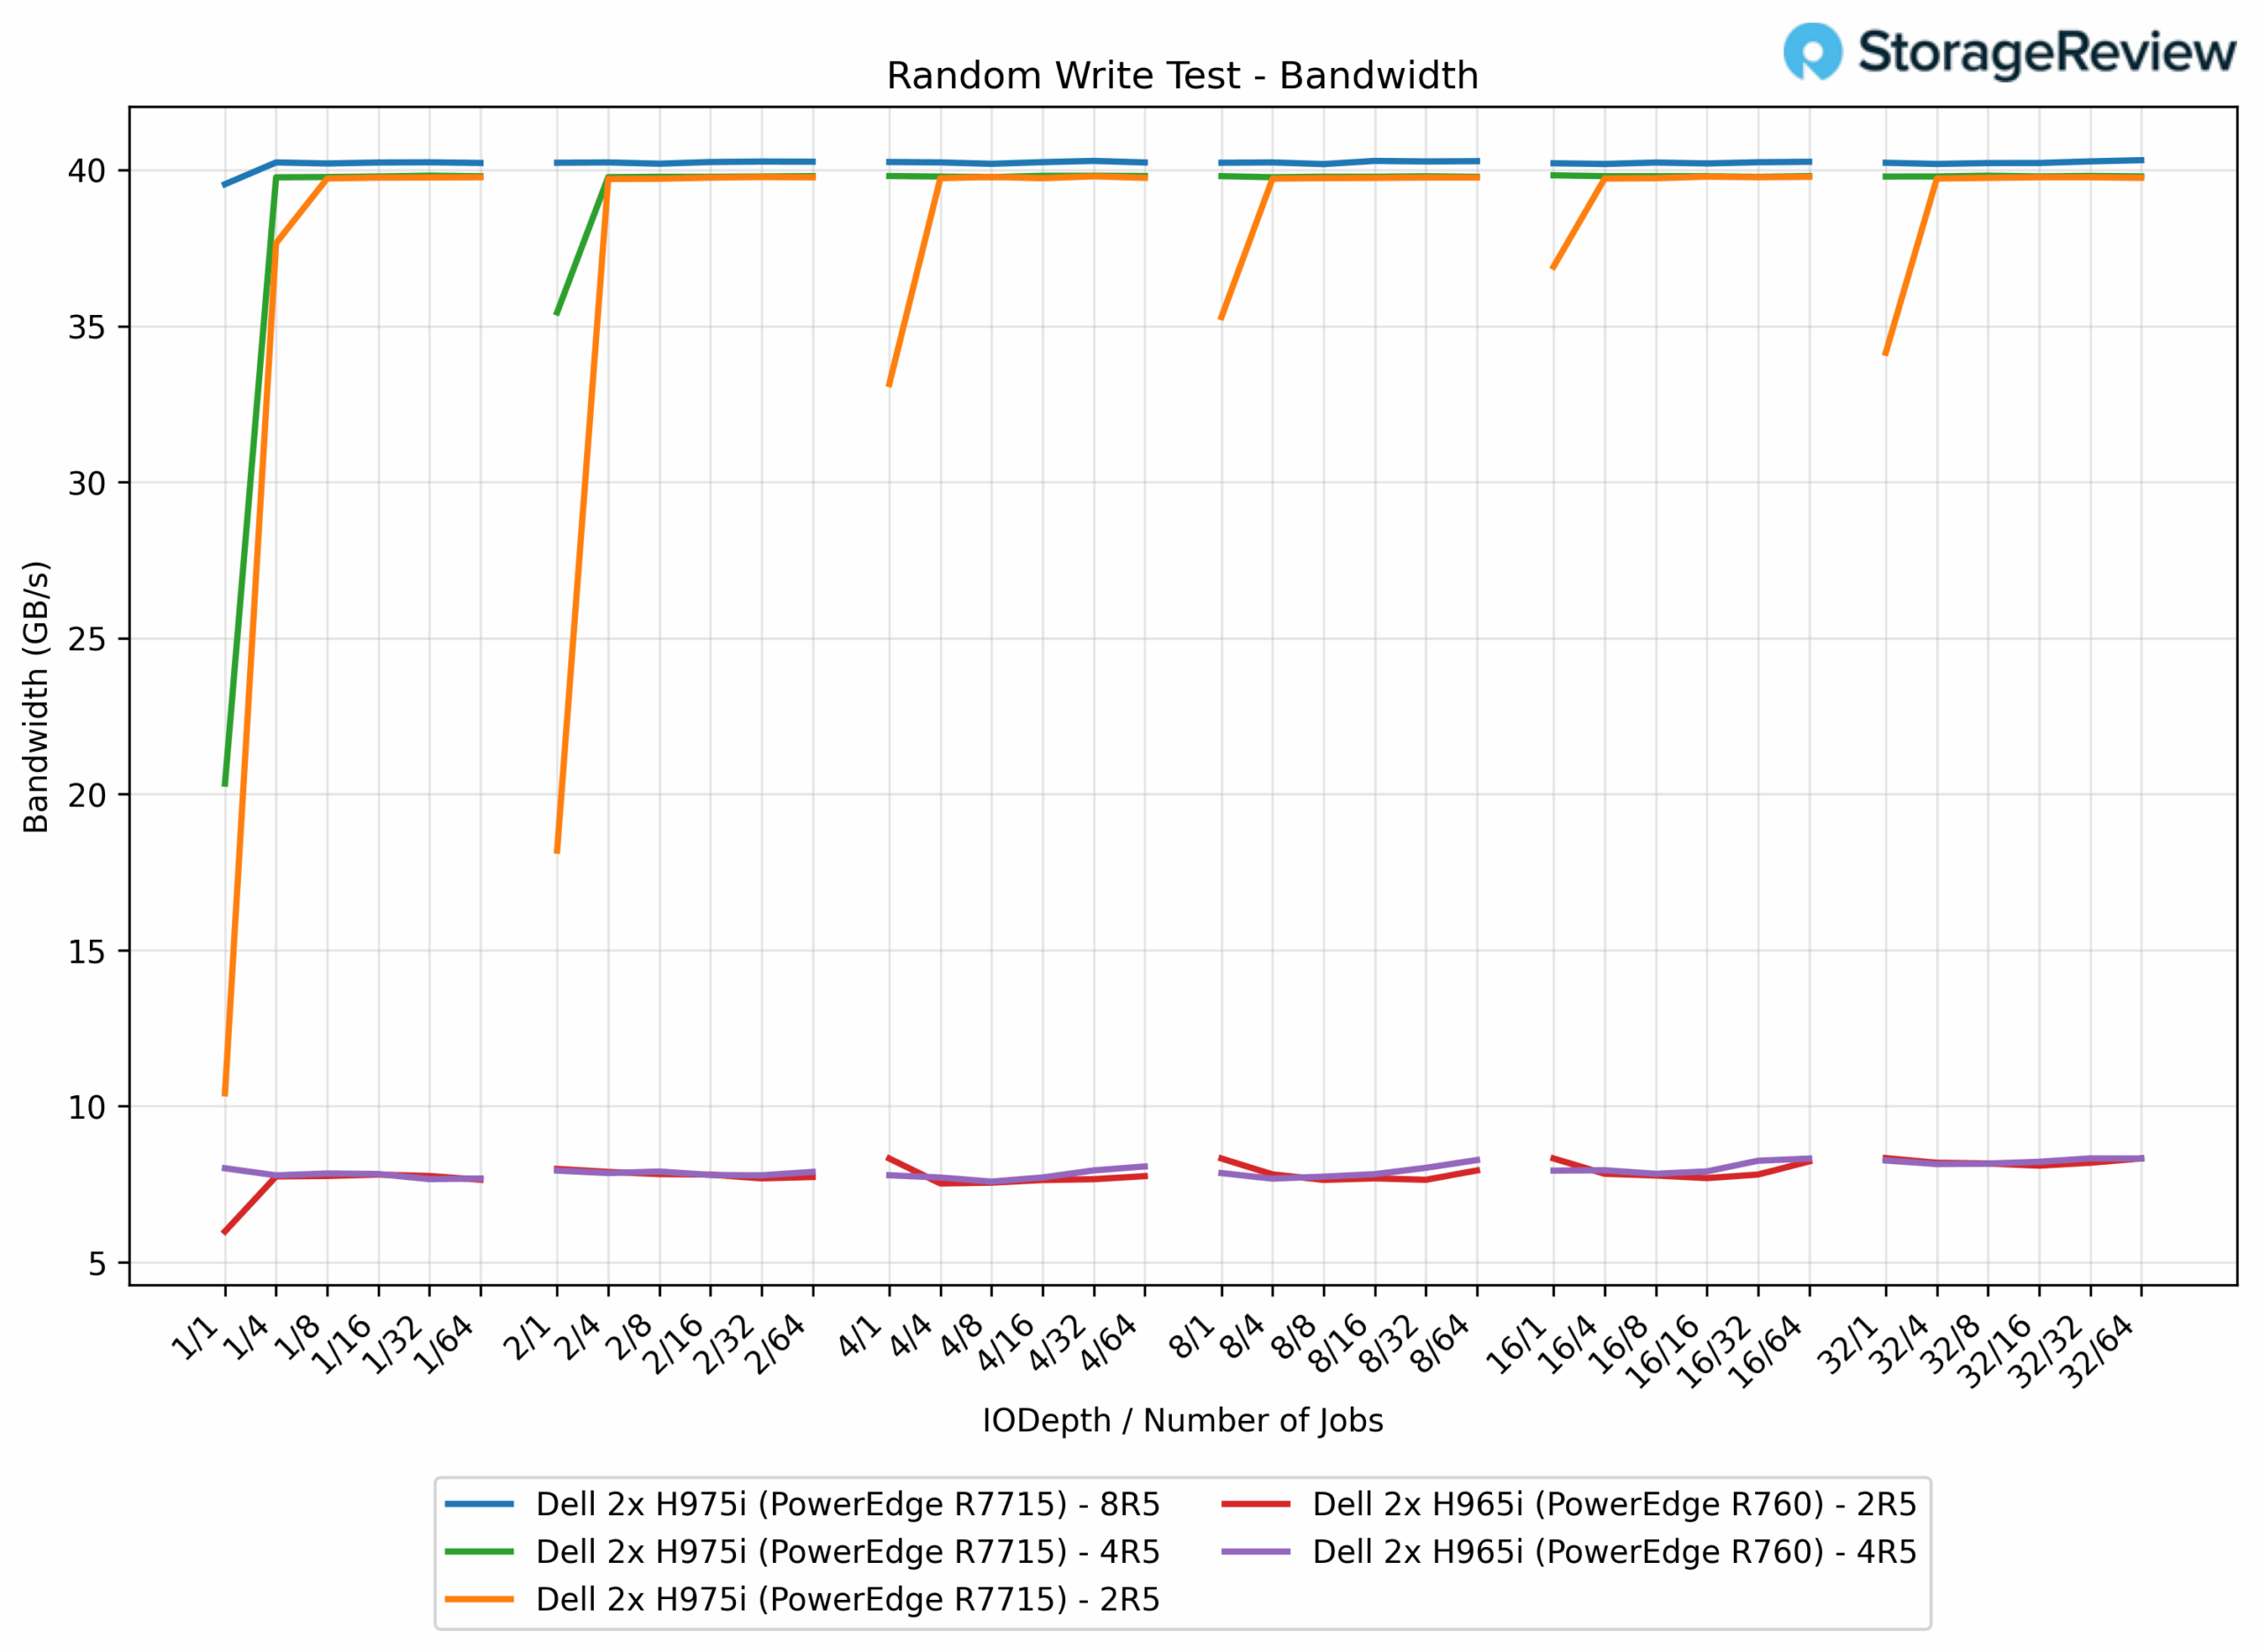
64Kランダム書き込みテストでは、旧型のPERC H965iコントローラは安定したパフォーマンスを示しましたが、ディスク数に関わらず、2R5構成と4R5構成の両方でほぼ同等のスループット(8.3 GB/秒)を達成しました。これとは対照的に、PERC H975iコントローラは驚異的なパフォーマンス向上を示しました。2R5構成では39.8 GB/秒(379%向上)、4R5構成ではピーク帯域幅39.8 GB/秒(379%向上)を維持しました。H8iの5R975アレイは40.3 GB/秒(386%向上)とわずかに上回りました。
64k ランダム書き込みレイテンシ
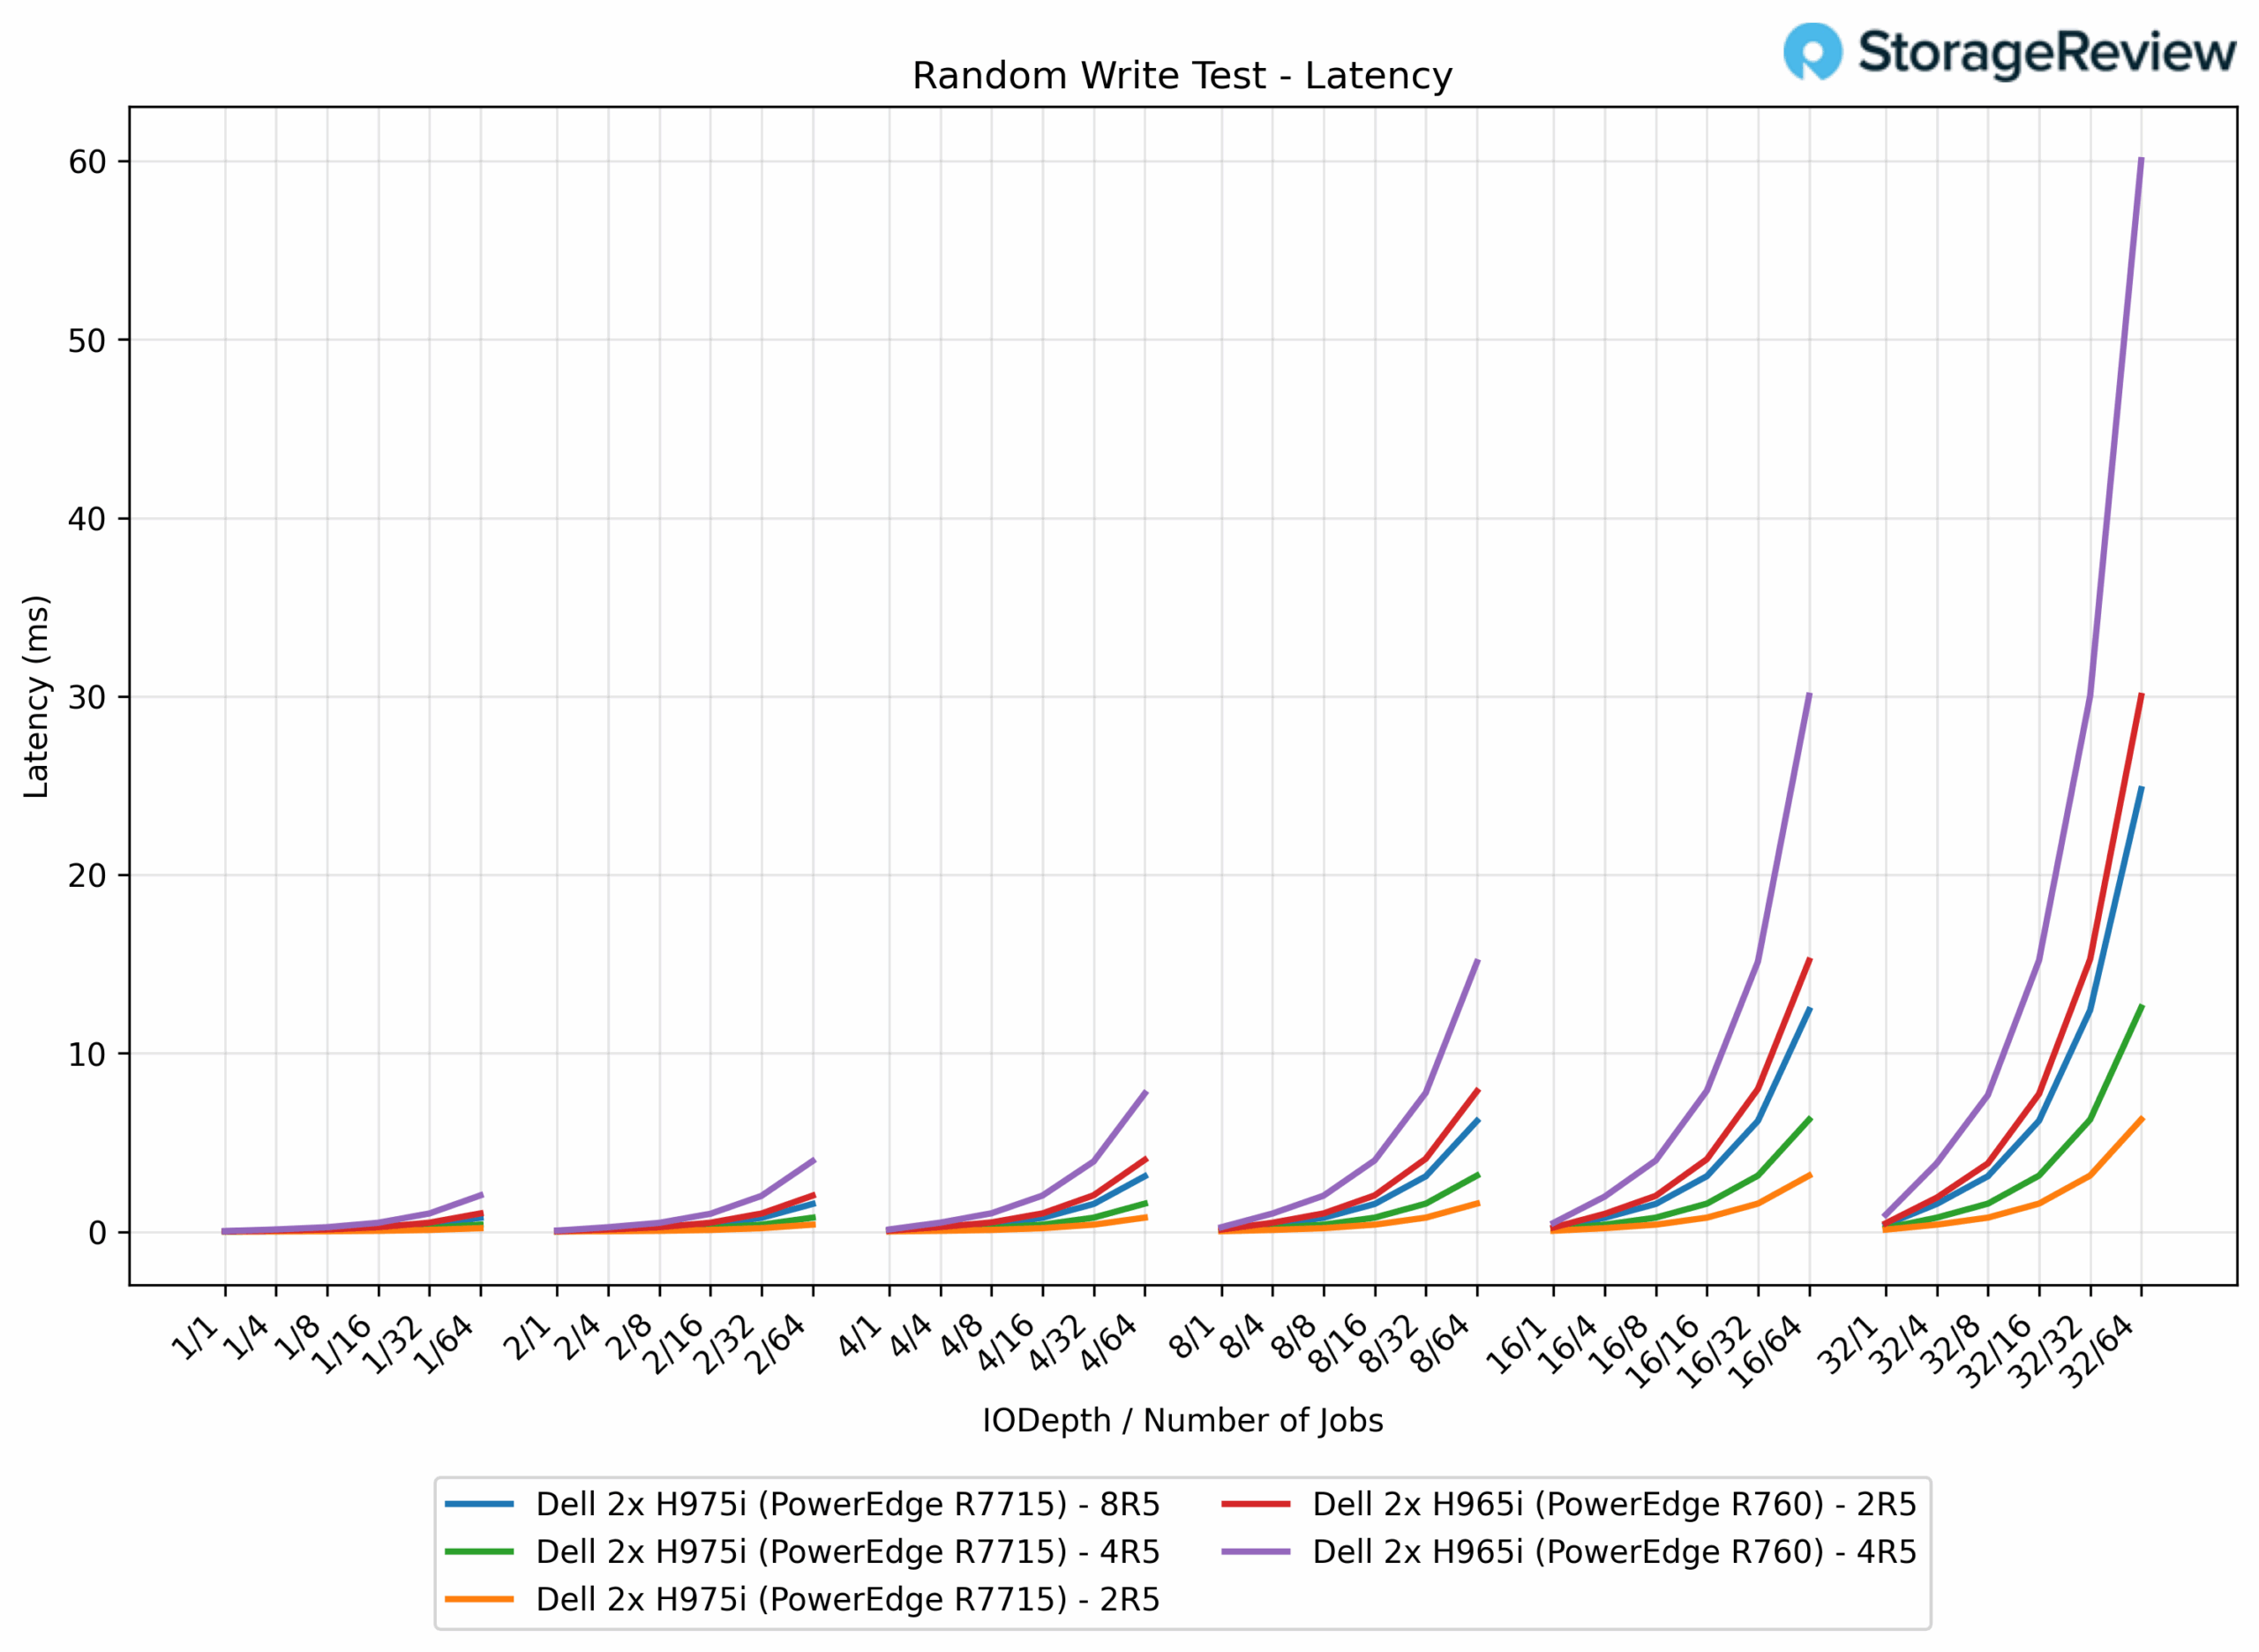
64Kランダム書き込みレイテンシテストでは、H965iは高負荷時に苦戦し、2R5は0.020msから最大30.0ms、4R5は最大60.0msにまで達しました。対照的に、H975iコントローラのパフォーマンスは劇的に向上しました。2R5は0.0115msから6.3ms(ピークレイテンシが79%低下)、4R5はわずか12.6ms(79%低下)、8R5はピークで24.8ms(H59iの965R4と比較して5%低下)でした。
64kランダム読み取り帯域幅
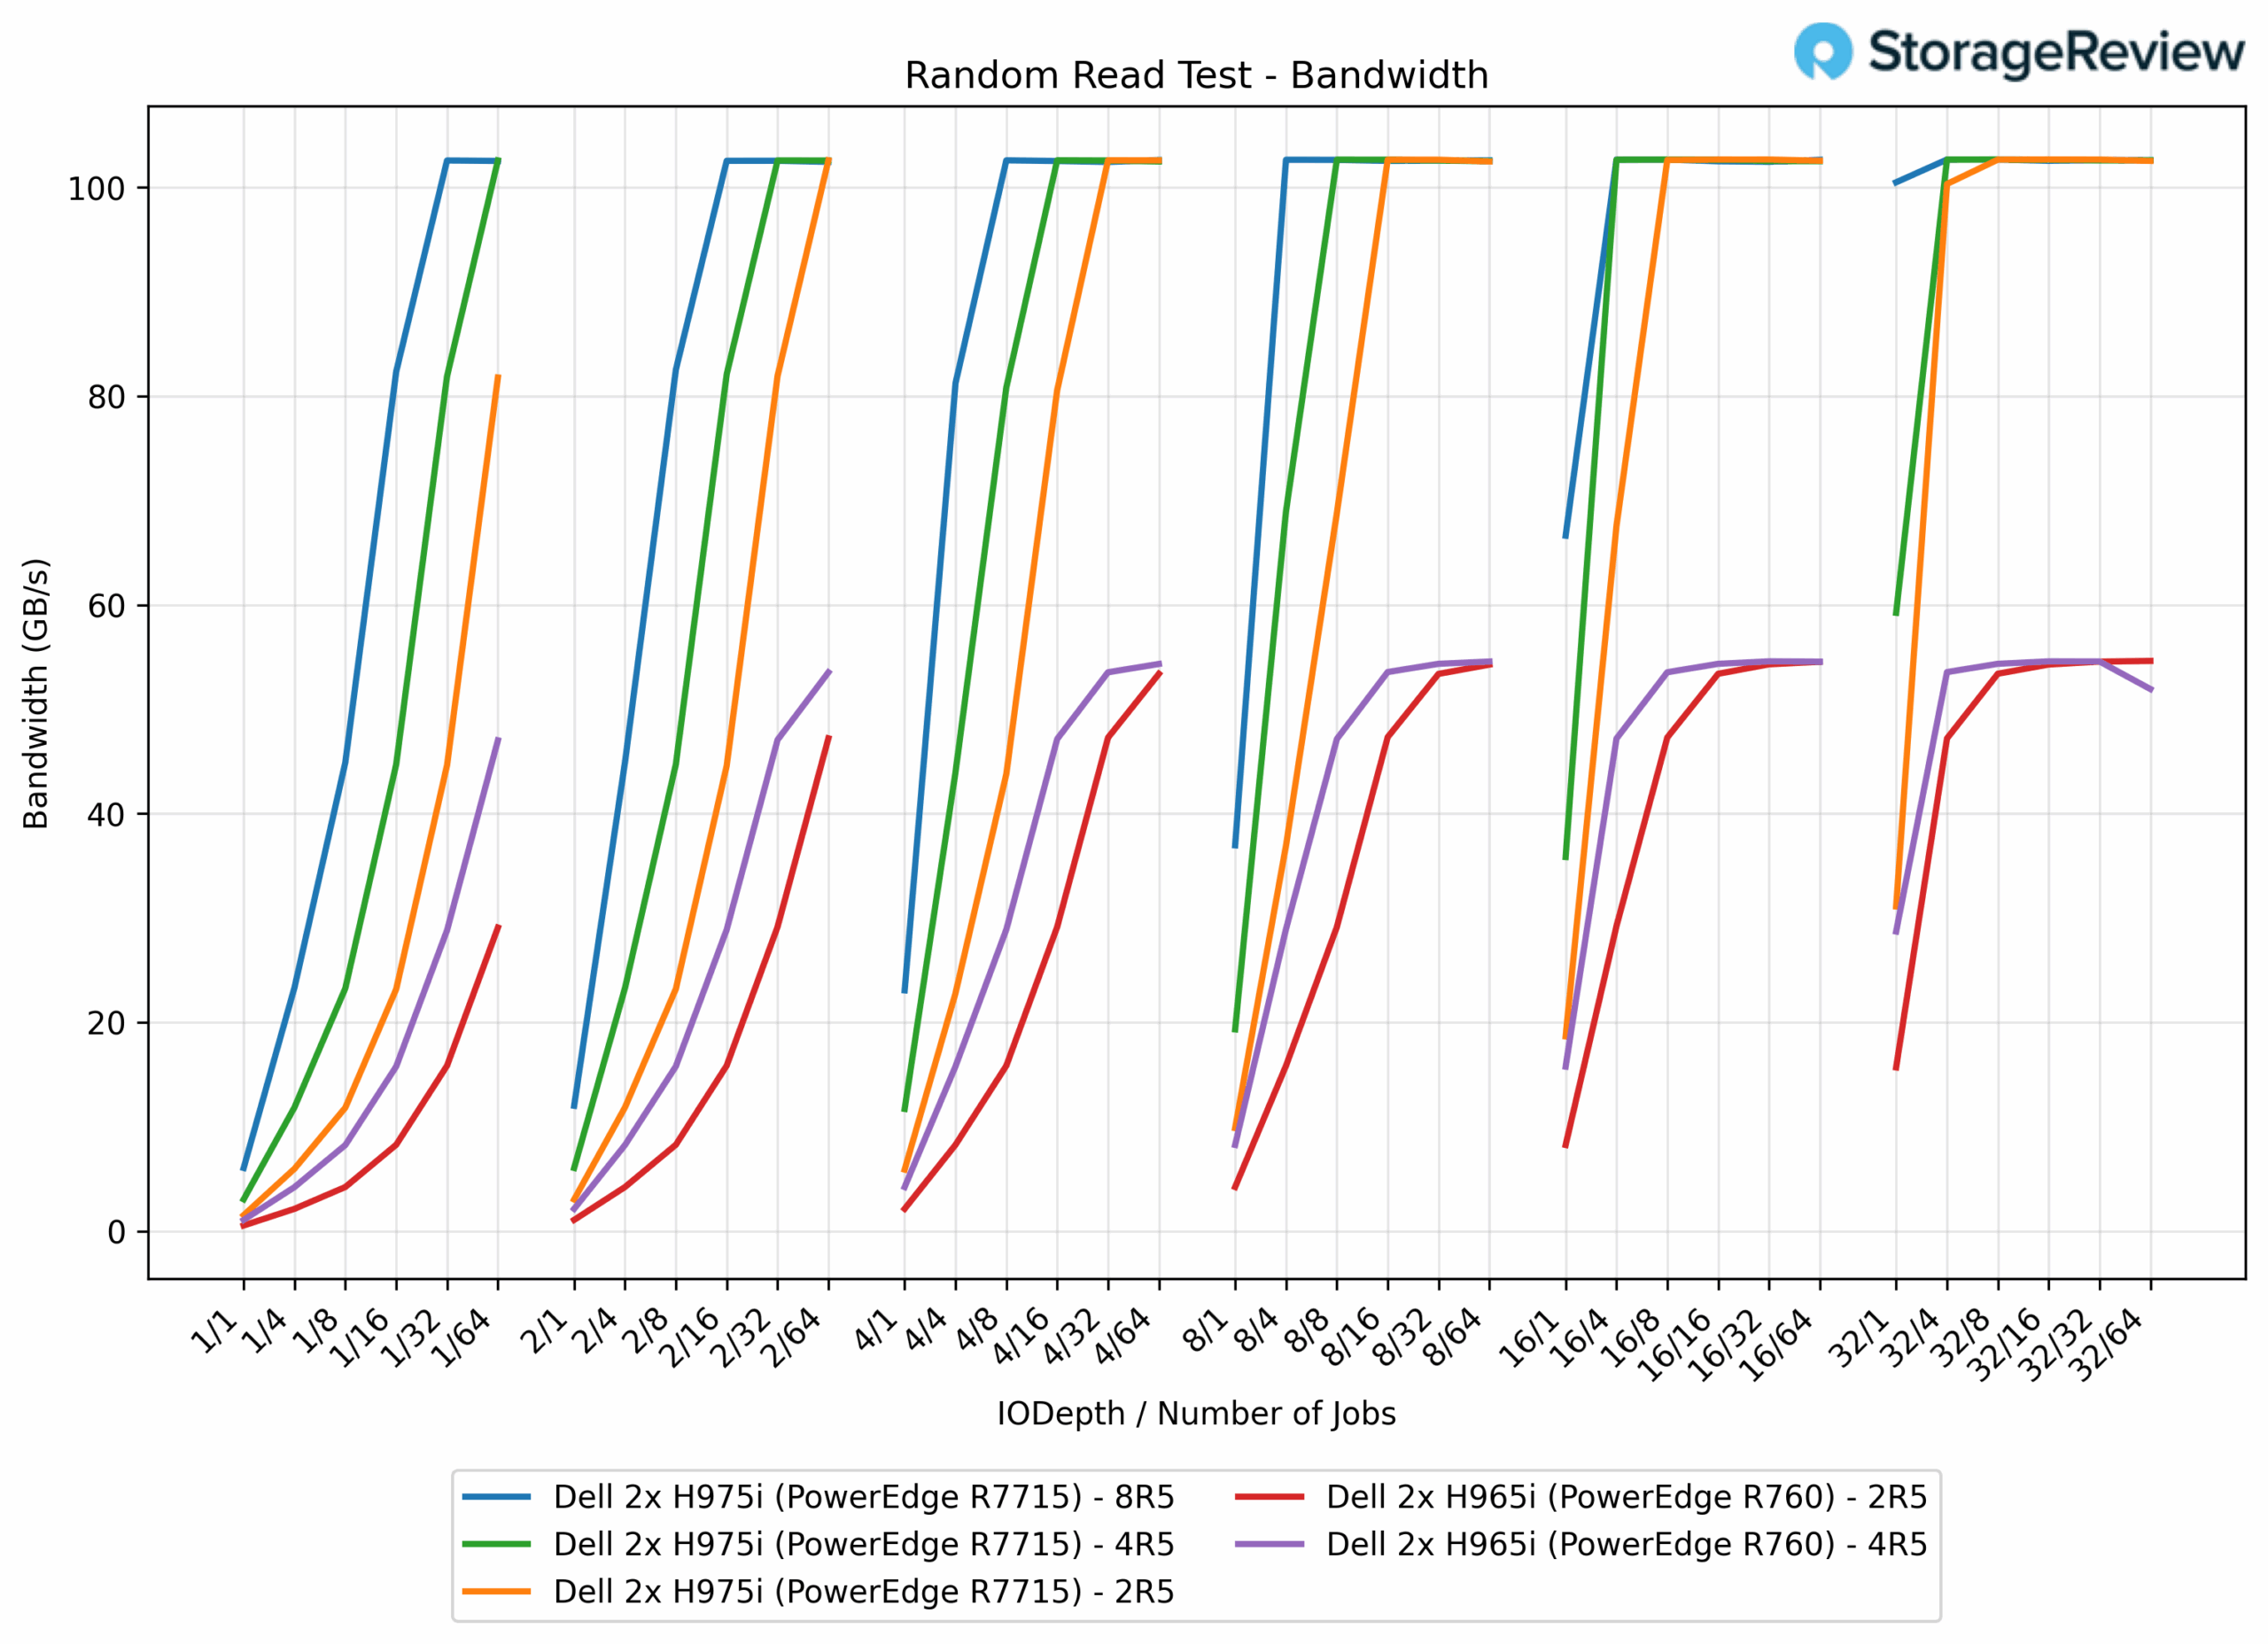
64Kランダム読み取りテストでは、PERC H965iは2R5アレイと4R5アレイの両方でほぼ同等の54.6GB/秒のスループットを達成しました。これとは対照的に、PERC H975iコントローラはここでも劇的な性能向上を示し、102.7つの構成全てで約88GB/秒に達し、H965iと比較して975%の性能向上を示しました。特筆すべきは、H102.7i構成はRAIDアレイのサイズに関わらず、ピーク帯域幅が102.7GB/秒から2GB/秒の範囲にとどまり、RAID-4アレイのドライブ数が8、5、または64台のいずれであっても、非常に安定したパフォーマンスを示したことです。これは、975Kランダム読み取りワークロードにおいて、コントローラを完全に飽和させることができ、新しいHXNUMXiプラットフォームではドライブ数による制限を受けていないことを示しています。
64k ランダム読み取りレイテンシ
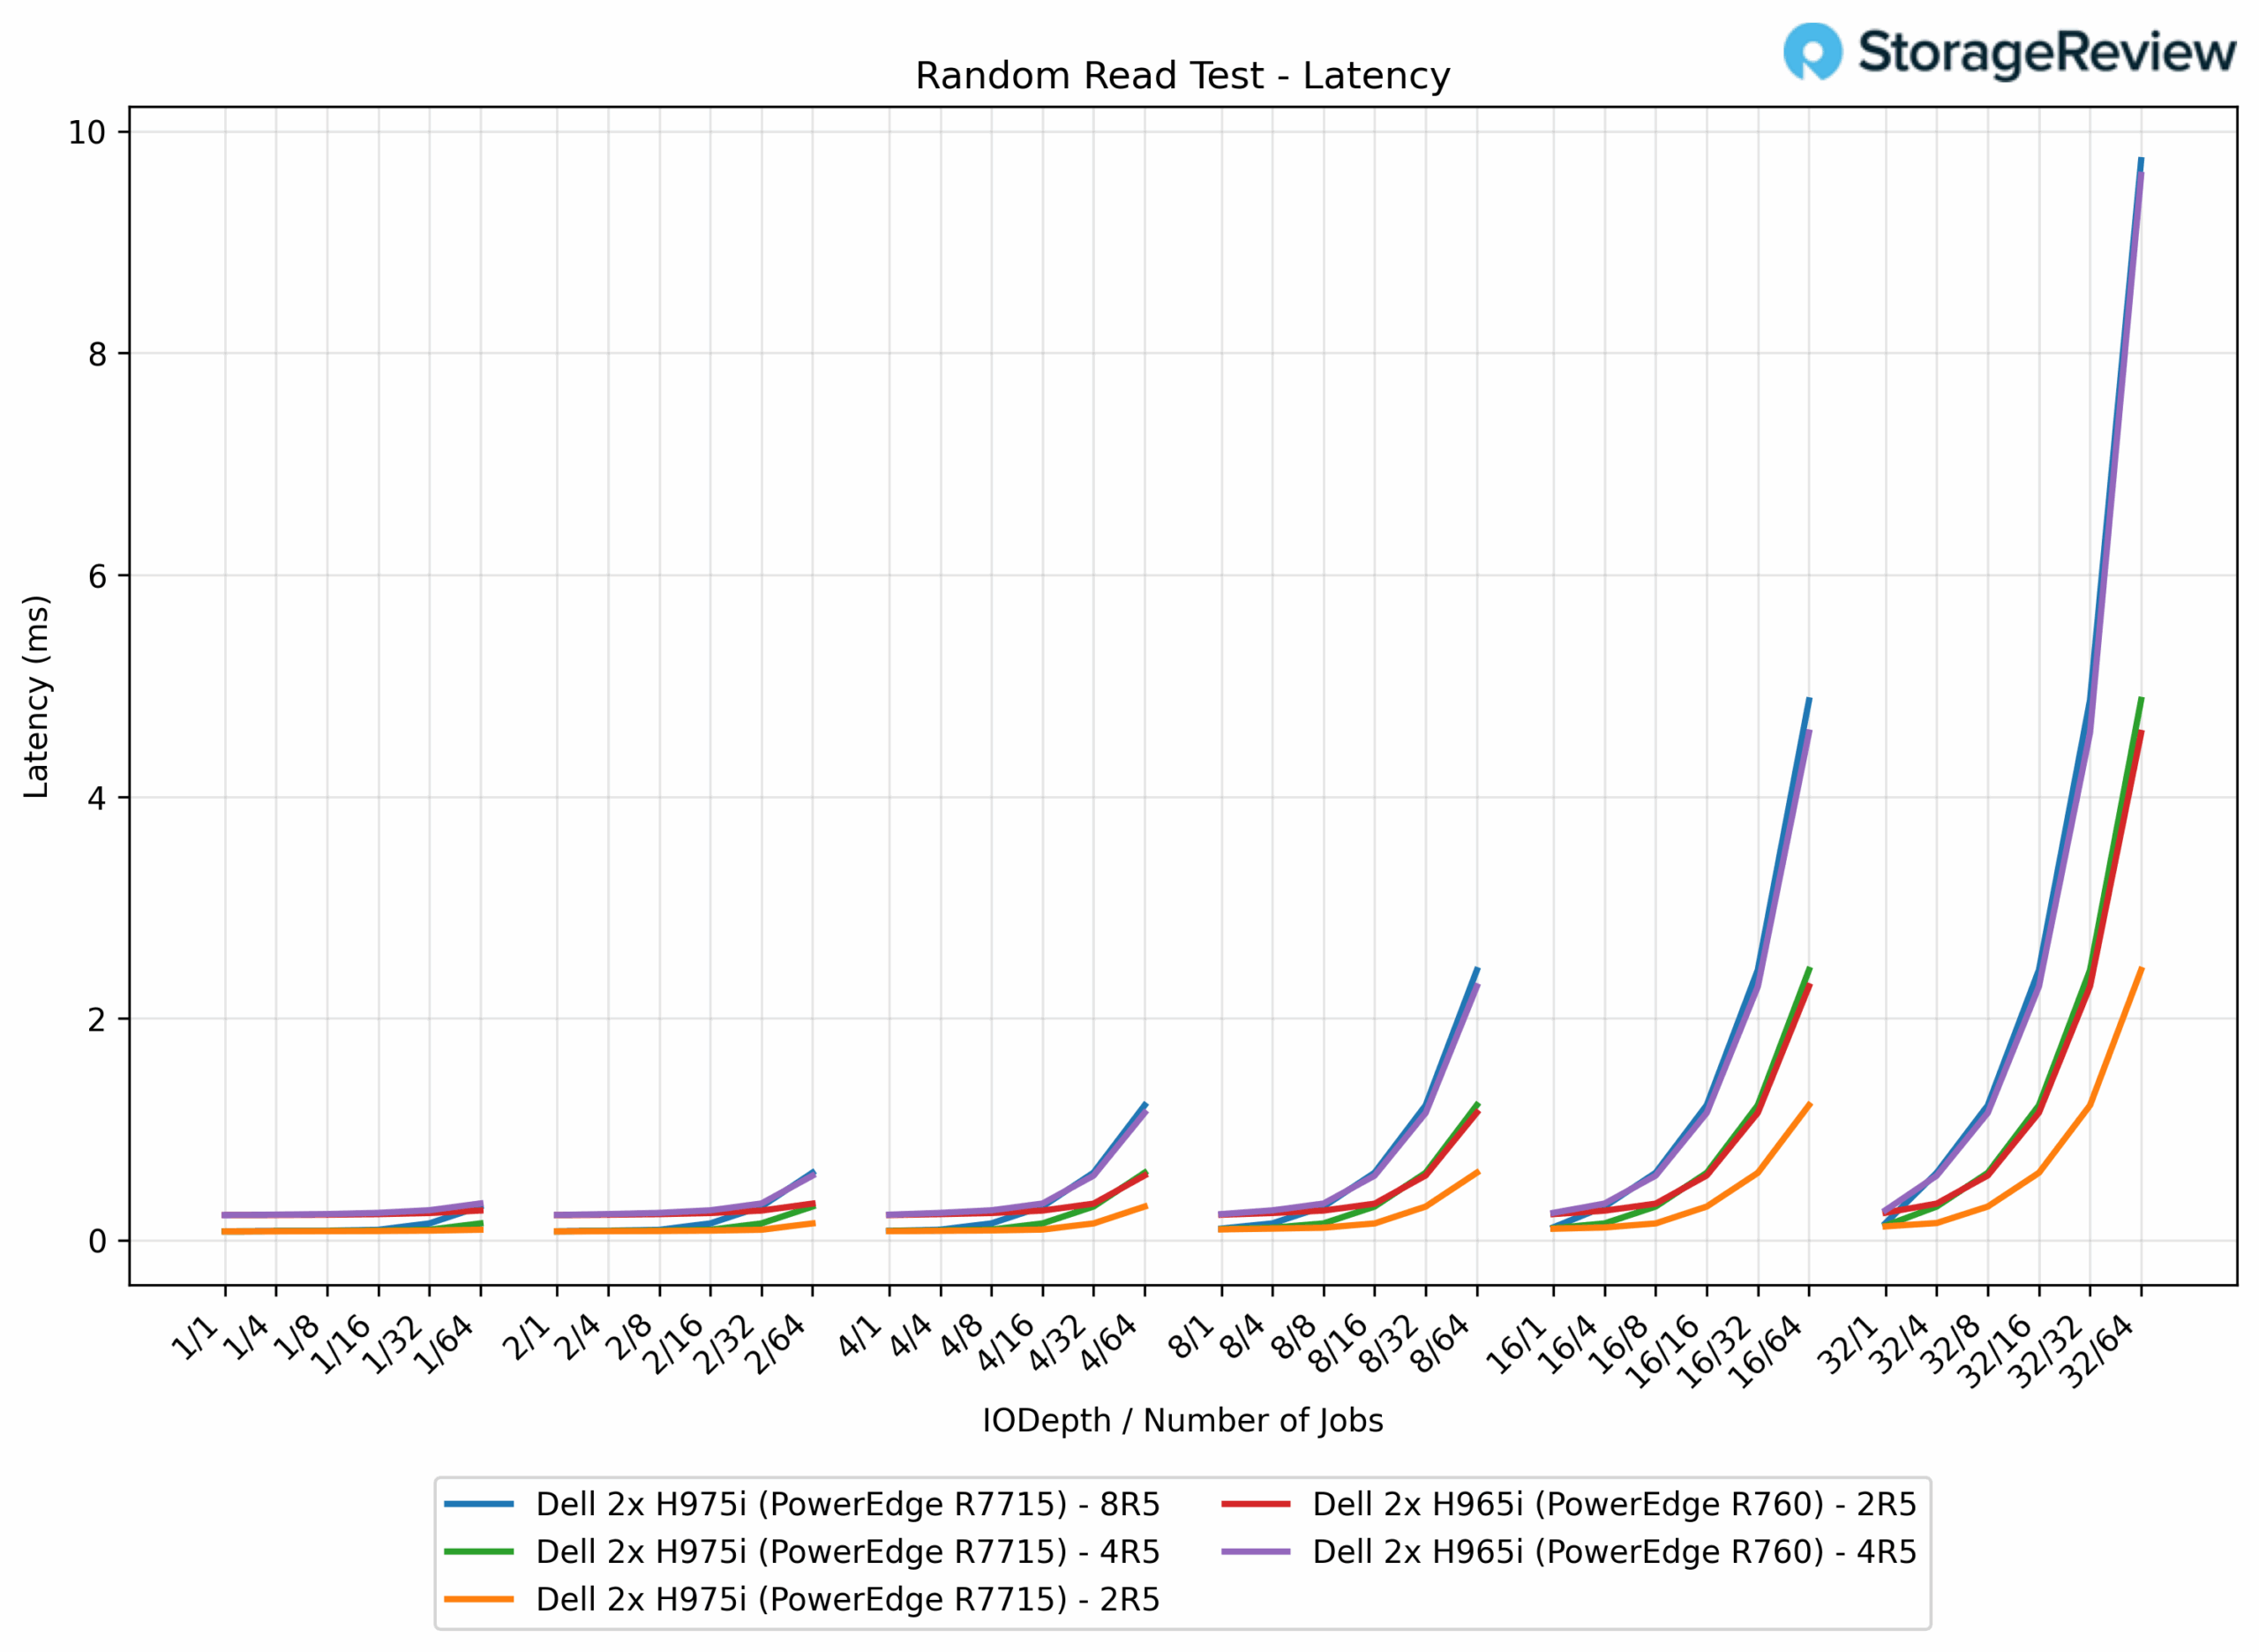
64Kランダムリードでは、H965i 2R5アレイでは0.226ms~4.6ms、4R5では9.6msでした。H975iに移行するとレイテンシは大幅に低下し、2R5では0.080ms~2.4ms(ピークレイテンシが48%低下)、4R5では0.080ms~4.9ms(49%低下)、8R5では0.080ms~9.7ms(H965i 4R5と同等)となりました。全体的に見て、H975iはRAIDグループ全体において、より緊密な制御と低いレイテンシ上限を示しました。
16k シーケンシャル書き込み IOPS
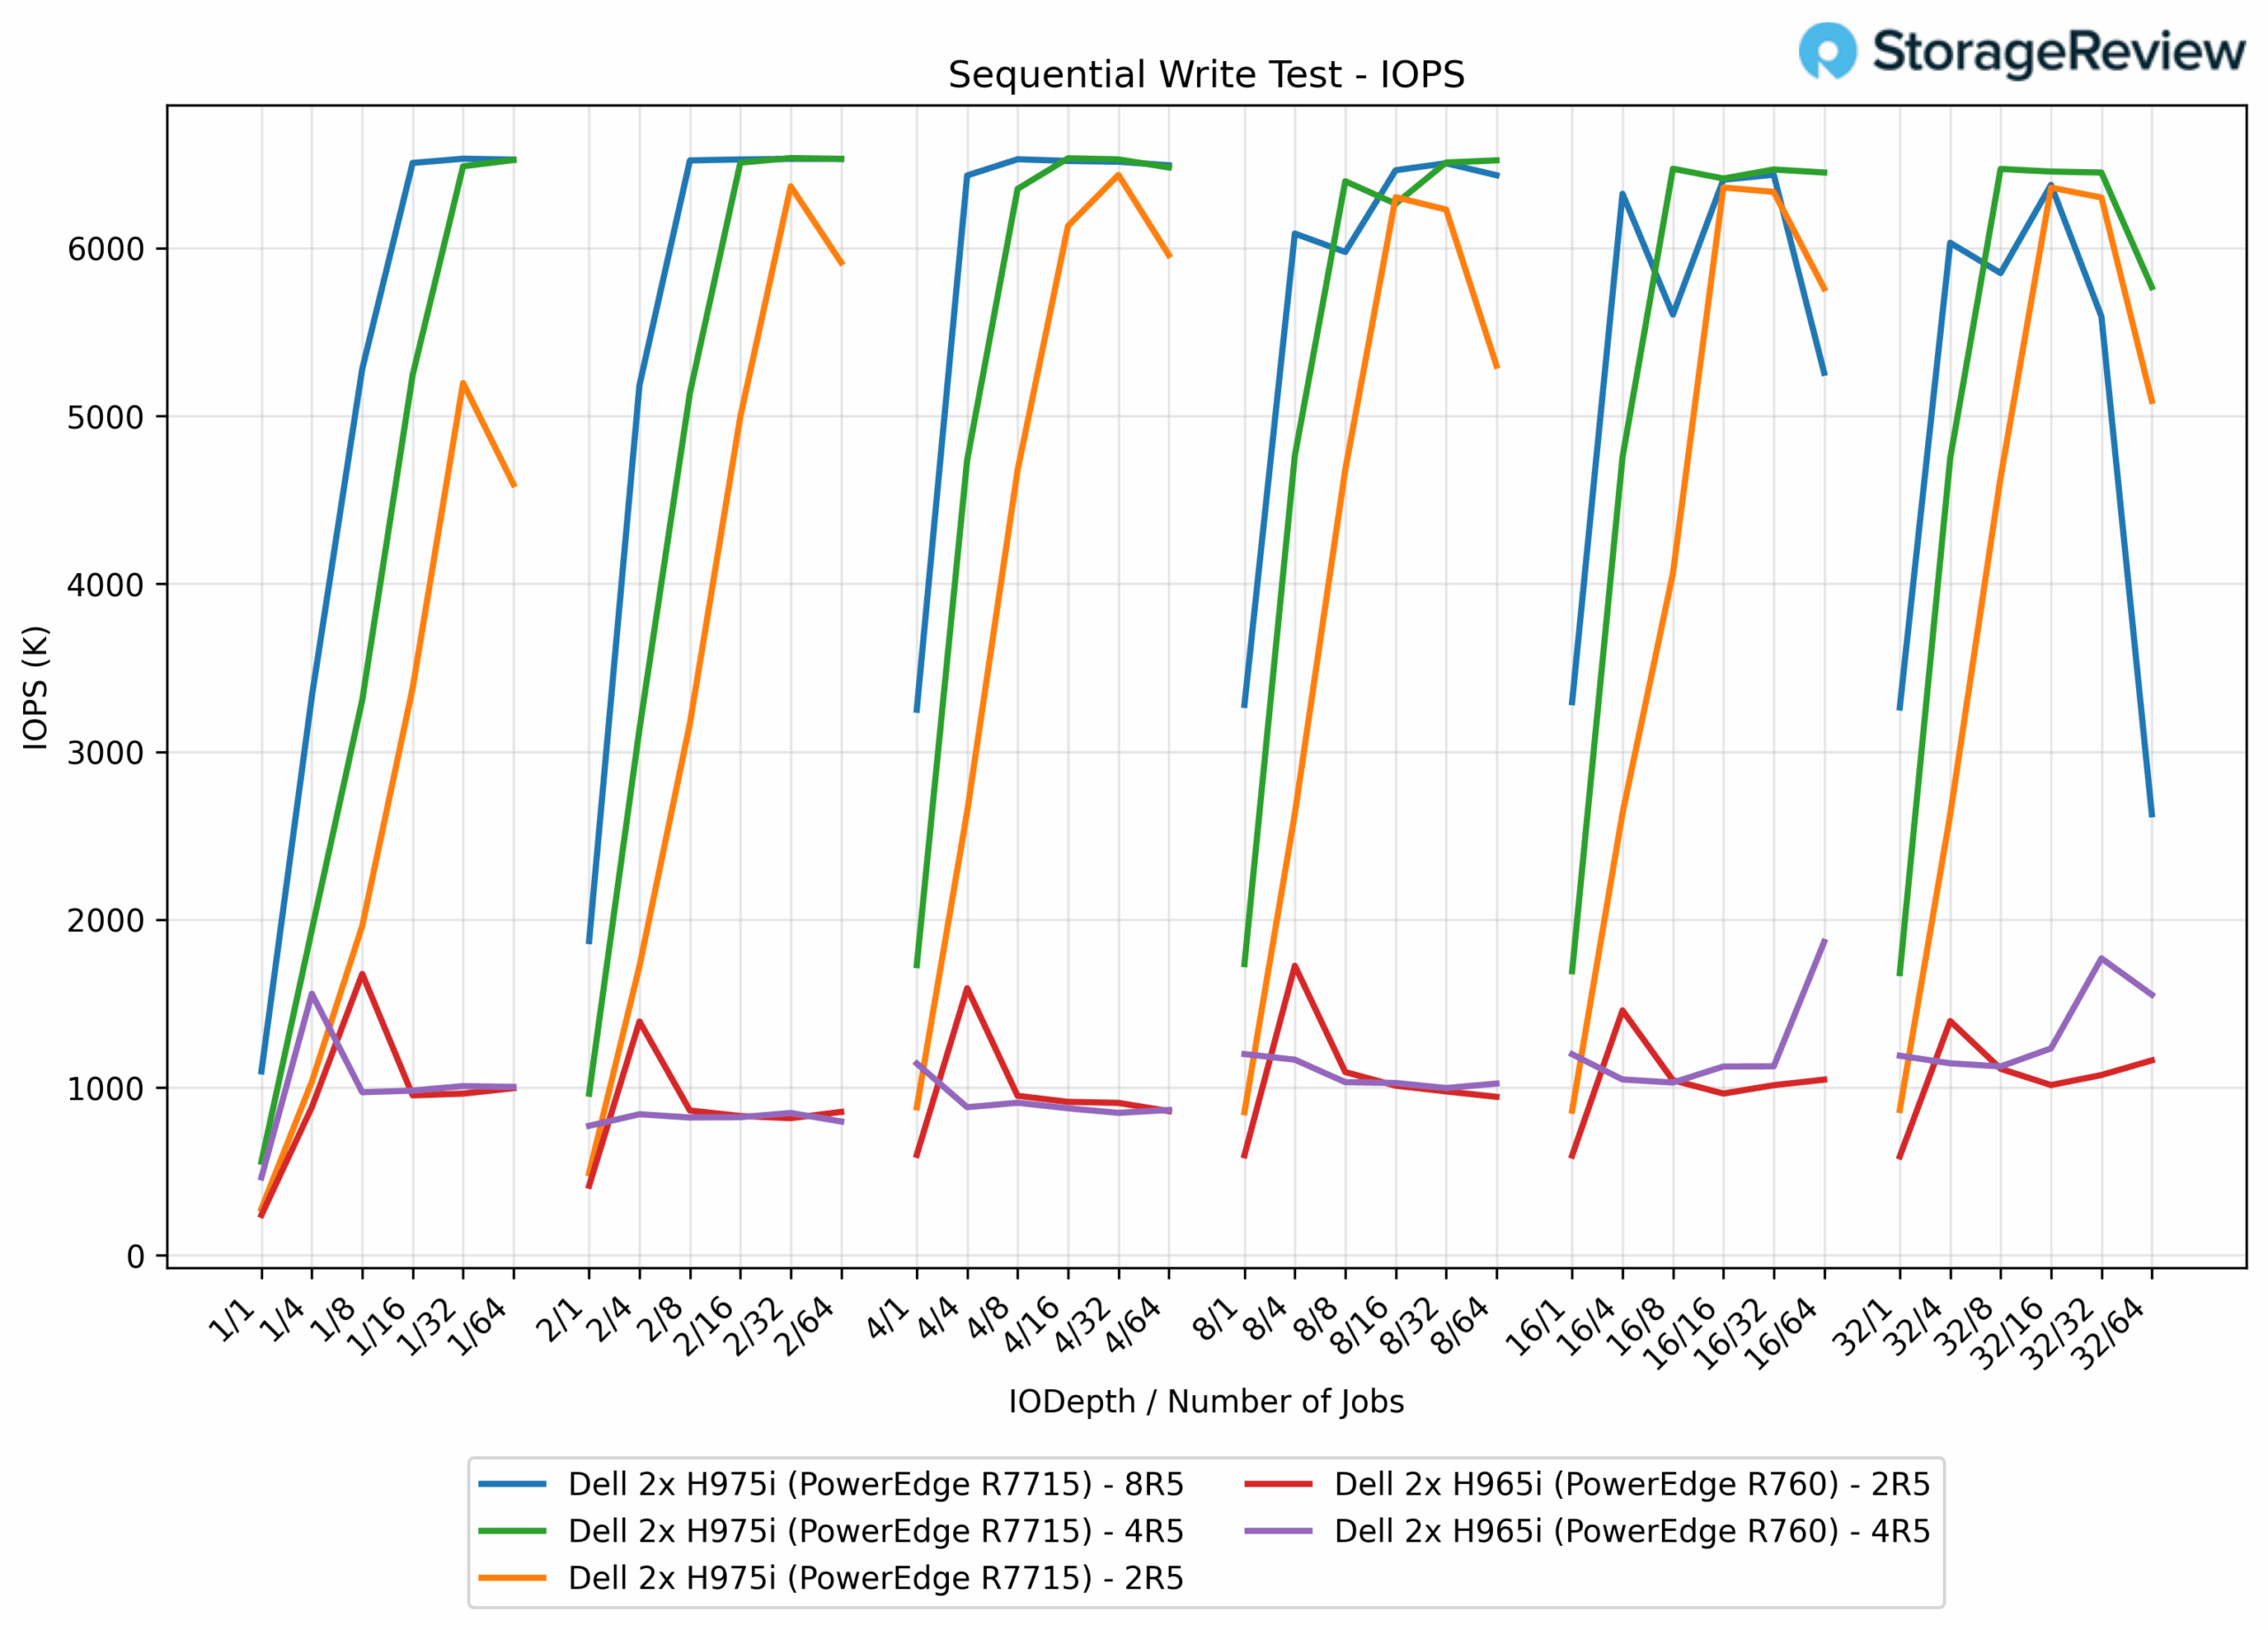
16Kシーケンシャル書き込みテストでは、PERC H965iコントローラのパフォーマンスは控えめで、2R5構成では1.73万IOPS、4R5構成では1.87万IOPSを達成しました。一方、PERC H975iは劇的な向上を見せ、2R5構成では6.44万IOPS(H272i比965%向上)を達成しました。H975iの4R5アレイではピーク時に6.54万IOPS(250%向上)、8R5構成では6.53万IOPS(H249i 965R4比5%向上)を達成しました。このことからも、6.5Kブロックサイズではコントローラが約16万IOPSで飽和することが分かります。
16k シーケンシャル書き込みレイテンシ
16Kシーケンシャルライトにおいて、H965iアレイは0.0080R3.5で2~5ms、0.0083R5.3で4~5msという優れた効率を示しました。H975iは2R5で0.0070ms~0.80ms(77%削減)、4R5で最大1.42ms(73%削減)、8R5で最大6.2ms(H17i 965R4比5%削減)と、優れた効率を示しました。 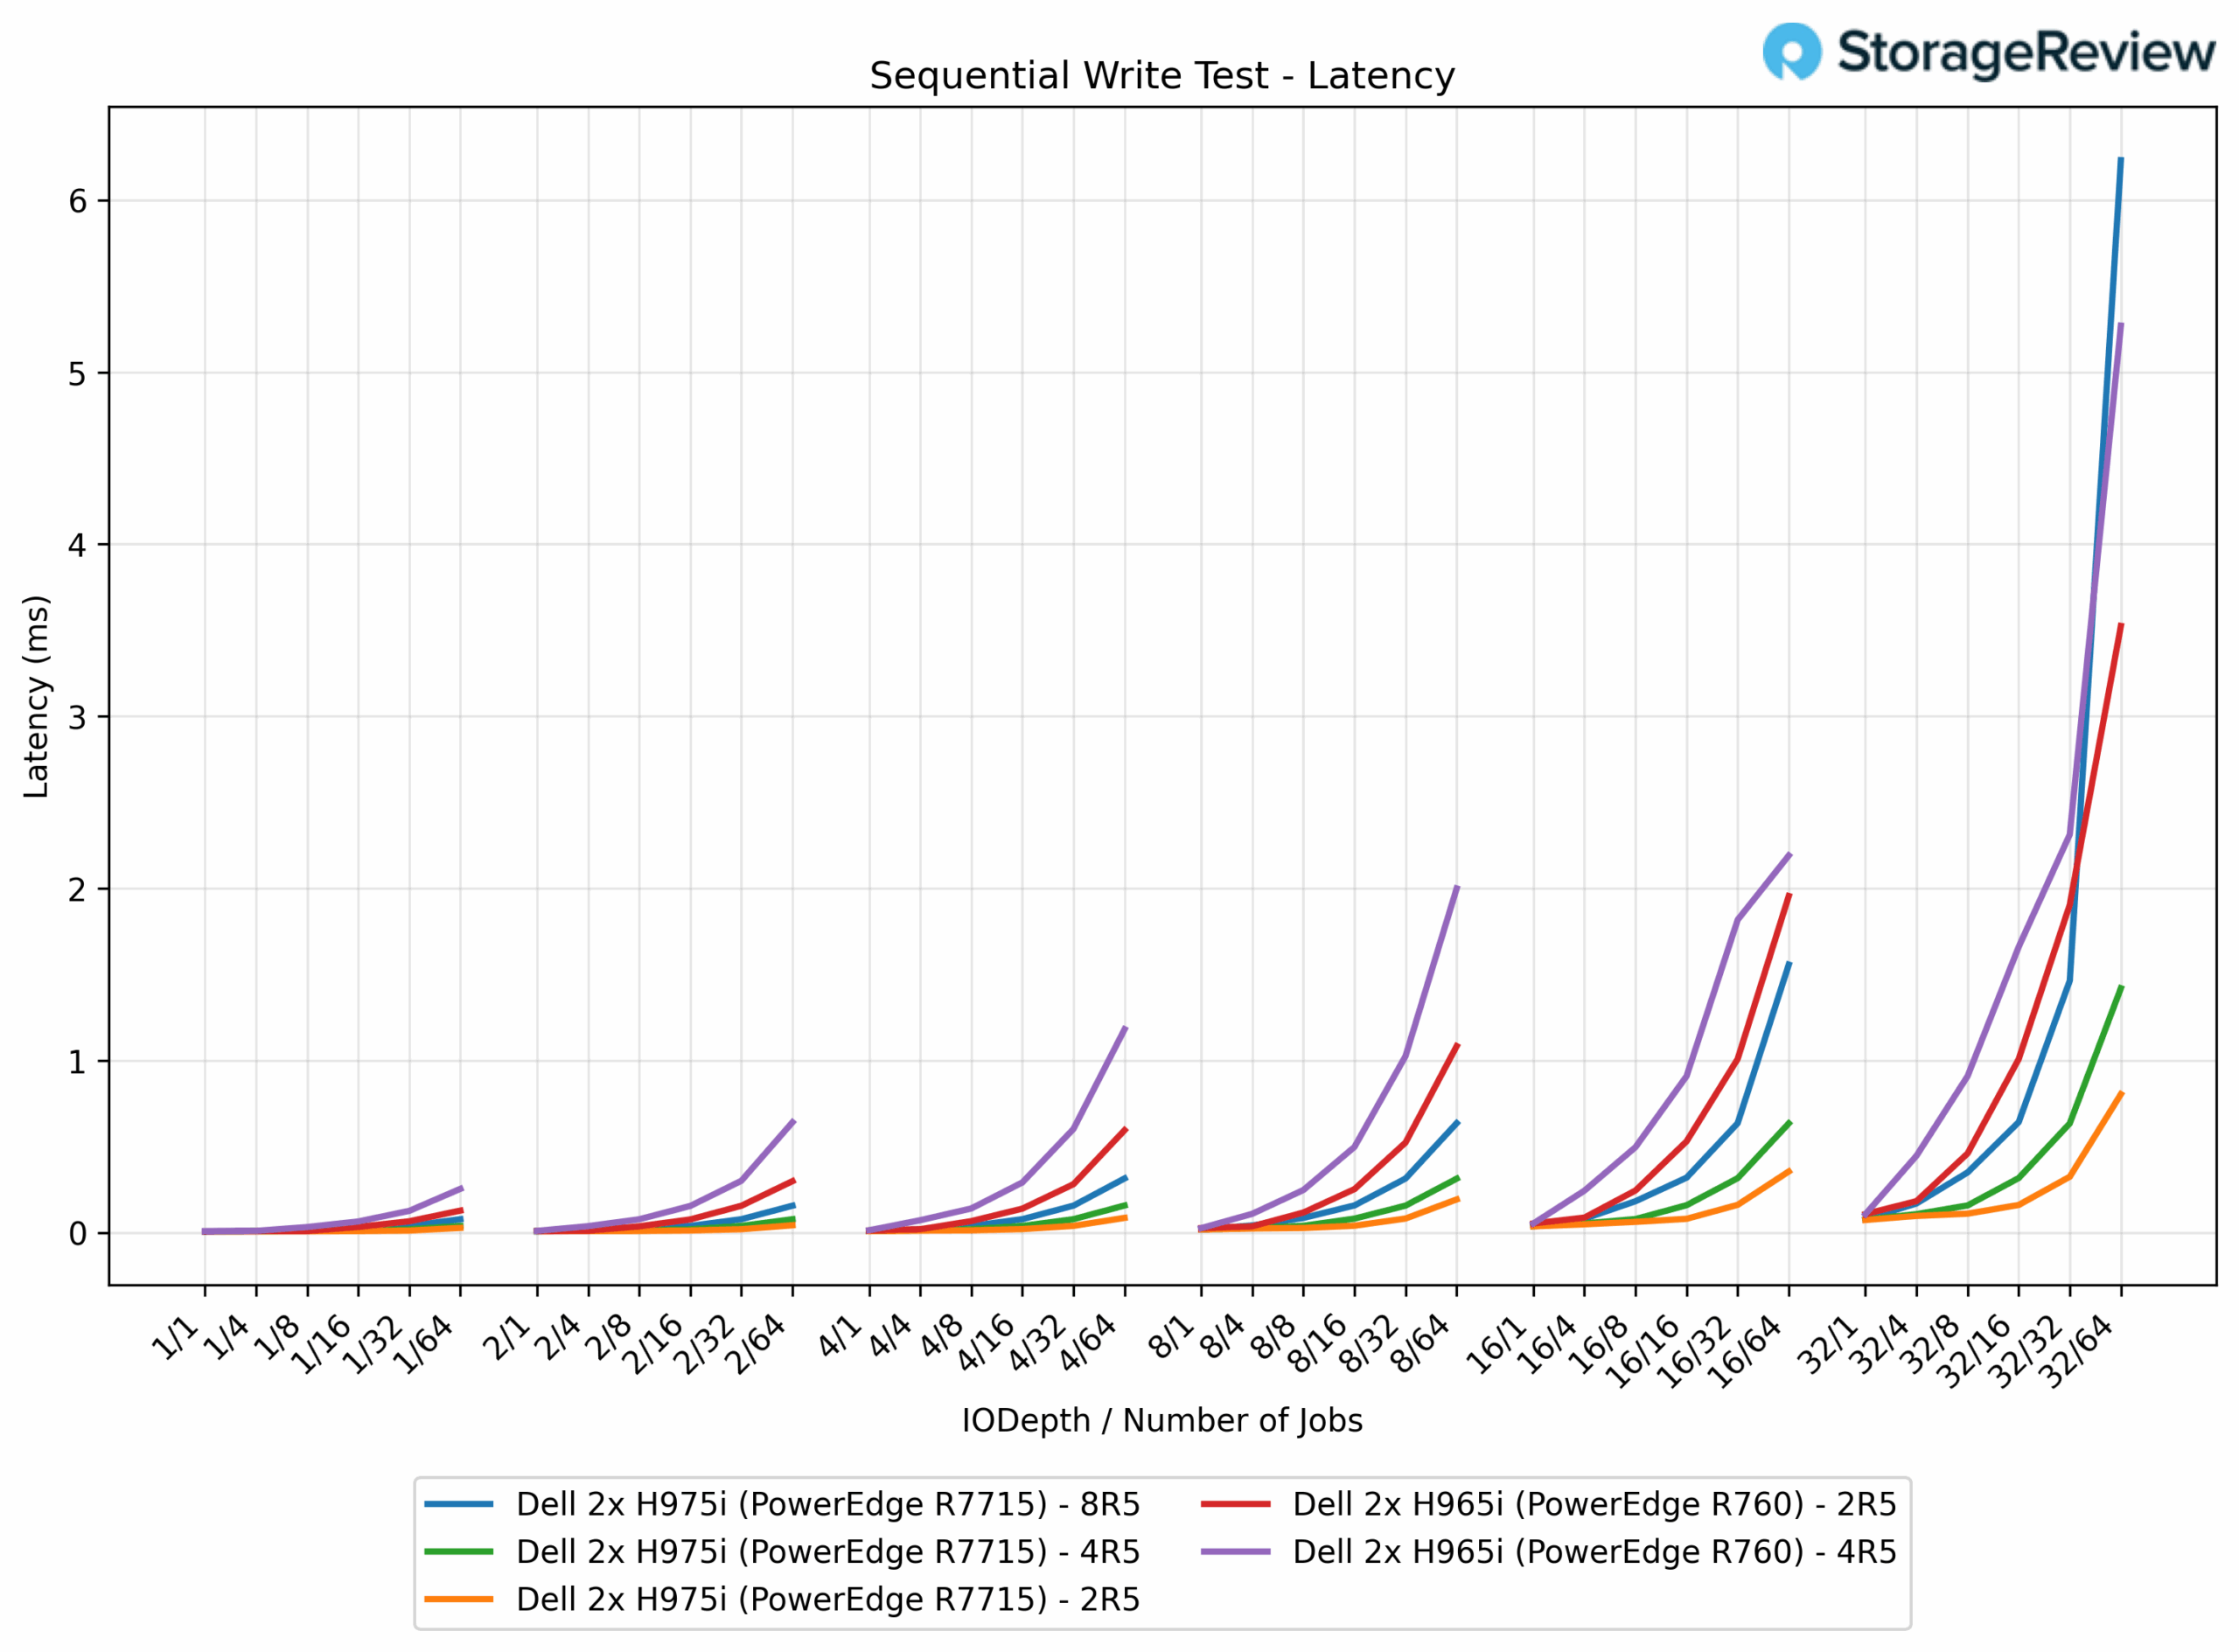
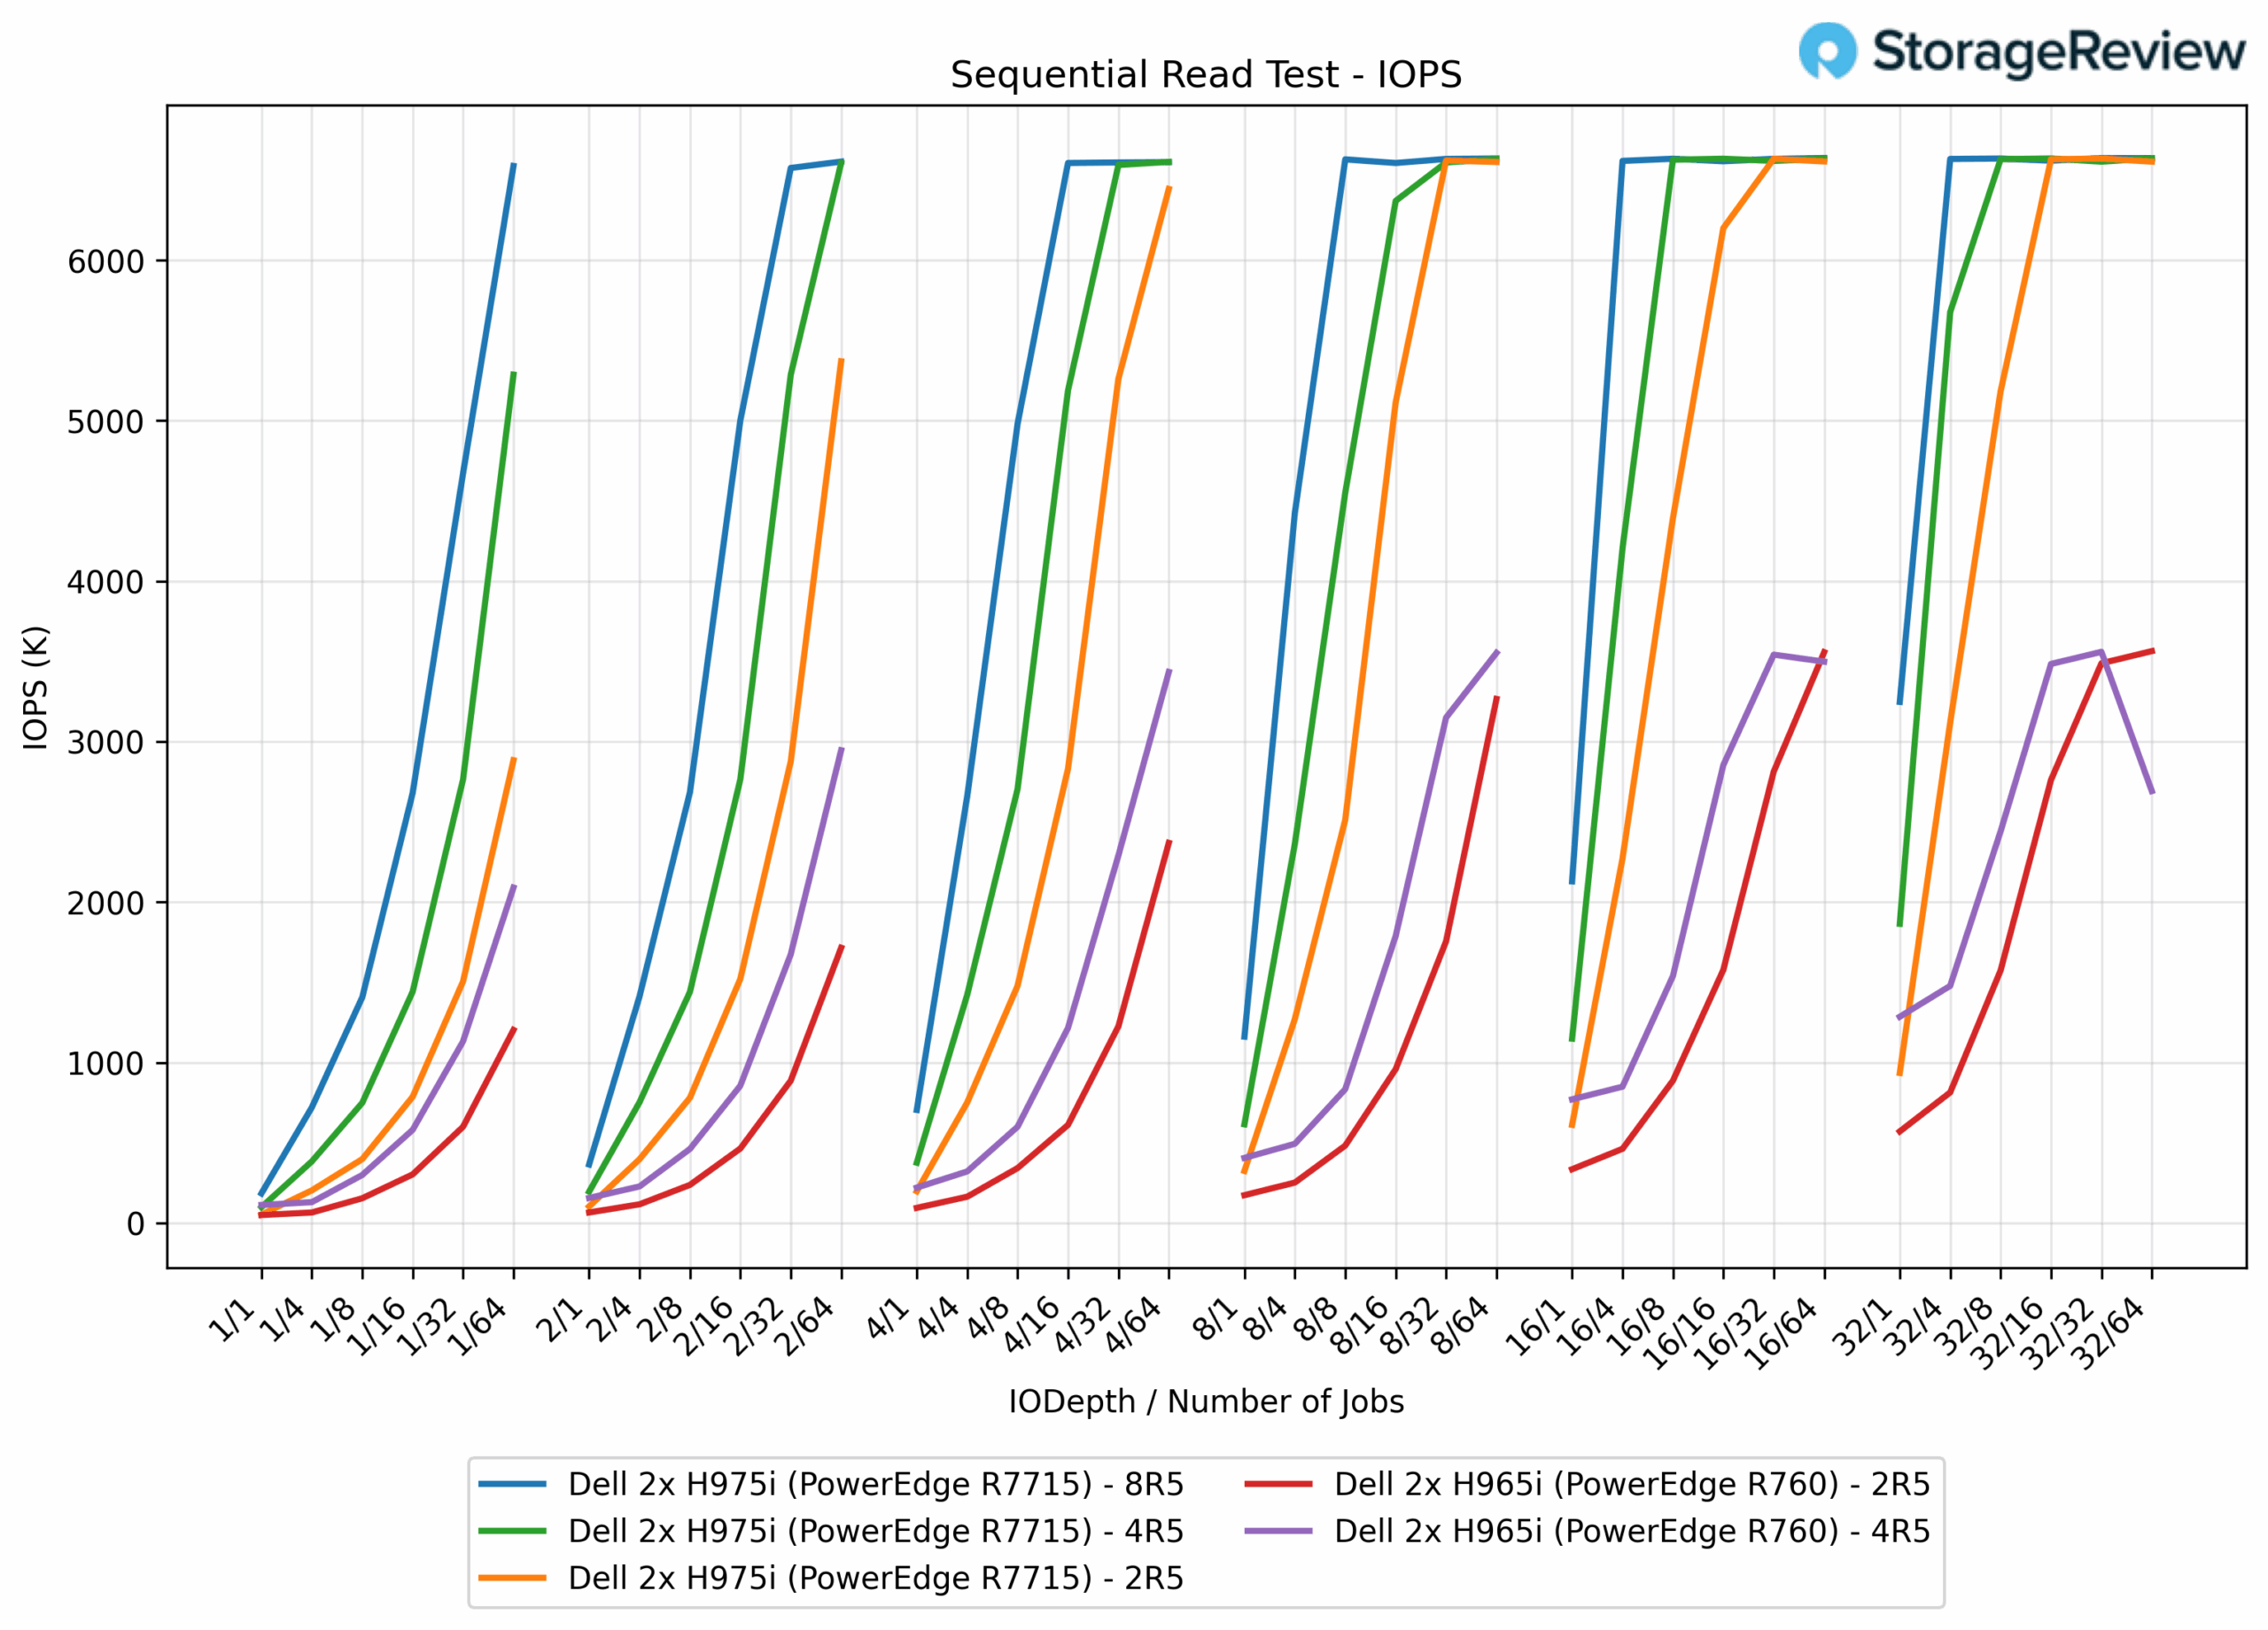
16k シーケンシャルリード IOPS
16Kシーケンシャルリードテストでは、PERC H965iコントローラは安定した結果を示し、2R5構成では3.56万IOPS、4R5構成でも3.56万IOPSを達成しました。一方、PERC H975iコントローラでは、全ての構成で6.64万IOPS前後に収束し、H86iと比較して965%の向上が見られました。
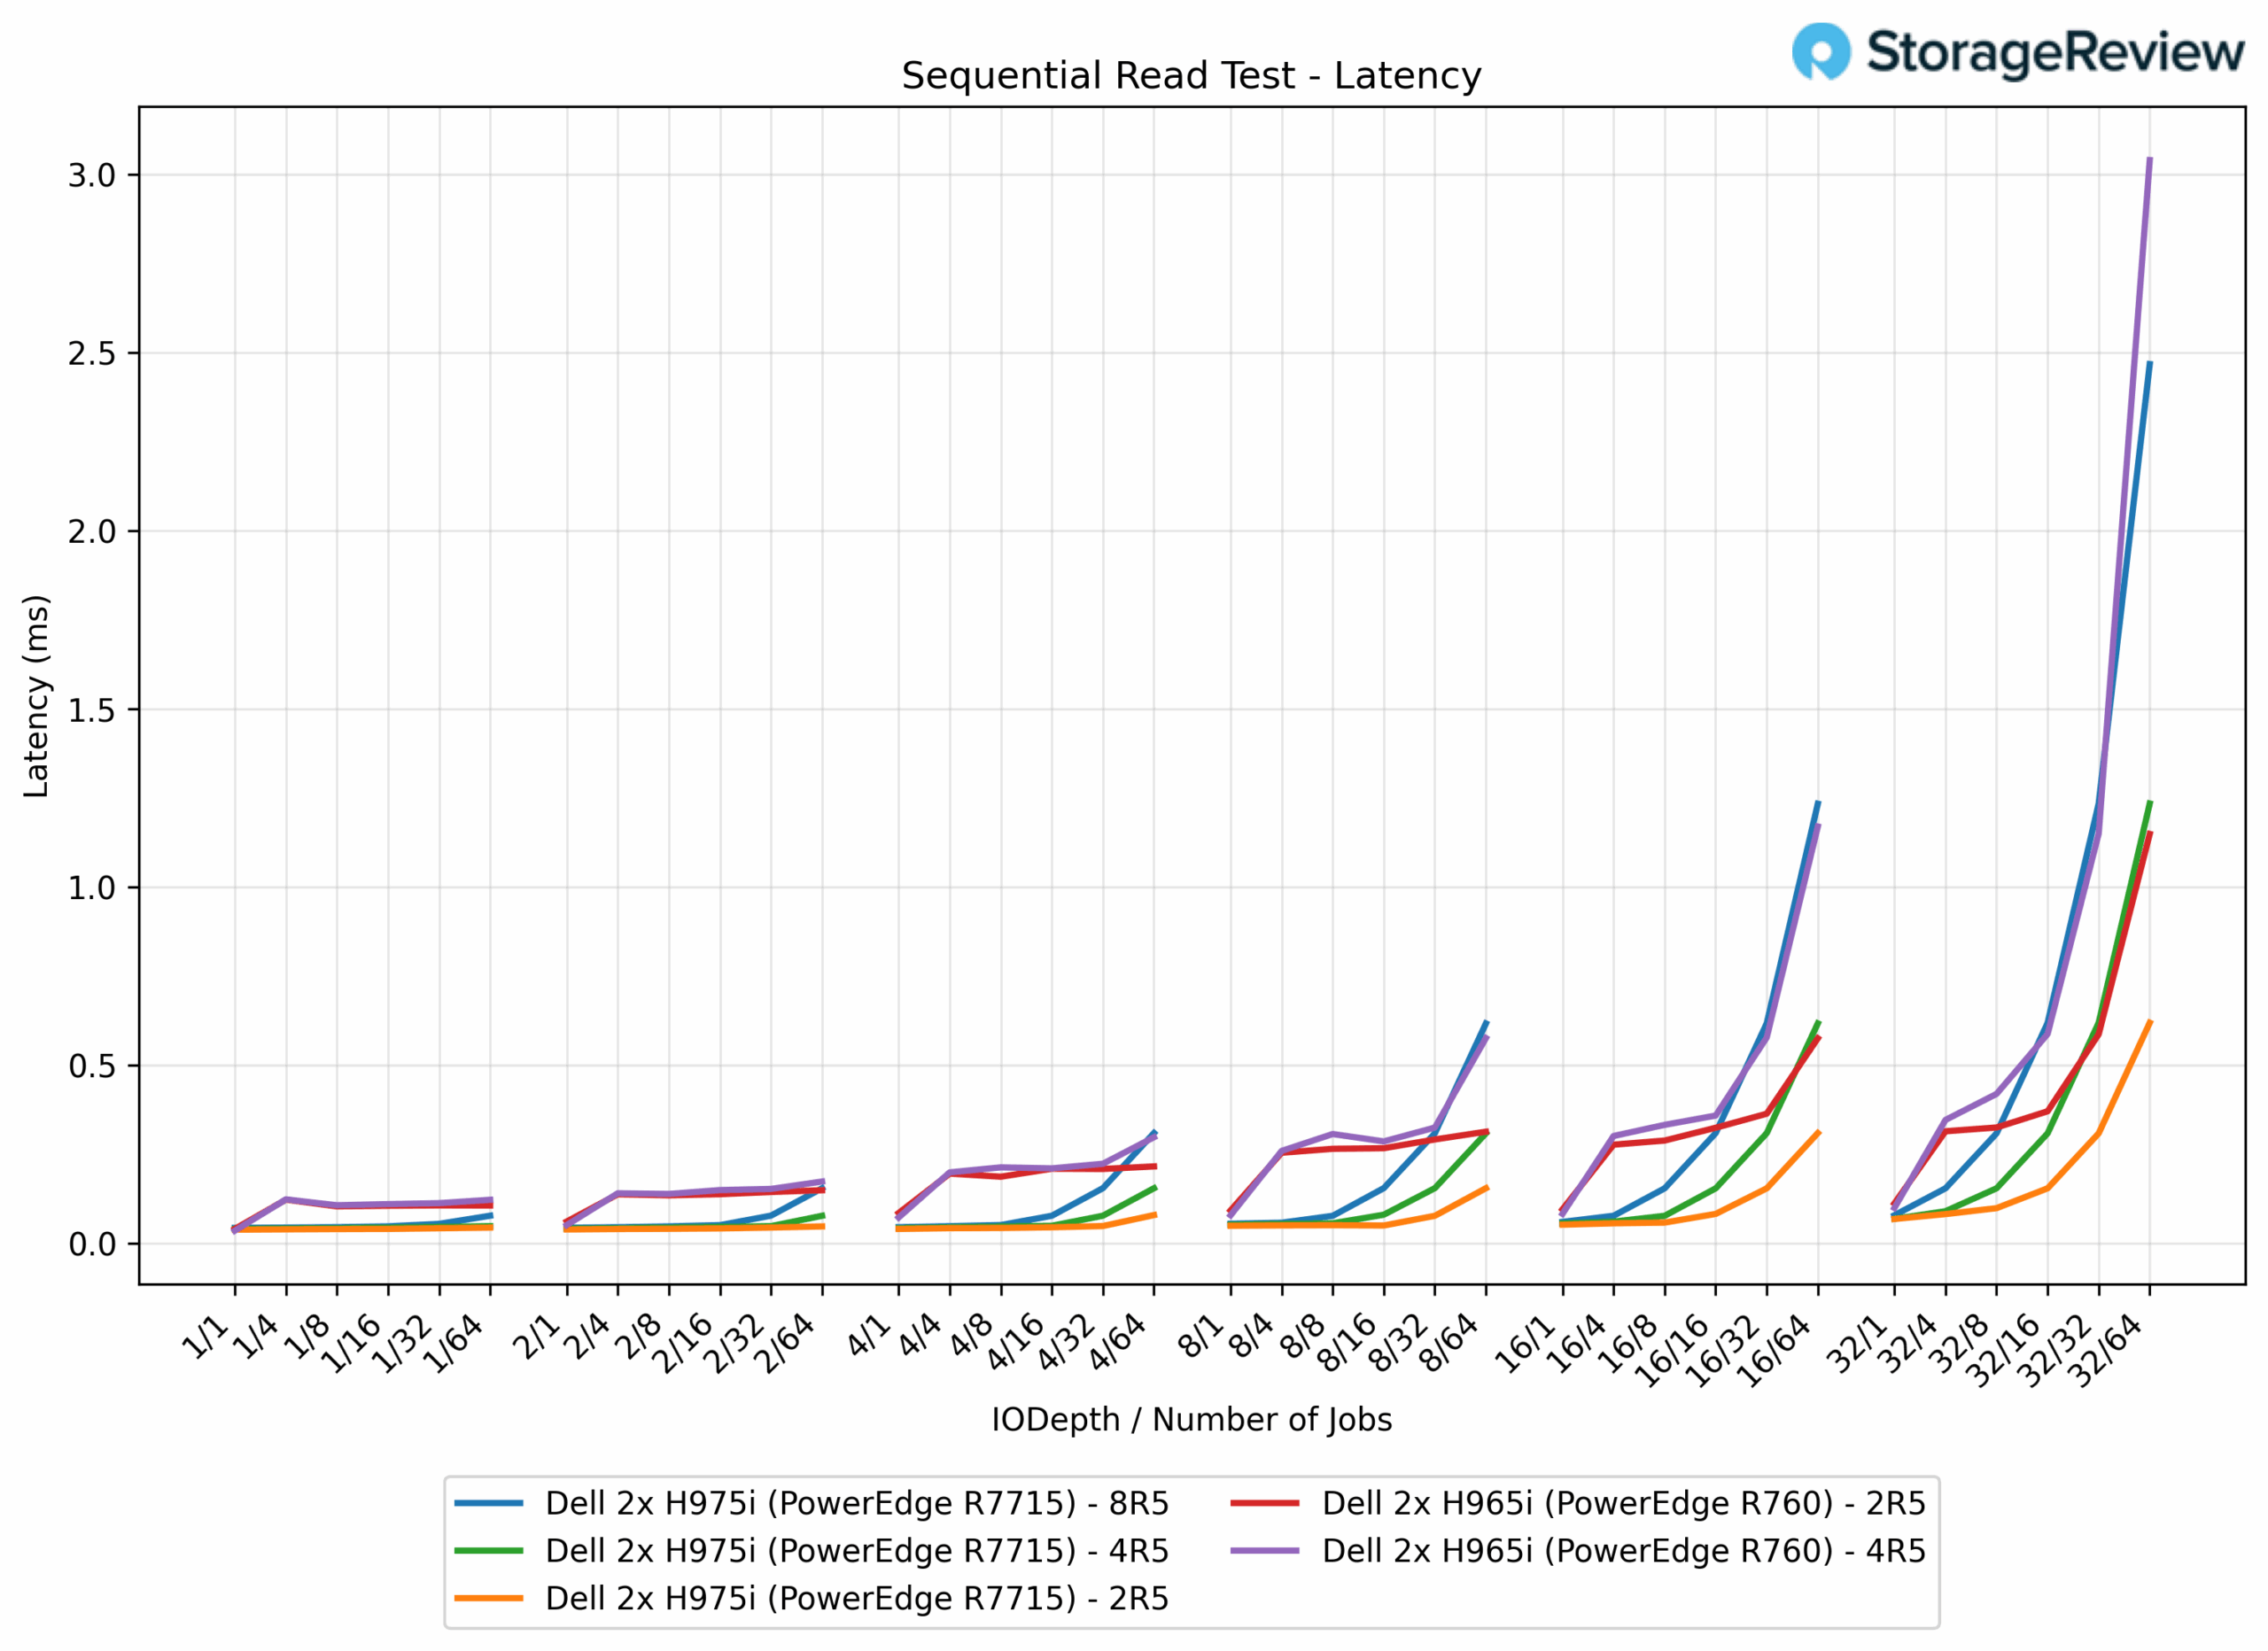
16k シーケンシャルリードレイテンシ
16Kシーケンシャルリードにおいて、H965i 2R5アレイは0.040ms~1.15msの範囲でしたが、4R5では最大3.0msまで上昇しました。H975iではレイテンシが改善され、2R5は0.038~0.62ms(46%削減)、4R5は最大1.23ms(59%削減)、8R5は2.47ms(H19i 965R4比5%削減)となりました。
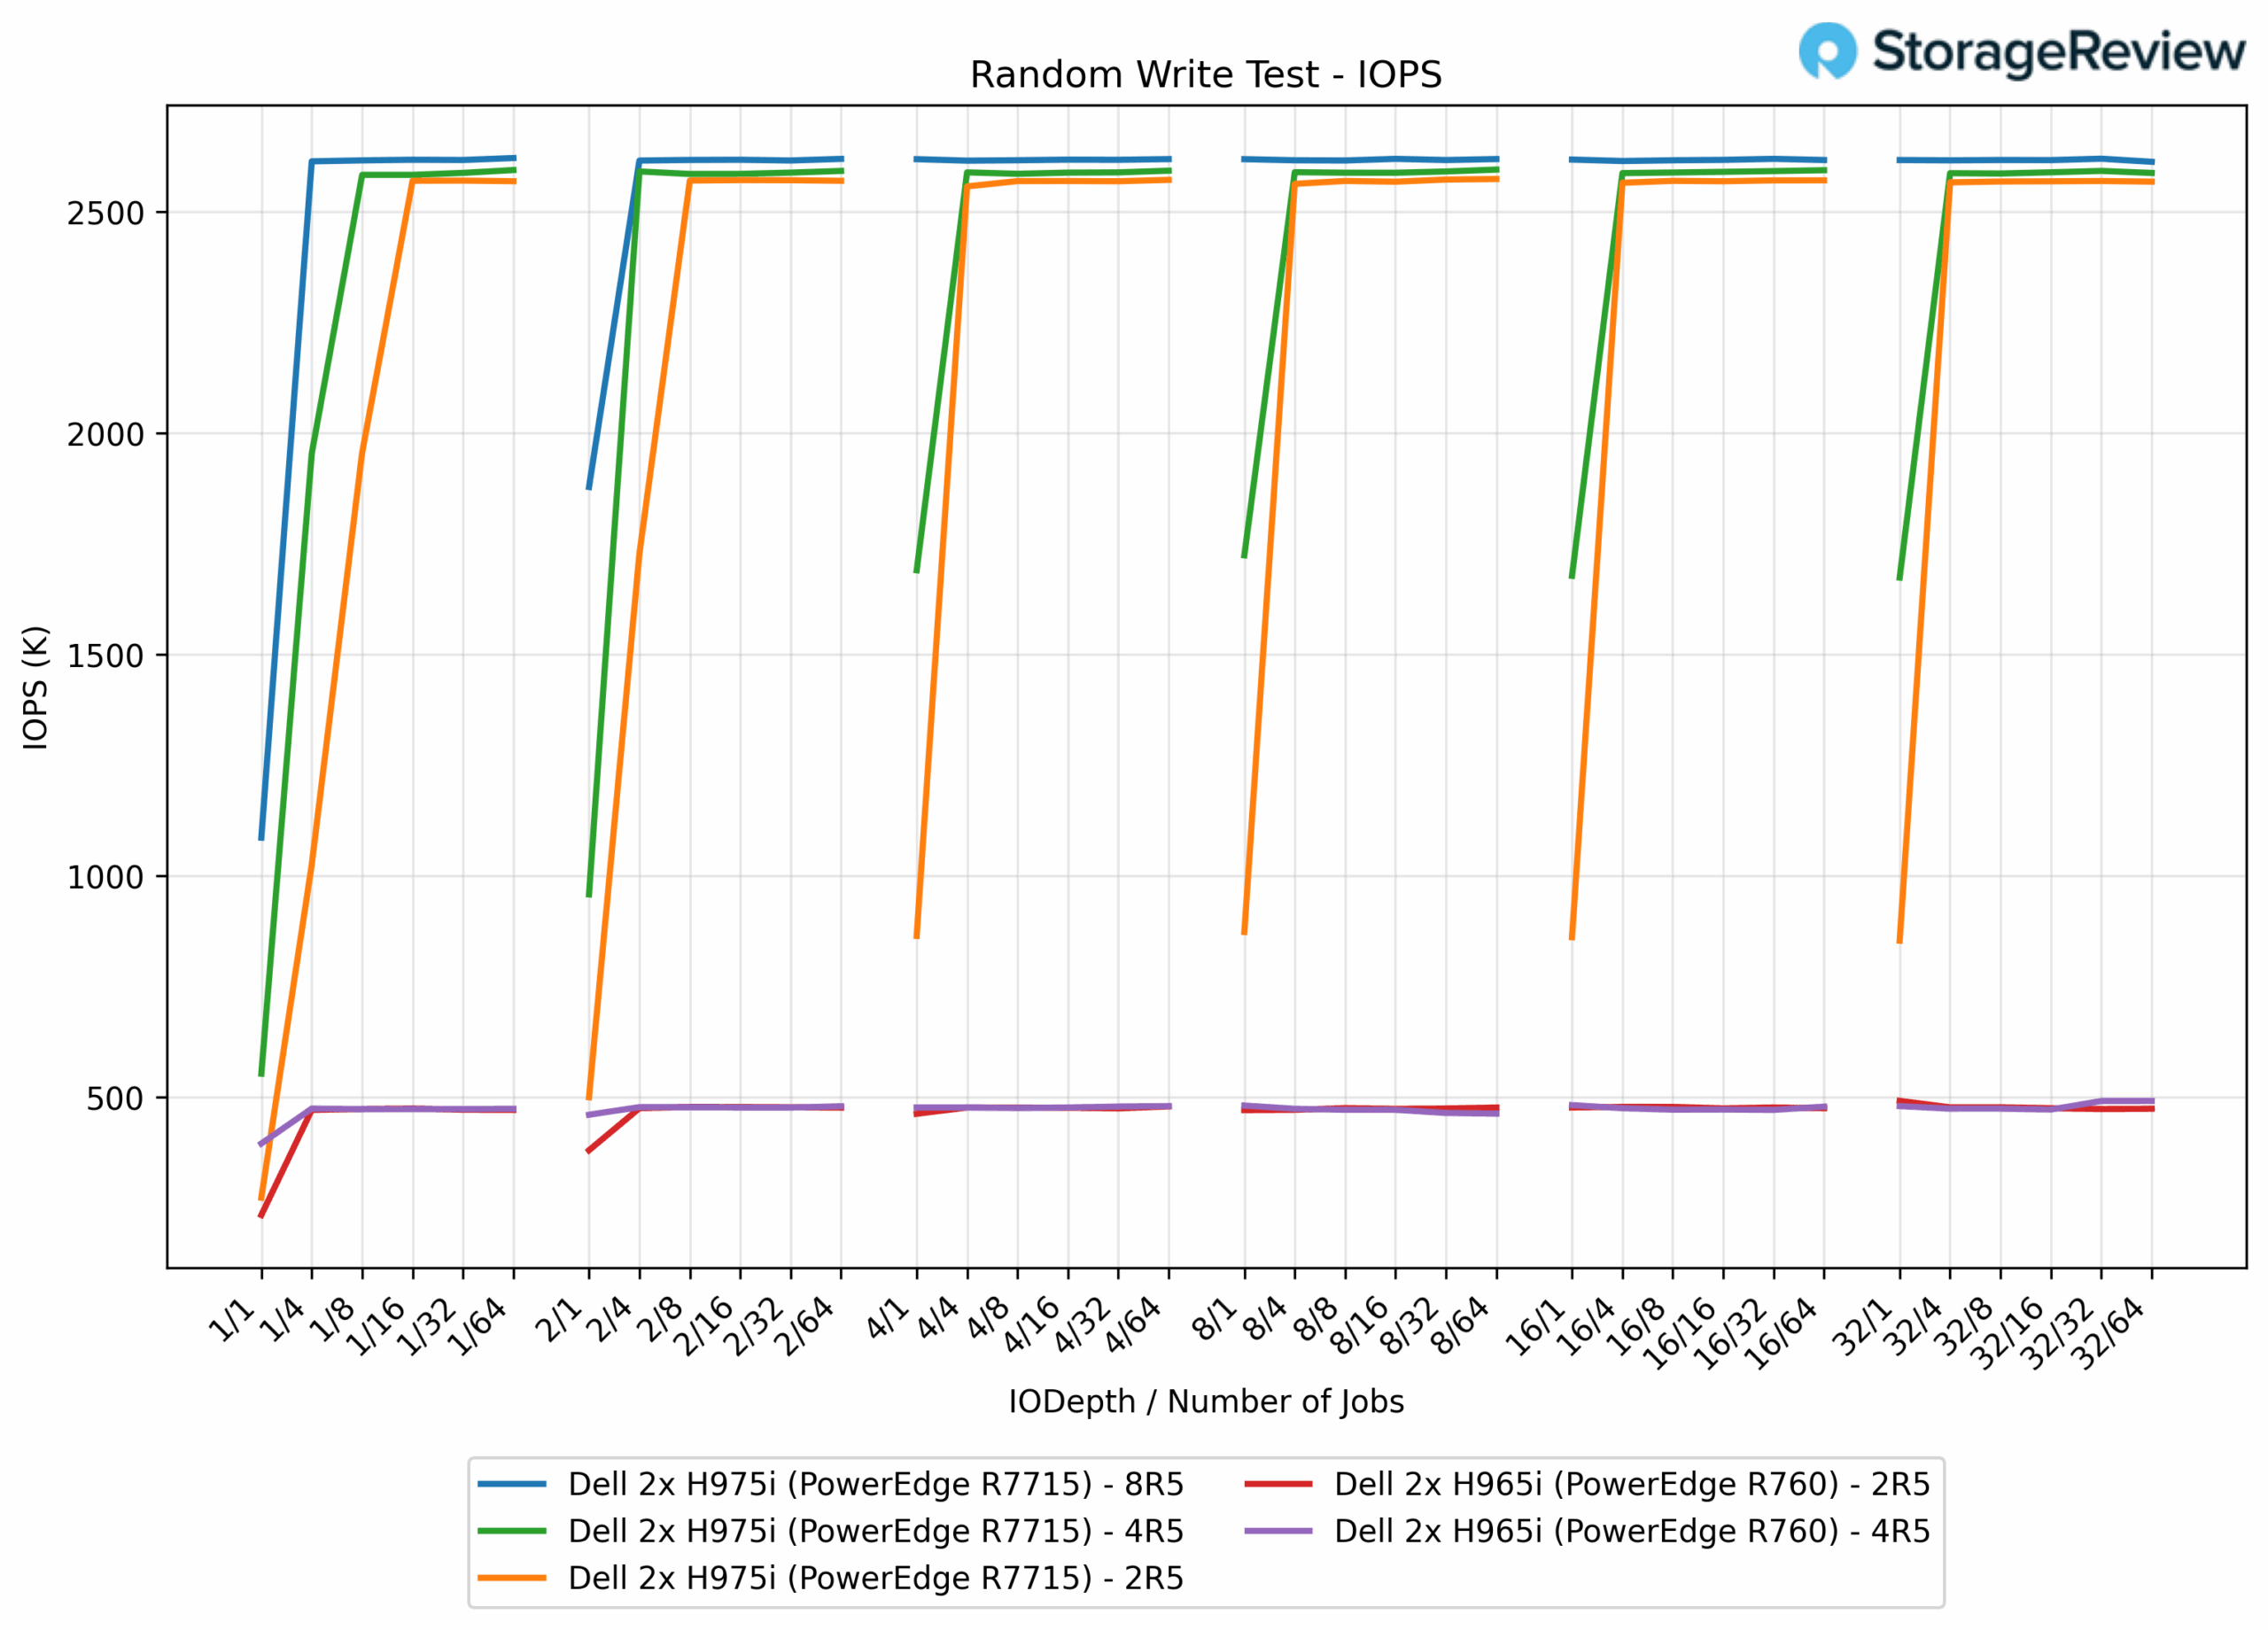
16K ランダム書き込み IOPS
16KブロックサイズでのランダムIOでは、テスト開始直後から飽和点に達していることがわかりました。PERC H965iの両構成(2R5および4R5)は、約492,000 IOPSとほぼ同等のパフォーマンスを示しました。PERC H975iコントローラと2R5アレイの組み合わせは、2.57万IOPS(422%の向上)を達成しました。H975iの4R5および8R5構成では、約2.60万IOPS(428%の向上)と、わずかに高い数値となりました。
16k ランダム書き込みレイテンシ
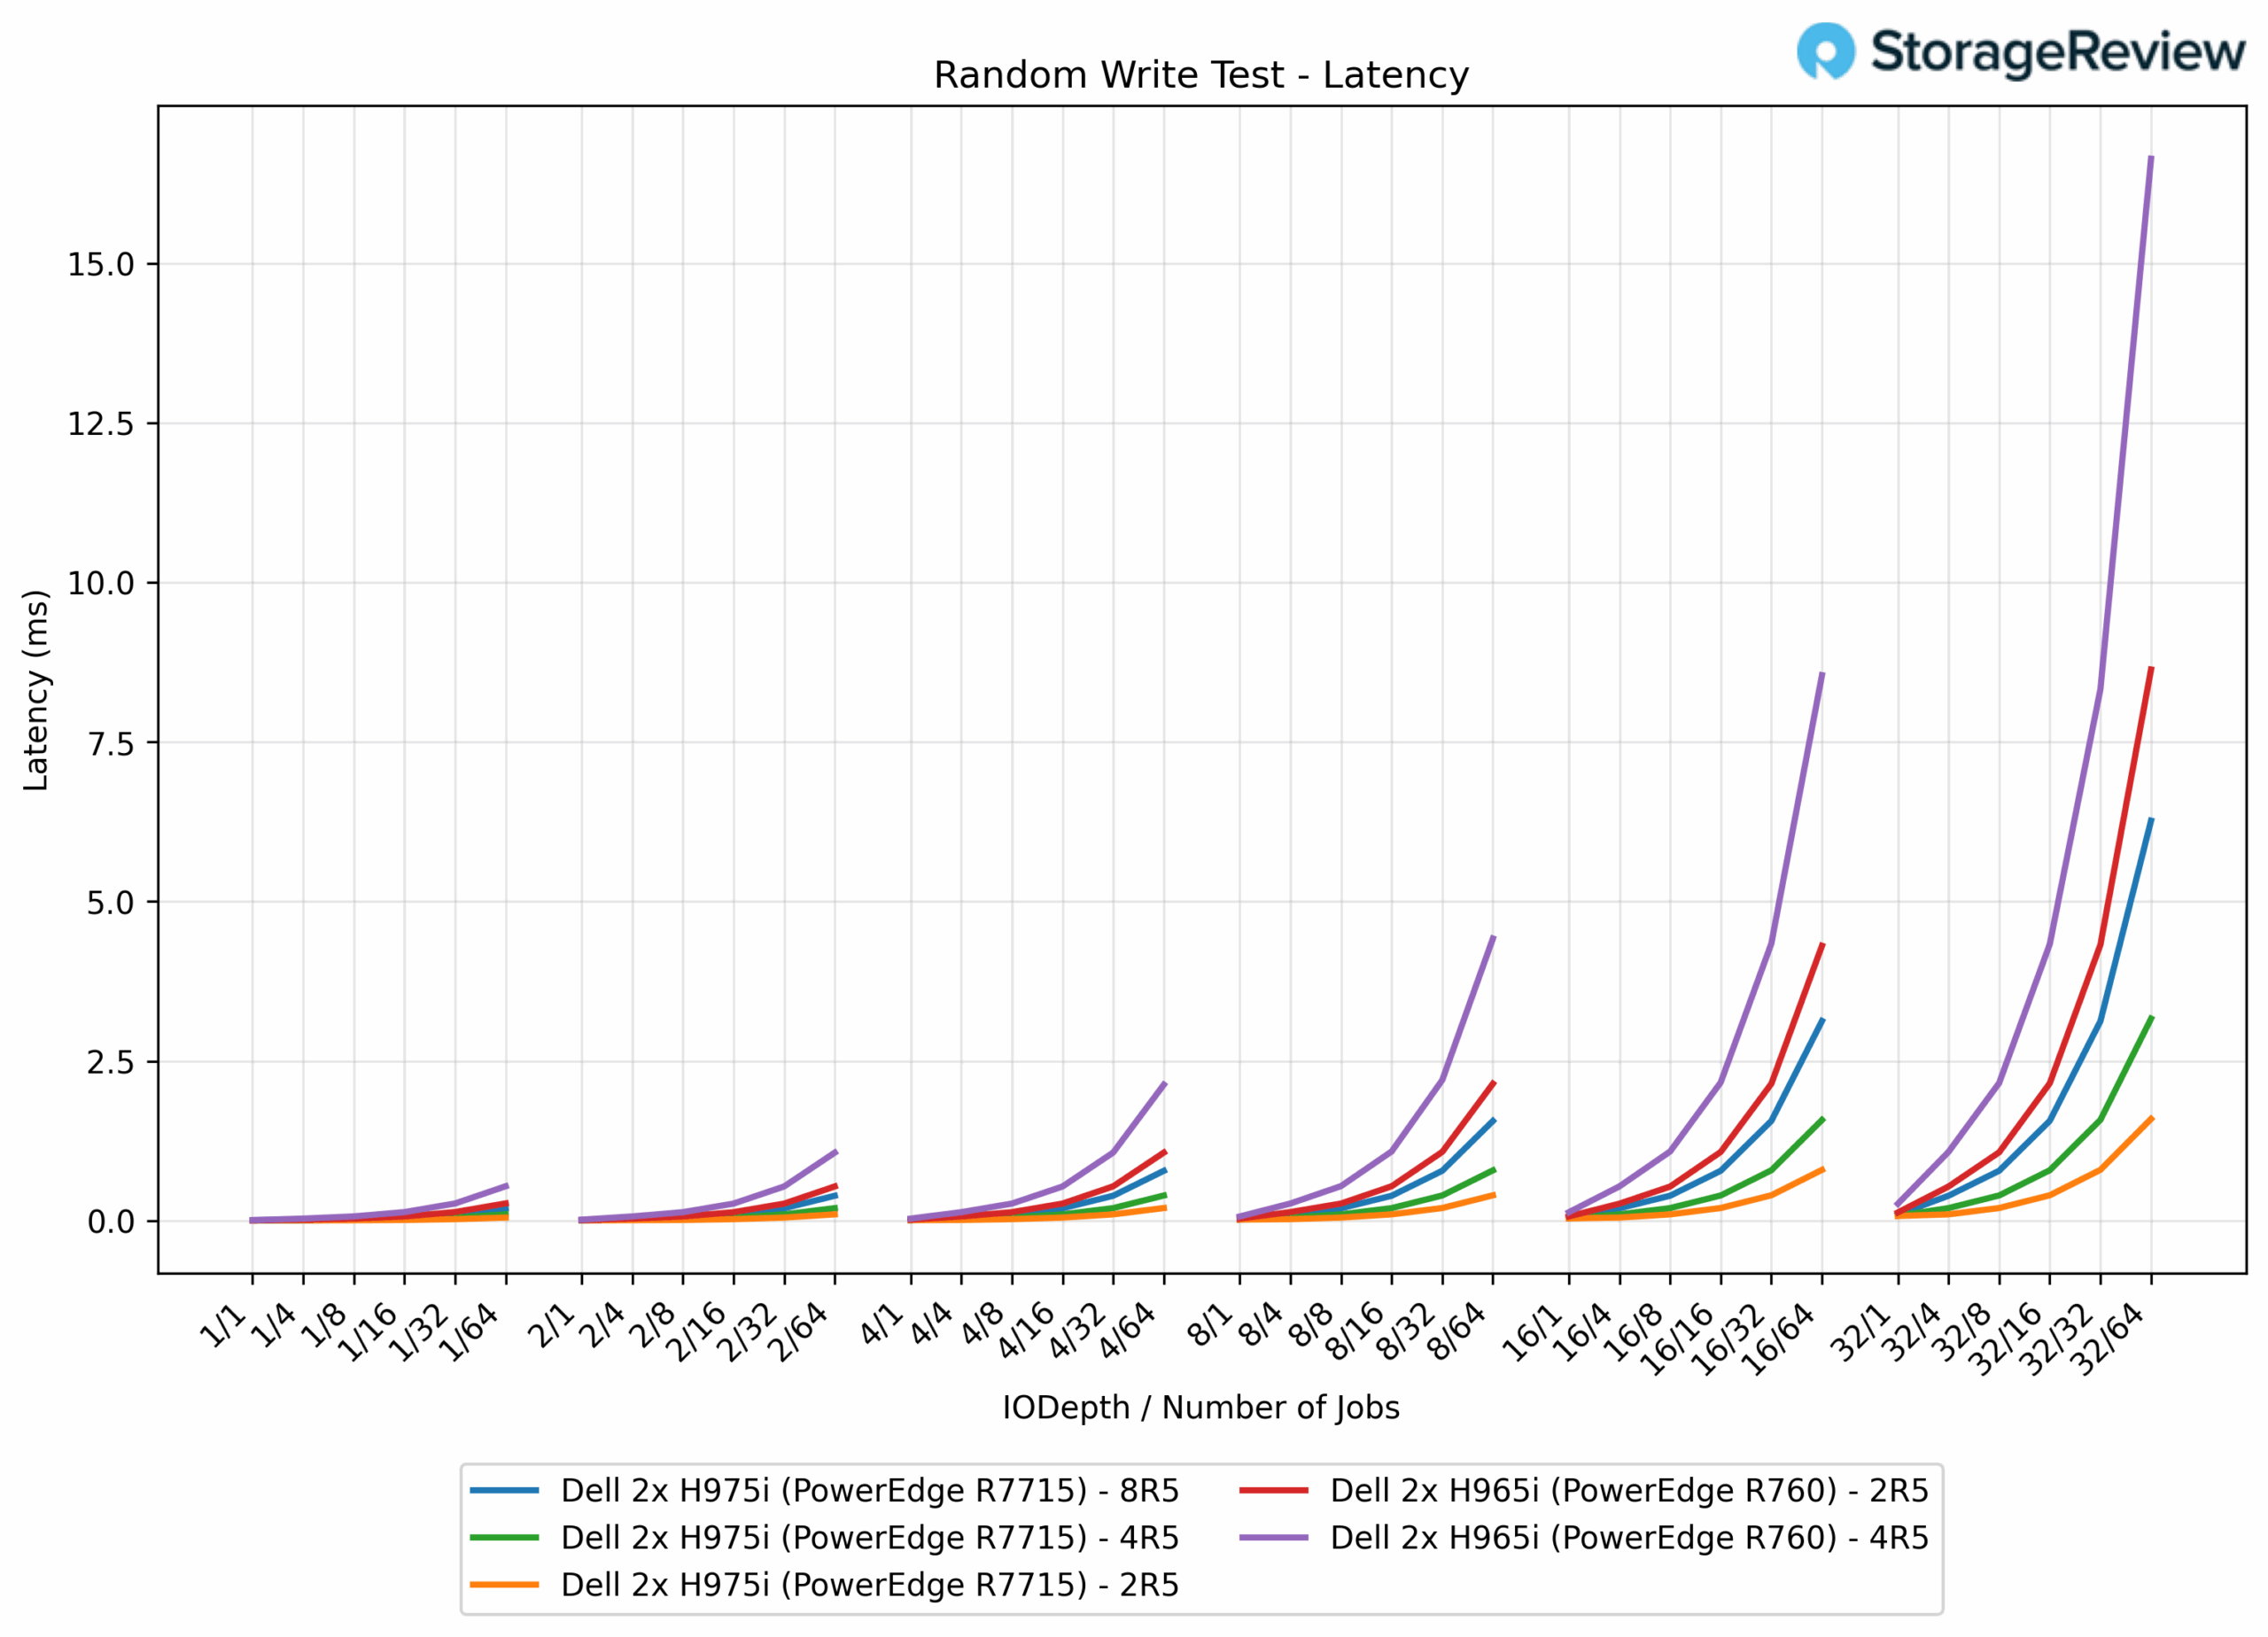
16Kランダム書き込みでは、H965iのレイテンシは高く、2R5では0.0082~8.6ms、4R5では16.6msにまで低下しました。H975iではレイテンシが大幅に改善され、2R5では0.0070~1.59ms(82%削減)、4R5では最大3.17ms(81%削減)、8R5では最大6.27ms(H62iの965R4と比較して5%削減)となりました。
16K ランダム読み取り IOPS
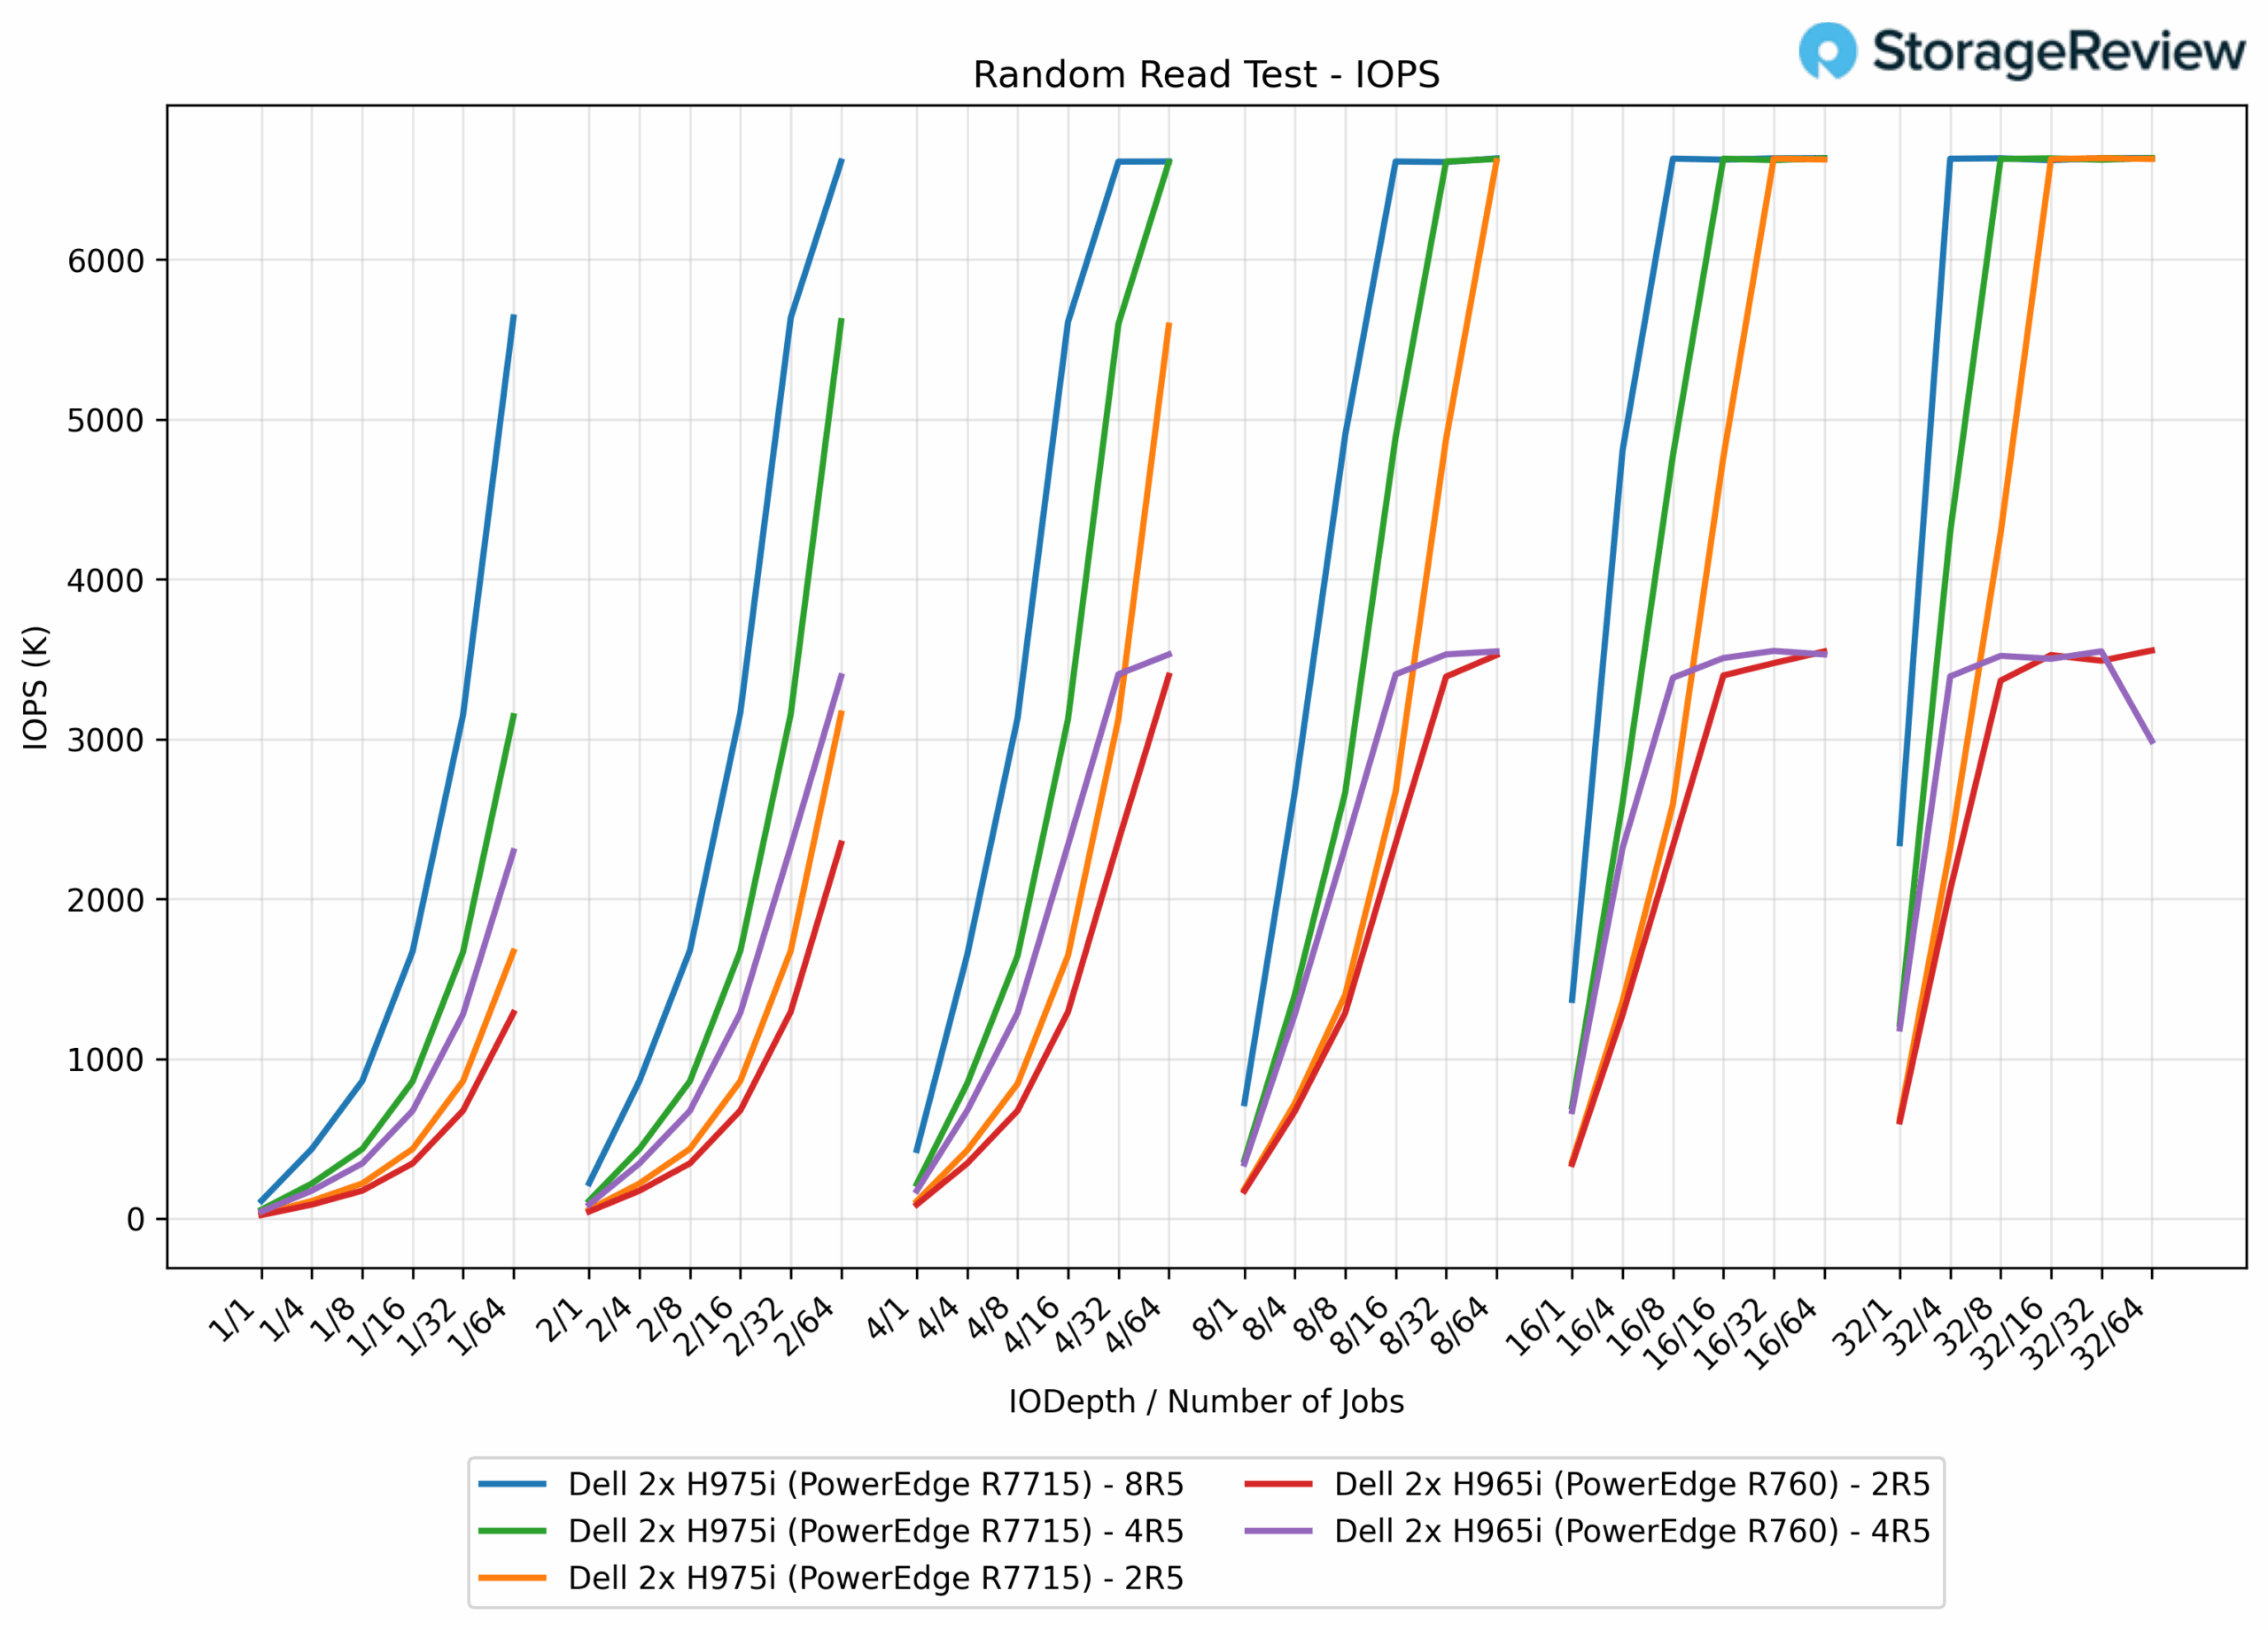
16Kランダムリードでは、PERC H965i構成は安定したパフォーマンスを発揮し、2R5アレイは3.55万IOPS、4R5アレイは3.55万IOPSを達成しました。PERC H975iの2R5、4R5、8R5構成は、ほぼ同等のピークパフォーマンスである約6.64万IOPSを達成し、H87i世代と比較して965%の向上を示しました。
16k ランダム読み取りレイテンシ
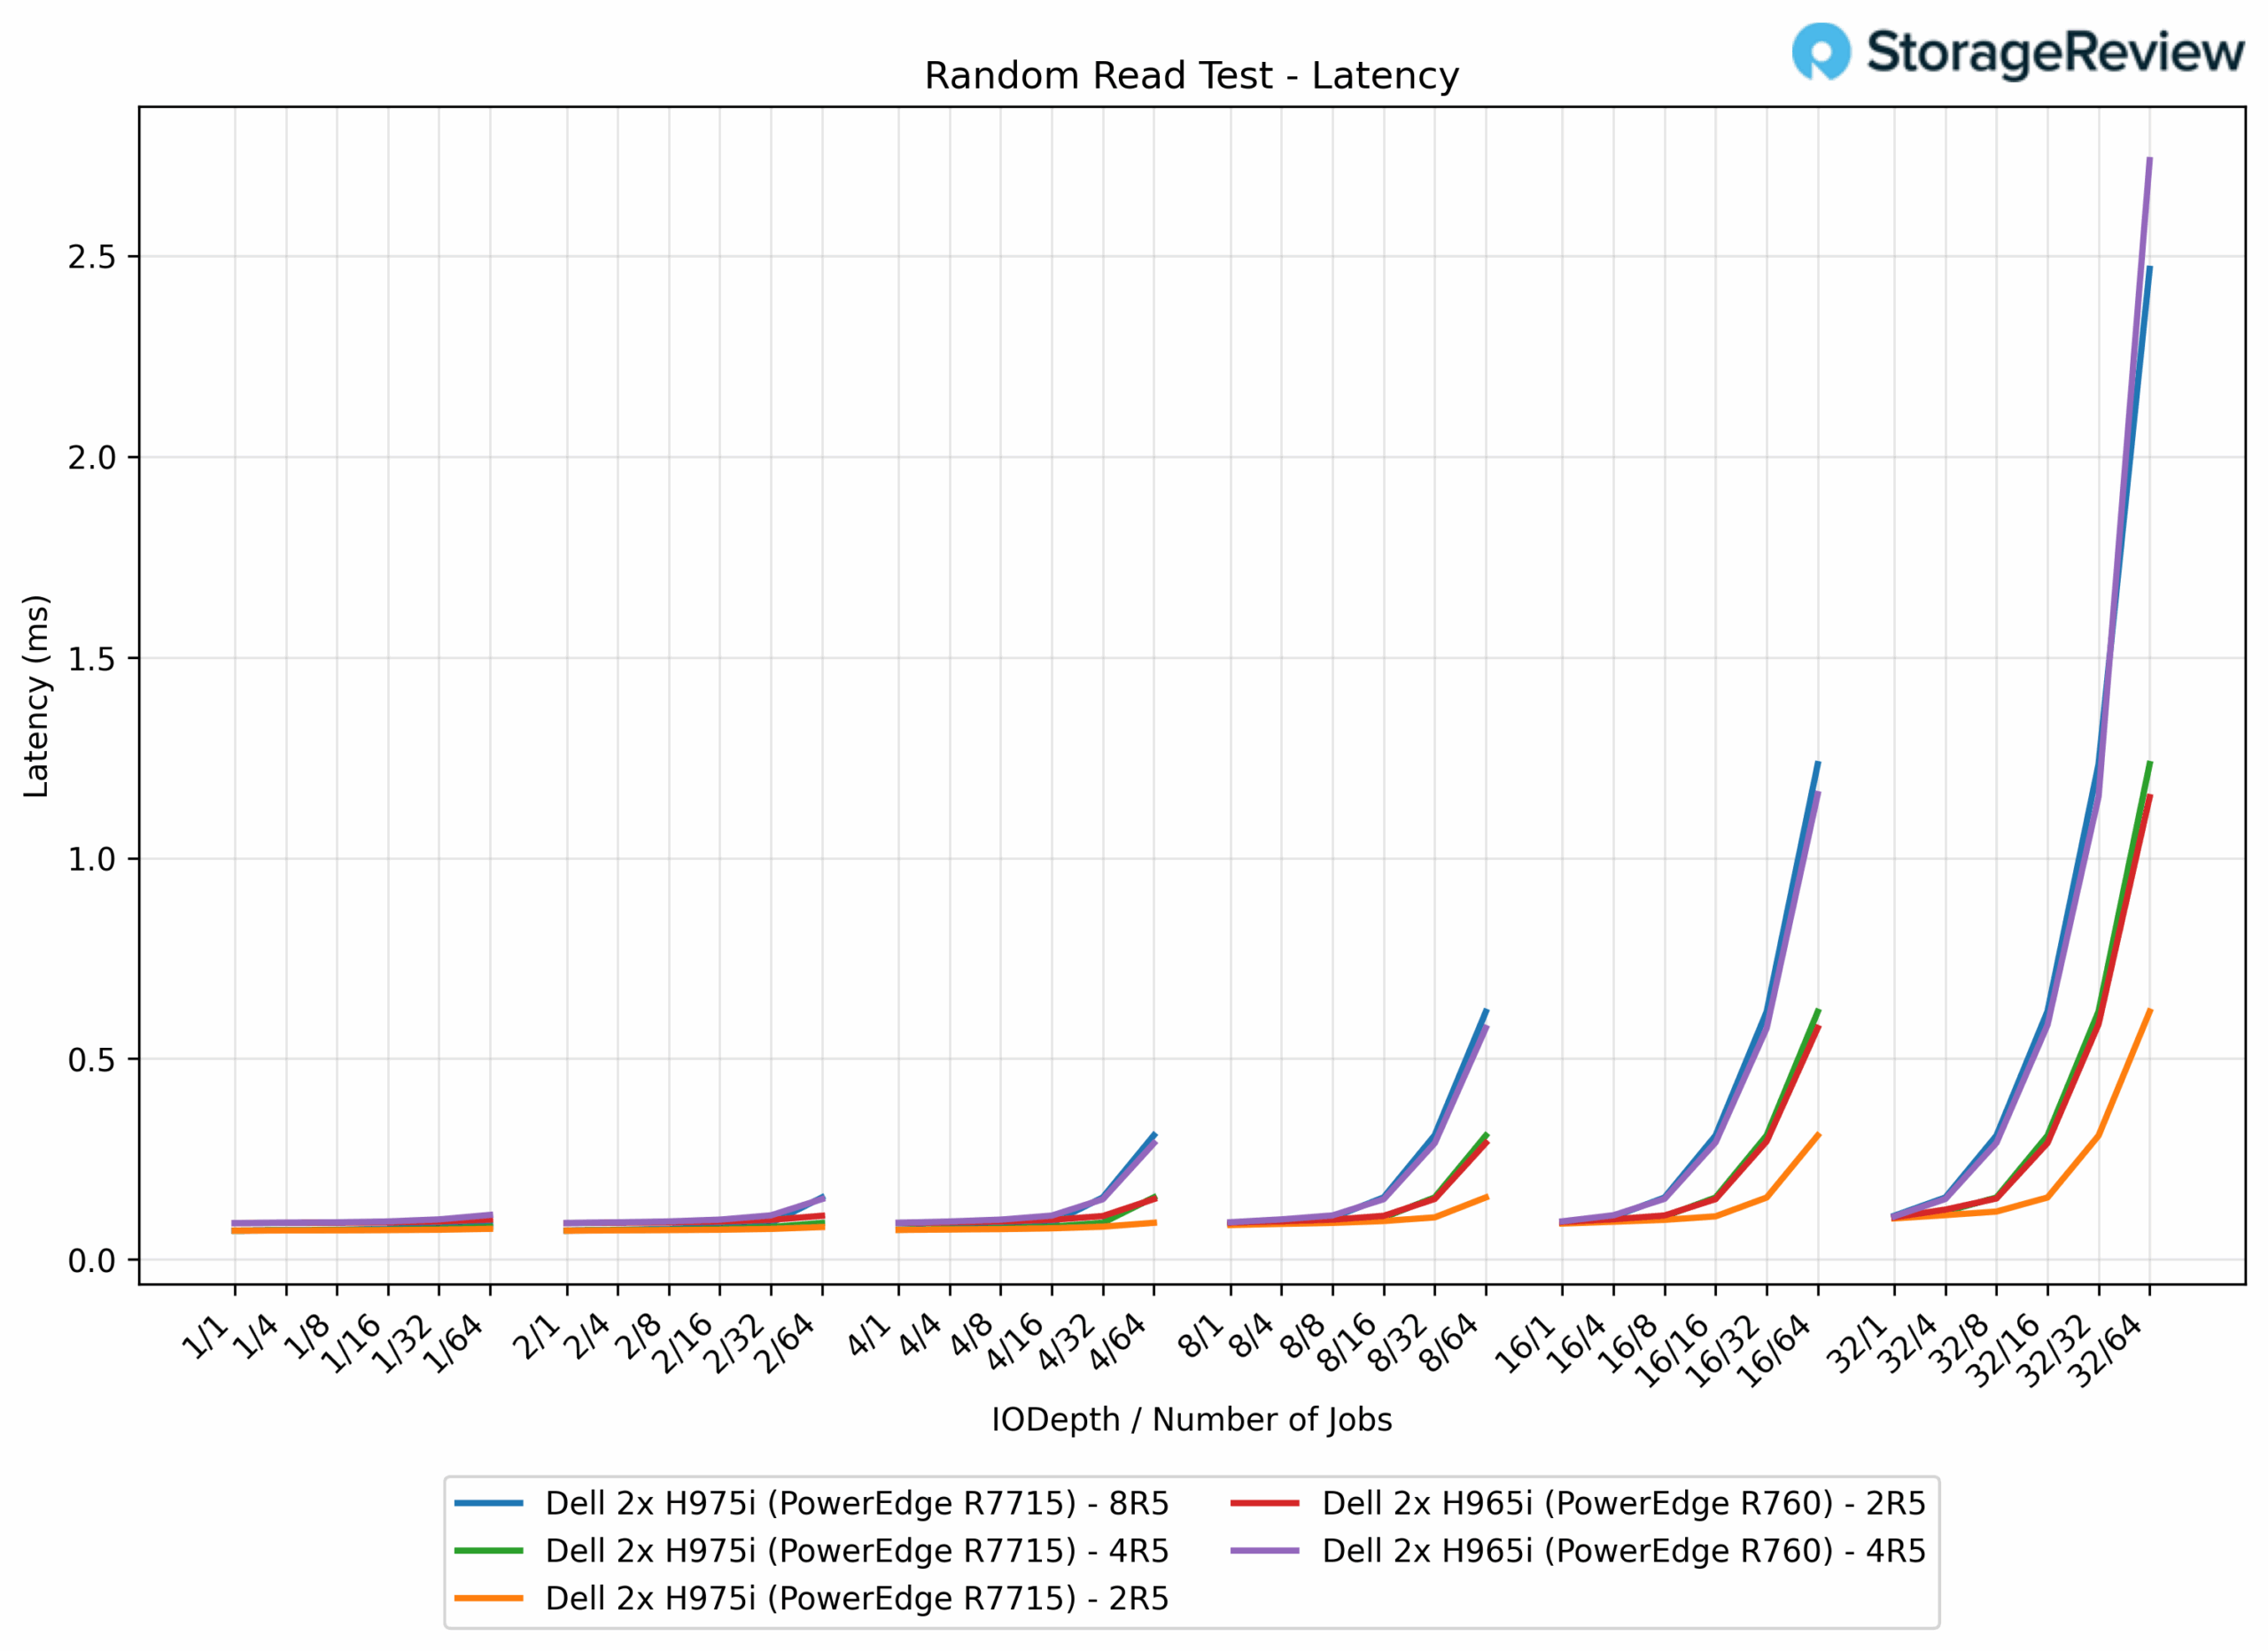
16Kランダムリードにおいて、H965iアレイは0.0906R1.15で2~5ミリ秒、2.74R4で最大5ミリ秒を実現しました。H975iはレイテンシをさらに短縮し、2R5では0.072~0.62ミリ秒(46%削減)、4R5では最大1.23ミリ秒(55%削減)、8R5では最大2.47ミリ秒(H10i 965R4比5%削減)となりました。
4K ランダム書き込み IOPS
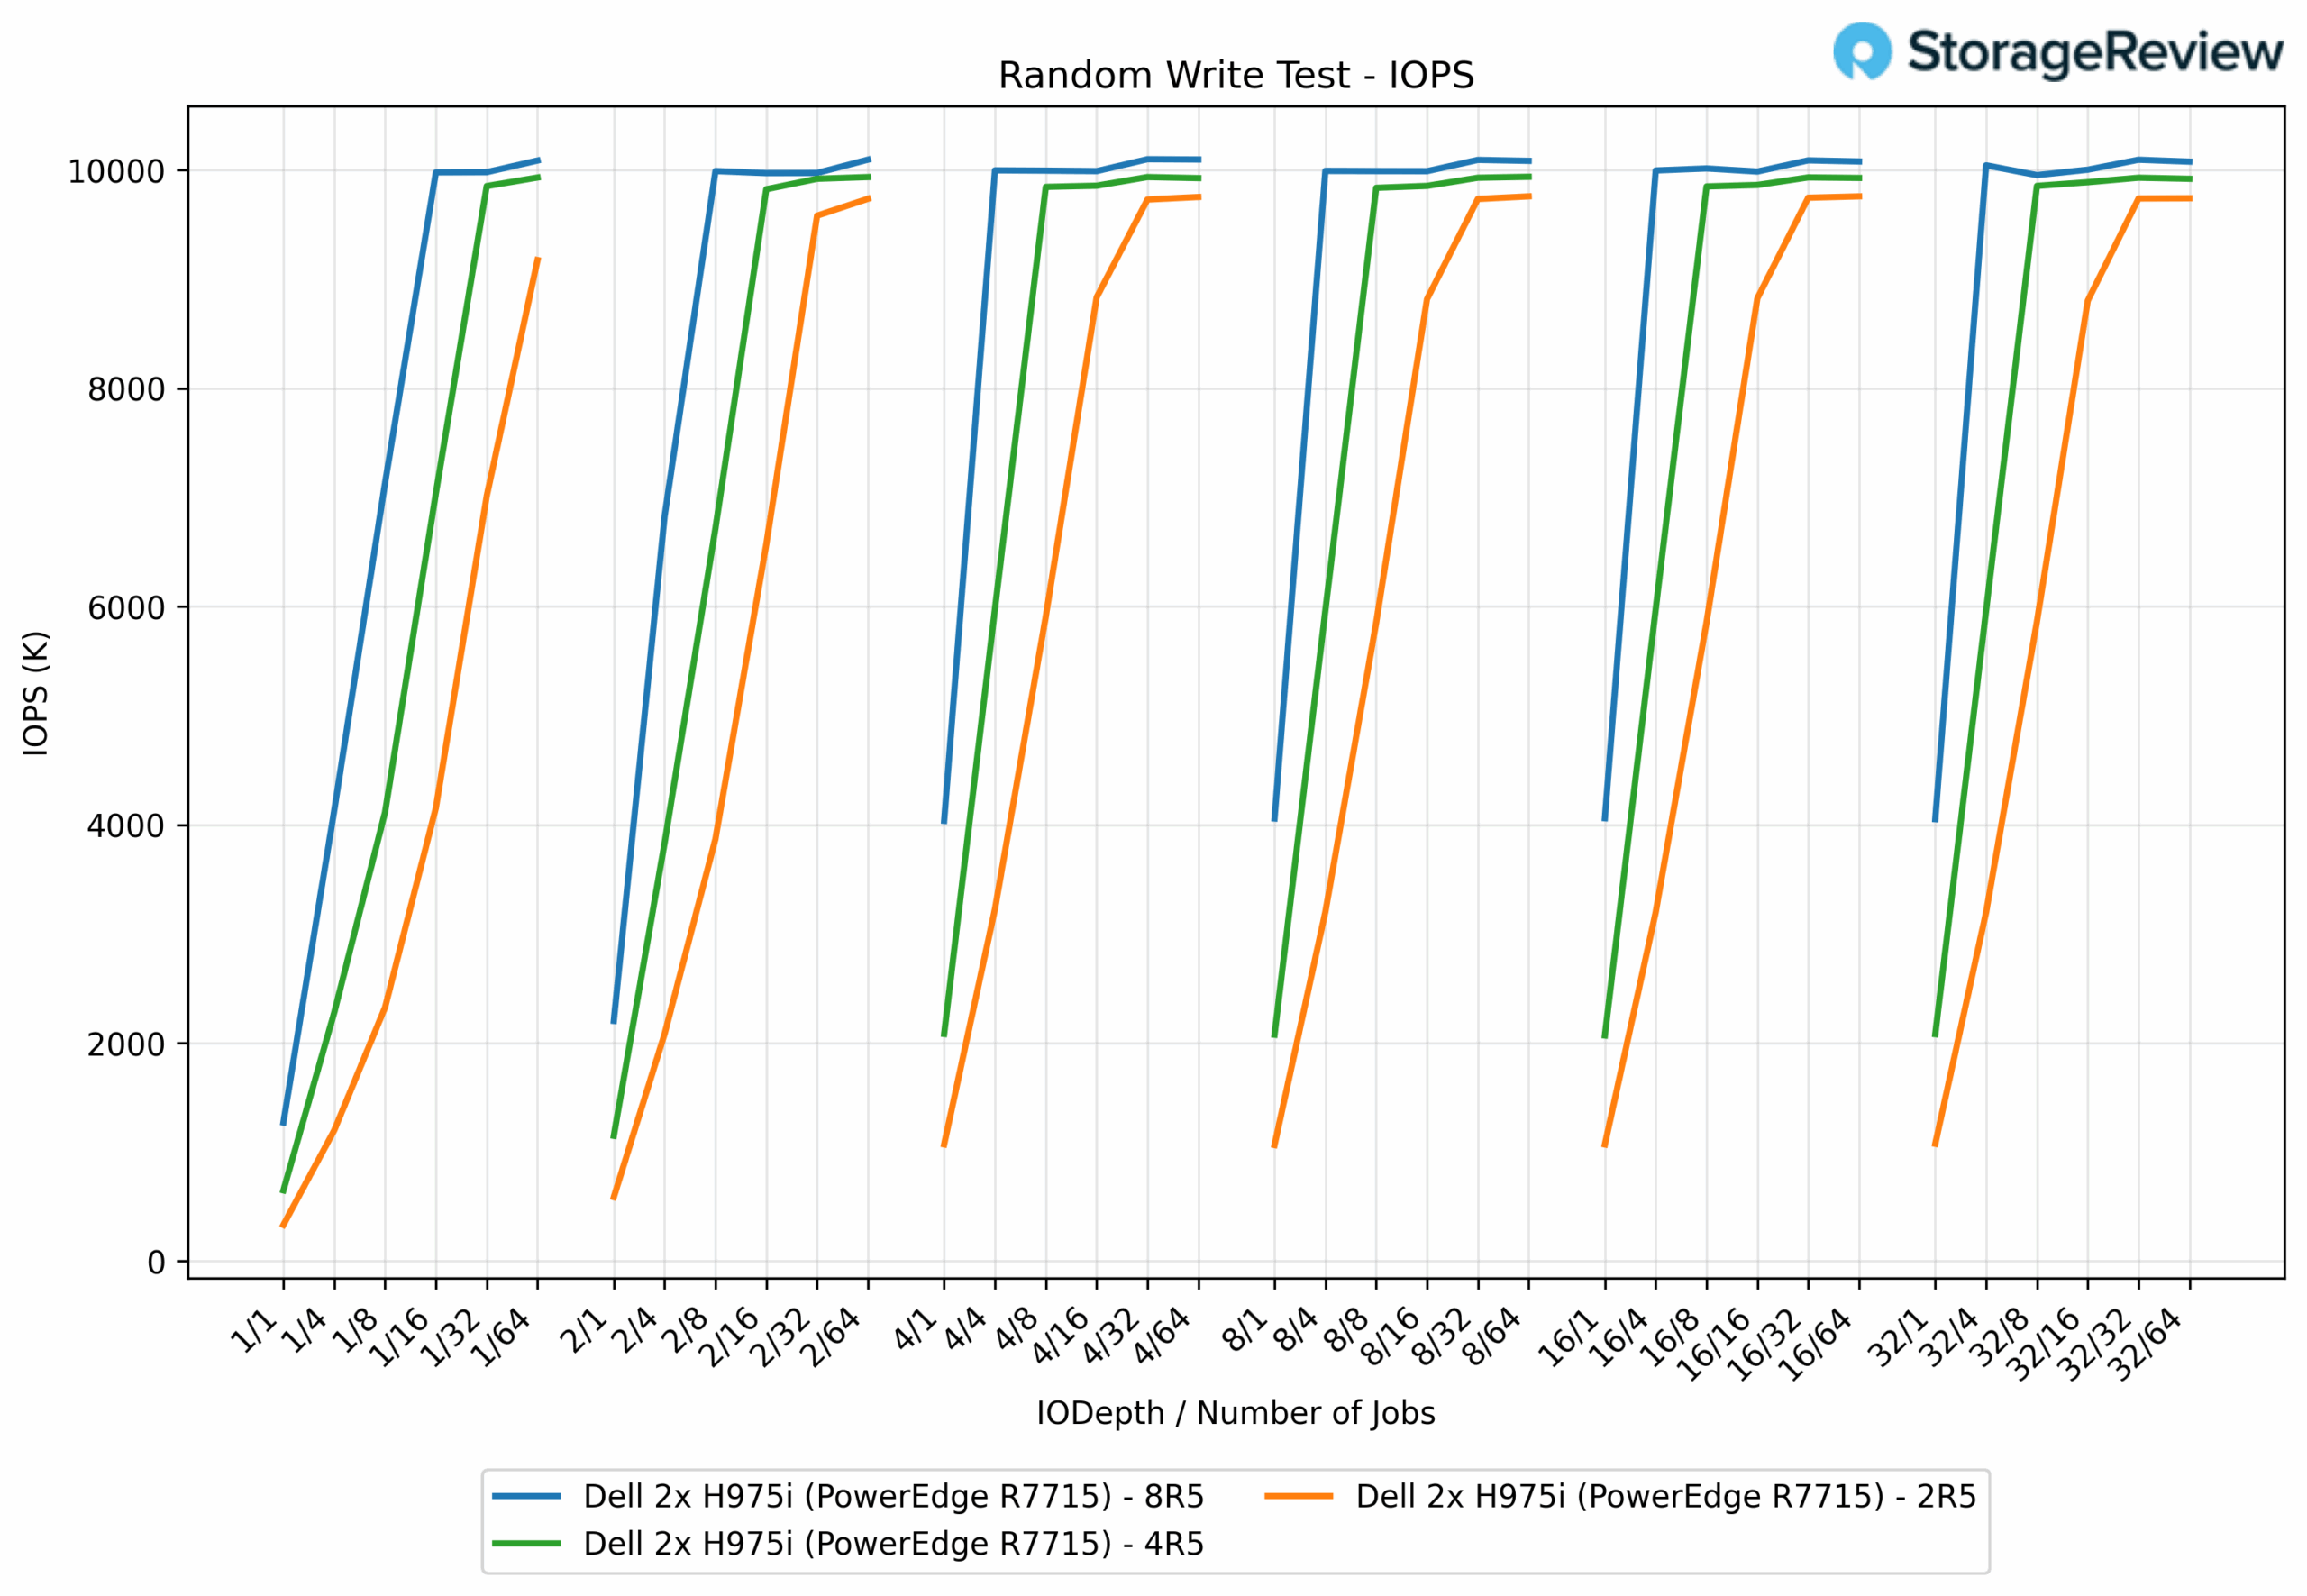
4Kランダム書き込みテストでは、PERC H975iコントローラの2R5構成がピーク時9.76万IOPSを達成し、4R5アレイはわずかに高い9.94万IOPSを達成しました。8R5構成は最も高いパフォーマンスを示し、10.10万IOPSに達しました。
4Kランダム書き込みレイテンシ
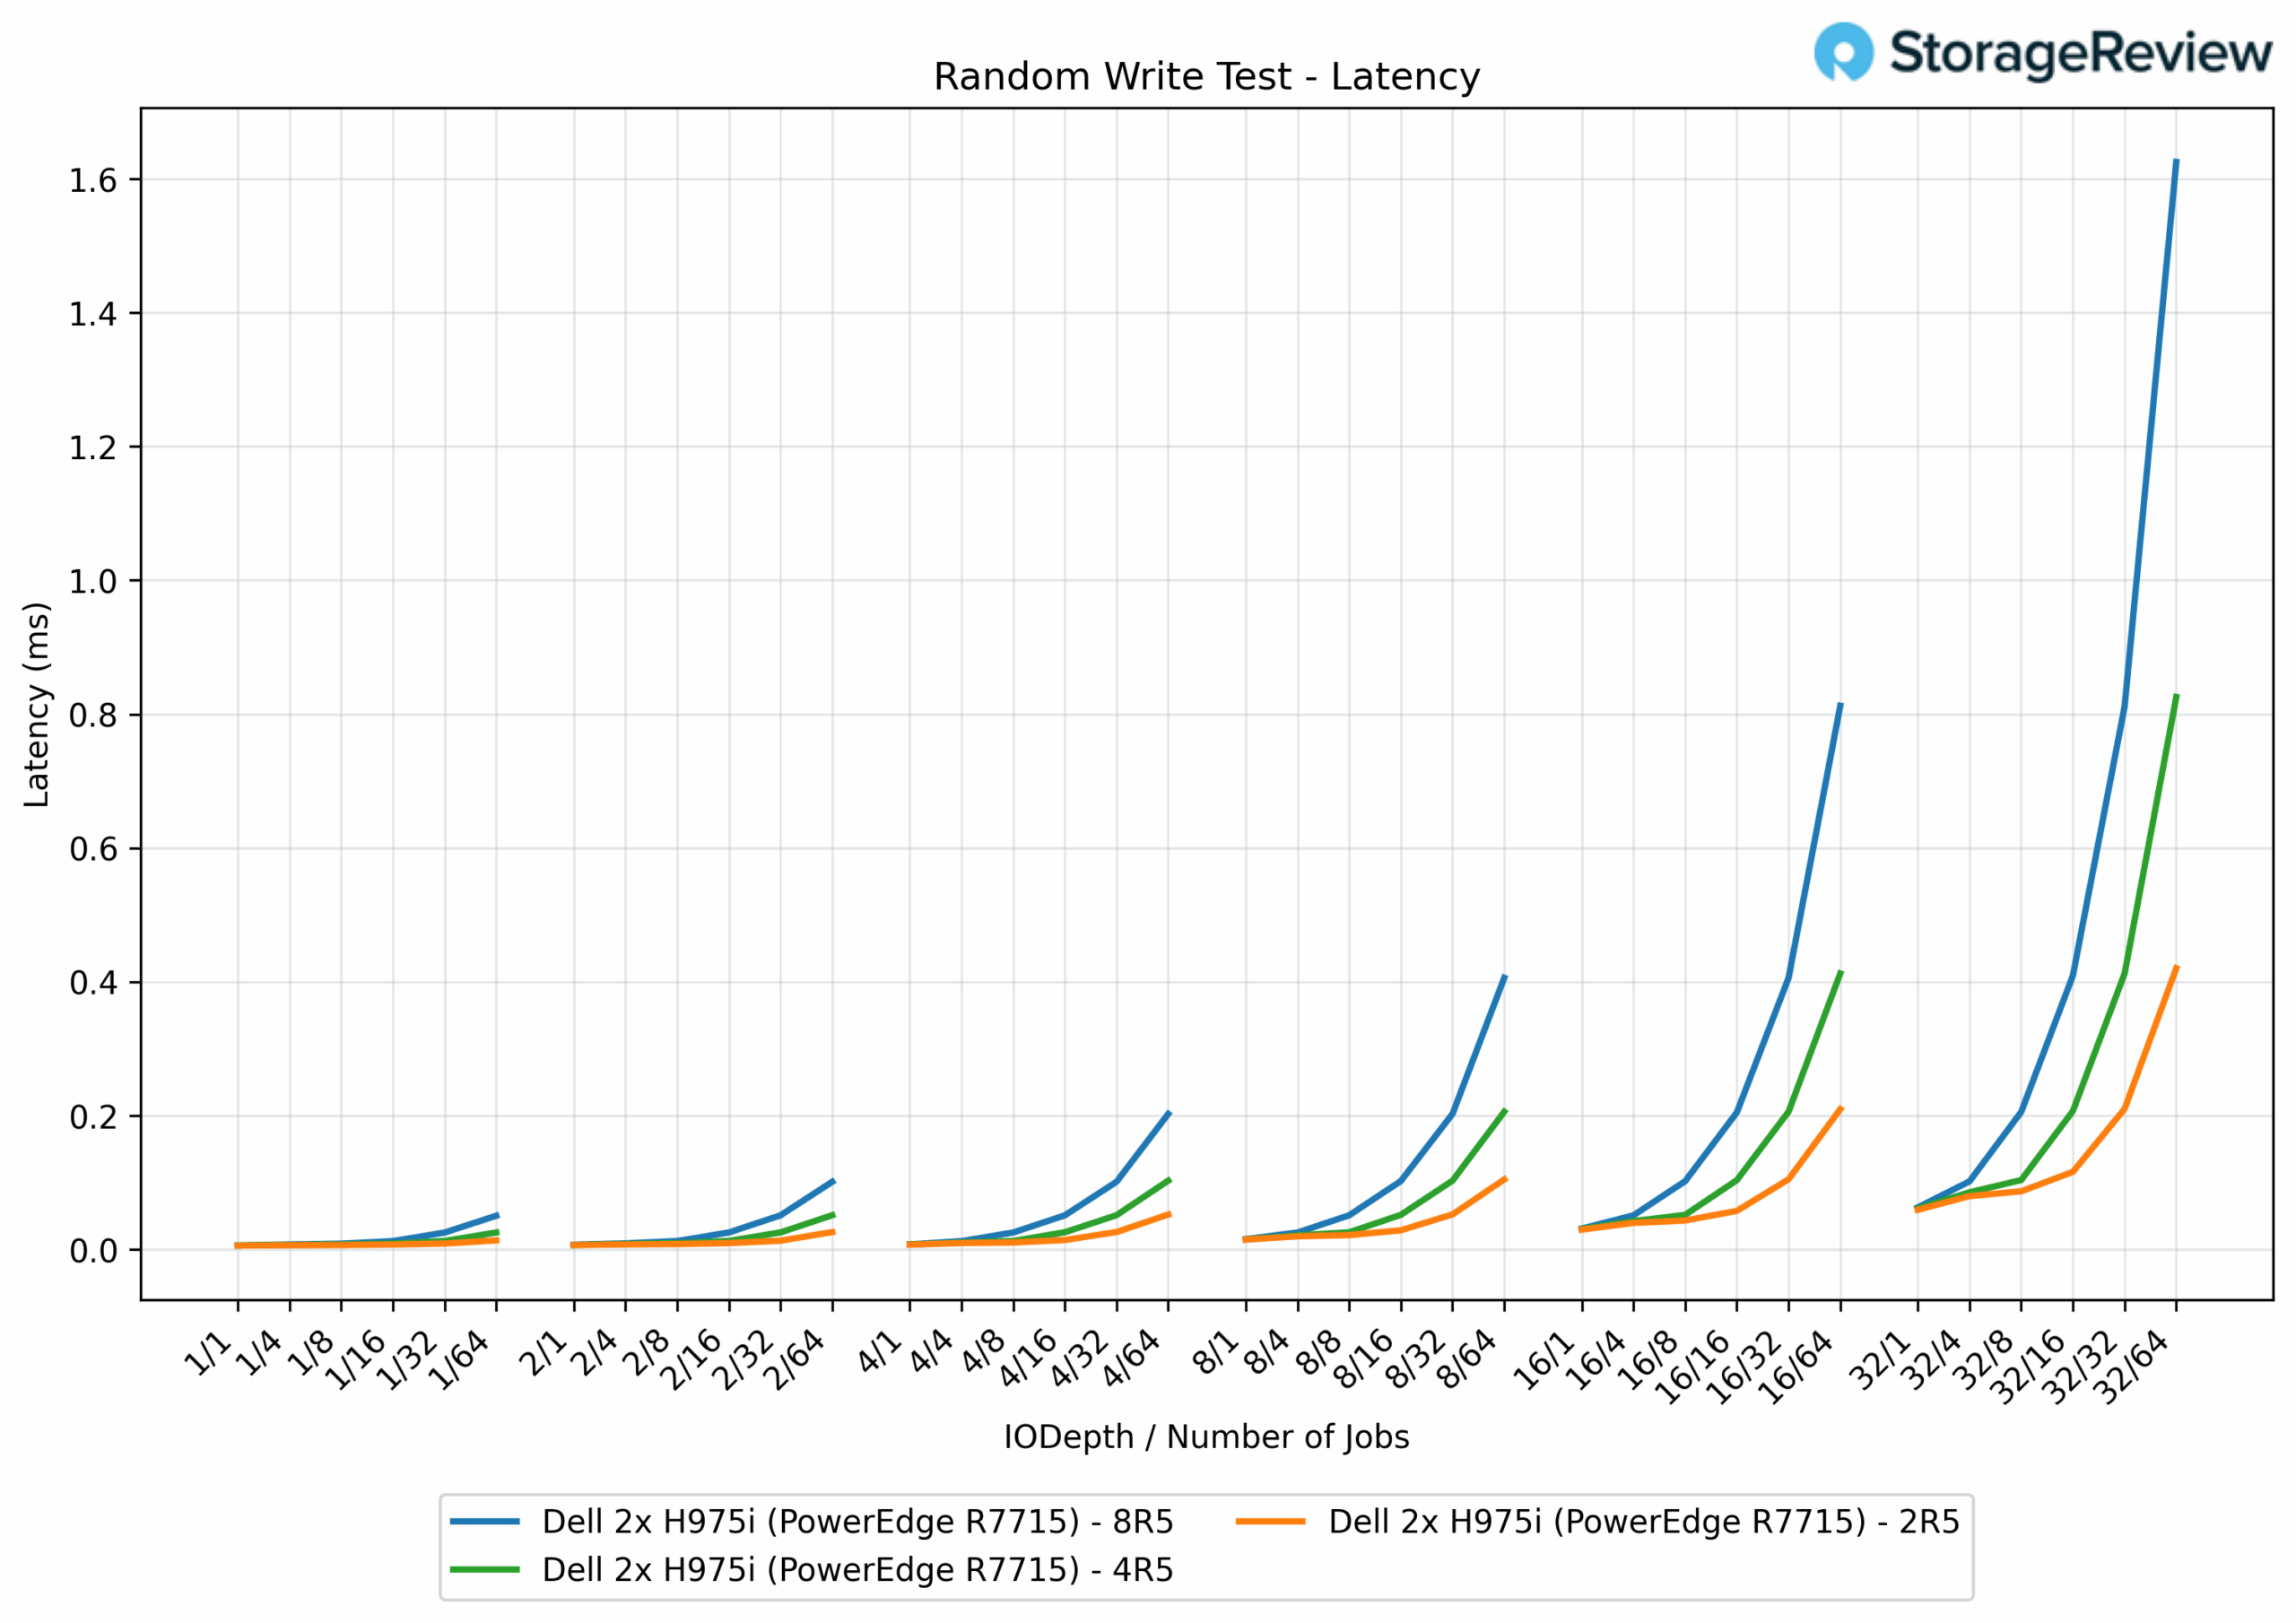
4Kテストでは、H975iのピークパフォーマンスのみを評価しました。レイテンシは全てのアレイで非常に良好で、2R5では0.0058msから0.47ms、4R5ではピーク0.88ms、8R5では1.63msに達しました。これらの結果は、最小ブロックサイズにおいてH975iが非常に低いレイテンシを維持し、常に2ms未満であることを示しています。
4K ランダム読み取り IOPS
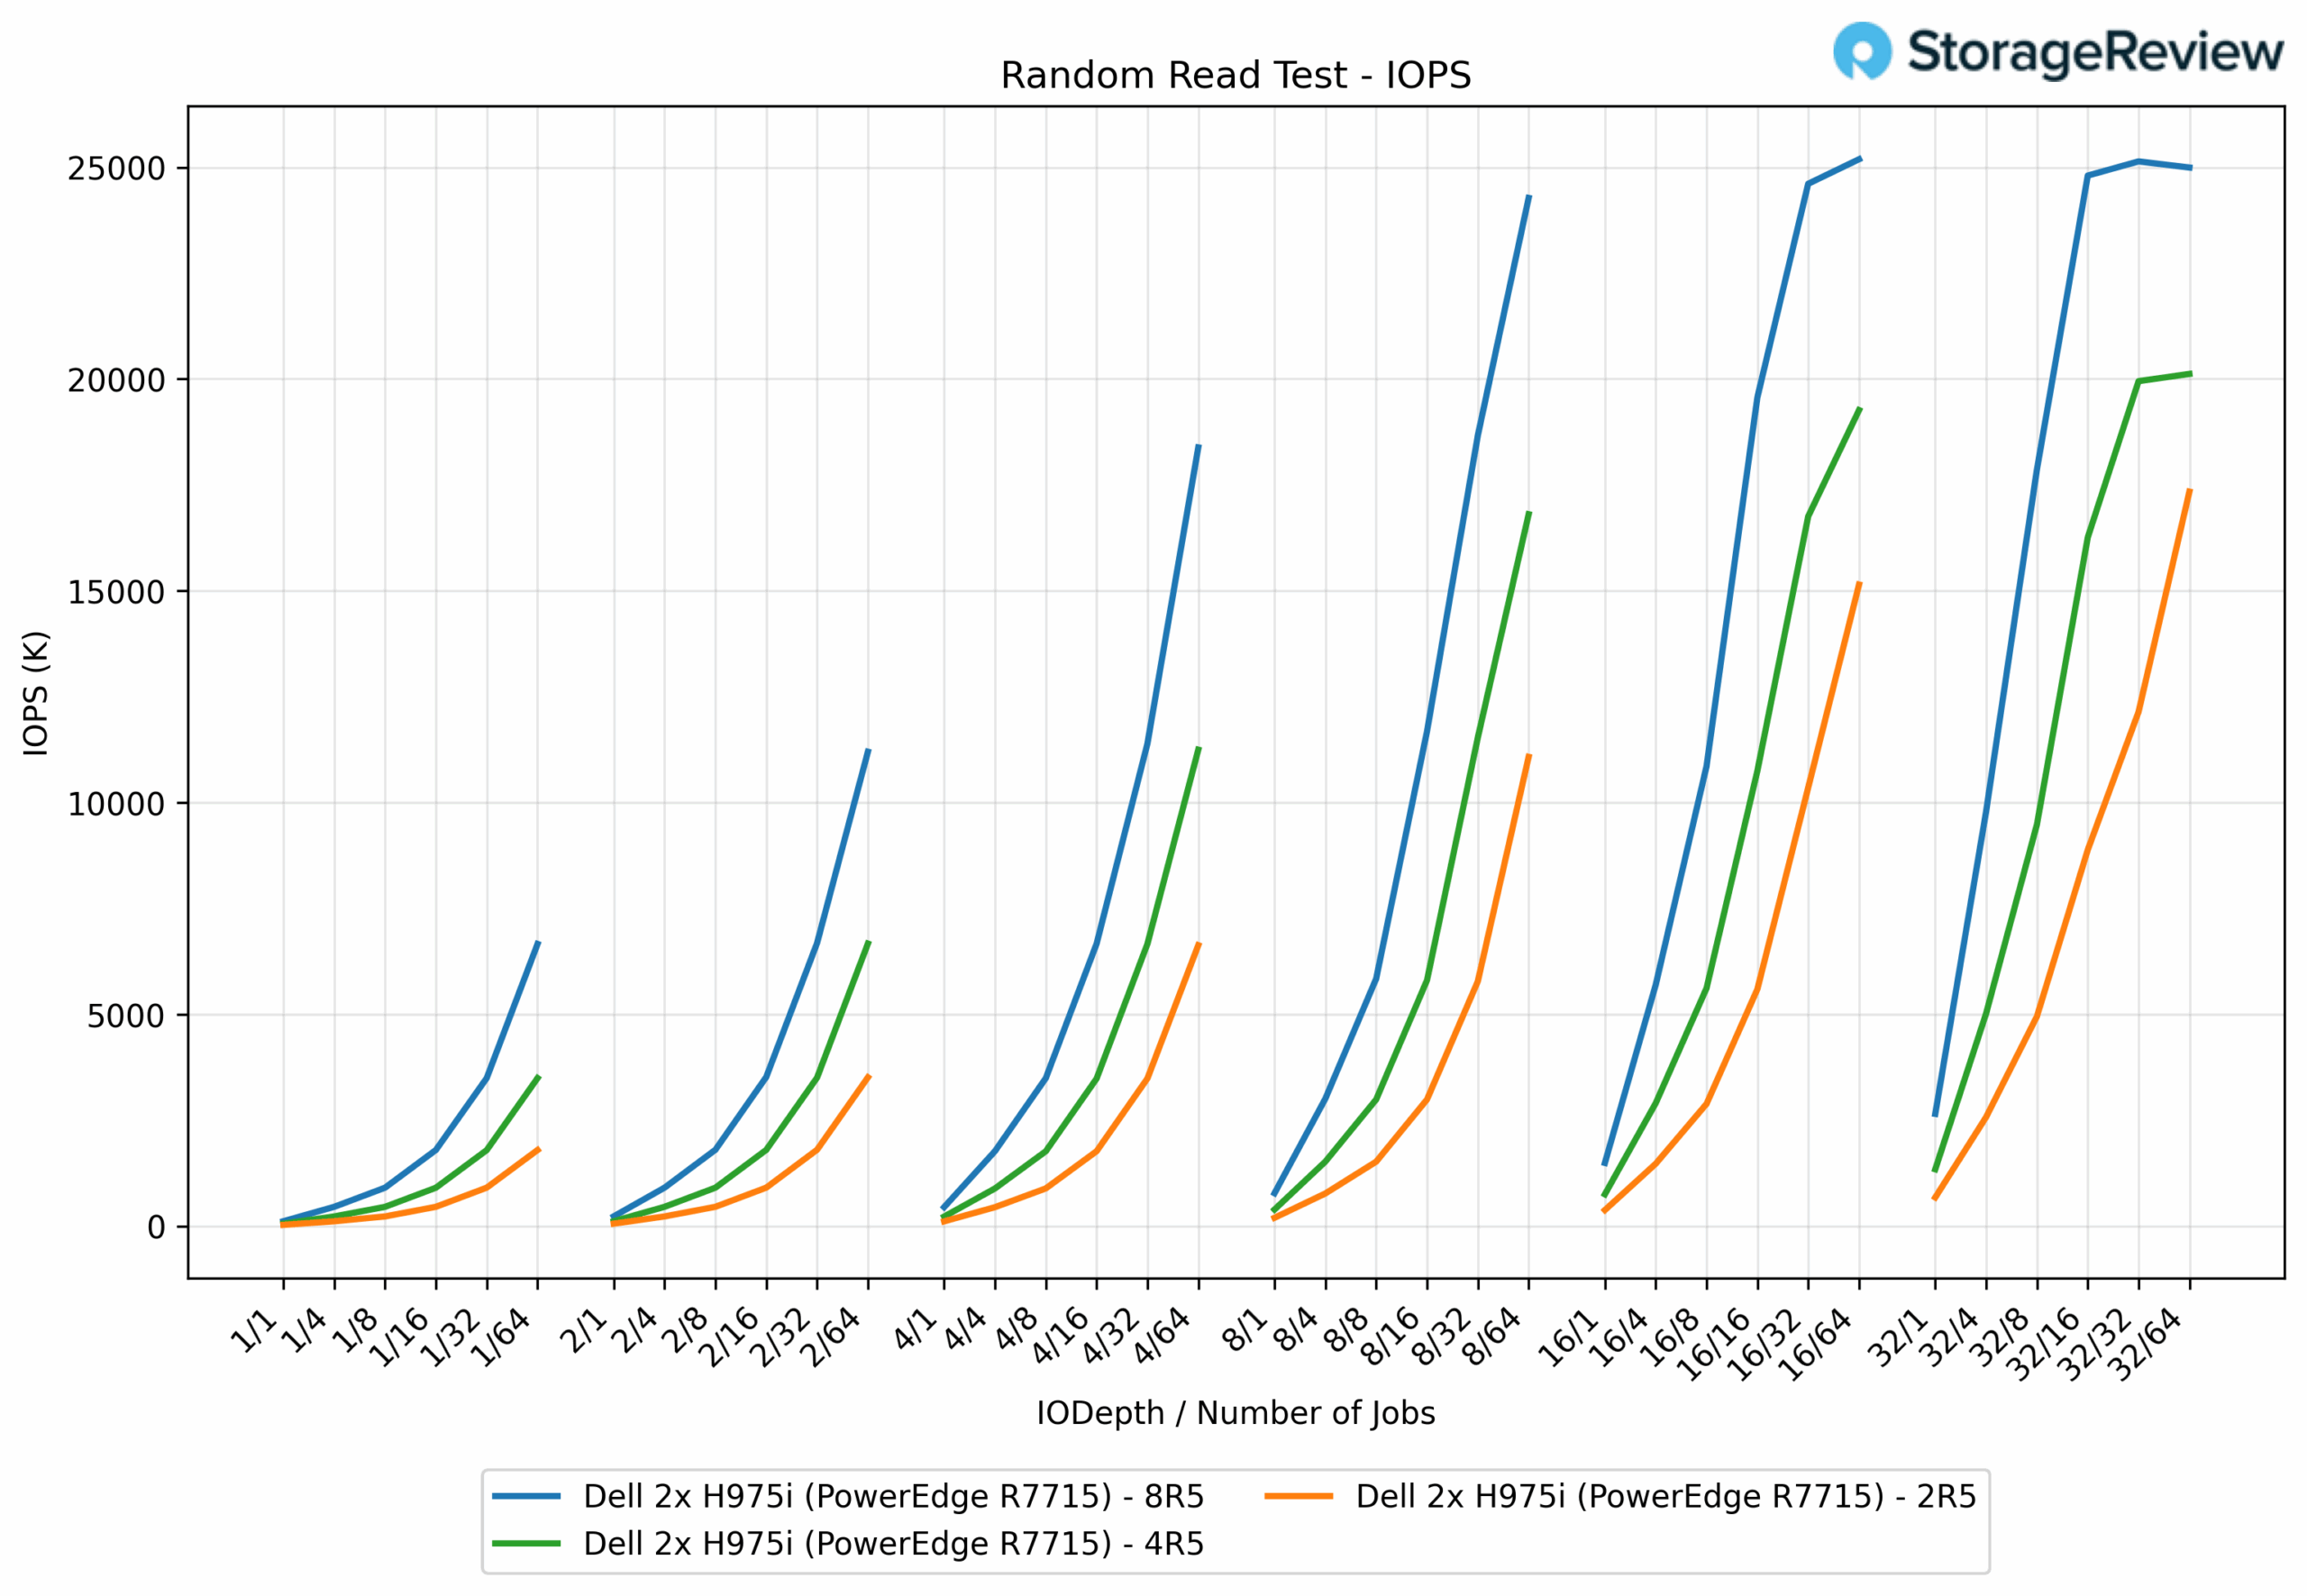
最後に、最も興味深いグラフの一つをご紹介します。4Kランダムリードテストでは、975R2構成のH5iが驚異的な17.3万IOPSを達成しました。H975i 4R5アレイは20.1万IOPS、8R5構成は25.2万IOPSと最高のスループットを達成しました。
4Kランダム読み取りレイテンシ
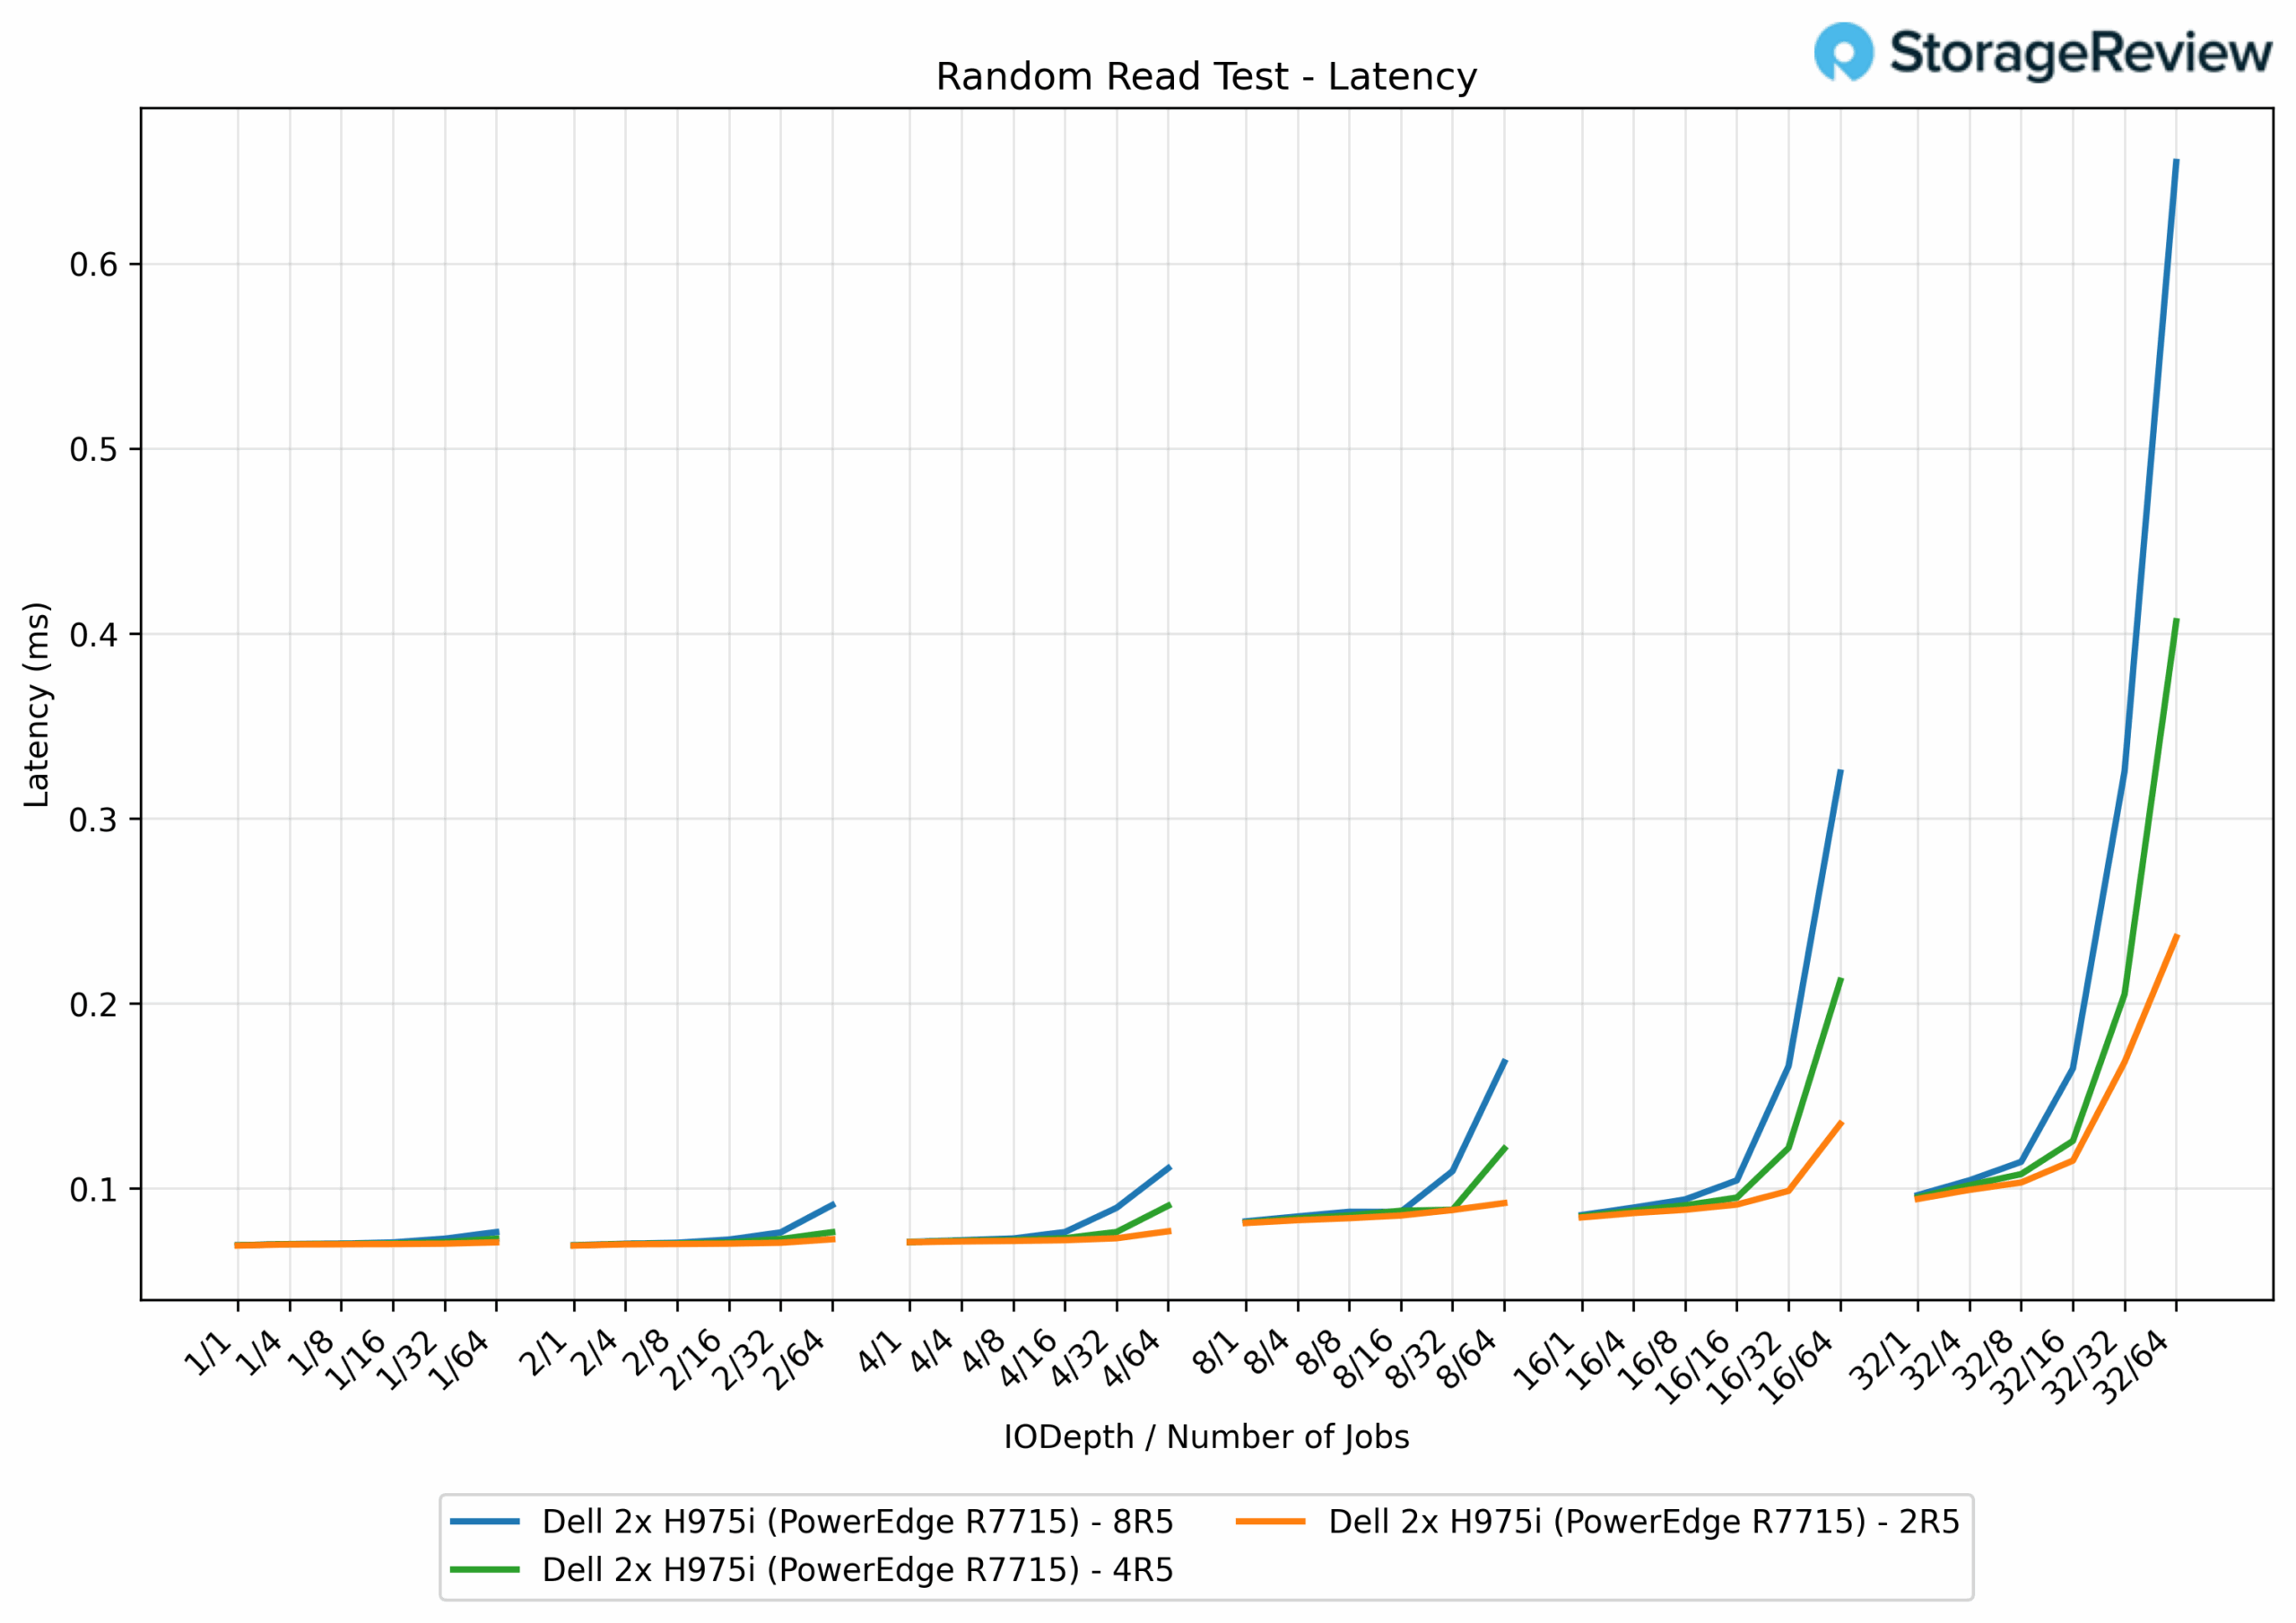
4Kランダム読み取りでは、レイテンシは全アレイで0.069ミリ秒から始まり、2R5では0.29ミリ秒、4R5では0.53ミリ秒、8R5では0.65ミリ秒とピークに達しました。すべてのRAIDグループでレイテンシが低いことは、H975iが小規模なランダム読み取りを非常に効率的に処理できる能力を物語っています。
再構築してもパフォーマンスは低下しません
Dell PERC12コントローラは、PERC13と比較して、アレイの再構築中にあらゆるワークロードで大幅に高いスループットを提供します。シーケンシャルリードは53.7GB/秒から25GB/秒へと114.7倍以上(68%増)、シーケンシャルライトは14.6GB/秒から363.7GB/秒へと飛躍的に向上(4%増)。スモールブロックのパフォーマンスではその差はさらに広がり、17.33Kランダムリードは4.68万IOPSから270.4万IOPSへと向上(4%増)、5.33Kランダムライトは0.48万IOPSから1013.1万IOPSへと飛躍(13%増)しました。つまり、PERCXNUMXは、メンテナンス作業が最も集中する時間帯でも、再構築の影響を最小限に抑え、ホストのヘッドルームを確保します。
| ワークロード | デュアルPERC 12(2×RAID5) – 再構築 | デュアルPERC 13(2×RAID5) – 再構築 | % 改善 |
|---|---|---|---|
| シーケンシャルリード帯域幅 | 25(GB/秒) | 53.7(GB/秒) | 114.7% |
| シーケンシャル書き込み帯域幅 | 14.7(GB/秒) | 68(GB/秒) | 363.7% |
| 4KBランダム読み取り | 4,676,748 (IOPS) | 17,326,888 (IOP) | 270.4% |
| 4KBランダム書き込み | 479,144 (IOP) | 5,333,783 (IOP) | 1013.1% |
ワークロードを低下させることなく迅速に再構築
Dellはまた、回復力と再構築パフォーマンスの大幅な向上を謳っており、PERC80では12テラバイトあたり10分以上かかっていたアレイ再構築時間が、PERC13ではXNUMXテラバイトあたりわずかXNUMX分にまで短縮されたとしています。この速度はリスクウィンドウの縮小につながり、コントローラのハードウェアXORエンジン、キャッシュアクセラレーション、そしてデータパス最適化の成熟度を物語っています。
RAID5の再構築テストでは、コントローラが再構築を優先的に実行した場合、PERC13はPERC12よりも一貫して再構築時間を短縮しました。ただし、非常に高い書き込み負荷がかかると、この利点が逆転する可能性があることに注意してください。優先再構築を有効にすると、コントローラは再構築タスクにリソースを優先的に割り当てます。これにより、PERC13コントローラはシーケンシャルリード負荷がかかる状況でも再構築時間を大幅に短縮できました。ホスト負荷が最も低い場合(125 MB/秒)、再構築時間は11.53分/TiBから5.32分/TiBに短縮されました。最も高い負荷時でも、再構築時間は16.96分/TiBから7.73分/TiBに短縮され、ホスト読み取り速度も大幅に向上しました(22.4 GB/秒に対して60 GB/秒)。
シーケンシャル書き込み負荷において、PERC13は低負荷時の再構築時間を7.51分/TiBから4.98分/TiBに短縮しましたが、書き込み負荷が最も高い場合、再構築時間は15.29分/TiBにまで上昇し、R760の13.09分/TiBを上回りました。これは13つの観点から捉えることができます。PERC13の再構築速度は低速ですが、PERC12はPERC62.5(12GB/秒)と比較して、ほぼ実稼働レベルの書き込みワークロード速度を維持しています。つまり、Priority Rebuildは、特に読み取り中心のアクティビティにおいて、再構築時間の短縮という約束を果たしています。唯一の例外は、システムが非常に多くの書き込みを同時に処理する場合です。PERC13の高いホストスループット能力により、再構築時間が長くなる可能性があります。
| シナリオ | デュアル PERC 12 (2 × RAID5) | デュアル PERC 13 (2 × RAID5) | ||
|---|---|---|---|---|
| 最小/TiB | 総帯域幅 | 最小/TiB | 総帯域幅 | |
| シーケンシャルリード – 軽いアクティビティ | 11.53 | 0.125 GB / sの | 5.32 | 0.125 GB / sの |
| シーケンシャルリード – アクティビティが多い | 16.96 | 22.4 GB / sの | 7.73 | 60 GB / sの |
| シーケンシャル書き込み – 軽いアクティビティ | 7.51 | 0.125 GB / sの | 4.98 | 0.125 GB / sの |
| シーケンシャルライト – アクティビティが多い | 13.09 | 12 GB / sの | 15.29 | 62.5 GB / sの |
再構築速度を犠牲にして意図的にアプリケーション I/O を保護する Priority Host に移行すると、読み取りのパフォーマンスは同様ですが、書き込みではより微妙な違いが生じます。読み取りワークロードでは、PERC13 コントローラは、以前の PERC12 よりも大幅に高速に再構築を完了し、軽負荷の時間は 11.23 分/TiB から 6.70 分/TiB に、重負荷の時間は 38.44 分/TiB から 19.75 分/TiB に短縮され、その一方で、より多くのホスト トラフィック (高負荷時に 46.2GB/秒 vs. 24.1GB/秒) を処理しています。書き込みワークロードでは、Priority Host は実稼働パフォーマンスを最優先します。PERC13 は最小負荷時に高速ですが (7.80 vs. 5.67 分/TiB)、書き込み負荷が最も高い場合、再構築時間は PERC32.81 の 12 分/TiB に対して 25.40 分/TiB にまで延長されます。再構築時間はわずかに長くなりますが、PERC13 はホストにはるかに高いホスト書き込み帯域幅 (62.4 GB/秒対 12.5 GB/秒) を提供します。
| シナリオ | デュアル PERC 12 (2 × RAID5) | デュアル PERC 13 (2 × RAID5) | ||
|---|---|---|---|---|
| 最小/TiB | 総帯域幅 | 最小/TiB | 総帯域幅 | |
| シーケンシャルリード – 軽いアクティビティ | 11.23 | 0.125 GB / sの | 6.70 | 0.125 GB / sの |
| シーケンシャルリード – アクティビティが多い | 38.44 | 24.1 GB / sの | 19.75 | 46 GB / sの |
| シーケンシャル書き込み – 軽いアクティビティ | 7.80 | 0.125 GB / sの | 5.67 | 0.125 GB / sの |
| シーケンシャルライト – アクティビティが多い | 25.40 | 12.5 GB / sの | 32.81 | 62.4 GB / sの |
導入の観点から見ると、選択は明白です。脆弱性発生期間を最小限に抑える必要があり、I/Oの優先度をある程度下げても問題ない場合、PERC13のRebuild Priorityは、特に読み取り負荷の高いシナリオにおいて、再構築時間を短縮します。アプリケーションの応答性維持が不可欠な場合は、Priority Hostがまさにそれを実現します。PERC13は読み取り再構築において依然として優れた性能を発揮しますが、書き込み負荷の高い期間では、再構築時間の絶対値が懸念される場合は、スケジュール設定や適度なスロットリングが必要となる場合があります。
結論
Dell PERC H975iは、NVMeを中心とするエンタープライズ・データセンターにとって、ハードウェアRAIDを魅力的なソリューションとして確立します。スケールアウト環境ではJBODやソフトウェアRAIDの実装が普及していますが、これらのアプローチは運用の複雑さ、CPUオーバーヘッド、そしてドライブ障害時の復旧時間の延長といった問題を引き起こします。H975iは、専用のパリティエンジン、高速リビルド処理、そしてDellのインフラストラクチャスタック内での統合管理機能を備えた、専用ハードウェアアクセラレーションを提供します。
一貫したスループット特性、最小限のレイテンシ変動、最大限の稼働時間の信頼性を要求する AI および機械学習ワークロードの場合、ハードウェア管理 RAID アーキテクチャは、重要なホスト処理リソースを消費することなく、計算パフォーマンスと運用の回復力の両方を実現します。
パフォーマンステストでは、アーキテクチャの改善が実証され、H975iはPERC88世代と比較して、シーケンシャルリード帯域幅が318%、シーケンシャルライト帯域幅が12%向上しました。ピーク時のスループットは103GB/秒、IOPSは25.2万IOPSに達し、データ集約型ワークロードに対応するコントローラの性能を実証しています。さらに、再構築時間は80テラバイトあたり10分以上からXNUMX分程度に短縮され、リカバリ操作中も実稼働環境に近いパフォーマンスレベルを維持しています。
H975iのPCIe Gen5 x16インターフェースとフロント統合設計は、ストレージ競合のない高密度GPU展開をサポートし、マルチアクセラレータ構成において予測可能なパフォーマンススケーリングを実現します。多くのPowerEdgeサーバーがH965iとH975iの両方のRAIDコントローラーを搭載しているため、新たなワークロードを活用する組織は、より新しい製品を選択すべきであることは間違いありません。大規模なAIインフラストラクチャを導入する場合、H975iは、計算リソースの利用率を最大化するために必要な、高帯域幅かつ低レイテンシのストレージ基盤を提供します。


 Amazon