

テクノロジーは周期的に変化しますが、現在、エッジでの AI の重視ほどその周期が顕著になっているものはありません。特に、エッジ推論に大きな変動があることがわかりました。 NVIDIA はこの推進に大きく貢献しており、データセンター外での GPU の採用を推進したいと考えています。それでも実際には、企業はより多くの意思決定をより迅速に行う必要があるため、AI インフラストラクチャはデータに近づく必要があります。
ハブアンドスポークを覚えていますか?
「昔」、私たちはデータ作成の観点からのエッジと、従来のハブアンドスポーク手法を採用してそのデータを迅速かつ効率的にデータセンターに戻す方法について話しました。この設計は、多くの冗長性とハードウェアを備えたコア、アクセス、分散に基づいた階層設計に取って代わられ、データをプライマリ データ センターに戻すことを唯一の目的としました。エッジで収集されたすべてのデータは、処理のためにメイン データセンターに戻され、その後エッジ デバイスにプッシュバックされるため、非効率的でコストと時間がかかることが判明しました。
ハブアンドスポーク設計も、結局はそれほど悪くなかったのかもしれません。AIによるエッジでのインテリジェンス向上への取り組みやクラウドコンピューティングの台頭により、設計はネットワーク設計、エッジ展開、そしてデータ処理場所に大きな影響を与えているようです。実際、今年のHPE Discoverカンファレンスのキャッチフレーズは、「コア」を「クラウド」に置き換えれば、クラウドブーム以前のどの年でもお馴染みのフレーズだったでしょう。「エッジ・トゥ・クラウド・カンファレンス」です。
勢いに乗ってジャンプ
業界にとってエッジツークラウド コンピューティングの重要性を認識しているベンダーは HPE だけではなく、Dell Technologies も Dell Technologies World イベント中に同様のストーリーを発表しました。 IBM、Lenovo、NetApp、Supermicro も、クラウド リソースをより効果的に利用しながら、エッジでより多くのことを行う必要性を声高に主張しています。
何がエッジ コンピューティングのレーザー フォーカスを推進しているのでしょうか?顧客は、センサー、IoT デバイス、自動運転車のデータ収集から収集された大量のデータをエッジで生成しています。ソースのデータに近接することで、正確な予測によるより迅速な洞察や、より優れた帯域幅使用率によるより高速な応答時間など、ビジネス上のメリットがもたらされます。エッジでの AI 推論(AI 技術を使用した実用的なインテリジェンス)により、パフォーマンスが向上し、時間(推論時間)が短縮され、ネットワーク接続への依存が軽減され、最終的にビジネスの収益が向上します。
クラウドでエッジ推論を実行してみませんか?
エッジ推論をクラウドで実行できないのはなぜですか?時間に敏感でなく、重要でないとみなされるアプリケーションの場合は、クラウド AI 推論が解決策になる可能性があります。ただし、リアルタイム推論には多くの技術的な課題があり、その中で最も重要なのは遅延です。さらに、IoT デバイスとエッジでの処理を必要とする関連アプリケーションが継続的に成長しているため、すべてのデバイスで高速クラウド接続を利用できるようにするのは現実的ではない可能性があります。
エッジ コンピューティングには、オンサイト サポート、物理的およびアプリケーションのセキュリティ、ストレージの制限につながるスペースの制限など、独自の課題が伴います。今日のエッジ サーバーは、従来のエッジ ワークロードに適切な計算能力を提供し、GPU によって複雑さを増すことなくさらに多くの能力を追加できます。
エッジオプションの増加
興味深いことに、小規模なシステム プロバイダーが主にエッジ インフラストラクチャ市場を支配しています。たとえば、Supermicro は何年もの間、電柱上で 5G とデータセンターについて話し続けており、Advantech や他の多くの専門サーバー プロバイダーも同様のことを行っています。しかし、GPU が向上し、さらに重要なことに、GPU をサポートするソフトウェアも向上するにつれて、エッジにおける AI の概念全体がより現実的なものになりつつあります。
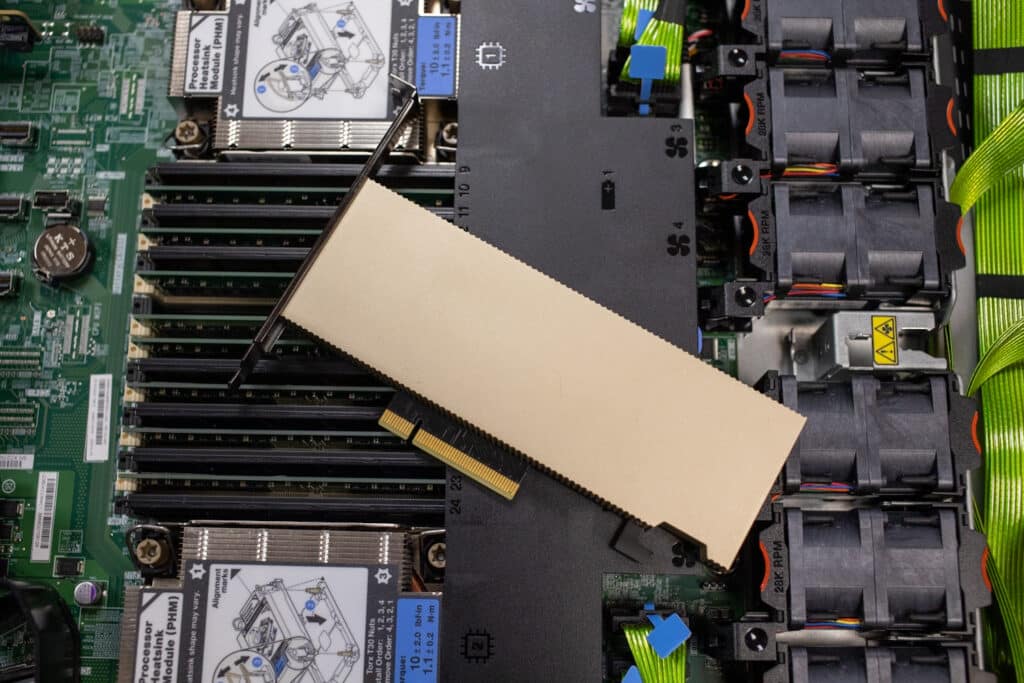
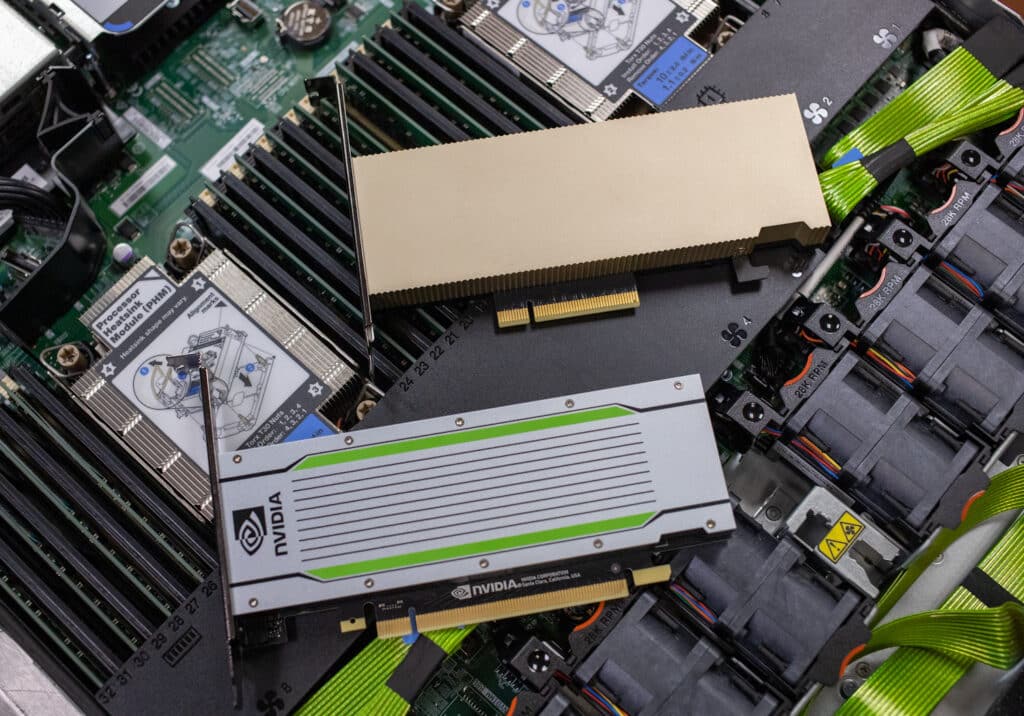
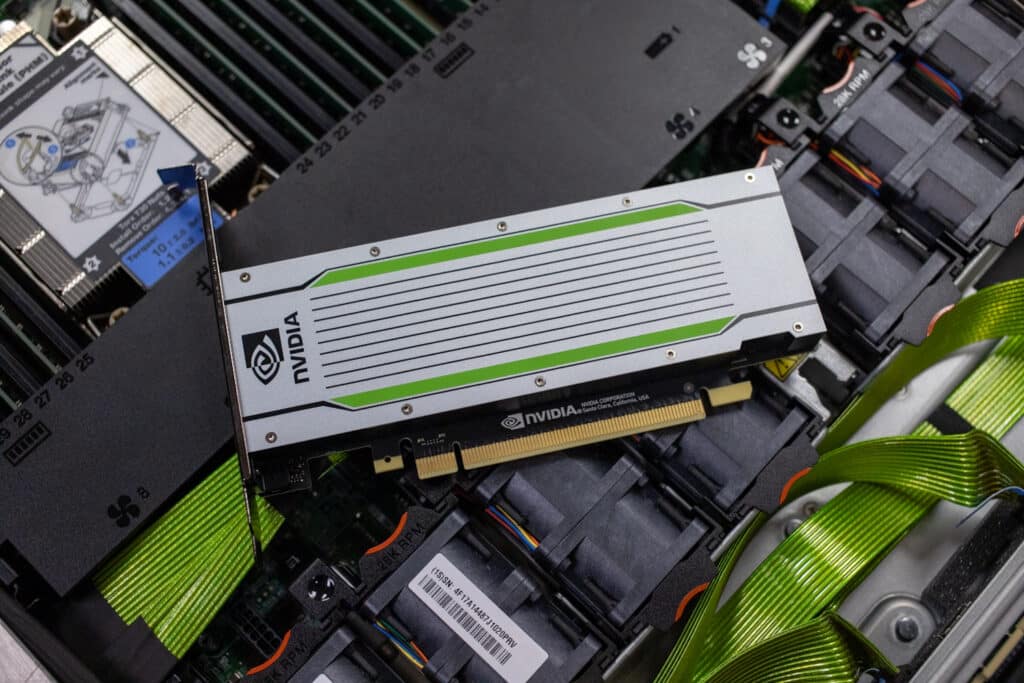
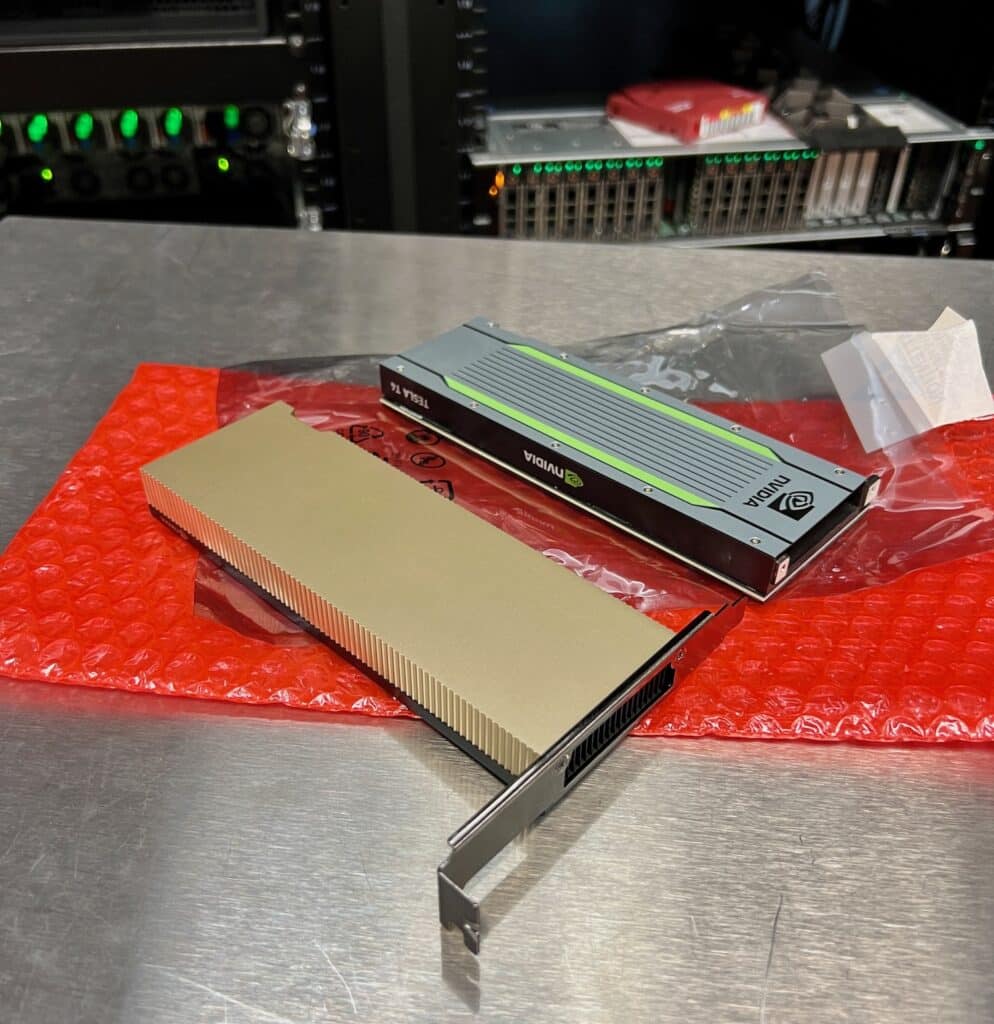
私たちは最近、この変化をいくつかの異なる方法で研究室で観察しました。まず、新しいサーバー設計には、A2 や人気の高い T4 など、NVIDIA のシングル スロットの低電力 GPU が搭載されています。最近、Lenovo と Supermicro の両方が、これらの GPU を統合したサーバーを評価するために私たちに送ってきましたが、そのパフォーマンスは印象的でした。
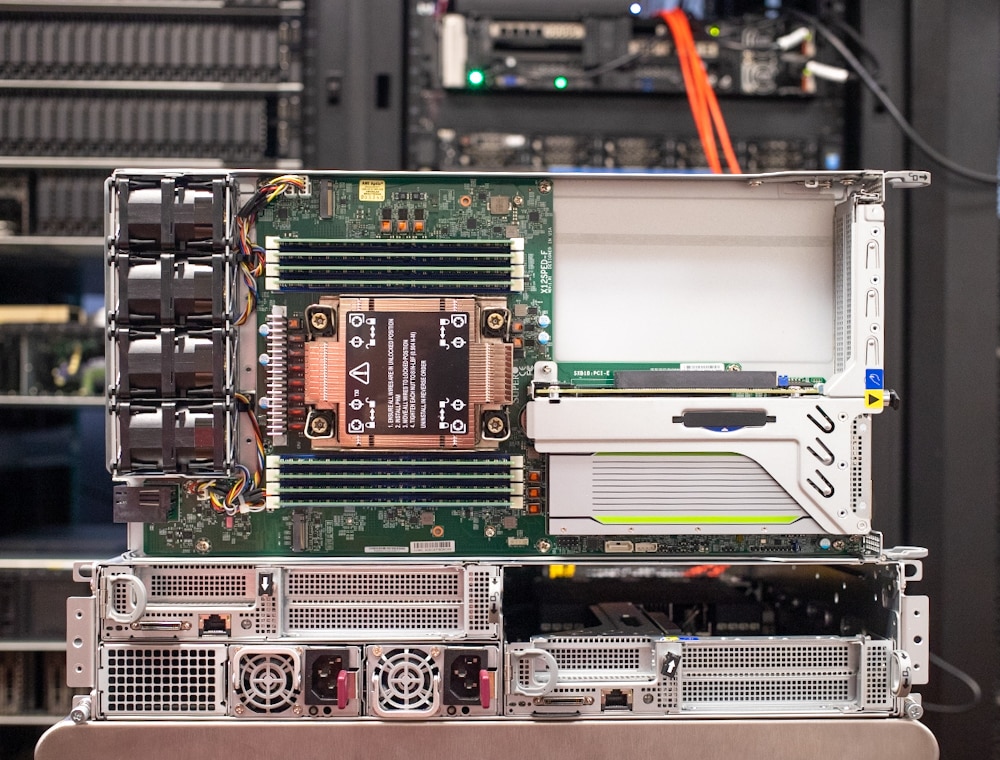 SuperMicro IoT スーパーサーバー SYS-210SE-31A NVIDIA T4を搭載
第二に、インフラストラクチャプロバイダーは、低遅延やセキュリティといったデータセンターの主要要素に直接結びついた指標を持つエッジソリューションの提供に非常に力を入れています。私たちは最近、Dell PowerVault ME5を使ってこうしたユースケースをいくつか検証しました。ME5 は中小企業向けストレージソリューションとして売り出されていますが、そのコストパフォーマンスの高さから、エッジユースケースでも大きな注目を集めています。
ただし、最終的には、エッジ推論のストーリーは非常に単純です。それは、多くの場合、オンザフライでデータを処理する GPU の能力にかかっています。私たちは、これらの新しいサーバーと GPU がエッジ推論の役割でどのように機能するかをよりよく理解するために、テストの拡大に取り組んできました。具体的には、画像認識や自然言語処理モデルなどの一般的なエッジ ワークロードに注目してきました。
テストの背景
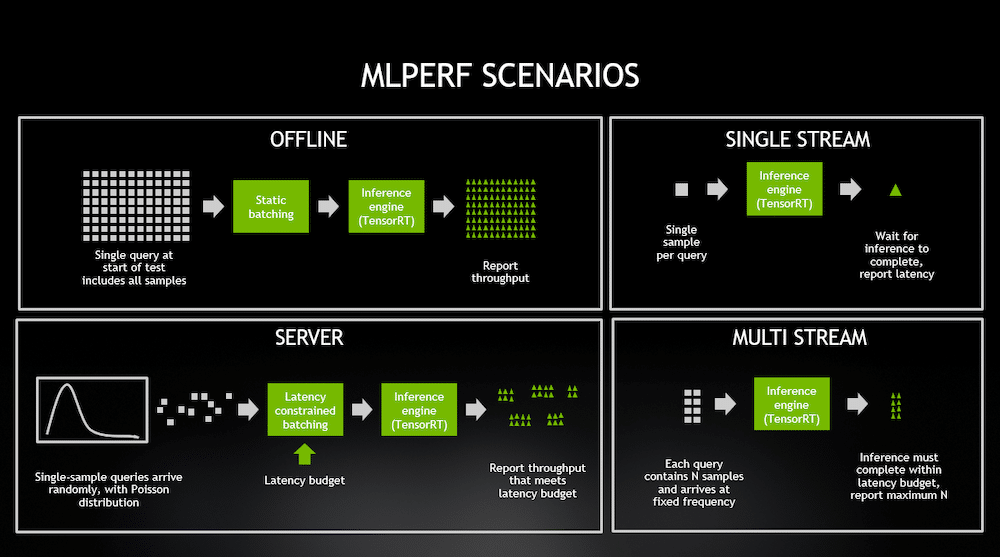
私たちは MLPerf Inference: Edge ベンチマーク スイートを使用して作業しています。このツール セットは、現実世界のさまざまなエッジ シナリオにおける一般的な DL モデルの推論パフォーマンスを比較します。私たちのテストでは、質問応答タスク用の ResNet50 画像分類モデルと BERT-Large NLP モデルの数値が得られました。どちらもオフラインおよびシングルストリーム構成で実行されます。
オフライン シナリオでは、すべてのテスト データがすぐに利用可能であり、待ち時間は考慮されない「バッチ モード」で推論パフォーマンスを評価します。このタスクでは、推論スクリプトはテスト データを任意の順序で処理でき、目標は 1 秒あたりのクエリ数 (QPS=スループット) を最大化することです。 QPS 数値が高いほど優れています。
対照的に、シングル ストリーム構成では、一度に 50 つのテスト サンプルが処理されます。単一の入力 (ResNet90 の場合、入力は単一の画像) で推論が実行されると、レイテンシが測定され、次のサンプルが推論ツールで使用できるようになります。目標は、各クエリを処理する待ち時間を最小限に抑えることです。遅延が短いほど良いです。クエリ ストリームの XNUMX パーセンタイル レイテンシーは、簡潔にするためのターゲット メトリックとしてキャプチャされます。
下の画像は、NVIDIAのブログ記事「MLPerf推論0.5」からのもので、様々なシナリオを非常に分かりやすく視覚化しています。様々なシナリオの詳細については、こちらのMLPerf推論に関する原文をご覧ください。
エッジ推論 – Lenovo ThinkEdge SE450
ThinkEdge SE450のレビュー後、Lenovoと協力して、システム搭載のNVIDIA A2およびT4でMLPerfを実行しました。目的は、SE450が単一のGPUだけでどの程度の性能を発揮できるかを把握することでした。なお、このシステムは低消費電力のNVIDIA GPUを最大4枚までサポートできるため、これらの数値を基に、必要なカード枚数を推測するのは理にかなっています。
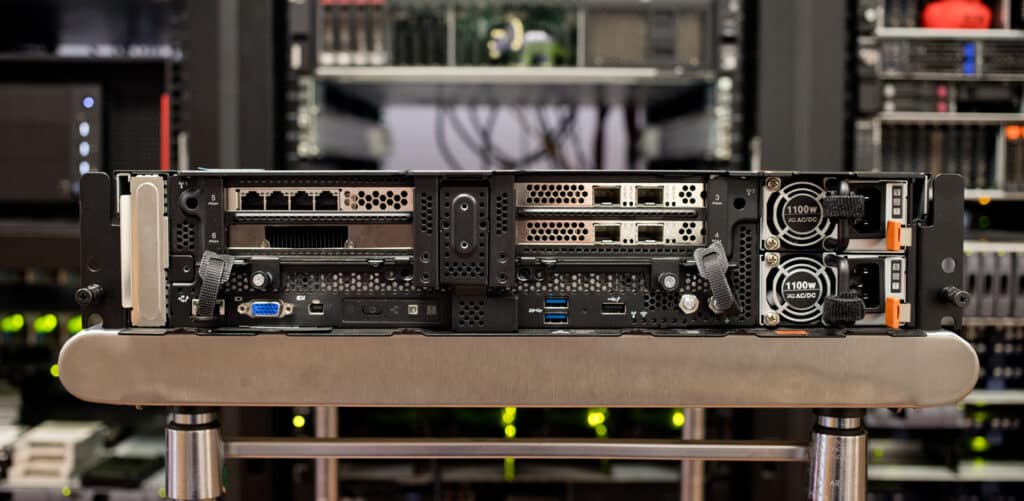
このテストでは、Lenovo と直接協力し、NVIDIA A2 と T4 の両方を使用してラボ内のさまざまな構成をテストしました。 MLPerf を使用すると、ベンダーは特定のプラットフォーム向けに調整された特定のテスト ハーネスを入手できます。これらの人気のある GPU がどこで登場するかを知るために、このエッジ推論ベンチマークに Lenovo のテスト ハーネスを使用しました。
私たちのラボでの SE2 の A4 および T450 のテスト結果は次のとおりです。
| ベンチマーク | NVIDIA A2 (40-60W TDP) | NVIDIA T4 (70W TDP) |
|---|---|---|
| ResNet50 シングルストリーム | 0.714ミリ秒の遅延 | 0.867 レイテンシ |
| ResNet50 オフライン | 3,032.18 サンプル/秒 | 5,576.01 サンプル/秒 |
| BERT シングルストリーム | 8.986ミリ秒の遅延 | 8.527ミリ秒の遅延 |
| BERT オフライン | 244.213 サンプル/秒 | 392.285 サンプル/秒 |
興味深いことに、NVIDIA T4 は全体を通して非常に優れたパフォーマンスを示しましたが、その年齢だけを理由に驚く人もいます。 T4 のパフォーマンス プロファイルは、T4 が依然として絶大な人気を誇る理由として明らかです。そうは言っても、A2 には、リアルタイム画像推論において T4 に比べてレイテンシの面で大きな利点があります。
最終的に、GPU に関する決定は、当面の特定のタスクに合わせて調整されます。古い NVIDIA T4 はより多くの電力 (70 W) を消費し、PCIe Gen3 x16 スロットを使用しますが、新しい A2 はより少ない電力 (40 ~ 60 W) で動作するように設計されており、PCIe Gen4 x8 スロットを使用します。組織がエッジのインフラストラクチャに何を求めているかをよりよく把握できるようになると、結果はより意味のあるものになり、エッジ推論プロジェクトが成功する可能性が高くなります。
最終的な考え
ベンダーはエッジ市場向けに、より小さく、より高速で、より堅牢なサーバーの開発を競っています。小売業から工場、医療に至るまでの組織は、ソースで収集されたデータについてより迅速に洞察を得ることを求めています。推論時間の短縮、レイテンシの短縮、パフォーマンスを向上させるオプションの利用、および新しいテクノロジーの利用により、勝者と敗者がすぐに分かれます。
組織が増え続ける IoT デバイスから収集された洞察を活用する新しい方法を模索する中、エッジ市場は立ち止まっていません。私たちのチームは、それぞれの業界で迅速に行動できる企業にとって、このエッジ推論のユースケースを含むエッジで AI を活用する大きなチャンスがあると考えています。
今後1年間で、主要なITインフラ企業がこの特定のユースケースに対応する革新的なソリューションを提供してくれると期待しています。また、おそらくより重要な点として、こうしたエッジコンピューティングのユースケースにおけるGPUの利用を促進するソフトウェアの進歩が数多く見られると予想しています。この技術が真に革新的なものとなるためには、現状よりも導入が容易でなければなりません。NVIDIAだけでなく、Vantiq、Viso.aiをはじめとする多くのソフトウェア企業が取り組んでいることを考えると、より多くの組織がこの技術を実用化できると楽観視しています。



 Amazon