

グラフィックス処理ユニット(GPU)の分野は、過去20年間で劇的な変化を遂げてきました。特に近年では、AIの台頭によりその変化は顕著です。この進化の大きな要因の一つは、複数のGPUを連携させて動作させる技術の開発です。GPU分野の先駆者であるNVIDIAは、Scalable Link Interface(SLI)とNVIDIA NVLinkという2つの重要な技術で、この革命の最前線に立ってきました。この記事では、SLIからNVLinkへの道のりをたどり、NVIDIAが絶えず変化するコンピューティングのニーズにどのように対応しているかを解説します。
SLIの夜明け
NVIDIA は 2000 年代初頭に SLI を導入しました。これはもともと Voodoo3 カード シリーズ用に 2dfx によって開発されたもので、ビデオ ゲームやコンシューマー アプリケーションにおけるより高いグラフィック忠実度に対する NVIDIA の答えでした。 SLI の中核では、代替フレーム レンダリング (AFR) として知られる技術を使用して、レンダリング ワークロードを複数の GPU に分割します。各カードは XNUMX フレームおき、または各フレームの一部を描画するため、グラフィックス処理能力が効果的に XNUMX 倍になります。 SLI は当時革新的でしたが、待ち時間が長くなったり、GPU 間のデータ共有の柔軟性が欠如したりするなどの制限がありました。
SLI 対 CrossFire: マルチ GPU ソリューションにおけるライバル関係
NVIDIAのSLIはマルチGPU構成の先駆けとなったが、競争相手がいなかったわけではない。AMDのCrossFireは直接のライバルであり、マルチGPU構成において同様の機能を提供していた。SLIと同様に、CrossFireもオルタネートフレームレンダリング(AFR)やスプリットフレームレンダリング(SFR)といった技術を用いてグラフィック性能の向上を目指していた。

画像クレジット:ダラス・ムーア
ただし、CrossFire には独自の利点と課題がありました。一般に、使用できる GPU の組み合わせがより柔軟になり、さまざまな AMD カードの組み合わせが可能になりました。マイナス面としては、CrossFire はそのソフトウェア スタックについてしばしば批判され、一部のユーザーは NVIDIA の SLI よりも信頼性が低く、構成が複雑であると感じました。これらの違いにもかかわらず、両方のテクノロジーは、ゲームと消費者のグラフィック エクスペリエンスを向上させるという同じ目標を目指していました。より高度なデータ集約型タスクの処理には限界があるため、最終的には NVLink のような次世代ソリューションへの道が開かれることになります。
2010 年代に入ると、コンピューティングを取り巻く環境は劇的に変化し始めました。人工知能 (AI)、ハイパフォーマンス コンピューティング (HPC)、ビッグ データ分析の台頭により、より堅牢なマルチ GPU ソリューションが必要になりました。 SLI は、当初ゲームやコンシューマーのワークロードを念頭に置いて設計されましたが、これらの計算集約型タスクには不十分であることが明らかになりました。 NVIDIA には新しいパラダイムが必要でした。
デュアル GPU カードの時代: マルチ GPU コンピューティングへの独自のアプローチ
SLI や CrossFire などのテクノロジーは複数の個別 GPU の接続に焦点を当てていましたが、マルチ GPU 構成に対するあまり一般的ではない別のアプローチ、つまりデュアル GPU カードがありました。これらの特殊なグラフィックス カードは、単一の PCB (プリント回路基板) 上に 690 つの GPU コアを搭載しており、単一のカード上で SLI または CrossFire セットアップとして効果的に機能します。 NVIDIA GeForce GTX 6990 や AMD Radeon HD XNUMX などのカードは、このアプローチの一般的な例です。
デュアル GPU カードにはいくつかの利点があります。 2 つの GPU を 1 つのカード スロットに凝縮することでスペースを節約し、小型フォーム ファクター PC にとって魅力的なものにしました。また、別個のカードを外部コネクタにリンクする必要がなくなり、セットアップが簡素化されました。ただし、これらのカードにも問題がなかったわけではありません。熱放散は重大な問題であり、多くの場合、高度な冷却ソリューションが必要でした。消費電力も高く、システムを安定させるために強力な電源が必要でした。
興味深いことに、デュアル GPU カードは、マルチ GPU セットアップの生のパワーと 1 枚のカードのシンプルさを組み合わせた、一種の「両方の長所」ソリューションでした。しかし、それらはコストが高く、それに伴う技術的な課題があるため、ニッチな製品とみなされがちでした。 NVLink などのマルチ GPU テクノロジが進化して、より高い帯域幅とより低いレイテンシーを提供するようになったことで、デュアル GPU カードの必要性が減少しました。それでも、それらは GPU 開発の歴史における魅力的な一章であり続けています。
NVIDIA の Tesla GPU シリーズは、エンタープライズ レベルのコンピューティング、特にデータ センターやハイ パフォーマンス コンピューティング クラスターの基盤でした。ほとんどの Tesla GPU は最大のパフォーマンスと効率を実現するように設計されたシングル GPU カードですが、Tesla K80 のように XNUMX 枚のカードにデュアル GPU を搭載した例外もあります。これらのマルチ GPU Tesla カードは、高度な並列計算用に最適化されており、科学研究、機械学習、ビッグ データ分析の定番となっていました。これらのアプリケーションは、これらのアプリケーション特有の要求を満たすように設計されており、高い計算スループット、大容量のメモリ、誤り訂正符号 (ECC) メモリなどの高度な機能を提供します。シングル GPU の同等品ほど一般的ではありませんが、これらのデュアル GPU Tesla カードは、エンタープライズ コンピューティングにおいて、ニッチではあるものの強力なソリューションを提供しました。
NVLinkの登場
2017 年に NVIDIA の Volta アーキテクチャで導入された NVLink が登場します。このテクノロジは単なるアップグレードではなく、GPU の相互接続方法を根本的に再考しました。 NVLink は、大幅に高い帯域幅 (最新バージョンでは最大 900 GB/秒)、低いレイテンシ、および GPU 間のより複雑で多数の相互接続を可能にするメッシュ トポロジを提供しました。さらに、NVLink はユニファイド メモリの概念を導入し、接続された GPU 間のメモリ プーリングを可能にし、大規模なデータセットを必要とするタスクに重要な機能を提供します。
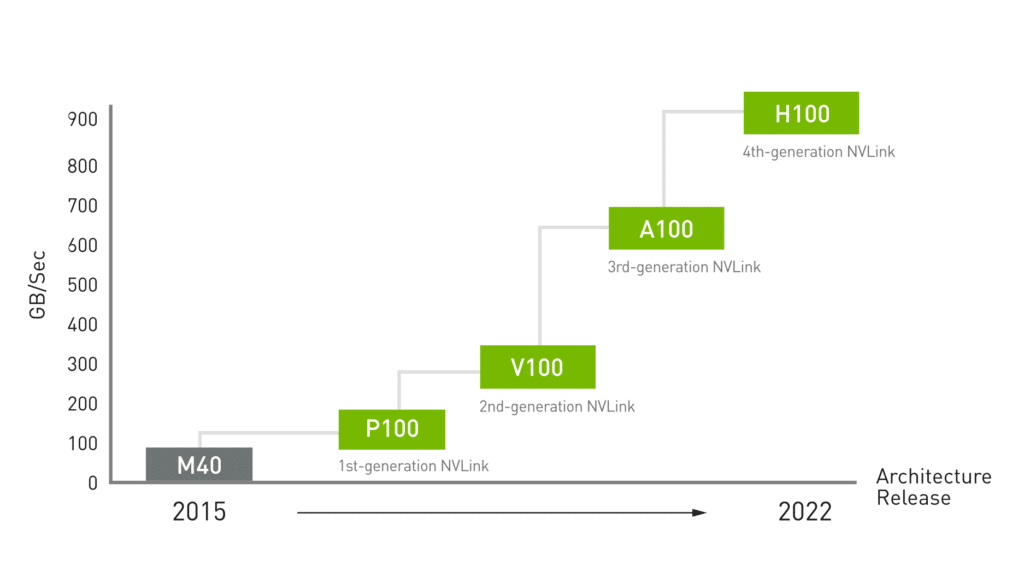
NVLink パフォーマンスの進化
SLI と NVLink の比較
一見すると、NVLink を「強化された SLI」と考える人もいるかもしれませんが、それは単純化しすぎです。どちらのテクノロジーも複数の GPU をリンクすることを目的としていますが、NVLink は異なるユーザーを念頭に置いて設計されています。これは、科学研究、データ分析、そして最も注目すべき AI および機械学習アプリケーション向けに作成されています。 NVLink は、より高い帯域幅、より低いレイテンシー、統合メモリにより、今日の計算上の課題に対するはるかに柔軟で強力なソリューションになります。
NVLink の技術的バックボーン
NVLink は、速度だけでなくアーキテクチャ設計においても、マルチ GPU インターコネクト テクノロジの論理的な進化を表しています。 NVLink のファブリックは、データを双方向に転送できる高速データ レーンで構成されています。従来のバスベースのシステムとは異なり、NVLink はポイントツーポイント接続を使用するため、ボトルネックが効果的に軽減され、データ スループットが向上します。最新のイテレーションでは最大 900 GB/秒の帯域幅が提供され、SLI の機能が大幅に強化されています。
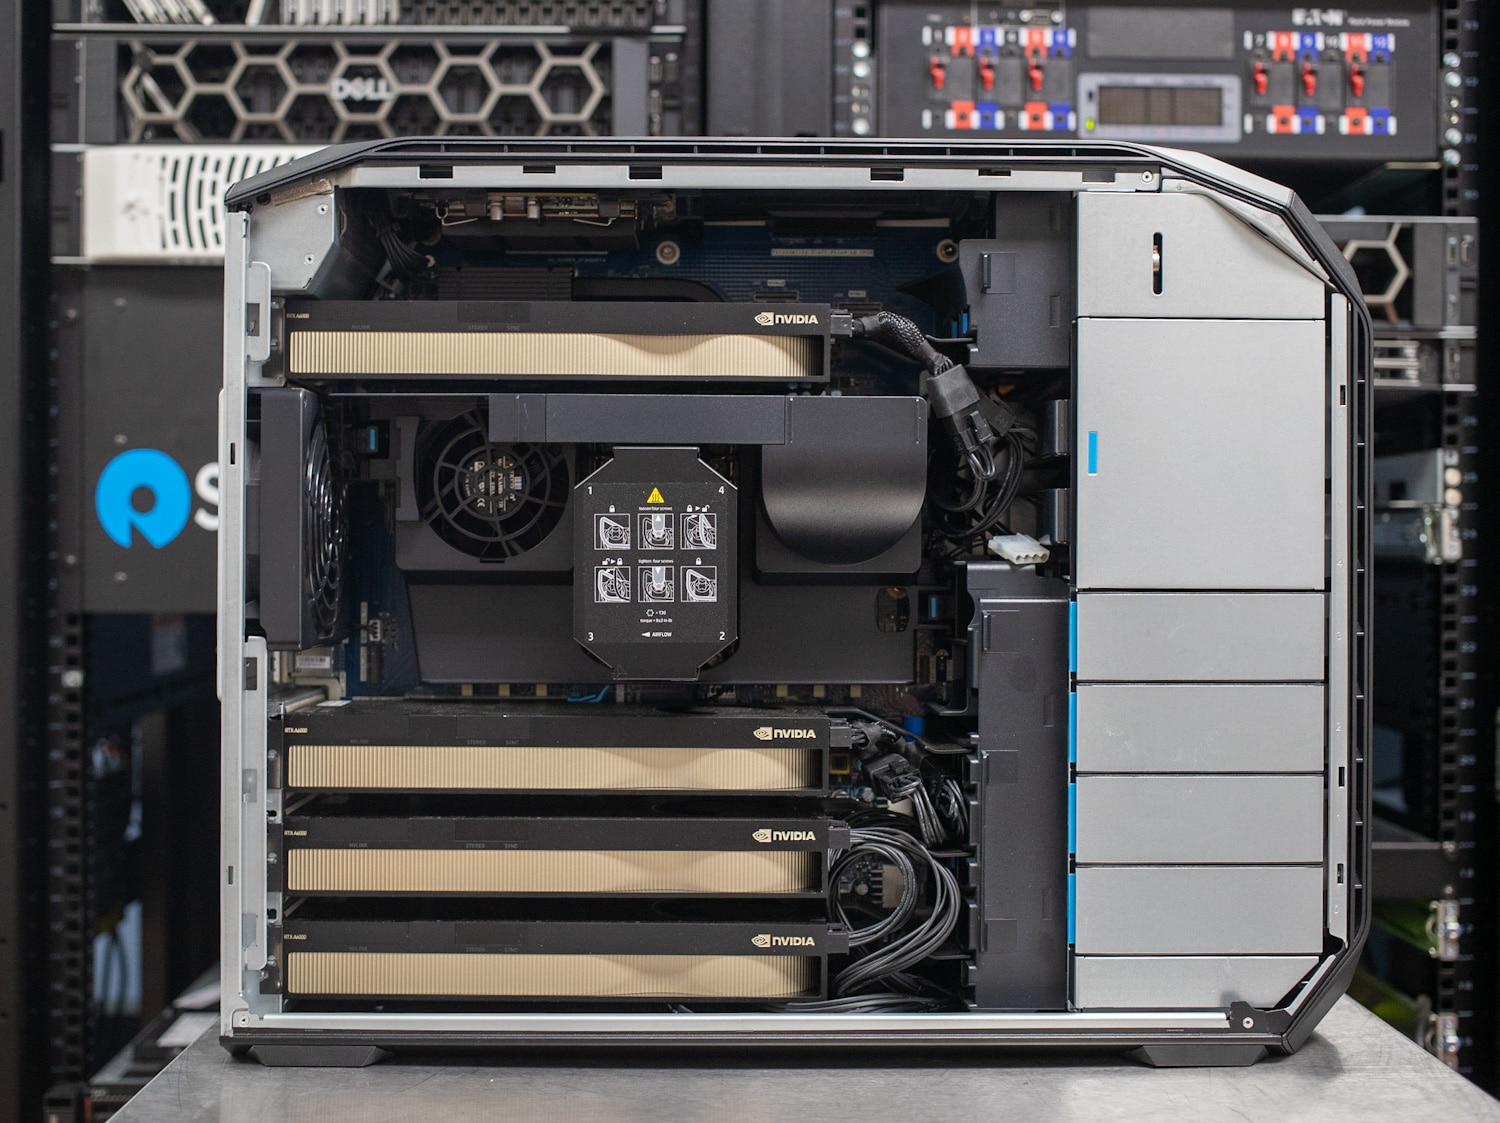
8x A5 GPU を搭載した HP Z4 Fury G6000
NVLink を際立たせる重要な機能の 1 つは、メッシュ トポロジをサポートする機能です。古いテクノロジーのデイジーチェーンまたはハブアンドスポーク トポロジとは対照的に、メッシュ セットアップでは、GPU 間のより多用途かつ多数の接続が可能になります。これは、複雑なデータ ルートが標準であるデータ センターやハイ パフォーマンス コンピューティング アプリケーションで特に役立ちます。
ユニファイド メモリは NVLink のもう 1 つの機能です。これにより、GPU が共通のメモリ プールを共有できるようになり、より効率的なデータ共有が可能になり、GPU 間でデータをコピーする必要性が減ります。これは、大規模なデータセットが単一の GPU のメモリ容量を超えることが多い、機械学習やビッグ データ分析などのアプリケーションにとって大幅な強化となります。
NVLink は、ハイ パフォーマンス コンピューティングのセットアップにおいて重要な要素であるレイテンシーも改善します。レイテンシが低いため、GPU 間のデータ転送と同期がより速くなり、より効率的な並列計算が可能になります。これは、NVLink のダイレクト メモリ アクセス (DMA) 機能によって実現され、GPU が CPU を介さずに相互のメモリに直接読み書きできるようになります。
AI と機械学習への影響
現代のコンピューティングにおける AI の重要性が高まっていることを考えると、NVLink の利点は単なる増分ではなく、変革をもたらします。 AI モデルのトレーニングとデータ作成では、NVLink により GPU 間のデータ転送が高速化され、より効率的な並列処理が可能になります。これは、AI モデルのトレーニング データ作成という新興分野と密接に連携するテーマである大規模なトレーニング データセットを扱う場合に特に有益です。
量子シミュレーション、リアルタイム分析、次世代 AI アルゴリズムなどの高度なコンピューティングの需要が高まるにつれ、NVLink の機能がさらに強化されることが期待されます。帯域幅の増加であれ、GPU 間の連携をさらに強化する新機能であれ、NVLink またはその後継は間違いなく、将来の計算ニーズを満たすための中心であり続けるでしょう。
SLI から NVLink への移行は、マルチ GPU テクノロジにとって重要なマイルストーンとなります。これは、イノベーションに対する NVIDIA の取り組みと、変化するコンピューティング環境に対する鋭い理解を反映しています。ゲームから AI、コンシューマ アプリケーションからデータ センターに至るまで、ゲームと SLI における NVLink のルーツは、必要性がどのようにイノベーションを生み出し、終わりのない改善サイクルでテクノロジーを前進させるかを示しています。


 Amazon