

L40Sは、データセンターGPUエコシステムにおける重要なギャップを埋めます。NVIDIA H100のようなコンピューティング重視のAIトレーニングGPUは、純粋なパフォーマンスを重視し、グラフィックスアクセラレーションを完全に省略しています。一方、従来のプロフェッショナル向けビジュアライゼーションカードは、現代の推論ワークロードや新興のAI駆動型グラフィックスアプリケーションに求められるAIコンピューティング能力を欠いているのが一般的です。このポジショニングにより、LXNUMXSは、コンピューティングとグラフィックスの両方の性能が不可欠な合成データ生成、マルチモーダルAI開発、そしてOmniverseアプリケーションにおいて特に価値を発揮します。
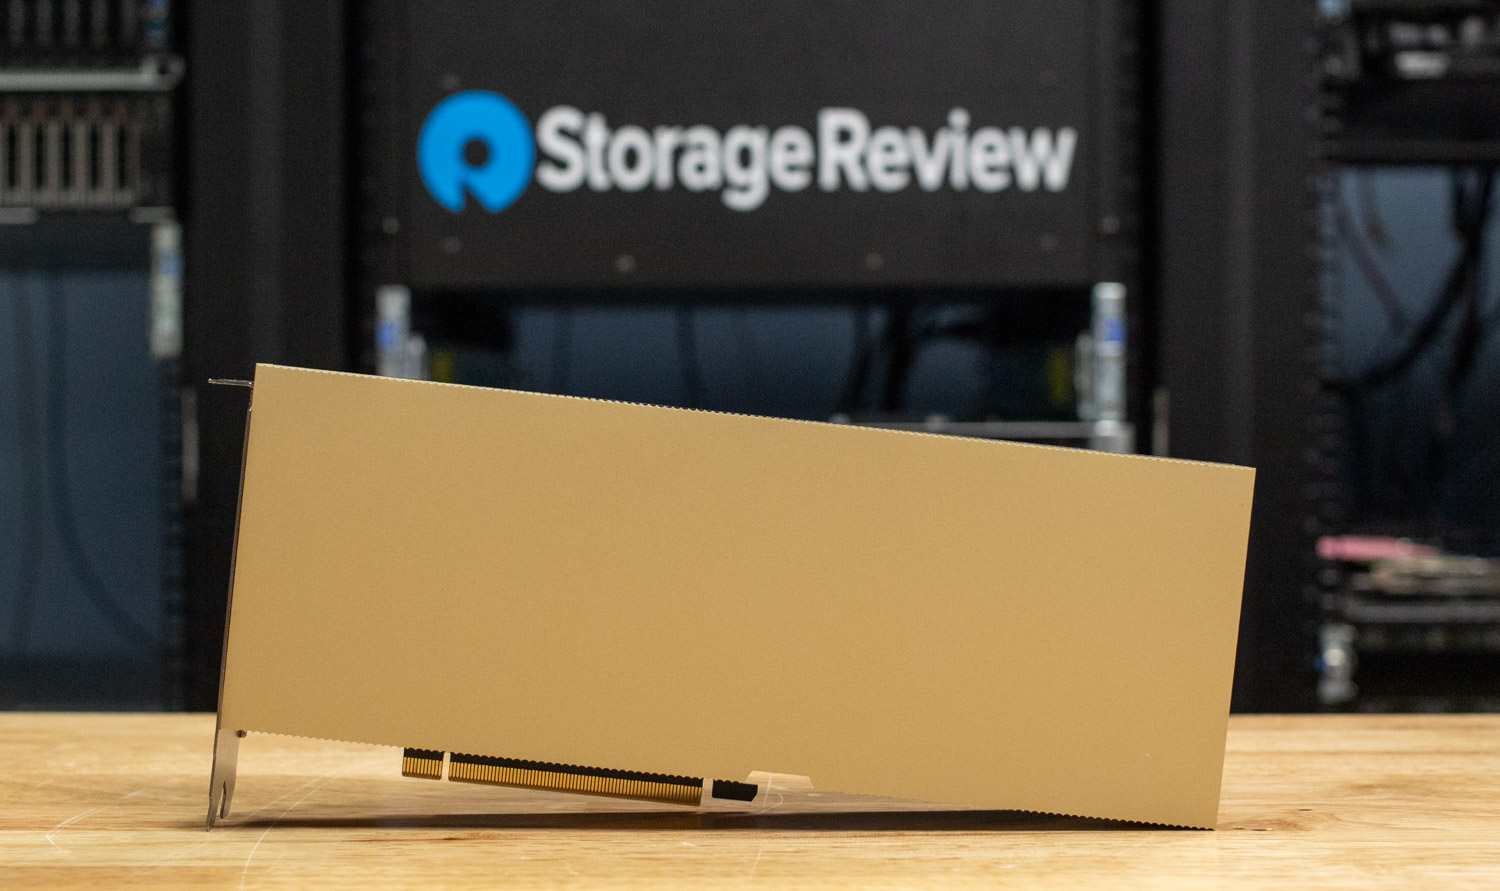
NVIDIA L40S 仕様
| 製品仕様 | L40 | L40S | H100 80G PCIe |
| GPUアーキテクチャ | エイダラヴェレス | エイダラヴェレス | ホッパー |
| GPUダイ | AD102 | AD102 | GH100 |
| CUDAコア | 18,176 | 18,176 | 14,592 |
| テンソルコア | 568(第4世代) | 568(第4世代) | 456 |
| RTコア | 142(第3世代) | 142(第3世代) | – |
| GPUメモリ | ECC付き48GB GDDR6 | ECC付き48GB GDDR6 | 80GBHBM2e |
| メモリ帯域幅 | 864 GB / sの | 864 GB / sの | 2 TB /秒 |
| メモリインターフェイス | 384ビット | 384ビット | 5120ビット |
| 最大電力消費量 | 300W | 350W | 350W |
| フォームファクター | 高さ4.4インチ x 長さ10.5インチ: デュアルスロット | 高さ4.4インチ x 長さ10.5インチ: デュアルスロット | 高さ4.4インチ x 長さ10.5インチ: デュアルスロット |
| 熱ソリューション | パッシブ | パッシブ | パッシブ |
| ディスプレイコネクタ | 4x DisplayPort 1.4a | 4x DisplayPort 1.4a | – |
| PCIeインターフェース | Gen4 x16 | Gen4 x16 | Gen5 x16 |
| 電源コネクタ | 16ピン | 16ピン | 16ピン |
| vGPU サポート | はい | はい | いいえ |
| マルチインスタンス GPU (MiG) | いいえ | いいえ | はい |
| NVLink サポート | いいえ | いいえ | いいえ |
性能仕様
| メトリック | L40パフォーマンス | L40Sパフォーマンス | H100パフォーマンス |
| FP32のパフォーマンス | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| TF32 テンソル コア | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| FP16テンソルコア | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| FP8テンソルコア | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| ピークINT8テンソルTOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026トップス |
| RTコアパフォーマンス | 209 TFLOPS | 212 TFLOPS | – |
(パフォーマンス数値はスパース性あり)
NVIDIA L40SとH100の比較
仕様を詳しく見てみると、NVIDIA L40SとH100の背後にある明確な設計哲学が明らかになります。L40SはAda Lovelaceアーキテクチャを基盤とし、NVIDIAのハイエンドワークステーション向けグラフィックスカードに搭載されているものと同じAD102ダイを採用しています。この伝統により、18,176個という膨大な数のCUDAコアを搭載し、従来のグラフィックスレンダリングや科学計算の基盤となる単精度FP32において優れた性能を発揮します。一方、H100のHopperアーキテクチャとGH100ダイは、AIとHPCワークロードに特化した設計となっています。
最も顕著な差別化要因はコア構成です。L40Sには、第142世代RTコアが568個、第100世代Tensorコアが40個搭載されています。RTコアはレイトレーシングを高速化するための専用ハードウェアで、H100には全く搭載されていません。そのため、L8Sは独自のフォトリアリスティックなレンダリングを実現しています。HXNUMXはTensorコアの数は少ないものの、FPXNUMXなどの新しいAIデータ形式に最適化されており、より高速で先進的であるため、AIの性能において圧倒的な優位性を発揮しています。
このトレードオフはメモリサブシステムにも顕著に表れています。H100は80GBの高価なHBM2eメモリを搭載し、驚異的な2TB/sの帯域幅を実現しています。これは、大規模なAIモデルのトレーニングと推論において、メモリサブシステムへのデータ供給を維持するために不可欠です。一方、L40Sはより一般的な48GBのGDDR6メモリを搭載し、864GB/sの帯域幅を提供しています。H100の半分以下ではありますが、それでも十分な容量であり、大規模な3Dシーン、高解像度テクスチャ、そして推論用の大規模なAIモデルの読み込みには十分です。
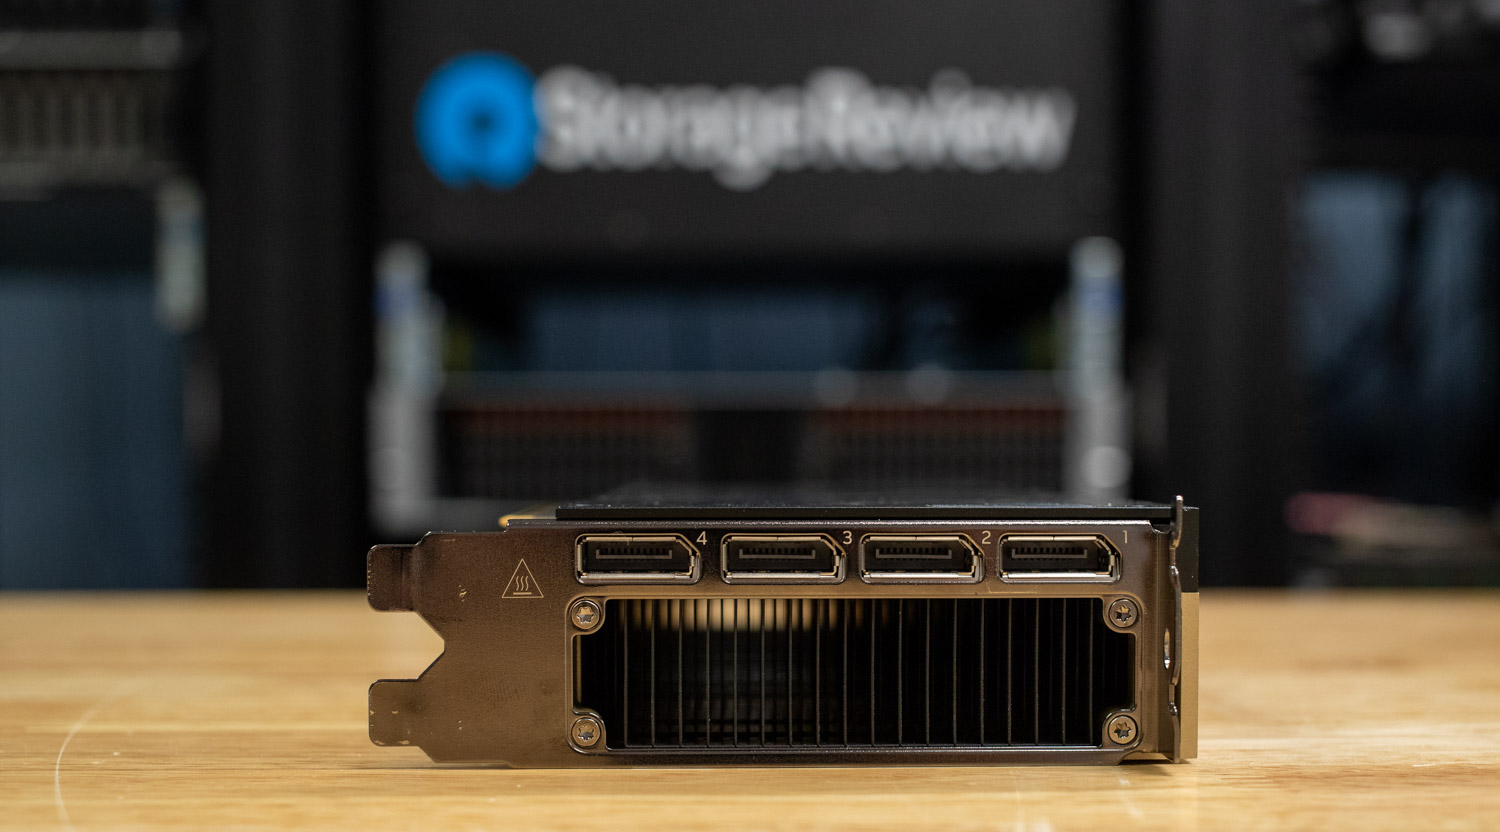
最後に、機能セットはそれぞれの想定される役割を概説しています。L40Sは1.4つのDisplayPort 100a出力と堅牢なvGPUサポートを備えており、仮想ワークステーション、レンダーファーム、クラウドゲーミング環境に最適です。H350はディスプレイ出力やvGPU機能を備えていませんが、代わりにマルチインスタンスGPU(MiG)テクノロジーを搭載しています。これにより、GPUを複数の小規模で独立したインスタンスに分割し、複数の計算負荷の高いワークロードを同時に処理できます。L40SとPCIe H100は、デュアルスロットのパッシブ熱設計とXNUMXWの消費電力エンベロープを共有しており、幅広い業界標準サーバーへの導入柔軟性を実現します。
L40SとNVIDIAのフラッグシップモデルH100を比較すると、それぞれの想定される役割の違いが明らかになります。H100は、この世代のGPUの中で、AIトレーニングにおける純粋なパフォーマンスにおいて紛れもないリーダーですが、この比較は全体像の一部に過ぎません。注目すべきは、L40もNVIDIAのラインナップに含まれており、L300Sの40Wの消費電力に対して350WのTDPで、同等の性能をより低い消費電力で提供している点です。
ここで検証するH100は、HBM80eメモリを搭載したオリジナルの2GB PCIeバージョンです。NVIDIAはその後、H100 NVLなどのバリエーションを追加し、ラインナップを拡大してきました。H80 NVLはオリジナルの94GB PCIeモデルの代替として、400GBのメモリと100Wの高出力TDPを備え、デュアルGPU構成向けにNVLinkサポートを追加しています。H8ファミリーは、200GPU SXM構成にも対応しており、同じGPUダイを共有しながらもPCIeとSXMの両方のフォームファクターで強化されたパフォーマンスを提供する新しいHXNUMXもラインナップされています。
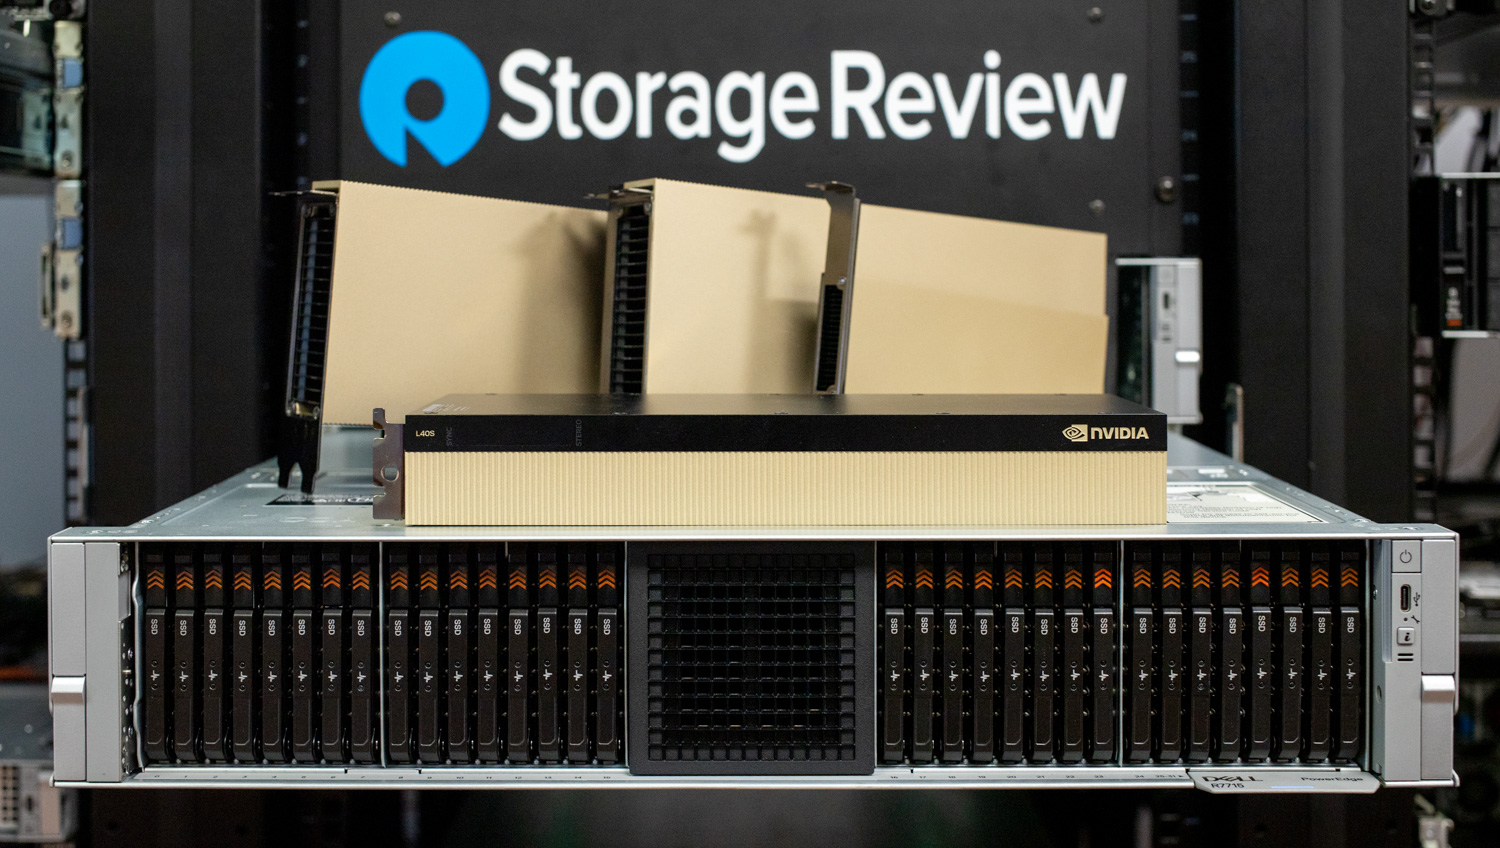
L40SとH100の違いは、データセンターGPU設計における戦略的な相違を浮き彫りにしています。H100は純粋にコンピューティングに特化したカードで、AIおよびハイパフォーマンスコンピューティングのワークロードに特化して最適化されています。最大の計算スループットを最優先とする大規模AIトレーニングをターゲットとしています。HBM2eの広大なメモリ帯域幅から専用のTensorコアに至るまで、設計のあらゆる側面は、最も要求の厳しいニューラルネットワークトレーニングシナリオ向けに設計されています。
対照的に、L40Sは汎用性を重視して設計されたユニバーサルGPUであり、AI推論に加え、グラフィックスを多用するワークロードやNVIDIA vGPUの導入にも対応しています。AI推論において優れたコスト効率のソリューションとして機能する一方で、真の強みは、H100では対応していない多様なグラフィックスを多用するアプリケーションをサポートしていることにあります。
グラフィックスを多用するワークロードとプロフェッショナルアプリケーション
L40Sは、計算能力と高度なレンダリング機能の両方を必要とする、グラフィックスを多用する多くの領域で優れた性能を発揮します。3Dレンダリングやアニメーションの分野では、スタジオは複雑なシーンのレンダリングにL40Sを活用しています。RTコアは、演算処理のみのGPUでは不可能だったレイトレーシング計算を高速化します。映画・テレビ制作会社は、これらの機能をリアルタイムのプリビズに活用し、監督や撮影監督が撮影中にCGIシーンのフォトリアリスティックなレンダリングを確認できるようにすることで、ポストプロダクションの時間とコストを大幅に削減します。
建築・エンジニアリング会社は、L40Sをリアルタイムの建築ビジュアライゼーションと製品設計に活用しています。クライアントは、実際の建設工事が始まる前に、フォトリアリスティックな建物のレンダリング画像をウォークスルーしたり、詳細な製品プロトタイプを検証したりできます。このカードのプロフェッショナル向けグラフィックス機能は、複雑なシミュレーションに必要な計算能力と、スムーズで高忠実度のビューポートパフォーマンスを実現するグラフィックスアクセラレーションの両方を必要とするCADワークステーションにも最適です。
メディア&エンターテインメント分野では、L40Sは最終品質のアニメーションフレームを処理するレンダリングファームを支えています。同時に、vGPU機能により、アーティストが強力なグラフィックワークステーションにリモートアクセスできるクラウドベースのクリエイティブワークフローを実現します。ビデオ編集およびポストプロダクション施設では、グラフィックスアクセラレーションと膨大な計算リソースの両方を必要とするリアルタイムエフェクト処理、カラーグレーディング、合成ワークフローにL40Sが使用されています。
仮想デスクトップインフラストラクチャ(VDI)市場は、L40SのvGPUテクノロジーを活用した、もう一つの重要なアプリケーション領域です。この分野では、複数のユーザーがGPUリソースを共有し、グラフィックスアクセラレーション機能を備えた仮想デスクトップを実現できます。これにより、エンタープライズ環境において、各ユーザーに個別のGPUを用意することなく、プロフェッショナルなグラフィックス機能を利用できるようになります。
物理学に基づくAIトレーニングへの進化
さらに重要なのは、L40SがH100に完全に欠けている機能を提供していることです。重要な差別化要因は、L40Sが142個の第100世代RTコアを搭載していることです。これにより、リアルタイム・レイトレーシングとフォトリアリスティック・レンダリングが可能になります。H40にはRTコアが搭載されておらず、グラフィックス・アクセラレーションは実行できませんが、LXNUMXSのRTコアは、AIコンピューティングと高度なグラフィックスの両方を必要とするアプリケーションに最適です。
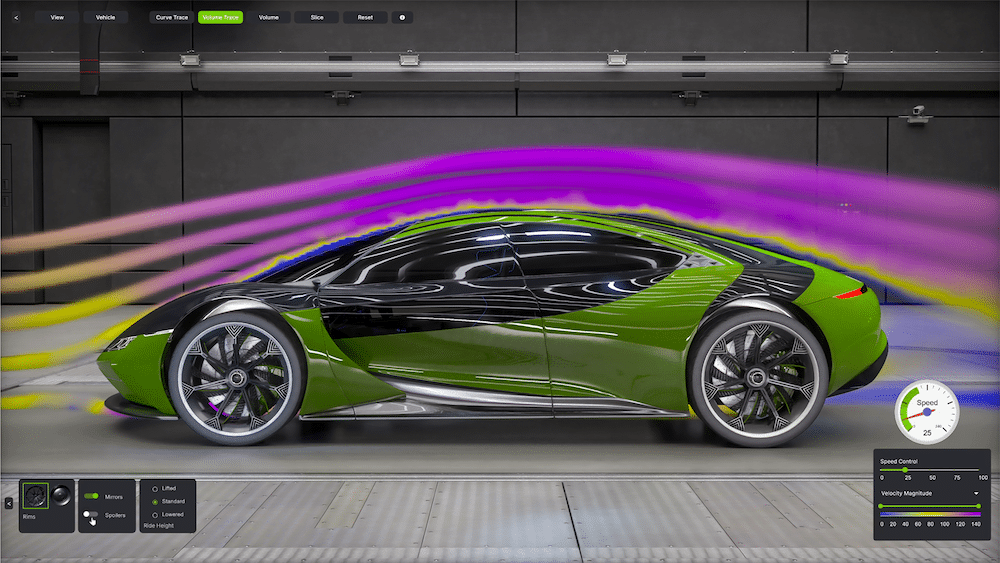
出典: Nvidia
AI生成3Dモデリング、デジタルツインシミュレーション、そしてUniversal Scene Description(OpenUSD)ワークフローの普及に伴い、この区別はますます重要になっています。人工知能の次のフロンティアは、より大規模な言語モデルの学習だけではありません。物理特性、空間関係、そして現実世界の相互作用を理解する世界モデルの開発です。この進化は、学習データ生成へのアプローチを根本的に転換することを必要とします。
従来のAIモデルのトレーニングはNVIDIAの主力コンピューティングGPUに大きく依存していますが、次世代の物理的に根拠のある世界モデルのトレーニングには異なるアプローチが必要です。これらの高度なAIシステムには、視覚情報だけでなく、物理的特性、照明の挙動、材質の相互作用、空間関係など、様々な要素を捉えた膨大なトレーニングデータが必要です。L40SのようなGPUは、大規模なトレーニングデータ生成に不可欠であり、RTコアは、より高度なAIモデルのトレーニングの基盤となる、物理的に正確な合成環境の構築を可能にします。
専用の RT コアによって実現される高度なグラフィック レンダリング機能こそが、L40S を NVIDIA の Omniverse プラットフォームや物理ベースの AI 開発のより広範なエコシステムにとって理想的なエンジンにしているのです。
オムニバース
Omniverseは、開発者がUniversal Scene Description(OpenUSD)に基づいてアプリケーションやワークフローを構築できるAPI、SDK、およびサービスの開発プラットフォームです。物理的に正確なリアルタイム3D仮想世界を作成し、接続するように設計されています。これは、NVIDIAのRTXテクノロジーを統合し、フォトリアリスティックなレイトレーシングレンダリングを産業およびロボットシミュレーションワークフローに直接組み込むことで実現されます。強力なRTコアを搭載したL40Sは、これらの要求の厳しいRTXレンダリングワークロードを駆動するための不可欠なハードウェアアクセラレーションを提供し、開発者が光、マテリアル、物理現象を驚くほどリアルにシミュレートできるようにします。
Omniverseは単なる可視化ツールにとどまらず、次世代の物理AIを開発するためのプラットフォームです。現実に忠実な仮想世界、つまり「デジタルツイン」を作成することで、開発者は複雑な産業施設のシミュレーション、ロボット群のテスト、そして実世界への導入前に安全な仮想環境での自律走行車の検証を行うことができます。重要なのは、これらの高忠実度シミュレーションが、膨大な量の物理ベースの合成データを生成するための基盤となることです。これは、コンピューティングに特化したGPU上で実行される強力なAIモデルの学習に不可欠なリソースです。
ロボットのための合成操作動作生成
NVIDIA Isaac GR00Tの合成マニピュレーション動作生成ブループリントは、ロボットトレーニングのためのフレームワークを提供し、L40SのRT Core機能によって、最小限の人間のデモンストレーションから大規模なデータセットを作成できることを示しています。このワークフローは、ロボット開発における主要な課題の1つである、ロボットマニピュレーションタスクに必要な高品質のトレーニングデータを収集するための時間とコストのかかるプロセスに対処します。
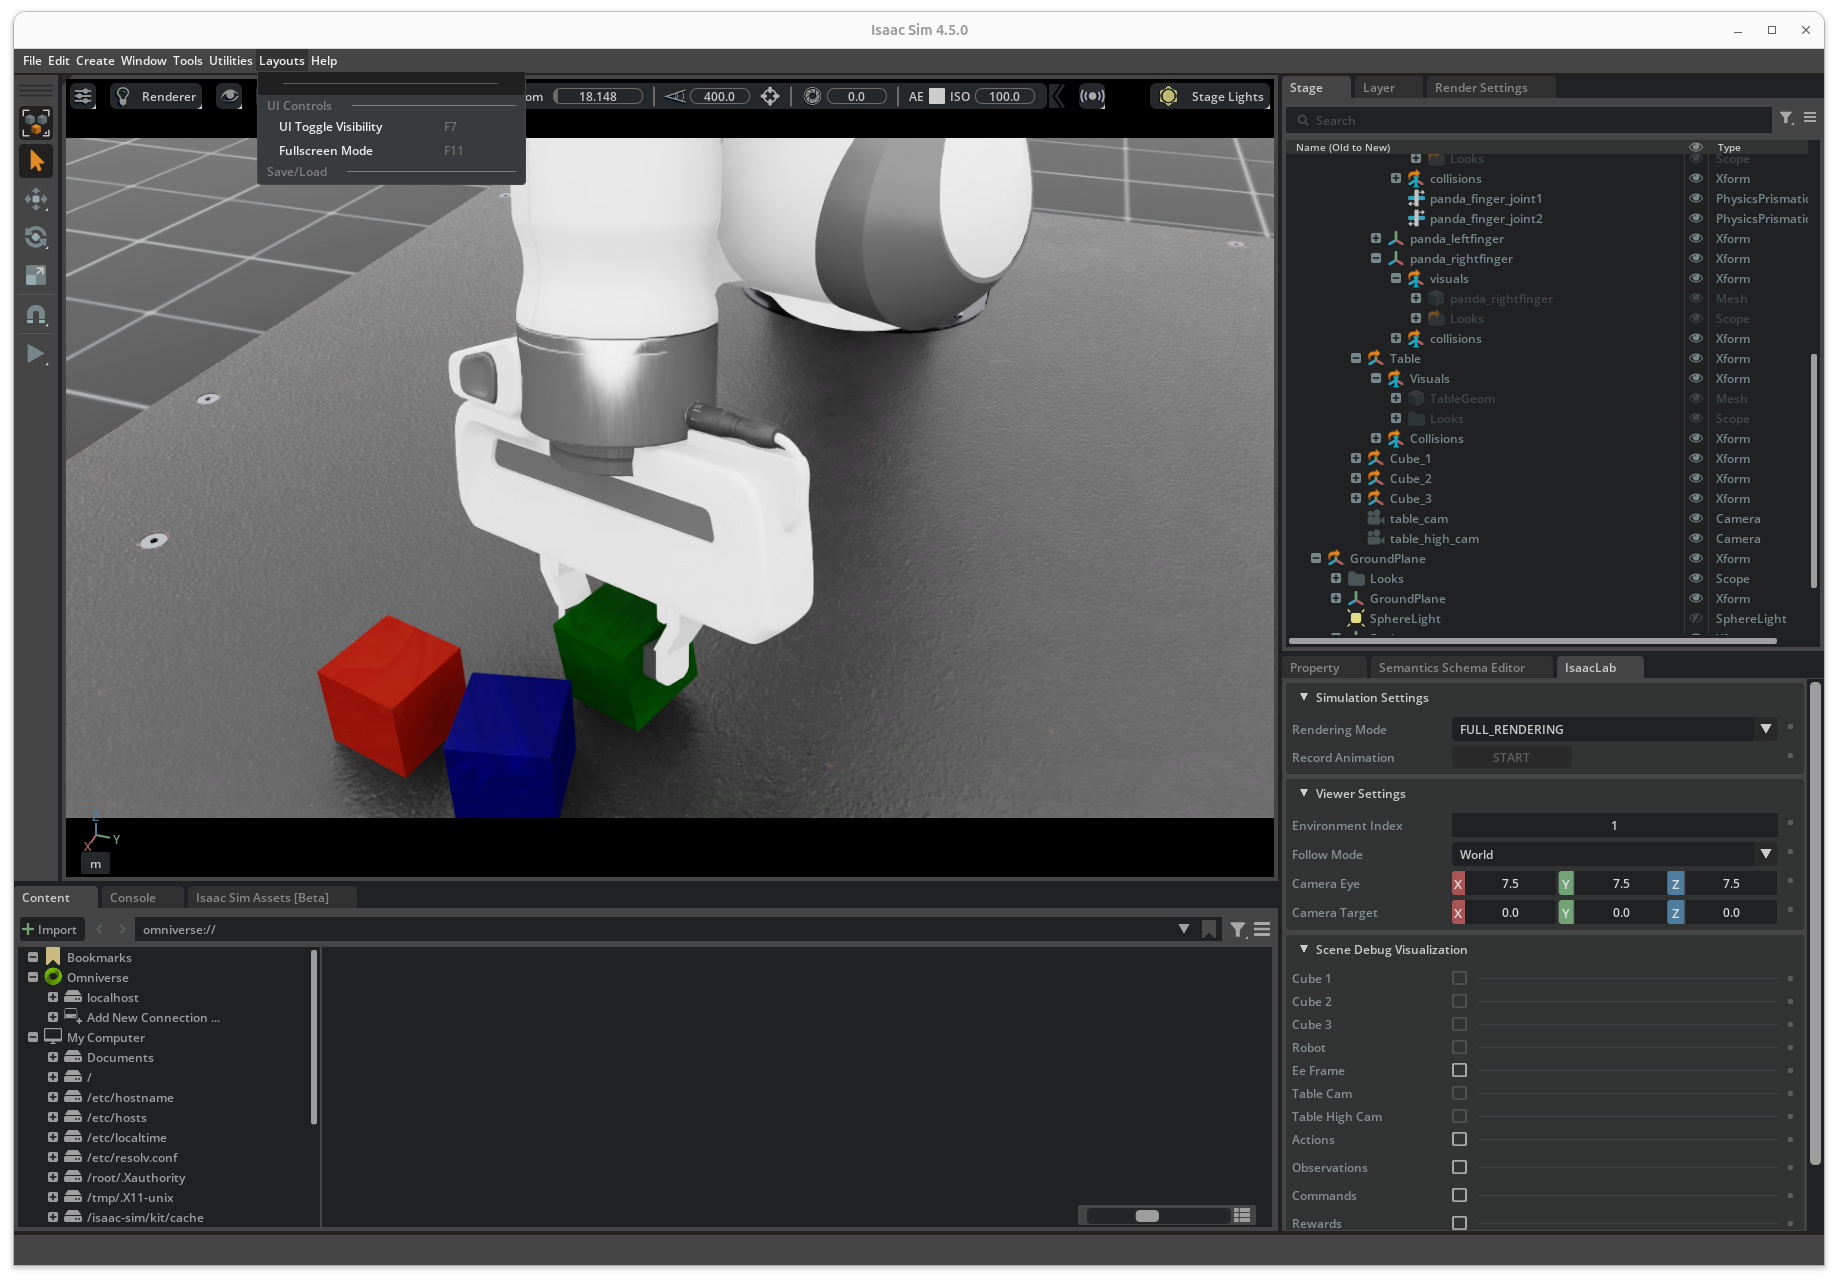
従来のロボット工学のトレーニングは、教師あり学習や模倣学習に大きく依存しており、ロボットは熟練した人間のデモンストレーションを観察し模倣することで新しいスキルを習得します。しかし、完璧なデモンストレーションを作成することは困難であり、実世界で広範かつ高品質なデータセットを収集することは、手間と時間と費用がかかる作業です。適切に訓練された人間のオペレーターが1つの高品質なデモンストレーションを記録するのには通常約1分かかりますが、これは膨大な人的労力と潜在的なエラーのためにスケールアップが困難です。
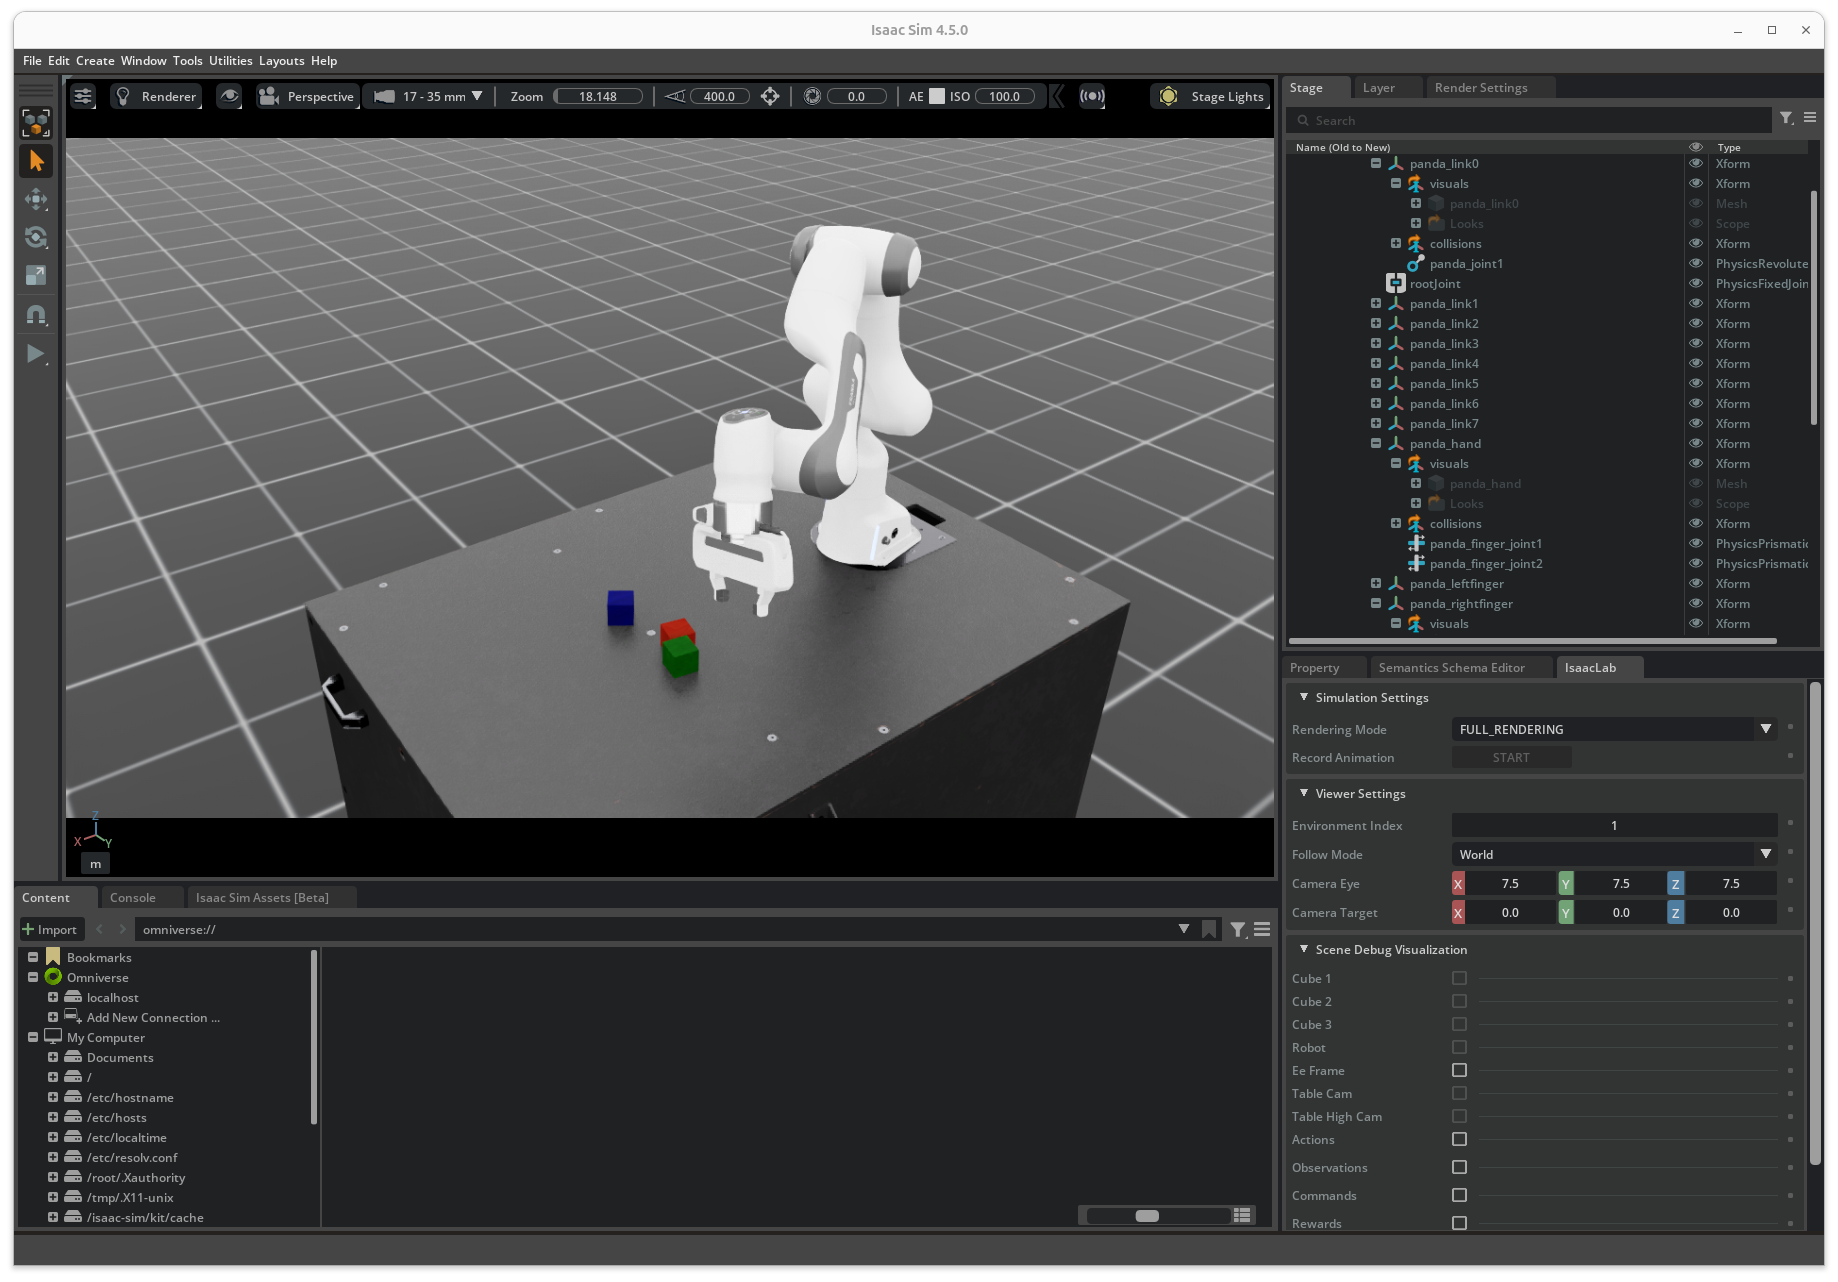
Isaac GR00Tのブループリントは、物理的に正確なシミュレーションから生成された合成データを活用してデータ収集プロセスを加速することで、この課題に対処します。組織は、わずか数時間の人間によるデモンストレーションから、飛躍的に多くのデータを収集できます。
Isaac GR00Tの設計図は、包括的な合成データ生成パイプラインを構築するために連携して動作する3つの主要コンポーネントで構成されています。
- GR00T-テレオプ Apple Vision Proなどの空間コンピューティングデバイスを用いて、熟練した人間のオペレーターが仮想ロボットを操作できるようになります。このシステムにより、オペレーターはフォトリアリスティックな仮想環境で複雑な操作タスクをデモンストレーションすることができ、動作軌跡だけでなく、環境コンテキストや物体との相互作用も捉えることができます。Apple Vision Proは手の追跡データをIsaac Labにストリーミングし、同時にロボットの周囲の没入型ビューをデバイスにストリーミングすることで、ロボットを直感的かつインタラクティブに操作できるようになります。
- GR00T-ミミック 記録されたデモンストレーションを、高度なシミュレーション技術を用いてより大きな合成データセットに増幅します。このコンポーネントは、記録されたデモンストレーションを入力としてIsaac Labで追加の合成動作軌跡を生成します。これにより、片腕および両手によるヒューマノイドロボットの操作をサポートします。このプロセスでは、デモンストレーションの主要ポイントに注釈を付け、補間を用いて合成軌跡が滑らかで状況に適したものになるようにします。
- GR00T-Gen NVIDIA OmniverseおよびCosmosプラットフォームを活用し、3Dアップスケーリングとドメインランダム化により合成データセットを拡張します。このコンポーネントは、背景、照明、その他のシーン内の変数をランダム化することで、さらなる多様性を実現します。生成された画像はNVIDIA Cosmos Transferを介して拡張され、フォトリアリズムを実現することで、シミュレーションと現実のギャップを埋めるのに役立ちます。
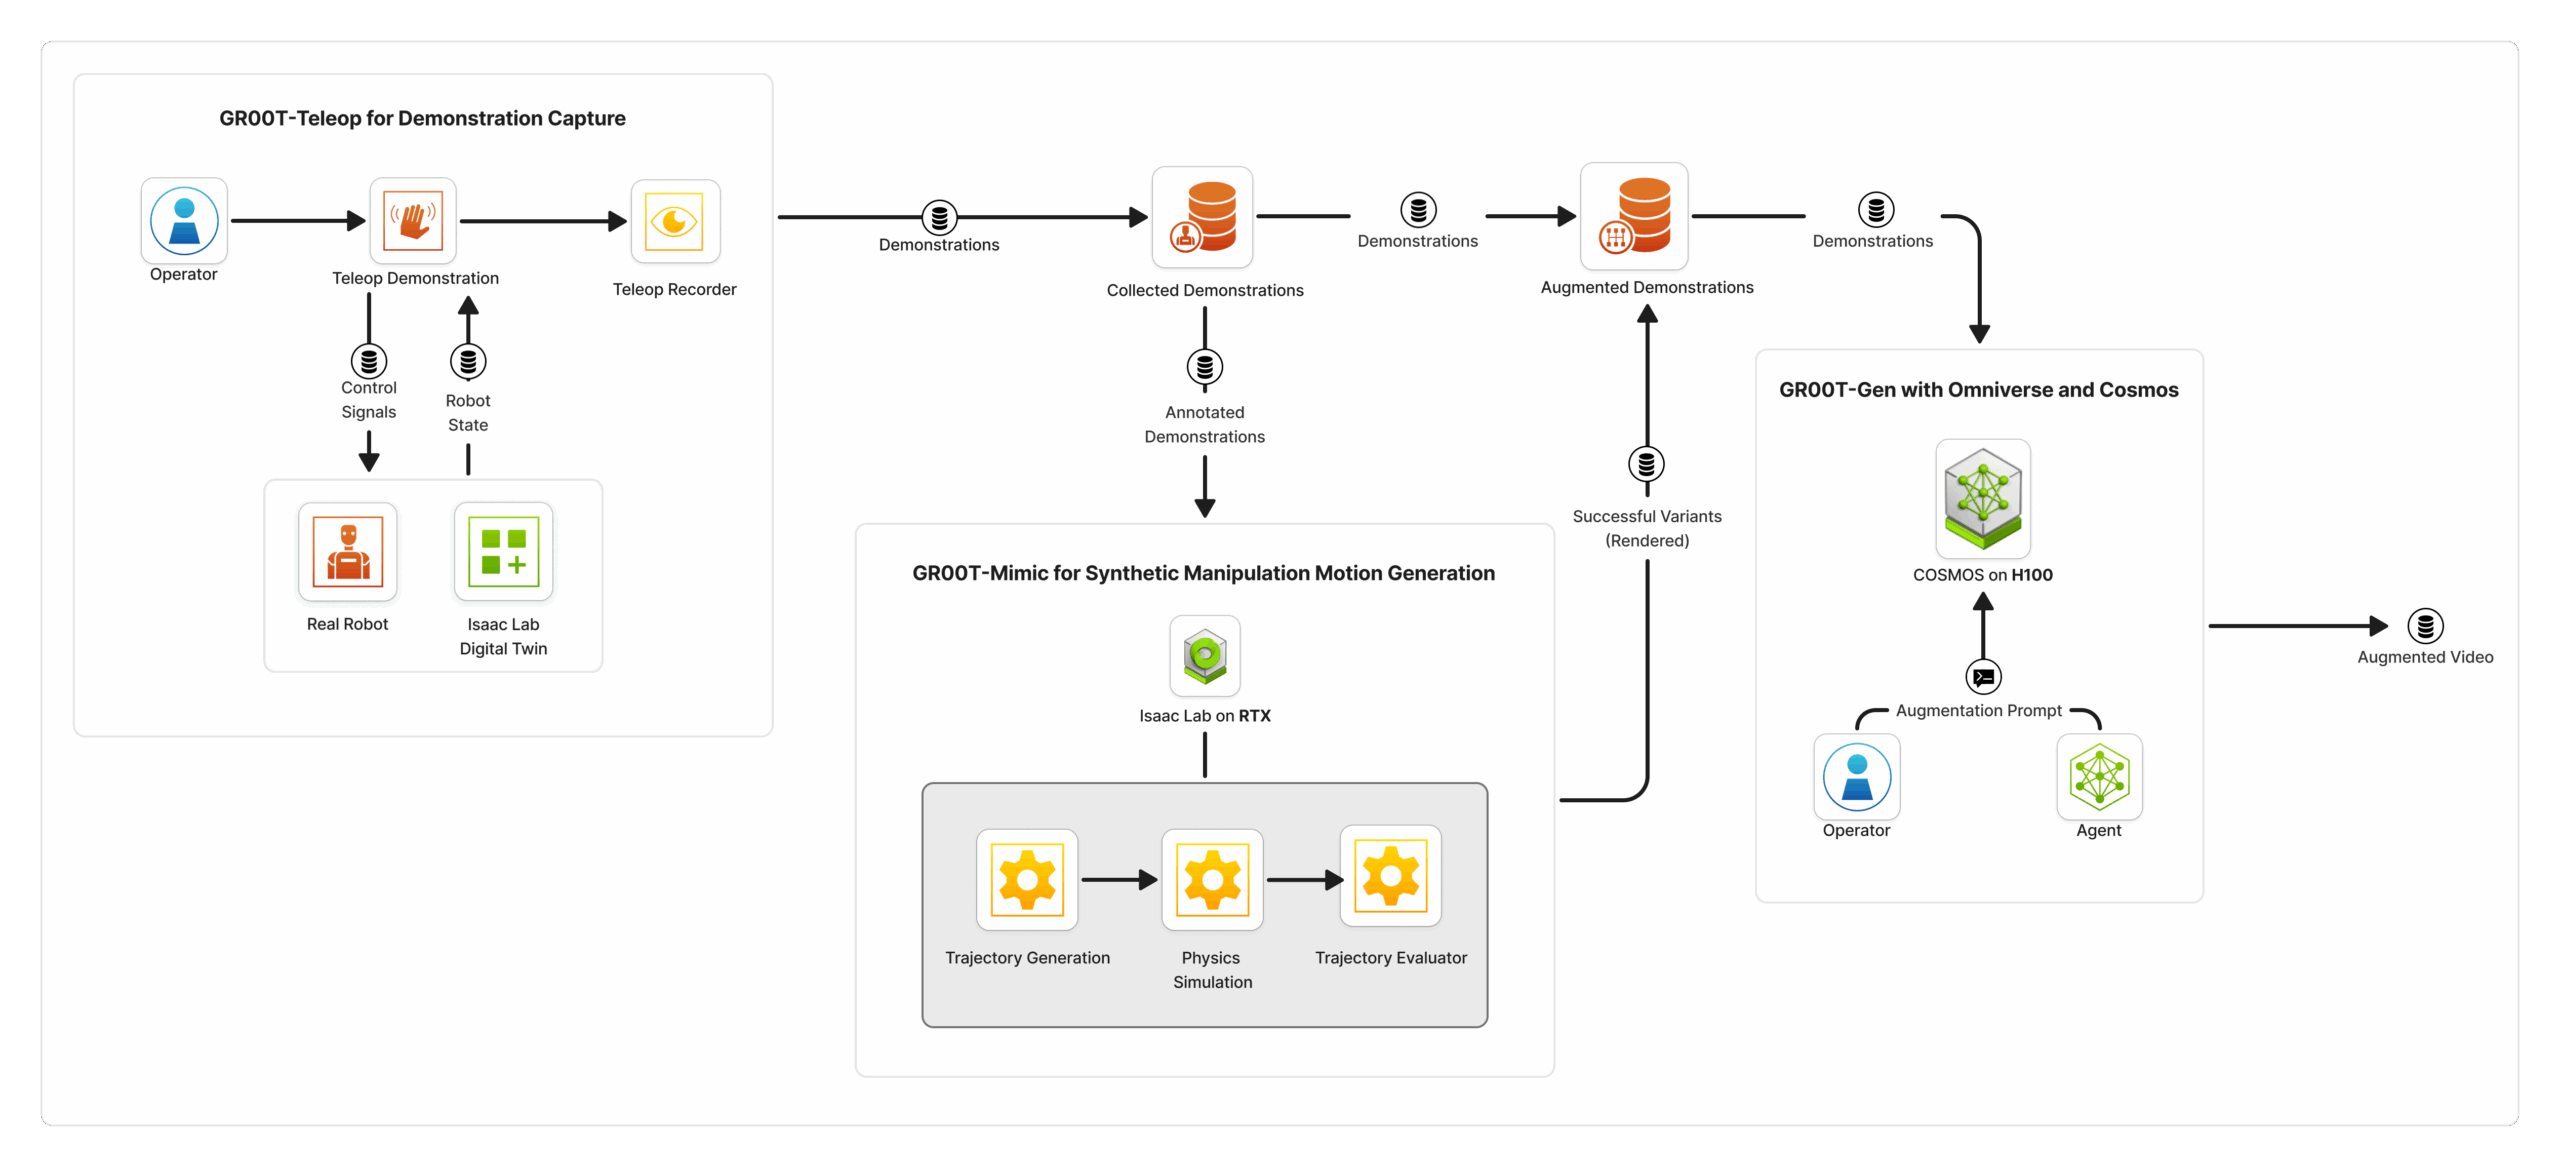
このパイプラインは、現代のデータセンターGPUの専門的かつ補完的な役割を完璧に体現しています。専用のRTコアを搭載したL40Sは、ワールドビルダーとして機能します。データ生成の初期段階に不可欠な存在であり、フォトリアリスティックで多様な仮想環境を構築するために必要な物理ベースレンダリング、リアルタイムレイトレーシング、そしてドメインランダム化を処理します。
この高精細な仮想世界は、次の生成段階のキャンバスとなります。NVIDIA Cosmosなどの生成型AIモデルは、H100のような演算処理に特化したGPU上で実行され、最終的なトレーニングデータが生成されます。H100は、L40Sによって構築されたリアルな環境を活用し、数百万もの動的で物理法則に基づいたシナリオを生成します。
AI推論パフォーマンスベンチマーク
L40Sのようなカードが人気を集めるもう一つのユースケースは、コスト効率の高い推論です。L40Sの実世界におけるAI推論能力をH100と比較して評価するため、NvidiaのOpen Reasoning Nemotron 14BパラメータモデルをBF16、最大トークン長32Kで実行し、vLLMを用いてLLMパフォーマンスをベンチマークしました。
vLLMベンチマーク結果
H100はL4.2Sと比較して約40倍のスループットを実現し、パフォーマンスにおいて明確なリーダーシップを発揮しています。この優位性は、H100のTensorコア性能が2倍に向上し、メモリ帯域幅も864倍以上(XNUMXTB/秒 vs. XNUMXGB/秒)に大きく貢献しています。
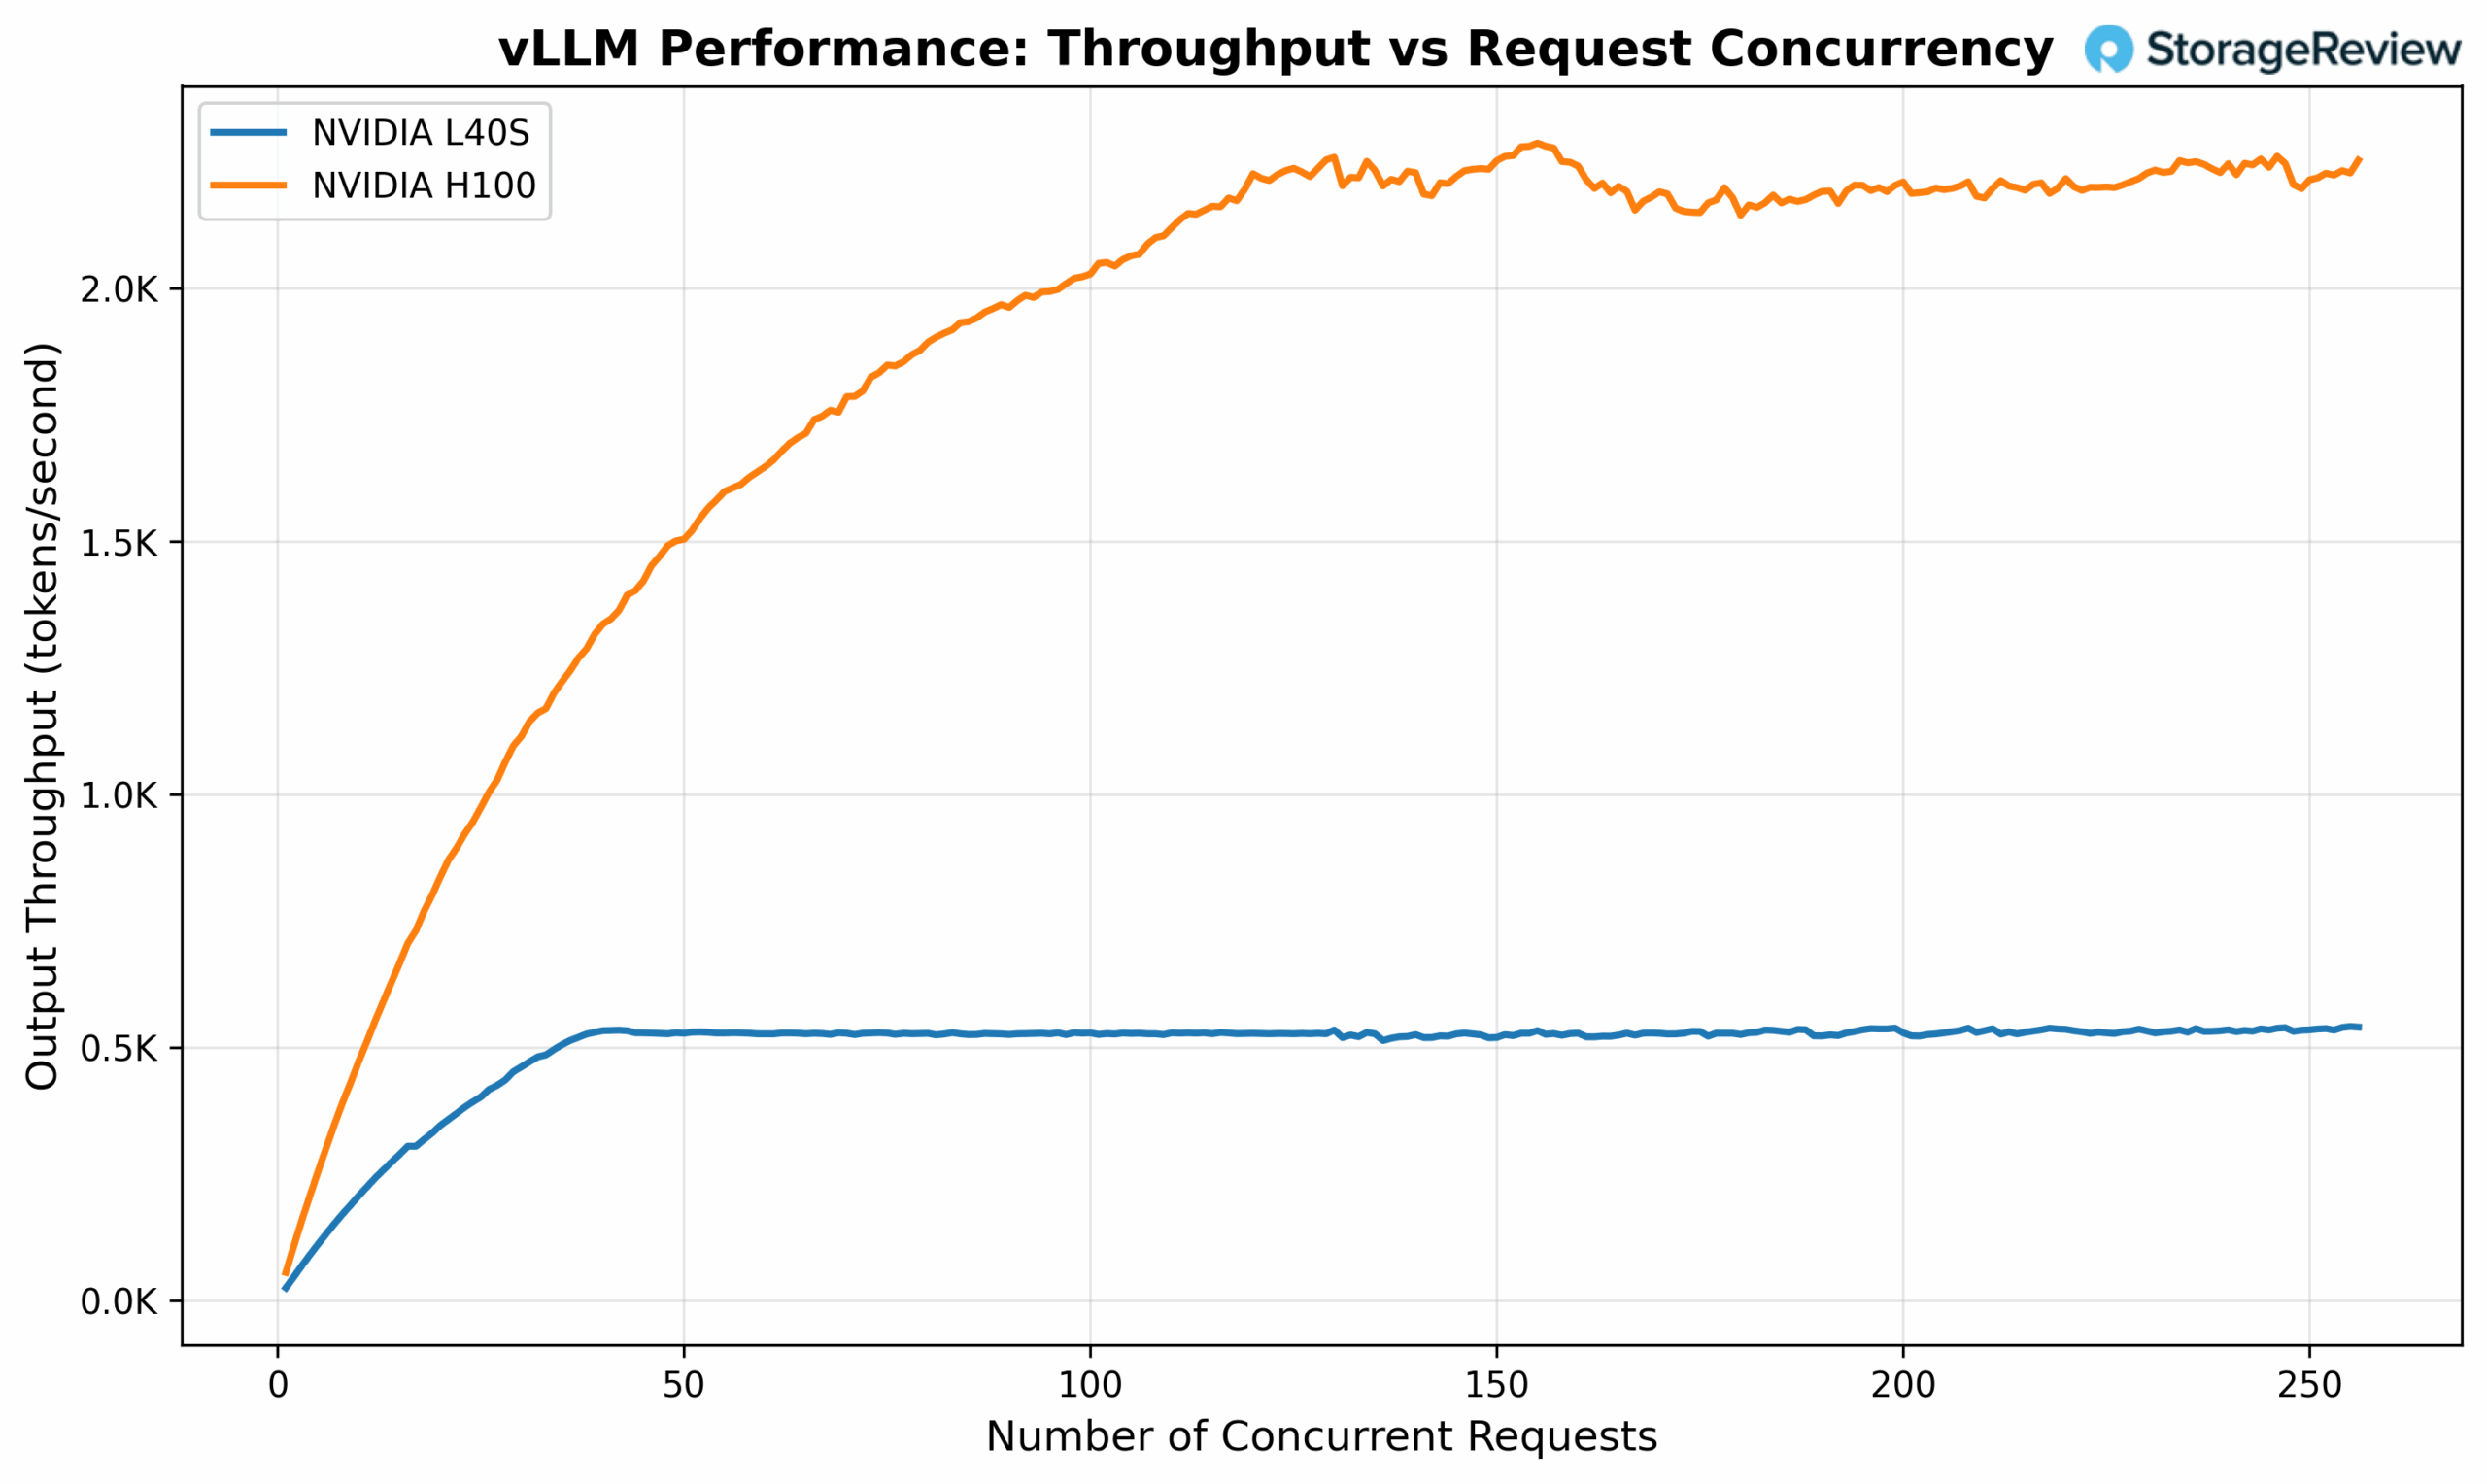
しかし、コストパフォーマンスは別の側面を物語っています。L40Sは通常、H100の40分のXNUMX以下の価格であるため、多くの推論ワークロードにおいてより費用対効果の高い選択肢となります。絶対的なピークパフォーマンスが重要ではない推論サービスを実行している組織では、LXNUMXSの方が総所有コストが低いと感じるケースが多く見られます。
線形パフォーマンスのセクションをダブルクリックすると、L40S が非常に許容できるレベルのパフォーマンスを提供し、約 16 ミリ秒の TPOT (出力トークンあたりの時間) SLO で 52 件の同時リクエストを処理できることがわかります。
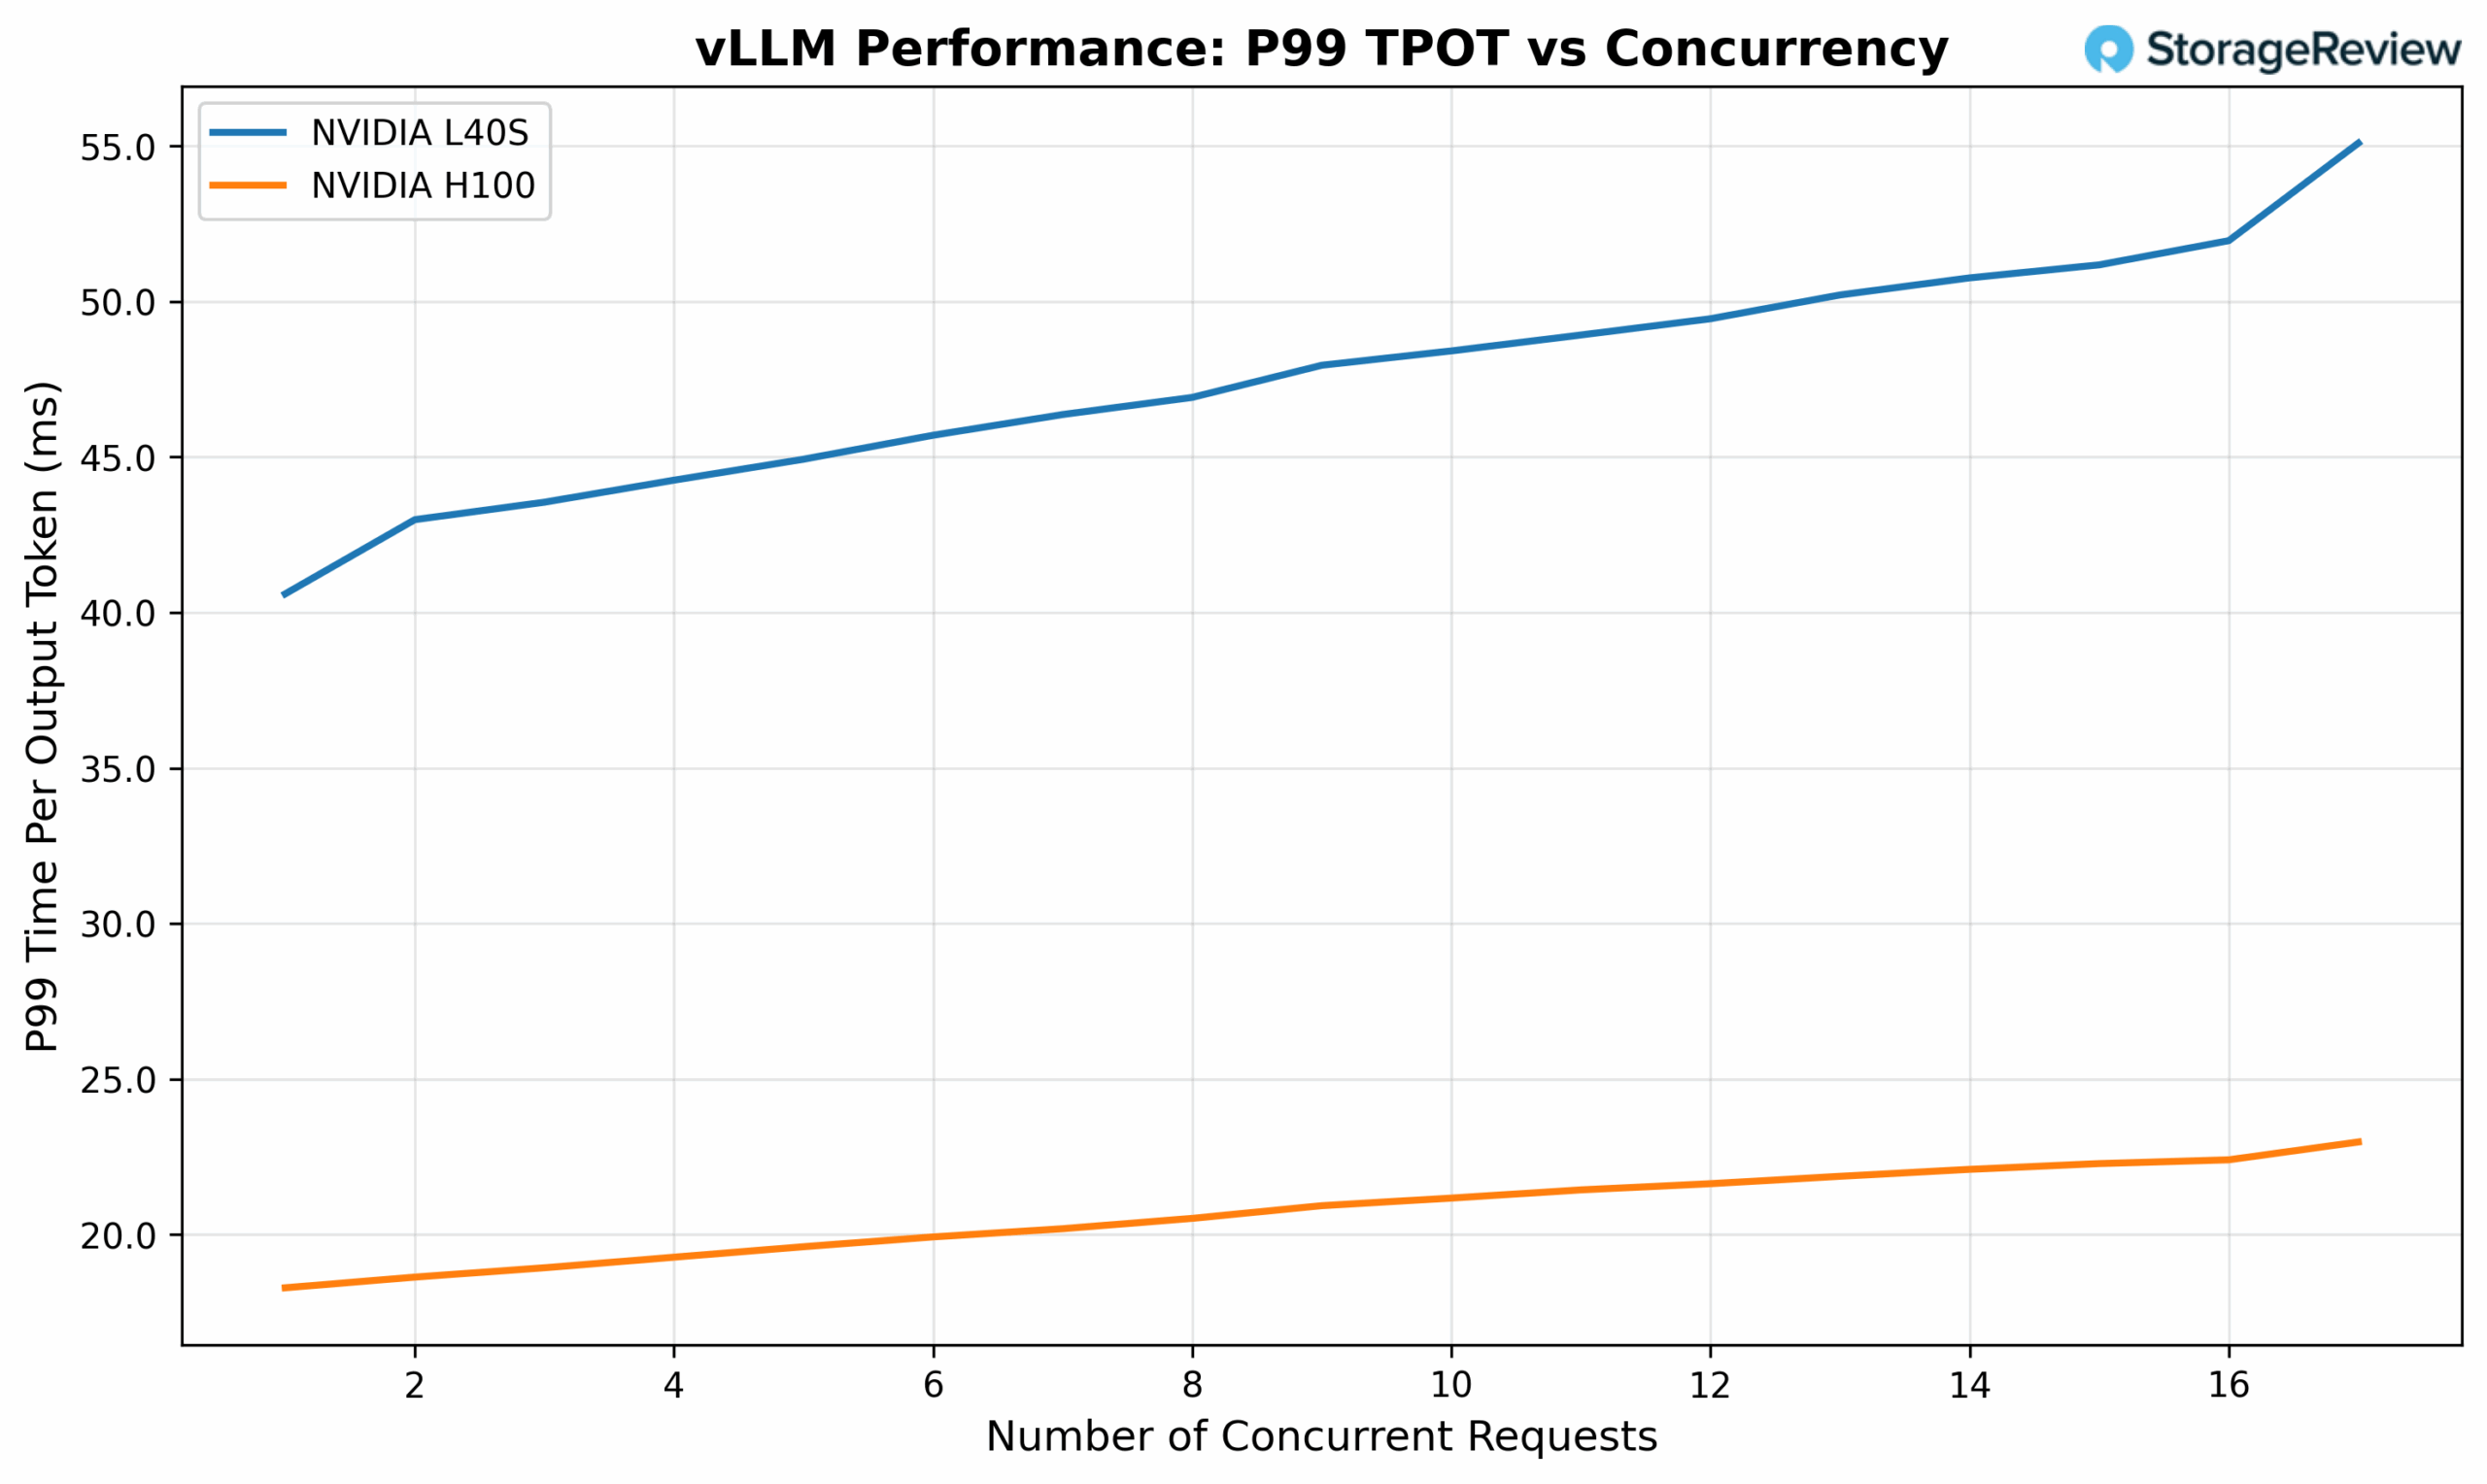
注目すべき重要な点は、AI推論、特にテキスト生成のデコードフェーズは、基本的にメモリ帯域幅を大量に消費する処理であるということです。推論中、モデルは新しいトークンを生成するためにGPUメモリに保存された重みに繰り返しアクセスする必要があり、メモリスループットが重大なパフォーマンスボトルネックとなります。この特性こそが、優れたメモリ帯域幅と強化されたTensorコア性能を備えたH100が、当然ながら高い推論スループットを実現する理由です。
ただし、AI 強化効果によるリアルタイム レンダリングや AI 搭載機能を備えたインタラクティブ アプリケーションなど、AI 推論とグラフィックス アクセラレーションの両方を必要とする展開シナリオでは、L40S が唯一の実行可能なオプションになります。
結論
NVIDIA L40Sと最新のBlackwell RTX Pro 6000の後継機種は、AIコンピューティングと高度なグラフィックス機能がますます融合する現代のデータセンターの進化するニーズに応える、戦略的に位置づけられたGPUです。H100クラスとB200クラスのGPUは、純粋なAIトレーニングおよび推論ワークロードにおいて依然として揺るぎないリーダーですが、L40Sは、コンピューティング重視のAIカードと従来のプロフェッショナル向けビジュアライゼーションソリューションとの間のギャップを埋める、ユニバーサルGPUとして、独自の価値あるニッチ市場を切り開きます。
L40Sの独自の価値提案は、AI推論機能とグラフィックスアクセラレーションの両方が求められるシナリオにおいて最も顕著に表れます。142基の第100世代RTコアを搭載することで、HXNUMXのような演算専用GPUでは不可能だったアプリケーションが可能になります。例えば、プロフェッショナルワークフローにおけるリアルタイムレイトレーシングから、次世代AIトレーニングのためのフォトリアリスティックな合成データ生成まで、その可能性は無限大です。このデュアル機能により、LXNUMXSはデジタルツイン開発、物理ベースAIトレーニング、そして成長を続けるOmniverseエコシステムといった新興アプリケーションに不可欠な存在となっています。
経済的な観点から見ると、L40SはH100ほどのピークAI性能を必要としない組織にとって魅力的な価値を提供します。H100の約40分の40のコストで、LXNUMXSは優れた推論性能を提供すると同時に、データセンターの導入に多大な汎用性をもたらすグラフィックス機能も提供します。多くの組織にとって、このコスト効率と汎用性の組み合わせは、AIとグラフィックスのソリューションを個別に投資するよりもLXNUMXSの方が現実的な選択肢となります。


 Amazon