

SupermicroのJumpStartプログラムは、ハードウェア評価において従来とは全く異なるアプローチを採用しています。共有ラボ環境での短時間のスクリプト化されたデモではなく、JumpStartでは、対象となる顧客に、実際の運用サーバーのカタログへの無料かつ時間制限付きのベアメタルアクセスを提供します。Intel Xeon 6を搭載した最新のX14プラットフォームから、第5世代AMD EPYCと大規模なHGX GPU構成を備えたH14システムまで、顧客はシステムを予約し、リモートでログインして、まるで自社のラックにハードウェアが設置されているかのように、独自のワークロードを実行できます。
ビジネス価値は、迅速かつ情報に基づいたプラットフォーム決定を行うことで明確になります。AIやハイパフォーマンスコンピューティングの現実的な概念実証(PoC)を構築するには、通常、評価用ハードウェアの到着を待ち、複数のベンダーと調整し、テスト構成が導入予定の構成に十分近いことを祈るしかありません。JumpStartは、こうした煩わしさを解消します。チームは、社内のラボサイクルを無駄にしたり、サーバーをパレット単位で全国に輸送したりすることなく、パフォーマンス検証、ソフトウェア互換性の確認、電力と熱挙動の調査、アーキテクチャの比較を行うことができます。ほとんどの組織にとって、適切な構成に1週間集中して取り組むだけで、プラットフォームがニーズに適合していることを確認したり、採用に踏み切る前にそのプラットフォームを除外したりするのに十分な時間です。
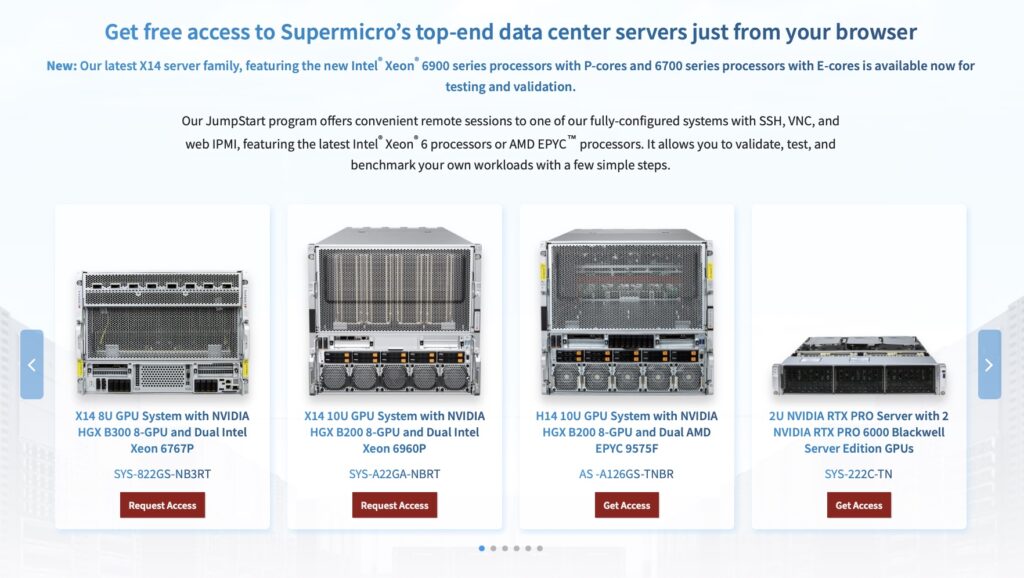
Supermicro JumpStart 起動ページ
JumpStartが特に魅力的なのは、オンラインシステムの数だけでなく、Supermicroが公開するテクノロジーの奥深さも魅力です。人気の選択肢としては、インテルXeon 6およびNVIDIAアクセラレーターを搭載したX14 GPUサーバー、第5世代AMD EPYCを搭載し高密度CPUコンピューティングに最適化されたH14プラットフォーム、最新のCPUとNVMeバックエンドを組み合わせたストレージ重視のシステムなどが挙げられます。ハイエンドでは、SupermicroはすでにAIトレーニングと推論用のHGX B200およびB300クラスのシステムへのアクセスを提供しており、JumpStartを使用して、まだ広く出荷されていない次世代プラットフォームを早期にNDAベースで検討しています。一般提供前のインフラストラクチャを構造化された反復可能なリモートラボエクスペリエンスに変えることにこれほど積極的なOEMは他にありません。
ほとんどのベンダーのデモ環境は、ガイド付きのソリューションラボや限定的な製品サンドボックスで止まっています。これらは管理ツールやオーケストレーションワークフローの習得には役立ちますが、最上位サーバーへのルートアクセスや、独自のスタックをインストールして実行する自由度が提供されるケースはほとんどありません。JumpStartは、リモートデータセンターの貸し出しラックのような役割を果たします。特定のシステムを予約すると、予約期間中はSSH、VNC、IPMI経由で完全な制御権が与えられ、Supermicroは次にお客様が使用する前に環境を消去して再構築します。実際には、これはマーケティングデモというより、適切に運営されたリモートラボでの短期集中型のエンゲージメントといった印象です。
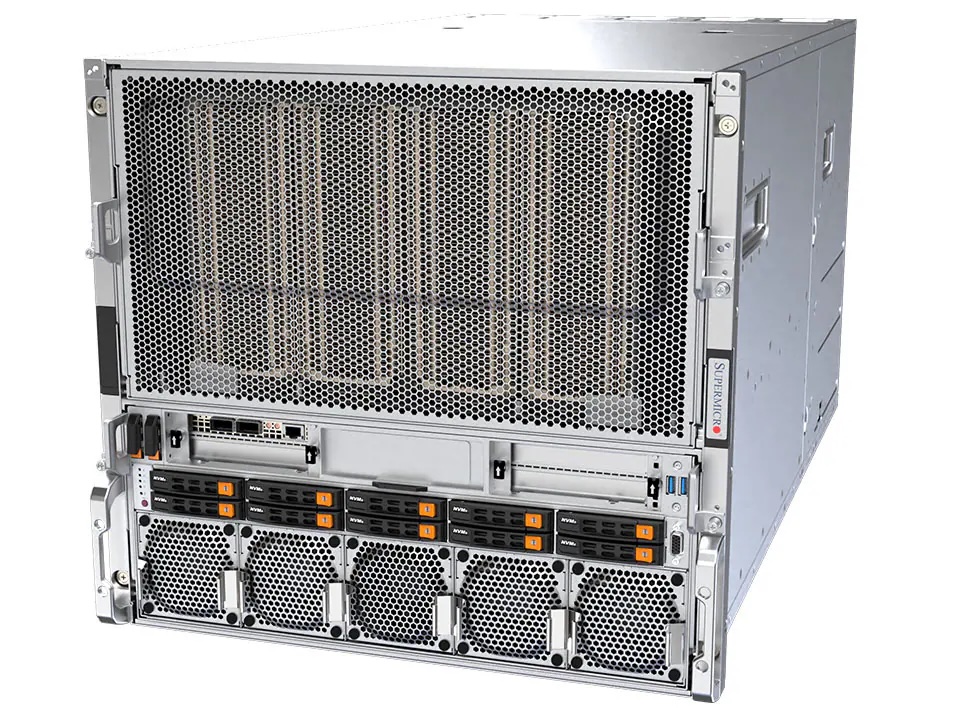
Supermicro ジャンプスタート X14 B200 システム
今回の分析のために、SupermicroはStorageReviewに対し、顧客が実際に体験するのと全く同じようにJumpStartへのアクセスを提供しました。私たちは、 NVIDIA HGX B200 8-GPUベースボードと第6世代Intel Xeon Platinum 6960Pプロセッサ2基を搭載したX14 10U GPUシステムで時間を確保しました。サーバーは、3TBのDDR5-6400 ECCメモリ、ローカルストレージ用のM.2およびU.2 NVMe SSDの混在、そしてそれぞれ180GBのHBM3eを搭載した8基のB200 GPUで構成されていました。私たちは1週間にわたり、このプラットフォームを使用してAIワークロードとシステム動作をスポットチェックし、実際の購入者が新世代インフラストラクチャへの投資を決定する前に知りたいと思うような質問に焦点を当てました。
Supermicro JumpStart プログラムでの 1 週間
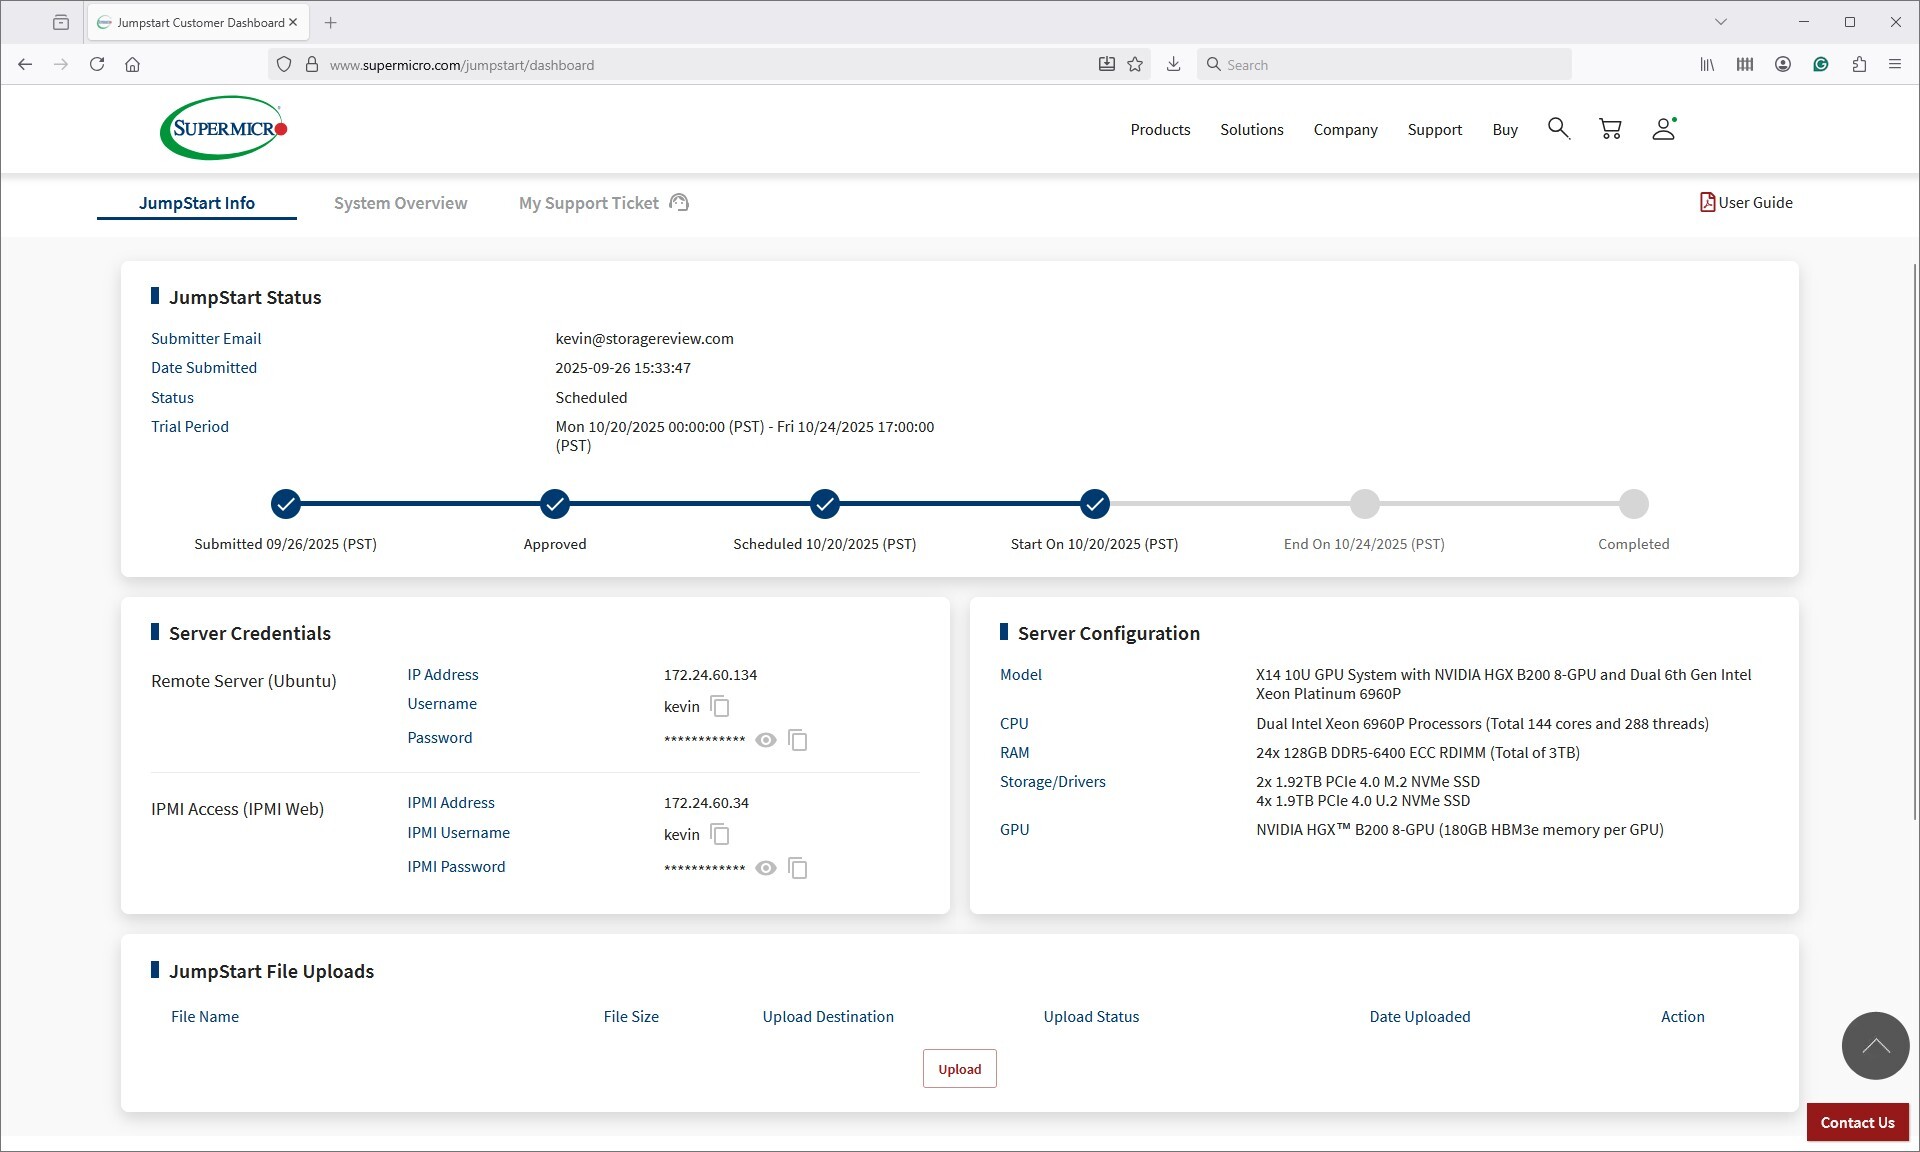
予約期間が開始すると、JumpStartポータルがテストの中心となりました。下図に示す最初のダッシュボードには、予約のタイムラインが表示され、リモートUbuntu環境用のSSH認証情報やIPMIへのフルアクセスなど、開始に必要なすべての情報が提供されていました。両方のインターフェースがすぐに利用可能だったため、プロビジョニングやサポートの介入を待つことなく、数分以内にシステムの検証を開始できました。
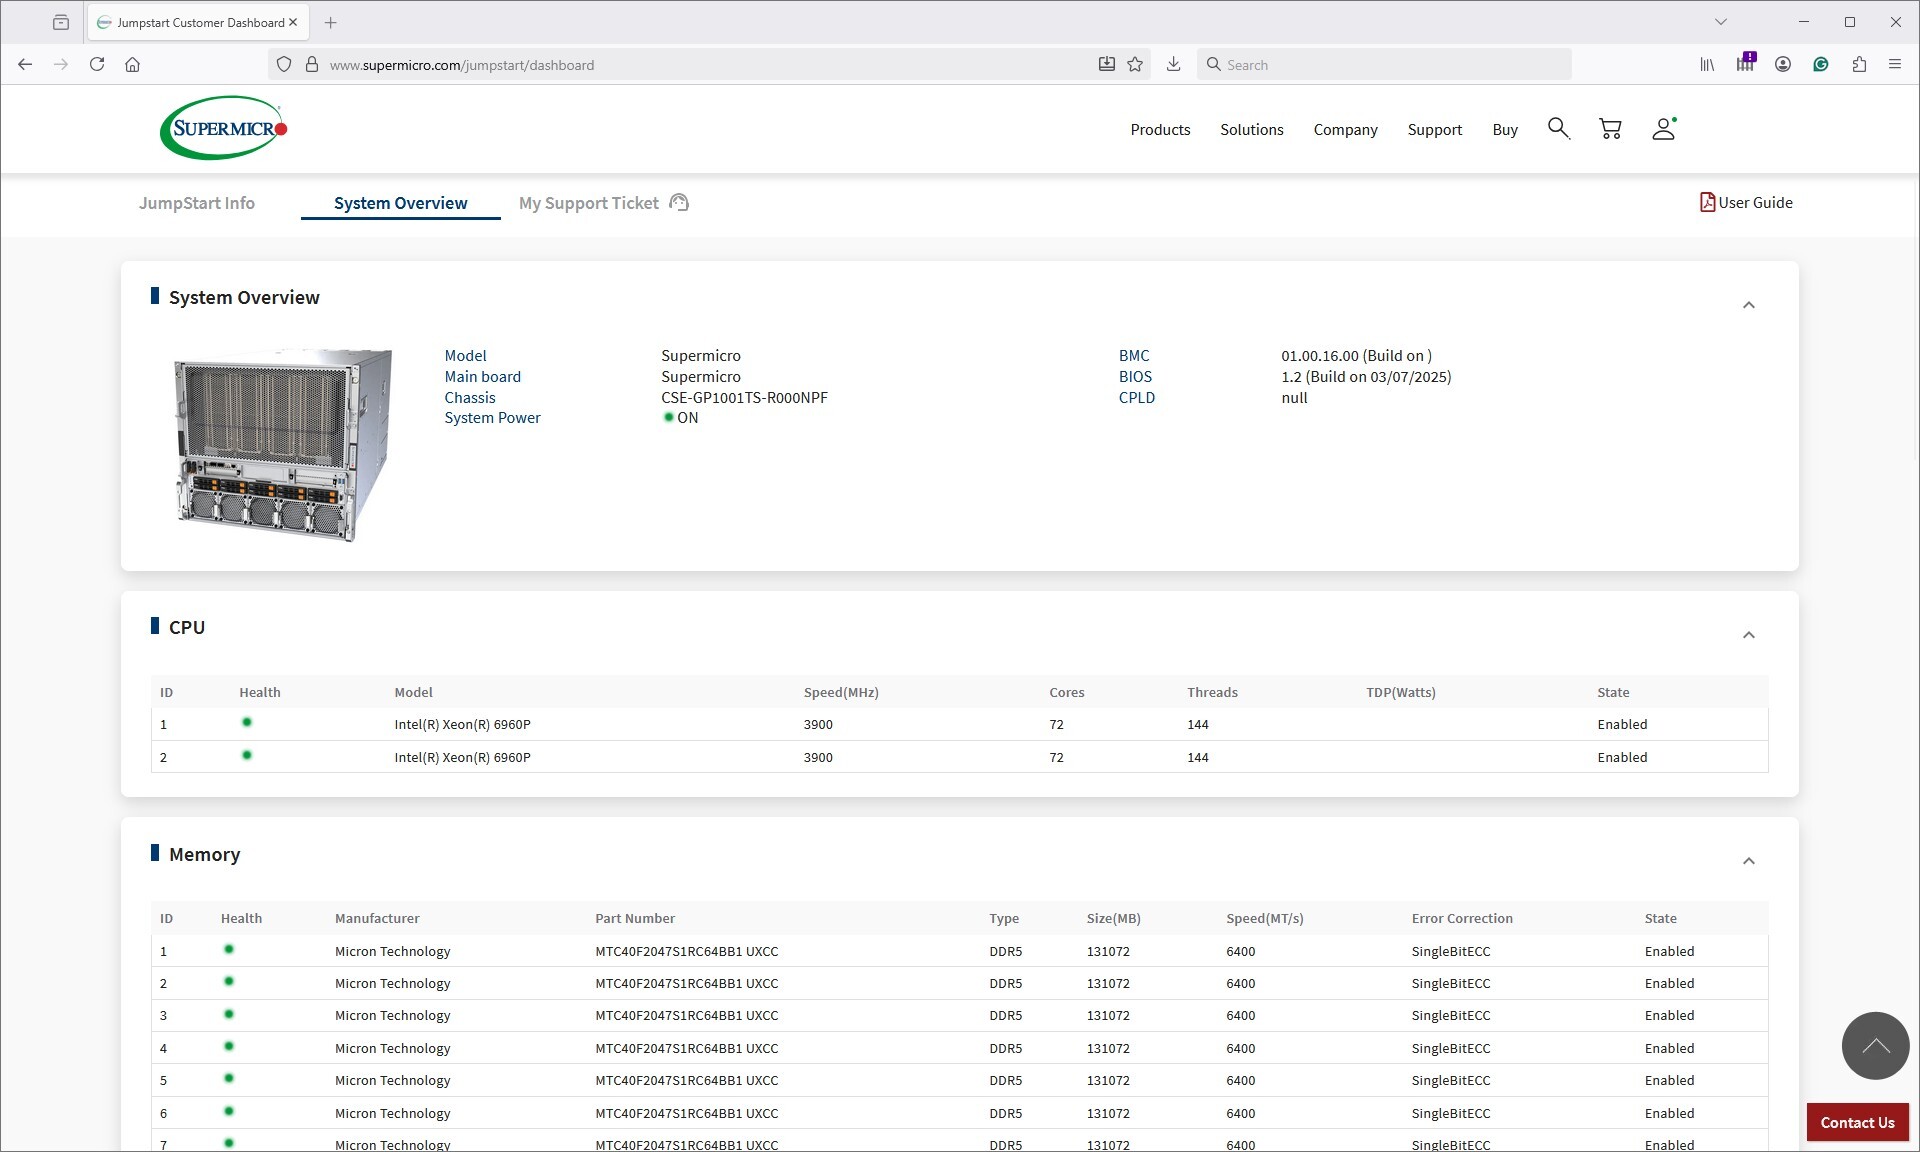
ワークフローの最初のステップは、ハードウェアの準備状況を確認することでした。ポータルのシステム概要ページ(下のスクリーンショットを参照)を使用して、シャーシの電源がオンになっていること、両方のCPUが検出されていること、メモリがフルに搭載されていること、BMCがシステムの正常性を緑色で報告していることを確認しました。この簡単なチェックは、ラボでの評価において標準的な手順となっており、ポータルを介したリモート可視化によって、このプロセスが効率化されました。
システムの検証が完了した後、実作業に移行しました。テストアセットのファイルアップロードはJumpStartインターフェースを介して直接処理されたため、リモートプラットフォームにデータセットをステージングする際の煩わしさが解消されました。そこから、ワークロードのデプロイにはSSH経由で接続し、低レベルのアクセスや起動時の挙動の観察が必要な際にはIPMI経由でリモートコンソールを使用しました。
1週間を通してのワークフローは、自社のラボで機器を操作するのと非常に似ていました。ワークロードの起動、停止、反復処理を迅速に実行し、必要に応じてプラットフォームを再起動し、Supermicroのサポートを介さずにハードウェアの動作を監視することができました。OSレベルのアクセスと完全な帯域外制御の組み合わせにより、短いテストサイクルでも予測可能で効率的な環境が実現しました。
予約期間の終了時に、システムは自動的に回収・リセットされ、エンゲージメントは円滑に終了しました。この予測可能な構造により、ロジスティクスではなくテストに集中することができ、限られたアクセス時間を最大限に活用することができました。
GPUDirect ストレージパフォーマンス
Supermicro X14プラットフォームで実施したテストの一つに、Magnum IO GPUDirect Storage(GDS)テストがあります。GDSはNVIDIAが開発した機能で、NVMeドライブやその他の高速ストレージデバイスに保存されたデータへのアクセス時に、GPUがCPUをバイパスできるようにします。GDSは、CPUとシステムメモリを経由する代わりに、GPUとストレージデバイス間の直接通信を可能にするため、レイテンシが大幅に削減され、データスループットが向上します。
GPUDirectストレージの仕組み
従来、GPUがNVMeドライブに保存されたデータを処理する場合、データはGPUに到達する前にCPUとシステムメモリを経由する必要があります。このプロセスはCPUを介在させるためボトルネックとなり、レイテンシが増加し、貴重なシステムリソースが消費されます。GPUDirect Storageは、GPUがPCIeバスを介してストレージデバイスから直接データにアクセスできるようにすることで、この非効率性を解消します。この直接パスにより、データ移動のオーバーヘッドが削減され、より高速で効率的なデータ転送が可能になります。
AIワークロード、特にディープラーニングを含むワークロードは、膨大なデータ処理を必要とします。大規模なニューラルネットワークのトレーニングにはテラバイト単位のデータ処理が必要であり、データ転送の遅延はGPUの活用率低下やトレーニング時間の長期化につながる可能性があります。GPUDirectストレージは、データがGPUに可能な限り迅速に転送されることで、アイドル時間を最小限に抑え、計算効率を最大化することで、この課題に対処します。
さらに、GDS は、ビデオ処理、自然言語処理、リアルタイム推論など、大規模なデータセットのストリーミングを伴うワークロードに特に役立ちます。CPU への依存度を下げることで、GDS はデータの移動を高速化し、CPU リソースを他のタスクに解放して、システム全体のパフォーマンスをさらに向上させます。
GPUDirectとNVMe-oF(TCP/RDMA)は、帯域幅の限界を超えて、超低レイテンシI/Oを実現します。これにより、GPUがデータ不足に陥る心配がなくなり、リアルタイムAI推論、分析パイプライン、ビデオリプレイに最適なシステムとなります。
GDSIO 読み取りシーケンシャルスループット
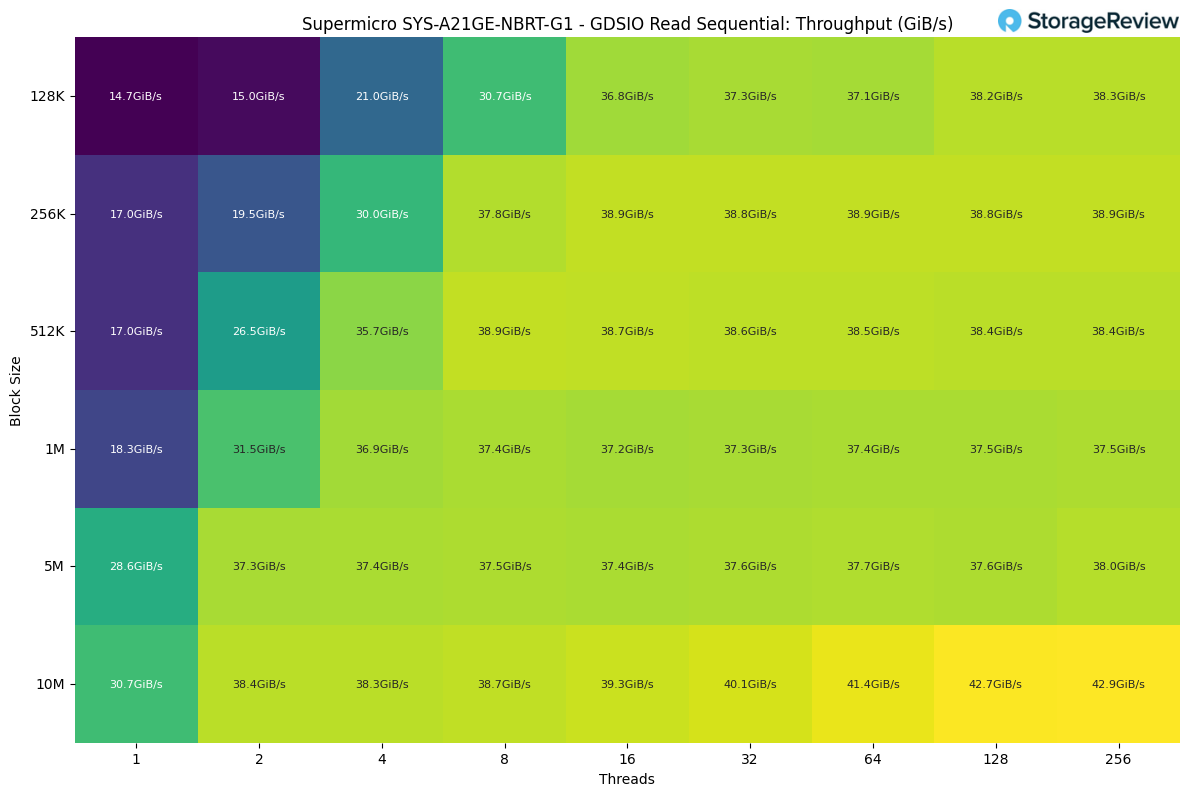
B200プラットフォームでのGDSIOシーケンシャルリードテストでは、ワークロードはブロックサイズに応じて1スレッドあたり14~15GiB/秒程度と、最初は控えめな値でした。スレッド数とブロックサイズの両方を増やすと、パフォーマンスは急速に向上しました。2スレッド、4スレッドに移行すると、スループットは20~36GiB/秒の範囲にまで上昇し、並列処理を導入することでシステムがどれほど優れたスケールアップを実現できるかを示しました。
真の加速はスレッド数が8以上に達した時点で現れ、ほとんどのワークロードは30GiB/秒台後半に落ち着きました。ブロックサイズが大きいほどその恩恵が大きく、5MBと10MBのサイズでは、すべてのスレッド数において一貫して高い数値を達成しました。
スループットは最終的に、256 スレッドで 10M ブロック サイズでおよそ 43GiB/s に達し、このテストで観測された最高の持続的な順次読み取り速度を示しています。
GDSIO 読み取りシーケンシャルレイテンシ
レイテンシに関しては、ワークロードの応答性は非常に高く、シングルスレッドの読み取りでは小さなブロックで0.06~0.1ミリ秒の範囲に収まりました。スレッド数が増えるにつれてレイテンシは徐々に増加し、ほとんどのワークロードで8スレッドまで1ミリ秒未満を維持しました。
16スレッドを超えると、ストレージパスの飽和状態が進むにつれて、ブロックサイズが大きくなり、数ミリ秒の領域にまで達し始めました。レイテンシが最も高くなったのはテストの終盤で、10MBのブロックサイズで256スレッドの場合、わずか1.2秒強(約1200ミリ秒)に達しました。これは、システムを圧倒するように設計された最悪の負荷を反映しています。

GDSIO 書き込みシーケンシャルスループット
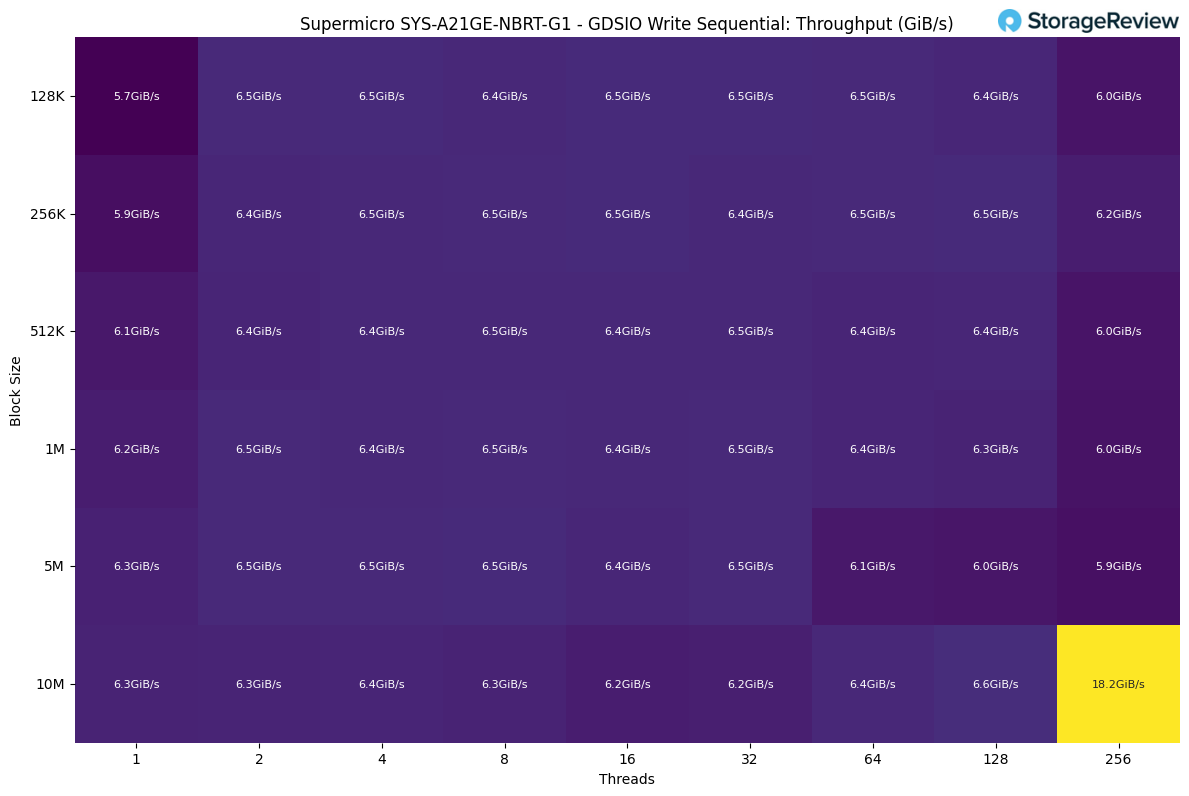
シーケンシャル書き込みでは、読み取りに比べてパフォーマンスははるかに平坦でした。ワークロードはすぐに落ち着き、ほとんどのスレッドサイズとブロックサイズの組み合わせで6.3~6.5 GiB/s程度に落ち着きました。これは、書き込みパスが早い段階で一定の上限に達したことを示しており、これはGPUやPCIeの制限ではなく、ストレージメディアとバッファリングに起因していると考えられます。
スレッド数のスケーリングは大きな影響を及ぼさず、スループットは2スレッドから128スレッドまでほぼ変化しませんでした。唯一際立った結果は、256スレッドで10MBのブロックサイズで18.2GiB/sまで急上昇した時点で、システムがディープキューと書き込みアグリゲーションを最大限に活用できる場合の一時的な優位性を示しました。
GDSIO 書き込みシーケンシャルレイテンシ
書き込みレイテンシは比較的低く、シングルスレッドのワークロードでは、小さいブロックサイズで約0.15~0.5ミリ秒でした。スレッド数が増えるにつれて、レイテンシは読み取り側よりもはるかに急激に増加し、4スレッドでは1~4ミリ秒、8スレッドでは4~9ミリ秒の範囲になりました。
ブロックサイズが大きくなった32スレッドに達すると、レイテンシが急激に増加し、5MBおよび10MBのブロックでは170~350msの範囲にまで跳ね上がりました。最も極端なケースは、256スレッドで10MBのブロックサイズの場合で、ピーク時は3秒弱(約2900ms)に達しました。これは、高負荷の並列処理では書き込みパスがいかに急速に飽和状態になるかを明確に示しています。

GDSIOランダム読み取りスループット
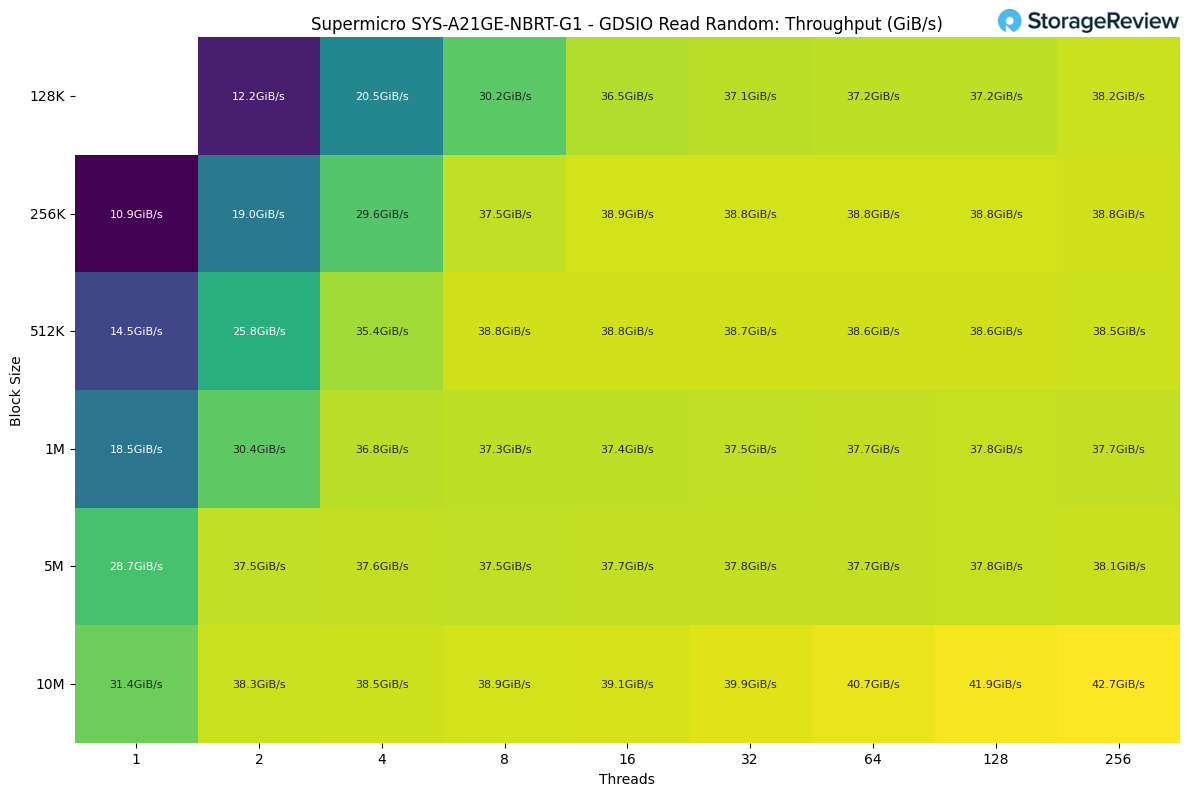
ランダム読み取りでは、ワークロードは急速に増加しました。シングルスレッドのパフォーマンスは、ブロックサイズに応じて約11~31GiB/秒の範囲で推移し、ブロックサイズが大きいほど、より高い帯域幅の恩恵をすぐに受けました。2スレッド、4スレッドに移行すると、スループットは20~36GiB/秒の範囲にまで上昇し、早い段階で強力なスケーリングを示しました。
8スレッド以上になると、システムは30GiB/秒台後半で安定した状態になり、これはシーケンシャルリードテストで観測された結果とほぼ一致しています。最高値は10MBのブロックサイズと256スレッドで達成され、約42.7GiB/秒に達しました。
GDSIOランダム読み取りレイテンシ
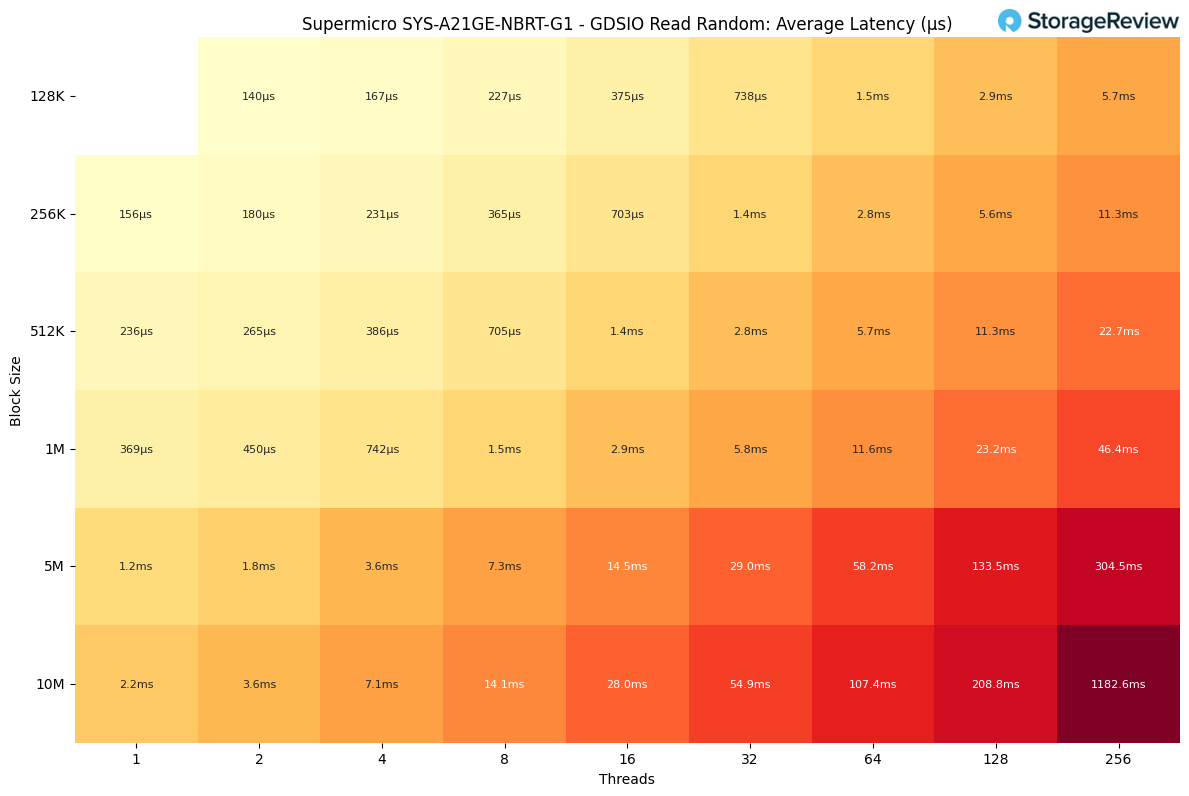
ランダム読み取りのレイテンシは非常に低く、シングルスレッドのワークロードではブロックサイズが小さい場合、約0.15~0.4ミリ秒でした。スレッド数が増えるにつれてレイテンシは徐々に増加し、4スレッドの時点では1ミリ秒未満を維持し、8スレッドになると約1~3ミリ秒になりました。
32スレッドとブロックサイズが大きくなると、レイテンシはさらに急激に増加し、5MBおよび10MBの転送では30~55ミリ秒の範囲に達しました。最も極端なケースは、256スレッド、10MBのブロックサイズで発生し、レイテンシはピーク時に1.1秒強(約1180ミリ秒)に達しました。
GDSIOランダム書き込みスループット
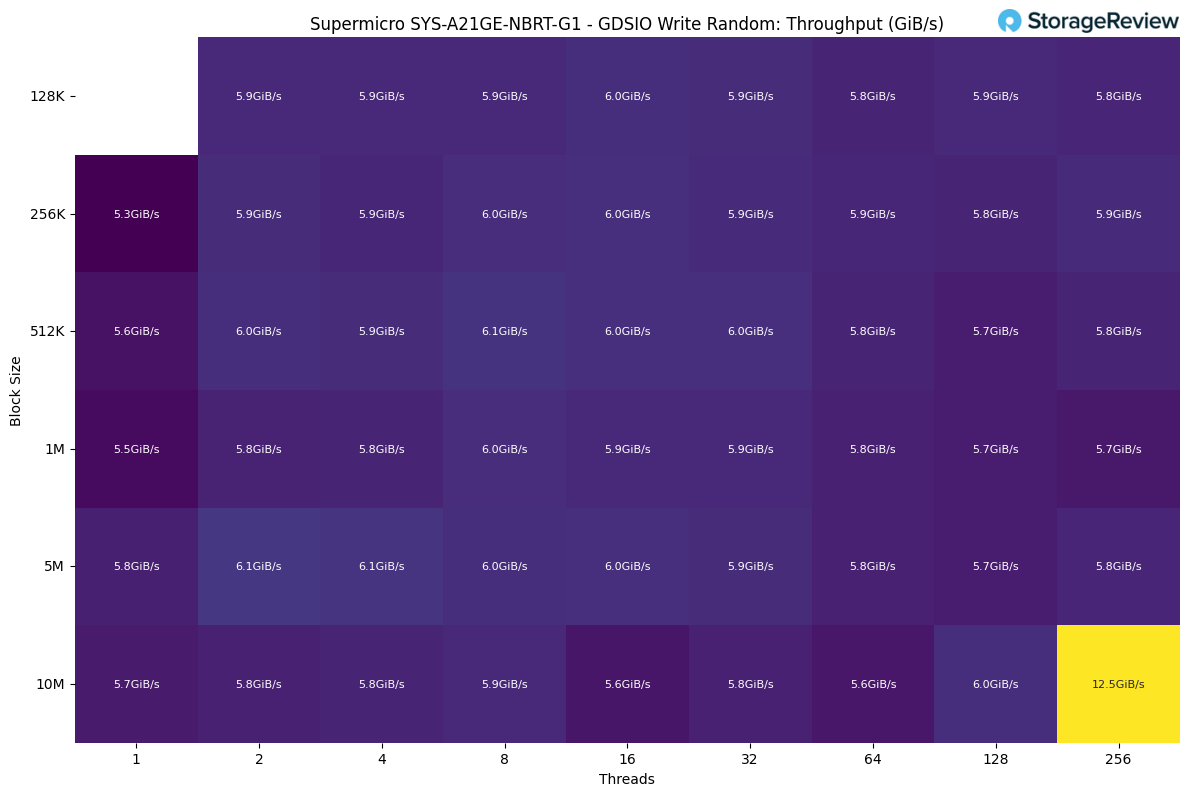
ランダム書き込みパフォーマンスは全体的に非常に安定しており、ほとんどのブロックサイズとスレッド数で5.8~6.1GiB/s程度でした。ワークロードはほぼ即座にこのレベルに達し、追加スレッドが導入されてもスケーリングは最小限に抑えられており、書き込みパスが早期に限界に達したことを示しています。
唯一の注目すべき外れ値はテストの最後に発生し、256 スレッドで 10M のブロック サイズが一時的に 12.5GiB/s に急上昇しました。これは、大量の並列負荷下での深いキューイングと書き込み集約の恩恵を受けていると考えられます。
GDSIOランダム書き込みレイテンシ
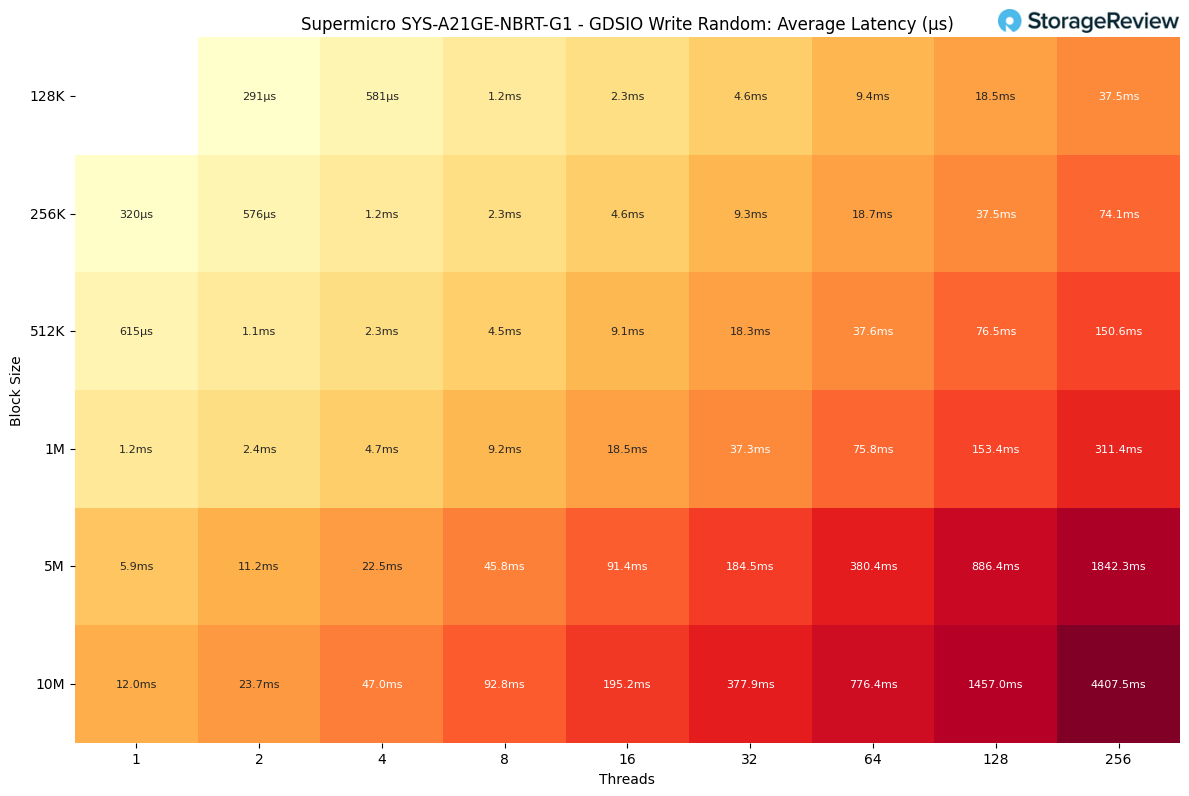
ランダム書き込みのレイテンシは比較的低く、シングルスレッドのパフォーマンスは、ブロックサイズが小さい場合は約0.6~1.2ミリ秒、転送サイズが大きい場合は5~12ミリ秒でした。同時実行数が増えるにつれて、レイテンシは急速に増加し、8スレッドでは4~9ミリ秒、32スレッドでは18~38ミリ秒に達しました。
そのポイントを超えると、書き込みパスは飽和状態になりました。ブロックサイズが大きくなると、64スレッドで150~380ミリ秒の範囲にまで跳ね上がり、さらにスケーリングを続けるとレイテンシが急激に増加しました。最悪のケースは、256スレッドで10MBのブロックサイズの場合で、約4.4秒でピークに達しました。
vLLMオンラインサービング – LLM推論パフォーマンス
vLLMは、LLM向けの最も普及している高スループット推論およびサービス提供エンジンです。vLLMオンラインサービス提供ベンチマークは、同時リクエスト下におけるこの推論エンジンの実世界におけるサービス提供能力を測定するパフォーマンス評価ツールです。このベンチマークは、リクエストレート、入出力長、同時クライアント数などの設定可能なパラメータを使用して、実行中のvLLMサーバーにリクエストを送信することで、実稼働ワークロードをシミュレートします。このベンチマークは、スループット(1秒あたりのトークン数)、最初のトークンまでの時間、出力トークンあたりの時間(TPOT)などの主要な指標を測定することで、ユーザーがさまざまな負荷条件下でのvLLMのパフォーマンスを理解するのに役立ちます。
さまざまなアーキテクチャ、パラメータスケール、量子化戦略にわたる包括的なモデルスイート全体で推論パフォーマンスをテストし、さまざまな同時実行プロファイルでのスループットを評価しました。
高密度モデルのパフォーマンス
密モデルは従来のLLMアーキテクチャに準拠しており、推論中にすべてのパラメータと活性化関数が使用されるため、スパースモデルよりも計算負荷の高い処理となります。モデルスケールと量子化戦略にわたるパフォーマンス特性を包括的に評価するため、Llama 3.1 8Bファミリーの複数の密モデル構成をベンチマークしました。
テストスイートには、Meta Llama 3.1 8Bの評価を、標準構成に加え、NVIDIAのNVFP4形式を利用したFP8およびFP4量子化バージョンの3つの精度形式で実施しました。vLLMは現在、NVFP4量子化モデルにMarlinカーネルを使用しており、この量子化形式によるパフォーマンス上のメリットは、これらのベンチマークではまだ十分に発揮されていないことにご注意ください。ネイティブNVFP4テンソルコア演算を対象としたvLLMの将来的な最適化により、さらなるパフォーマンス向上が期待できます。このモデル選択戦略により、プログレッシブ量子化が推論スループットに与える影響を分離しながら、直接的なパフォーマンス比較が可能になります。
ラマ 3.1 8B パフォーマンス
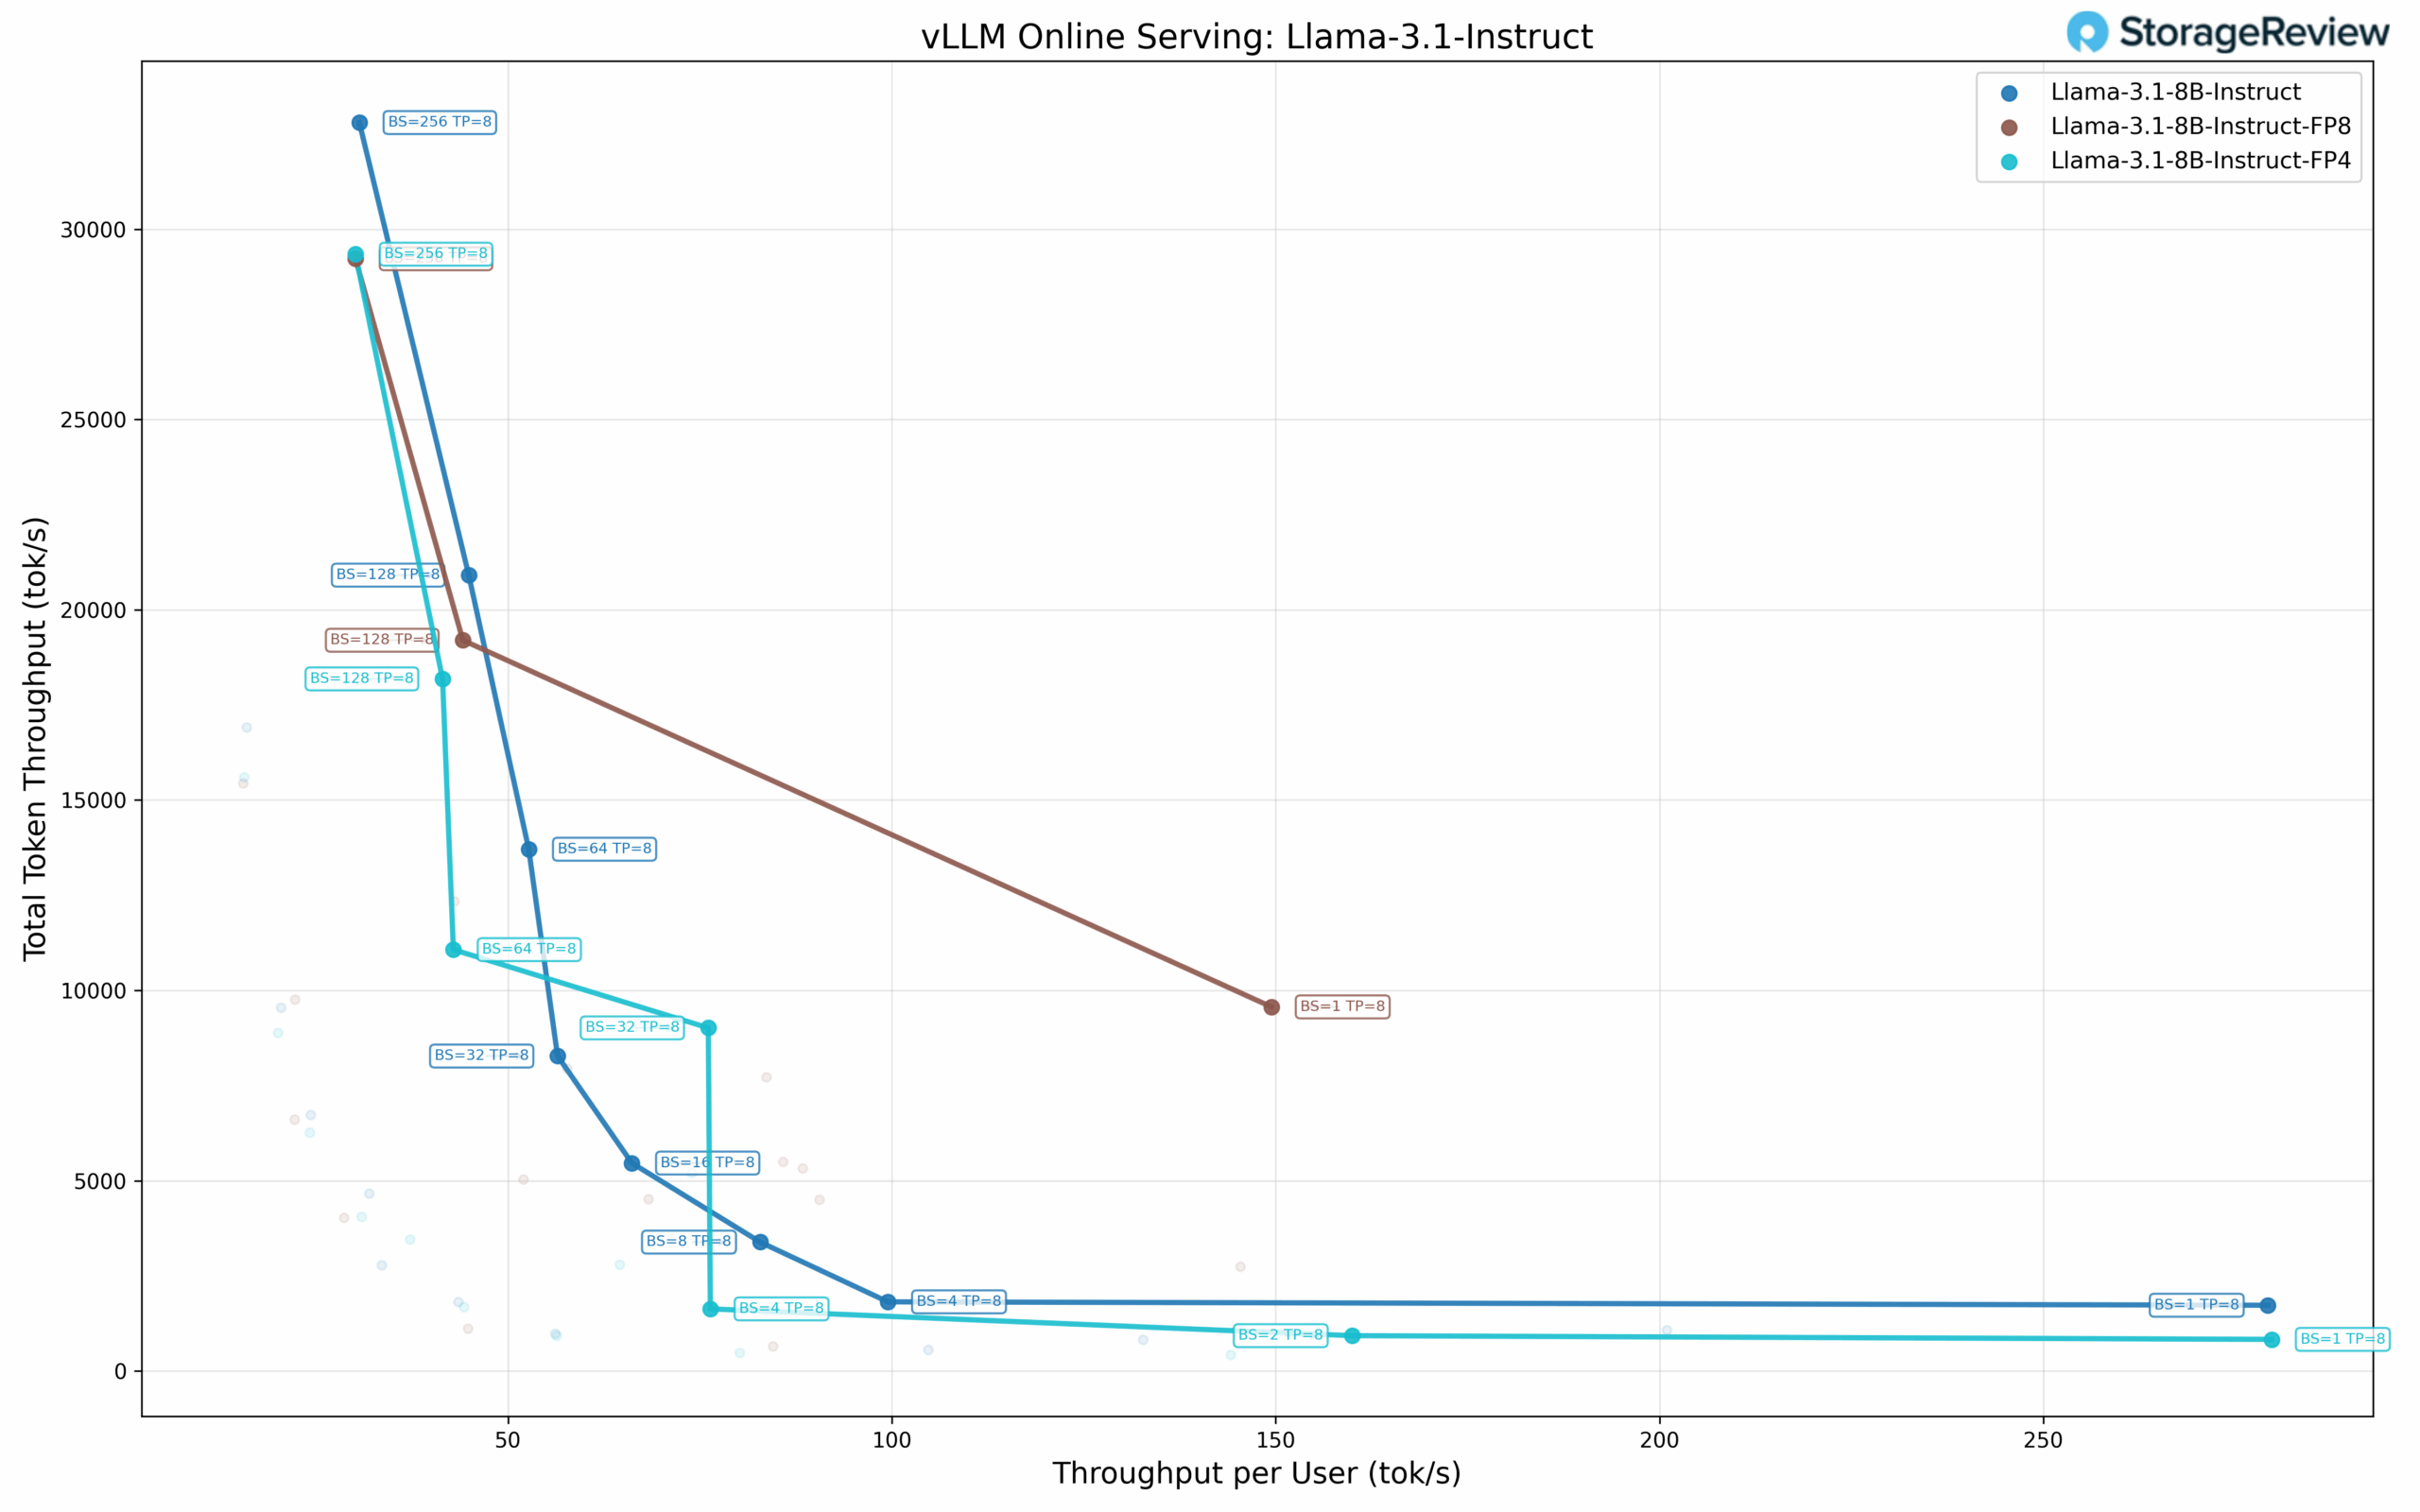
Llama 3.1 8Bは、標準精度において、同時実行レベル全体にわたって以下のスケーリング特性を示します。シングルユーザー同時実行(BS=1)では、ユーザーあたり279.27 tok/sのスループット、総スループット1,727.62 tok/s、TPOT3.37ミリ秒を実現します。バッチサイズが大きくなるにつれて、ユーザーあたりのスループットは低下しますが、総スループットは増加します。BS=8では、ユーザーあたり82.85 tok/s、総スループット3,386.48 tok/s、TPOT3.28ミリ秒を実現します。BS=32(ユーザーあたり56.46 tok/s、総スループット8,274.66 tok/s)およびBS=64(ユーザーあたり52.70 tok/s、総スループット13,707.66 tok/s)まで、パフォーマンスはスケーリングし続けます。
このモデルはBS=256で最大総スループットに達し、32,797.67 tok/s(ユーザーあたり30.64 tok/s、TPOTは16.13ミリ秒)を実現しました。これは、シングルユーザーパフォーマンスと比較して総スループットが19倍向上したことを意味します。TPOTの値はBS=64まで3~4ミリ秒の範囲で推移し、BS=256では16.13ミリ秒に増加します。
Llama 3.1 8B FP8 パフォーマンス
FP8量子化バリアントは異なる特性を示します。BS=1では、ユーザーあたり149.46 tok/s、総スループット9,565.20 tok/s、TPOT3.44msを達成しました。パレートフロンティア分析では、3つの最適点(BS=1、BS=128、BS=256)が明らかになりました。
BS=128では、モデルはユーザーあたり44.12 tok/s、合計19,198.40 tok/s、11.04 msを実現します。
TPOT。最大総スループットはBS=256で発生し、合計29,219.67 tok/s、ユーザーあたり30.13 tok/s、TPOTは13.26msです。FP8バリアントは、標準精度と比較して最大総スループットが低くなります(29.2K tok/s vs. 32.8K tok/s)。
Llama 3.1 8B FP4 パフォーマンス
FP4量子化構成では、以下の結果が得られました。シングルユーザー同時実行(BS=1)では、ユーザーあたり279.73 tok/s、総スループット830.46 tok/s、TPOT3.43 msを達成しました。
FP4モデルは7つのパレートフロンティアポイントを示します。BS=2では、ユーザーあたり159.95 tok/s、合計928.60 tok/s、TPOTは3.43ミリ秒です。BS=4(ユーザーあたり76.36 tok/s、合計1,631.69 tok/s)およびBS=32(ユーザーあたり76.09 tok/s、合計9,014.29 tok/s)までパフォーマンスは向上し続けます。モデルはBS=256で最大総スループットに達し、合計29,340.89 tok/s、ユーザーあたり30.13 tok/s、TPOTは16.18ミリ秒です。
スパースモデルのパフォーマンス
スパースモデル、特にMixture of Experts(MoE)アーキテクチャは、言語モデルを効率的にスケーリングするための新たなアプローチです。これらのアーキテクチャは、トークンごとにパラメータのサブセットのみをアクティブ化しながら、総パラメータ数を多く維持するため、アクティブパラメータあたりのパフォーマンスが向上する可能性があります。
推論重視のDeepSeek-R1と、コード生成に特化したスパースアーキテクチャであるQwen3 Coder 30B-A3Bという2つのMoEアーキテクチャを評価しました。DeepSeek-R1は推論重視の最も人気のあるモデルであり、従来の言語モデルと比較して明確なパフォーマンス特性を示しています。Qwen3 Coderモデルは、生成されたトークンごとに30Bのパラメータのみをアクティブ化しながら、30Bのパラメータサイズを維持します。量子化戦略間のパフォーマンス特性を理解するため、Qwen3 Coderの標準バージョンとFP8量子化バージョンの両方でベンチマークを実施しました。
DeepSeek-R1のパフォーマンス
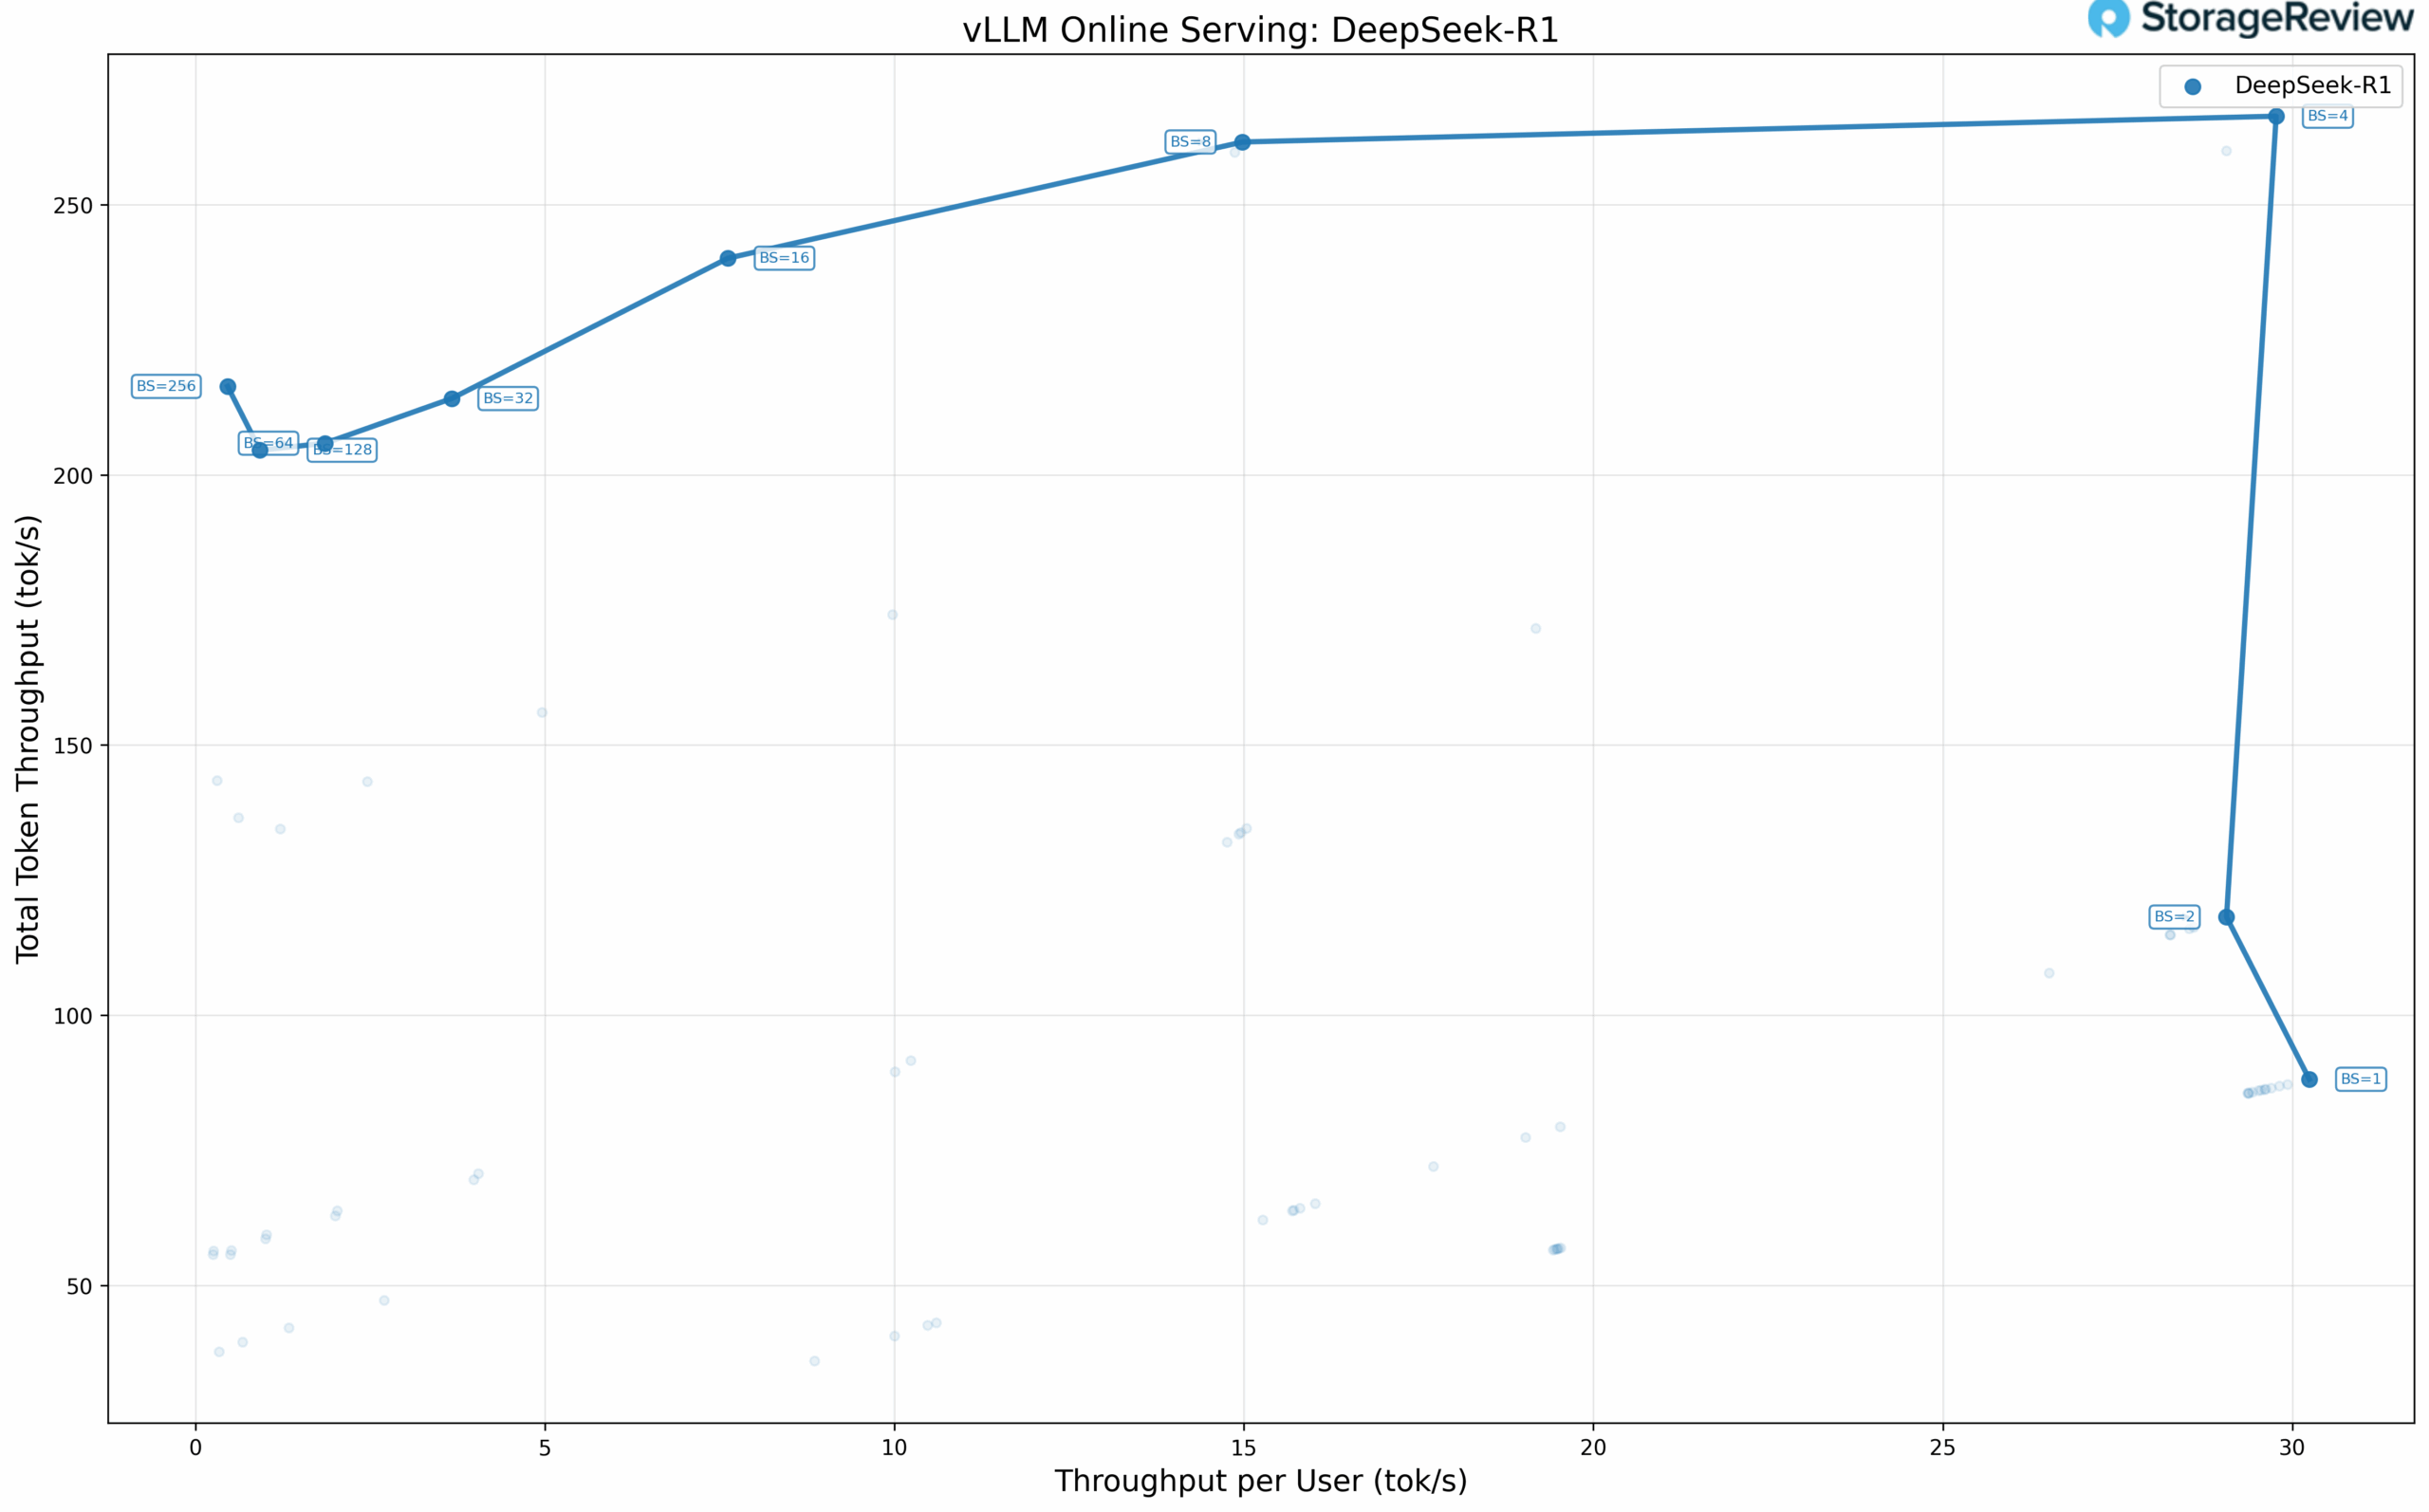
DeepSeek-R1モデルは、バッチサイズ全体にわたって興味深いスケーリング挙動を示します。シングルユーザー同時実行(BS=1)では、ユーザーあたり30.24 tok/s、総スループット88.13 tok/s、TPOT29.85ミリ秒を達成しました。BS=4にスケーリングすると、ユーザーあたり29.77 tok/s、総スループット266.40 tok/s、TPOT32.04ミリ秒に達し、全構成で最大の総スループットを達成しました。
DeepSeek-R1のパフォーマンスは、BS=4を超えると頭打ちになります。BS=8では、ユーザーあたりのスループットが14.98 tok/sに急激に低下し、バッチサイズが大きくなるにつれて低下は続き、BS=256ではユーザーあたりわずか0.46 tok/sにまで低下します。BS=4からBS=256まで、総スループットは200 tok/sから260 tok/sの間で比較的安定しています。これは、単一ノードでの同時リクエストの増加に対応できないため、レイテンシが増加するだけでスループットの向上は見込めないためです。ここで注目すべき重要な点は、B200 DGXが、この大規模なモデルを実行できる数少ない単一サーバーソリューションの一つであるということです。
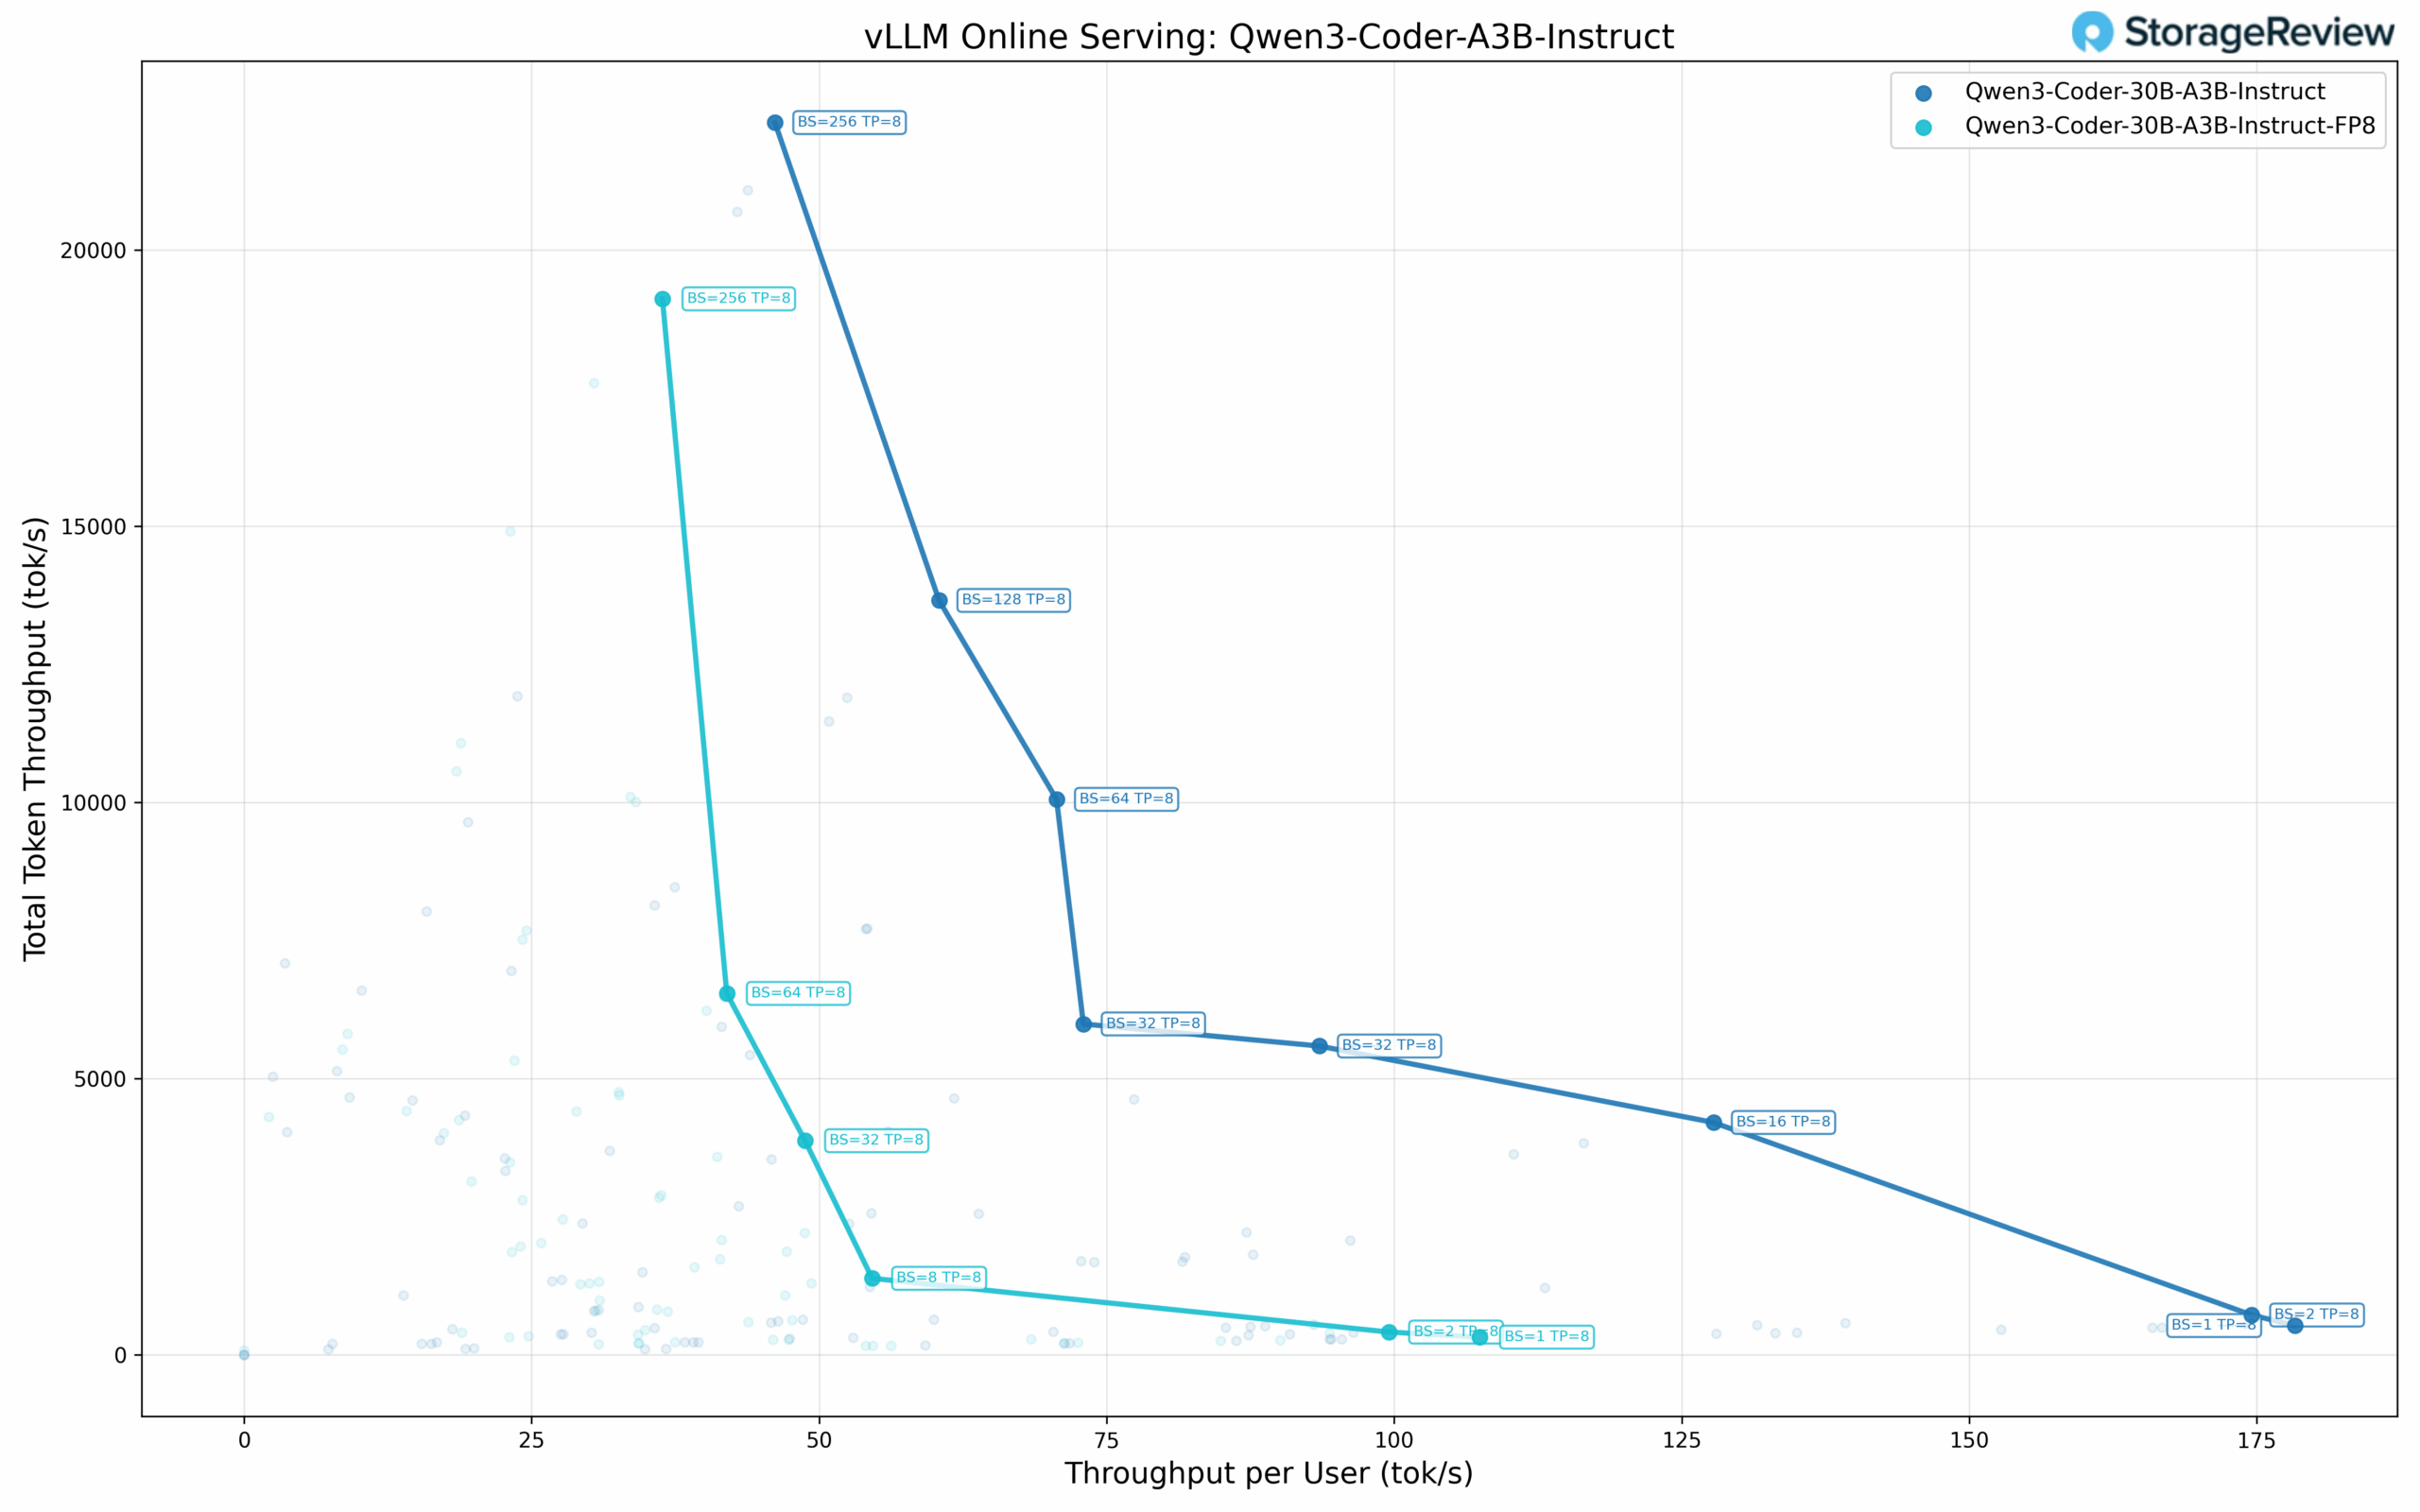
Qwen3 Coder 30B-A3B のパフォーマンス
標準精度のQwen3 Coderは、同時実行レベル間で以下のスケーリングを示します。シングルユーザー同時実行(BS=1)では、モデルはユーザーあたり178.30 tok/s、総スループット527.25 tok/s、TPOT5.46ミリ秒を達成しました。BS=2では、ユーザーあたり174.56 tok/s、総スループット718.70 tok/s、TPOT5.60ミリ秒に達します。バッチサイズが大きくなるにつれて、ユーザーあたりのスループットは低下しますが、総スループットはスケーリングし続けます。BS=16では、ユーザーあたり127.76 tok/s、総スループット4,204.40 tok/s、TPOT6.93ミリ秒を達成しました。
このモデルはBS=256で最大総スループットに達し、合計22,305.88 tok/s、ユーザーあたり46.16 tok/s、TPOT(平均スループット)17.64ミリ秒を達成しました。パレートフロンティアには8つの異なる点があり、BS=32(ユーザーあたり72.97 tok/sと93.50 tok/s)には重複した点があり、異なる構成を示している可能性があります。TPOT値はBS=64まで5~9ミリ秒の範囲を維持します。
Qwen3 Coder 30B-A3B FP8 パフォーマンス
FP8量子化バリアントは、以下の性能特性を示します。シングルユーザー同時実行(BS=1)では、ユーザーあたり107.46 tok/s、総スループット317.75 tok/s、TPOT9.16msを実現します。BS=2では、ユーザーあたり99.55 tok/s、総スループット409.87 tok/s、TPOT9.86msを実現します。
より大きなバッチサイズへのスケーリング:BS=8では、ユーザーあたり54.60 tok/s、合計1,383.13 tok/s、TPOT10.24ミリ秒を実現します。一方、BS=32では、ユーザーあたり48.78 tok/s、合計3,874.21 tok/s、TPOT10.67ミリ秒を実現します。最大合計スループットはBS=256で発生し、合計19,114.86 tok/s、ユーザーあたり36.38 tok/s、TPOT20.00ミリ秒となります。これは、標準精度の最大スループットの約86%に相当します。
マイクロスケーリングデータ型パフォーマンス
マイクロスケーリングは、大規模なパラメータグループ全体にわたる均一な量子化ではなく、小さな重みブロックにきめ細かなスケーリング係数を適用する高度な量子化手法です。NVIDIAのNVFP4フォーマットは、8~32個の値からなるマイクロスケールブロックごとに共通の指数をスケーリング係数として共有するブロック化浮動小数点表現を通じてこの手法を実装しています。このきめ細かなアプローチは、数値精度を維持しながら4ビット表現を実現し、Transformerアーキテクチャに不可欠なダイナミックレンジを維持します。このフォーマットはNVIDIAのTensor Coreアーキテクチャと統合されており、行列演算中にオンザフライで展開することで、効率的な混合精度計算を可能にします。
OpenAIのGPT OSSモデルを、NVFP4量子化を用いて2つのパラメータスケール(20Bバリアントと、より大きな120Bバリアント)で評価しました。これらのベンチマークは、マイクロスケーリング量子化がさまざまなモデルサイズでどのように機能するかを示しています。
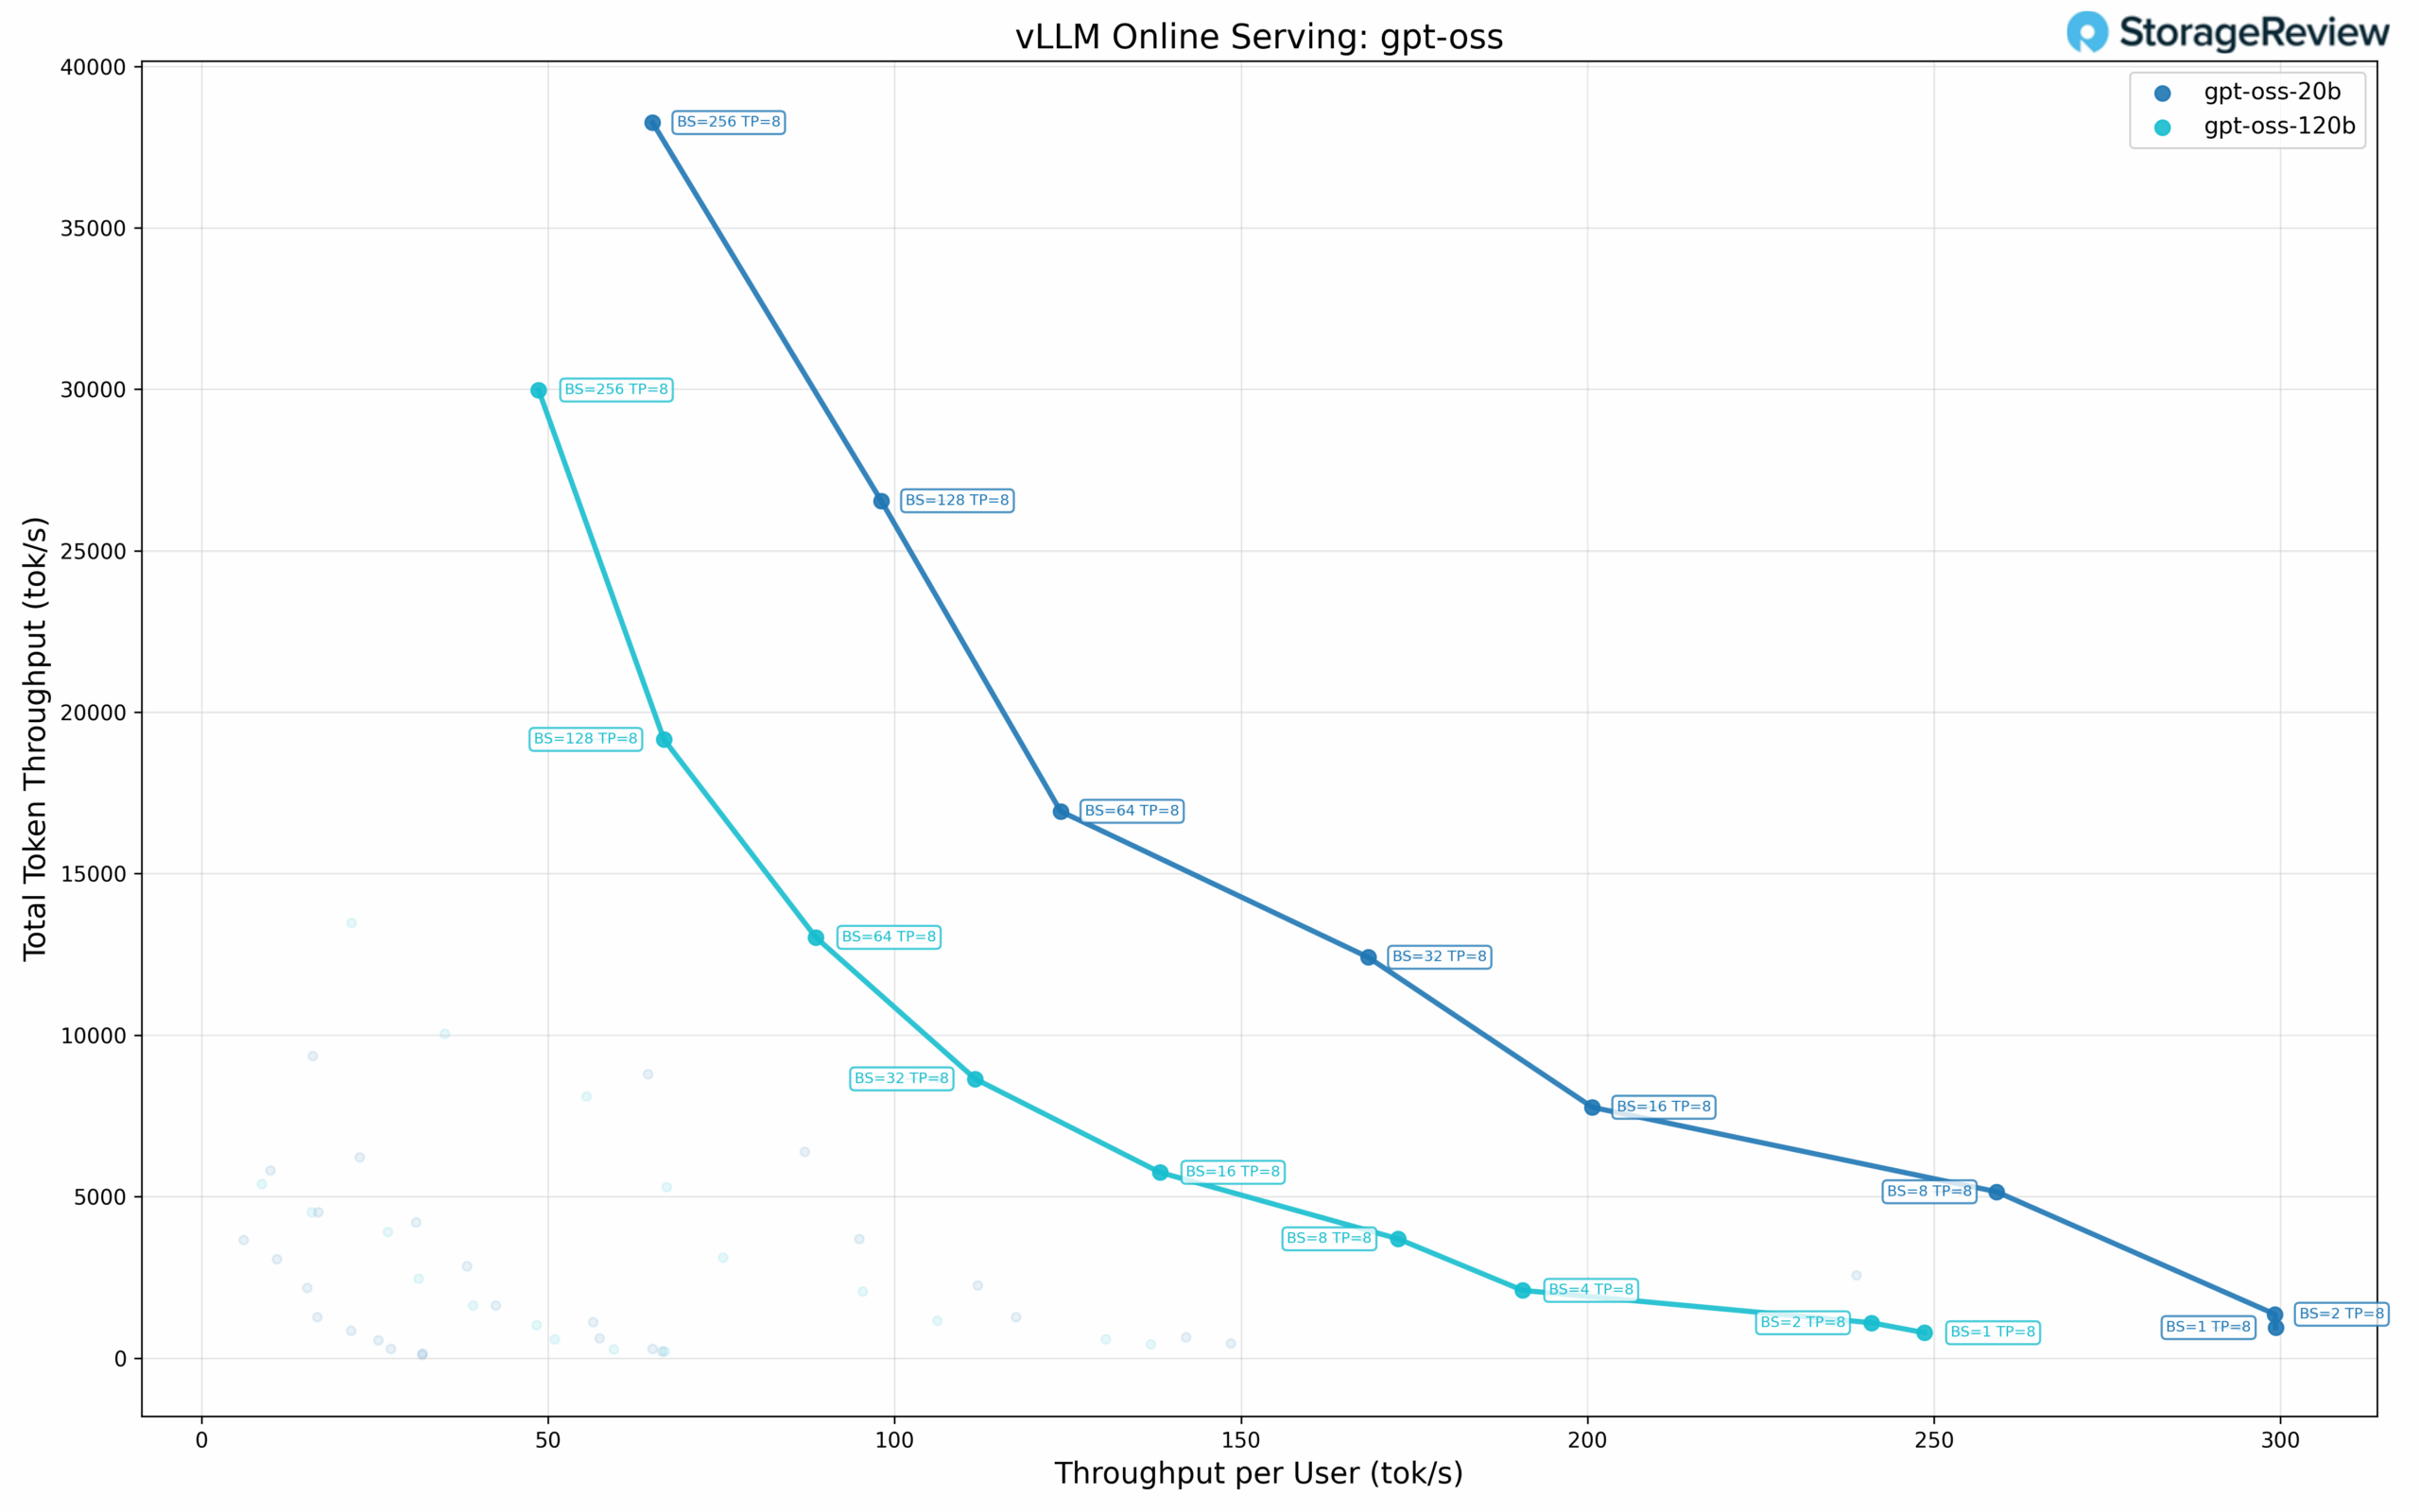
GPT-OSS-20B のパフォーマンス
20Bパラメータモデルは、バッチサイズ全体にわたって以下のパフォーマンスを達成しました。シングルユーザー同時実行(BS=1)では、ユーザーあたり299.28 tok/s、総スループット943.43 tok/s、TPOT3.23ミリ秒を実現します。BS=2では、ユーザーあたり299.19 tok/s、総スループット1,356.87 tok/s、TPOT3.19ミリ秒を維持します。
より大きなバッチサイズへのスケーリング:BS=8では、ユーザーあたり259.02 tok/s、合計5,149.59 tok/s、TPOT3.42 msを達成しました。一方、BS=16では、ユーザーあたり200.69 tok/s、合計7,765.73 tok/s、TPOT3.77 msを達成しました。このモデルは、BS=32(ユーザーあたり168.34 tok/s、合計12,411.72 tok/s)およびBS=64(ユーザーあたり123.96 tok/s、合計16,931.47 tok/s)までスケーリングを続けます。
総スループットはBS=256で発生し、ユーザーあたり65.08 tok/s、TPOT(Telemetry Time Out:時間外応答時間)9.39msで、合計38,258.50 tok/sを達成しました。これは、シングルユーザーパフォーマンスと比較して、総スループットが40.5倍向上したことを意味します。TPOTの値はBS=32まで3~5msの範囲に留まります。パレートフロンティアには8つの明確な点が含まれます。
GPT-OSS-120B のパフォーマンス
120Bパラメータの大型モデルは、パラメータ数が増加しているにもかかわらず、以下のパフォーマンスを維持しています。シングルユーザー同時実行(BS=1)では、ユーザーあたり248.62 tok/s、総スループット783.73 tok/s、TPOT3.89msを実現します。BS=2では、ユーザーあたり240.99 tok/s、総スループット1,092.91 tok/s、TPOT3.99msを実現します。
バッチサイズが大きくなるにつれて、パフォーマンスは向上し続けます。BS=4では、ユーザーあたり190.63 tok/s、合計2,096.73 tok/s、TPOT4.22 msを達成し、BS=8ではユーザーあたり172.66 tok/s、合計3,692.10 tok/s、TPOT4.54 msを達成しました。BS=16(ユーザーあたり138.28 tok/s、合計5,751.41 tok/s)、BS=32(ユーザーあたり111.63 tok/s、合計8,646.05 tok/s)、BS=64(ユーザーあたり88.64 tok/s、合計13,027.97 tok/s)と拡張していくことで、一貫したスループットの拡張が見られます。
このモデルはBS=256で最大総スループットに達し、29,976.99 tok/s(ユーザーあたり48.64 tok/s、TPOTは12.53ミリ秒)を実現しました。これは、シングルユーザーパフォーマンスと比較して総スループットが38.2倍向上したことを意味します。最大総スループットは、20Bモデルのピーク値の約78%です。パレートフロンティアには9つの明確な点が含まれており、これはテストしたモデルの中で最も多くの点です。
予想外の量子化モデルのパフォーマンス
量子化モデルの結果は予想外であり、さらなる調査が必要です。NVFP4およびFP8の量子化バージョンは、いくつかのケースにおいて、ネイティブ精度のモデルと比較して期待されるパフォーマンス向上を達成しませんでした。例えば、Llama 3.1 8B FP4モデルは、ユーザーあたりのスループットは同等であったにもかかわらず、BS=1で合計スループットが830.46 tok/sにとどまりましたが、標準精度バージョンでは1,727.62 tok/sでした。バッチサイズが大きいほど、量子化モデルは標準精度のスループットに近づきましたが(BS=256で29.2K~29.3K tok/sに対し、32.8K tok/s)、全体的な結果から、vLLMの現在の実装はBlackwell向けに完全に最適化されていない可能性があることが示唆されます。
私たちは、vLLM の追加テストを実施し、TensorRT-LLM と比較して、エンドユーザーが現在期待できるパフォーマンスを確認する予定です。
Supermicro JumpStart が AI PoC の常識を変える
SupermicroのJumpStartプログラムは、その約束どおり、従来のPoCのような物流、配送遅延、ラボのオーバーヘッドなしに、実運用クラスのハードウェアに実質的かつ無制限にアクセスできるというメリットを提供します。X14 HGX B200プラットフォームでのJumpStartウィークは、迅速に開始され、スムーズに進行し、自社のラックに機器を取り付けた場合と同じようにパフォーマンスを評価することができました。
AIインフラに関する迅速な意思決定を行う組織にとって、このようなプラットフォームへのアクセスは、数週間かかる計画を数日に短縮することを可能にします。GPUスループット、ストレージの挙動、モデルパフォーマンスの検証、あるいはスタックの互換性の確認など、様々な目的がある場合でも、JumpStartを活用すれば、最小限の手間で必要な答えを得ることができます。これはハードウェア評価における信頼性重視のアプローチであり、より多くのベンダーに採用されることを期待しています。


 Amazon