

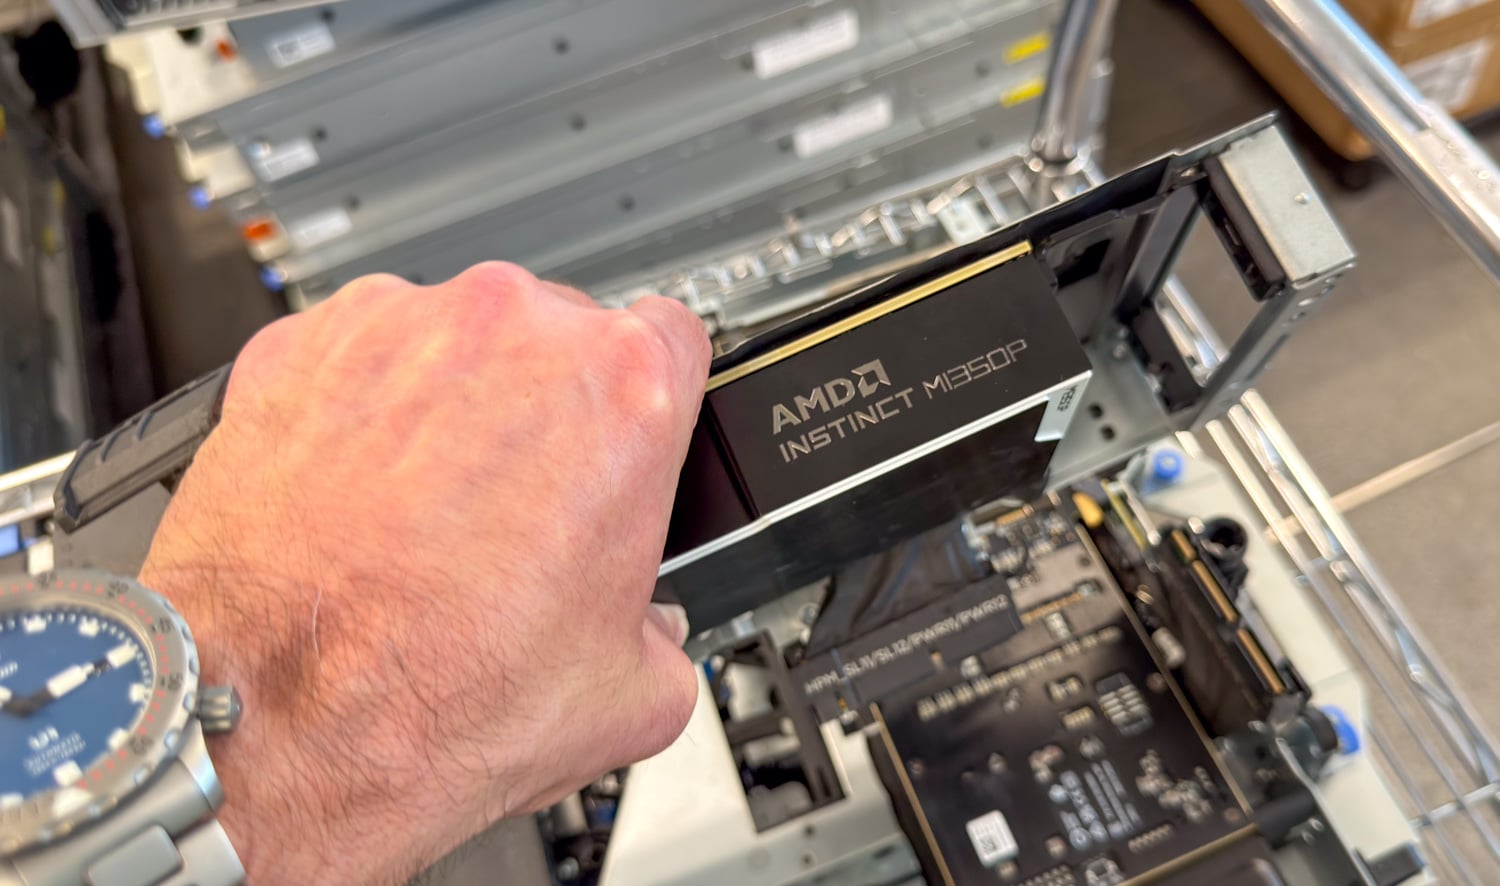
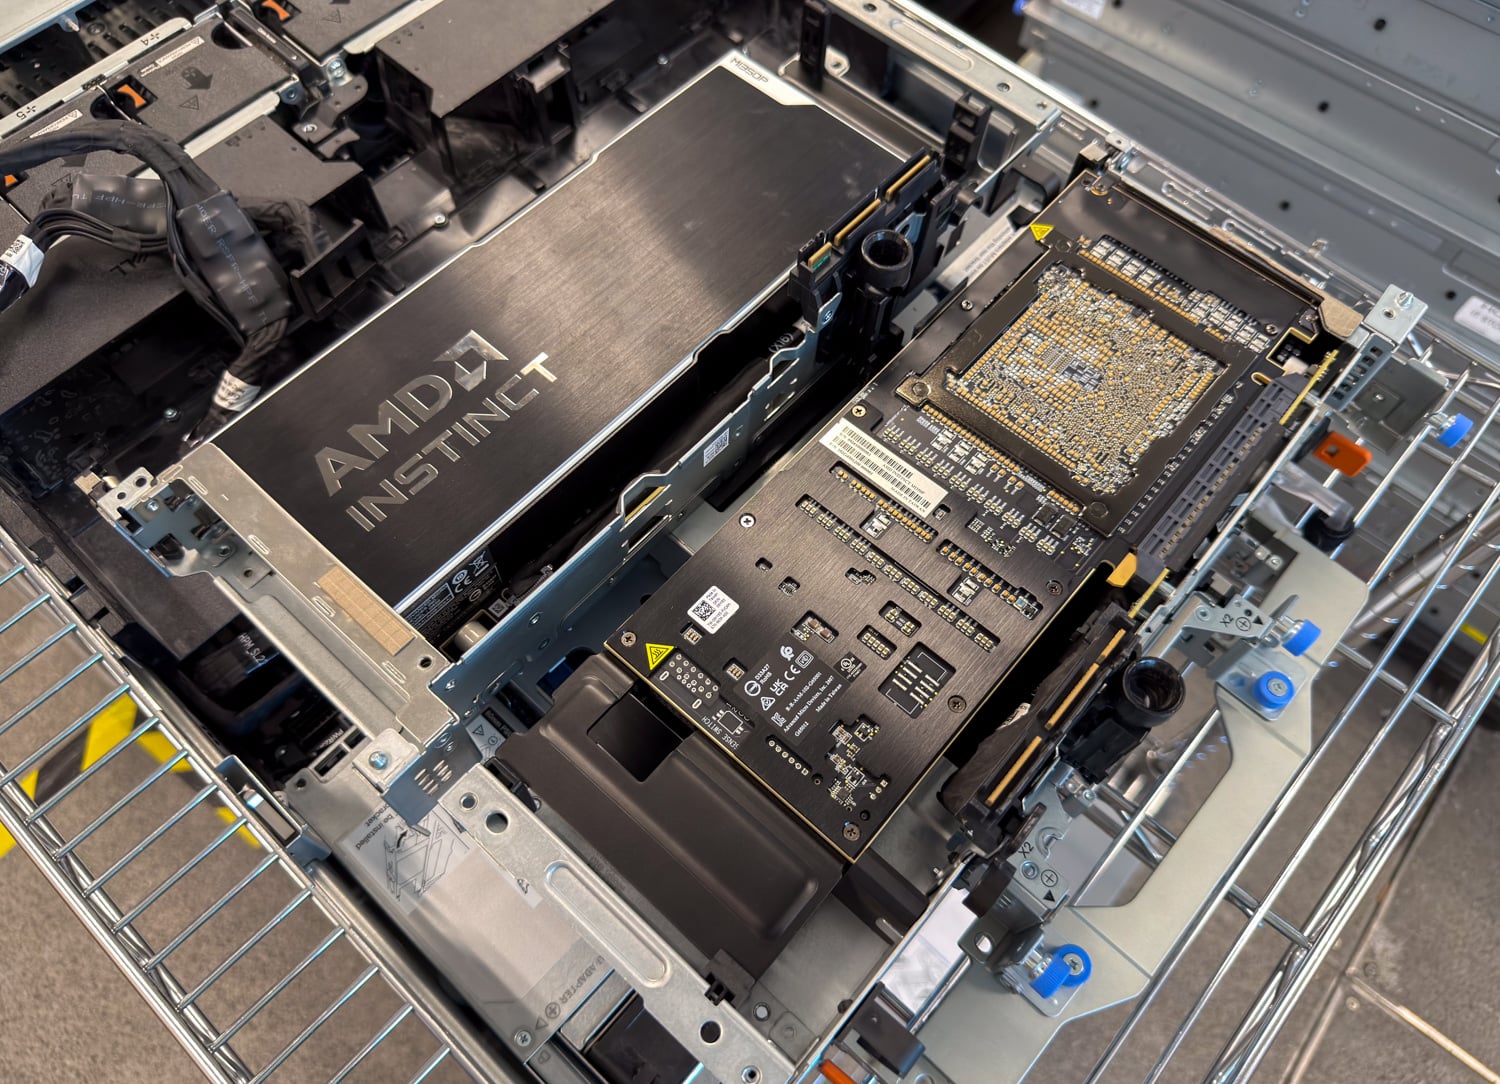
AMD Instinct MI350P — это первая новая видеокарта AMD Instinct с интерфейсом PCIe за четыре года, после MI210, выпущенной в 2022 году. Она переносит архитектуру CDNA 4 в обычную плату расширения, обеспечивая производительность до 4.6 PFLOPS в формате MXFP4, 144 ГБ памяти HBM3E и пропускную способность 4 ТБ/с. Все это помещается в двухслотовую карту с воздушным охлаждением мощностью 600 Вт, предоставляя пользователям еще один способ развертывания видеокарт Instinct без перехода на более крупную платформу OAM MI350/5X с 8 графическими процессорами.
Основные выводы
- Главная особенность — 144 ГБ памяти в слоте PCIe. Видеокарта MI350P обладает самым большим объемом памяти среди всех современных PCIe-ускорителей: на 3 ГБ больше, чем у H200 NVL, и на 48 ГБ больше, чем у RTX PRO 6000 Blackwell, с пропускной способностью 4 ТБ/с HBM3E. Десять из четырнадцати комбинаций моделей и характеристик, рассмотренных в этом обзоре, работали на одной карте.
- По результатам измерений, вычислительные мощности находятся между показателями двух видеокарт NVIDIA. При мощности 450 Вт MAMF достигла 580 TFLOPS в BF16, 1,120 в FP8 и 2,228 в масштабированном по блокам FP4, что на 36-38 процентов выше, чем у 600-ваттной RTX PRO 6000 при любой точности, и уступает H200 NVL в BF16 и FP8, у которой отсутствует путь FP4.
- GPT-OSS — это лучший результат, достигнутый MI350P. На AMDGPU 31.60, ROCm 10.1.0 и vLLM 0.32.0 GPT-OSS-120B достиг производительности 5,057 выходных токенов в секунду при 128 потоках в режиме чата, что на 65 процентов опережает RTX PRO 6000 и на 50 процентов опережает H200 NVL, и кривая продолжает расти при 128 потоках для обеих форм подсказок.
- Для коротких сообщений в чате предпочтение отдается MI350P; длинные сообщения показывают смешанные результаты. При запросах на 512 токенов карта превосходит RTX PRO 6000 на всех моделях FP8, BF16 и GPT-OSS на 35–65 процентов при 128 потоках, а в двух сравнениях FP4 против NVFP4 разница составляет 5 и 21 процент соответственно, в то время как при запросах на 8,192 токена она лидирует на GPT-OSS и Mistral Small и отстает на Llama, Qwen FP8 и MiniMax-M2.7, где ее кривая производительности выравнивается на ранних этапах.
- Результаты розыгрыша двух карт доступны в ROCm 7.2.3. DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 и GLM-5.3 Flash были протестированы на этой платформе, поскольку в тестах ROCm 10.1 для этих моделей использовалась экспертная разгрузка ЦП, а в DeepSeek — спекулятивный декодер, который не применялся в тестах NVIDIA.
- Вопрос о мощности в 600 Вт по-прежнему остается открытым. Компания Dell задокументировала восемь устройств MI350P, работающих на мощности 600 Вт в коммутаторе PowerEdge XE7745, и планируется проведение последующих испытаний на полной мощности.
Компания AMD также продемонстрировала MI350P на выставке IFA 2026 в прототипе рабочей станции Threadripper Halo Station, где те же ускорители были с жидкостным охлаждением. Концепция рабочей станции поддерживает до четырех MI350P вместе с 96-ядерным процессором Threadripper PRO, обеспечивая суммарную емкость HBM3E в 576 ГБ в одном устройстве; на странице продукта AMD, обновленной в октябре, теперь указано, что система появится в 2027 году. Это дает нам два способа взглянуть на MI350P: как на ускоритель PCIe для серверов и как на строительный блок для более крупной настольной системы искусственного интеллекта, конкурирующей с такими машинами, как GB300 DGX Station.
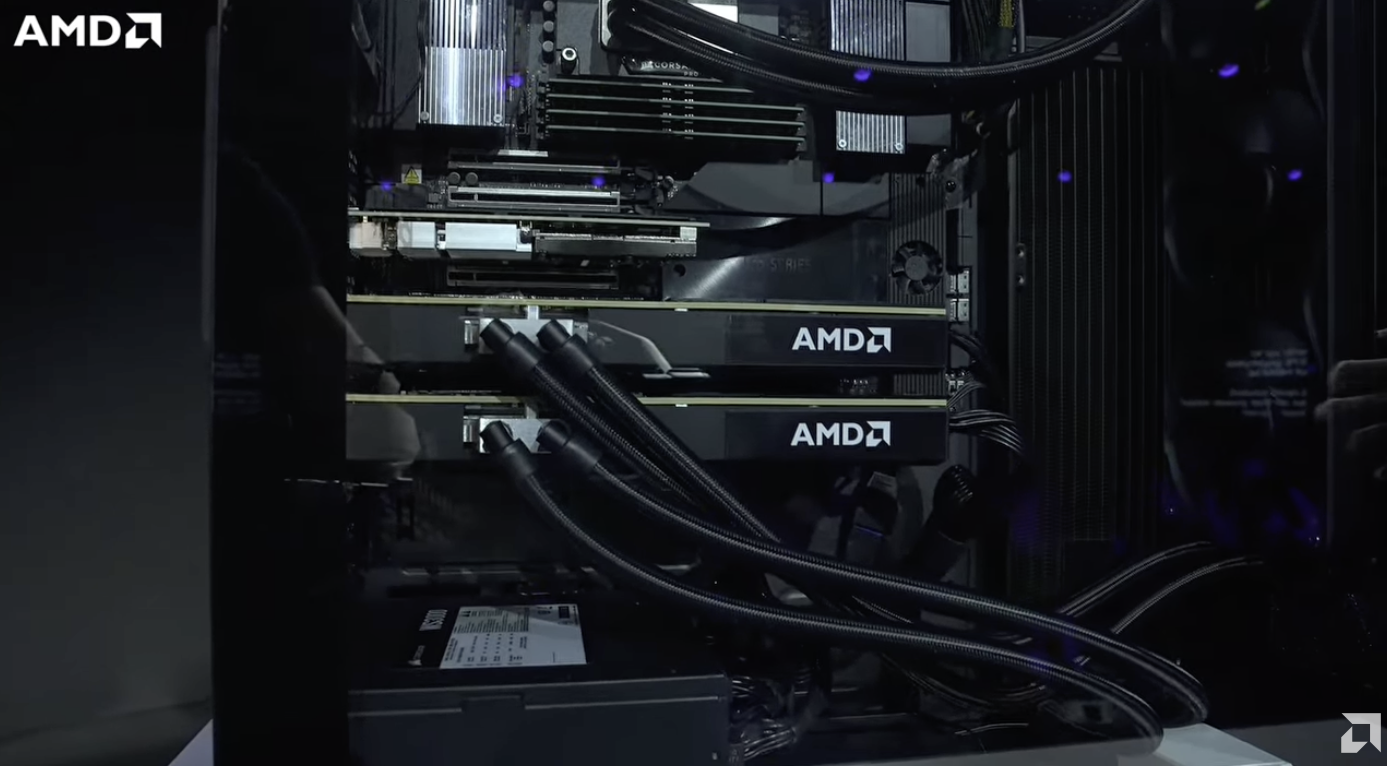
На первом этапе рассматривается серверная версия, поэтому для покупателя, выбирающего PCIe-ускоритель, важным сравнением является NVIDIA RTX PRO 6000 Blackwell — карта того же класса мощности и для тех же слотов, а H200 NVL занимает лидирующие позиции в рейтинге как наиболее производительная карта NVIDIA для рабочих нагрузок, где пропускная способность памяти определяет результат. В качестве примера для настольного варианта используется GB300 DGX Station — машина другого класса по другой цене, и она демонстрирует, насколько полноценный графический процессор Blackwell Ultra превосходит любую из PCIe-карт.
Технические характеристики AMD Instinct MI350P
Согласно опубликованным данным AMD, основная производительность MI350P приходится на вычисления с низкой точностью: 4.6 PFLOPS при MXFP4 и MXFP6, 2.3 PFLOPS при FP8 и 1.15 PFLOPS при FP16 или BF16 — все эти показатели являются плотными. Вторая половина карты — это система памяти: 144 ГБ HBM3E с 4,096-битным интерфейсом и скоростью 4 ТБ/с, за 128 МБ кэша Infinity Cache, на который опираются результаты однопотоковых вычислений, представленные ниже. Потребляемая мощность платы составляет 600 Вт с возможностью настройки на 450 Вт; наш тестовый образец работал при мощности 450 Вт.
В MI350P используется та же архитектура CDNA 4, что и в более крупных и мощных графических процессорах MI350/5X. MI350P можно рассматривать как, по сути, половину MI350X. Чтобы понять почему, полезно взглянуть на конструкцию более крупного графического процессора.
MI350X — это чиплетная архитектура с трехмерной структурой, построенная на основе технологии CoWoS (Chip-on-Wafer-on-Substrate) от TSMC, без единого монолитного кристалла. Восемь кристаллов ускорительного комплекса (XCD) расположены над двумя кристаллами ввода-вывода, по четыре XCD на каждом кристалле ввода-вывода. Чиплеты соединены технологией AMD Infinity Fabric, а восемь стеков HBM3E обеспечивают память графического процессора. CoWoS описывает интеграцию на уровне корпуса; вычислительная структура над вводом-выводом — это вертикальный трехмерный компонент конструкции.

В MI350P используется половина этой конфигурации: четыре XCD, один чип ввода-вывода и четыре стека HBM3E. Каждый XCD имеет 32 активных вычислительных блока, что дает карте 128 вычислительных блоков по сравнению с 256 у MI350X. Ресурсы памяти также уменьшены вдвое: 144 ГБ HBM3E против 288 ГБ, пропускная способность 4 ТБ/с против 8 ТБ/с и 128 МБ кэша Infinity против 256 МБ.

| Параметр | AMD Instinct MI350P |
|---|---|
| Обзор платформы | |
| Архитектура | кДНК 4 |
| Вычислительные единицы | 128 |
| Потоковые процессоры | 8,192 |
| Матричные ядра | 512 |
| Разработка | TSMC 3 нм и 6 нм |
| Транзисторы | 73 млрд |
| Пиковое время работы двигателя | 2,200MHz |
| Память | |
| Рабочий диапазон | 144 ГБ HBM3E |
| Интерфейс | 4,096-бит |
| Пропускная способность | 4 ТБ / с |
| Последний уровень кэша | 128MB |
| ECC | Полный чип |
| Максимальная производительность (по заявлению AMD) | |
| MXFP4 | 4.6 пфлопс |
| MXFP6 | 4.6 пфлопс |
| MXFP8 | 2.3 пфлопс |
| OCP FP8 | 2.3 пФЛОПС; 4.6 пФЛОПС со структурированной разреженностью |
| FP16 | 1.15 пФЛОПС; 2.3 пФЛОПС при разреженности |
| BF16 | 1.15 пФЛОПС; 2.3 пФЛОПС при разреженности |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| Мощность, охлаждение и форм-фактор | |
| Типичная мощность платы | Максимальная мощность 600 Вт; регулируемая мощность 450 Вт. |
| разъем питания | 12В-2×6 |
| Охлаждение | Пассивный |
| Форм-фактор | Плата расширения PCIe, полноразмерная, двухслотовая. |
| Длина доски | 10.5 дюйм (267 мм) |
| Host Interface | PCIe 5.0 x16 |
| Особенности | |
| СР-ИОВ | Да |
| Бесконечный кэш | Да |
| РАН | Да |
| Страница «Отставка и избегание» | Да |
Указанное значение в 600 Вт является максимальным, и AMD позволяет настроить видеокарту на мощность до 450 Вт, именно на этом уровне она работала в нашем 2U-корпусе. H200 NVL показала аналогичное значение в 450 Вт в R770, но RTX PRO 6000 работала на полной мощности в 600 Вт в XE7740, поэтому у видеокарты NVIDIA было на 150 Вт больше мощности во всех сравнениях. Результаты на полной мощности ожидаются в корпусе, способном охлаждать пассивную видеокарту мощностью 600 Вт, а в техническом руководстве Dell для XE7745 указаны восемь видеокарт MI350P мощностью 600 Вт.
Ещё одно замечание: единственный разъём 12V-2×6 и 10.5-дюймовая двухслотовая материнская плата позволяют устанавливать карту в те же райзеры, что и RTX PRO 6000 или H200 NVL сегодня.

В таблице ниже MI350P сопоставляется с тремя системами NVIDIA, представленными в наших таблицах: RTX PRO 6000 Blackwell Server Edition, которая использует тот же слот, диапазон мощности и хост-соединение PCIe 5.0 x16; H200 NVL, карта Hopper с соответствующей пропускной способностью памяти; и GB300 DGX Station, представляющая собой один графический процессор Blackwell Ultra в паре с процессором Grace через NVLink-C2C.
В первую очередь следует прочитать следующие строки: объем памяти, где 144 ГБ у MI350P — это самый большой объем из трех карт PCIe, на 3 ГБ больше, чем у H200 NVL, и на 48 ГБ больше, чем у RTX PRO 6000; пропускная способность памяти, где ее 4 ТБ/с находится между двумя показателями; и строка FP4, где AMD приводит показатель для плотной памяти, а NVIDIA — для разреженной.
| Параметр | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA H200 NVL PCIe | Станция NVIDIA GB300 DGX |
|---|---|---|---|---|
| Архитектура графического процессора | кДНК 4 | Блэквелл | хоппер | Блэквелл Ультра |
| Фактор формы | Ускоритель PCIe | Ускоритель PCIe | Ускоритель PCIe | Одна видеокарта Blackwell Ultra в паре с 72-ядерным процессором Grace. |
| Память GPU | 144 ГБ HBM3E | 96 ГБ GDDR7 ECC | 141 ГБ HBM3E | 252 ГБ HBM3E |
| пропускная способность памяти графического процессора | 4 ТБ / с | 1.6 ТБ / с | 4.8 ТБ / с | 7.1 ТБ / с |
| FP4 | 4.6 PFLOPS MXFP4 (Dense) | 4 PFLOPS NVFP4 (Sparse) | Нет встроенной поддержки FP4 | 20 PFLOPS NVFP4 (Sparse) |
| FP8 | 2.3 пФЛОПС (плотная структура) | 2 PFLOPS (разреженные) | 3.3 PFLOPS (разреженные) | 10 PFLOPS (разреженные) |
| BF16 | 1.15 пФЛОПС (плотная структура) | 1 PFLOPS (разреженные) | 1.6 PFLOPS (разреженные) | 5 PFLOPS (разреженные) |
| FP32 | 72 TFLOPS (Dense) | 120 терафлопс (разреженный) | 60 терафлопс (разреженный) | 80 терафлопс (разреженный) |
| Хост-соединение | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | Технология NVLink-C2C между Grace и GPU, 900 ГБ/с (BiDi) |
| Многопроцессорная связь | на основе PCIe | на основе PCIe | Двух- или четырехканальный NVLink, до 900 ГБ/с на каждый графический процессор (BiDi) | Сетевое соединение ConnectX-8 со скоростью 800 Гбит/с между станциями. |
| Мощность | Настраиваемая мощность от 450 до 600 Вт | Настраиваемая мощность от 300 до 600 Вт | Настраиваемая мощность от 450 до 600 Вт | Видеокарта мощностью до 1200 Вт с учетом колебаний мощности. |
По сравнению с RTX PRO 6000, наиболее очевидным отличием MI350P является подсистема памяти. Она имеет на 50 процентов больше памяти для графического процессора и примерно в 2.5 раза большую пропускную способность. Для модели, которая не очень хорошо вписывается в 96 ГБ памяти, дополнительная емкость может определить, будет ли она работать на одном графическом процессоре или потребуется распределить память между несколькими.
Однако RTX PRO 6000 подходит для более широкого спектра задач, предлагая аппаратные возможности для графики, трассировки лучей и обработки видео, а также для искусственного интеллекта. Выбор зависит не только от двух показателей пиковой вычислительной мощности; он также зависит от того, какие еще задачи должна выполнять система.
H200 NVL является более прямым аналогом MI350P среди высокопроизводительных PCIe-ускорителей; более крупные графические процессоры Blackwell для центров обработки данных относятся к другому классу. Объем памяти практически идентичен: 144 ГБ против 141 ГБ у H200, оба используют HBM3E, а H200 обеспечивает на 20 процентов большую пропускную способность памяти — 4.8 ТБ/с. Они также масштабируются по-разному: все три карты PCIe подключаются к хосту через PCIe, но H200 NVL добавляет выделенное соединение между графическими процессорами через мосты NVLink, соединяющие до четырех графических процессоров.
Более крупные модели MI350X и MI355X были созданы для конкуренции с Blackwell, но MI350P вдвое уменьшает аппаратную конфигурацию. Это приближает её к H200 NVL по характеристикам памяти и общему позиционированию. Однако MI350P по-прежнему выделяется благодаря встроенной поддержке MXFP4 и MXFP6, что становится всё более важным по мере того, как точность вычислений снижается.
Меньший размер подсистемы памяти — ещё один компромисс, поскольку AMD не компенсировала уменьшение количества стеков HBM более быстрой HBM3E, в результате чего пропускная способность MI350P составляет 4 ТБ/с, что отстаёт от H200 NVL по этому показателю. Это может ограничивать производительность в задачах, где пропускная способность памяти имеет решающее значение, независимо от доступных вычислительных ресурсов, как показывают результаты анализа пропускной способности памяти и выполнения длительных запросов, представленные далее в обзоре.
Сравнение с DGX Station происходит в обратную сторону, поскольку GB300 Station оснащена полноценным графическим процессором B300 с отключенным одним стеком HBM — чипом класса дата-центр с соответствующим энергопотреблением, в то время как MI350P представляет собой половину чипа класса дата-центр, установленного в 600-ваттный корпус карты расширения PCIe. AMD требуется две или четыре карты MI350P, чтобы обеспечить производительность одного графического процессора, и на бумаге две из них это обеспечивают: 288 ГБ и 8 ТБ/с против 252 ГБ и 7.1 ТБ/с у Station. Однако эти ресурсы размещены на двух картах, а рабочая нагрузка, охватывающая обе карты, обменивается данными по протоколу PCIe peer-to-peer, что ограничивает возможности второй карты.
Эффективности
Тестовая платформа
В качестве тестового образца использовался сервер Dell PowerEdge R7725 с двумя процессорами AMD EPYC 9555 (по 64 ядра каждый), 1.5 ТБ оперативной памяти DDR5-6400 на 24 слотах DIMM и двумя видеокартами MI350P, настроенными на потребление 450 Вт, что является максимальным показателем для сервера форм-фактора 2U. Видеокарты RTX PRO 6000 Blackwell Server Edition (600 Вт) использовались в сервере Dell PowerEdge XE7740 , в котором размещена наша конфигурация для вывода данных с четырьмя картами, одна видеокарта H200 NVL (450 Вт) использовалась в сервере Dell PowerEdge R770 из нашего обзора, а данные по GB300 получены с помощью ASUS ExpertCenter Pro ET900N G3 DGX Station, обзор которой мы публиковали в сентябре.

Приведенная ниже инвентаризация iDRAC показывает, как установлены две карты. Они находятся в слотах PCIe 2 и 7, оба Gen5 x16, и оба показывают исправность. Ключи устройств 0-139-0 и 1-199-0 считываются как одна карта за каждым сокетом EPYC, поэтому тензорный параллельный трафик между двумя MI350P проходит через канал сокета на пути между корневыми комплексами. Это стандартная компоновка для развертывания двух карт в сервере 2U, и об этом стоит помнить при анализе результатов работы с двумя картами.

В представлении памяти отображается остальная часть хоста: 24 модуля DIMM по 64 ГБ DDR5-6400, двухранговые, общей емкостью 1,536 ГБ в сервере с максимальным объемом памяти 6 ТБ, все с многобитной коррекцией ошибок ECC. Запас памяти важен для запуска GLM-5.2, где контрольная точка MXFP4 не помещается в 288 ГБ памяти двух карт, и vLLM переносит часть весовых коэффициентов экспертной оценки в память хоста.

Максимально достижимое количество операций с плавающей запятой в FLOPS (MAMF)
Чтобы оценить вычислительные возможности MI350P в контексте, мы запустили MAMF на четырех системах. MAMF (Maximum Achievable Matmul FLOPS) — это практический показатель производительности, предназначенный для измерения реального пикового количества операций с плавающей запятой в секунду, достигаемого ускорителем во время умножения матриц. Это более полезный бенчмарк, чем теоретическое пиковое значение FLOPS, указанное в спецификации. Мы протестировали каждую систему в режимах BF16, FP8 и блочно-масштабированном FP4 и сообщили о лучшем устойчивом результате в плотном режиме для каждой точности; заштрихованные полосы умножают результат каждой карты PCIe на количество карт, использованных в запусках обслуживания больших моделей, и вычисляются без каких-либо измерений.

При потребляемой мощности 450 Вт видеокарта MI350P достигает 580 TFLOPS в BF16, 1,120 в FP8 и 2,228 в FP4. RTX PRO 6000 Blackwell показывает результаты 419, 820 и 1,634 соответственно, поэтому MI350P опережает NVIDIA на 36-38 процентов по точности, работая при этом на 150 Вт меньше, а наибольший разрыв наблюдается в BF16 — 38.4 процента.
Показатели H200 NVL — 652 TFLOPS в BF16 и 1,205 в FP8 — ставят её выше MI350P по обоим параметрам, при этом у неё отсутствует путь FP4. GB300 DGX Station превосходит все три карты PCIe по показателям 1,924, 3,802 и 6,024, что примерно в 3.3 раза выше, чем у MI350P в BF16, и в 2.7 раза выше в FP4; две MI350P по характеристикам близки к 1,160 и 4,456, но всё ещё уступают единственной видеокарте Station. Показатели NVIDIA MAMF в этом обзоре получены в результате наших последних тестов каждой карты и заменяют результаты наших предыдущих испытаний.
Пропускная способность памяти графического процессора
Вычислительная мощность графического процессора полезна только в том случае, если ускоритель может постоянно обеспечивать свои исполнительные блоки данными. Это наиболее важно для вывода результатов, где генерация токенов на этапе декодирования в большей степени ограничена пропускной способностью памяти, чем доступным количеством операций с плавающей запятой (FLOPS). Тест пропускной способности выполняет чтение, запись и копирование памяти графического процессора через вычислительные ядра и механизм копирования, показывая доступную пропускную способность каждого графического процессора по сравнению с его номинальным значением.

Одна карта MI350P считывает данные из памяти HBM3E со скоростью 3,291 ГБ/с и записывает со скоростью 3,204 ГБ/с, что составляет около 80 процентов от заявленной скорости 4 ТБ/с, а скорость копирования составляет от 1,276 до 1,283 ГБ/с; копирование потребляет пропускную способность дважды: один раз для чтения исходного файла и еще раз для записи в целевой файл. Память GDDR7 видеокарты RTX PRO 6000 обеспечивает скорость чтения 1,540 ГБ/с и скорость записи 1,483 ГБ/с, поэтому MI350P обеспечивает примерно в 2.1 раза большую полезную пропускную способность на карту.
Показатели скорости чтения и записи H200 NVL — 4,472 ГБ/с и 4,156 ГБ/с — на 36 и 30 процентов выше, чем у MI350P, что соответствует его заявленной скорости 4.8 ТБ/с против 4 ТБ/с, а GB300 DGX Station достигает 6,869 ГБ/с. Две модели MI350P, измеренные вместе, достигают скорости чтения 6,529 ГБ/с, что близко к Station, но эта пропускная способность сосредоточена в двух слотах PCIe, и модель, использующая оба слота, окупает каждый обмен данными через PCIe.
вывод
После рассмотрения низкоуровневых тестов переходим к выводу LLM. Наш онлайн-тест vLLM запускает совместимую с OpenAI конечную точку с фиксированным числом одновременных потоков и записывает количество токенов в секунду на протяжении всего выполнения. Мы получаем два результата: 512 токенов на входе и 512 на выходе, что соответствует размеру чата и требует интенсивного декодирования, и 8,192 на входе и 1,024 на выходе, что соответствует размеру RAG и документа и предполагает предварительное заполнение. Параллелизм удваивается, начиная с одного потока, и каждый график останавливается на максимальном уровне параллелизма, при котором каждая карточка в нем завершилась. Каждая точка соответствует двум запросам на поток, поэтому показатели для одного потока основаны на двух запросах и имеют большую вариативность от запуска к запуску, чем показатели для более высоких уровней параллелизма.
Каждая модель работала на минимальном количестве карт, которые могли её вместить: одна MI350P для всего, вплоть до GPT-OSS-120B и MiniMax-M2.7, и две для DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 и GLM-5.3 Flash. Для RTX PRO 6000 действует то же правило: две карты RTX против одной MI350P на MiniMax-M2.7 и четыре против двух на MiniMax-M3 и GLM-5.2. Конфигурации с низкой точностью различаются в зависимости от производителя: у AMD используется MXFP4 до Quark, у NVIDIA — NVFP4, и пары FP4 обозначены соответствующим образом. GPT-OSS поставляется в формате MXFP4 и использует одинаковые весовые коэффициенты на всех картах. Конфигурации H200 NVFP4 не включены.
| Модель | МИ350П | RTX PRO 6000 Блэквелл | Н200 НВЛ | Станция GB300 DGX |
|---|---|---|---|---|
| GLM-5.3 Flash | 2 карты, MXFP4 | Не запущено | Не запущено | НВФП4 |
| ГЛМ-5.2 | 2 карты, MXFP4 (разгрузка данных в память хоста) | 4 карты, NVFP4 | Не запущено | NVFP4 (около 215 ГБ экспертных данных в памяти Grace) |
| МиниМакс-М3 | 2 карты, MXFP4 | 4 карты, NVFP4 | Не запущено | NVFP4 (группа экспертов, посвященная памяти Грейс) |
| DeepSeek-V4-Flash | 2 карты, FP8 | 2 карты, FP8 | Не запущено | FP8 |
| МиниМакс-М2.7 | 1 карта, MXFP4 | 2 карты, NVFP4 | Не запущено | НВФП4 |
| ГПТ-ОСС-120Б | 1 карта, MXFP4 | 1 карта, MXFP4 | 1 карта, MXFP4 | MXFP4 |
| ГПТ-ОСС-20Б | 1 карта, MXFP4 | 1 карта, MXFP4 | 1 карта, MXFP4 | MXFP4 |
| Qwen3-Coder-30B-A3B | 1 карта, FP8 и BF16 | 1 карта, FP8 и BF16 | 1 карта, FP8 и BF16 | FP8 и BF16 |
| Мистраль Малый 3.1 24Б | 1 карта, FP8 и BF16 | 1 карта, FP8 и BF16 | 1 карта, FP8 и BF16 | FP8 и BF16 |
| Лама 3.1 8Б | 1 карта, MXFP4, FP8 и BF16 | 1 карта, NVFP4, FP8 и BF16 | 1 карта, FP8 и BF16 | NVFP4, FP8 и BF16 |
Прочитав столбец MI350P, вы сразу увидите количество карт памяти — 144 ГБ. Шесть из десяти моделей работают на одной MI350P, тогда как для MiniMax-M2.7 с 96 ГБ RTX PRO 6000 требуется вторая карта, а для двух контрольных точек MXFP4, работающих на паре MI350P (MiniMax-M3 и GLM-5.2), необходимы четыре RTX PRO 6000. GLM-5.2 превосходит даже 288 ГБ по объему памяти, и vLLM переносит часть своих экспертных весов в память хоста R7725 для этого запуска; GB300 делает то же самое с примерно 215 ГБ экспертных данных в памяти Grace.
Результаты тестирования MI350P для однокарточных моделей были получены 27 октября на AMDGPU 31.60, ROCm 10.1.0 и vLLM 0.32.0. Проверенная Dell комбинация — vLLM 0.27 с ROCm 10.0 и AMDGPU 31.5, а мы перешли на версию ROCm 10.1 от 5 октября. На видеокартах NVIDIA использовался контейнер vLLM 26.08 с CUDA 13.4.1. В таблице указана версия сборки для каждого запуска.
| Модель | vLLM Изображение |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| GLM-5.3 Flash MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| Лама 3.1 8B BF16 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| Лама 3.1 8B FP8 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| Лама 3.1 8B MXFP4 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| Mistral Small 3.1 24B BF16 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| Mistral Small 3.1 24B FP8 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| Qwen3-Coder-30B BF16 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| Qwen3-Coder-30B FP8 | vLLM 0.32.0 на ROCm 10.1.0, AMDGPU 31.60 (27 октября) |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Лама 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Лама 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Лама 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Лама 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Лама 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
Четыре модели с двумя видеокартами — DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 и GLM-5.3 Flash — получены в результате тестирования на ROCm 7.2.3. В наших тестах ROCm 10.1 для этих моделей использовалось ускорение работы CPU Expert, а для DeepSeek-V4-Flash — спекулятивный декодер, который не применялся в тестах NVIDIA, что делает их разными тестами. Поэтому они сохраняются для чистого прохождения по текущему стеку, а в таблицах каждая строка MI350P помечена соответствующим стеком.
Для этих моделей AMD предпочитает использовать контейнеры AIM; релиз Enterprise AI Suite 2.5 от 9 октября протестирован на ROCm 10 и содержит AIM для GPT-OSS-120B, Llama 3.3 70B и Gemma 3 27B, но в таблице ускорителей AMD пока указан оптимизированный профиль MI350P только для Wan2.2. Поэтому стандартный vLLM по-прежнему является предпочтительным вариантом для покупателей MI350P, и именно его мы измерили.
Результаты выводов вкратце
Ниже представлены 28 диаграмм, поэтому вот краткая версия в двух таблицах: количество токенов в секунду для каждой модели при максимальной параллельности обработки каждой картой, начиная с рабочей нагрузки размером с чат (512 входящих и 512 исходящих сообщений). Показатели для MI350P относятся к одной карте мощностью 450 Вт, если в строке не указано иное, с отдельным столбцом для стека, к которому относится каждая строка; станция GB300 DGX — это одна карта B300.
| Модель | Видеокарты (MI350P / RTX PRO 6000) | Стек MI350P | Стримы | МИ350П | RTX PRO 6000 | Н200 НВЛ | Станция GB300 DGX |
|---|---|---|---|---|---|---|---|
| Флэш-память GLM-5.3 (MXFP4 против NVFP4) | 2 / нет | РОКм 7.2.3 | 32 | 1,462 | Не запущено | Не запущено | 828 |
| GLM-5.2 (MXFP4 против NVFP4) | 2 / 4 | РОКм 7.2.3 | 32 | 59 | 40 | Не запущено | 139 |
| MiniMax-M3 (MXFP4 против NVFP4) | 2 / 4 | РОКм 7.2.3 | 32 | 1,509 | 759 | Не запущено | 1,041 |
| DeepSeek-V4-Flash | 2 / 2 | РОКм 7.2.3 | 32 | 1,081 | 829 | Не запущено | 1,766 |
| MiniMax-M2.7 (MXFP4 против NVFP4) | 1 / 2 | РОКм 10.1 | 128 | 1,524 | 1,932 | Не запущено | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | РОКм 10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | РОКм 10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1 / 1 | РОКм 10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1 / 1 | РОКм 10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| Mistral Small 24B FP8 | 1 / 1 | РОКм 10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| Mistral Small 24B BF16 | 1 / 1 | РОКм 10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | РОКм 10.1 | 128 | 8,383 | 8,869 | Не запущено | 28,400 |
| Лама 3.1 8B FP8 | 1 / 1 | РОКм 10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| Лама 3.1 8B BF16 | 1 / 1 | РОКм 10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
В таблице чата выделяются два результата: MI350P превосходит RTX PRO 6000 по всем параметрам FP8, BF16 и GPT-OSS на 35–65 процентов при 128 потоках, уступает сборкам NVIDIA NVFP4 только на пике кривых Llama и MiniMax-M2.7 и примерно вдвое превосходит карту NVIDIA при одном потоке на Llama 3.1 8B и Mistral Small 24B, где работу выполняет 4 ТБ/с HBM3E.
H200 NVL, обладающий на 20 процентов большей пропускной способностью, опережает конкурентов на 4–18 процентов в плотных моделях FP8 и BF16 при 128 потоках и показывает одинаковые результаты в Llama 3.1 8B FP8; в двух моделях GPT-OSS ситуация меняется, и MI350P опережает конкурентов на 50 и 78 процентов.
Во второй таблице упражнение повторяется на запросах с 8,192 токенами, где предварительное заполнение играет доминирующую роль, а баланс между вычислительной мощностью и пропускной способностью памяти смещается в сторону видеокарт NVIDIA.
| Модель | Видеокарты (MI350P / RTX PRO 6000) | Стек MI350P | Стримы | МИ350П | RTX PRO 6000 | Н200 НВЛ | Станция GB300 DGX |
|---|---|---|---|---|---|---|---|
| Флэш-память GLM-5.3 (MXFP4 против NVFP4) | 2 / нет | РОКм 7.2.3 | 32 | 760 | Не запущено | Не запущено | 1,219 |
| GLM-5.2 (MXFP4 против NVFP4) | 2 / 4 | РОКм 7.2.3 | 16 | 6 | 9 | Не запущено | 87 |
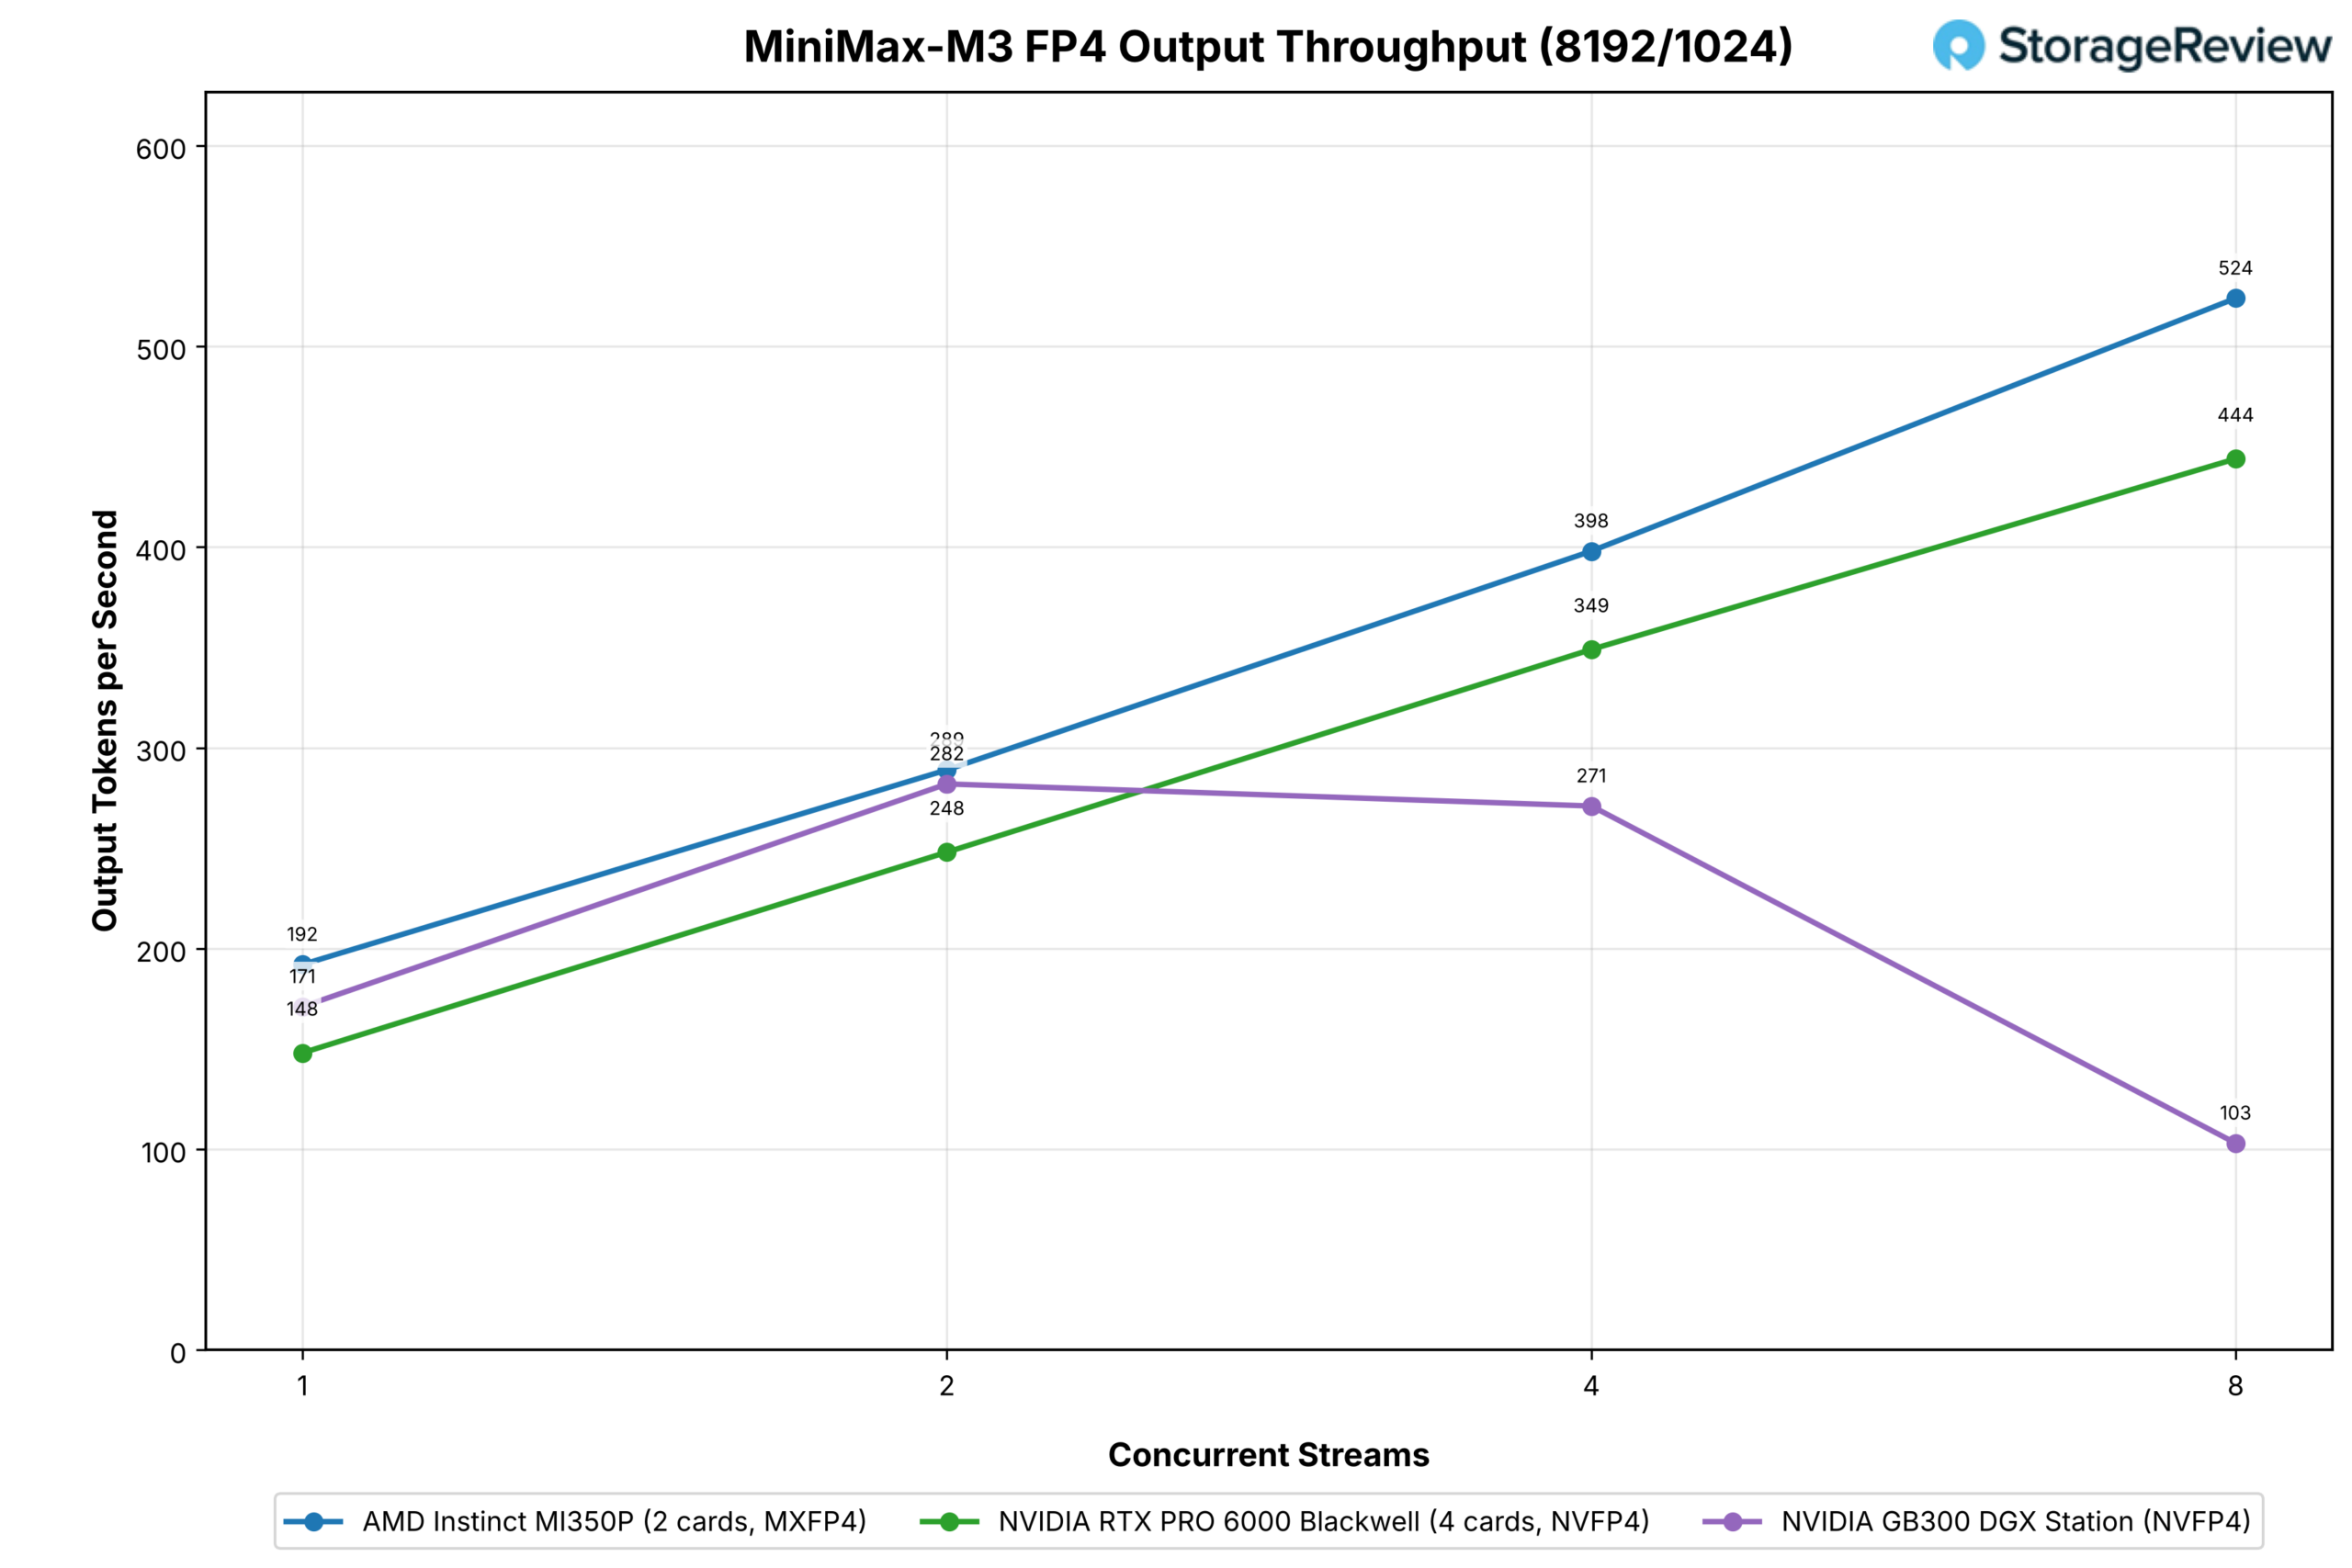
| MiniMax-M3 (MXFP4 против NVFP4) | 2 / 4 | РОКм 7.2.3 | 8 | 524 | 444 | Не запущено | 103 |
| DeepSeek-V4-Flash | 2 / 2 | РОКм 7.2.3 | 32 | 621 | 345 | Не запущено | 954 |
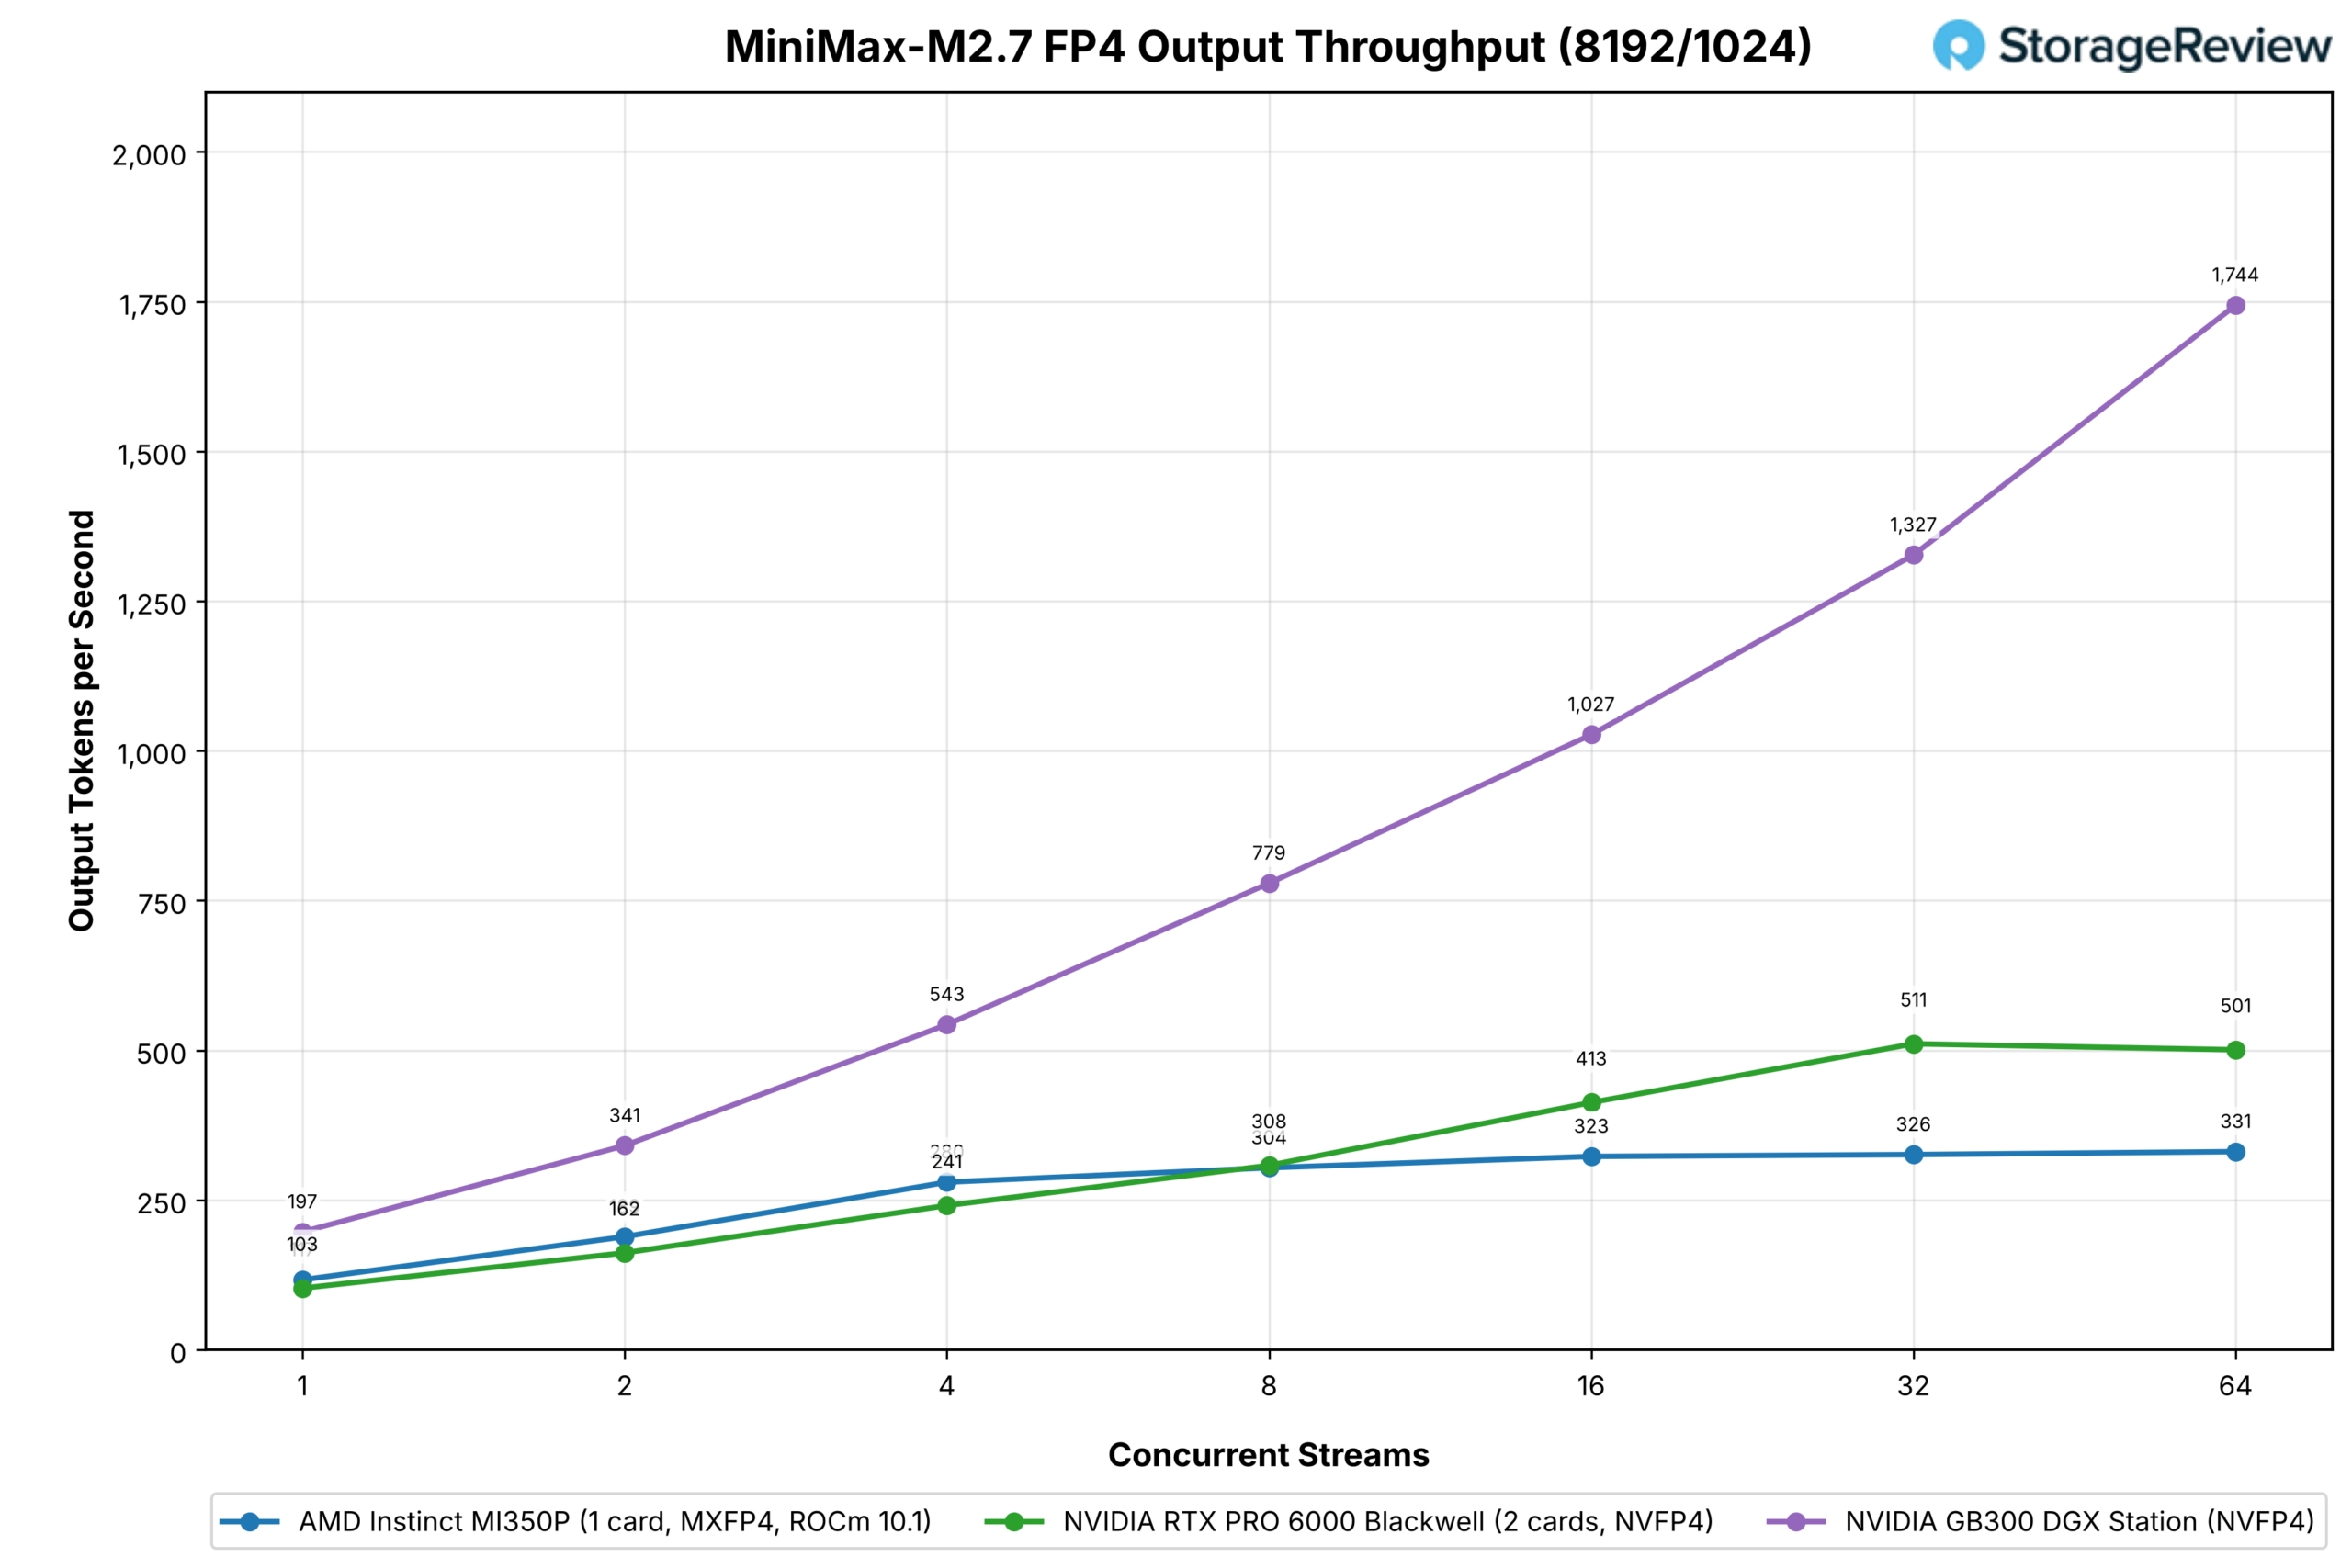
| MiniMax-M2.7 (MXFP4 против NVFP4) | 1 / 2 | РОКм 10.1 | 64 | 331 | 501 | Не запущено | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | РОКм 10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | РОКм 10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
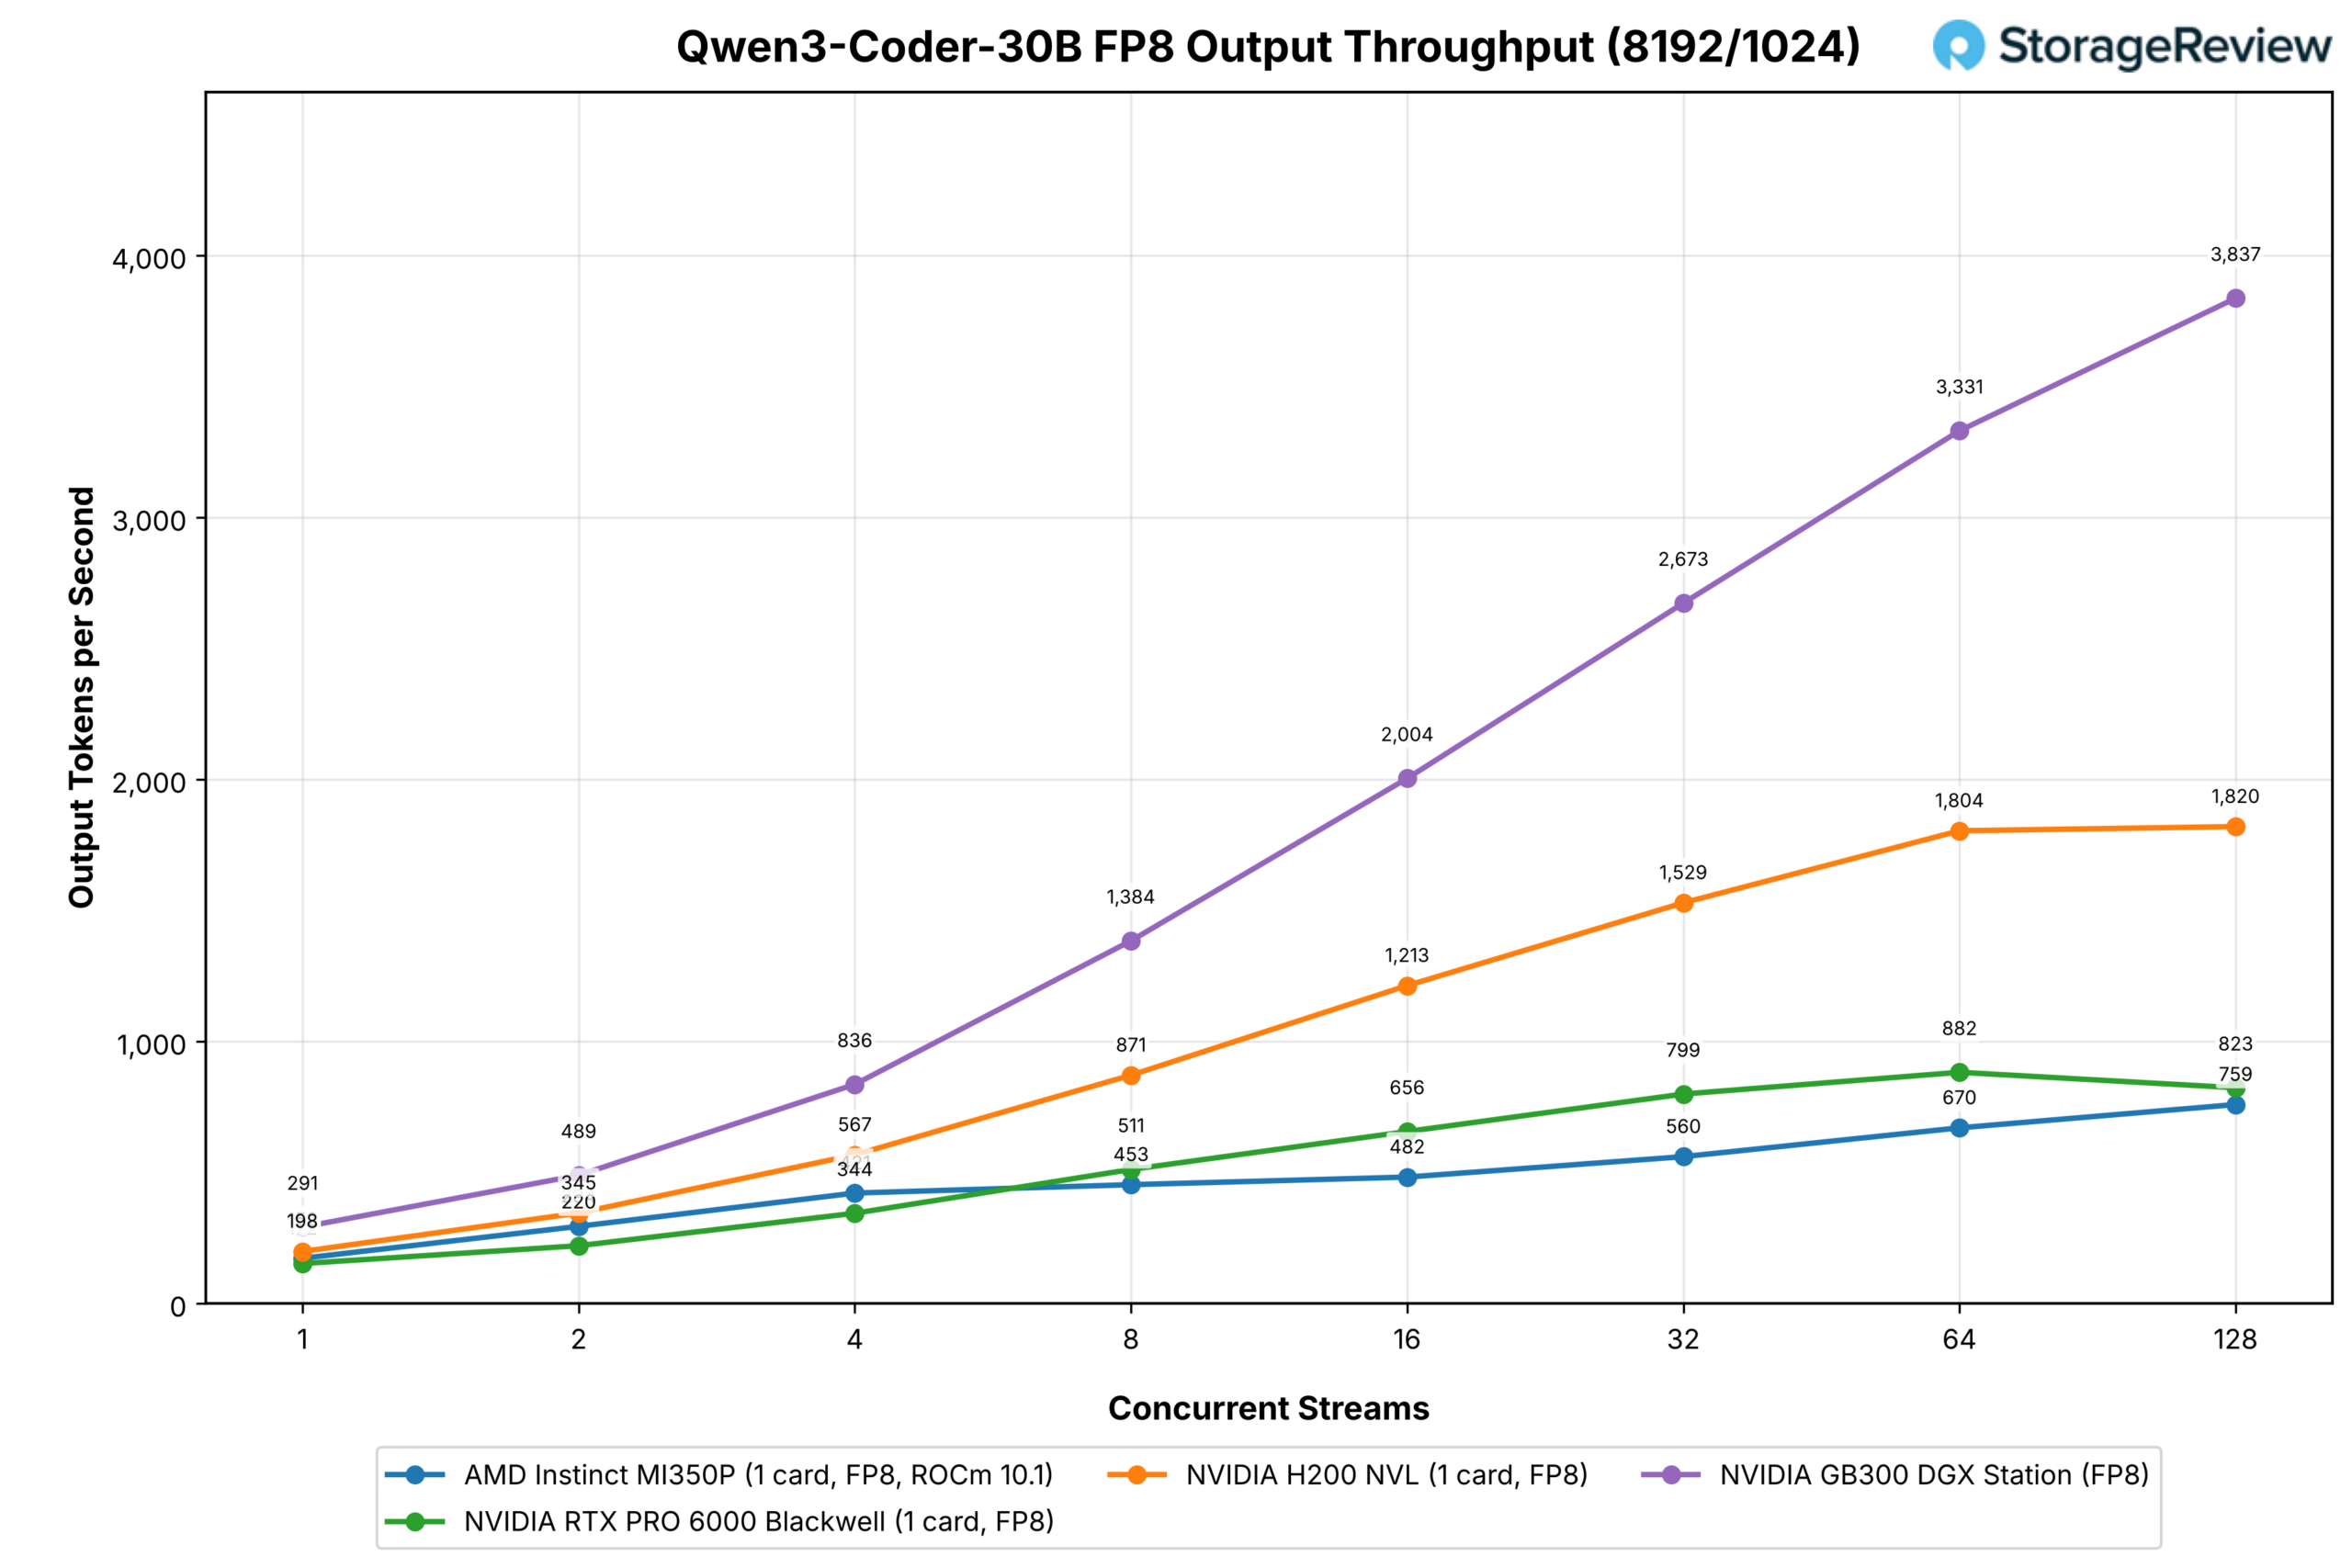
| Qwen3-Coder-30B FP8 | 1 / 1 | РОКм 10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
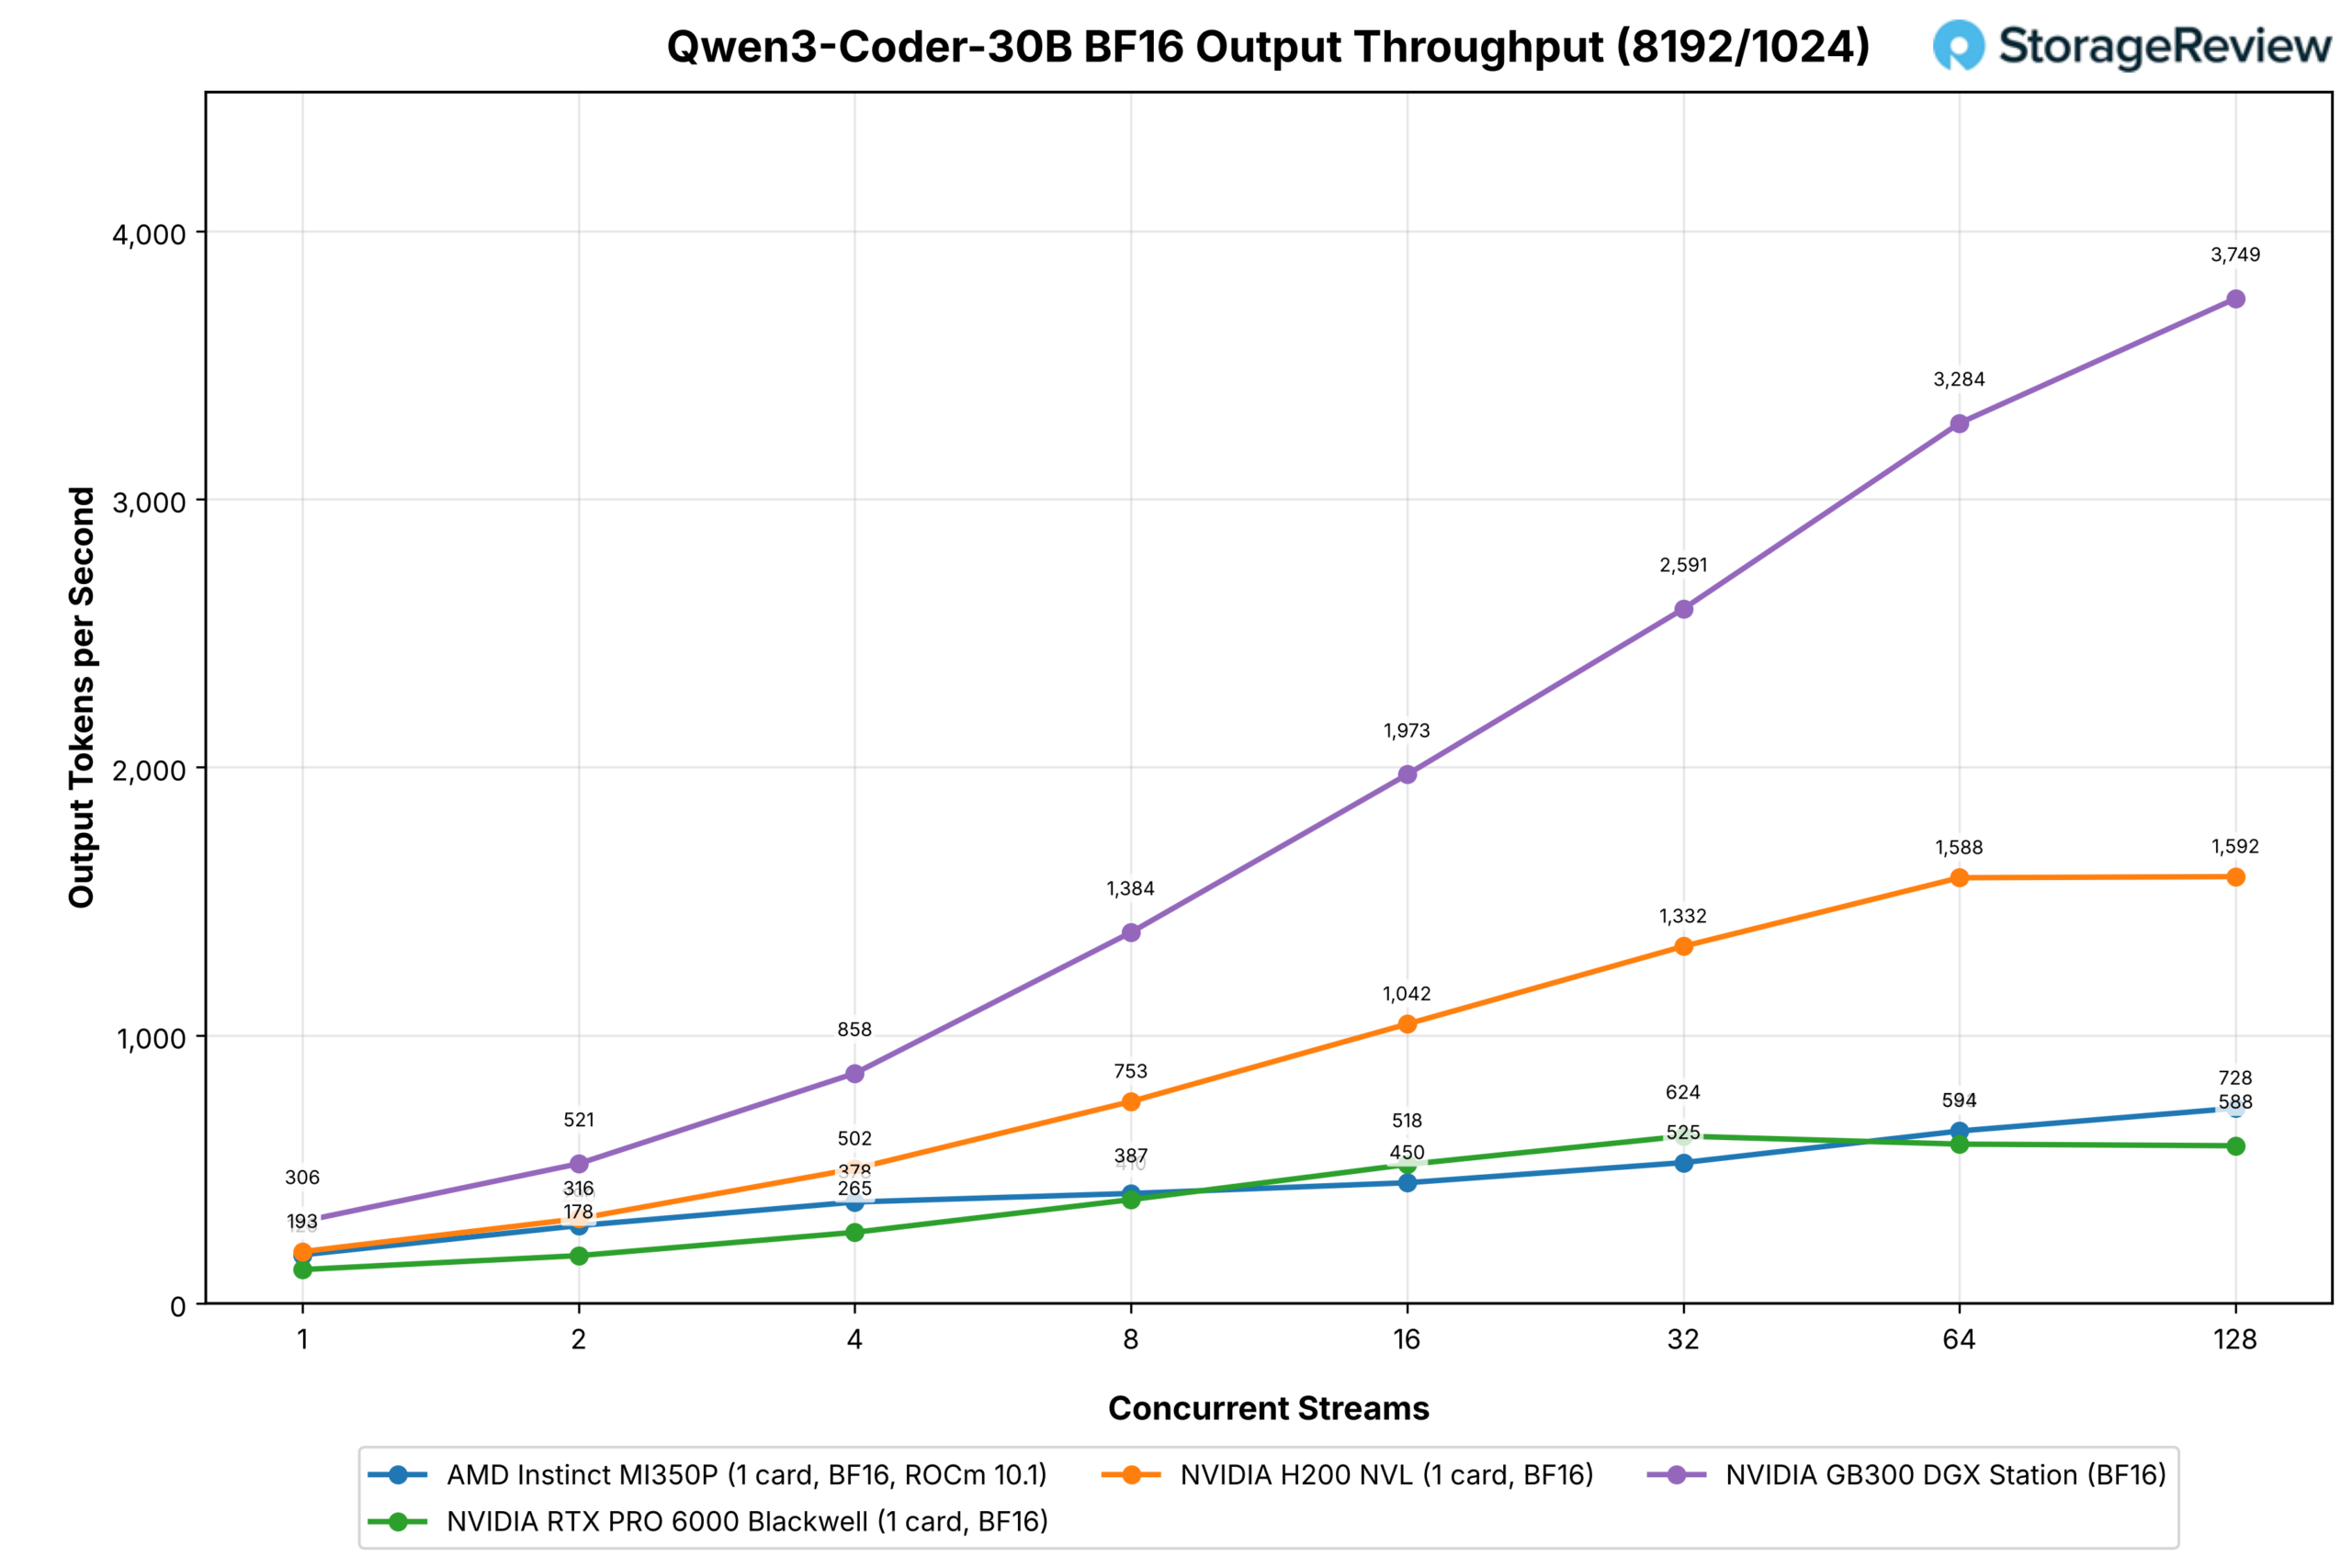
| Qwen3-Coder-30B BF16 | 1 / 1 | РОКм 10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
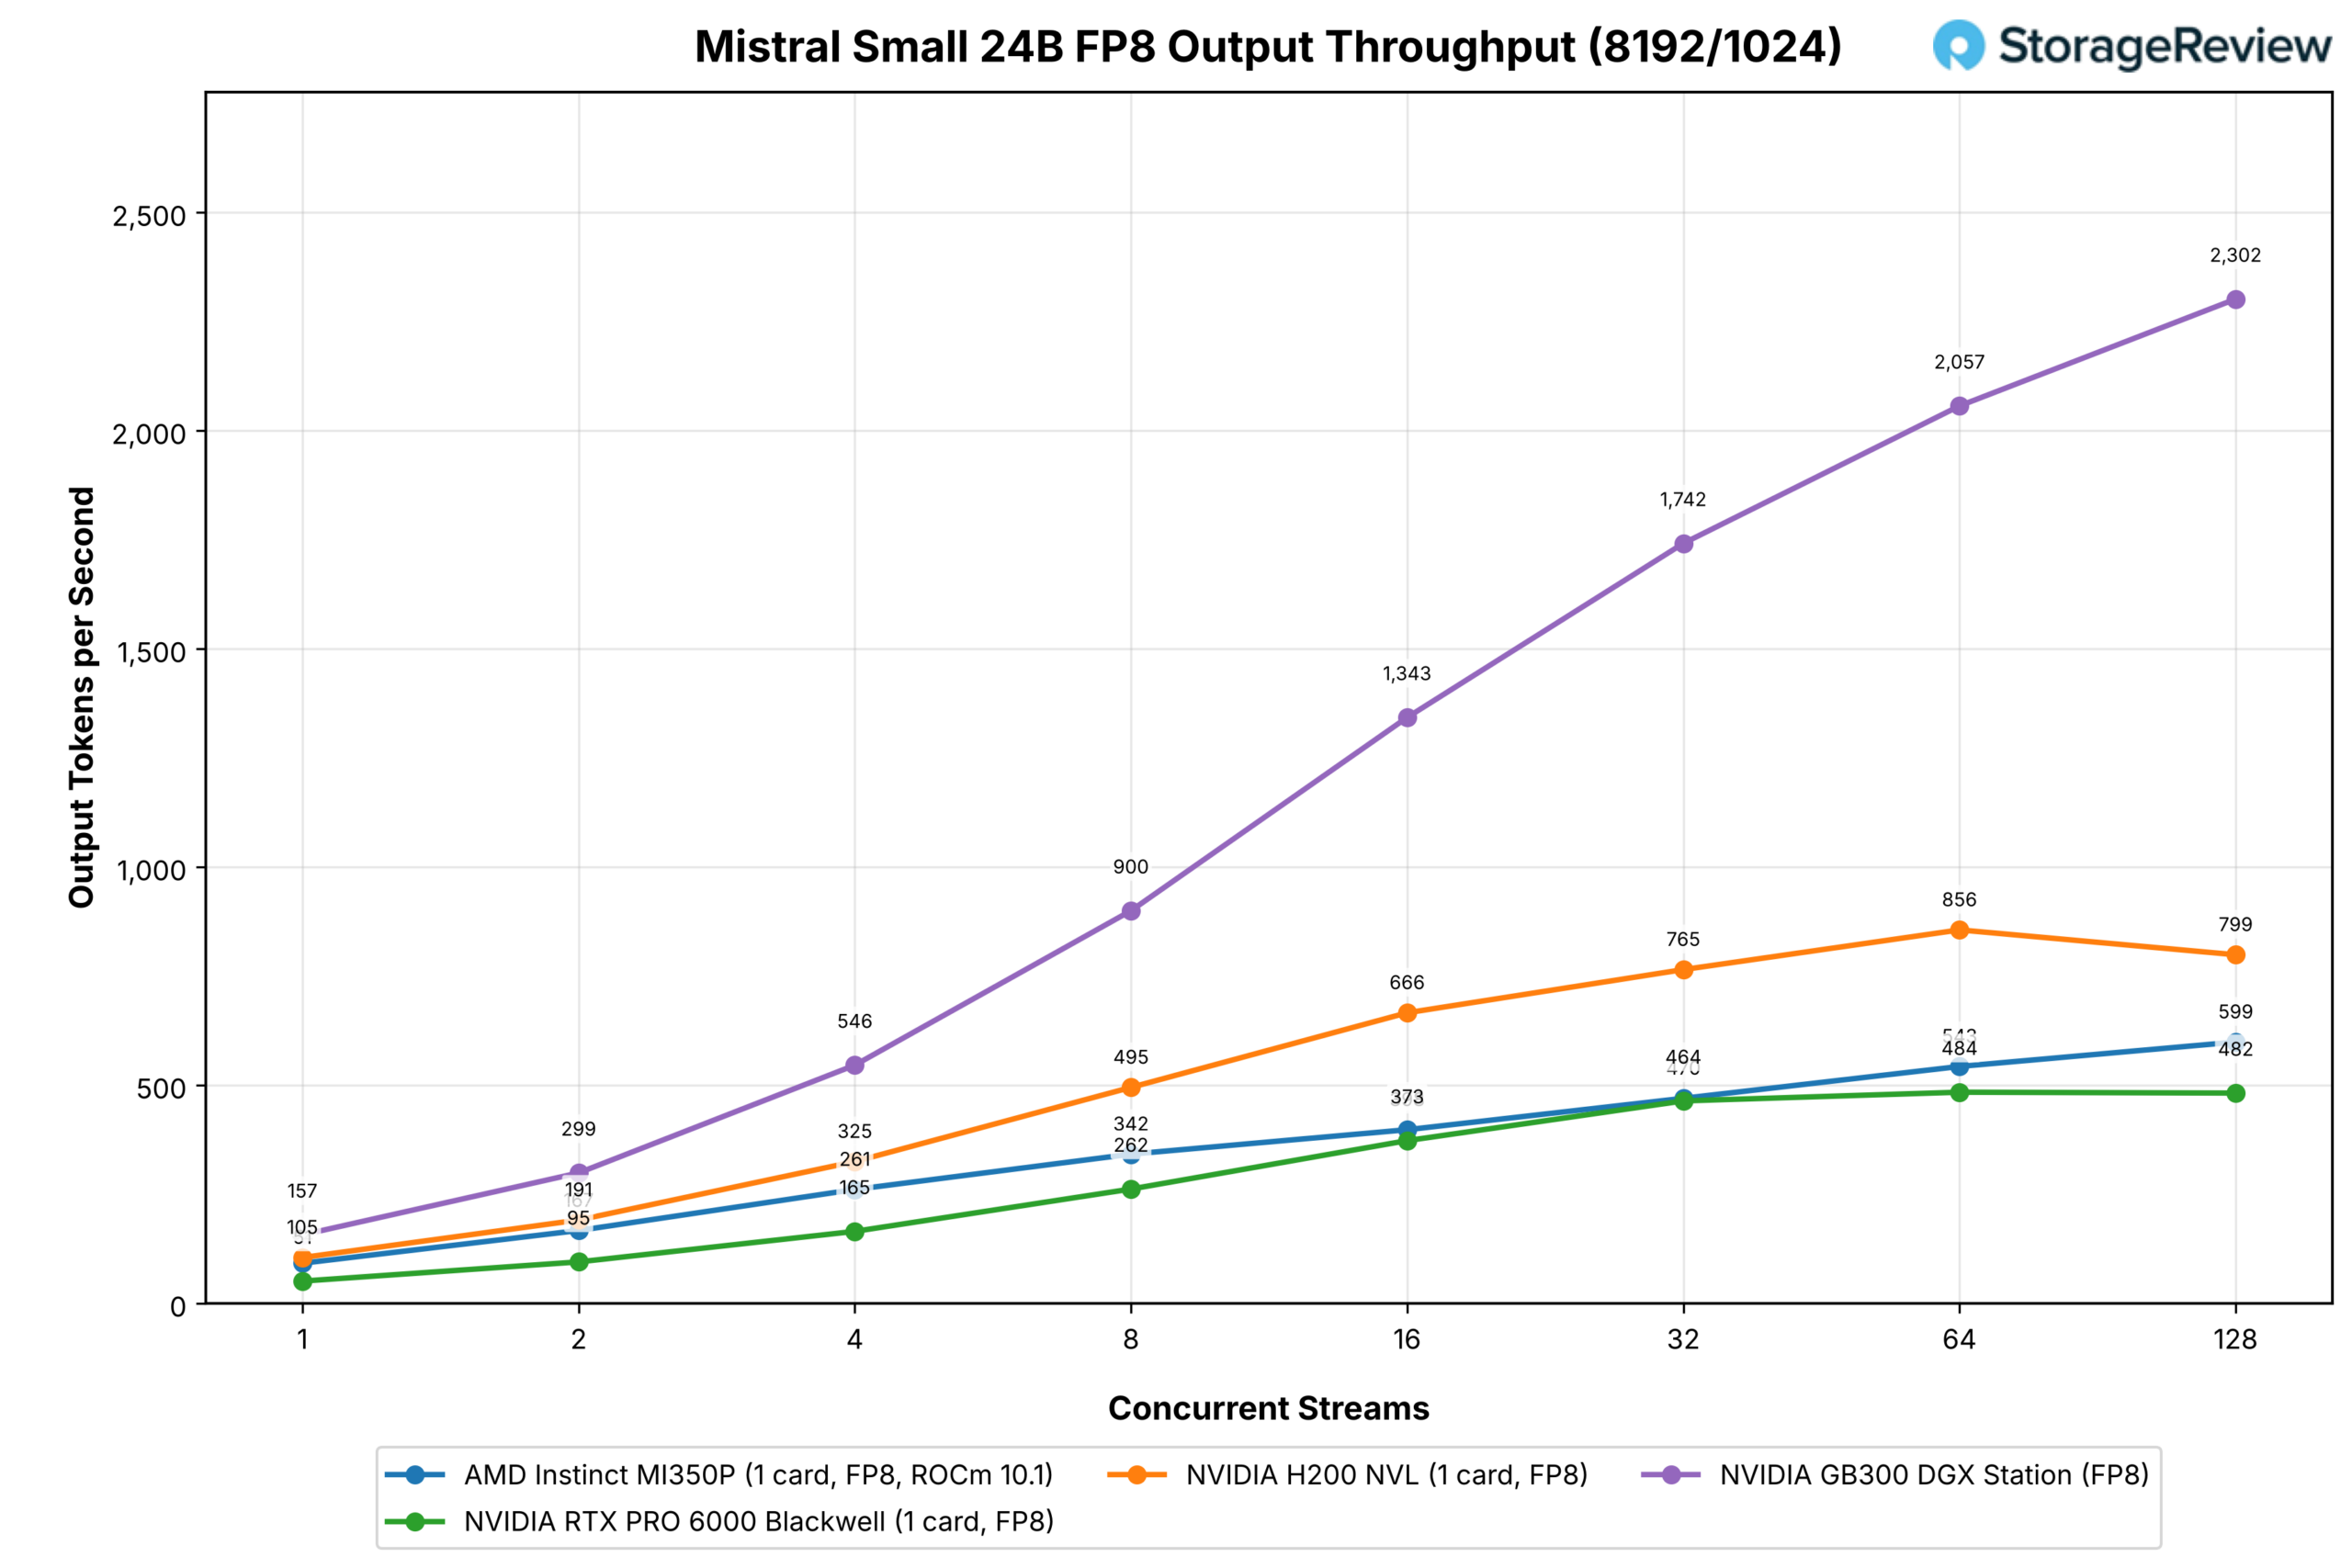
| Mistral Small 24B FP8 | 1 / 1 | РОКм 10.1 | 128 | 599 | 482 | 799 | 2,302 |
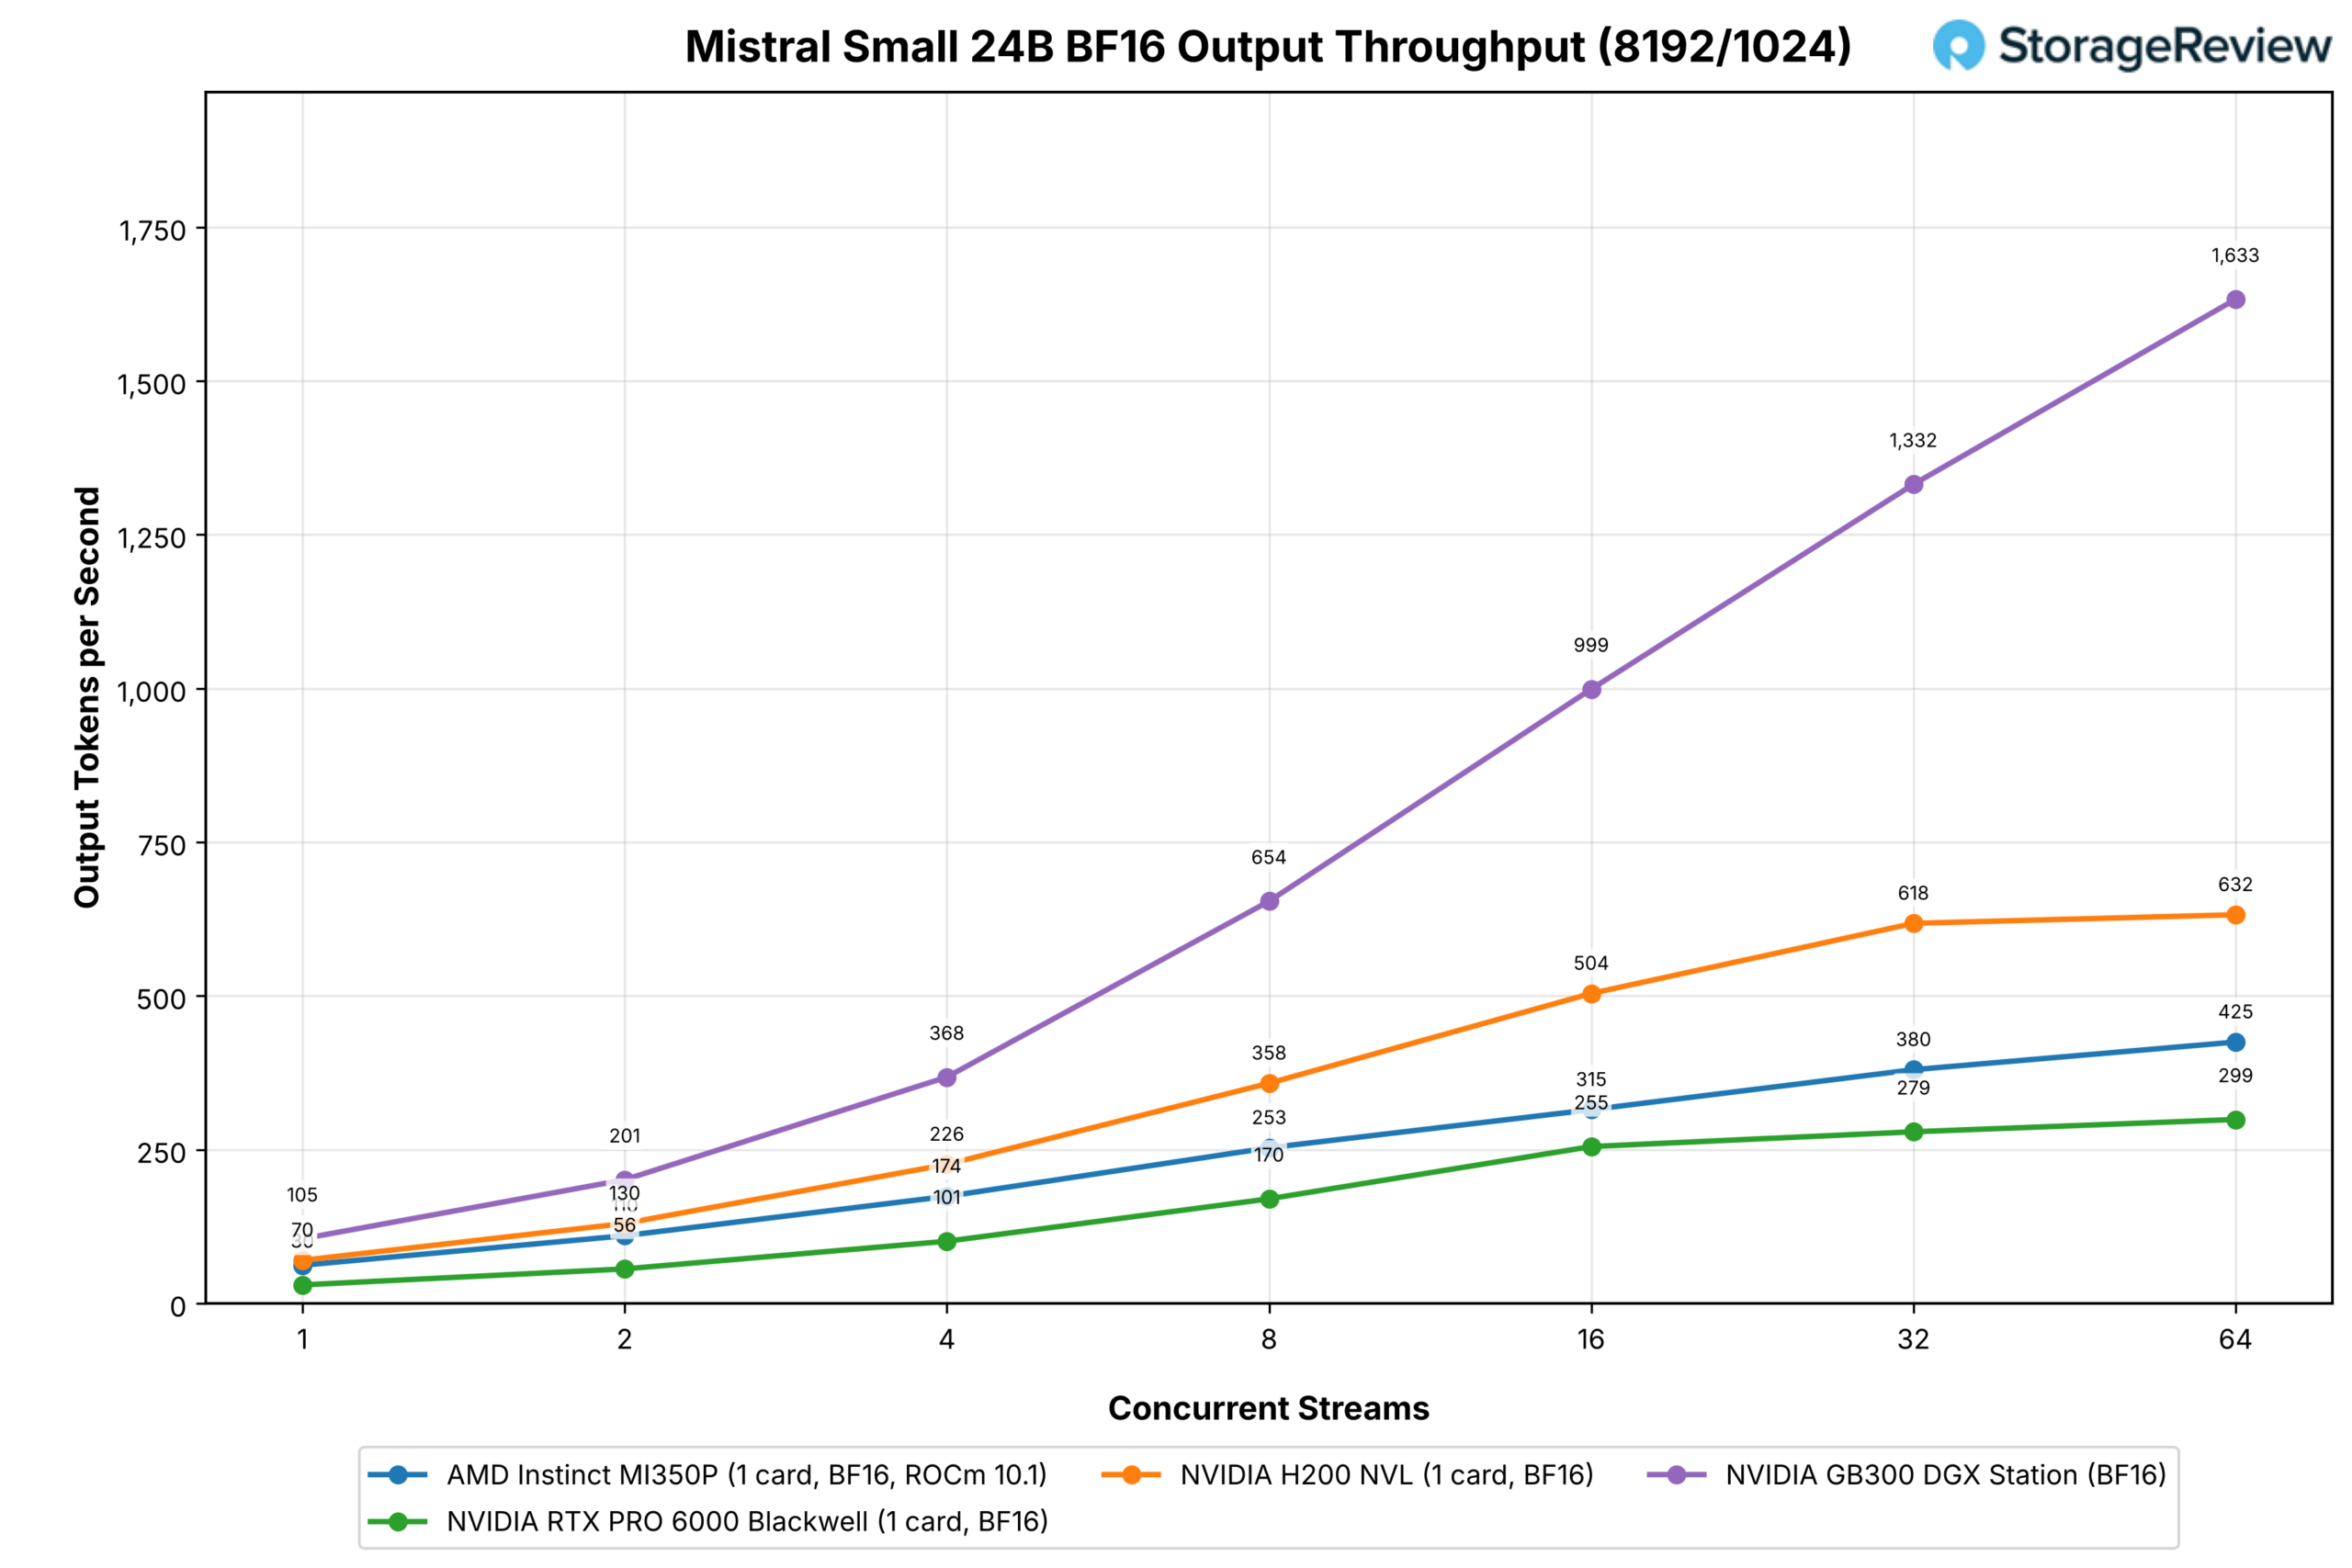
| Mistral Small 24B BF16 | 1 / 1 | РОКм 10.1 | 64 | 425 | 299 | 632 | 1,633 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | РОКм 10.1 | 128 | 964 | 1,644 | Не запущено | 6,737 |
| Лама 3.1 8B FP8 | 1 / 1 | РОКм 10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
| Лама 3.1 8B BF16 | 1 / 1 | РОКм 10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
В задачах с большим количеством предварительных заполнений ситуация неоднозначна: MI350P опережает RTX PRO 6000 на обеих моделях GPT-OSS при любом количестве потоков и в Mistral Small, делит первое место с Qwen3-Coder при 128 потоках (на 24% опережает в BF16, на 8% отстает в FP8) и выравнивается на 16 потоков в Llama и MiniMax-M2.7, где оказывается позади карты NVIDIA. В сравнении с H200, она лидирует в GPT-OSS на 15% в модели 120B и на 5% в модели 20B при 128 потоках, а в более ресурсоемких моделях отстает на 25–58%.
В самых больших моделях, где два MI350P противостоят четырем RTX PRO 6000, комплект NVIDIA лидирует в GLM-5.2 при 16 потоках в задаче чата, имея 384 ГБ GDDR7 против 288 ГБ HBM3E, в то время как в MiniMax-M3 все три конфигурации остаются в пределах 10 процентов при восьми потоках, прежде чем четырехъядерный RTX вырывается вперед с 16 потоками. Один GB300 значительно превосходит все конфигурации PCIe по производительности на любых устройствах, помещающихся в его 252 ГБ памяти.
GLM-5.3 Flash
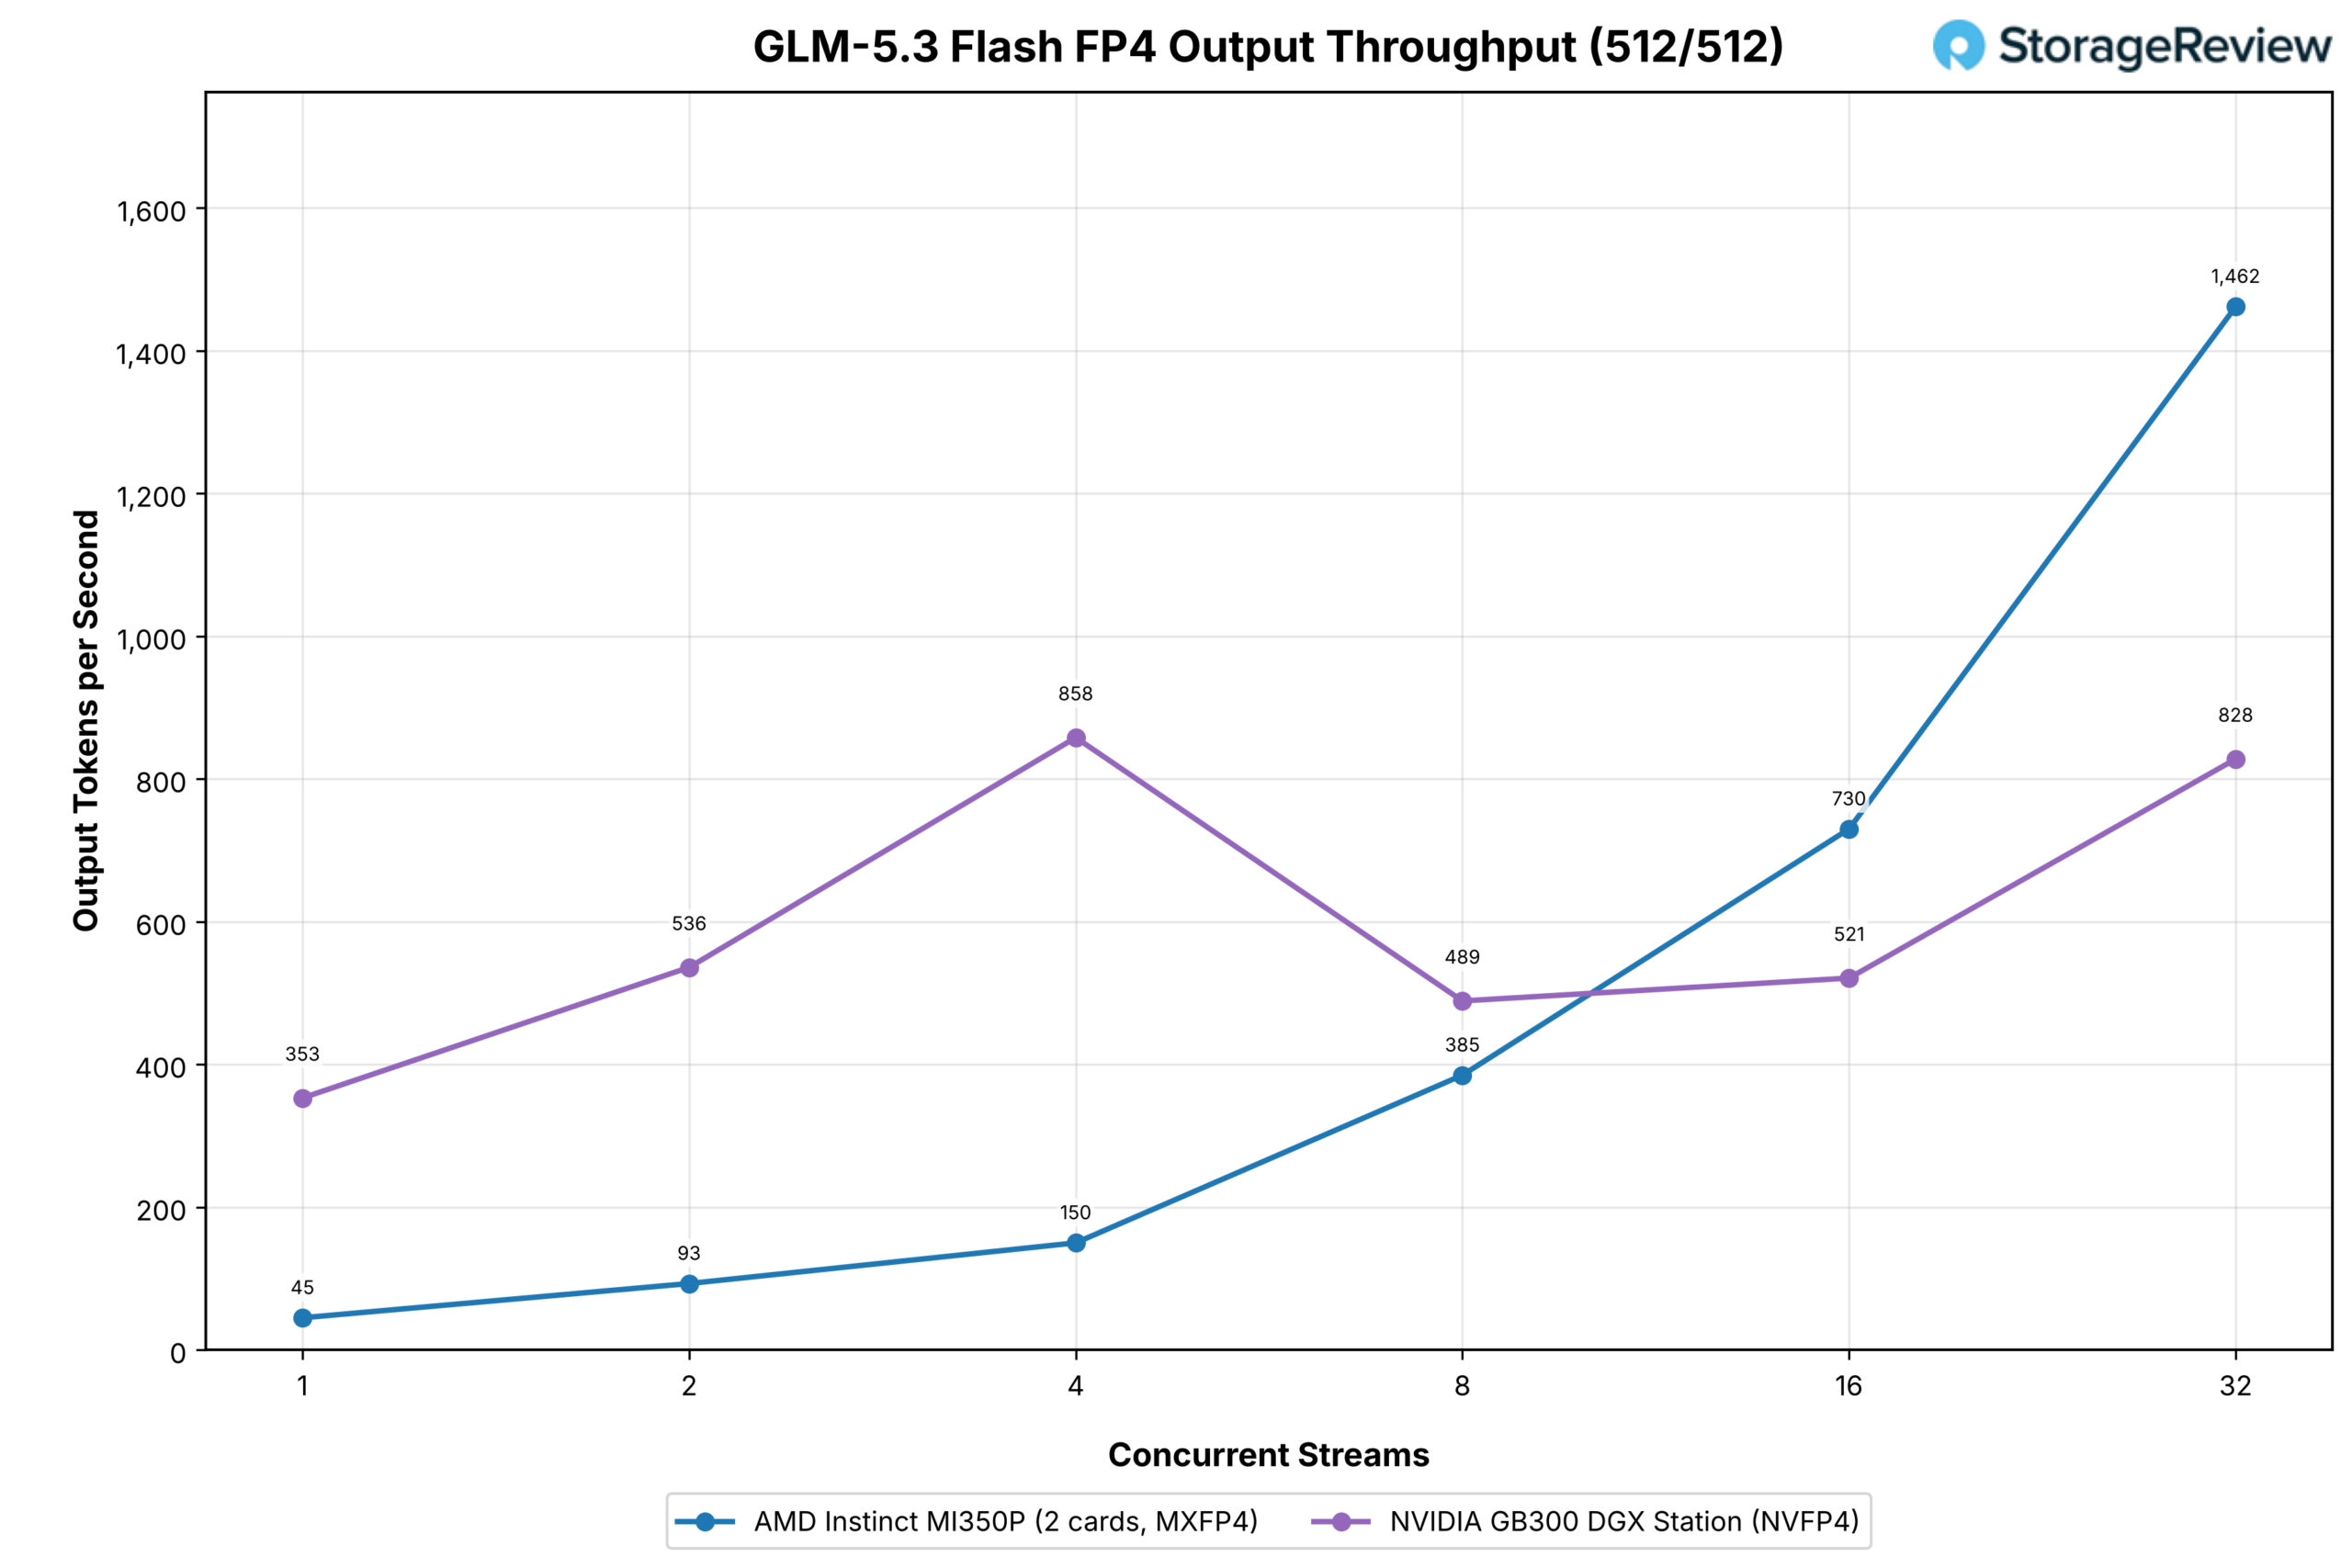
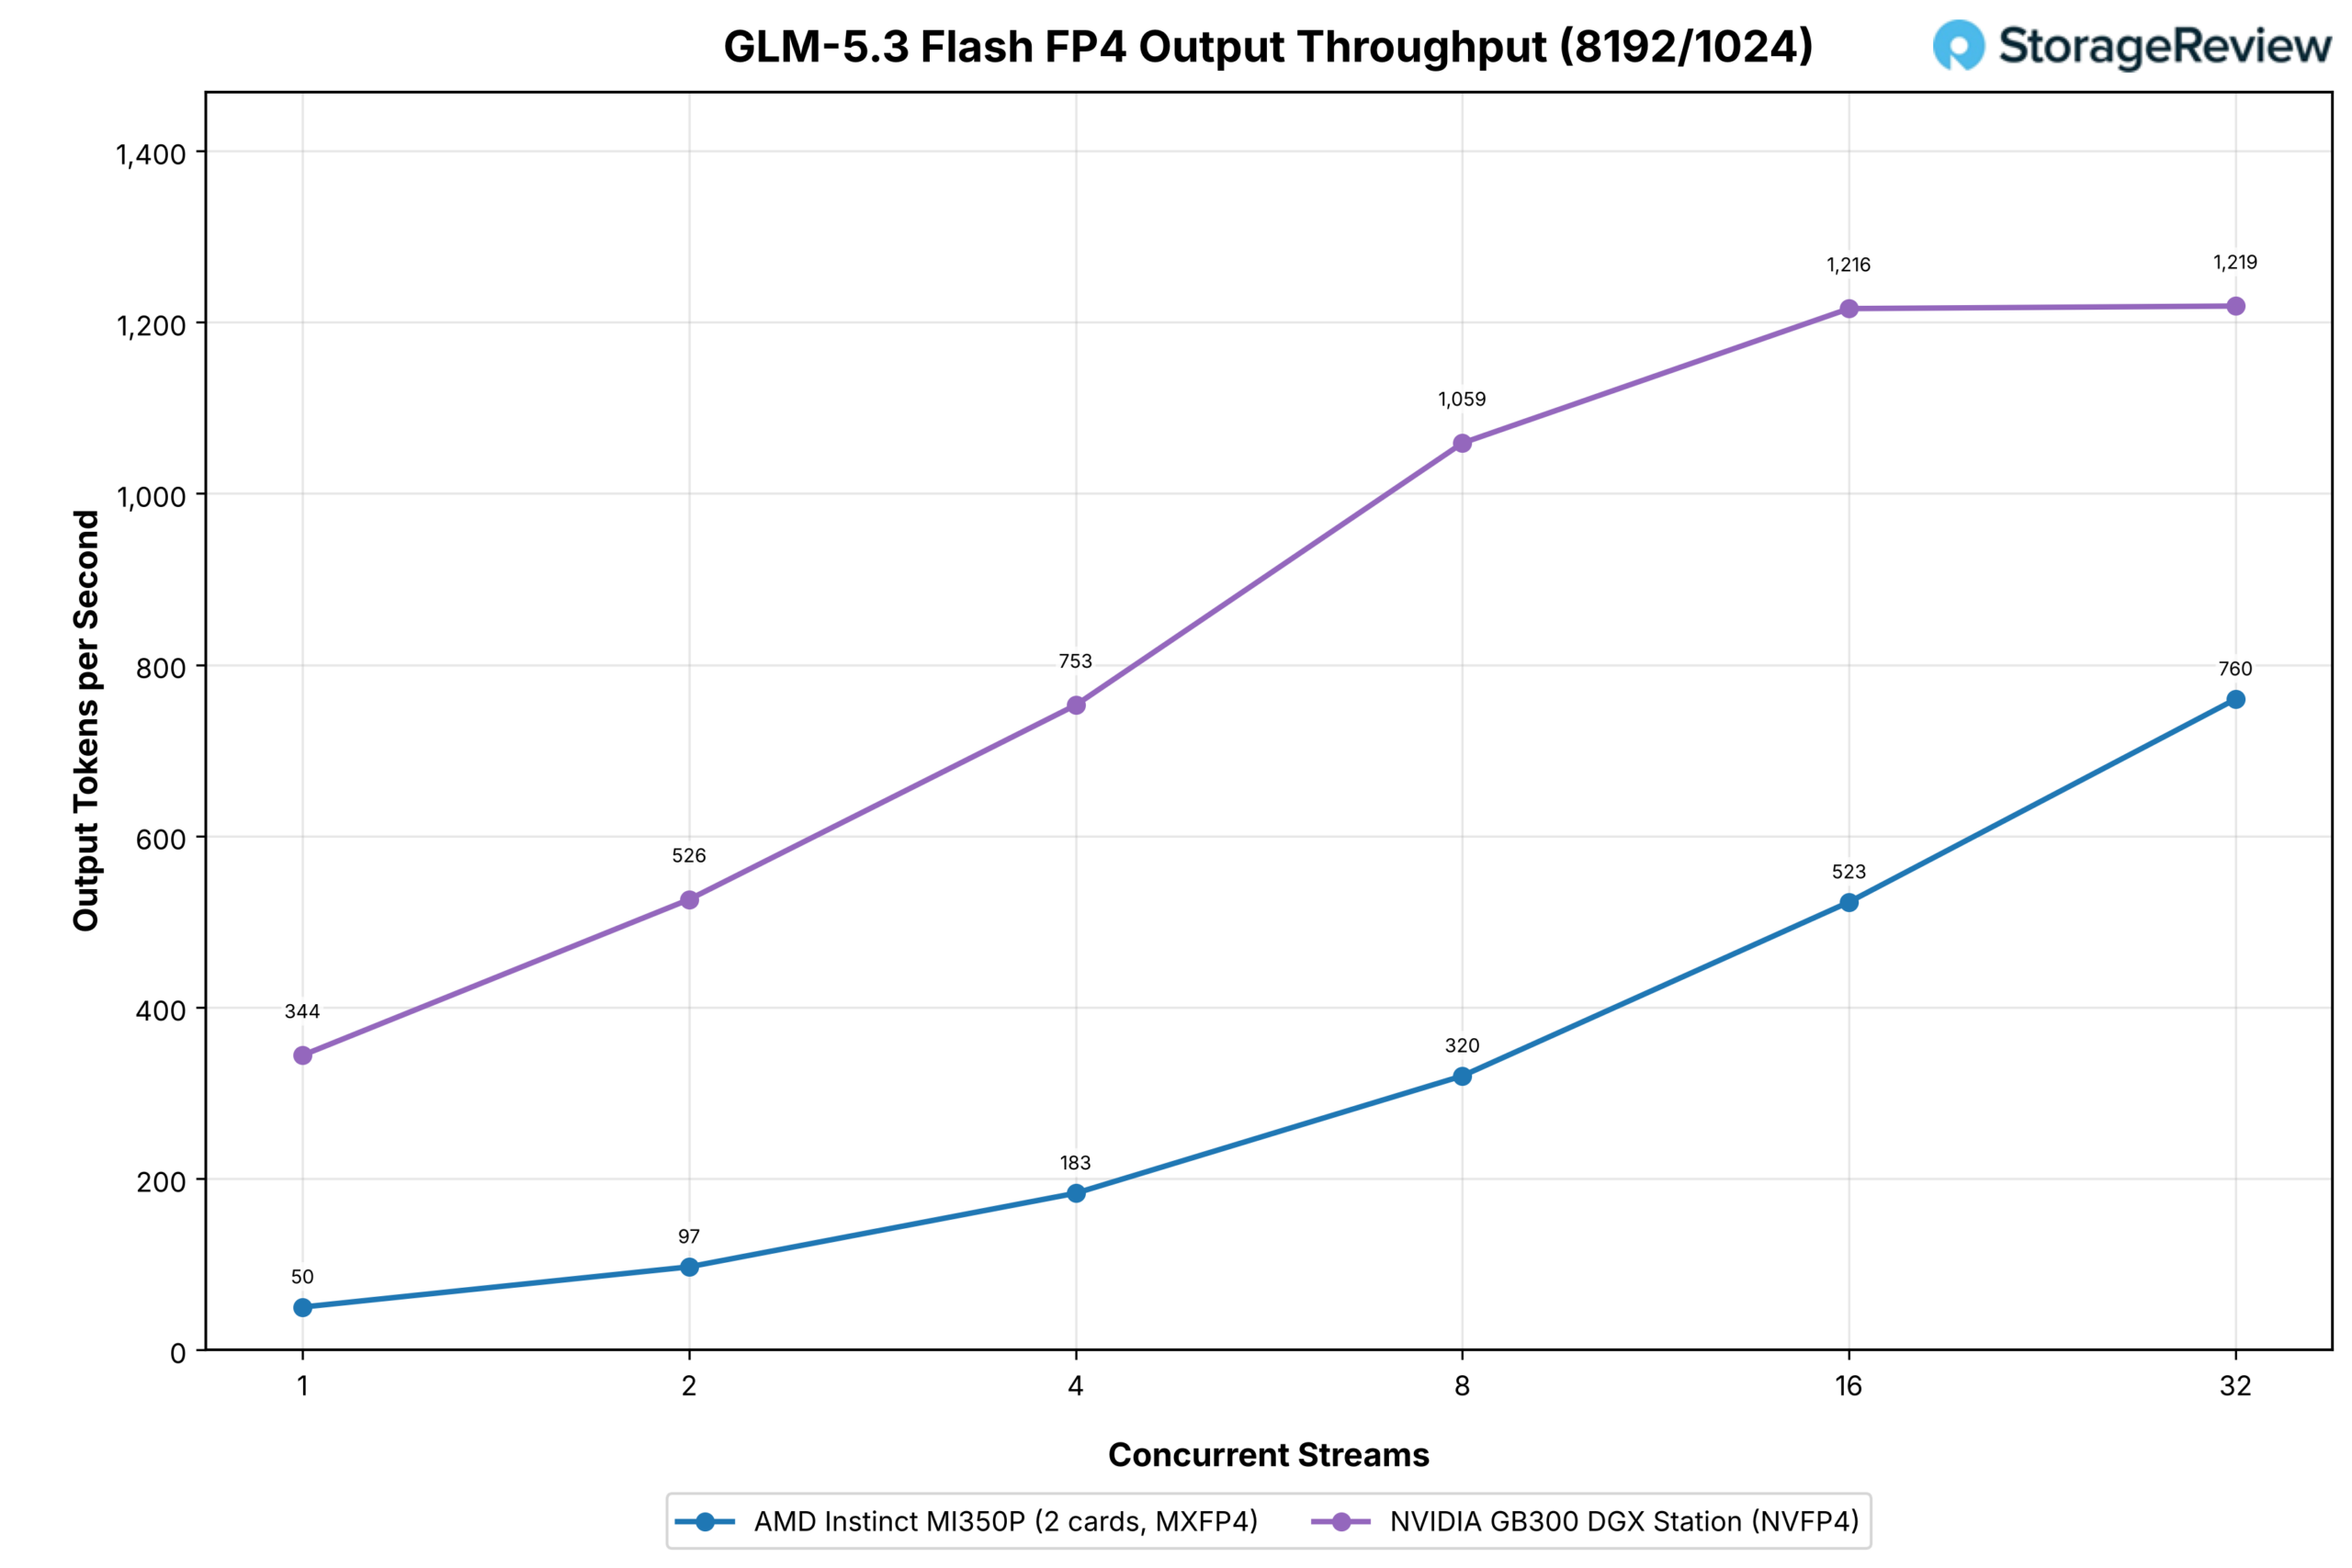
Флэш-память GLM-5.3 не запускалась на RTX PRO 6000, поэтому сравнение проводилось между двумя картами MI350P и одной GB300 Station при 32 потоках. В задаче обработки чата пара MI350P отстает, показывая 45 против 353 выходных токенов в секунду при одном потоке, и превосходит Station при восьми потоках, достигая 1,462 при 32 потоках против 828 у Station. В задаче с интенсивным заполнением памяти Station лидирует, показывая 1,219 против 760 при 32 потоках, где заполнение памяти у пары карт происходит через PCIe между двумя картами, а B300 делает это за один раз с помощью памяти HBM.
ГЛМ-5.2
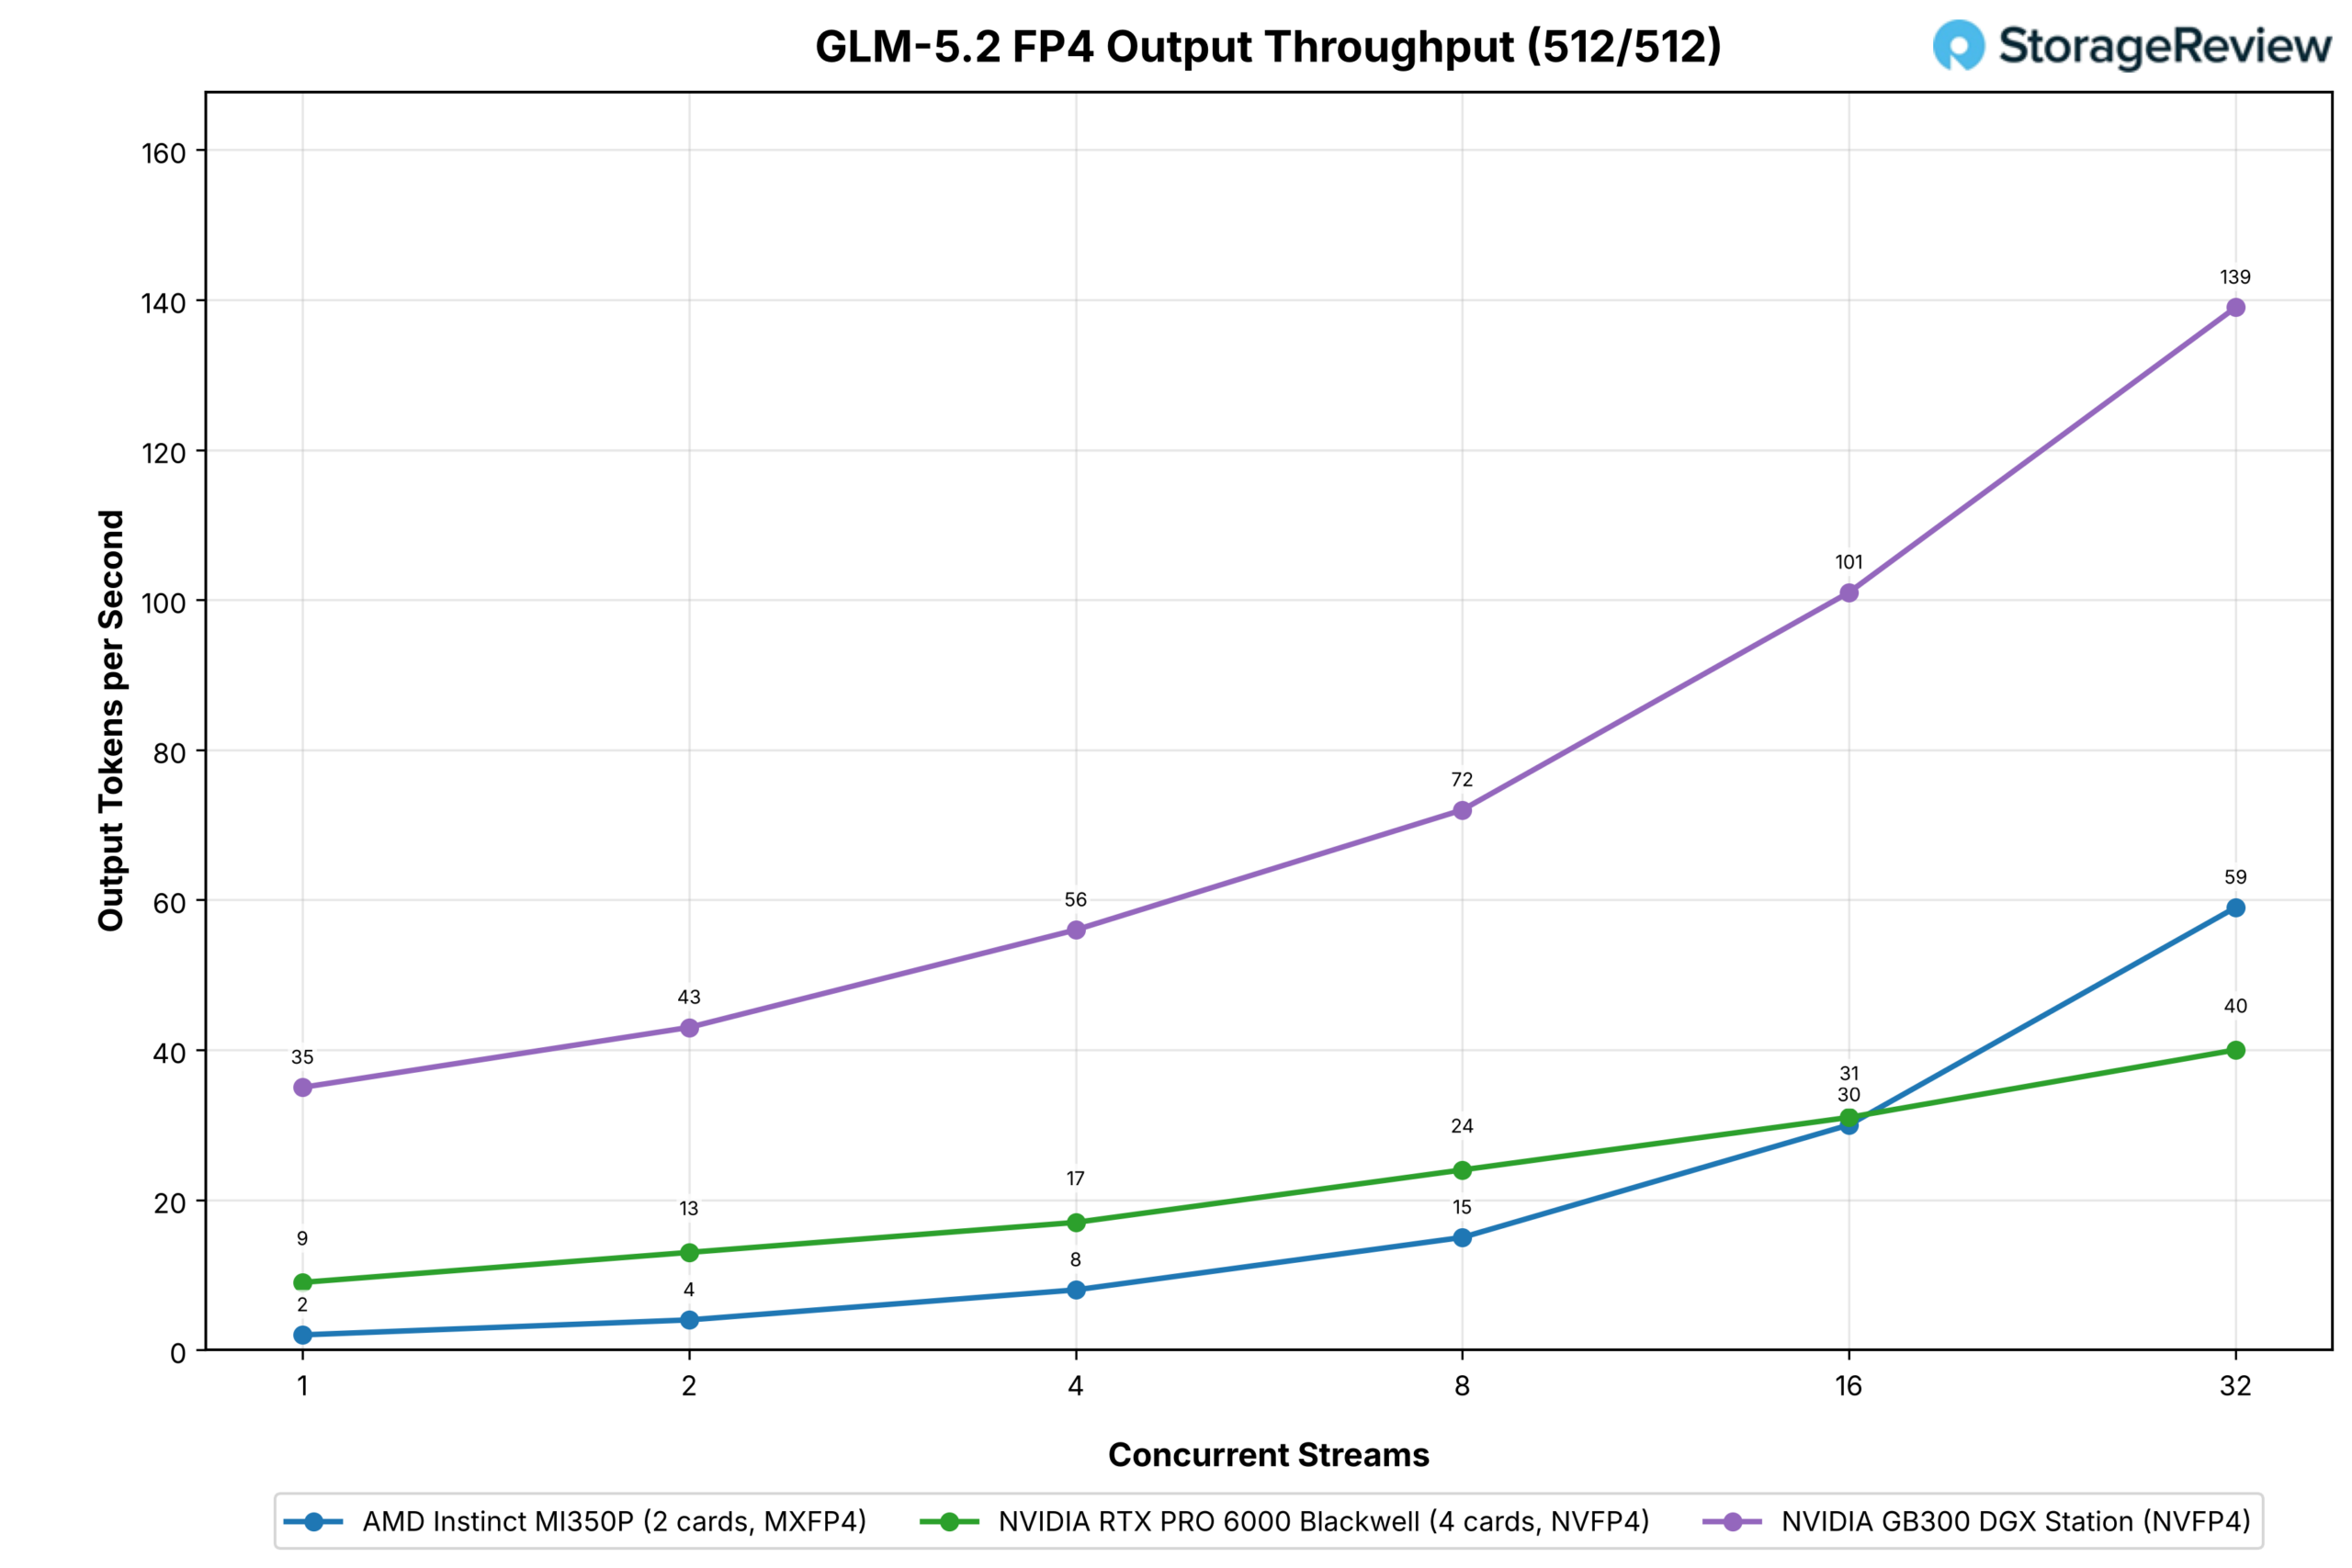
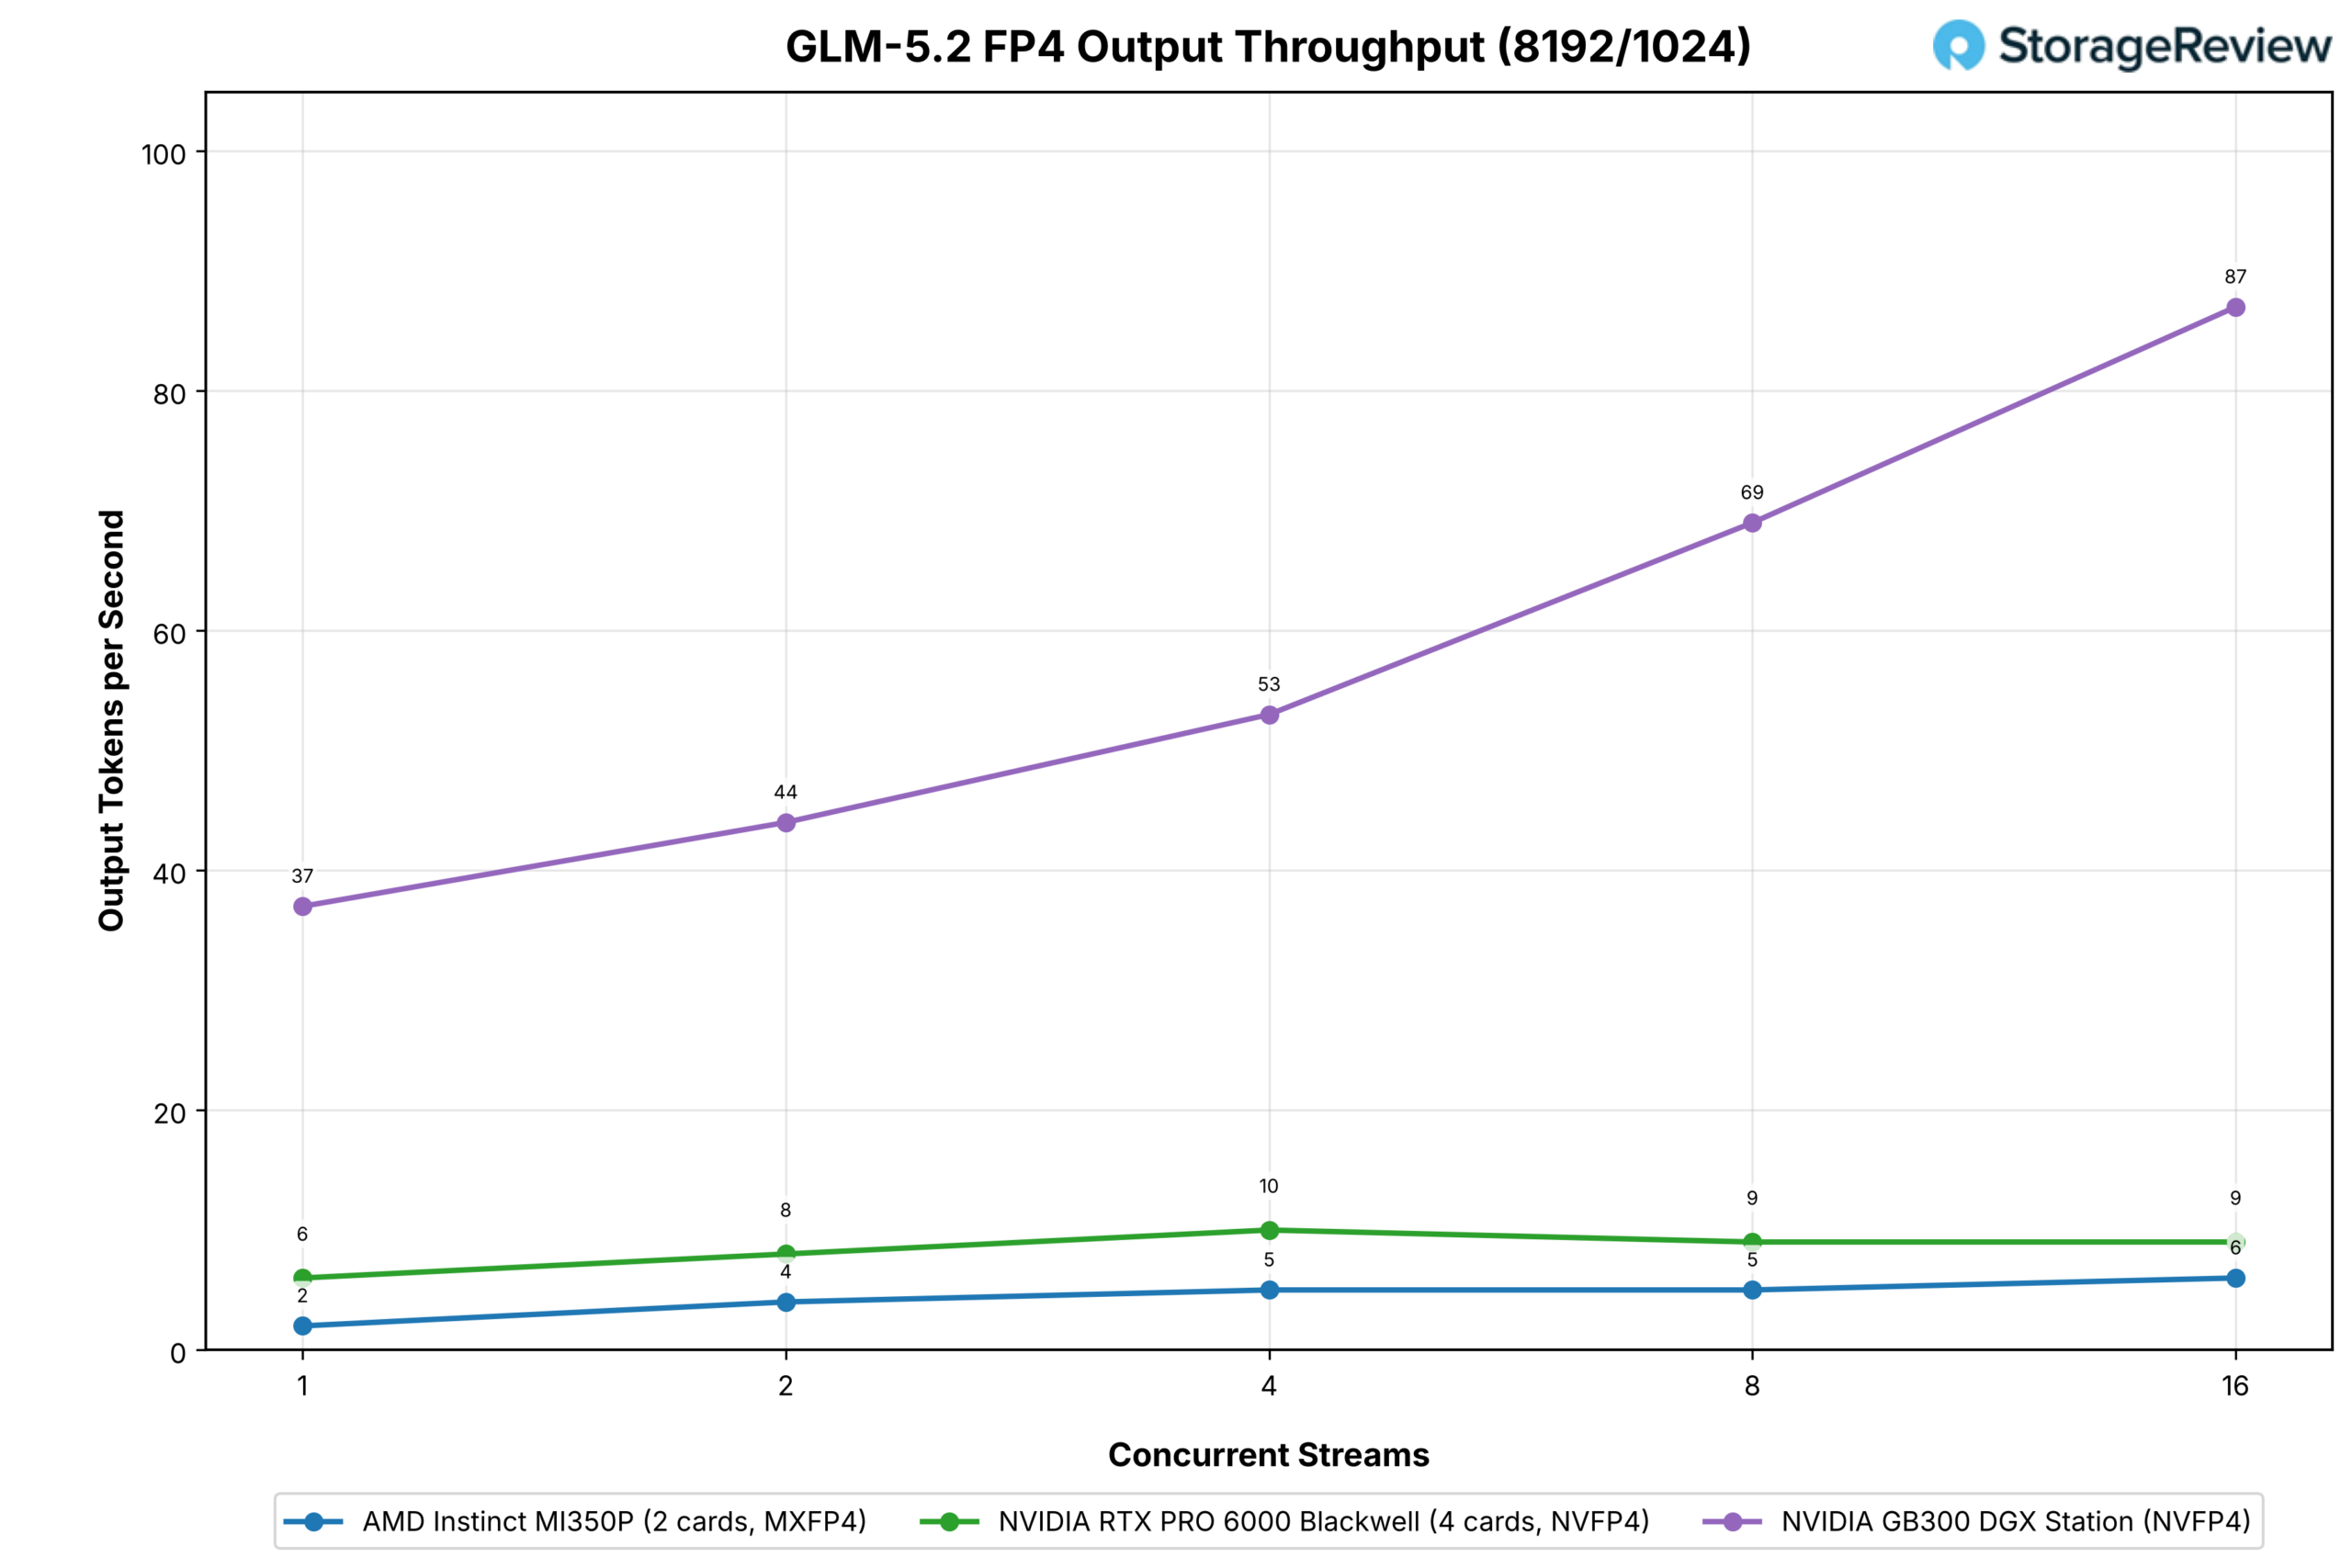
В этом наборе основное внимание уделяется памяти GLM-5.2. Контрольная точка MXFP4 выходит за рамки 288 ГБ памяти двух карт MI350P, поэтому пропускная способность одного потока составляет 2 токена в секунду для пары, против 9 для четырех карт RTX PRO 6000, использующих NVFP4 в 384 ГБ GDDR7, и 35 для Station, которая переносит около 215 ГБ экспертных весов в память Grace. Четырехъядерная система RTX лидирует при 16 потоках в рабочей нагрузке чата; пара MI350P достигает 59 потоков при 32 потоках против 40, а Station — 139. При запросах с большим количеством предварительных заполнений ни одна из конфигураций PCIe не превышает однозначного числа при 16 потоках, против 87 у Station.
МиниМакс-М3
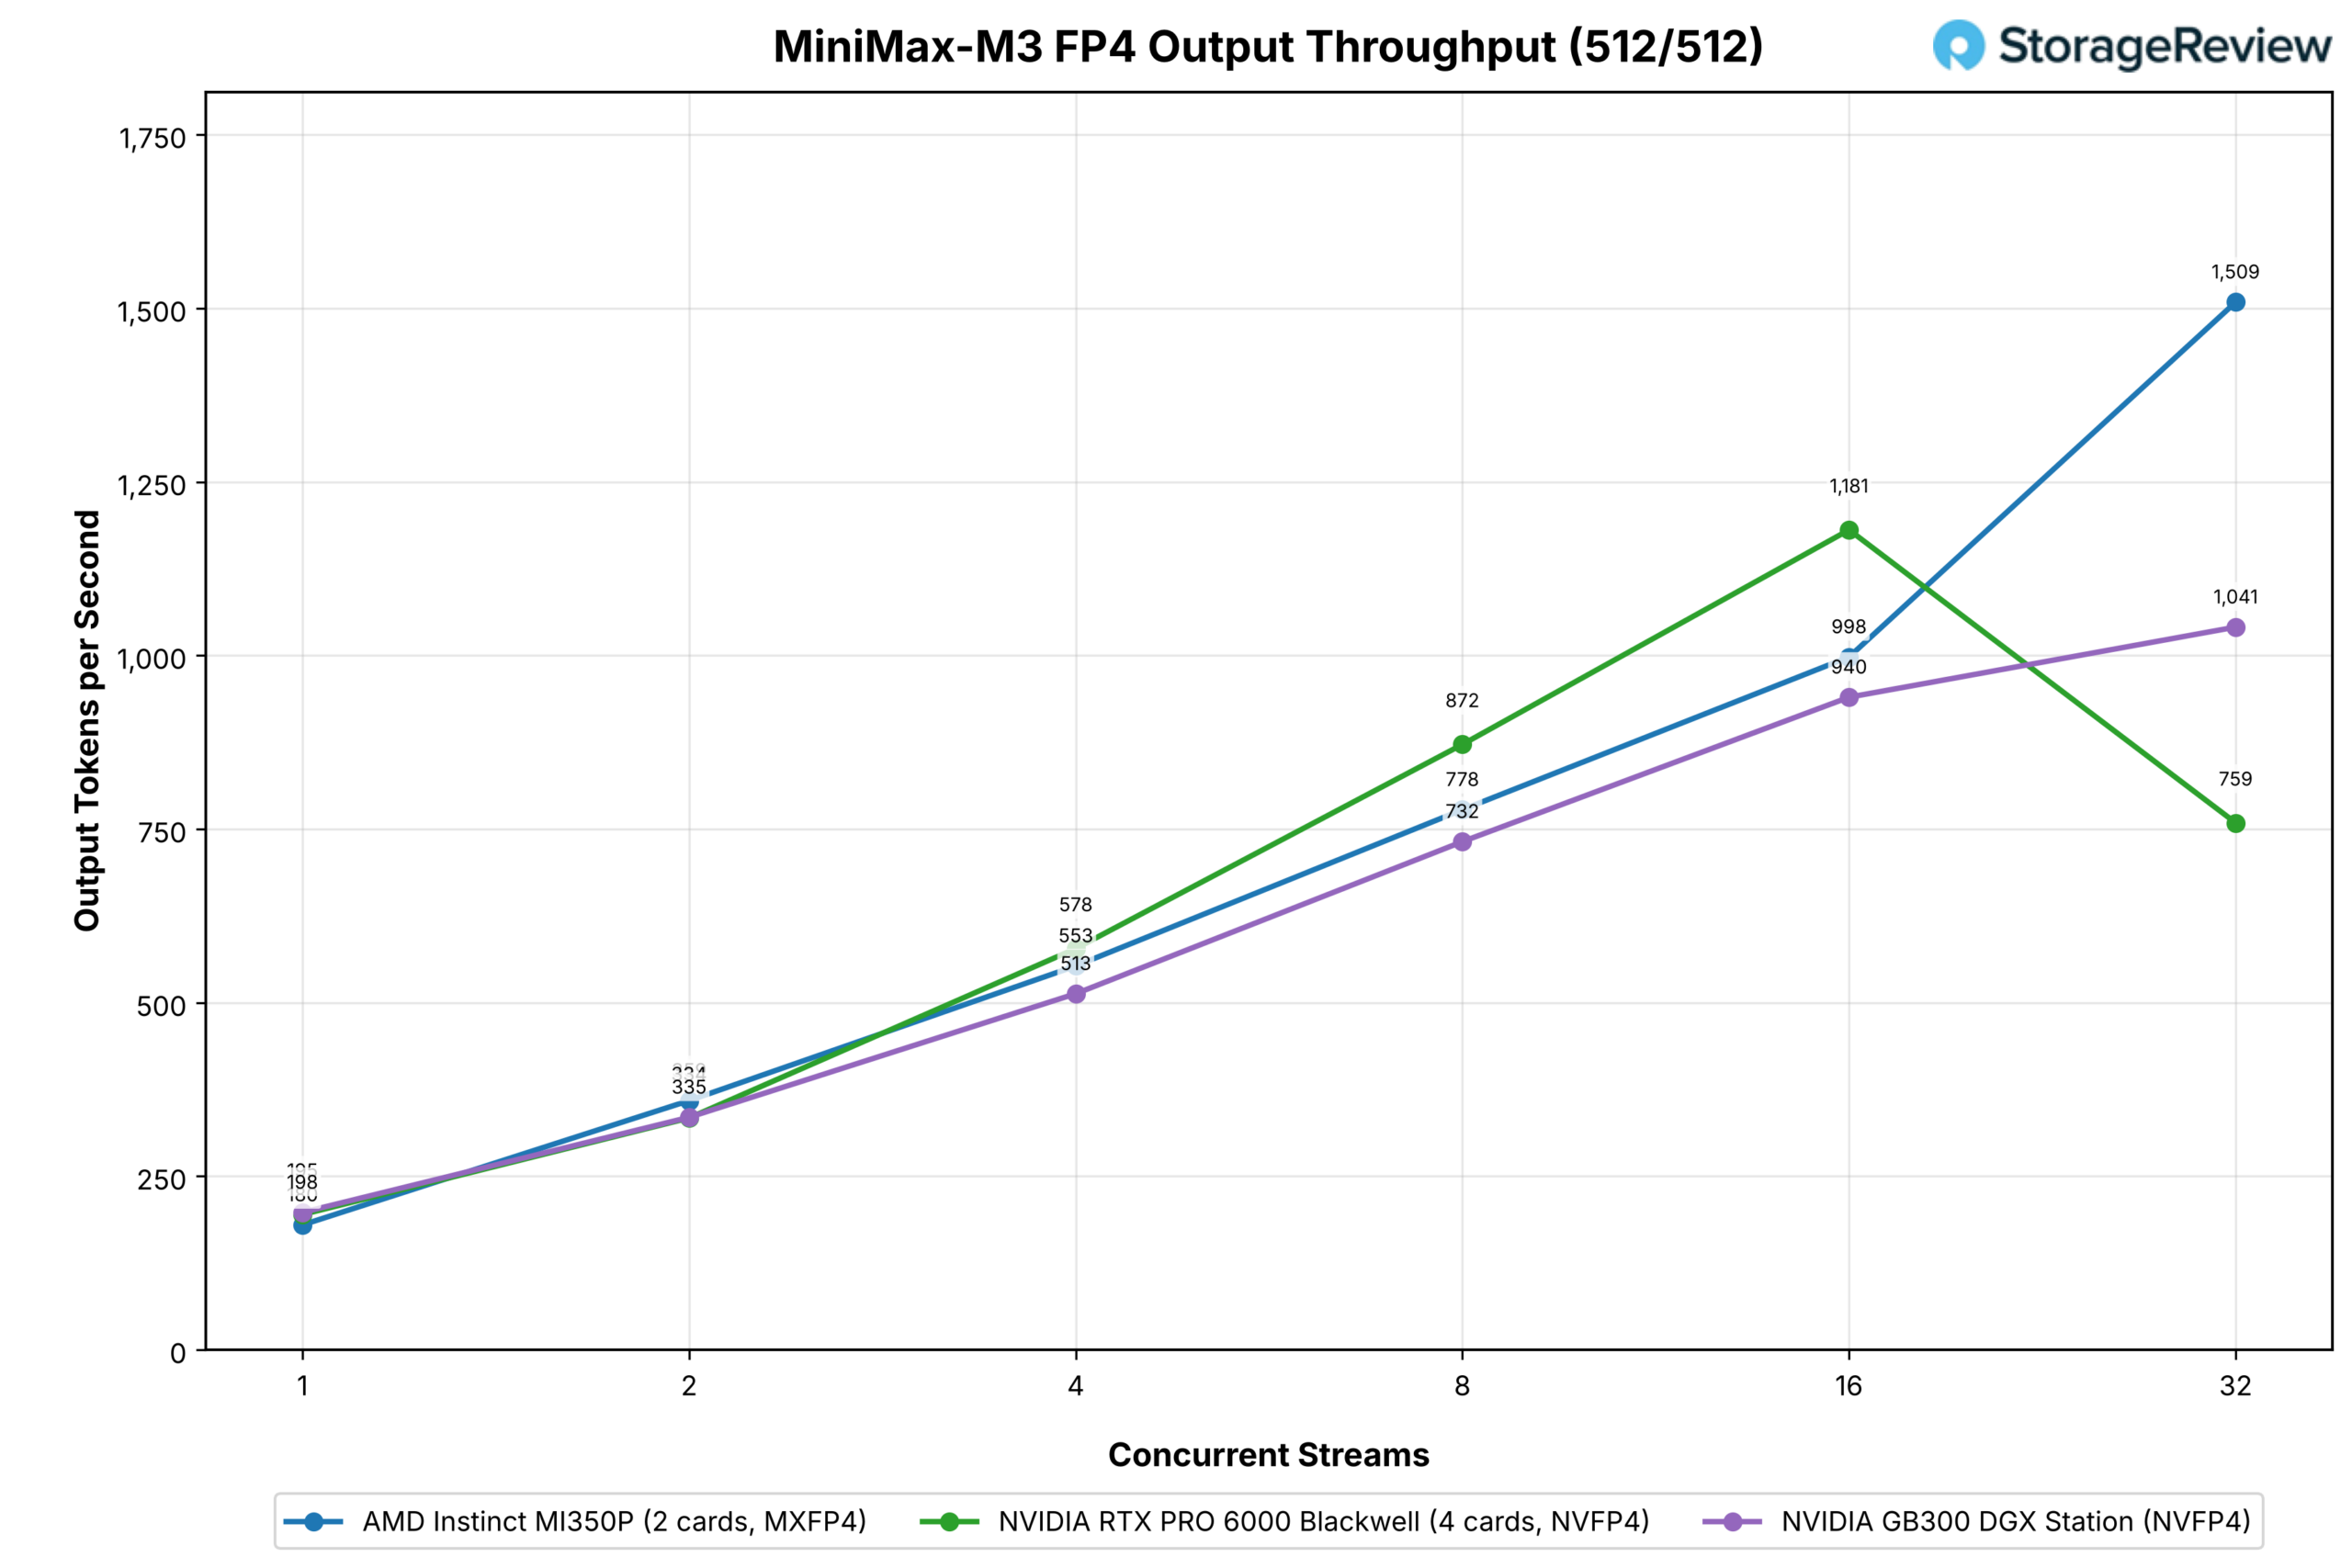
Две системы MI350P вмещают сборку MXFP4 MiniMax-M3 объемом 288 ГБ; для работы с NVIDIA требуется четыре карты RTX PRO 6000. Три конфигурации показывают результаты, отличающиеся друг от друга не более чем на 10 процентов, при обработке восьми потоков данных в чате; система с четырьмя RTX опережает со временем 16 (1,181 против 998 у пары и 940 у Station), а система с двумя MI350P показывает время 32 со временем 1,509 против 759 у четырех и 1,041 у Station.
При использовании функции предварительного заполнения подсказок пара MI350P лидирует на каждом этапе, обрабатывая восемь потоков: 524 против 444 у квадрокоптера, в то время как Station, которая сохраняет часть данных экспертов этой модели в памяти Grace, показывает результат 103.
DeepSeek-V4-Flash
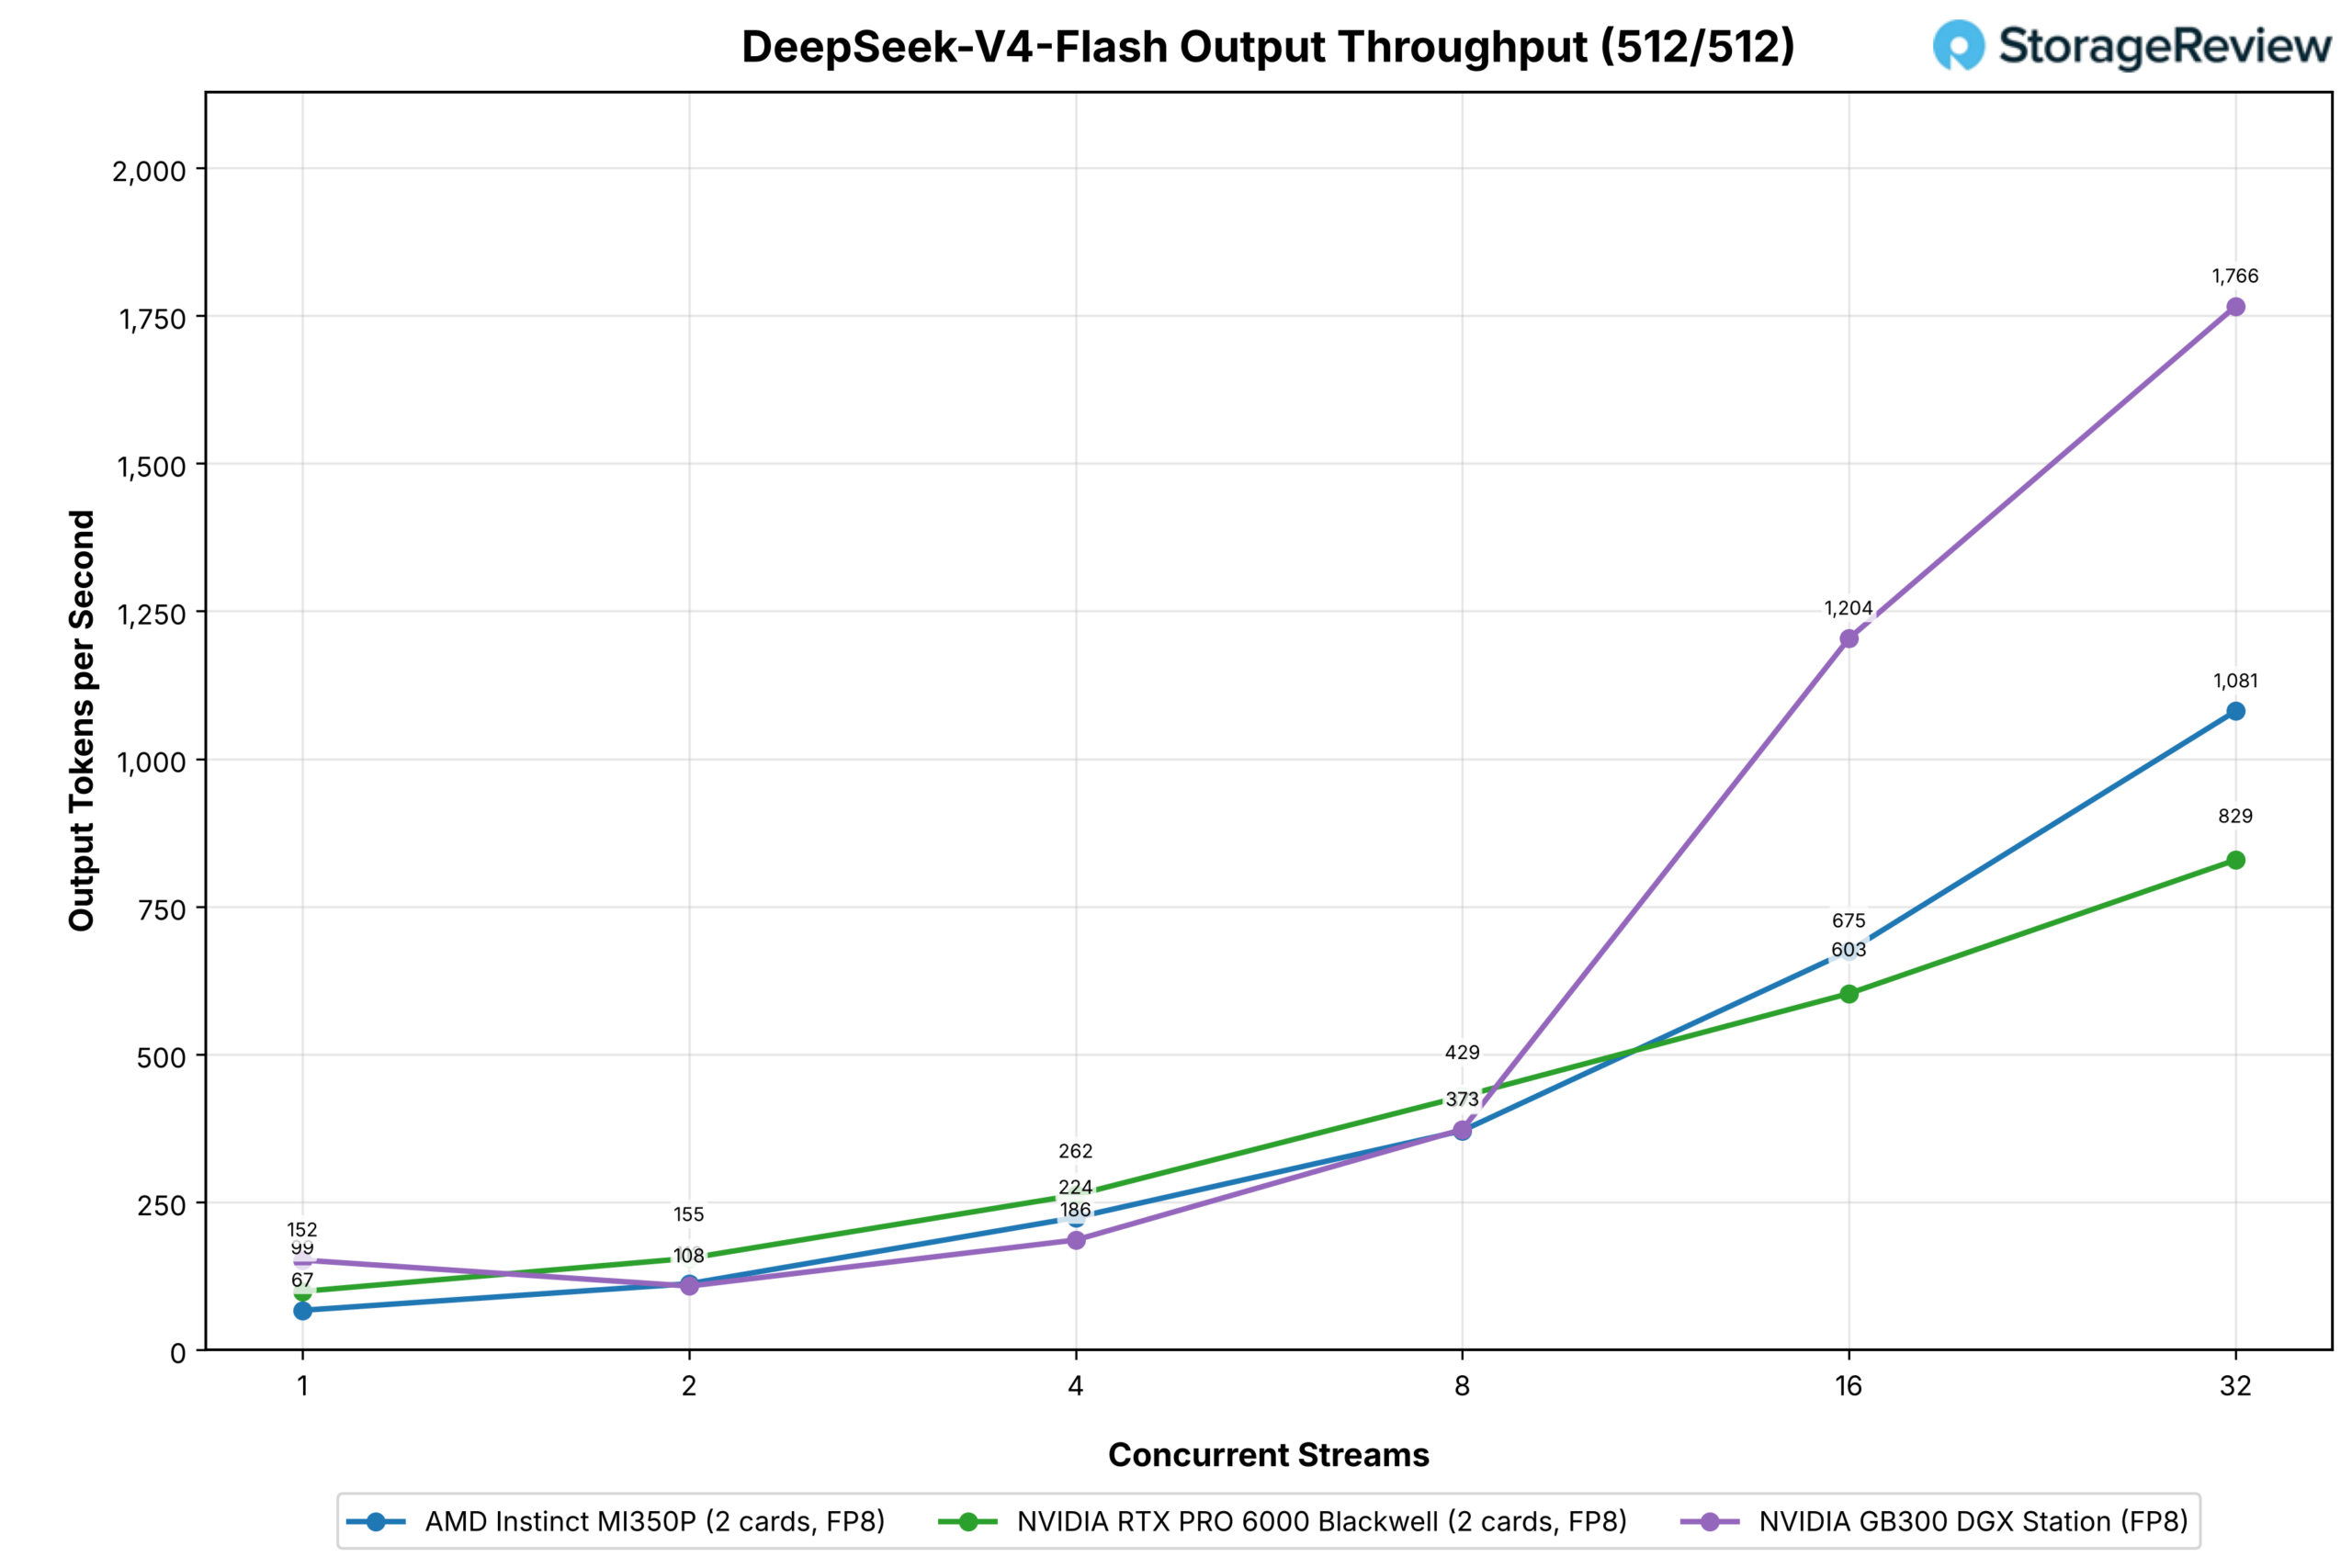
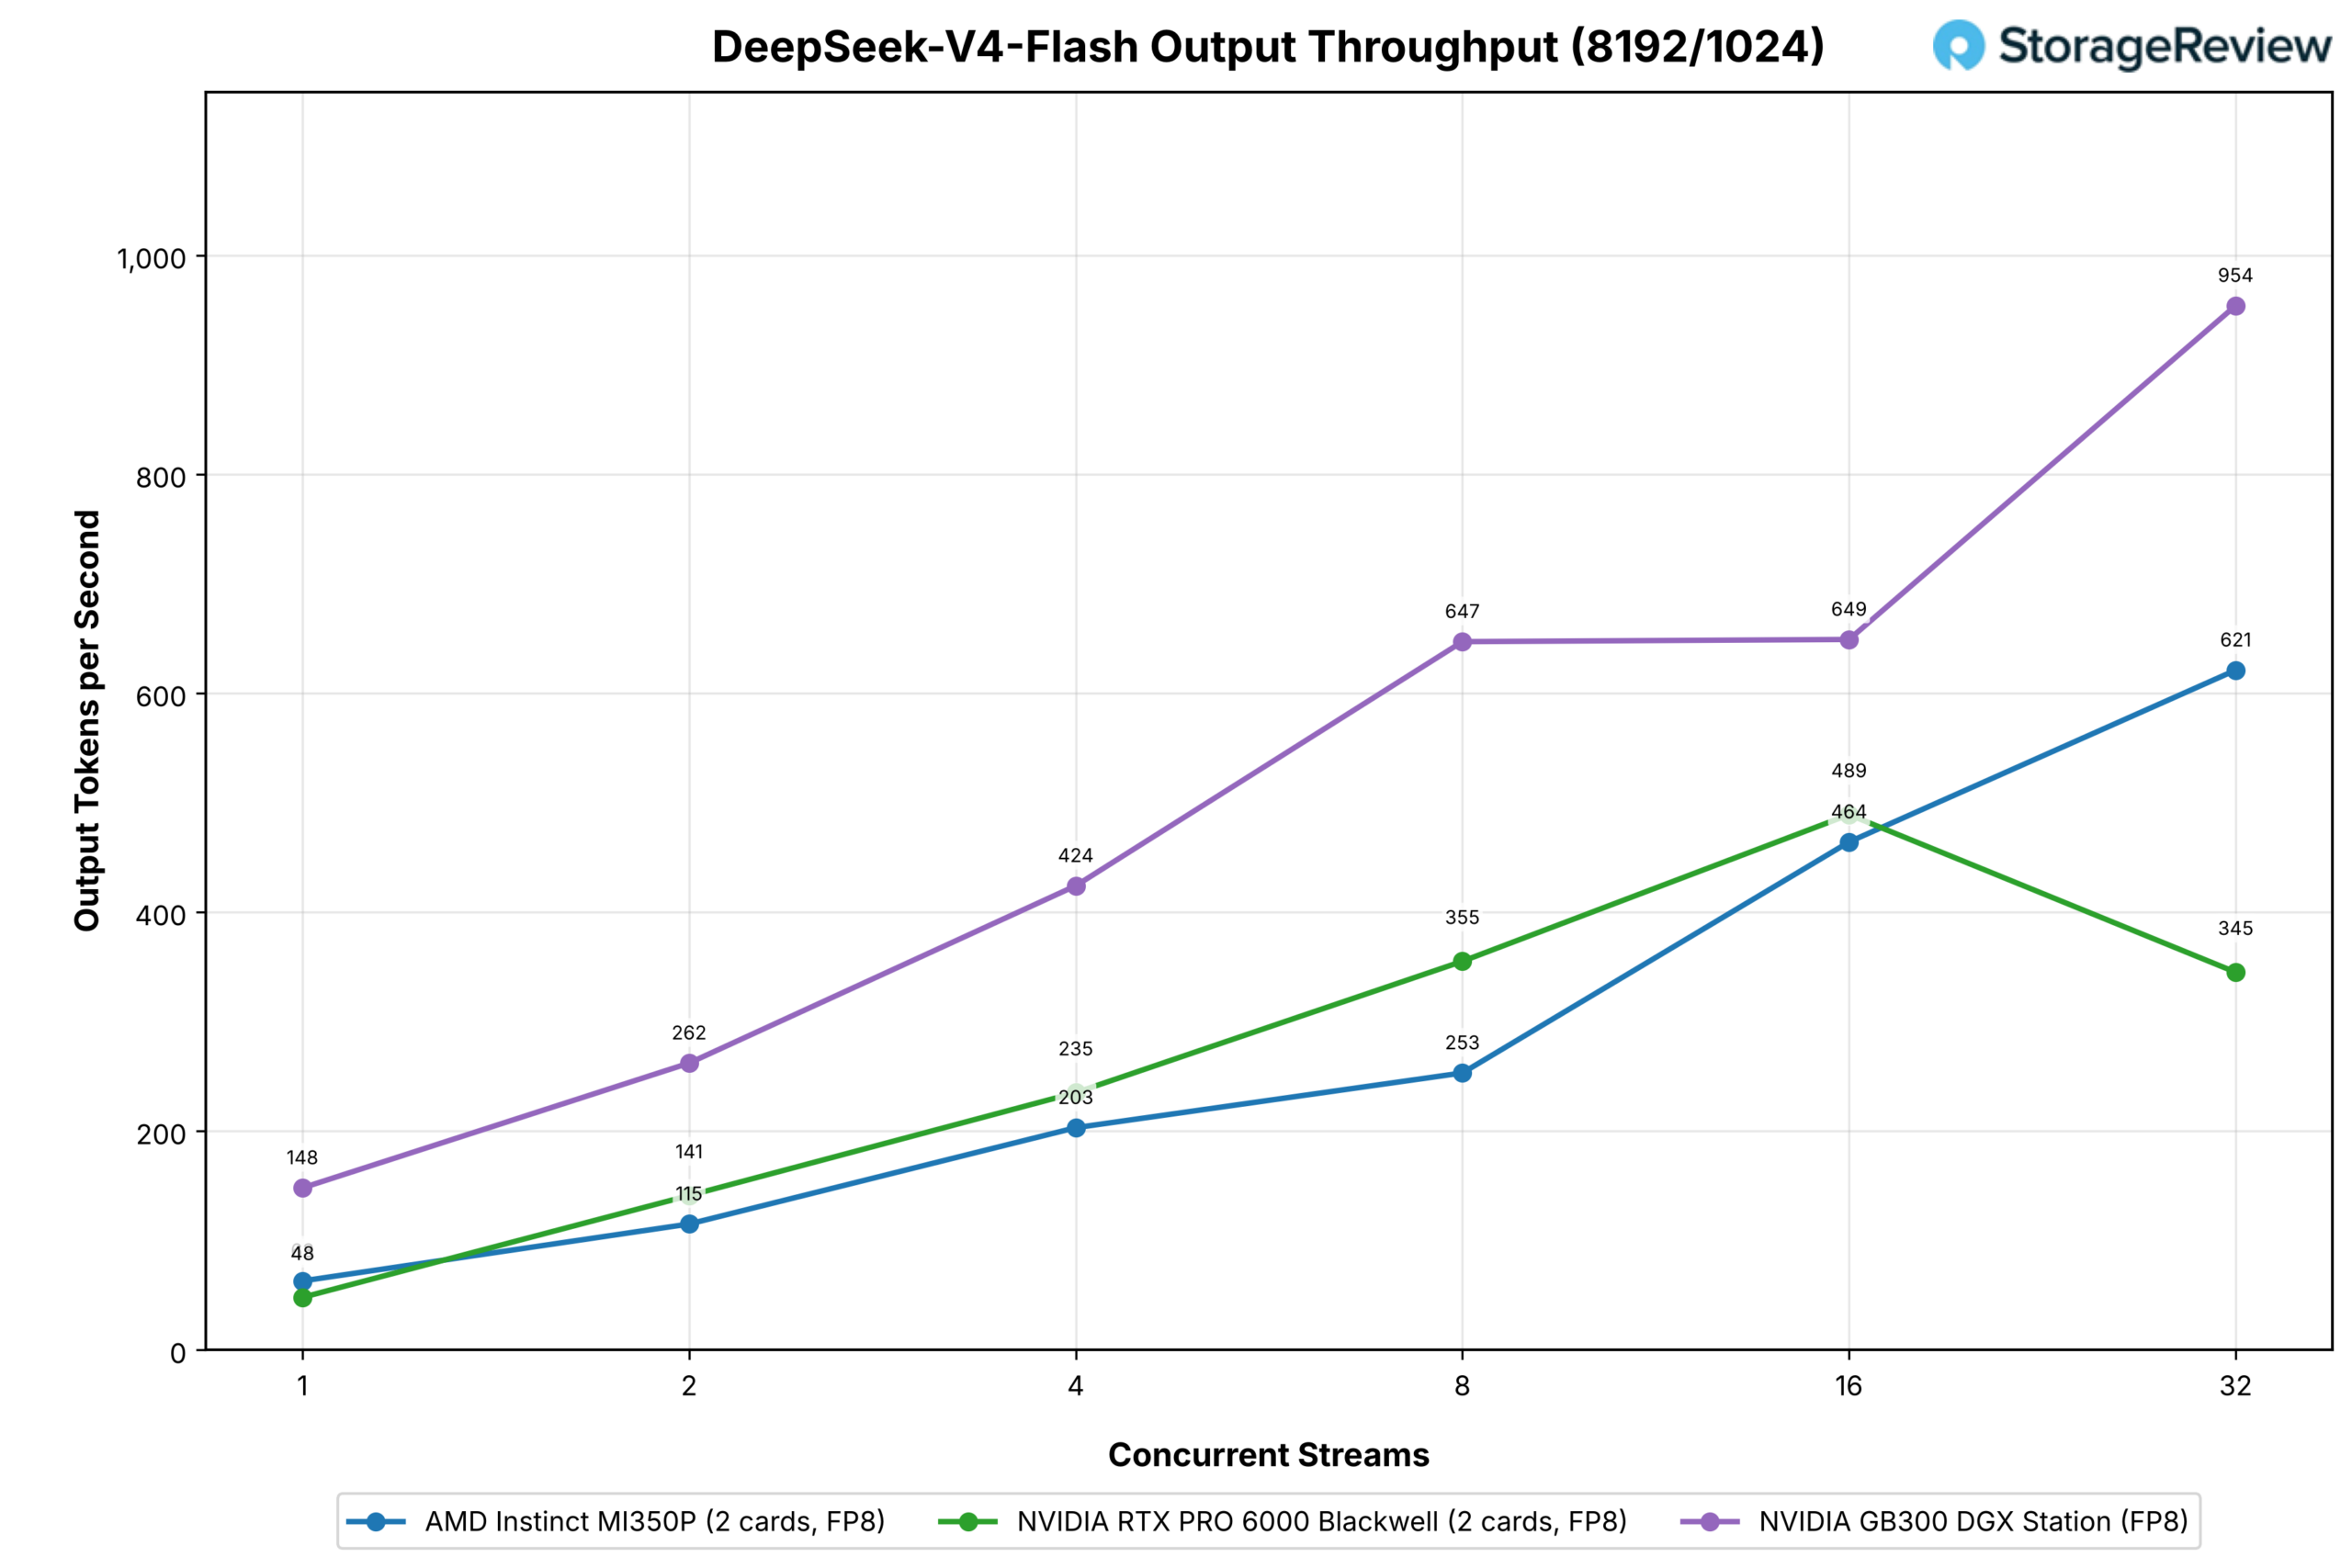
Благодаря наличию двух видеокарт с каждой стороны и встроенной контрольной точке FP8, пара RTX PRO 6000 лидирует в обработке восьми потоков в чате, а пара MI350P опережает её с 16 потоков, набрав 1,081 балл против 829 при 32 потоках; одиночная станция достигает 1,766 баллов на том же этапе. Результаты в режиме интенсивного предварительного заполнения также схожи: пара MI350P набирает 621 балл против 345 у пары RTX при 32 потоках и 954 у станции.
МиниМакс-М2.7
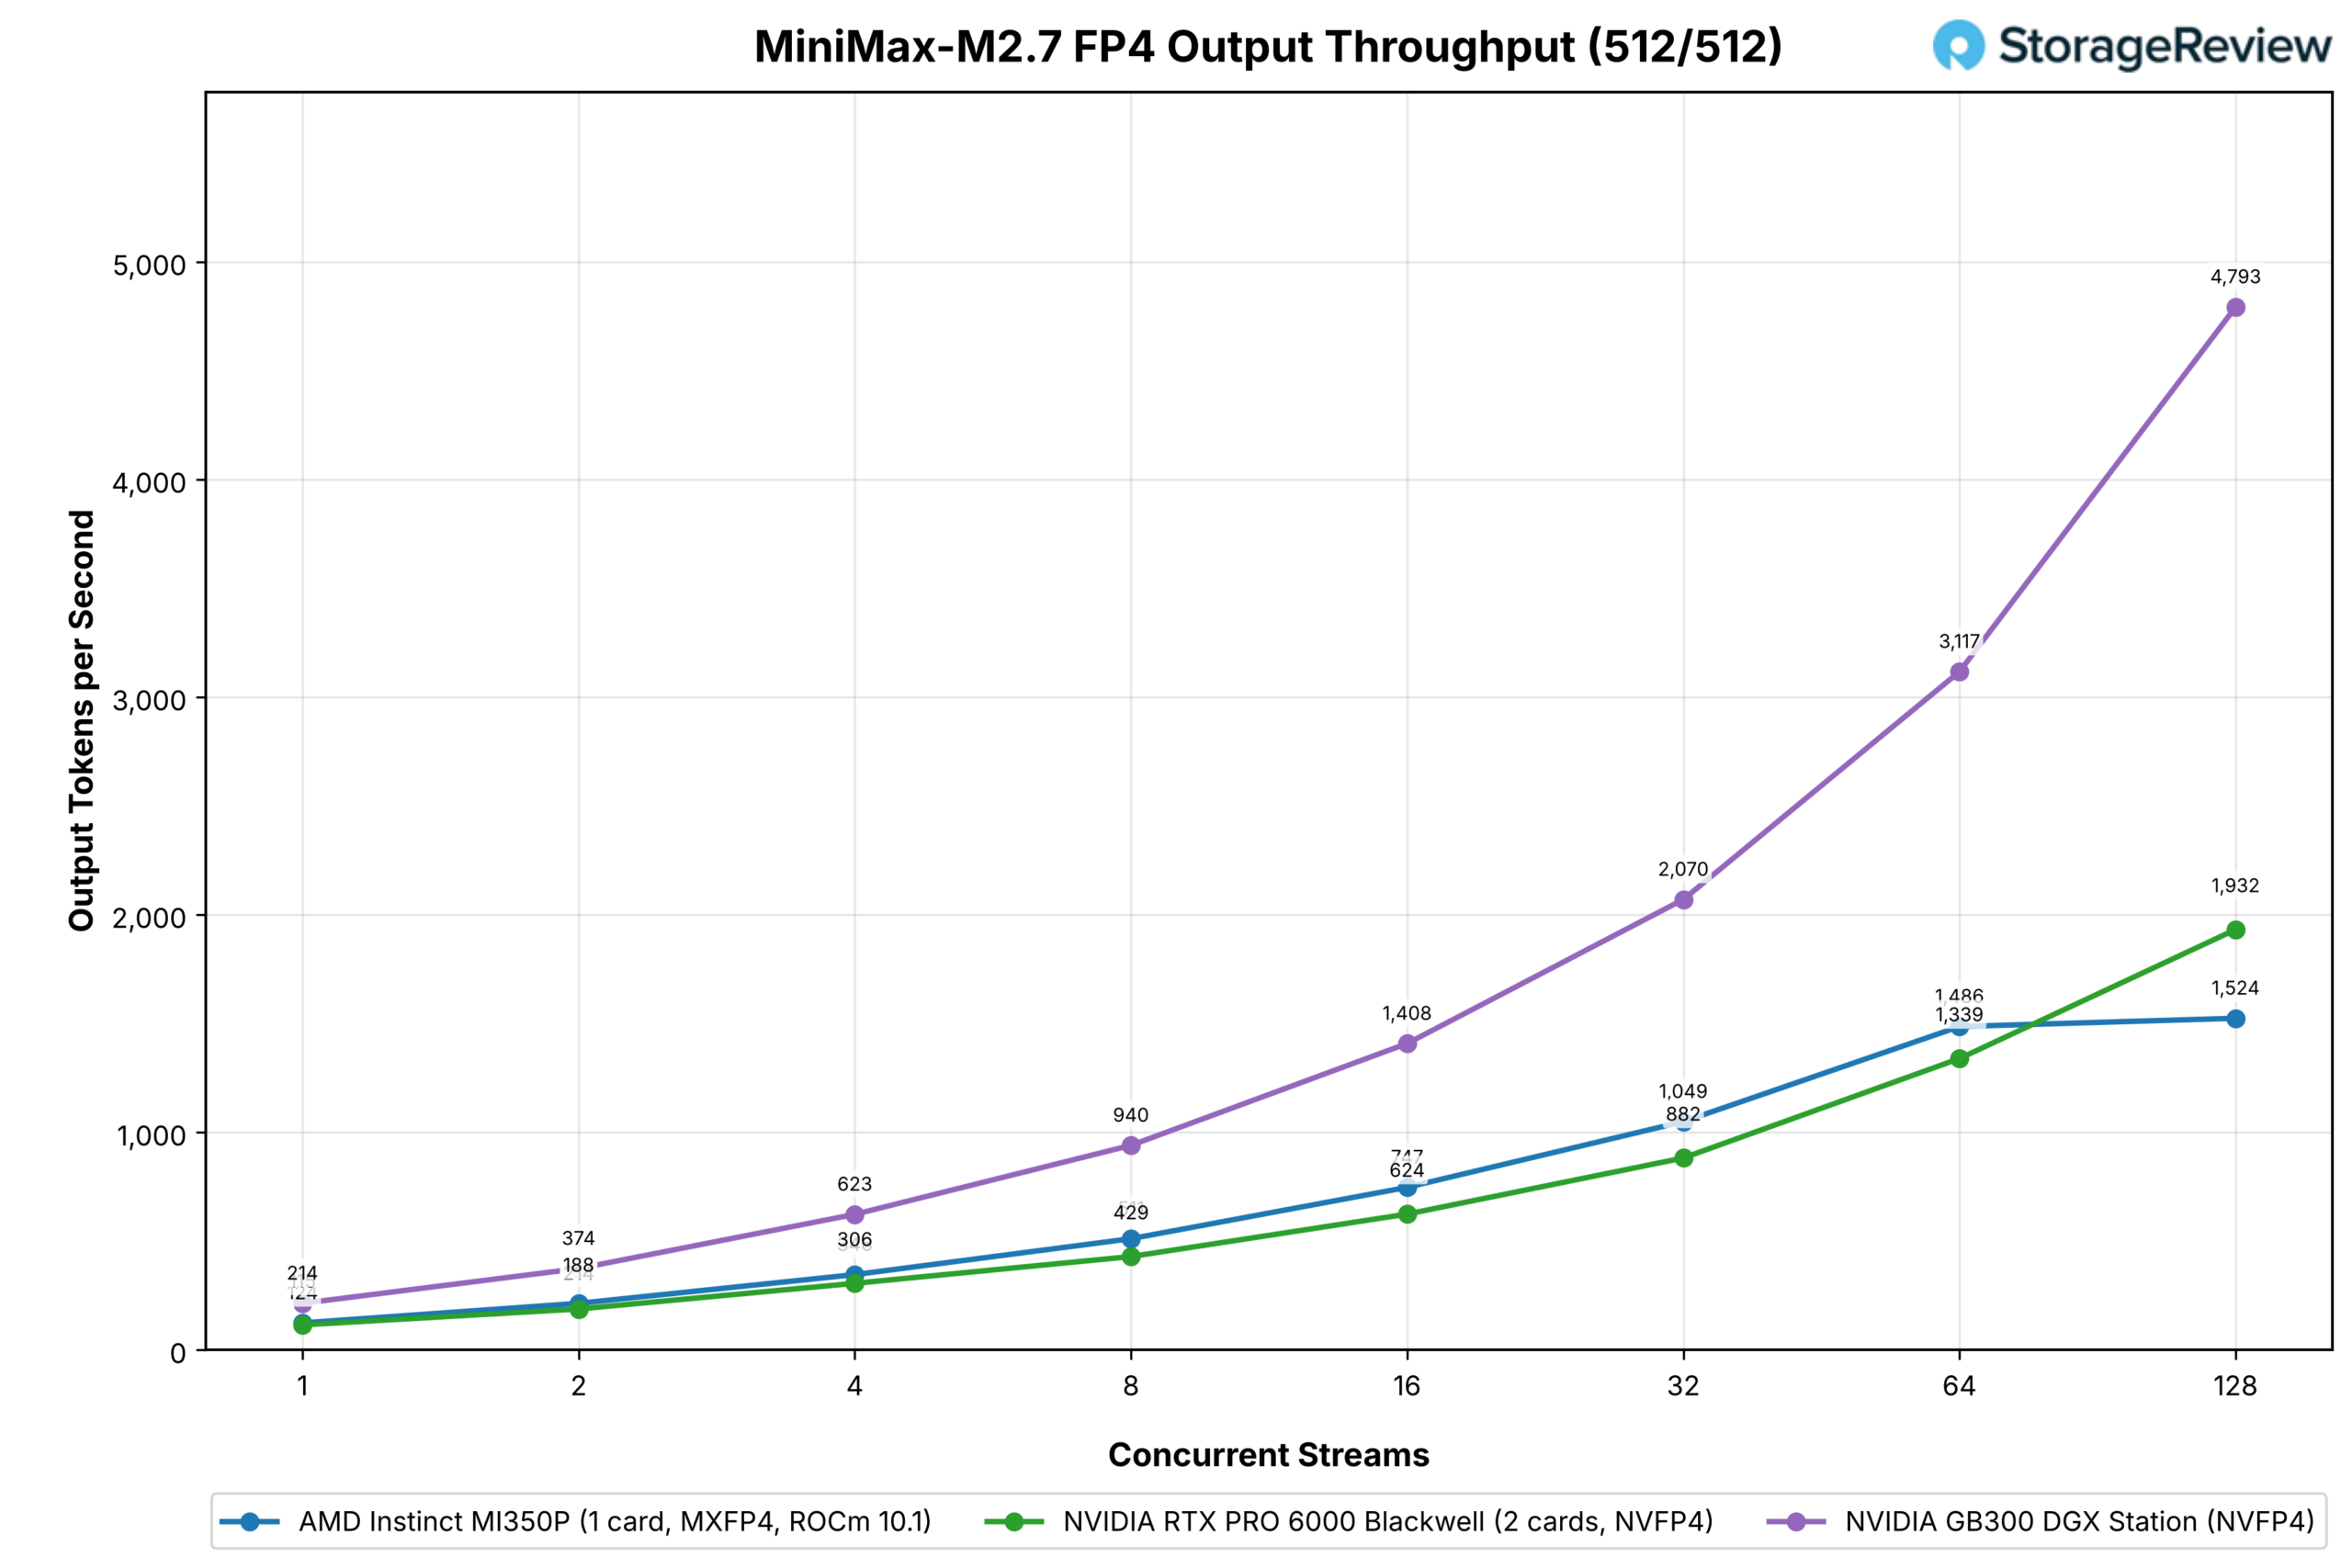
Одна видеокарта MI350P использует сборку MXFP4 MiniMax-M2.7 против двух карт RTX PRO 6000 на NVFP4. MI350P лидирует в паре по количеству потоков (124 против 115), удерживает преимущество в 8-20% на протяжении 64 потоков (1,486 против 1,339), затем стабилизируется на отметке 1,524 при 128 потоках и 1,557 при 256 потоках, в то время как пара RTX продолжает показывать результаты 1,932 и 2,842; Station достигает 4,793.
При интенсивной предварительной обработке данных MI350P обеспечивает скорость вывода от 304 до 331 токена в секунду при обработке от восьми до 64 потоков, против 501 у пары RTX и 1,744 у Station.
ГПТ-ОСС-120Б
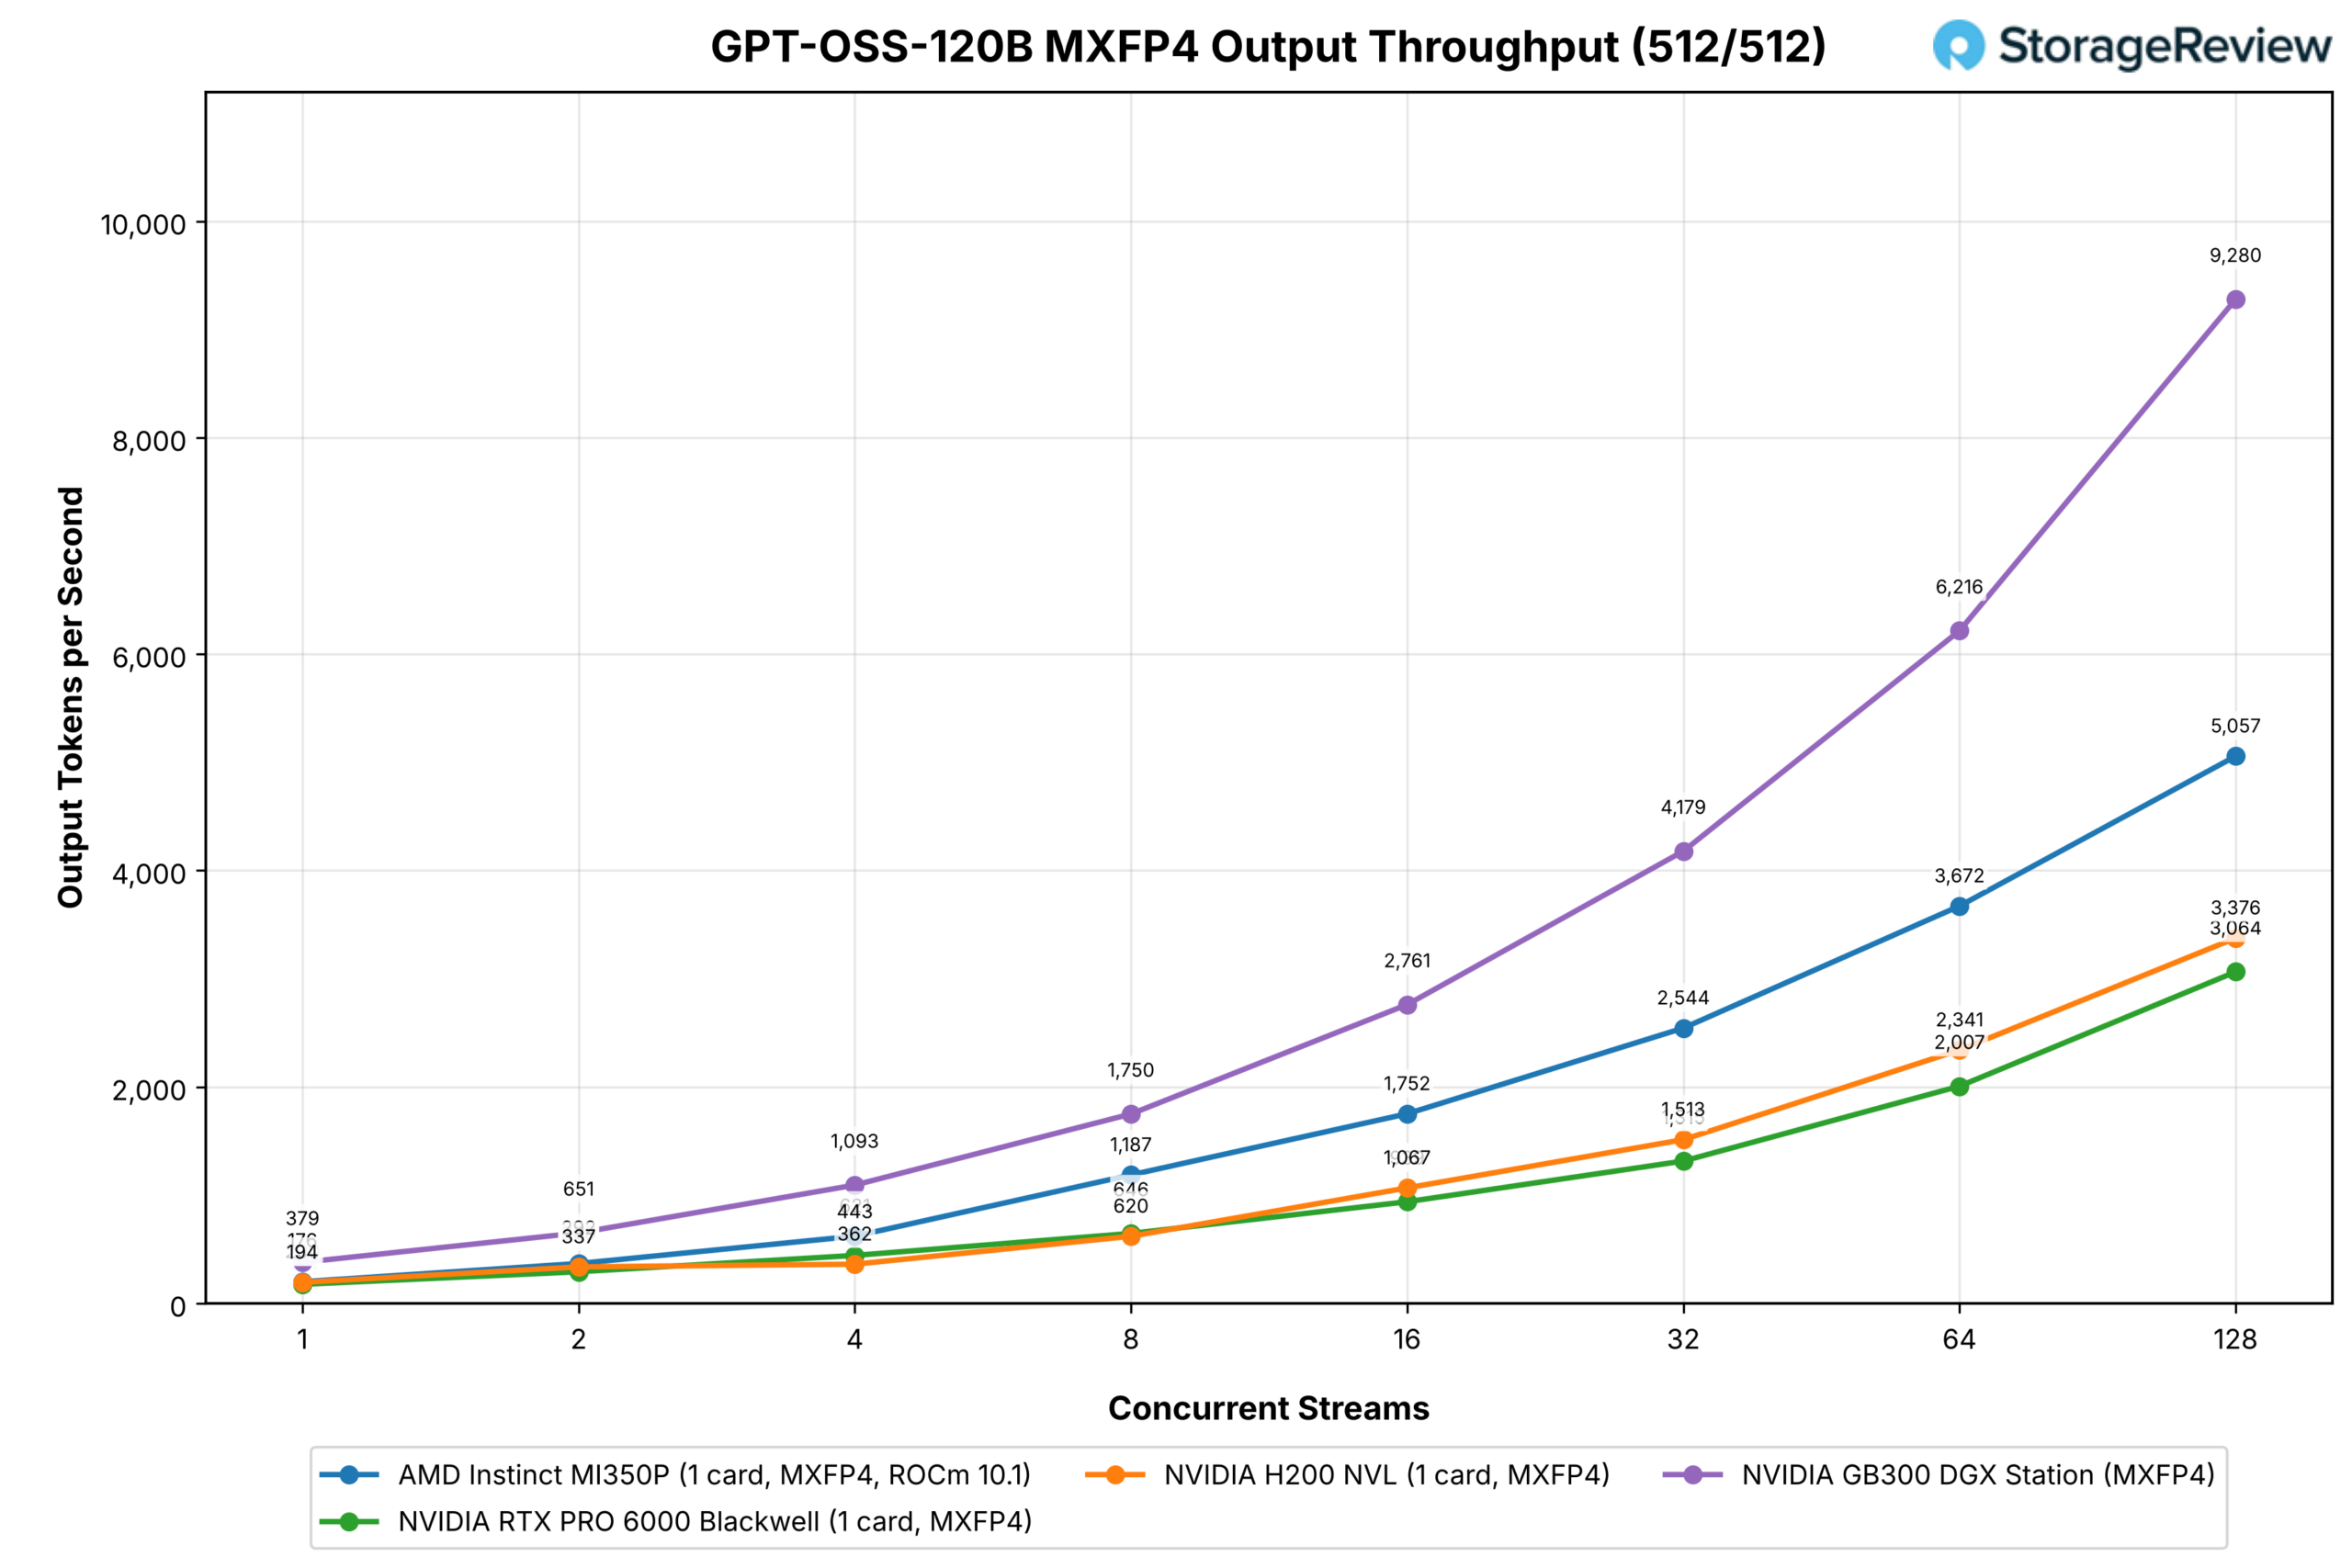
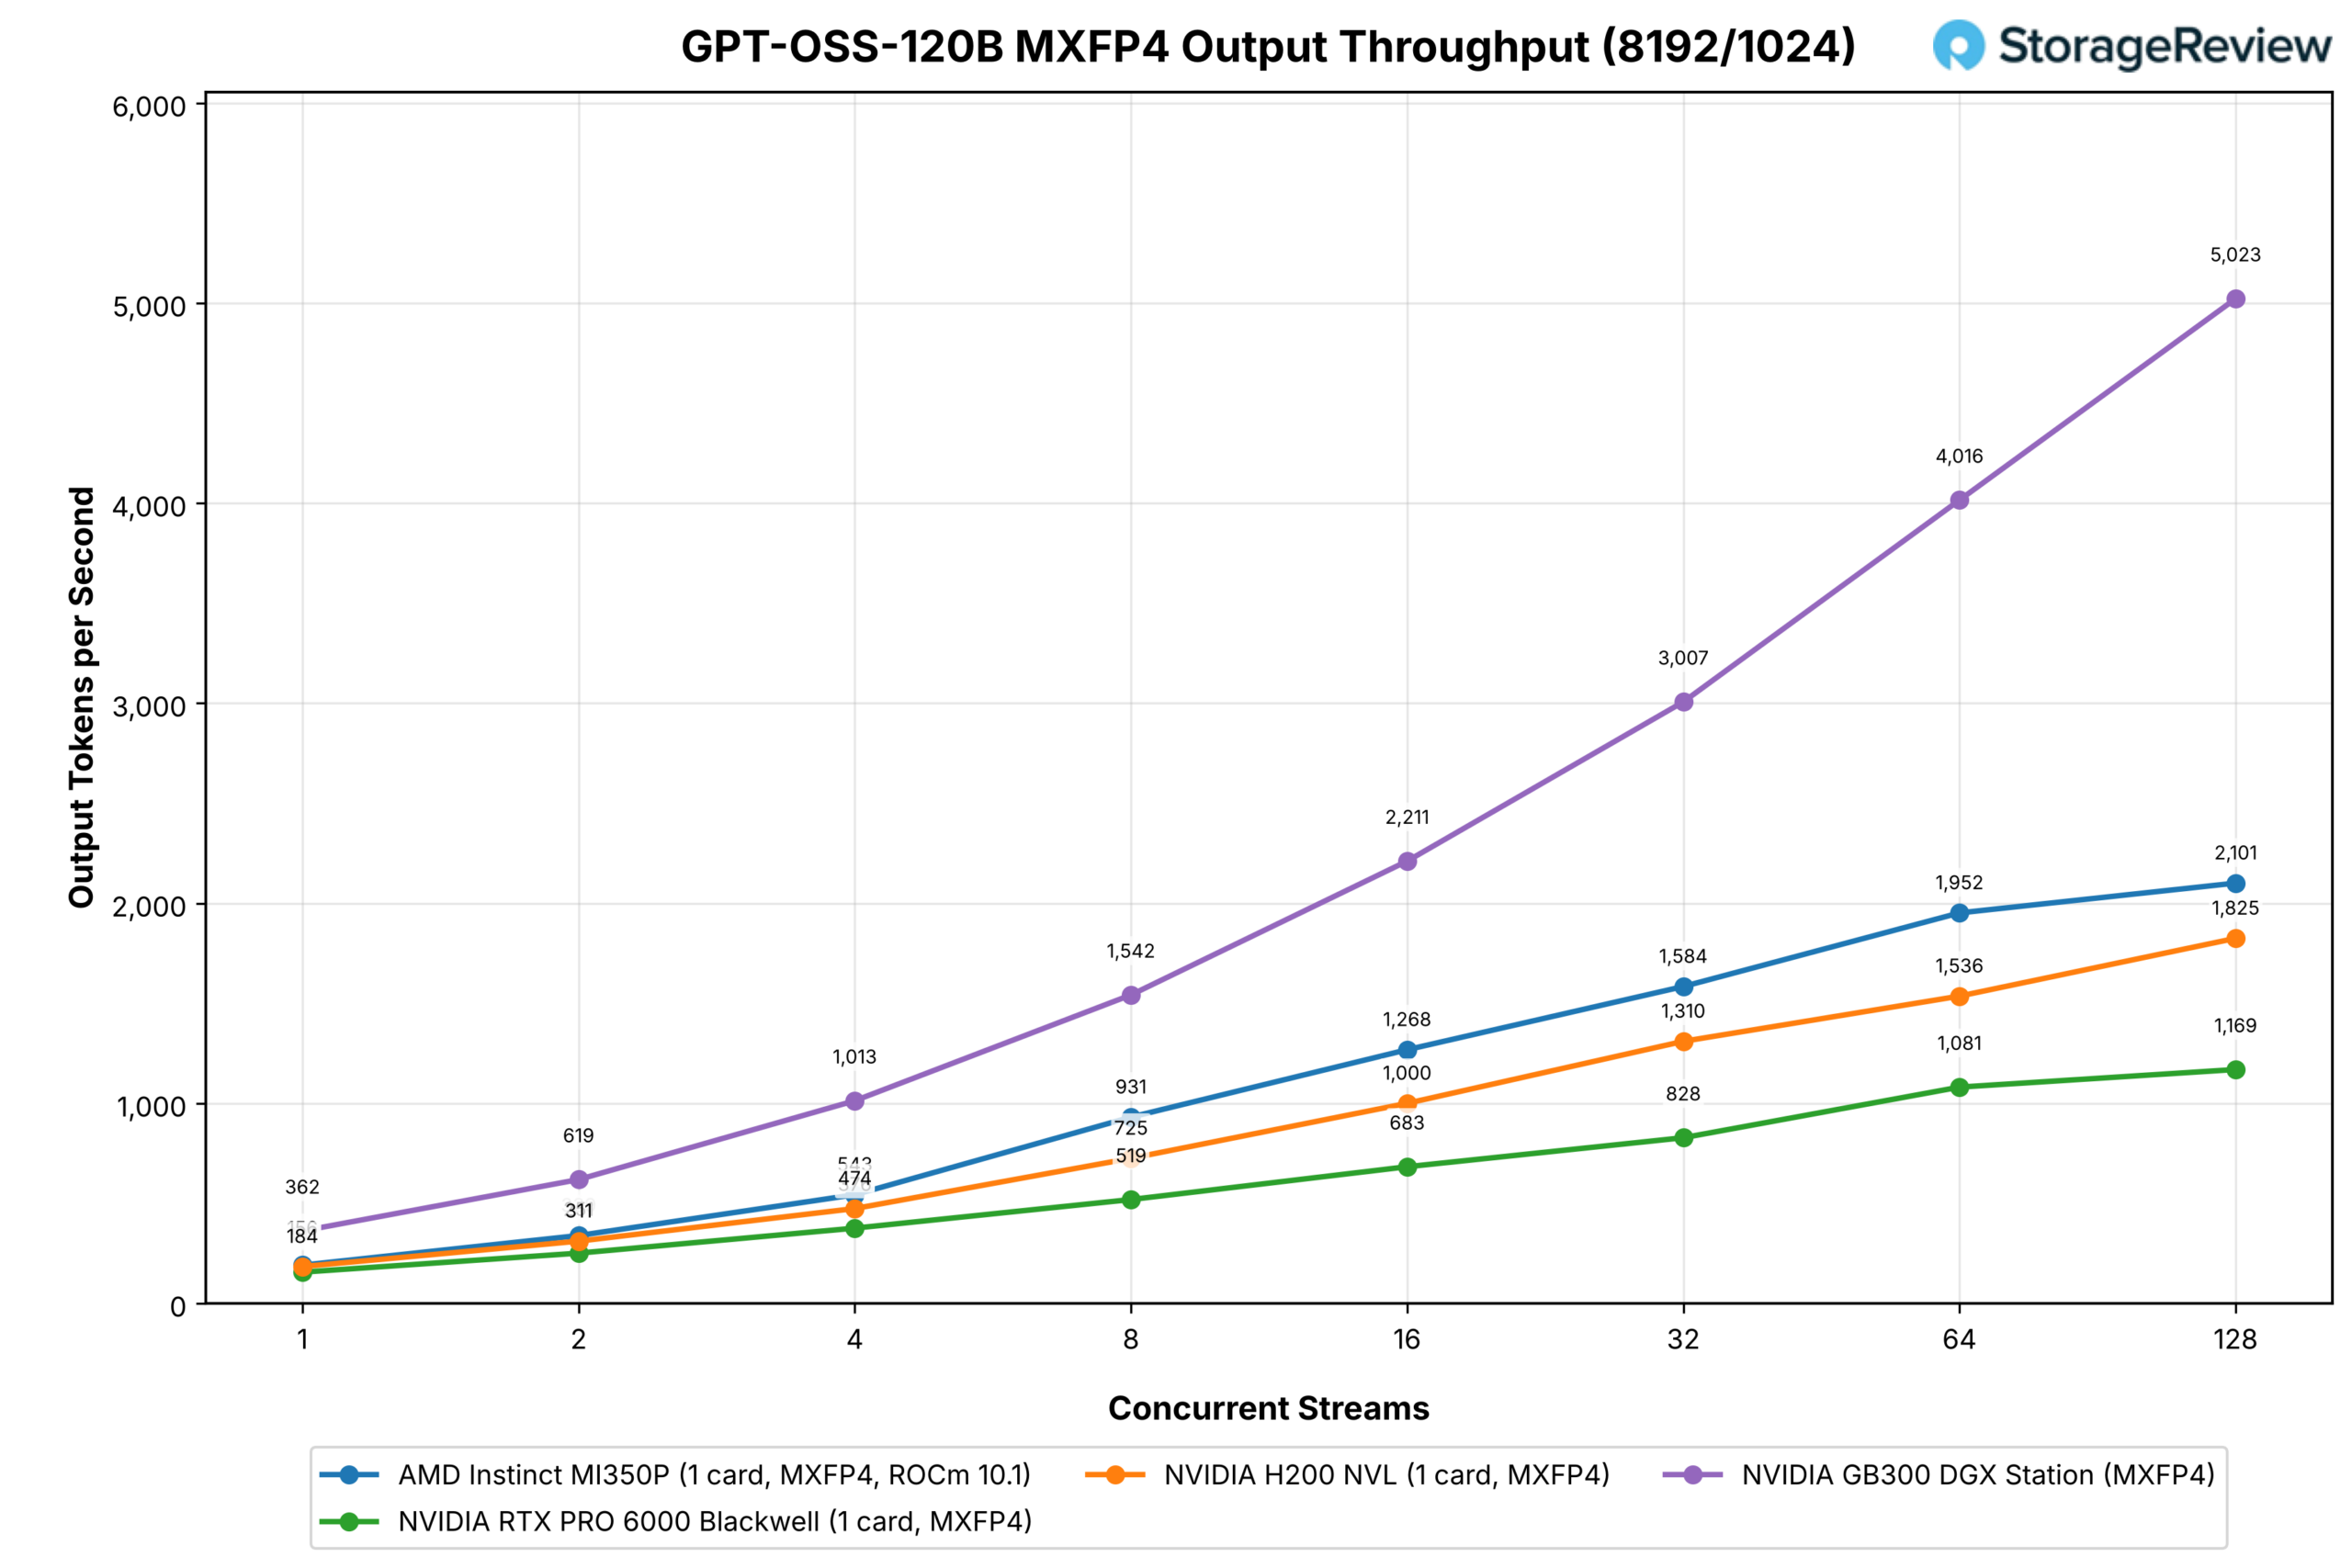
GPT-OSS поставляется в формате MXFP4, поэтому все карты работают с одинаковыми весовыми коэффициентами. Одна MI350P превосходит одну RTX PRO 6000 по количеству потоков в обеих рабочих нагрузках, на 40–93 процента начиная с четырех потоков, и завершает работу с показателем 5,057 выходных токенов в секунду в режиме чата и 2,101 в режиме подсказок с большим количеством предварительных заполнений при 128 потоках, против 3,064 и 1,169 у RTX PRO 6000 и 3,376 и 1,825 у H200 NVL; Station достигает 9,280 и 5,023.
Результаты тестирования MLPerf Inference v6.1 от AMD и Dell от 16 сентября показывают предельные значения для той же модели: восемь MI350P в PowerEdge XE7745 показали 48 971 токен в секунду в автономном режиме и 40 868 в серверном сценарии на GPT-OSS-120B, что составляет 6,121 и 5,108 токенов на каждый графический процессор соответственно, при использовании оптимизированного стека тестов. Наши результаты не совсем идентичны, но 5,057 токенов, измеренные нами при 128 потоках на стандартном vLLM, находятся в нижней части этого диапазона.
ГПТ-ОСС-20Б
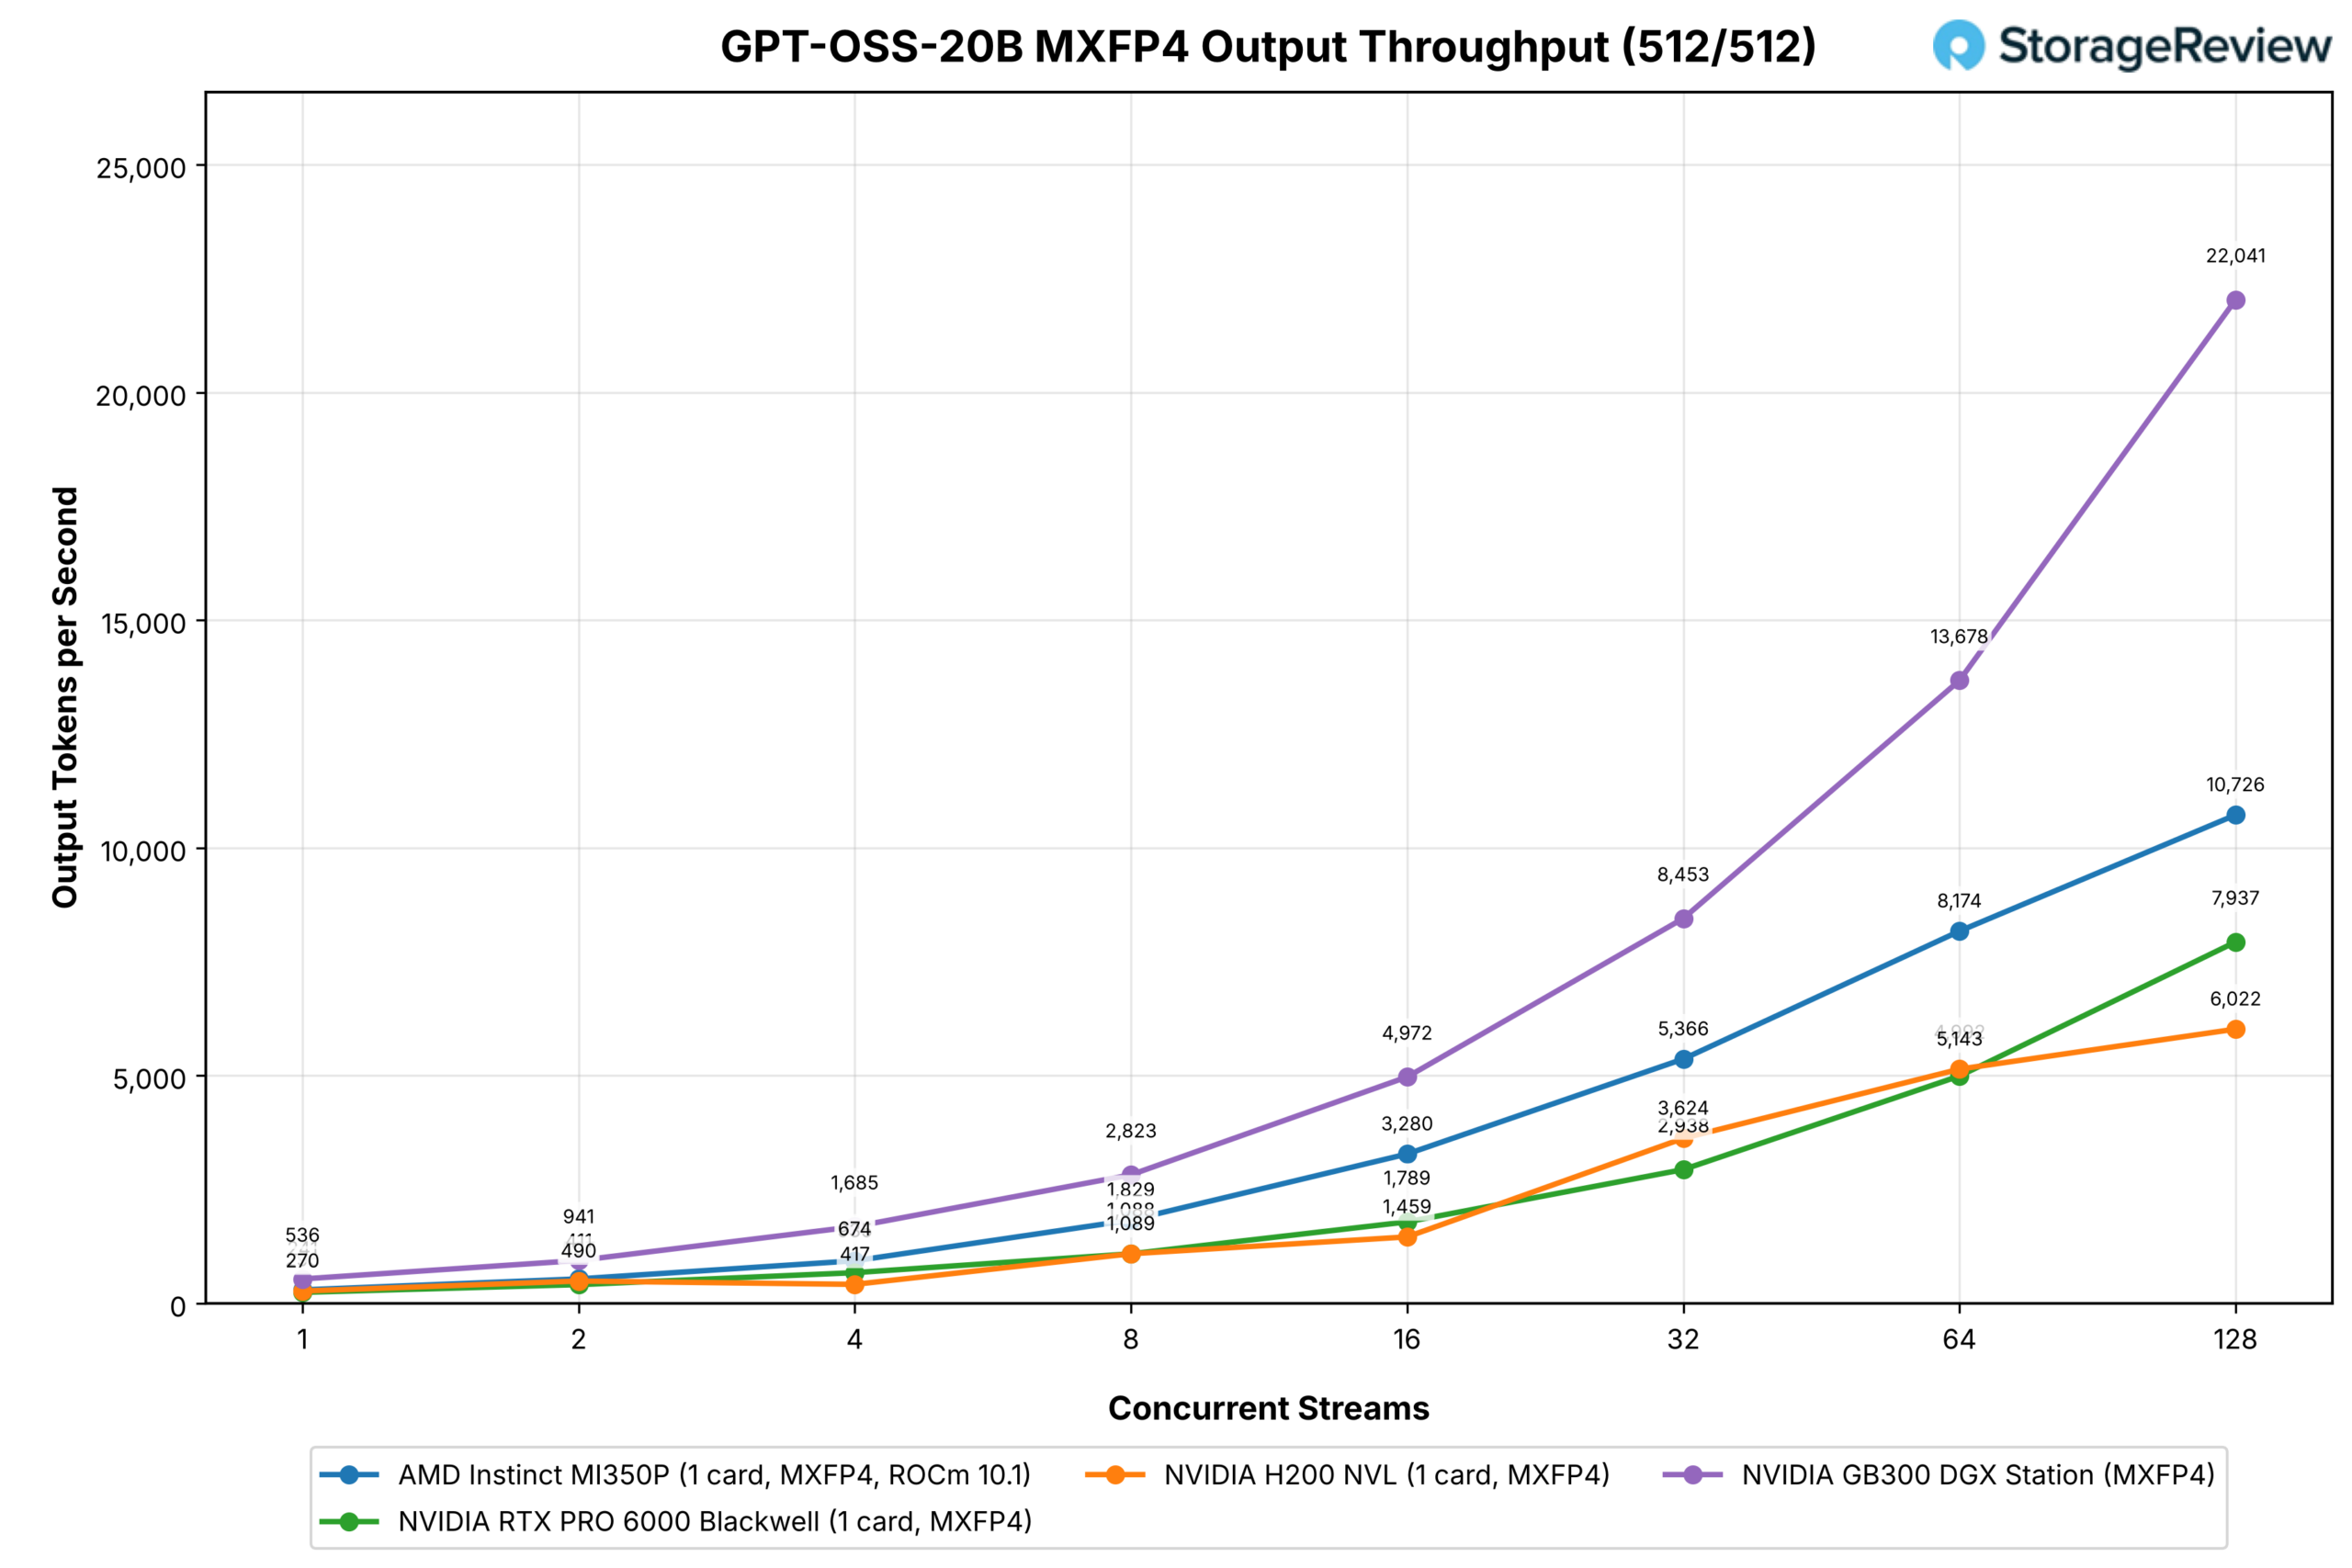
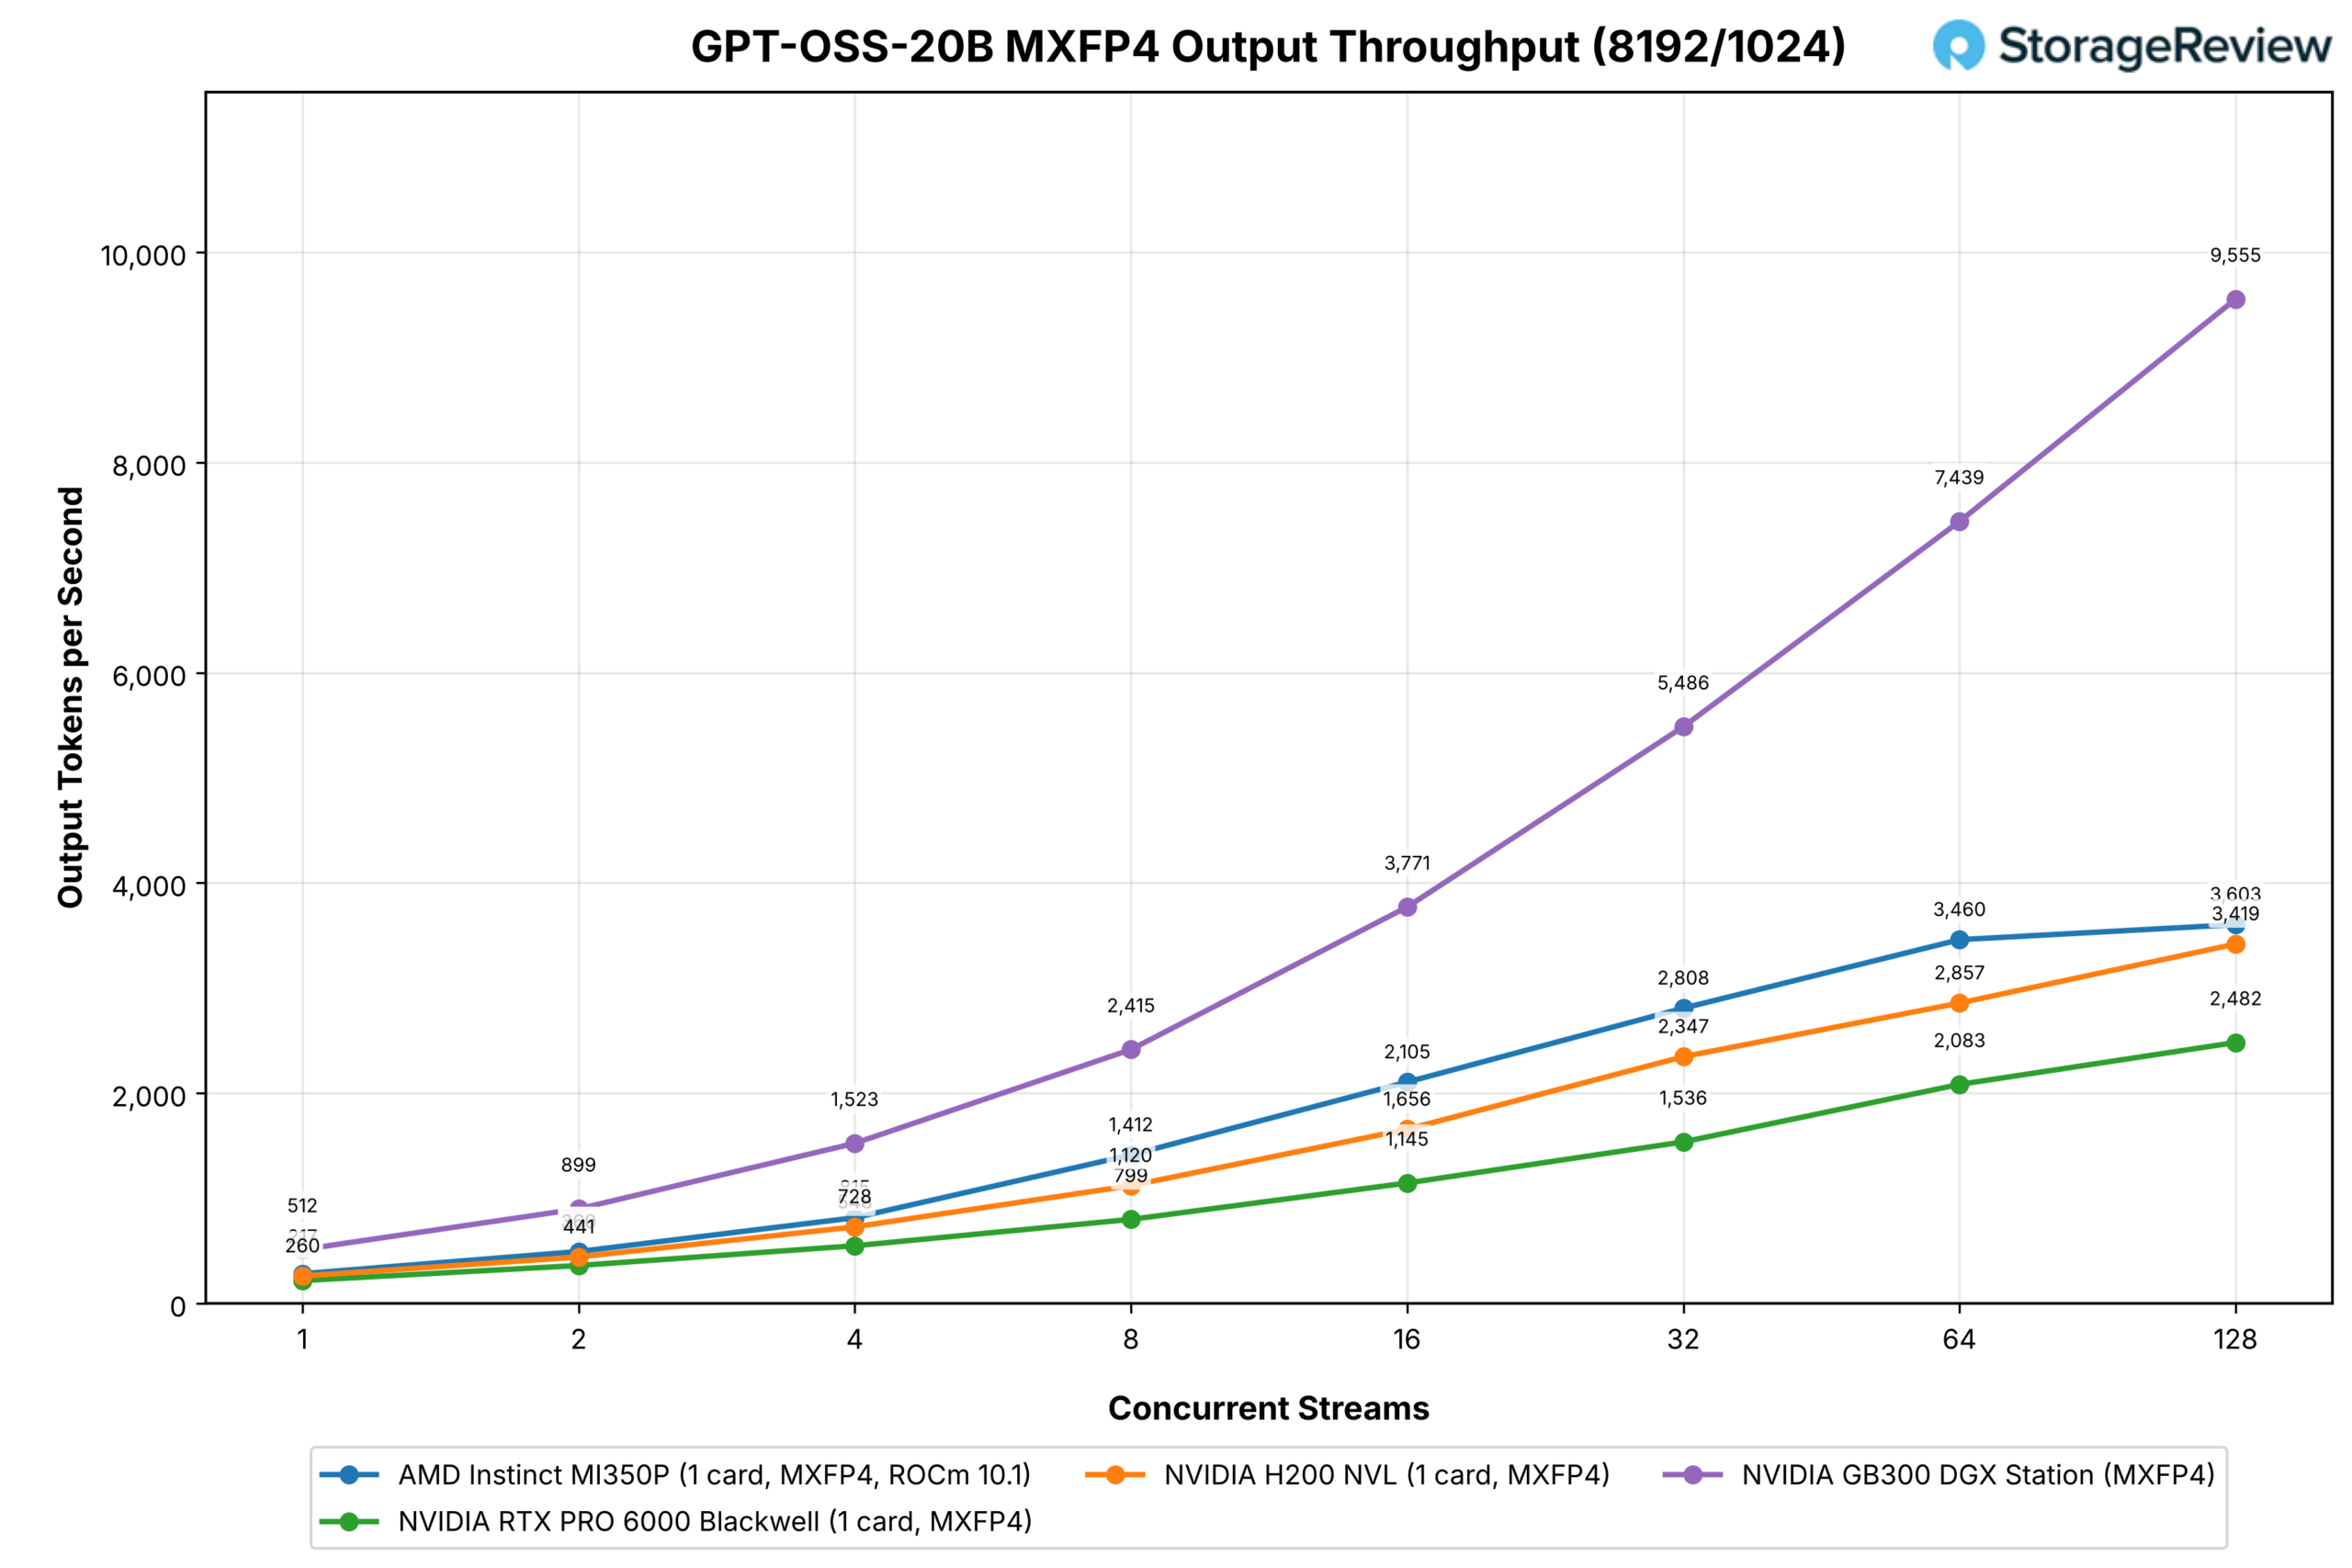
Меньшая по размеру модель OpenAI следует той же кривой. MI350P превосходит RTX PRO 6000 по всем показателям: 8,174 против 4,992 при 64 потоках и 10,726 против 7,937 при 128 потоках в режиме чата, а также 3,460 против 2,083 и 3,603 против 2,482 в запросах с большим количеством предварительных заполнений. При 256 потоках показатель MI350P достигает 16,406, тогда как RTX PRO 6000 показывает 11,077. H200 NVL отстает от MI350P по обоим показателям: 6,022 и 3,419 при 128 потоках, а Station — 22,041 и 9,555.
Qwen3-Coder-30B-A3B
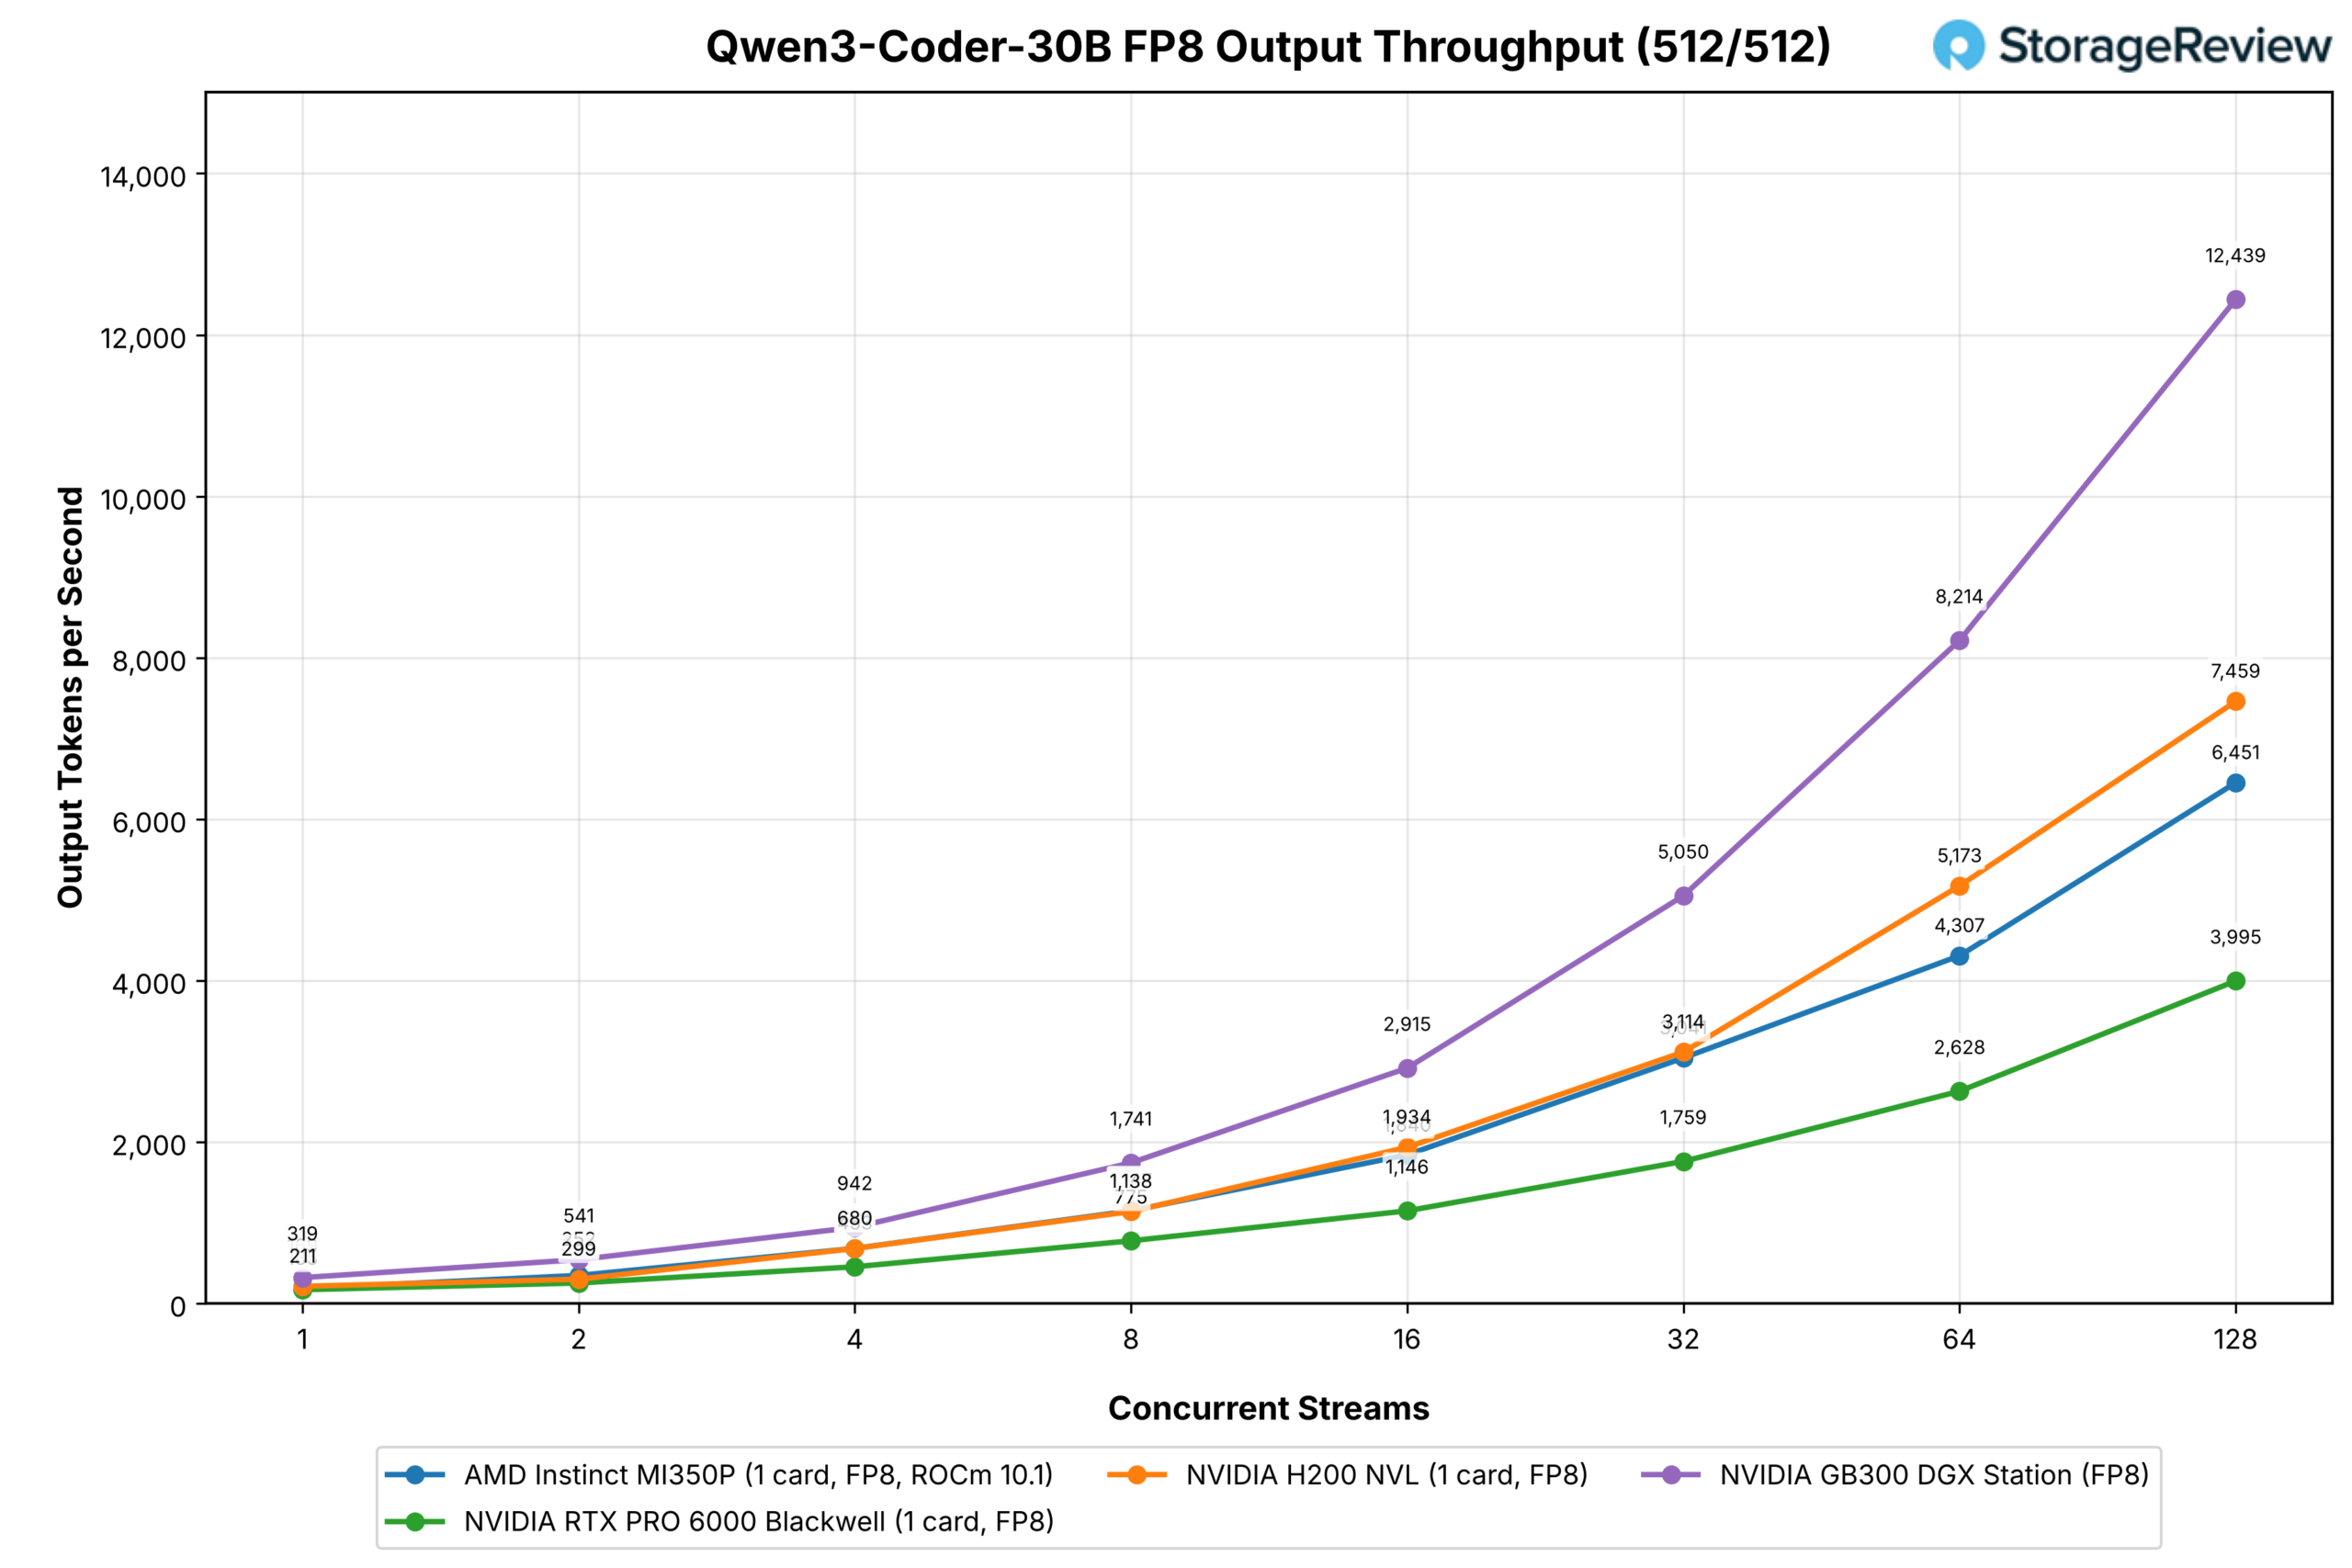
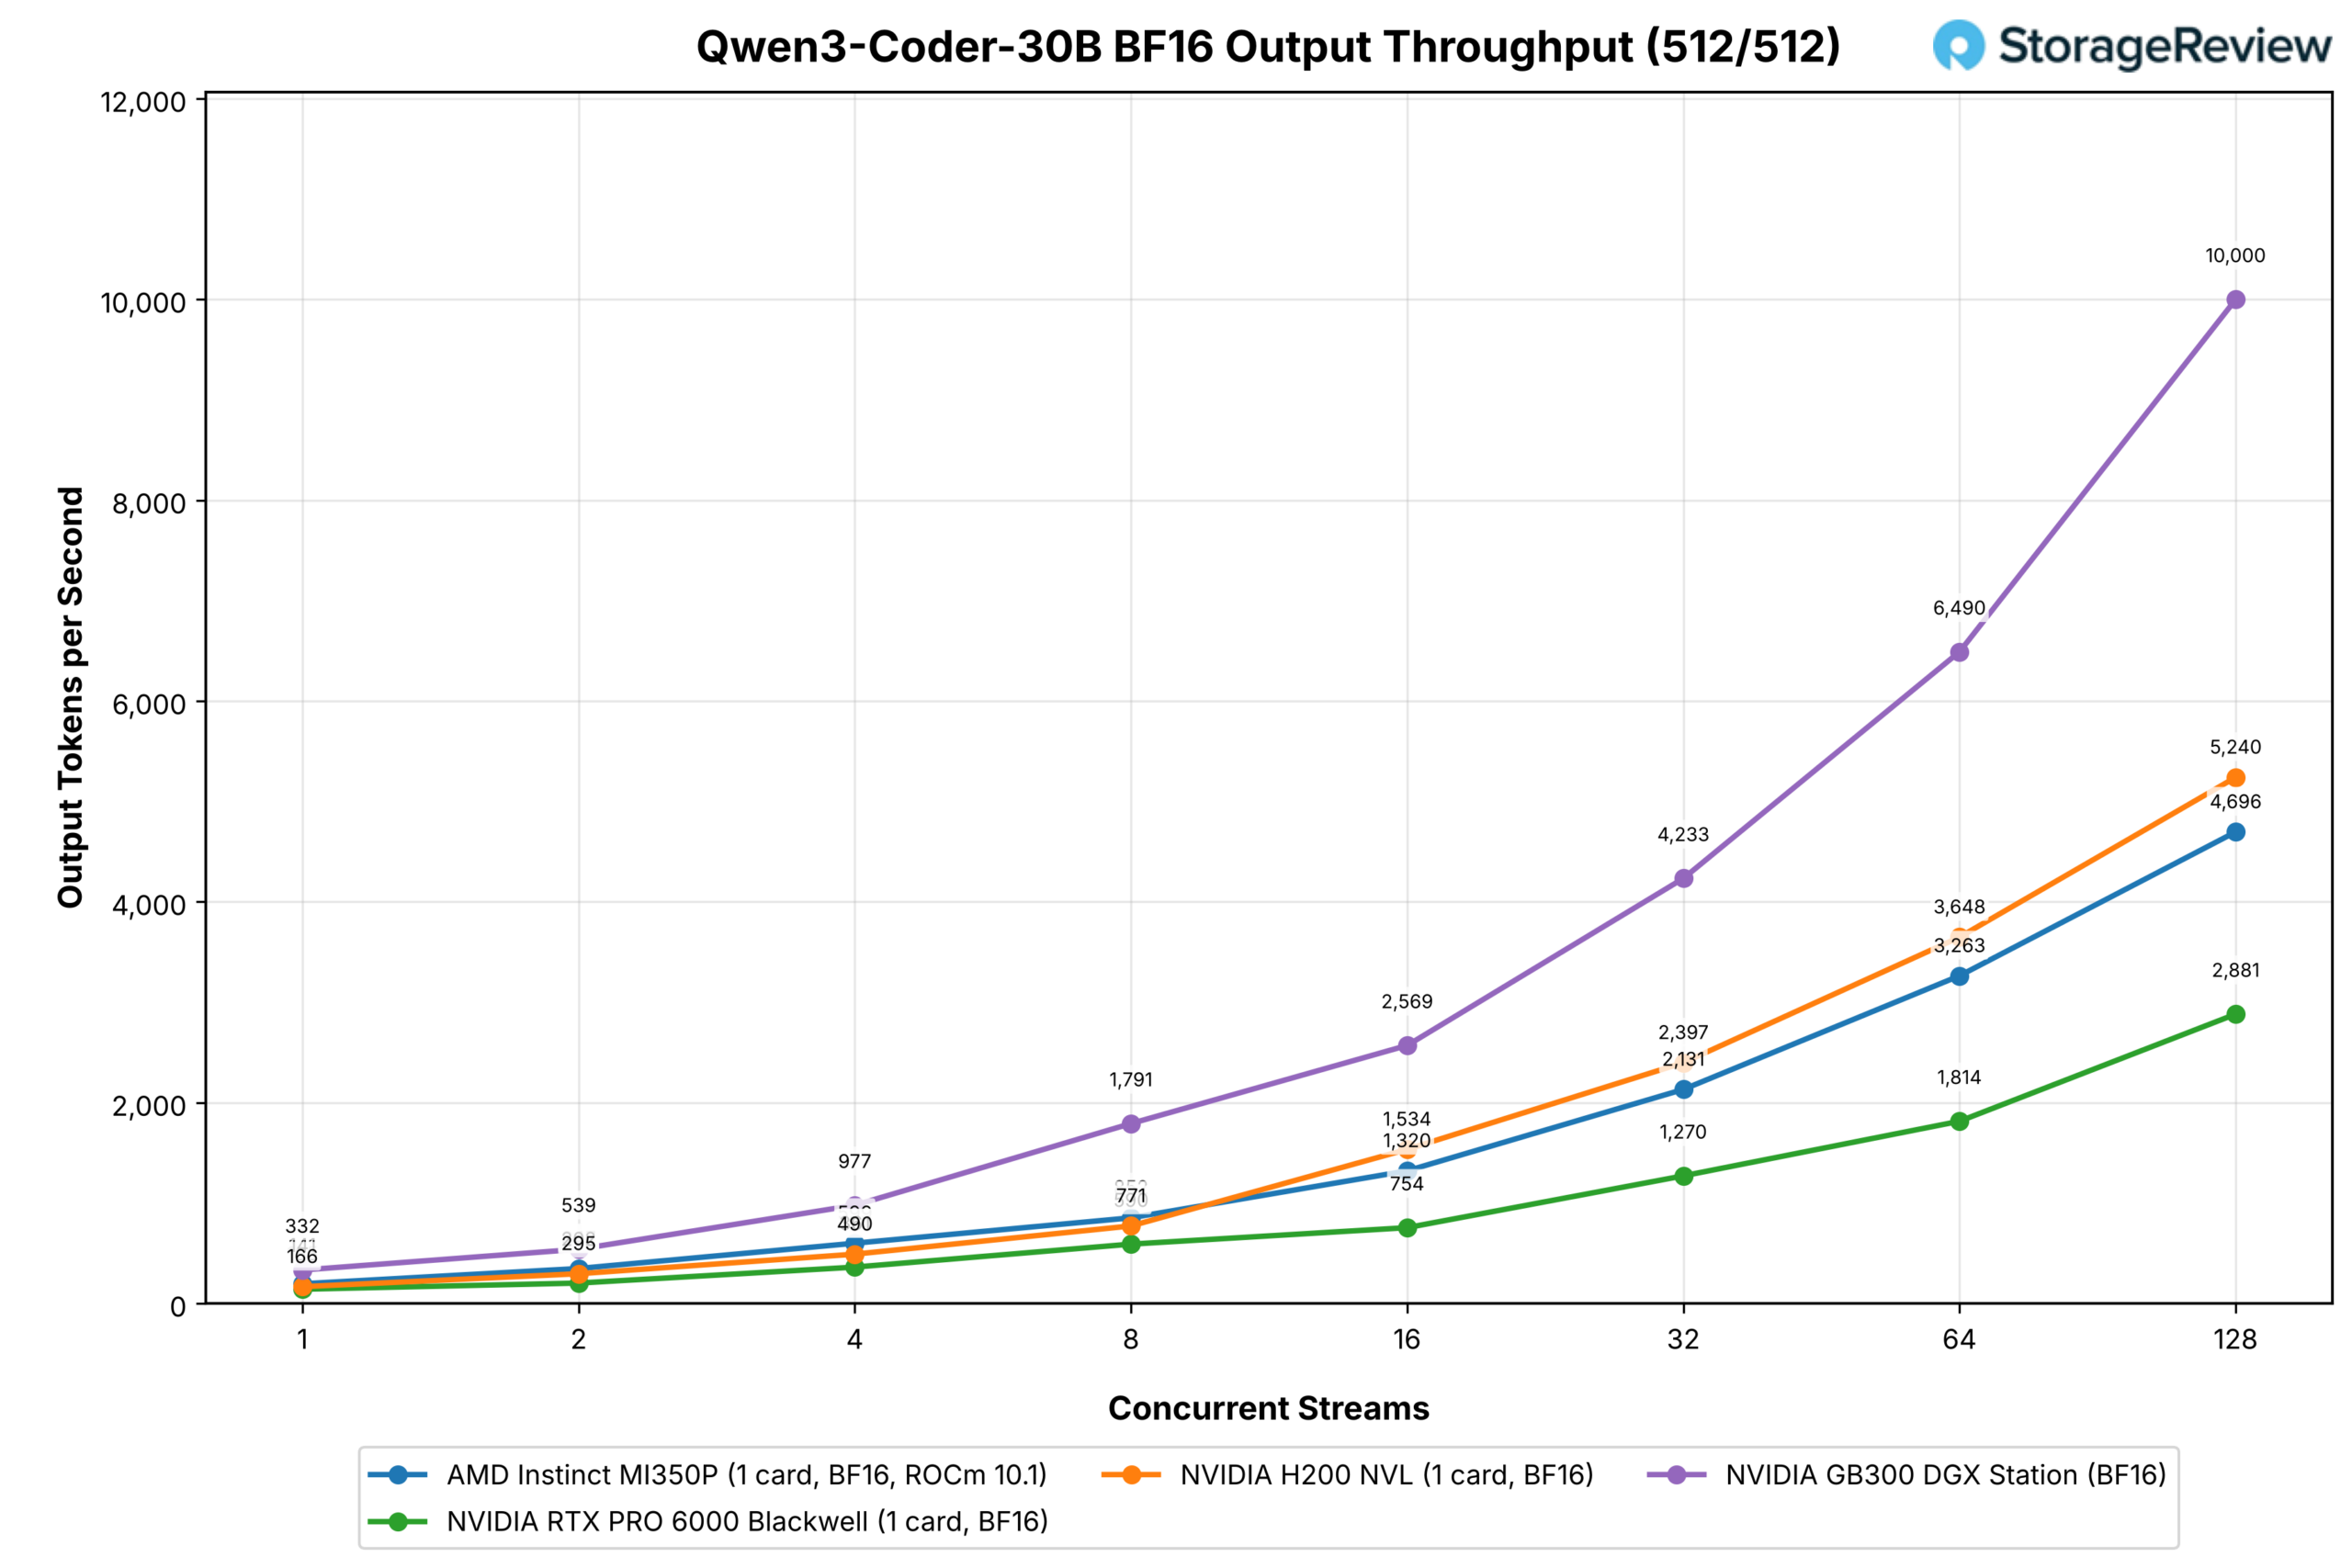
30-битный MoE с 3-битными активными параметрами обеспечивает MI350P преимущество перед RTX PRO 6000 по всем показателям параллельной обработки в чате, достигнув 6,451 против 3,995 в FP8 и 4,696 против 2,881 в BF16 при 128 потоках, в то время как H200 показал 7,459 и 5,240 результатов соответственно.
В тестах с большим количеством предварительных заполнений, FP8 лидирует только на протяжении четырех потоков, а затем отстает от RTX PRO 6000 с восьми до 128, показывая результат 759 против 823 в верхней части таблицы, при этом H200 имеет результат 1,820; в тесте BF16 результат поднимается до 728 при 128 потоках против 588 и 1,592.
Мистраль Малый 3.1 24Б
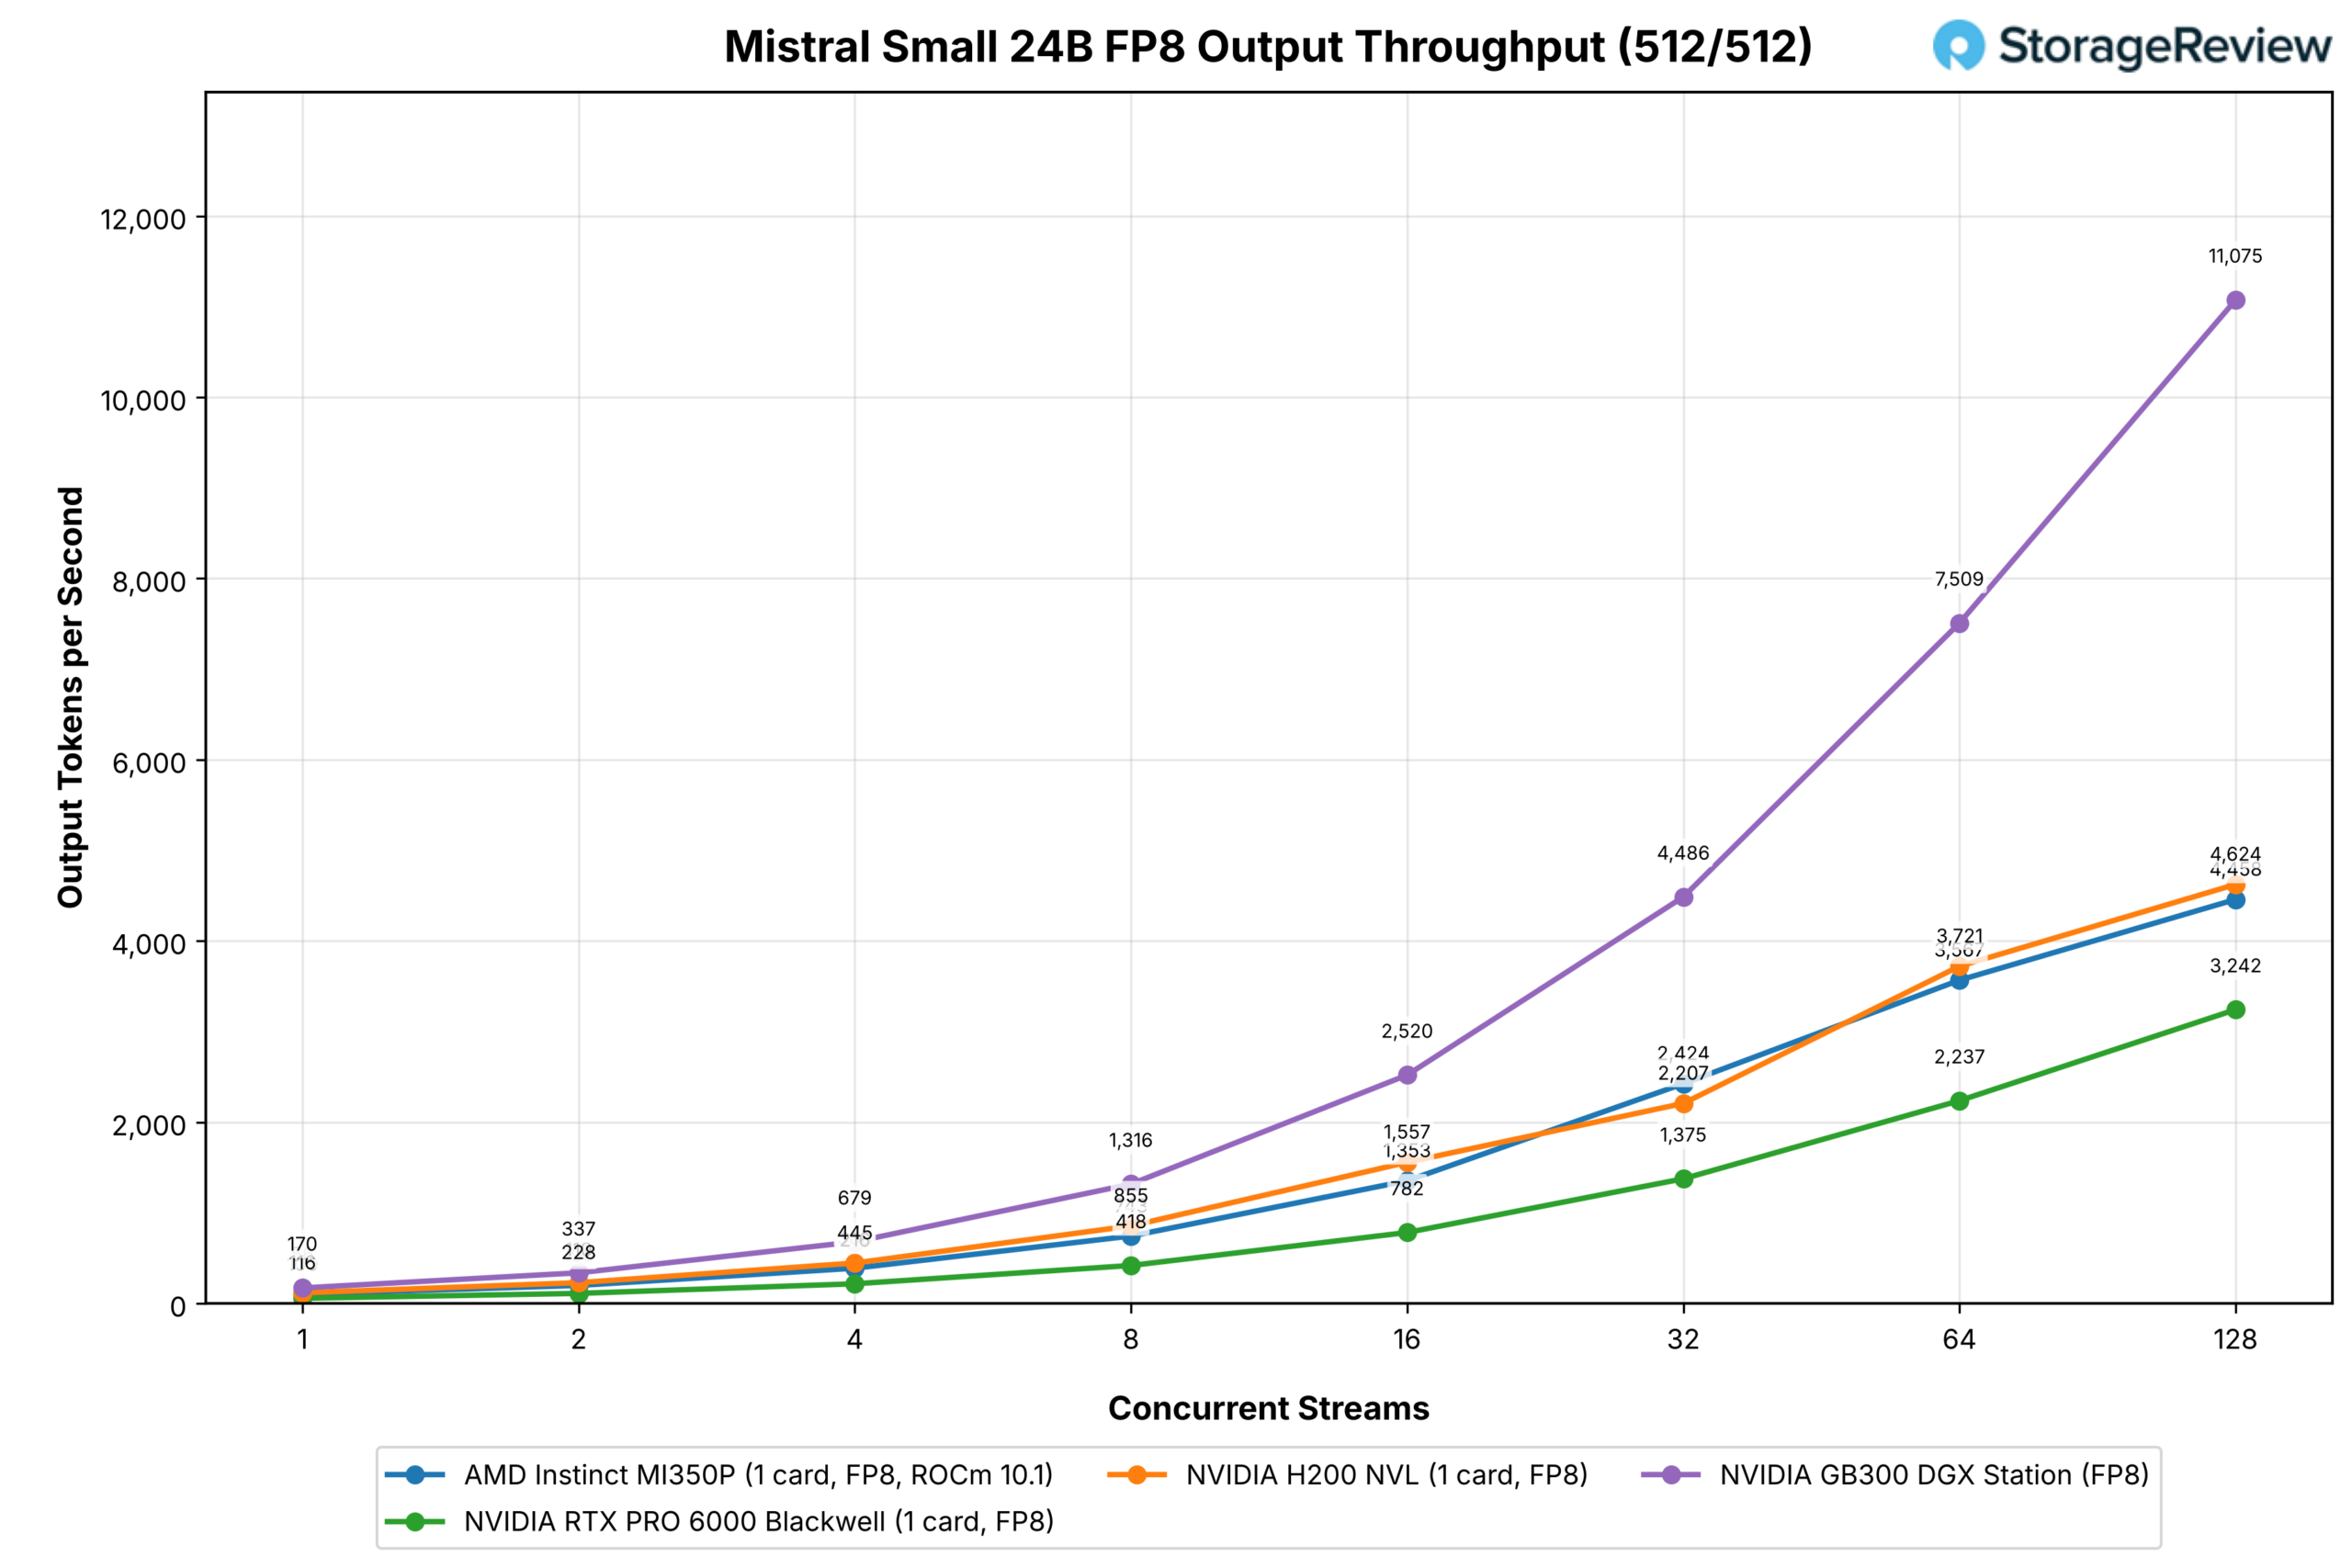
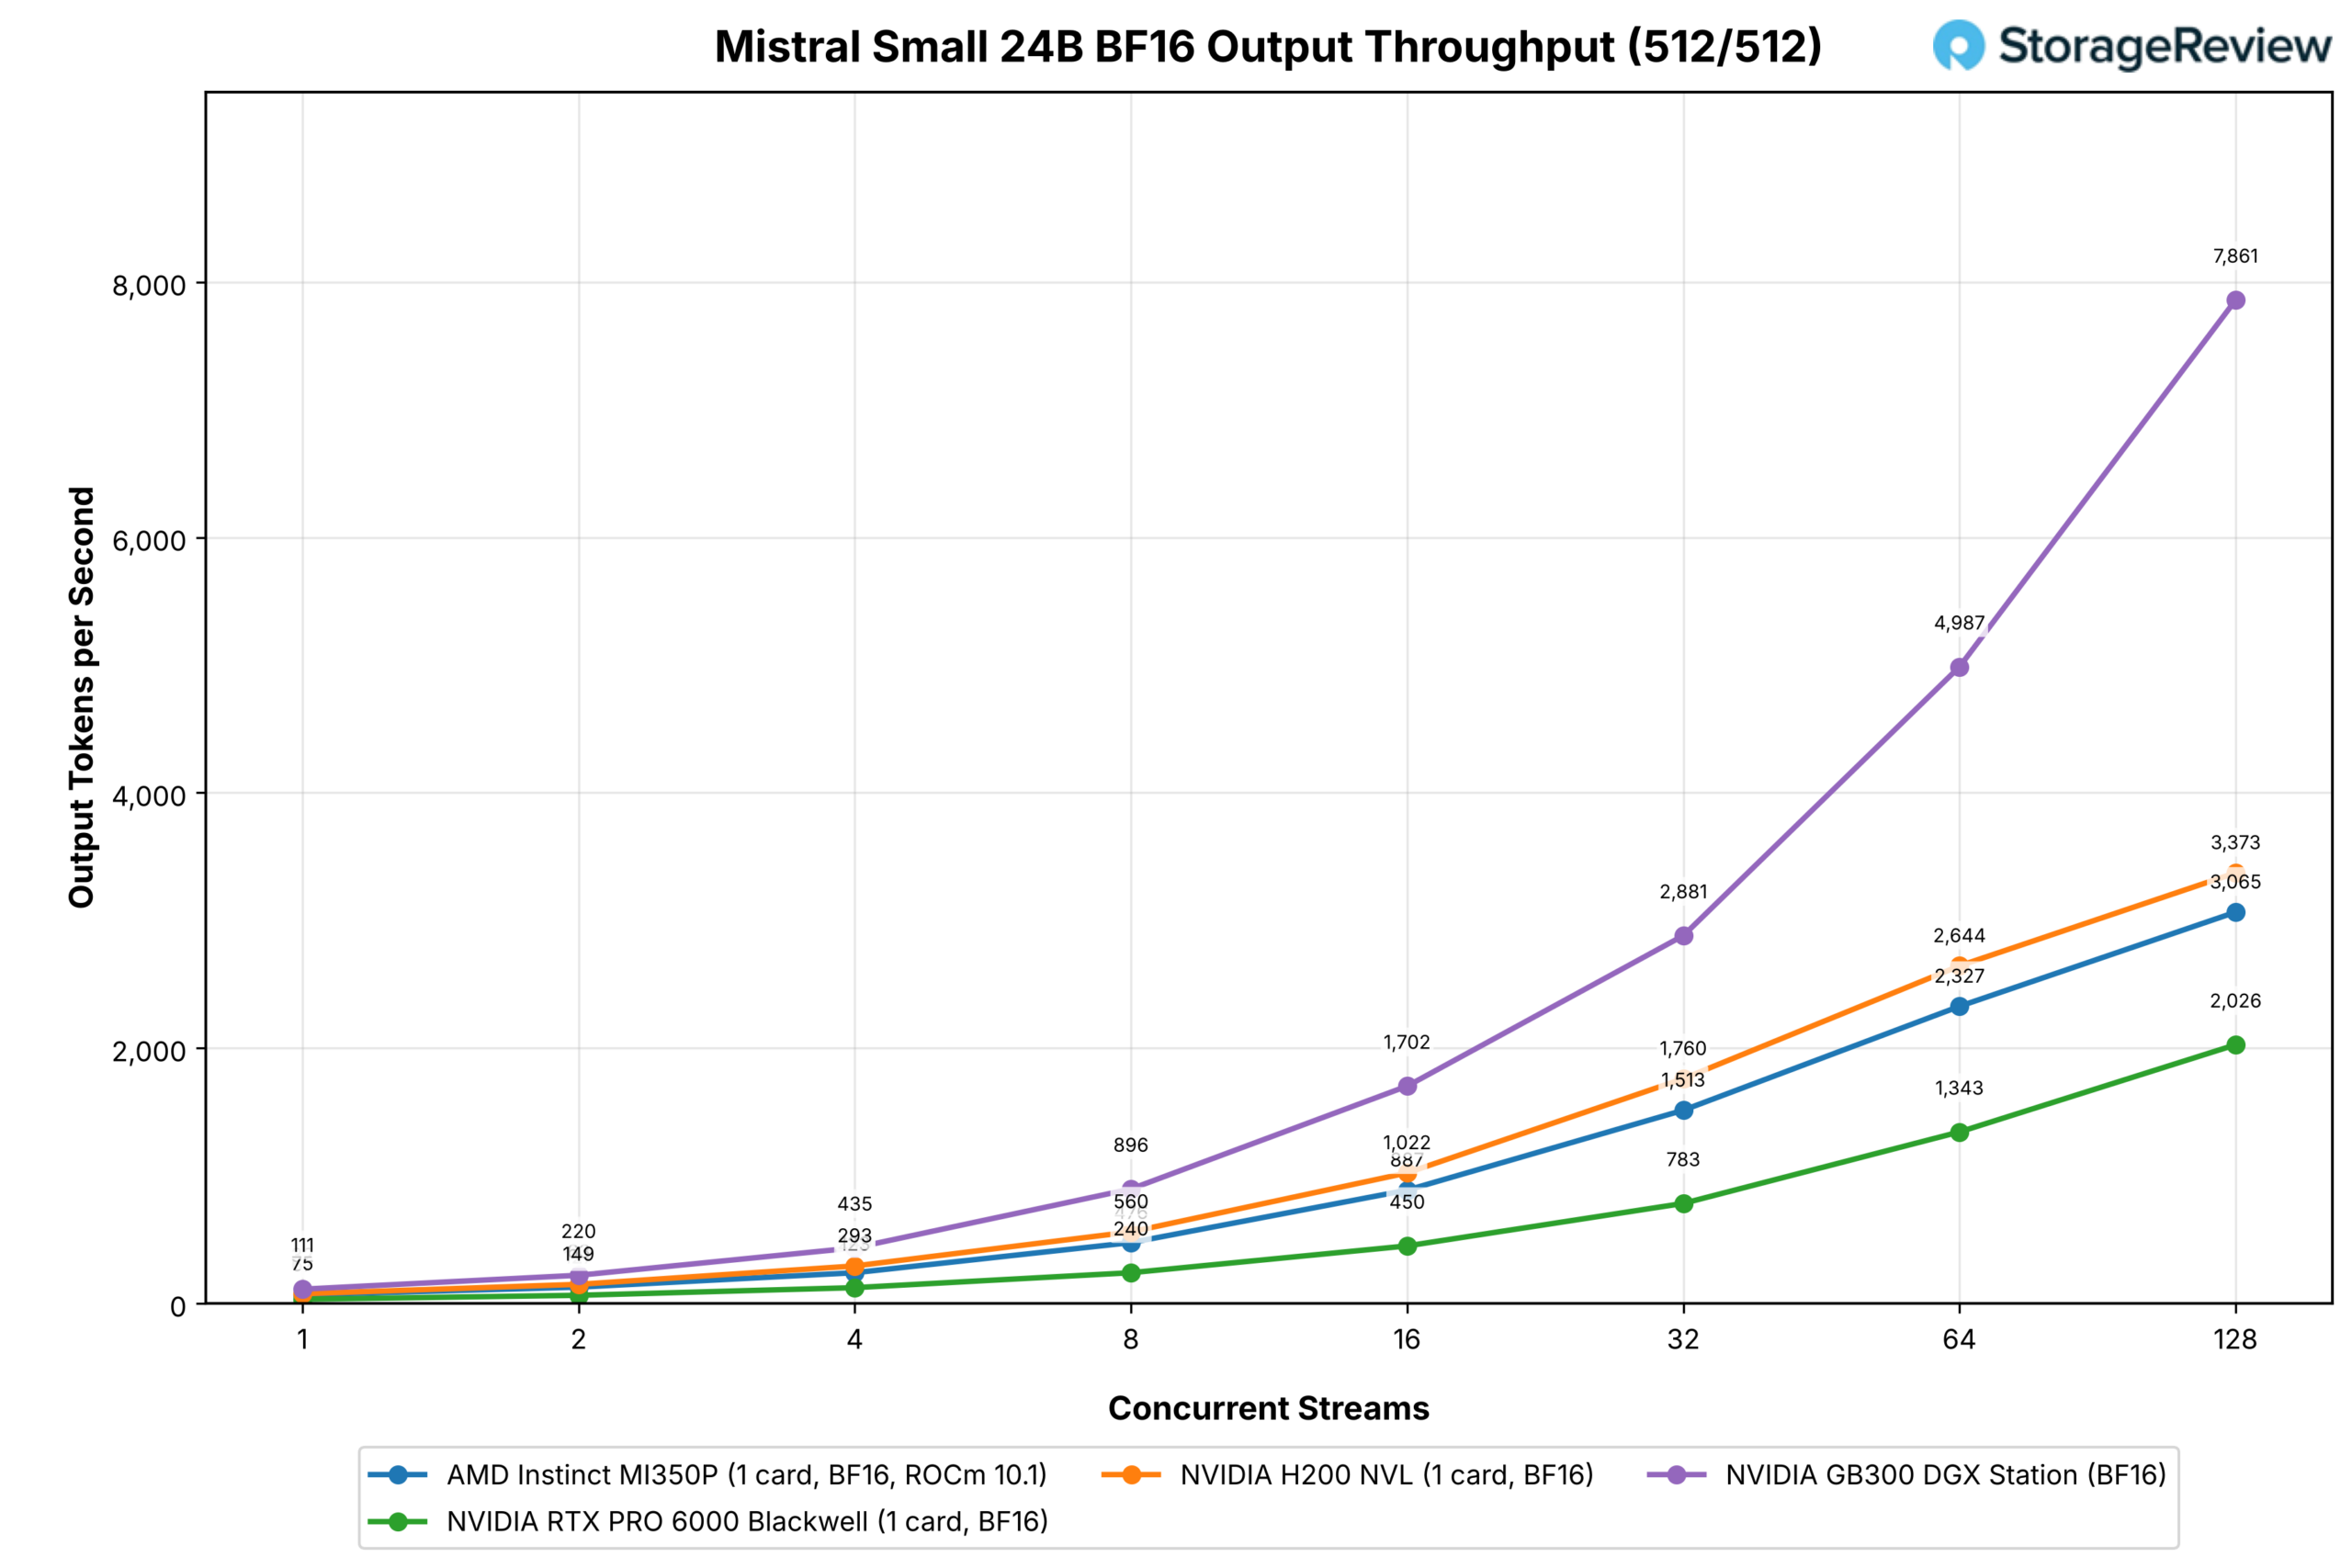
Mistral Small демонстрирует лучшие результаты MI350P по плотности потоков по сравнению с RTX PRO 6000: 4,458 против 3,242 в FP8 и 3,065 против 2,026 в BF16 при 128 потоках в чате, а при одном потоке MI350P примерно вдвое превосходит карту NVIDIA (100 против 56 в FP8, 67 против 32 в BF16).
Это также модель с высокой плотностью запросов, где MI350P лидирует по количеству запросов с интенсивным предварительным заполнением: 599 против 482 в FP8 при 128 потоках и 425 против 299 в BF16 при 64 потоках, хотя H200 достигает 799 и 632 в тех же точках.
Лама 3.1 8Б
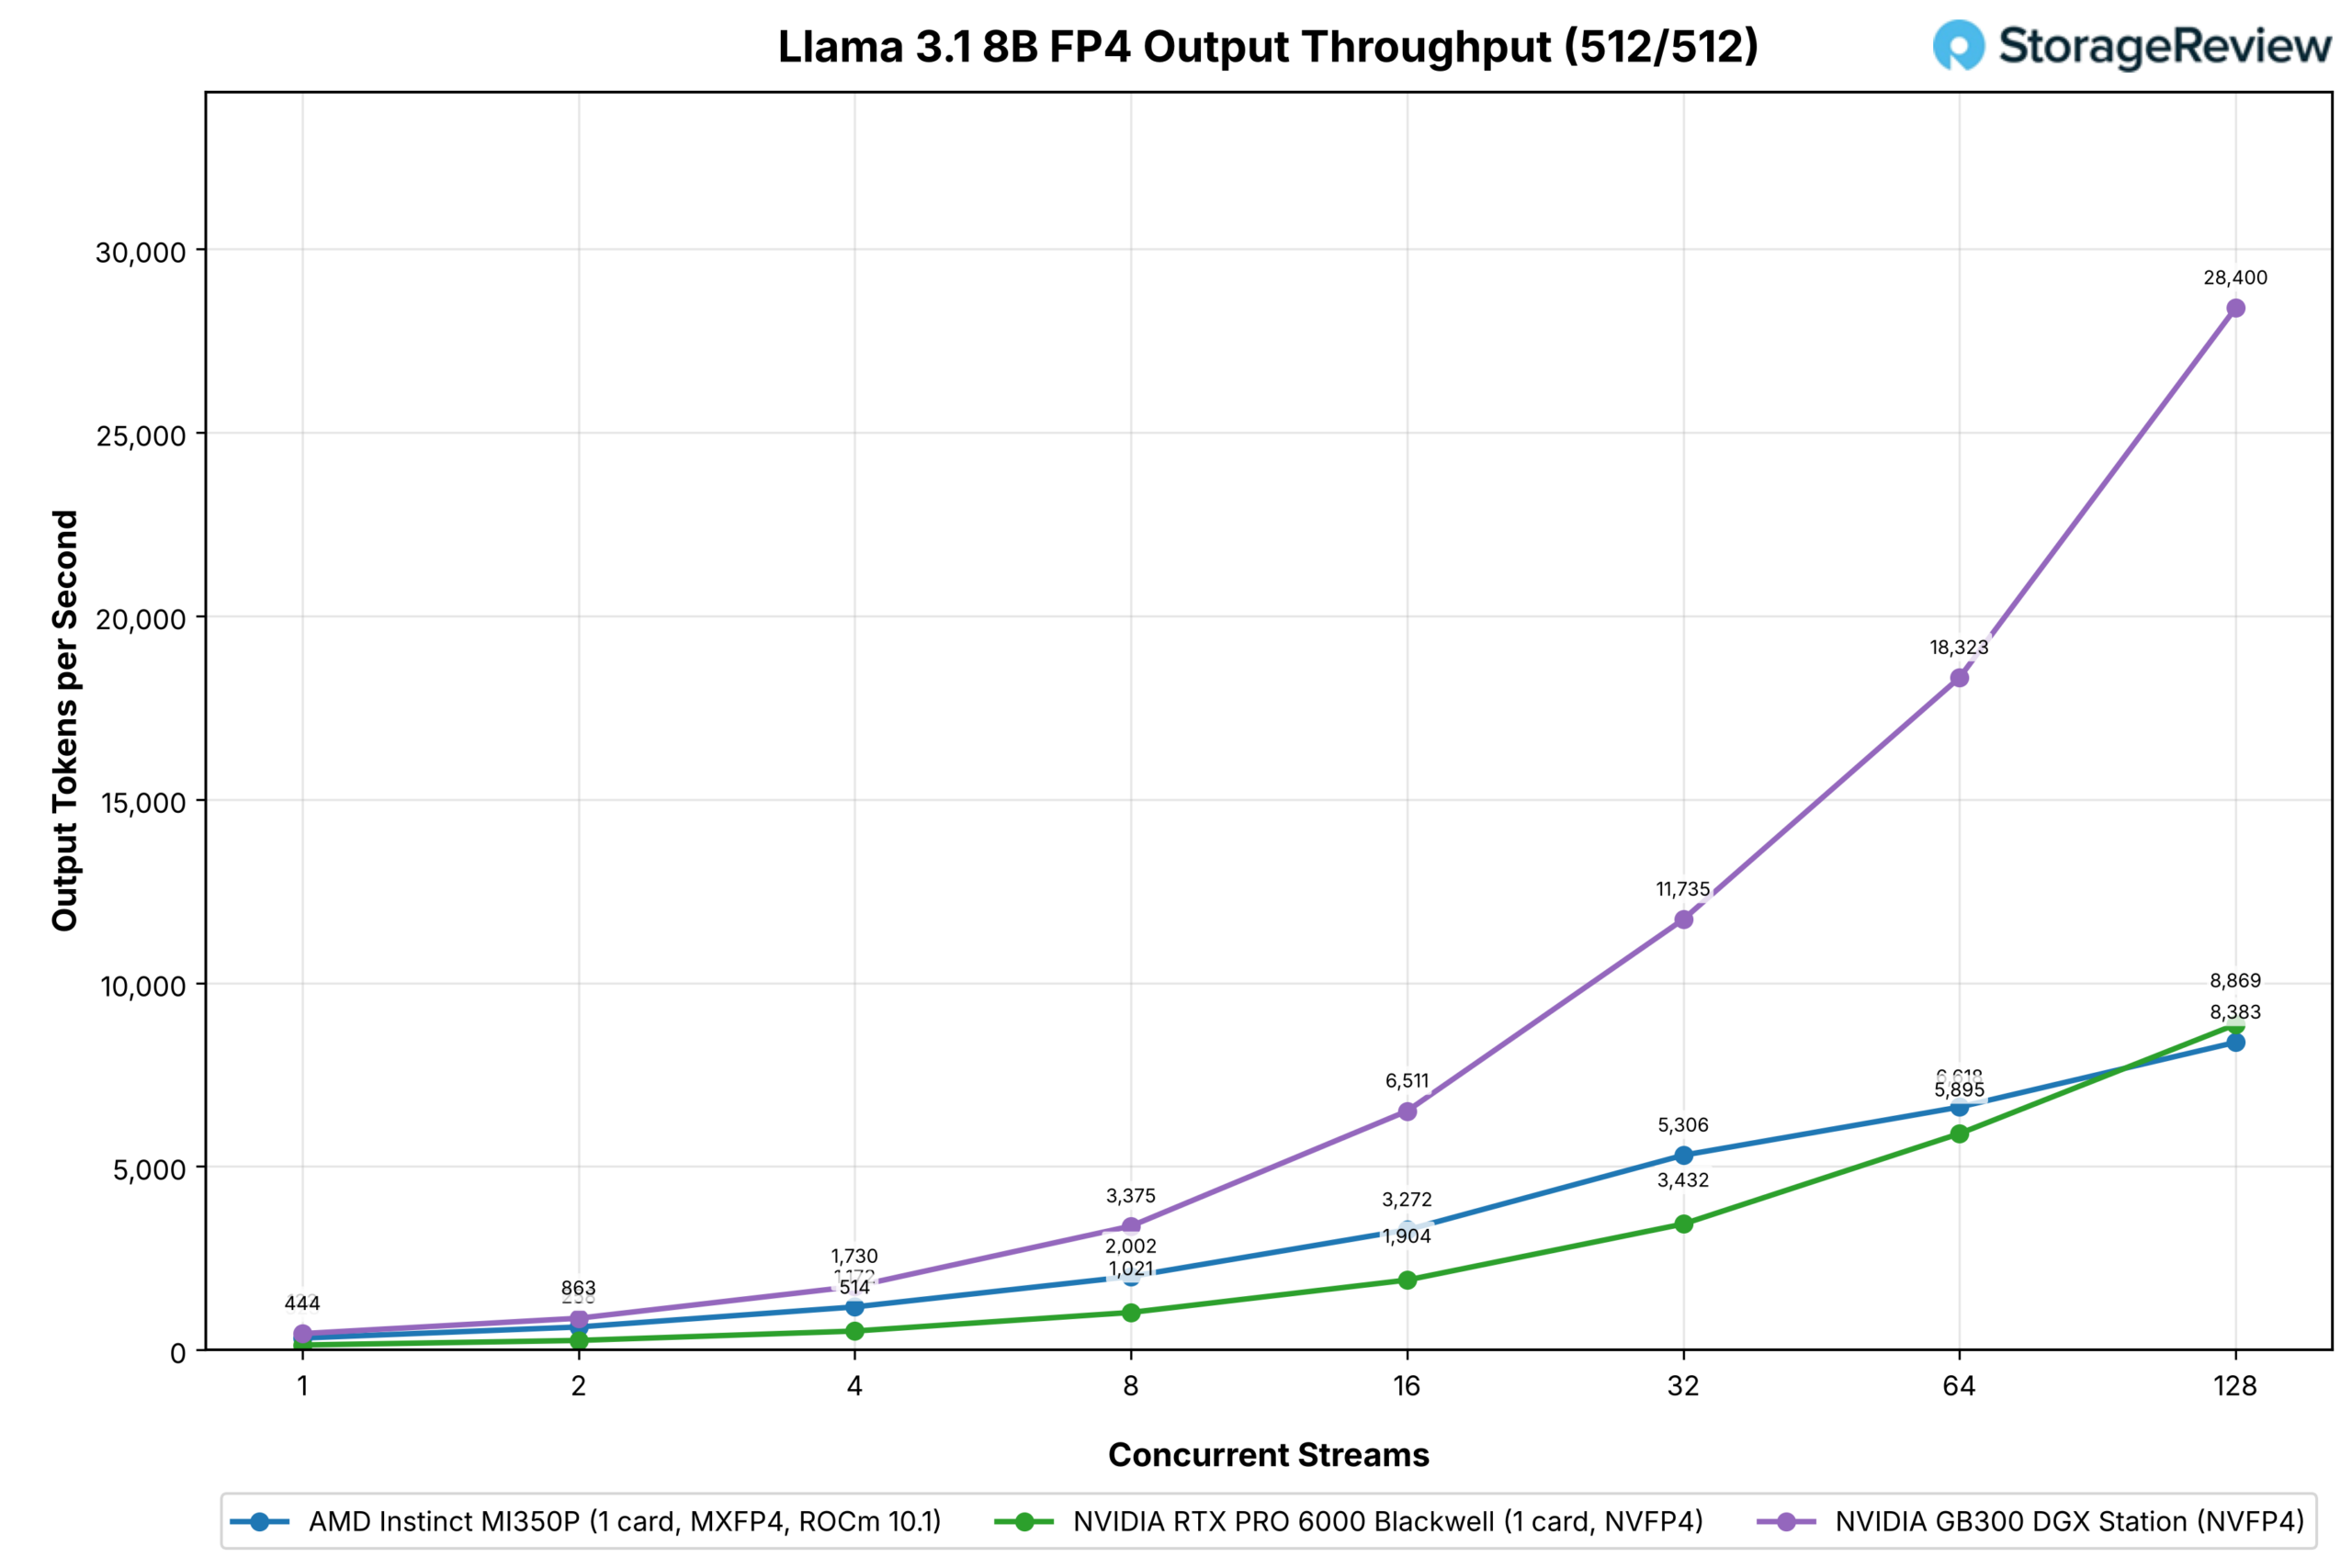
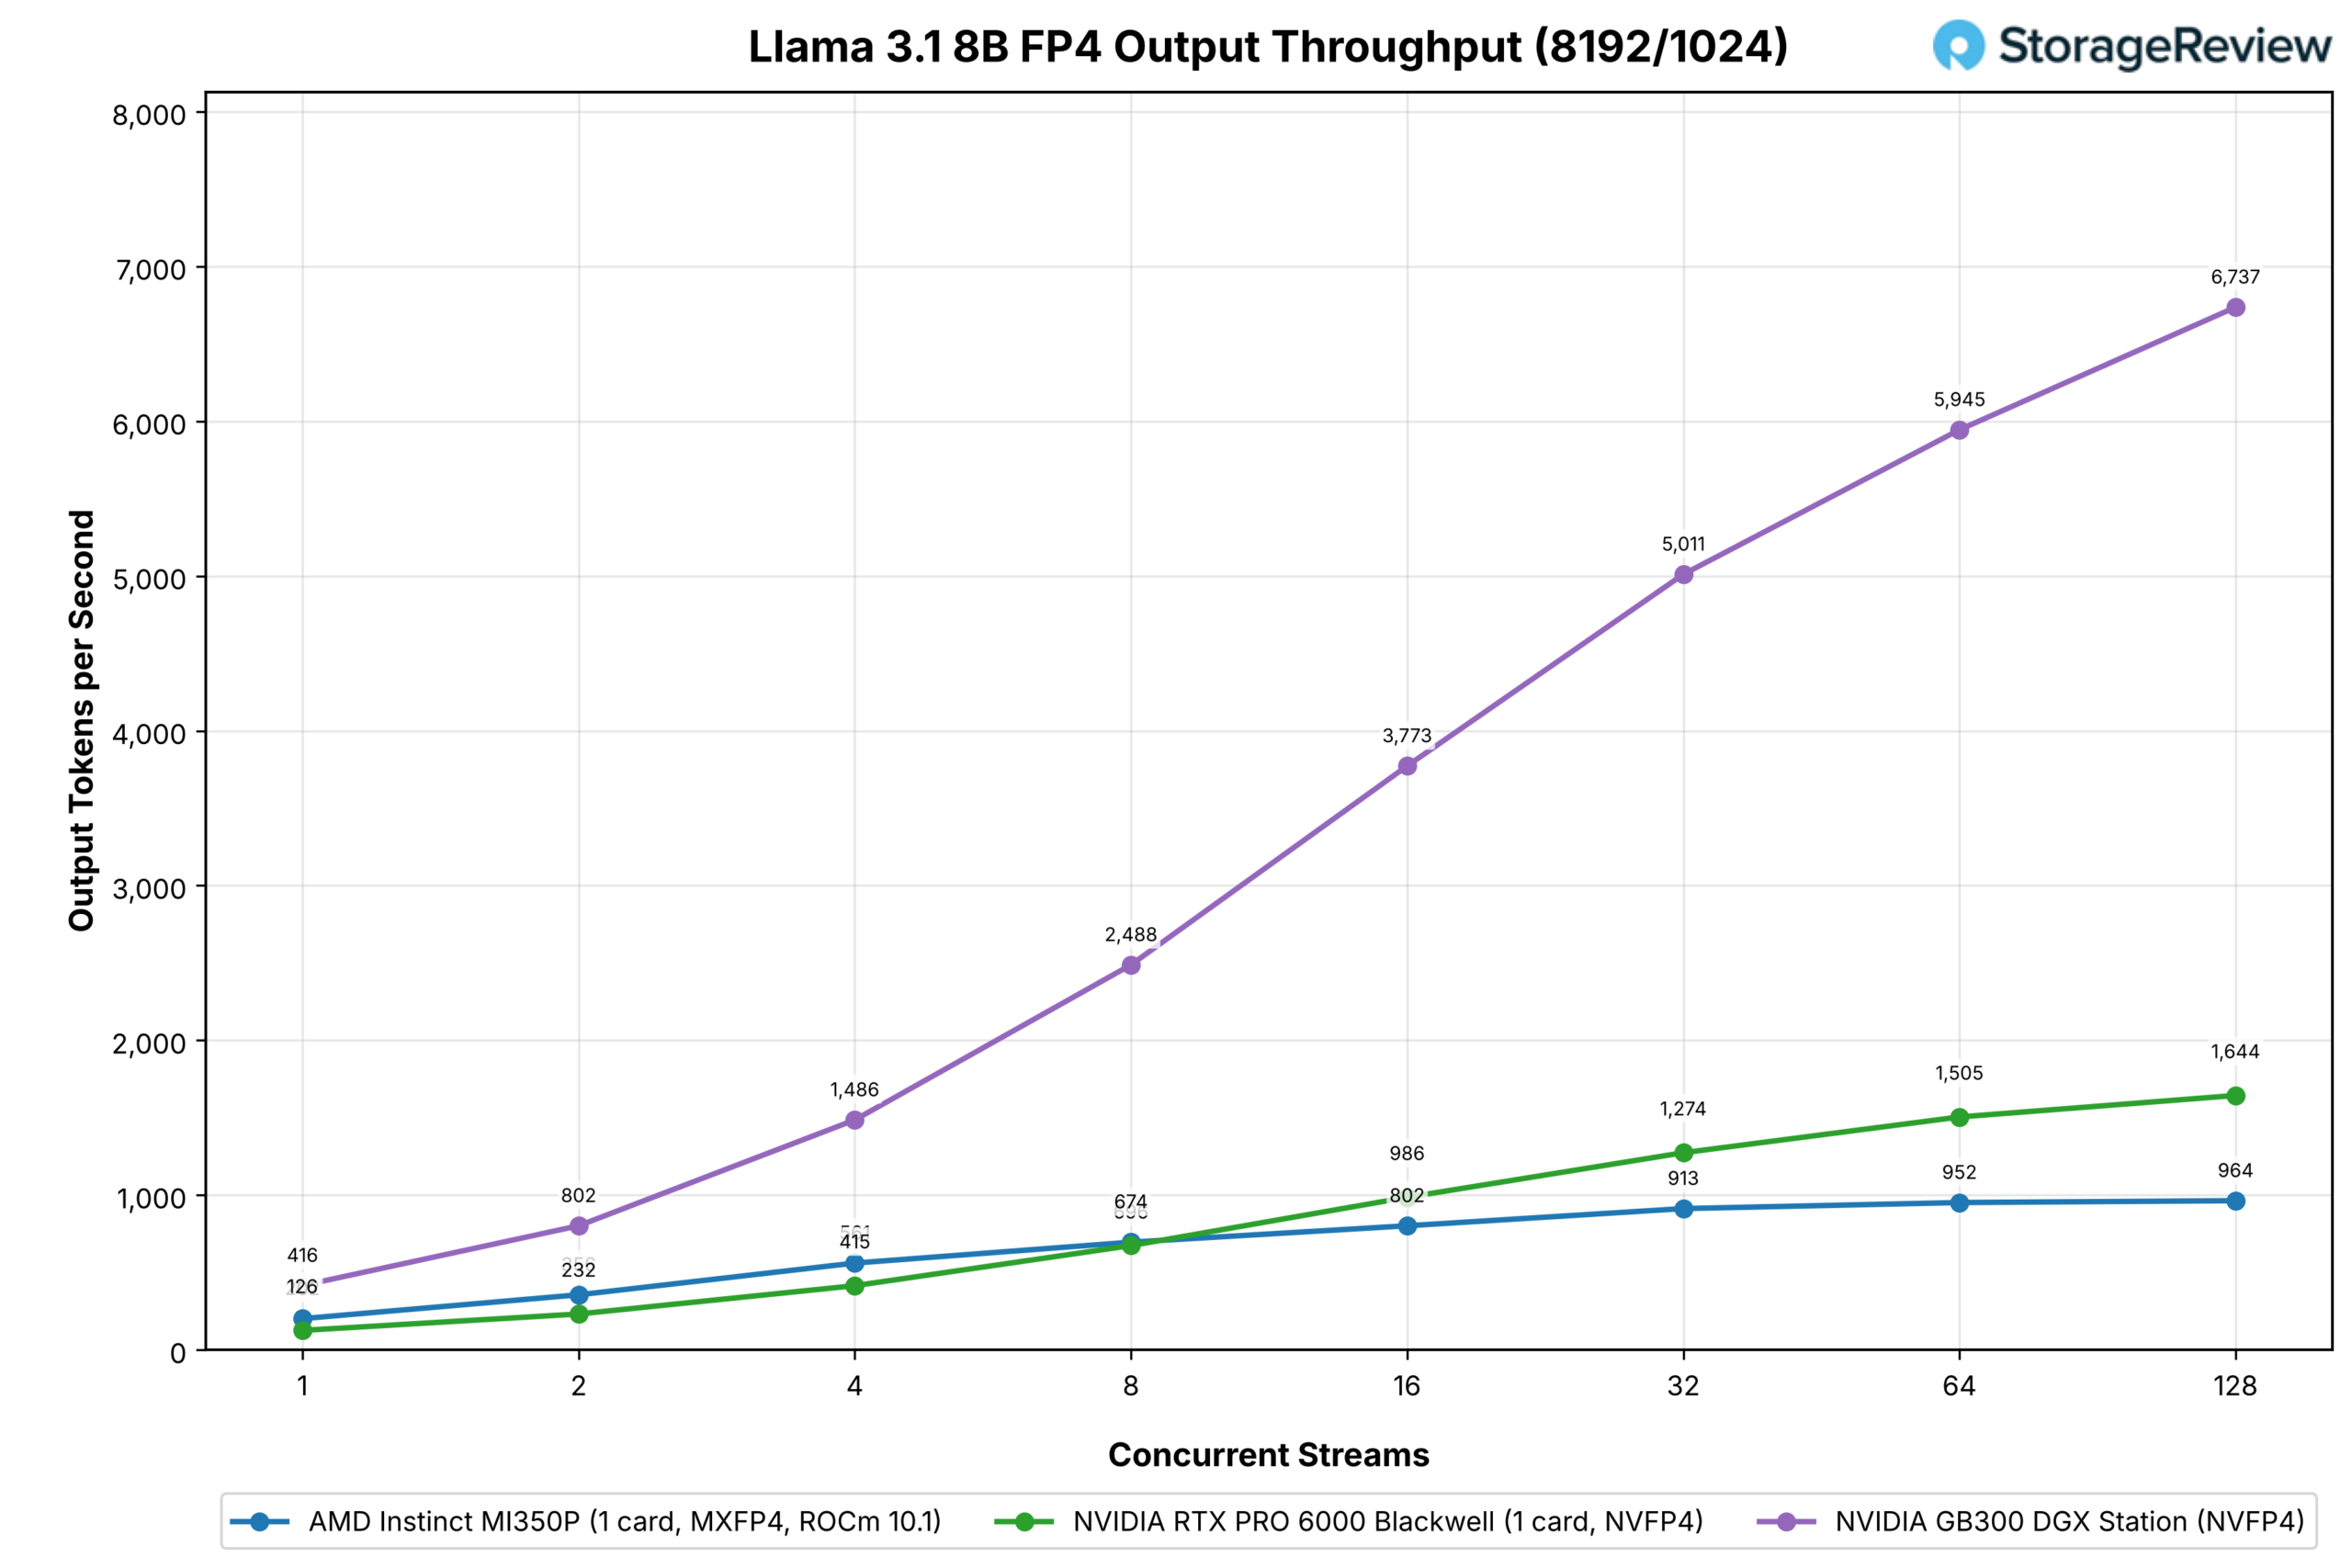
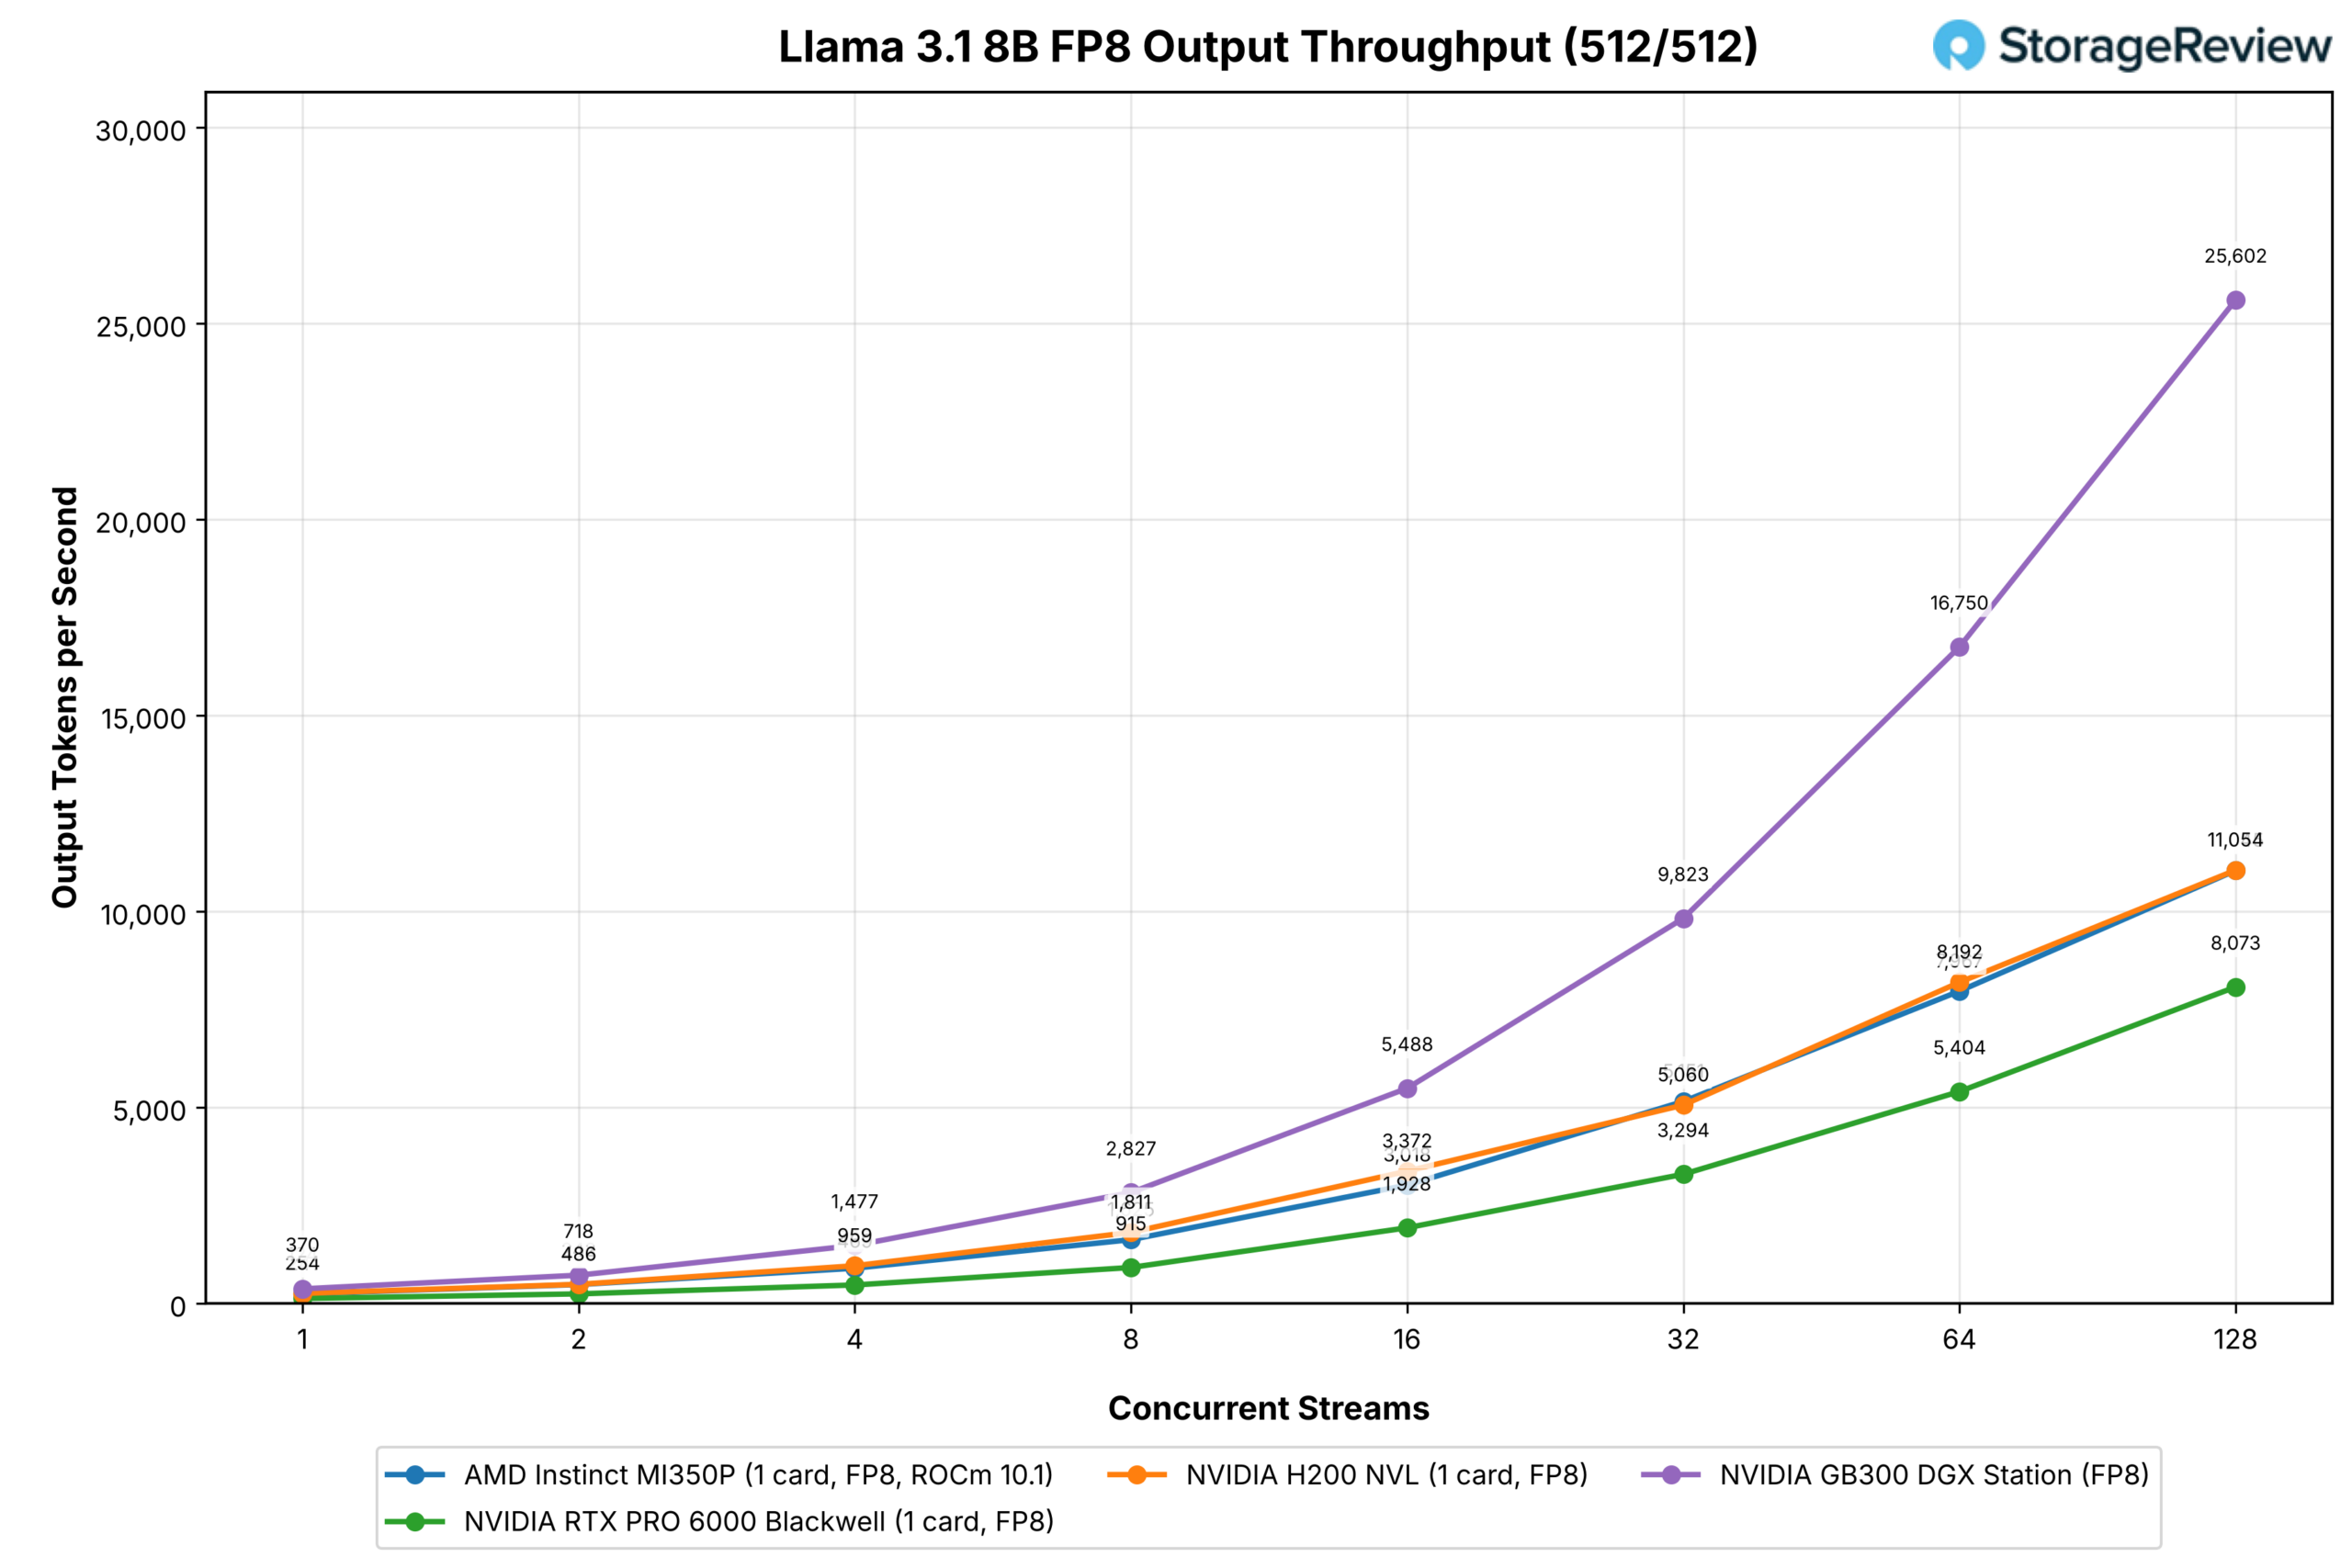
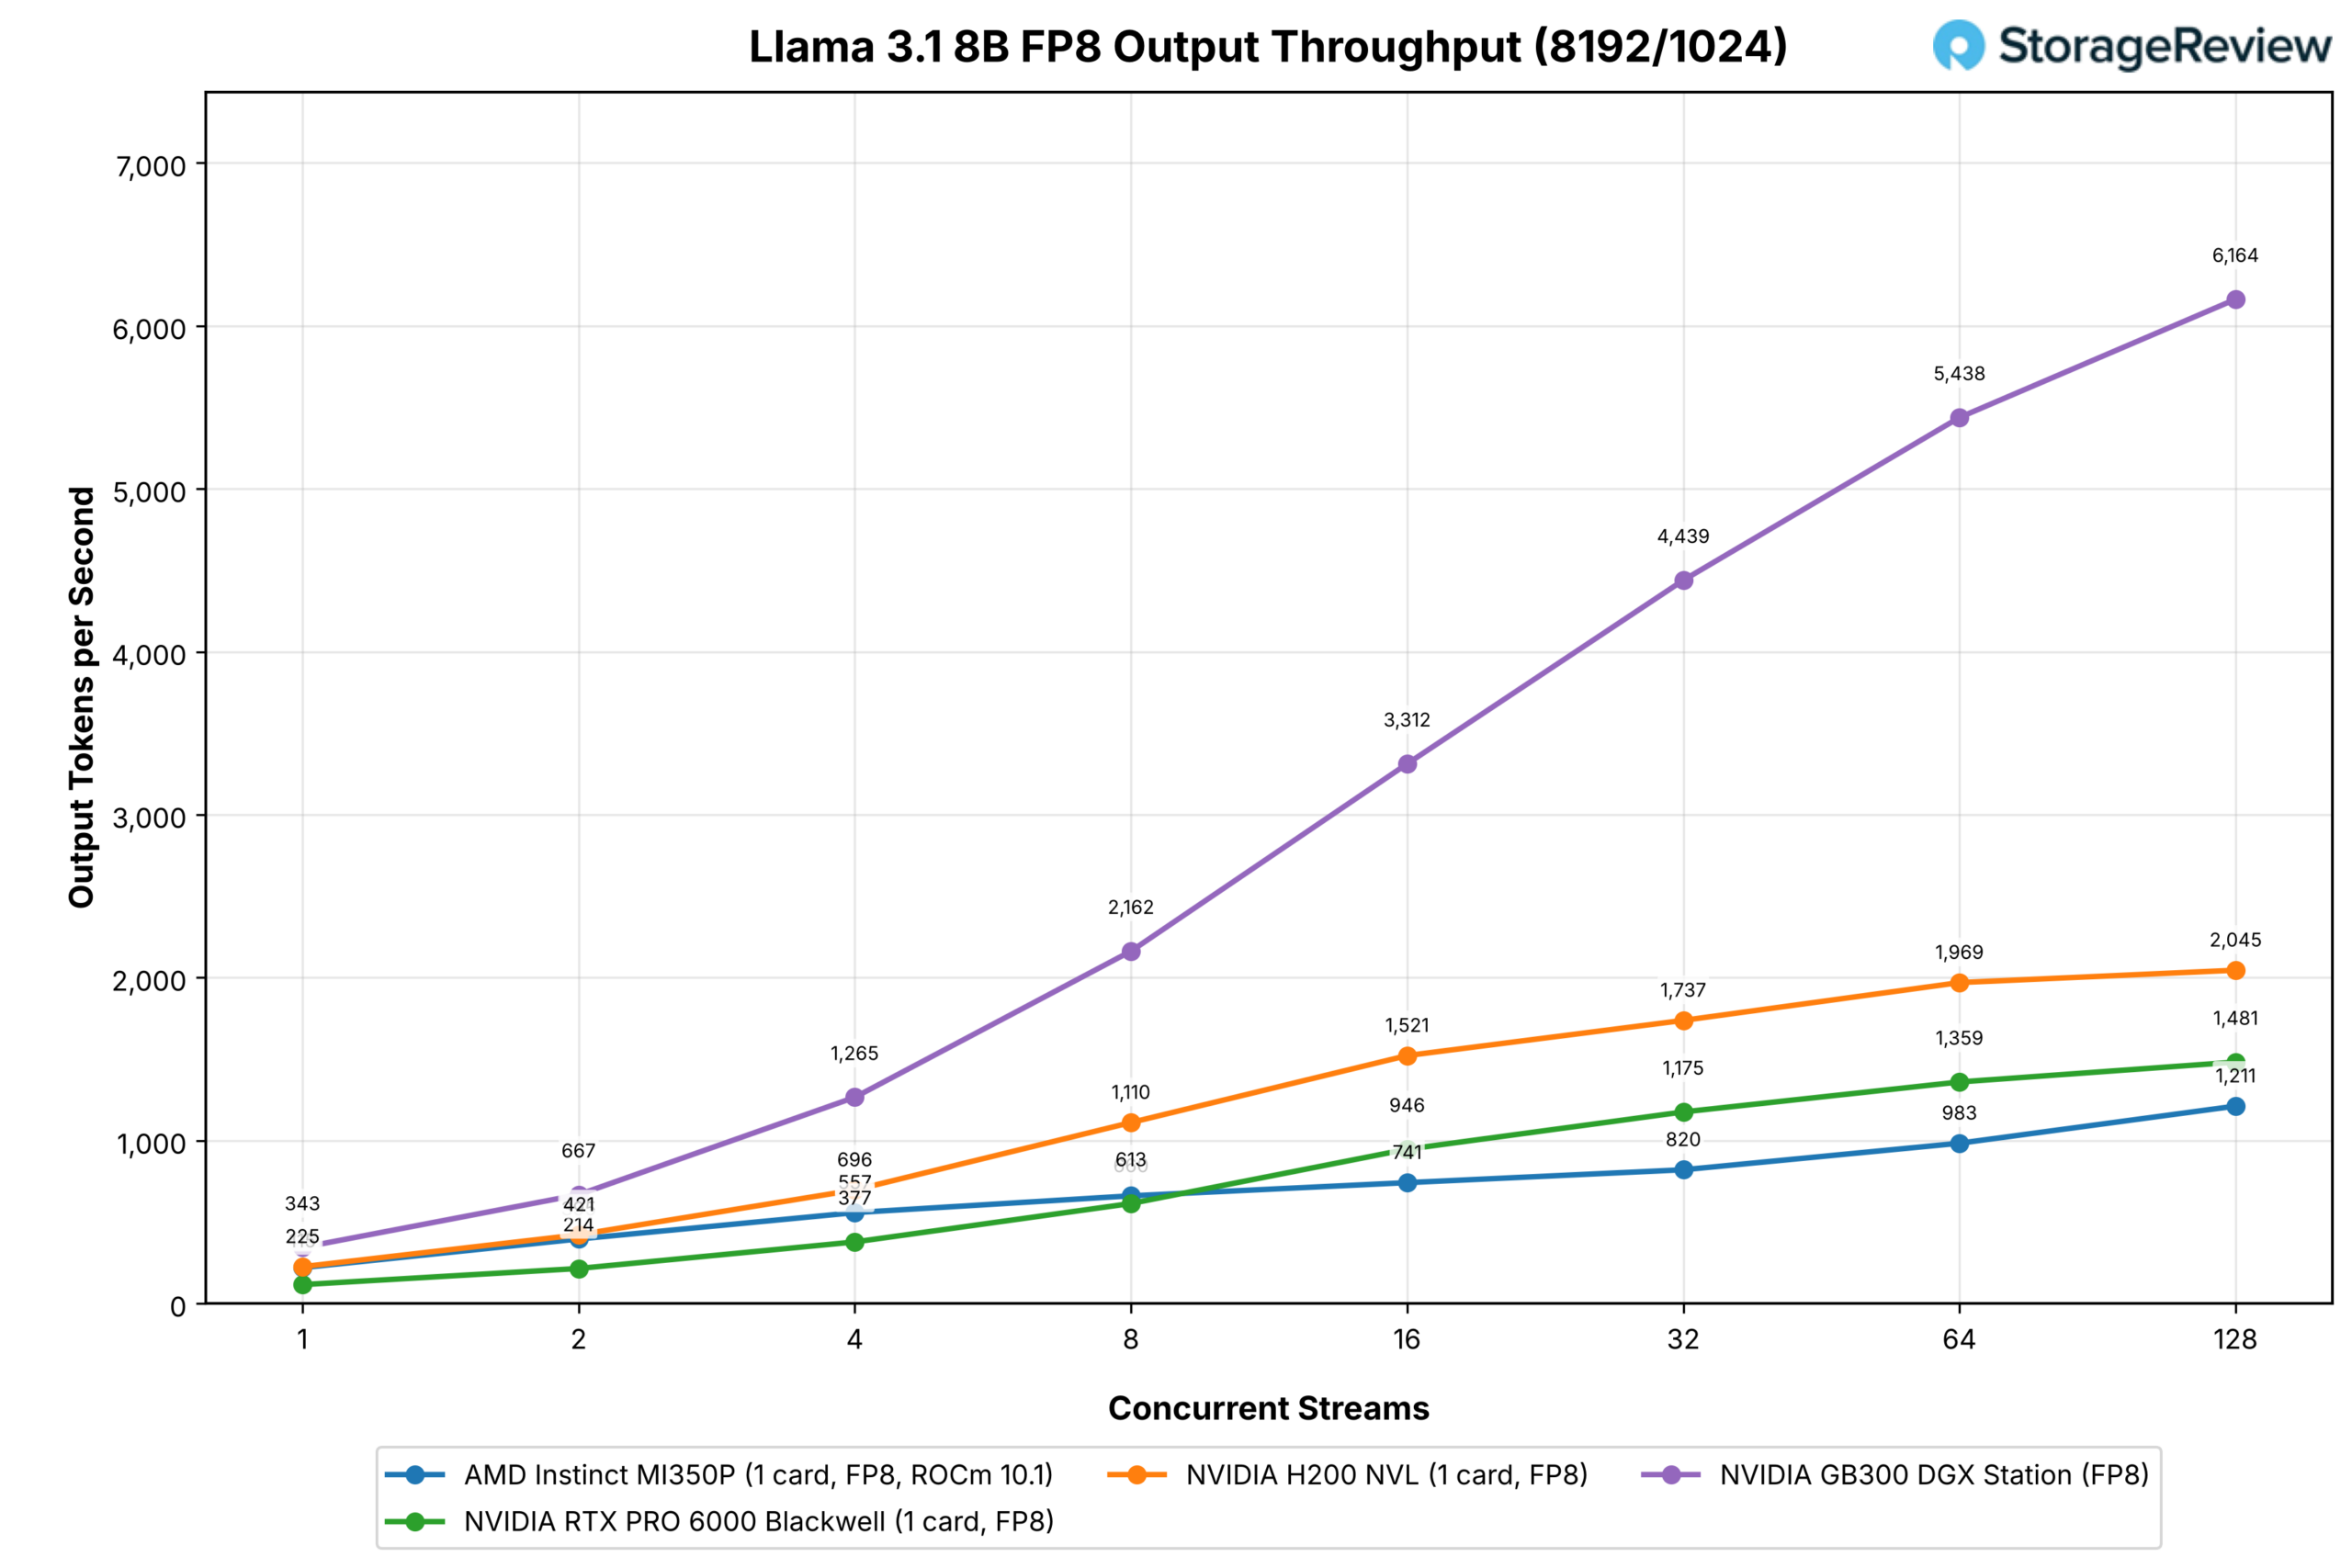
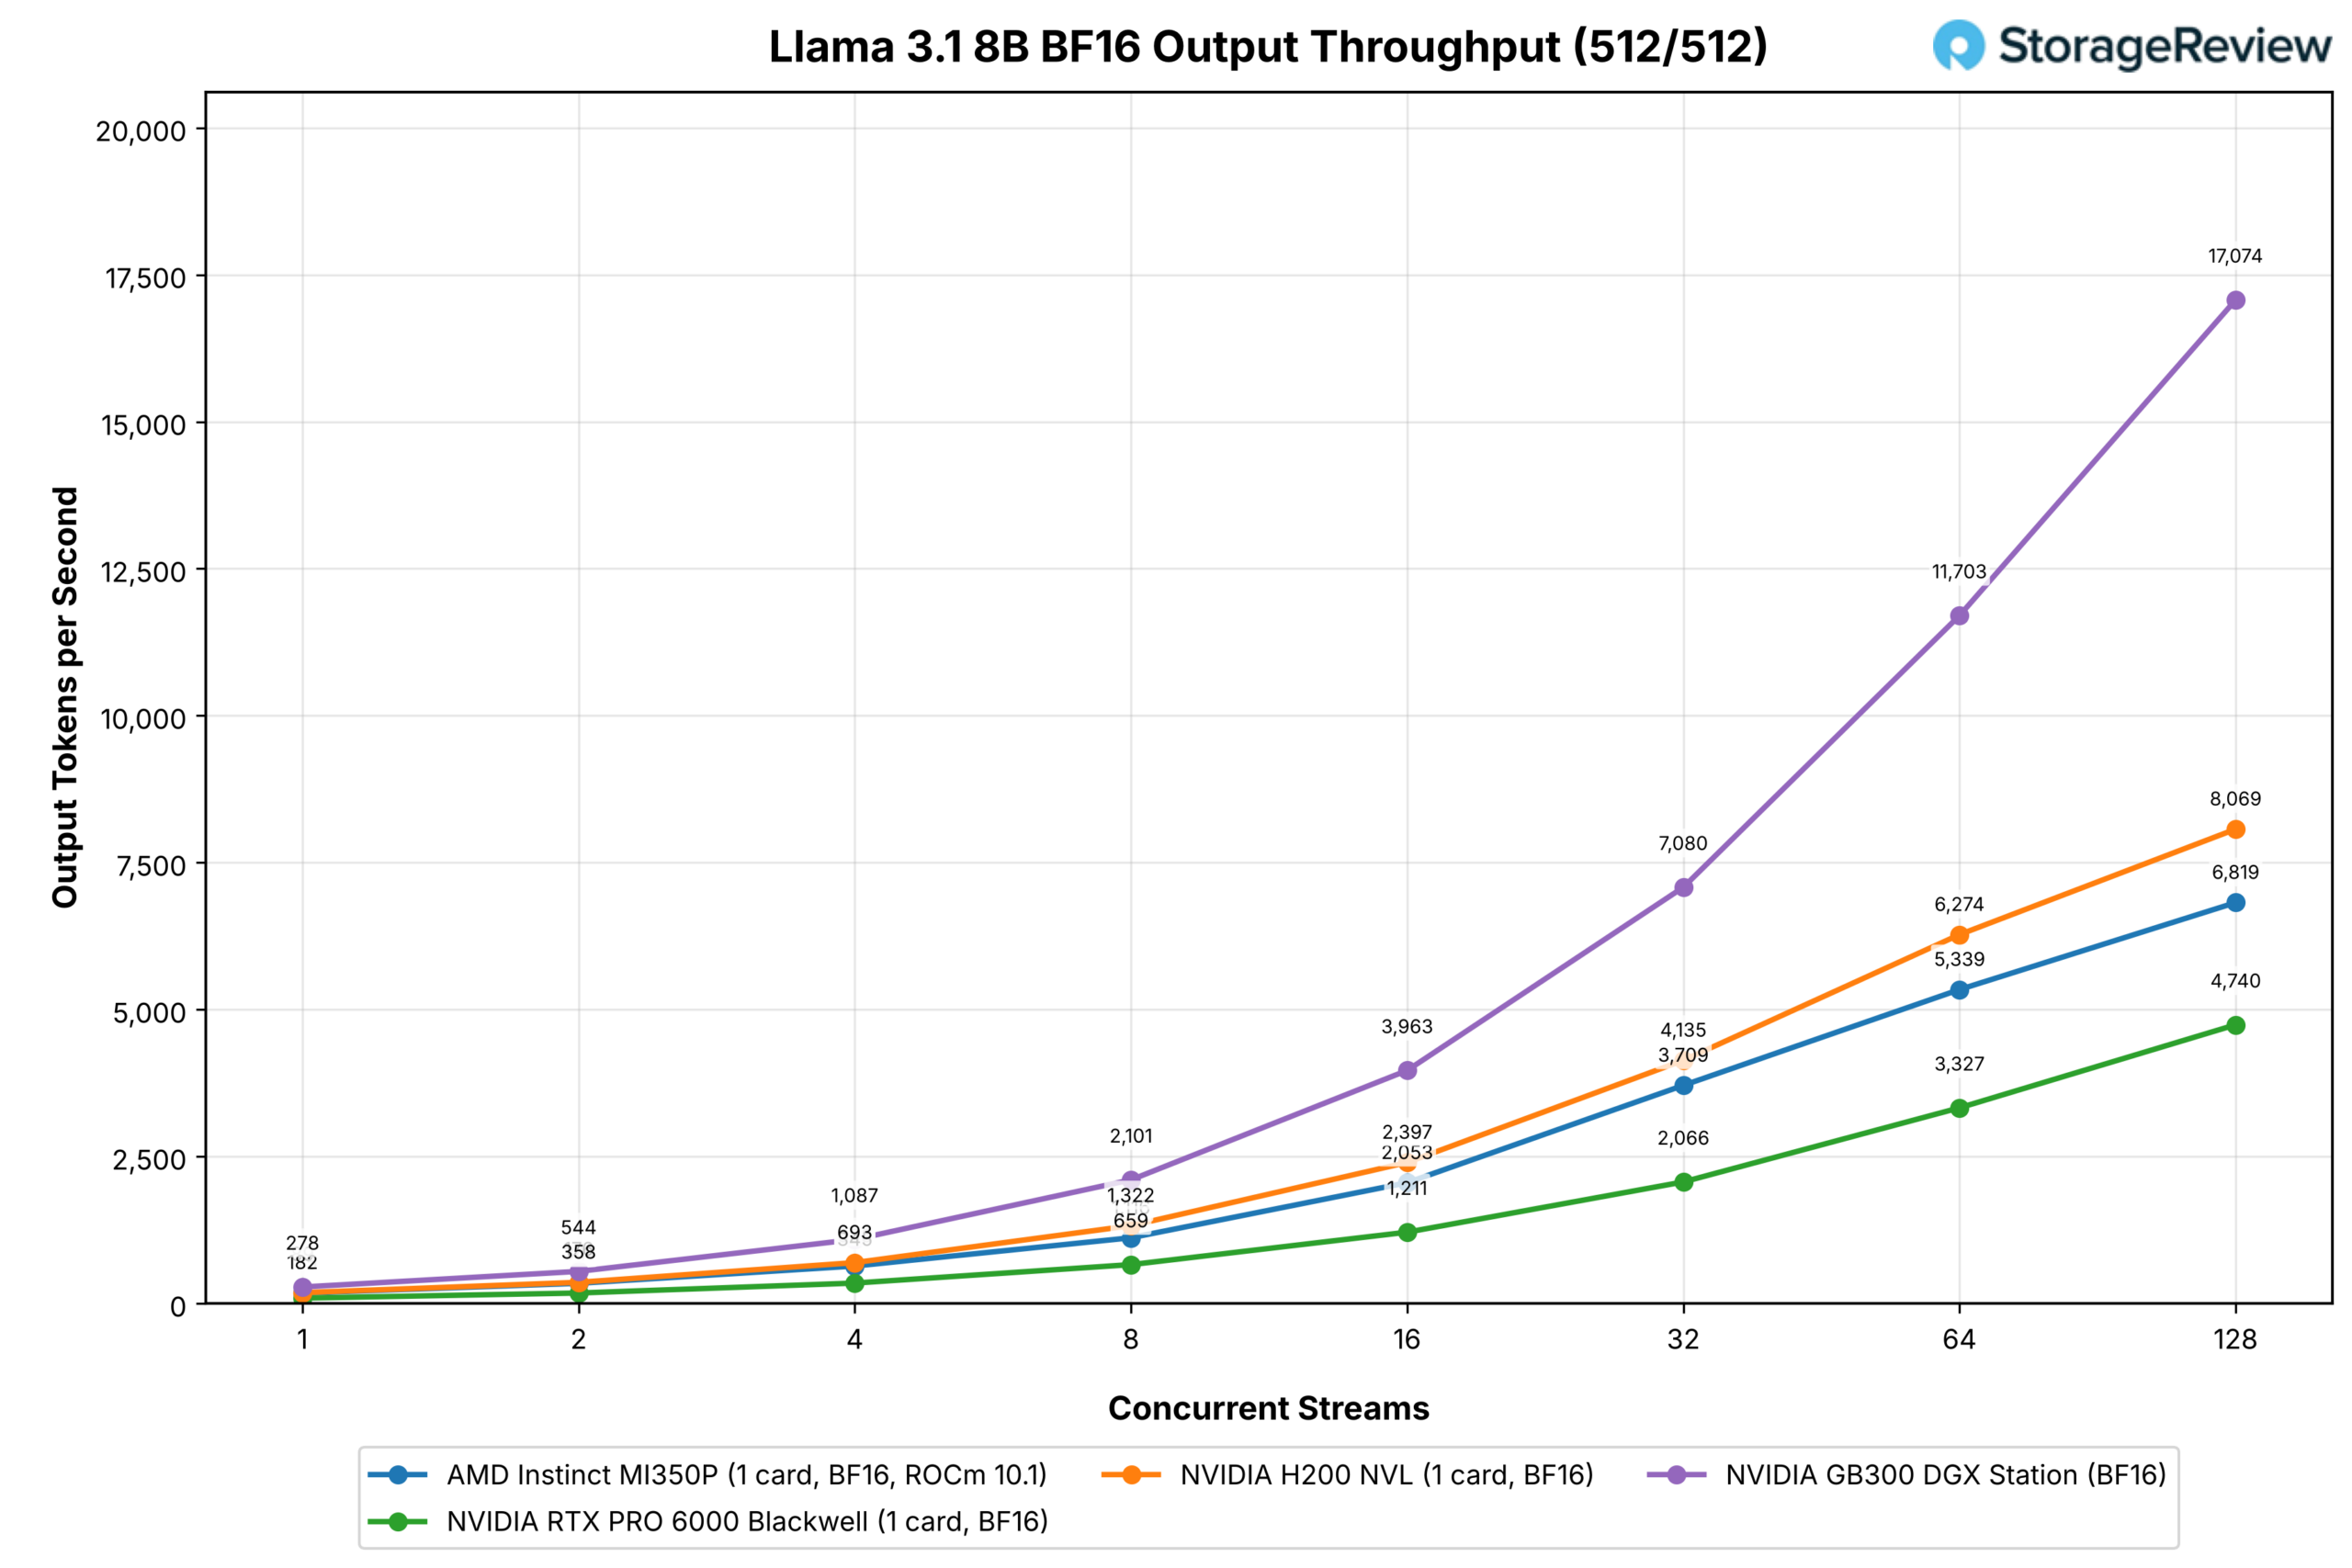
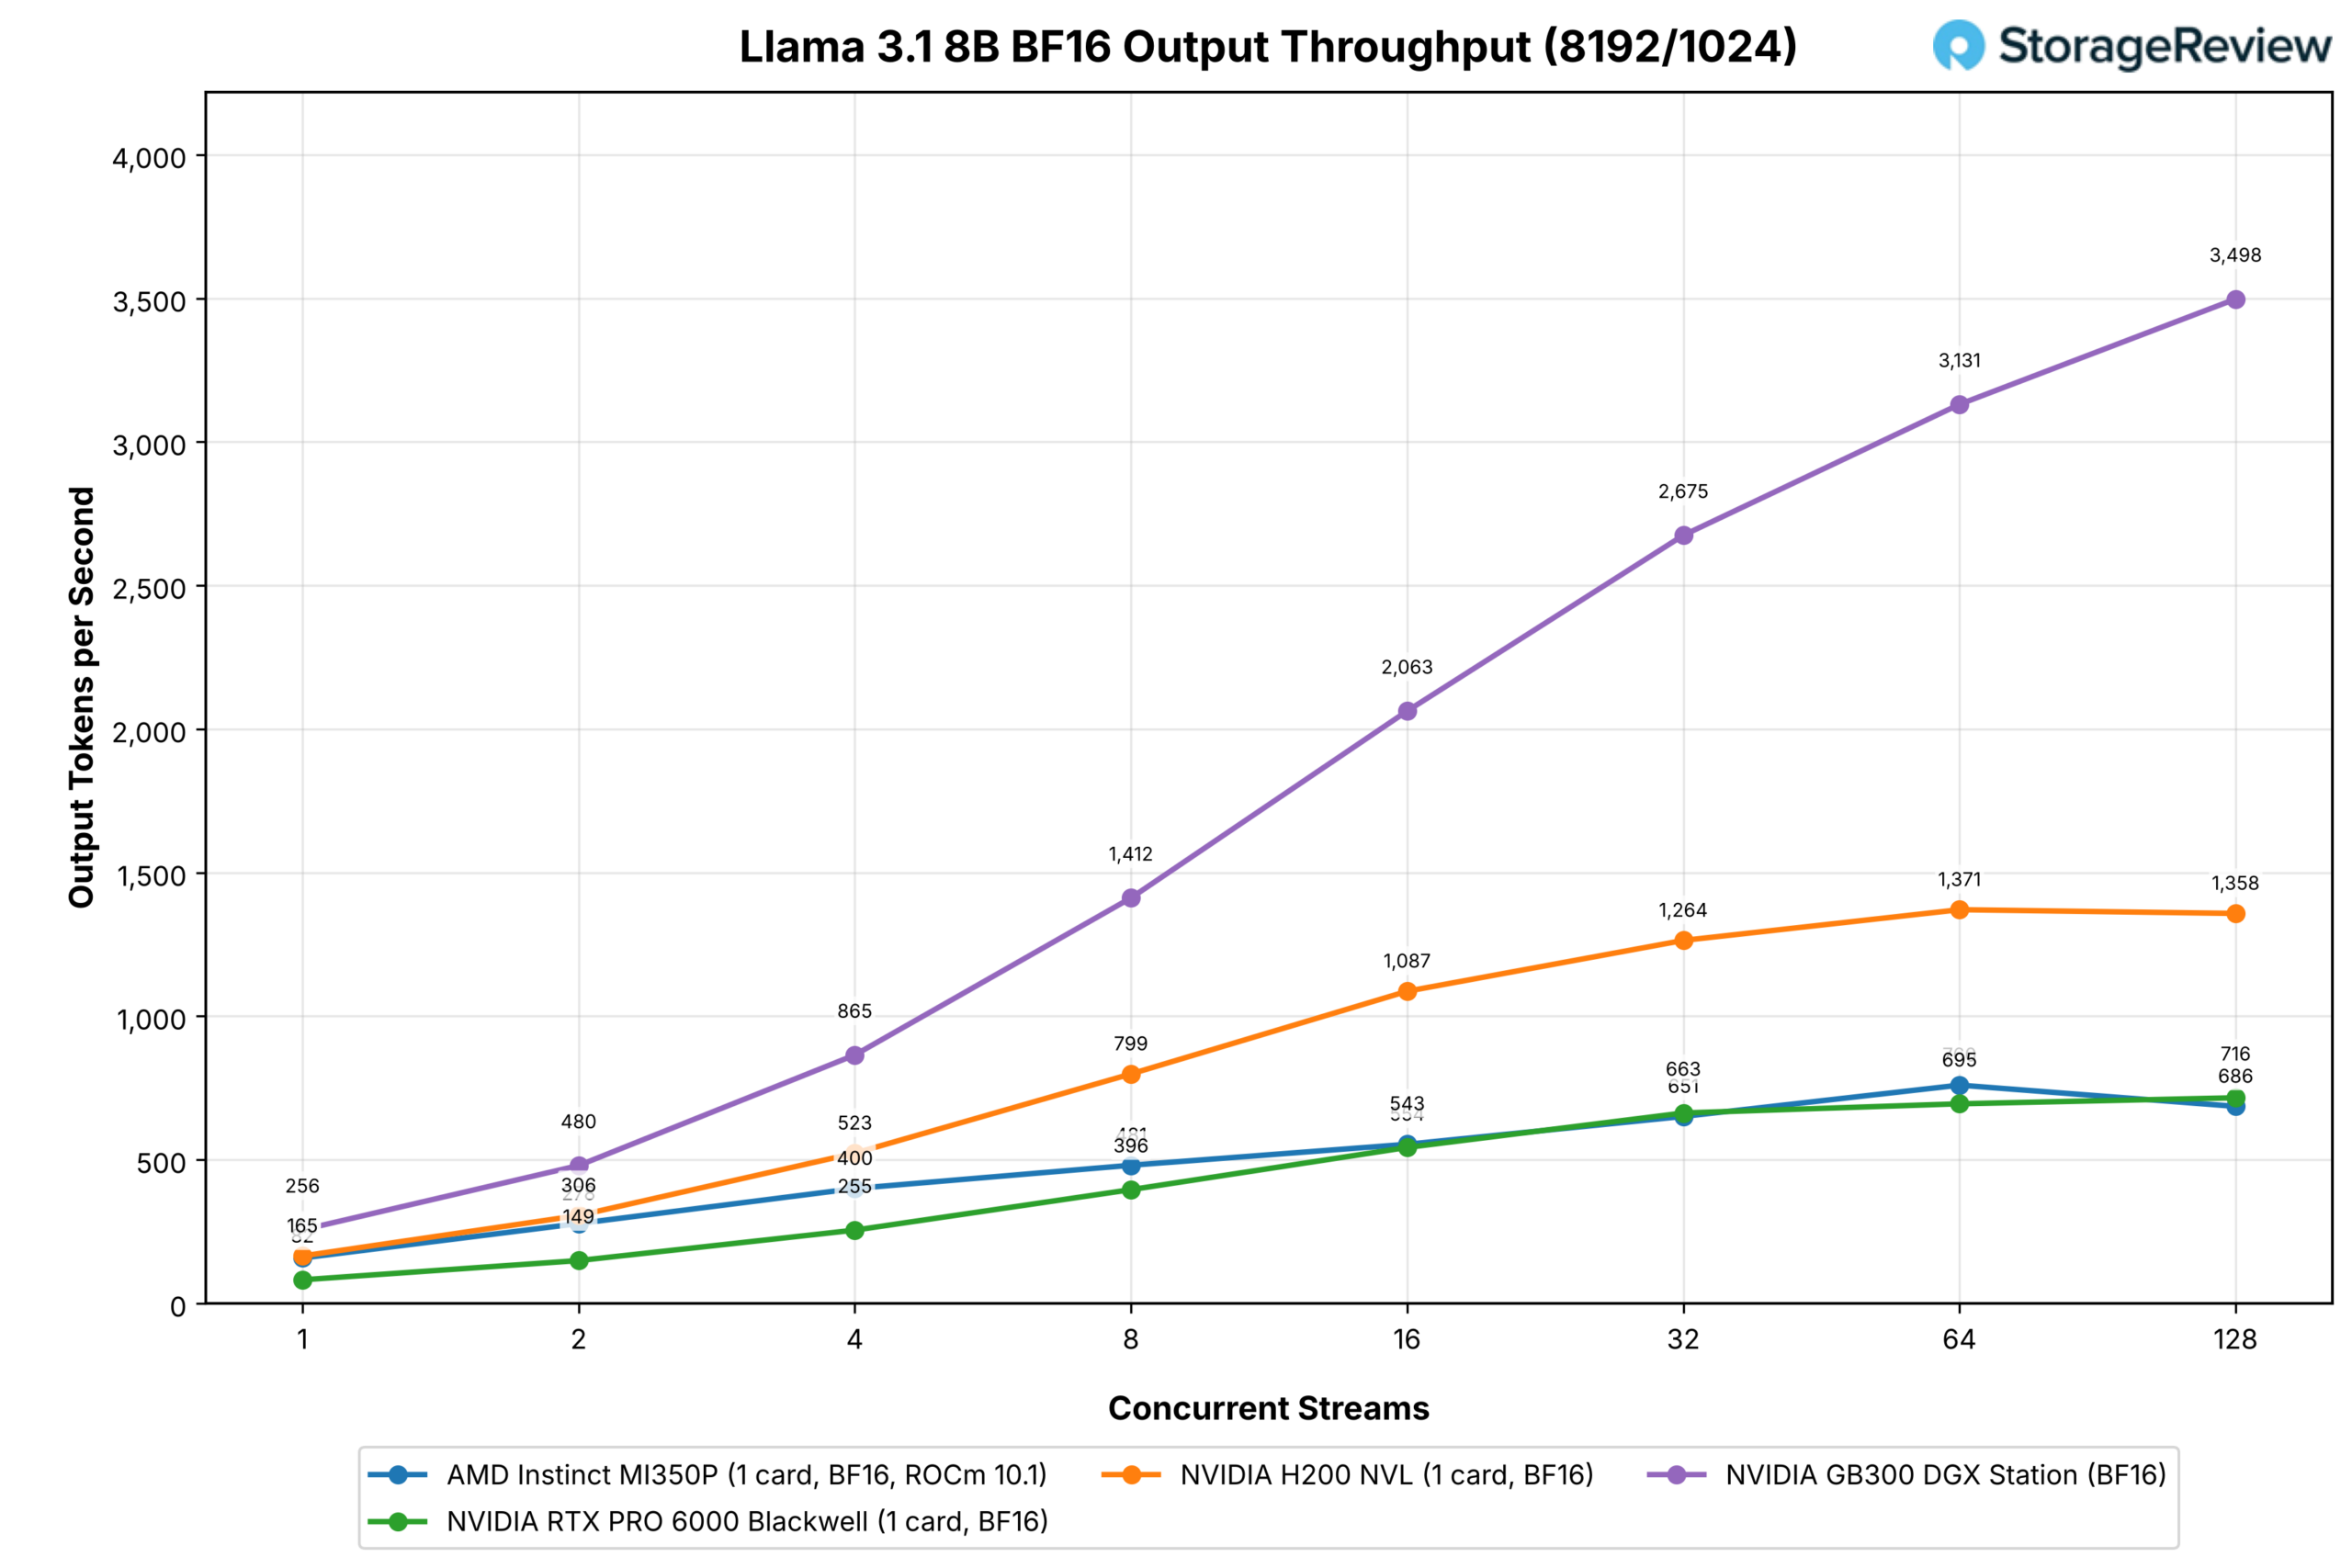
Llama 3.1 8B представлена для обеспечения преемственности с нашими предыдущими обзорами GPU. При 128 потоках в чате MI350P выдает 11 045 выходных токенов в секунду в FP8 против 8 073 у RTX PRO 6000 и 11 054 у H200, что соответствует показателю карты Hopper, и 6 819 в BF16 против 4 740 и 8 069. Сборка AMD MXFP4 достигает 8 383 при 128 потоках, что на 5 процентов меньше, чем сборка NVIDIA NVFP4 на RTX PRO 6000 (8 869), после того как опережала ее на 12–143 процента при каждом меньшем количестве потоков; при одном потоке запуск MXFP4 показывает 323 против 133.
В тестах с интенсивным предварительным заполнением результат меняется на противоположный: MI350P FP8 показывает на 16 потоков меньше, чем RTX PRO 6000, и завершает тест с результатом 1,211 против 1,481 у RTX PRO 6000 и 2,045 у H200, хотя MI350P на старте опережает RTX PRO 6000 на 90 процентов при одном потоке, а сборка MXFP4 отстает от NVFP4 на 41 процент при 128 потоках.
Заключение
MI350P — это первая за четыре года карта Instinct, которая устанавливается в стандартный сервер, и при потребляемой мощности 450 Вт в корпусе 2U она демонстрирует отличные показатели в качестве ускорителя PCIe: 144 ГБ HBM3E со скоростью 4 ТБ/с, 1,120 TFLOPS в FP8 и 2,228 в масштабированном по блокам FP4 в MAMF против 820 и 1,634 у RTX PRO 6000 Blackwell, а также примерно в 2.1 раза большая полезная пропускная способность памяти по сравнению с картой NVIDIA.
В сравнении с RTX PRO 6000, MI350P показала более высокую скорость обработки запросов размером с чат на всех моделях FP8, BF16 и GPT-OSS — на 35–65 процентов при 128 потоках, при этом пропускная способность и емкость HBM3E превзошли карту GDDR7 объемом 96 ГБ, а на обеих моделях GPT-OSS она лидирует по количеству потоков при обоих типах запросов.
H200 NVL по-прежнему превосходила её в плотных тестах FP8 и BF16 на 4–18 процентов при 128 потоках в чат-запросах и ещё больше при длинных запросах, имея на 20 процентов большую пропускную способность и отсутствие пути FP4; в GPT-OSS MI350P опередила карту Hopper на 50 и 78 процентов соответственно. Более крупные модели менее стабильны, поскольку четыре RTX PRO 6000 превосходят пару MI350P в GLM-5.2 при 16 потоках, имея 384 ГБ против 288 ГБ и большую суммарную пропускную способность и вычислительные возможности.
MiniMax-M3 показывает более близкие результаты: разница между тремя конфигурациями составляет не более 10 процентов при восьми потоках запросов в чате, четырехъядерная RTX опережает с 16 процентами, а пара MI350P лидирует при длинных запросах при восьми потоках. Измеренная частота FP4 у MI350P на 36 процентов выше, чем у RTX PRO 6000, поэтому преимущество заключается в количестве карт. Эти результаты для двух карт получены на стеке ROCm 7.2.3 и будут повторно проверены на ROCm 10.1 одновременно с тестированием на 600 Вт.
Окончательное мнение о MI350P пока невозможно без тестирования его на полной мощности при 600 Вт, что мы планируем сделать в корпусе PowerEdge XE7745; Dell поддерживает восемь MI350P при 600 Вт в этом корпусе. Мы слышали, что, по оценке AMD, дополнительные 150 Вт дают примерно на 10 процентов большую производительность.
Компания AMD прошла долгий путь, и линейка MI350/5X демонстрирует возможности этой архитектуры. В нашей лаборатории для разработки используется система на базе MI300X, и темпы развития программного обеспечения показали, насколько хорошо большая часть пакета работала на стандартной версии vLLM без сбоев.
Судя по представленной конфигурации, MI350P предназначен для покупателей, ищущих альтернативу графическим процессорам NVIDIA, будь то из-за сроков поставки, цены или желания избежать зависимости от одного производителя. Поддержка этой модели компанией Dell в линейке PowerEdge обеспечивает разнообразие кремниевых компонентов в массовых серверах, отвечающих этим потребностям.
Честно говоря, наша работа здесь еще далека от завершения. Хотя многие покупатели могут устанавливать эти карты в серверы форм-фактора 2U, при использовании в более крупных корпусах, рассчитанных на карты мощностью 600 Вт, достигается больший прирост производительности. Независимо от способа их развертывания, это отличный первый взгляд на возвращение AMD на рынок серверных плат расширения, и по мере развития программного обеспечения MI350P и последующие модели имеют многообещающее будущее. Сегодня для покупателей, чьи модели имеют объем памяти от 96 ГБ до 144 ГБ, MI350P является одной из двух карт PCIe, позволяющих использовать только одну видеокарту, и единственной, поддерживающей более 141 ГБ памяти.
В рейтинге лучших корпоративных видеокарт AMD Instinct MI350P фигурирует в разделе «Также протестировано» , а результаты тестирования двух видеокарт в категории «Масштабируемые конфигурации».



 Amazon