

На саммите RAISE в Париже компания DDN представила результаты своего продолжающегося сотрудничества с Nebul, европейским поставщиком суверенных гибридных облачных услуг, направленного на повышение эффективности крупномасштабных развертываний систем вывода ИИ. Объявленное на прошлой неделе сотрудничество объединяет платформу вывода Nebul, архитектуру обработки данных Infinia от DDN и ускоренные вычисления NVIDIA для решения растущей проблемы, связанной с ограничениями в производственной среде ИИ: стоимостью и производительностью перемещения данных во время вывода.
DDN строит свою работу вокруг ключевых производственных показателей, включая загрузку графического процессора, пропускную способность токенов, стоимость токена и задержку. Предполагается, что обучение модели определяет ценность актива ИИ, а вывод определяет его операционную и коммерческую отдачу. По мере распространения агентного ИИ, генерации с дополненной реальностью и высокопроизводительного вывода, инфраструктура хранения и данных может напрямую влиять на использование ускорителей и время отклика.
Работа представляет собой продолжающийся экспериментальный проект, и DDN характеризует полученные на данный момент результаты как многообещающие на ранних этапах. Компании сообщают об измеримых улучшениях времени до получения первого токена при включенном кэше ключ-значение и завершили проверку инфраструктуры на основе RoCE, а тестирование производительности продолжается на более длинных последовательностях вывода, поскольку они выявляют дальнейшие возможности оптимизации в рамках платформы Infinia. Проект также расширился и включает сотрудничество с NVIDIA в области методологий тестирования производительности, проверки масштабируемости и будущих технических публикаций.
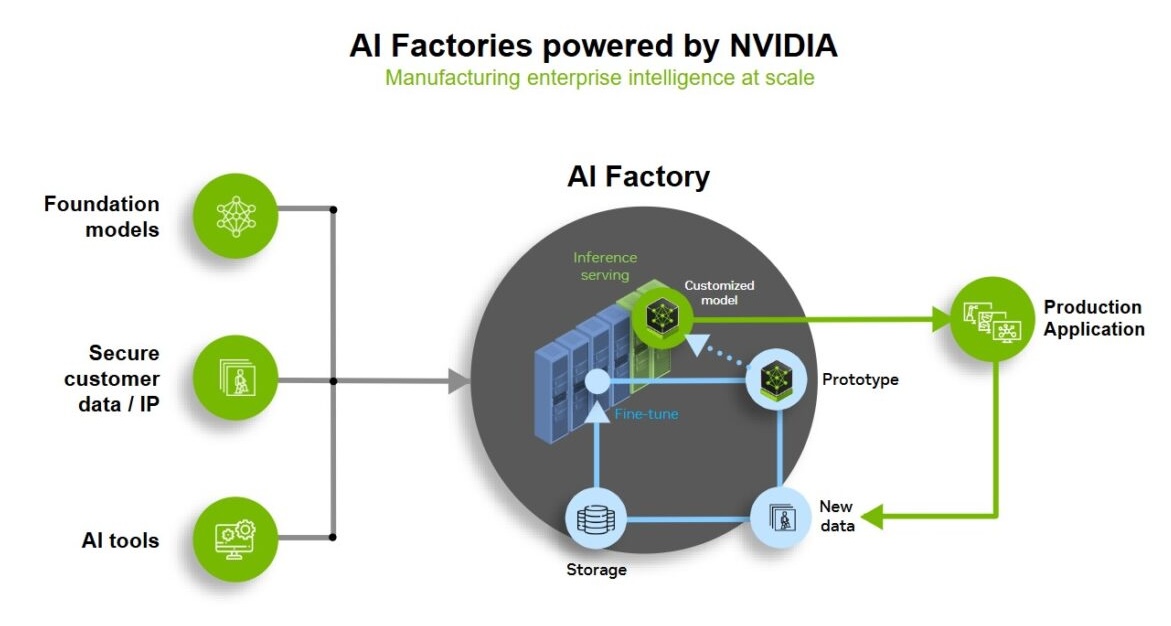
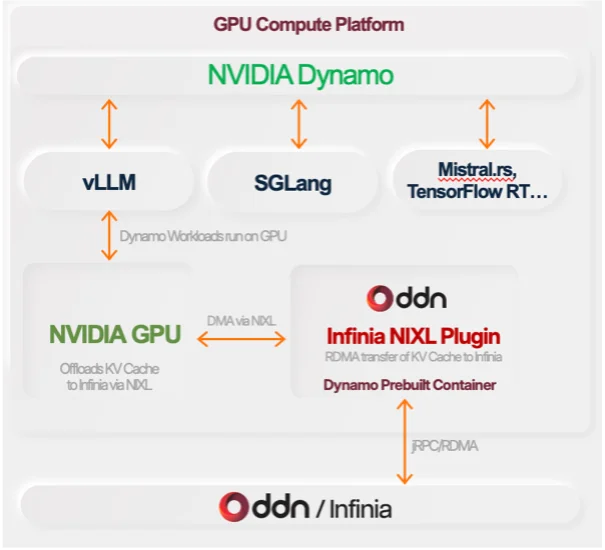
Платформа использует распределенные службы кэширования ключ-значение, перемещение данных, осуществляемое непосредственно на графическом процессоре, оркестрацию данных и высокопроизводительные архитектуры хранения. Ускорение кэширования ключ-значение особенно актуально для инференции, поскольку оно сохраняет и быстро извлекает ранее вычисленное состояние внимания, сокращая количество повторных вычислений и ограничивая задержки доставки данных, которые могут привести к простою графических процессоров.
Лидеры DDN, Nebul и NVIDIA обозначили фундаментальный сдвиг в отрасли: от приобретения графических процессоров к повышению операционной эффективности с упором на максимизацию отдачи от развернутых ускорителей. Генеральный директор DDN Алекс Бузари и генеральный директор Nebul Арнольд Юффер подчеркнули, что, хотя исторически приоритетом был масштаб моделей, нынешняя проблема заключается в экономике вывода и обеспечении коммерческой жизнеспособности производственного ИИ за счет снижения стоимости токенов. Род Эванс, вице-президент по облачной инфраструктуре NVIDIA, добавил, что по мере перехода организаций к крупномасштабным агентным рабочим нагрузкам успех инфраструктуры все чаще измеряется использованием графических процессоров и задержкой, а не чистой вычислительной мощностью.
Компания DDN утверждает, что инфраструктура ИИ должна развиваться, выходя за рамки традиционных операций хранения данных, и стать активным участником выполнения задач ИИ. Компания заявляет, что ее платформы поддерживают более миллиона графических процессоров по всему миру, охватывая гипермасштабные компании, облачные провайдеры, предприятия, государственные структуры и исследовательские институты.
Для команд, занимающихся инфраструктурой, к соответствующим производственным показателям все чаще относятся:
- Использование графического процессораизмеряет, насколько эффективно дорогостоящие ускорители остаются активными во время выполнения вычислений.
- Стоимость за токенсвязывая эффективность инфраструктуры со стоимостью результатов моделирования.
- Токены за ваттизмеряя эффективность работы устройства в зависимости от потребляемой мощности.
- Время до получения первого токеначто влияет на воспринимаемую скорость отклика интерактивных приложений искусственного интеллекта.
- Время внедрения отражает оперативные усилия, необходимые для перевода сервисов ИИ из стадии тестирования в производственную среду. Масштабируемое развертывание.
Поскольку вывод данных становится доминирующей рабочей нагрузкой в сфере ИИ, способность предоставлять кэшированный контекст и корпоративные данные графическим процессорам с низкой и предсказуемой задержкой будет приобретать все большее значение для поддержания эффективности использования и контроля затрат.


 Amazon