

Контейнеризация рабочих процессов разработки, тестирования и эксплуатации в производственной среде совершает революцию в управлении ИТ на всех уровнях, будь то приложения и сервисы, ориентированные на клиентов или внутренние приложения. Организации повышают эффективность разработки и сокращают время развертывания, используя микросервисные архитектуры, построенные на основе контейнеров, и применяя фреймворки оркестрации контейнеров, такие как Kubernetes.
Переход от классических ИТ-решений к контейнерным подходам часто начинается с инициатив команд или отделов DevOps по созданию прототипов среды, которые затем копируют другие команды. Хотя эти команды делают это для повышения эффективности и гибкости, результатом часто становятся изолированные кластеры DevOps, что приводит либо к низкой производительности (недостаток ресурсов), либо к низкой эффективности использования (недоиспользование ресурсов вне пиковых часов). Обычно происходит и то, и другое: пока одна команда испытывает нехватку ресурсов, у других команд может быть много свободных ресурсов. Хуже того, команды часто выделяют избыточное количество ресурсов, и тогда затраты становятся огромными. Отраслевые стандарты использования кластеров часто находятся в диапазоне 20%.
Объединение множества кластеров (или облачных учетных записей) в меньшее количество, в идеале — в один кластер, и совместное использование ресурсов между командами и сценариями использования — это рецепт повышения производительности и эффективности при одновременном снижении затрат. Консолидация и совместное использование действительно позволяют делать больше с меньшими ресурсами — если вы можете эффективно, автоматически и справедливо распределять ресурсы.
Однако существующие фреймворки оркестрации контейнеров, такие как Kubernetes , Docker Swarm или Mesos, не позволяют этого сделать «из коробки». Kubernetes и Swarm предоставляют упрощенные схемы распределения рабочих нагрузок, такие как «распределение» (круговое распределение), «пакетирование» или «случайное распределение», в противном случае вам придется вручную сегментировать ресурсы кластера с помощью таких концепций, как пространства имен или метки. В Mesos различные типы рабочих нагрузок (например, Spark, Hadoop или сервисы в рамках Marathon) имеют собственный планировщик, который может предлагать или не предлагать некоторые политики совместного использования ресурсов (со своей собственной логикой и конфигурацией), но рабочие нагрузки будут конкурировать друг с другом за доступ к ресурсам, и нет всеобъемлющей системы политик, которая понимала бы, какие рабочие нагрузки наиболее важны для бизнеса и как удовлетворить его потребности, не перегружая его ресурсами.
В сложных сценариях совместного использования ресурсов каждая из этих систем потребует значительного ручного вмешательства и по-прежнему будет либо нуждаться в избыточном выделении ресурсов, либо страдать от снижения производительности из-за конфликтов ресурсов.
Для эффективного распределения ресурсов между организациями и обработки произвольных типов рабочих нагрузок (как контейнеризированных, так и неконтейнеризированных) действительно необходима усовершенствованная система управления ресурсами, которая понимает характеристики рабочих нагрузок и приоритеты бизнеса, чтобы автоматизировать принятие решений о распределении ресурсов и перераспределять ресурсы по мере необходимости, когда изменяются граничные условия или потребности.
Navops Command — это уникальный на сегодняшний день пример подобной возможности. Он дополняет Kubernetes, добавляя сложные, динамические и управляемые по требованию политики, которые автоматизируют принятие решений о приоритезации рабочих нагрузок и потреблении ресурсов в любой момент времени. По сравнению с другими фреймворками оркестрации контейнеров, Kubernetes предоставляет самый богатый набор возможностей для надежного управления рабочими нагрузками (таких как автоматизированные контроллеры для реплик, заданий, развертываний, допуска рабочих нагрузок и т. д.). С помощью Navops Command поверх Kubernetes вы можете запускать сборки программного обеспечения, автоматизированные тесты и развертывания в производственной среде нескольких приложений и сервисных сред на одном кластере или в одном облачном пуле. Задачи DevOps и производственные сервисы могут поступать от нескольких команд и иметь разную важность, которая может меняться в течение дня. Navops Command гарантирует, что ни одна из связанных рабочих нагрузок не будет мешать другой, при этом выполняя необходимые действия.
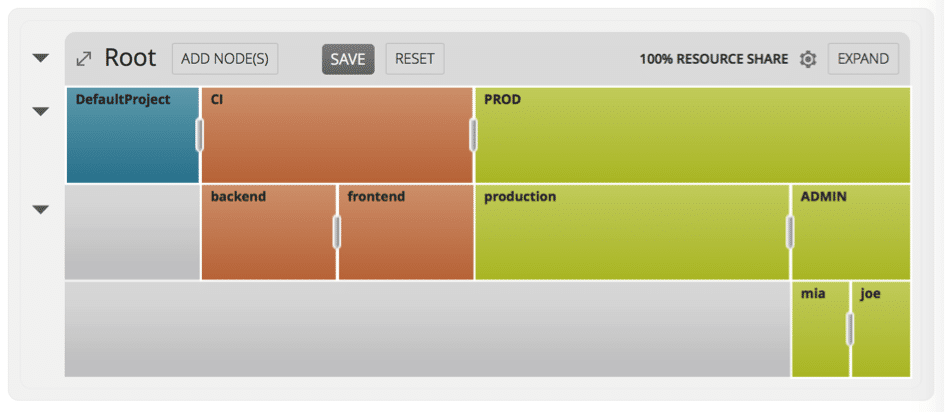
Рисунок 1: Политика Командования оперативных операций «Пропорциональное распределение ресурсов», автоматизирующая совместное использование ресурсов между группами, проектами и отдельными лицами.
С помощью Navops Command можно достичь коэффициента использования кластера в 80% и даже выше. Он приносит свои плоды даже в рамках одной команды при выполнении различных задач, таких как сборка, тестирование и эксплуатация, и обеспечивает еще большую выгоду при совместном использовании между командами.
Navops Command демонстрирует, что необходимо для эффективного запуска приложений на основе микросервисов, а также других контейнеризированных рабочих нагрузок в общей среде (локальной или облачной). В настоящее время он доступен для любого типа дистрибутива Kubernetes и может быть легко протестирован, как описано здесь.
Об авторе
Фриц Ферстль в настоящее время является техническим директором и руководителем отдела развития бизнеса в регионе EMEA в компании Univa Corporation.
Фриц Ферстль привнесет в Univa 20-летний опыт работы в области распределенных и облачных вычислений, и в качестве технического директора он поможет определить техническое видение, а также возглавит стратегические альянсы. Фриц, которого долгое время считали отцом программного обеспечения Grid Engine и его предшественников Codine и GRD, последние 10 лет руководил бизнесом по разработке программного обеспечения Grid Engine в Sun Microsystems и Oracle, превратив его из перспективной технологии в наиболее широко используемое решение для управления рабочими нагрузками в самых сложных средах центров обработки данных на планете. Под руководством Фрица программное обеспечение Grid Engine было открыто для публичного доступа и сформировало активное сообщество.


 Amazon