

Компания IBM представила архитектуру хранения данных с учетом содержимого (CAS), которая интегрирует обработку данных с помощью ИИ непосредственно в уровень хранения. Этот подход ориентирован на рабочие процессы генерации с расширенным поиском (RAG) путем встраивания векторизации документов в систему хранения, что снижает потребность во внешних конвейерах предварительной обработки.
CAS переносит ключевую функцию RAG — встраивание документов с использованием методов, основанных на больших языковых моделях, — в инфраструктуру хранения данных. Это позволяет предприятиям обрабатывать и индексировать данные на месте, согласовывая системы хранения с рабочими нагрузками, управляемыми ИИ, и сокращая перемещение данных между уровнями инфраструктуры. IBM позиционирует это как способ упростить развертывание, одновременно повышая производительность и локальность данных для приложений ИИ.
Масштабируемая векторная база данных
В основе реализации CAS от IBM лежит векторная база данных, оптимизированная для семантического поиска. Векторные базы данных поддерживают приблизительный поиск ближайшего соседа, что позволяет системам ИИ извлекать релевантные фрагменты данных на основе метрик сходства, таких как косинусное сходство или расстояние L2. Эта возможность является основополагающей для RAG, где пользовательские запросы преобразуются в векторы и сопоставляются с индексированными корпоративными данными для предоставления контекстно-зависимых ответов.
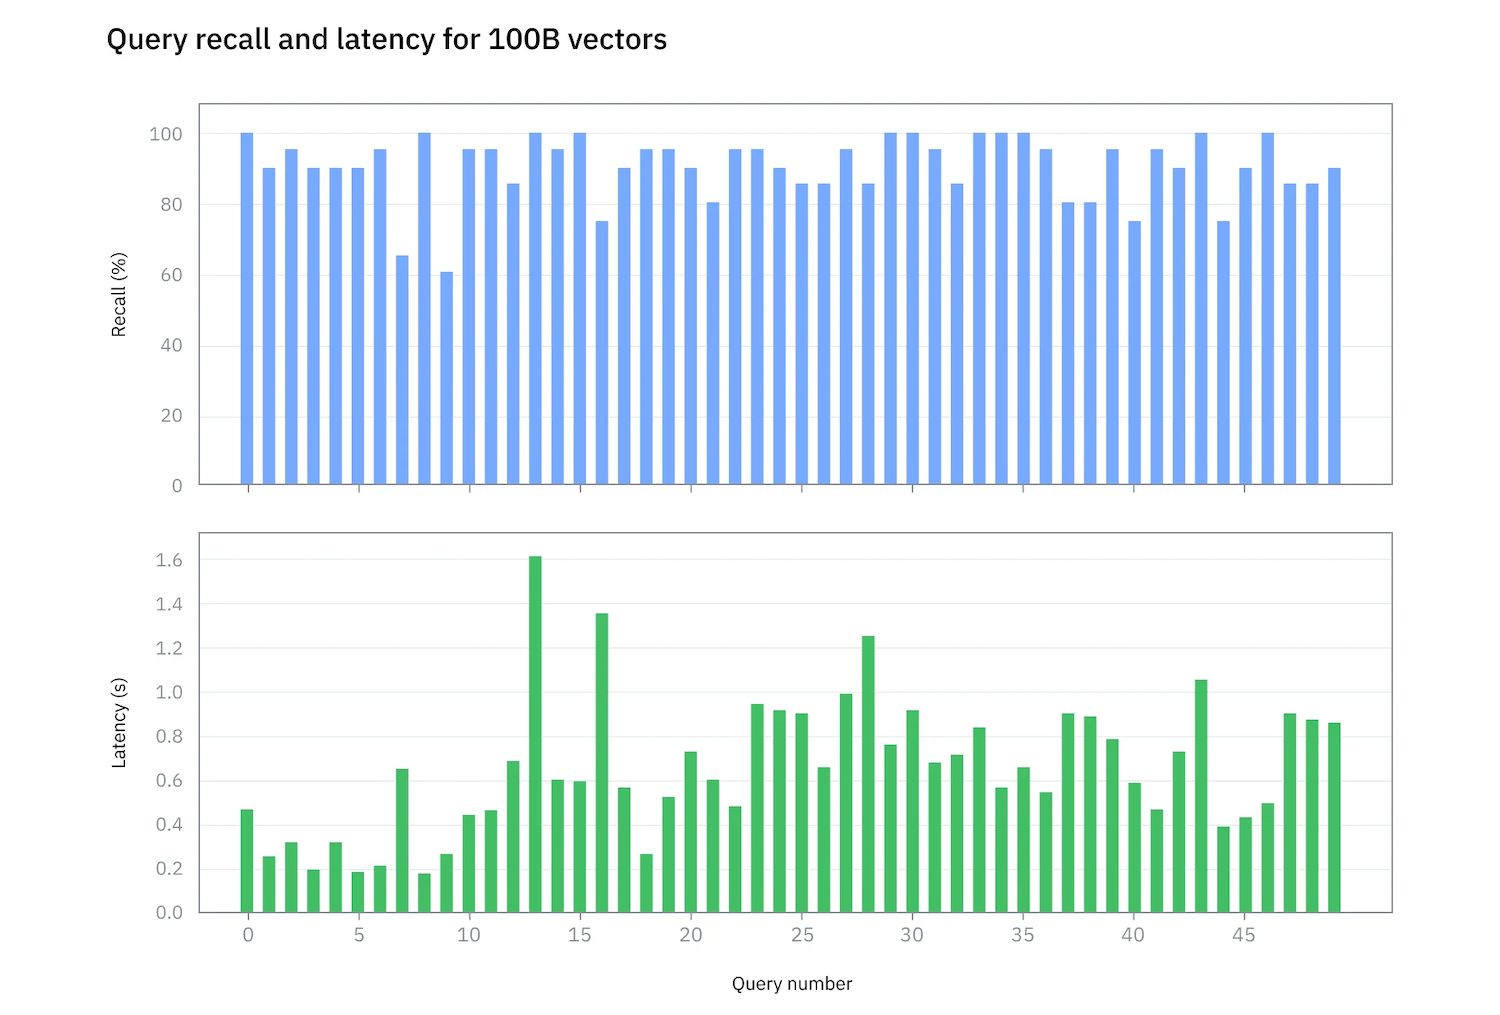
Источник: IBM
Научно-исследовательское подразделение IBM совместно с Samsung и NVIDIA продемонстрировало прототип системы, способной обрабатывать до 100 миллиардов векторов на одном сервере. Система достигла более чем 90-процентной полноты и точности, при этом средняя задержка запроса составила менее 700 миллисекунд. Такой масштаб ориентирован на корпоративные среды, где наборы данных могут содержать миллиарды файлов и, после полной индексации, достигать сотен миллиардов векторов.
Интеграция трубопровода RAG
Метод RAG становится предпочтительным подходом для корпоративного ИИ, поскольку он повышает точность результатов без необходимости переобучения модели. Он работает путем дополнения запросов данными, специфичными для предприятия, полученными из векторной базы данных.
Процесс начинается с загрузки данных, где документы, такие как PDF-файлы и презентации, анализируются, разбиваются на фрагменты и преобразуются в векторные представления. Эти представления хранятся в векторной базе данных, которая организует данные для эффективного поиска сходства. Во время выполнения запроса пользовательский ввод преобразуется в векторные представления и сопоставляется с сохраненными векторами, а соответствующее содержимое передается в языковую модель в качестве контекста. Этот механизм сопоставления уменьшает количество ложных срабатываний и повышает доверие к результатам, генерируемым ИИ.
Система CAS от IBM интегрирует этот конвейер непосредственно в хранилище, объединяя процессы приема, индексирования и извлечения данных ближе к самим данным.
Решение проблем масштаба и стоимости
Корпоративные системы хранения данных уже работают в петабайтном масштабе. При расширении до CAS каждый файл может генерировать сотни векторов, что быстро увеличивает размер набора данных. Традиционные векторные базы данных обычно масштабируются на нескольких серверах, что приводит к увеличению затрат и сложности в эксплуатации. Индексирование и переиндексирование больших наборов данных также становятся трудоемкими процессами.
Подход IBM сосредоточен на повышении плотности векторных данных и снижении накладных расходов на индексирование для ограничения разрастания инфраструктуры. Архитектура разделяет хранение векторных данных и индексов от вычислительных ресурсов для выполнения запросов, что позволяет независимо масштабировать ресурсы хранения и вычислительные ресурсы. Это достигается благодаря IBM Storage Scale и его высокопроизводительной параллельной файловой системе.
Архитектура хранения данных и аппаратного обеспечения
В реализации CAS используется платформа IBM Storage Scale System 6000 (ESS 6000), полностью флэш-памяти, разработанная для задач искусственного интеллекта и высокопроизводительных рабочих нагрузок. Система поддерживает до 48 NVMe-накопителей на один корпус форм-фактора 4U, с емкостью от 7 ТБ до 60 ТБ на накопитель. Она интегрирует интерфейсы PCIe Gen5, InfiniBand 400 Гбит/с или Ethernet 200 Гбит/с и обеспечивает пропускную способность до 340 ГБ/с при чтении и 175 ГБ/с при записи на узел, с производительностью до 7 миллионов операций ввода-вывода в секунду.
Платформа также поддерживает NVIDIA GPUDirect Storage, обеспечивая прямые каналы передачи данных между хранилищем и графическими процессорами, а также DPU BlueField-3 для разгрузки сетевой и информационной обработки.
Твердотельные накопители Samsung PM9D3a PCIe Gen5 NVMe обеспечивают высокую пропускную способность и высокую плотность хранения данных. Основанные на V-NAND-памяти восьмого поколения TLC, эти накопители обеспечивают до 30.72 ТБ на устройство, со скоростью последовательного чтения до 12 ГБ/с и скоростью записи до 6.8 ГБ/с. Использование доступных на рынке корпоративных SSD-накопителей позволяет масштабировать архитектуру с помощью стандартных компонентов.
Иерархическое индексирование и ускорение с помощью графического процессора
Для решения задачи индексирования в больших масштабах IBM разработала иерархическую модель индексирования, включающую множество подындексов, которые можно оптимизировать независимо друг от друга. Такая структура позволяет выполнять поэтапные обновления и локальную переиндексацию без нарушения целостности всего набора данных, что повышает как доступность, так и операционную эффективность.
Ускорение с помощью графических процессоров значительно сокращает время индексирования по сравнению с подходами, использующими только центральный процессор. Задачи, которые на центральных процессорах занимали бы часы, можно выполнить за минуты с помощью графических процессоров NVIDIA. В ходе тестирования построение индексов для 100 миллиардов векторов заняло 4 дня с 6 графическими процессорами NVIDIA H200, по сравнению с предполагаемыми 120 днями на двухпроцессорной системе с центральным процессором.
Полный набор данных, включая векторы и индексы, занял приблизительно 153 ТиБ памяти. Первоначальная загрузка и разбиение данных заняли девять дней. В результате система показала среднюю задержку запроса в 694 мс с полнотой 90%, что было подтверждено путем перебора эталонных данных.
Roadmap
IBM и NVIDIA продолжают оптимизировать платформу, уделяя особое внимание снижению задержки индексирования и запросов. Текущие цели включают индексирование 100 миллиардов и более векторов в день, сокращение времени загрузки данных с девяти дней до одного дня и снижение задержки запросов до 50-100 миллисекунд при сохранении 90-процентной полноты.
Интеграция векторного индексирования в стандартные файловые системы призвана упростить развертывание и снизить барьеры для внедрения ИИ в корпоративной среде. Встраивая возможности RAG непосредственно в хранилище, IBM позиционирует CAS как базовый уровень для инфраструктуры с поддержкой ИИ.


 Amazon