

Сегодня на глобальном саммите OCP компания Intel присвоила продукту название Crescent Island. Графические процессоры Intel серии D построены на архитектуре Xe3P и сочетают в себе до 480 ГБ памяти LPDDR5X с пропускной способностью 1.5 ТБ/с и вычислительной мощностью 1.3 петафлопс в FP8, и всё это в компактном корпусе PCIe с воздушным охлаждением мощностью 350 Вт. Цифра в 480 ГБ относится к картам, выпускаемым партнёрами; карта под собственным брендом Intel имеет 160 ГБ. Intel заявляет, что тестирование уже ведётся среди OEM-производителей серверов, ODM-производителей, неооблачных провайдеров и независимых разработчиков программного обеспечения. Рендер, выпущенный Intel вместе с новостью, обозначен как GPU D270 — это первый номер, который мы видели у этой серии.
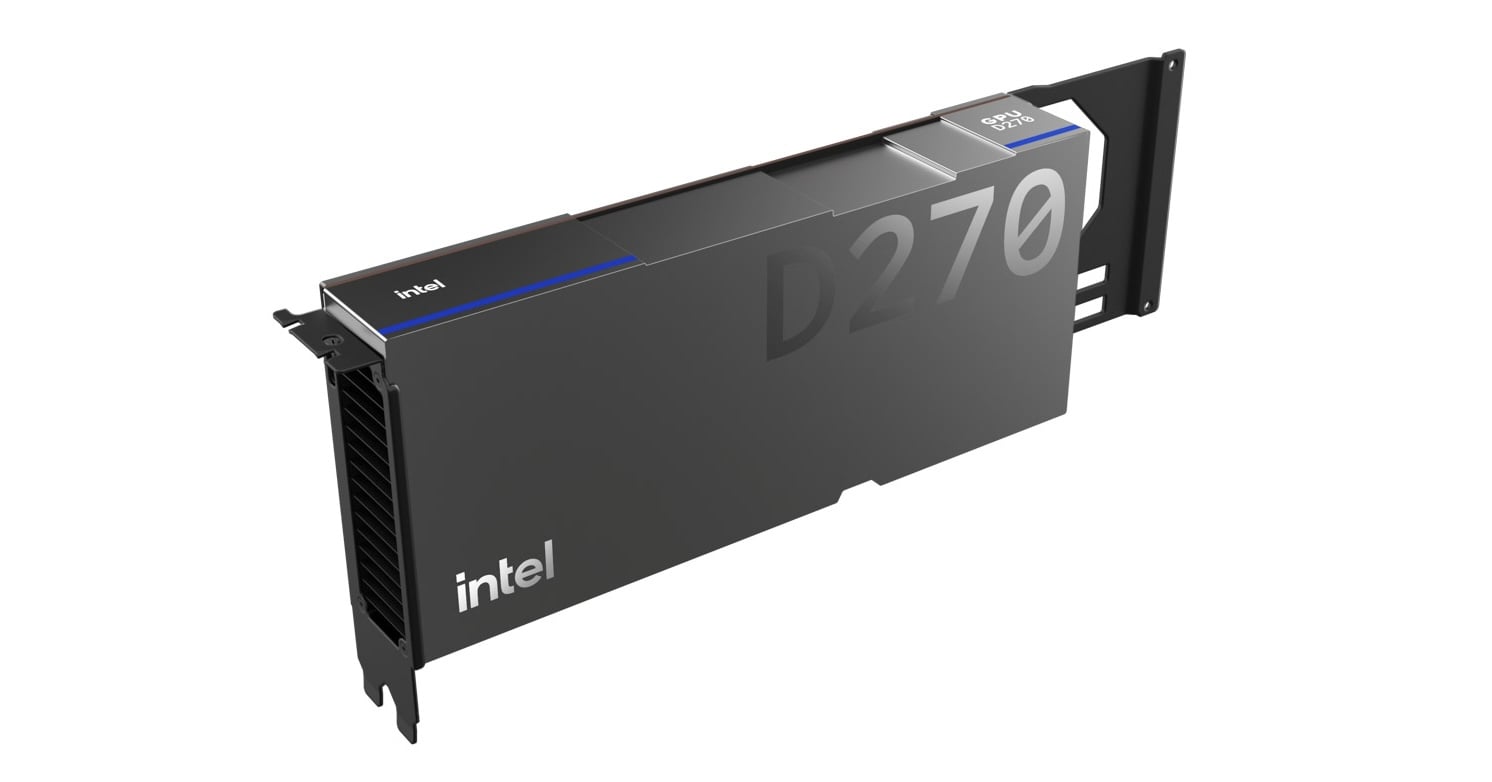
Архитектура Xe3P ориентирована на вывод данных, ограниченный объемом памяти.
Компания Intel впервые описала Crescent Island на конференции OCP 2025 и подробно рассказала о характеристиках процессора на конференции Hot Chips в августе : 32 ядра Xe и 256 процессоров XMX на архитектуре Xe3P, с памятью LPDDR5X вместо HBM, что позволяет устанавливать карту в существующие стойки с воздушным охлаждением. Сегодняшние дополнения включают название продукта, показатели пропускной способности и вычислительной мощности, а также подтверждение того, что клиенты получили образцы оборудования.
Для сравнения, Intel сегодня поставляет ускоритель вывода PCIe Gaudi 3 с 128 ГБ памяти HBM2e со скоростью 3.7 ТБ/с, и мы подробно рассмотрели эту карту в Dell PowerEdge XE7740 в феврале. Intel использовала Crescent Island в сочетании с стоечными конструкциями Gaudi 3, когда впервые представила графический процессор на OCP 2025, а в серии D ситуация обратная: почти в четыре раза большая емкость на карту при пропускной способности значительно меньше половины.
По данным Intel, одна видеокарта серии D может обрабатывать модели с количеством параметров до 300 миллиардов, а система с восемью графическими процессорами масштабируется до более чем одного триллиона параметров. Компания позиционирует эту карту для длительной многопользовательской обработки данных и агентных задач с длительным контекстом, где рост кэша ключ-значение увеличивает объем используемой памяти быстрее, чем вычислительные ресурсы. При пропускной способности 1.5 ТБ/с карта значительно уступает ускорителям класса HBM, и Intel позиционирует производительность на ватт и доллар как показатель, имеющий значение для обработки больших объемов данных, требующих декодирования, а не для пиковой пропускной способности.
«Вычисления становятся определяющей рабочей нагрузкой в области ИИ, и предприятиям необходима инфраструктура, обеспечивающая необходимую производительность по оптимальной цене», — сказал Анил Нандури, вице-президент по продуктам ИИ и стратегии выхода на рынок в группе центров обработки данных Intel. «С графическими процессорами Intel серии D мы сосредоточены на том, чтобы сделать высокопроизводительные вычисления практичными в развертывании и экономичными в масштабировании». Программная часть основана на общей платформе Xe, которая, по словам Intel, обеспечивает бинарную переносимость между линейками графических процессоров, поэтому код, разработанный на картах Arc Pro, переносится на серию D без переписывания ядра.
Стек Intel интегрирует среды выполнения и фреймворки обслуживания от разработчиков на хостах Xeon и ускорителях серии D, обеспечивая поддержку Meta Muse Glimmer с первого дня — модели с открытым исходным кодом и 30 миллиардами параметров, разработанной Meta для локальной работы агентов. Intel AI for Enterprise Agent Toolkit, работающий сегодня на Xeon, использует архитектуру на основе поставщика, которая будет ориентирована на серию D по мере появления оборудования, поэтому уровень оркестрации будет создан до массового поступления ускорителей.
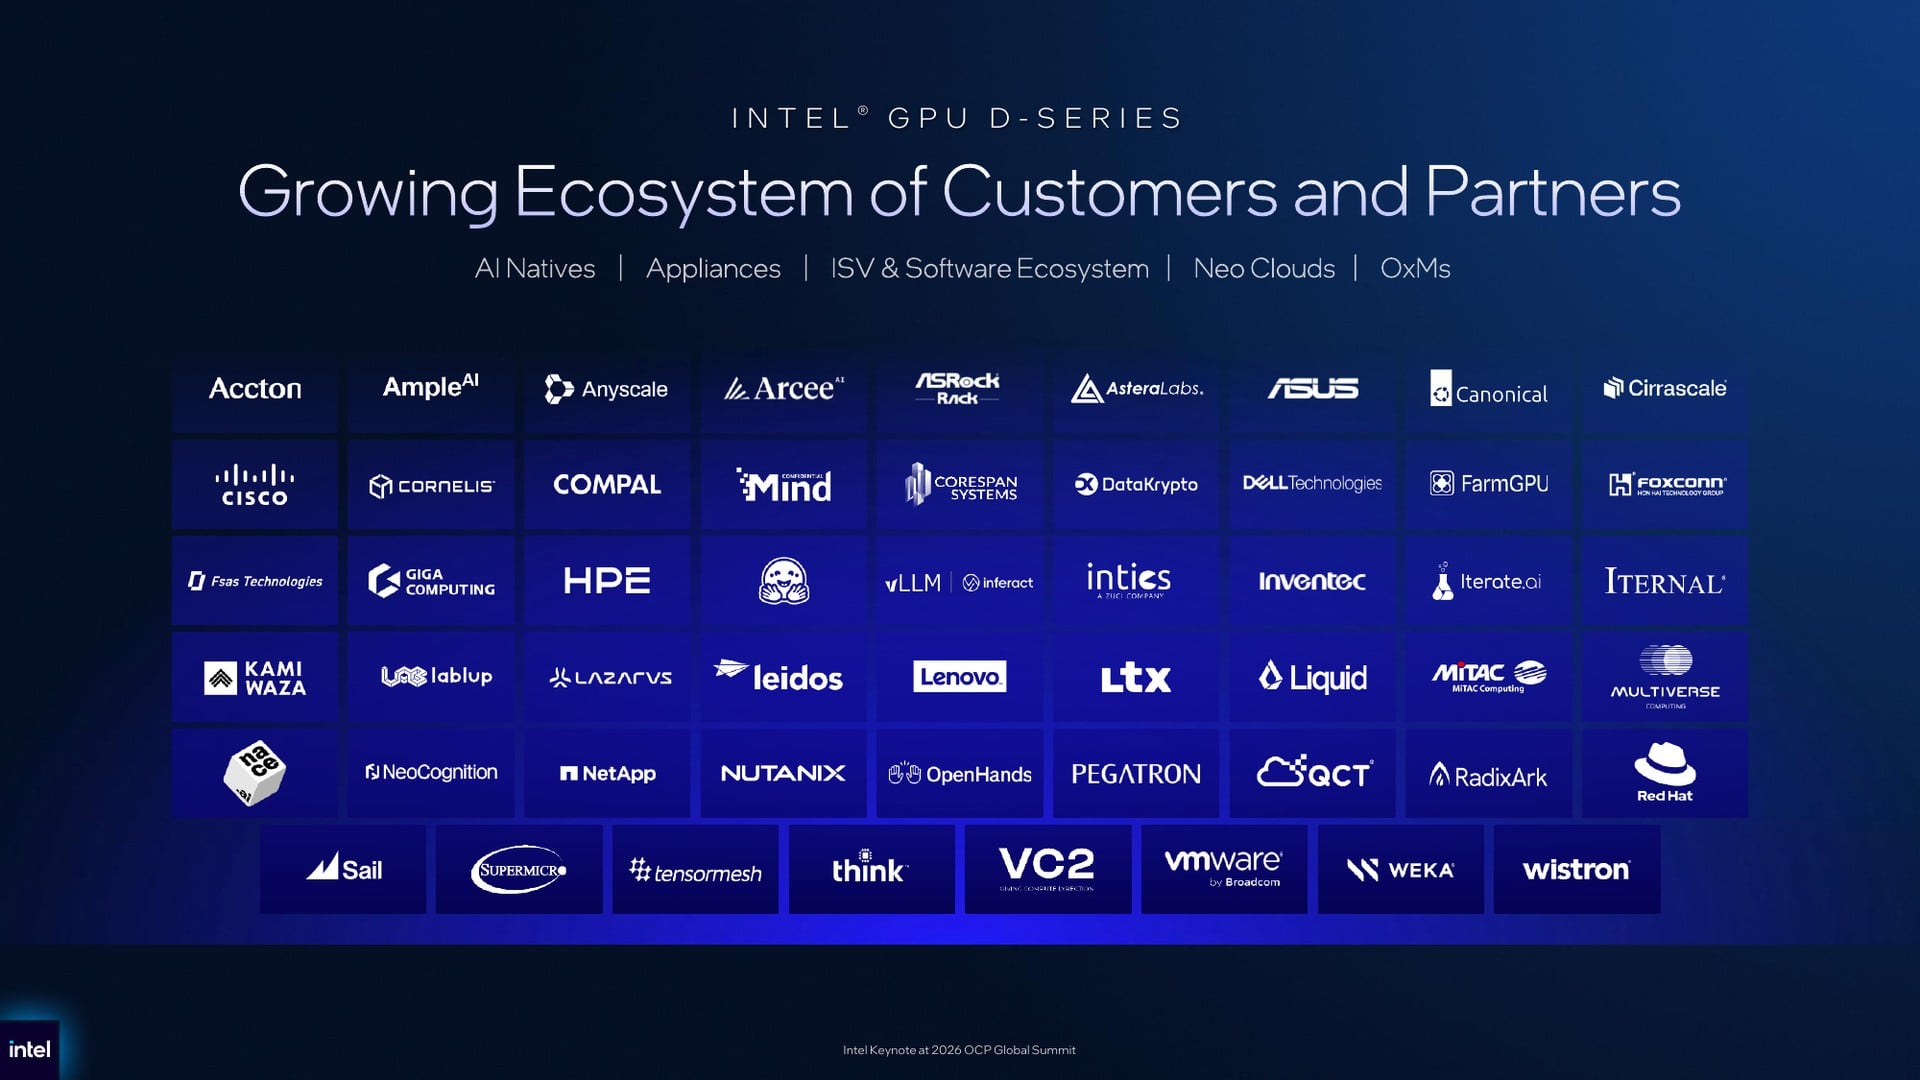
На слайде, показанном Intel на презентации, представлено 53 логотипа от компаний, занимающихся разработкой решений для искусственного интеллекта, производителей устройств, программного обеспечения, неооблачных решений, а также OEM- и ODM-производителей. Названия серверных решений ожидаемы: Dell, HPE, Lenovo, Supermicro, Cisco, ASUS, ASRock Rack, Giga Computing, MiTAC, Pegatron, QCT, Wistron, Inventec, Compal и Foxconn. Список программного обеспечения более важен для карты, ориентированной на портативность: Red Hat, Canonical, VMware by Broadcom, Nutanix, NetApp, WEKA, vLLM, Hugging Face, Anyscale и OpenHands представлены на карте, а Astera Labs и Cornelis — на стороне межсоединений.
Стойки Xeon ORv3 масштабируются до более чем 46 000 ядер.
Наряду с видеокартой, Intel продемонстрировала стоечные системы, построенные в соответствии со спецификацией OCP Open Rack v3 на базе процессоров Xeon 6+ . Intel заявляет, что самые плотные конфигурации достигают более 46 000 ядер на стойку при общем потреблении 133.45 кВт. 288-ядерный Xeon 6+ обеспечивает это при наличии 160 сокетов, что составляет 80 двухсокетных узлов в одной стойке с потреблением около 834 Вт на сокет, включая остальную часть стойки. Intel размещает эти стойки для обработки данных на стороне ЦП в конвейере обработки агентов: маршрутизация токенов, извлечение данных, поиск в базах данных, выполнение кода и обеспечение работы ускорителей с помощью операций ввода-вывода.
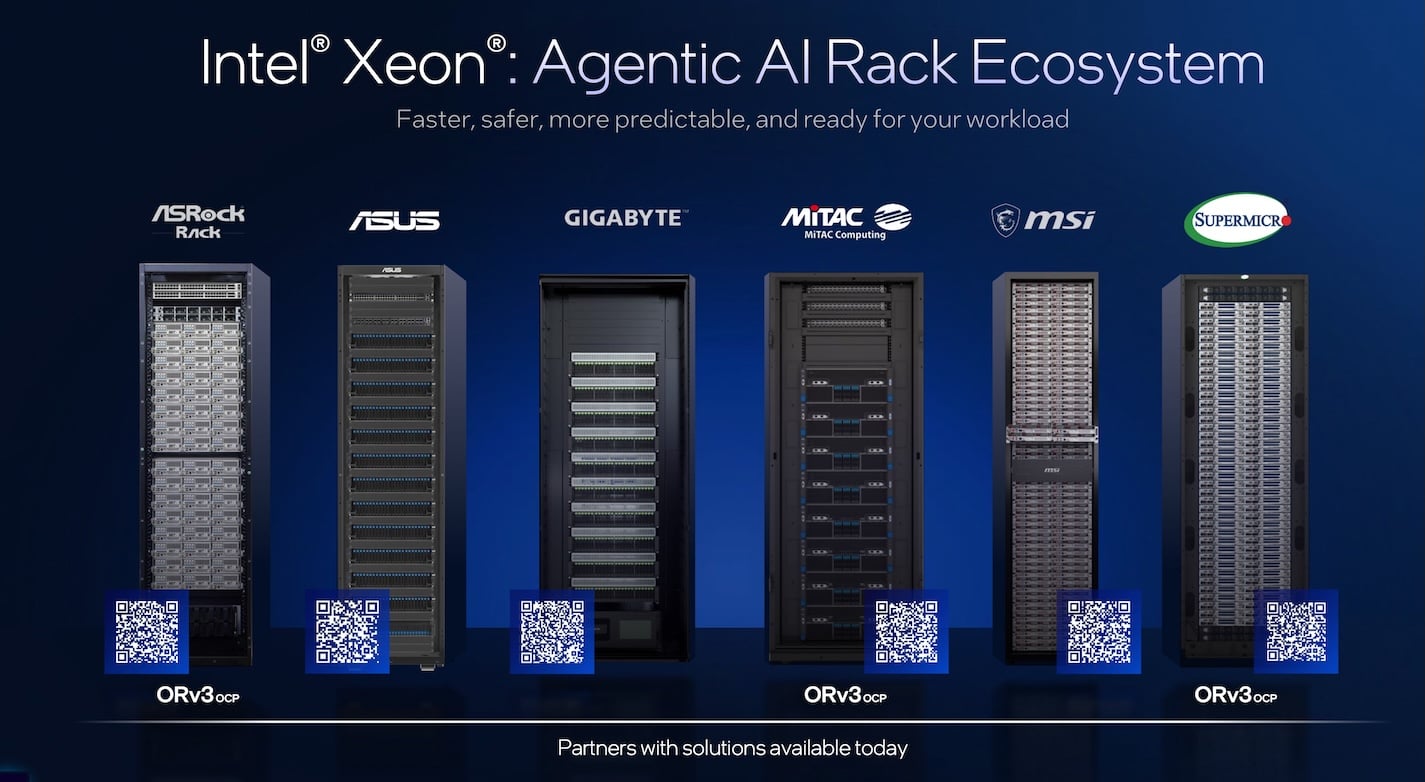
На слайде с партнерами указаны ASRock Rack, ASUS, GIGABYTE, MiTAC Computing, MSI и Supermicro в качестве поставщиков, чьи системы доступны уже сегодня. Три из шести представленных стоек — это модели ORv3, а остальные — 19-дюймовые шасси. Intel заявляет, что критерием оценки стойки для ИИ становится количество одновременно работающих агентов, которые она может поддерживать с заданной задержкой. «Агентный ИИ меняет потребности клиентов в центрах обработки данных. Уже недостаточно просто быстрее генерировать токены. Инфраструктура должна организовывать сложные рабочие процессы, выполнять задачи и эффективно предоставлять полезную работу в масштабе», — сказал Кеворк Кечичян, исполнительный вице-президент и генеральный директор группы центров обработки данных Intel.
В OCP продолжается работа над открытой адаптерной платой.
Intel также упомянула о своей работе в рабочей группе OCP Open Adapter Card, которую она сформировала совместно с AMD, Dell, NVIDIA и Qualcomm в начале этого года. Группа разрабатывает форм-фактор ускорителя для установки в стойку, который находится между стандартной картой PCIe и полноценной системой стоечного масштаба, со стандартизированными механическими, силовыми и внеполосными интерфейсами управления, чтобы ускорители от разных производителей могли устанавливаться в один и тот же открытый корпус.
Заявленная цель рабочей группы — создание мощных адаптеров для платформ инференции и обучения среднего уровня в стоечных корпусах размером 19 и 21 дюйм, а Intel и AMD представят прогресс в разработке спецификации на саммите на этой неделе. Intel внесла 116 вкладов в OCP с 2011 года, а выступление Ника Дюбе «Расставьте все подсказки по своим местам» запланировано на 13 октября в 10:30 утра по тихоокеанскому времени.


 Amazon