

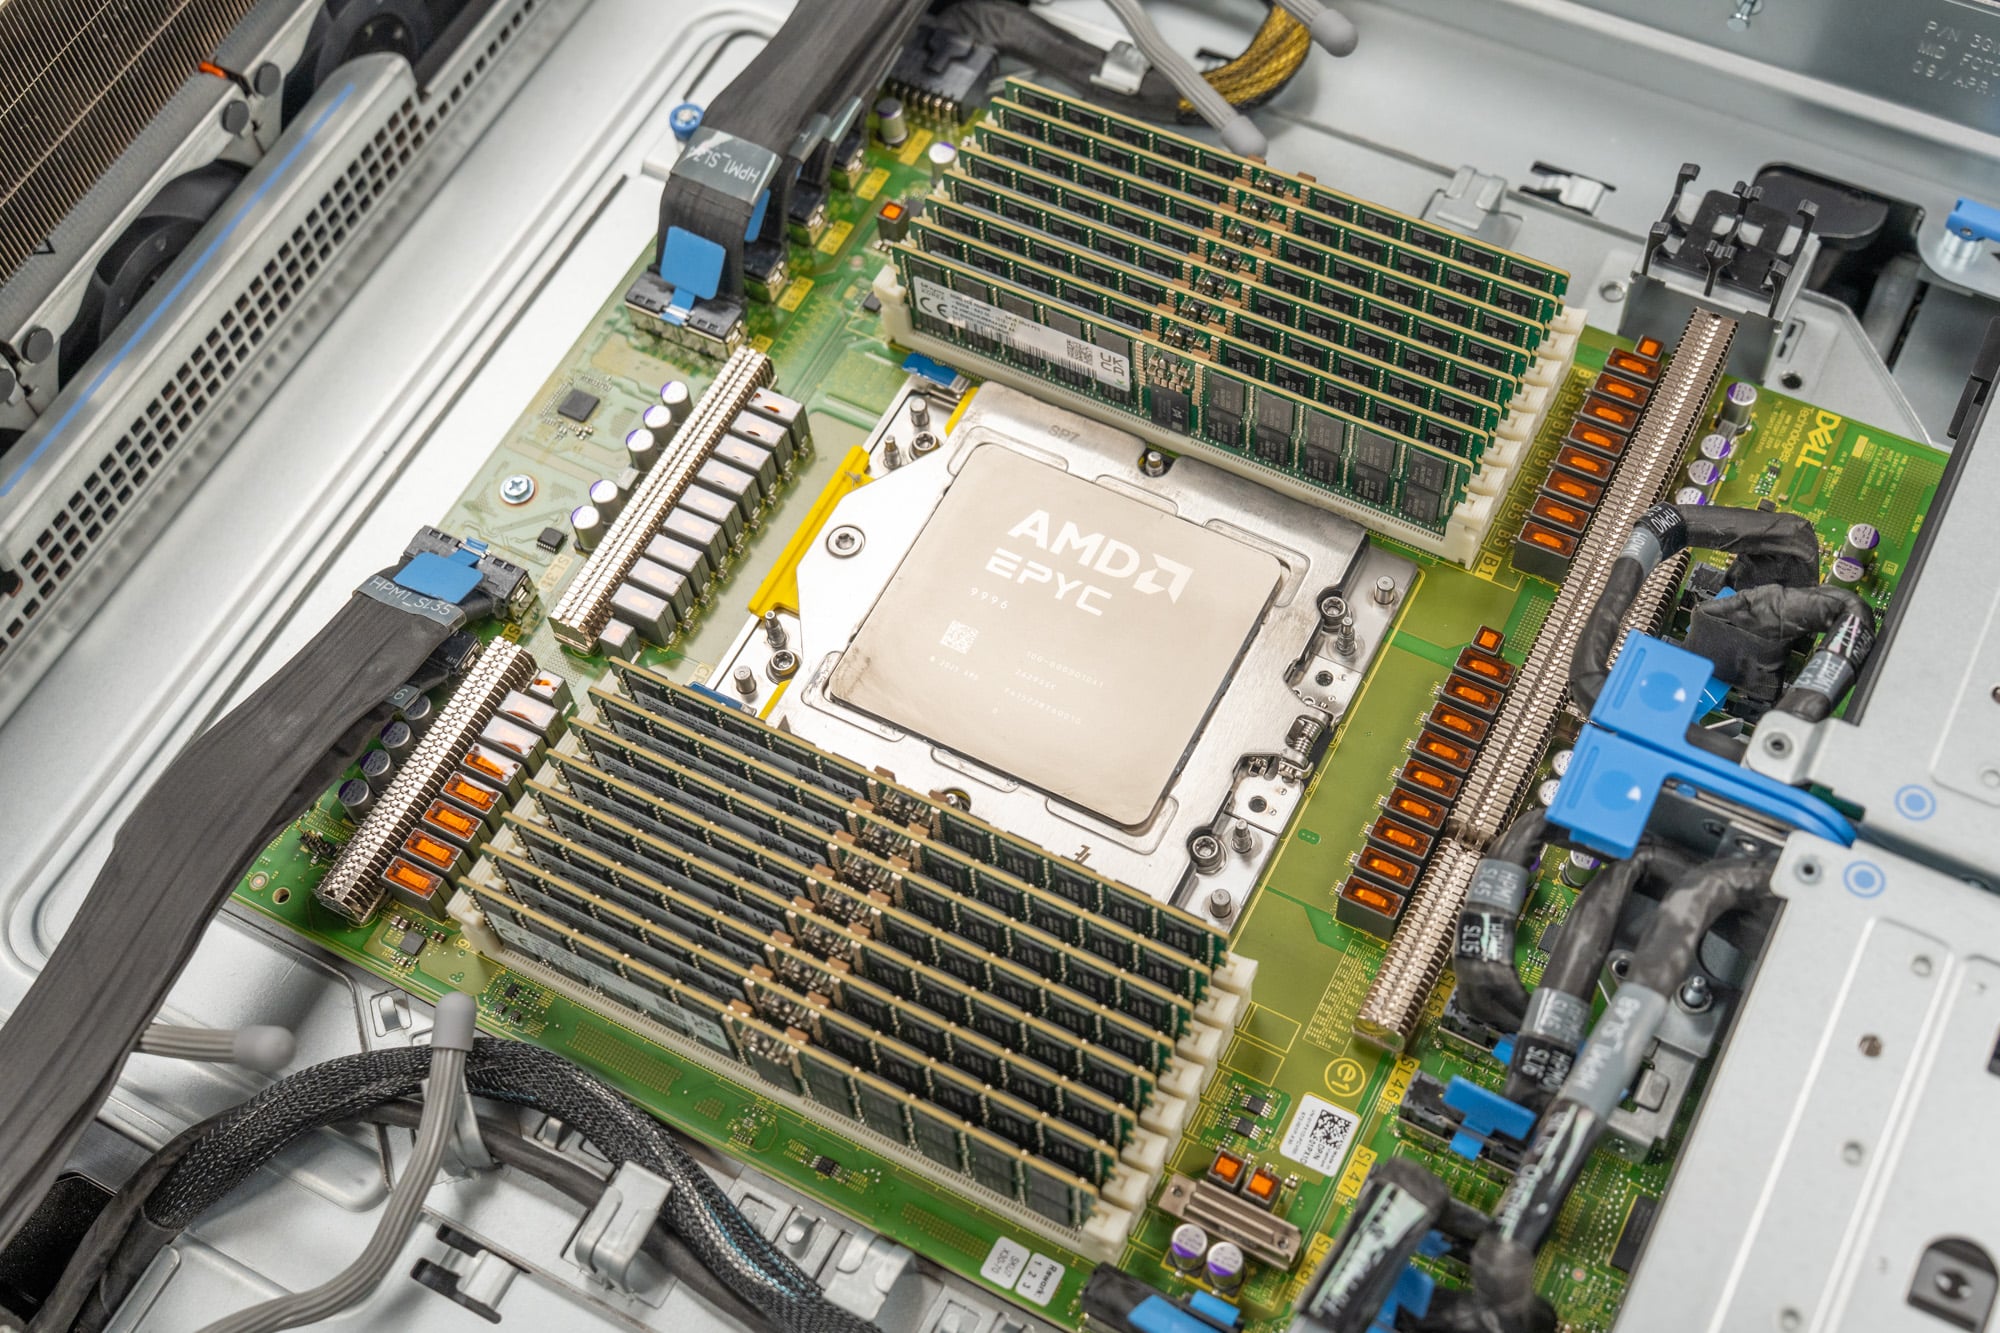
Серийные процессоры AMD EPYC 6-го поколения, получившие кодовое название Venice, объединяют ядра Zen 6 и Zen 6c в линейке, созданной для удовлетворения потребностей всех сегментов серверного рынка. AMD увеличивает количество ядер и тактовые частоты, а также значительно расширяет пропускную способность этих ядер за счет увеличения объема подсистемы памяти и перехода на PCIe Gen6. Широкий ассортимент семейства позволяет AMD стремиться к максимальной вычислительной плотности, одновременно создавая решения, отвечающие требованиям корпоративных серверов и хостов искусственного интеллекта.
В этом обзоре основное внимание уделяется Venice SP7, более крупному сокету AMD для центров обработки данных, который поддерживает шестнадцать каналов памяти и процессоры мощностью до 600 Вт. Ориентированная на корпоративный сегмент платформа Venice SP8 и Verano на базе LPDDR, ответ AMD на NVIDIA Vera , должны появиться в следующем году, в 2027 году. Наши тестовые данные получены с 256-ядерного EPYC 9996 в Dell PowerEdge R9825 и с эталонной платформы AMD в Нигерии, которая также позволила нам оценить 96-ядерный EPYC 9686F с частотой 5.3 ГГц и то, что добавляет к этому процессору память MRDIMM-12800.
Основные выводы
- Самый быстрый серверный процессор из всех, что мы тестировали. Два 256-ядерных процессора EPYC 9996 в сервере Dell PowerEdge R9825 показали в 1.8 раза более высокую скорость выполнения теста GROMACS benchPEP, чем сервер с 384-ядерным процессором EPYC 9965, в 2.6 раза быстрее решили задачу обработки большой сетки OpenFOAM и в 1.7 раза быстрее зашифровали данные с помощью AES-256-GCM, обеспечив скорость 6.8 ТБ/с. Один сокет обрабатывал 76.5 млн запросов Valkey GET в секунду.
- В большинстве вычислительных задач Venice превосходит Vera и Xeon. В сравнении с Vera, R9825 показал результат в 4.7 раза выше в benchPEP, в 5.4 раза выше в шифровании, в 2.1 раза выше в сжатии в 7-Zip, в 1.8 раза выше в решении больших задач OpenFOAM mesh и в 3.4 раза больше запросов Valkey с одного сокета, при этом сократив задержку обработки HammerDB на 30–51% при сопоставимой нагрузке. В сравнении с Xeon 6978P он показал результат в 2.6 раза выше в benchPEP и в 2.7 раза выше в AES.
- Скорость на ядро снова вернулась на уровень x86. На 16 ядрах Zen 6c показал в тесте GROMACS benchMEM на 67% более высокую скорость, чем Zen 5c, и в 2.5 раза более высокую, чем Olympus. Один закрепленный поток Zen 6c сжал данные в 7-Zip на 16% быстрее, чем Olympus, и зашифровал в 2.9 раза быстрее, а 5.3-гигагерцовый EPYC 9686F превзошел Vera во всех трех тестах Python, сократив время выполнения на 10–38%.
- Объем памяти имеет такое же значение, как и количество ядер процессора. Перенос тех же двух процессоров 9996 с памяти DDR5-8000 на MRDIMM-12800 увеличил пропускную способность STREAM Triad на 58% и сократил объем вычислений в OpenFOAM на 21%. 96-ядерный процессор 9686F на MRDIMM достиг скорости почти 2 ТБ/с и завершил обработку этой сетки с точностью до 13% от 512-ядерного R9825 на DDR5-8000.
- Vera сохраняет преимущество в пропускной способности и межсоединениях. В режиме реального времени (STREAM Triad) Venice отстает от Vera (2,073 ГБ/с) на 42% при использовании DDR5-8000 и на 8% при использовании MRDIMM, хотя конфигурация с MRDIMM передает больше данных, чем Vera, если добавить обратно данные чтения из STREAM-сети. Технология NVLink-C2C в Vera обеспечивает в 4.6 раза большую пропускную способность удаленного сокета, чем xGMI от AMD, и этот же канал связи обеспечивает Vera соединение CPU-GPU, пропускная способность которого не имеет аналогов среди платформ x86.
- Базы данных разделены между этими двумя типами. В ноябрьском раунде HammerDB один 256-ядерный сокет EPYC 9996 превзошел 88-ядерный сокет Vera на 14% в MySQL и сравнялся по результатам в VillageSQL, в то время как Vera опередила MariaDB и PostgreSQL на 11% против 12%. Venice сократила задержку PAYMENT p99 на 30% до 51% при сопоставимой нагрузке, а один 96-ядерный сокет 9686F показал лучший результат в раунде для PostgreSQL — 3.03 млн NOPM.
Линейка SP7
Линейка SP7 задаёт рамки для последующего обсуждения архитектуры. Флагманом линейки Venice является EPYC 9996 с 256 ядрами, что на 33.3% больше, чем у 192-ядерного EPYC 9965 от Turin . AMD делает ещё больший скачок в своих высокочастотных процессорах, увеличивая количество ядер с максимальных 64 у Turin 9575F до 96 у 9686F, что на 50% больше, а 9686F также достигает максимальной частоты в режиме Boost 5.3 ГГц. AMD опубликовала полный список из 31 процессора EPYC 9006 в октябре; процессоры SP7, на которые мы ссылаемся в этом обзоре, приведены ниже.
| процессор | Сердечники/потоки | Базовое/максимальное ускорение | кэш L3 | Мощность процессора по умолчанию |
|---|---|---|---|---|
| EPYC 9996 | 256 / 512 | 2.55 / 4.1 ГГц | 1,024MB | 600 Вт |
| EPYC 9966 | 192 / 384 | 2.9 / 4.0 ГГц | 768MB | 600 Вт |
| EPYC 9846 | 168 / 336 | 2.85 / 3.7 ГГц | 768MB | 500 Вт |
| EPYC 9756 | 128 / 256 | 3.15 / 4.0 ГГц | 512MB | 500 Вт |
| ЭПИК 9686F | 96 / 192 | 4.05 / 5.3 ГГц | 384MB | 600 Вт |
| EPYC 9G76 | 96 / 192 | 3.4 / 4.8 ГГц | 384MB | 500 Вт |
| EPYC 9656 | 96 / 192 | 3.05 / 3.7 ГГц | 512MB | 400 Вт |
| ЭПИК 9586F | 64 / 128 | 3.75 / 5.0 ГГц | 384MB | 500 Вт |
| EPYC 9556 | 64 / 128 | 2.75 / 4.3 ГГц | 384MB | 300 Вт |
Компания AMD объявила о начале продаж процессоров SP7 10 ноября, после чего начнутся поставки OEM-систем, а также появятся экземпляры Azure и OCI. Заявленные производителем характеристики задали планку для наших тестов. По сравнению с процессорами EPYC 5-го поколения, AMD оценивает производительность Venice в 2.0 раза выше в SPECint 2026, в 2.4 раза выше в SPECfp 2026, в 2.7 раза выше в STREAM, в 1.4 раза выше в HPL и в 1.3 раза выше в DGEMM.
Это данные тестирования AMD, а ниже мы приводим заявленные показатели IPC для данной конфигурации ядра; наш результат STREAM Triad, показанный ниже, в 1.9 раза превосходит флагманскую модель Turin на DDR5-8000 и в 3.0 раза — на MRDIMM-12800.
По сравнению с NVIDIA Vera, AMD заявляет о 1.2-кратном увеличении производительности на ядро в тесте SPECrate 2026 для 96-ядерной версии и 2.2-кратном увеличении на платформу для 9996. На момент запуска производительность увеличилась в 3.7 раза в тесте SPECrate 2017 для двухсокетной версии 9996, составив 5,470 против оценки AMD в 1,459 для Vera. Показатель на ядро совпадает с нашим зафиксированным результатом в 7-Zip, где 9686F сжимал данные на 16% быстрее, чем ядро Olympus, а показатели платформы охватывают наш набор тестов, где преимущество 9996 над Vera варьируется от паритета в OLTP до 5.4x в криптографическом коде. Тот же опубликованный результат в 1.68 раза выше, чем 3,260 у двухсокетного EPYC 9965.
AMD также описывает три рабочих режима для этой линейки. 256-ядерный процессор мощностью 400 Вт предназначен для массового агентского хостинга, где загрузка составляет от 50% до 100%, а энергопотребление — от 1.2 до 2.0 Вт на ядро; те же 256-ядерные процессоры мощностью 600 Вт ориентированы на облачные вычисления и работу в центрах обработки данных среднего уровня с энергопотреблением от 1.7 до 3.5 Вт на ядро; а 96-ядерные процессоры мощностью 500 и 600 Вт предназначены для высокопроизводительных вычислительных узлов и задач, чувствительных к задержкам, с энергопотреблением от 5 до 10 Вт на ядро и возможностью разгона до 5.3 ГГц. Протестированные нами модели 9996 и 9686F соответствуют второму и третьему режимам.
В Venice также реализованы три варианта управления питанием на уровне платформы, начиная с Unified Power Provisioning, которая устанавливает единый бюджет для SoC и его модулей DIMM, позволяя стойке высвободить неиспользуемую мощность; по словам AMD, обычно не используется от 15% до 25% мощности стойки. В стартовой модели AMD размещено 16 двухпроцессорных серверов 9996 в стойке мощностью 35 кВт с бюджетом по умолчанию 830 Вт для каждого SoC и его модулей DIMM, и почти 19 серверов с бюджетом, установленным на 15% ниже — 706 Вт, что в среднем приводит к снижению производительности на 1%.
Технология масштабирования мощности на основе использования позволяет отслеживать количество активных ядер, сохраняя полную мощность в резерве для пиковых нагрузок, а технология адаптивного частотного спектра устанавливает минимальную частоту для каждой группы ядер, так что один физический компонент может продаваться в нескольких уровнях производительности. Ни одна из этих трех технологий не повлияла на наши тесты при стандартном уровне мощности, и мы рассмотрим, как производители оборудования предоставляют к ним доступ по мере развития прошивки.
В основе архитектуры: Zen 6 и Zen 6c
В линейке Venice используются процессоры AMD Zen 6 и Zen 6c, оба построены по техпроцессу N2 компании TSMC. По сравнению с процессорами Zen 5 и Zen 5c, разработанными в Турине, эти новые кристаллы с ядерным комплексом (CCD) предлагают большее количество ядер и больший объем кэш-памяти.
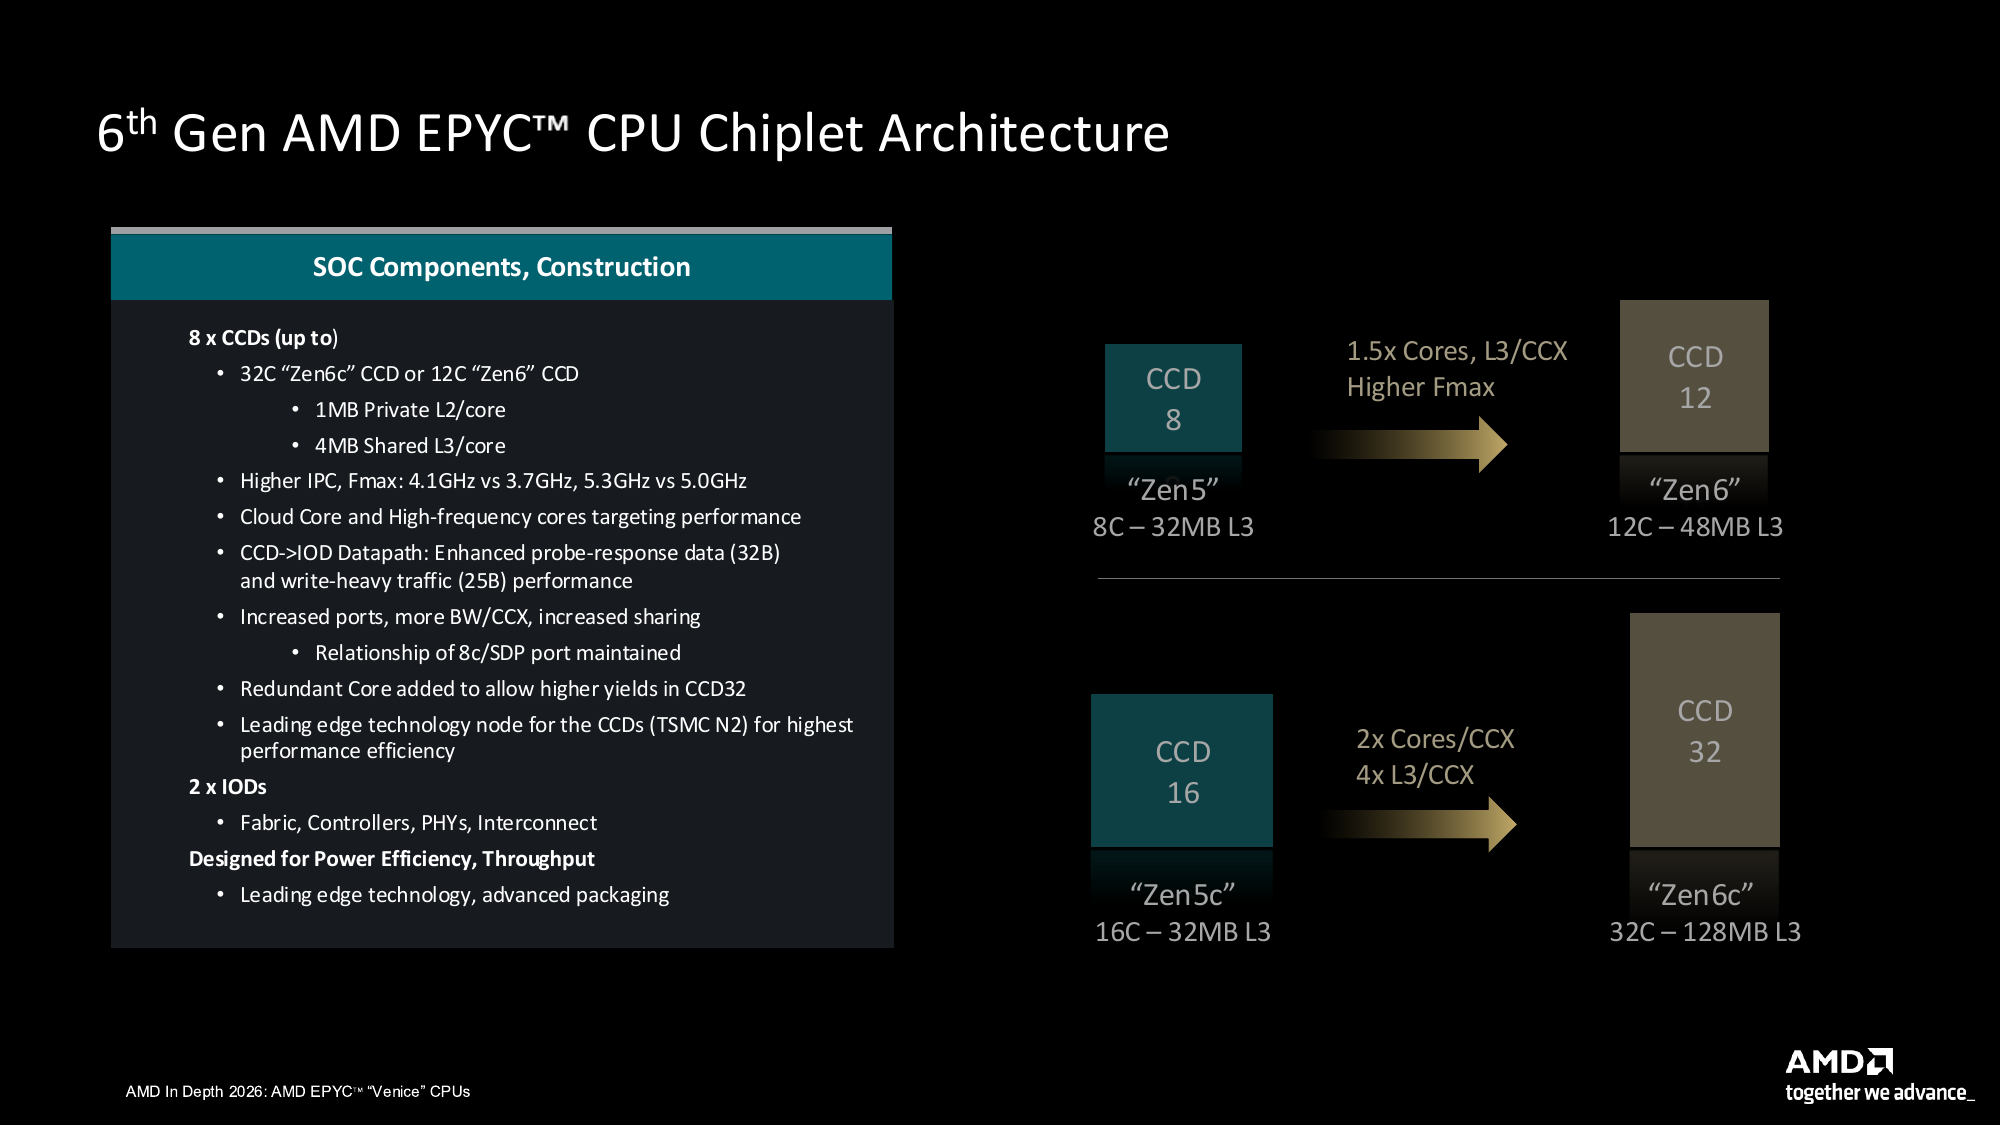
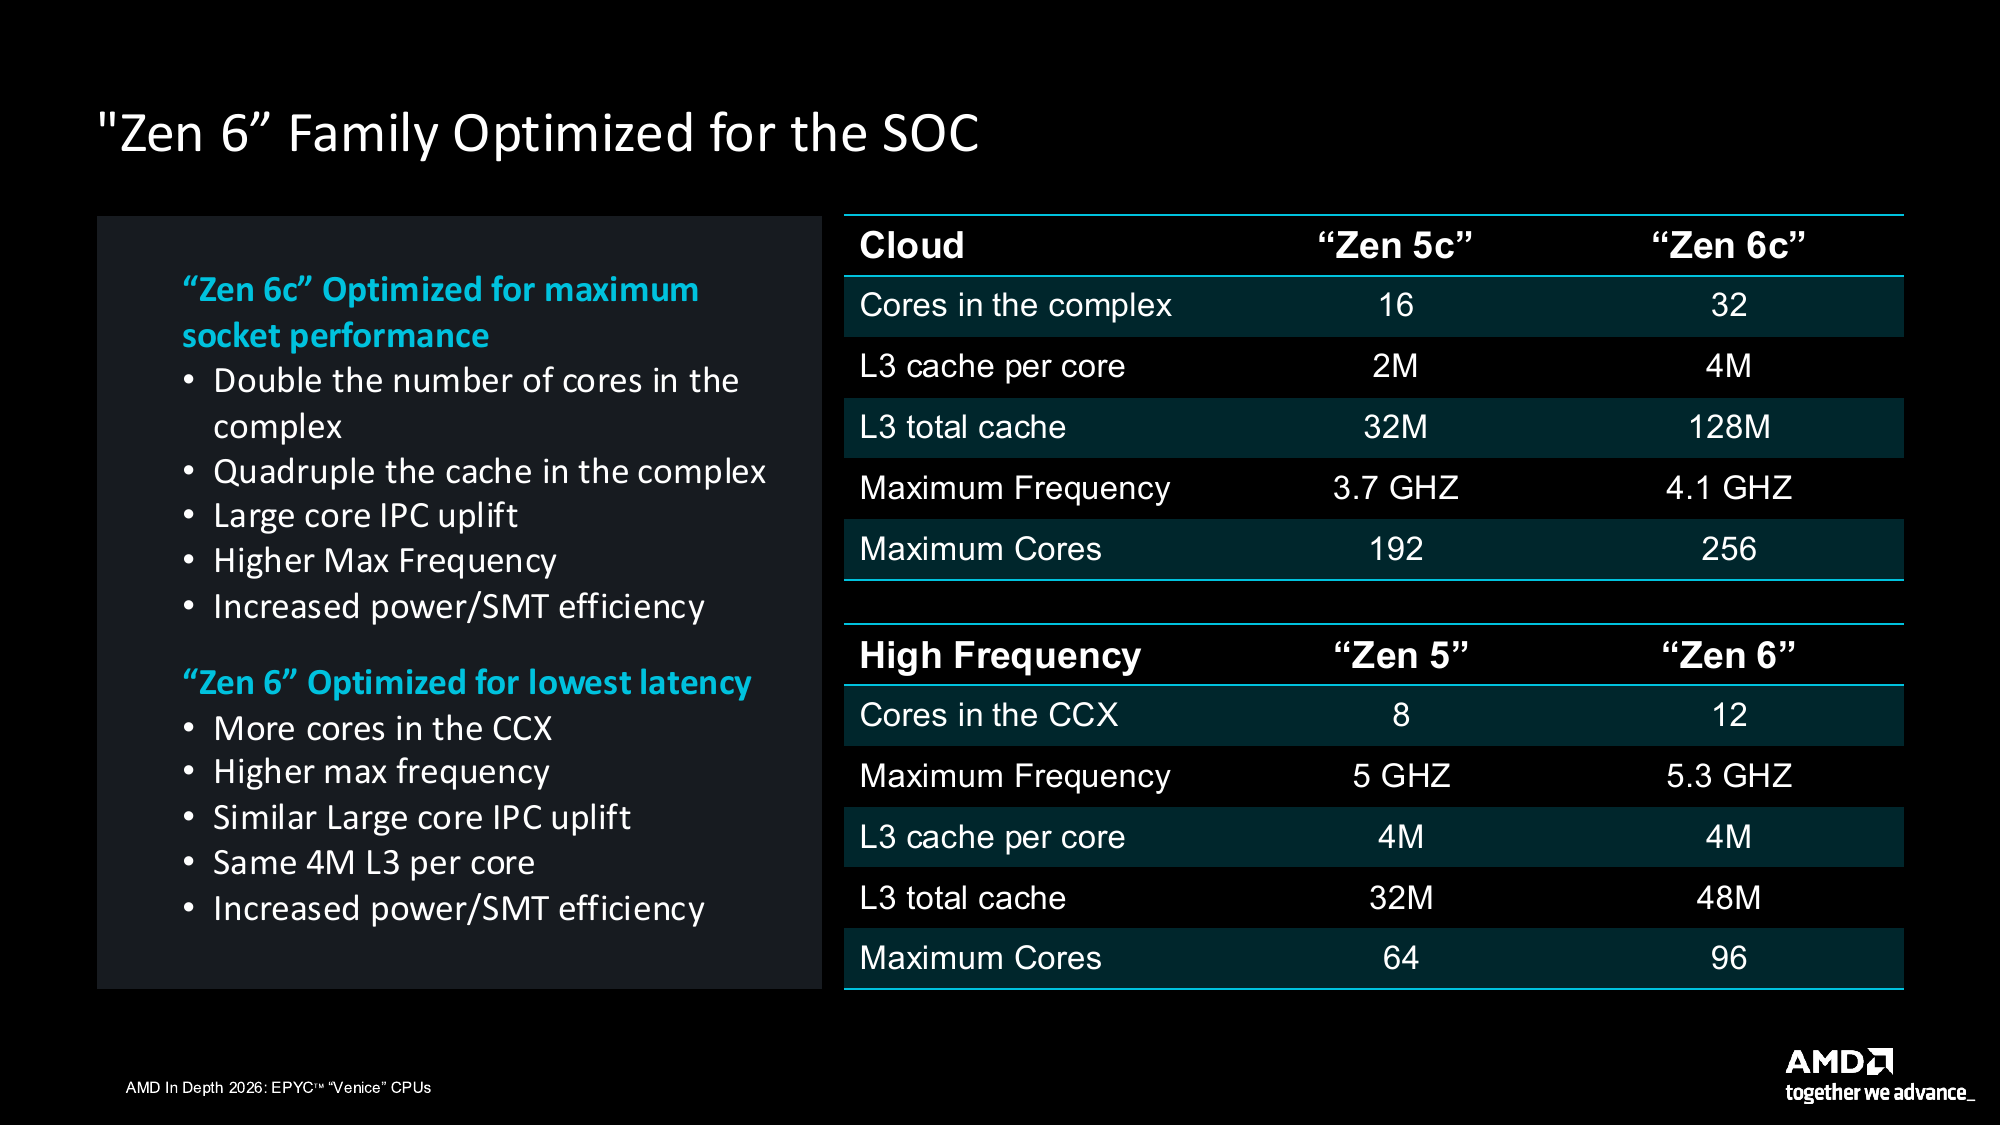
Важно понимать, что Zen 6 и Zen 6c — это не две разные архитектуры, как, например, P-ядра и E-ядра Intel. AMD использует одну и ту же микроархитектуру, при этом все функции и пути передачи данных являются общими для обеих систем. Zen 6c — это физически компактная реализация, в которой тактовая частота уменьшена за счет площади и энергопотребления, что позволяет разместить гораздо больше ядер на одном кристалле. AMD указывает максимальную частоту 5.3 ГГц для Zen 6 (по сравнению с 5.0 ГГц у Zen 5) и 4.1 ГГц для Zen 6c (по сравнению с 3.7 ГГц у Zen 5c).
Стандартный CCD Zen 6 увеличивается с восьми ядер Zen 5, используемых в архитектуре Turin, до двенадцати. Каждое ядро сохраняет 1 МБ частного кэша L2, что дает CCD в сумме 12 МБ кэша L2, в то время как общий кэш L3, используемый всеми двенадцатью ядрами, увеличивается с 32 МБ до 48 МБ. Это сохраняет соотношение 4 МБ кэша L3 на ядро, как и в Zen 5, поэтому больший размер кристалла увеличивает емкость без уменьшения объема кэша, доступного каждому ядру.
Zen 6c совершает более значительный скачок, удваивая количество ядер в процессоре Zen 5c CCD от Turin с шестнадцати до 32 и увеличивая в четыре раза общий кэш L3 с 32 МБ до 128 МБ, что также удваивает объем кэша L3 на ядро с 2 МБ до 4 МБ. Каждое ядро сохраняет свой 1 МБ кэша L2, в результате чего общая емкость кэша L2 составляет 32 МБ. Восемь таких процессоров CCD дают 9996 256 ядер и 512 потоков, а также 256 МБ общего кэша L2 и 1,024 МБ кэша L3.
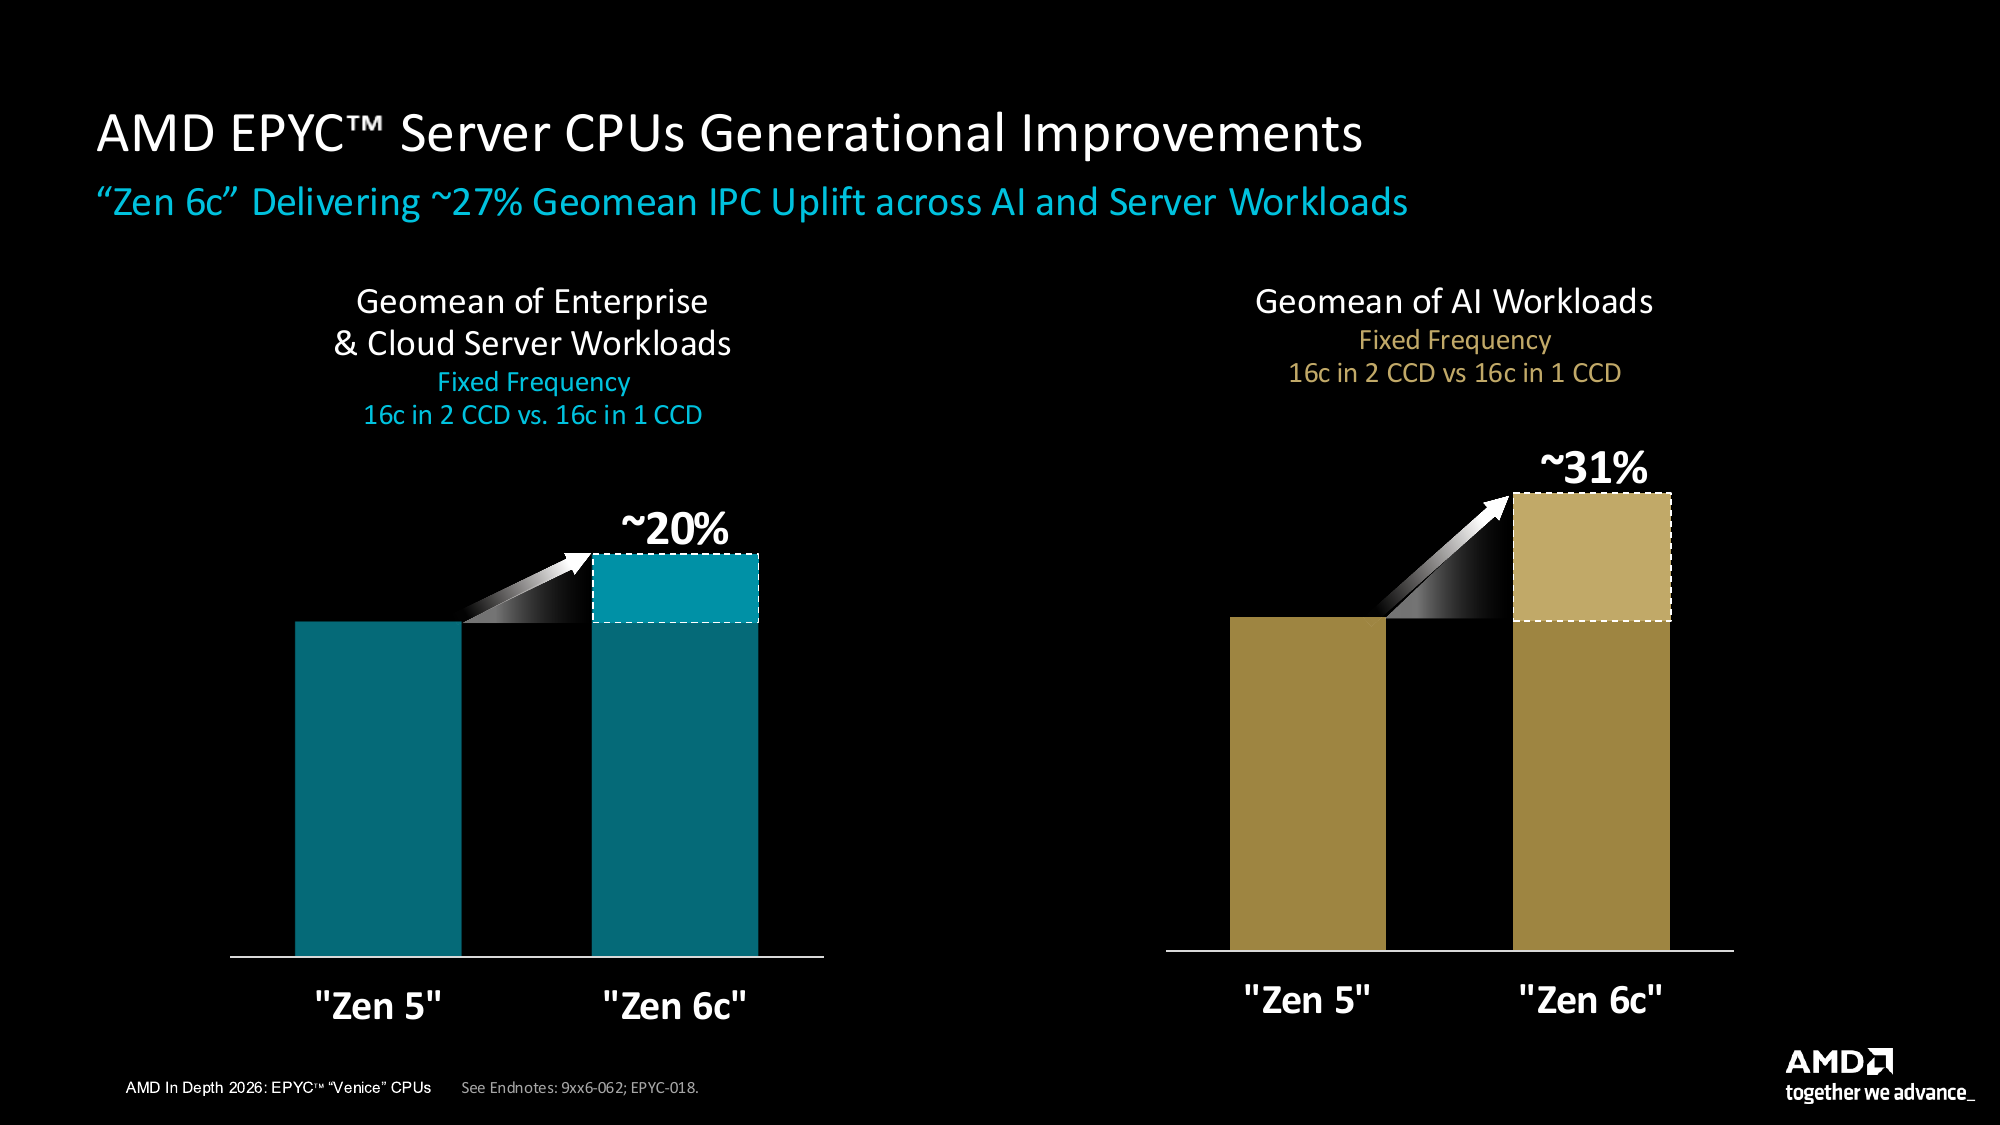
Эта структура важна для того, как AMD формулирует свои заявления о производительности. Главный показатель AMD — это увеличение среднего геометрического значения IPC примерно на 27% для Zen 6c по сравнению с Zen 5 в рабочих нагрузках ИИ и серверных задачах. IPC, или количество инструкций за цикл, описывает, сколько работы выполняет ядро за каждый такт, независимо от частоты. AMD разделяет этот результат на два средних геометрических значения: около 20% для корпоративных и облачных серверных рабочих нагрузок и около 31% для рабочих нагрузок ИИ. AMD подчеркивает, что измерения проводились на фиксированной частоте, сравнивая 16 ядер Zen 5, распределенных по двум CCD, с 16 ядрами Zen 6c в одном CCD.
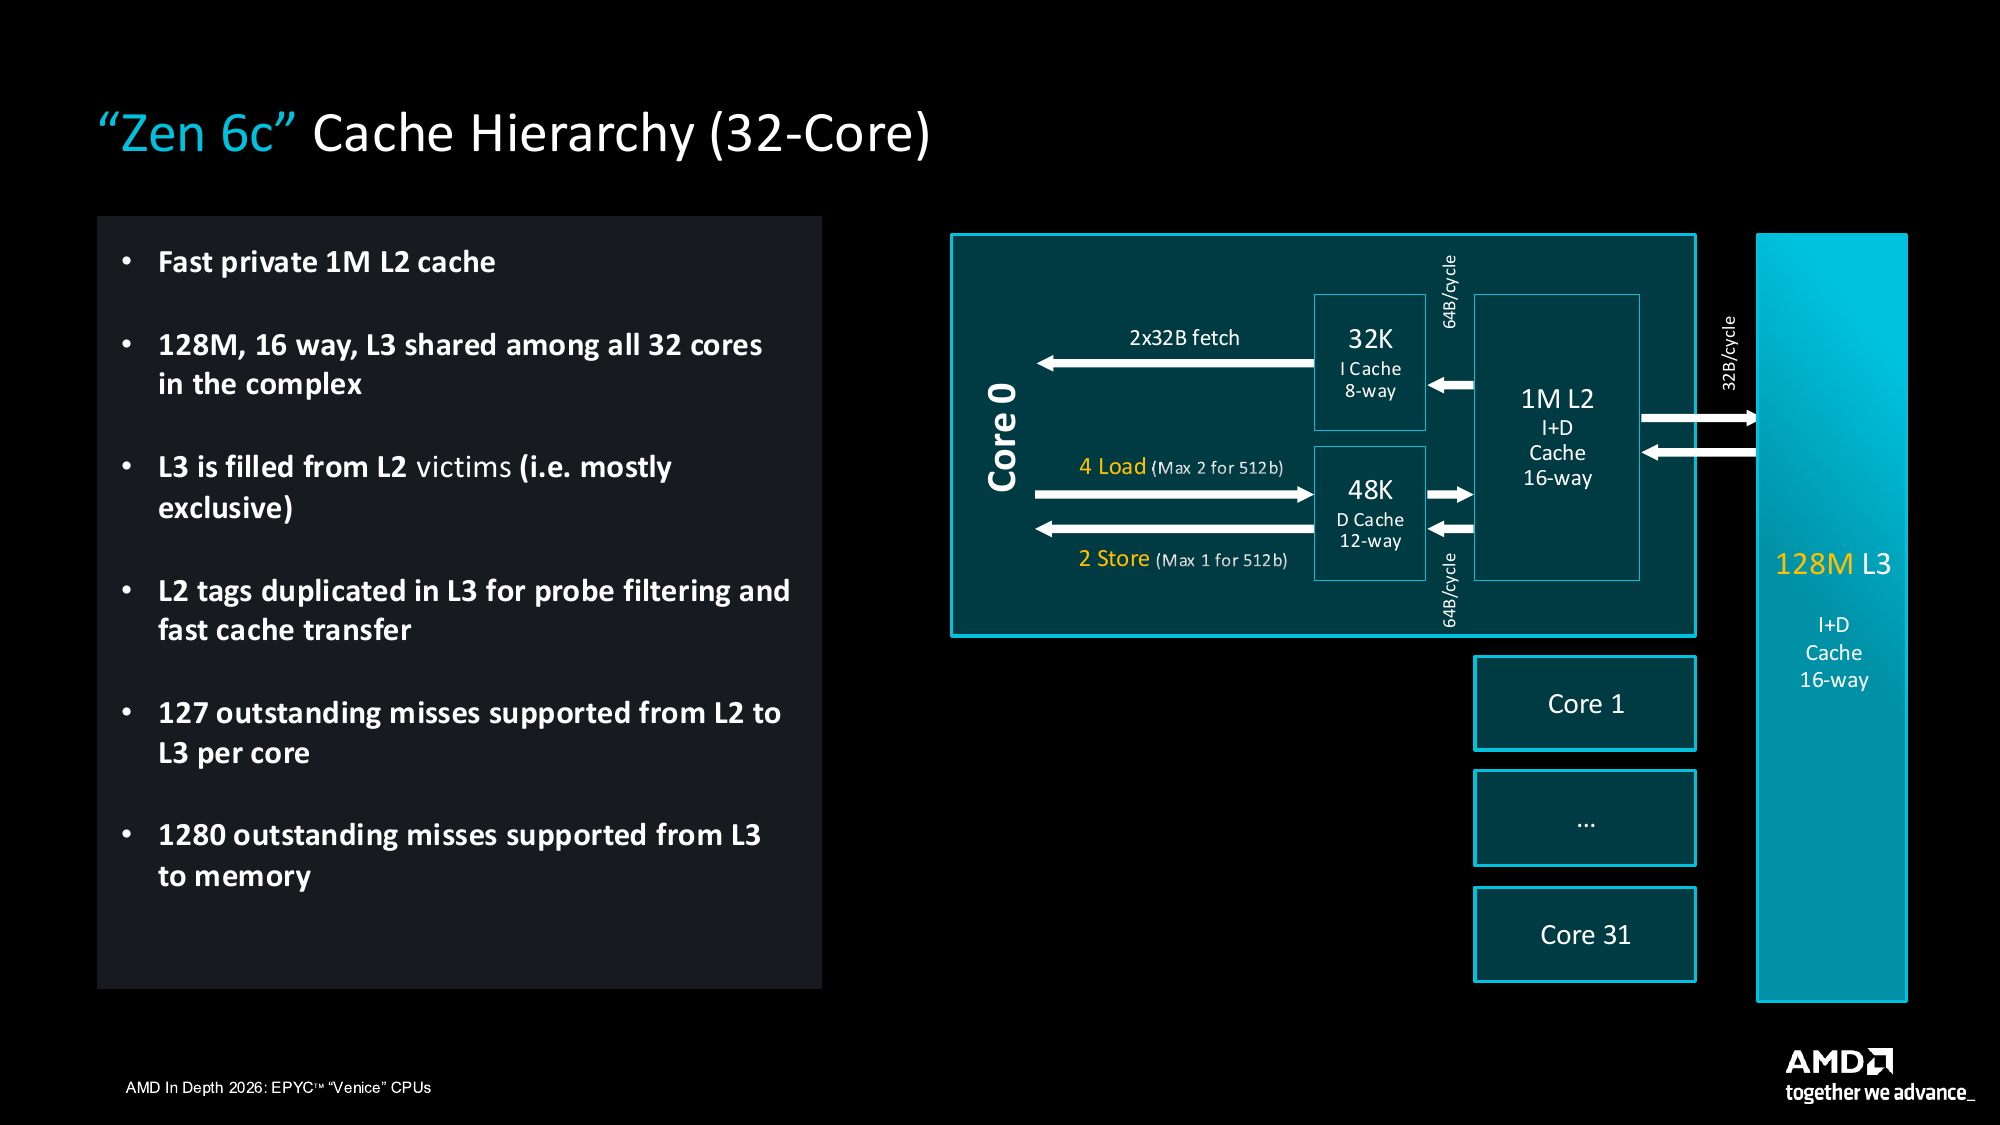
Возвращаясь к исполнительным блокам, каждое ядро Zen 6c имеет 32 КБ 8-канального кэша инструкций L1 и 48 КБ 12-канального кэша данных L1. Ассоциативность описывает, сколько ячеек в кэше может занимать данный адрес памяти; более высокая ассоциативность снижает вероятность того, что два часто используемых фрагмента данных будут вытеснять друг друга. Единственный конкурент текущего поколения, NVIDIA Vera с ядром Olympus, имеет 64 КБ кэша инструкций, 96 КБ кэша данных и 2 МБ частного кэша L2 на ядро.
| Основной ресурс | AMD Дзен 6с | NVIDIA Olympus |
|---|---|---|
| Прогнозирование по принципу "взятой ветви" | До двух окон прогнозирования за цикл; до трех окон прогнозирования за цикл | До двух за цикл |
| Стек адресов возврата | Записи 64 | Не разглашается |
| выборка инструкции L1 | Два потока по 32 байта (64 байта за цикл) | 128 байт за цикл |
| Ширина декодирования | Два четырехполосных декодера | Десятиполосный |
| Кэш декодированных операций | 6.75 тыс. операций; до 18 операций за цикл в очередь. | Не описан эквивалентный путь кэширования операций в стиле x86. |
| Диспетчерская служба / выход на пенсию | Восьмиполосный / восьмиполосный | Распределение/обязательство в масштабе десяти человек |
| Буфер переупорядочивания | Записи 640 | Вместимость не разглашается |
| Целочисленные планировщики | Разделение: 96 общих записей ALU/AGU плюс 48 отдельных записей ALU. | Не разглашается |
| Целочисленные физические регистры | 352 | Не разглашается |
| Целочисленное выполнение | Шесть АЛУ, два умножителя | Восемь простых АЛУ, два сложных АЛУ, два блока CRC |
| Подразделения выполнения филиалов | Три | Четыре |
| Векторное исполнение | 512-битный тракт данных; два конвейера умножения/FMA и два конвейера сложения; четыре конвейера VNNI INT8. | Шесть 128-битных конвейеров SVE2, два из которых используют криптографию. |
| Загрузка/сохранение конвейеров | Четыре загрузочно-складских трубопровода; до четырех загрузок и двух складов за цикл. | Четыре загрузки, два склада |
| Загрузка/сохранение очередей | 80 / 128 записей | Не разглашается |
| Блок передачи данных (TLB) (L1 / L2) | 96 участников / 4 тыс. участников | Не разглашается |
| Кэш инструкций L1 | 32 КБ, 8-канальный | 64 КБ, 4-канальный |
| Кэш данных L1 | 48 КБ, 12-канальный, четырехтактная задержка загрузки | 96 КБ, 6-канальный |
| Частный L2 | 1 МБ, 16-канальный | 2 МБ, 8-канальный |
| Общий кэш последнего уровня | 128 МБ, 16-потоковый, на каждый 32-ядерный CCD-процессор | Системный кэш объемом 164 МБ, распределенный между 88 ядрами. |
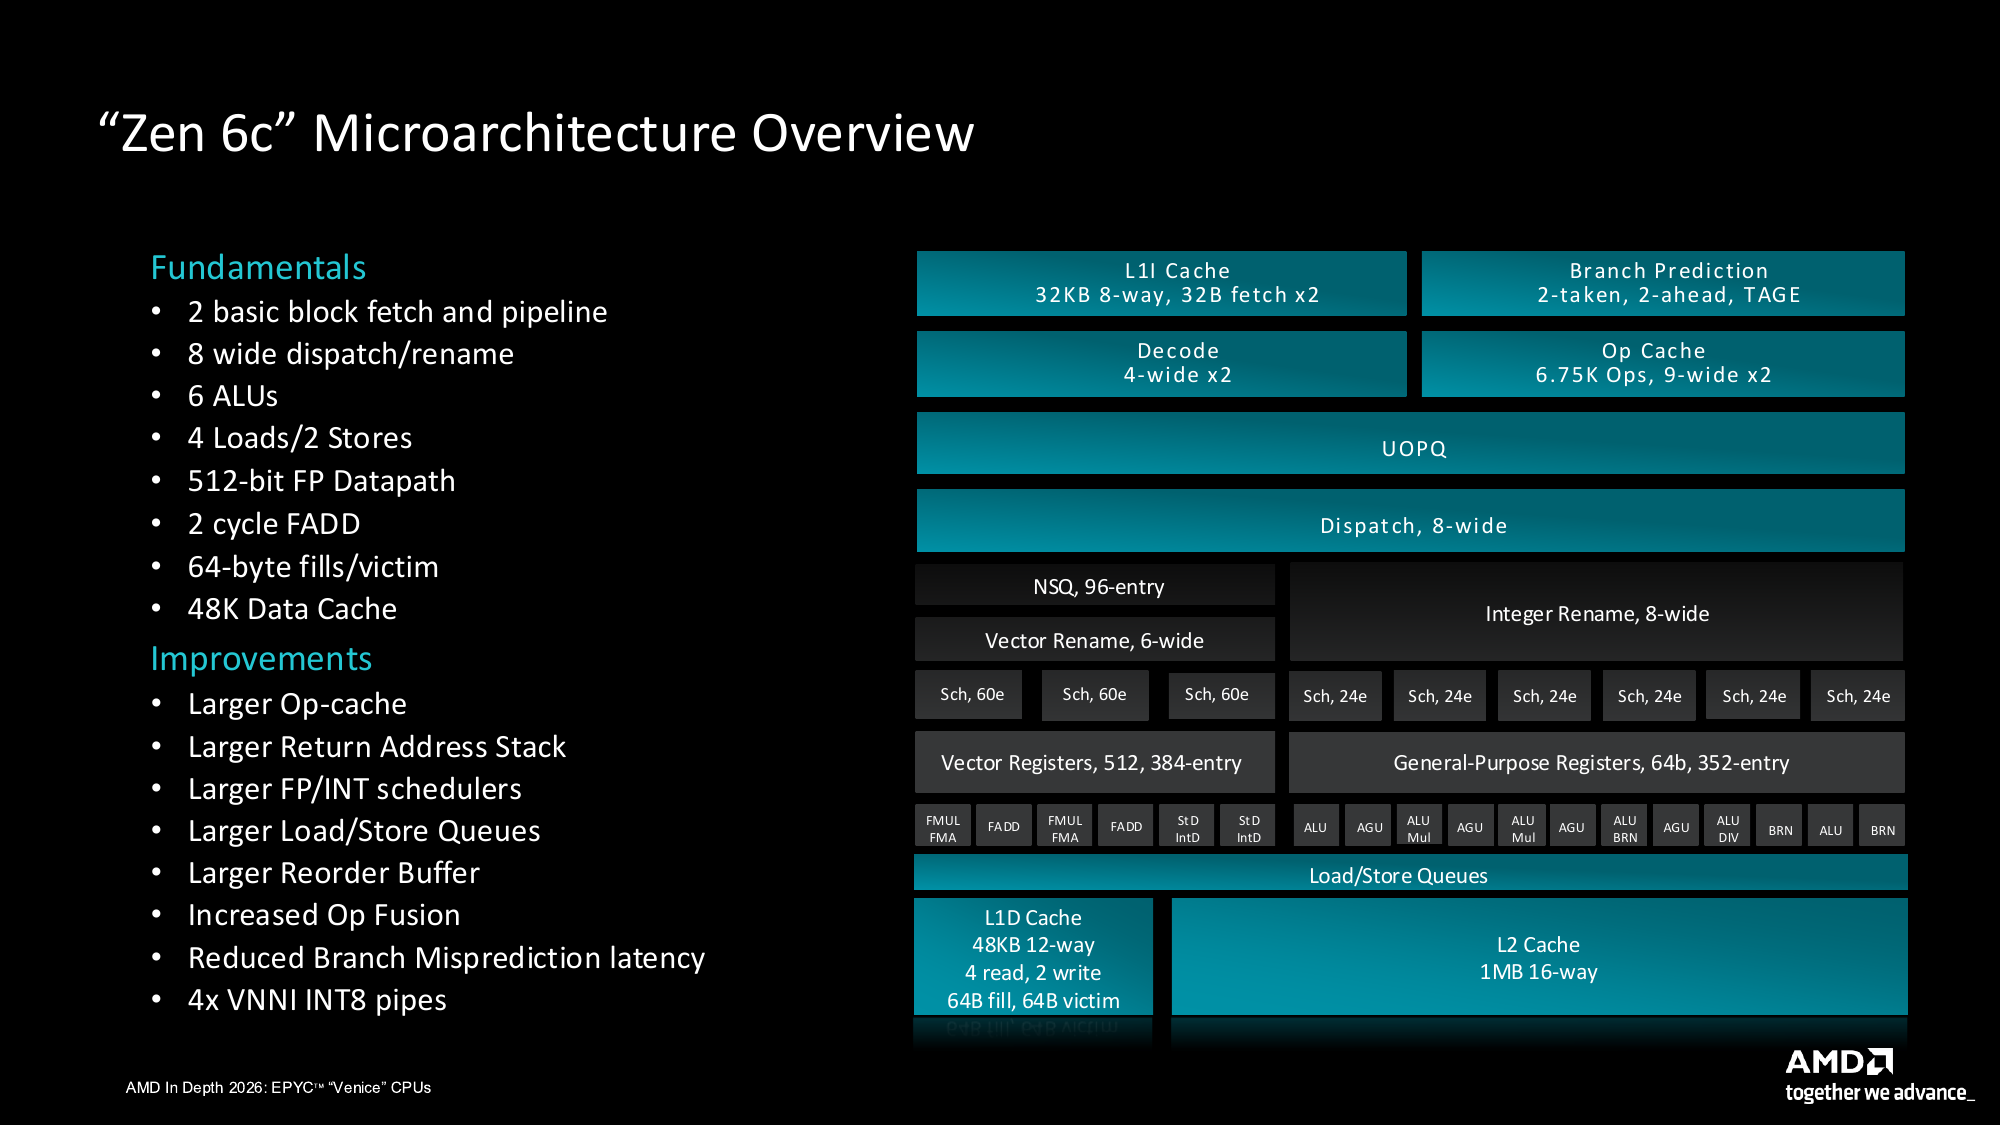
Фронтенд: прогнозирование, получение и декодирование
Фронтенд — это часть ядра, отвечающая за снабжение исполнительного механизма инструкциями. Он предсказывает, куда программа перейдет дальше, извлекает байты инструкций из этого места и декодирует их во внутренние операции, которые ядро может запланировать. Интерпретаторы, системы управления базами данных и большие серверные приложения выполняют эту работу с большими затратами, поскольку их короткие блоки кода часто заканчиваются ветвлениями, которые изменяют следующий адрес выборки. Выбранное ветвление отправляет выполнение к целевому адресу, в то время как невыбранное ветвление продолжает выполнение последующих инструкций. Каждый раз, когда фронтенд ошибается в предположении, работа, выбранная по неправильному пути, должна быть отброшена.
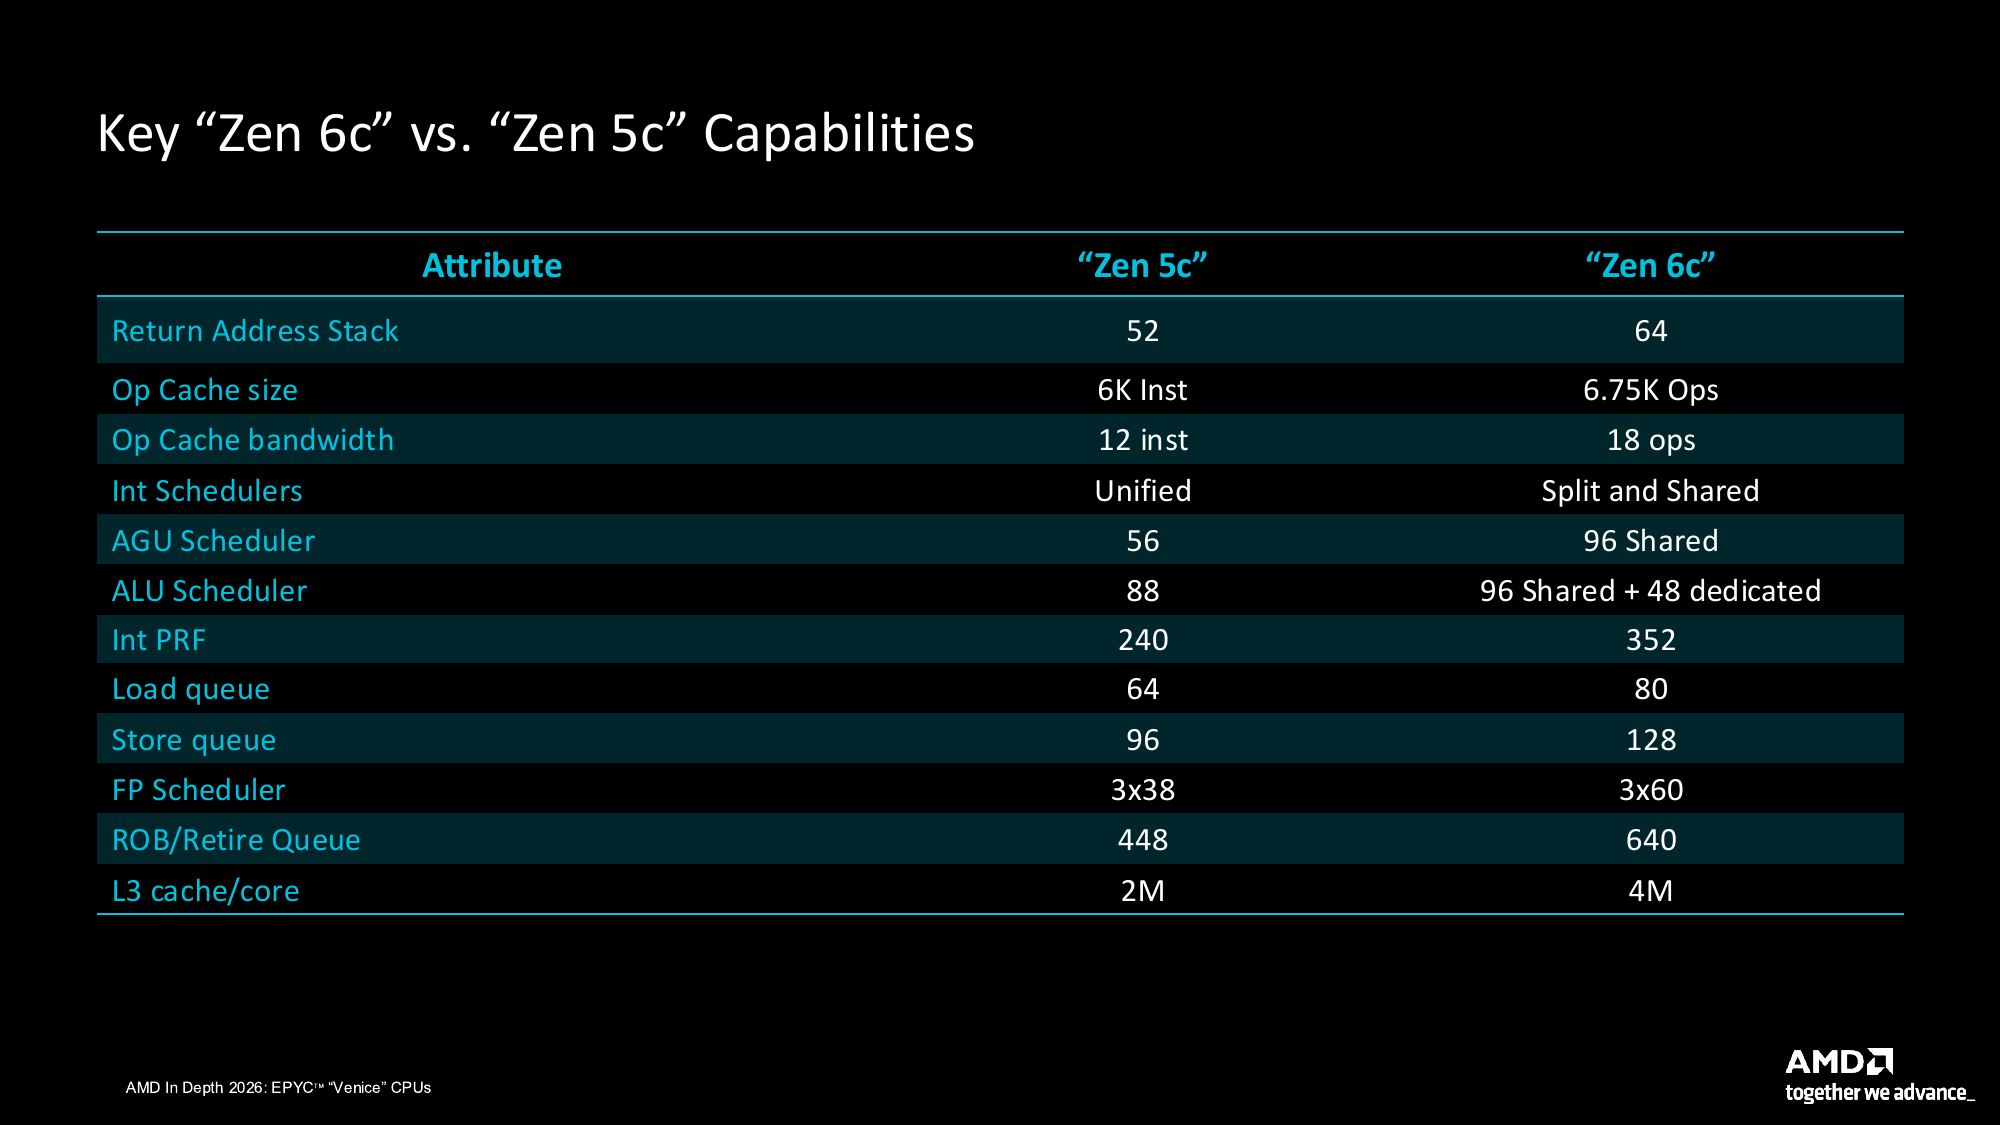
Для точного прогнозирования Zen 6c использует алгоритм предсказания TAGE, и AMD заявляет, что её таблицы предсказаний были оптимизированы для Zen 6, а очереди предсказания ветвлений увеличены. Алгоритм может выдавать два предварительных предсказания за цикл и до трёх окон предсказания за цикл. Стек адресов возврата, состоящий из 64 элементов (вместо 52 в Zen 5c), отслеживает, куда должны возвращаться вызовы функций.
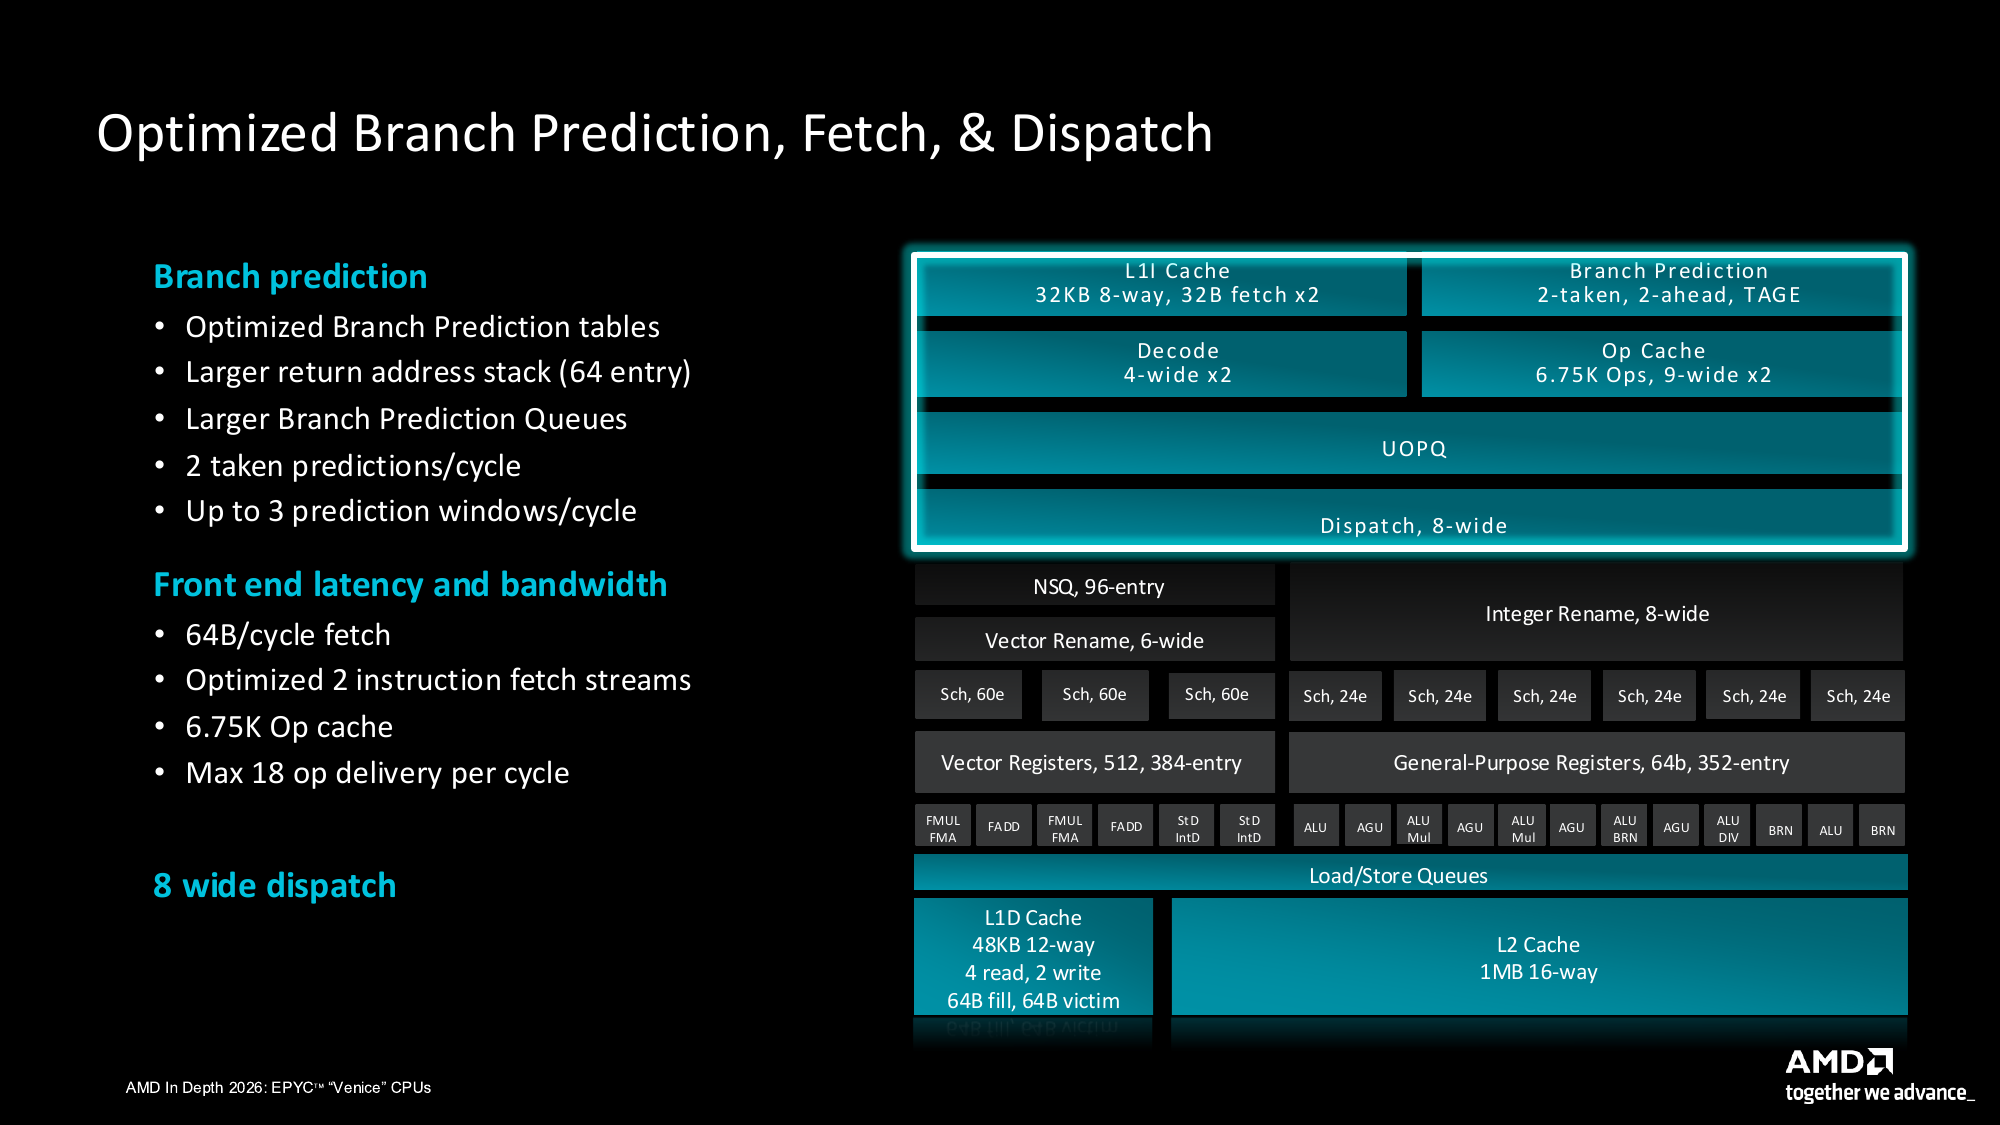
Ядро следует предсказанному маршруту и восстанавливается, если предсказание оказывается неверным, и, по словам AMD, Zen 6 сокращает это восстановление за счет уменьшения задержки, связанной с ошибочным предсказанием ветвления. Vera достигает предела в два выполненных ветвления за цикл благодаря нейронному предсказателю и специализированным механизмам предсказания. Таким образом, обе архитектуры могут прогнозировать более одного перенаправления за цикл, что помогает поддерживать скорость доставки инструкций в соответствии с кодом, который часто меняет направление.
После того, как путь предсказан, должны поступить байты инструкций. Zen 6c передает два потока выборки по 32 байта, всего 64 байта за цикл, из своего 32-килобайтного кэша инструкций L1 в парные четырехканальные декодеры. Olympus выбирает 128 байт за цикл и использует десятиканальный декодер, что дает Vera более широкий путь выборки и декодирования. Два набора инструкций кодируют работу по-разному: инструкции x86 различаются по длине и могут выполнять больший объем работы за инструкцию, в то время как инструкции Arm имеют фиксированную длину. Таким образом, эти ширины описывают объем предоставляемых инструкций и не определяют соотношение между пропускной способностью приложения на двух ядрах.
AMD также оснастила Zen 6c кэшем операций объемом 6.75 тыс. операций (по сравнению с 6 тыс. в Zen 5c), в котором хранится ранее декодированная работа. Декодирование x86 — одна из самых энергоемких задач в ядре, поэтому пропуск этой задачи очень важен. Попадание в кэш операций напрямую пополняет очередь операций, исключая повторное декодирование.
Кэш может передавать в эту очередь до 18 операций за цикл, вместо прежних 12, что значительно опережает этап диспетчеризации с восемью операциями. Горячие циклы позволяют повторно использовать эти операции, освобождая декодеры от необходимости перестраивать одну и ту же работу при каждом проходе. AMD также улучшила слияние операций в Zen 6, объединив определенные пары операций в одну, чтобы они занимали меньше места в очередях.
Планирование и целочисленное выполнение
После фронтенда ядро выполняет поток операций в порядке следования программ, но нет правила, обязывающего их выполняться именно в таком порядке. Внеочередное выполнение позволяет ядру запускать любую операцию, входные данные которой готовы, даже если более старые инструкции все еще ожидают. Для обеспечения безопасности ядро сначала выполняет переименование регистров. Программы многократно используют небольшой набор архитектурных имен регистров; переименование сопоставляет каждое новое значение с одним из гораздо большего пула физических регистров, поэтому независимые инструкции, которые случайно используют одно и то же имя, не должны ждать друг друга.
В Zen 6c восьмиканальный этап переименования и диспетчеризации обрабатывает данные из 352 целочисленных физических регистров, по сравнению с 240 в Zen 5c. Буфер переупорядочивания на 640 записей, по сравнению с 448, отслеживает каждую выполняемую операцию. Буфер переупорядочивания — это структура учета, которая позволяет операциям завершаться вне порядка, в то время как ядро продолжает фиксировать результаты в исходном порядке программы. Его размер определяет, насколько далеко вперед от зависшей инструкции ядро может искать независимую работу.
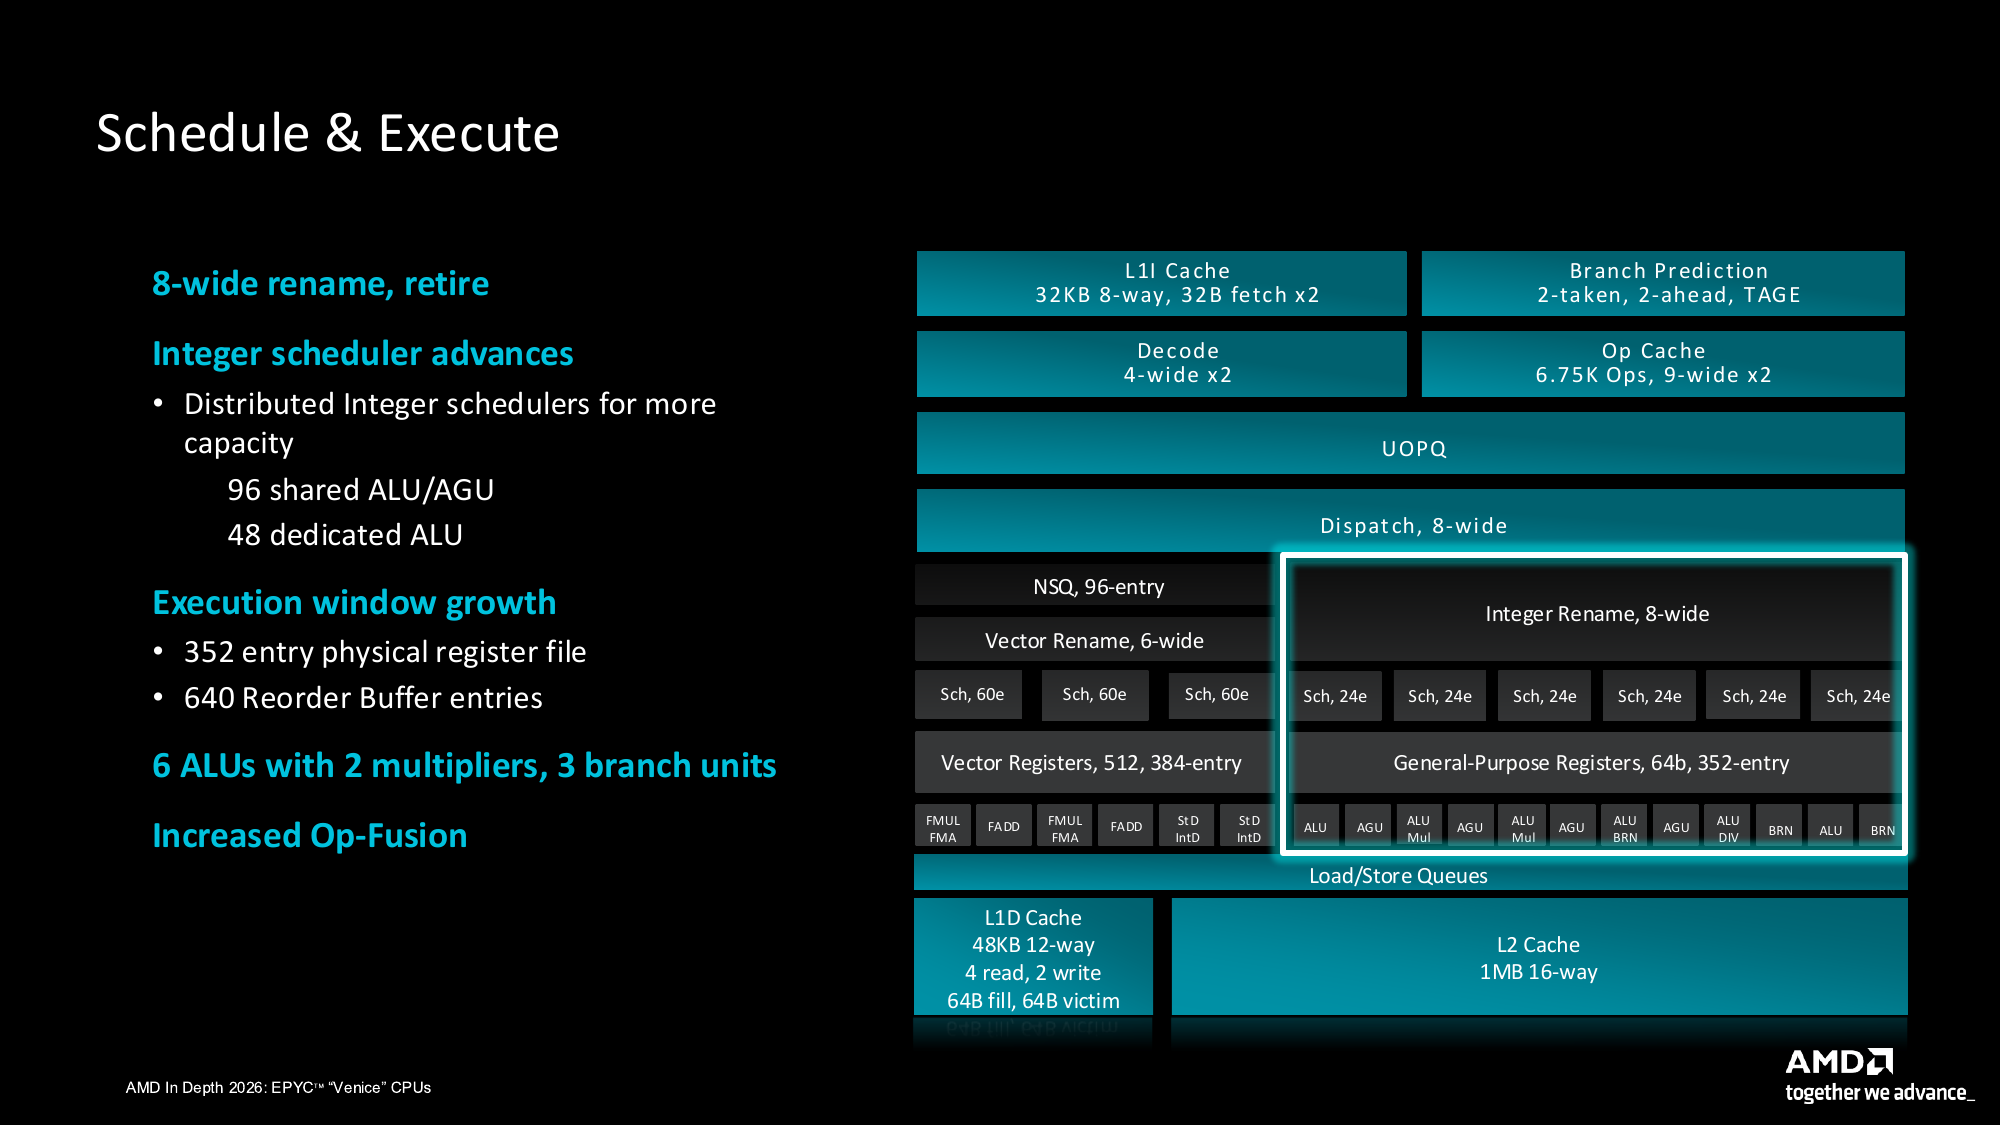
Между блоками диспетчеризации и исполнительными блоками находятся планировщики, которые удерживают операции до тех пор, пока не будут готовы их входные данные. Здесь AMD внесла структурные изменения: в Zen 5 использовался унифицированный целочисленный планировщик, а в Zen 6 он разделен: 96 записей, разделяемых между арифметическими операциями (АЛУ) и генерацией адресов (ГАУ), плюс 48 записей, предназначенных для операций АЛУ. В Zen 5c было 88 записей АЛУ и 56 записей ГАУ. AMD также увеличила количество планировщиков операций с плавающей запятой, и в результате общая пропускная способность планирования возросла, так что больше операций могут ожидать своих входных данных, не задерживая диспетчеризацию.
Это окно планирования позволяет, например, рабочему процессу базы данных перекрывать независимые операции поиска или продолжать арифметические вычисления, пока более ранняя загрузка ожидает данных. Olympus использует выделение памяти шириной в десять ячеек для обеспечения работы своего исполнительного механизма и добавляет прогнозирование значений и переименование памяти для облегчения продвижения по зависимостям.
В процессоре Zen 6c целочисленный механизм включает шесть АЛУ, два целочисленных умножителя и три блока выполнения ветвлений. Эти блоки определяют фактический результат каждой ветви после того, как фронтенд уже предсказал путь. Olympus имеет четыре блока выполнения ветвлений, а также более широкий механизм выделения и фиксации ресурсов. Эти ресурсы используются для обработки различных частей инструкций, поскольку предсказание ветви на ранней стадии и её разрешение во время выполнения — это отдельные задачи.
Выполнение вектора
Векторные, или SIMD, инструкции применяют одну операцию ко многим элементам данных одновременно, что делает их центральными для численных вычислений, сжатия, обработки мультимедиа и, все чаще, для вывода данных в рамках искусственного интеллекта. Собственный 512-битный векторный движок AMD возвращается как в Zen 6, так и в Zen 6c, что означает, что одна инструкция AVX-512 работает со всем 512-битным регистром за один проход, без разделения на две части. Аппаратное обеспечение включает в себя два конвейера умножения/FMA, два конвейера сложения и четыре конвейера VNNI INT8, что вдвое больше, чем два в Zen 5.
Самое значительное изменение — это полная арифметика AVX-512 FP16: Zen 5 мог преобразовывать только значения половинной точности, а Zen 6 выполняет вычисления непосредственно над ними. Для программного обеспечения, способного использовать арифметику половинной точности, 512-битный вектор содержит 32 значения FP16 и шестнадцать значений FP32.
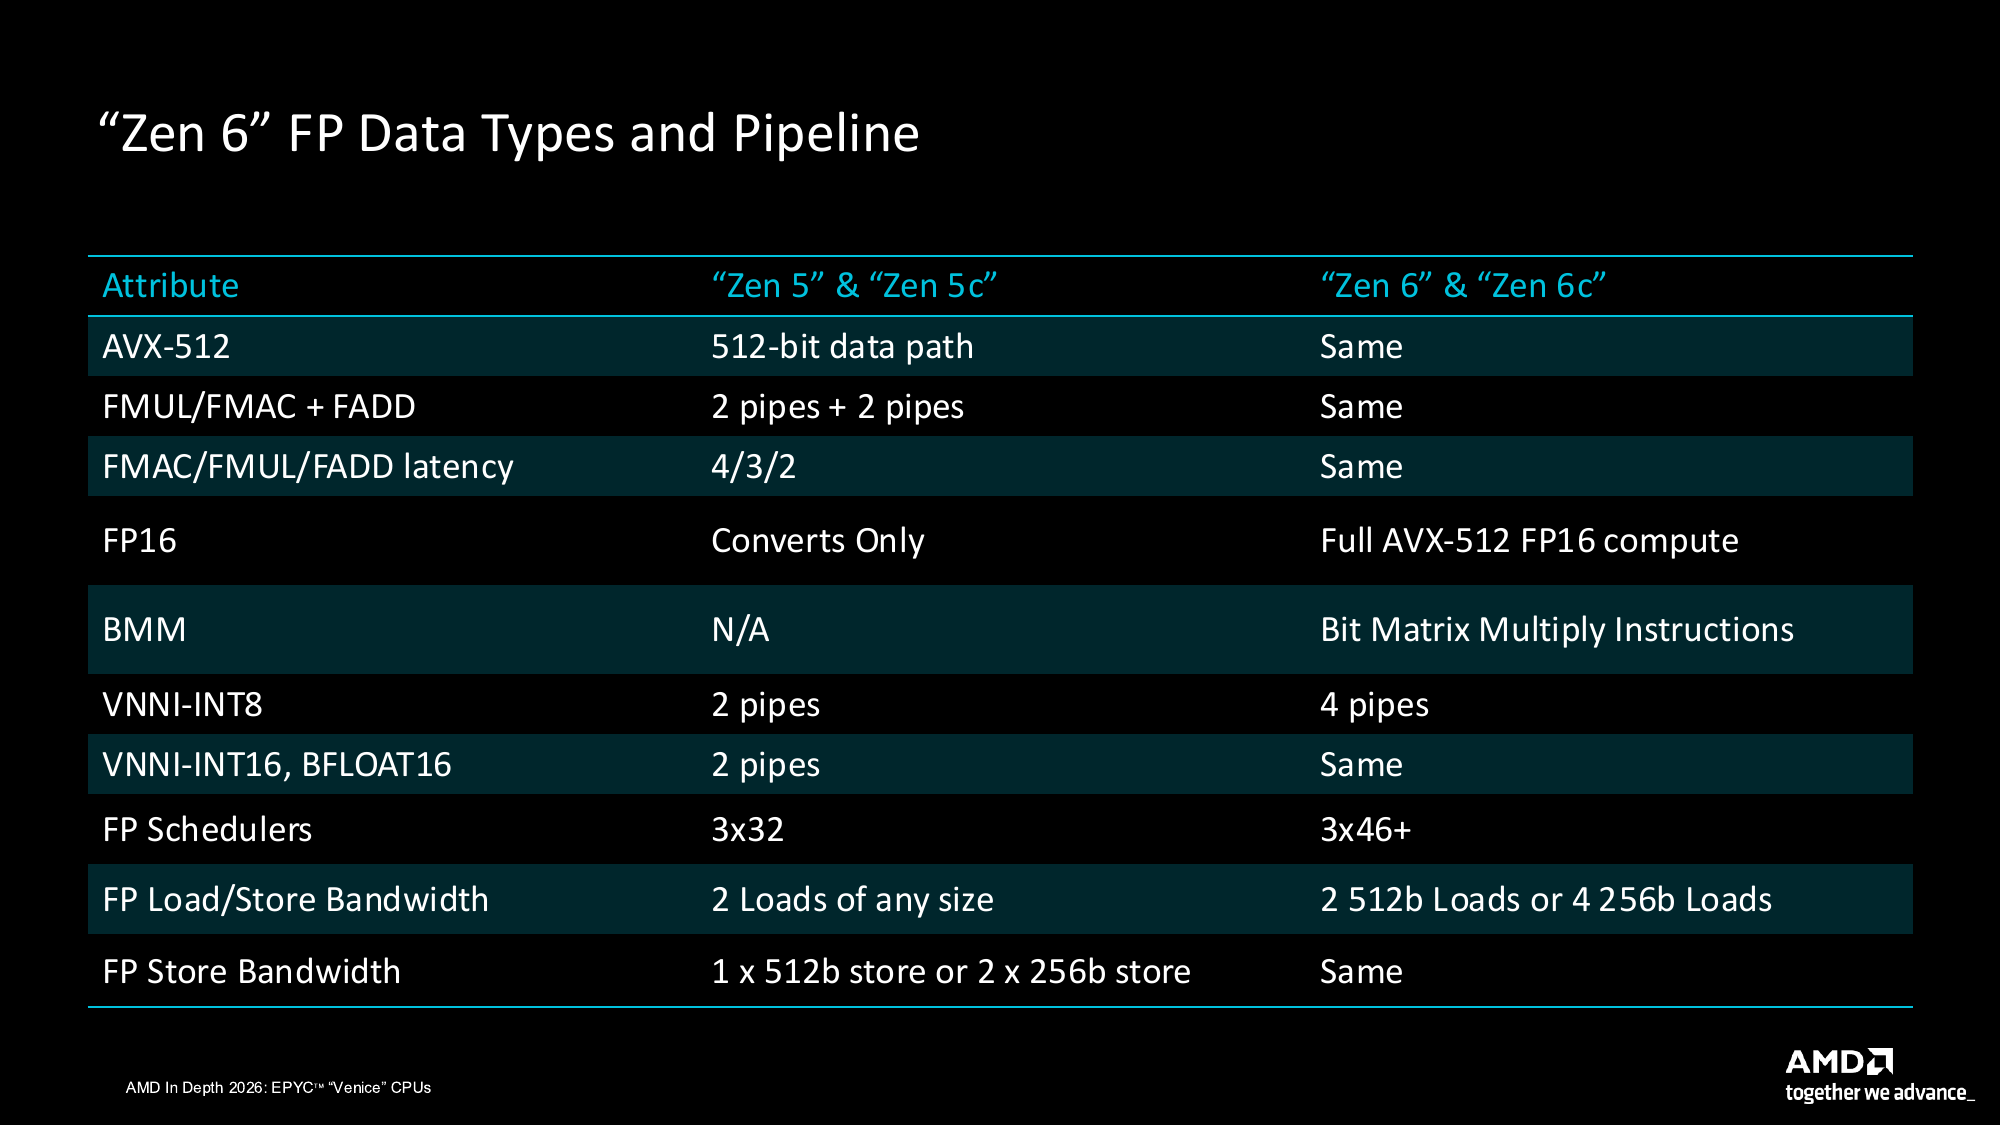
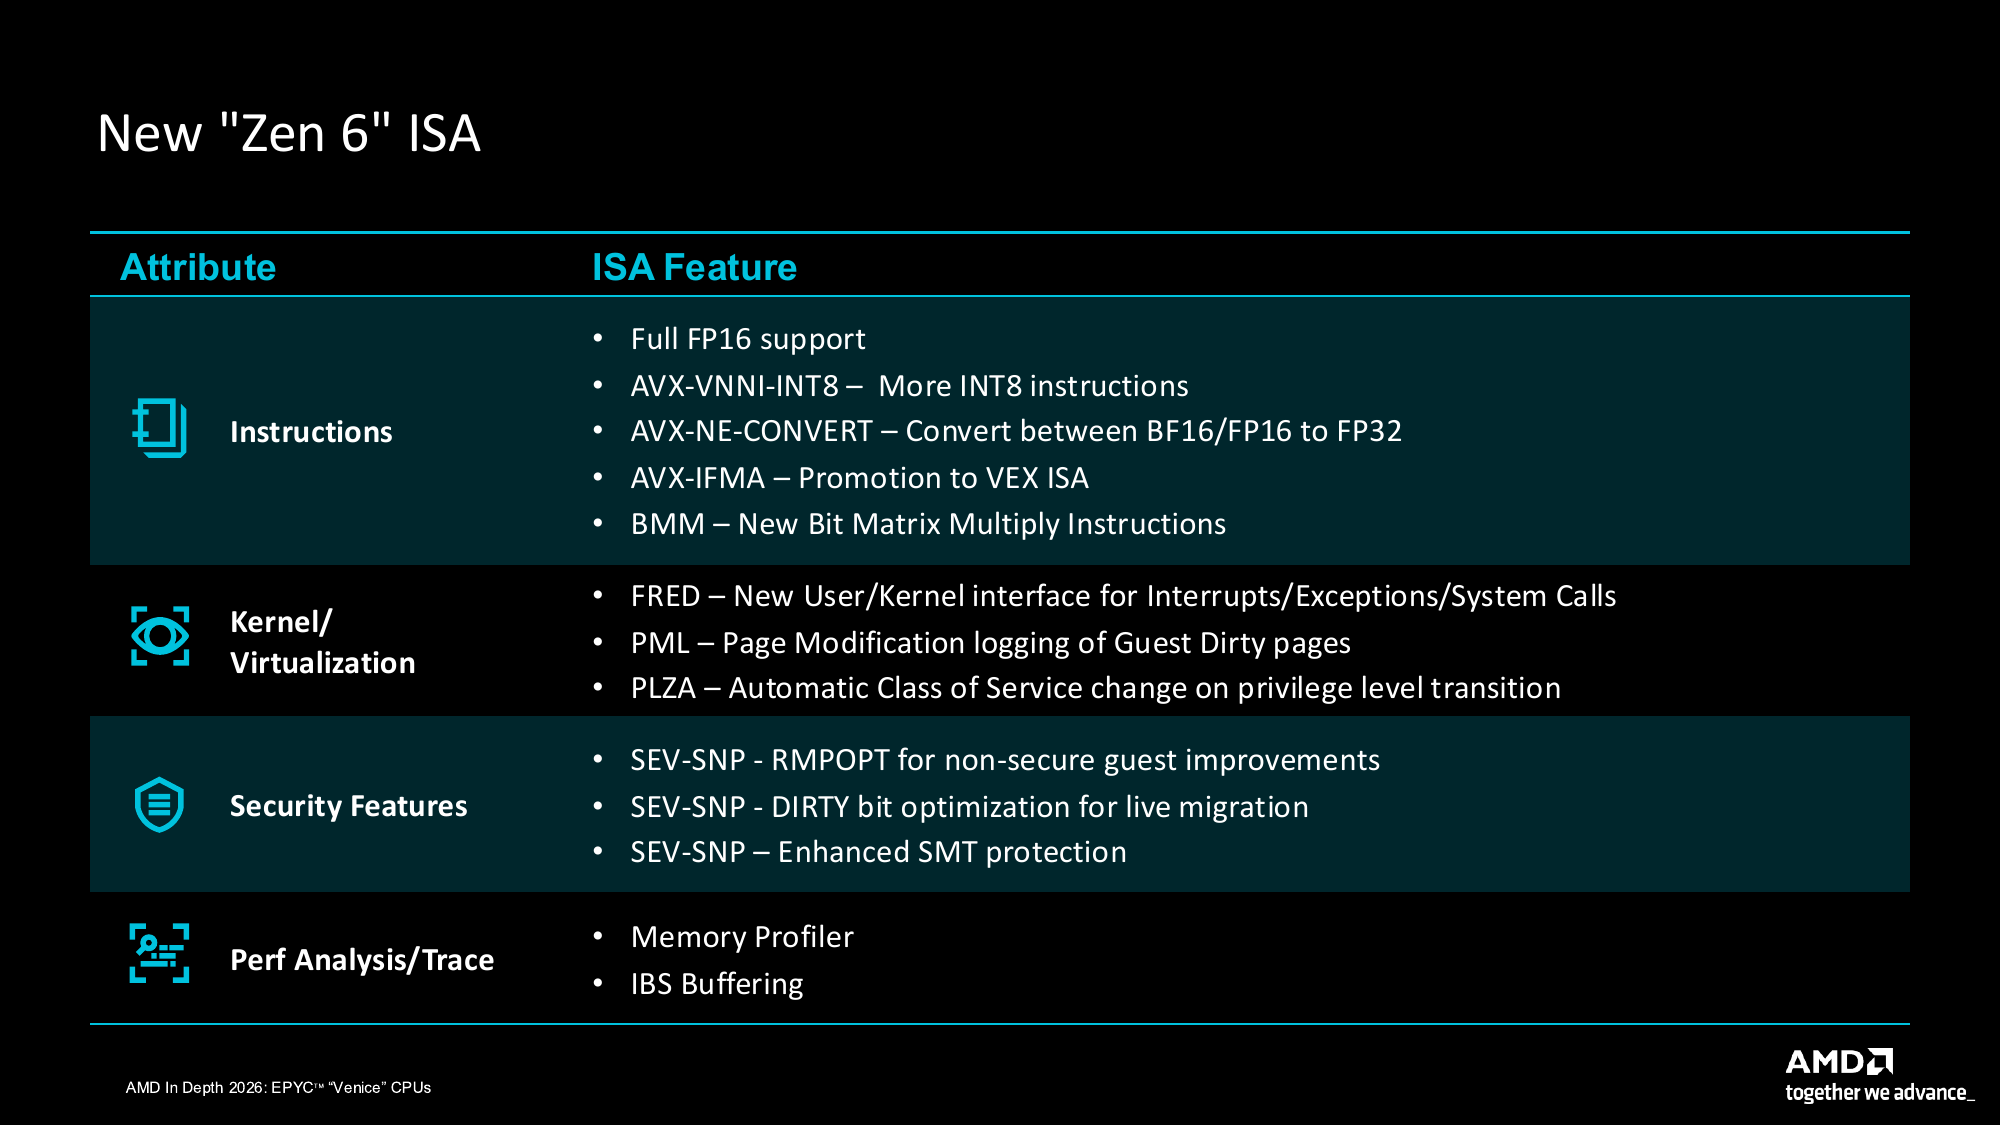
Zen 6 добавляет несколько других расширений набора инструкций, ориентированных на те же рабочие нагрузки: AVX-512 BMM, новый набор инструкций умножения битовых матриц; AVX-VNNI-INT8, дополнительные инструкции скалярного произведения INT8 в кодировке VEX; AVX-NE-CONVERT, для преобразования значений BF16 и FP16 в FP32; и AVX-IFMA, целочисленное объединенное умножение-сложение, переведенное в кодировку VEX. Существующая поддержка AVX-512, включая BF16 и VNNI-INT16, перенесена из Zen 5. Для использования этих расширений программному обеспечению необходима поддержка компилятора и библиотек.
Vera использует другой подход, имея шесть 128-битных исполнительных блоков SVE2 и поддержку FP8. Venice обладает более широкими собственными векторами, в то время как Vera имеет шесть более узких блоков, доступных для обработки инструкций SIMD. Полезность сравнения зависит от арифметических задач, необходимых для рабочей нагрузки: вычисления FP16, скалярные произведения INT8 и операции FP8 используют разные инструкции и предъявляют разные требования к аппаратному обеспечению.
Обе разработки предусматривают двухтактную задержку для сложения чисел с плавающей запятой. Это важно, когда каждое сложение требует результата предыдущего, поскольку широкому векторному движку все равно приходится ждать этих зависимостей. Векторный поиск и численные задачи могут выиграть от ширины Venice, если их код обеспечивает достаточное количество параллельных операций и использует типы данных, подходящие для доступных конвейеров, и наши результаты GROMACS ниже показывают, как это выглядит на практике.
Загрузка, хранение и обеспечение бесперебойной передачи данных.
Скорость 512-битного векторного процессора зависит от скорости поступающих к нему данных, и эта задача ложится на блок загрузки/сохранения. Zen 6c имеет четыре конвейера загрузки/сохранения, которые могут обрабатывать до четырех операций загрузки и двух операций сохранения за цикл. Для векторного кода это означает две 512-битные или четыре 256-битные операции загрузки за цикл, тогда как Zen 5 обрабатывал две операции загрузки любого размера, а также одну 512-битную или две 256-битные операции сохранения, в зависимости от комбинации инструкций.
Очередь загрузки на 80 записей и очередь сохранения на 128 записей (в отличие от 64 и 96 в Zen 5c) обеспечивают обработку запросов, наряду с масштабируемой очередью упорядочивания загрузки. Загрузка, попадающая в кэш данных L1, имеет заданную задержку в четыре такта, а обмен данными между L1 и L2 происходит по пути заполнения и получения данных со скоростью 64 байта за такт.
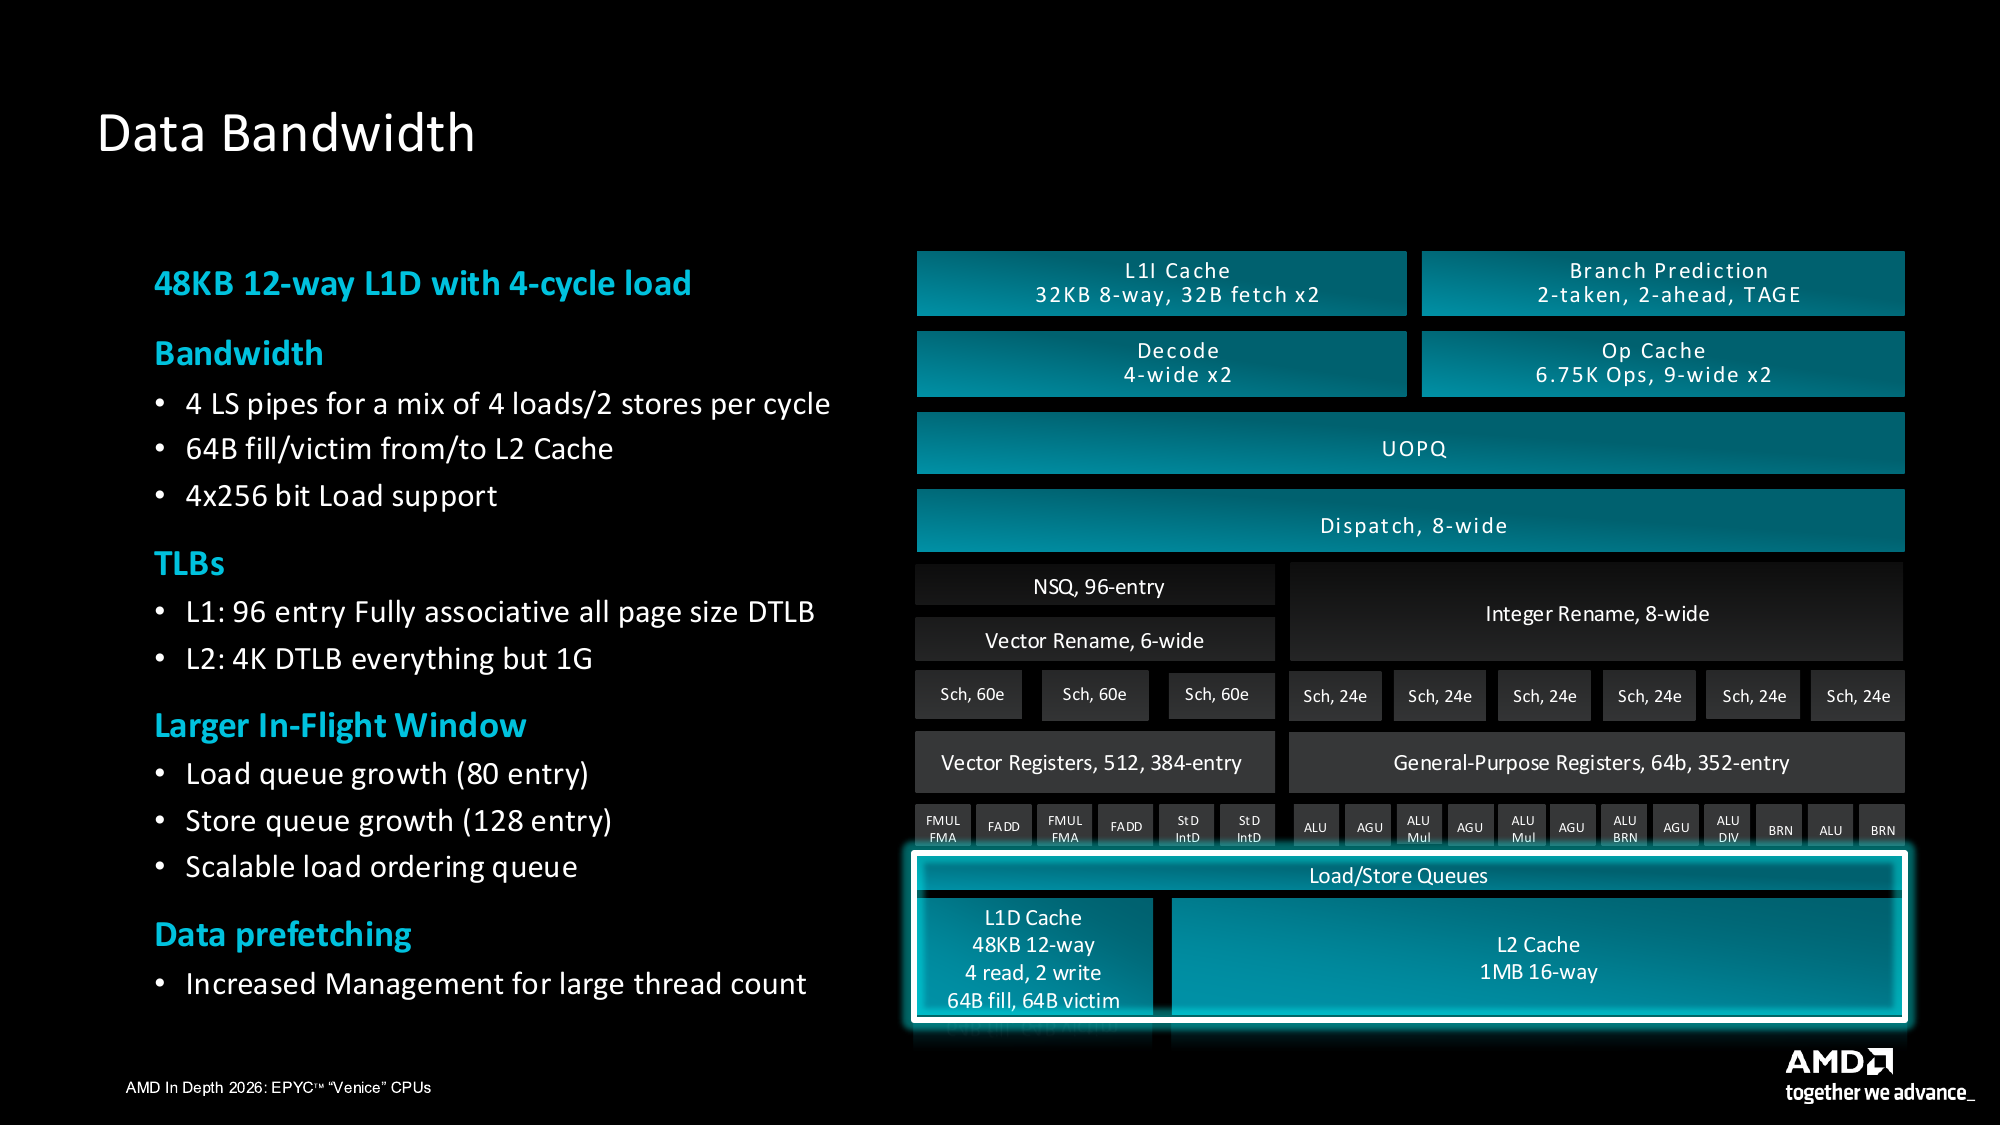
При каждой загрузке виртуальный адрес также преобразуется в физический, а буферы трансляции адресов (TLB) кэшируют эти преобразования, чтобы ядру не приходилось просматривать таблицы страниц при каждом обращении. Zen 6 имеет 96-записный L1-буфер данных, поддерживаемый 4K-записным L2-буфером данных, который охватывает все размеры страниц, кроме страниц размером 1 ГБ. Крупные базы данных в оперативной памяти и аналитические системы с разрозненными шаблонами доступа в значительной степени полагаются на охват TLB.
Эти очереди позволяют ядру перекрывать независимые обращения к памяти. Отслеживание цепочки указателей сложнее, поскольку одна операция загрузки должна завершиться до того, как станет известен следующий адрес. Ядро Olympus в Vera решает часть этой задачи с помощью механизма предварительной выборки графов, который распознает такие шаблоны, как A[B[i]], где индекс, полученный из одного массива, определяет необходимый элемент из другого, давая оборудованию возможность получить это второе значение раньше, чем потребуется.
Промах в кэше L1 отправляет запрос дальше по иерархии кэша. 16-канальный частный кэш L2 ядра и общий кэш L3 его CCD предоставляют следующие возможности для поиска данных, при этом запросы проходят через микросхему ввода-вывода, когда им необходимо достичь памяти. Именно здесь схема чиплетной архитектуры Venice начинает влиять на то, как долго ядро ожидает свои операнды. Тем временем ядро продолжает выполнять независимые операции в произвольном порядке, чтобы поддерживать свою занятость. Завершенные инструкции затем завершаются в порядке выполнения программы, чтобы программное обеспечение видело ожидаемую последовательность результатов; Zen 6c имеет восьмиканальный этап завершения, в то время как Olympus имеет десятиканальный этап фиксации.
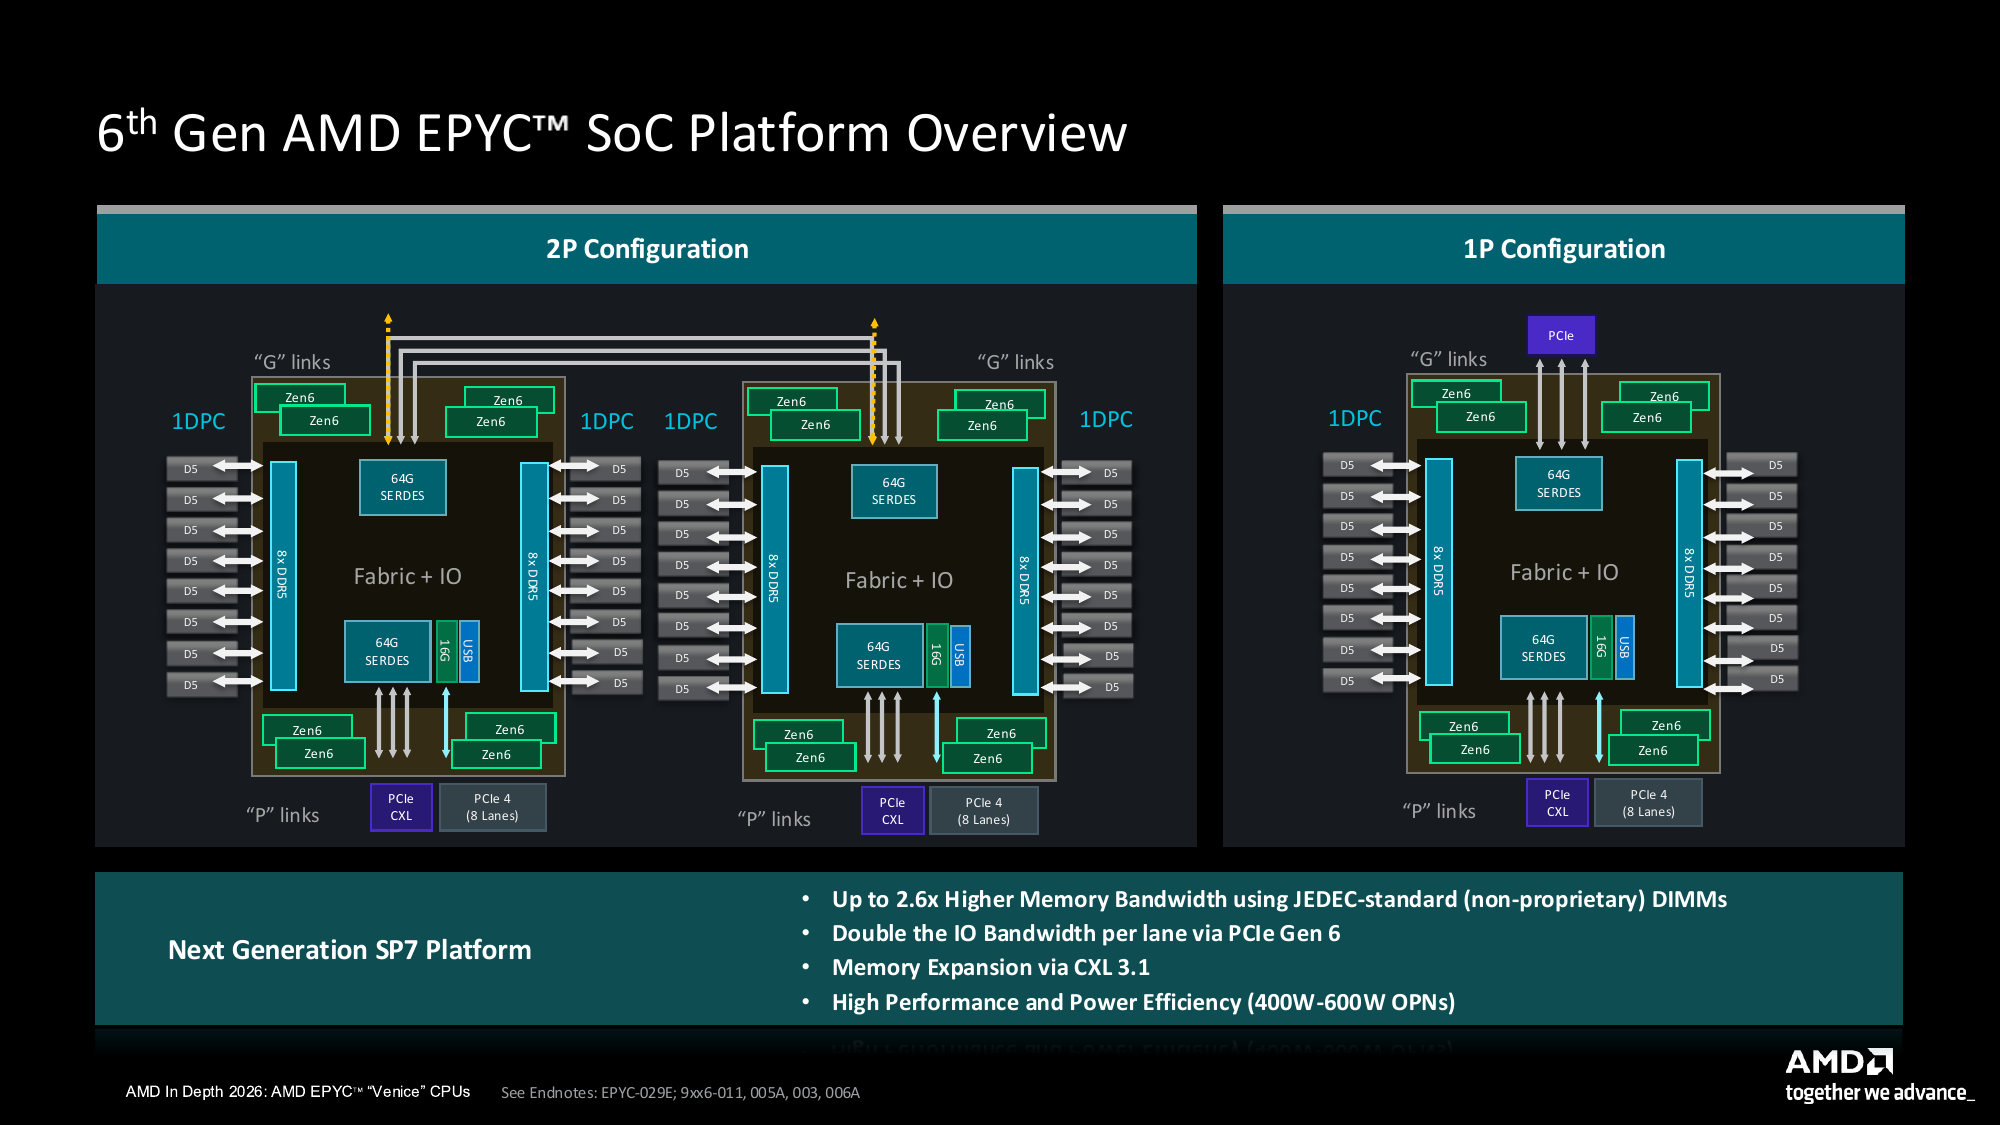
Два модуля ввода/вывода и шестнадцать каналов памяти.
Помимо ПЗС-матриц, ядрам необходим способ связи с памятью, устройствами и друг с другом. Во всех процессорах EPYC, начиная с Rome, эта задача выполнялась отдельным чипом ввода-вывода (IOD), а в Venice она разделена между двумя. Каждый IOD содержит восемь каналов памяти DDR5, 48 линий SerDes со скоростью 64 Гбит/с и восемь линий более медленных SerDes со скоростью 16 Гбит/с для вспомогательного ввода-вывода. SerDes, сокращение от serializer/deserializer (сериализатор/десериализатор), — это высокоскоростной приемопередатчик, передающий трафик PCIe, CXL и межсокетный трафик.
В полноразмерном корпусе с восемью ПЗС-матрицами к каждому IOD крепятся четыре ПЗС-матрицы, причем две IOD-матрицы представляют собой идентичные кристаллы, повернутые на 180 градусов относительно друг друга. Они используют 6-нм техпроцесс, в то время как ПЗС-матрицы переведены на 2-нм техпроцесс, поскольку аналоговые схемы ввода-вывода мало выигрывают от новейших технологических узлов.
Изменился и способ взаимодействия чиплетов друг с другом. AMD использует мосты с увеличенным разветвлением (EFB) для связи между кристаллами, стремясь снизить энергопотребление и задержку передачи данных. В предыдущих поколениях EPYC использовались последовательные соединения между кристаллами через органическую подложку корпуса. EFB размещает небольшой плотный мост под краями кристалла, что позволяет создавать гораздо больше коротких и широких соединений. AMD утверждает, что это снижает энергопотребление на бит и высвобождает энергию для ядер. В этих соединениях используется архитектура Infinity Fabric пятого поколения от AMD, которая также обеспечивает более быстрые изменения состояния энергопотребления, позволяя межсоединению снижать энергопотребление при низкой нагрузке.
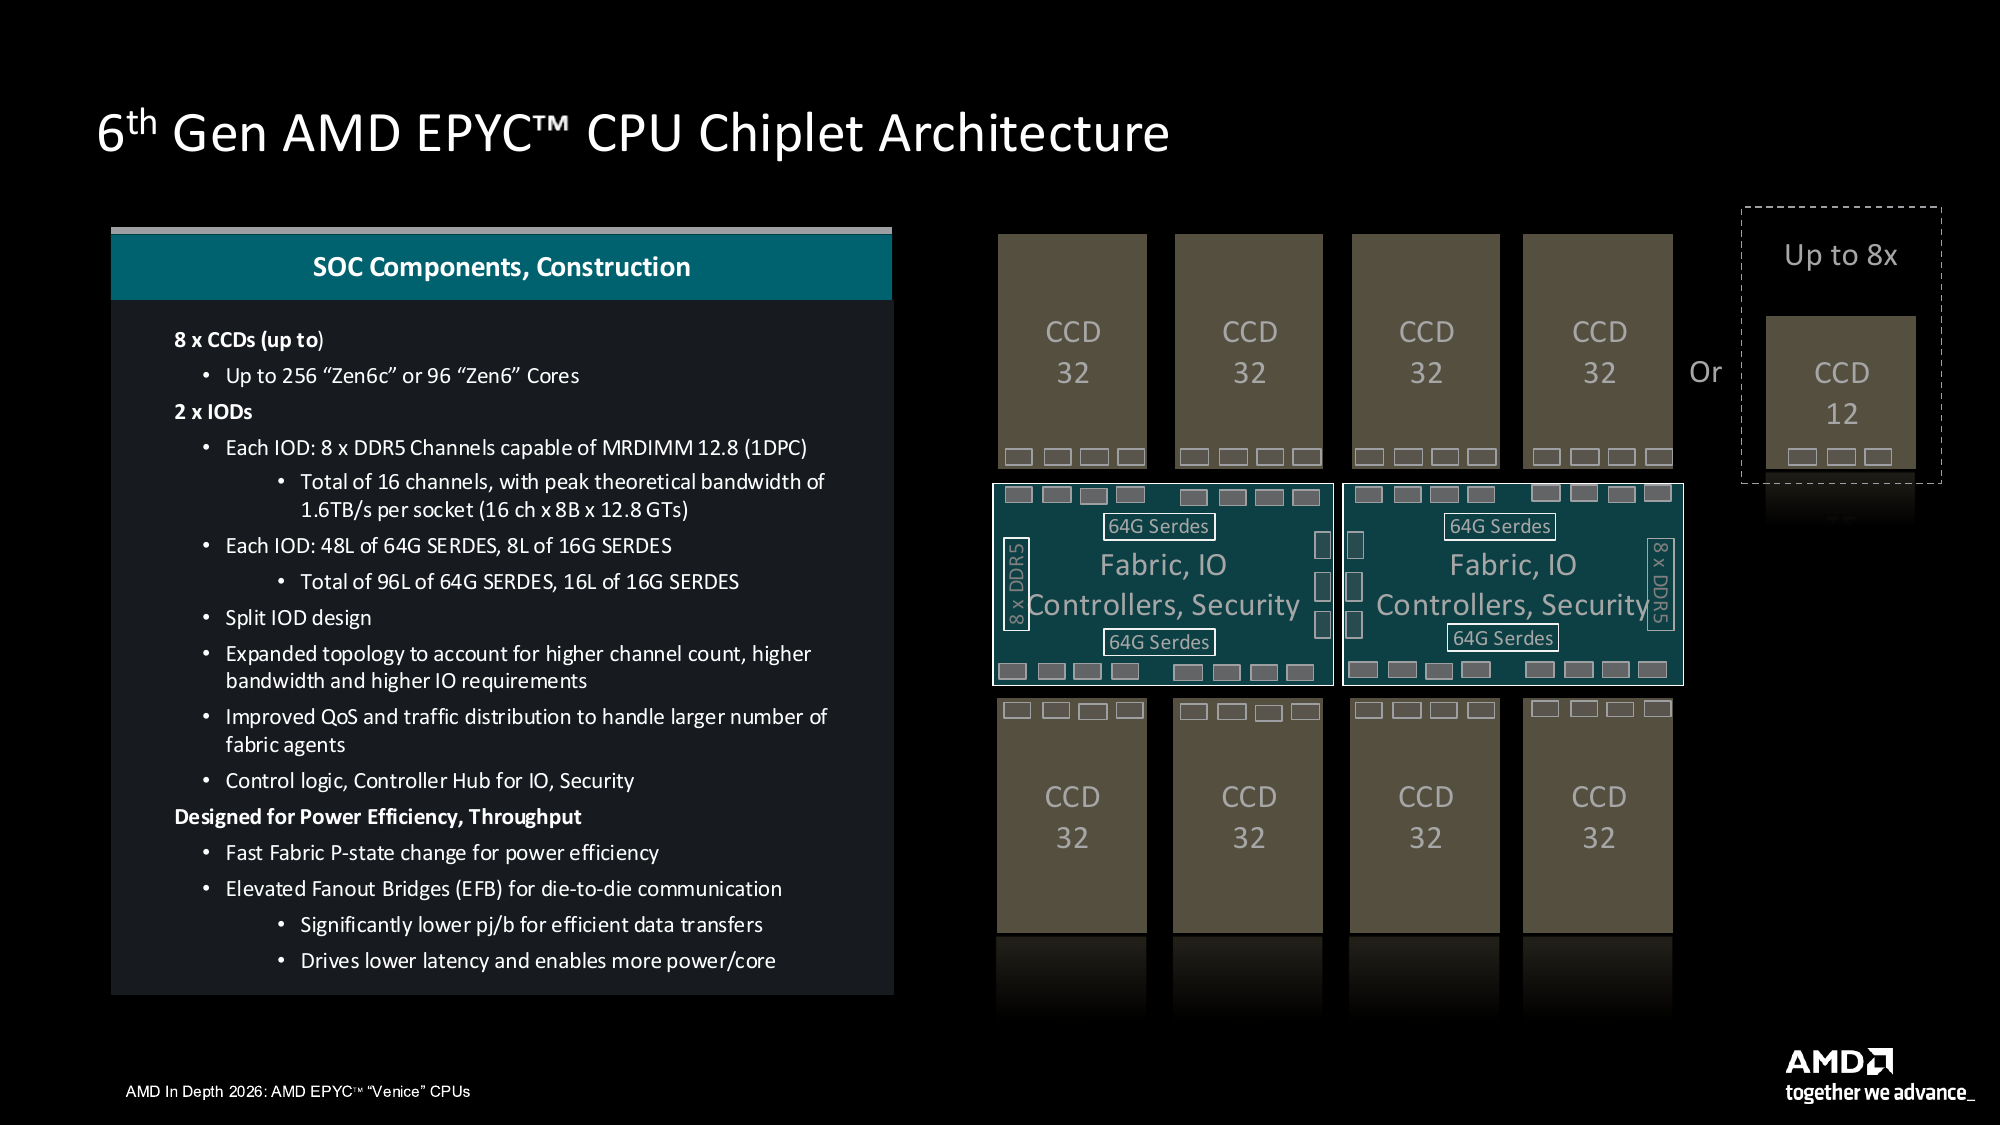
Это позволяет каждой половине процессора иметь выделенные контроллеры памяти, средства ввода-вывода, ресурсы безопасности и коммутационной матрицы. Контроллер CCD получает доступ к своим локальным контроллерам памяти через подключенный к нему IOD, а доступ к контроллерам на другом IOD добавляет еще один шаг через Infinity Fabric и связанную с этим задержку. Настройки NPS позволяют программному обеспечению использовать это разделение при размещении потоков и их памяти.
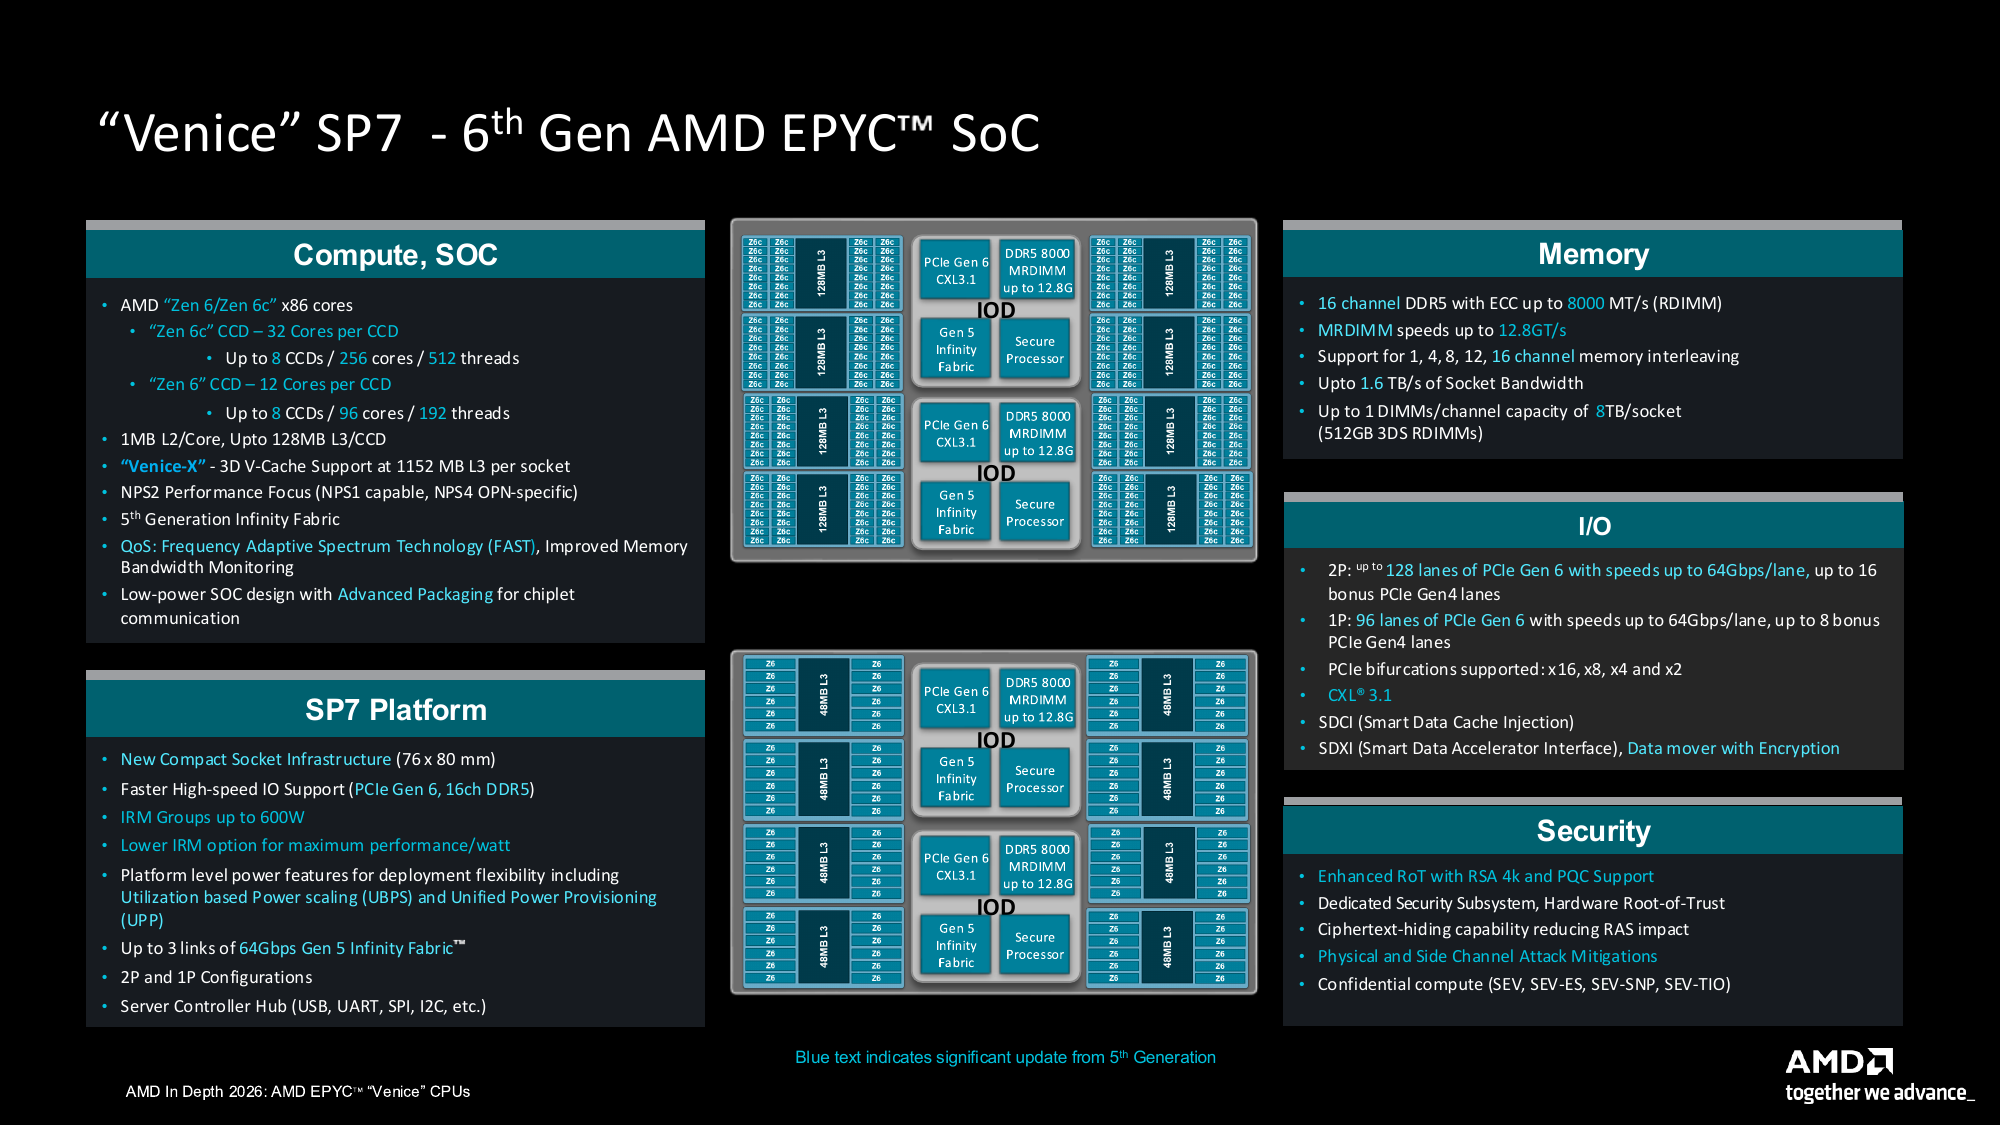
Вместе два модуля IOD обеспечивают SP7 шестнадцать каналов памяти по одному DIMM на канал. Модули DDR5 RDIMM работают со скоростью до 8,000 МТ/с, обеспечивая теоретическую пропускную способность в 1.024 ТБ/с. Модули MRDIMM увеличивают скорость интерфейса до 12,800 МТ/с, поднимая этот потолок до 1.6384 ТБ/с, что и легло в основу заявленной AMD цифры в 1.6 ТБ/с.
Скорость модуля MRDIMM (multiplexed-rank DIMM) обеспечивается буферами на самом модуле, которые объединяют трафик с нескольких уровней на более быстрый интерфейс хоста, увеличивая объем данных, которые могут передавать каналы. Задержка произвольного доступа по-прежнему зависит от таймингов памяти и пути к ней. SP7 также поддерживает установку до 8 ТБ памяти, используя шестнадцать модулей 3DS RDIMM по 512 ГБ.
В сравнении с конкурентами, сменные модули LPDDR5X SOCAMM2 в Vera поддерживают до 1.5 ТБ памяти и пропускную способность до 1.2 ТБ/с, что ставит её между пределами пропускной способности RDIMM и MRDIMM в Venice. Дальность этой пропускной способности также зависит от количества ядер. Разделив основные показатели, получаем примерно 6.4 ГБ/с на ядро для 256-ядерного Venice с MRDIMM, 17.1 ГБ/с для 96-ядерного Venice с той же пропускной способностью памяти и 13.6 ГБ/с для 88-ядерного Vera. Каналы памяти являются общими, поэтому отдельные ядра не получают фиксированного выделения, но этот расчет помогает объяснить, почему 9996 и 9686F могут предъявлять очень разные требования к одной и той же подсистеме памяти SP7.
Когда шестнадцати каналов DRAM недостаточно, емкость может быть увеличена за счет CXL. SP7 также поддерживает CXL 3.1 на 96 линиях PCIe Gen6 на каждый сокет, а AMD заявляет, что пропускная способность каждого канала x16 составляет около 128 ГБ/с при задержке в один NUMA-участок, что является путем к памяти за пределами шестнадцати каналов, когда емкость важнее скорости.
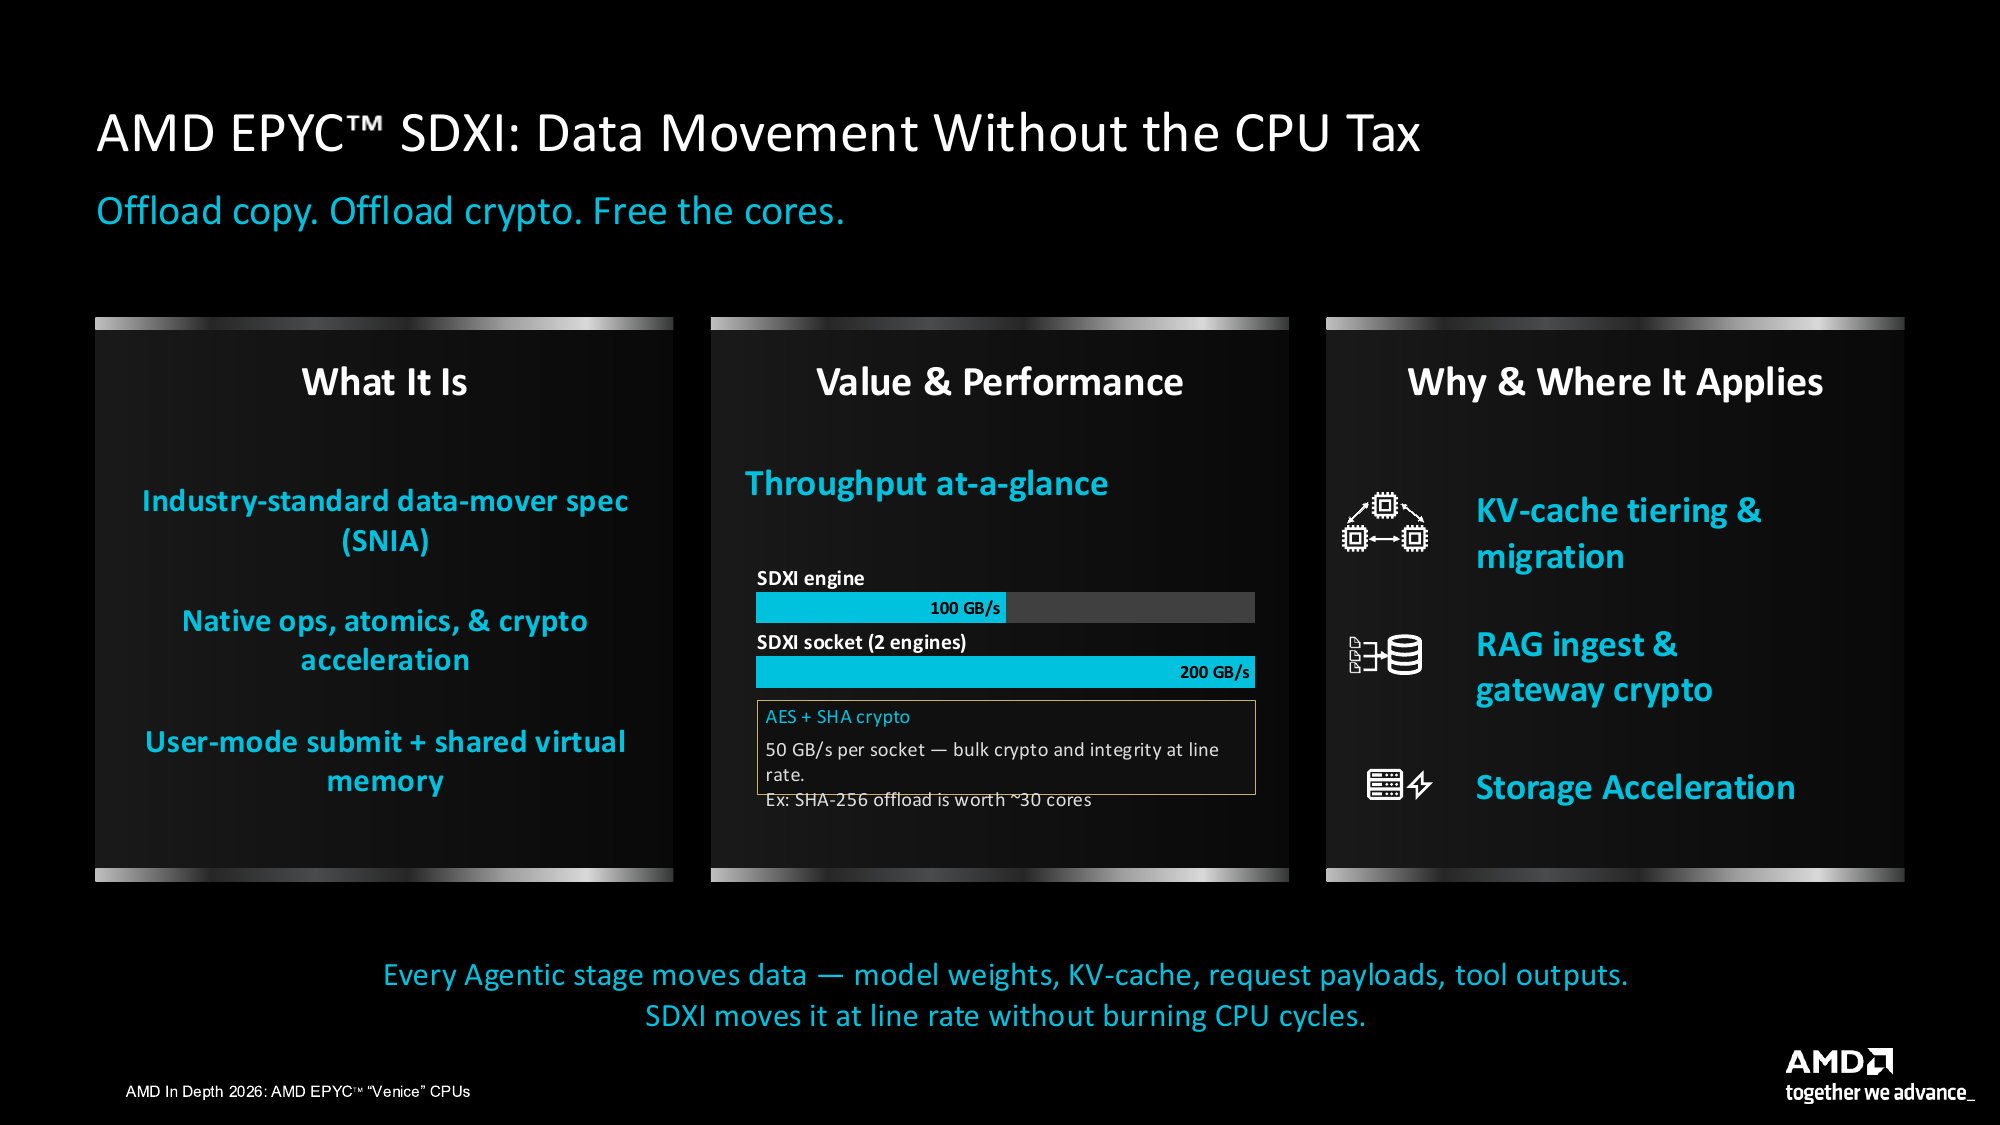
Те же линии 64 Гбит/с используются для PCIe Gen6: односокетная система SP7 получает 96 линий Gen6 плюс восемь дополнительных линий PCIe Gen4, а двухсокетная система — до 128 линий Gen6 плюс 16 линий Gen4. Каналы могут разветвляться на x16, x8, x4 или x2. IOD также поддерживают технологию Smart Data Cache Injection, которая позволяет направлять входящие данные устройства непосредственно в кэш, и интерфейс Smart Data Accelerator Interface для разгрузки копирования данных из памяти.
LPDDR5X на SOCAMM2 поставляется с Verano, где AMD заявляет о объеме памяти до 1.5 ТБ на сокет со скоростью около 0.8 ТБ/с и энергопотреблением на 30-40% ниже, чем у DDR5 RDIMM или MRDIMM при той же пропускной способности, поэтому в следующем году у Verano появится прямой аналог от AMD.
Когерентность и локальность кэша
При наличии 1 ГБ кэша L3 в верхней части, местоположение этого кэша начинает иметь такое же значение, как и его объем. Большая емкость кэша L3 в Venice распределена по CCD-матрицам, поэтому расположение совместно используемых данных является частью уравнения производительности. Когерентность — это аппаратная гарантия того, что каждое ядро видит согласованное значение для заданного адреса памяти, даже если его копии находятся в нескольких кэшах.
Потоки на одном ПЗС-матрице могут повторно использовать его локальный L3. Как и в случае с Turin, передача данных потоку на другой ПЗС-матрице добавляет шаг через сеть ввода-вывода. В Venice добавляется еще один шаг через сеть Infinity Fabric к другому IOD, а затем к целевой ПЗС-матрице, когда эта ПЗС-матрица подключена к другому кристаллу ввода-вывода.
AMD описывает 16-канальный кэш L3 в Zen 6c как преимущественно эксклюзивный кэш-памяти, что означает, что он в основном содержит строки, вытесненные из L2, и не дублирует то, что уже содержится в L2, что увеличивает эффективную емкость двух уровней вместе взятых. Дублированные теги L2 в L3 помогают аппаратному обеспечению когерентности находить кэшированные данные и фильтровать запросы, сокращая ненужные запросы к частным кэшам и ускоряя передачу данных между кэшами. Иерархия может отслеживать 127 незавершенных промахов L2-L3 на ядро и 1,280 промахов L3-памяти на комплекс, что позволяет многим запросам продвигаться вперед, в то время как более ранние обращения все еще ожидают данных.
Системный кэш Vera объемом 164 МБ распределен между всеми 88 ядрами на одном вычислительном кристалле и соединен когерентной структурой, расположенной на кристалле. В топовой линейке Venice объем кэша последнего уровня значительно больше и распределен между чиплетами, поэтому программное обеспечение, которое многократно передает общие данные между рабочими процессами, должно учитывать эти отдельные домены кэша.
Для приложений, использующих хранилище данных, размещение очереди, её метаданных и обслуживающих её рабочих процессов на одном и том же CCD способствует повторному использованию локального кэша. Распределение этих рабочих процессов по сокету может увеличить трафик между CCD, поскольку они обращаются к одним и тем же структурам, а размещение памяти добавляет ещё один уровень, поскольку DRAM потока может располагаться за любым из двух микросхем ввода-вывода.
Режимы NPS и размещение памяти
Эта физическая структура передается программному обеспечению через NUMA, или неравномерный доступ к памяти: операционной системе сообщается, какие ядра расположены ближе всего к какой области памяти, чтобы она могла соответствующим образом распределять задачи. NPS, сокращение от NUMA nodes per socket (узлы NUMA на сокет), определяет, как Venice представляет свои домены памяти операционной системе. AMD делает акцент на NPS2 для производительности SP7, а поддержка NPS1 и NPS4, специфичная для процессора, предоставляет другие способы организации сокета, и все результаты Venice в этом обзоре были получены в режиме NPS2.
| режим | Домены памяти на каждый сокет | Количество каналов на домен | Связанные ПЗС-матрицы в восьмиканальном корпусе |
|---|---|---|---|
| НПС1 | 1 | 16 | 8 |
| НПС2 | 2 | 8 | 4 |
| НПС4 | 4, где поддерживается | 4 | 2 |
В таблице указано количество CCD-модулей, описывающих полную восьмиканальную схему; количество активированных ядер и поддерживаемые режимы различаются в зависимости от процессора. NPS1 предоставляет операционной системе один домен памяти и чередует память по всем шестнадцати каналам, что является простейшим представлением для программного обеспечения, хотя доступ к памяти по-прежнему должен осуществляться по физическим соединениям между CCD-модулем и IOD, обслуживающим данный адрес.
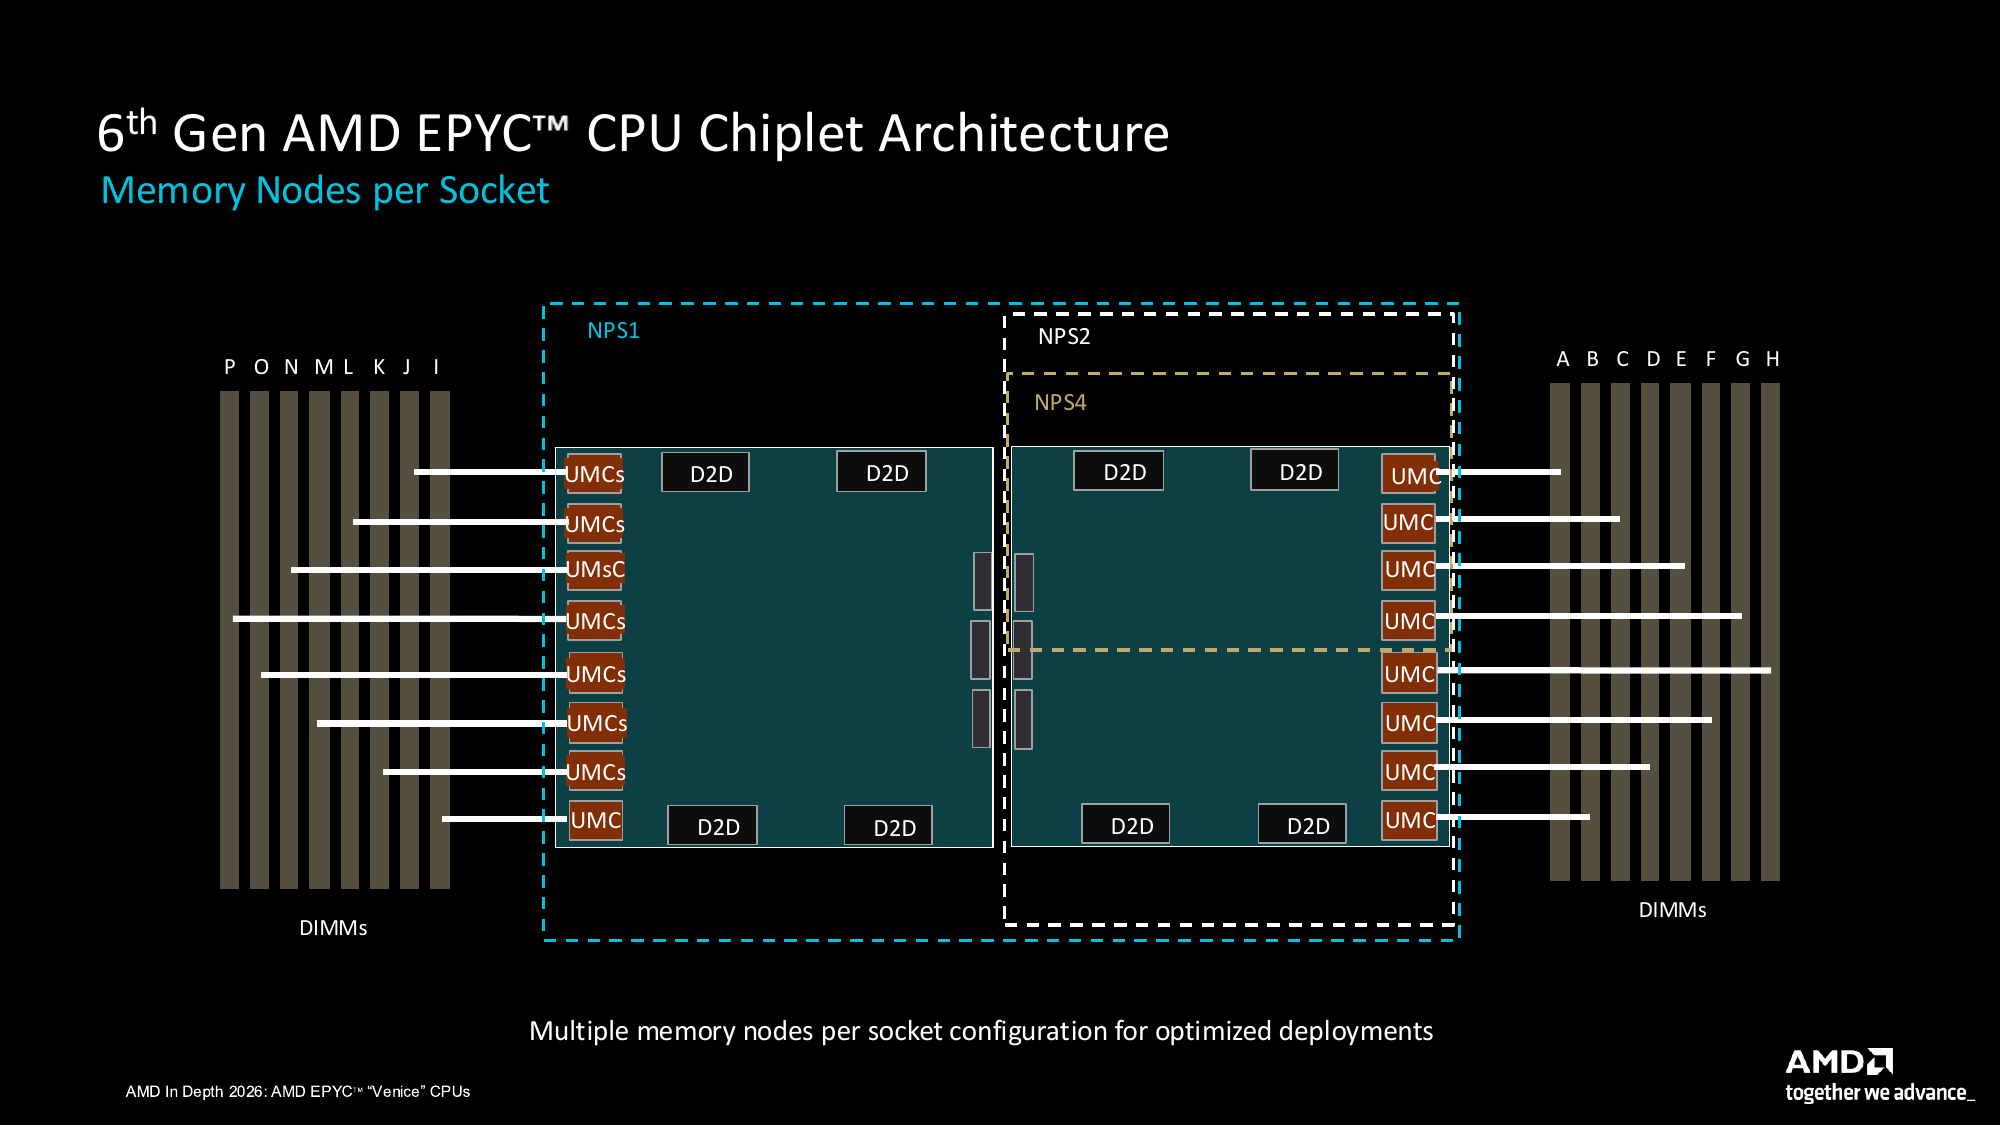
NPS2 использует две половины пакета. Каждый домен объединяет восемь контроллеров памяти одного IOD и четыре связанных с ними CCD. В полностью активированных процессорах, рассматриваемых здесь, это составляет 128 ядер на домен на 9996 и 48 на 9686F. Размещение потока и его памяти в одном домене позволяет обрабатывать обращения к DRAM только на этой стороне процессора.
В режиме NPS4 ресурсы каждого IOD снова распределяются, предоставляя каждому домену четыре канала памяти и два связанных с ними CCD. Это позволяет получить 64-ядерные домены в примере с 256 ядрами или 24-ядерные домены в примере с 96 ядрами, если процессор поддерживает этот режим. Программное обеспечение получает более точный контроль над размещением, поскольку внутри каждого домена доступно меньше каналов.
Эти настройки изменяют чередование памяти и информацию о локальности, предоставляемую программному обеспечению, в то время как физические границы кэша остаются неизменными: четыре CCD в домене NPS2 по-прежнему имеют четыре отдельных кэша L3, и трафик между ними по-прежнему использует общую сеть. Поэтому привязка потоков и распределение памяти должны быть согласованы, поскольку привязка рабочего потока к одному домену, оставляя его страницы в другом, приводит к тому, что обращения к ним происходят по более длинному пути. Размер виртуальной машины и выделение памяти при первом обращении, когда Linux размещает страницу на узле потока, который первым ее записывает, заслуживают такого же внимания.
Vera упрощает этот процесс, предоставляя только один домен NUMA на каждый сокет, или два в двухсокетной системе. Ее когерентная структура обрабатывает обмен данными внутри вычислительного кристалла, а NVLink-C2C передает трафик на другой ЦП, что уменьшает количество NUMA-ограничений, которыми необходимо управлять программному обеспечению внутри сокета.
xGMI и Vera: межпроцессорное взаимодействие
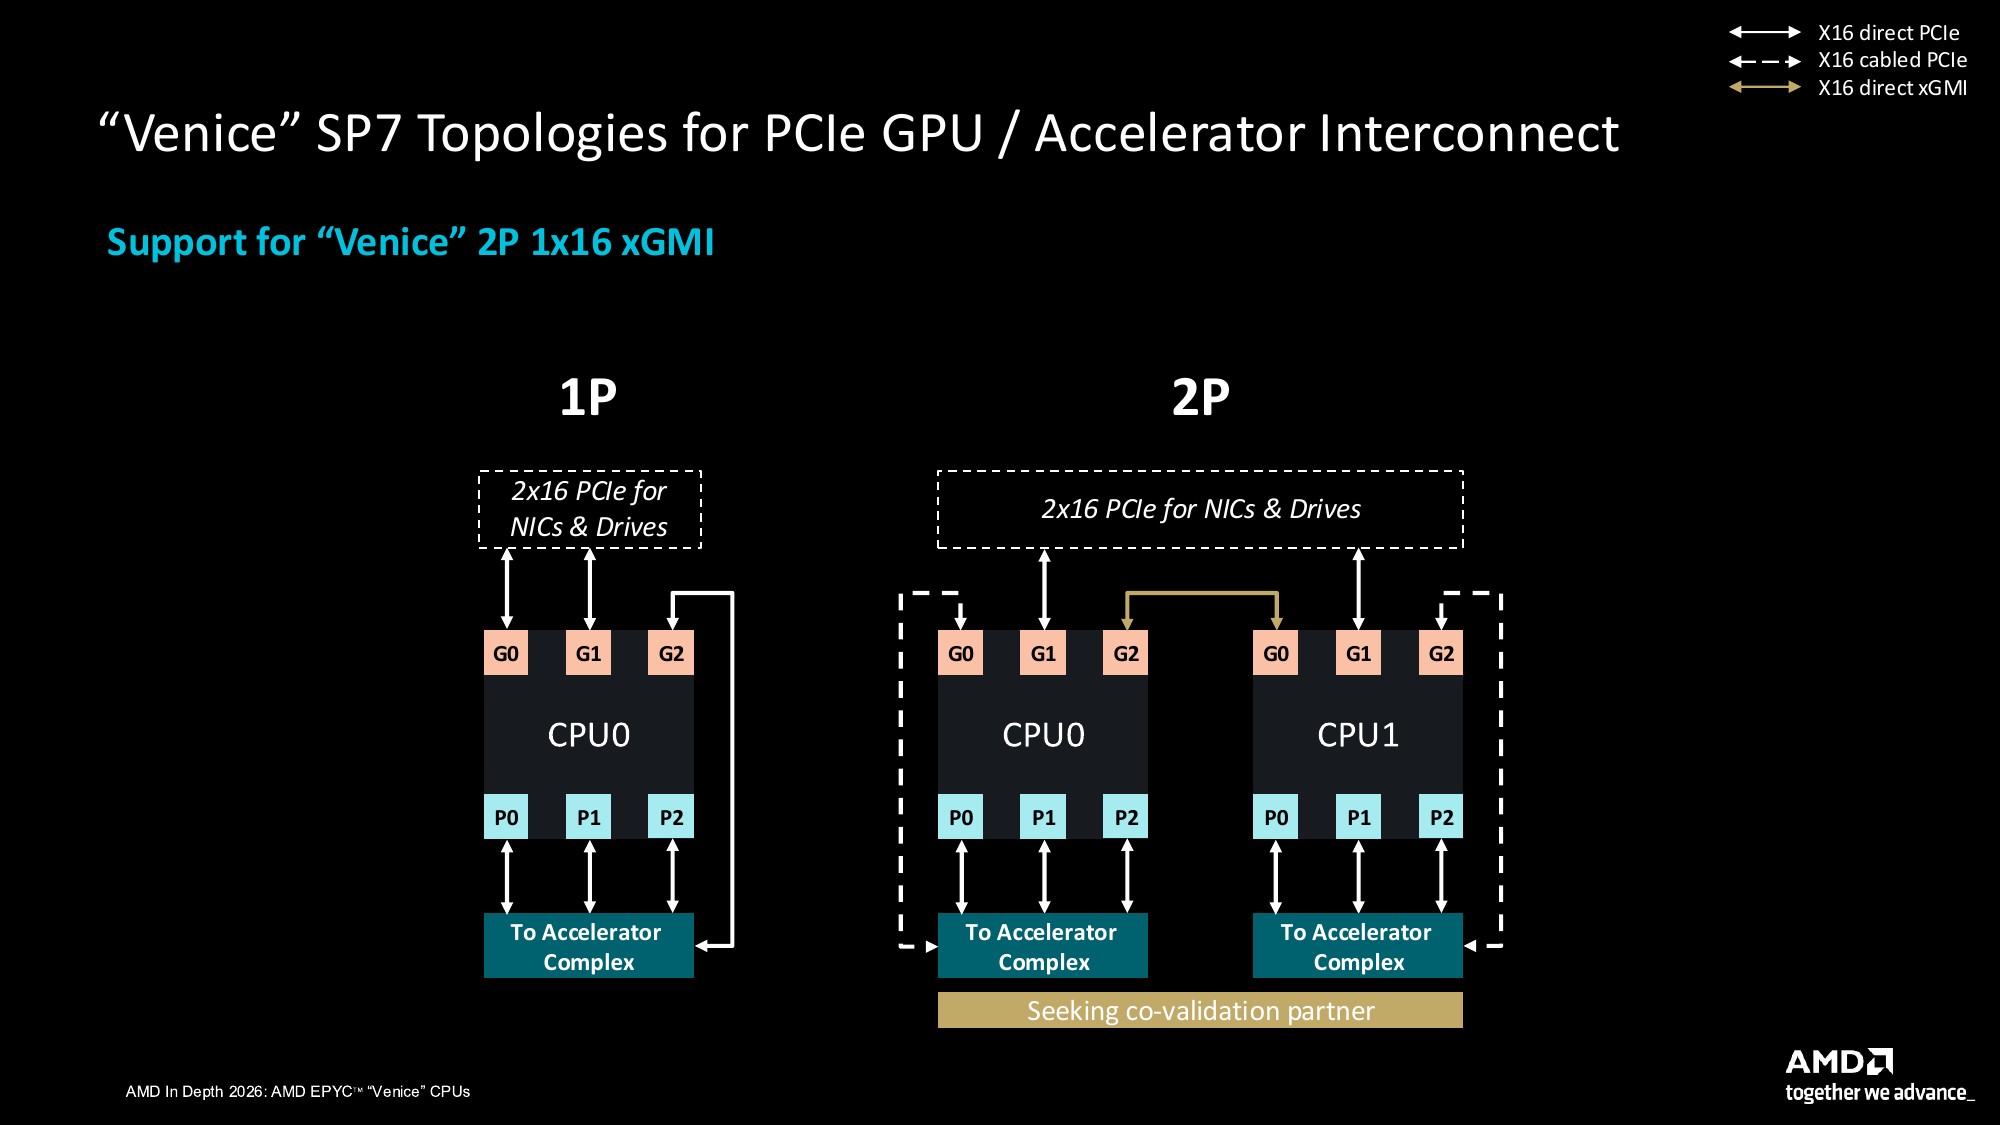
Переход от одного сокета к использованию xGMI-соединений в Venice позволяет реализовать эту технологию. xGMI — это согласованная версия Infinity Fabric от AMD, объединяющая физические линии с PCIe. AMD поддерживает до трех x16-соединений со скоростью 64 Гбит/с на линию, используя те же высокоскоростные ресурсы, что и для PCIe. При наличии двух x16 xGMI-соединений между процессорами, в конфигурации AMD для вычислительных систем остается 128 доступных линий PCIe Gen6 на двухсокетном сервере, а переход к трем xGMI-соединениям сокращает общее количество линий PCIe в системе до 96.
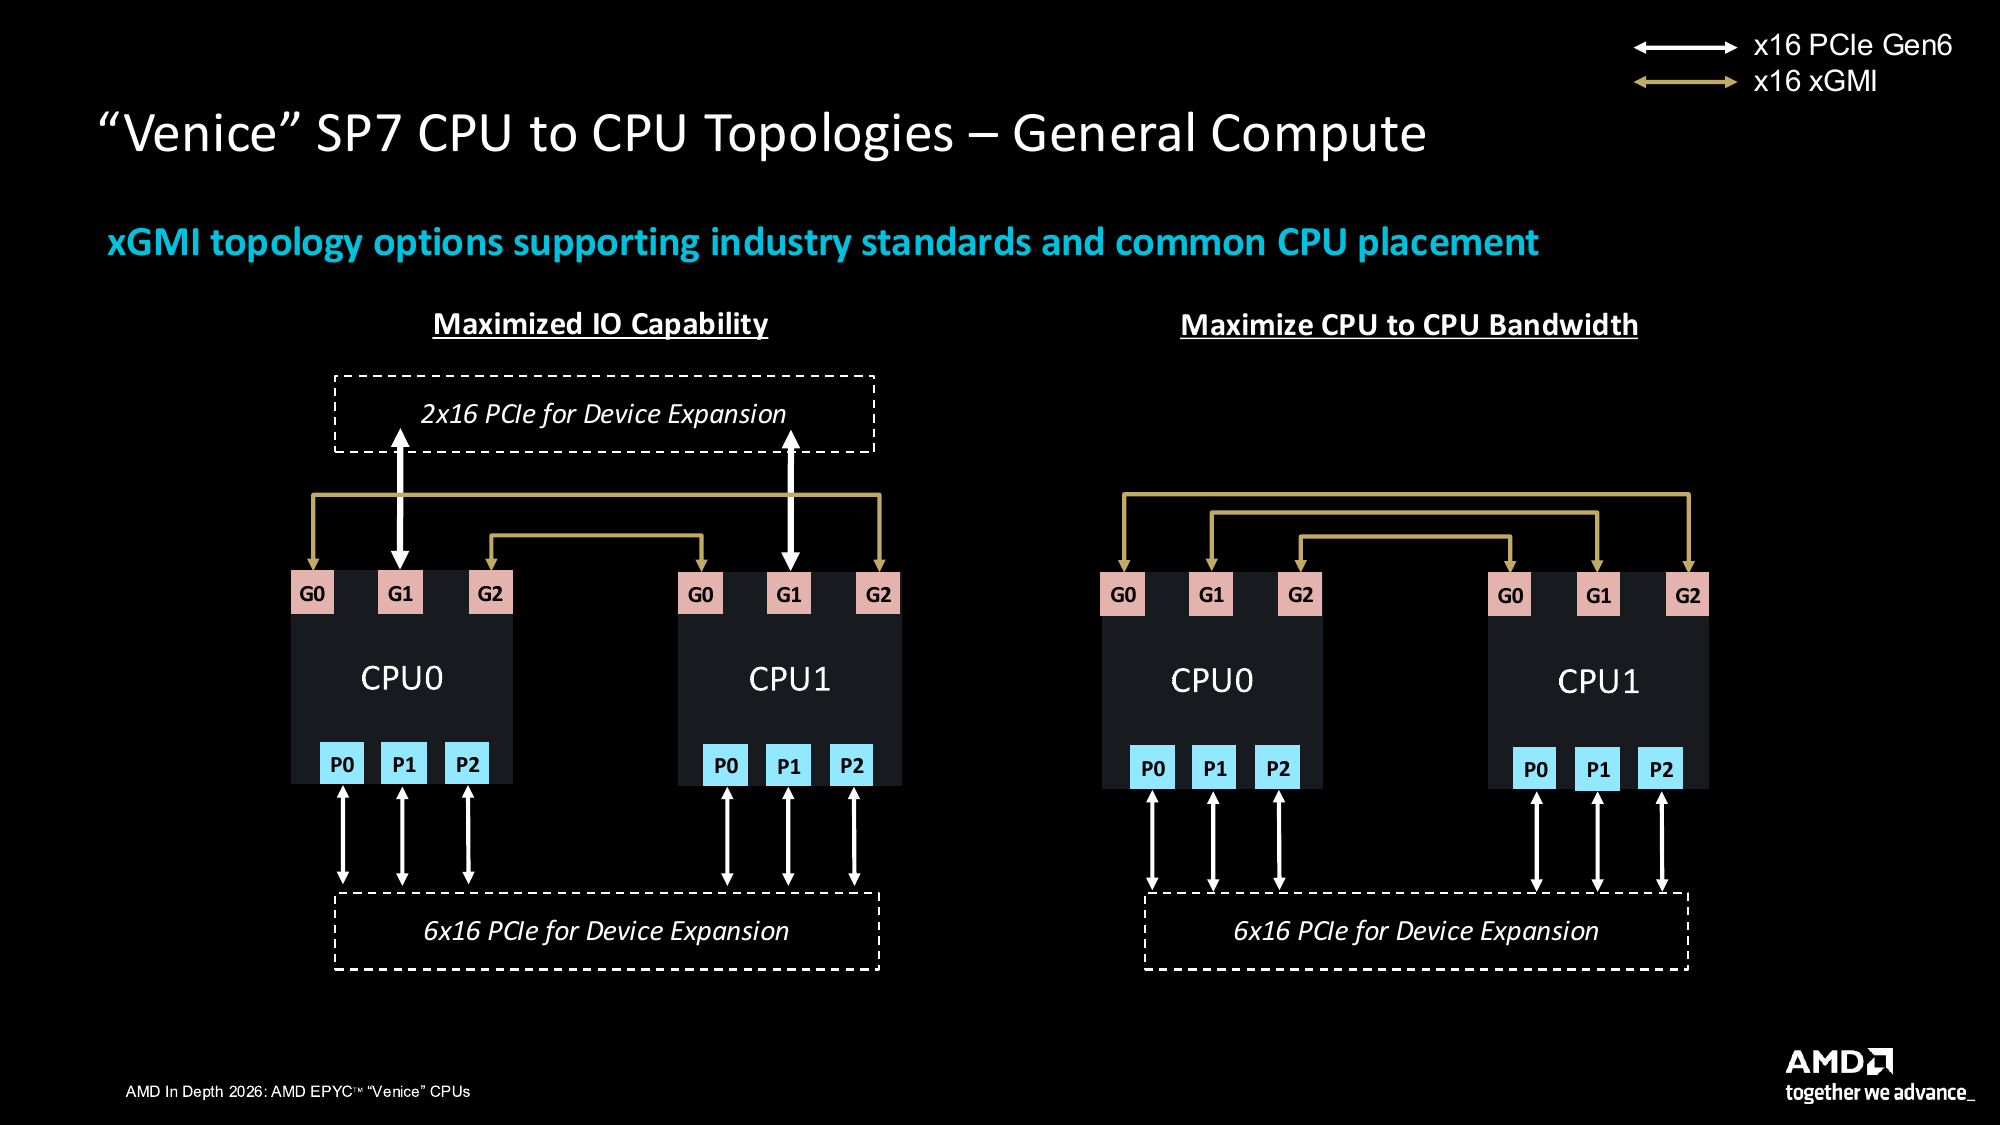
Каждый канал x16 xGMI обеспечивает пропускную способность 128 ГБ/с в каждом направлении без учета протокольных накладных расходов. Два канала обеспечивают 256 ГБ/с в каждом направлении, а три увеличивают этот показатель до 384 ГБ/с, поэтому добавление третьего канала увеличивает пропускную способность между процессорами на 50 процентов за счет 32 линий PCIe на сервере.
NVIDIA значительно расширяет возможности технологии NVLink-C2C второго поколения: соединение между процессорами Vera обеспечивает двунаправленную передачу данных со скоростью 1.8 ТБ/с или 900 ГБ/с в каждом направлении, и та же технология межсоединений используется в тесно интегрированном соединении между процессором и графическим процессором NVIDIA.
| конфигурация канала связи ЦП | Пропускная способность в каждом направлении | Сумма обоих направлений |
|---|---|---|
| Венеция, два канала x16 xGMI | 256 ГБ/с (в необработанном виде, расчетная скорость) | 512 ГБ/с (в необработанном виде, расчетная скорость) |
| Венеция, три x16 xGMI-соединения | 384 ГБ/с (в необработанном виде, расчетная скорость) | 768 ГБ/с (в необработанном виде, расчетная скорость) |
| Вера, NVLink-C2C | 900 ГБ/с, указано производителем. | 1,800 ГБ/с, указано производителем. |
Каналы xGMI передают не только трафик ЦП, но и трафик, генерируемый устройствами PCIe. Сетевая карта или NVMe-накопитель, подключенный к одному ЦП, может считывать или записывать буферы в памяти, подключенной к другому ЦП, отправляя эти DMA-передачи через канал связи. Для сохранения буферов локально на устройстве по-прежнему требуется передача данных, если рабочий процесс на другом ЦП обрабатывает эти данные. Передачи ускорителей, затрагивающие удаленную память хоста, создают аналогичную нагрузку, и все они используют xGMI совместно с доступом к удаленной памяти ЦП, передачей данных через кэш-линии и сообщениями когерентности. Приведенные ниже результаты STREAM для удаленных сокетов дают измеренное значение для этого канала связи.
Венеция как место проведения мероприятия с использованием искусственного интеллекта.
Система Venice также играет ключевую роль в стойках AMD Helios , где 96-ядерный процессор EPYC 9G76 размещает четыре графических процессора Instinct MI455X на каждом вычислительном блоке. В этой роли центральный процессор выступает в роли контроллера трафика: он подготавливает данные, запускает программное обеспечение, обеспечивающее загрузку графических процессоров, и отвечает за сетевые и хранилищные данные. Подробное описание от AMD подтверждает схему, которую мы обсуждали в нашем материале «Развитие ИИ» : четыре соединения x16, по одному к каждому графическому процессору.
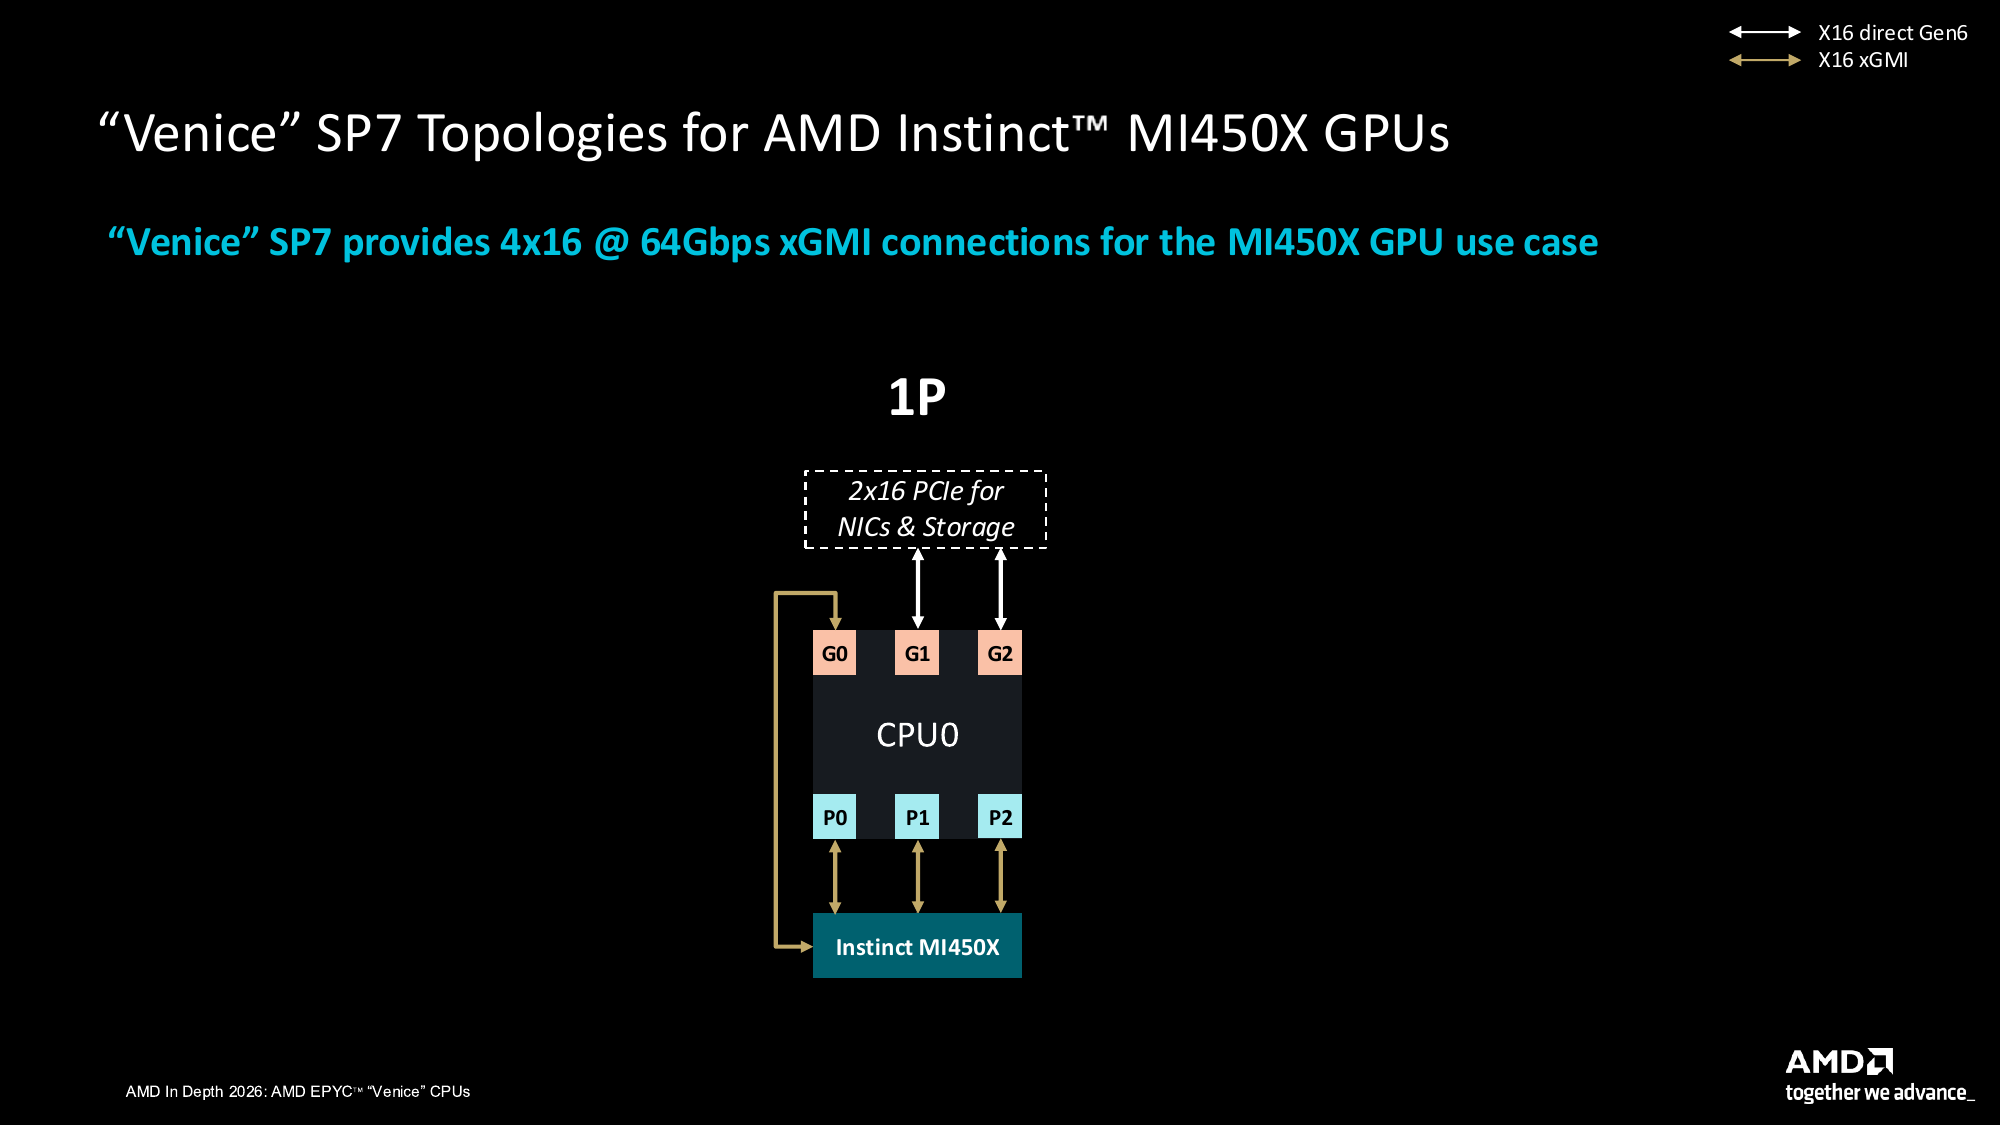
При скорости 64 Гбит/с на линию, каждый канал рассчитан на 128 ГБ/с в каждом направлении, или 256 ГБ/с в двунаправленном режиме, что вдвое превышает пропускную способность хоста по сравнению с соединением PCIe Gen5 x16 на MI355X. В сумме со всеми четырьмя графическими процессорами это составляет 512 ГБ/с в каждом направлении, или 1.024 ТБ/с в двунаправленном режиме, при этом центральный процессор сохраняет две группы x16 PCIe Gen6 для сети и хранения данных.
Эти хост-соединения используют согласованную архитектуру Infinity Fabric вместо обычного PCIe, предоставляя Venice кэшированный доступ к памяти графического процессора, так что ЦП и ГП могут совместно использовать структуры данных без явного копирования. Технология NVIDIA NVLink-C2C по-прежнему обеспечивает более высокую пропускную способность между ЦП и ГП, и нам понадобятся системы Helios и NVL72 в лаборатории, чтобы измерить, насколько эта разница важна для обучения и инференса. Мы предполагаем, что инференс является основным направлением для Helios, который теоретически должен меньше ощущать влияние более медленных соединений ЦП-ГП.
Производительность и тесты
В ходе тестов проверяется, как конструкция Venice влияет на производительность, начиная от одного закрепленного потока и заканчивая рабочими нагрузками, которые загружают каждое ядро двухпроцессорного сервера. Наши тесты охватывают пропускную способность и задержку памяти, научные вычисления, аналитику, программное обеспечение общего назначения и базы данных, демонстрируя, как ядра Venice и система памяти SP7 справляются с различными задачами.
Тестовые системы
| Система | Dell PowerEdge R9825 | Референсная платформа AMD в Нигерии | Референсная платформа AMD в Нигерии | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R770AP |
|---|---|---|---|---|---|---|
| Процессоры | ||||||
| ЦП | AMD EPYC 9996 | AMD EPYC 9686F | NVIDIA Vera | AMD EPYC 9965 | Интел Ксеон 6978P | |
| Розетки | 2 | |||||
| Количество ядер/потоков на процессор | 256 / 512 | 96 / 192 | 88 / 176 | 192 / 384 | 120 / 240 | |
| Базовые часы | 2.55 GHz | 4.05 GHz | 2.25 GHz | 2.1 GHz | ||
| Макс. часы | 4.1 GHz | 5.3 GHz | 3.4 GHz | 3.7 GHz | 3.9 GHz | |
| Память | ||||||
| Конфигурация | 32x 64GB | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | ||
| Тип / Скорость | DDR5-8000 | MRDIMM-12800 | LPDDR5X-9600 | DDR5-6400 | ||
| Общая мощность | 2TB | 1.5TB | 3TB | 1.5TB | ||
| Память | ||||||
| SSD | Solidigm D7-PS1030 12.8TB | Micron 9650 PRO 7.68TB | Solidigm D7-PS1010 7.68TB | Solidigm D7-PS1030 12.8TB | Solidigm D7-PS1010 7.68TB | |
| SSD Link | PCIe Gen5 x4 | PCIe Gen6 x4 | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | |
| прошивки | ||||||
| Системный BIOS | 1.0.4 | RNIV1001H | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | |
| Профиль BIOS | Эффективности | По умолчанию | По умолчанию | По умолчанию | Эффективности | |
| Программный стек | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 26.04 | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||
| ядро | 7.0.0-42-родовое | 7.2.0-rc5 | 7.2.0-rc5 | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-138 |
| НКУ | 15.2.0 | 13.3.0 | ||||
| Glibc | 2.43 | 2.39 | ||||
| Открытый MPI | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Мы сравнили Venice с тремя системами, протестированными с помощью того же пакета программ: NVIDIA Vera, процессором EPYC 9965 на базе архитектуры Turin в Dell PowerEdge R7725 и процессором Xeon 6978P в Dell PowerEdge R770AP. Компания AMD предоставила удаленный доступ к Nigeria, своему двухпроцессорному эталонному серверу SP7, для получения результатов тестирования MRDIMM и EPYC 9686F, которые являются единственными результатами в этом обзоре, полученными не в нашей лаборатории.
Системы Venice и Vera работали на более новом программном стеке, чем системы Turin и Xeon, как указано выше, поэтому более старый GCC дает системам Turin и Xeon небольшое преимущество. В остальном версии бенчмарков, входные данные и флаги сборки были идентичны на всех системах. Все системы Venice работали в режиме NPS2, рекомендованном AMD для SP7, и результаты приведены с отключенным SMT, если не указано иное.
Пропускная способность памяти
В памяти SP7 должно отображаться шестнадцать каналов на сокет, поэтому мы начинаем тестирование именно с этого. Мы протестировали STREAM Triad, запустив его с одним потоком OpenMP на каждое физическое ядро на массивах 16 ГБ. В основном тесте использовались все ядра обоих сокетов, а затем мы повторили его, закрепив за одним сокетом, сначала считывая его локальную память, а затем память удаленного сокета. На диаграмме ниже показаны результаты тестирования Triad для всей системы и для каждого сокета при отключенном SMT.
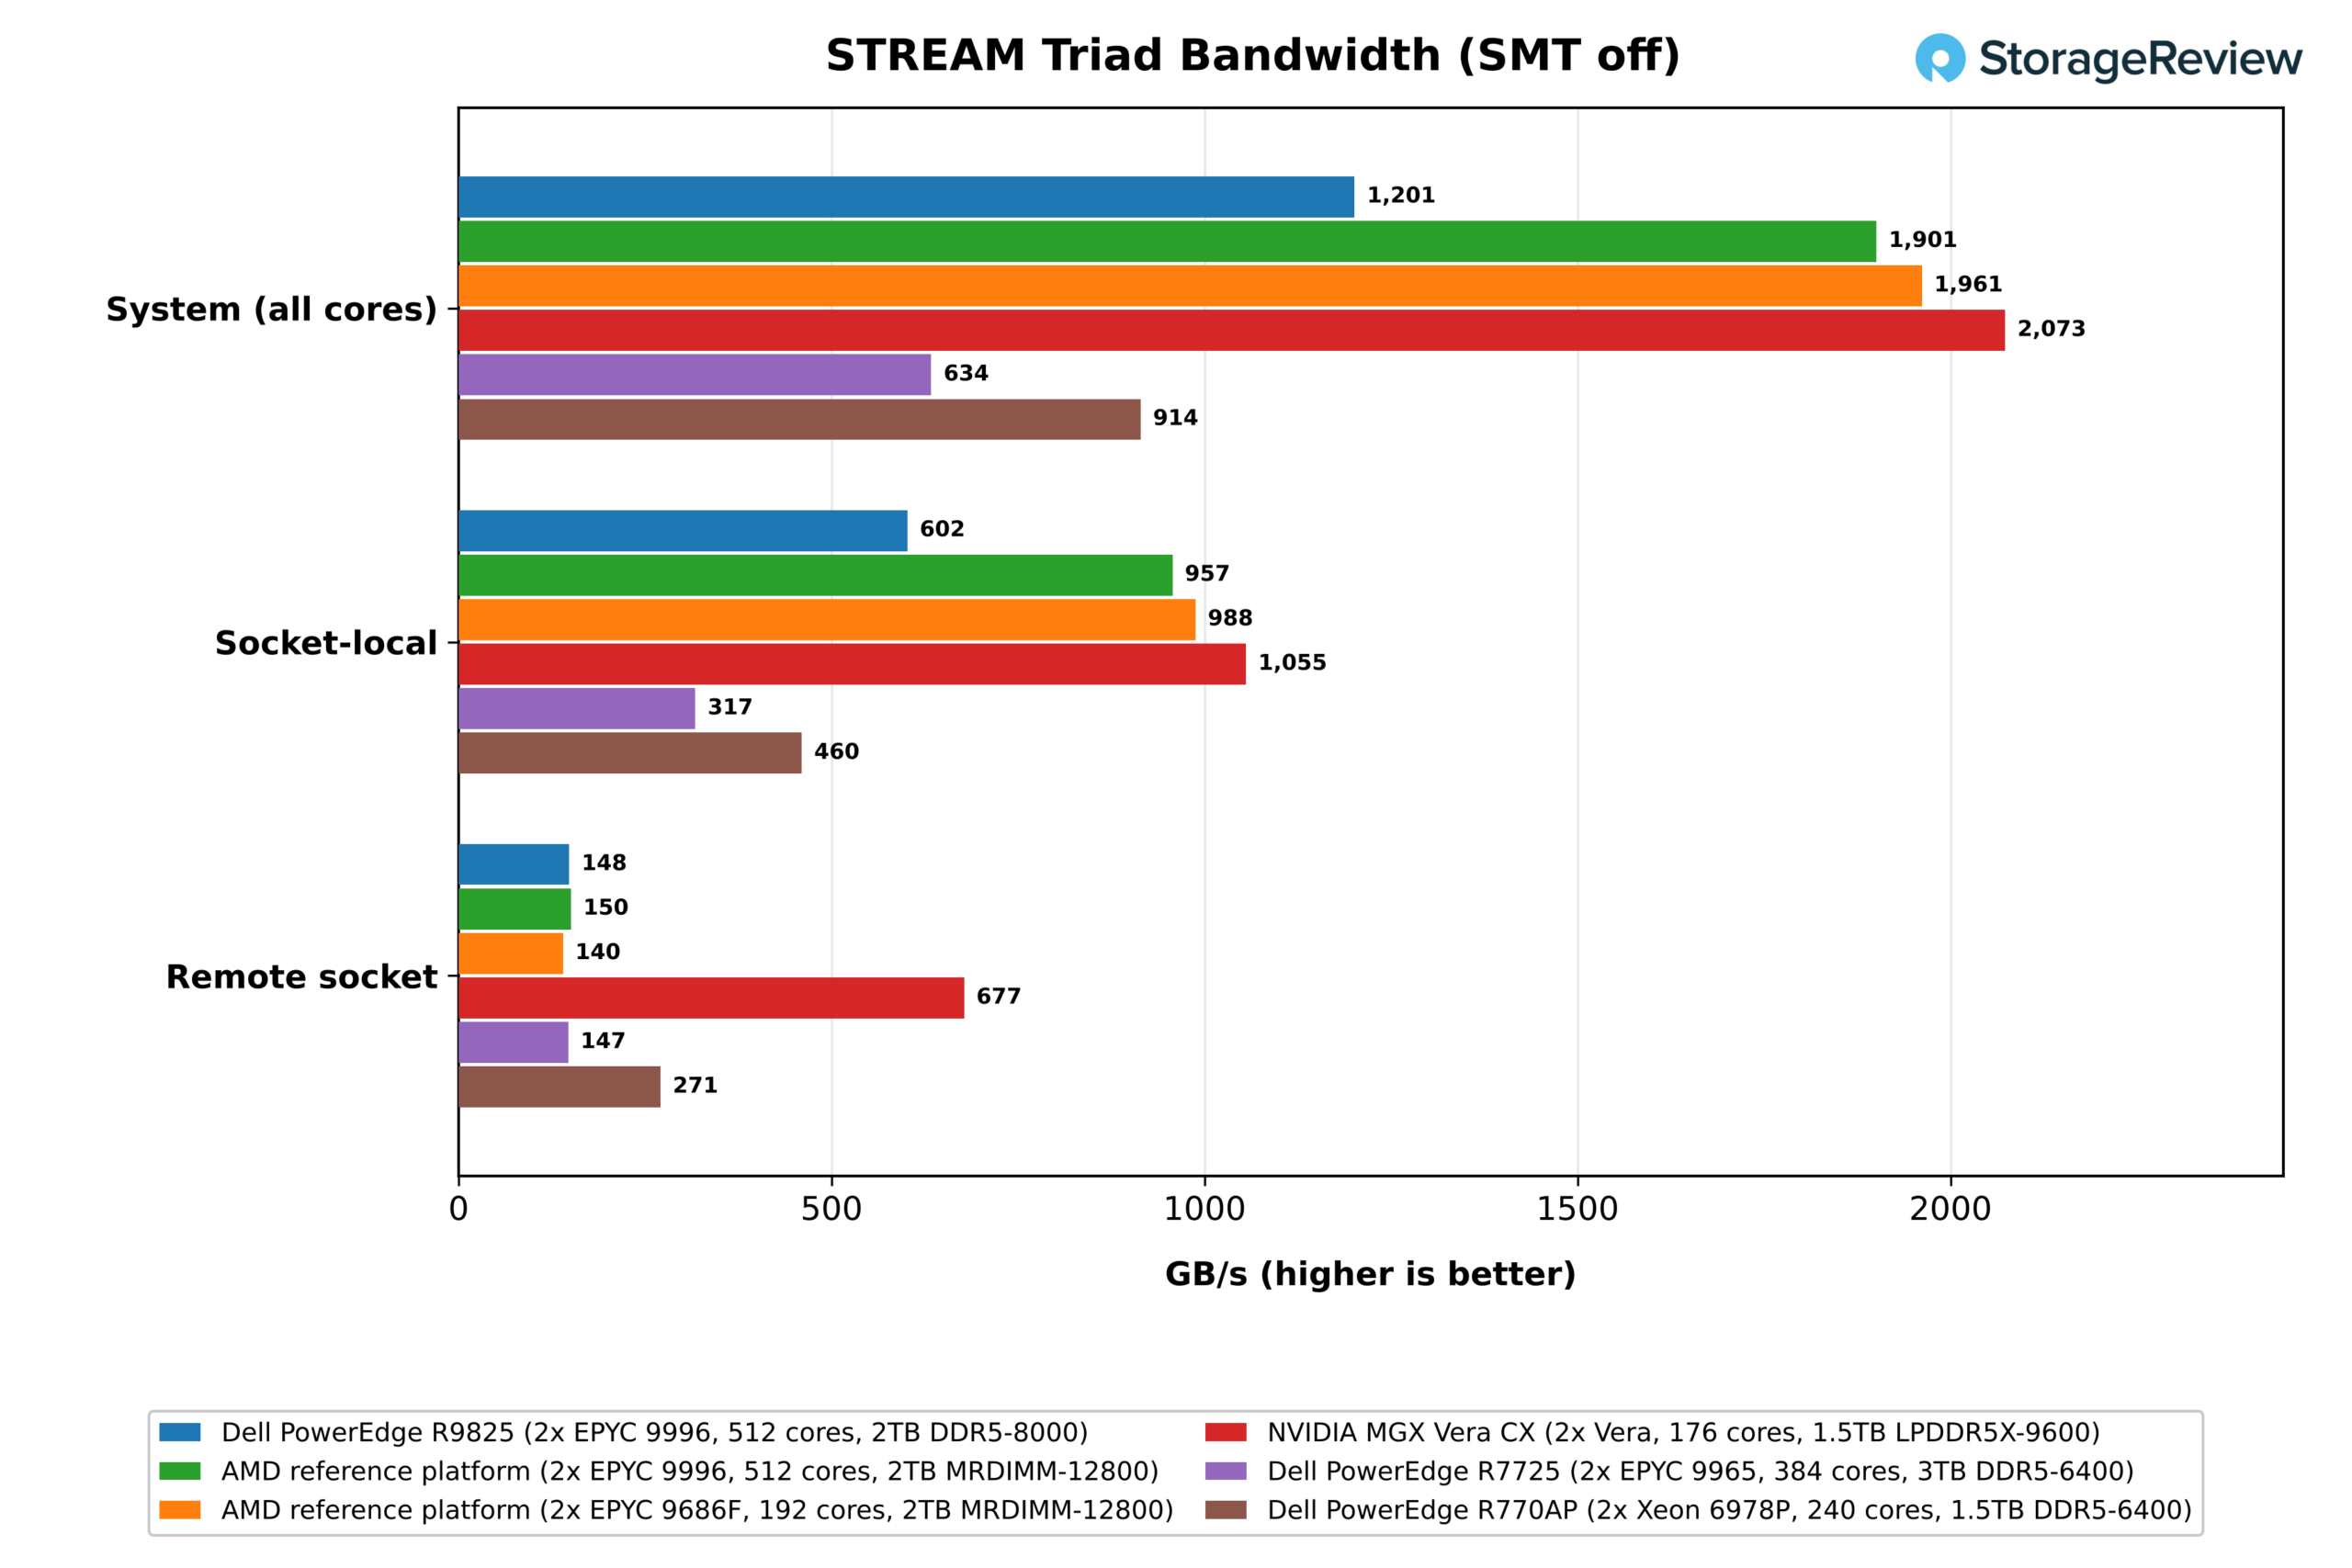
Процессор R9825 показал скорость 1,201 ГБ/с на DDR5-8000, что составляет 59% от заявленных 2,048 ГБ/с при 32 каналах с частотой 8,000 МТ/с. Это в 1.9 раза больше, чем 634 ГБ/с у системы EPYC 9965 на 24 каналах DDR5-6400, и в 1.3 раза больше, чем 914 ГБ/с у Xeon 6978P, но всё ещё на 42% меньше, чем 2,073 ГБ/с у Vera.
Ограничивающим фактором для R9825 является скорость памяти, поскольку те же два процессора на MRDIMM-12800 в эталонной платформе AMD достигли скорости 1,901 ГБ/с, что на 58% больше только за счет памяти. 96-ядерный 9686F на тех же MRDIMM показал немного более высокую скорость — 1,961 ГБ/с, при этом количество ядер, работающих на каналах, было вдвое меньше. На MRDIMM Venice отстает от Vera на 8% по показателю STREAM.
В расчете на ядро по-прежнему преобладают меньшие по размеру компоненты. Распределенная по 512 ядрам скорость 1,901 ГБ/с составляет 3.7 ГБ/с на ядро у 9996, против 10.2 ГБ/с у 192-ядерного 9686F и 11.8 ГБ/с у 176-ядерного Vera. Это компромисс, на который идет покупатель, чтобы получить 256 ядер в сокете, и именно поэтому существует 9686F.
Частично разница с Vera объясняется тем, как STREAM подсчитывает трафик. Пакет программ строит STREAM с использованием обычного GCC, который не генерирует потоковые операции записи, поэтому операция записи, которая сначала не попадает в кэш, считывает целевую строку из памяти. STREAM не учитывает это чтение, а это значит, что Triad занижает объем передаваемого трафика примерно на четверть, независимо от места его возникновения. Ядра Zen от AMD учитывают это при каждой операции записи. Ядра Arm, такие как более ранние ядра Grace от NVIDIA, обнаруживают запись всей строки и пропускают чтение, а последние процессоры Xeon от Intel могут пропускать большую часть операций при высокой загрузке памяти.
С учетом неучтенных операций чтения, скорость чтения R9825 составила около 78% от теоретического пика. Та же поправка увеличивает скорость передачи данных в конфигурации MRDIMM 9996 по сравнению с показателем Vera в 2,073 ГБ/с, поэтому разница в 8% исчезает, когда обе системы измеряются по объему трафика, передаваемого их памятью. Показатель Vera ближе к реальному трафику, поэтому данные о пропускной способности в Венеции и Турине в этом обзоре занижены.
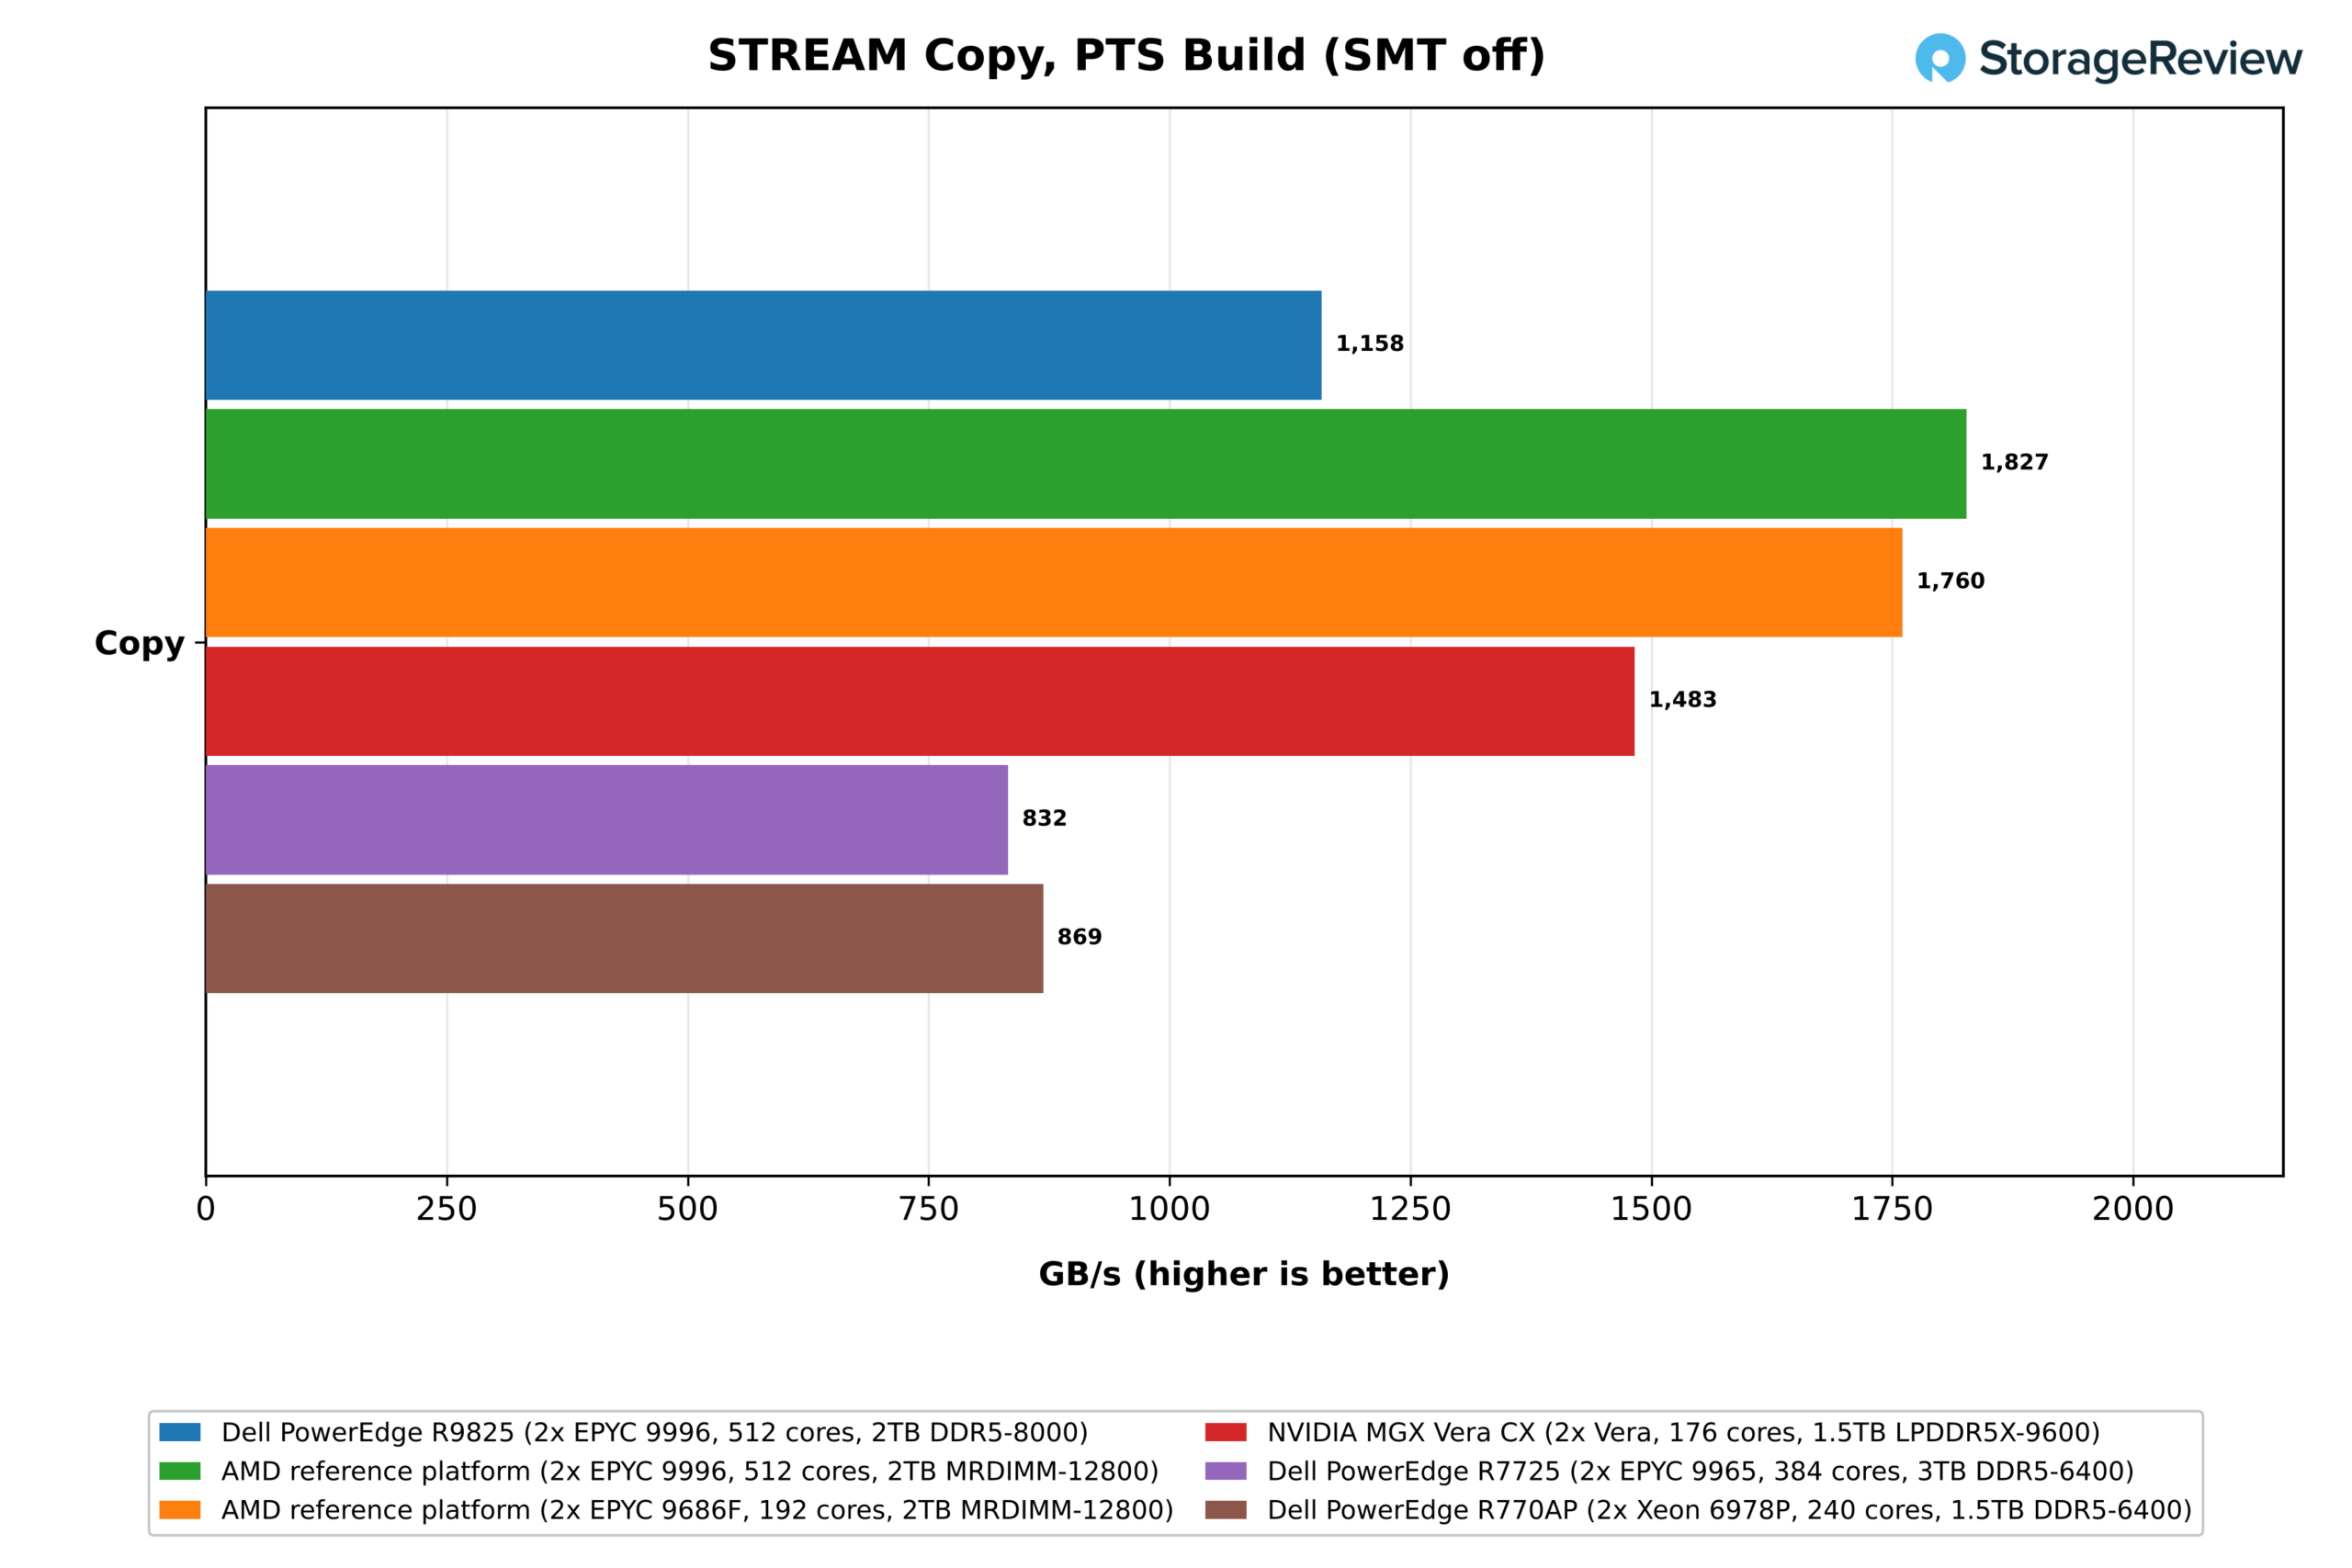
Обратите внимание на показатель 1.9x для разных поколений и на показатель 3.0x, полученный с помощью конфигурации MRDIMM на том же сервере. Оба показателя основаны на результате Triad для EPYC 9965, составляющем 634 ГБ/с, который, как показал наш обзор Vera, занижен отчасти из-за этих неучтенных операций чтения. Venice оплачивает те же операции чтения, поэтому сами по себе они не завышают соотношение, но тест STREAM Copy показывает меньшую разницу между поколениями: 1,158 ГБ/с на R9825 против 832 ГБ/с на 9965.
Тест Copy — это отдельная сборка STREAM из Phoronix Test Suite с другим расположением потоков, и он также меняет порядок верхней части графика. При отключенном SMT две конфигурации MRDIMM достигли скорости 1,827 ГБ/с и 1,760 ГБ/с, опередив Vera с 1,483 ГБ/с, в то время как Xeon 6978P показал 869 ГБ/с.
Разделение теста по сокетам показывает, как сеть обрабатывает данные, находящиеся за пределами локальной памяти ядер. Один сокет R9825, считывающий данные из локальной памяти, показал скорость 602 ГБ/с, а те же ядра, считывающие данные через xGMI в память другого сокета, показали скорость 148 ГБ/с, что составляет 25% от скорости считывания данных из удаленной и локальной памяти. Платформа MRDIMM увеличила локальный показатель до 957 ГБ/с на 9996 и 988 ГБ/с на 9686F, в то время как пропускная способность удаленной памяти осталась на уровне 150 ГБ/с и 140 ГБ/с соответственно. Таким образом, более быстрая память увеличивает разрыв, и поток, попавший на неправильный сокет, получает четверть своей локальной пропускной способности (8,000 МТ/с) и примерно шестую часть (12,800 МТ/с).
Это соотношение представляет собой измеренную стоимость двух описанных ранее каналов x16 xGMI, и это наиболее очевидное архитектурное отличие от Vera во всем наборе данных. Сокет Vera обеспечивает скорость чтения 1,055 ГБ/с локально и 677 ГБ/с удаленно через NVLink-C2C, что составляет 64%, а Xeon 6978P — 59% через UPI. Turin R7725 показал почти такой же показатель удаленного доступа, как и Venice, поэтому это характеристика Infinity Fabric, унаследованная от предыдущих версий, и размещение NPS2 и программное обеспечение, поддерживающее NUMA, имеют большее значение для Venice, чем для любого из конкурентов.
Задержка
Пропускная способность — это лишь половина дела, связанного с памятью. Задержка определяет, как долго ядро ожидает каждый раз, когда происходит промах в кэше, и это наиболее важно для кода, который отслеживает указатели в памяти. Мы измеряем это с помощью tinymembench, который измеряет время случайного чтения из буфера размером 1 ГБ одним потоком на сокете 0, и сравниваем системы Venice с Vera.
При чтении локальной памяти R9825 работает быстрее, чем Vera. При использовании страниц размером 2 МБ локальное чтение заняло 87.6 нс на R9825 и 89.5 нс на платформе MRDIMM, против 99.2 нс на Vera. Удаленное чтение заняло 200.8 нс на R9996 и 212.3 нс на платформе MRDIMM, против 212.7 нс у Vera, поэтому кросс-сокетный доступ на Venice в 2.3–2.4 раза быстрее локального, тогда как у Vera — в 2.1 раза.
Venice также менее чувствителен к размеру страницы. При использовании страниц размером 4 КБ, где пропущенные преобразования адресов увеличивают время чтения, R9825 считывал данные за 106.9 нс локально и 225.9 нс удаленно, в то время как Vera показала 135.8 нс и 308.4 нс соответственно. Двухуровневый TLB в Zen 6c лучше компенсирует потери, связанные с малым размером страницы, чем Olympus.
HPC
Пропускная способность и задержка описывают работу системы памяти в отрыве от контекста. Научные приложения показывают, что происходит, когда эта система памяти и ядра должны работать вместе, и наши два теста высокопроизводительных вычислений используют совершенно разные части центрального процессора.
GROMACS, программа для моделирования молекулярной динамики, большую часть времени использует векторную арифметику, при этом циклы обработки данных пишутся вручную для каждой ширины SIMD-операции. OpenFOAM, решатель задач вычислительной гидродинамики, работает с большими разреженными матрицами и большую часть времени тратит на ожидание доступа к памяти. На большинстве процессоров эти две программы работают в противоположных направлениях, и Venice — первая платформа в нашем наборе, которая лидирует по обоим параметрам.
GROMACS
Мы протестировали GROMACS 2025.3 с помощью benchPEP, модели, включающей 12 миллионов атомов и запущенной на каждом физическом ядре сервера. В сборке использовался AVX-512 на всех системах x86 и ARM_SVE на Vera, а благодаря закрепленным входам и отключенной настройке PME, все платформы выполняли одинаковую работу.
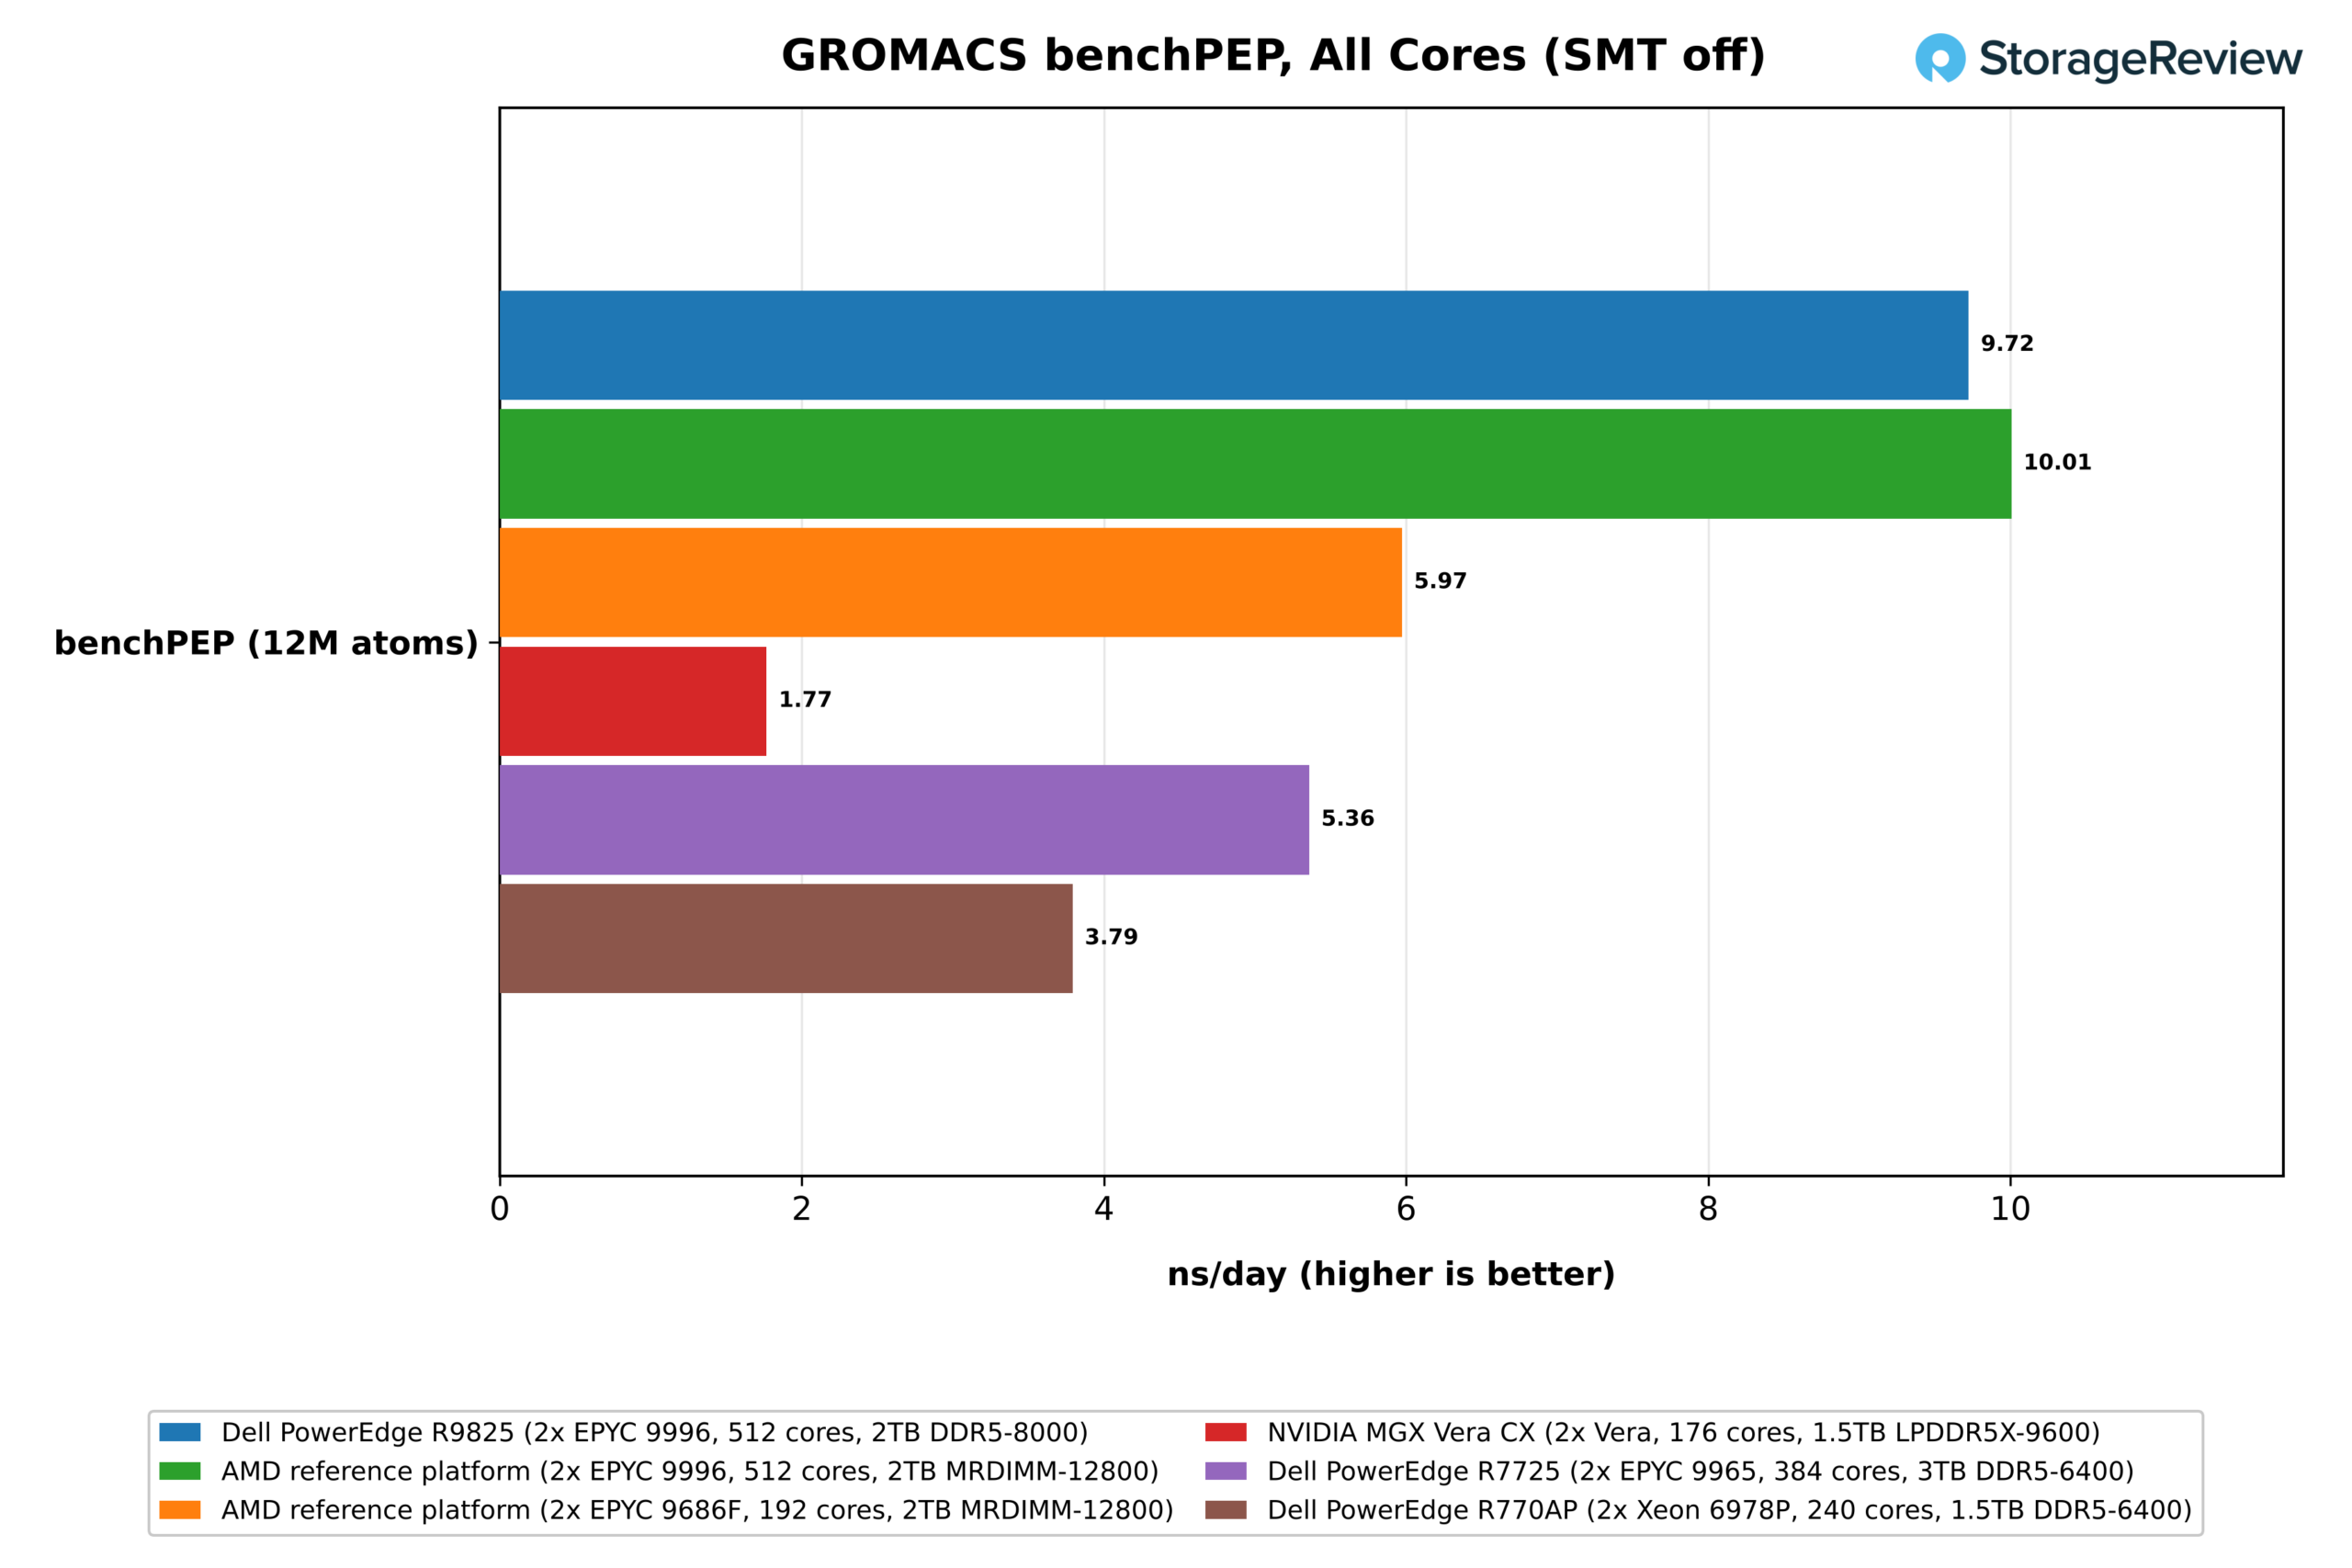
При отключенной технологии SMT процессор R9825 показал в тесте benchPEP результат 9.72 нс/день, что в 1.8 раза выше, чем у серверного EPYC 9965 (5.36 нс/день) на 384 ядрах, и в 2.6 раза выше, чем у Xeon 6978P (3.79 нс/день) на 240 ядрах. Платформа MRDIMM показала прирост в 3% (10.01 нс/день), поэтому этот тест ограничен вычислительной мощностью на 512 ядрах. 192-ядерный 9686F достиг 5.97 нс/день, опередив флагманский 384-ядерный Turin на половине ядер, а лучший результат Vera (2.07 нс/день) с включенной технологией SMT составляет примерно пятую часть от показателя R9825.
Нормализация по количеству ядер показывает, какая часть этого разрыва обусловлена архитектурой. Для R9825 это составляет 0.0190 нс/день на ядро, против 0.0140 у EPYC 9965 и 0.0158 у Xeon 6978P, что составляет прирост производительности на 36% на ядро по сравнению с Zen 5c, который достигается за счет более быстрого ядра Zen 6c, большего объема кэша L3 и дополнительных каналов памяти. Показатель 0.0311 на ядро у 9686F демонстрирует, что дает 5.3 ГГц и 384 МБ кэша L3 на 96 ядрах при работе с этим кодом.
В Венеции SMT практически не изменила свои результаты: два запуска 9996 показали результаты, отличающиеся от результатов без SMT всего на 1.5%, а 9686F прибавила 5% при использовании схемы ранжирования 192×2.
В тесте benchMEM разница между производительностью одного ядра определяется путем запуска системы с 82 000 атомами на 16 физических ядрах сокета 0 на каждой платформе, поэтому количество ядер не учитывается, и результат отражает векторную пропускную способность, кэш и локальную память.
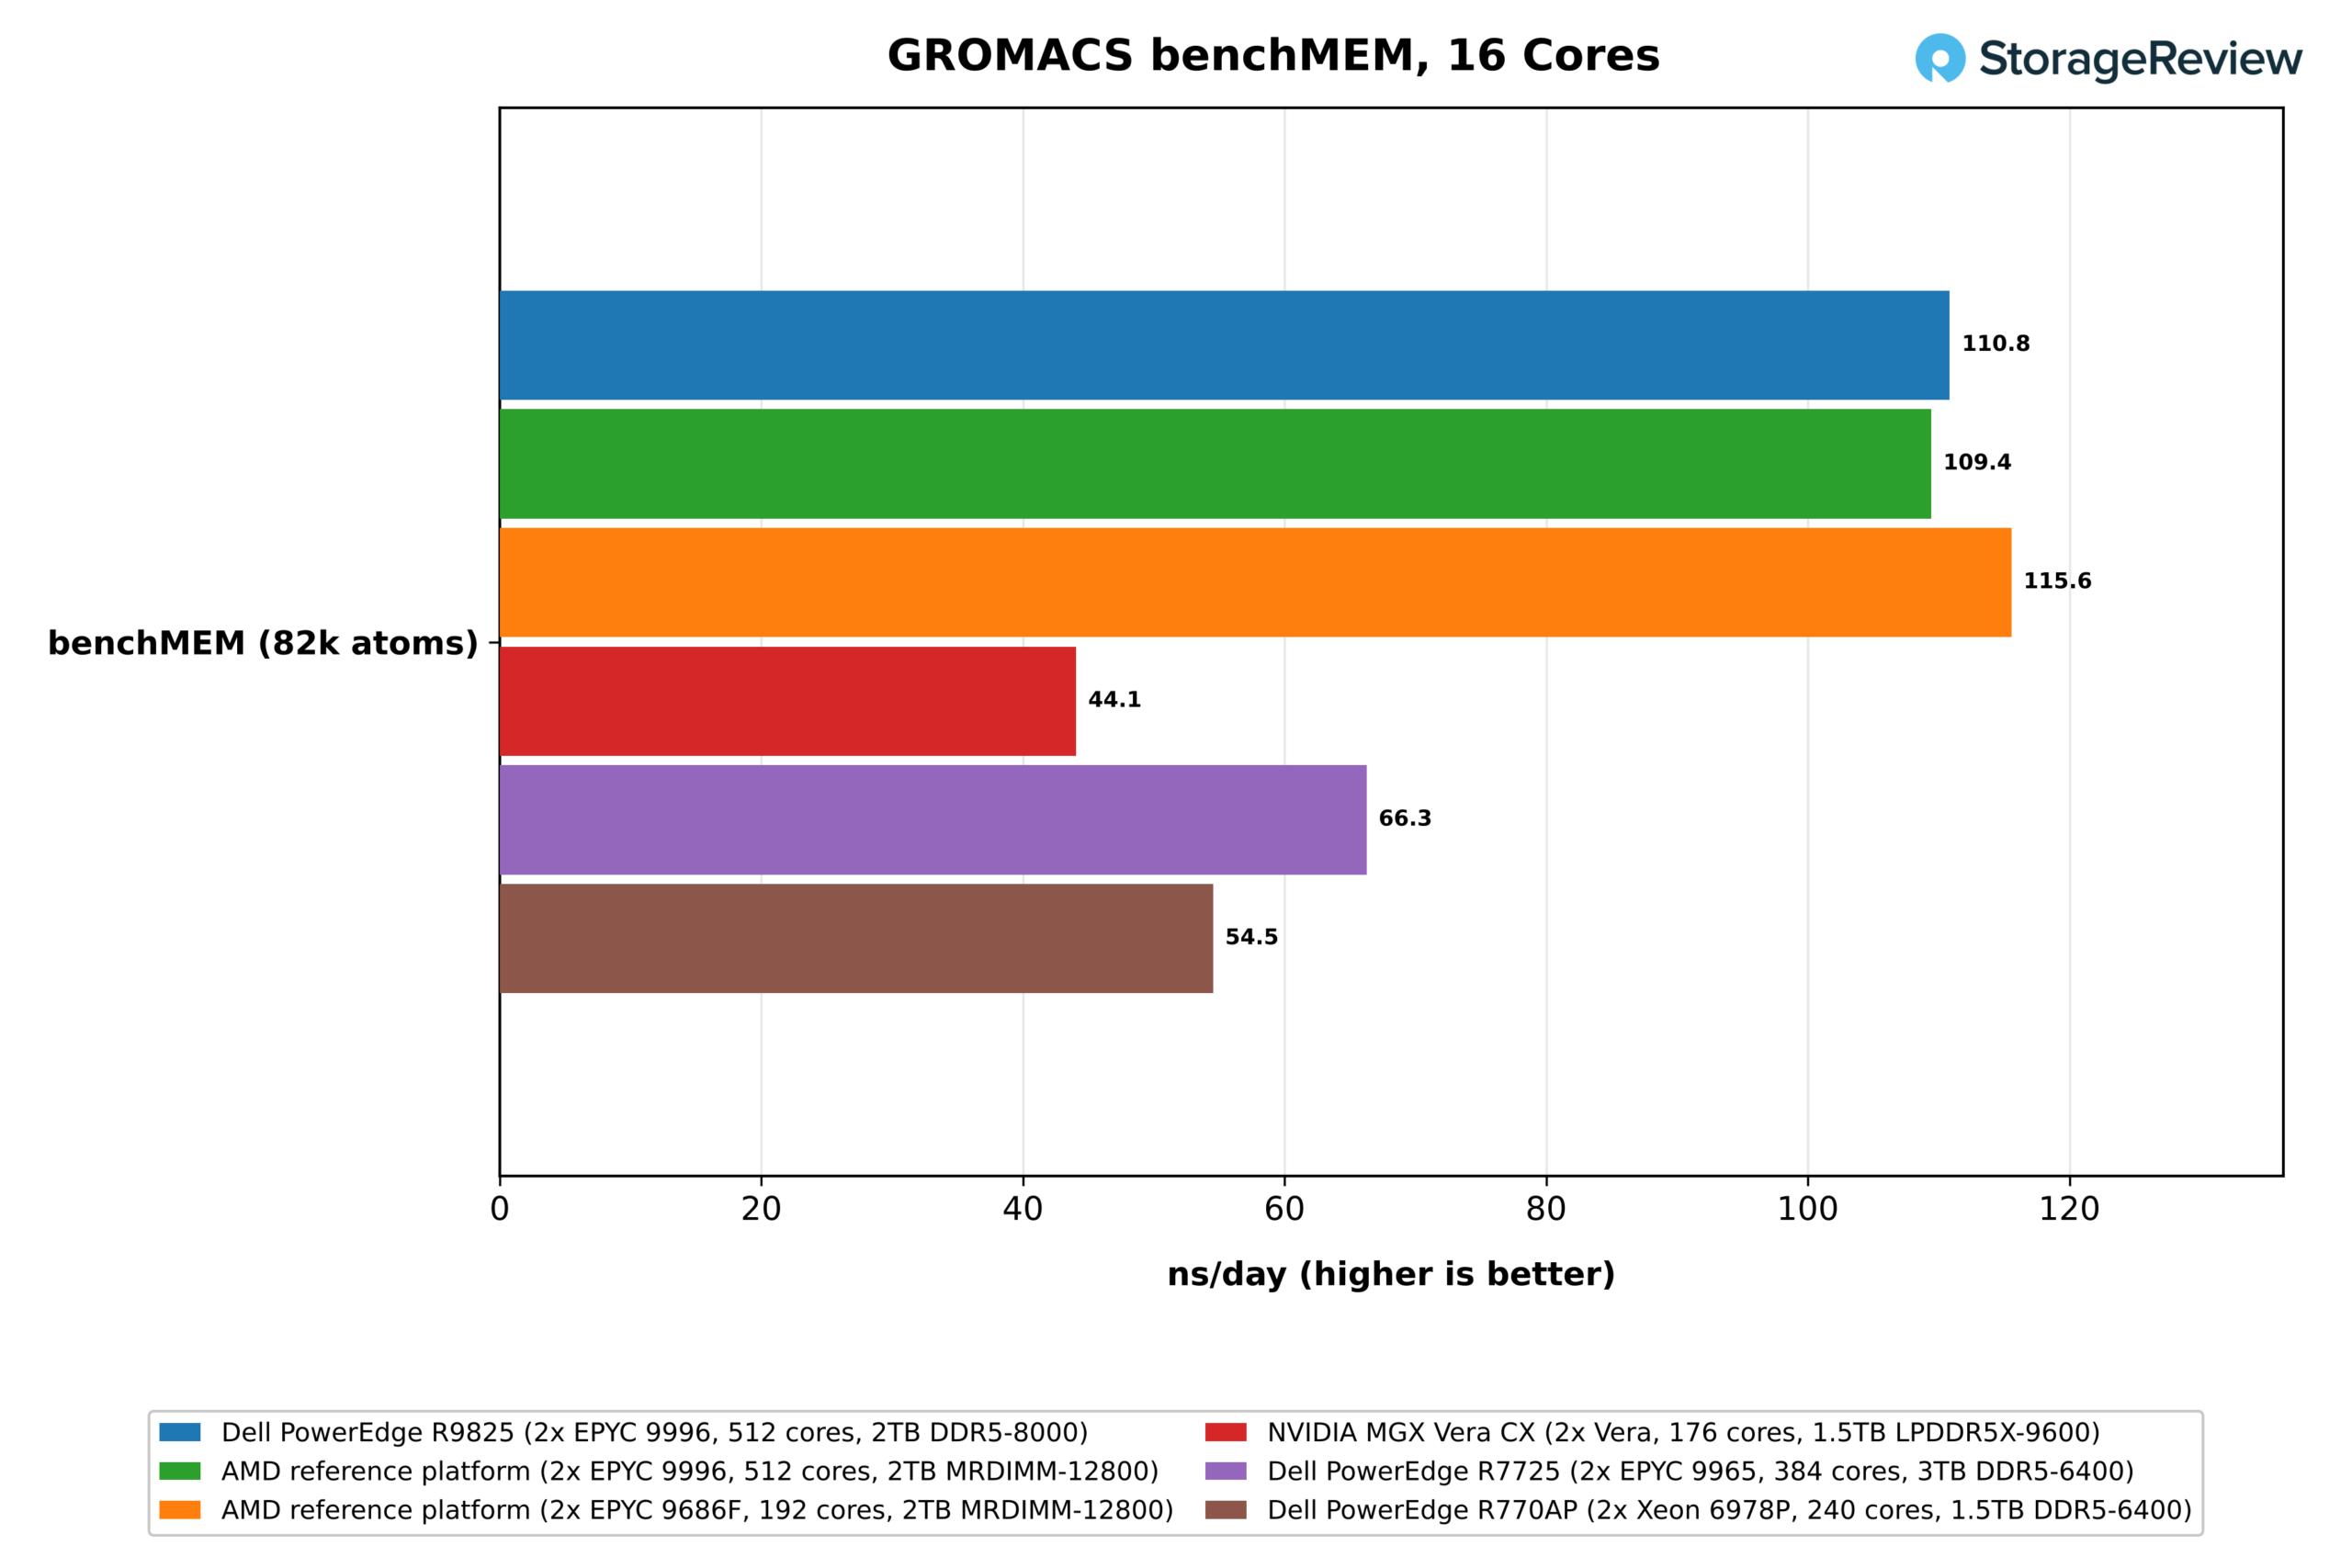
Здесь 16 ядер Zen 6c на R9825 показали производительность 110.8 нс/день, MRDIMM 9996 — 109.4, а 9686F — 115.6. Шестнадцать ядер Zen 5c на EPYC 9965 достигли 66.3, опередив Xeon 6978P (54.5) и Vera (44.1). Это на 67% больше производительности на ядро по сравнению с процессором Turin с плотной архитектурой ядра при выполнении одной и той же рабочей нагрузки, и в 2.5 раза больше, чем шесть 128-битных SVE2-конвейеров Olympus.
Рабочий набор из 82 000 атомов помещается в 128-мегабайтный L3-диапазона ПЗС-матрицы Zen 6c с запасом места, поэтому три конфигурации из Венеции отличаются друг от друга всего на 6%, что значительно меньше, чем разница между любой из них и остальными образцами.
OpenFOAM
OpenFOAM переносит нагрузку с векторных блоков на систему памяти, и здесь в игру вступают как система памяти, так и количество ядер. Мы запускаем OpenFOAM 13 на примере автомобильной аэродинамики driveerFastback, используя один ранг MPI на каждое физическое ядро, с двумя размерами сетки: средней сеткой с 2.98 миллионами ячеек и большой сеткой с 22.6 миллионами ячеек.
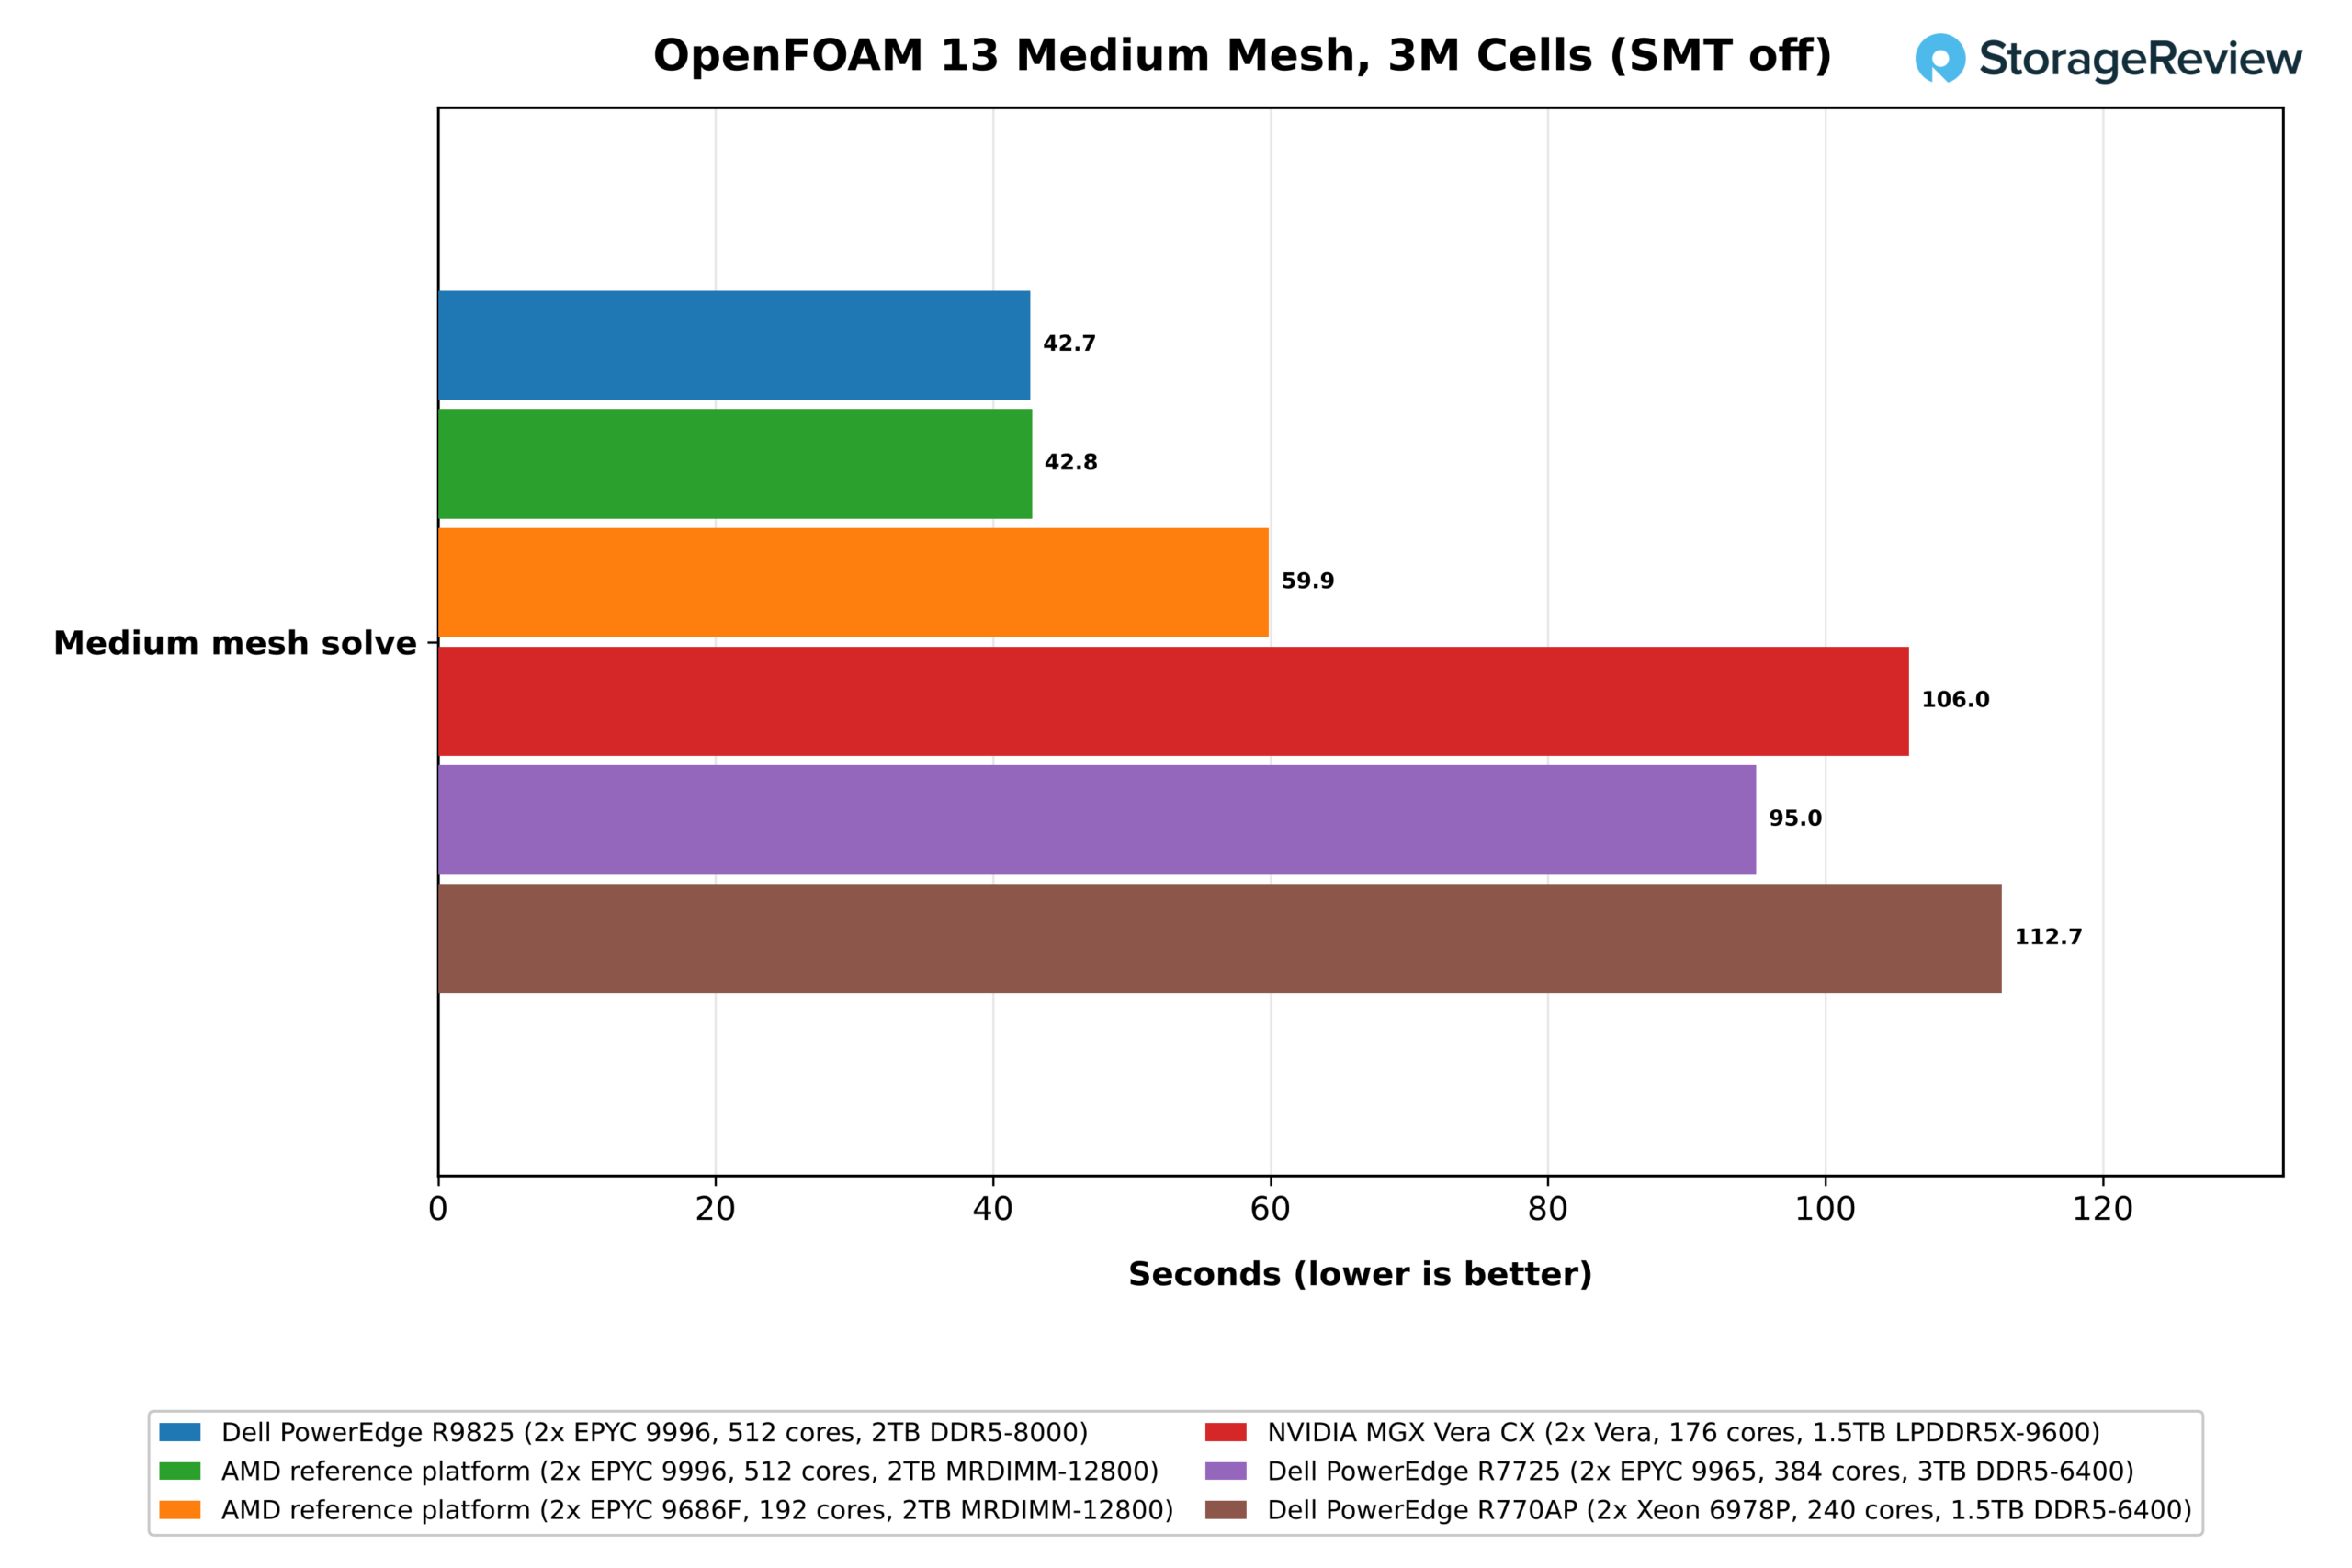
Решение задачи на средней сетке заняло 42.7 секунды на R9825 и 42.8 секунды на платформе MRDIMM, что в 2.2 раза быстрее, чем 95.0 секунд у EPYC 9965, и в 2.5 раза быстрее, чем 106.0 секунд у Vera. Совпадающие результаты для обоих типов памяти указывают на то, что небольшая проблема связана с количеством ядер и кэшем на уровне 512 рангов. Результат 9686F в 59.9 секунды на 192 ядрах подтверждает это, поскольку 96-ядерная система выполнила задачу на 40% дольше, чем системы на базе 9996, но при этом завершила её в 1.6 раза быстрее, чем Turin.
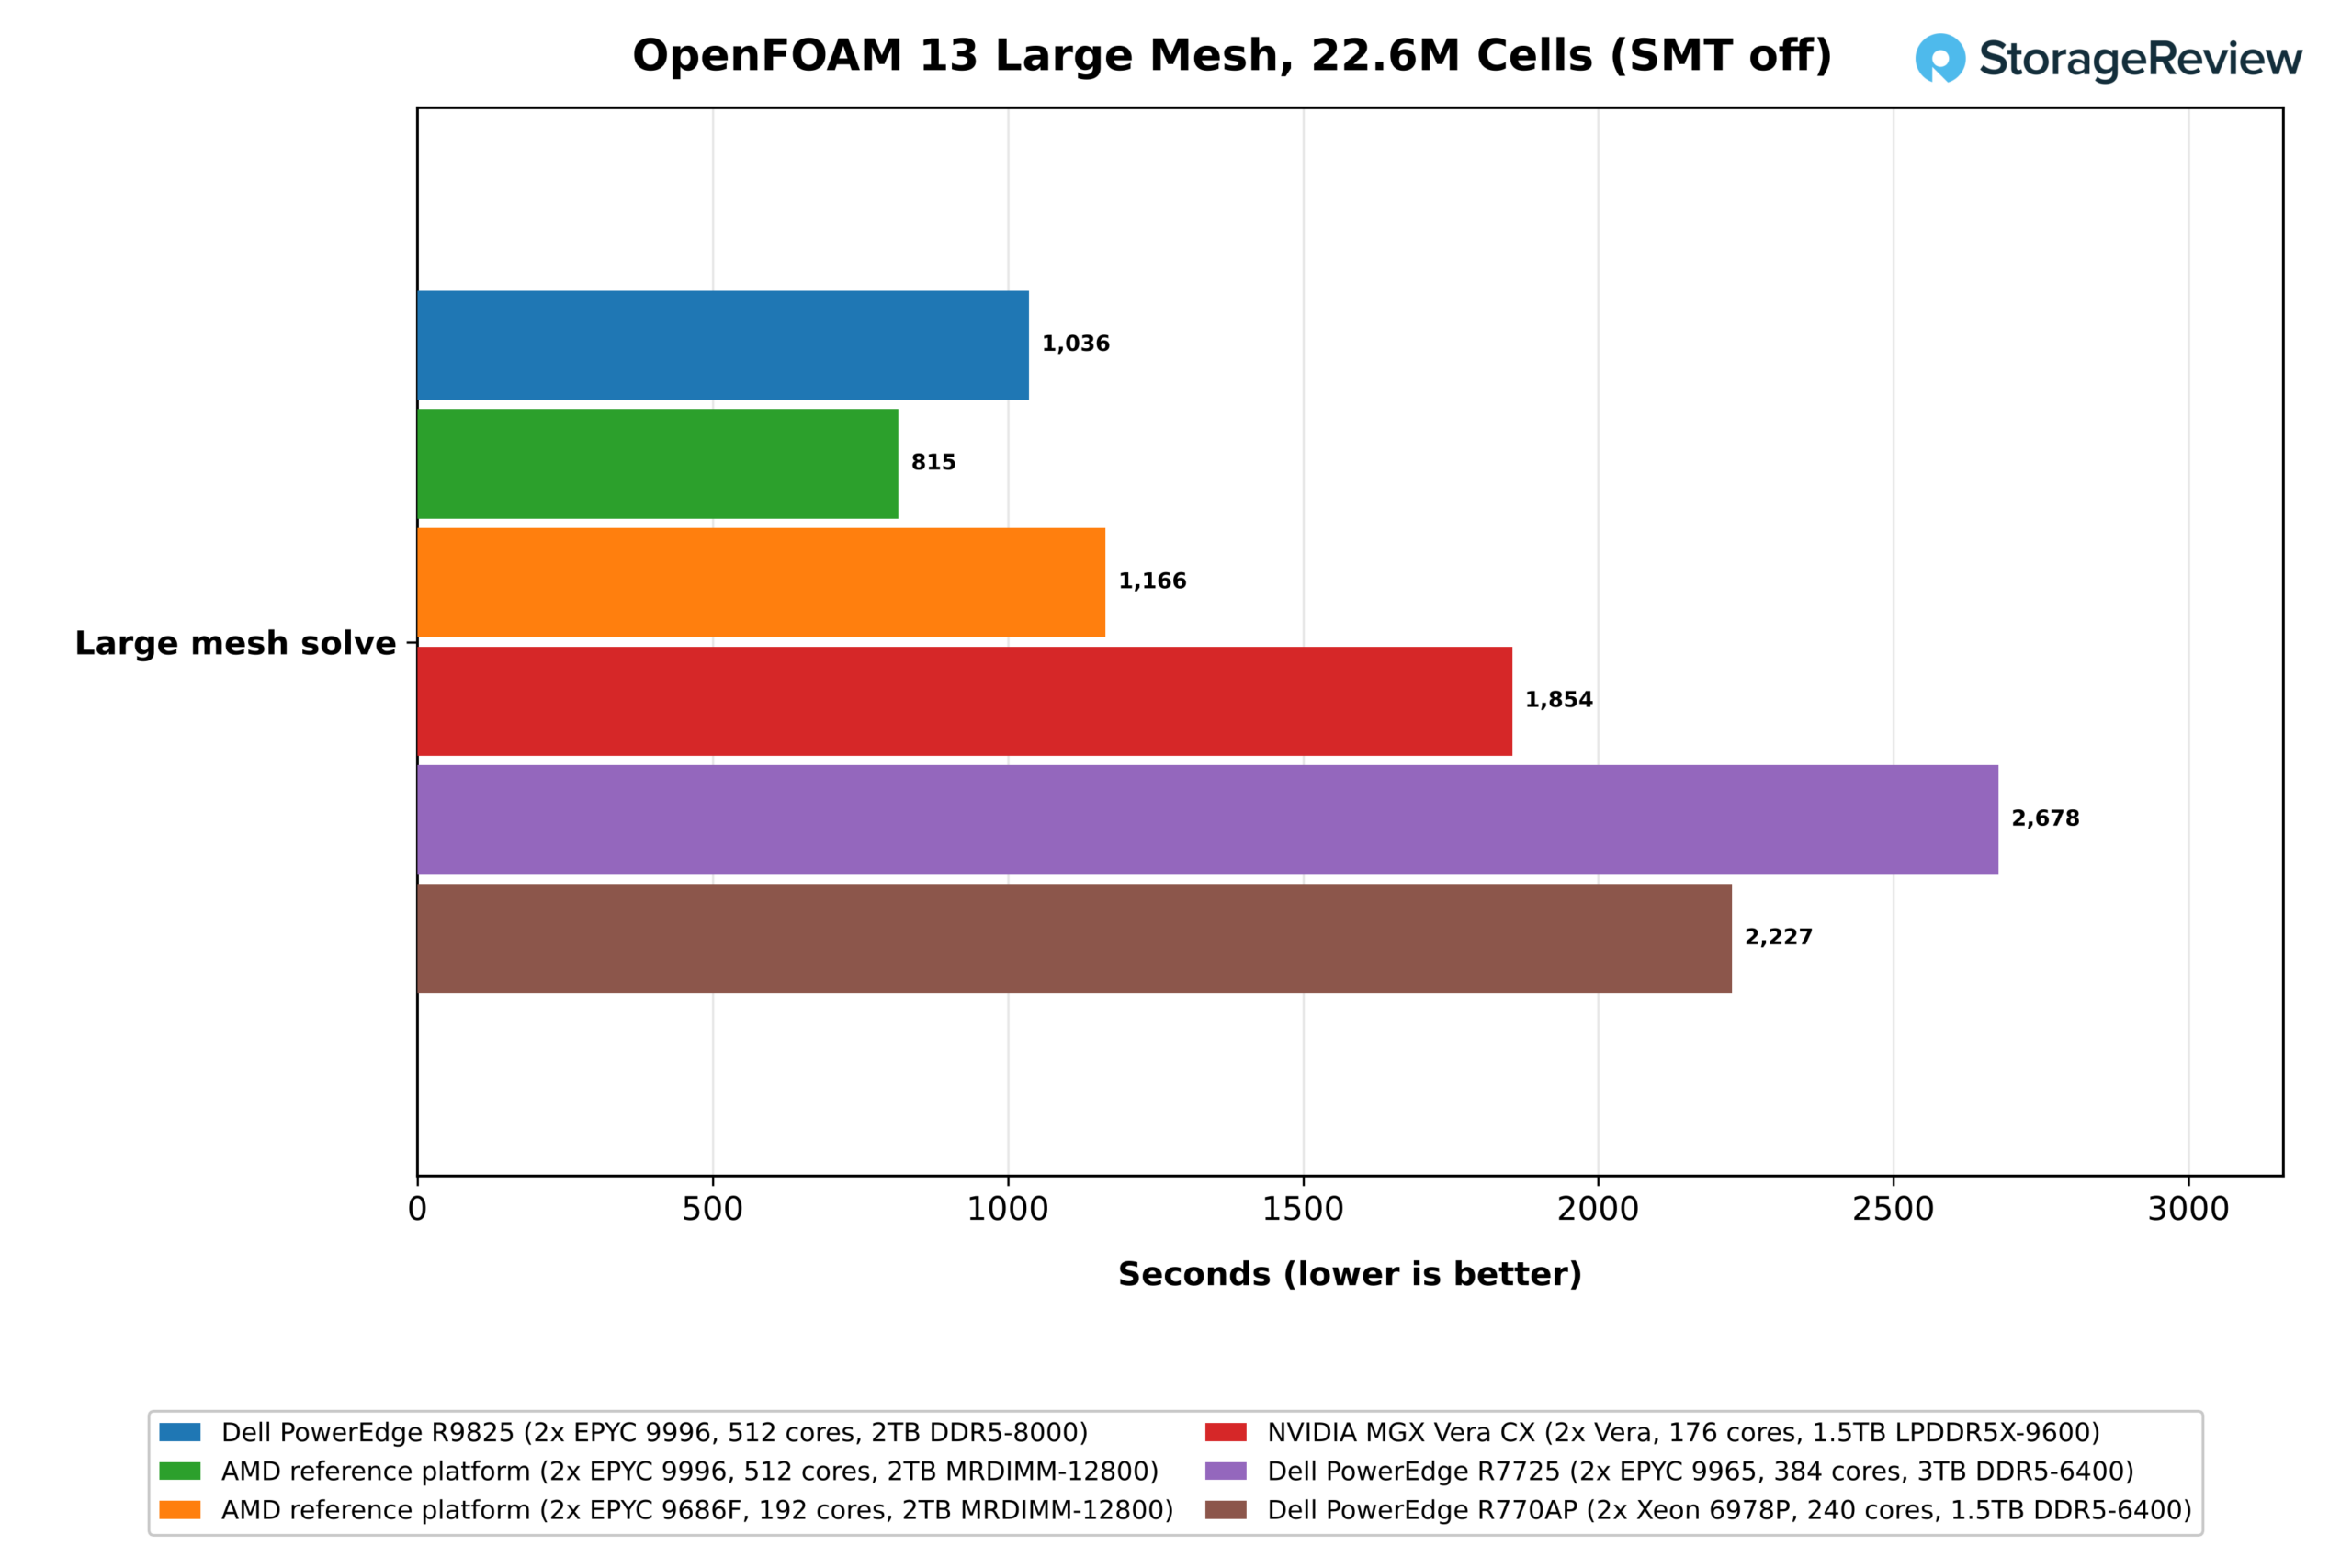
В большой сетке отображается тип памяти. Процессор R9825 справился с задачей за 1,036 секунд, что в 2.6 раза быстрее, чем EPYC 9965 (2,678 секунд), и в 1.8 раза быстрее, чем Vera (1,854 секунды), а те же процессоры на MRDIMM-12800 завершили задачу за 815 секунд, на 21% быстрее.
Время выполнения 9686F, составляющее 1,166 секунд на 192 ядрах, отличается от показателя 512-ядерного R9825 всего на 13%, что демонстрирует работу предела пропускной способности. При таком размере сетки система с пропускной способностью 8,000 МТ/с обрабатывает 256 ядер на сокет, при этом общая пропускная способность меньше, чем у системы с MRDIMM, обеспечивающей 96 ядер. На тех же MRDIMM переход от 96 к 256 ядрам на сокет снижает время решения на 30%, а на тех же 256 ядрах MRDIMM снижает его на 21%. Таким образом, для CFD-моделирования, метеорологических расчетов и других задач, требующих большого объема памяти, при производственных размерах сетки выбор памяти имеет примерно такое же значение, как и количество ядер.
Аналитика и данные в оперативной памяти
Результаты высокопроизводительных вычислений показали, на что способны ядра и память Venice для решения научных задач. Сервисы обработки данных используют одно и то же оборудование по-разному, и наши два теста задействуют его с противоположных сторон. ClickBench выполняет аналитические запросы, которые сканируют и агрегируют большие столбцы данных, распределяя каждый запрос по пулу потоков, размер которого соответствует системе. Valkey, форк Redis с открытым исходным кодом, обрабатывает небольшие запросы типа «ключ-значение» и разделяет задержку на ядро и общую пропускную способность.
ClickBench
Мы протестировали ClickBench, выполнив 43 запроса к таблице веб-аналитики, содержащей 100 миллионов строк, на ClickHouse 26.8. Его показатель «горячей суммы», где каждый запрос считывает данные из кэша страниц, является лучшим в нашем наборе показателей того, как процессор и его память обрабатывают столбцовые сканирования и агрегации. «Холодная сумма» добавляет перезапуски сервера и операции чтения с SSD перед первым выполнением каждого запроса.
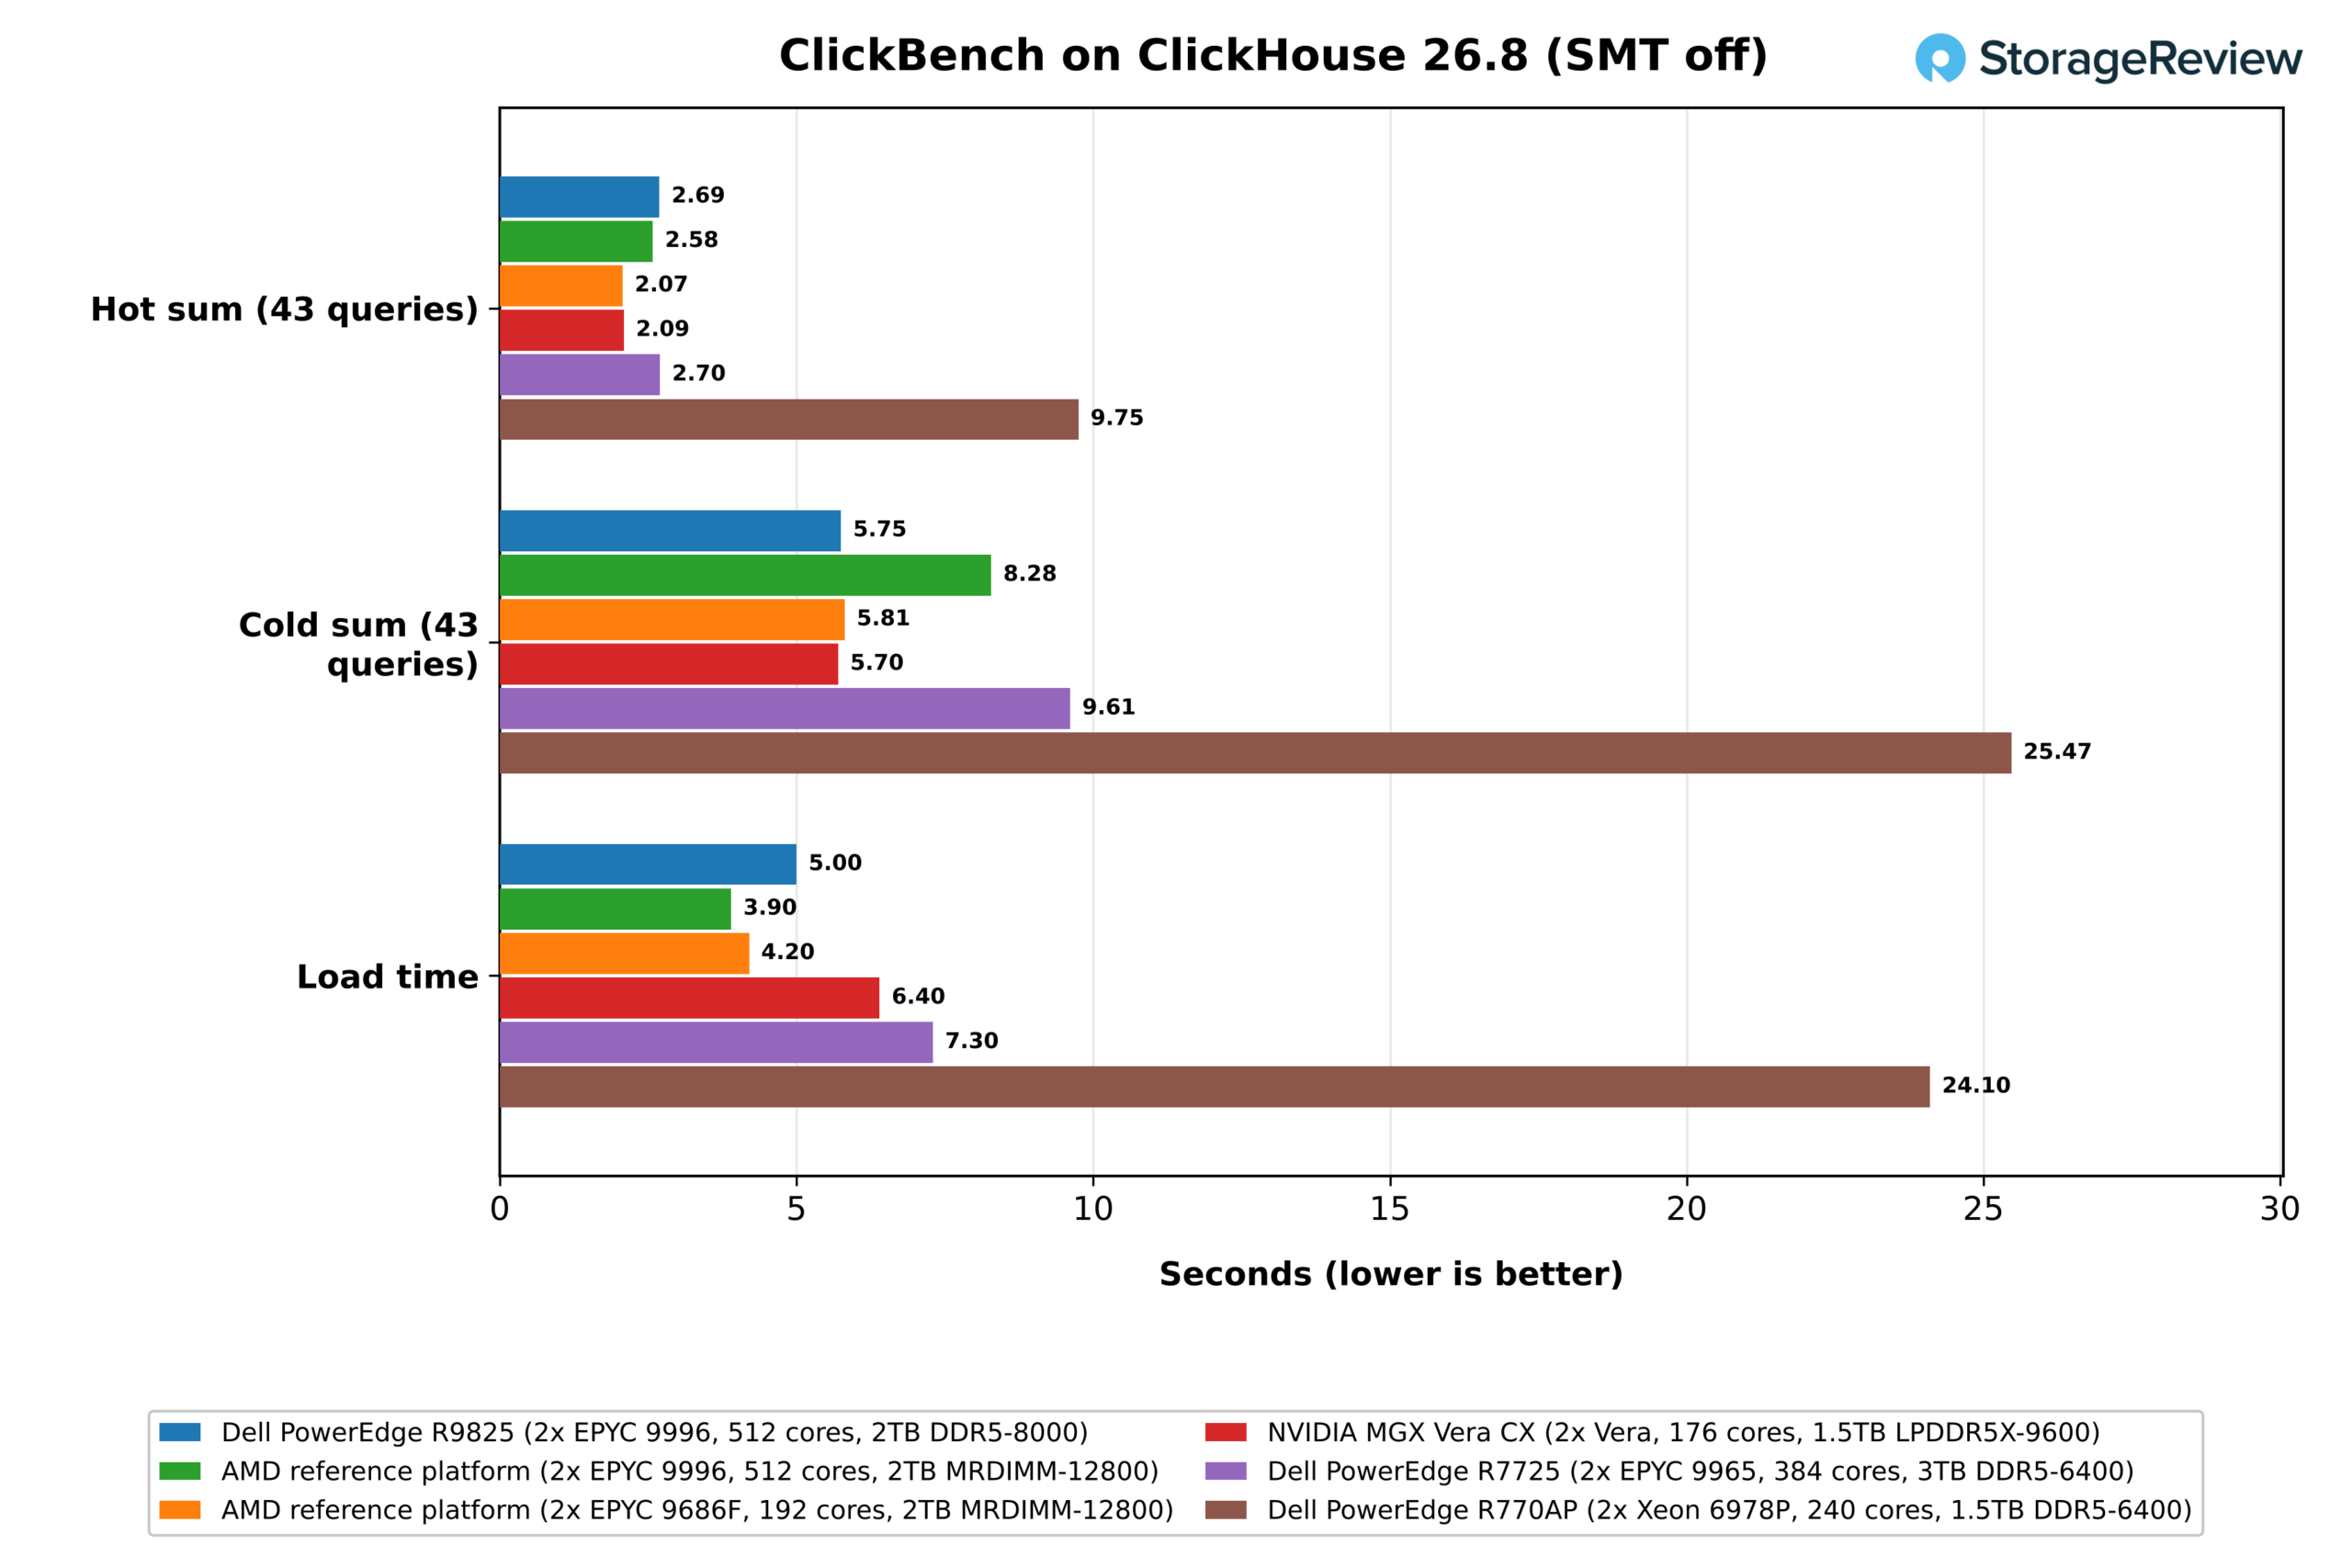
При отключенном SMT медианное время выполнения трех тестов на R9825 составило 2.69 секунды, что соответствует показателю EPYC 9965 (2.70 секунды), находящемуся в пределах 7%-ного порога, а показатель платформы MRDIMM (2.58 секунды) также попадает в этот диапазон. 9686F выполнил набор тестов за 2.07 секунды, что соответствует показателю Vera (2.09 секунды) и является самым быстрым результатом для x86, который мы зафиксировали. При 512 потоках на систему, накладные расходы ClickHouse на планирование и слияние запросов расходуют дополнительные ядра, в то время как 96 ядер на частоте 5.3 ГГц с 384 МБ кэша L3 обрабатывают 43 запроса быстрее, чем 256 на частоте 4.1 ГГц.
В тесте "холодный режим" большее значение имеет хранилище данных, а используемые накопители различаются между нашей лабораторией и платформой AMD. R9825 завершил тест "холодным режимом" за 5.75 секунды, в то время как Vera показала 5.70 секунды, а 9965 — 9.61 секунды, а 9686F показал такой же результат — 5.81 секунды. Конфигурация MRDIMM 9996 заняла 8.28 секунды на платформе AMD, где использовался другой накопитель и предварительная версия ядра Linux 7.2.0-rc5 от AMD. Тест перезапускает сервер перед каждым запросом, поэтому мы не учитываем этот результат.
Процессор R9825 загрузил 15-гигабайтный набор данных Parquet за 5.0 секунд, против 3.9 и 4.2 секунд на двух эталонных платформах, 6.4 секунды на Vera и 7.3 секунды на 9965. Результаты тестирования системы на базе Xeon 6978P (9.75 секунды в «горячей» области и 25.47 секунды в «холодной» области) остаются несогласованными по сравнению с нашими предыдущими тестами, поэтому мы приводим их без ранжирования.
Включение SMT увеличило время выполнения на «горячей» архитектуре R9825 до 2.67 секунд, а на «холодной» — до 6.53 секунд, поэтому дополнительные 512 потоков не изменили время выполнения на «горячей» архитектуре, но увеличили время на «холодной». Vera потеряла 10% своей производительности на «горячей» архитектуре при удвоении количества потоков, что отражает то, как конкурентоспособная технология SMT в Zen 6c и технология пространственной многопоточности NVIDIA справляются с пулом потоков, размер которого соответствует логическим процессорам.
Валки
Valkey выполняет команды в однопоточном цикле для каждого экземпляра, поэтому мы рассматриваем это с двух сторон: то, что один сервер предоставляет на сопоставимых ядрах, и то, что предоставляет сокет, когда он заполнен экземплярами.
Профиль конфигурации сервера Valkey предоставляет каждому серверу девять физических ядер на каждой платформе и охватывает глубину конвейера и размер рабочего набора, демонстрируя поведение каждого ядра при одинаковом количестве ядер. На диаграмме также показаны результаты в режиме сокета при отправке запросов по одному, что мы рассмотрим на примере других диаграмм сокетов ниже.
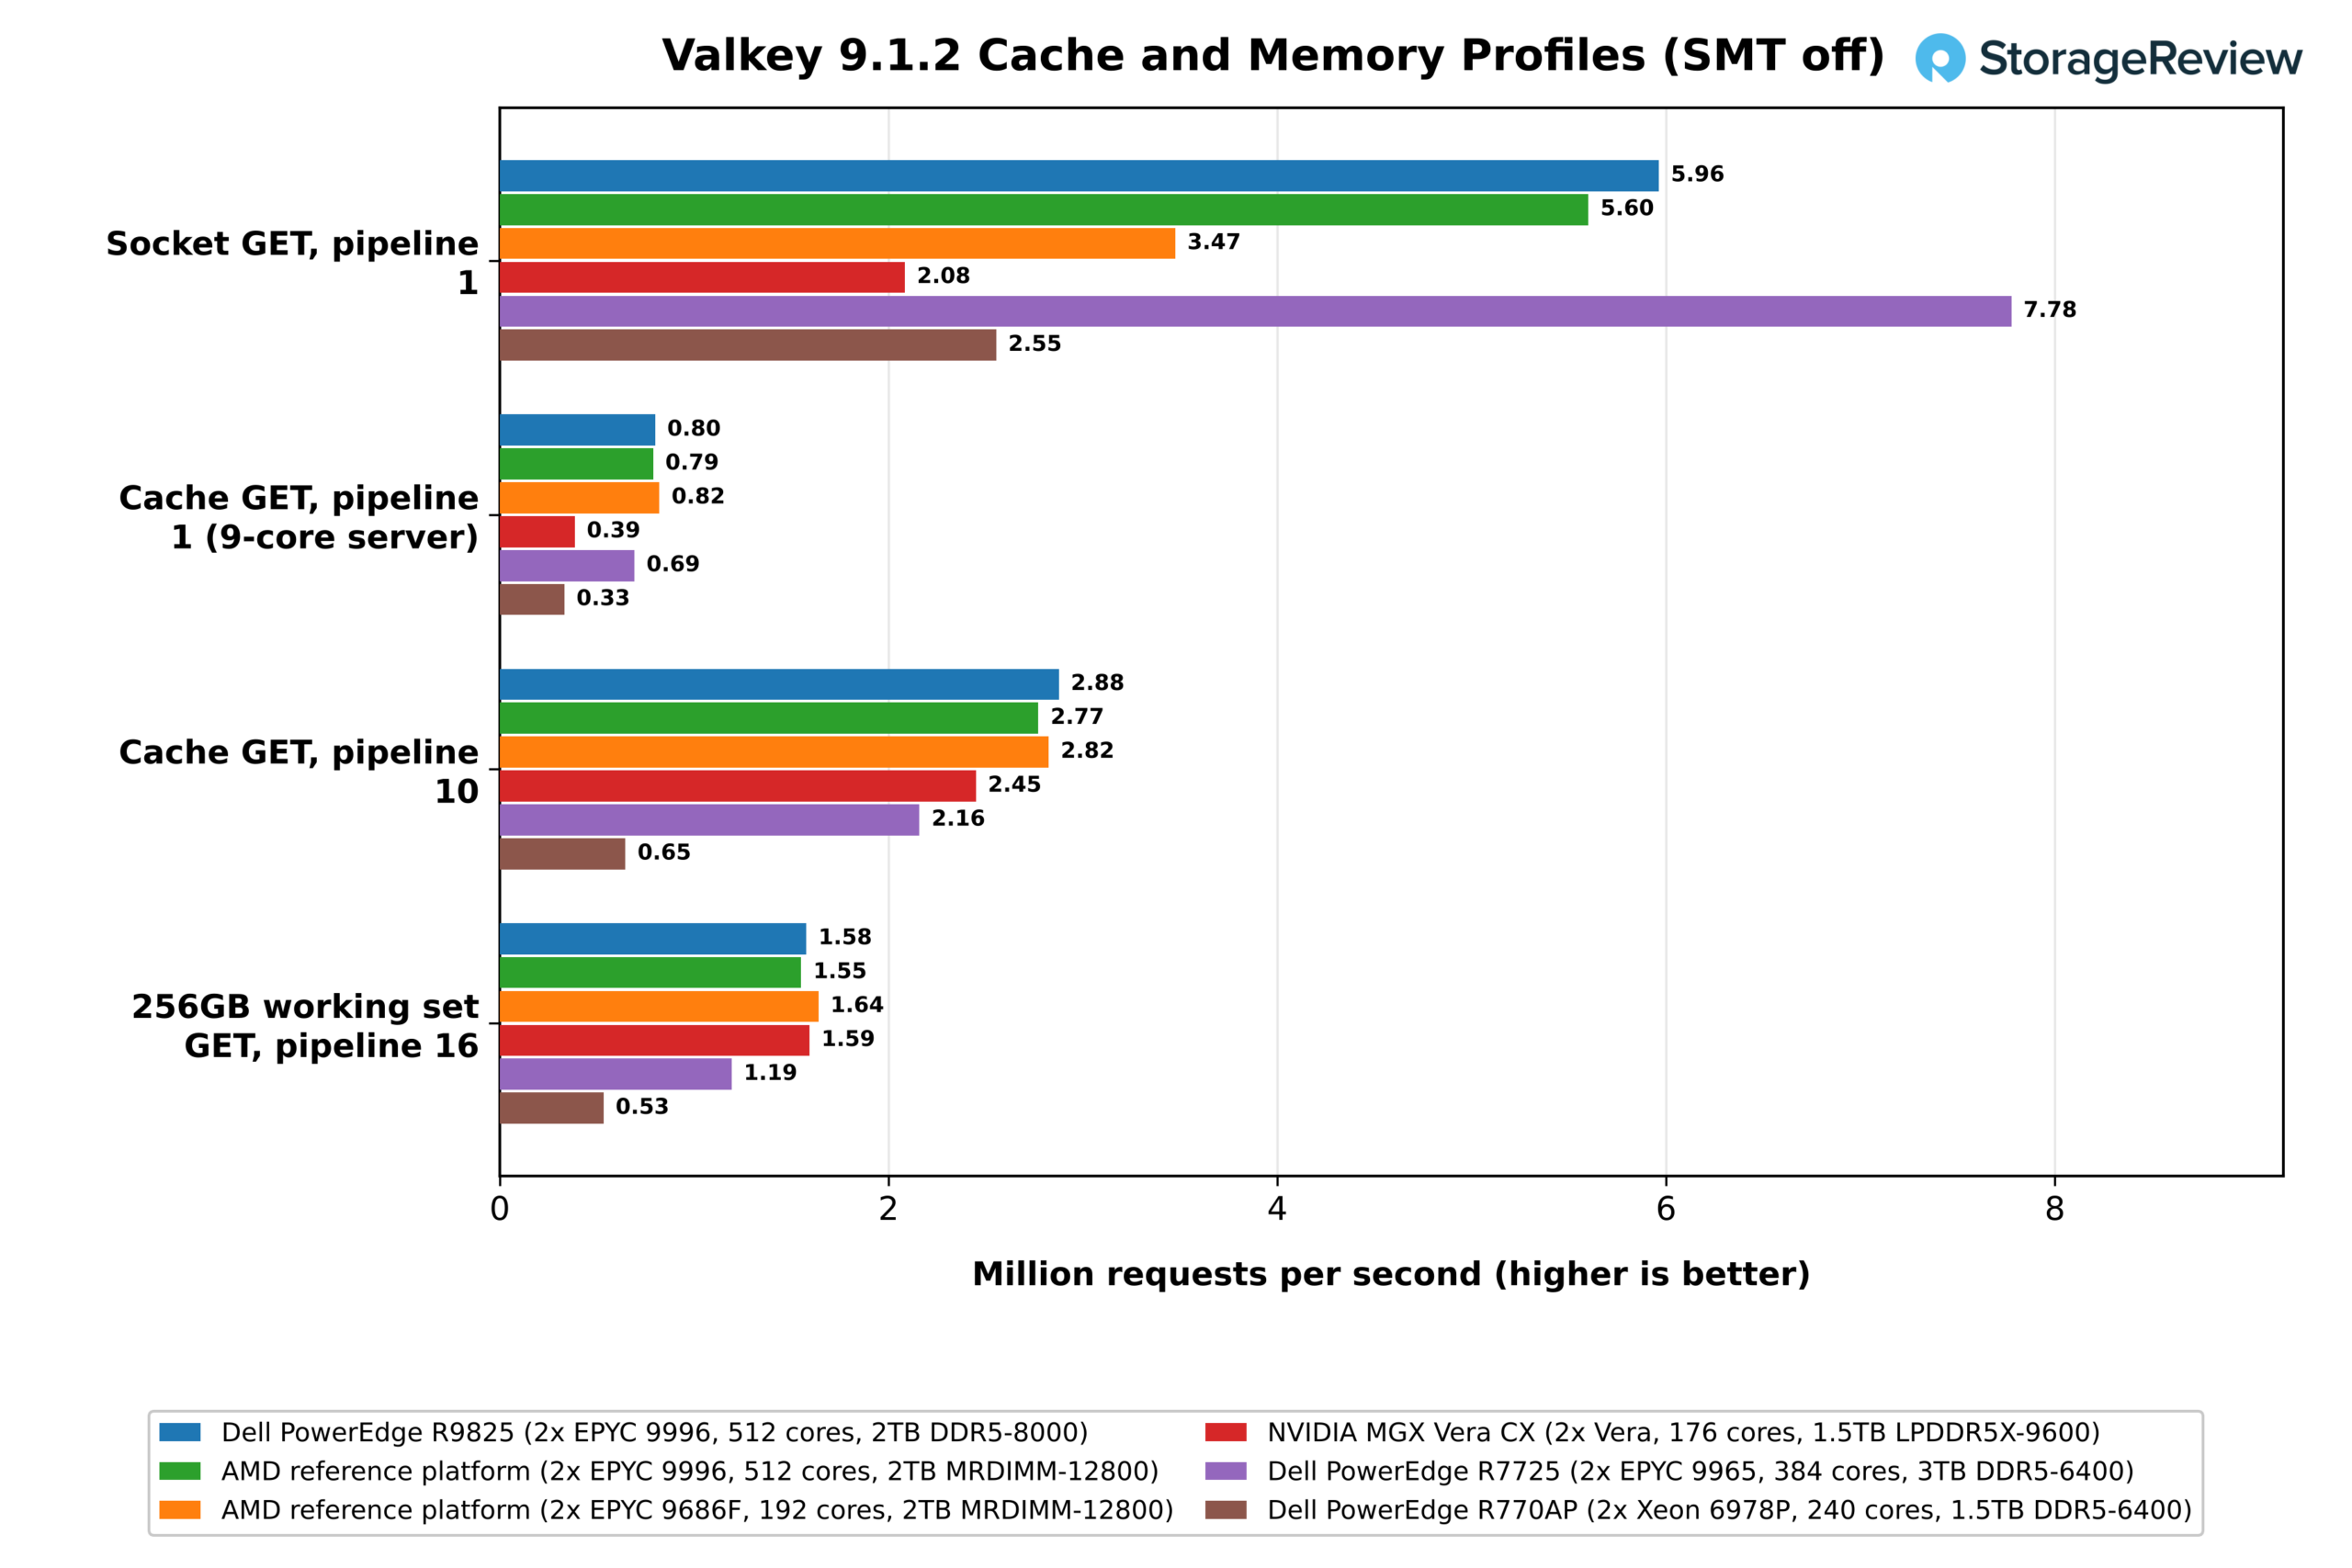
При пошаговой отправке запросов GET в кэш скорость составляла 799 000 в секунду на R9825 с показателем p99 0.84 мс, против 692 000 и 1.08 мс на 9965, 385 000 и 1.76 мс на Vera и 332 000 на Xeon 6978P, в то время как 9686F лидировал с 821 000. При отправке партиями по 10 запросов R9825 достиг 2.88 млн против 2.16 млн у 9965 и 2.45 млн у Vera, что на 33% больше, чем у AMD, и на 18% больше, чем у Olympus.
Рабочий набор данных объемом 256 ГБ превосходит по производительности любой кэш, поэтому его результат отражает одновременно задержку памяти и пропускную способность, и здесь Venice и Vera фактически сравнялись, выполнив от 1.55 до 1.64 млн GET-запросов в секунду. R9825 обработал 1.58 млн запросов, MRDIMM 9996 — 1.55 млн, 9686F — 1.64 млн, а Vera — 1.59 млн, при этом 9965 показал 1.19 млн, а Xeon — 0.53 млн. Результат Vera — 1.76 млн с включенным SMT — является лучшим показателем в этом тесте и единственным результатом в наборе Valkey, где система памяти Olympus демонстрирует преимущество перед Zen 6c.
В режиме сокета экземпляры сервера привязываются к сокету 0, по одному на каждые четыре или восемь ядер, и управляются клиентами через сокет 1 по протоколу loopback, поэтому в результате получается пропускная способность одного сокета для передачи данных типа «ключ-значение» без сетевого адаптера на пути.
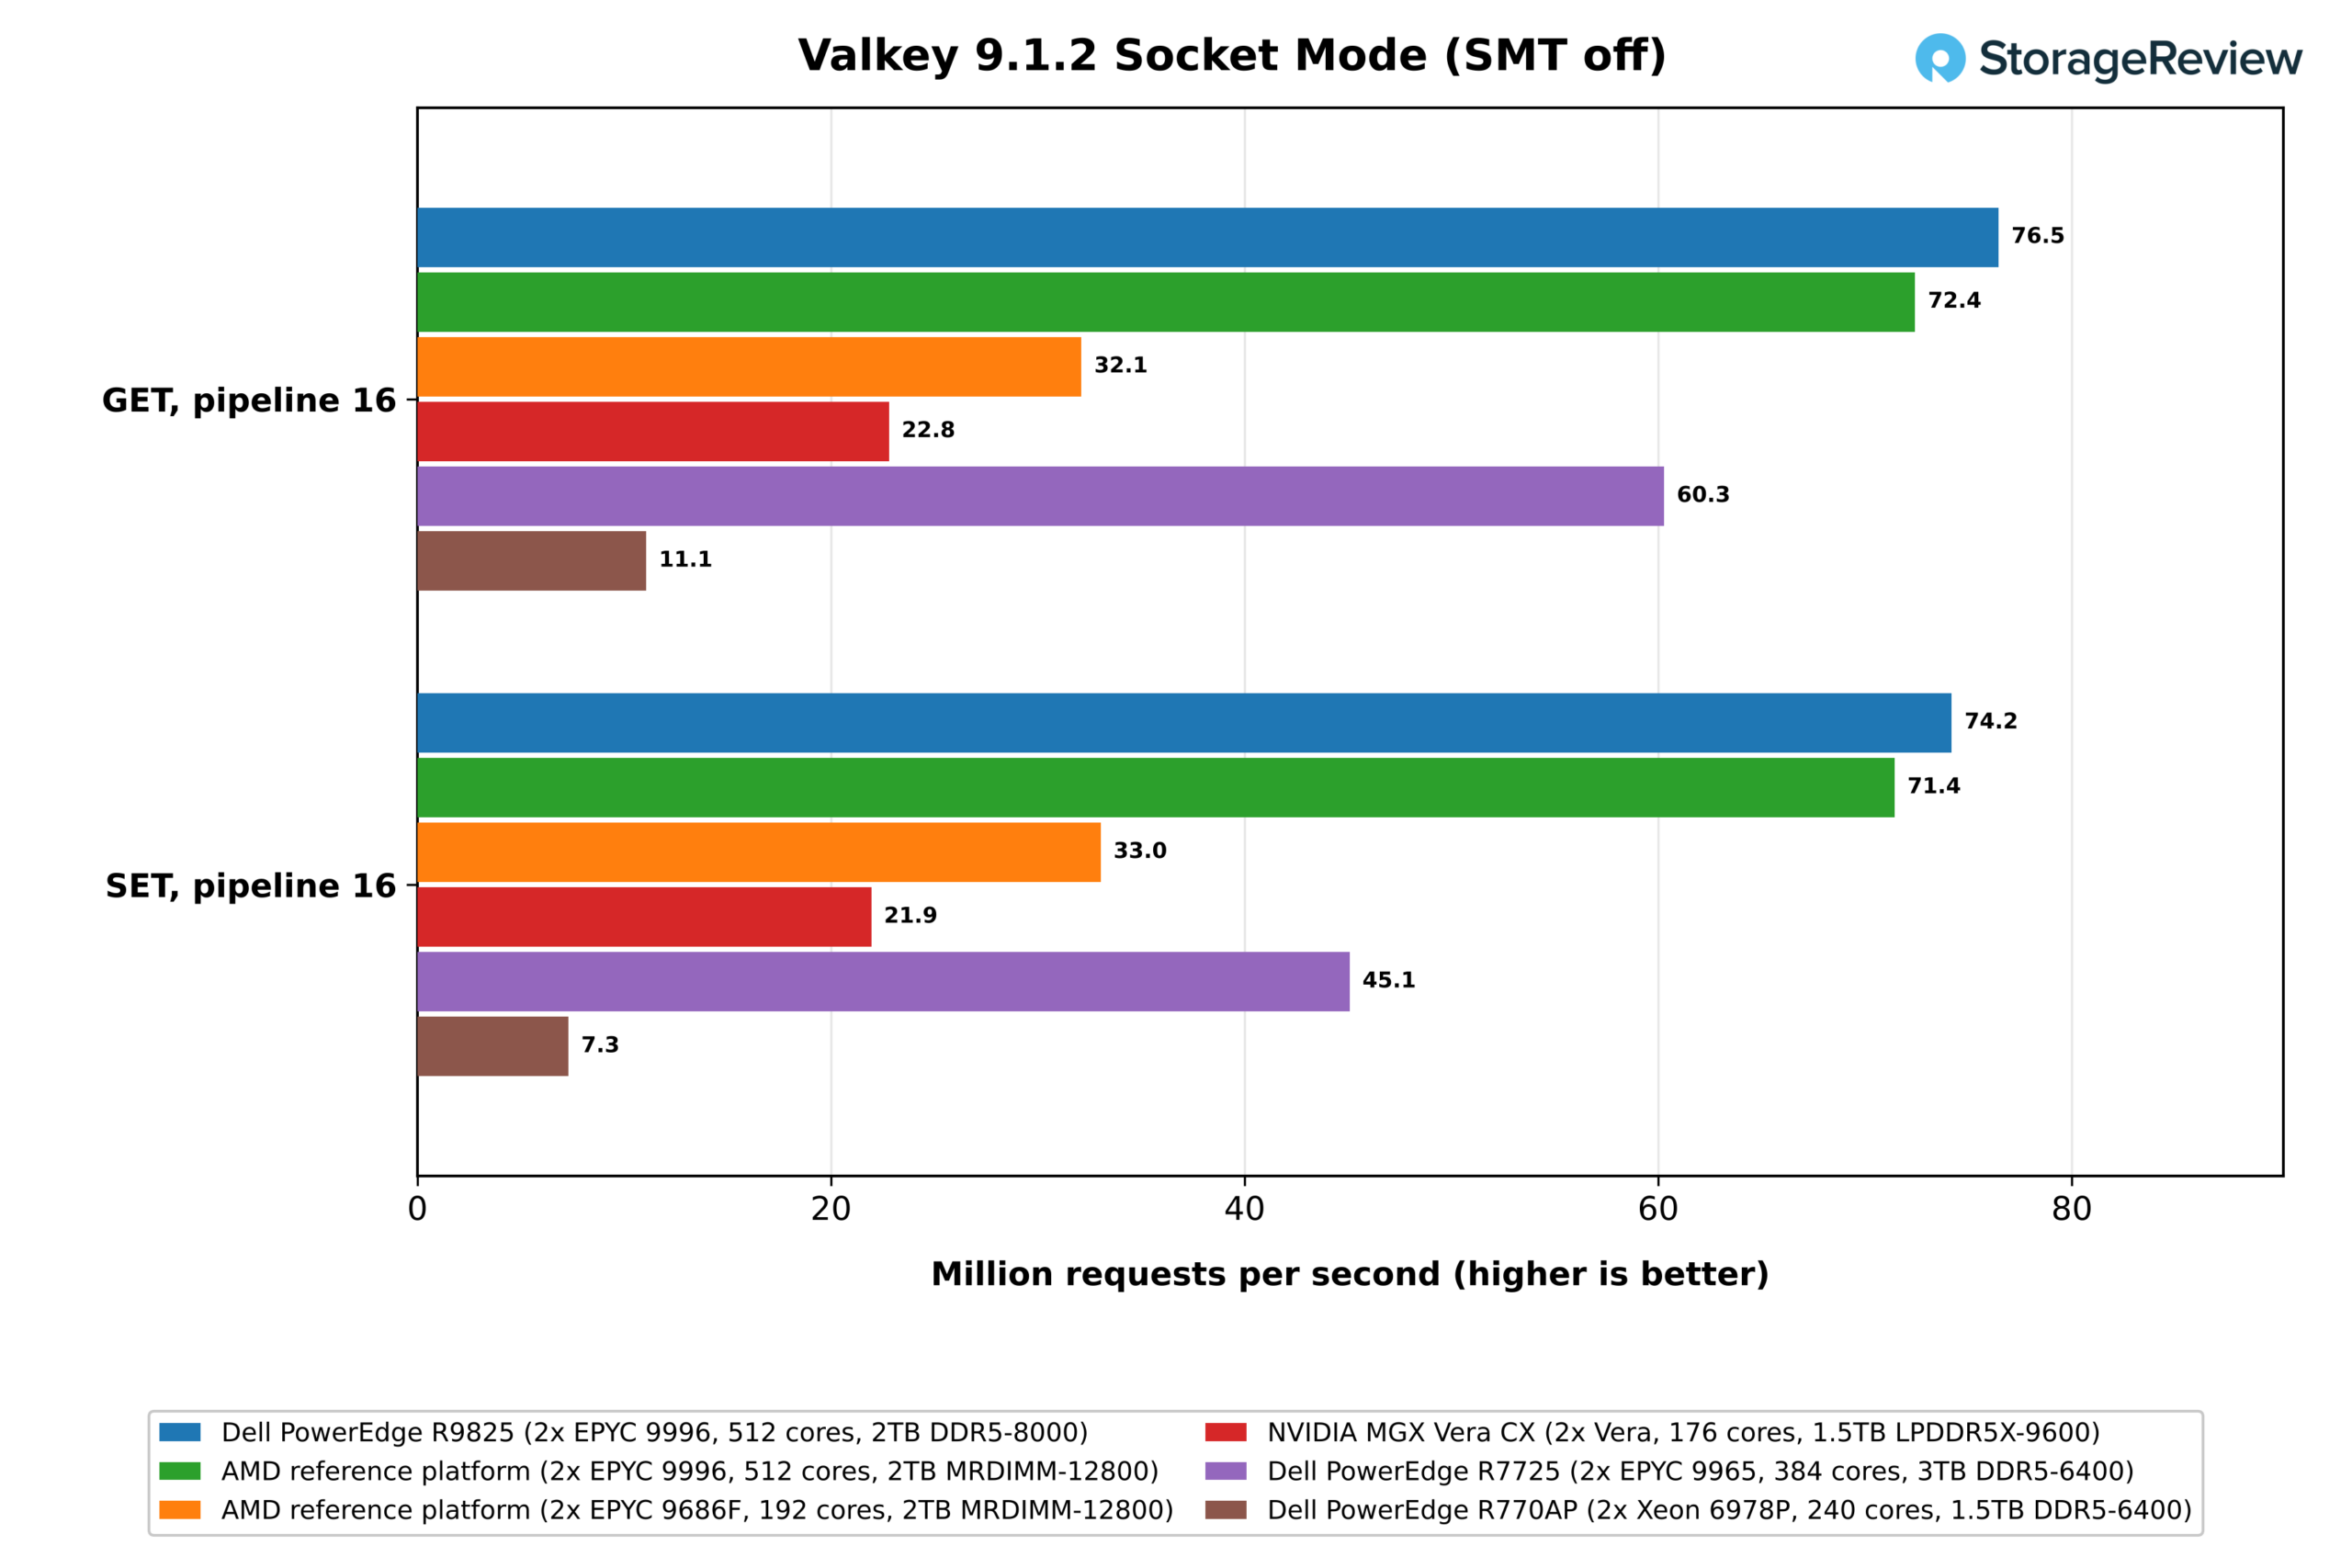
При обработке пакетов по 16 запросов один 256-ядерный сокет R9825 обеспечил 76.5 млн запросов GET и 74.2 млн запросов SET в секунду при конфигурации с 8 ядрами и 4 потоками ввода-вывода. Это на 27% и 65% больше, чем у 192-ядерного сокета EPYC 9965 (60.3 млн и 45.1 млн) и в 3.4 раза больше, чем у Vera (22.8 млн и 21.9 млн). Платформа MRDIMM показала результаты, отличающиеся от R9825 всего на 6% по обоим параметрам, поэтому пропускная способность в режиме сокета не ограничена объемом памяти.
В расчете на одно ядро 96-ядерный процессор 9686F показал лучшие результаты, выполняя 32.1 млн запросов GET и 33.0 млн запросов SET в секунду, или 334 000 запросов GET в секунду на ядро, против 299 000 у 9996, 314 000 у 9965 и 259 000 у Vera.
В режиме сокета, когда запросы отправляются по одному, как показано на диаграмме профиля выше, сокет Turin демонстрирует лучшие результаты. Сокет R9825 обработал 5.96 млн GET-запросов в секунду против 7.78 млн у EPYC 9965, 3.47 млн у 9686F, 2.55 млн у Xeon 6978P и 2.08 млн у Vera. На ядро это составляет 23 300 запросов на 9996, 40 500 на 9965, 36 200 на 9686F и 23 700 на Vera, поэтому плотный сокет Zen 6c в NPS2 обрабатывает один командный цикл примерно с той же скоростью, что и Olympus, и значительно медленнее, чем Zen 5c.
Расположение экземпляров имеет значение на таком плотном сокете, и мы еще не протестировали достаточно конфигураций, чтобы сказать, какая переменная определяет оптимальную компоновку: 128-ядерный домен NUMA или граница 32-ядерного CCD. Размещение находится в нашем списке задач на будущее.
Однопоточность и пропускная способность
Valkey и ClickBench в равной степени опирались на систему памяти и ядра, и в этом разделе мы переходим к самим ядрам. NVIDIA позиционирует Vera как процессор с максимальной производительностью в однопоточном режиме, а AMD в этом поколении предлагает увеличение частоты на 4.1 ГГц для 256-ядерного процессора и на 5.3 ГГц для 96-ядерного 9686F. 7-Zip, OpenSSL и Python работают как отдельные потоки, а затем 7-Zip и OpenSSL запускаются во всех потоках системы.
Тестовый стенд запускает каждый тест на самом низкономерном процессоре NUMA-узла сокета 0, который не находится на ядре 0. Процессор R9825 показал максимальную частоту 4,115 МГц, 9686F — 5,323 МГц, Vera — 3,375 МГц, а EPYC 9965 — 3.7 ГГц. Тактовая частота — это лишь часть картины, и два результата 7-Zip ниже это наглядно демонстрируют.
7-Zip
В 7-Zip используется алгоритм сжатия и распаковки LZMA, основанный на целочисленных операциях ветвления, и две половины теста по-разному реагируют на тактовую частоту.
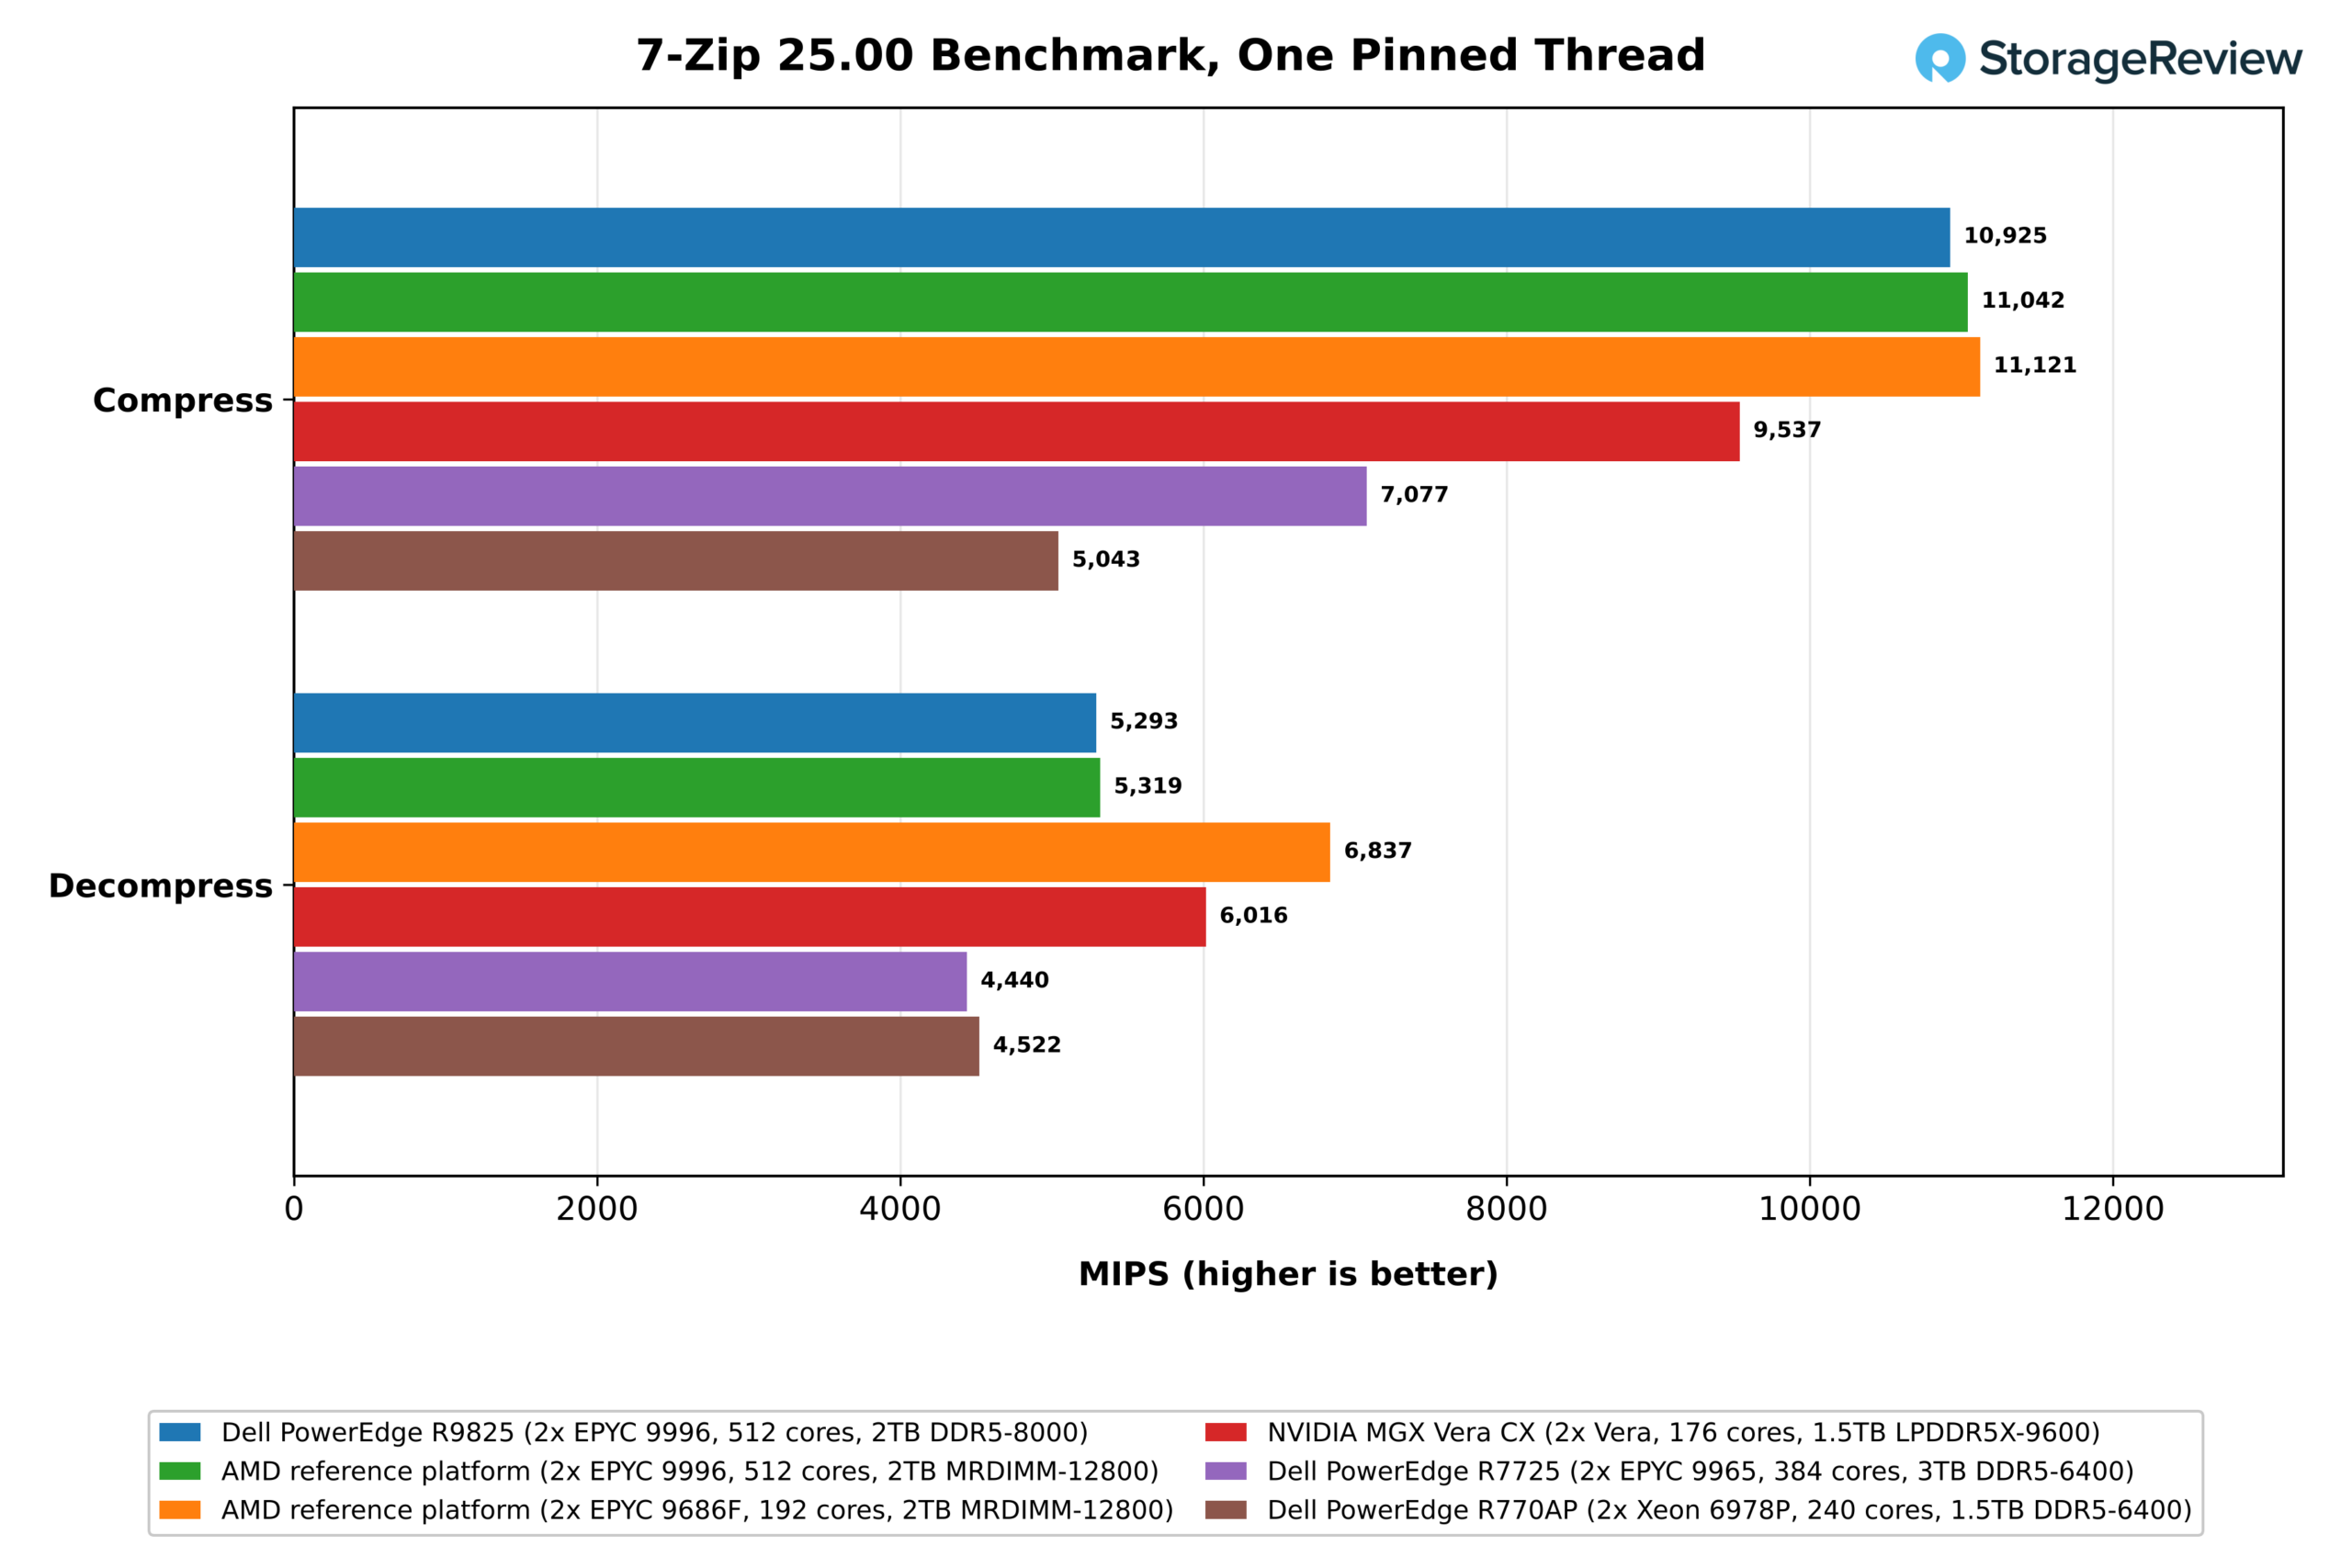
В однопоточном режиме ядро Zen 6c процессора R9825 показало результат 11 068 MIPS, что на 16% выше, чем у Olympus (9 537 MIPS), на 56% выше, чем у Zen 5c (7 077 MIPS), и в 2.2 раза выше, чем у Xeon 6978P (5 043 MIPS). Процессор 9686F с частотой 5.3 ГГц показал результат 11 091 MIPS, такой же, как у 9996 с частотой 4.1 ГГц, поэтому алгоритм сжатия LZMA на Zen 6c ограничен задержкой памяти и поведением ветвлений, а не тактовой частотой.
Результаты декомпрессии оказались противоположными: Olympus 9996 показал 5,334 MIPS, что ниже показателя Vera (6,016), в то время как 9686F с его 29%-ным преимуществом в тактовой частоте вышел вперед. В расчете на тактовую частоту Olympus 3.4 ГГц по-прежнему демонстрирует лучшие результаты декомпрессии среди всех моделей.
Проверка производительности каждого потока показывает, что делают 1,024 потока при такой скорости работы каждого ядра.
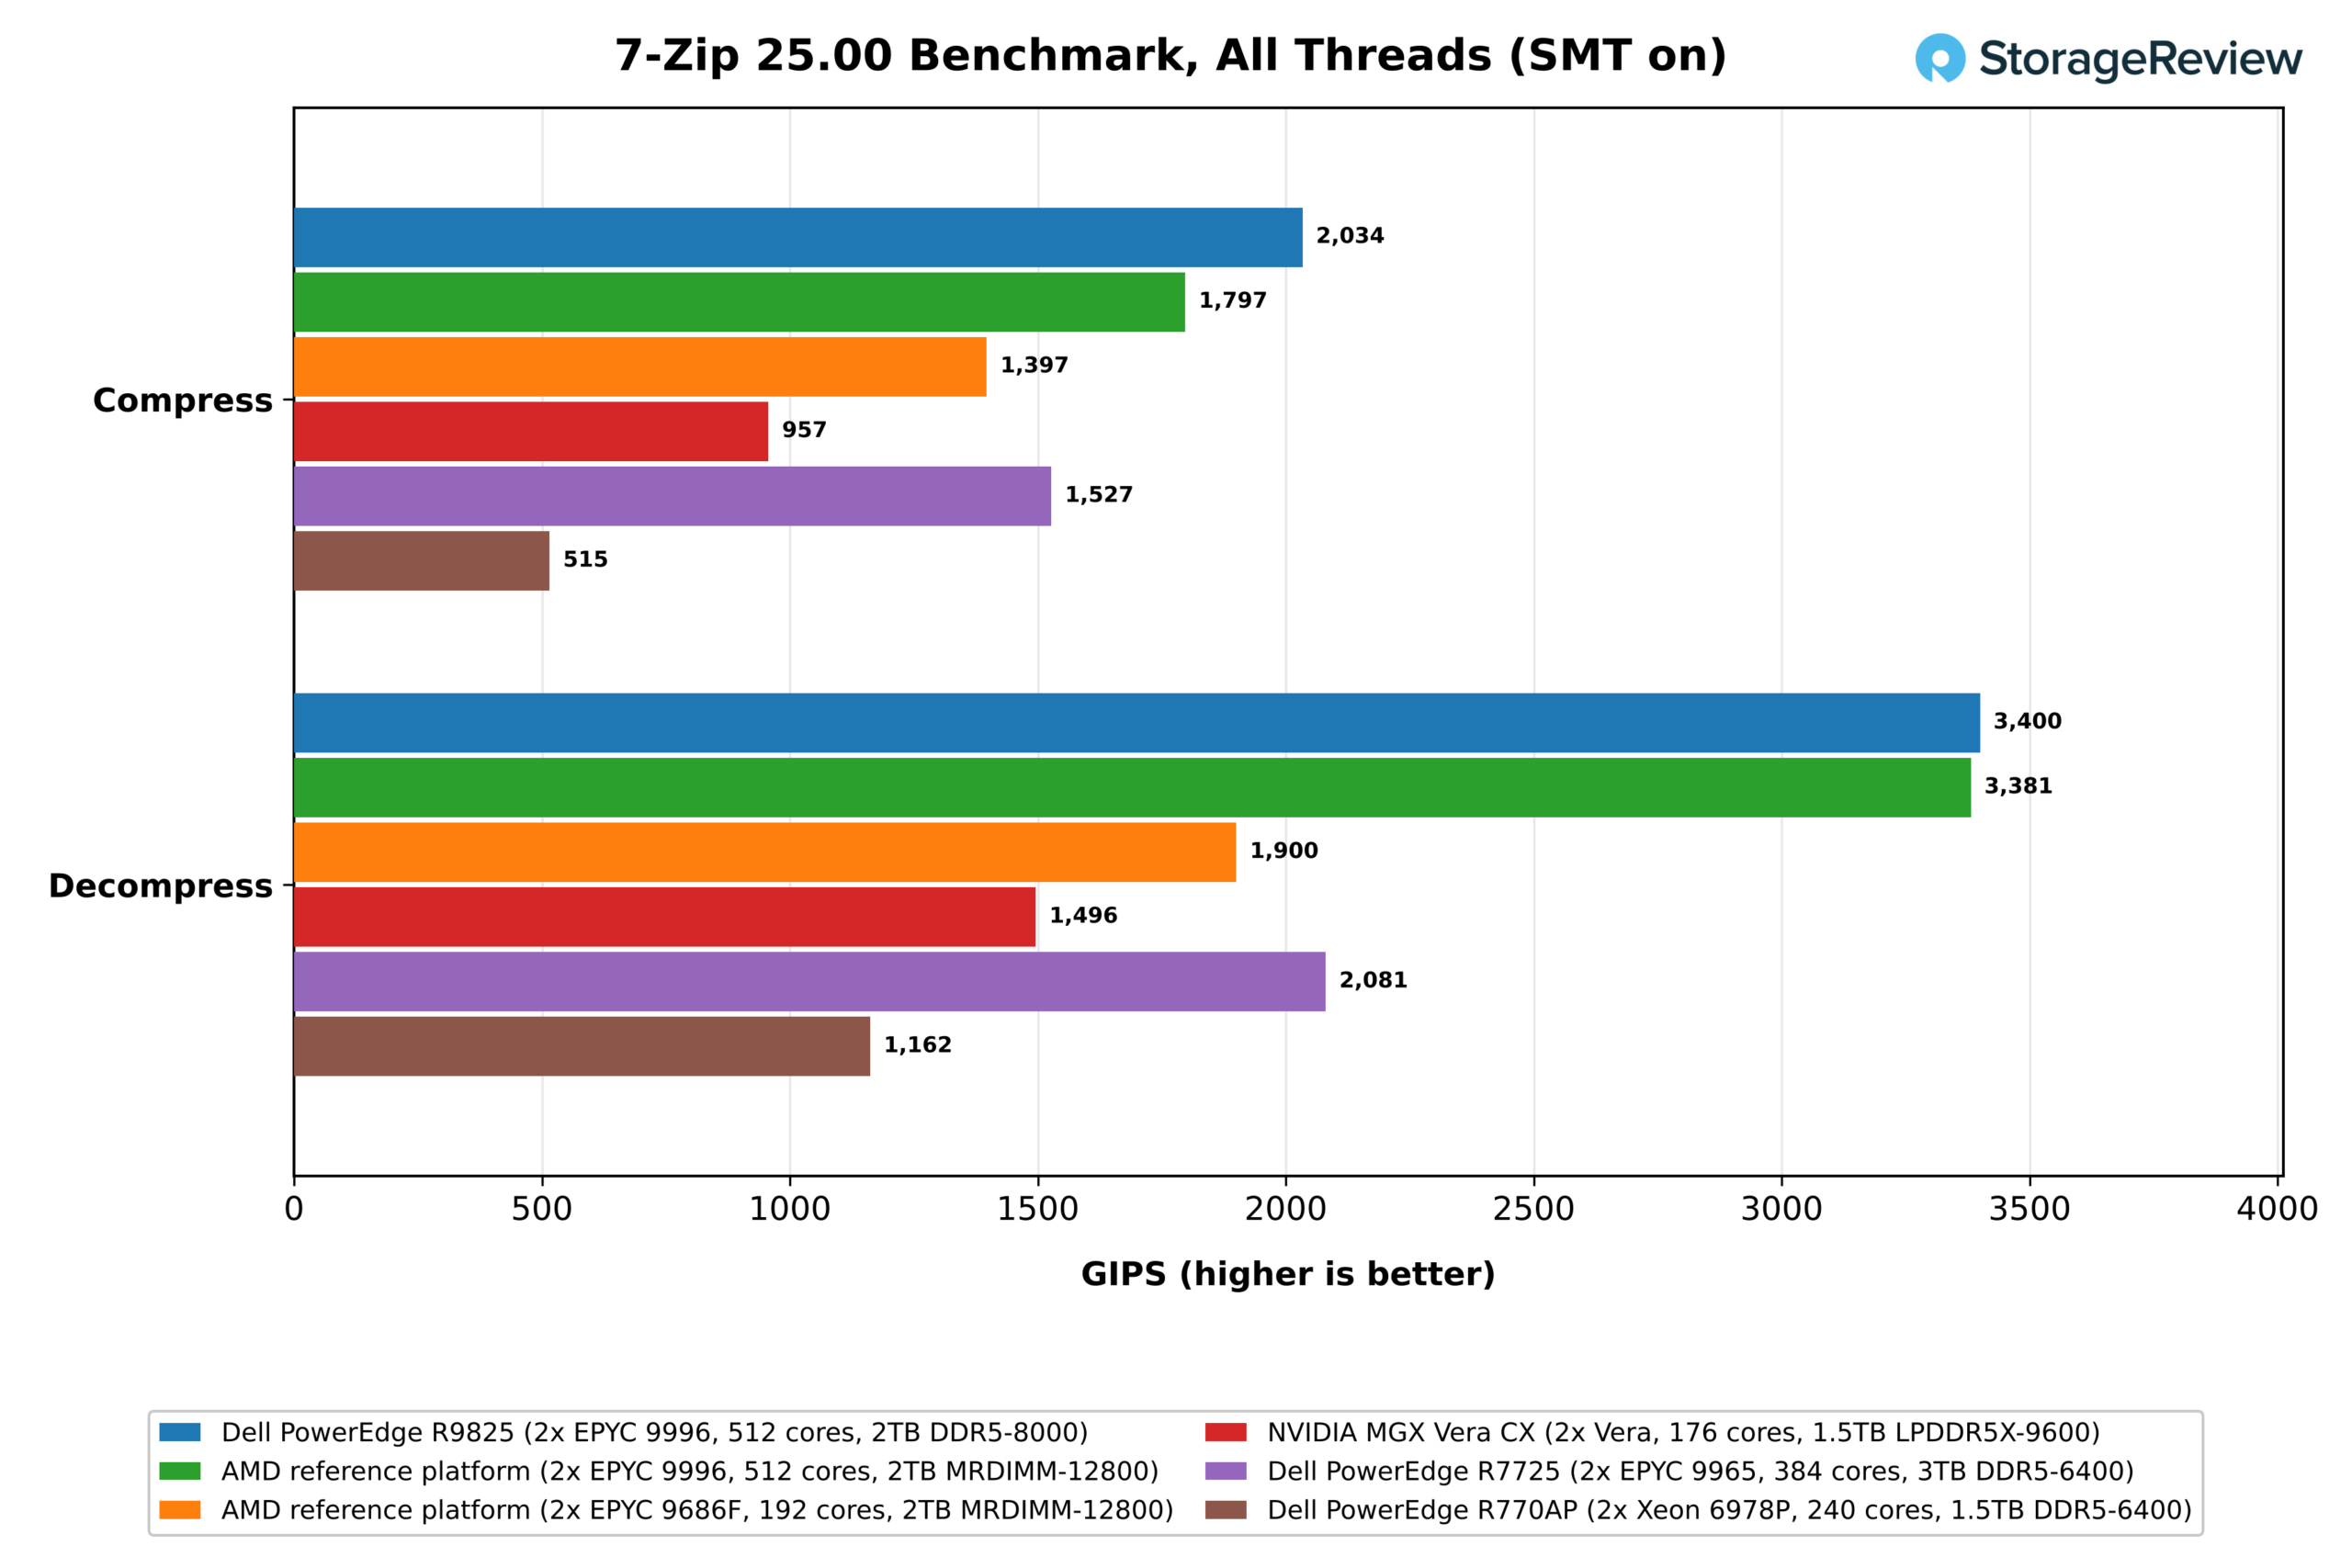
При включенной технологии SMT процессор R9825 сжимал данные со скоростью 2,034 GIPS и распаковывал со скоростью 3,400 GIPS, что на 33% и 63% опережает 768-поточный сервер EPYC 9965 (1,527 и 2,081 GIPS) и в 2.1 и 2.3 раза превосходит показатели Vera (957 и 1,496 GIPS). Платформа MRDIMM показала аналогичные результаты с разницей не более 12% по сжатию и 1% по распаковке.
При измерении на одно физическое ядро, показатель сжатия находится на одном уровне с Turin и составляет около 4.0 GIPS, поэтому выигрыш в производительности всех потоков обусловлен количеством ядер, а показатель декомпрессии в 6.6 GIPS на ядро превосходит 5.4 GIPS у Zen 5c на 23%. 1,397 и 1,900 GIPS у 9686F на 192 ядрах дают в сумме 7.3 и 9.9 GIPS на ядро, что является самыми высокими показателями производительности на ядро в этом обзоре.
OpenSSL
В тесте AES-256-GCM от OpenSSL ширина набора инструкций имеет наибольшее значение. В архитектуре x86 AES выполняется на 512-битных регистрах с использованием VAES, в то время как Olympus имеет два 128-битных криптографических канала.
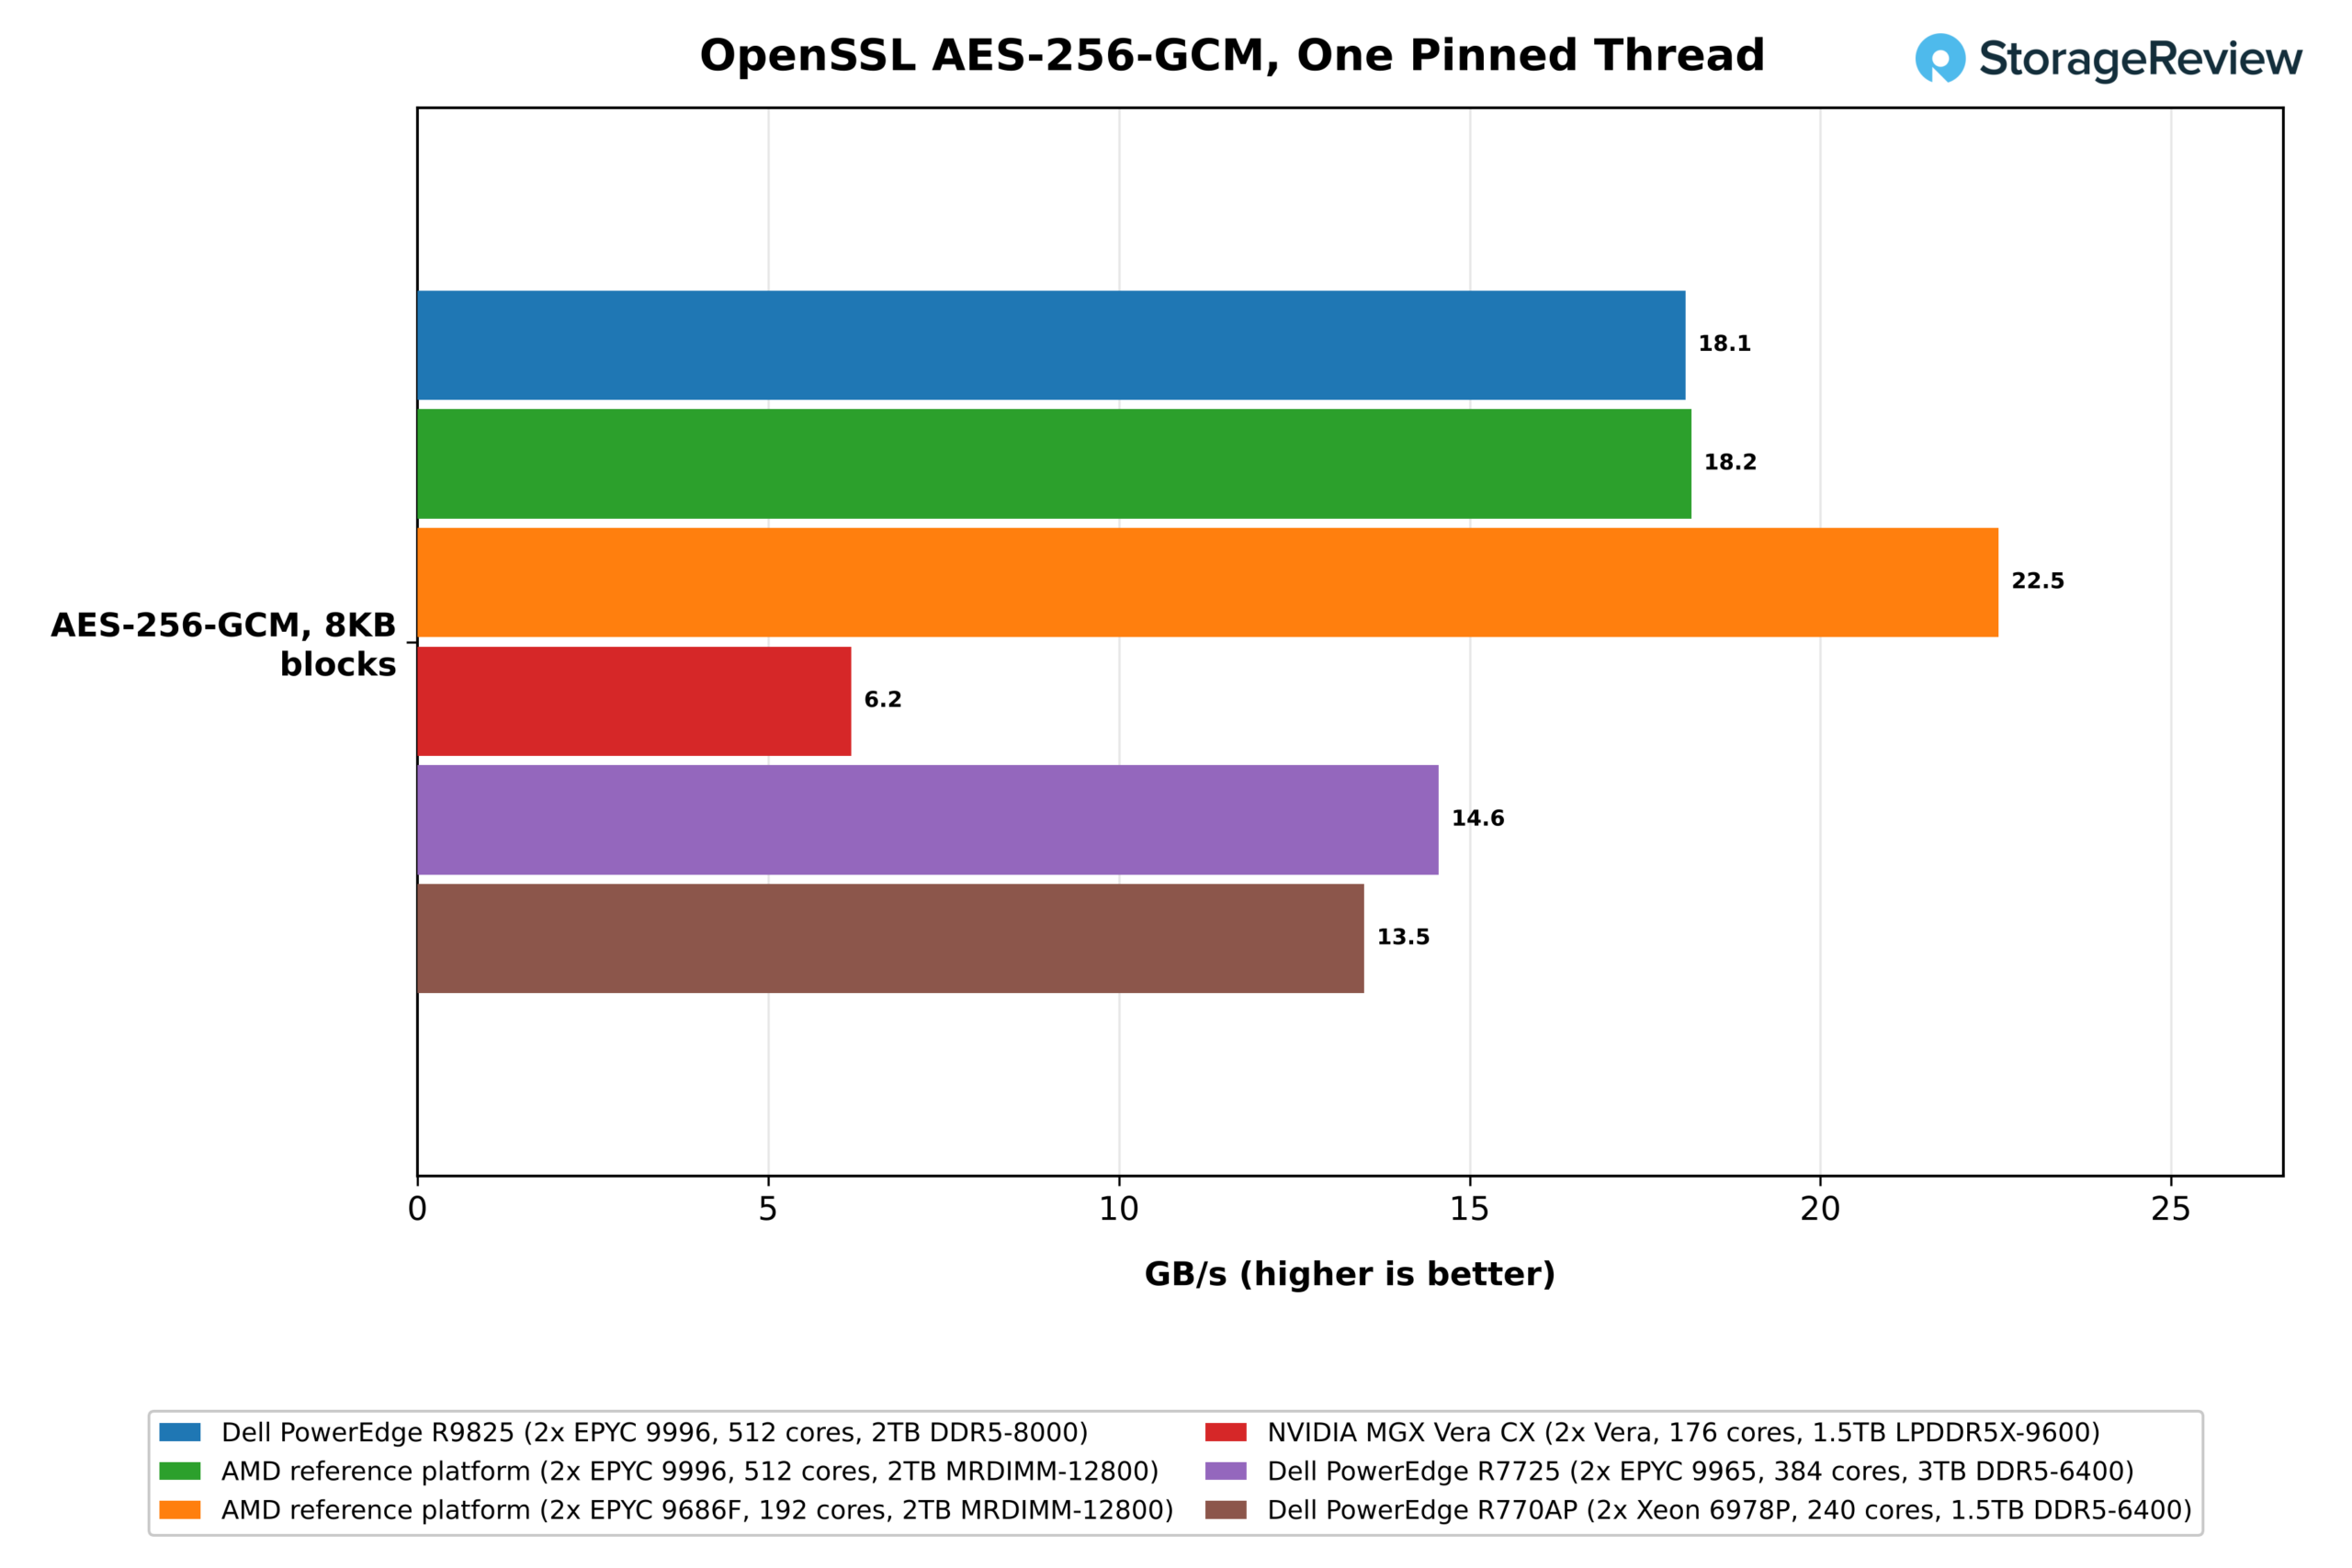
Разница наиболее очевидна при работе в одном потоке. Один поток Zen 6c обеспечил скорость шифрования 18.1 ГБ/с на R9825, что в 2.9 раза выше, чем у Olympus (6.2 ГБ/с), и на 24% опережает показатель Zen 5c (14.6 ГБ/с), а 22.5 ГБ/с у 9686F — это самый быстрый показатель для одного потока, который мы зафиксировали.
В каждой ветке событий количество ядер в Венеции многократно увеличивает это преимущество на одно ядро.
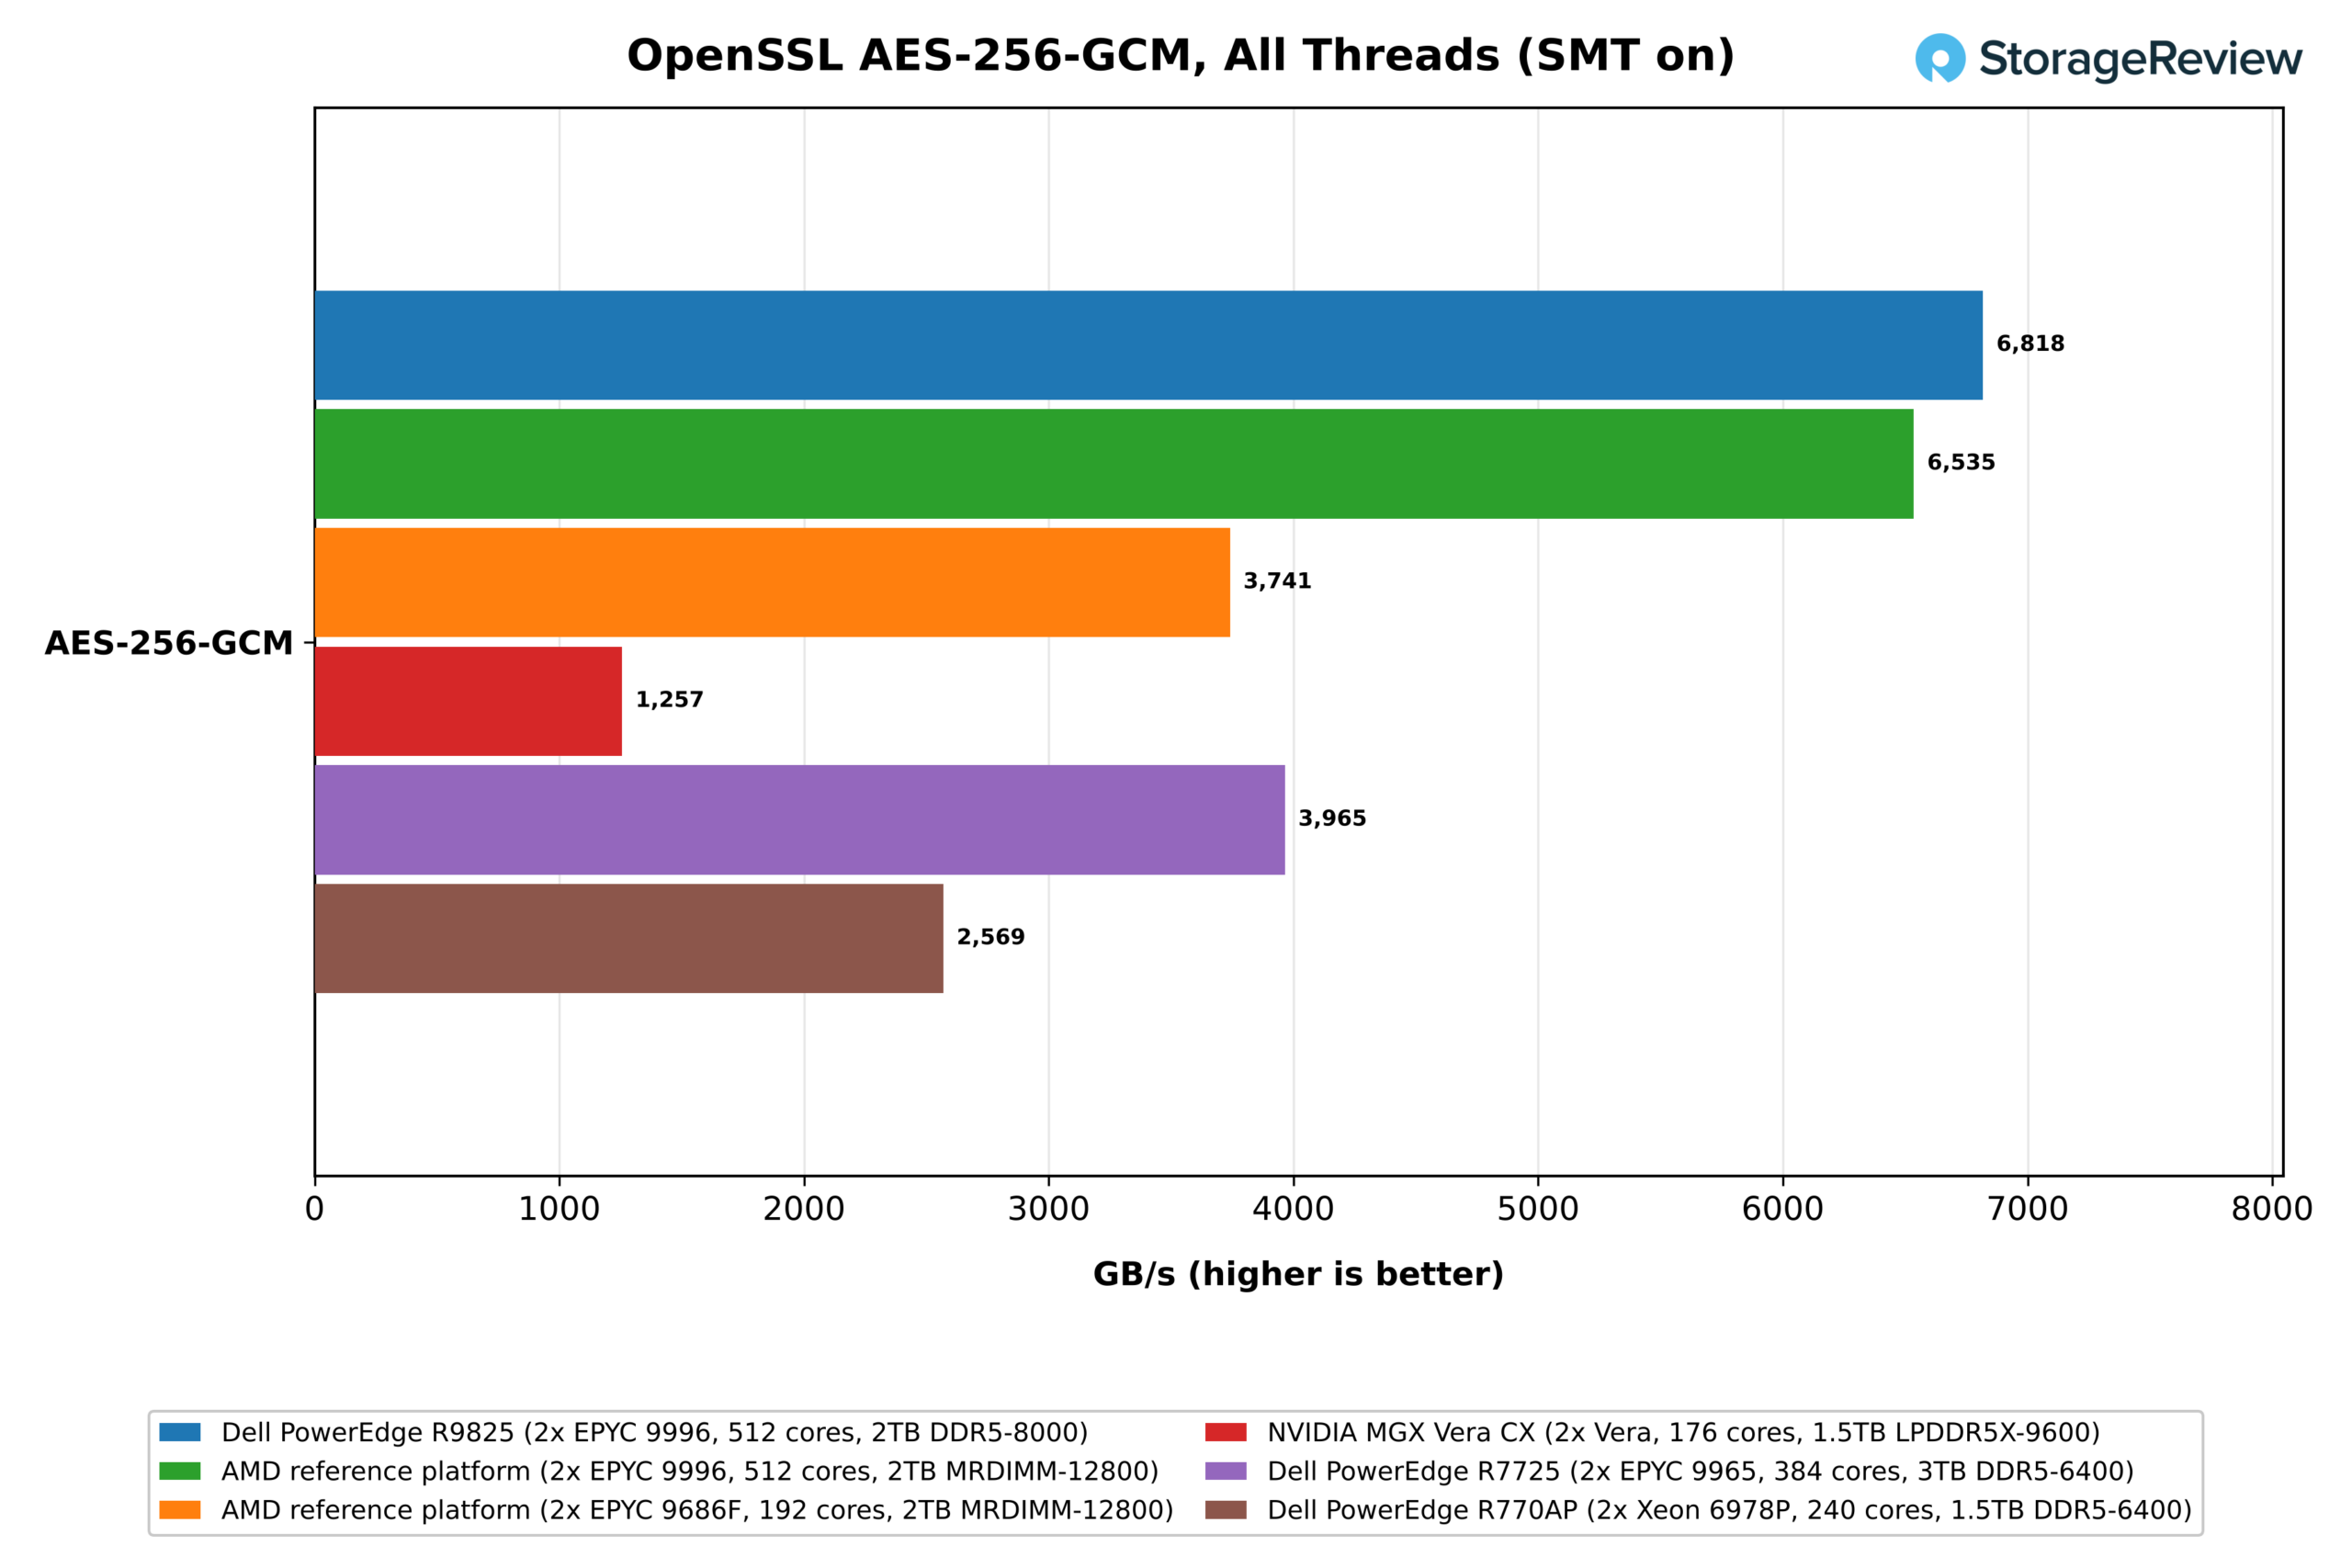
При включенной технологии SMT процессор R9825 достиг скорости 6.8 ТБ/с, что в 1.7 раза превышает показатель EPYC 9965 (3.96 ТБ/с), в 2.7 раза — Xeon 6978P (2.57 ТБ/с) и в 5.4 раза — Vera (1.26 ТБ/с). VAES на 512-битных регистрах на 512 ядрах представляет собой совершенно иной класс пропускной способности для криптографических операций, чем два 128-битных криптографических канала на 176 ядрах, и для завершения TLS или шифрования в состоянии покоя, выполняемого программно, показатели x86 в этом сравнении значительно ниже.
Питон
В NVIDIA чаще всего указывают Python в качестве рабочей нагрузки для агентских песочниц, и pyperformance предоставляет три закрепленных однопоточных теста: go, поиск по игровому дереву с большим количеством объектов; regex_compile, компилятор регулярных выражений; и nbody, цикл с n телами и плавающей запятой. Здесь есть одно различие в программном обеспечении: в Venice и Vera использовался Python 3.14.4 из Ubuntu 26.04, в то время как в сравнениях с Turin и Xeon — 3.12.3, что на несколько процентов завышает результаты Venice и Vera по сравнению с этими двумя.
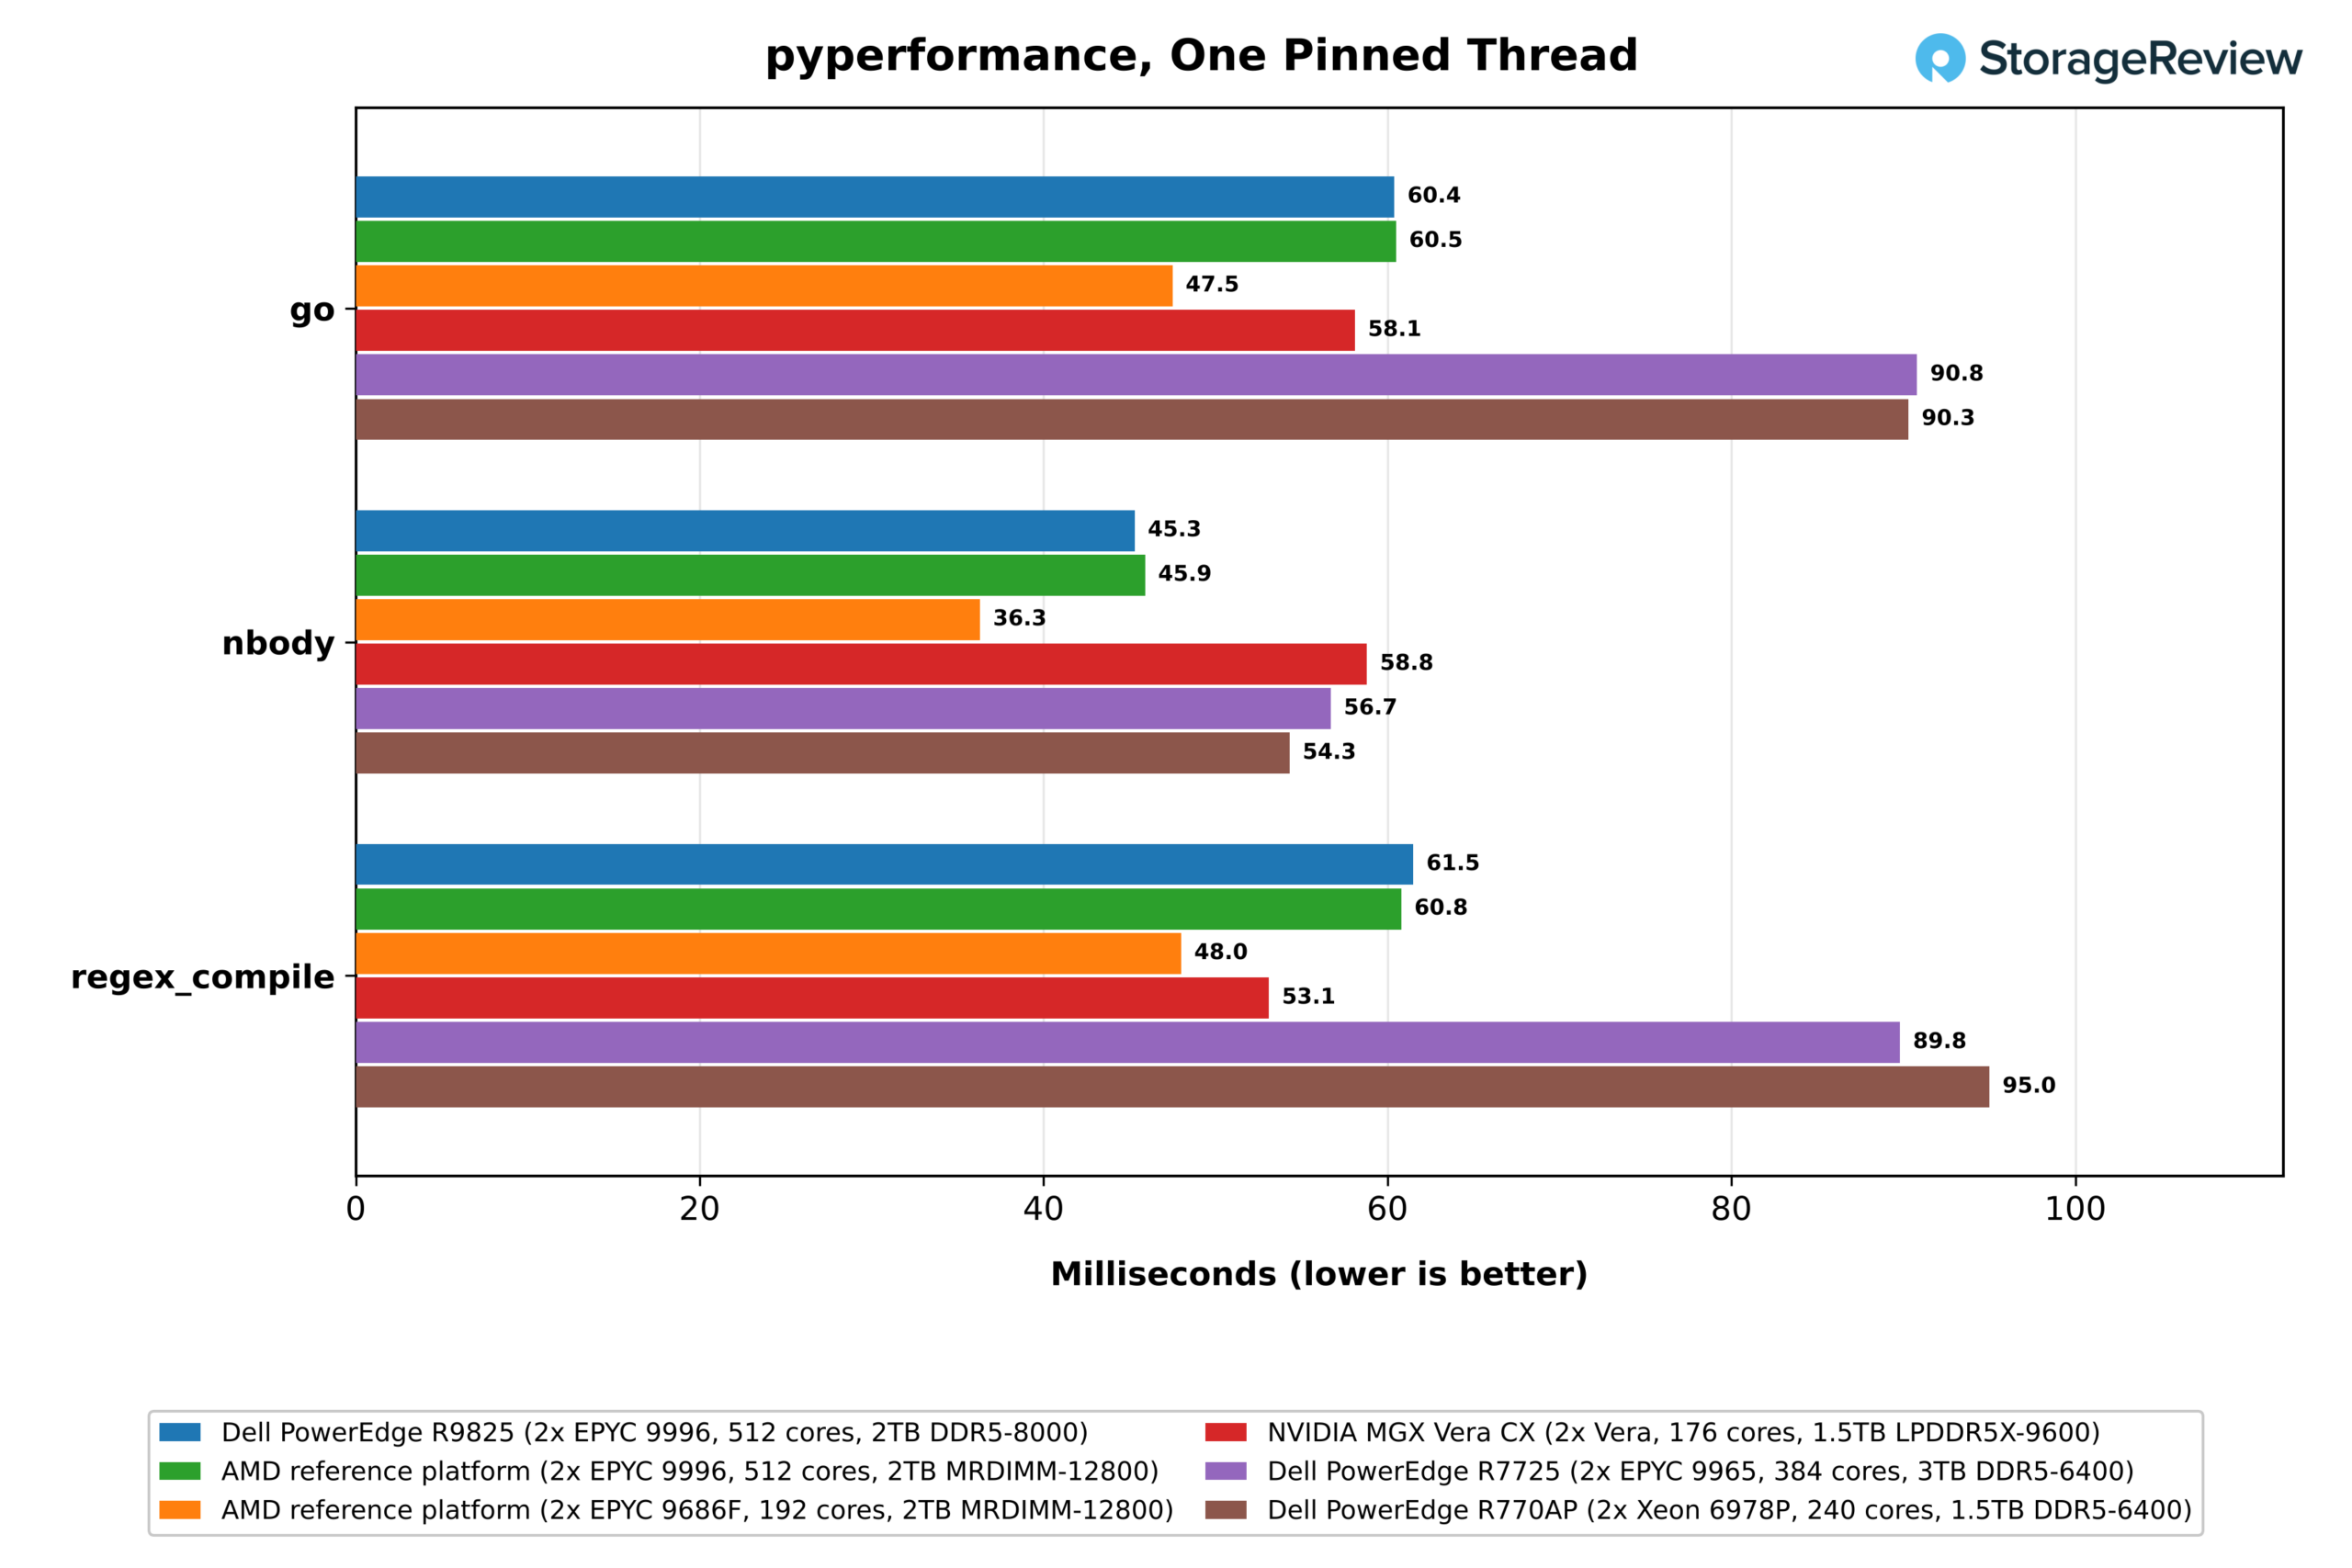
Процессор 9996 делит набор задач Python с Vera, а 9686F превосходит его. В тесте Go R9825 показал время 60.4 мс против 58.1 мс у Vera, что на 4% больше, чем у Vera, и находится в пределах погрешности между запусками, а 47.5 мс у 9686F — на 18% меньше, чем у Olympus. В тесте regex_compile время выполнения Vera (53.1 мс) на 14% меньше, чем у 9996 (61.5 мс), а 48.0 мс у 9686F — на 10% меньше, чем у Vera. В цикле с плавающей запятой nbody время выполнения 9996 (45.3 мс) на 23% меньше, чем у Vera (58.8 мс), а 36.3 мс у 9686F — на 38% меньше.
В сравнении с Turin, процессор 9996 сократил время выполнения на 33% на Go, на 20% на nbody и на 32% на regex_compile при более высокой тактовой частоте на 400 МГц, так что большая часть этого прироста приходится на ядро. Поскольку в Venice также использовался более новый Python, эти показатели Turin следует рассматривать как верхние границы.
Результаты Python демонстрируют стабильную закономерность во всех трех тестах. В тестах, где производительность ограничена задержкой памяти на рабочем наборе данных после L2, как в случае с go и regex_compile, 2 МБ памяти L2 и предварительная выборка графов Olympus позволяют ему показывать результаты на уровне или даже выше, чем у ядра Zen 6c с частотой 4.1 ГГц. В тестах, где производительность ограничена вычислительными параметрами или тактовой частотой, как в случае с nbody, Zen 6c лидирует, а 9686F с частотой 5.3 ГГц лидирует во всех трех тестах.
Задержка веб-сервера, JVM и планировщика задач.
Последняя группа тестов охватывает программное обеспечение, окружающее приложение: веб-стек, виртуальную машину Java, планировщик задач Linux и набор инструментов компилятора. Результаты некоторых из этих тестов зависят как от количества потоков, работающих в каждой системе, так и от скорости каждого ядра, поэтому они говорят о Zen 6c меньше, чем предыдущие разделы.
NGINX
NGINX обрабатывает HTTPS-запросы для генератора рабочей нагрузки, работающего на той же машине, поэтому клиент и сервер конкурируют за одни и те же ядра. Результат больше отражает стек TLS и HTTP, чем количество ядер, и стабилизируется на уровне 300 000–400 000 запросов в секунду на каждом из 2026 запущенных нами серверов.
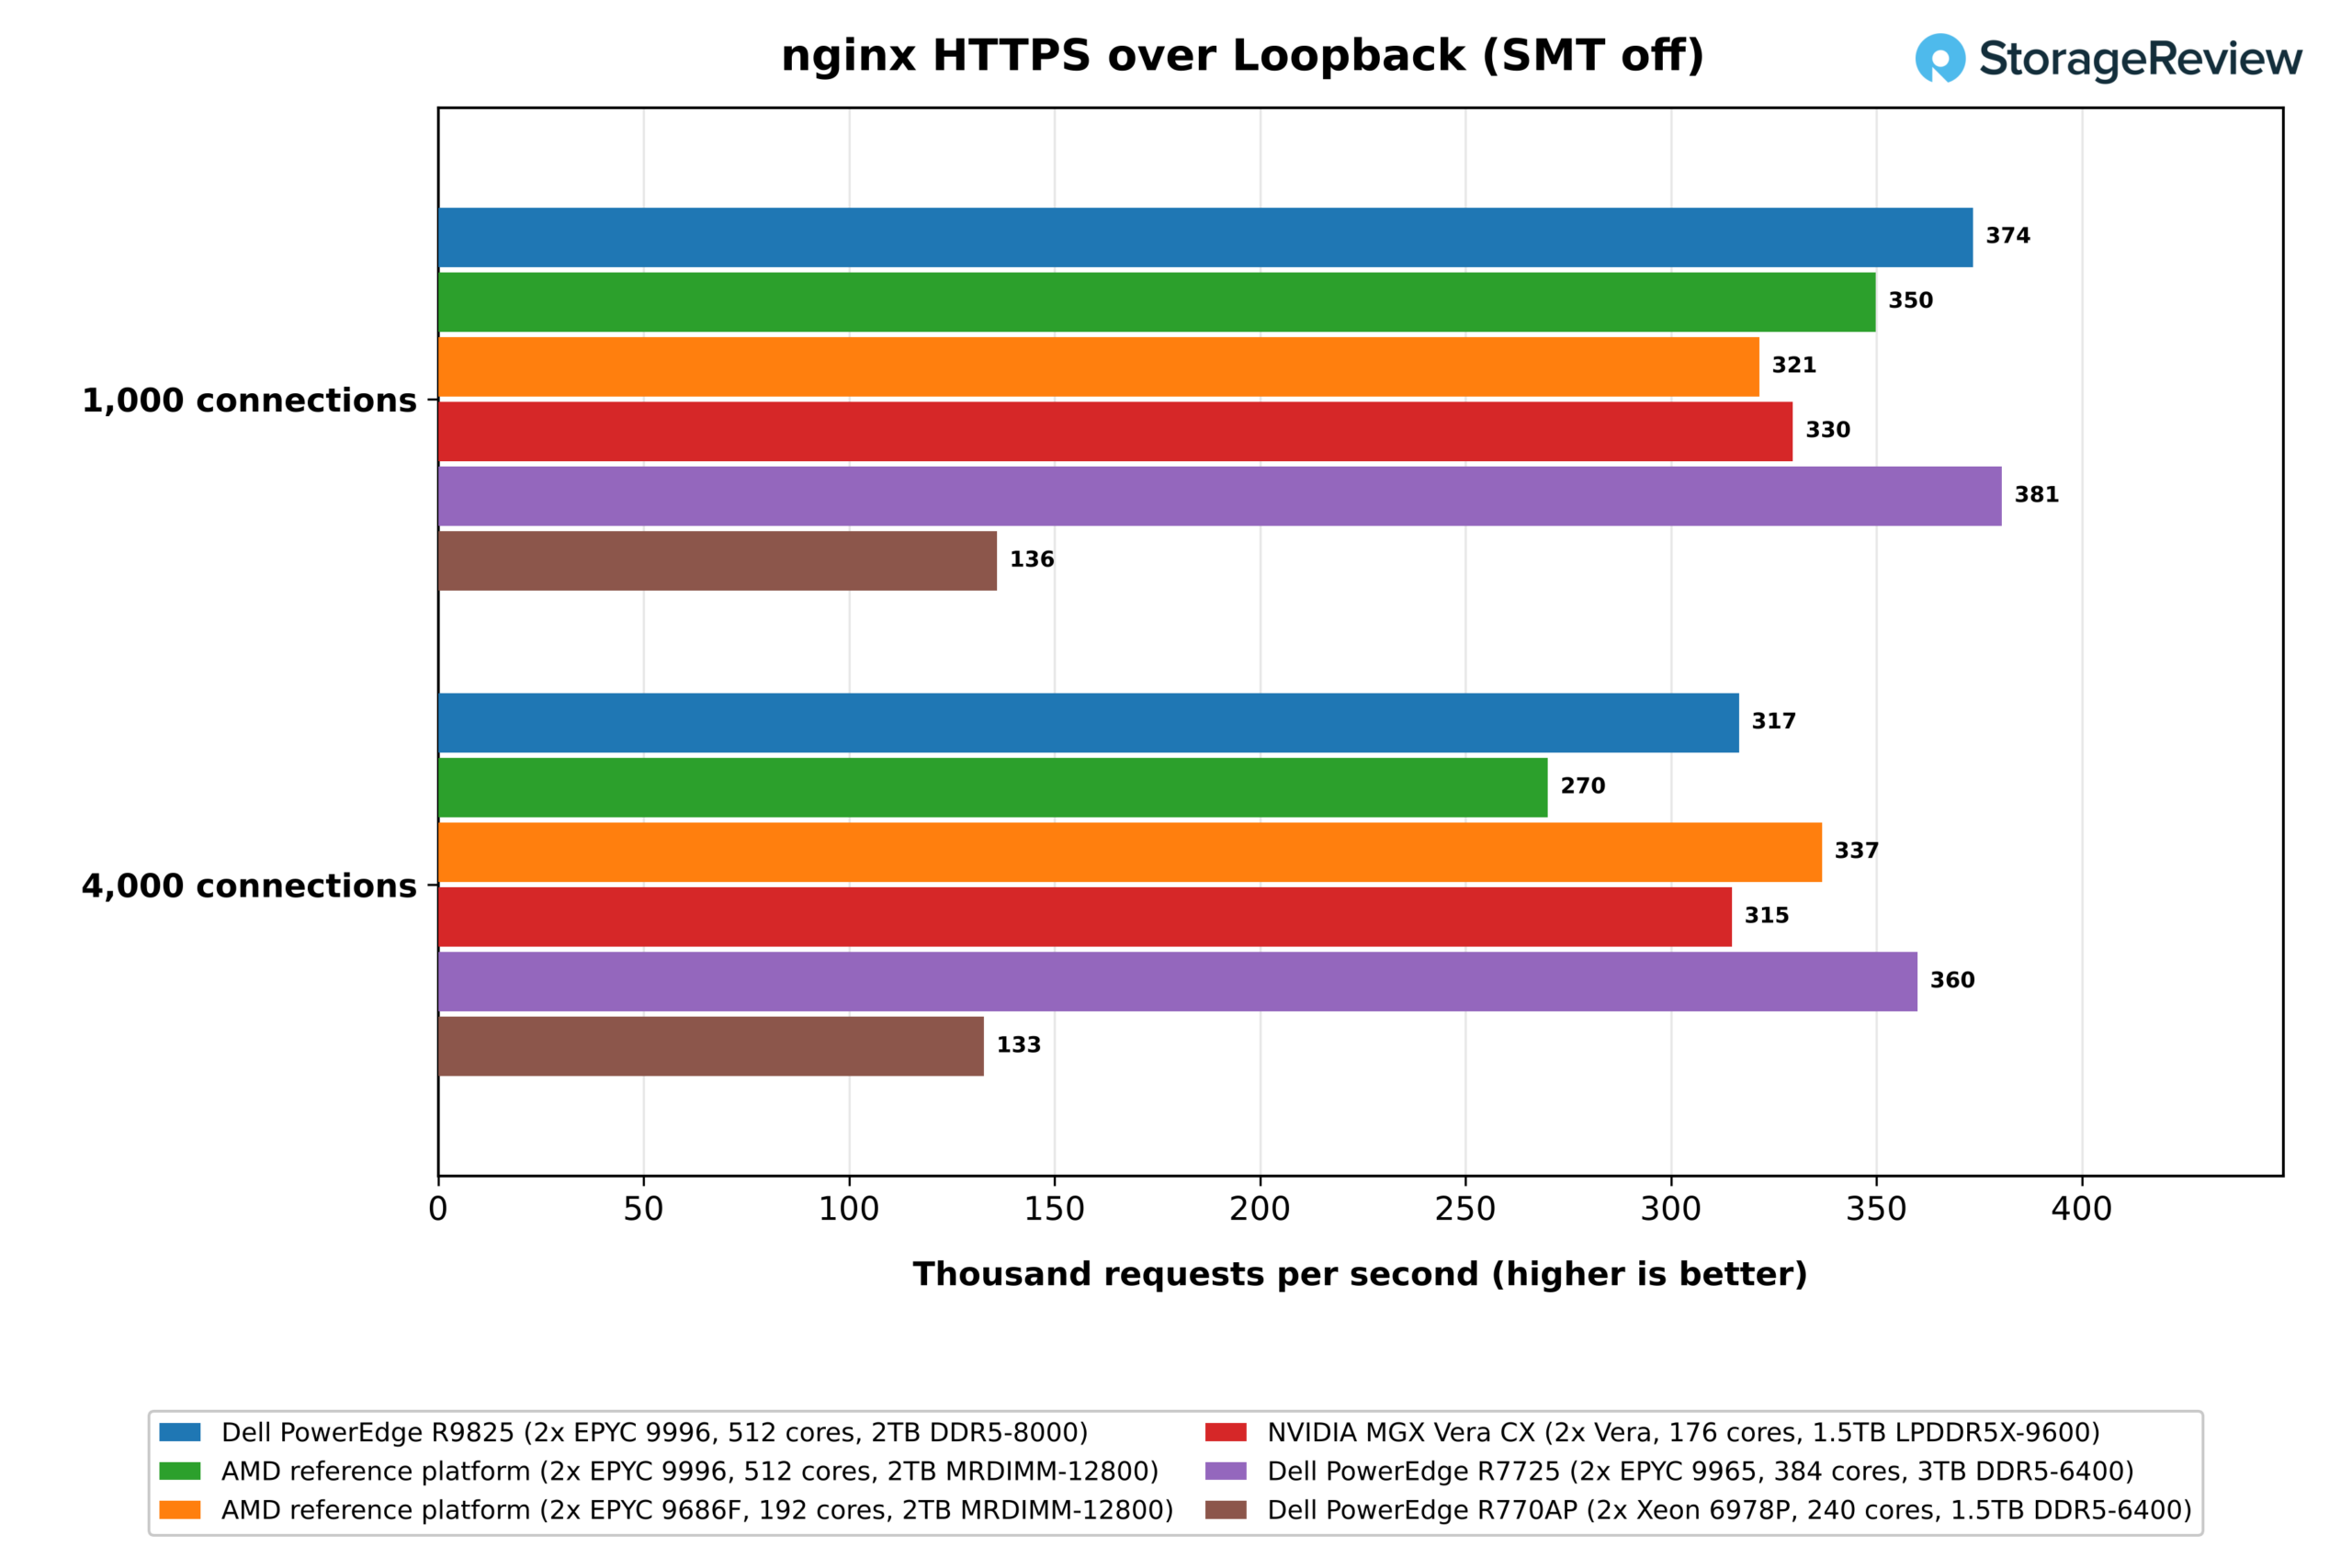
При отключенном SMT процессор R9825 обрабатывал 374 000 запросов в секунду при 1,000 соединениях и 317 000 при 4,000, против 381 000 и 360 000 у EPYC 9965, 330 000 и 315 000 у Vera и 321 000 и 337 000 у 9686F. Все эти показатели находятся в пределах оптимального диапазона, а значения 136 000 и 133 000 у Xeon 6978P являются аномальными. Тест подтверждает, что сетевой стек Venice ведет себя так же, как и любой другой сервер x86, но он ничего не говорит о количестве ядер.
Ренессанс
Renaissance запускает Java-нагрузки на OpenJDK 11: тест Finagle HTTP проверяет сетевой стек Scala, тест Akka — фреймворк для параллельного выполнения на основе модели акторов, а третий тест — генетический алгоритм. JVM распределяет задачи между всеми логическими процессорами, что ставит 512-ядерную систему, такую как R9825, в невыгодное положение, поэтому мы приводим эти результаты для полноты картины и не ранжируем их.
| Тест | Dell R9825 (2x 9996) | AMD ref (2x 9996, MRDIMM) | AMD ref (2x 9686F) | NVIDIA Vera (2x 88c) | EPYC 9965 (2x 192c) | Xeon 6978P (2x 120c) |
|---|---|---|---|---|---|---|
| Renaissance 0.16 на OpenJDK 11, миллисекунды, SMT отключен (чем меньше значение, тем лучше) | ||||||
| HTTP-запросы Finagle | 13,949 | 14,423 | 5,135 | 4,298 | 8,218 | 54,612 |
| Акка Неуравновешенное Паутинное Дерево | 150,034 | 146,208 | 32,396 | 44,557 | 56,163 | 103,649 |
| Генетический алгоритм (Jenetics + Futures) | 1,836 | 2,596 | 2,234 | 2,170 | 2,250 | 10,767 |
Две конфигурации 9996 показывают самые низкие результаты в тестах Finagle и Akka среди систем AMD, поскольку тесты actor-model и Scala networking выполняются последовательно при синхронизации, которая увеличивается с 512 потоками. 9686F со 192 потоками на частоте 5.3 ГГц показывает лучший результат в тесте Akka и уступает только Vera в Finagle, в то время как R9825 лидирует в генетическом алгоритме с результатом 1,836 мс.
шбенч
schbench измеряет скорость пробуждения рабочих потоков планировщиком Linux, запуская примерно один рабочий поток на каждый логический процессор с 4 потоками обработки сообщений и около восьми на каждый процессор с 32 потоками. Поскольку количество рабочих потоков увеличивается с ростом системы, более крупные серверы выполняют больший объем работы, поэтому эти результаты описывают задержку при полной нагрузке на каждой машине и не являются прямым сравнением, поэтому мы не ранжируем их.
| Тест | Dell R9825 (2x 9996) | AMD ref (2x 9996, MRDIMM) | AMD ref (2x 9686F) | NVIDIA Vera (2x 88c) | EPYC 9965 (2x 192c) | Xeon 6978P (2x 120c) |
|---|---|---|---|---|---|---|
| schbench, 4 потока обработки сообщений, микросекунды, SMT отключен (чем меньше, тем лучше) | ||||||
| p50 | 142 | 155 | 64 | 177 | 87 | 423 |
| p90 | 251 | 266 | 100 | 235 | 153 | 589 |
| p99.9 | 3,804 | 1,245 | 1,335 | 339 | 3,104 | 3,721 |
| schbench, 32 потока сообщений (перегрузка), микросекунды, SMT отключен (чем меньше, тем лучше) | ||||||
| p50 | 6,019 | 4,125 | 3,776 | 3,996 | 5,714 | 4,384 |
| p99.9 | 44,821 | 29,003 | 28,368 | 32,320 | 44,565 | 37,935 |
Значение p99.9 при четырех потоках сообщений требует дополнительного пояснения. Показатель R9825 в 3,804 мкс сопоставим с 1,245 мкс на идентичных процессорах платформы AMD, что представляет собой разницу в задержке между двумя комбинациями прошивки и платы, которую мы не смогли выявить, хотя медианные значения для четырех потоков совпадают с точностью до 10%.
Сборка ядра Linux
Сборка ядра Linux с помощью allmodconfig сопоставима для всех систем x86, но Vera компилирует дерево ядра arm64, которое включает в себя другой набор модулей и драйверов по сравнению с деревом x86-64, поэтому мы не включаем его в таблицу и не ранжируем.
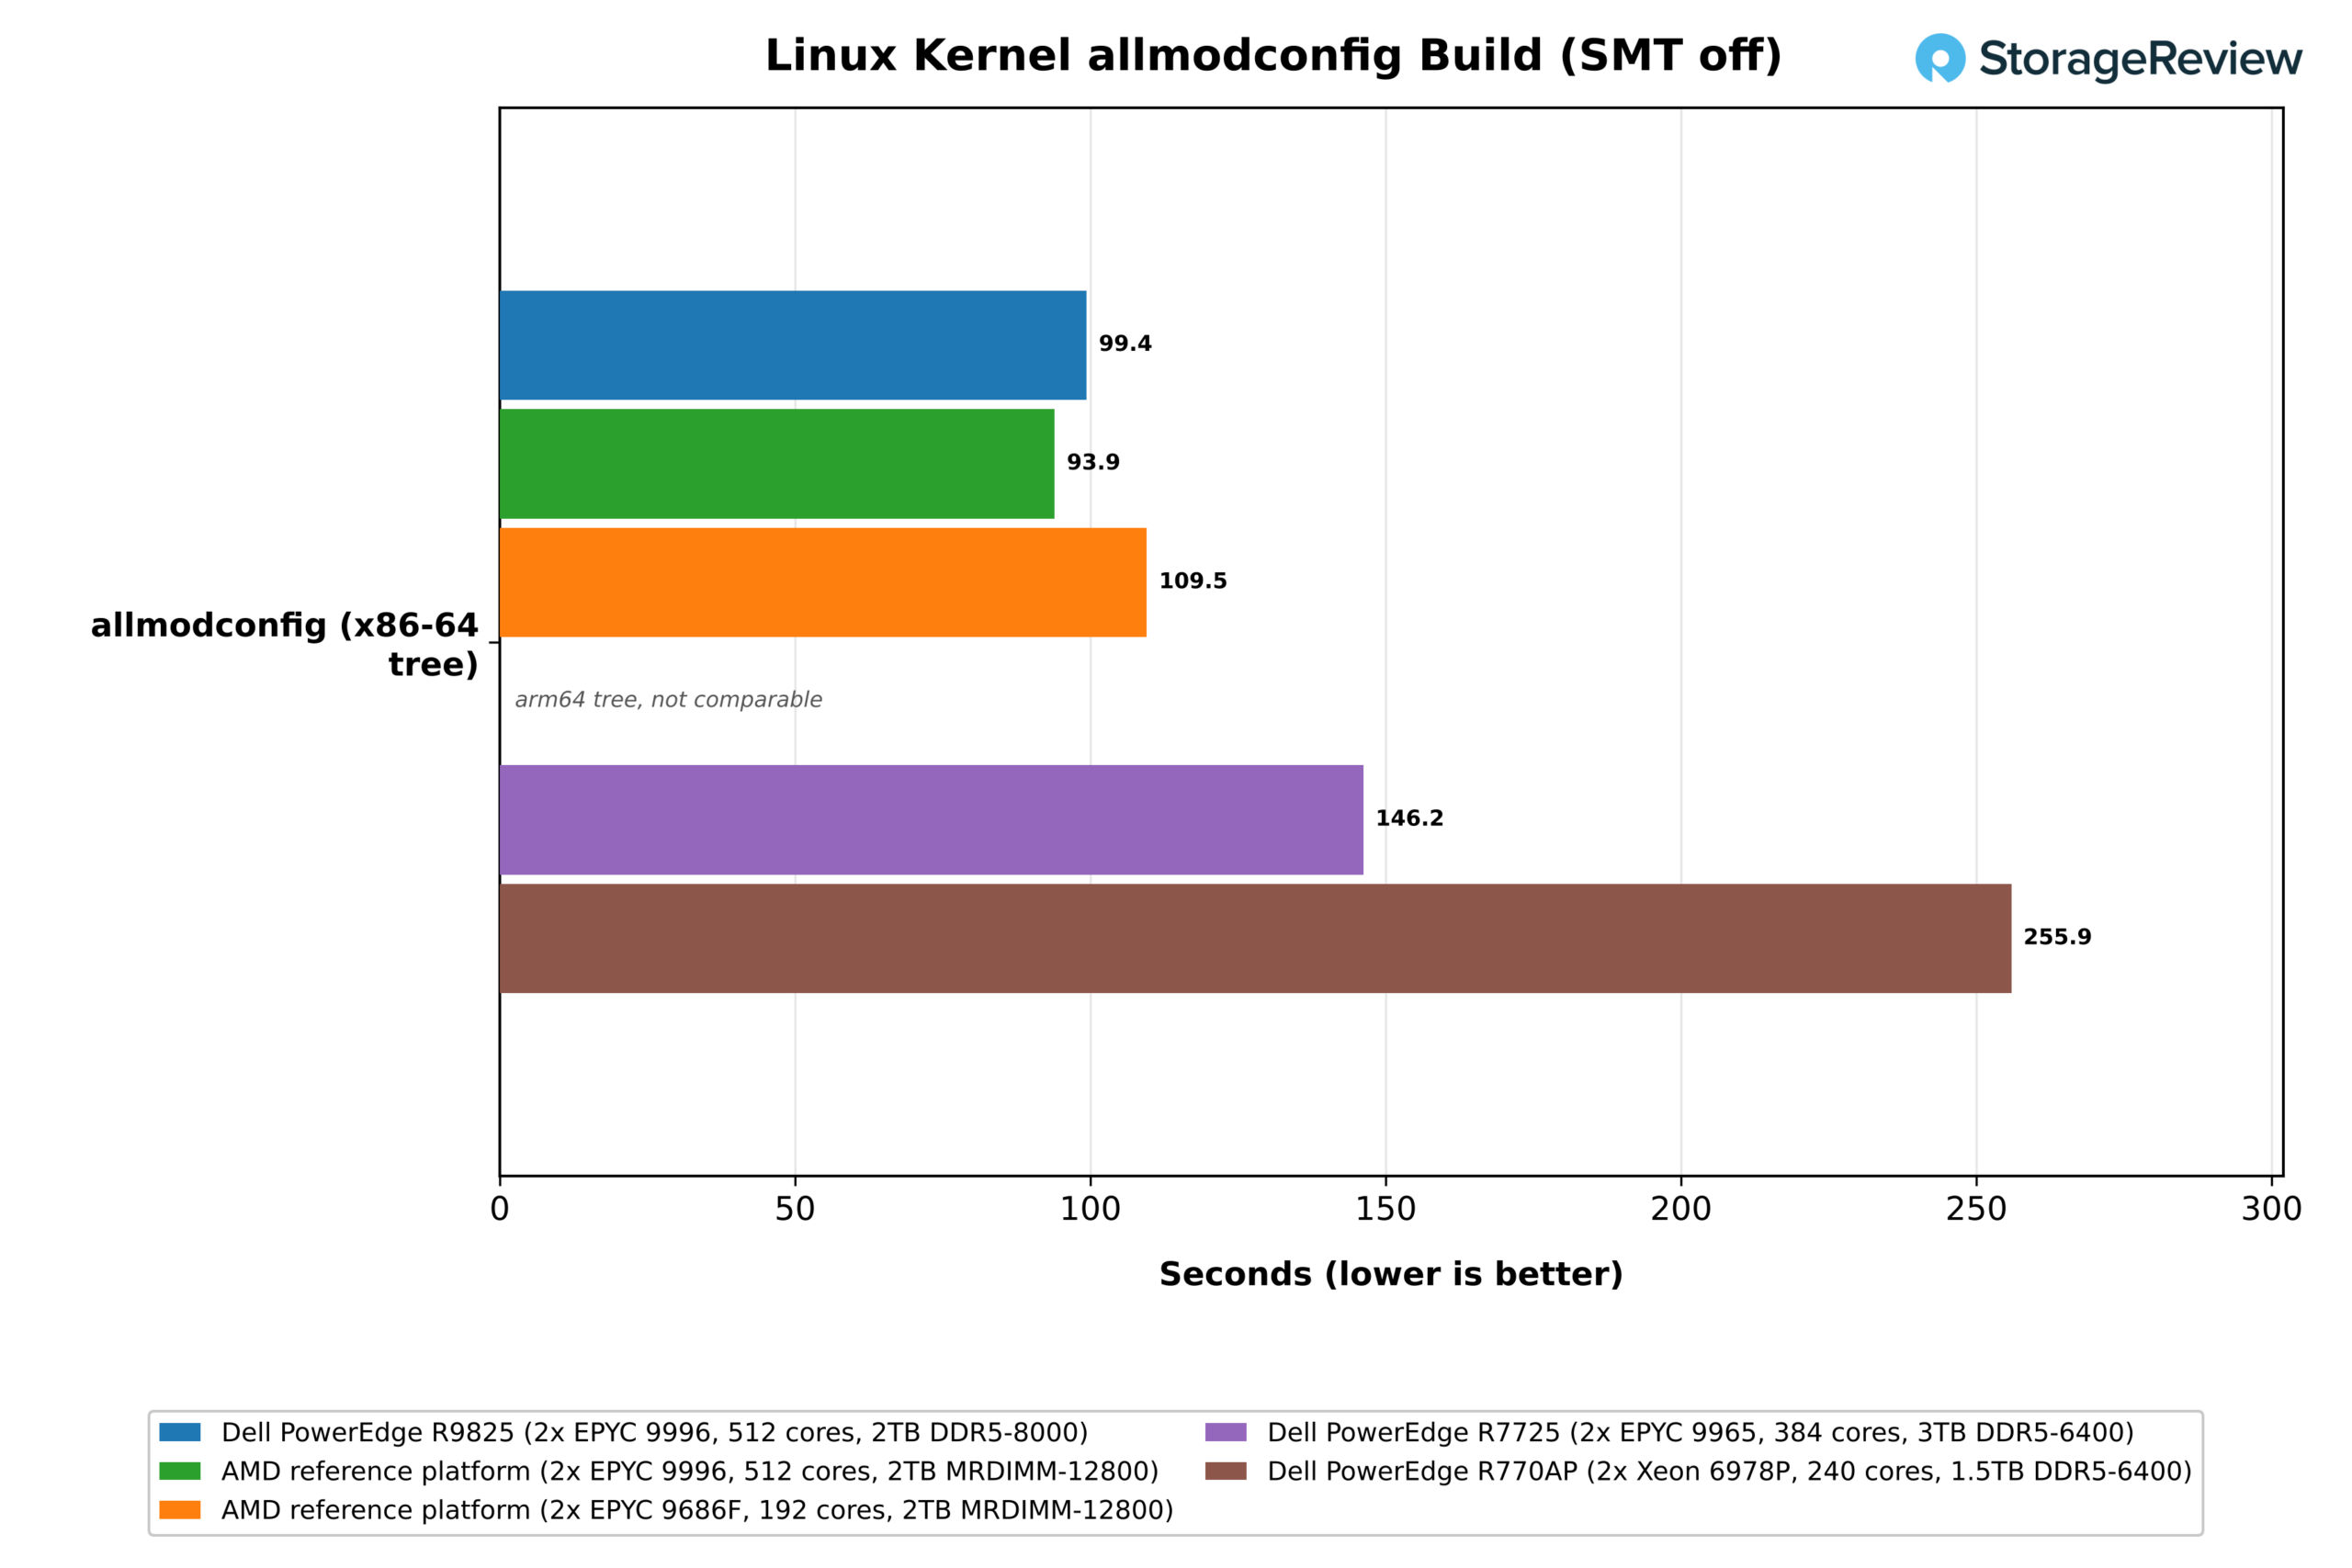
При отключенном SMT сборка ядра процессором R9825 заняла 99.4 секунды, что на 32% меньше, чем у EPYC 9965 (146.2 секунды) и в 2.6 раза быстрее, чем у Xeon 6978P (255.9 секунды). Конфигурация MRDIMM 9996 завершилась за 93.9 секунды, а 9686F — за 109.5 секунды. Включение SMT замедлило работу R9825 до 103.1 секунды, а MRDIMM 9996 — до 101.3 секунды, поэтому дополнительные потоки не помогли ни одному из процессоров 9996 в сборке, в то время как 9686F улучшил свои показатели до 100.8 секунды, а EPYC 9965 и Xeon 6978P замедлились до 181.0 и 288.9 секунды соответственно. Построение дерева архитектуры arm64 программой Vera заняло 180.7 секунды при выключенном SMT и 196.4 секунды при включенном SMT.
ХаммерДБ
Для тестирования баз данных мы снова пригласили Стива Шоу, создателя и разработчика HammerDB. В ноябре Шоу запустил рабочую нагрузку TPROC-C для HammerDB 6.1.1 — OLTP-бенчмарк, производный от TPC-C, но не сопоставимый с опубликованными результатами TPC, — на четырех системах: Dell PowerEdge R9825, сервере Vera, Dell PowerEdge R7725 с двумя 16-ядерными процессорами EPYC 9175F и эталонной платформе AMD Nigeria с 96-ядерным процессором EPYC 9686F. На каждой системе он протестировал четыре движка с открытым исходным кодом: MariaDB 13.0.2, MySQL 26.10.0, VillageSQL 0.0.7 и PostgreSQL 18.6. Размер базы данных масштабировался до восьми хранилищ на один логический процессор.
Шоу запускал R9825 как однопроцессорную систему с процессором EPYC 9996, задействовав все 256 ядер и отключив SMT, на 2,048 складах, Vera — как 88-ядерный процессор с включенным SMT на 1,408 складах, а систему 9175F — как 32-ядерный двухпроцессорный сервер на 512 складах. Он создает профили для однопроцессорной системы, отключая процессоры второго сокета через интерфейс горячего подключения ЦП Linux без изменения BIOS, поскольку ни один из движков с открытым исходным кодом не масштабируется на двух сокетах. Двухпроцессорная версия показывает сильную конкуренцию мьютексов и более низкую пиковую нагрузку — ограничение, которое Oracle, SQL Server и Db2 уже обошли при разработке.
Поскольку количество пользователей в хранилище данных различается между четырьмя системами, пиковое значение каждого движка отображается с учетом количества виртуальных пользователей и размера базы данных, которые его обеспечили, как и в октябрьском раунде. Результаты за октябрь для 192-ядерного сокета EPYC 9965, запущенного на HammerDB 6.1 месяцем ранее, приведены в нашем обзоре Vera . Мы ссылаемся на них здесь только там, где направление однозначно, поскольку клиент перешел на версию 6.1.1, а MySQL — с 26.7 на 26.10 между раундами, и пиковые значения Vera на том же оборудовании за тот же период колебались от снижения на 12% до увеличения на 4%.
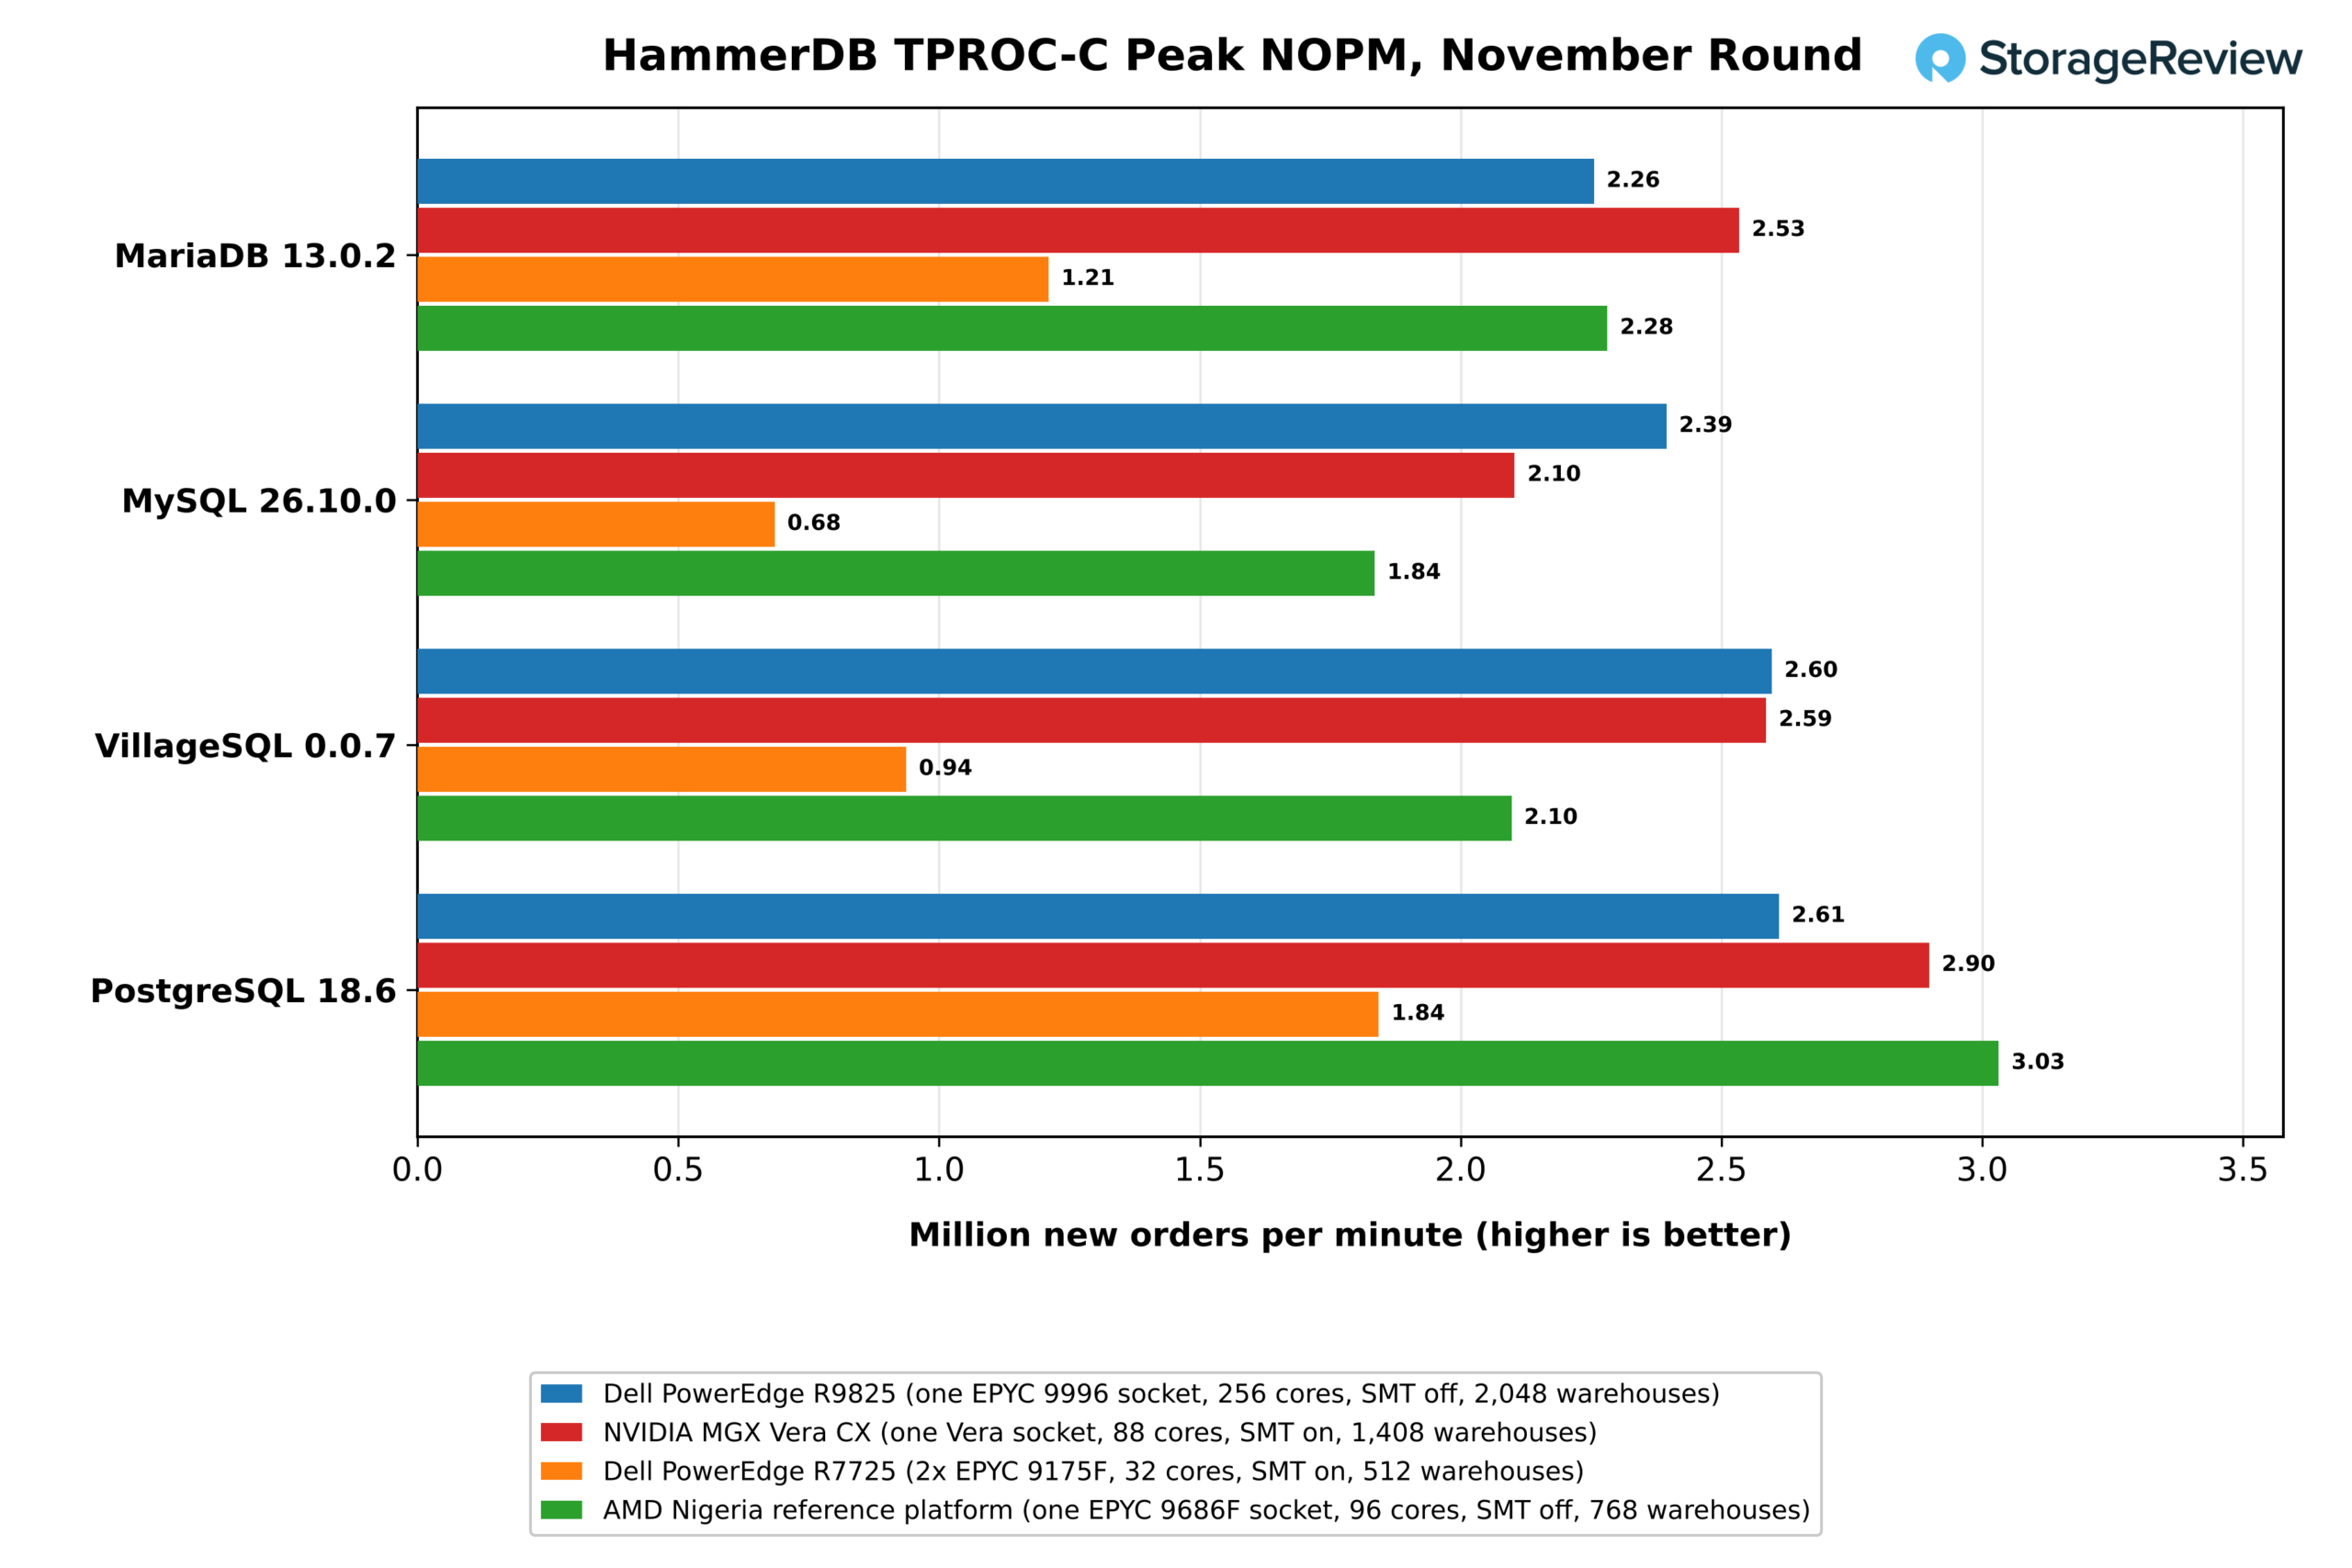
На одном из сокетов 256 ядер Zen 6c и 88 ядер Olympus разделили между собой четыре процессора. Пиковое количество новых заказов в минуту (NOPM) на сокете R9825 составило 2.39 млн для MySQL 26.10 против 2.10 млн для Vera, что на 14% больше, а на VillageSQL эти две системы показали одинаковые результаты — 2.60 млн и 2.59 млн соответственно. Vera сохранила показатель для MariaDB 13.0.2 на уровне 2.53 млн против 2.26 млн, разница в 12%, а PostgreSQL 18.6 — 2.90 млн против 2.61 млн, разница в 11%. Два процессора 9175F достигли показателей 1.21 млн, 0.68 млн, 0.94 млн и 1.84 млн на базах данных MariaDB, MySQL, VillageSQL и PostgreSQL, при этом результат в 1.84 млн на 32 ядрах с частотой 5.0 ГГц является лучшим показателем на ядро в этом раунде.
Наиболее показательным является уровень загрузки ЦП на пиковых значениях. R9825 достиг пика загрузки PostgreSQL при 144 виртуальных пользователях и 18% загрузке сокета, пик загрузки MariaDB — при 51%, а пик загрузки MySQL и VillageSQL — при 74% и 75% соответственно. Пиковые значения загрузки Vera достигали 35–74%, а 32-ядерный 9175F работал на 85–90% загрузки трех из четырех процессоров.
Ни один из четырех движков не смог задействовать 256 ядер, что является пределом масштабируемости, зафиксированным компанией Shaw на каждом этапе этой кампании. Движки с открытым исходным кодом достигают своего максимума задолго до того, как будет использован сокет; передача блокировки внутри движка устанавливает пиковое значение, и процессор ожидает. Таким образом, данные базы R9825 измеряют, насколько каждый движок масштабируется на одном сокете, и они недооценивают возможности 512 ядер при сегментированном или многоэкземплярном развертывании.
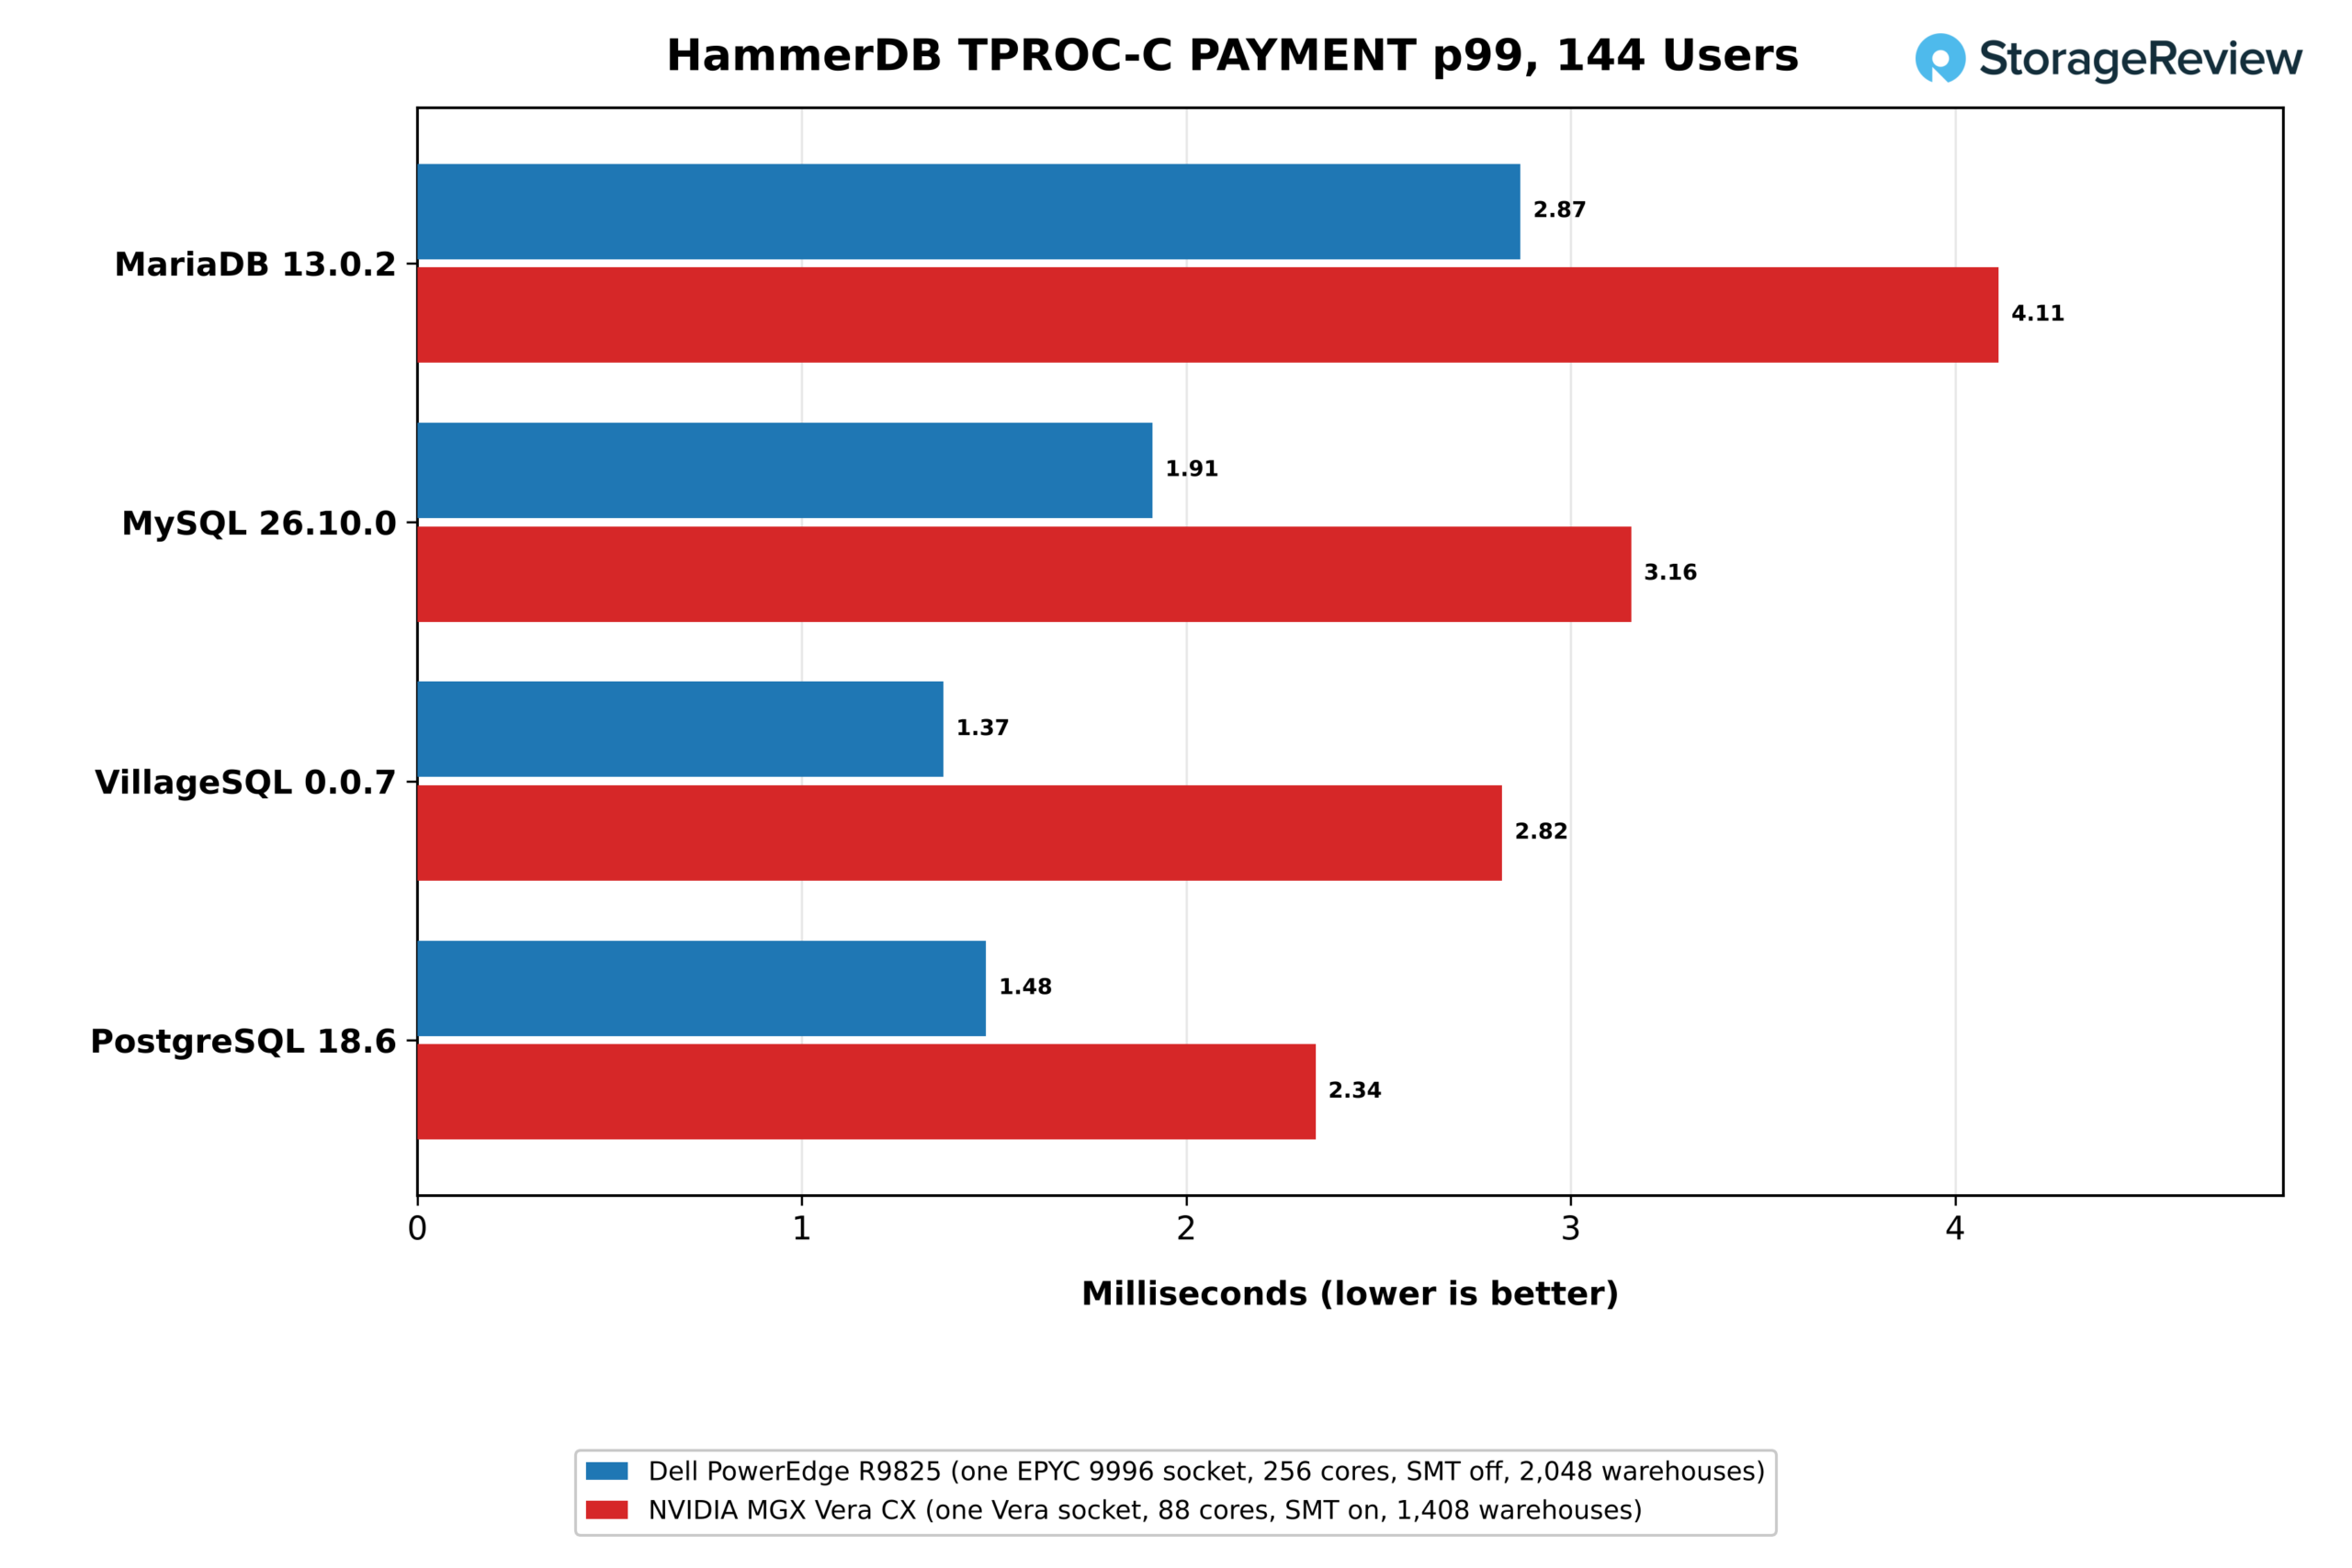
При одинаковой нагрузке в 144 виртуальных пользователя задержка в конце цепочки запросов (tail latency) на каждом движке приходится на Venice. Задержка PAYMENT p99 на R9825 составила 2.87 мс на MariaDB, 1.91 мс на MySQL, 1.37 мс на VillageSQL и 1.48 мс на PostgreSQL, против 4.11, 3.16, 2.82 и 2.34 мс на Vera, поэтому задержка в конце цепочки запросов на Venice была на 30–51% ниже. EPYC 9965 также показал более низкую задержку в конце цепочки запросов, чем Vera, на большинстве движков в октябре. 9175F при 32 пользователях показал 0.85, 1.35, 1.18 и 0.38 мс, что соответствует задержке в конце цепочки запросов OLTP для ядра с частотой 5.0 ГГц и 32 МБ кэша L3 на ядро.
Компания Shaw также протестировала 96-ядерный EPYC 9686F на нигерийской платформе AMD в режиме одного сокета, с 96 ядрами в рабочем состоянии и отключенной технологией SMT на 768 складах. В профиле, ориентированном на ЦП, который соответствует другим системам, PostgreSQL достиг пика в 3.03 млн NOPM при 56 пользователях и 38% загрузке сокета, что является самым высоким результатом PostgreSQL в ноябрьском раунде, опередив Vera (2.90 млн) и 9996-й сокет (2.61 млн). MariaDB достигла 2.28 млн, VillageSQL — 2.10 млн, а MySQL — 1.84 млн при загрузке от 79% до 89%.
По мнению Шоу, производительность процессора с частотой 5.3 ГГц оказалась ниже его ожиданий, и, поскольку он использовал сокет с отключенной функцией SMT, его рекомендация по выбору 256-ядерного сокета может оказаться невыгодной для 96-ядерного сокета на трех процессорах семейства MySQL. Он также протестировал сокет 9686F с полной надежностью, включенным бинарным логированием, WAL и fsync, что соответствует конфигурации, используемой в производственной OLTP-системе и обеспечивающей подключение хранилища к контуру управления.
MariaDB 13.0.2 лидировала по этому показателю с 1.43 млн NOPM, опережая VillageSQL (1.39 млн), PostgreSQL (1.30 млн) и MySQL (1.09 млн), при этом PostgreSQL обеспечивала скорость передачи данных 5.5 ГБ/с на Micron 9650. Запуск второго сокета на 1,536 хранилищах снизил пиковую нагрузку каждого движка до 1.43–1.80 млн, что соответствует описанной выше межсокетной конкуренции, и именно поэтому в этом разделе сравниваются одиночные сокеты.
Ноябрьские показатели Vera на обновленной прошивке NVIDIA на 5% ниже октябрьских для MariaDB и на 12% ниже для PostgreSQL в пиковый период, но при этом наблюдается рост на 23-24% при 16 пользователях, что указывает на сдвиг кривой масштабирования. Оценка Шоу, данная в октябре, о том, что Arm стала конкурентоспособным сервером баз данных, подтверждает эти данные. В ноябрьском обзоре также отмечается, что 256-ядерный сокет Venice не отстает от 88-ядерного сокета Vera по пропускной способности и опережает его по задержке, причем предельные значения для обоих показателей определяются не процессором, а самим процессором.
Заключение
Процессоры AMD EPYC 6-го поколения представляют собой самое широкое семейство серверных процессоров на рынке, а протестированный нами флагманский процессор SP7 устанавливает новый потолок производительности для двухпроцессорных серверов x86. Два процессора EPYC 9996 в сервере Dell PowerEdge R9825 показали в 1.8 раза более высокую скорость выполнения теста GROMACS benchPEP, чем система с 384 ядрами Turin, в 2.6 раза быстрее решили большую сетку OpenFOAM и обеспечили скорость шифрования 6.8 ТБ/с.
Эти достижения значительно превосходят 33-процентное увеличение количества ядер, поскольку само ядро Zen 6c работает быстрее на такт, обрабатывает в четыре раза больше запросов L3 на каждый CCD-чип и теперь имеет шестнадцать каналов. Исключением среди основных результатов является Valkey: один сокет обработал 76.5 млн GET-запросов в секунду, что на 27% больше, чем у Zen 5c, и меньше, чем при увеличении количества ядер, в то время как пропускная способность SET выросла на 65%.
В сравнении с NVIDIA Vera, Venice выигрывает большинство наших вычислительных тестов: 9996 опережает на 2.5 раза на ядро в векторной математике, в 5 раз в сумме в программной криптографии и в 2 раза по пропускной способности целочисленных операций во всех потоках, а 5.3 ГГц EPYC 9686F превосходит Olympus во всех закрепленных однопоточных тестах в тестовой среде, включая тесты Python с высокой задержкой, где Vera немного превосходит 9996.
Vera по-прежнему лидирует по пропускной способности памяти: при своих 2,073 ГБ/с в режиме STREAM Triad, Venice отстает на 42% на DDR5-8000 в R9825 и на 8% на MRDIMM, причем этот разрыв уменьшается на MRDIMM, если добавить обратно данные чтения из STREAM. Она также имеет значительное преимущество между сокетами, где NVLink-C2C обеспечивает в 4.6 раза большую пропускную способность удаленного сокета, чем xGMI. Тот же канал NVLink-C2C напрямую соединяет Vera с графическими процессорами NVIDIA, и по пропускной способности между ЦП и ГП Vera не имеет себе равных.
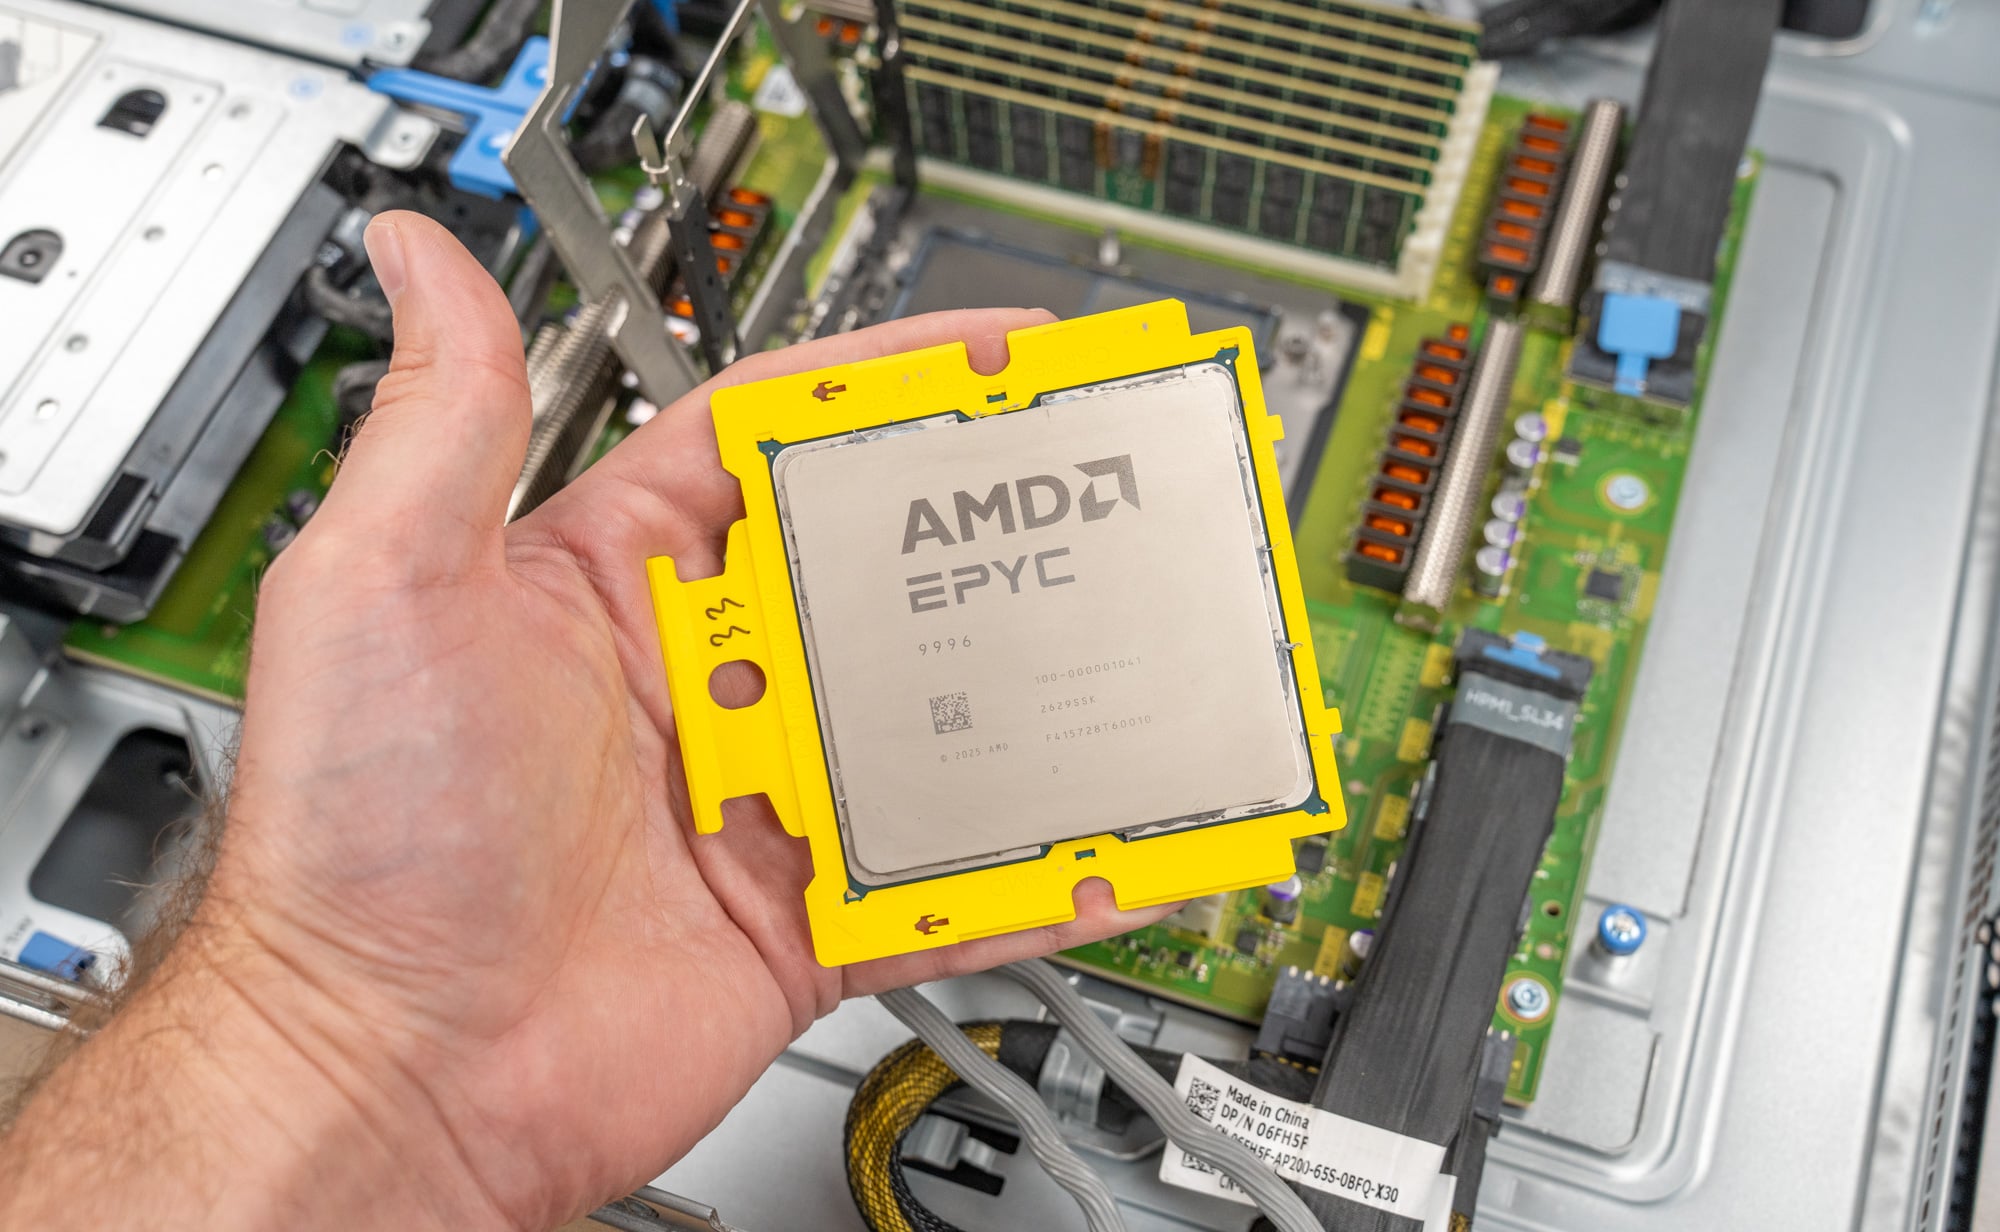
На современном рынке наибольшую проблему для покупателей представляет собой оперативная память. На процессоре R9825 с DDR5-8000 скорость 9996 ГБ/с достигает 1,201 ГБ/с, но на большой сети OpenFOAM она настолько ограничена пропускной способностью, что 96-ядерный 9686F на MRDIMM показывает результаты, отличающиеся от него всего на 13%. MRDIMM-12800 повышает скорость тех же процессоров до 1,901 ГБ/с, снижая производительность на 21%, в то время как 256 ядер обеспечивают прирост производительности на 30% по сравнению с 96 на тех же MRDIMM. Таким образом, для высокопроизводительных вычислений, где важна скорость памяти, выбор памяти имеет примерно такое же значение, как и количество ядер. ClickBench остался в пределах 7%-ного порога на более быстрой памяти, а рабочий набор Valkey с 256 ГБ памяти не показал улучшения.
Недостатки касаются только наиболее загруженной части системы: система с 512 потоками работает медленнее, чем система со 192 потоками, при выполнении задач на JVM, синхронизирующихся между всеми логическими процессорами; показатель «горячей суммы» ClickBench не улучшается после 192 ядер; а показатель Valkey по количеству запросов на ядро находится на уровне Olympus и ниже, чем у Zen 5c. Это ограничения масштабируемости и размещения при 256 ядрах на сокет, и покупателям, чьи задачи выглядят подобным образом, следует обратить внимание на 96-ядерный 9686F и 128-ядерный 9756, что является самым широким ассортиментом, который AMD предлагает в сравнении с конкурентом, выпускающим только одну модель.
В HammerDB один из сокетов EPYC 9996 поменялся местами с сокетом Vera, выиграв MySQL на 14%, сравнявшись с VillageSQL и отстав на 11–12% в MariaDB и PostgreSQL, при этом сократив задержку обработки платежей на 30–51% при одинаковой нагрузке. Один из сокетов 96-ядерного 9686F показал лучший результат в PostgreSQL в этом раунде — 3.03 млн NOPM. Поскольку ни один из процессоров не смог использовать более трех четвертей из 256 ядер сокета 9996, результаты OLTP говорят больше о масштабируемости базы данных, чем о процессоре.
Сервер Dell, на котором мы проводили основное тестирование EPYC 9996, получил награду «Лучший сервер в целом» в нашем обзоре PowerEdge R9825 , а системы HPE ProLiant Gen13 Venice поставляются параллельно с ним, вслед за ним в 2027 году появятся и другие серверы OEM-линейки, а также платформы SP8 и Verano. Для покупателей центров обработки данных, выбирающих сегодня двухпроцессорный сервер, EPYC 9996 — это самый быстрый процессор общего назначения из протестированных нами, а 9686F — это лучший выбор, когда для рабочей нагрузки важнее тактовая частота, чем количество ядер. Далее мы подробно рассмотрим производительность агентов — ту рабочую нагрузку, для которой покупатели следующего поколения хотят получить решение.
Рейтинг: Процессор EPYC 9996 используется в сервере Dell PowerEdge R9825, который занимает первое место в нашем рейтинге лучших серверов , где также фигурируют процессоры EPYC 9996 и 9686F.


 Amazon