

На протяжении большей части своего существования в центрах обработки данных NVIDIA рассматривала центральный процессор как нечто большее, чем просто чип, питающий графический процессор. Grace, её первый серверный процессор, соответствовал этой модели. Он использовал стандартные ядра Arm Neoverse V2 и поставлялся в основном как центральная часть суперчипов Grace Hopper и Grace Blackwell. Эти суперчипы, однако, представили один важный элемент платформы: NVLink-C2C, канал связи, обеспечивающий согласованный доступ центрального и графического процессоров к памяти друг друга с гораздо большей пропускной способностью, чем PCIe.
Его преемник, Vera, гораздо амбициознее. Это совершенно новая разработка, построенная на базе Olympus, собственного ядра Arm от NVIDIA. Olympus реализует Armv9.2, и каждый процессор Vera имеет 88 ядер и 176 потоков. Помимо новых ядер, еще одним важным преимуществом является подсистема памяти. Каждый процессор поддерживает до 1.5 ТБ LPDDR5X на модулях SOCAMM, с заявленной пиковой пропускной способностью 1.2 ТБ/с на сокет, что обеспечивает Vera энергоэффективность мобильной DRAM, сохраняя при этом возможность замены памяти в полевых условиях. На двух сокетах нашего тестового сервера эта скорость составляет 2.4 ТБ/с, а мы измерили 2,073 ГБ/с в STREAM Triad.
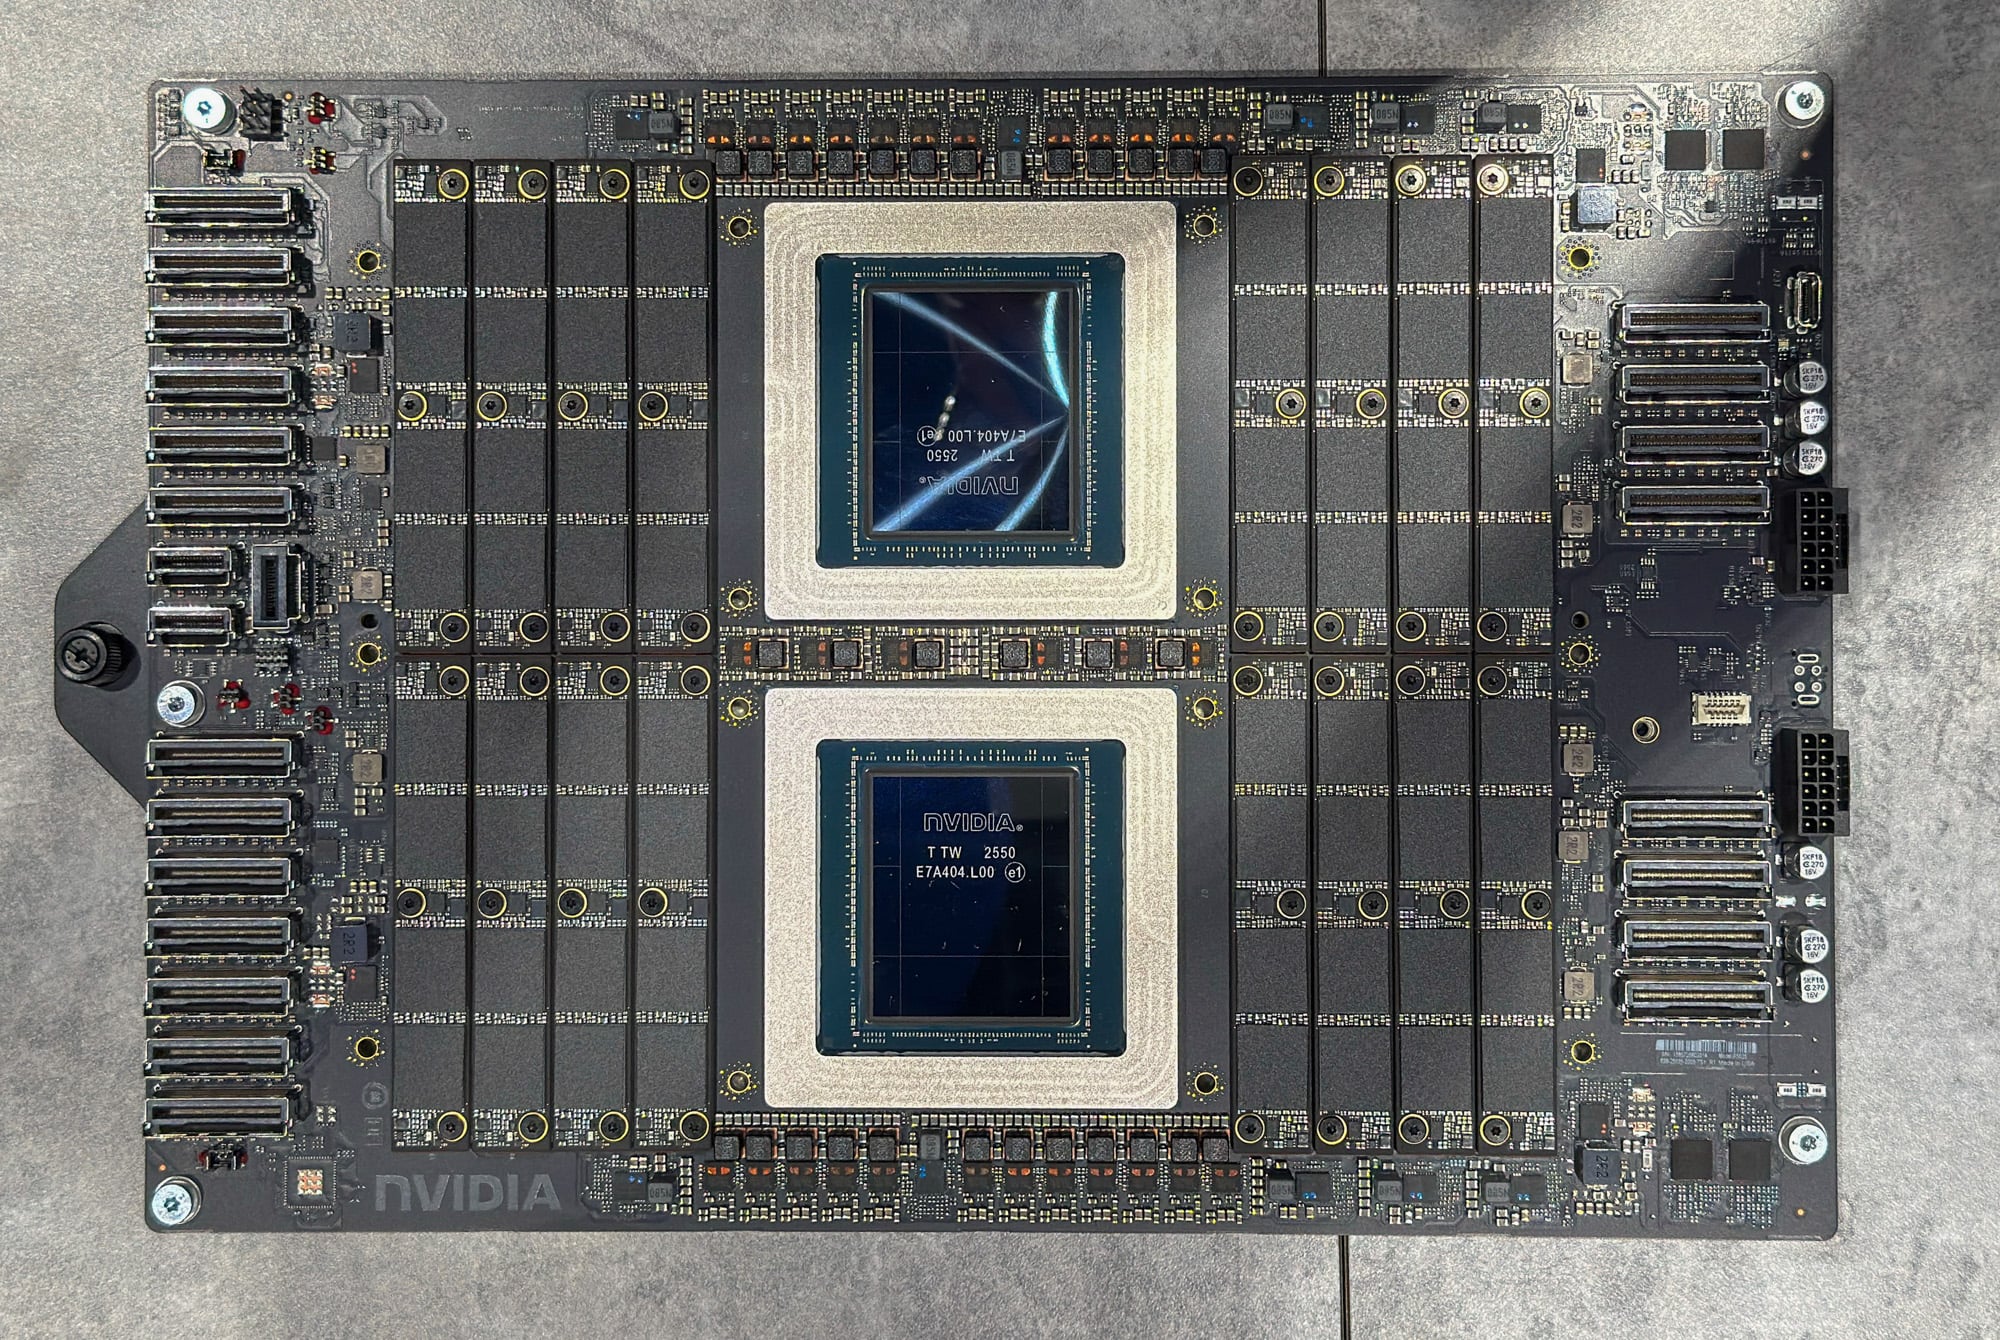
Эти амбиции распространяются и на области применения Vera. Она по-прежнему поставляется в составе суперчипа в системах Vera Rubin, но NVIDIA также расширила ее использование на свою платформу хранения данных BlueField-4 STX и на автономные серверы с процессорами для агентских песочниц. Vera также получает широкую поддержку от OEM-производителей, гипермасштабируемых компаний и сетевых провайдеров: Dell, HPE и Supermicro добавили серверы Vera в свои линейки, а гипермасштабируемые компании и сетевые провайдеры готовы сделать ее массовым предложением. Такая широкая доступность важна, потому что, как покажут наши результаты, Vera является серьезным конкурентом своим аналогам на базе x86 и предоставляет организациям третьего поставщика процессоров, что помогает диверсифицировать их цепочки поставок.
Основные выводы
- Пропускная способность памяти увеличивается более чем вдвое в каждой системе x86. Два сокета Vera показали скорость передачи данных более 2 ТБ/с в STREAM Triad, что в 2.3 раза превышает лучший результат, достигнутый на протестированном нами сервере DDR5. Даже при чтении памяти другого сокета через NVLink-C2C ядра Vera использовали больше пропускной способности, чем любой сокет x86 получает от локальной памяти, а локальная задержка при работе с большими страницами памяти была на 13% ниже, чем на EPYC 9175F.
- Сбалансированный чип для широкого сегмента среднего рынка. Одно ядро Olympus с частотой 3.4 ГГц сжимало 7-Zip на 12% быстрее, чем EPYC 9175F с частотой 5.0 ГГц, и выиграло два из трех однопоточных тестов Python. При полной нагрузке Vera достигла 63–72% пропускной способности EPYC 9965 в 7-Zip, используя менее половины ядер, оставаясь близкой к показателю производительности ядра AMD в одном потоке и к показателю производительности всей системы.
- Явным недостатком является работа с векторами и криптографией. Шесть 128-битных каналов SVE2 не могут сравниться с 512-битным AVX-512 в коде, написанном для него. На 16 ядрах Vera выполнила тест GROMACS benchMEM со скоростью вдвое меньшей, чем у EPYC 9175F, и в два раза меньшей, чем у EPYC 9965, а также одноядерное шифрование AES-256-GCM примерно в три раза медленнее, чем у 9175F. В целом по системе 384-ядерный EPYC 9965 показал примерно в 3 раза лучшие результаты как в тесте GROMACS benchPEP, так и в тесте AES.
- Высокопроизводительные вычисления с ограничением объема памяти преобразуют пропускную способность в скорость. На большой сети OpenFOAM Vera показала результат в 1.44 раза быстрее, чем 384-ядерный EPYC 9965, и в 1.20 раза быстрее, чем 240-ядерный Xeon 6978P. На меньшей сети, где большая часть проблем связана с кэшами L3 x86, Vera заняла второе место, отстав от 9965 всего на 12%.
- Базы данных и аналитика уже сейчас являются конкурентоспособными. В HammerDB TPROC-C на одном сокете 88 ядер Vera превзошли 192-ядерный сокет EPYC 9965 на 26% по PostgreSQL и на 8% по MariaDB, в то время как отстали на 19% по MySQL и на 15% по VillageSQL; Xeon 6787P уступил Vera по всем пяти движкам. Vera также завершила тест ClickBench на 23% быстрее, чем EPYC 9965, и обработала на 34% больше запросов на рабочем наборе Valkey объемом 256 ГБ.
Характеристики
| Параметр | Процессор NVIDIA Vera |
|---|---|
| Вычислительные и энергетические ресурсы | |
| Основные | NVIDIA Olympus, Armv9.2 с SVE2 и FP8 |
| Количество ядер и потоков на сокет | 88 ядер, 176 потоков (NVIDIA Spatial Multithreading) |
| Тактовая частота (измеренная) | 3.41GHz |
| TDP | Настраиваемая мощность от 250 Вт до 450 Вт |
| Охлаждение | Воздух или жидкость |
| Кэш | |
| Инструкция L1 | 64 КБ на ядро |
| Данные L1 | 96 КБ на ядро, 6-процессорная архитектура |
| L2 | 2 МБ на ядро, приватное |
| Кэш системного уровня (L3) | 164 МБ на сокет, разметка MPAM для архитектуры Arm. |
| Ткань | Масштабируемая когерентная сеть второго поколения, скорость бисекции 3.4 ТБ/с. |
| Память | |
| Тип | LPDDR5X на 8 модулях SOCAMM2 на каждый разъем |
| Контроллеры | 8 x 128-бит (в сумме 1,024 бита) |
| Скорость | До 9,600 МТ/с |
| Пропускная способность | До 1.2 ТБ/с на сокет (по заявленным производителем параметрам) |
| Рабочий диапазон | От 256 ГБ до 1.5 ТБ на сокет |
| Ввода / вывода | |
| PCIe | Gen6, 88 линий на сокет (платформа только с процессором) бифуркация x16, x8, x4, x2 |
| CXL | 3.1. Расширение и объединение памяти типа 3. |
| НВЛинк-C2C | Шифрование второго поколения, двунаправленное, когерентное, аутентифицированное, со скоростью 1.8 ТБ/с |
| Безопасность. | |
| Конфиденциальные вычисления | Области Arm CCA, RME-DA и RME-CDA, TDISP, ключи для каждой виртуальной машины. |
Почему NVIDIA хочет выйти на рынок процессоров?
Чтобы понять, почему Vera важна для NVIDIA, давайте посмотрим, как развивалась компания. NVIDIA построила свою стратегию в области центров обработки данных вокруг графических процессоров, а затем расширила инфраструктуру, необходимую для обеспечения работы этих графических процессоров. Что касается аппаратной части, приобретение Mellanox в 2020 году обеспечило сетевые технологии, которые соединяют серверы и передают данные между ними. Что касается программного обеспечения, CUDA, DOCA и более широкий программный стек расширили возможности NVIDIA в области программирования и управления этим оборудованием. Вместе эти компоненты дали компании контроль над большей частью платформы ускоренных вычислений.
Но платформе по-прежнему требовался универсальный центральный процессор. Необходимо было обеспечить работу операционной системы, подготовку данных, управление приложениями и координацию задач, передаваемых ускорителям. На протяжении большей части периода расширения NVIDIA эту роль выполняли Intel и AMD. Это поставило NVIDIA в неловкое положение: компания могла поставлять графические процессоры, сетевое оборудование и большую часть программного обеспечения, но при этом всё ещё зависела от процессора другой компании, который находился в центре серверной части.
Grace стал первым важным шагом к изменению этой ситуации. Созданный на основе ядер Arm Neoverse V2, он предоставил NVIDIA процессор для центров обработки данных и способ более тесного взаимодействия этого процессора с графическими процессорами через NVLink-C2C. Тем не менее, Grace оставил пробел в производительности, который необходимо было заполнить. Его пропускная способность памяти и эффективность делали его конкурентоспособным в качестве процессора для хост-систем искусственного интеллекта, но ведущие процессоры x86 сохраняли существенные преимущества в большинстве других рабочих нагрузок. Эта неравномерная производительность ограничивала аргументы в пользу выбора Grace в качестве универсальной замены для серверов EPYC или Xeon.
Vera значительно сокращает этот разрыв, заменяя ядра Neoverse V2 в Grace на разработанные NVIDIA по индивидуальному заказу Olympus и существенно увеличивая пропускную способность и объем памяти. Предлагая конкурентоспособный процессор наряду со своими графическими процессорами, DPU и сетевым оборудованием, NVIDIA может получить большую долю расходов на каждый сервер. Это также дает компании больший контроль над своей экосистемой и тем, как компоненты взаимодействуют: ядра процессора, подсистема памяти, межсоединение и графический процессор могут быть спроектированы с учетом одних и тех же требований. Наглядным примером такой интеграции является согласованная связь между процессором и графическим процессором в Vera, теперь с пропускной способностью до 1.8 ТБ/с.
Увеличение доли затрат каждой системы — это лишь часть решения. Обучение с подкреплением (RL) и агентный ИИ дают NVIDIA еще одну причину предлагать автономную систему на базе ЦП. Агент делает больше, чем просто генерирует ответ. Он вызывает инструменты, извлекает информацию, выполняет код и проверяет результаты, прежде чем решить, что делать дальше. Большая часть этого выполнения происходит на ЦП, и когда следующий шаг модели зависит от результата задачи ЦП, медленное выполнение задерживает всю последовательность. Поэтому производительность на ядро, задержка памяти и предсказуемое поведение под нагрузкой становятся важными факторами для быстродействия агента.
Ядро Олимпа
Эти требования тесно связаны с конструкцией 88 ядер Olympus процессора Vera, которые построены с учетом четкого приоритета: высокая производительность каждого ядра, поддерживаемая при полной загрузке всего сокета. Olympus — это реализация NVIDIA набора инструкций Armv9.2, заменившая ядра Neoverse V2, использовавшиеся в Grace. Это различие имеет значение: Arm определяет инструкции, которые выполняет процессор, а NVIDIA разработала механизм, который их извлекает, планирует и выполняет. Этот контроль позволяет NVIDIA настраивать ядро для достижения его цели: быстрого завершения отдельных задач при одновременном выполнении множества задач.
Первая половина этой цели начинается с количества инструкций за цикл (IPC): сколько инструкций ядро выполняет в среднем за каждый тактовый цикл. Тактовая частота определяет, как часто происходят эти циклы; микроархитектура определяет, какой объем полезной работы может быть в них умещен. NVIDIA заявляет об улучшении IPC в 1.5 раза по сравнению с предыдущим поколением. Максимальная тактовая частота, которую мы наблюдали, составляла 3.41 ГГц, но архитектура Vera делает акцент на извлечении большего объема работы за цикл и поддержании этого прогресса под нагрузкой. Этот акцент важен, потому что для компилятора, интерпретатора или работы с базой данных, имеющей длинную последовательность зависимых шагов, одних только дополнительных ядер недостаточно для ускорения завершения этой последовательности.
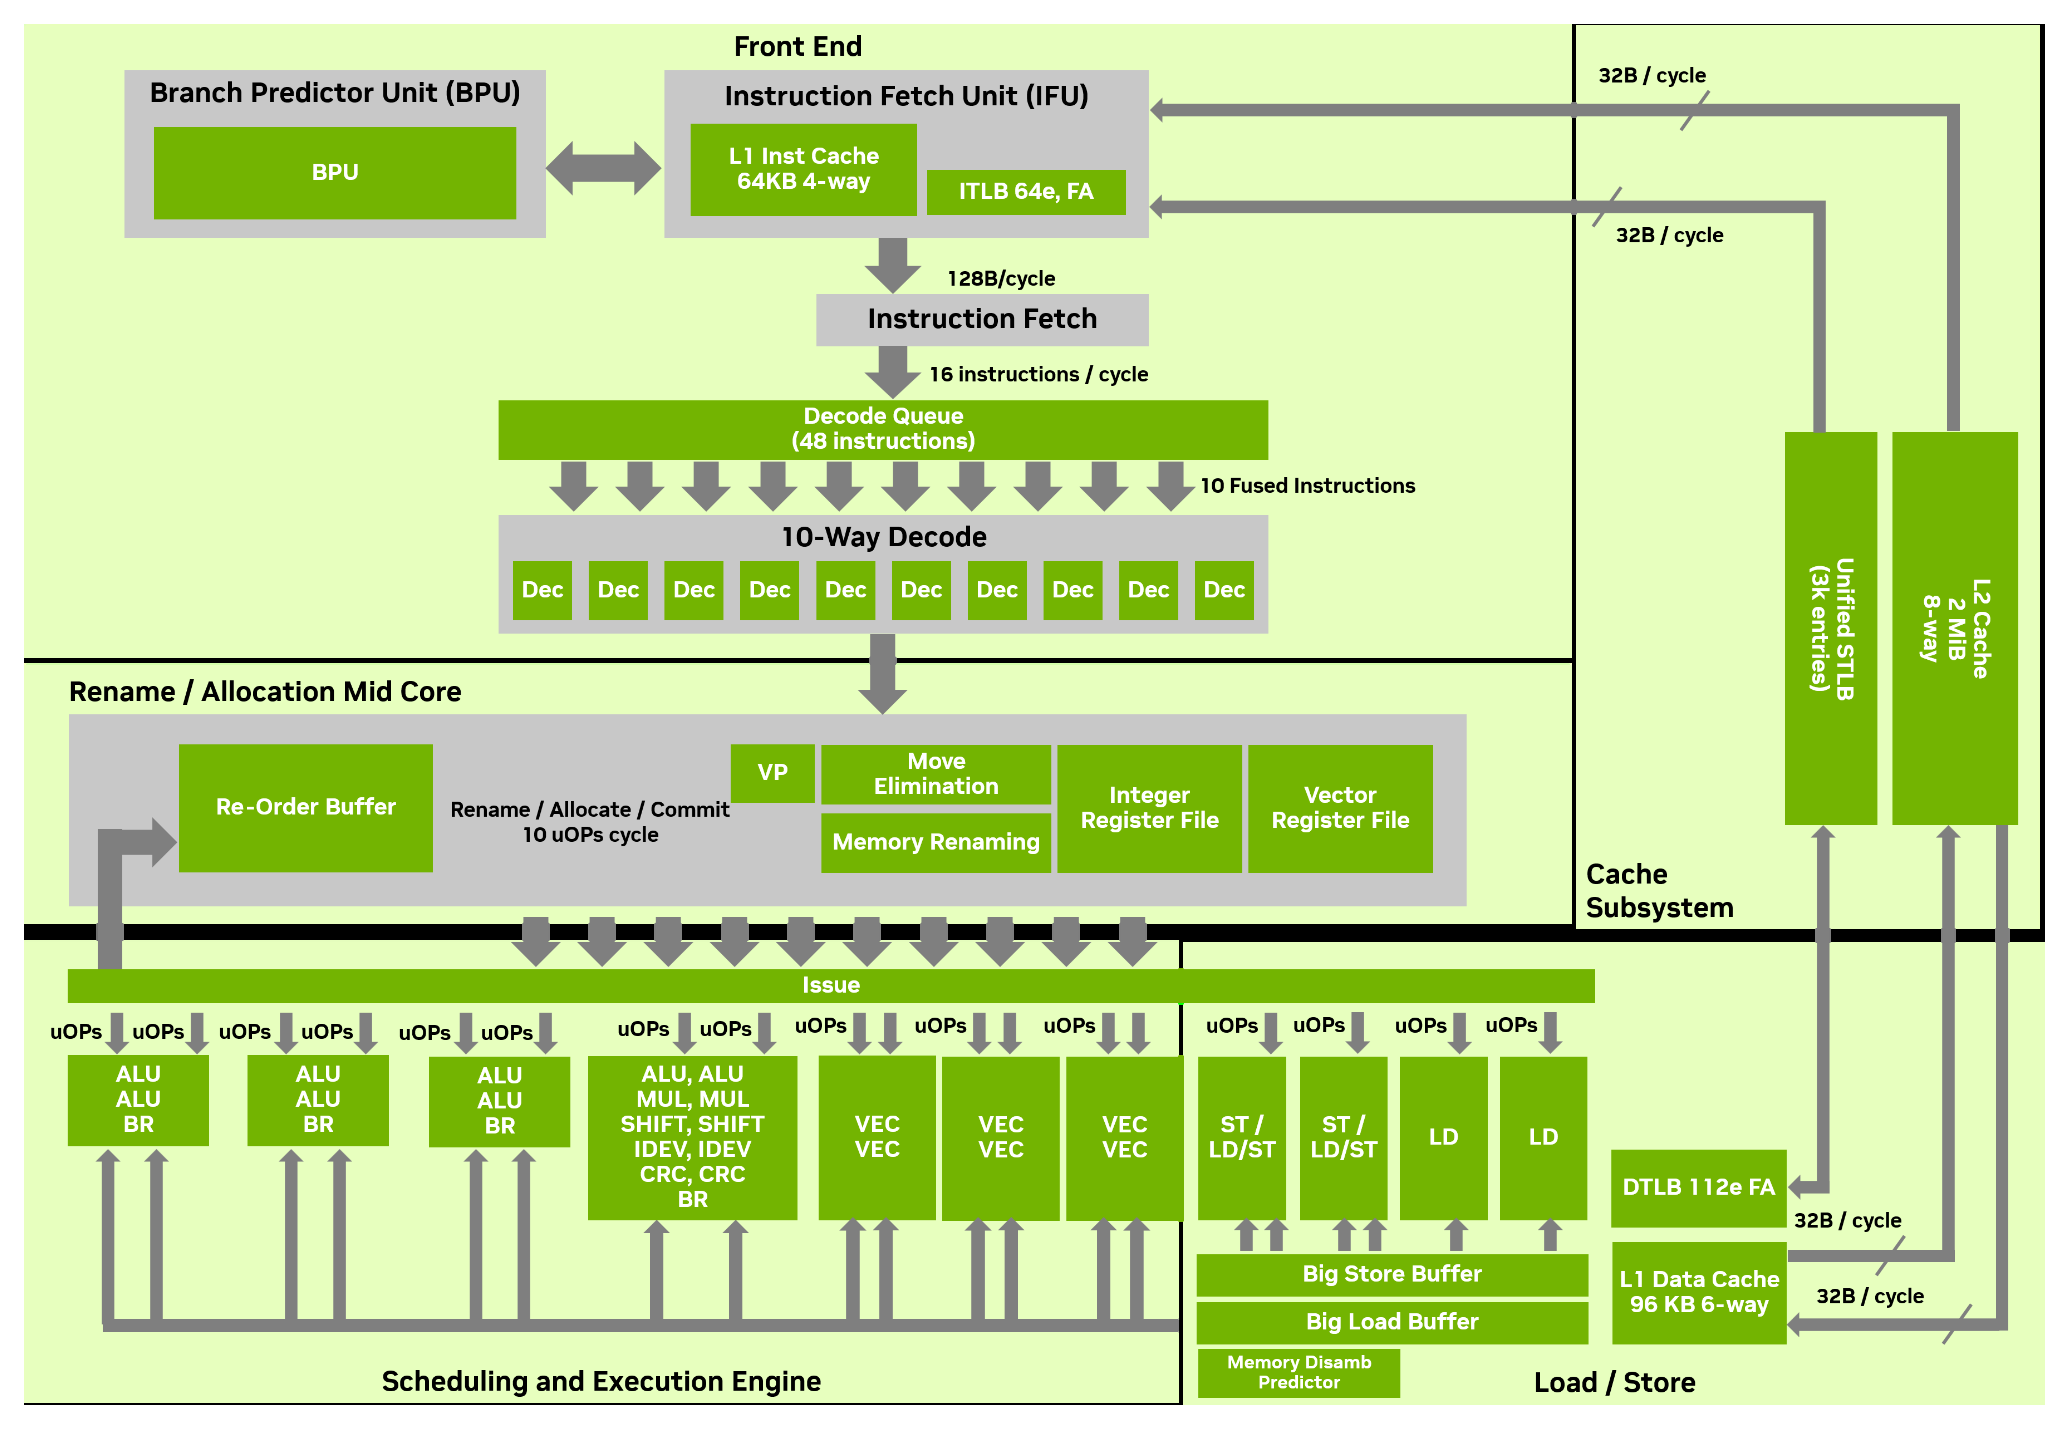
Достижение такого уровня межпроцессного взаимодействия (IPC) начинается со стабильного потока полезных инструкций. Фронтенд Olympus, часть ядра, которая считывает и декодирует инструкции программы, может декодировать до десяти инструкций за цикл. Такая пропускная способность важна только в том случае, если она постоянно пополняется, что становится сложным, когда программное обеспечение часто переходит между путями выполнения кода. Поэтому Olympus объединяет нейронный предсказатель ветвлений с другими специализированными предсказателями и поддерживает до двух выполненных ветвлений за цикл. Более точное предсказание помогает ядру считывать необходимые инструкции, сокращая время, затрачиваемое на выполнение неправильного пути и перезапуск после ошибки.
После того как инструкции будут получены и декодированы, Olympus использует внеочередное выполнение инструкций, чтобы найти работу, которая может быть выполнена, пока более ранние инструкции ожидают. Например, если одна операция ожидает доступа к памяти, независимое вычисление может быть выполнено раньше нее. Большое окно инструкций дает процессору больше возможностей для поиска такой независимой работы.
Тем не менее, некоторые последовательности, такие как описанные выше зависимые цепочки, не поддаются такому подходу, поскольку каждый шаг требует результата предыдущего шага. Для таких последовательностей Olympus также использует прогнозирование значений, позволяя зависимым операциям начинаться с прогнозируемого значения, а затем проверяет это значение, когда становится доступен фактический результат. Правильные прогнозы могут сократить фактическое время ожидания вдоль этих зависимых цепочек; неправильные прогнозы требуют корректировки и повторного вычисления спекулятивных вычислений.
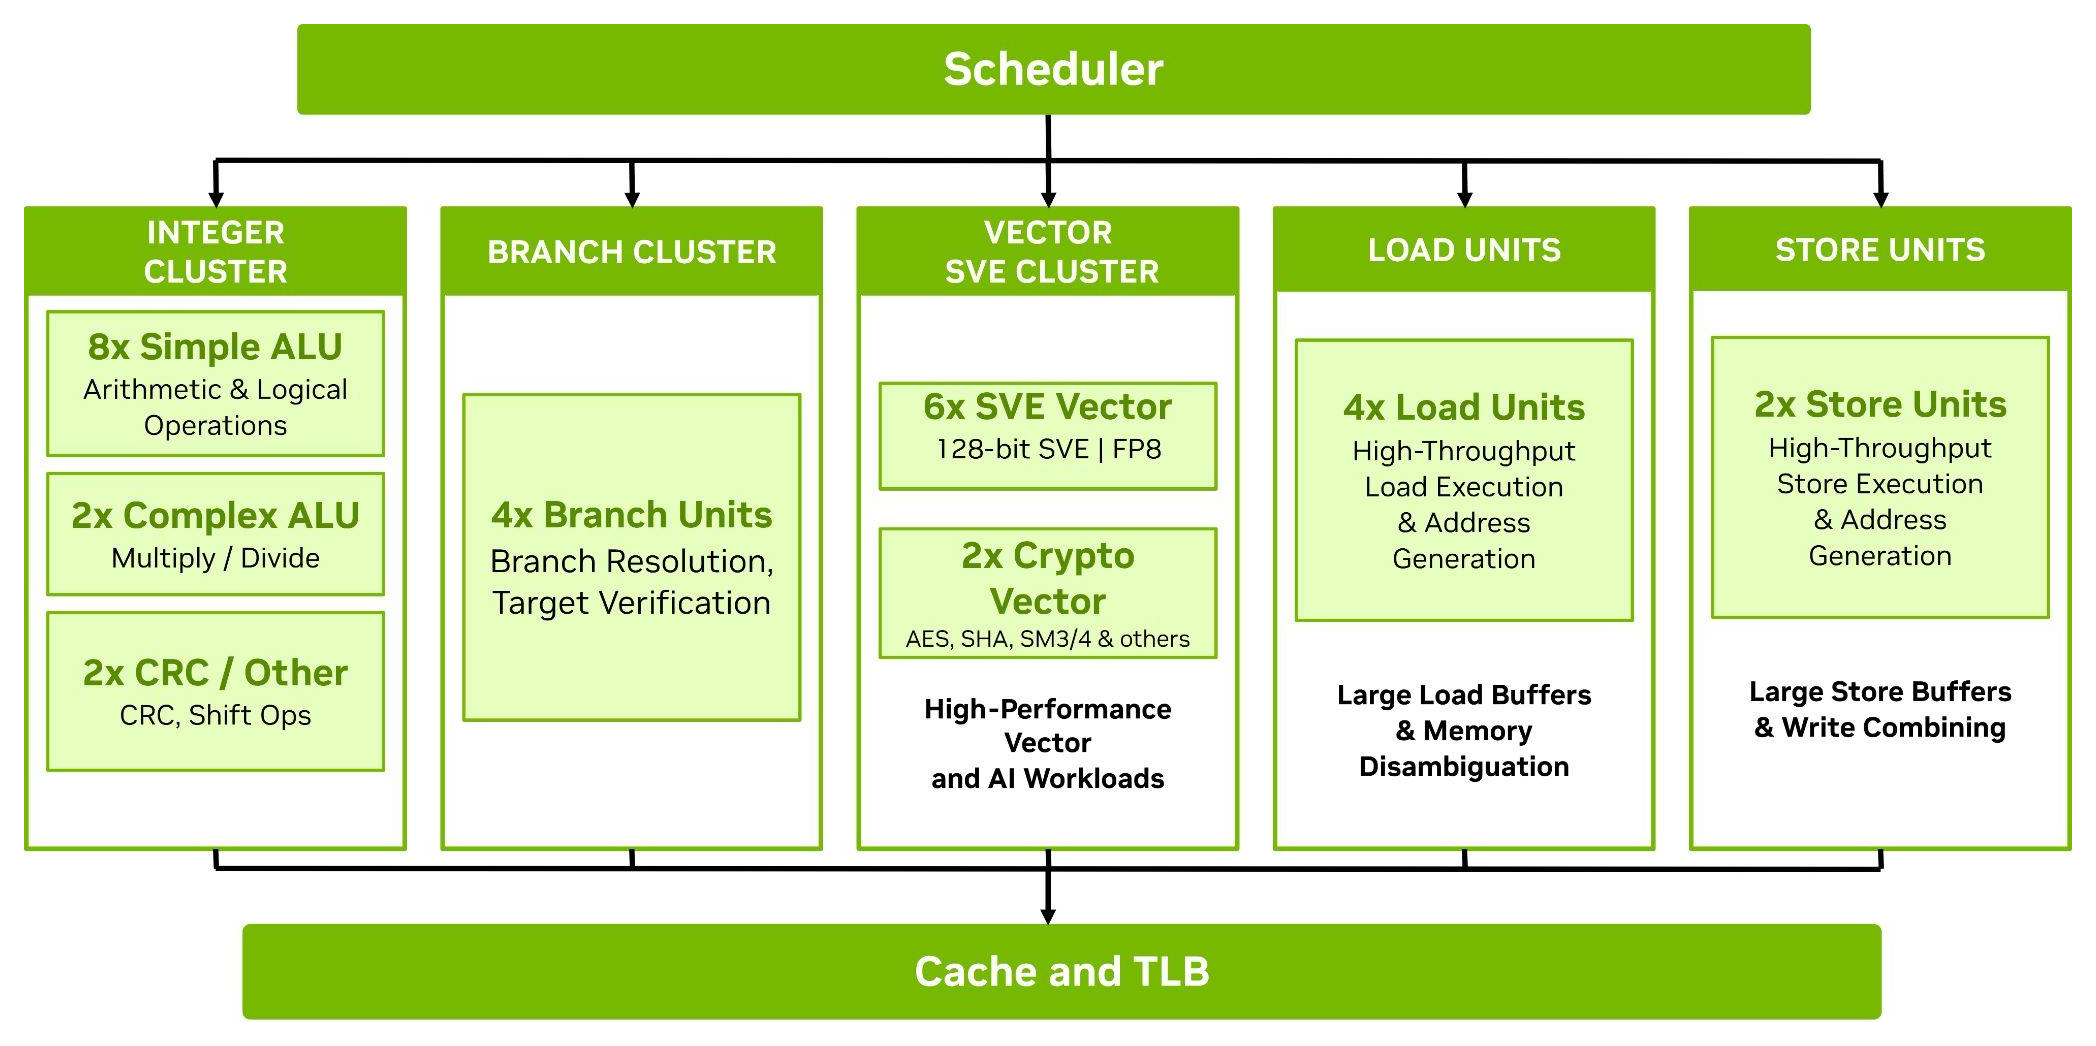
Затем исполнительному движку требуется достаточная мощность для преобразования этого набора инструкций в завершенную работу. Olympus сочетает в себе широкие ресурсы для выполнения целочисленных операций с выделенными блоками ветвления, четырьмя конвейерами загрузки и двумя конвейерами сохранения. Эти ресурсы удовлетворяют различным требованиям: блоки целочисленных операций обрабатывают арифметические операции, сравнения и логику; блоки ветвления определяют поток управления; а конвейеры загрузки/сохранения перемещают данные между ядром и его кэшами. Баланс имеет значение, поскольку более широкий декодер принесет мало пользы, если инструкции просто будут накапливаться из-за узкого места в выполнении или памяти.
Помимо этих скалярных ресурсов, Olympus располагает шестью 128-битными векторными конвейерами, поддерживающими SVE2, а также двумя конвейерами с поддержкой FP8 и криптографическими возможностями. Векторные инструкции применяют операцию к нескольким элементам данных, что делает их полезными для численных вычислений, сжатия и обработки данных.
В этом отношении Olympus явно идет на компромисс: ширина вектора в 128 бит меньше, чем 512-битная ширина, доступная через AVX-512 на конкурирующих процессорах x86. Эта разница имеет значение для оптимизированных численных ядер и даже токенизаторов, хотя производительность приложений также зависит от пропускной способности конкретных инструкций, сгенерированного кода и объема предоставляемых данных. Поэтому научные приложения, такие как GROMACS, остаются отдельной проверкой сильных сторон конструкции.
Каждый из этих ресурсов выполнения, скалярный или векторный, зависит от своевременного поступления данных, поэтому хранение часто используемых данных вблизи исполнительного механизма имеет такое же важное значение. Каждое ядро имеет кэш инструкций объемом 64 КБ, кэш данных объемом 96 КБ и частный кэш второго уровня (L2) объемом 2 МБ. Небольшие кэши первого уровня обеспечивают быстрый доступ к наиболее полезным инструкциям и данным; больший кэш L2 сохраняет большую часть рабочего набора ядра, прежде чем доступ к нему будет осуществляться через процессор. Предоставление каждому ядру значительного частного кэша L2 поддерживает ту же цель для каждого ядра: больше работы может быть обработано локально, что снижает нагрузку на общий кэш и основную память.
Предварительная выборка данных дополняет эти кэши, пополняя их до того, как инструкция запросит их. Наряду с предварительными выборками для обычных шаблонов доступа, Olympus включает предварительную выборку данных для графов, предназначенную для косвенного доступа, например, A[B[i]], где один поиск предоставляет индекс для другого. После определения этой взаимосвязи оборудование может начать выборку второго фрагмента данных до того, как программа потребует его. Это помогает решить распространенную проблему в обработке графов и других нерегулярных рабочих нагрузках: процессор обладает достаточной вычислительной мощностью, но прогресс зависит от нахождения следующего фрагмента данных.
Последняя составляющая Olympus решает вторую половину её задачи: одновременное выполнение множества задач. Каждое ядро поддерживает два аппаратных потока, что даёт Vera 176 потоков на сокет. NVIDIA называет свою схему пространственной многопоточностью. Ядро может выделять свои ресурсы одному активному потоку или распределять ресурсы между двумя активными потоками, предоставляя выбор между концентрацией вычислительной мощности на одном потоке инструкций и поддержкой большего количества параллельных задач.
Заявленная цель NVIDIA — уменьшить помехи между двумя потоками, сделав производительность более предсказуемой, когда оба потока заняты, что аналогично предсказуемости, от которой зависят агентные рабочие нагрузки под нагрузкой. Два потока по-прежнему используют общее физическое ядро и более широкую систему памяти, поэтому разделение ресурсов не гарантирует фиксированную задержку приложения.
Фазовая структура, память и ввод-вывод
Помимо отдельных ядер, для обеспечения производительности 88-ядерной архитектуры требуется нечто большее, чем просто быстрое подключение к DRAM. Ядрам также необходимо обмениваться данными, получать доступ к общему кэшу и взаимодействовать с подключенными устройствами. Vera соединяет эти ресурсы с помощью второго поколения масштабируемой когерентной структуры NVIDIA (Scalable Coherency Fabric), внутренней сетки, которая также обеспечивает когерентность кэшированных копий общих данных. Ядра, структура и 164 МБ системного кэша расположены на одном вычислительном кристалле, а контроллеры памяти и ввод-вывод — на соседних чиплетах. NVIDIA оценивает пропускную способность структуры в 3.4 ТБ/с по принципу бисекционного поиска, что является показателем пропускной способности сети, независимо от пропускной способности основной памяти.
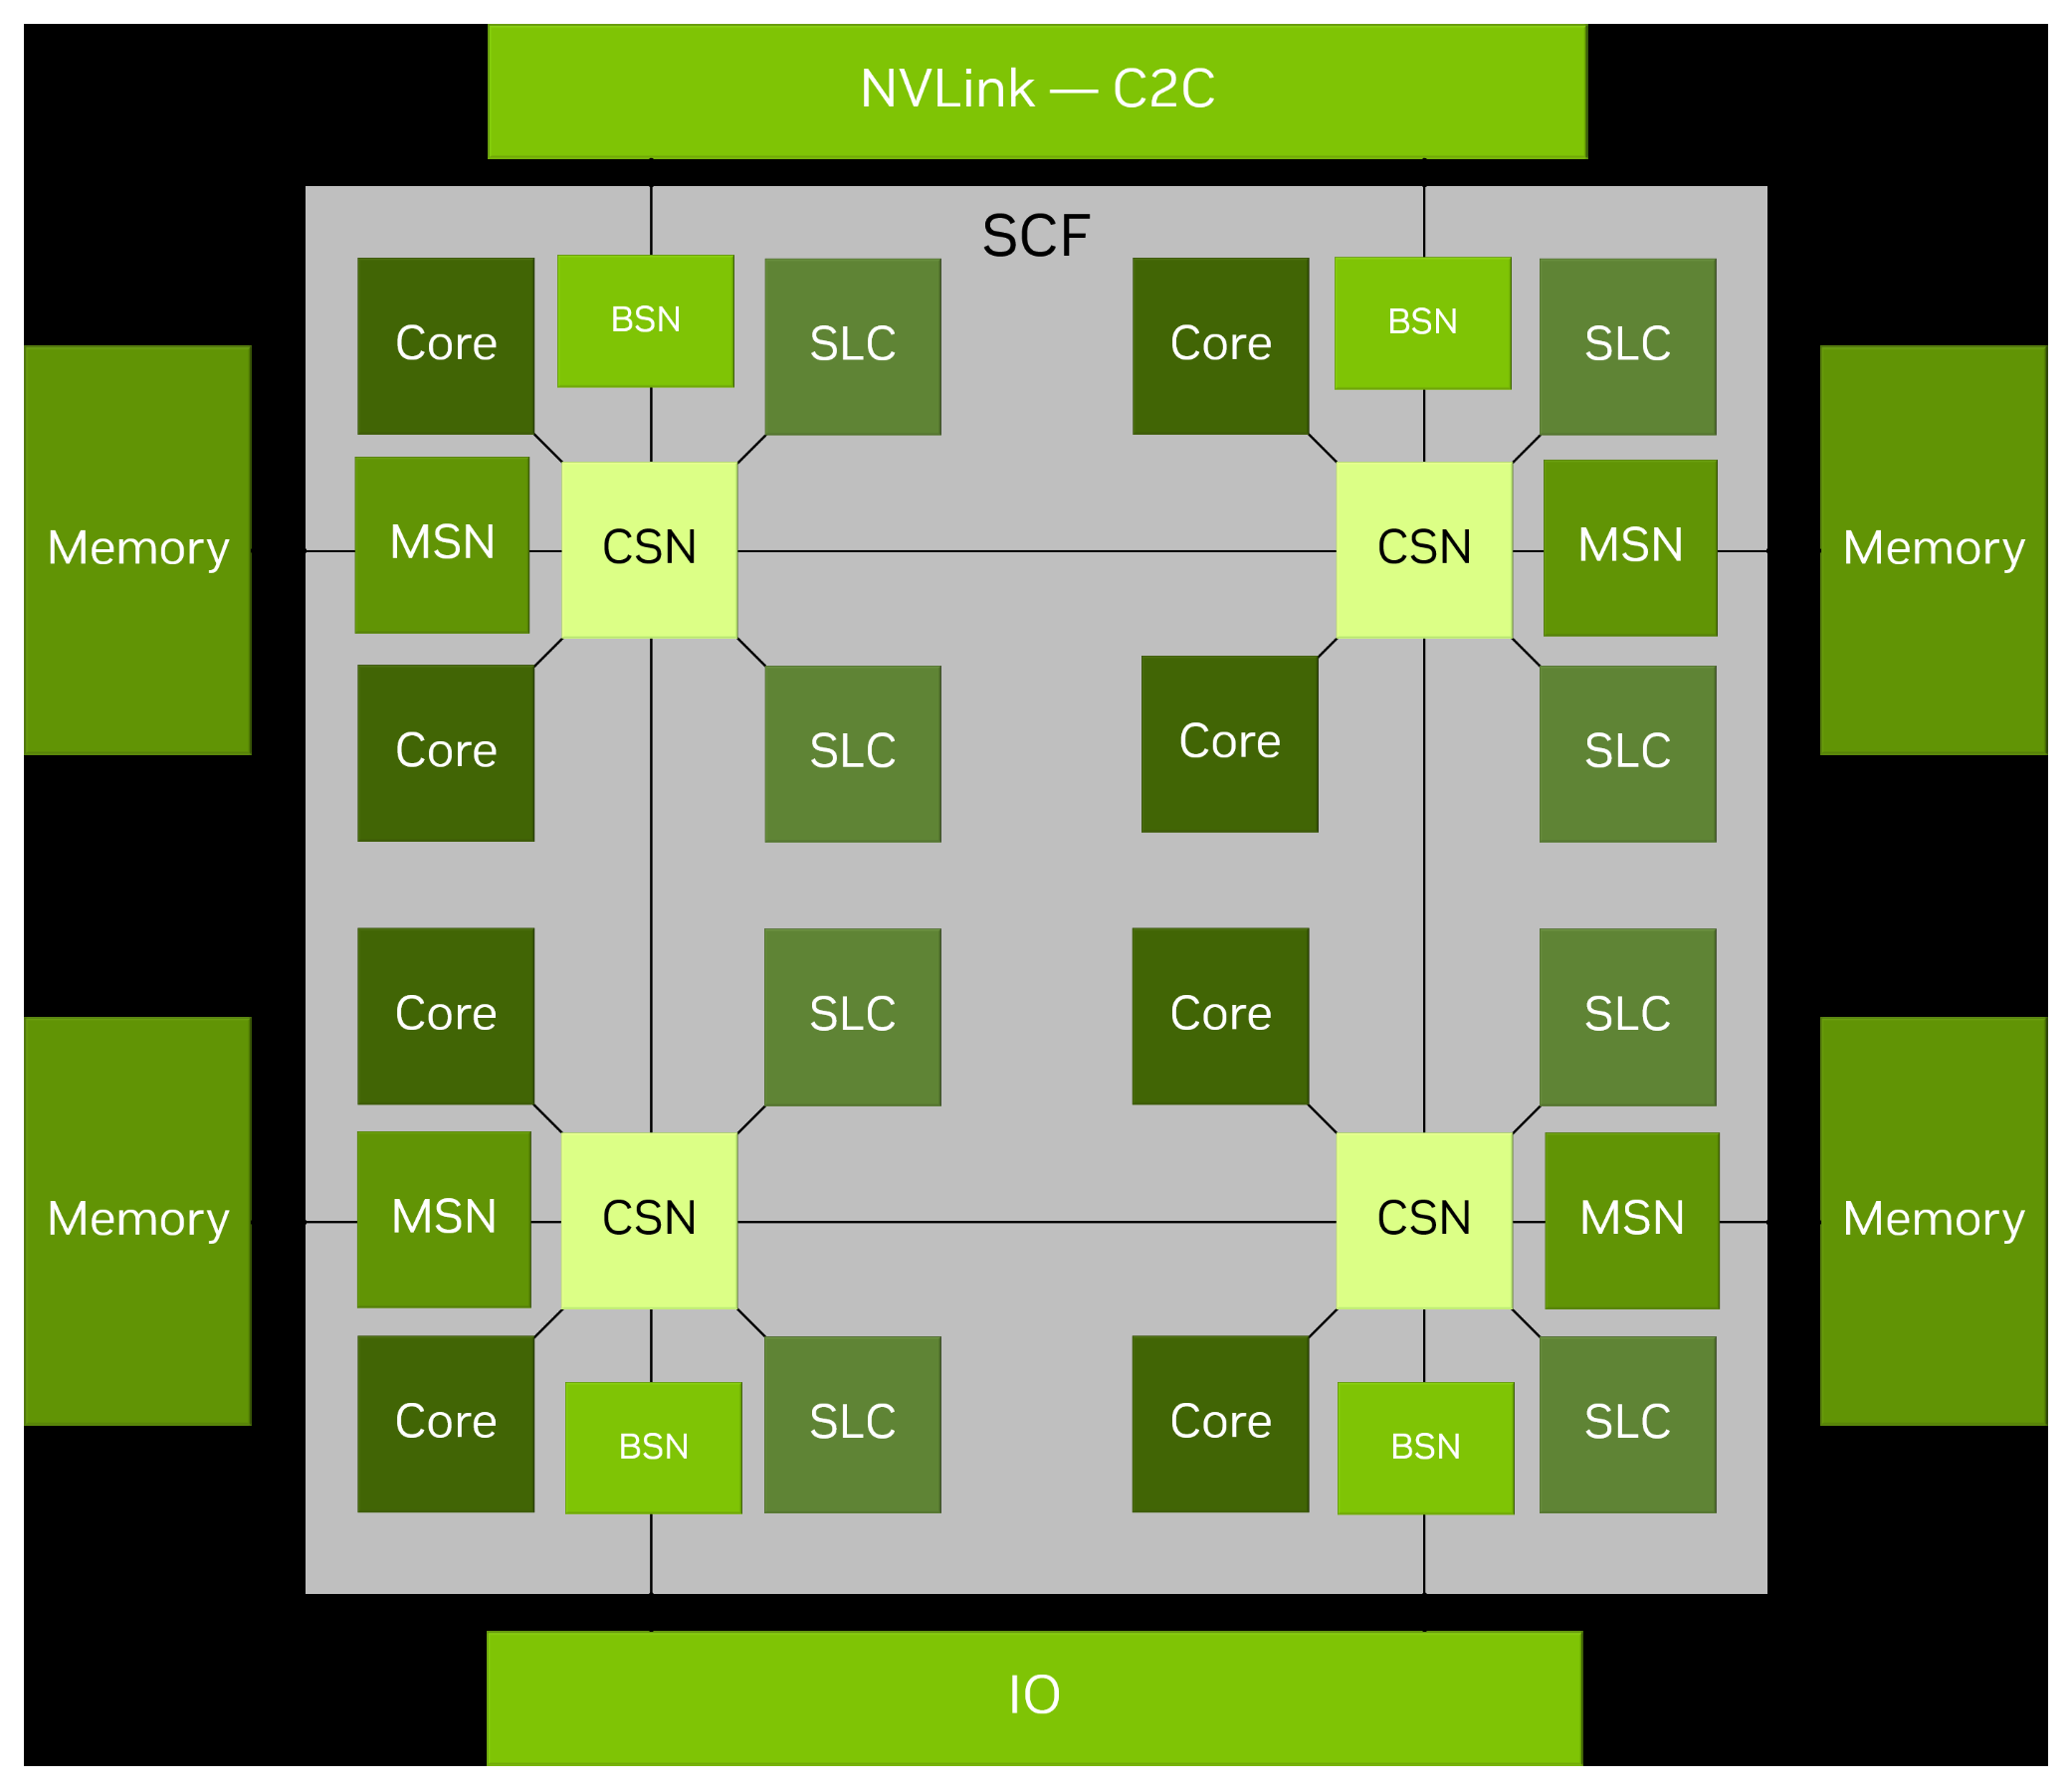
Такая однокристальная компоновка позволяет избежать передачи данных между отдельными вычислительными ядрами при взаимодействии ядер или доступе к общему кэшу. Что касается программного обеспечения, Vera также предоставляет один узел NUMA на каждый сокет: операционная система рассматривает каждый сокет как группу ядер и локально подключенной памяти. Это упрощает размещение внутри сокета, хотя и не означает, что каждый путь через сеть имеет одинаковую задержку. Сервер с двумя сокетами по-прежнему имеет два узла NUMA, и доступ к памяти другого сокета отличается от доступа к локальной памяти.
В каждом сокете общий системный кэш, или L3, расположен на один уровень выше частных кэшей L2, описанных ранее. Он дает ядрам еще одну возможность повторно использовать данные без обращения к DRAM и обеспечивает общую емкость, доступную по всему сокету. Его объем в 164 МБ является существенным, но некоторые конкурирующие процессоры предлагают значительно больший объем L3. Это важно, когда многократно используемый рабочий набор данных слишком велик для L2 ядра, но помещается в больший общий кэш. Высокая пропускная способность DRAM помогает, когда данные должны поступать из памяти; это не отменяет преимущества избегания такого доступа изначально.
Поскольку эта емкость является общей, Vera также поддерживает Arm MPAM, что позволяет системному программному обеспечению разделять общую емкость кэша и управлять распределением пропускной способности памяти между рабочими нагрузками.
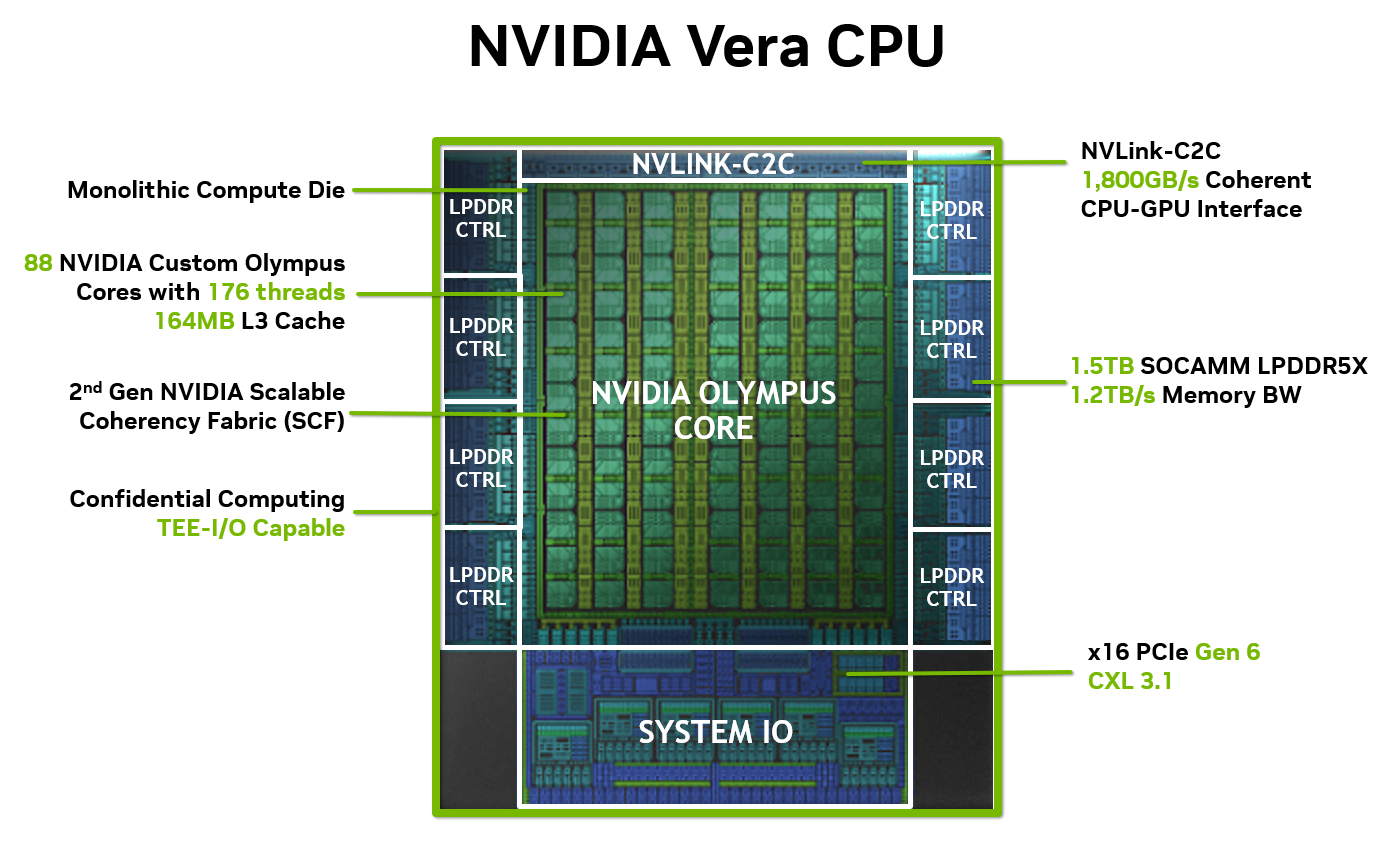
Когда обращения достигают основной памяти, Vera обладает значительной пропускной способностью. Восемь 128-битных контроллеров LPDDR5X обеспечивают суммарный интерфейс 1,024 бит, при этом память работает со скоростью до 9,600 МТ/с, что соответствует номинальной скорости 1.2 ТБ/с на сокет. Память размещена на восьми съемных модулях SOCAMM2, сочетающих LPDDR5X с модулями, заменяемыми в полевых условиях. Это обеспечивает Vera широкий и быстрый интерфейс памяти без необходимости припаивания модулей памяти.
Однако чистая пропускная способность — это лишь часть картины. Более полезной является зависимость между этой пропускной способностью и количеством ядер, которые её используют. Разделив заявленную пропускную способность в 1.2 ТБ/с на 88 ядер, получаем примерно 13.6 ГБ/с на физическое ядро. Это способ описать баланс процессора, а не выделенное пространство или гарантию того, что получит каждый поток. Увеличение количества ядер без соответствующего увеличения пропускной способности памяти снизит это соотношение.
Разделив измеренную пропускную способность потока на количество физических ядер, получаем 11.8 ГБ/с на ядро в системе Vera, по сравнению с 3.8 ГБ/с в системе с 240 ядрами Xeon 6978P. Это наглядный пример того, как Vera обеспечивает значительную пропускную способность памяти относительно своих вычислительных ресурсов.
Энергоэффективность — это часть того же самого конструктивного решения. По оценкам NVIDIA, полная загрузка подсистемы памяти LPDDR5X составляет примерно от 30 до 40 Вт в зависимости от объема. Преимущество LPDDR5X заключается в обеспечении такой пропускной способности при сохранении низкого вклада памяти в общее энергопотребление сервера, оставляя большую часть мощности и ресурсов системы для охлаждения для вычислительных задач.
Пропускная способность и эффективность по-прежнему ничего не говорят о том, сколько данных помещается, и емкость остается отдельным фактором. NVIDIA указывает до 1.5 ТБ непосредственно подключенной памяти LPDDR5X на сокет или 3 ТБ на два сокета. Для рабочих нагрузок, которым требуется, чтобы их рабочий набор данных находился в памяти, более высокие скорости передачи не могут компенсировать недостаточную емкость.
Там, где напрямую подключенной емкости недостаточно, возможности ввода-вывода Vera обеспечивают путь к увеличению емкости, а также соединения для устройств. Автономная платформа ЦП предоставляет 88 линий PCIe Gen6 на каждый сокет для сетей, хранения данных и ускорителей, в то время как конфигурация Vera Rubin предоставляет 96 линий. Что касается памяти, поддержка CXL 3.1 включает устройства памяти типа 3 и объединение памяти в пулы, что позволяет расширить емкость за пределы модулей SOCAMM2. Эта расширенная память использует другой путь доступа, отличный от напрямую подключенной LPDDR5X, поэтому ее производительность необходимо оценивать отдельно.
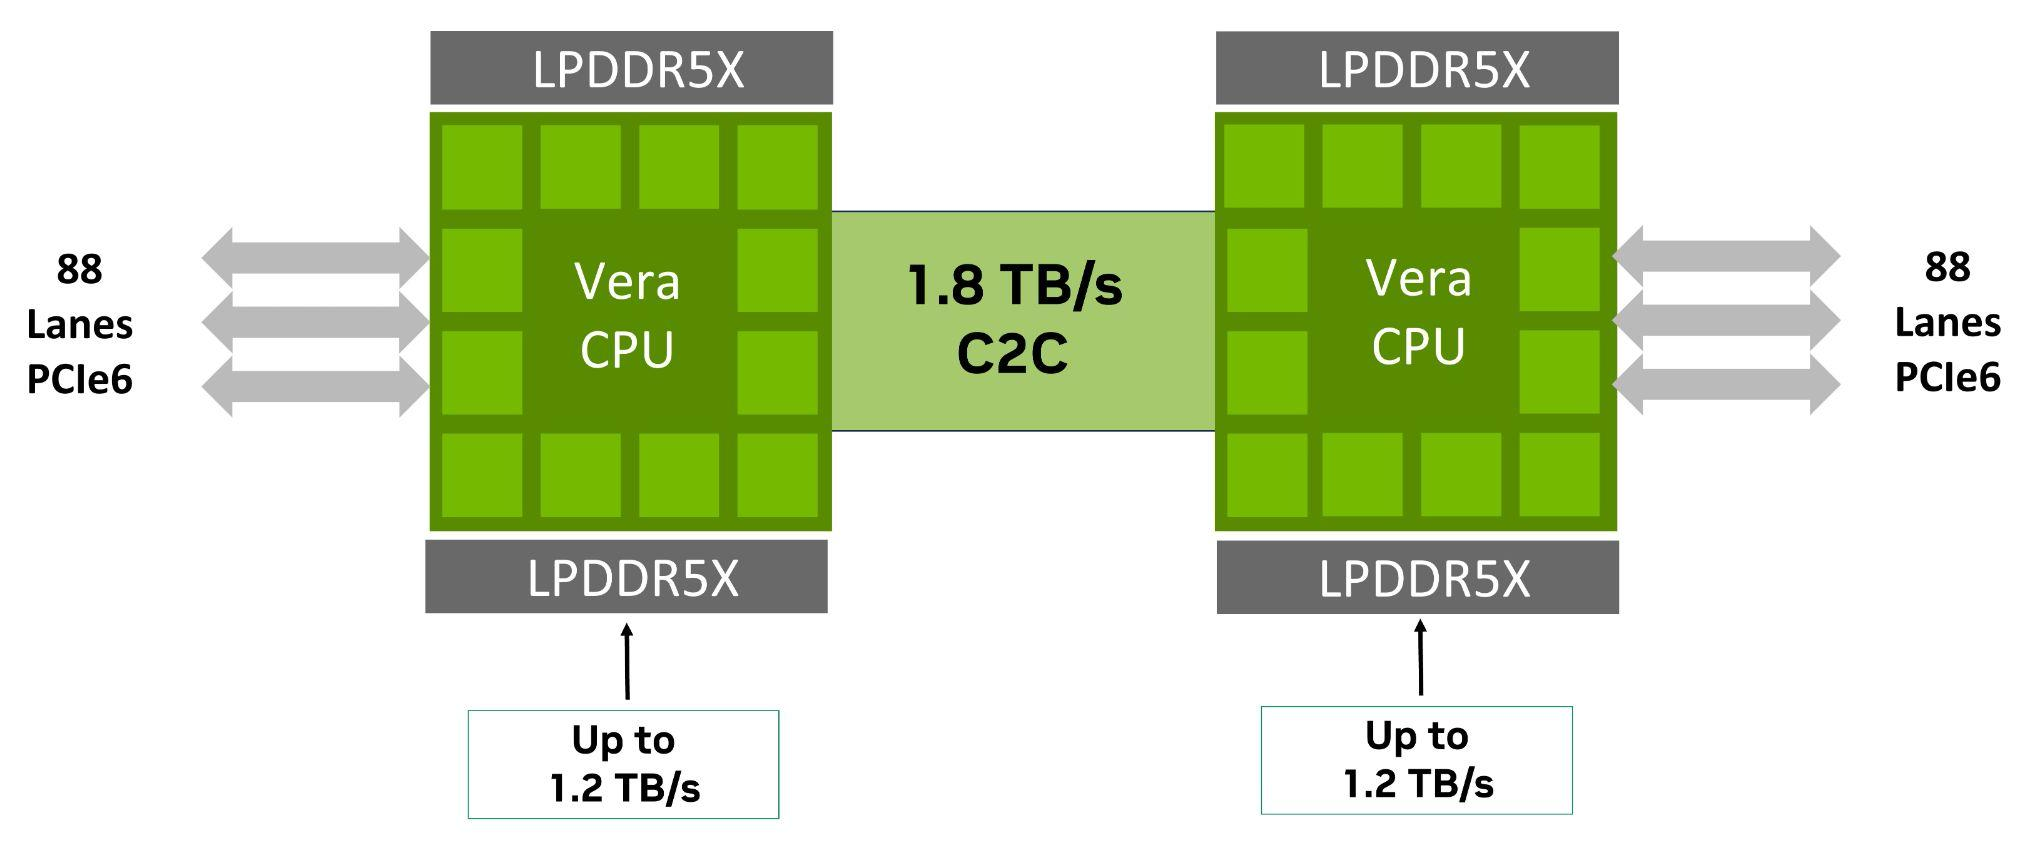
Наконец, для связи между процессорами Vera использует NVLink-C2C второго поколения, преемника канала связи, представленного вместе с суперчипами Grace. Он соединяет два процессора Vera в двухпроцессорном сервере или связывает Vera с графическими процессорами Rubin в суперчипе. Канал обеспечивает суммарную двунаправленную пропускную способность до 1.8 ТБ/с, или 900 ГБ/с в каждом направлении, и отражает ту же тесную интеграцию ЦП и ГП, которая изначально и побудила NVIDIA выйти на рынок ЦП.
Внутри эталонного сервера MGX Vera C2
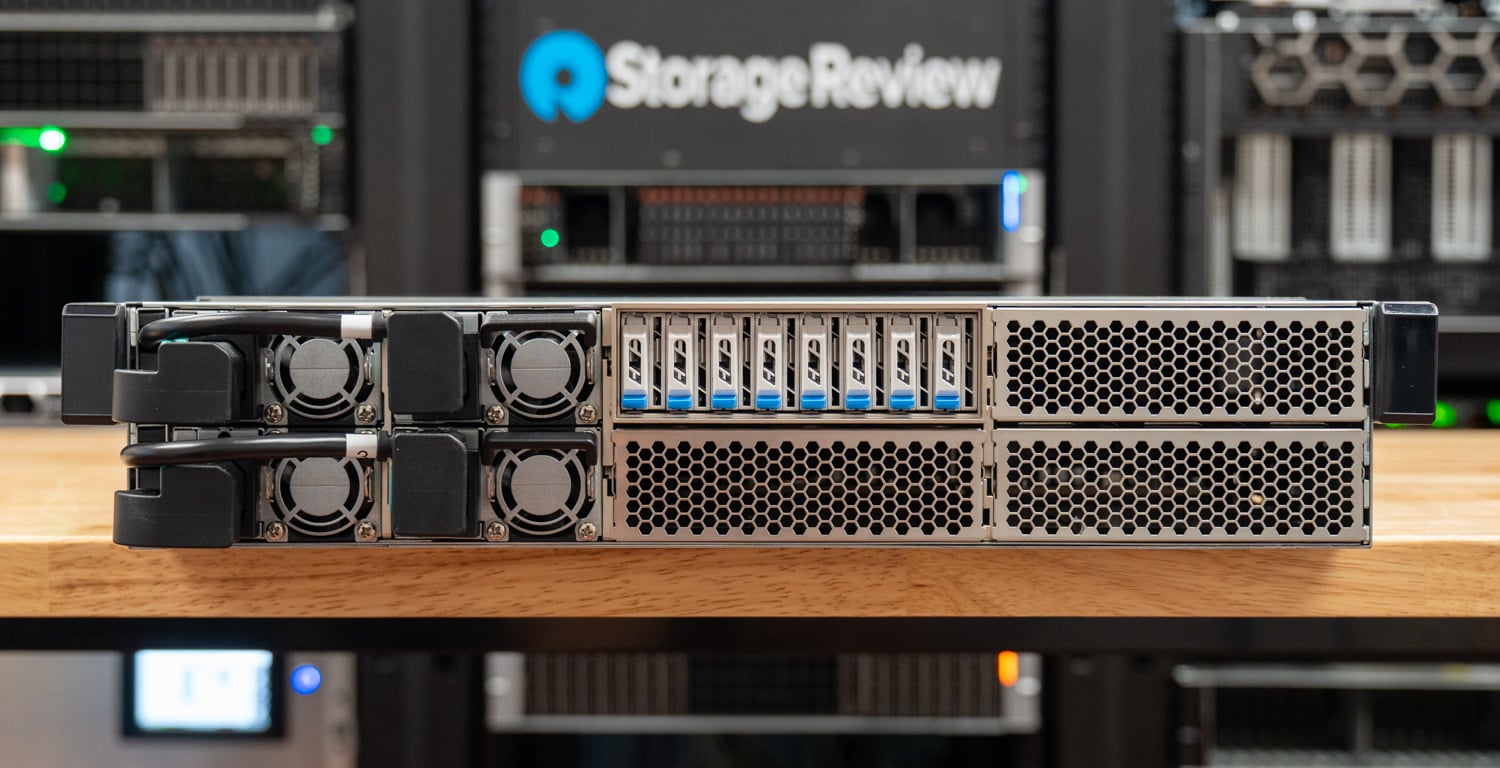
В качестве тестового образца мы использовали NVIDIA MGX Vera C2 — двухпроцессорный сервер форм-фактора 2U с воздушным охлаждением, который партнеры NVIDIA используют в качестве основы для своих первых систем Vera. Восемь отсеков E1.S расположены в верхней части передней панели рядом с четырьмя блоками питания Delta с возможностью горячей замены, а остальная часть передней панели заполнена воздухозаборниками сотовой конструкции. Поскольку блоки питания загружаются спереди, задняя панель остается свободной для кабелей ввода-вывода в стойке и отведена под райзеры PCIe и интерфейсы управления.
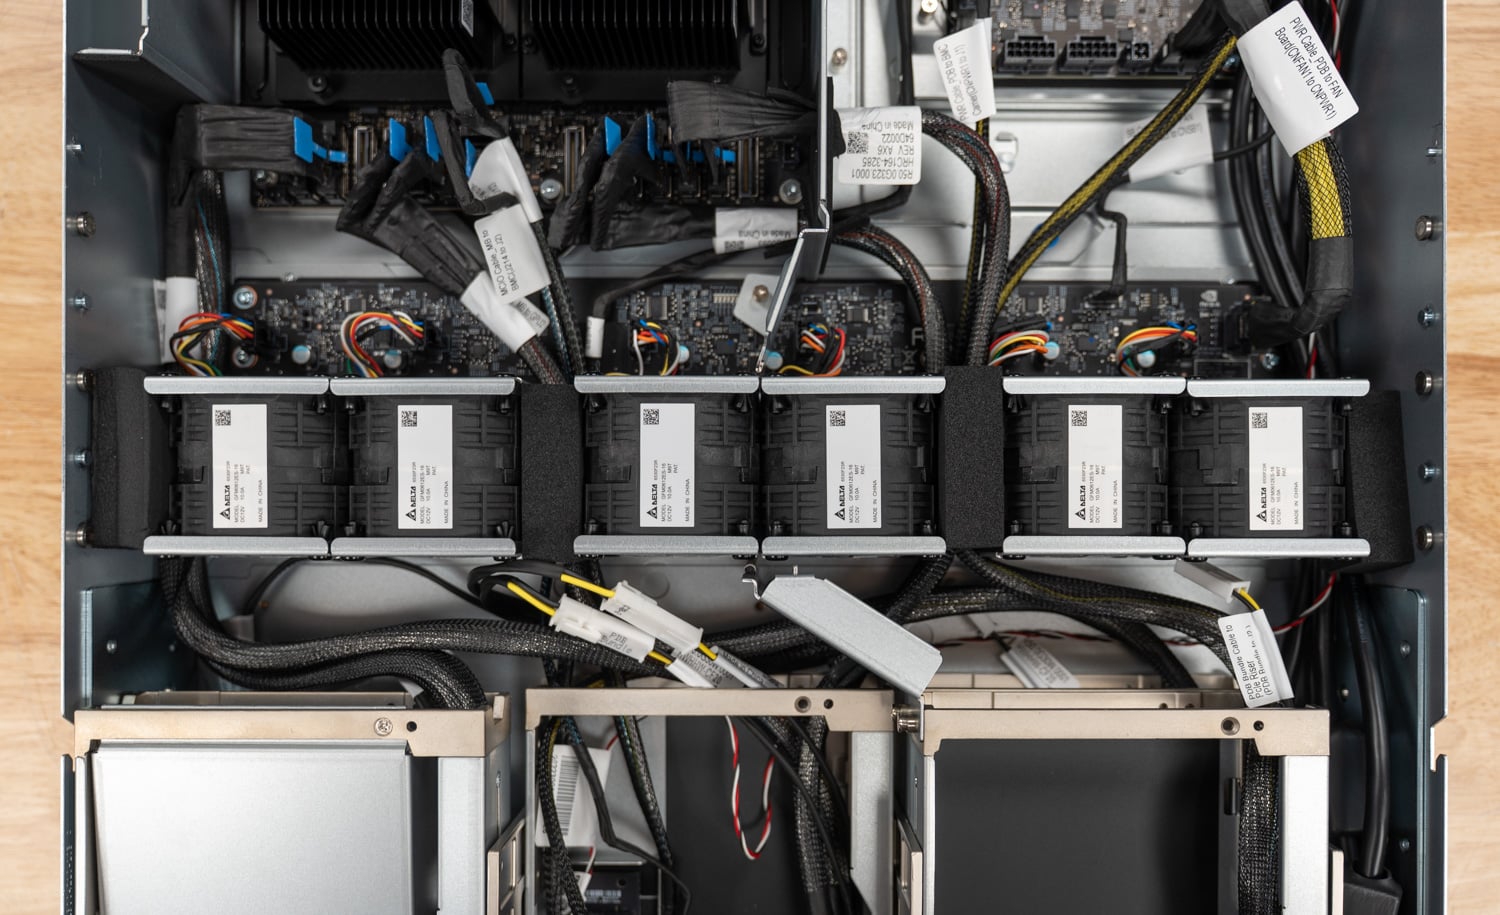
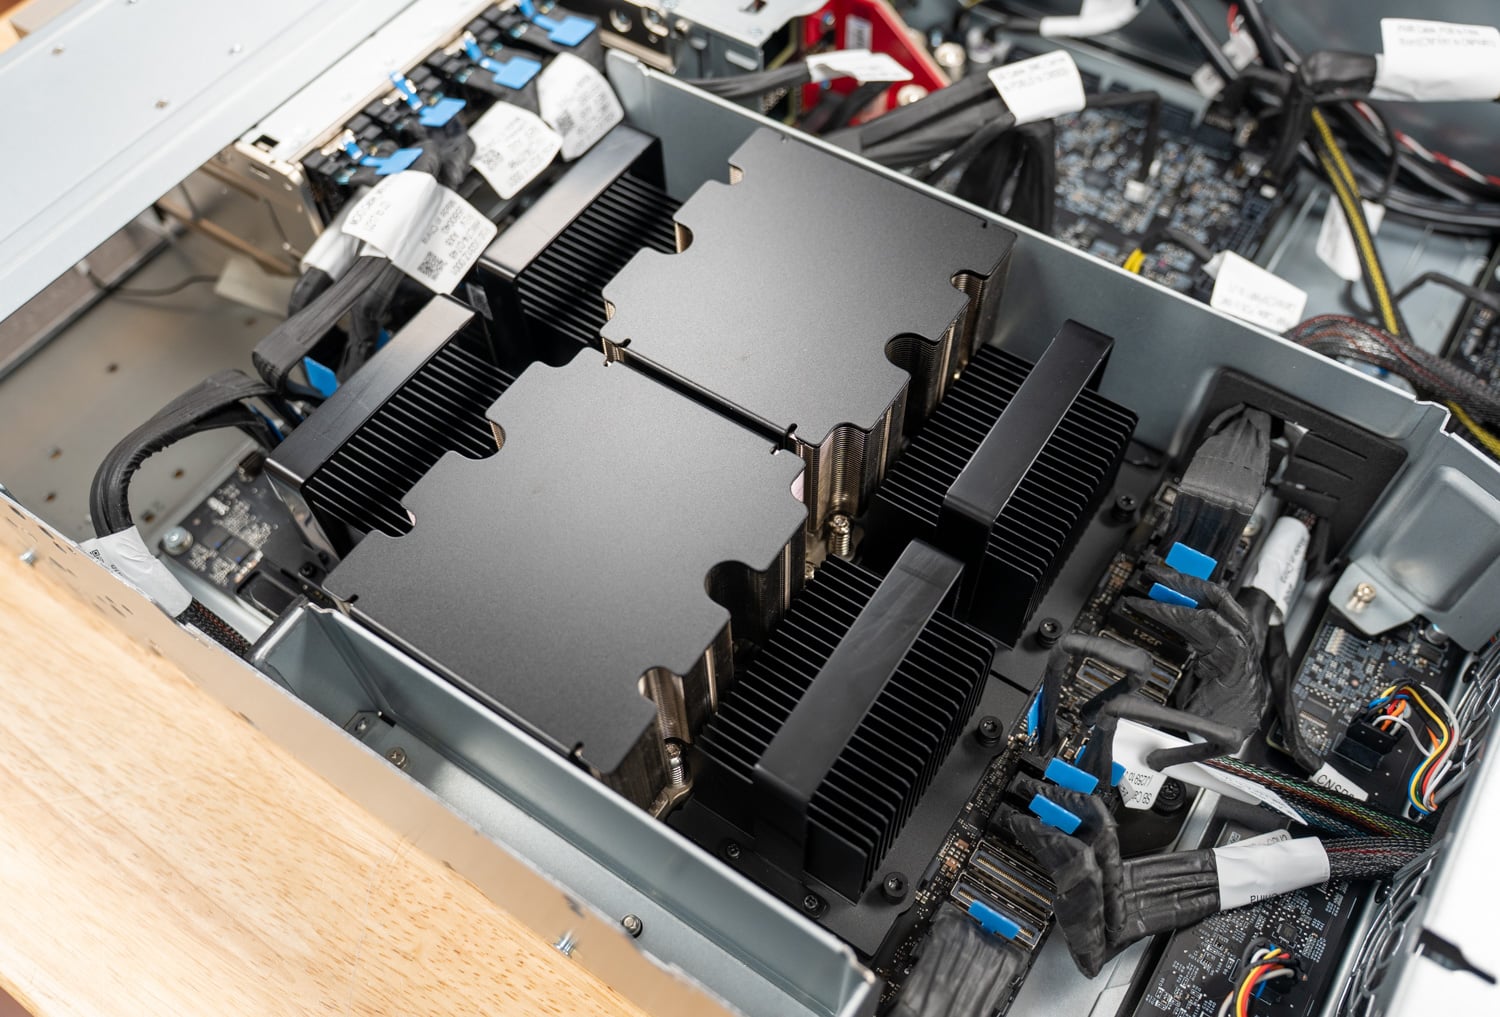
Внутри два процессора Vera расположены бок о бок под пассивными радиаторами, а по бокам от них размещены модули SOCAMM2. Стенка из шести вентиляторных модулей в центре корпуса, сразу за отсеками для накопителей, направляет поток воздуха к обоим сокетам, а поролоновые блоки между каждой парой вентиляторов регулируют воздушный поток. С точки зрения охлаждения, компоновка хорошо продумана.
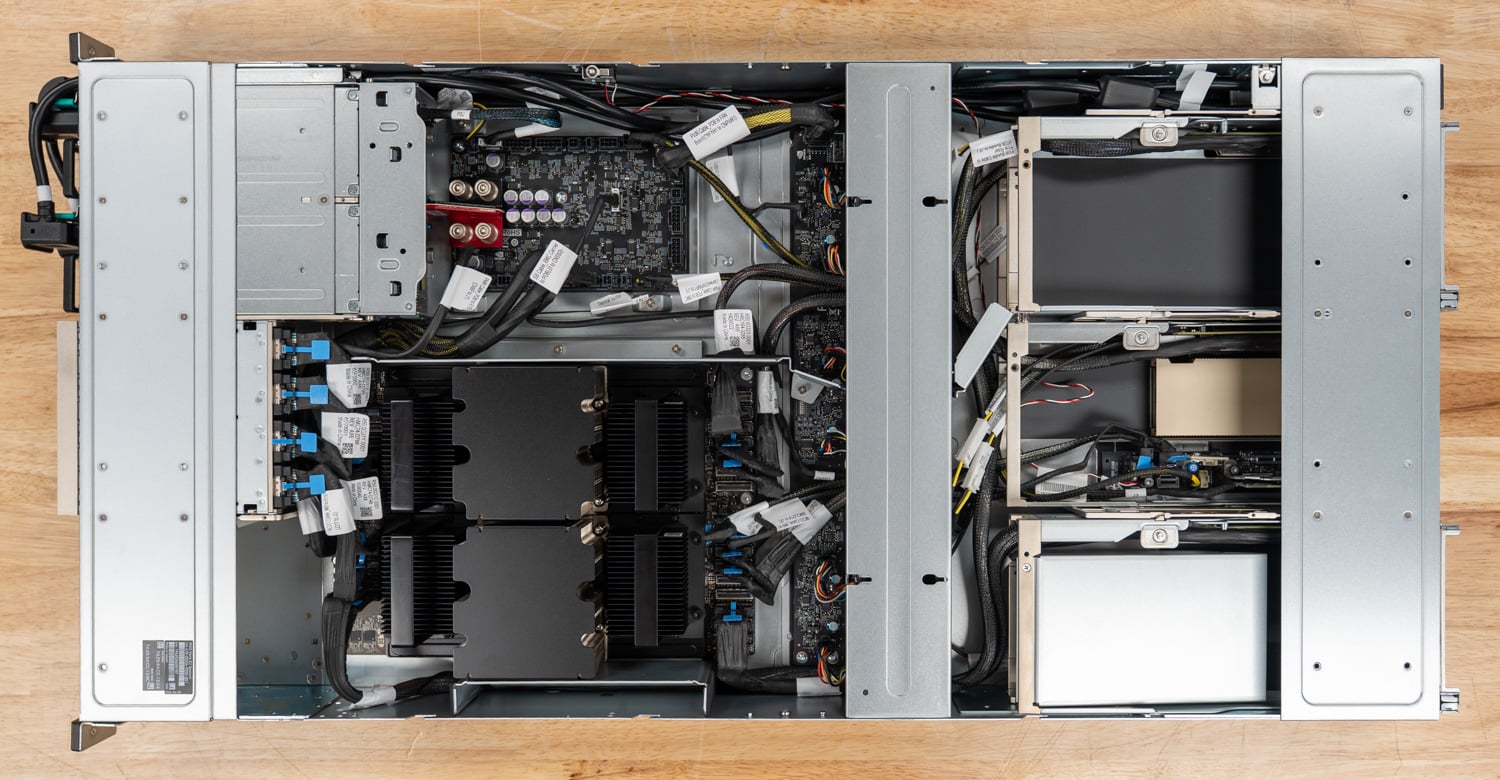
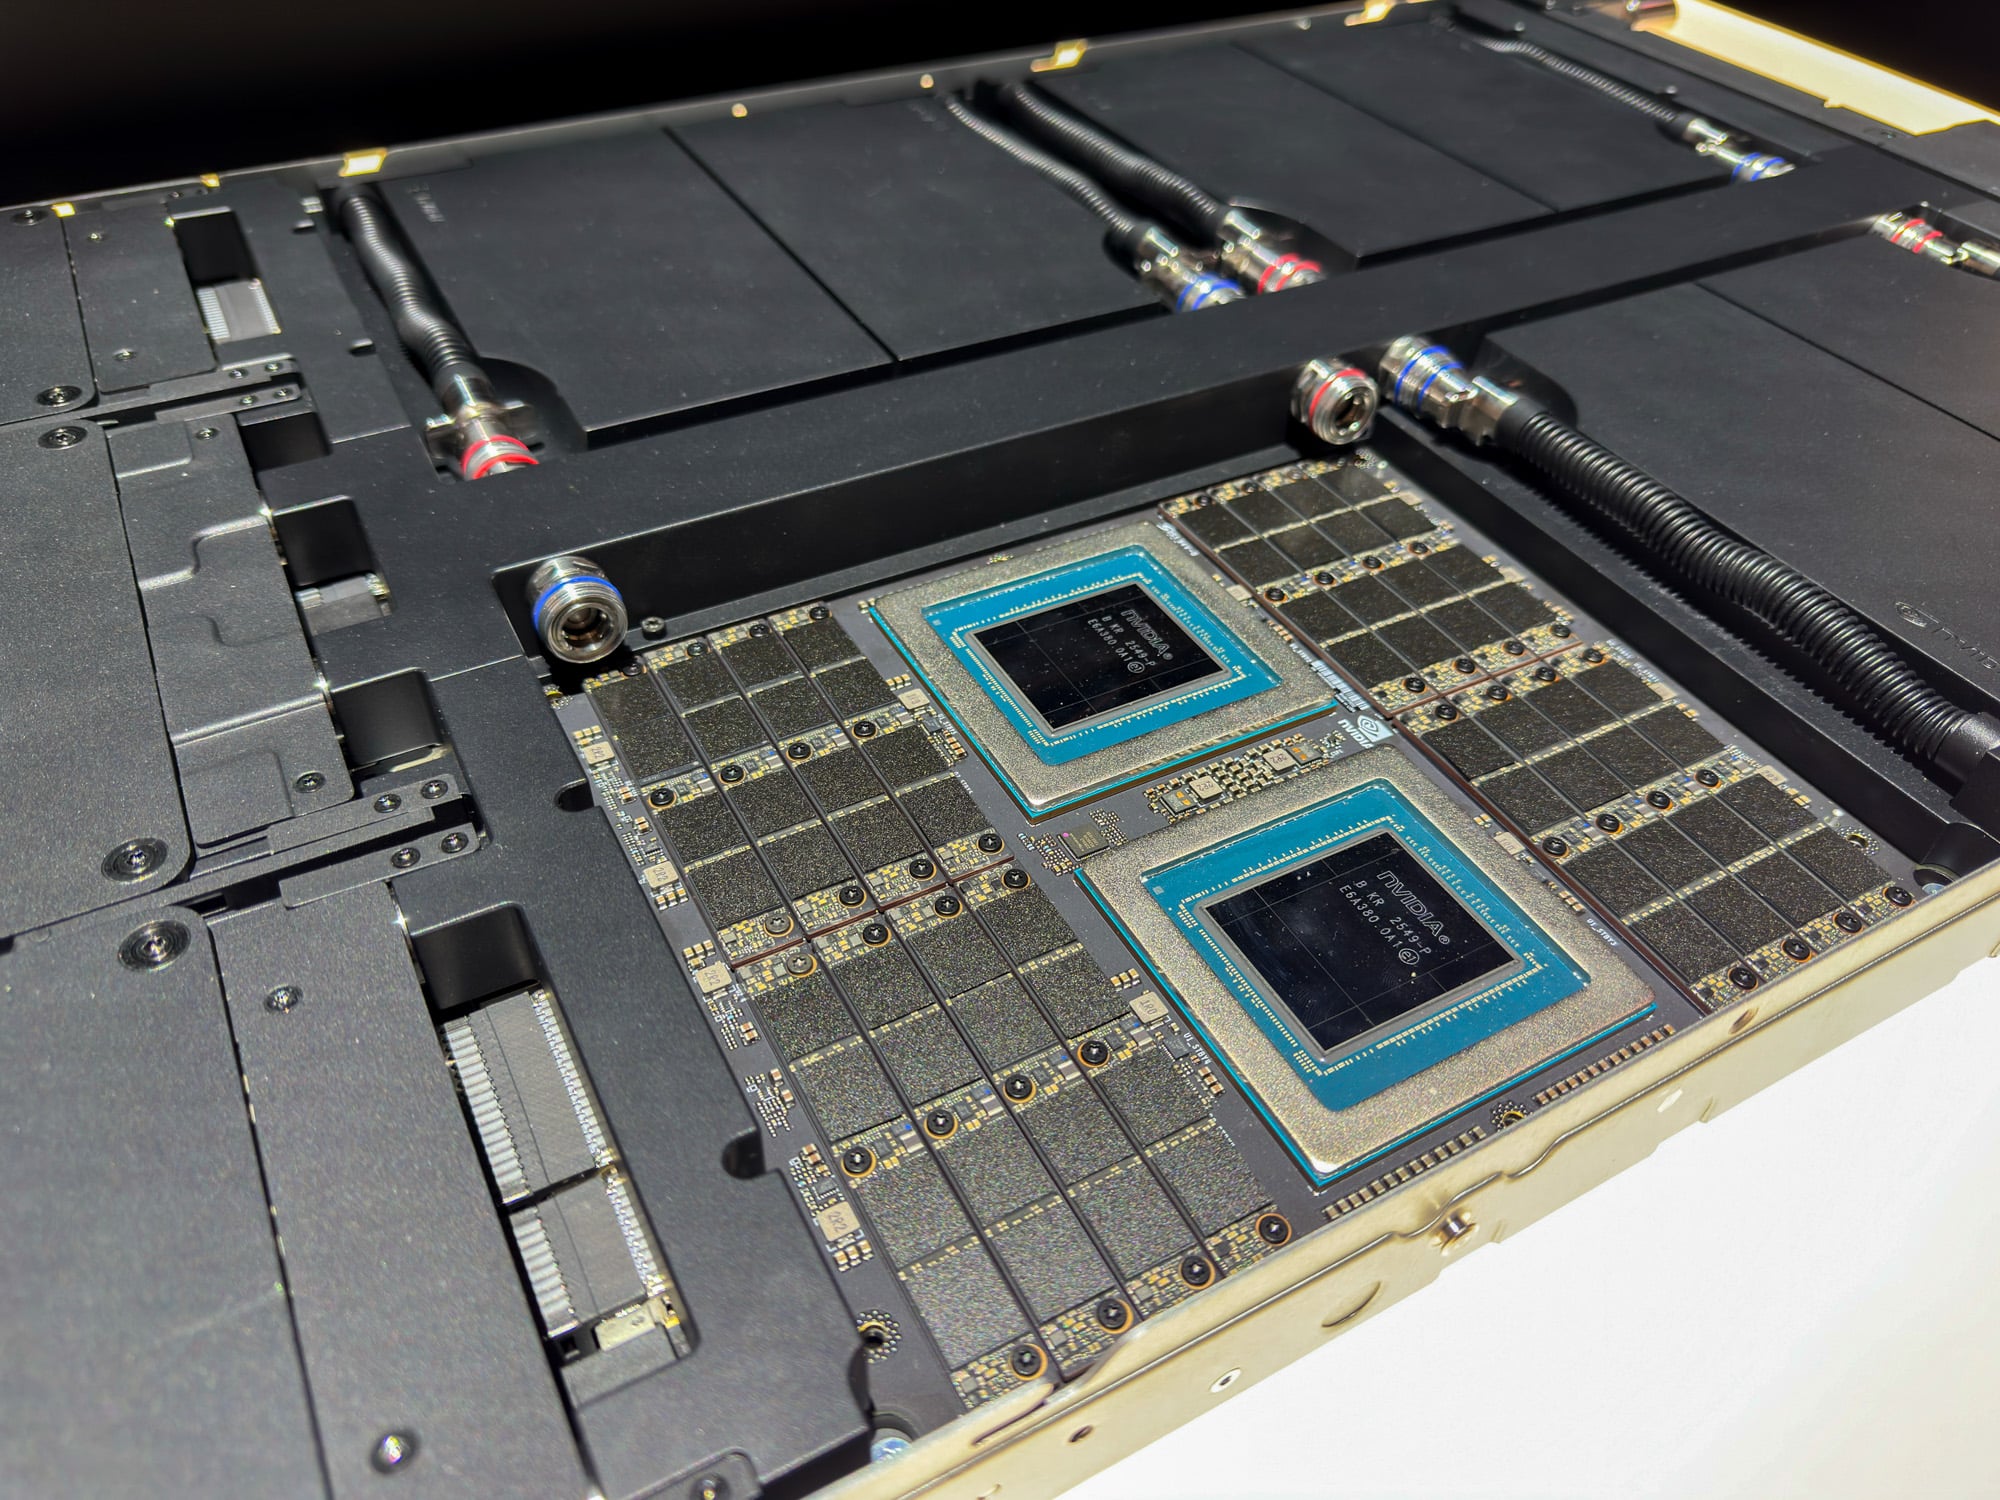
Оба процессора установлены непосредственно на печатную плату без разъемов, аналогично тому, как NVIDIA поставляет Vera в своих суперчипах. 16 слотов SOCAMM2 окружают оба корпуса, поэтому память остается заменяемой на месте, хотя процессоры — нет; замена процессора означает замену платы. Летом мы также рассматривали версию той же платы с жидкостным охлаждением, в которой быстроразъемные линии подачи охлаждающей жидкости проходят по верхней части платы к холодным пластинам процессоров, в то время как модули SOCAMM2 охлаждаются воздухом.
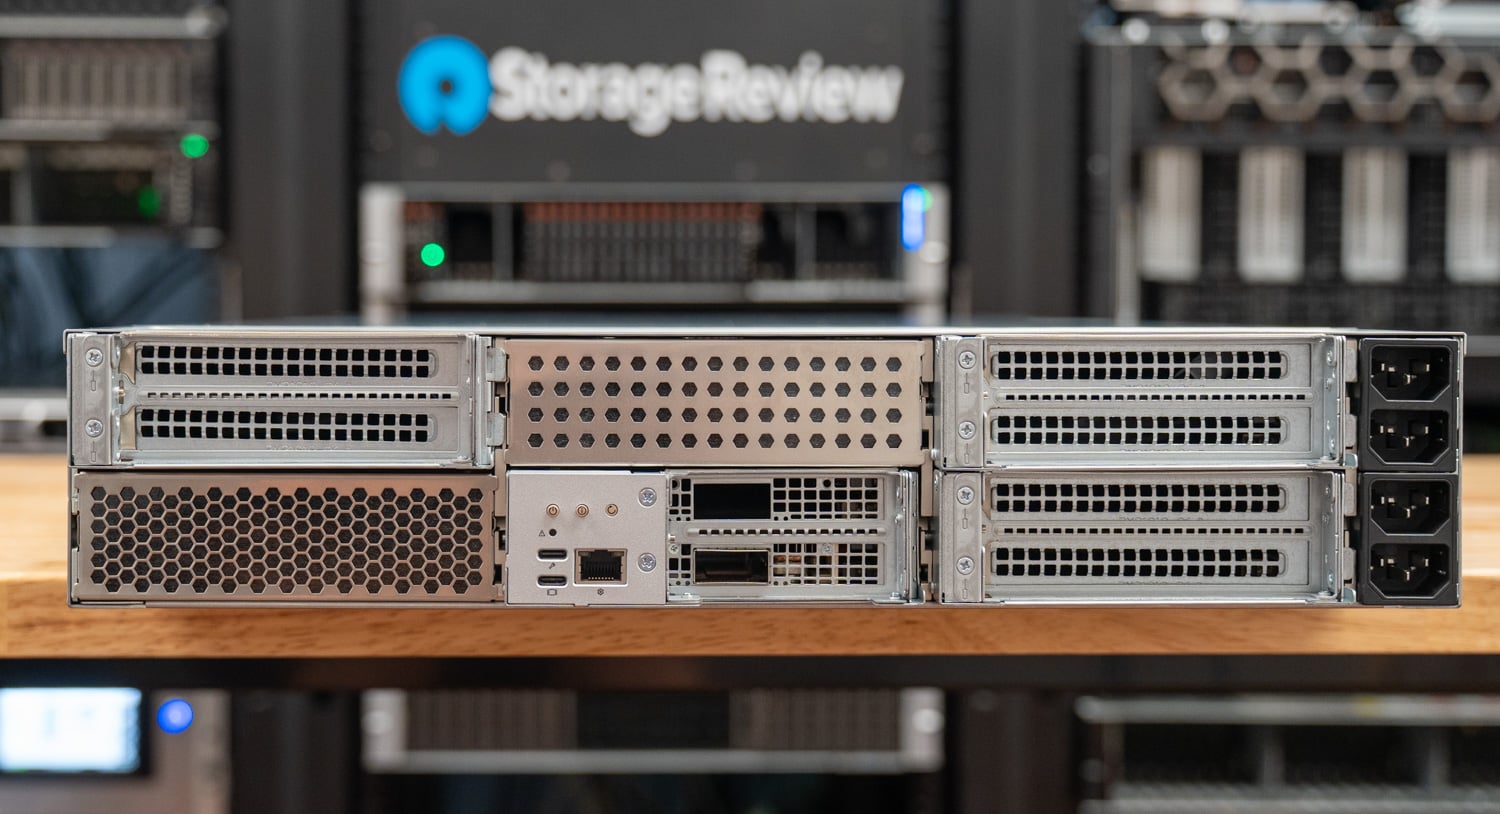
В центральной части корпуса расположен адаптер NVIDIA ConnectX-8 для работы в сети до 800 Гбит/с, а на задней панели размещены порты USB, DisplayPort и выделенный сетевой порт для внеполосного управления.
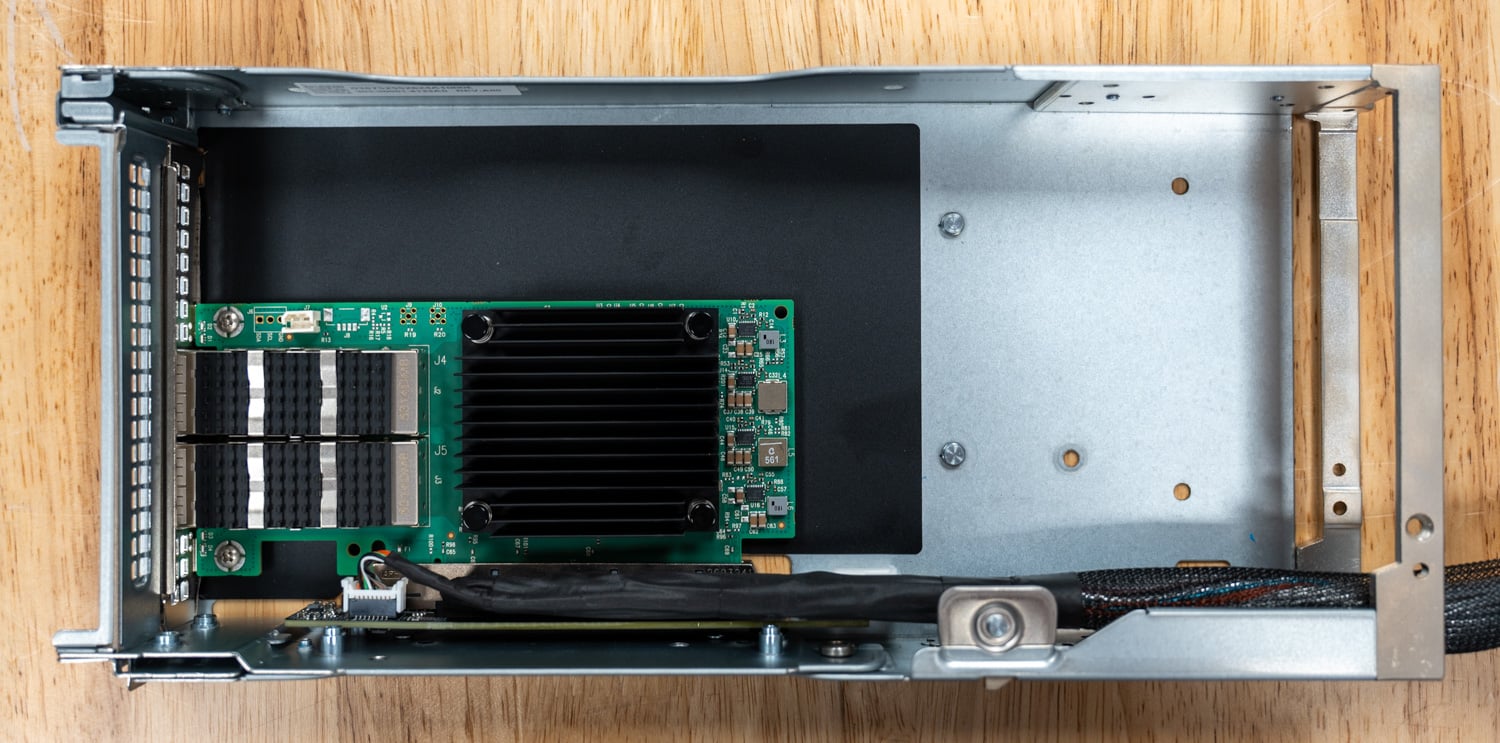
Платформа отличается высокой модульностью и поддерживает различные конфигурации накопителей и задних PCIe-портов, но эта гибкость достигается за счет увеличения времени обслуживания. Три райзера FHFL PCIe на первый взгляд кажутся простыми в обслуживании. В типичном сервере замена карты означает отсоединение райзера, откидывание опорного фиксатора или откручивание винта и извлечение карты.
На сервере Vera сначала нужно снять крышку вентилятора, удалить один или несколько поролоновых блоков, а также отсоединить и извлечь кабели питания и PCIe райзера. Только после этого весь райзер можно выдвинуть через заднюю часть корпуса. Как только салазки освободится, их необходимо разобрать, чтобы добраться до карты, а затем собрать обратно после замены. Работа, которая на обычном сервере занимает несколько секунд, здесь занимает от 5 до 10 минут на одну салазку.
На практике обслуживание в стойке невозможно, если вы не готовы постоянно перемещать сервер туда-обратно, поэтому для большинства замен компонентов требуется переместить сервер на верстак для проведения работ.
Производительность и тесты
В ходе тестов проверяется, как конструкция Vera влияет на производительность, от отдельных потоков до рабочих нагрузок, использующих всю систему. Наши тесты охватывают пропускную способность и задержку памяти, научные вычисления, программное обеспечение общего назначения и базы данных, демонстрируя, как процессор справляется с различными требованиями к своим ядрам и системе памяти.
Тестовые системы
| Система | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | Dell PowerEdge R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| Процессоры | ||||||
| ЦП | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC 9175F | Интел Ксеон 6978P | Интел Ксеон 6787P | Intel Xeon Платинум 8592+ |
| Розетки | 2 | |||||
| Количество ядер/потоков на процессор | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| Базовые часы | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Макс. часы | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Память | ||||||
| Конфигурация | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Тип / Скорость | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Общая мощность | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Память | ||||||
| SSD | Solidigm D7-PS1010 7.68TB | Solidigm D7-PS1030 12.8TB | Micron 9550 PRO 7.68TB | Solidigm D7-PS1010 7.68TB | Samsung PM1745 6.4TB | Solidigm D7-P5520 3.84TB |
| SSD Link | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| прошивки | ||||||
| Системный BIOS | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| Профиль BIOS | По умолчанию | Эффективности | ||||
| Программный стек | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||||
| ядро | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| НКУ | 15.2.0 | 13.3.0 | ||||
| Glibc | 2.43 | 2.39 | ||||
| Открытый MPI | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Мы сравнили Vera с пятью конфигурациями Dell PowerEdge с оптимальной конфигурацией памяти и протестировали их с помощью одного и того же набора тестов, охватывающего процессоры AMD EPYC с максимальным количеством ядер и оптимизированной частотой, а также процессоры Xeon текущего и предыдущего поколений.
Поскольку поддержка Olympus впервые появилась в GCC 15, Vera использовала более новый программный стек, чем системы x86, как указано выше. В остальном версии бенчмарков, входные данные и флаги сборки были идентичны на всех системах.
Пропускная способность памяти
Наибольшее отличие Vera от x86 заключается в памяти, поэтому мы начинаем тестирование именно с неё. Мы протестировали STREAM Triad, запустив его с одним потоком OpenMP на каждом физическом ядре на массивах 16 ГБ. В основном тесте использовались все ядра системы, при этом данные каждого потока размещались на одном и том же сокете. Затем мы повторили тест, сначала считывая данные из локальной памяти сокета 0, а затем из памяти удалённого сокета, при этом каждое ядро считывало страницы, чередуя их между обоими сокетами. На диаграмме ниже показаны результаты тестирования Triad для всей системы на каждом сервере с отключенным SMT.
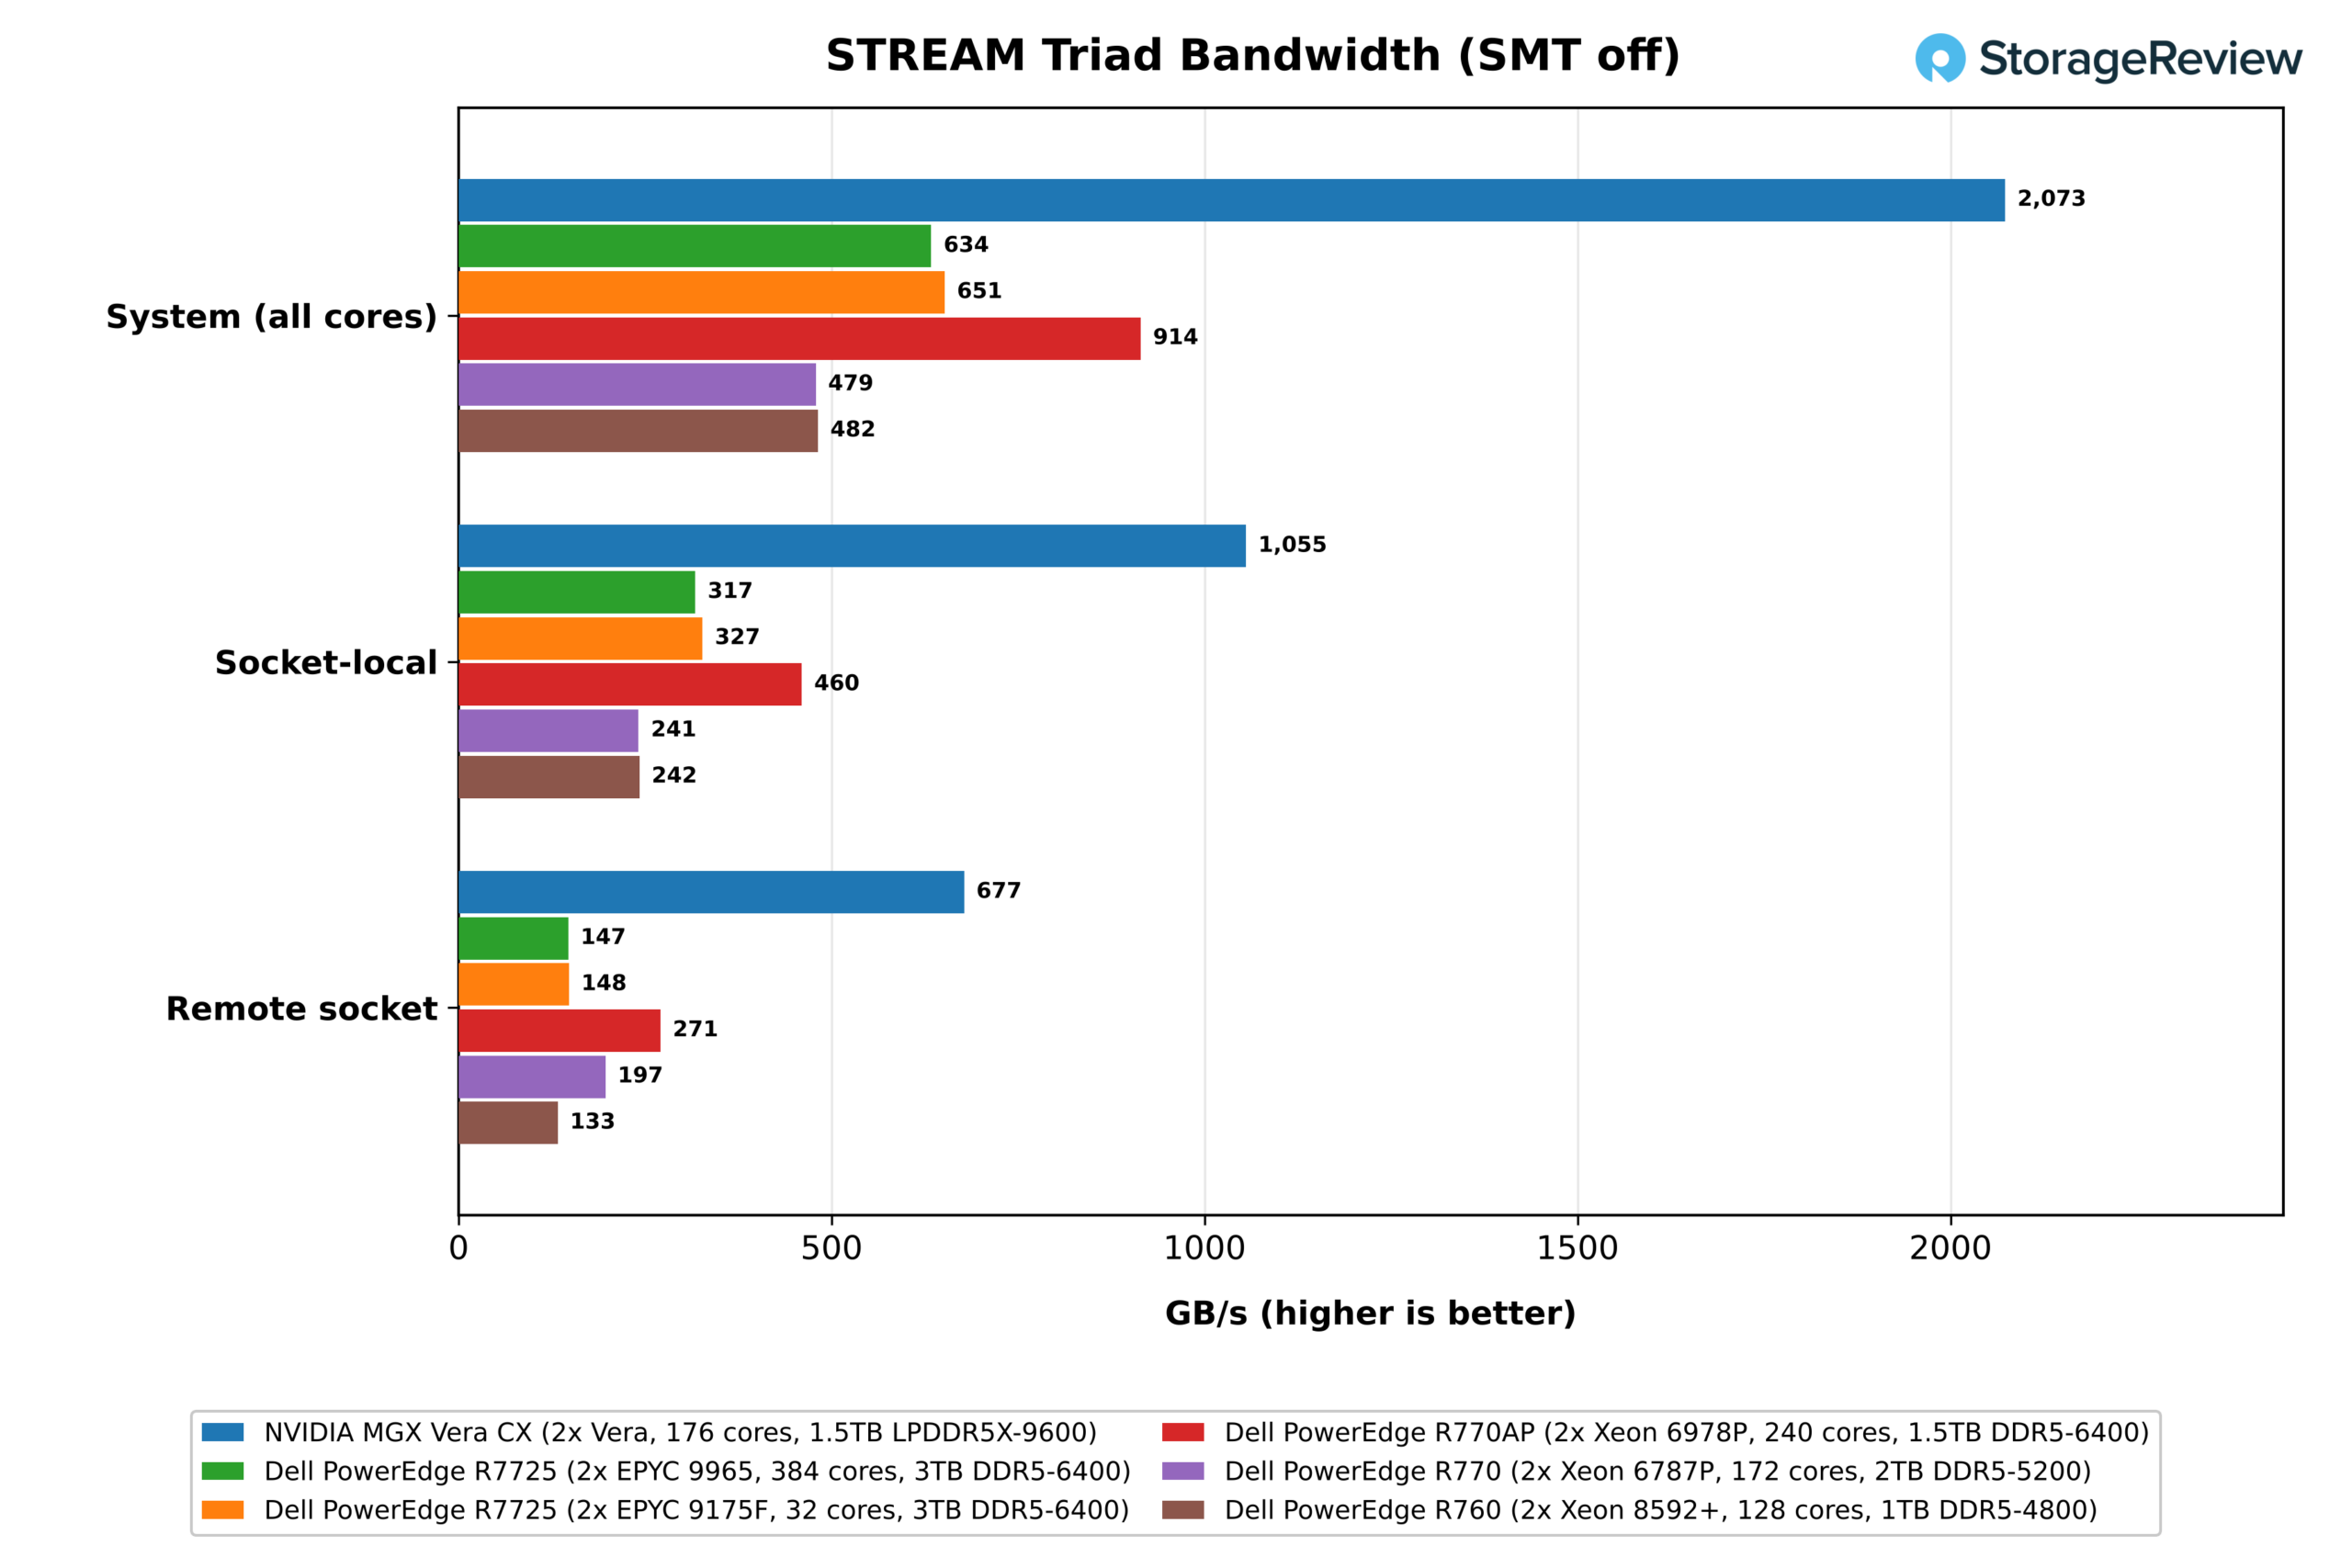
Vera показала стабильную скорость 2,073 ГБ/с, что составляет 86% от заявленной скорости 2.4 ТБ/с для двухпроцессорной системы. Ближайшей системой на базе x86 оказалась Xeon 6978P, 24 канала DDR5-6400 которой обеспечили скорость 914 ГБ/с, что составляет 74% от теоретической пиковой скорости в 1,229 ГБ/с, обеспечив преимущество Vera в 2.3 раза. Обе системы на базе EPYC работали с теми же 24 каналами DDR5-6400, но показали значительно более низкие результаты: 651 ГБ/с для 32-ядерного 9175F и 634 ГБ/с для 384-ядерного 9965, что составляет всего 52% от пиковой скорости и преимущество Vera в 3.3 раза. Наконец, процессоры Xeon 6787P и 8592+ отстают от остальных, работая на более медленных DDR5-5200 и DDR5-4800, достигая скорости 479 ГБ/с и 482 ГБ/с соответственно.
Частично недостатки EPYC связаны с тем, как STREAM подсчитывает трафик. Пакет компиляции собирает STREAM с использованием обычного GCC, который не генерирует потоковые операции записи, поэтому операция записи, которая сначала не попадает в кэш, считывает целевую строку из памяти. STREAM не учитывает это чтение, а это значит, что Triad занижает объем передаваемого трафика на четверть, независимо от места его возникновения. Ядра Zen от AMD учитывают это при каждой операции записи. Ядра Arm, такие как более ранние ядра Grace от NVIDIA, обнаруживают запись всей строки и пропускают чтение, а последние процессоры Xeon от Intel могут пропускать большую часть операций при высокой загрузке памяти.
Отдельная сборка STREAM из Phoronix Test Suite подтверждает это. При отключенном SMT скорость копирования достигла 832 ГБ/с на 9965 и 873 ГБ/с на 9175F, что примерно в 1.5 раза выше, чем у сборки из пакета (551 ГБ/с и 570 ГБ/с соответственно), и соответствует приросту скорости копирования после устранения дополнительного чтения; на процессорах Xeon результаты двух сборок отличались всего на 9%.
С учетом неучтенных операций чтения, скорость передачи данных у 9965 составила около 845 ГБ/с, что примерно соответствует 69% от пиковой скорости, а преимущество Vera по объему переданных данных сократилось примерно до 2.5 раз. Для 6978P требуется гораздо меньшая коррекция, поэтому его показатель в 2.3 раза является наиболее консервативным сравнением в этом наборе данных.
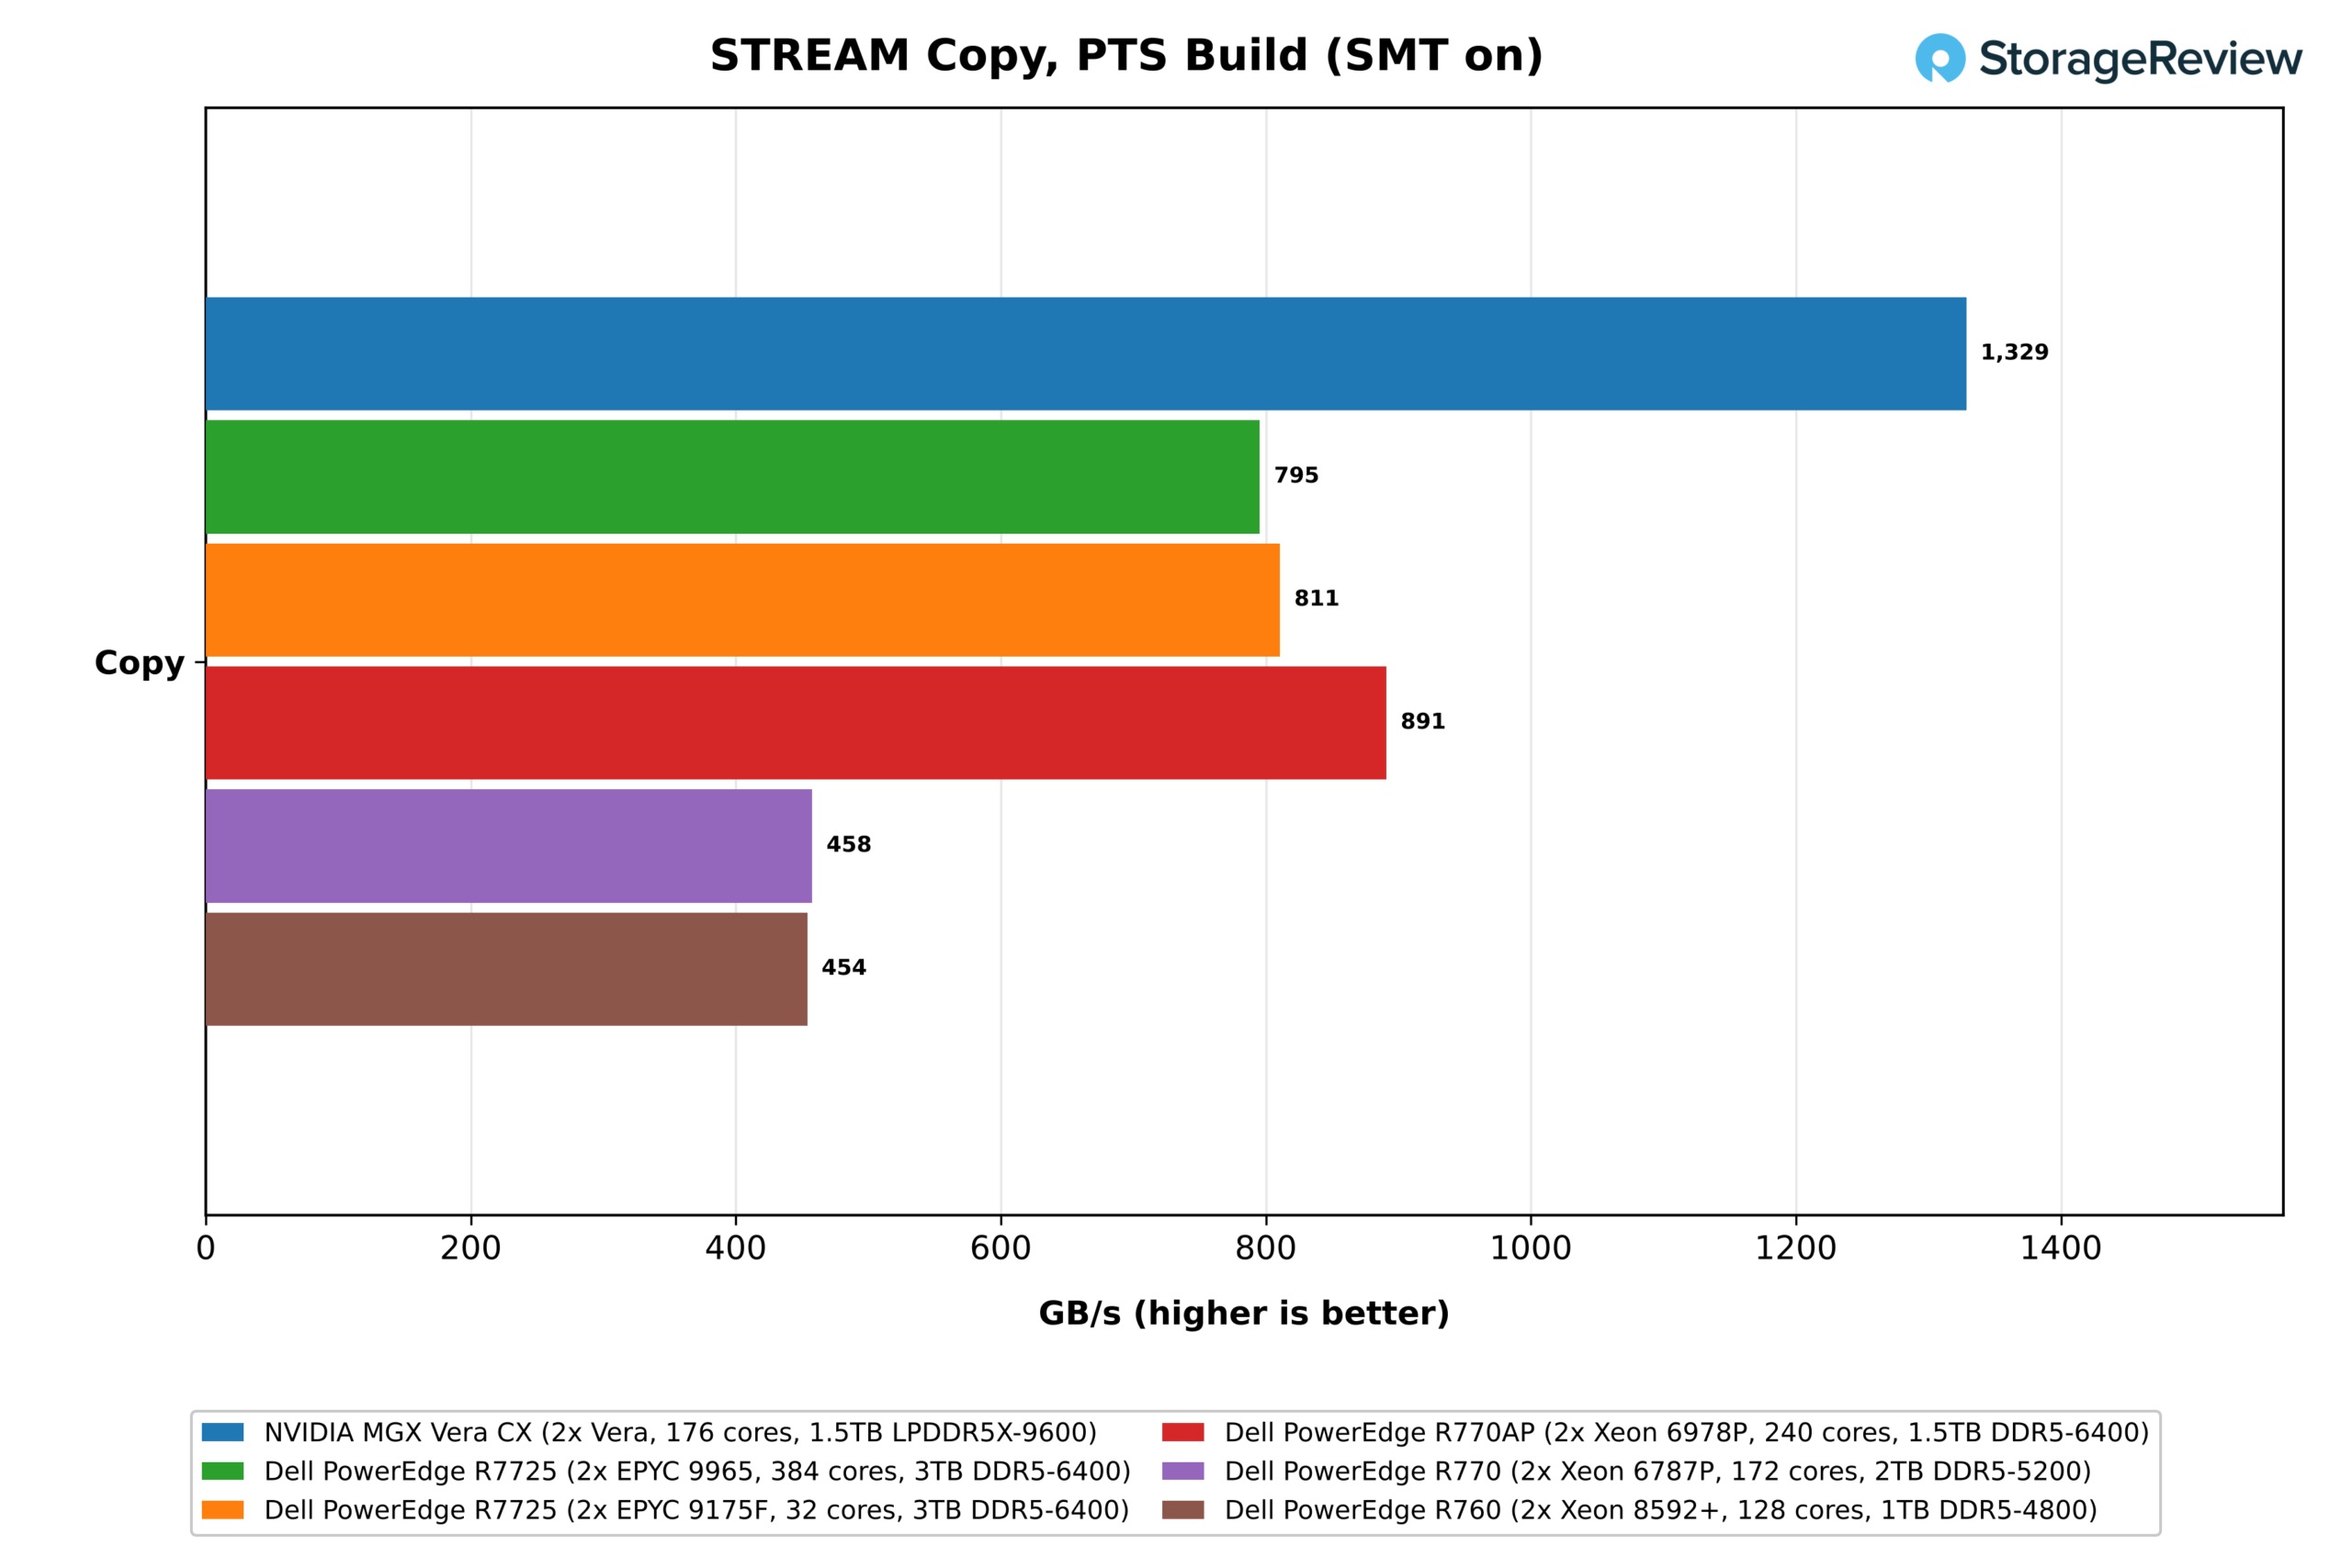
Разделение теста по сокетам показывает, как сеть обрабатывает данные, находящиеся за пределами локальной памяти ядер. Ядра сокета 0, считывающие данные из локальной памяти, достигли скорости 1,055 ГБ/с, что составляет 88% от заявленной скорости 1.2 ТБ/с на сокет и превышает скорость любого сервера x86 в наборе. При чтении данных из памяти другого сокета через NVLink-C2C те же ядра поддерживали скорость 677 ГБ/с, что составляет 64% от локального показателя, против 59% на Xeon 6978P и 45% на EPYC 9175F (148 ГБ/с на удаленном доступе против 327 ГБ/с на локальном). Таким образом, даже рабочая нагрузка, размещенная на неправильном сокете, получает большую пропускную способность, чем любой сокет x86, считывающий данные из локальной памяти, которая достигает максимума в 460 ГБ/с на 6978P.
В качестве заключительного теста для Vera мы протестировали передачу данных с чередованием страниц STREAM Triad по обоим сокетам, что соответствует ситуации, наблюдаемой в приложениях, не поддерживающих NUMA-интерфейс. В результате Vera показала скорость 1,372 ГБ/с, что в 1.5 раза выше, чем у системы 6978P в целом.
Задержка
Пропускная способность — это лишь половина дела. Задержка определяет, как долго ядро ожидает каждый раз, когда происходит промах в кэше, и это наиболее важно для кода, который отслеживает указатели в памяти. Мы измеряем её с помощью tinymembench, который измеряет время случайного чтения из буфера объёмом 1 ГБ одним потоком на сокете 0. EPYC 9175F — единственная система x86 в нашем наборе, для которой есть результаты этого теста, поэтому мы сравниваем её с другими.
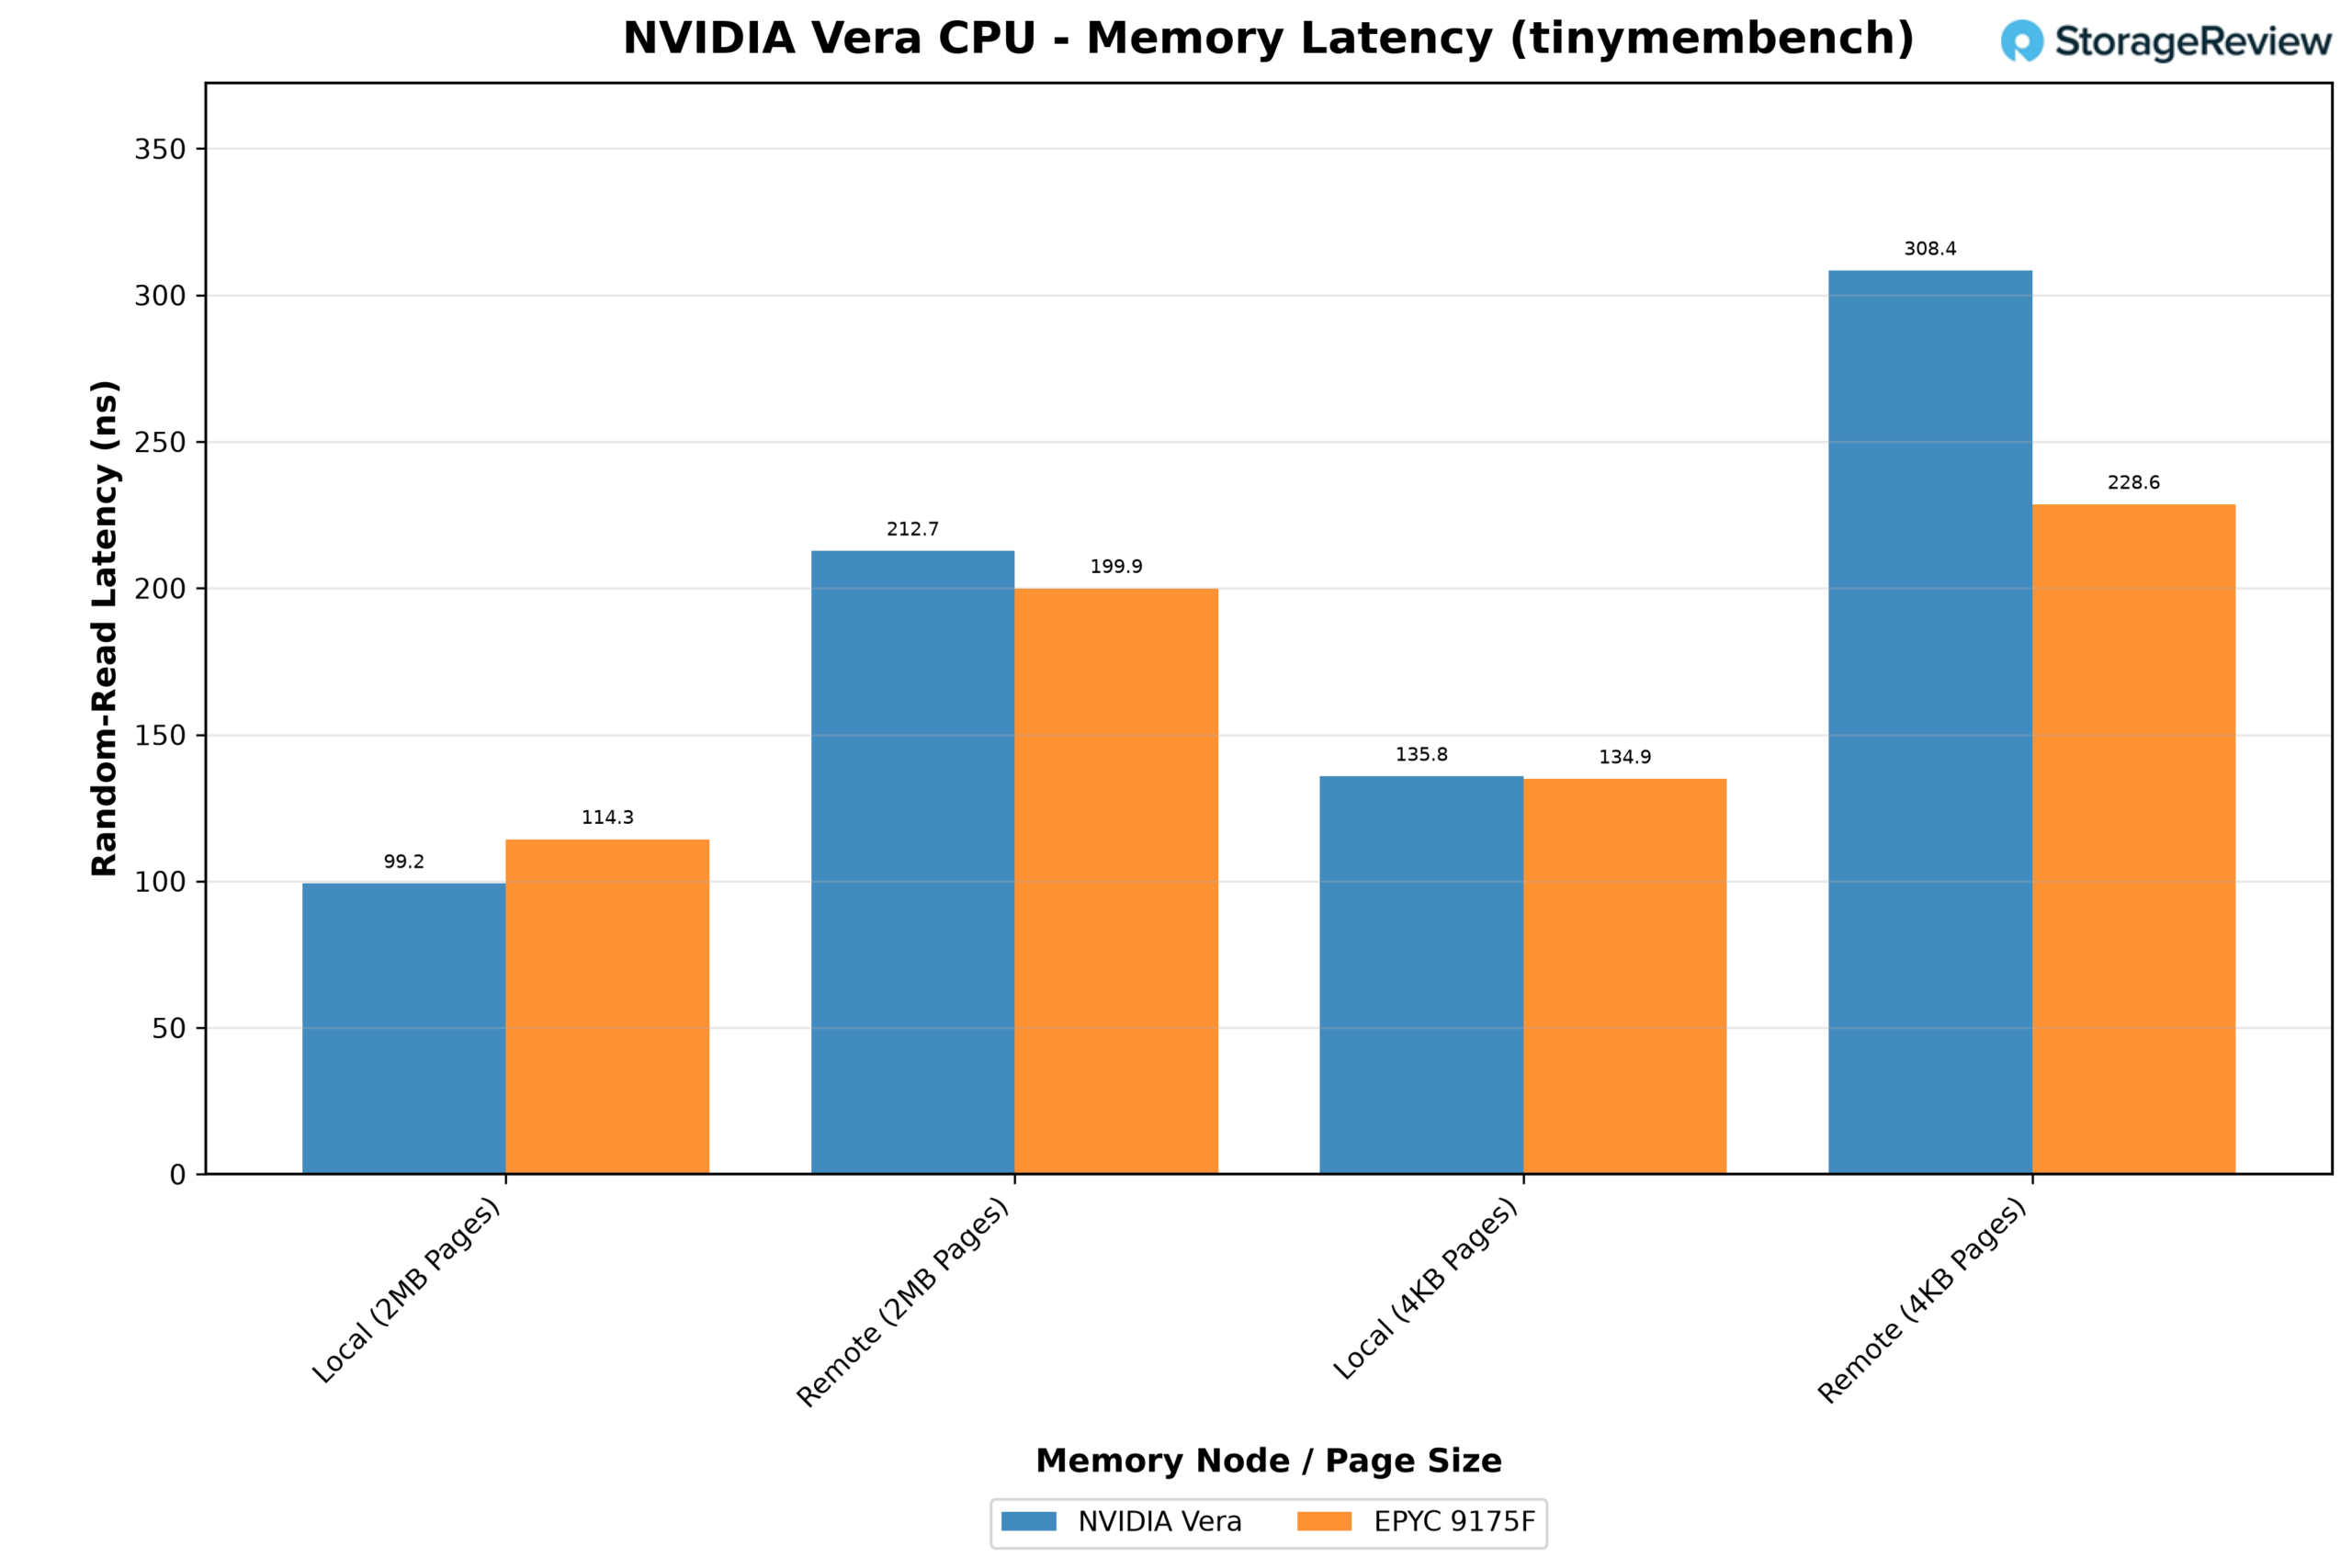
При чтении локальной памяти Vera работает быстрее, чем EPYC. При использовании больших страниц размером 2 МБ локальное чтение заняло 99.2 нс на Vera против 114.3 нс на 9175F, что на 13% быстрее; со стандартными страницами размером 4 КБ время чтения сравнялось и составило около 135 нс. Затраты времени проявляются при передаче данных на другой разъем. Удаленное чтение заняло 212.7 нс на Vera, что примерно в 2.1 раза больше, чем локальное время, в то время как 199.9 нс у EPYC — всего в 1.75 раза больше локального времени.
Vera также более чувствительна к размеру страниц. При использовании страниц размером 4 КБ, где пропущенные преобразования адресов увеличивают время чтения, локальная задержка выросла на 37%, а удаленная задержка достигла 308.4 нс, в то время как на EPYC рост составил 18%, а время чтения — 228.6 нс. На Vera мы бы использовали большие страницы.
HPC
Пропускная способность и задержка описывают систему памяти в отрыве от контекста. Научные приложения показывают, что происходит, когда эта система памяти и ядра должны работать вместе, и наши два теста высокопроизводительных вычислений опираются на совершенно разные аспекты конструкции процессора.
GROMACS, программа для моделирования молекулярной динамики, большую часть времени использует векторную арифметику, при этом для каждой ширины SIMD-симуляции вручную создаются циклы обработки. Это делает её наиболее прямым тестом компромисса, описанного в разделе об Olympus: шесть 128-битных SVE2-процессоров против 512-битных AVX-512-процессоров на x86-системах. OpenFOAM, решатель задач вычислительной гидродинамики, работает с большими разреженными матрицами и большую часть времени тратит на ожидание доступа к памяти, поэтому он показывает, применима ли измеренная выше пропускная способность к реальному приложению.
GROMACS
Мы протестировали GROMACS 2025.3 с помощью benchPEP, модели, включающей 12 миллионов атомов, запущенной на каждом физическом ядре сервера. В сборке использовался ARM_SVE на Vera и AVX-512 на всех системах x86, а благодаря фиксированным входам и отключенной настройке PME, все платформы выполняли одинаковую работу.
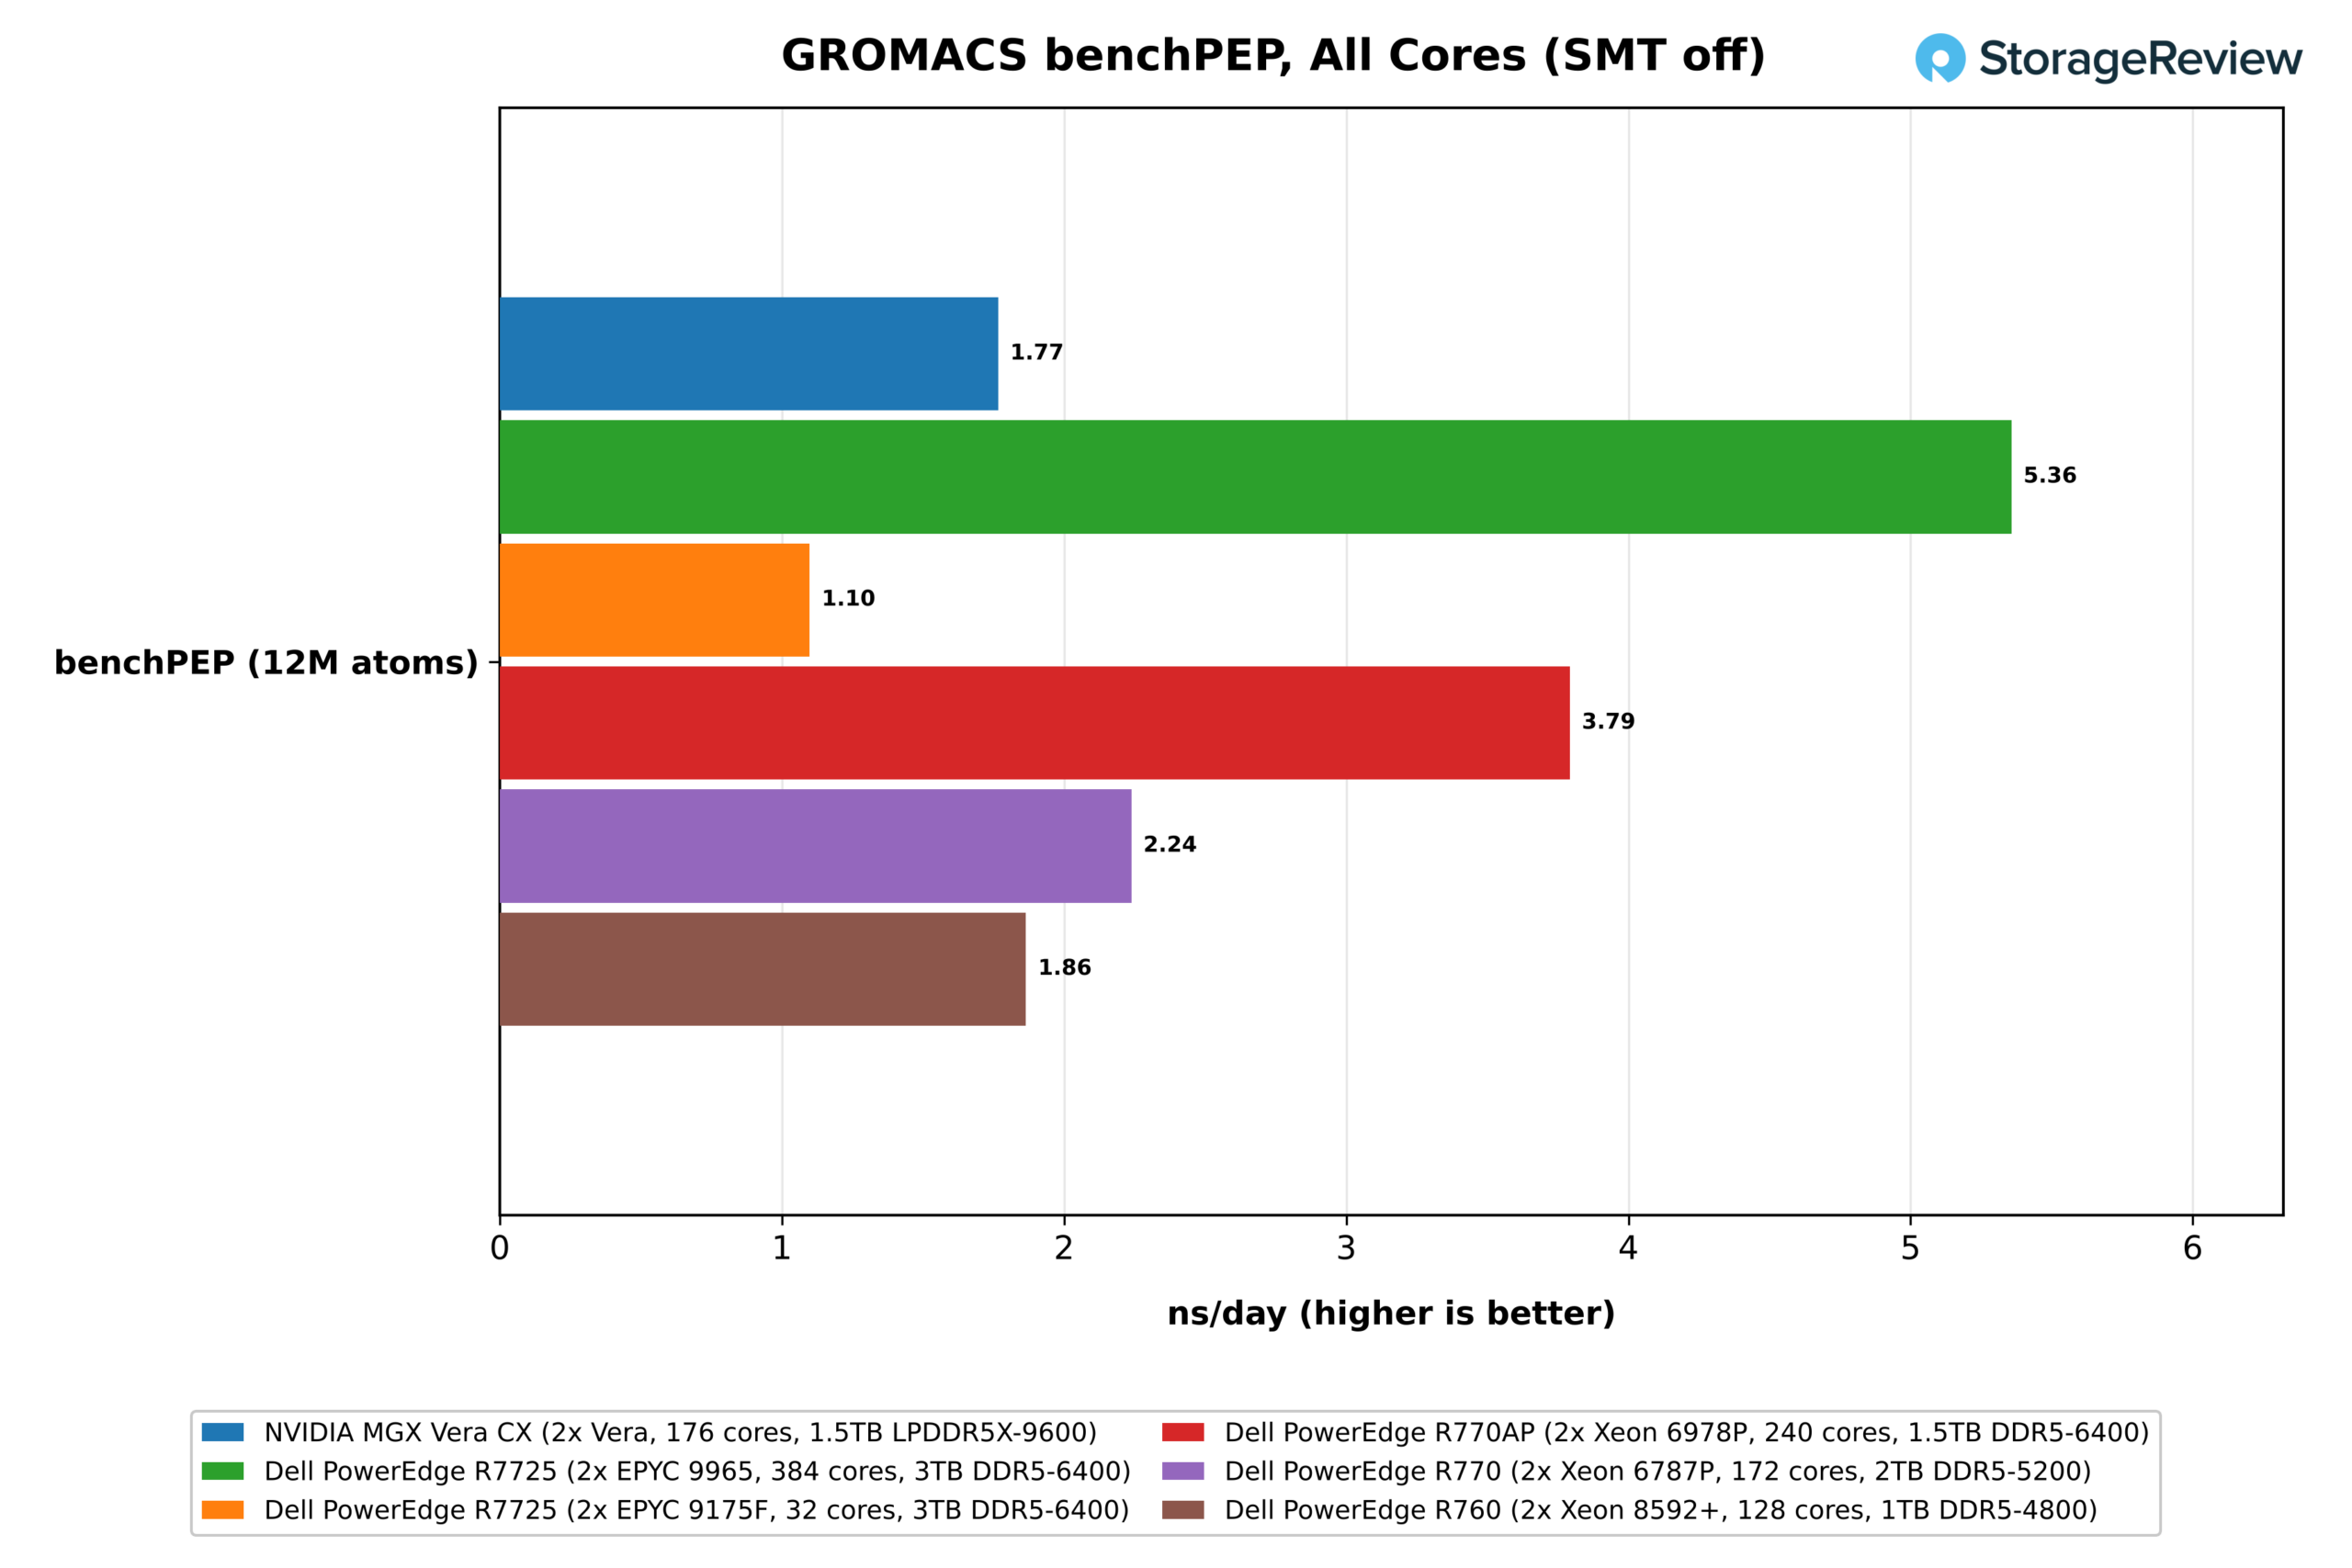
При отключенном SMT Vera завершила тест benchPEP с результатом 1.77 нс/день. 384-ядерный EPYC 9965 лидировал с результатом 5.36 нс/день, в 3.0 раза превосходя Vera, за ним следовали 240-ядерный Xeon 6978P с результатом 3.79 (в 2.1 раза) и 172-ядерный Xeon 6787P с результатом 2.24 (в 1.27 раза). 128-ядерный Xeon 8592+ также показал лучший результат — 1.87, оставив позади Vera только 32-ядерный EPYC 9175F с результатом 1.10. Нормализация по количеству ядер показывает, какая часть этого разрыва обусловлена архитектурой. Показатель производительности Vera составляет 0.0100 нс/день на ядро, против 0.0130 у 6787P, 0.0140 у 9965, 0.0146 у 8592+ и 0.0158 у 6978P, поэтому отставание от более мощных x86-процессоров частично объясняется количеством ядер, а частично — производительностью на ядро.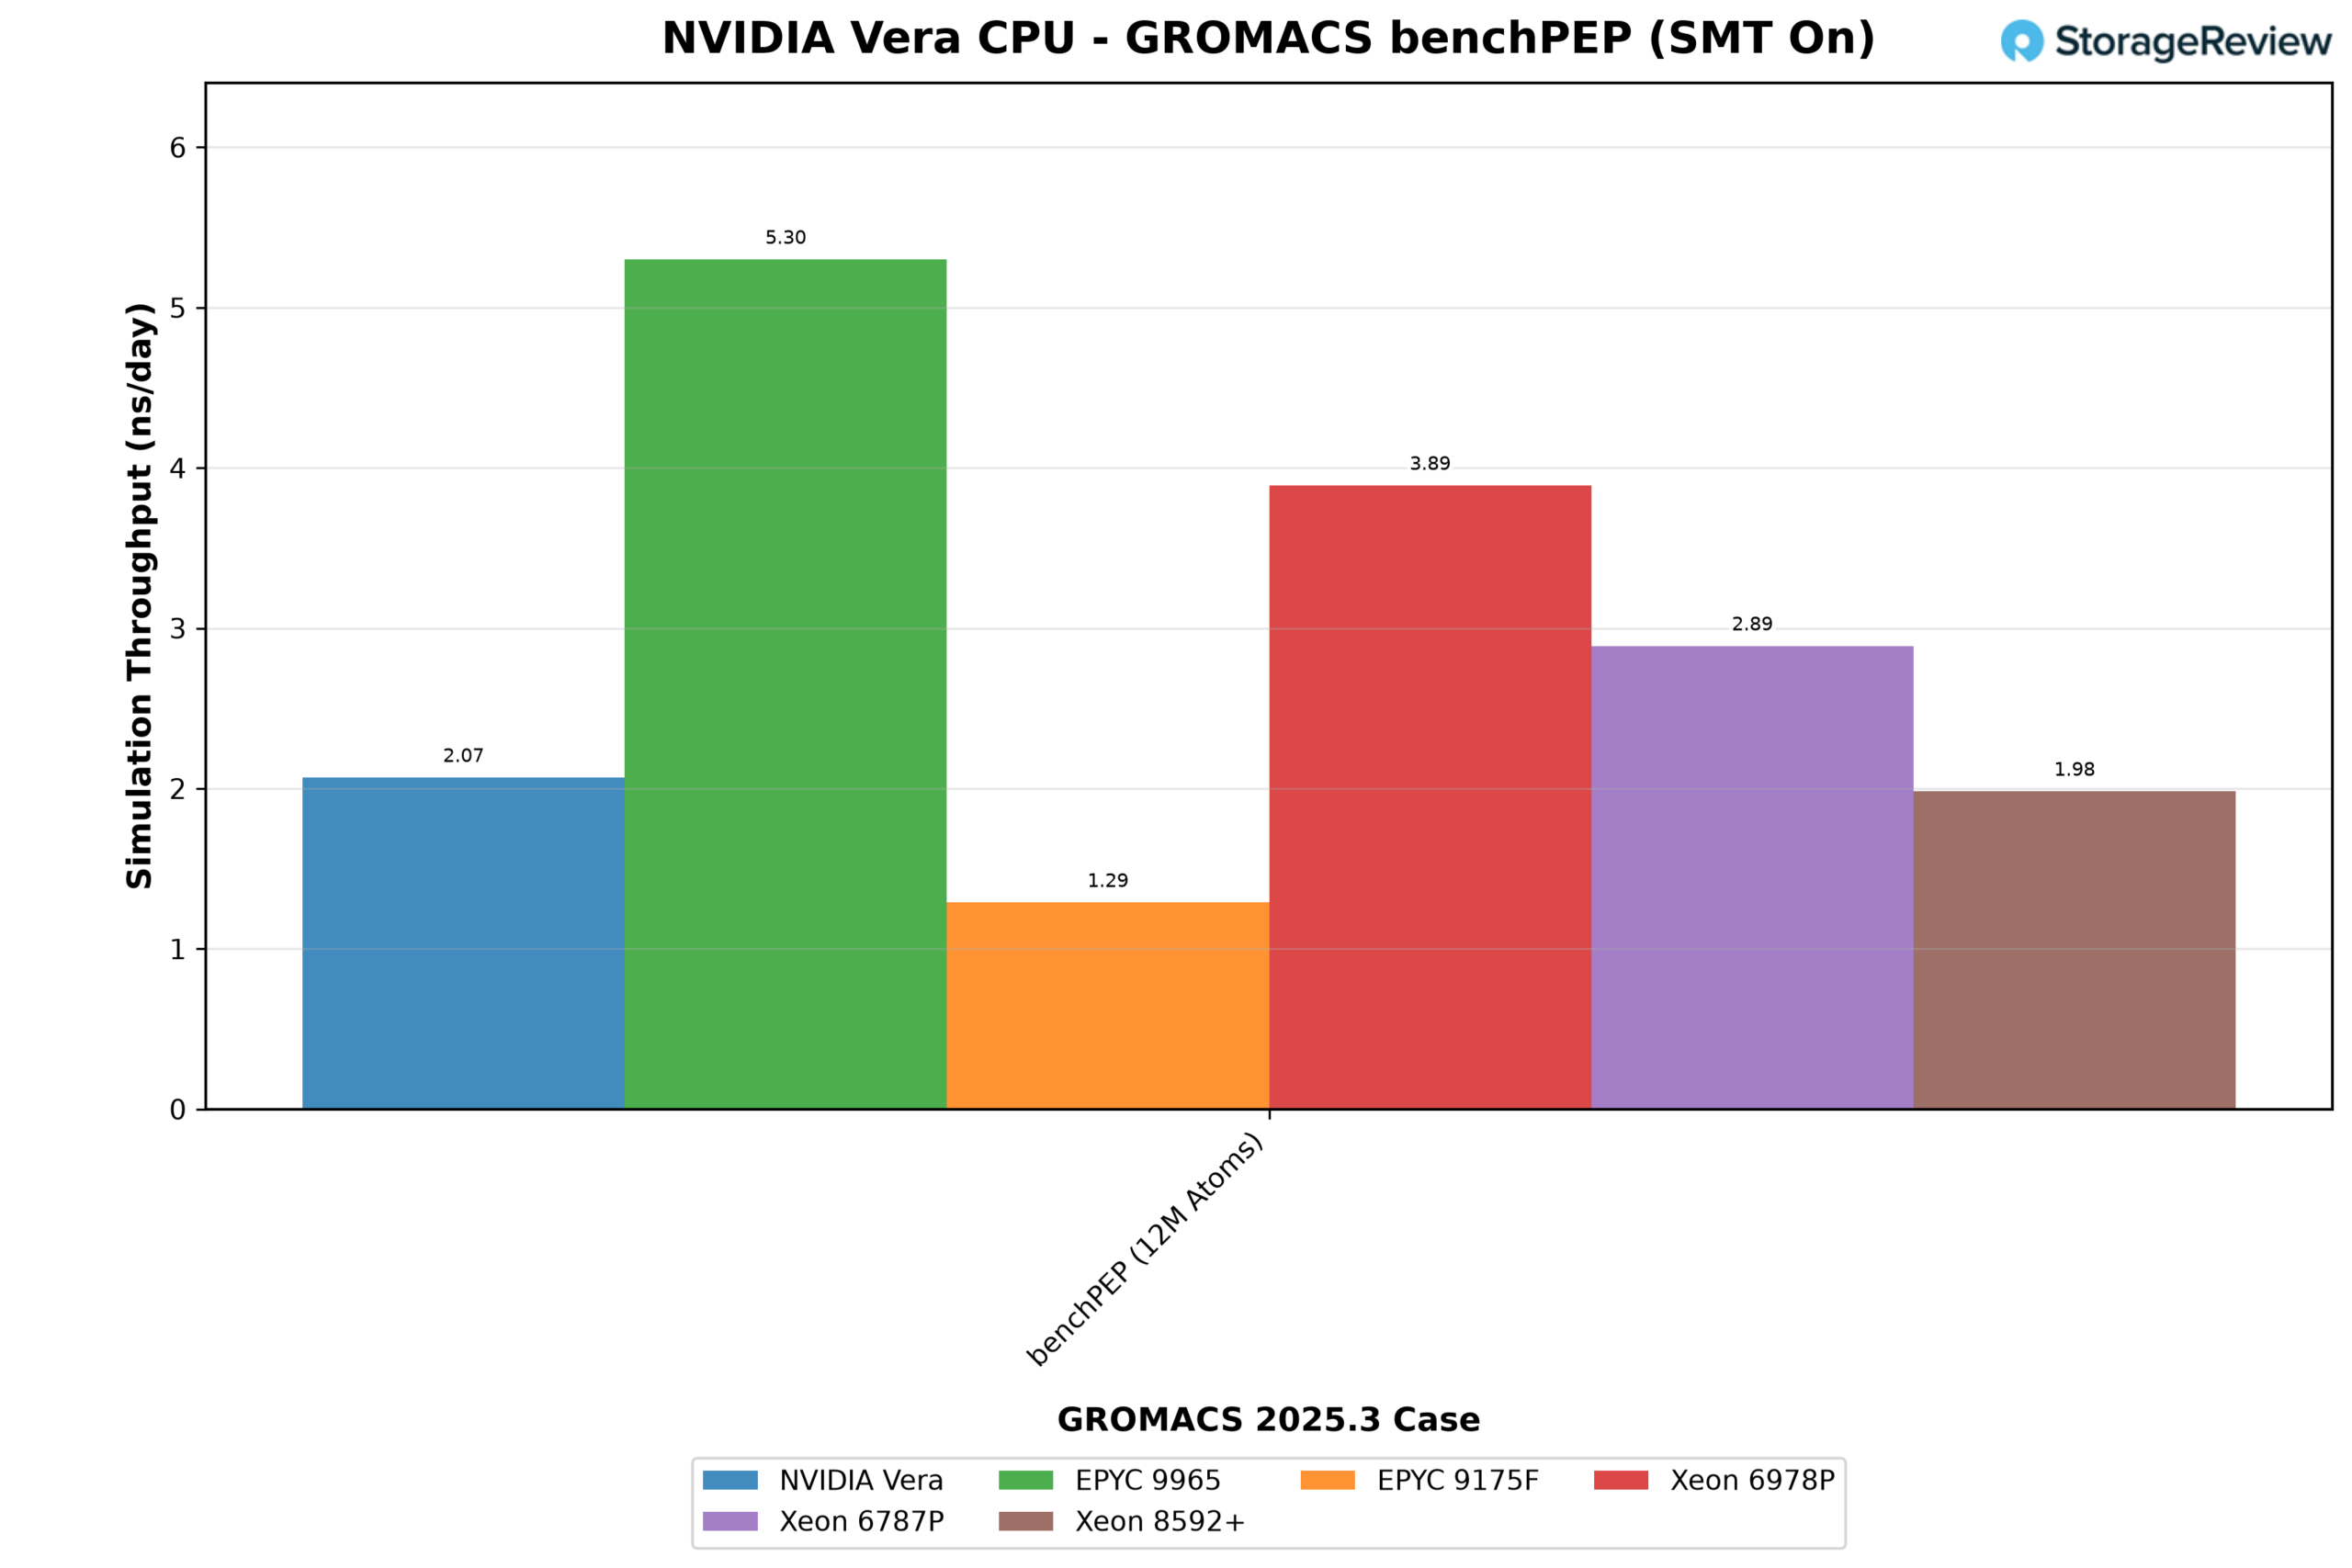
Пространственная многопоточность частично компенсирует этот прогресс, поскольку её включение повысило результат Vera на 17% до 2.07 нс/день, при этом наилучшая конфигурация запускала все 352 аппаратных потока в качестве рангов thread-MPI. Это больший прирост, чем тот, который SMT дала Xeon 6978P (3%) или 8592+ (11%) в наших предыдущих тестах, а EPYC 9965 потерял 3.5% при её включении. Благодаря разделению ресурсов между двумя потоками, каждый ранг получает часть ядра, и сочетание векторной математики и задержек памяти в решателе, похоже, лучше заполняет эти части, чем один ранг.
В тесте benchMEM разница между производительностью одного ядра определяется путем запуска системы с 82 000 атомами на 16 физических ядрах сокета 0 на каждой платформе, поэтому количество ядер не учитывается, и результат отражает векторную пропускную способность, кэш и локальную память.
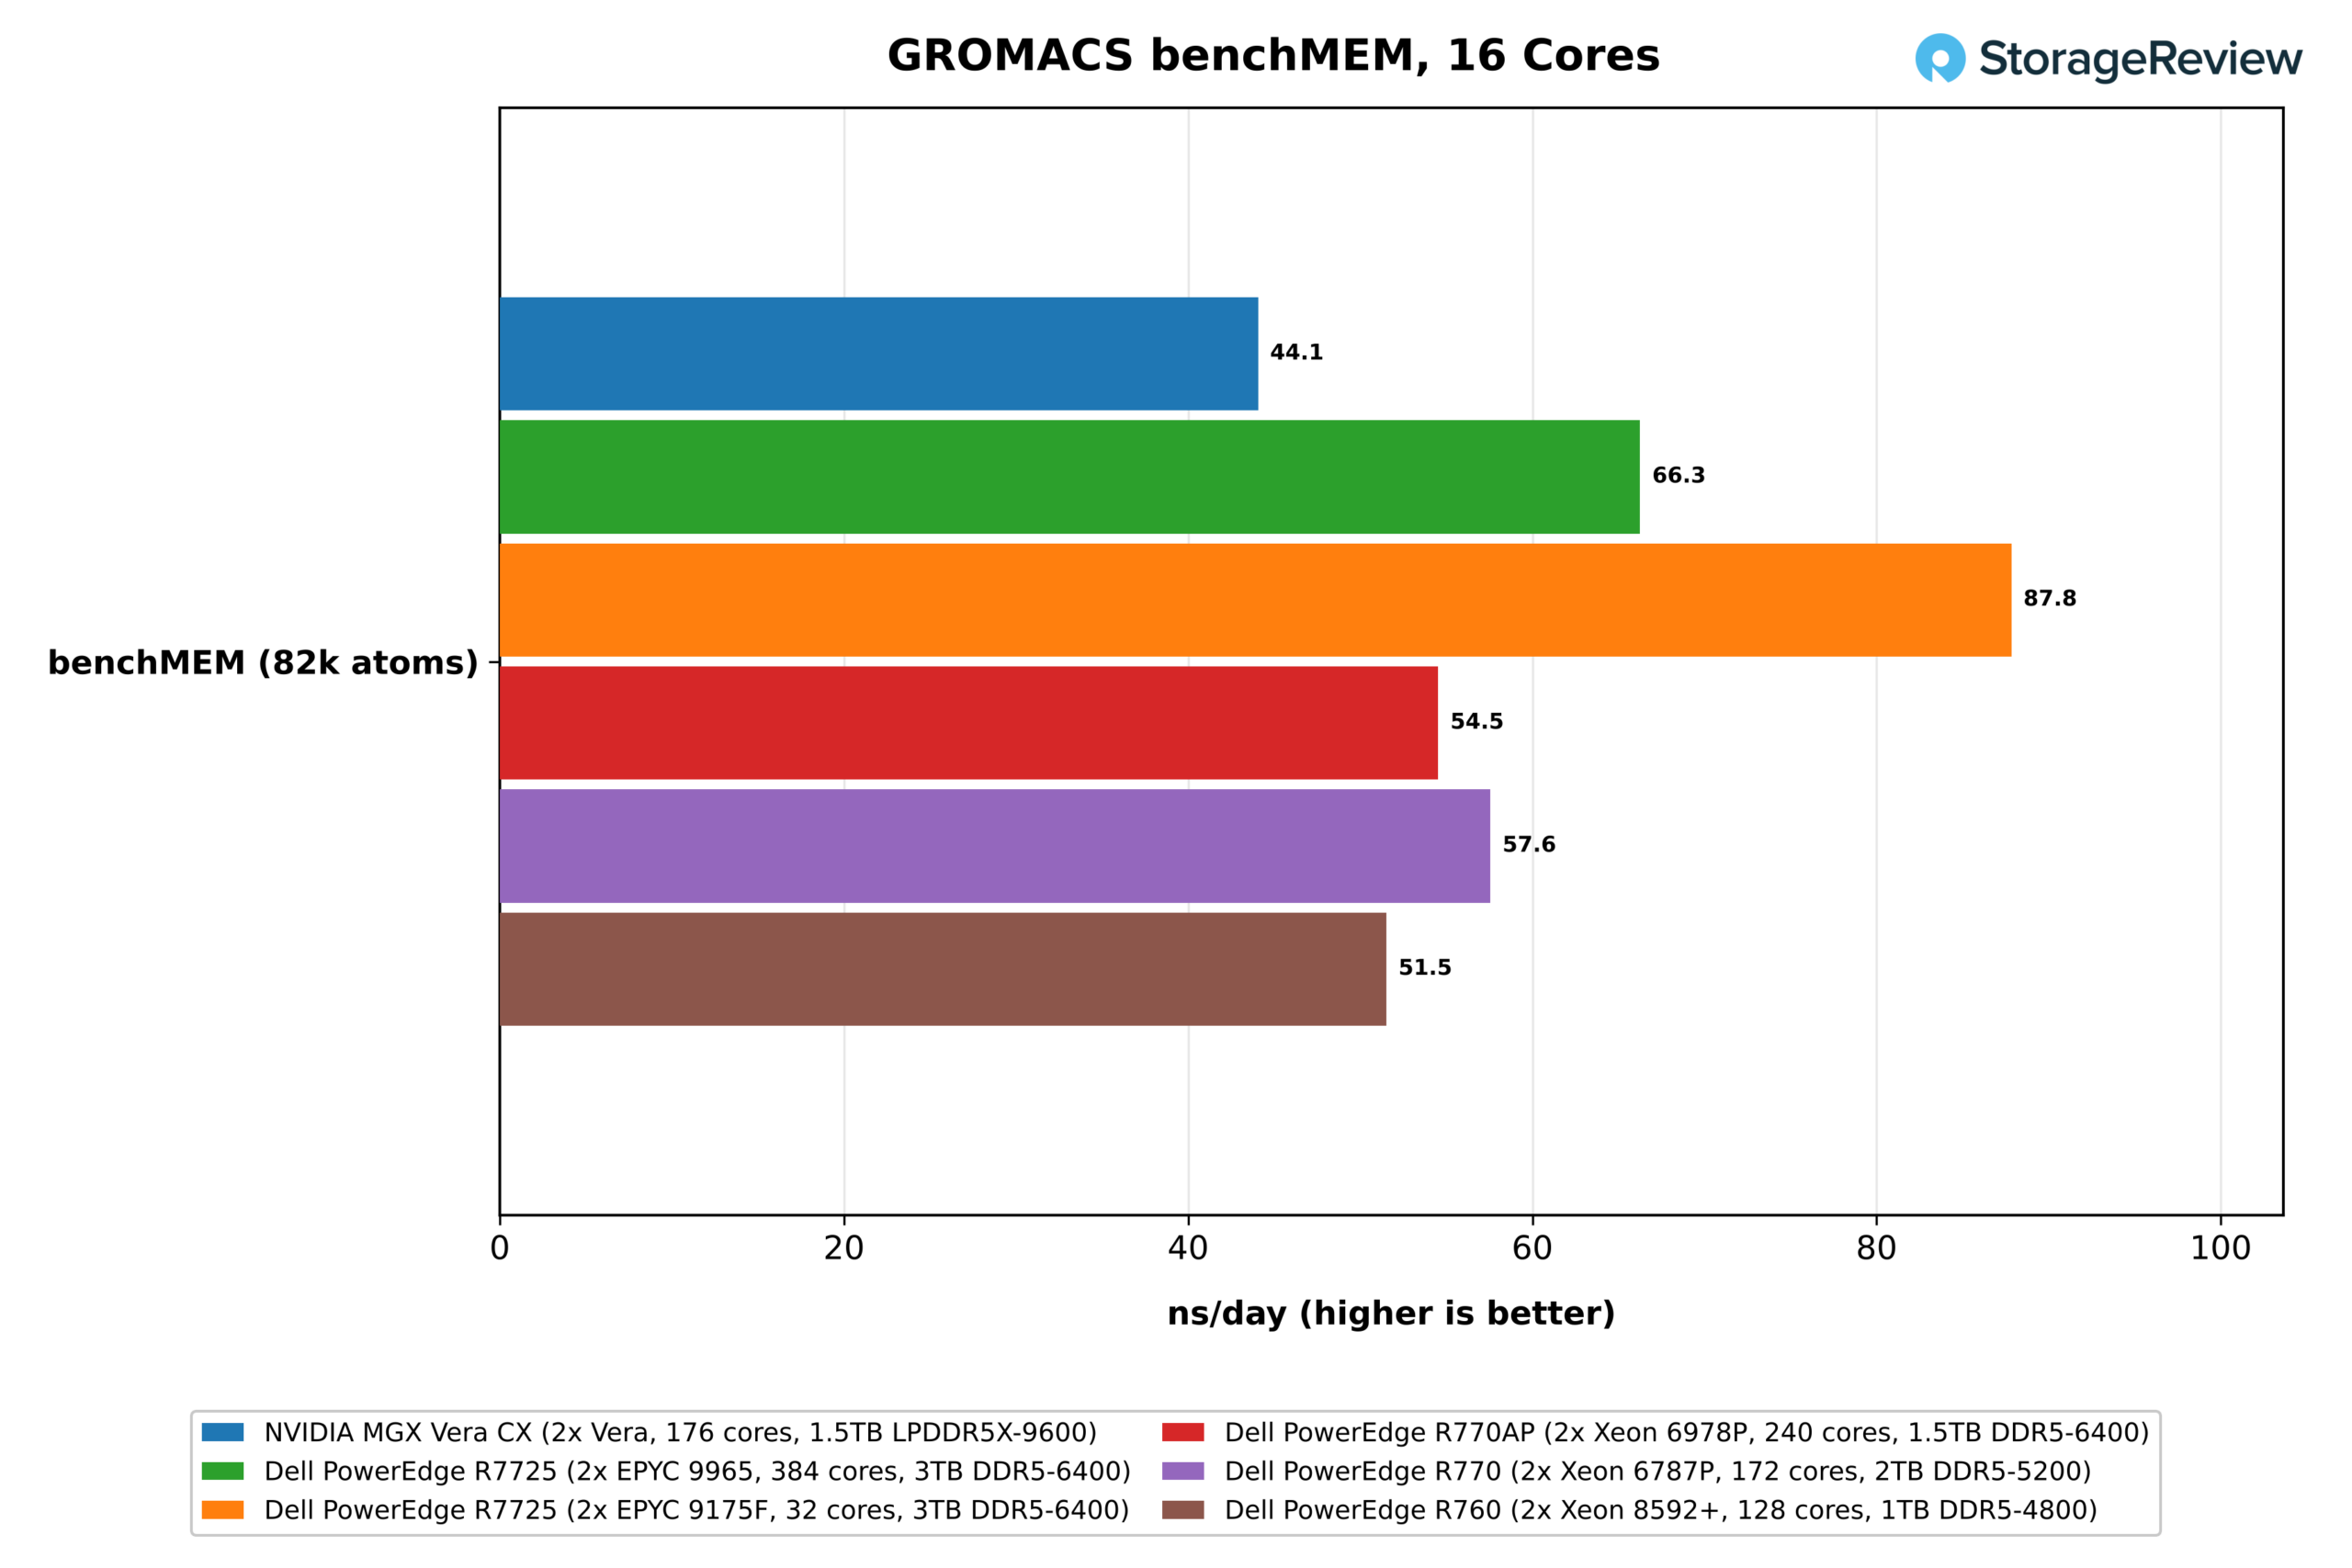
Здесь Vera показала результат 44.1 нс/день. 5.0 ГГц EPYC 9175F удвоил этот показатель, достигнув 87.8, а EPYC 9965 — 66.3, что в 1.5 раза больше, чем у Vera, опередив Xeon 6787P (57.6), 6978P (54.5) и 8592+ (51.5).
Таким образом, 16-ядерный процессор Vera выполняет примерно две трети работы, которую выполняет 16-ядерный процессор Zen 5c, даже несмотря на то, что эти 16 ядер Zen 5c используют один общий кэш L3 объемом 32 МБ, в то время как Vera может использовать свой 164 МБ системного кэша. Это делает данное измерение наиболее наглядным из имеющихся у нас данных о стоимости 128-битных векторов в коде, написанном для 512-битных векторов. Дальнейшее преимущество 9175F над 9965 примерно соответствует его тактовой частоте: 5.0 ГГц против 3.7 ГГц.
OpenFOAM
OpenFOAM переносит нагрузку с векторных блоков на систему памяти. Мы запускаем OpenFOAM 13 на примере автомобильной аэродинамики driverFastback, используя один ранг MPI на каждое физическое ядро, с двумя размерами сетки: средней сеткой в 2.98 миллиона ячеек и большой сеткой в 22.6 миллиона ячеек.
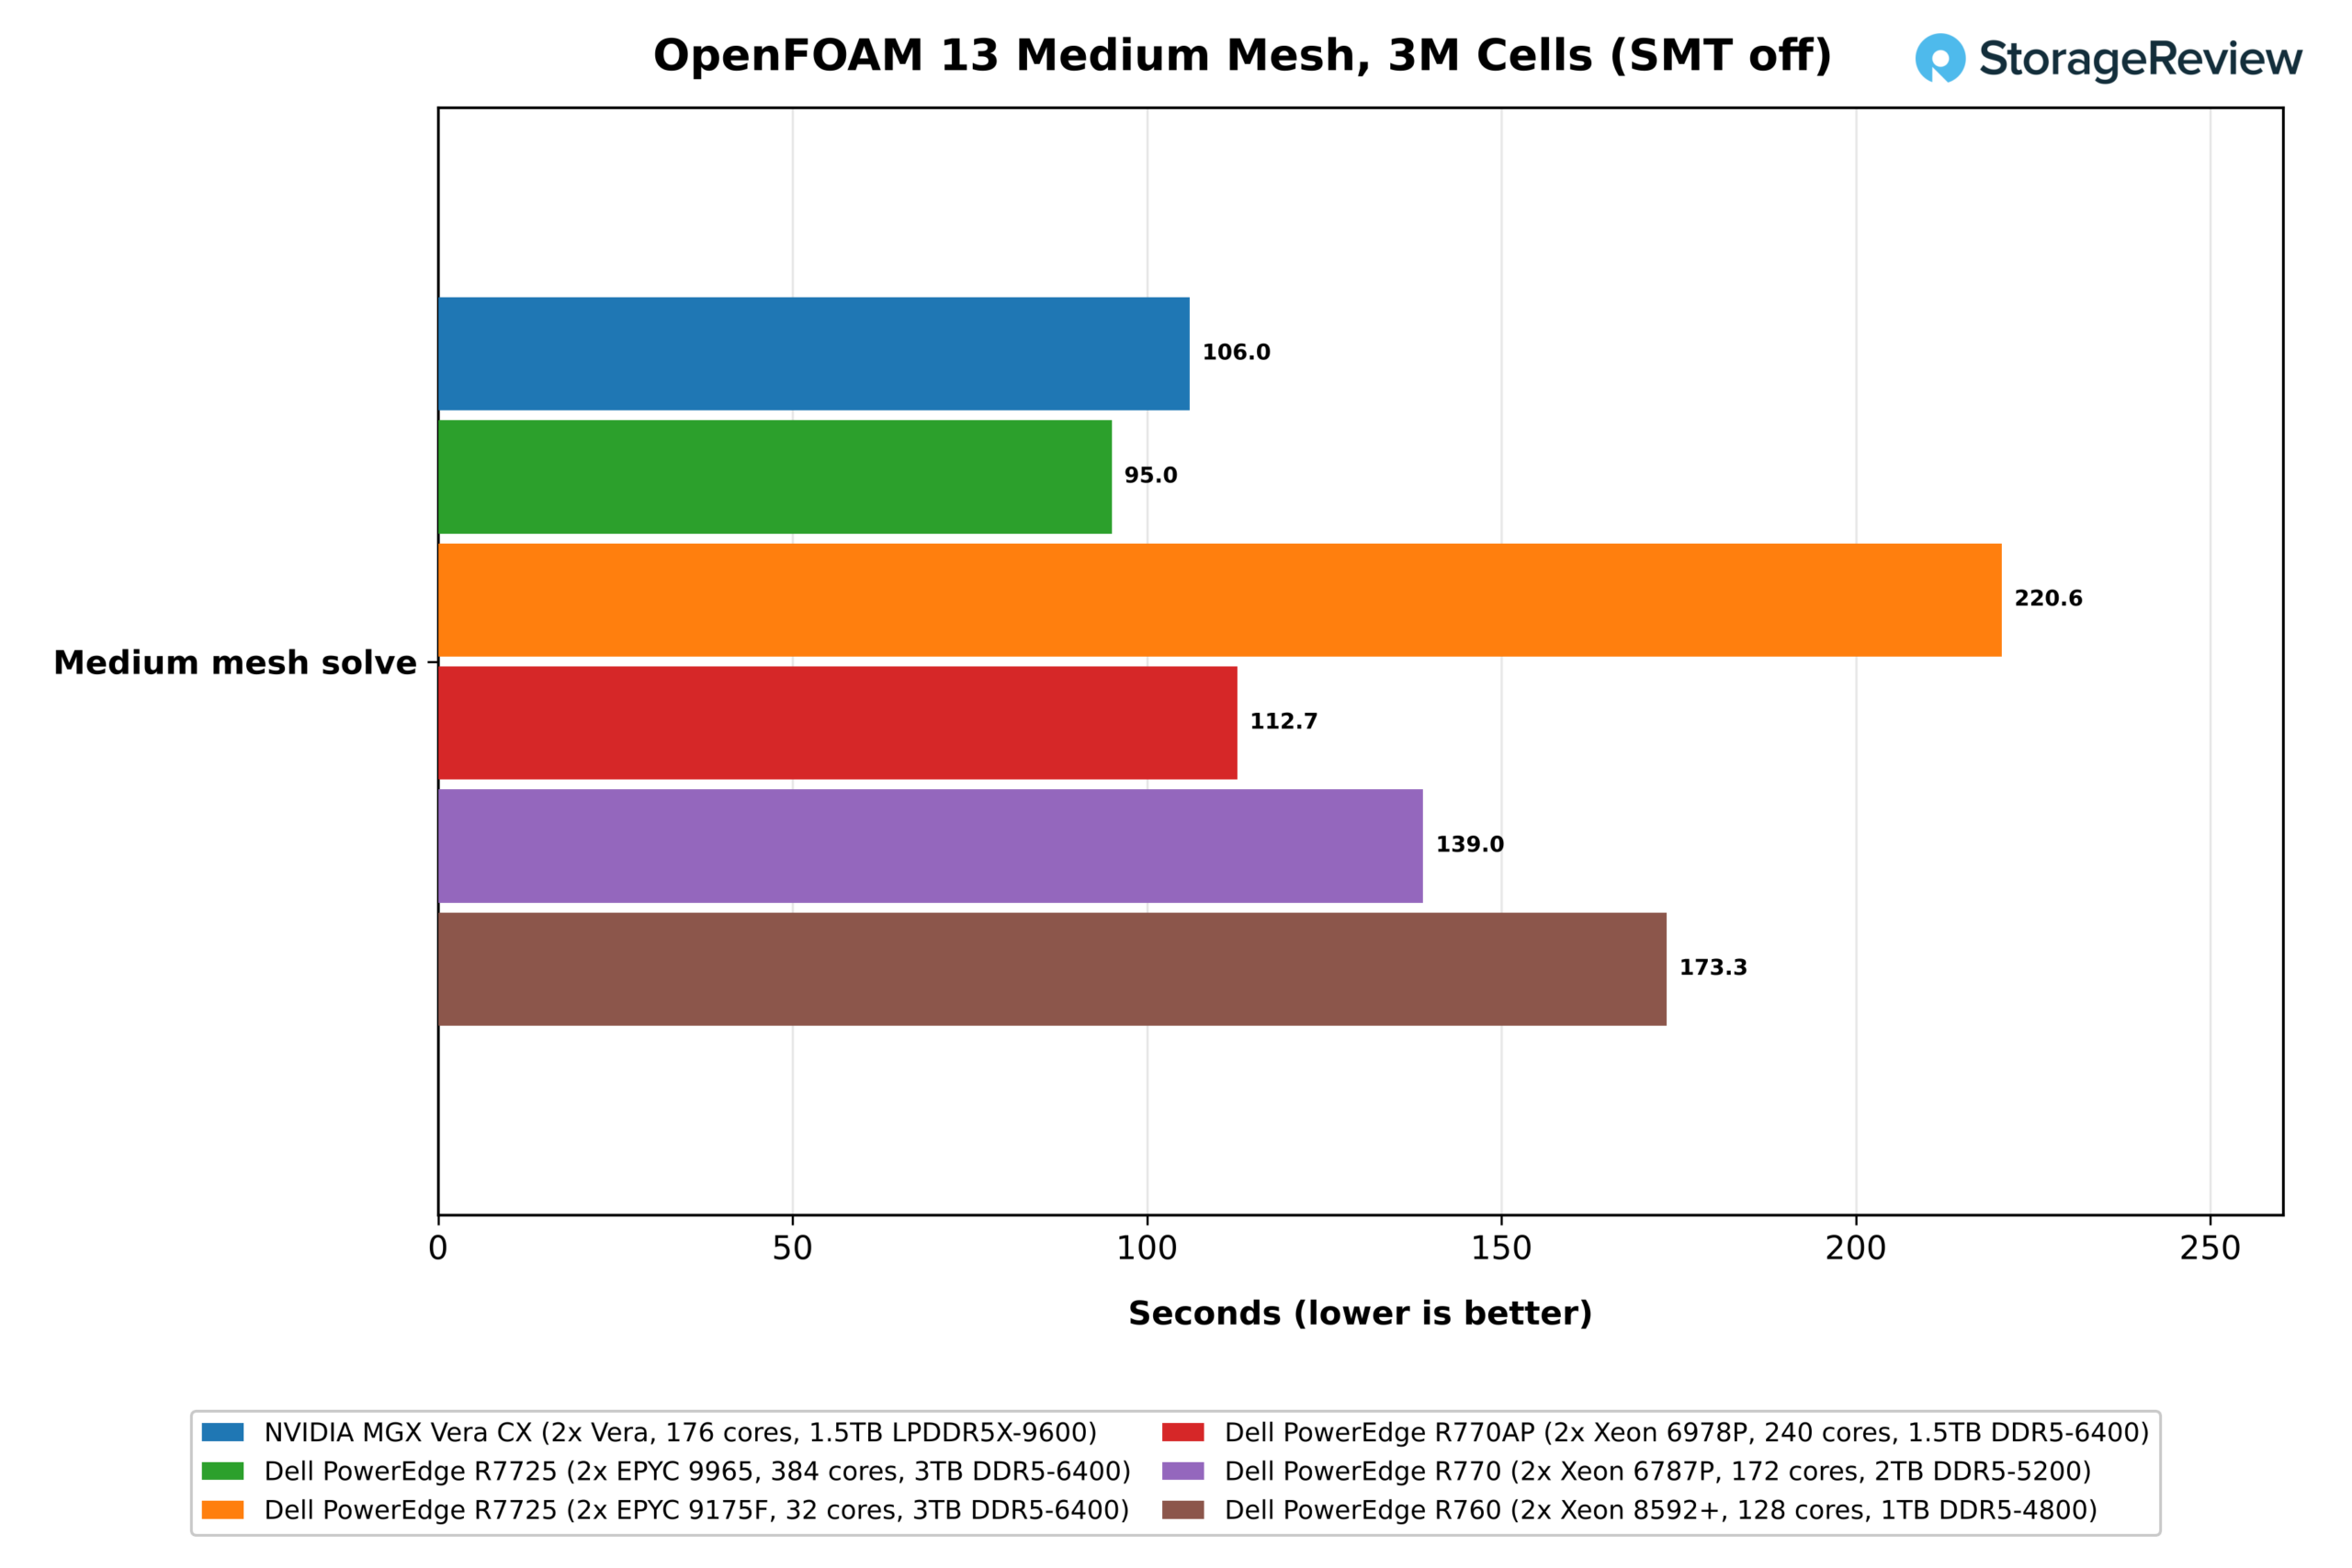
Решение задачи для сетки среднего размера заняло 106.0 секунд на Vera, против 95.0 секунд на EPYC 9965, 112.7 секунд на Xeon 6978P, 139.0 секунд на 6787P, 173.3 секунд на 8592+ и 220.6 секунд на 32-ядерном 9175F. При таком размере 384 ядра 9965 выигрывают, а Vera тратит на 12% больше времени, но занимает второе место, на 6% опережая 240-ядерный Xeon. При наличии всего 3 миллионов ячеек, более крупные кэши L3 процессоров x86, вероятно, в большей степени определяют решение задачи, что позволяет контролировать количество ядер.
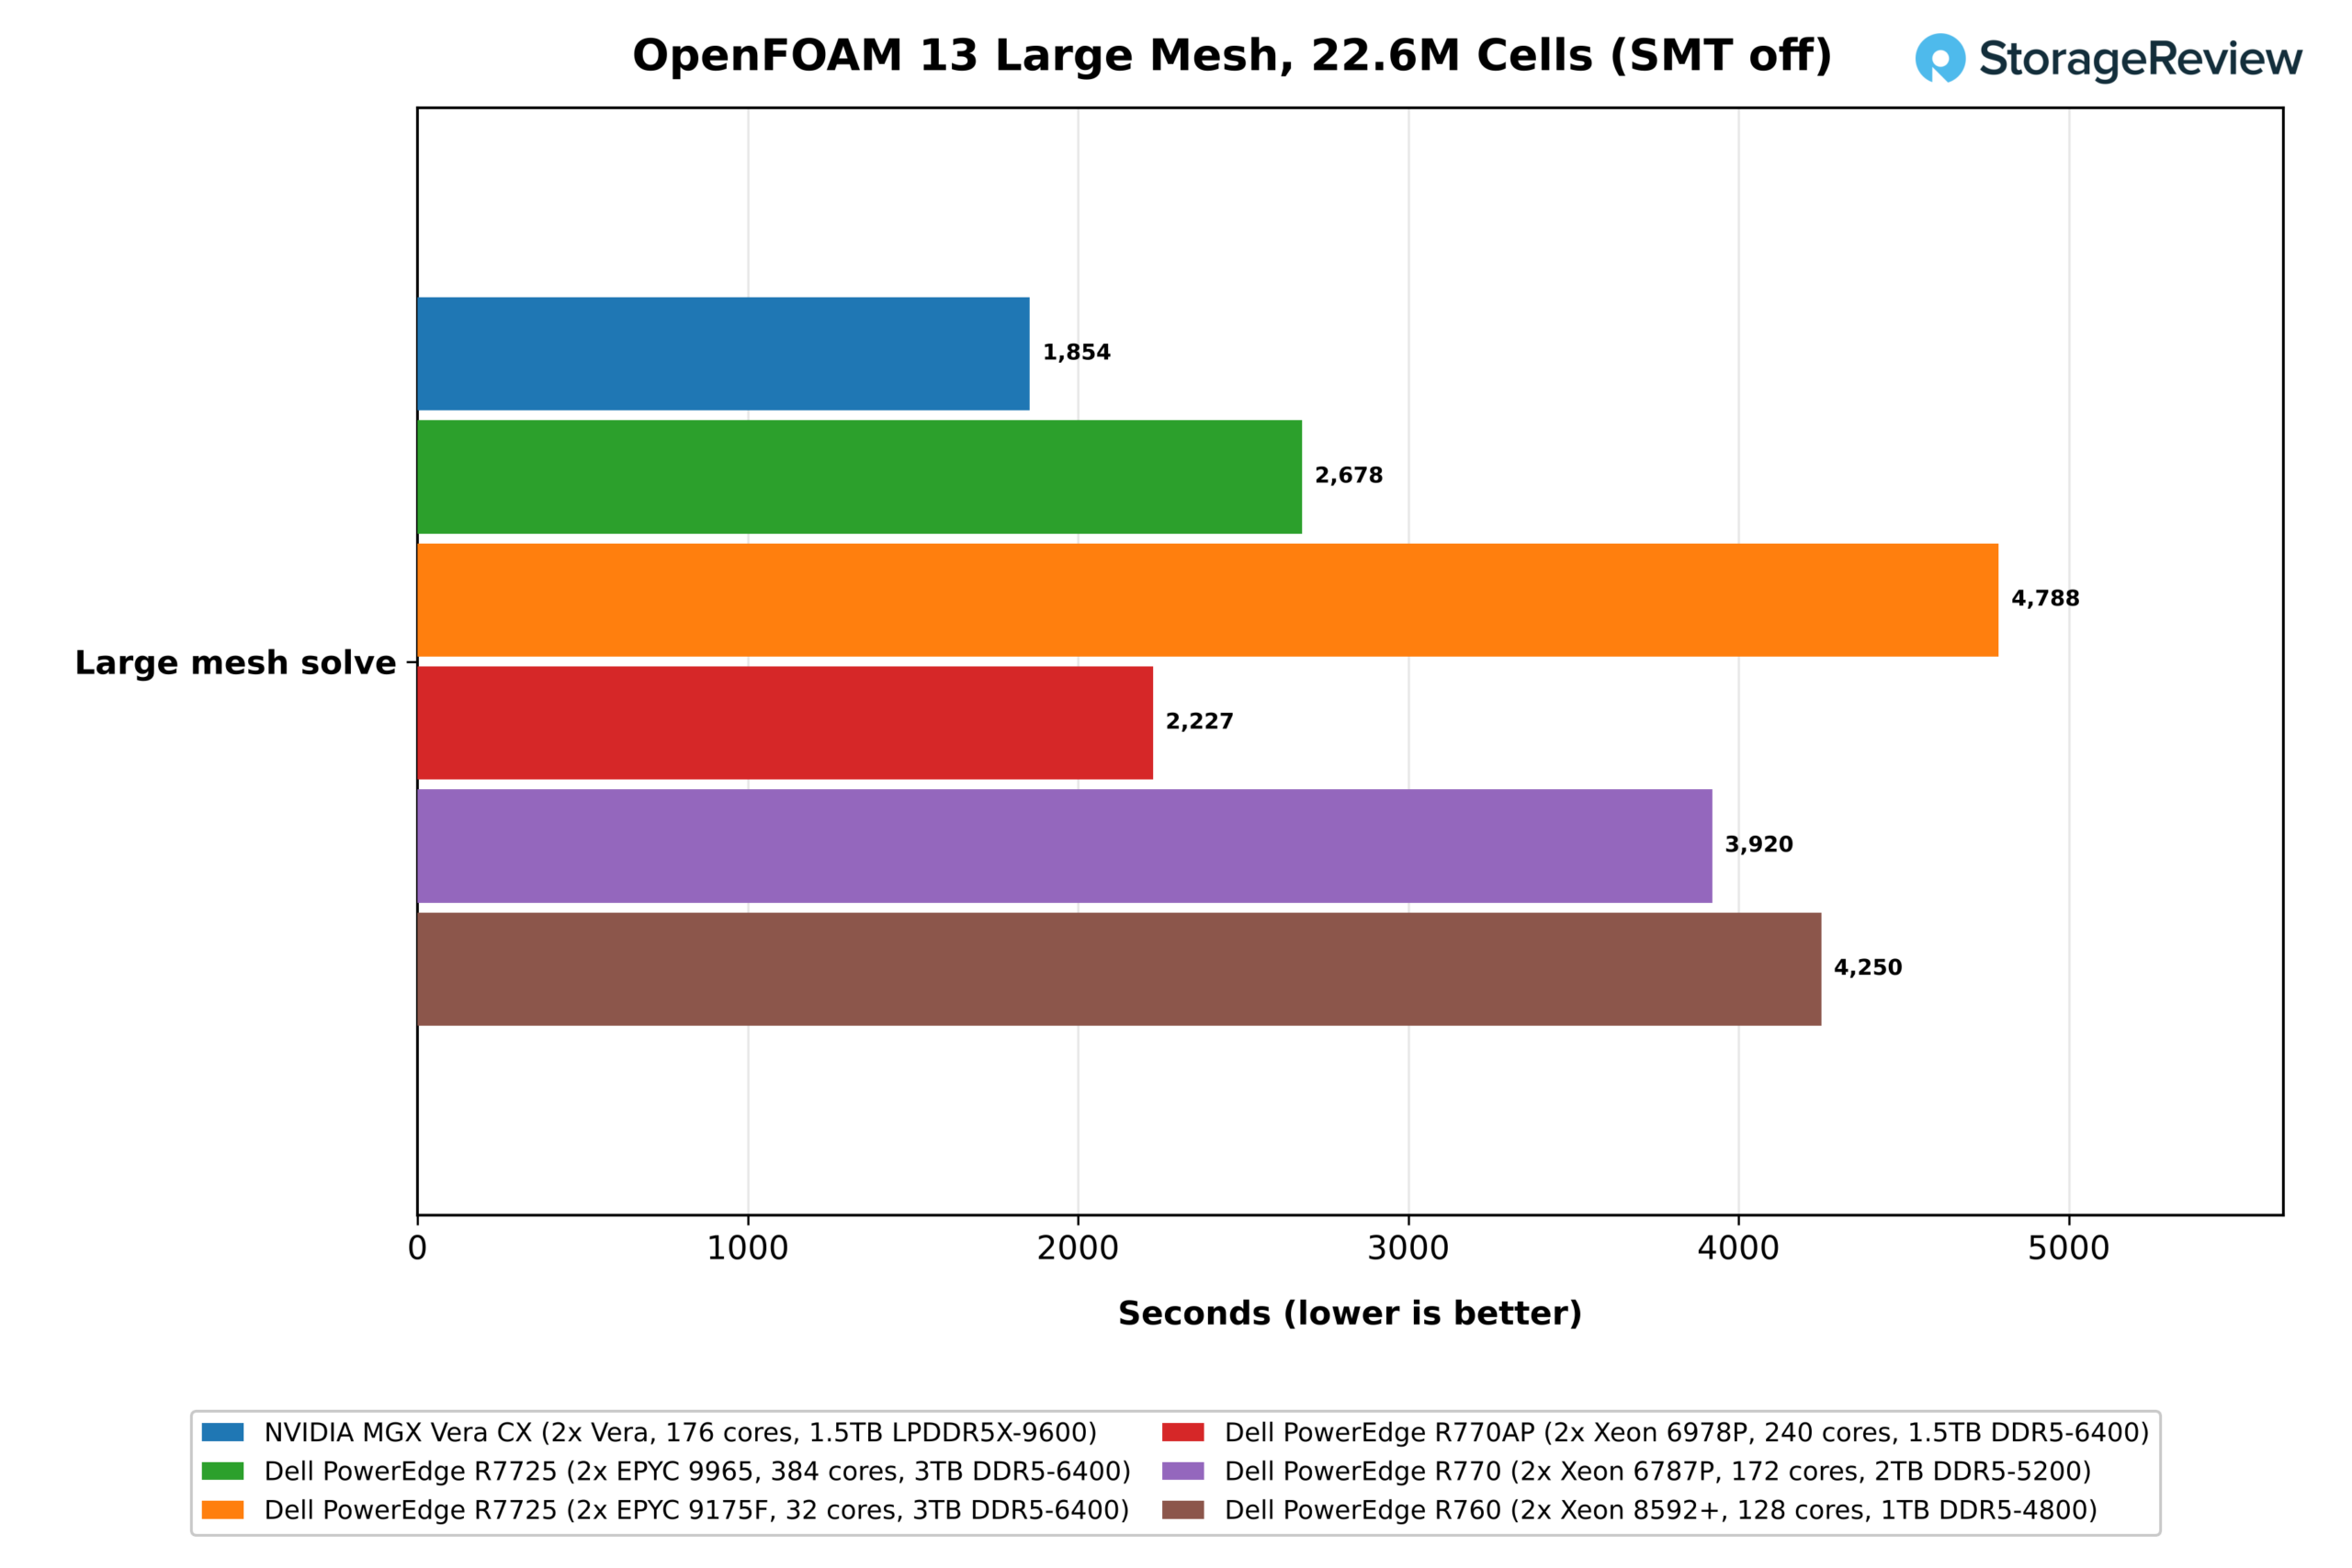
В случае с крупной ячейкой порядок задач меняется: Vera решает задачу за 1,854 секунды, против 2,227 секунд у Xeon 6978P, 2,678 секунд у EPYC 9965, 3,920 секунд у 6787P, 4,250 секунд у 8592+ и 4,788 секунд у 9175F, что делает её в 1.44 раза быстрее, чем 384-ядерный сервер AMD, и в 1.20 раза быстрее, чем 240-ядерный сервер Intel. Vera также укладывается в номинальный максимум в 450 Вт на сокет, по сравнению с 500 Вт у 9965.
Аналитика и данные в оперативной памяти
Результаты высокопроизводительных вычислений показали, как пропускная способность Vera влияет на работу научного решателя. Сервисы обработки данных используют одну и ту же систему памяти по-разному, и наши два теста задействуют ее с противоположных сторон. ClickBench выполняет аналитические запросы, которые сканируют и агрегируют большие столбцы данных, распределяя каждый запрос по каждому ядру, поэтому он вознаграждает систему, которая объединяет множество ядер с достаточной пропускной способностью для их обработки. Valkey, хранилище типа «ключ-значение» в оперативной памяти, обрабатывает миллионы небольших запросов, каждый из которых читает или записывает одно значение, поэтому его эффективность больше зависит от скорости обработки запроса отдельным ядром, а после того, как данные превышают объем кэша, — от задержки памяти и пропускной способности.
ClickBench
Мы протестировали ClickBench, выполнив 43 запроса к таблице веб-аналитики, содержащей 100 миллионов строк, на ClickHouse 26.8. Его «горячая сумма», где каждый запрос считывает данные из кэша страниц, измеряет, сколько ядер система может задействовать для столбцового сканирования и агрегирования, и насколько хорошо её память справляется с этим. «Холодная сумма» добавляет перезапуск сервера и чтение с SSD-накопителя перед первым выполнением каждого запроса.
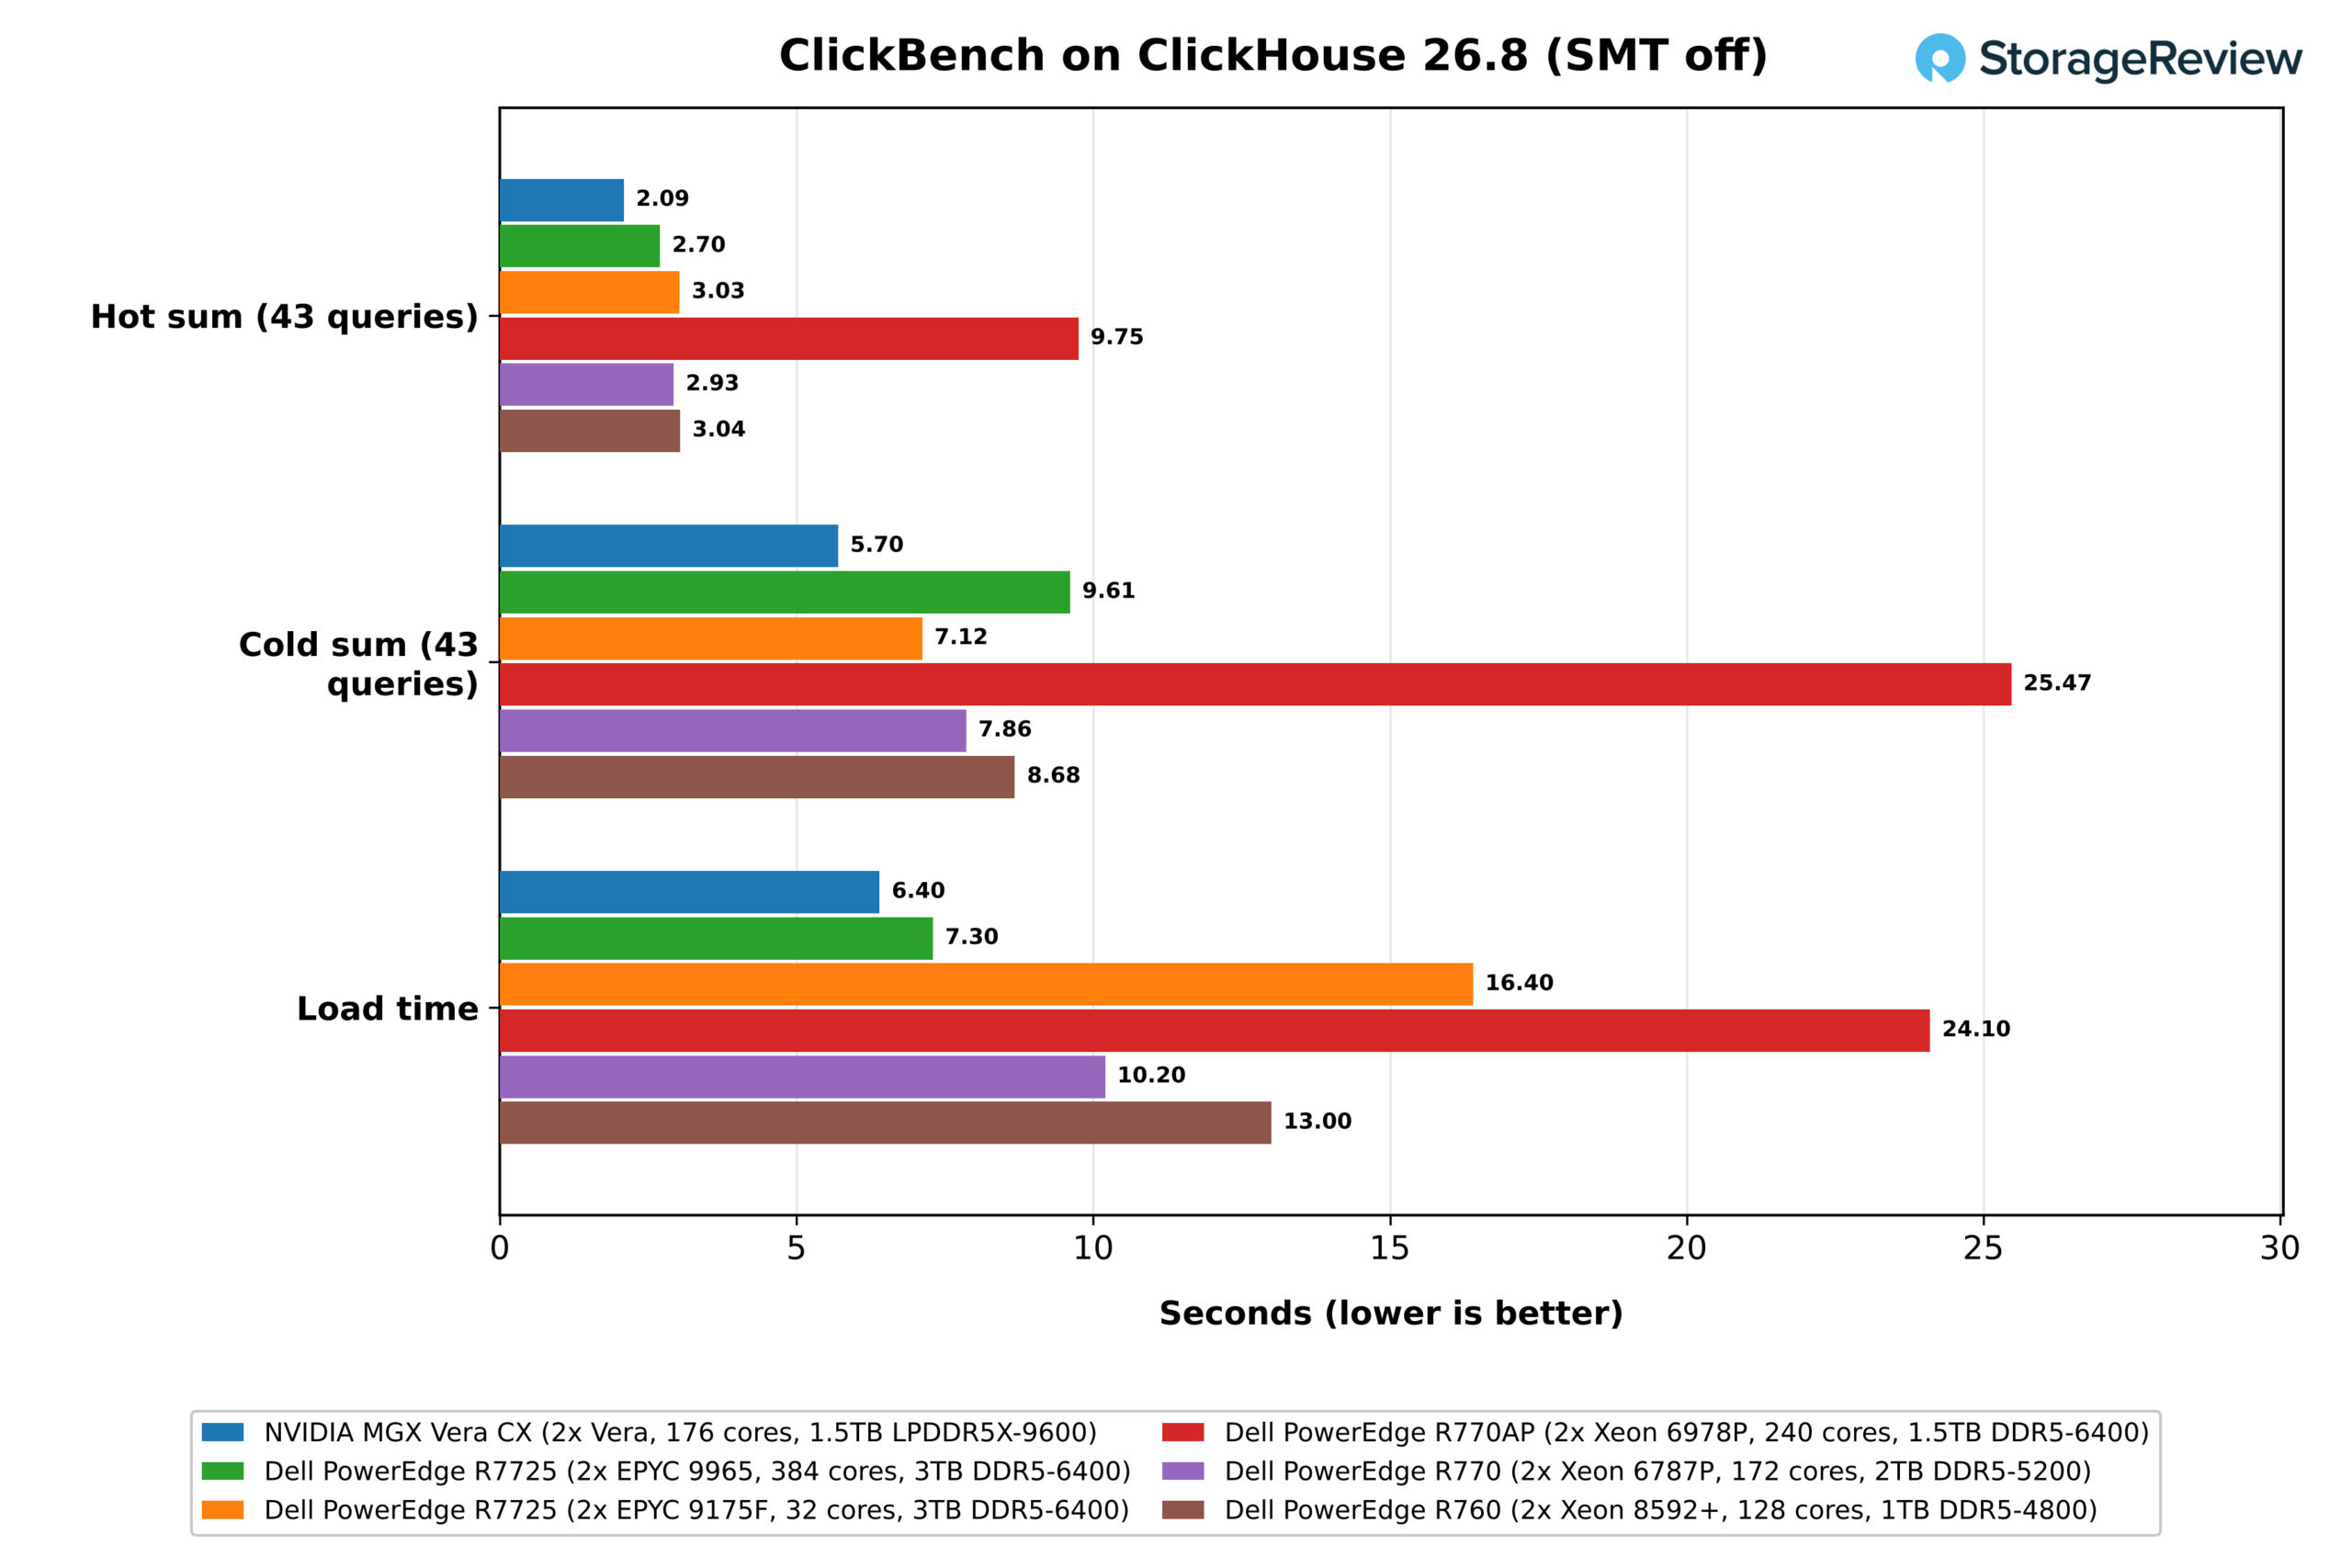
При отключенной технологии SMT Vera завершила тест на максимальную производительность за 2.09 секунды, показав лучший результат в нашем наборе данных. EPYC 9965 занял второе место с результатом 2.70 секунды, что в 1.29 раза больше, а Xeon 6787P, EPYC 9175F и Xeon 8592+ показали практически одинаковые результаты — от 2.93 до 3.04 секунды. Разница отражает баланс между количеством ядер и пропускной способностью. 384-ядерный 9965 имеет достаточное количество ядер, но низкую пропускную способность на ядро; у 32-ядерного 9175F ситуация обратная; а Vera использует 176 ядер с пропускной способностью более чем в три раза большей, чем у любого из них.
Vera также лидировала в заезде в холодном режиме с результатом 5.70 секунды, опередив 9175F (7.12), 6787P (7.86), 8592+ (8.68) и 9965 (9.61). В заезде в холодном режиме большее значение имеет хранилище данных, а тип соединений накопителей различается: Gen5 x4 на Vera и 6787P, x2 на обеих системах EPYC и Gen4 на 8592+.
Vera также быстрее всех загрузила набор данных объемом 15 ГБ — за 6.4 секунды, по сравнению с 7.3 секундами у 9965 и 10.2–16.4 секундами у остальных. Xeon 6978P, с показателями 9.75 секунды в горячем состоянии и 25.47 секунды в холодном, значительно отстал от других процессоров Xeon по причинам, которые мы не выяснили, поэтому мы не включаем его в рейтинг.
Включение пространственной многопоточности замедлило работу Vera до 2.31 секунды в «горячем» режиме и 6.09 секунды в «холодном», что составляет 10% потери от суммы в «горячем» режиме. Распределение ресурсов каждого ядра между двумя потоками привело к тому, что сканирование ClickHouse потеряло больше ресурсов, чем получило пользы.
Валки
Valkey выполняет команды в одном основном потоке, а потоки ввода-вывода помогают лишь до определённого момента, поэтому развертывание расширяется за счёт добавления шардов, поскольку увеличение количества ядер на один экземпляр мало что даёт. Поэтому мы рассматриваем Valkey с двух точек зрения: что обеспечивает один шард на сопоставимых ядрах и что обеспечивает каждый шард, когда сокет заполнен ими. В обоих тестах клиенты работают на другом сокете той же машины, поэтому сетевая карта не задействована.
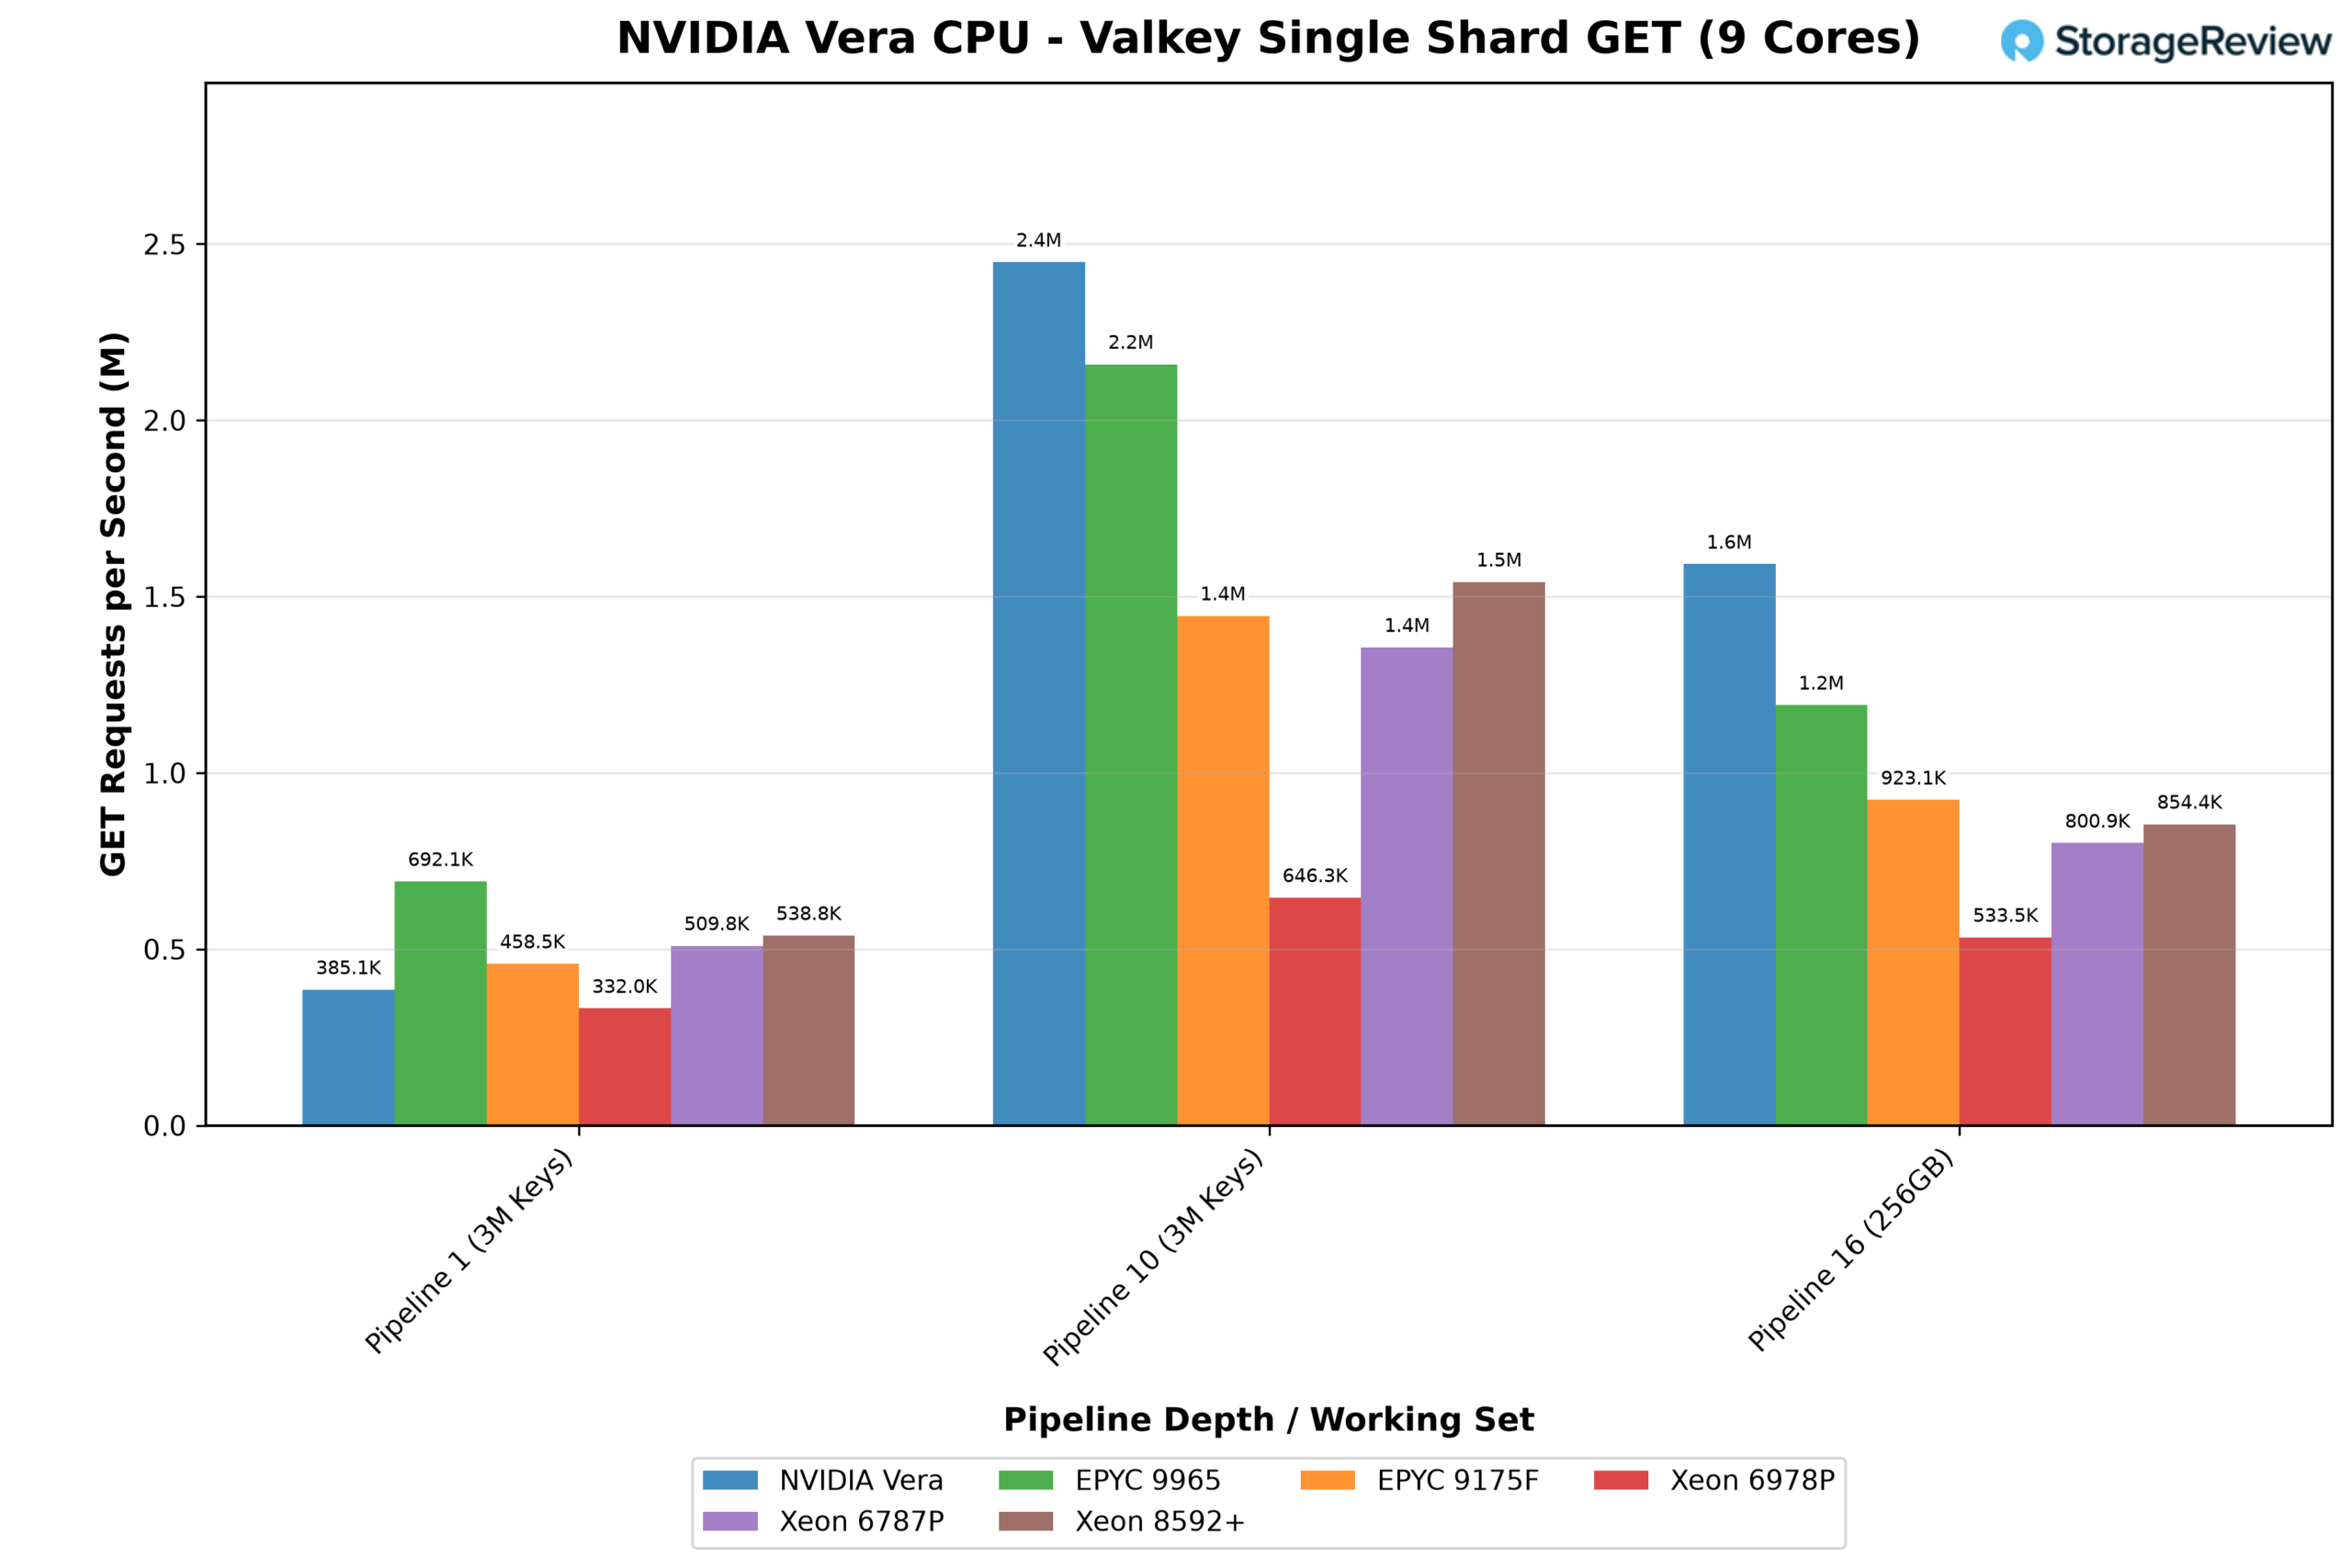
Тест на одном сегменте сервера Valkey использует девять физических ядер на каждой платформе. Он обрабатывает набор данных с 3 миллионами ключей, отправляя запросы по одному, затем партиями по 10, а затем обрабатывает набор данных объемом 256 ГБ, слишком большой для любого кэша, партиями по 16. При отправке запроса по одному, каждый запрос должен завершить свой цикл обработки, прежде чем будет отправлен следующий, и именно здесь Vera показывает себя с самой слабой стороны. Ее сегмент обработал 385 000 GET-запросов в секунду, опередив только Xeon 6978P, в то время как EPYC 9965 показал результат в 692 000 запросов. Задержка p99 у Vera также была выше: 1.76 мс против 1.08 мс у 9965.
Пакетная обработка устраняет большую часть затрат на обмен данными, и Vera выходит в лидеры. При обработке пакетов по 10 запросов ее сегмент обрабатывал 2.45 млн GET-запросов в секунду, что на 13% больше, чем у 9965, и значительно опережает все процессоры Xeon. Набор данных объемом 256 ГБ еще больше увеличил разрыв. Благодаря тому, что почти каждый запрос обрабатывался в памяти, Vera обрабатывала 1.59 млн GET-запросов в секунду, что на 34% больше, чем у 9965, в то время как у остальных процессоров этот показатель варьировался от 0.53 млн до 0.92 млн. Результаты SET-тестов показали одинаковую закономерность в обоих тестах.
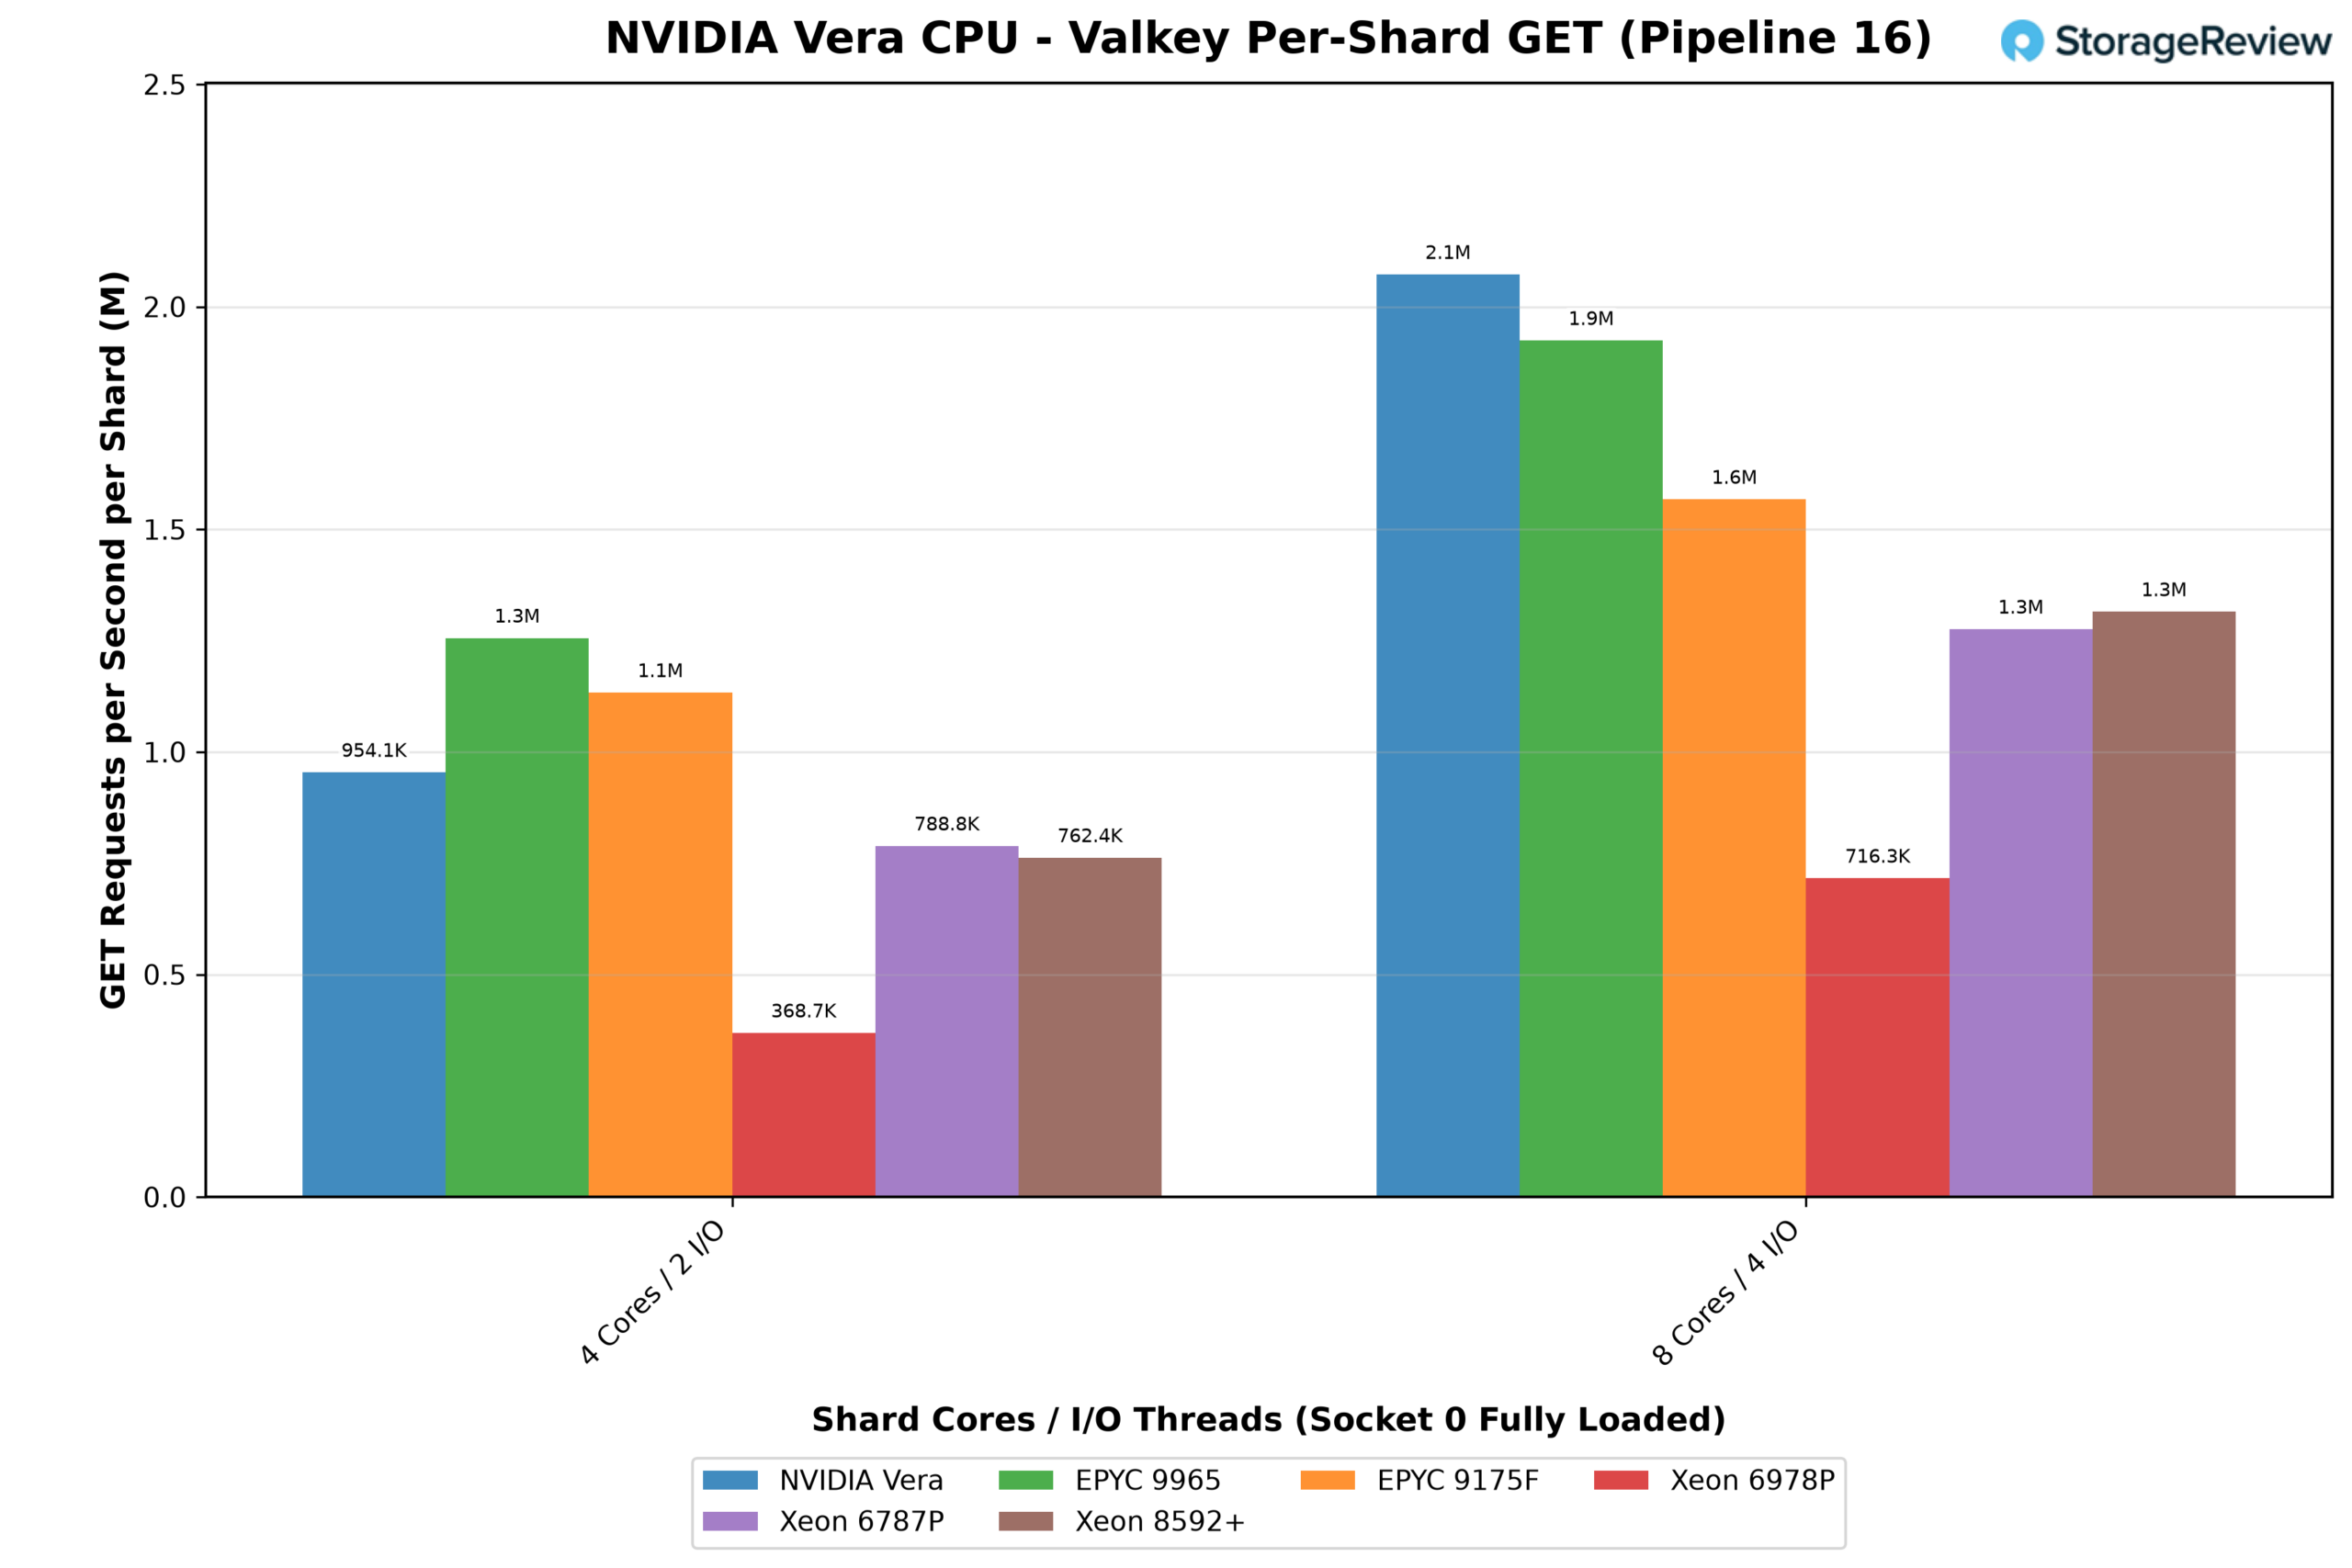
В режиме сокета 0 сокет заполняется идентичными сегментами по четыре или восемь ядер, которые одновременно обрабатывают трафик, что ближе к работе выделенного хоста Valkey. При использовании 8-ядерных сегментов и пакетов по 16 ядер каждый сегмент Vera обрабатывал 2.07 млн GET-запросов в секунду, что опережает показатель 9965 (1.92 млн) и примерно в 1.6 раза превосходит показатели Xeon 6787P и 8592+, хотя задержка p99 увеличилась до 2.2 мс против примерно 0.5 мс у 9965.
В сегменте с меньшим количеством 4-ядерных процессоров AMD показала лучшие результаты: 9965 — 1.26 млн GET-запросов на сегмент против 0.95 млн у Vera, хотя Vera по-прежнему лидировала среди всех процессоров Xeon. При отправке запросов по одному сегменты 9965 были в 1.5–1.7 раза быстрее, чем у Vera, при любом размере, а 6787P и 8592+ также вырвались вперед в сегменте с 8-ядерными процессорами.
Плотность размещения определяет общее количество сокетов: сокет Vera вмещает 11 восьмиядерных сегментов и обрабатывает 22.8 млн GET-запросов в секунду, в то время как 192 ядра 9965 вмещают 48 четырехядерных сегментов и обрабатывают 60.3 млн. Vera обеспечивает самую высокую скорость работы сегментов в нашем наборе, когда каждый сегмент имеет восемь или более ядер и запросы обрабатываются пакетами, но 9965 вмещает более чем в два раза больше сегментов в сокет.
Однопоточность и пропускная способность
Valkey и ClickBench в равной степени опирались на систему памяти и ядра. В этом разделе мы переходим к самим ядрам и к двум целям, лежащим в основе Olympus, описанным ранее: быстрое завершение отдельных задач и поддержание этой скорости, когда весь сокет занят. 7-Zip, OpenSSL и Python работают в виде отдельных потоков, привязанных к одному ядру, демонстрируя возможности ядра Olympus. Затем 7-Zip и OpenSSL запускаются снова во всех потоках системы, показывая, какая часть скорости каждого ядра сохраняется, когда все ядра конкурируют за одни и те же кэши и память.
7-Zip
Сжатие LZMA в 7-Zip — это целочисленный код с большим количеством ветвлений и непредсказуемым доступом к памяти, именно для таких задач и предназначены интерфейсная часть Olympus с поддержкой 10-битных данных и предварительная выборка графов.
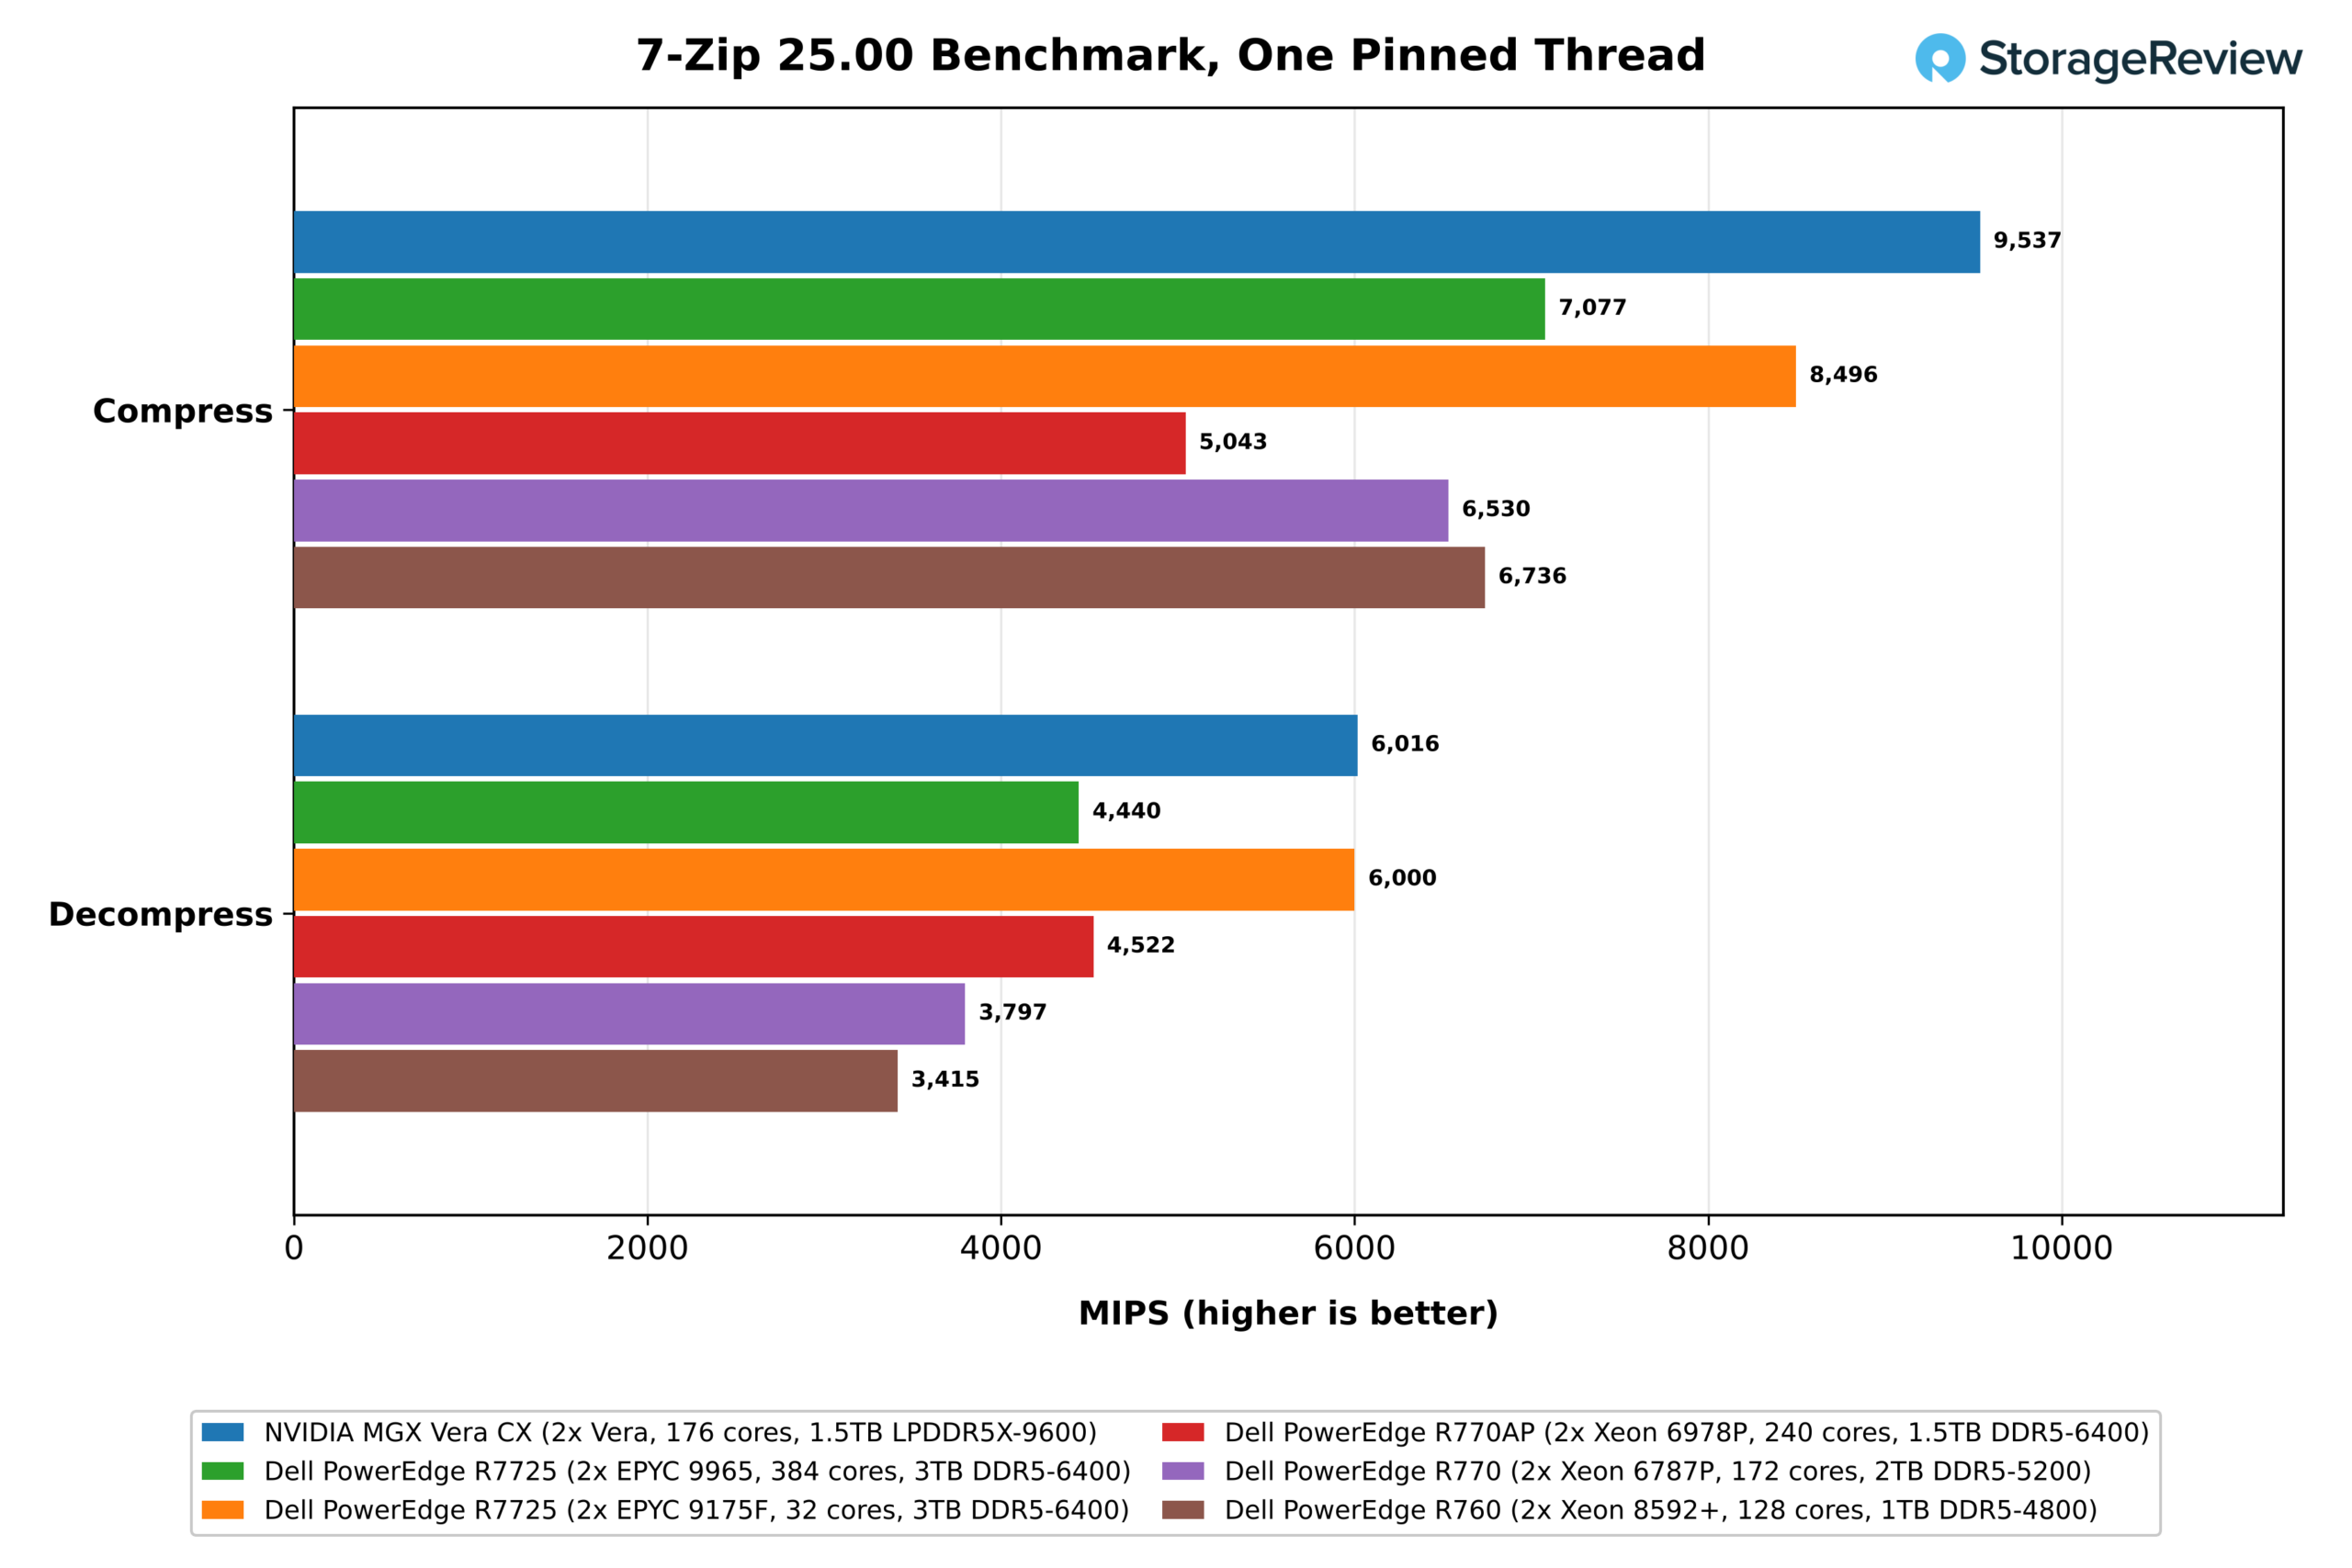
В однопоточном режиме Olympus показал самую высокую скорость сжатия в нашем наборе. Он достиг 9,537 MIPS, что на 12% опережает 5.0 ГГц EPYC 9175F, самое быстрое ядро x86 в нашем исследовании, и значительно превосходит EPYC 9965 и все процессоры Xeon. В режиме декомпрессии результаты были практически одинаковыми: 6,016 MIPS у Vera и 6,000 у 9175F, при этом ни одна другая система не показала результаты, отличающиеся менее чем на 20%.
Проанализировав каждую ветку обсуждения, можно увидеть, сколько этого свинца сохраняется, когда вся система перегружена.
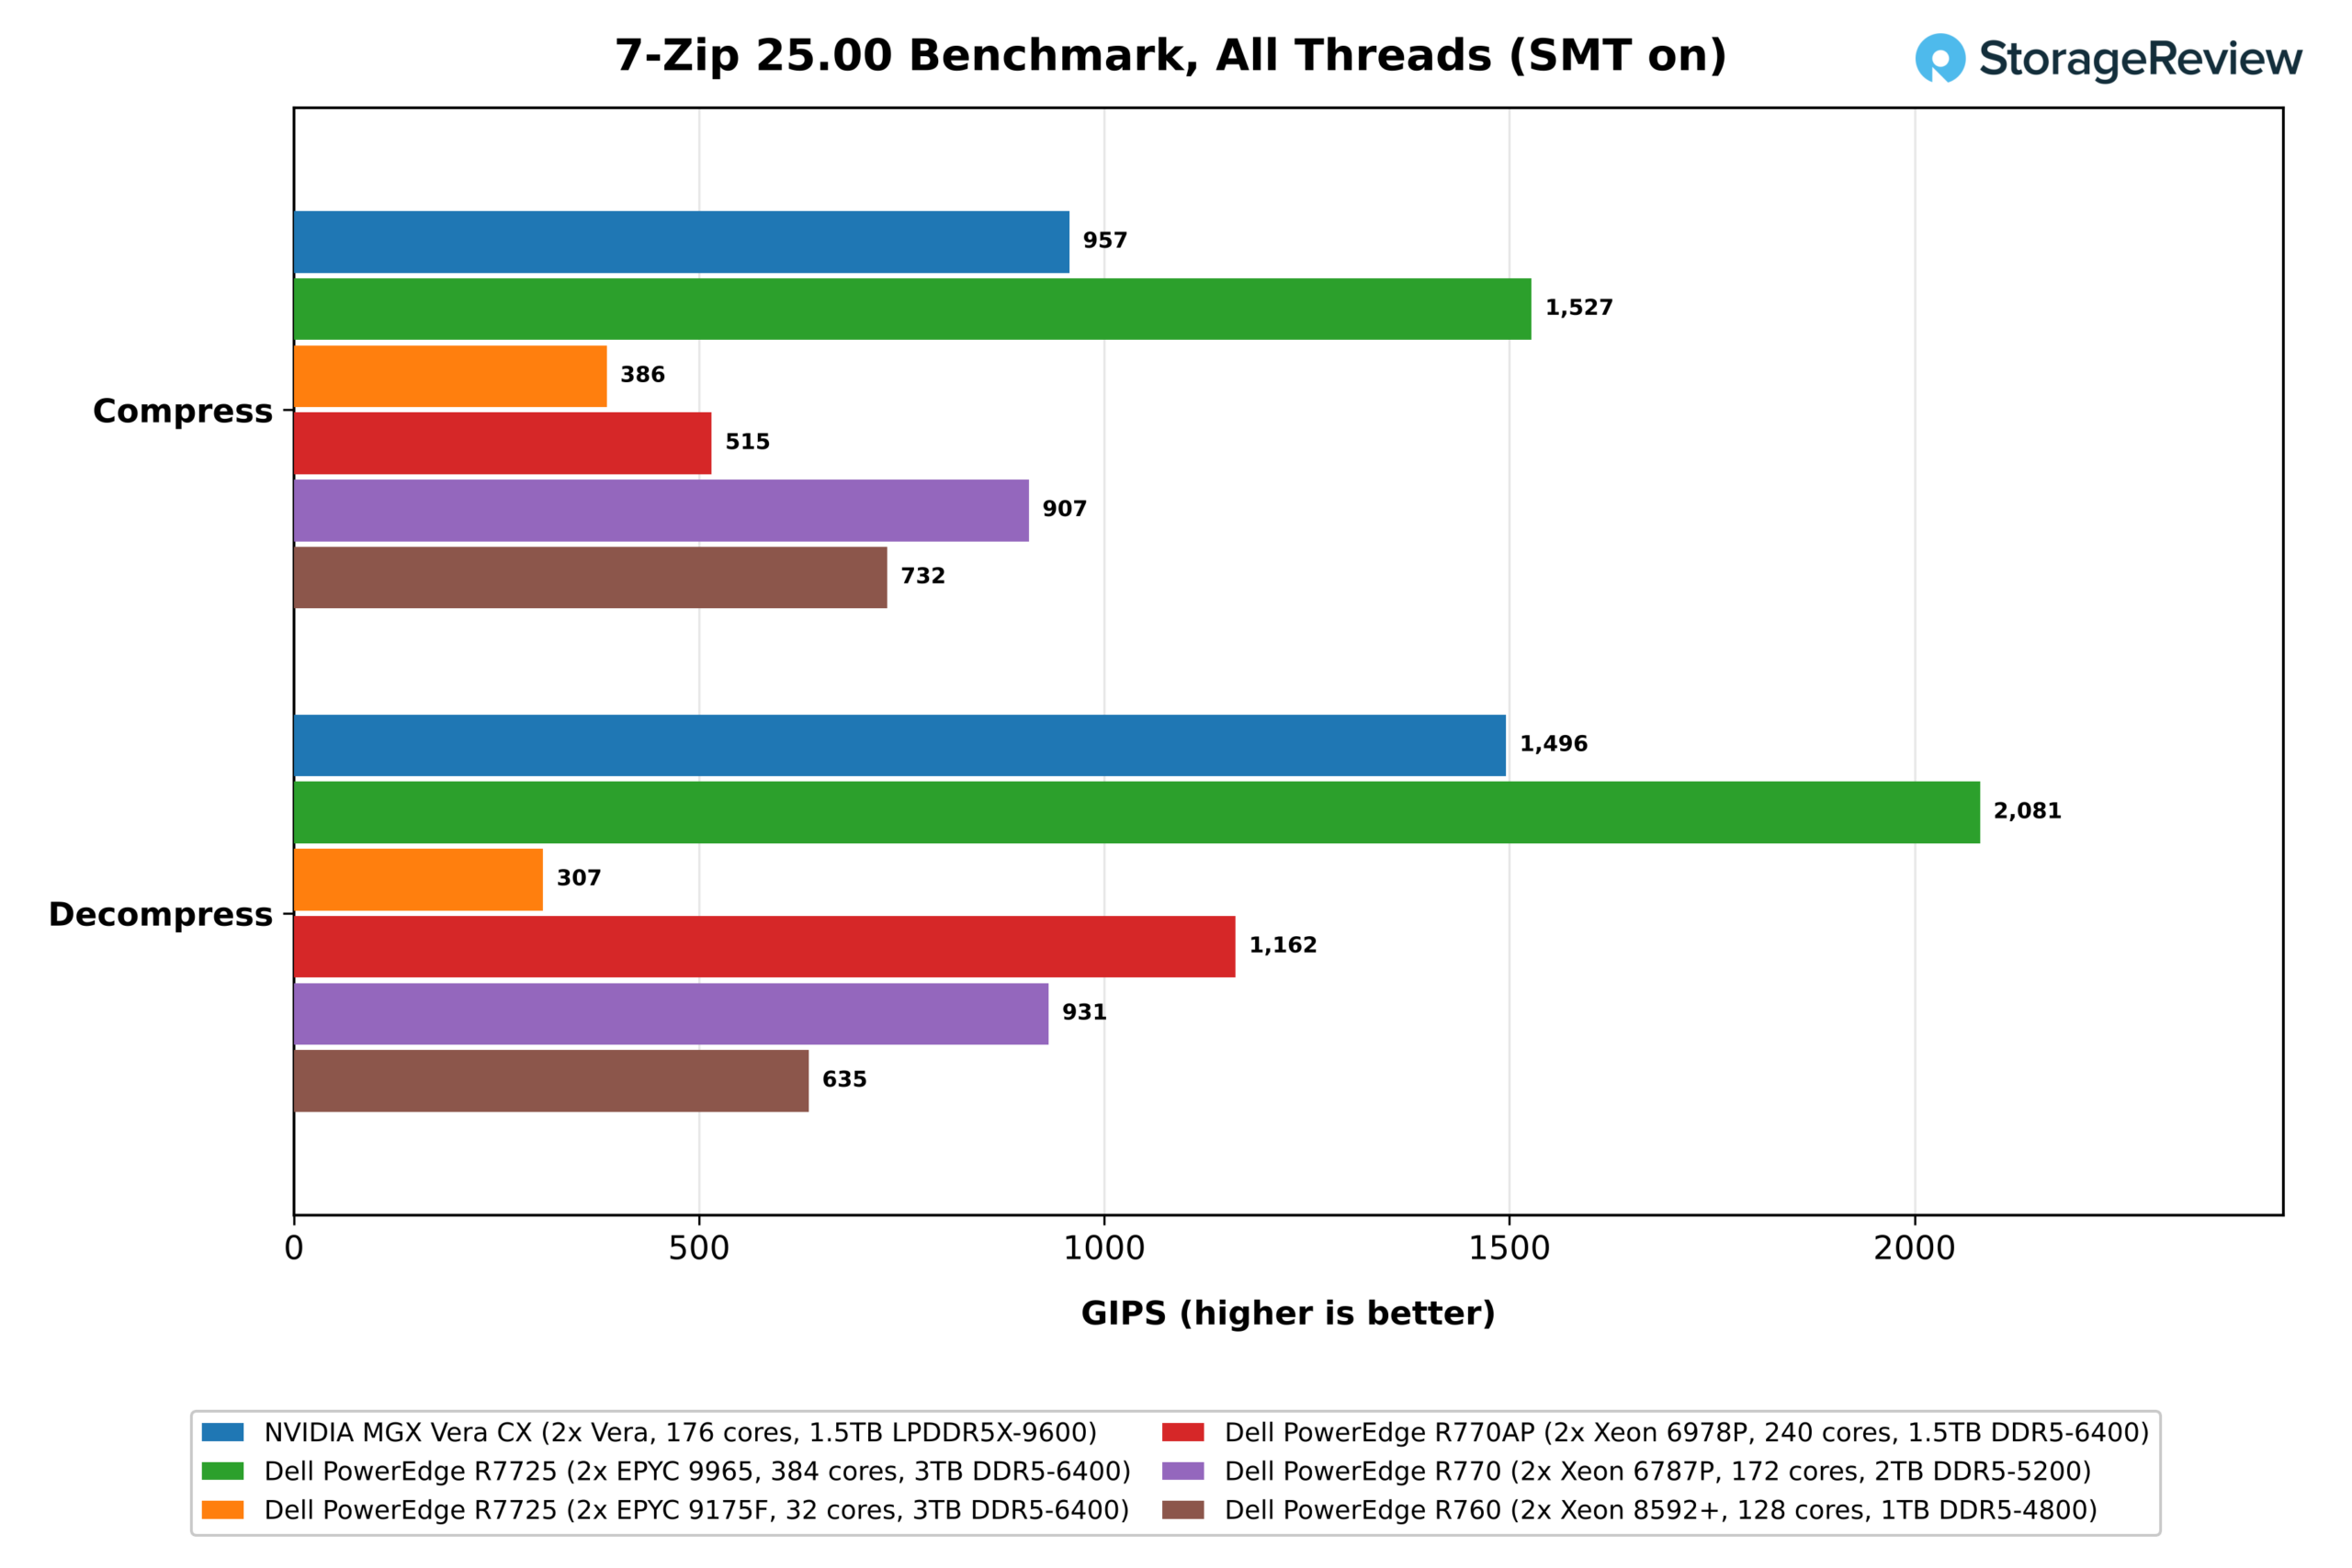
При одновременной загрузке всех потоков EPYC 9965 с его 768 потоками занял первое место, показав 1,527 GIPS при сжатии и 2,081 GIPS при распаковке. Vera с 352 потоками заняла второе место с 957 и 1,496 GIPS, опередив все процессоры Xeon, а 6787P показал ближайший результат — 907 и 931 GIPS. В расчете на одно физическое ядро Vera демонстрирует хорошие результаты. Ее 5.4 GIPS при сжатии на ядро соответствуют показателям 6787P и 8592+ и превосходят 4.0 GIPS у 9965, а 8.5 GIPS при распаковке на ядро на 57% выше, чем у 9965, и превосходят все процессоры Xeon. Только 32-ядерный 9175F, имеющий значительно меньшее количество ядер, использующих кэш и память каждого сокета, показал лучшие результаты на ядро в обоих случаях.
OpenSSL
Наибольшие недостатки Vera проявляет в тесте AES-256-GCM от OpenSSL. Только два из шести 128-битных каналов SVE2 процессора Olympus могут выполнять криптографические инструкции, в то время как процессоры x86 могут запускать AES на 512-битных регистрах с использованием VAES.
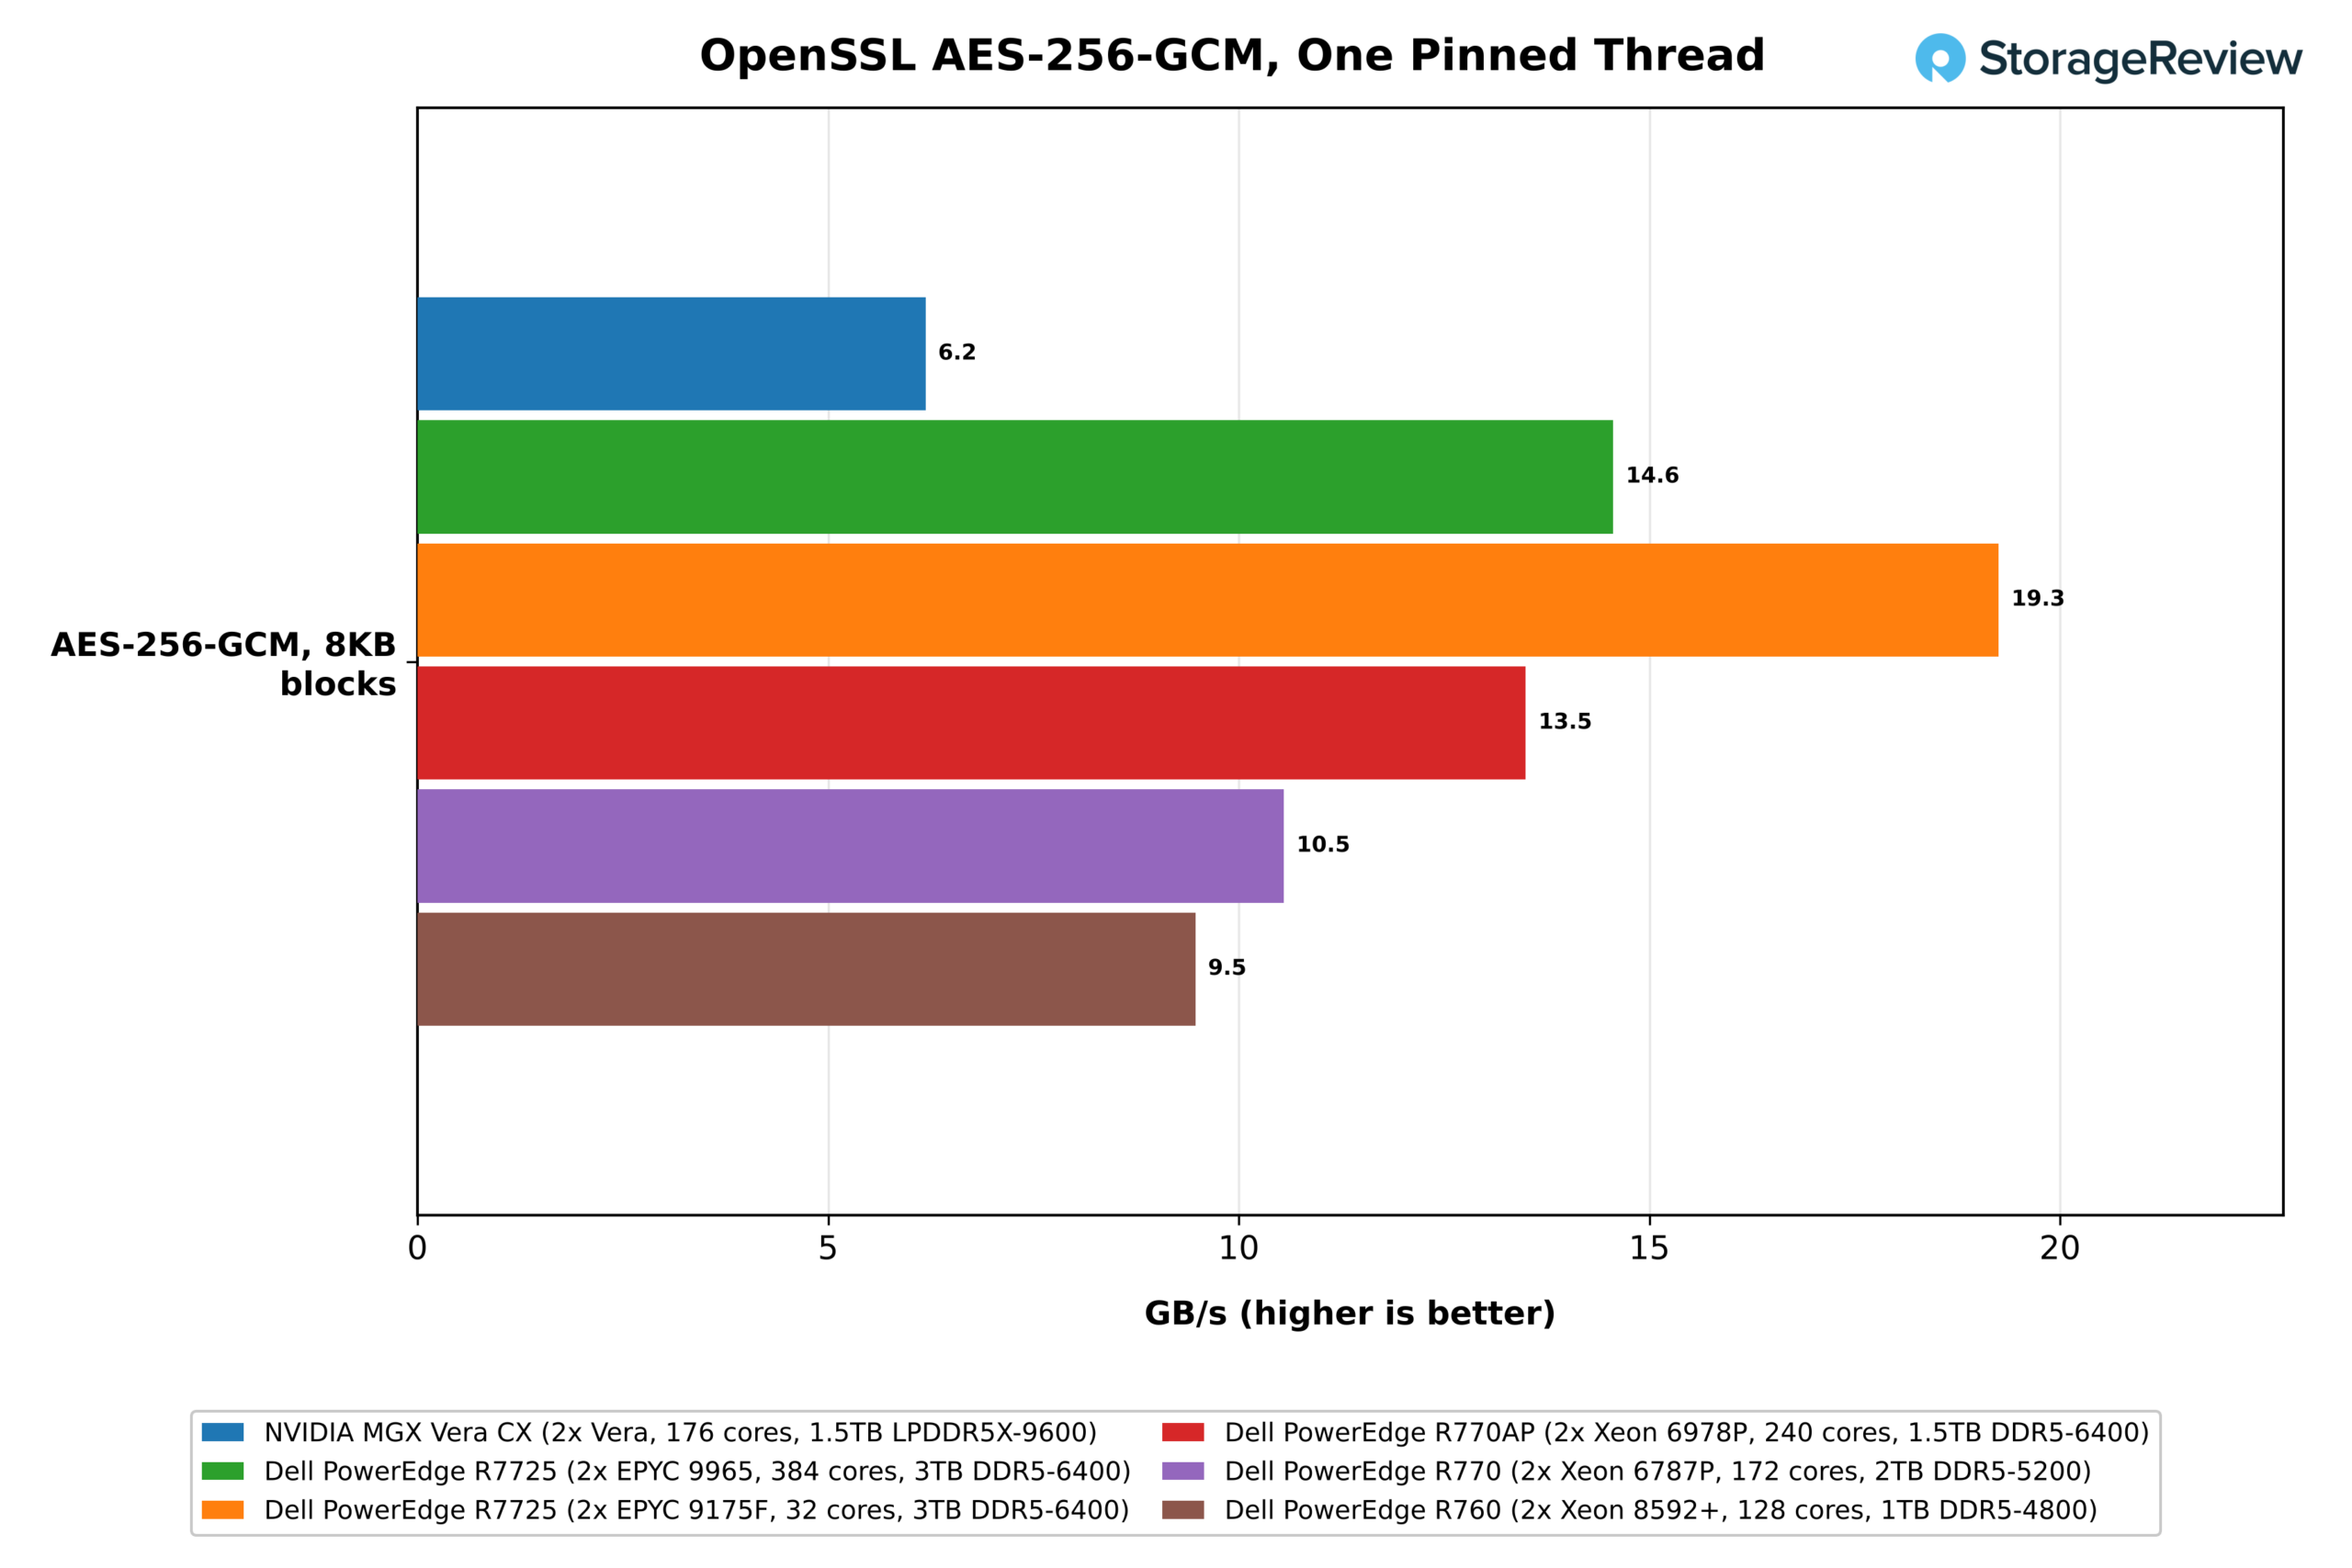
Разница наиболее очевидна при работе с одним потоком. Одно ядро Olympus обеспечивает скорость шифрования 6.2 ГБ/с, что составляет примерно треть от 19.3 ГБ/с у EPYC 9175F и значительно отстает от EPYC 9965 (14.6 ГБ/с) и Xeon 6978P (13.5 ГБ/с).
В каждом потоке системы x86 выравниваются по количеству ядер, что показывает, какое влияние этот дефицит на ядро оказывает на Vera.
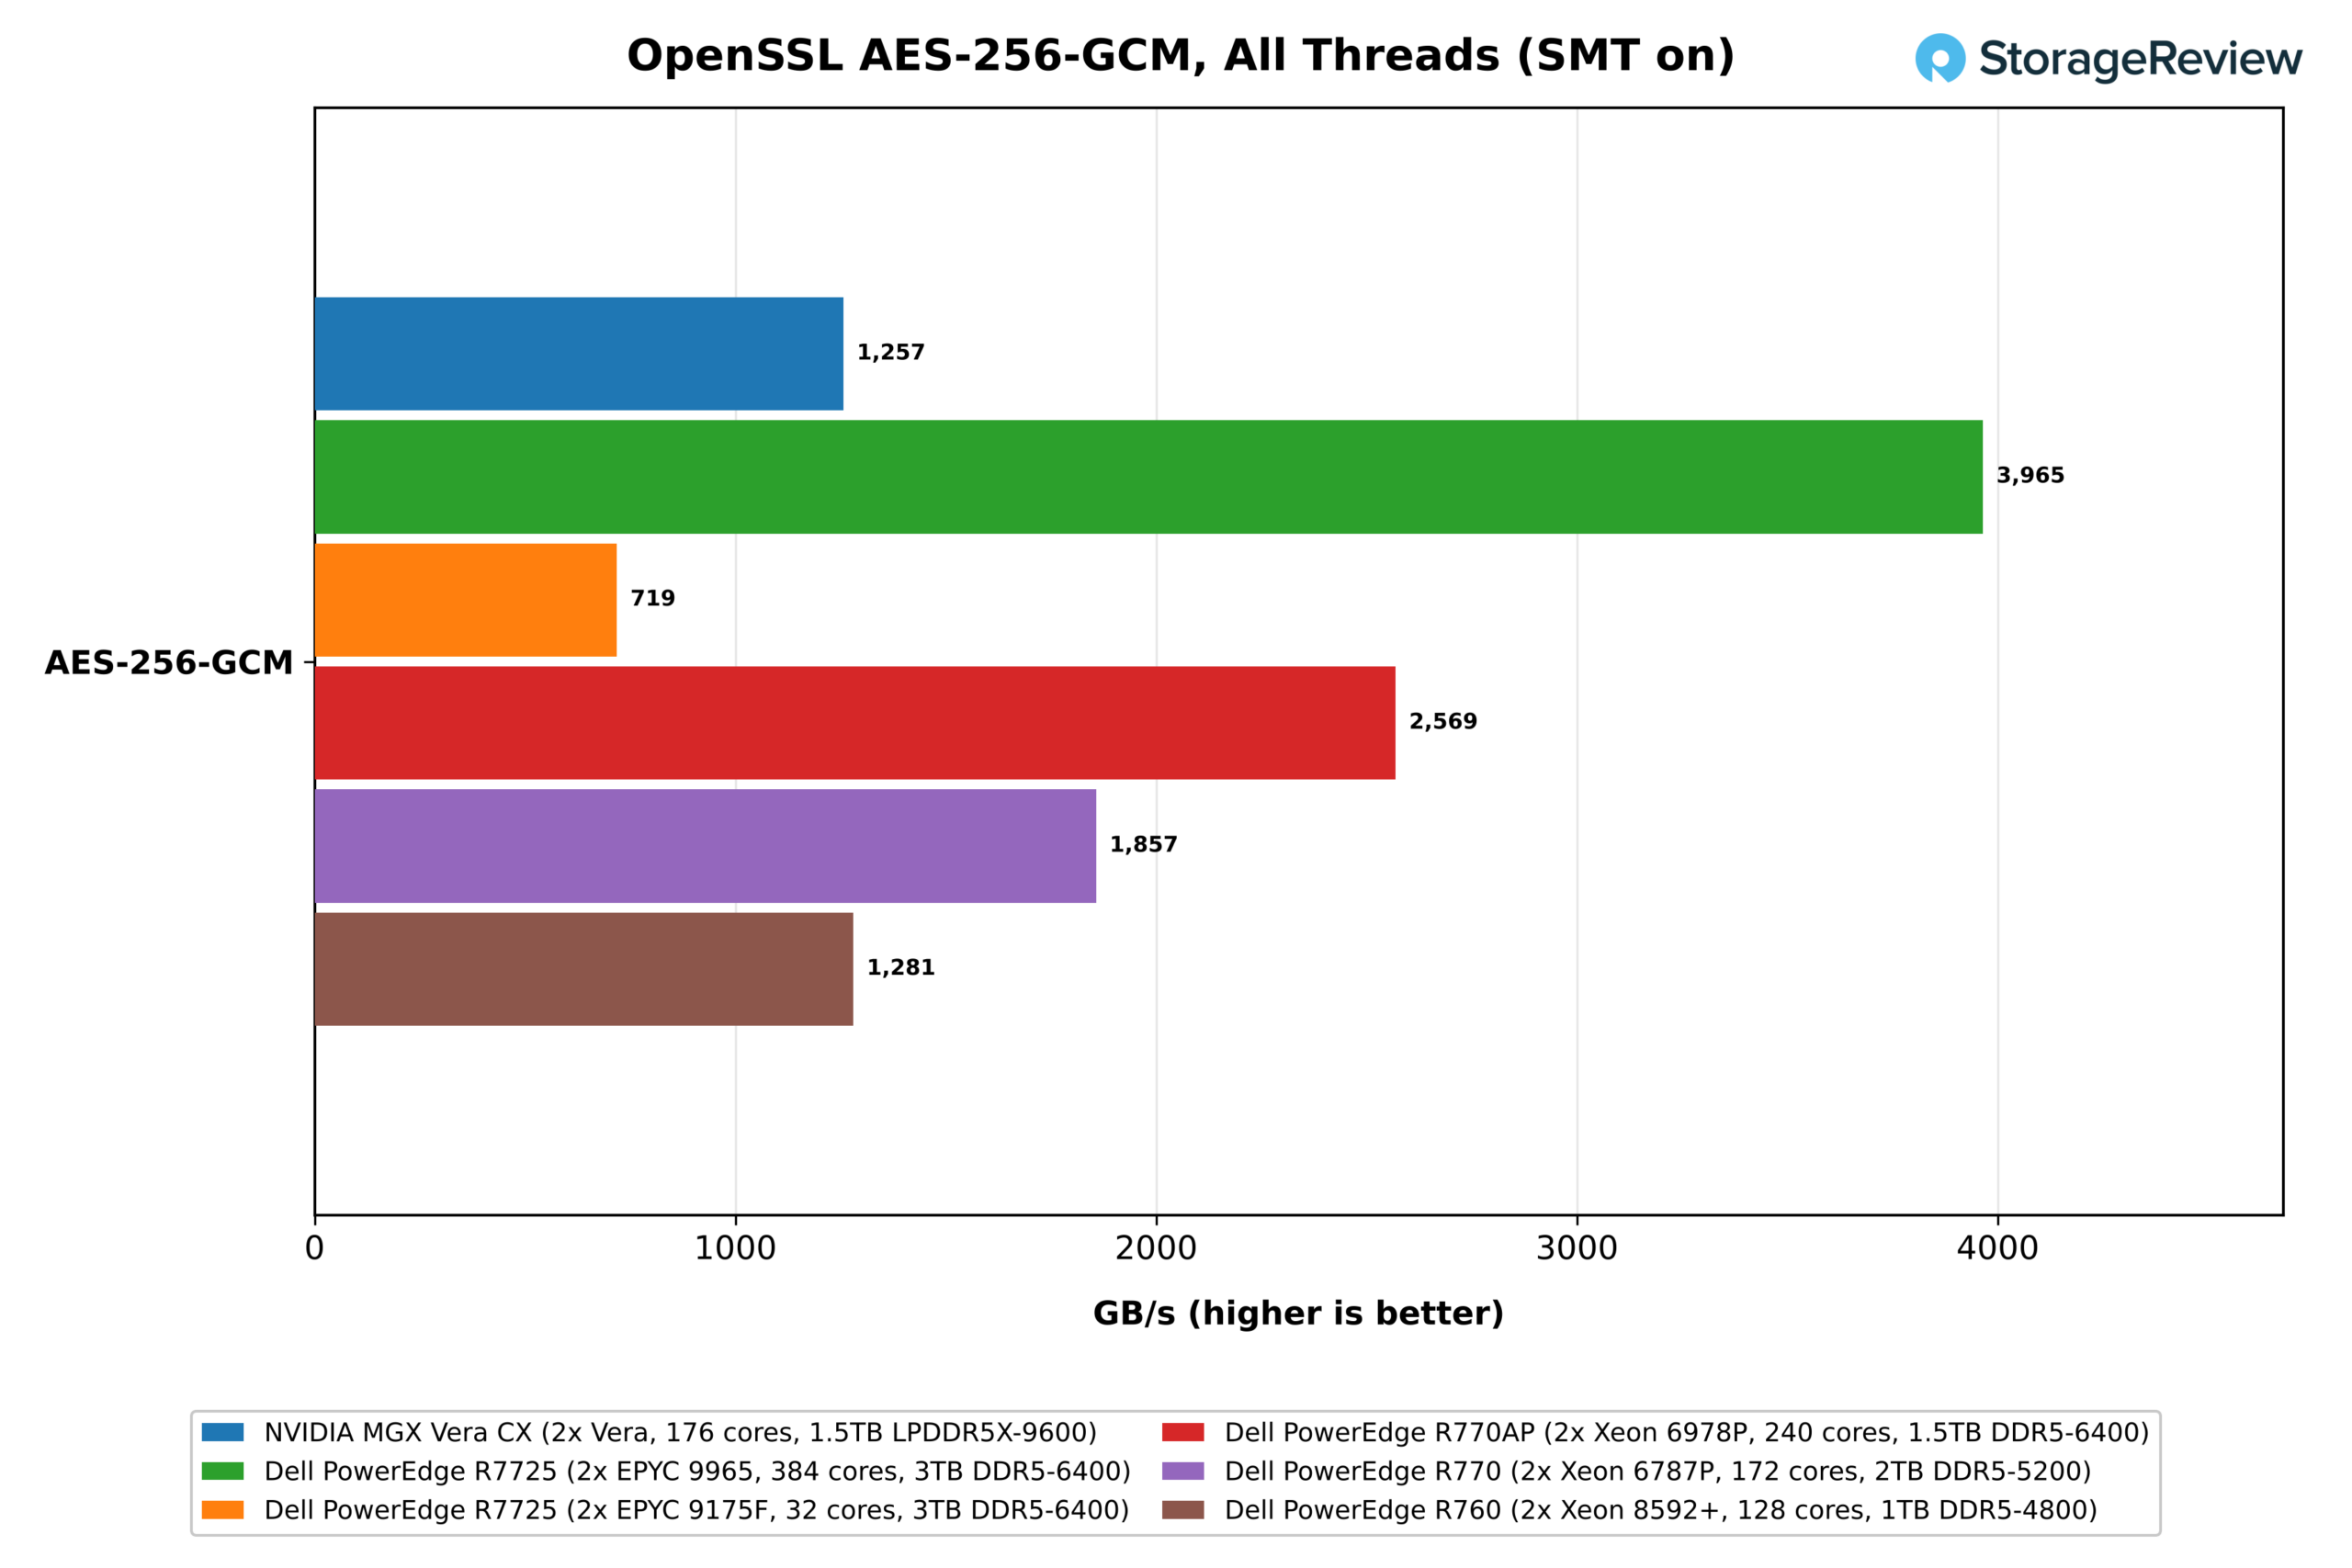
При одновременной загрузке всех 352 потоков Vera достигла скорости 1.26 ТБ/с, что соответствует показателю 128-ядерного Xeon 8592+ (1.28 ТБ/с) и опережает только 32-ядерный EPYC 9175F. EPYC 9965 показал лучший результат — 3.96 ТБ/с, примерно в три раза превзойдя результат Vera, за ним следуют Xeon 6978P с 2.57 ТБ/с и 6787P с 1.86 ТБ/с.
Питон
Python играет центральную роль в тестах агентских песочниц, которые NVIDIA разрабатывает для Vera, и pyperformance предоставляет нам три закрепленных однопоточных теста: go, поиск по игровому дереву с большим количеством объектов; regex_compile, компилирующий регулярные выражения; и nbody, моделирование физических процессов с плавающей запятой. Здесь есть одно различие в программном обеспечении: Vera работала на Python 3.14.4 из Ubuntu 26.04, в то время как системы x86 работали на 3.12.3 из Ubuntu 24.04, и более новая версия обеспечивает ускорение интерпретатора.
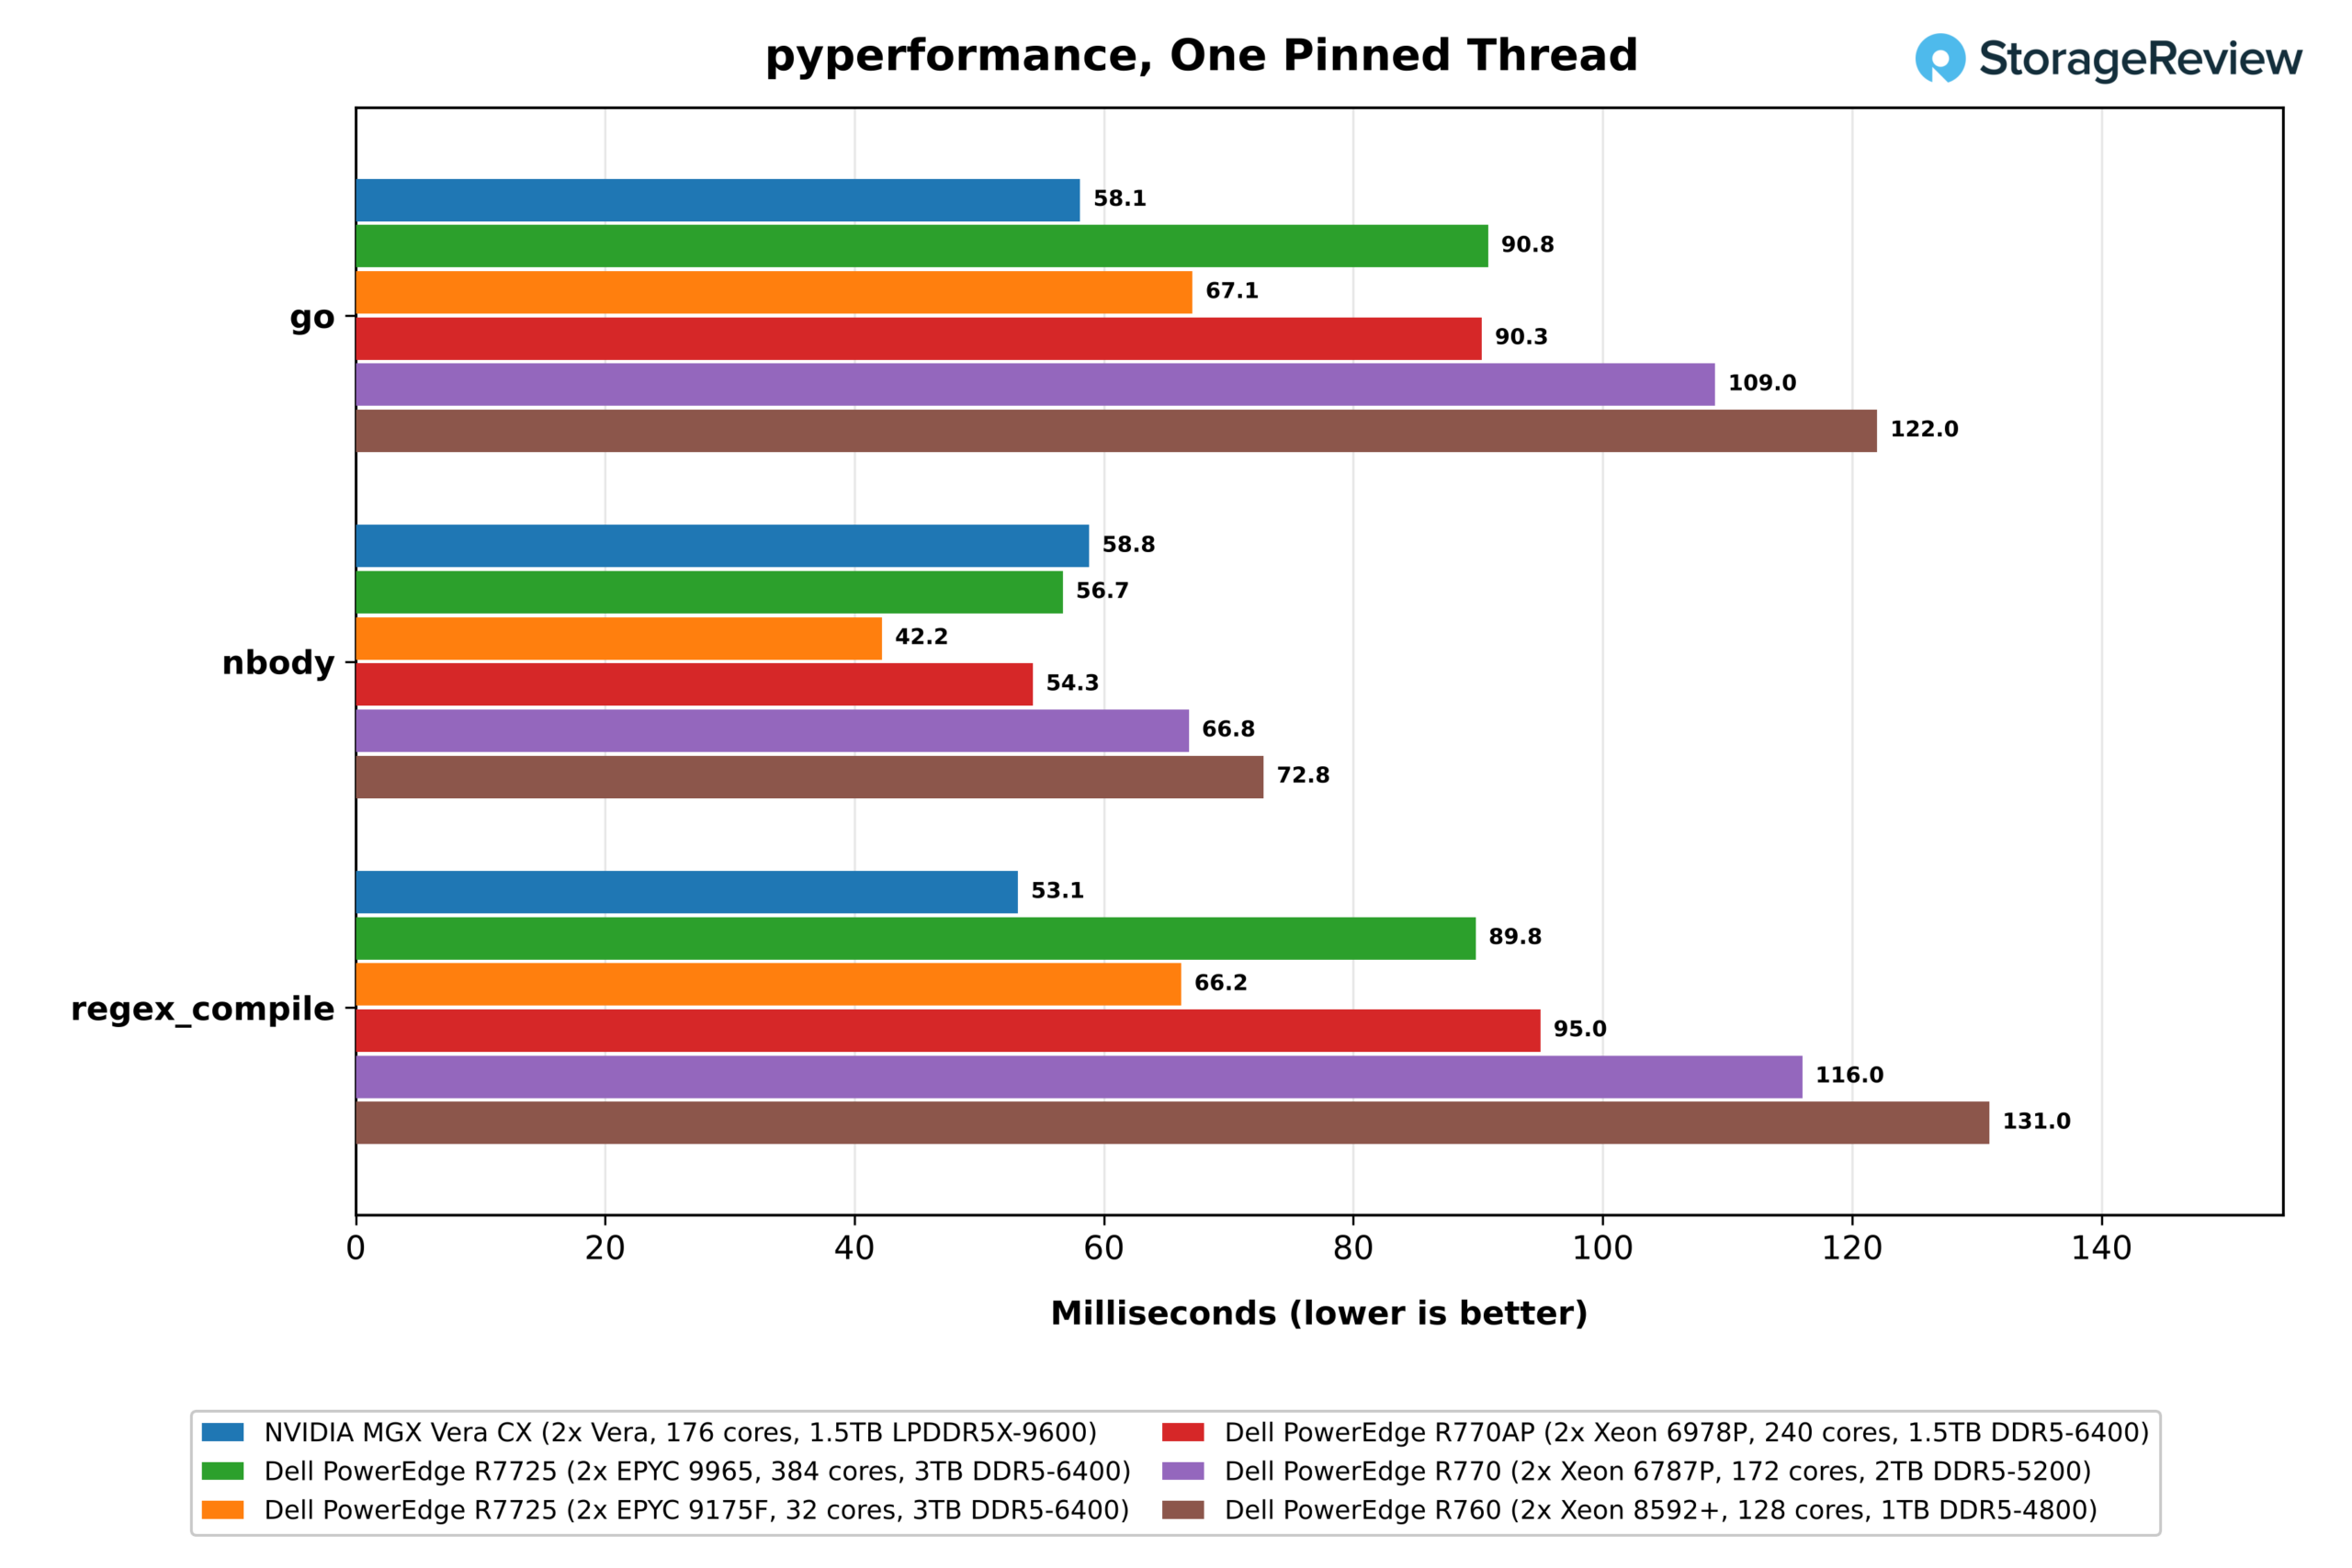
Vera выиграла два теста, построенных на основе разветвленного, объектно-ориентированного кода. Go завершился за 58.1 мс, что на 15% быстрее, чем EPYC 9175F, самое быстрое ядро x86 в этом тесте, и в 1.6–2.1 раза быстрее, чем остальные. regex_compile показал еще больший отрыв, завершившись за 53.1 мс, на 25% быстрее, чем 9175F, и в 1.7 раза быстрее, чем EPYC 9965. Поскольку Vera также использовала более новую версию Python, оба показателя следует рассматривать как верхние границы.
Процессор nbody показал противоположный результат, поскольку его короткий цикл вычислений с плавающей запятой и небольшой рабочий набор данных, как правило, благоприятствуют высоким тактовым частотам, и 5.0-гигагерцовый 9175F победил с результатом 42.2 мс, что на 39% быстрее, чем 58.8 мс у Vera. Xeon 6978P и EPYC 9965 также опередили Vera, показав время 54.3 мс и 56.7 мс соответственно, даже с более новым Python от Vera.
Задержка веб-сервера, JVM и планировщика задач.
Последняя группа тестов охватывает программное обеспечение, окружающее приложение: веб-стек, виртуальную машину Java, планировщик задач Linux и набор инструментов компилятора. Эти результаты зависят как от количества потоков, выполняемых каждой системой, так и от скорости каждого ядра, поэтому они говорят меньше о самой компании Olympus, чем предыдущие разделы, но они показывают, как сервер Vera ведет себя под управлением обычного серверного программного обеспечения.
NGINX
NGINX обрабатывает HTTPS-запросы к генератору рабочей нагрузки, работающему на той же машине, поэтому клиент и сервер конкурируют за одни и те же ядра, и результат отражает скорее работу стека TLS и HTTP, чем простое количество ядер.
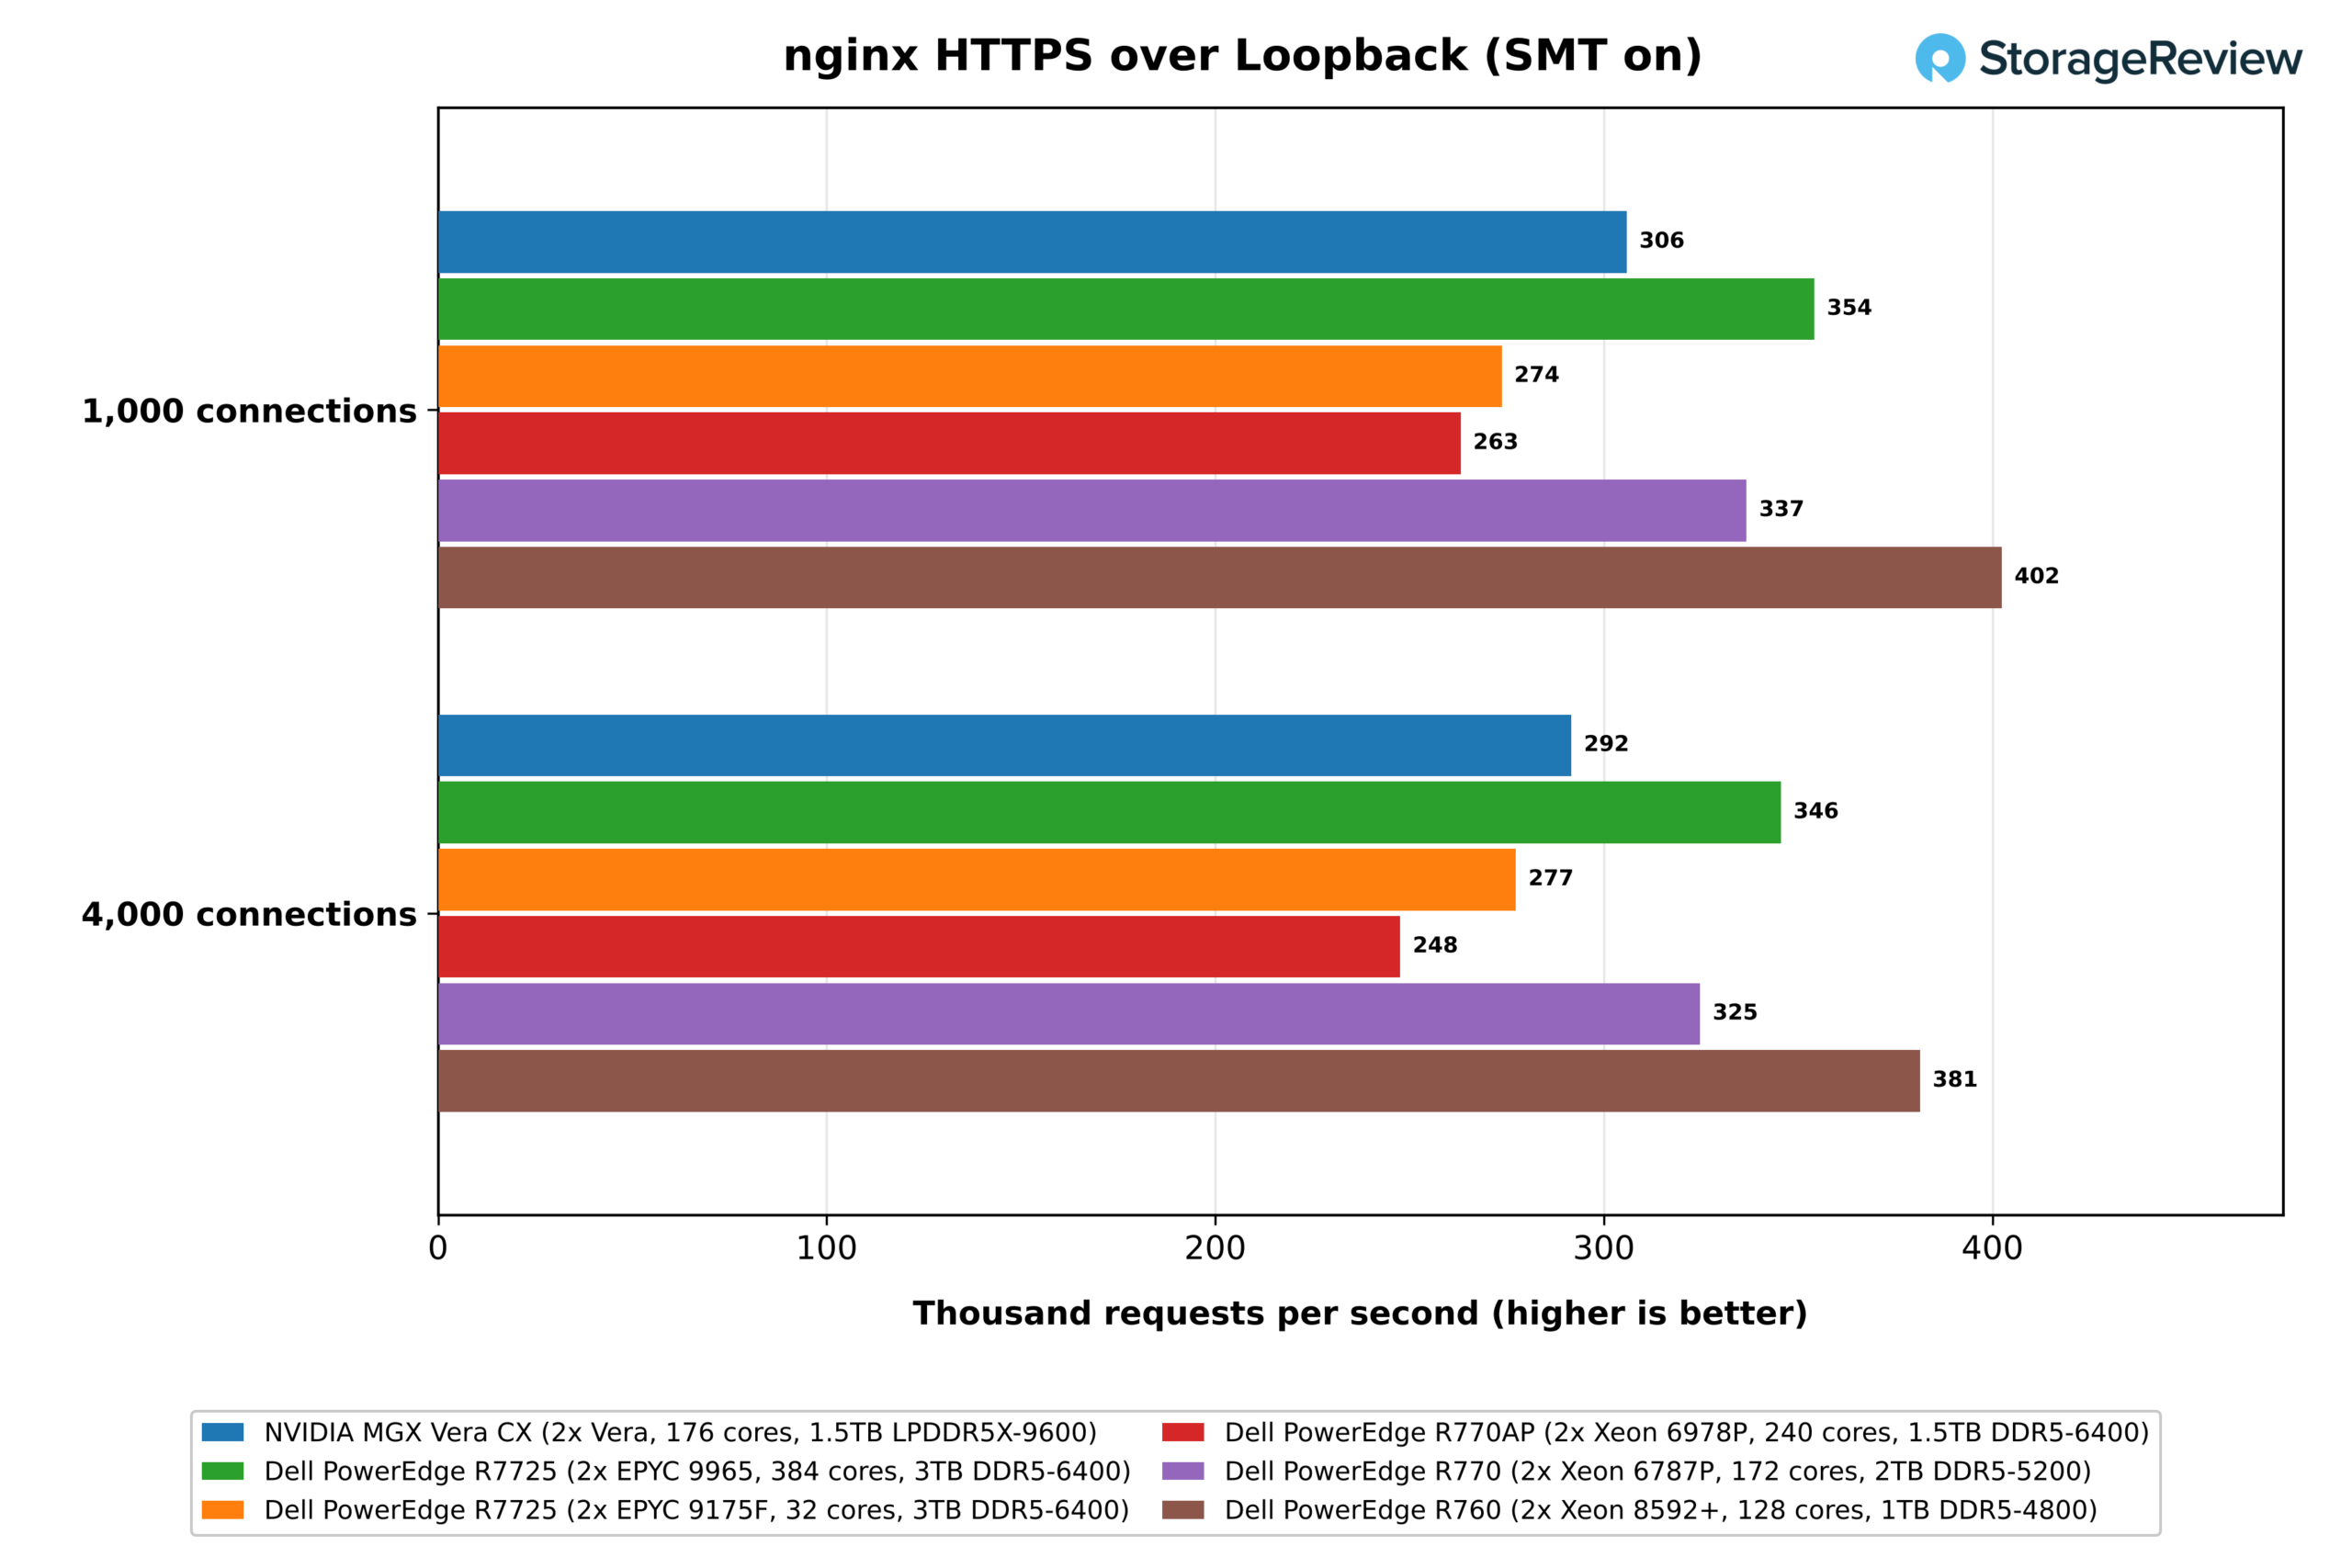
При включенной технологии SMT Vera обрабатывала 306 000 запросов в секунду при 1,000 соединениях и 292 000 при 4,000, что находится в середине диапазона, варьирующегося от 263 000 на Xeon 6978P до 402 000 на Xeon 8592+. EPYC 9965 достиг 354 000, а Xeon 6787P — 337 000, и отключение SMT увеличило производительность Vera до 330 000. Сетевой стек Vera вполне сопоставим с системами x86.
Ренессанс
Renaissance запускает Java-нагрузки на OpenJDK 11. Тест Finagle HTTP проверяет сетевой стек Scala, а тест Akka — фреймворк для параллельного выполнения с использованием модели акторов. Оба теста распределяют работу между всеми логическими процессорами, доступными JVM, поэтому мы запускали их как с включенным, так и с выключенным SMT.
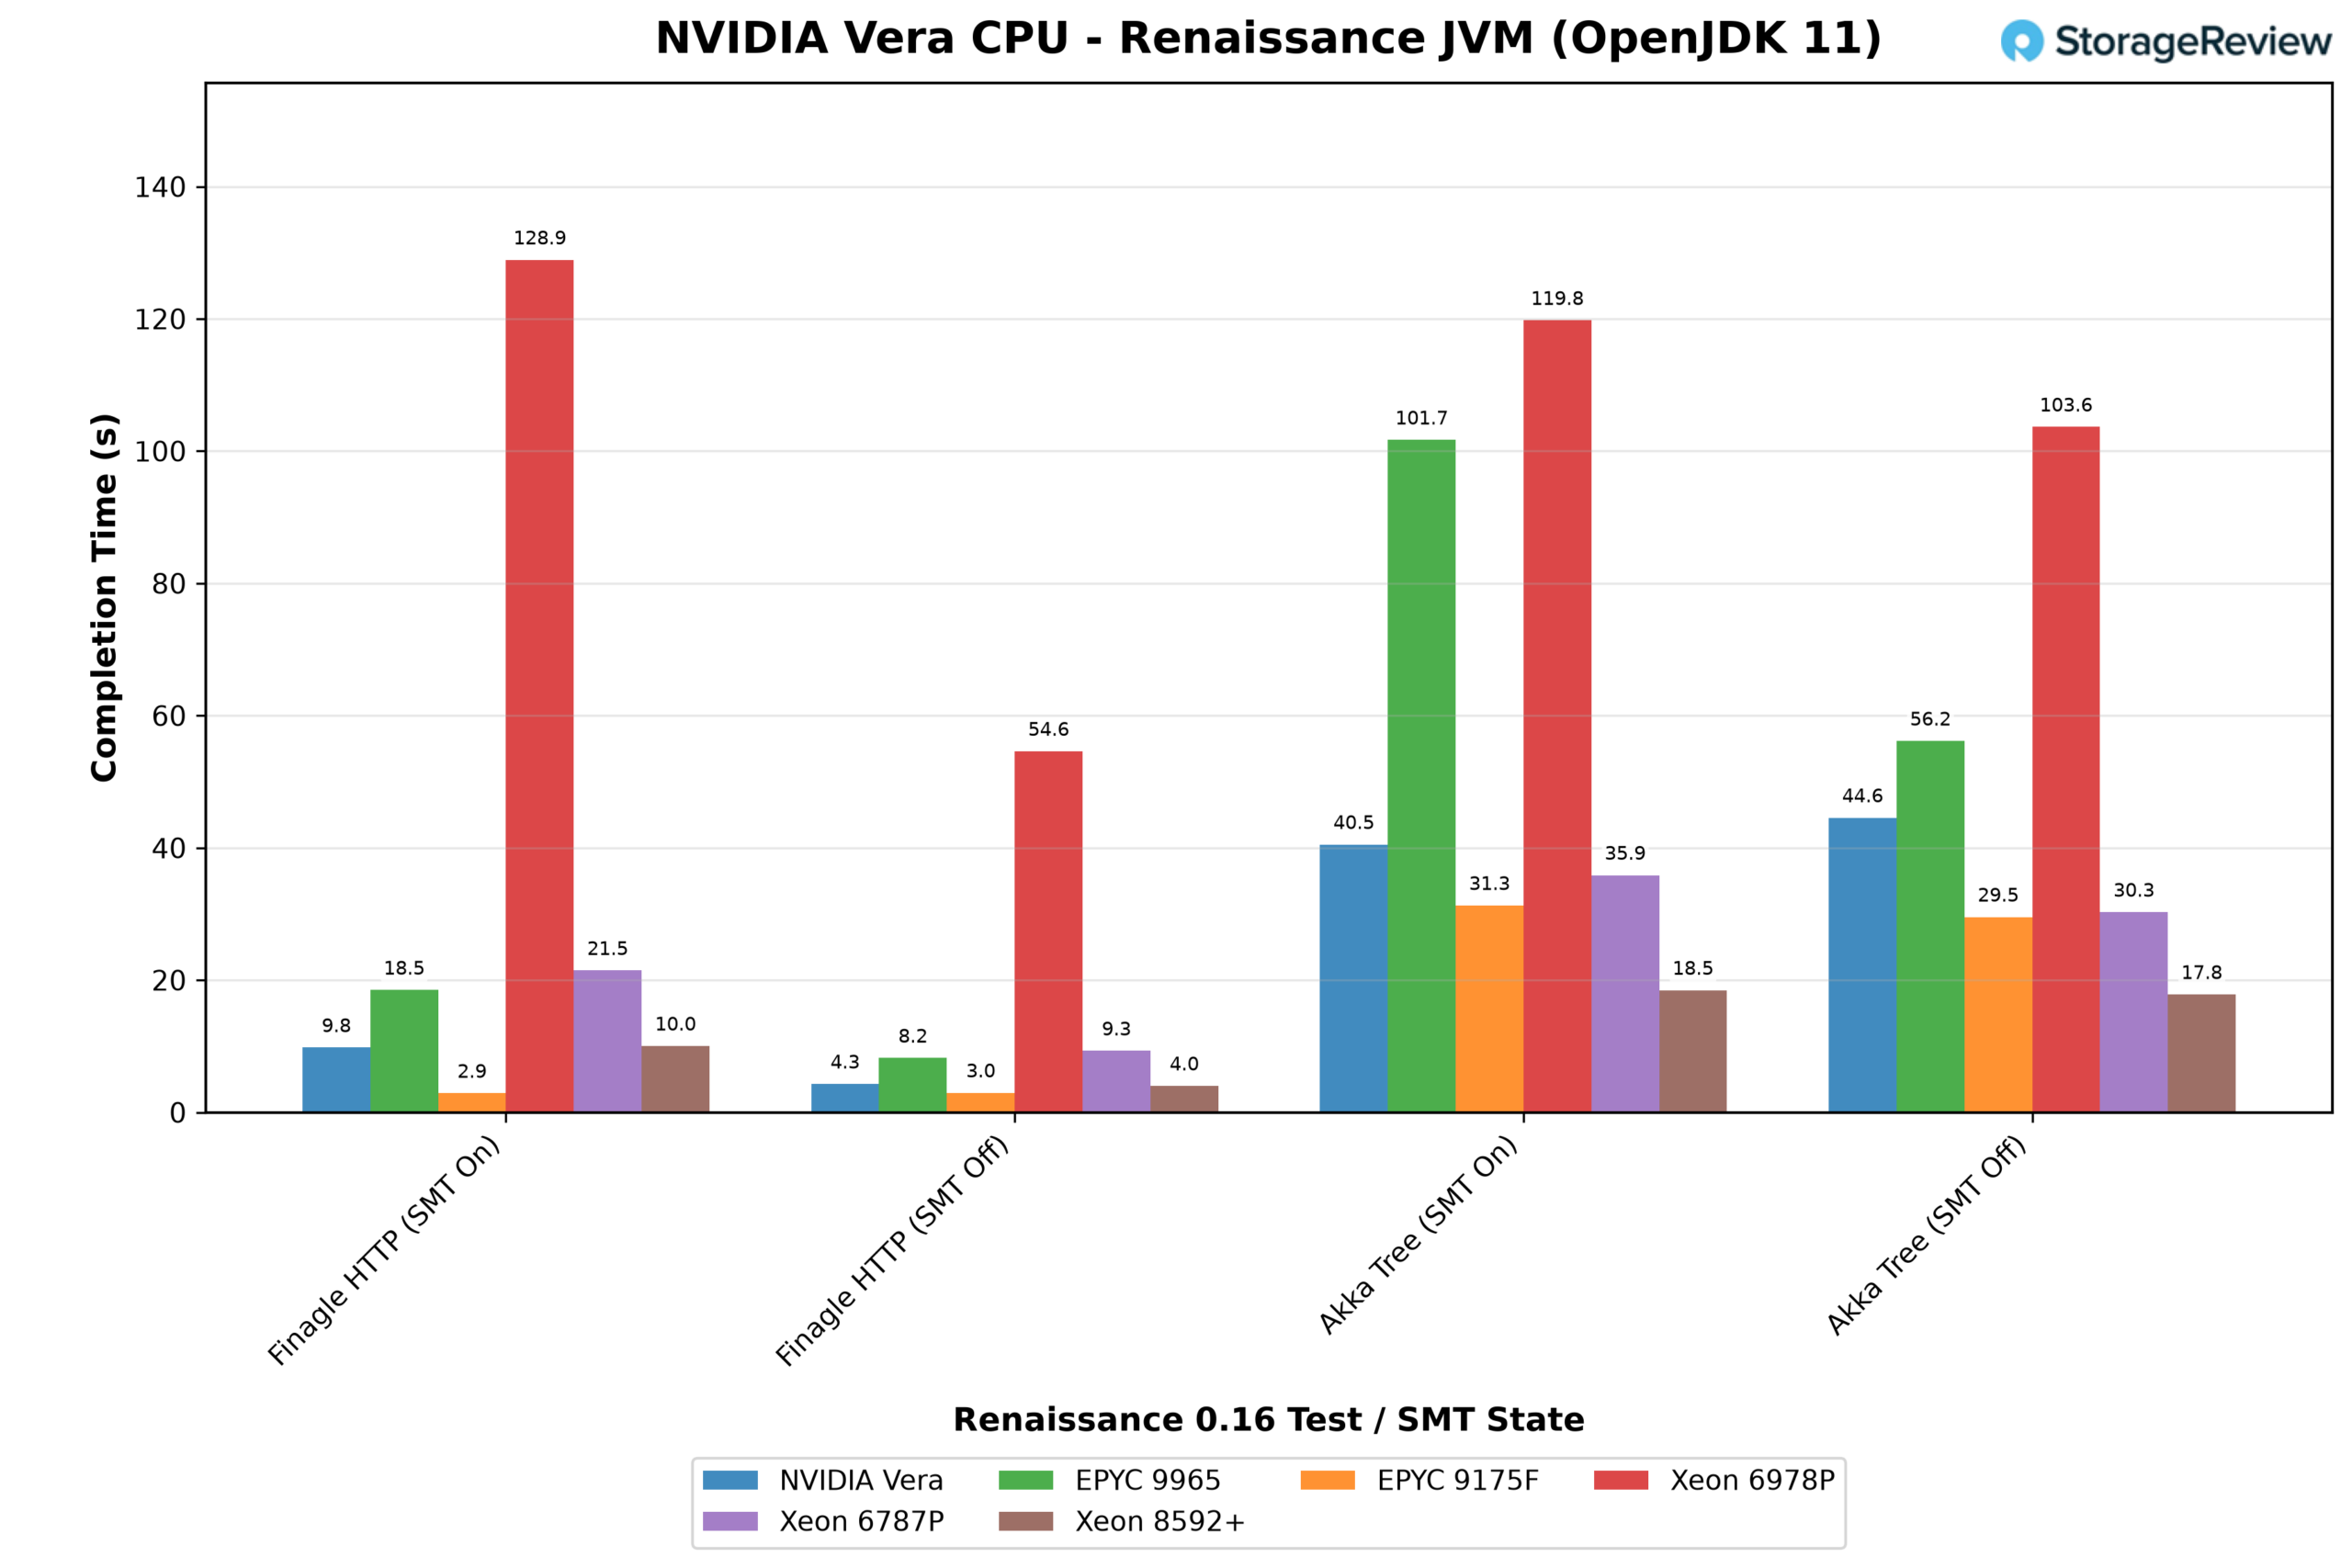
Finagle работает быстрее с меньшим количеством потоков. Отключение SMT, которое уменьшает количество потоков вдвое, сократило время выполнения Vera с 9.8 до 4.3 секунд, а более крупные системы x86 улучшили свои показатели примерно в 2.3–2.5 раза. 32-ядерный EPYC 9175F, изначально имеющий небольшое количество потоков, показал лучший результат, отстав примерно на 3 секунды.
Akka отдала предпочтение Xeon 8592+, который справился с задачей примерно за 18 секунд с включенной или выключенной SMT, в то время как Vera потребовалось 40.5 секунд с включенной SMT, а две самые мощные системы, EPYC 9965 и Xeon 6978P, оказались самыми медленными — 101.7 и 119.8 секунд соответственно. Третий тест Renaissance, генетический алгоритм, завершился за 1.6–2.6 секунды с включенной SMT на всех системах, кроме 6978P, у Vera — за 2.6 секунды.
шбенч
schbench измеряет скорость пробуждения рабочих потоков планировщиком Linux, запуская примерно один рабочий поток на каждый логический процессор с 4 потоками обработки сообщений и около восьми на каждый процессор с 32 потоками. Поскольку количество рабочих потоков увеличивается с ростом системы, более крупные серверы выполняют больший объем работы, поэтому эти результаты описывают задержку при полной нагрузке на каждой машине и не являются прямым сравнением.
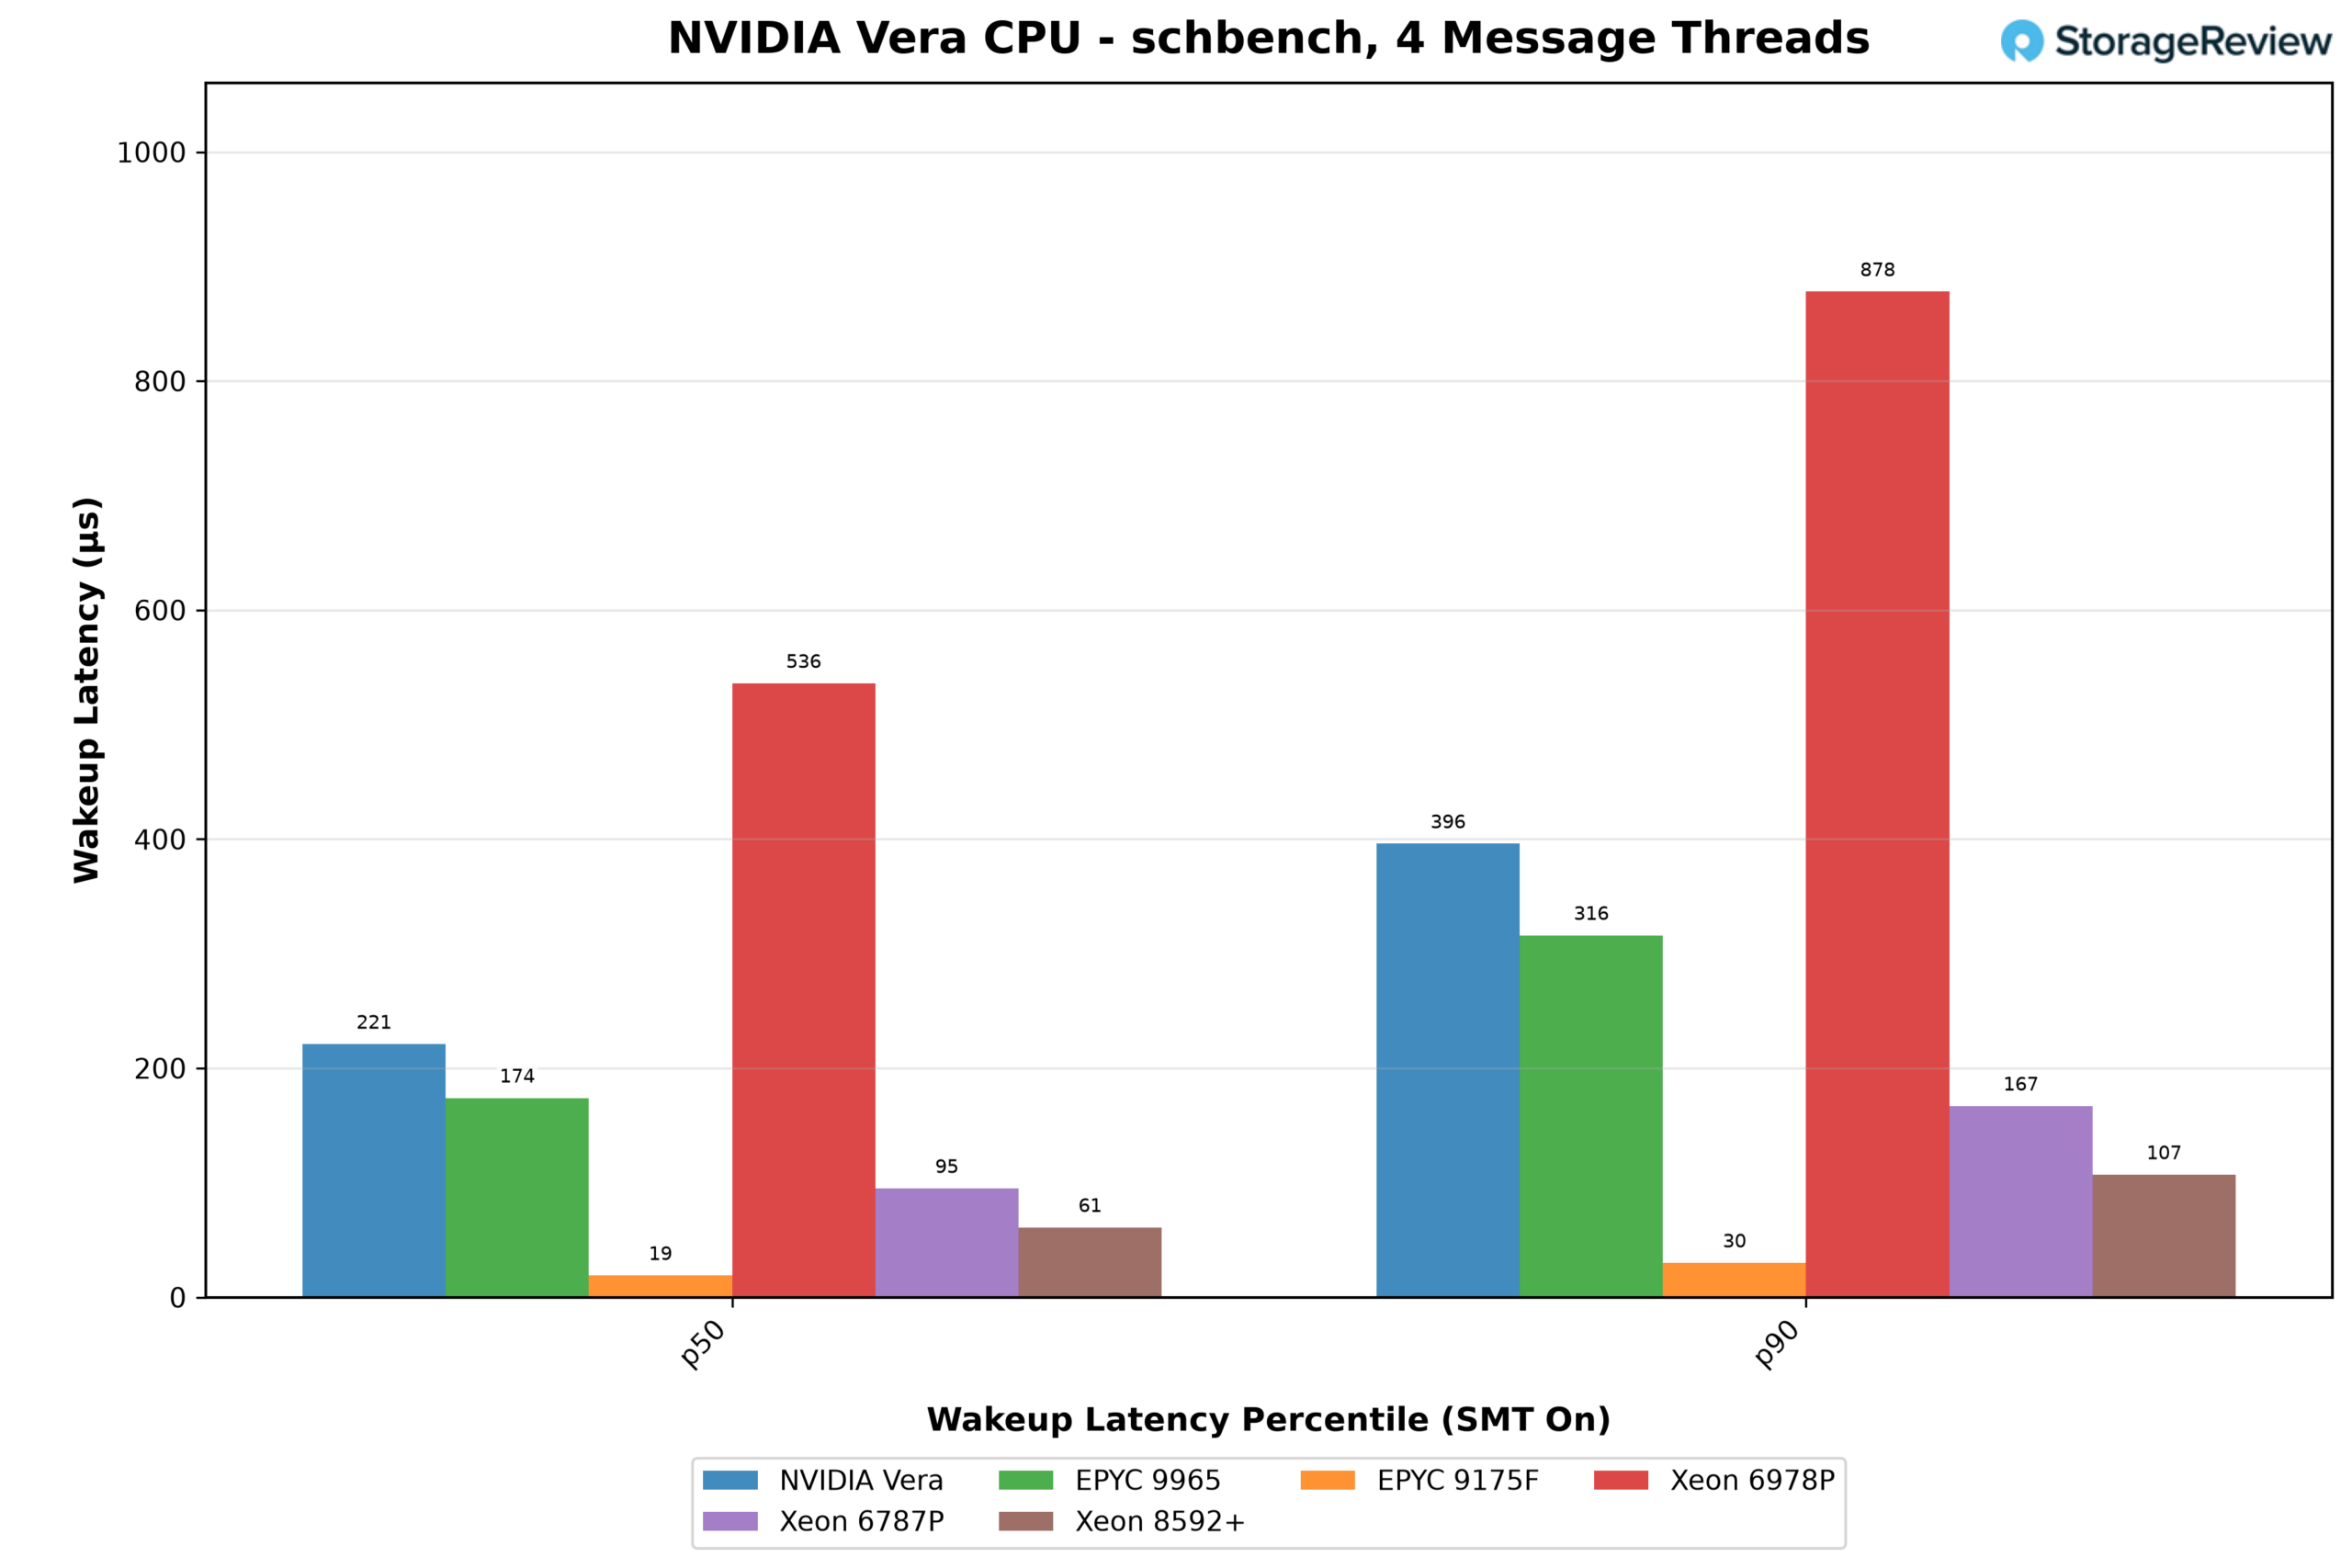
При использовании 4 потоков обработки сообщений медианная задержка пробуждения Vera составила 221 мкс, а p90 — 396 мкс, что выше, чем у всех систем, за исключением Xeon 6978P, у которого эти показатели составляли 536 мкс и 878 мкс соответственно. Самые компактные машины быстрее всего пробуждали свои потоки: 32-ядерный EPYC 9175F — за 19 мкс, а 128-ядерный Xeon 8592+ — за 61 мкс.
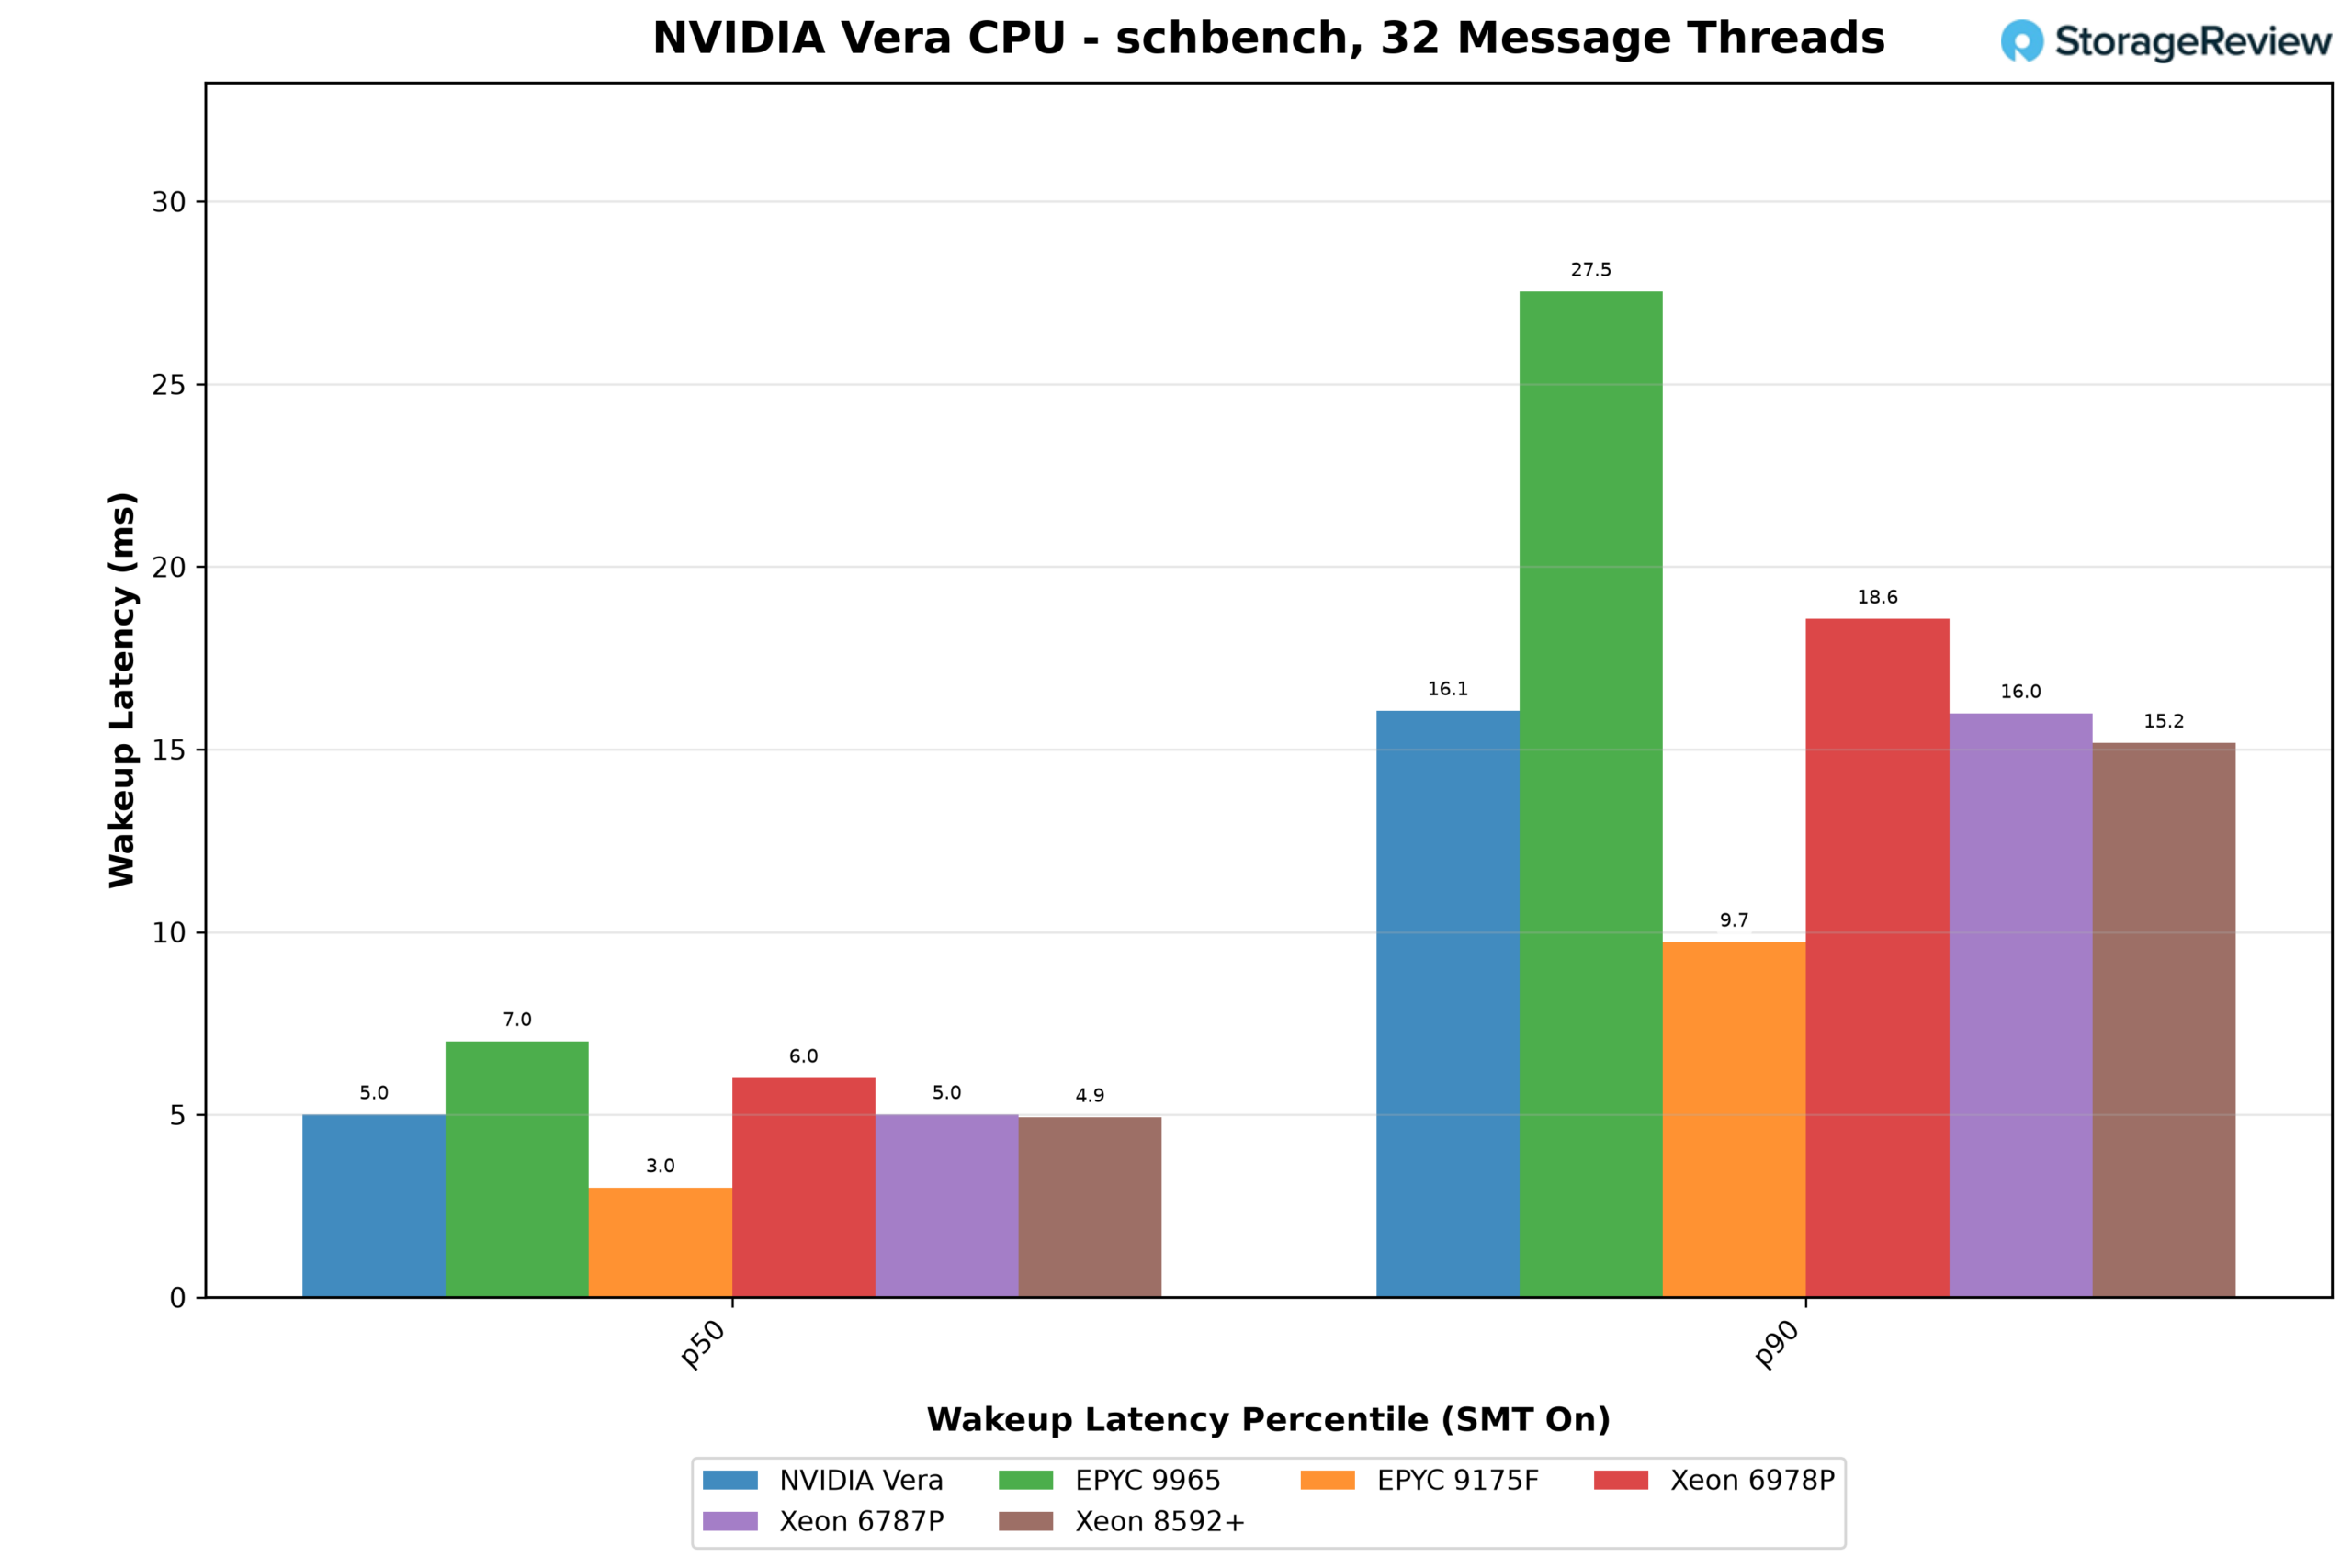
Благодаря большому количеству запросов (32 потока), Vera переместилась в середину списка. Ее медианное значение 5.0 мс и время отклика p90 16.1 мс сравнялись с показателями Xeon 6787P и 8592+ и превзошли показатели Xeon 6978P и EPYC 9965, которые достигли 27.5 мс при p90. Только 9175F был явно быстрее, показав время 3.0 мс и 9.7 мс соответственно.
Сборка ядра Linux
Единственный результат в этом разделе, который мы не оцениваем, — это сборка ядра Linux с использованием команды allmodconfig. Vera компилирует дерево ядра arm64, которое включает в себя другой набор модулей и драйверов по сравнению с деревом x86-64, компилируемым в других системах, и мы не пытались выполнить кросс-компиляцию.
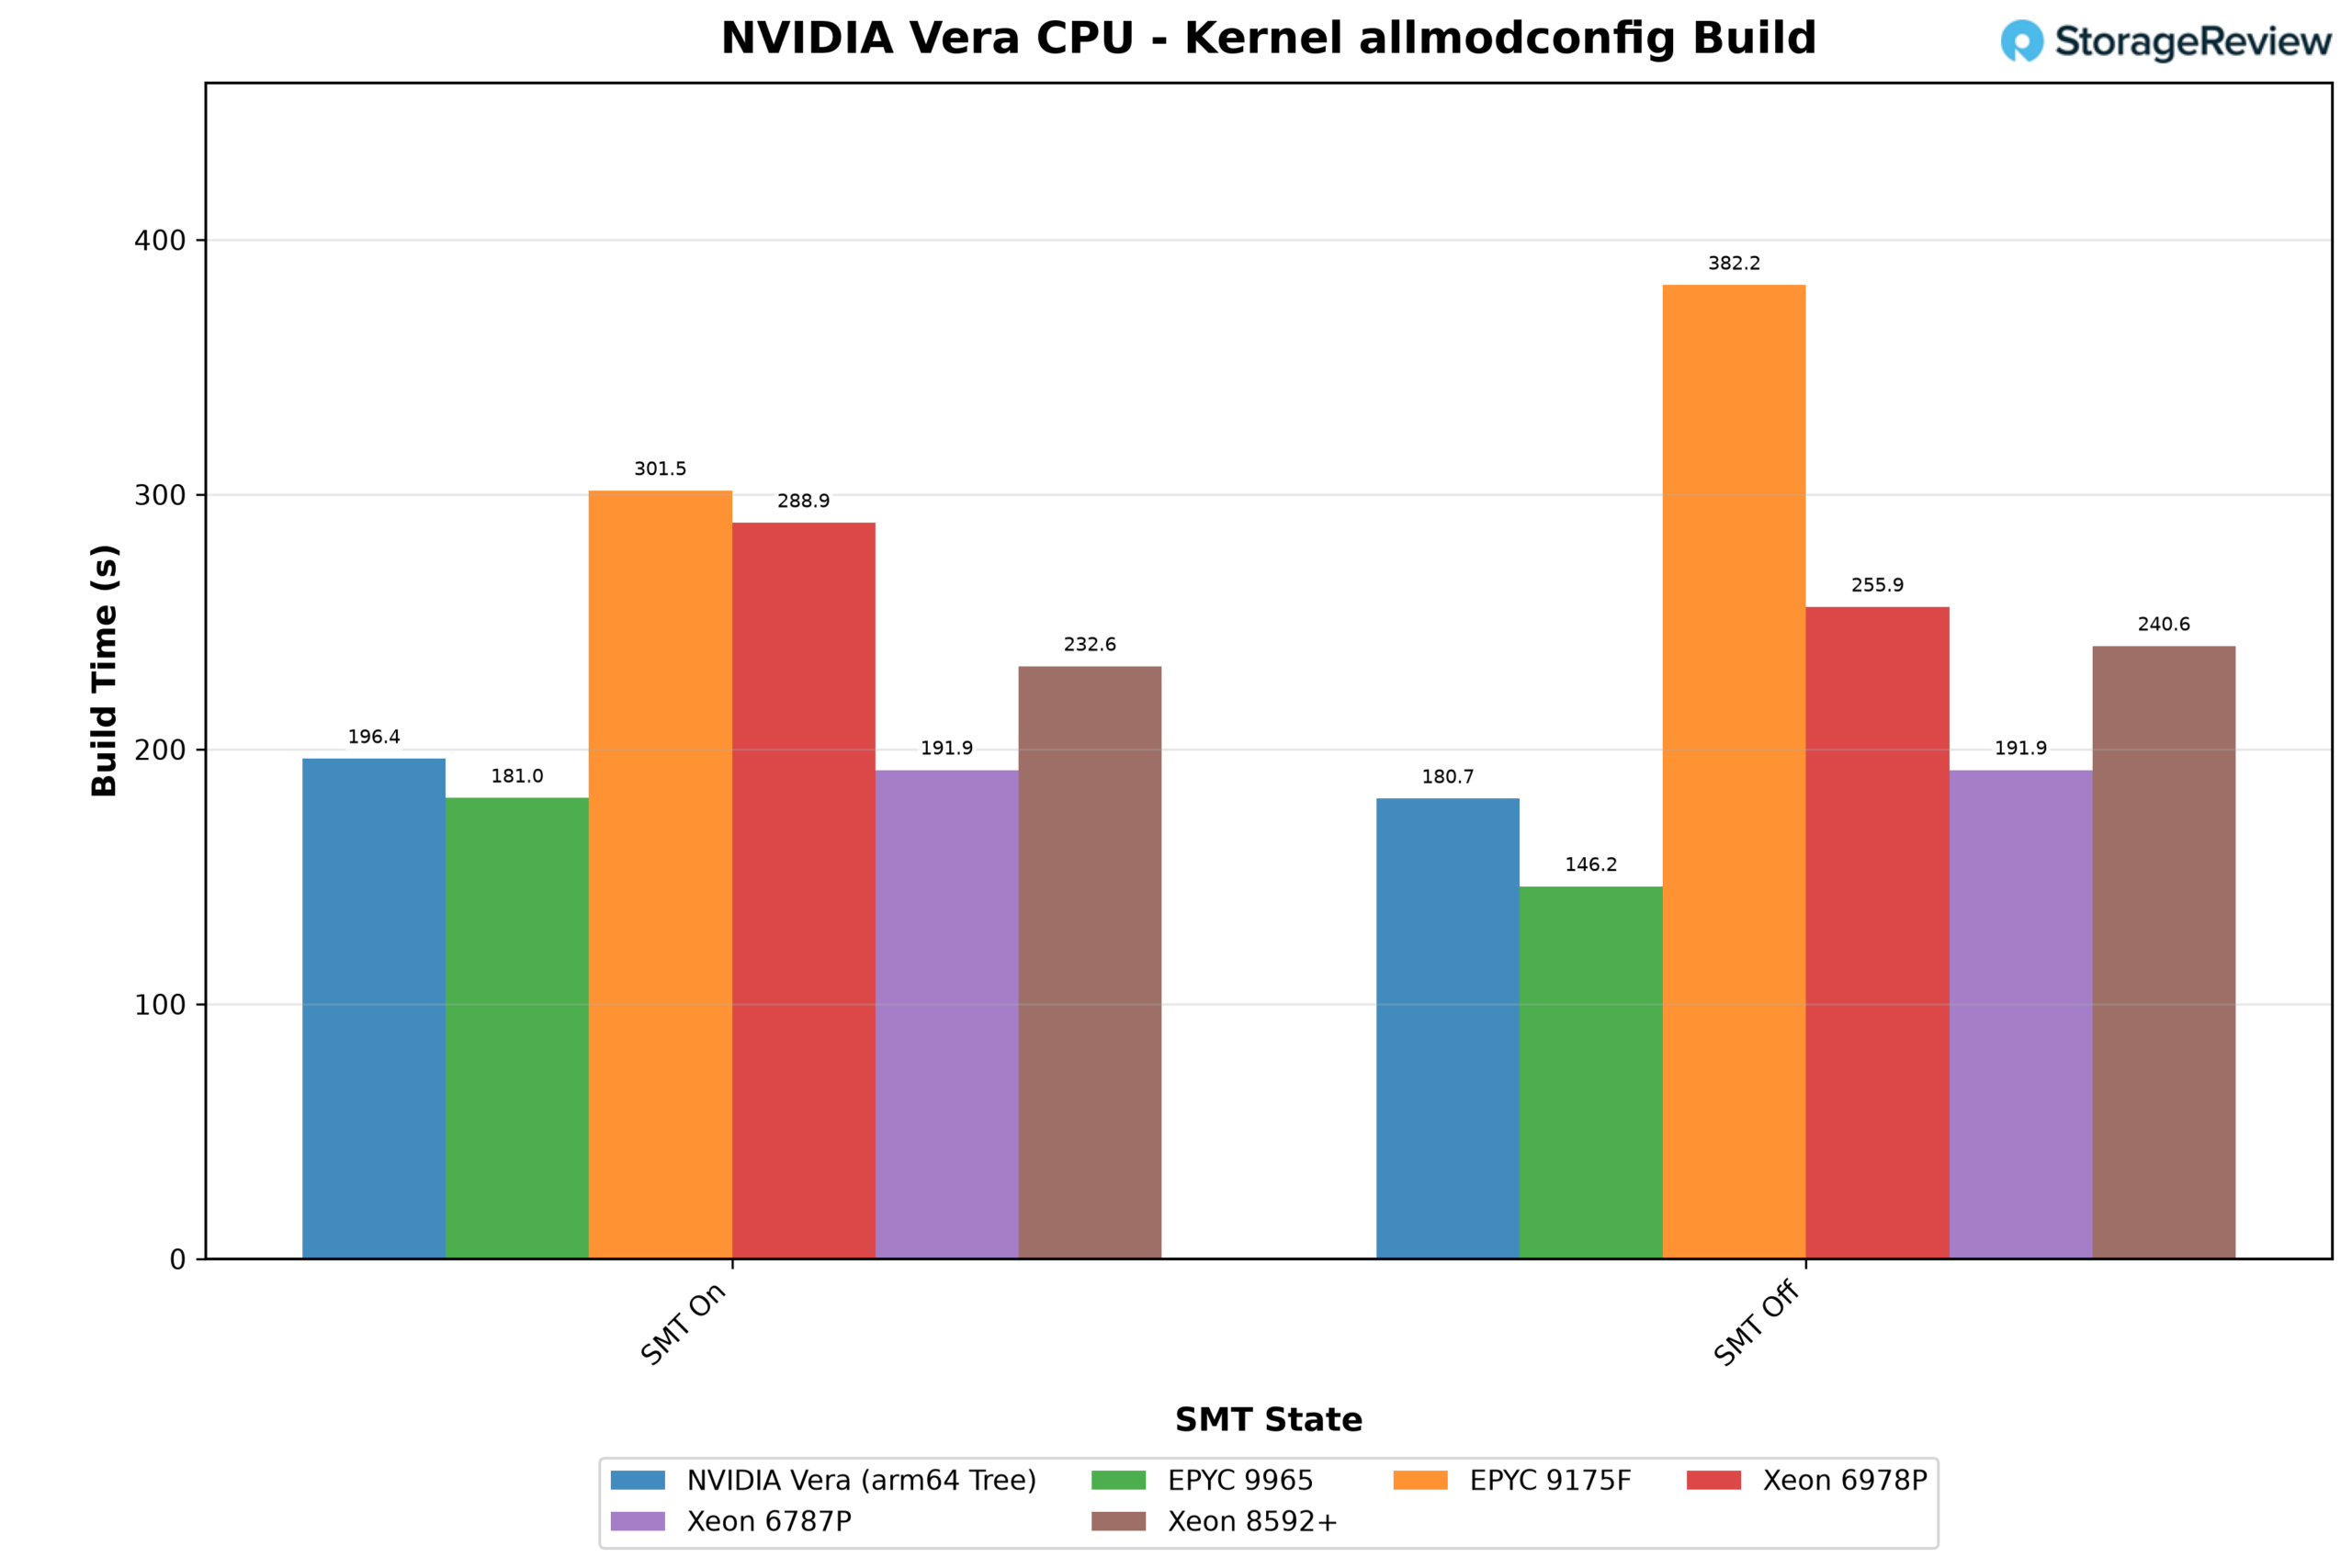
Vera построила дерево зависимостей за 180.7 секунды с отключенным SMT и за 196.4 секунды с включенным SMT, поэтому дополнительные потоки замедлили процесс построения. На разных системах x86, каждая из которых строила собственное дерево зависимостей, время варьировалось от 146.2 секунды на EPYC 9965 с отключенным SMT до 382.2 секунды на 32-ядерном EPYC 9175F.
ХаммерДБ
Для тестирования баз данных мы пригласили Стива Шоу, создателя и разработчика HammerDB. Шоу запустил рабочую нагрузку TPROC-C от HammerDB — OLTP-бенчмарк, производный от TPC-C, но не сопоставимый с опубликованными результатами TPC, — на сервере Vera, Dell PowerEdge R7725 с процессором EPYC 9965 и PowerEdge R770 с процессором Xeon 6787P. Он протестировал пять движков с открытым исходным кодом на каждом из них: MariaDB 12.3.3 и 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 и PostgreSQL 18.6. Размер базы данных масштабировался в зависимости от количества ядер: 16 хранилищ на физическое ядро, или 1,408 для одного сокета Vera.
Каждый движок работал на одном сокете, а при работе на двух сокетах процессоры второго сокета отключались для односокетных запусков, и во всех системах производительность на одном сокете была выше, что типично для баз данных. Во всех 15 парах добавление второго сокета снизило пиковую пропускную способность на 23–47%, а на Vera — на 29–45%. Компания Shaw давно обнаружила, что базы данных с открытым исходным кодом достигают предела масштабируемости, прежде чем у них заканчиваются ядра. После этого момента поддержание согласованности кэшей на двух сокетах обходится дороже, чем дополнительные ядра. Поэтому мы сосредоточимся на результатах односокетной обработки, показанных на диаграмме ниже.
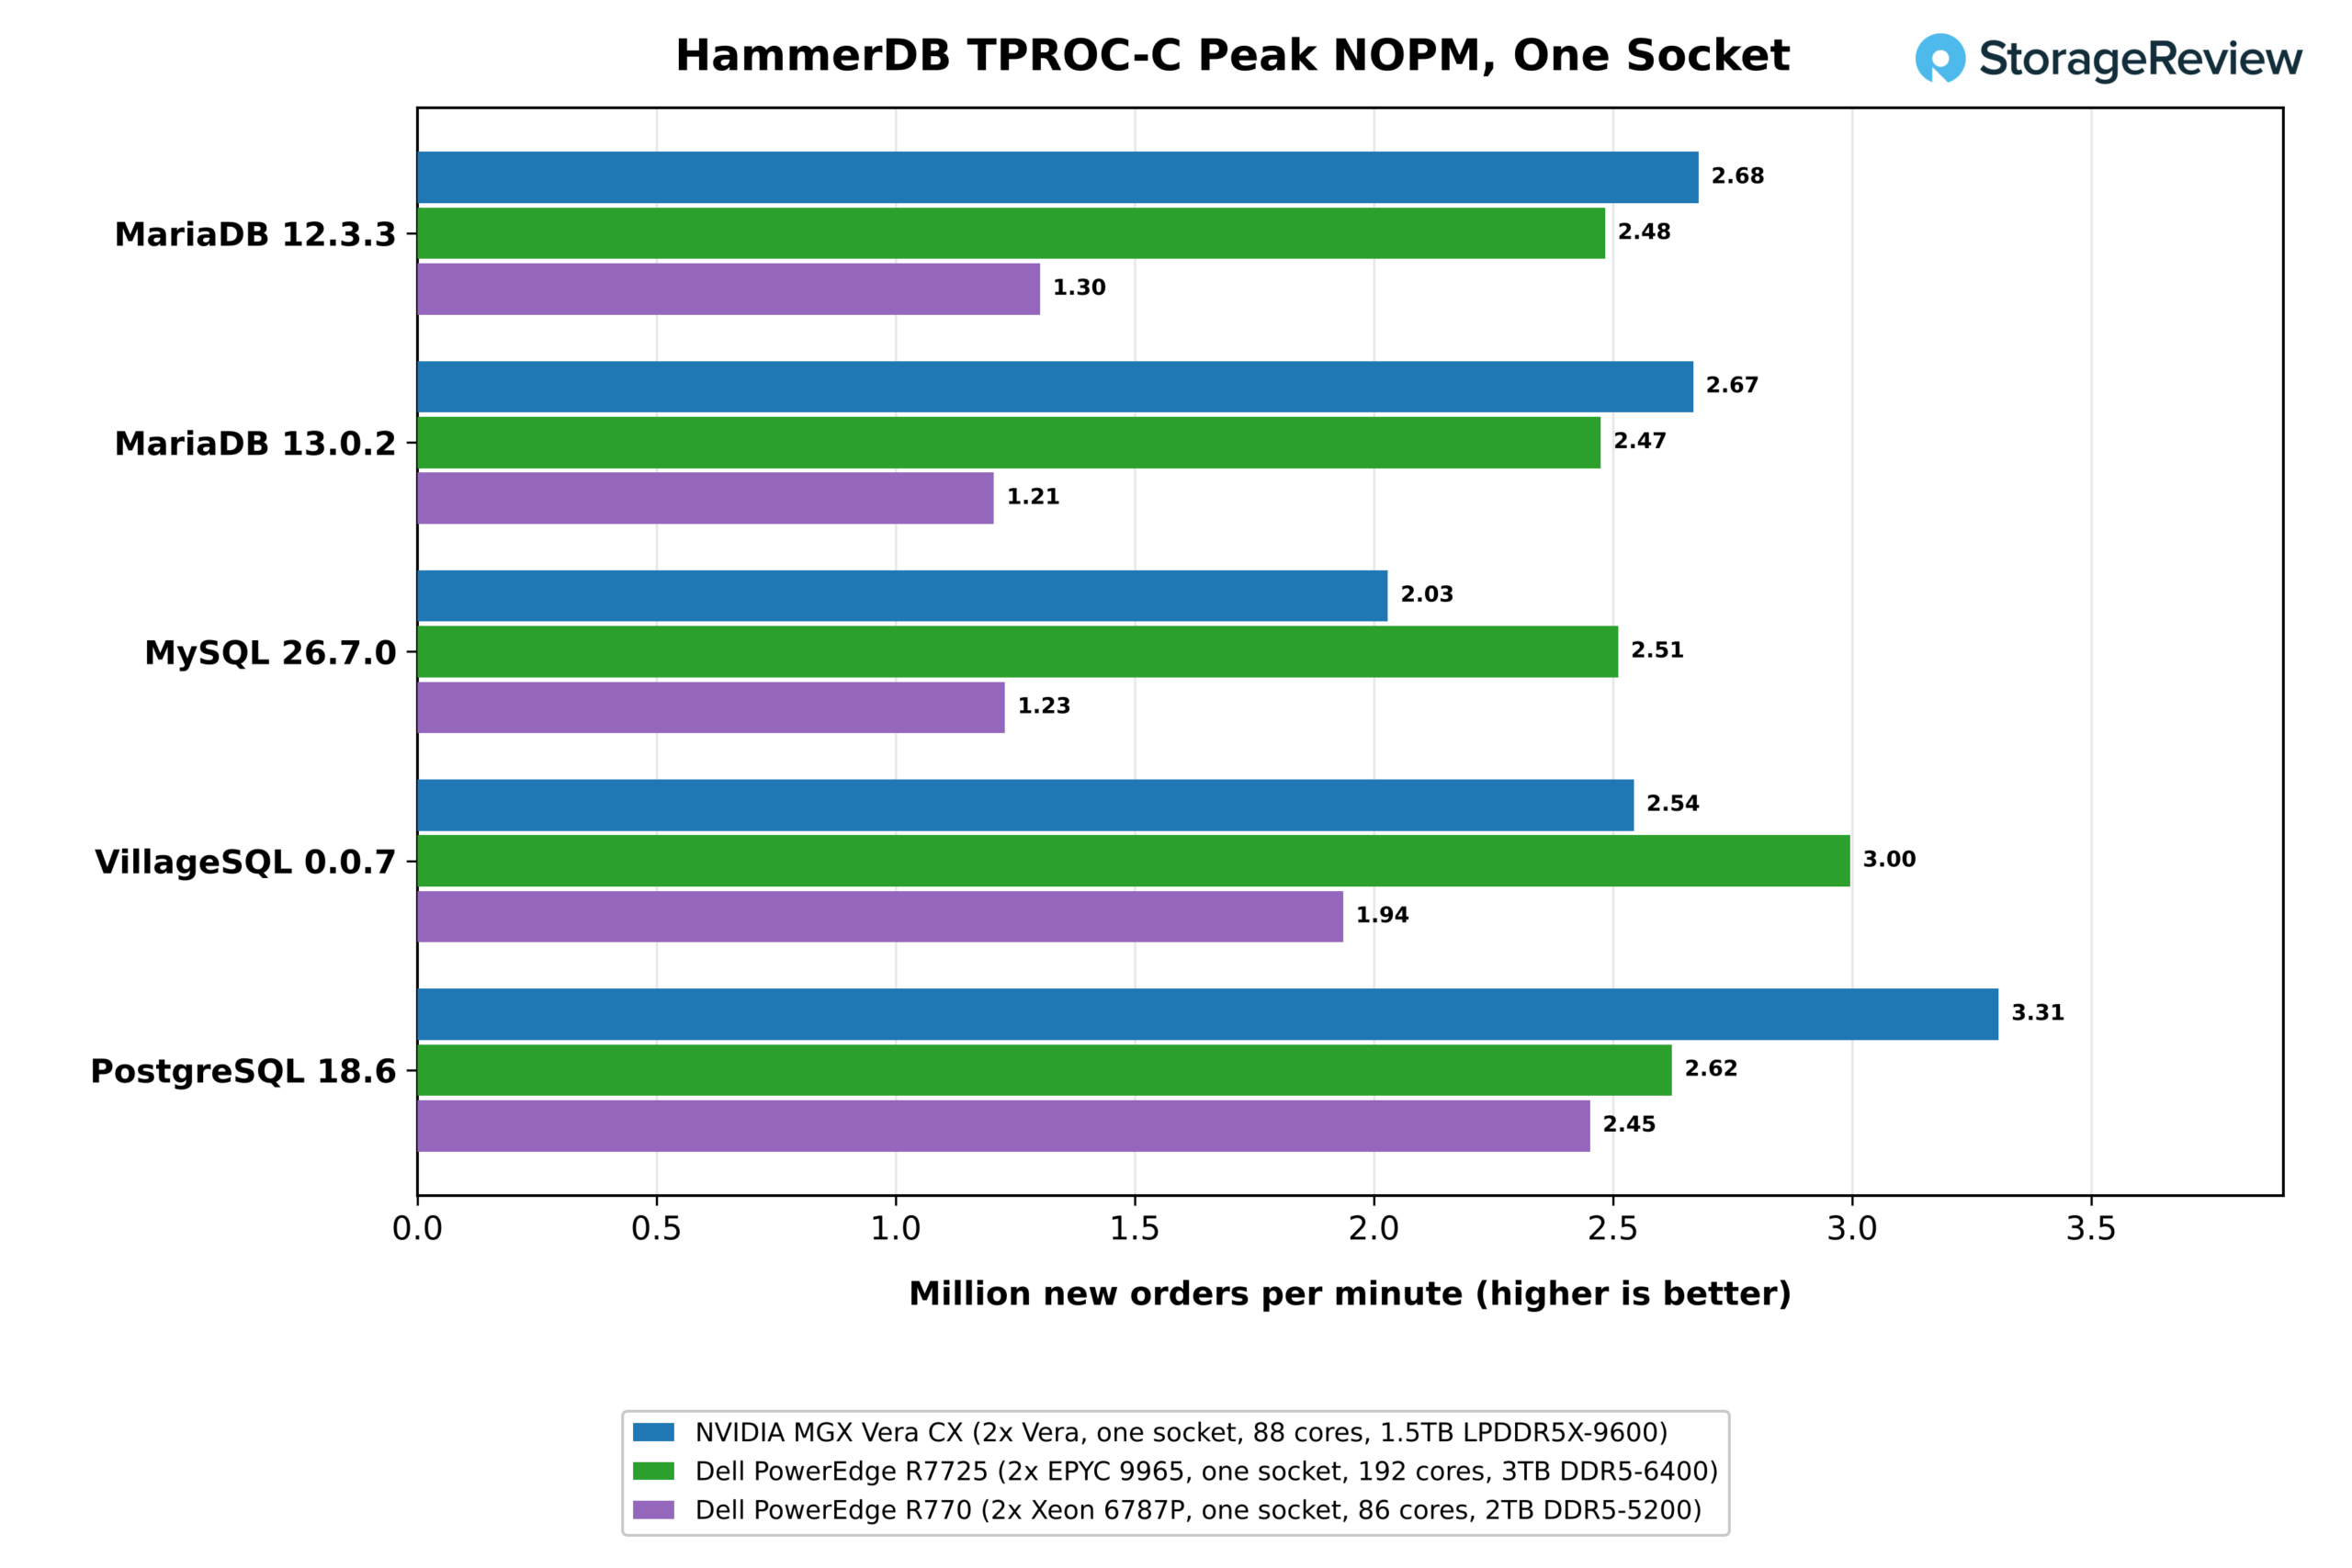
На одном из сокетов 88 ядер Vera лидировали на трех из пяти движков. PostgreSQL 18.6 обеспечил Vera наибольшее преимущество, показав 3.31 млн новых заказов в минуту (NOPM) при 128 виртуальных пользователях, по сравнению с 2.62 млн на 192-ядерном сокете EPYC 9965 и 2.45 млн на 86-ядерном Xeon 6787P. Обе версии MariaDB также достались Vera: 2.68 млн и 2.67 млн, по сравнению с 2.48 млн и 2.47 млн на EPYC. AMD сохранила MySQL 26.7.0 на уровне 2.51 млн против 2.03 млн у Vera, и VillageSQL на уровне 3.00 млн против 2.54 млн. Xeon отставал на всех пяти движках на 1.21 млн против 2.45 млн, а его результаты по MariaDB были менее чем вдвое ниже, чем у Vera.
Вероятно, разница в производительности зависит от масштабируемости каждого движка. Модель обработки процессов на одно соединение в PostgreSQL и InnoDB в MariaDB распределяют работу между множеством ядер с интенсивным трафиком общей памяти, что соответствует более чем 1 ТБ/с локальной пропускной способности каждого сокета Vera в режиме STREAM. MySQL и VillageSQL быстрее сталкиваются с внутренними конфликтами блокировок, поэтому их результаты больше зависят от того, насколько быстро каждое ядро очищает критическую секцию, и именно здесь 9965 оказывается впереди. После октябрьского раунда Шоу оценил Arm как самую быструю платформу в целом, заявив, что Arm «определенно стала конкурентоспособным сервером баз данных», хотя он добавил, что протестированный им ранее односокетный 96-ядерный EPYC может его превзойти.
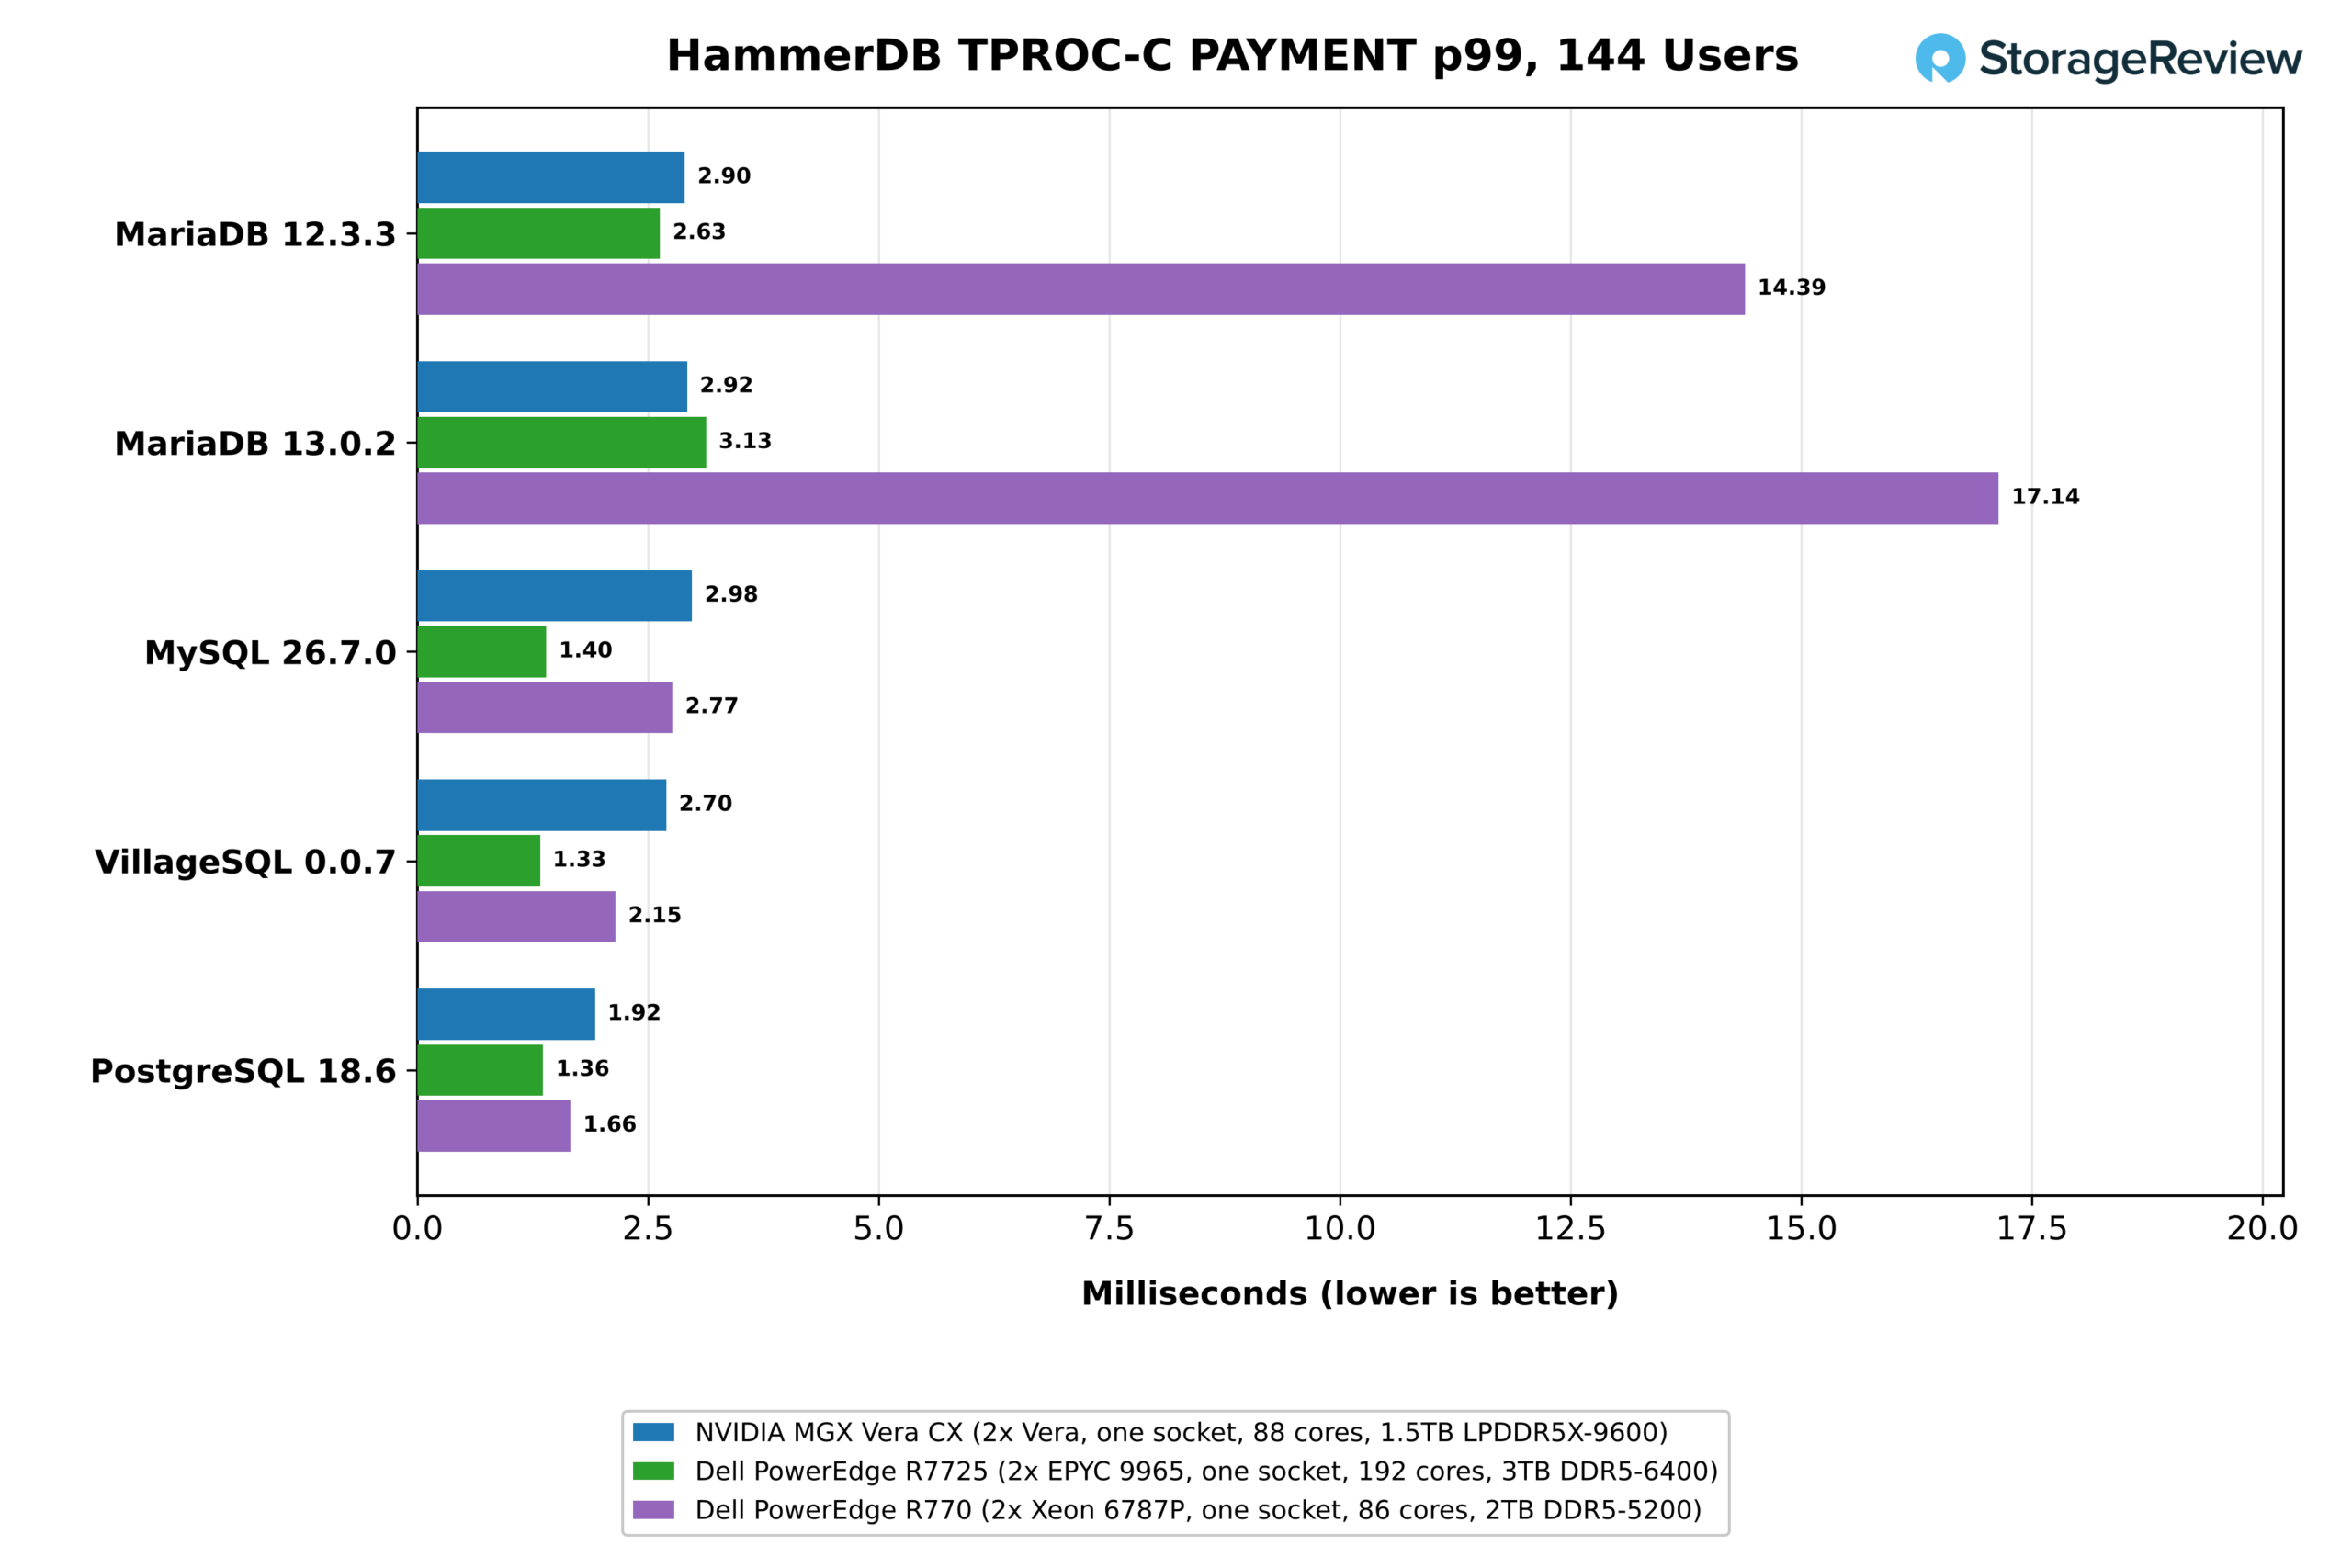
Задержка обработки запросов в хвостовой части стека при одинаковой нагрузке в 144 виртуальных пользователях демонстрирует аналогичное распределение. Задержка PAYMENT p99 у Vera варьировалась от 1.92 мс на PostgreSQL до 2.98 мс на MySQL. EPYC 9965 показал задержку обработки MySQL, VillageSQL и PostgreSQL в диапазоне от 1.33 мс до 1.40 мс, что на 29–53% ниже, чем у Vera, но его показатель 3.13 мс на MariaDB 13.0.2 отставал от 2.92 мс у Vera. Задержки обработки запросов в хвостовой части стека у Xeon 6787P на MariaDB, составляющие 14.4 мс и 17.1 мс, были в несколько раз выше, чем у обоих процессоров, что соответствует его гораздо меньшей пропускной способности при той же нагрузке. Передача блокировок внутри движков, вероятно, обуславливает более высокие задержки обработки запросов у Vera, что перекликается с результатами Valkey, где запросы, отправляемые по одному, также были предпочтительнее для AMD.
В ноябрьском раунде была проверена интуиция Шоу. Он запустил одну и ту же рабочую нагрузку на одном из сокетов нового 256-ядерного процессора AMD EPYC 9996 и на 96-ядерном EPYC 9686F, используя в качестве сравнения сокет Vera. 9996 и Vera поменялись движками: Vera сохранила поддержку PostgreSQL и MariaDB, а EPYC показала лучшие результаты по задержке, в то время как 96-ядерный процессор немного превзошел Vera по PostgreSQL. Полные результаты представлены в нашем обзоре AMD EPYC Venice.
«Я был искренне впечатлен производительностью баз данных с открытым исходным кодом на NVIDIA Vera. Здорово видеть, что Arm конкурирует в верхнем сегменте производительности баз данных и предлагает убедительную альтернативу корпоративному рынку», — сказал Стив Шоу, создатель и разработчик HammerDB, после завершения раунда финансирования.
Заключение
Процессор Vera не является самым быстрым во всех категориях, поскольку AMD отвечает на каждый сегмент рынка своей собственной моделью. Оптимизированный по частоте EPYC 9175F создан для обеспечения высокой скорости на ядро и по-прежнему выигрывает в задачах, требующих высокой тактовой частоты, от nbody и однопоточного AES в Python до запросов Valkey по одному. EPYC 9965 создан для обеспечения высокой пропускной способности и выигрывает в задачах, масштабируемых в зависимости от количества ядер, включая GROMACS, многопоточный 7-Zip и AES, а также количество сегментов Valkey, помещающихся в сокет.
Vera выделяется среди конкурентов, занимая промежуточное положение и приближаясь к каждому из этих специалистов в их области. В однопоточном режиме она сравнялась или превзошла 9175F в задачах на целочисленные вычисления и в двух из трех тестов Python, сжимая данные на 12% быстрее в 7-Zip и выполняя go и regex_compile на 15% и 25% быстрее соответственно, в то время как отставала в вычислениях с плавающей запятой и криптографии.
В масштабах всей системы он достиг 63–72% от показателей 9965 в многопоточном режиме в тесте 7-Zip и завершил средний тест OpenFOAM с результатом, отличающимся от него всего на 12%, а затем вырвался вперед, когда на первый план вышла память, в тестах Large Mesh и ClickBench. Такая близость к лидеру по производительности на одном ядре в одном потоке и к лидеру по пропускной способности во всей системе — вот что делает Vera таким сильным процессором общего назначения. Для покупателей, которым нужна одна платформа для широкого среднего сегмента рынка без существенных компромиссов в обоих направлениях, это чрезвычайно выгодное предложение.
Vera обеспечивает гораздо большую пропускную способность памяти, чем любая протестированная нами система x86. Два сокета Vera показали стабильную скорость 2,073 ГБ/с в STREAM Triad, что в 2.3 раза выше, чем у лучшего сервера DDR5 в этом исследовании, а технология NVLink-C2C поддерживает эту пропускную способность в пределах досягаемости между сокетами: ядра Vera считывают память другого сокета со скоростью 677 ГБ/с, что больше, чем любой сокет x86 считывает из локальной памяти.
Затем последовали задачи, требующие большого объема памяти: обработка большой сетки OpenFOAM заняла в 1.44 раза больше времени, чем на EPYC 9965, тест ClickBench завершился за 2.09 секунды против 2.70, рабочий набор Valkey объемом 256 ГБ выполнился на 34% быстрее, а на одном сокете Vera превзошла HammerDB на PostgreSQL и обеих версиях MariaDB. Стоимость соединения определяется задержкой: удаленное чтение занимает примерно в 2.1 раза больше времени, чем локальное, против 1.75 раза на EPYC 9175F, поэтому размещение с учетом NUMA и большие страницы памяти по-прежнему важны на Vera.
Уязвимости на удивление незначительны и напрямую связаны с конструкцией. Шесть 128-битных каналов SVE2 не соответствуют 512-битным блокам AVX-512 в коде, написанном для них, поэтому 16-ядерный модуль Vera запускал GROMACS benchMEM вдвое медленнее, чем 9175F, и в два раза медленнее, чем 9965. При использовании только двух из этих каналов для криптографии, одно ядро Olympus шифровало AES-256-GCM примерно в три раза медленнее, чем 9175F.
Успех Vera во многом будет зависеть от OEM-партнеров. Сервер Dell PowerEdge R8822 начал поставляться в октябре, а стойка M9882 Vera CPU Rack ожидается в первом квартале 2027 года. HPE ProLiant Compute DL394 Gen12 появится этой осенью, Supermicro предлагает свою стойку Vera на 256 процессоров с воздушным охлаждением в форм-факторах 1U и 2U, а ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron и Lenovo уже продемонстрировали свои решения на базе Vera. Oracle Cloud предлагает общедоступные экземпляры Vera , а CoreWeave, Nebius, Lambda и другие последуют их примеру.
Vera — первый серверный процессор Arm, который мы тестировали, и который по своим характеристикам может конкурировать с флагманскими процессорами x86 в задачах общего назначения, а также первый процессор от любого производителя, обеспечивающий пропускную способность памяти в 2 ТБ/с в двухсокетном корпусе с воздушным охлаждением. Для широкого сегмента среднего рынка это уже сегодня достойный вариант, и NVIDIA выходит на рынок процессоров с подсистемой памяти, которую никто другой не выпускает. Для высокопроизводительных вычислений с большим объемом векторной обработки и криптографически сложных сервисов специалисты по x86 сохраняют свое лидерство. Мы протестируем OEM-системы с помощью того же набора тестов, что и в лаборатории, начиная с роли агентной песочницы, для выполнения которой NVIDIA и создала этот процессор.
После этого обзора процессор AMD EPYC Venice попал в нашу лабораторию, и в наших обзорах AMD EPYC Venice SP7 и Dell PowerEdge R9825 мы протестировали 256-ядерный EPYC 9996 с помощью одного и того же набора тестов против Vera, используя последнюю версию прошивки Vera.
В таблице лидеров: NVIDIA Vera занимает первое место в рейтинге лучших серверов по версии Arm.


 Amazon