

ASUS ExpertCenter Pro ET900N G3 — это вторая тестовая станция GB300 DGX, и первая, которую мы тестировали в лаборатории; тестирование MSI XpertStation WS300 проводилось удаленно. В ней используется тот же процессор NVIDIA, что и в MSI XpertStation WS300: Grace Blackwell Ultra Desktop Superchip с 72 ядрами Grace, графический процессор B300, 252 ГБ HBM3e, 496 ГБ LPDDR5X и сетевой адаптер ConnectX-8 SuperNIC с двумя портами 400GbE. ASUS поместила эту фиксированную платформу в аккуратный корпус, созданный для настольных компьютеров с поддержкой ИИ, добавив несколько элементов, отсутствующих в WS300: две ручки для переноски сверху, отдельный вентилятор, направленный на отсеки для оптики ConnectX-8, и блок питания мощностью 1,600 Вт с рейтингом 80 PLUS Titanium.
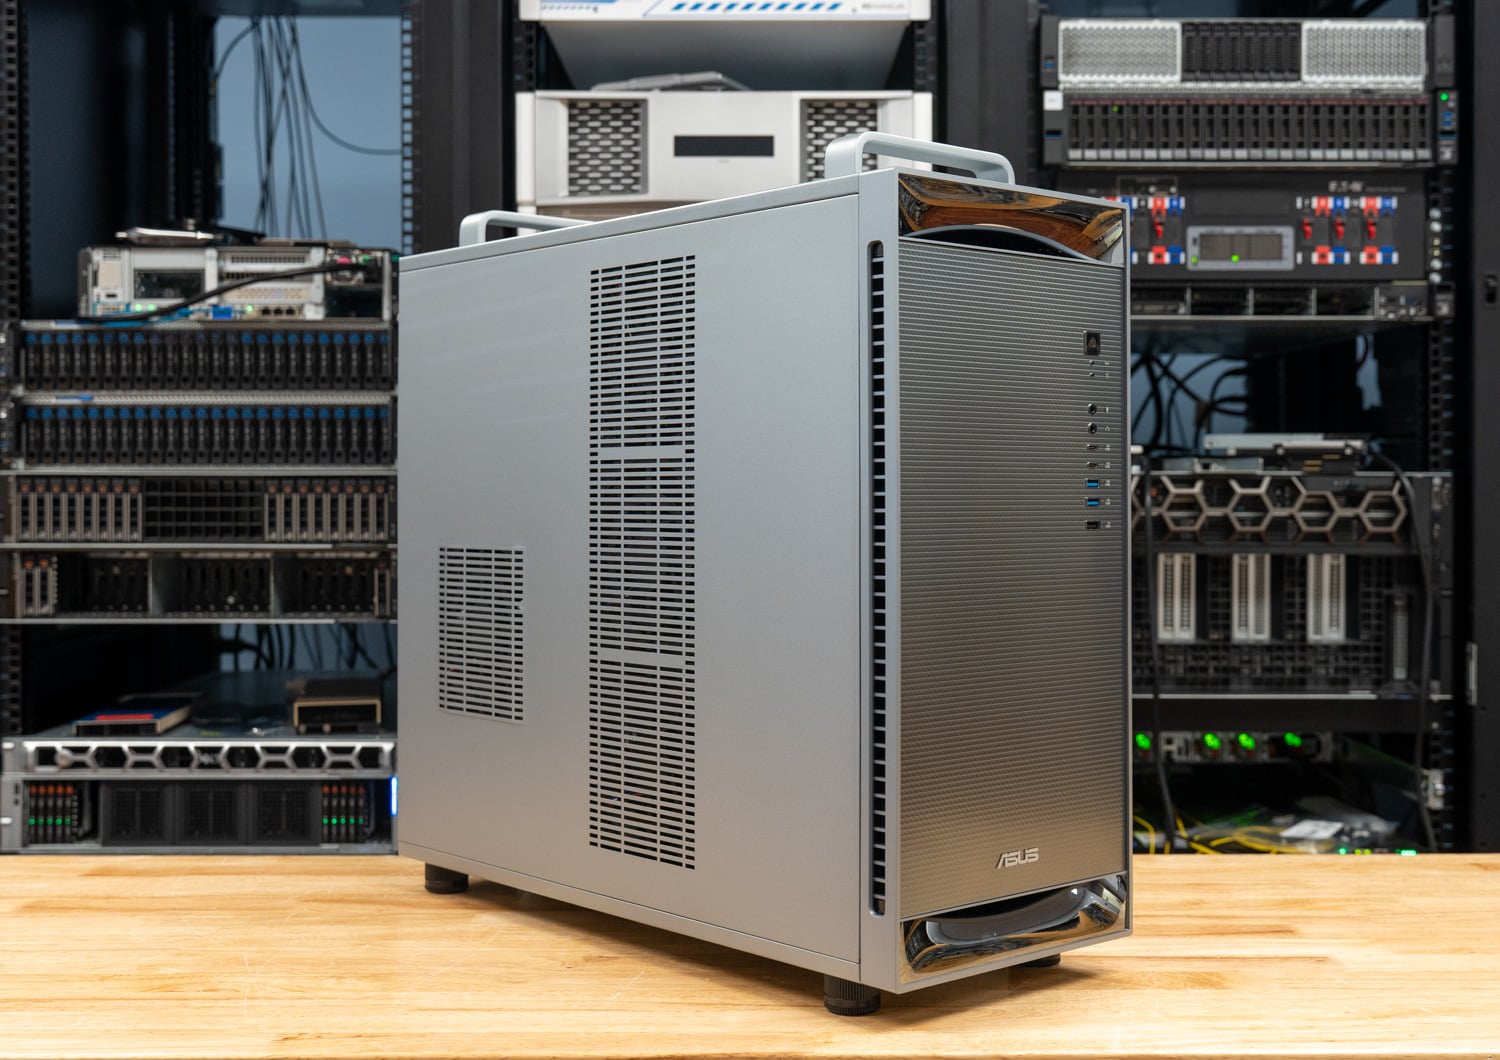
Компания ASUS отправила в лабораторию ET900N G3 примерно на неделю для тестирования производительности, фотосъемки и физических проверок, с установленной видеокартой RTX PRO 2000. Обзор WS300 охватывает саму платформу, материнскую плату B300, технологию Grace, NVLink-C2C, MIG-сварку и назначение DGX-станции. В этом обзоре речь пойдет о том, что ASUS создала на базе Superchip, и о том, насколько хорошо показатели соответствуют результатам первого протестированного нами настольного компьютера GB300.
Технические характеристики ASUS ExpertCenter Pro ET900N G3
| Параметр | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Обзор платформы | |
| Суперчип | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| ЦП | NVIDIA Grace, 72 ядра Arm Neoverse V2 |
| GPU : | NVIDIA Blackwell Ultra (B300), до 20 PFLOPS NVFP4 с разреженностью |
| Взаимодействие ЦП-ГП | NVLink-C2C, двунаправленный, 900 Гбит/с |
| Память | |
| Связная память | 748GB |
| Память графического процессора | 252 ГБ HBM3e, 7.1 ТБ/с |
| Память ЦП | 496 ГБ LPDDR5X, 396 ГБ/с, 4x SOCAMM |
| Память | |
| Загрузочные диски | 2x M.2 2280 PCIe 5.0 x4 (Key M), с установленными 2x 2TB NVMe в режиме RAID 1 |
| Расширительные приводы | 2x M.2 2280 (Key M), PCIe 6.0 x4 (по данным ASUS), заводская вскрытость. |
| Networking | |
| СуперНИК | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| расширение | |
| Слоты PCIe | 1 х PCIe 5.0 х16 2x PCIe 5.0 x16 (8 сигналов) |
| Дополнительный графический процессор | До одной видеокарты NVIDIA RTX PRO Blackwell; тестовый образец поставлялся с видеокартой RTX PRO 2000 Blackwell. |
| Ввода / вывода | |
| Фронт | 2 порта USB 10 Гбит/с Type-C 2 порта USB 10 Гбит/с Type-A 1x USB 2.0 Разъемы для наушников и микрофона |
| задний | 4 порта USB 10 Гбит/с Type-A 1x Micro-USB COM (последовательная консоль BMC) 1x Mini DisplayPort (BMC) 3x аудиоразъемов |
| Управление и безопасность | |
| BMC | ASPEED AST2600 с прошивкой AMI MegaRAC, IPMI и Redfish. |
| Безопасность. | Встроенный TPM 2.0 |
| Мощность и охлаждение | |
| Электропитание | 1x 1,600 Вт ATX, 80 PLUS Titanium |
| Охлаждение | Система жидкостного охлаждения «замкнутый контур» (по стандартам ASUS) с охлаждающими пластинами на GB300, SOCAMM и ConnectX-8; передний и верхний радиаторы, задний вентилятор корпуса, отдельный вентилятор над отсеками для модулей QSFP112. |
| Рабочая Температура | 10C - 35C |
| Программное обеспечение и форм-фактор | |
| Operating System | Ubuntu с инструментами разработчика NVIDIA для искусственного интеллекта; ASUS заявляет о планах поддержки разработки ИИ на базе Windows. |
| Габаритные размеры: | 584 x 232 x 565 мм (23.0 x 9.1 x 22.3 дюйма), согласно данным ASUS. |
| Вес | 27 кг нетто, 32 кг брутто |
Дизайн и сборка
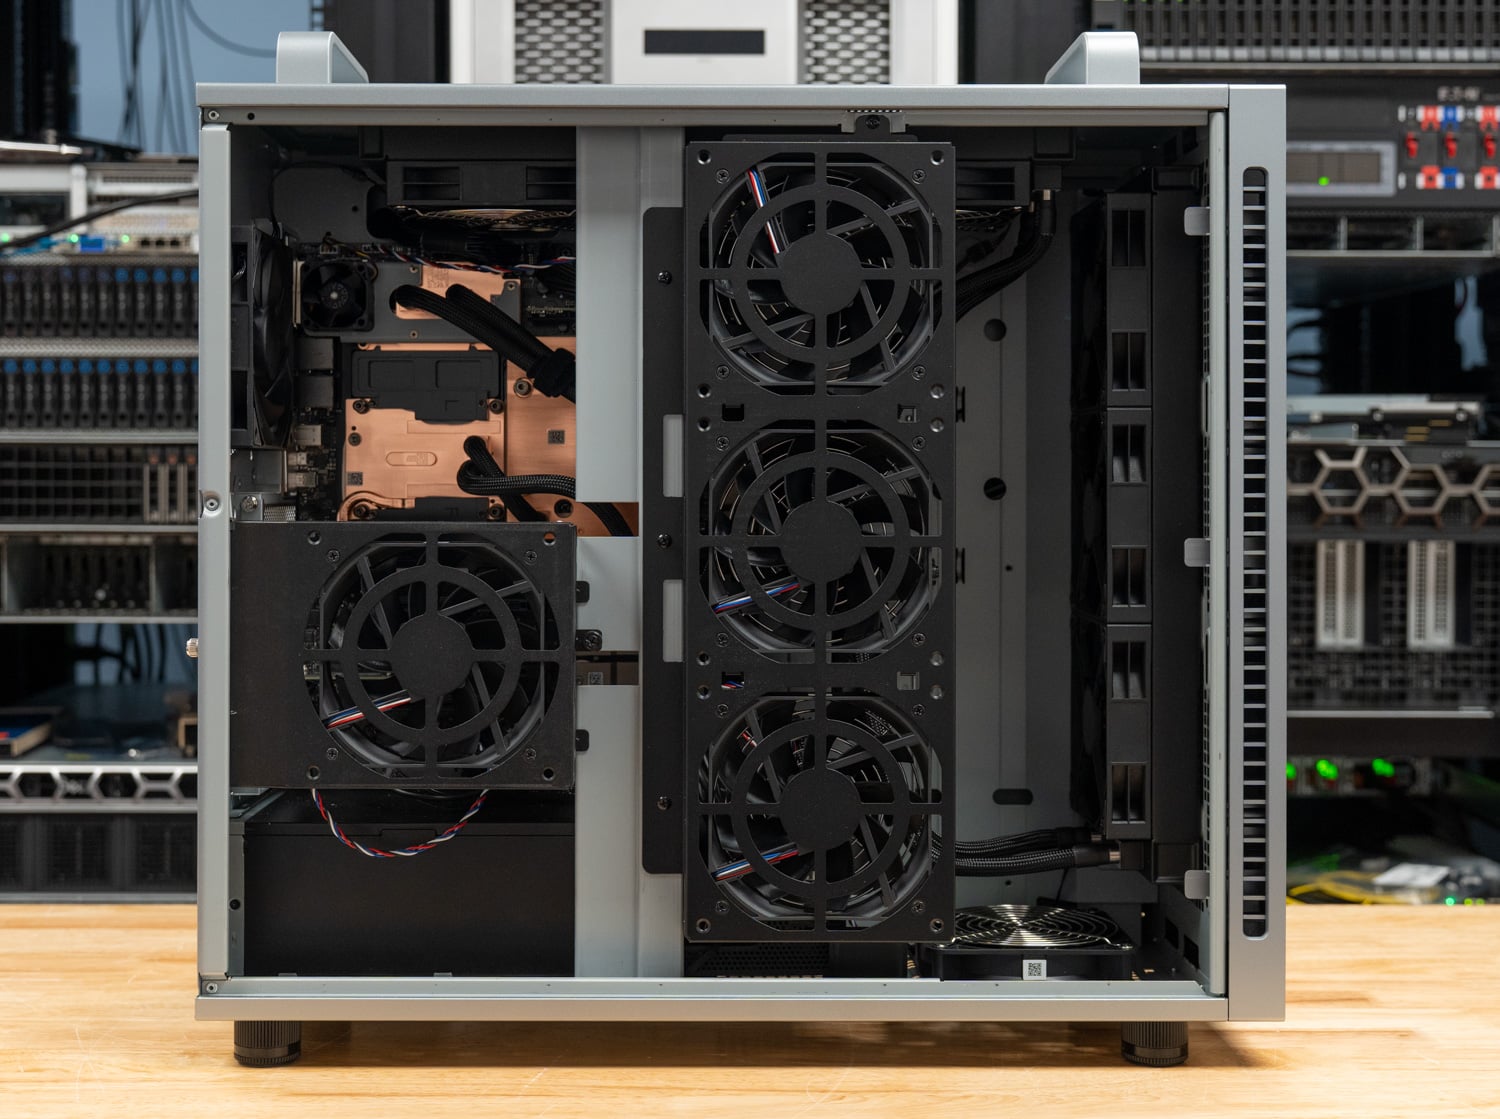
ASUS позиционирует ET900N G3 как рабочую станцию для бизнеса, с корпусом из матового серебра, темной сетчатой передней панелью, хромированной отделкой крышки и ножки, а также логотипом ASUS внизу передней панели. Пропорции соответствуют заявленным размерам платформы: 584 x 232 x 565 мм по данным ASUS, что немного выше и чуть уже, чем у WS300 (529 мм в высоту, 570 мм в глубину и 246 мм в ширину). При весе 27 кг это не та система, которую кто-то будет перемещать небрежно, и именно здесь вступает в игру первое решение, разработанное специально для ASUS. Две металлические ручки на верхнем крае, одна спереди и одна сзади, позволяют двум людям поднять системный блок на стол или в тележку, не держась за панели. Они выглядят несколько неуместно на офисном компьютере, пока вам не придется переносить системный блок GB300 через лабораторию.
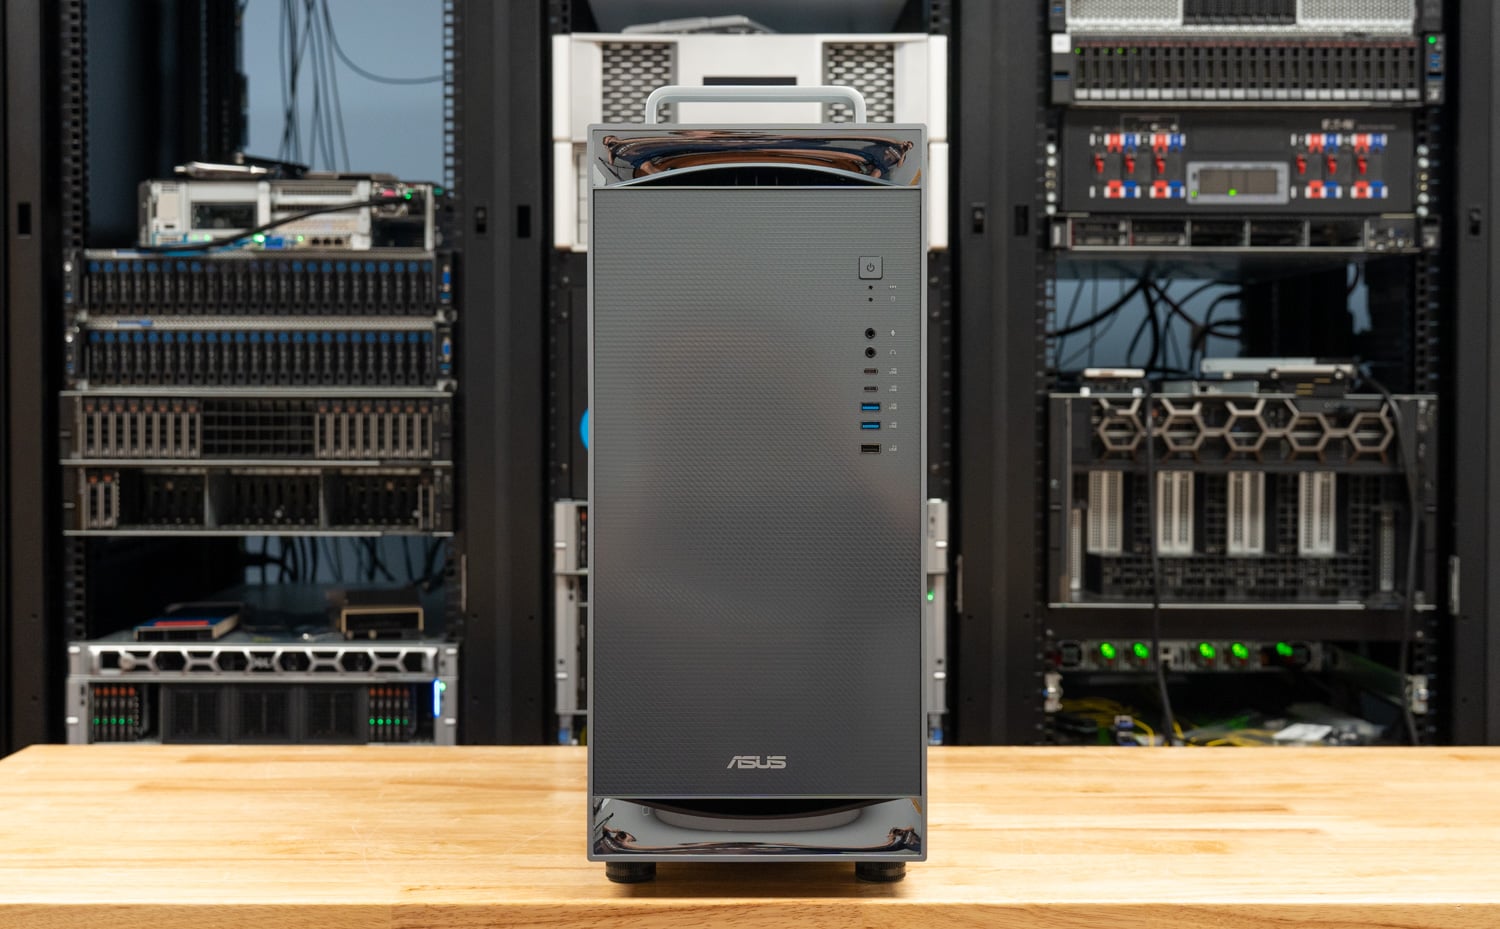
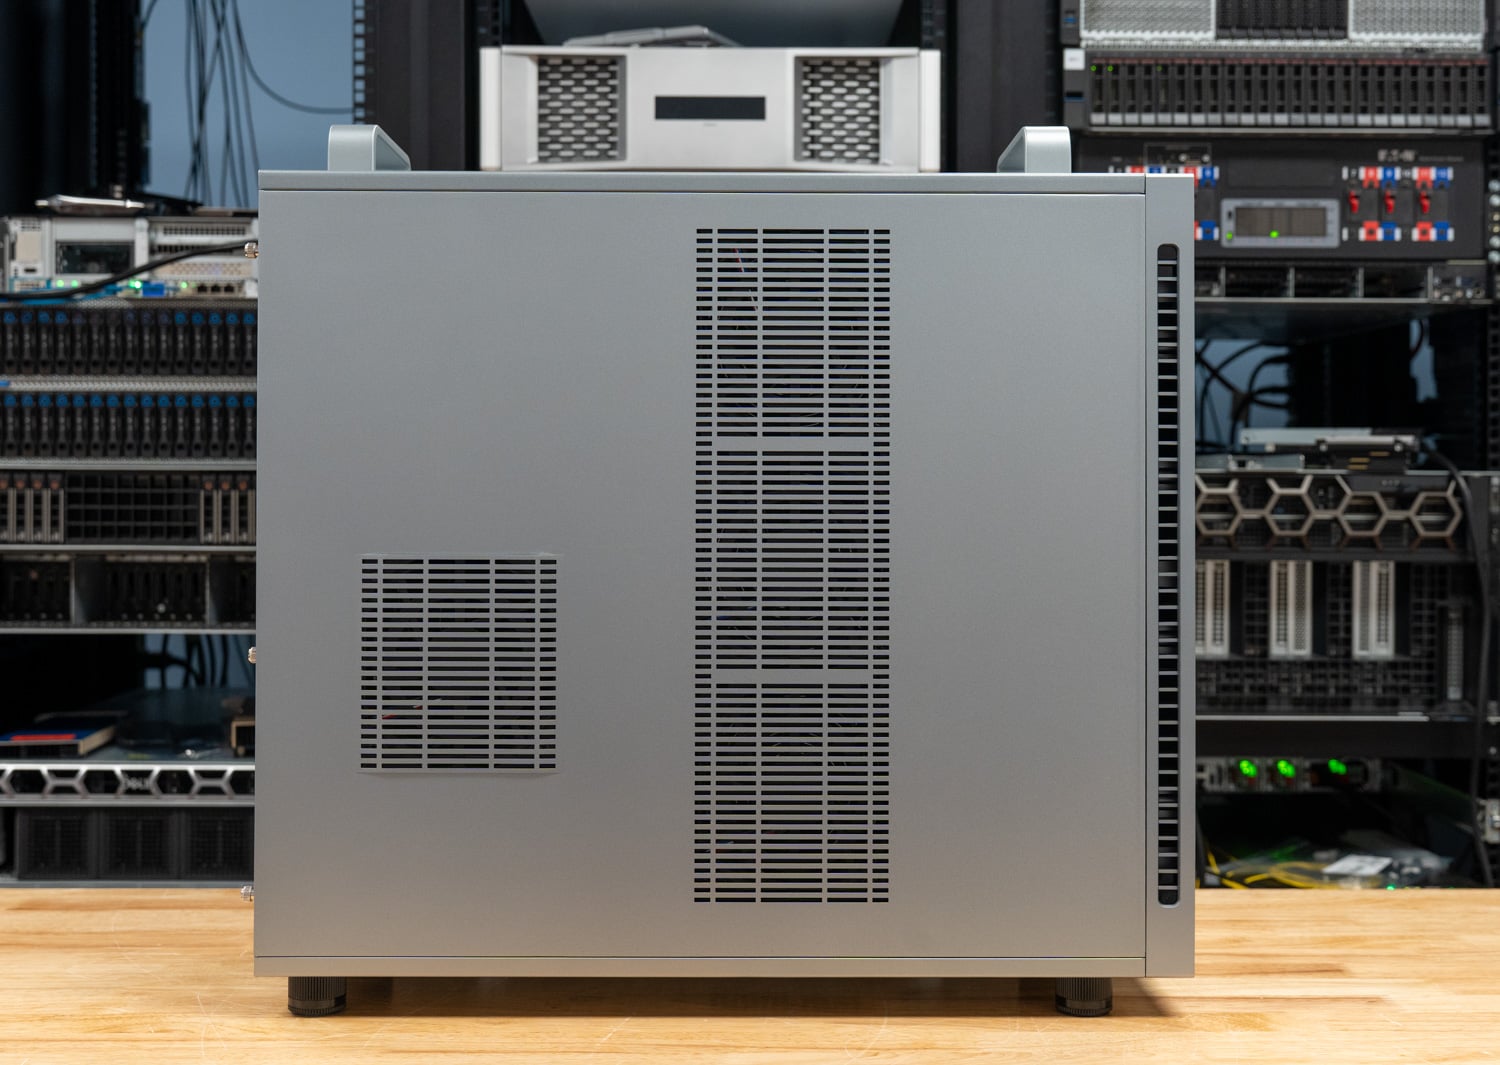
На передней панели расположены кнопка питания, два порта USB Type-A 10 Гбит/с, два порта USB Type-C 10 Гбит/с, порт USB 2.0, а также отдельные разъемы для наушников и микрофона, все они расположены вертикальной полосой в правом верхнем углу сетки. Боковая панель представляет собой большую вентилируемую панель с длинной перфорированной колонной в передней части для забора воздуха из радиатора и меньшей квадратной решеткой в задней части, которая расположена напротив системных вентиляторов. Отсутствует окно и подсветка, что устраивает целевую аудиторию.
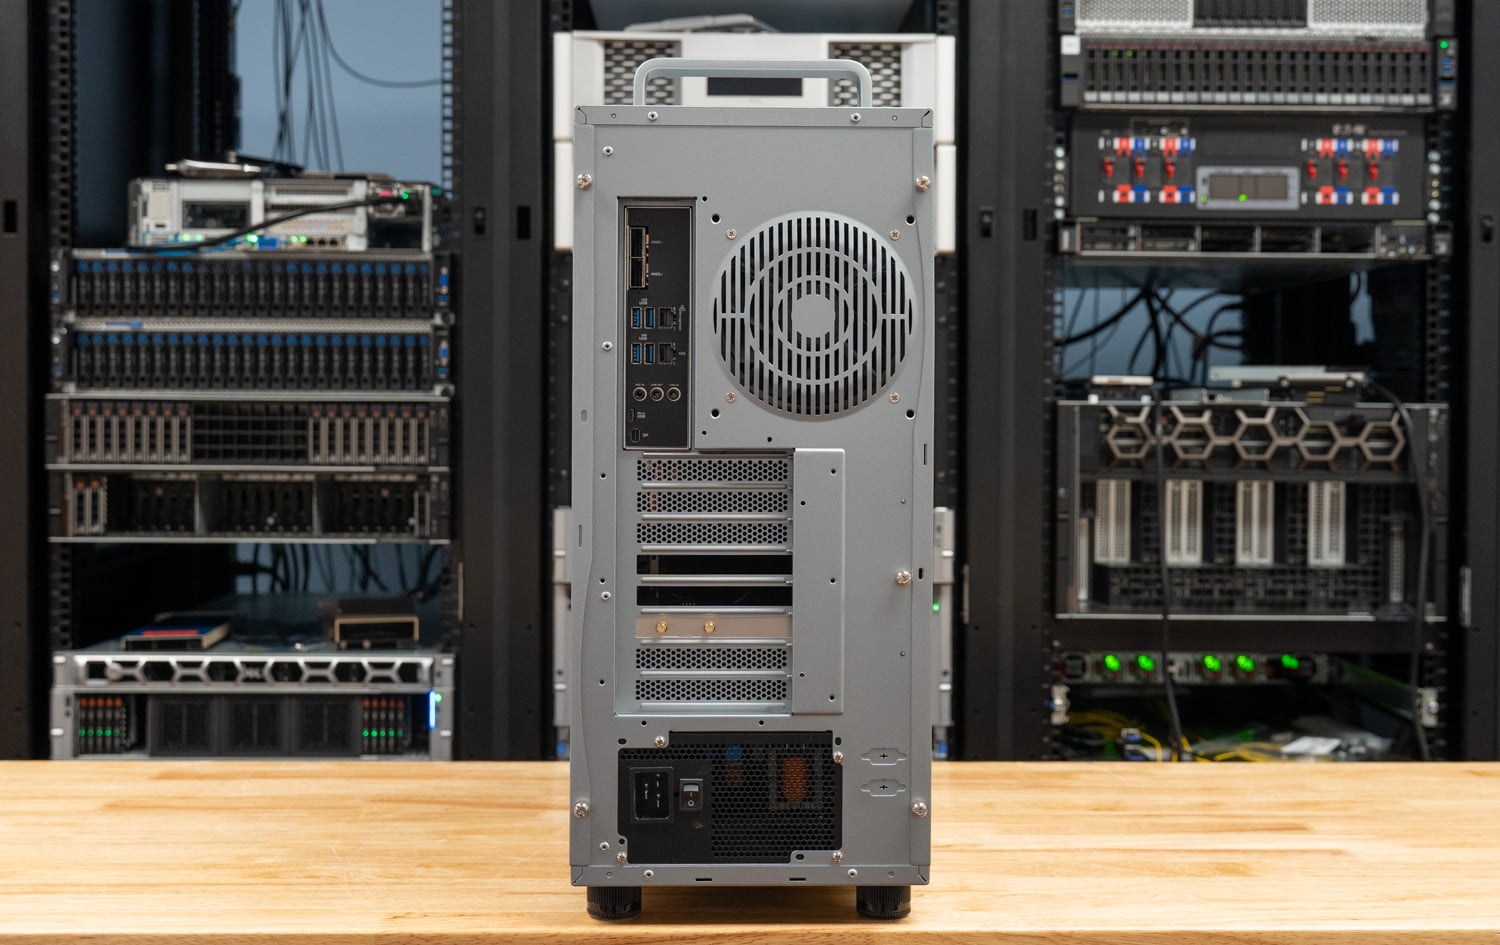
С задней стороны компоновка разделяет порты ввода-вывода рабочей станции от расположенного под ними серверного оборудования. В верхнем блоке находятся четыре порта USB Type-A 10 Гбит/с, разъемы RJ45 10GbE и 1GbE, три аудиоразъема, консольный порт Micro-USB для BMC и Mini DisplayPort, который BMC использует для настройки. Два отсека QSFP112 для ConnectX-8 расположены в верхней части панели ввода-вывода; рядом с ними находится вытяжной вентилятор; три крышки слотов расширения расположены посередине; а блок питания с разъемом C19 находится внизу. Как и на WS300, Mini DisplayPort является выходом BMC для первоначальной настройки и устранения неполадок; для работы с настольным компьютером на этой машине необходима видеокарта RTX PRO.
Внутри ET900N G3
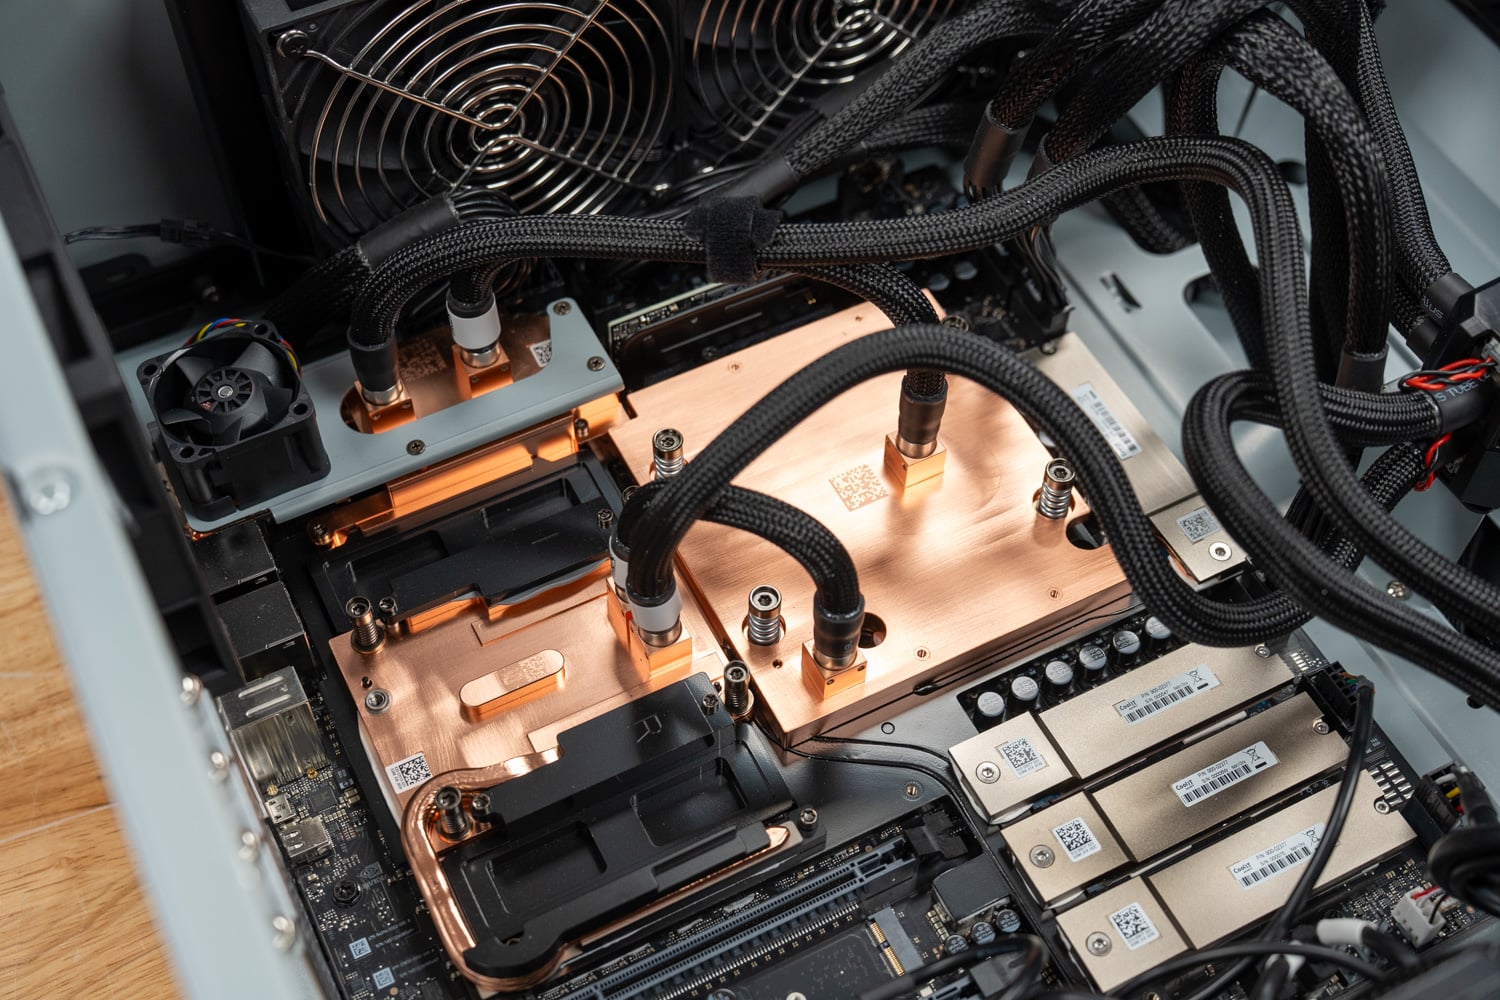
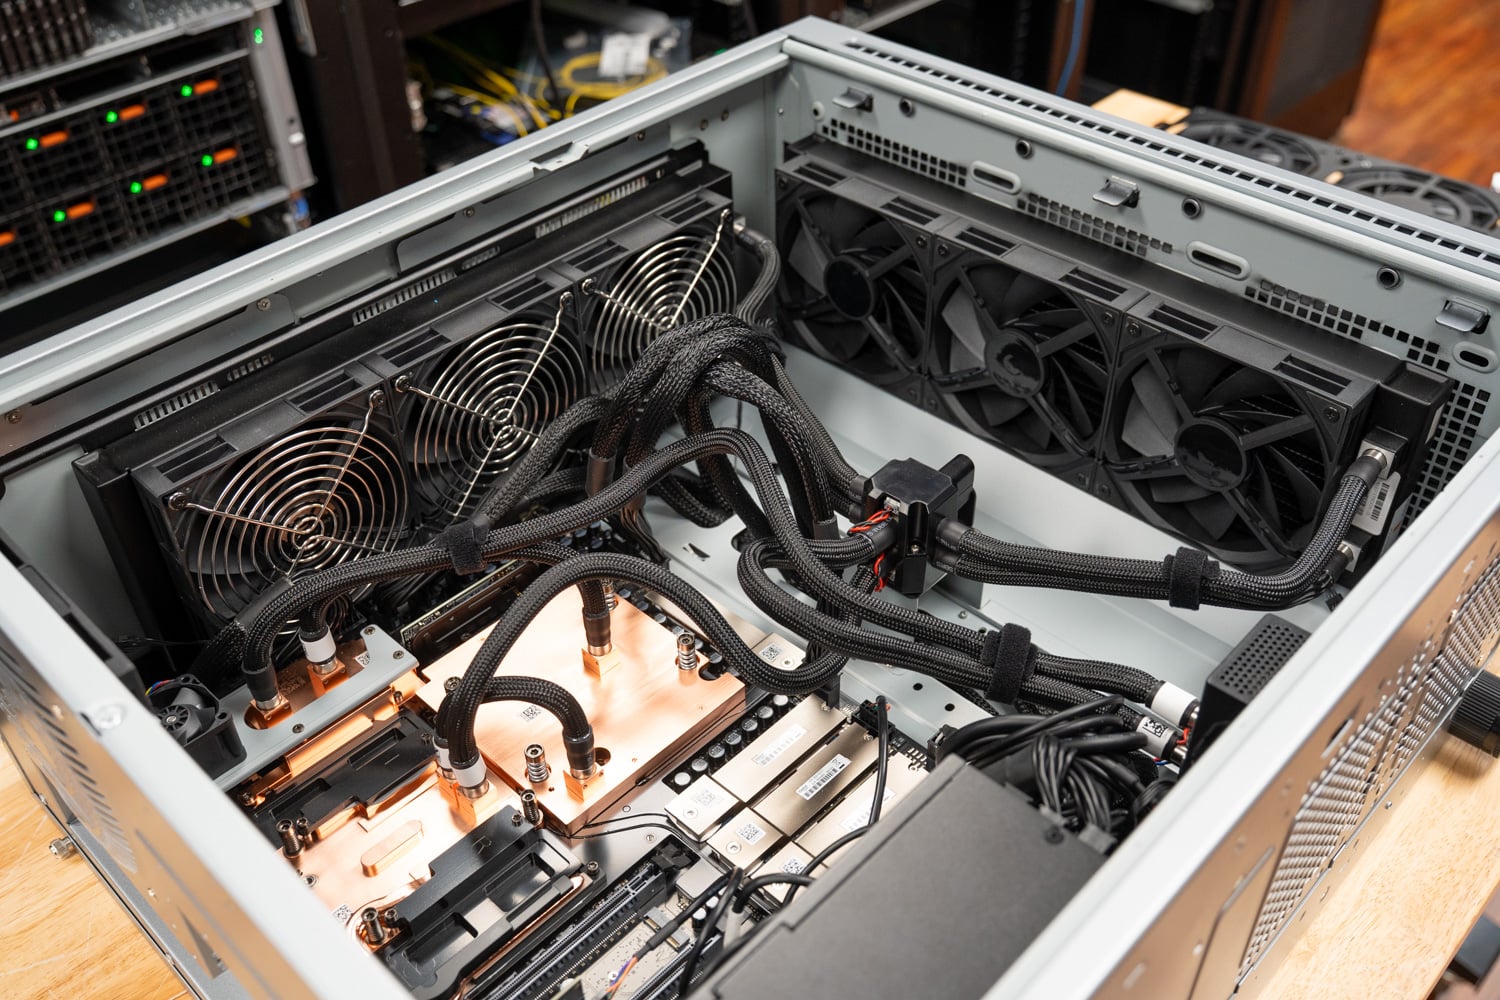
Без боковой панели ET900N G3 выглядит близким родственником WS300, что и следовало ожидать, учитывая, что оба используют одну и ту же материнскую плату NVIDIA. Процессор GB300 Superchip расположен под медной охлаждающей пластиной слева от корпуса, модули SOCAMM — под своими собственными медными пластинами рядом с ним, а ConnectX-8 — под третьим блоком возле задней панели ввода/вывода. Трубки в оплетке идут от блоков к распределительному коллектору, установленному на поперечине корпуса, а оттуда — к радиаторам. Три полноразмерных слота PCIe расположены под Superchip, блок питания занимает нижний передний угол, а металлический кожух закрывает кабельный канал вдоль нижней части корпуса.
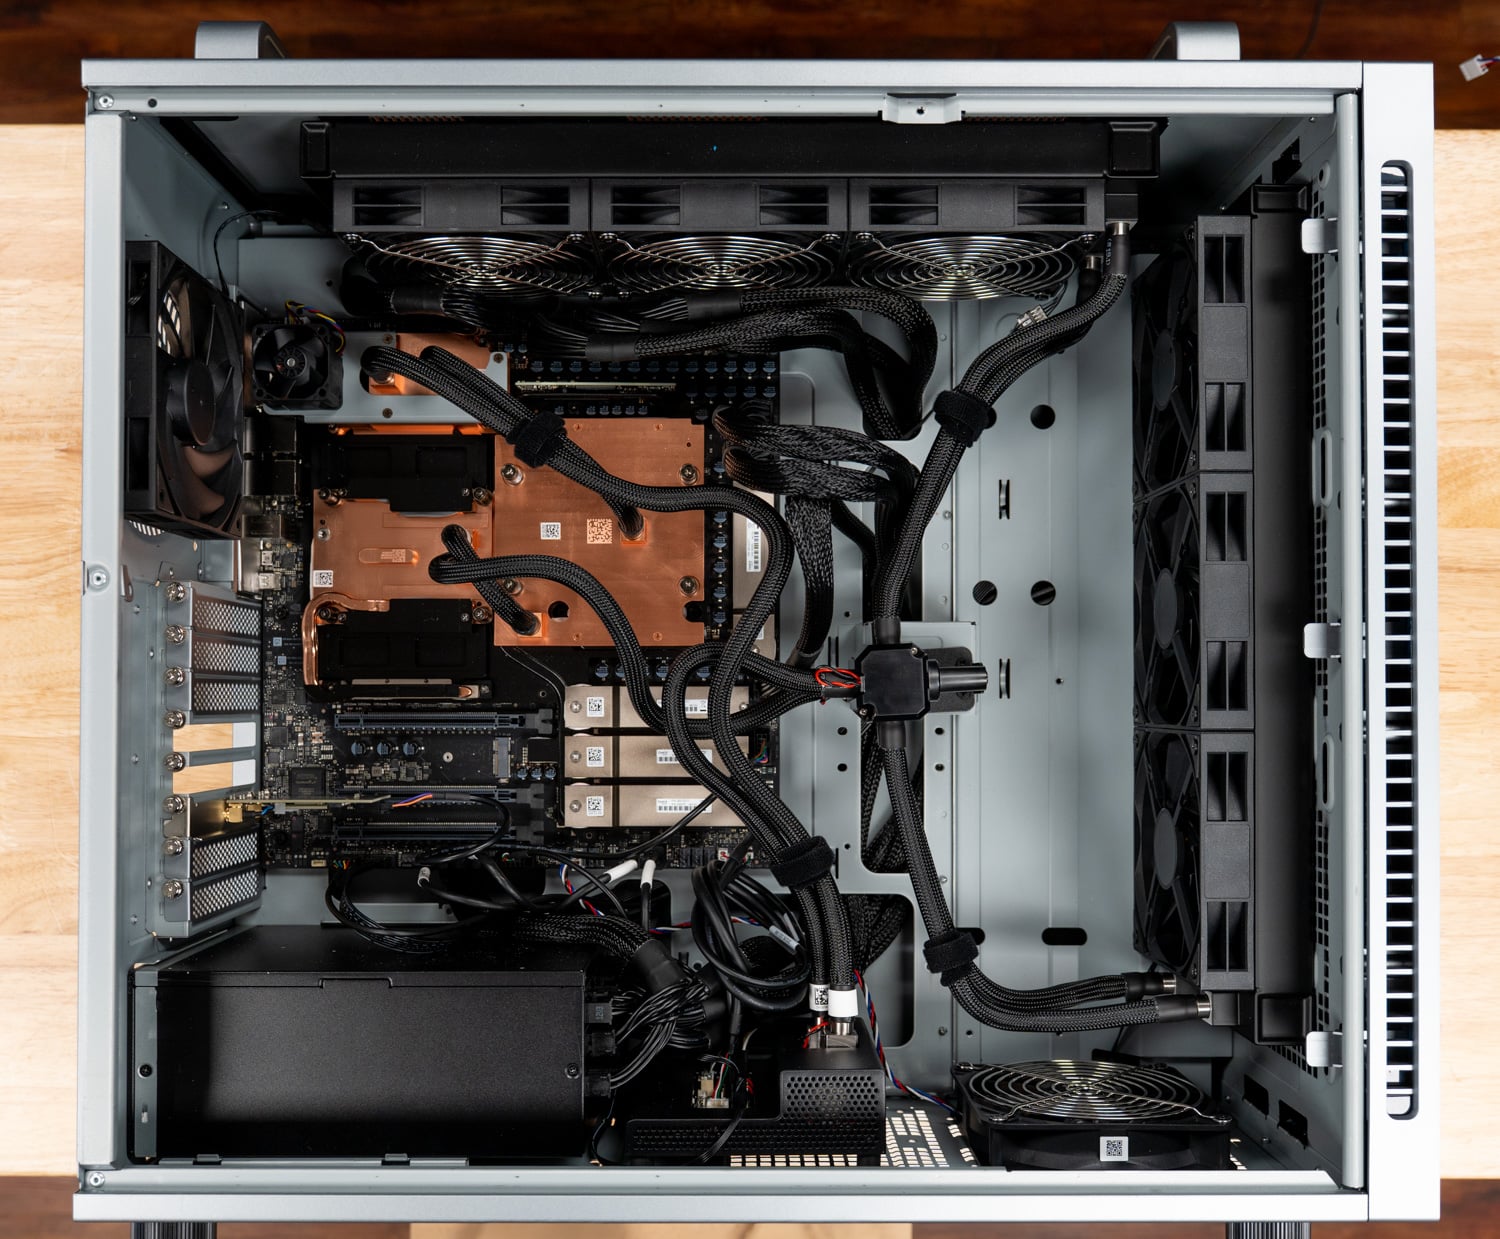
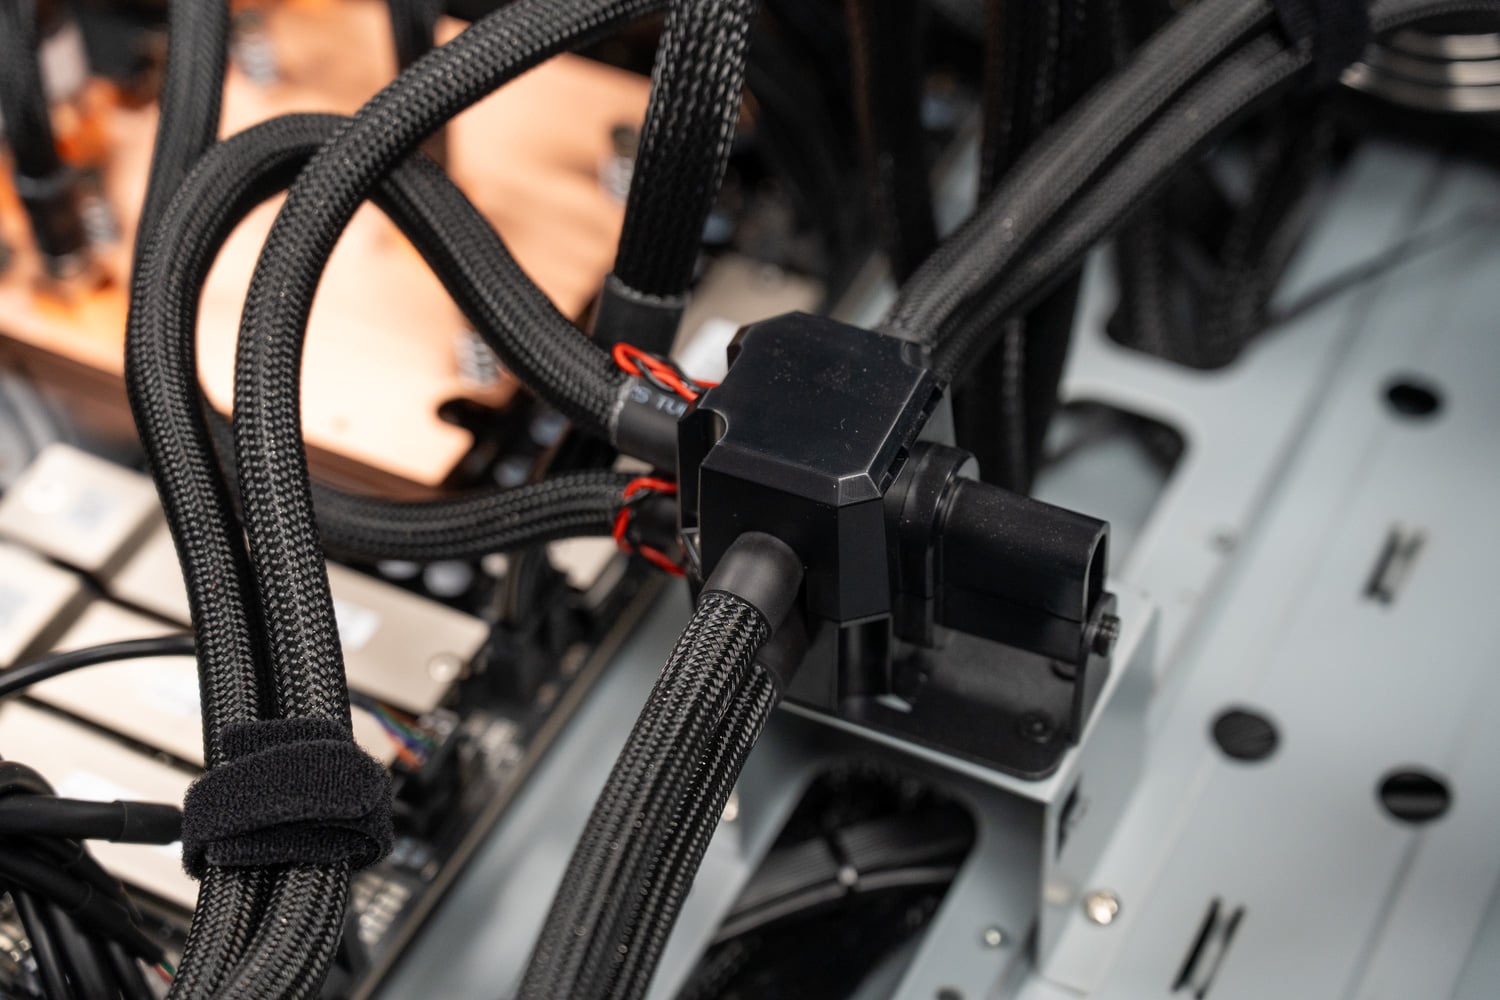
Внутренняя компоновка выполнена по тому же принципу, что и у WS300: один радиатор установлен вертикально за передней сеткой, а второй — вдоль верхней части, каждый с рядом вентиляторов, плюс дополнительный вентилятор для шасси сзади. Трубопроводы системы охлаждения заключены в защитные кожухи и закреплены на поперечине с помощью ремней на липучках, а коллектор объединяет трубопроводы от четырех холодных пластин, так что к каждому радиатору подходят только две трубки.
Вентилятор оптики
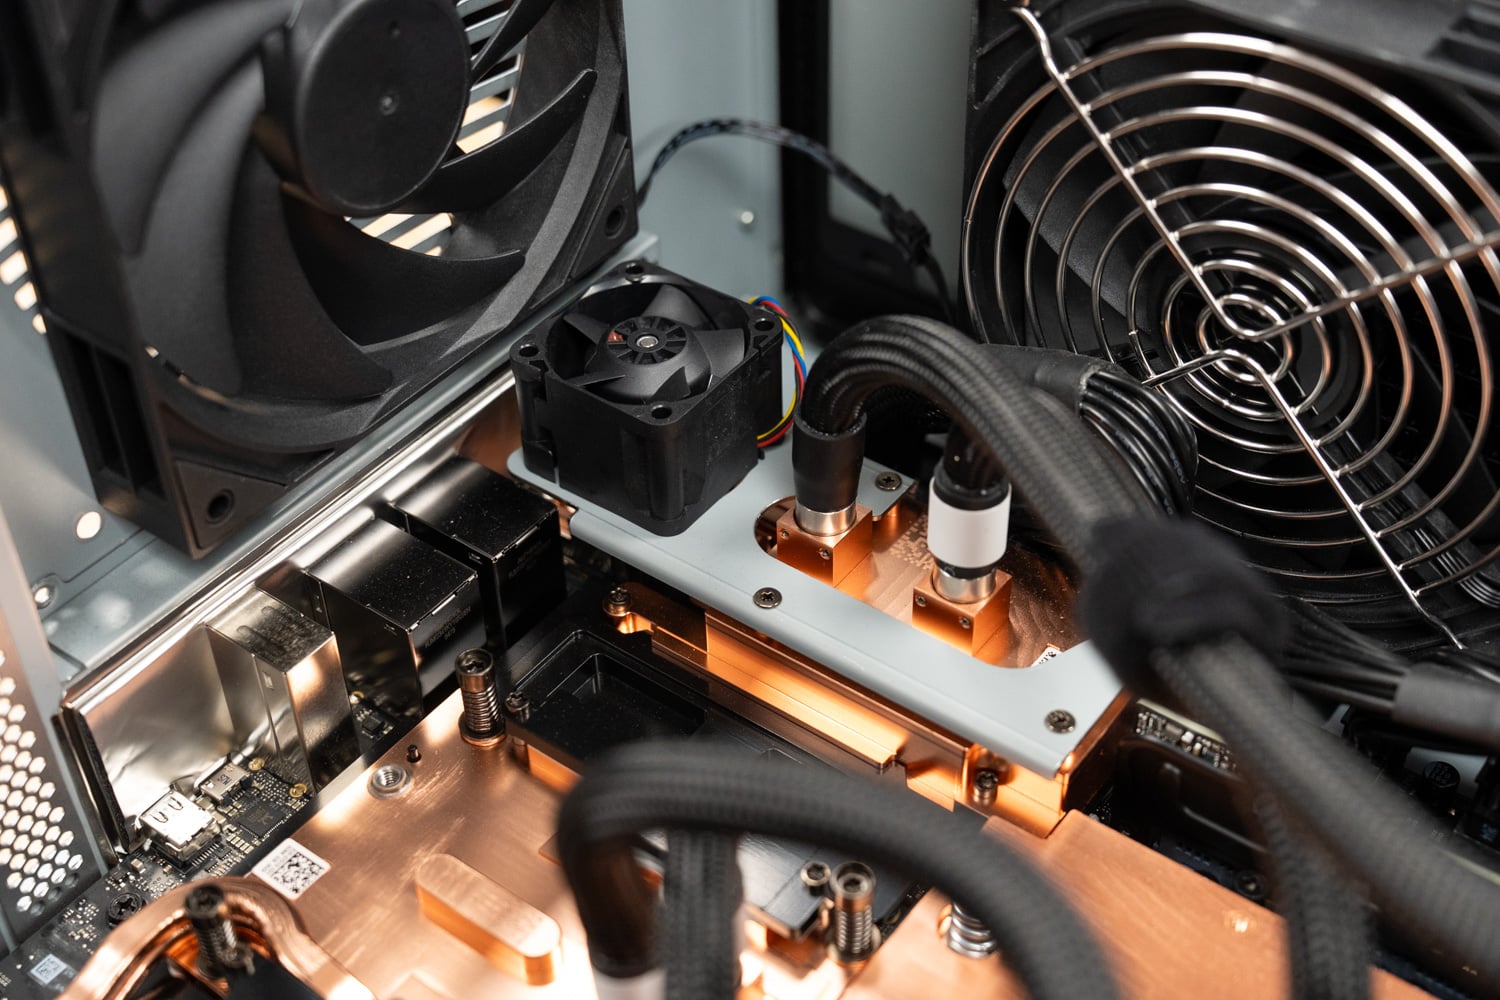
Единственный элемент охлаждения, не имеющий аналогов в WS300, — это небольшой вентилятор, установленный на кронштейне над охлаждающей пластиной ConnectX-8 и направленный на отсеки QSFP112. Жидкостный контур обеспечивает охлаждение самих микросхем SuperNIC, но оптические трансиверы 400G генерируют собственное тепло и находятся в металлических отсеках, к которым охлаждающая пластина может доставлять тепло только путем теплопроводности. В ходе других тестов мы отметили, что ConnectX-8 нагревается при длительной нагрузке, а сами оптические компоненты могут сильно нагреваться, поэтому выделенный путь воздушного потока через отсеки — это удачное конструктивное решение для тех, кто планирует использовать ET900N G3 по оптоволокну в течение нескольких часов подряд. При использовании ЦАП (как мы подключали его к второй станции GB300 для углубленного анализа кластерного инференцирования, который еще продолжается), вентилятору приходится меньше работать.
Хранение данных, расширение и электропитание
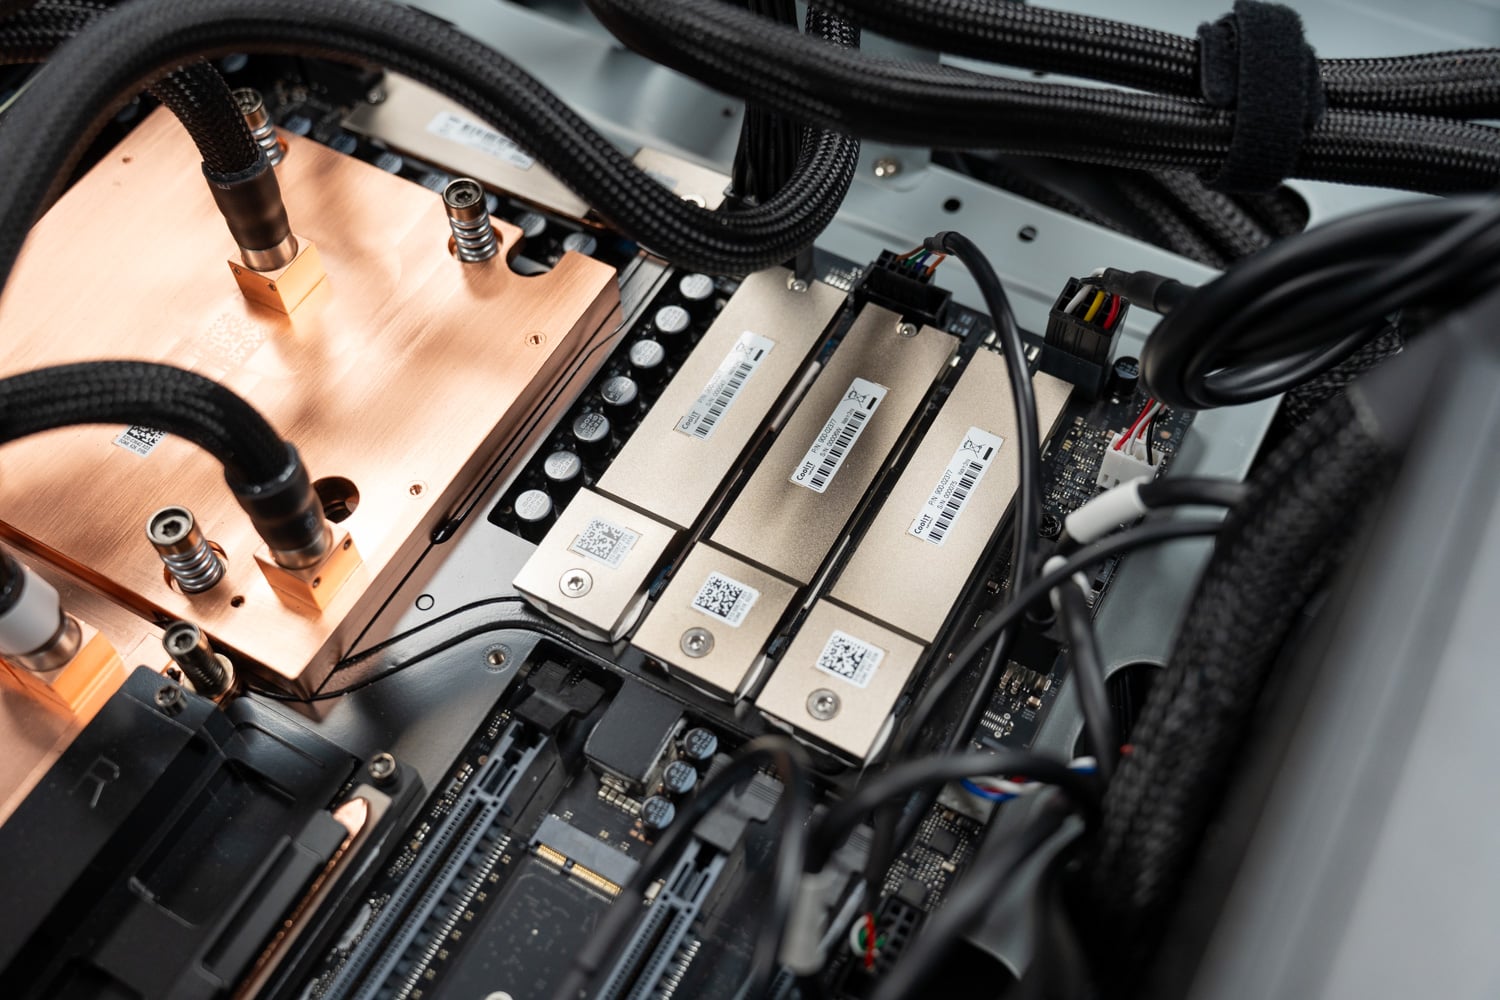
ASUS поставляла ET900N G3 с одним 2-терабайтным NVMe-накопителем для операционной системы и программного обеспечения NVIDIA, который устанавливался в два слота M.2 2280, подключенных по технологии Grace через PCIe 5.0 x4. Вторая пара слотов подключалась к встроенному PCIe-переключателю ConnectX-8 и поставлялась пустой.
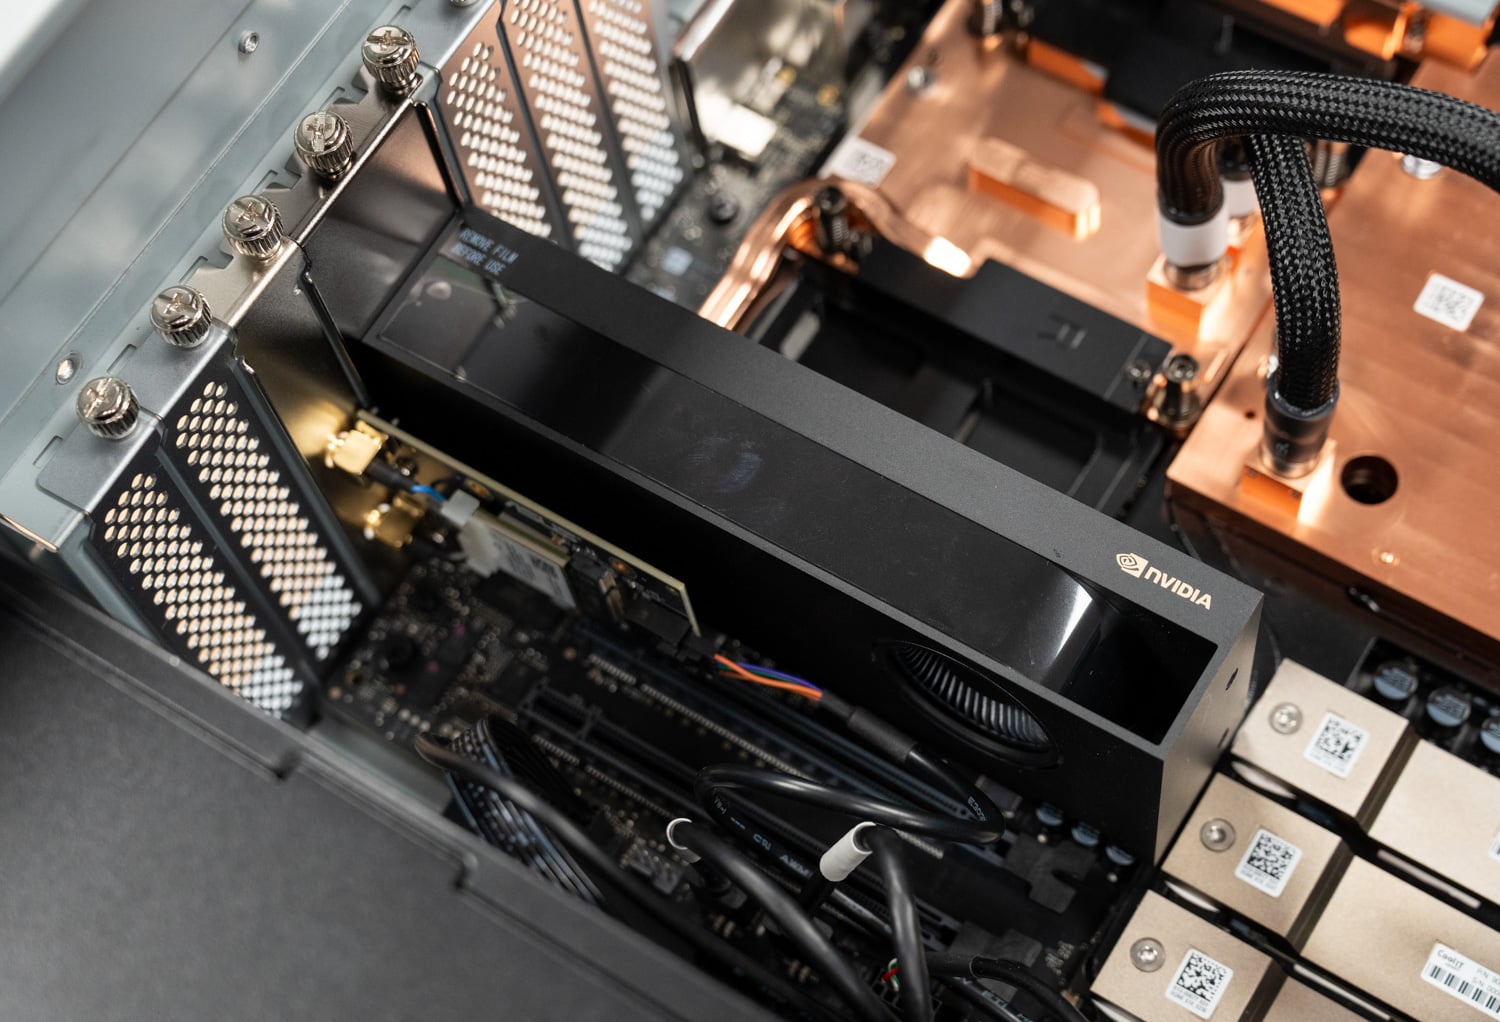
Наш тестовый образец поставлялся с видеокартой NVIDIA RTX PRO 2000 Blackwell в слоте PCIe 5.0 x16, что является одной из конфигураций, предлагаемых ASUS. Карта обеспечивает вывод изображения, не потребляя значительно больше энергии, чем позволяет корпус GB300, и ASUS заявляет, что в корпус можно установить до одной карты RTX PRO Blackwell. Мы извлекли RTX PRO 2000 перед тестированием, чтобы Superchip использовал весь доступный энергетический бюджет, как и в случае с WS300, и не тестировали мощную карту RTX PRO в этом корпусе; этот вариант и его влияние на общий энергетический бюджет мы рассмотрим в одном из следующих обзоров GB300 Station.
Блок питания представляет собой 1,600-ваттный ATX-блок, сертифицированный ASUS по стандарту 80 PLUS Titanium, что на ступень выше, чем Platinum в WS300. Для стандарта Titanium требуется 94% КПД при 50% нагрузке на входе 115 В по сравнению с 92% для Platinum, и это единственный уровень, который устанавливает минимальный уровень нагрузки в 10%, поэтому ET900N G3 должен потреблять на несколько десятков ватт меньше электроэнергии при полной нагрузке GB300. Потребляемая мощность по-прежнему общая: Grace, B300, помпы, вентиляторы, накопители и любая видеокарта RTX PRO потребляют от одного и того же блока питания мощностью 1,600 Вт, а сервис NVIDIA vsloshd изменяет запас мощности между Superchip и дополнительной видеокартой в зависимости от их потребления, без фиксированного ограничения для обоих. В обзоре WS300 эта политика подробно описана, и здесь она не изменилась. Для североамериканских установок по-прежнему требуется выделенная цепь на 20 А.
связь
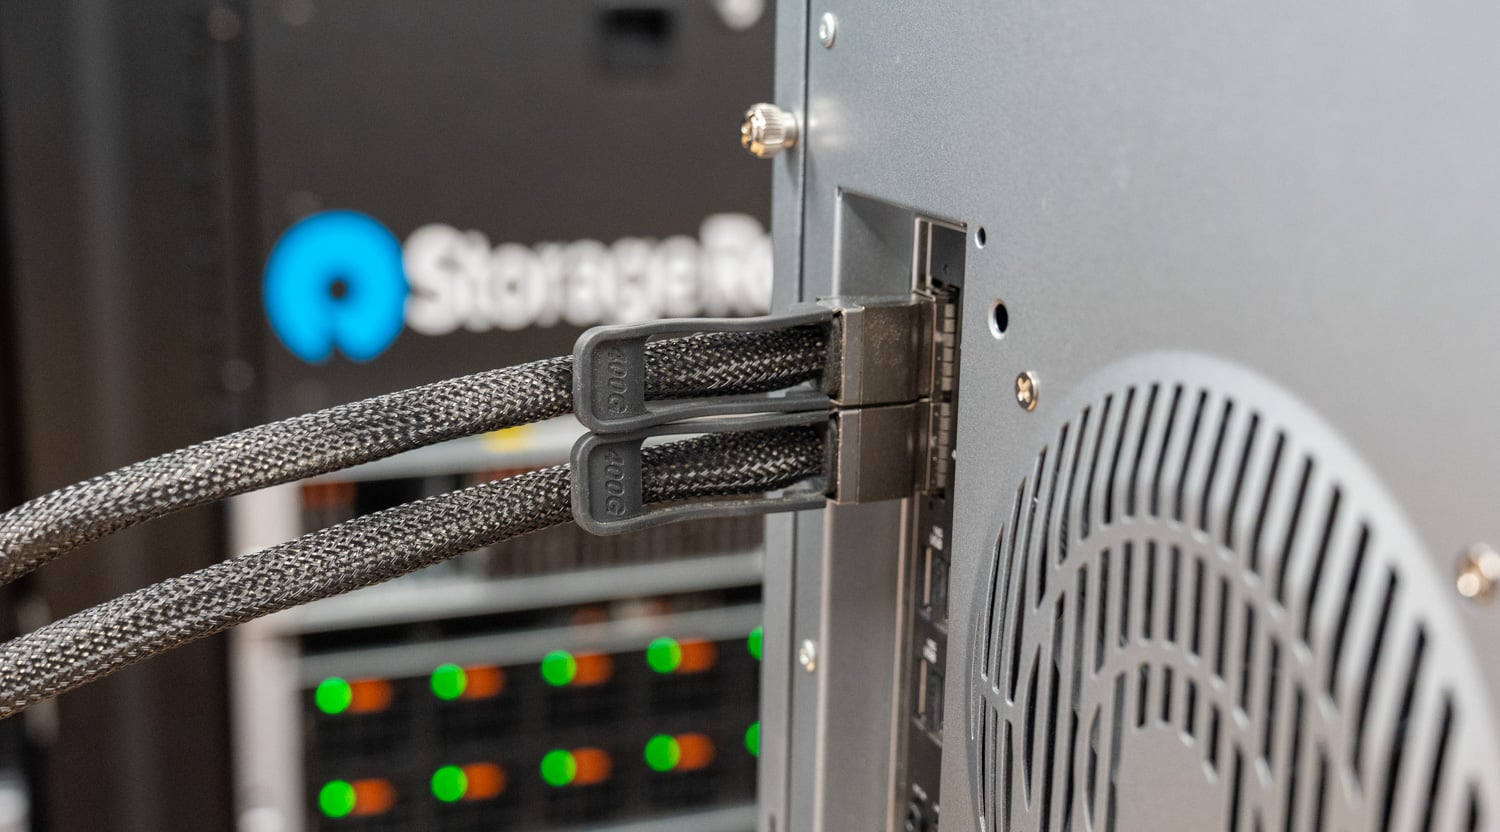
Два порта QSFP112 на ConnectX-8 служат для связи ET900N G3 со всем остальным: хранилищем данных, второй станцией DGX или кластерной сетью. Эти порты уже используются в лаборатории: ET900N G3 подключен к второй станции GB300 через ЦАП 400G для подробного анализа кластерного инференцирования, результаты которого мы опубликуем отдельно. Порт 10GbE Marvell обрабатывает обычный трафик хоста, а порт Realtek 1GbE выделен для BMC.
Примечания к тестированию
Все результаты в этом обзоре получены на устройстве, предоставленном компанией ASUS нашей лаборатории, в стандартной конфигурации памяти с 252 ГБ HBM3e и 496 ГБ LPDDR5X. Система работала без установленной видеокарты RTX PRO, поэтому процессор GB300 Superchip имел полный энергетический бюджет ускорителя, что соответствует условиям нашего тестирования WS300. Программное обеспечение, конфигурация vLLM, профили рабочих нагрузок и анализ параллельной обработки данных идентичны тем, которые мы использовали для WS300, поэтому сравнение двух башенных систем возможно напрямую. Этот обзор посвящен только производительности; мы не измеряли энергопотребление или температуру данного устройства.
В качестве рабочих нагрузок используются те же два профиля vLLM для выполнения инференции в реальном времени, которые мы запускаем на каждой локальной системе ИИ: одинаковая рабочая нагрузка с 512 входными и 512 выходными токенами, и рабочая нагрузка с интенсивным предварительным заполнением, включающая 8,192 входных и 1,024 выходных токена, с количеством одновременных потоков от одного до 128. Для моделей граничного масштаба мы сравниваем их с сервером Dell PowerEdge XE7740 с графическими процессорами, оснащенным двумя или четырьмя картами RTX PRO 6000 , — ближайшей альтернативой в виде единого блока для этих контрольных точек. Для моделей меньшего масштаба мы сравниваем их с одной картой RTX PRO 6000 в том же XE7740, одной картой H200 NVL в Dell PowerEdge R770 и GB10 DGX Spark, представленным Acer Veriton GN100 , тем же Spark, который мы использовали в обзоре WS300. Все приведенные ниже цифры — это точные значения из журналов работы каждой системы, а результаты DGX Spark получены в ходе тестирования WS300.
Производительность вывода
Передовые модели на основе пула когерентной памяти
Основная цель GB300 — обслуживание моделей, использующих память HBM3e объемом до 252 ГБ, что значительно превышает возможности B300. Поэтому мы начинаем с четырех контрольных точек, охватывающих этот объем: DeepSeek V4 Flash и MiniMax M2.7 помещаются в HBM с запасом места, MiniMax M3 едва помещается и переносит часть своих экспертных функций в память Grace, а GLM-5.2 переносит примерно половину своей нагрузки. На другой стороне каждой диаграммы находится ближайшая альтернатива в одном корпусе: карты RTX PRO 6000, объединенные в PowerEdge XE7740, с переносом экспертных функций в основную память там, где это необходимо.
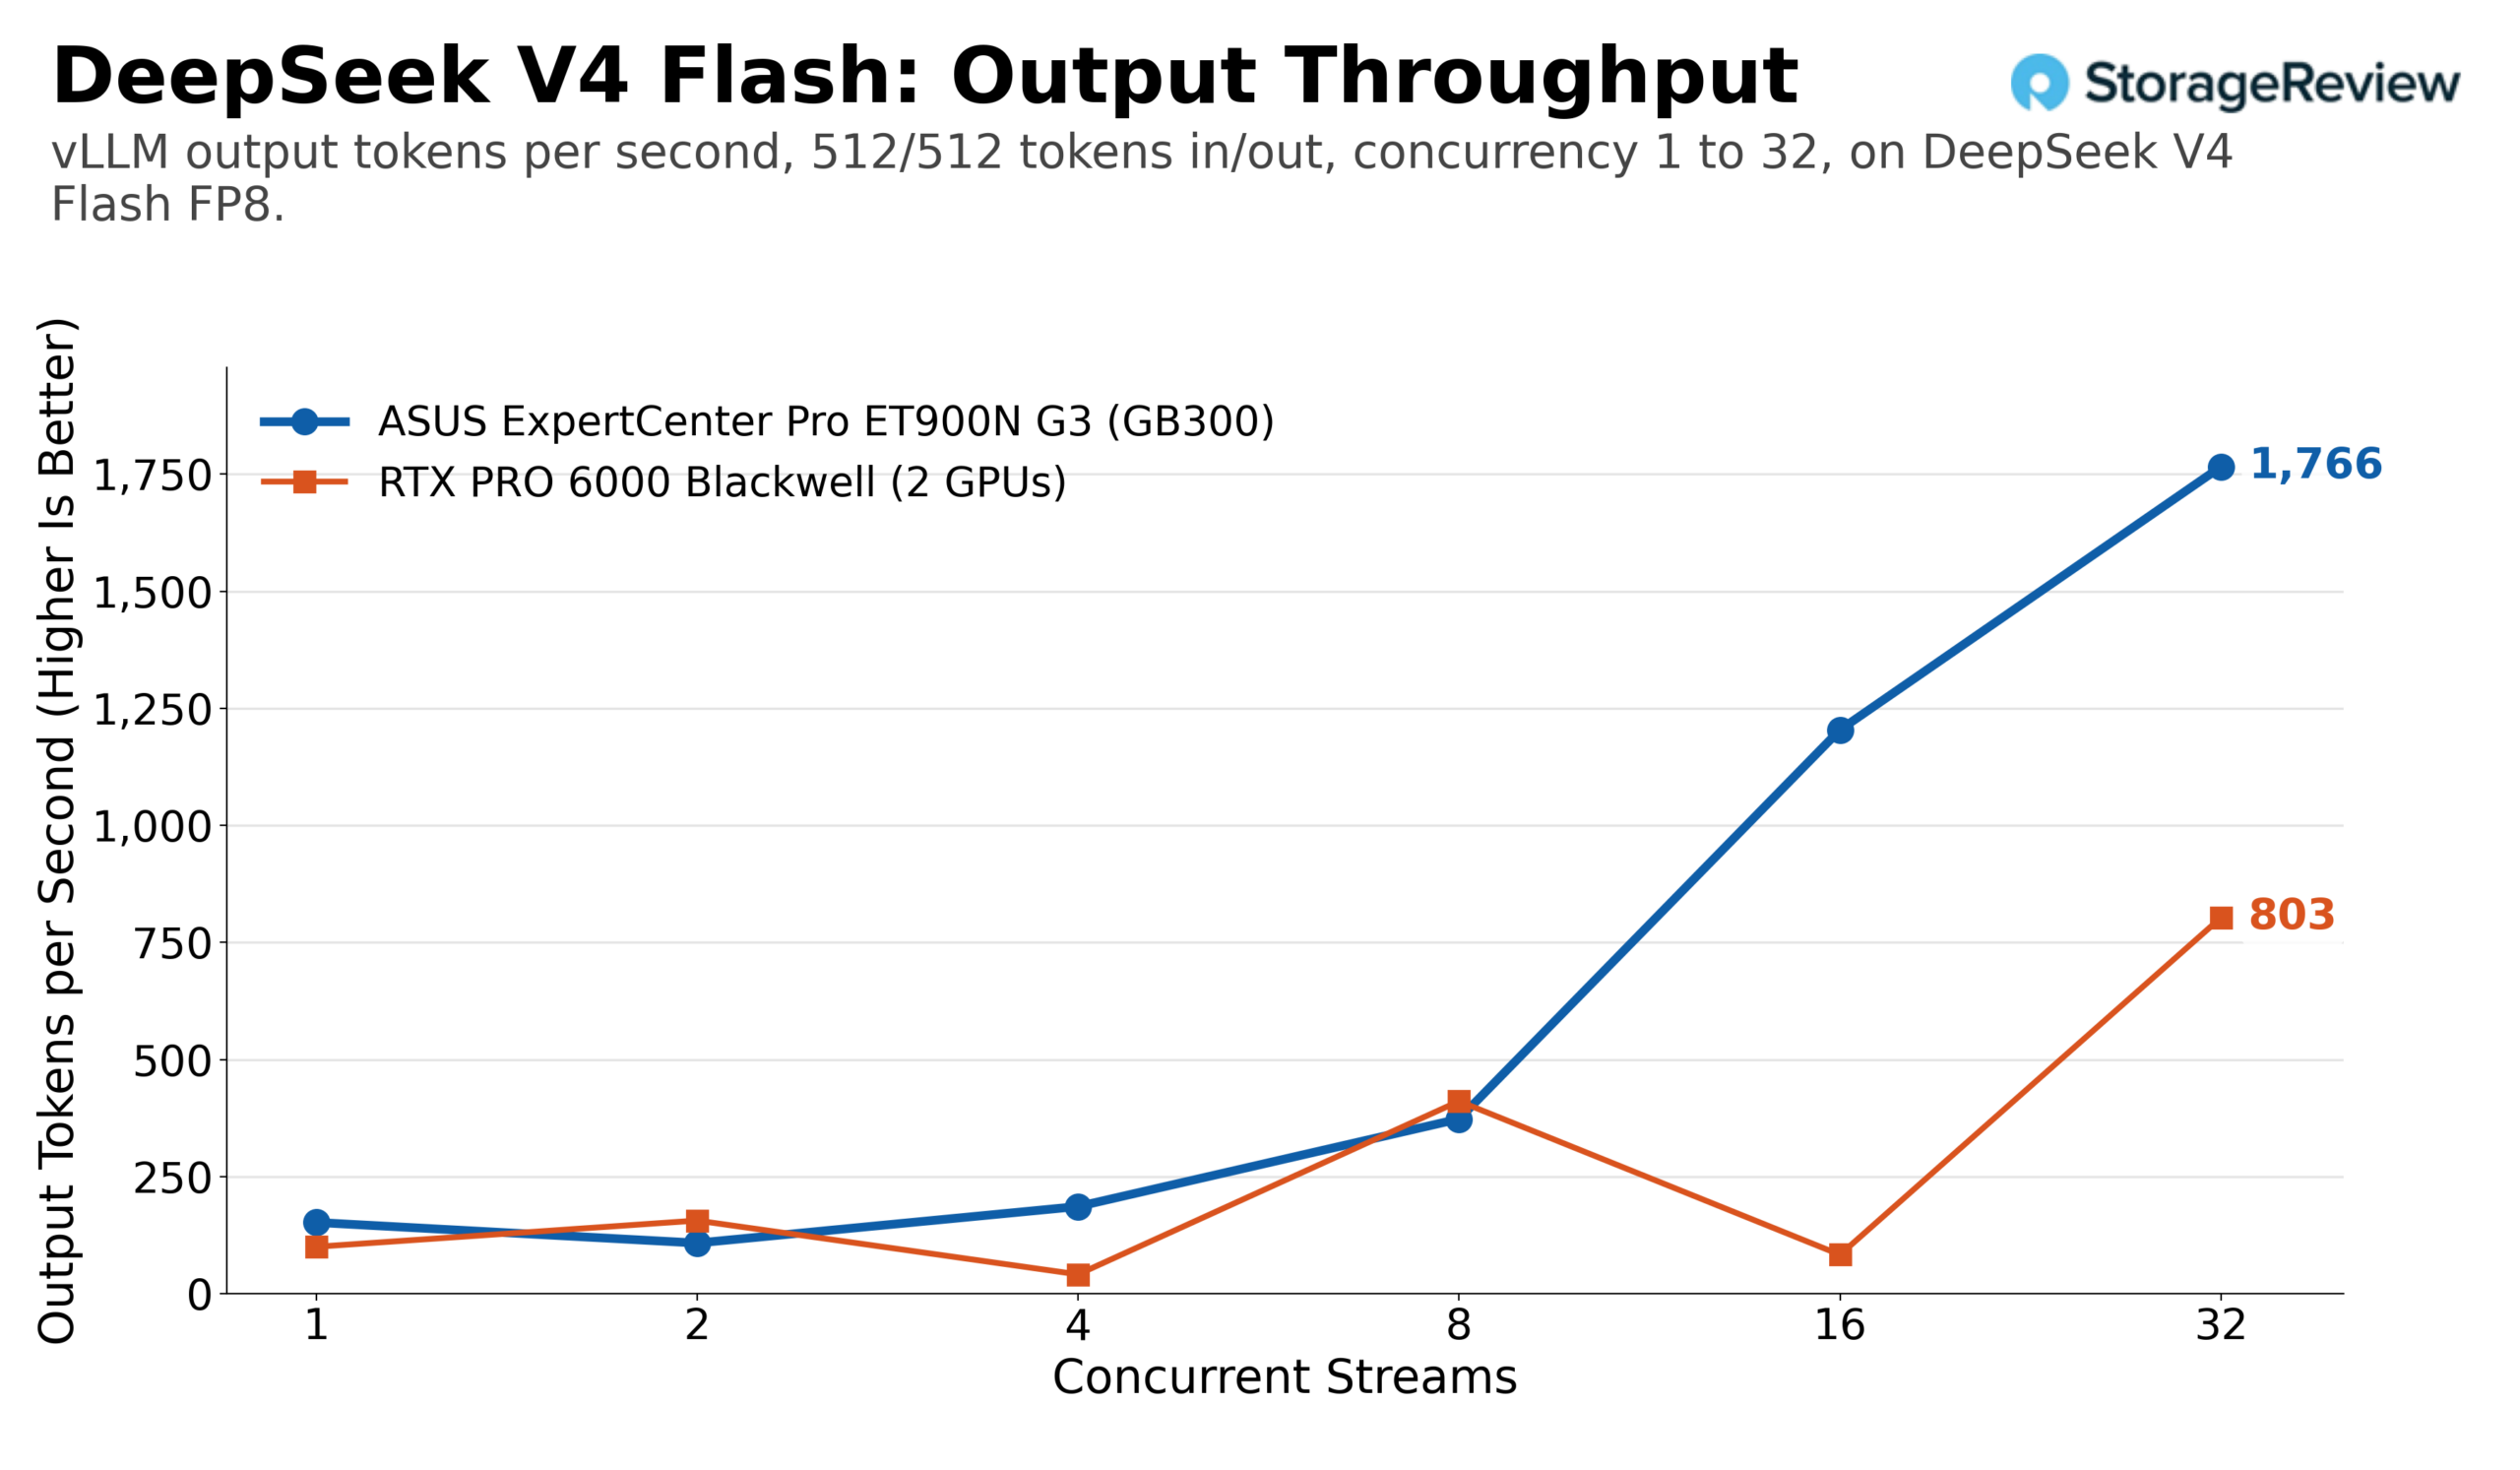
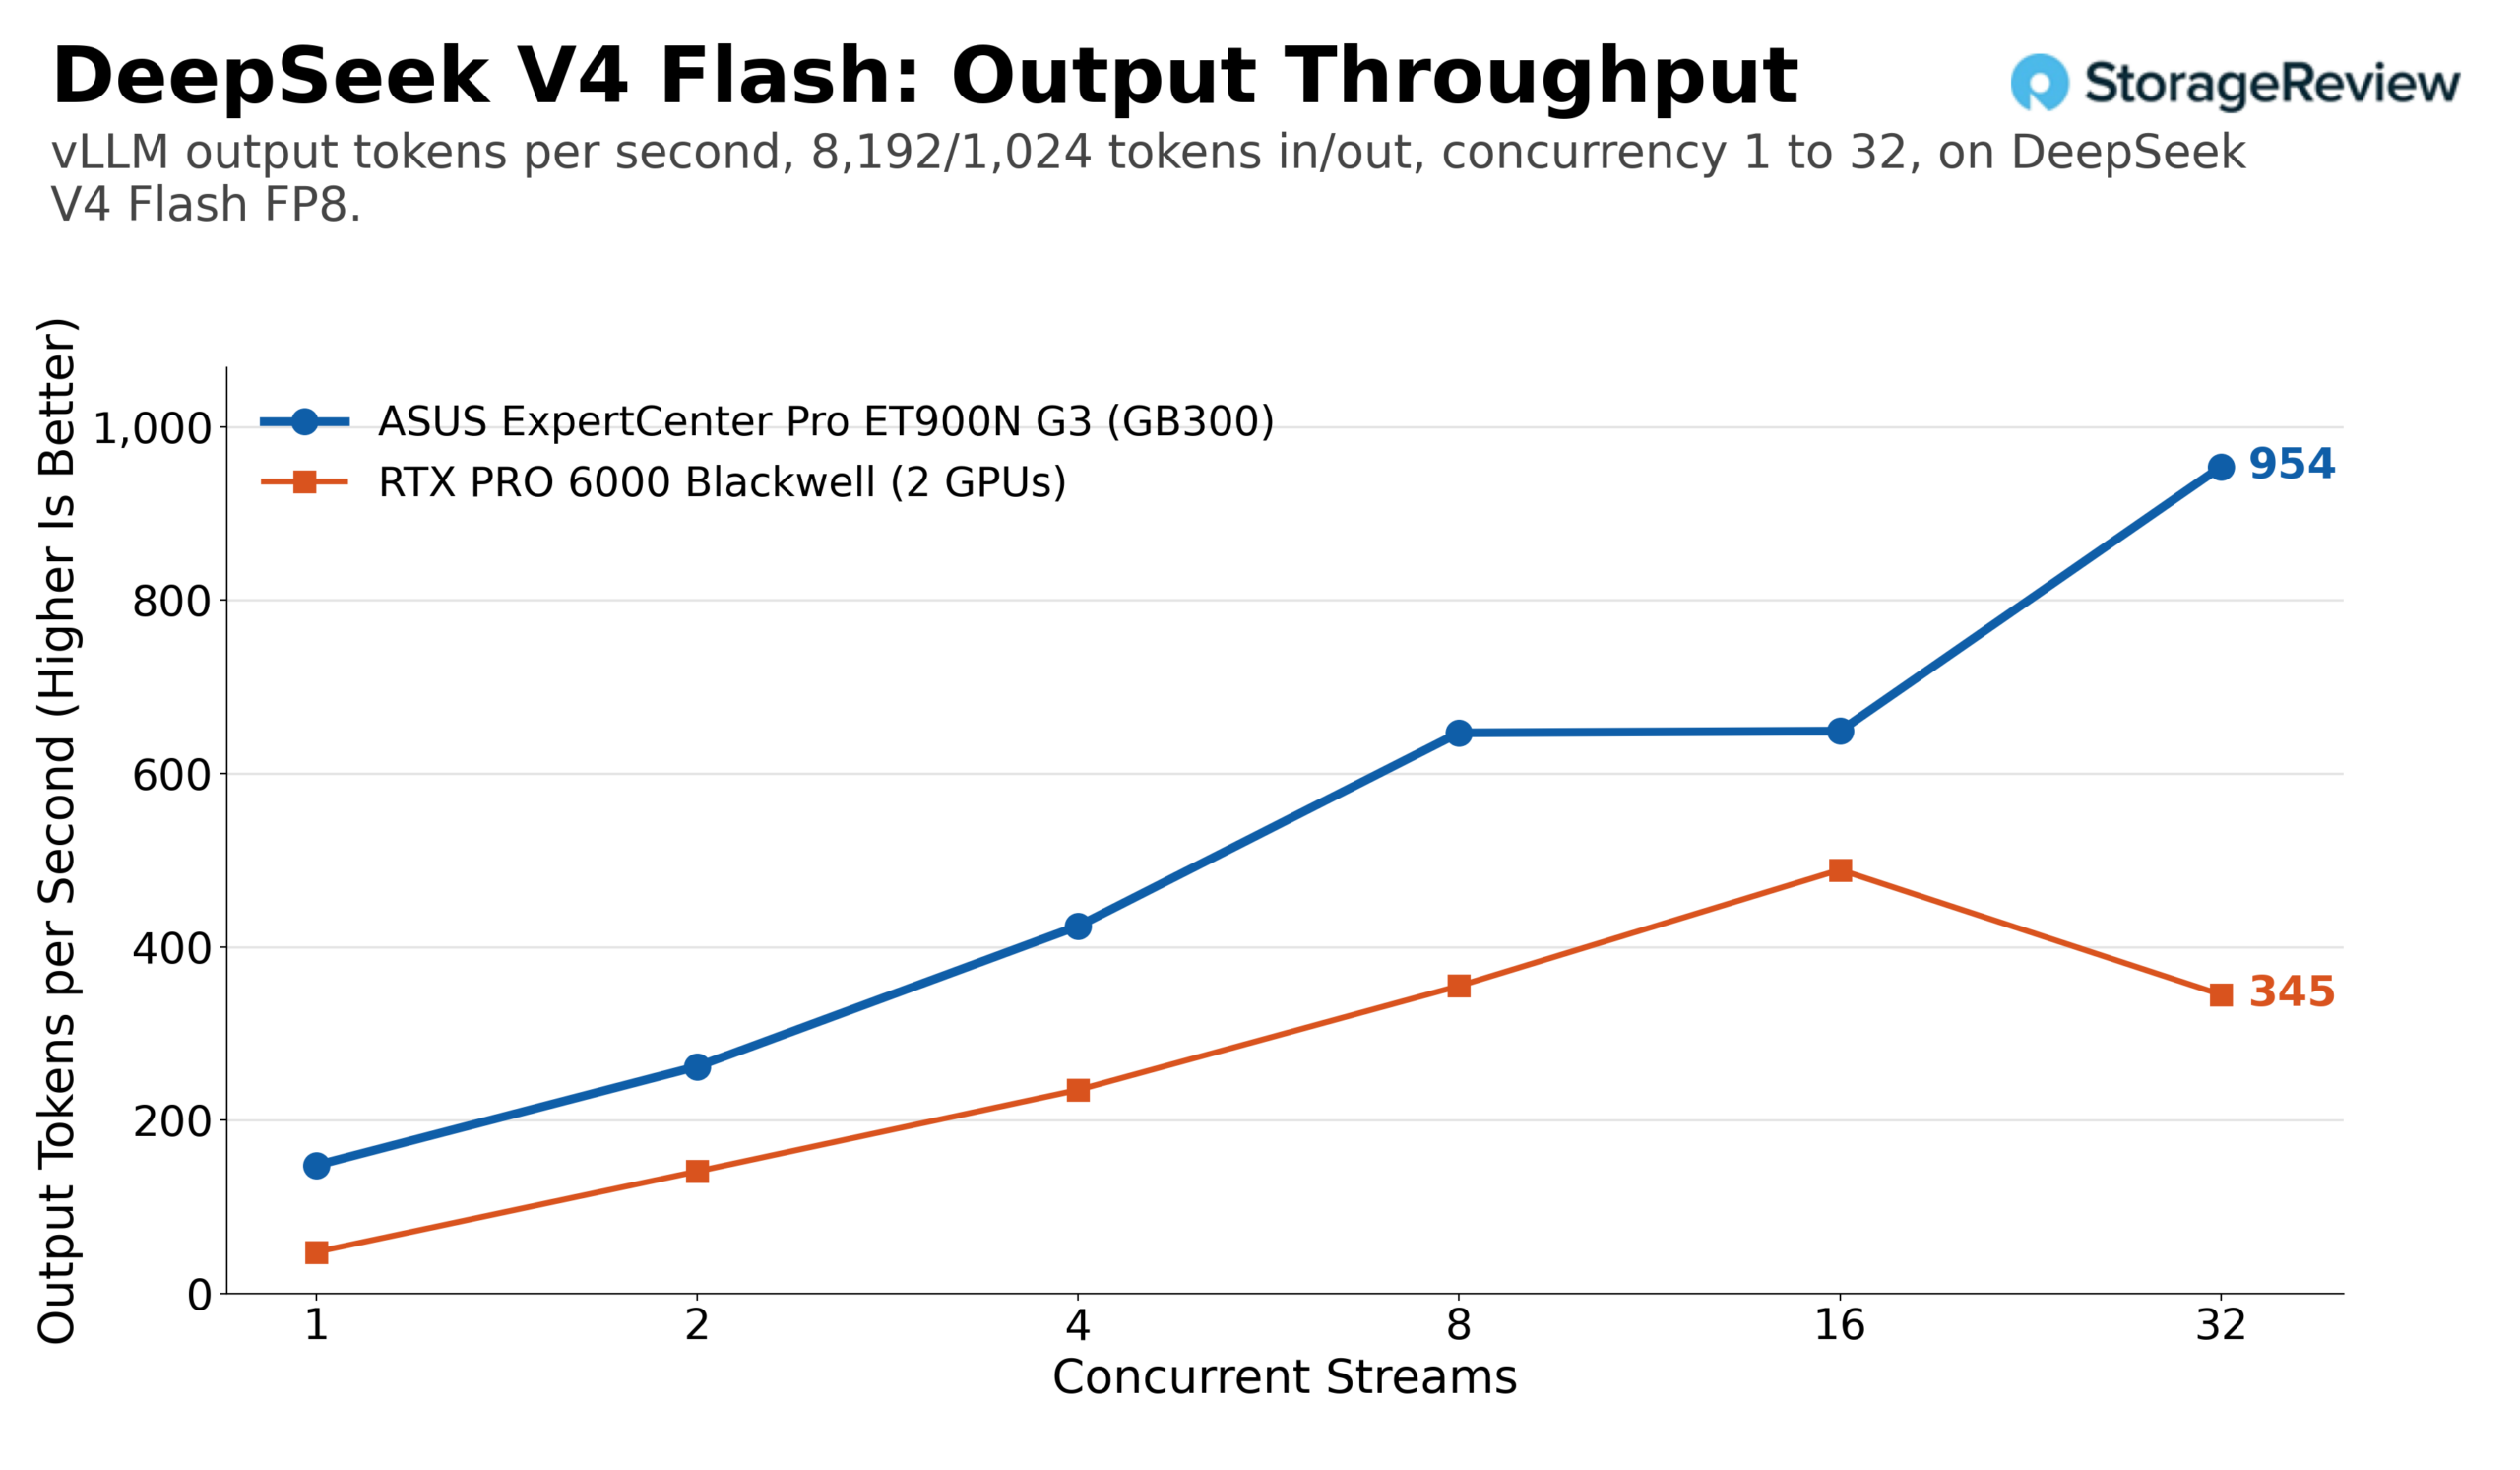
DeepSeek V4 Flash — это простой случай: нативная контрольная точка FP8 объемом около 20 ГБ, которую B300 обрабатывает без проблем. Пропускная способность при той же нагрузке выросла со 152 токенов в секунду при 1 потоке до 1,766 при 32 потоках, в результате чего общая пропускная способность токенов составила 3,532. В профиле с интенсивным предварительным заполнением ET900N G3 увеличила пропускную способность с 148 до 954 токенов в секунду, достигнув в общей сложности 8,587 токенов. В том же диапазоне от 1 до 32 потоков пара карт RTX PRO 6000 достигла 803 токенов в секунду при одинаковой нагрузке и 489 при длинных запросах, с неравномерной кривой при низкой параллельности.
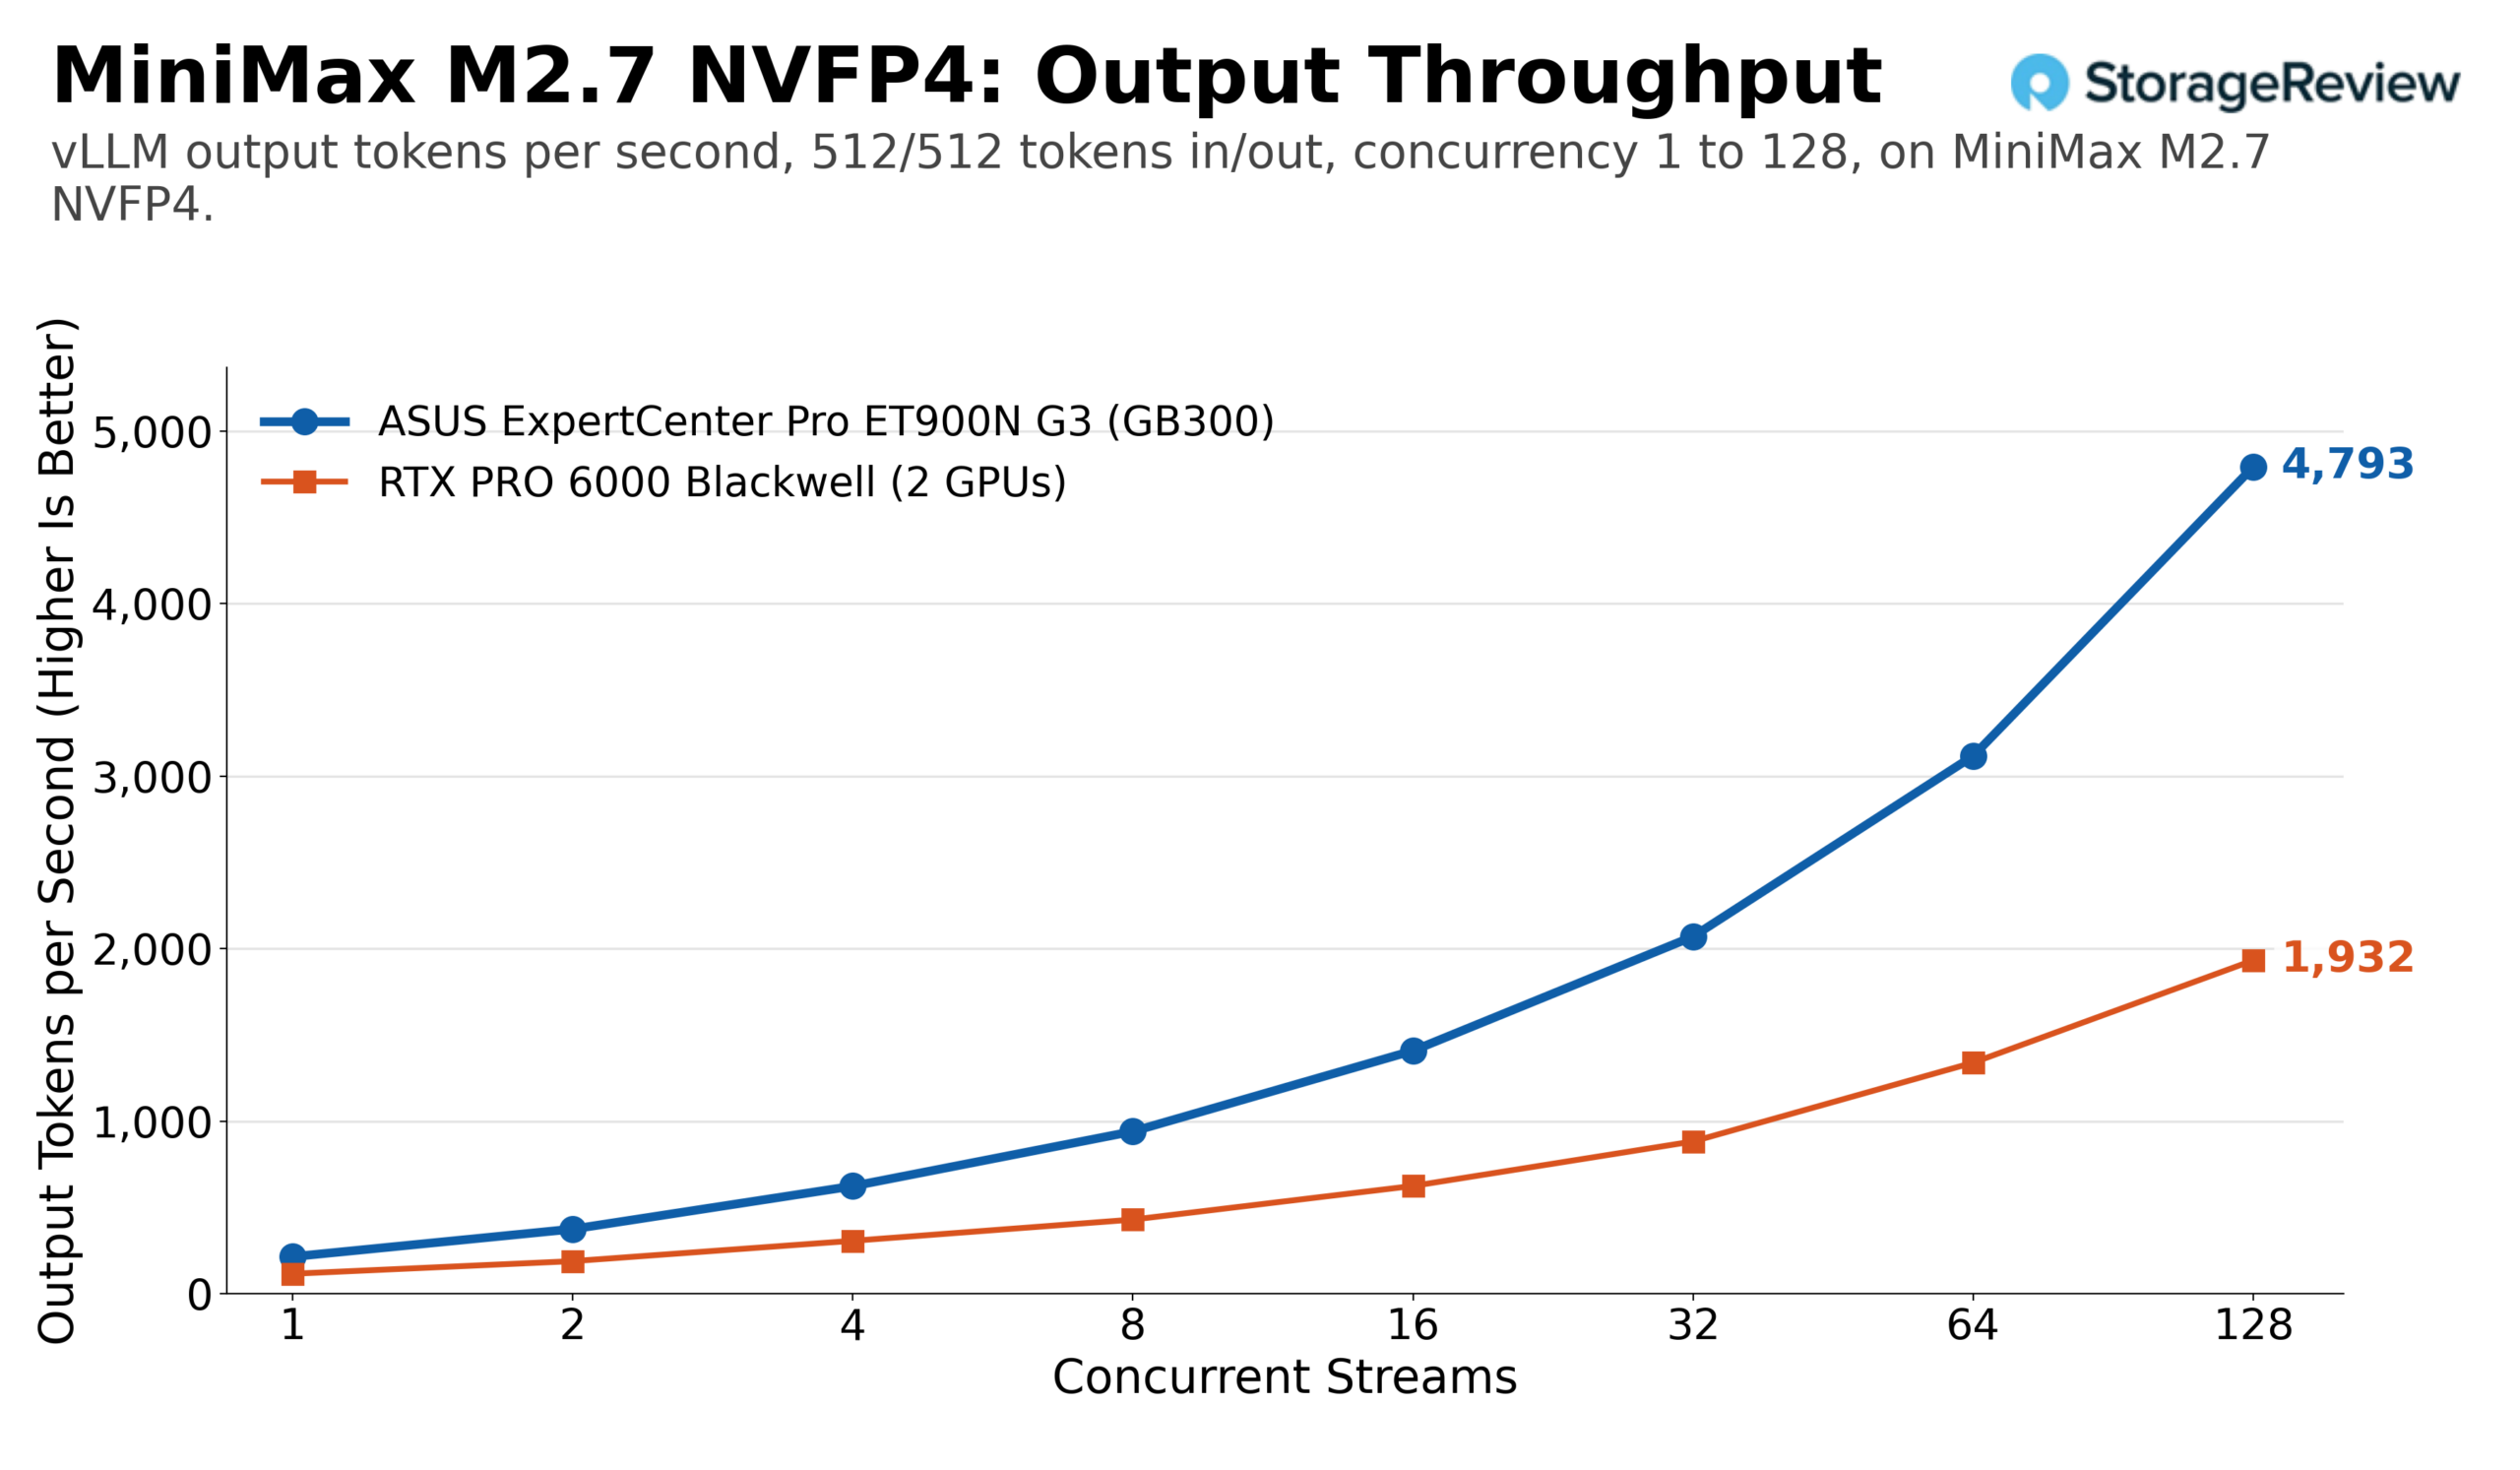
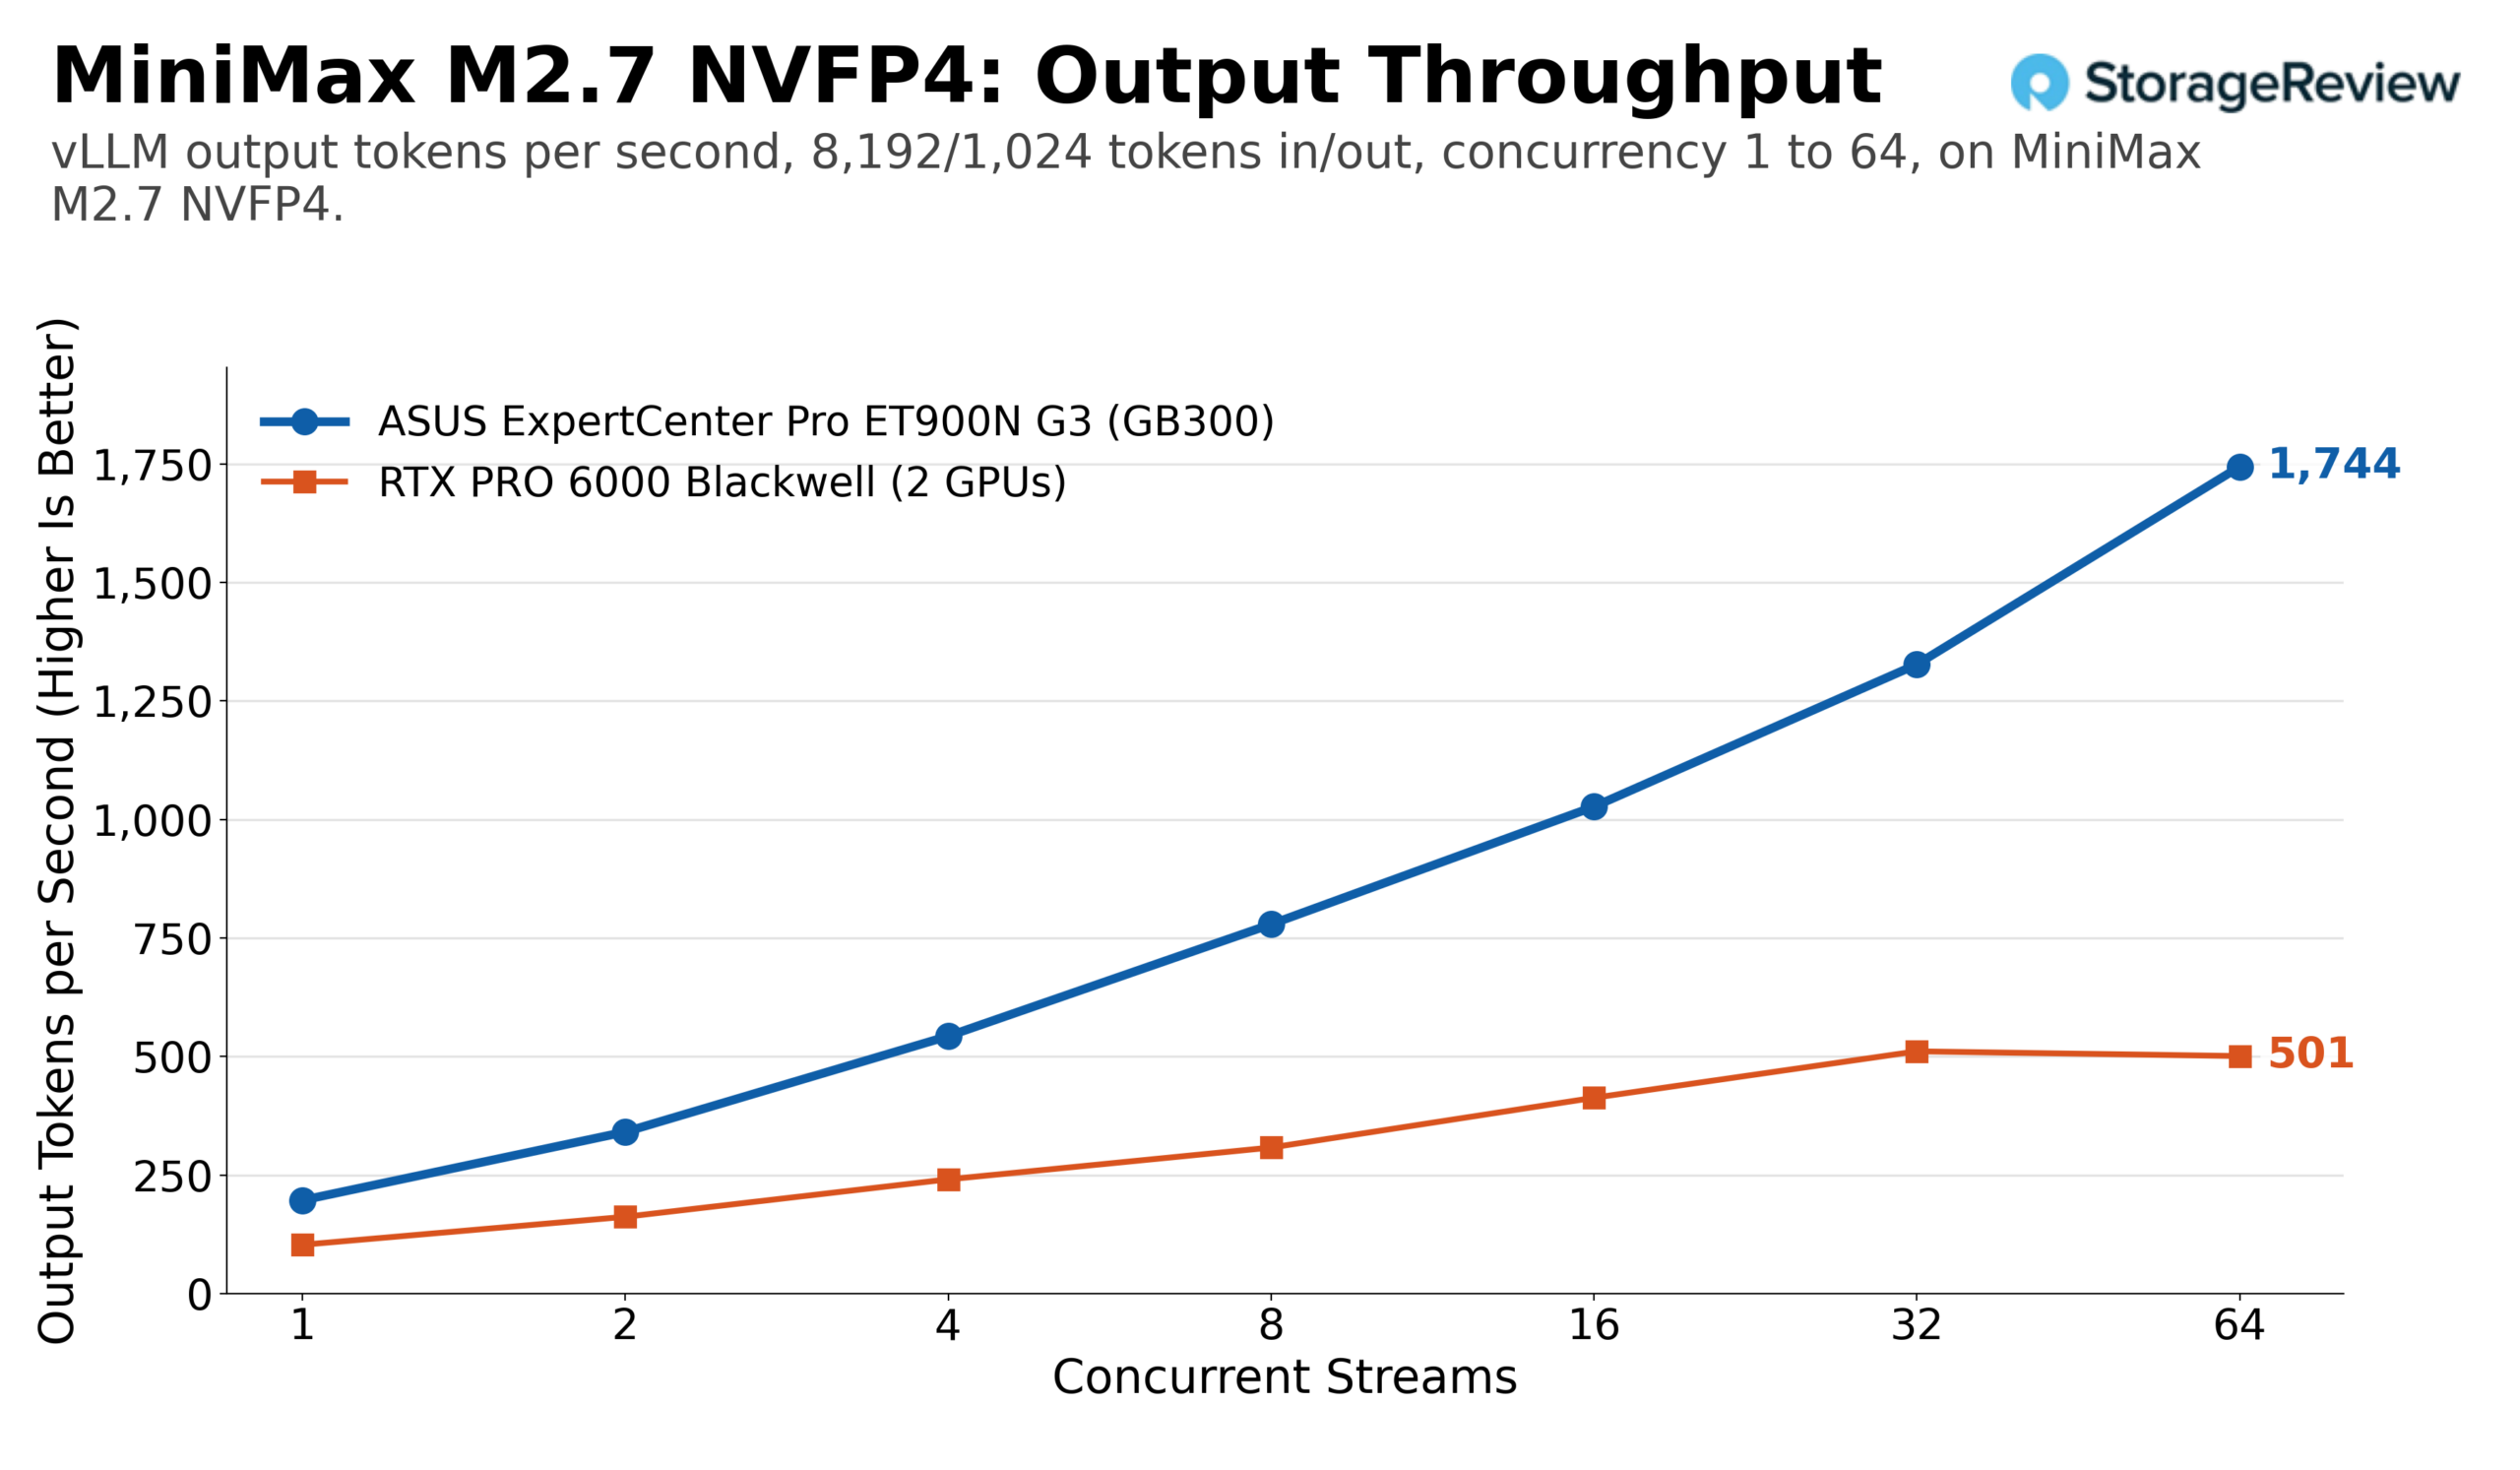
MiniMax M2.7 с квантизацией NVFP4 от NVIDIA занимает около 125 ГБ памяти HBM и показал наилучшие результаты из четырех. При одинаковой нагрузке производительность выросла с 214 выходных токенов в секунду на одном потоке до 4,793 на 128 потоках, а общая пропускная способность достигла 9,586. При интенсивном предварительном заполнении производительность выросла до 1,744 выходных токенов в секунду и 15,700 общих токенов в секунду при 64 потоках. Две карты RTX PRO 6000 показали аналогичную производительность, но с меньшей высотой (менее половины), достигнув 1,932 выходных токенов в секунду при 128 потоках при одинаковой нагрузке и 511 при длительных запросах.
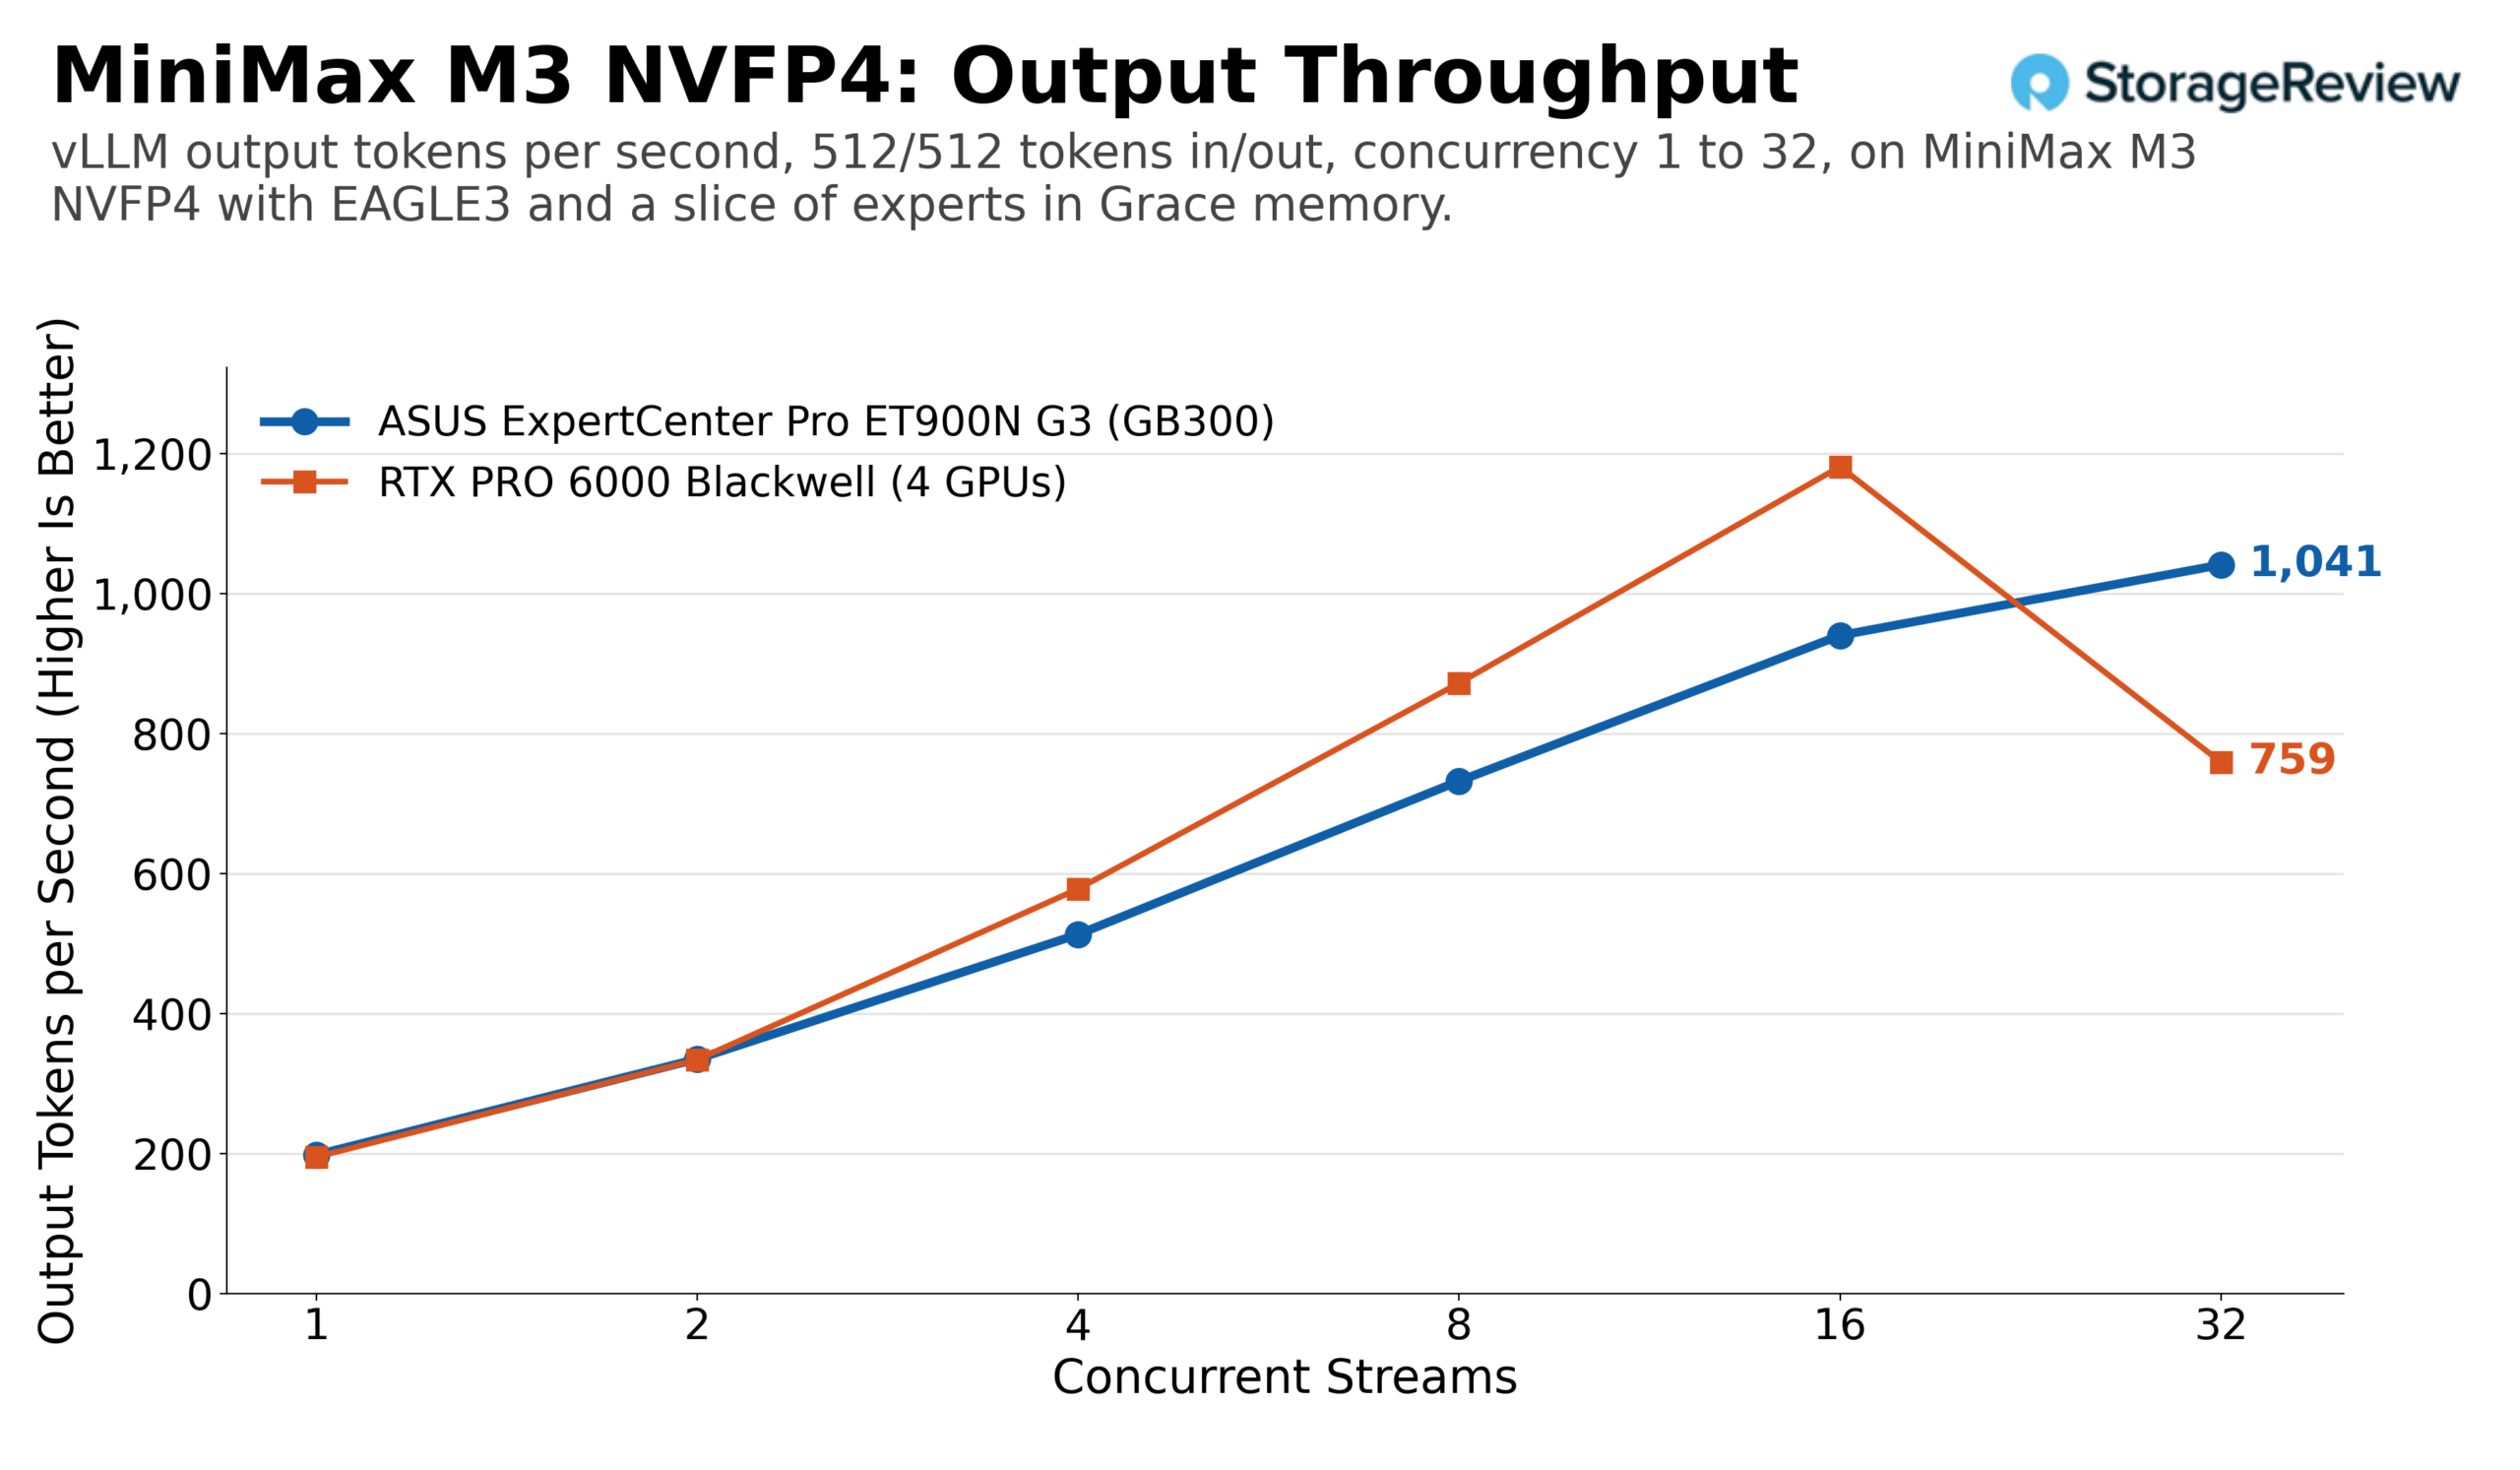
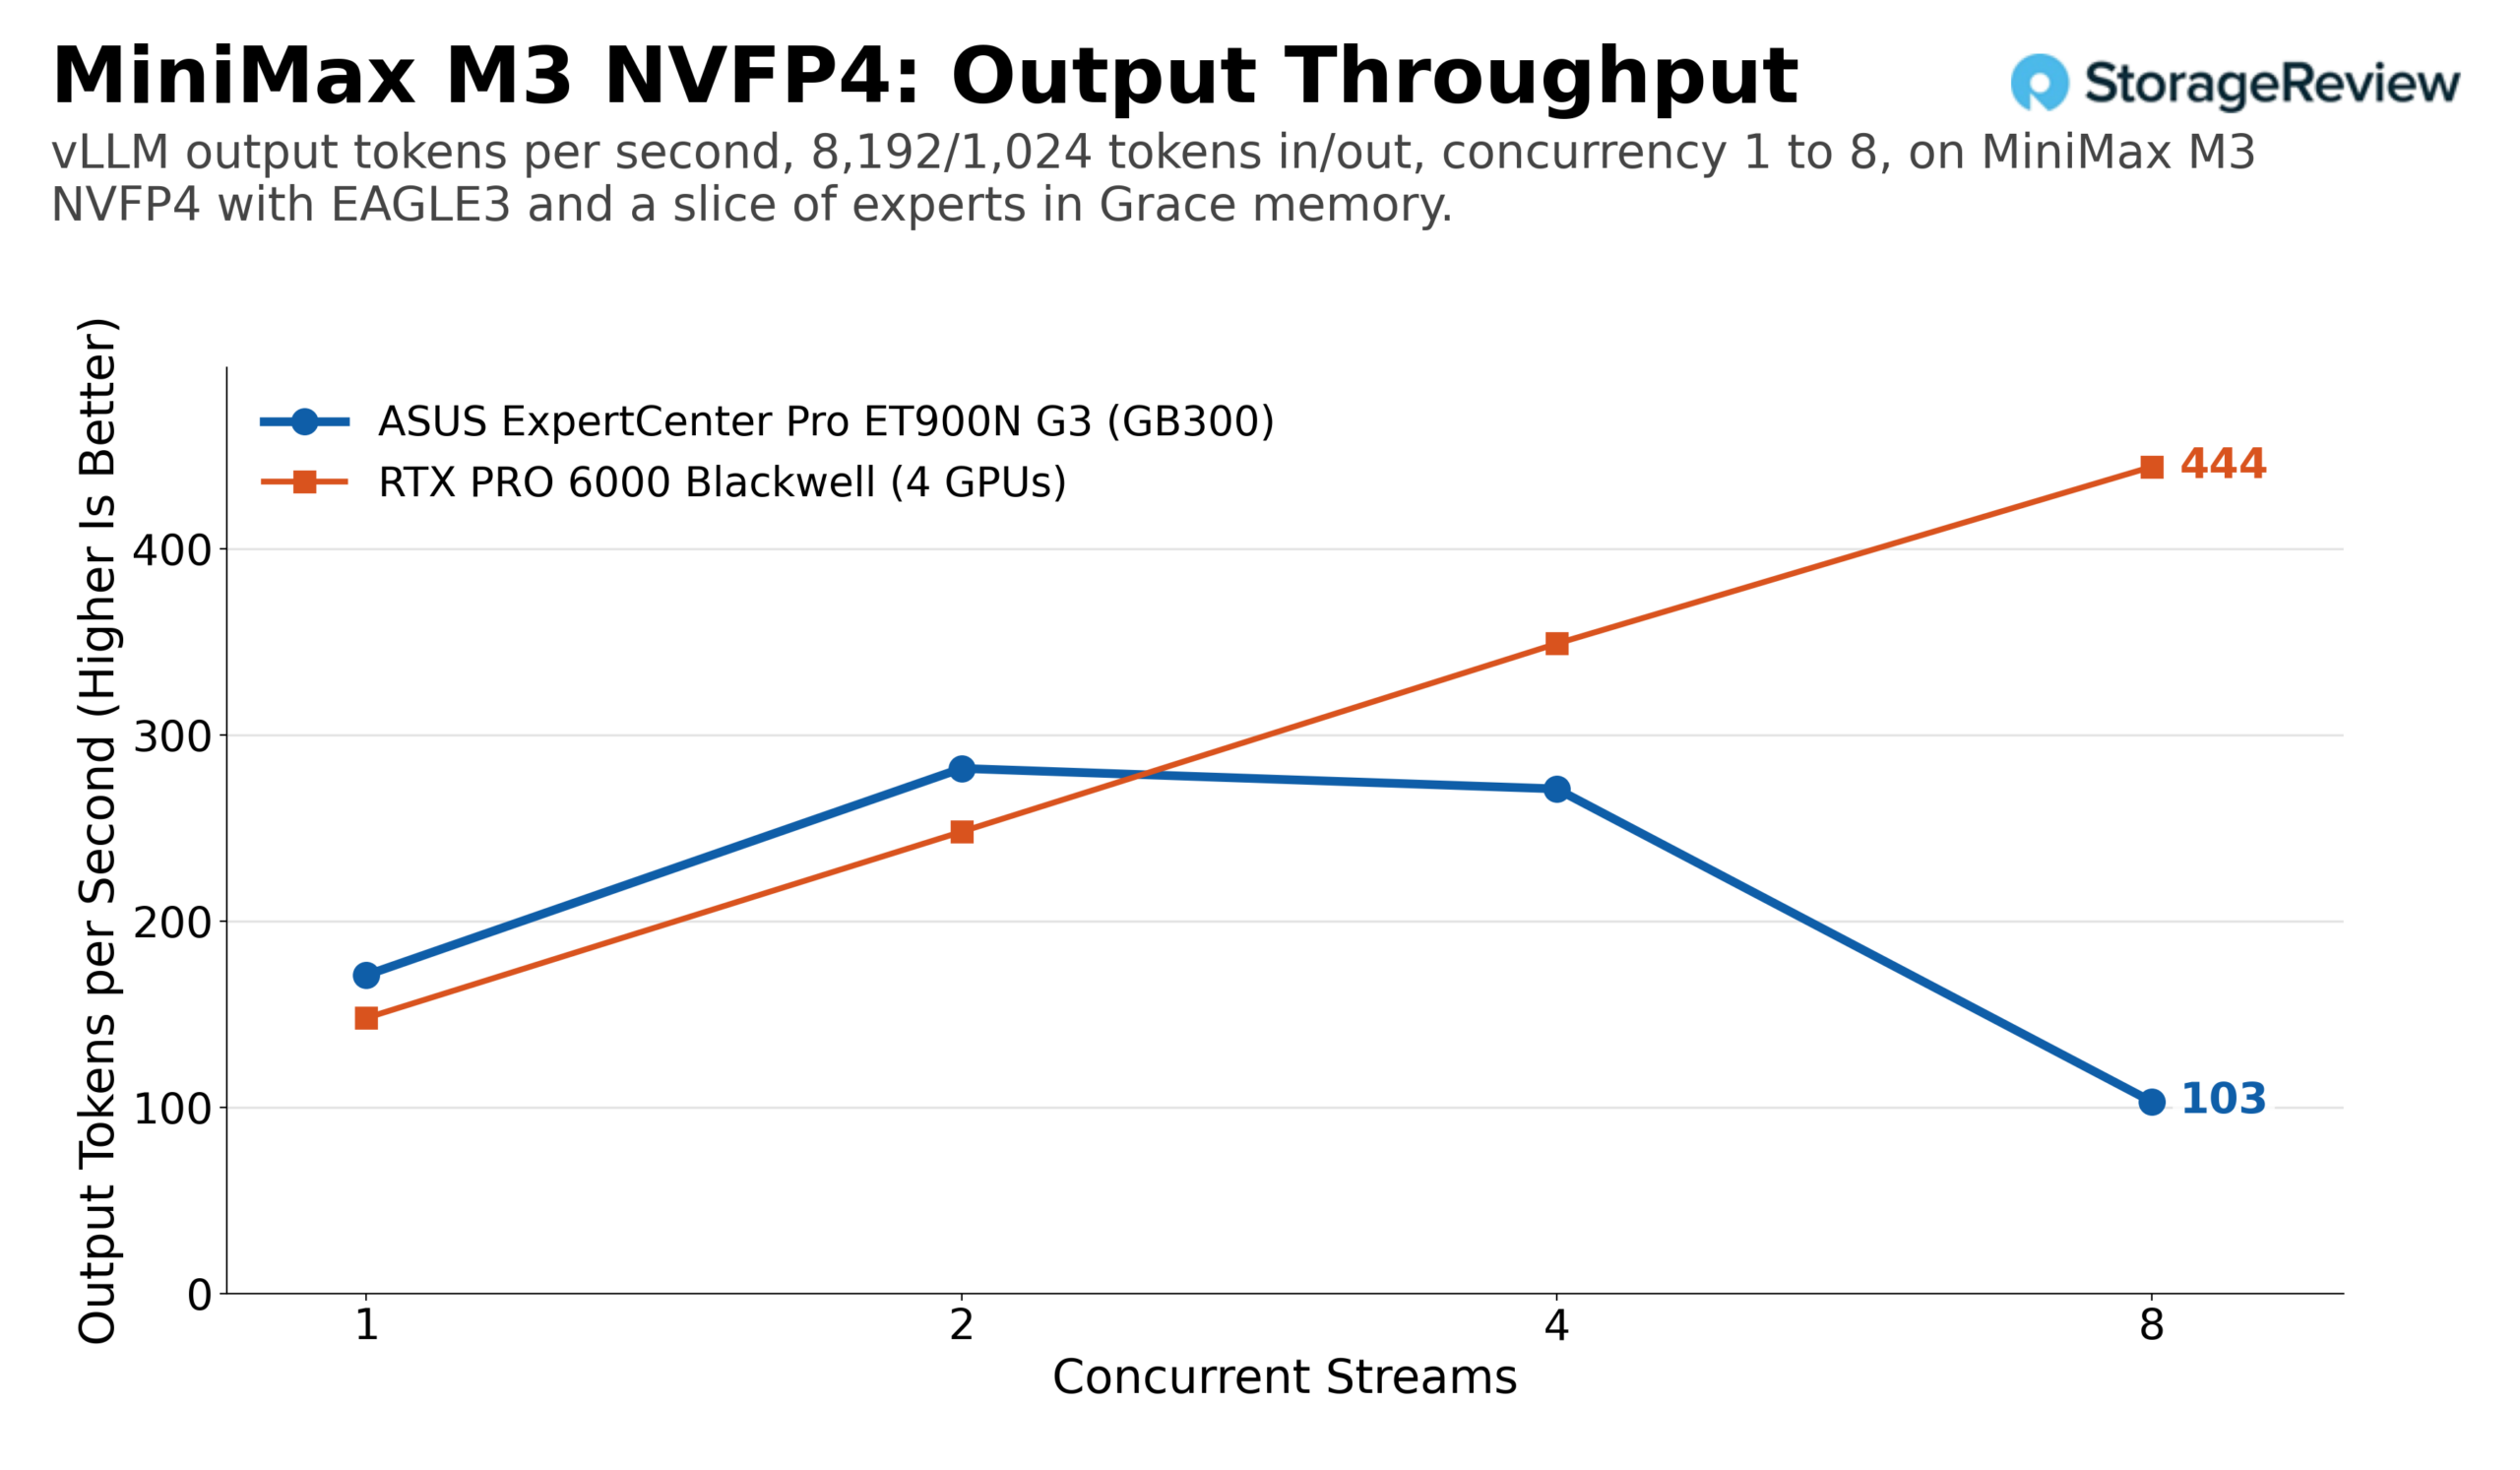
MiniMax M3 демонстрирует, каково это – едва помещаться в память. Контрольная точка NVFP4 меньше 252 ГБ, но кэш времени выполнения и кэш ключ-значение также требуют места, поэтому часть экспертных функций находится в памяти Grace, и каждый шаг декодирования, затрагивающий их, проходит через NVLink-C2C. При спекулятивном декодировании EAGLE3 ET900N G3 достиг 1,041 выходного токена в секунду при 32 потоках на одинаковой нагрузке, а профиль с интенсивным предварительным заполнением достиг пика в 282 токена при двух потоках, удержался на уровне 271 при четырех и упал до 103 при восьми, поскольку длинные подсказки потребляли оставшийся кэш. Четыре карты RTX PRO 6000 с тем же спекулятивным декодером показали результаты, сопоставимые со Station, при одном и двух потоках, вырвались вперед с четырех потоков до 1,181 выходного токена в секунду при 16 потоках, а затем упали до 759 при 32 потоках. В режиме интенсивного предварительного заполнения, блок из четырех карт обеспечивал около 349 выходных токенов в секунду при четырех потоках по сравнению с 271 токеном у станции. Модель, находящаяся на границе возможностей HBM, является единственным примером в этом наборе, где 384 ГБ видеопамяти на четырех картах конкурируют с 252 ГБ HBM плюс выгрузка данных.
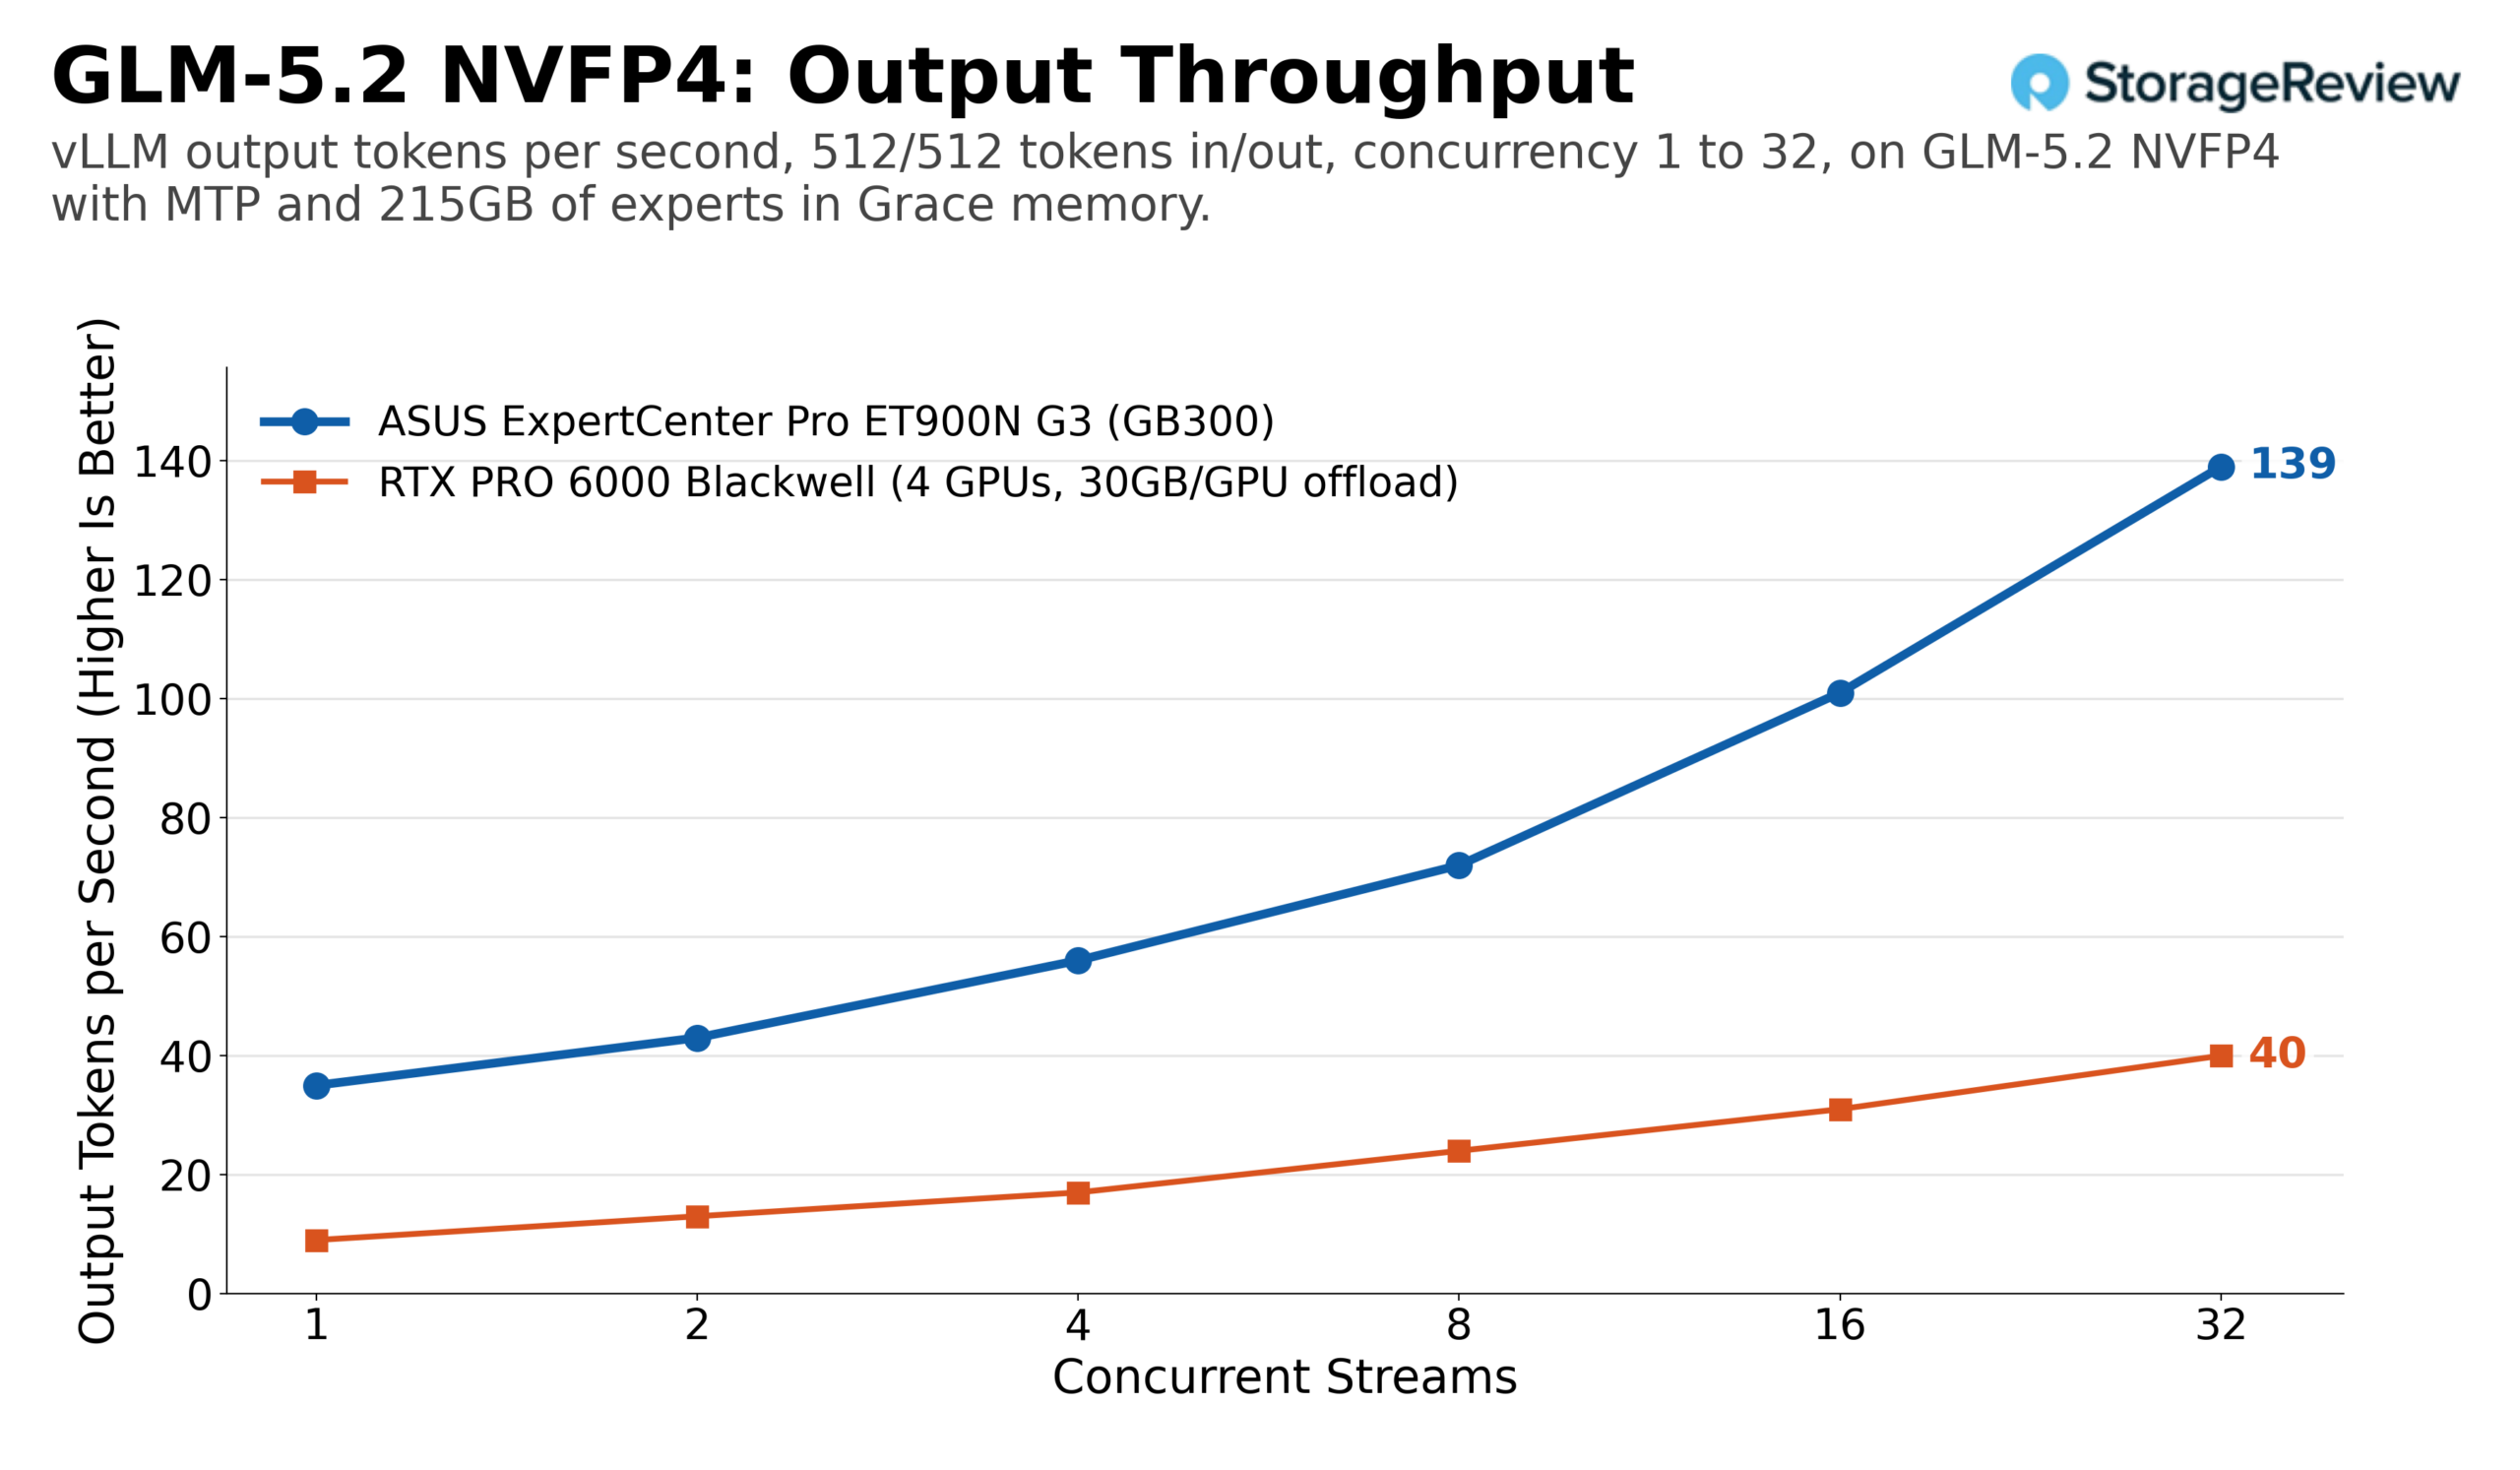
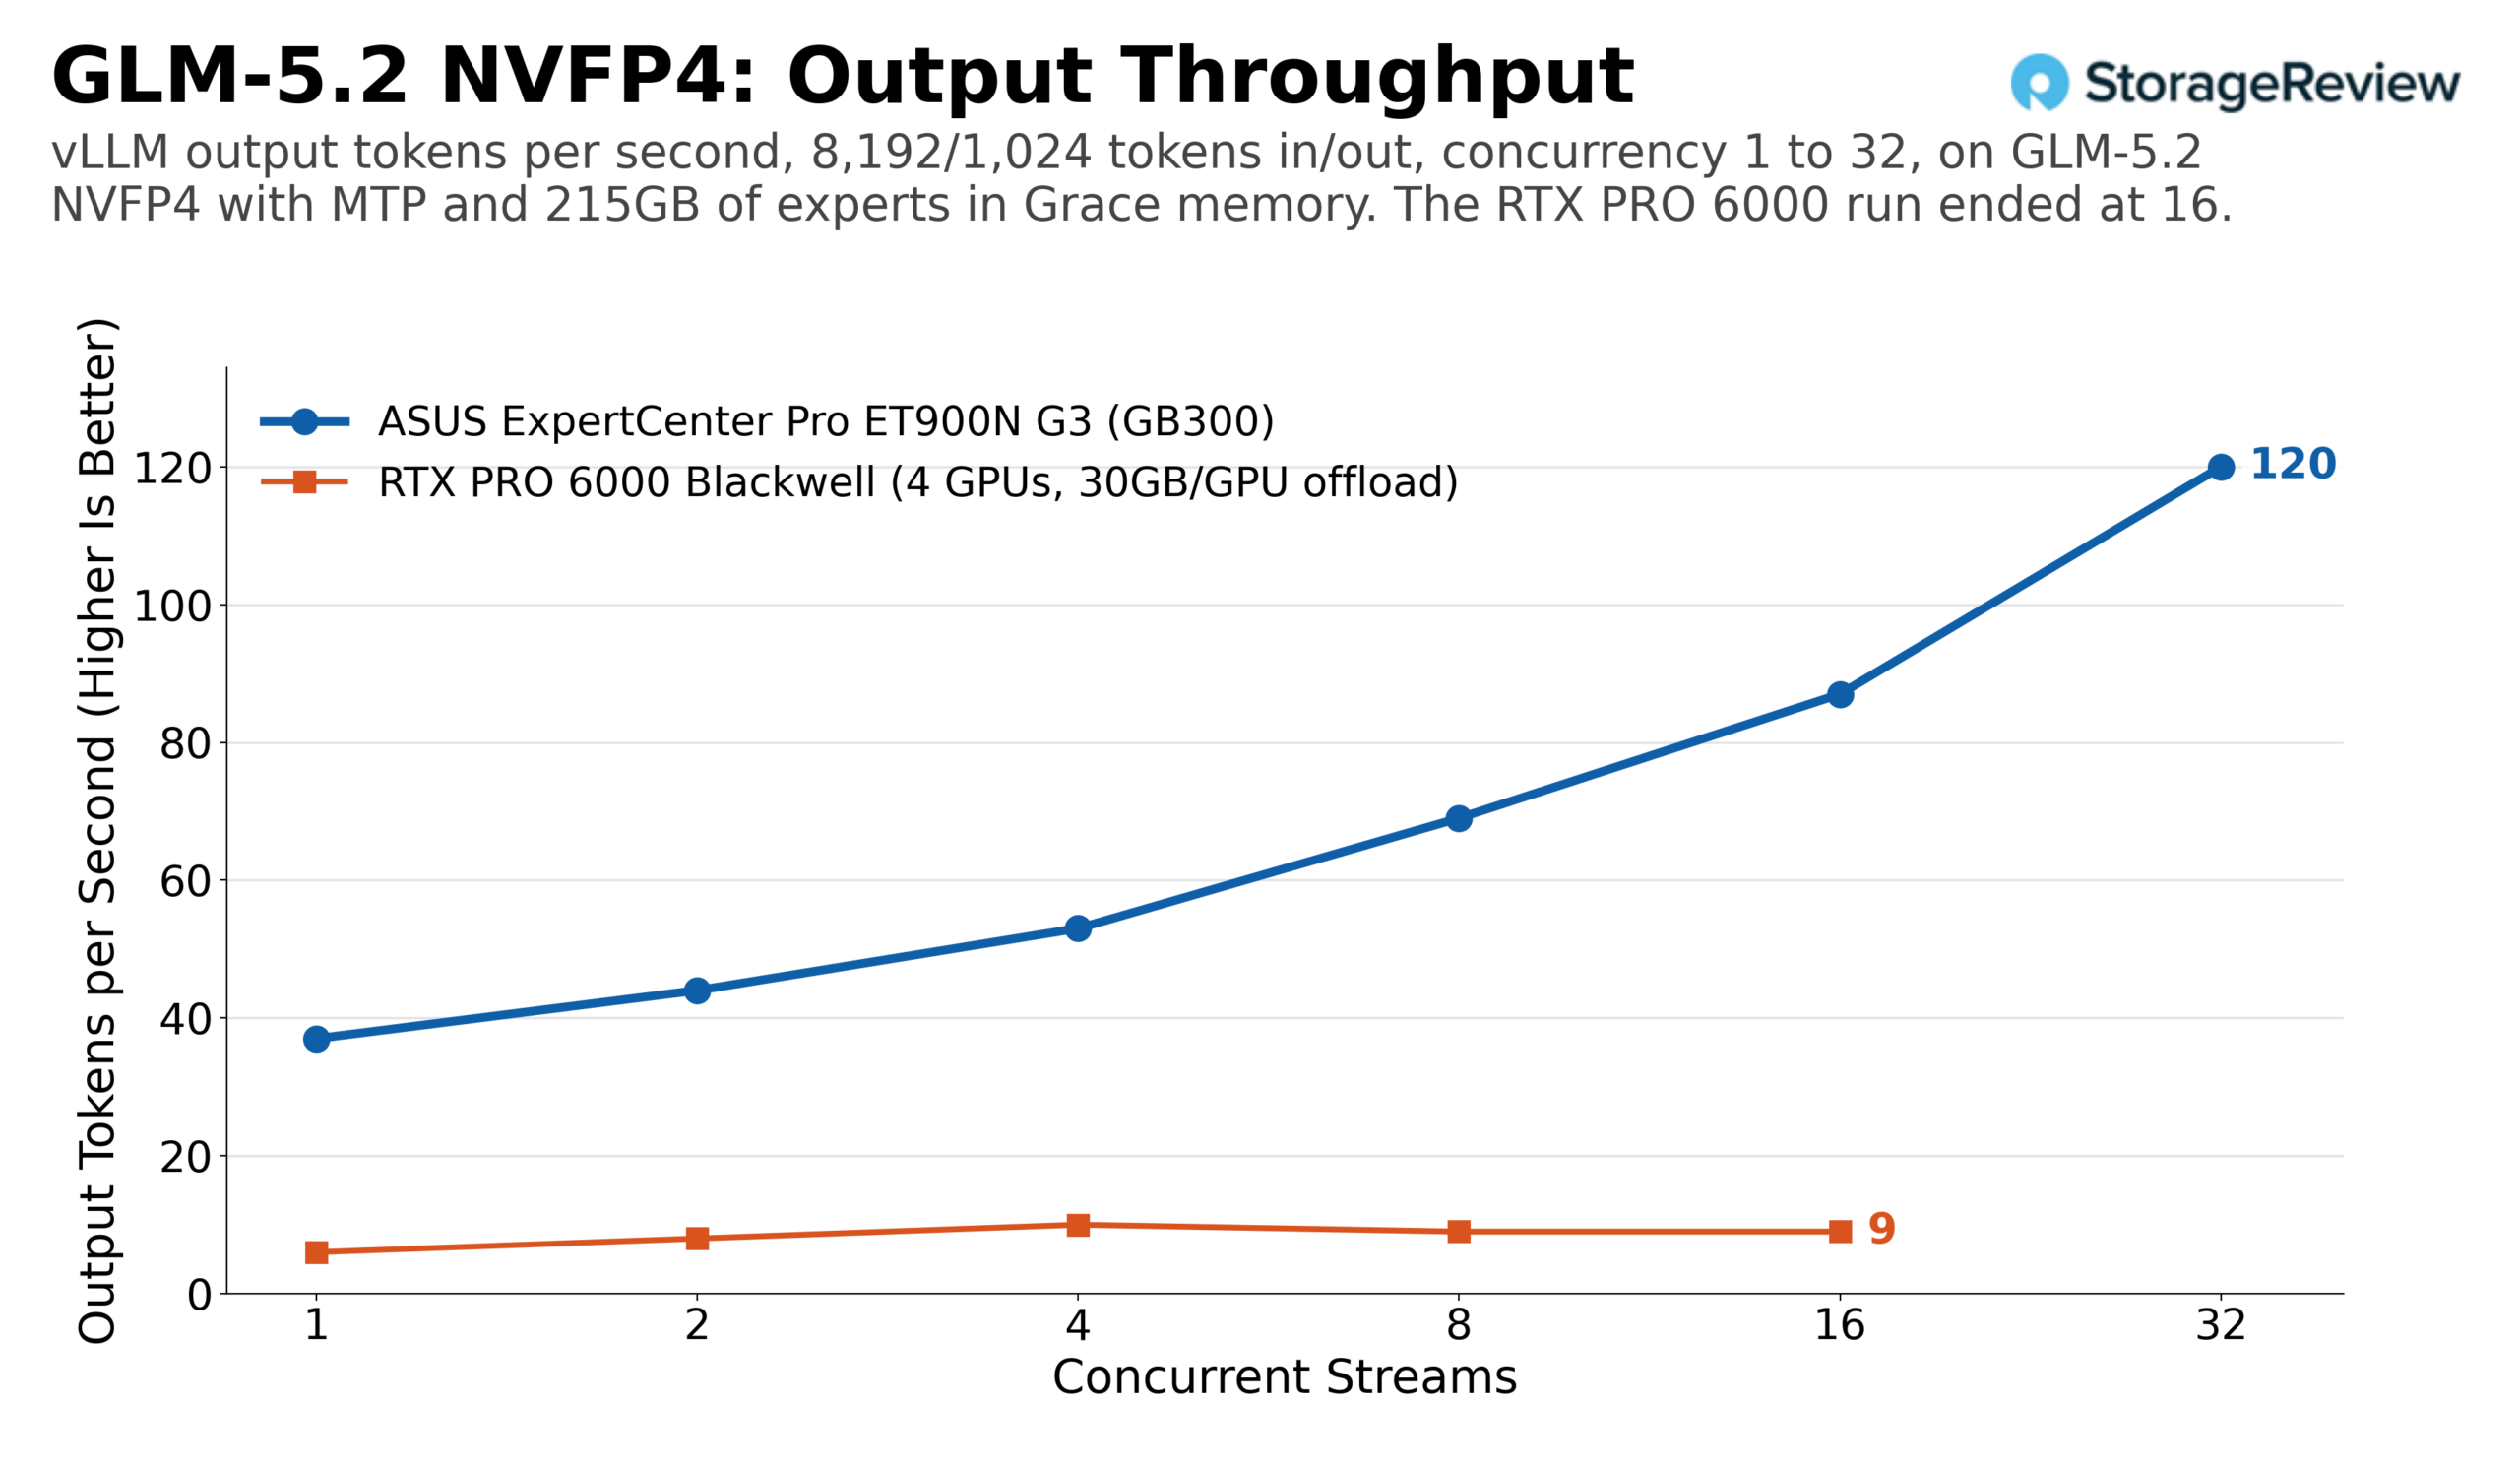
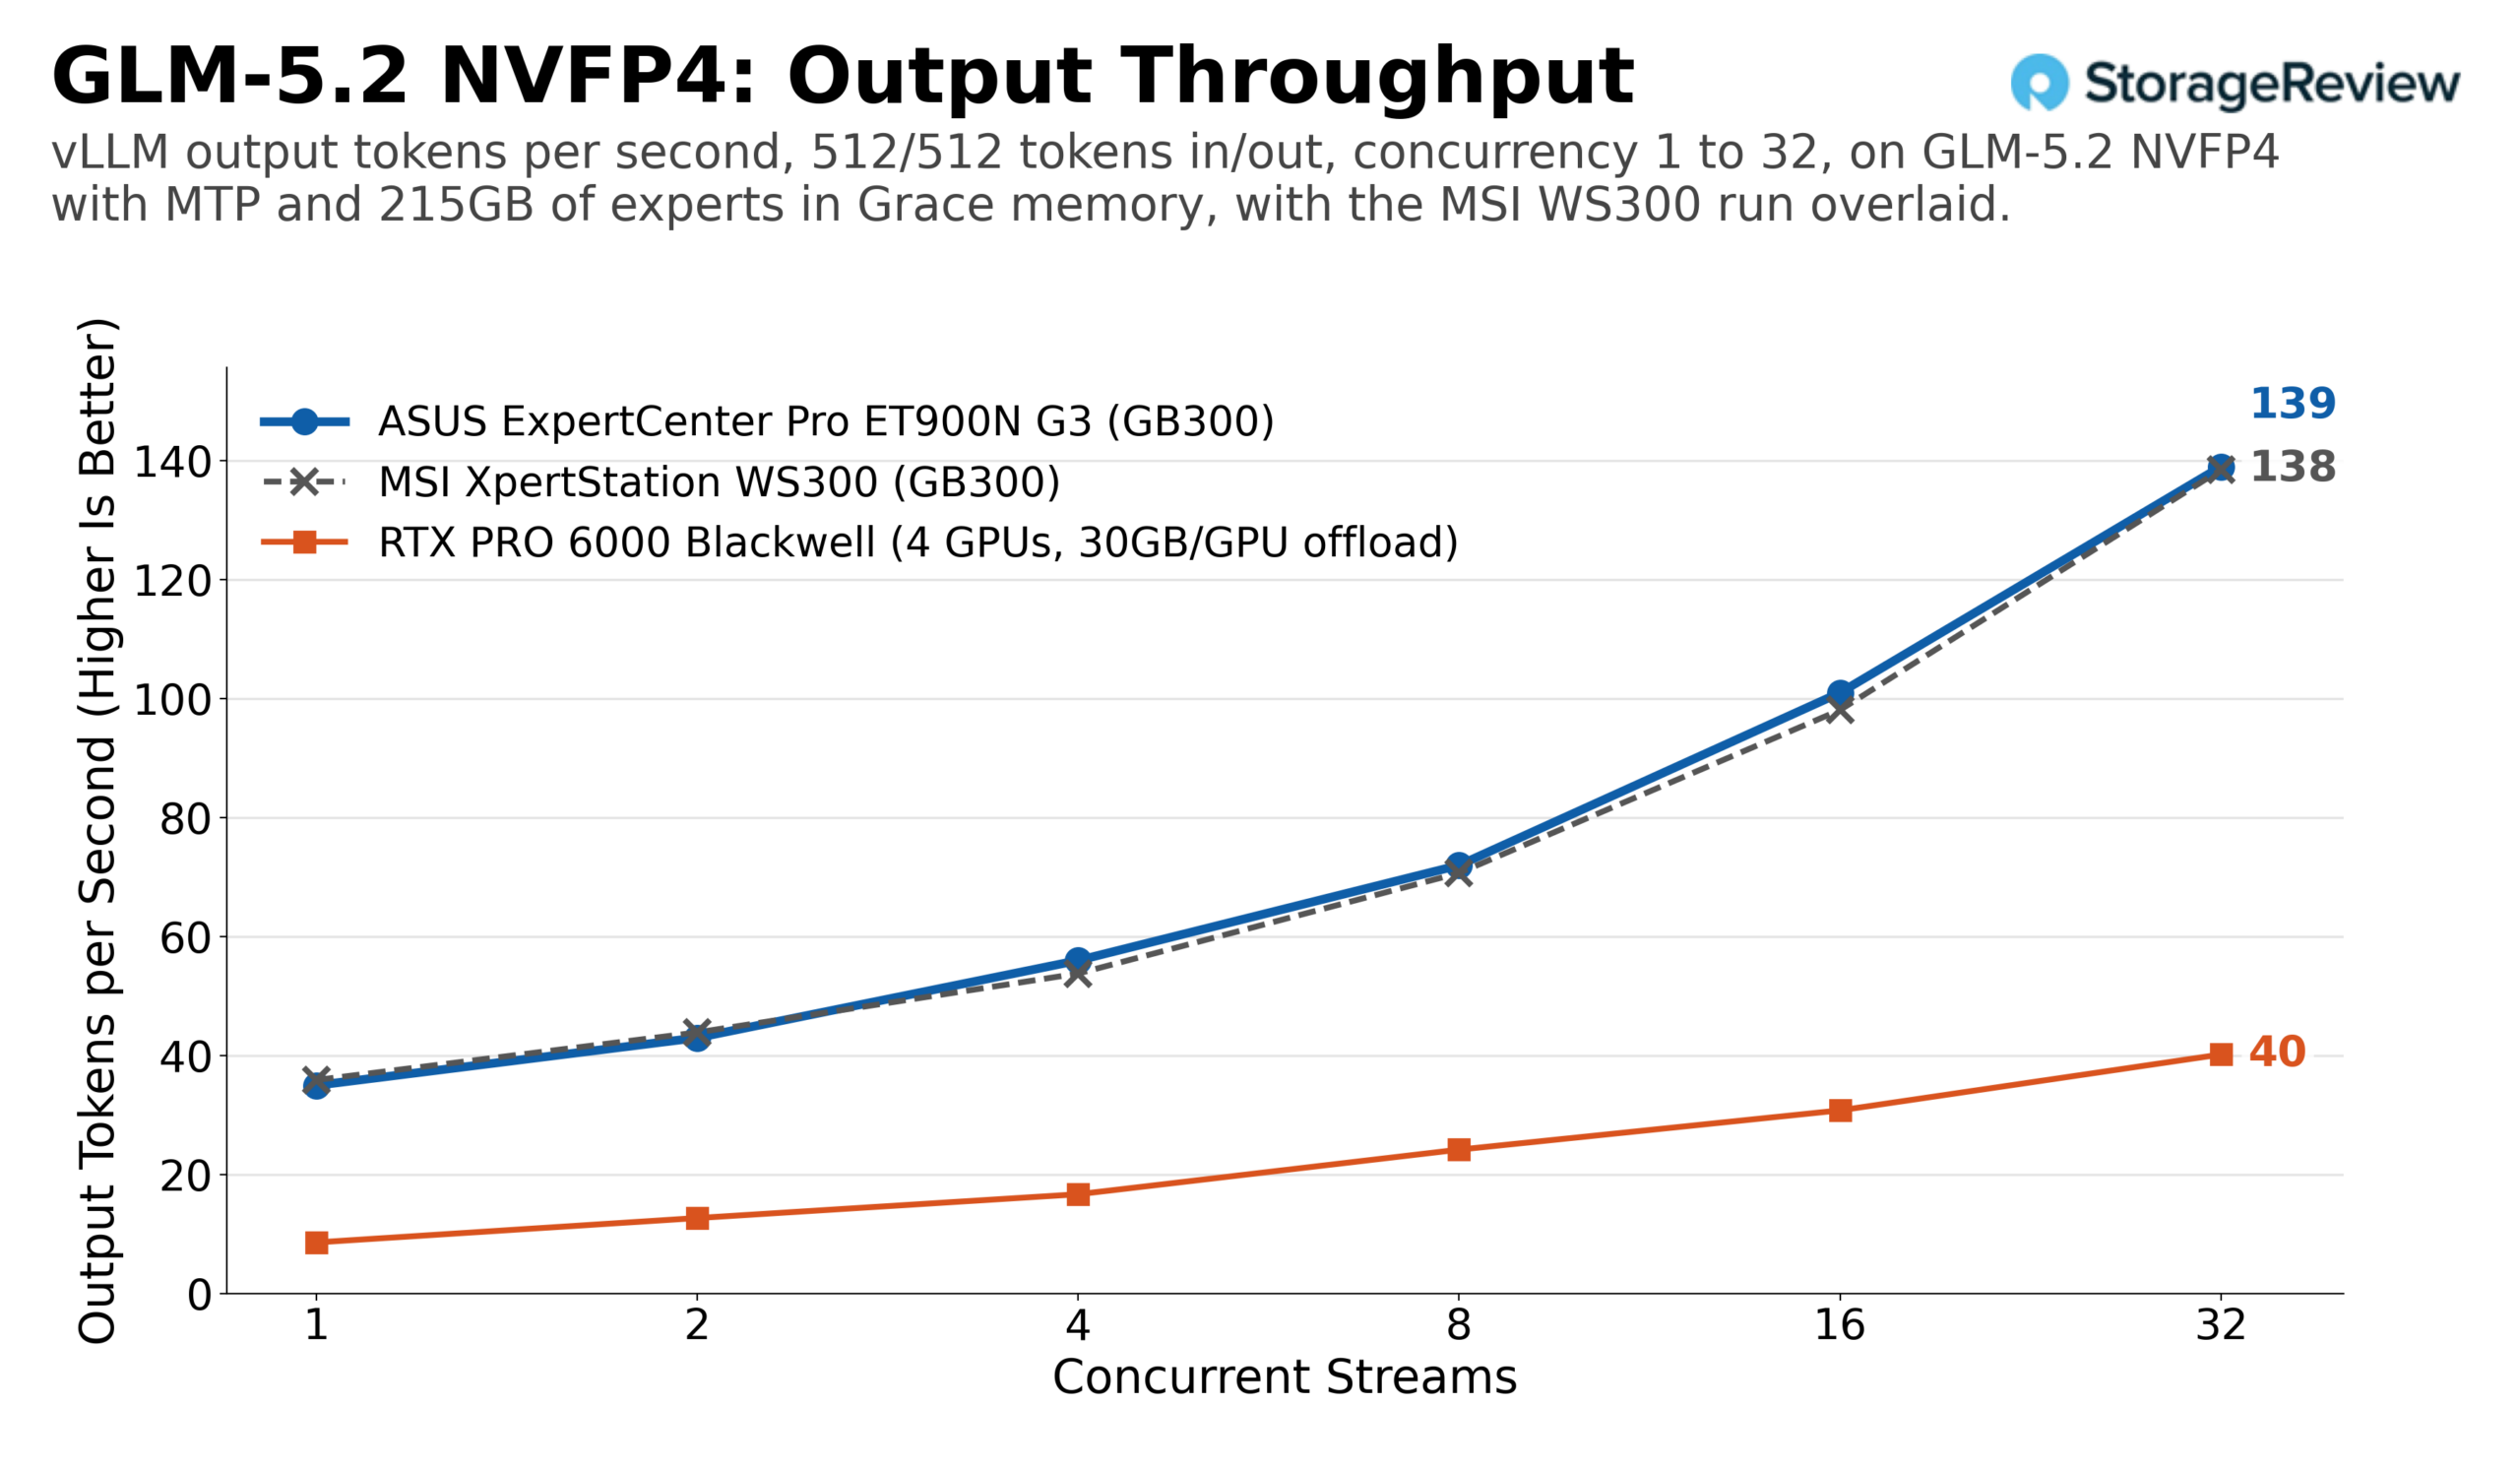
GLM-5.2 — это вариант использования, который возможен только при наличии когерентного пула. Контрольная точка NVFP4 хранит около 215 ГБ экспертных весов в памяти Grace с спекулятивным декодированием MTP, а ET900N G3 обрабатывал их со скоростью 35 выходных токенов в секунду для одного потока и 139 для 32 потоков при одинаковой нагрузке, при этом общая пропускная способность достигла 277. В профиле с интенсивным предварительным заполнением скорость обработки достигла 120 выходных токенов в секунду и 1,079 токенов в общей сложности при 32 потоках. Четыре карты RTX PRO 6000, каждая из которых выгружала около 30 ГБ в память хоста, обеспечивали около 40 выходных токенов в секунду при 32 потоках, снижаясь примерно до 9-10 при длительных запросах, начиная с четырех потоков. Ни одна из систем не позволяет модели с 433 ГБ памяти казаться быстрой, но возможности GB300 по передаче данных со скоростью 396 ГБ/с через LPDDR5X и 900 ГБ/с через NVLink-C2C для специалистов по разгрузке вычислительных задач продолжают масштабироваться там, где заканчивается доступ к оперативной памяти, подключенной через PCIe на четырех картах.
В сравнении с MSI WS300, результаты ET900N G3, полученные с помощью модели премиум-класса, отличаются примерно на 1% по всем параметрам: 1,766 выходных токенов в секунду на DeepSeek V4 Flash при 32 потоках на обоих устройствах, 4,793 против 4,801 на MiniMax M2.7 при 128 потоках, 1,041 на MiniMax M3 при 32 потоках на обоих устройствах и 139 на GLM-5.2 при 32 потоках на обоих устройствах.
Используются общие модели с RTX PRO 6000, H200 NVL и DGX Spark.
Во второй половине тестирования используются модели, достаточно компактные для обслуживания любой системы: GPT-OSS-20B и 120B в нативном формате MXFP4; Llama 3.1 8B в форматах BF16 и FP8; Mistral Small 24B в форматах BF16 и FP8; и Qwen3 Coder 30B в форматах BF16 и FP8. Новинкой со времен обзора WS300 стала единственная карта H200 NVL, NVIDIA Hopper с 141 ГБ памяти, что позволяет сравнивать ускорители для центров обработки данных предыдущего поколения.
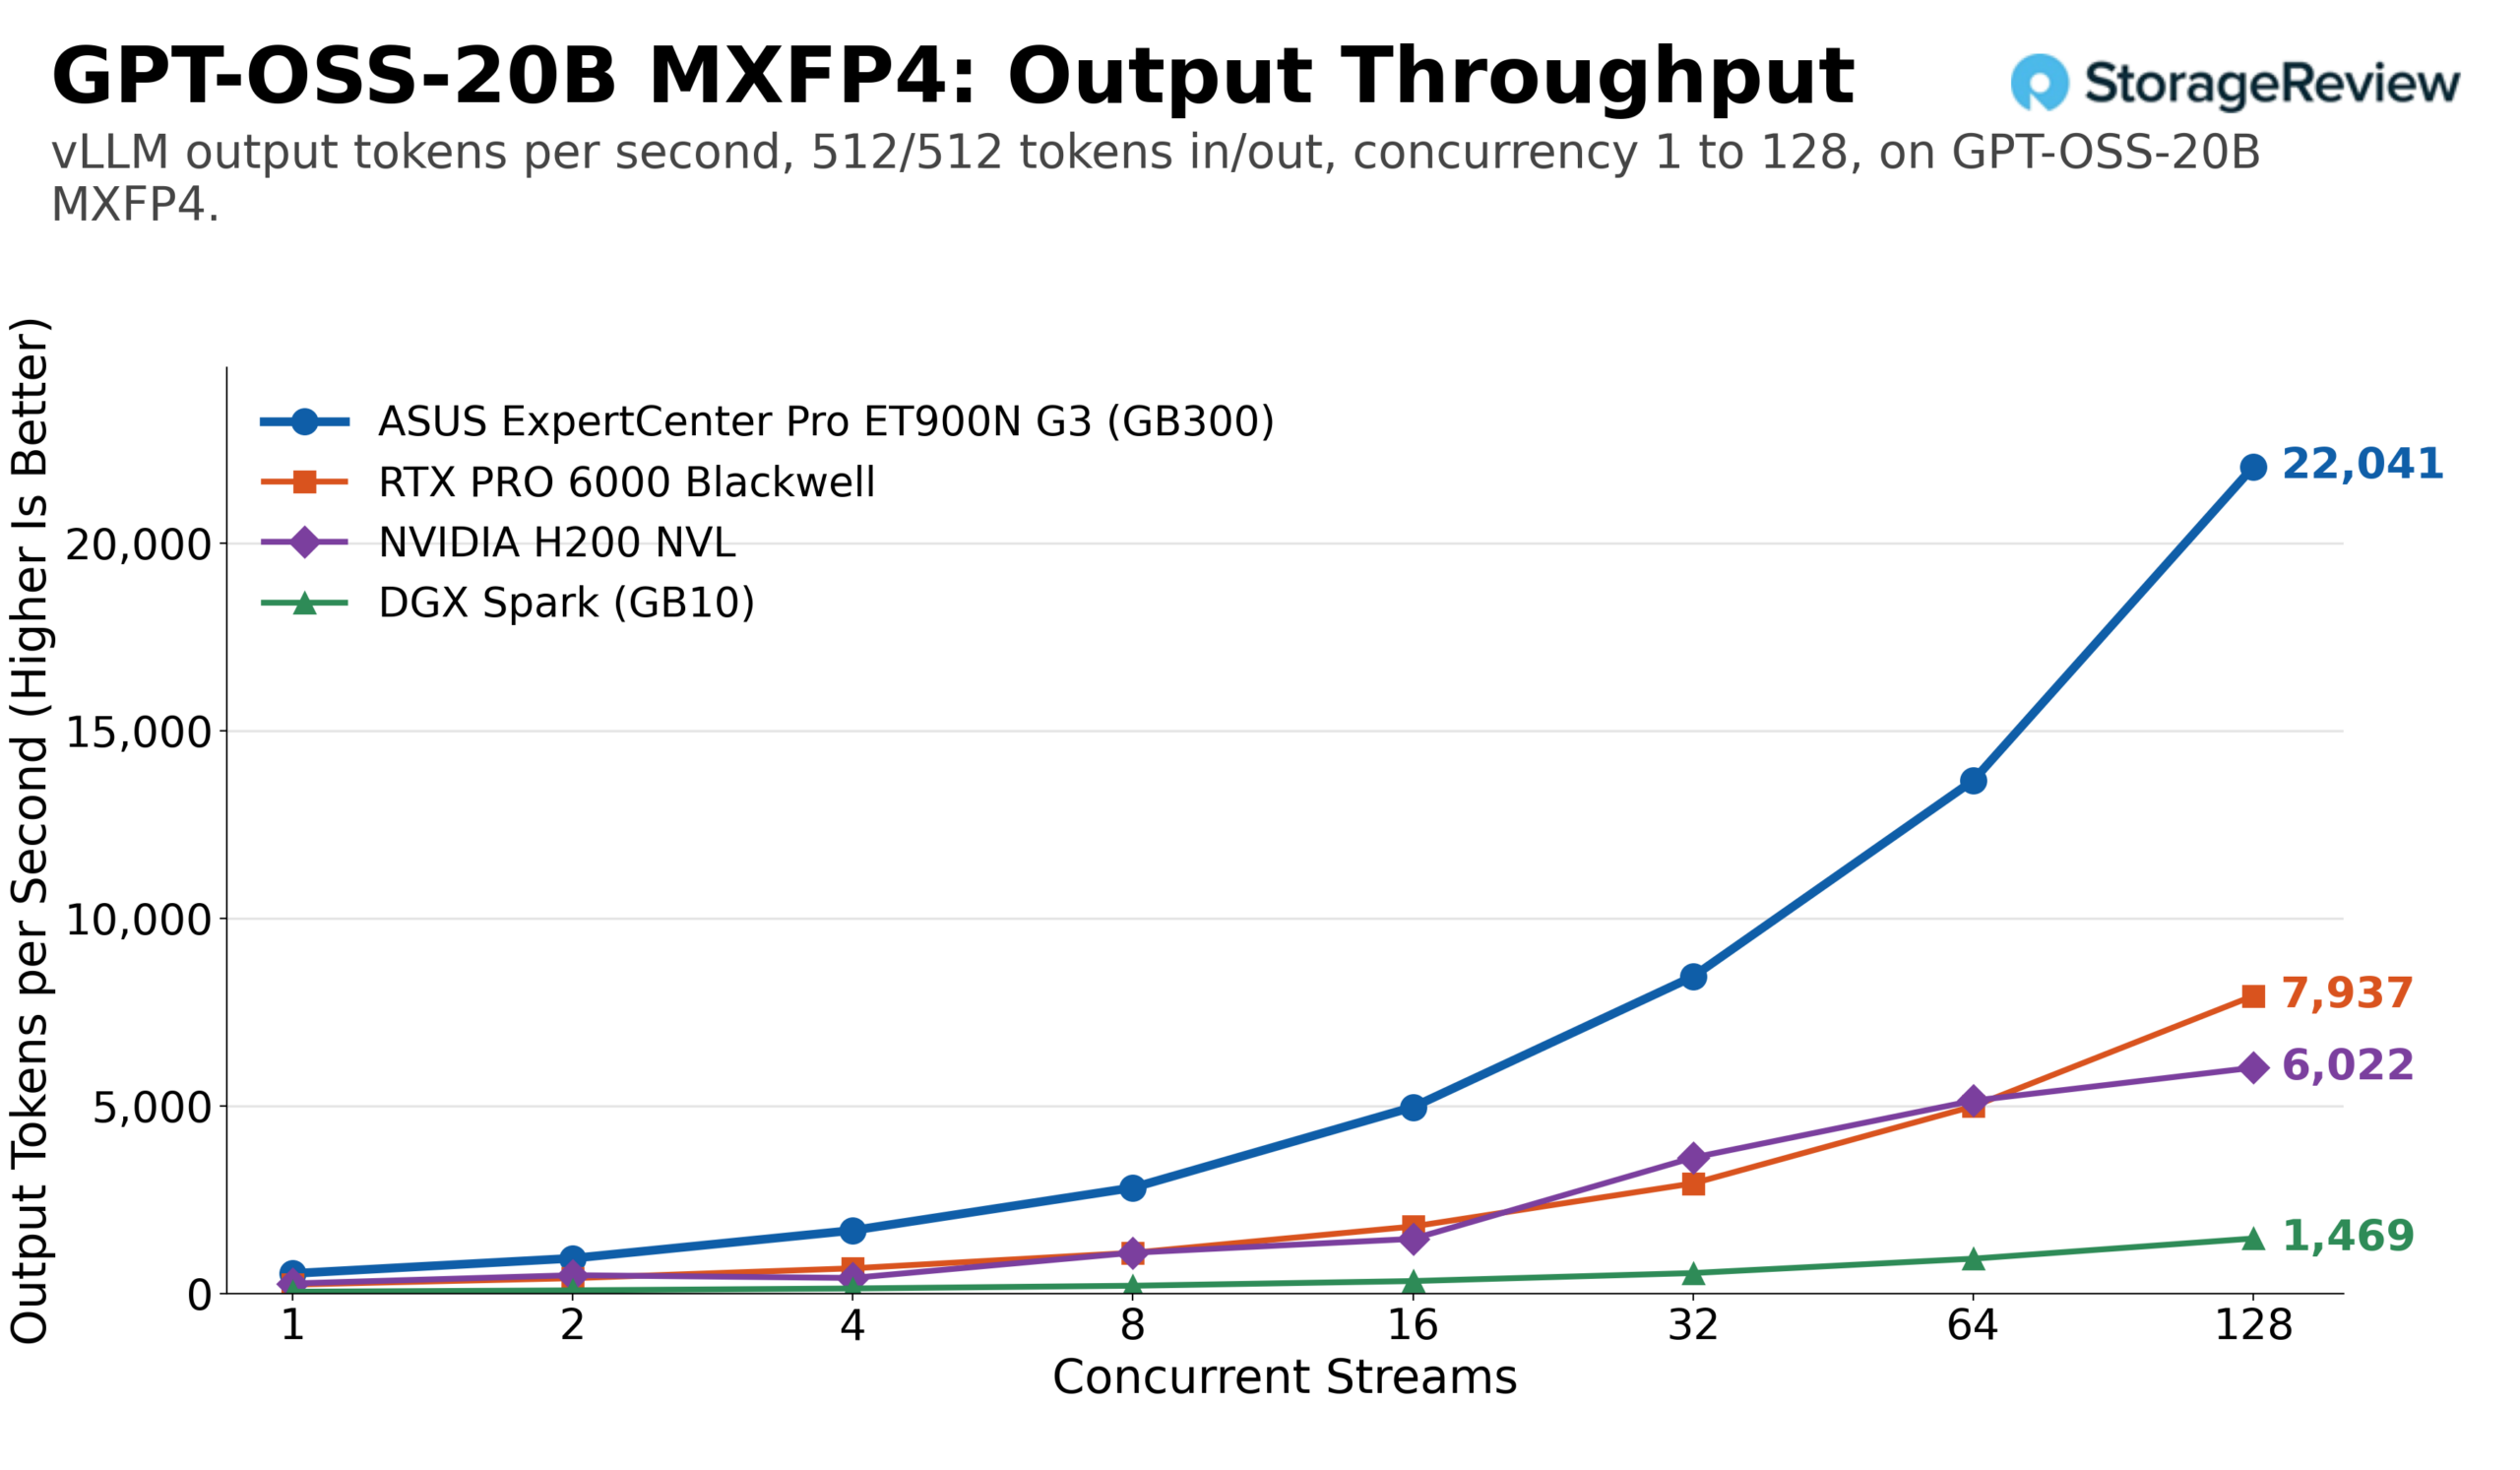
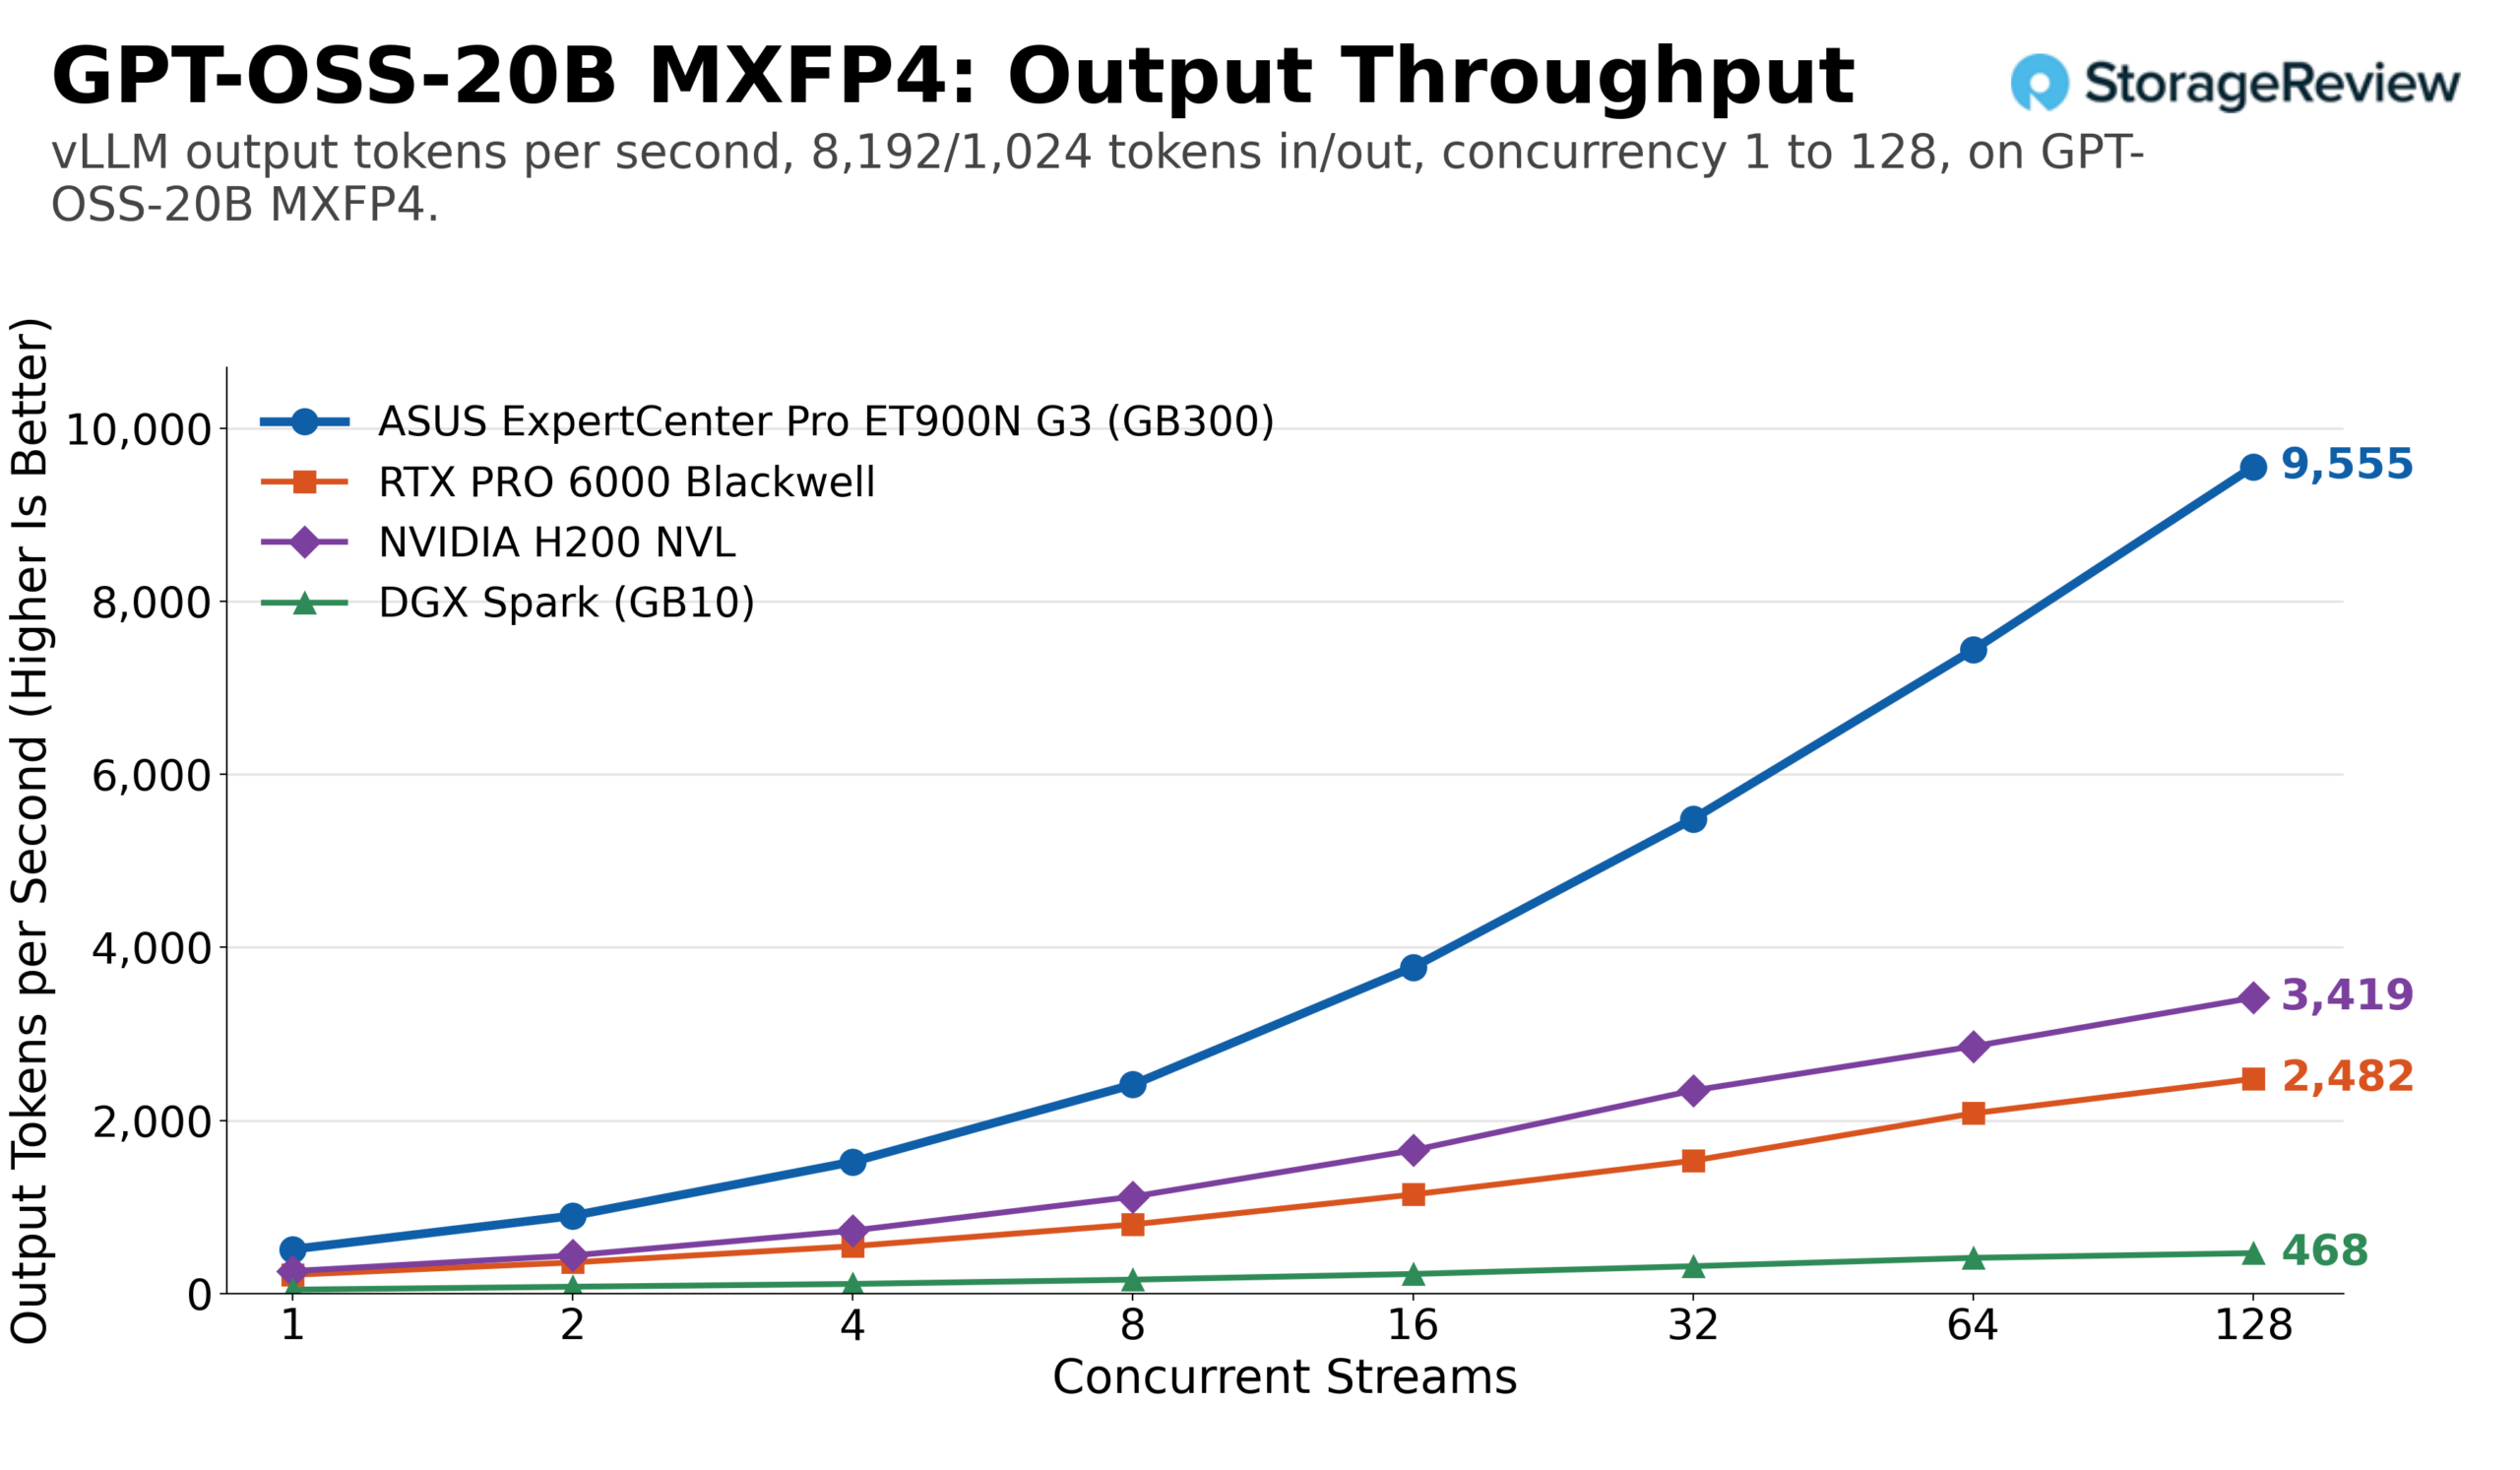
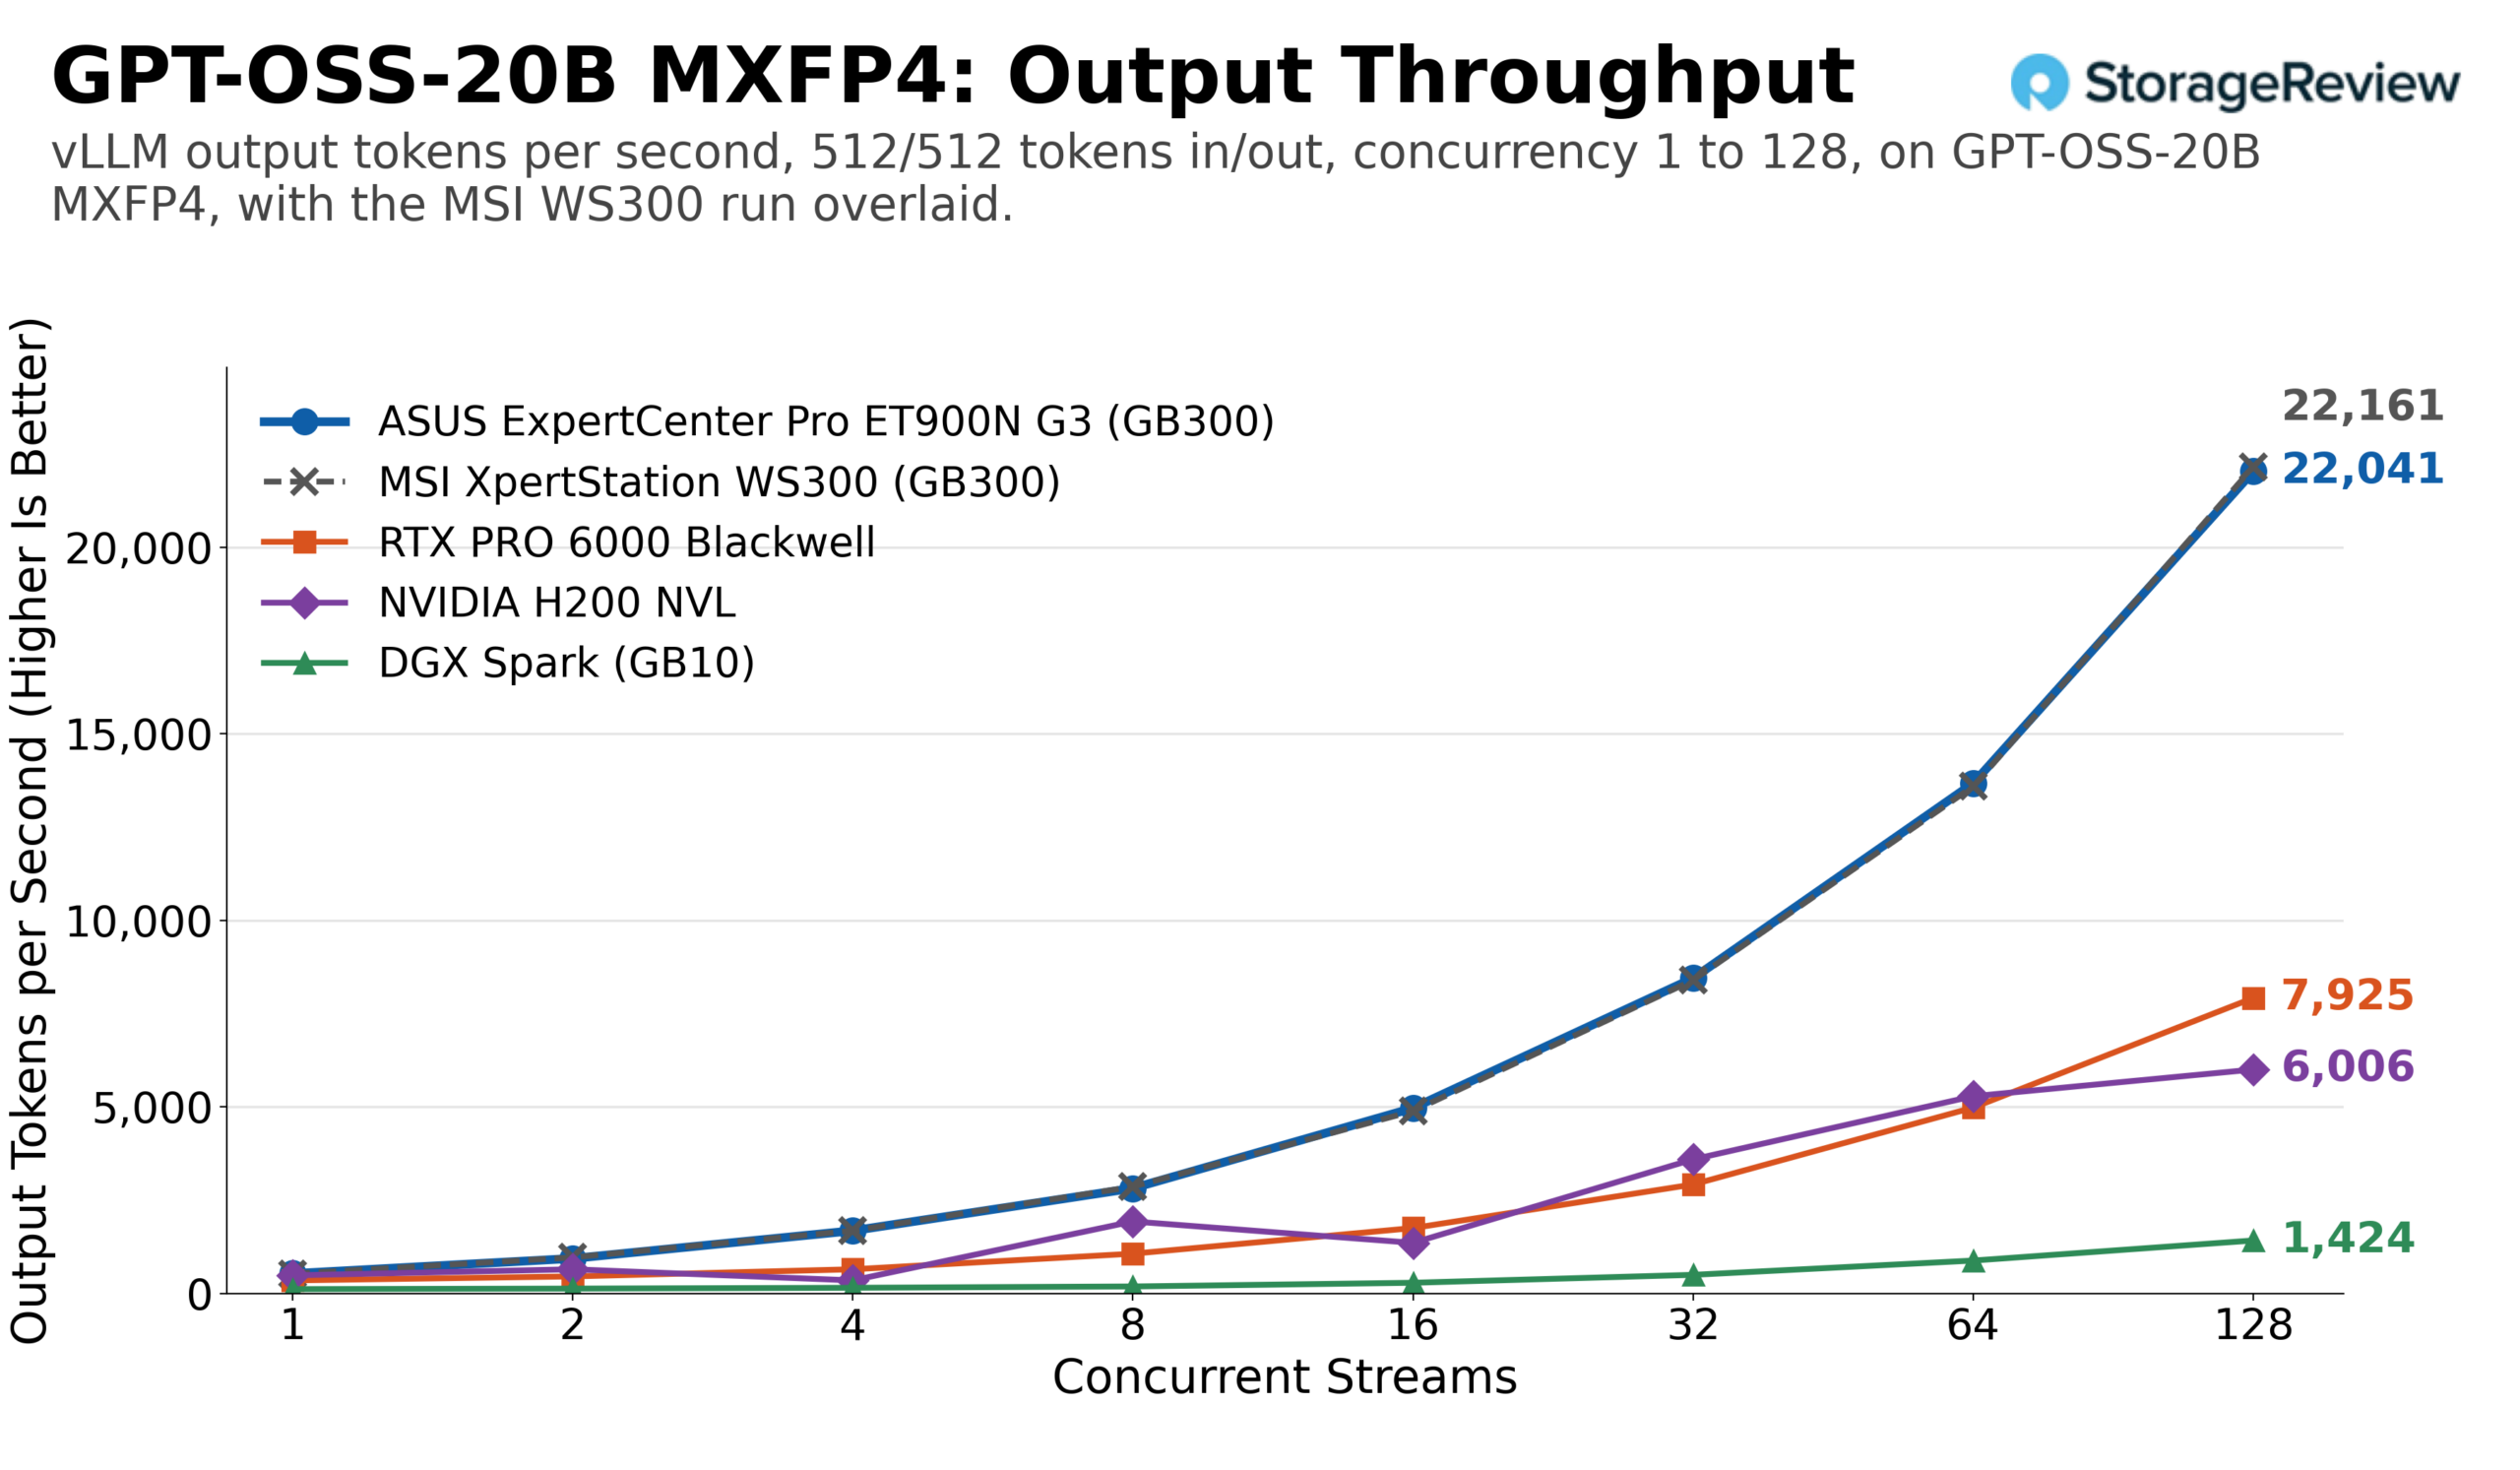
GPT-OSS-20B — самый простой тест из всего набора, контрольная точка, которую легко проходит любая система. При одинаковой нагрузке ET900N G3 показал производительность 22 041 выходных токенов в секунду при 128 потоках, или 44 082 всего, против 7 937 у RTX PRO 6000, 6 022 у H200 NVL и 1 469 у DGX Spark. В однопоточном режиме Station выдавала 536 выходных токенов в секунду, по сравнению с 241 у видеокарты, 270 у H200 и 50 у Spark. Профиль с большим количеством предварительного заполнения увеличил разрыв: 9,555 выходных токенов в секунду и 85,994 всего при 128 потоках для Station, 2,482 у RTX PRO 6000, 3,419 у H200 NVL и 468 у Spark.
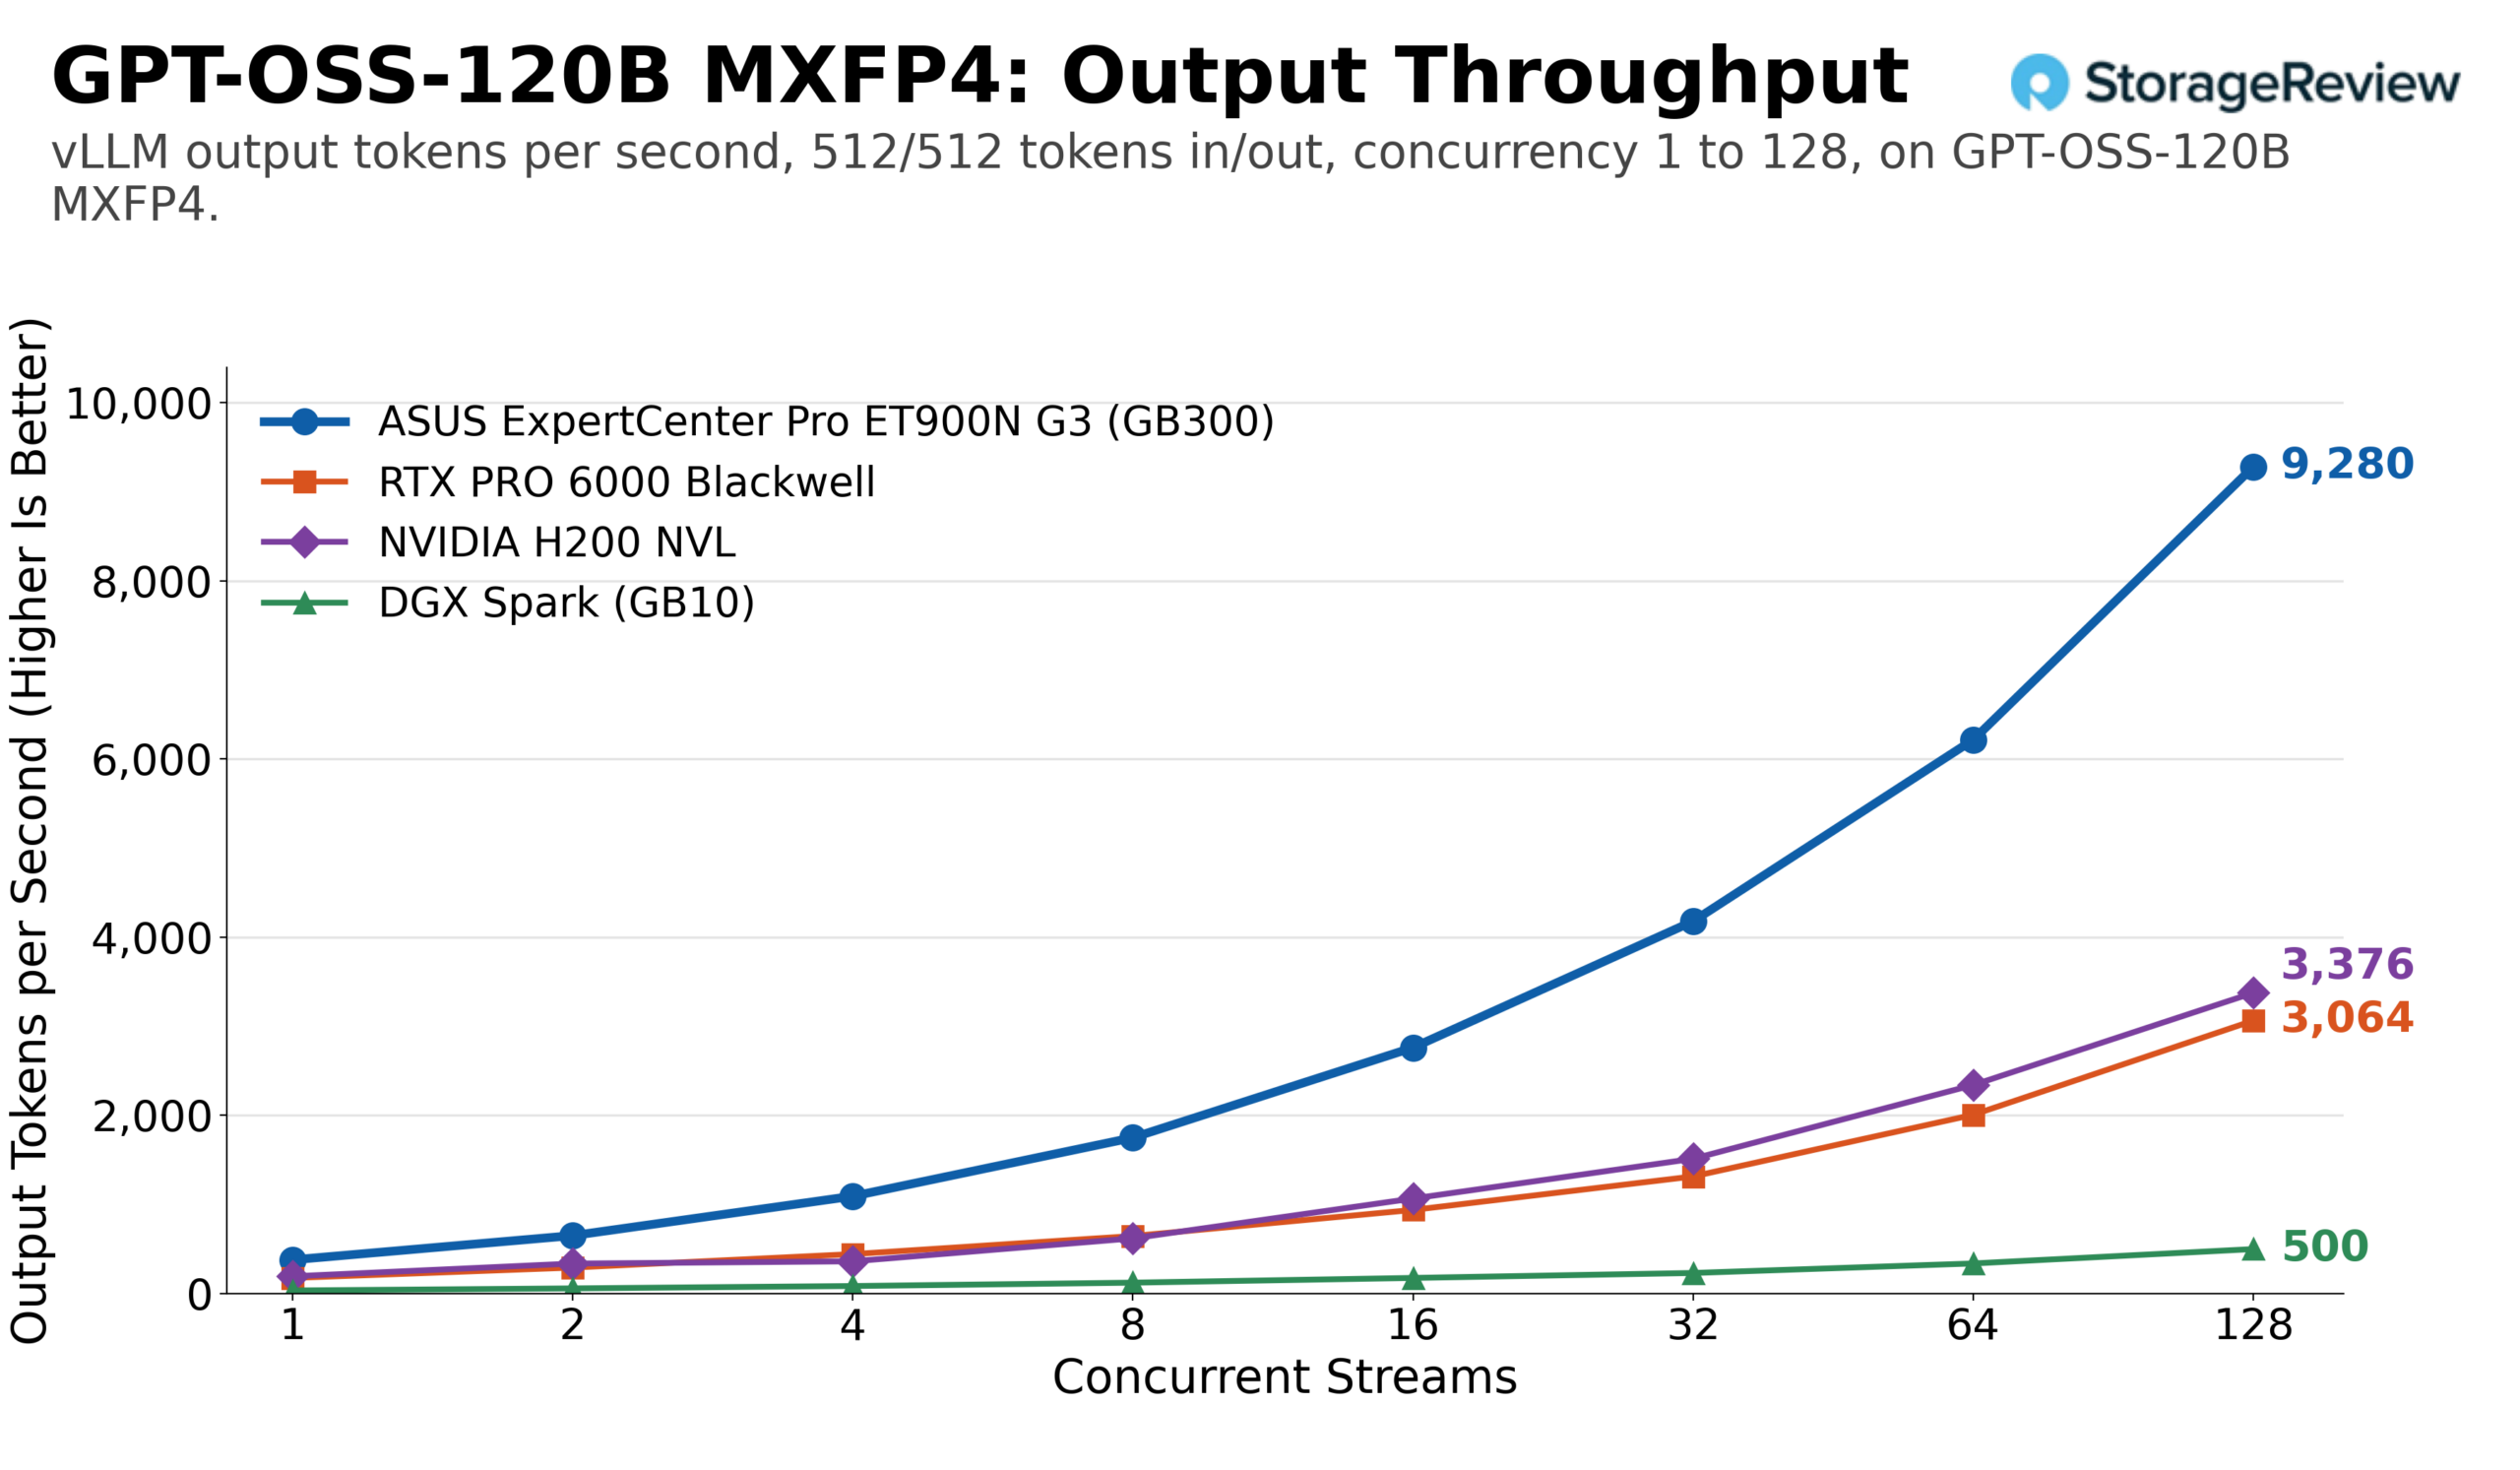
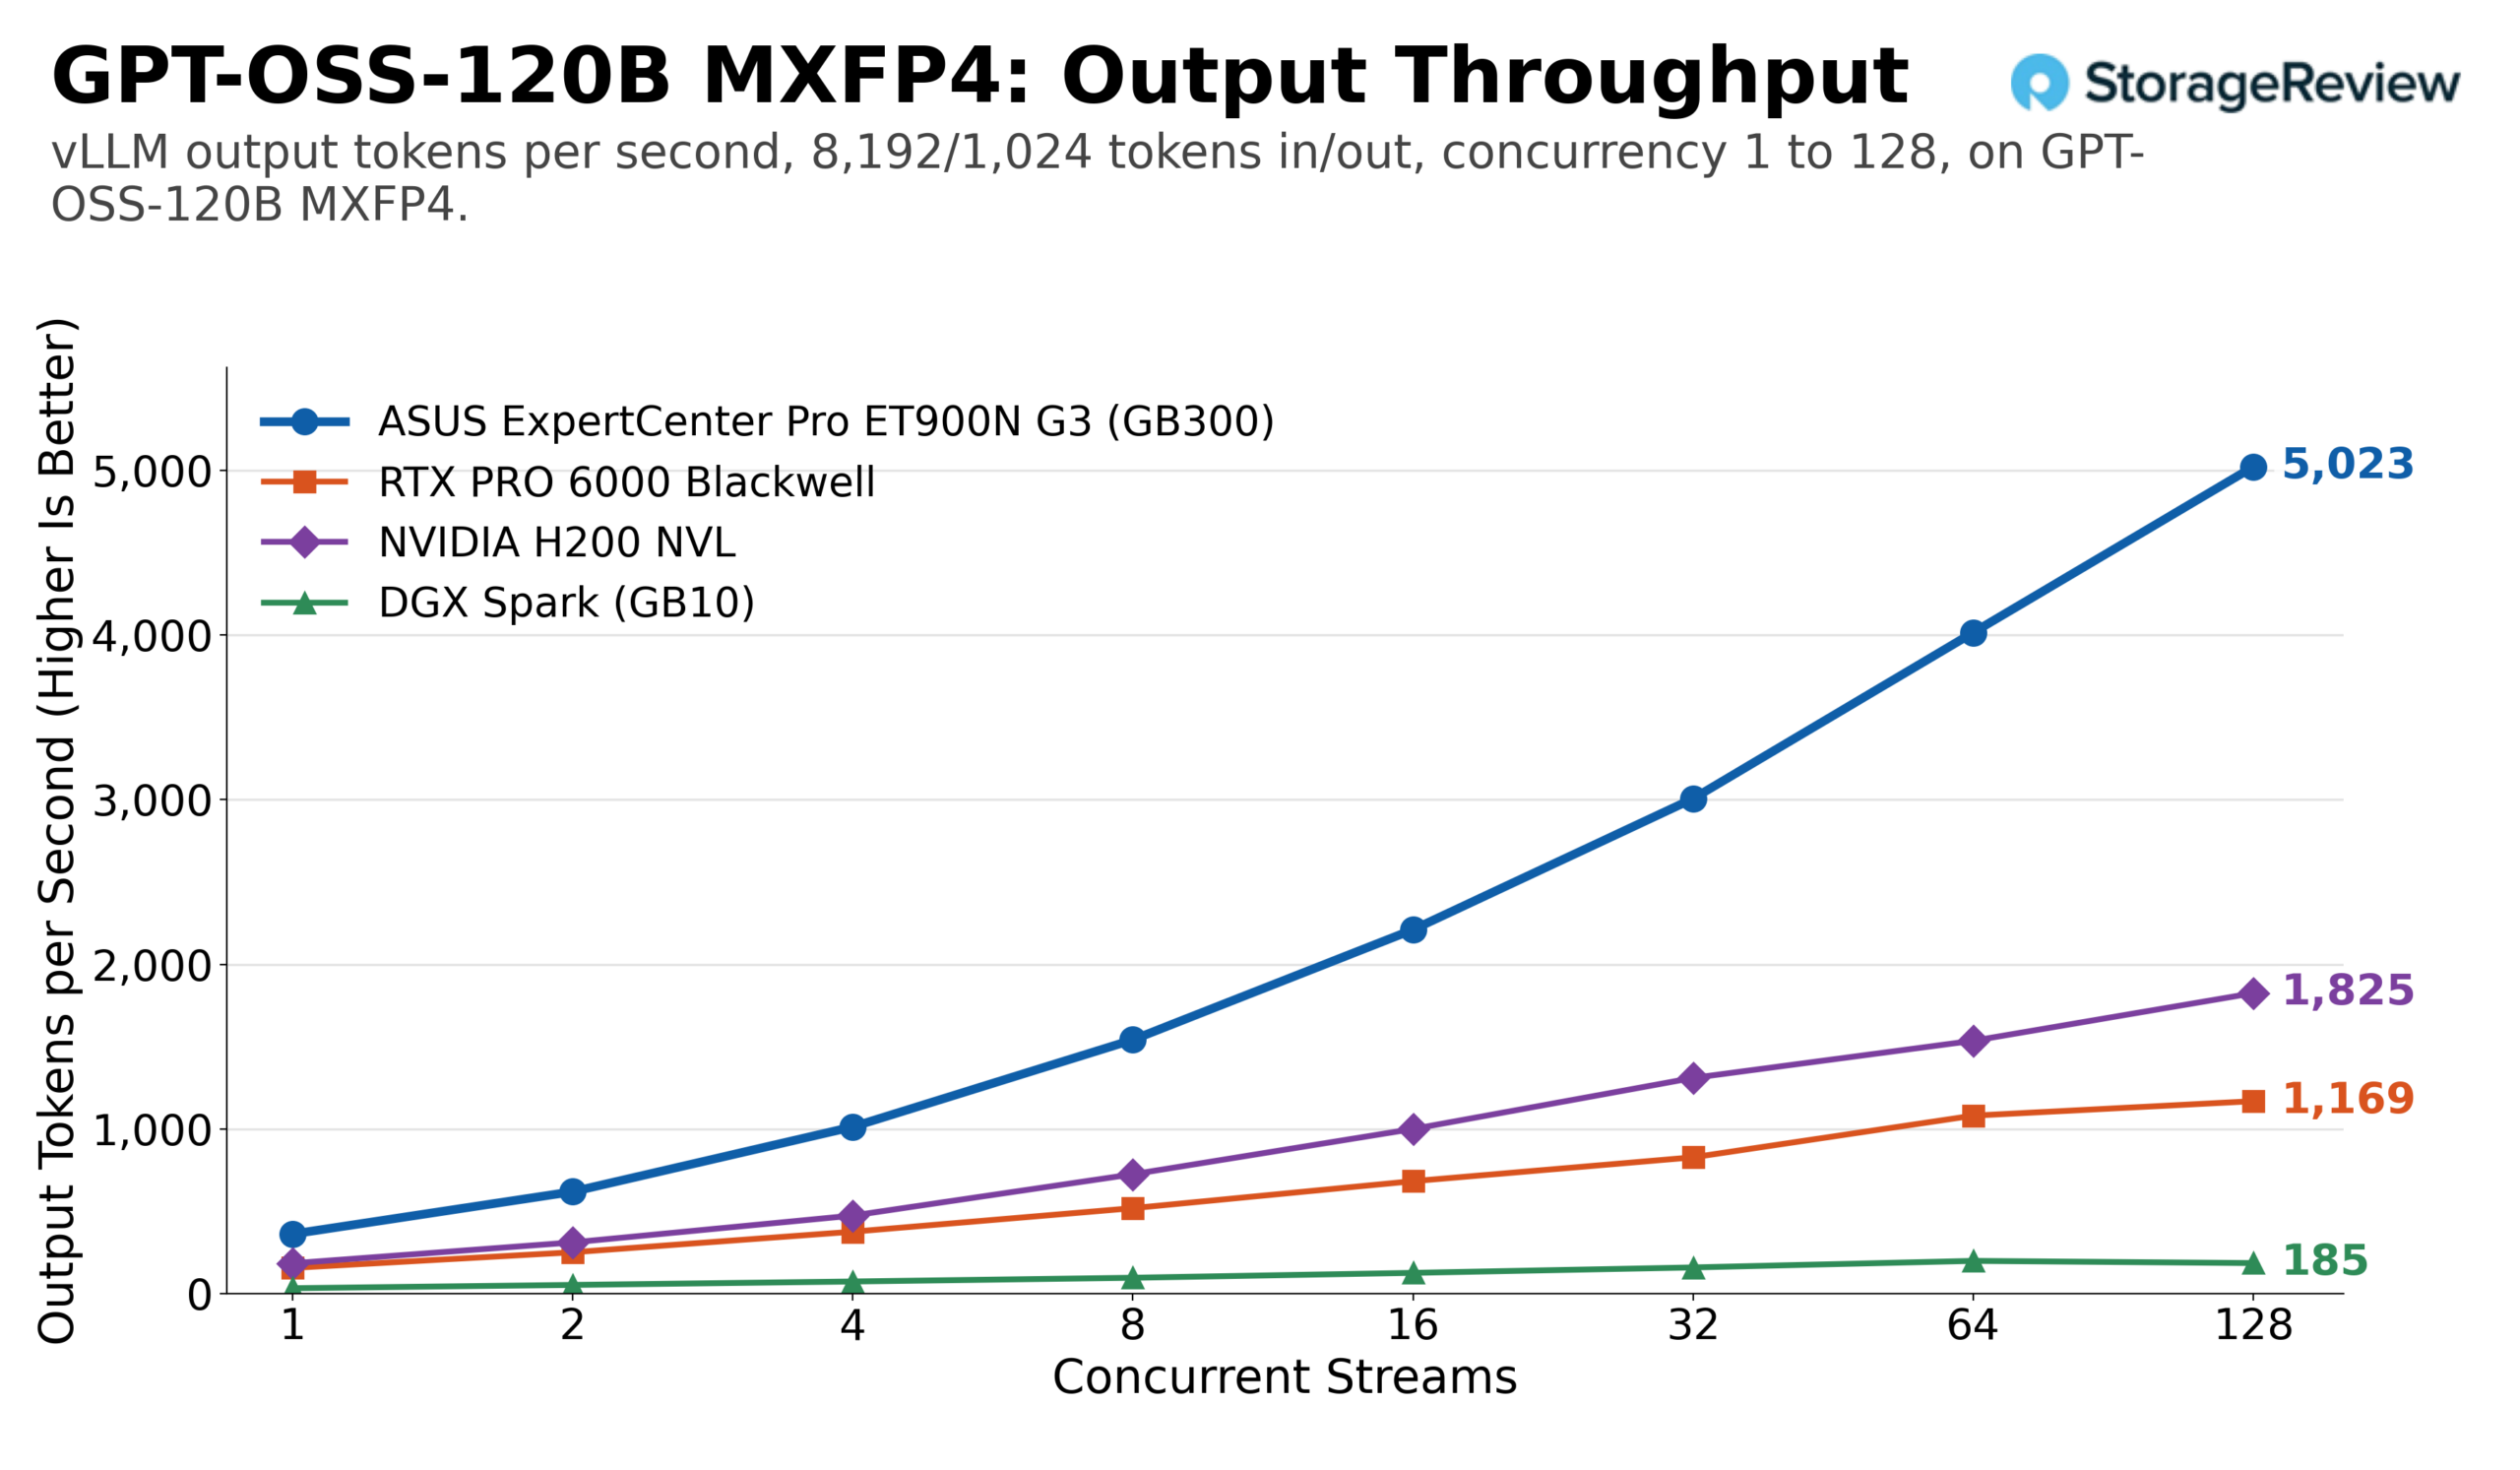
GPT-OSS-120B — это стандарт, с которого начинается сортировка параметров памяти. ET900N G3 достиг 9,280 выходных токенов в секунду при одинаковой нагрузке в 128 потоков, что примерно в три раза больше, чем у RTX PRO 6000 (3,064), в 2.7 раза больше, чем у H200 NVL (3,376), и более чем в 18 раз больше, чем у Spark (500). При длительных запросах более компактные системы показали гораздо худшие результаты, чем Station: RTX PRO 6000 достиг 1,169 выходных токенов в секунду при 128 потоках, а H200 NVL — 1,825, в то время как Station продолжала набирать обороты при 128 потоках и завершила работу с результатом 5,023, с общей пропускной способностью 45,205 токенов в секунду.
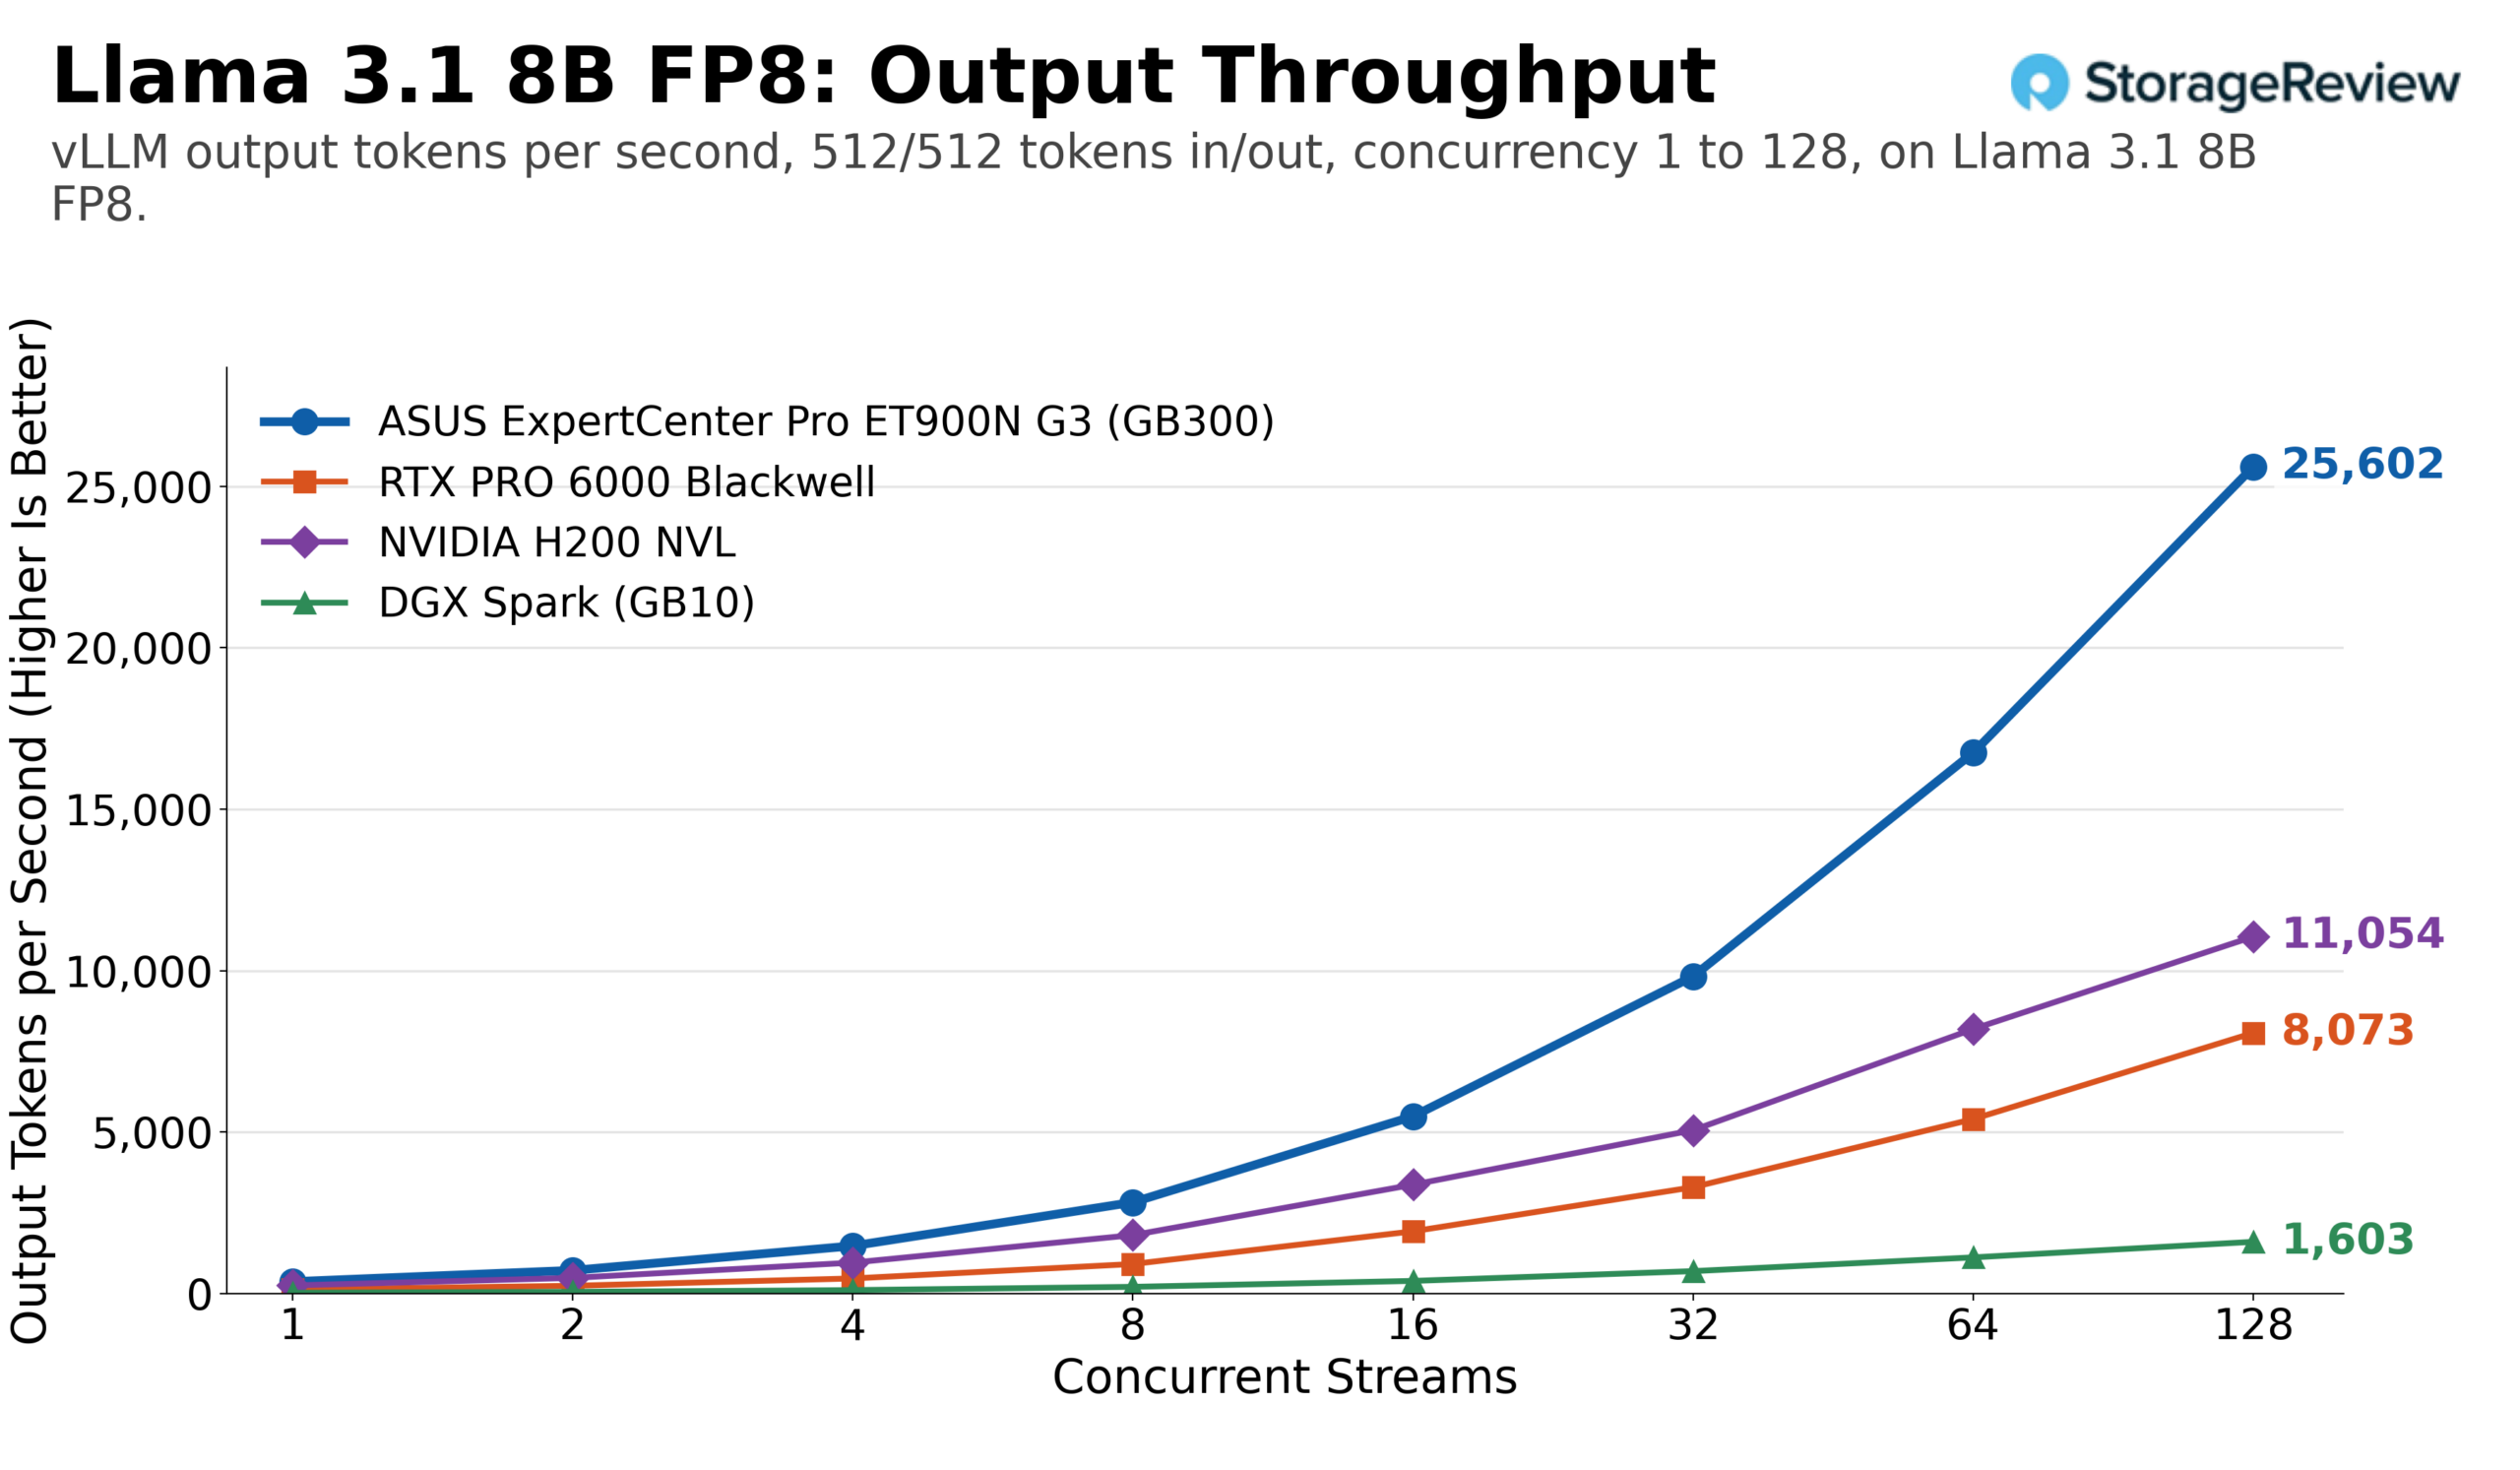
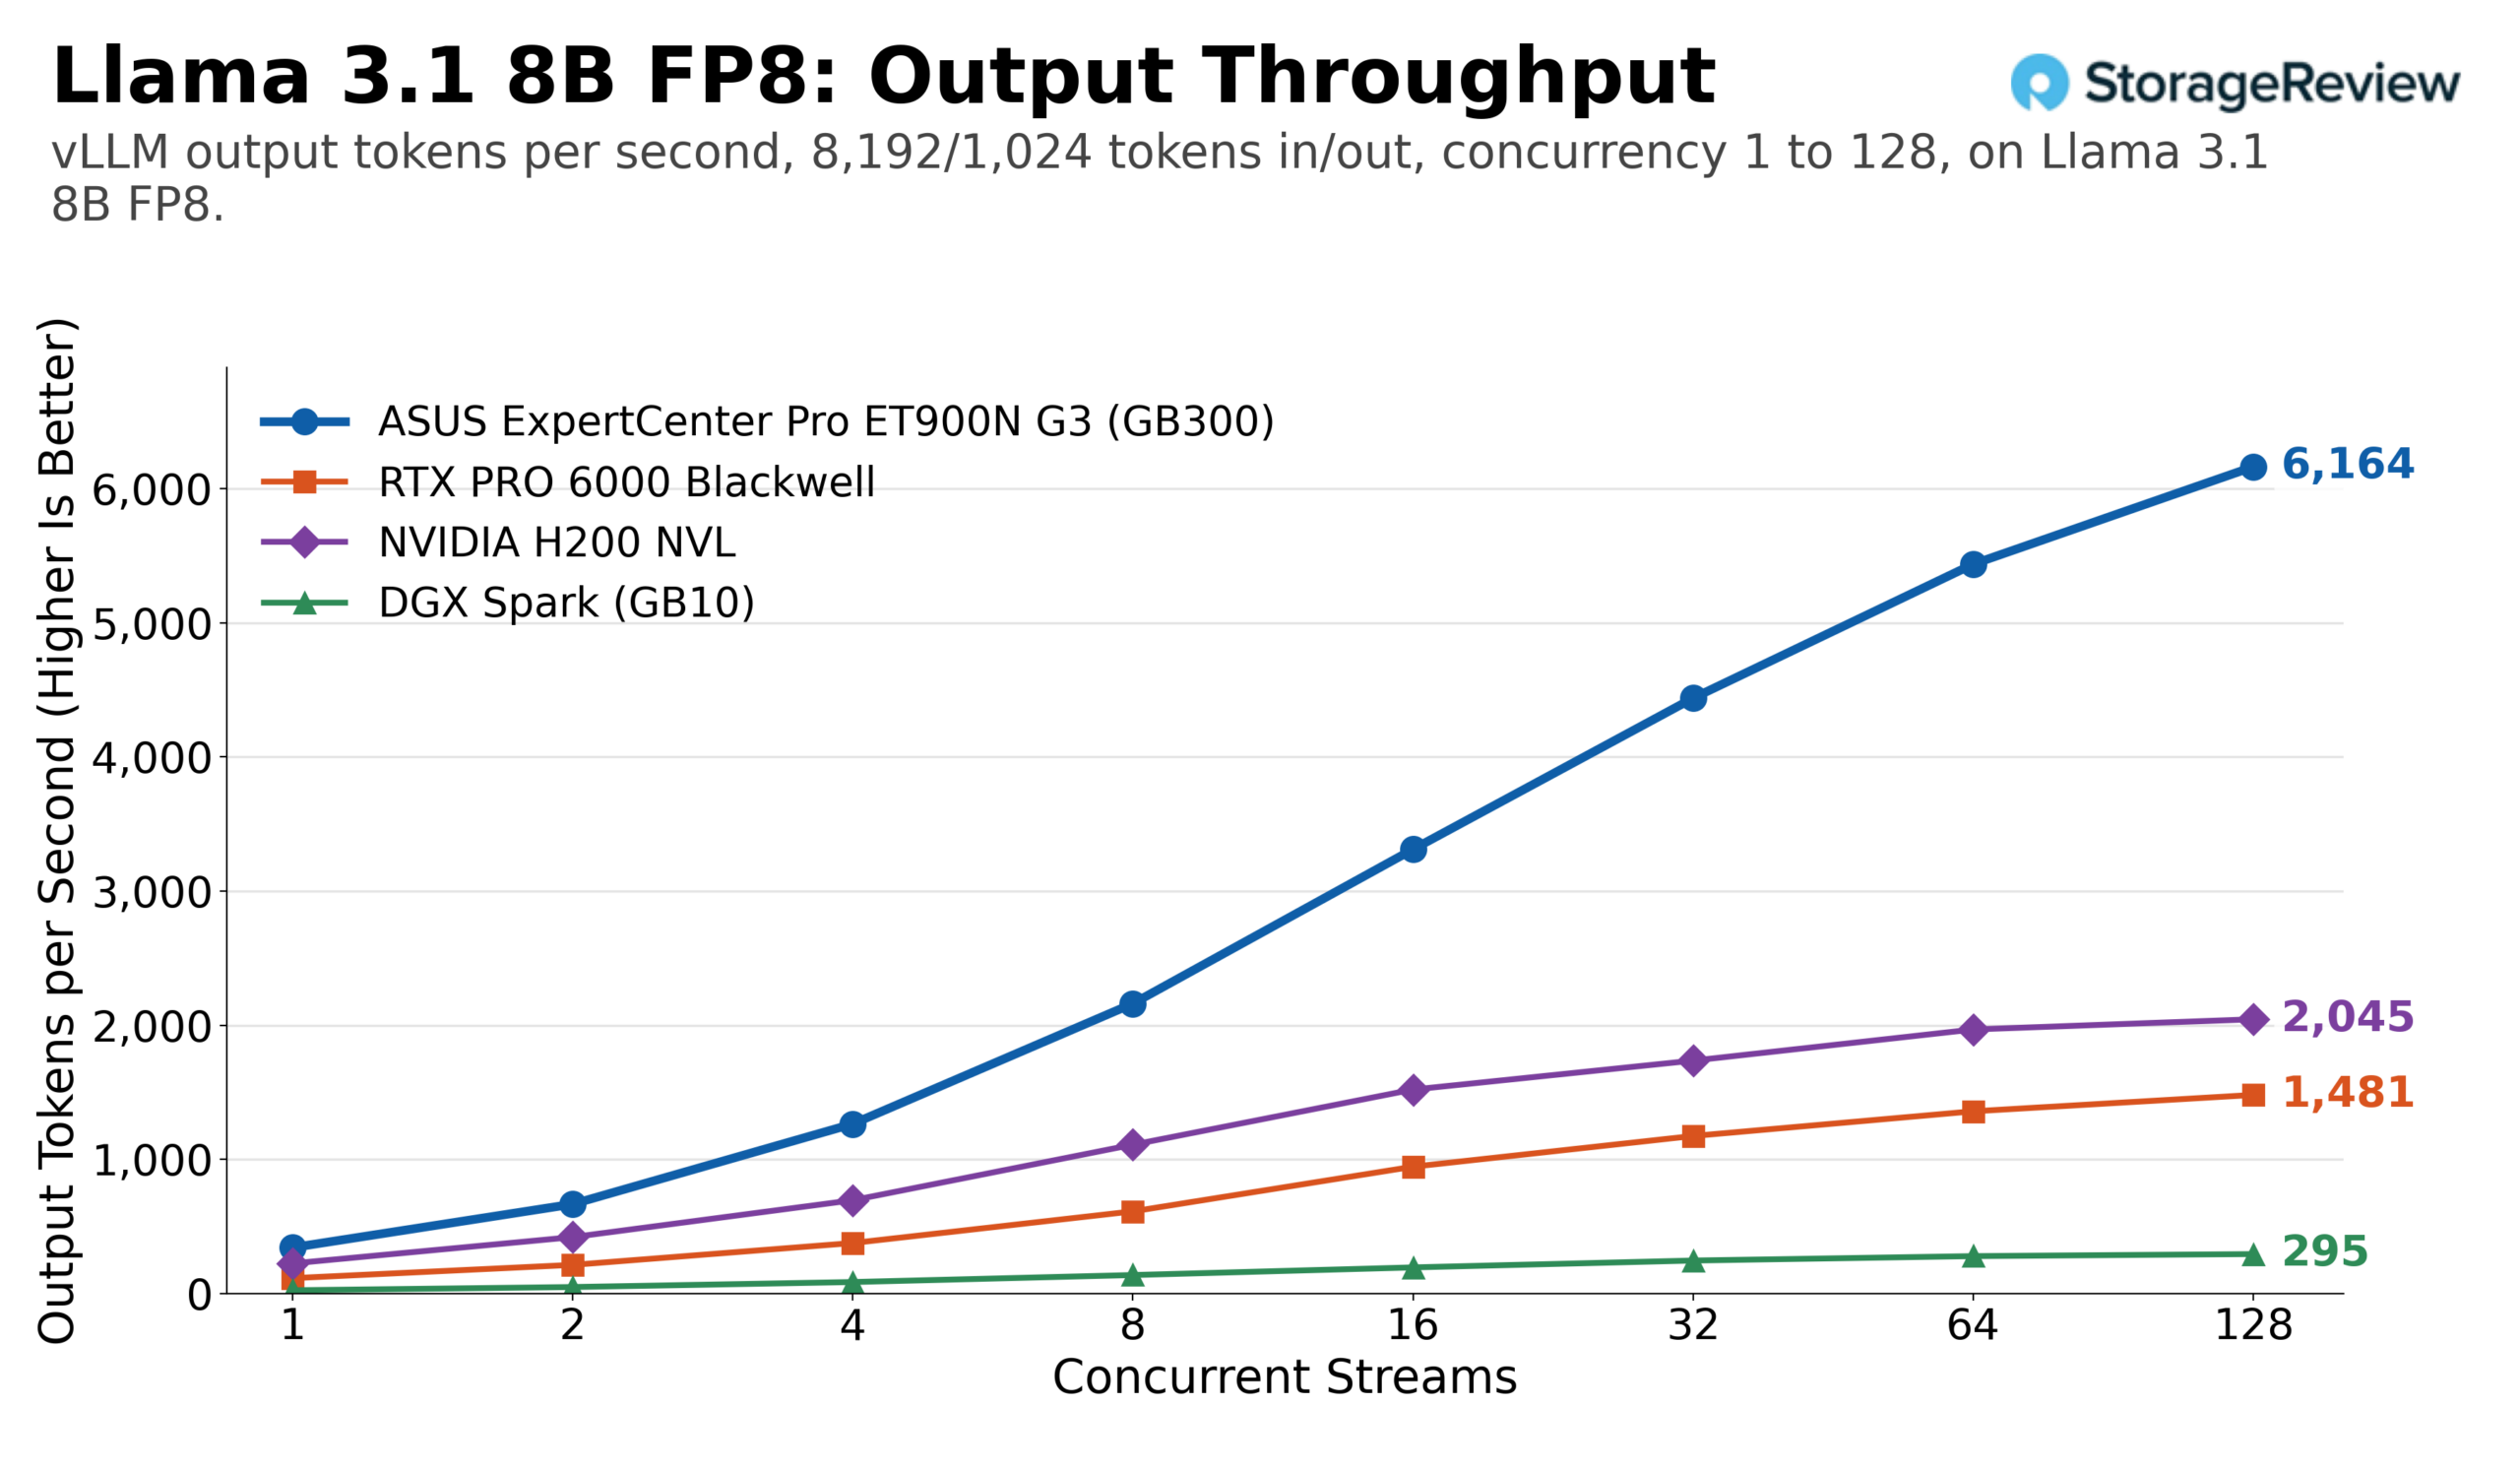
Llama 3.1 8B на FP8 — это самый высокий показатель в наборе. ET900N G3 выдала 25 602 токена в секунду при 128 потоках на одинаковой нагрузке, всего 51 205, по сравнению с 8,073 у RTX PRO 6000 и 11 054 у H200 NVL. Переход с BF16 на FP8 увеличил производительность Station примерно на 50% (с 17 074 до 25 602), в то время как RTX PRO 6000 получила прирост примерно на 70%, а H200 NVL — примерно на 37% от того же изменения. Профиль с интенсивным предварительным заполнением сжал все данные, в результате чего Station показала 6,164 токена в секунду, карта — 1,481, а H200 — 2,045.
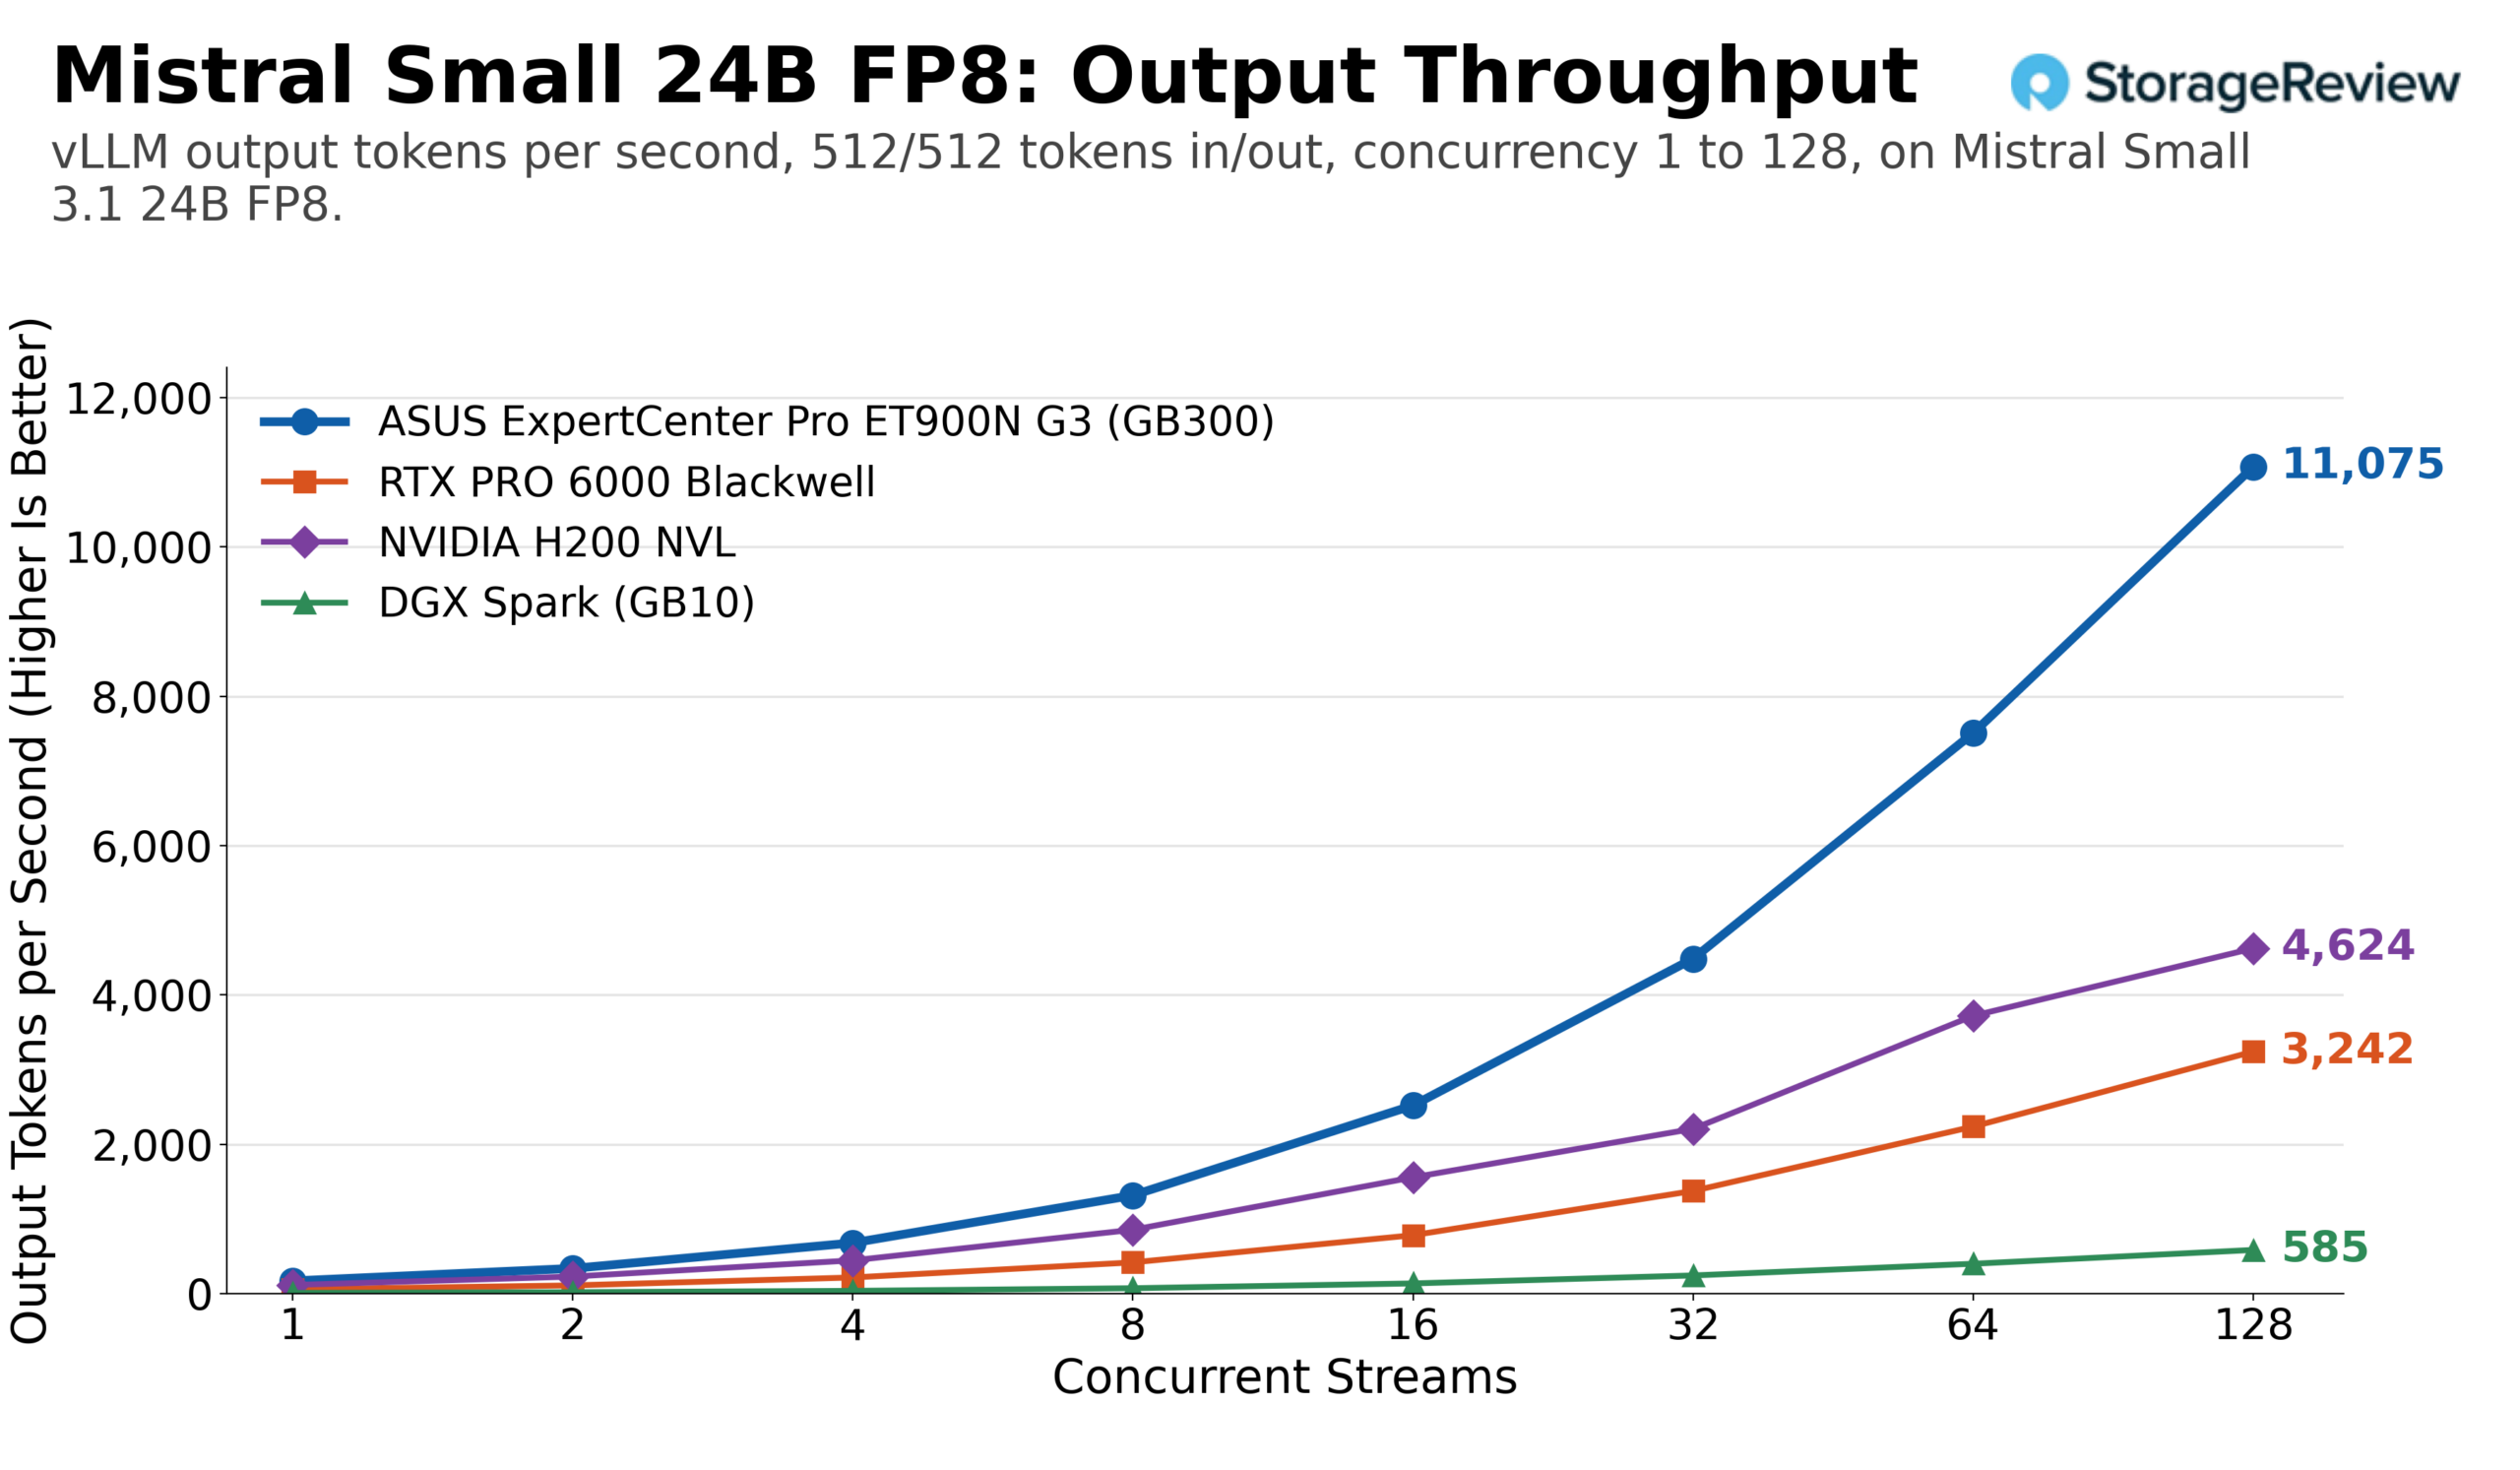
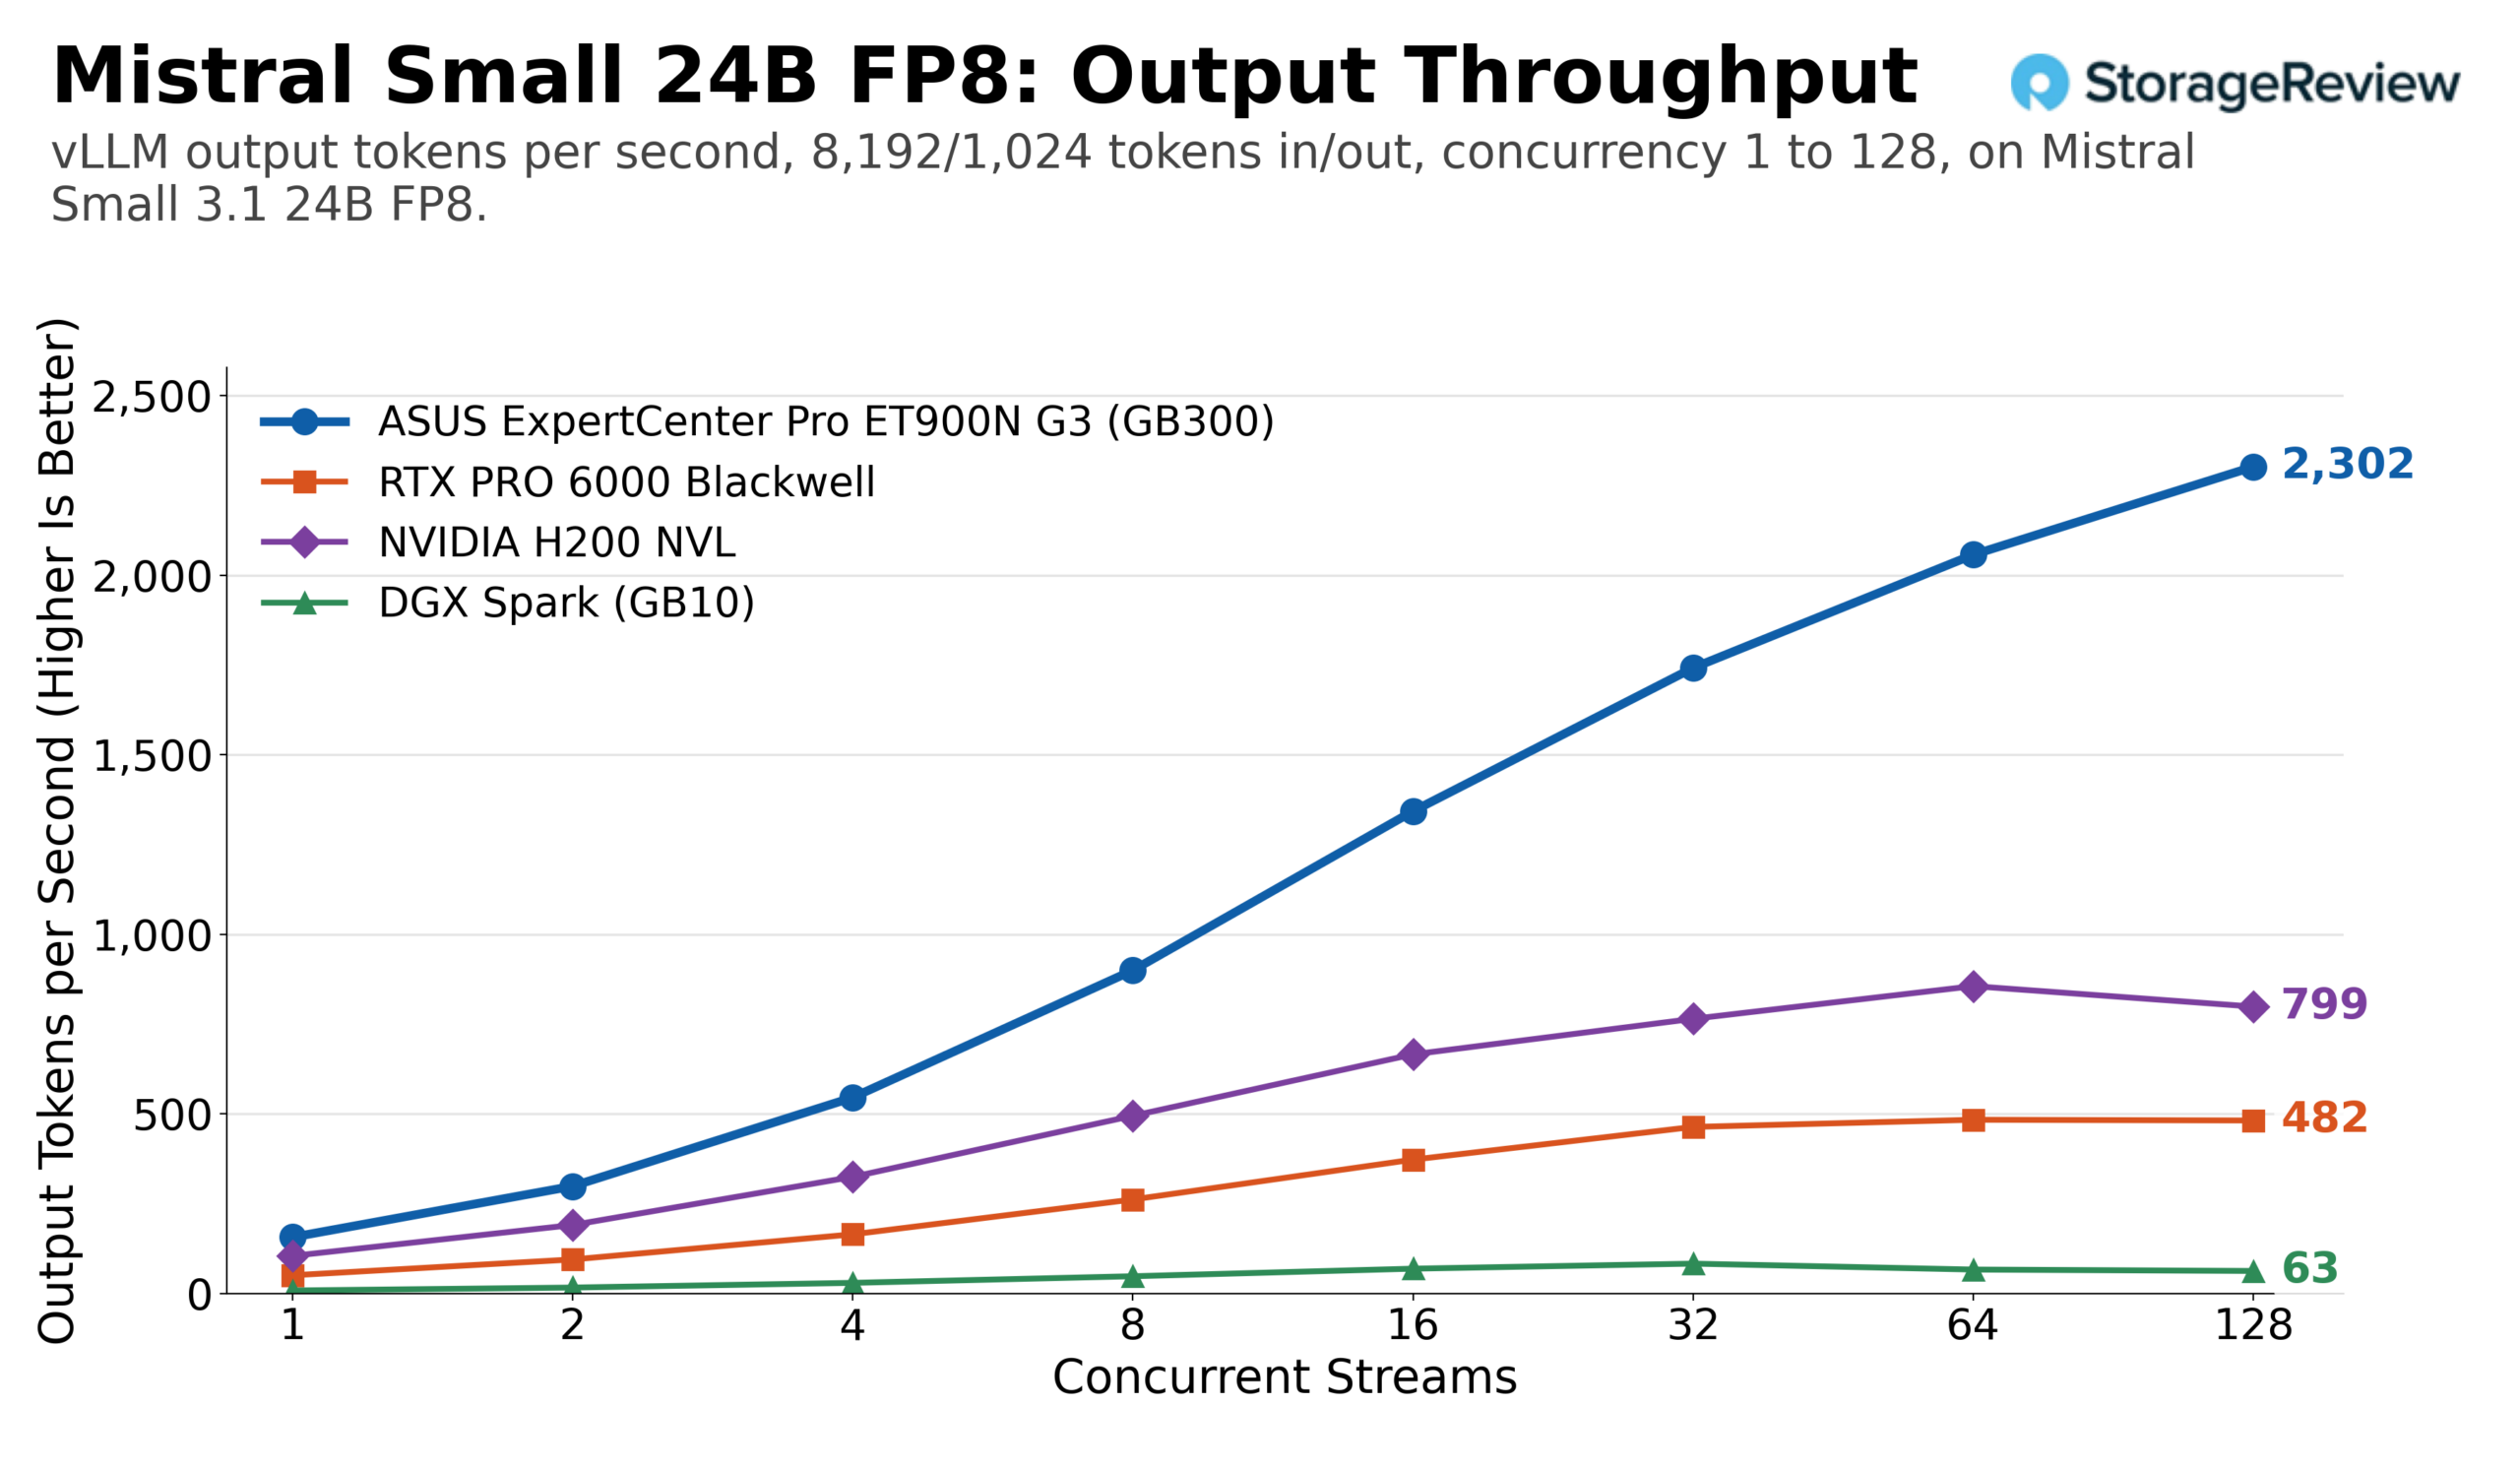
Mistral Small 24B на FP8 показал самые широкие коэффициенты. ET900N G3 достиг пиковой производительности в 11 075 токенов в секунду при одинаковой нагрузке, что в 3.4 раза выше, чем у RTX PRO 6000 (3,242), в 2.4 раза выше, чем у H200 NVL (4,624), и почти в 19 раз выше, чем у Spark (585). При длительных запросах RTX PRO 6000 достиг пиковой производительности в 484 токена в секунду при 64 потоках и удерживал этот уровень; H200 NVL достиг максимума в 856 при 64 потоках, а Station — 2,302 при 128 потоках.
Qwen3 Coder 30B, модель, сочетающая в себе функции нескольких экспертов и небольшое количество активных параметров, — это тот случай, когда разрыв в производительности при работе с одним потоком сокращается. При работе с одним потоком и одинаковой рабочей нагрузкой RTX PRO 6000 выдала 169 выходных токенов в секунду, в то время как Station — 319, а H200 NVL — 211, что является самым близким результатом к Station среди моделей с общими параметрами. Пакетная обработка снова увеличивает разрыв: при работе со 128 потоками ET900N G3 достигла 12 439 выходных токенов в секунду при FP8, что в 3.1 раза больше, чем у карты (3,995), и в 1.7 раза больше, чем у H200 NVL (7,459). При интенсивном предварительном заполнении данных Station достигла производительности в 3,837 токенов в секунду, в то время как RTX PRO 6000 показала пиковое значение в 882 токена при 64 потоках, а H200 NVL — 1,820.
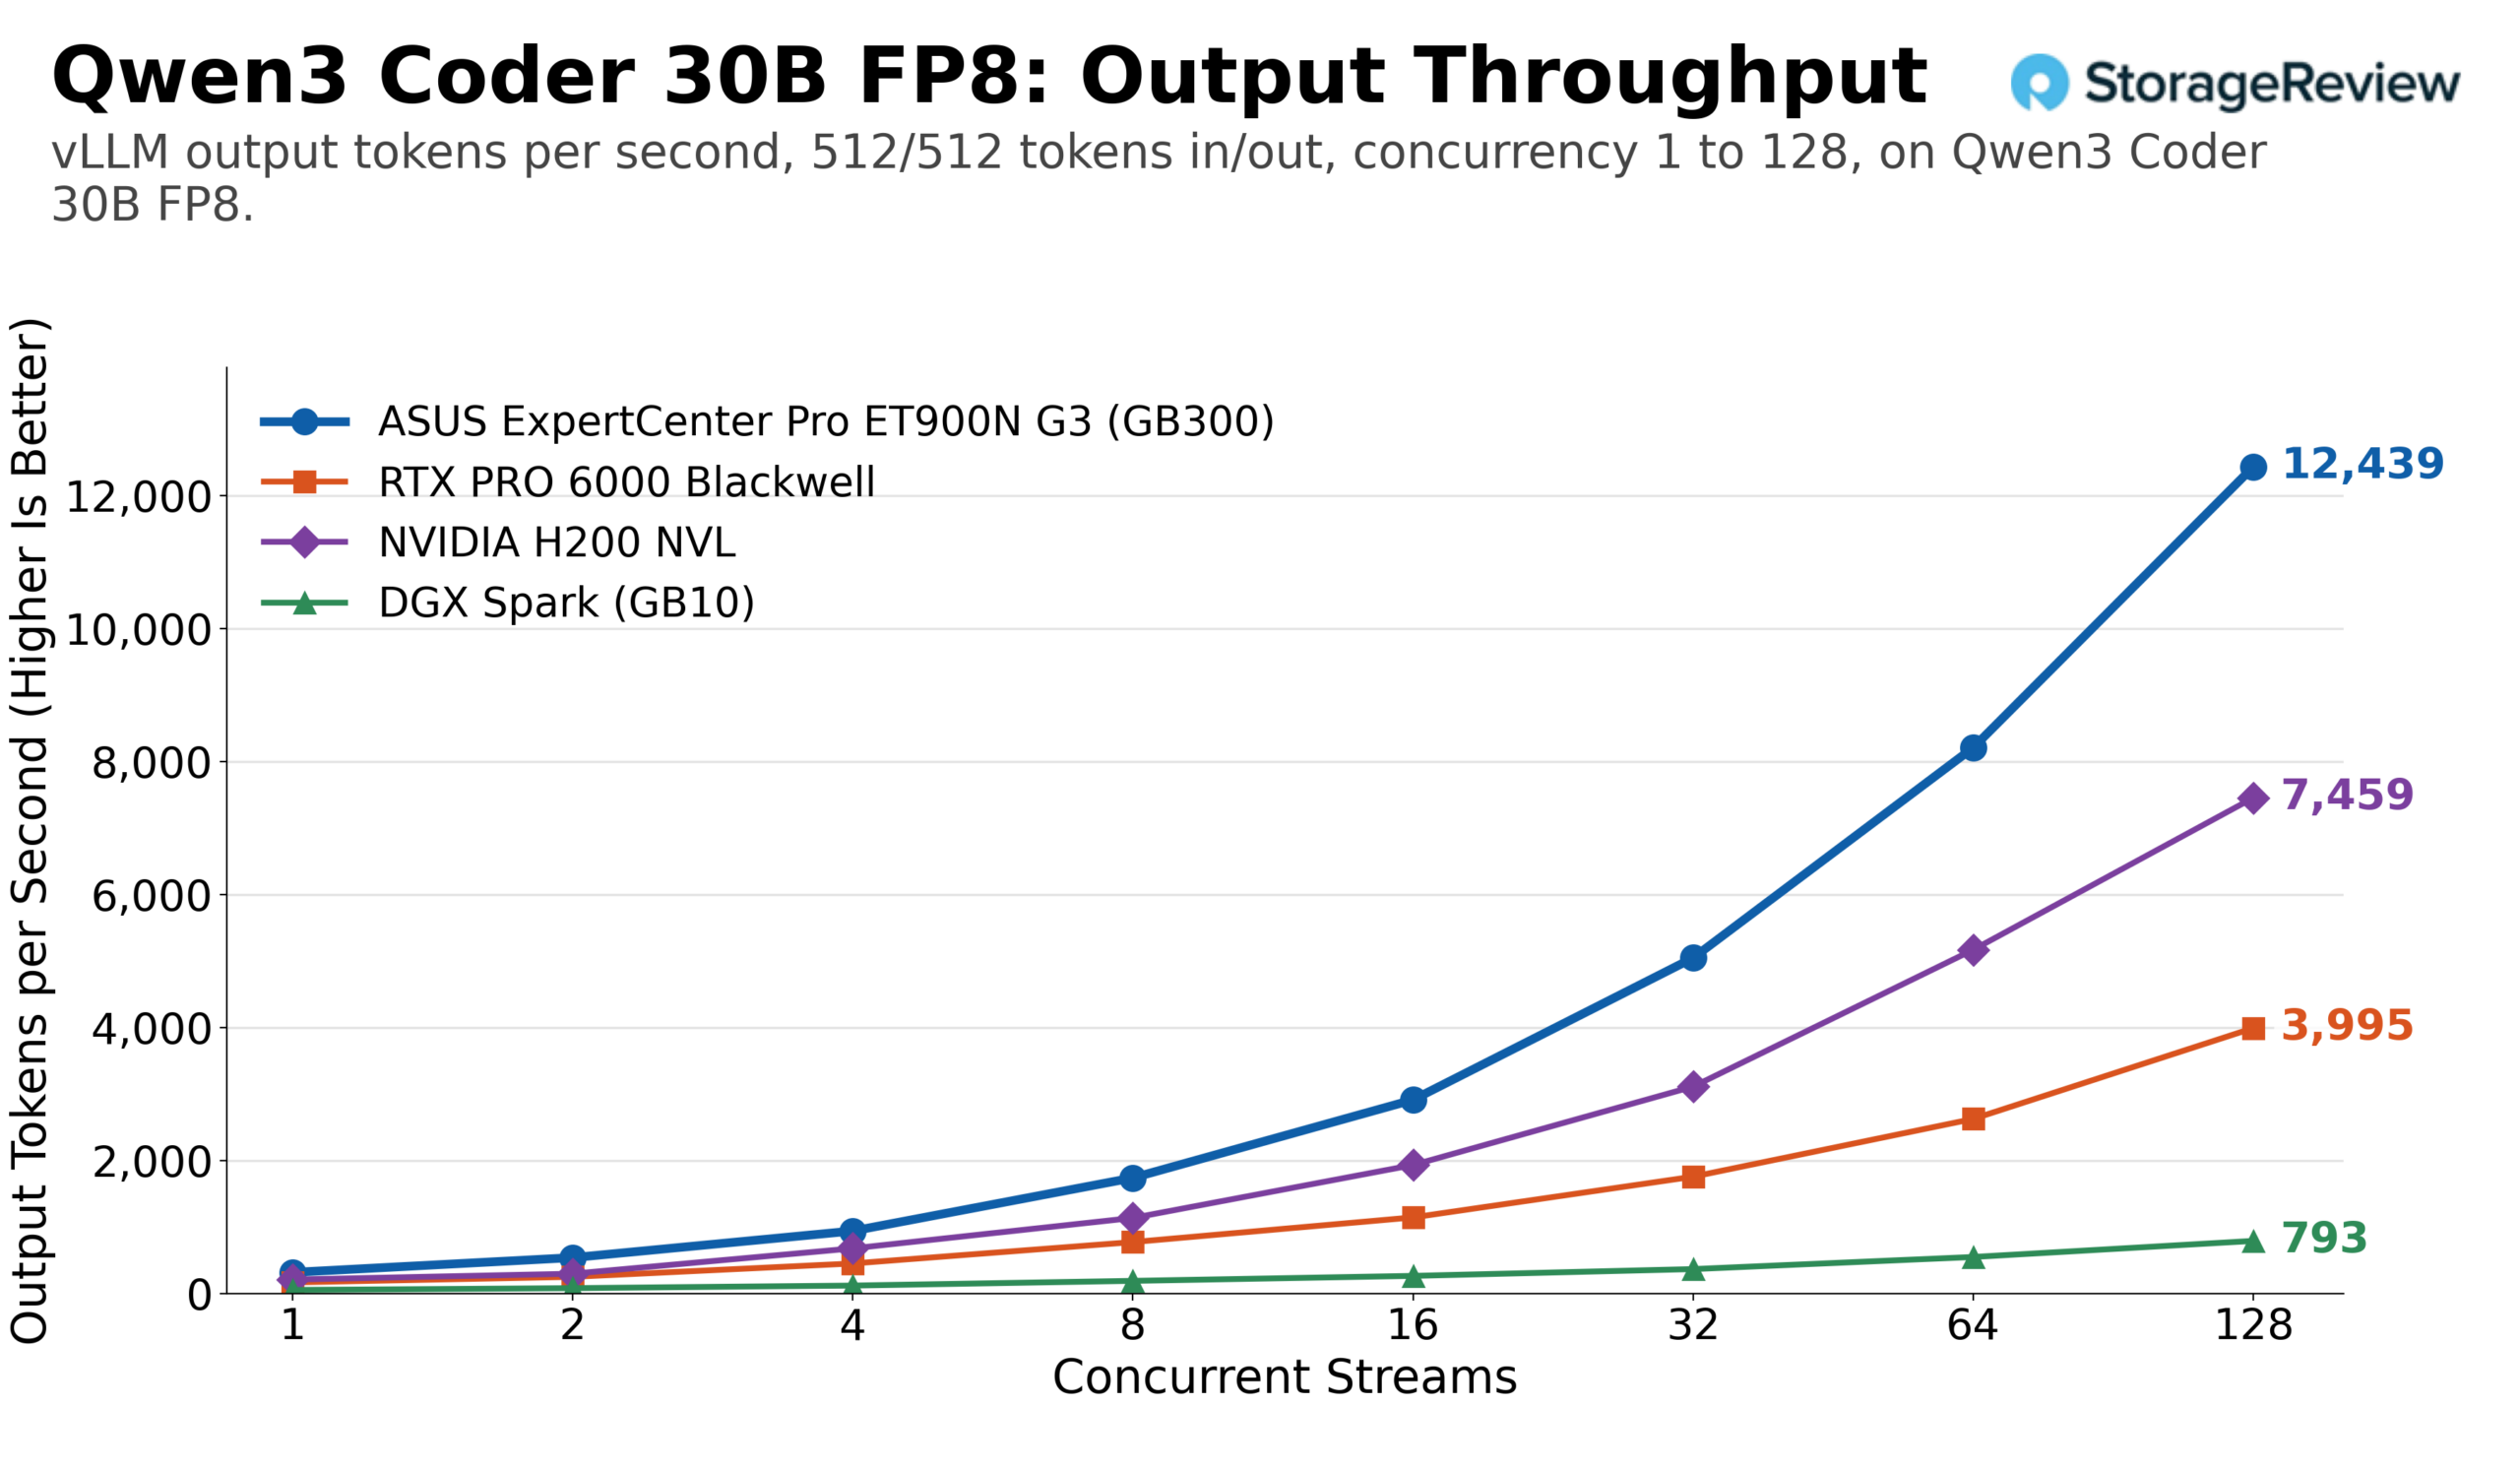
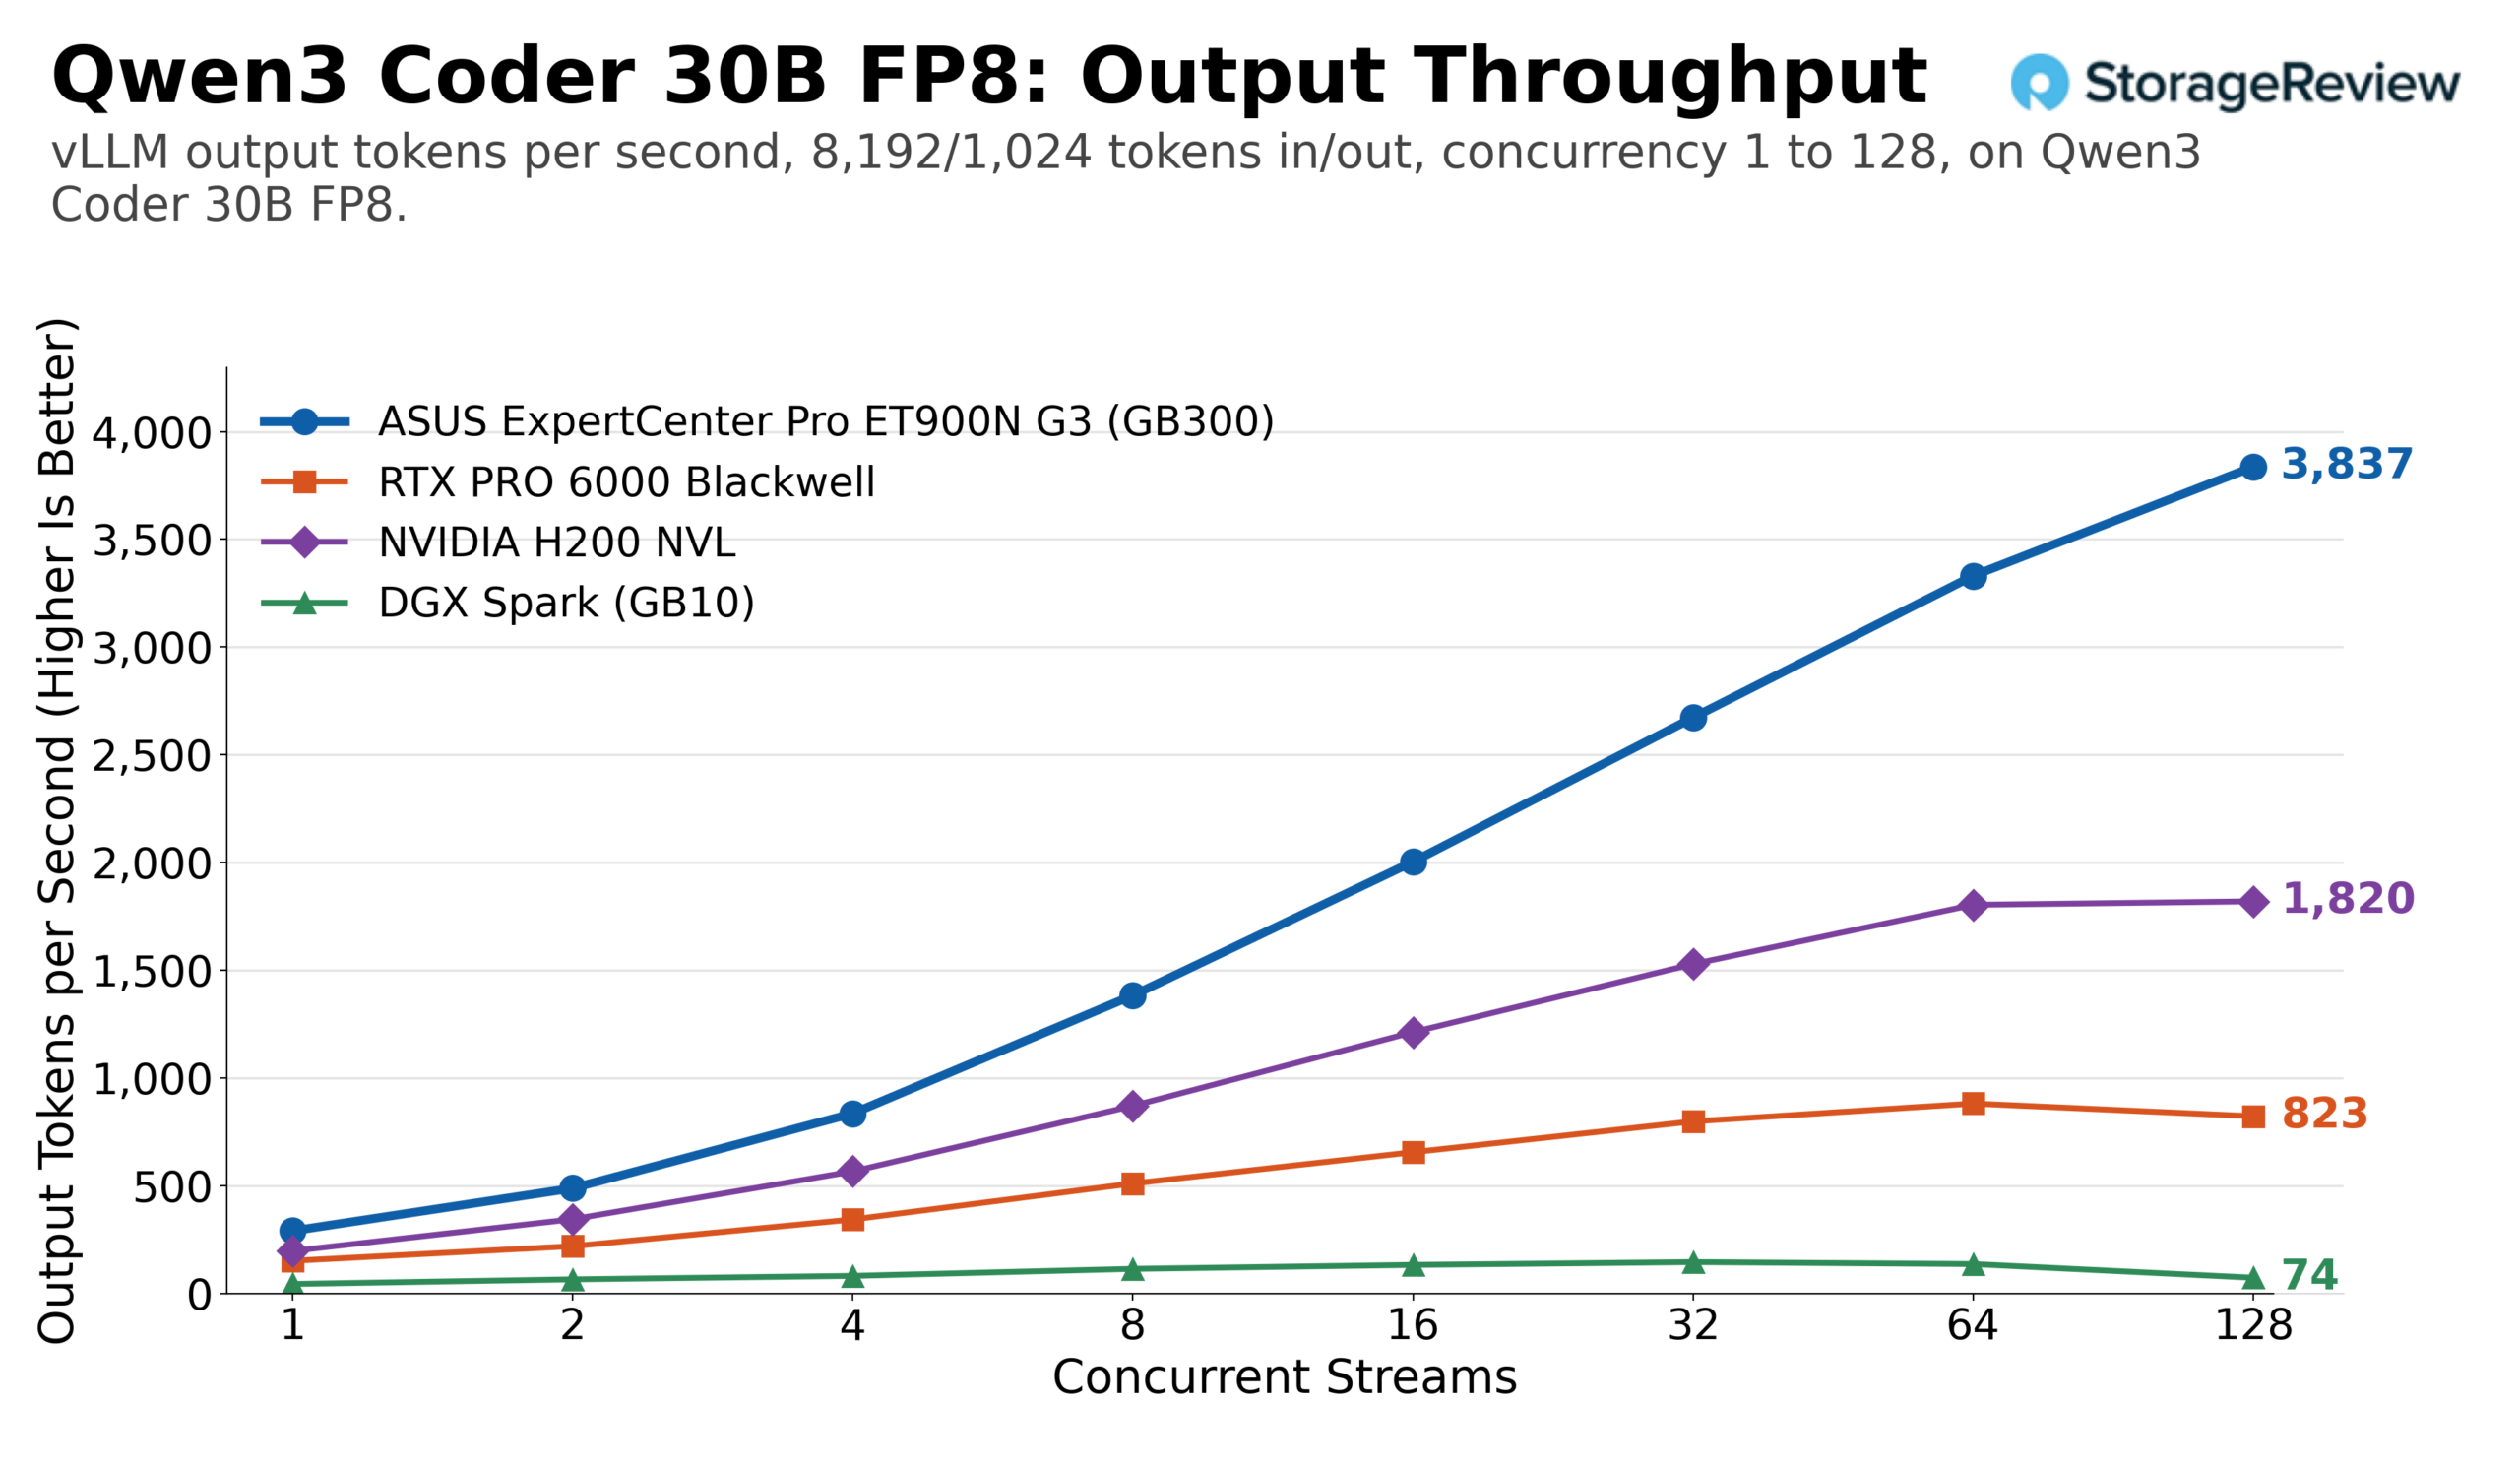
В сравнении с другими моделями, ET900N G3 показала результат в 2.8–3.9 раза выше, чем у одной RTX PRO 6000, и в 1.7–3.7 раза выше, чем у H200 NVL при полной параллельной обработке, при этом разница увеличивалась при длительных запросах по мере исчерпания запаса памяти в кэше KV. По сравнению с WS300, разница между этими четырьмя моделями снова составляет менее 1%: 22 041 против 22 161 на GPT-OSS-20B, 9 280 против 9 294 на GPT-OSS-120B, 11 075 против 11 157 на Mistral Small FP8 и 12 439 против 12 425 на Qwen3 Coder FP8. Полное сравнение 14 моделей, включая три модели с большей разницей, приведено в следующем разделе.
Две башни, одна материнская плата: ASUS ET900N G3 против MSI WS300
ET900N G3 и MSI XpertStation WS300 — это одна и та же материнская плата NVIDIA GB300 DGX Station, установленная в двух OEM-корпусах. Обе прошли тестирование на 14 моделях, с использованием двух одинаковых рабочих нагрузок и с одинаковым уровнем параллельного выполнения на одной и той же сборке vLLM. На диаграмме ниже сравнивается пиковая производительность ET900N G3 по всем моделям с показателями WS300.
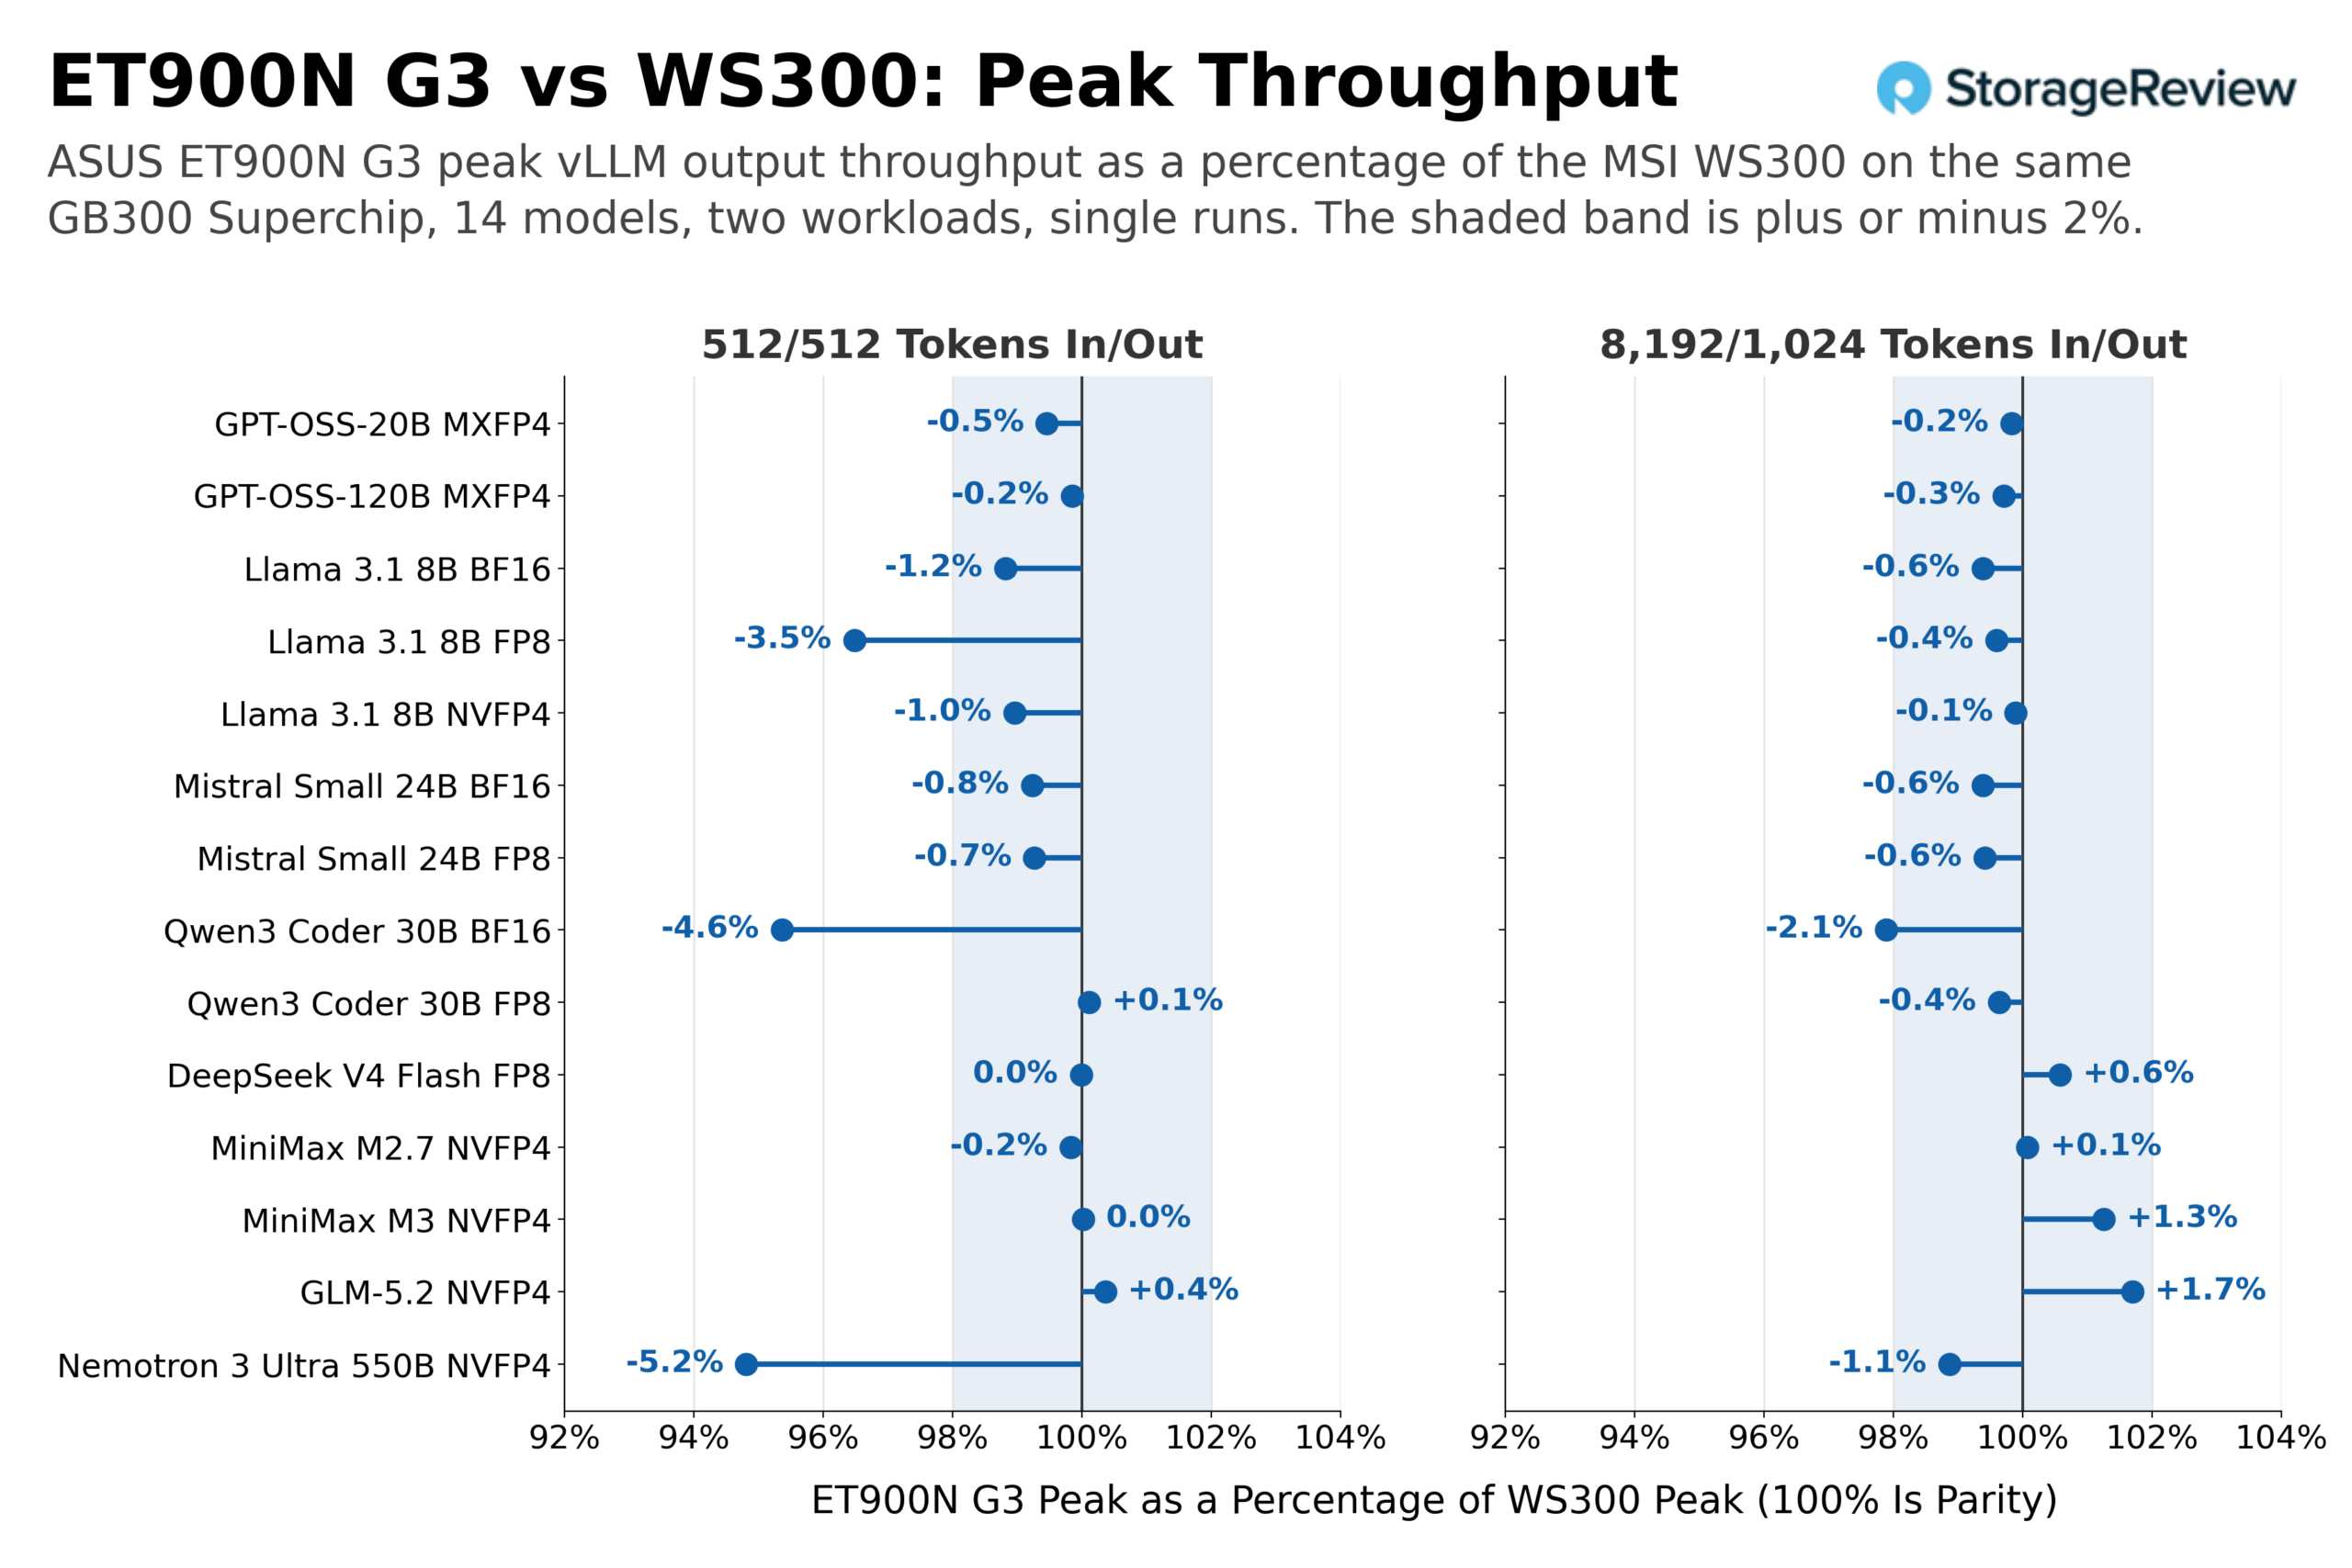
Из 28 пар «модель-нагрузка» 24 отличаются друг от друга не более чем на 2%, и большинство из них на долю процента выигрывают у WS300. Четыре выходят за пределы этого диапазона, три из них при одинаковой нагрузке: Llama 3.1 8B FP8 на 3.5% меньше, чем у WS300 (25 602 против 26 536 выходных токенов в секунду), Qwen3 Coder 30B BF16 на 4.6% меньше (10 000 против 10 486) и Nemotron 3 Ultra 550B на 5.2% меньше (159 против 168), а также Qwen3 Coder 30B BF16 снова на 2.1% меньше при длинных запросах. Все приведенные здесь данные получены в ходе одного запуска на каждом шасси, поэтому разница в 2-5% между тремя моделями из 14 не будет объясняться особенностями шасси; Мы просто отмечаем данные и разницу между ними. Модели, использующие когерентный пул памяти, MiniMax M3 и GLM-5.2, показывают одинаковые или даже лучшие результаты в обеих рабочих нагрузках; это результат, который, по нашему мнению, наиболее важен для платформы: путь разгрузки Grace работает одинаково как в корпусах ASUS, так и в корпусах MSI.
| Модель | WS300 512/512 | ET900N G3 512/512 | Delta | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Лама 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Лама 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Лама 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Small 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Small 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Qwen3 Coder 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Qwen3 Coder 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B, самый высокопроизводительный плотный случай в наборе, и GLM-5.2, случай с разгрузкой, демонстрируют перекрытие без коэффициента: в обоих случаях результаты работы WS300 точно повторяют результаты ET900N G3.
Это сравнение мы будем проводить по мере поступления в лабораторию новых настольных компьютеров GB300. Следующим будет HP ZGX, за ним последуют и другие, и каждый из них будет проходить один и тот же тест, поэтому любые различия между OEM-версиями будут показаны здесь, на отдельном графике для каждого компьютера, при этом графики моделей будут содержать исходные кривые.
Заключение
ASUS ExpertCenter Pro ET900N G3 делает то, что должна делать вторая версия эталонной платформы: она подтверждает первую. В 14 моделях и при двух рабочих нагрузках пиковая пропускная способность vLLM оказалась в пределах 2% от MSI XpertStation WS300 в 24 из 28 сравнений, от 1,766 выходных токенов в секунду на DeepSeek V4 Flash до 22,041 на GPT-OSS-20B, с четырьмя выбросами в отдельных запусках, отличающимися на 2-5%, и обеспечивала работу GLM-5.2 с 215 ГБ экспертной памяти Grace со скоростью, недостижимой для четырех карт RTX PRO 6000. GB300 Superchip устанавливает потолок, и ASUS хорошо справилась с его реализацией.
Что добавляет ASUS, так это практичность: ручки превращают 27-килограммовый корпус в устройство, которое могут переместить два человека, не держась за панели, вентилятор над отсеками для модулей QSFP112 решает потенциальную проблему для тех, кто использует 400G-оптику в течение нескольких часов, а блок питания Titanium снижает энергопотребление на несколько ватт. Архитектура Arm, 20-амперная схема, вывод изображения только через BMC и общий бюджет в 1,600 Вт при установке большой видеокарты — это особенности платформы, которые в равной степени применимы к обоим корпусам.
GB300 DGX Station по-прежнему остается самым функциональным устройством, которое мы когда-либо ставили на стол, и ASUS сделала свою версию отличным вариантом для его приобретения.
На нашей Лучшие настольные компьютеры для локального ИИ В рейтинге лучших систем на базе GB300 ET900N G3 теперь занимает место рядом с WS300 в качестве проверенной альтернативы.
В рейтинге лучших видеокарт для корпоративного сектора H200 NVL возвращается в качестве лучшей видеокарты с PCIe-ускорителем ИИ , а конфигурации с XE7740 RTX PRO 6000 появляются в таблице масштабируемости.



 Amazon