

MSI XpertStation WS300 построена на новейшей архитектуре NVIDIA DGX Station, самом производительном поколении на сегодняшний день, и размещает полноценный узел GB300 Grace Blackwell Ultra рядом с вашим рабочим столом. Главная производительность составляет 20 петафлопс вычислений FP4, обеспечиваемых одним графическим процессором Blackwell Ultra, работающим в паре с 72-ядерным процессором Grace по каналу NVLink-C2C со скоростью 900 ГБ/с. Оба процессора используют один общий пул памяти объемом 748 ГБ: 252 ГБ HBM3e в паре с 496 ГБ LPDDR5X, чего достаточно для хранения модели с триллионом параметров в локальной памяти.
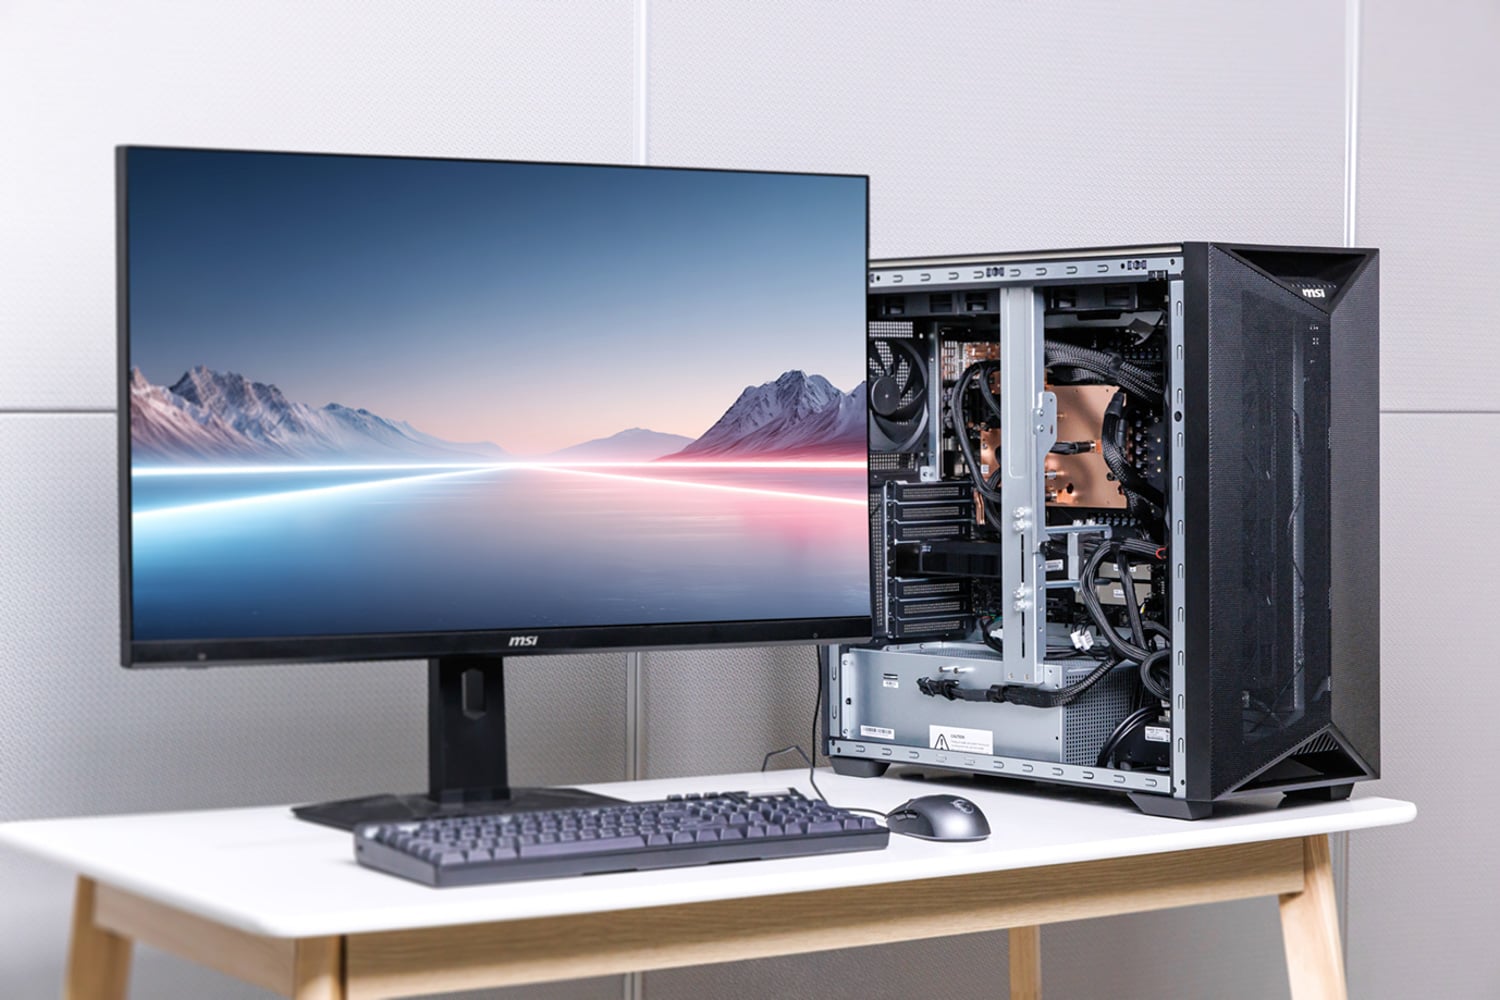
DGX Station также поддерживает кластеризацию нескольких устройств с помощью своей сетевой карты ConnectX-8 SuperNIC, которая предоставляет два порта 400GbE для обеспечения скорости передачи данных 800 Гбит/с. В результате получается машина класса дата-центра, которая может работать дома или в офисе, а не в серверном зале.
Технические характеристики NVIDIA DGX Station
XpertStation WS300 — это реализация компанией MSI платформы NVIDIA GB300 DGX Station. NVIDIA предоставляет материнскую плату Grace Blackwell Ultra и программную среду, а MSI — корпус, систему жидкостного охлаждения, систему питания, схему размещения накопителей, внешние порты ввода-вывода и сервисную модель, которые превращают платформу в полноценную настольную систему. Поскольку процессор Grace, графический процессор Blackwell Ultra, межсоединение NVLink-C2C и сетевое соединение ConnectX-8 являются фиксированными, реальное отличие для OEM-производителей заключается в том, насколько эффективно окружающая система поддерживает, управляет и предоставляет доступ к этому оборудованию. Для тестирования MSI использовала в этой системе четыре твердотельных накопителя Micron 4600 Gen5 M.2 емкостью 2 ТБ. Два SSD были сконфигурированы в RAID1 для загрузочного хранилища, а два других представляли собой дискретные SSD для временного хранилища или других целей.
| Параметр | Описание |
|---|---|
| Архитектура | |
| ЦП | NVIDIA Grace, 72-ядерный процессор Arm Neoverse V2 |
| GPU : | NVIDIA Blackwell Ultra (B300) |
| Тензорные сердечники | 5th Generation |
| Взаимодействие ЦП-ГП | NVLink-C2C, двунаправленный, 900 Гбит/с |
| Память | |
| Связная память | До 748 ГБ |
| Память графического процессора | До 252 ГБ HBM3e |
| Пропускная способность памяти графического процессора | 7.1 TB / s |
| Память ЦП | До 496 ГБ LPDDR5X (4 x SOCAMM) |
| Пропускная способность памяти процессора | 396 Гб / с |
| Память | |
| Загрузочные диски | 2 x M.2 2280 PCIe 5.0 x4 NVMe (подключены к процессору), с двумя накопителями Micron 4600 Gen5 по 2 ТБ в режиме RAID 1. |
| Расширительные приводы | 2 x M.2 2280 PCIe 5.0 x4 NVMe (подключены через ConnectX-8), установлены для тестирования с 2 x 2 ТБ Micron 4600 Gen5 |
| Networking | |
| NIC | NVIDIA ConnectX-8 SuperNIC, 2 x 400G QSFP112 (суммарная скорость 800 Гбит/с) |
| Ethernet | 1 x 10GBase-T RJ45 (Marvell AQC113) |
| Порт управления | 1 x 1000Base-T RJ45 (выделенный внеполосный разъем) |
| Беспроводной сети | Слот M.2 2230 Key-E, PCIe 2.0 x1 (Wi-Fi 6E / Wi-Fi 7, Bluetooth) |
| расширение | |
| Слоты PCIe | 1 x PCIe 5.0 x16 FHFL двухслотовый; 2 x PCIe 5.0 x16 FHFL однослотовый (8 сигналов) |
| Поддерживаемые дополнительные графические процессоры | NVIDIA RTX PRO 2000 Blackwell, RTX PRO 4000 Blackwell SFF, RTX PRO 6000 Blackwell Workstation / Max-Q |
| Передняя/верхняя панель ввода/вывода | |
| USB | 2 порта USB 3.2 Gen 2 Type-A; 2 порта USB 3.2 Gen 2 Type-C (5 В/3 А) |
| Аудио | 2 разъема (линейный выход / микрофонный выход) |
| Задний ввод-вывод | |
| USB | 4 порта USB 10 Гбит/с Type-A; 1 порт Micro-USB COM (последовательная консоль). |
| Дисплей | 1 разъем Mini DisplayPort (видео BMC, максимальное разрешение 1024 x 768, без DP++) |
| Аудио | 3 разъема (линейный вход / линейный выход / микрофонный разъем) |
| Управление и безопасность | |
| BMC | ASPEED AST2600 с прошивкой AMI MegaRAC, IPMI 2.0 и Redfish, локальное хранилище eMMC. |
| Безопасность. | TPM 2.0, обнаружение проникновения в корпус, аппаратный корень доверия Microchip CEC1736 (ERoT) |
| Охлаждение | |
| Жидкое охлаждение | Модуль жидкостного охлаждения, рассчитанный на мощность 1400 Вт для процессора и видеокарты, с блоками для видеокарты, процессора, памяти и разъемом ConnectX-8. |
| Радиаторы / Вентиляторы | 2 радиатора 360 мм; 1 системный вентилятор 12025 |
| Мощность | |
| Электропитание | 1 блок питания 1600 Вт ATX, 80 PLUS Platinum (150 x 86 x 210 мм) |
| Переменного тока | 100-114 В переменного тока, 15 А, 47-63 Гц (максимальная выходная мощность 1300 Вт); 115-240 В переменного тока, 15-8 А, 47-63 Гц (максимальная выходная мощность 1600 Вт) |
| Форм-фактор | |
| Габаритные размеры: | 245.7 x 529.0 x 570.4 мм (9.67 x 20.83 x 22.46 дюйма), Ш x В x Г |
Дизайн и сборка
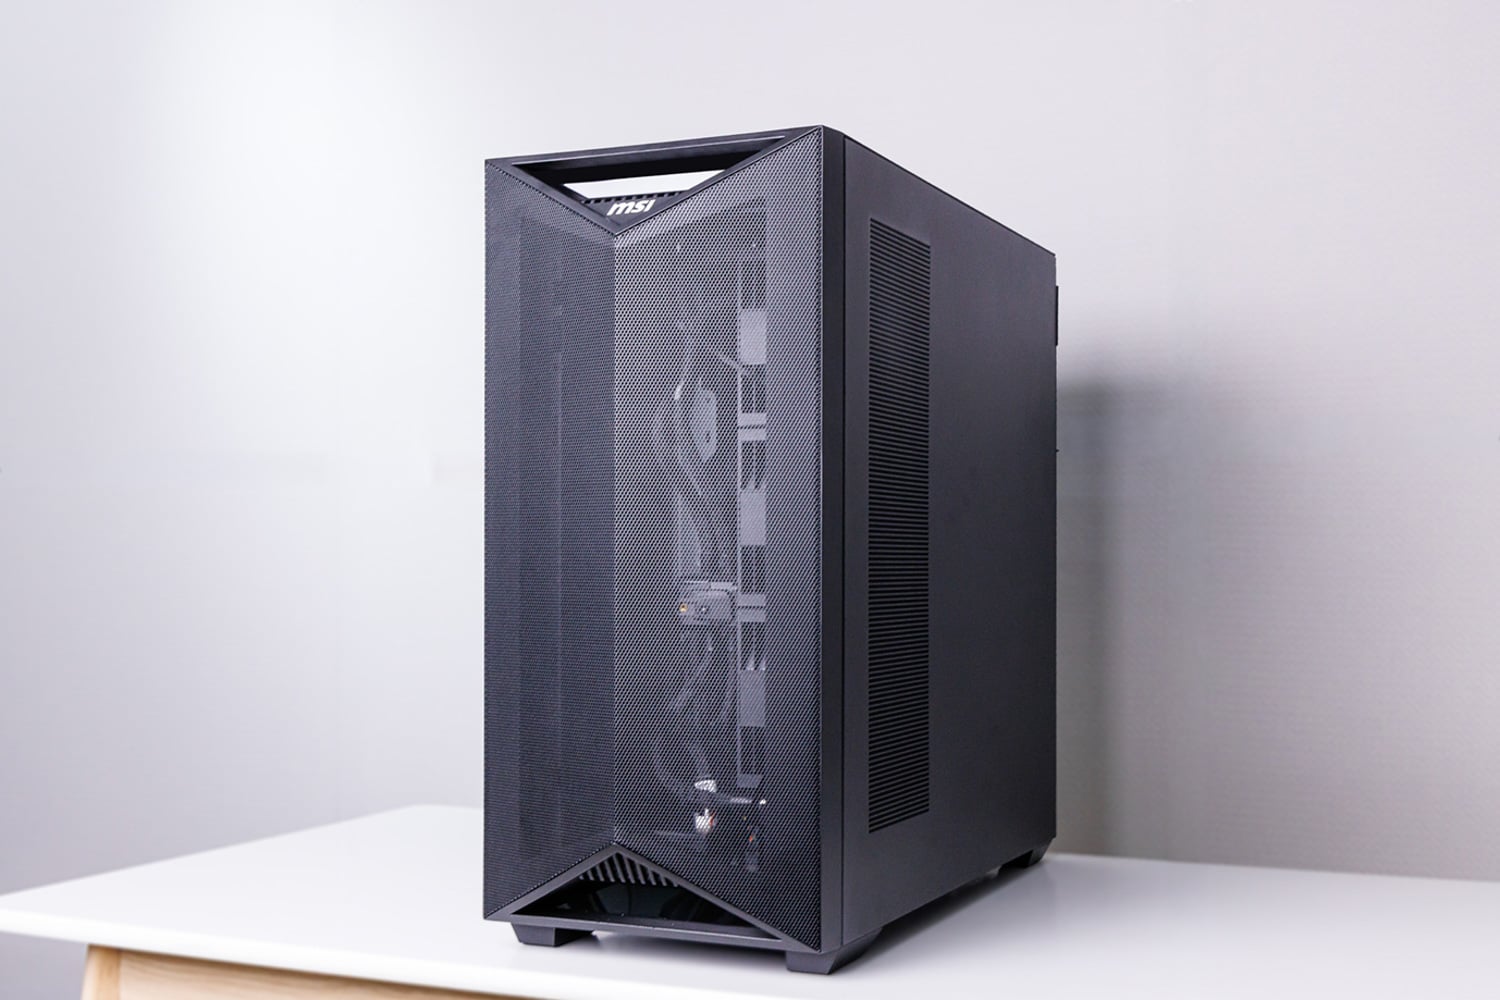
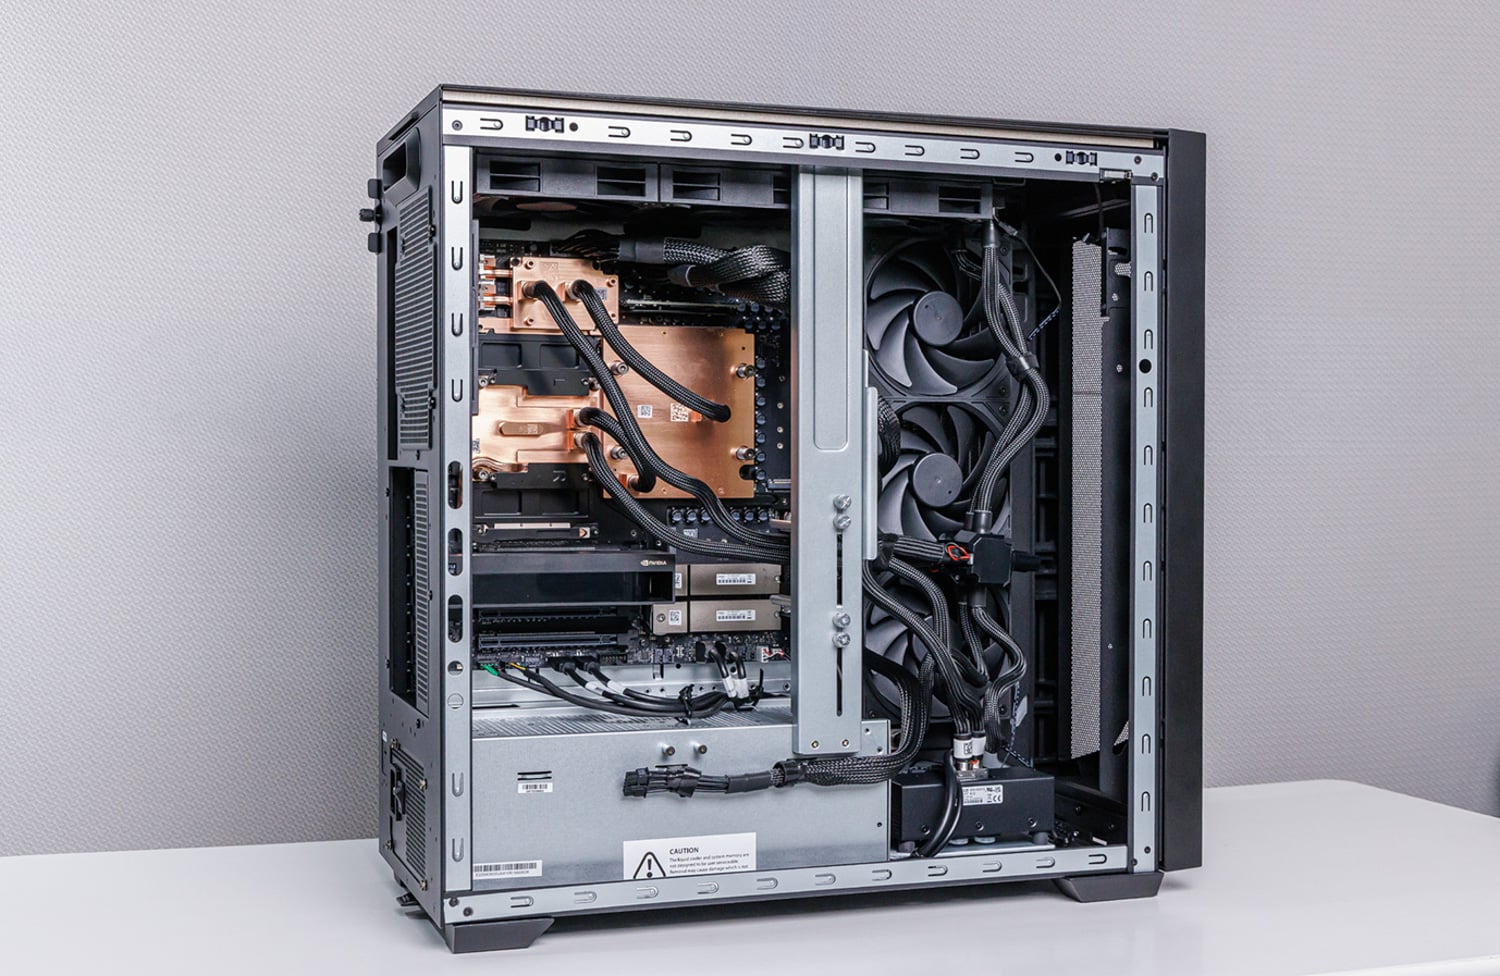
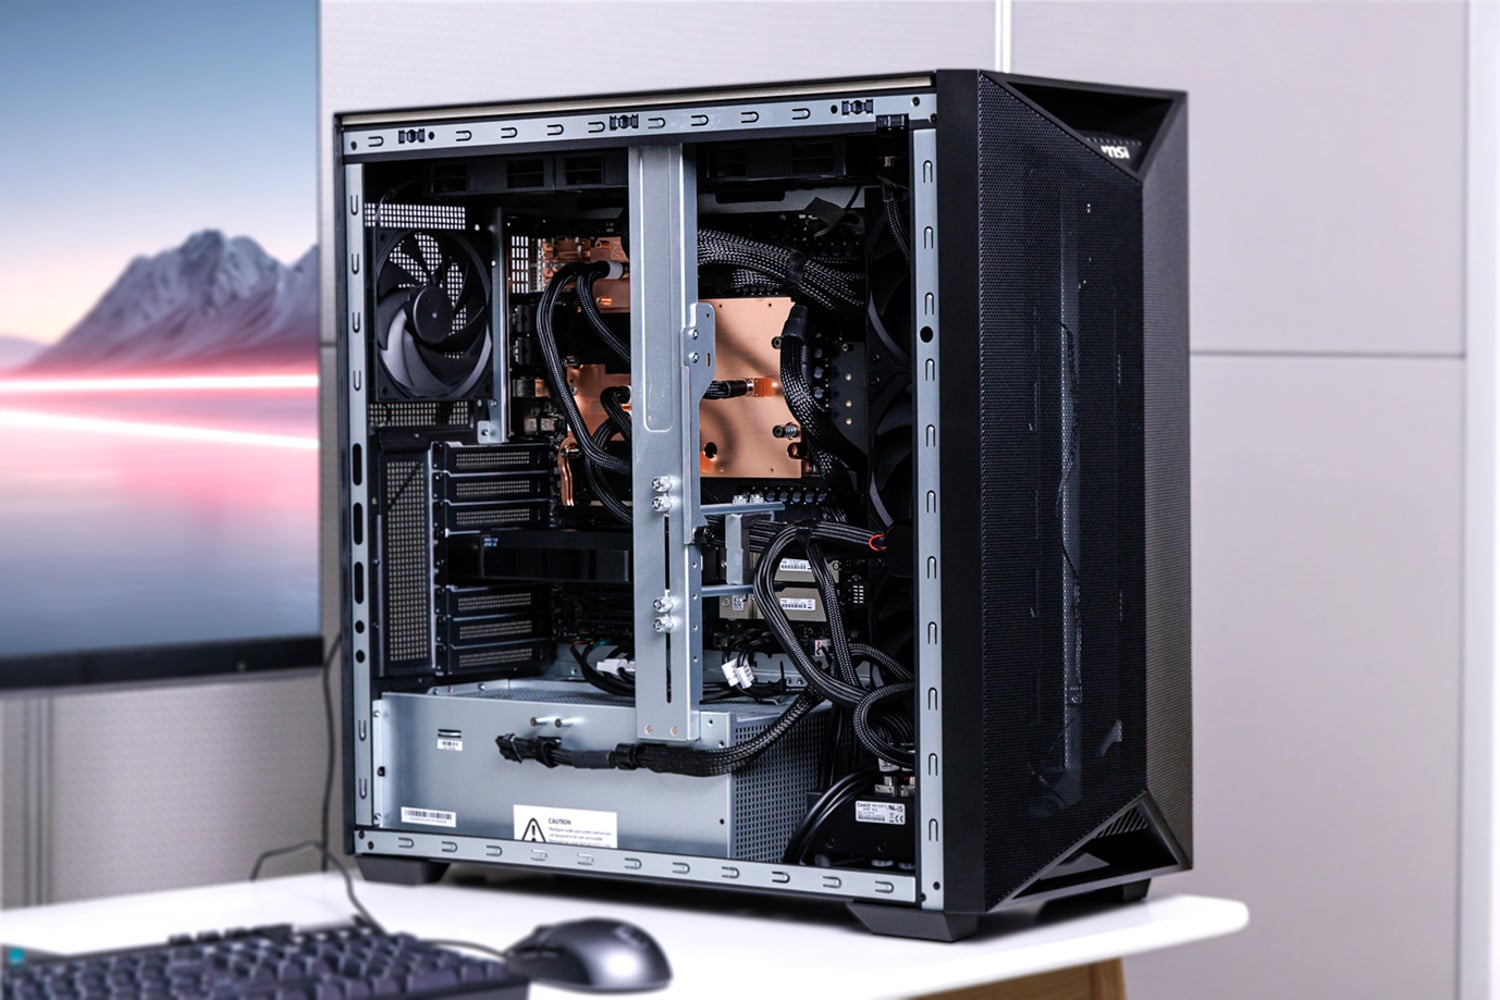
На первый взгляд, XpertStation выглядит как стандартная современная рабочая станция с элегантным профессиональным дизайном. Но стоит снять боковую панель, и на этом сходство заканчивается.
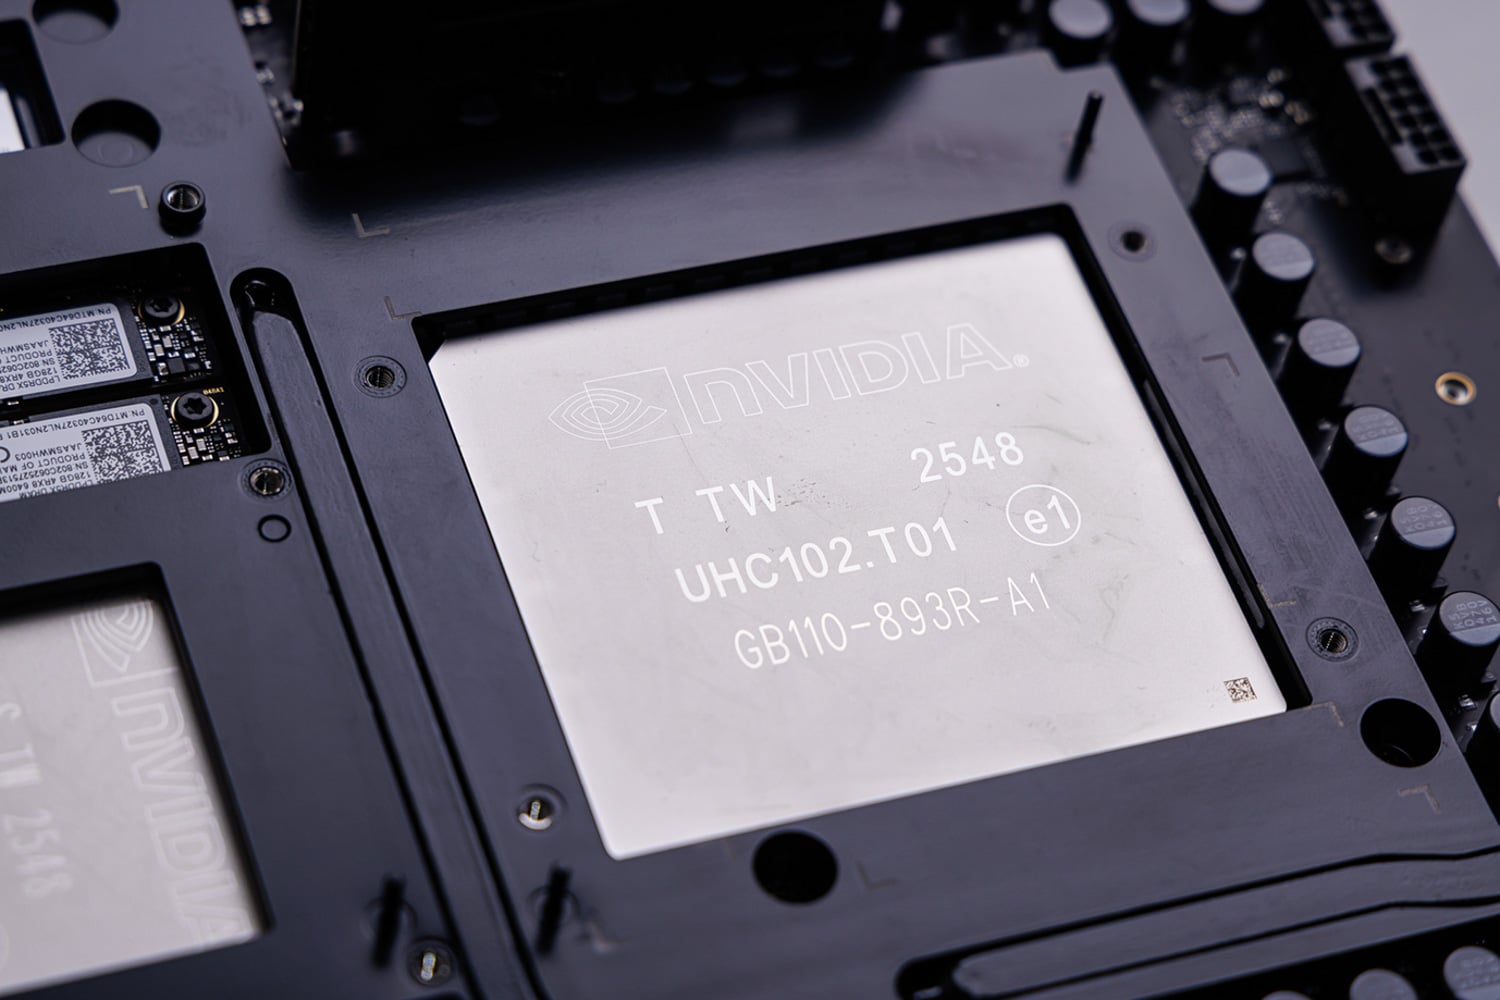
GB300 Grace Blackwell Ultra Desktop Superchip
В основе WS300 лежит наша главная звезда: графический процессор NVIDIA B300, построенный на архитектуре Blackwell Ultra.
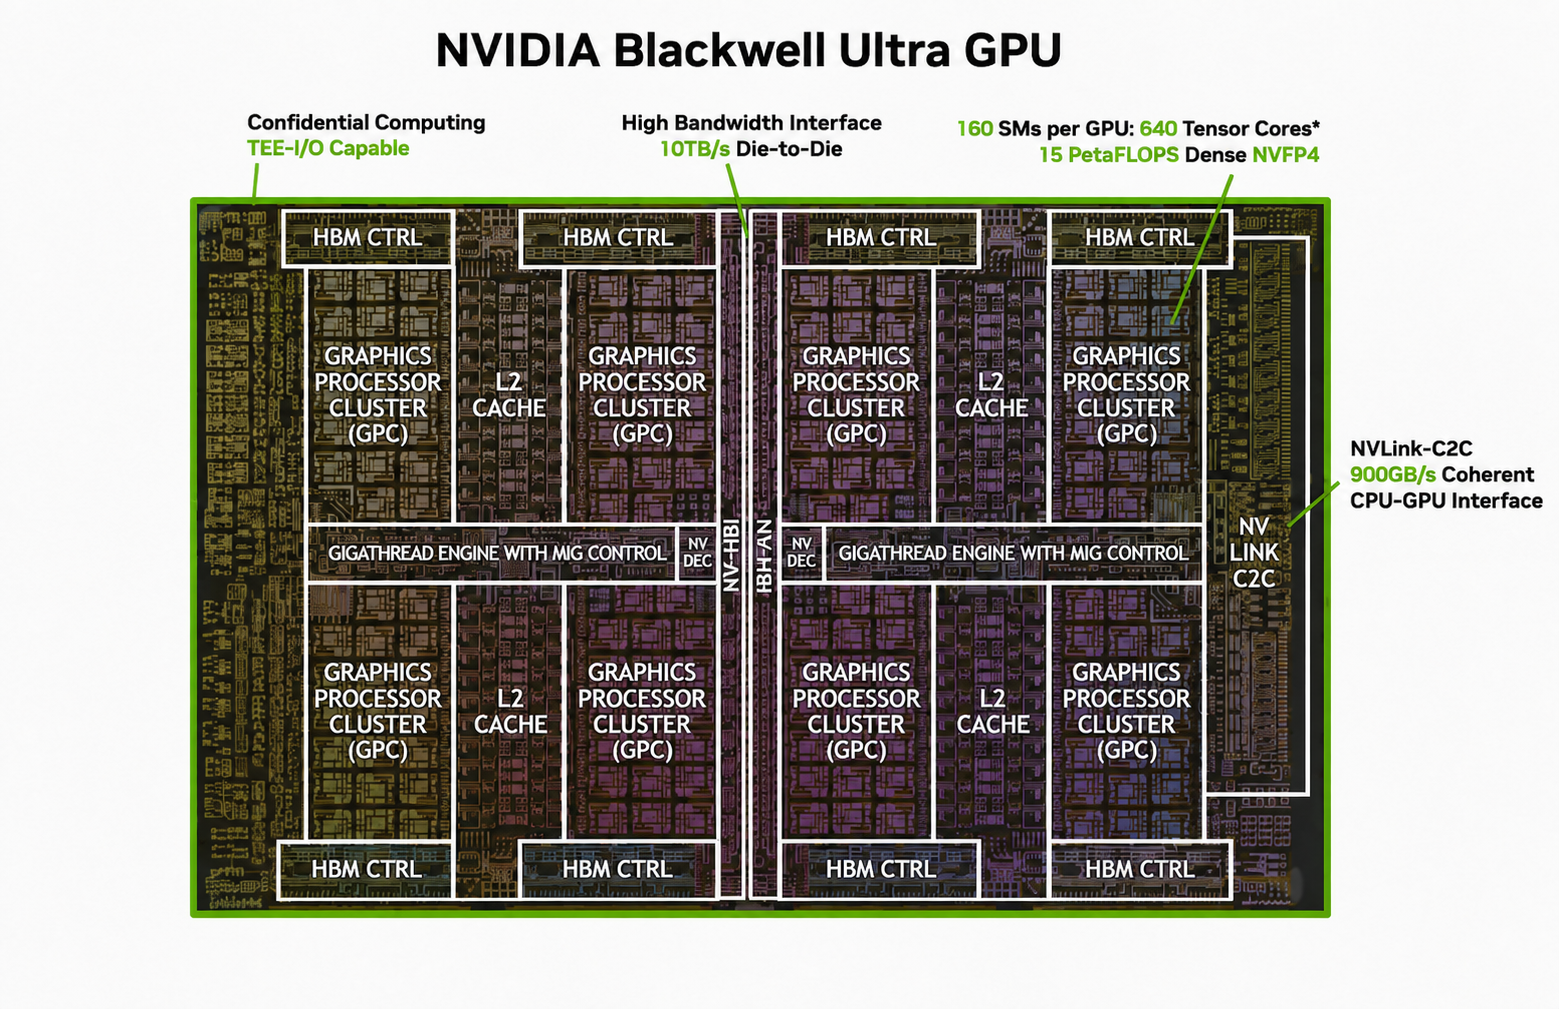
Источник: NVIDIA, комментарии предоставлены StorageReview.
B300 — один из самых передовых графических процессоров, доступных сегодня, с двухкристальной конструкцией, построенной на основе 4NP-процесса TSMC. Два кристалла соединены интерфейсом NV-HBI от NVIDIA со скоростью 10 ТБ/с, что позволяет графическому процессору работать как единый ускоритель CUDA. B300, используемый в DGX Station, основан на 208-миллиардном транзисторном проекте Blackwell Ultra, с количеством SM до 160 и 640 тензорными ядрами пятого поколения. Он также имеет 252 ГБ памяти HBM3e с пропускной способностью 7.1 ТБ/с. Как компонент для центров обработки данных, B300 не имеет стандартного вывода на экран и аппаратных кодировщиков NVENC. Однако он включает семь NVDEC-движков и семь декодеров nvJPEG. Графический процессор также поддерживает MIG, что позволяет разделить его на семь изолированных экземпляров. Что касается вычислительных возможностей, B300 предлагает:
| Точность | Peak Performance |
|---|---|
| Производительность вычислений B300 | |
| NVFP4 Tensor Core | 20 PFLOPS разреженные / 15 PFLOPS плотные |
| FP8 / FP6 Tensor Core | 10 пфлопс |
| Тензорное ядро INT8 | 330 TOPS |
| FP16 / BF16 Tensor Core | 5 пфлопс |
| Тензорное ядро TF32 | 2.5 пфлопс |
| FP32 | 80 TFLOPS |
| FP64 / FP64 Tensor Core | 1.3 TFLOPS |
| Максимальная скорость основана на тактовой частоте графического процессора в режиме Boost. В спецификациях Tensor Core используется разреженность, если не указано иное. | |
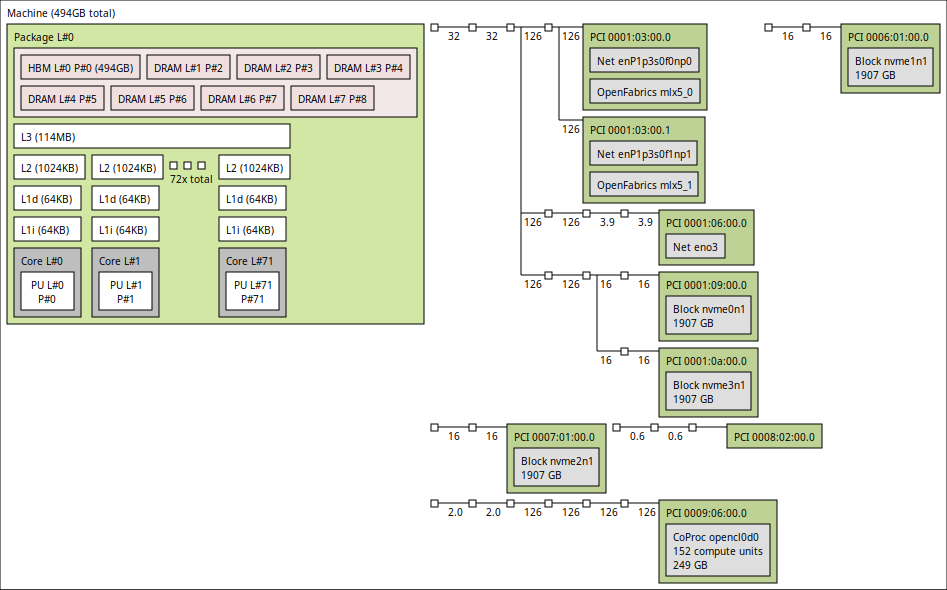
В паре с B300 используется Grace, первый процессор NVIDIA для центров обработки данных. Он использует 72 ядра Arm Neoverse V2, но окружающий процессор разработан самой NVIDIA, включая иерархию кэша, контроллеры памяти, системный ввод-вывод, масштабируемую когерентную структуру и интерфейс NVLink-C2C. Grace предоставляет 72 ядра и 72 аппаратных потока, при этом каждое ядро реализует Armv9 с криптографическими расширениями и четырьмя 128-битными векторными блоками SVE2. Ядро имеет шестиканальный декодер инструкций, способный обрабатывать до восьми инструкций за такт, шесть скалярных АЛУ, по 64 КБ кэша инструкций и данных L1, а также 1 МБ частного кэша L2. По всему кристаллу процессор использует 114 МБ кэша L3.
Ядра и кэш-память L3 соединены через масштабируемую когерентную структуру NVIDIA (Scalable Coherency Fabric), представляющую собой ячеистую сеть с пропускной способностью 3.2 ТБ/с. Эта структура также соединяет ядра ЦП с памятью, системным вводом-выводом и интерфейсом NVLink-C2C, обеспечивая Grace необходимую пропускную способность для передачи данных, чтобы поддерживать работу B300. В WS300 Grace обрабатывает задачи на стороне ЦП, связанные с ускорителем: запуск ядра GPU, загрузка данных, предварительная обработка, токенизация и управление моделями. Представленная ниже топология наглядно демонстрирует односокетную конструкцию с одним 72-ядерным процессором Grace и подключенными к нему устройствами платформы.
Система Grace оснащена 496 ГБ памяти LPDDR5X, обеспечивающей пропускную способность 396 ГБ/с. Вместо прямой пайки памяти к материнской плате, DGX Station использует четыре модуля SOCAMM. SOCAMM, или System-on-Chip Advanced Memory Module (усовершенствованный модуль памяти на кристалле), представляет собой компактный съемный корпус для памяти LPDDR5X. Это позволяет платформе сохранить преимущества LPDDR5X в плане пропускной способности и энергоэффективности, обеспечивая при этом возможность обслуживания памяти. Вышедший из строя модуль можно заменить без замены всей материнской платы.
Интерфейс NVLink-C2C от NVIDIA соединяет Grace и B300, обеспечивая двунаправленную пропускную способность 900 ГБ/с, что примерно в семь раз больше, чем у соединения PCIe Gen5 x16. Более важное отличие заключается в когерентности памяти. В обычной рабочей станции ЦП и дискретный графический процессор используют отдельные адресные пространства, а данные копируются между ними по PCIe. С помощью NVLink-C2C Grace и B300 используют когерентное адресное пространство, позволяя каждому процессору напрямую обращаться к памяти, подключенной к другому.
В результате получается когерентное адресное пространство объемом 748 ГБ, а не блок HBM объемом 748 ГБ. B300 имеет 252 ГБ HBM3e, обеспечивающих скорость 7.1 ТБ/с, в то время как Grace добавляет 496 ГБ LPDDR5X со скоростью 396 ГБ/с. Данные, хранящиеся в памяти Grace, по-прежнему должны проходить через канал C2C, поэтому HBM остается лучшим местом для часто используемых весов моделей, тензоров и буферов. Память Grace, напротив, действует как уровень большой емкости, позволяя рабочим нагрузкам, превышающим 252 ГБ локальной памяти B300, оставаться на одной системе, а не распределяться между несколькими графическими процессорами. Мы измерим влияние на производительность перехода на этот второй уровень памяти позже в разделе тестирования.
Топология системы
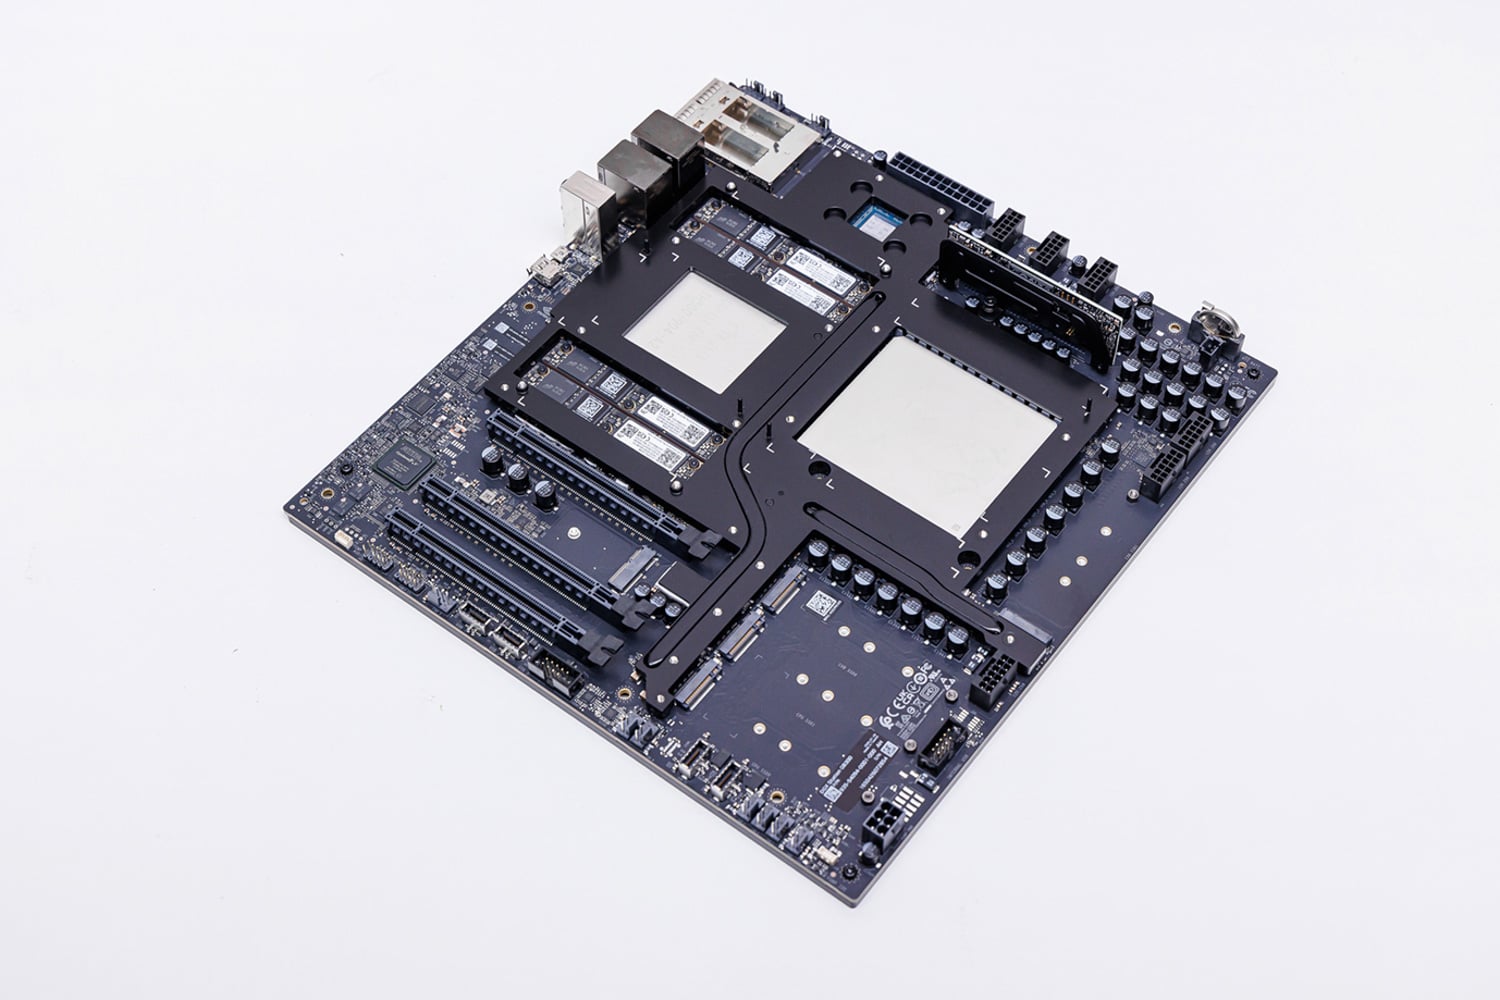
На блок-схеме MSI, помимо корпуса GB300, показано, как остальные компоненты системы подключаются к архитектуре Grace. Процессор расположен в центре топологии ввода-вывода, к нему напрямую подключены два слота M.2 PCIe 5.0 x4. MSI устанавливает в них пару твердотельных накопителей Micron 4600 емкостью 2 ТБ , сконфигурированных в RAID 1 для операционной системы и программного обеспечения NVIDIA. Три полноразмерных слота расширения также подключаются напрямую к Grace: один с интерфейсом PCIe 5.0 x16 и два с интерфейсом PCIe 5.0 x8.
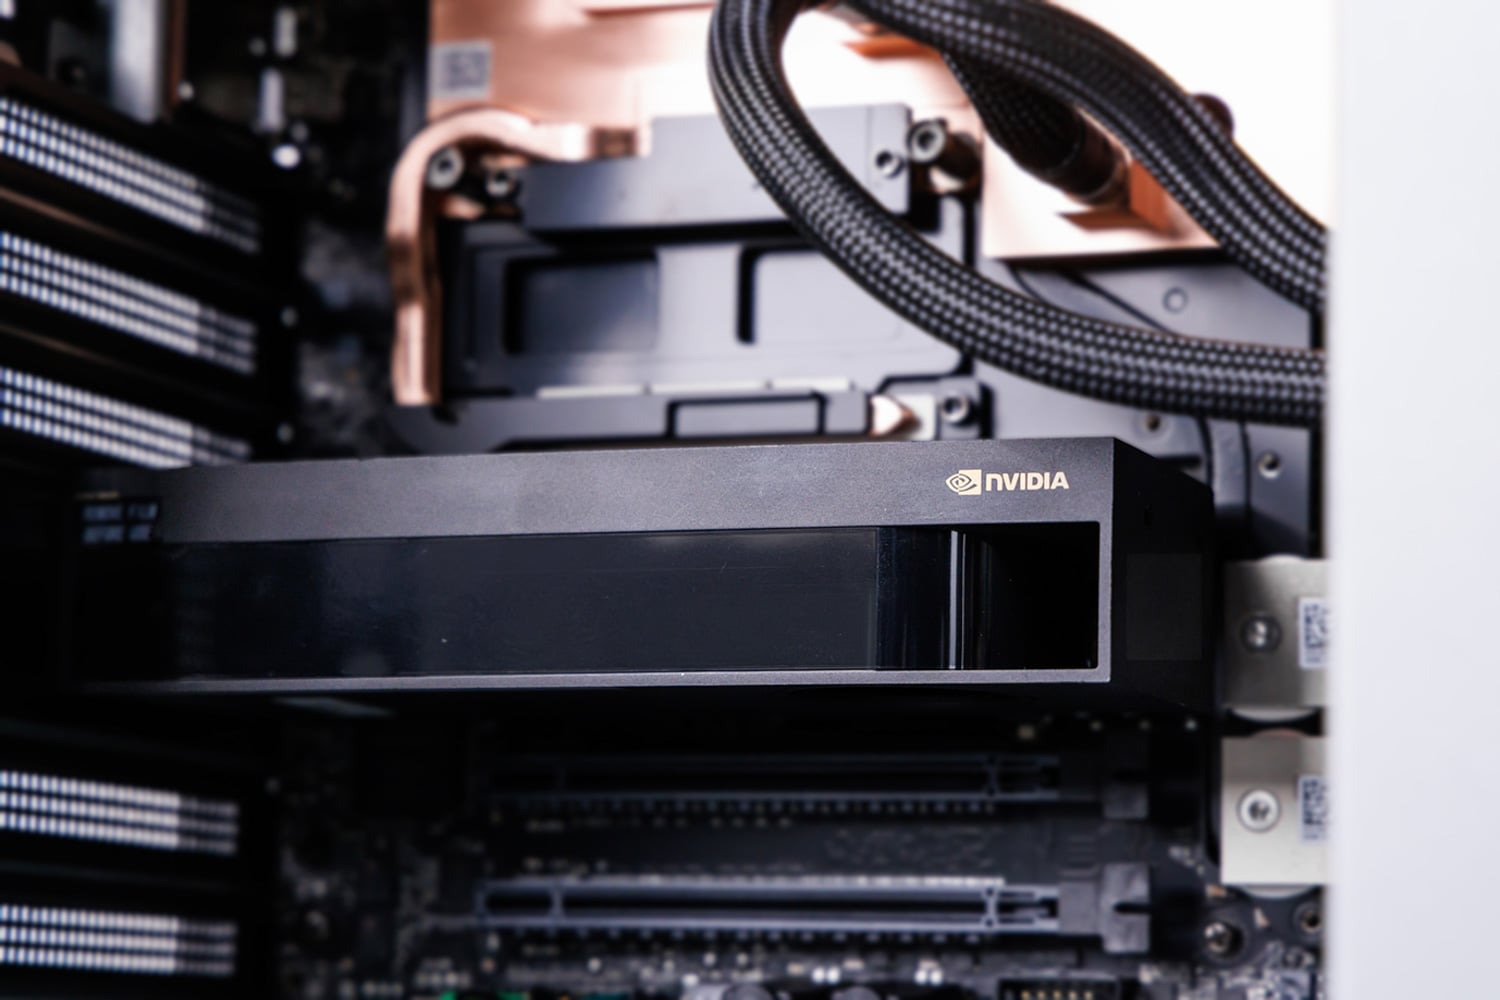
Компания MSI также подготовила корпус для установки крупной видеокарты. Предварительно проложенный кабель питания 12 В HPWR легко доступен с передней стороны корпуса, что избавляет от необходимости прокладывать дополнительный кабель внутри системы. Вертикальная металлическая распорка, придающая корпусу жесткость, также включает в себя кронштейн, предотвращающий провисание, для поддержки длинных и тяжелых видеокарт RTX PRO.
Контроллер USB на стороне Grace управляет основными передними и задними USB-портами системы, а также аудиокодеком. Grace также подключается к ASPEED AST2600 BMC, который обеспечивает выделенный порт управления 1GbE, выход Mini DisplayPort с разрешением 1024 x 768 и последовательный порт Micro-USB. Mini DisplayPort предназначен для первоначальной настройки и устранения неполадок, а не в качестве основного видеовыхода системы. Тем, кто планирует использовать WS300 в качестве обычного настольного компьютера, по-прежнему потребуется одна из дополнительных карт расширения RTX PRO.
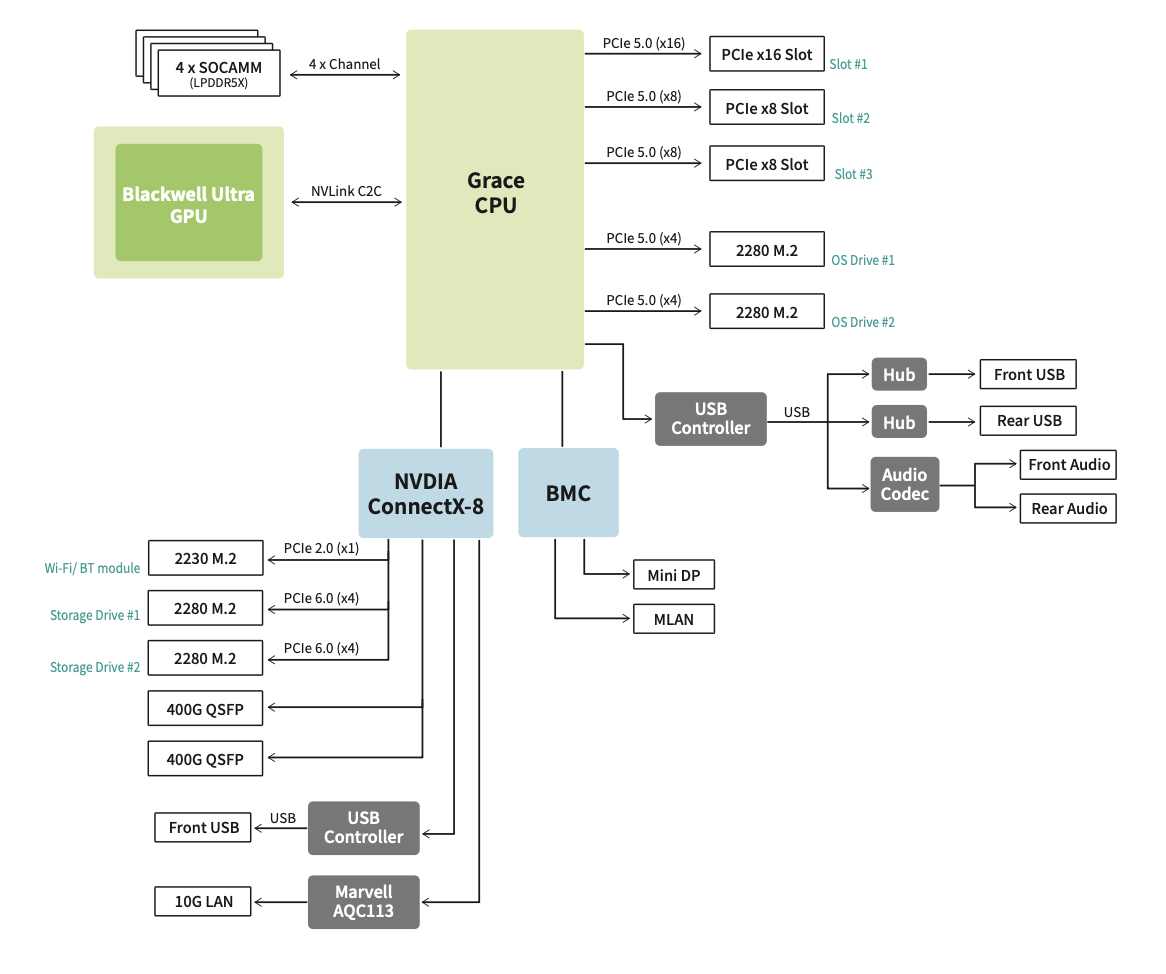
Другая важная ветвь — это сетевой адаптер NVIDIA ConnectX-8 SuperNIC. Его наиболее заметная особенность — пара портов 400GbE QSFP112 на задней панели, обеспечивающих суммарную пропускную способность сети до 800 Гбит/с. ConnectX-8 также включает в себя встроенный коммутатор PCIe с 48 линиями; его восходящий канал поддерживает PCIe Gen6, но нисходящие порты, которые он предоставляет устройствам, работают на PCIe 5.0, что позволяет MSI использовать его в качестве вторичного концентратора ввода-вывода, а не просто сетевого адаптера.
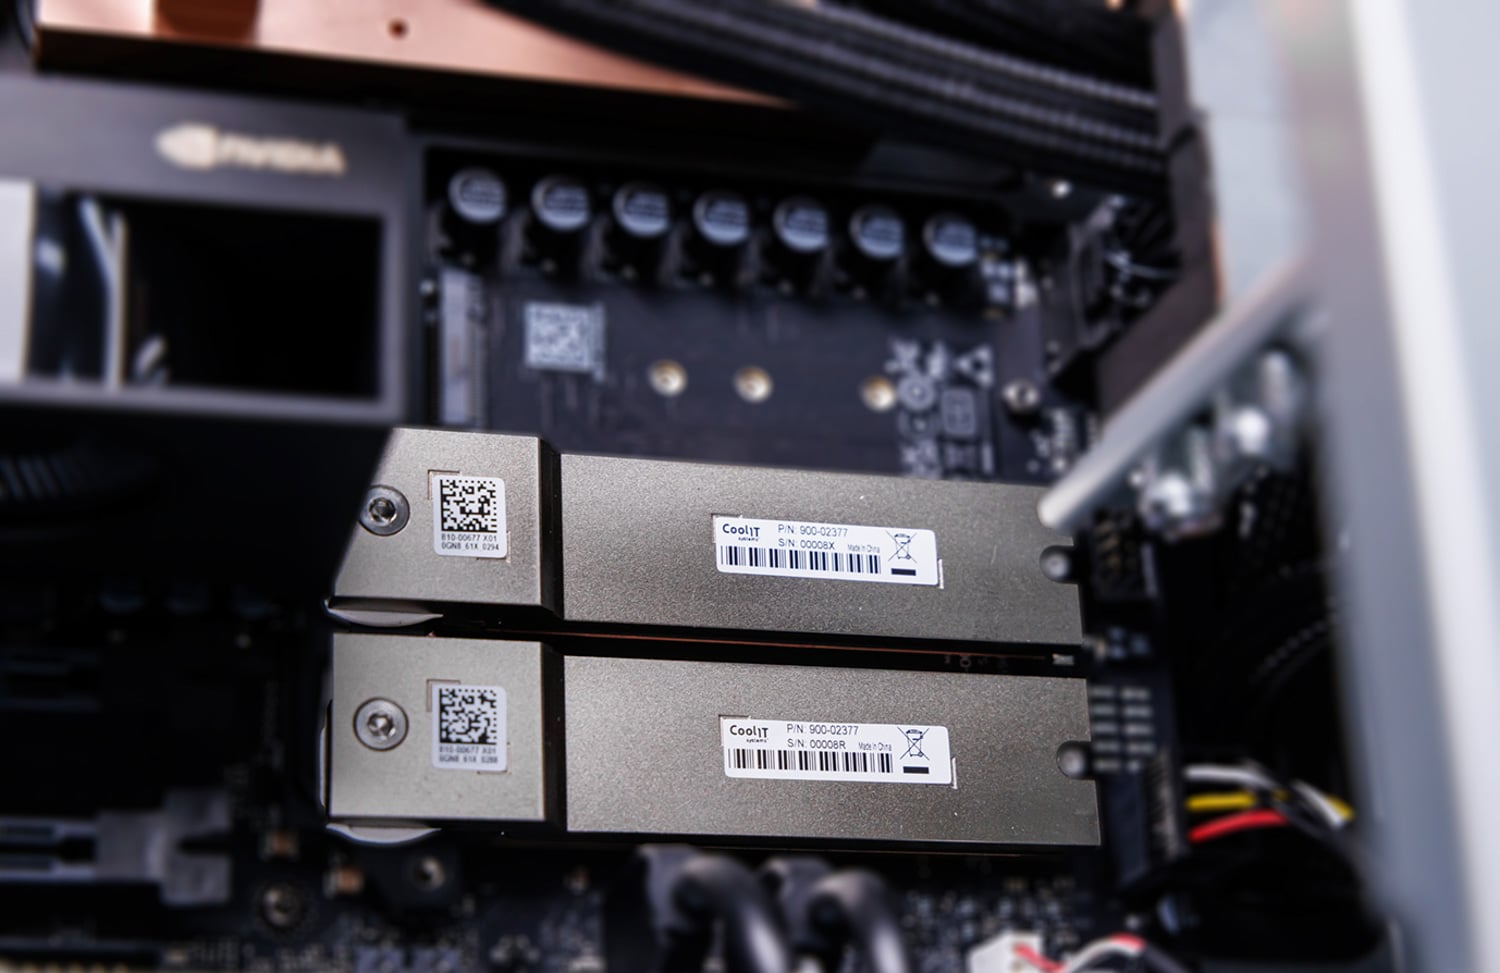
Два канала PCIe 5.0 x4 от ConnectX-8 обеспечивают питание оставшихся слотов M.2 2280, которые MSI оставляет свободными для расширения. Эта же ветвь также соединяет слот M.2 2230 Wi-Fi и Bluetooth через PCIe 2.0 x1, контроллер Marvell AQC113 для порта 10GBase-T и второй контроллер USB, обеспечивающий дополнительный USB-порт на передней панели.
Питание и охлаждение
Питание WS300 осуществляется от одного блока питания ATX мощностью 1,600 Вт, сертифицированного по стандарту 80 PLUS Platinum, с входом C19. Для установки в Северной Америке DGX Station требует выделенной цепи на 20 А для обеспечения системы полной потребляемой мощностью.
Номинальная мощность в 1,600 Вт — это предельная мощность для всей системы. Блок питания Grace, материнская плата B300, накопители, помпы, вентиляторы и любая опциональная видеокарта RTX PRO потребляют энергию от одного источника. Добавление мощной видеокарты расширяет возможности WS300, но не расходует энергию из другого источника. Когда материнская плата B300 и видеокарта RTX работают под нагрузкой, им приходится делить уже доступную мощность, что может снизить производительность графического процессора B300.
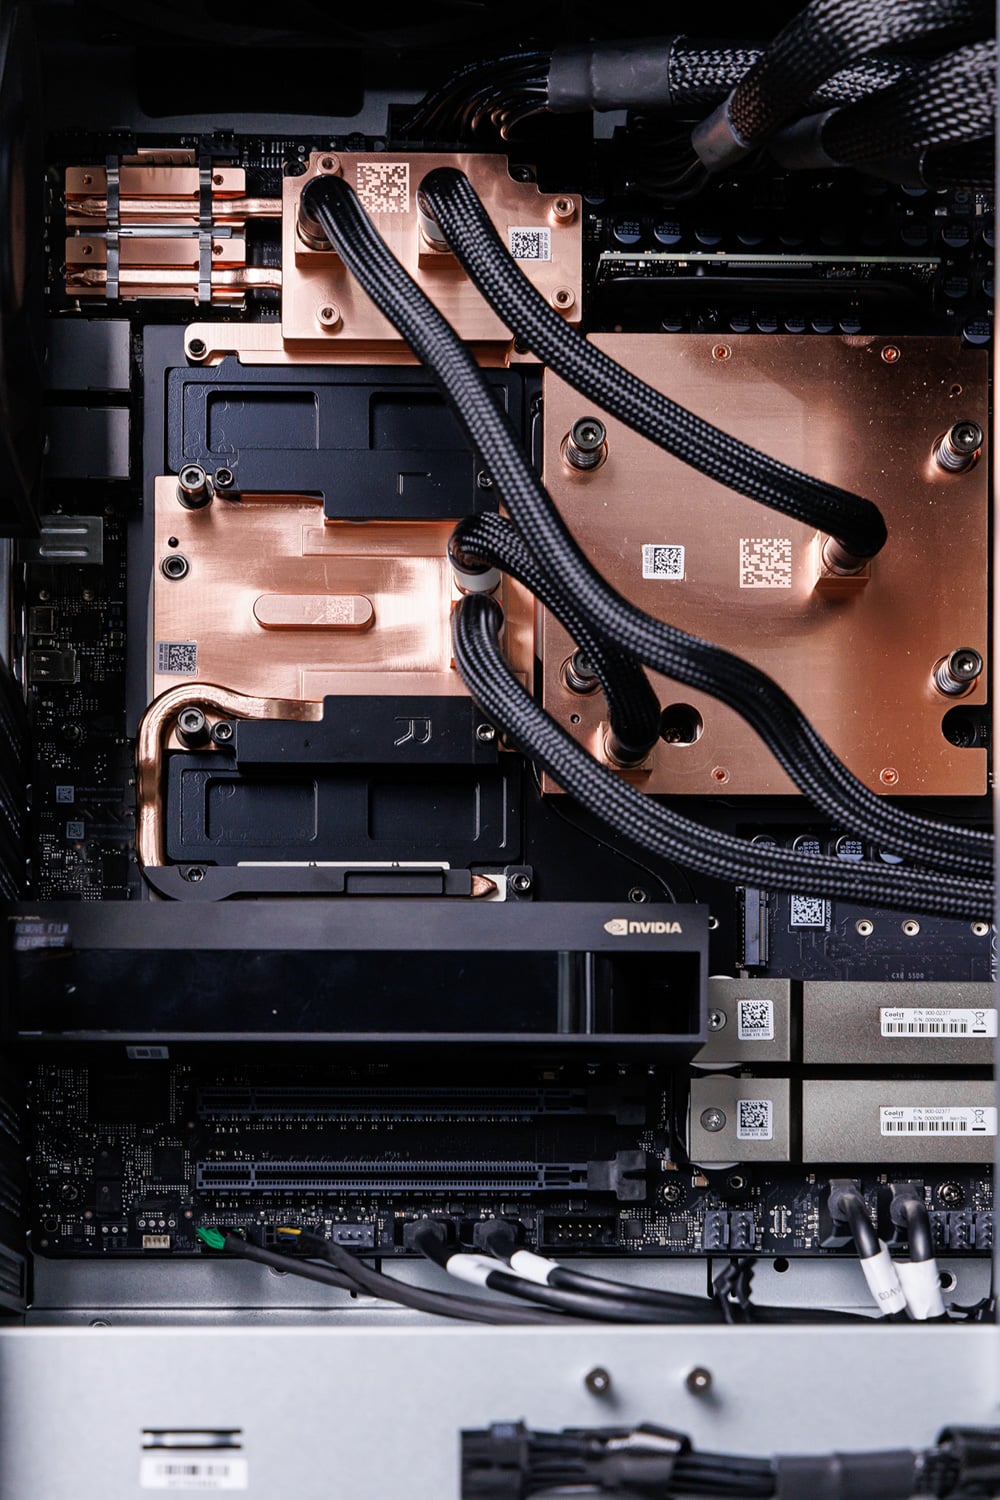
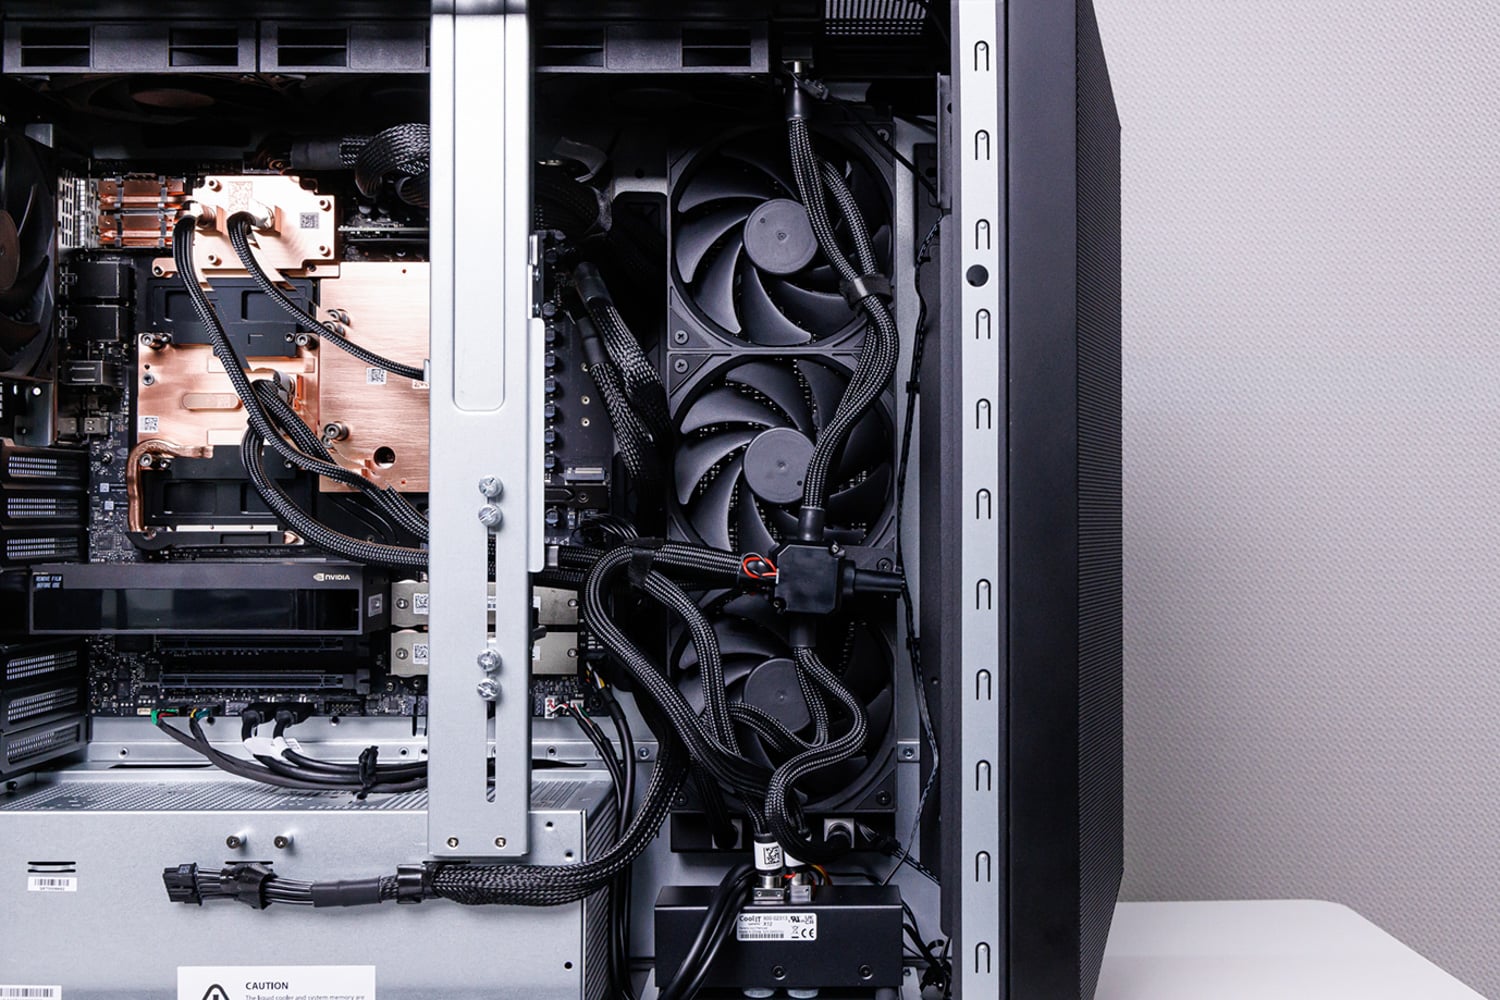
MSI справляется с возникающей тепловой нагрузкой с помощью пользовательской системы жидкостного охлаждения, охватывающей материнскую плату B300, процессор Grace, память SOCAMM и ConnectX-8, включая отсеки для оптики. Тепло отводится через два 360-мм радиатора, а отдельный 120-мм вентилятор перемещает воздух по остальной части корпуса. MSI заявляет, что система охлаждения рассчитана на мощность до 1,400 Вт для процессора и видеокарты. В ходе наших тестов температура материнской платы B300 достигла пика в 71°C, в то время как процессор никогда не нагревался выше 65°C при потребляемой видеокартой мощности 1292 Вт.
Мощное плескание
NVIDIA управляет этим общим бюджетом через службу vsloshd. В своем динамическом режиме по умолчанию служба отслеживает потребление энергии модулем GB300 и опциональной видеокартой RTX PRO в режиме реального времени, перераспределяя доступный запас мощности между ними, а не устанавливая для каждого устройства фиксированный лимит. В соответствии с текущей политикой, приоритет отдается видеокарте RTX, поэтому, когда ей требуется больше энергии, система сначала снижает лимит мощности GB300, а затем повышает лимит мощности RTX. При отсутствии установленной видеокарты RTX весь бюджет политики остается доступным для модуля GB300.
Это означает, что опциональная RTX PRO 6000 — это не просто дополнительная производительность по сравнению с B300. Когда обе видеокарты загружены, мощность, выделенная для карты RTX, напрямую расходуется из бюджета GB300 и может снижать тактовую частоту и производительность B300.
Платформа также включает в себя аппаратный тормоз питания на случай, если система обнаружит ухудшение качества подачи питания. Мы наблюдали это во время нашей практической работы, когда неплотно закрепленные силовые разъемы приводили к тому, что WS300 снижал предел мощности вместо того, чтобы выключиться или продолжать потреблять полную мощность из-за поврежденного соединения. Машина оставалась в режиме пониженного энергопотребления до тех пор, пока проблема с соединением не была устранена.
связь
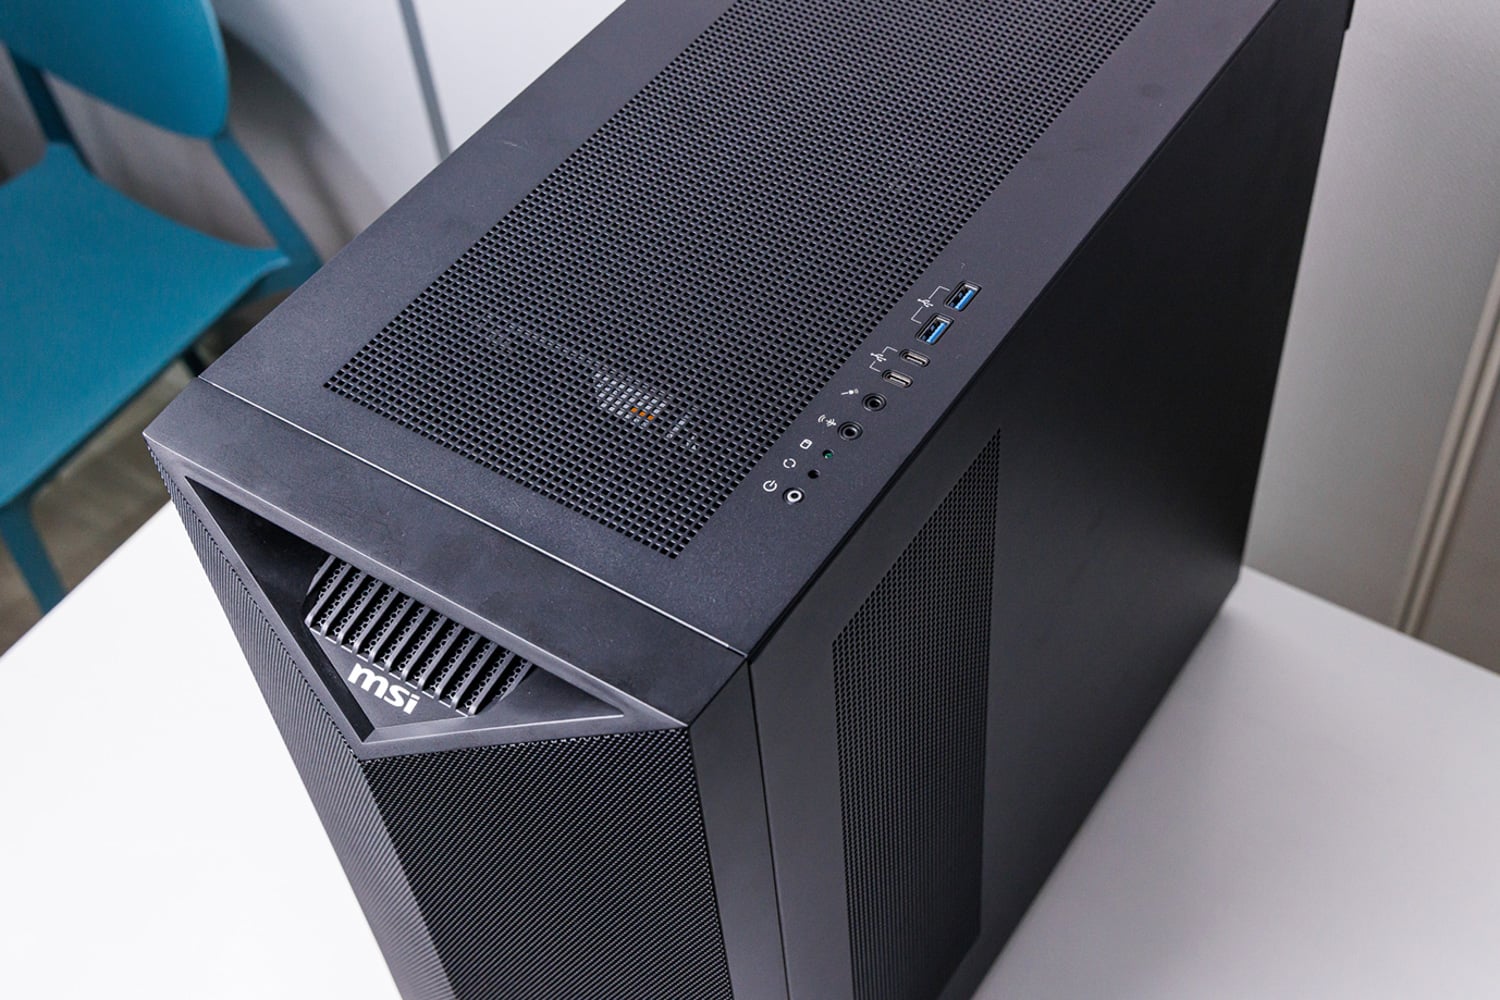
Прежде чем перейти к обзору корпуса, стоит кратко рассмотреть переднюю и заднюю панели ввода/вывода. Передняя панель ввода/вывода включает в себя два порта USB 3.2 Gen 2 Type-A, два порта USB 3.2 Gen 2 Type-C, отдельные разъемы для линейного выхода и микрофона, а также кнопки питания и перезагрузки.
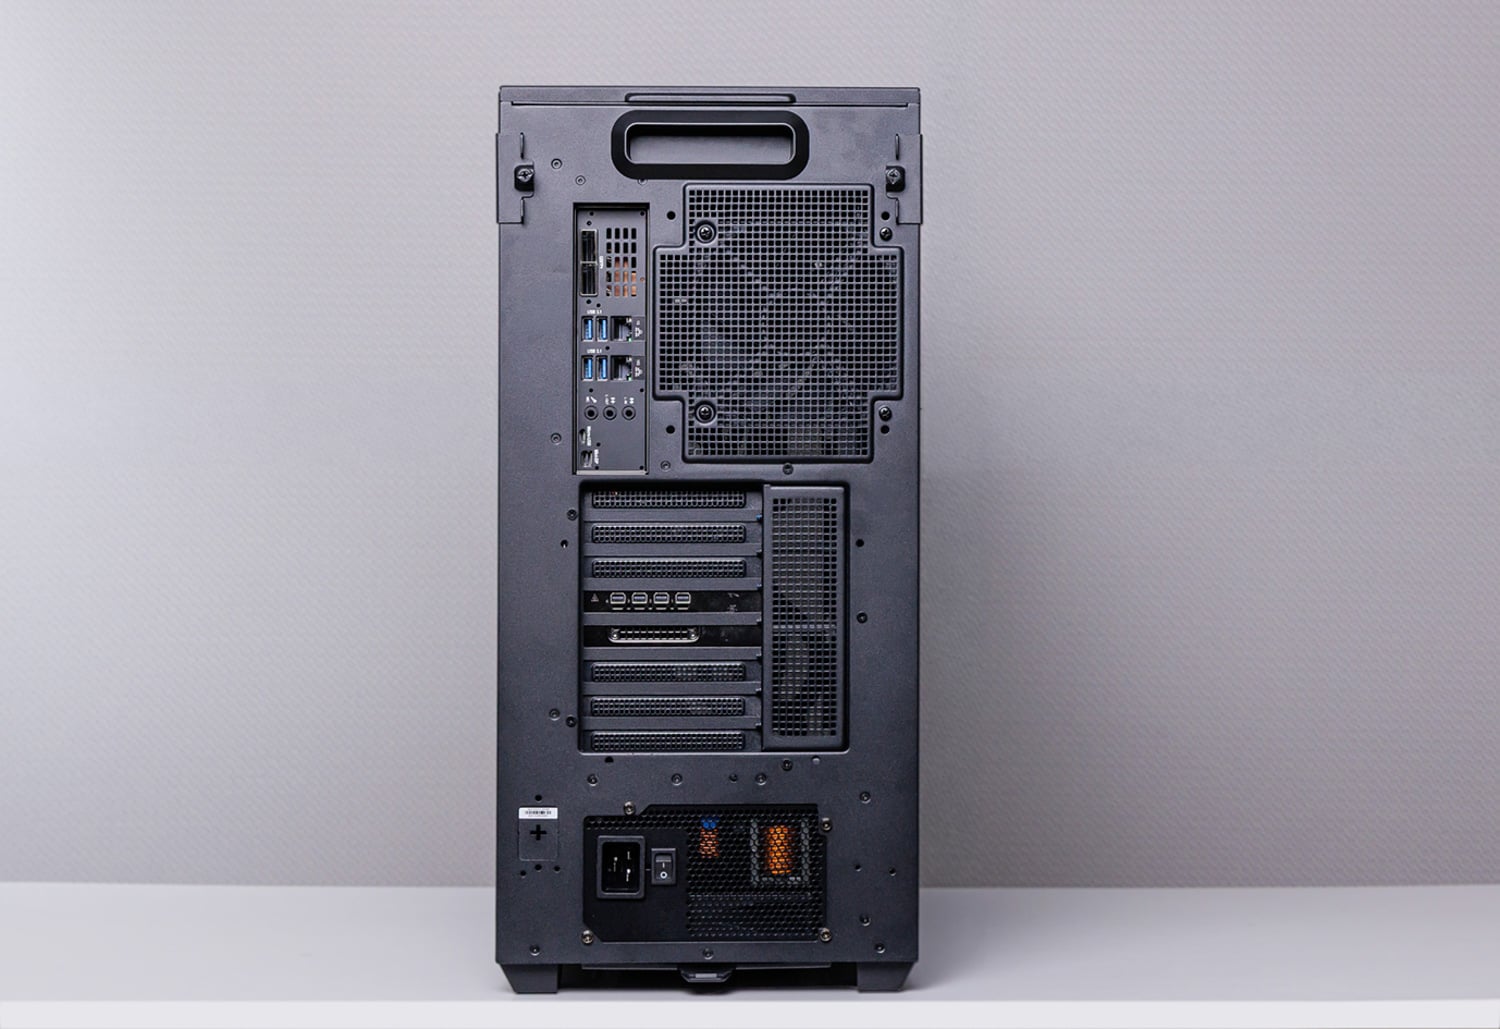
Задняя панель разделена между разъемами для подключения рабочих станций и расположенным под ними серверным оборудованием. ConnectX-8 предоставляет два порта 400GbE QSFP112, а отдельный порт 10GBase-T обеспечивает стандартное сетевое подключение хоста, и выделенный порт 1GbE подключается к BMC. Четыре порта USB Type-A 10 Гбит/с и три аудиоразъема обеспечивают подключение локальных периферийных устройств. BMC также имеет последовательный порт Micro-USB и порт Mini DisplayPort. Разъем питания C19 расположен в нижней части корпуса, а Wi-Fi 6E или Wi-Fi 7 с Bluetooth можно подключить через внутренний слот M.2 2230 Key-E.
Рабочие нагрузки центра обработки данных на рабочем месте
Всё вышесказанное описывает, что представляет собой DGX Station; более важный вопрос для покупателей — что XpertStation позволяет команде делать. Ценность WS300 становится яснее, если рассматривать его как платформу для разработки, а не просто как высокопроизводительную систему для выполнения инференций. Его графический процессор B300, центральный процессор Grace, поддержка MIG, опциональная графика RTX PRO и программный стек для центров обработки данных позволяют перенести несколько рабочих процессов, которые обычно зависят от общего оборудования кластера, на один локальный узел.
MIG как инструмент разработки
Представьте, что на одном графическом процессоре одновременно выполняется несколько совершенно отдельных задач, каждая из которых изолирована от других. Именно это и делает технология Multi-Instance GPU (MIG): она аппаратно разделяет B300 на семь одинаковых по размеру сегментов, или экземпляров. Каждый экземпляр получает свою фиксированную долю SM, HBM, кэша и пропускной способности памяти, имеет свой собственный идентификатор устройства и отображается для CUDA как отдельный графический процессор.
Это позволяет разрабатывать, тестировать и проверять рабочие нагрузки с использованием нескольких графических процессоров; обучать скрипты; и разрабатывать приложения для таких инструментов, как Dynamo, LLM-D и др.
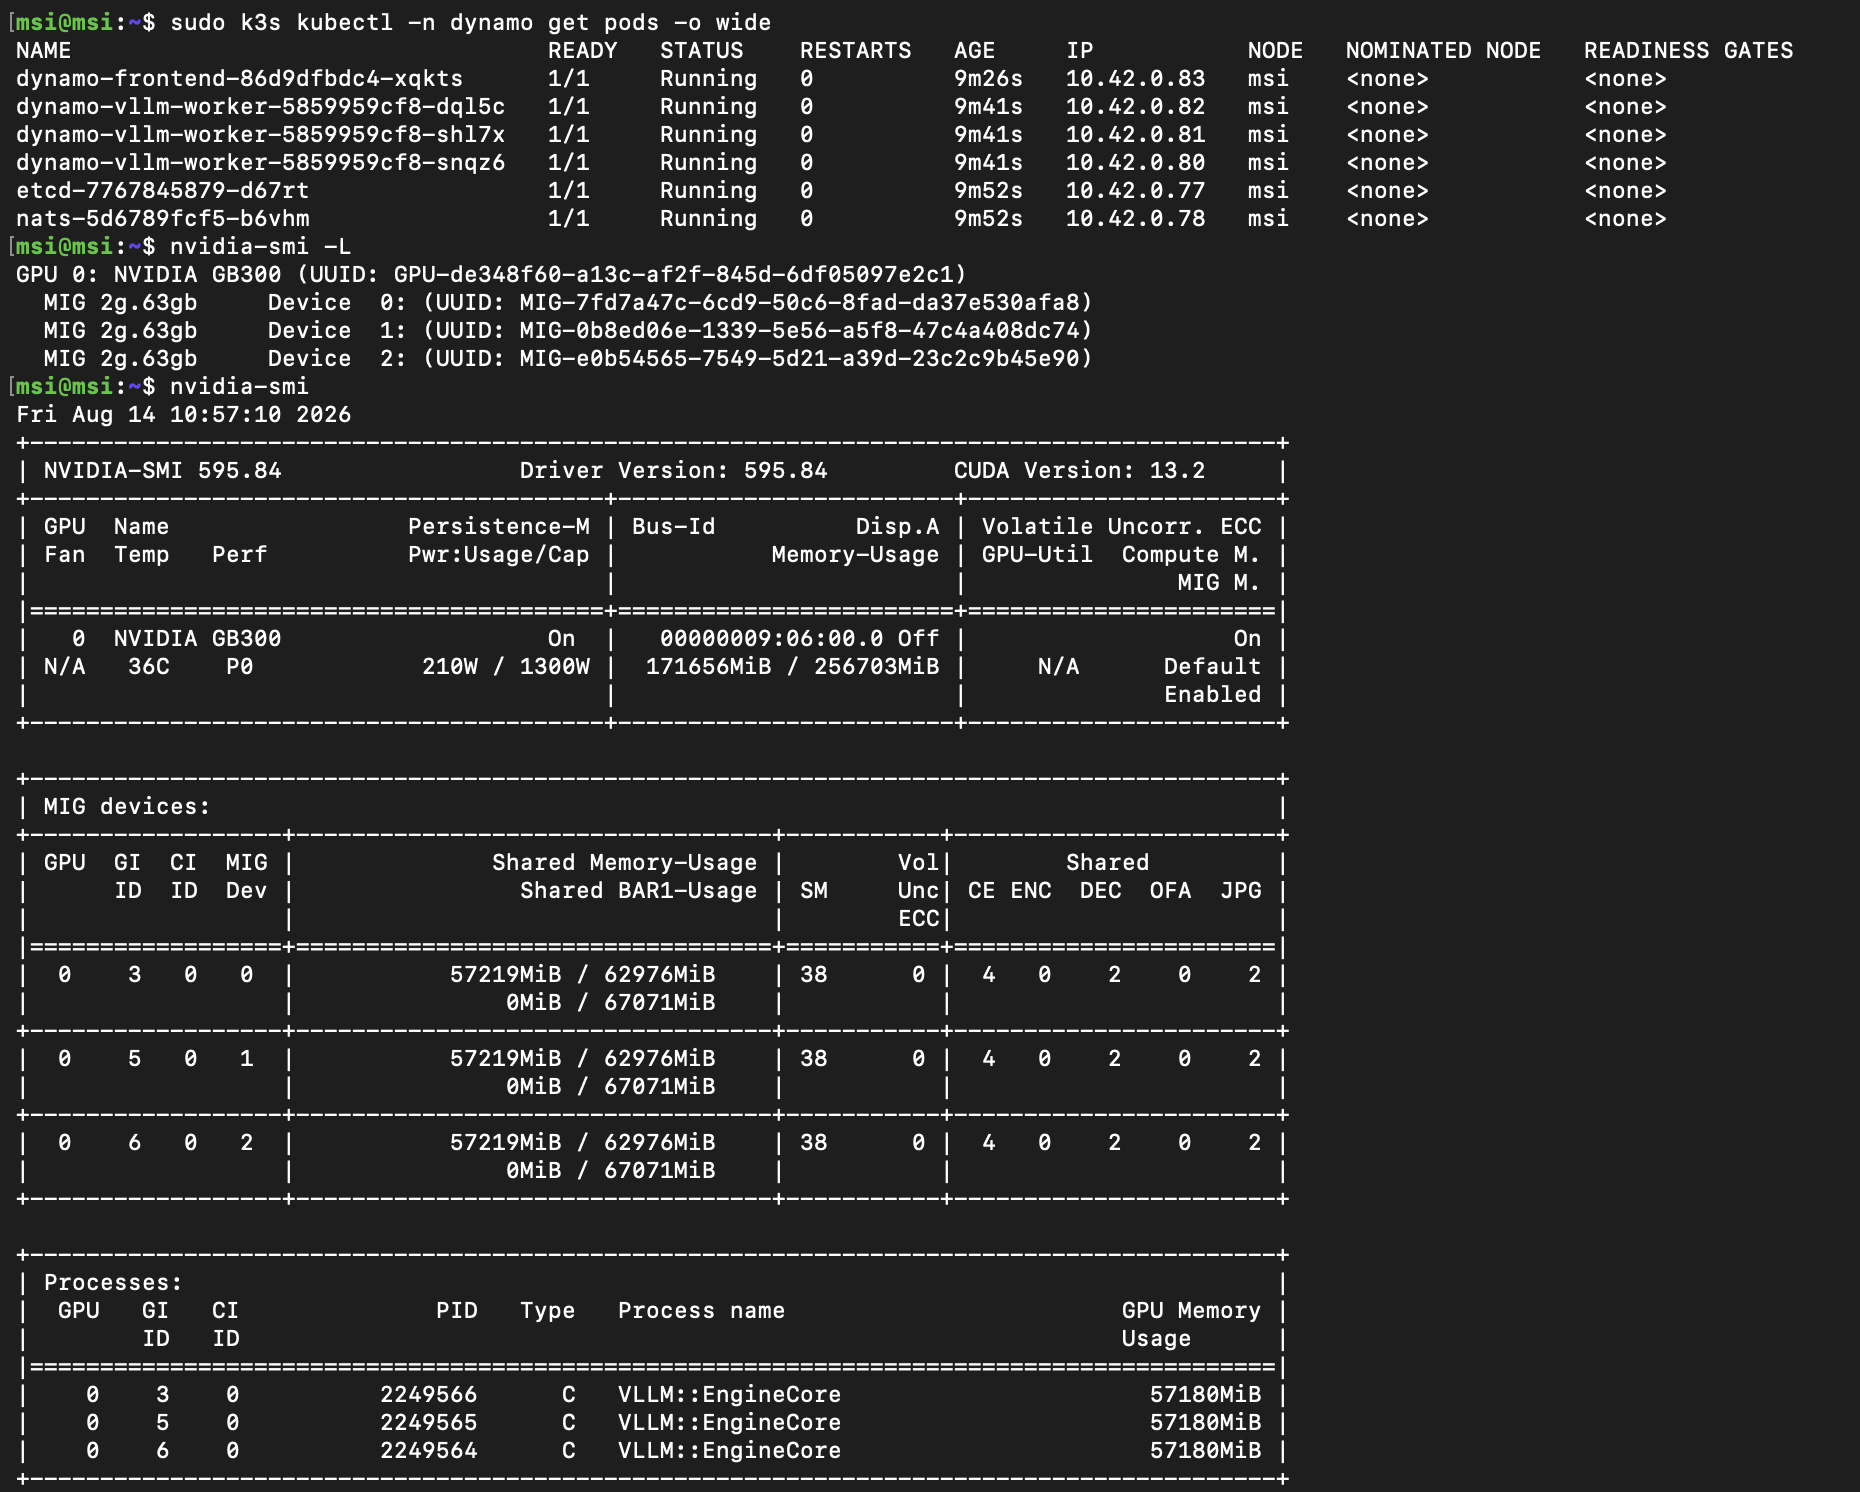
Для тестирования мы настроили B300 с тремя экземплярами MIG и использовали их для запуска компонентов NVIDIA Dynamo на отдельных устройствах, поддерживающих CUDA. Это отражает то, как разрабатывается большая часть наших собственных инструментов для бенчмаркинга: проверка корректной работы системы требует многократного тестирования на реальном оборудовании. Наличие локального B300, который мы можем перенастраивать и изменять без необходимости выделять время на общем сервере, а также без энергопотребления, нагрева и шума, характерных для стойки в помещении, значительно снижает объем подобной итеративной работы.
Исаак GR00T и физический цикл искусственного интеллекта
Ещё один рабочий процесс, который особенно хорошо подходит для станции DGX, — это физический искусственный интеллект.
Мы уже тестировали подобный рабочий процесс , но тогда требовалось несколько систем, оснащенных графическими процессорами разных классов. DGX Station объединяет эти ранее разрозненные этапы в одном настольном устройстве.
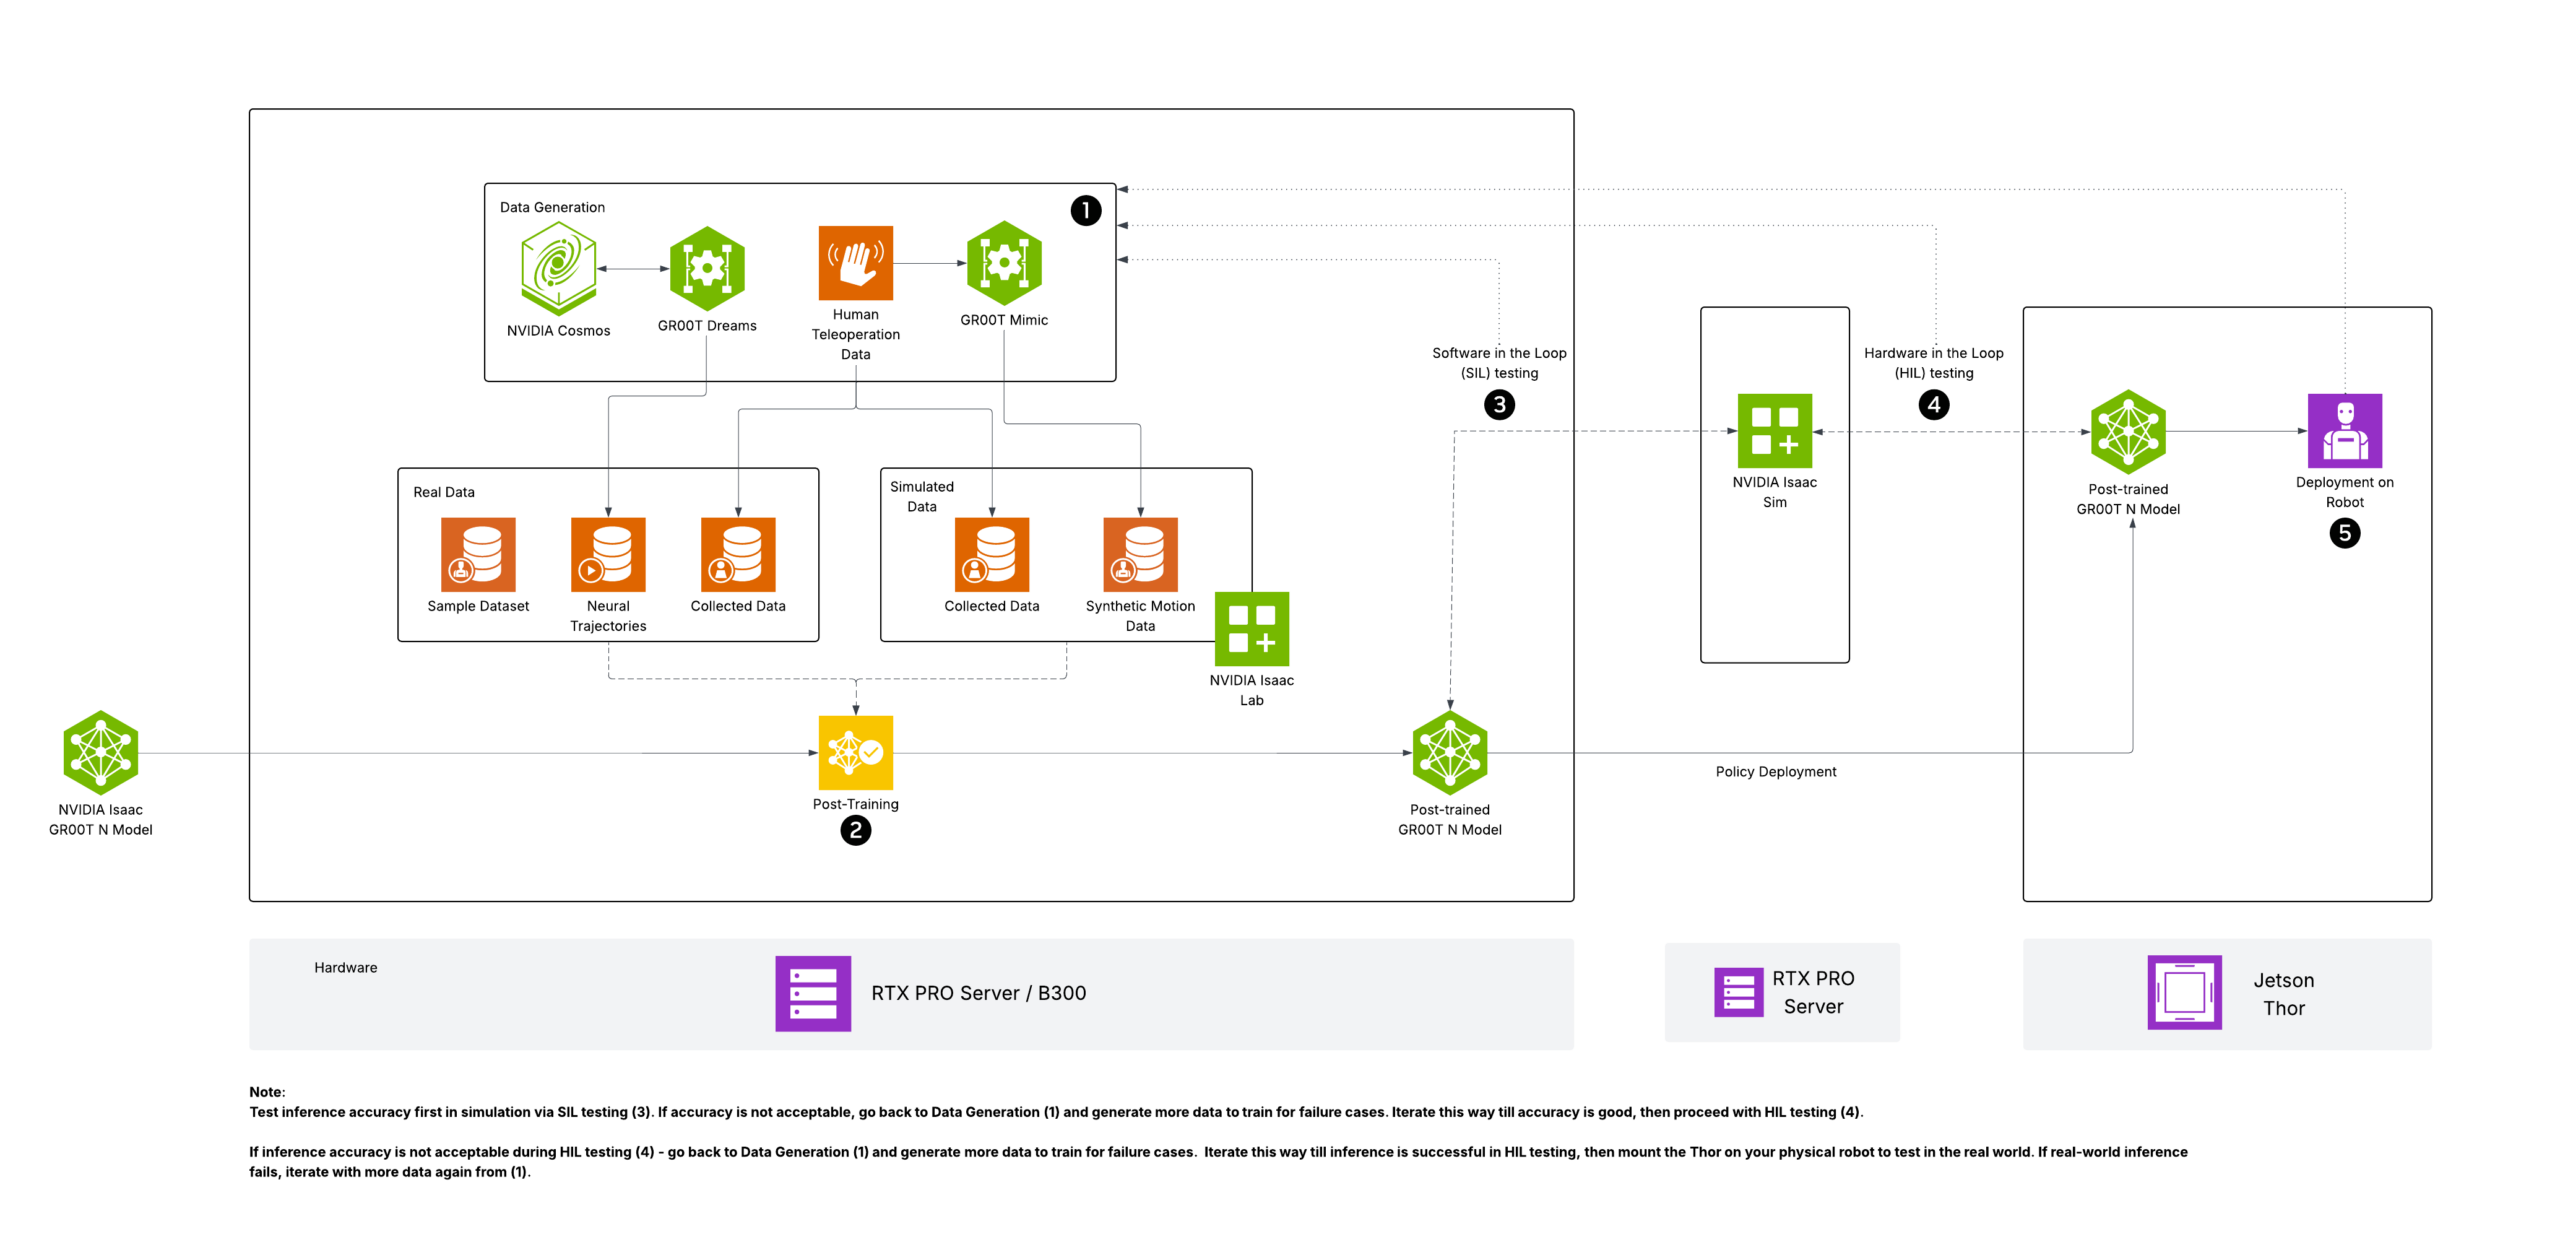
Процесс начинается с дистанционного управления: оператор направляет робота, чтобы выполнить задачу и получить небольшой набор реальных демонстраций. Затем эти примеры поступают в рабочий процесс Isaac GR00T. Дополнительный графический процессор RTX PRO обрабатывает графику и трассировку лучей в Isaac Sim, в то время как Isaac Lab и GR00T-Mimic расширяют исходные демонстрации до гораздо большего набора физически правдоподобных синтетических траекторий. Наконец, B300 выполняет тонкую настройку модели GR00T, используя объединенный набор реальных и синтетических данных.
Источник: NVIDIA
После тонкой настройки полученная стратегия может быть проверена в симуляции, прежде чем быть развернута на роботе для оценки в реальных условиях. Это создает замкнутый цикл разработки: зафиксировать реальную демонстрацию, воспроизвести и изменить ее в симуляции, переобучить модель и протестировать обновленную стратегию на оборудовании. Для команд с ограниченным доступом к роботам, операторам или временным окнам для сбора данных объединение симуляции, генерации синтетических данных и обучения модели в единой системе на рабочем столе может значительно снизить сложность каждой итерации.
Разработка ядра Blackwell Ultra
Однако, пожалуй, наилучшее применение DGX Station — это оптимизация ядра. Когда команда разрабатывает ядра CUDA или Triton для Blackwell Ultra, ничто не заменит работу на целевой архитектуре. WS300 предоставляет разработчику доступ к B300 и 252 ГБ HBM3e, позволяя профилировать реальные рабочие нагрузки, анализировать поведение памяти, настраивать пути Tensor Core, объединять операции и итерировать процессы без необходимости тратить время на восьмипроцессорный сервер или стоечную систему.
Более крупные системы по-прежнему важны, но их можно зарезервировать для задач, требующих их использования: масштабирование NVLink, коллективные вычисления NCCL, ядра связи, вывод результатов на нескольких графических процессорах и окончательная проверка пропускной способности. WS300 выполняет работу с ядром на одном графическом процессоре локально, сохраняя эти дорогостоящие общие системы доступными для масштабируемого тестирования. Для команды, занимающейся оптимизацией Blackwell Ultra, это, пожалуй, наиболее подходящая машина для разработки, которую можно найти на рынке.
Если бы DGX Station поставлялась одновременно с первыми системами Blackwell Ultra, мы предполагаем, что первоначальные запасы практически мгновенно исчезли бы в лабораториях искусственного интеллекта, среди групп разработчиков компиляторов, разработчиков механизмов вывода и других групп, стремящихся оптимизировать программное обеспечение для B300. Даже сейчас прямой доступ к целевому графическому процессору может быть самой очевидной причиной для организации приобрести его.
Эффективности
Примечание к тестированию: Тестирование проводилось удаленно на системе, размещенной на сервере MSI, при этом StorageReview контролировала всю программную среду на протяжении всего периода тестирования. Система тестировалась без установленной видеокарты RTX PRO или каких-либо других дополнительных карт PCIe. Это позволило GB300 Superchip использовать весь доступный энергетический бюджет ускорителя системы на протяжении всего тестирования.
Максимально достижимое количество операций с плавающей запятой в FLOPS (MAMF)
Во-первых, чтобы оценить вычислительные возможности B300 в контексте, мы запустили MAMF на трех системах поколения Blackwell. MAMF (Maximum Achievable Matmul FLOPS) — это практический показатель производительности, предназначенный для измерения реального пикового количества операций с плавающей запятой в секунду, которое может быть достигнуто на ускорителях машинного обучения во время операций умножения матриц. Он предлагает более точный бенчмарк, чем теоретическое пиковое значение FLOPS, часто указываемое в технических характеристиках оборудования.
Для этого теста мы сканируем каждую из 3 систем в режимах BF16, FP8 и NVFP4 и сообщаем о наилучшем устойчивом (плотном) результате для каждой точности.
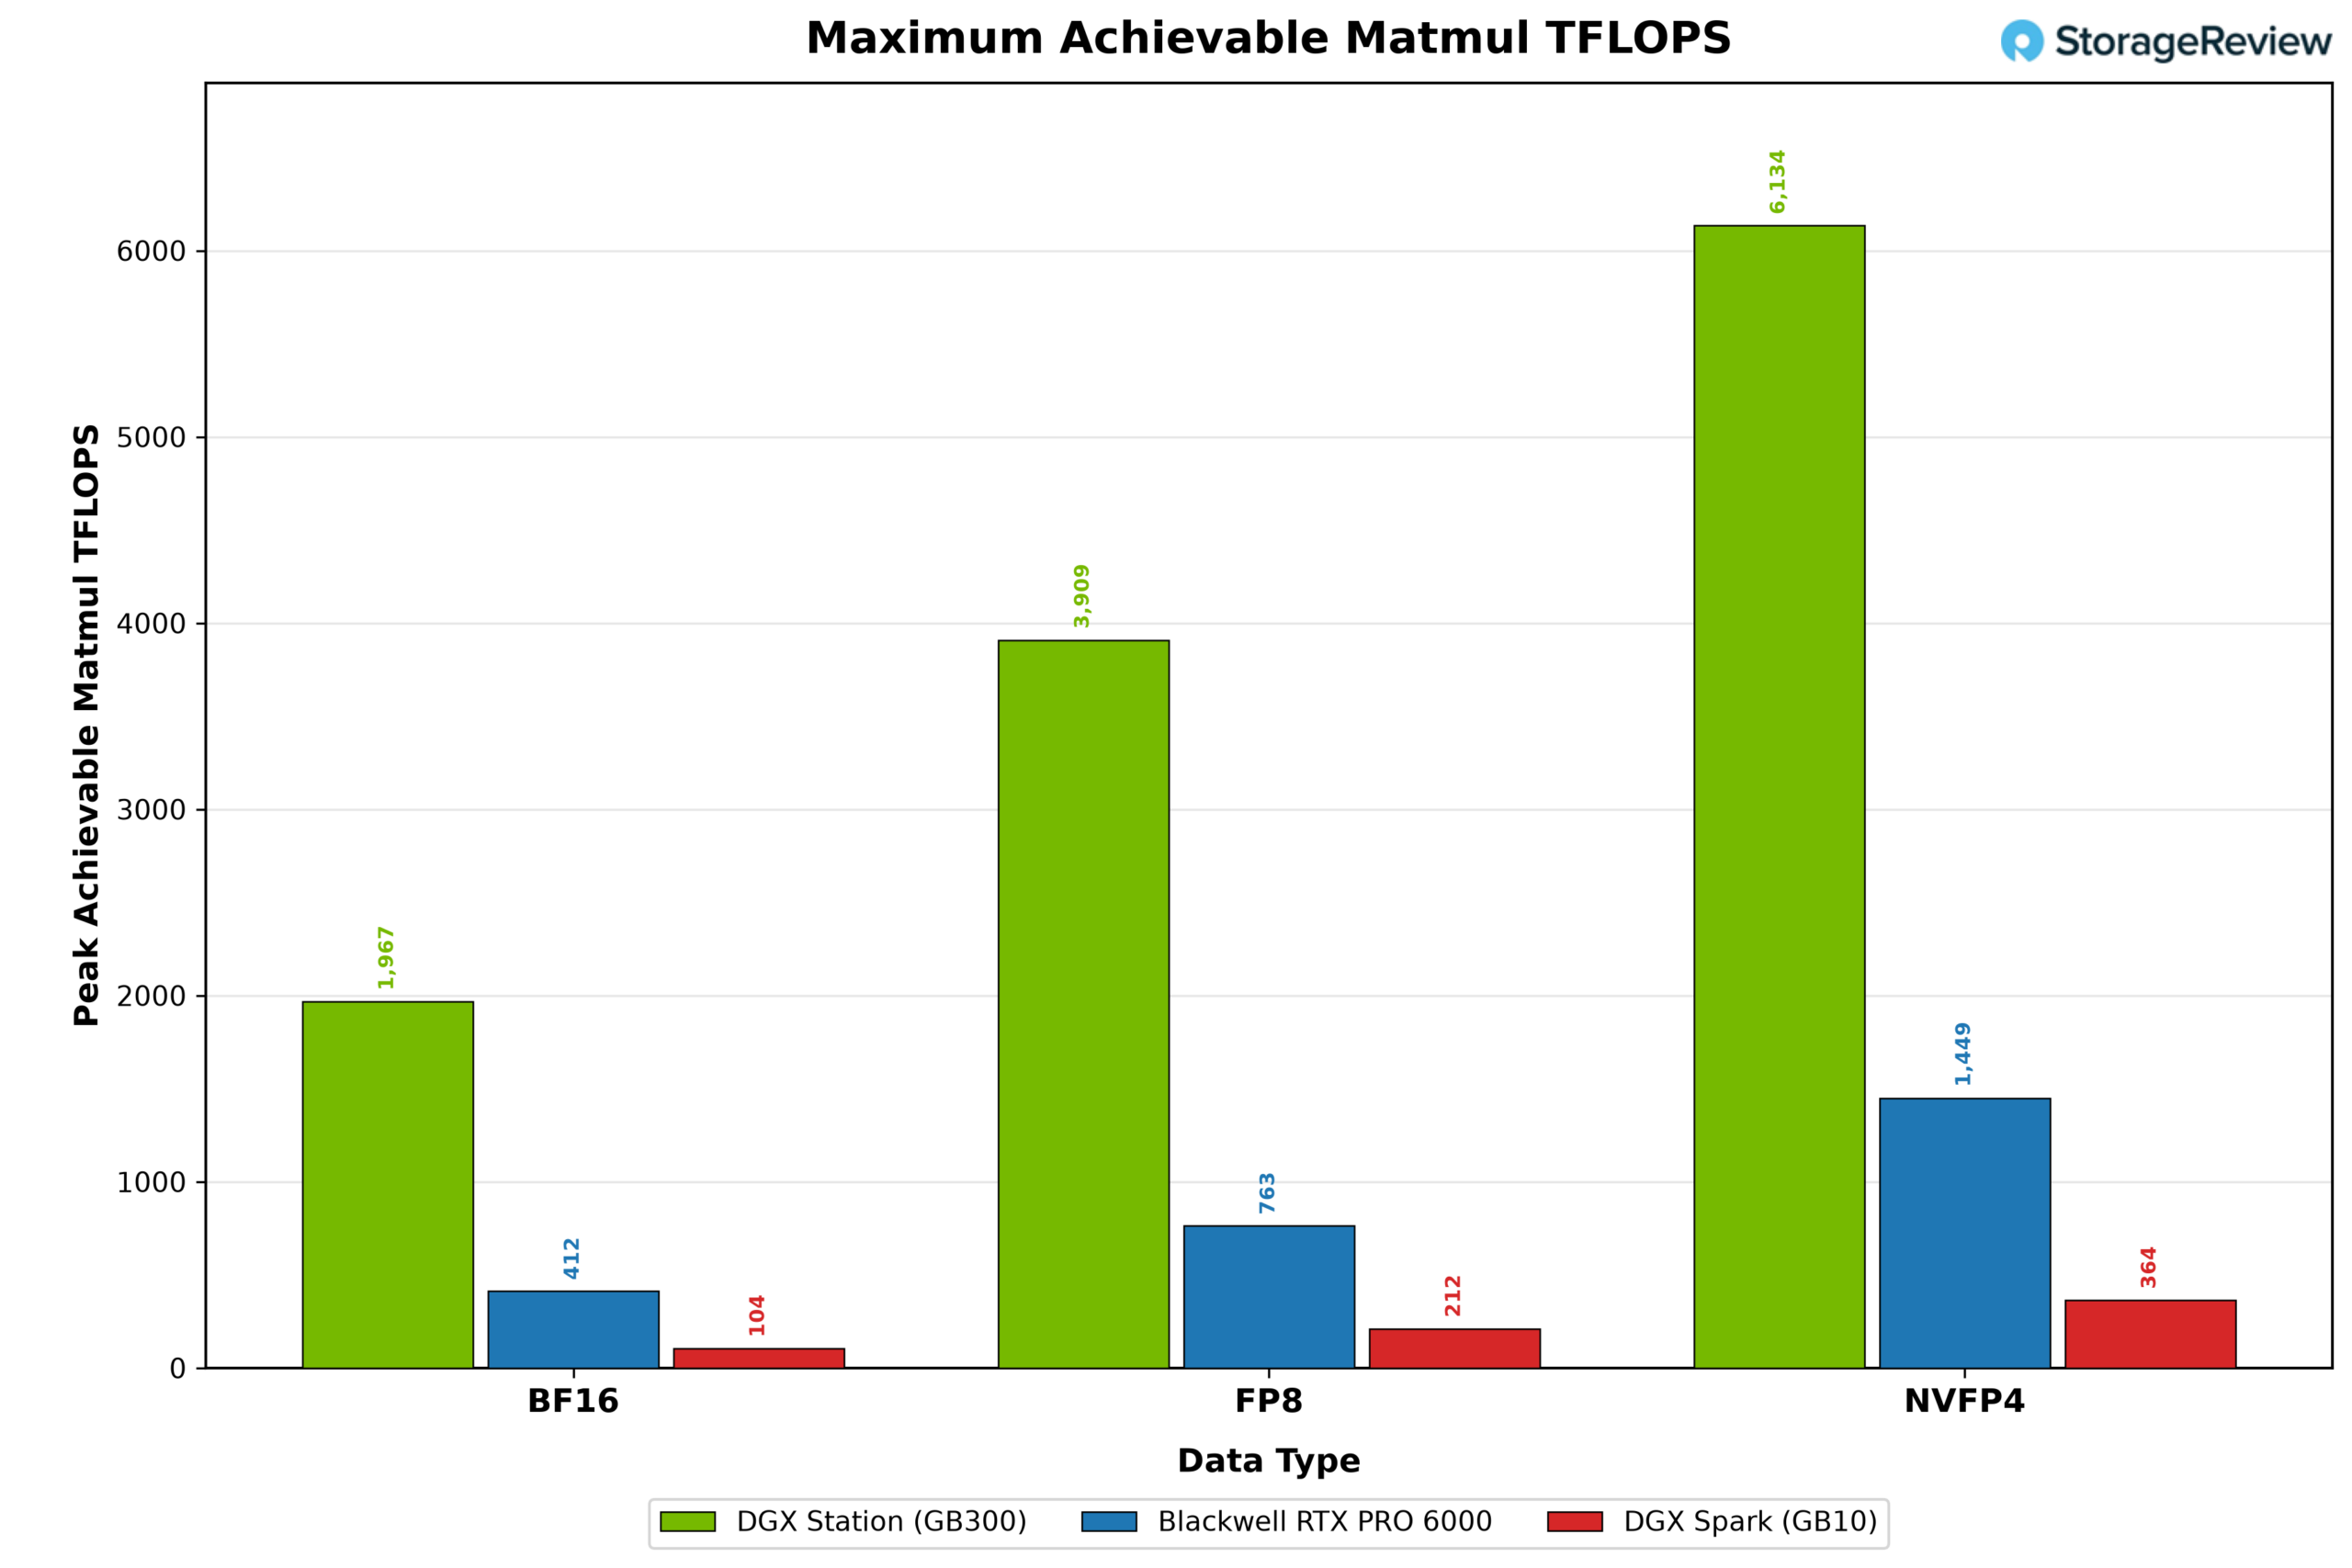
GB300 лидирует по всем параметрам точности. В BF16 она достигает 1,967 TFLOPS против 412 у RTX PRO 6000 и 104 у DGX Spark . В FP8 наблюдается аналогичная картина: 3,909, 763 и 211. В NVFP4 GB300 показывает 6,134 TFLOPS, RTX PRO 6000 — 1,449, а Spark — 364. Соотношения остаются удивительно стабильными во всех трех режимах точности: GB300 имеет преимущество в 4-5 раз над RTX PRO 6000 и в 17-19 раз над Spark, в то время как RTX PRO 6000 сохраняет примерно 4-кратное преимущество над Spark.
NVBandwidth
Вычислительная мощность в чистом виде полезна только в том случае, если ускоритель может постоянно обеспечивать свои исполнительные блоки данными. Это особенно важно для вывода результатов в искусственном интеллекте, где генерация токенов на этапе декодирования часто ограничивается скорее пропускной способностью памяти, чем доступными FLOPS.
На процессоре GB300 Superchip эта иерархия охватывает локальную память HBM3e процессора B300, память LPDDR5X процессора Grace и соединительный интерфейс NVLink-C2C. Утилита NVIDIA NVBandwidth анализирует различные пути копирования данных между этими компонентами, показывая как доступную пропускную способность внутри графического процессора, так и стоимость перемещения данных между доменами памяти графического и центрального процессоров.
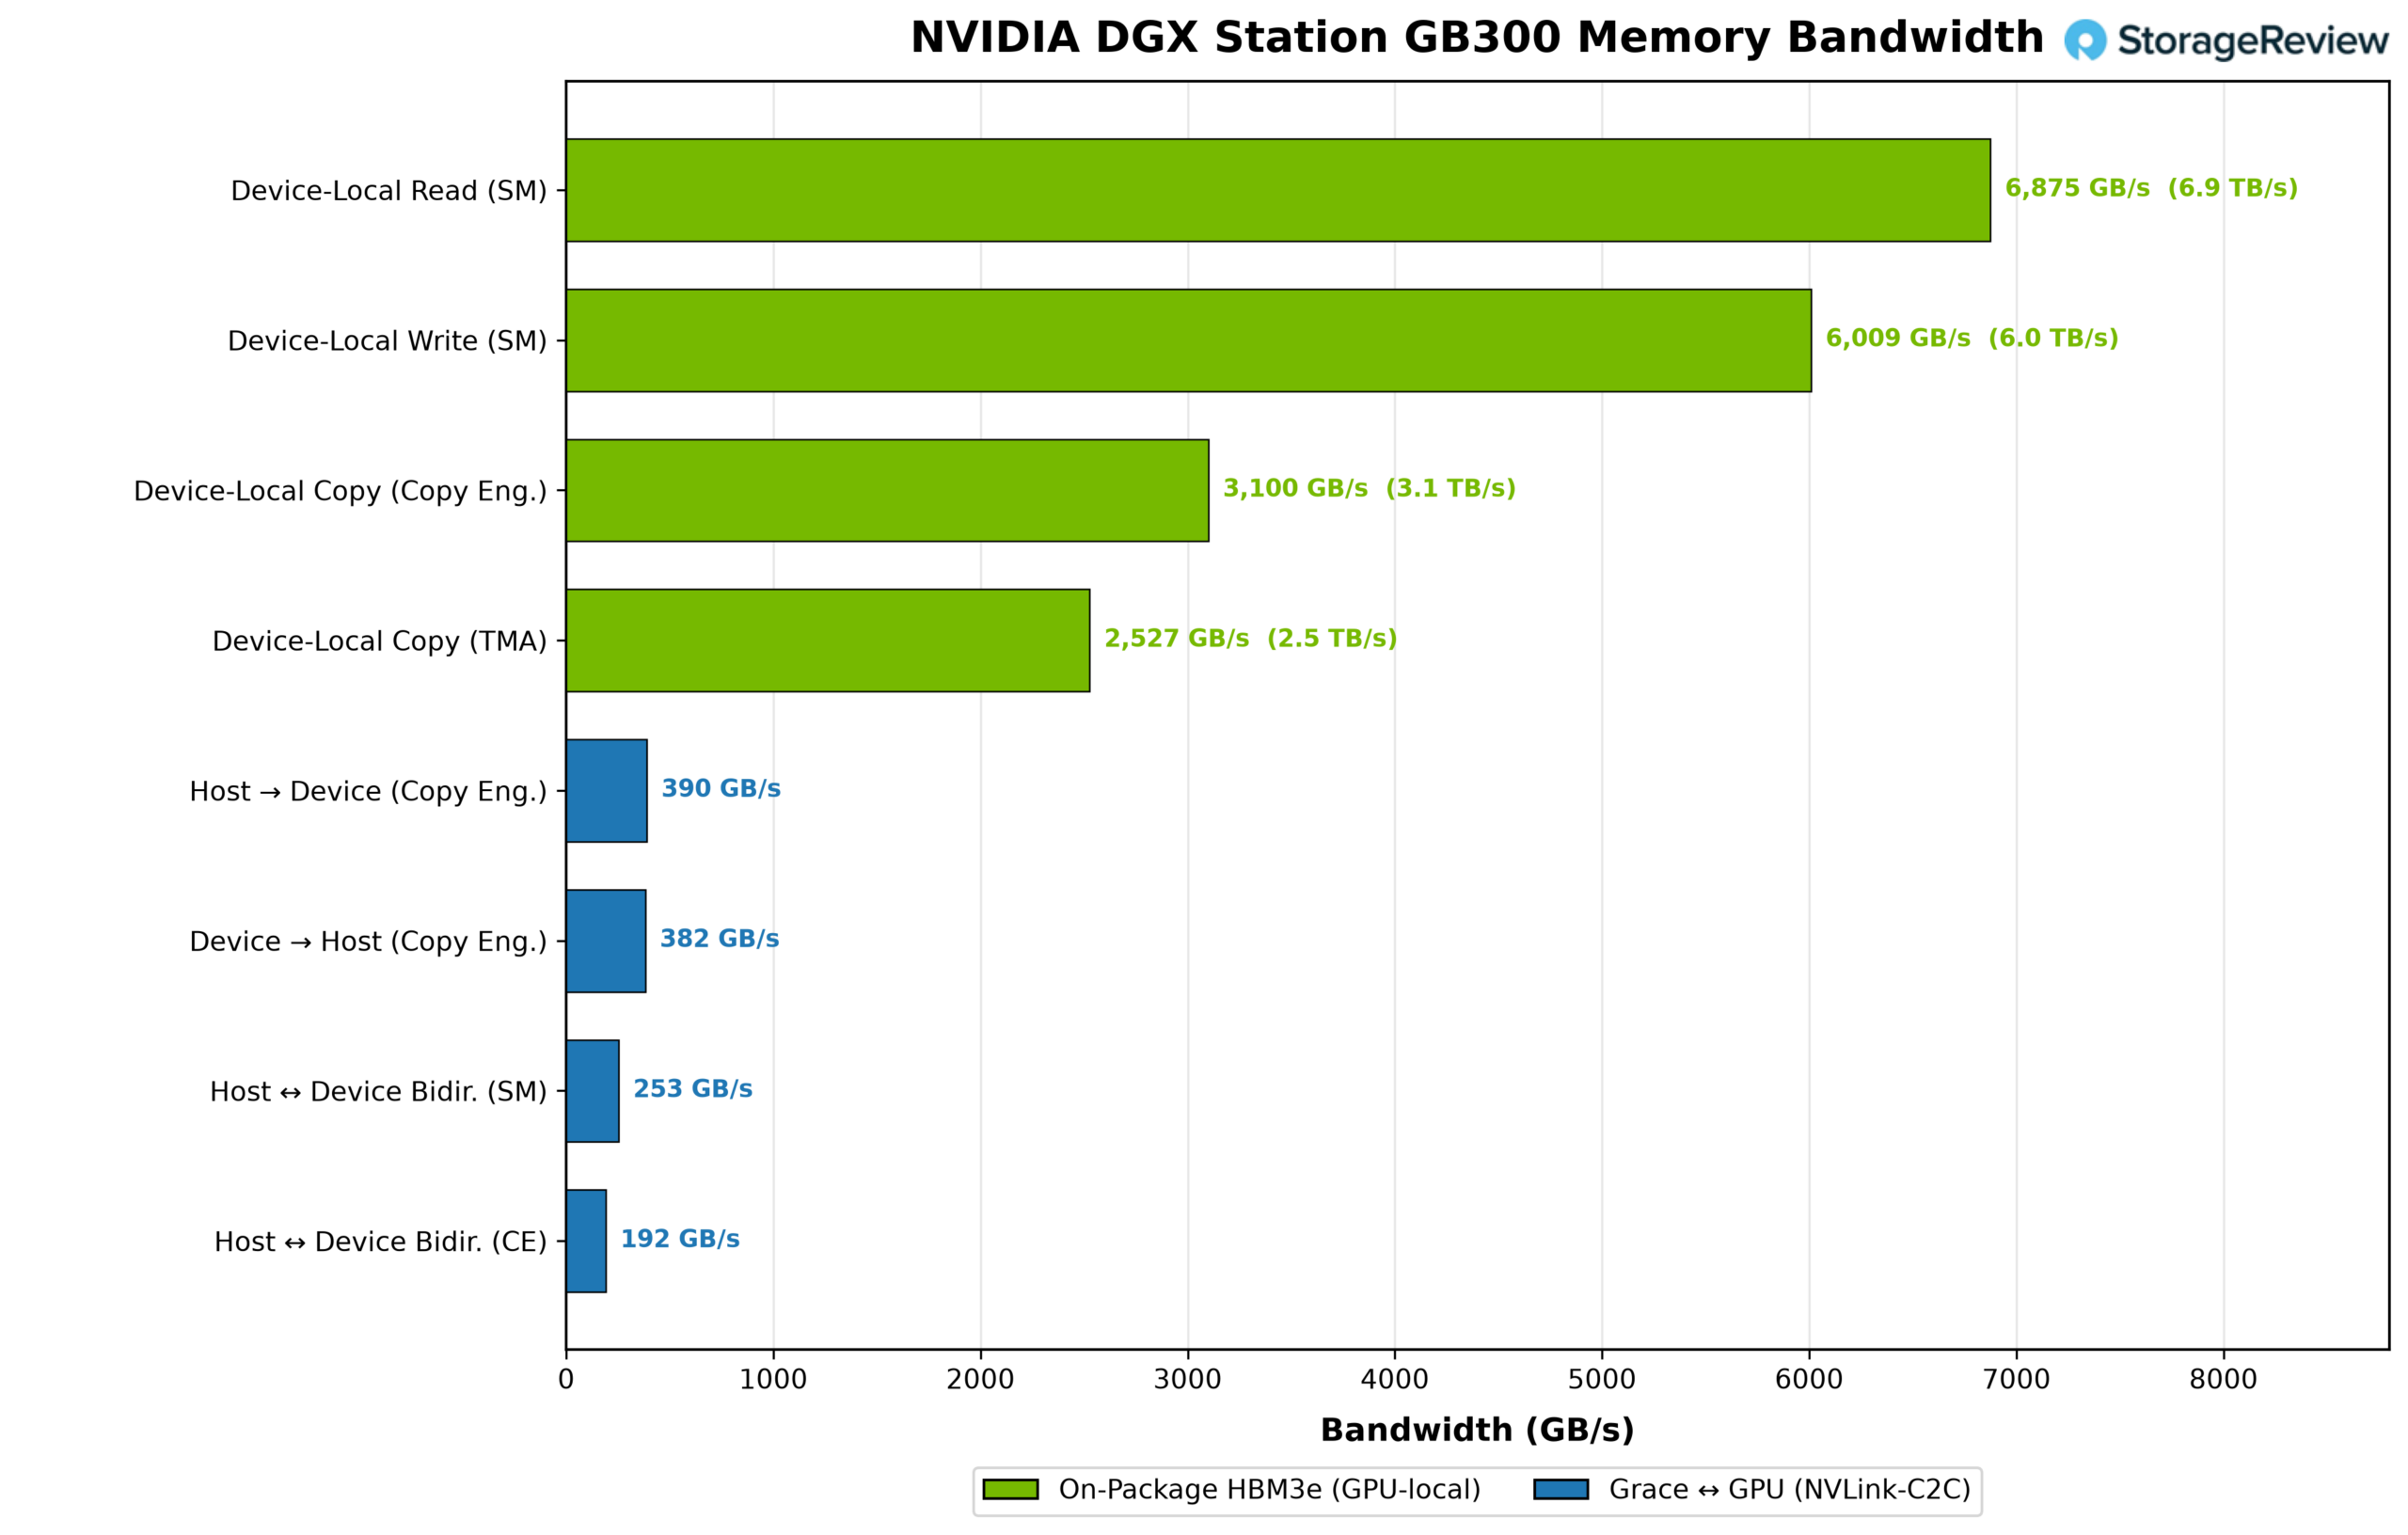
Первые четыре теста измеряют скорость перемещения данных в пределах 252 ГБ памяти HBM3e видеокарты B300. Скорость чтения с устройства достигает 6,875 ГБ/с, или приблизительно 6.9 ТБ/с, что составляет всего несколько процентов от заявленной пропускной способности памяти графического процессора в 7.1 ТБ/с. Скорость записи с устройства достигает 6,009 ГБ/с.
Операции копирования HBM-to-HBM требуют меньших ресурсов, поскольку каждое копирование потребляет пропускную способность дважды: один раз для чтения исходного файла и еще раз для записи в целевой файл. Специализированные механизмы копирования достигают скорости 3,100 ГБ/с, в то время как Tensor Memory Accelerator показывает 2,527 ГБ/с.
Оставшиеся тесты используют протокол NVLink-C2C и обращаются к 496 ГБ памяти LPDDR5X процессора Grace. Скорость передачи данных из памяти Grace в память B300 HBM достигает 390 ГБ/с, а скорость передачи в обратном направлении — 382 ГБ/с. Хотя NVLink-C2C обеспечивает когерентную пропускную способность до 900 ГБ/с между ЦП и ГП, измеренные показатели передачи ограничены пропускной способностью памяти LPDDR5X процессора Grace в 396 ГБ/с. Двунаправленная передача данных дополнительно подтверждает это ограничение. Одновременный трафик достигает 253 ГБ/с при использовании копирования на основе SM и 192 ГБ/с через механизмы копирования.
вывод
После рассмотрения низкоуровневых тестов переходим к выводу LLM. Здесь акцент смещается с пиковых значений на количество токенов в секунду, время до получения первого токена и задержку под нагрузкой, что позволяет нам лучше понять, как WS300 ведет себя в качестве системы обслуживания.
Начнём с определяющей возможности GB300 Superchip: поддержка моделей, по обе стороны от ограничения объёма памяти HBM3e в 252 ГБ, установленного на B300. Именно здесь наиболее важен его пул когерентной памяти объёмом 748 ГБ. Пять контрольных точек последовательно охватывают следующие этапы: от двух моделей, которые комфортно помещаются в память HBM, до одной, которая номинально помещается, но оставляет слишком мало места для кэша времени выполнения и кэша ключ-значение, и, наконец, до двух моделей, которым необходимо перенести значительную часть своих весовых функций в память Grace.
Примечание: В тех случаях, когда это указано, модели запускались со спекулятивным декодированием для повышения пропускной способности декодирования, при этом количество токенов принудительного принятия было установлено равным количеству токенов спекулятивного декодирования. Таким образом, результаты показывают наилучшую производительность; в реальных условиях пропускная способность является динамической и зависит от качества токенов спекулятивного декодирования.
Модели, которые полностью помещаются в HBM.
DeepSeek v4 Flash (0731)
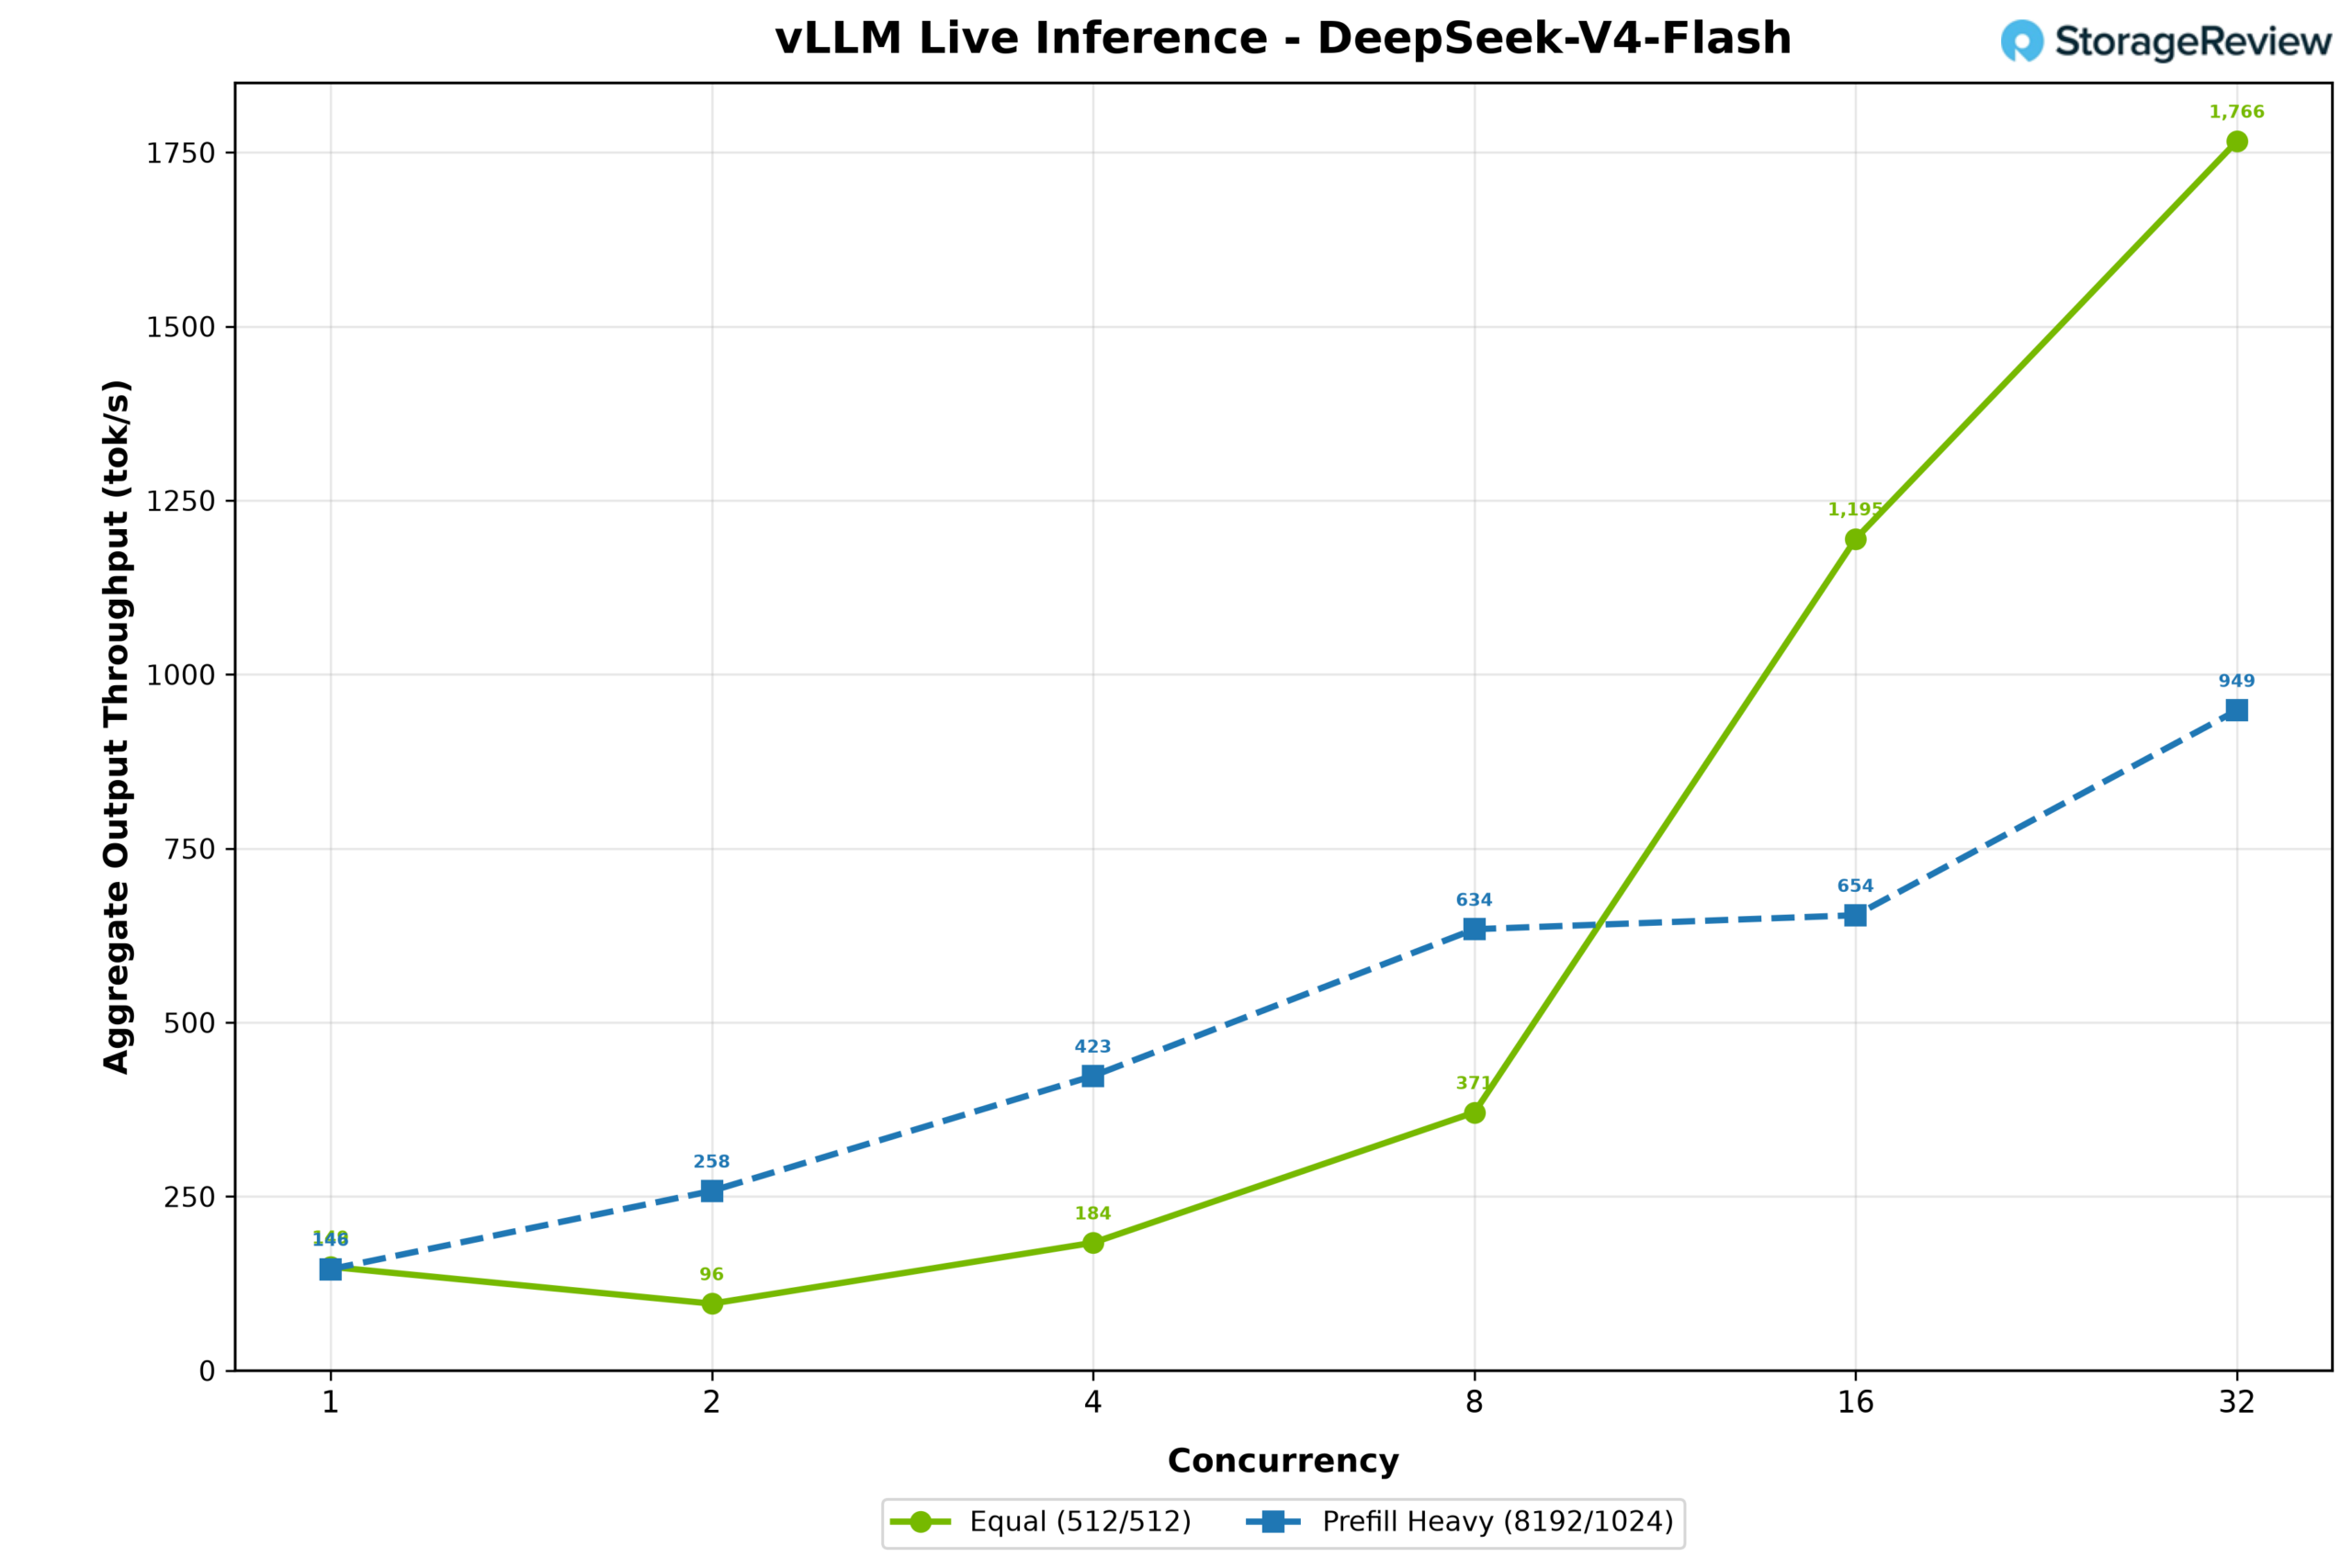
Первым делом мы протестировали невероятно популярную флешку DeepSeek v4 (0731), которая потребляет 14+6 ГБ памяти в качестве нативной контрольной точки FP8. Эта модель известна своей высокой эффективностью и простотой в использовании, что мы и подтвердили на DGX Station. В рабочей нагрузке 512/512 пропускная способность начиналась со 149 токенов в секунду при параллелизме 1, быстро увеличиваясь до 1,766 при параллелизме 32. В рабочей нагрузке с интенсивным предварительным заполнением производительность выросла со 146 до 949 токенов в секунду.
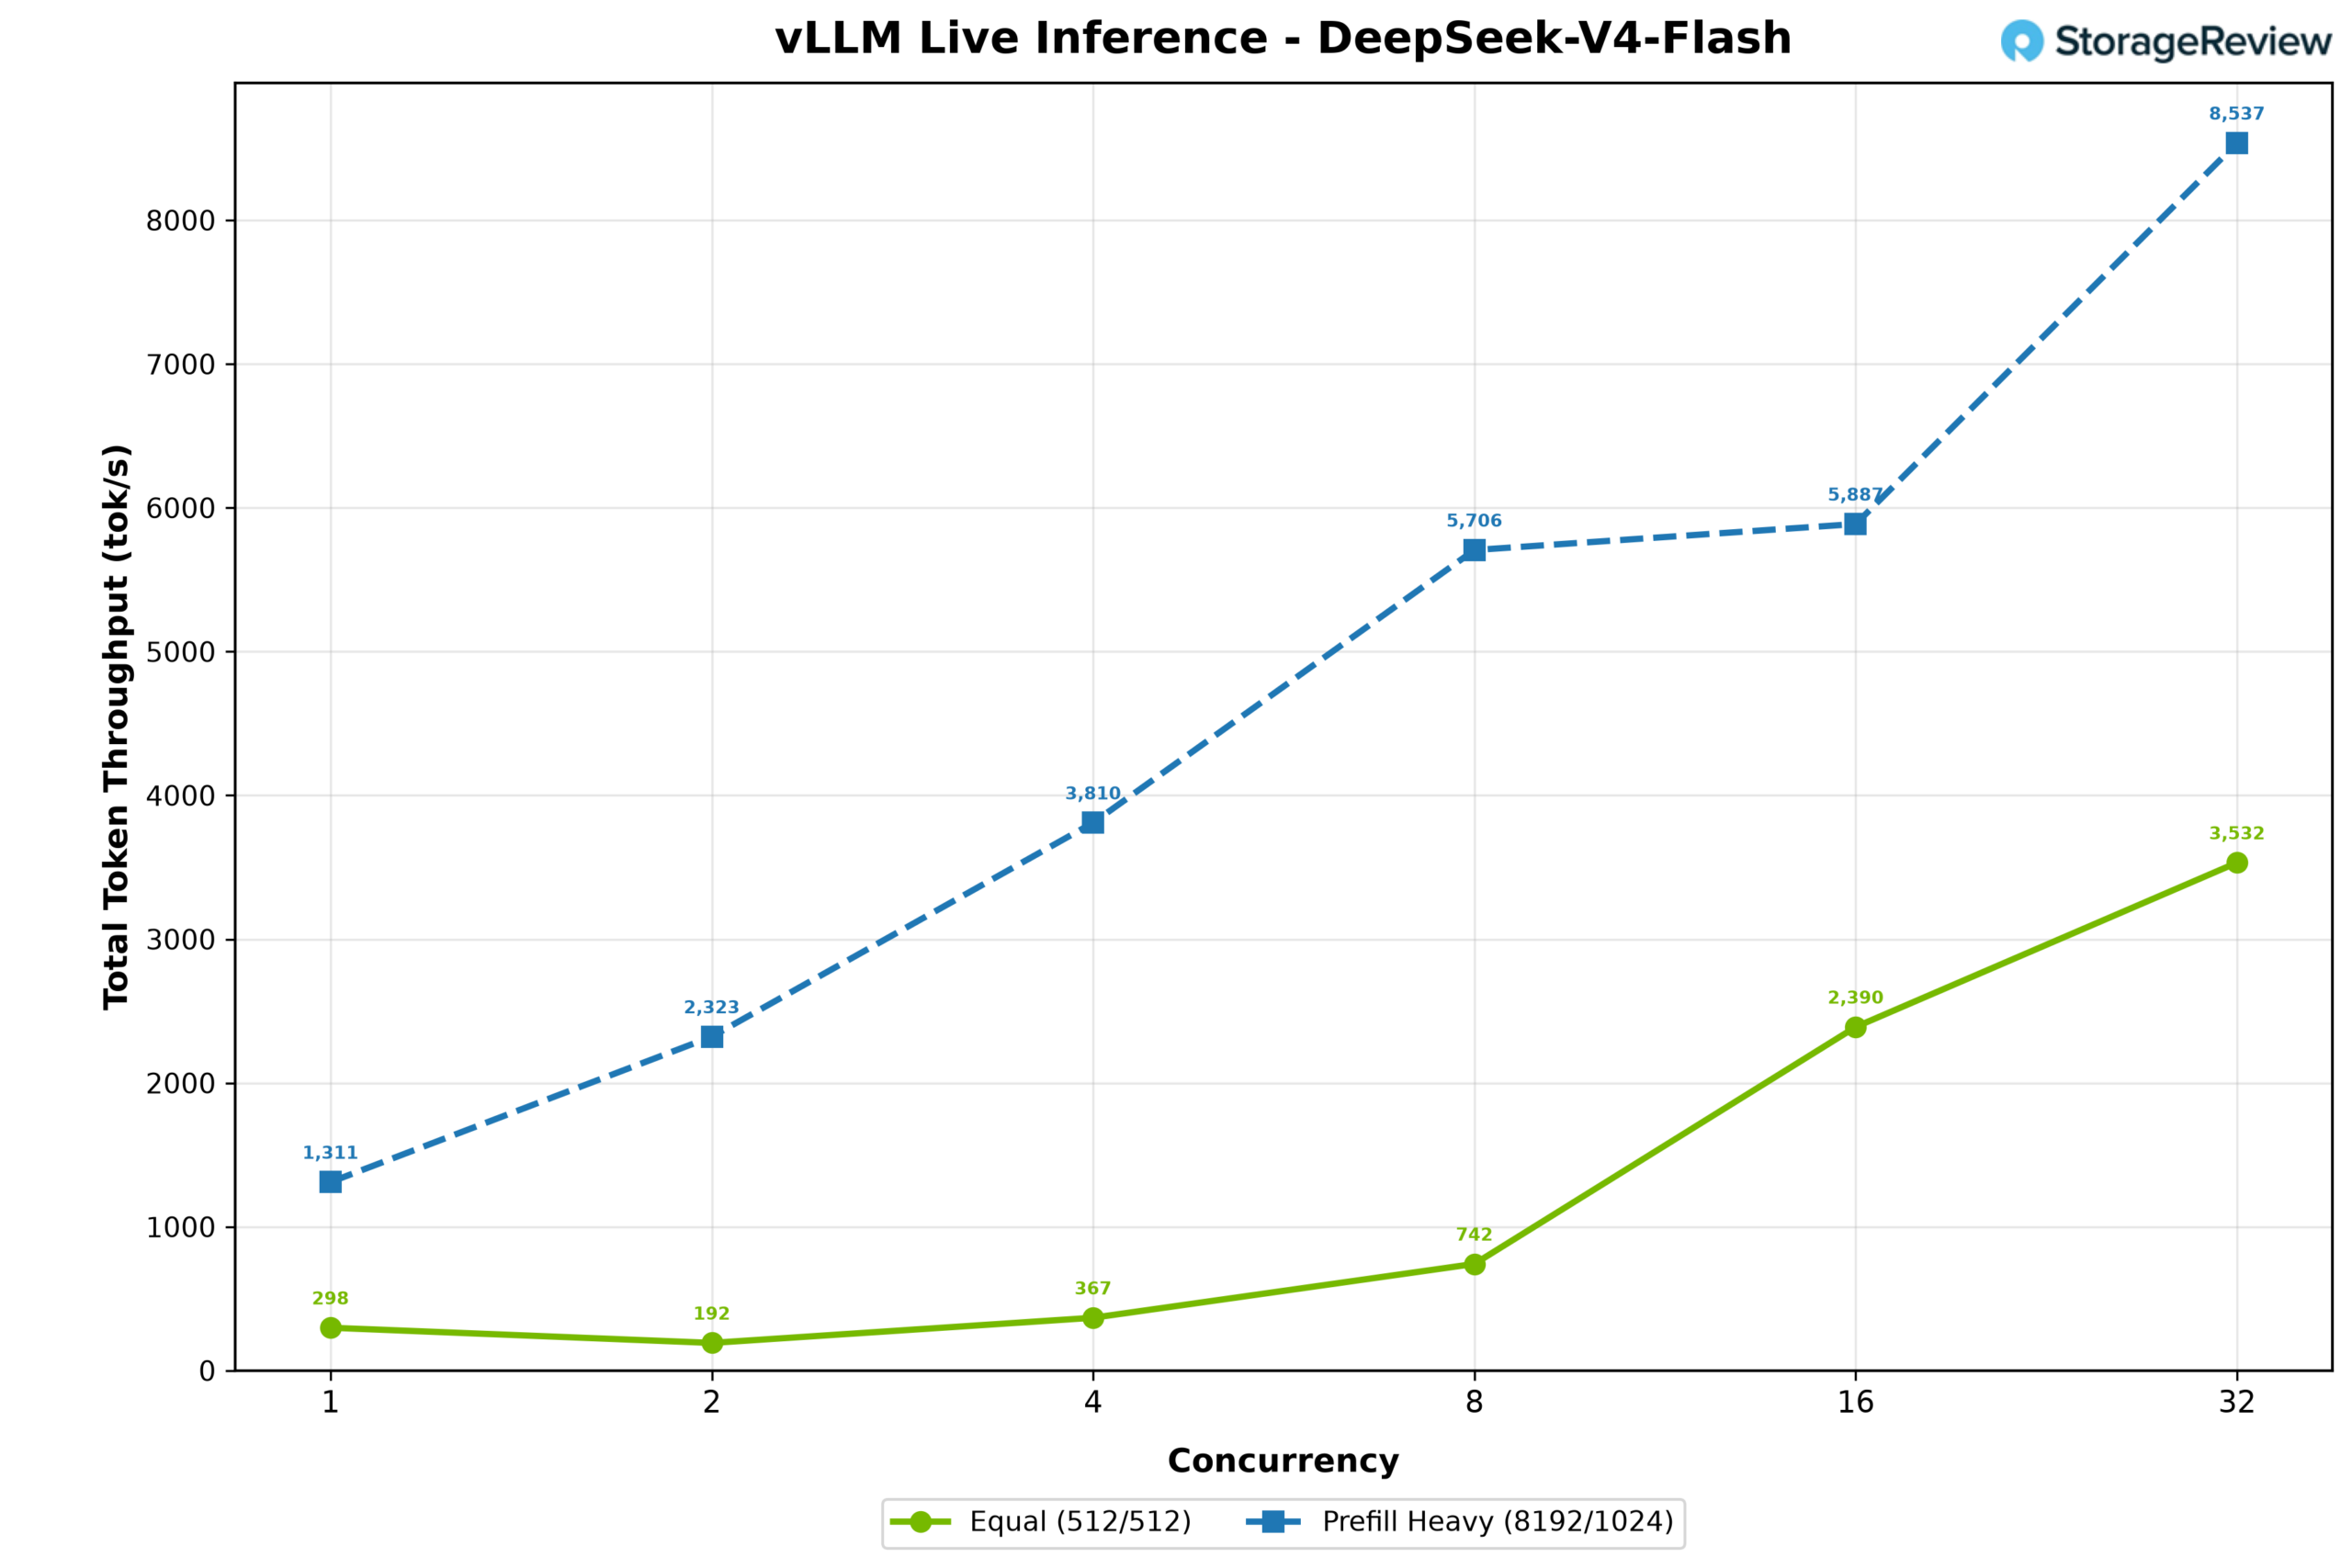
Общий объем обрабатываемых токенов увеличивался синхронно: нагрузка 512/512 выросла с 298 до 3,532 токенов в секунду, а нагрузка, требующая предварительного заполнения, — с 1,311 до 8,537.
MiniMax M2.7 (NVFP4)
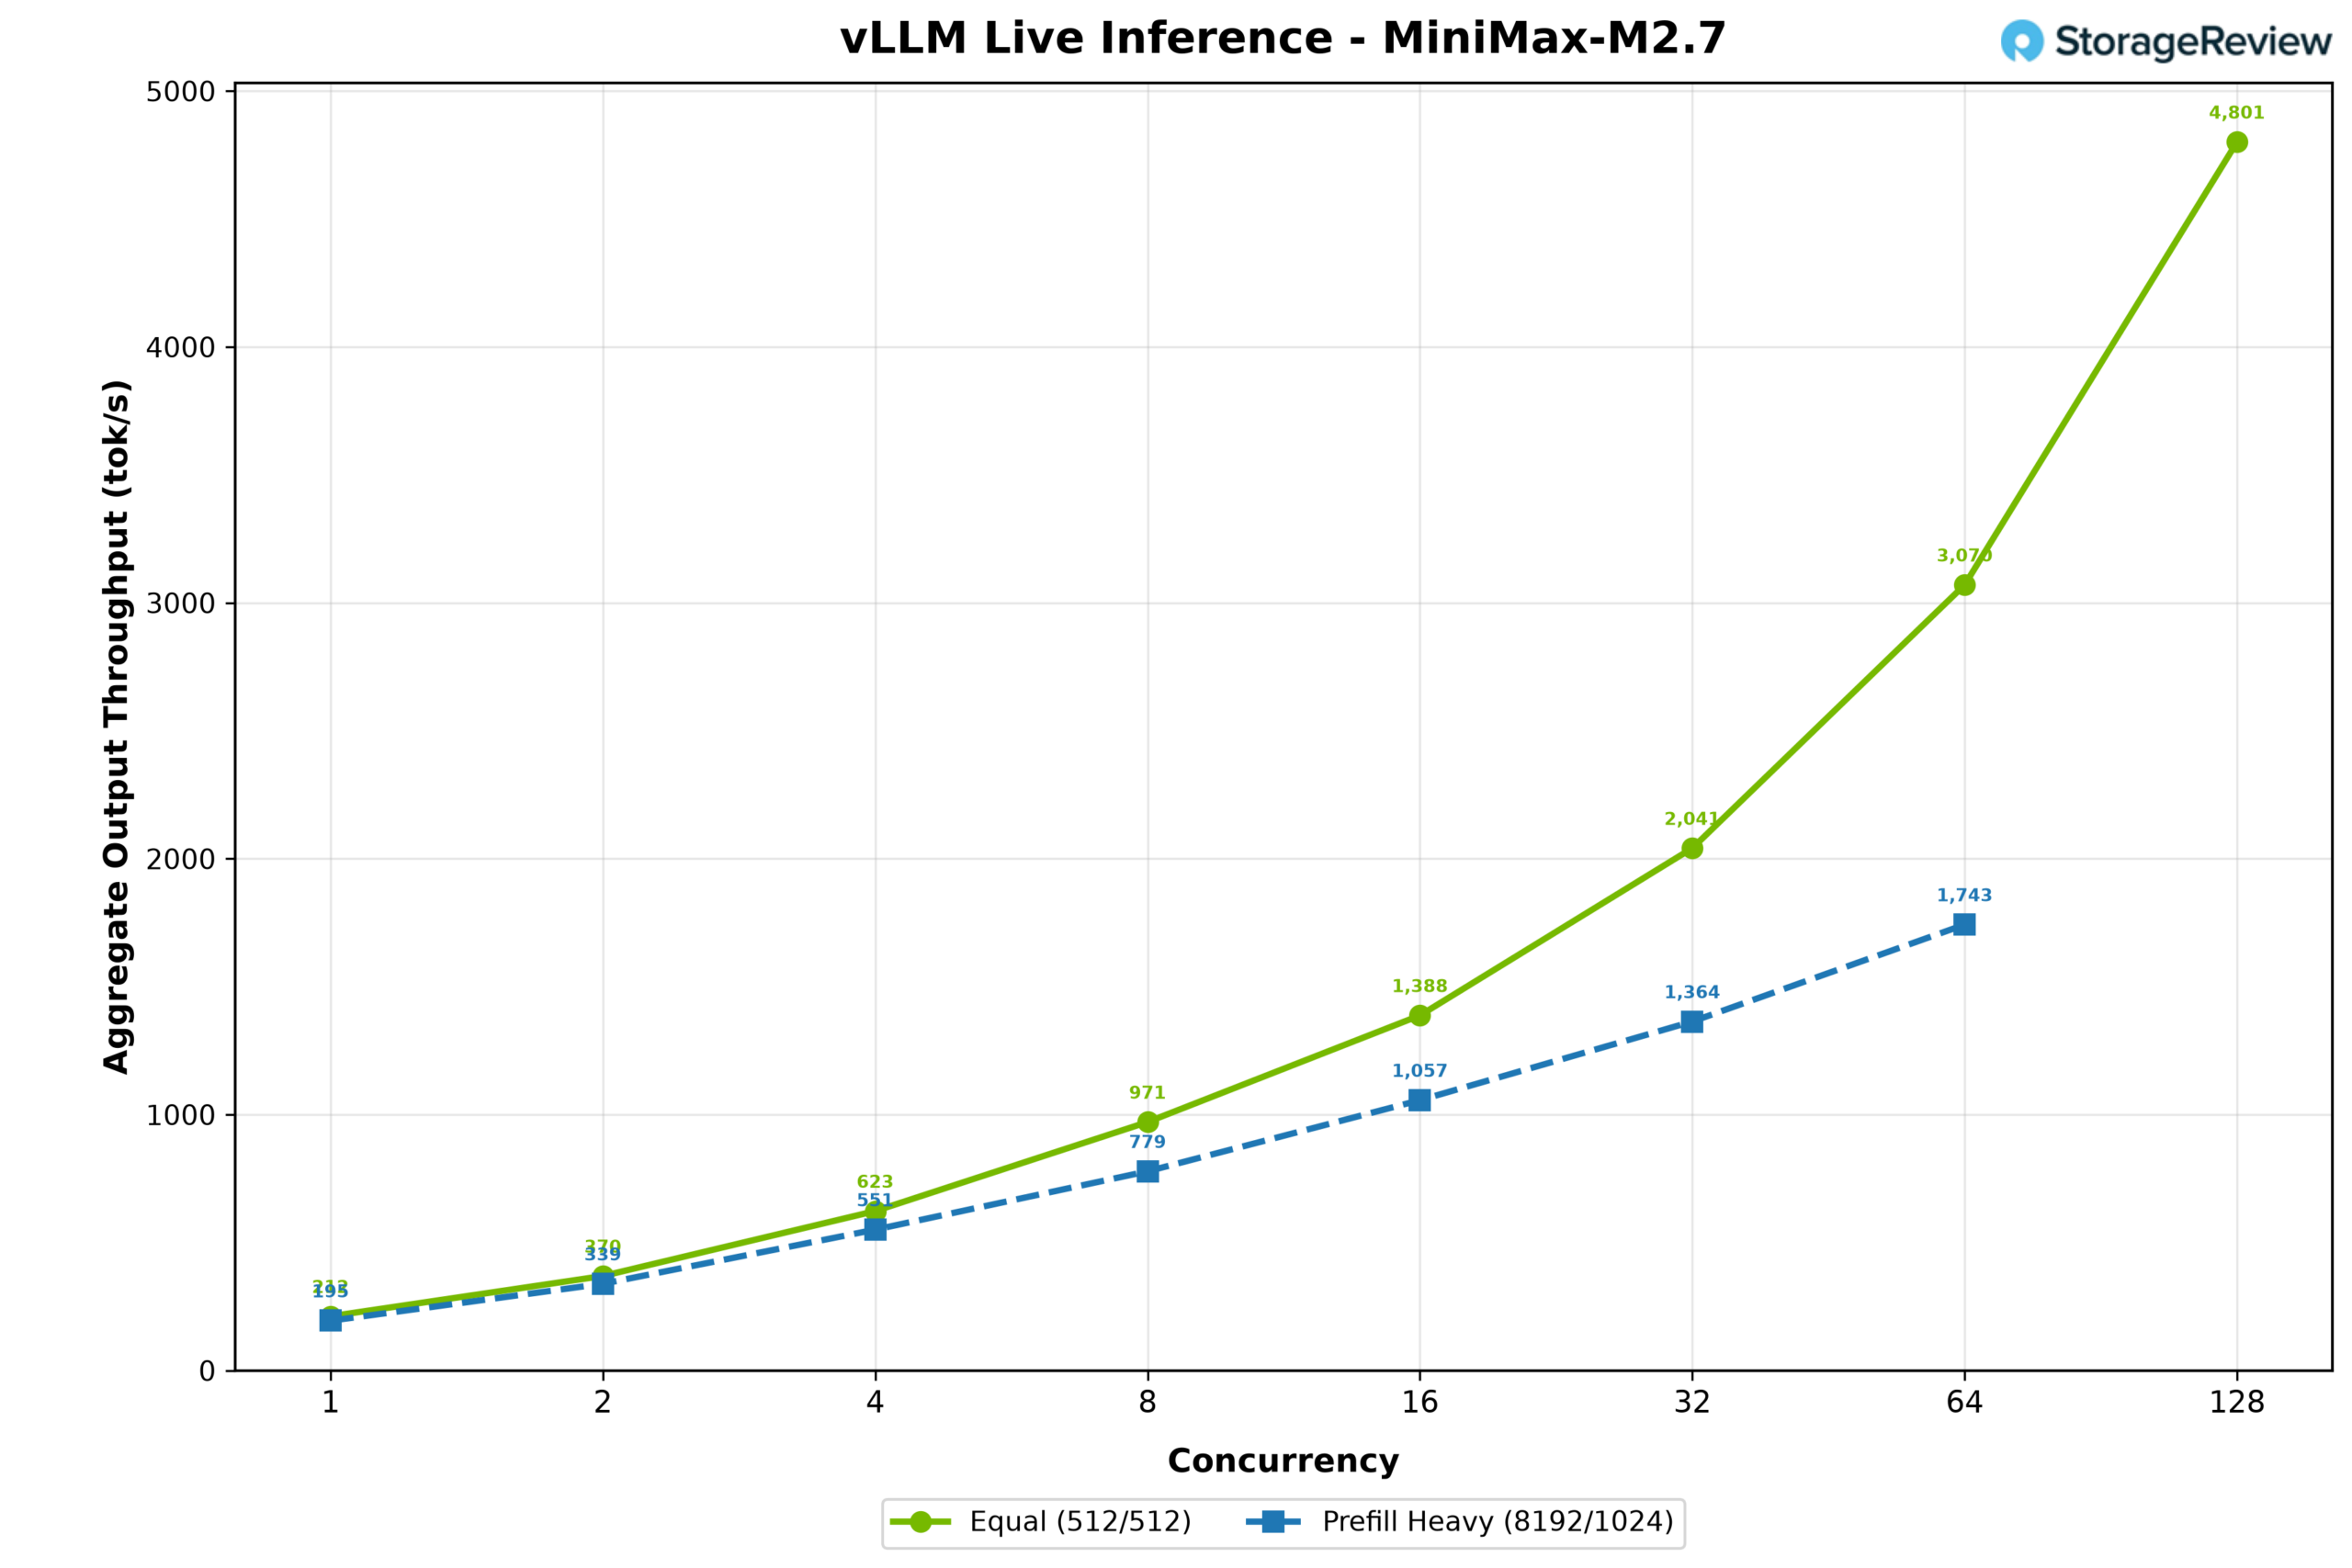
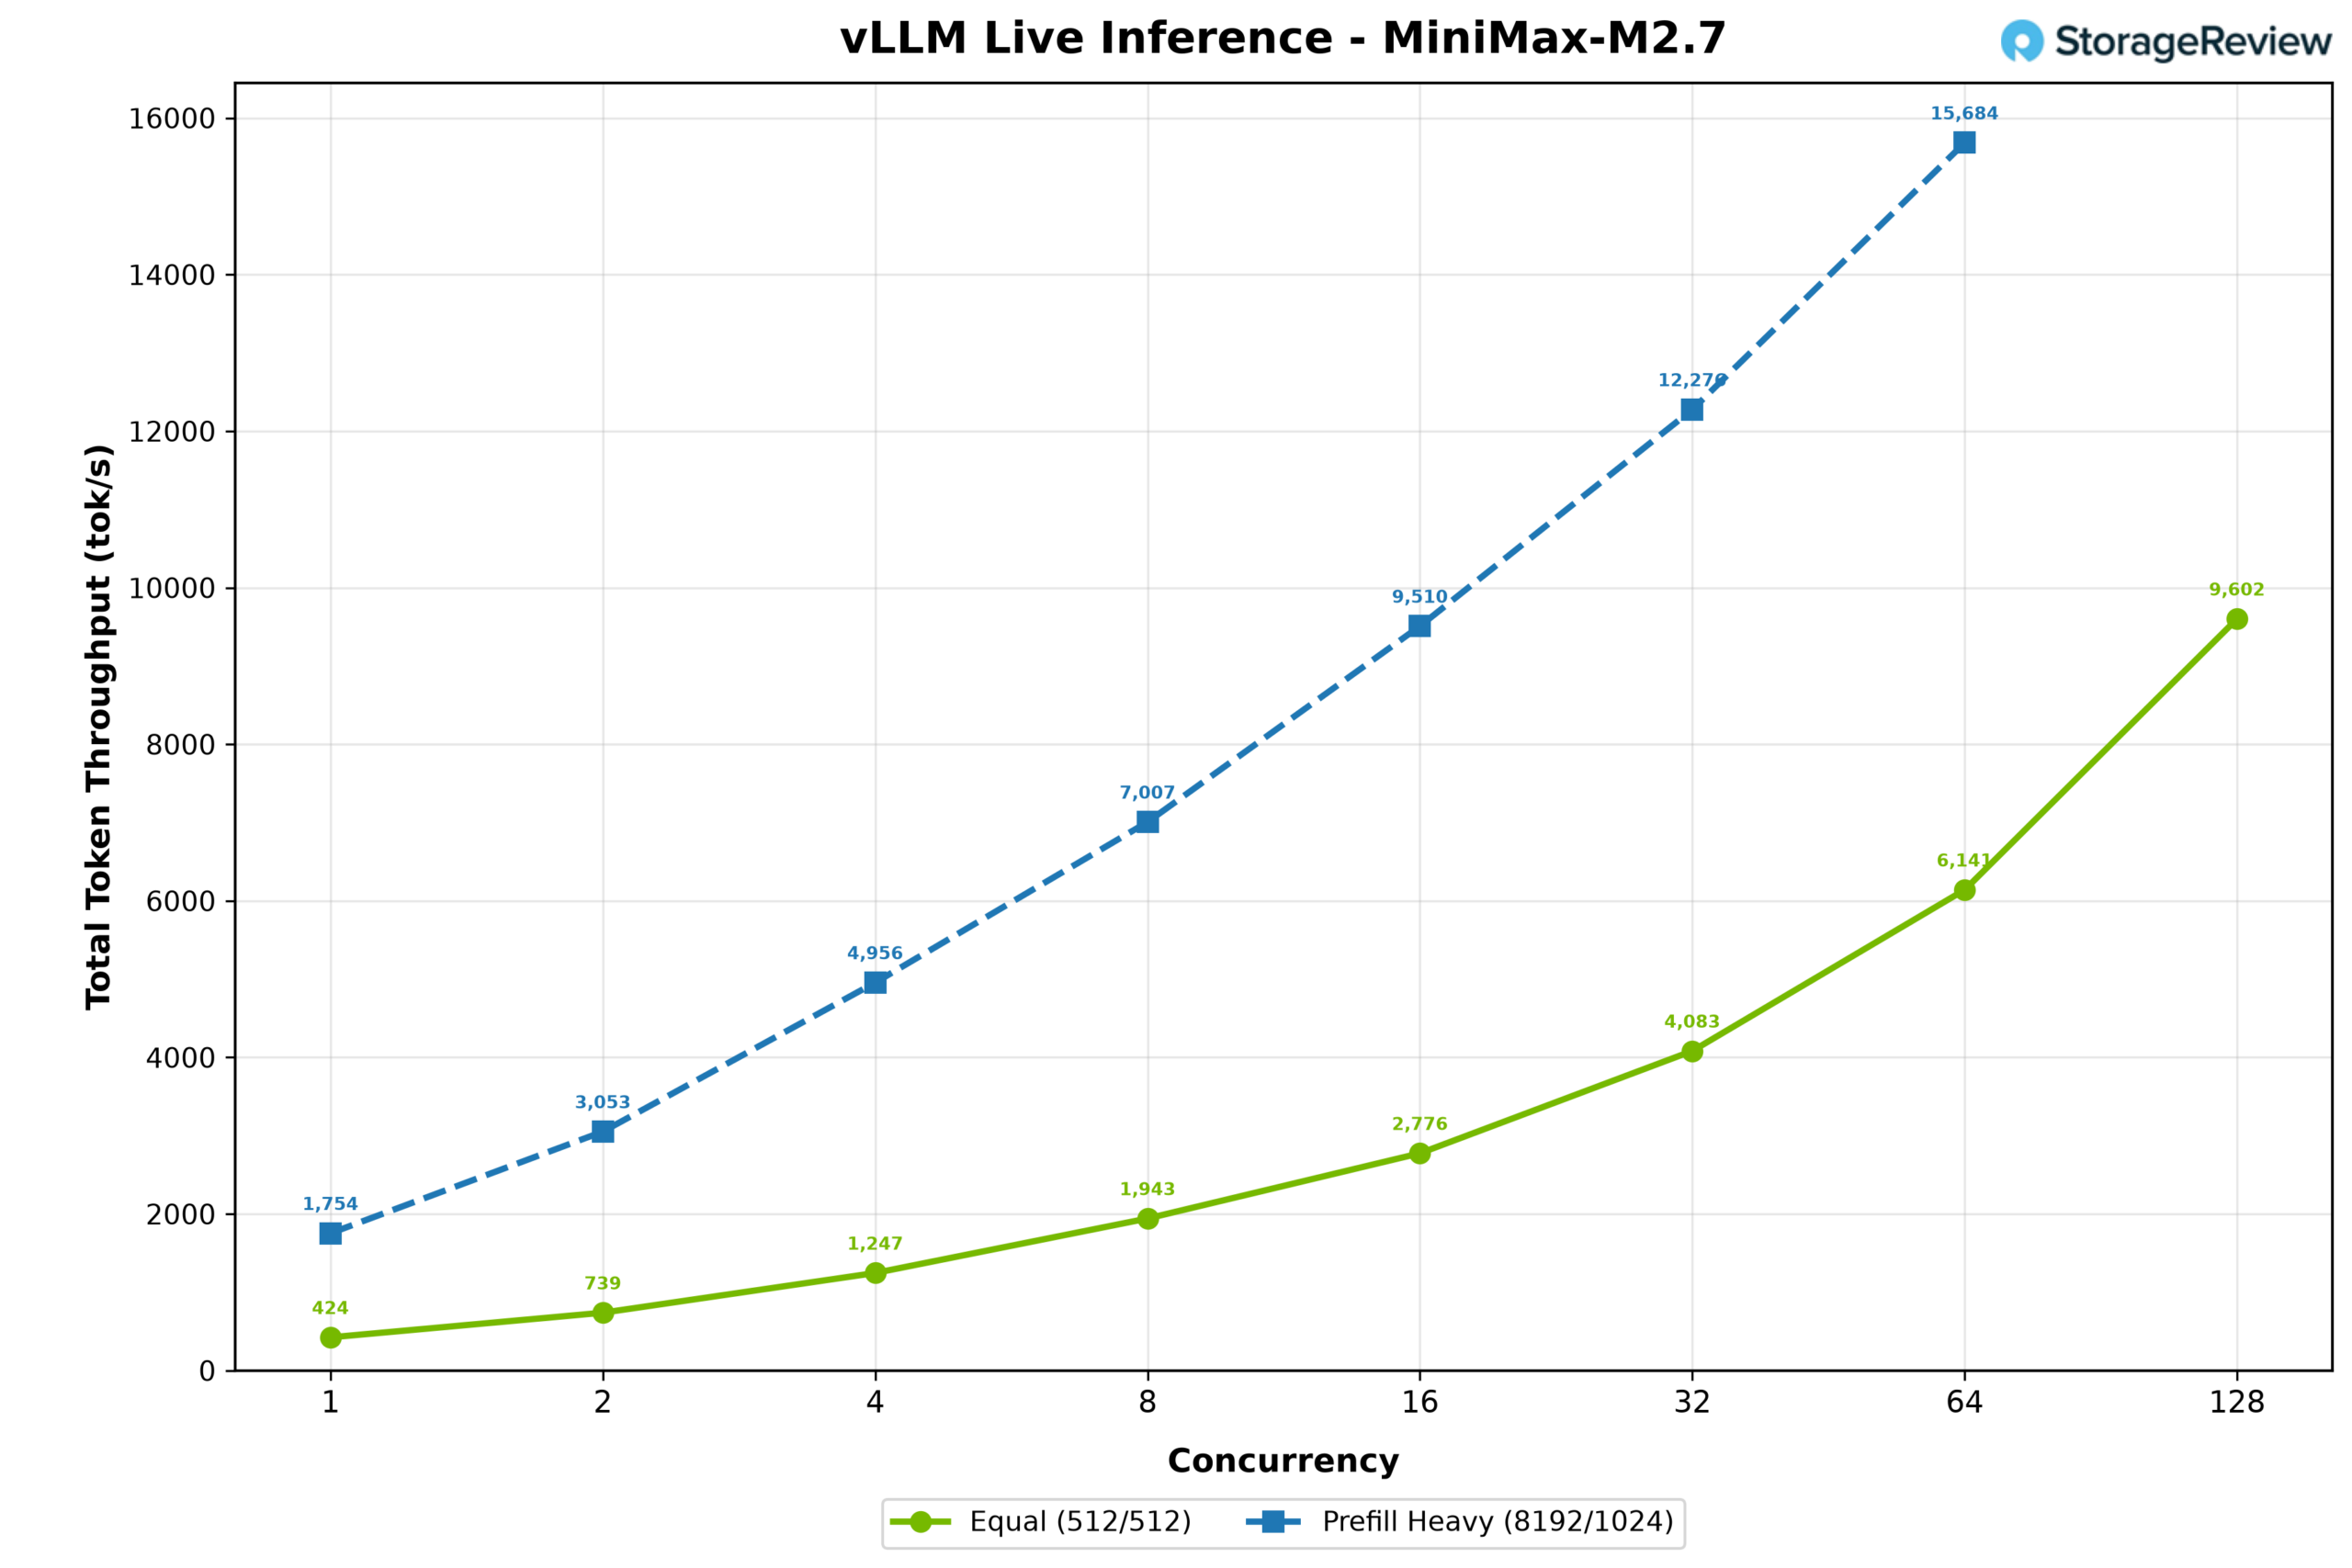
Далее рассмотрим MiniMax M2.7, одну из наших любимых моделей, протестированную с использованием технологии NVIDIA NVFP4 quant, занимающую 125 ГБ видеопамяти. В рабочей нагрузке 512/512 пропускная способность начиналась со 193 токенов в секунду при параллелизме 1 и быстро увеличивалась до 4,801 токена в секунду при параллелизме 128. В рабочей нагрузке с интенсивным предварительным заполнением пропускная способность увеличилась со 195 токенов в секунду при параллелизме 1 до 1,743 токенов в секунду при параллелизме 64. Общая пропускная способность по токенам показала противоположную тенденцию: в рабочей нагрузке с интенсивным предварительным заполнением пропускная способность выросла с 1,754 до 15,684 токенов в секунду при параллелизме 64, в то время как в рабочей нагрузке 512/512 она увеличилась с 424 до 9,602 токенов в секунду при параллелизме 128.
Общая пропускная способность токенов показала противоположную тенденцию: объем работы с интенсивным предварительным заполнением вырос с 1,754 до 15,684 токенов в секунду при уровне параллелизма 64, в то время как объем работы 512/512 увеличился с 424 до 9,602 токенов в секунду при уровне параллелизма 128.
Модели, которые едва помещаются в HBM
MiniMax M3 (NVFP4)
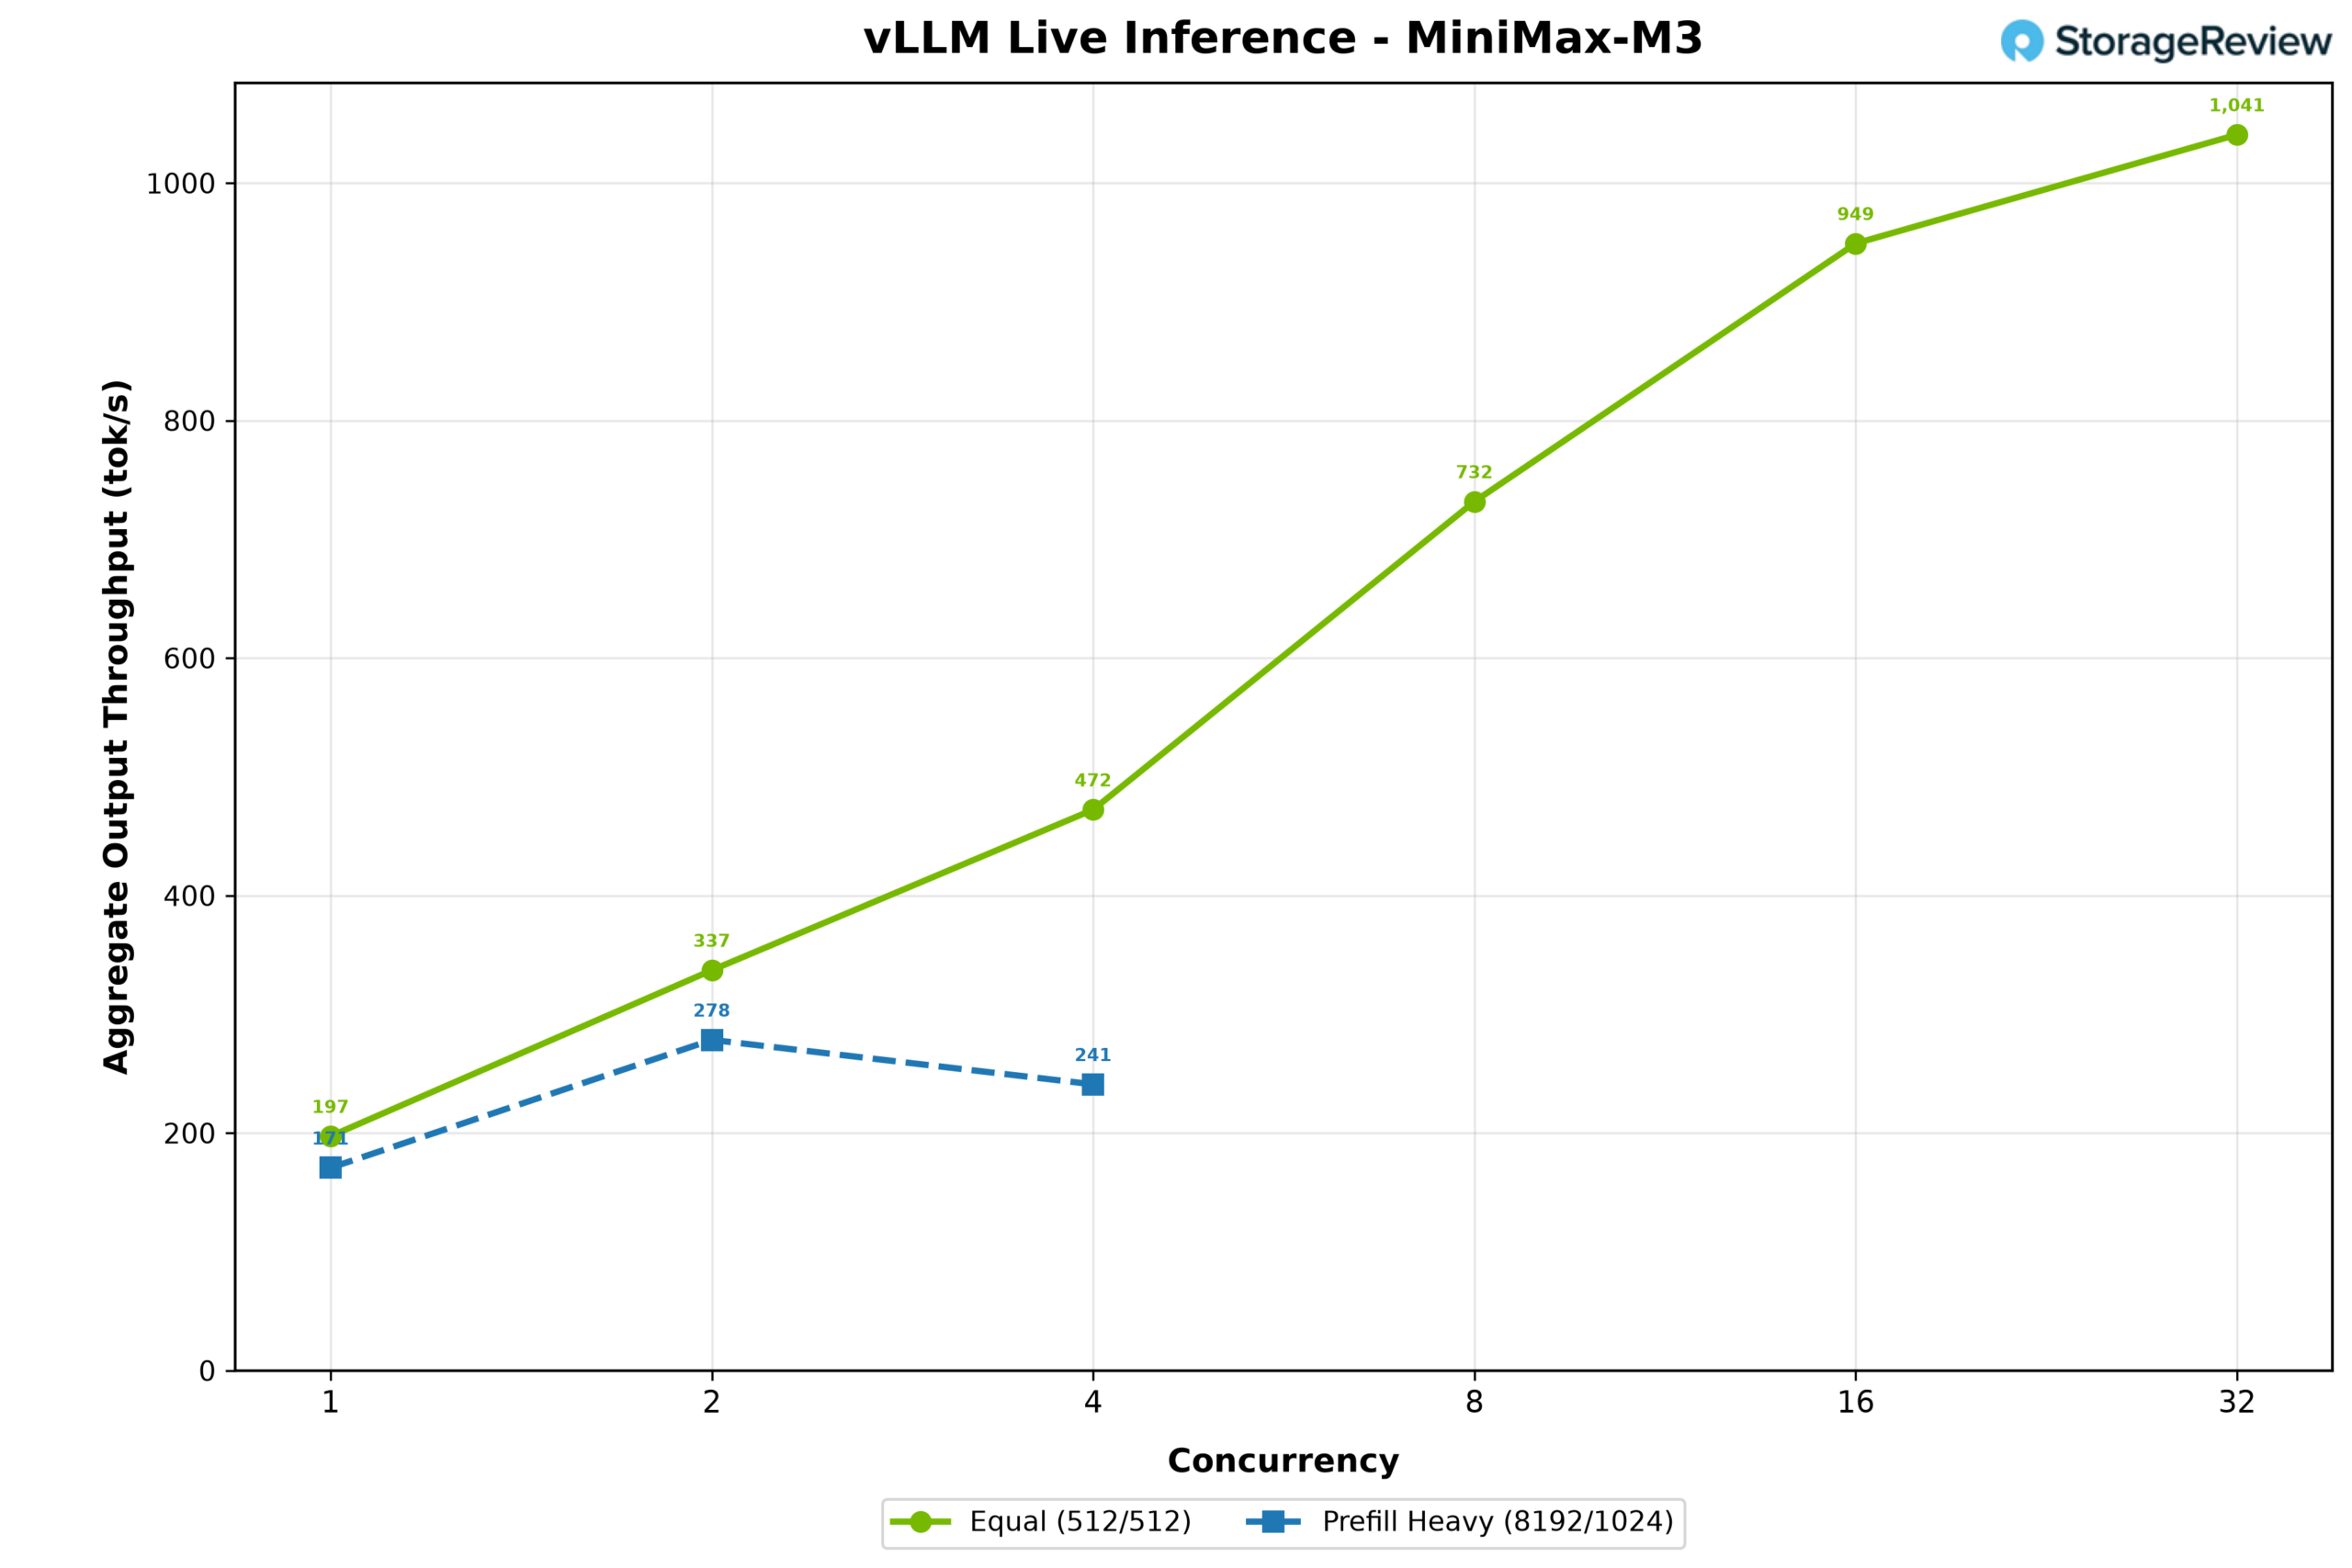
MiniMax M3 демонстрирует на практике, как выглядит ситуация, когда места едва хватает. Его контрольная точка NVFP4 объемом 233 ГБ меньше, чем 252 ГБ HBM у B300, но модели все еще требуется место для кэша среды выполнения и кэша ключ-значение. В итоге она заняла 223 ГБ HBM, при этом 21 ГБ экспертных операций были выгружены в Grace. Использовалось спекулятивное декодирование EAGLE3-GQA с синтетической длиной принятия 3 токена. В рабочей нагрузке 512/512 пропускная способность вывода начиналась со 197 токенов в секунду при параллелизме 1 и стабильно увеличивалась до 1,041 токена в секунду при параллелизме 32. Рабочая нагрузка с большим количеством предварительного заполнения увеличилась со 171 токена в секунду при параллелизме 1 до пика в 278 при параллелизме 2, а затем снизилась до 241 при параллелизме 4.
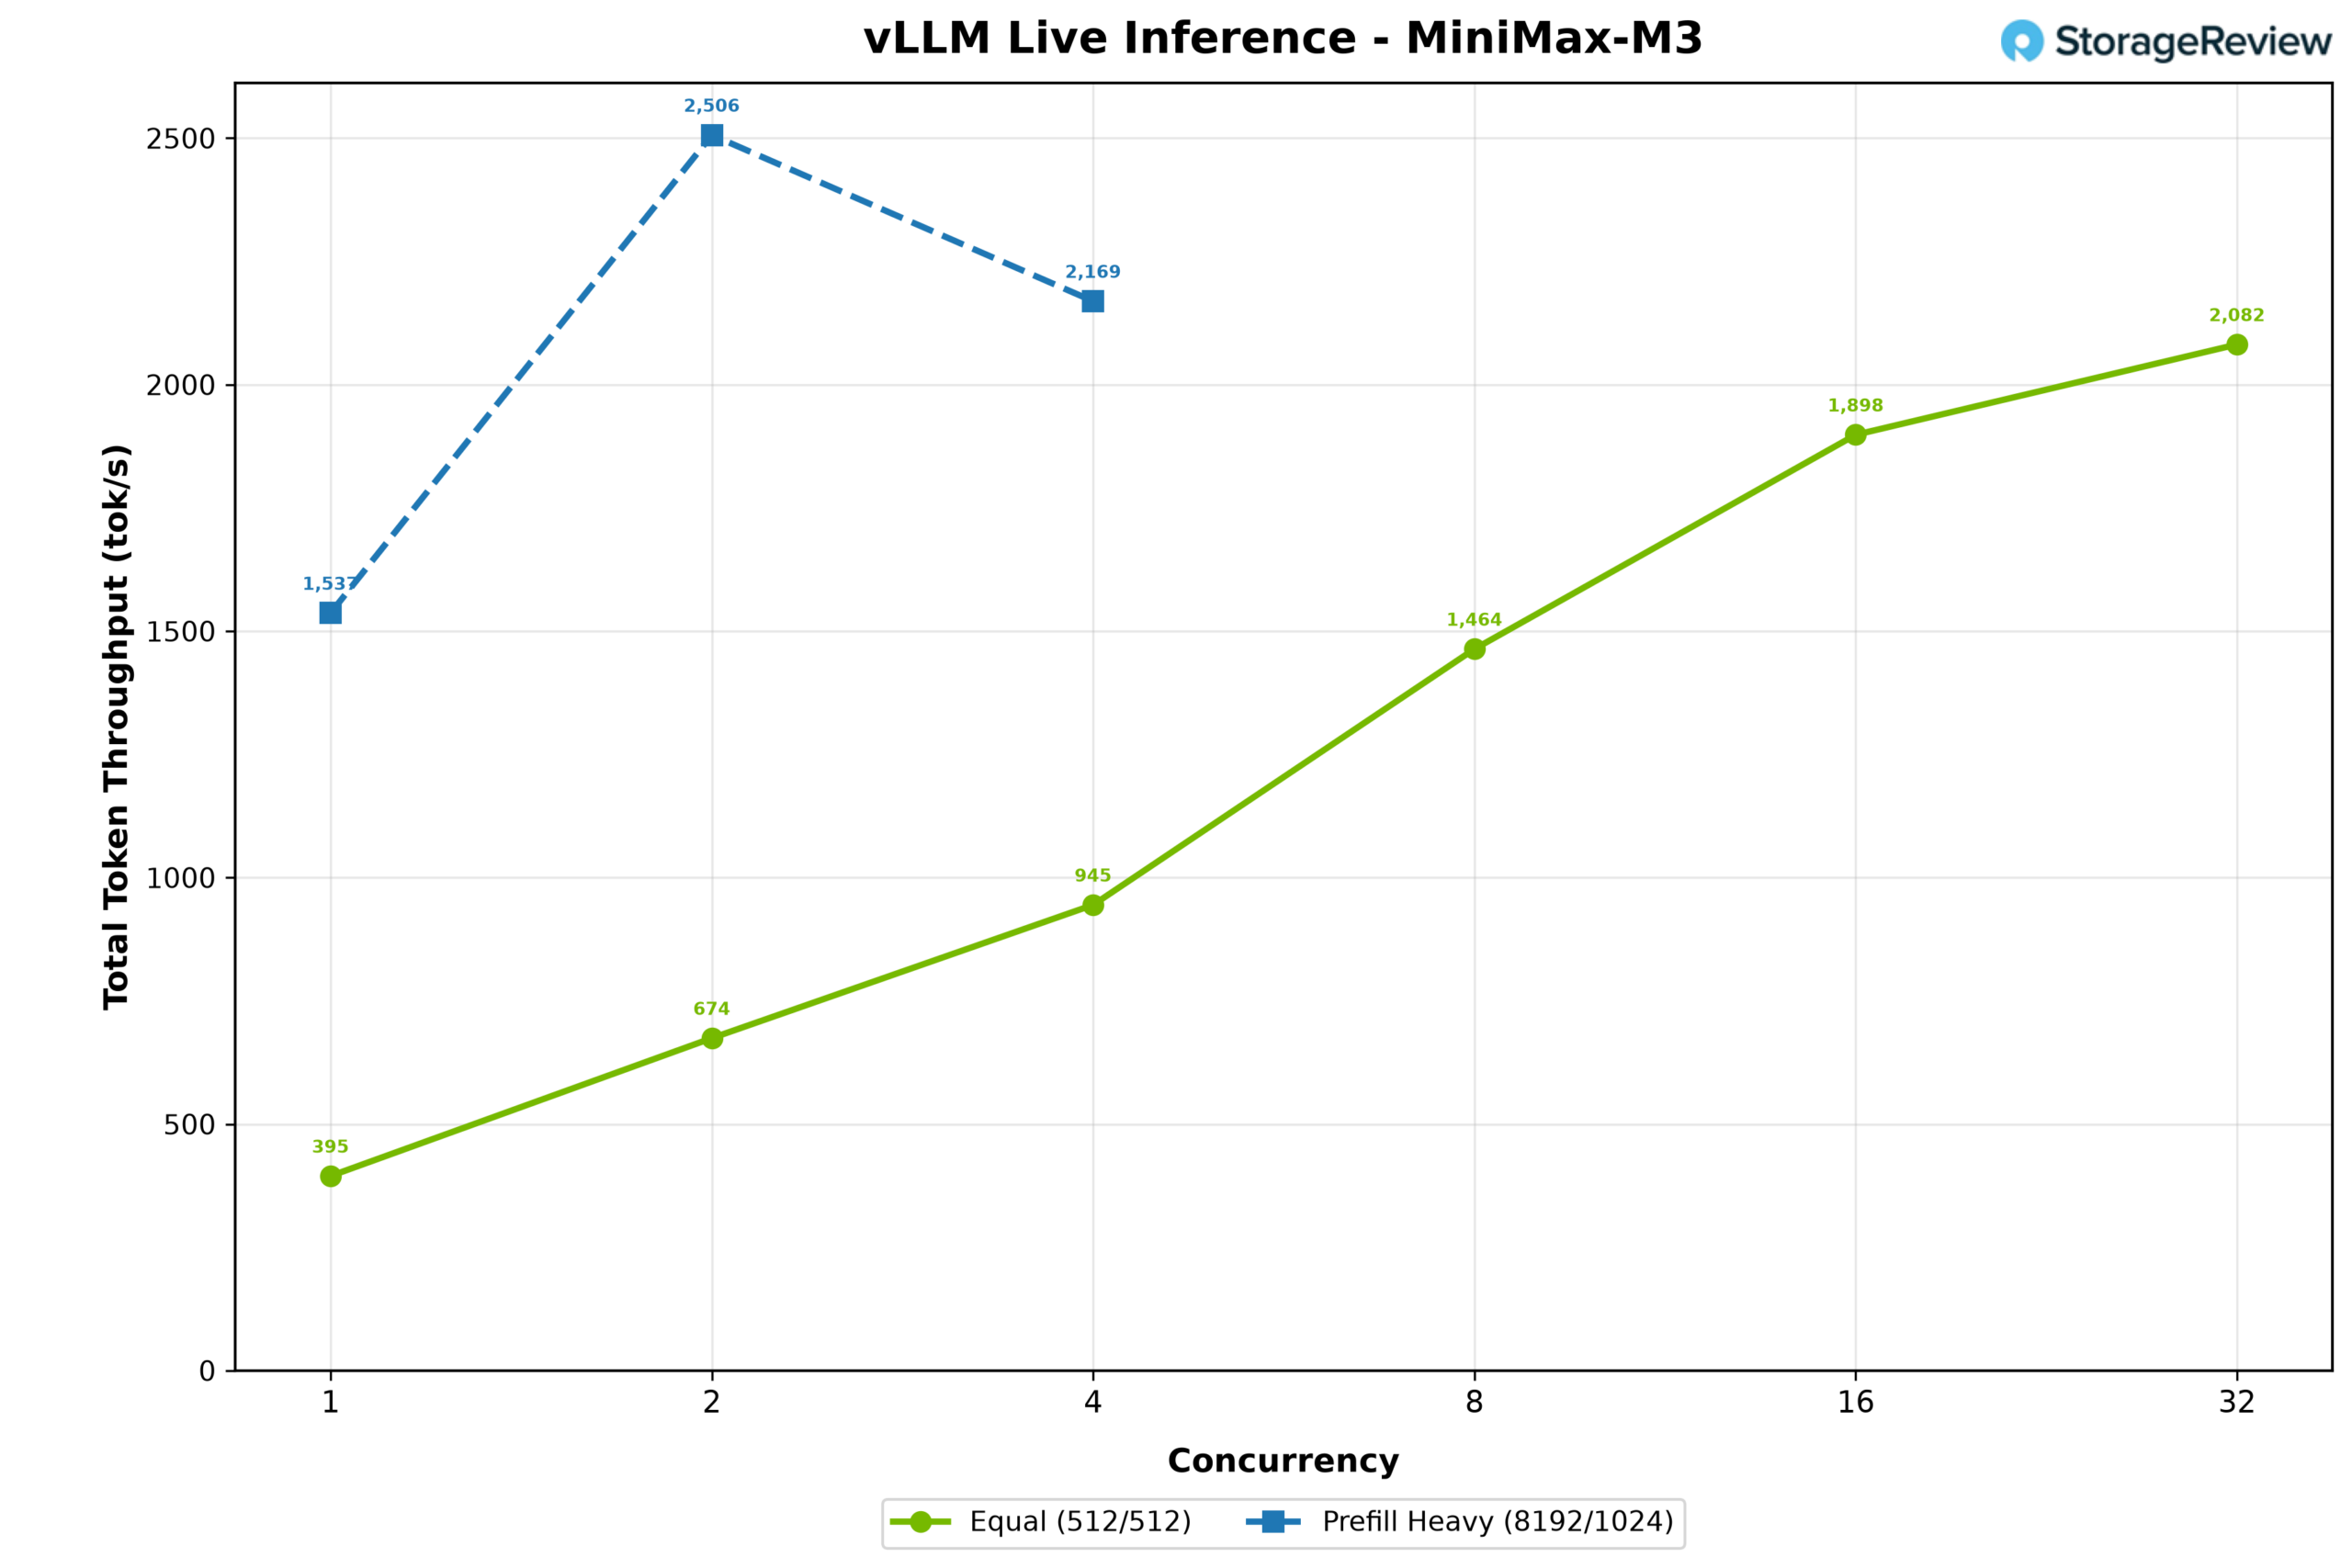
Общий объем обрабатываемых токенов следовал аналогичной закономерности: нагрузка 512/512 выросла с 395 до 2,082 токенов в секунду, в то время как нагрузка, в основном связанная с предварительным заполнением, достигла пика в 2,506 токенов в секунду при уровне параллелизма 2, а затем снизилась до 2,169 при уровне параллелизма 4.
Модели, которые не подходят для HBM
GLM-5.2 (NVFP4)
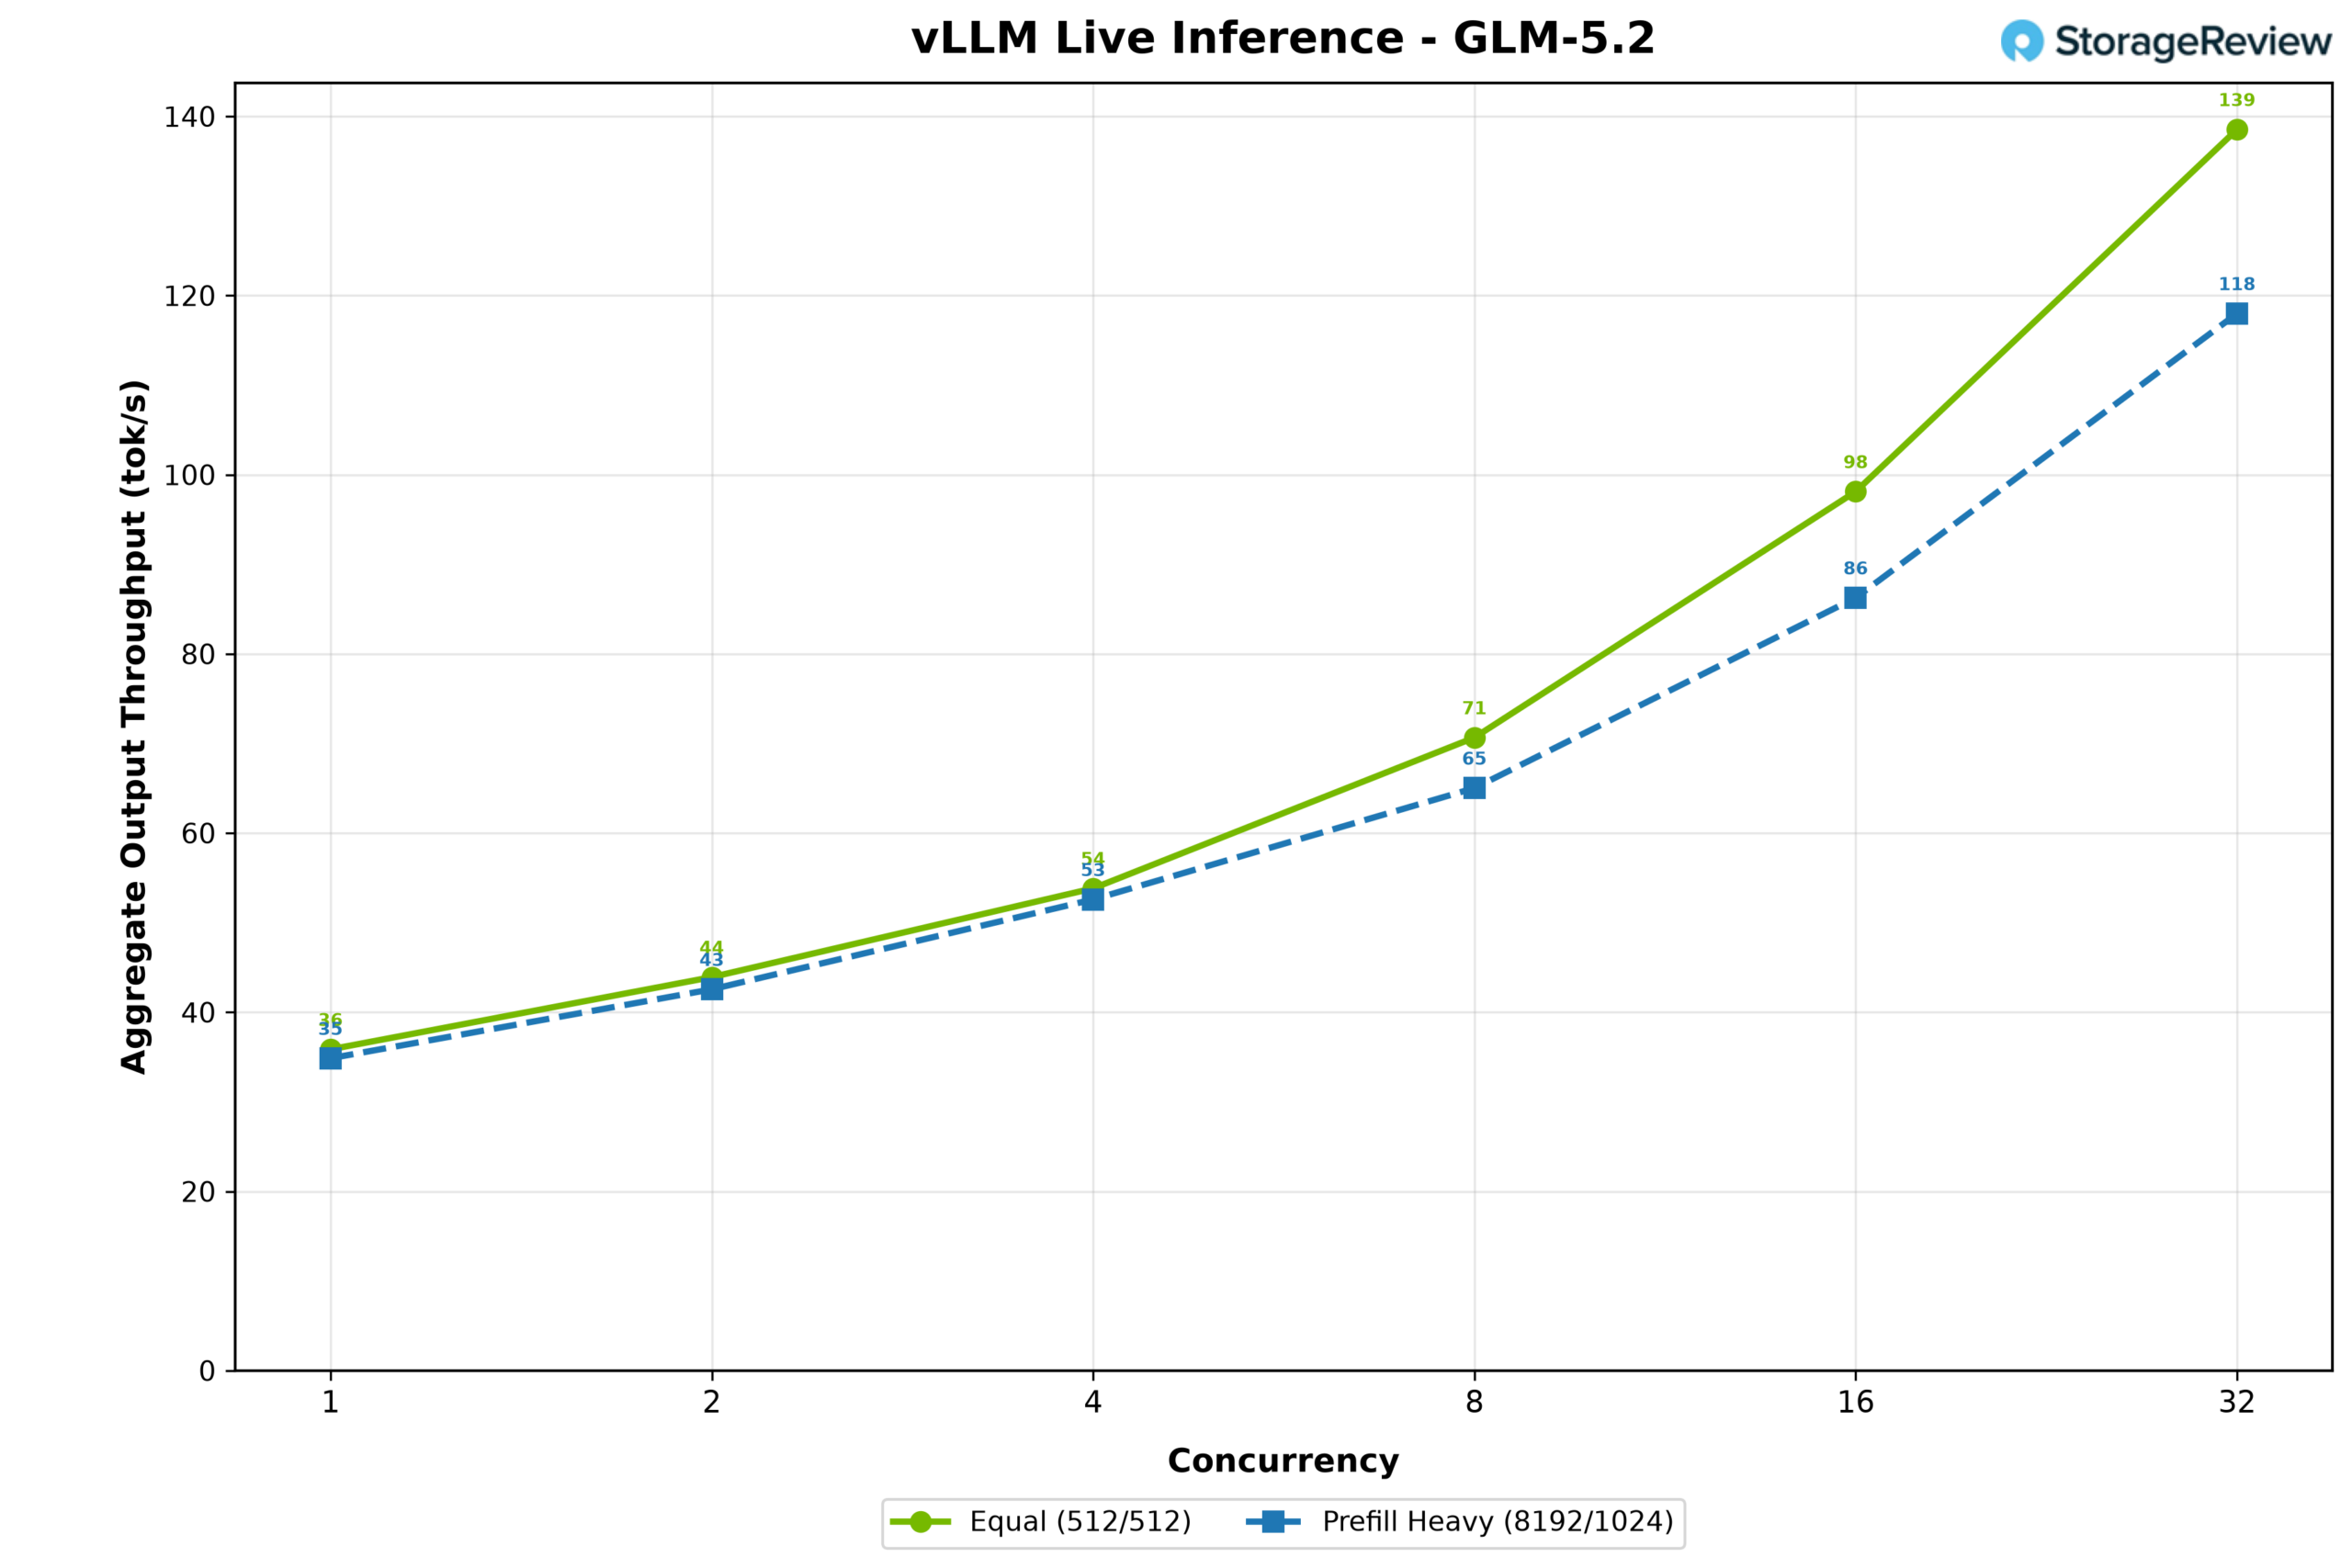
Тестирование GLM-5.2 проводилось с использованием квантового процессора NVIDIA NVFP4. Контрольная точка объемом 433 ГБ использовала 218 ГБ памяти HBM, при этом 216 ГБ экспертных весов были выгружены в память Grace. Использовалось спекулятивное декодирование MTP с синтетической длиной принятия в 3 токена. Пропускная способность в рабочей нагрузке 512/512 увеличилась с 36 токенов в секунду при параллелизме 1 до 139 при параллелизме 32. Рабочая нагрузка 8,192/1,024 показала аналогичное увеличение с 35 до 118 токенов в секунду. Сходные результаты в обоих профилях показывают, что генерация оставалась ограниченной в основном перемещением выгруженных экспертов между памятью Grace и графическим процессором. Тестирование завершилось при параллелизме 32, поскольку не осталось достаточно памяти HBM для дополнительного контекста.
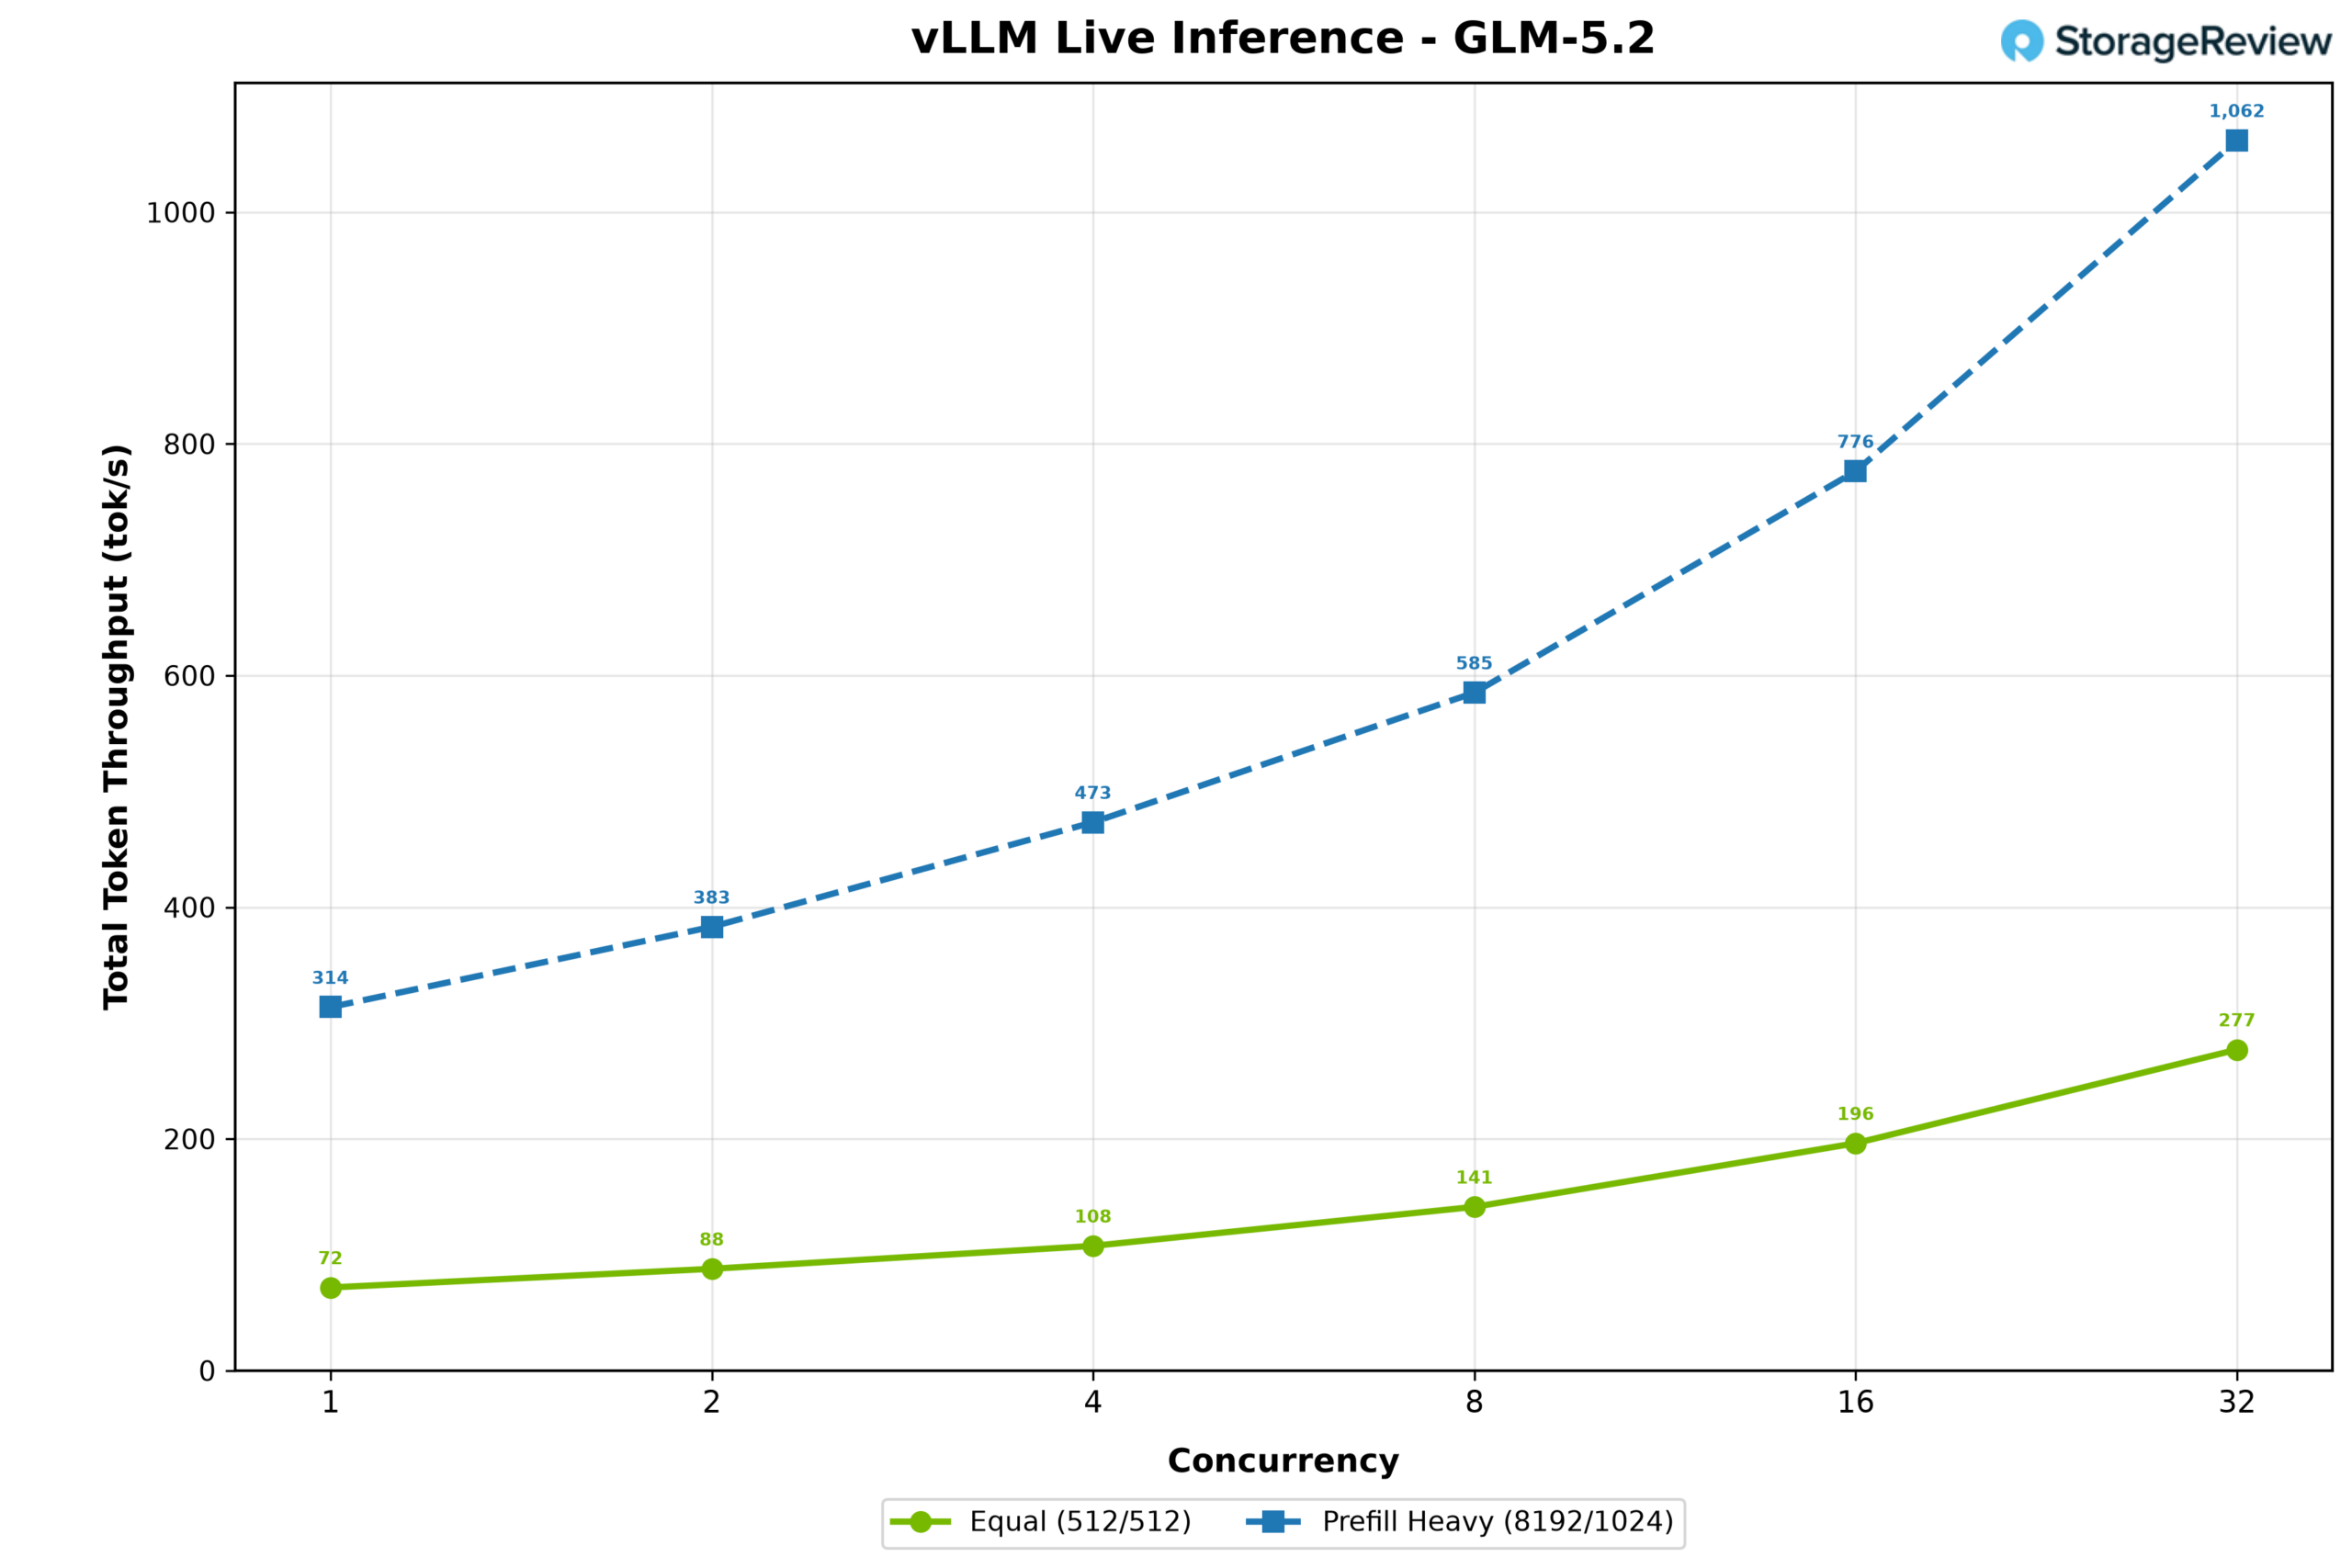
Общий объем обрабатываемых токенов следовал той же схеме: нагрузка 512/512 выросла с 72 до 277 токенов в секунду, а нагрузка с интенсивным предварительным заполнением — с 314 до 1,062; здесь более длинные запросы, наконец, разделяют два профиля, поскольку сами токены предварительного заполнения учитываются в общем объеме.
Немотрон-3-Ультра 550Б (НВФП4)
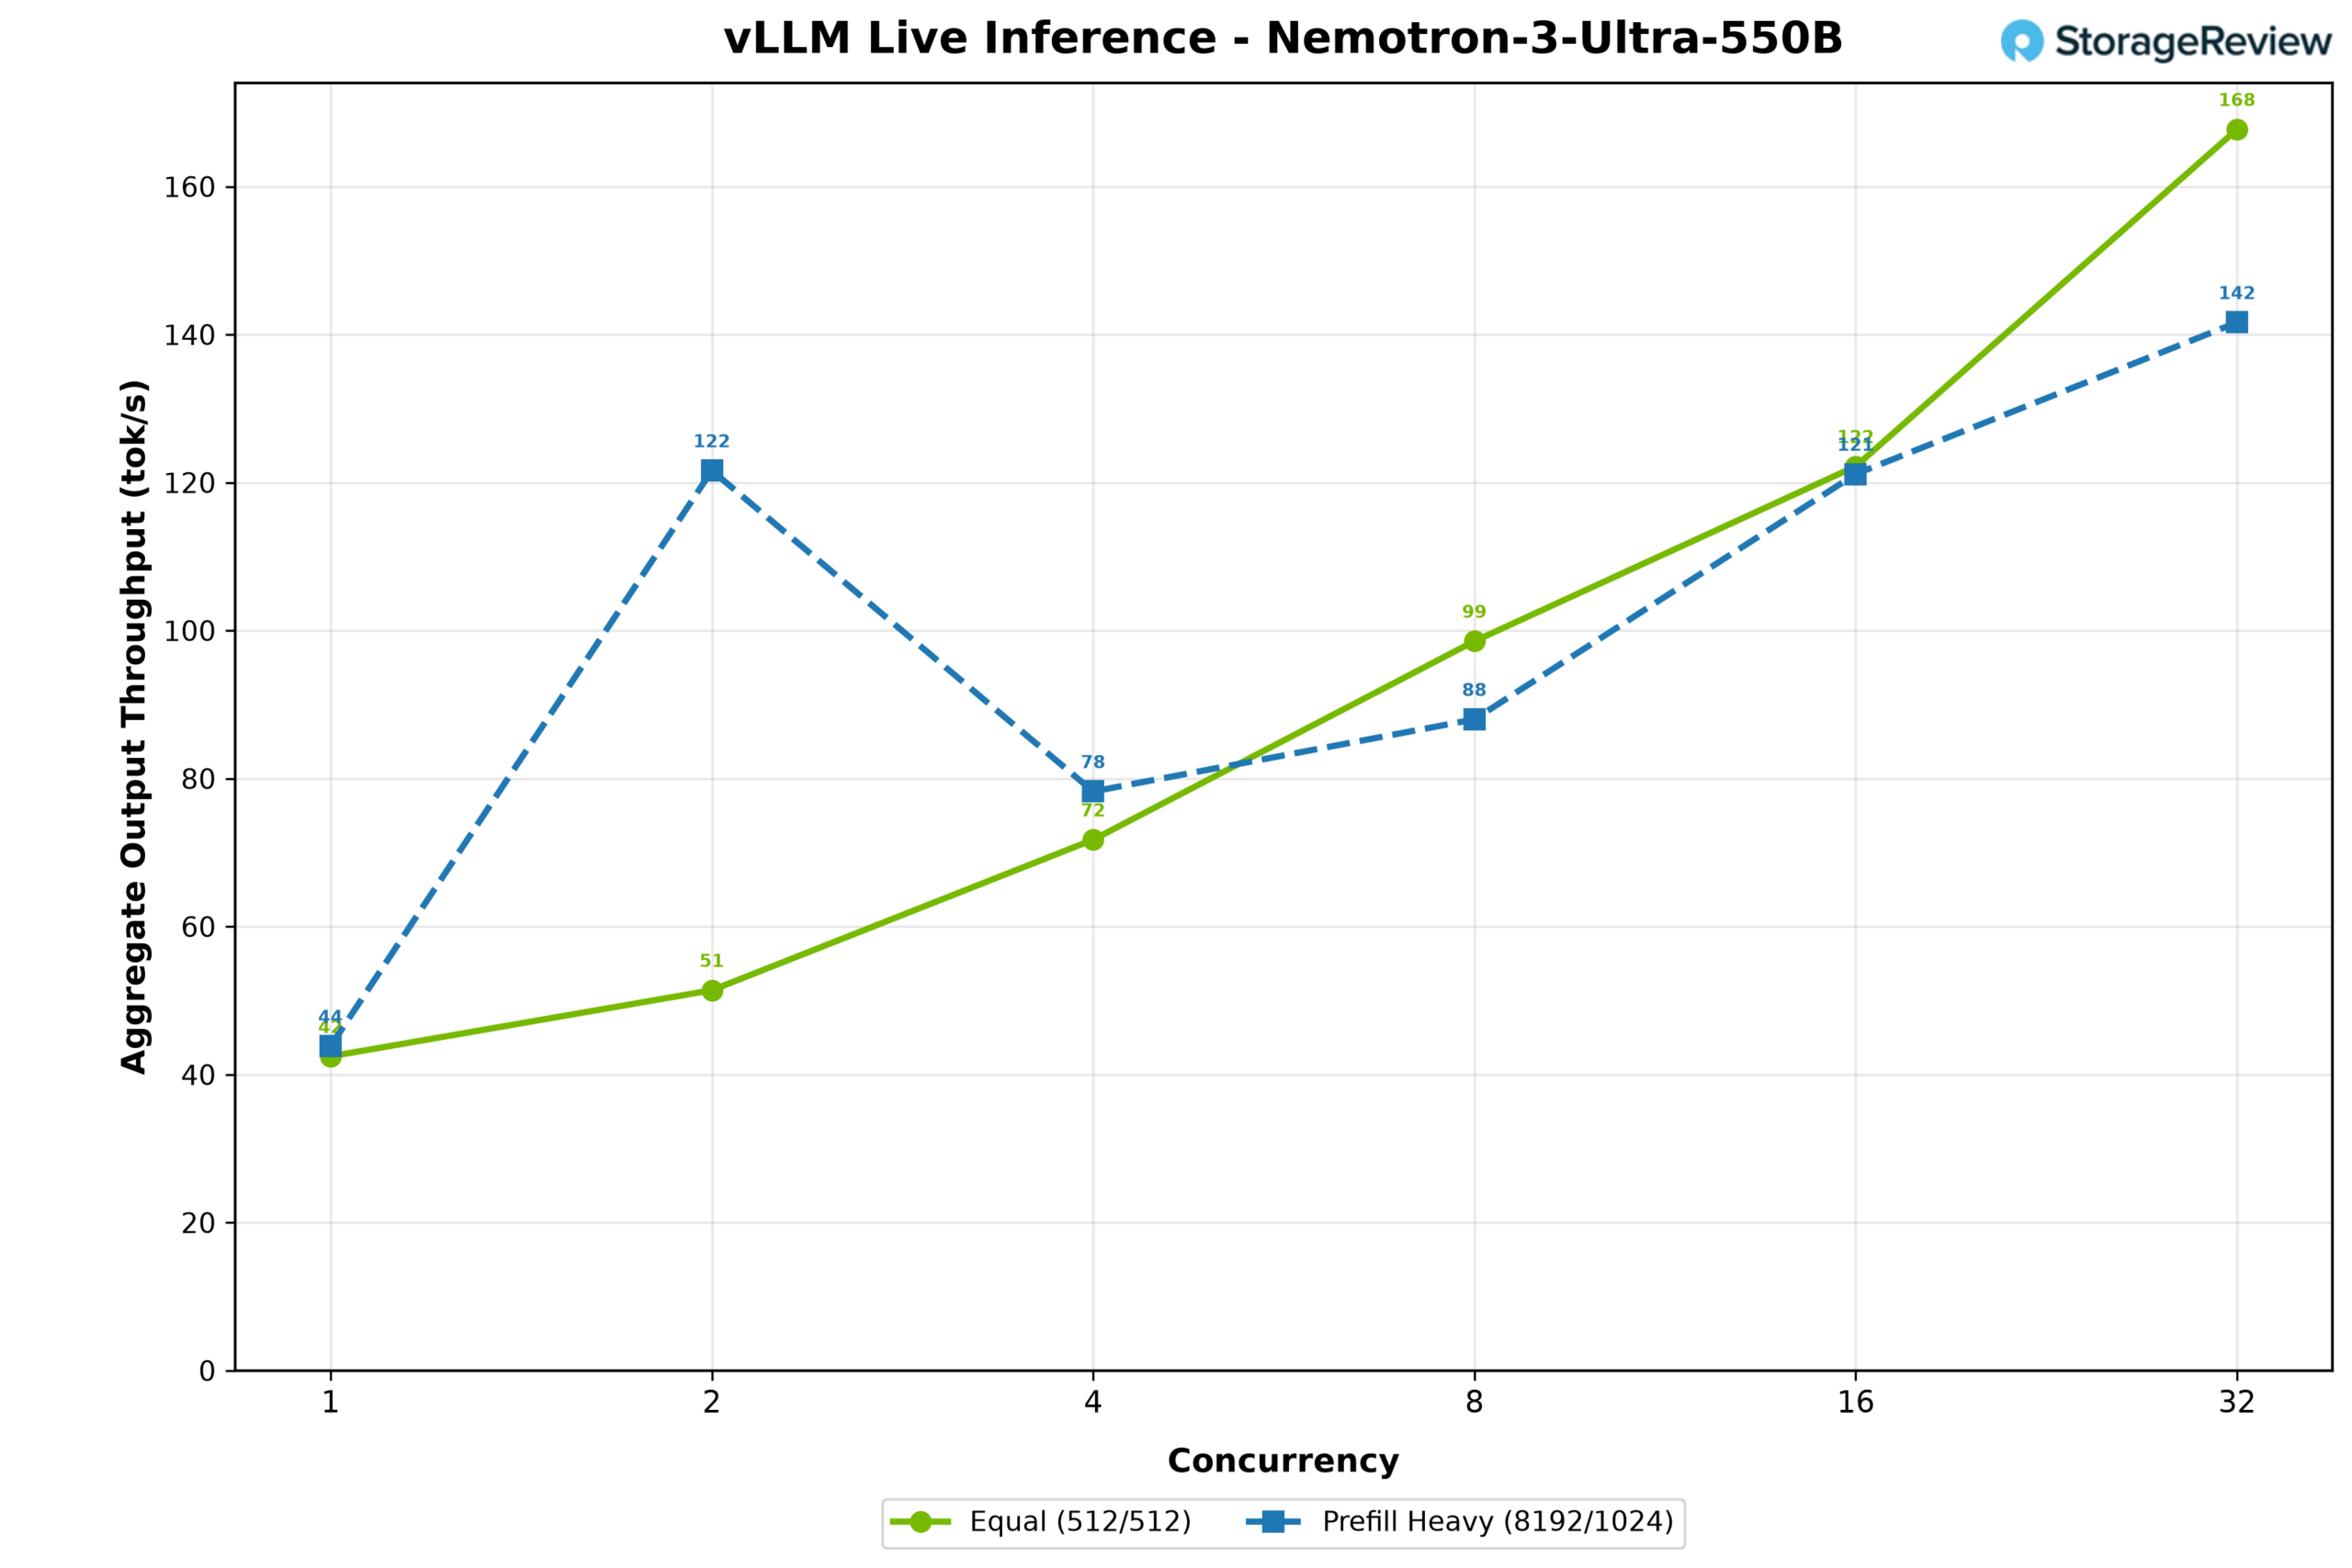
Nemotron-3-Ultra 550B — самая большая из протестированных нами моделей, и именно она наиболее непосредственно задействует весь когерентный пул. Это гибридная модель Transformer-Mamba с NVFP4 объемом 307 ГБ, слишком большая для использования только HBM, при этом 114 ГБ ее весов выгружены в память Grace. Использовалось спекулятивное декодирование MTP с синтетической длиной принятия в 5 токенов. Пропускная способность в рабочей нагрузке 512/512 начиналась с 43 токенов в секунду при параллелизме 1 и выросла до 168 при параллелизме 32. Рабочая нагрузка с интенсивным предварительным заполнением показала более интересную картину: пропускная способность выросла с 44 токенов в секунду при параллелизме 1 до пика в 122 при параллелизме 2, но затем упала до 78 при параллелизме 4, поскольку длинные подсказки заполняли ограниченный кэш ключ-значение. Как и в случае с GLM-5.2, два профиля очень близки друг к другу, что снова указывает на миграцию экспертов между Grace и GPU как на ограничивающий фактор, а не на вычислительные мощности. Проверка завершилась на уровне параллелизма 32 по той же причине: не осталось достаточно HBM для дополнительного контекста.
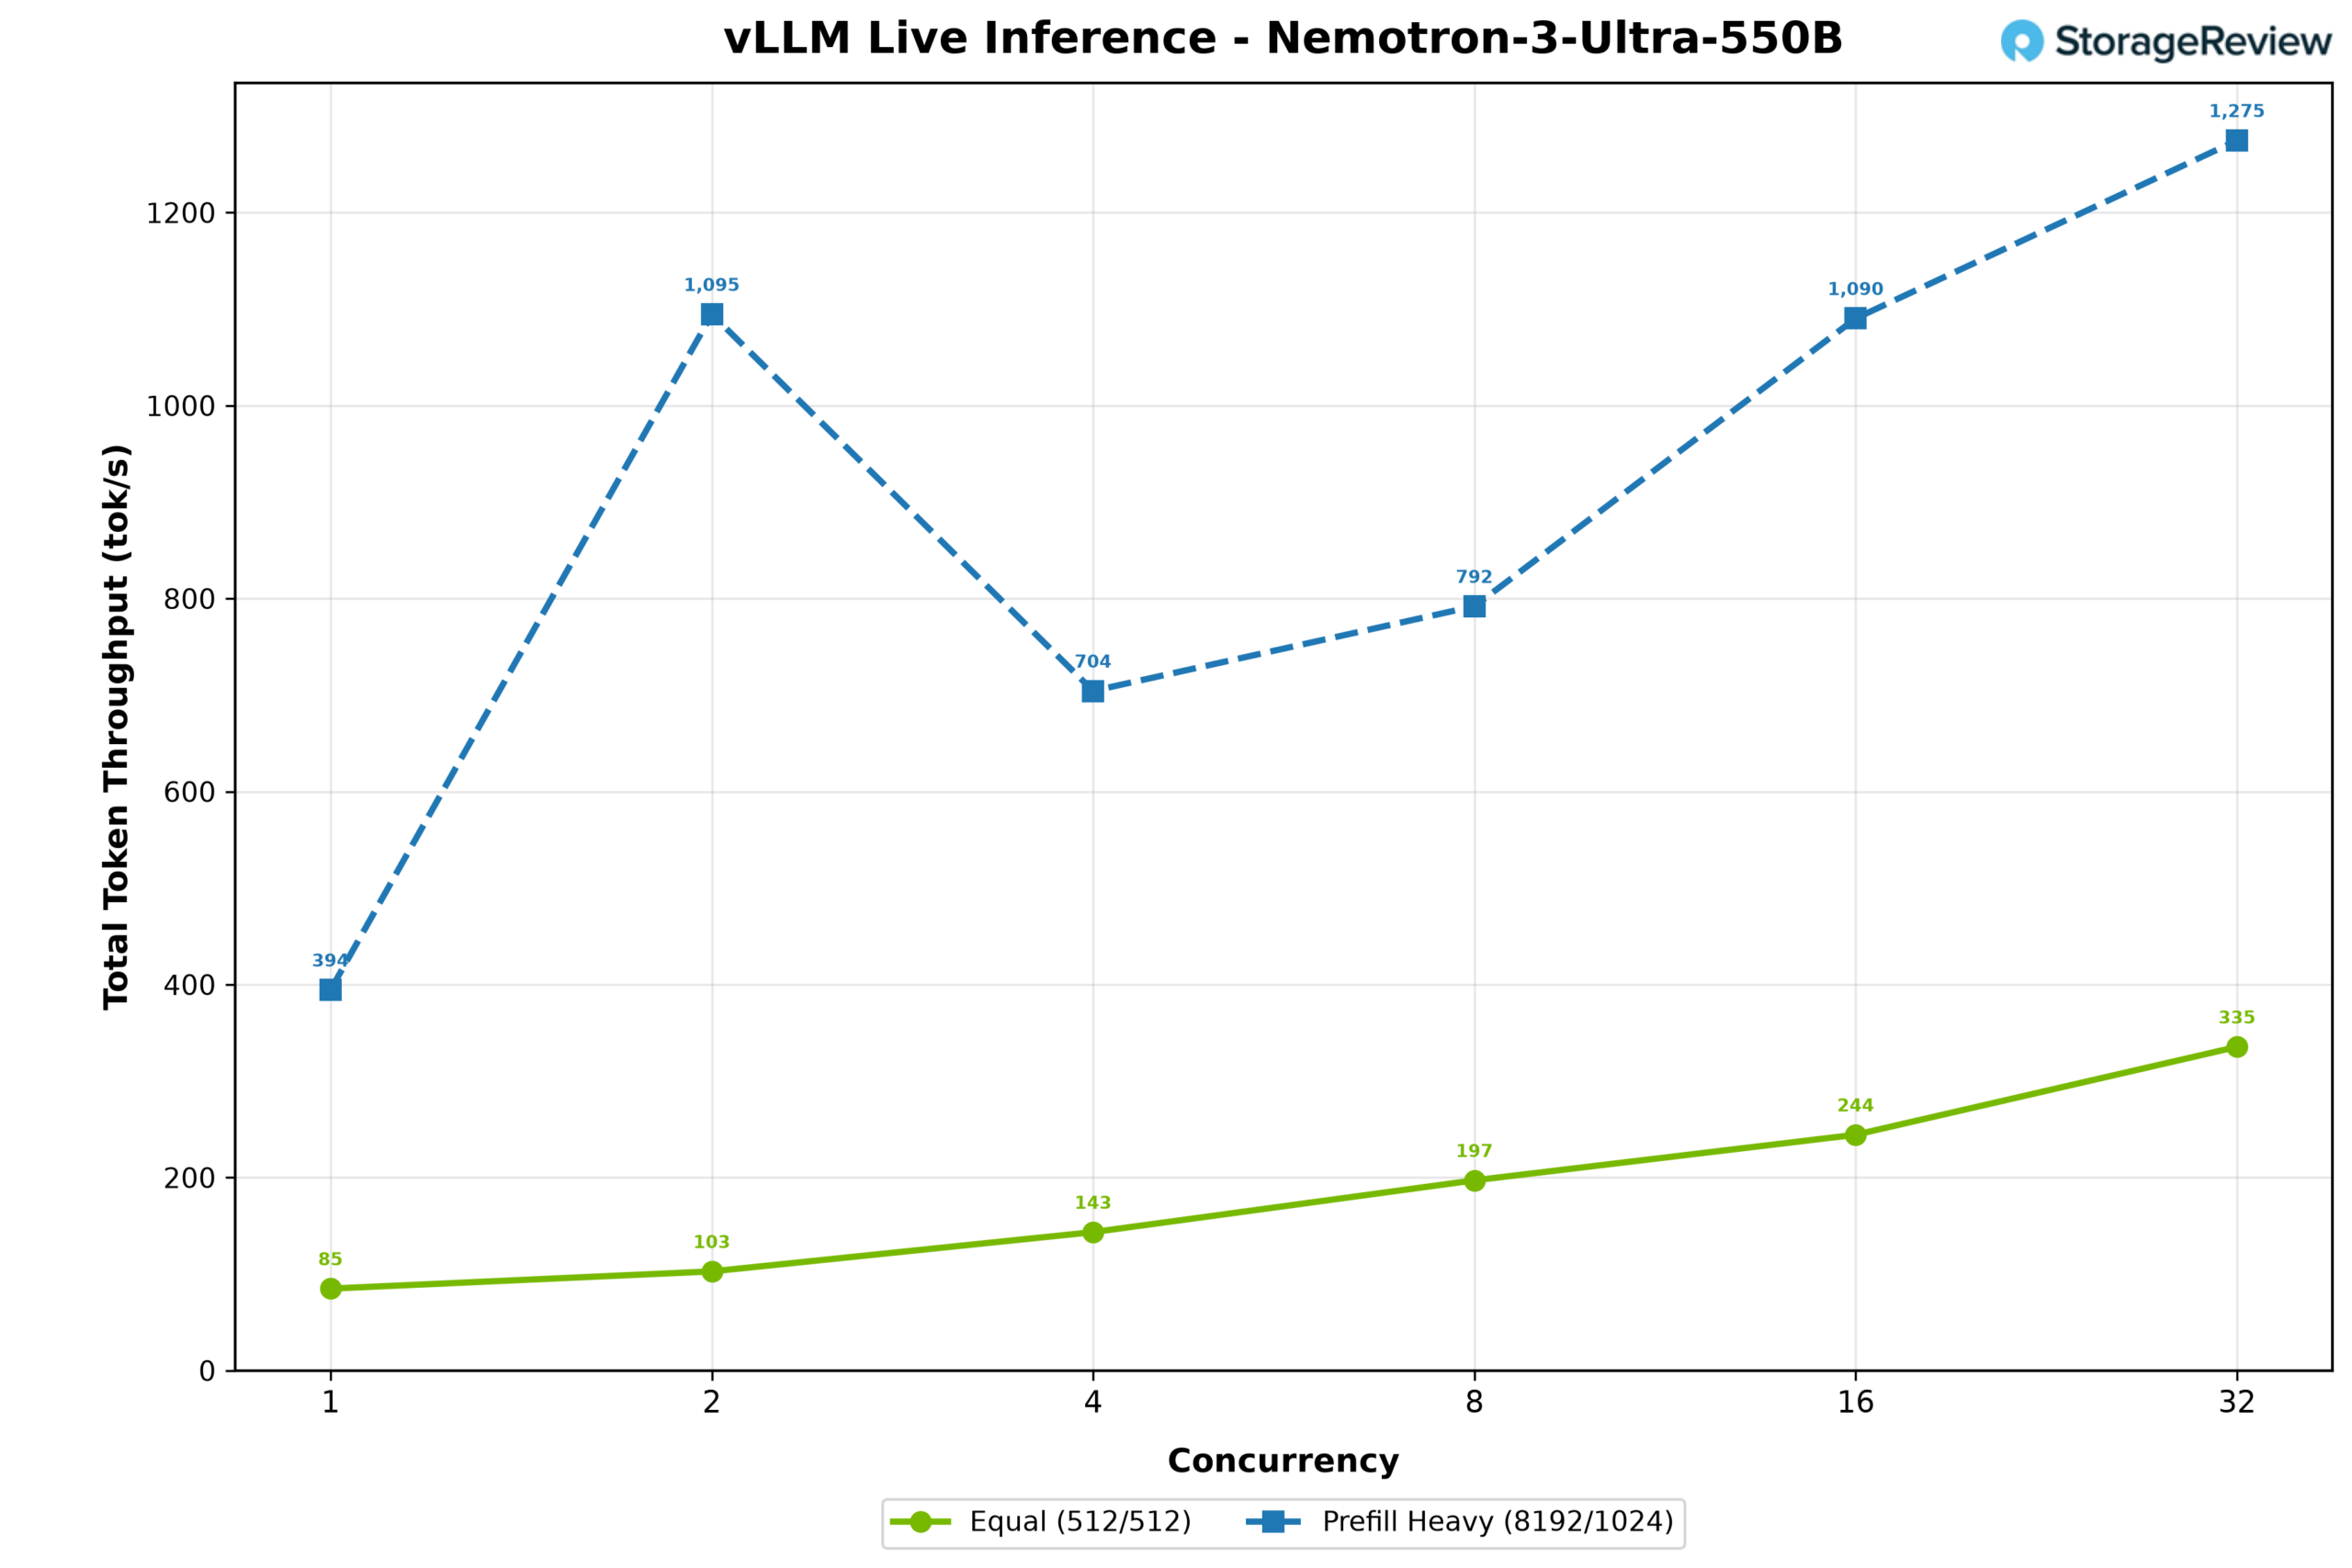
Затем следовал общий объем обрабатываемых токенов, при этом нагрузка, в основном связанная с предварительным заполнением, достигла пика в 2,506 токенов в секунду при уровне параллелизма 2, а затем снизилась до 2,169 при уровне параллелизма 4, в то время как нагрузка 512/512 увеличилась с 85 до 336 токенов в секунду.
WS300 против Blackwell RTX PRO 6000 против DGX Spark
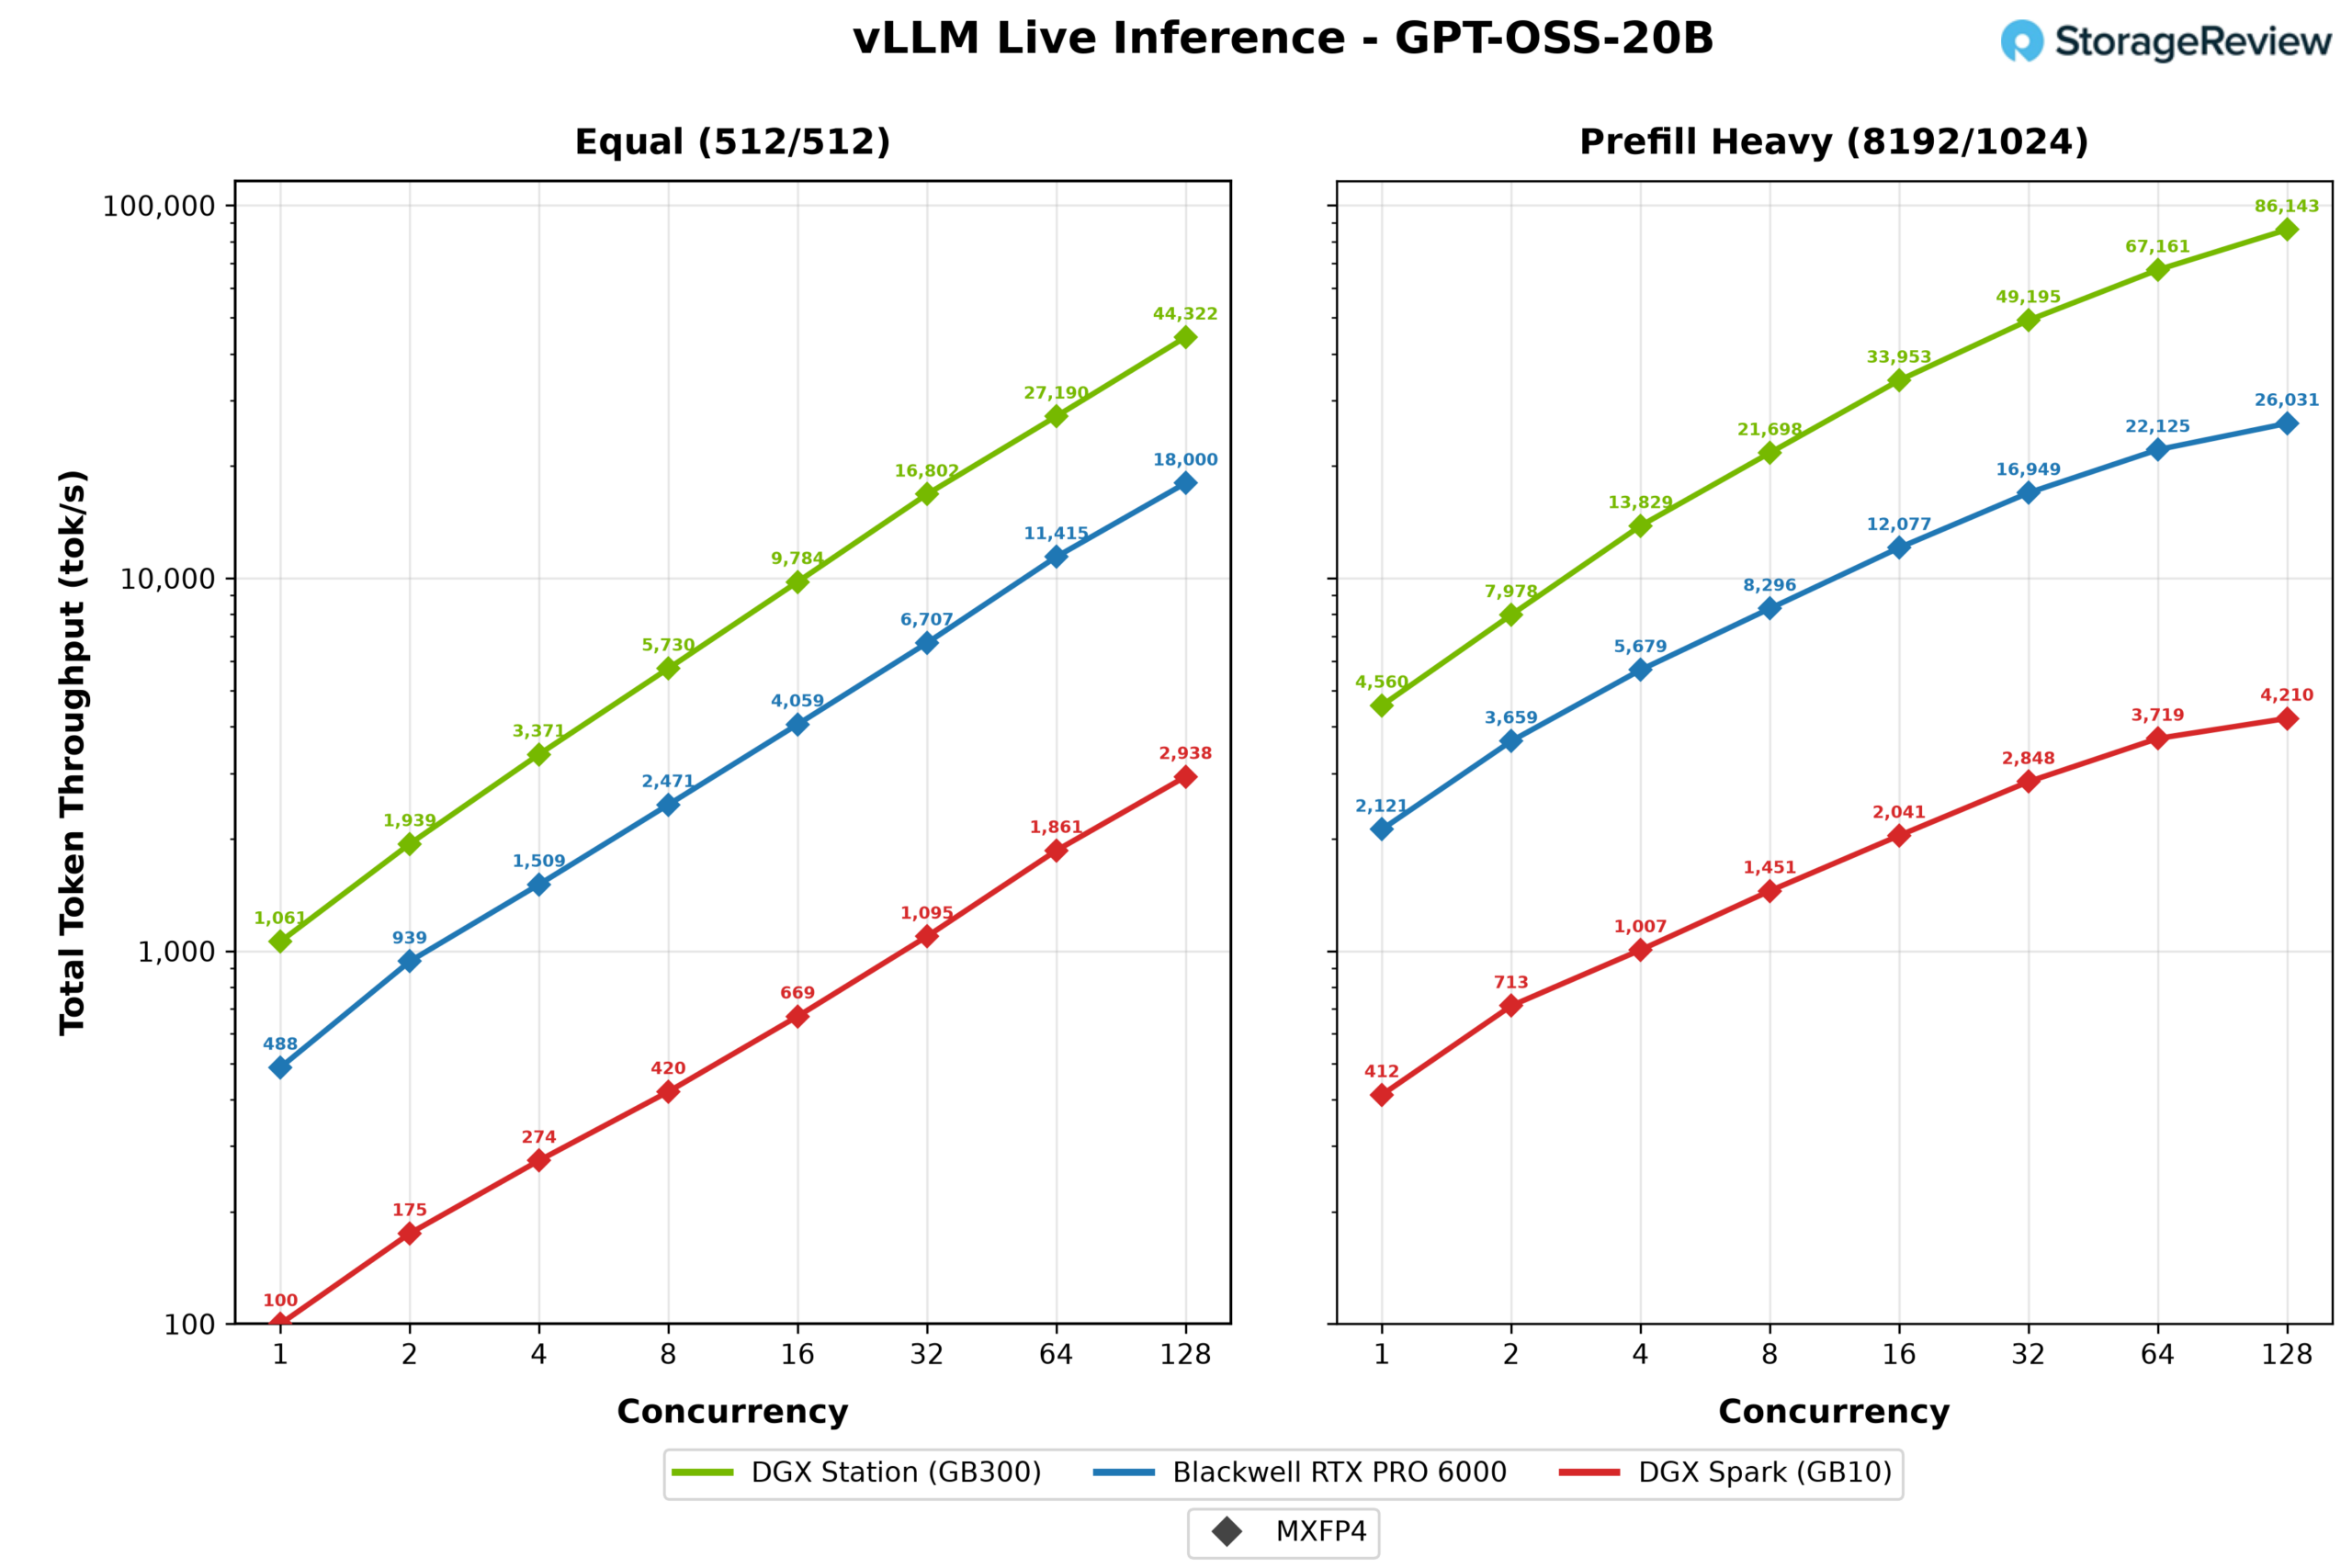
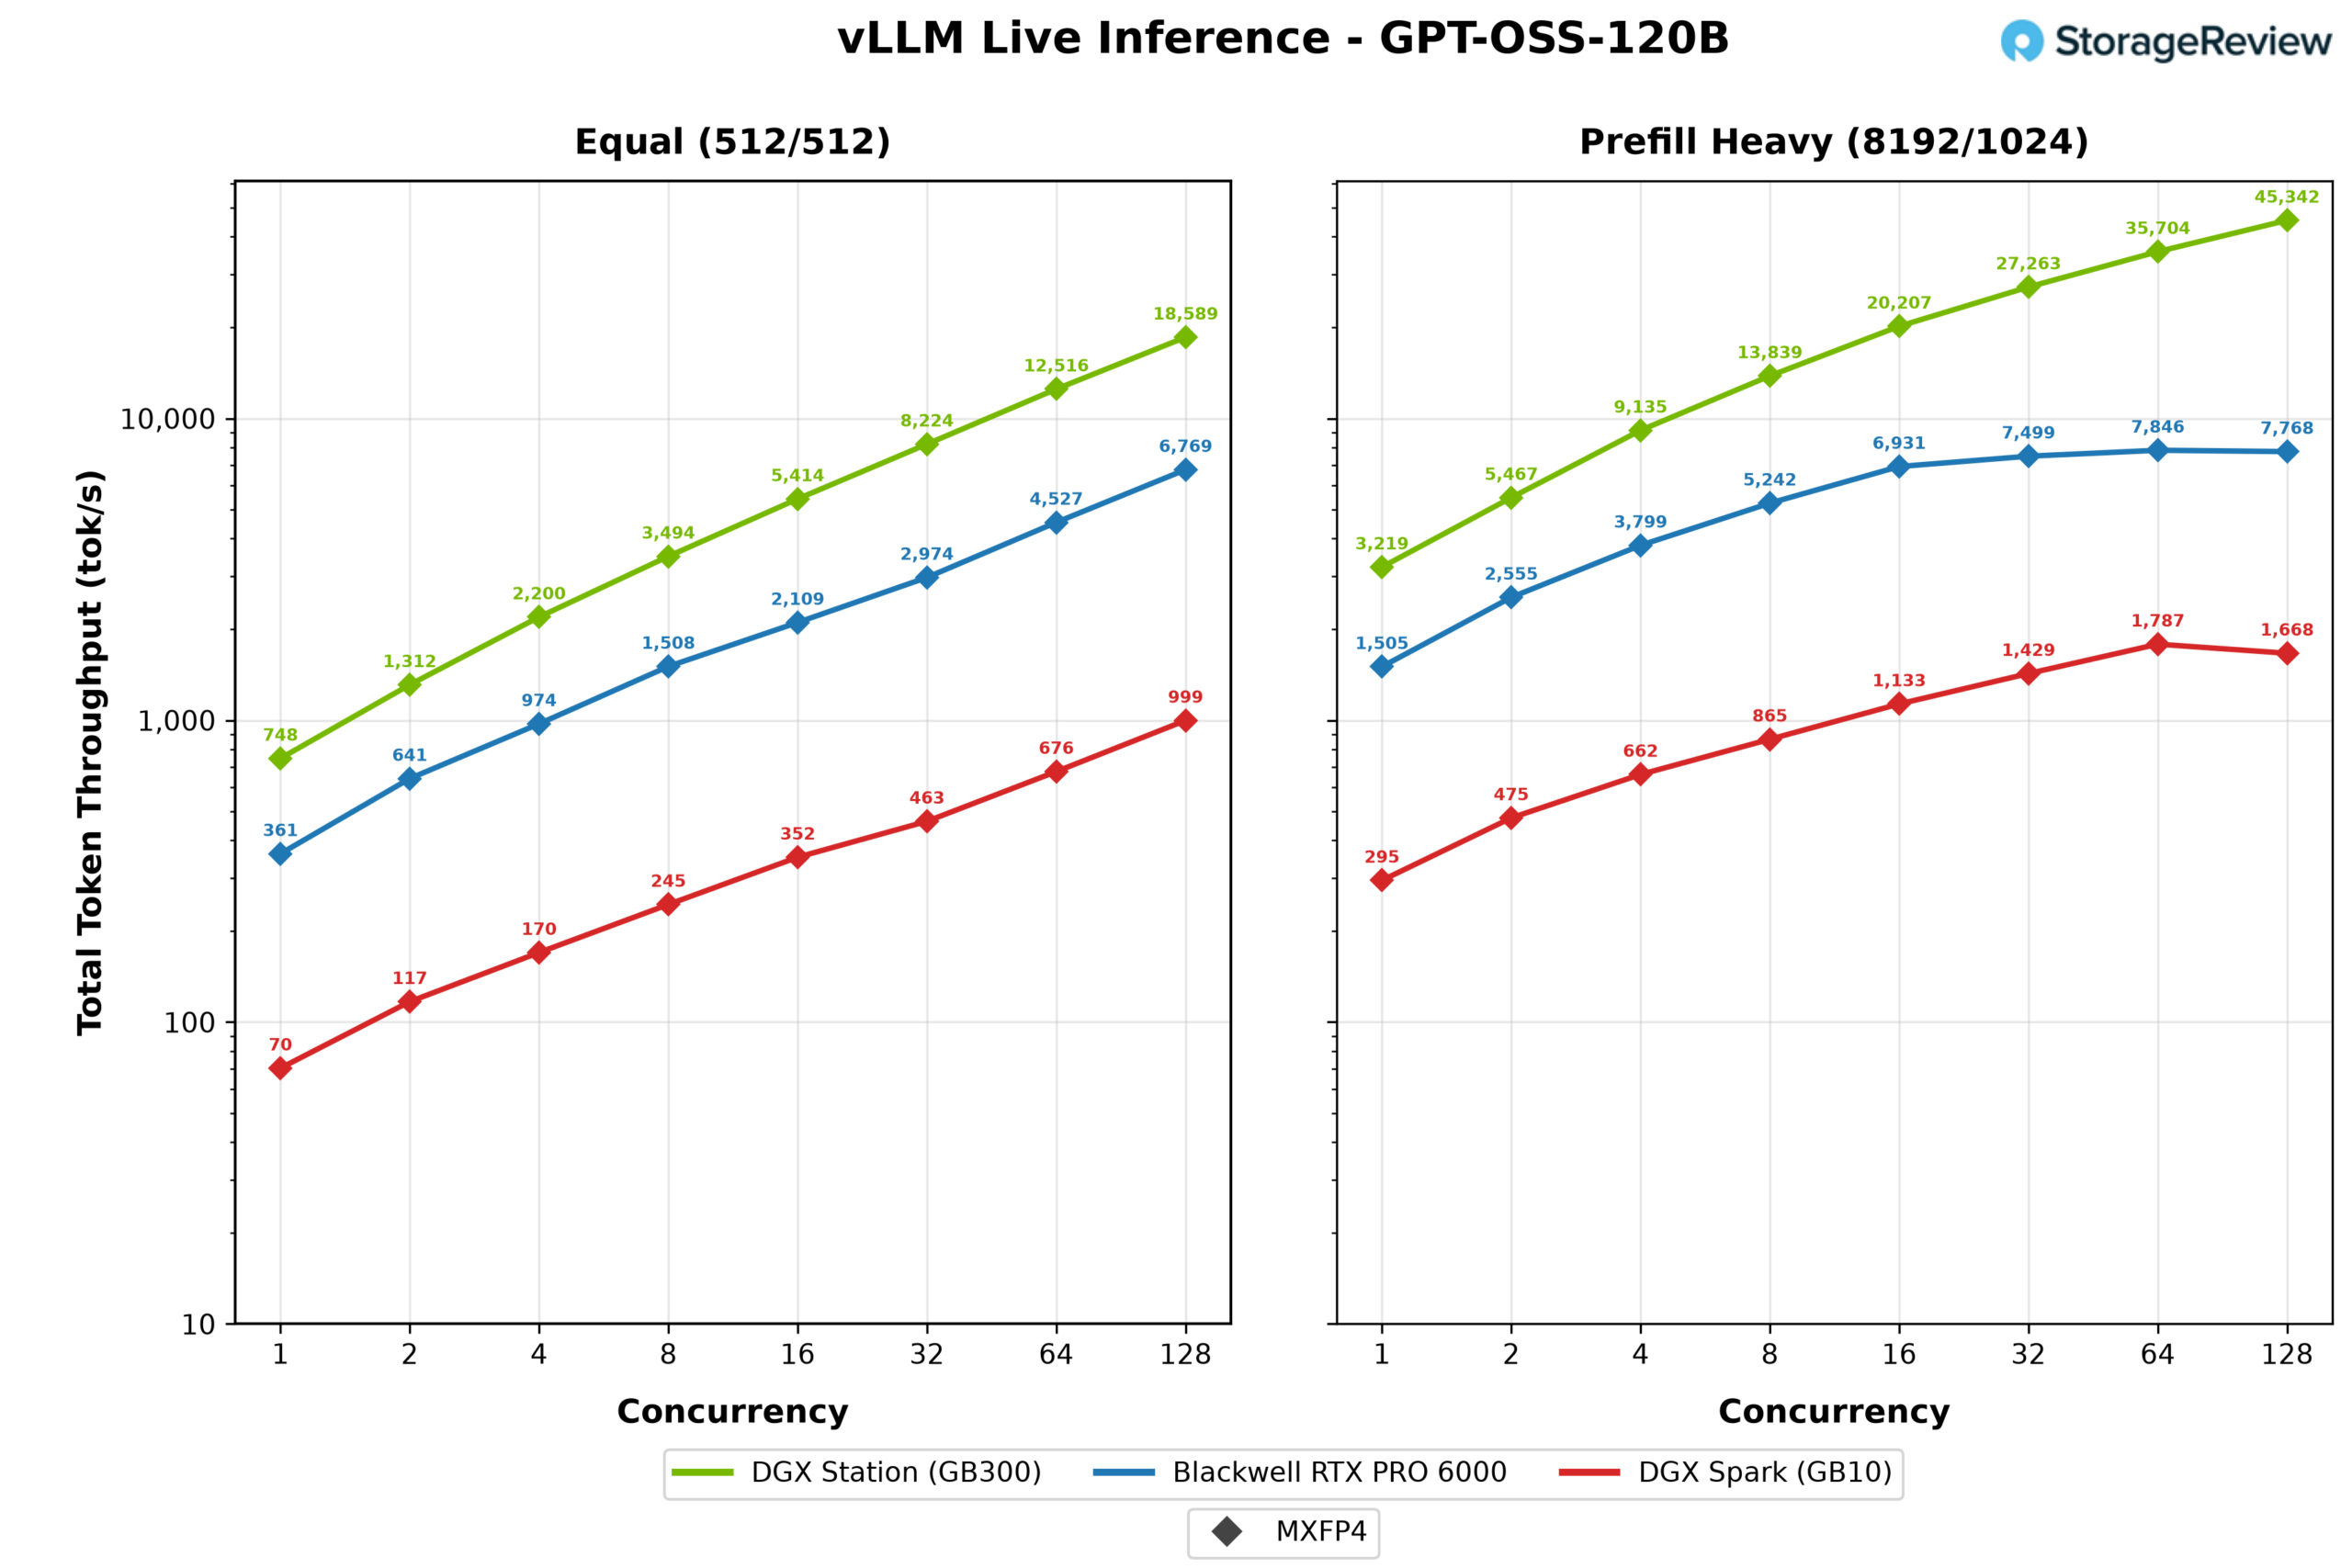
В этой части нашего тестирования производительности WS300 сравнивается с двумя другими способами размещения видеокарт Blackwell на рабочем столе или рядом с ним: Blackwell RTX PRO 6000, рабочей станцией NVIDIA мощностью 600 Вт, установленной в корпусе Dell Pro Max Tower T2, обзор которого мы публиковали ранее, и DGX Spark на базе GB10, представленной здесь Acer Veriton GN100 . Каждая система выполняла одинаковые рабочие нагрузки vLLM для вывода данных в реальном времени в двух сценариях: одинаковая рабочая нагрузка с 512 входными и 512 выходными токенами и рабочая нагрузка с интенсивным предварительным заполнением, включающая 8,192 входных и 1,024 выходных токена, при уровнях параллелизма от 1 до 128. Мы построили графики совокупной производительности и общей пропускной способности для каждой модели, которую могут обслуживать все три системы: GPT-OSS-20B и GPT-OSS-120B в их собственном формате MXFP4, Llama 3.1 8B в форматах BF16, FP8 и NVFP4, а также Mistral Small 24B и Qwen3 Coder 30B в форматах BF16 и FP8.
ГПТ-ОСС-20Б
GPT-OSS-20B — самый удобный тест из всего набора, контрольная точка, которая легко устанавливается на все три системы. При одинаковой нагрузке WS300 без проблем масштабировалась до 22 161 выходного токена в секунду при 128 одновременных потоках, что примерно в 2.5 раза больше, чем у RTX PRO 6000 (9,000 потоков) и в 15 раз больше, чем у DGX Spark (1,469 потоков). Результаты для одного потока показывают ту же картину в миниатюре: 530 токенов в секунду на Station, 244 на видеокарте и 50 на Spark.
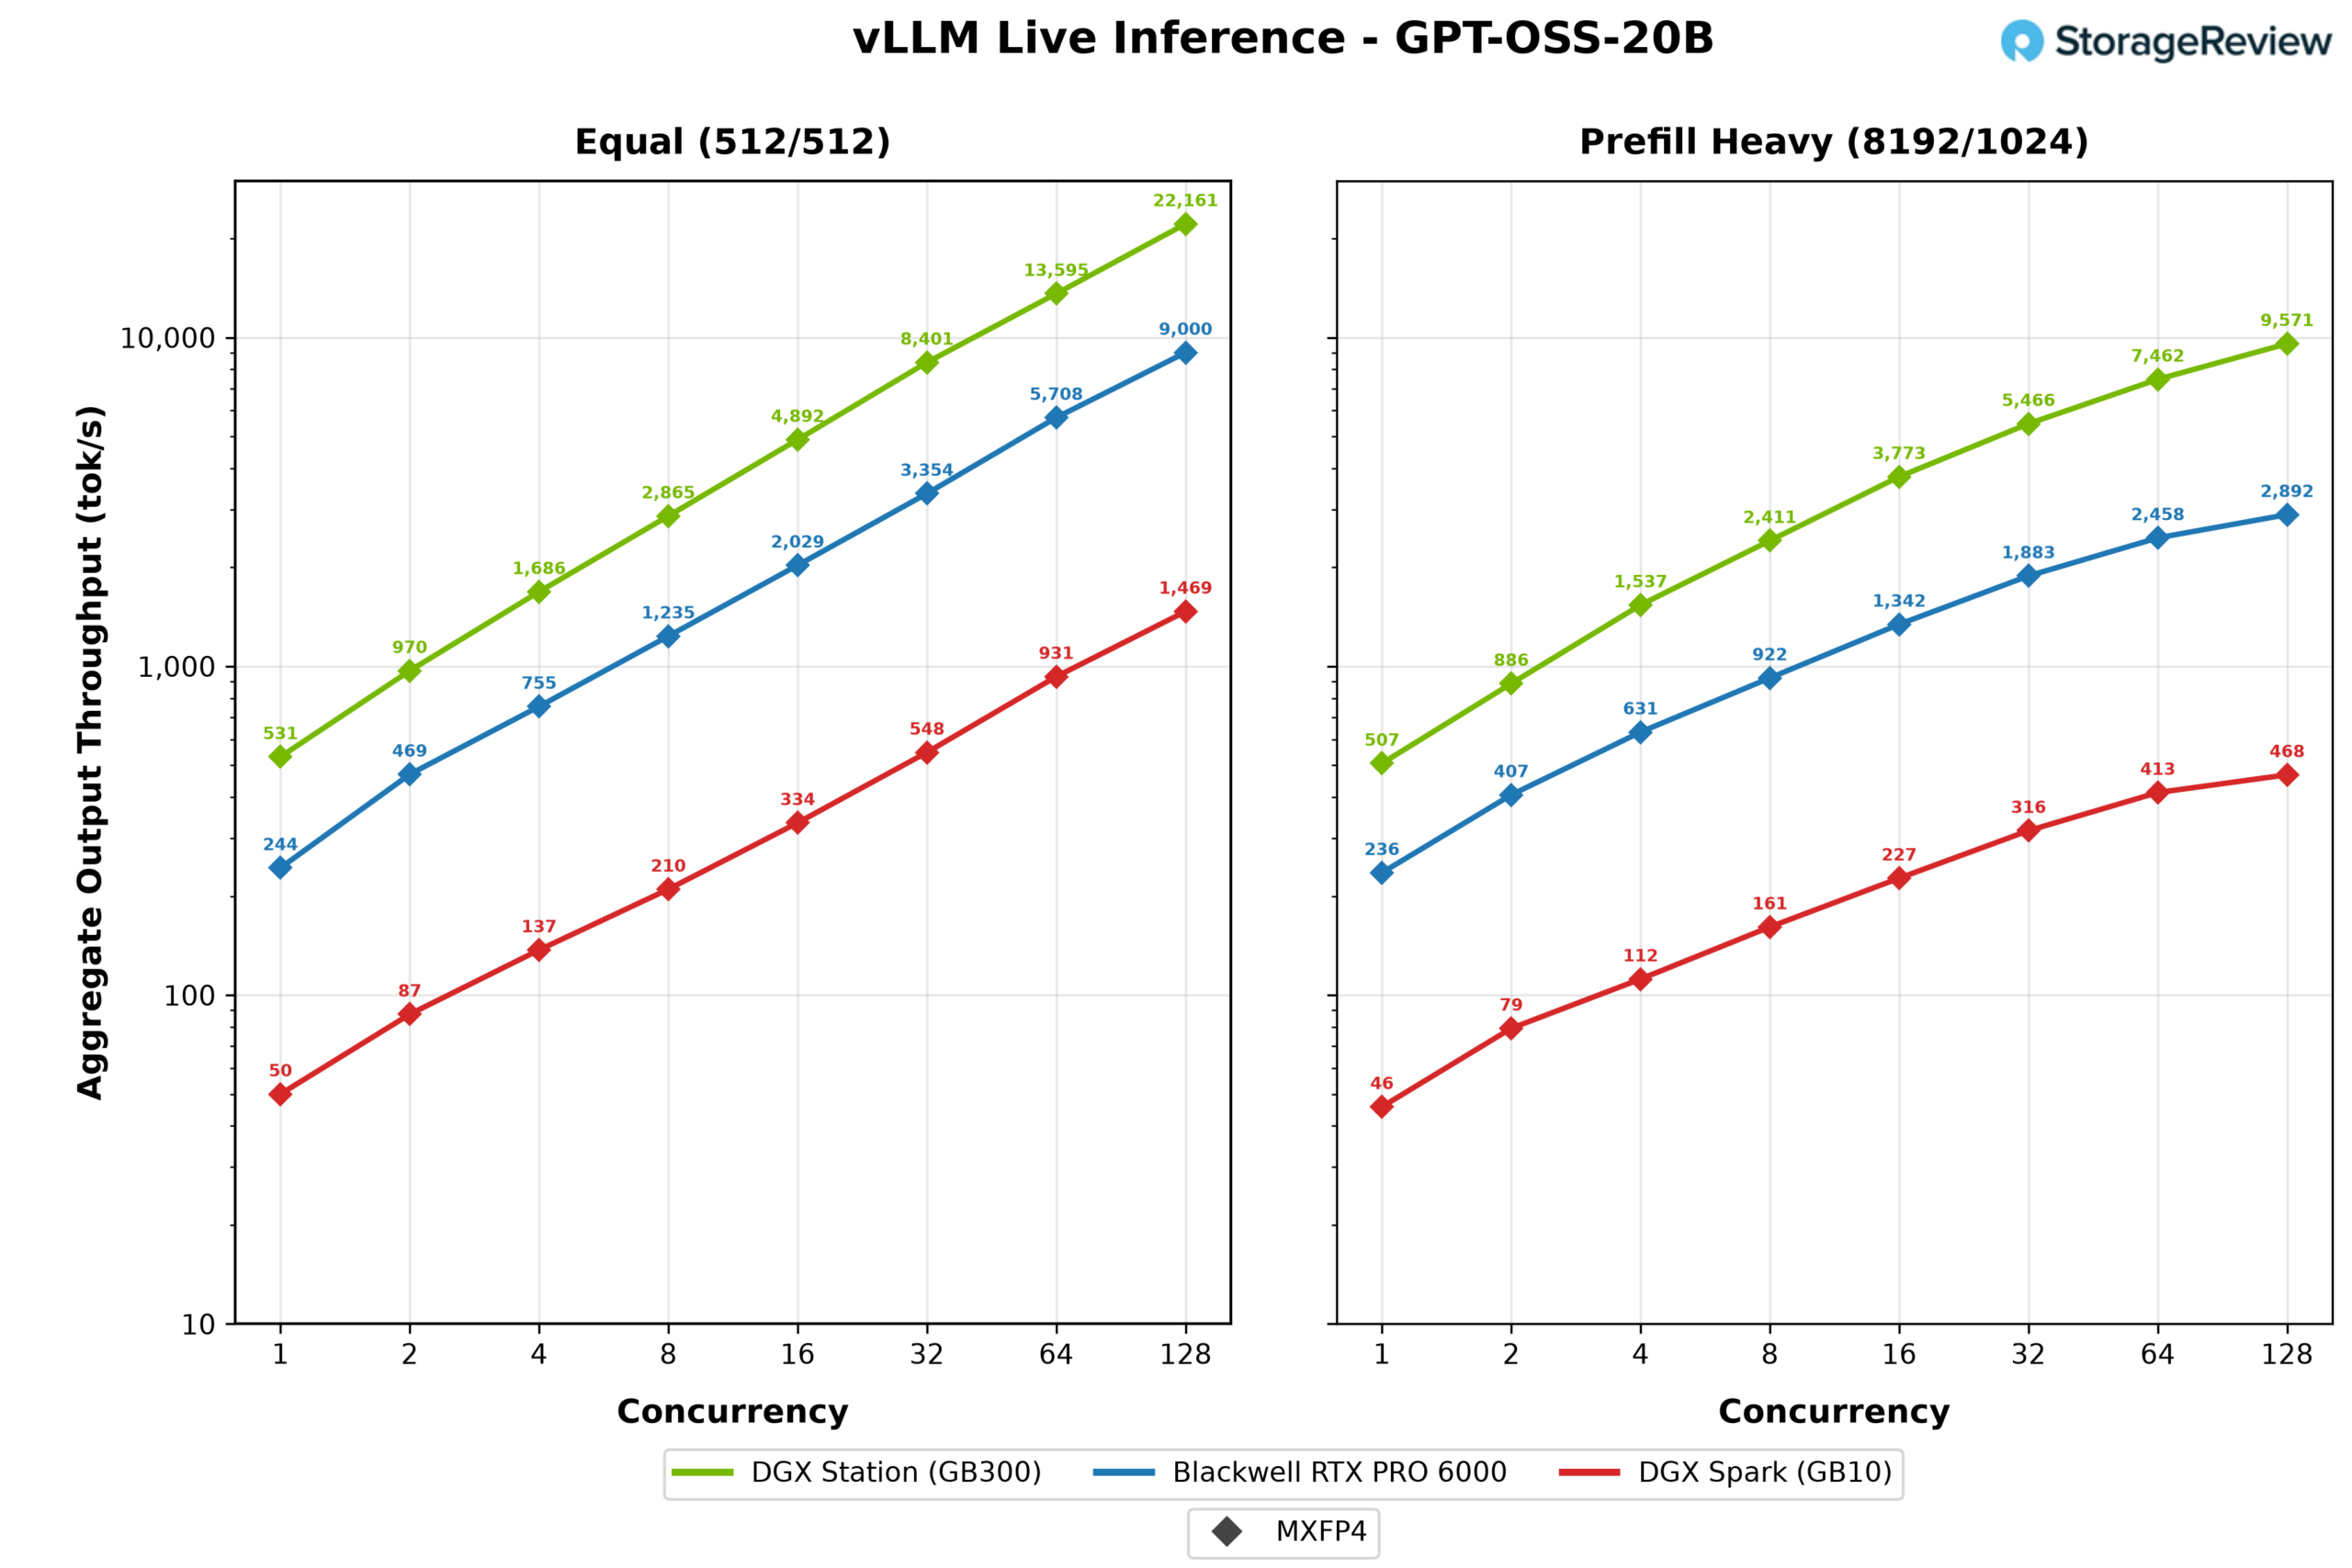
Сценарий с большим количеством предварительных заполнений еще больше выделяет конкурентов. При отправке 8,192 запросов на ввод токенов, WS300 все еще выдавал 9,572 токена в секунду на пике, что составляет более 86 000 токенов в секунду с учетом предварительного заполнения, в то время как RTX PRO 6000 достиг максимума в 2,892 токена, а Spark — 468.
ГПТ-ОСС-120Б
При переходе на GPT-OSS-120B все три системы по-прежнему могут загружать модель, но иерархия памяти начинает иметь значение. WS300 достиг пиковой производительности в 9,294 токена в секунду при одинаковой нагрузке, что в 2.7 раза выше, чем у RTX PRO 6000 (3,384 токена) и почти в 19 раз выше, чем у DGX Spark (500 токенов).
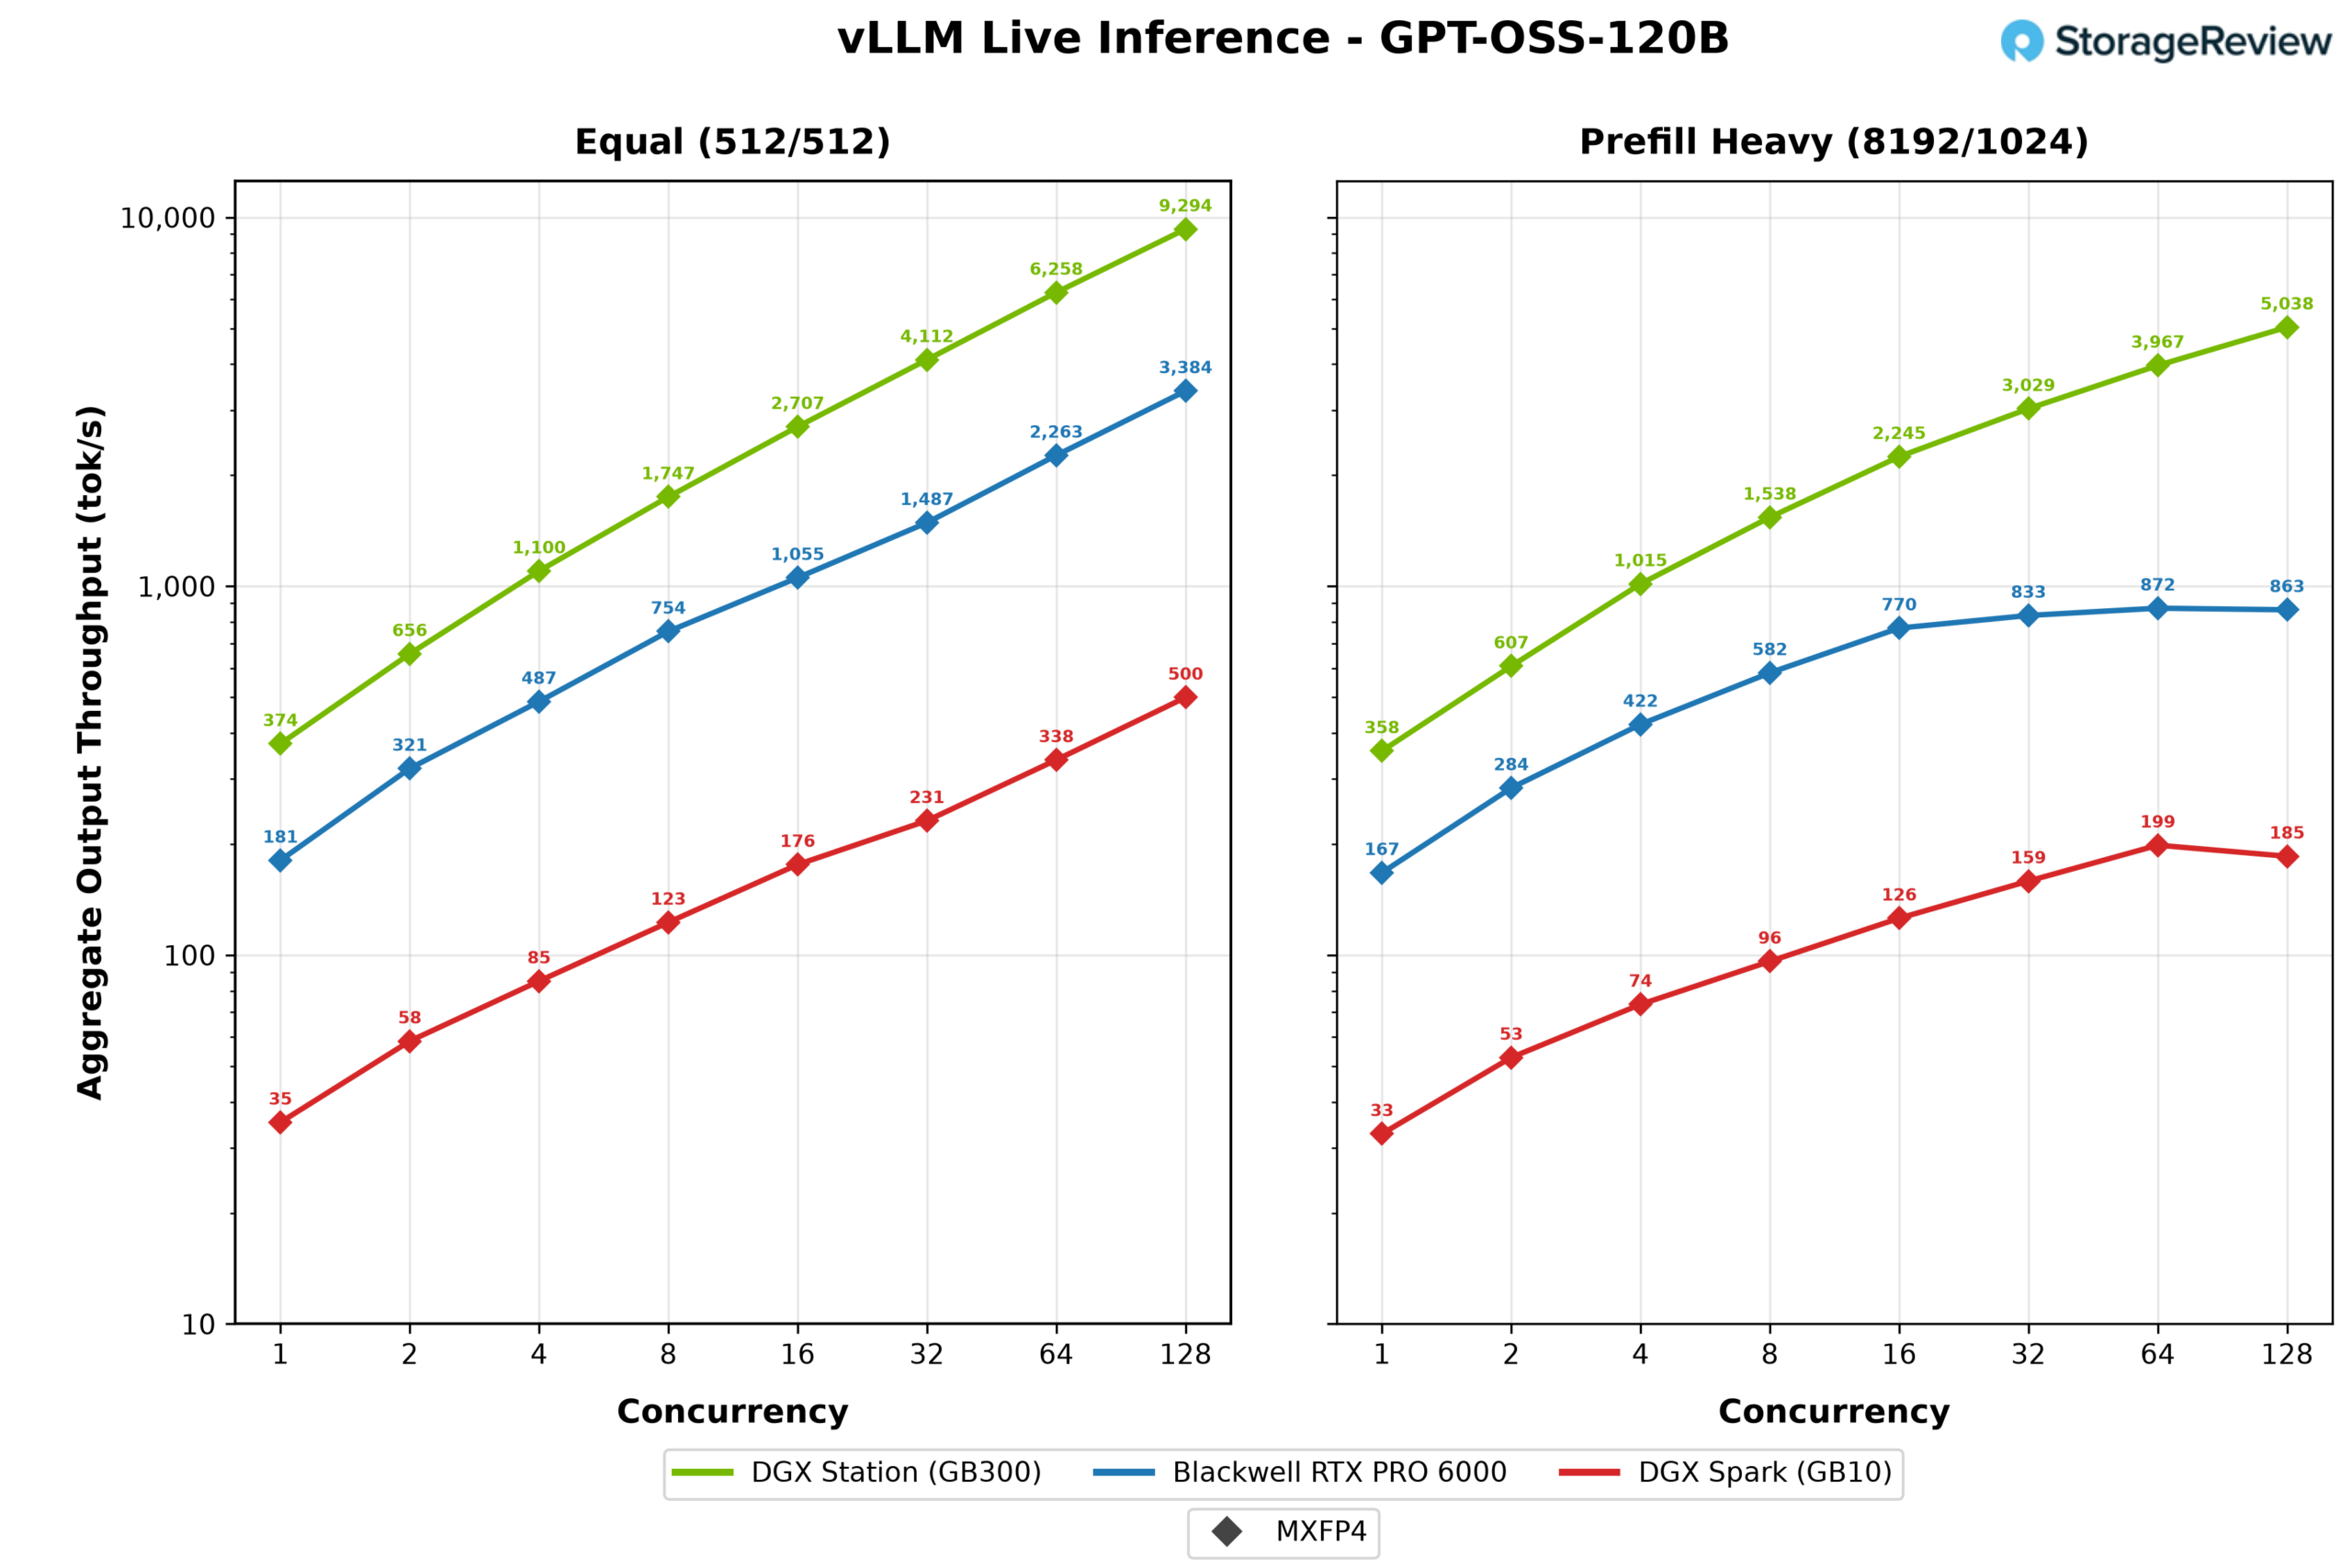
На этапе интенсивного предварительного заполнения памяти меньшие по размеру системы достигают своего предела. RTX PRO 6000 показала стабилизацию на уровне 872 выходных токенов в секунду при 64 одновременных потоках, а Spark — на уровне 199, в то время как WS300 продолжала расти, достигнув 128 потоков и в итоге выдав 5,038, что почти в 6 раз превышает показатели видеокарты. Длительные запросы увеличивают кэш-память типа «ключ-значение», и системы с меньшим объемом памяти исчерпывают место для пакетной обработки задолго до Station.
Лама 3.1 8Б
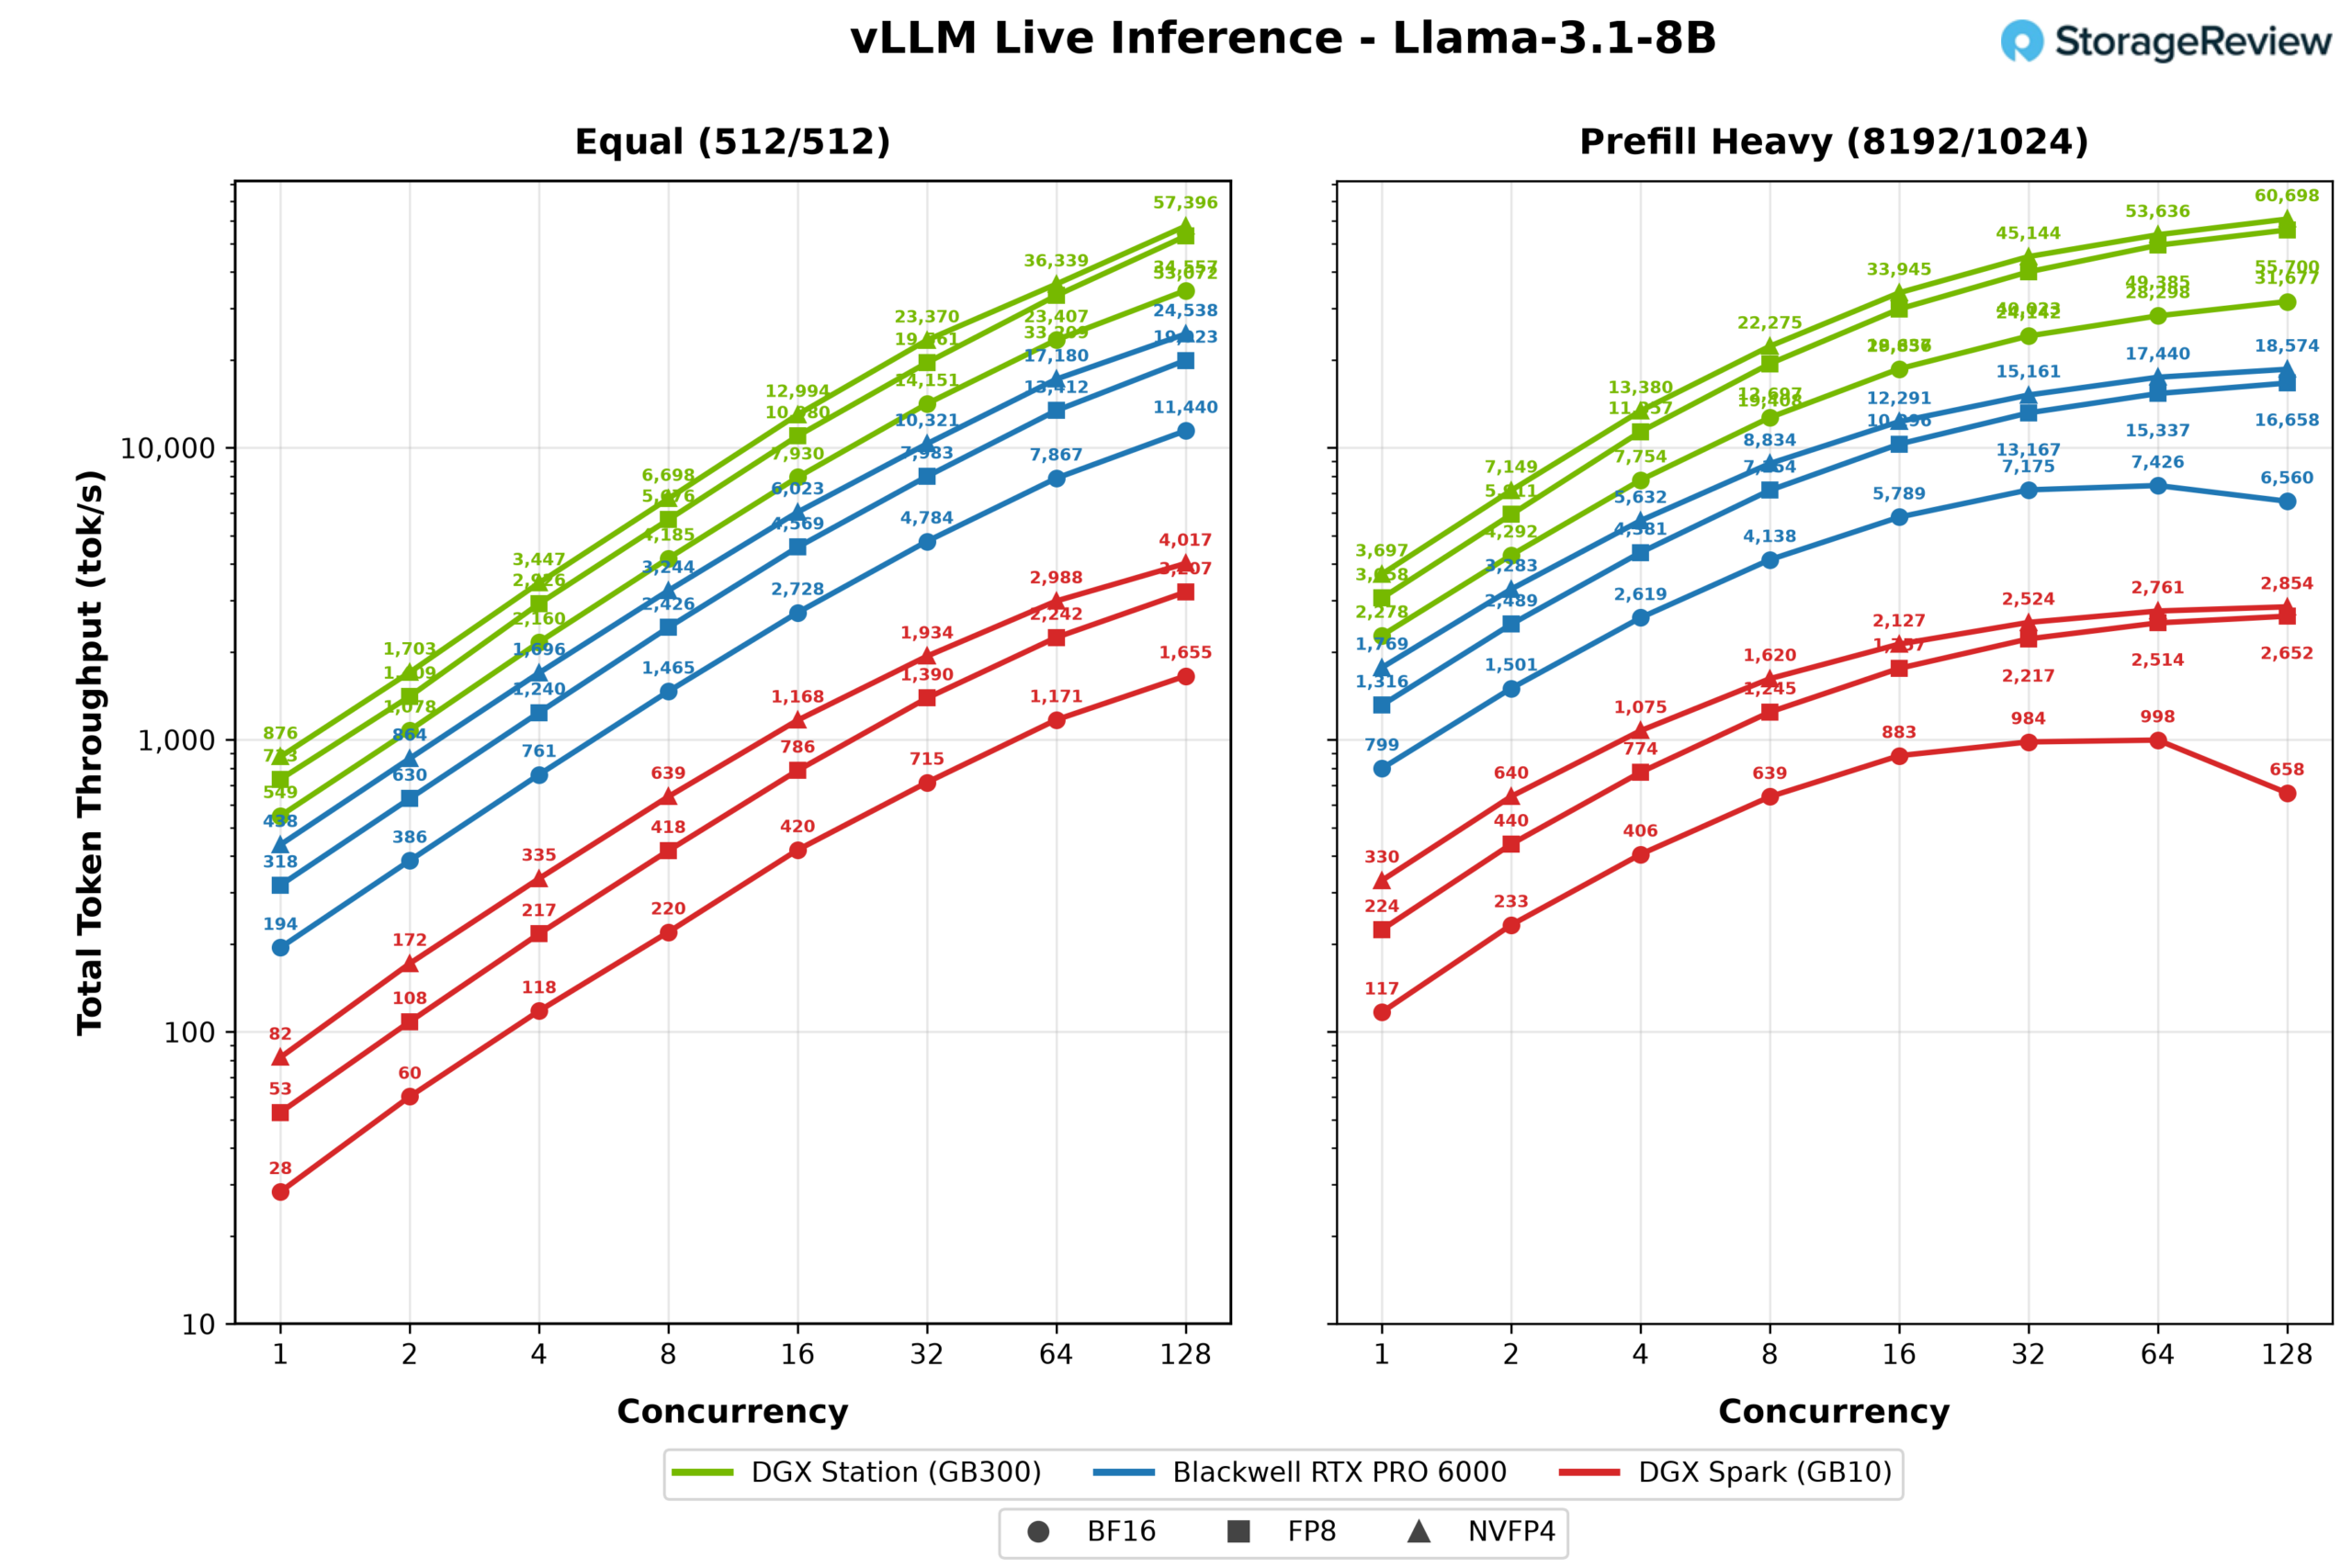
Llama 3.1 8B достаточно компактна, чтобы мы могли запустить её на частотах BF16, FP8 и NVFP4 на каждой системе, что позволяет наиболее наглядно оценить преимущества квантования на каждой машине. При 128 одновременных потоках и одинаковой нагрузке WS300 увеличила производительность с 17 278 выходных токенов в секунду на частоте BF16 до 28 698 на частоте NVFP4, что составляет прирост в 66 процентов. RTX PRO 6000 увеличила производительность на 114 процентов, с 5,720 до 12 269, а DGX Spark — на 143 процента, с 828 до 2,009. Стоит запомнить эту закономерность: чем меньше машина, тем выгоднее квантование.
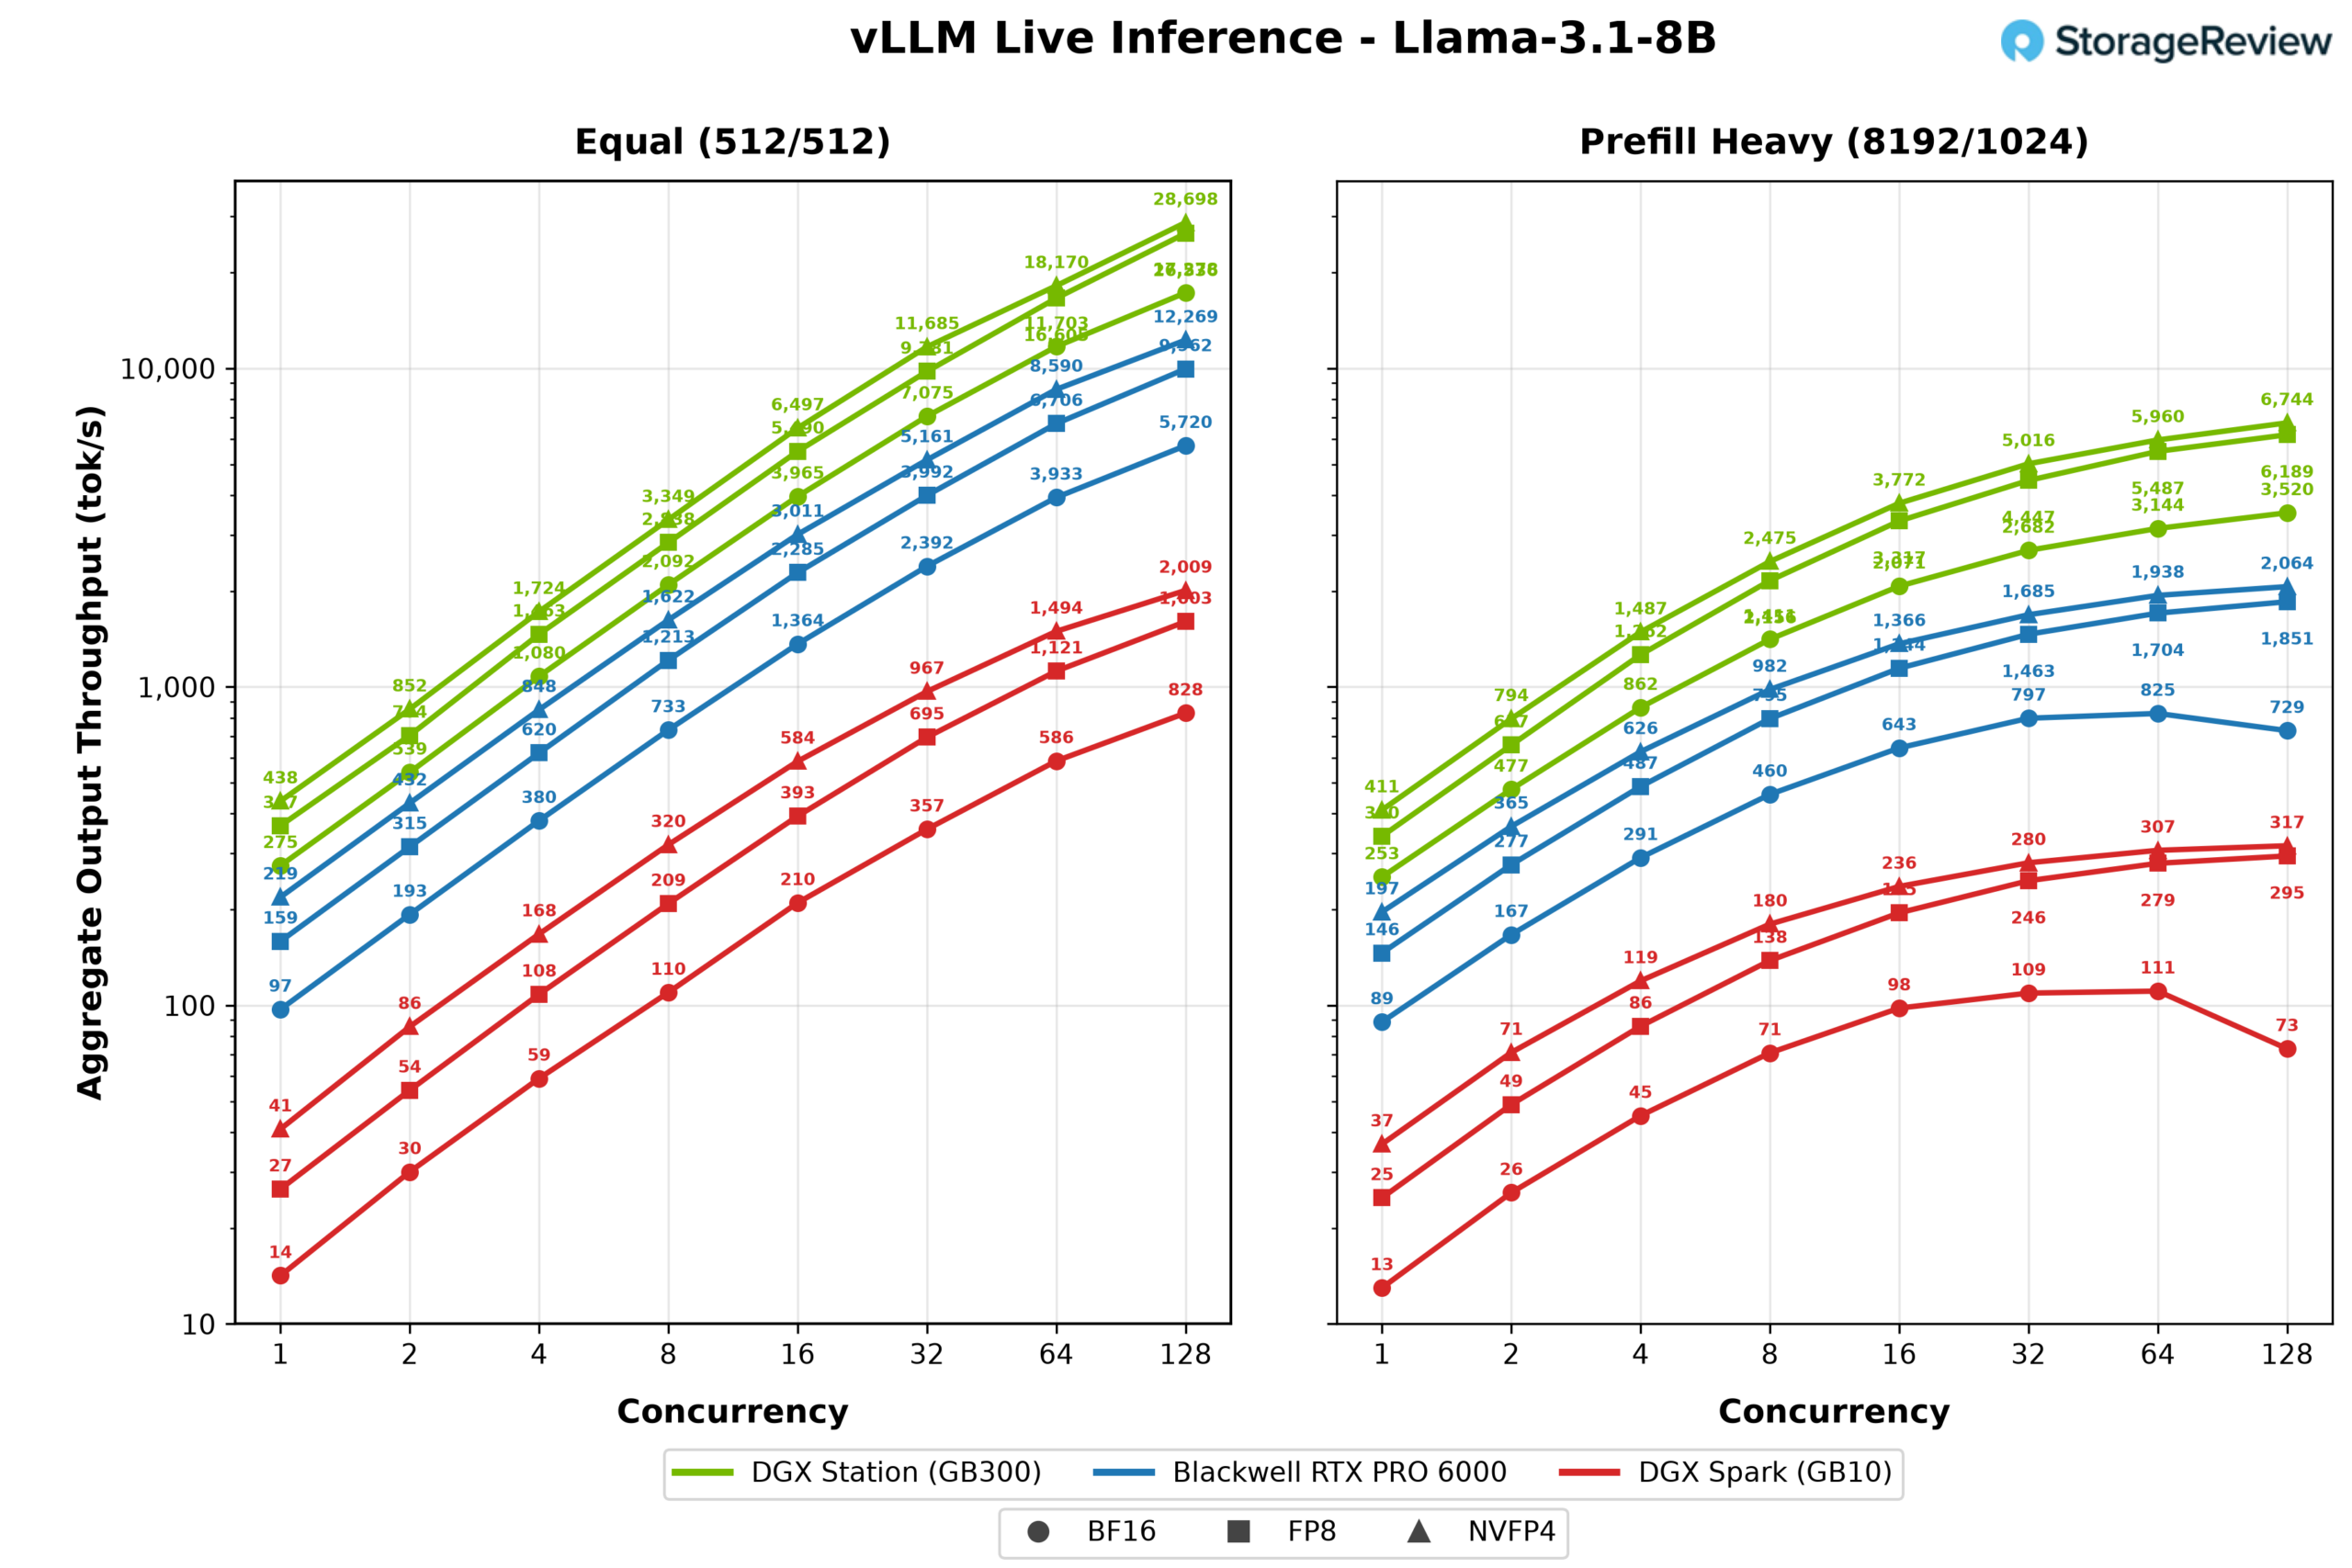
Результаты предварительного заполнения сильно сжимают все поле, при этом пиковая производительность WS300 в режиме NVFP4 составляет 6,744 токена в секунду, против 2,064 у карты и 317 у Spark.
Мистраль Малый 24Б
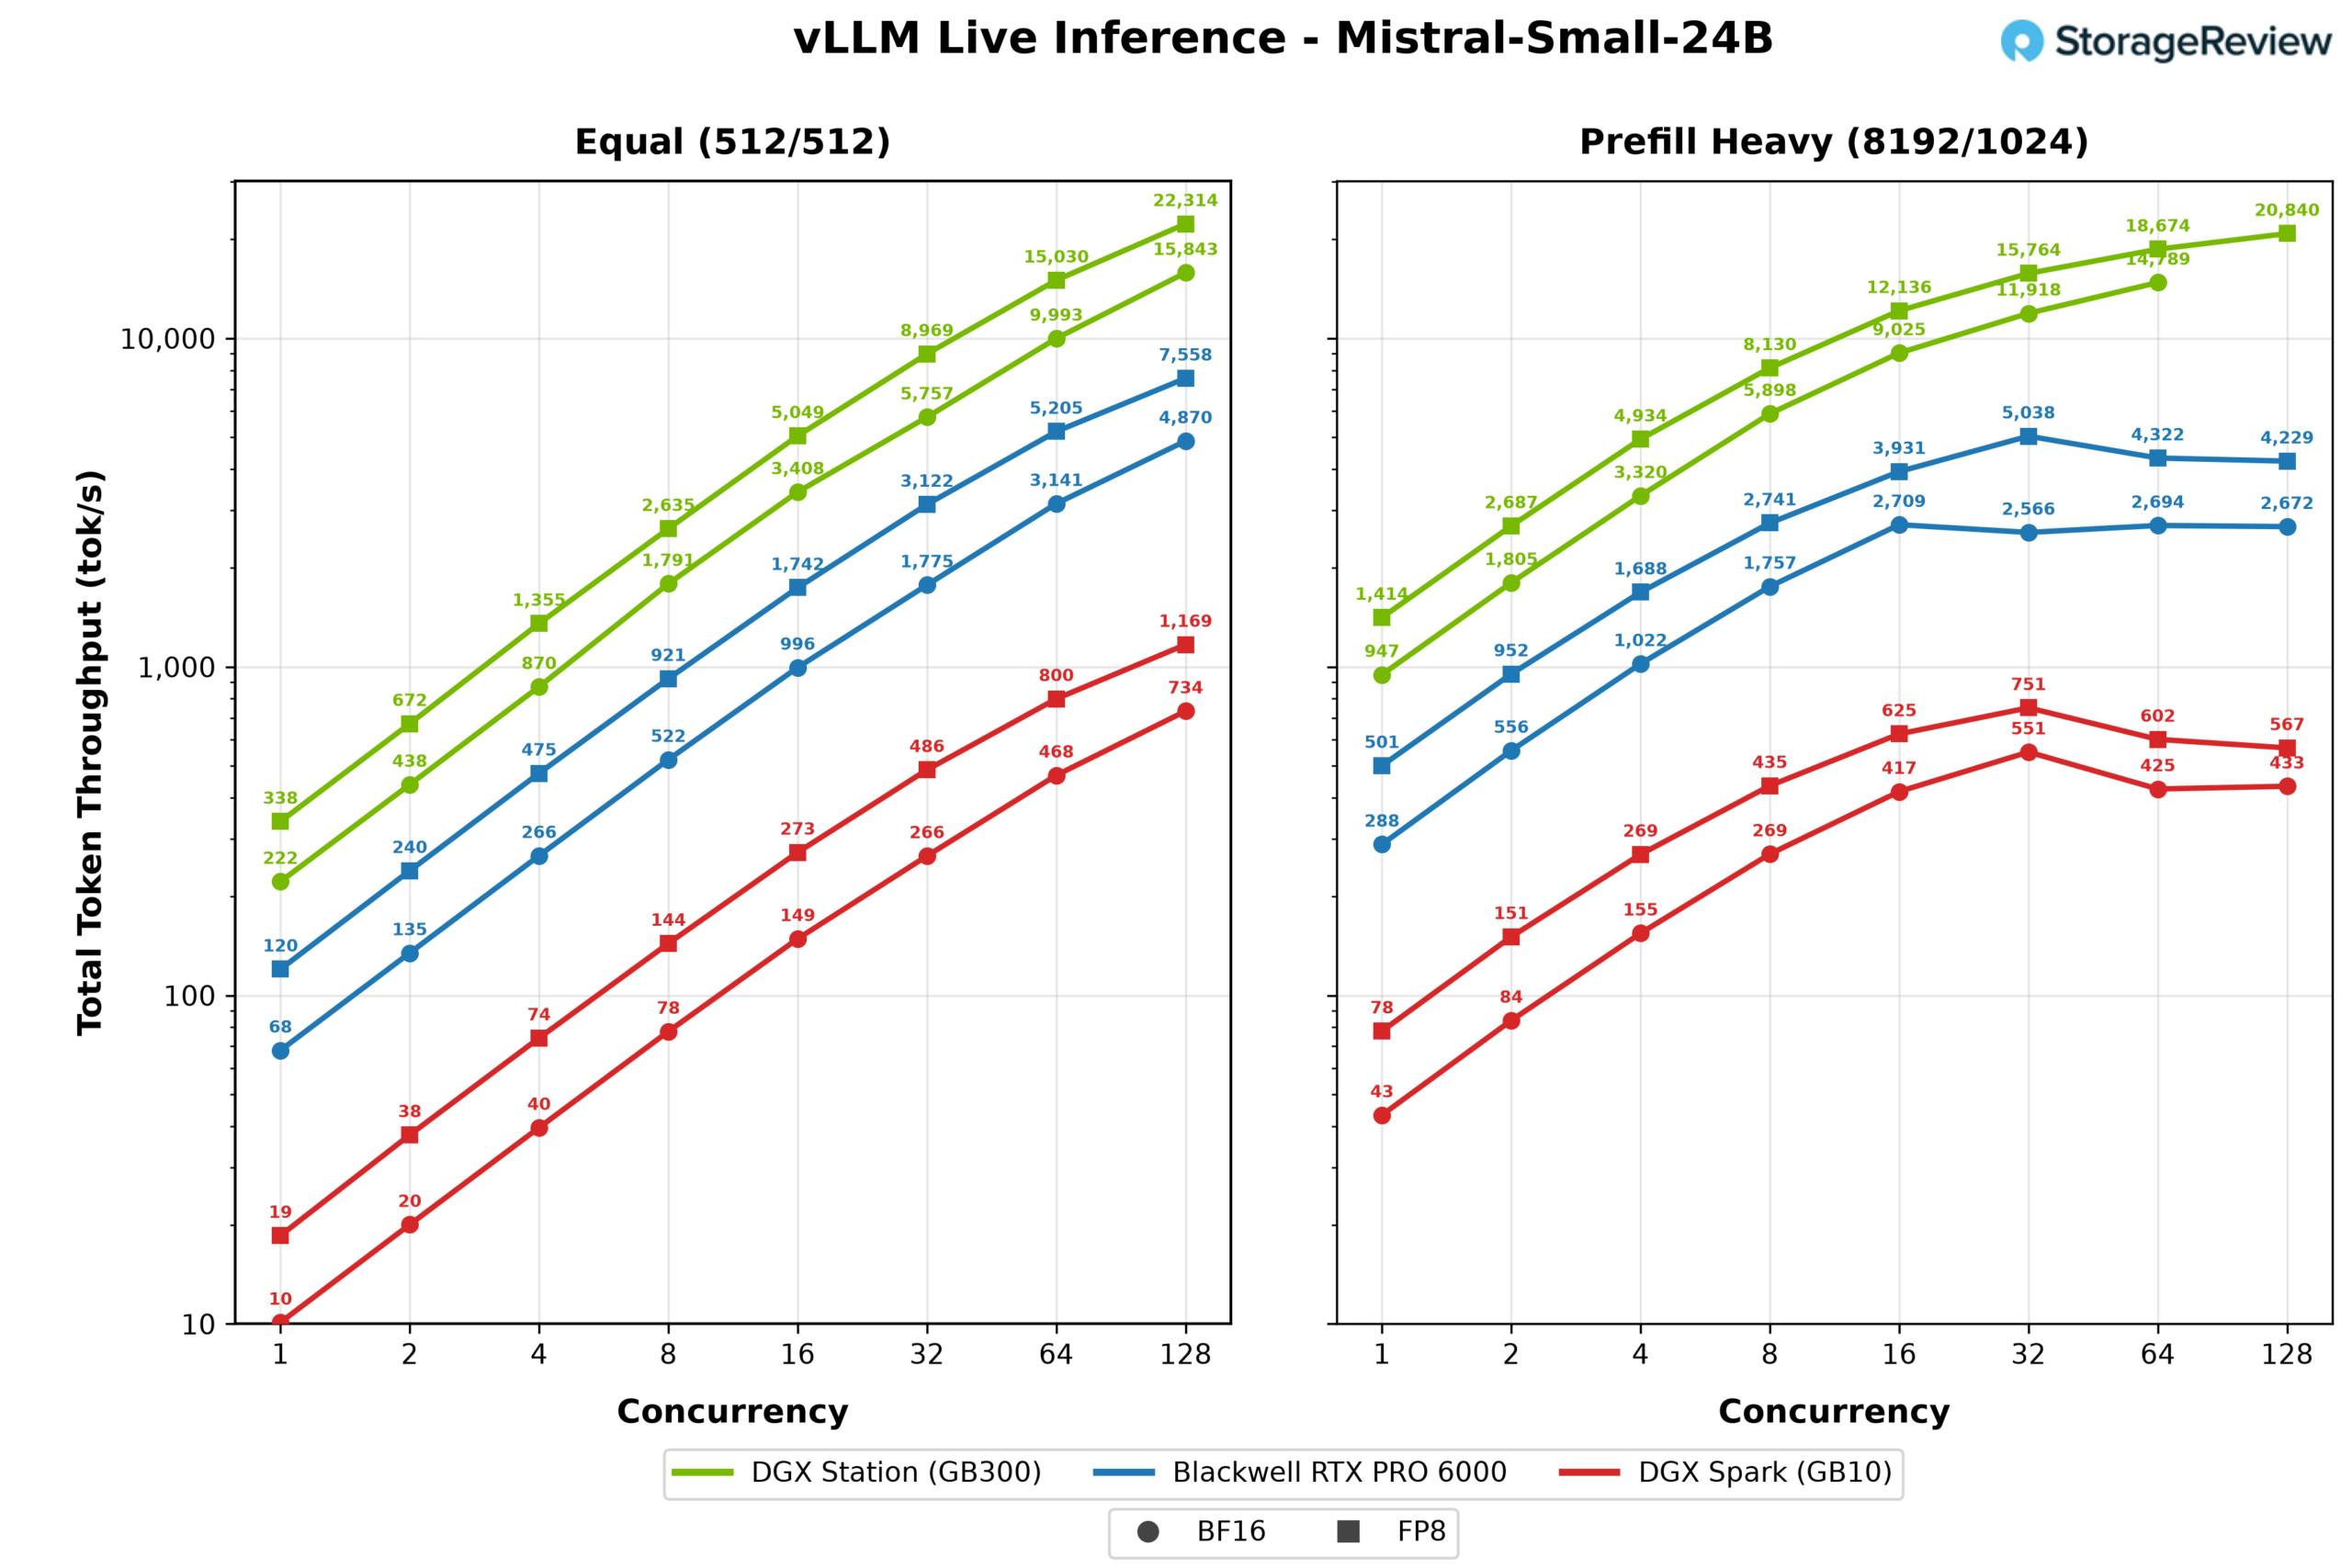
Mistral Small 24B показал самые большие промежутки между сигналами в тестах. При FP8 и одинаковой нагрузке WS300 достиг пиковой производительности в 11 157 токенов в секунду, что в три раза больше, чем у RTX PRO 6000 (3,779) и в 19 раз больше, чем у DGX Spark (585). При работе с одним потоком 169 токенов в секунду у Station гораздо ближе к комфортному уровню интерактивности, чем 9 токенов у Spark.
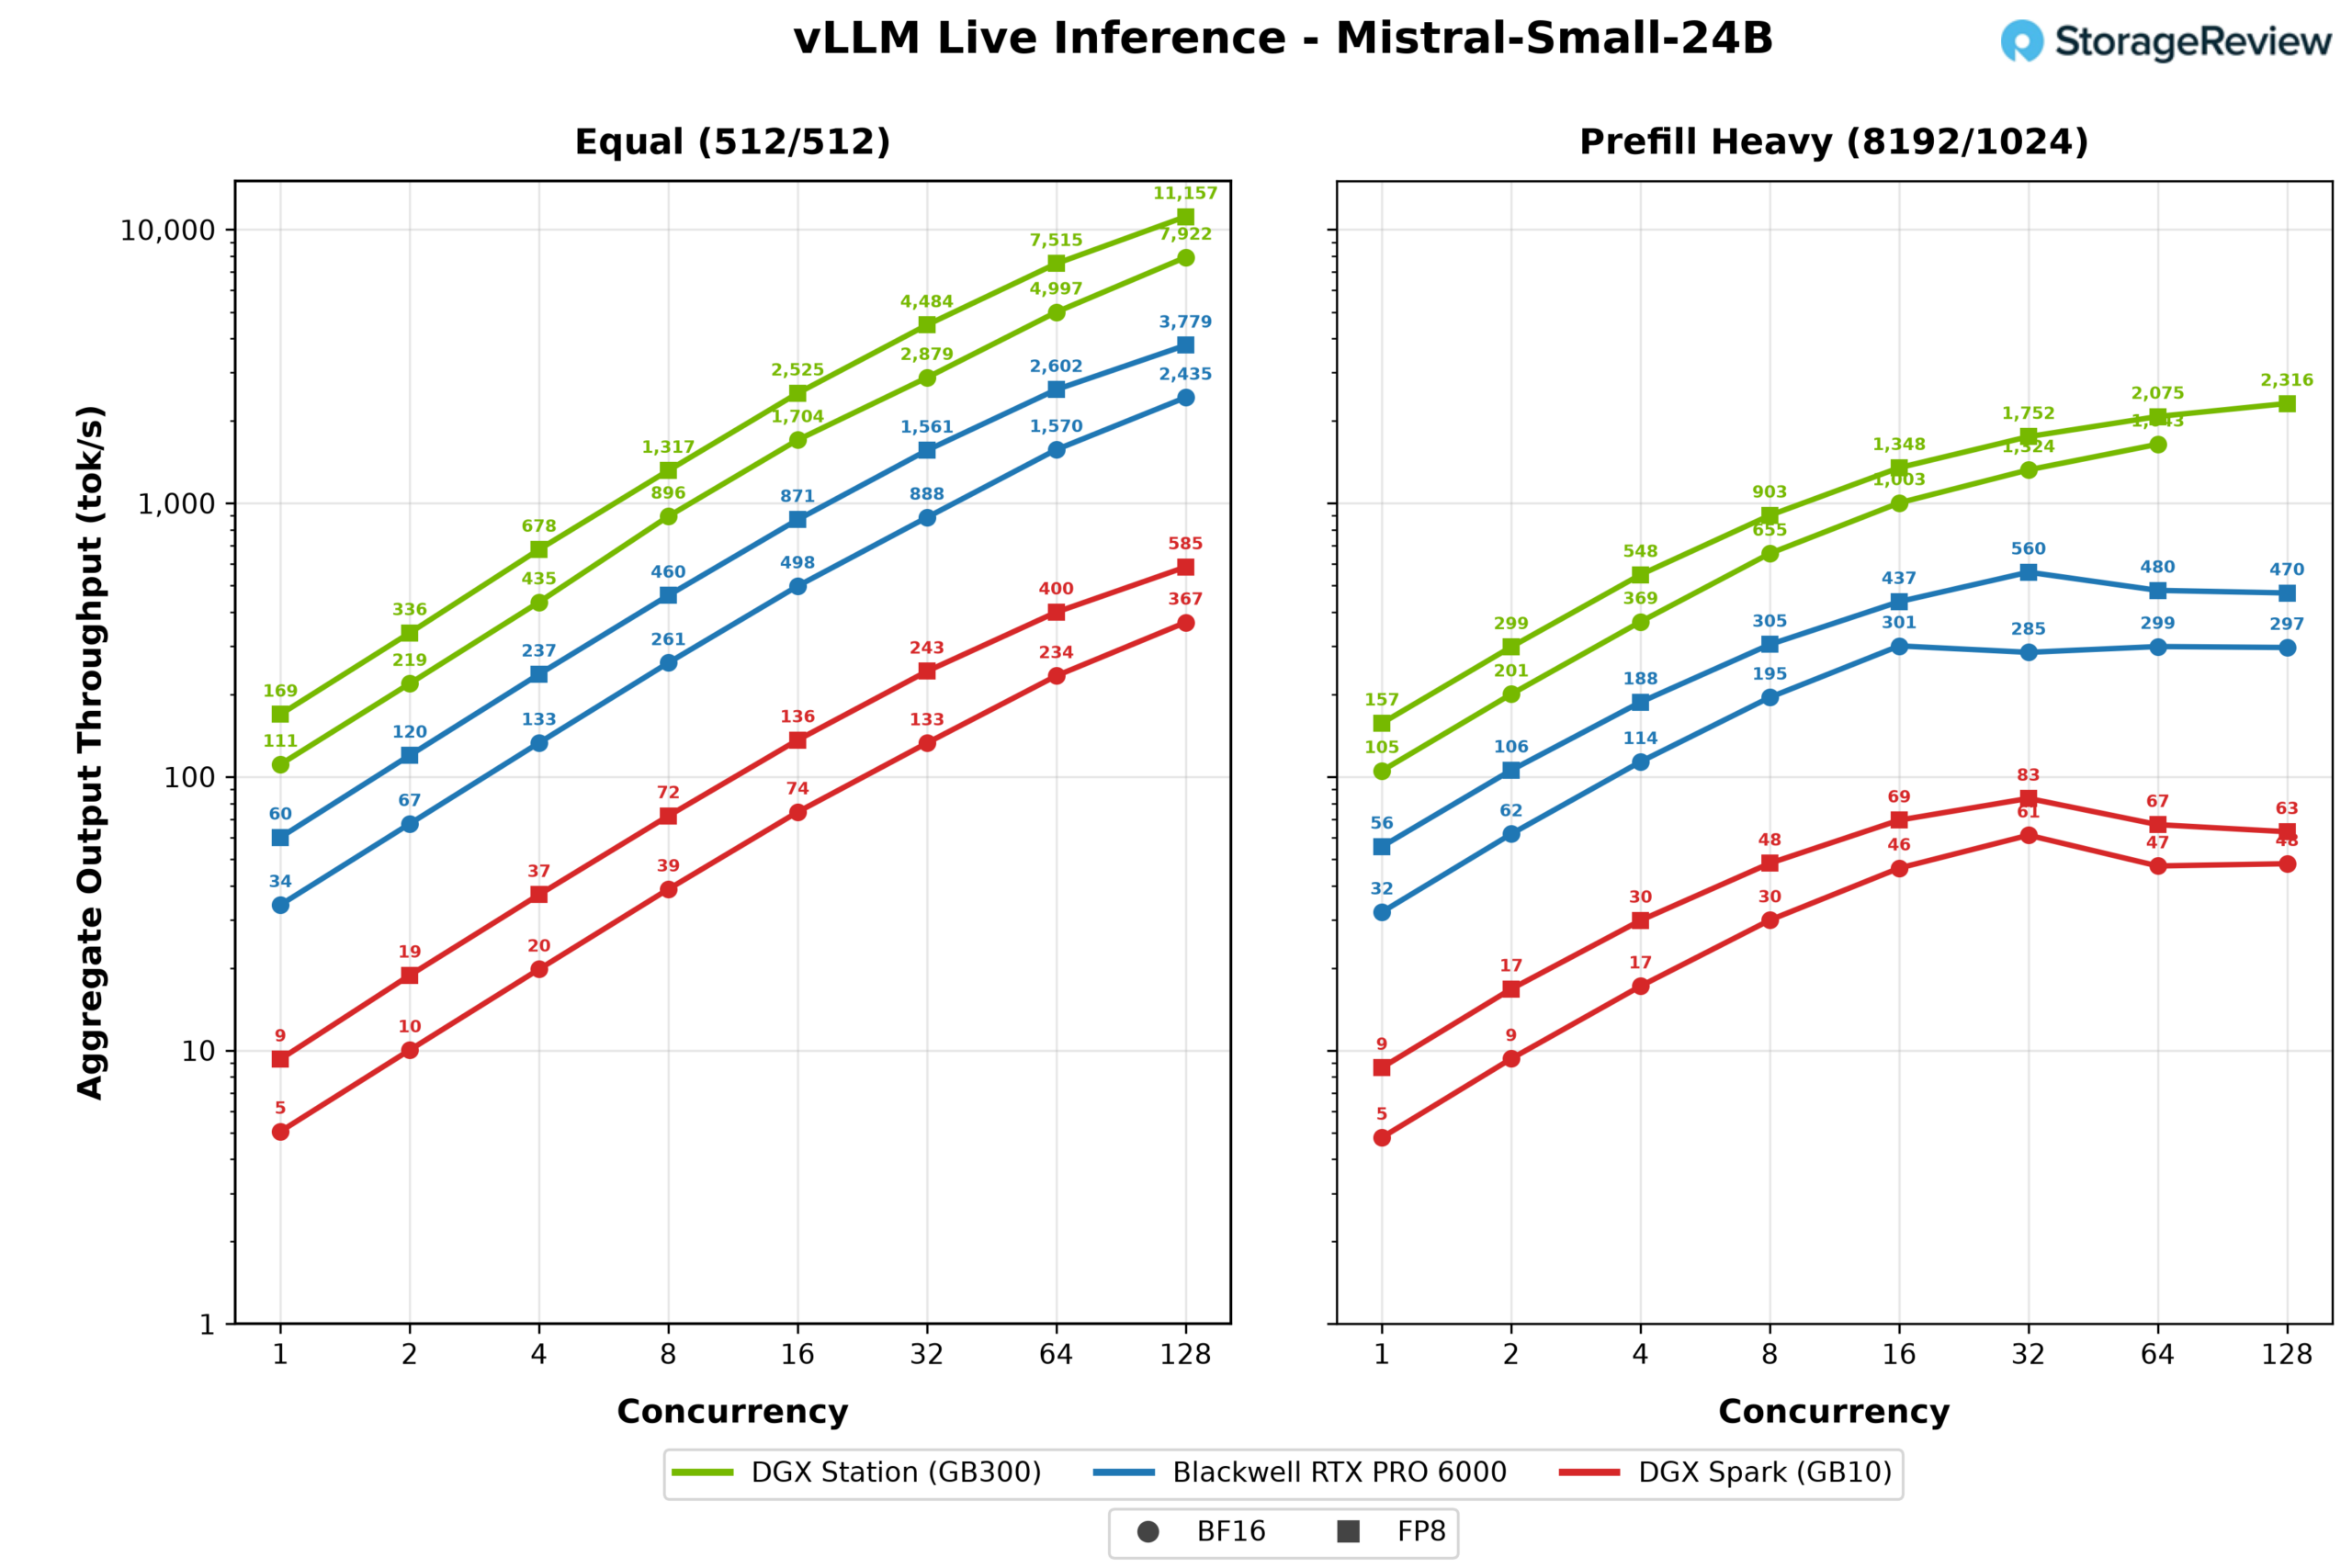
При высокой нагрузке с предварительным заполнением RTX PRO 6000 достигла пика всего в 32 одновременных потока и 560 выходных токенов в секунду, после чего производительность снизилась, в то время как WS300 продолжила работу с 2,316 потоками при 128 потоках.
Qwen3 Кодер 30B
Тест Qwen3 Coder 30B, представляющий собой смесь экспертных моделей с небольшим количеством активных параметров, является единственным тестом, где более компактные системы сокращают разрыв в производительности при обработке одного потока. При одном параллельном запросе при одинаковой нагрузке RTX PRO 6000 выдала 208 выходных токенов в секунду против 310 у WS300, что является самым близким результатом к Station в этом сравнении, и даже Spark показал приемлемый результат в 55. Пакетная обработка восстанавливает обычный порядок: при 128 потоках производительность Station в 12 425 выходных токенов в секунду при FP8 в 2.4 раза выше, чем у карты, и почти в 16 раз выше, чем у Spark.
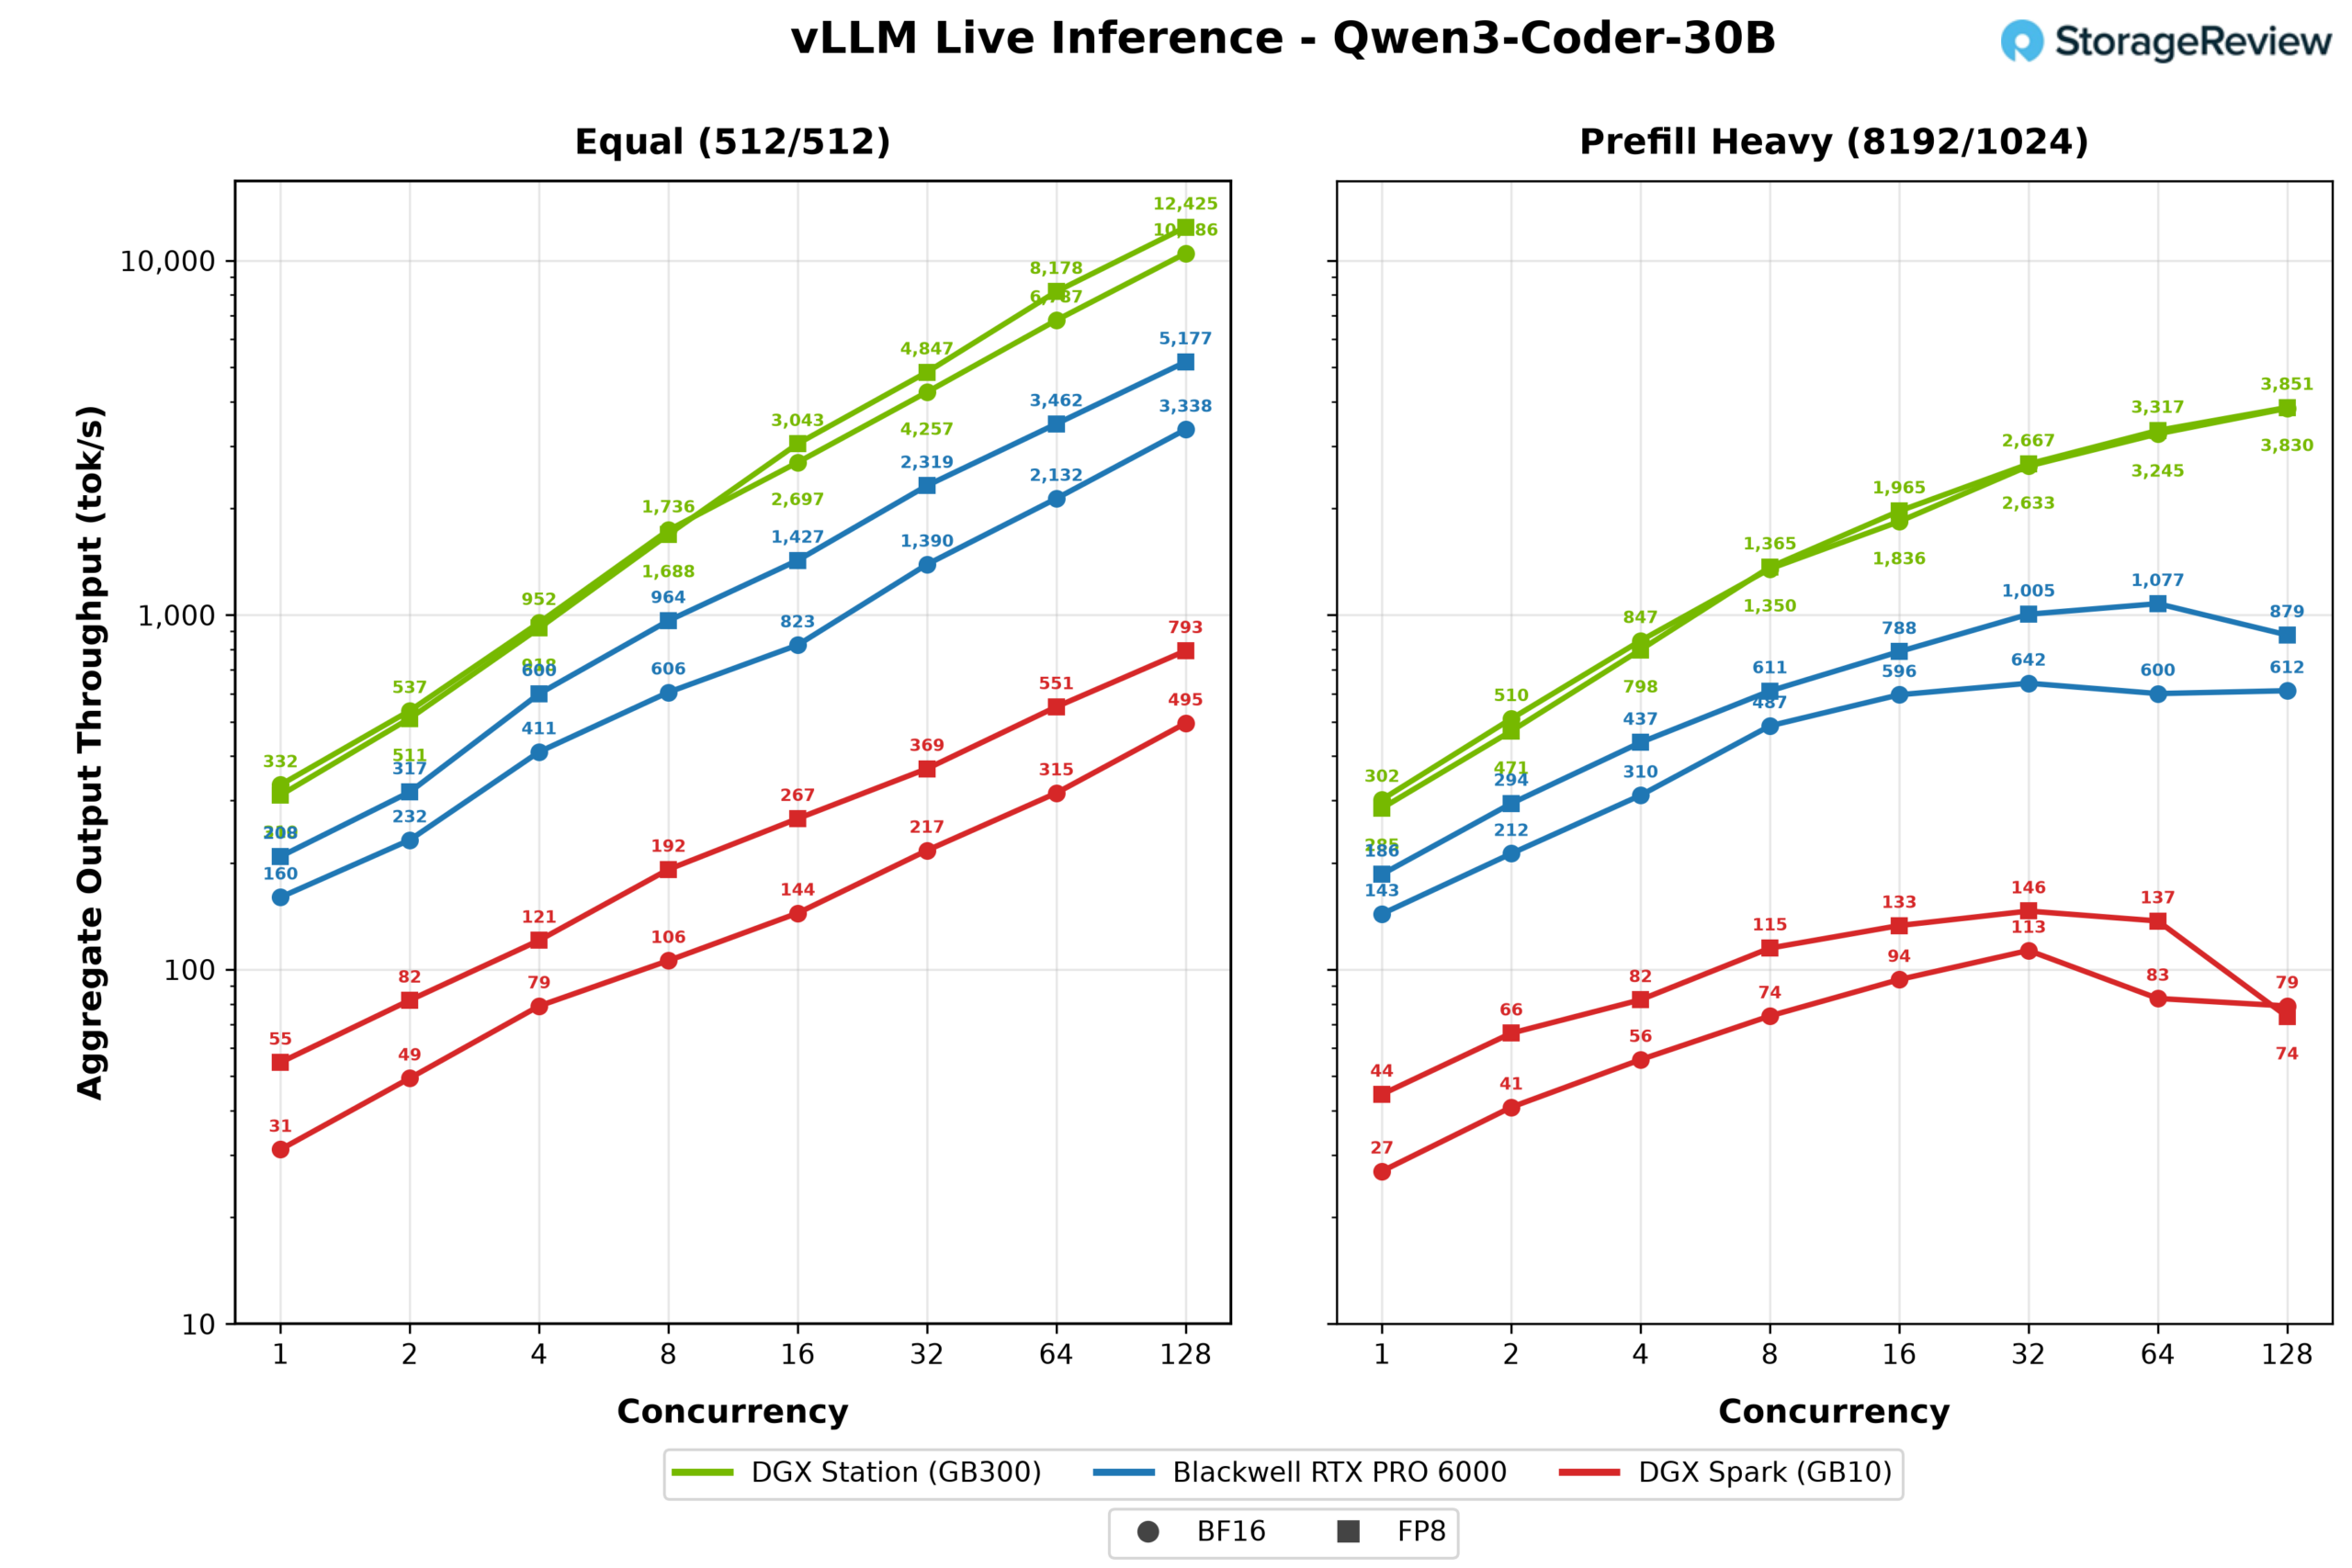
Производительность системы WS300 с высокой предварительной загрузкой следовала установленной схеме: она достигла 3,851 токена в секунду, карта — пикового значения в 1,077, а Spark — 146.
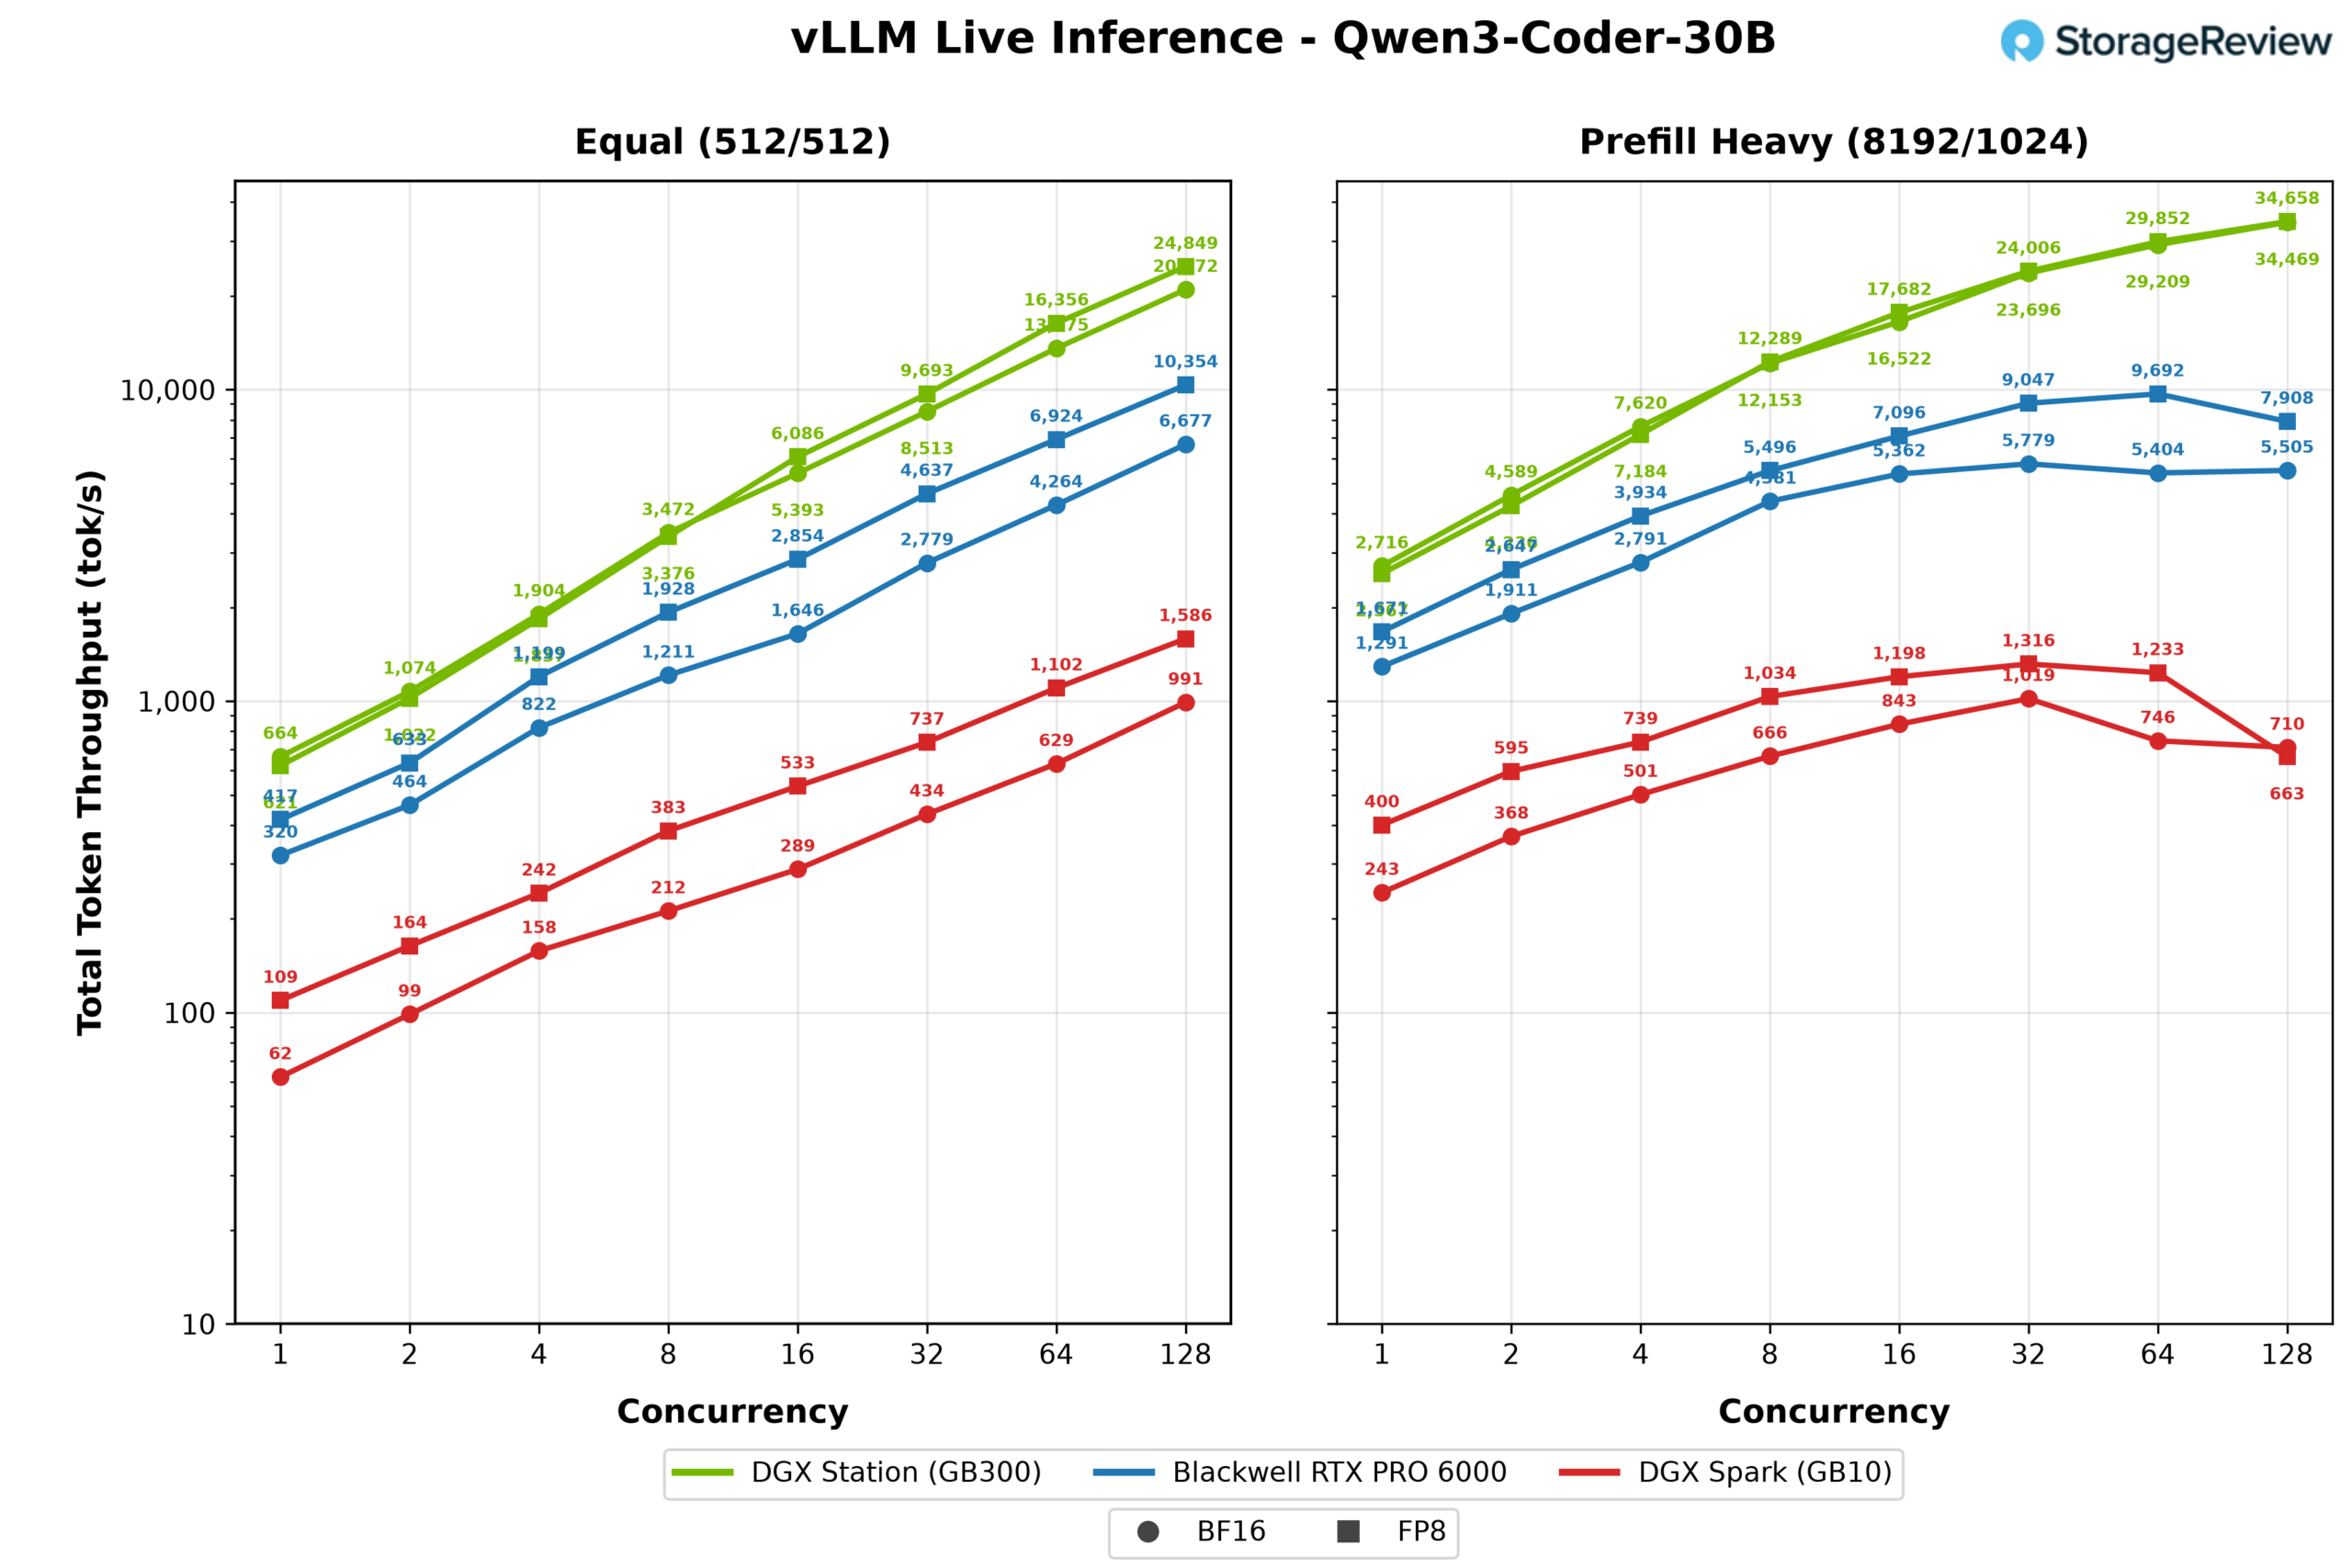
В пяти исследованных моделях WS300 показала в 2.3–3 раза большую пропускную способность, чем Blackwell RTX PRO 6000, и в 14–19 раз большую, чем DGX Spark, при полной параллельной обработке, причем разрыв увеличивается до 6 раз, когда длинные запросы создают нагрузку на кэш ключ-значение. Все три машины используют один и тот же стек CUDA и одни и те же пути квантования; Station же приобретает объем памяти и пропускную способность, что здесь проявляется как запас по параллельной обработке и устойчивость к длинным контекстам. Не менее важно и то, что эти диаграммы не могут показать: ни одна из моделей граничного масштаба, описанных в разделах выше, даже не загрузится на двух других системах.
ГДСИО
Современные задачи искусственного интеллекта зависят от достаточно быстрой передачи пакетов данных, весов моделей и контрольных точек из хранилища в память графического процессора, чтобы обеспечить постоянную загрузку ускорителя. Технология NVIDIA GPUDirect Storage устраняет традиционный двухэтапный процесс копирования, при котором данные сначала считываются с SSD-накопителя в системную память, а затем копируются в память графического процессора.
В GB300 DGX Station это реализовано иначе, чем в обычном сервере с графическим процессором PCIe. Используемый для нашего теста Micron 4600 подключен к коммутатору PCIe, встроенному в ConnectX-8. ConnectX-8 подключается к процессору Grace, а графический процессор B300 подключается к Grace через NVLink-C2C. SSD и графический процессор не находятся под одним и тем же коммутатором PCIe. Вместо этого трафик хранилища проходит через коммутатор ConnectX-8, попадает в корневой комплекс PCIe Grace, проходит через когерентную матрицу Grace и через NVLink-C2C достигает HBM3e сервера B300.
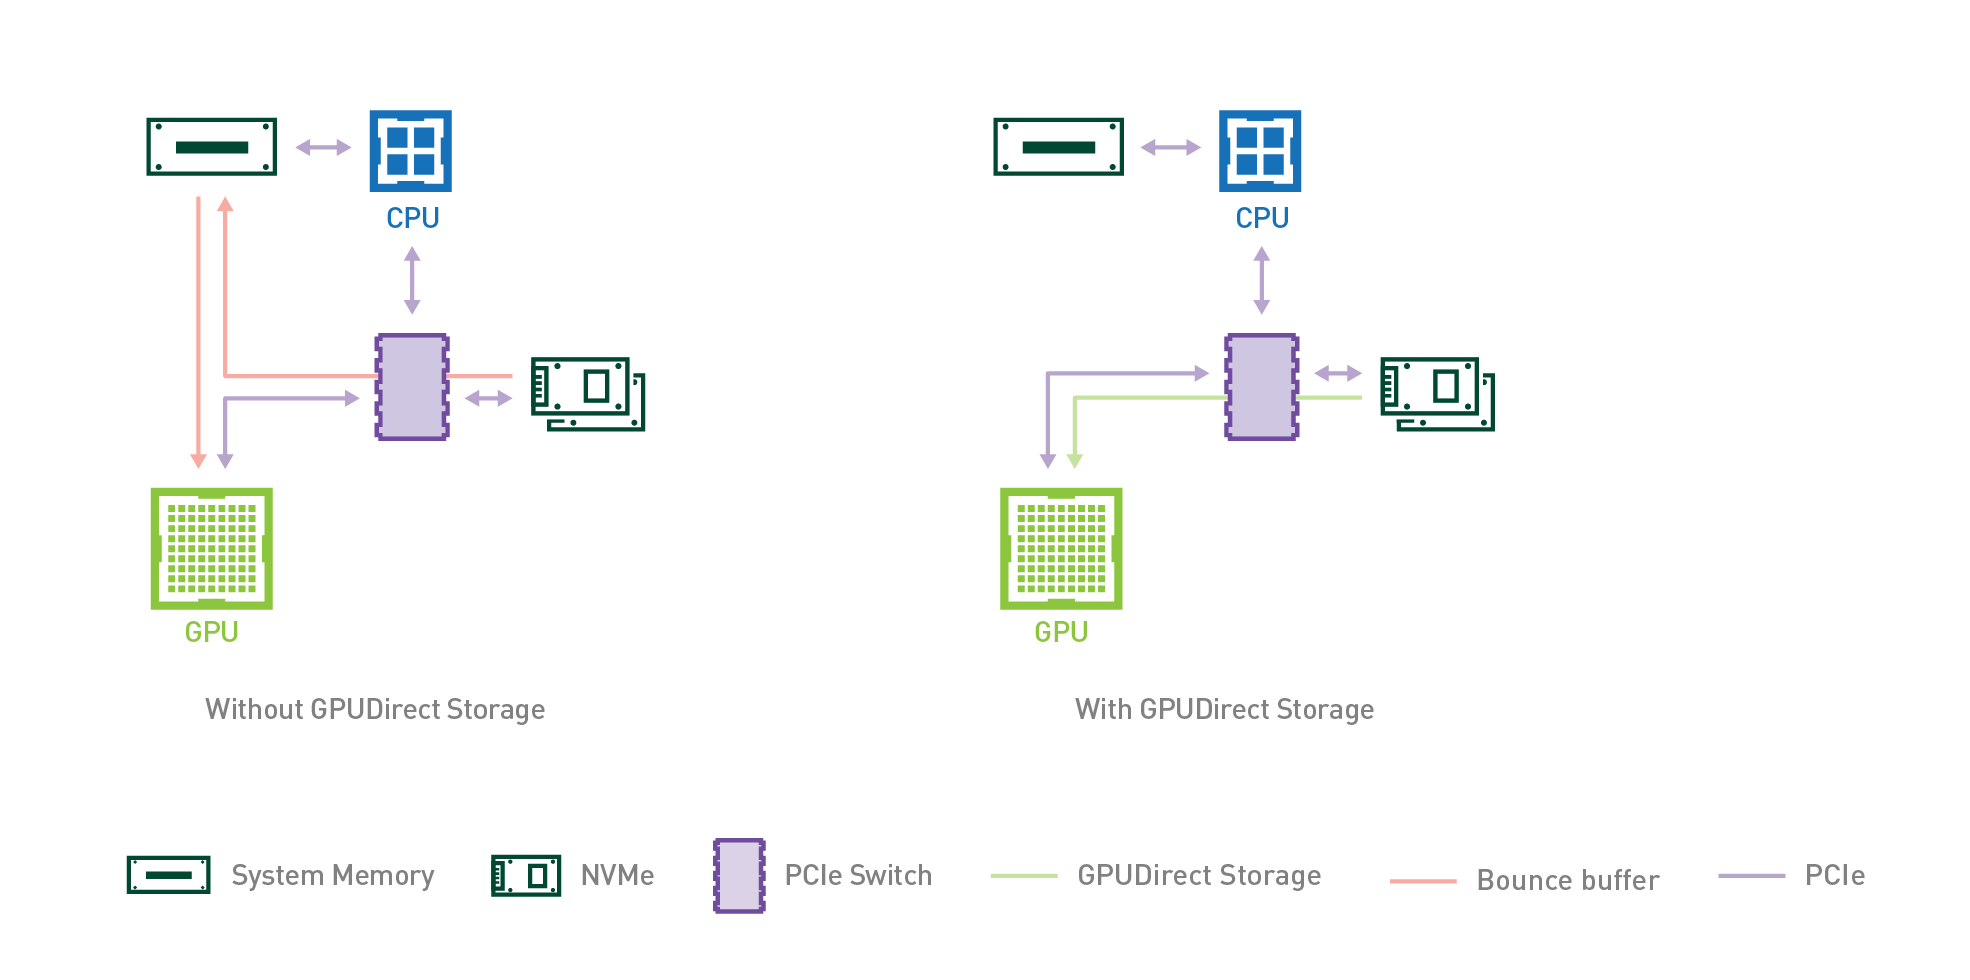
При использовании GPUDirect Storage, cuFile регистрирует буфер, выделенный в B300 HBM3e, в качестве источника или назначения для операций ввода-вывода хранилища. При чтении контроллер Micron 4600 использует DMA для размещения данных в HBM3e; при записи он извлекает данные из HBM3e. Обе операции следуют описанному выше пути Grace и NVLink-C2C без предварительной подготовки полезной нагрузки в памяти LPDDR5X Grace. Grace по-прежнему управляет файловой системой и плоскостью управления NVMe, включая отправку команд и преобразование адресов, но не копирует данные. Таким образом, GPUDirect Storage исключает этап предварительной подготовки в системной памяти, даже несмотря на то, что трафик по-прежнему проходит через Grace на пути между SSD и памятью B300. Для рабочих нагрузок ИИ последовательное чтение соответствует потоковой передаче наборов данных, загрузке моделей и восстановлению контрольных точек, а последовательная запись соответствует сохранению контрольных точек и другим передачам обратно в хранилище. Для тестирования производительности GDSIO мы измерили производительность хранилища, используя один автономный вторичный SSD.
Конфигурация тестирования GDSIO
- Загрузочное хранилище: 2 x Micron 4600 2 ТБ в RAID1
- Дополнительное хранилище: 2 x Micron 4600 2 ТБ
Анализируя производительность последовательного чтения GDSIO, можно отметить, что устройство стабильно масштабируется как по количеству потоков, так и по размеру блока. При размере блока 16K пропускная способность возрастает с 16 МиБ/с при 1 потоке до 250 МиБ/с при 16 потоках, достигая 2.0 ГиБ/с при 128 потоках. При больших размерах блока скорость увеличивается гораздо быстрее: при 256K пропускная способность достигает 11.8 ГиБ/с при 64 потоках и пикового значения в 12.9 ГиБ/с при 128 потоках. Наилучшие результаты наблюдаются при размерах блоков 512K и 1M, где пропускная способность достигает максимума в 13.1 ГиБ/с, при этом рабочая нагрузка в 1M достигает этого уровня всего при 32 потоках и поддерживает его до 128 потоков.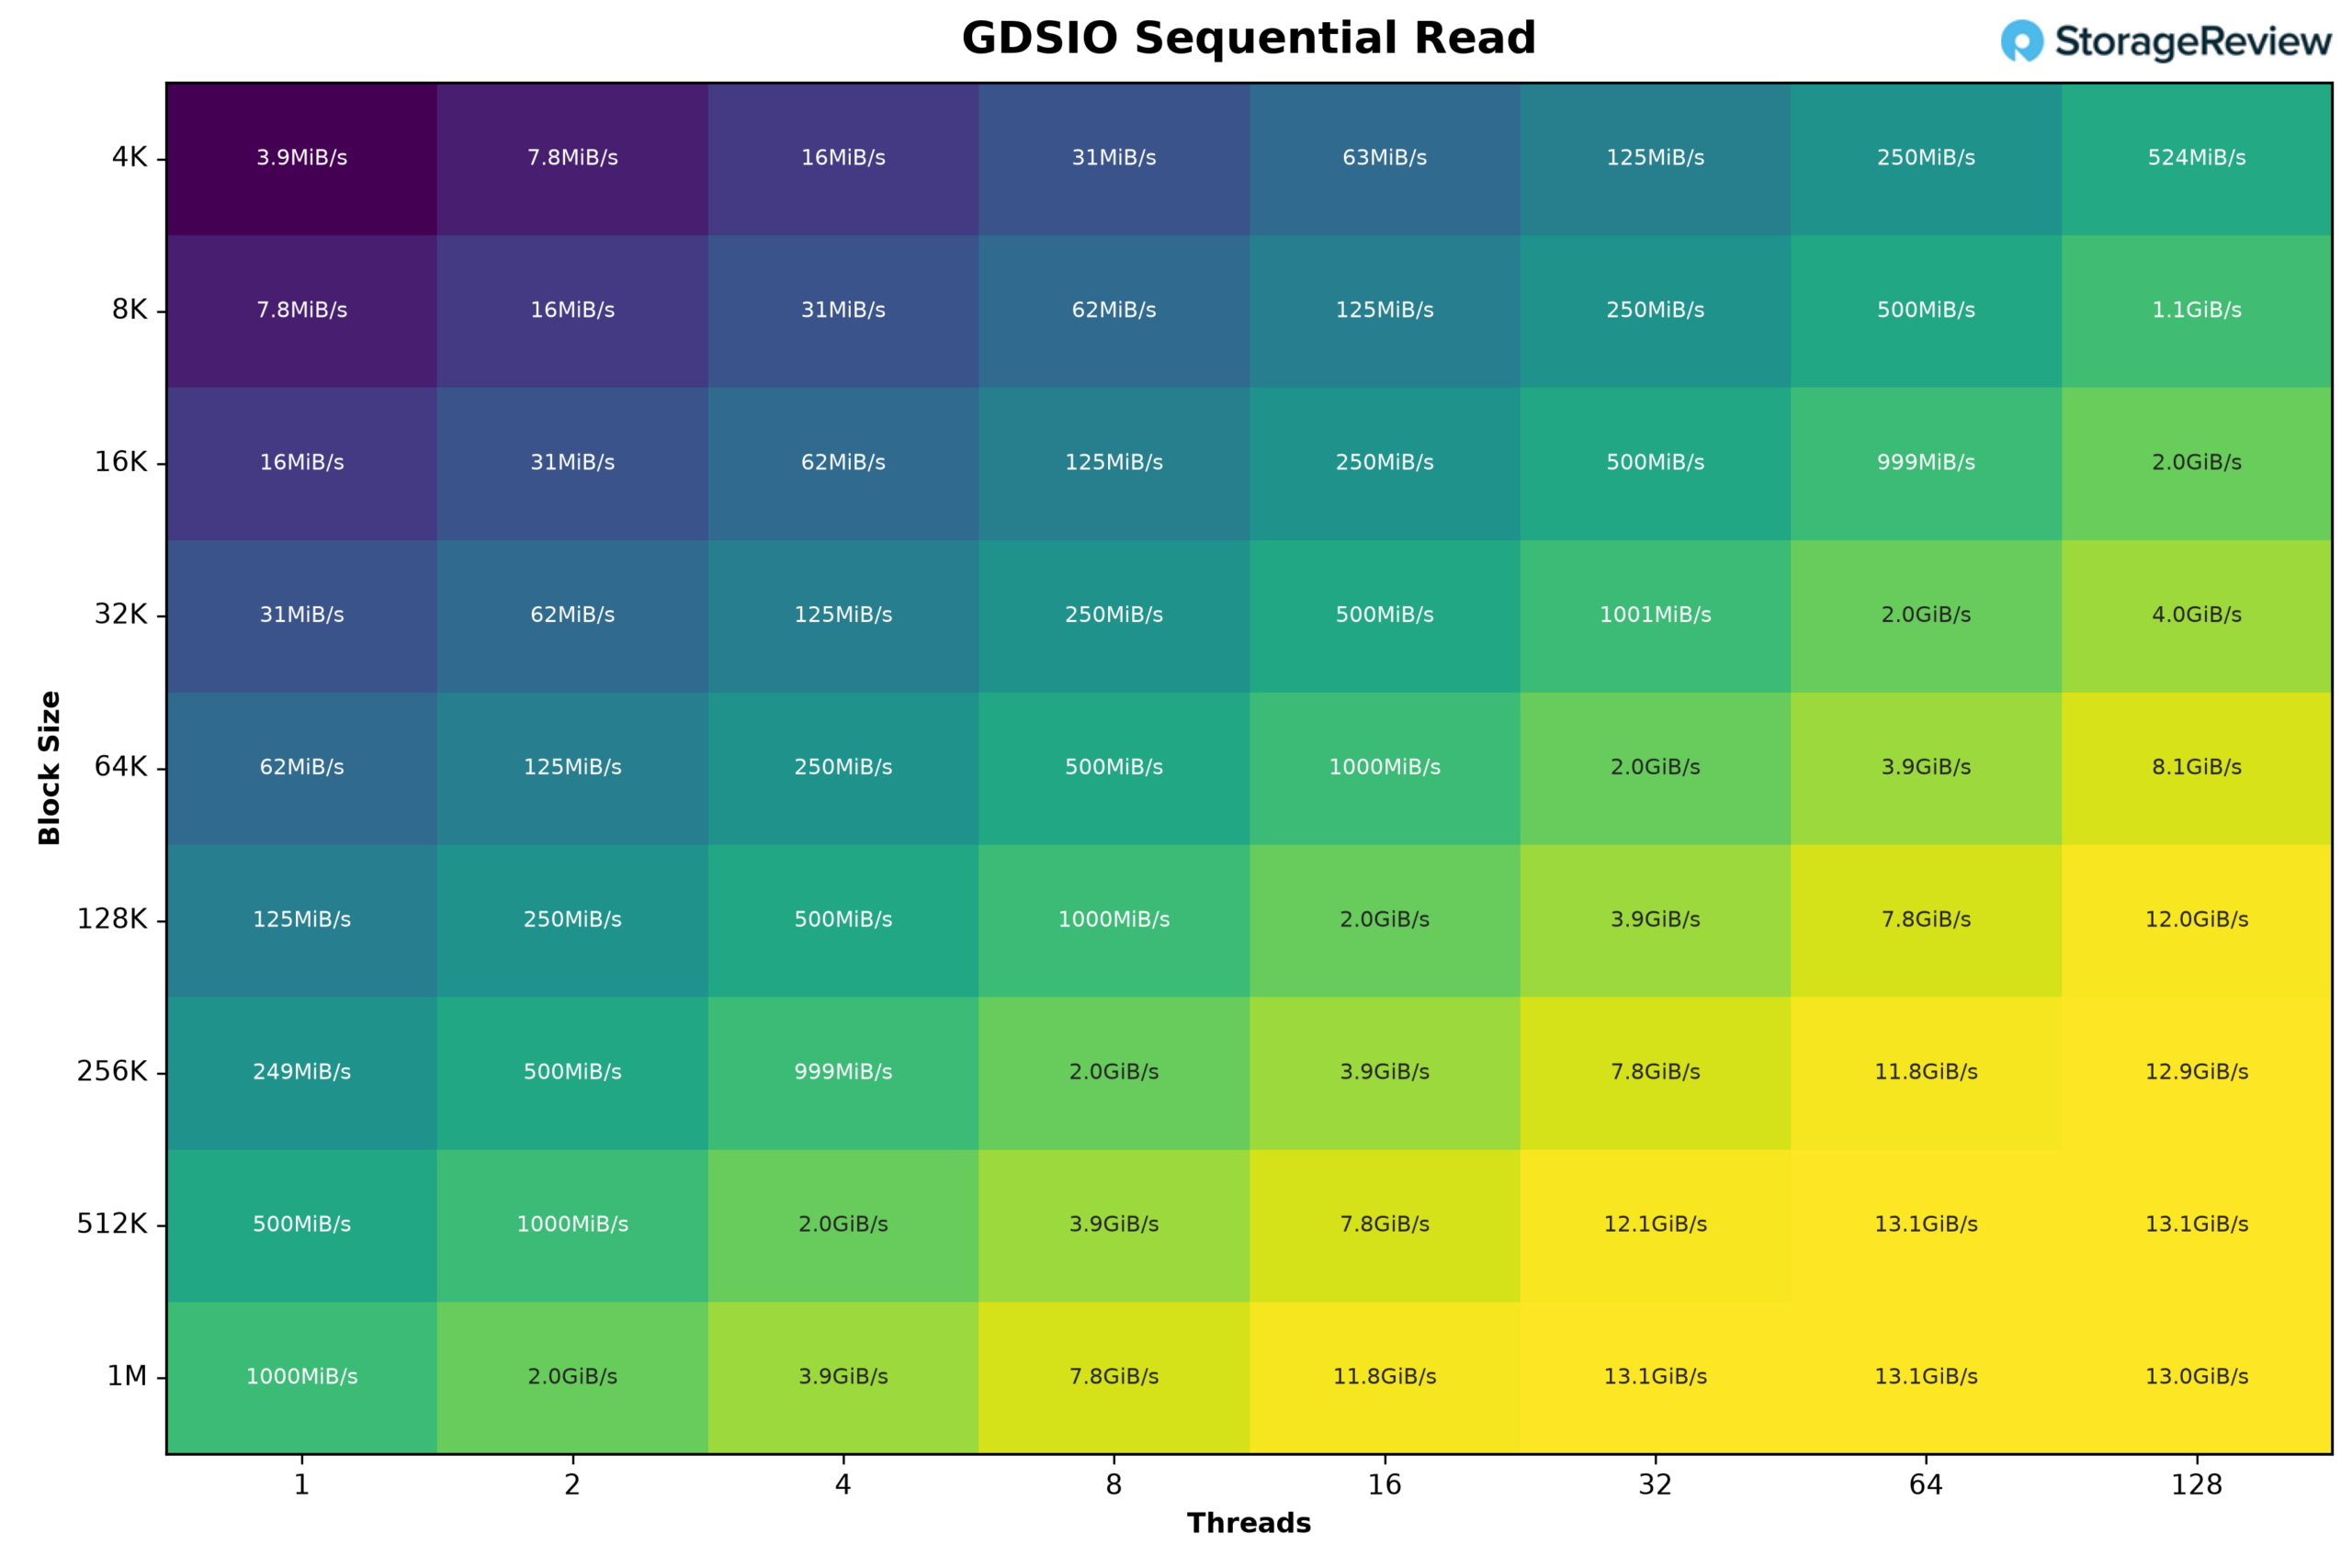
Что касается производительности последовательной записи GDSIO, то устройство стабильно масштабируется как по количеству потоков, так и по размеру блока. При размере блока 16K пропускная способность увеличивается с 16 МиБ/с при 1 потоке до 250 МиБ/с при 16 потоках, достигая 2.0 ГиБ/с при 128 потоках. При больших размерах блока производительность увеличивается гораздо быстрее: при 256K она достигает 7.5 ГиБ/с при 32 потоках и 12.0 ГиБ/с при 64 потоках. Наилучший результат достигается при нагрузке в 1 МБ, которая достигает потолка в 12.0 ГиБ/с всего при 16 потоках и поддерживает эту производительность до 128 потоков. 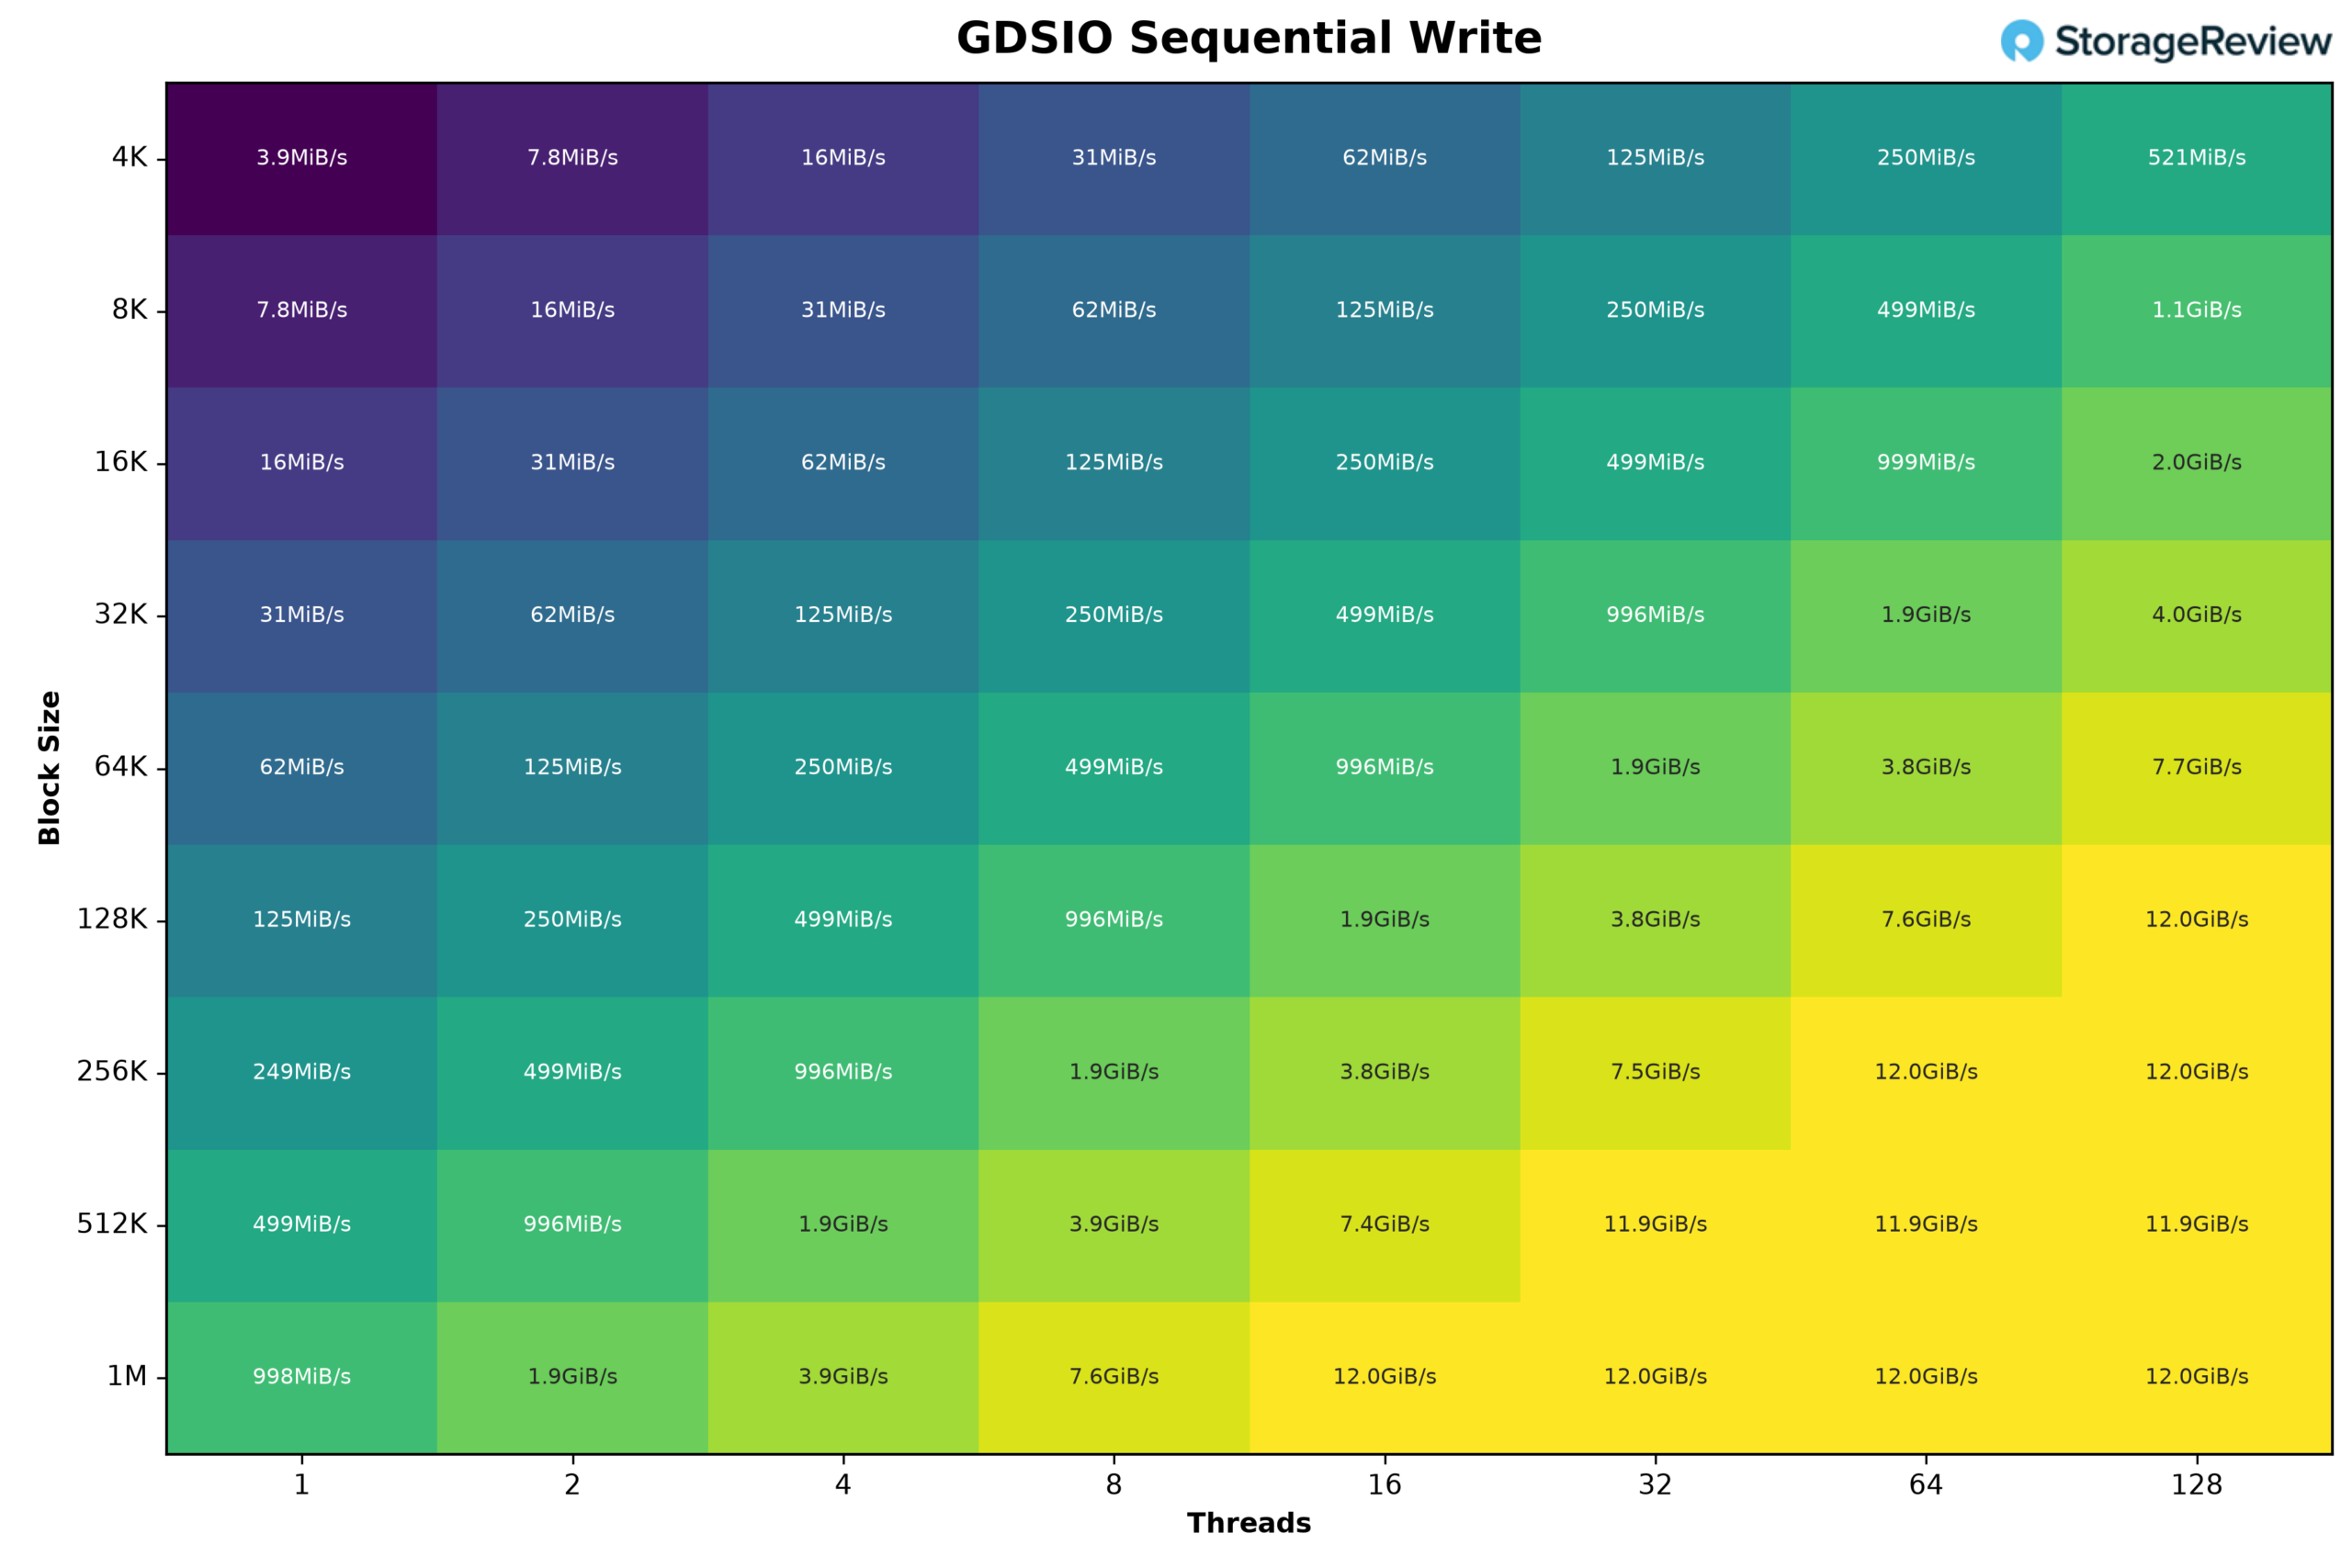
Для кого предназначена MSI XpertStation WS300?
WS300 предназначен для организаций, которым необходим прямой доступ к Blackwell Ultra, но которые не хотят начинать каждый эксперимент с резервирования кластера или запроса на облачные ресурсы. Лаборатории ИИ, разработчики механизмов вывода, команды разработчиков фреймворков и компиляторов, группы робототехники и корпоративные команды ИИ могут использовать его в качестве локального узла разработки для описанных выше рабочих процессов. MIG позволяет разработчикам тестировать и разрабатывать решения для многопроцессорной конфигурации, а BMC обеспечивает удаленное управление системой.
Это также имеет смысл для опытных разработчиков ИИ, которым нужна система, готовая к работе сразу после покупки. Ценность заключается не только в материнской плате B300. Это полноценная платформа вокруг неё: 252 ГБ HBM3e, Grace и 496 ГБ LPDDR5X, ConnectX-8, зеркальное загрузочное хранилище, жидкостное охлаждение, удалённое управление и поддержка MSI в одном корпусе. Практическими ограничениями являются архитектура Arm, необходимость в выделенной цепи на 20 А и общий бюджет в 1,600 Вт при установке мощной видеокарты RTX PRO.
Максимальная эффективность WS300 также зависит от программного обеспечения, используемого в системе. NVIDIA предоставляет широкий набор руководств и инструкций по развертыванию, призванных помочь командам быстро запустить систему и задействовать ее ресурсы. В будущих материалах мы рассмотрим несколько таких инструментов, включая Brev, который может упростить общий доступ к рабочей станции и повысить эффективность ее использования, чтобы такой дорогостоящий ресурс не простаивал без дела.
Что касается цены, MSI ее не опубликовала, и машины этого класса редко имеют рекомендованную розничную цену; это вопрос, требующий согласования с отделом продаж, а не вопрос добавления в корзину. Честное сравнение проводится не с другими рабочими станциями, а с тем, за что команда, занимающаяся разработкой ИИ, уже платит: зарезервированное время кластера, обязательства по использованию облачных графических процессоров и затраты на ожидание доступа к общему оборудованию.
Заключение
MSI XpertStation WS300 — это самая производительная рабочая станция из всех, что мы когда-либо тестировали, и редкий продукт, который меняет представление о том, что может сделать один специалист. Контрольные точки передового масштаба, которые обычно находятся за резервированием кластера, GLM-5.2 объемом 433 ГБ, Nemotron-3-Ultra с 550 миллиардами параметров, загружаются и обслуживаются на устройстве рядом с рабочим столом, обеспечивая конфиденциальность и постоянную доступность. В этом и заключается наш энтузиазм по отношению к этой системе.
DGX Station ориентирована на разработчиков: разработчиков ядра, работающих с Blackwell Ultra, команды, занимающиеся разработкой движков и фреймворков для вывода результатов, группы робототехники, использующие полный цикл Isaac, и в целом пользователей, недовольных планированием экспериментов на основе общего оборудования. За пределами этой ниши аргументы в пользу покупки этих систем довольно ограничены. Хост на базе Arm исключает некоторые наборы инструментов; 20-амперная цепь является обязательным требованием для установки в сетях 120 В; отсутствует вывод изображения без дополнительной карты расширения; а рабочая станция RTX PRO 6000 стоит гораздо дешевле, что позволяет использовать её для работы одному пользователю на моделях с 96 ГБ оперативной памяти.
Экономические соображения также ограничивают оптимальный размер развертывания. Один WS300 легко оправдать за счет зарезервированного времени кластера, и пара на команду по-прежнему остается оправданным вариантом. Дальнейшее увеличение количества серверов в кластере перестает иметь смысл на определенном этапе: к тому времени, когда организация, например, покупает четыре башенных сервера GB300, за те же деньги можно приобрести восьмипроцессорный сервер B300 с большим объемом памяти на каждый графический процессор, более плотным разделением MIG и NVLink между каждым графическим процессором. Оптимальный вариант — один сервер на рабочем столе, возможно, два в лаборатории, дополняющие инвестиции в центр обработки данных.
NVIDIA предоставляет базовую плату, поэтому различия между OEM-производителями сводятся к реализации, и MSI здесь демонстрирует солидный результат. Жидкостный контур мощностью 1,400 Вт охлаждает B300, Grace, SOCAMM и ConnectX-8, и платформа оставалась стабильной на протяжении всего тестирования. Более подробный анализ теперь опубликован: наш подробный обзор температурного режима WS300 сочетает данные MSI о холодной пластине и радиаторе с результатами 2.8-часового инструментального тестирования, показавшего поддержание температуры кристалла на уровне 60°C и стабильной тактовой частоты 2.07 ГГц при полной нагрузке. Энергетический бюджет в 1,600 Вт распределяется между компонентами автоматически, и когда мы тестировали аппаратный тормоз питания с нестабильным соединением, он снижал производительность, а не отключался. Предварительно подключенный кабель 12VHPWR и кронштейн против провисания поддерживают путь расширения RTX PRO. Протестировав первую попавшуюся нам станцию GB300 DGX, мы можем сказать, что XpertStation WS300 устанавливает высокую планку для этой платформы.
XpertStation WS300 теперь занимает первое место в нашем рейтинге лучших настольных компьютеров для локального ИИ по показателю памяти GB300 , а также является ключевым элементом в обсуждении памяти в нашем руководстве по ОЗУ, графическому процессору и хранилищу для агентного ИИ.


 Amazon