

Системы искусственного интеллекта для рабочих мест, построенные на базе NVIDIA GB10, выполняют одну задачу, и делают это хорошо: размещают 128 ГБ унифицированной памяти и петафлоп вычислительной мощности на рабочем столе достаточно близко к пользователю, чтобы итерации происходили мгновенно. Чего им не хватает, так это подключения к уже используемому в организации хранилищу. Каждая система DGX Spark и её OEM-версия поставляется с одним коротким слотом M.2, который ограничивает локальную емкость примерно до 4 ТБ и размещает все наборы данных, модели и контрольные точки на этом устройстве вне системы управления, контроля доступа, резервного копирования и аудита, которые хранятся в центре обработки данных. Умножьте это на лабораторию, отдел или кампус, и вы получите десятки изолированных 4-терабайтных «островов», каждый из которых содержит свою собственную копию одних и тех же моделей и наборов данных, и безопасность каждого из них зависит только от безопасности рабочего стола, на котором он находится.
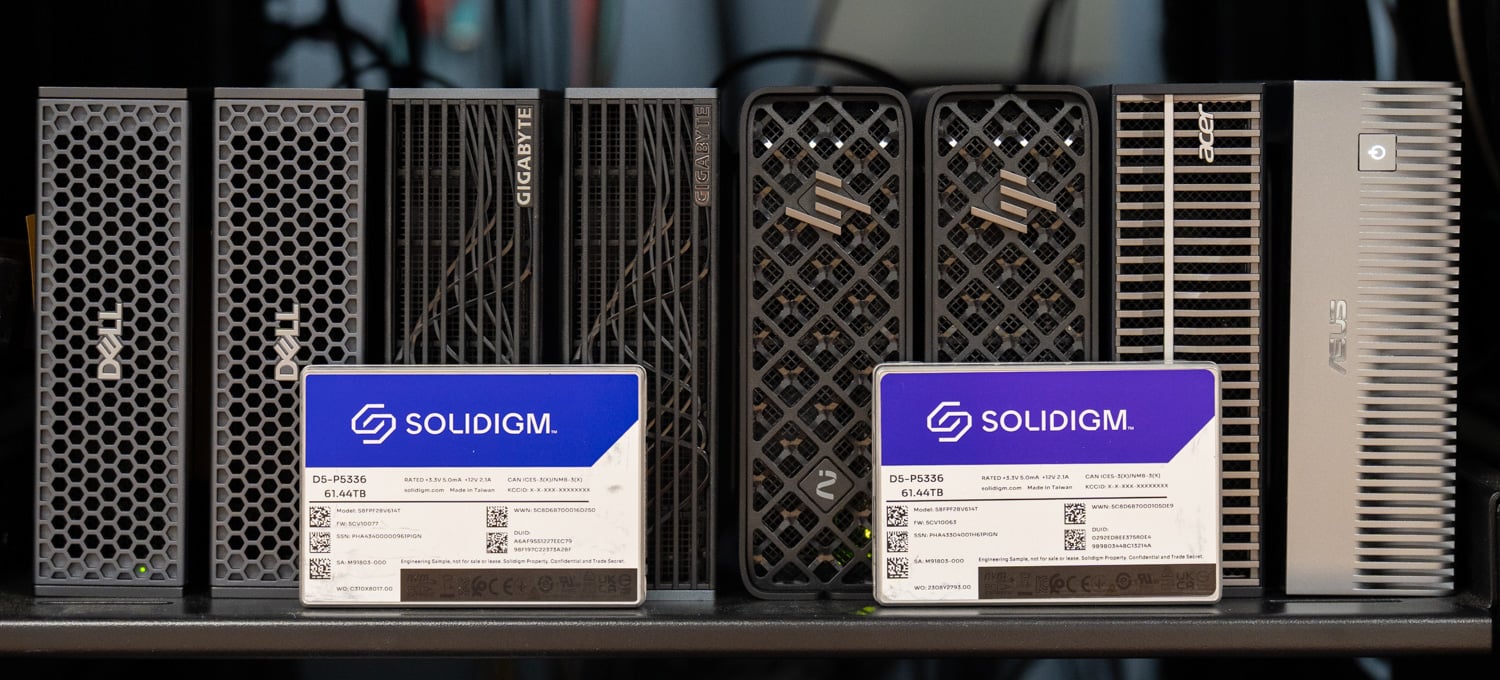
Этот проект возвращает проблему хранения данных в центр обработки данных. Мы создали хост общего хранилища DGX Spark на базе Dell PowerEdge R770AP, восьми SSD-накопителей Solidigm D5-P5336 QLC в конфигурации Graid SupremeRAID RAID 5, сетевого оборудования Broadcom 400GbE и Tuxera Fusion, предоставляющего NFS через RDMA, а затем подключили восемь Spark к его портам 100GbE. Каждый Spark в сети монтирует один и тот же управляемый пул хранения с защитой четности по одной линии; одна копия каждой модели и набора данных обслуживает все устройства, ни одной рабочей станции не требуется больше места для хранения, чем она имеет по умолчанию, а сами Spark могут размещаться в стойке рядом с массивом, где их проще защитить, охладить и совместно использовать. Суть этой конструкции в том, где хранятся данные, и любой NVMe-сервер с быстрыми сетевыми адаптерами может сыграть эту роль. Университет штата Орегон, который изучает возможность создания крупномасштабной лаборатории Spark для обучения искусственному интеллекту и хочет предоставить студентам доступ к исследовательским наборам данных объемом в десятки терабайт, поделился с нами своими соображениями в процессе проектирования системы, и для данных такого масштаба подход к общему хранилищу оказался наиболее подходящим для данной оценки.
Основные выводы
- Один массив, восемь Spark-ов, без клиентского программного обеспечения: Восемь устройств DGX Spark от пяти производителей монтируют NFS/RDMA-ресурсы с одного массива Solidigm D5-P5336 QLC, расположенного за системами Graid SupremeRAID и Tuxera Fusion, используя уже имеющиеся порты 100GbE и выполняя монтирование одной строкой в стандартной версии Ubuntu.
- Размещенные модели загружаются так же, как и локальные: Загрузка 78-гигабайтной модели Qwen3.5-122B-A10B-NVFP4 из общего массива заняла 269.6 секунды на одном устройстве Spark, что всего на 13% меньше, чем 239.6 секунды, которые потребовались тому же устройству Spark для работы с внутренним NVMe-накопителем. При одновременной загрузке одной и той же копии восемью устройствами Spark завершили процесс за время от 232.8 до 326.5 секунд.
- Один экземпляр заменяет собой бункер на каждом столе: Модели и наборы данных на управляемых, защищенных от ошибок хранения данных хранилищах центров обработки данных заменяют копии на 4-терабайтных M.2-накопителях для каждой рабочей станции, что повышает эффективность использования, снижает объем копируемых данных, и отпадает необходимость в модернизации хранилища или дополнительном месте для Spark. Для крупномасштабной лаборатории обучения ИИ, подобной той, которую исследует Университет штата Орегон, где исследовательские наборы данных достигают десятков терабайт, этот подход идеально подходит для задач, рассмотренных в нашей оценке.
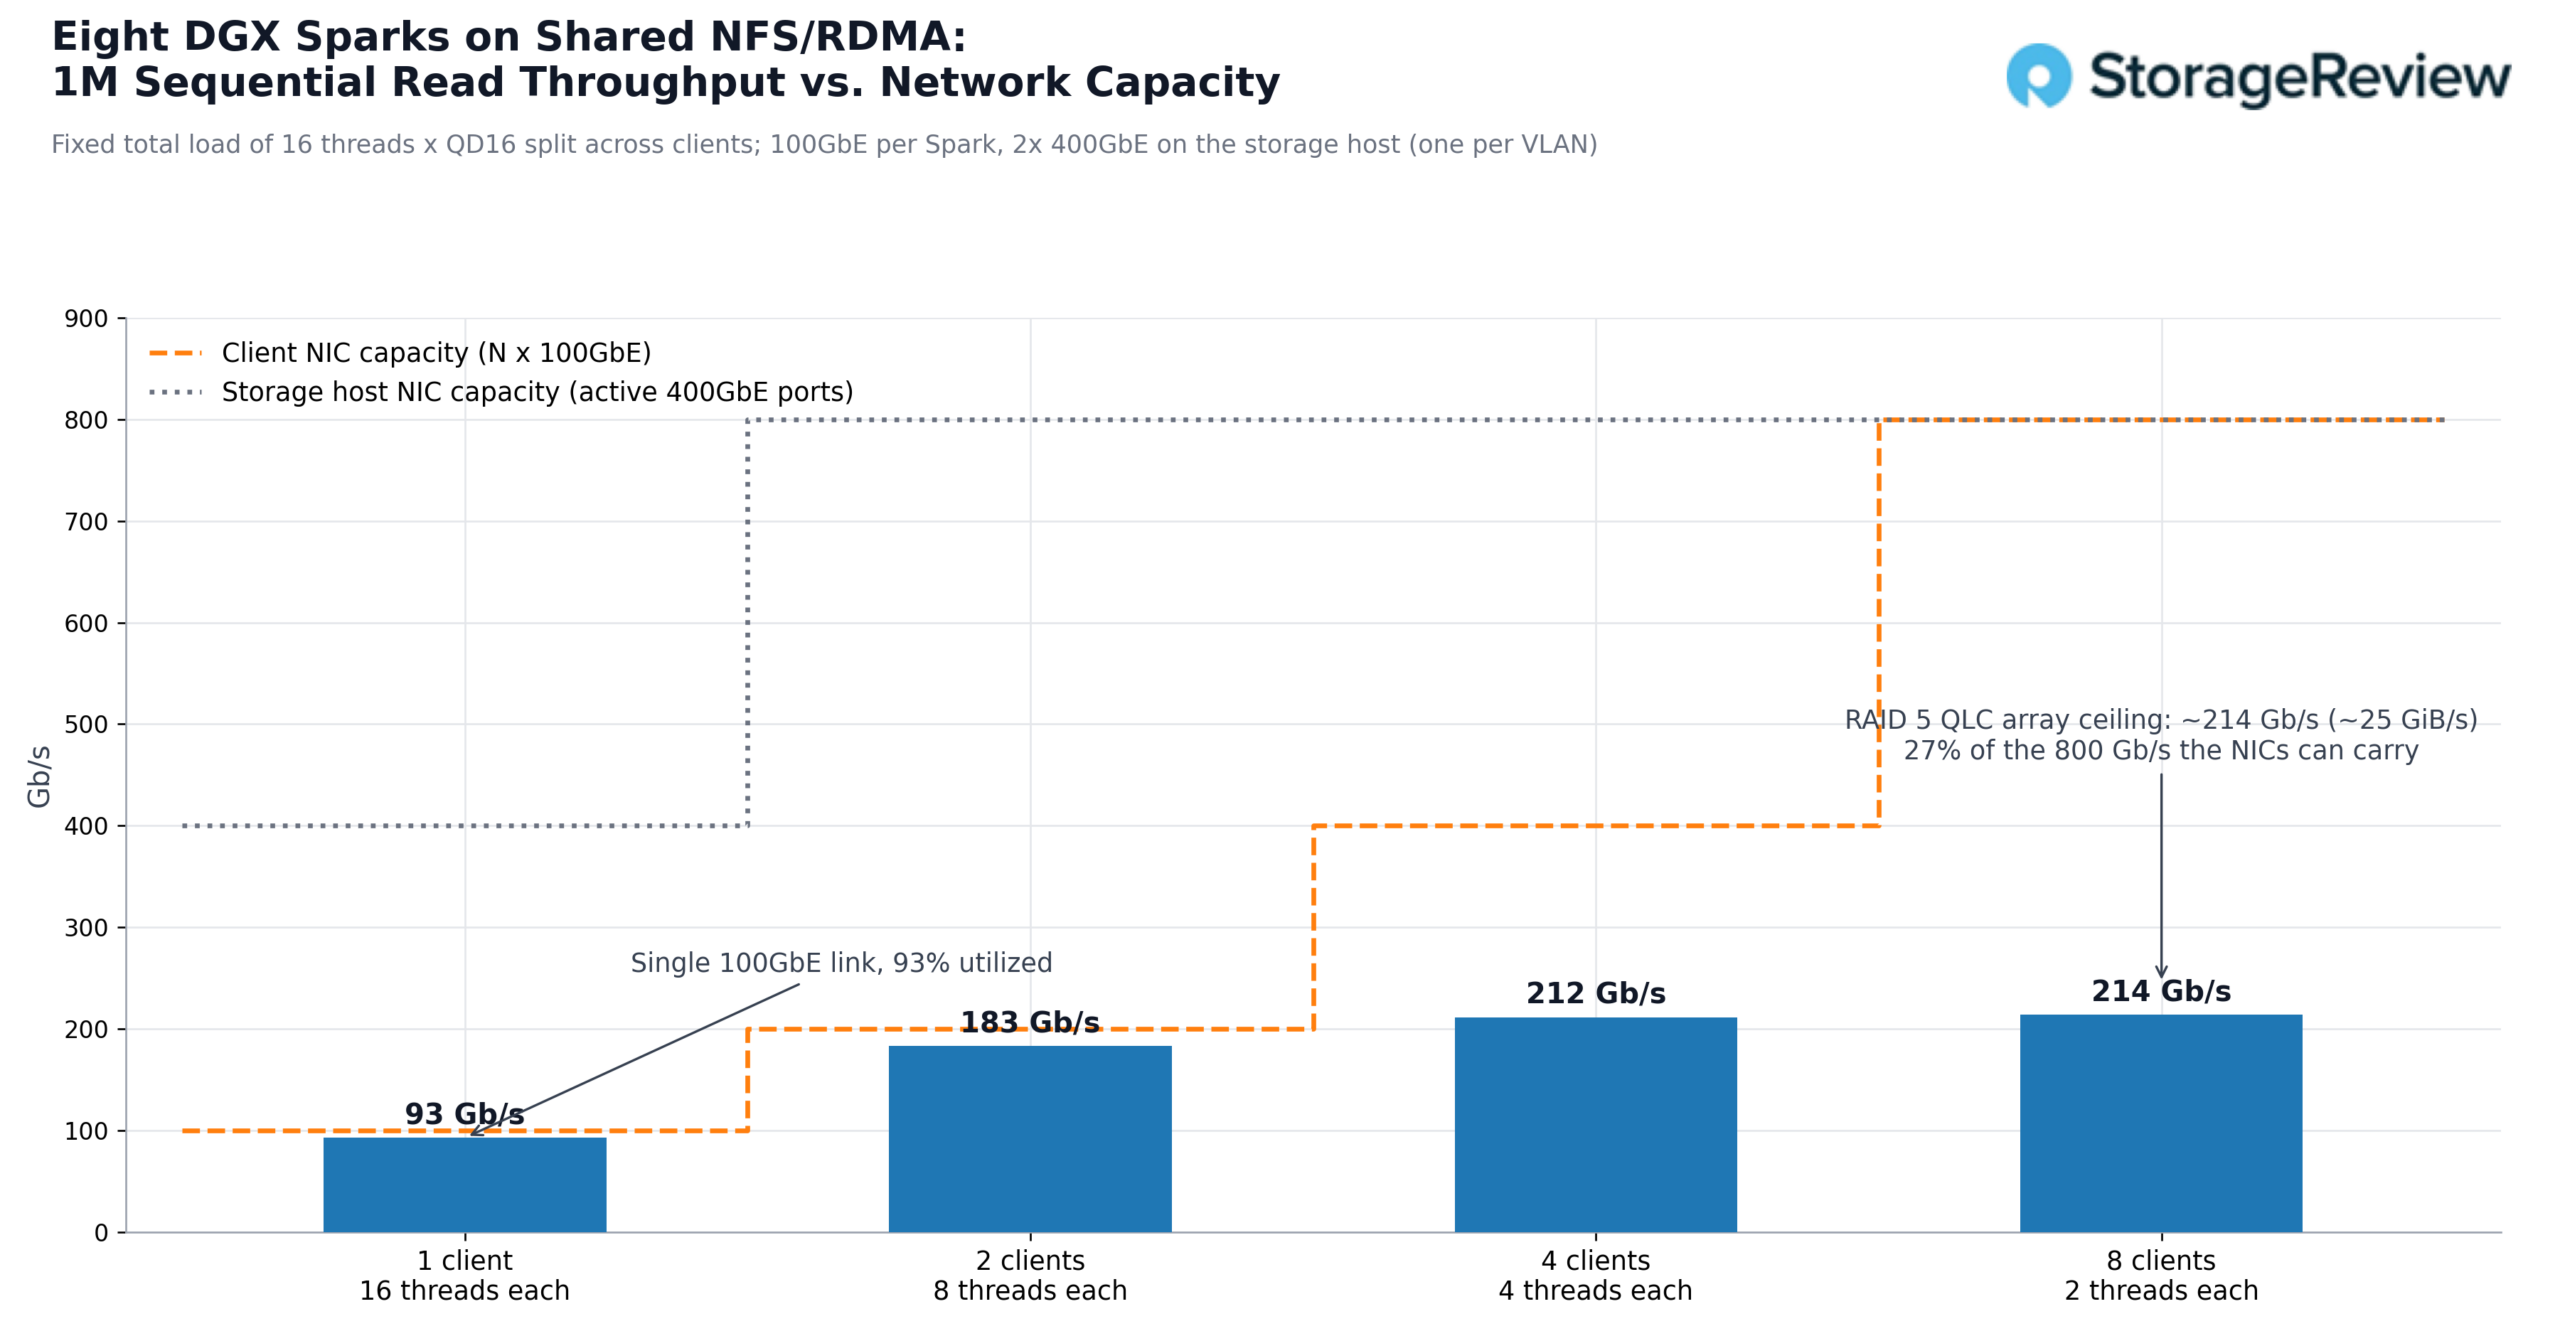
- Накопители задают верхний предел, и у сети есть запас по мощности: При одновременном чтении данных всеми восемью устройствами Spark, массив RAID 5 из восьми дисков достиг максимальной скорости около 25 Гбит/с, что составляет примерно 214 Гбит/с, и использовал 27% от 800 Гбит/с, которые могут обеспечить две сетевые карты Broadcom BCM57608 в хосте. Скорость чтения одного устройства Spark из массива составила 10.8 Гбит/с, что соответствует самой быстрой скорости внутреннего M.2, измеренной нами в системе GB10.
- Управление осуществляется в рамках протокола: NFS с RDMA объединяет папки для каждого пользователя, общие наборы данных и размещенные модели в одном пространстве имен с поддержкой Active Directory, Kerberos и LDAP, что позволяет данным оставаться под контролем центра обработки данных, пока устройства Spark перемещаются в стойку.
Проблема с островом искусственного интеллекта на каждом рабочем столе
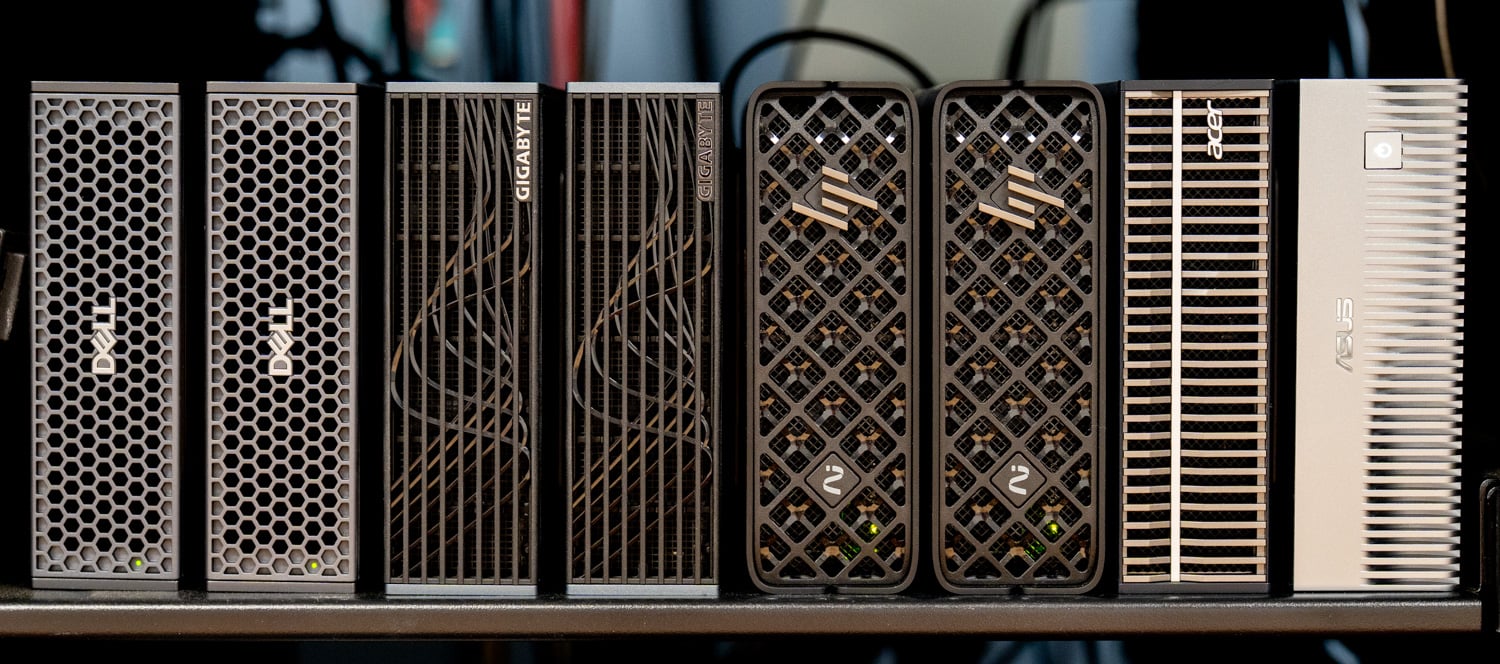
DGX Spark и его OEM-варианты от Dell, GIGABYTE, HP, Acer и ASUS используют платформу GB10 и имеют одинаковый максимальный объем памяти. В нашем первоначальном обзоре DGX Spark наиболее очевидным ограничением платформы был объем памяти. Внутренний слот предназначен для коротких M.2-накопителей, поэтому 8-терабайтные SSD-накопители для клиентов, поставляемые в форм-факторе 2280, физически не помещаются. Luisuantech GP Spark, обзор которого мы публиковали в августе, решает эту проблему с помощью четырехсекционного корпуса для M.2-накопителей, подключенного к одному порту 100GbE, что является удобным решением для одного Spark на одном столе и, в лабораторных условиях, для более вместительного хранилища на каждом столе.
Проблема с объемом памяти — это половина проблемы; другая половина — это то, что происходит с данными после того, как они попадают на настольный компьютер. Модель с 78 ГБ данных, загруженная на Spark, — это копия, которую никто в ИТ-отделе не видит. Исследовательский набор данных, размещенный на локальной флешке, — это копия, не включенная в график резервного копирования, политику доступа и институциональные проверки. Десять Spark в лаборатории означают десять копий одних и тех же весов, занимающих 780 ГБ флешки, которую можно было бы использовать для чего-то другого, и десять мест, откуда набор данных может уйти вместе с компьютером. Проблема усугубляется по мере роста количества компьютеров, будь то системы GB10 или любая настольная инфраструктура ИИ. Каждая организация, управляющая парком ноутбуков, знает эту закономерность, и ответ тогда был тот же: хранить данные на общем хранилище в центре обработки данных, а конечная точка должна оставаться конечной точкой.
К счастью, NVIDIA разработала Spark с портами, позволяющими это реализовать. Каждый блок оснащен двумя отсеками QSFP56 на интегрированном модуле ConnectX-7, с максимальной полезной пропускной способностью платформы в 200 Гбит/с за парой каналов PCIe Gen5 x4. В нашем обзоре кластера DGX Spark мы описали конфигурацию с разделением ролей, в которой один отсек используется для подключения к соседнему Spark, а другой — для хранения данных. В этом проекте для каждого Spark используется один отсек для хранения данных со скоростью 100 Гбит/с, оставляя второй свободным для кластеризации или дополнительной пропускной способности. При скорости 100 Гбит/с каждый Spark имеет примерно 12.5 ГБ/с теоретической пропускной способности до хоста хранения данных, что превышает пропускную способность, обеспечиваемую внутренним слотом M.2 в большинстве таких систем.
Как только данные оказываются на другом конце этого канала связи, роль Spark меняется. Он становится вычислительной точкой с загрузочным диском и локальным кэш-диском, и емкость больше не является покупкой для каждой рабочей станции отдельно. Модель или набор данных записываются один раз и считываются каждым клиентом, поэтому использование хранилища увеличивается, а количество копий уменьшается. Защита данных перемещается в массив с защитой четности в серверном шасси, а контроль доступа, шифрование данных в состоянии покоя, резервное копирование и аудит выполняются там же, где и для всего остального. И поскольку Spark теперь требует только питания и канала 100GbE, ему вообще не нужно стоять на столе. Размещенный в стойке рядом с хостом хранения данных, он охлаждается, работает тише, физически защищен и доступен тому, кому он понадобится в следующий раз.
Хост хранилища
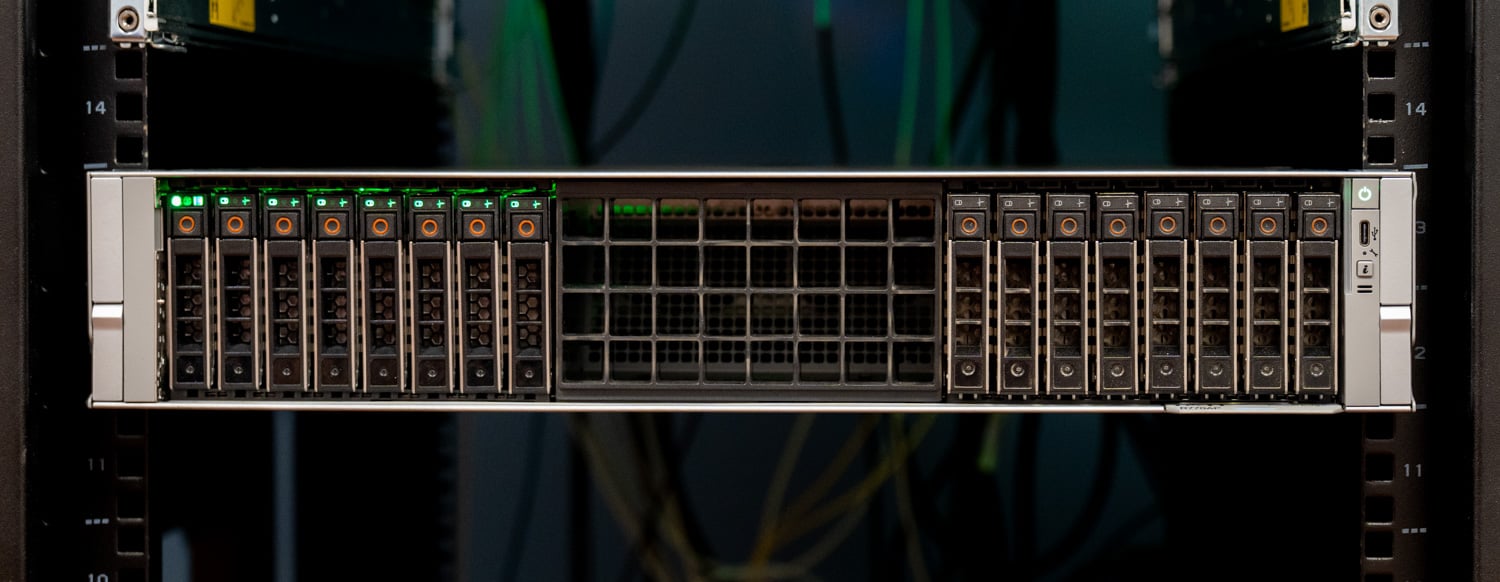
В качестве хранилища данных используется Dell PowerEdge R770AP , та же платформа 2U на базе процессоров Xeon 6, которую мы рассматривали ранее в этом году. Мы использовали её, потому что она была бесплатной в лаборатории, когда проект только начинался. Любой NVMe-сервер с местом для быстрых сетевых адаптеров и небольшого графического процессора мог бы справиться с этой задачей, и R770AP — один из способов её создания, пусть и несколько избыточный. Наш сервер работает на двух процессорах Xeon 6 6978P с 1.5 ТБ оперативной памяти DDR5 на 24 слотах DIMM, использует один из двух блоков по восемь отсеков для NVMe-накопителей Gen5 и подключает диски и графический процессор Graid к процессору CPU 0, а два адаптера 400GbE — к процессору CPU 1. Сервер работает под управлением Ubuntu 24.04.
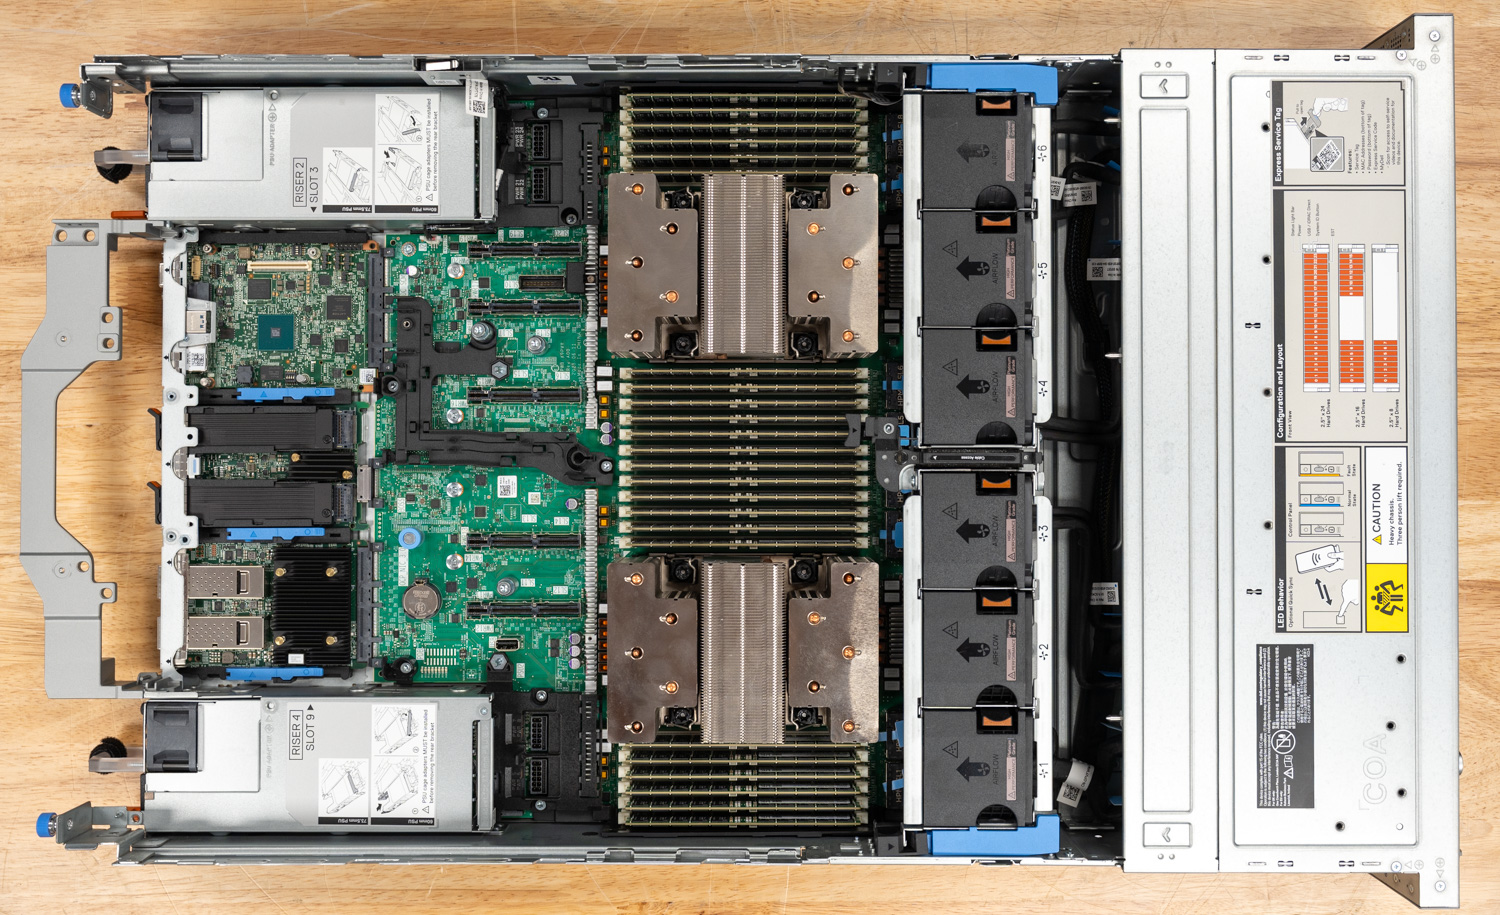
| Компонент | Конфигурация хоста хранилища |
|---|---|
| серверу | Dell PowerEdge R770AP, 2U, 16 отсеков для 2.5-дюймовых NVMe-накопителей Gen5. |
| ЦП | 2 процессора Intel Xeon 6 6978P |
| Память | 1.5 ТБ DDR5 (24 x 64 ГБ) |
| Память | 8x Solidigm D5-P5336 61.44 ТБ U.2 PCIe 4.0 QLC (491.52 ТБ в необработанном виде) |
| RAID | Graid SupremeRAID, RAID 5 на всех восьми дисках, видеокарта NVIDIA RTX A2000 на ЦП 0 |
| Файловая система | XFS на виртуальном диске SupremeRAID |
| Файловый сервер | Tuxera Fusion (Fusion NFS, закрытая предварительная сборка), NFS 4.1 через RDMA (RPC-RDMA на порту 20049), пользовательский режим |
| Networking | 2x Broadcom BCM57608 (Thor 2) однопортовый 400GbE, PCIe Gen5 x16 на процессоре 1, RoCEv2 |
| Коммутатор | Dell PowerSwitch Z9864F-ON, 64x 800GbE OSFP112, Enterprise SONiC |
| Клиентские ссылки | Оптический кабель 800G разветвлён на 8 каналов 100GbE, по одному каналу на каждый Spark, четыре Spark на каждый сетевой адаптер хранения данных в отдельных VLAN. |
| Наши клиенты | 2 ноутбука Dell Pro Max с GB10, 2 видеокарты GIGABYTE AI TOP ATOM, 2 материнские платы HP ZGX Nano G1n, ноутбук Acer Veriton GN100, материнская плата ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
Почему QLC и почему D5-P5336?
В ходе наших обсуждений с Университетом штата Орегон по концепции лаборатории Spark, первым требованием была емкость, поскольку используемые наборы данных для исследований очень велики. Задача этого сервера — хранить все данные, которые могут понадобиться группе пользователей Spark, и предоставлять их в формате, доступном для одновременного чтения многими клиентами. Это профиль с высокой интенсивностью чтения, большими блоками и большой емкостью, и именно для такого профиля была создана технология QLC. Семейство D5-P5336 предлагает диски объемом от 7.68 ТБ до 122.88 ТБ; используемые здесь диски U.2 емкостью 61.44 ТБ, по оценке Solidigm, обеспечивают скорость последовательного чтения до 7,000 МБ/с, скорость последовательной записи до 3,000 МБ/с, 1.005 млн операций случайного чтения 4K в секунду и ресурс 65.2 ПБВт, или 0.58 операций записи в день в течение пяти лет, на 192-слойной QLC NAND с блоком косвенного доступа 16 КБ.
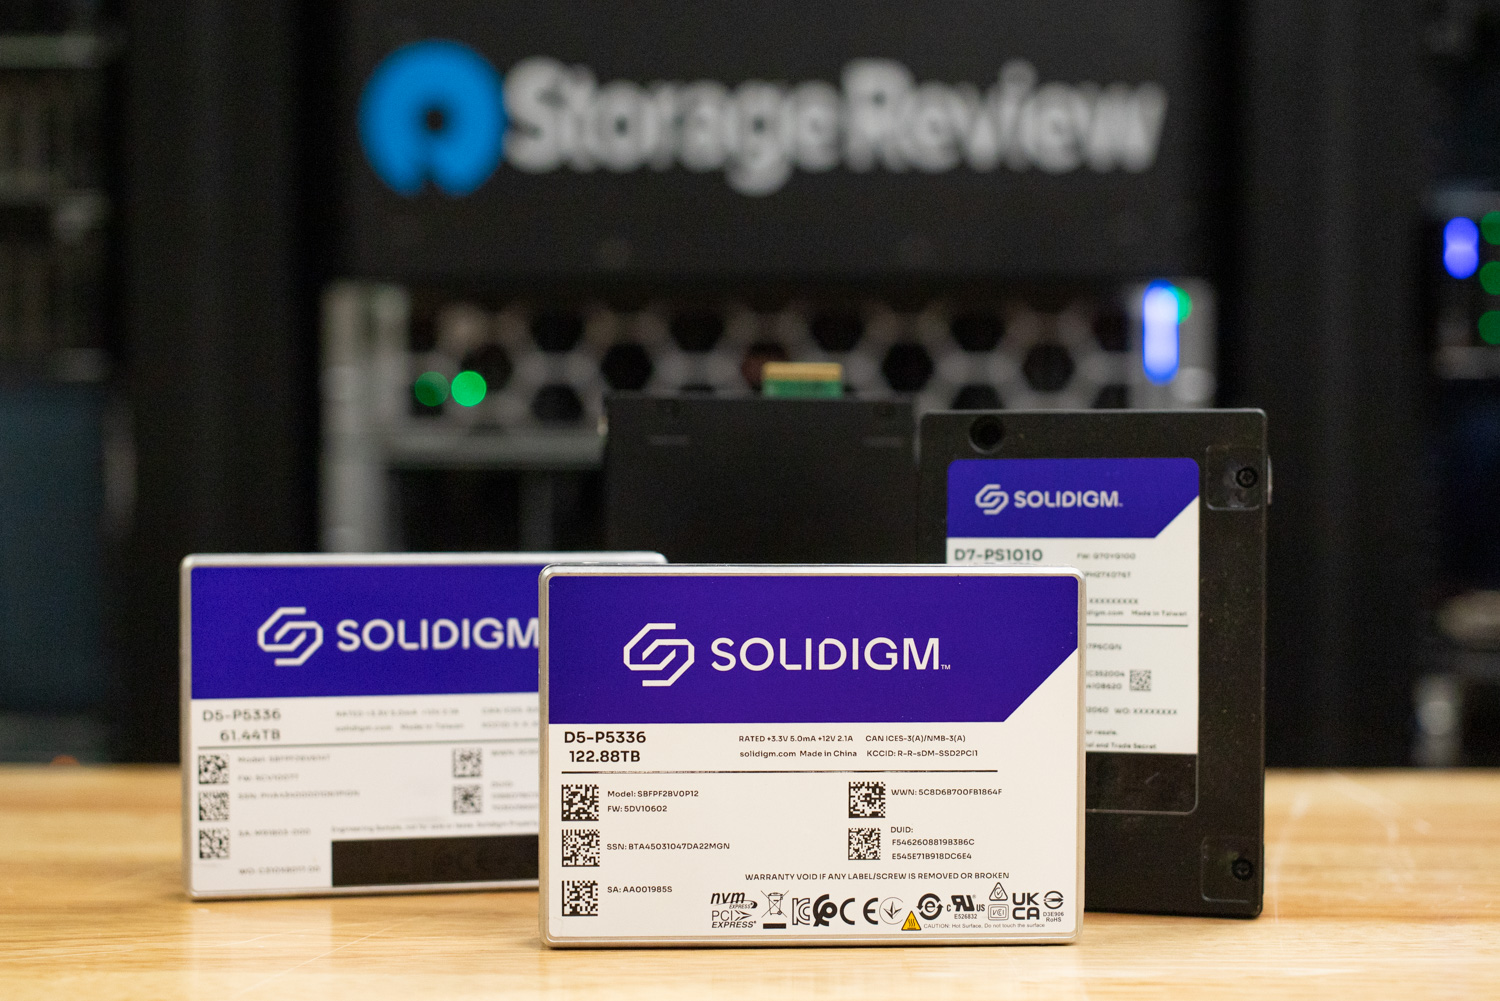
Восемь дисков по 61.44 ТБ занимают половину передних отсеков R770AP, и в производственной конфигурации можно выбрать любой объем из семейства и любое количество отсеков. Тем не менее, восемь дисков в режиме RAID 5 обеспечивают около 430 ТБ полезного пространства с отказоустойчивостью на уровне одного диска. Это более чем в 100 раз больше, чем вмещает слот M.2 Spark, и достаточно для библиотеки моделей факультета, общих наборов данных, с которыми работают студенты, и домашних каталогов для каждого пользователя. Заполнение остальных восьми отсеков удваивает этот объем без изменения сетевой архитектуры, а приведенные далее в этом обзоре данные о размерах показывают, почему именно диски являются оптимальной частью системы.
Для этой рабочей нагрузки важен 16-килобайтный модуль косвенного доступа, поскольку больший модуль IU от Solidigm жертвует эффективностью небольших случайных записей ради плотности и стоимости, а для общего хранилища, обслуживающего модели и наборы данных, небольшие случайные записи являются меньшинством. Загрузка моделей — это большие последовательные операции чтения. Потоковая передача наборов данных — это большие последовательные операции чтения. Контрольные точки и файлы студентов записываются один раз и считываются часто. Полученное таким образом разделение труда является правильным для лаборатории Spark: общий массив QLC хранит все, что считывается многими устройствами, а собственный M.2-накопитель Spark обрабатывает трафик временных файлов и файлов подкачки, записываемый одним устройством.
RAID на графическом процессоре: Graid SupremeRAID
NVMe RAID на восьми накопителях Gen4, каждый из которых способен считывать данные со скоростью 7,000 МБ/с, — это точка, в которой обычная аппаратная RAID-карта становится узким местом, поскольку каждый байт должен проходить через слот PCIe карты. Программный RAID сталкивается с другими проблемами, связанными с ресурсами. Graid SupremeRAID переносит вычисления четности на графический процессор и сохраняет путь передачи данных по линиям PCIe хоста, поэтому в наших тестах SupremeRAID AE с 16 накопителями мы наблюдали масштабирование до более чем 180 ГБ/с. Для этого хоста мы запускали SupremeRAID на NVIDIA RTX A2000, небольшом рабочем графическом процессоре.
Восемь дисков D5-P5336 были подвергнуты безопасному стиранию данных и последовательному заполнению, после чего переданы компании Graid и сконфигурированы как единый массив RAID 5. Полученный виртуальный диск был отформатирован в XFS и обслуживался Tuxera. RAID 5 — оптимальный уровень для такого общего ресурса: отказ диска поддерживает работу массива, восстановление происходит без удаления пользовательских данных, а потеря емкости составляет один диск из восьми. RAID 6 или RAID 10 были бы разумным выбором для производственной среды, где защита окна восстановления ценится больше, чем емкость, и SupremeRAID поддерживает оба варианта.
Сеть: Broadcom 400GbE и ядро 800G.
В качестве устройства хранения данных используются два адаптера Broadcom BCM57608 Thor 2 в маршрутизаторе R770AP, каждый из которых представляет собой однопортовый сетевой адаптер 400GbE с интерфейсом PCIe Gen5 x16. Broadcom позиционирует BCM57608 как самый энергоэффективный сетевой адаптер 400G в отрасли, и его набор функций делает его удачным выбором: RoCEv2 с улучшенным управлением перегрузкой DCQCN, адаптивная маршрутизация, безопасная загрузка с кремниевым корнем доверия и разгрузка шифрования kTLS. RoCEv2 в этой конструкции передает NFS через RDMA, а управление перегрузкой предотвращает одновременное подключение нескольких клиентов. Во время сборки драйвер bnxt_en сообщил, что оптические модули на портах 400G достигают порогового значения в 70°C при длительной нагрузке. Мы устранили эту проблему, немного изменив профиль вентилятора на R770AP, после чего сетевые адаптеры работали без сбоев.
Обе сетевые карты подключены к коммутатору Dell PowerSwitch Z9864F-ON , основному коммутатору 800G в нашей лаборатории, работающему под управлением Enterprise SONiC. Z9864F-ON имеет 64 порта OSFP112 со скоростью 800 Гбит/с и может разветвлять любой из них на 2x400G, 4x200G или 8x100G. Один оптический кабель 800G, разветвленный на 8x100G, соединяет восемь устройств Spark (по одному каналу связи на каждое) с тем же коммутатором, который обслуживает два канала 400G для хранения данных. Каждая сетевая карта 400G находится в своей собственной VLAN и обслуживает четыре устройства Spark, поэтому хост хранения данных предоставляет два целевых устройства RDMA, и нагрузка равномерно распределяется между ними по умолчанию. На практике это топология с полной пропускной способностью: 8 x 100 Гбит/с клиентской полосы пропускания с одной стороны, 2 x 400 Гбит/с полосы пропускания хранилища с другой и коммутатор с пропускной способностью 102.4 Тбит/с посередине.
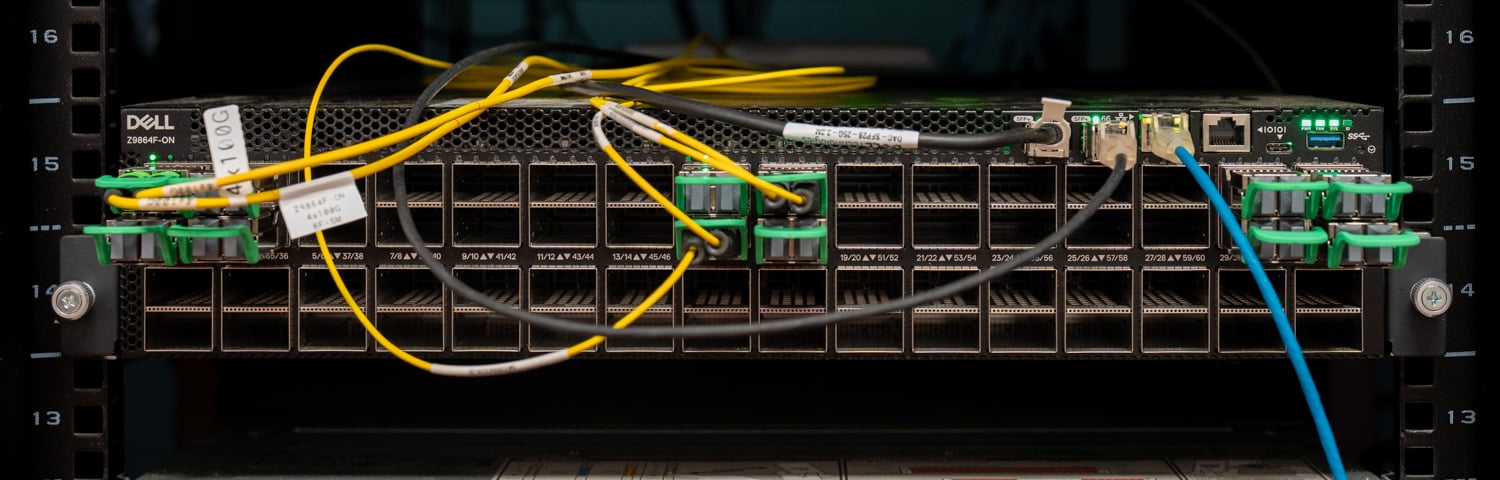
Мы проверили работоспособность сети до того, как к ней подключилось какое-либо программное обеспечение для хранения данных. Тесты взаимодействия между серверами, между R770AP и вторым хостом по каналам 400G, проводились на линейной скорости в обоих направлениях, а трафик RDMA от Sparks подтвердил, что порты 100G работают на полной скорости. После того, как инженеры Tuxera запустили NFS-ресурсы, iperf3 с Sparks на соответствующие сетевые карты показал стабильную скорость 99 Гбит/с при четырех параллельных потоках и отсутствии повторных передач.
Почему NFS и почему Tuxera?
Благодаря быстрому блочному устройству Graid, хост хранения может предоставлять Spark-устройства либо в качестве блочных целевых устройств NVMe-oF, либо в качестве файловых ресурсов. Мы протестировали блочный путь в обзоре GP Spark, и он хорошо работает для одного клиента. Для лаборатории с большим количеством Spark-устройств нам нужно было что-то другое. Блочные тома имеют отношение «один к одному»; каждому пользователю потребуется LUN, и как только два пользователя захотят получить доступ к одному и тому же набору данных, произойдет его копирование, что и является проблемой, для решения которой и предназначена вся эта конструкция. NFS находится в центре диаграммы Венна: единое пространство имен содержит общие наборы данных, размещенные модели и папки для каждого пользователя. Каждое монтирование Spark использует клиент NFS, уже имеющийся в Ubuntu, и инструменты Kubernetes и Slurm, которые университет мог бы установить поверх Spark-лаборатории, все поддерживают NFS.
Fusion NFS — это NFS-часть Tuxera Fusion, многопротокольного файлового сервера, который поддерживает SMB и NFS на одном многопоточном ядре в пользовательском режиме; мы впервые рассмотрели Fusion SMB в проекте Solidigm и Tuxera по обработке медиаданных в 2024 году. Tuxera заявляет о скорости до 22.7 ГБ/с по одному соединению 200GbE с RDMA, что выше, чем у ядра NFSD и Ganesha по результатам собственных тестов компании, а также о поддержке NFS 4.1, кластеризации active-active scale-out, прозрачного переключения при сбоях и интеграции с Active Directory, Kerberos и LDAP. Последний набор функций отвечает за управление: тот же каталог, который контролирует, кто может войти в Spark, также контролирует, что они могут видеть в общем ресурсе. К каждому показателю Tuxera в этой статье следует отнестись с осторожностью: используемая нами сборка — это частная предварительная версия Fusion NFS, которая, по словам Tuxera, еще не полностью оптимизирована для повышения производительности, и программное обеспечение пока недоступно для коммерческой продажи. Планируется, что товар поступит в продажу в ноябре, после конференции SC'26.
Компания Tuxera установила Fusion на R770AP, отформатировала том Graid в XFS и настроила сервер с NFS на стандартном порту и RPC-RDMA на порту 20049, исключив прослушиватели SMB, поскольку этот проект использует только NFS. Начальная конфигурация потоков включала четыре потока протокола, каждый из которых содержал восемь потоков для передачи и приема данных, данных VFS и метаданных VFS, что, по словам Tuxera, является отправной точкой для настройки. Службы каталогов были намеренно исключены из лабораторной сборки; в университетской среде поверх них будут использоваться собственные службы идентификации. На стороне Spark монтирование общего ресурса осуществляется одной командой:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Эта единственная строка кода описывает всю интеграцию с клиентом, без драйверов, без конфигурации инициатора и без программного обеспечения стороннего поставщика на Spark. Пользователь, который завтра войдет в другую систему Spark, запустит ту же строку и увидит те же файлы.
Подтверждение конфигурации: восемь искр на одном наборе данных.
Перед началом работы над моделью мы провели проверку работоспособности каждого Spark по отдельности: последовательное чтение fio объемом 1 млн операций с 16 заданиями и глубиной очереди 16 в собственную папку на массиве. Восемь устройств показали скорость от 10.0 до 11.2 ГиБ/с, полностью загрузив канал 100GbE на каждом из них. Затем мы провели сканирование, чтобы доказать, что все восемь устройств могут выдержать свою долю нагрузки. В каждом запуске поддерживается фиксированное количество потоков — 16 с общей глубиной очереди 16, которые распределяются между одним, двумя, четырьмя и восемью Spark, обрабатывая 1 млн последовательных, 64 тыс. случайных, 16 тыс. последовательных и 4 тыс. случайных рабочих нагрузок, с чтением и записью, прямым вводом-выводом, 60 секунд на тест. Каждый Spark записывает данные в свою собственную папку на массиве, по четыре на каждый сетевой адаптер хранения, и нигде в стеке не используется QoS. При одновременной загрузке всех восьми устройств скорость последовательного чтения на 1 миллион операций на единицу составляла от 3.09 до 3.13 ГиБ/с, скорость случайного чтения 64 КБ — от 6,648 до 6,779 операций ввода-вывода в секунду, а скорость случайной записи 4 КБ — от 2,136 до 2,155 операций ввода-вывода в секунду, при этом использовались данные пяти производителей оборудования в двух VLAN без применения механизма обеспечения справедливости распределения ресурсов. Каждый Spark подключался к массиву, каждый Spark получал равную долю ресурсов, и конфигурация была готова к выполнению важных задач.
| Spark (восемь клиентов, по 2 потока x QD16 каждый) | Сетевая карта хранения | 1М последовательного чтения | 64K случайное чтение IOPS | 4K случайное чтение IOPS | 4K случайная запись IOPS |
|---|---|---|---|---|---|
| Dell Pro Max с 10 ГБ оперативной памяти (1) | 1 | 3,176 МБ/с | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195 МБ/с | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 МБ/с | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 МБ/с | 6,670 | 10,100 | 2,149 |
| Dell Pro Max с 10 ГБ оперативной памяти (2) | 2 | 3,184 МБ/с | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187 МБ/с | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 МБ/с | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 МБ/с | 6,734 | 10,300 | 2,145 |
Расчет мощности хоста: две сетевые карты и достаточный запас мощности.
Аналогичный анализ отвечает на вопрос, который лаборатория или предприятие должны решить перед покупкой: где находится предел производительности и какая часть хоста его определяет? Четыре панели ниже показывают пропускную способность чтения для всех четырех рабочих нагрузок при увеличении фиксированной нагрузки от одного Spark до восьми; производительность записи рассмотрена в тексте и таблице ниже.
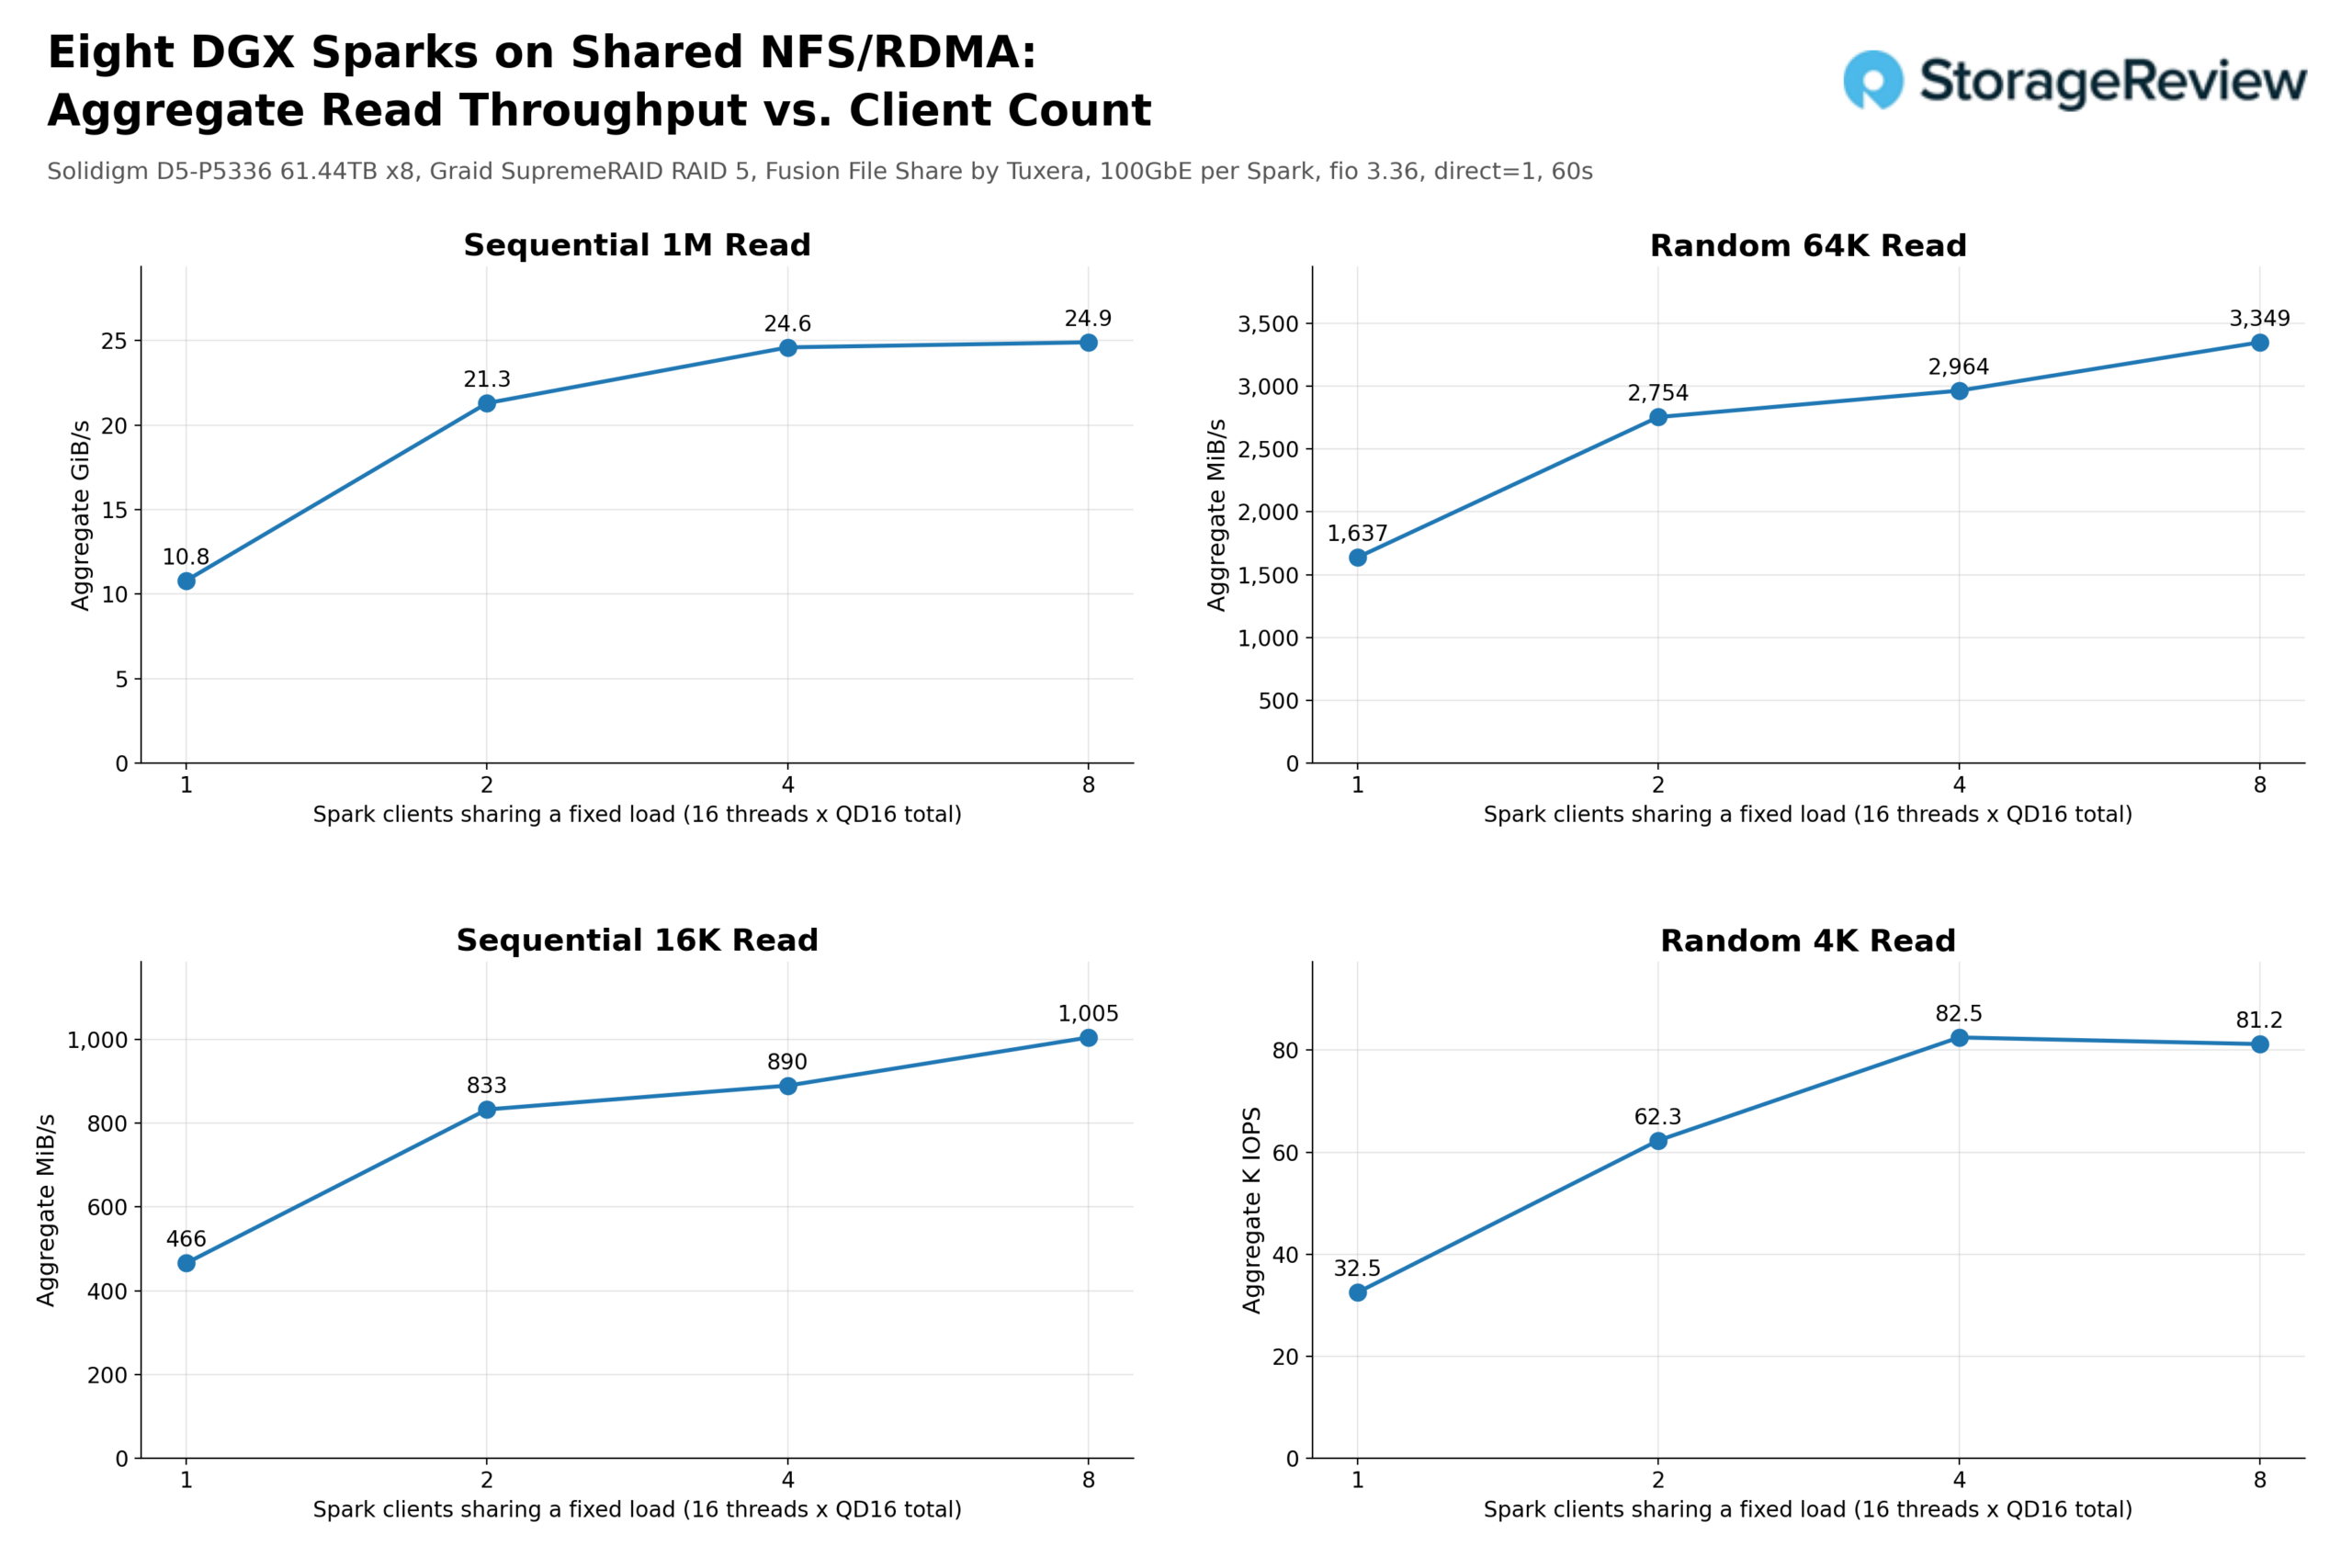
Суммарная скорость последовательного чтения 1 млн устройств выросла с 10.8 Гбит/с на одном Spark до 21.3 Гбит/с на двух, 24.6 Гбит/с на четырех и 24.9 Гбит/с на восьми. В сетевом выражении это 93 Гбит/с, 183 Гбит/с, 212 Гбит/с и 214 Гбит/с против 800 Гбит/с, которые могут обеспечить две сетевые карты Broadcom 400GbE, поэтому при полной нагрузке на восемь клиентов массив использовал 27% сетевой емкости хоста. Плато около 25 Гбит/с принадлежит массиву RAID 5 QLC из восьми дисков; сетевые карты, коммутатор и собственные каналы 100GbE устройств Spark никогда не достигали предела.
Две серверные сетевые карты уже обеспечивают покрытие восьми дисков Spark на линейной скорости, и они также обеспечат покрытие остальных восьми отсеков в R770AP: удвоение количества дисков, будь то в виде второго массива или более широкого RAID-массива, увеличивает пропускную способность чтения за теми же двумя портами, с запасом. То же самое относится и к операциям ввода-вывода. Скорость случайного чтения 4K увеличилась с 32.5 тыс. IOPS на одном клиенте до плато около 81 тыс. IOPS на четырех клиентах и более, при этом задержка на операцию ввода-вывода снизилась с 7.9 мс до 3.1 мс по мере уменьшения очереди каждого клиента, а скорость случайного чтения 64K увеличилась с 1,637 до 3,349 МиБ/с, при этом сеть в обоих случаях значительно не достигла своего предела.
Другой важный параметр сравнения — это объем памяти, уже имеющийся у Spark. В наших обзорах GB10 скорость чтения GDSIO 1M с внутреннего M.2 накопителя достигала почти 11.2 ГБ/с на Acer Veriton GN100 и GIGABYTE AI TOP ATOM. Dell Pro Max с GB10 и HP ZGX Nano G1n достигали около 5.5 ГБ/с, а ASUS Ascent GX10 — около 5 ГБ/с. Для сравнения, внешний NVMe-oF-накопитель Luisuantech GP Spark обеспечивал скорость 9.5 ГБ/с через тот же порт 100GbE. Скорость чтения одного Spark с общего массива QLC составляет 10.8 ГБ/с, что соответствует самым быстрым внутренним накопителям в этой группе и примерно вдвое превышает скорость самого медленного накопителя, передаваемую по одному кабелю, по сравнению с данными, которые могут считывать все остальные Spark. Используемые инструменты различаются: GDSIO на внутренних дисках и fio через NFS здесь, поэтому это сравнение диапазонов.
Ниже представлен полный обзор с агрегированными данными для всех четырех рабочих нагрузок при каждом количестве клиентов. Каждая строка чтения увеличивается с увеличением количества клиентов, пока массив не исчерпает запас по объему данных, а каждая строка записи остается неизменной от одного до восьми Spark, поскольку путь четности RAID 5 удерживает массив на фиксированном уровне записи независимо от количества клиентов, использующих его совместно. Для общего ресурса, предназначенного для чтения многими пользователями и записи только один раз при поступлении данных, именно для такого профиля и разработана данная конструкция.
| В совокупности (16 потоков) | 1 Spark | 2 Искры | 4 Искры | 8 Искры |
|---|---|---|---|---|
| 1М последовательного чтения | 10.8 ГиБ/с | 21.3 ГиБ/с | 24.6 ГиБ/с | 24.9 ГиБ/с |
| 1М Последовательная запись | 2.4 ГиБ/с | 2.4 ГиБ/с | 2.4 ГиБ/с | 2.4 ГиБ/с |
| 64K Произвольное чтение | 1,637 МБ/с | 2,754 МБ/с | 2,964 МБ/с | 3,349 МБ/с |
| 64K Случайная запись | 722 МБ/с | 719 МБ/с | 723 МБ/с | 703 МБ/с |
| 16K последовательное чтение | 466 МБ/с | 833 МБ/с | 890 МБ/с | 1,005 МБ/с |
| Последовательная запись 16K | 57 МБ/с | 60 МБ/с | 62 МБ/с | 28 МБ/с |
| 4K Произвольное чтение | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4K Случайная запись | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Модели размещения на общем хранилище
Тест fio подтверждает, что массив и сеть более чем способны справиться с этой задачей. Следующий важный тест для данного сценария использования — это проверка того, насколько хорошо загружается модель, размещенная на общем массиве, по сравнению с моделью, размещенной на собственном NVMe-накопителе Spark, поскольку именно на этом рабочем процессе основана вся конструкция: одна копия, размещенная централизованно и загружаемая любым пользователем. Мы выбрали Qwen3.5-122B-A10B в формате NVFP4, модель с 122 миллиардами параметров, представляющую собой смесь экспертов, которая занимает 78 ГБ на диске и помещается в 128 ГБ унифицированной памяти одного Spark. Мы измерили время от запуска сервера вывода до сообщения о его работоспособности, а также среднюю пропускную способность хранилища за этот период в трех сценариях: загрузка одним Spark с его внутреннего NVMe-накопителя, загрузка тем же Spark через NFS/RDMA с общего массива и одновременная загрузка всеми восемью Spark одной и той же копии с массива.
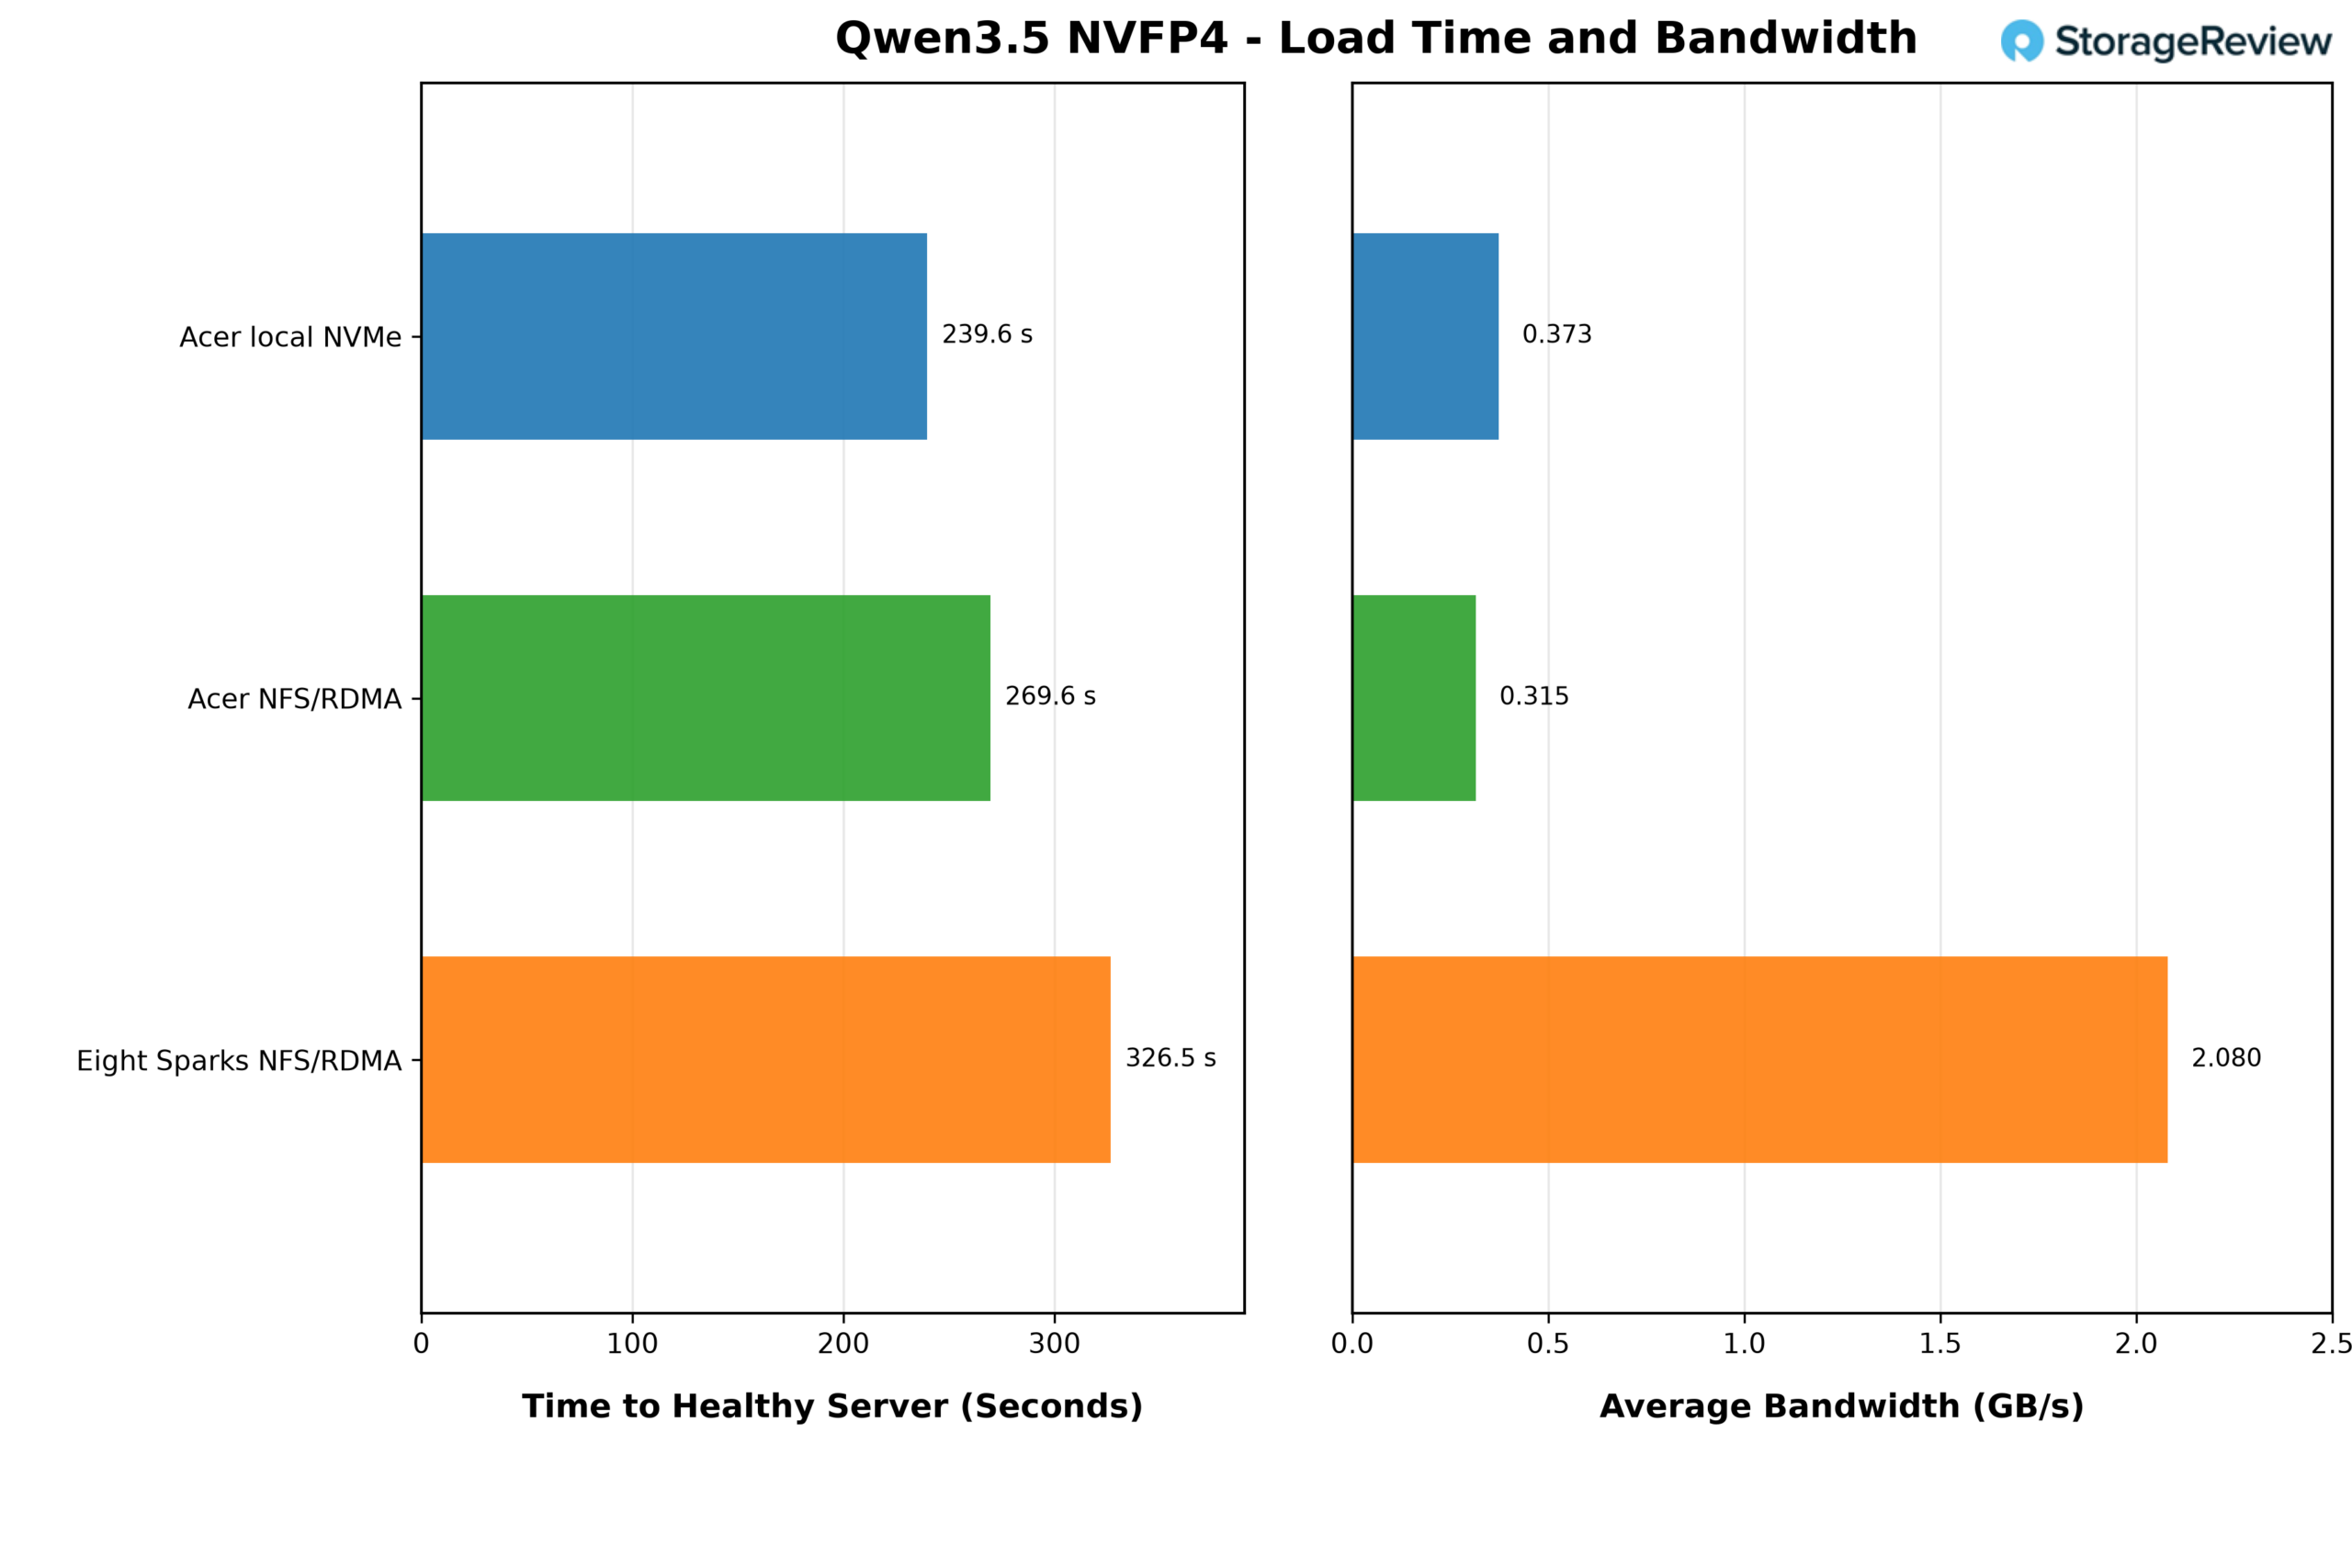
При использовании внутреннего NVMe-накопителя Acer Veriton GN100 загрузил сервер за 239.6 секунды со средней скоростью 0.373 ГБ/с. При использовании общего массива через NFS/RDMA тому же серверу Spark потребовалось 269.6 секунды со скоростью 0.315 ГБ/с, что примерно на 30 секунд, или на 13%, дольше. Средние значения показывают, что при загрузке 78 ГБ данных за четыре минуты загрузка модели на Spark не ограничена объемом хранилища ни в одном из случаев. Скорость загрузки задается собственной обработкой весов GB10, и большую часть времени ожидания тратит хранилище.
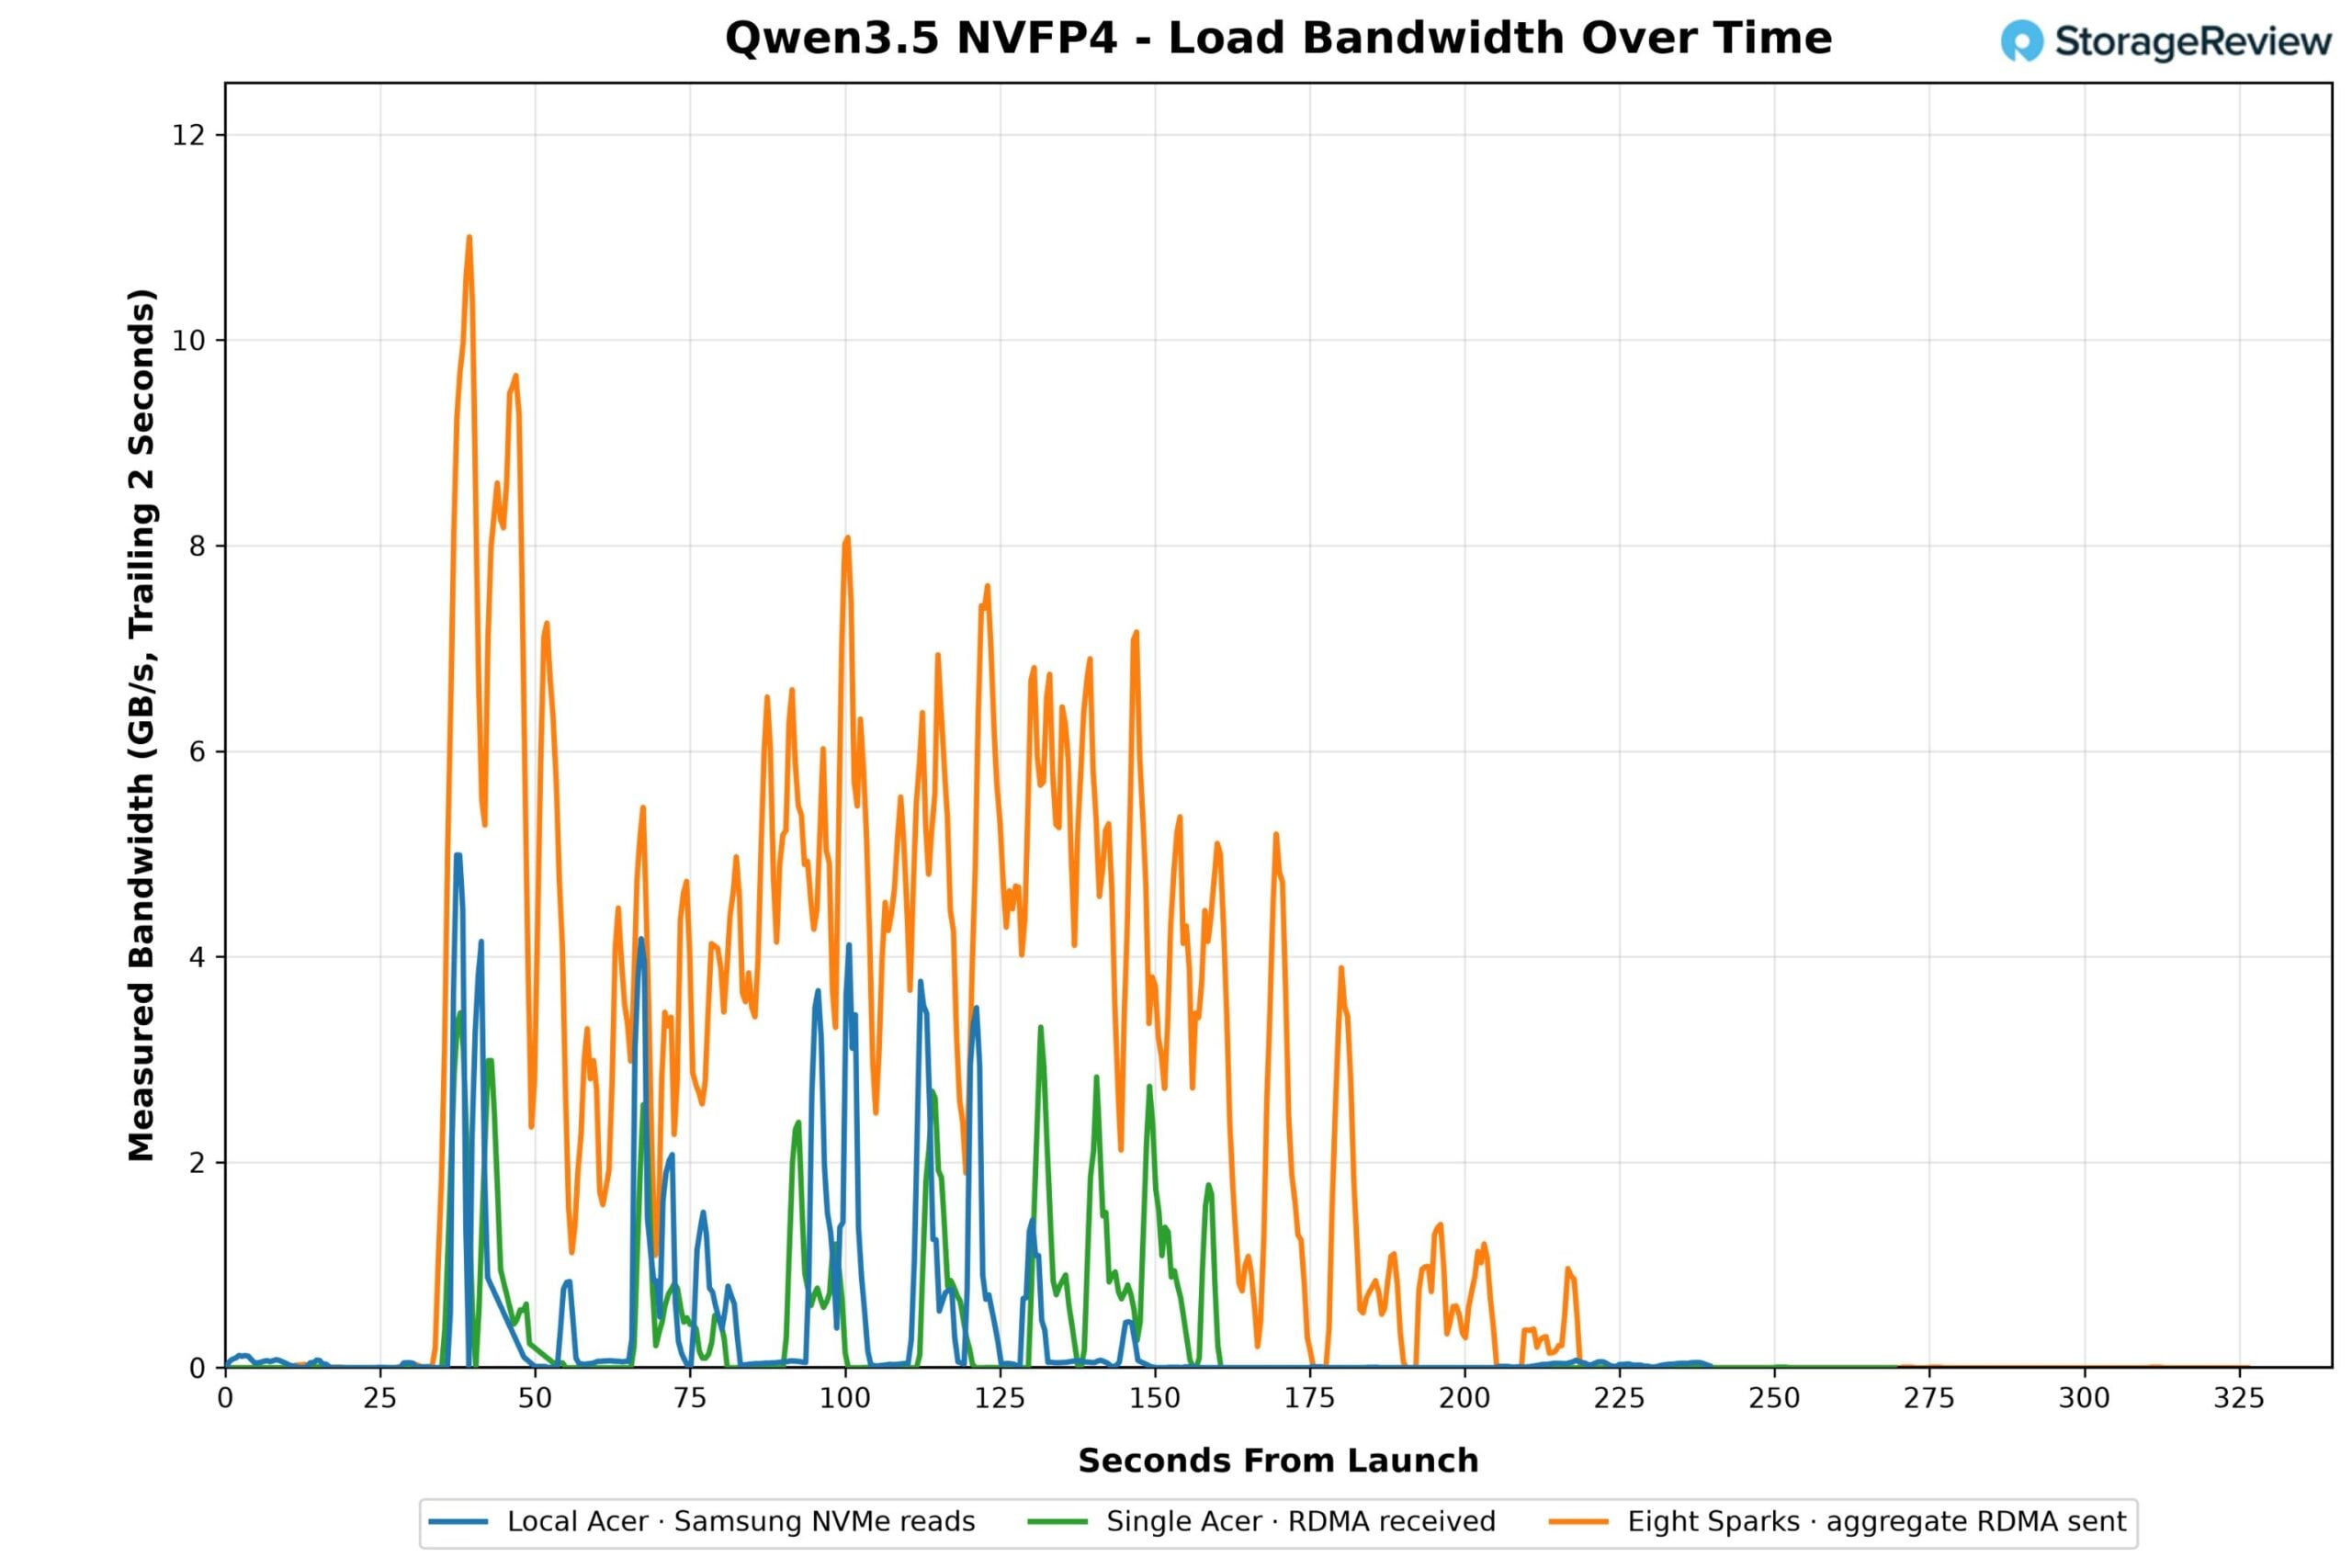
График пропускной способности показывает эту закономерность: локальные операции чтения с NVMe поступают импульсами, достигающими пика около 5 ГБ/с с большими промежутками между ними; один клиент NFS демонстрирует ту же форму импульса с несколько меньшими пиками. Линия суммарного потока от восьми Spark показывает работу массива при одновременной нагрузке. При одновременной загрузке всеми восемью устройствами одного и того же объема данных в 78 ГБ массив достиг суммарного пика в 11 ГБ/с в первую минуту, затем стабилизировался в диапазоне примерно от 4 до 8 ГБ/с в течение следующих двух минут, пока Spark обрабатывали свои данные, в среднем достигая 2.08 ГБ/с за весь период. В отличие от 25 ГиБ/с, которые, как показало сканирование fio, может обеспечить массив, восемь Spark, одновременно загружающих модель, использовали лишь малую часть доступной мощности.
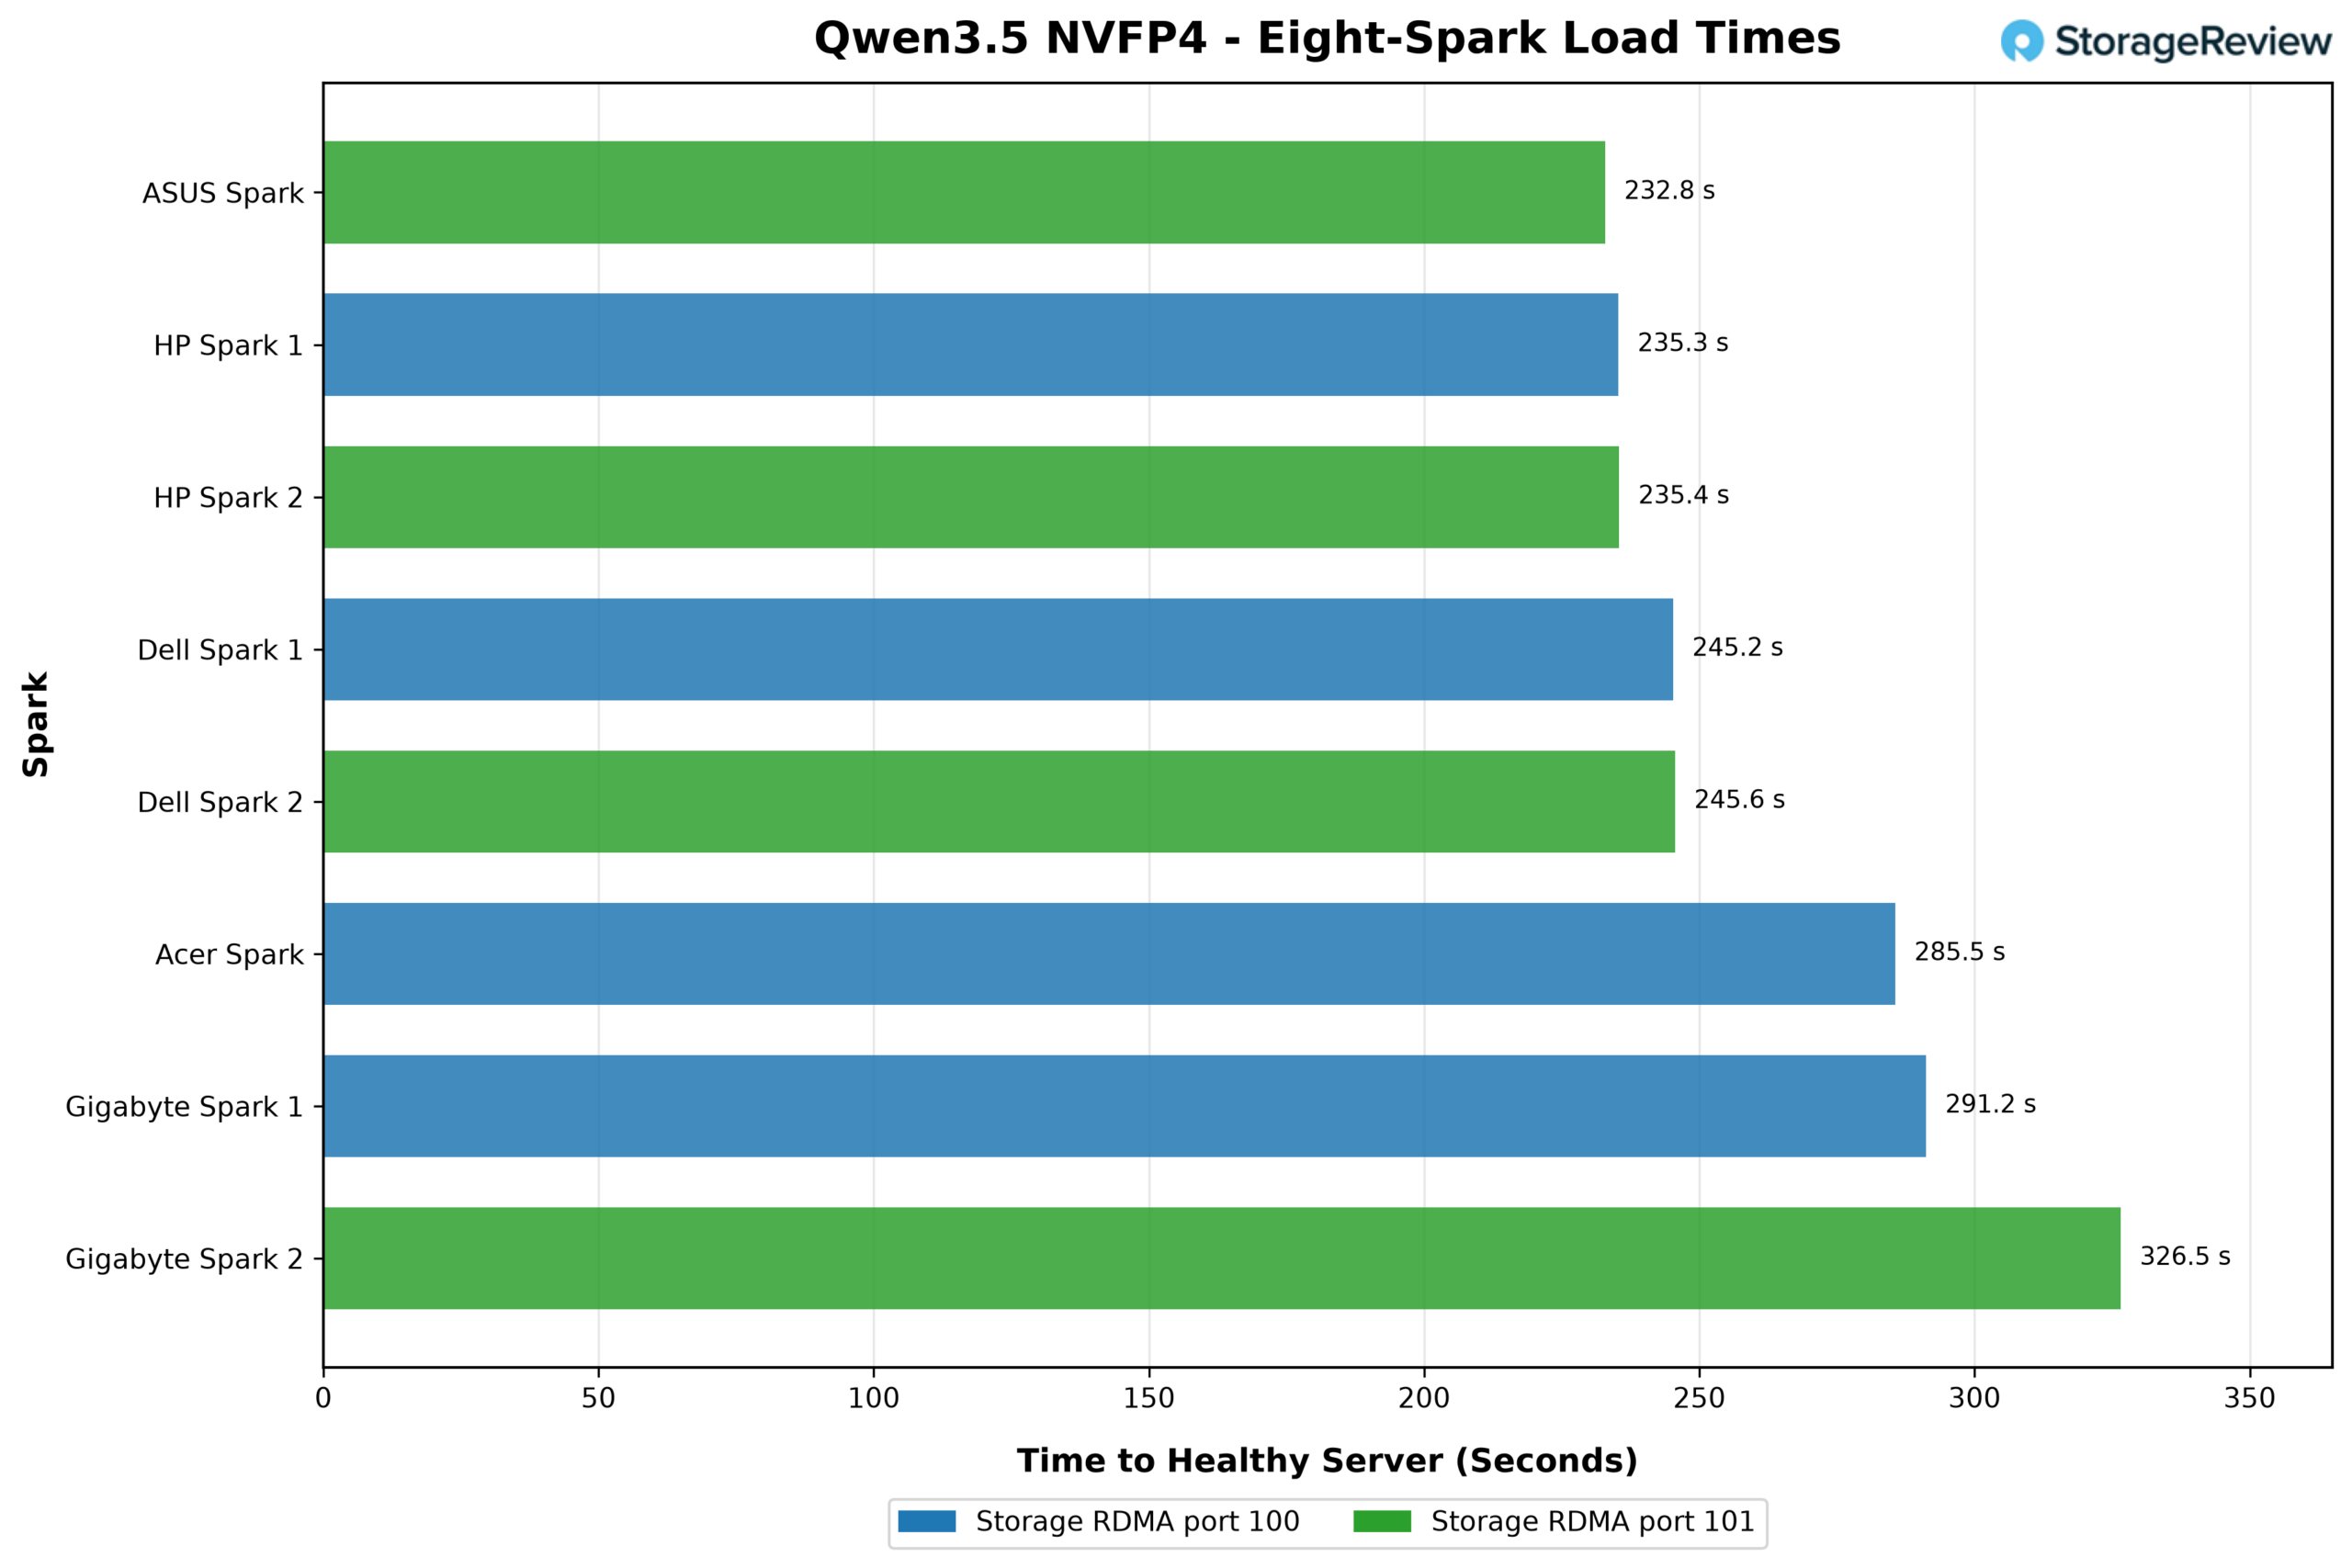
В восьмифакторном тесте время загрузки каждого устройства варьировалось от 232.8 секунд на ASUS Ascent GX10 до 326.5 секунд на одном из устройств GIGABYTE AI TOP ATOM, при этом две системы HP ZGX Nano G1n показали время 235.3 и 235.4 секунд, а две системы Dell Pro Max с GB10 — 245.2 и 245.6 секунд. Пять из восьми устройств Spark, загружающих данные одновременно с общего массива, превзошли по времени загрузки одного устройства Spark по протоколу NFS/RDMA, а три из них превзошли по времени локальной загрузки с NVMe. Разница не зависит от производителя; поскольку в стеке отсутствует QoS, какое устройство в любой момент времени ожидает подключения к массиву, меняется от запуска к запуску, и два устройства на каждом сетевом адаптере хранения данных равномерно распределяются между быстрыми и медленными концами диаграммы.
Для лаборатории это означает, что она может хранить одну копию каждой модели на массиве, и любой Spark, или любой Spark, загружает её примерно за то же время, что и локальную копию, без этапа загрузки, без использования локального пространства и без необходимости хранить копию весов на столе.
Пример использования в штате Орегон
Колледж наук о Земле, океане и атмосфере Университета штата Орегон неоднократно сотрудничал с нами в разработке инфраструктуры искусственного интеллекта, от исследований океана в реальном времени на борту научно-исследовательского судна до академической оценки с использованием ИИ с помощью Metrum AI . Крис Салливан, директор по исследованиям и академическим вычислениям в Университете штата Орегон, и его архитектор Томас Олсон изучают возможность создания крупномасштабной лаборатории Spark для обучения ИИ, которая могла бы вмещать до 100 устройств, и их идеи относительно хранения данных повлияли на наш проект в двух конкретных аспектах.
Во-первых, хранилище должно быть независимым от Spark-серверов. OSU рассматривал файловую систему, распределенную по самим Spark-серверам, но отказался от нее для использования в классе, поскольку добавление или удаление одного узла нарушило бы работу службы хранения данных для всех. Центральный массив, к которому подключается любой Spark-сервер, означает, что Spark можно добавлять, удалять, переустанавливать операционную систему или передавать другому студенту, не затрагивая данные других пользователей. Во-вторых, хранилище должно следовать за пользователем. Мы описываем требование OSU как улучшенную версию файловых ресурсов для целей искусственного интеллекта, где студенты хранят постоянную информацию при переходе между системами. С NFS это папка для каждого студента; войдите в любой Spark-сервер, подключите общий ресурс, и ваша работа будет там.
Именно наборы данных делают этот вопрос более важным для OSU, чем для домашнего сервера. Колледж наук о Земле, океане и атмосфере хочет предоставить студентам доступ к своим исследовательским данным — океанографическим и атмосферным коллекциям объемом в десятки терабайт — для их собственных исследований. На настольных накопителях такой возможности нет: слот M.2 на 4 ТБ не вмещает ни одной такой коллекции, и даже лаборатория, полностью оборудованная внешними накопителями, означала бы покупку и заполнение каждой копии для каждого рабочего места, а затем поддержание каждой копии в актуальном состоянии, что ни один факультет не может себе позволить. Размещение данных на массиве и их подключение через 100GbE — это подход, который соответствует этим требованиям в нашей оценке. На этом же массиве размещается библиотека моделей, поэтому студенты могут запускать Qwen, Llama или любую другую модель во время своих занятий без необходимости загрузки данных. Тот же принцип применим и к предприятиям, развертывающим настольные системы ИИ в качестве рабочих станций для разработчиков: подключите производственный набор данных к быстрой сети и позвольте системе работать с ним на месте, что устраняет необходимость в создании второго хранилища данных для настольных компьютеров. Данные остаются в центре обработки данных под контролем доступа, шифрованием и резервным копированием, которые уже там существуют, и Spark не хранит ничего важного, когда покидает его.
Заключение
Настольное оборудование для ИИ хорошо справляется со многими задачами, но оно не очень подходит для интеграции в общую информационную инфраструктуру организации, и единственный слот M.2 в каждой системе GB10 это гарантирует: все, что нужно пользователю, копируется на локальную флешку, невидимую для ИТ-специалистов, незащищенную и дублируется на каждом другом рабочем месте, которому требуется то же самое. Для одного Spark разумным решением является внешний локальный накопитель. Для лаборатории, отдела или предприятия, развертывающего десятки таких устройств, каждое рабочее место со своими данными представляет собой изолированное хранилище, и решение заключается в том, к чему центры обработки данных пришли много лет назад: разместить ресурсы за быстрой сетью, управлять ею один раз и делиться ею. Spark уже имеют высокоскоростную сеть; этот проект показывает, что происходит, когда вы предоставляете ей место для передачи, и доказывает, что сами Spark должны стоять в стойке рядом с ним.
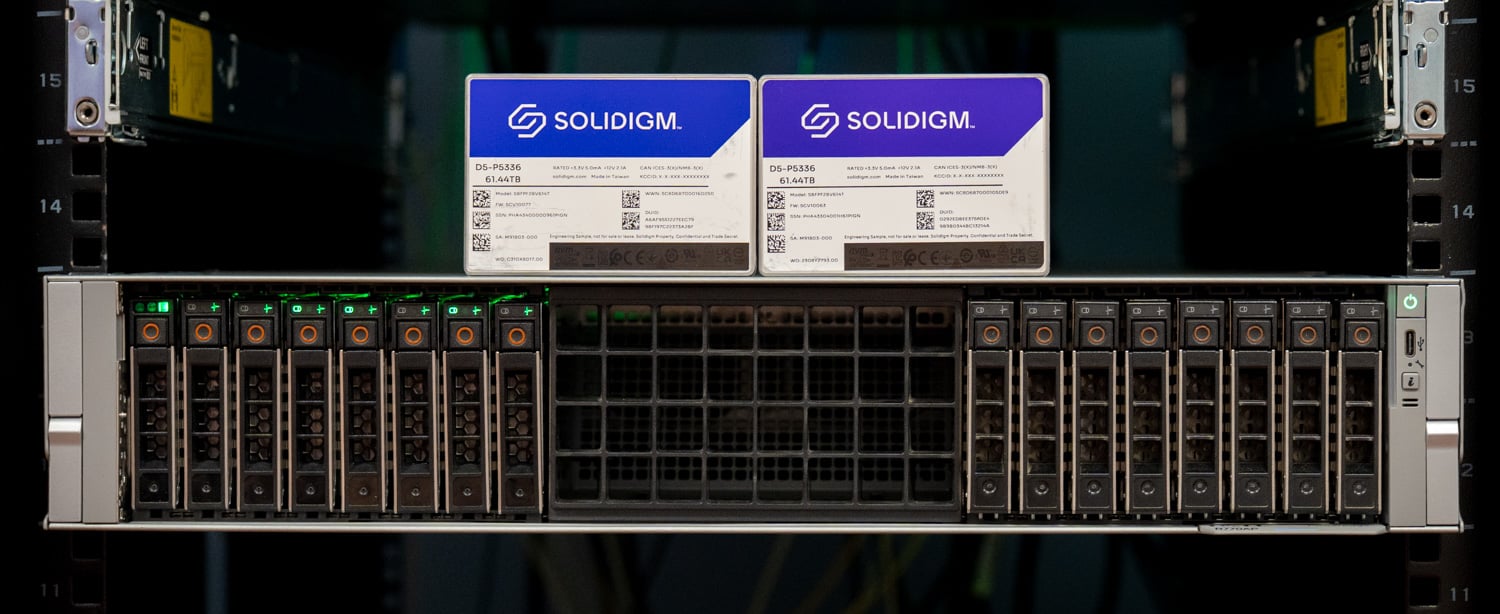
Восемь жестких дисков Solidigm D5-P5336 QLC в конфигурации Graid RAID 5 на сервере Dell обеспечили восьми накопителям Spark единый набор данных с защитой четности. Две сетевые карты Broadcom 400GbE и материнская плата Dell Z9864F-ON с модулем 800G обеспечили восьми накопителям Spark по 100GbE каждый. Технология Fusion NFS over RDMA от Tuxera позволила смонтировать эту емкость в одну строку на стандартной Ubuntu с использованием перехватчиков службы каталогов для контроля доступа. При фиксированной нагрузке, распределенной между всеми восемью накопителями, массив обеспечил суммарную скорость последовательного чтения 24.9 ГиБ/с, равномерно распределенную без QoS, а один накопитель Spark полностью загрузил свой канал на уровне 10.8 ГиБ/с, что сопоставимо со скоростью лучшего внутреннего диска в любой протестированной нами системе GB10; этот предел использовал 27% от пропускной способности двух серверных сетевых карт, поэтому сеть рассчитана на более мощный сервер, чем этот. Тестирование модели подтвердило работоспособность алгоритма: модель размером 78 ГБ, размещенная один раз на общем массиве, загружается на одном Spark с задержкой не более 13% по сравнению с локальным NVMe-накопителем, а также на восьми Spark одновременно, причем пять из восьми завершили работу быстрее, чем запуск NFS в одиночку.
Флэш-память QLC обеспечивает экономическую эффективность, поскольку рабочая нагрузка требует больших объемов данных и интенсивного чтения, что является сильной стороной D5-P5336, а один сервер может вместить то, что сотня Sparks никогда не смогла бы вместить локально, при этом все данные хранятся в одной копии, и каждая копия находится под контролем центра обработки данных. В Университете штата Орегон есть хранилище для исследовательских работ, которые не терпят отлагательств. Концепция, которую изучают Крис Салливан и Томас Олсон, представляет собой образовательный уровень, которого сегодня нет в университете: управляемый, общий пул данных, рассчитанный на одну или несколько стоек Sparks, построенный из сервера и нескольких высокоемких накопителей, который мог бы передавать десятки терабайт реальных океанографических и атмосферных данных в крупномасштабную лабораторию обучения ИИ на той же сети, которую используют Sparks.
Данный отчет подготовлен при поддержке компании Solidigm. Все мнения и взгляды, выраженные в этом отчете, основаны на нашем объективном взгляде на рассматриваемый продукт (продукты).
Упоминания коммерческих продуктов в данной статье носят информационный характер и не являются подтверждением их одобрения со стороны Университета штата Орегон.



 Amazon