

NVIDIA DGX Spark представляет собой переломный момент в развитии доступной инфраструктуры искусственного интеллекта. В 2017 году в знаковой статье «Внимание — это всё, что вам нужно», представившей архитектуру Transformer, использовалась конфигурация сервера P100 с восемью графическими процессорами, потреблявшая десятки киловатт-часов и занимавшая значительную площадь в центрах обработки данных. Сегодня DGX Spark обеспечивает превосходную вычислительную производительность в компактном форм-факторе настольного компьютера мощностью 240 Вт. Эта кардинальная эволюция в энергоэффективности и уменьшении размеров делает ранее доступные только в центрах обработки данных возможности ИИ доступными для отдельных исследователей, небольших групп и распределенных организаций, занимающихся разработкой.
Отличительной чертой Spark от предыдущих настольных решений в области ИИ является комплексный подход ко всему жизненному циклу разработки. Вместо того чтобы идти на компромиссы между экспериментами, тонкой настройкой и развертыванием, Spark обеспечивает реальные возможности на всех этапах. Архитектура с унифицированной памятью объемом 128 ГБ позволяет выполнять полную тонкую настройку параметров моделей, для которых на обычных рабочих станциях потребовались бы облачные ресурсы, обеспечивая при этом пропускную способность в сотни токенов в секунду, подходящую для пакетных вычислений, включая генерацию синтетических данных. Включение сетевого интерфейса ConnectX-7 с пропускной способностью 200 Гбит/с означает, что организации могут объединять несколько систем Spark в кластеры для еще более масштабного исследования моделей, хотя, как мы покажем, даже один блок демонстрирует замечательные возможности.
Основные выводы
Мощный процессор для дата-центра в настольном компьютере : GB10 Grace Blackwell в корпусе объемом 1.13 литра и мощностью 240 Вт, цена 3,999 долларов, обеспечивающий производительность до 1 петафлопс в режиме разреженного вычисления FP4.
Память, меняющая рабочие процессы : унифицированная память объемом 128 ГБ позволяет выполнять локальную тонкую настройку всех параметров 8-битных моделей и обеспечивает высокопроизводительный вывод. В ходе тестирования мы наблюдали, как Llama 3.1 8B FP4 достигала ~924 токена в секунду при 128 параллельных операциях, а Qwen3 Coder 30B-A3B FP8 — ~483 токена в секунду при 64 пакетах.
Готовность к масштабированию и подключению высокоскоростных хранилищ : интегрированная технология ConnectX-7 обеспечивает 200G-сеть для кластеризации или NVMe-oF. Внутренний NVMe-накопитель 2242 Gen5 удобен, но ограничен в возможностях для интенсивных операций ввода-вывода, поэтому внешний NVMe-oF через RDMA является лучшим вариантом для обеспечения стабильной пропускной способности.
Программное обеспечение готово к использованию с первого дня : поставляется с DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, контейнерами и сценариями рабочих процессов, что позволяет командам немедленно запускать реальные рабочие нагрузки.
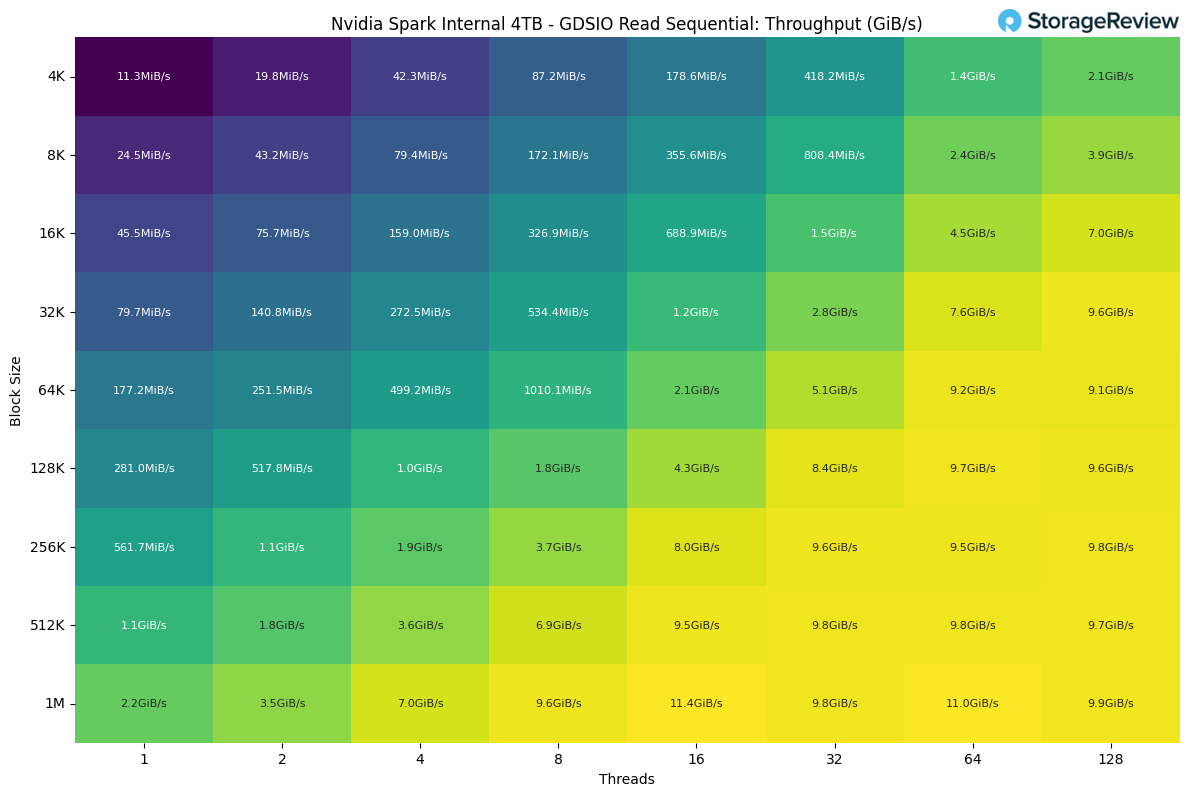
Подтвержденная производительность в реальных условиях : MAMF показала ~99.8 TFLOPs в режиме BF16 и ~207.7 TFLOPs в режиме FP8. Максимальная скорость чтения GDSIO составила ~11.4 ГиБ/с, при этом ожидается более высокий предел производительности в сети 200G.
Что такое DGX Spark и кому стоит его рассмотреть?
NVIDIA DGX Spark — это, по сути, полноценная платформа для разработки ИИ, а не просто компонент графического процессора. В её основе лежит GB10 Grace Blackwell Superchip, который объединяет графический процессор архитектуры Blackwell с тензорными ядрами пятого поколения и 20-ядерный процессор Arm (10× Cortex-X925 + 10× Cortex-A725), соединённый через NVLink-C2C. По словам NVIDIA, эта согласованная архитектура межсоединений обеспечивает до 5 раз большую пропускную способность по сравнению с PCIe Gen 5, создавая единую вычислительную структуру, а не отдельные вычислительные домены.
Для удобства пользователей NVIDIA поставляет DGX OS, построенную на базе Ubuntu Desktop, с предварительно настроенным полным набором программного обеспечения для ИИ, включая CUDA, cuDNN, TensorRT, NVIDIA Container Runtime и AI Workbench, что устраняет типичные проблемы с драйверами и накладные расходы на настройку среды, характерные для пользовательских сборок рабочих станций. Система предлагает гибкие варианты развертывания: подключите периферийные устройства и используйте ее как компактную рабочую станцию с полным набором функций Ubuntu Desktop, или разверните ее как безмониторное сетевое устройство, доступное через NVIDIA Sync, обеспечивающее бесшовную интеграцию с JupyterLab, VS Code, Cursor IDE и SSH-терминалами.
Это специально созданная инфраструктура для специалистов по искусственному интеллекту, исследователей, занимающихся тонкой настройкой языковых моделей, специалистов по обработке данных, ускоряющих рабочие процессы RAPIDS, разработчиков, внедряющих агентные системы, или команд, экспериментирующих с архитектурами с аблятивными моделями в небольших масштабах. Spark ориентирован на профессионалов, которым необходимы серьезные вычислительные возможности в области ИИ без сложностей, связанных с центрами обработки данных.
Технические характеристики NVIDIA DGX Spark
| Параметр | Описание |
|---|---|
| Архитектура | |
| GPU : | Архитектура NVIDIA Blackwell |
| ЦП | 20-ядерный процессор Arm (10 ядер Cortex-X925 + 10 ядер Cortex-A725) |
| Тензорные сердечники | 5th Generation |
| RT Cores | 4th Generation |
| NVENC / NVDEC | 1×/1× |
| Память | |
| Системная память | 128 ГБ LPDDR5X (унифицированная системная память) |
| Интерфейс памяти | 256-бит |
| Пропускная способность памяти | 273 Гб / с |
| Эффективности | |
| FP4 | до 1 петафлопс (с разреженностью) |
| Память | |
| Память | 1 ТБ или 4 ТБ NVMe M.2 (с самошифрованием) |
| связь | |
| USB | 4 разъема USB 3.2 Gen 2×2 Type-C (20 Гбит/с) |
| Ethernet | 1× 10GbE RJ-45 |
| NIC | ConnectX-7 Smart NIC – 2x 200G QSFP (обеспечивает максимальную пропускную способность 200 Гбит/с) |
| Беспроводной сети | Wi-Fi 7, Bluetooth 5.3 |
| Аудио выход | Многоканальный аудиовыход HDMI |
| Разъемы дисплея | 1× HDMI 2.1a |
| Механический | |
| Габаритные размеры: | 150 × 150 × 50.5 мм (5.9 × 5.9 × 1.98 дюйма) |
| Вес | 1.2 кг |
| потребляемая мощность | 240 W |
Проектирование и сборка NVIDIA DGX Spark
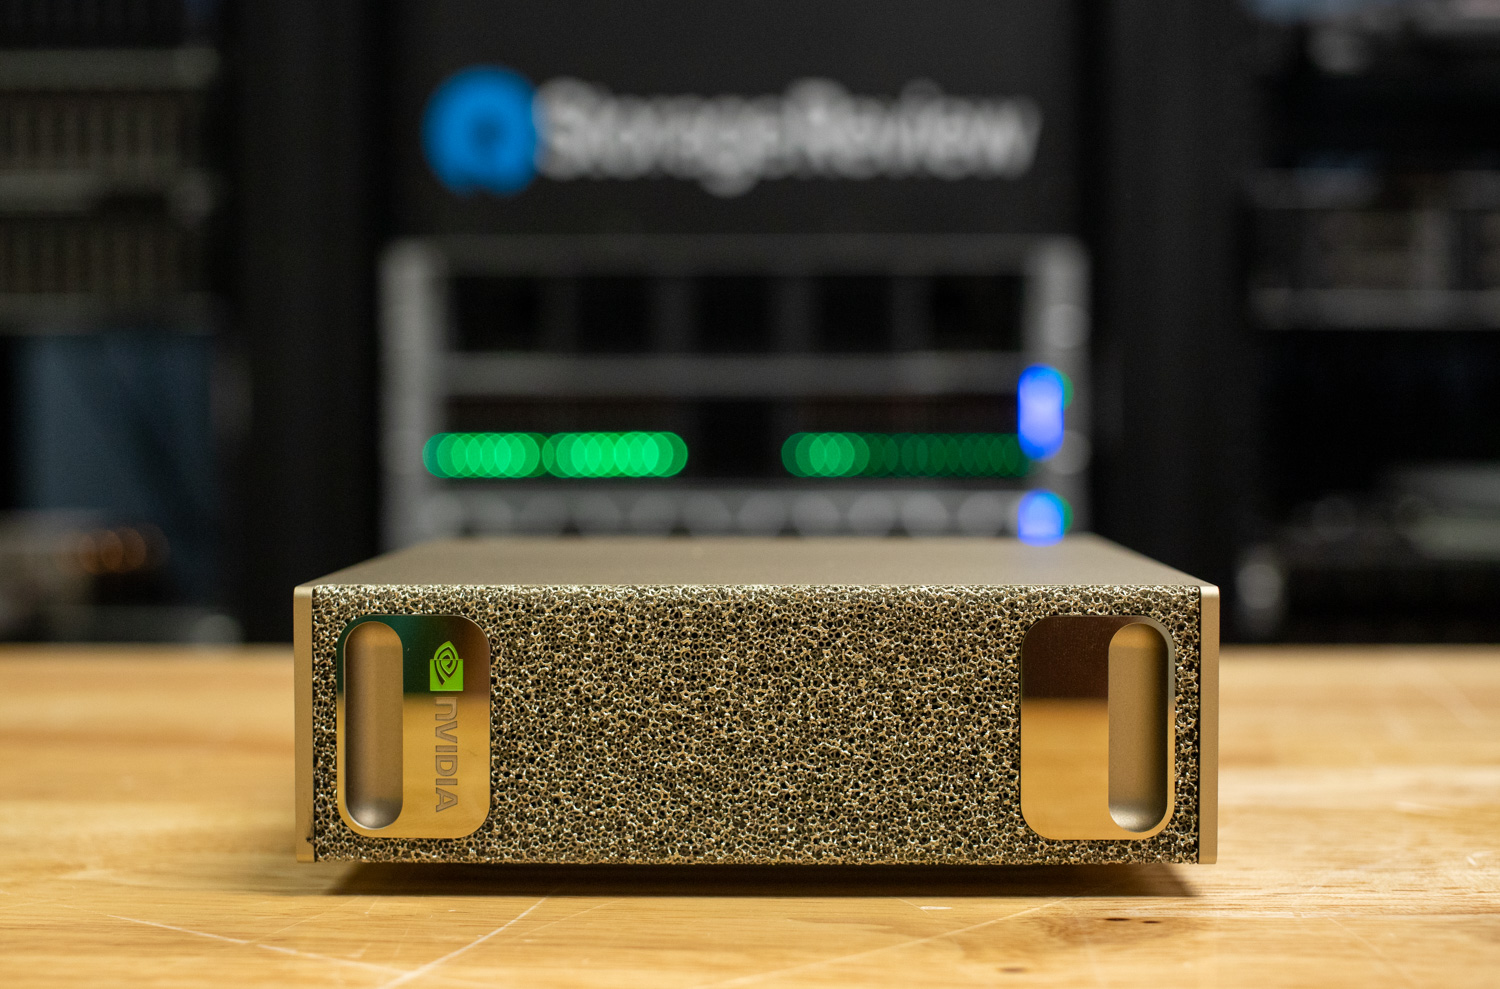
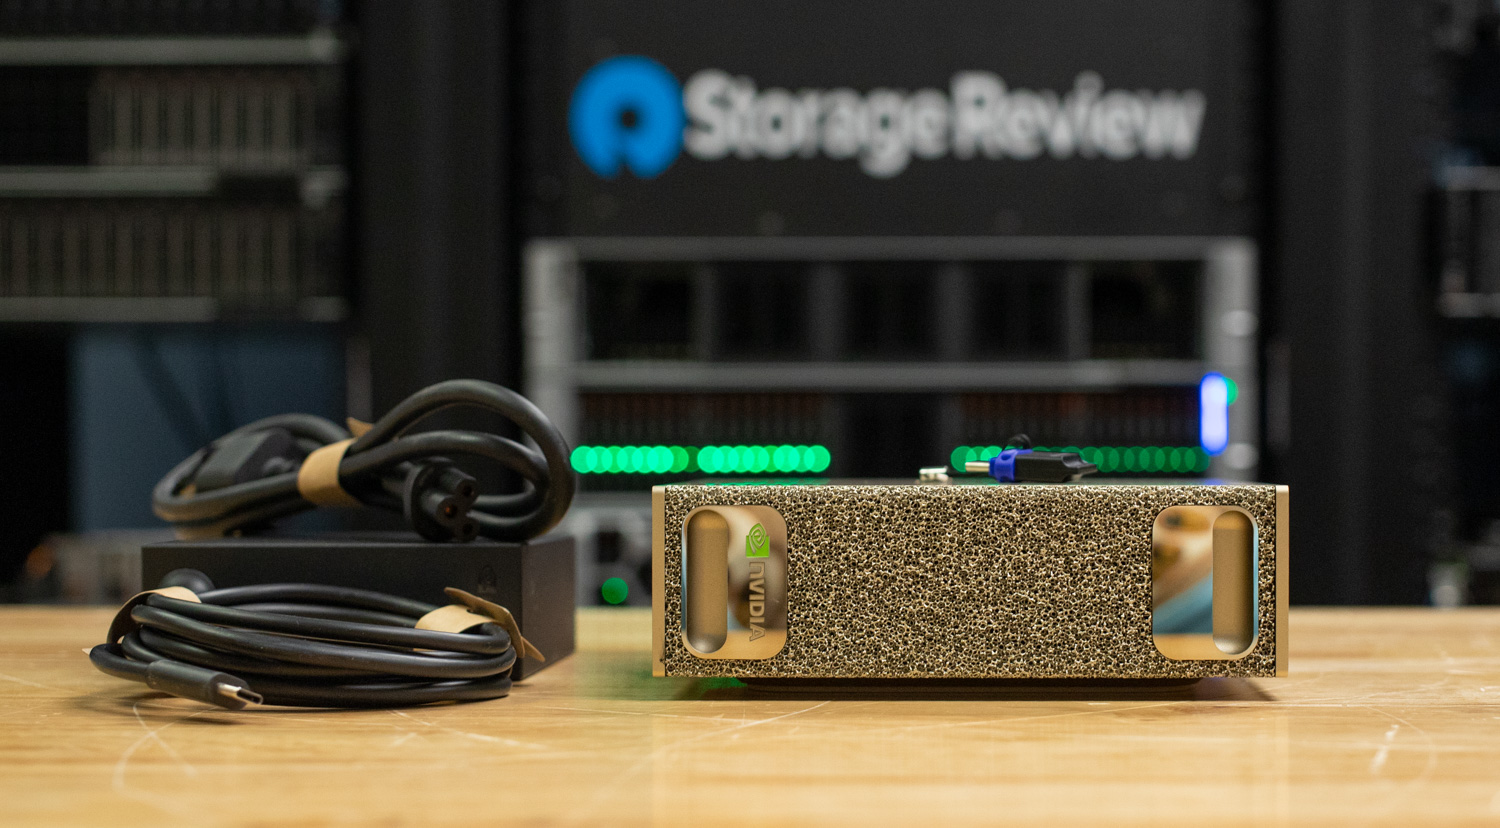
NVIDIA DGX Spark продолжает безошибочно узнаваемый фирменный стиль промышленного дизайна NVIDIA, отличаясь компактным корпусом, который повторяет внешний вид и ощущения от использования более крупных систем DGX. На передней панели имеются миниатюрные вырезы для захвата руками, отсылающие к ручкам оригинальных полноразмерных устройств DGX, а также металлическая отделка с золотистыми вкраплениями, обеспечивающая изысканную текстуру премиум-класса, подчеркнутую культовым зеленым логотипом NVIDIA.
В габаритах DGX Spark составляет 5.9 × 5.9 × 1.98 дюйма (150 × 150 × 50.5 мм), а вес — 2.6 фунта (1.2 кг), что дает ему общий внутренний объем 1.13 литра. Это прочно относит его к классу компактных ПК объемом 1 литр. Несмотря на минимальные размеры, система ощущается плотной и прочной благодаря цельнометаллическому корпусу из сплава, который также служит пассивным теплоотводом, что подчеркивает как эстетику, так и функциональность.
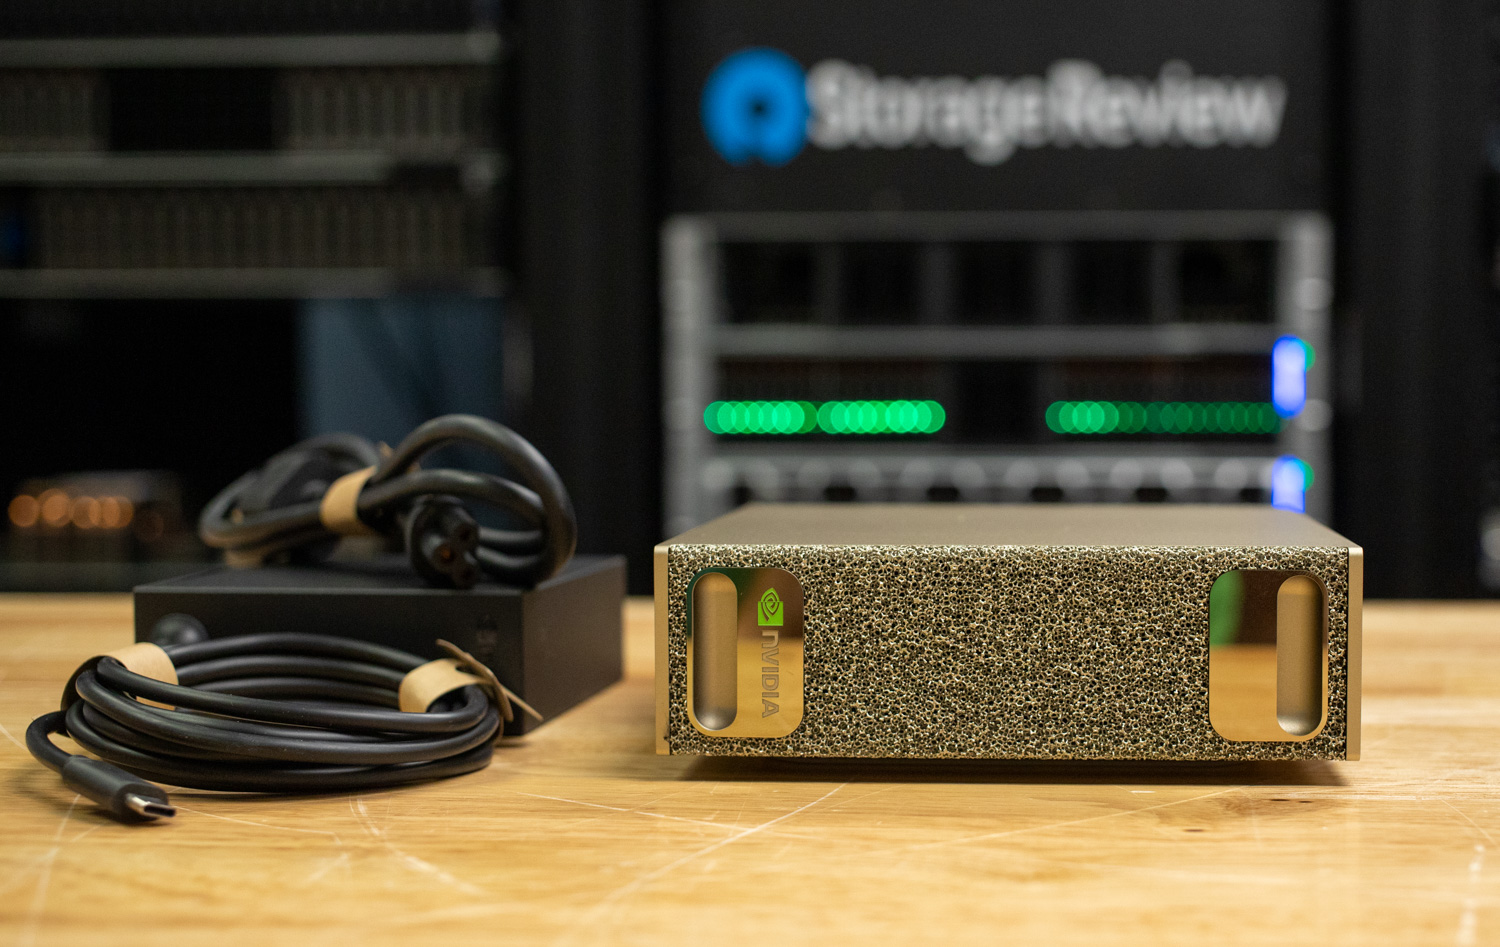
Питание осуществляется от внешнего блока питания USB-C мощностью 240 Вт, который виден рядом с основным блоком на изображении. Блок питания компактный и качественно изготовленный, использует стандартный разъем C5 (типа «клеверный лист») для подключения переменного тока и соответствует лаконичному и эффективному дизайну DGX Spark.
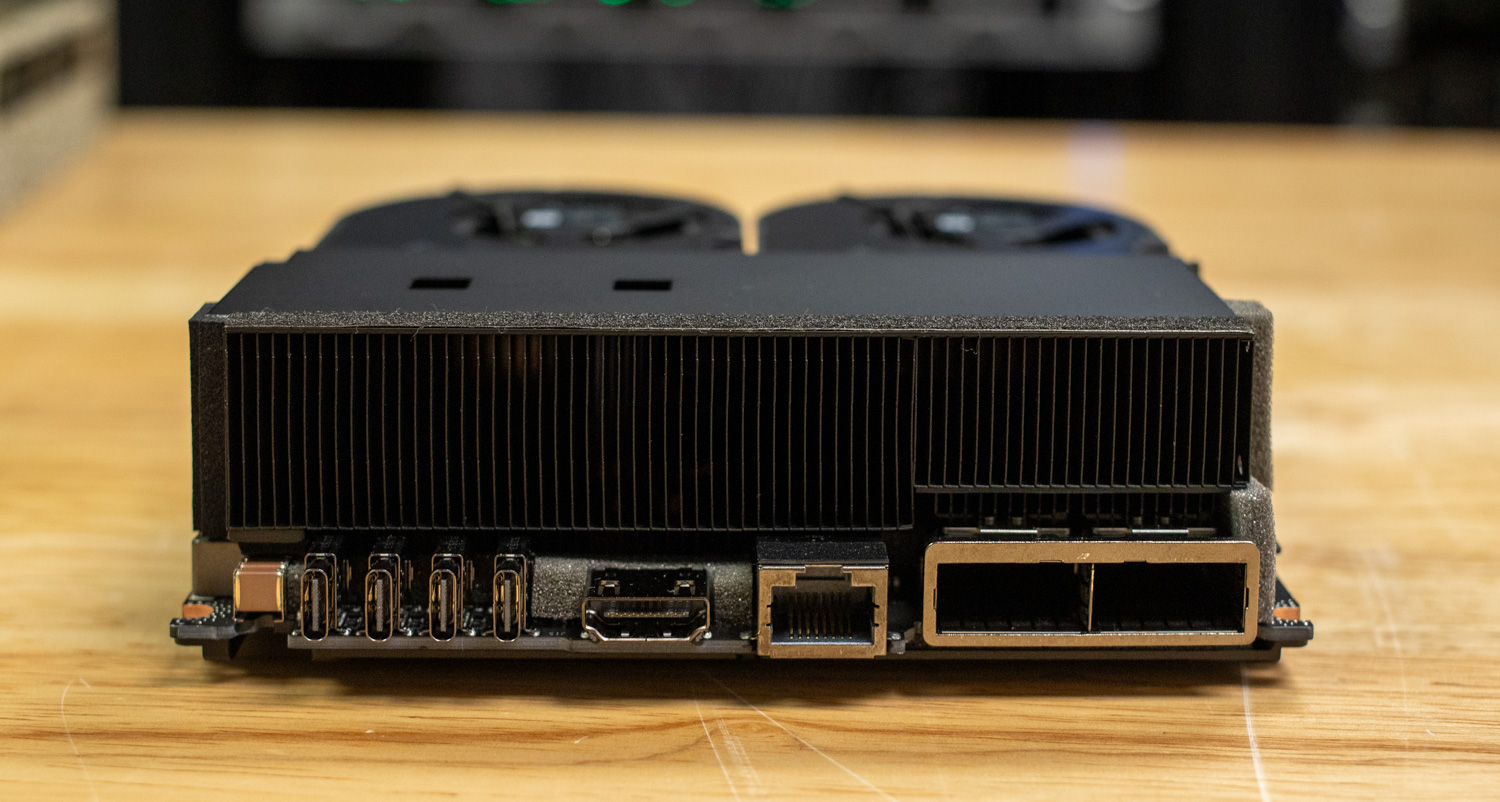
На задней панели DGX Spark сохранена та же текстурированная отделка с золотистыми вкраплениями, что и на передней панели, что обеспечивает целостный дизайн всего корпуса. Слева расположена кнопка питания, рядом с ней четыре порта USB-C, один из которых обеспечивает подачу питания (Power Delivery). Далее следуют один выход HDMI 2.1a, порт RJ-45 10 GbE, а интересной особенностью этого устройства являются два интерфейса QSFP56 200 GbE, работающие на базе интегрированной сетевой карты NVIDIA ConnectX-7 SmartNIC.
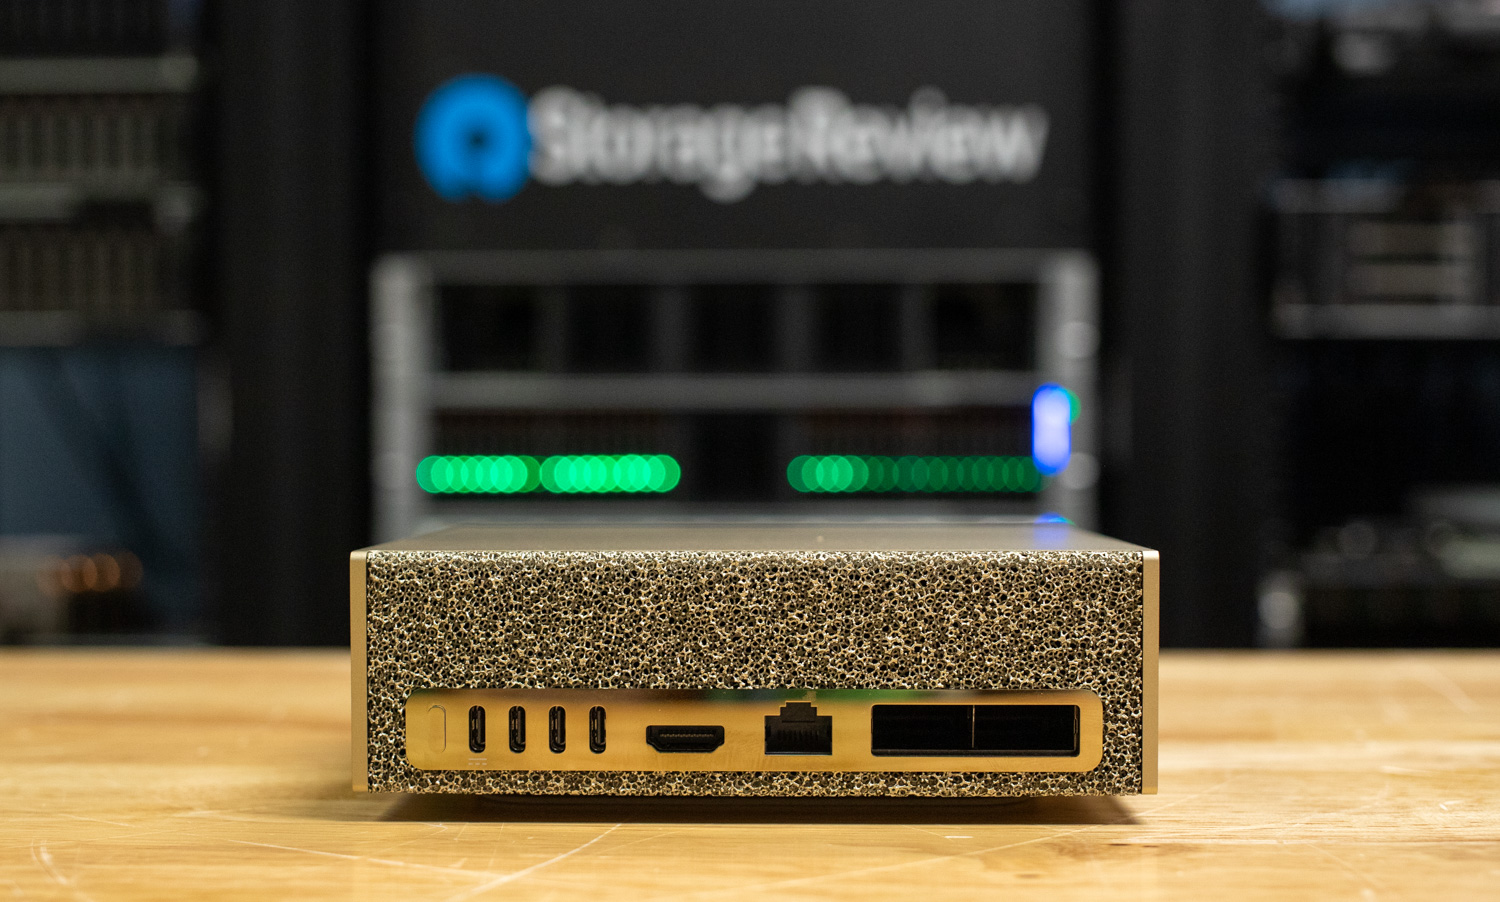
На первый взгляд может показаться, что Spark обеспечивает скорость подключения 400 Гбит/с; к сожалению, из-за ограничений PCIe, Spark способен обеспечить только 200 Гбит/с. Желая узнать больше, мы углубились в топологию Spark:
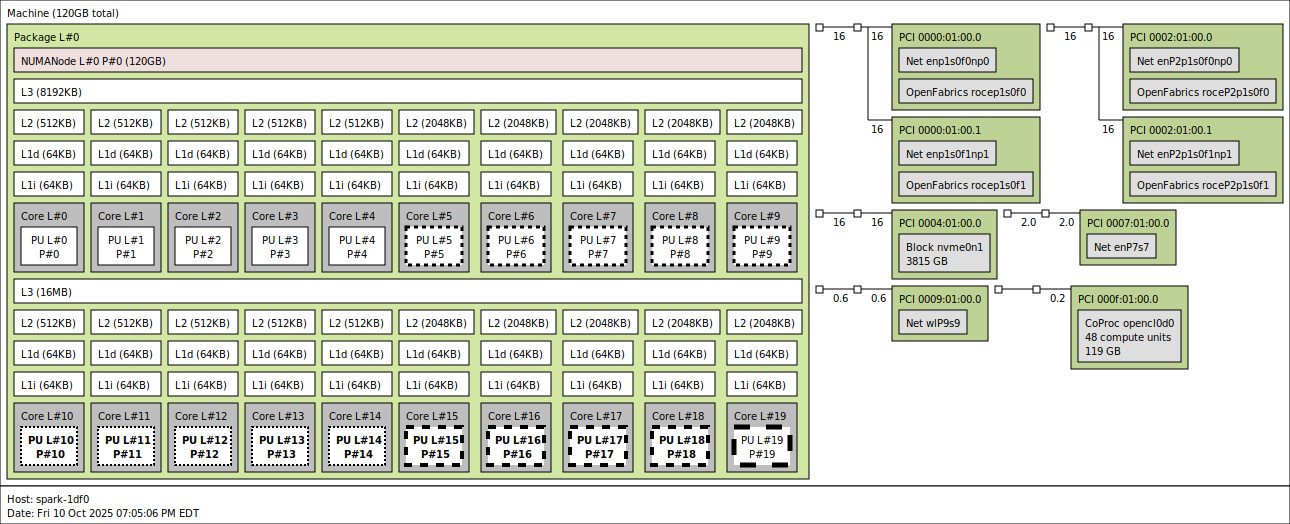
С помощью команды lstopo мы наблюдаем два соединения от сетевой карты CX7. Электрически CX7 соединена двумя каналами Gen5 x4. В операционной системе эти соединения отображаются как четыре интерфейса, каждый из которых поддерживает максимальную пропускную способность 200 Гбит/с. Из-за ограниченного времени тестирования нам не удалось обнаружить все сетевые особенности этой платформы, за исключением тестов NVMe-oF, которые подробно описаны далее в статье. Однако мы планируем продолжить изучение этой платформы и в будущих статьях более подробно расскажем о ее возможностях, например, о кластеризации нескольких Spark для создания мини-кластера.
Рассматривая другие подключенные устройства, далее следует миниатюрный твердотельный накопитель M.2 форм-фактора 2242, подключенный через интерфейс Gen5 x4, затем контроллер Realtek RJ45 10GbE, подключенный через интерфейс PCIe Gen4 x1, и контроллер Wi-Fi MediaTek, подключенный через интерфейс PCIe Gen3 x1.
Что касается процессора, Spark содержит 20-ядерный процессор Arm с гетерогенной архитектурой Big Little, аналогичной новейшим процессорам Intel, состоящий из 10 энергоэффективных ядер Cortex-A725 и 10 высокопроизводительных ядер Cortex-X925, распределенных по двум кластерам кэш-памяти L3. Первый кластер (8 МБ L3) содержит процессоры 0-4 (Cortex-A725, макс. 2808 МГц) и процессоры 5-9 (Cortex-X925, макс. 3900 МГц), а второй кластер (16 МБ L3) содержит процессоры 10-14 (Cortex-A725, макс. 2860 МГц) и процессоры 15-19 (Cortex-X925, макс. 3978-4004 МГц). Каждое ядро имеет собственный кэш L1 объемом 64 КБ и кэш инструкций L1 объемом 64 КБ, но размер кэша L2 значительно различается в зависимости от типа ядра: энергоэффективные ядра Cortex-A725 имеют кэш L2 объемом 512 КБ, в то время как высокопроизводительные ядра Cortex-X925 имеют существенно больший кэш L2 объемом 2 МБ (в 4 раза больше). Самыми быстрыми ядрами являются процессоры 15-19, которые выигрывают как от большего кэша L3 объемом 16 МБ, так и от более высоких частот, при этом процессор 19 является ядром с пиковой производительностью — 4004 МГц. Эти различные уровни мощности/частоты обозначены пунктирными линиями на ядре в топологии, показанной выше.
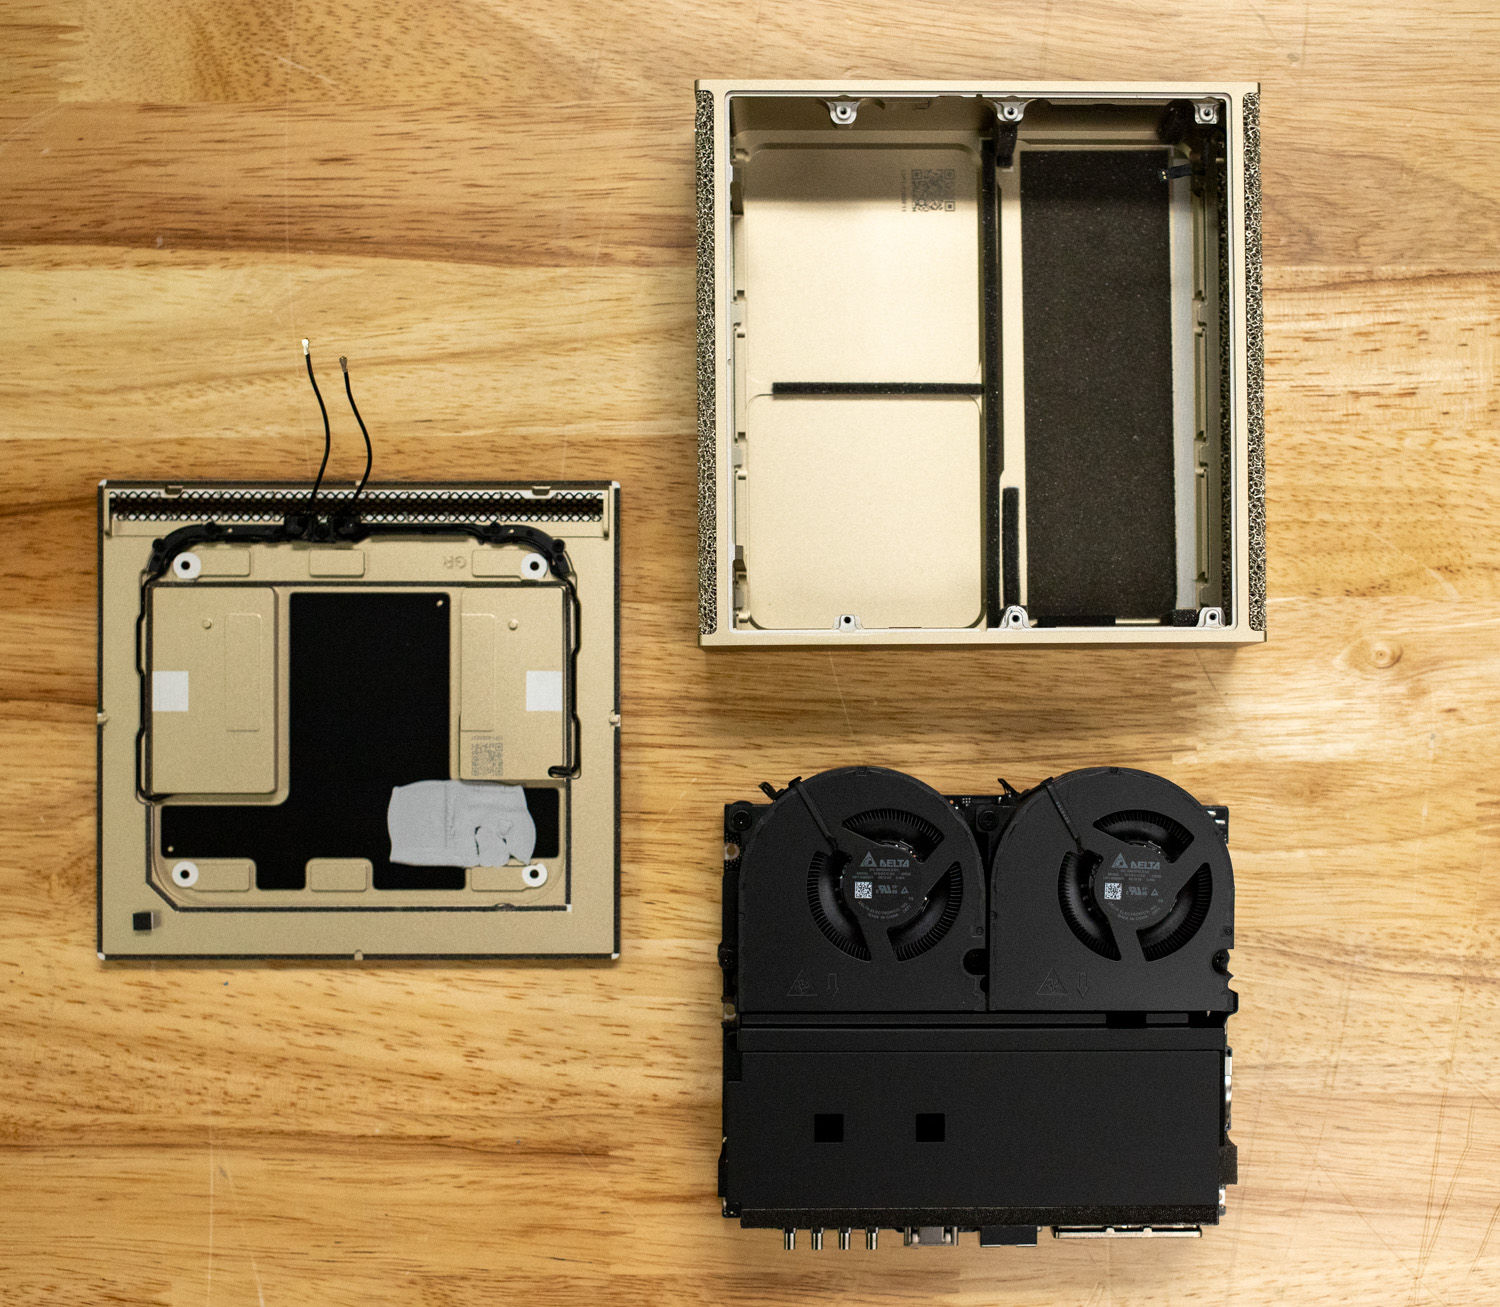
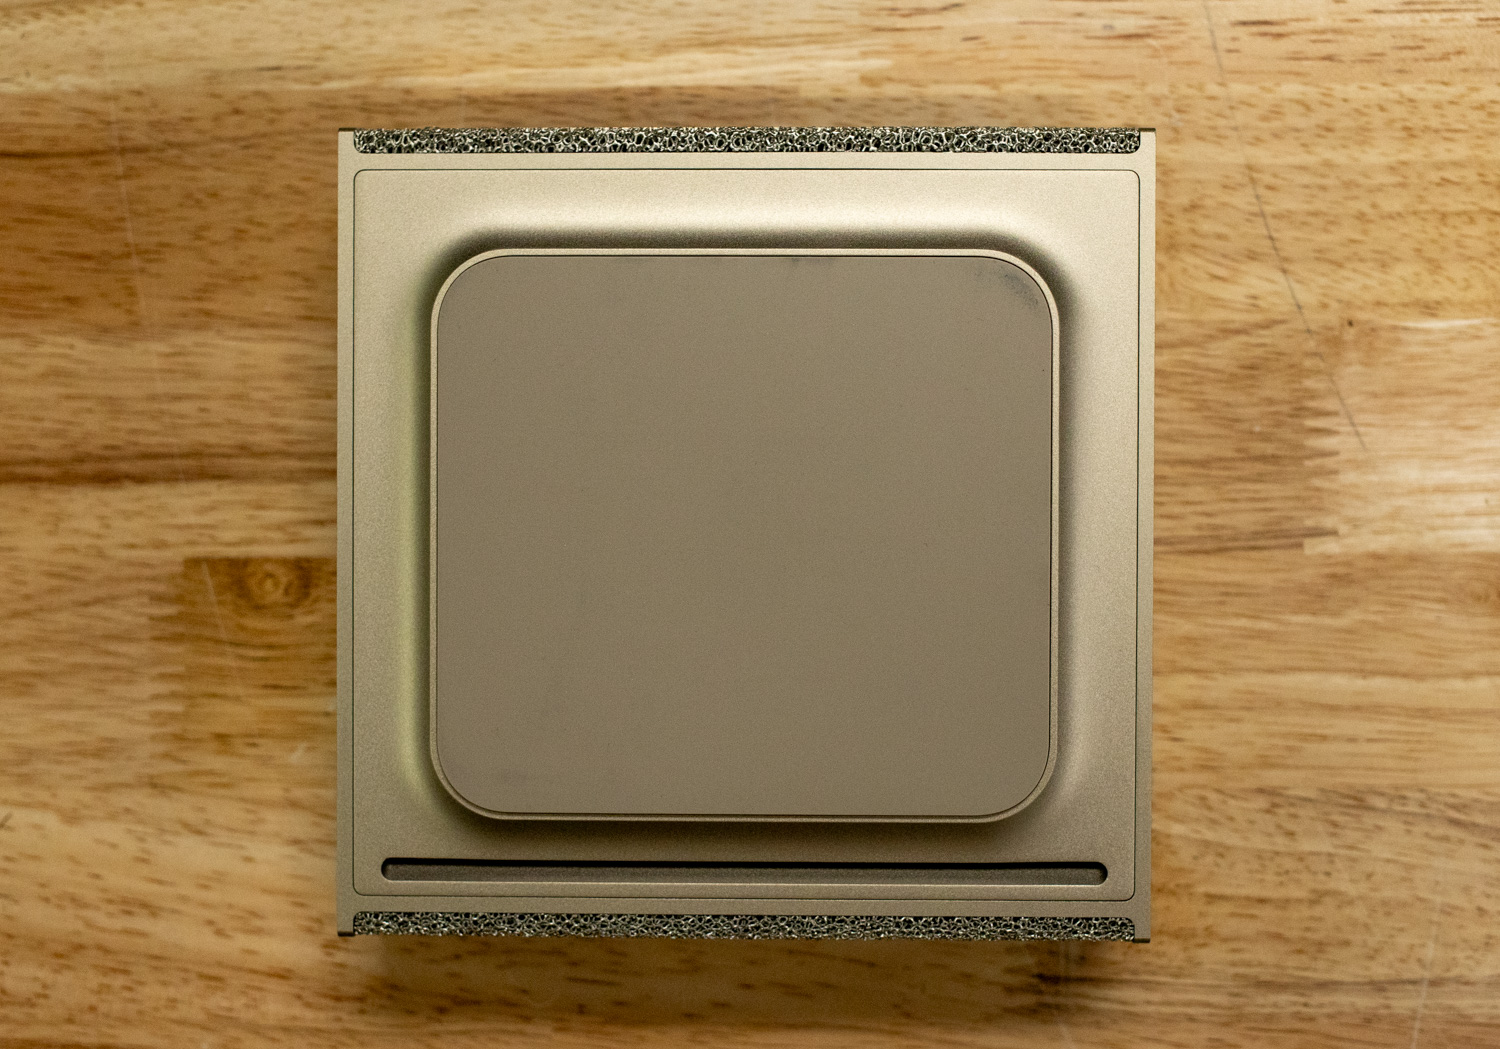
Отдалившись от монитора, переворачиваем DGX Spark; единственная видимая пластиковая деталь — это крышка основания, которая крепится к нижней части корпуса с помощью магнитов. Такая конструкция обеспечивает чистоту внешнего вида и быстрый доступ к внутренним компонентам. После снятия магнитной крышки открываются четыре винта, обеспечивающие доступ к основному внутреннему отсеку.
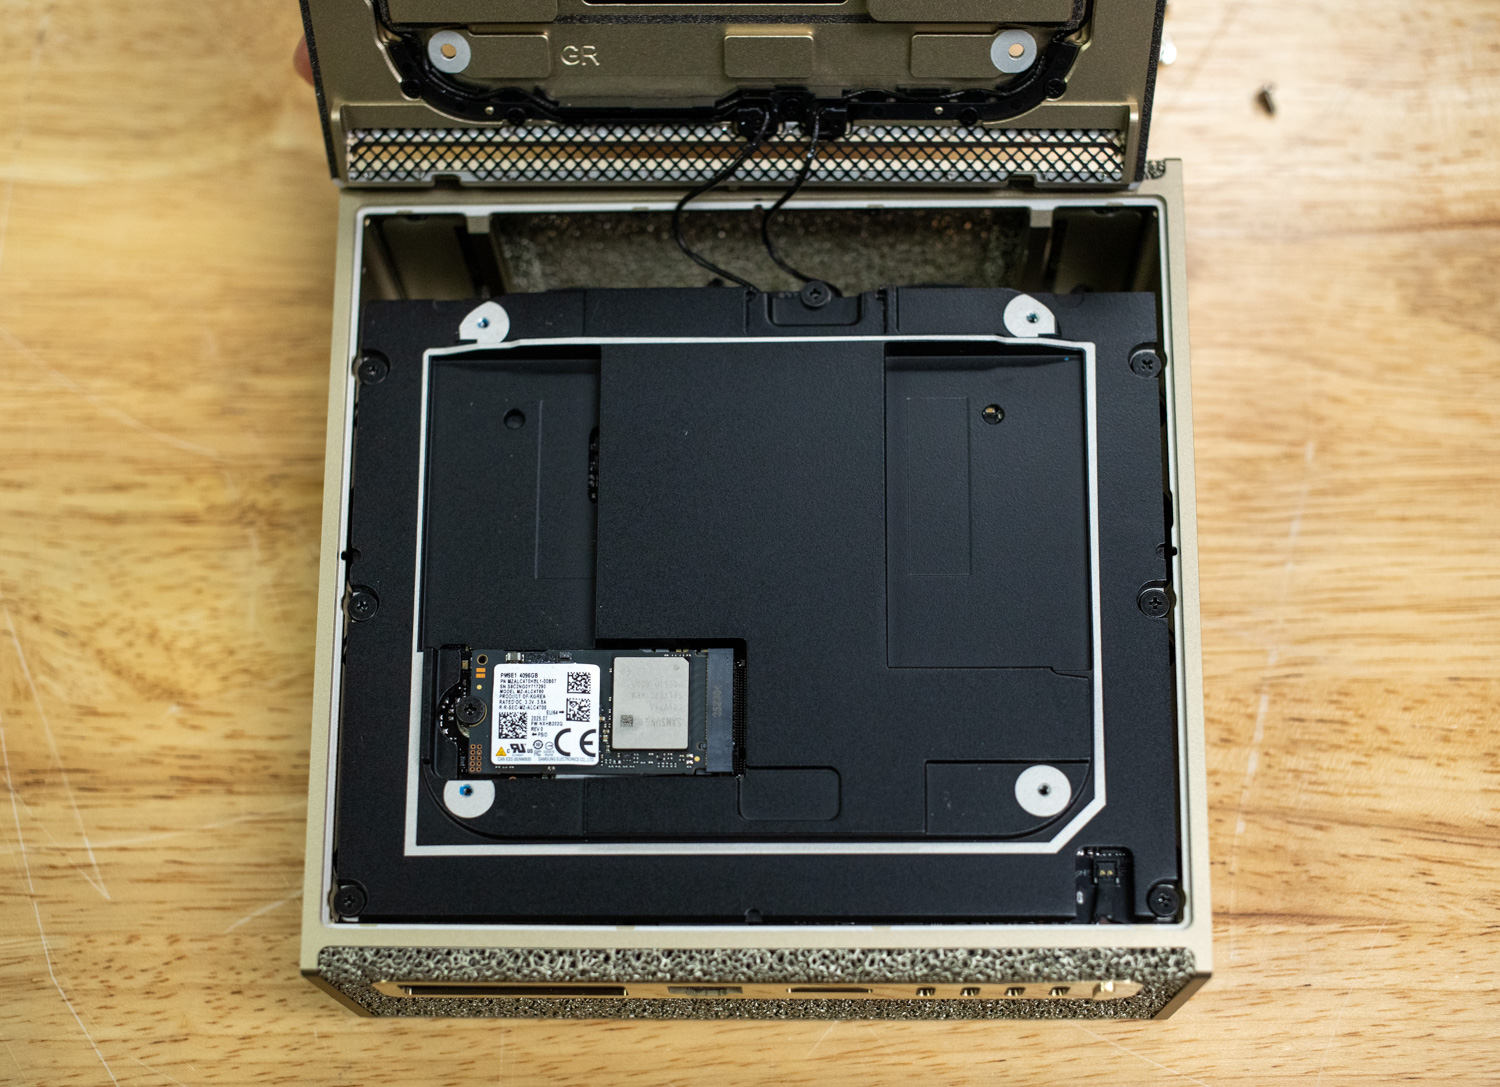
Внутри устройства мы видим антенные провода, проложенные к верхней части корпуса, что подтверждает наличие поддержки Wi-Fi 7 и Bluetooth 5.3. Это обеспечивает гибкие сетевые возможности, особенно полезные для мобильных или лабораторных развертываний, где проводной доступ может быть недоступен.
Также виден накопитель устройства — твердотельный накопитель PCIe Gen5 2242 M.2, менее распространенный форм-фактор для такого высокопроизводительного оборудования. В представленной здесь конфигурации используется 4-терабайтный NVMe-накопитель Samsung.
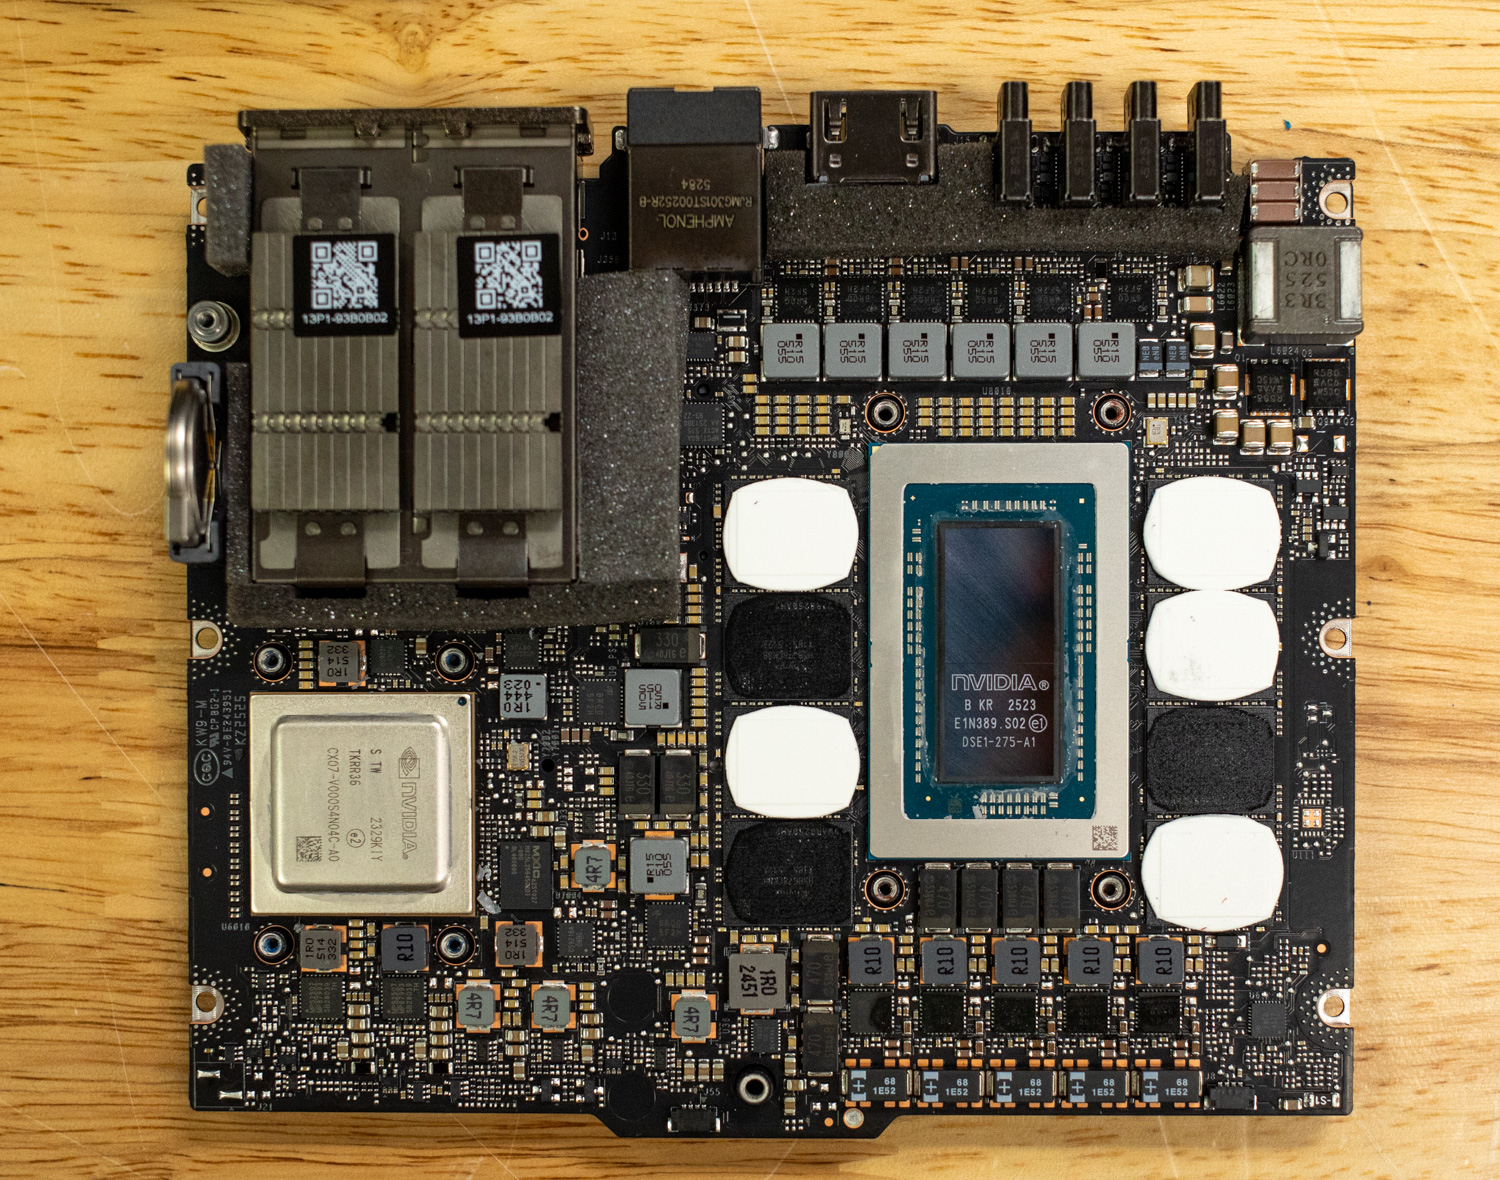
Более детальное изучение DGX Spark раскрывает сердце системы — процессор NVIDIA Grace Blackwell GB10 Superchip. По бокам от GB10 Superchip расположены 8 припаянных модулей унифицированной системной памяти LPDDR5X, обеспечивающих пропускную способность 273 ГБ/с, что гарантирует быстрый доступ к данным как для центрального, так и для графического процессора.
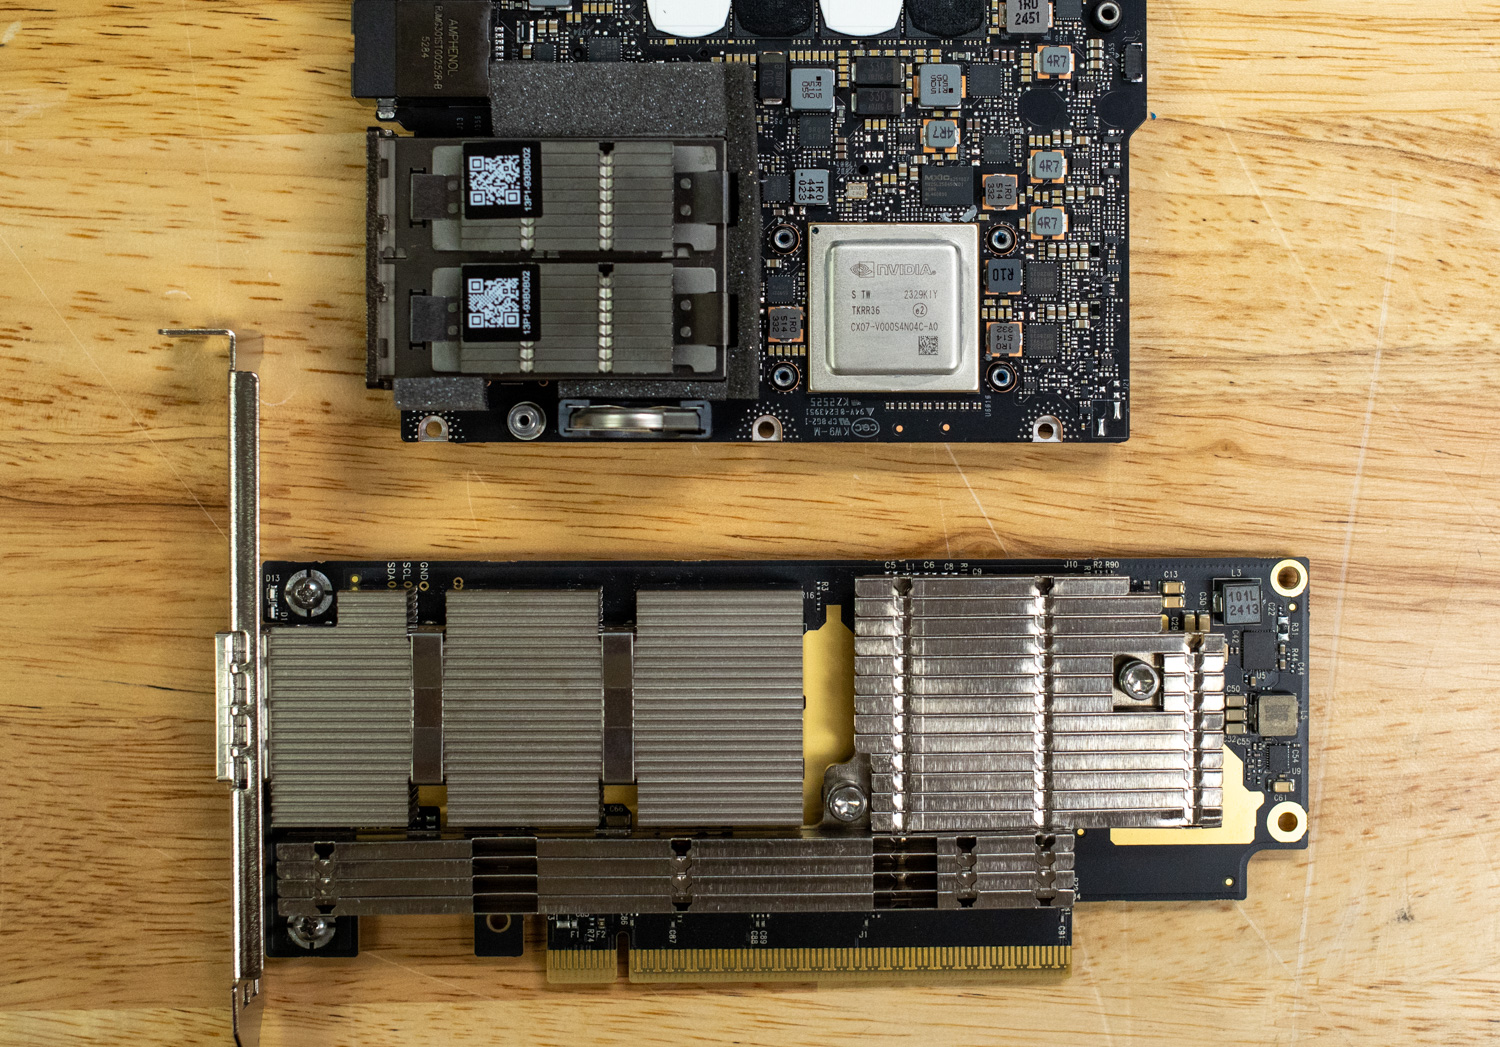
Рядом с чипом находится сетевая карта CX7, которая, как уже упоминалось, обеспечивает скорость подключения 200 Гбит/с. Это позволяет пользователям подключать Spark к высокоскоростным хранилищам или даже объединять несколько экземпляров Spark в кластер. NVIDIA протестировала и продает кластер из двух Spark, которые можно напрямую подключить для поддержки еще более крупных моделей искусственного интеллекта.
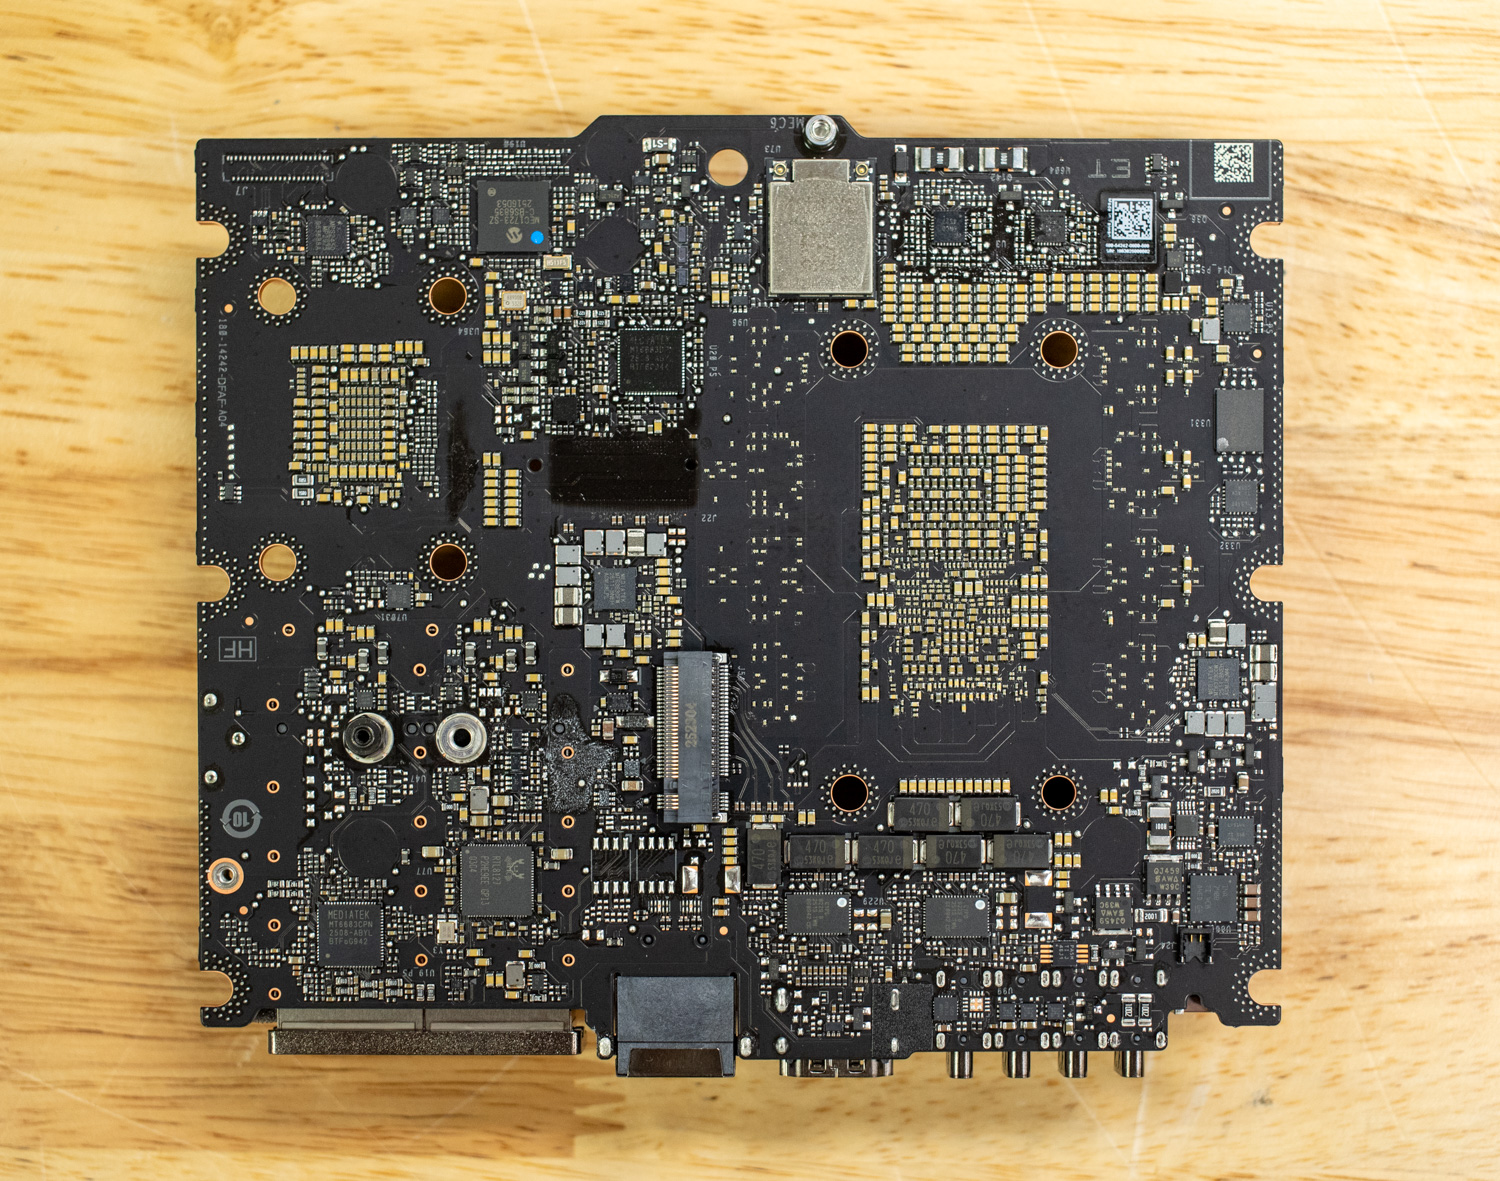
Наконец, перевернув плату, можно увидеть все разъемы PCIe, включая твердотельный накопитель M.2 PCIe Gen5 x4 2242 и адаптер Wi-Fi MediaTek PCIe Gen3x1.
Где Spark становится незаменимым: современное устройство для разработки ИИ.
DGX Spark демонстрирует особенно привлекательные характеристики в различных профессиональных контекстах, каждый из которых выигрывает от уникального сочетания унифицированной памяти, компактного форм-фактора и комплексной интеграции с программным обеспечением.
Ускорение обработки данных в науке: от Pandas до внедрения в производство.
Для специалистов по обработке данных NVIDIA DGX Spark представляет собой значительное улучшение скорости и удобства работы. Сетевое соединение ConnectX-7, обеспечивающее пропускную способность 200 Гбит/с, в сочетании с библиотеками ускорения CUDA X, преобразует предварительную обработку данных. Искусственный интеллект и наука о данных строятся на принципе «качественные данные на входе — качественные данные на выходе». Традиционно наиболее трудоемким этапом любого проекта машинного обучения является очистка данных и извлечение признаков. Традиционные рабочие процессы обычно включают загрузку наборов данных в такие инструменты, как pandas, и выполнение преобразований на ядрах ЦП, что, как правило, медленно. Ручное исследование и разработка признаков также могут стать серьезным препятствием. Spark обеспечивает сквозное ускорение GPU с помощью RAPIDS.
Типичный сценарий обработки данных в корпоративной среде включает в себя проектирование признаков на наборах данных объемом 40-80 ГБ: объединение нескольких таблиц, вычисление агрегаций по временным окнам, обработку категориального кодирования и нормализацию распределений. На инфраструктуре CPU эта предварительная обработка может занять часы. Благодаря тому, что RAPIDS cuDF загружает весь набор данных в унифицированную память Spark объемом 128 ГБ, эти операции выполняются за минуты с ускорением в 10 раз и более. Последующее обучение модели одинаково эффективно как для классического машинного обучения с cuML, так и для глубокого обучения с PyTorch, устраняя традиционное узкое место, когда специалисты по обработке данных ждут восстановления инфраструктуры, вместо того чтобы итеративно проверять гипотезы.
Генерация синтетических данных: робототехника и моделирование
Включение ядер RT четвертого поколения делает Spark уникальным инструментом для нового рабочего процесса: генерации синтетических данных для обучения моделей окружающего мира. Обучение надежных стратегий манипулирования традиционно требует десятков тысяч реальных демонстраций, что является непомерно дорогим и трудоемким процессом. Фотореалистичное моделирование на таких платформах, как Isaac Sim или Omniverse, предоставляет альтернативу, но рендеринг изображений с трассировкой лучей и физически точным освещением, отражениями и материалами исторически требовал дорогостоящих графических процессоров для рабочих станций, таких как NVIDIA L40S и RTX 6000 Ada.
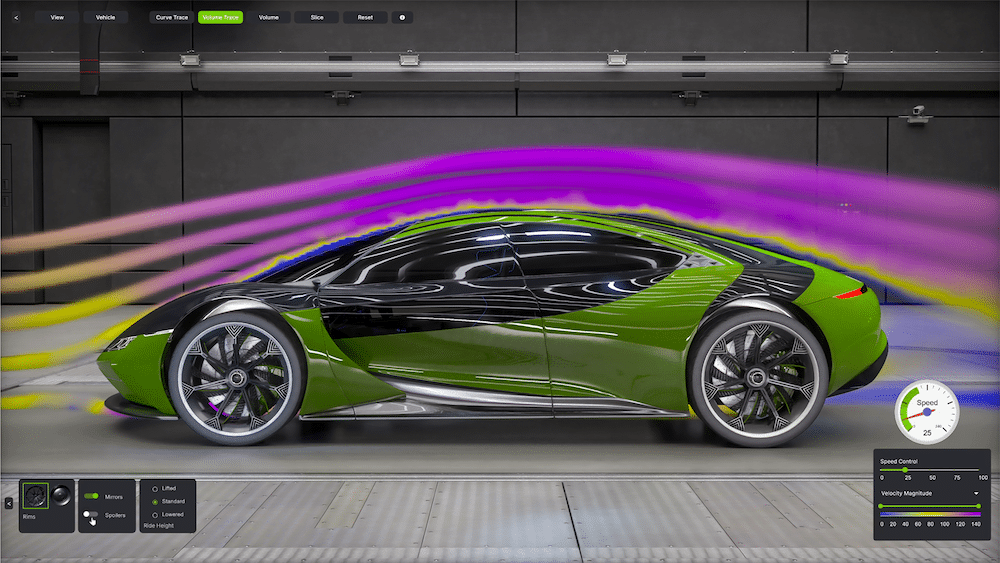
Источник: NVIDIA
Spark унифицирует этот рабочий процесс. Ядра реального времени (RT Cores) позволяют рабочим нагрузкам OpenUSD обрабатывать генерацию синтетических данных, а ядра Tensor Cores используются для вывода результатов ИИ в рамках плана/рабочего процесса. Ранее организациям приходилось развертывать несколько машин для рендеринга и отдельный сервер, оптимизированный для вывода результатов. Теперь это достижимо с помощью одного устройства мощностью 240 Вт. Для стартапов в области робототехники, университетских лабораторий или автопроизводителей, изучающих автономное манипулирование, эта интеграция значительно сокращает сроки разработки и капитальные затраты.
Ранее в нашем обзоре NVIDIA L40S мы уже рассматривали аналогичные конвейеры генерации синтетических данных с использованием специализированных систем рендеринга L40S в паре с H100 для вывода результатов . Архитектурное объединение этих возможностей в единое устройство разработки в GB10 представляет собой убедительное развитие этого рабочего процесса. В предстоящем анализе мы планируем провести дополнительное тестирование производительности ядра Spark RT Core в этих дискретных конфигурациях, изучив рендеринг и другие рабочие нагрузки для типичных сценариев манипуляций роботами.
Революция в программировании Vibe
Андрей Карпати, бывший директор по искусственному интеллекту в Tesla и один из основателей OpenAI, ввел термин «вайб-кодирование» для описания нового подхода к быстрой разработке программного обеспечения с помощью ИИ. Вместо кропотливого написания кода построчно, вайб-кодирование использует программистов с лингвистическим образованием в качестве интерактивных пар: описание функциональности на естественном языке, создание каркаса реализации, итеративное уточнение в диалоге и быстрое прототипирование функций. Этот рабочий процесс превращает кодирование из целенаправленного конструирования в управляемый диалог с ИИ, который понимает контекст, API и архитектурные шаблоны, позволяя отдельным разработчикам создавать невероятно сложные системы с беспрецедентной скоростью.
Масштабы внедрения ИИ-помощников в программировании подтверждаются рейтингами использования OpenRouter , где модели, ориентированные на программирование, неизменно доминируют по объему вывода. Технические специалисты, основная целевая аудитория программистов, как правило, являются опытными пользователями, запуская несколько агентов программирования параллельно в различных контекстах. И поскольку модели с открытыми весами все чаще соответствуют проприетарным альтернативам по ключевым показателям производительности , разработчики изучают возможность локального развертывания вывода, чтобы исключить ограничения скорости, обеспечить доступность в критически важные периоды разработки и сохранить конфиденциальность кода для проприетарных проектов.
Сообщество r/LocalLLaMA демонстрирует поистине впечатляющие пользовательские сборки, от многопроцессорных рабочих станций до серверов, собранных из разных частей и работающих с локальными моделями, распределенным выводом данных на потребительском оборудовании и сложными системами охлаждения, обеспечивающими стабильную высокопроизводительную генерацию. Однако эти конфигурации сопряжены со значительными трудностями: капитальные затраты часто превышают десятки тысяч долларов, существенное энергопотребление, проблемы с тепловым режимом, требующие выделенных помещений, а не стандартных офисных условий, и значительные технические знания для настройки, оптимизации и устранения неполадок.
Spark коренным образом меняет это ценностное предложение. При цене в 3,999 долларов США и объеме унифицированной памяти в 128 ГБ он обеспечивает впечатляющую производительность при выводе моделей в тихом, компактном и энергоэффективном устройстве, потребляющем всего 240 Вт. Пользователям, стремящимся создать локальную инфраструктуру для программирования, больше не требуются сложные домашние лаборатории, потребляющие киловатт-часы и выделяющие значительное количество тепла. Проверенный подход к созданию устройства с предварительно настроенной ОС DGX устраняет сложность конфигурации, которая ранее ограничивала развертывание локальных LLM пользователями с глубокими знаниями Linux и CUDA.
Помимо устранения проблем с инфраструктурой, Spark решает критически важные вопросы, связанные с конфиденциальностью кода и настройкой моделей. Облачные помощники по программированию обязательно передают исходный код на удаленные серверы, что неприемлемо для организаций, работающих с собственными алгоритмами, критически важной для безопасности инфраструктурой или регулируемыми данными. Локальный вывод на Spark гарантирует, что код никогда не покинет среду разработки. Кроме того, объем памяти в 128 ГБ позволяет полностью настраивать параметры моделей программирования, что дает опытным разработчикам возможность специализировать модели на основе внутренних кодовых баз. Эта возможность особенно ценна для организаций, использующих предметно-ориентированные языки программирования, собственные фреймворки или архитектурные шаблоны, которые недостаточно представлены в общедоступных обучающих данных.
Тонкая настройка с помощью NVIDIA NeMo на DGX Spark
Единая память DGX Spark объемом 128 ГБ позволяет выполнять полную тонкую настройку параметров 8B-моделей, для которых традиционно требовались дорогостоящие облачные системы с несколькими графическими процессорами. Полная тонкая настройка Qwen3 8B со стандартной оптимизацией Adam требует приблизительно 132 ГБ (16 ГБ весов модели, 96 ГБ состояний оптимизатора, 16 ГБ градиентов плюс активации), что превышает возможности двух конфигураций H100 с 80 ГБ памяти. Использование эффективного с точки зрения памяти 8-битного Adam снижает требования примерно до 70 ГБ, в зависимости от размера пакета, что комфортно помещается в пул памяти Spark. Это важно, поскольку полная тонкая настройка обеспечивает на 4-6% более высокую точность, чем LoRA, в сложных задачах логического рассуждения. В то время как облачные системы с двумя H100 и 80 ГБ памяти стоят около 5 долларов в час при распределенной сложности обучения, Spark обеспечивает обучение на одной системе при единовременных инвестициях в размере 3,999 долларов.
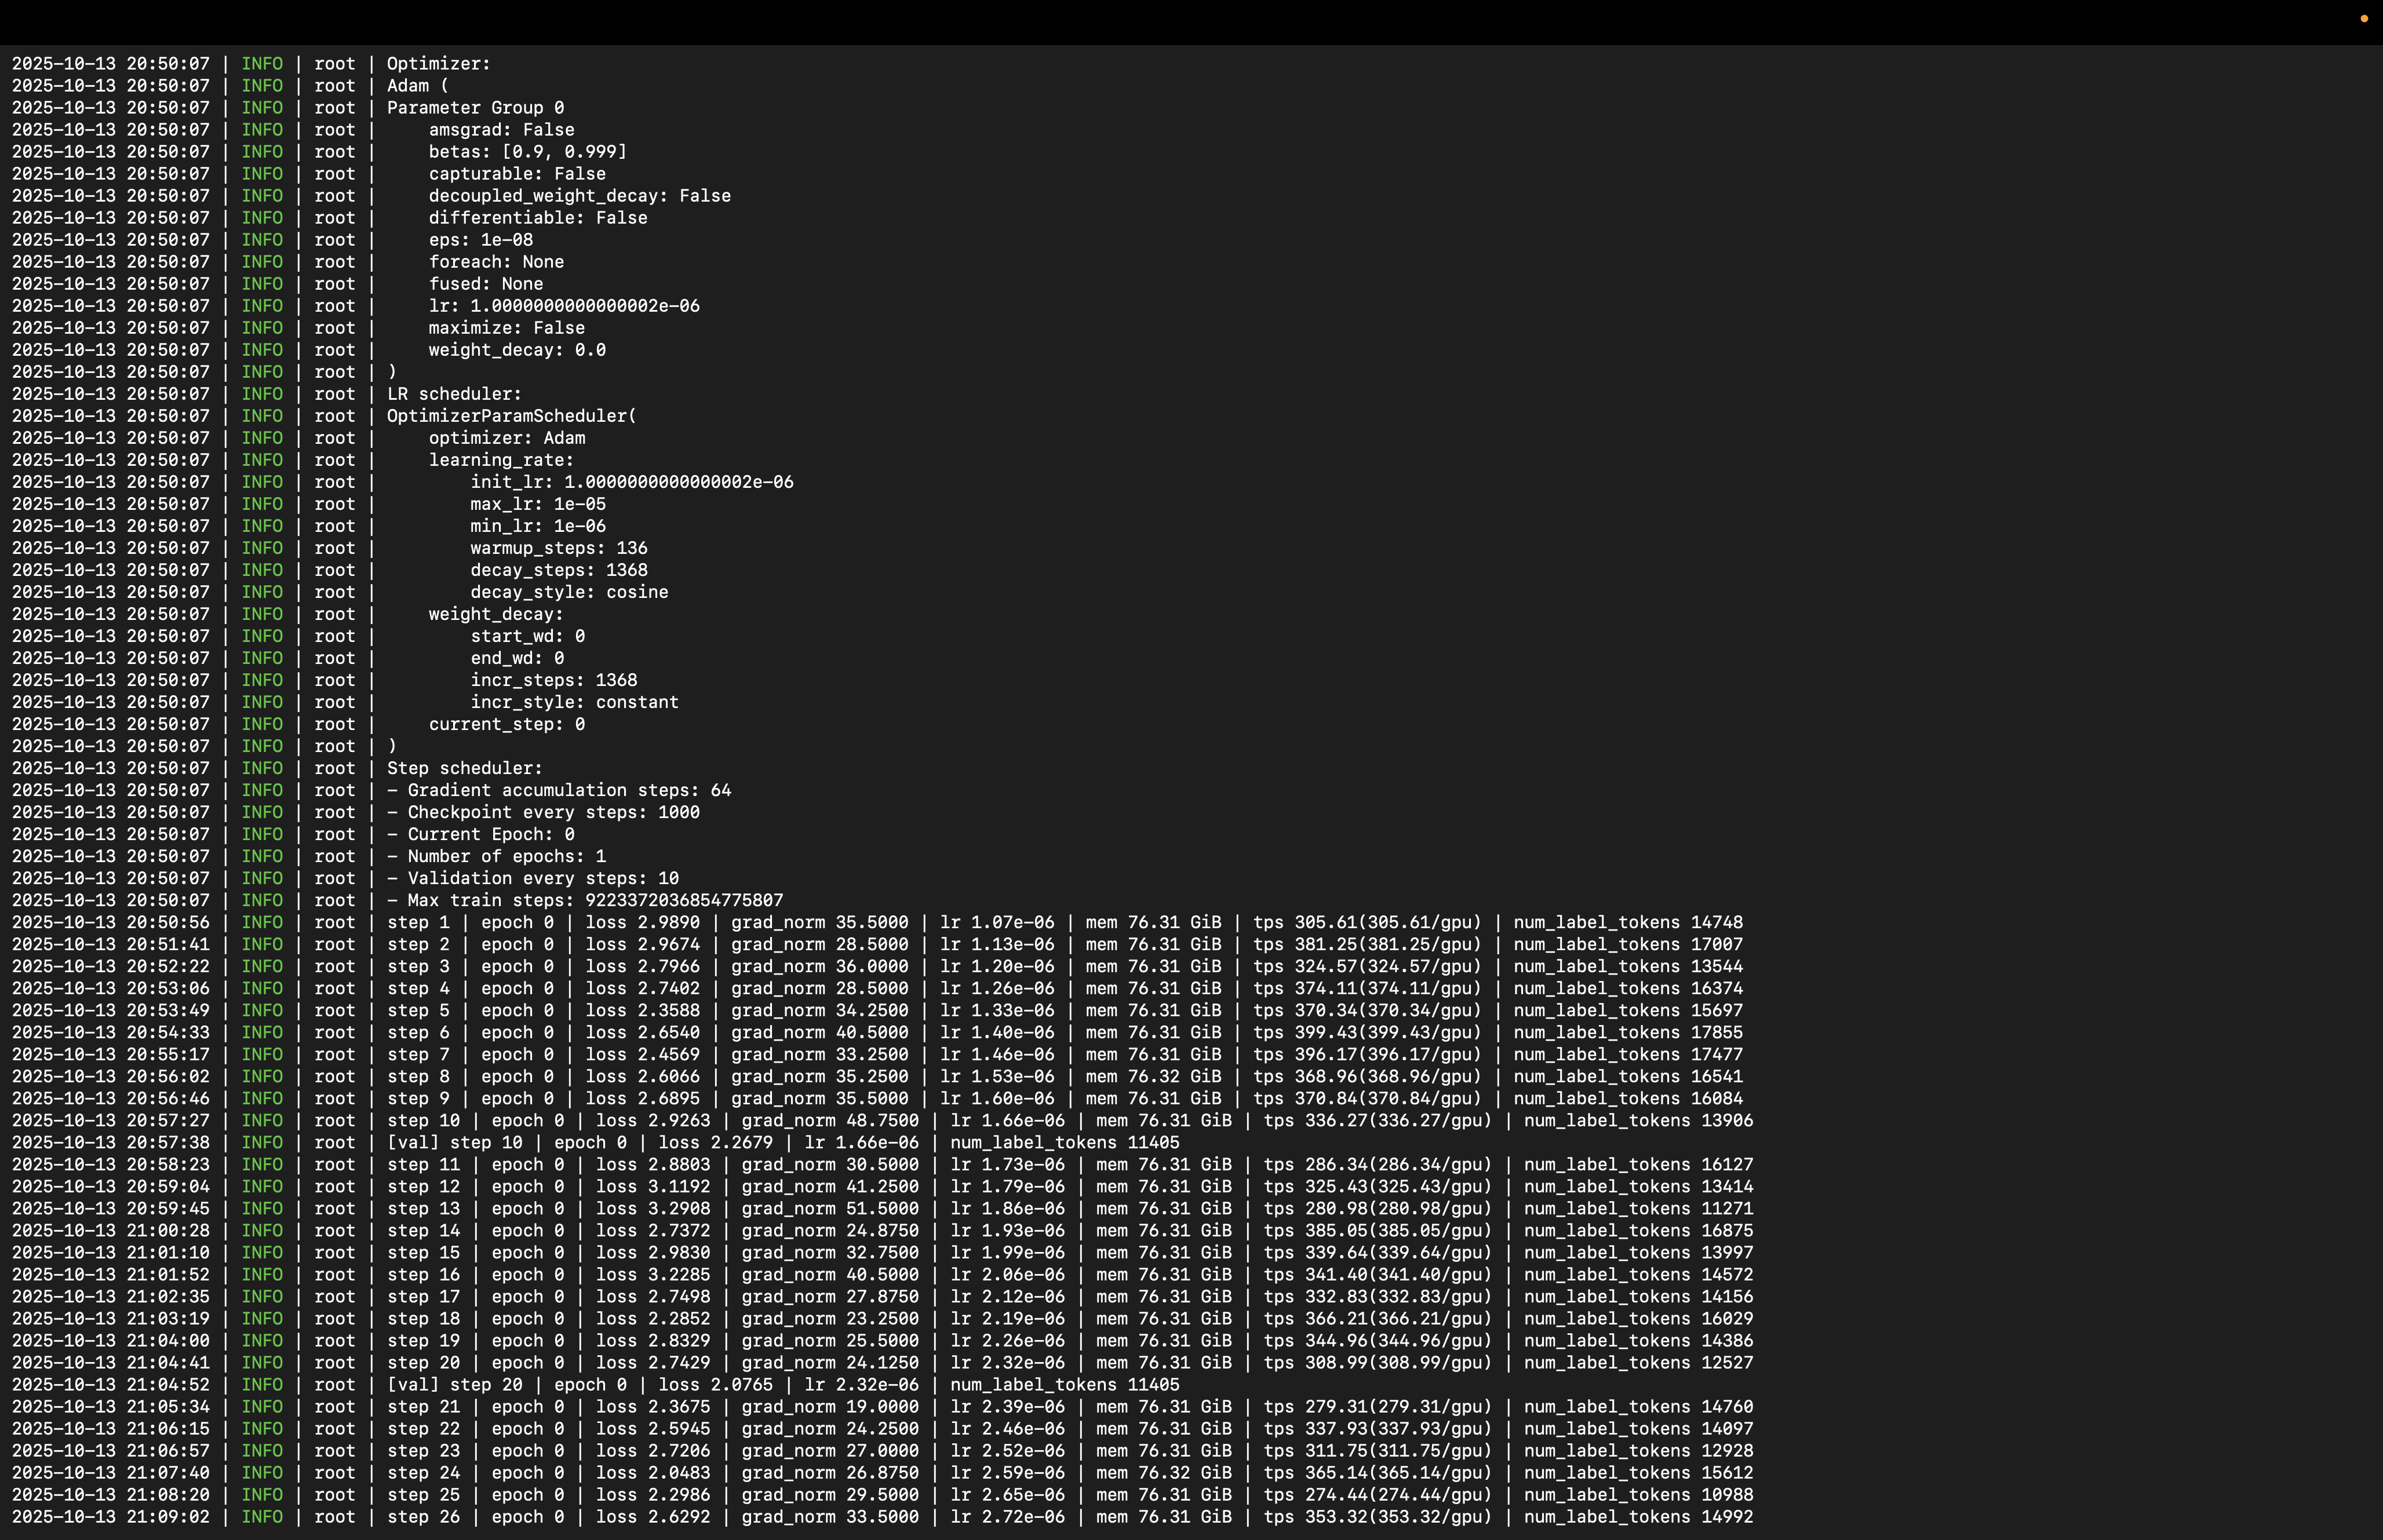
NVIDIA NeMo Automodel устраняет сложности, связанные с корпоративными платформами обучения, обеспечивая поддержку любой модели Hugging Face с первого дня без преобразования контрольных точек. Загрузите Qwen3 8B непосредственно из HuggingFace Hub и настройте тонкую настройку с помощью YAML-файлов, указывающих источники данных, параметры оптимизатора и целевые значения LoRA. NeMo автоматизирует распределенное сохранение контрольных точек с совместимостью с safetensors, реализует объединенные ядра CUDA для ускорения в 2-5 раз и обрабатывает накопление градиентов.
Создание изображений с удобным пользовательским интерфейсом
ComfyUI предоставляет графический интерфейс на основе узлов, который преобразует модели стабильной диффузии и связанные с ними модели диффузии в высоко настраиваемые творческие конвейеры. В отличие от традиционных веб-интерфейсов, которые абстрагируют сложность за упрощенными ползунками параметров, ComfyUI использует визуальную графовую архитектуру, где пользователи строят рабочие процессы, соединяя дискретные функциональные узлы, каждый из которых представляет собой определенную операцию, такую как загрузка модели, кодирование подсказок, выборка скрытой диффузии, декодирование VAE или масштабирование преобразований. Такая модульная конструкция обеспечивает детальный контроль над всем конвейером генерации, делая каждый вычислительный шаг прозрачным и настраиваемым. Она также позволяет пользователям объединять несколько моделей, реализовывать пользовательские расписания выборки или интегрировать передовые методы, такие как управление ControlNet, что было бы невозможно в упрощенных интерфейсах.
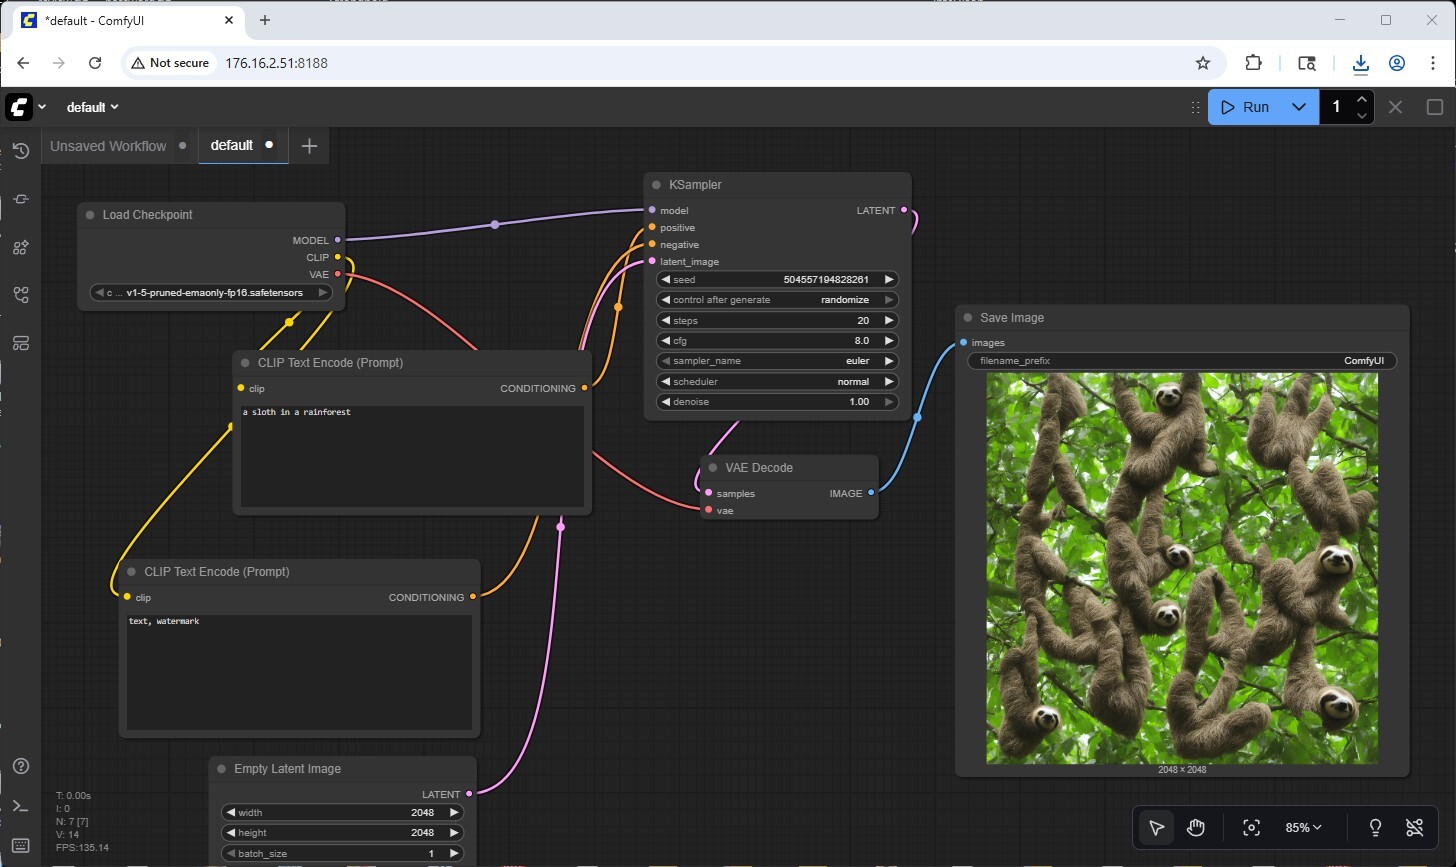
В DGX Spark ComfyUI использует тензорные ядра графического процессора Blackwell для ускорения диффузионной выборки, обычно завершая генерацию за 15-30 секунд в зависимости от сложности выборки. Особенно выгодной оказывается унифицированная архитектура памяти объемом 128 ГБ, позволяющая одновременно хранить в памяти несколько контрольных моделей, адаптеров LoRA и декодеров VAE, что исключает накладные расходы на перезагрузку, характерные для систем с ограниченным объемом видеопамяти. Пользователи могут создавать практически неограниченное количество графических изображений ИИ локально, без ограничений скорости API, облачных расходов на генерацию и проблем конфиденциальности, связанных с проприетарными рабочими процессами. Модель сохранения рабочих процессов повышает операционную ценность: полные конвейеры сериализуются в файлы JSON, которые можно контролировать по версиям, совместно использовать между командами или встраивать непосредственно в сгенерированные изображения в качестве метаданных, обеспечивая воспроизводимость, критически важную для организаций, создающих конвейеры синтетических наборов данных или поддерживающих согласованный художественный стиль во всех сгенерированных активах.
Тестирование производительности NVIDIA DGX Spark
Онлайн-сервис vLLM – Тест на логическое мышление LLM
vLLM — это самый популярный высокопроизводительный механизм вывода и обслуживания запросов для LLM. Онлайн-бенчмарк vLLM — это инструмент оценки производительности, предназначенный для измерения реальных возможностей этого механизма вывода при обработке одновременных запросов. Он имитирует производственные нагрузки, отправляя запросы на работающий сервер vLLM с настраиваемыми параметрами, такими как скорость запросов, длина входных/выходных данных и количество одновременных клиентов. Бенчмарк измеряет ключевые показатели, включая пропускную способность, т.е. количество токенов в секунду, время до получения первого токена и время на один выходной токен, помогая пользователям понять, как vLLM работает в различных условиях нагрузки.
Мы протестировали производительность вывода на основе широкого набора моделей, представляющих наиболее популярные архитектуры и типы моделей, используемые сегодня в производственных средах.
Модели смешанных экспертов
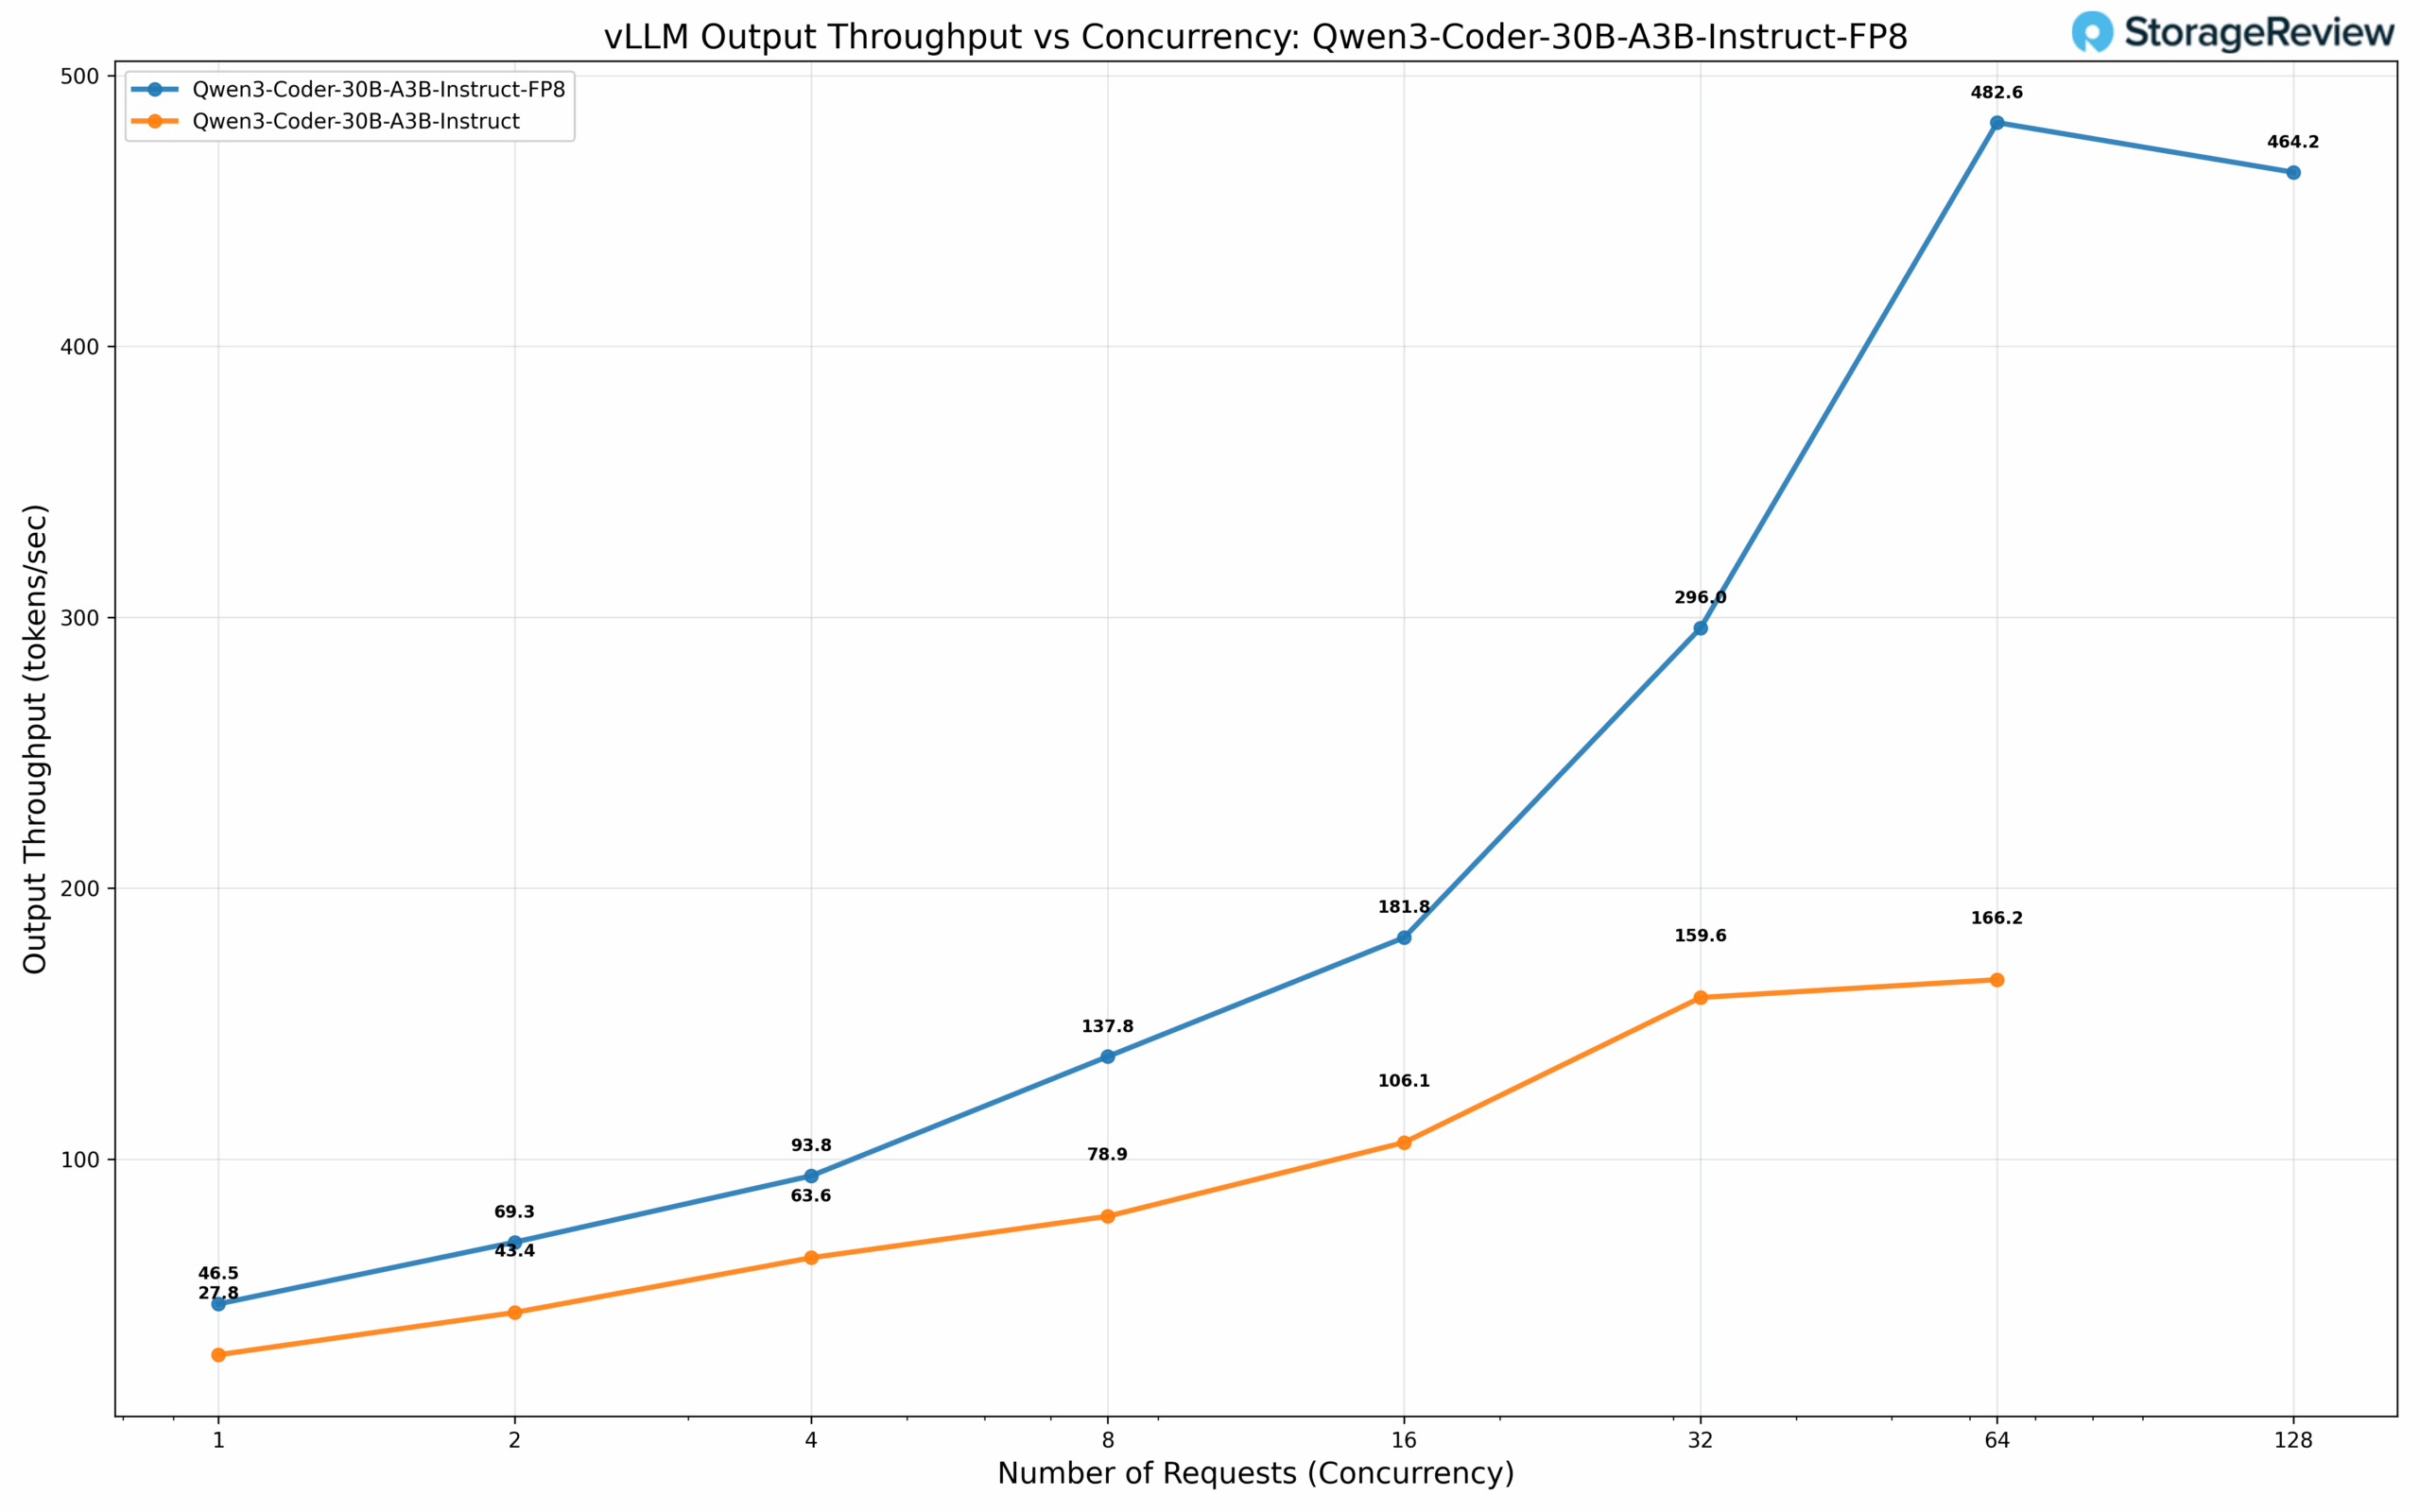
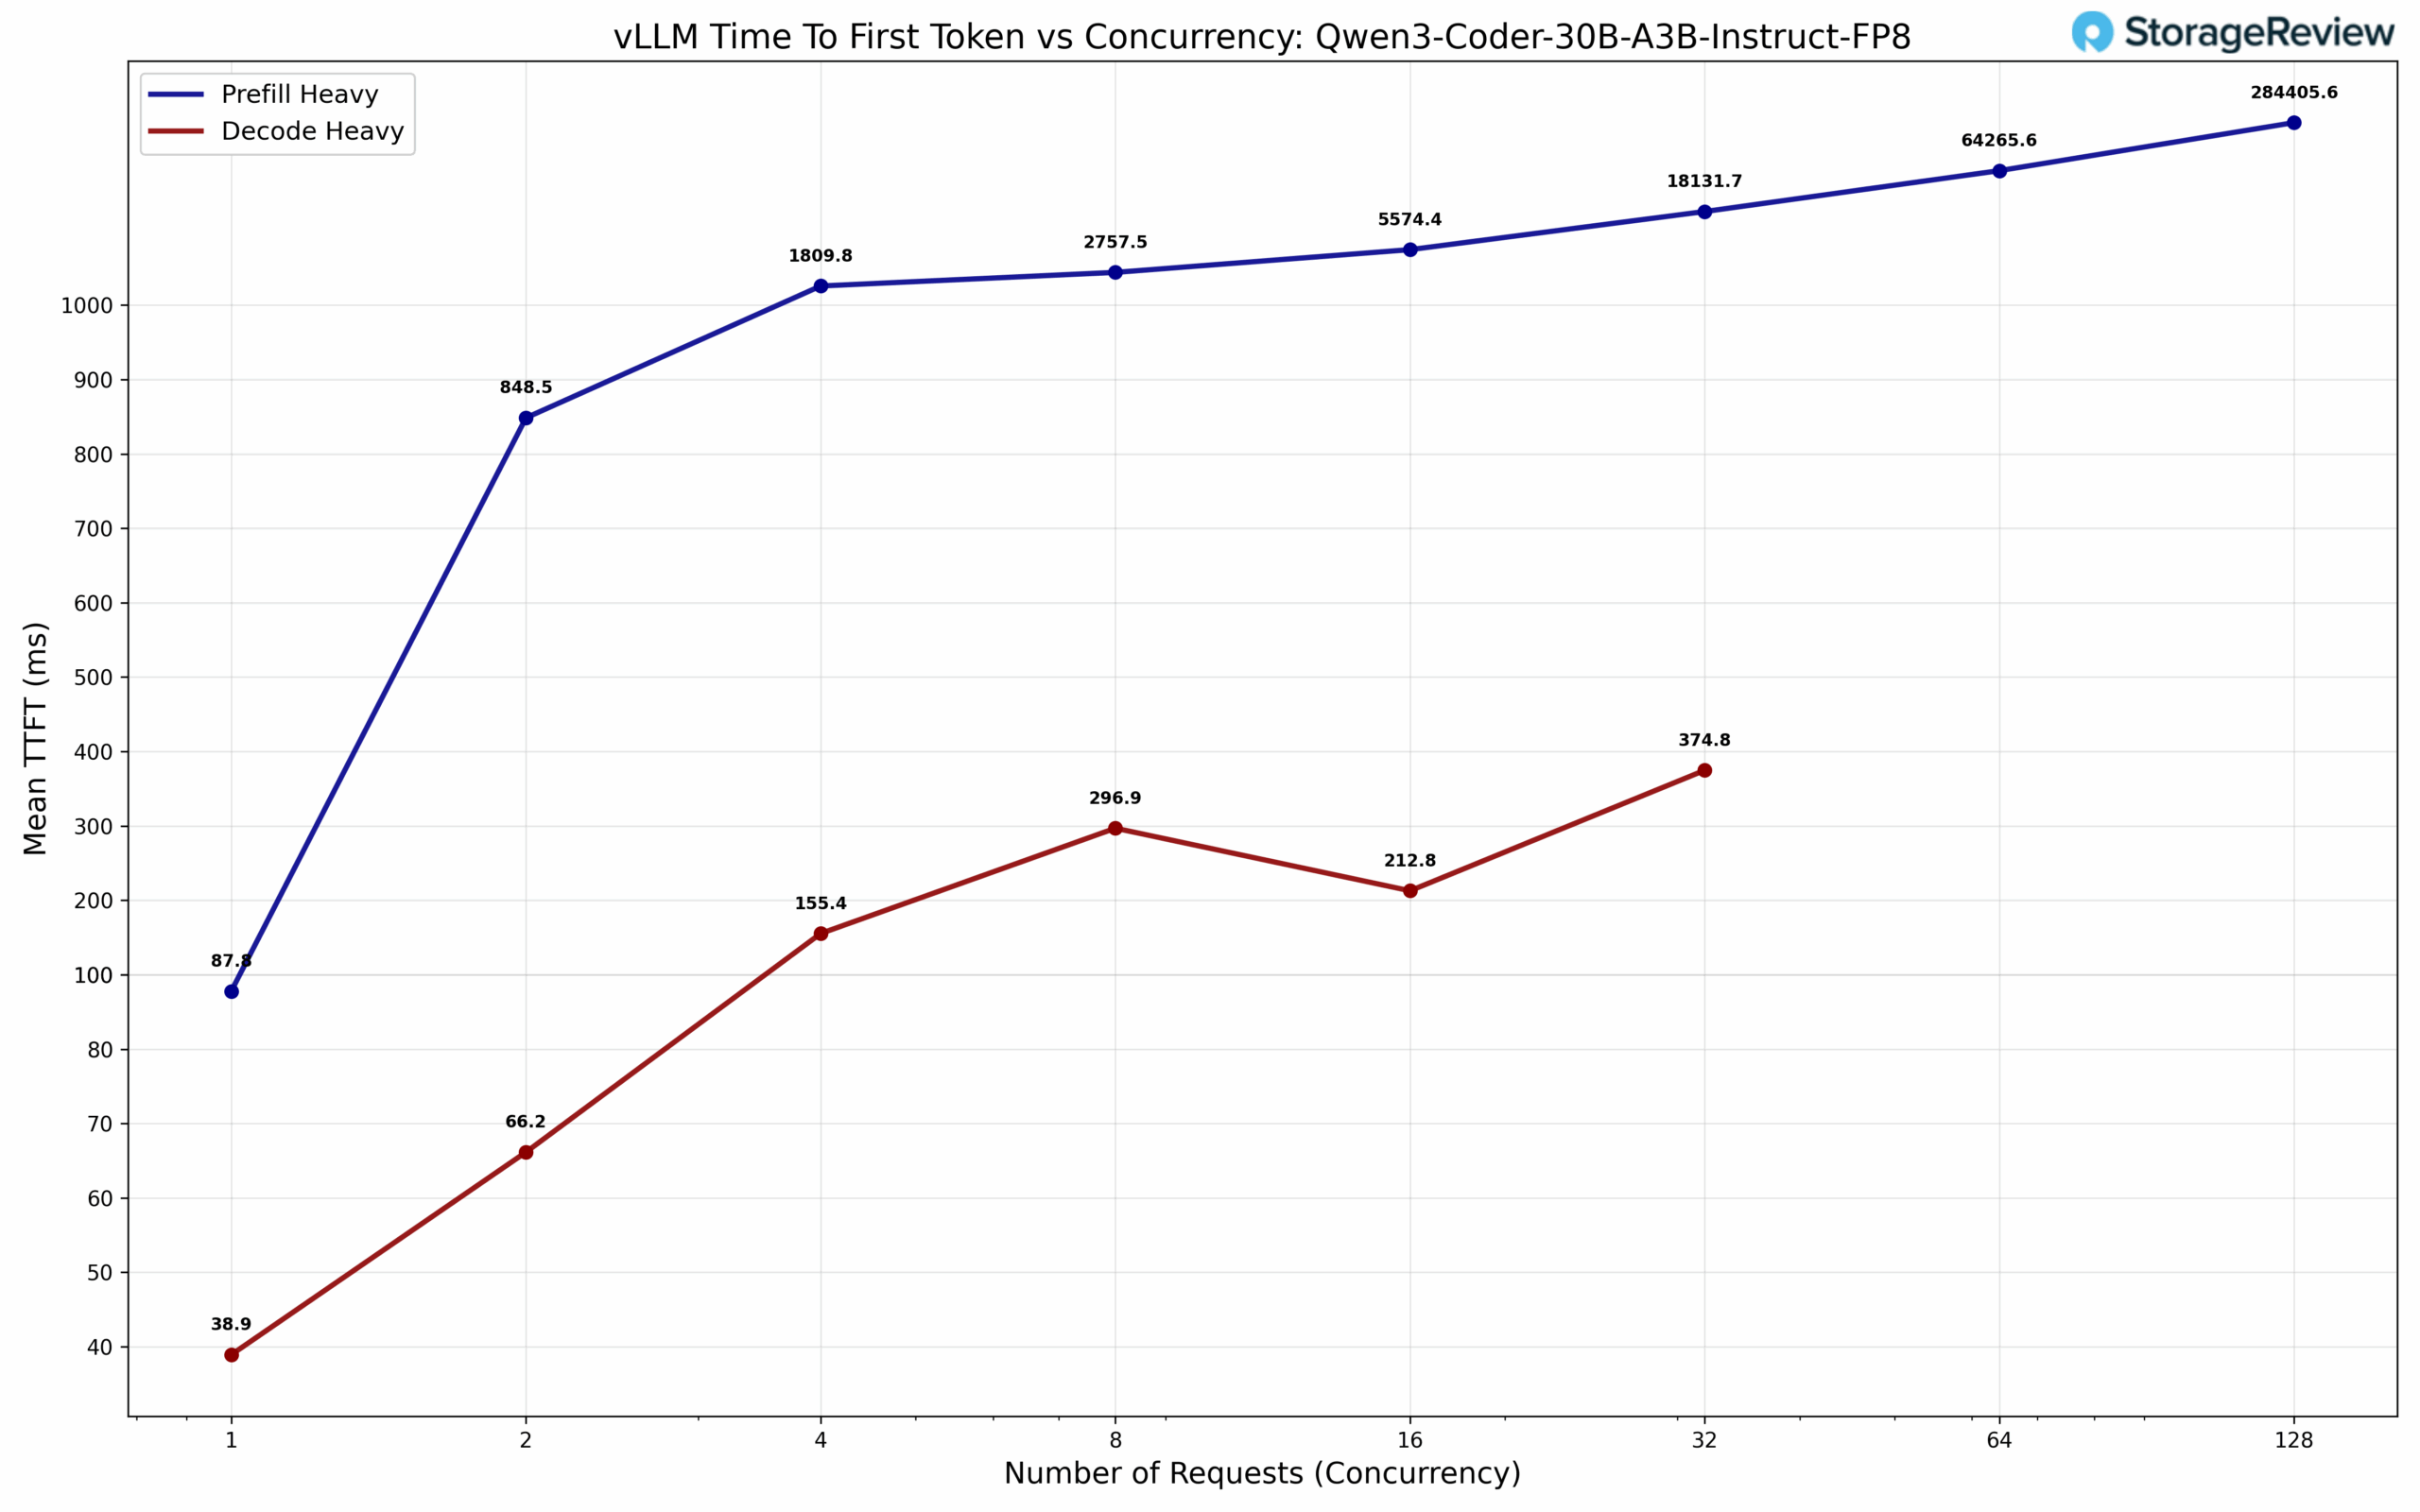
Мы оценили Qwen3 Coder 30B-A3B, одну из самых популярных моделей кодирования для развертывания локального вывода. Эта разреженная архитектура поддерживает полный размер модели в 30 миллиардов параметров с точностью BF16, активируя при этом только 3 миллиарда параметров на каждый сгенерированный токен. Мы протестировали как стандартную модель, так и вариант с квантованием FP8 от Qwen. Модель с квантованием FP8 демонстрирует существенное повышение производительности: достигая 46.5 токенов в секунду при параллелизме 1 и масштабируясь до впечатляющих 482.6 токенов в секунду при размере пакета 64. Стандартная модель BF16 обеспечивает 27.8 токенов в секунду при параллелизме 1 и достигает 166.2 токенов в секунду при размере пакета 64, что почти в 3 раза превышает производительность.
Плотные модели
Плотные модели представляют собой традиционную архитектуру LLM, где все параметры и активации задействованы в процессе вывода, что приводит к более ресурсоемкой вычислительной обработке по сравнению с их разреженными аналогами. Для всесторонней оценки характеристик производительности в зависимости от масштаба модели и стратегий квантования мы провели сравнительный анализ пяти конфигураций плотных моделей.
В наш набор тестов входила модель Mistral Small 3.1 24B от Mistral AI с точностью BF16, а также динамически квантованный вариант Mistral Small 3.1 24B FP8 от RedHat AI. Динамическое квантование использует методы выборочного квантования весов для оптимизации компромисса между производительностью и точностью, стратегически снижая точность при минимизации ухудшения модели. Мы дополнили эти более крупные плотные модели оценками Meta Llama 3.1 8B в трех форматах точности: стандартная конфигурация BF16, а также квантованные версии FP8 и FP4 от NVIDIA. Такая стратегия выбора модели позволяет напрямую сравнивать производительность в разных масштабах моделей, изолируя при этом влияние прогрессивного квантования на пропускную способность вывода.
Анализ производительности: Большие плотные модели
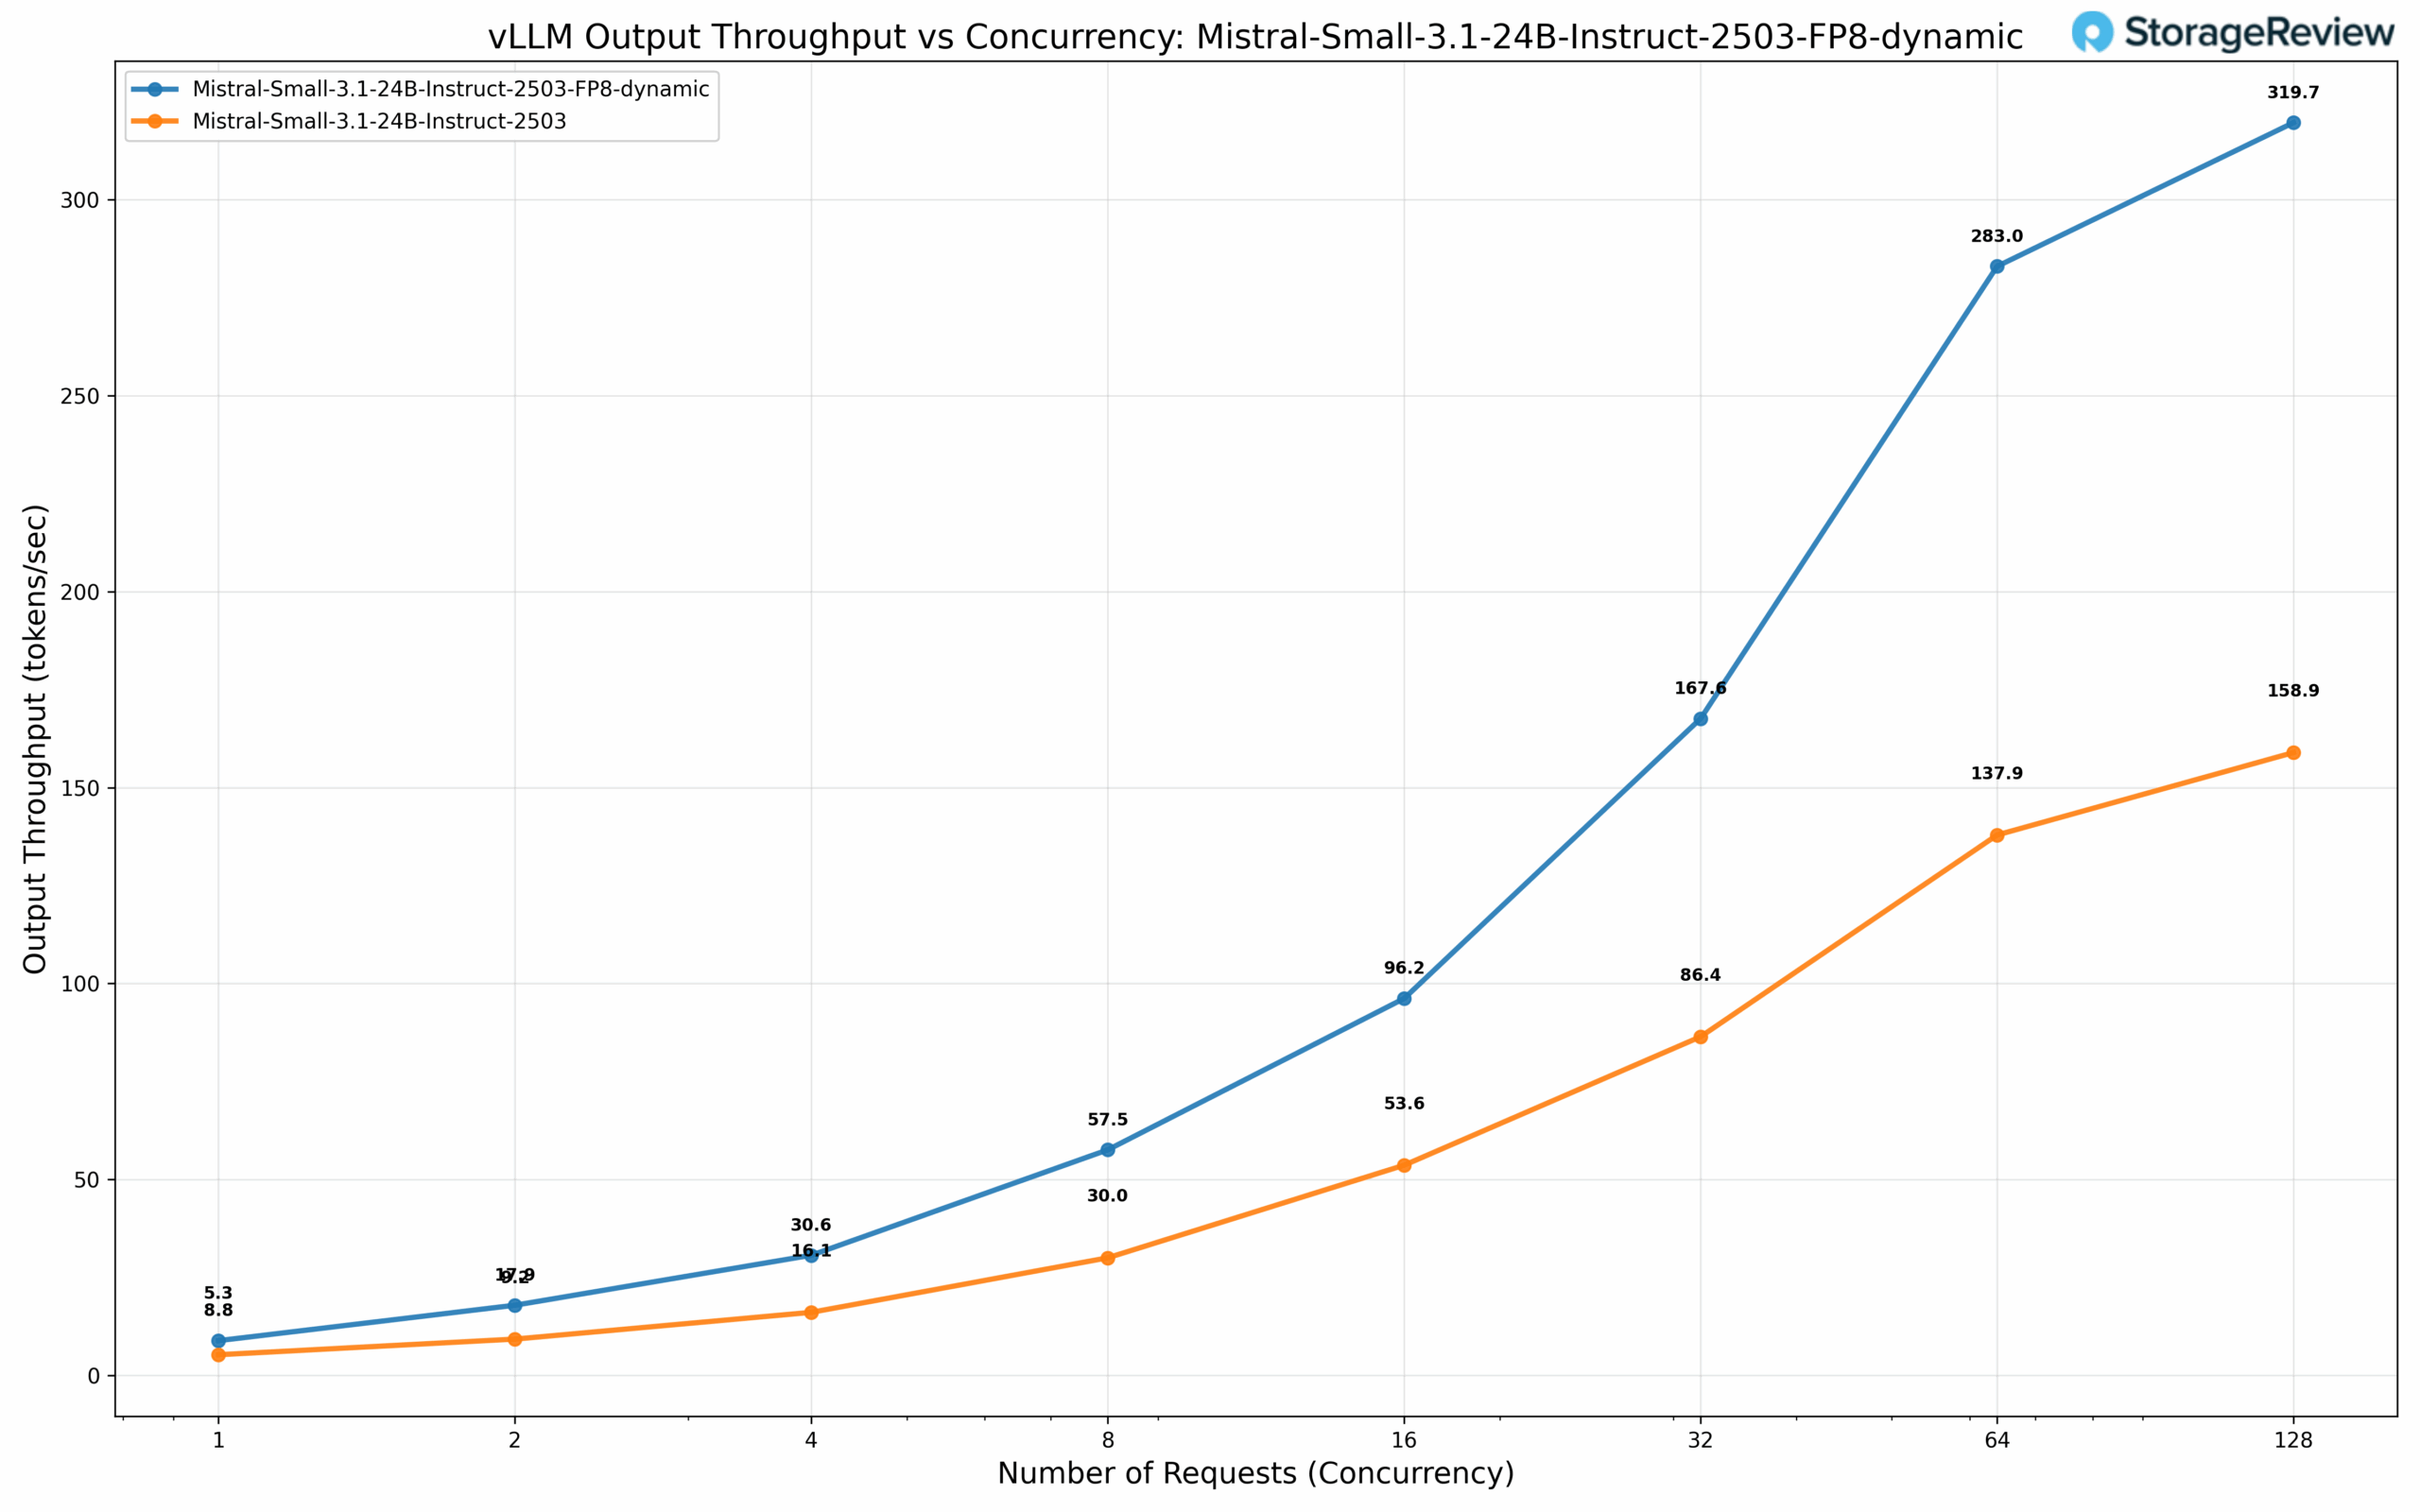
Процессор Mistral Small 3.1 24B с точностью BF16 демонстрирует базовую пропускную способность 5.3 ток/с при параллелизме 1, масштабируясь до существенных 158.9 ток/с при 128 одновременных запросах. Вариант с динамическим квантованием FP8 демонстрирует умеренный прирост при более низком параллелизме с показателем 8.8 ток/с, но обеспечивает убедительный двукратный множитель производительности при масштабировании, достигая 319.7 ток/с при 128 одновременных запросах — подчеркивая эффективность динамического квантования для сценариев обслуживания с высокой пропускной способностью.
Анализ производительности: Компактные плотные модели
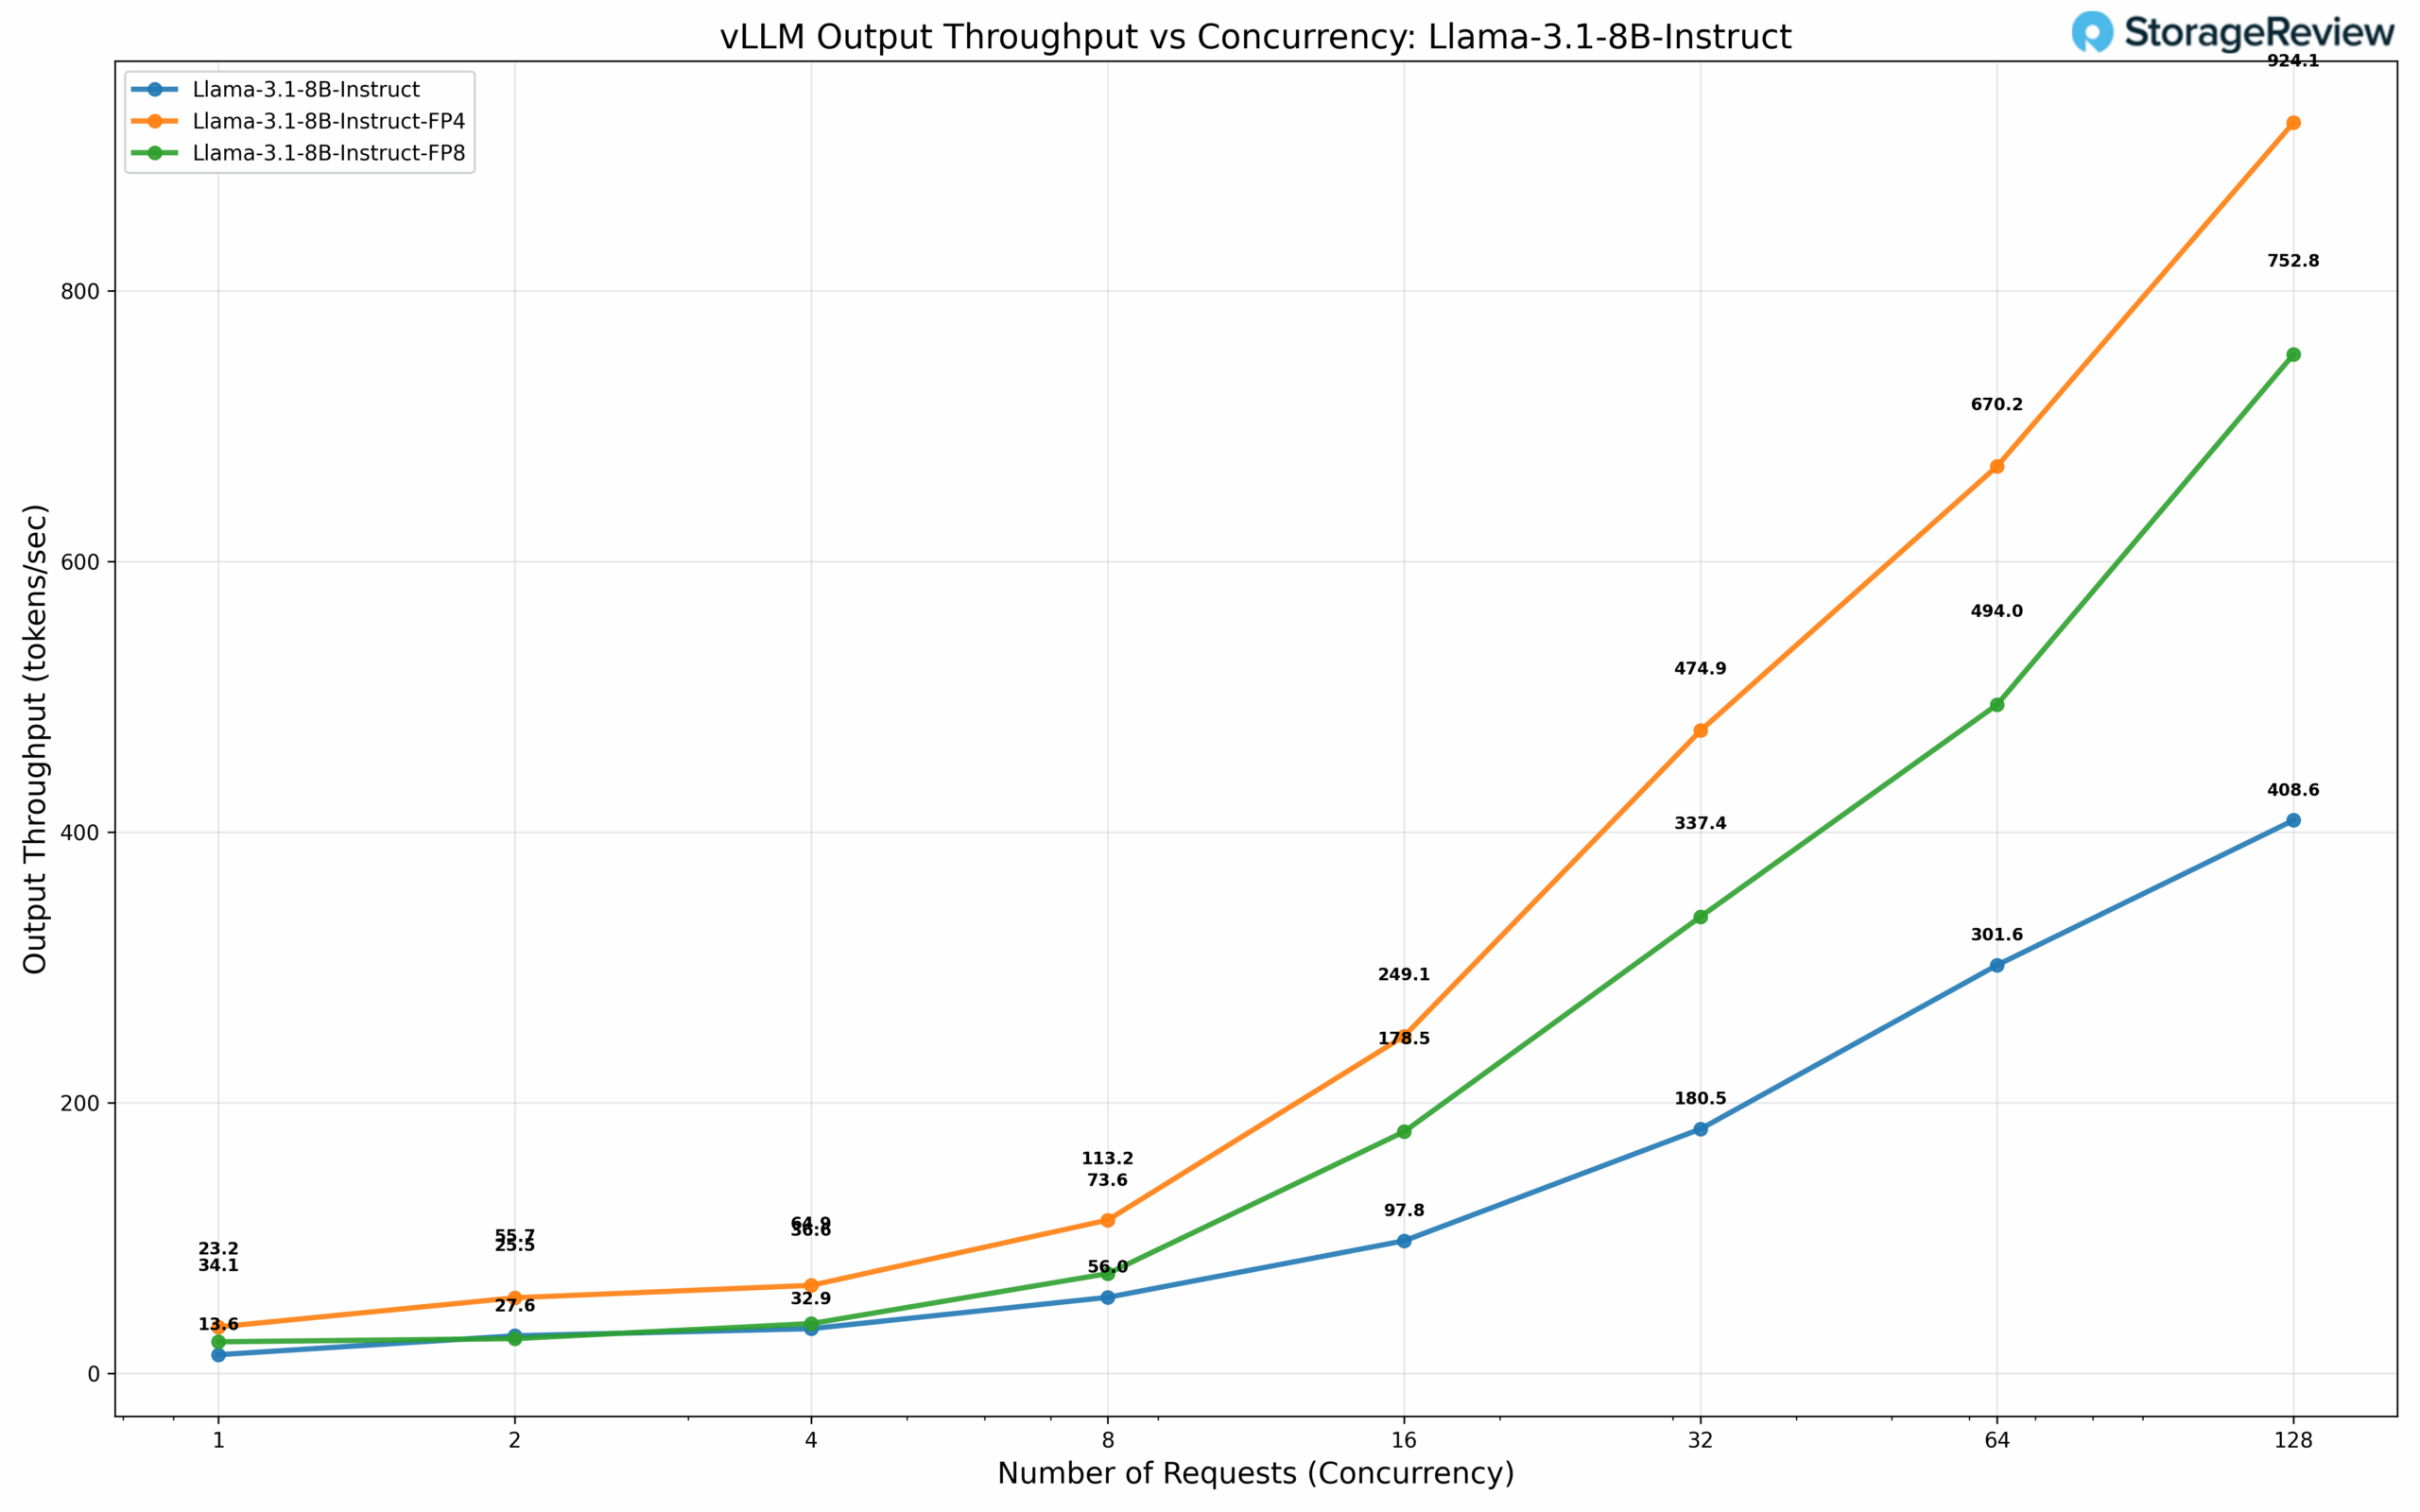
Архитектура Llama 3.1 8B демонстрирует заметно различающиеся характеристики производительности в зависимости от стратегии квантования. При точности BF16 модель обеспечивает 13.6 ток/с при параллелизме 1, увеличиваясь до 408.6 ток/с при 128 одновременных запросах. Переход к квантованию FP8 дает 23.2 ток/с и 752.8 ток/с при уровнях параллелизма 1 и 128 соответственно, что представляет собой увеличение пропускной способности на 84% в масштабе. Конфигурация FP4 еще больше повышает производительность, достигая 34.1 ток/с и 924.1 ток/с при тех же уровнях параллелизма, демонстрируя, что агрессивные стратегии квантования могут обеспечить 2.3-кратное увеличение производительности по сравнению с базовой точностью, сохраняя при этом приемлемое качество модели для многих производственных нагрузок.
Тип данных микромасштабирования
Микромасштабирование представляет собой усовершенствованный подход к квантованию, который применяет мелкозернистые коэффициенты масштабирования к небольшим блокам весов, а не равномерное квантование для больших групп параметров. Формат NVFP4 от NVIDIA реализует эту технику с помощью блочного представления чисел с плавающей запятой, где каждый микромасштабный блок из 8-32 значений имеет общий показатель степени в качестве коэффициента масштабирования. Такой гранулярный подход сохраняет численную точность, обеспечивая при этом 4-битное представление и поддерживая динамический диапазон, критически важный для трансформерных архитектур. Формат интегрируется с архитектурой Tensor Core от NVIDIA, обеспечивая эффективные вычисления со смешанной точностью и декомпрессию на лету во время матричных операций.
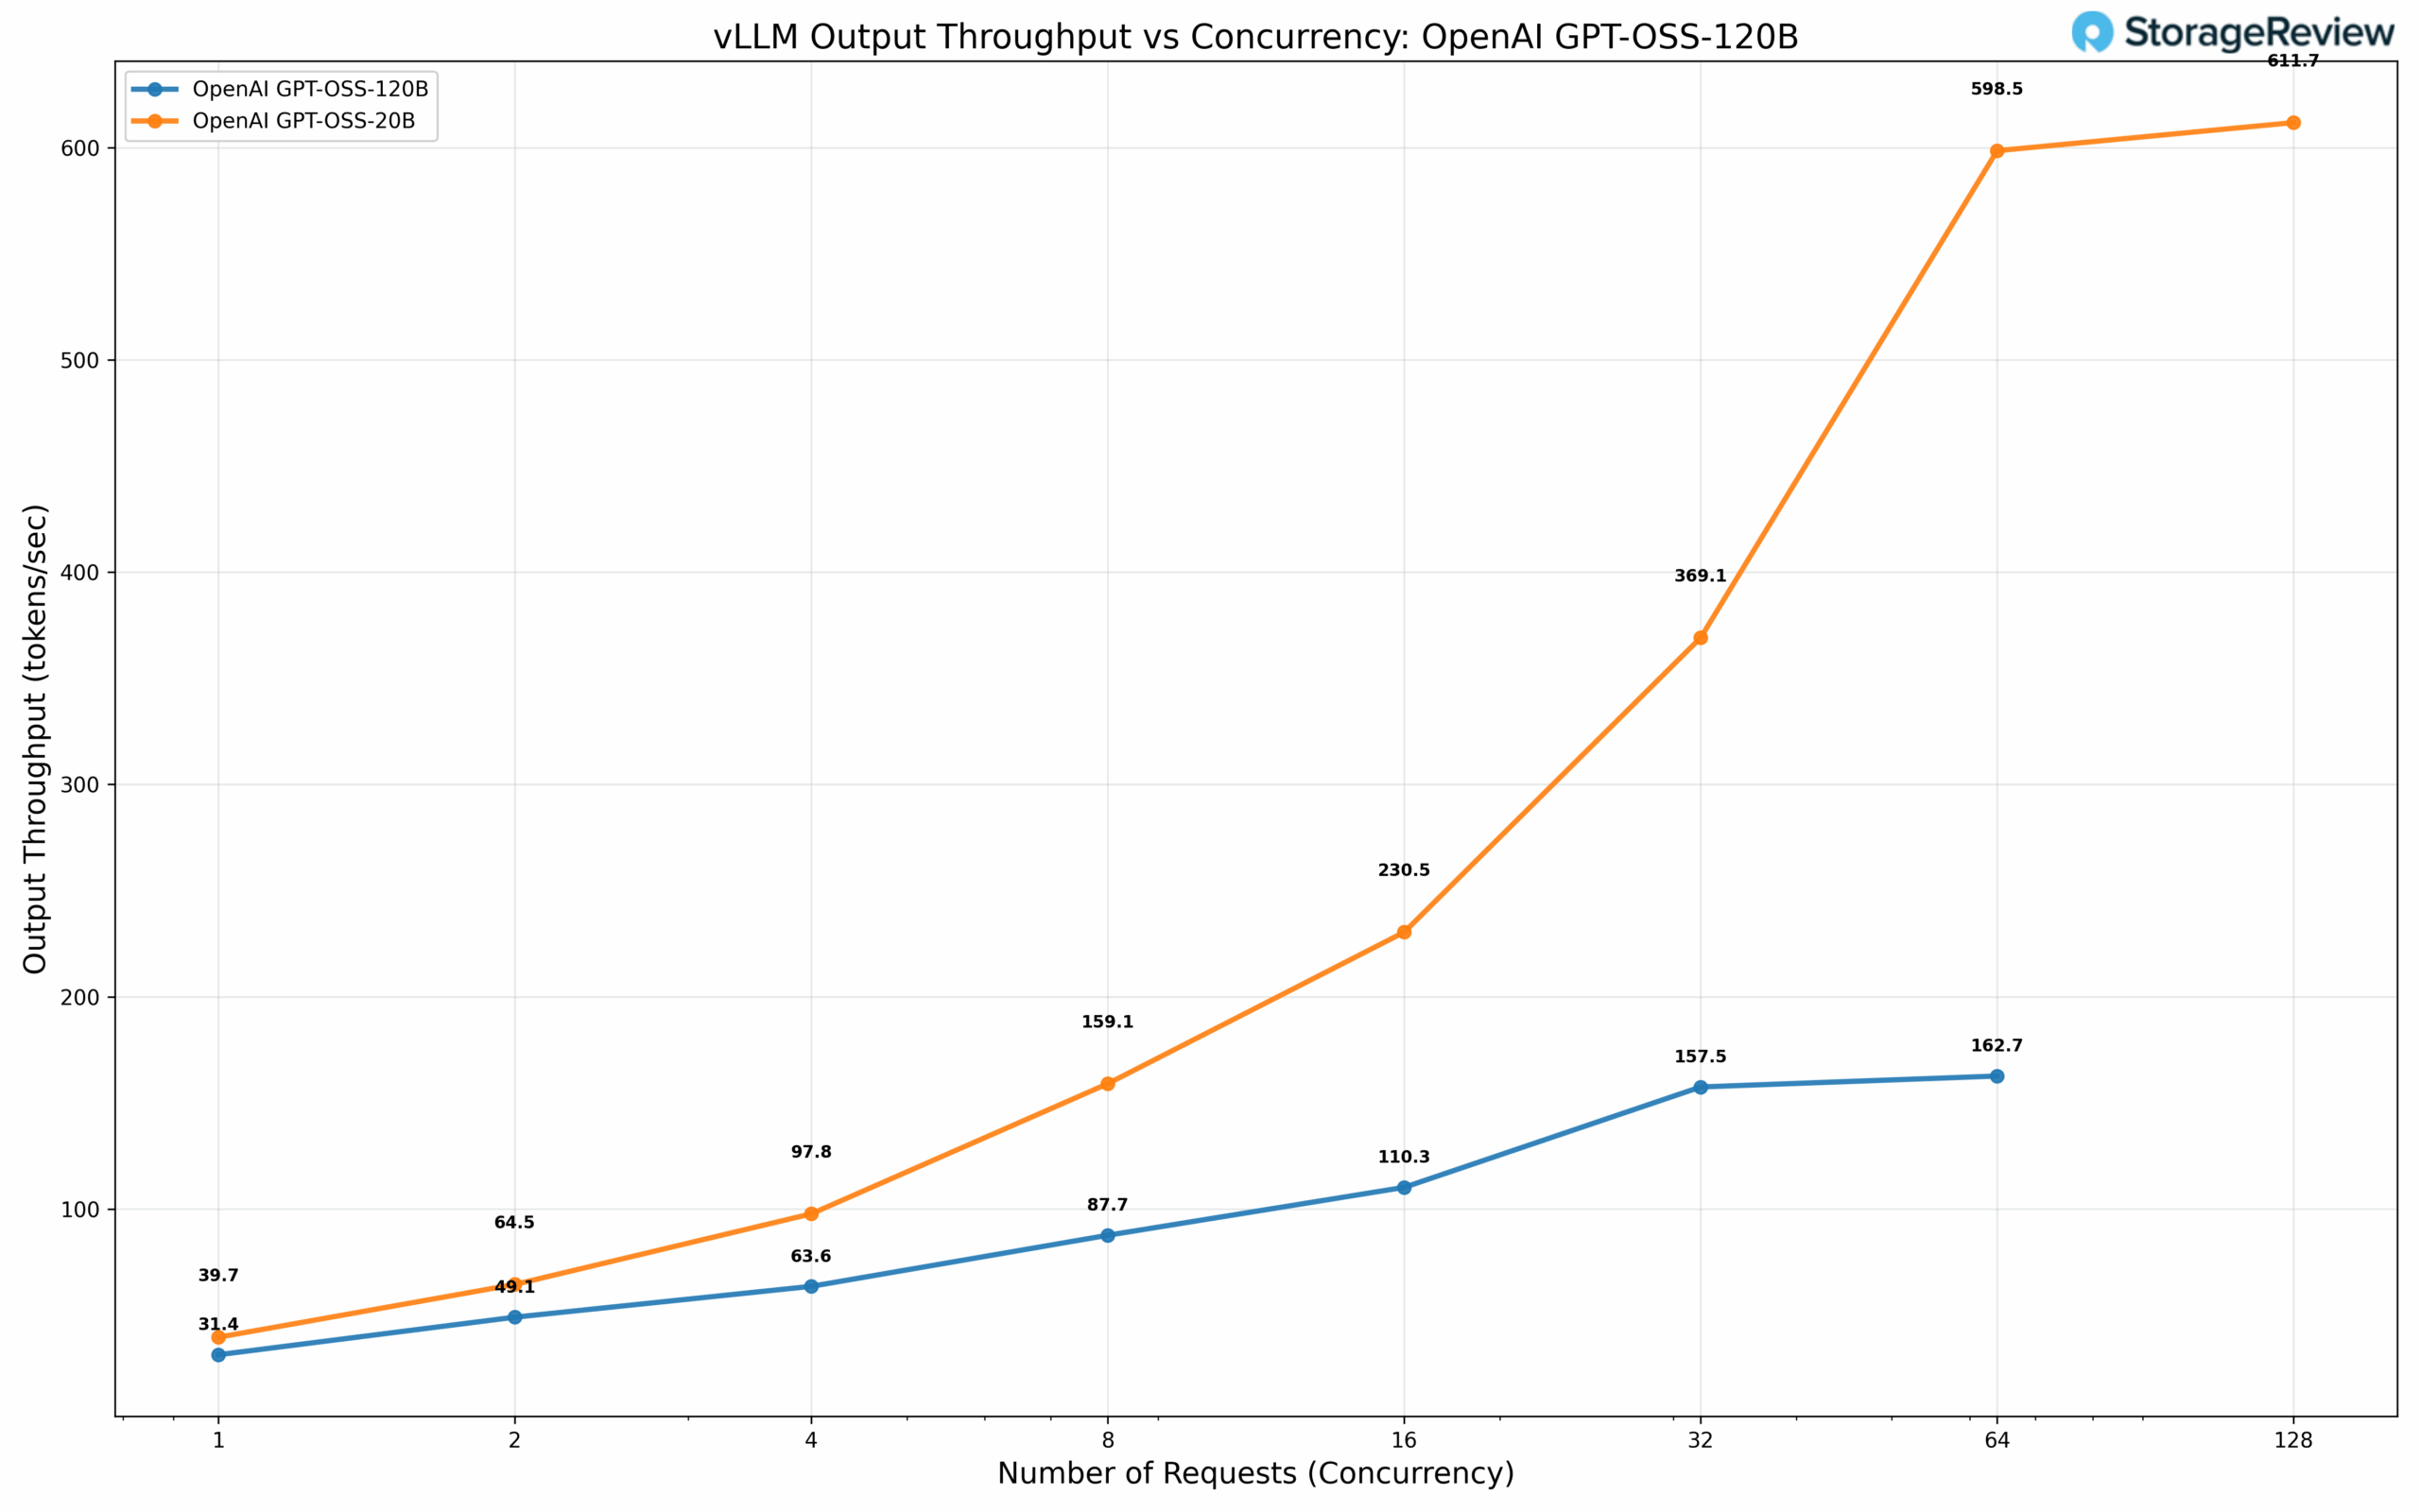
Мы оценили модели OpenAI GPT с открытым исходным кодом при масштабах параметров 20 и 120 млрд, используя квантование NVFP4. Модель с 20 млрд параметров достигает производительности 39.7 ток/с при параллелизме 1 и масштабируется до 611.7 ток/с при 128 одновременных запросах. Вариант с 120 млрд параметров обеспечивает производительность 31.4 ток/с при параллелизме 1 и 162.7 ток/с при 64 одновременных запросах.
Примечание: Пропускная способность на выходе — это пропускная способность по всем запросам, а не пропускная способность по одному запросу.
Из-за ограниченного времени мы не смогли завершить тестирование TensorRT. Следите за обновлениями, посвященными Spark, где мы изучим производительность на других фреймворках для вывода результатов.
Предварительное заполнение и декодирование сложных логических выводов
Вывод LLM-модели можно принципиально разделить на две отдельные вычислительные фазы, каждая из которых демонстрирует существенно различающиеся характеристики производительности и модели использования ресурсов. Фаза предварительного заполнения обрабатывает весь входной запрос за одну параллельную операцию, вычисляя механизмы внимания одновременно для всех входных токенов — это ресурсоемкая операция, которая полностью загружает тензорные ядра и вычислительные блоки. Напротив, фаза декодирования генерирует выходные токены авторегрессивно, создавая по одному токену за раз посредством последовательных операций, которые демонстрируют меньшую вычислительную интенсивность, но предъявляют существенные требования к пропускной способности памяти, поскольку модель должна многократно обращаться к весам и растущему кэшу ключ-значение. Это создает принципиально разные профили узких мест: операции предварительного заполнения, как правило, ограничены вычислительными ресурсами, в то время как операции декодирования становятся ресурсоемкими с точки зрения пропускной способности памяти, что делает их особенно восприимчивыми к ограничениям подсистемы памяти.
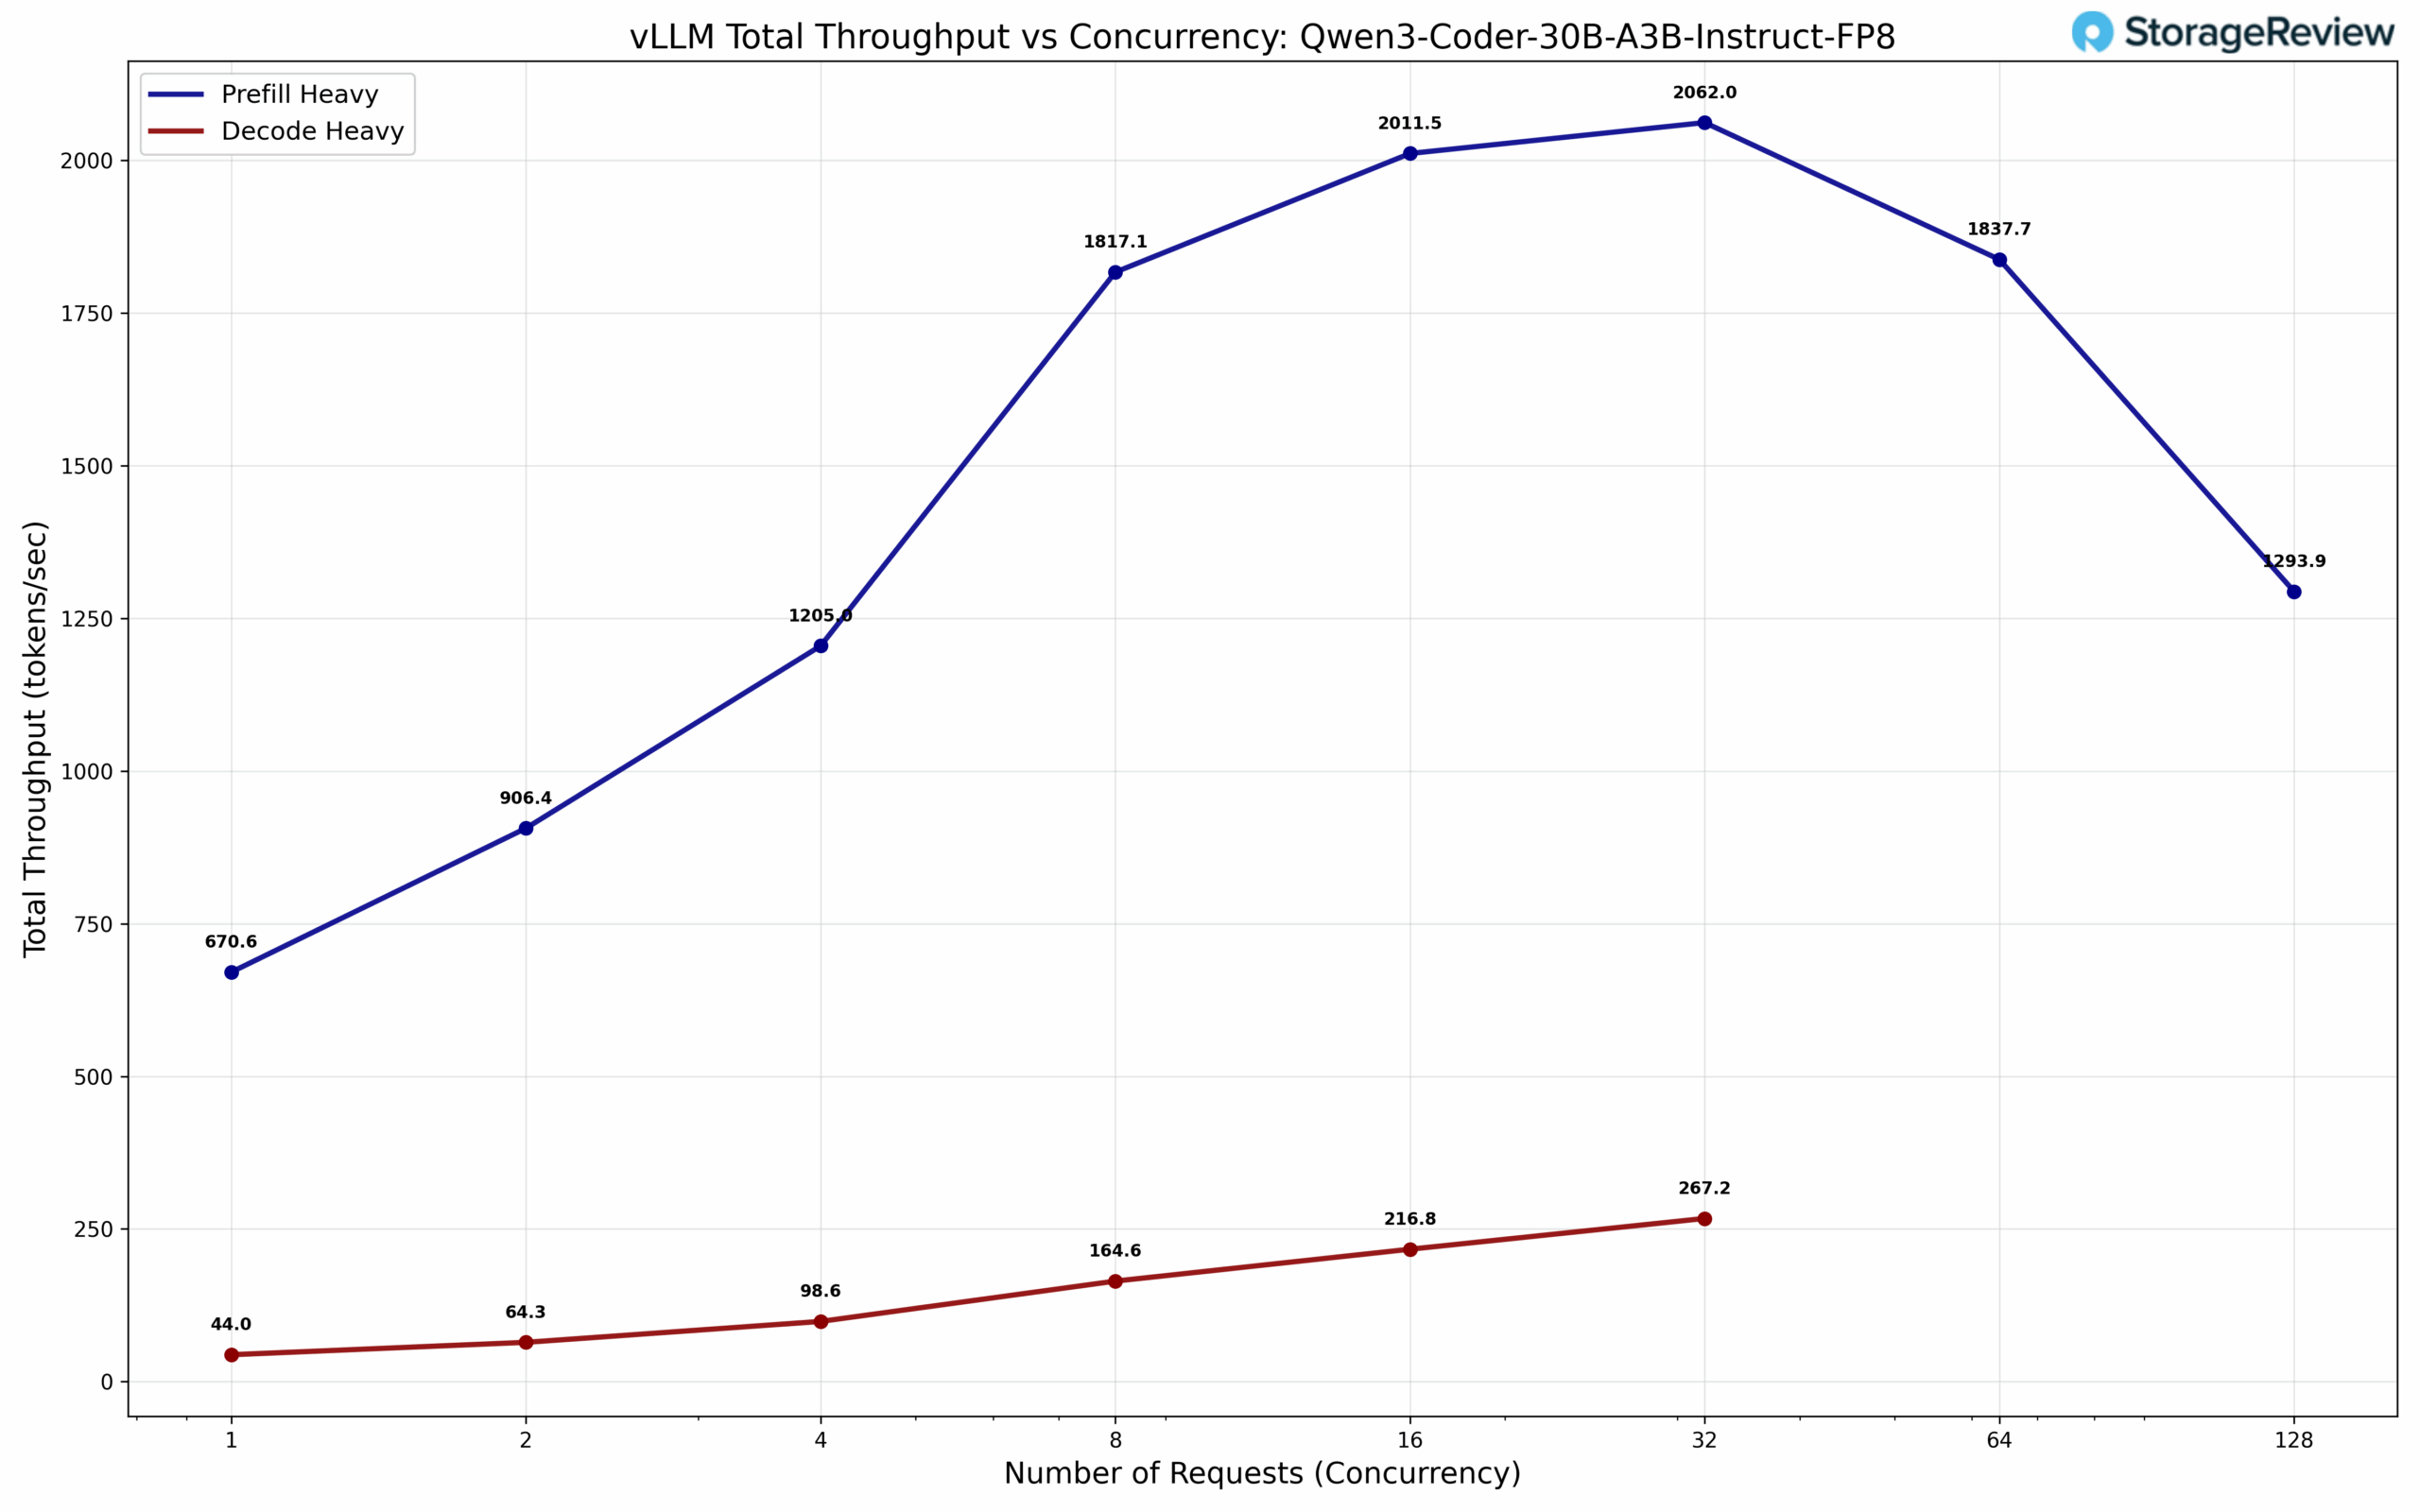
Мы провели всестороннее тестирование в двух различных профилях рабочей нагрузки: инференция с интенсивным декодированием (512 входных и 8,192 выходных токенов) и инференция с интенсивным предварительным заполнением (8,192 входных и 512 выходных токенов). Характеристика производительности выявляет ожидаемые архитектурные компромиссы: Spark демонстрирует конкурентоспособную пропускную способность в задачах с интенсивным предварительным заполнением, где вычислительные ресурсы остаются основным узким местом, но показывает снижение производительности в сценариях с интенсивным декодированием. Эта разница в производительности точно соответствует ограничениям пропускной способности памяти. Последовательный характер операций декодирования и интенсивный доступ к памяти напрямую выявляют ограничения пропускной способности, присущие архитектуре Spark. Эти результаты обеспечивают важный контекст для интерпретации измерений MAMF в следующем разделе, поскольку оба набора тестов последовательно определяют пропускную способность памяти как основной фактор, ограничивающий производительность в реальных развертываниях инференции.
Максимально достижимое количество операций с плавающей запятой в FLOPS (MAMF)
MAMF (Maximum Achievable Matmul FLOPS) — это практический показатель производительности, предназначенный для измерения реального пикового количества операций с плавающей запятой в секунду, которое может быть достигнуто на ускорителях машинного обучения во время операций умножения матриц. Он предлагает более точный бенчмарк, чем теоретическое пиковое значение FLOPS, часто указываемое в технических характеристиках оборудования. Мы используем бенчмарк mamf-finder от Стаса Бекмана.
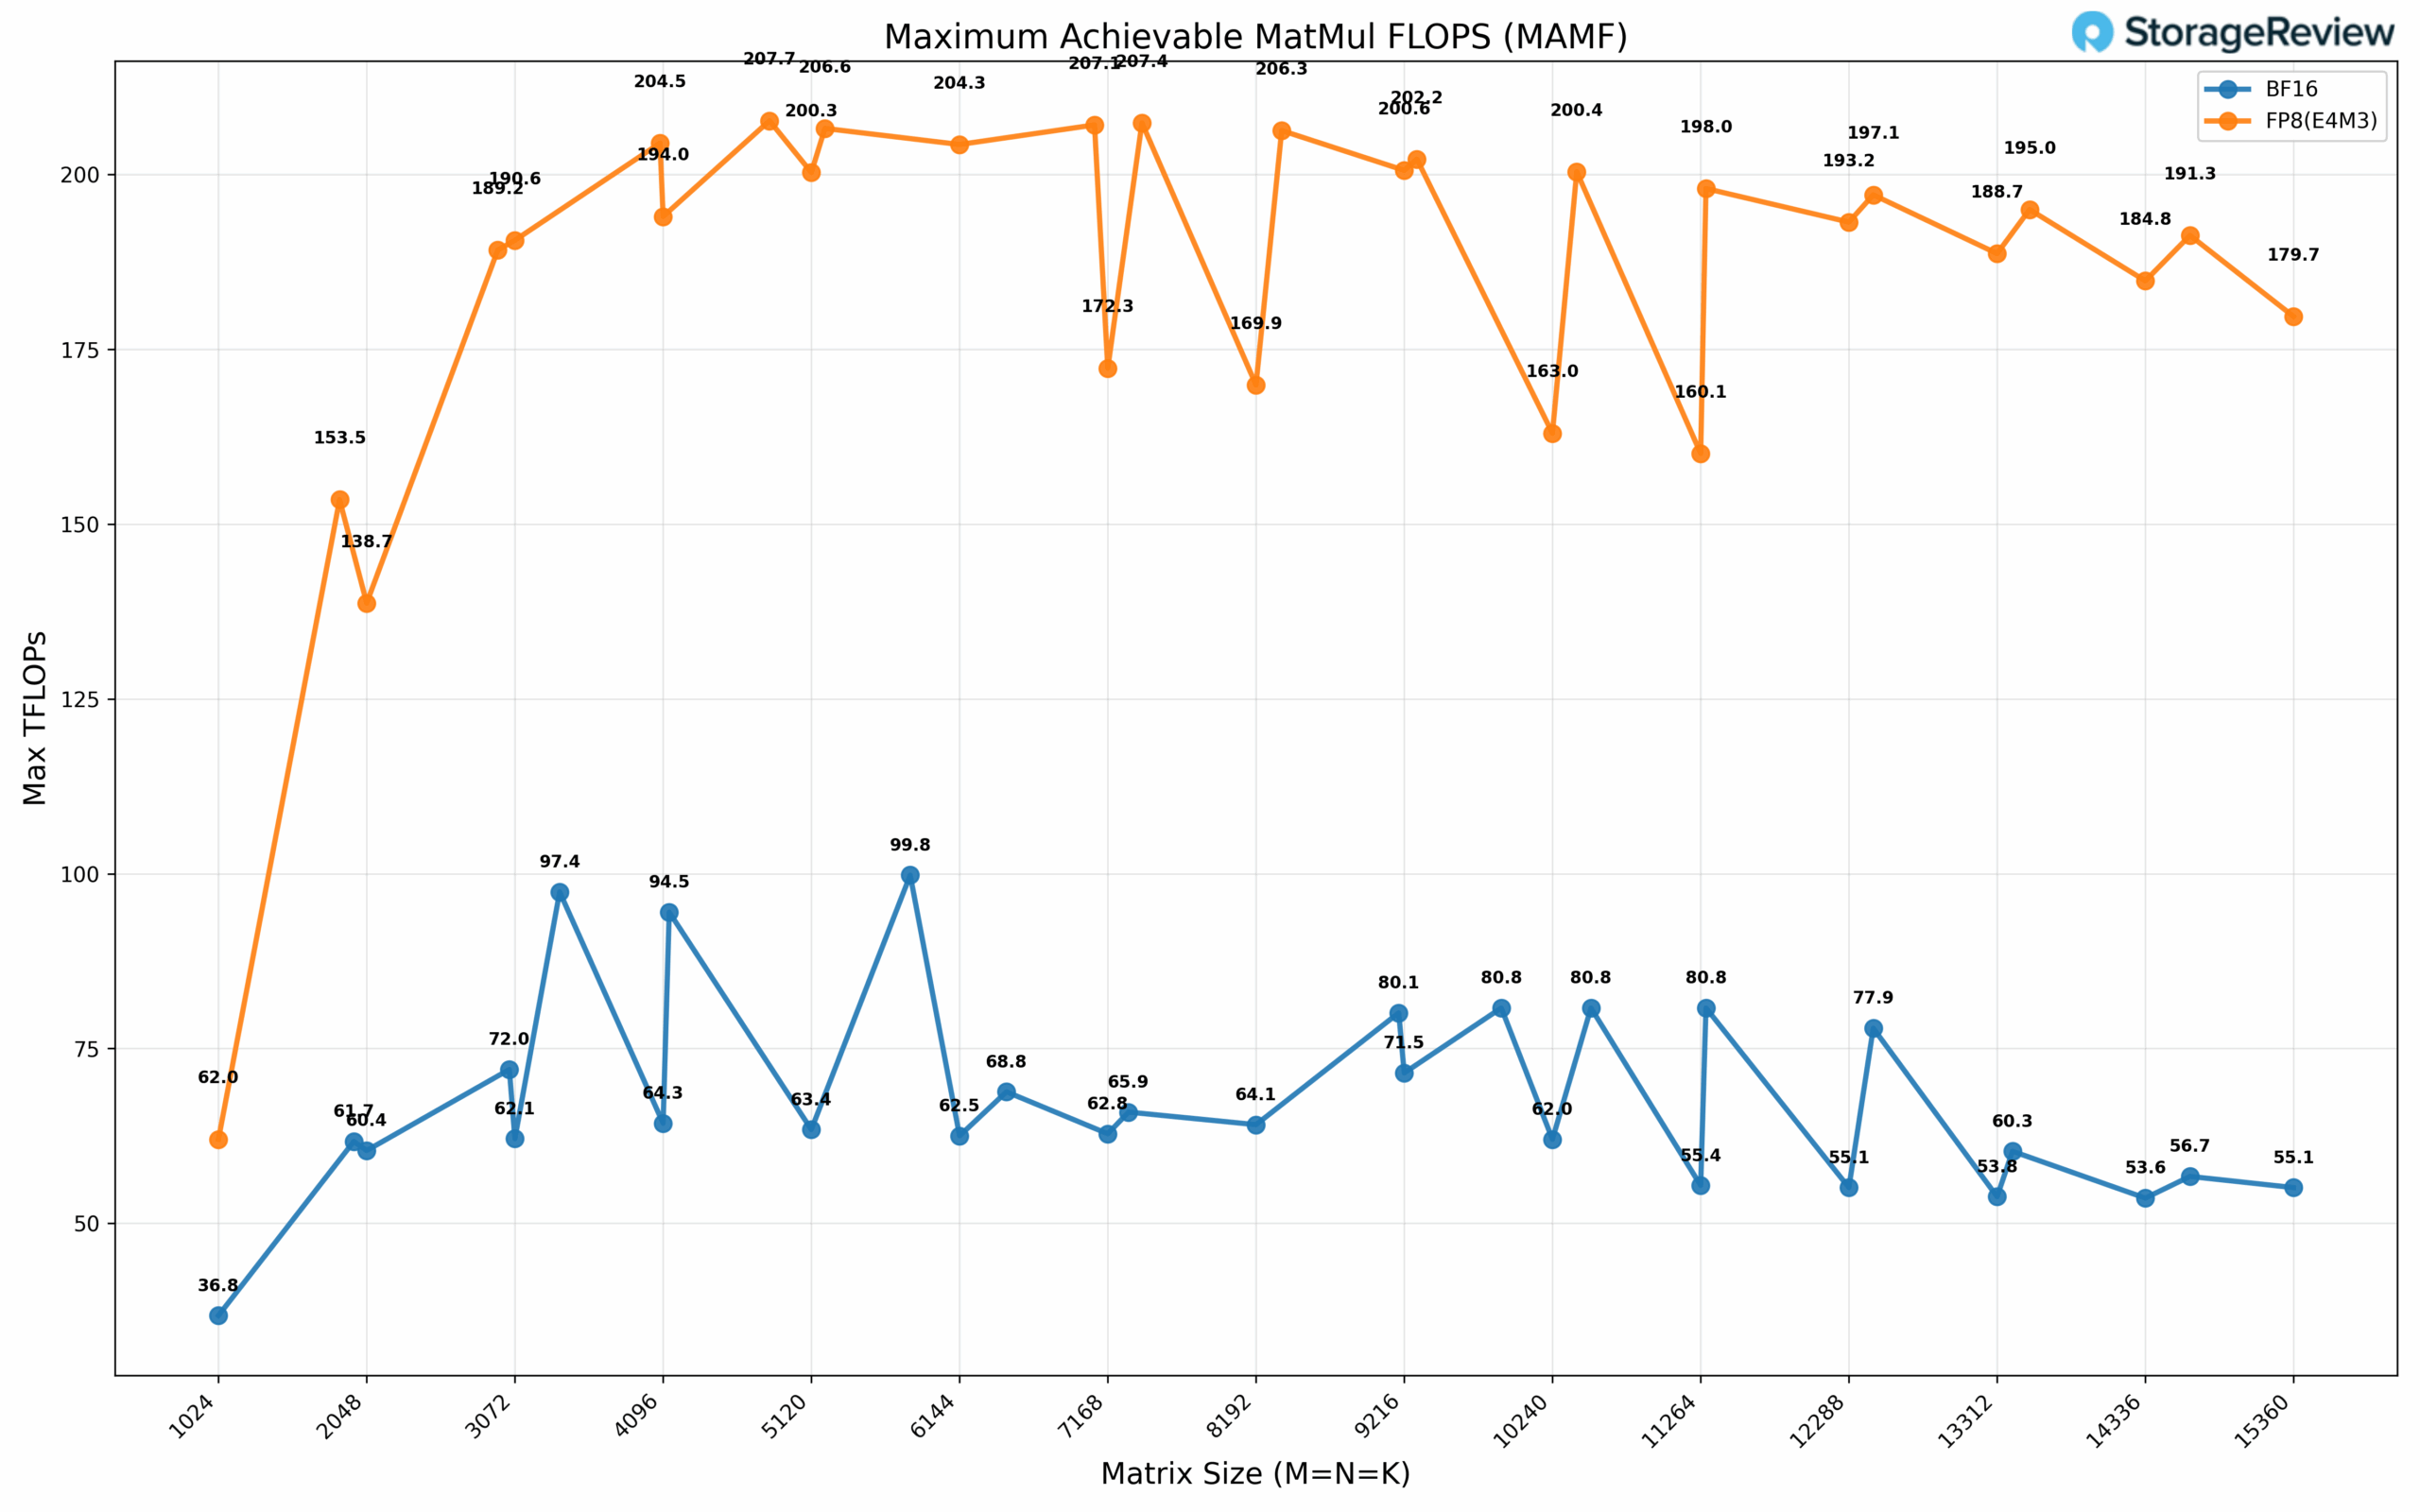
При точности BF16 мы наблюдаем MAMF 99.8 TFLOPs, в то время как FP8 (E4M3) демонстрирует MAMF 207.7 TFLOPs. Из-за ограничений по времени мы не смогли провести всестороннюю характеристику MAMF для FP4; однако, экстраполируя наблюдаемые закономерности масштабирования на основе точности, мы ожидаем дополнительного двукратного прироста производительности по сравнению с FP8, что составит приблизительно 400 TFLOPs для плотных операций FP4. С учетом оптимизации структурированной разреженности 2:1 это соответствует примерно 80% теоретических возможностей производительности FP4, достигая приблизительно 800 TFLOPs при разреженных вычислительных нагрузках. Важно отметить, что эти измерения MAMF могут оказаться ниже теоретически заявленных характеристик по многим причинам, которые мы не будем рассматривать в этом обзоре.
GPU Direct Storage
Одним из тестов, проведенных нами на Spark, был тест MagnumIO GPU Direct Storage (GDS). GDS — это функция, разработанная NVIDIA, которая позволяет графическим процессорам обходить центральный процессор при доступе к данным, хранящимся на NVMe-накопителях или других высокоскоростных устройствах хранения. Вместо маршрутизации данных через центральный процессор и системную память, GDS обеспечивает прямую связь между графическим процессором и устройством хранения, значительно снижая задержку и повышая пропускную способность данных.
Как работает функция GPU Direct Storage
Традиционно, когда графический процессор обрабатывает данные, хранящиеся на NVMe-накопителе, данные сначала должны пройти через центральный процессор и системную память, прежде чем достигнут графического процессора. Этот процесс создает узкие места, поскольку центральный процессор становится посредником, увеличивая задержку и потребляя ценные системные ресурсы. Технология GPU Direct Storage устраняет эту неэффективность, позволяя графическому процессору получать доступ к данным непосредственно с устройства хранения через шину PCIe. Этот прямой путь уменьшает накладные расходы, связанные с перемещением данных, обеспечивая более быструю и эффективную передачу данных.
Задачи искусственного интеллекта, особенно те, которые связаны с глубоким обучением, требуют больших объемов данных. Обучение больших нейронных сетей требует обработки терабайтов данных, и любая задержка в передаче данных может привести к недоиспользованию графических процессоров и увеличению времени обучения. Технология GPU Direct Storage решает эту проблему, обеспечивая максимально быструю доставку данных на графический процессор, минимизируя время простоя и максимизируя вычислительную эффективность.
Кроме того, GDS особенно полезен для рабочих нагрузок, связанных с потоковой передачей больших наборов данных, таких как обработка видео, обработка естественного языка или вывод в реальном времени. Снижая зависимость от ЦП, GDS ускоряет перемещение данных и высвобождает ресурсы ЦП для других задач, что еще больше повышает общую производительность системы.
GDSIO – Внутренний M.2-накопитель объемом 4 ТБ
NVIDIA DGX Spark предлагает интересный выбор накопителя. Чтобы сохранить компактные размеры в небольшом корпусе, NVIDIA выбрала менее распространенный M.2 SSD Gen5 2242. Для тех, кто не знаком с этим типом SSD, поясним: это более короткая версия длиной 42 мм по сравнению с 80 мм, более распространенной в настольных компьютерах. Выбор накопителей ограничен, максимальная емкость в этом размере составляет 4 ТБ. Однако главный вопрос — производительность. В небольших SSD, таких как модели 2242 и 2230, приоритет отдается компактности, а скорость работы отходит на второй план. Они часто используются в портативных игровых консолях, планшетах и некоторых ноутбуках.
На печатной плате SSD-накопителей 2230 и 2242 мало места, что приводит к уменьшению пространства для контроллеров, DRAM и NAND-памяти. В ходе тестирования мы наблюдали некоторые из этих компромиссов. При применении нашей рабочей нагрузки GDSIO в конфигурации объемом 1 ТБ или 128 ГБ SSD зависал и требовал переустановки образа Spark. Снижение тестового объема до 64 ГБ, а также уменьшение количества потоков позволили обойти эту проблему. Подобные проблемы обычно не возникают у более распространенных высокопроизводительных SSD-накопителей размером 80 мм.
Анализируя производительность последовательного чтения внутреннего накопителя, мы видим, что максимальная пропускная способность достигается при размере блока 1 МБ с 16 потоками, составляя 11.4 ГиБ/с.
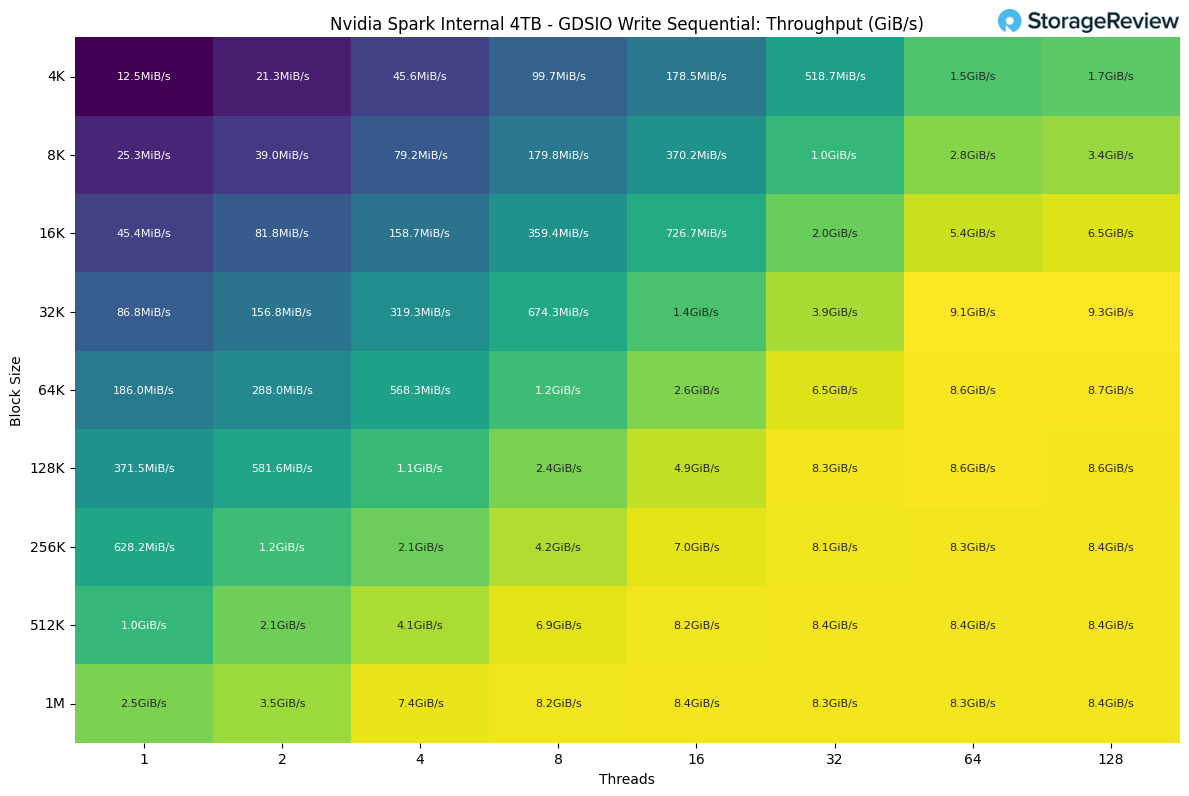
Анализируя производительность последовательной записи, можно отметить, что накопитель достигает максимальной пропускной способности при размере блока 32 КБ с 128 потоками. При больших размерах блока производительность, по-видимому, стабилизируется, составляя в среднем около 8.3 ГиБ/с.
Покупателям, планирующим приобрести NVIDIA DGX Spark для более ресурсоемких задач разработки, особенно компаниям, которые могут создавать на их основе небольшие кластеры, мы настоятельно рекомендуем использовать встроенную сетевую карту NVIDIA ConnectX-7 200 Гбит/с.
GDSIO – NVMe-oF поверх RDMA
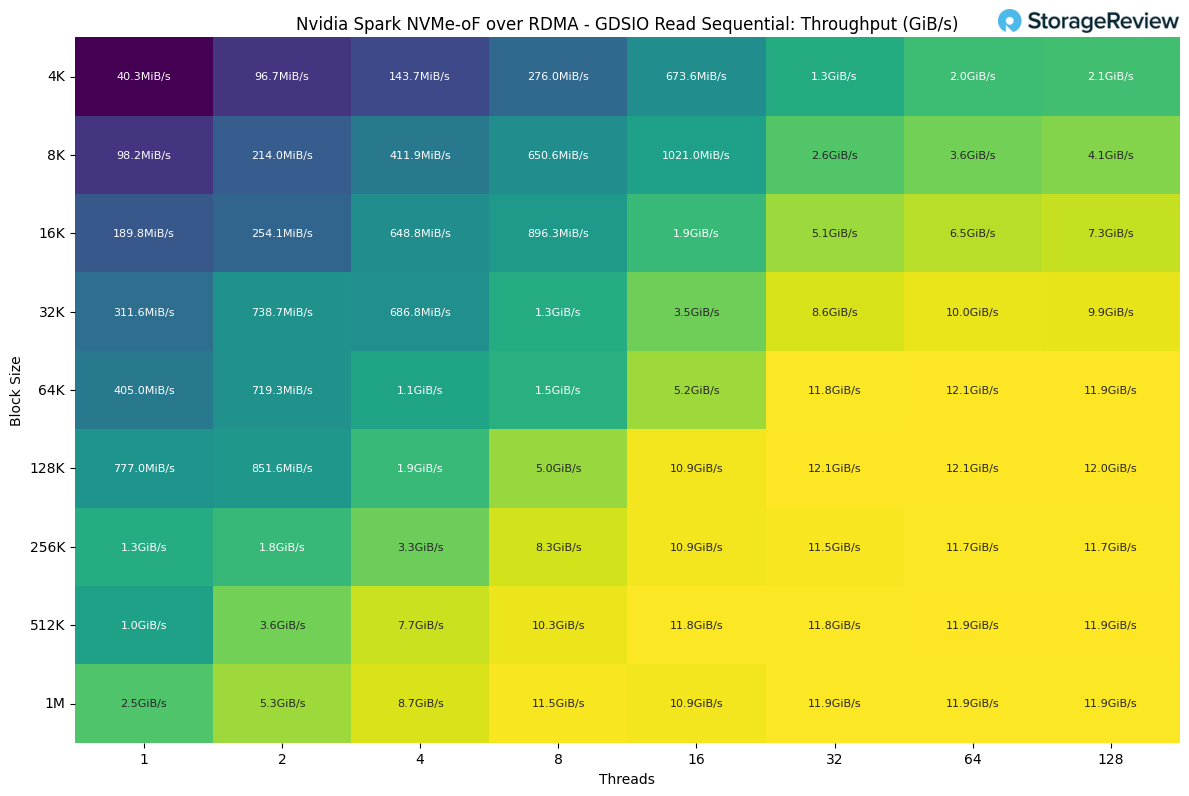
Для тестирования NVMe-oF RDMA с NVIDIA DGX Spark мы использовали программное обеспечение PEAK:AIO для создания целевого NVMe-oF устройства на сервере Dell PowerEdge R770 с шестью твердотельными накопителями Micron 9550 объемом 3.84 ТБ и подключением по протоколу RDMA. Как мы уже упоминали, сетевая карта CX7 в Spark имеет свои особенности, и из-за нехватки времени мы смогли протестировать Spark только с подключением по сети 100G. И Spark, и PEAK:AIO способны достичь значительно более высоких показателей. Дополнительные тесты хранилища и сети с использованием Spark мы проведем в последующих статьях.
Анализируя производительность последовательного чтения внутреннего накопителя, мы видим, что максимальная пропускная способность достигается при размере блока 128 КБ с 32 потоками, составляющая 12.1 ГиБ/с.
Анализируя производительность последовательной записи, можно отметить, что накопитель достигает максимальной пропускной способности при размере блока 128 КБ с 16 потоками. При больших размерах блока производительность, по-видимому, стабилизируется, составляя в среднем около 11.3 ГиБ/с.
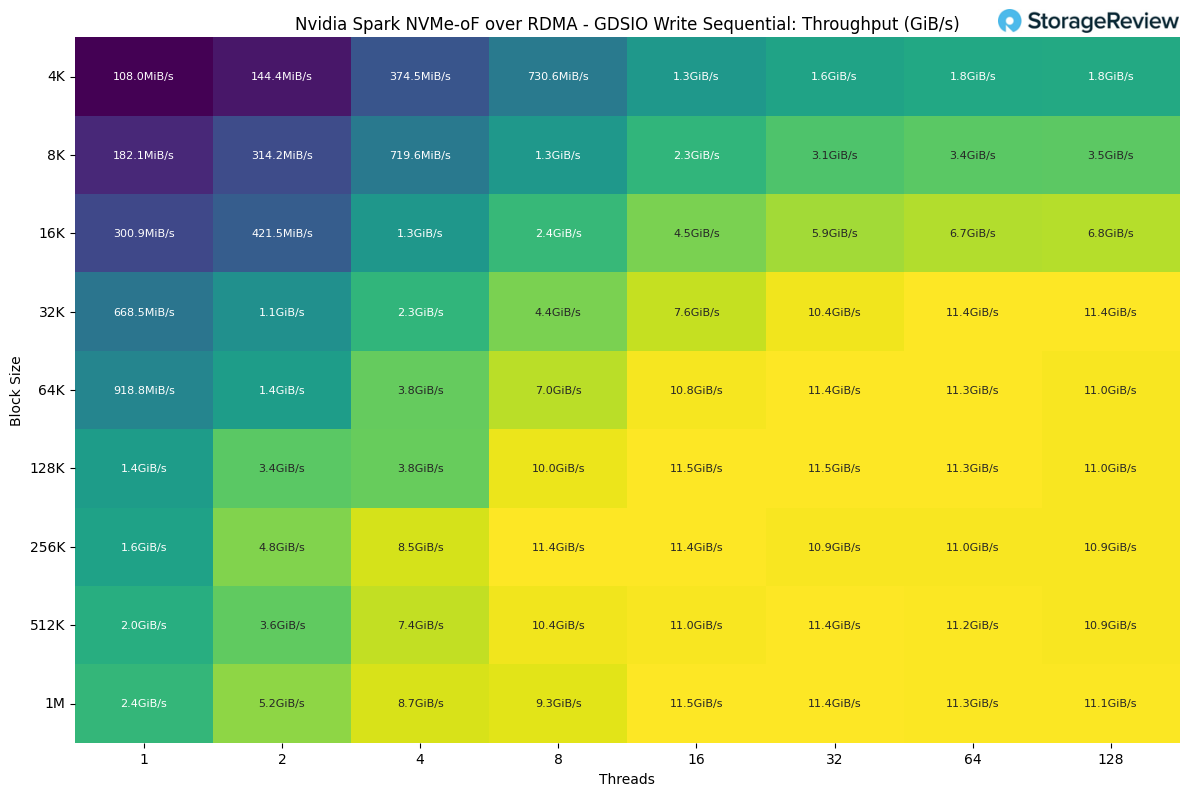
В этих результатах много нюансов, мы видим лишь половину теоретического максимума из-за упомянутых выше временных и сетевых факторов. Кроме того, максимальная пропускная способность при размере блока 128 КБ зависит от множества факторов, таких как используемые нами корпоративные накопители или то, как PEAK:AIO обрабатывает этот ввод-вывод. Ваши результаты могут отличаться, и мы планируем провести дополнительные тесты с помощью Spark в будущем.
Программная экосистема с первого дня
NVIDIA и другие поставщики вложили значительные средства в готовность программного обеспечения, что резко контрастирует с типичными запусками аппаратного обеспечения, когда первые пользователи сталкиваются с неполной документацией и отсутствием необходимых инструментов. Spark запускается с исчерпывающими руководствами, охватывающими распространенные рабочие процессы: ComfyUI для моделей диффузии, TRT-LLM для оптимизированного вывода, Ollama с Open WebUI для локального развертывания моделей, Unsloth для тонкой настройки и многоагентные архитектуры с LangGraph.
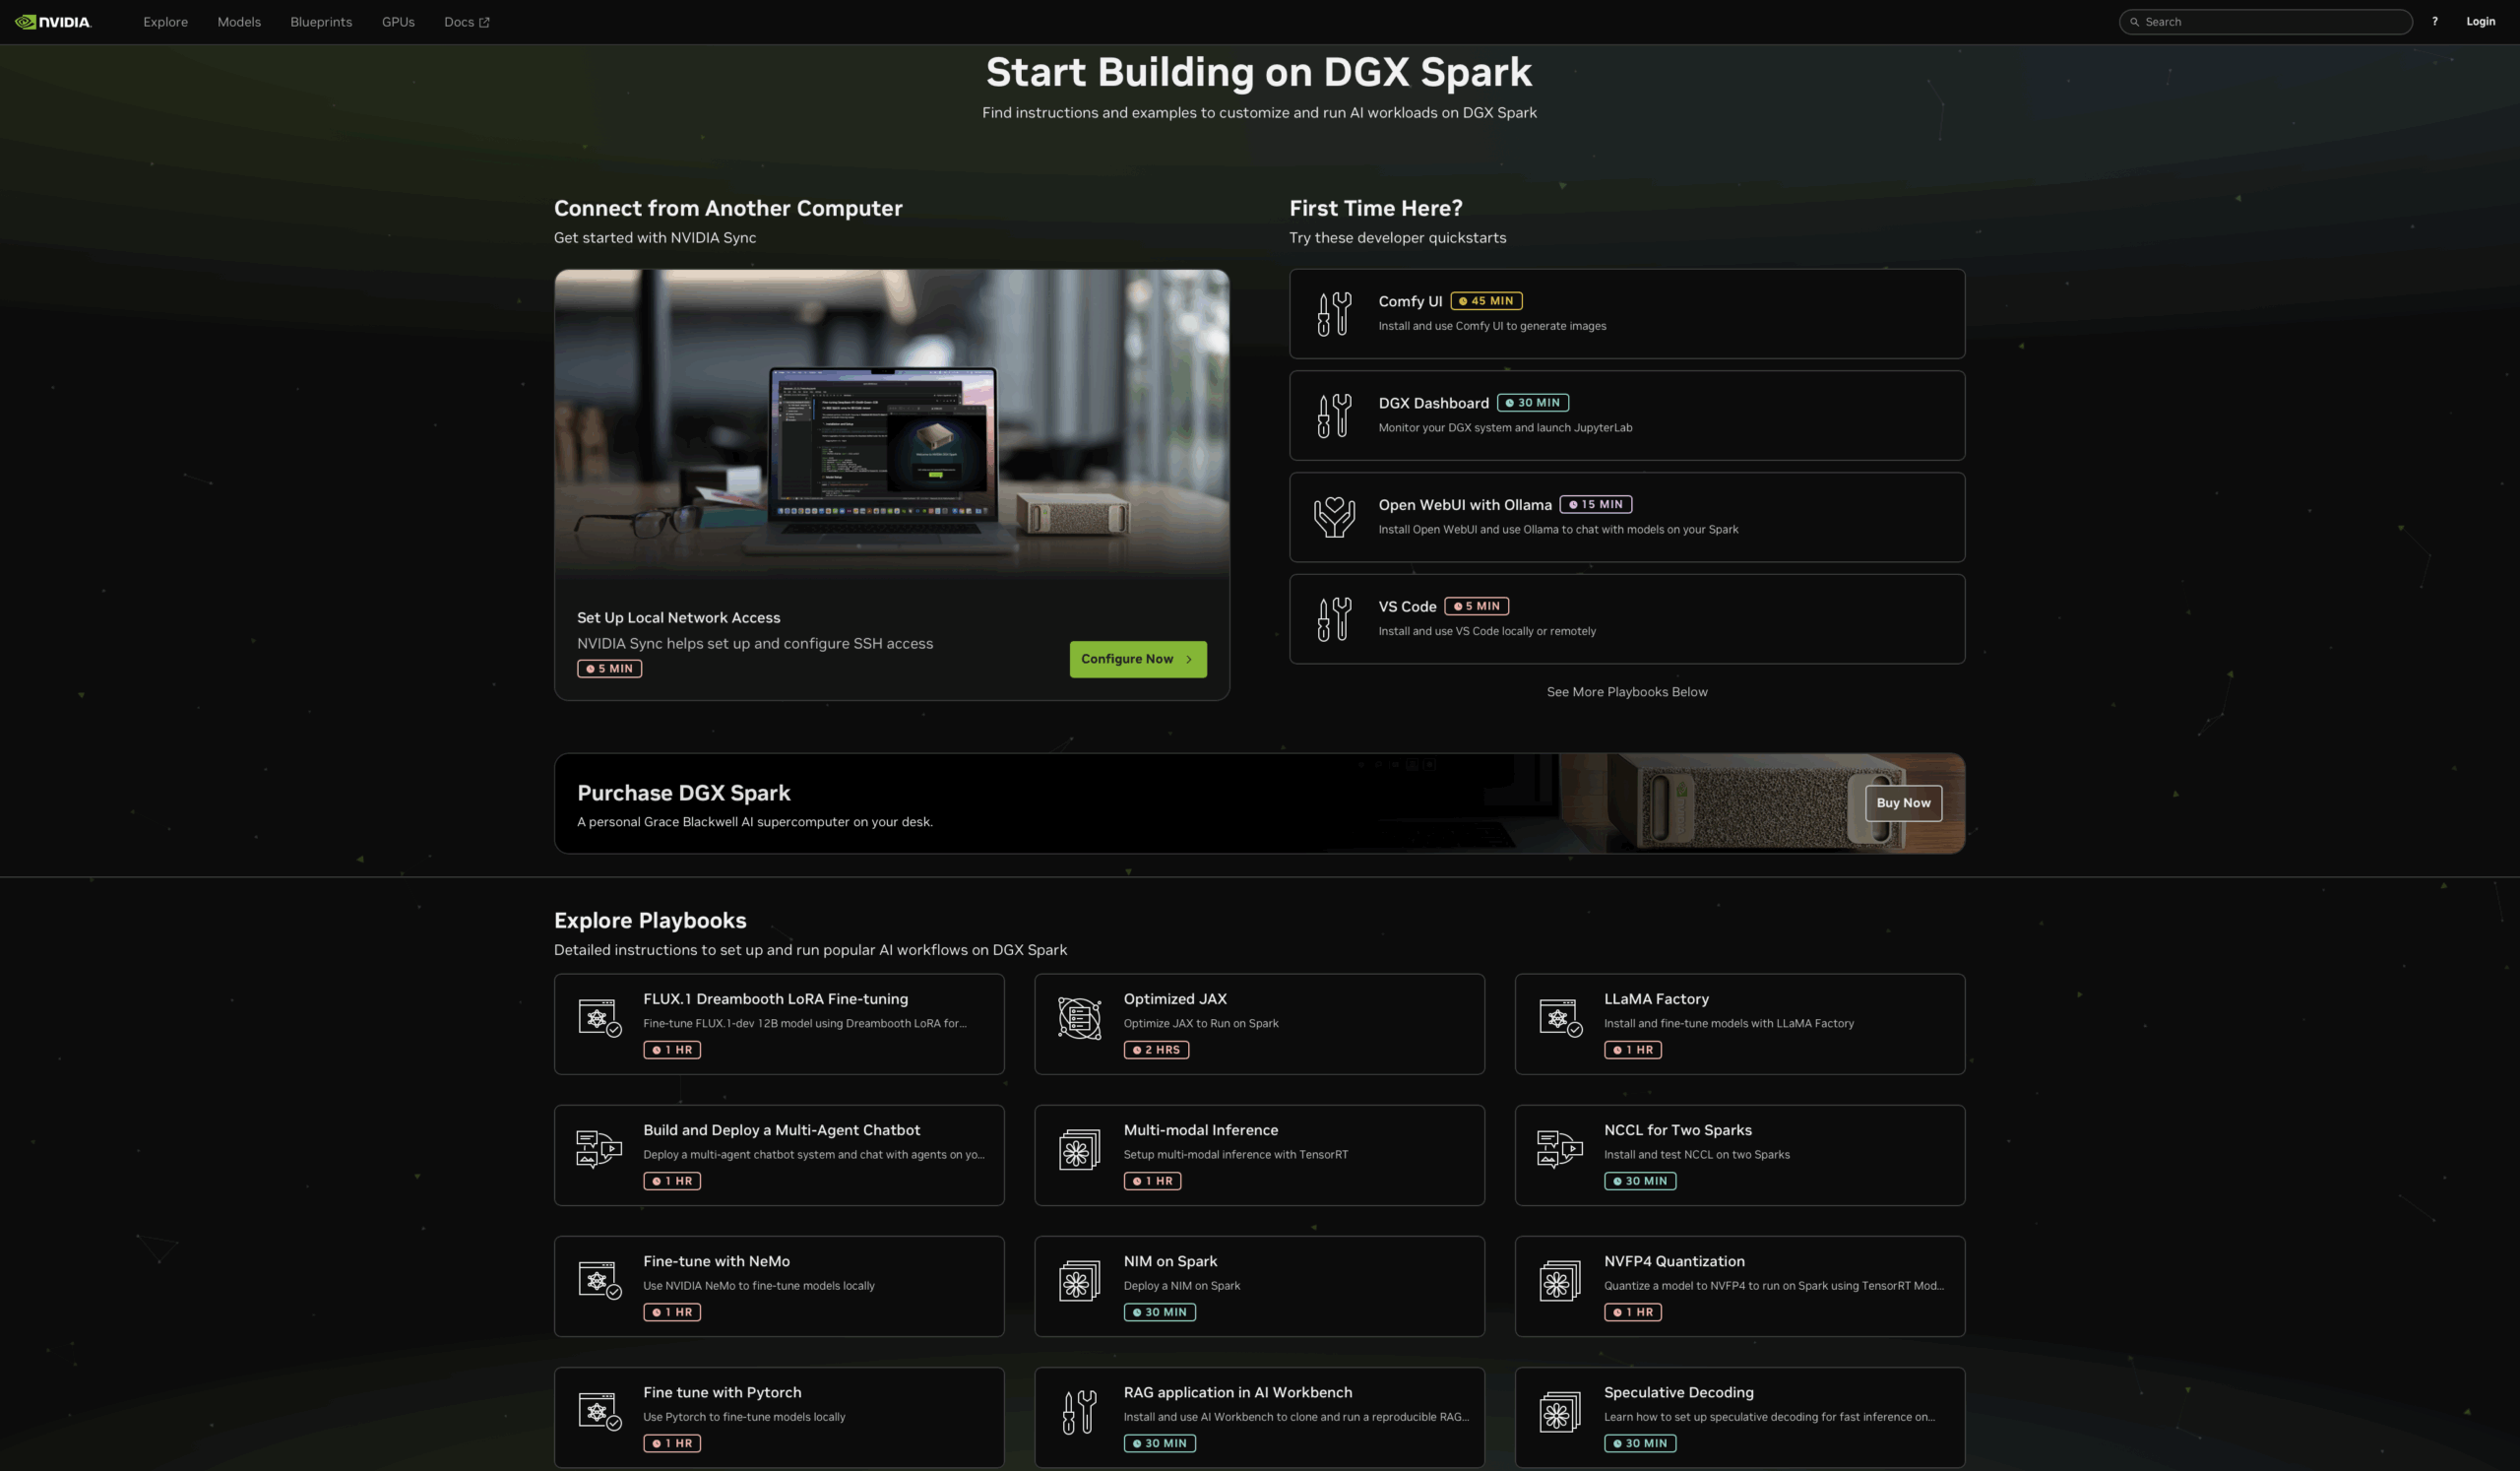
Этот уровень зрелости программного обеспечения кардинально меняет процесс оценки. Вместо того чтобы тратить дни на настройку сред, разработчики могут немедленно оценить, соответствует ли Spark их требованиям, запустив репрезентативные рабочие нагрузки. Плейбуки содержат не только инструкции, но и контейнеризированные среды, примеры наборов данных и ожидаемые показатели производительности.
Доступность и OEM-системы
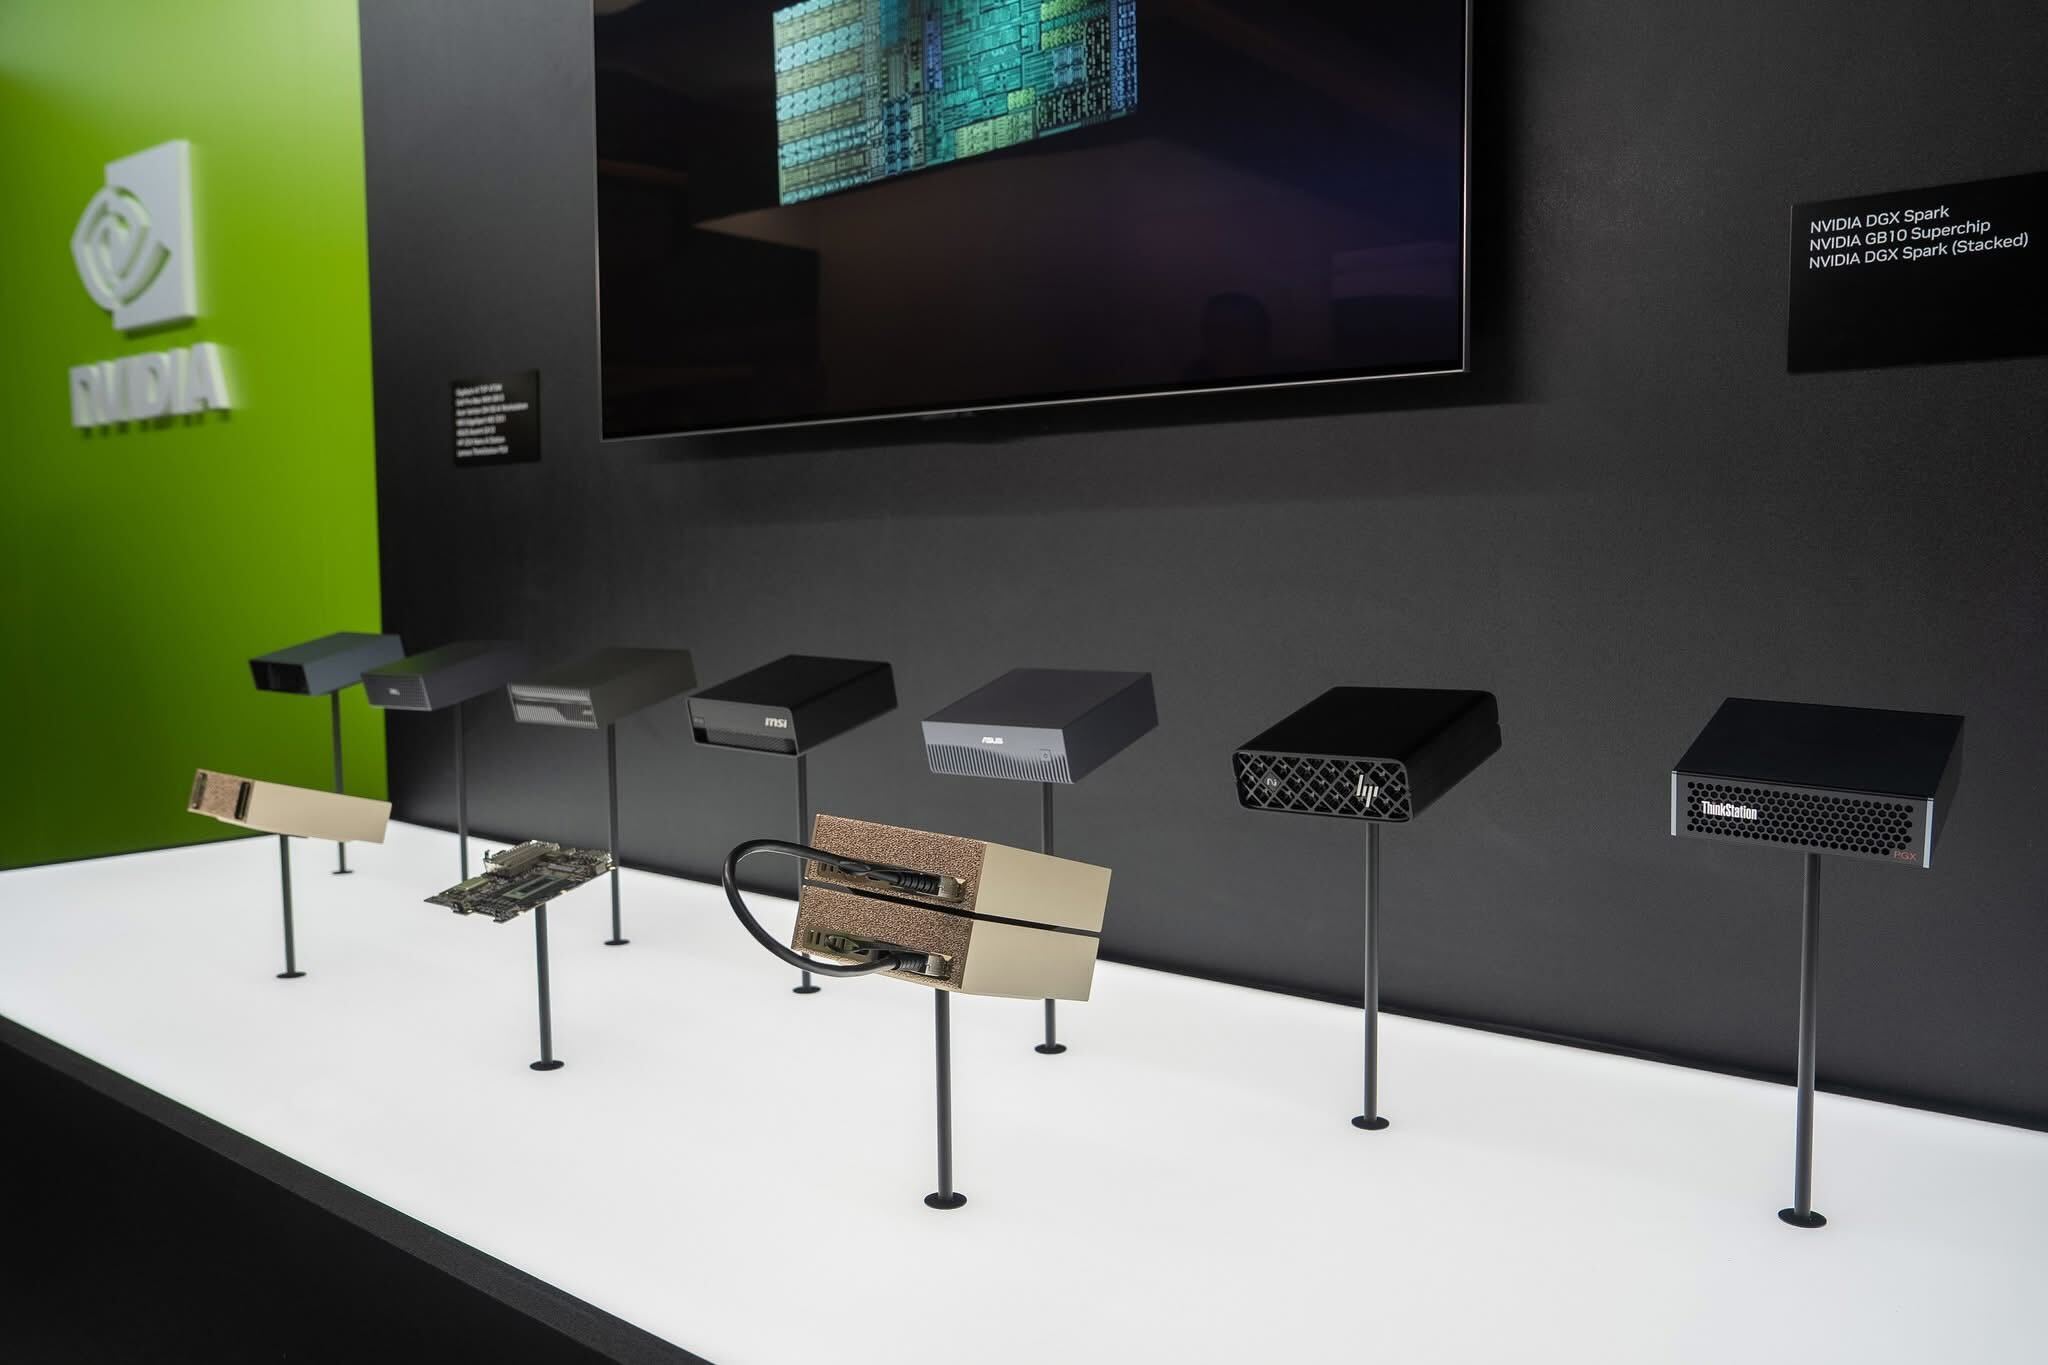
NVIDIA Founders Edition доступна для заказа по цене 3,999 долларов за конфигурацию с 4 ТБ, а в продажу она поступит 15 октября. Наряду с собственной моделью NVIDIA, несколько настольных компьютеров с 10 ГБ оперативной памяти появятся и от крупных OEM-производителей. Основные аппаратные характеристики будут довольно схожими у всех OEM-производителей, но возможны небольшие различия, хотя большая часть ценовой разницы, вероятно, будет связана с выбором накопителей. Уже было много анонсов, включая Dell Pro Max с 10 ГБ оперативной памяти, Lenovo ThinkStation PGX, Acer Veriton GN100 и ASUS Ascent GX10.
Источник: Нвидия
Заключение
NVIDIA DGX Spark представляет собой фундаментальный поворотный момент в парадигме доступности передовой вычислительной инфраструктуры для искусственного интеллекта. Объединив возможности суперчипа GB10 Grace Blackwell: 128 ГБ унифицированной памяти, производительность 1 петафлопс в режиме разреженного FP4, ядра RT четвертого поколения и сетевые возможности ConnectX-7 в устройстве мощностью 240 Вт и объемом 1.13 литра по цене 3,999 долларов, NVIDIA фактически разрушила барьеры, которые исторически отделяли возможности ИИ для центров обработки данных от отдельных исследователей и небольших групп разработчиков.
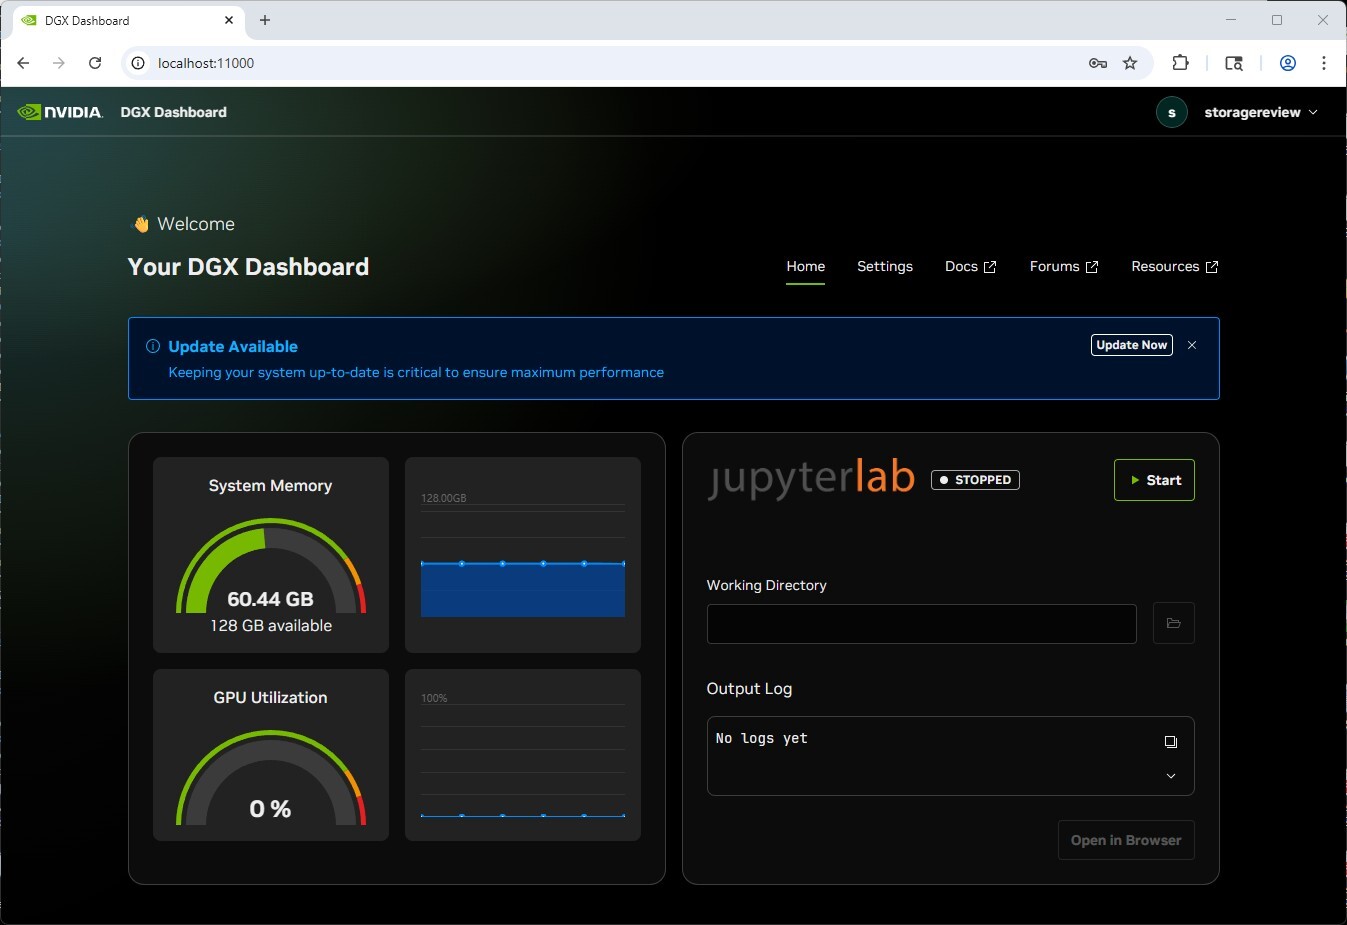
Подход с использованием проверенных аппаратных средств решает давнюю проблему развертывания инфраструктуры ИИ: операционные издержки, связанные с поддержкой пользовательских конфигураций. Организации, развертывающие устройства Spark, получают выгоду от всестороннего тестирования и проверки NVIDIA всего стека, включая DGX OS, инструментарий CUDA, контейнеры фреймворка и аппаратное обеспечение, тем самым устраняя проблемы с конфигурацией, которые преследуют пользовательские сборки рабочих станций. Интегрированное управление обновлениями, мониторинг системы и подготовка JupyterLab в панели управления DGX дополнительно снижают операционную нагрузку, а автоматическое распределение ключей SSH и управление туннелями NVIDIA Sync делают удаленный доступ действительно беспроблемным. Для масштабируемых организаций это означает заметно более быстрое подключение: новые исследователи получают стандартизированное оборудование, подключаются к существующей инфраструктуре через проверенную двухузловую кластерную конфигурацию и начинают продуктивную работу в течение нескольких часов, а не дней, потраченных на устранение конфликтов драйверов или настройку сетевой инфраструктуры.
DGX Spark уже обеспечивает реальную вычислительную мощность для ИИ в компактном и бесшумном устройстве, и наши первые результаты показывают, почему это важно для команд, которым нужны серьезные возможности без дополнительных затрат на центры обработки данных. История только начинается. Мы планируем расширить тестирование с использованием 200G-сети, NVMe-oF-устройств и многоузловых кластеров, чтобы изучить эффективность масштабирования, больший объем используемых моделей и архитектуры общего хранения. По мере развития программного обеспечения и партнерской экосистемы мы ожидаем, что развертывания Spark будут эволюционировать от мощных одноузловых конфигураций к тесно интегрированным высокопроизводительным мини-кластерам, которые еще больше расширят возможности этой платформы.
В рейтинге лучших настольных систем искусственного интеллекта NVIDIA DGX Spark занимает первое место в категории «Лучшие настольные системы для локального использования ИИ».
Таблица лидеров: Рекомендации по выбору оптимального объема оперативной памяти, графического процессора и хранилища для систем этого класса приведены в нашем руководстве по выбору оборудования для Agentic AI.


 Amazon