

Advancing AI 2026 は AMD 史上最大の発表イベントであり、その規模の大きさから、記事を 2 つに分けました。最初の記事では Instinct MI455X と 72 GPU 搭載の Helios ラックについて取り上げましたが、今回の記事ではそれらと並べて掲載するには不十分だった第 6 世代 EPYC サーバー CPU (コードネーム Venice) と Verano ホスト プロセッサについて取り上げます。CPU は単独で取り上げる価値があります。Venice はソケットあたり最大 256 コアと 512 スレッド、1.6TB/s のメモリ帯域幅、サーバー CPU としては初の PCIe Gen 6、そして 2017 年の初代 EPYC の 18 倍のスループットを実現しています。
Veniceは単なるチップではありません。ポートフォリオであり、AMDは各セッションでこの点を繰り返し強調しました。つまり、1つのCPUプロファイルで全てに対応できるわけではないということです。同じZen 6世代でも、高密度向け、エンタープライズ向け、スタックキャッシュ搭載HPC向け、低消費電力LPDDRホスト向けといったように、様々な製品群が用意されています。そこで、スペックの詳細に入る前に、まずはラインナップを見ていきましょう。
ヴェネツィアとヴェラーノのラインナップ
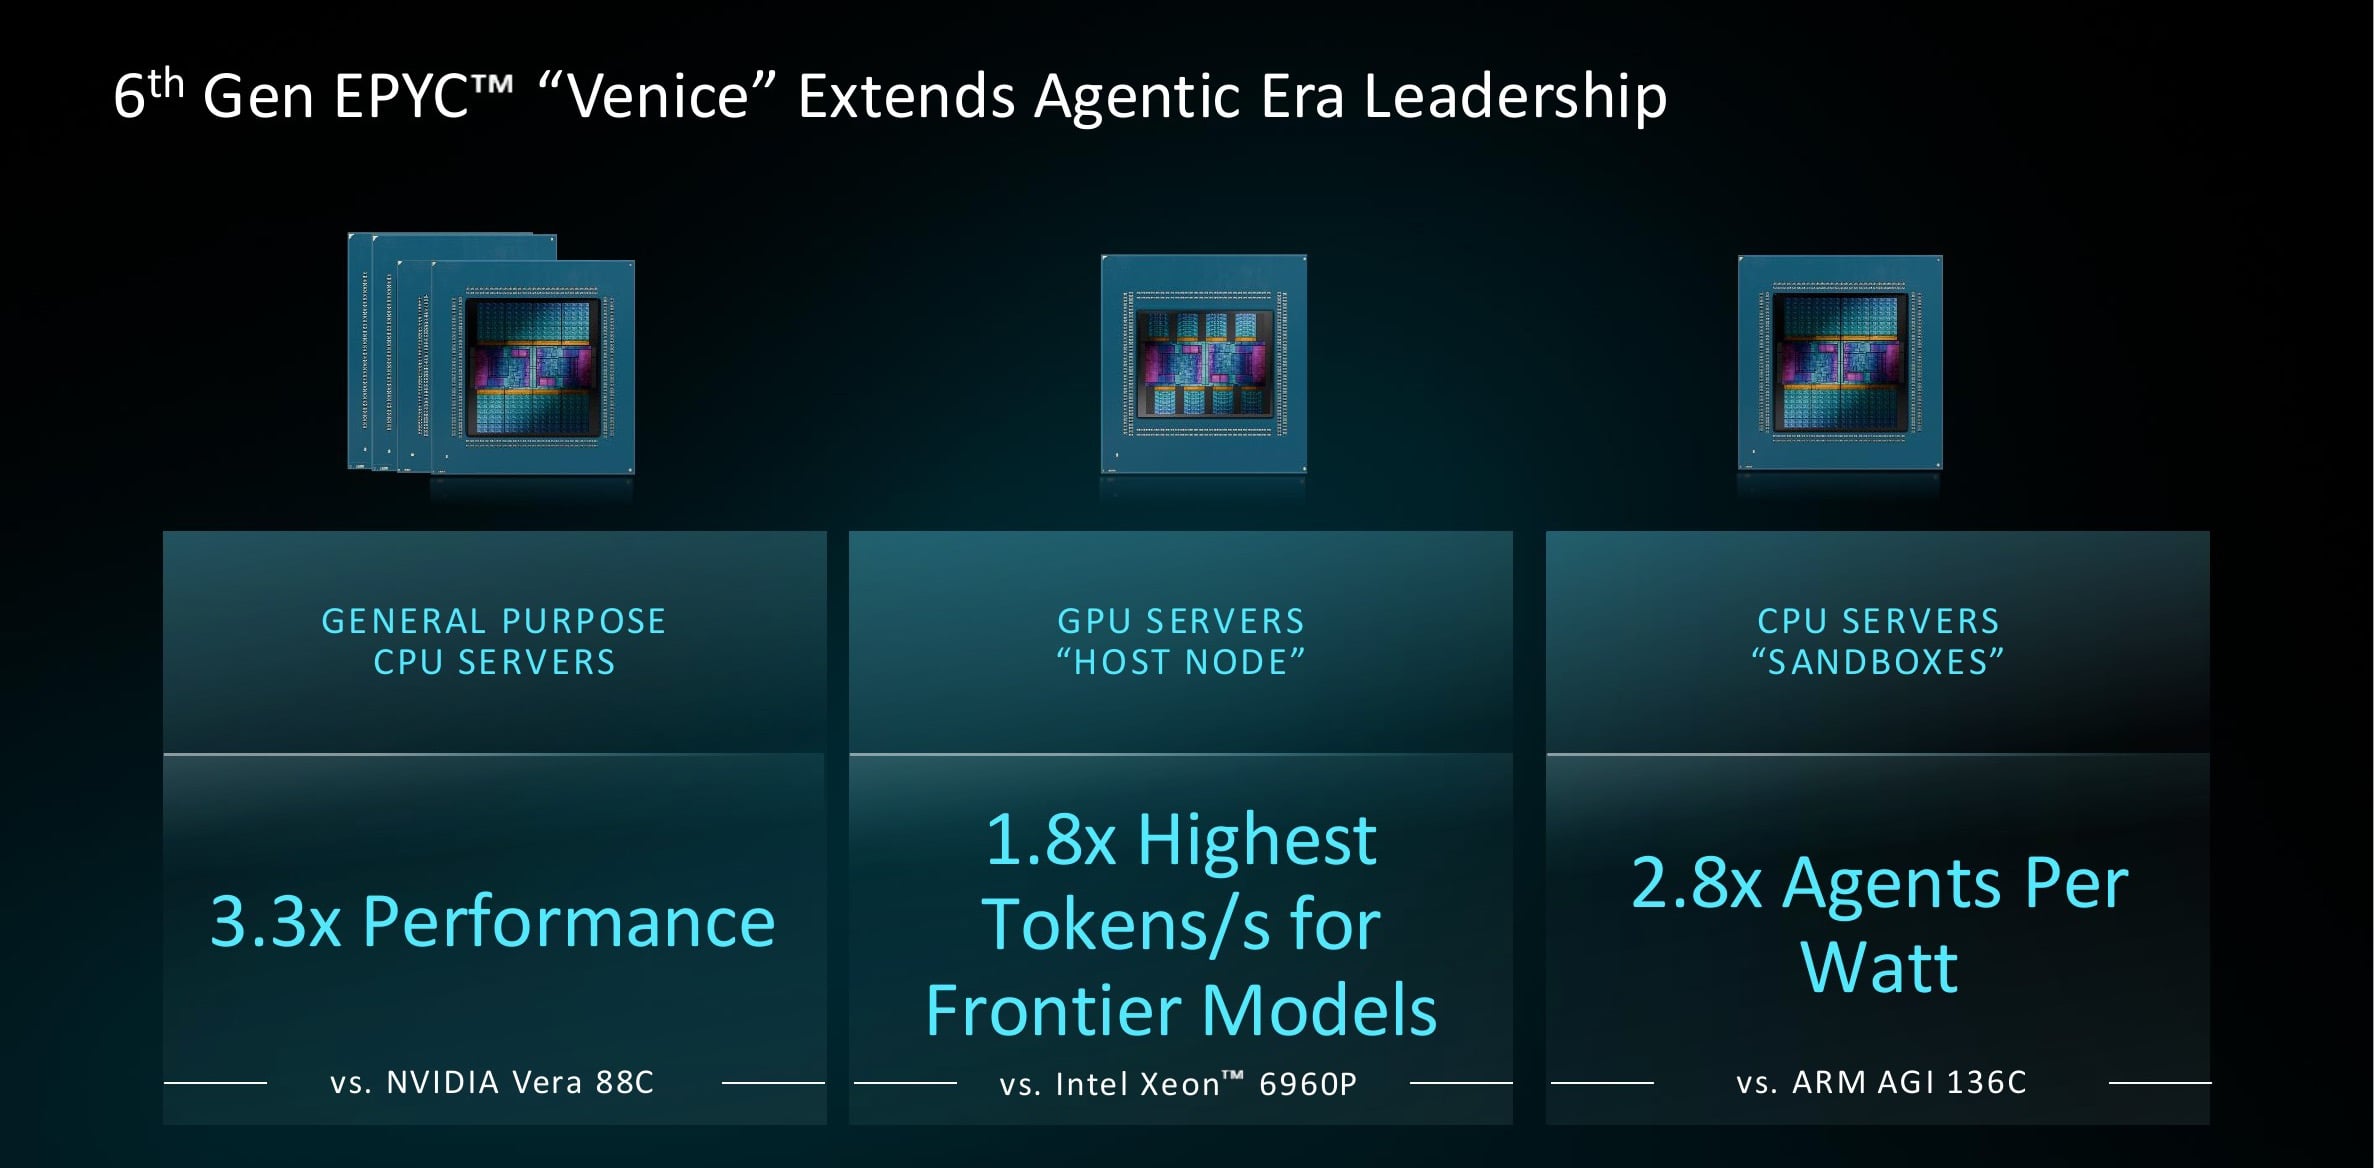
AMDは現代のデータセンターを3つのサーバークラスに分類し、そのポートフォリオはそれらすべてに対応できるように構築されています。汎用CPUサーバーは、他のすべてのサービスが依存するWebゲートウェイ、キャッシュ、アプリケーション層、データベース、ストレージを実行します。GPUサーバーには、アクセラレータにデータを供給するホストCPUが必要であり、この役割ではコア数よりもシングルスレッド速度とI/O帯域幅が重要になります。3つ目のクラスは、AIサービスを中心に発展してきたオーケストレーションおよびツール実行コードのための高密度CPUサーバーです。このコードは分岐が多く、停止しやすいため、何よりもスレッド数を必要とします。
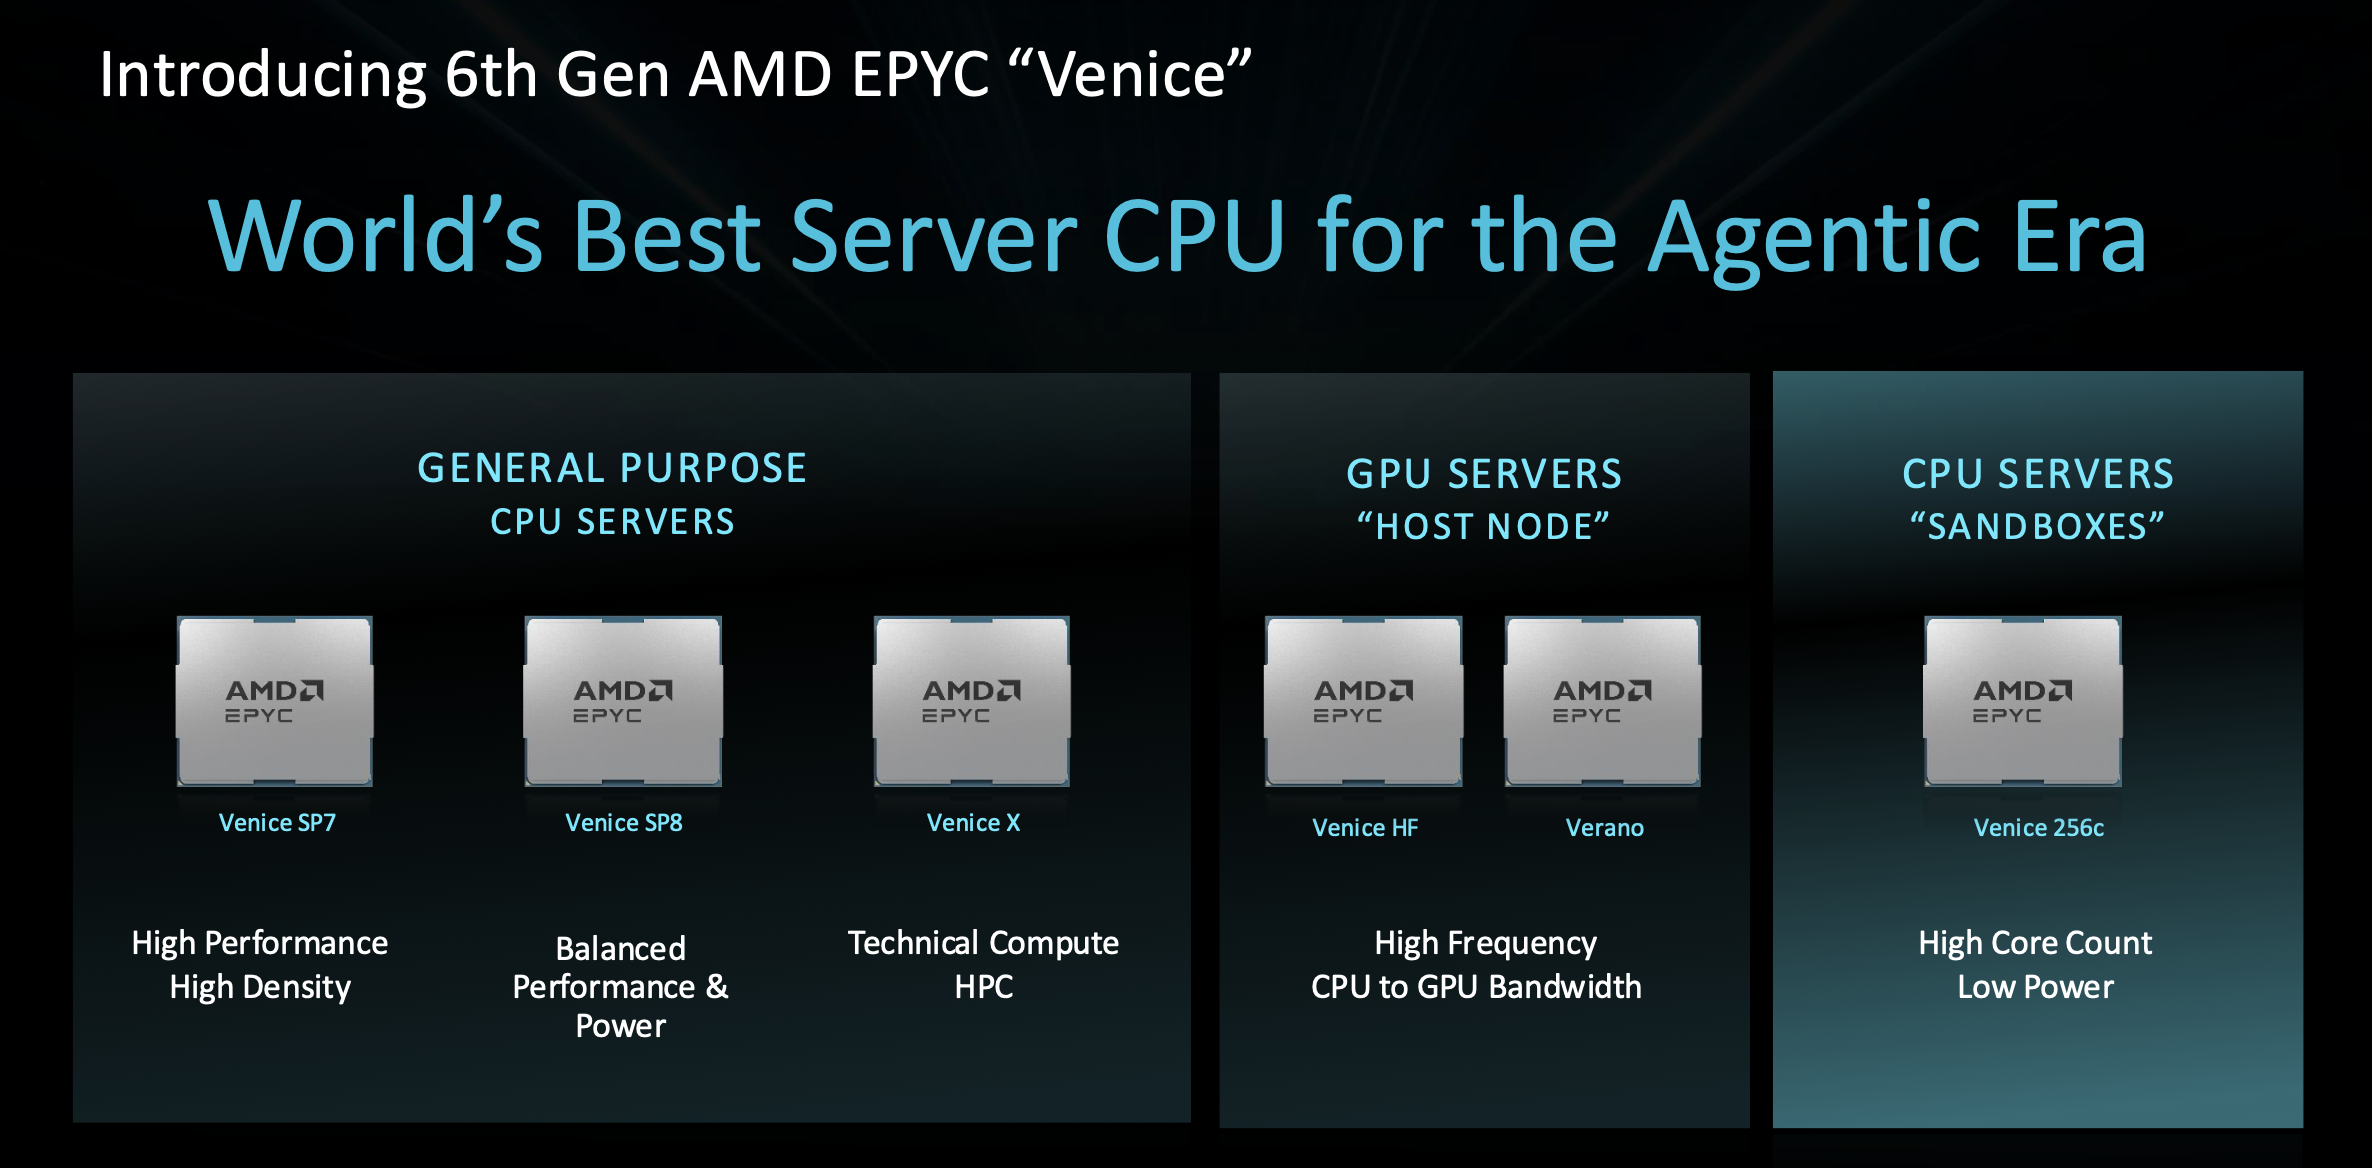
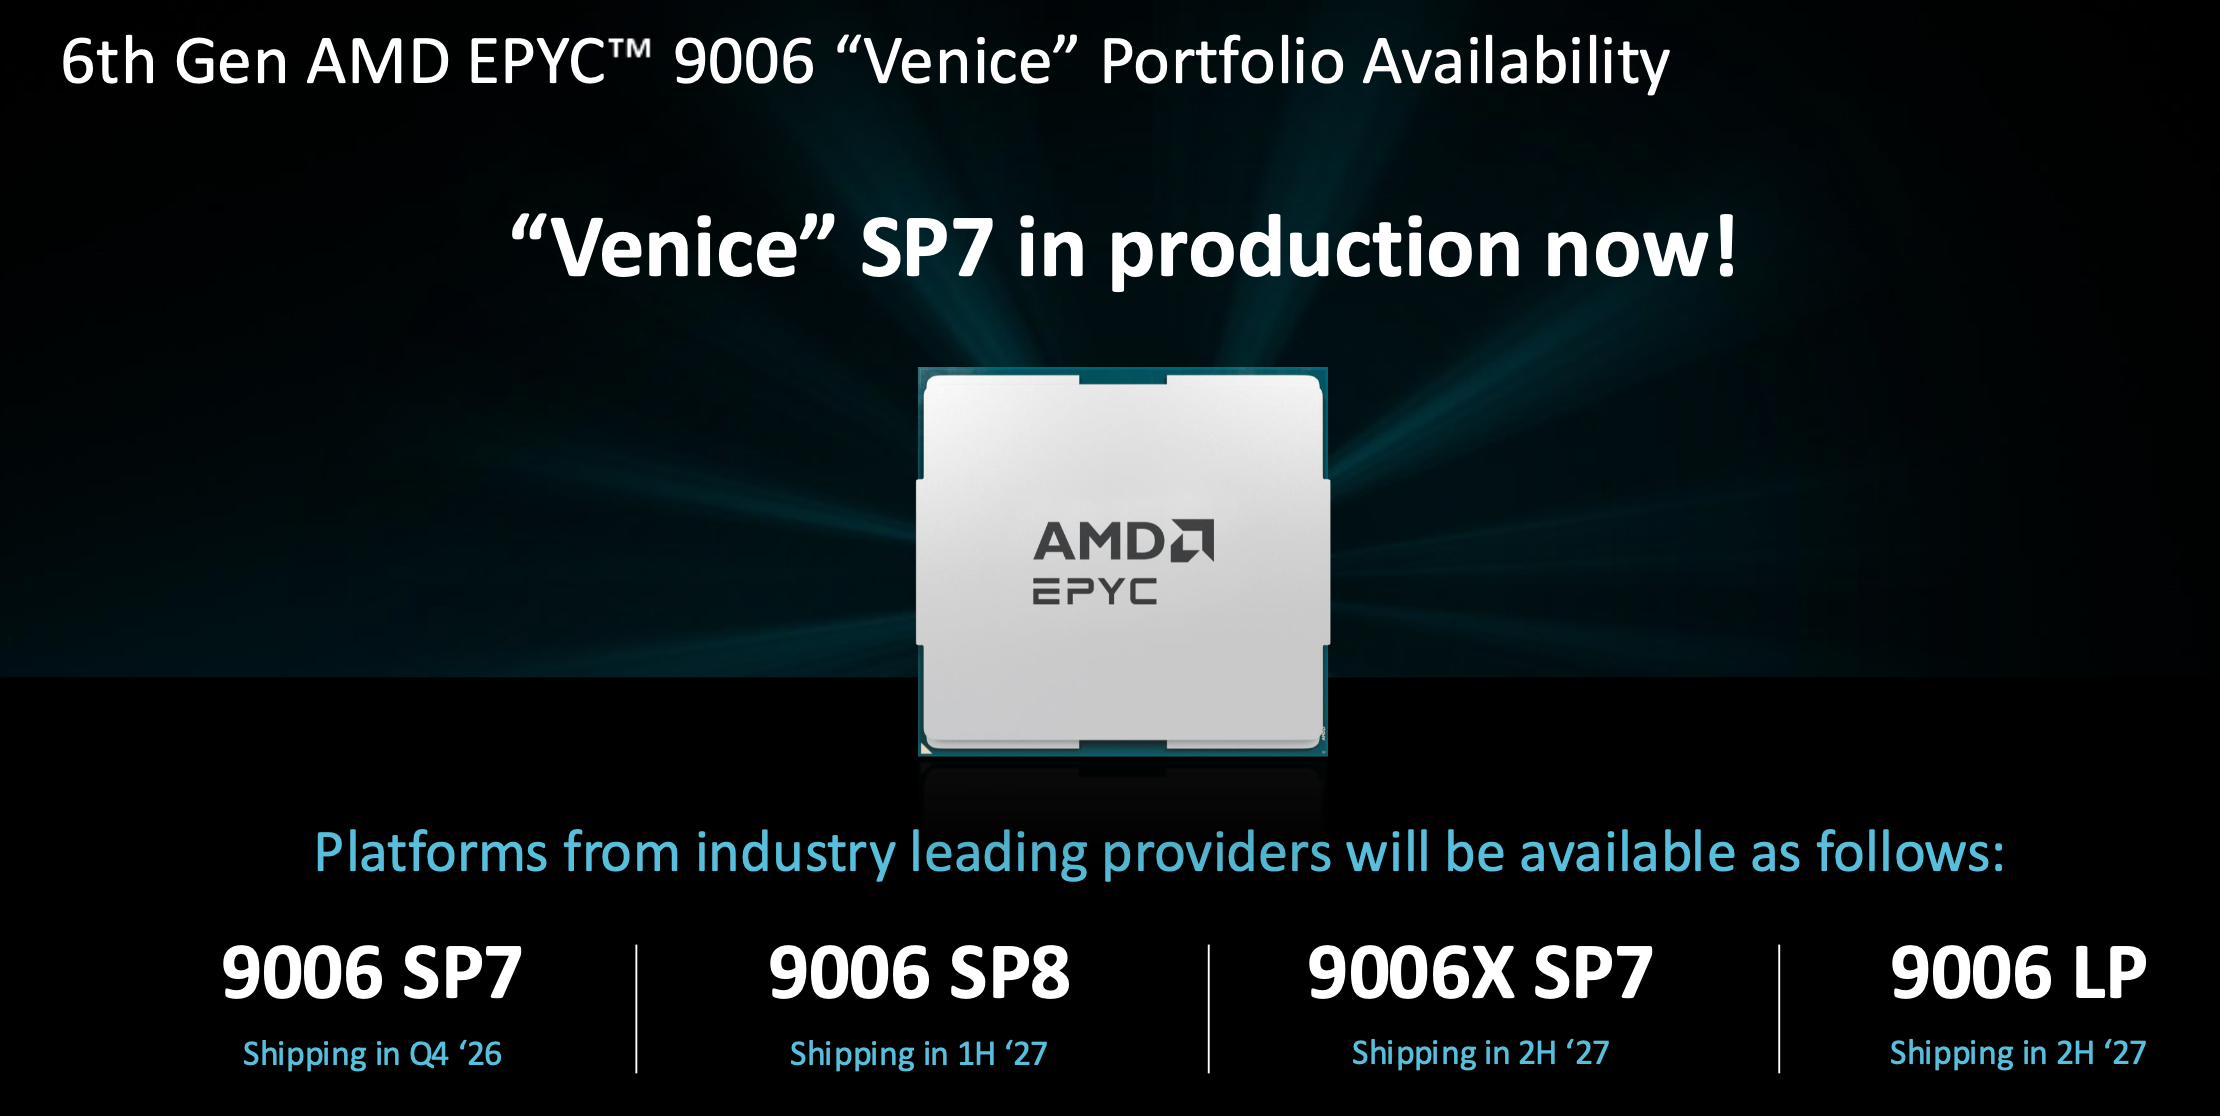
ラインナップは 4 つの製品で構成され、プラットフォームは波状的に登場します。2026 年第 4 四半期に Venice SP7、2027 年前半に Venice SP8、後半に Venice-X と Verano が登場します。AMD は同じシリコンを 6 分割し、より細かいカットが 3 つの階層に直接マッピングされます。汎用には Venice SP7、SP8、Venice-X が提供されます。ホスト バケットは、高周波 Venice ビンと Verano およびその LPDDR メモリを組み合わせます。高密度コンピューティングには、資料で Venice 256c と呼ばれるものが使用されます。これは、低電力でコア数が多く、電力予算が許す限りラックにできるだけ多くのスレッドを詰め込むように設計されています。Verano も副業として使用されます。AMD によると、一部の顧客は、システム ワットあたりのパフォーマンスが制約となるあらゆる場所で、汎用プロセッサとして Verano を導入する予定です。
脚注のおかげで、SKUを少しだけ垣間見ることができます。256コアのEPYC 9996が最上位機種で、9956は同じコア数ながら400Wで動作し、96コアの9686Fは高周波ホストチップです。Heliosは、各コンピューティングトレイに、このホストシリコンの独自バージョンであるEPYC 9G76を搭載しています。
妥協なしのティア
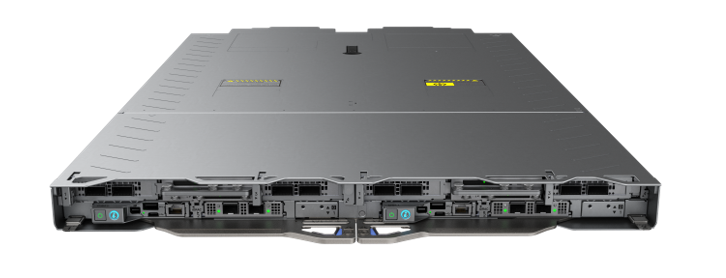
仕様表の前に、この大型ソケットがどこに位置づけられるかについて少し説明しましょう。Venice SP7は、AMDの最高級かつ妥協のないパフォーマンス層、つまりデータセンター、ハイパースケーラー、HPCコンピューティング展開向けに用意されています。これらの環境では、ラックあたりのスループットが決定的な要素であり、コストを惜しむことはありません。サーバーベンダーはすでにこのソケットを中心に製品群を再編成しています。Dellは、スペースを確保するために長年使用してきたPowerEdgeの命名規則を分割し、このクラスのコンピューティングは現在、PowerEdge R9825とRack Scale M9825を筆頭とする新しい9000シリーズに位置づけられています。これらは、3Uシャーシに2つのVeniceチップを搭載したフラッグシップモデルです。
主な仕様
家族全員が同じ基盤の上に築き上げており、トリノ以降、そのほぼすべての部分が新しくなった。
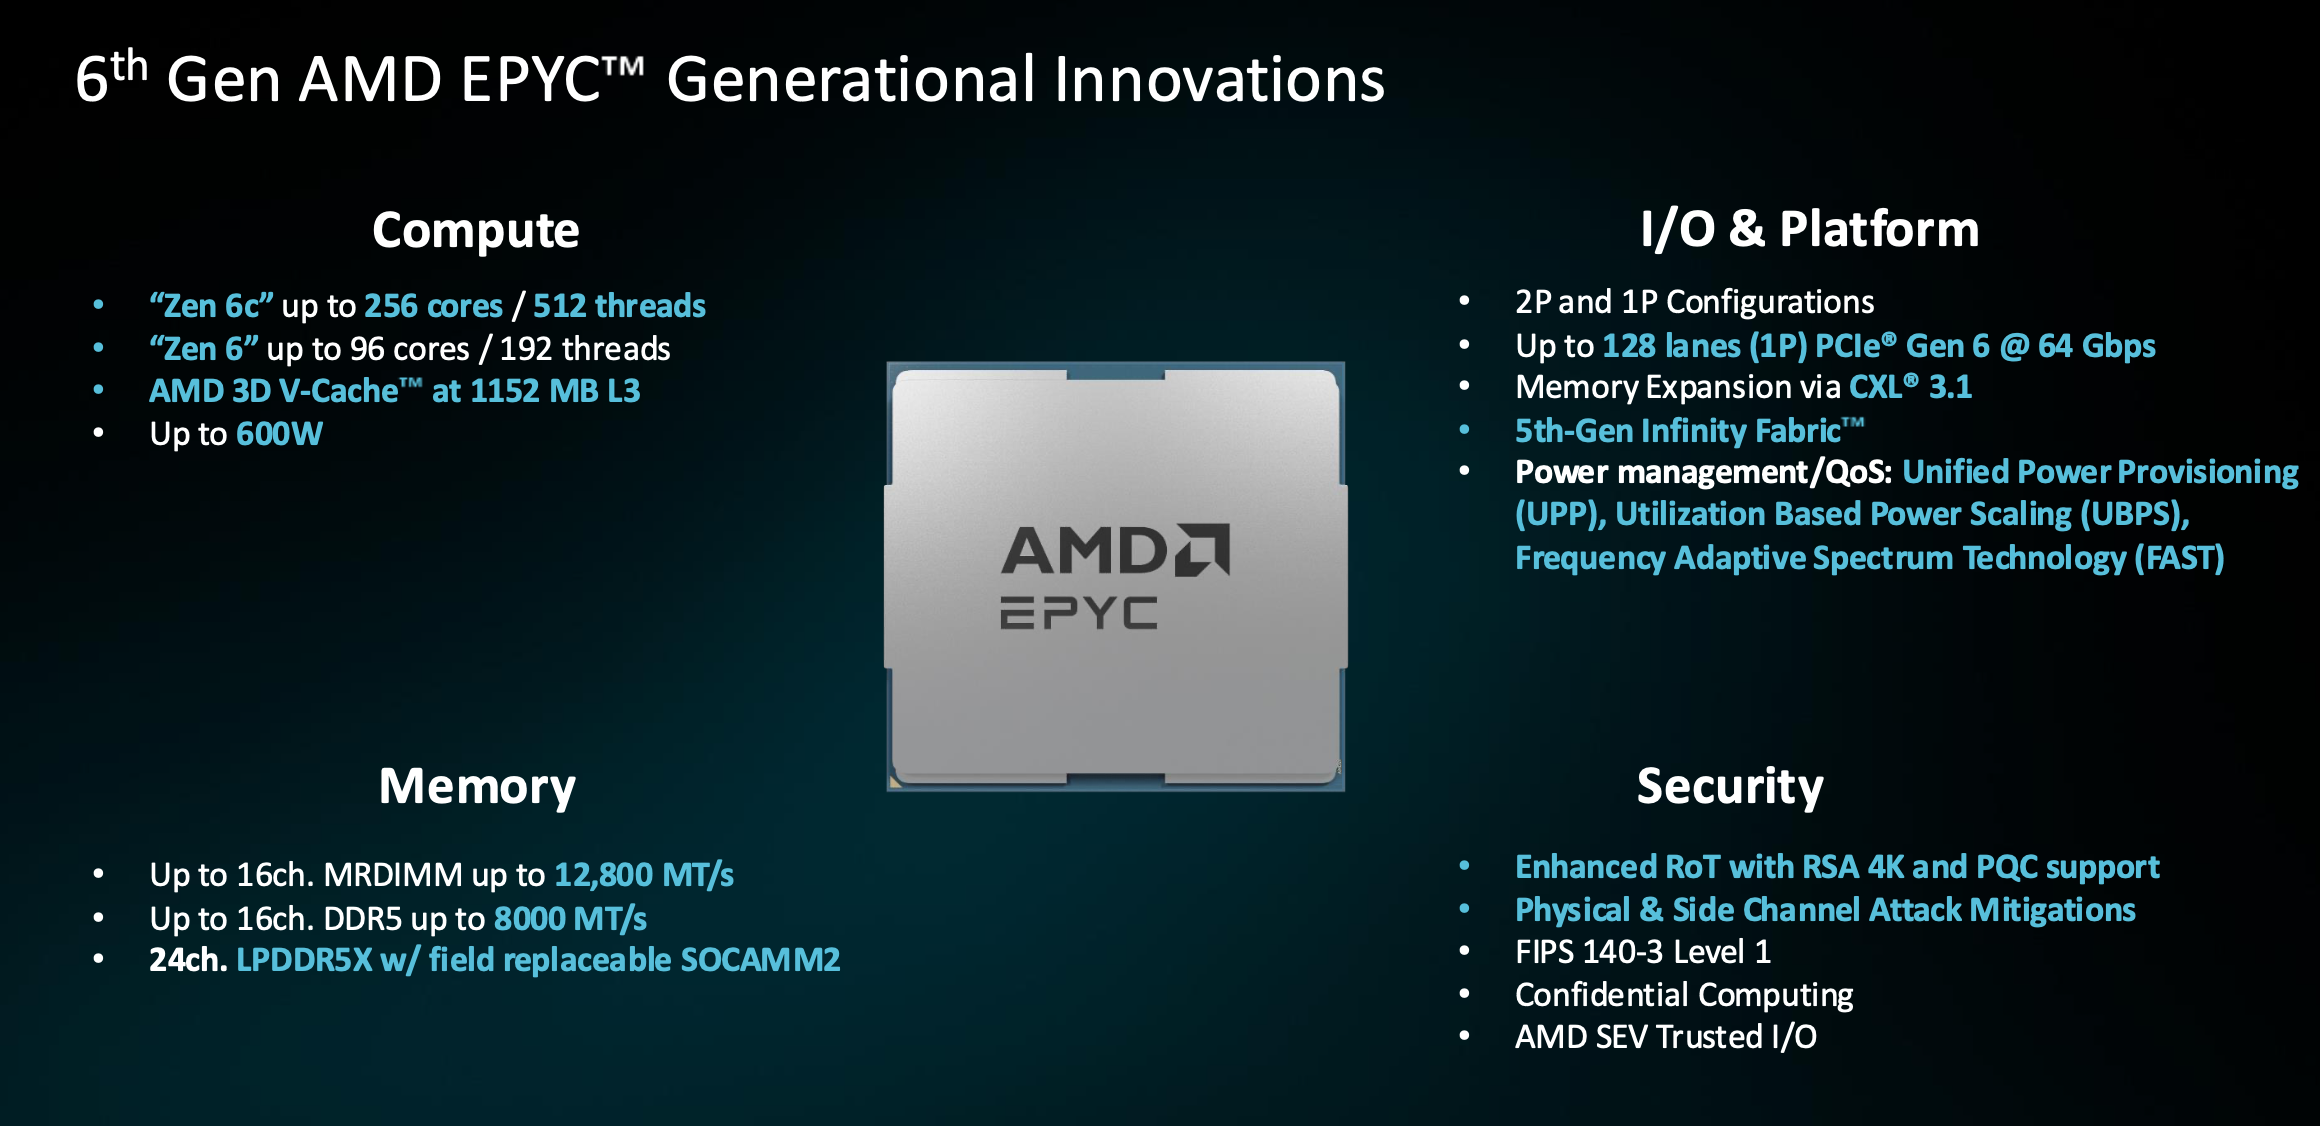
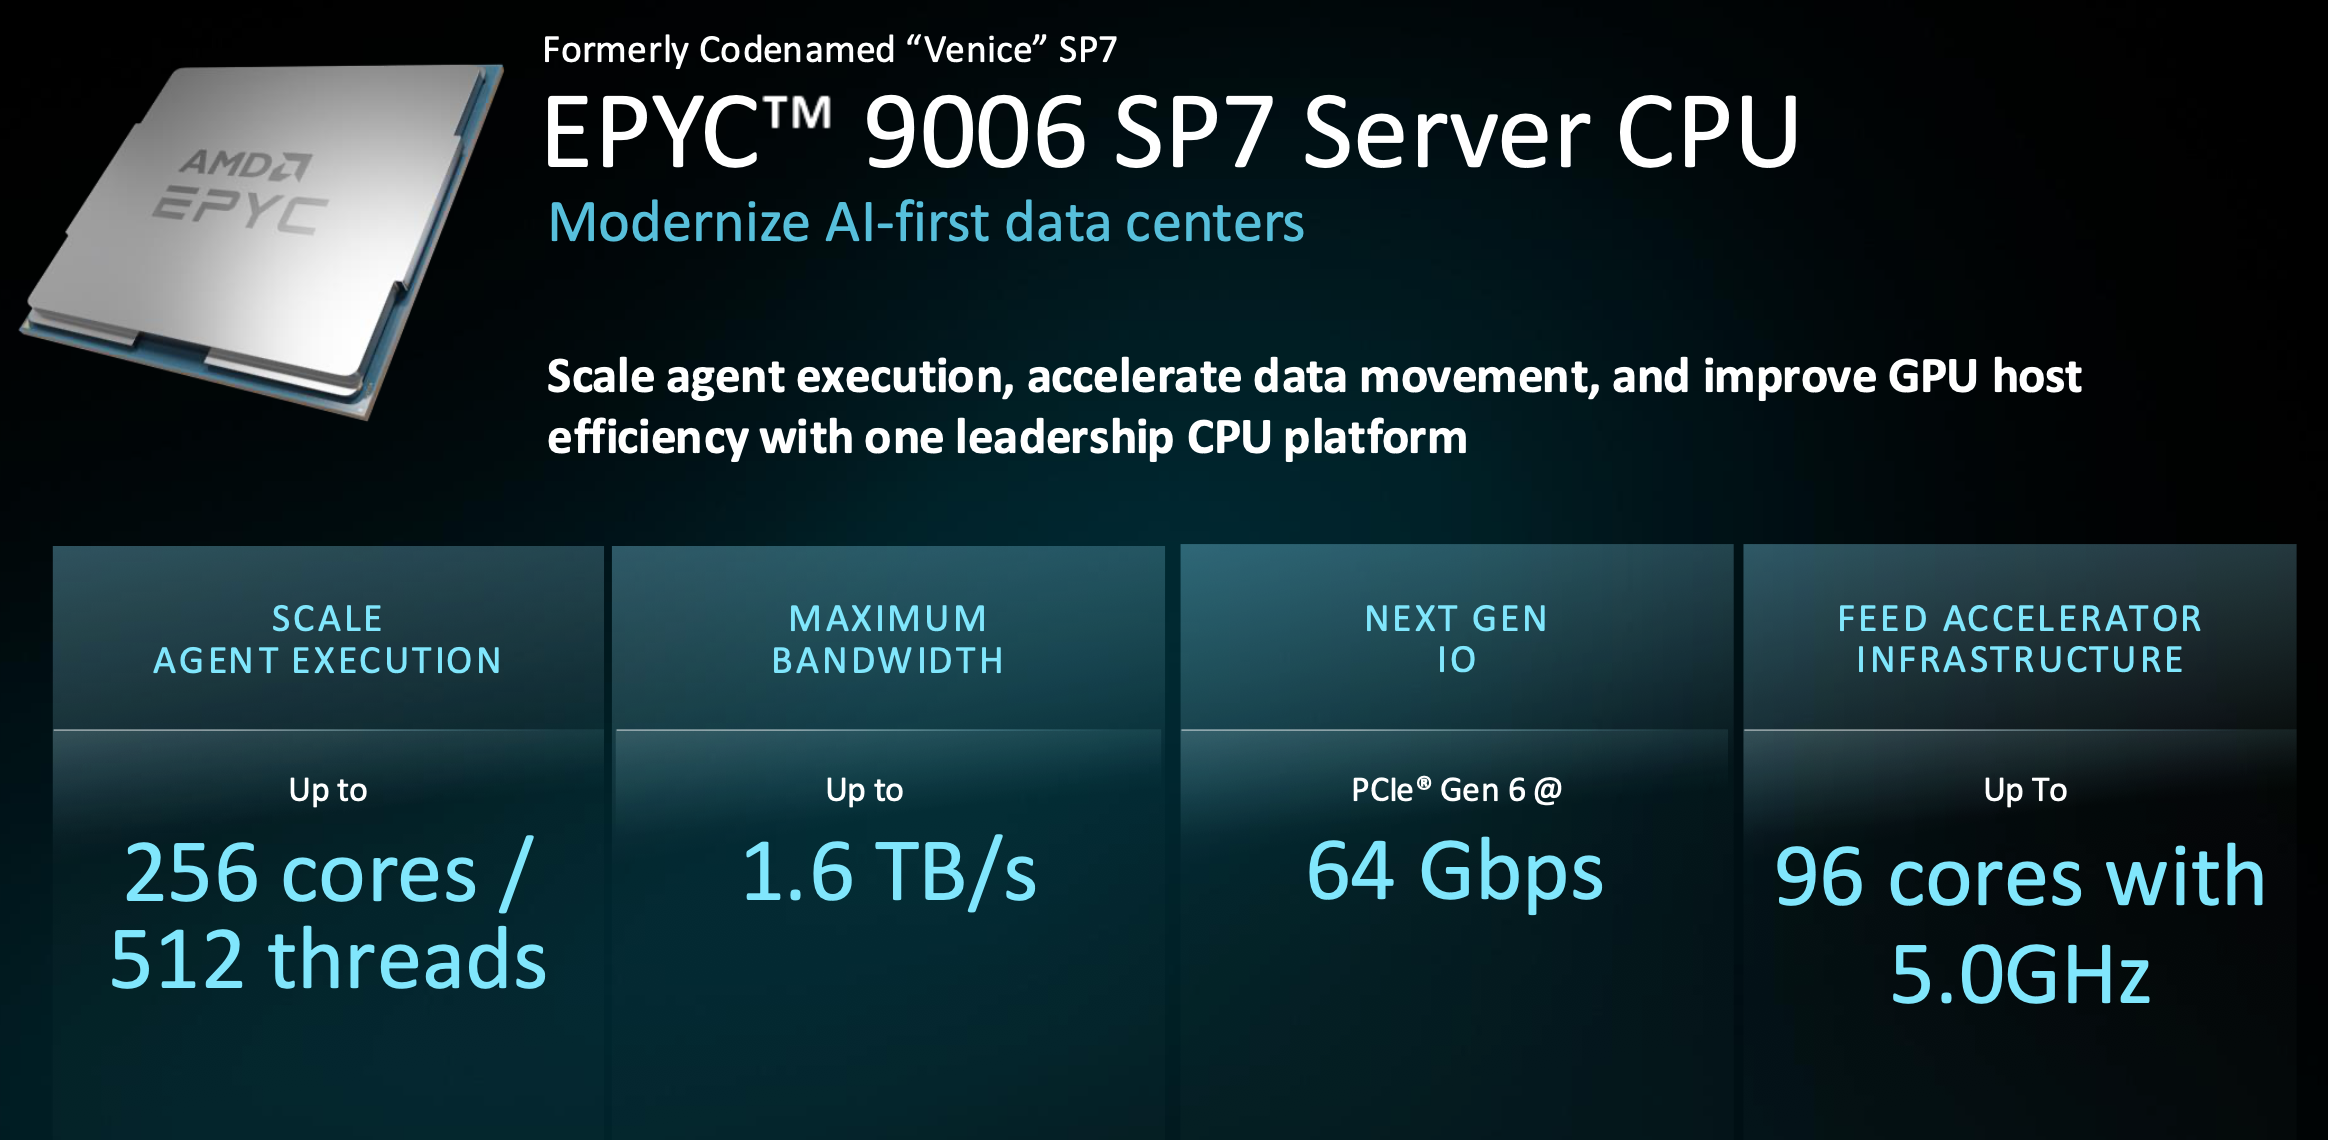
コアから見ていきましょう。 Zen 6 には 2 つの種類があります。コンパクトな Zen 6c は、最大 600W でソケット内に 256 コアと 512 スレッドを搭載し、標準コアは 96 コアで、クロック周波数は 5GHz です。 AMD は、コア数が同等の競合製品よりもコアあたりのパフォーマンスが 20% 以上向上していると主張しており、密度が高くてもキャッシュが薄くなることはありません。256 コアのダイでも、コアあたり約 4MB の L3 キャッシュを保持しており、フラッグシップでは 1 ギガバイトになります。 AVX-512 は、CPU 自体で実行されることが増えているトークナイザーと 30 億から 80 億のパラメータを持つモデルを処理します。
これらのコアにメモリを供給するには、はるかに大きなメモリ システムが必要です。8,000MT/s の DDR5 を 16 チャネル、または 12,800 の MRDIMM で、ソケットあたり 1.6TB/s の性能を発揮します。一方、Turin は 12 チャネルで 614GB/s を実現していました。I/O も同様に飛躍的に向上しています。Venice は PCIe Gen 6 を搭載した最初のサーバー CPU で、64 GT/s の 128 レーンを備え、現在アクセラレータに接続されている他のどのレーンよりも 2 倍の帯域幅を実現しており、後述するホスト ノードの主張の基盤となっています。CXL 3.1 はメモリ拡張のためにこれらのレーンを利用し、一部の 2 ソケット AI ホスト プラットフォームでは、ソケット間の xGMI 幅を犠牲にして I/O を優先し、使用可能なレーン数を 160 に増やしています。 2つのより静かな追加機能は、コアを酷使することなくデータを転送します。SDXIはメモリコピーと30~50コア分の暗号化処理をオフロードし、スマートデータキャッシュインジェクションはネットワークパケットをDRAMを経由させるのではなく、直接キャッシュにドロップします。
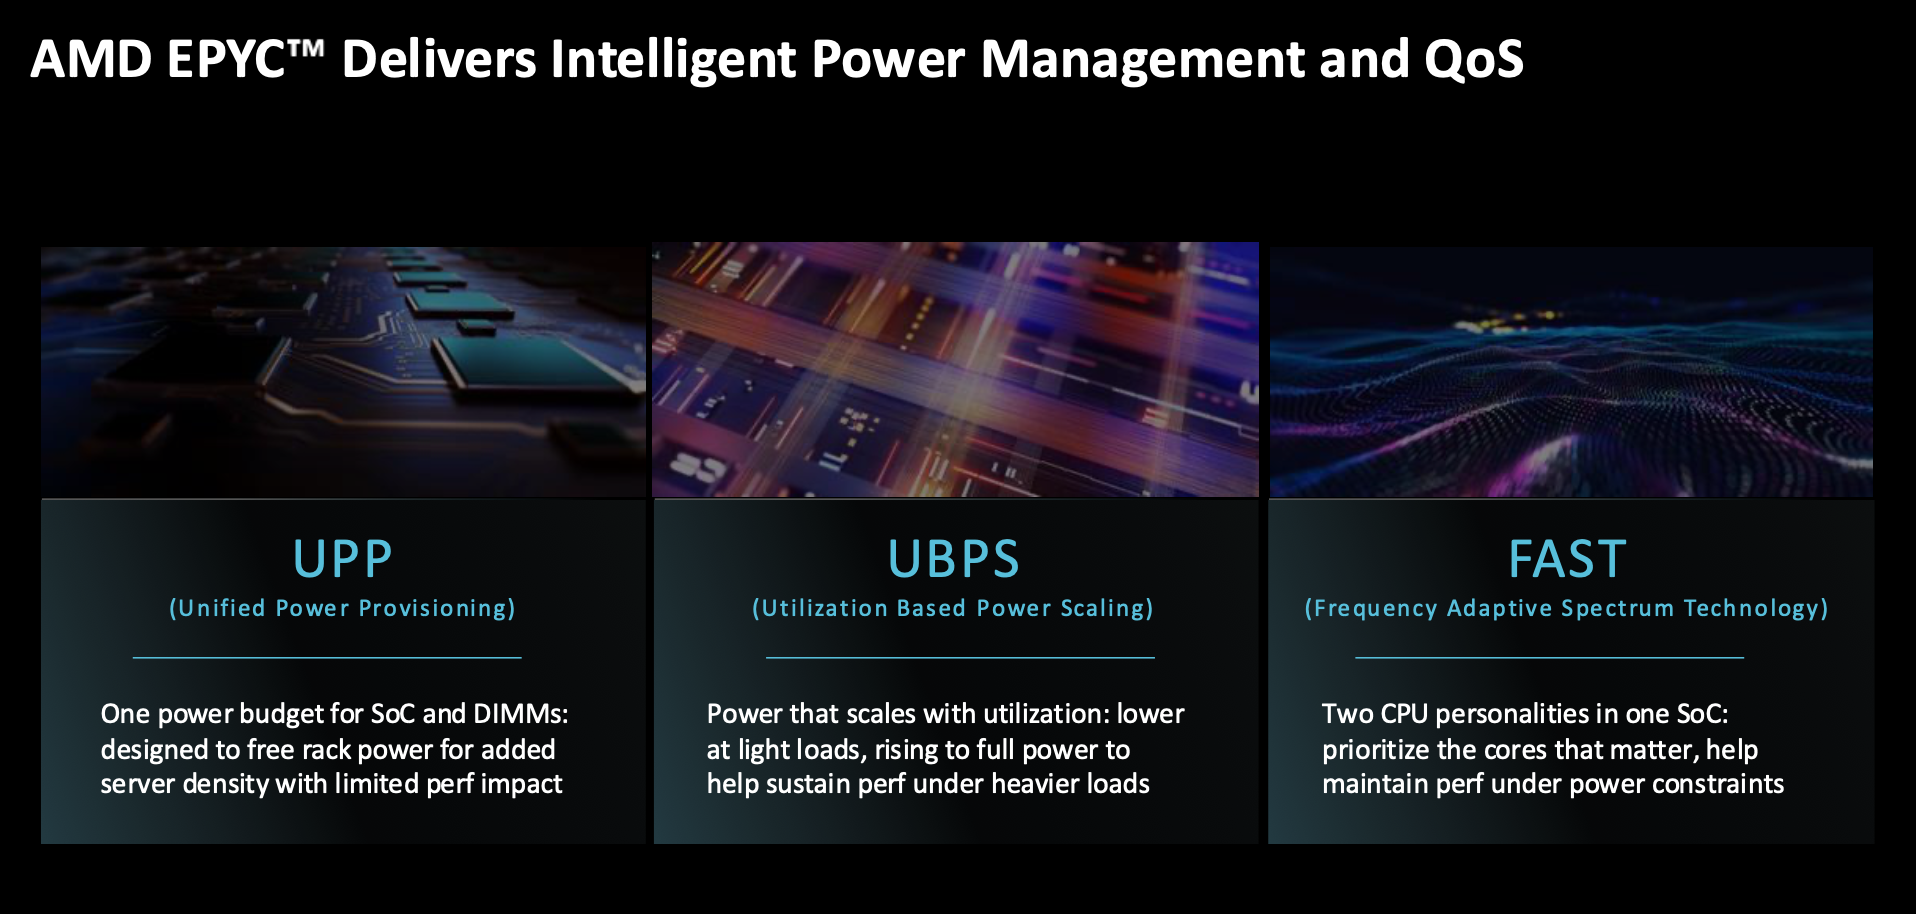
電力管理には 3 つの新しいノブが追加され、これらは重要です。なぜなら、AMD が後ほど行うラック比較はすべて電力予算内で行われるからです。UPP は SoC と DIMM の予算を 1 つに統合するため、メモリがボトルネックとなるワークロードでは DIMM にワットがシフトし、計算がボトルネックとなるワークロードでは DIMM が引き戻されます。これにより、固定予算内でパフォーマンスが向上するか、ラックの電力を解放してより多くのノードに割り当てることができます。UBPS は低使用率で電力を制限し、通常の軽負荷時のパフォーマンス向上を犠牲にして、平坦で予測可能な負荷ラインを実現します。パフォーマンス向上を好むオペレーターは、この機能をオフにすることができます。FAST は 1 つの SoC を 2 つのパーソナリティに分割し、優先度の高いコアを高周波数で維持し、バックグラウンド コアを低速で実行することで、バッチ ジョブとソケットを共有するレイテンシが重要な作業が影響を受けないようにします。
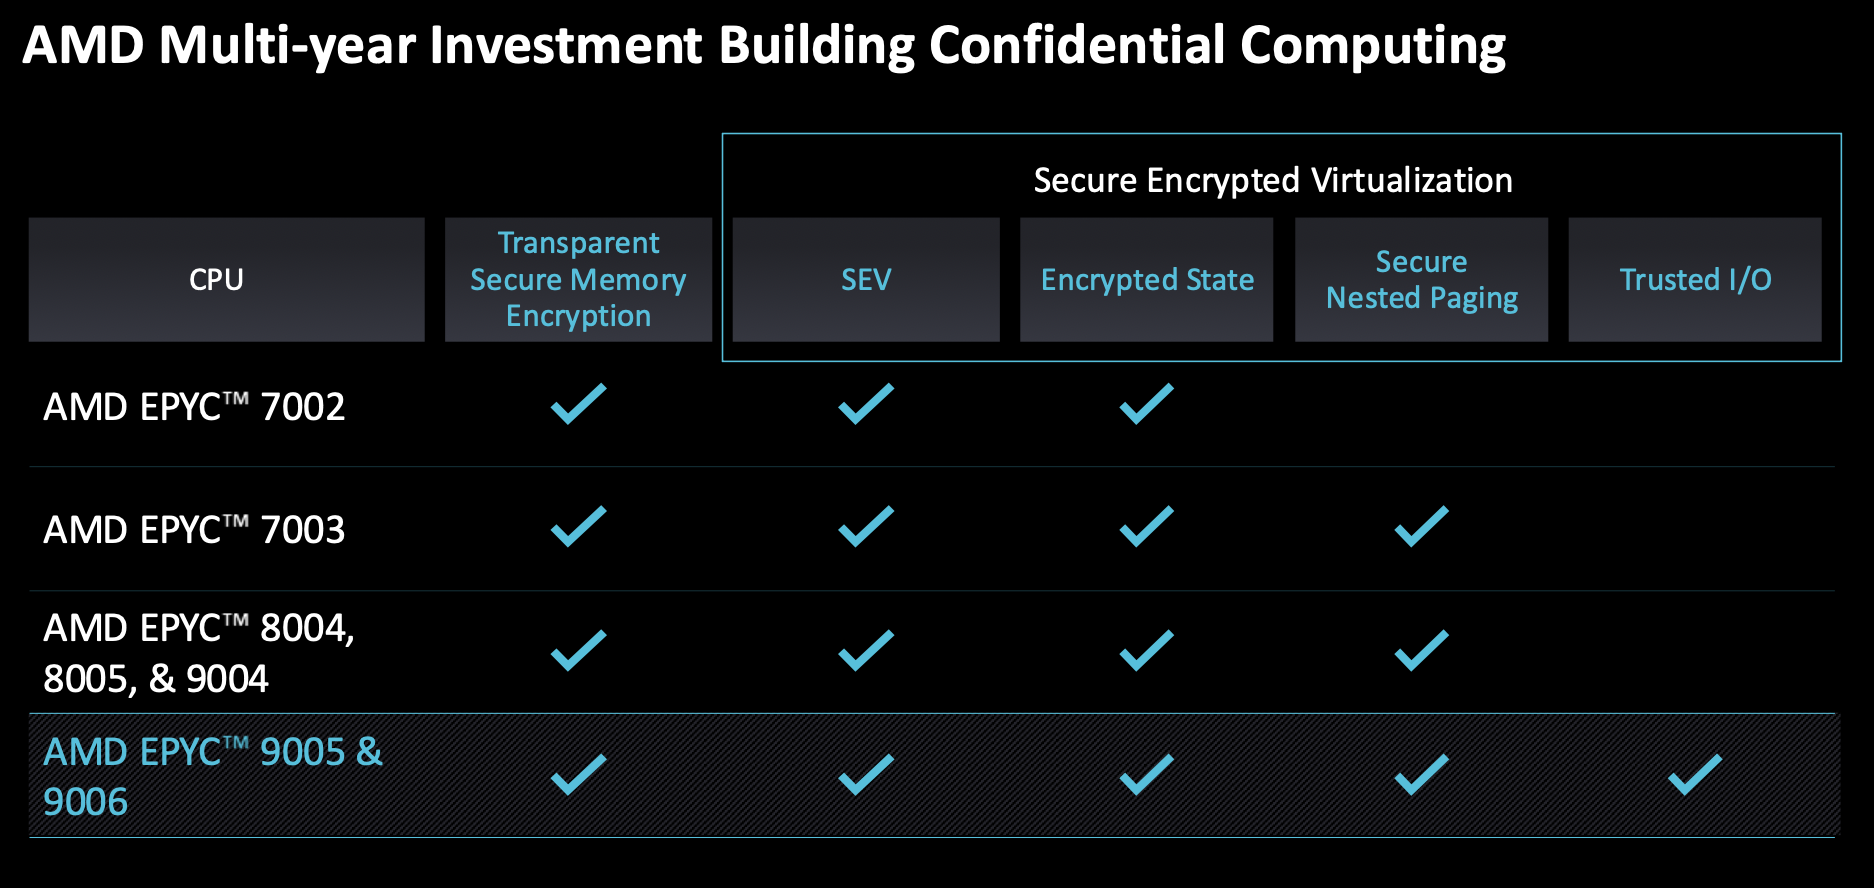
セキュリティ面では、VeniceはEPYC 7002のSEVから始まり、暗号化されたステート、セキュアなネストされたページング、そしてTurinで導入されたTrusted I/Oへと続く、機密コンピューティングの系譜を継承しています。今世代の新機能としては、RSA-4Kとポスト量子アルゴリズムによる強化された信頼の基点、物理的およびサイドチャネル攻撃の緩和、FIPS 140-3レベル1認証、そしてVeniceがAMD製品として初めて搭載する、証明可能な製造履歴であるデバイスプロベナンスが挙げられます。
ポートフォリオの中身
4つの部分は、同じ名前が示す以上に違いが大きい。
| 製品仕様 | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP「ベラノ」 |
|---|---|---|---|---|
| コア | 最大256(512スレッド) | 8〜128 | 最大96 | 最大72 |
| ピーク周波数 | 5.0GHz、96コア(HF) | HFオプションが提供されています | 〜5.15GHz | 最大5.0GHz |
| メモリ | 16ch、最大1.6TB/秒 | 8チャンネル、チャンネルあたり2つのDIMM | 16ch MRDIMM、12,800 MT/s | 24ch LPDDR5X、SOCAMM2 |
| L3キャッシュ | 最大1024MB | コア数に依存する | 1152MB(3D Vキャッシュ) | コア数に依存する |
| I / O | PCIe Gen 6、96レーン | 128 PCIeレーン、1Pおよび2P | PCIe Gen6 | 112 GT/s での強化型 xGMI |
| を目的とした | ハイパースケール密度、AIホスト | エンタープライズ、エッジ、NEBS対応 | HPC、AI前処理 | ラック規模のAIホスト |
EPYC 9006 SP7
SP7はフラッグシップソケットであり、現在生産中のものです。パートナープラットフォームは第4四半期に登場予定です。その高周波ビンは、AMDが最速で立ち上げられたSKUの一つだと述べているTurin HFパーツの後継であり、最大の導入事例はHeliosです。Heliosでは、各コンピューティングトレイのホストCPUが、1TBのDDR5メモリを背後に持つInfinity Fabricを介してラックのコヒーレントメモリドメインに接続されます。ソケットは標準規格であるため、256コアのフラッグシップまで、どのSP7 SKUでもそのまま使用できます。この点については、姉妹記事で詳しく説明しました。
EPYC 9006 SP8
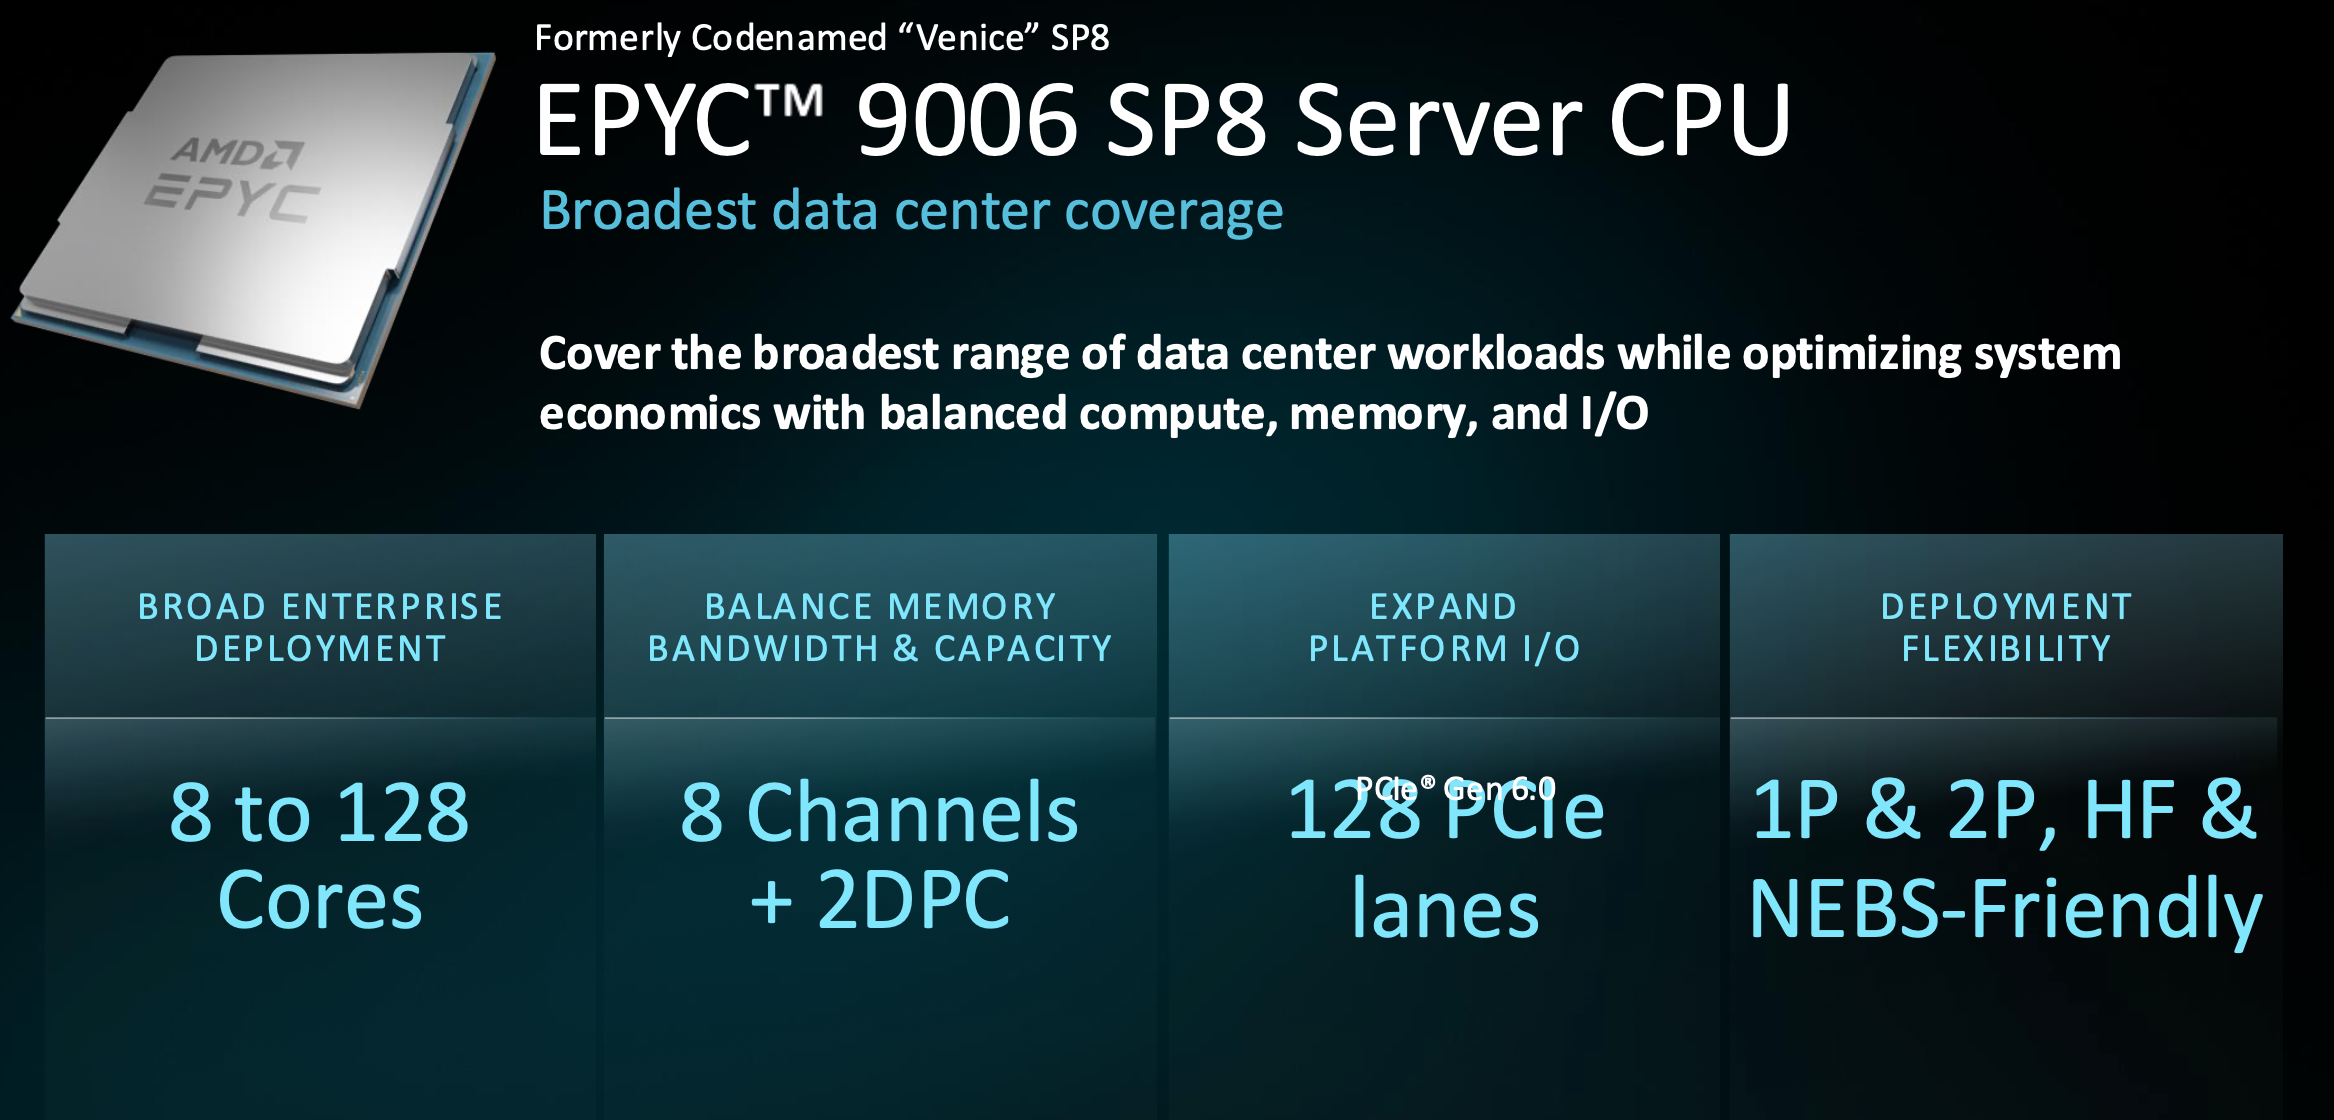
SP8は、巨大なソケットを犠牲にしてシステム経済性を追求しています。8~128コアに対応し、8つのメモリチャネル(チャネルあたり2つのDIMM)を備え、128レーンのPCIeを維持します。また、通信事業者やエッジ環境向けに、高周波オプションとNEBS対応オプションを備えた1Pと2Pの構成が用意されています。AMDの売り文句は、企業向けに適切なサイズのパフォーマンスを提供することです。企業では、ラック単位ではなく、システム1ドルあたりのパフォーマンスが契約の決め手となるからです。
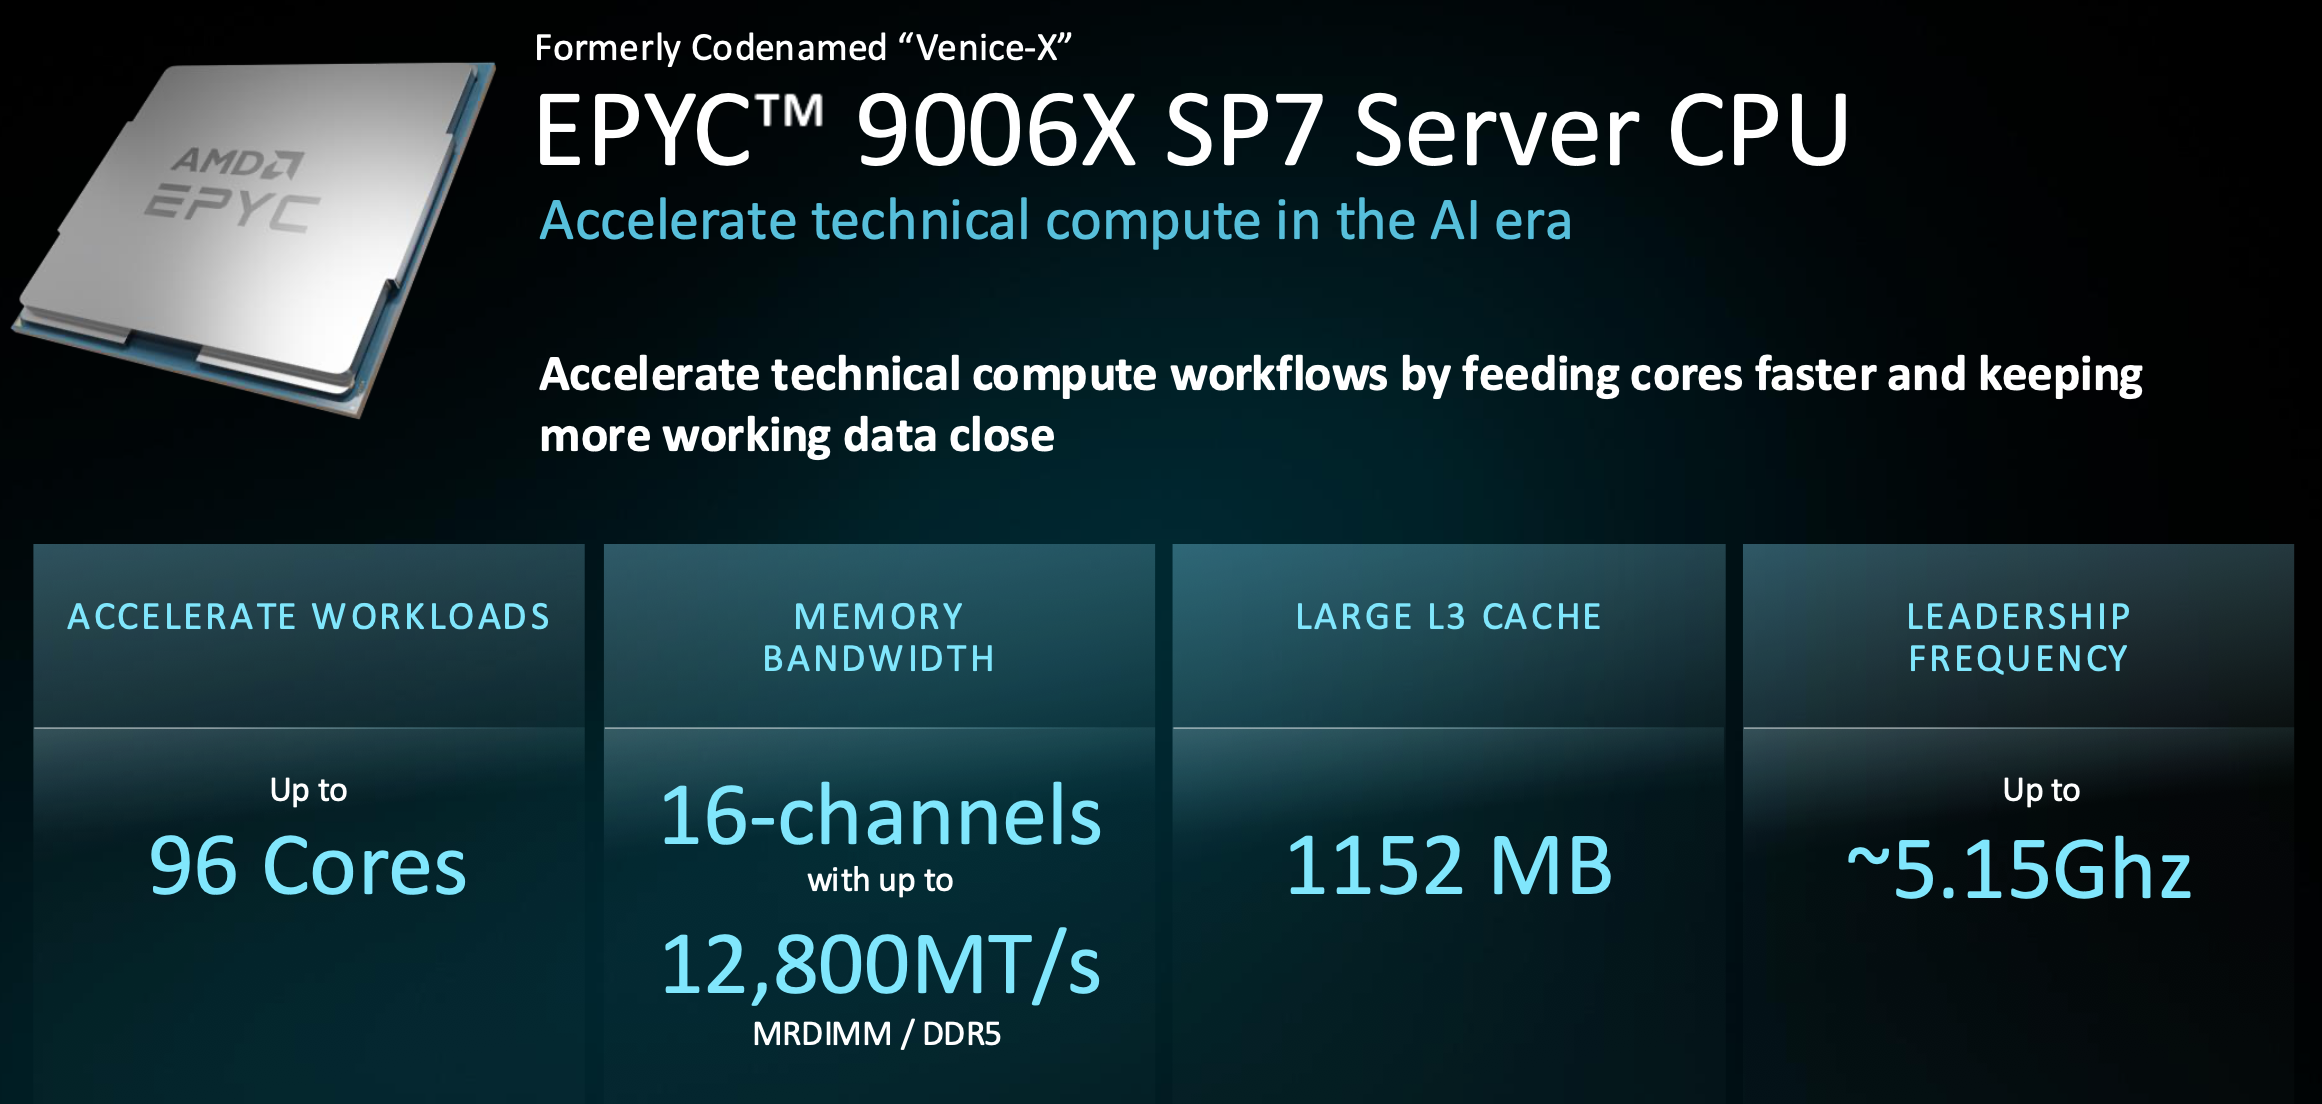
EPYC 9006X “Venice-X”
Venice-Xは、96コアの高周波構成に3D V-Cacheを搭載し、L3キャッシュを1152MBに拡張。これは、標準のSP7プロセッサのコアあたり約3倍のキャッシュ容量です。クロック周波数は約5.15GHzに達し、16チャネル、12,800MT/sのフルメモリシステムもそのまま引き継がれています。ターゲットは、シミュレーションとモデリング、大規模分析、インメモリデータベース、トレーニングパイプラインにデータを供給するAI前処理など、コア数の増加よりもキャッシュに保持されるワーキングセットが重要なワークロードです。
EPYC 9006 LP「ベラノ」
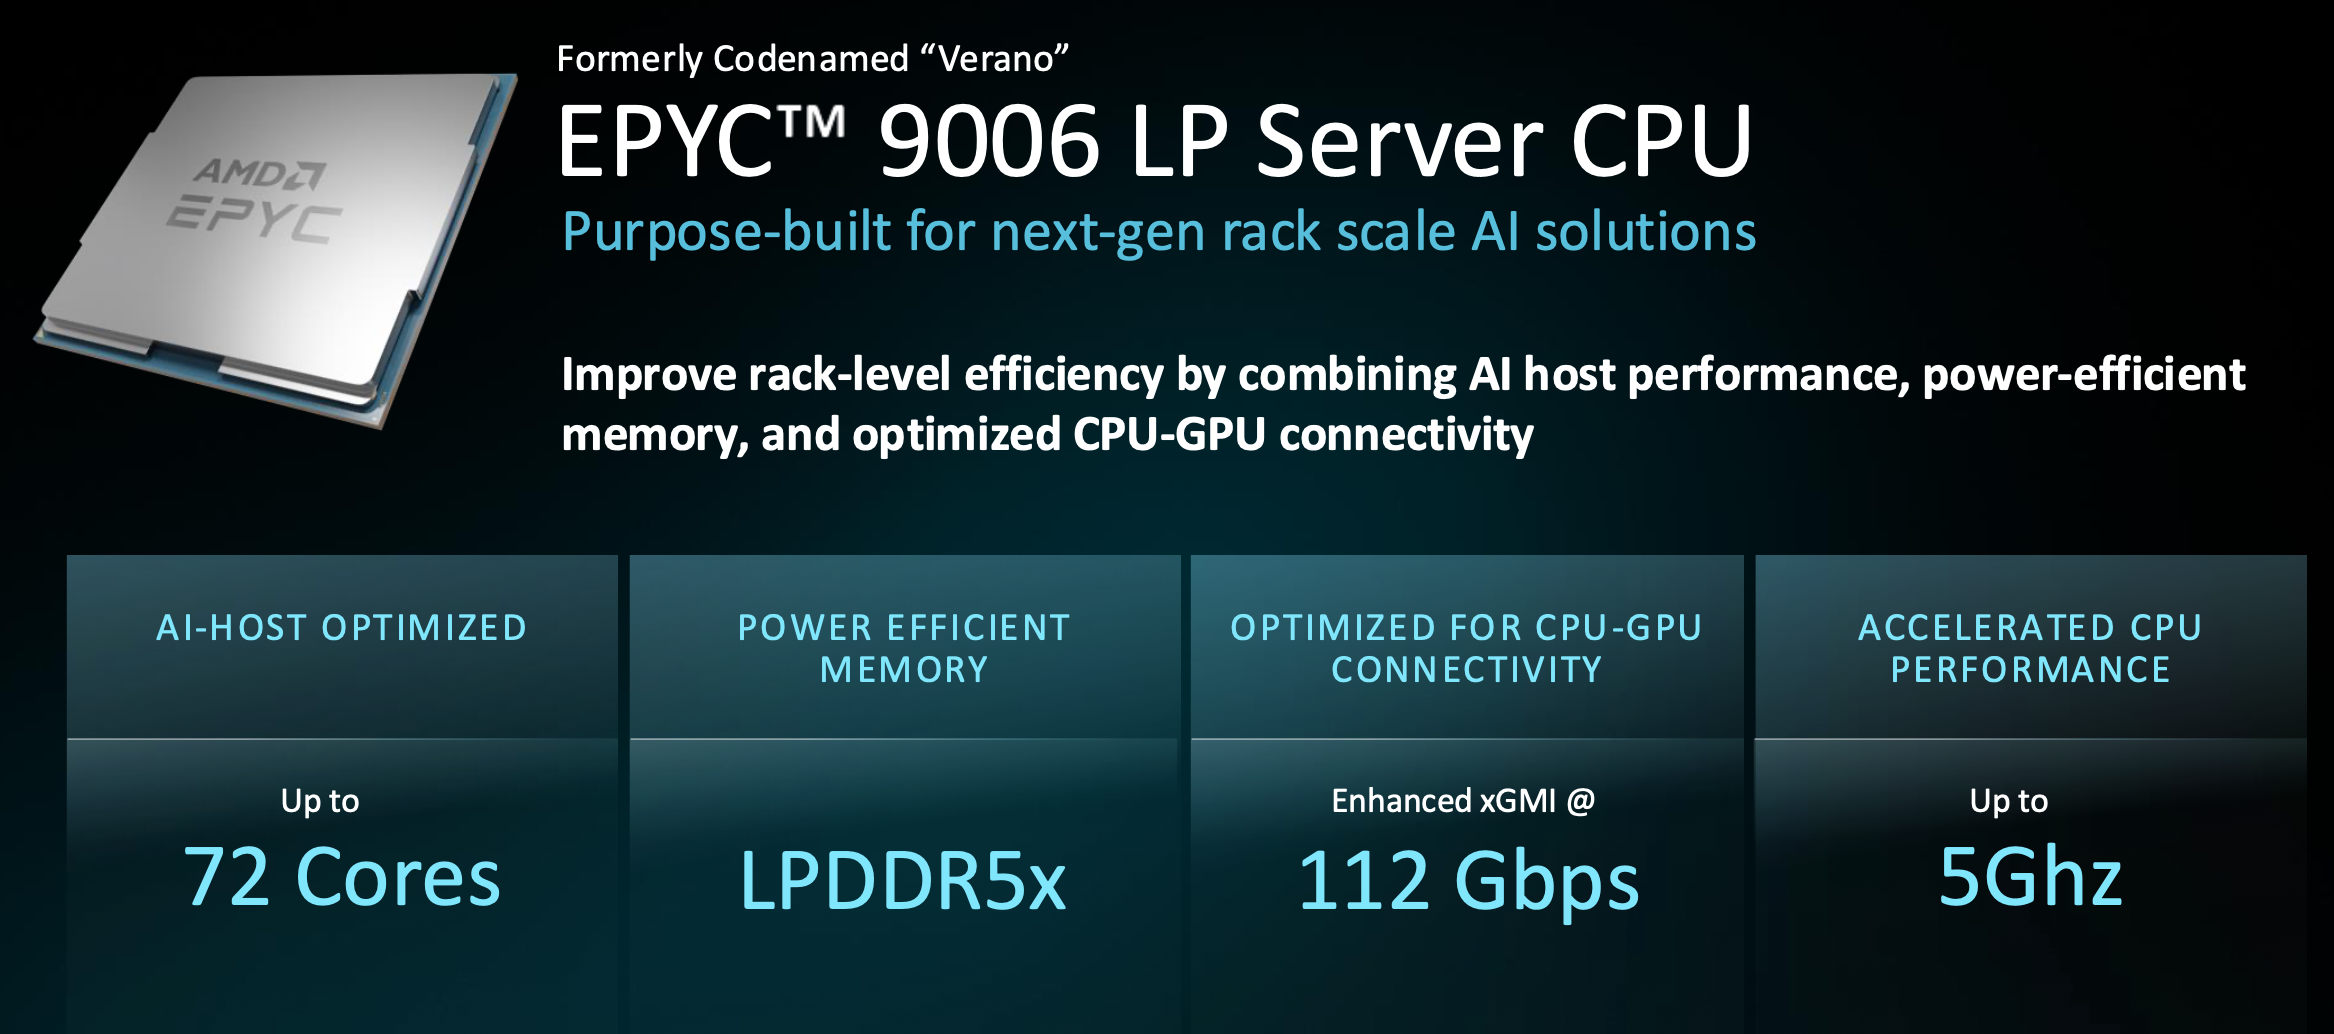
Veranoは、このファミリーの中で最も特化した製品です。まずAIホストノードとして設計され、最大72コア(5GHz)、24チャネルのLPDDR5Xメモリ、そしてCPUとGPU間の通信速度を向上させる112GT/sのxGMIリンクを備えています。LPDDRメモリはSOCAMM2モジュール上に搭載されており、現場で交換可能です。これは、はんだ付けされたメモリの故障でボード全体が廃棄されるような大規模なシステム構成において重要な点です。また、VeranoはNVIDIAのVeraに対するAMDの直接的な回答でもあり、この比較については後ほど詳しく見ていきます。AMDは確かにNVIDIAのVeraに対抗する製品を開発しました。
ヴェネツィアはどのような位置づけにあるのか
AMDは2回のテストでその優位性を示した。まずトリノで既に獲得しているリードを示し、次にヴェネツィアでどれほど差を広げているかをアピールした。
トリノが今日リード
AMDは比較対象の大部分をNVIDIAのVera、Vera RubinプラットフォームのArm CPUに向け、既に出荷されている世代から始めた。AMDのラックレベルのモデリングによると、TurinのラックはVeraの汎用スループットの2.4倍、ワットあたりのエージェント数は2倍になる。このモデルでは、両方のラックの電力予算を100kWに固定し、384コアの2P EPYC 9965と176コアの2P Veraボードを比較し、推定SPECrate 2017、サーバーサイドJava、NGINX、Redis、Memcached、TPC-C派生の6つのワークロードで結果を平均している。
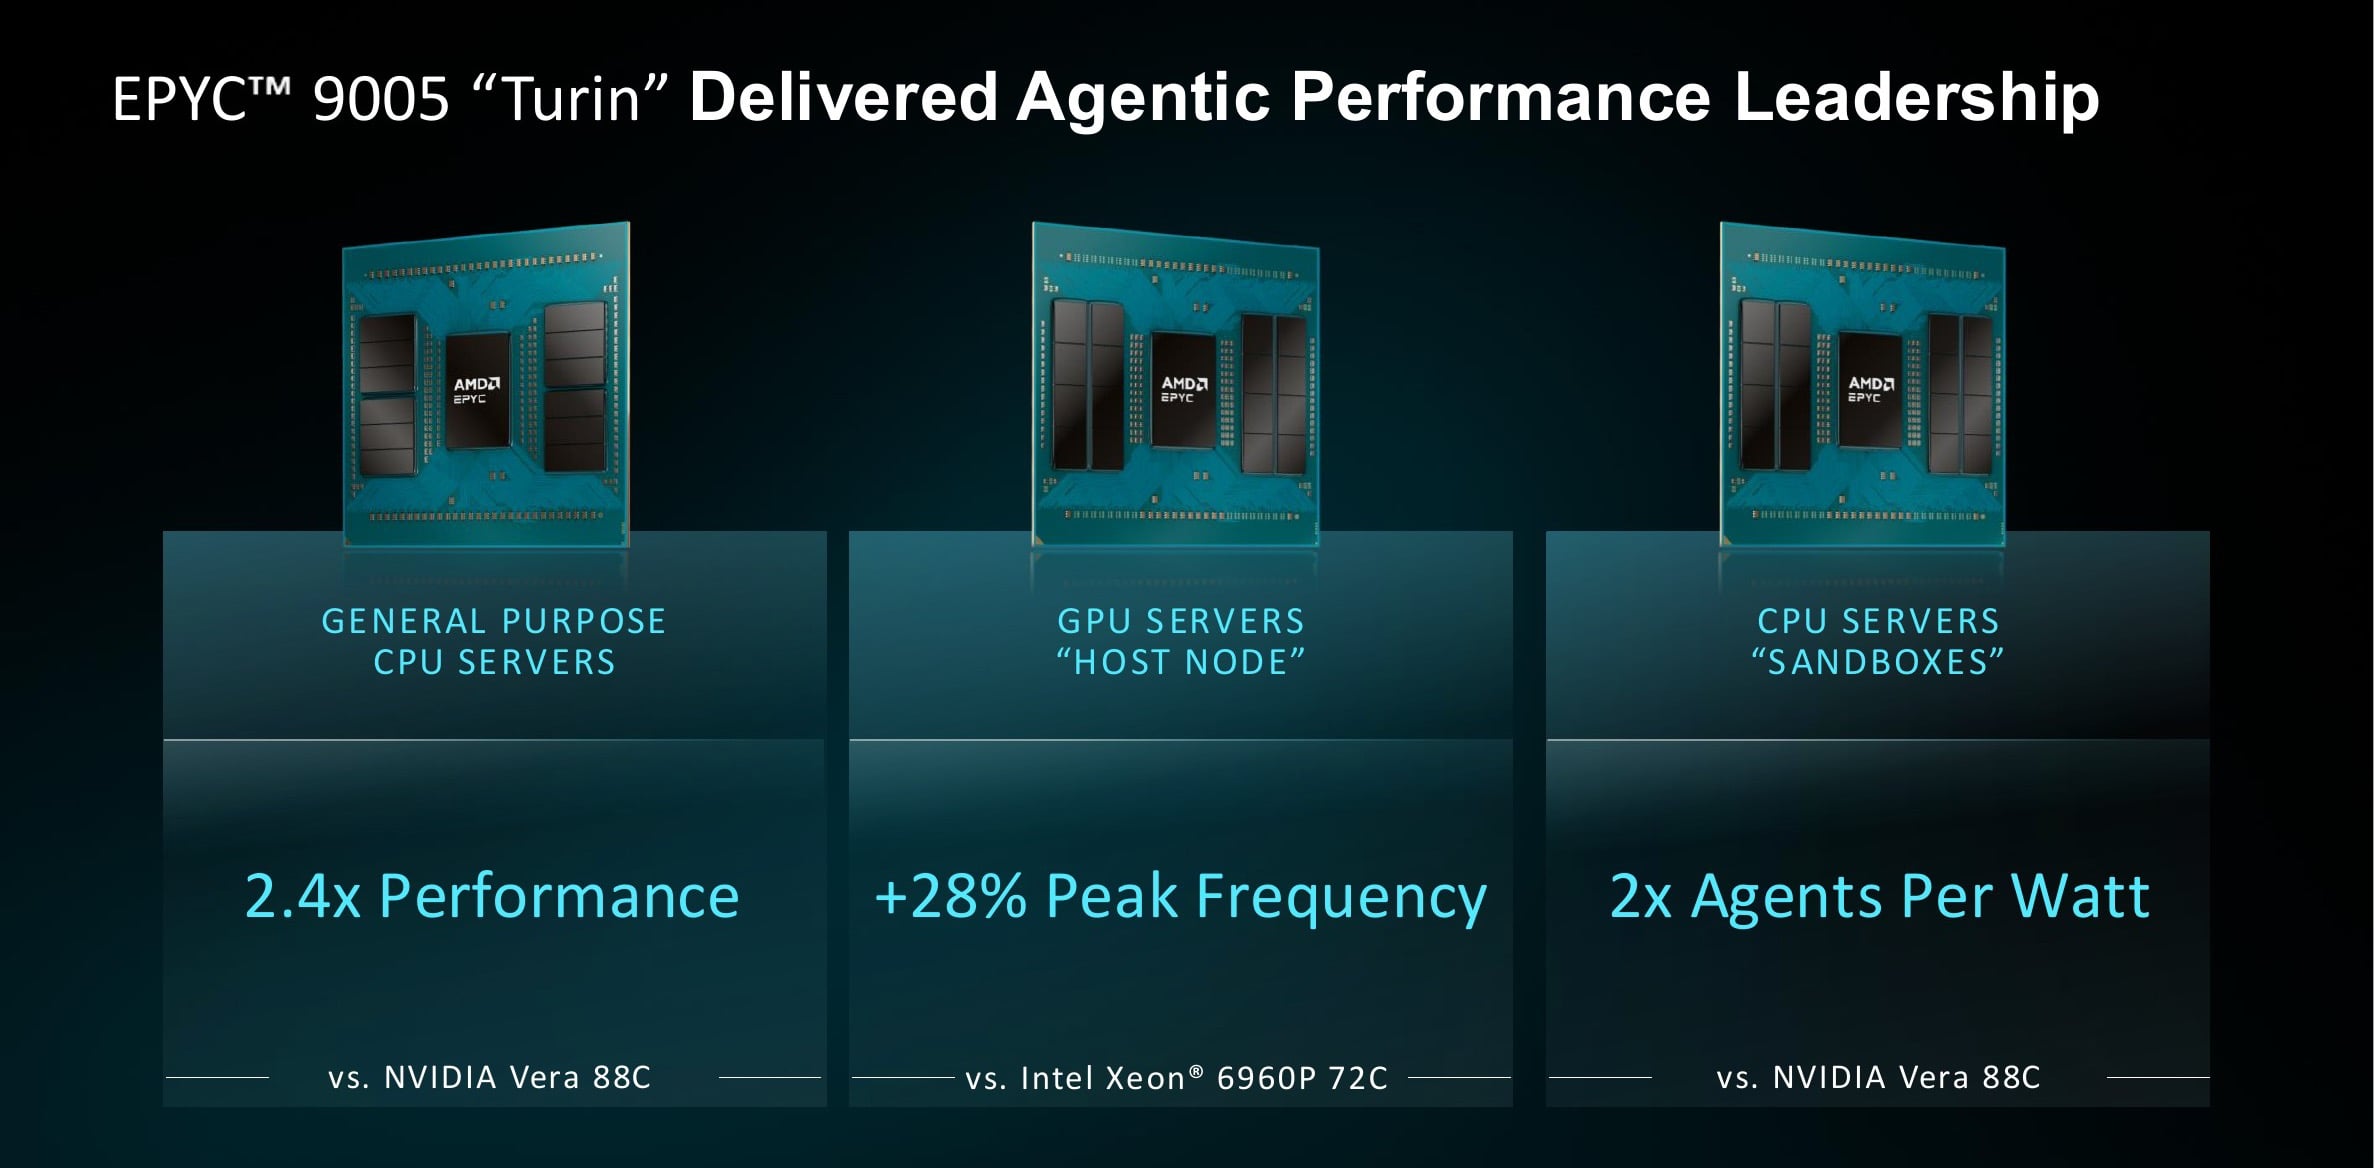
本記事全体を通して、以下の2点にご注意ください。Veraはまだ出荷されていないため、Veraに関する数値はすべて、NVIDIAが公開資料で説明している88コア、450Wの製品に対するAMDの推定値です。また、エージェントワークロードの標準ベンチマークが存在しないため、AMDはエージェント/ワットの計算において、ハードウェアスレッドをエージェントの代理指標として用いています。
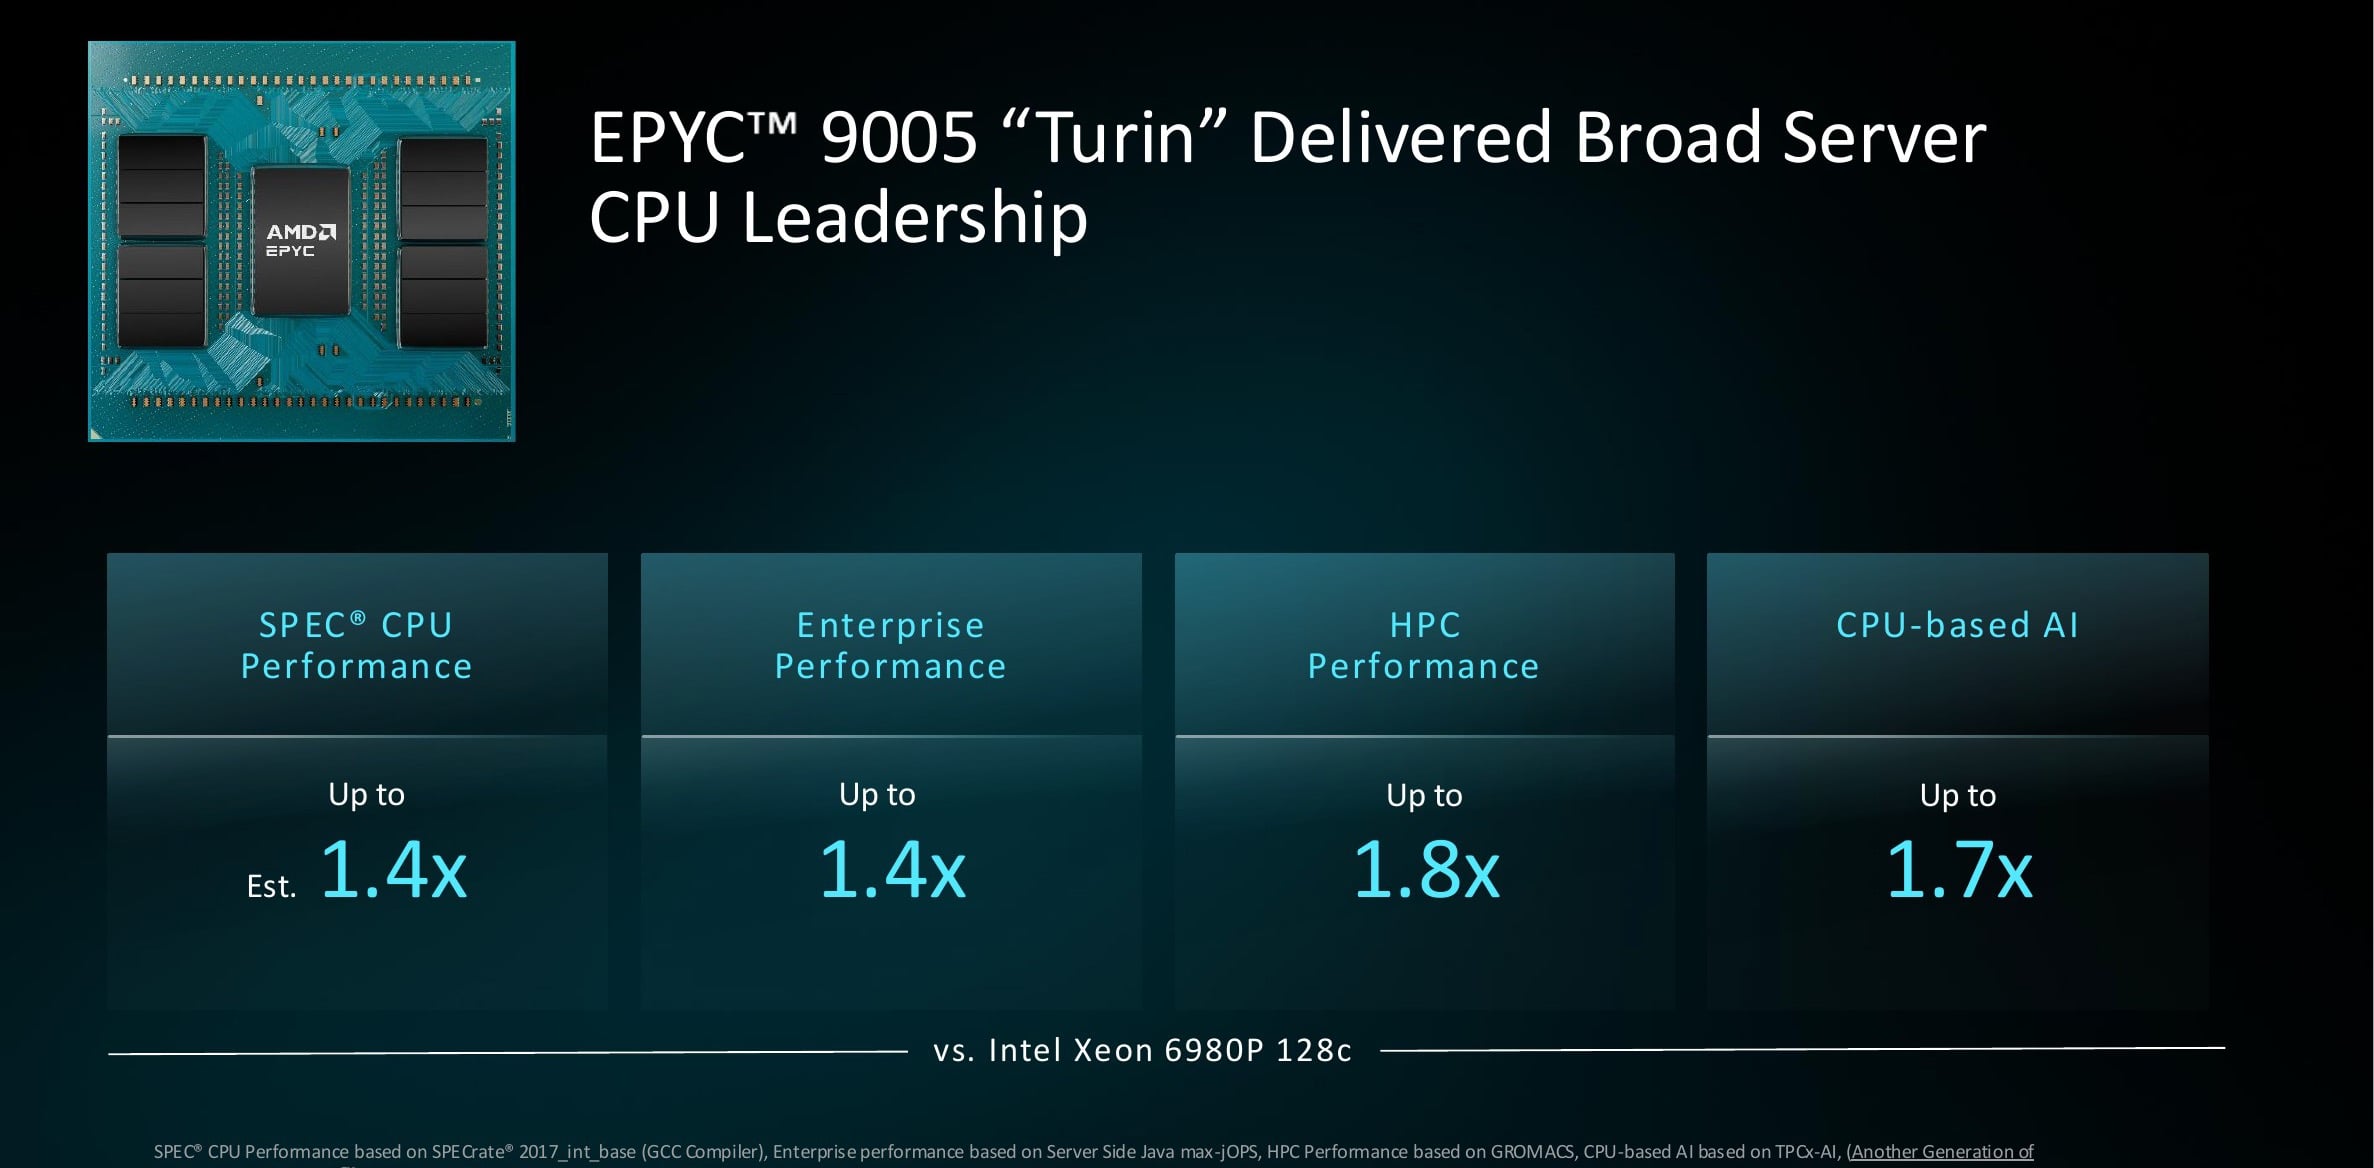
Intelとの比較は、両社がAMDが直接ベンチマークできる部品を出荷しているため、より確固たる根拠に基づいています。TurinのホストCPUは5.0GHzに達しますが、同等のXeonは最大3.9GHzで、シングルスレッドがGPUに供給される場合、28%の周波数優位性が重要になります。128コアのXeon 6980Pとソケットごとに比較すると、AMDはSPEC CPUで最大1.4倍、エンタープライズJavaで1.4倍、HPCで1.8倍、CPUベースのAIで1.7倍のTurinの性能を測定しています。
ヴェネツィアはあらゆるギャップを広げる
Veniceは、これらのリードをさらに拡大しています。同じ100kWラックモデルにおいて、Veraの176コアに対し、Veniceは512コアを搭載し、AMDは汎用性能でVeraの3.3倍の性能を実現したと主張しています。Veniceは、136コアのArm AGIと比較して、1ワットあたりのエージェント数が2.8倍、VeniceがGPUをホストする最先端モデルでは1秒あたりのトークン数が1.8倍となっています。この1.8倍という数値は、見出しが示唆するよりも狭い範囲のシナリオを測定したものであり、これについては後述のホストノードのセクションで改めて説明します。
ヴェラとの直接対決
SPECrate 2026において、AMDは2P Venice 9996の性能を2070と推定しており、Veraの925と比較してスループットは2.2倍優れている。また、96コアの高周波版は、コアあたりでVeraの約1.2倍の性能を発揮するとしている。これらの結果はどちらもGCC 15.2でコンパイルされており、これはNVIDIAがVeraの数値を発表する際に使用したのと同じツールチェーンである。
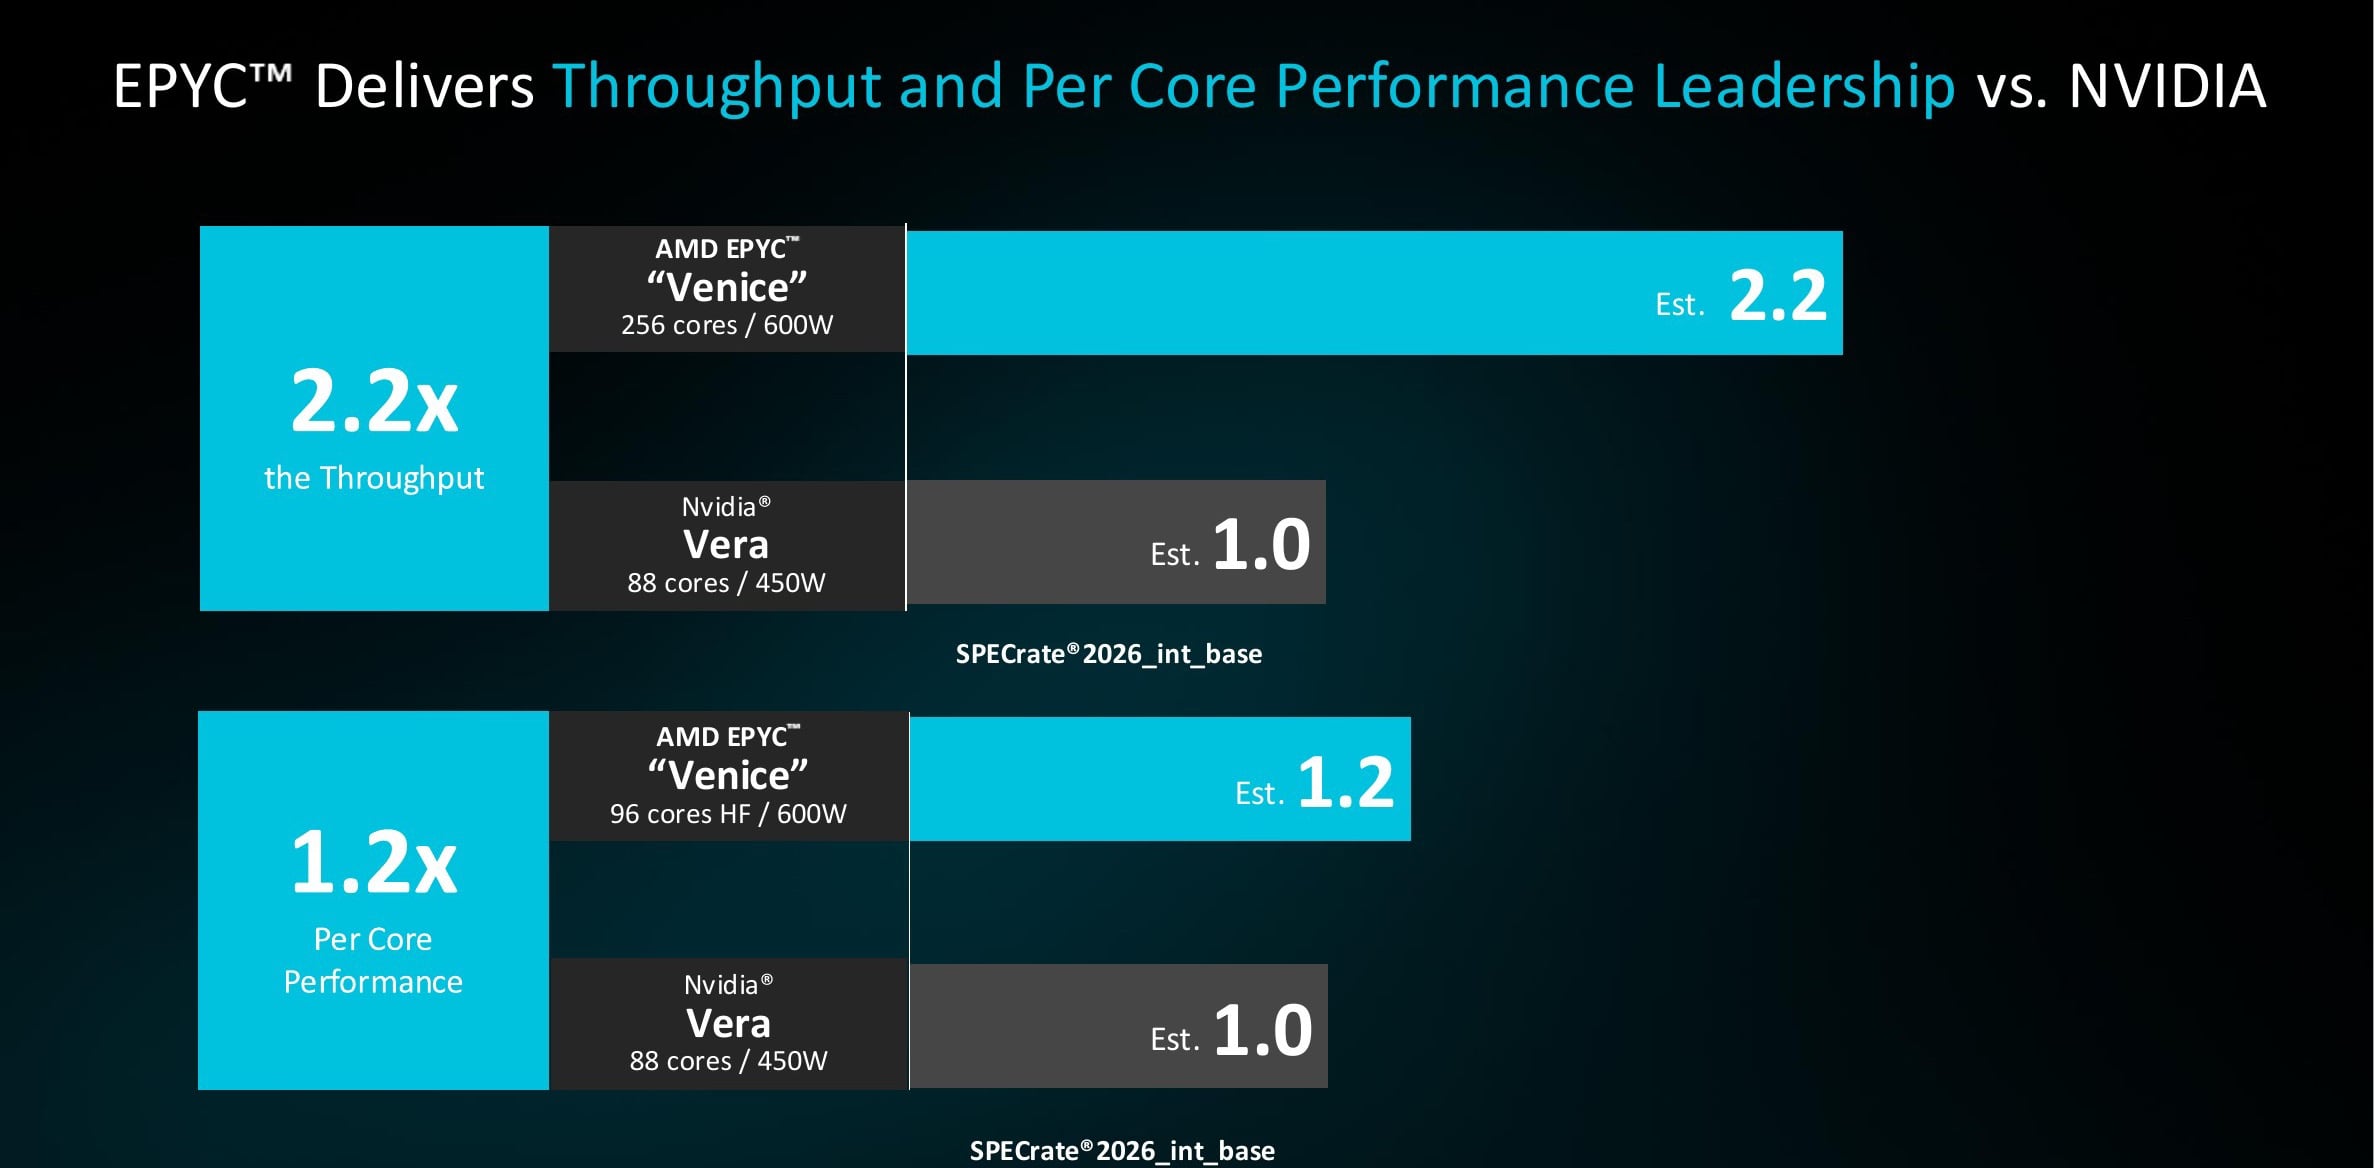
コアあたりの性能に関する主張は、発売週中に実際に拡大した。AMDのCPUエンジニアリングを統括するラヴィ・クップスワミー氏は報道陣に対し、AMDは当初、コアあたり10%の優位性を主張していたと語った。NVIDIAが週初めに独自のVeraの数値を発表した後、NVIDIAのチームは同じコンパイラと設定を使用して比較を再実行し、チューニングがまだ完了していないにもかかわらず20%のリードを計測した。同氏によると、2.2倍のスループットの差は、AMDが当初から社内で予測していた値と一致していた。別の注釈では、AMD独自のAOCCコンパイラを使用してSPECrate 2017のコアあたりの比較を再計算し、1.7倍という結果を得ており、20%の方が2つの計算のうちより控えめな値となっている。
インテルとアーム
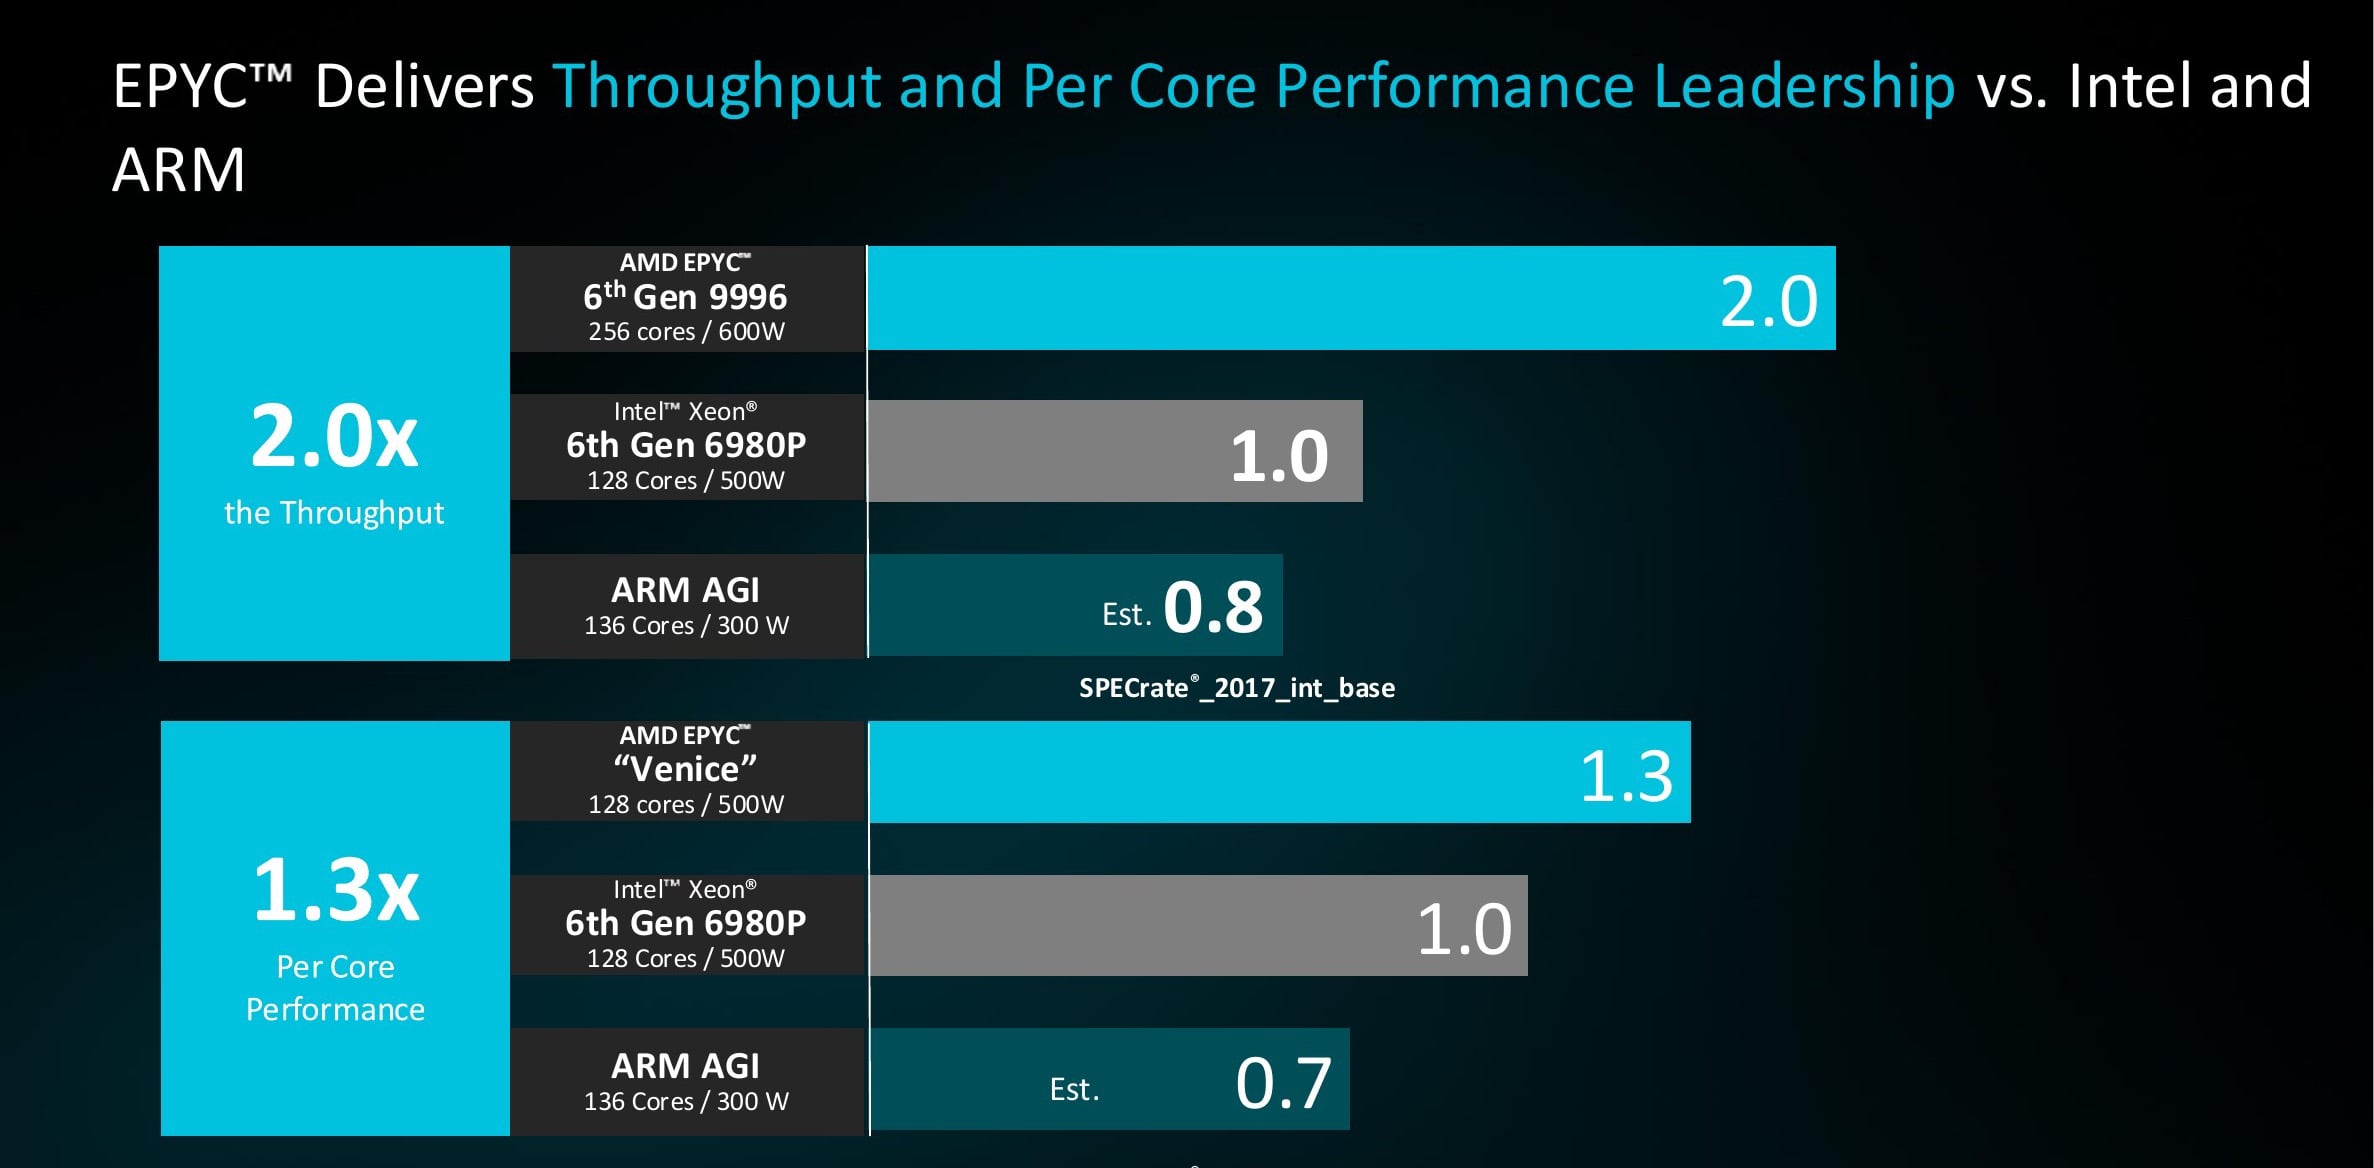
AMDはSPECrate 2017のランキングも幅広く発表した。Venice 9996が4900(256コア、600W、1Kuで14,904ドル)でトップ、続いてTurin 9965が3240、IntelのXeon 6980Pが2510(128コア、500W、13,955ドル)、Arm AGIが1944(136コア、300W)、Veraが1459となっている。9996、AGI、Veraの数値はAMDの推定値であり、TurinとIntelのスコアは公表された結果である。Intelと比較すると、同等の定価でスループットが約2倍、つまり1ドルあたりの性能が2倍になる計算だ。コアあたりのスコアで見ると、128コア、500WのVenice構成は6980Pの1.3倍、Arm AGIは0.7倍となっています。上記のVeraの比較とは異なり、ここでは各ベンダーのスコアは、AMDの場合はAOCC、Intelの場合はOneAPI、Armの場合はGCC 13という、それぞれの最適なツールチェーンを使用して算出されています。
クラウドネイティブとHPC
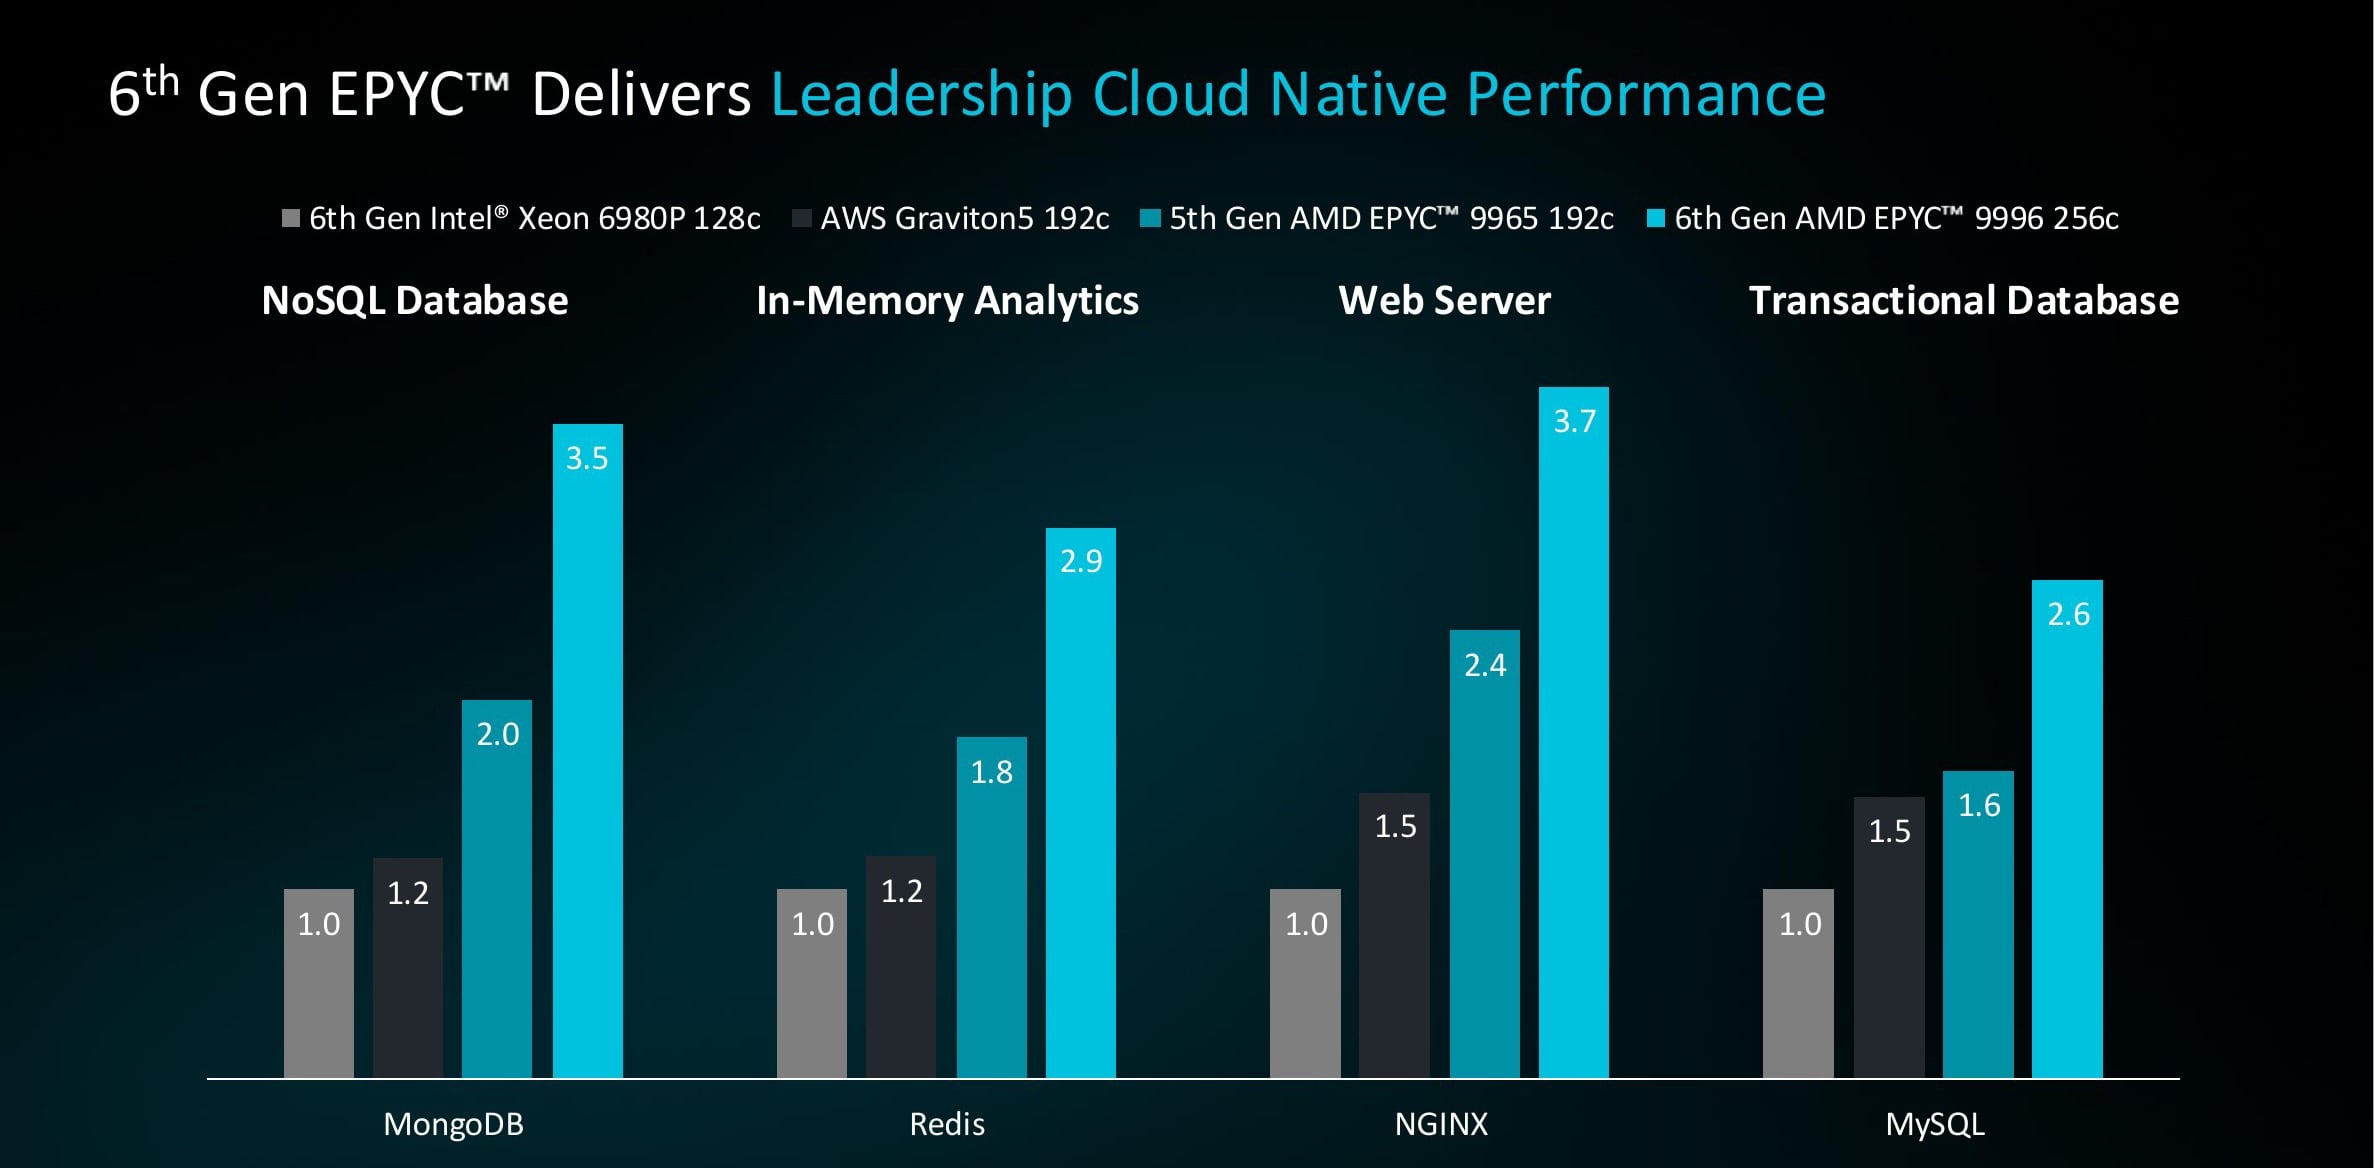
AMDはワークロード別に比較結果を細分化し、すべての結果をIntelの6980Pを1.0としてインデックス化しました。クラウドネイティブ側では、256コアのVenice 9996がMongoDBで3.5倍、Redisで2.9倍、NGINXで3.7倍、MySQLで2.6倍の性能を発揮しました。Turinは同じテストで1.6倍から2.4倍、Graviton5は1.2倍から1.5倍の性能を示しました。
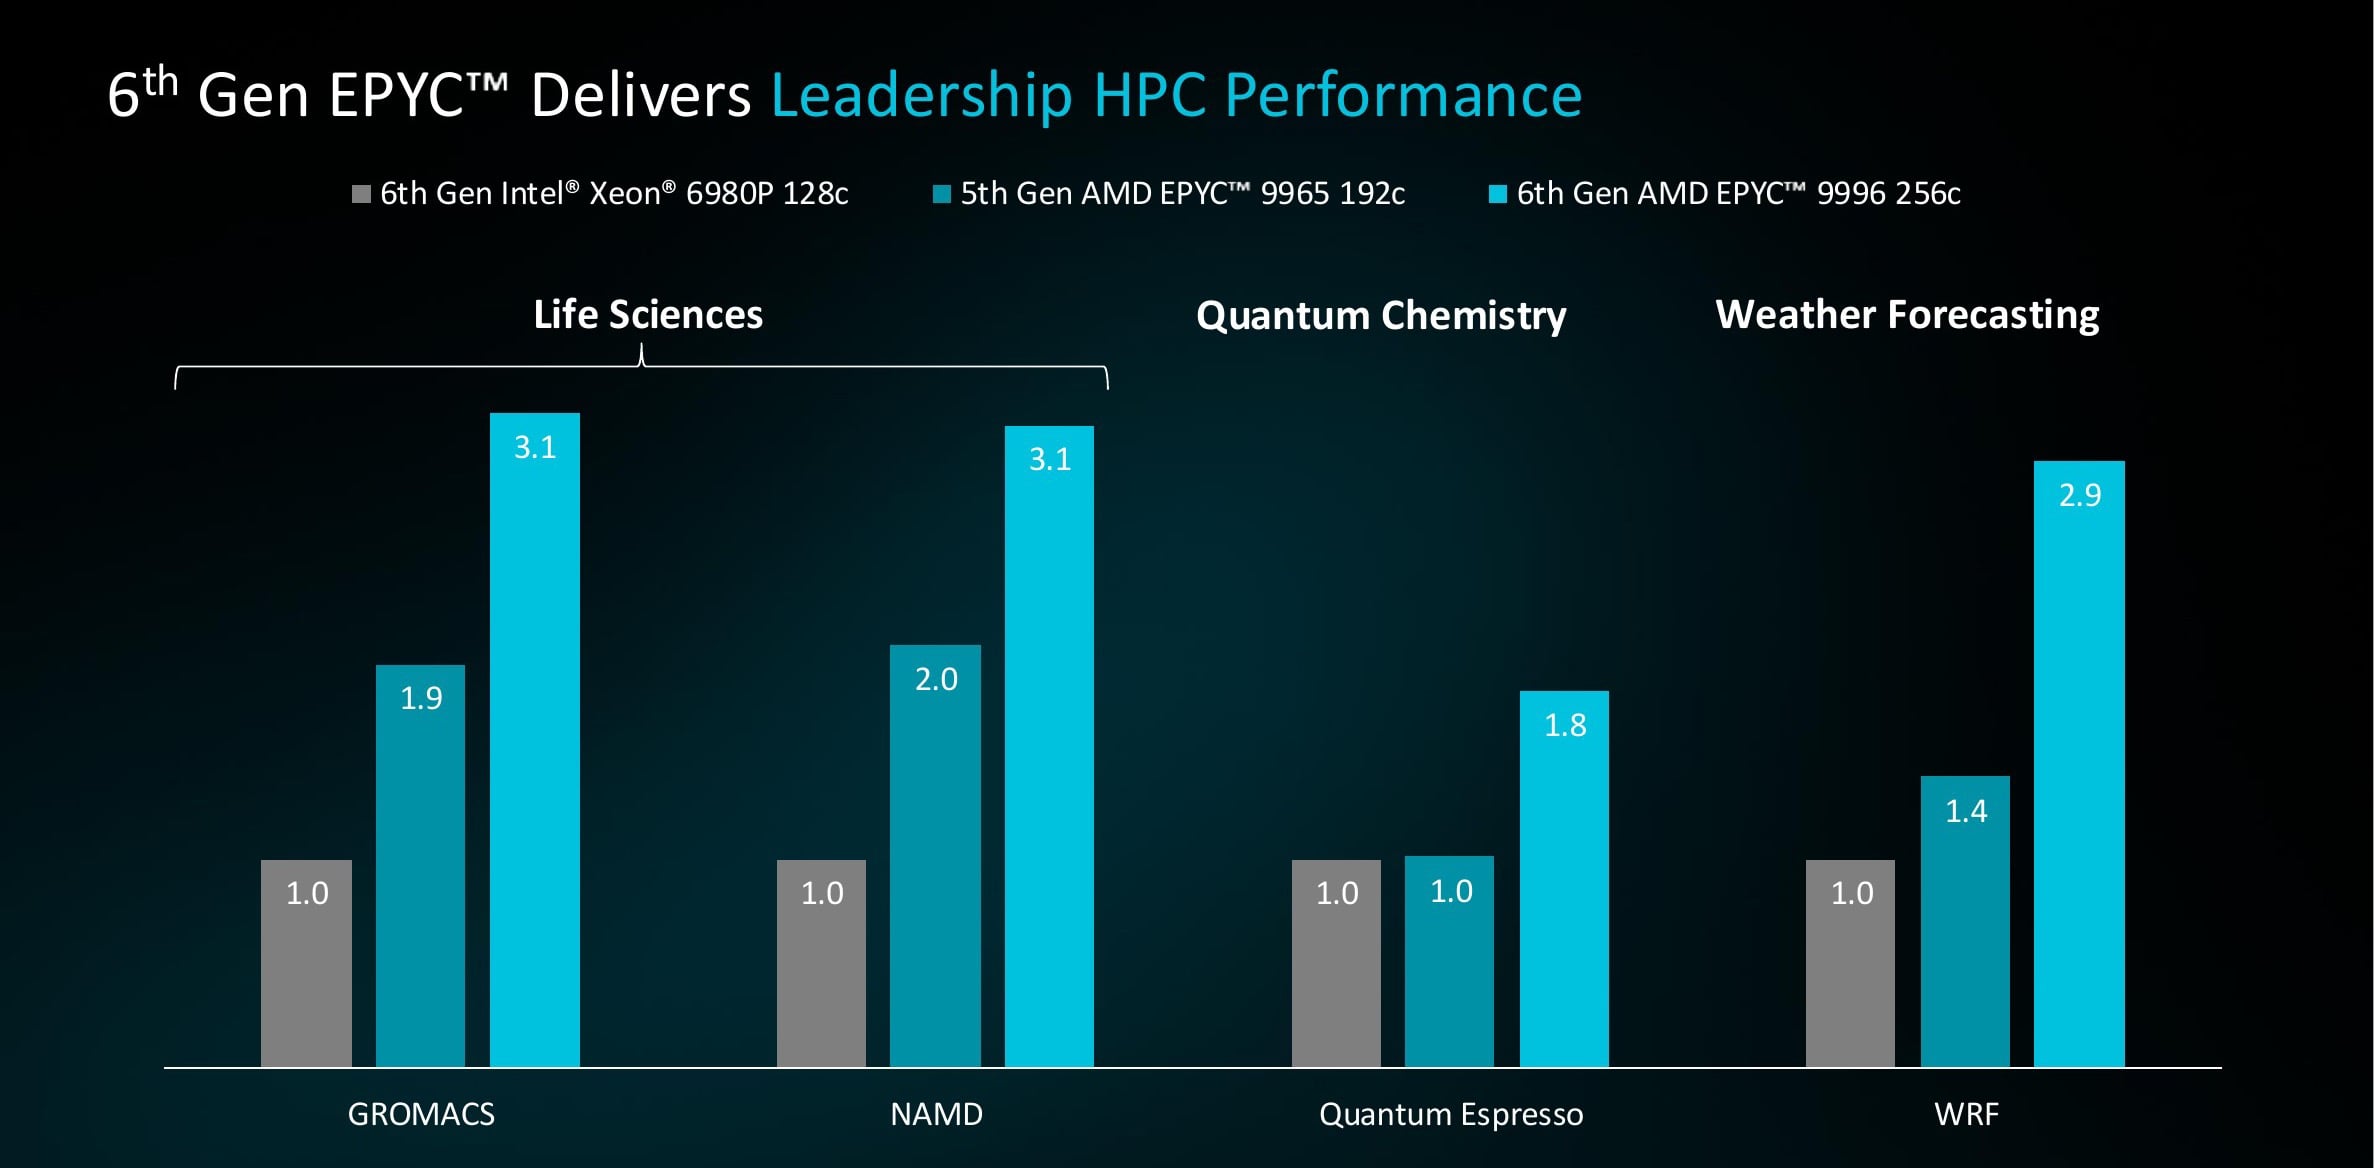
HPC では、Venice は GROMACS と NAMD で 3.1 倍、WRF で 2.9 倍、Quantum Espresso で 1.8 倍のスコアを獲得しています。メモリ構成によってこれらの数値は大きく変わります。標準の 8,000 MT/s RDIMM を使用した場合、Venice は GROMACS で Xeon ベースラインの 2.81 倍のスコアを獲得します。12,800 MT/s MRDIMM を使用すると、スコアは 3.13 倍に上昇し、同じアップグレードにより WRF は 2.25 倍から 2.90 倍に上昇します。AMD は、ワークロードとメモリによって HPC での優位性が 1.8 倍から 3.5 倍まで変化するとまとめています。Intel ベースラインは 8,800 MT/s MRDIMM で動作していたため、この差は、アップグレードされた AMD メモリと低速な Intel 構成の組み合わせによるものではありません。
ホストノードと1.8倍の主張
ここで、1秒あたり1.8倍のトークン処理能力という主張に戻ります。その背後にあるハードウェアの改良点は簡単に列挙できます。5GHzのホスト部分は64コアから96コアに増え、ホストメモリの帯域幅は614GB/sから1.6TB/sに向上し、PCIe Gen 6によってCPUとGPU間のリンクの帯域幅が2倍になっています。
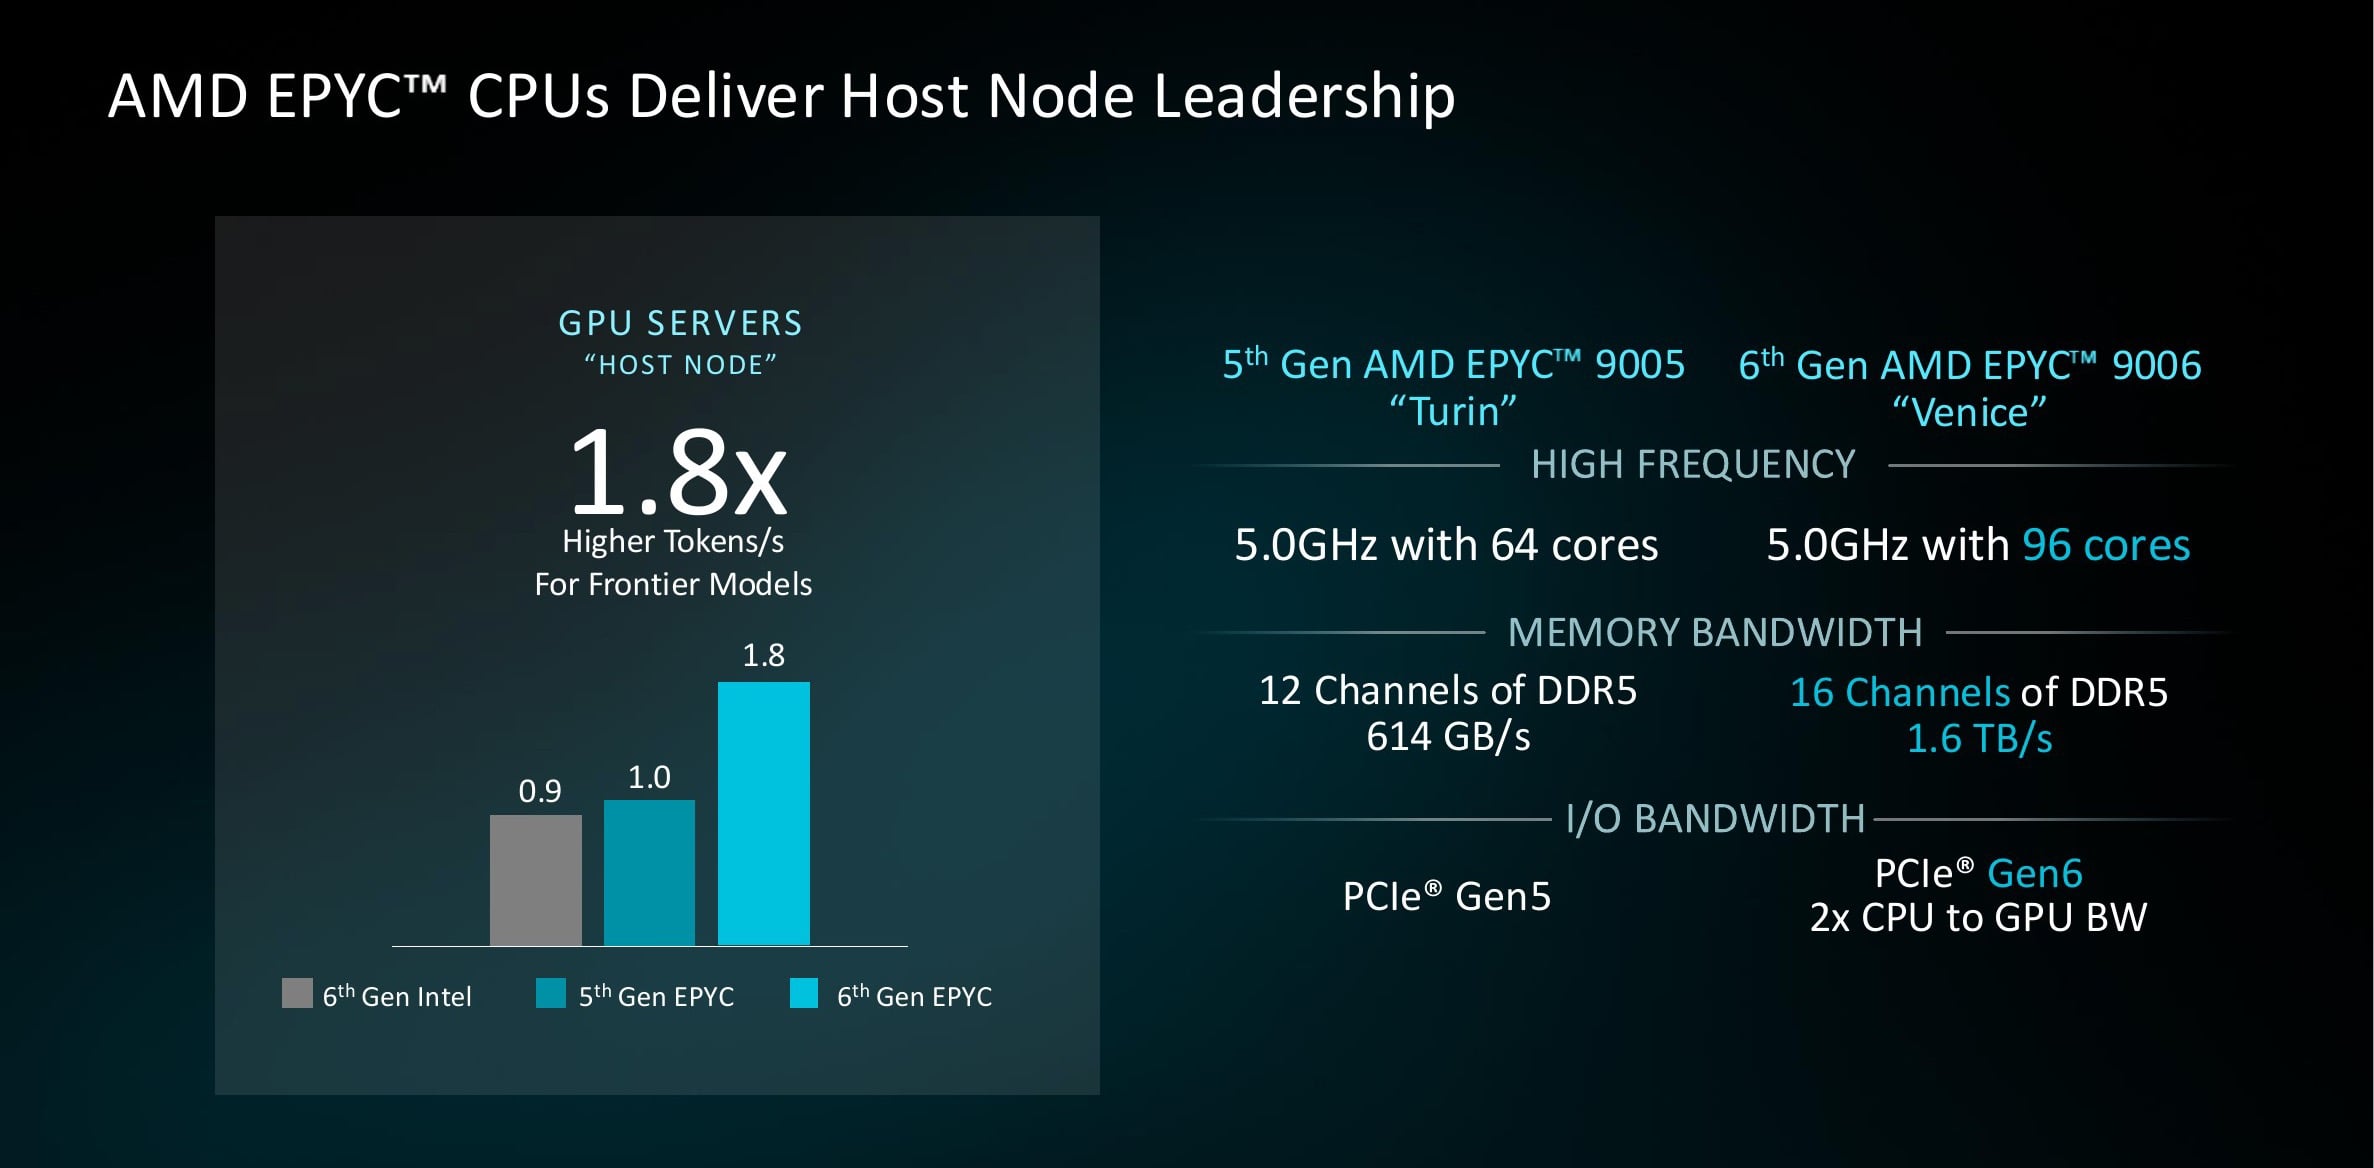
まず最初に確認すべきはベースラインです。AMD はこのチャートを Intel ではなく Turin を 1.0 としてインデックス化し、第 6 世代 Xeon を 0.9 に設定しました。そのため、同じ主張を Xeon 6960P と比較すると 2 倍近くになります。予測されるゲインはほぼすべて I/O 帯域幅によるものです。AMD は、Qwen3-30B の BF16 ウェイトをホスト メモリから GPU にストリーミングする CPU オフロード テストを実行し、PCIe Gen 5 x16 受信パスが理論上の上限の 89% ~ 95% で動作しているのに対し、ホスト DRAM の読み取りは理論上の上限の 10% 未満にとどまっていることを発見しました。デコード速度は転送によって制限されていたため、PCIe Gen 6 でリンクを 2 倍にすると、このテストで 1.8 倍 ~ 1.9 倍の改善が得られます。現在、アクセラレータに PCIe Gen 6 を提供するサーバー CPU は Venice だけなので、この利点は現実のものであり、今のところ独占的なものです。ただし、その適用範囲は限定的です。1.8X は帯域幅が制限されるオフロードパターンの 1 つを説明するものであり、Venice ホスト上で GPU がすべてのモデルを 1.8 倍高速に処理するという約束として解釈すべきではありません。現在出荷されているハードウェアでは、同じ 8X B200 システム上で、Turin ホストは、vLLM および NIM ワークロード全体で最初のトークンまでの時間において Xeon 6960P を幾何平均で 13% 上回り、最良の場合には 36% の改善が見られます。
ラック密度
最後の主張は密度に関するもので、ラック1つあたりヴェネツィアの芯は49,152本であるのに対し、トリノは36,864本、ヴェラは22,528本であり、各パーツには芯の2倍の数の糸が通っている。この資料に記載されている主張の中で、注釈を適用すると最も大きく変わるのがこの主張である。
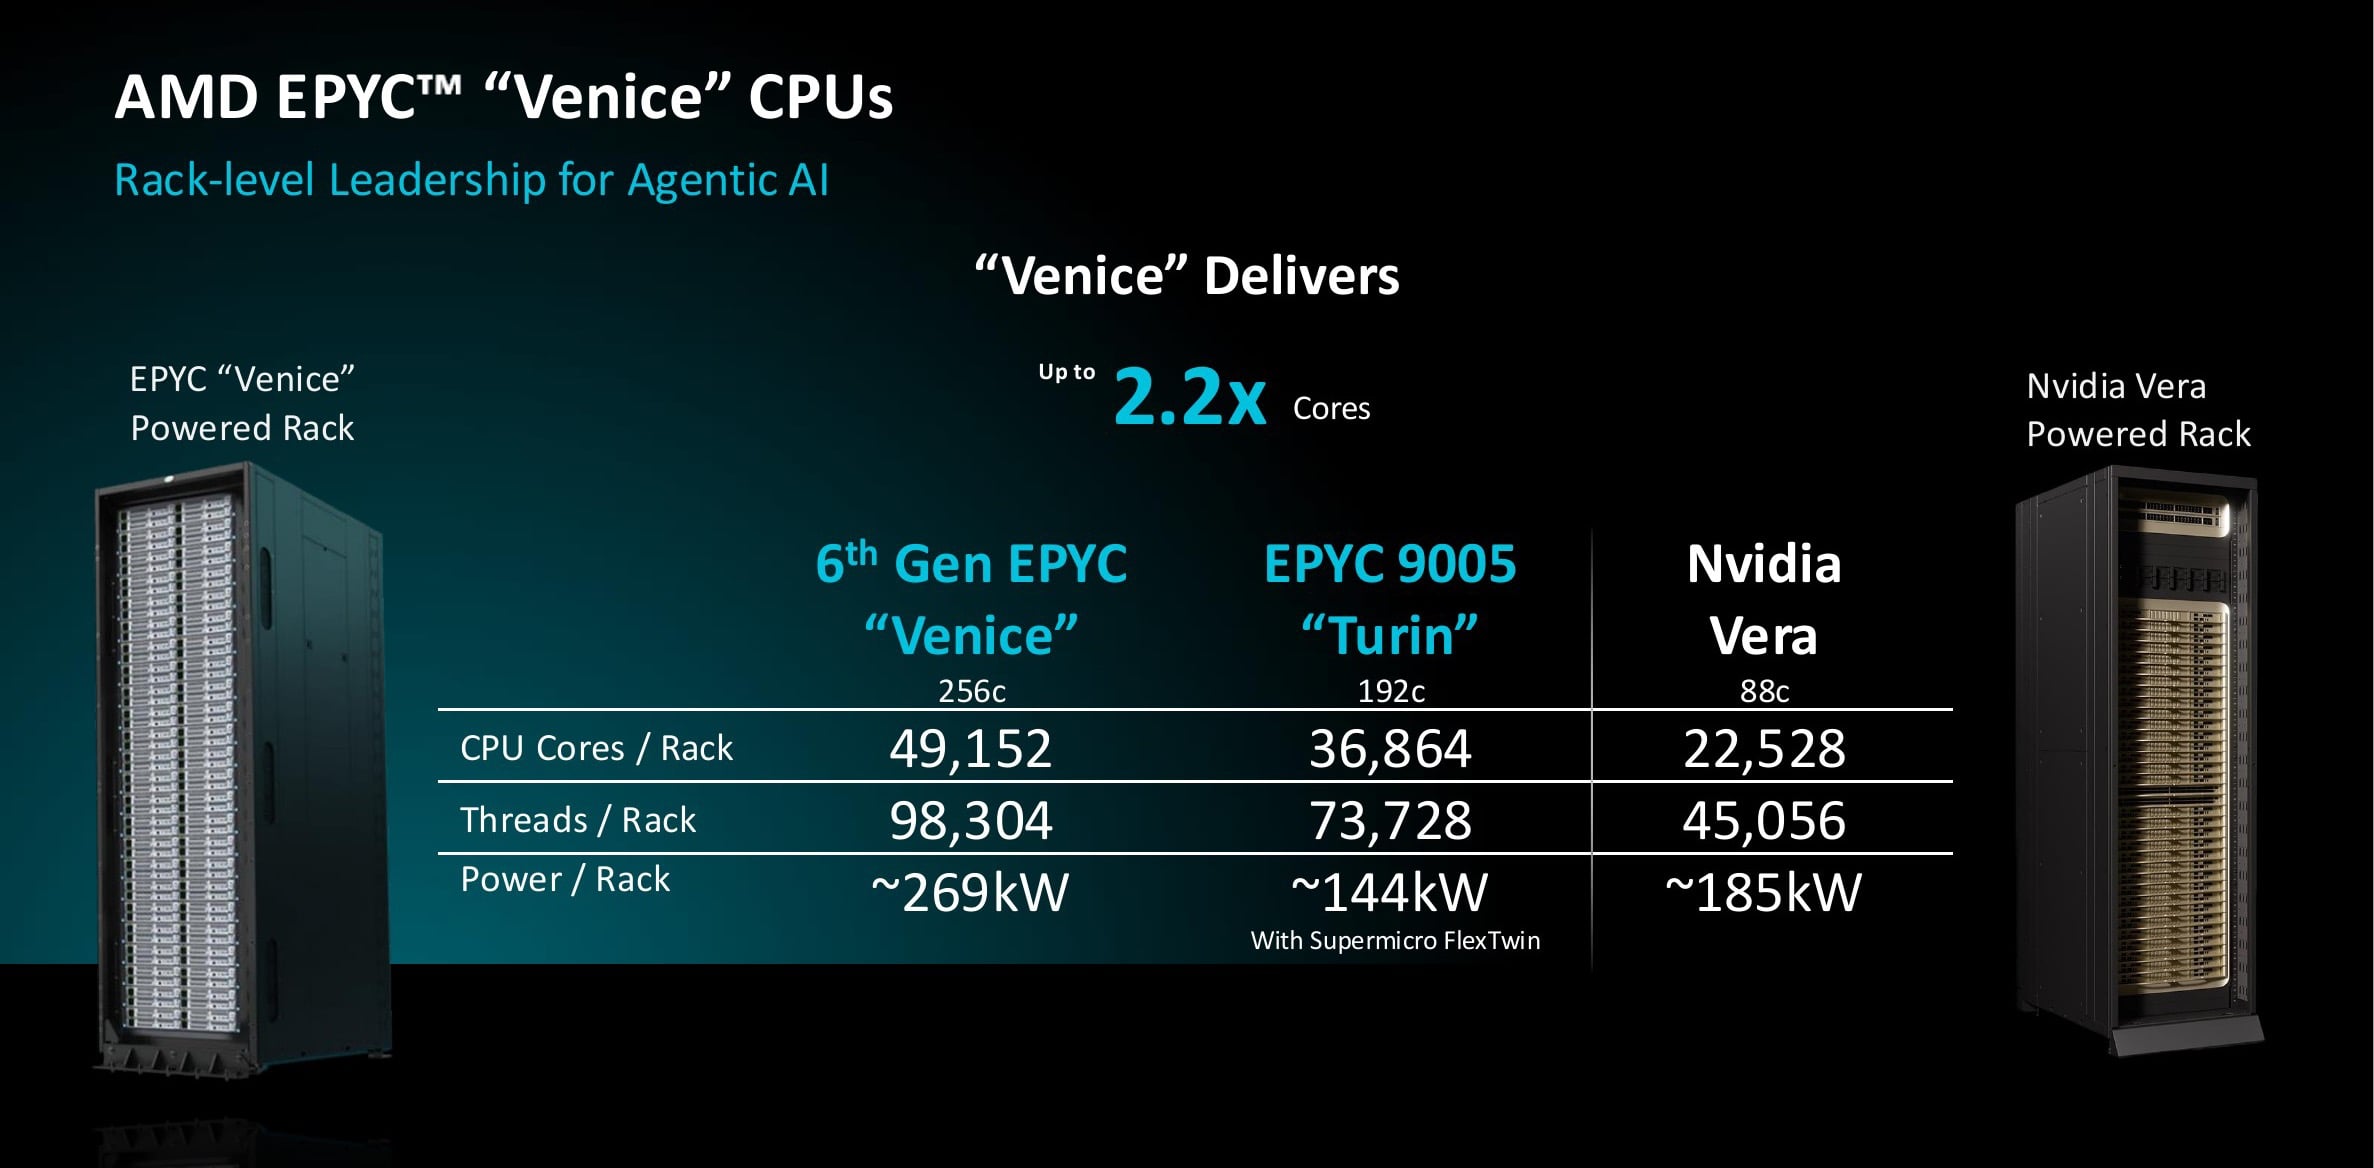
見出しは Vera の 2.2 倍のコアですが、Venice ラックは Vera の 185kW に対して 269kW の電力を消費してこの値に達しているため、2 つのラックは電力を一致させた状態で比較されていません。AMD の注釈には正規化されたバージョンが記載されています。両方のラックを 100kW の制約内に収めると、9996 は Vera の 2.08 倍、Turin の 1.86 倍、Intel の 6980P の 1.24 倍のコアを提供します。フラッグシップの代わりに 400W の EPYC 9956 を使用すると、AMD は 26% 少ない電力で Vera の 1.91 倍のコアを推定し、結果としてラック ワットあたり 2.57 倍のコアになります。どの電力予算を固定するかによって、リードは 1.9 倍から 2.2 倍の間になります。また、この記事のすべての Vera の数値と同様に、NVIDIA ラックは測定されたハードウェアではなく、公開されている仕様に基づいてモデル化されています。密度の優位性は正規化後も維持されるが、単に2.2倍という見出しほどの差ではないというだけだ。
いじめっ子
個々の主張はさておき、サーバーCPU市場の最上位では、AMDには現在直接のライバルはいない。Intelの最高性能は、AMDが既に置き換えている世代であるTurinに劣る。Armの競合製品は、AMDが示したすべてのチャートでTurinより下位に位置している。Veraはまだ出荷されておらず、AMDの見積もりでは、そのスループットは1年半前に市場に出たTurin 9965の半分以下であり、VeniceはTurinのスループットを再び約2倍にしている。Mercury Researchによると、この地位によりAMDはサーバーCPU売上高の46%を占めている。市場の証拠も同様の方向を示している。現在、最上位EPYC部品の需要は供給を上回っており、その結果、リードタイムが長くなっている。
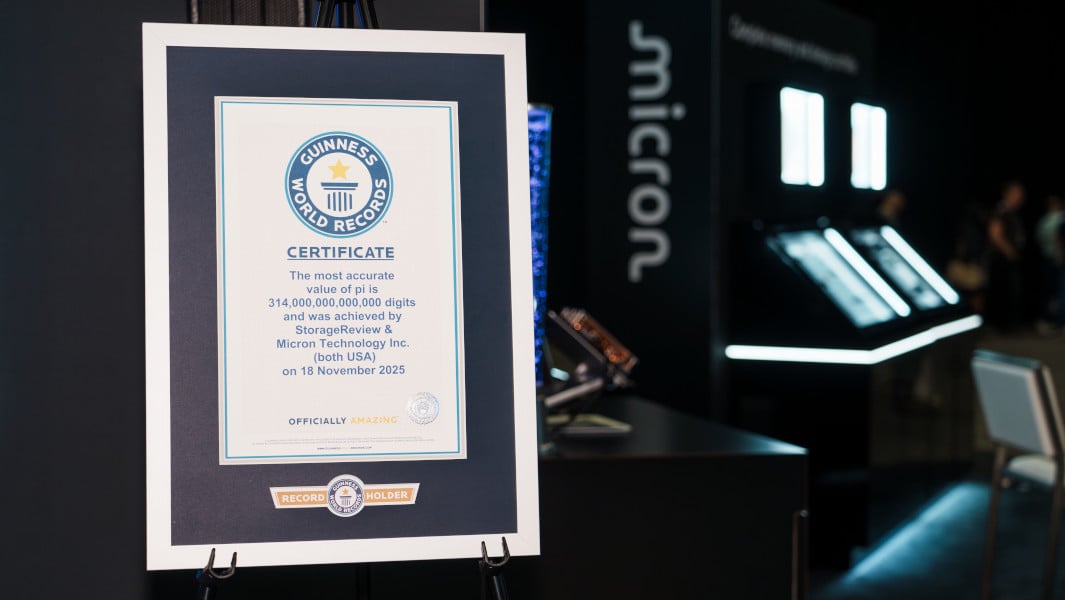
ここで、我々のデータポイントを追加できます。我々が達成した314兆桁の円周率の世界記録は、 2基の192コアEPYC 9965と1.5TBのDDR5を搭載したDell PowerEdge R7725で実行されました。これは、AMDがTurinラックのモデルとした384コア2P構成と同じです。計算は110日間すべてのコアに負荷をかけ続け、1秒たりともダウンタイムなく完了しました。途中でメモリエラーやクラッシュが1つでも発生すれば、試みは失敗に終わっていたでしょう。平均消費電力は約1,600Wで、実行全体で4,305kWh、つまり1兆桁あたり13.7kWhを消費しました。これは、以前の300兆桁の記録で約225日間で推定33,600kWhを消費したのと比較すると大幅に少ない値です。
結論
Veniceは、AMDがこれまで開催した中で最も強力なサーバーCPUの発表会であり、その真のテーマは製品ラインナップの幅広さにある。Zen 6の1世代は、256コア密度の製品からエンタープライズソケット、1152MBスタックキャッシュHPCチップ、LPDDRホストノードまでを網羅しており、顧客は同じアーキテクチャとソフトウェアベースでデータセンターのあらゆる階層を構築できる。発表会の基盤となる数値は、注釈を読めば納得できる。同等の定価でIntelの約2倍のスループット、同じコンパイラでVeraをコアあたり20%上回る性能、そして電力消費量に応じてNVIDIAのホストCPUの1.9倍から2.2倍のラック密度を実現している。
商業面に関しては予測は不要でしょう。SP7は現在生産中で、パートナープラットフォームは第4四半期に登場予定です。SP8は2027年前半に登場し、その後にはVenice-XとVeranoが続きます。これらの製品を販売する同社は既にサーバーCPU売上高の46%を占めており、現在の製品の需要は供給をはるかに上回っているため、顧客は他社製品に乗り換えるよりも順番待ちをしています。Veniceの発売が1年遅れたとしても、この記事での比較は依然としてリーダーシップを示すものとなるでしょう。なぜなら、Turinは既に出荷済みか未出荷かを問わず、チャート上の他のすべての製品を上回っているからです。AMDはあまりにも先行しているため、現時点で最も近い競合製品は自社の前世代製品です。


 Amazon