

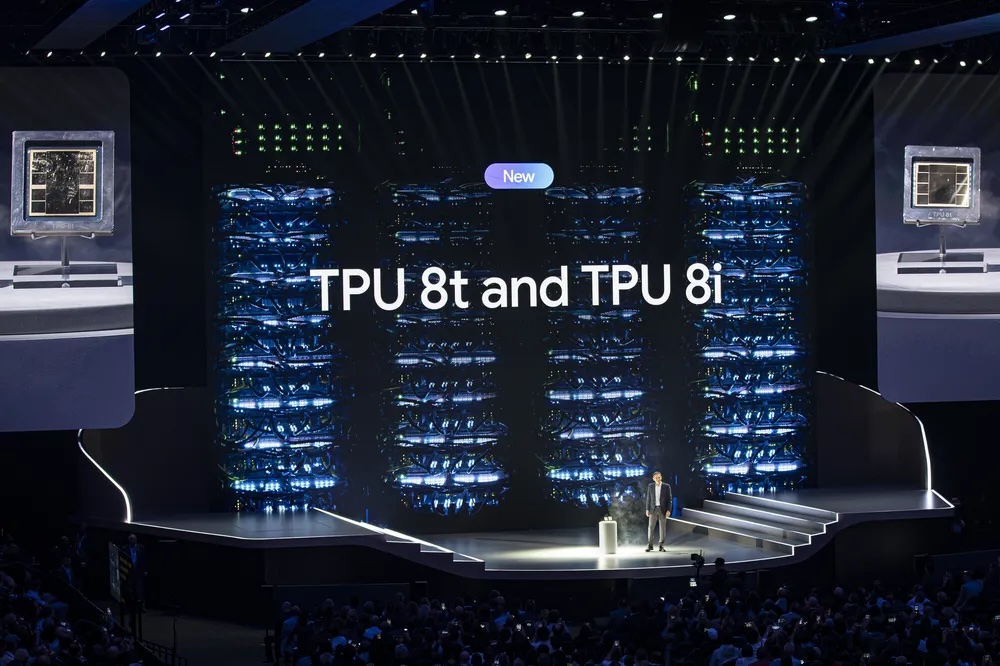
Google Cloud Next で、Google は次世代 AI アクセラレータを発表しました。トレーニング用の TPU 8t「Sunfish」と推論用の TPU 8i「Zebrafish」、そして新しい Virgo データセンター ファブリックです。Google のブログ記事から、これらのチップが「エージェント時代」に最適化されていることは明らかです。つまり、数十万個のチップ規模で最先端の混合エキスパート モデルをトレーニングし、同じモデルを低レイテンシと積極的なトークンあたりの価格目標で提供します。8t と 8i は、ホスト プラットフォームとファブリックを共有するものの、メモリ容量、オン チップ SRAM、相互接続トポロジ、オン ダイの特殊化が異なる、アーキテクチャ的に異なる 2 つのチップです。8t は大規模な密行列乗算 (matmul) 用に設計されていますが、8i はシリコン上の KV キャッシュとトークンごとの集合的レイテンシを中心に設計されています。
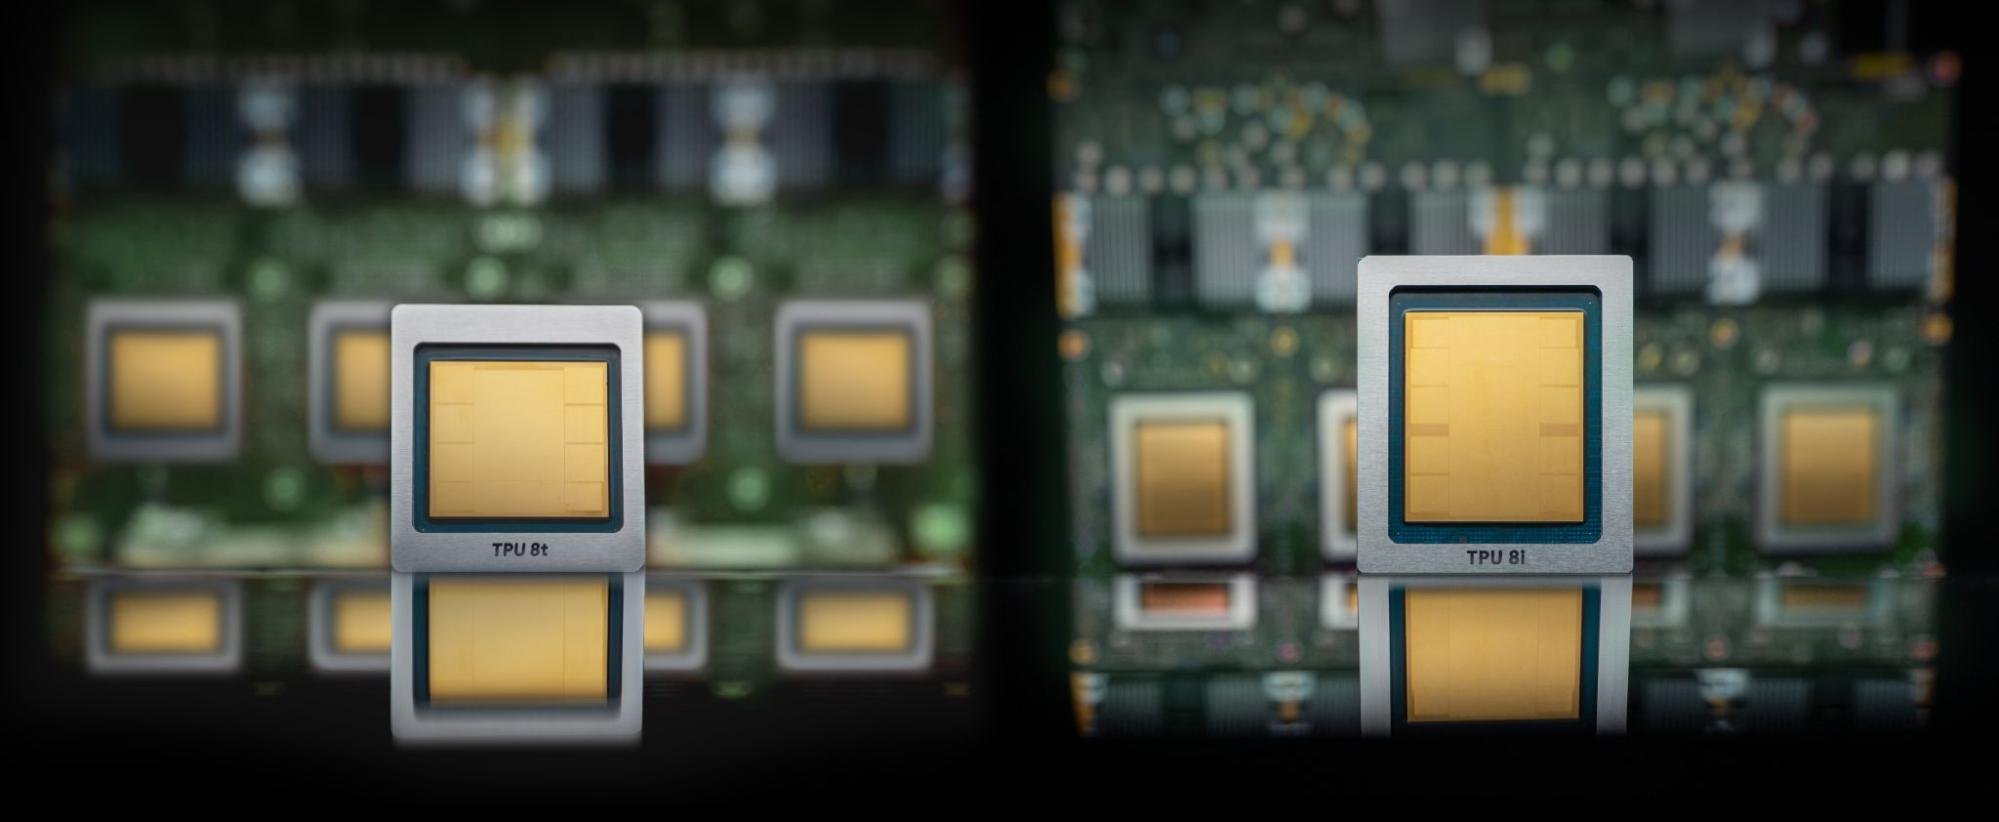
単一の 8t スーパーポッドは 9,600 チップまで拡張可能で、2 PB の HBM を搭載し、121 EFLOPS の FP4 演算能力を実現。これは Ironwood スーパーポッドのポッドあたりの演算能力の約 3 倍です。8i は 1,152 チップのスケールアップ領域内で 288 GB の HBM と 384 MB のオンチップ SRAM (Ironwood の 3 倍) を組み合わせ、LLM 推論において Ironwood より 80% 優れたコストパフォーマンスを実現しています。Virgo は、両方のチップ ファミリーを単一のデータ センター ファブリックに統合し、134,000 個を超える 8t チップを 47 Pb/s のノンブロッキング バイセクション帯域幅で接続。アクセラレータあたりの帯域幅は前世代より最大 4 倍、アンロード レイテンシは 40% 低くなっています。
TPUとは一体何なのか
8つのシリコンについて説明する前に、TPUとは何か、そしてGPUとどのように異なるのかについて少し背景知識を述べておきましょう。なぜなら、8つの設計上の決定は、その背景を理解した上で初めて意味を持つからです。
テンソル処理ユニット(TPU)は、Googleが2015年から改良を重ねてきたカスタムASICです。どの世代も同じコアアイデアに基づいて構築されています。GPUのように数千個の小さなコアを動的にスケジューリングするのではなく、TPUは少数の非常に大きなMXU(行列乗算ユニット)を中心に構成され、オンチップのソフトウェア管理SRAMスクラッチパッドからデータを受け取り、事前コンパイラによって駆動されます。各チップには、それぞれ1つの大きなシストリックアレイMXUを中心に構築された少数のTensorCoreと、レコメンデーション埋め込みで支配的な不規則なギャザー・スキャッター検索専用の少数のSparseCoreが搭載されています。データはHBMからスクラッチパッド、MXU、スクラッチパッドへと流れ、ベクトル処理ユニット(VPU)がアクティベーション、正規化、および削減処理を並行して行います。ハードウェアワープスケジューラはなく、GPUのようなL1またはL2キャッシュ階層も、動的ディスパッチもありません。
この設計の利点は、密な線形代数における効率性です。コンパイラがすべてのテンソルの格納場所とすべての集合演算の発火タイミングを事前に決定するため、キャッシュミスによるジッターやワープスケジューラの負荷がなく、数万個のチップが集合演算を通じて同期を保つ必要がある場合には、その重要性は想像以上に高まります。適切に調整されたトレーニングワークロードの場合、TPU での実世界のモデル FLOP 利用率は、従来の GPU よりも高くなる傾向があります。欠点は、大きな密な行列乗算にきれいにマッピングできないもの、特に動的な形状、不規則な疎性パターン、トークン分布が不均一な MoE ルーティング、またはグラフニューラルネットワークは、効率的に表現するのが難しいことです。また、TPU は、従来、チップあたりの HBM 容量が GPU よりも少なく、フレームワークのサポート範囲もはるかに狭くなっています。XLA と JAX はファーストクラスですが、PyTorch は最近まで変換レイヤーを必要としていました。さらに、コンパイラ、ランタイム、ネットワークライブラリ、マルチポッドソフトウェアスタックは、Google 内でクローズドソースのままです。
スパース性は、GPUとTPUの間の哲学的なギャップを最も明確に示す例であり、その理由はマーケティングではなく構造的なものです。NVIDIAはAmpere以降、Tensor Coreで2:4構造のスパース性をサポートしており、理論上、スパースワークロードのパフォーマンスは密なワークロードの2倍です。Tensor Coreは基本的にディスパッチユニットであり、MMA命令ごとに明示的なオペランドロードを受け取ります。そのため、圧縮された2-out-of-4ブロックとインデックスメタデータを受け入れるスパースMMAバリアントを追加することは、既存の命令セットの単純な拡張です。各サイクルで、ハードウェアはゼロ以外の値とそのインデックスのみを乗算器配列に取り込み、ゼロは暗黙的にスキップします。
シストリックアレイはこれとは逆の動作をします。各PE(処理要素)は毎サイクル演算を行い、オペランドはレジスタ間を直接パスしてPE間を同期的に流れます。この決定論的なデータフローこそが、SIMTに対する電力効率の優位性、すなわちSRAMの繰り返し読み出しがなく、命令ディスパッチのオーバーヘッドがなく、オペランドの再利用が最大限に高まる理由です。しかし、これは同時に、パイプラインを中断することなく、ハードウェアが毎サイクルでゼロ値の要素をスキップできないことを意味します。

出典:グーグル
TPU はタイルレベルでスパース性を利用できます。MXU サイズのタイル全体がすべてゼロの場合、コンパイラはそれに対して処理をスケジュールしません。しかし、Google が構造化スパース性のためのハードウェア アクセラレーションを追加しないという選択は意図的なものです。シストリック アレイに M:N 構造化スパース性を追加するには、それぞれ異なるトレードオフを持つ複数の手法を使用できます。そのような手法の 1 つは、SRAM とアレイの入力ポートの間に圧縮ユニットを配置する必要があります。しかし、シストリック アレイはパイプラインであり、ディスパッチャではありません。その効率性は、オペランドが決定論的なリズムで到着し、すべての処理要素が毎サイクルビジーになることによって保証されます。オペランドをスキップできるようにすると、2 つのコストのいずれかが発生します。ゼロでパイプラインを停止させると、そもそもこのアーキテクチャの動機となった効率性の利点が失われます。または、専用のデコンプレッサ ハードウェアを追加して、圧縮された入力から全幅ストリームを再構築してからアレイに入力すると、ダイ面積が消費され、レイテンシが増加します。
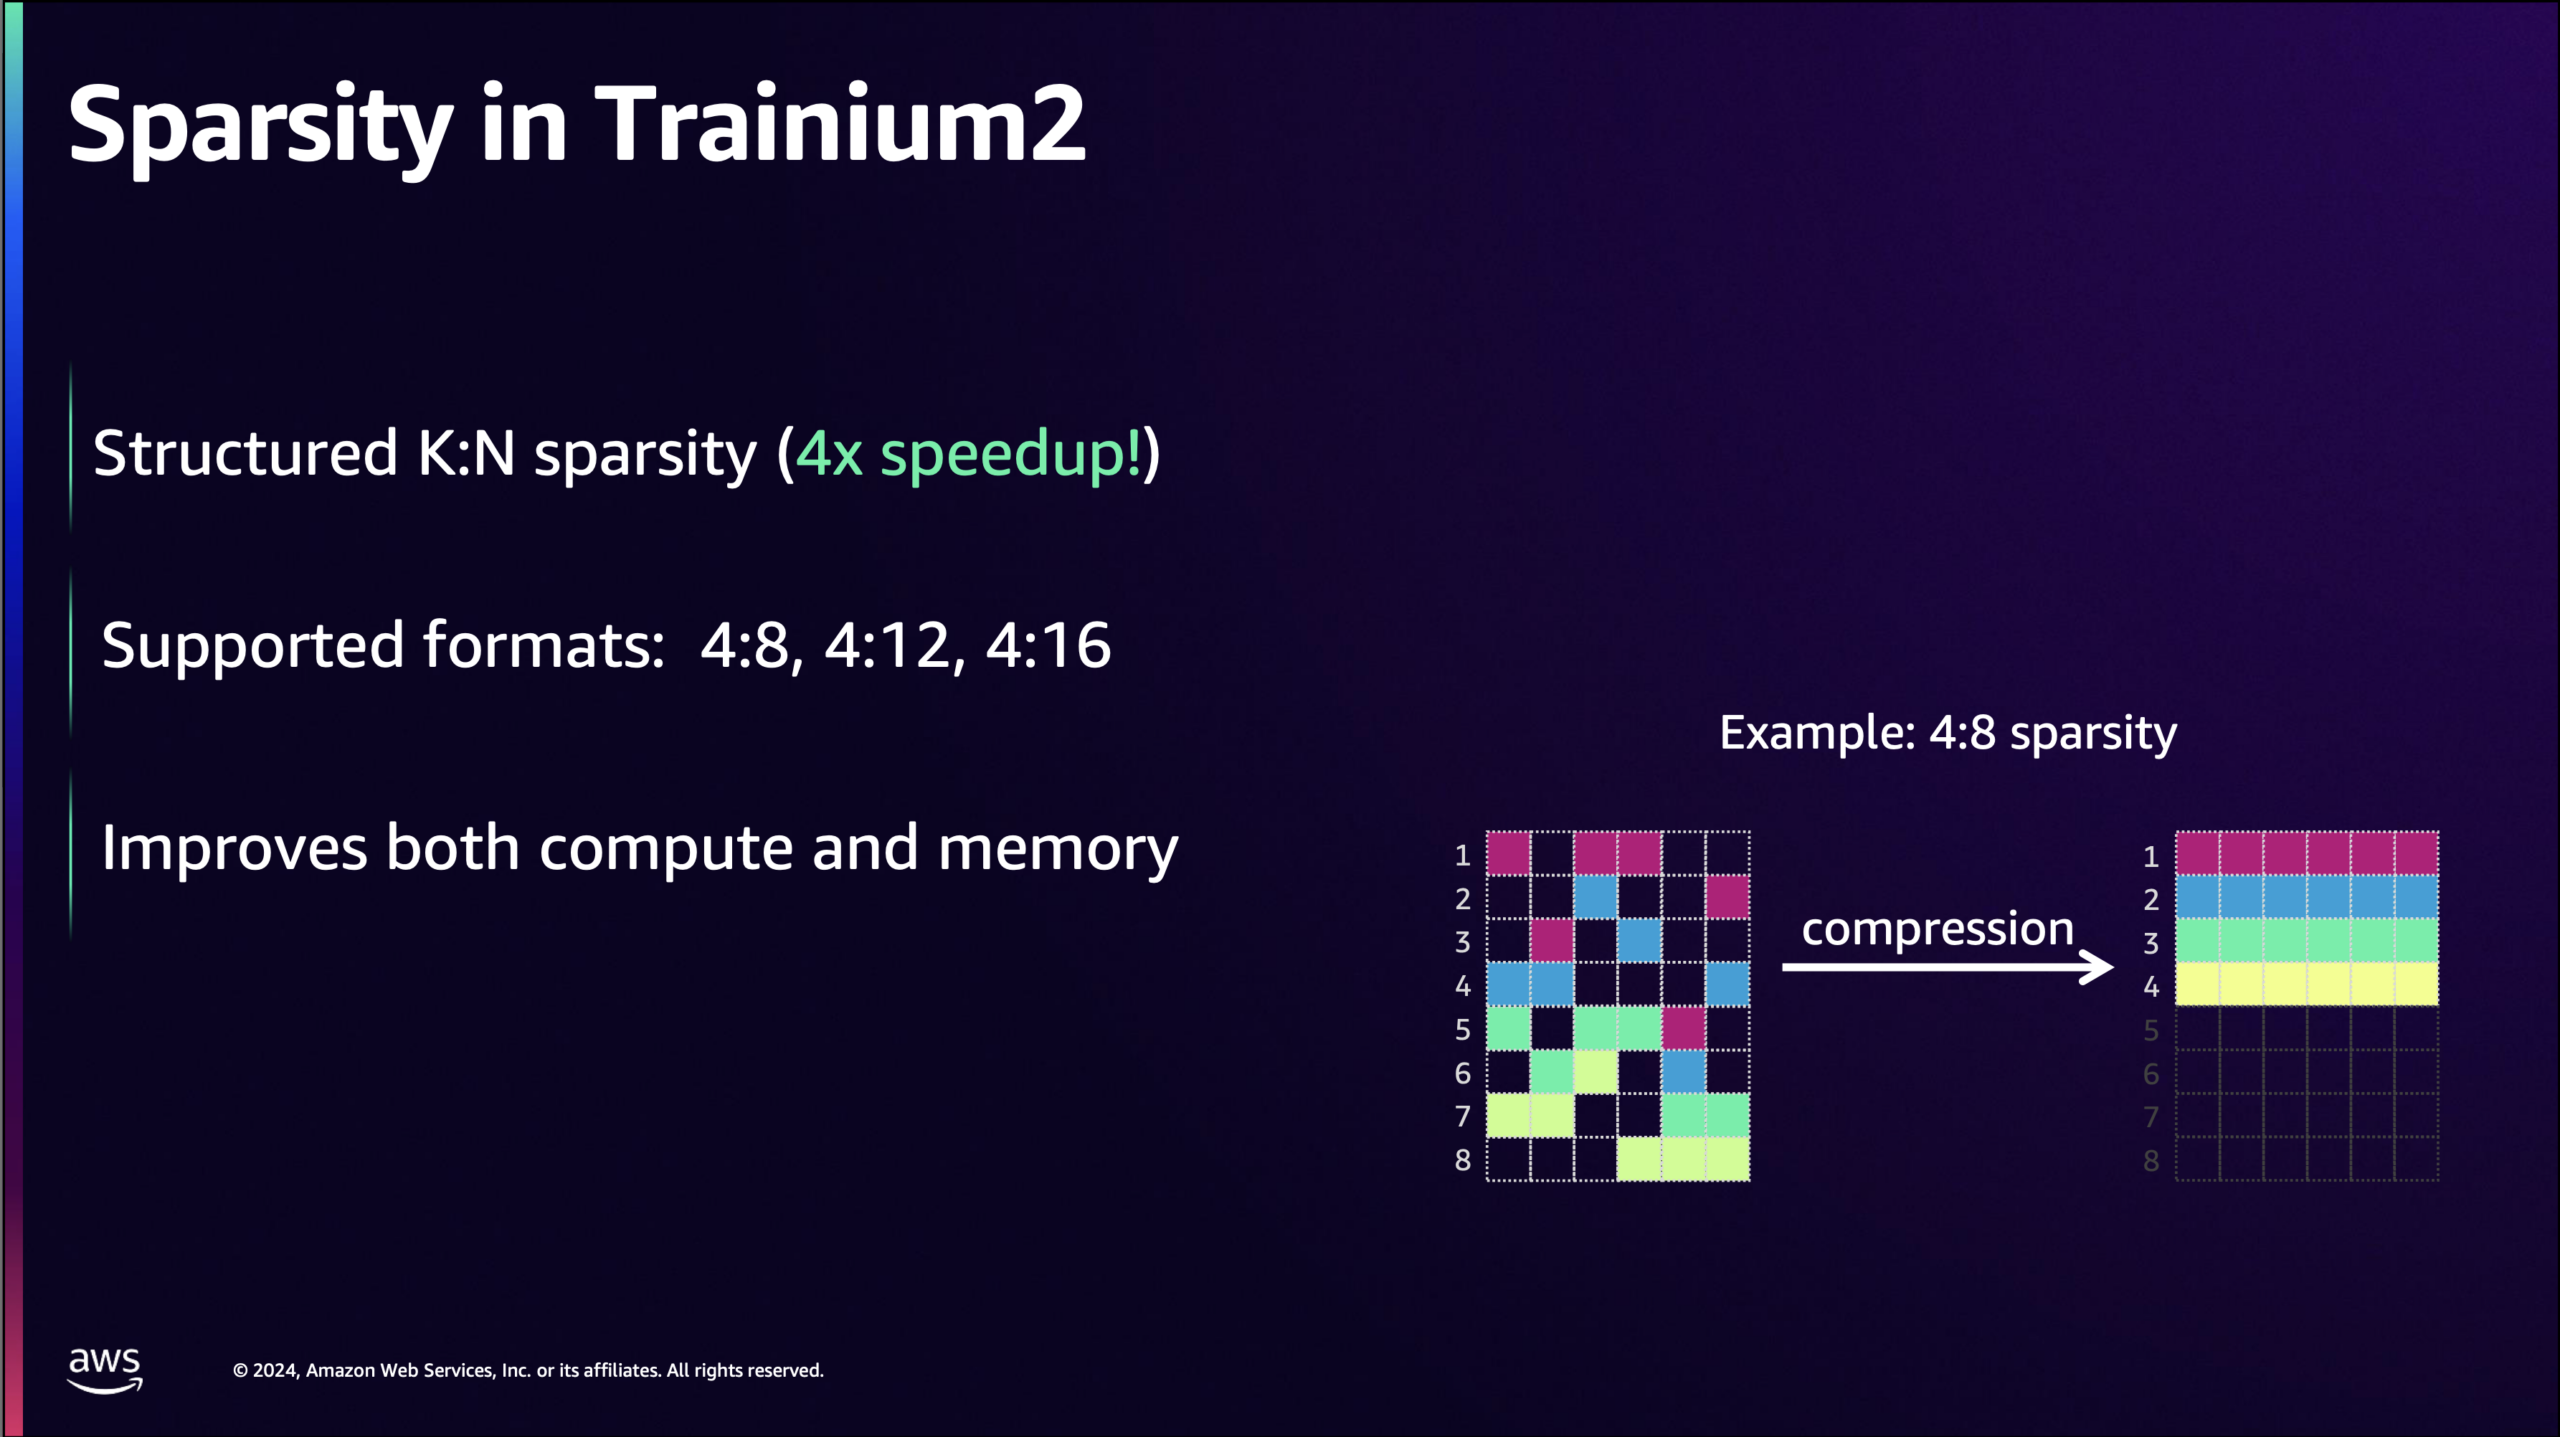
出典: AWS
一部のアクセラレータは、シストリック配列とスパース性のためのハードウェアサポートを組み合わせています。AWS は、Trainium2 および Trainium3 の内部エンジンである NeuronCore-v3 を皮切りに、そのようなアクセラレータを構築しました。この実装は、ハードウェアスパースシストリック配列がどのようなものかを示しています。NeuronCore-v3 テンソルエンジンは、静止重み行列とストリーミング活性化行列で動作する 128×128 シストリック配列で、縮約次元は配列のパーティション次元に揃えられています。スパースモードでは、入力データパスは、密な BF16 および FP16 のサイクルあたり 2×128 要素から、サイクルあたり 5×128 要素に広がり、静止側は元の密な重みではなく、重み行列の圧縮表現からフィードされます。コンパイル時に、重みテンソルは M:N 形式に処理されます。縮約次元に沿った N 個の連続する要素のうち、M 個のみが保持され、どの位置が非ゼロであるかをコンパクトなビットマスクでエンコードします。圧縮バッファにはM個の値のみが格納され、N/M倍に縮小されます。matmul命令が実行されると、ハードウェアは圧縮された重みを読み取り、ビットマスクを使用して、対応するアクティベーションを固定タイルから適切な処理要素にルーティングします。ゼロを乗算するはずだったPEは、そのスロットの処理を受けません。ビットマスクのルックアップとルーティングは、配列自体ではなく、配列にデータを供給するデコンプレッサに存在するため、パイプラインはゼロで停止することなく、ゼロ以外の値に対してフルスループットでクロック動作を継続します。
TPU は密行列乗算だけを行うわけではありません。ここ数世代にわたり、TPU には TensorCore に加えて SparseCore が搭載されています。SparseCore は、レコメンデーション モデルを定義する不規則な収集・散布アクセス パターンに対応するように設計されたドメイン固有のエンジンです。YouTube ランキング モデルや検索広告関連性モデルは、密行列変換モデルとは異なります。これらのモデルのパラメータのほとんどは、数百ギガバイトからペタバイト規模に及ぶ埋め込みテーブルに格納されており、計算時間の大部分は、これらのテーブルからの小さなルックアップ、取得した値の軽い変換、および結果の結合に費やされます。このアクセス パターンは、MXU にとっては最悪のケースであり、GPU のキャッシュ階層にとってもわずかに改善される程度です。SparseCore はまさにこのために最適化されています。HBM に格納された埋め込みテーブルに対する高スループットの収集・散布操作、および埋め込みパイプラインの残りの部分が依存する重複排除と結合操作のハードウェア サポートを備えています。同じハードウェアはMoEエキスパートルーティングにも役立ちます。なぜなら、トップkの選択によってエキスパートインデックスが生成されると、残りのルーティングプロセス(エキスパートごとにトークンを並べ替え、チップ間でディスパッチし、エキスパートの出力を収集し、重み付き削減を実行する)は、埋め込みパイプラインと同じ収集/分散/削減パターンに従い、SparseCoreのソートサポートがトップkステップ自体をカバーするからです。
以上の背景を踏まえ、以下に発表内容をお伝えします。
TPU 8t「サンフィッシュ」
最初の発表は、コードネーム「Sunfish」と呼ばれるTPU 8tで、トレーニング用チップです。Ironwoodからの世代交代は、メモリ容量の増加、帯域幅の拡大、より狭いデータ型のネイティブサポートなど、ほとんどの点で予想通りの方向性を示しています。各チップには、合計216 GB、6.5 TB/sの6つの12-Hi HBM3eスタックから供給される単一のTensorCoreが搭載されており、Ironwoodの8つのスタックで192 GBから増加しています。オンチップのVmem SRAMは128 MBのままです。
MXUのネイティブFP4が、計算能力の飛躍的な向上の主要因です。行列乗算を8ビットではなく4ビットで実行することで、同じ物理配列でもサイクルあたりのスループットが2倍になり、GoogleはIronwoodの4.6 PFLOPS FP8から8tの12.6 PFLOPS FP4へと性能を向上させています。混合精度トレーニングでは、最適化ステップ用に重みのFP32マスターコピーを保持しますが、FP4は計算時間の大部分を消費する作業テンソルを縮小します。
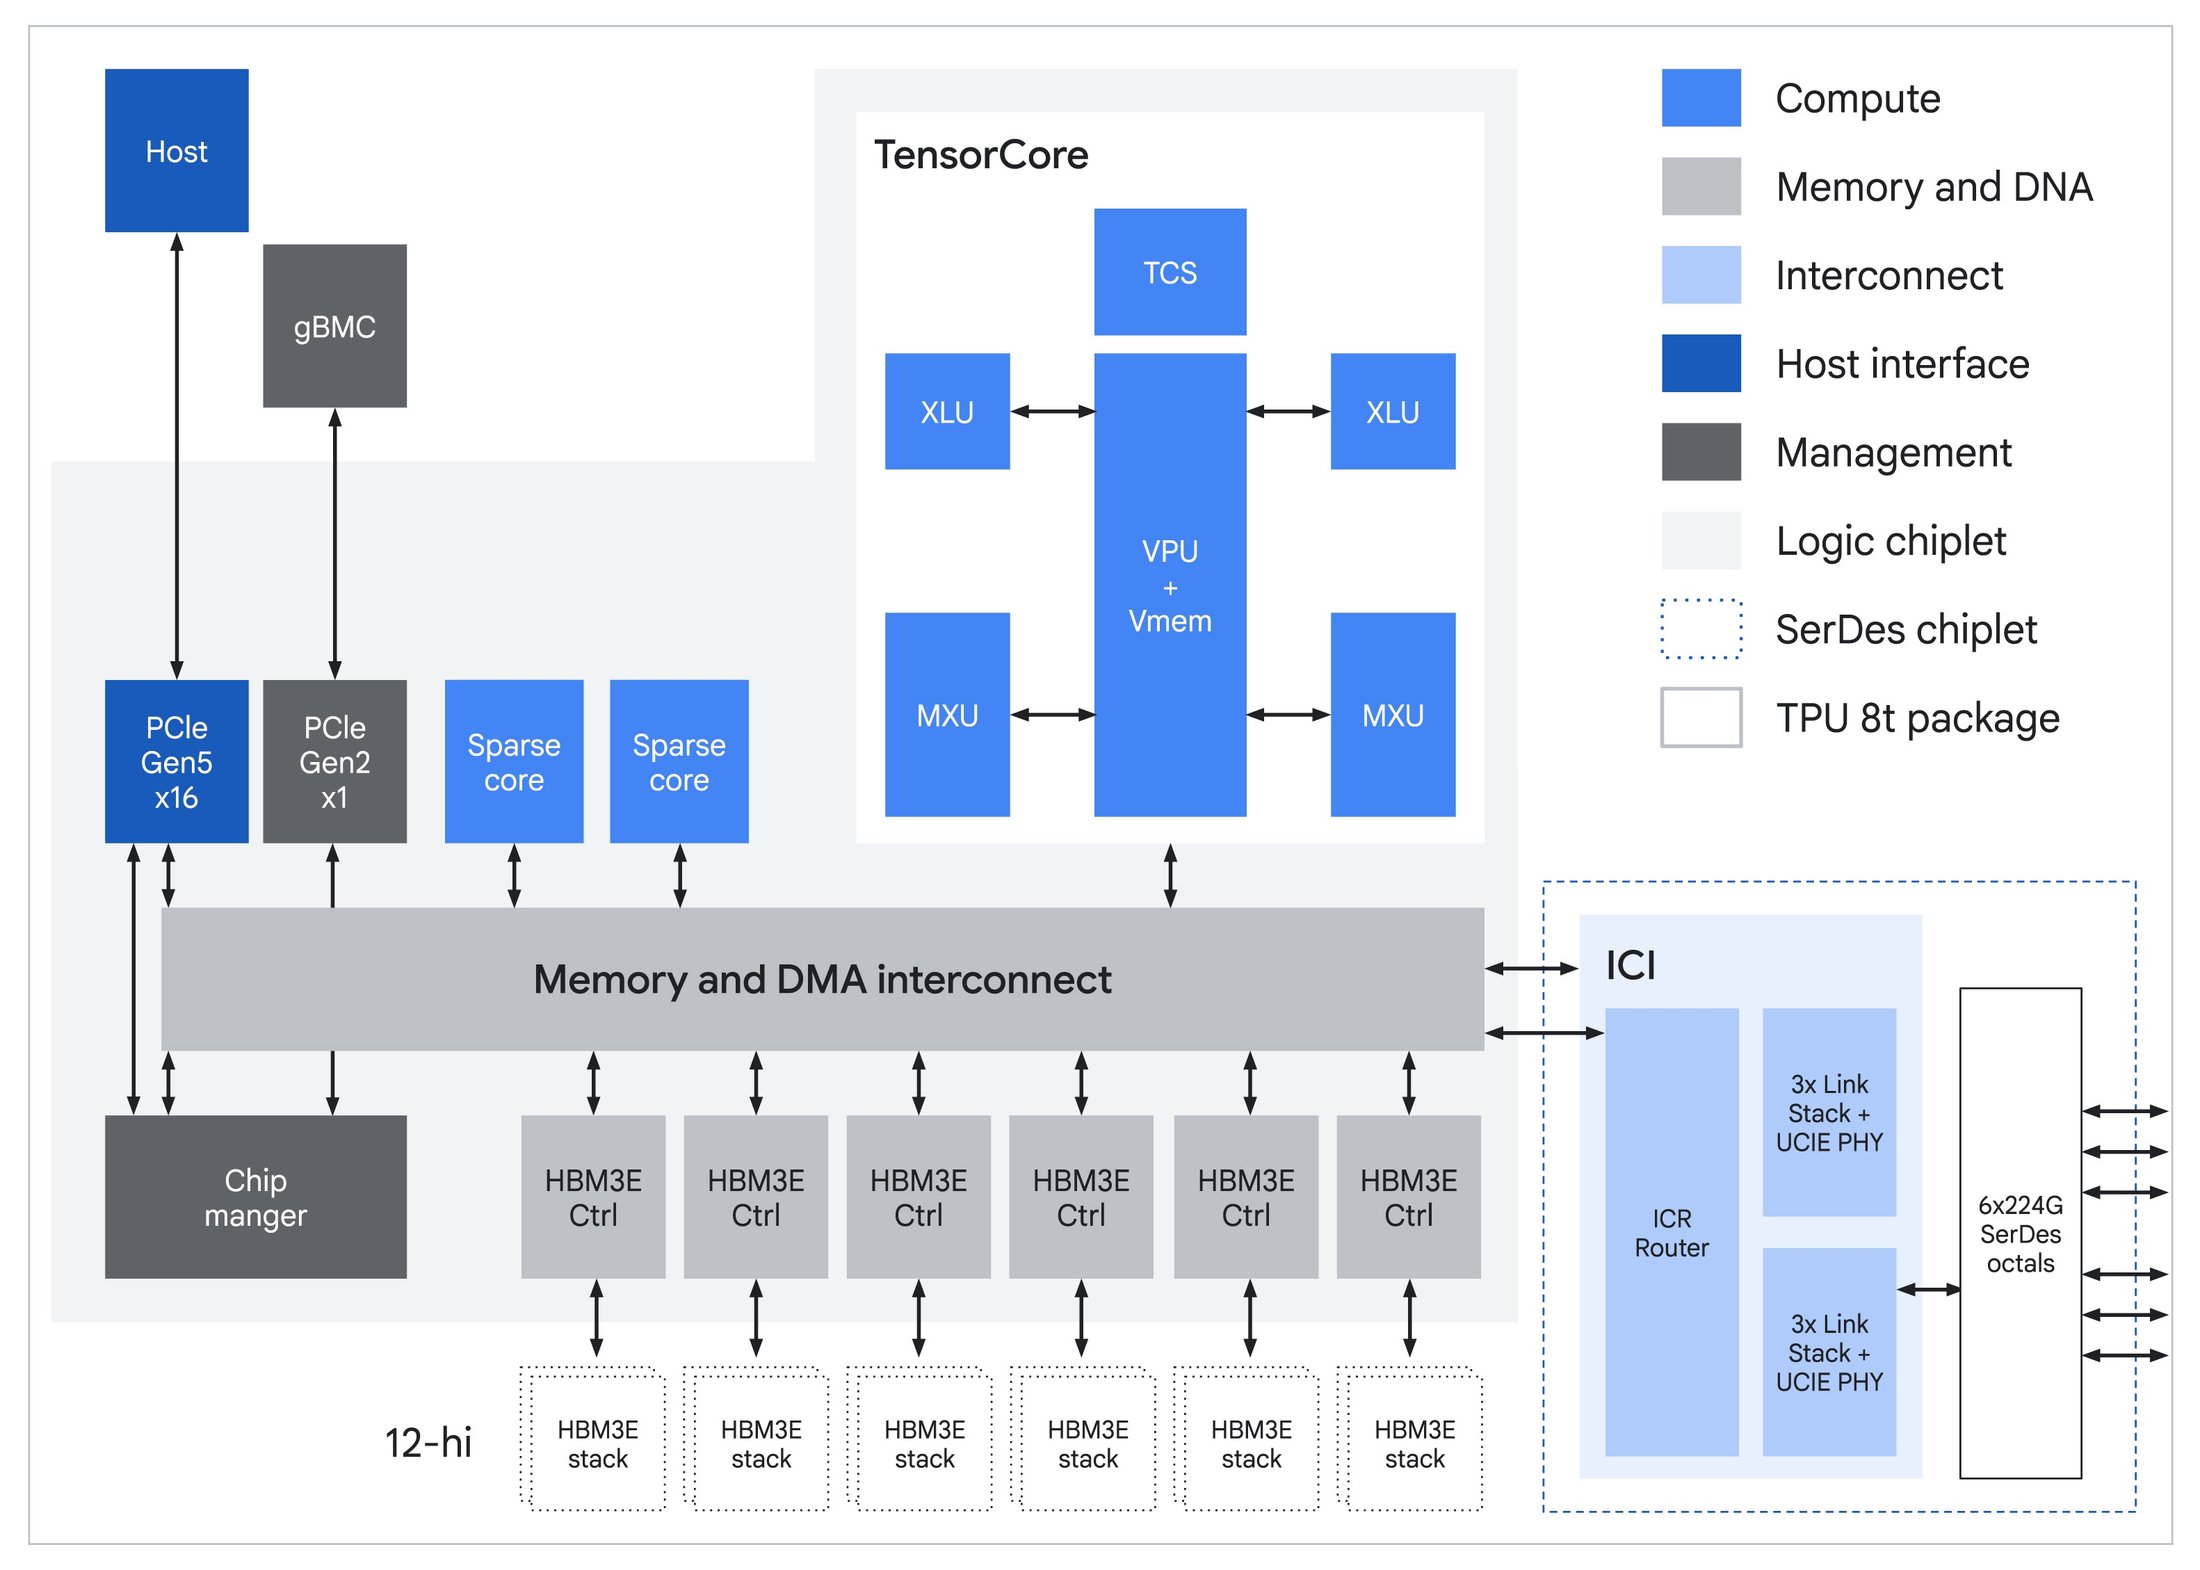
出典:グーグル
相互接続のストーリーは単純明快です。ICI帯域幅はチップあたり19.2 Tb/sに倍増し、9,600チップのスーパーポッドは2 PBのHBMと121 EFLOPSを集約し、3Dトーラストポロジーは維持されます。トーラスはトレーニングに適しています。なぜなら、最先端のジョブは、データとテンソルの並列処理のためのオールリデュース、FSDPのためのオールギャザーとリデューススキャッター、パイプライン並列のポイントツーポイント送信など、リングに適した集合処理が中心となるからです。これらはすべて、トーラスの軸にきれいにマッピングされます。
Googleは、v4以降すべてのTPUに搭載されているSparseCoreも引き続き使用しています。SparseCoreの本来の目的は、DLRMスタイルのレコメンデーションモデルであり、計算時間の大部分は、大規模な埋め込みテーブルに対する不規則なギャザー・スキャッター処理に費やされます。同じハードウェアは、MoEルーティングも処理します。JAXは、各チップが異なるサイズのチャンクを各ピアに送信できる、不規則な全対全通信とそれに対応するragged_dotを第一級の操作として公開しています。これは、トップkルーティングがデータに依存し、各エキスパートに流れるトークンの数がステップごとに変化するため、MoEディスパッチの実際の形状と一致します。コンパイラは、不規則な通信と不規則なエキスパート行列乗算を単一のスケジュールされた操作に統合し、SparseCoreは周囲のソートとパーミュテーションを処理します。現在、混合エキスパートが最先端モデルの主流アーキテクチャとなっているため、このハードウェアは、当初設計された広告やランキングワークロードだけでなく、あらゆる最新のトレーニングジョブでその価値を証明しています。
これらは進化的な段階です。より大きな変化は、TPUDirectとAxionベースのホストへの移行であり、どちらも最先端の規模でのみ顕在化するボトルネックに対処するものです。
TPUDirect RDMAとTPUDirectストレージ
以前の世代のTPUでは、ネットワークとストレージのI/Oにホストを介したパスが使用されていました。パケットはまずホストのDRAMに書き込まれ、その後別のDMAによってTPUのHBMにコピーされていました。これは、ホストCPUが関与する2つのメモリトランザクションです。TPUDirect RDMAはバウンスバッファを排除します。NICはPCIeピアツーピアを介してTPUのHBMを直接読み書きし、データパスからホストを排除します。NVIDIAはGPUDirect RDMAで長年にわたり同等の機能を提供しており、ホストを介したパスと比較して約10倍の改善を実現したとしています。Googleは現在、TPU側でこれに匹敵する機能を提供しています。
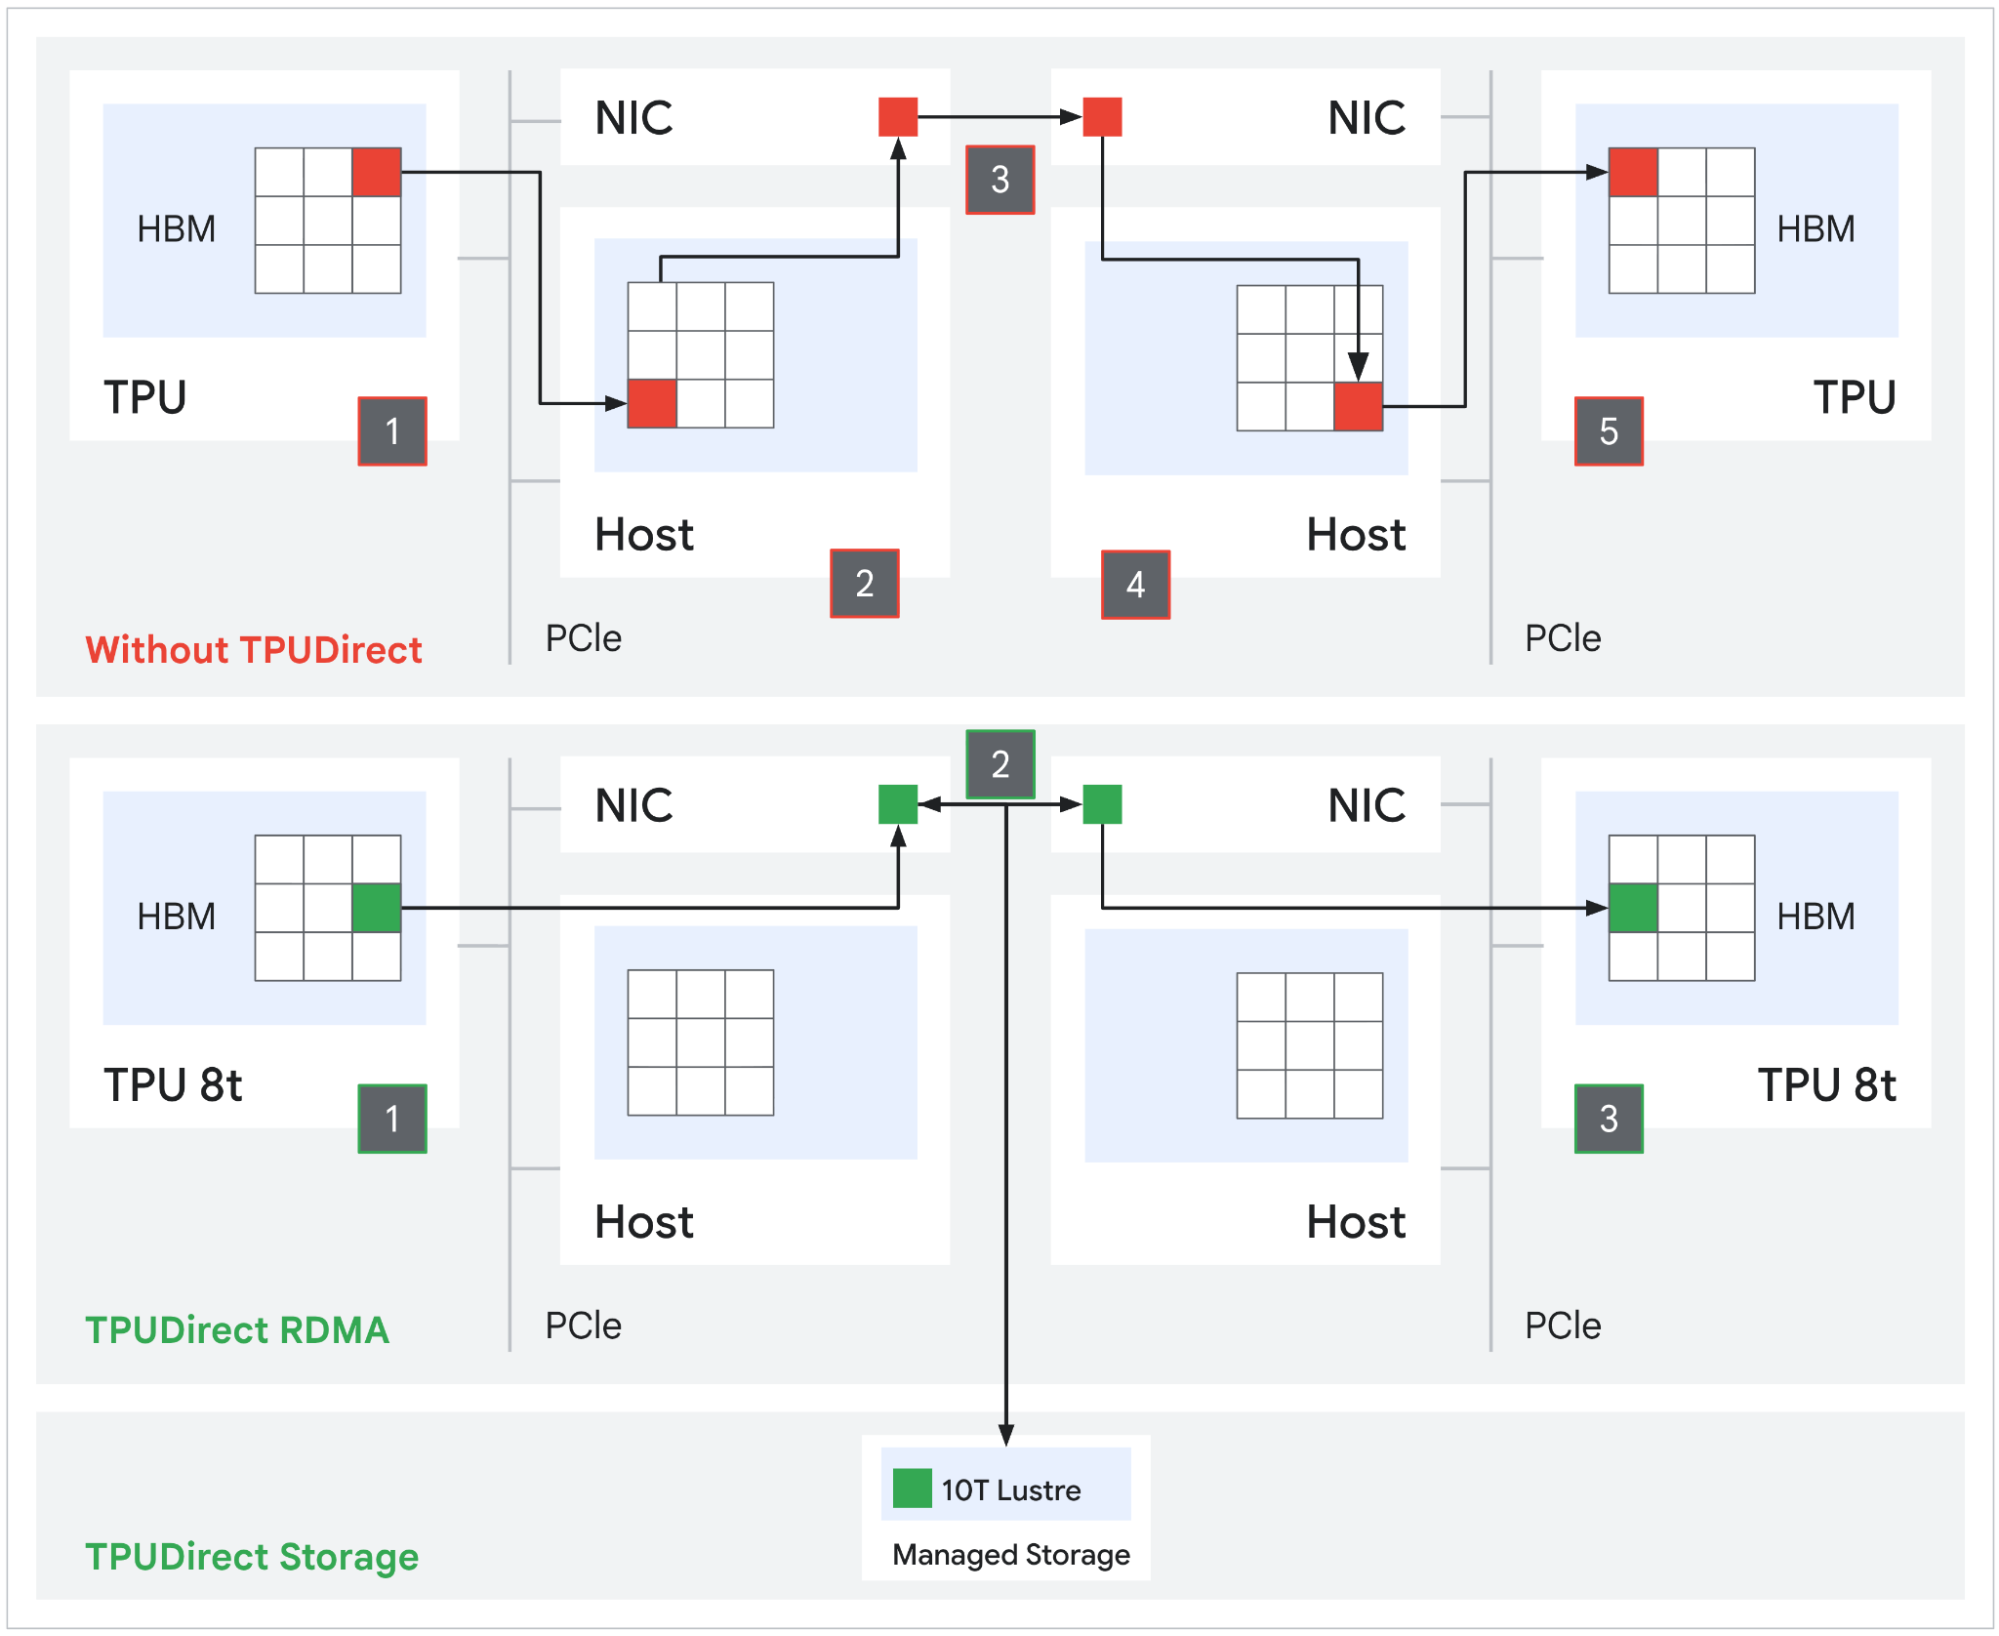
出典:グーグル
TPUDirect Storage は、同じ原理を永続ストレージにも拡張します。テンソルは、TPU HBM と Managed Lustre 間で合計 10 TB/s の速度で直接移動し、Google は、これにより Ironwood の同等のパスよりも 10 倍高速なストレージ アクセスが実現すると主張しています。チェックポイントが数百テラバイトに達する最先端規模では、数週間にわたるトレーニング実行でチェックポイントとデータセットをライン レートでストリーミングするか、ホスト I/O を待って MXU パイプラインが停止するかの違いが生じます。
アームアクシオンホスト
これまでのすべてのTPU世代は、サードパーティ製のx86ホスト上で動作していました。8tは、システムヘッダーとしてGoogle独自のAxionプロセッサ(Arm Neoverse V2ベースのCPU)を初めて採用しました。TPUポッドにおけるホストCPUの役割は重要であり、最先端規模ではさらに複雑になります。入力パイプラインの駆動、マルチペタバイト規模のデータセットのデコードとシャッフル、JAX/XLA制御プレーンの管理、チェックポイントシリアル化の処理、数千個のチップにわたるSPMDディスパッチの調整などを行います。ホストが停止すると、MXUはアイドル状態になります。
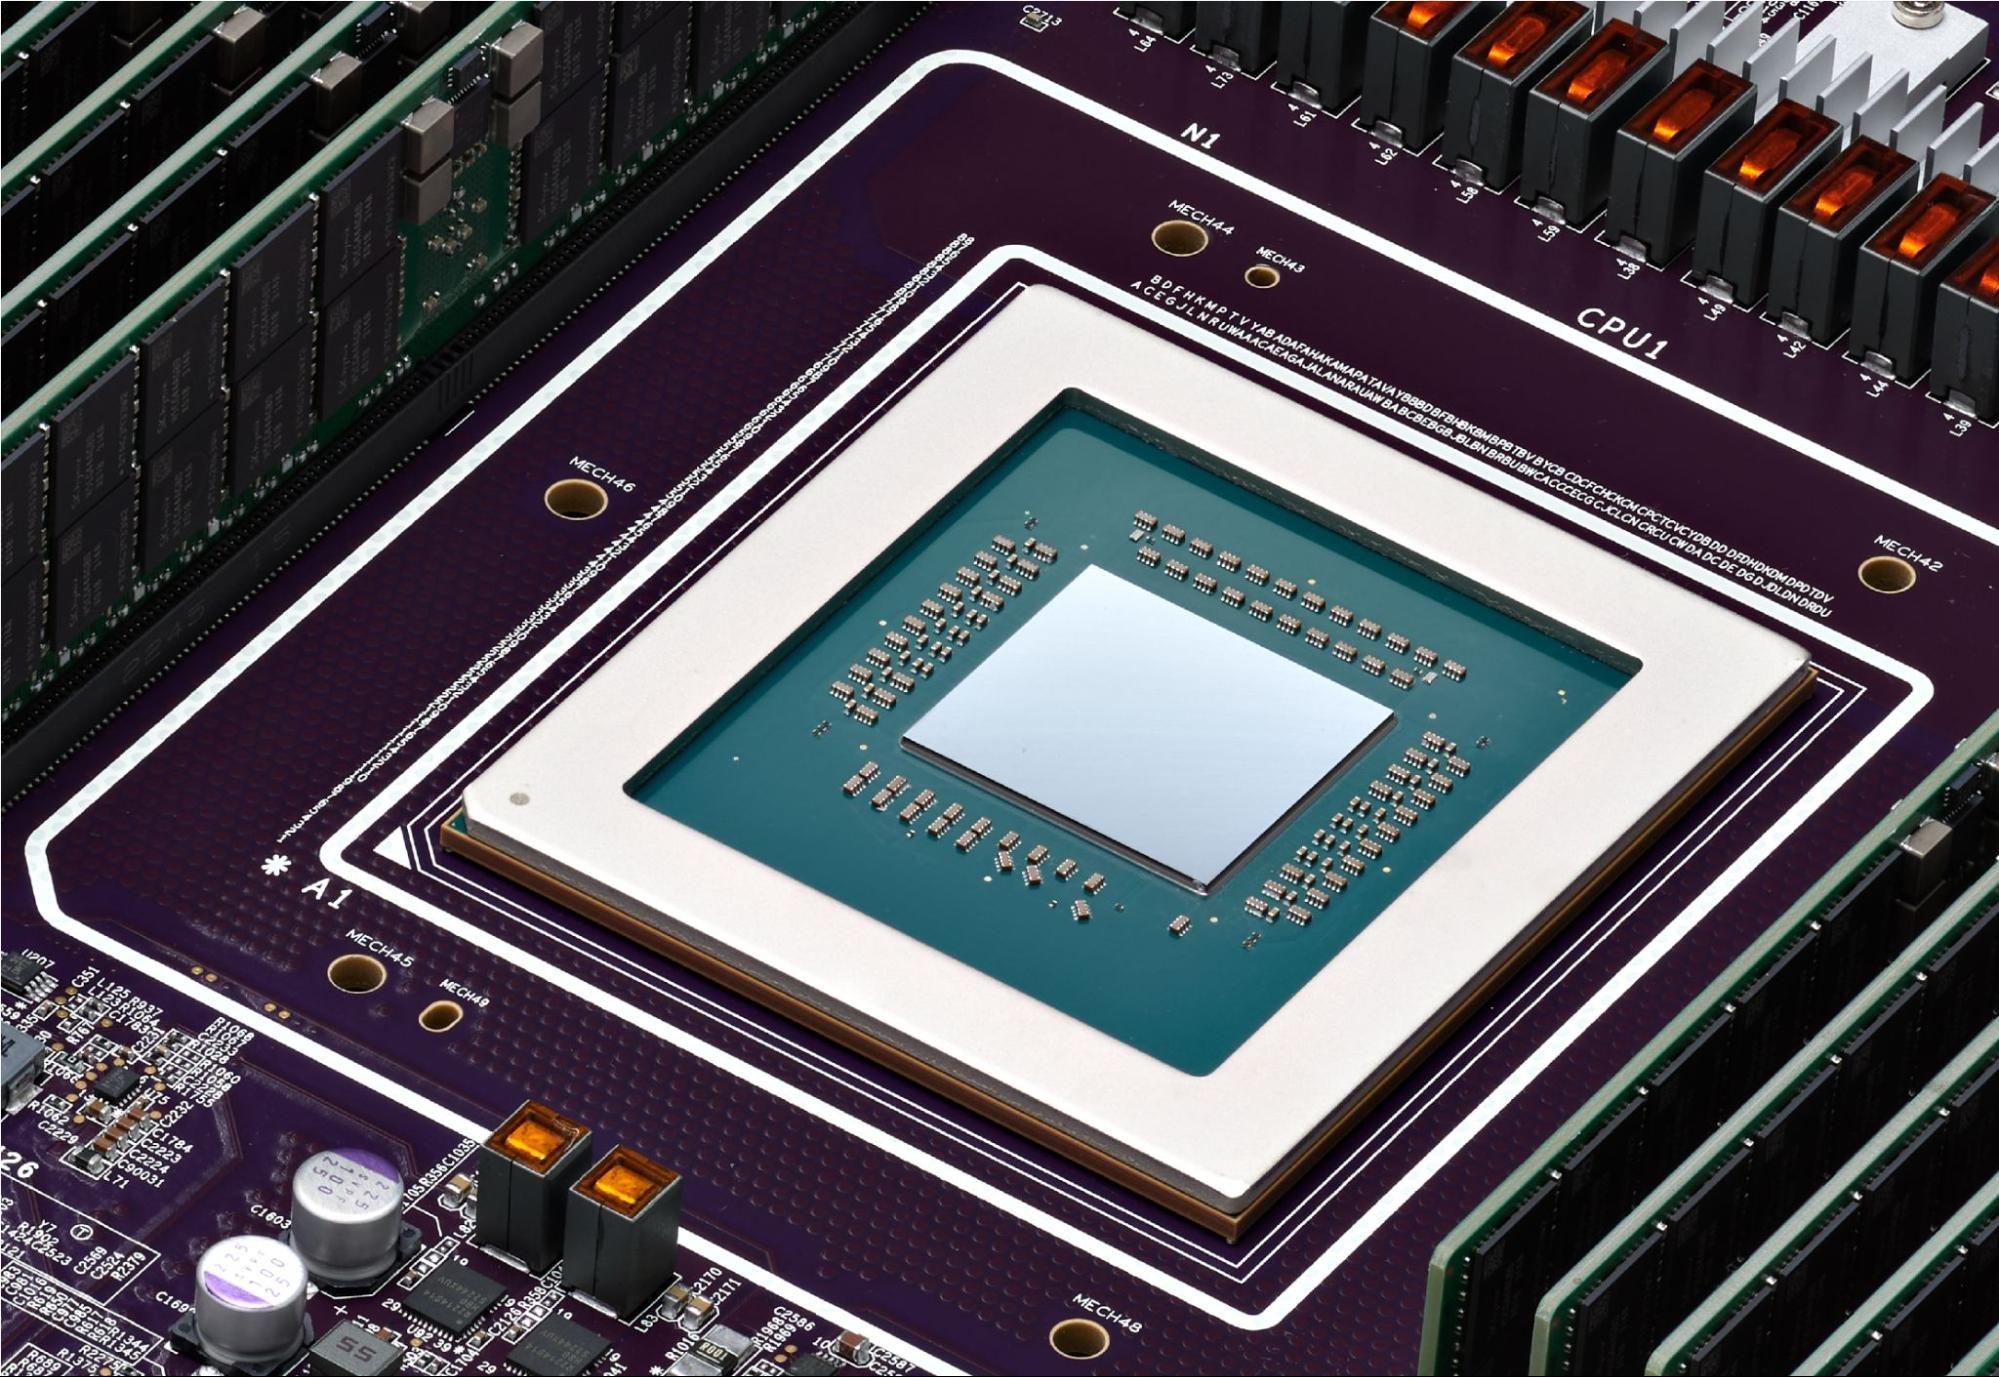
Google は、8t の Axion による NUMA 分離を、ホスト側のジッターがトレーニングの同期された集合フェーズに漏れるのを防ぐメカニズムとして特に挙げています。ポッドあたり 9,600 個のチップがあるため、ホストごとの小さな不具合でも、測定可能なグッドプットの低下につながります。TPUDirect は、バルク転送からホストを除外することでデータ パス側を処理します。Axion は、各 TPU に十分な専用 CPU 帯域幅を与えることで、前処理がボトルネックにならないように制御パス側を処理します。Google はまた、第 8 世代プラットフォームでサーバーあたりの物理的な Axion ホストの比率を増やし、チップ数に応じてスケーリングするオーケストレーションのオーバーヘッドに、Ironwood のホスト構成よりも余裕を持たせています。
TPU 8i「ゼブラフィッシュ」
推論チップは、8tのAxionホストプラットフォーム、ネイティブFP4、およびHBM3eメモリ生成機能を共有していますが、その基盤となるシリコンは異なるボトルネックをターゲットとしています。トレーニングは計算処理能力がボトルネックとなり、推論デコードはメモリ帯域幅がボトルネックとなります。8iのアーキテクチャ上の相違点のほとんどは、この点に起因しています。
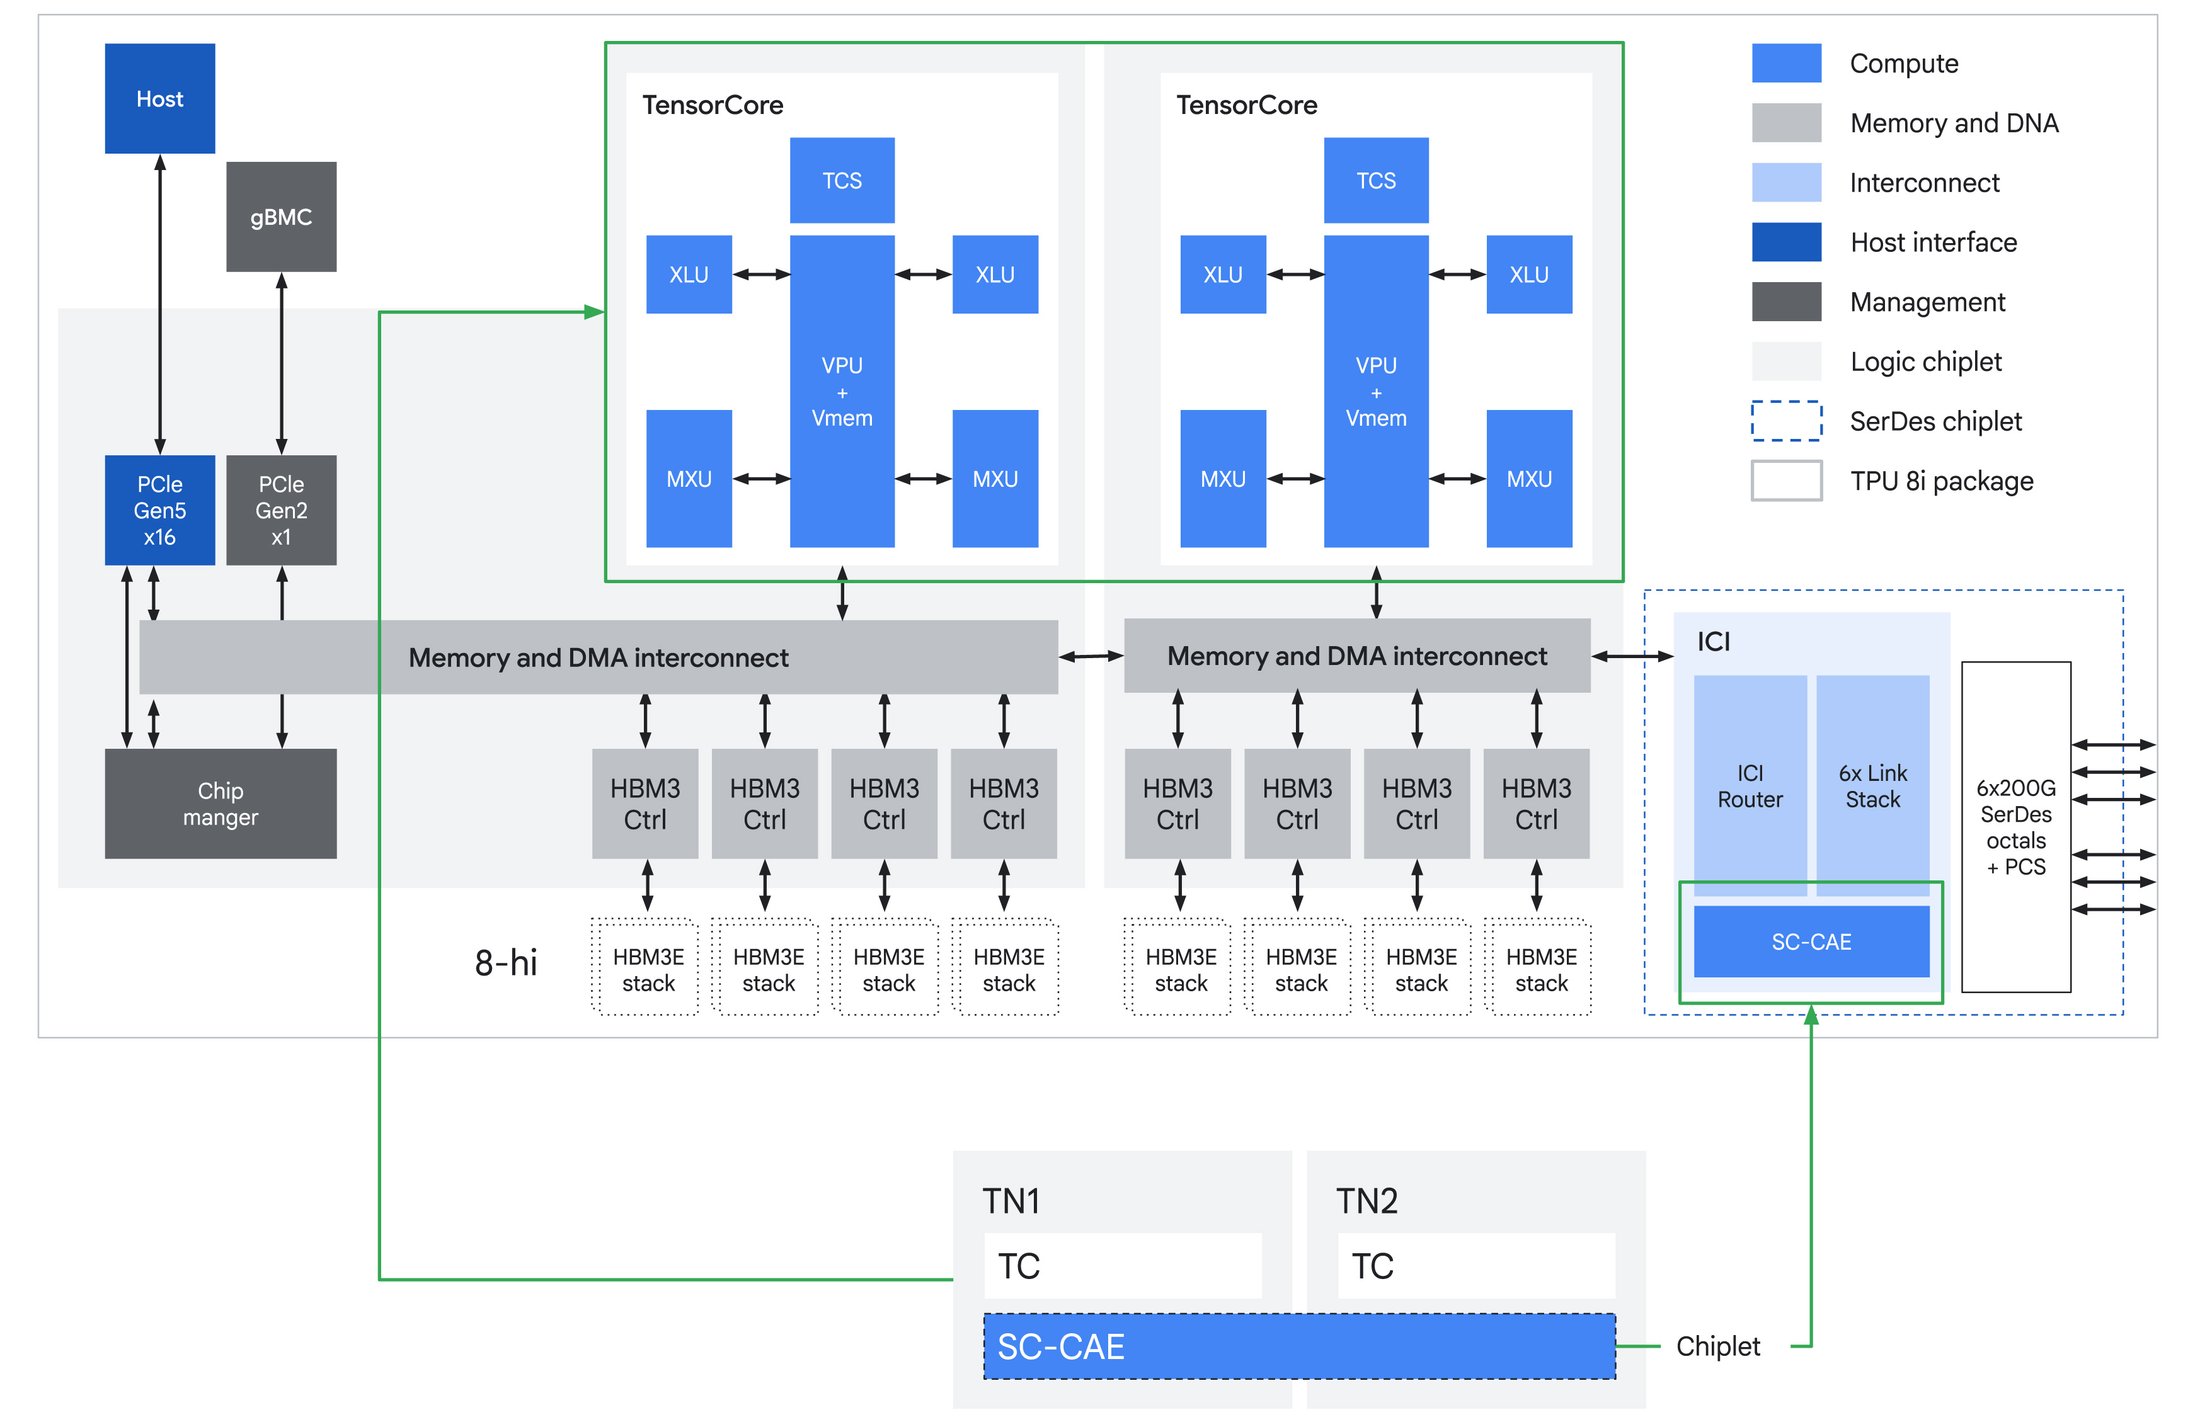
最大の変更点は、オンチップSRAMです。8iは384MBのVmemを搭載しており、これはIronwoodの3倍です。これが重要な理由はKVキャッシュにあります。ロングコンテキストデコード中、生成された各トークンは、以前のトークンから蓄積されたキー値状態を読み取る必要があります。ほとんどのアクセラレータでは、この読み取りはHBMから行われるため、デコードスループットは演算ではなくメモリ帯域幅によって制限されます。8iは、シリコン上に意味のあるKVキャッシュフットプリントを完全に保持できるサイズになっています。オンチップSRAMの帯域幅はHBMよりも約1桁高いため、HBMではなくSRAMから提供されるすべてのKV読み取りは、同じ電力でトークンあたりのレイテンシが短縮され、1秒あたりのトークン数が増加します。
出典:グーグル
TensorCore の構成も大きな変更点です。8t では 12.6 PFLOPS の単一の TensorCore を使用していますが、8i では 2 つの TensorCore に演算を分割し、合計 10.1 PFLOPS を実現しています。ピーク スループットの低下は、チップ レベルでの推論が実際にどのようなものかを考慮するまでは、ダウングレードのように聞こえます。トレーニング ワークロードはバッチ処理が中心です。大規模な行列乗算によって固定オーバーヘッドが償却され、単一の大規模な MXU でピークに近い使用率を維持できます。推論デコードはその逆です。バッチ サイズは小さく、トークンごとの演算ウィンドウは短く、チップは純粋な行列乗算ではなく、集合演算、サンプリング、ルーティングにかなりの時間を費やします。単一の大規模なエンジンでは、これらの不規則なギャップで停止します。2 つの TensorCore に分割することで、8i は演算フェーズをより効果的にオーバーラップさせることができ、各 TensorCore は直接接続された 4 つの HBM スタックによって供給され、パッケージ全体で合計 288 GB、8.6 TB/s の速度を実現しています。その結果、インタラクティブなサービス提供で実際に実行されるバッチサイズにおいて、より高い持続的な利用率が得られる。
スケールアップドメインレベルでは、Boardflyポッド内の1,024個のアクティブチップは、合計で約295TBのHBM、384GBのオンチップSRAM、および10.3EFLOPSのFP4演算能力を備えています。推論において最も重要なのはSRAMの容量です。ドメイン全体で384GBのオンチップキャッシュがあれば、HBMにアクセスすることなく十分なKV状態を保持できるため、低遅延で長時間のコンテキスト提供が可能になります。
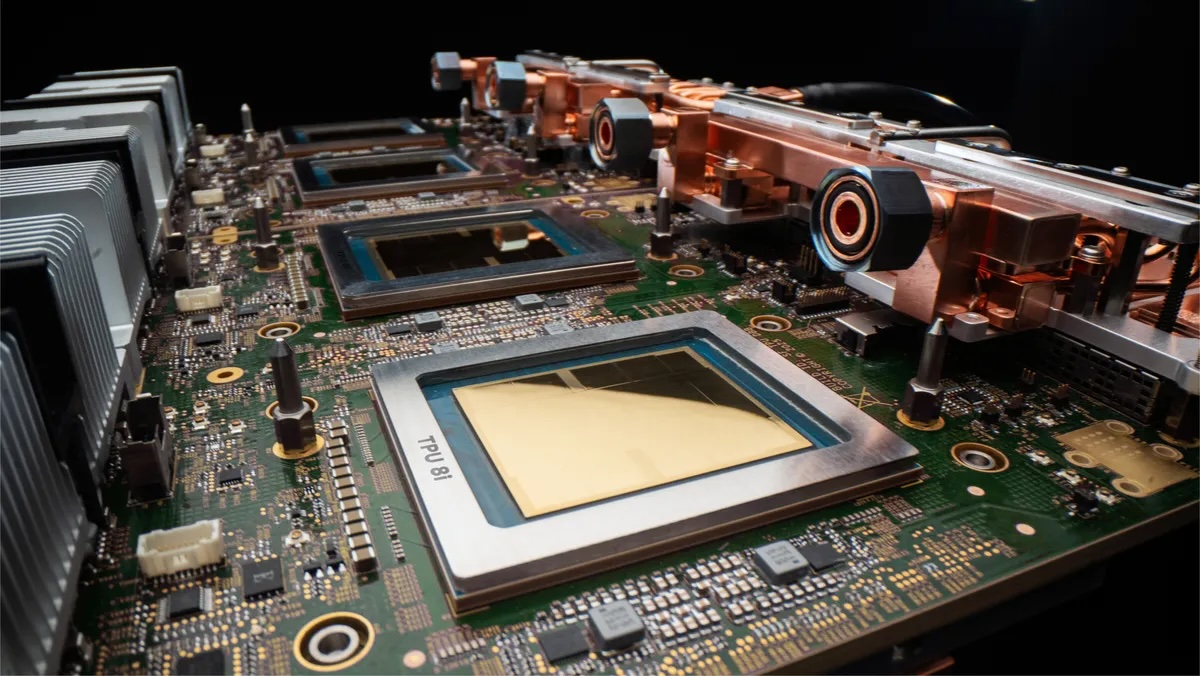
ホスト側も同様のロジックに従います。Google は、8i では Ironwood と比較してサーバーあたりの物理 Axion ホスト数を増やしたと述べています。推論サーバーは、トークン化、サンプリングロジック、ルーティング、バッチ処理、およびエージェントランタイムオーケストレーションにトークンあたりの時間のかなりの割合を費やします。これらのオーバーヘッドはモデルサイズではなく同時実行数に応じて増加するため、エージェントワークロードが生成するリクエストレートでは、ホストがボトルネックになる可能性があります。アクセラレータあたりのホスト CPU を増やすことが、最も簡単な解決策です。
集団加速エンジン
もう一つの大きなオンダイ変更は、Ironwoodに搭載されていた4つのSparseCoreを置き換えるCollectives Acceleration Engineです。SparseCoreは専用のgather-scatterハードウェアを使用してMoEルーティングと埋め込みルックアップを処理するため、推論チップからこれらを削除することで、8iは別のボトルネックを最適化していることがわかります。
CAEが解決するボトルネックは、コレクティブレイテンシです。デコードされたトークンごとに、参加するチップ間の同期が必要となります。アテンション出力はすべて削減され、エキスパートルーティングメタデータはブロードキャストされ、サンプリングされたトークンは次のステップに伝播されなければなりません。GPUでは、この調整はNCCLを介してソフトウェアで行われ、NCCLはコレクティブをカーネル起動とネットワーク操作のシーケンスとしてスケジュールします。8iでは、CAEはTensorCoresと並んで独自のチップレットダイ上に配置された専用シリコンであり、これらの同期プリミティブをハードウェアで処理します。
Googleは、Ironwoodと比較してオンチップの集合的レイテンシが最大5倍低いと主張している。トレーニング規模のバッチサイズでは、この改善は計算時間によって相殺されてしまう。集合的レイテンシは計算時間のごく一部に過ぎないからだ。しかし、対話型推論のような小さなバッチサイズと短いトークンごとの処理時間では、集合的レイテンシがトークンごとの処理時間を支配するため、5倍の削減は1秒あたりのトークン数とトークンあたりの価格に反映される。
8iでは、3Dトーラス型トポロジーから、GoogleがBoardflyと呼ぶ、Dragonflyに着想を得た階層型トポロジーへと移行します。これは、リング状の集合帯域幅を犠牲にして、全対全のレイテンシを実現するものです。Boardflyについては、以下で詳しく見ていきます。
ボードフライトポロジー
8iは、トレーニングと推論の通信パターンが異なるため、8tとは異なるトポロジーを使用します。
3D トーラスはリング コレクティブに最適です。各チップには 6 つの隣接チップがあり、データはリングを一周し、任意のトラフィックをルーティングするチップはありません。トレーニングはこれらのリングに適したパターンが中心となるため、8t はトーラスを維持しています。リング オール リデュースは、単一のトーラス軸に完全にマッピングされます。最先端のジョブは通常、1 つの軸にデータ並列処理、別の軸にテンソル並列処理、3 番目の軸にパイプライン並列処理を配置します。トポロジーとワークロードが一致しています。
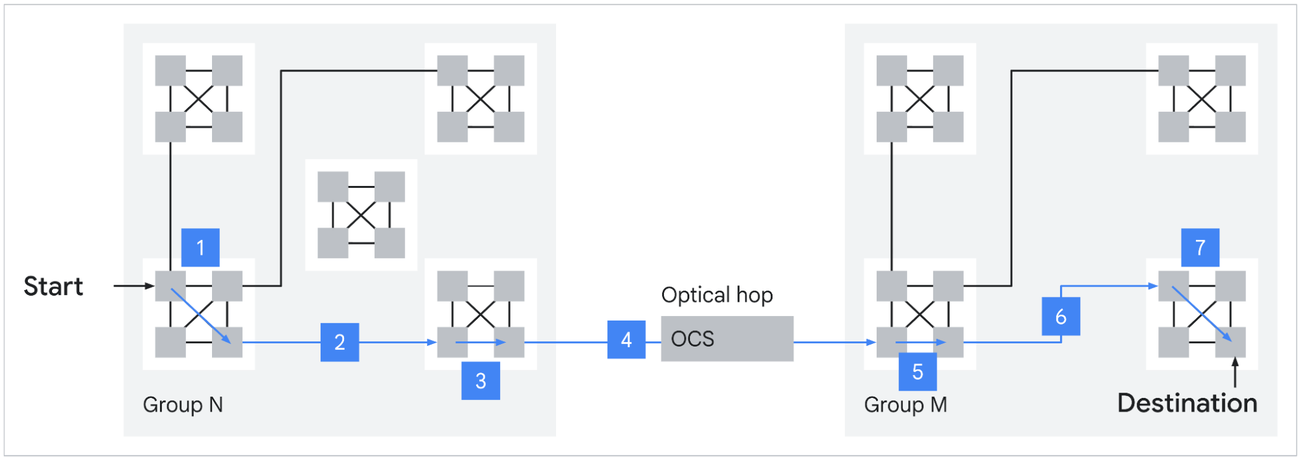
大規模な MoE モデルを処理する推論は、異なる通信プロファイルを持っています。エキスパートは多数のチップに分散しており、デコードされたトークンごとにオールツーオールがトリガーされます。トークンはファブリック全体に分散している割り当てられたエキスパートに到達し、エキスパートの出力が返される必要があります。これはリングではありません。任意のポイントツーポイントのトラフィックであり、1,024 チップの 3D トーラスでは、任意の 2 つのチップ間の最悪のパスは 16 ホップです。Google はこの計算を次のように説明しています。「3D トーラスでは、ノードは各次元がリングのように巻き付くグリッドに配置されます。8 x 8 x 16 (1024 チップ) 構成で可能な限り遠いチップに到達するには、パケットは各リングの半分の距離を通過する必要があります。
3Dトーラス = 8/2(X) + 8/2(Y) + 16/2(Z) = 16ホップ
トーラスは、高密度学習でよく見られるような隣接ノード間の通信には非常に効率的ですが、全ノード間の通信パターンではレイテンシの増大という弊害をもたらします。推論モデルやMoEの時代においては、トークンをルーティングするためにどのチップも他のどのチップとも通信する必要があるため、このホップ数は重要な意味を持ちます。
レイテンシに敏感なインタラクティブなサービス提供においては、これらの余分なホップによってトークンごとのレイテンシがSLO(サービスレベル目標)を超えてしまう。
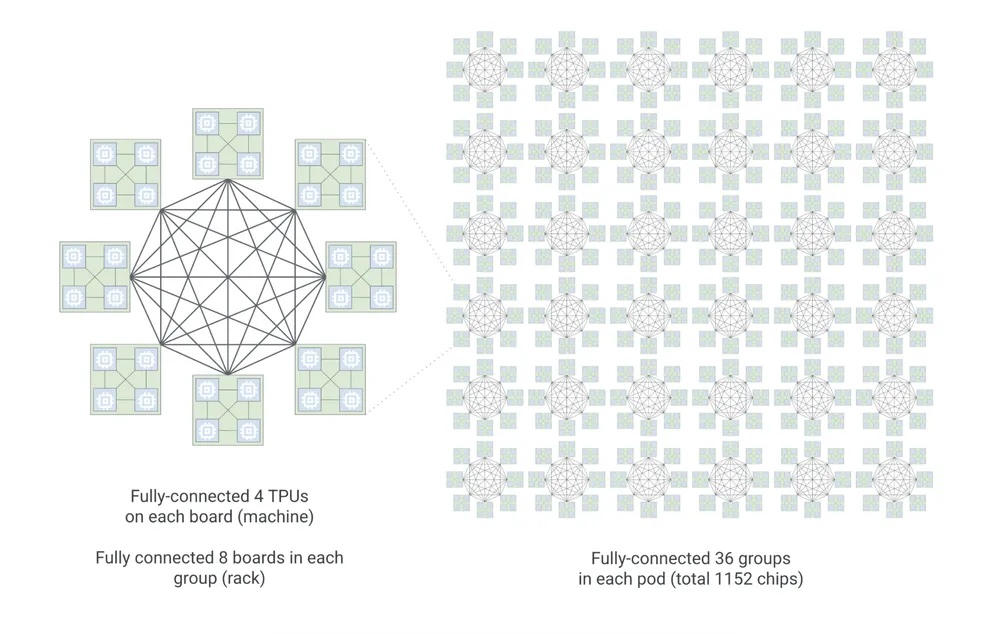
出典:グーグル
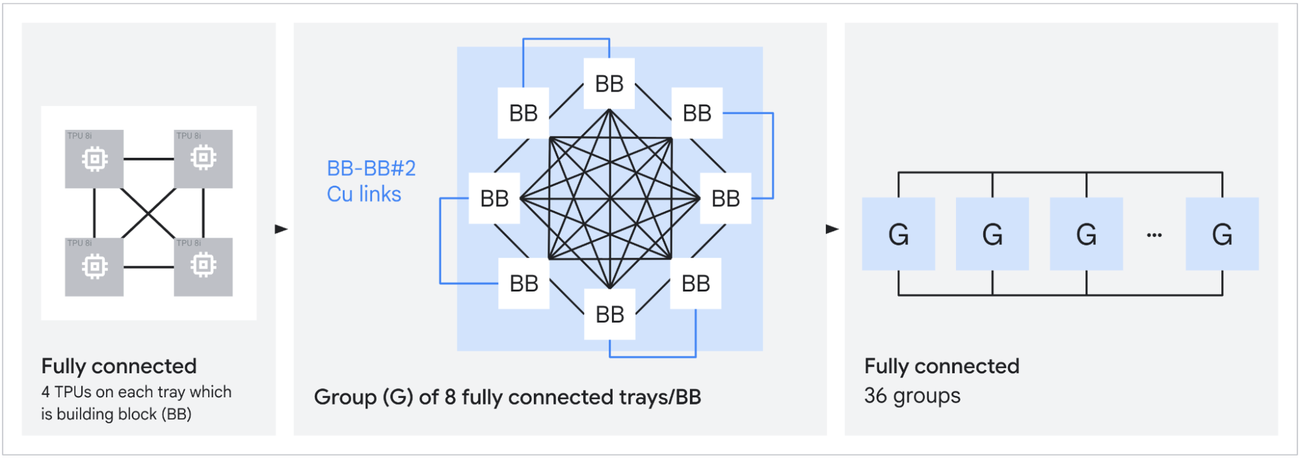
Boardflyは、Dragonflyに着想を得た階層構造で、その直径を圧縮するように設計されています。構造は3つのレベルで構成されています。構成要素は、16個の外部接続を持つ4チップリングです。これらの構成要素のうち8個がグループを形成し、各グループにつき11個のリンクを持つ銅線ケーブルで完全に接続されます。36個のグループが光回路スイッチを介して接続され、ポッドを形成します。その結果、1,152チップのスケールアップドメイン(1,024チップがアクティブ)が実現し、任意の2つのチップ間のホップ数は最大7回となり、トーラスと比較して56%削減されます。Googleは、これによりMoEオールツーオールなどの通信集約型ワークロードのレイテンシが最大50%改善されると主張しています。
スケールアップ領域が大きくなると、エキスパートのレプリケーションにも影響します。ICIファブリックあたりのチップ数が増えると、大規模なMoE内の各エキスパートをより多くの回数複製できるため、ルーティングの不均衡が緩和され、トークンの分布が偏っている場合でもデコード遅延が一定に保たれます。トップkルーティングはデータに依存するため、特定のステップで一部のエキスパートは他のエキスパートよりも多くのトークンを受け取ります。レプリケーションはこの変動を吸収します。結果として生じるトラフィックを処理するため、ICI帯域幅はチップあたり19.2 Tb/sに倍増されました。
ヴァーゴネットワーク
9,600個のチップを搭載したスーパーポッドは大規模ですが、最先端のトレーニング実行では、より多くのチップが必要となるケースが増えています。Virgoは、データセンター内のスーパーポッドを接続するスケールアウトファブリックであり、ジョブが単一のスケールアップドメインの容量を超えた場合に、ポッド間の東西方向のRDMAトラフィックを処理します。
単一のVirgoファブリックは、134,000個以上の8tチップを47Pb/sのノンブロッキング二分割帯域幅で接続し、前世代と比較してアクセラレータあたりの帯域幅を最大4倍、アンロードレイテンシを40%削減します。このアーキテクチャは、マルチプレーン設計と独立した制御ドメインを備えた高基数スイッチ上に構築された、フラットな2層ノンブロッキングトポロジーです。
従来の Clos ファブリックは、上位層でポート数とコストを管理可能な範囲に保つためにオーバーサブスクライブします。これは、トラフィックの大部分が南北方向である場合にうまく機能します。これは、汎用クラウドのパターンです。クライアントがロードバランサーにアクセスし、ロードバランサーがアプリケーションサーバーにアクセスし、アプリケーションサーバーがストレージにアクセスします。AI トレーニングワークロードは、ファブリック全体でチップ間をほぼ完全に東西方向に流れ、集合体は二分法が支配的です。どの層でもオーバーサブスクライブが発生すると、トレーニングステップの時間に直接影響します。Virgo のフラットな 2 層設計と高基数スイッチにより、ASIC あたり十分なポートを備えたスイッチを構築することで、ファブリックの相当な部分を 2 ホップで終端し、スパイン層のボトルネックを解消します。
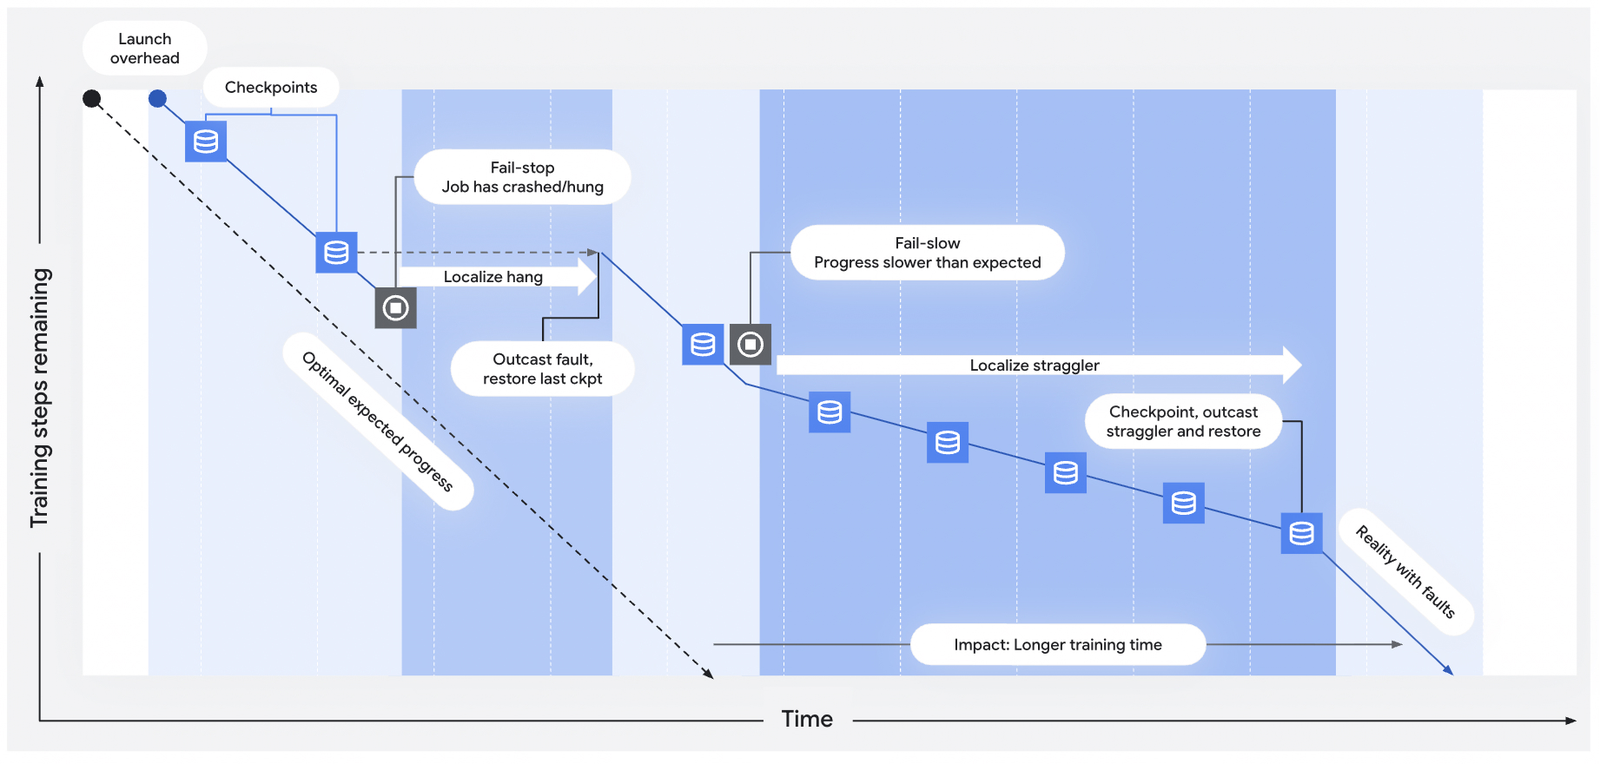
この規模では信頼性エンジニアリングが重要であり、GoogleのMEMSベースの光回路スイッチ(OCS)に大きく依存しています。OCSにより、Googleは配線をやり直すことなくジョブ間で物理トポロジーを再構成でき、さらに重要なことに、実行中に障害が発生したチップやリンクを迂回してルーティングできます。障害が検出されると、OCSは影響を受けるファブリックの部分をミリ秒単位で再マッピングできるため、手動による介入は不要になります。サブミリ秒のテレメトリは、自動化された遅延検出とハング検出に使用されます。高速検出とOCSベースの再ルーティングの組み合わせにより、100,000万個以上のチップ規模で、数週間の実行中に何らかの障害が発生する統計的確実性が100%に近づく場合でも、割り込み間の平均時間と回復までの平均時間が最適化されます。Googleが8tポッドに対して提示している97%のグッドプット目標は、このインフラストラクチャに依存しています。同じOCSテクノロジーはTPUスタック全体に使用されています。ICIレイヤーでキューブをスーパーポッドに結合し、8iスケールアップレイヤーでBoardflyグループを接続し、Virgoレイヤーでポッド間のトラフィックを処理します。
13万4000個のチップを搭載した場合、総演算能力はFP4換算で約1,690 EFLOPS、つまり約1.7 ZFLOPSに達する。Googleは、このアーキテクチャは単一の論理トレーニングクラスタで最大100万個のチップまでほぼ線形にスケーリングできると述べているが、現在の展開ではまだその上限に達していない。
ジュピターとマルチデータセンター規模
Virgoはデータセンター内の東西方向のアクセラレータトラフィックを処理しますが、最上位の層ではありません。JupiterはGoogleの既存の南北方向のファブリックで、現在第5世代にあたり、フロントエンドトラフィックと分散ストレージおよびコンピューティングリソースへのアクセスを処理します。JupiterはCloud Nextで発表されたものではなく、第8世代の基盤となる既存のインフラストラクチャです。
最新のJupiterは、Apollo MEMS OCSスイッチを使用し、データセンタービルごとに13 Pb/sの双方向帯域幅と99.999%の可用性を実現しています。消費電力はOCSあたり約108Wで、同等の電気式パケットスイッチの約3,000Wと比べて大幅に低くなっています。これは、Googleのデータセンターを外部世界およびデータセンター同士に接続する基盤となるものです。
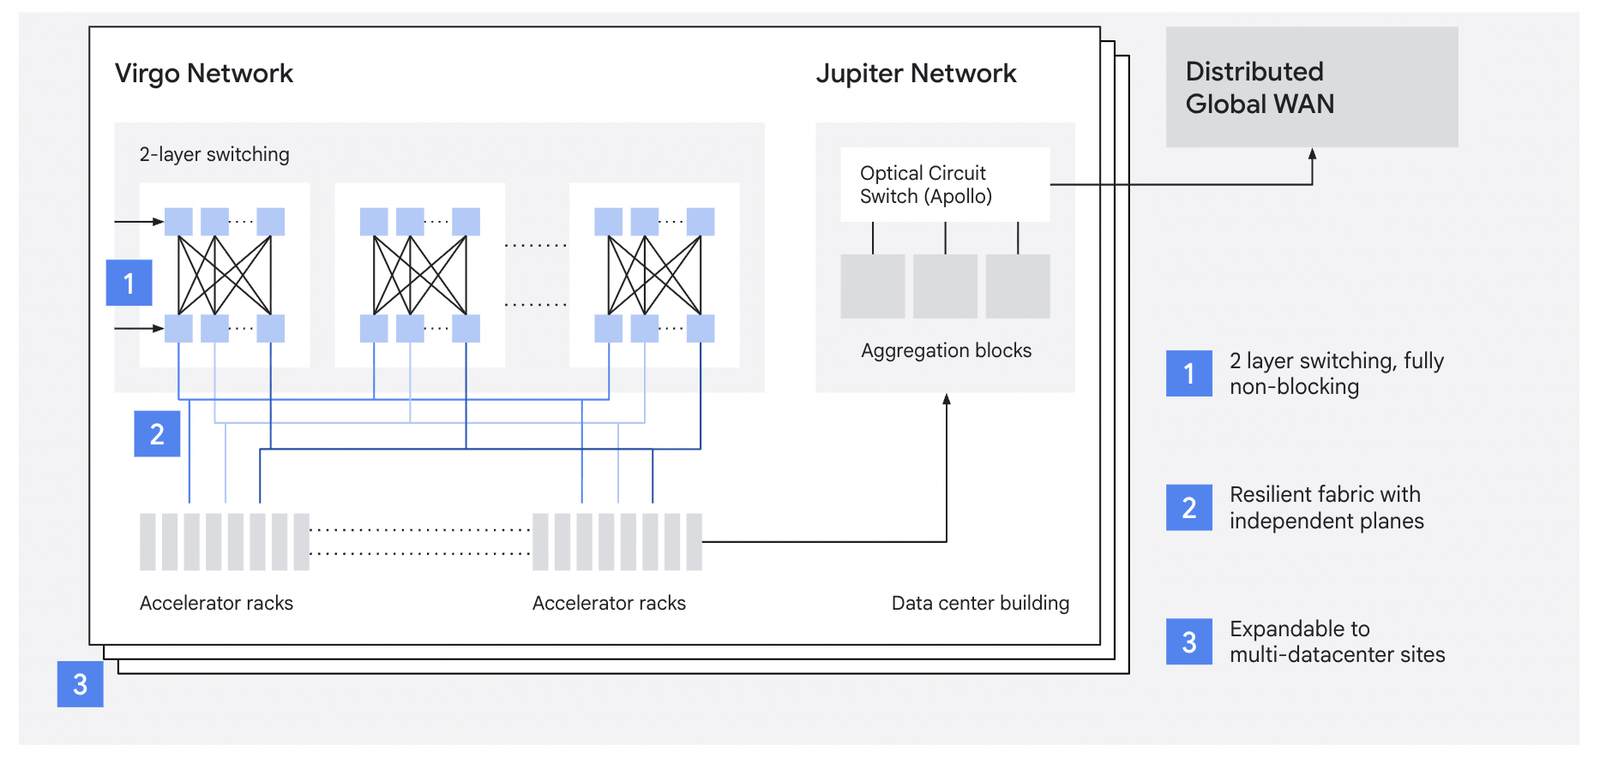
単一のデータセンターの能力とスペースを超えるトレーニング実行の場合、Jupiter は複数のサイトにわたるスケーリングを可能にします。この組み合わせは階層化されており、ポッド内には ICI、サイト内のポッド間には Virgo、サイト間には Jupiter が配置されます。Google の Pathways ソフトウェアスタックは、これらのマルチデータセンタードメインにわたるワークロードを単一の論理クラスタとして処理できます。
約1.7 ZFLOPSの性能を持つ単一のVirgoファブリックは、発表されている中で最大のAIトレーニングクラスタです。Jupiterで接続された複数のVirgoファブリックは、100万個以上のTPUチップを制御可能であり、これはGoogleが目標とする規模です。ただし、現在の展開規模ではこのレベルには達していません。
生産量と利用率
生のFLOPs値よりも、そのうち実際に有用な処理を実行する割合の方が重要です。Googleは8tスーパーポッドの目標値を97%のグッドプットとしており、これは実時間(ウォールクロック時間)の97%がリカバリ、停止、調整オーバーヘッドではなく、生産的な計算に費やされることを意味します。この数値は、前述のOCSベースのフォールトトレランスとサブミリ秒単位のテレメトリに依存します。
モデルFLOPs利用率(MFU)はもう1つの変数です。MFUは、チップが実際のワークロードで実際に維持できる理論上のピークFLOPsの割合を測定します。SemiAnalysisは、TPU MFUが40%の場合、GB300 NVL72と比較して、実効トレーニングFLOPあたりのコストが約62%低下し、損益分岐点が約15%のTPU MFUであると推定しています。Anthropicが公開しているTPUの経済性は、損益分岐点をはるかに上回るレベルで動作することを示唆しています。高いグッドプット(チップを稼働させ続けること)と競争力のあるMFU(チップが稼働しているときに常に稼働していること)の組み合わせが、TPUのTCOを大規模に機能させる要因です。
8番が座る場所
TPU 8をNVIDIAの現行および今後のプラットフォームと比較する際には、単位に細心の注意を払う必要があります。NVIDIAはNVLinkの帯域幅を双方向合計値として示しており、1.8 TB/sのNVLink 5を搭載したB200は、片方向あたり900 GB/sとなります。NVIDIAの主要FLOPsは通常2:4スパースであり、高密度はその半分です。GoogleのTPUの数値は高密度かつ双方向です。比較表を読む際には、帯域幅が単方向か双方向か、FLOPsが高密度かスパースかを確認してください。
チップあたりのFP4は、8tで12.6 PFLOPSの密な演算能力を持ち、GB200の10 PFLOPSの疎な演算能力(5 PFLOPSの密な演算能力)とGB300の20 PFLOPSの疎な演算能力(15 PFLOPSの密な演算能力)の中間に位置します。チップあたりの比較は近いですが、スケールアップの比較はそうではありません。GB300 NVL72ラックには、1つのNVLinkドメインに72個のGPUが搭載されています。8tスーパーポッドは、単一の3Dトーラスに9,600個のチップで構成されています。これは、単一の集合ドメインに133倍ものチップが搭載されていることを意味し、これが最先端のトレーニング用プラットフォーム間のギャップとなっています。
NVIDIA は立ち止まっていません。Vera Rubin は 2026 年下半期に出荷され、パッケージあたり 50 PFLOPS の NVFP4 推論 (ただし SemiAnalysis はこの数値が適応圧縮を前提としているかどうか疑問を呈しています)、22 TB/s の 288 GB の HBM4、双方向 3.6 TB/s の NVLink 6 を搭載しています。2027 年下半期の Rubin Ultra は、4 つのレチクル ダイを結合し、パッケージあたり最大 100 PFLOPS の FP4 と 1 TB の HBM4e を実現します。Kyber NVL576 は、2 つのラックに 576 個の Rubin Ultra GPU を結合し、15 EFLOPS の FP2 推論を実現します。これにより、Google のスケールアップの優位性が縮小し始めますが、576 個の GPU は、8 トンのスーパーポッドよりまだ桁違いに小さいです。
8が優れている点:スケールアップドメインサイズ(72個のGPU、またはKyber以降では576個に対し、9,600個のチップ)、シングルファブリックスケール(47 Pb/sで134,000個以上のチップ)、静的XLAスケジューリングによる決定論的なレイテンシ、およびTPUモデルに適合するワークロードのTCO。
8つのトレイルがあります。チップあたりのHBM容量(216GBに対し、RubinのHBM4は288GB)、スパース性(NVIDIAは2:4のハードウェアパスを持っていますが、Googleは持っていません)、エコシステムの幅広さ(CUDA、cuDNN、TensorRT-LLM、およびPyTorchファーストのサービングスタックはNVIDIAに最初に搭載されます。TPU上のネイティブPyTorchはまだプレビューです)。
どちらのプラットフォームにも需要がある。Metaは、2027年から自社のデータセンターにGoogle TPUを導入する数十億ドル規模の契約について協議中と報じられており、2026年にはCloud TPUのレンタルも開始される可能性がある。同時に、Google CloudはNVIDIA Vera Rubin NVL72をベースにしたA5Xインスタンスを発表し、単一サイト内で最大80,000万個のRubin GPU、複数サイト展開では最大960,000万個のGPUまで拡張可能とした。Googleは両プラットフォームを大規模に展開している。
要約
第 8 世代 TPU は、汎用 AI ワークロードではなく、現在の大規模トレーニングやエージェント推論の形態に合わせて構築された、1 個ではなく 2 個のチップです。8t は、スーパーポッドあたり 9,600 個のチップまでスケールアップし、Virgo ファブリックあたり 134,000 個以上のチップまでスケールアウトします。8i は、SparseCores を集合的アクセラレーション シリコンに置き換え、3D トーラスを Boardfly に置き換えて、大規模での MoE サービングに必要なレイテンシ ターゲットを満たします。NVIDIA のロードマップでは、Vera Rubin、Rubin Ultra、Kyber により、2026~2027 年にかけてこれらのギャップの一部が縮小されますが、スケールアップ領域での優位性は今のところ維持されます。何十万個ものチップで混合エキスパート モデルを実行する最先端ラボにとって、8 は Grace Blackwell の信頼できる代替品であり、Meta の議論は、市場がそれを価格に織り込み始めていることを示唆しています。


 Amazon