

Googleは、クラウドプラットフォーム製品群に新たなクラウドテクノロジー「Google Cloud Dataproc」を発表しました。この新技術は、Google Cloud Platform内でHadoopとSparkをより簡単に導入・管理できるようにすることを目的としています。DellとClouderaが最近発表した技術と同様に、この技術によって、高額なトレーニング費用をかけずにHadoopを利用できるようになります。
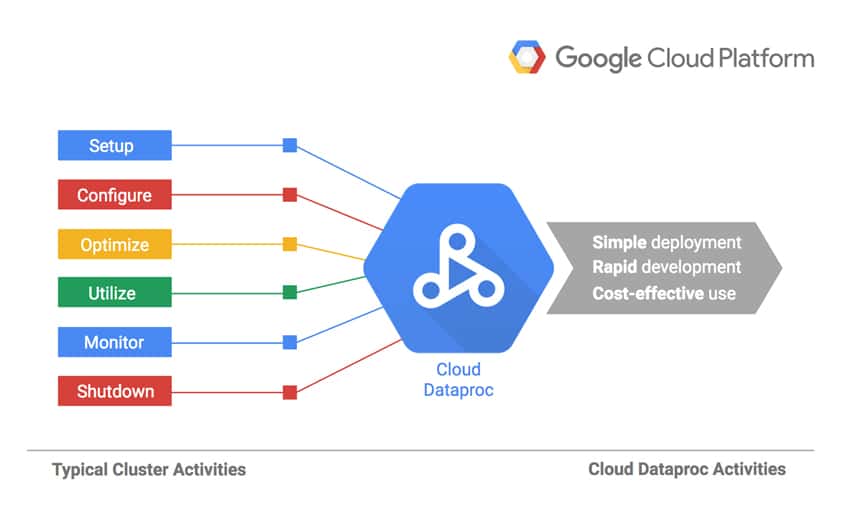
データセットのサイズと複雑さが増大し続けるにつれて、これらのデータセットを分析するにはより強力なツールが必要になります。ツールは存在しますが、多くの場合、さらに複雑さが増し、新しいテクノロジについて管理者をトレーニングしたり、コンサルタントを雇ったりするとコストがかかる可能性があります。 Google は、Hadoop と Spark 用の自動マネージド サービスである Dataproc を導入します。 Dataproc を使用すると、ユーザーはバッチ処理、クエリ、ストリーミング、機械学習にオープンソース データ ツールを利用できると同時に、その自動化を利用してクラスタを迅速に作成および管理できます。 Dataproc では、使用していないときにクラスタをオフにすることもできるため、分単位で請求が行われるため、コストを節約できます。
主なメリット:
- Cloud Dataproc の料金は、使用される他の Cloud Platform リソースに加えて、顧客のクラスタ内の仮想 CPU あたり 1 時間あたりわずか XNUMX セントです。 Cloud Dataproc クラスタには、コンピューティング価格が低いプリエンプティブル インスタンスを組み込むことができ、コストをさらに削減できます。 Cloud Dataproc では、使用量を最も近い時間に切り上げるのではなく、分単位の請求と最低 XNUMX 分の請求期間で使用した分のみを顧客に請求します。
- Dataproc を使用しない場合、オンプレミスまたは IaaS プロバイダを通じて Spark クラスタと Hadoop クラスタを作成するには 5~30 分かかる場合があります。比較すると、Cloud Dataproc クラスタは起動、スケーリング、シャットダウンが迅速であり、これらの各操作にかかる時間は平均 90 秒以下です。これは、ユーザーがクラスターを待つ時間を短縮し、データの操作に多くの時間を費やすことができることを意味します。
- Cloud Dataproc には、他の Google Cloud Platform サービスとの統合が組み込まれています。 ビッグクエリー、 クラウドストレージ、 クラウドBigtable、Cloud Logging、Cloud Monitoring を利用できるため、顧客は Spark や Hadoop クラスタだけでなく、完全なデータ プラットフォームを手に入れることができます。たとえば、Cloud Dataproc を使用すると、ビジネス レポート用に数テラバイトの生ログ データを直接 BigQuery に簡単に ETL できます。
- お客様は、Google Developers Console、Google Cloud SDK、または Cloud Dataproc REST API を通じて、クラスタと Spark または Hadoop ジョブを簡単に操作できます。クラスターの使用が終了したら、クラスターをオフにするだけで、アイドル状態のクラスターにお金が無駄に費やされなくなります。 Cloud Dataproc は Cloud Storage、BigQuery、Cloud Bigtable と統合されているため、データが失われる心配はありません。
- Cloud Dataproc を使用するために新しいツールや API を学ぶ必要はなく、再開発することなく既存のプロジェクトを Cloud Dataproc に簡単に移行できます。 Spark、Hadoop、Pig、Hive は頻繁に更新されるため、ユーザーはより早く生産性を高めることができます。
可用性と価格
Google Cloud Dataproc は現在、仮想 CPU あたり 0.01 ドルからベータ サービスとして利用できます。


 Amazon