

HPEは、 NVIDIA AI Gridリファレンスアーキテクチャに準拠した包括的なインフラストラクチャソリューションであるHPE AI Gridを発表しました。これは、地域および遠隔地のエッジロケーションに分散するAIファクトリーと分散推論クラスタを安全に接続するように設計されています。HPEはこのプラットフォームを、数千もの分散推論サイトを単一の統合システムとして展開および管理する必要のあるサービスプロバイダー向けに位置付けています。
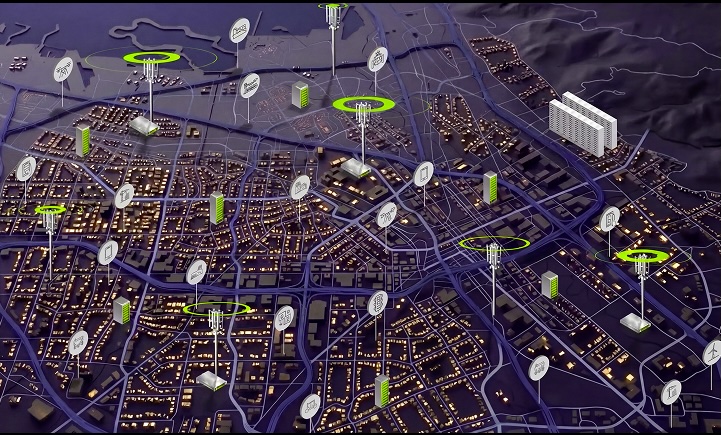
HPEは、予測可能なレイテンシ、決定論的なパフォーマンス、分散展開がますます求められるAIネイティブアプリケーション向けのソリューションとして、AI Gridを発表しました。同社によれば、このソリューションは、ゼロタッチプロビジョニング、統合されたオーケストレーション、自動化されたセキュリティにより、大規模かつ地理的に分散した展開環境全体でライフサイクル管理を容易にし、超低レイテンシを大規模に実現するとのことです。
HPEのEVP、社長兼ネットワーキング担当ゼネラルマネージャーであるラミ・ラヒム氏は、この戦略はデータの生成と利用が行われる場所にインテリジェンスをより近づけることであり、ネットワークインフラストラクチャがリアルタイムAIサービスの重要な実現要因となる、と説明した。NVIDIAのグローバルバイスプレジデント(通信担当)であるクリス・ペンローズ氏は、地理的に分散したクラスターを接続し、パフォーマンス、コスト、レイテンシに基づいてワークロードを動的に割り当てるAIグリッドの重要性を強調し、HPEがマルチクラウドルーティングとエッジインフラストラクチャを提供し、NVIDIAが高速コンピューティングとネットワーキングコンポーネントを提供すると述べた。
フルスタックのハードウェアおよびネットワークの基礎
HPEは、HPE AI Gridが、マルチテナントやクラウドネイティブセキュリティなど、サービスプロバイダーの運用モデルをサポートするように設計された、統合されたハードウェアおよびソフトウェアプラットフォームを提供すると述べています。このアーキテクチャは、マルチクラウドルーティングや長距離およびメトロ接続用のコヒーレント光など、通信事業者グレードのネットワークを実現するHPE Juniperの機能を中心に構築されています。HPEはまた、ゼロタッチ展開と継続的なライフサイクル管理を可能にする統合ファイアウォール、WAN自動化、およびオーケストレーションについても強調しています。
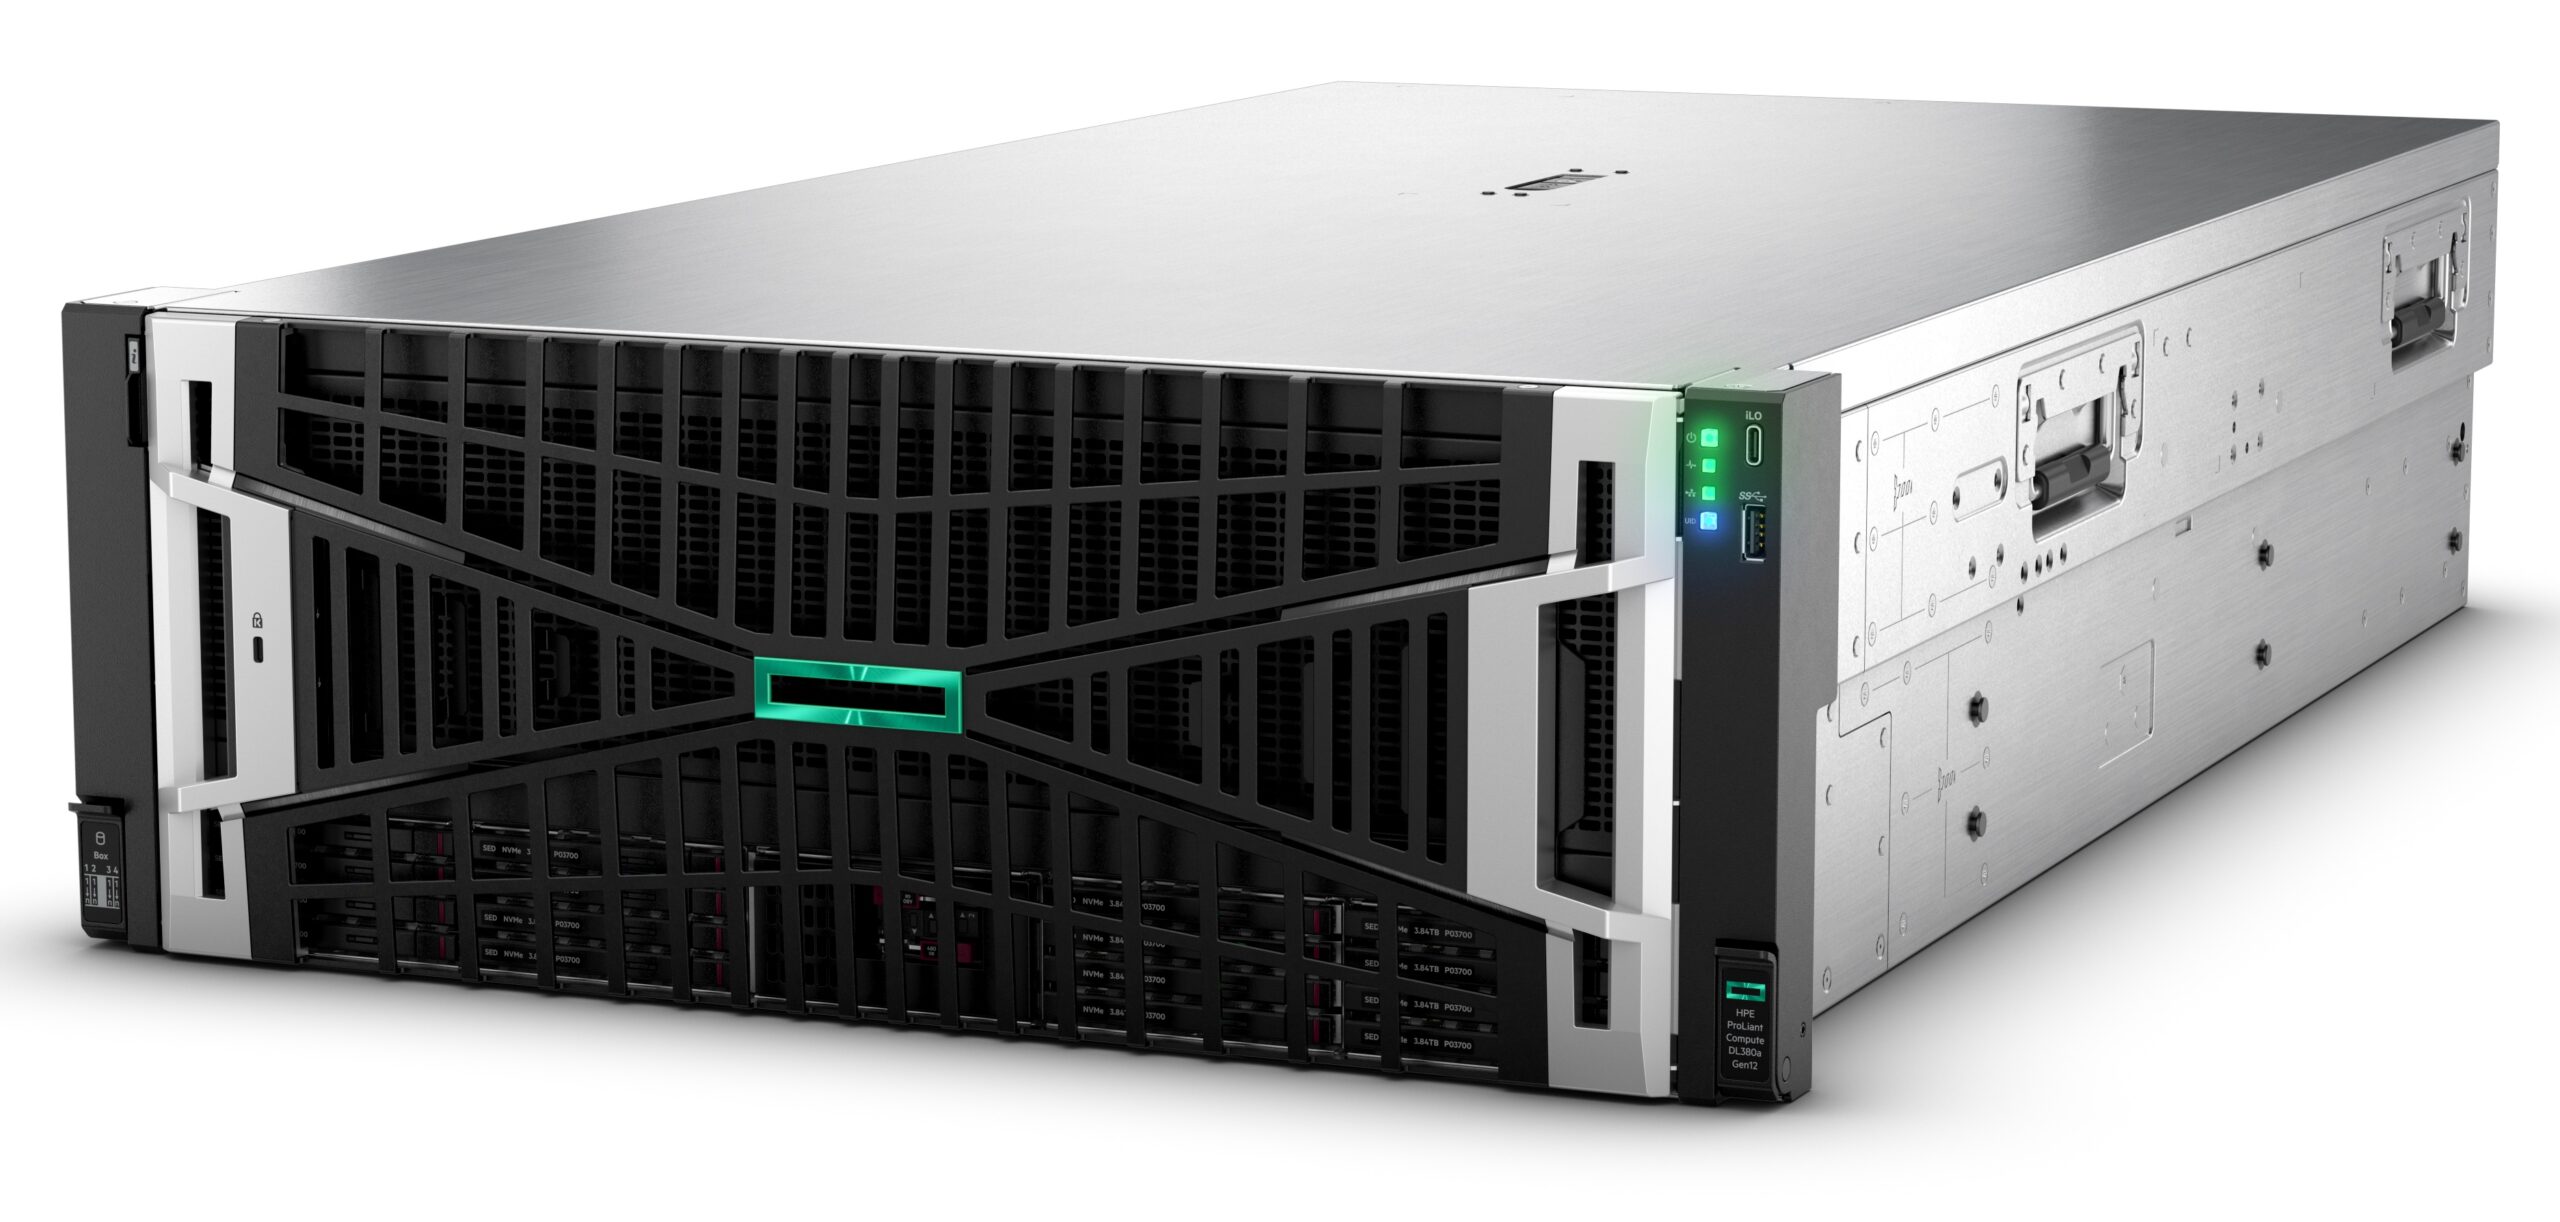
コンピューティング面では、HPEはエッジサーバーとラックサーバーにNVIDIAアクセラレーテッドコンピューティングと高性能ネットワークおよびI/Oスタックを組み合わせています。HPEは、NVIDIA RTX PRO 6000 Blackwell Server Edition GPU、NVIDIA BlueField DPU、Spectrum-X Ethernetスイッチ、およびConnectX SuperNICのサポートを明記しています。このスタックには、分散サイト全体で推論サービスの展開を加速するためのNVIDIA AIブループリントも含まれています。
サービスプロバイダーの焦点
HPEは、小売業におけるパーソナライゼーション、予知保全、エッジヘルスケア、キャリアグレードのAIサービスなど、予測可能なレイテンシと信頼性の高い接続性を必要とするアプリケーション向けにAI Gridを位置付けています。同社によると、このプラットフォームは、既存の電力と接続性を備えた拠点をRAN対応のAIグリッドノードに変換するのに役立ち、各拠点を個別の展開として扱うことなく、推論を実行できる場所を効果的に拡大できるとのことです。
実地試験とパートナーエコシステム
より広範なAIグリッド戦略の一環として、コムキャストは、リアルタイムのエッジ推論に焦点を当てた分散ネットワーク上での新たなAIフィールドトライアルを発表した。HPEは、初期のトライアルには、中小企業を対象としたAI駆動型の「フロントデスク」サービス向けに、NVIDIA GPU上でPersonal AI(HPEのUnleash AIパートナープログラムの一部)の小規模言語モデルを実行するHPE ProLiantサーバーが含まれていると述べた。


 Amazon