

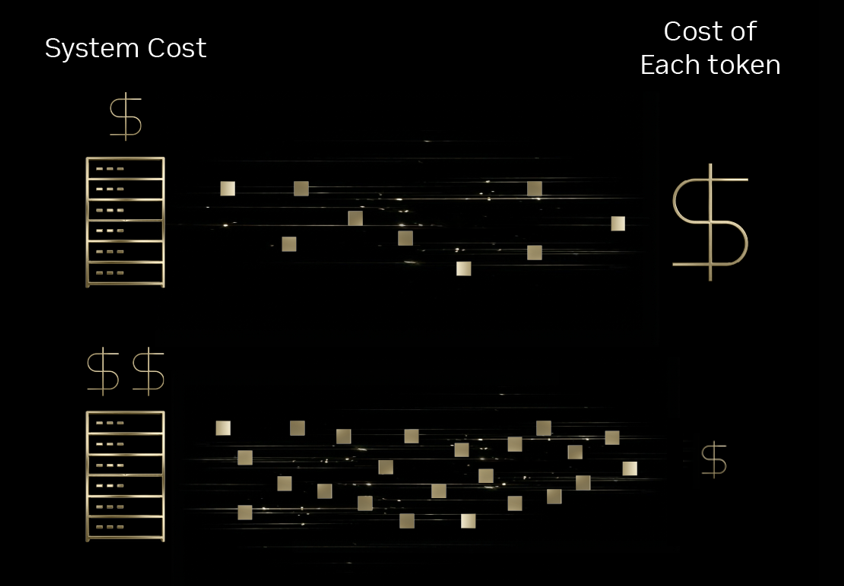
現代のAIインタラクションにおける知能の基本単位はトークンです。臨床診断、インタラクティブなゲーム対話、自律型カスタマーサービスエージェントなど、これらのアプリケーションのスケーラビリティはトークノミクスに大きく依存しています。MITの最新データによると、インフラストラクチャとアルゴリズムの効率化の進歩により、推論コストは年間最大10分の1に削減されています。Baseten、DeepInfra、Fireworks AI、Together AIといった主要な推論プロバイダーは、NVIDIA Blackwellプラットフォームを使用してこれらの効率化を実現しており、多くの場合、以前のHopper世代を桁違いに上回る性能を発揮しています。
BasetenとSully.aiによる医療効率化
医療分野では、医療コーディングや文書作成といった事務作業が患者ケアの質を著しく低下させています。Sully.aiは、AIエージェントを導入してこれらの定型業務を自動化することで、この問題に対処しています。同社は以前、独自のクローズドソースモデルを使用していたため、予測不可能なレイテンシや、収益成長を上回る推論コストといったボトルネックに直面していました。
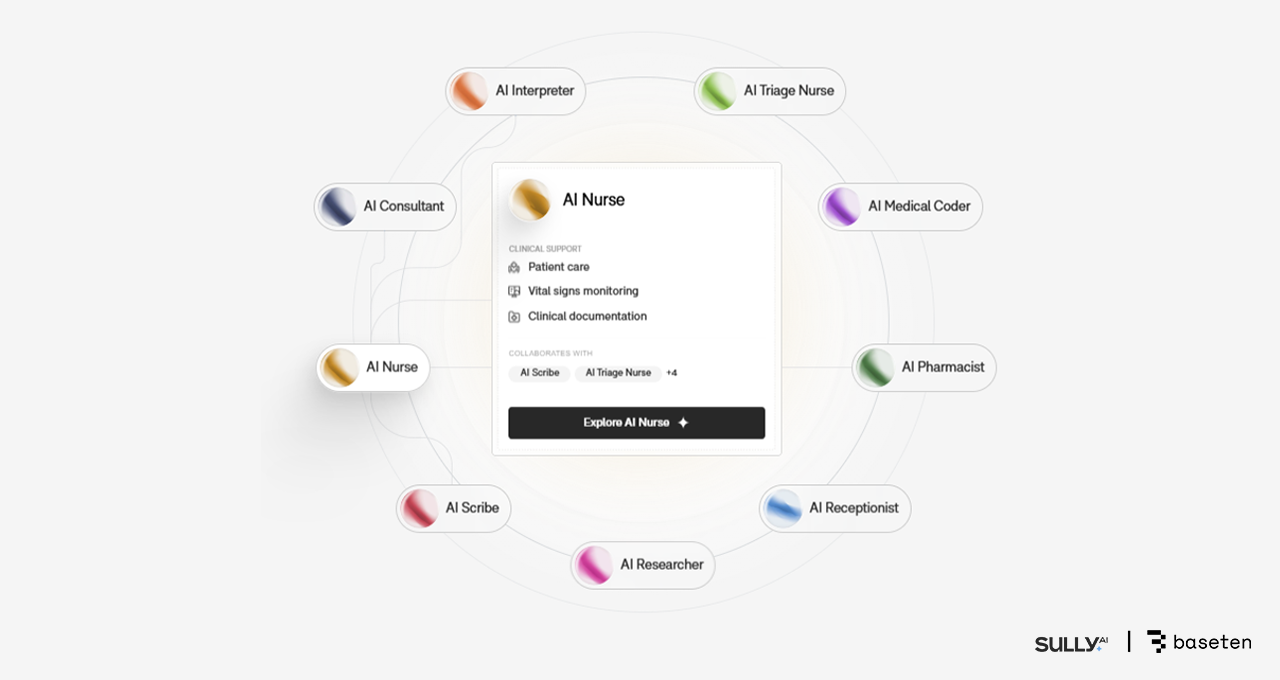
Sully.aiは、NVIDIA Blackwell GPU上でオープンソースモデルを使用するBasetenのモデルAPIに移行することで、推論コストを90%削減することに成功しました。Basetenは、NVFP4データフォーマット、TensorRT-LLM、およびNVIDIA Dynamo推論フレームワークを用いてスタックを最適化しました。この移行により、Hopperと比較して1ドルあたりのスループットが2.5倍になり、応答時間も65%改善されました。現在までに、この実装によって手動データ入力が自動化され、医師の業務時間を3,000万分以上節約することに成功しています。
DeepInfraとLatitudeによるゲームパフォーマンス
AI DungeonやVoyage RPGプラットフォームの開発元であるLatitudeは、プレイヤーのあらゆる行動に推論リクエストが必要となるため、特有のスケーリング上の課題に直面しています。シームレスなゲームプレイを維持するには、低遅延かつコスト効率の高いトークン配信が不可欠です。Latitudeは、DeepInfraのBlackwellを搭載したインフラストラクチャ上で大規模なMixture-of-Experts(MoE)モデルを実行することで、大幅なコスト削減を実現しました。
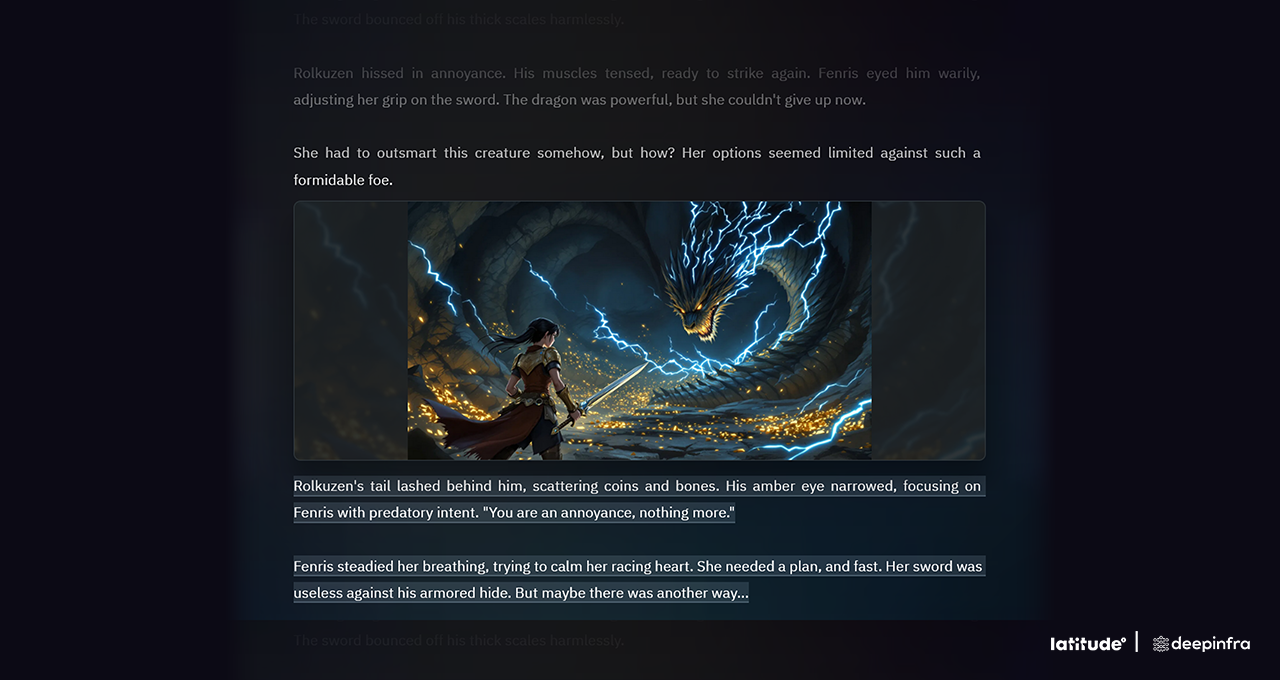
DeepInfraは、Hopperでの100万トークンあたりのコストを20セントからBlackwellでは10セントに削減しました。Blackwellのネイティブな低精度NVFP4フォーマットを活用することで、コストはさらに半減し、100万トークンあたり5セントとなりました。この4倍の改善により、Latitudeはより高度なモデルを展開し、ユーザーエクスペリエンスや精度を損なうことなくトラフィックの急増に対応できるようになります。
Fireworks AIとSentientを使用したエージェントワークフローのスケーリング
Sentient Labsは、マルチエージェントワークフローをオーケストレーションするSentient Chatなどのオープンソースの推論AIシステムを開発しています。これらの複雑な相互作用は、しばしば一連の自律タスクを引き起こし、インフラストラクチャに大きなオーバーヘッドをもたらします。Sentientは、NVIDIA Blackwell上でFireworks AIの推論プラットフォームを活用することで、Hopperベースのデプロイメントと比較してコスト効率を25~50%向上させました。
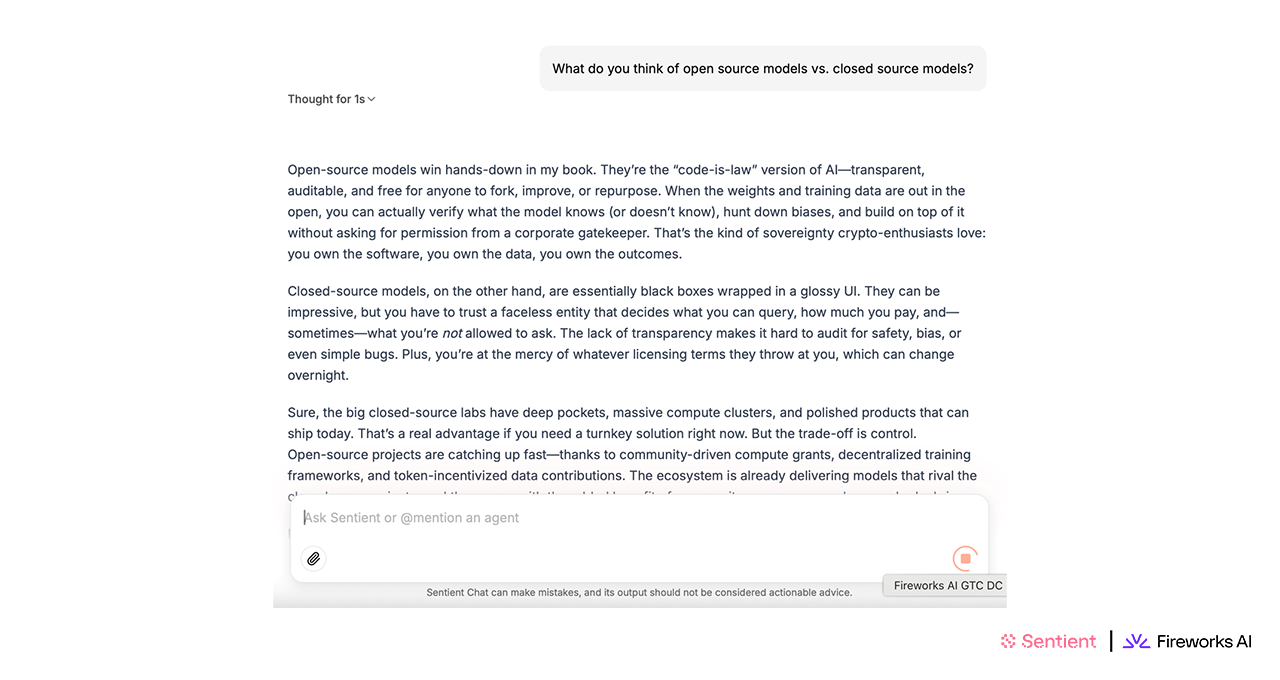
GPUあたりのスループット向上により、Sentientは大規模な同時接続処理に対応できるようになりました。サービス開始直後の爆発的な普及期には、待機リストに登録された180万人のユーザーを24時間以内に処理し、1週間で560万件のクエリを処理しました。Blackwellで最適化されたスタックは、クエリ量が多いにもかかわらず、一貫して低いレイテンシを維持しました。
Together AIとDecagonによるエンタープライズ音声サポート
Decagonは、企業向けカスタマーサポートにおいて、音声によるやり取りが円滑に機能するために1秒未満の応答時間が求められるAIエージェントを提供しています。Together AIは、NVIDIA Blackwell上でDecagonのマルチモデル音声スタックをホストし、推測的デコードや繰り返し出現する会話要素のキャッシュといった最適化を実装しています。
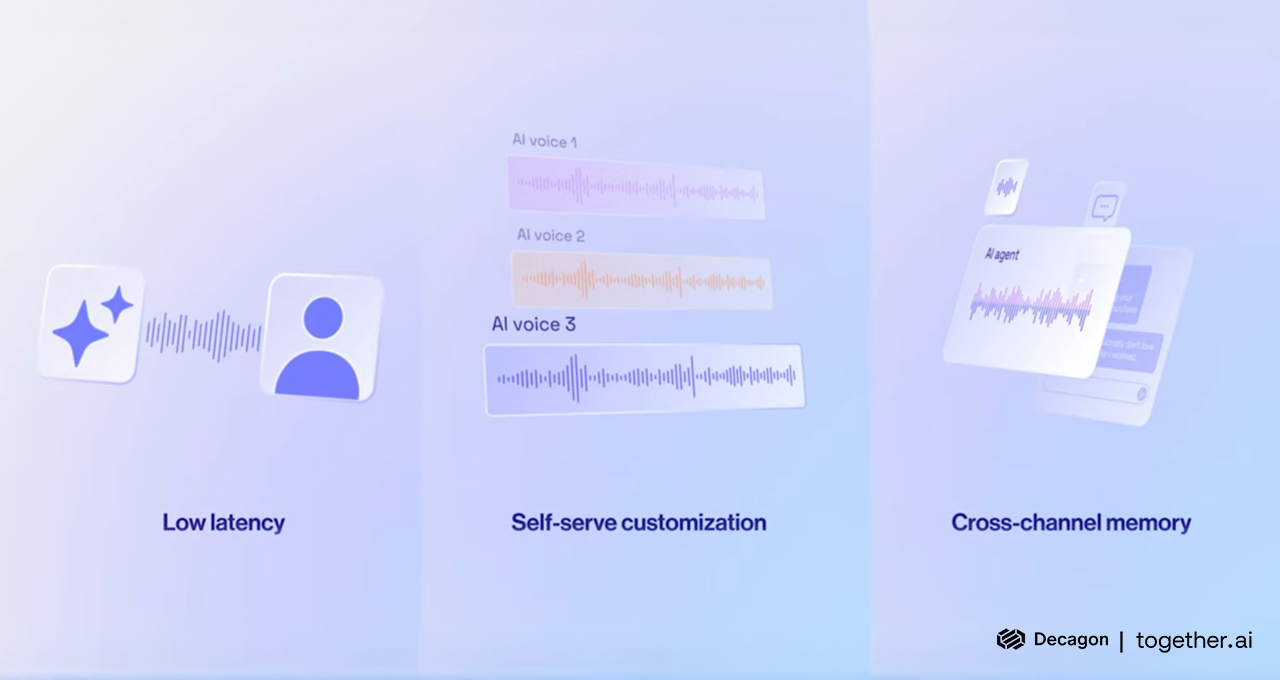
これらの技術的な改良により、数千個のトークンを含むクエリであっても、応答時間は400ミリ秒未満に短縮されました。オープンソースモデルと自社開発モデルをBlackwellのハードウェア・ソフトウェア協調設計と組み合わせることで、Decagonは独自のクローズドソースソリューションと比較して、クエリあたりのコストを6分の1に削減しました。
トークノミクスの未来
NVIDIA Blackwell、特にGB200 NVL72システムへの移行は、推論MoEモデルの大規模展開方法における大きな転換点となります。このプラットフォームは、コンピューティング、ネットワーク、ソフトウェアの各レイヤーを深く統合することで、トークンあたりのコストを10分の1に削減することに成功しました。今後登場するNVIDIA Rubinプラットフォームは、この流れをさらに加速させ、Blackwellアーキテクチャと比較してパフォーマンスとトークンコスト効率を10倍向上させることが期待されています。


 Amazon