

Hot Chips 2026において、インテルは、データセンター、推論、エッジの各層にわたるエンタープライズ向けエージェント型AIワークロードを対象とした、今後登場する3つのシリコンプラットフォームのアーキテクチャの詳細を発表しました。ラインナップは、ワークロードオーケストレーション向けの次世代Xeonプロセッサ(コードネーム:Diamond Rapids)、高密度推論専用のデータセンター向けGPUであるCrescent Island、そしてクライアントおよびエッジデバイス向けのWildcat Lake SoC(Intel Core Series 3)で構成されています。
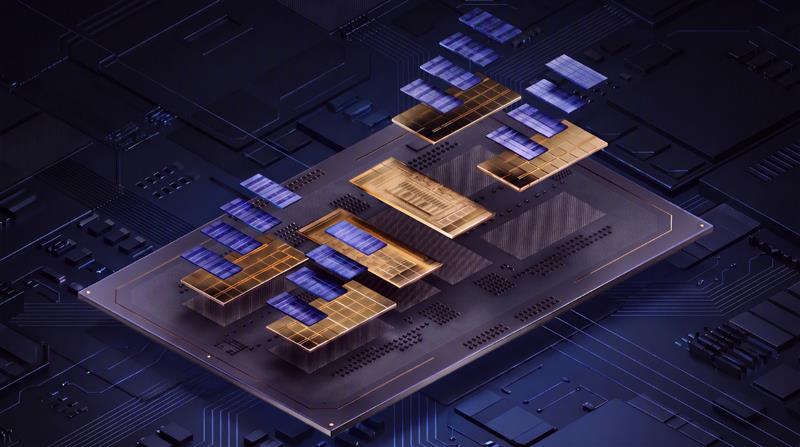
インテルの技術責任者によると、エージェント型AIワークロードには、汎用コンピューティングと専用アクセラレーション、高度なパッケージング、モジュール式チップレット相互接続を組み合わせた異種混在設計が必要だという。インテルによれば、これら3つのプラットフォームは、インテルファウンドリー18Aプロセスノードファミリーで製造され、Foveros Direct 3DパッケージングとUniversal Chiplet Interconnect Express(UCIe)オープンスタンダードを基盤としており、エンタープライズ展開における電力、帯域幅、密度に関する要件を満たす。
Diamond Rapids:高コア数コンピューティングおよびI/O基盤
性能が向上したIntel 18A-Pプロセスノードをベースに構築されたDiamond Rapidsは、エージェントワークフローと大規模エンタープライズコンピューティングをオーケストレーションするために設計された、Intelの次世代Xeonアーキテクチャです。このシステムオンチップは、Foveros Direct 3DスタッキングとUCIe-Sインターコネクトを利用して、モジュール式のコンピューティングタイルを統合メモリサブシステムと高速I/Oに接続します。
- 最大256個の新しいコアと1.28GBのLLCを搭載
- 12,800 MT/sの16個のメモリチャネル
- PCIe Gen6およびCXL 3.0の128レーン
シリコン実行リソースに関しては、このプラットフォームは最大256個の物理コアと1.28GBのラストレベルキャッシュ(LLC)を備えています。コンピューティング機能の強化には、Intel Advanced Performance Extensions(APX)と更新されたAdvanced Matrix Extensions(AMX)命令が含まれます。メモリとバスの接続性は世代間で大幅に向上しており、このアーキテクチャは最大12,800MT/sのデータレートをサポートする16個のメモリチャネルと、128レーンのPCIe Gen6、およびCompute Express Link(CXL)3.0を統合し、高スループットのアクセラレータ接続とメモリ拡張を管理します。
クレセントアイランド:高容量空冷式推論アクセラレータ
Crescent Islandは、リアルタイム推論およびロングコンテキストのエージェントモデルにおけるトークンスループットと運用効率を最適化するために設計された、専用のPCIeアクセラレータです。Xe3Pアーキテクチャをベースに構築されたこのカードは、32個のXeコアと256個のIntel Matrix Extension(XMX)エンジンを搭載しています。
- Xe3Pをベースとした32個のXeコアと256個のXMXエンジン
- 最大480GBのLPDDR5Xメモリ
- 350ワット空冷式PCIeカード
Crescent Islandは、電力密度の高い高帯域幅メモリ(HBM)に頼るのではなく、最大480GBのLPDDR5Xメモリを統合しています。このメモリアーキテクチャにより、アクセラレータは大規模なパラメータモデルをホストし、拡張コンテキストウィンドウをサポートし、複数の同時エージェントを処理しながら、350ワットの熱設計電力範囲内に収まります。物理設計は標準的なPCIeフォームファクタに準拠しているため、液冷化を必要とせずに、既存の空冷式データセンターラックに直接統合できます。
Wildcat Lake:クライアントおよびエッジSoCの統合
インテルのCore Series 3プロセッサーファミリー(コードネーム:Wildcat Lake)は、主流のノートパソコン、軽量モバイルワークステーション、インテリジェントエッジアプライアンス向けに設計されており、クライアントインフラストラクチャにAI実行機能をもたらします。インテル18Aプロセスで製造されたWildcat Lakeは、インテル初のUCIeパッケージングを主流クライアントプロセッサーに統合した製品であり、モジュール式でコスト効率の高いシリコンアセンブリを実現します。
- パフォーマンスコア2基と効率コア4基
- LPDDR5X-7467まで対応
- WiFi7およびBluetooth6.0
演算トポロジーは、シングルスレッド処理とバックグラウンド処理に対応するため、2つの高性能コアと4つの高効率コアを組み合わせています。グラフィックスと行列演算は、XMXアクセラレーションを備えた統合型Xe3 GPUによって駆動され、ハイブリッドオンデバイス推論用に最大17 TOPSの専用ニューラルプロセッシングユニット(NPU)によって補完されます。このプラットフォームは、最大LPDDR5X-7467メモリをサポートし、Wi-Fi 7とBluetooth 6.0接続をネイティブに統合しています。
これら3つのアーキテクチャは、データセンターインフラストラクチャと分散型エッジノード全体にわたるエージェント型AIの導入における、計算能力、メモリ容量、および熱に関する制約に対処するためのインテルの戦略を概説するものです。


 Amazon