

2025 OCP Global Summit において、Intel は AI 推論を強調し、「Crescent Island」と呼ばれる新しいデータセンター GPU と、Gaudi 3 のラックスケール リファレンス デザインという 2 つの重要な進歩を発表しました。どちらの開発も、モデル トレーニングからリアルタイムの広範な推論への移行の進展と一致しており、レイテンシ、メモリ帯域幅、効率、運用の簡素化などの要素が重要になっています。
静的トレーニングから広範囲にわたるリアルタイム推論へ
インテルのCTO、サチン・カッティ氏は、この移行を総括し、エージェントAIの普及に伴い、推論は継続的、コンテキストリッチ、そしてシステム集約的になると述べました。増大するトークン量、複雑なモダリティの組み合わせ、そして厳格なSLA要件を管理するには、最適なシリコンとオープンで開発者中心のソフトウェアスタックを組み合わせた異機種混合のインフラストラクチャが必要となります。この環境において、インテルのXeアーキテクチャ・データセンターGPUは、シーケンス長とトークンレートの増加に対応できる容量と信頼性を提供し、Gaudi 3は、予測可能な総所有コスト(TCO)でオープンでスケーラブルな推論エコシステムをサポートします。
重要なのは、単に「より高速なチップ」だけではありません。推論の成功はシステム統合にかかっています。トポロジーを考慮したメモリ、柔軟なインターコネクト、利用プロファイルに合わせた電力と冷却、そしてモデル、トークン、ストリームを第一級オブジェクトとして扱うオーケストレーションなどです。企業は、モデル、フレームワーク、そしてサービススタックを反復処理する必要があるまさにその瞬間に、ロックインされることを望んでいません。
PC、エッジ、データセンターを網羅
インテルは、Xeon 6 CPU、Gaudi 3 アクセラレータ、そしてインテルGPUを基盤としたAI PC、産業用エッジ、そしてデータセンターラックなど、エンドツーエンドの幅広いソリューションを提供できる独自の立場にあると主張しています。共通のテーマは以下の通りです。
- PCIe の多様性の柔軟性により、適切な場合には既存のフットプリントを再利用でき、必要に応じてファブリック中心のラックに拡張できます。
- ラックスケール設計により、ワットあたりのパフォーマンスが予測可能になり、高密度と熱要件で必要な場合には液体冷却オプションも組み込まれます。
- さまざまなシリコン タイプと展開レベルにわたってシームレスな開発を実現することを目的とした、包括的な統合ソフトウェア プラットフォームです。
OCP との提携は、調達、検証、運用の拡張が容易な、オープンで参照可能な設計に対する同社の好みをサポートします。
クレセントアイランド: 推論経済向けに調整されたデータセンター GPU
Crescent Islandは、高度な電源や冷却ソリューションを必要とせず、高いトークンスループットを必要とする空冷式エンタープライズサーバー向けに設計された、Intelの次世代データセンターGPUです。その焦点は実用性にあり、コスト効率とエネルギー性能を優先しながら、最新の推論タスクに不可欠なメモリ容量と帯域幅を提供します。
ハイライトは以下を含む:
- Xe3Pマイクロアーキテクチャは、ワットあたりのパフォーマンスに重点を置いています。これは、使用率が一定でコスト感度が高い定常状態推論に適しています。
- 160 GB LPDDR5Xメモリをオンカードに搭載。LLM/RAGサービング、ロングコンテキスト要約、マルチモーダルパイプラインなどでは、メモリ容量と帯域幅が、生のTOPSよりもQPSとテールレイテンシを左右することがよくあります。
- 幅広いデータ型をサポートし、「トークン・アズ・ア・サービス」プロバイダーを念頭に設計されています。混合精度/量子化の柔軟性は、実稼働エンドポイントの精度を維持しながらスループットを向上させるために不可欠です。
- Intelのオープン統合スタックによるソフトウェアの準備。Arc Pro BシリーズGPUの早期最適化により、開発者のワークフローを合理化し、移植時の摩擦を最小限に抑えます。
- タイムライン: Crescent Island の顧客サンプリングは 2026 年後半に予定されています。2026 ~ 2027 年の更新サイクルを計画している購入者にとっては、ソフトウェア スタックとモデル提供パターンを今すぐ試用できる実用的な機会となります。
Crescent Islandは、大規模な推論経済性を実現します。空冷式で、容量重視、そしてワット当たりのパフォーマンスに重点を置いたソリューションです。例えば、厳格なレイテンシSLOを遵守したトークン処理がワークロードの大部分を占めているとします。その場合、オンボードの160GBのメモリと効率的なデータタイプにより、ワット当たりの同時セッション数が増加し、シーケンス長の増加に伴うクラスターの予期せぬ問題も軽減されます。
Gaudi 3: 大規模モデルとリアルタイム推論のための参照可能なラックスケール
Gaudi 3は、PCIe展開からラック規模の構成までを拡張し、一度にアーキテクチャを全面的に変更することなく、拡張への道筋を提供します。この新しいラック規模のリファレンスデザインは、大規模モデル推論とレイテンシが重要なリアルタイムシステムを標準化しようとしている企業を対象としています。
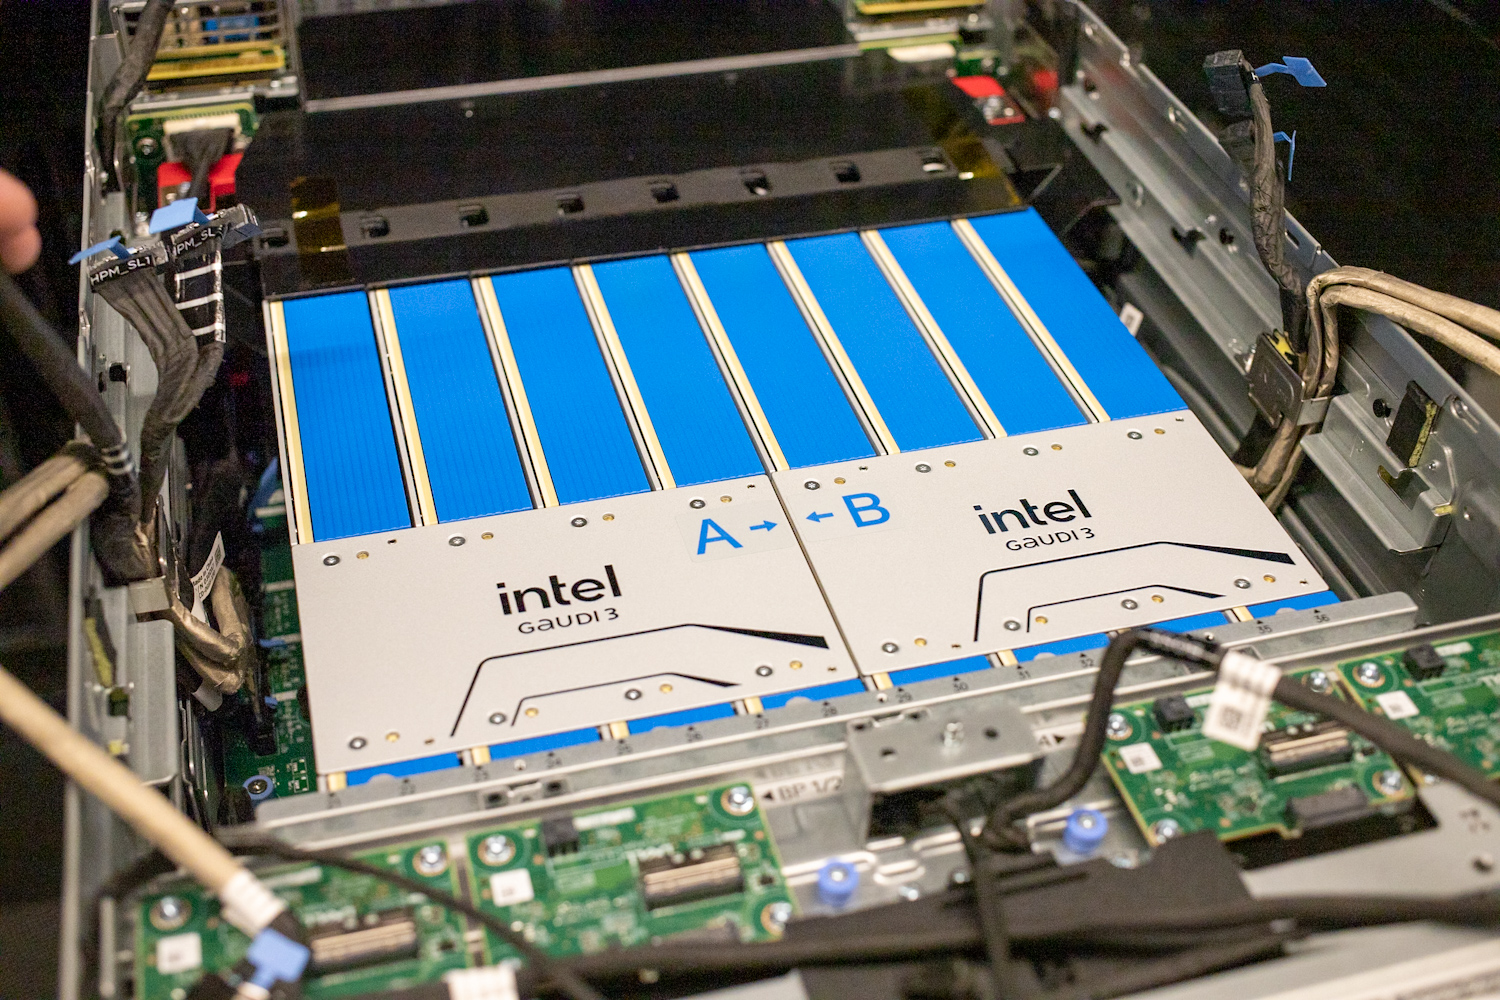
重要な要素:
- PCIeからラックへのシーケンスは、既存のサーバーのPCIeカードから始まり、モデルのサイズ、同時実行性、SLAプロファイルに応じてラックへと拡張されます。このアプローチは一般的な企業戦略であり、プロジェクトリスクの最小化に役立ちます。
- 8.2TBの高帯域幅メモリを搭載し、ラックあたり最大64基のアクセラレータをサポートします。主要機能であるメモリドメイン(HBD)により、より多くのパラメータとより長いメモリコンテキストが実現し、パフォーマンスの低下が少なく、テールレイテンシの安定性が向上します。
- 加速器の密度が高く、空気冷却だけでは持続的な推論が制限される場合、液体冷却オプションは不可欠です。
- オーケストレーションには、Kubernetes、標準モデル サーバー、一般的なフレームワークなどのオープン ソフトウェア スタックが含まれ、既存の MLOps およびサービス メッシュ アーキテクチャとの統合が簡素化されます。
実稼働環境での推論においては、メモリトポロジや一貫した熱管理といった要素が理論上のピーク性能を上回ります。64基のアクセラレータに8.2TBのHBMを搭載したGaudi 3ラックは、複数の大規模バリアントのロード、長いプロンプトの管理、スラッシングを起こさずにバースト処理といった実用的なニーズに対応します。このような高密度環境では、液冷は単なるオプションではなく、熱ストレス下でもQPSとレイテンシを維持するために不可欠です。
タイムライン
- ソフトウェアIntel の統合オープン ソフトウェア スタックは、Arc Pro B シリーズ GPU 上で準備されており、開発者に最適化と CI/CD 統合の早期機会を提供します。
- クレセント島: 顧客サンプリングは2026年下半期に予定されています。ソフトウェアの準備状況、メモリ駆動型サービスプロファイル、空冷式データセンターの制約を考慮した評価を計画します。
- ガウディ3ラック: リファレンス デザインでは、ラックあたり最大 64 台のアクセラレータ、8.2 TB の HBM、液体冷却が指定されており、DC/colo チームと早い段階で設備と電力/冷却エンベロープを調整します。


 Amazon