

Metaは、Meta Training and Inference Accelerator(MTIA)プログラムの急速な発展について概説した。同社は、約2年間で開発された4世代のチップについて説明した。これらのチップは、Metaが世界中のAIにとって不可欠と考える重要なインフラストラクチャの問題を解決する。それは、長いシリコン開発サイクルに頼ることなく、低コストで進化するモデルアーキテクチャに迅速に対応できるというものだ。MTIAはより広範なシリコン戦略の一環であり、Metaはこれらのチップの開発においてBroadcomとの協力関係を改めて表明した。
Metaによると、同社はすでに数十万台のMTIAデバイスを本番環境に展開し、複数の社内モデルを統合している。検証作業には、Llamaなどの大規模言語モデルのテストが含まれる。同社は以前、MTIA 100とMTIA 200という最初の2世代のMTIAに関する技術的な詳細をISCAの研究論文で発表した。現在、MTIA 300、400、450、500でプラットフォームを拡張している。これらの新しいコンポーネントは、ランキングと推薦(R&R)推論からR&Rトレーニング、そしてますます一般的なGenAIワークロード、特に推論へと適用範囲を拡大し、展開は進行中または2026年と2027年に計画されている。
設計原則としての反復
重要なテーマは、開発のペースです。Metaは、設計から生産まで2年かかることもある従来のチップ開発よりも、モデルの進化の方が速いと主張しています。Metaは、オープンソースのRISC-Vアーキテクチャに基づいてMTIAチップを製造しており、台湾積体電路製造(TSMC)が製造を担当しています。その対応策は、反復的でモジュール式の設計アプローチです。各世代は再利用可能なチップレットをベースに構築され、オペレーターとサービスに関する最新の知見を使用して微調整されます。同社はまた、チップ自体を超えた再利用の重要性も強調しています。MTIA 400、450、および500は、同じシャーシ、ラック、およびネットワークインフラストラクチャを共有しています。これにより、迅速なアップグレードが可能になり、シリコンの準備完了からデータセンターへの展開までの時間を短縮できます。
MTIA 300:シリコンに組み込まれたネットワーキングとコレクティブ
MTIA 300は、新しいロードマップの基盤となるものです。当初は、GenAIの台頭以前のMetaの主要なワークロードであったR&Rトレーニング向けに最適化されていました。このアーキテクチャには、ネットワークチップレットの内蔵、効率的な集団通信のための専用メッセージエンジン、集団演算の負荷を軽減するためのニアメモリコンピューティングが含まれています。R&Rに重点を置いていますが、これらの通信コンポーネントは、後のバージョンでGenAIトレーニングと推論効率もサポートします。
ブロックレベルでは、Meta社はMTIA 300を、1つの演算チップレット、2つのネットワークチップレット、および複数のHBMスタックを備えたマルチチップレット設計であると説明しました。演算ブロックは、処理要素(PE)のグリッドとして配置され、歩留まりを向上させるために追加のPEが設けられています。各PEには、2つのRISC-Vベクトルコア、行列演算用のドット積エンジン、アクティベーションと要素ごとの演算用の専用機能ユニット、累積とPE間通信用のリダクションエンジン、およびローカルデータ転送用のDMAエンジンが含まれています。
MTIA 400:競争力のあるスループットを謳う、GenAIへの転換
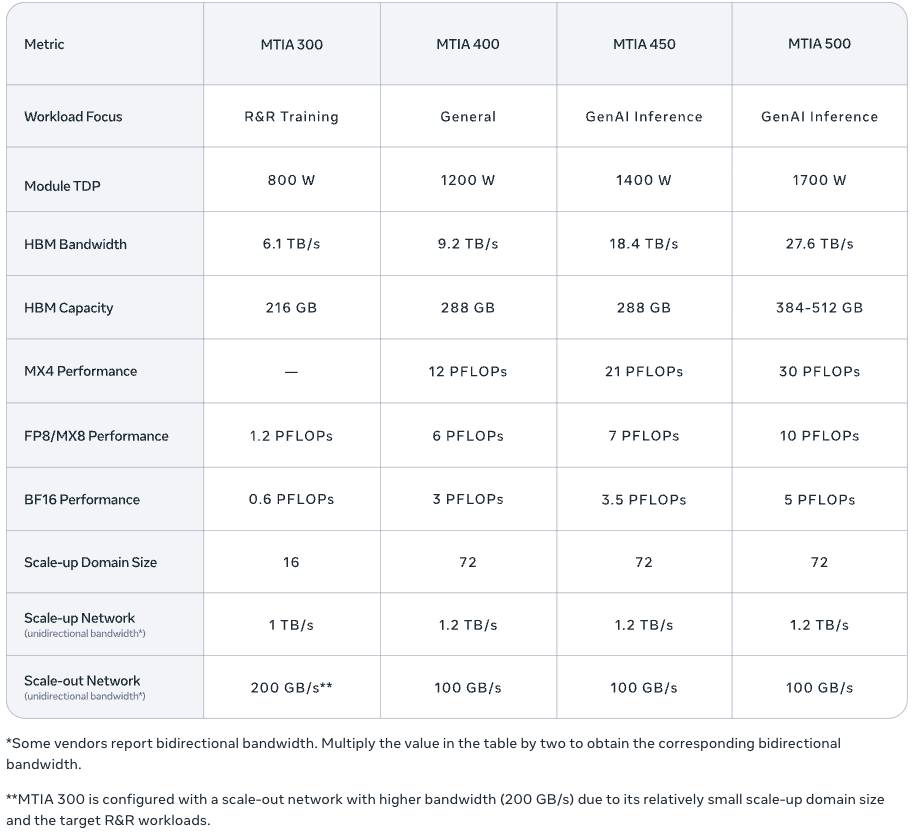
MTIA 400は、R&R機能を維持しながらGenAIをより適切にサポートするためにMTIA 300をアップグレードしたものです。MetaはMTIA 400をメジャーアップグレードと位置付けており、MTIA 300と比較してFP8 FLOPSが400%、HBM帯域幅が51%向上したと報告しています。アーキテクチャ的には、MTIA 400は2つの演算チップレットを統合して演算密度を高め、改良されたMX8およびMX4低精度フォーマットのサポートを追加しています。Metaは、これらのフォーマットが効率的なGenAI推論に不可欠であると考えています。

システム設計は引き続き重要な焦点となっている。Metaは、72台のMTIA 400デバイスがスイッチドバックプレーンを介して接続され、単一のスケーラブルなドメインを形成するラック規模の展開について説明した。柔軟な展開のために、Metaは既存のデータセンターでのセットアップを迅速化するためのエアアシスト液冷(AALC)ラックについて言及した。また、このプラットフォームは液冷ソリューションをサポートできることも指摘した。
MTIA 450: GenAI推論最適化はメモリ帯域幅から始まる
MTIA 450は、MTIA 400の改良版であり、推論に特化し、GenAI推論に対する需要の高まりを受けて開発されました。Metaは、推論性能を制限する主な要因としてHBM帯域幅を特定し、MTIA 400からMTIA 450にかけて帯域幅を2倍に拡張しました。また、MX4 FLOPSを75%向上させてエキスパート混合計算を改善したほか、ハードウェアアクセラレーションによって、アテンションおよびフィードフォワード演算、特にSoftmaxとFlashAttentionの動作における一般的なボトルネックを軽減しました。
Meta社は、データ型に関する取り組みを重要な要素として強調した。MTIA 450はFP8とMX8を凌駕し、FP16/BF16の6倍の速度でMX4のスループットを実現する。このチップは、ソフトウェア変換を必要とせずに低精度演算の混在をサポートする。また、最小限の面積影響でFLOPSを向上させながらモデル品質を維持するように設計された、データ型向けの独自のイノベーションを特徴としている。MTIA 450は2027年初頭に量産展開される予定だ。
MTIA 500:より広い帯域幅、より広い容量、さらなるチップレット分解
MTIA 500は推論に引き続き重点を置き、メモリと演算能力をさらに向上させています。Metaによると、MTIA 500はMTIA 450に比べてHBM帯域幅を50%増加させ、HBM容量を最大80%増加させ、MX4 FLOPSを43%増加させています。チップレット設計は、より小型の演算チップレットを2×2構成で配置し、複数のHBMスタックと2つのネットワークチップレットで囲むことで進化しています。また、ホストCPUとスケールアウトNICへのPCIe接続のためのシステムオンチップ(SoC)チップレットも含まれています。Metaは、推論のボトルネックに対処するために、追加のハードウェアアクセラレーションとデータ型の変更についても言及しました。
MTIA 500は2027年に本格展開される予定です。
簡単に導入
Metaは、MTIAの導入の容易性を重視し、特定のフレームワークではなく業界標準のツールに重点を置いています。同社はMTIAをPyTorchネイティブと位置付け、PyTorch 2.xのコンパイルプロセスとシームレスに連携し、Eager実行とグラフ実行の両方をサポートすると説明しています。グラフモードでは、開発者はtorch.compileとtorch.exportを使用して、MTIA固有のモデルを書き直すことなくグラフを最適化できるため、GPUとMTIA間での並列展開が可能になります。
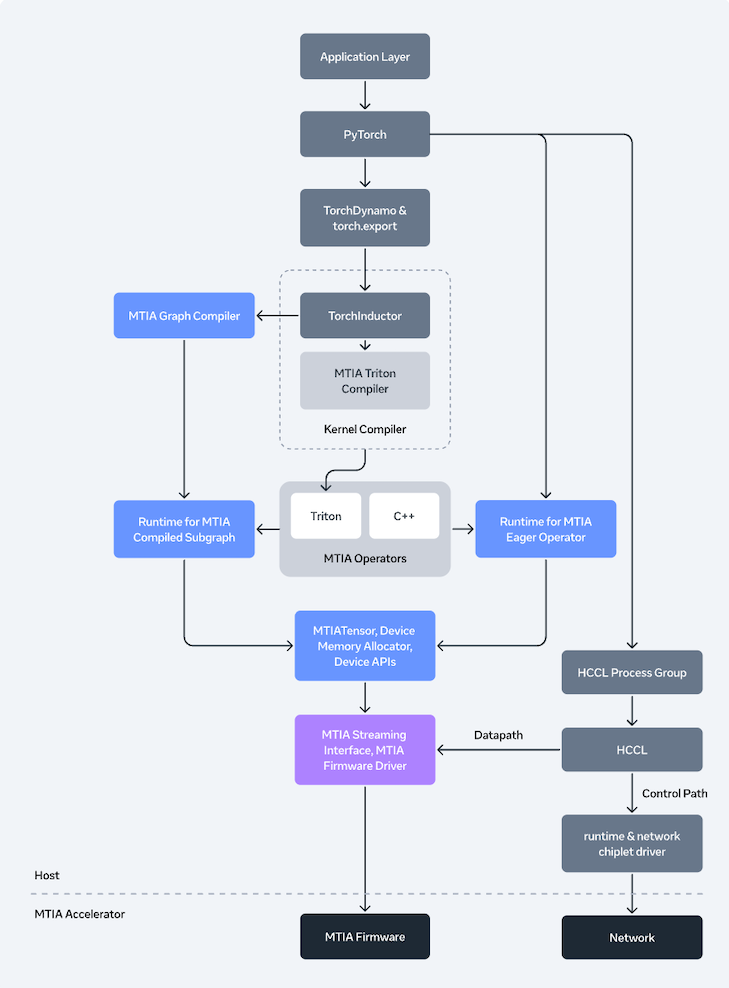
Metaは舞台裏で、Torch FX IRとTorchInductorをベースに構築されたMTIAコンパイラスタックの詳細を明らかにした。下位レイヤーでは、Triton、MLIR、LLVMに加え、カーネル融合の改善やパフォーマンス重視部分の拡張など、MTIA固有の最適化が施されている。自動チューニングは、さまざまなコンパイル戦略の中から最適なものを選択するための重要な機能である。
分散実行向けに、MetaはHoot Collective Communications Library(HCCL)を導入しました。このライブラリはGPUのコレクティブスタックに似ていますが、MTIAの内蔵ネットワークチップレットとメッセージエンジン向けに最適化されています。ニアメモリコンピューティングを使用してリダクション演算を高速化します。Metaはまた、レイテンシを低減するためのコンピュートコレクティブフュージョンをサポートし、データパスを管理してホストのオーバーヘッドを削減するように設計されたトランスポートスタックを備えています。
Metaは実行時において、メモリ管理、スケジューリング、およびイーガーモードとグラフモード間の連携を管理するデバイスランタイムを実証した。また、従来のカーネル内Linuxドライバから脱却し、Rustベースのユーザー空間ドライバを導入した。ファームウェアはベアメタルRustで記述されており、低遅延と安全性を重視している。
GenAIのサービス提供に関して、Metaはプラグインシステムを用いたvLLM統合について説明した。これにより、FlashAttentionや融合LayerNormといった主要なオペレーターがMTIA固有のカーネルに置き換えられる。また、カスタムtorch.compileバックエンドを介してグラフモードも有効化される。さらに、Metaは、ホストやデバイス全体にわたる監視、プロファイリング、デバッグ、可観測性など、大規模なMTIA展開を管理するためのツールについても言及した。
次は何ですか
Metaが更新したMTIAロードマップでは、GenAI推論の経済性を重視し、HBMの帯域幅と低精度フォーマットを重要な要素として挙げています。Metaが予定通りに展開を進めれば、MTIA 450と500は、チップレットの迅速な反復開発と標準化されたソフトウェアに基づく推論優先のアクセラレータ戦略が、GenAIサービスの提供において主流のGPUプラットフォームに対する優位性を維持できるかどうかを判断するための、最初の大規模テストとなるでしょう。


 Amazon