

マイクロソフトは本日、OCPグローバルサミットでAzure Maia 300を発表しました。これは同社が開発した推論アクセラレータの第3世代であり、マルチチップレット構成としては初の製品です。各アクセラレータは、TSMC N2Pコンピューティングダイと8つのHBM4スタックを組み合わせ、950WのTDP内で288GBのメモリを18TB/sで提供します。Maia 300ラックには、167kWの筐体内に96個のMaia 300が搭載されます。マイクロソフトは、主要なGPUベースのシステムと比較してメガワットあたりのトークン数が40%多く、ラック規模のトークンスループットはMaia 200の最大7倍になると主張しています。本番環境への展開は、マイクロソフトがマルチギガワット規模のMaia展開と呼ぶ計画の一環として、2027年に開始される予定です。
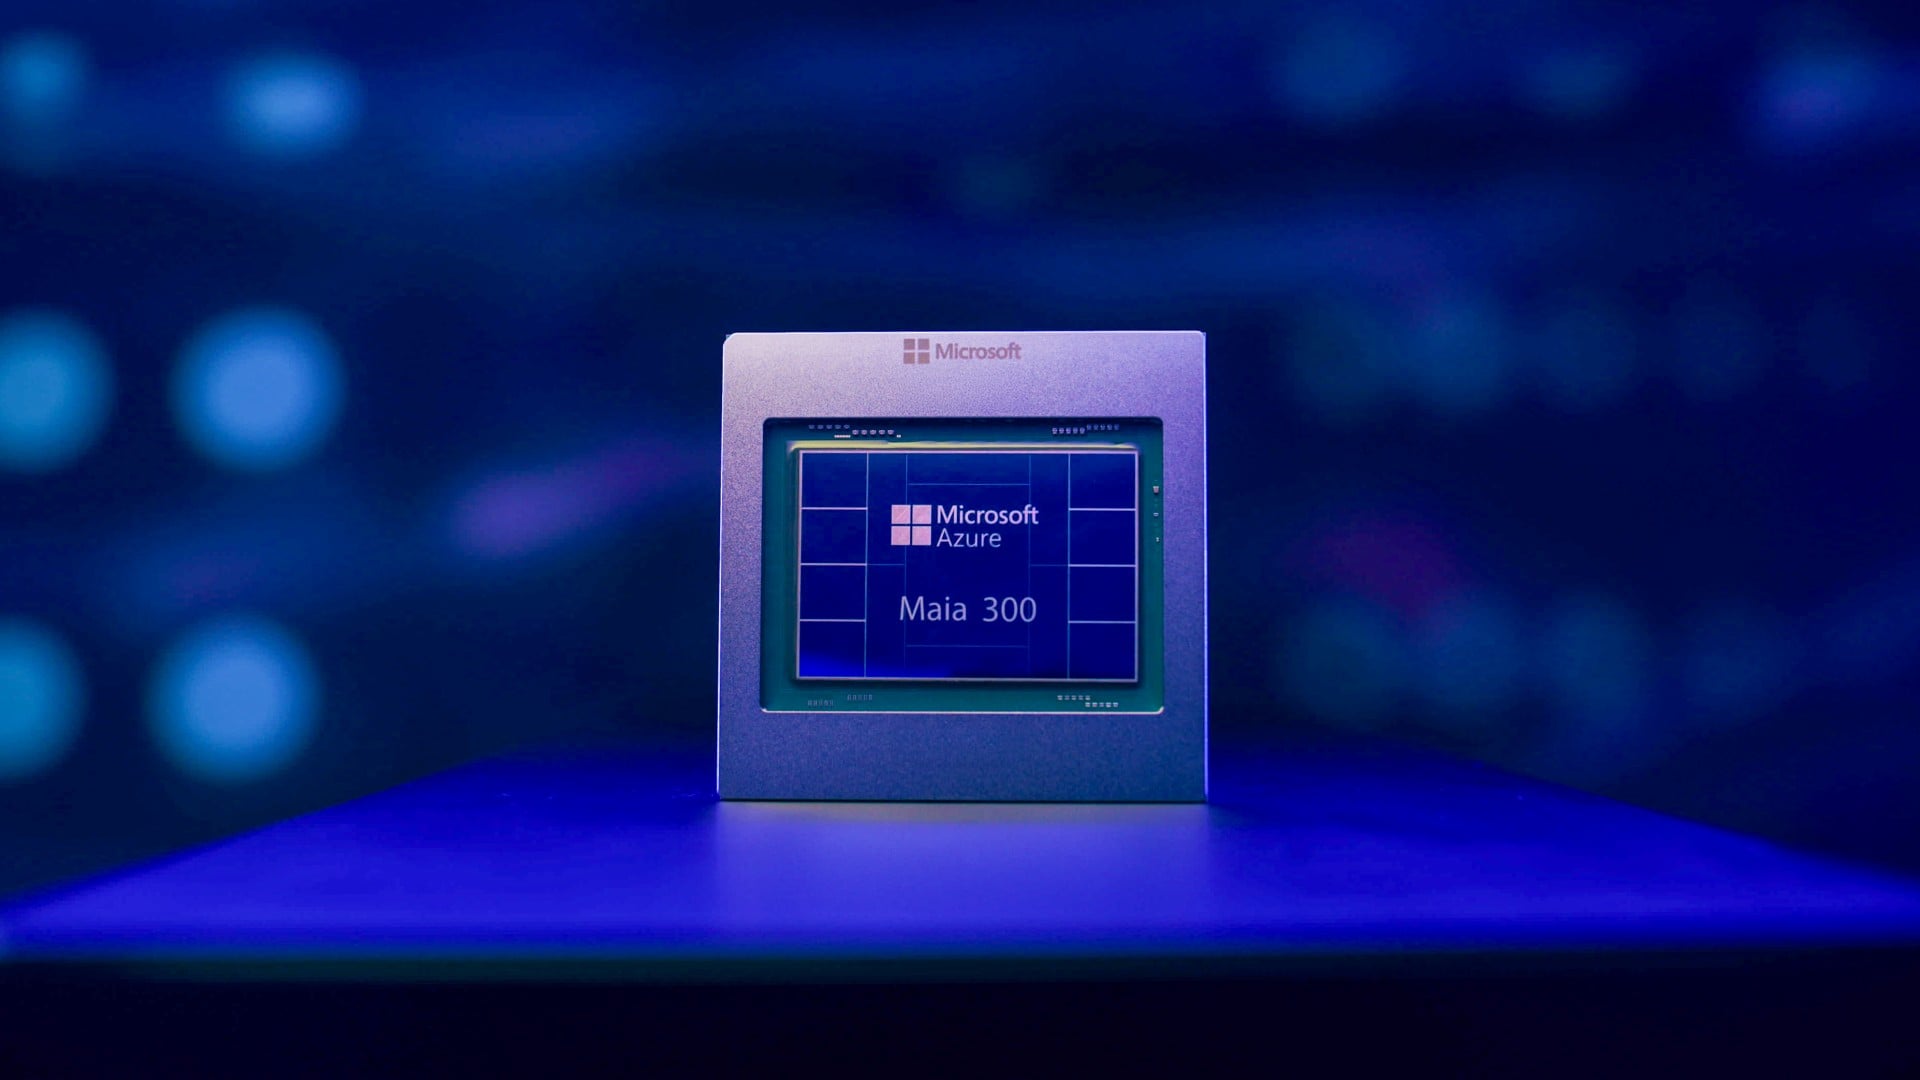
Maia 300シリコン:N2P演算ダイ、8つのHBM4スタック、400Gポート32個
Maia 200 は、6 つの HBM3E スタックを備えたモノリシック N3P ダイでした。Maia 300 では、設計が N2P 上のメイン演算ダイ、2 つの I/O ダイ、および 4 つのメモリ ダイに分割され、8 つの HBM4 スタックにより容量が 216GB から 288GB に、帯域幅が 7.1TB/s から 18TB/s に増加しています。ピーク演算はそれほど変化していません。FP4 で 13.8 POPS、FP8 で 6.9 POPS であり、10.1 と 5.1 から増加しています。したがって、この世代では、メモリ帯域幅が 2.5 倍に増加するのに対して、FP4 演算が 37% 増加しています。Microsoft によるこのチップの概要は、Maia 200 と比較して、帯域幅が 2.5 倍、容量が 33% 増加、ワットあたりの HBM 帯域幅が約 2 倍です。
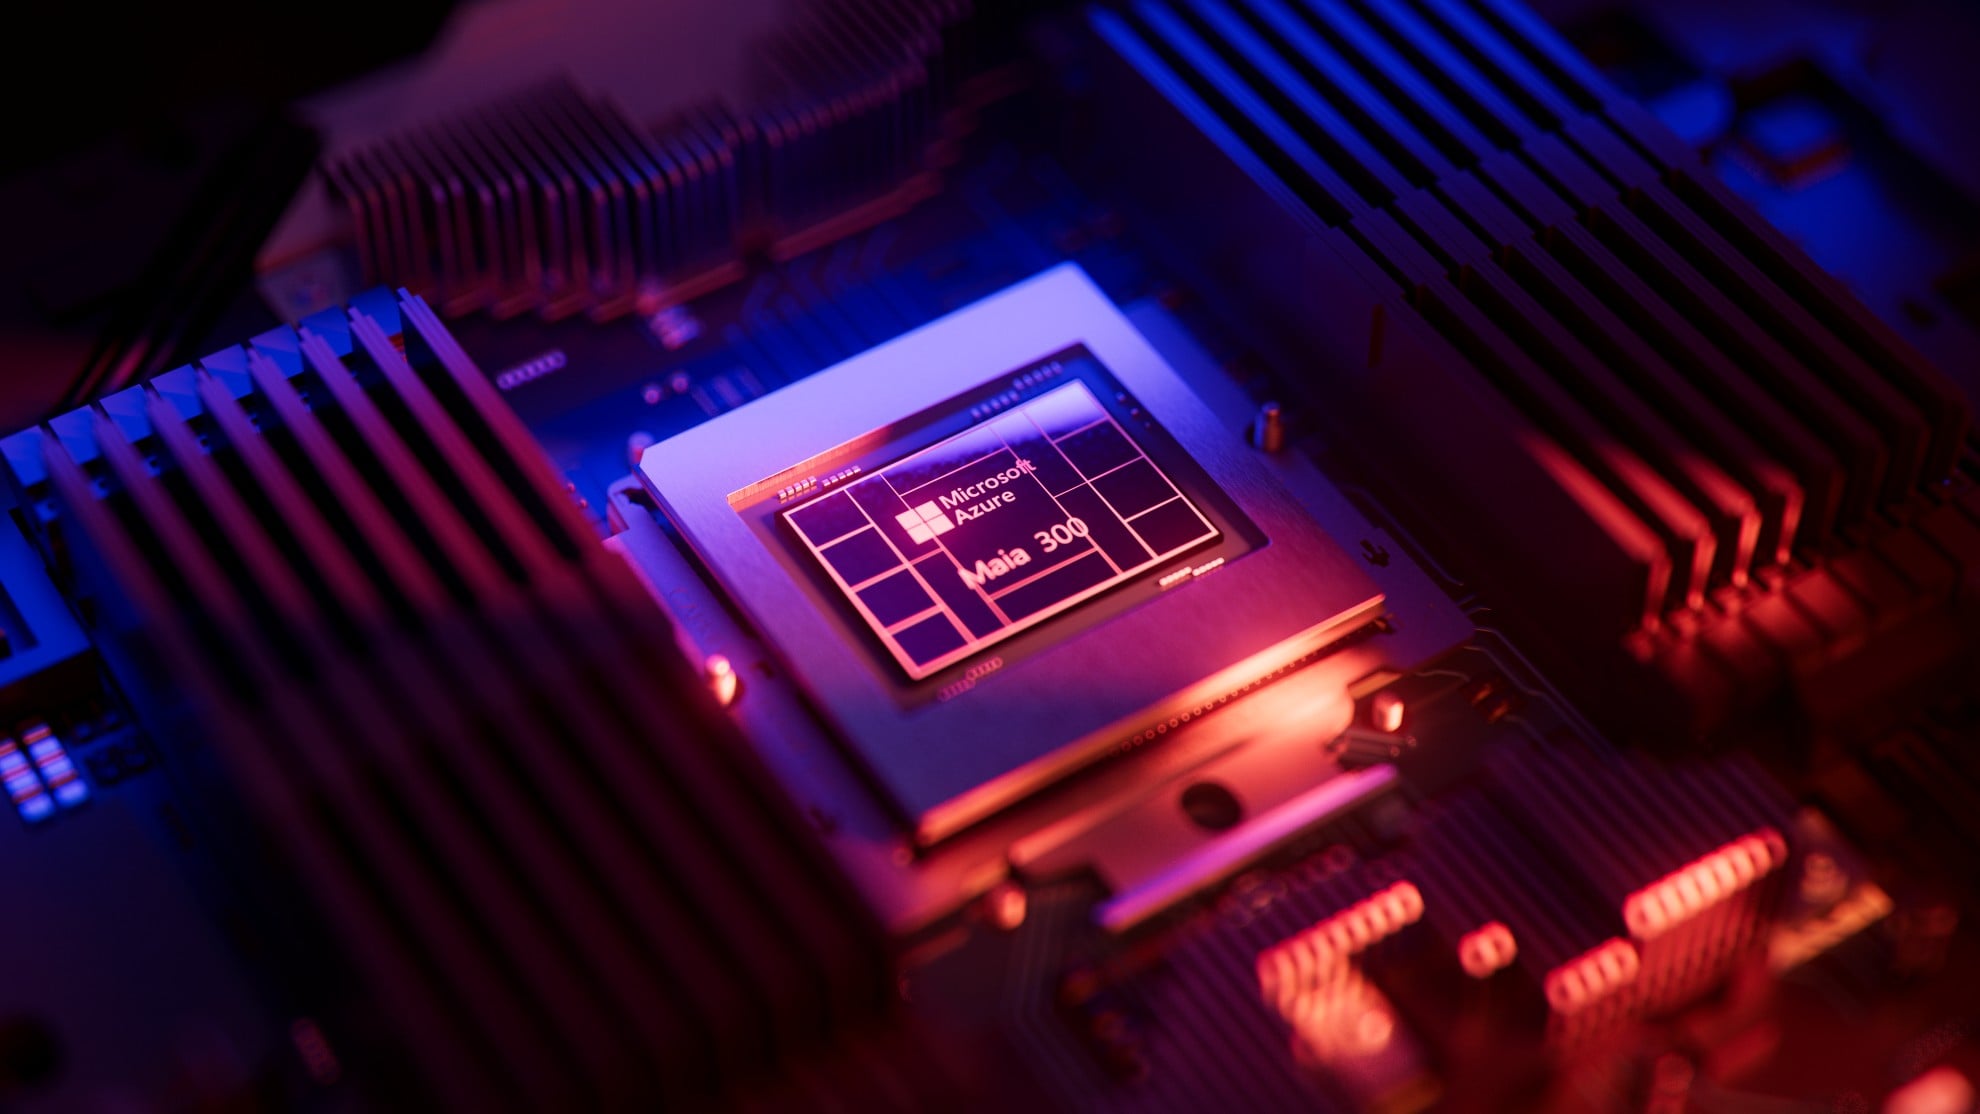
演算処理部分は、12個のタイルからなる4つのクラスタで構成され、各タイルにはテンソルユニット、ベクトルプロセッサ、リシェイパー、DMAエンジン、ローカルSRAMが搭載され、その上に共有クラスタSRAMとネットワークオンチップが配置されています。マイクロソフトはこのアプローチをソフトウェア定義データフローアーキテクチャと呼んでおり、ソフトウェアがローカルメモリ、DMAエンジン、ネットワーク全体にデータを配置します。SoCは、オンダイAIネットワークコントローラ(スケールアップファブリック)を介して、ホストにPCIe Gen6 x16と32ポートの400Gb/sイーサネットを提供します。
Maia 300では、メモリ構成がチップレット全体にわたって均一アクセスからNUMAレイアウトに変更され、データを使用する演算処理の近くにデータを配置できるようになりました。また、MXFP4の強化とハードウェアデータ型変換により精度がさらに低下し、演算処理とKVキャッシュストレージの両方でトークンあたりのバイト数を削減することを目的としています。カーネルは、オンダイSRAMをソフトウェア管理のスクラッチパッドとして使用して、HBMへのトラフィックを抑えることもできます。Microsoftは、TDPが750Wから950Wに上昇する一方で、ワットあたりのパフォーマンスが2.5倍以上向上したと主張しており、ワットあたりの性能向上はこれらの変更によるものだとしています。
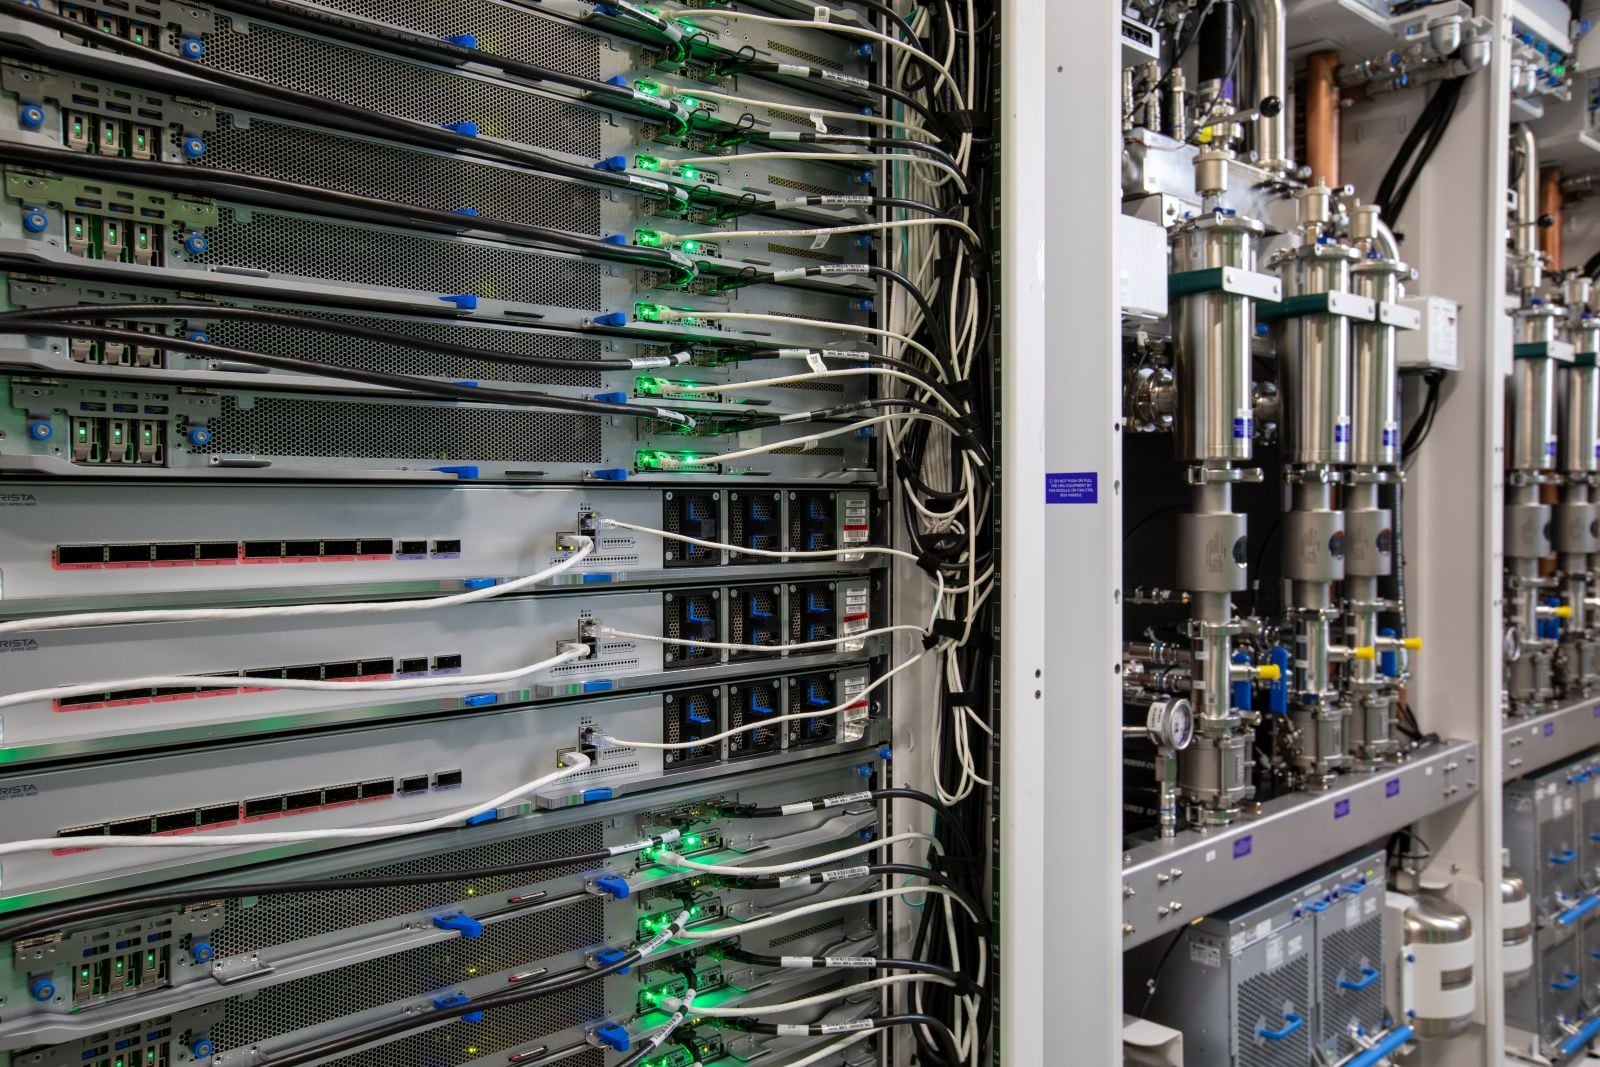
ラックあたり96基の加速器、スーパーポッドには12,288基の加速器を収容可能。
Maia 300 ラックでは、アクセラレータの数が 96 に倍増し、ラックの電力は 64kW から 167kW に増加します。これは、ネットワーク、冷却、電力変換を含めて、アクセラレータ スロットあたり約 1.74kW に相当します。ラック全体では、Microsoft の数値によると、HBM が 27.6TB、HBM の総帯域幅が 1,728TB/s、FP4 の POPS が 1,324 になります。これは、Maia 200 ラックの 10.4TB、341TB/s、485 POPS と比較して高い値です。アクセラレータあたりの双方向スケールアップ帯域幅は 2.8TB/s から 3.2TB/s に増加し、Microsoft 独自の AI トランスポートを備えた 2 層イーサネット スケールアップ ネットワークは、前世代の約 6,000 の 2 倍となる 12,288 個のアクセラレータのスーパーポッドに到達します。
マイクロソフトのラック図は、スケールアップファブリック上のラック間でジョブがシャーディングされ、シャーディング間でエキスパート並列トラフィックが発生する様子を示しています。これは、大規模なエキスパート混合モデルがサービス提供時に生成するトラフィックパターンです。同社によれば、同じ通信モデルがスーパーポッド内のどのアクセラレータにも適用されるため、16個のアクセラレータを使用するジョブと4つのラックにまたがるジョブは同じセマンティクスを使用します。
マイア300の仕様
| 製品仕様 | 300月XNUMX日 | 200月XNUMX日 |
|---|---|---|
| 加速器 | ||
| プロセス | マルチチップレット、N2P コンピューティング ダイ | モノリシックN3P |
| FP4ピーク | 13.8 ポップ | 10.1 ポップ |
| FP8ピーク | 6.9 ポップ | 5.1 ポップ |
| SoCのTDP | 950W | 750W |
| HBM | HBM4 x 8、288GB、18TB/s | HBM3E x 6、216GB、7.1TB/s |
| ホストインターフェース | PCIe Gen6 x16 | 記載されていない |
| 帯域幅の拡張(双方向) | 3.2TB /秒 | 2.8TB /秒 |
| バックエンドネットワーク | AIトランスポートによる2層イーサネットスケールアップ、32 x 400Gb/s | AIトランスポートによる2層イーサネットスケールアップ |
| ラックとスケールアップの領域 | ||
| ラックあたりのアクセラレータ数 | 96 | 48 |
| ラック電源 | 167kW | 64kW |
| ラックHBM容量 | 27.6TB | 10.4TB |
| ラックHBM帯域幅 | 1,728TB /秒 | 341TB /秒 |
| ラックFP4ピーク | 1,324 ポップ | 485 ポップ |
| スケールアップ領域 | 約12,288台の加速器 | 約6,000台の加速器 |
Maia 300はどのような位置づけにあるのか、そしてその主張の根拠は何なのか
Maia 200は現在、Microsoft CopilotとMAIモデルチームによって運用されており、GitHub CopilotとMicrosoft Foundryも年末までに移行する予定です。Microsoftは、Teams、Copilot、Coworkに組み込まれているAI機能向けに、GPUインフラストラクチャよりも1ワットあたり最大1.7倍多くのトークンを生成し、米国、ヨーロッパ、オーストラリアに展開していると述べています。
「2027年からAzure Maiaファミリーをマルチギガワット規模に拡張し、MaiaをMicrosoft製品およびサービスの主要な推論システムにする予定です」と、クラウド+AI担当エグゼクティブバイスプレジデントのスコット・ガスリー氏はMaia 300の発表時に述べています。NVIDIAとAMDはMicrosoftのトレーニングフリートに残っており、同社はAzure顧客がレンタルできるインスタンスタイプとしてMaiaを提供していません。メガワットあたり40%多くのトークンを主要なGPUベースのシステムよりも多く獲得できるという、効率性に関する主要な主張には、GPU、モデル、またはサービス構成が明記されておらず、MaiaはMicrosoft社内でのみ実行されるため、社外の誰もテストできません。
公開された仕様は、この設計を裏付けています。アクセラレータあたりのメモリ帯域幅は2.5倍に増加し、FP4演算性能は37%向上しました。また、このラックは、Maia 200ラックの2.6倍の電力で5.1倍のHBM帯域幅を実現しています。これは、ロングコンテキスト推論とエージェント推論のデコードフェーズ向けに設計されたチップであり、ボトルネックは演算ユニットへのデータ供給です。このチップは、ハイパースケーラーがワークロードをエンドツーエンドで管理する場合に、推論部分をどのようにサイジングするかを示しています。私たちは1月にMaia 200の発表について記事にしましたが、マイクロソフトは11月のIgniteでさらに詳しい情報を提供すると述べています。




 Amazon