

本日、延期されていたGTC(NVIDIA主催のGPUテクノロジーカンファレンス)において、NVIDIAは初の7nm GPUをアプライアンスメーカーに出荷し始めたことを明らかにした。2018年に7nm GPUをリリースしたAMDと同様に、NVIDIAも初の7nm GPUではデータセンターのユースケースに注力することを選択した。NVIDIAは人工知能やその他の高性能コンピューティングにおける開発を重視しており、最近ではMellanoxを買収した。今月初めには、Cumulusの買収も検討していることを発表した。
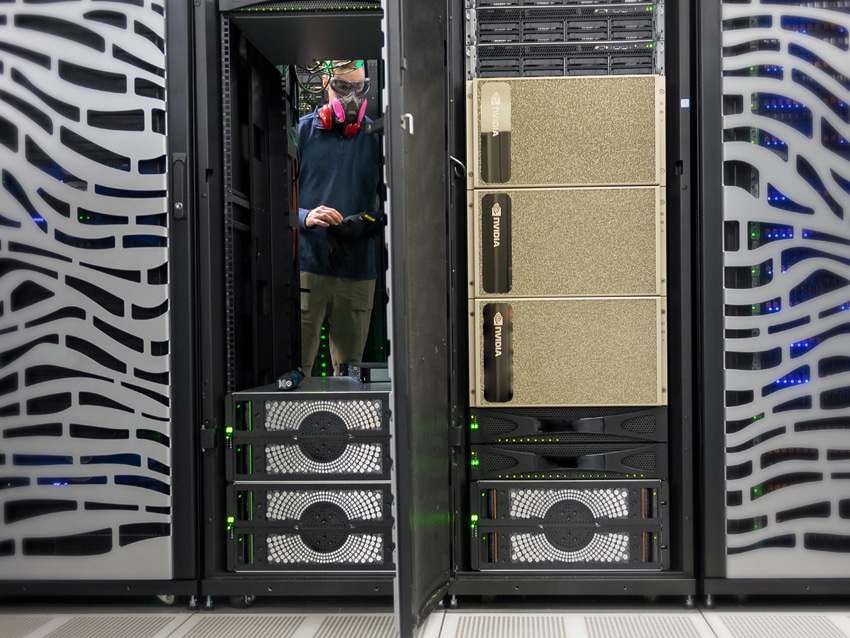
NVIDIA の最初の 7nm GPU は NVIDIA A100 です。 A100 は NVIDIA の Ampere アーキテクチャに基づいており、54 億個のトランジスタを搭載しています。以前の NVIDIA データセンター GPU と同様に、A100 には Tensor コアが含まれています。 Tensor コアは、推論で一般的に使用される一種の行列乗算および加算計算を迅速に実行するために特別に設計された GPU の特殊な部分です。新しいより強力な GPU に伴い、より強力な新しい Tensor コアが付属します。以前は、NVIDIA の Tensor コアは最大 100 ビットの浮動小数点数しかサポートできませんでした。 AXNUMX は XNUMX ビット浮動小数点演算をサポートしており、より高い精度が可能になります。
また、A100 の新機能として、マルチインスタンス GPU 機能があります。各 A100 GPU は、最大 XNUMX つの独立したインスタンスに分割して、多数のタスクを同時に処理できます。
NVIDIA A100の仕様
|
トランジスタ数 |
54億 |
|
ダイサイズ |
826 mm2 |
|
FP64 CUDAコア |
3,456 |
|
FP32 CUDAコア |
6,912 |
|
テンソルコア |
432 |
|
ストリーミングマルチプロセッサ |
108 |
|
FP64 |
9.7テラフロップス |
|
FP64テンソルコア |
19.5テラフロップス |
|
FP32 |
19.5テラフロップス |
|
TF32 テンソル コア |
156 テラFLOPS | 312テラFLOPS* |
|
BFLOAT16 テンソル コア |
312 テラFLOPS | 624テラFLOPS* |
|
FP16テンソルコア |
312 テラFLOPS | 624テラFLOPS* |
|
INT8テンソルコア |
624 トップス | 1,248トップス* |
|
INT4テンソルコア |
1,248 トップス | 2,496トップス* |
|
GPUメモリ |
40 GB |
|
GPU メモリ帯域幅 |
1.6 TB /秒 |
|
インターコネクト |
NVLink 600 GB/秒 PCIe Gen4 64 GB/秒 |
|
マルチインスタンス GPU |
最大 7MIG @5GB のさまざまなインスタンス サイズ |
|
フォームファクター |
HGX A4 の 8/100 SXM GPU |
|
マックスパワー |
400W(SXM) |
単一の A100 GPU に加えて、NVIDIA は 100 つのクラスター化 GPU も同時にリリースします。 NVIDIA DGX A100 システムは、NVIDIA NVSwitch と相互接続された 100 つの NVIDIA A100 GPU を備えています。弟の NVIDIA HGX A100 は、NVLink を介して相互接続された 100 つの A2 GPU で構成されています。 NVLINK と NVSwitch の両方を使用すると、個々の GPU が大規模なタスクで連携して動作できます。 NVLink は真の全対全相互接続です。 NVSwitch 相互接続上でより多くの GPU を処理するために、NVIDIA は GPU 間の NVLink を相互接続することにしました。 NVIDIA は、新しい A100 向けに全面的な相互接続を強化し、チップ内のより強力なコアをサポートするために接続性を 320 倍にしました。 NVIDIA は、以前の DGX システムのパフォーマンスが 6 倍以上になったと主張しています。彼らによると、新しい 200 GPU DGX A3.6 は、驚異的な XNUMX ペタフロップスのパフォーマンスを実現します。前世代の DGX-XNUMX は XNUMX 個の GPU を備えていますが、管理できるのは XNUMX ペタフロップスだけです。 XNUMX ペタフロップスを誇るシステムで「のみ」という言葉をすぐに使用することになるとは予想していませんでしたが、新しいクラスターが半分の GPU でパフォーマンスを XNUMX 倍以上にすると、それが適切であるように思えます。 DGX AXNUMX は、XNUMX GB のメモリと XNUMX つの NVIDIA Mellanox ConnectX-XNUMX HDR XNUMX Gb/秒ネットワーク インターフェイスも備えており、合計 XNUMX Tb/秒の双方向帯域幅を提供します。
DGX A100 の強力なパワーを大局的に見ると、世界で 18 番目に強力なスーパーコンピューターのベンチマークは XNUMX ペタフロップスです。 NVIDIA の新しい悪役を数人一緒に押し込めば、あなただけの世界クラスのスーパーコンピューターが完成します。驚くべきことに、NVIDIA はまさにそれを実現する DGX SuperPOD リファレンス アーキテクチャをリリースしました。もしシステムが NVIDIA の主張通りにパフォーマンスするなら、スーパーコンピューティング愛好家にとって今後数か月は非常に奇妙なものになるかもしれません。
通常の世界に戻って、より一般的なユースケースで、NVIDIA は新しい GPU を使用したエッジ サーバーを年末までにリリースする計画も発表しました。 EGX A100 は、新しい A100 GPU の 100 つだけを搭載します。 NVIDIA は、EGX A6 エッジ サーバーを Red Hat Enterprise Linux 上で実行することを計画しています。これらのアプライアンスは、NVIDIA が最近買収した Mellanox ConnectX-200 Dx ネットワーク カードを使用して、最大 5 Gbps のデータを受信し、AI または 100G 信号処理のために GPU メモリに直接送信する可能性があります。 NVIDIA 自体が、新しい GPU を 100 つだけ搭載したアプライアンスを年末までリリースするつもりはないということは、複数の DGX AXNUMX (それ自体は XNUMX つの AXNUMX のクラスターです) をクラスター化するという突飛なアイデアが実際にどのようなものであるかを明確に示しています。


 Amazon