

Open Compute Project (OCP) は、Wiwynn ES200 エッジ サーバーと NVIDIA HGX-H100 GPU ベースボードをプラットフォームに追加したことを発表しました。
Wiwynn の奥行きの短いエッジ サーバーは、特にインスタント AI 推論、オンサイト データ分析、マルチチャネル ビデオ処理などのアプリケーション向けに、エッジ サイトでのコンピューティング パワーに対する需要の高まりに対処するように設計されています。
NVIDIA の HGX-H100 GPU ベースボードの物理仕様は、OCP の OAI サブプロジェクトの HGX 活用能力を向上させ、AI および HPC アプリケーションにおけるハイパフォーマンス コンピューティングのためのコスト効率が高く、高効率でスケーラブルなプラットフォームとシステム仕様を開発するのに役立つと期待されています。
Wiwinn ES200 エッジサーバー
Wiwynn ES200 は、第 2 世代 Intel Xeon スケーラブル プロセッサを搭載した 3U デュアルソケット エッジ サーバーです。 NUMA バランス機能により、CPU 間に通信ボトルネックを生じさせることなく、インストールされている各プロセッサーのコンピューティング能力を提供して、さまざまなワークロードを個別に実行できます。
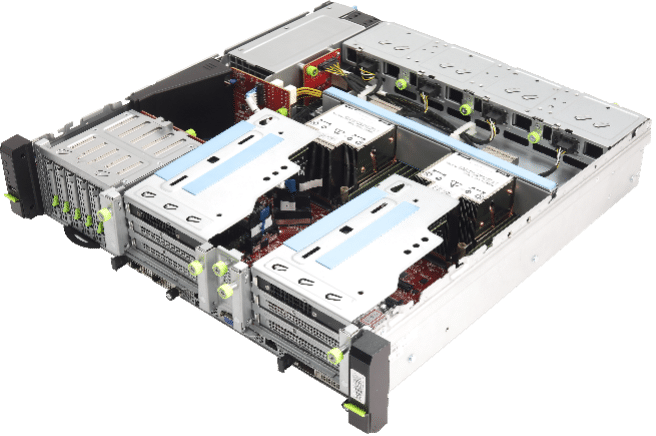
また、2枚のダブル幅拡張カードを搭載可能な追加のPCIe Gen4 x16スロットを備えています。これによりシステムの柔軟性が大幅に向上し、AI推論アクセラレーション、ビデオトランスコーディング、データ分析などの用途はもちろん、追加のネットワーク接続が必要な用途にも最適です。ストレージモジュールはEDSFF(E1.S)またはU.2 SSD、OCP NIC 3.0カード2枚など、柔軟な構成が可能で、ES200は優れたローカルデータ処理能力と高帯域幅のネットワーク接続を実現します。
ES200 は NEBS-3 にも準拠しており、奥行きが短いコンパクトなフォームファクタを備えています。さらに、Wiwynn は、困難な動作条件下でもスムーズに動作し、さまざまなエッジ サイトに適合できることを示しています。
Wiwinn ES200 エッジ サーバー ノードの仕様
| ノード仕様 | |
| プロセッサ | 第 3 世代インテル Xeon スケーラブル プロセッサー、TDP 250W/270W |
| プロセッサーソケット | 2 |
| チップセット | インテル C621A シリーズ |
| セキュリティ | TPM v2.0 (オプション) |
| システムバス | インテル UltraPath インターコネクト。 11.2GT/秒 |
| メモリ | 16 DIMM スロット。 DDR4 最大 3200 MT/s、DIMM あたり最大 64GB。 最大 12 つの DCPMM を備えた 2 個の DIMM スロット (Intel Barlow Pass) |
| Storage | ‧ オンボード 2280/22110 M.2 SSD モジュール スロット x XNUMX ‧ U.2 (15/7mm) 1 個、または EDSFF E5.9.S (9.5/XNUMXmm) XNUMX 個 |
| 拡張スロット | 最大 4 つの PCIe GenXNUMX スロット: ‧ PCIe x16 FHFL デュアル幅 8 つ + PCIe xXNUMX FHHL XNUMX つ ‧ PCIe x16 FHHL スロット 8 つ + PCIe xXNUMX FHHL XNUMX つ ‧ 8 つの PCIe xXNUMX FHHL スロットはご要望に応じてオプションです 3.0 つのオンボード OCP 16 NIC xXNUMX |
| 管理LAN | ‧ GbE 専用 BMC ポート 1 つ |
| I / Oポート | ‧ LED付き電源ボタン ‧ LED付きUIDボタン ‧ RSTボタン ‧ USB ポート 3 つ ‧ BMC 管理ポート (前面) ‧ VGAポート(D-sub) |
| シャーシ仕様 | |
| 寸法 | 2Uラック。 86(高さ)×440(幅)×450(奥行き)(mm) |
| PSU | ホットプラグ対応、冗長 (1+1) 1600W CRPS |
| ファン | 8038 つの 7 デュアルローター、冗長 (1+XNUMX) |
| 重量 | 14.47kg |
| 環境 | ‧ 使用周囲温度範囲: -5 ~ +55 ℃
‧ 動作時および保管時の相対湿度: 10% ~ 90% (結露なきこと) ‧ 保存温度範囲: -40 ~ +70 ℃ |
NVIDIA HGX-H100 ベースボード
NVIDIA HGX-H100は、最新のHopper GPUモジュールを8個搭載したベースボードです。HGXベースボードの物理仕様では、物理寸法、ホストインターフェース、管理インターフェース、デバッグインターフェースなどが定義されています。NVIDIAの貢献パッケージには、ベースボードの物理仕様、ベースボードの入出力ピンリストとピンマップ、2D/3D図面も含まれています。
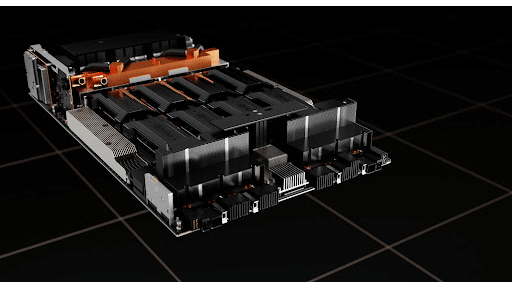
OCP の次のリストは、NVIDIA HGX の貢献が効率、スケーラビリティ、オープン性、インパクトという「4 つの原則」に基づいてどのように構築されているかを示しています。
- 効率 – これは第 3 世代の HGX ベースボード フォーム ファクターであり、各世代は同様の有効電力を消費しながら、約 3 倍から 5 倍高い AI トレーニング スループットを実現しました。その結果、HGX ベースボードは現在事実上の標準となっており、ほとんどの世界的なハイパースケーラーは AI のトレーニングと推論のためにこのフォーム ファクターを中心に設計しています。
- スケーラビリティ – 世界中で数十万台の HGX システムが稼働しています。このフォームファクタのシステムとエンクロージャは安定しており、大規模に構築できます。 HGX 仕様には、大規模サービスの物理的寸法、監視/デバッグ用の管理インターフェイスなどが含まれます。
- オープン性 – HGX ベースのシステムは、世界中で最も一般的な AI トレーニング プラットフォームです。多くの OEM/ODM は、HGX ベースの AI システムを構築しています。この HGX 物理仕様の貢献により、OAI グループは UBB2.0 と HGX 仕様を可能な限り統合します。 OEM/ODM は、同じベースボード寸法、ホスト インターフェイス、管理インターフェイス、電源供給など、UBB/HGX のようなベースボード上の異なるアクセラレータを備えた同じシステム設計を活用できます。
- 影響 – NVIDIA HGX プラットフォームは、AI トレーニング プラットフォームの事実上の世界標準となっています。この HGX ベースボード フォーム ファクタをオープンにすることで、他の AI アクセラレータ ベンダーがシステムとエンクロージャの HGX エコシステムを活用できるようになります。これにより、他の AI ベンダーが既存のインフラストラクチャを活用し、ソリューションをより早く導入することが加速されるはずです。これにより、AI/HPC分野のイノベーションがさらに加速します。


 Amazon