

NVIDIAはComputex 2025で、数々の刺激的な発表を行った。同社は、セミカスタムAIインフラストラクチャ、エンタープライズAIファクトリー、民主化されたAI開発ツール、ヒューマノイドロボット向け高度プラットフォームなど、幅広い新技術を発表し、AIがコンピューティングと産業のあらゆる側面に融合する動きが大幅に加速していることを示した。
NVLink Fusion:セミカスタムAIインフラストラクチャの新時代を実現
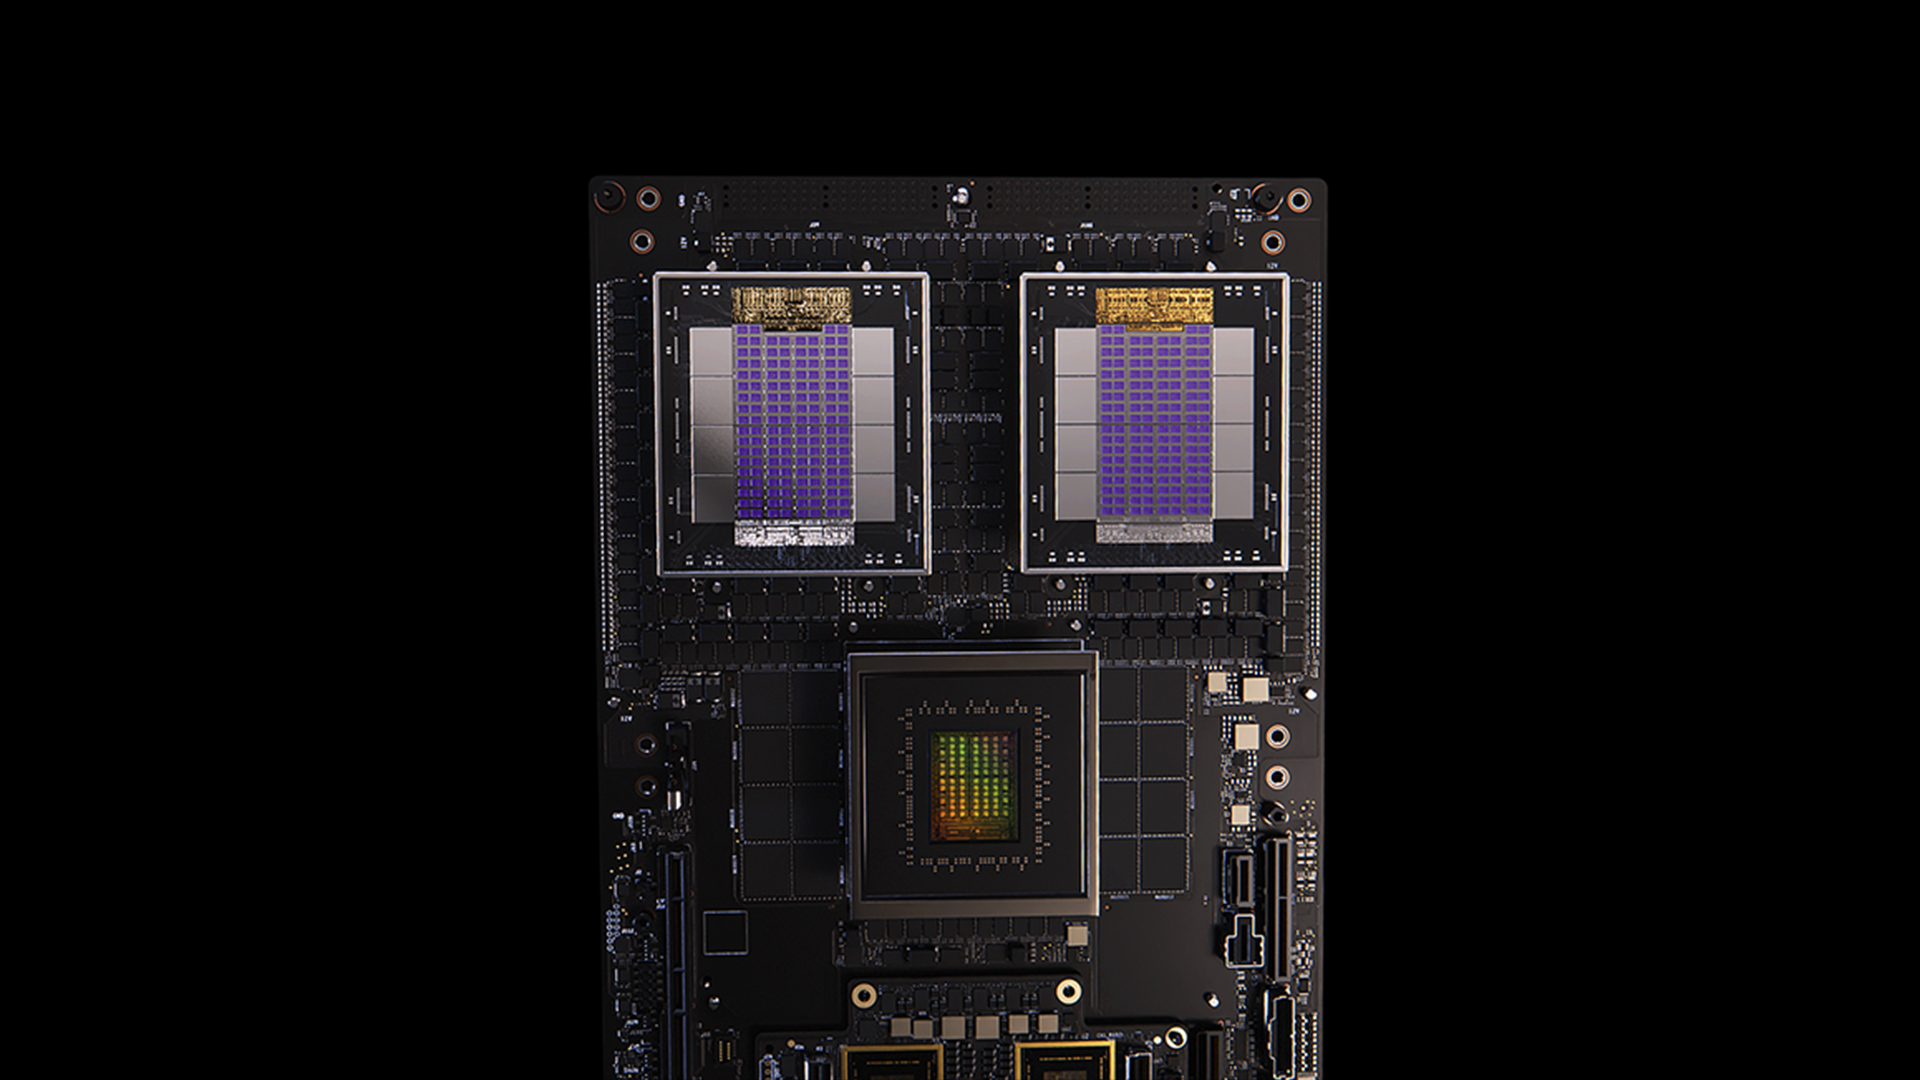
Computexにおける主要な発表の一つは、NVIDIAがNVLinkへの扉を開いたことです。NVIDIA NVLink Fusionは、業界が自社の技術をNVIDIAの高度なインターコネクトと統合することで、セミカスタムAIインフラを構築できるIPと新しいシリコン基盤を提供します。
顧客はカスタムASICを開発したり、CPUを高性能スケールアップファブリックに直接接続したりできます。たとえば、企業はC2Cリンクを使用してカスタムCPUとNVIDIA GPUを組み合わせたり、逆に、NVIDIAのGraceや今後登場するVeraなどのCPUと、独自のAI ASICを統合したりできます。これらはすべてNVLinkを介して相互接続されます。現行世代のチップ間インターフェースは、CPUとGPU間で900GB/sという十分な双方向帯域幅を提供します。同時に、より広範な第5世代NVLinkプラットフォームは、 GPUあたり1.8TB/sという驚異的な双方向帯域幅を誇ります。

これは業界にとって非常に喜ばしいニュースです。AIアクセラレータを構築する企業には、魅力的な選択肢が与えられました。例えば、次のような新しいオープンスタンダードを採用できるのです。 UAリンクはオープン性を推進しているものの、現時点ではNVIDIAの確立されたインターコネクト速度に遅れをとっており、開発もまだ続いています。一方、NVLink Fusionを利用すれば、現在利用可能な最速のスケールアップインターコネクトと統合し、最先端のパフォーマンスとNVIDIAの包括的で成熟したソフトウェアスイートを即座に利用できるようになります。

多くの業界パートナーが既にNVLink Fusionを採用しています。カスタムAIシリコンと専用インフラストラクチャの開発にNVLink Fusionを採用している主要企業には、ASICおよびIPパートナーであるMediaTek、Marvell、Alchip Technologies、Astera Labs、Synopsys、Cadenceなどが挙げられます。さらに、CPUイノベーターである富士通とQualcomm Technologiesも、NVIDIA GPUとNVLinkエコシステムと連携するカスタムCPUの開発を計画しています。
Blackwell Pro 6000 サーバー: エンタープライズ AI ファクトリーの推進力

NVIDIAがComputexで発表したもう一つの重要な発表は、NVIDIA RTX PRO BlackwellサーバーによるエンタープライズAIの革新に焦点を当てたものでした。コアGPUであるRTX PRO 6000 Blackwellは、ワークステーション向けと堅牢なアーキテクチャを共有していますが、より標準的なサーバー設計への統合は、独自のイノベーションであるNVIDIA ConnectX-8 (CX8)によって大幅に強化されています。ジェンセン・フアン氏はこれを「スイッチが第一、ネットワークチップが第二」と表現しました。

真のブレークスルーは、CX8がサーバー内のGPU間および複数のサーバー間で高速な東西トラフィックを直接実現する点にあります。Huang氏が述べたように、この機能により、RTX PRO 6000 GPUは要求の厳しい推論ワークロードに対して効率的に通信でき、フラッグシップのBlackwell GB200およびGB300 AIファクトリーシステムに搭載されているNVLinkによる高帯域幅の相互接続性を実現します。従来の低速な経路を迂回するこのGPU間直接通信により、RTX PRO Blackwellサーバーはエンタープライズ推論において非常に優れた価値を提供します。NVIDIA Dynamoなどのソフトウェアと組み合わせることで、これらのサーバーはAIエージェントの展開と運用を非常に効率的かつスケーラブルに実現します。

実際のボードも確認できました。RTX PRO 6000 Blackwell GPUを搭載するためのPCIeスロットが800基搭載されています。さらに、メインマザーボードに接続するPCIeポートも4つあります。そして、特筆すべきは、8基のCXXNUMXチップを搭載したXNUMXGbpsのネットワーク接続がXNUMXつ搭載されていることです。これらの高速ポートは堅牢なサーバー間通信を可能にし、企業は複数のRTX PRO Blackwellサーバーを強力なクラスターにネットワーク接続することで、推論能力を拡張できます。
最後に、Huang氏はパフォーマンスの飛躍的な向上を強調し、新しいRTX PRO BlackwellサーバーがLama 1.7B推論においてHopper H100 HGXシステムの70倍の性能を発揮することを示すベンチマークテストを発表しました。さらに印象的なのは、DeepSeek R1モデルにおいて、Blackwellサーバーが前世代の最先端H100と比較してXNUMX倍の性能向上を示したことです。XNUMX秒あたりのトークン数とXNUMXユーザーあたりの秒あたりのトークン数の大幅な向上は、このサーバーが高スループットかつ低レイテンシのインタラクティブAIタスクを処理できる能力を裏付けています。
ヒューマノイドロボティクス、Nvidia Jetson Thor、Project GR00T:物理AIの最先端を開拓
NVIDIAはまた、急成長を遂げているヒューマノイドロボティクス分野への計画にも焦点を当て、「フィジカルAI」の開発を加速させるNVIDIA Isaacプラットフォームの大幅な進化を発表しました。ジェンスン・フアン氏によると、この取り組みの中核を成すのは、生産を開始したばかりの新型Jetson Thorロボティクスプロセッサです。Jetson Thorは、新世代のヒューマノイドロボットと自律システムのための、パワフルでエネルギー効率の高い頭脳となるよう設計されています。

このハードウェアを補完するのが、NVIDIA Isaac GR00T N1.5です。これは、NVIDIAのヒューマノイドロボットの推論とスキルのためのオープンで汎用化された基盤モデルのアップデート版です。Huang氏は、GR00T N1.5がオープンソース化され、数千件のダウンロード数を記録し、大きな注目を集めていると発表しました。このモデルは、ロボットに複雑な指示を理解し、動的な人間環境において様々なタスクを実行できる知能を提供することを目指しています。
ロボット工学における重要な課題の一つは、トレーニング用の膨大かつ多様なデータセットの取得です。NVIDIAは、NVIDIA Cosmosの物理AIワールド基盤モデルをベースとした画期的な設計図であるIsaac GR00T-Dreamsでこの課題に取り組んでいます。Huang氏はこれを「実データから実データへのワークフロー」と説明し、AIが巧みに人間のデモンストレーションを増幅する仕組みだと説明しました。開発者は、人間が遠隔操作するタスクの初期デモンストレーションでCosmosを微調整できます。次に、GR00T-Dreamsを使用して、新しいシナリオや指示をモデルに与え、ロボットが新しい動作を実行する多数の「夢」合成ビデオシーケンスを生成できます。これらの2Dの夢のビデオは、GR00Tロボットモデルのトレーニングのために3Dの動作軌跡に変換されます。「つまり、少数の人間のデモンストレーターが何千人もの作業を実行できるようになったのです」とHuang氏は説明し、これがデータ生成を劇的に拡張することを強調しました。
このエコシステム全体は、現在GitHubでオープンソース化されているシミュレーション用Isaac Sim、ロボット学習用Isaac Lab、Google DeepMindとDisney Researchと共同開発した高度なNewton物理エンジン、そしてCosmos世界モデルを網羅し、包括的なクラウド・ツー・ロボットプラットフォームを提供します。Huang氏は、「物理AIとロボティクスが次の産業革命をもたらす」と予測しており、「ブラウンフィールド」の人間環境に特に適したヒューマノイドロボットは、「次の数兆ドル規模の産業」となる可能性を秘めています。
DGX Spark、Station、Cloud Lepton
NVIDIA は、グローバル クラウド マーケットプレイスから強力なパーソナル AI スーパーコンピューターに至るまで、DGX 製品に関する重要なアップデートを通じて、高性能コンピューティングへのアクセスを可能にする取り組みを継続しました。
発表された重要な新しい取り組みは、NVIDIA DGX Cloud Lepton です。これは、世界の AI 開発者と数万台の GPU を結び付けるように設計されたコンピューティング マーケットプレイスを備えた AI プラットフォームです。このプラットフォームは、CoreWeave、Crusoe、Foxconn、ソフトバンク株式会社などの NVIDIA クラウド パートナーのグローバル ネットワークからクラウド AI サービスと GPU 容量へのアクセスを統合することを目的としています。これらのパートナーは、DGX Cloud Lepton マーケットプレイスで NVIDIA Blackwell やその他の NVIDIA アーキテクチャ GPU を提供します。開発者はオンデマンドおよび長期的なニーズに合わせて特定の地域のコンピューティング容量を活用し、戦略的かつ独立した AI 運用をサポートできます。DGX Cloud Lepton は、NIM および NeMo マイクロサービスを含む NVIDIA のソフトウェア スタックと統合されており、AI アプリケーションの開発と展開を簡素化し、NCP と連携して地球規模の AI ファクトリーを構築します。
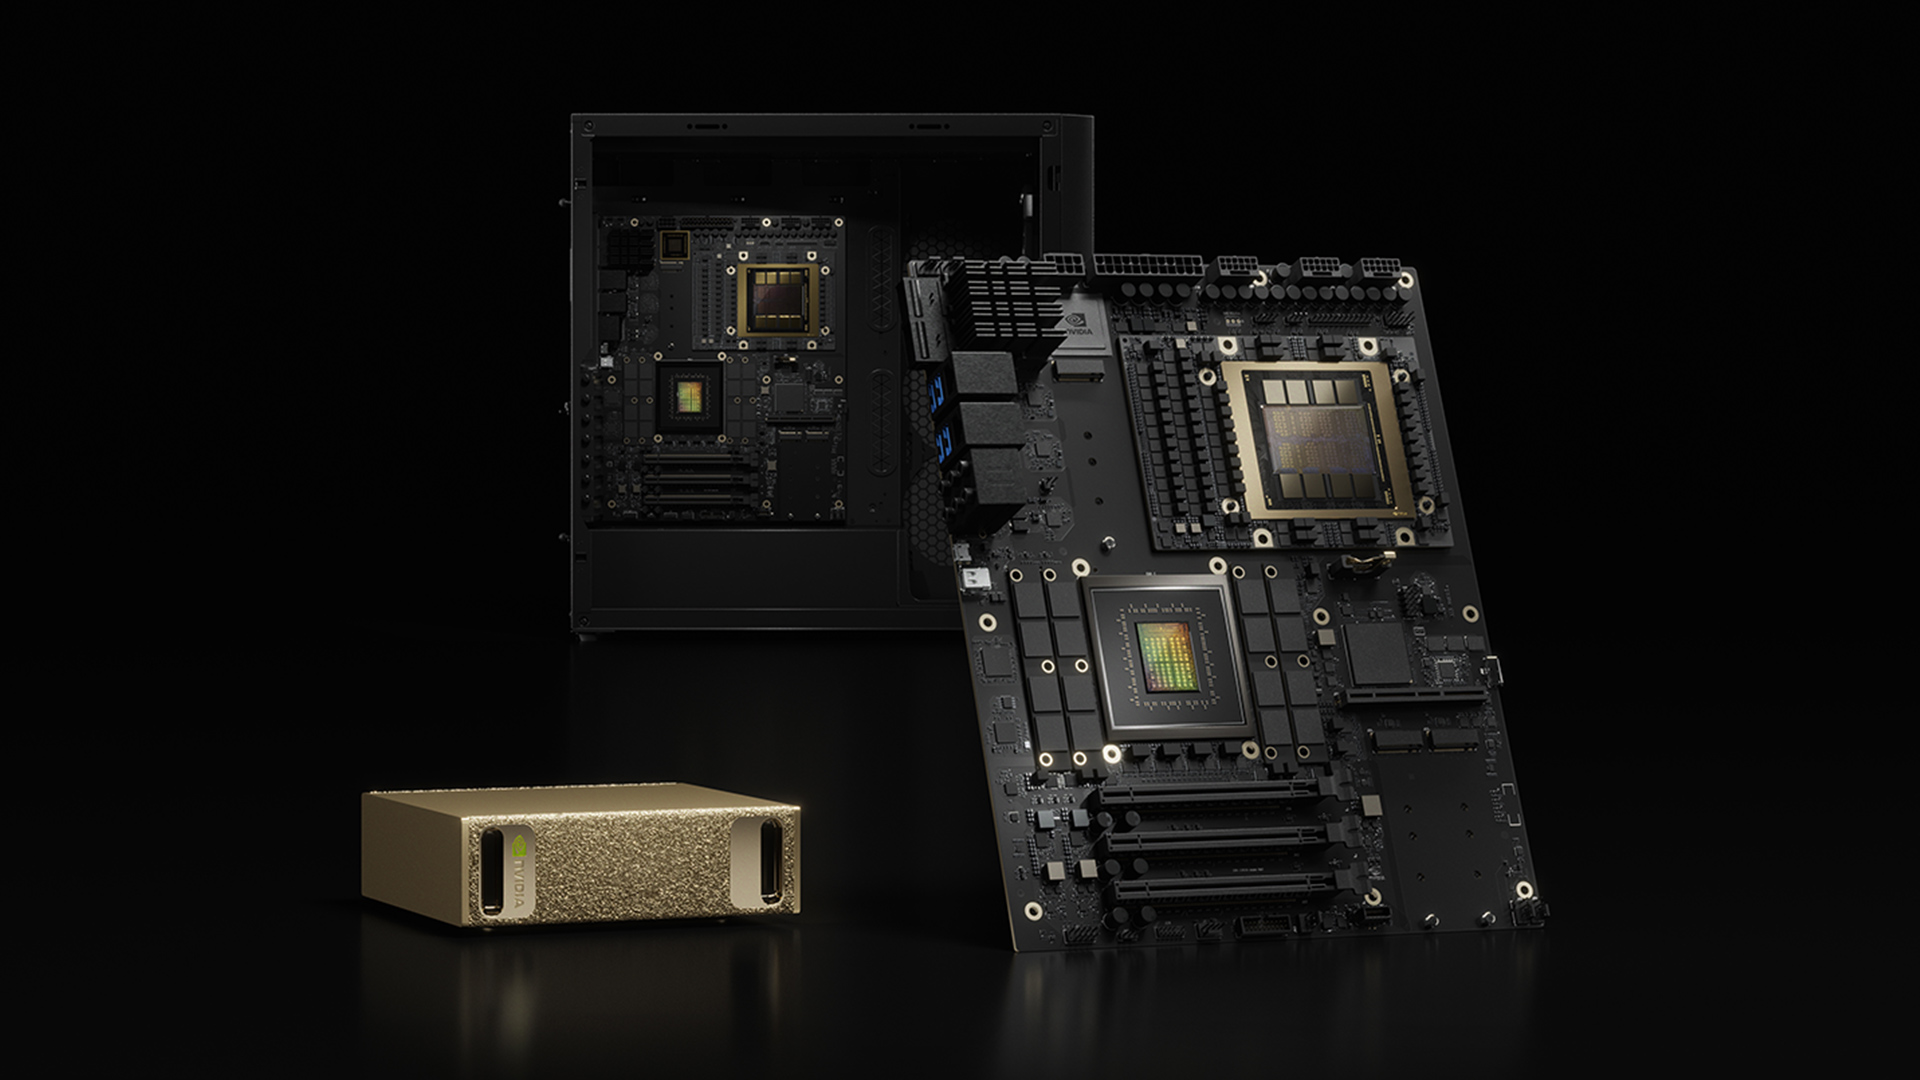
DGX Cloud Leptonが広範なクラウドアクセスに注力する一方、NVIDIAはパーソナルAIスーパーコンピューターであるNVIDIA DGX SparkとDGX Stationのエコシステムの拡大を強調しました。特に、パートナーシップの拡大と、より多くのベンダーによる可用性の向上に重点が置かれました。これらのシステムは、専用のAIクラウド環境を求める開発者、学生、研究者向けのAIネイティブコンピューターとして位置付けられています。
- NVIDIA GB10 Grace Blackwell スーパーチップを搭載した DGX Spark は、最大 1 ペタフロップスの AI コンピューティングを実現します。現在、量産段階にあり、Acer、ASUS、Dell Technologies、GIGABYTE、HP、Lenovo、MSI など、幅広いパートナー企業からまもなく提供開始される予定です。
- DGX Stationは、最大300ペタフロップスのAI性能を実現するNVIDIA GB20 Grace Blackwell Ultraデスクトップスーパーチップを搭載し、パートナー企業による採用も拡大しています。ASUS、Dell Technologies、GIGABYTE、HP、MSIから今年後半に提供開始予定で、兆パラメータのAIモデルを実行可能なデスクトップソリューションを提供します。
Nvidia RTX 5060の発売

NVIDIA は、Computex での広範な発表を締めくくるものとして、NVIDIA GeForce RTX 5060 も発表しました。パートナーからのアドイン カード フォーム ファクターと新しいゲーミング ノート PC への統合の両方で本日より提供が開始される RTX 5060 は、より幅広いユーザーに魅力的なパフォーマンスと機能を提供することを目指しています。
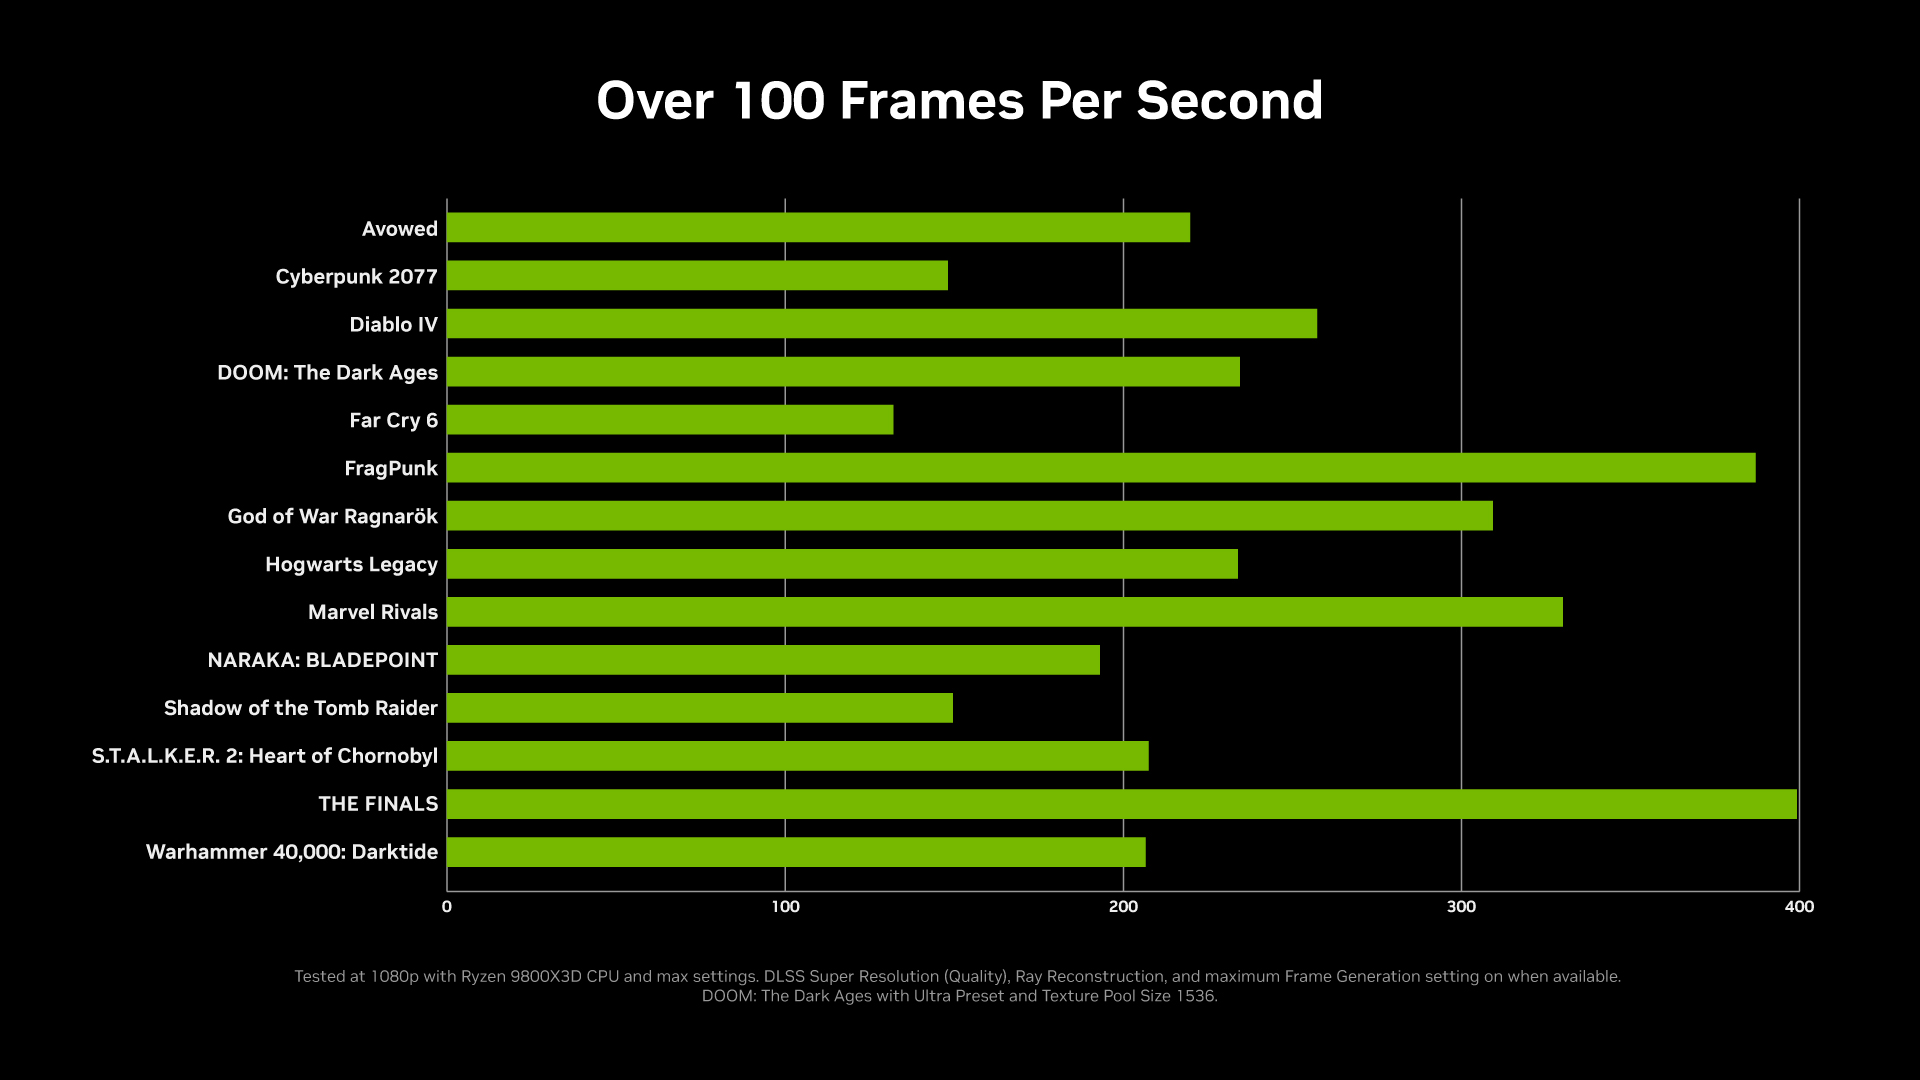
Blackwellアーキテクチャを採用したRTX 5060は、NVIDIAの最新のAIを活用した超解像およびフレーム生成技術を活用したDLSS 4に対応しています。614 AI TOPS(INT4)を誇り、AI処理能力を強化しています。第5世代Tensorコアと第4世代RTコアを搭載し、レイトレーシングとAIパフォーマンスを向上させています。メディア処理には、第9世代NVIDIAエンコーダー(NVENC)と第6世代NVIDIAデコーダー(NVDEC)をそれぞれ5060基ずつ搭載しています。RTX 8は7GBのGDDR448メモリを搭載し、XNUMXGB/秒のメモリ帯域幅を実現し、最新のゲームタイトルやクリエイティブなワークロードでスムーズなパフォーマンスを実現します。
これらのアップデートは、広大なクラウド ネットワークや専用の高性能デスクトップ システムを通じて強力な AI ツールとコンピューティング リソースをより容易に利用できるようにし、あらゆる規模の開発者が AI 革命に参加できるようにするという NVIDIA の戦略を総合的に表しています。


 Amazon