

NVIDIAは、Blackwell GPUアーキテクチャ向けに開発された新しい手法「Helix Parallelism」を発表しました。これは、大規模データセットにおけるリアルタイムAIパフォーマンスの向上を目的としています。この技術は、数百万トークン規模のコンテキストを処理するLLMへの高まるニーズに対応します。NVIDIAは、このアプローチにより従来の手法と比較して処理速度を最大32倍向上させ、より複雑で応答性の高いAIアプリケーションを実現できることを実証しました。
100万トークンチャレンジ:AIに新たなアプローチが必要だった理由
AIの最先端は、単純なクエリから複雑で長期的な推論へと移行しています。高度なアプリケーションが効果を発揮するには、膨大なコンテキストが不可欠です。数ヶ月分の会話を記憶するAIアシスタント、ギガバイト単位の判例を一気に分析する法律ツール、リポジトリ全体を理解するコーディングパートナーなど、これらのタスクには数百万単位のトークン処理が必要です。
ただし、このレベルまでスケーリングすると、2 つの根本的なボトルネックが発生します。
- KVキャッシュのボトルネック:自己回帰トークン生成において、モデルは2乗のスケーリング係数を回避するために、以前に生成されたトークンに注目して計算を行います。これを実現するために、以前に生成されたトークンはキャッシュされます。このプロセスはKVキャッシュと呼ばれます。数百万トークンのコンテキストでは、このキャッシュは膨大になり、GPUのメモリ帯域幅を飽和させ、応答時間を大幅に低下させます。
- FFN重みのボトルネック:モデルが新しいトークンを生成するたびに、膨大なフィードフォワードネットワーク(FFN)重みをメモリから読み込む必要があります。インタラクティブで低レイテンシのアプリケーションでは、この継続的な読み込みプロセスが遅延の主な原因となります。
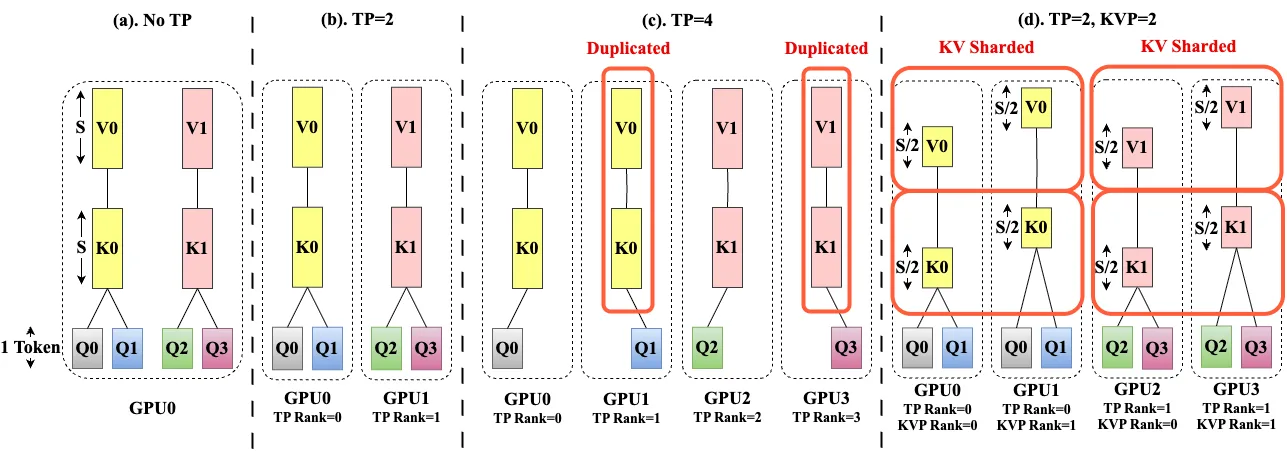
現在、私たちはTensor Parallelismのような手法に依存しています。これは、モデルのテンソルを分割し、必要なメモリと計算作業を複数のGPUに分散させるものです。一部のタスクでは効果的ですが、新しいアテンションメカニズムではそのメリットが低下します。GQA(Grouped Query Attention)やMLA(Multi-Latent Attention)などのアテンションメカニズムでは、メモリ使用量を削減するために、複数のクエリヘッドが少数のKVヘッドを共有します。しかし、Tensor ParallelismのサイズがKVヘッドの数を超えると、ステップごとにGPU間通信によって大きな遅延が発生するため、KVヘッドの複製が必要になります。この複製は、Tensor Parallelismの一部のメリットを相殺します。
らせん平行性
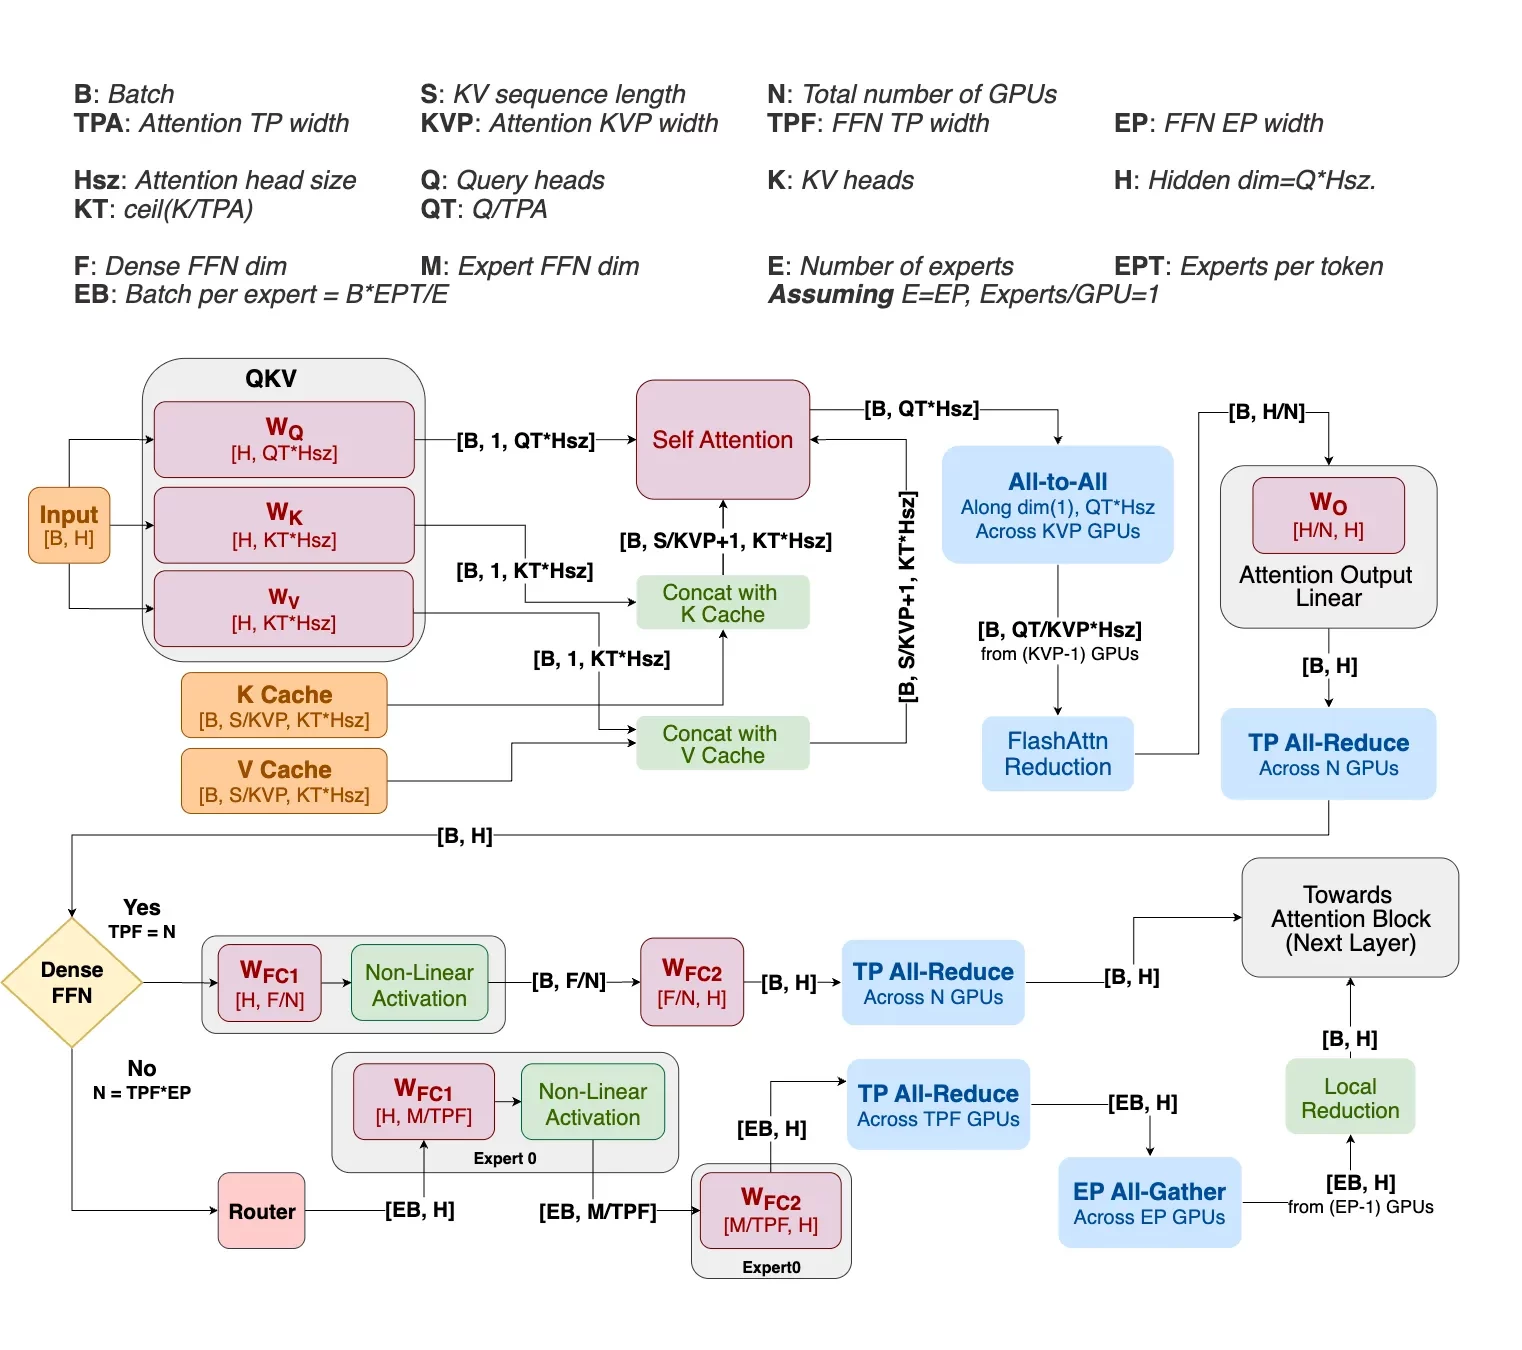
この難問を解決するために、NVIDIAのHelix Parallelismは、2つのボトルネックを別々の問題として扱い、シームレスな時間的パイプラインで解決するハイブリッド戦略を導入します。プロセス全体に単一の並列化手法を適用するのではなく、Helixは同じGPUプールを動的に再構成し、計算の各段階で最適な戦略を適用します。
このプロセスは、モデルの各レイヤーごとに 2 つの主要なフェーズに分けられます。
フェーズ 1: 注意フェーズ (KV キャッシュへの取り組み)
Helixは、2種類の並列処理を組み合わせることで、KVキャッシュのボトルネックに直接対処します。まず、KV並列処理を適用します。これは、KVキャッシュ自体をシーケンス次元に沿って複数のGPUに分割するものです。これにより、各GPUは全体のコンテキストの一部のみを保持し、メモリ負荷を軽減します。
同時に、テンソル並列処理を用いてアテンションヘッドを分割し、分割数がKVヘッドの数を超えないようにします。この組み合わせにより、従来のテンソル並列処理で問題となるキャッシュの重複を回避できます。その結果、GPUの2Dグリッドが実現し、単一のGPUに過負荷がかかることなく、大規模なコンテキストでアテンションを効率的に計算できます。これらのGPU間の通信は、単一の効率的な全対全交換によって処理されます。そのコストはコンテキストの長さに依存しないため、非常にスケーラブルです。
フェーズ2:FFNフェーズ(FFNウェイトへの取り組み)
アテンションフェーズの最後に行われる全対全通信では、出力データがGPU間で分割されます。つまり、FFN計算をすぐに開始できるように、データが既に完璧に配置されているということです。
同じGPUプールが、大規模なTensor Parallelismグループに再プロビジョニングされます。データは事前に分割されているため、各GPUは、膨大なFFN重みのシャードを用いて、ローカル行列乗算を実行できます。この初期計算はGPU間の通信なしに並列に行われるため、速度が最大限に高められます。このローカル計算ステップの後にのみ、GPUは効率的なall-reduce通信に参加し、部分的な結果を最終出力に統合します。
パズルの最後のピースは、HelixがKVキャッシュの増加に合わせてどのように管理するかです。モデルが新しいトークンを生成すると、それらをキャッシュに追加する必要があります。単純なアプローチでは、すべての新しいトークンを単一のGPUに書き込むことでメモリのホットスポットが発生する可能性があります。Helixは、巧妙なラウンドロビン更新システムによってこれを防ぎます。例えば、新しいトークンの最初のブロックはGPU 0に、次のブロックはGPU 1に、といった具合に書き込まれます。この段階的なアプローチにより、KV並列処理グループ内のすべてのGPUでメモリ使用量が均一に増加し、コンテキストサイズに関係なくバランスの取れたパフォーマンスと一貫したスループットが維持されます。
ブラックウェルの新たなパフォーマンスの境地
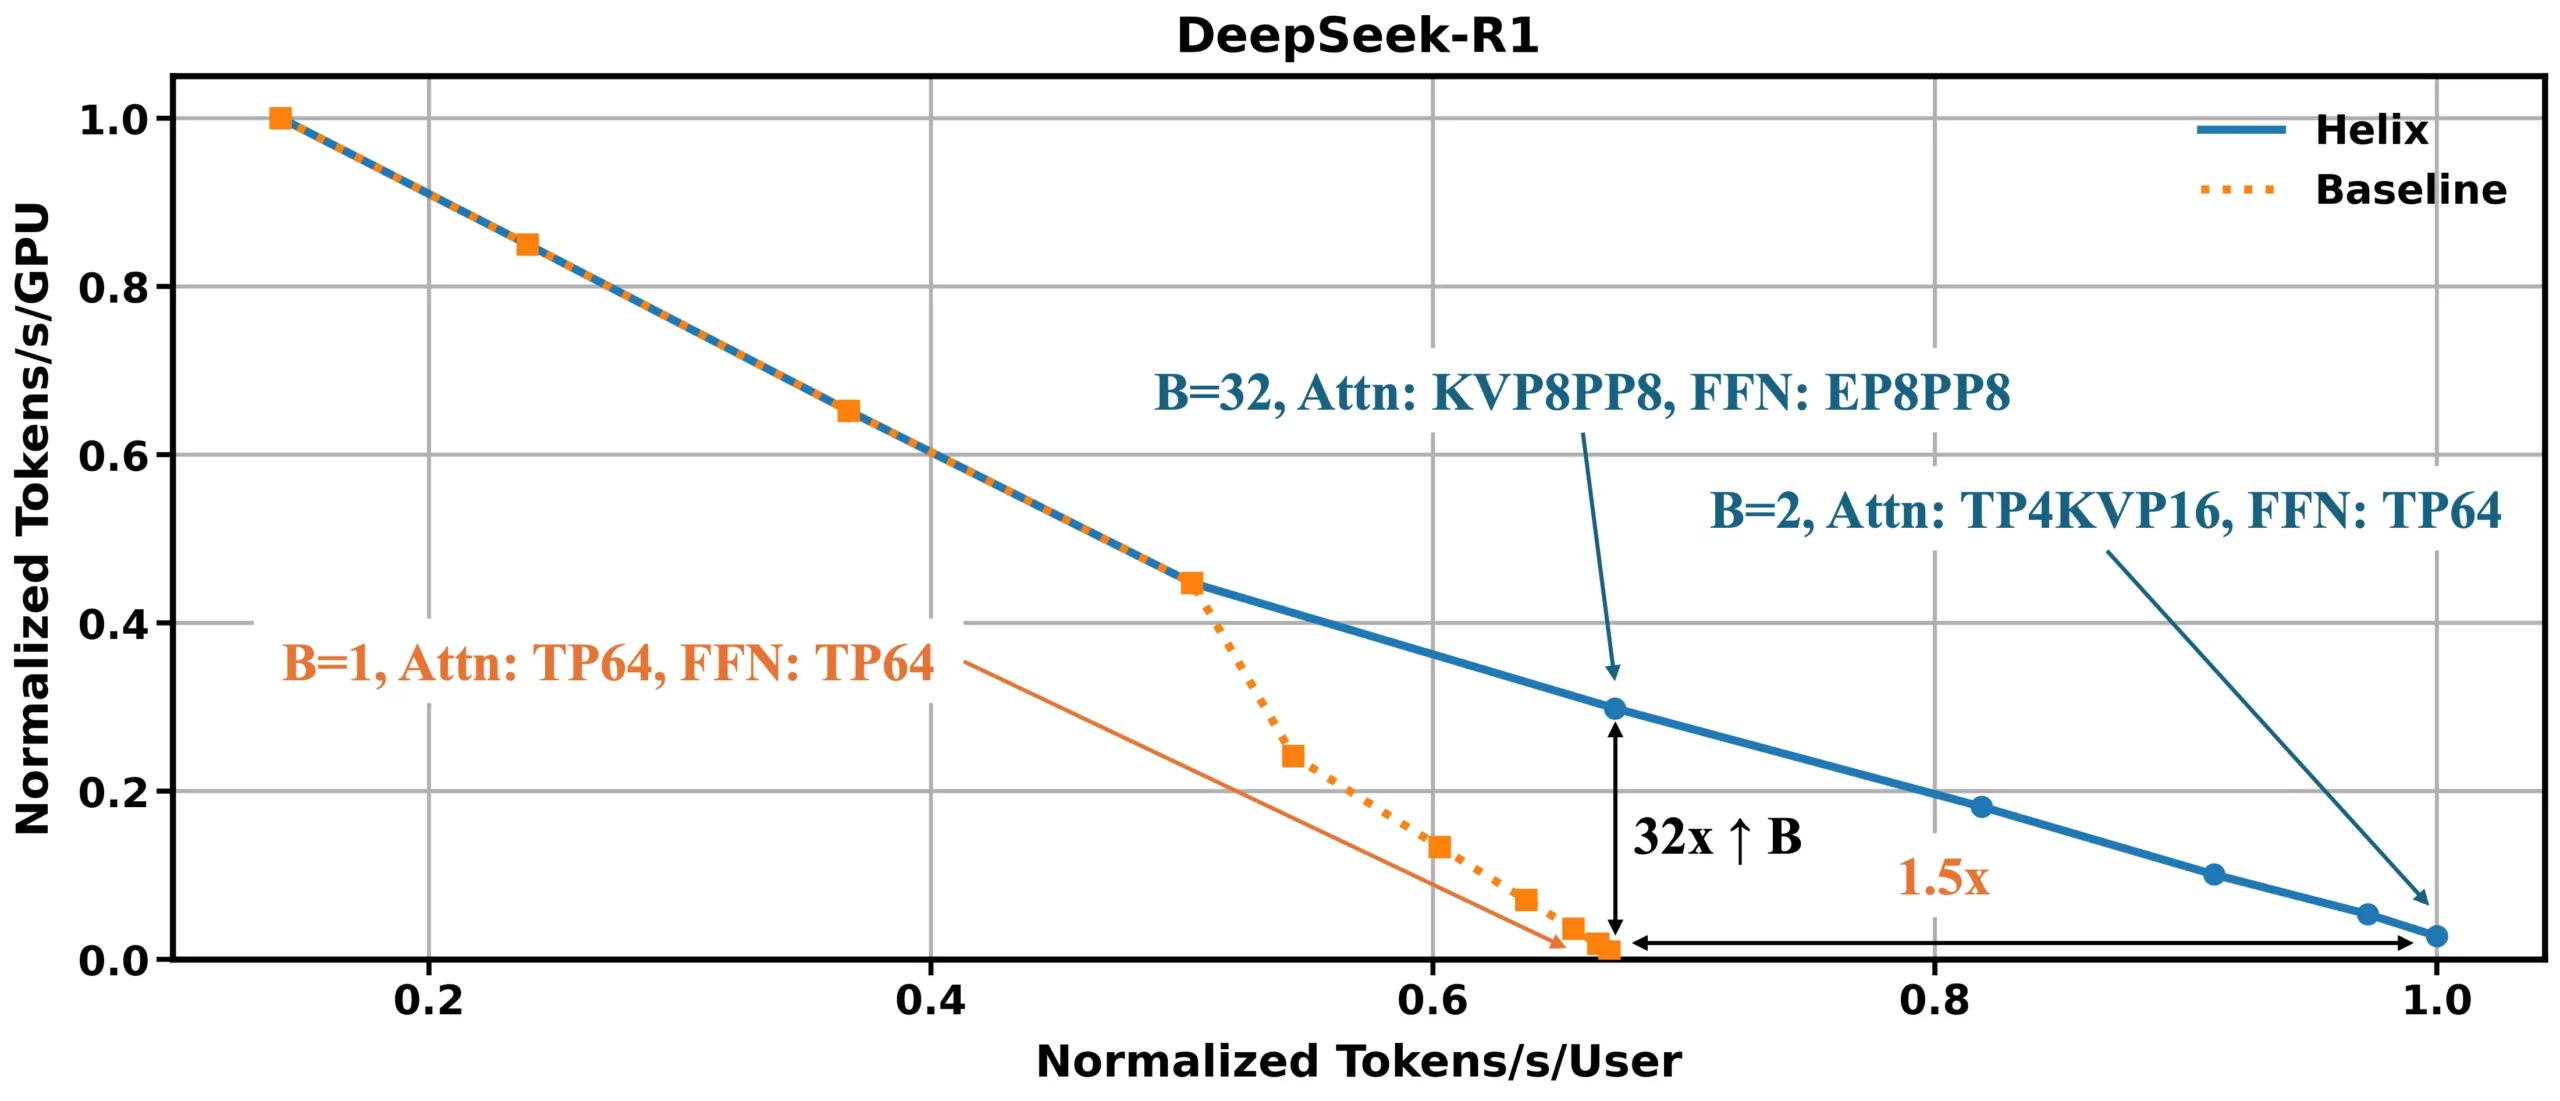
Helixは、ロングコンテキストLLMデコードにおける新たな性能ベンチマークを確立しました。この結果は、仮想的な72万トークンコンテキストにおいて、Blackwell NVL1上でDeepSeek R671 4Bパラメータモデル(FP32)を用いた徹底的なシミュレーションに基づいています。このシミュレーションでは、分割戦略とバッチサイズを体系的に変化させ、スループットとレイテンシの最適なトレードオフを導き出しました。多数のユーザーに同時にサービスを提供するなど、大規模なスケーラビリティが求められるアプリケーションでは、Helixは、与えられたレイテンシ予算内で同時ユーザー数を最大1.5倍向上させることができます。単一ユーザーの応答性が重要となる同時ユーザー数の少ない設定では、この技術により、達成可能な最小トークン間レイテンシを削減することで、ユーザーインタラクションを最大XNUMX倍向上させることができます。これらの性能向上は、KVキャッシュとFFNウェイトの両方を利用可能なすべてのデバイス間でシャーディングすることで実現され、DRAM負荷を大幅に低減し、計算効率を向上させます。
方法論とシミュレーション結果に関するより詳細な技術的な解説については、こちらのリンクから完全なレポートをご覧ください。


 Amazon