

Qumuloは、データ移動のボトルネックを解消することで企業AIインフラストラクチャの効率性を向上させることを目的とした新しいアーキテクチャであるCloud AI Acceleratorを発表しました。このプラットフォームは、レプリケーションやステージングを必要とせずに、リージョン、クラウド、ハイブリッド環境をまたいで分散データセットをリアルタイムでGPUリソースに提供します。
今回のリリースは、企業向けAIインフラストラクチャにおける非効率性という、これまで十分に指摘されてきた問題点を克服するものです。Qumuloは、Cast AIの2026年Kubernetes最適化レポートを引用し、企業におけるGPUの平均利用率は約5%にとどまり、残りの95%の高速コンピューティングリソースは、ワークロードを開始する前にデータのステージング、複製、配置を行う必要があるため、アイドル状態になっていると指摘しています。QumuloのCEOであるDoug Gourlay氏は、発表の中でこの問題を次のように説明しています。「私たちが話をするすべての企業はGPUの可用性に注目していますが、可用性は問題の半分に過ぎません。より根本的な問題は利用率であり、その原因はデータグラビティです。」
AIワークロードにおけるデータ配置の再考
従来のAIインフラストラクチャのアプローチでは、ストレージをGPUクラスタと同じ場所に配置し、高性能フラッシュシステムをコンピューティングに密接に連携させるのが一般的です。このモデルは、アクティブなトレーニングや推論時には効果的ですが、データ準備によるアイドル期間には対応できません。また、企業がデータセットをコンピューティングに近い場所に保持するために複数の環境に複製するため、ストレージが断片化され、サイロ化してしまうという問題もあります。
Qumuloのアプローチは、データの場所と計算場所を切り離すことで、従来のモデルを変革します。データをGPUに移動させるのではなく、Cloud AI AcceleratorはGPUがデータに直接アクセスできるようにします。これは、データの物理的な場所に関係なく、データセットへの一貫したリアルタイムアクセスを提供する分散データファブリックによって実現されます。
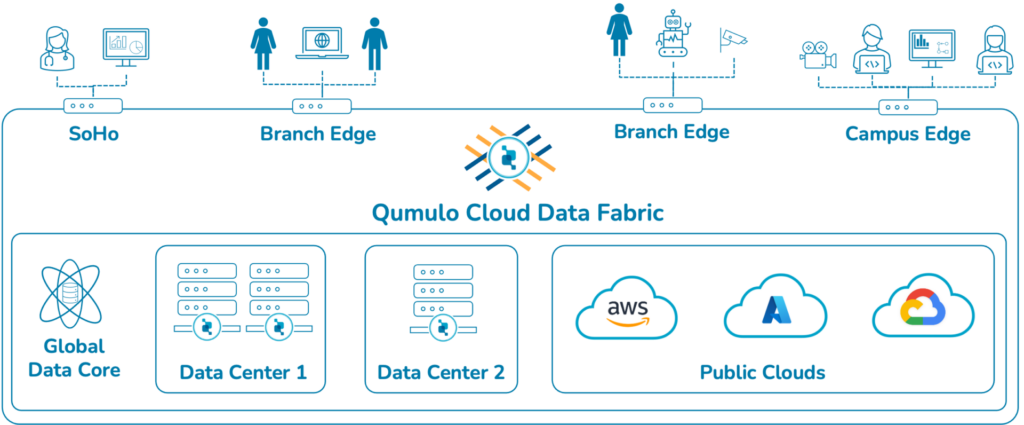
同社はこの機能を「GPU流動性」を実現するものと位置付けており、データ配置の制約ではなく、利用可能なコンピューティング能力に基づいてワークロードをスケジュールできるとしている。実際には、これにより企業はデータを事前に配置することなく、複数のクラウドやリージョンにまたがるGPUリソースを利用できるようになる。
アーキテクチャ:データファブリックとキャッシングレイヤー
Cloud AI Accelerator は、これまで別々に提供されていた 3 つの Qumulo 製品を統合したものです。Cloud Native Qumulo (CNQ) は、AWS、Azure、Google Cloud、Oracle Cloud Infrastructure 上でネイティブに動作する Qumulo のファイルシステムです。2025 年 2 月にリリースされた Cloud Data Fabric (CDF) は、エッジで一貫性のあるキャッシュを備えた中央のファイルおよびオブジェクトリポジトリを提供します。2025 年 4 月に CDF に追加された NeuralCache は、機械学習を予測的な読み書きキャッシュに適用し、Qumulo は GPU のデータロード時間を最大 64% 短縮できると主張しています。Cloud AI Accelerator 自体は 2025 年 11 月に初めて登場しました。5 月 26 日にリリースされたバージョンでは、Microsoft AI Foundry、AWS Bedrock、Google Vertex AI への直接接続が追加され、「GPU 流動性」の位置付けが正式に定義され、ハイブリッド展開のために製品が Cisco と連携しています。
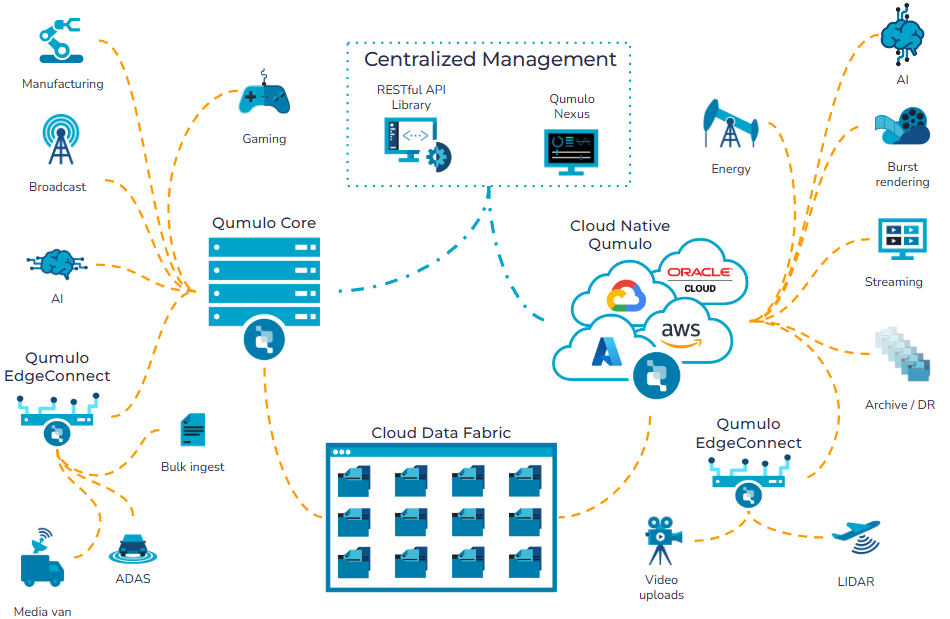
データパスは、ソースサイト(オンプレミスクラスター、クラウドリージョン、リージョン間レプリカ、またはCNQ S3バックアップストレージ)からブロックレベルでアクセラレータのCPU DRAMキャッシュを経由して、直接GPUへと送られます。このアーキテクチャは、オンプレミス、エッジ、マルチクラウド環境全体で単一の信頼できる情報源を維持し、一括レプリケーションを回避することで、ストレージのオーバーヘッドと同期の複雑さの両方を軽減します。
この設計は、マネージドAIサービスとの統合もサポートしています。企業は、既存のデータセットをMicrosoft AI Foundry、AWS Bedrock、Google Vertex AIなどのプラットフォームに直接接続でき、データをこれらの環境にコピーする必要はありません。
運用上の影響:アイドル時間と複雑さの削減
主な運用上のメリットは、データ準備の遅延を解消できることです。多くのAIワークフローでは、データ準備に数日から数週間かかることがあり、モデルのトレーニングが遅れ、GPUの有効利用率が低下します。Cloud AI Acceleratorはデータセットへの即時アクセスを可能にすることで、コンピューティングリソースが利用可能になり次第、ワークロードを開始できるようにします。
これにより、複数のストレージ環境を維持する必要性も軽減されます。GPUクラスターやクラウドリージョンごとに個別のデータサイロを作成する代わりに、組織は単一の論理データセットから運用できます。これはデータ管理を簡素化し、インフラストラクチャの乱立を抑制します。
コスト面から見ると、このモデルはGPUのアイドル状態のリソース消費を削減することを目的としています。GPUに接続されたストレージにデータを事前にロードする必要性をなくすことで、企業はGPUがデータを待つ時間を短縮し、高速コンピューティングへの投資対効果を向上させることができます。
ハイブリッドAIインフラストラクチャ向けCisco統合
シスコは、ハイブリッド展開における共同市場開拓パートナーであり、オンプレミスのコンピューティング基盤はシスコUCSが、データファブリックはシスコのネットワークおよびセキュリティソリューションによって提供されます。Qumuloとシスコは、このソリューションを、変化するGPU可用性に数分で適応できるインフラストラクチャとして位置づけており、これこそがエンタープライズ規模でのGPU流動性を実用的なものにする要素だと主張しています。
この提携は双方にとって非常に重要です。QumuloはCisco UCS環境への確実な参入経路を確立でき、Ciscoはハイパースケーラー上でコンピューティングを拡張しながらデータをオンプレミスに保持したいハイブリッドAI顧客向けのストレージソリューションを提供できます。データアクセスはサイト間の安定したデータ転送に依存するため、高スループットかつ低遅延のネットワークがここでの重要な要素となります。
可用性および展開モデル
Qumulo Cloud AI Acceleratorは、AWS、Microsoft Azure、Google Cloud、Oracle Cloud Infrastructureで利用可能になり、Cisco UCS環境でのハイブリッド展開もサポートしています。QumuloとCiscoは、5月31日から6月4日までラスベガスで開催されるCisco Live 2026のブース#4018に出展し、両社の共同ソリューションを展示します。
今回のリリースは、AIインフラ設計におけるデータ中心アーキテクチャへの広範なシフトを反映している。高速化されたコンピューティング能力が、それを支えるインフラのペースを上回り続ける中、利用率の向上は、GPUがデータを待つ時間を短縮することにかかっている。Qumuloは、データセットをモバイル対応ではなく、普遍的にアクセス可能にすることが、各GPUクラスタにフラッシュメモリを追加するよりも、より持続可能なアプローチだと考えている。


 Amazon