

AIインフラ市場は単一の方向に進んでいるのではなく、二つの異なる世界に分かれつつあります。一つは、大規模な基盤モデル開発のために構築され、独自のファブリックと限られたアクセラレータに密接に連携する最先端のトレーニングクラスタです。もう一つは、急速に拡大しているエンタープライズ推論の現実です。ここでは、組織がモデルを展開してユーザーにサービスを提供し、ライブデータを処理し、測定可能なビジネス価値を生み出しています。Dell PowerEdge XE7740は、まさにこの後者の世界のために設計されています。
主要なポイント(要点)
- PowerEdge XE7740はエンタープライズ推論向けに設計されています。 デュアルゾーン熱制御、構造化されたPCIe Gen5トポロジー、および実際の運用ワークロードに合わせたスケールアウトネットワークを備えています。
- システムのバランスは意図的なものであり、 Xeon 6コアの高密度、高いメモリ帯域幅、およびPCIe Gen 5 E3.S NVMeを組み合わせることで、KVキャッシュのオフロードとオーケストレーションをサポートします。
- シリコンの柔軟性は基礎となるものであり、 インフラストラクチャの再設計を必要とせずに、幅広いPCIe Gen5アクセラレータをサポートする。
- プラットフォームは時間の経過とともにスムーズに拡張され、 単一シャーシ内の部分的なGPU搭載から、背面にある8つのGen5 x16専用ネットワークスロットを使用したラック間での分散推論まで。
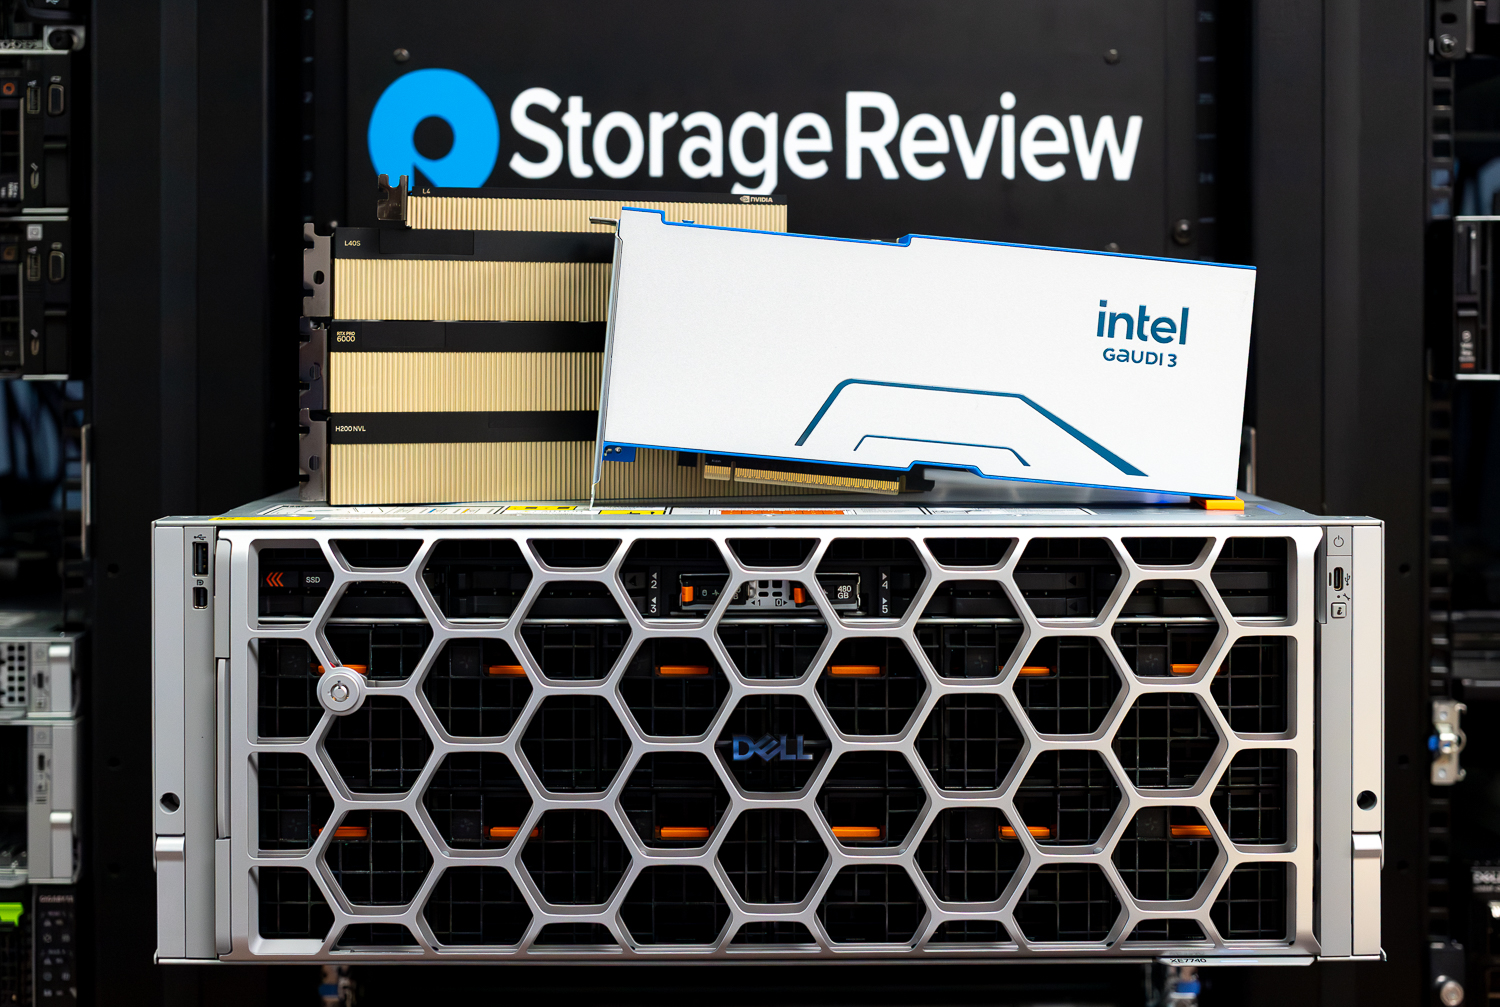
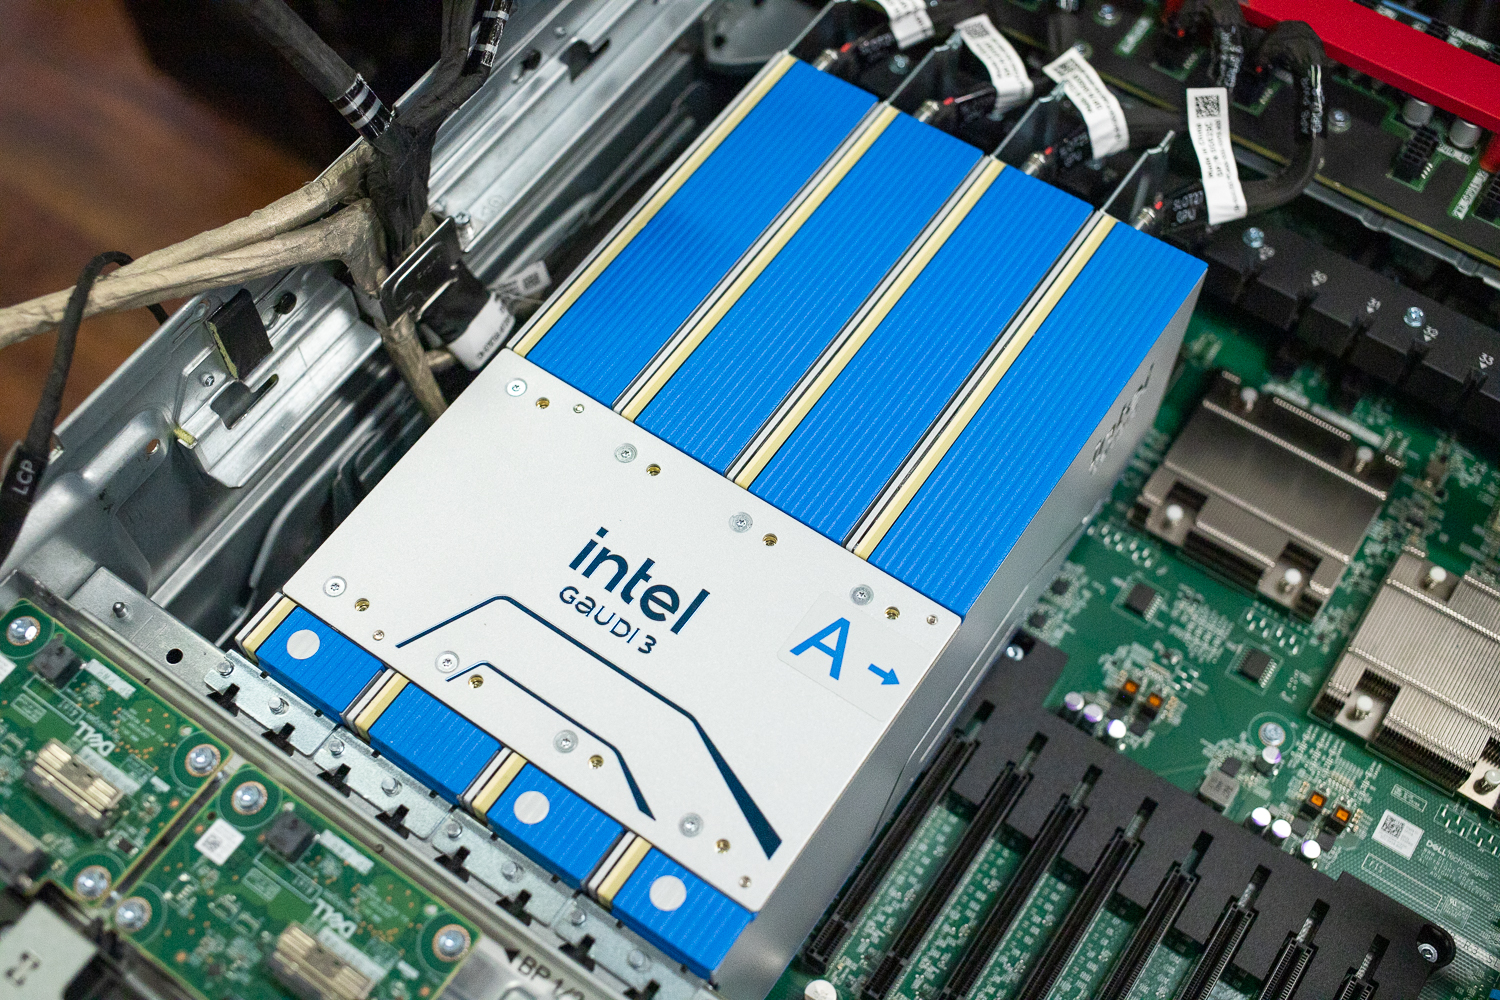
XE7740の中核を成すのは、シリコンの多様性へのこだわりです。プラットフォームを単一のアクセラレータロードマップに固定するのではなく、デルは可用性、コスト、組織の準備状況に合わせて柔軟に対応できるシステムを構築しました。XE7740は、幅広いエコシステム互換性を重視する組織向けにNVIDIAのRTX PRO 6000、H100/200、L40S、L4、A16 GPUを含む、さまざまなPCIe Gen5アクセラレータをサポートしています。また、よりコスト効率が高く、すぐに利用できる推論パスを求めるチーム向けには、Intel Gaudi 3もサポートしています。Gaudi 3アクセラレータは現在入手可能なため、組織はアクセラレータ戦略を左右することが多い調達の遅延を回避し、計画から導入へとスムーズに移行できます。
推論がAIワークロードの主流となるにつれ、可用性とコスト構造が重要になってきます。ほとんどの企業は、最先端規模のモデルをトレーニングしているわけではありません。推論パイプラインを実行し、中規模の言語モデルを提供し、検索拡張生成ワークフローを支え、コンピュータビジョンを本番環境に展開しています。このような状況において、Gaudi 3は市場で最も手頃な価格の最新推論アクセラレータの1つとして位置づけられており、フラッグシップのトレーニングGPUのようなコストプロファイルなしに、高帯域幅メモリとイーサネットベースのスケールアウトを備えた最新のアーキテクチャを提供します。XE7740におけるGaudi 3は、既存システムの置き換えというよりも、持続可能な推論展開を実現することに重点を置いています。
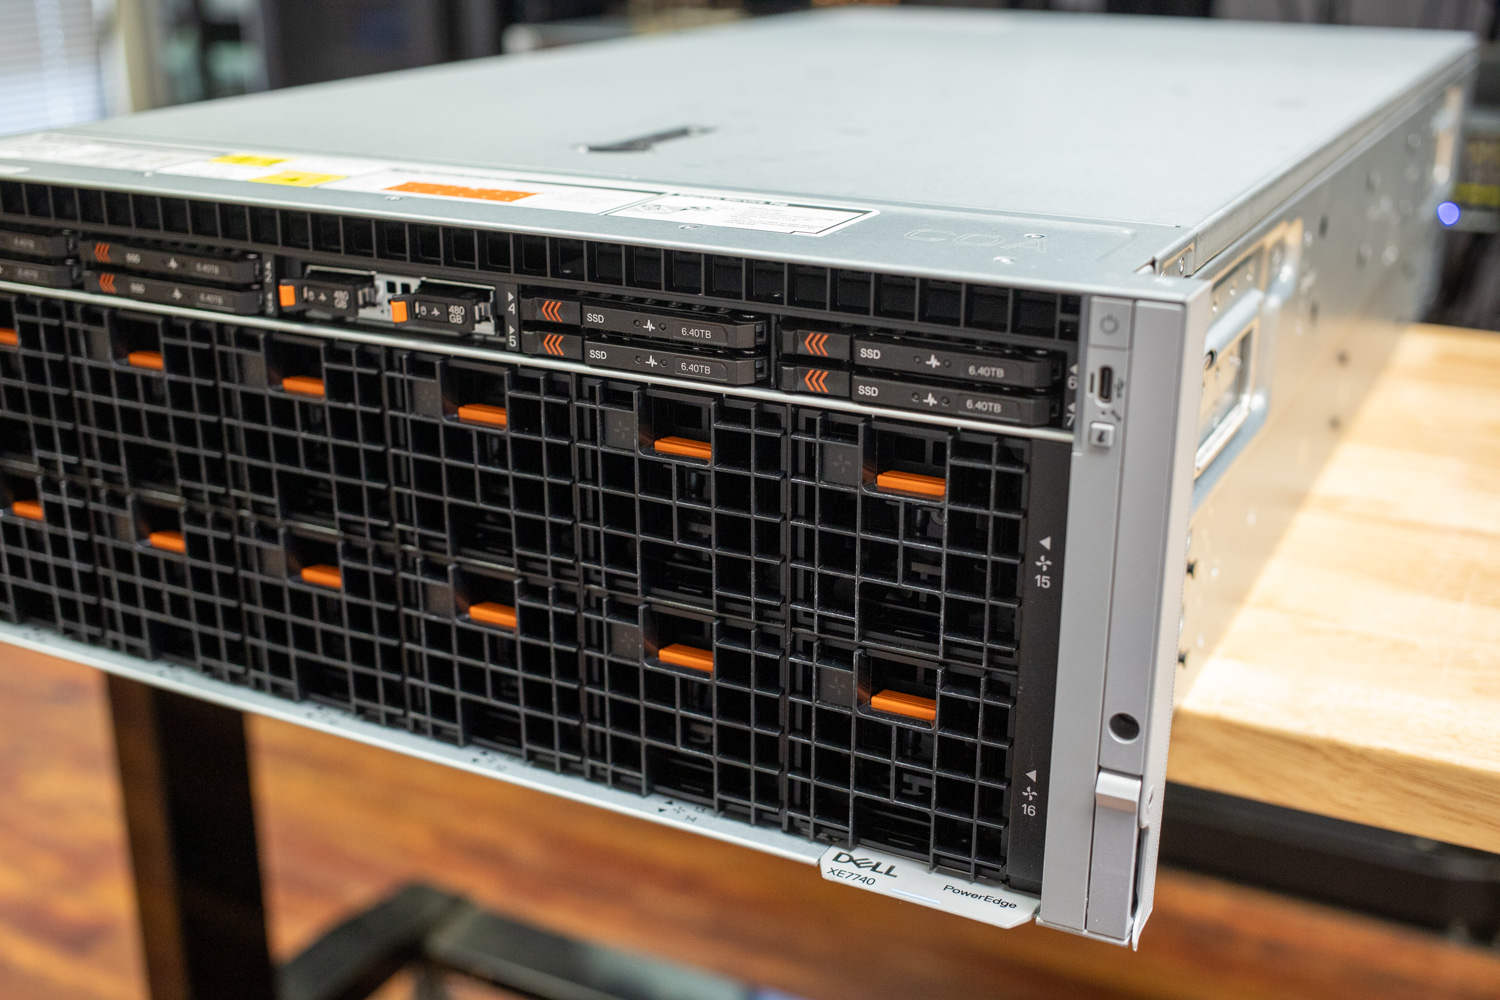
アクセラレータを取り巻くプラットフォームも同様に綿密に設計されています。XE7740はIntel Xeon 6プロセッサをベースとしており、推論に特化したシステムではCPUが重要なコンポーネントとなります。コア数の増加とメモリ帯域幅の拡大により、推論のクリティカルパス上に直接存在するスケジューラ、トークン化、前処理、オーケストレーションといったタスクに必要な余裕が確保されます。前面に搭載されたE3.S NVMeストレージは、ローカルデータステージングとKVキャッシュのオフロードをさらにサポートし、アクセラレータの負荷を軽減してシステム全体の効率を向上させます。このようなバランスの取れた設計は、推論パフォーマンスはアクセラレータ単体ではなく、システム全体によって左右されるという認識に基づいています。
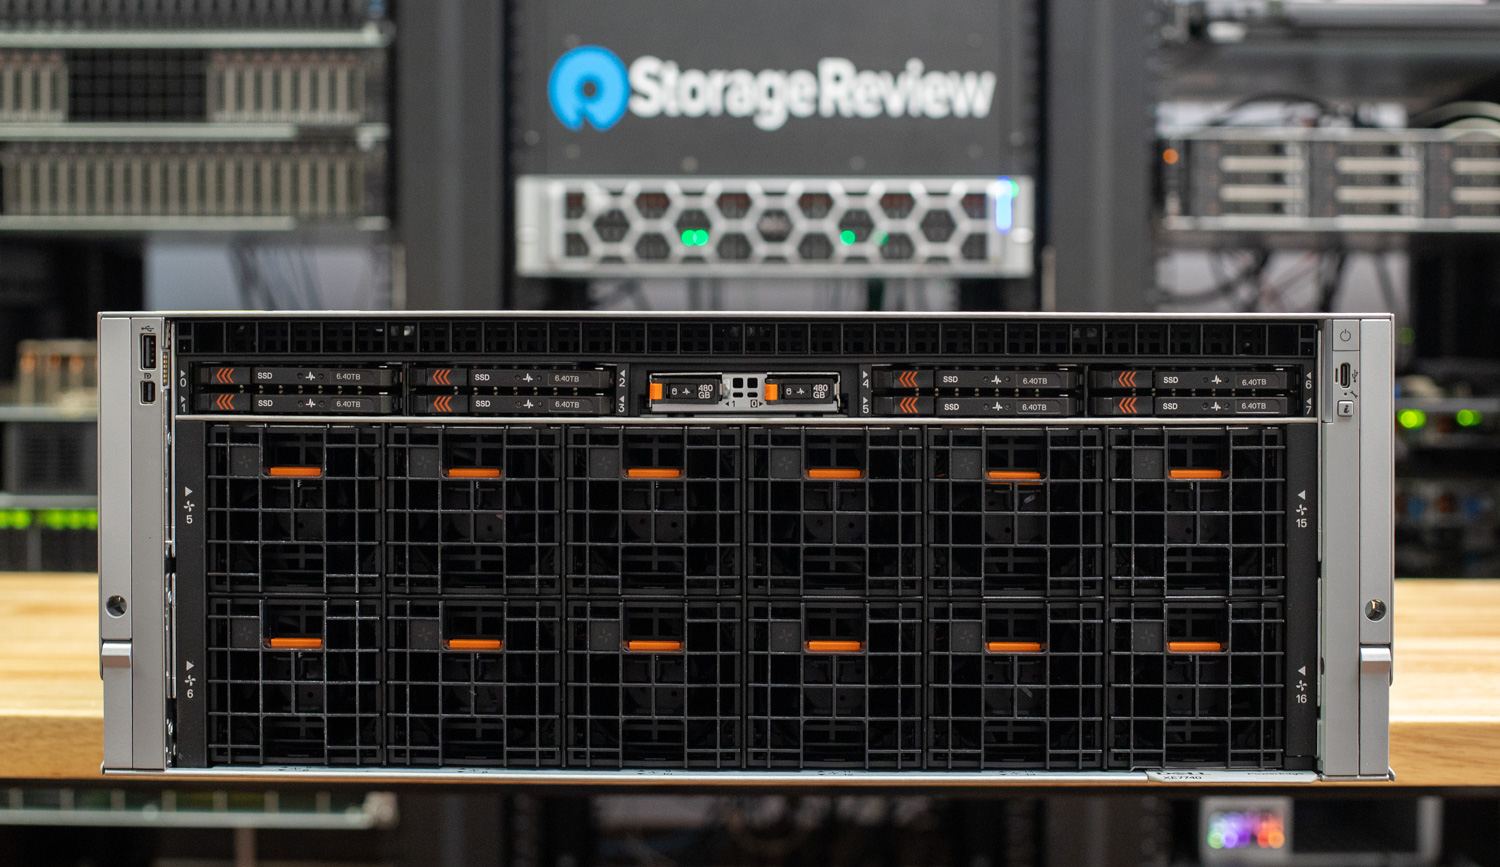
XE7740は、時間の経過とともにスムーズに拡張できるように設計されています。組織は、2つまたは4つのアクセラレータといった控えめな構成から始め、シャーシを完全に満杯にすることなく、すぐに価値を引き出すことができます。要件が拡大するにつれて、同じプラットフォームを垂直方向に拡張したり、分散推論に移行したりできます。背面にある8つのPCIe Gen5 x16スロットは、高速ネットワーク専用の帯域幅を提供し、XE7740をスケールアウト推論クラスタの構成要素として活用できるようにします。オプションのDPUサポートにより、導入が成熟するにつれてネットワークおよび通信タスクをオフロードすることで、この柔軟性がさらに拡張されます。
Dell PowerEdge XE7740の主な仕様
| 製品仕様 | パワーエッジ XE7740 |
|---|---|
| PowerEdge XE7740の特長 | |
| プロセッサ | Intel® Xeon® 6シリーズプロセッサー2基(プロセッサーあたり最大86コア) |
| スロット | |
| PCIeアクセラレータ | 8x PCIe Gen 5 x16 DW-FHFL 最大600W、または
16x PCIe Gen 5 x16 SW-FHFL 最大75W |
| PCIe NIC |
|
| フォームファクター | |
| フォームファクター | 4Uラックサーバー |
| メモリ | |
| DIMM速度、最大容量 | 最大6400 MT/s、最大4 TB |
| メモリモジュールスロット | 32個のDDR5DIMMスロット レジスタードECC DDR5 RDIMMのみをサポートします。 |
| Storage | |
| フロントベイ | 最大 8 x EDSFF E3.S Gen5 NVMe (SSD) 最大 122.88 TB |
| ストレージコントローラー | |
| 内部ブート | ブート最適化ストレージサブシステム(BOSS-N1 DC-MHS):HWRAID 1、M.2 x 2
NVMe SSD |
| 電源 | |
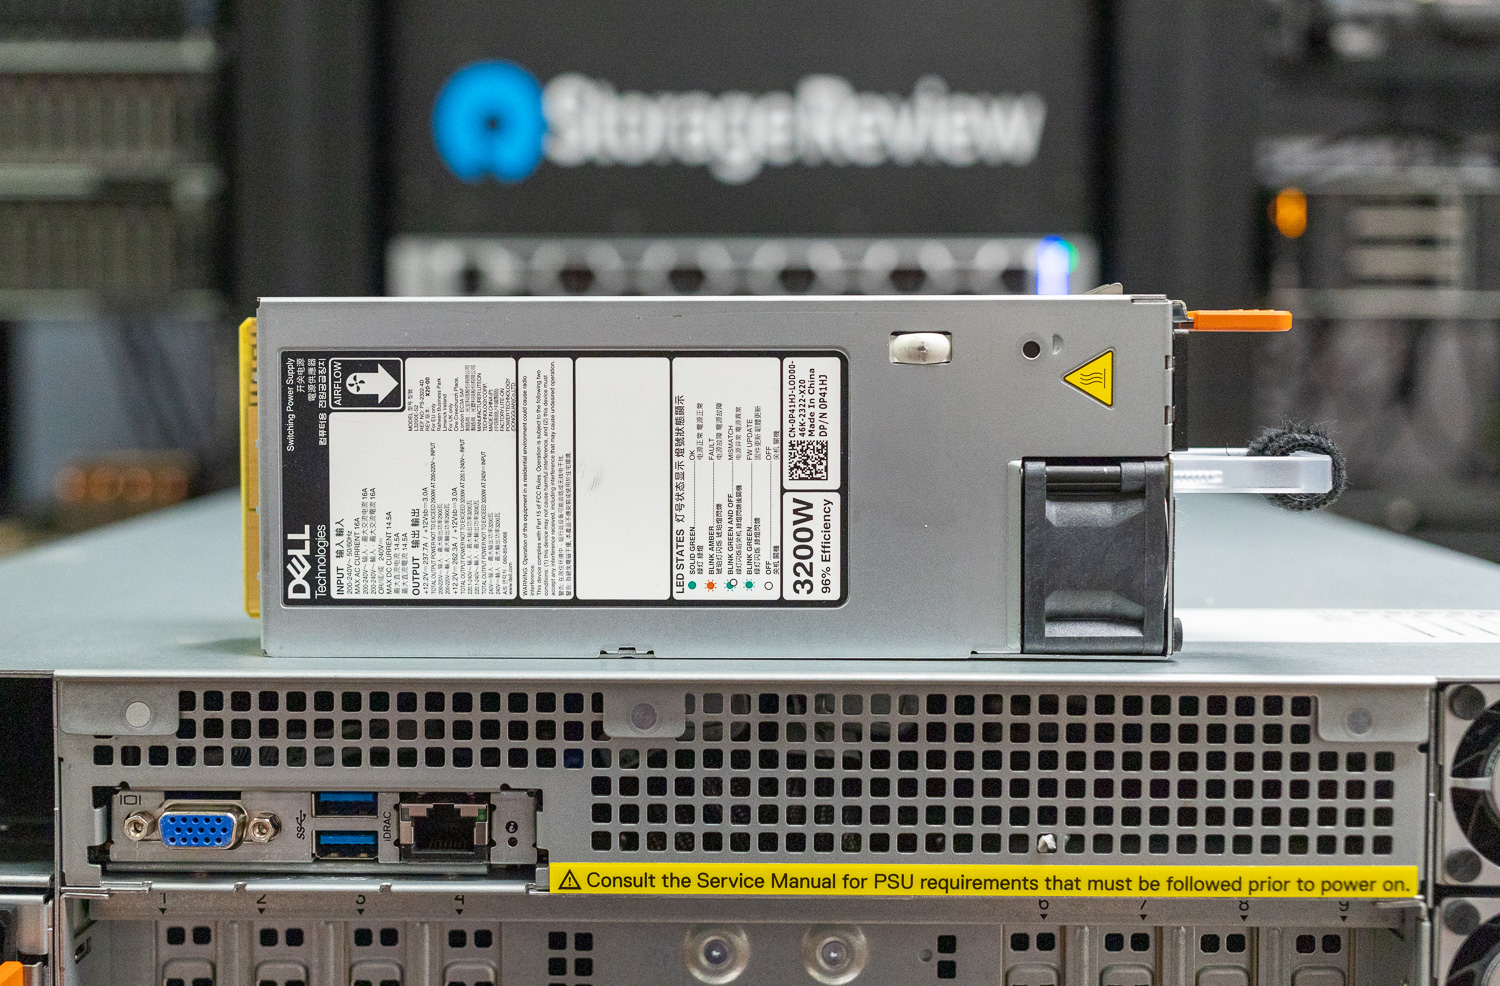
| 電源 | 3200Wチタン製、200~240V ACまたは240V DC、ホットスワップ対応冗長電源
3200W電源ユニットのマルチ容量対応:
2400W電源ユニットのマルチ容量対応:
注意:BMCとスタンバイ電源を維持するには、CPUゾーンに少なくとも1台、GPUゾーンに少なくとも1台のPSUが必要です。GPUゾーンにPSUが設置されていない場合、システムは待機状態のままになります。完全な冗長性を確保するには、各ゾーンにN+N台のPSUを設置してください。CPUゾーンには1台+1台、GPUゾーンには3台+3台です。システム起動中にCPUゾーンからすべてのPSUを取り外すと、システムが即座にシャットダウンし、データ損失が発生する可能性があります。 |
| 冷却オプション | |
| 冷却オプション | 空冷 |
| 扇 | ミドルトレイには、最大4セットの高性能(HPR)プラチナグレードファン(デュアルファンモジュール)を搭載可能。
システム前面に最大12個の高性能(HPR)プラチナグレードファンを搭載可能 全員がホットスワップのファンです |
| ポート | |
| ネットワークオプション | PCIe Gen 5 OCP 3.0互換I/Oポート×1(PCIe x8レーンでサポート) |
| フロントポート | USB 2.0 Type-Aポート×1(オプション) ミニディスプレイポート×1(オプション) USB 2.0 Type-Cデュアルモードポート(ホスト/iDRACダイレクトポート)×1 |
| 背面ポート | iDRAC/BMC専用ダイレクトイーサネットポート x 1 USB 3.1 Type Aポート×2 1 X VGA |
| 内部ポート | 1 x USB 3.1タイプ-A |
XE7740の設計と構築
デュアルゾーンアーキテクチャ:CPUとGPUの分離
XE7740の最も特徴的な設計上の選択肢の一つは、熱ゾーンと電源ゾーンが物理的に2つに分離されている点です。上部の1UセクションにはCPUゾーンが配置されており、2基のXeon 6プロセッサ、32個のDIMMスロット、ストレージ、およびDC-SCM管理モジュールが含まれています。CPUゾーンには、47.4 CFMのエアフローを供給する高性能デュアルファンモジュール(40×40×56mm)が4セット使用されています。
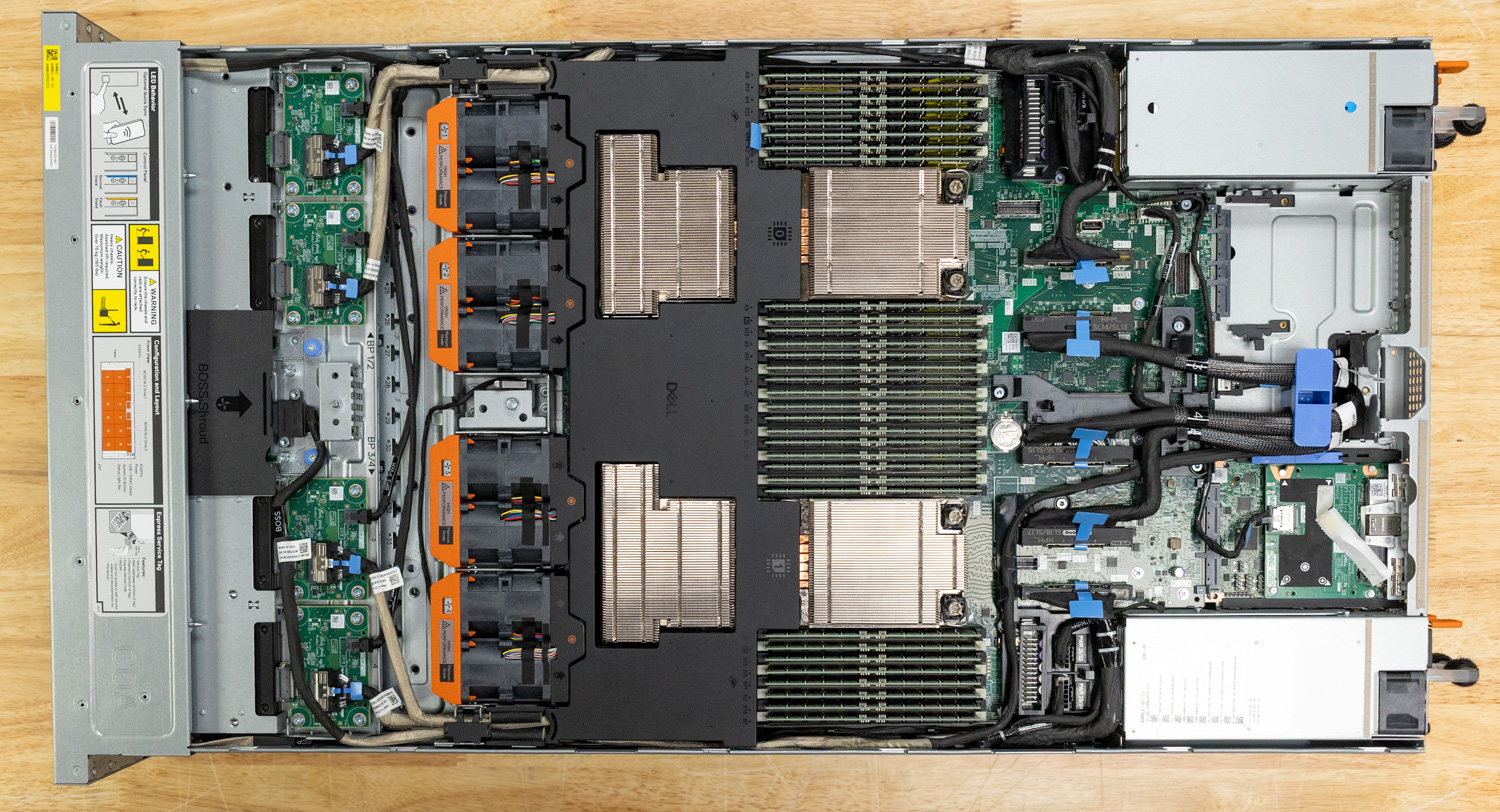
下部の 3U セクションは GPU ゾーンで、専用の冷却インフラストラクチャを備えたすべてのアクセラレータ スロット、PCIe ベース ボード (PBB)、背面の PCIe 拡張スロット、および OCP NIC 接続部が配置されています。GPU ゾーンには、CPU ファンと比較してファン 1 個あたり最大 122.2 CFM という大幅に高い風量容量を持つ、大型の高性能ファン (60×60×56mm) が 12 個使用されています。すべてのファンはホット スワップ可能です。このデュアル ゾーン冷却方式により、19 インチ標準ラックにおいて、高 TDP アクセラレータ (カード 1 枚あたり最大 600W) の熱要求が CPU およびメモリの冷却を損なうことがなく、またその逆も同様です。
DellはXE7740において、エアフローの最適化に細心の注意を払っています。アクセラレータが密集したシステムでは、GPU補助電源ケーブル、HPMボードとPBB間のPCIe信号ケーブル、ファンボード接続ケーブルなど、必然的に多くの内部ケーブルが必要になります。XE7740では、これらのケーブルは専用のケーブル保持ブラケットとケーブルカバーアセンブリを使用してシャーシの側壁に沿って配線されています。各ケーブルは必要な長さに正確に設計されているため、システム内部に余分なケーブル束はありません。ケーブルを中央のエアフローチャネルから遠ざけることで、前面から背面への明確なエアフロー経路が維持され、CPUとGPUの両方の冷却ゾーンにおける抵抗が最小限に抑えられます。
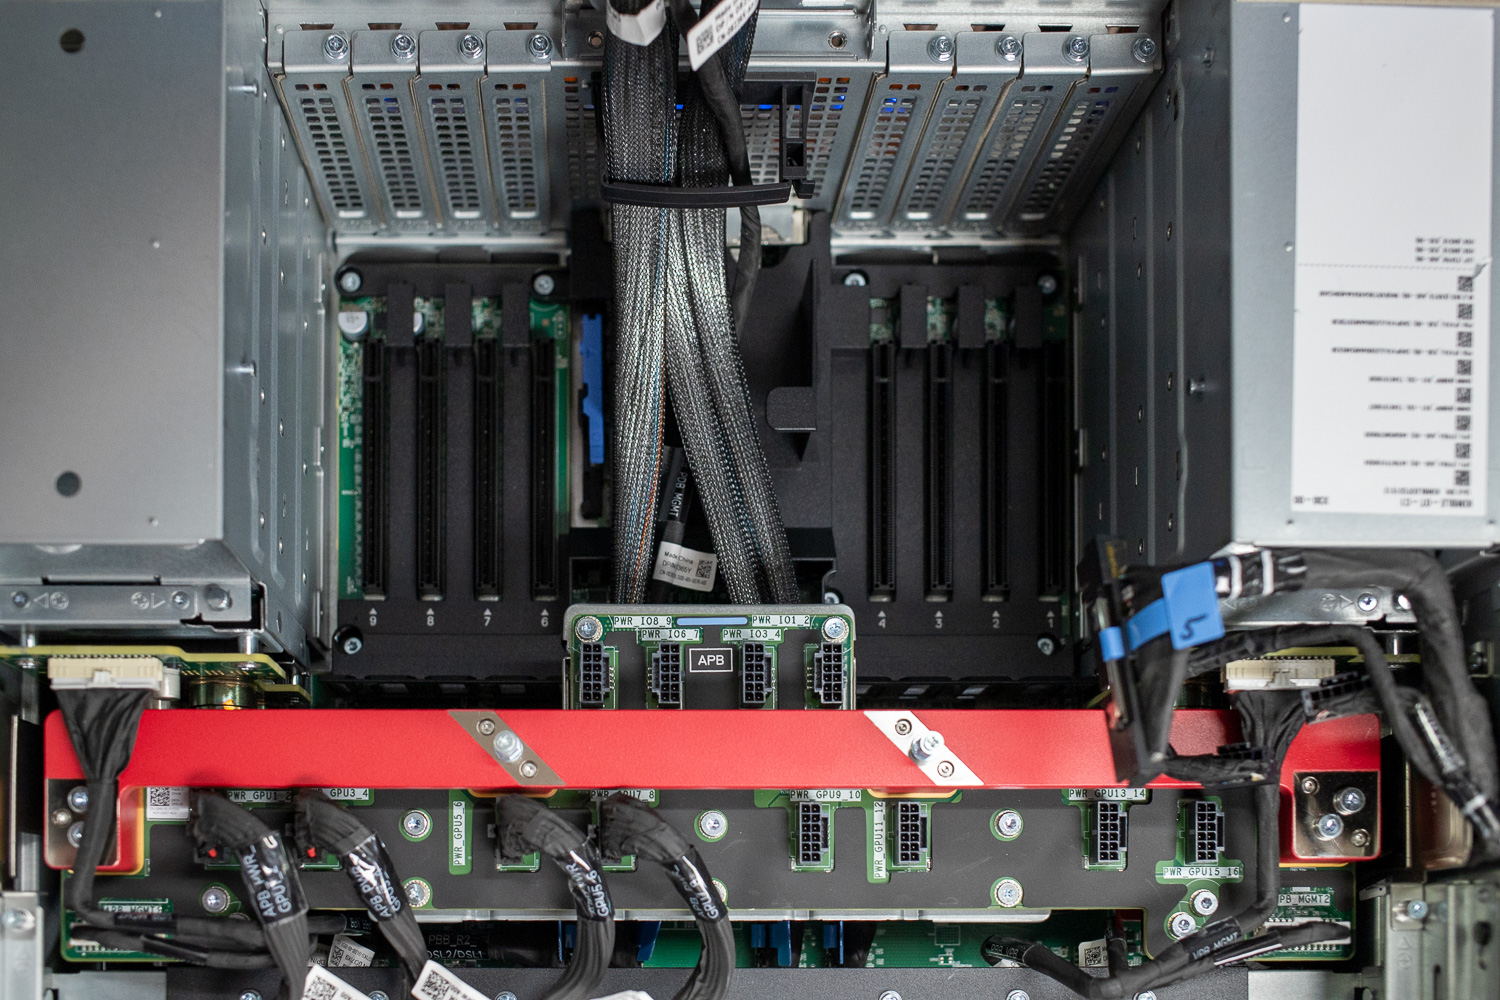
最大8基の600Wアクセラレータを搭載したシャーシでは、空気の流れにわずかな障害物があるだけでも局所的な高温箇所が発生し、ファンが高速回転を余儀なくされ、消費電力と騒音レベルの両方が上昇する可能性があります。デルのケーブル管理方式は、シャーシの中央部をすっきりと保ち、最も必要とするコンポーネントに直接、遮るもののない空気の流れを確保します。
PCIeスイッチのトポロジーとデータフロー
XE7740のPCIeサブシステムは、PBB(PCIeベースボード)上の4つのPCIe Gen 5スイッチ(SW1~SW4)を中心に構築されています。これらのスイッチはシステムのI/Oアーキテクチャの中核を成し、アクセラレータ、ネットワーク、ストレージを2つのXeon 6プロセッサに、綿密に構成されたトポロジーで接続します。
16 個の内部 GPU スロットは 8 個ずつ 2 つのバンクに分けられ、各バンクは 2 組の PCIe スイッチによってサービスされ、各スイッチは上流で CPU に接続されています。各バンク内では、隣接する 2 倍幅の GPU スロットのペアが 2 つのスイッチにまたがって配置されています。CPU0 側では、SW1 は GPU スロット 21 と 25、および背面 PCIe スロット 8 と 9 を、SW2 は GPU スロット 23 と 27、および背面 PCIe スロット 6 と 7 をサービスします。CPU1 側では、SW3 は GPU スロット 29 と 33、および背面 PCIe スロット 3 と 4 を、SW4 は GPU スロット 31 と 35、および背面 PCIe スロット 1 と 2 をサービスします。

したがって、各CPUドメインは、4つのダブル幅アクセラレータスロット、4つの背面NIC/I/Oスロット、および8つの前面E3.S NVMeストレージベイのうち4つを所有します。このスイッチトポロジは、特にRDMAベースのトラフィックにおいて、データフローに大きな影響を与えます。各スイッチはアクセラレータスロットと背面NICスロットの両方をホストするため、同じスイッチ上のアクセラレータとネットワークアダプタは、スイッチファブリック内で完全にRDMA転送を実行できます。データはCPUのルートコンプレックスを通過する必要がないため、1つのルートポート上のPCIeデバイスが別のルートポート上のデバイスと通信する際に必要となるCPUバウンスバッファが不要になります。これにより、レイテンシが削減され、貴重なCPUメモリ帯域幅の消費が回避され、CPUサイクルを他の作業に解放できます。
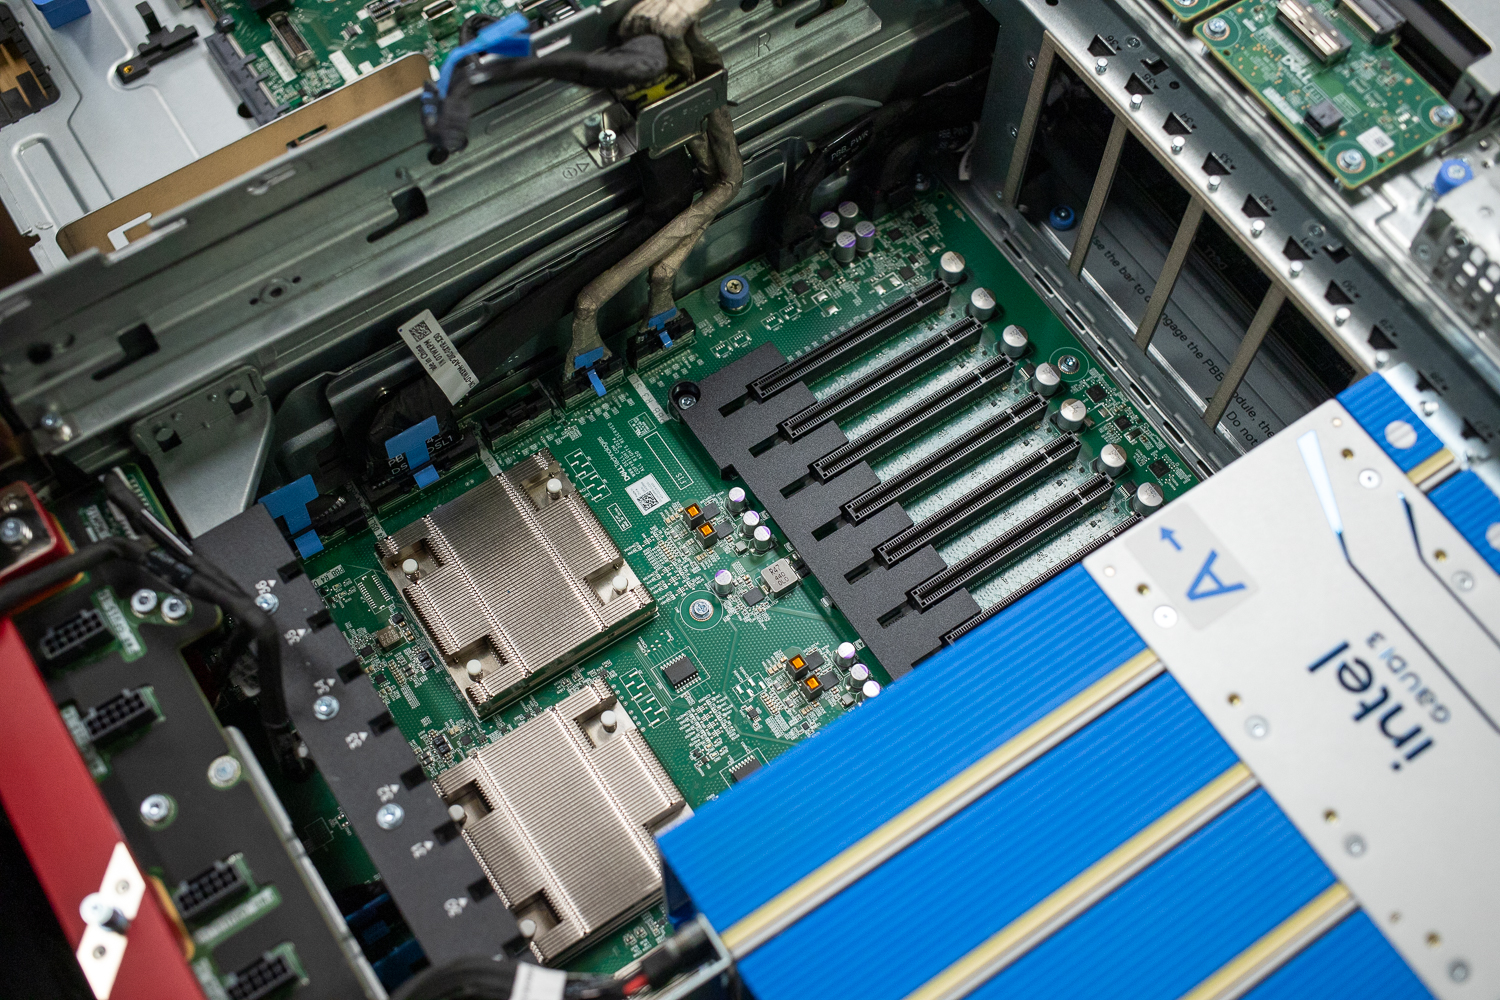
単一CPUのドメイン内における2つのスイッチ間の通信は、CPUルートコンプレックスを経由しますが、そのソケット内でのみ行われます。一方、CPU間の通信は、2つのXeon 6プロセッサ間のUPIリンクを経由する必要があります。6787Pは、それぞれ24 GT/sのUPI 2.0リンクを4つ提供し、ソケット間の十分な帯域幅を実現します。ただし、CPU0のスイッチバンク上のアクセラレータとCPU1のスイッチバンク上のNIC間のトラフィックは、スイッチ内または同一ソケット内の転送よりも必然的に高いレイテンシを伴います。
スイッチ自体は直接相互接続されていません。スイッチ間のトラフィックはすべてCPUルートコンプレックスを経由するため、GPUスロット、NICスロット、ストレージ、CPUソケット間の親和性を理解することが重要です。デルは、こうした複雑さを組織にとって簡素化するために、主要なアクセラレータ向けに検証済みかつ最適化された構成を提供しています。
デュアルゾーン電源
XE7740の電源供給は、その熱設計と同様に、やや珍しいデュアルゾーン電源ユニット設計を採用しています。このシステムは、最大8台のホットスワップ対応電源ユニットをサポートし、2つのゾーンに分かれています。ゾーン1(CPUゾーン)には電源ユニット1と2が、ゾーン2(GPUゾーン)には電源ユニット3~8が搭載されます。
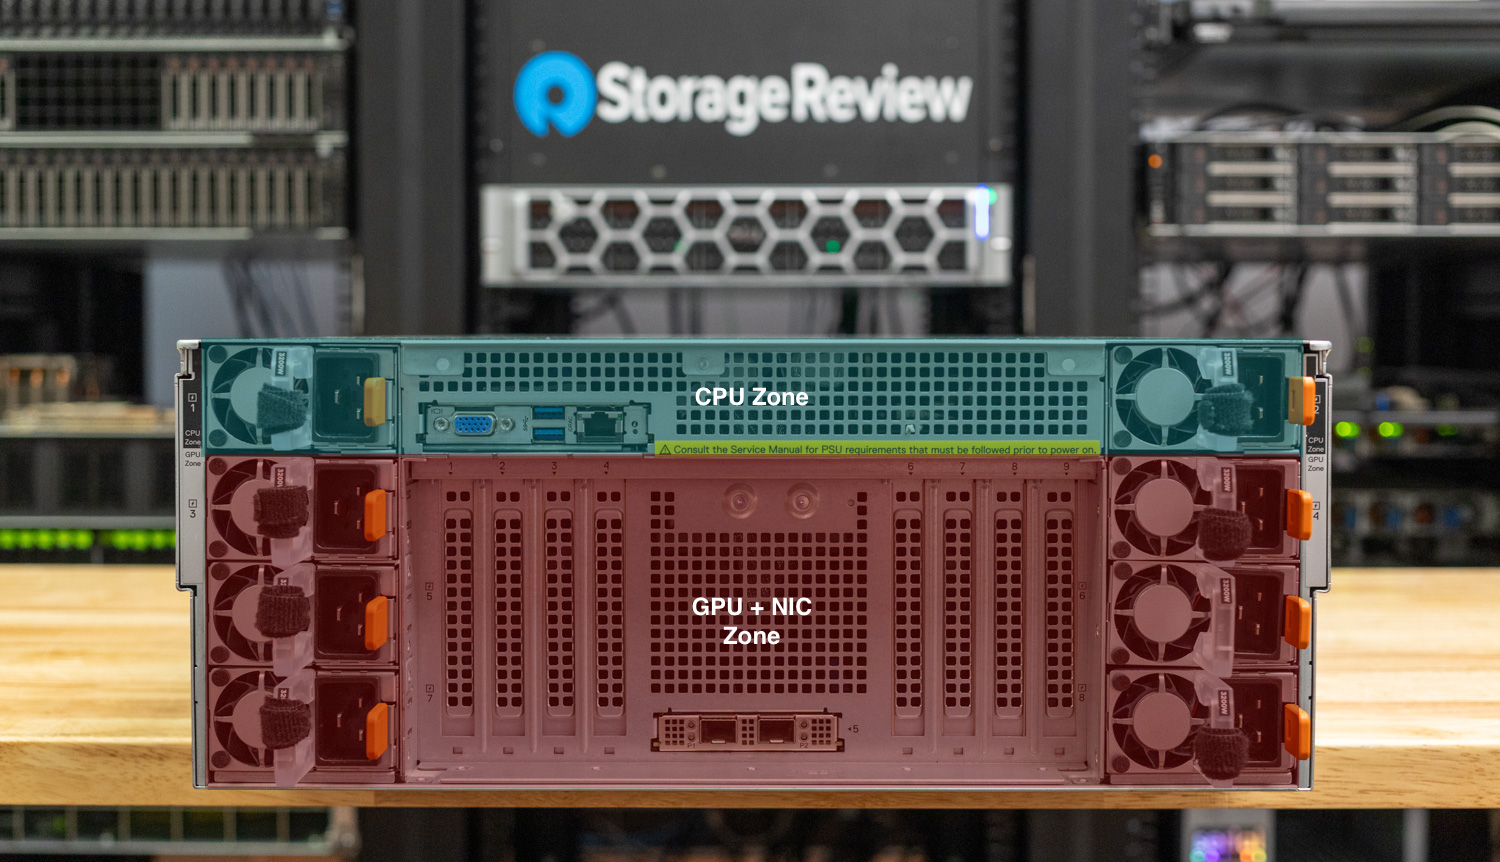
このシステムでは、BMCとスタンバイ電源を維持するために、各ゾーンに少なくとも1つの電源ユニット(PSU)が必要です。システム稼働中にいずれかのゾーンで交流電源が途絶えた場合、データ損失を防ぐため、システムは直ちにシャットダウンします。ゾーンは物理的にも電気的にも分離されていますが、動作には相互依存の関係にあります。完全な冗長性を確保するため、DellはCPUゾーンでは1+1構成、GPUゾーンでは3+3構成を推奨しています。つまり、完全な冗長構成を実現するには、8つのPSUベイすべてに電源ユニットを搭載する必要があります。
Dell AIOps、管理、およびエンタープライズ信頼性
DellのPowerEdgeプラットフォームは、業界で高い信頼性と保守性で定評があります。エンタープライズのお客様からは、PowerEdgeシステムは耐久性に優れ、Dellのサポート体制は問題を迅速に解決し、管理ツールは成熟していて統合性も高い、といった点が常に高く評価されています。XE7740もこの伝統を受け継ぎ、Dellはこの世代においてハードウェア管理とセキュリティの両面で大きな進歩を遂げました。
iDRAC 10
XE7740には、デルの次世代iDRAC 10が搭載されています。これは、デルのお客様が長年信頼を寄せてきた高性能なiDRAC 9を大幅に改良したものです。OCP DC-MHS規格に準拠したデータセンターセキュア制御モジュール(DC-SCM)として実装されたiDRAC 10は、単なるファームウェアのアップデートではなく、新しいハードウェアです。このコントローラは、64ビットアーキテクチャの1GHzコアを4つ搭載し、2GBのDDR4メモリ(前世代の2倍)を備えているため、管理操作のパフォーマンスと応答性が大幅に向上しています。
セキュリティ面では、iDRAC 10 はいくつかの注目すべき機能強化を導入しています。業界がポスト量子暗号の脅威に備える中、プラットフォーム全体で暗号化サポートが強化され、SHA-384 および SHA-512 認証、量子耐性 AES-256 暗号化などが搭載されています。iDRAC 10 シリコン内部の専用統合セキュリティ エンクレーブは、デバイス レベルの認証や Dell 独自のルート オブ トラストなど、サイバー レジリエンス機能を管理します。このハードウェア ベースのルート オブ トラストは、すべてのファームウェア (BIOS、iDRAC、およびコンポーネント ファームウェア) が実行前に暗号化検証されることを保証し、サプライ チェーン攻撃やファームウェアの改ざんから保護します。
セキュアコンポーネント検証機能により、デルの工場から出荷されるシステムが、顧客が指定したコンポーネントと構成を正確に備えていることが検証され、製造から導入まで一貫した品質が維持されます。最新のiDRAC 10ファームウェアは、刷新されたモジュール式のユーザーインターフェイスを提供し、日常的な管理作業の利便性を向上させます。
OpenManage エンタープライズ
大規模なフリート管理において、DellのOpenManage Enterpriseは、PowerEdge環境全体にわたる集中監視、ファームウェアアップデート、および構成管理を提供します。AIに特化した環境向けに最近追加された注目すべき機能は、OMEがGPUおよびアクセラレータの統計情報(消費電力、温度、使用率、エラー数など)を、ベンダー固有のツールを別途必要とせずに直接可視化できるようになったことです。推論クラスタで数十台または数百台のXE7740ノードを管理する組織にとって、この統合管理プレーンは運用を大幅に簡素化します。
インテル Xeon 6
XE7740の中核を成すのは、Xeon 6700PシリーズのフラッグシップモデルであるIntel Xeon 6 6787Pプロセッサ2基です。Intelの3nmプロセス技術を用いたGranite Rapidsアーキテクチャに基づいて構築された6787Pは、ソケットあたり86個のPコア(172スレッド)を搭載し、TDPは350W、ベースクロックは2.0GHz、ターボクロックは3.8GHzです。
Granite RapidsがAIインフラストラクチャにとって特に魅力的なのは、コア数の多さとメモリサブシステムの組み合わせにあります。各6787Pプロセッサは、最大6400MT/sのDDR5メモリチャネルを8つ提供します。デュアルソケットのXE7740に32個のDIMMを搭載することで、システム全体のメモリ容量は最大4TBまで構成可能です。
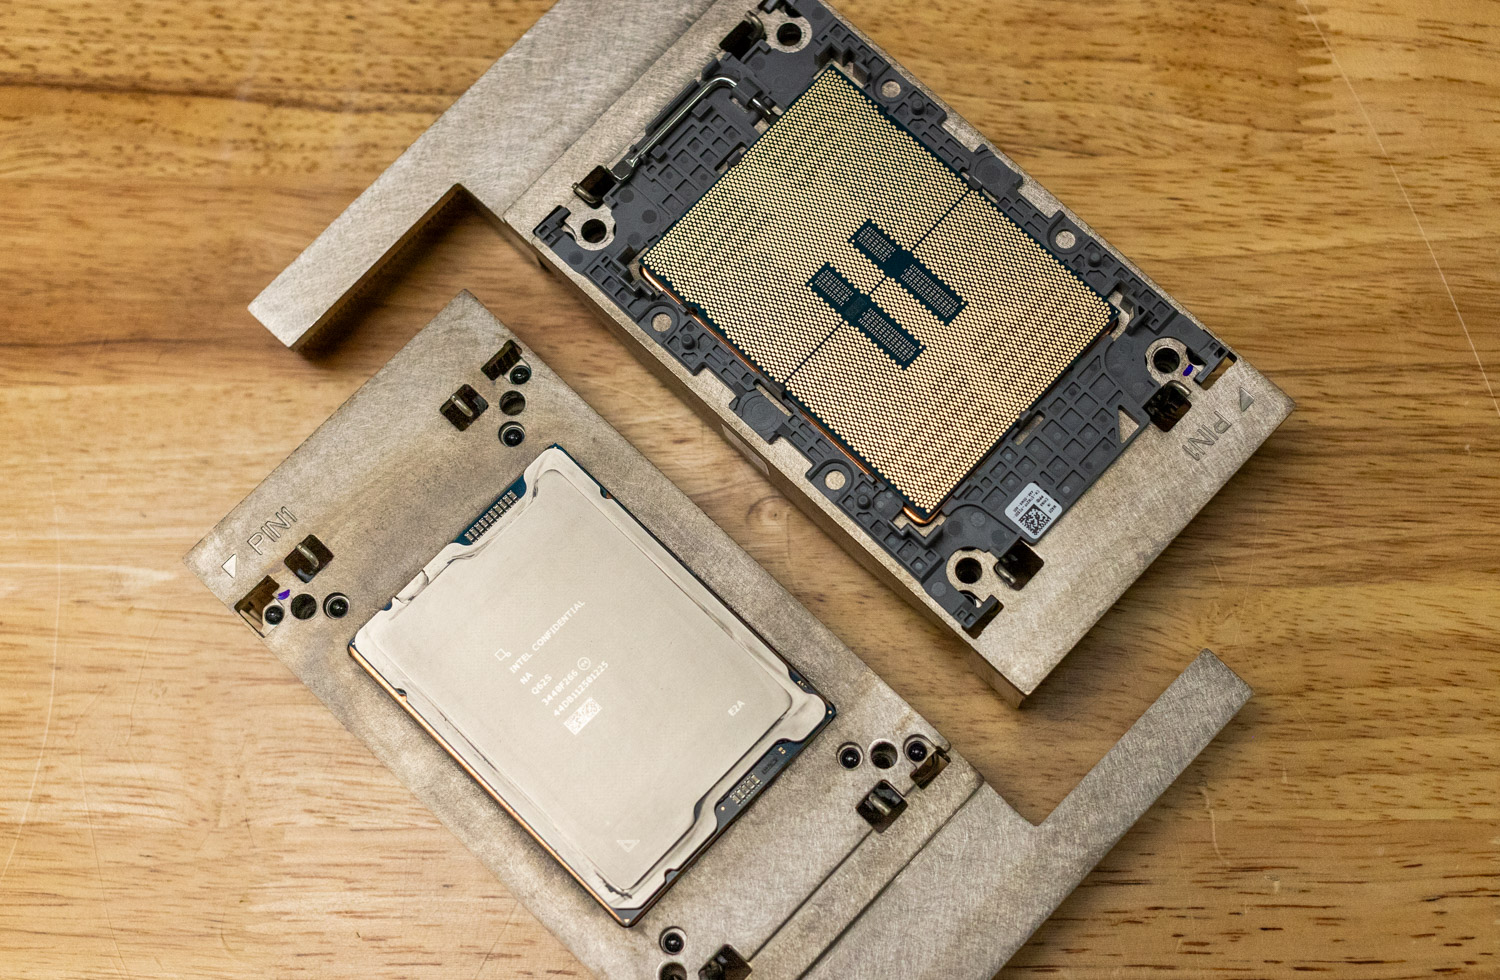
メモリ容量と帯域幅は、特にKVキャッシュのオフロードを使用する場合、AIワークロードにとって非常に重要です。大規模な言語モデルではコンテキスト長が増加するにつれて、KVキャッシュも比例して拡張され、アクセラレータのメモリを大量に消費する可能性があります。KVキャッシュの一部をシステムメモリまたは高速ストレージにオフロードすることで、アクセラレータのHBMをアクティブな計算に効率的に使用できるようになり、複数ターンのチャットにおける最初のトークン取得までの時間(TTFT)を短縮できます。
また、Xeon 6のAMXテンソルユニットも注目に値します。これはCPU側で重要な処理を担います。具体的には、前処理、トークン化、行列演算を伴うハイブリッド推論タスクなどが含まれます。これは、基数ツリーによるキーバリューキャッシュ管理やゼロオーバーヘッドスケジューリングにCPUを使用するSGLangのような推論フレームワークにおいて特に有効です。
Intel Gaudi 3 アドインカード:大規模な競合推論
IntelのGaudi 3は、同社の主力AIアクセラレーターであり、2024年第4四半期に発売されました。Intelは、最高レベルのデータセンター向けトレーニングアクセラレーターと直接競合するのではなく、これらのアクセラレーターを非常に積極的に位置付けています。Gaudi 3は、推論分野をターゲットとしています。
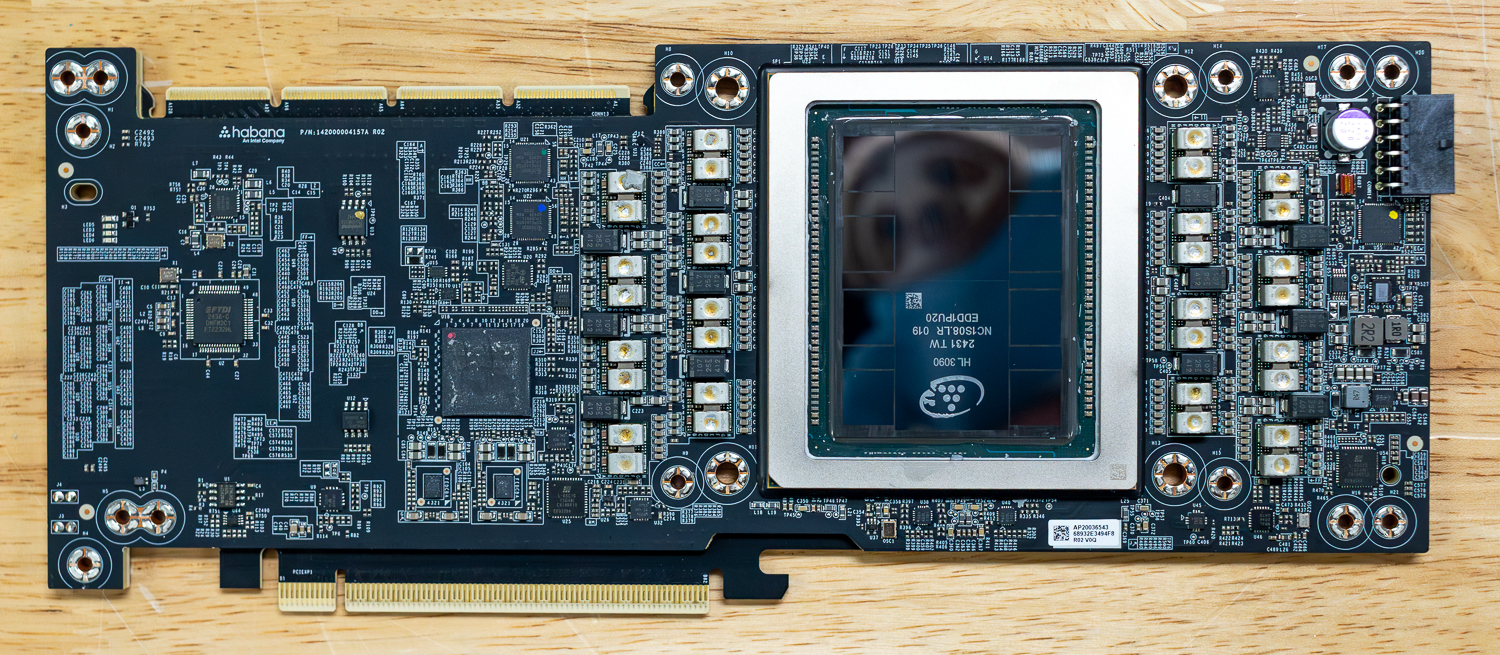
現在普及しているすべてのLLMにおけるTransformerベースのモデル推論は、根本的にメモリ制約を受けています。自己回帰生成のデコードフェーズでは、モデルはトークンを1つずつ生成し、生成された各トークンのモデル重みとKVキャッシュエントリを読み取ります。ボトルネックとなるのは計算能力ではなく、メモリ帯域幅、つまりアクセラレータがHBMから計算エンジンへデータをストリーミングできる速度です。
Gaudi 3は、128 GBのHBM2eメモリを搭載し、メモリ帯域幅は3.7 TB/sです。アーキテクチャ的には、Gaudi 3はTSMCの5nmプロセスで製造され、デュアルダイチップレット設計を採用しています。これは、高帯域幅の相互接続で接続された2つの同一のシリコンダイで構成され、ソフトウェアからは単一の統合デバイスとして認識されます。演算処理は4つのディープラーニングコア(DCORE)に分かれており、各コアには2つのMME、16のTPC、および24 MBのローカルSRAMキャッシュが含まれています。合計96 MBのオンダイSRAMにより、内部帯域幅は12.8 TB/sとなります。このアクセラレータには、14個の専用メディアデコーダ(H.265、H.264、JPEG、VP9)も統合されており、マルチモーダルワークロード向けの高速な画像前処理が可能です。
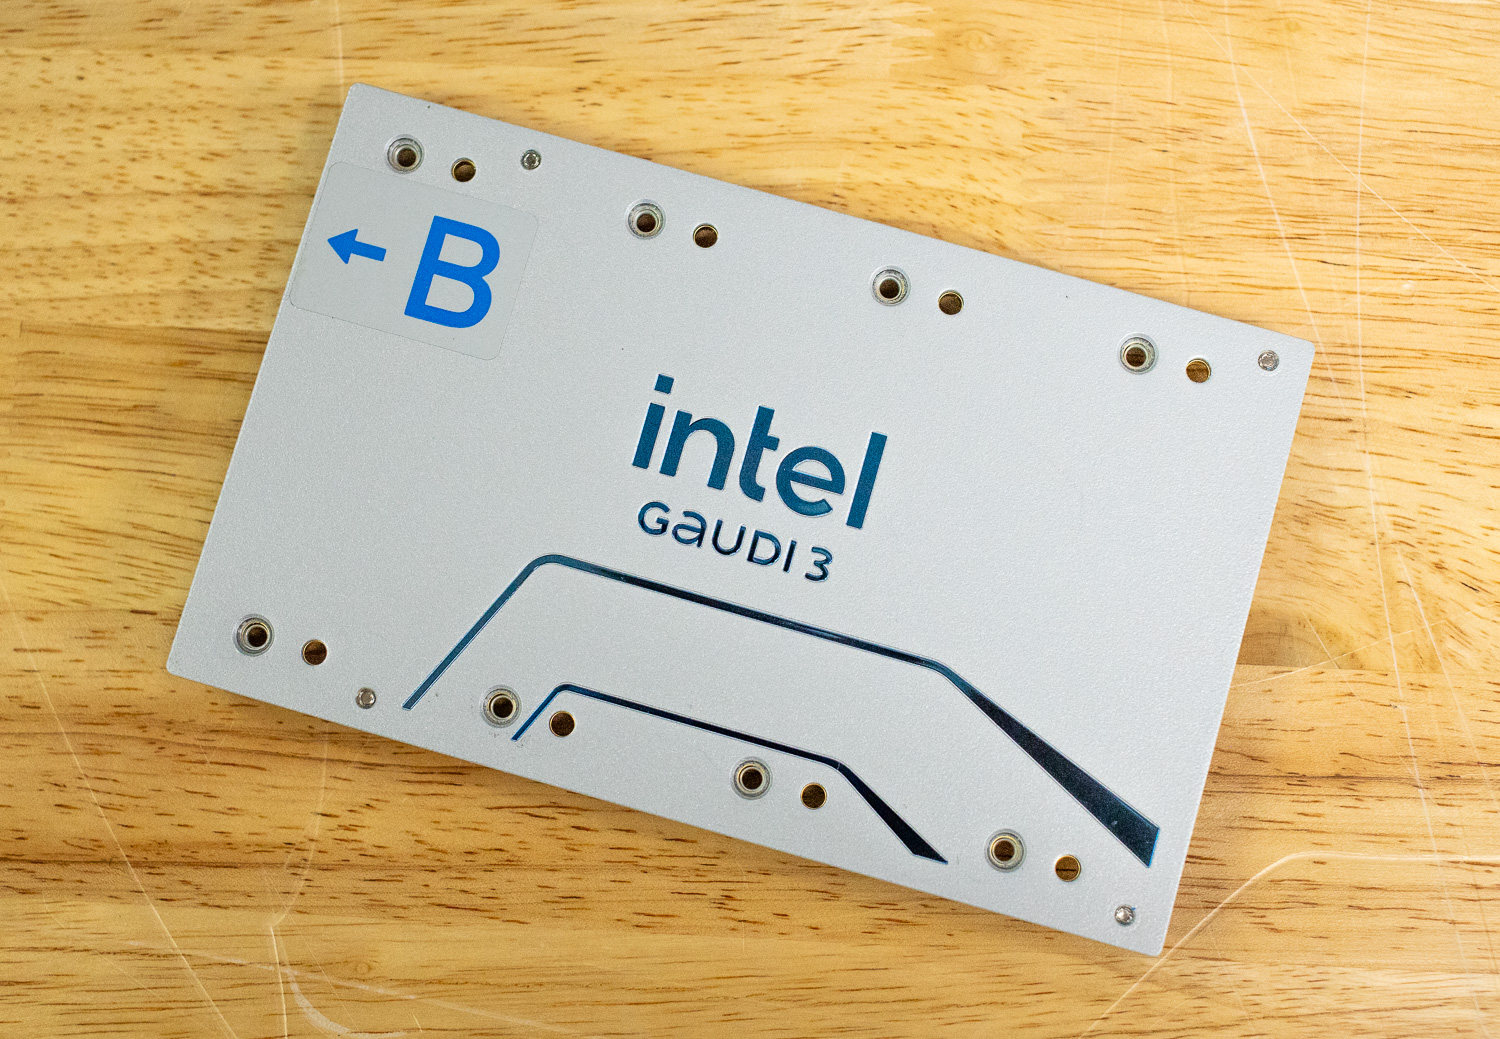
現在リリースされている最先端のオープンソースAIモデルの大部分は、ネイティブFP8で学習されたモデルか、FP8(E4M3)とBF16の重みを組み合わせたハイブリッドモデルです。Gaudi 3は、8つの行列乗算エンジンと64のテンソルプロセッサコアを通じて、これらのモデルにネイティブFP8アクセラレーションを提供し、1.8ペタフロップスのFP8演算性能を実現します。
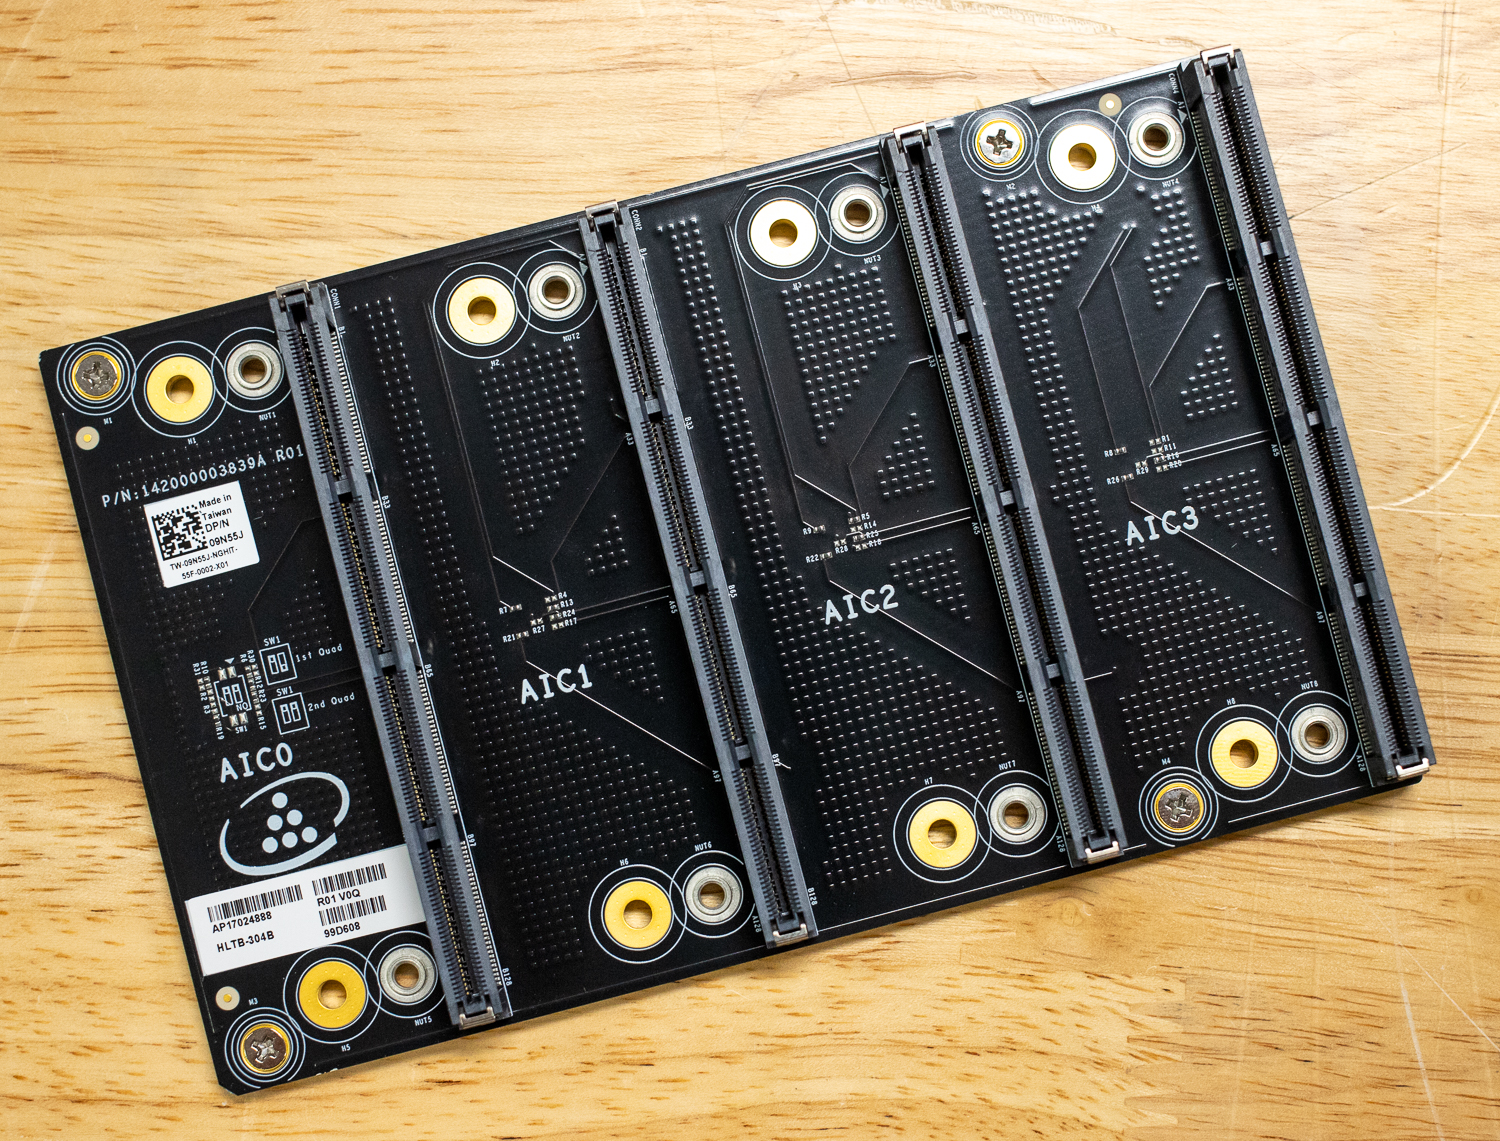
Gaudi 3は、OAMバージョンでは24個の200GbEポートを備え、シリコンに直接組み込まれたRDMA over Converged Ethernet(RoCEv2)ネットワークも統合しています。XE7740で使用されるPCIeアドインカードバリアントでは、これらのポートすべてが同じように公開されるわけではありませんが、アドインカードバリアントは4枚のカードをブリッジ接続して、カード間の通信速度を向上させることができます。
パフォーマンスとベンチマーク
XE7740の設定詳細:
- Intel Xeon 6787P プロセッサー (86コア、2.00GHz) x 2
- 2TB DDR5 (32 x 64GB 5200MT/s DDR5
- Intel Gaudi 3 PCIe AIアクセラレーター×4(128GB HBM搭載)
- Ubuntu 24.04.5 サーバー
vLLMオンラインサービスパフォーマンス
Intel Gaudi 3アクセラレータを搭載したDell XE7740の推論能力を評価するため、さまざまなアーキテクチャ、パラメータ数、精度フォーマットにわたる幅広い人気モデルで、vLLMオンラインサービングのパフォーマンスをベンチマークしました。各モデルは、同時リクエスト数が1から128まで変化する3つのワークロードプロファイルでテストされました。
LLM推論は、2つの異なるフェーズで構成されます。プリフィルフェーズでは、出力トークンが生成される前にすべての入力トークンを並列処理するため、入力トークンの数に比例して計算量が増加する処理となります。デコードフェーズでは、出力トークンを1つずつ(自己回帰的に)生成します。各トークンの生成には、メモリからモデル全体の重みを読み込む必要がありますが、トークンごとの計算量は比較的少ないため、メモリ帯域幅がボトルネックとなります。
これら2つのフェーズはアクセラレータの根本的に異なる部分に負荷をかけるため、両者のバランスを変化させる3つのワークロードプロファイルをテストします。
- 入力トークン数1024個、出力トークン数1024個が等しい場合、バランスの取れたチャットのやり取りを表します。
- Prefill Heavy(入力8192、出力1024)は、検索拡張型生成または長文コンテキスト要約をシミュレートするもので、システムは大きな入力コンテキストを処理する必要があります。
- Decode Heavy(1024入力/8192出力)は、持続的なメモリ帯域幅がスループットを決定する長尺コンテンツ生成を表します。
本節では、主に2つの指標に焦点を当てます。1つ目は、1秒あたりのトークン数で測定される総トークンスループットで、負荷がかかった状態でのシステムの全体的な処理能力を表します。2つ目は、最初のトークン取得までの時間(TTFT)で、リクエストの送信から最初の生成トークンの受信までの遅延を測定します。モデルは最初のトークンを発行する前にプリフィルフェーズ全体を完了する必要があるため、TTFTはアクセラレータの計算スループットに直接関係します。このため、プリフィル処理が多いシナリオ(TTFTと組み合わせた場合)は、Gaudi 3アクセラレータの生の計算能力を理解するための特に有用な指標となります。なぜなら、ユーザーが応答を見る前に、システムは8,192個の入力トークンすべてを処理する必要があるからです。
逆に、デコード処理が多いシナリオでは、システムが数千個のトークン生成に対して高いスループットを維持する必要があるため、アクセラレータのメモリ帯域幅が試されます。TTFTは、ユーザーがストリーミング開始前に応答を待つ必要があるインタラクティブなアプリケーションにとって非常に重要です。システムはバッチ処理を多用することで優れたスループットを実現できますが、TTFTが高すぎると動作が遅く感じられるため、本番環境での展開においては両方の指標が重要になります。
FP8精度の結果に関する注記:Intel Gaudi 3アクセラレータはネイティブFP8演算アクセラレーションを搭載しており(理論的にはFP8はBF16よりも高いスループットを実現するはずです)、ベンチマークにおけるFP8のパフォーマンス数値はBF16の数値よりも低くなっています。これはハードウェアの制限ではなく、Intel版vLLMのソフトウェア成熟度の問題です。テストしたバージョン(Gaudi Docker 1.22.2上のvLLMインストーラ2.7.1)は、FP8コードパスがまだ完全に最適化されていません。Intelは現在、これらのパフォーマンス上の課題の多くに対処できる可能性のある、プラグインベースの新しいvLLMバージョンをベータ版として提供しています。
ラマ3.1 8B 指示
Llama 3.1 8B Instructは、Meta社製の高密度トランスフォーマーモデルです。つまり、生成されるトークンごとにすべてのパラメータが有効になります。8億個のパラメータを持つこのモデルは、オープンソースモデルの中でも特に汎用性の高いモデルの一つです。この規模のモデルは、短い文書の要約、メールやメッセージの作成、簡単な質問への回答、そして高度な推論よりも速度とコスト効率が重視されるシンプルなチャットボットのやり取りなど、日常的なタスクで広く利用されています。
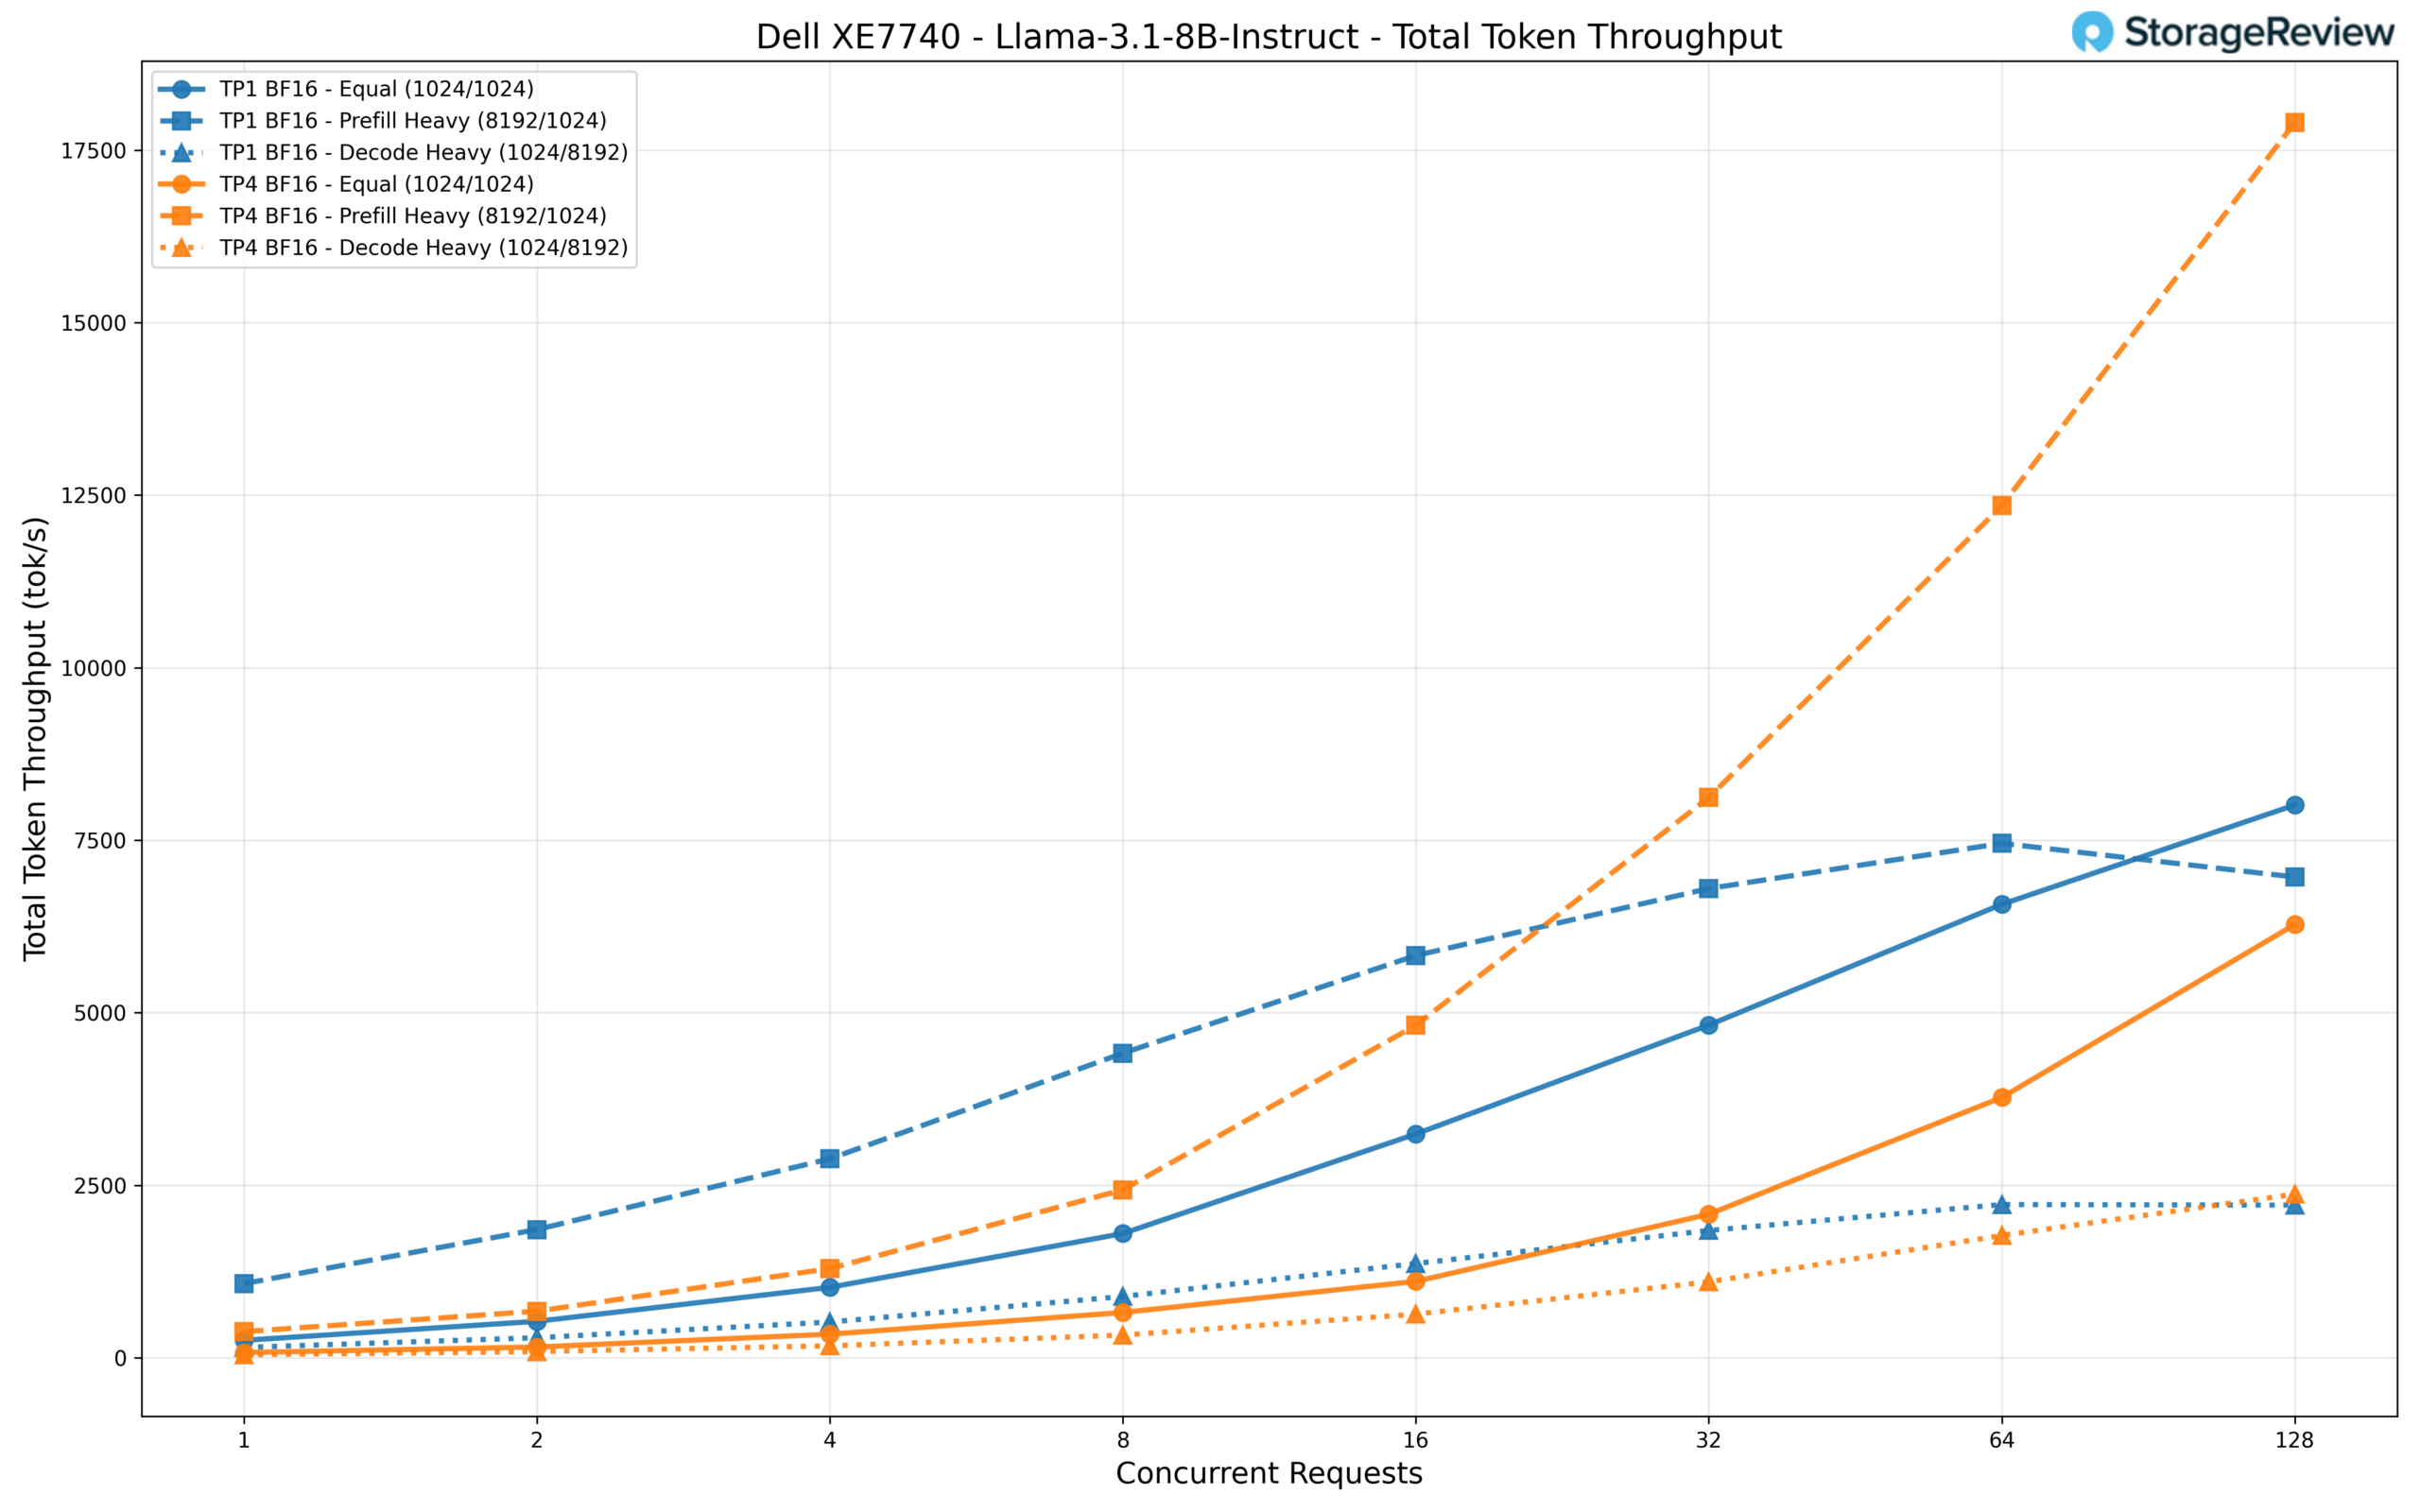
このモデルは、TP1(シングルアクセラレータ)とTP4(4つのGaudi 3アクセラレータすべて)の両方の構成でテストしました。TP1で実行した場合、モデルは同等のワークロードで128の同時リクエストで合計スループットが約8,000 tok/sに達し、シングルリクエストでの約250 tok/sからスムーズにスケーリングします。プリフィルが多いシナリオでは興味深いパターンが見られました。TP1ではピークが約7,000 tok/sであるのに対し、TP4では128の同時リクエストで17,900 tok/sを超え、追加のアクセラレータを活用して大きな入力コンテキストをより効率的に処理します。
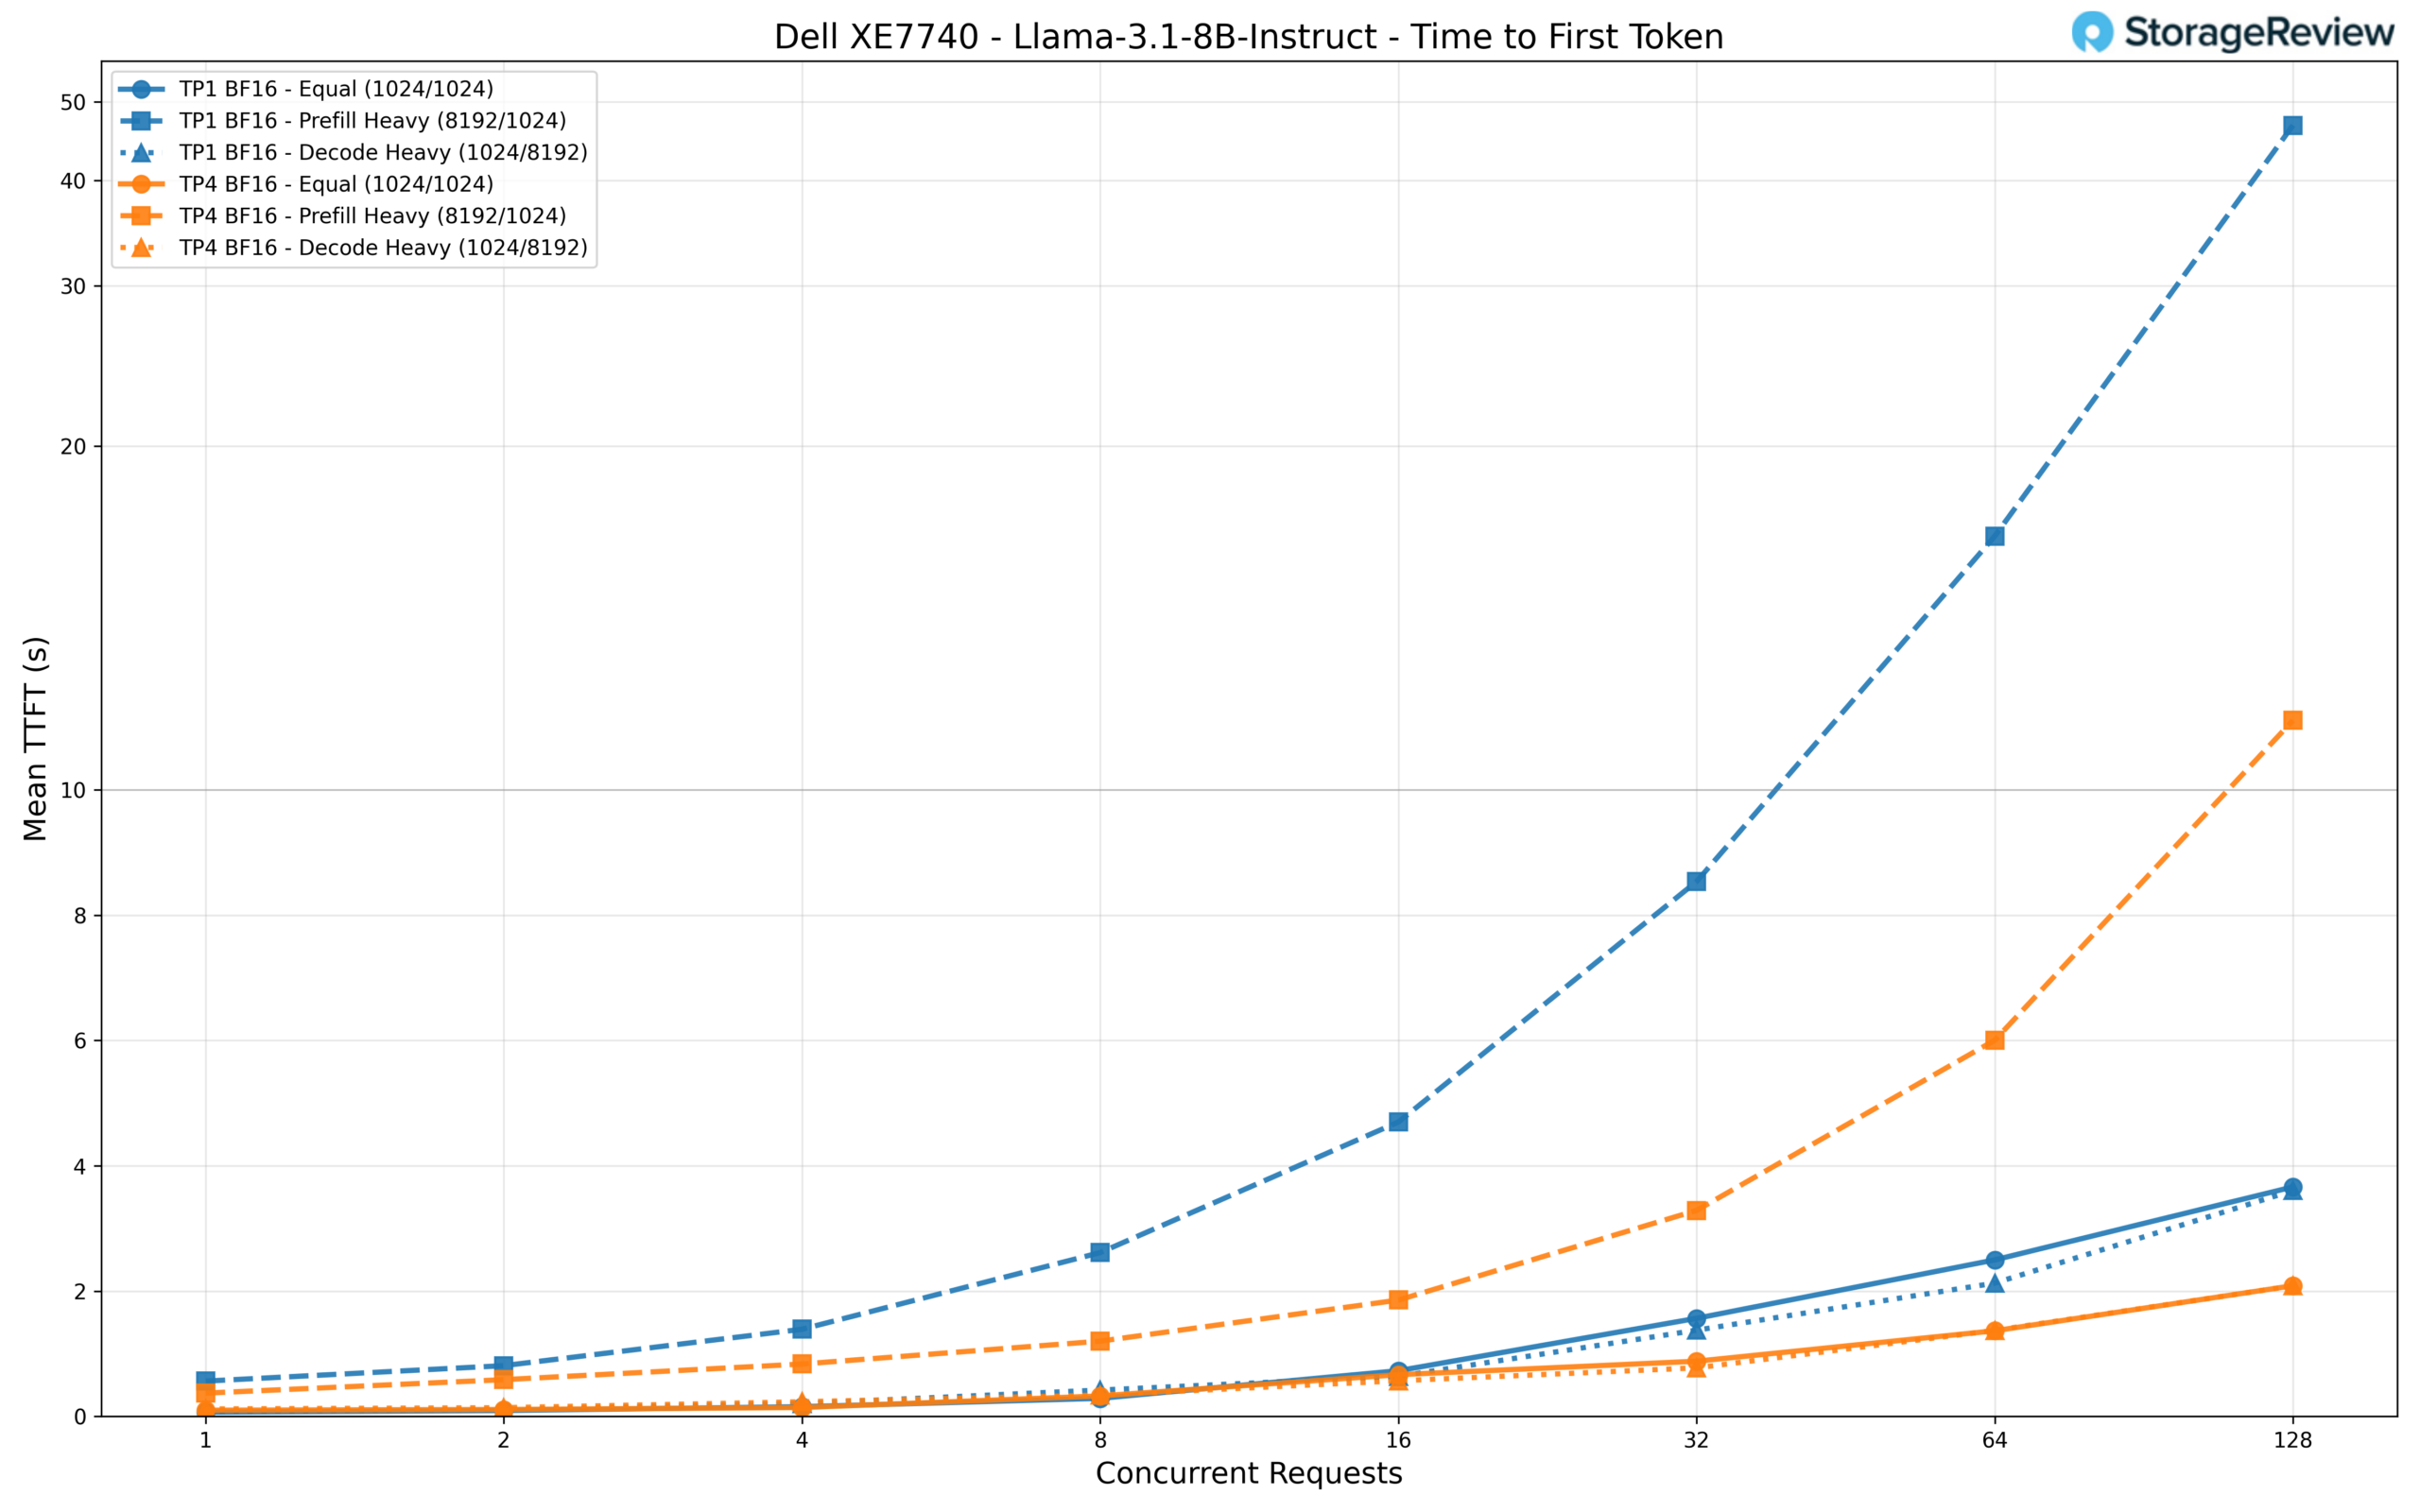
シングルユーザーのレイテンシでは、TP1 は低同時実行時で実際に低い TTFT を実現しています (TP4 の 98ms に対し 67ms)。これは、1 つのアクセラレータで快適に動作するモデルを 4 つのアクセラレータ間で調整するオーバーヘッドを反映しています。しかし、負荷が増加すると、TP4 が決定的にリードします。同時リクエストが 128 の場合、TP4 は同等のワークロードとデコードワークロードで TTFT を約 2 秒に抑えますが、TP1 はそれぞれ 3.7 秒と 6.6 秒に上昇します。プリフィルが多いシナリオでは、その差が最も顕著になります。TP1 は 128 リクエストで TTFT が 47 秒近くに達するのに対し、TP4 は約 11 秒に抑えます。
ラマ3.1 70B 指示
Llama 3.1 70B Instructは、Meta社のLlama 3.1ファミリーの中で、より大規模で高密度なモデルです。70Bのパラメータにより、8Bバージョンよりも大幅に優れた指示追従能力と多言語対応能力を実現しています。この規模のモデルは、カスタマーサポート担当者、複数ステップの調査アシスタント、複雑な文書分析、長時間のやり取りの中で一貫したコンテキストを維持する必要のあるタスクなど、より負荷の高いエージェントワークロードに最適です。
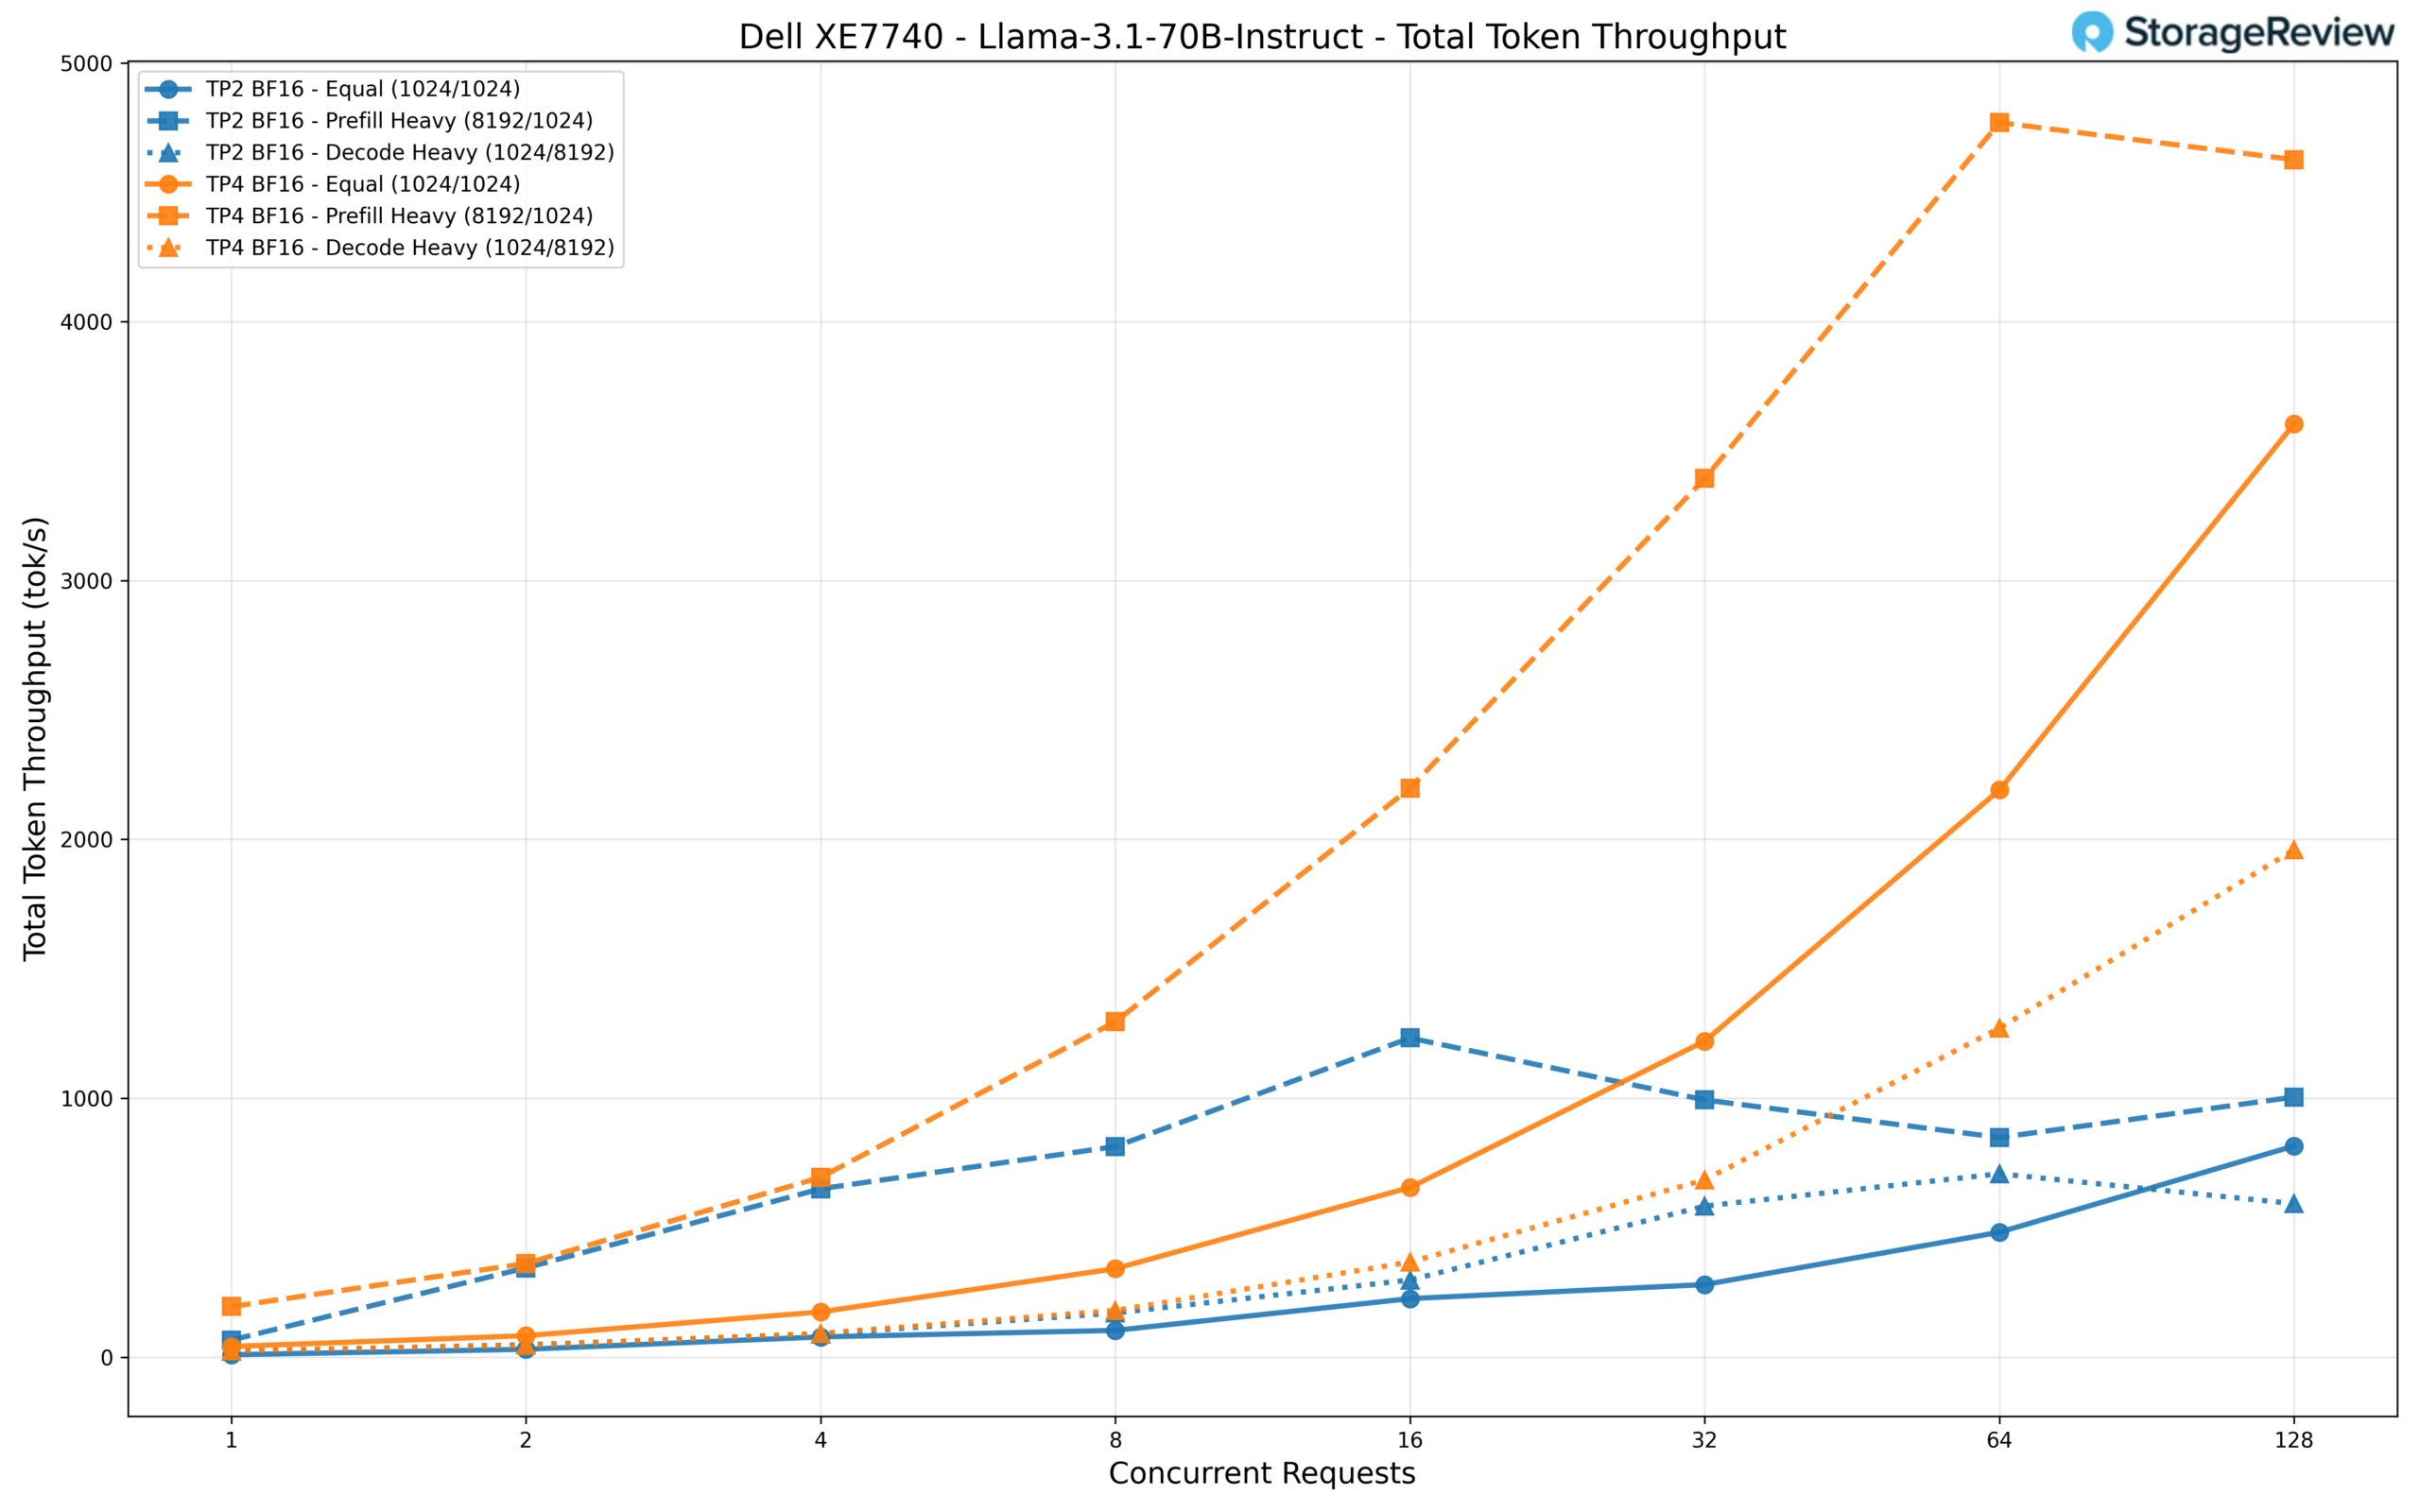
このモデルをTP2とTP4の構成でテストしました。両者のスループットの差は顕著です。同時リクエスト数が128の場合、TP4は同等のワークロードで約3,600 tok/s、プリフィル処理が多いシナリオではピーク時で約4,600 tok/sに達します。これは、それぞれ最大で約816 tok/sと1,005 tok/sのTP2のスループットの約4.4倍と4.6倍です。デコード処理が多いワークロードでも、TP4では約1,960 tok/sに達するのに対し、TP2では593 tok/sにとどまります。
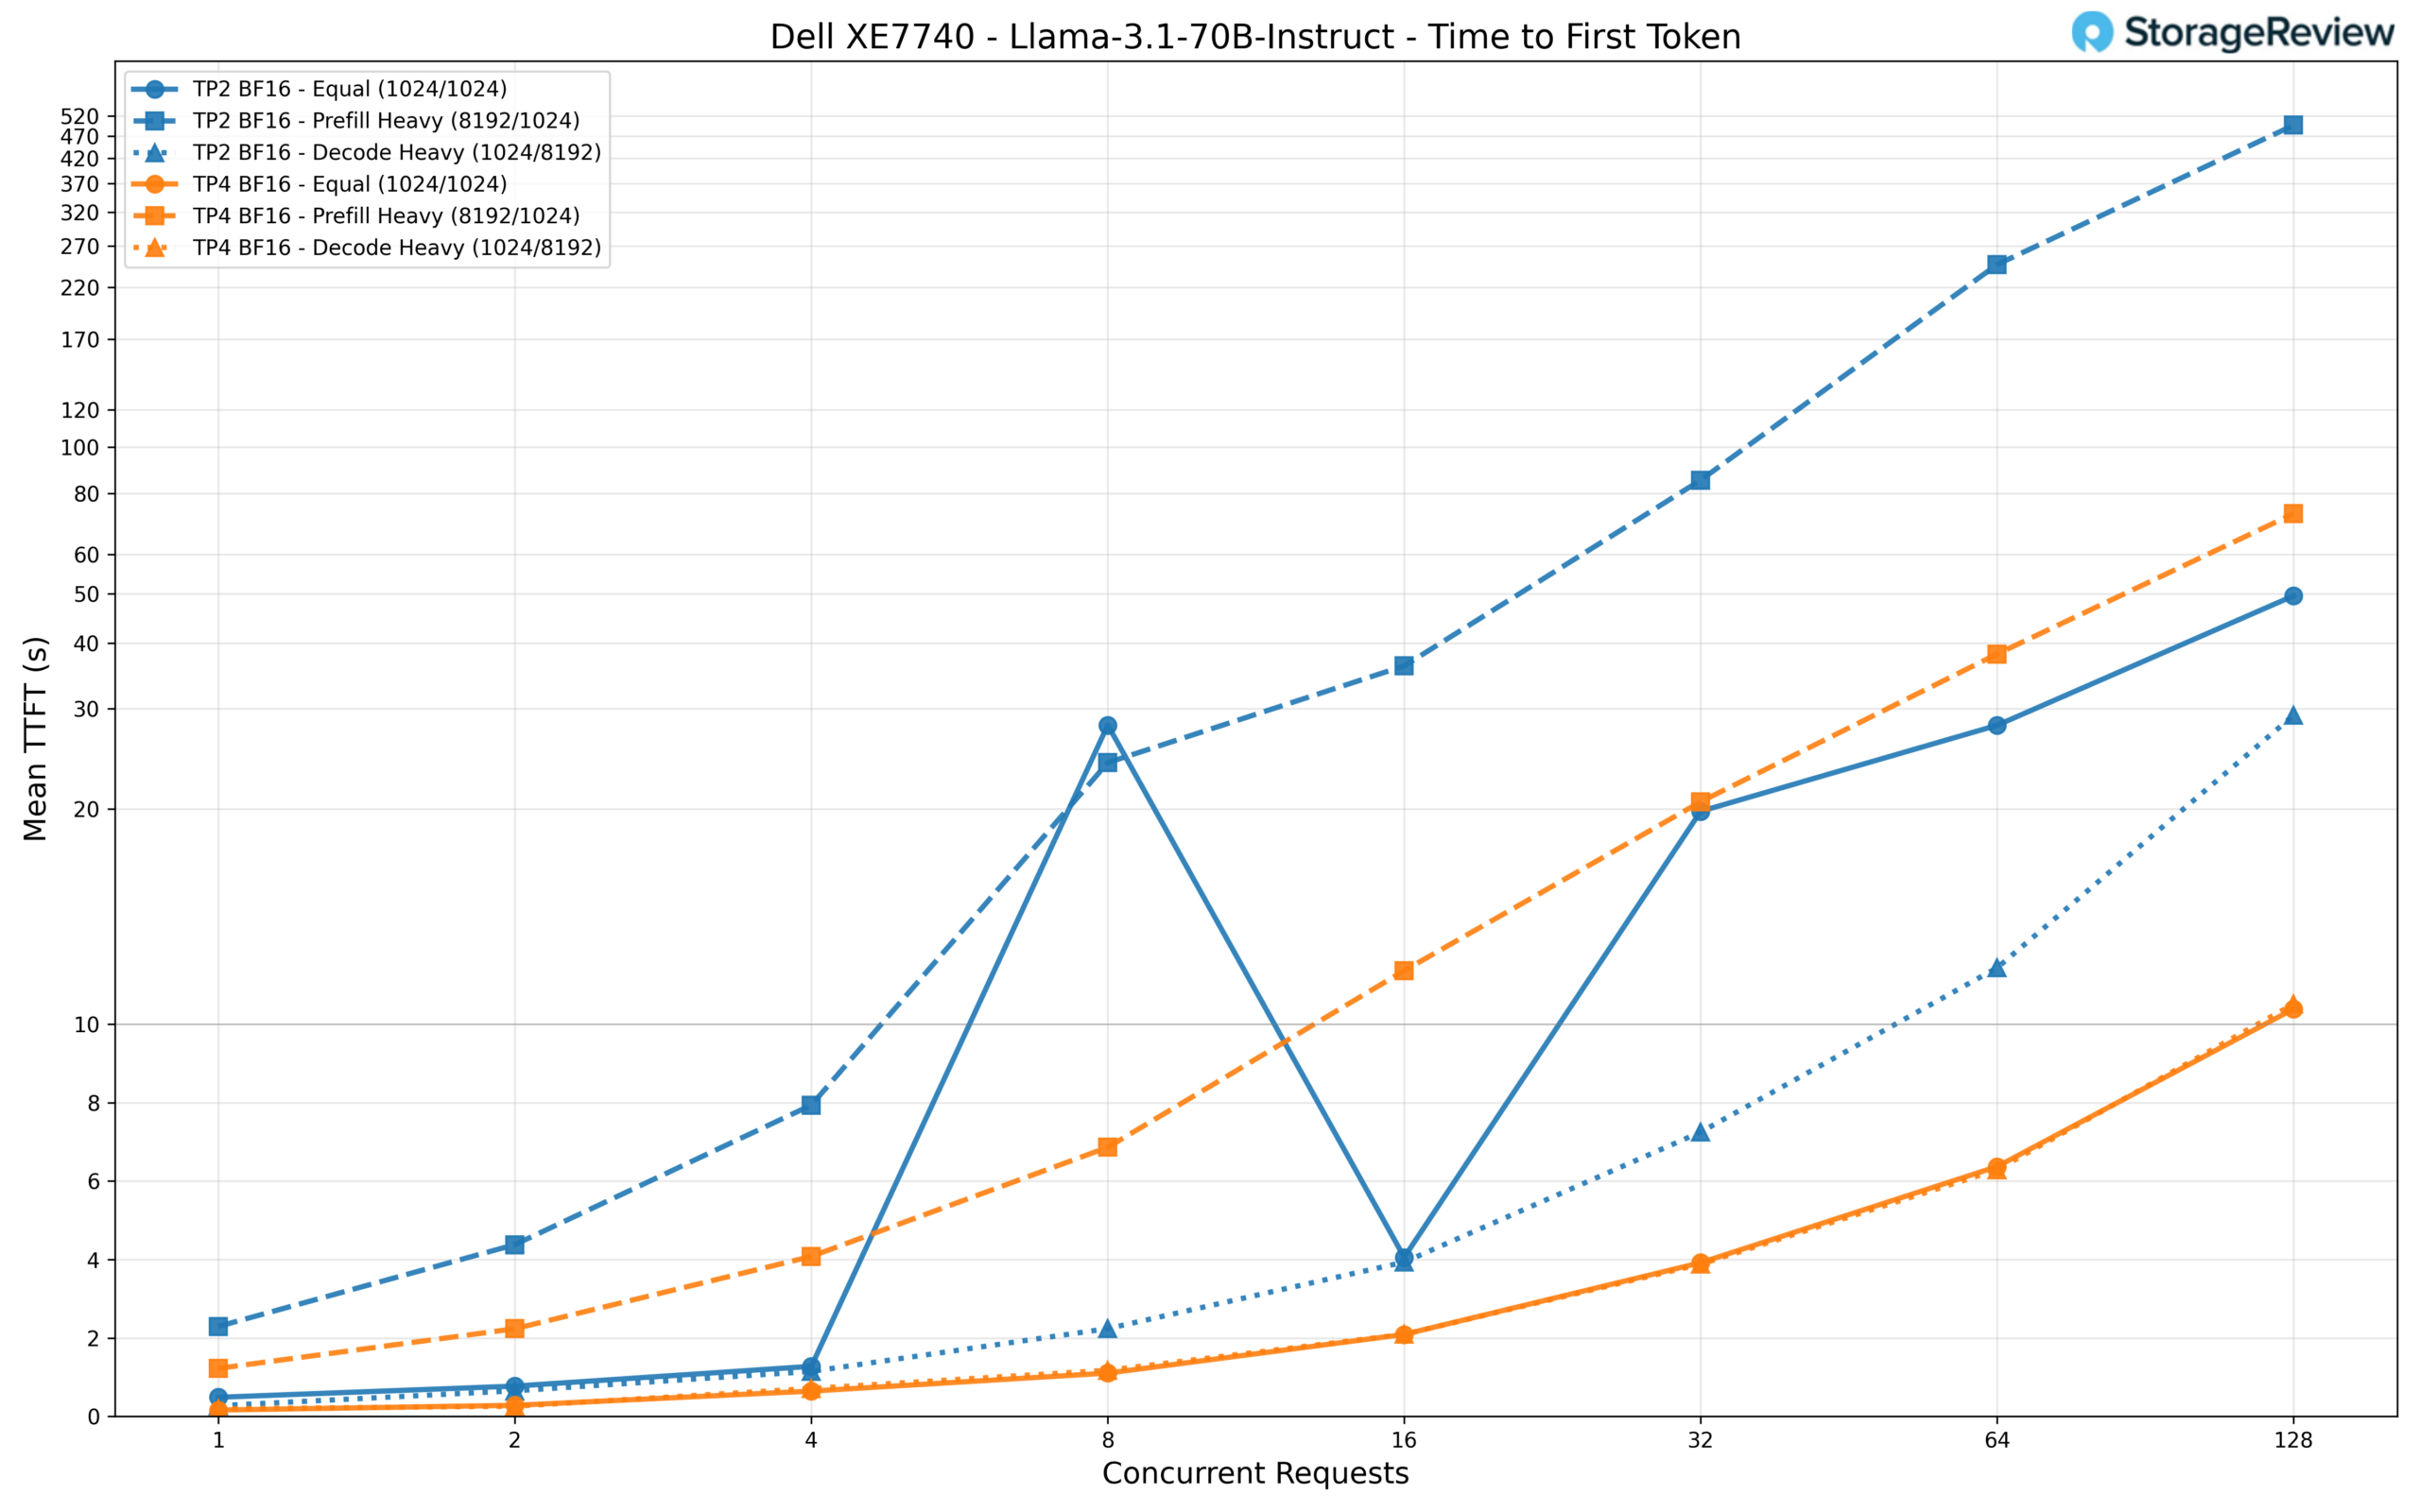
TTFT に関しては、TP2 はプリフィル負荷の高いワークロードで苦戦し、同時リクエスト 128 で驚異的な 496 秒にまで上昇し、対話型アプリケーションには事実上使用できません。TP4 ではこれを約 73 秒に短縮しています。equal および decode ワークロードでは、TP4 は 128 リクエストで TTFT を約 10 秒に抑えていますが、TP2 はそれぞれ 50 秒と 29 秒に達します。同時実行数が少ない場合、TP4 は equal ワークロードで最初のトークン応答を約 160 ms で提供しますが、TP2 では 486 ms かかります。
Qwen3 コーダー 30B-A3B 取扱説明書
Qwen3 Coder 30B-A3B は、ローカル推論展開で最も人気のあるコーディング モデルの 1 つであり、エキスパート混合 (MoE) アーキテクチャを採用しています。すべてのパラメータがすべての順伝播に参加する密なモデルとは異なり、MoE モデルでは、各トークンを少数の特殊なエキスパート ネットワークのサブセットを通してルーティングします。Qwen3 Coder は、BF16 精度で 30B パラメータのフル モデル サイズを維持しながら、生成されるトークンごとに 3B パラメータのみをアクティブ化します。この疎なアクティブ化パターンにより、モデルは、トークンごとに必要な計算量のごく一部で、はるかに大規模なネットワークと同等の品質を実現できるため、ルーティング オーバーヘッドをサポートするハードウェアでは非常に効率的です。エンド ユーザーにとって、このモデルは、定型コードの生成、関数の補完、コードの説明、単体テストの作成、コードに特化したモデルの恩恵を受けながら高度な推論を必要としないルーチン開発タスクの処理など、日常的なコーディング支援に最適です。
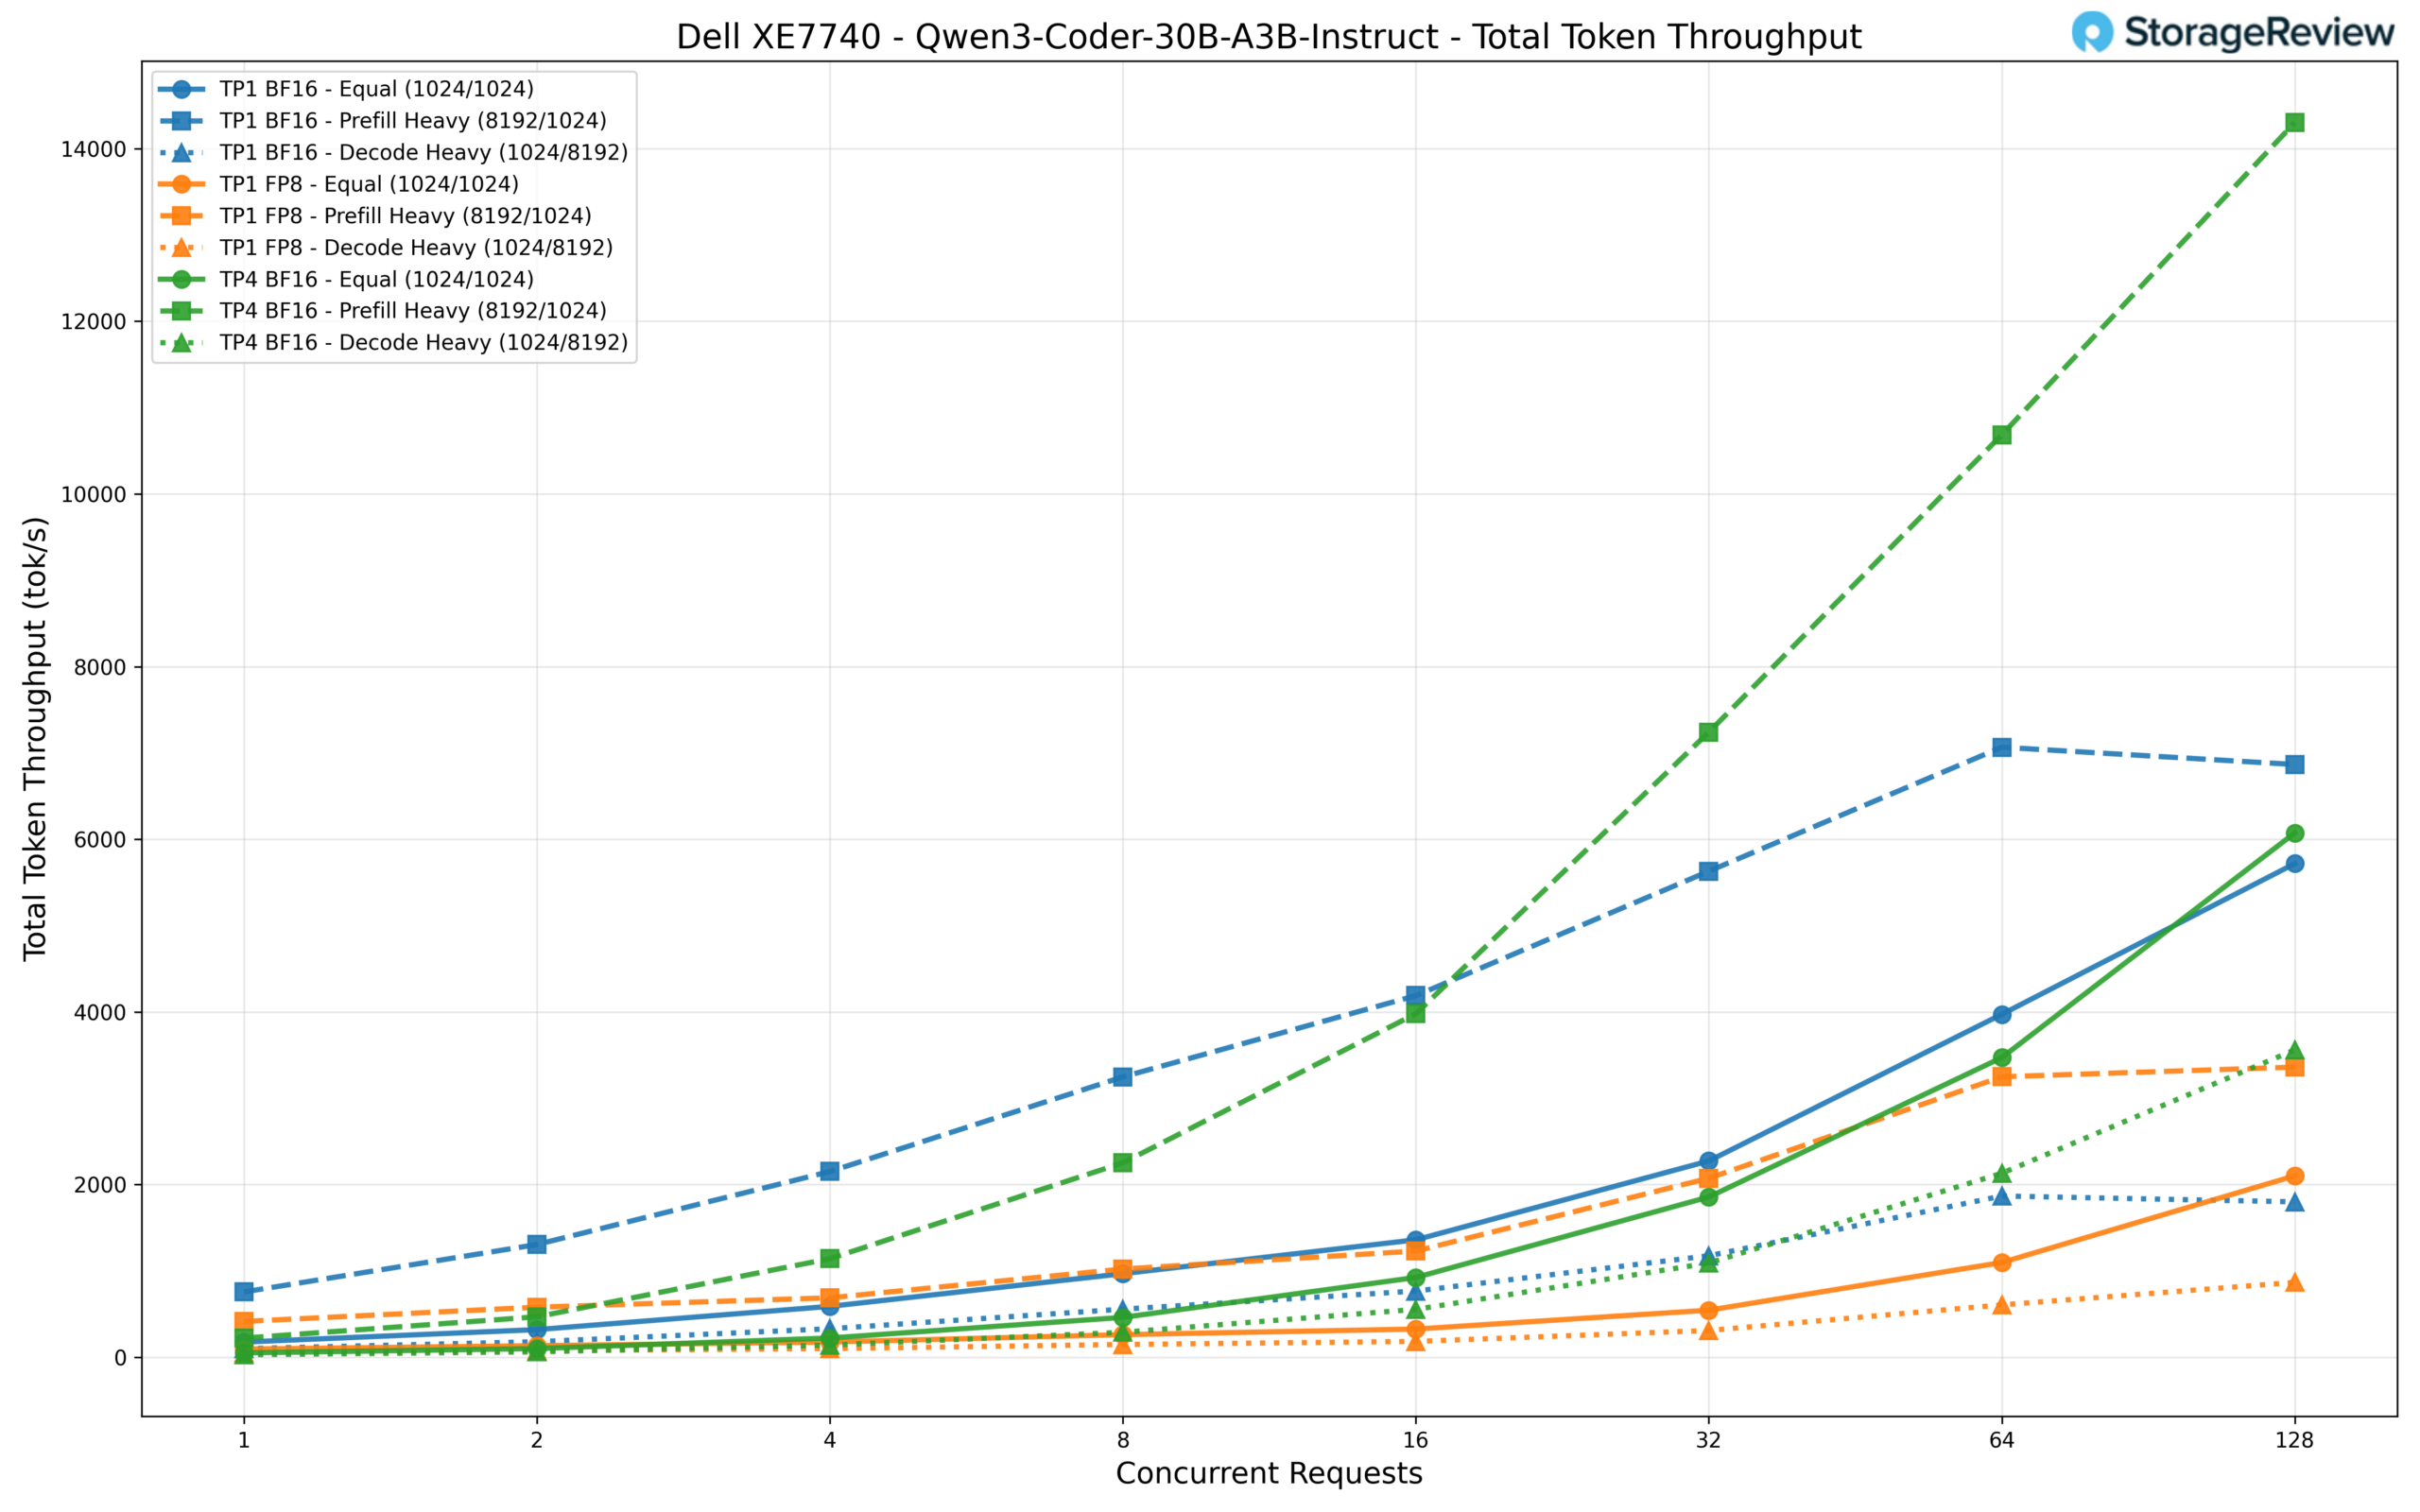
TP1 BF16、TP1 FP8、TP4 BF16 の 3 つの構成をテストしました。同時リクエスト数が 128 の場合、TP4 BF16 がプリフィル負荷の高いシナリオで約 14,300 tok/s を記録し、テスト スイート内のどのモデルよりも高いスループット値を示しました。同じシナリオでは、TP1 BF16 が約 6,900 tok/s で続き、TP1 FP8 は約 3,360 tok/s で後れを取っています。ワークロードが同じ場合、TP4 が 6,073 tok/s、TP1 BF16 が 5,718 tok/s、TP1 FP8 が 2,101 tok/s となり、差はやや縮まります。上記の FP8 の注記で説明したように、ここでの FP8 の数値が低いのは、ハードウェアのボトルネックではなく、Intel の vLLM フォークの現状を反映しています。
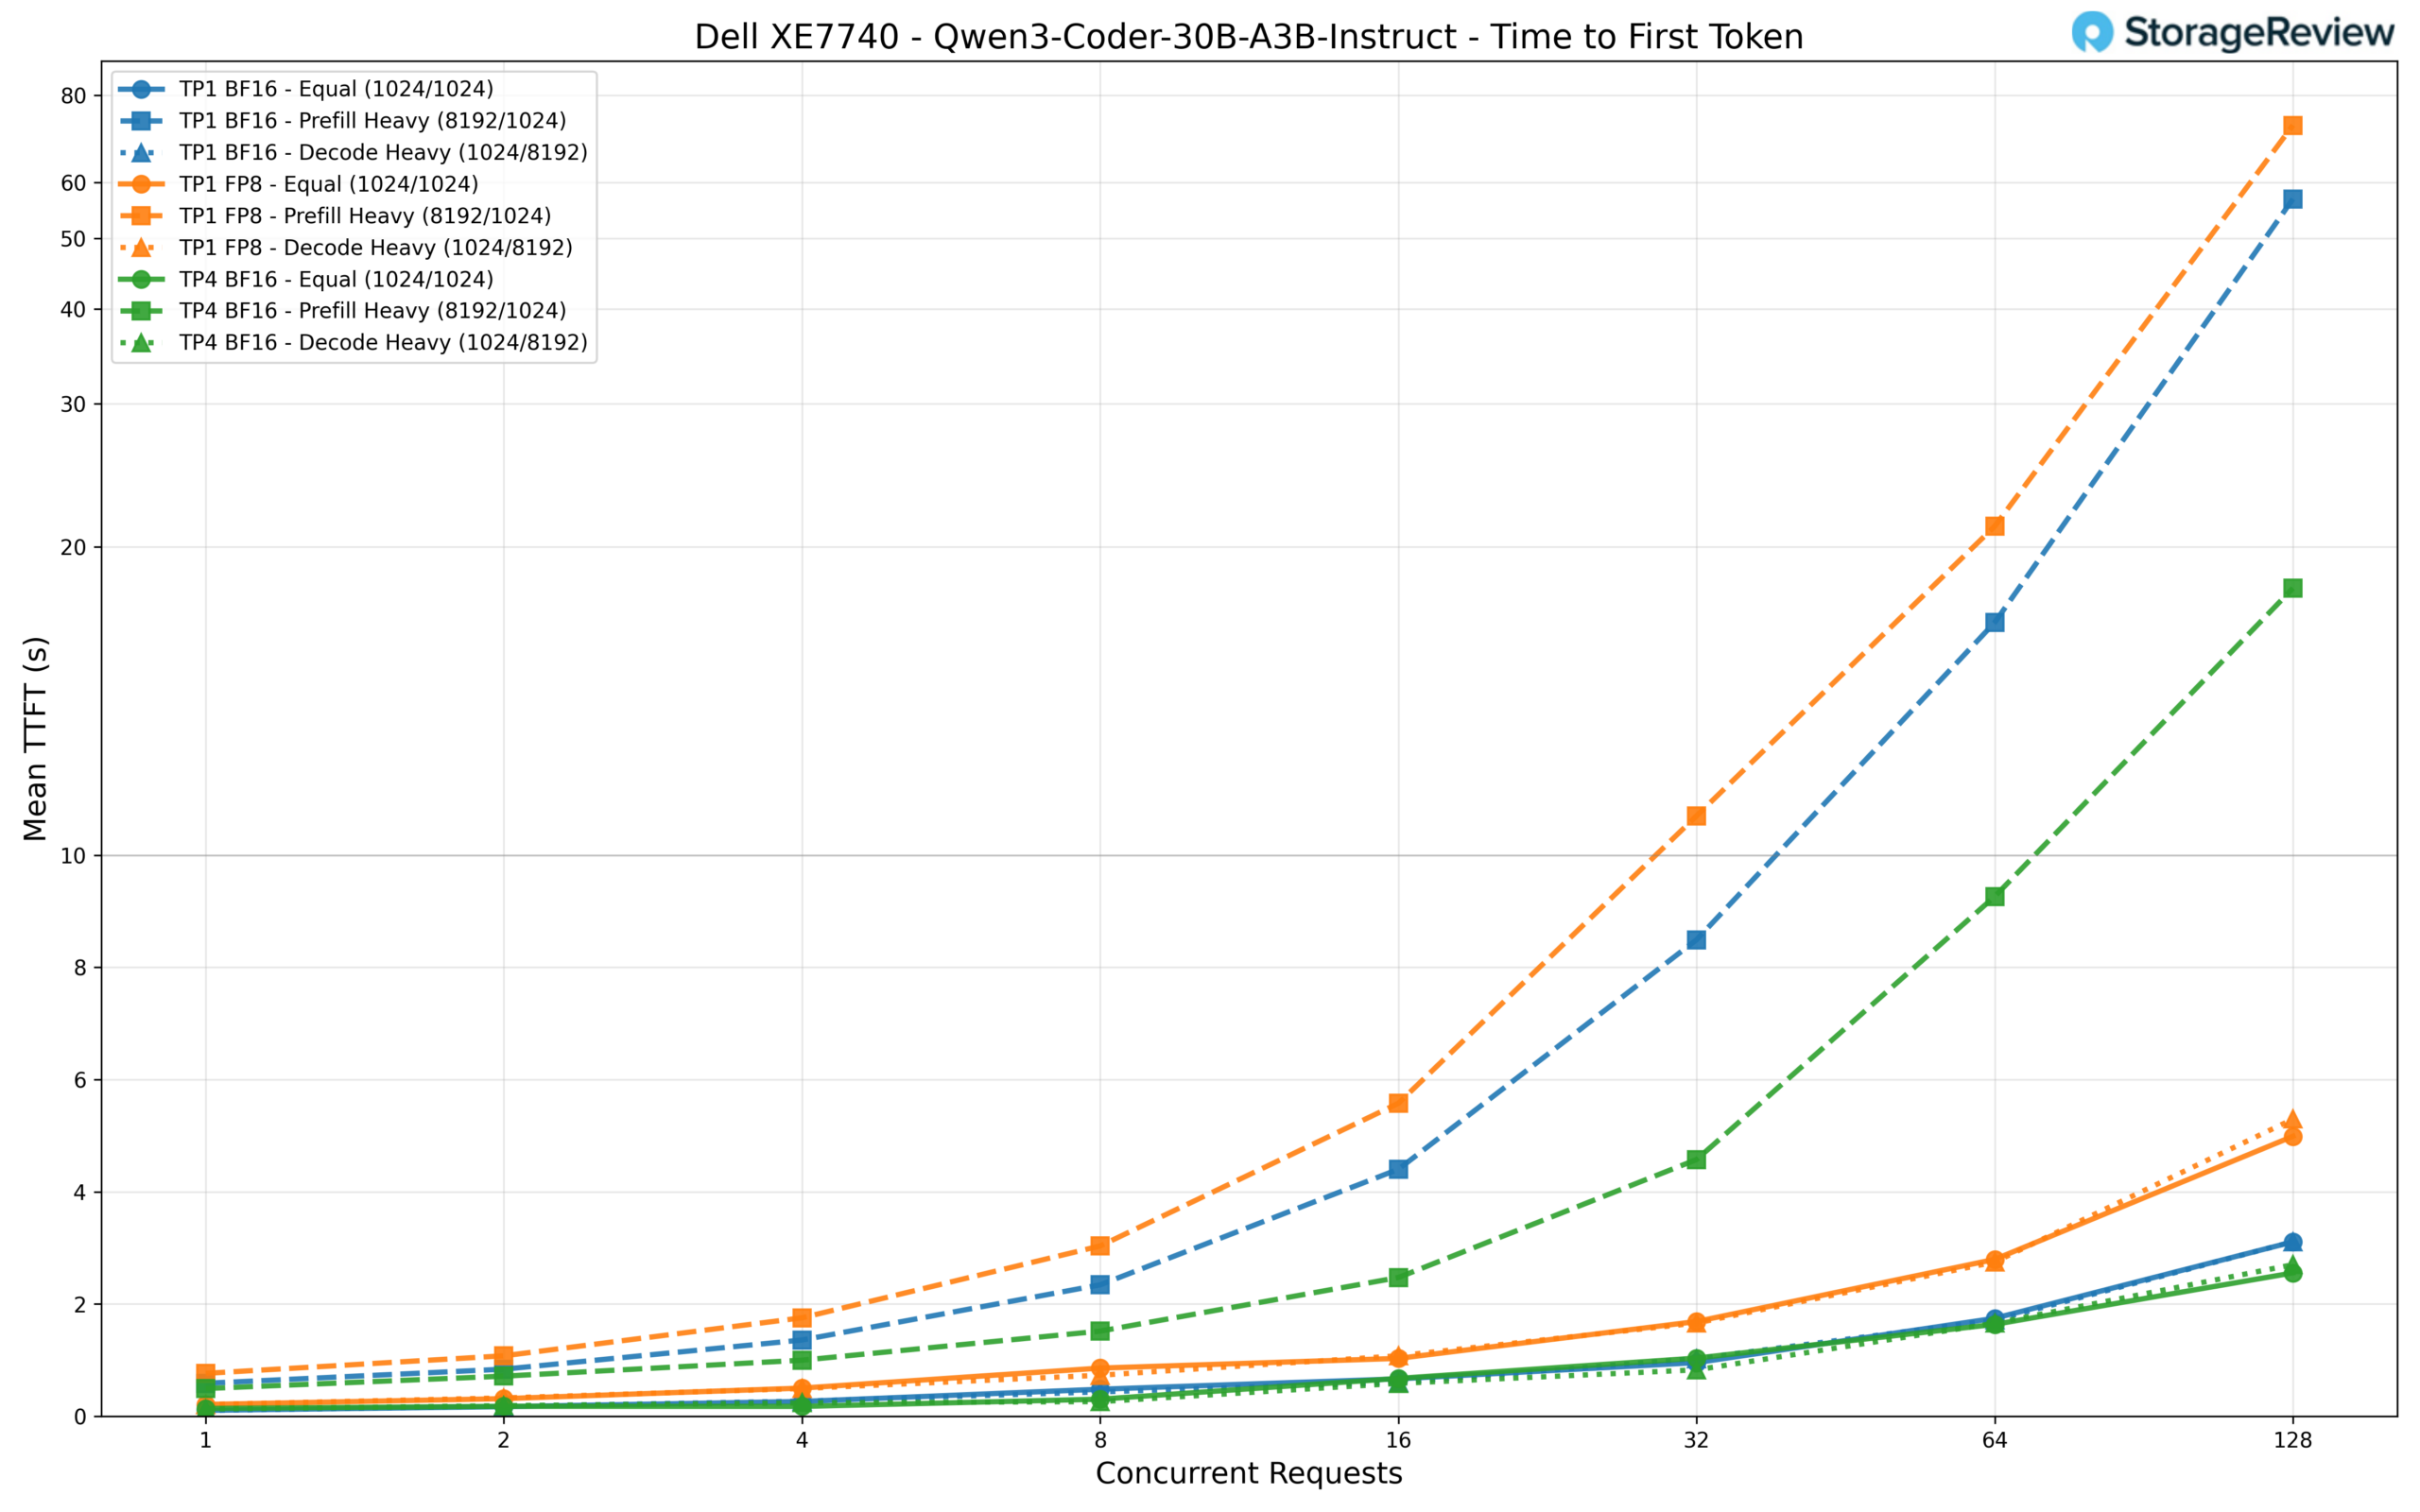
疎なアクティベーションパターンのおかげで、TTFT は低く抑えられています。TP4 BF16 は、シングルユーザー負荷で約 140ms のファーストトークンレイテンシを実現し、同じワークロードで 128 の同時リクエストでも約 2.6 秒を維持します。TP1 BF16 は低同時実行数では同等 (106ms) ですが、フルロードでは 3.1 秒に上昇します。プリフィルが多いシナリオでは、構成の違いが再び明確になります。TP4 は 128 リクエストで約 18 秒に達し、TP1 BF16 は 57 秒、TP1 FP8 は 72 秒に達します。
Qwen3 235B-A22B 思考
ベンチマークスイートの中で最大のモデルであるQwen3 235B-A22B Thinkingは、合計235B個のパラメータとトークンあたり22B個のアクティブパラメータを持つ大規模なMoE推論モデルです。このモデルは、その規模の大きさに加えて、思考連鎖推論機能を内蔵しており、より多くのデコードトークンを消費する代わりに、複雑な問題を段階的に分解して答えにたどり着くことができます。そのため、高度なコード生成とデバッグ、数学的問題解決、多段階論理推論、そして速度よりも精度が重要な複雑なエージェントワークフローなど、最も困難なタスクに特に適しています。このモデルを実行するにはTP4が必要で、BF16とFP8の両方の精度でテストしました。
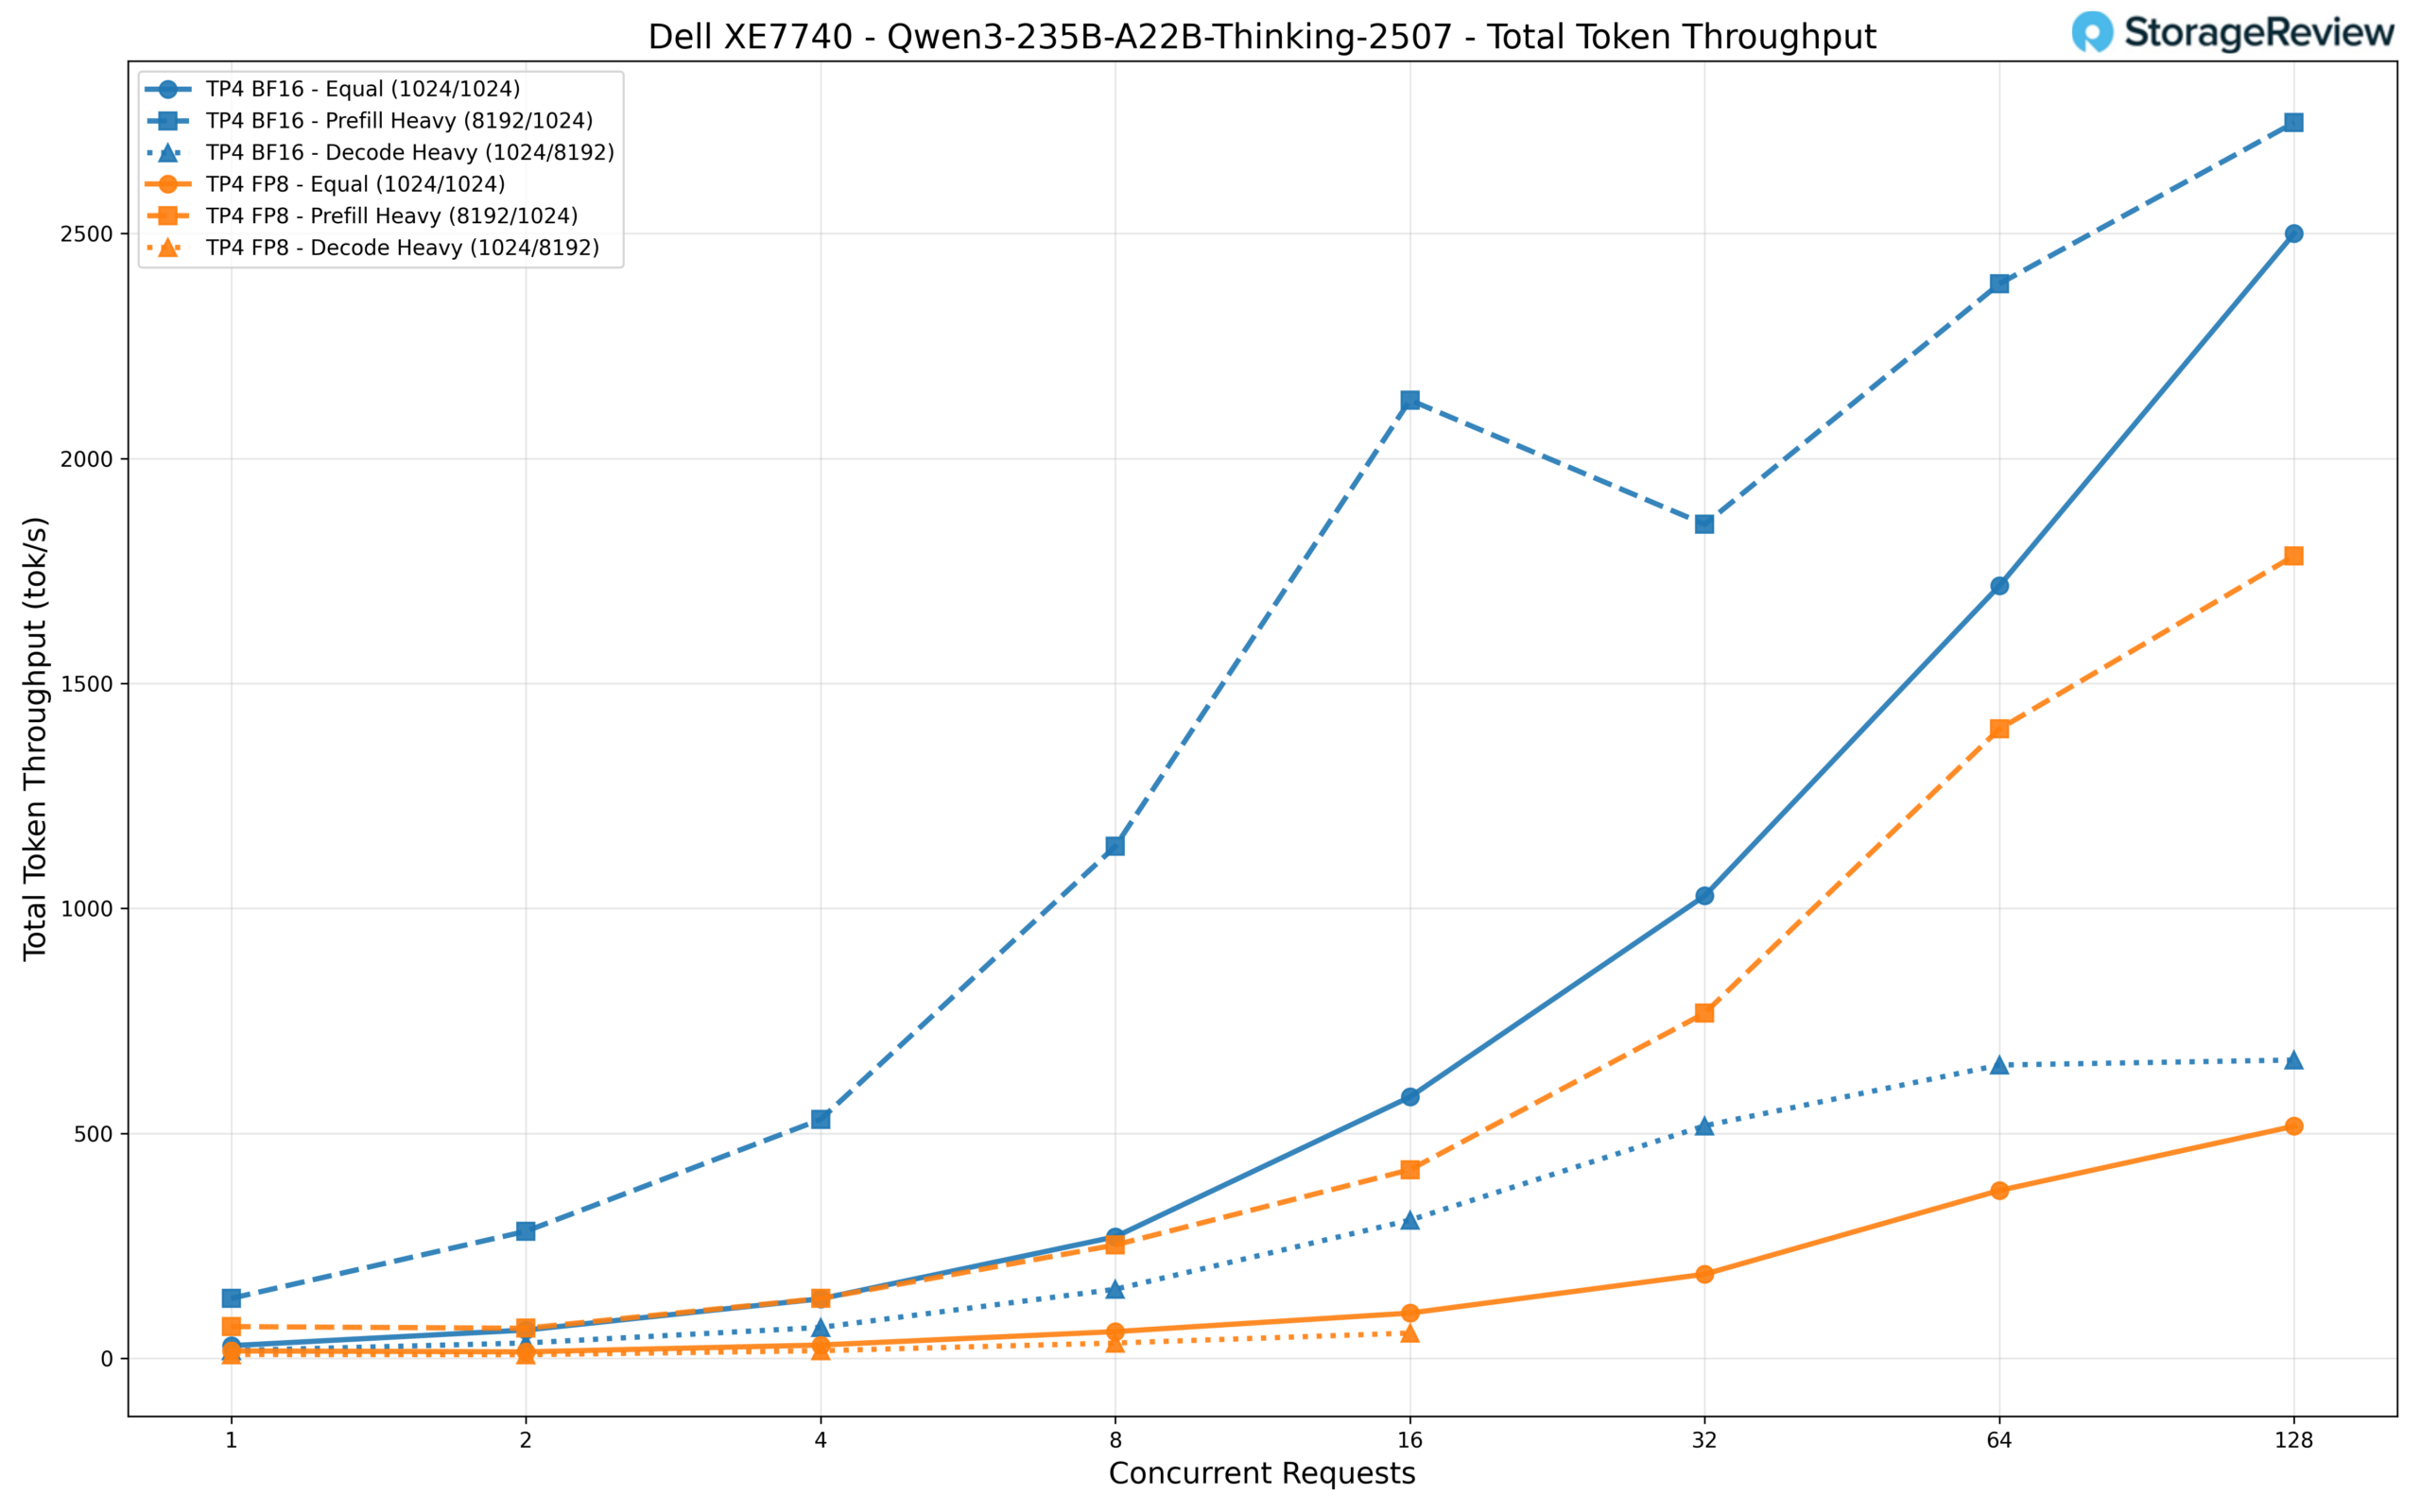
BF16はあらゆる面でFP8を明らかに上回っています。同時リクエスト数が128の場合、BF16はプリフィル負荷の高いワークロードで約2,750 tok/s、同等のワークロードで約2,500 tok/sに達するのに対し、FP8はそれぞれ約1,784 tok/sと516 tok/sにとどまります。また、FP8は同時リクエスト数が多い場合(32以上)、デコード負荷の高いシナリオでタイムアウトが発生しました。
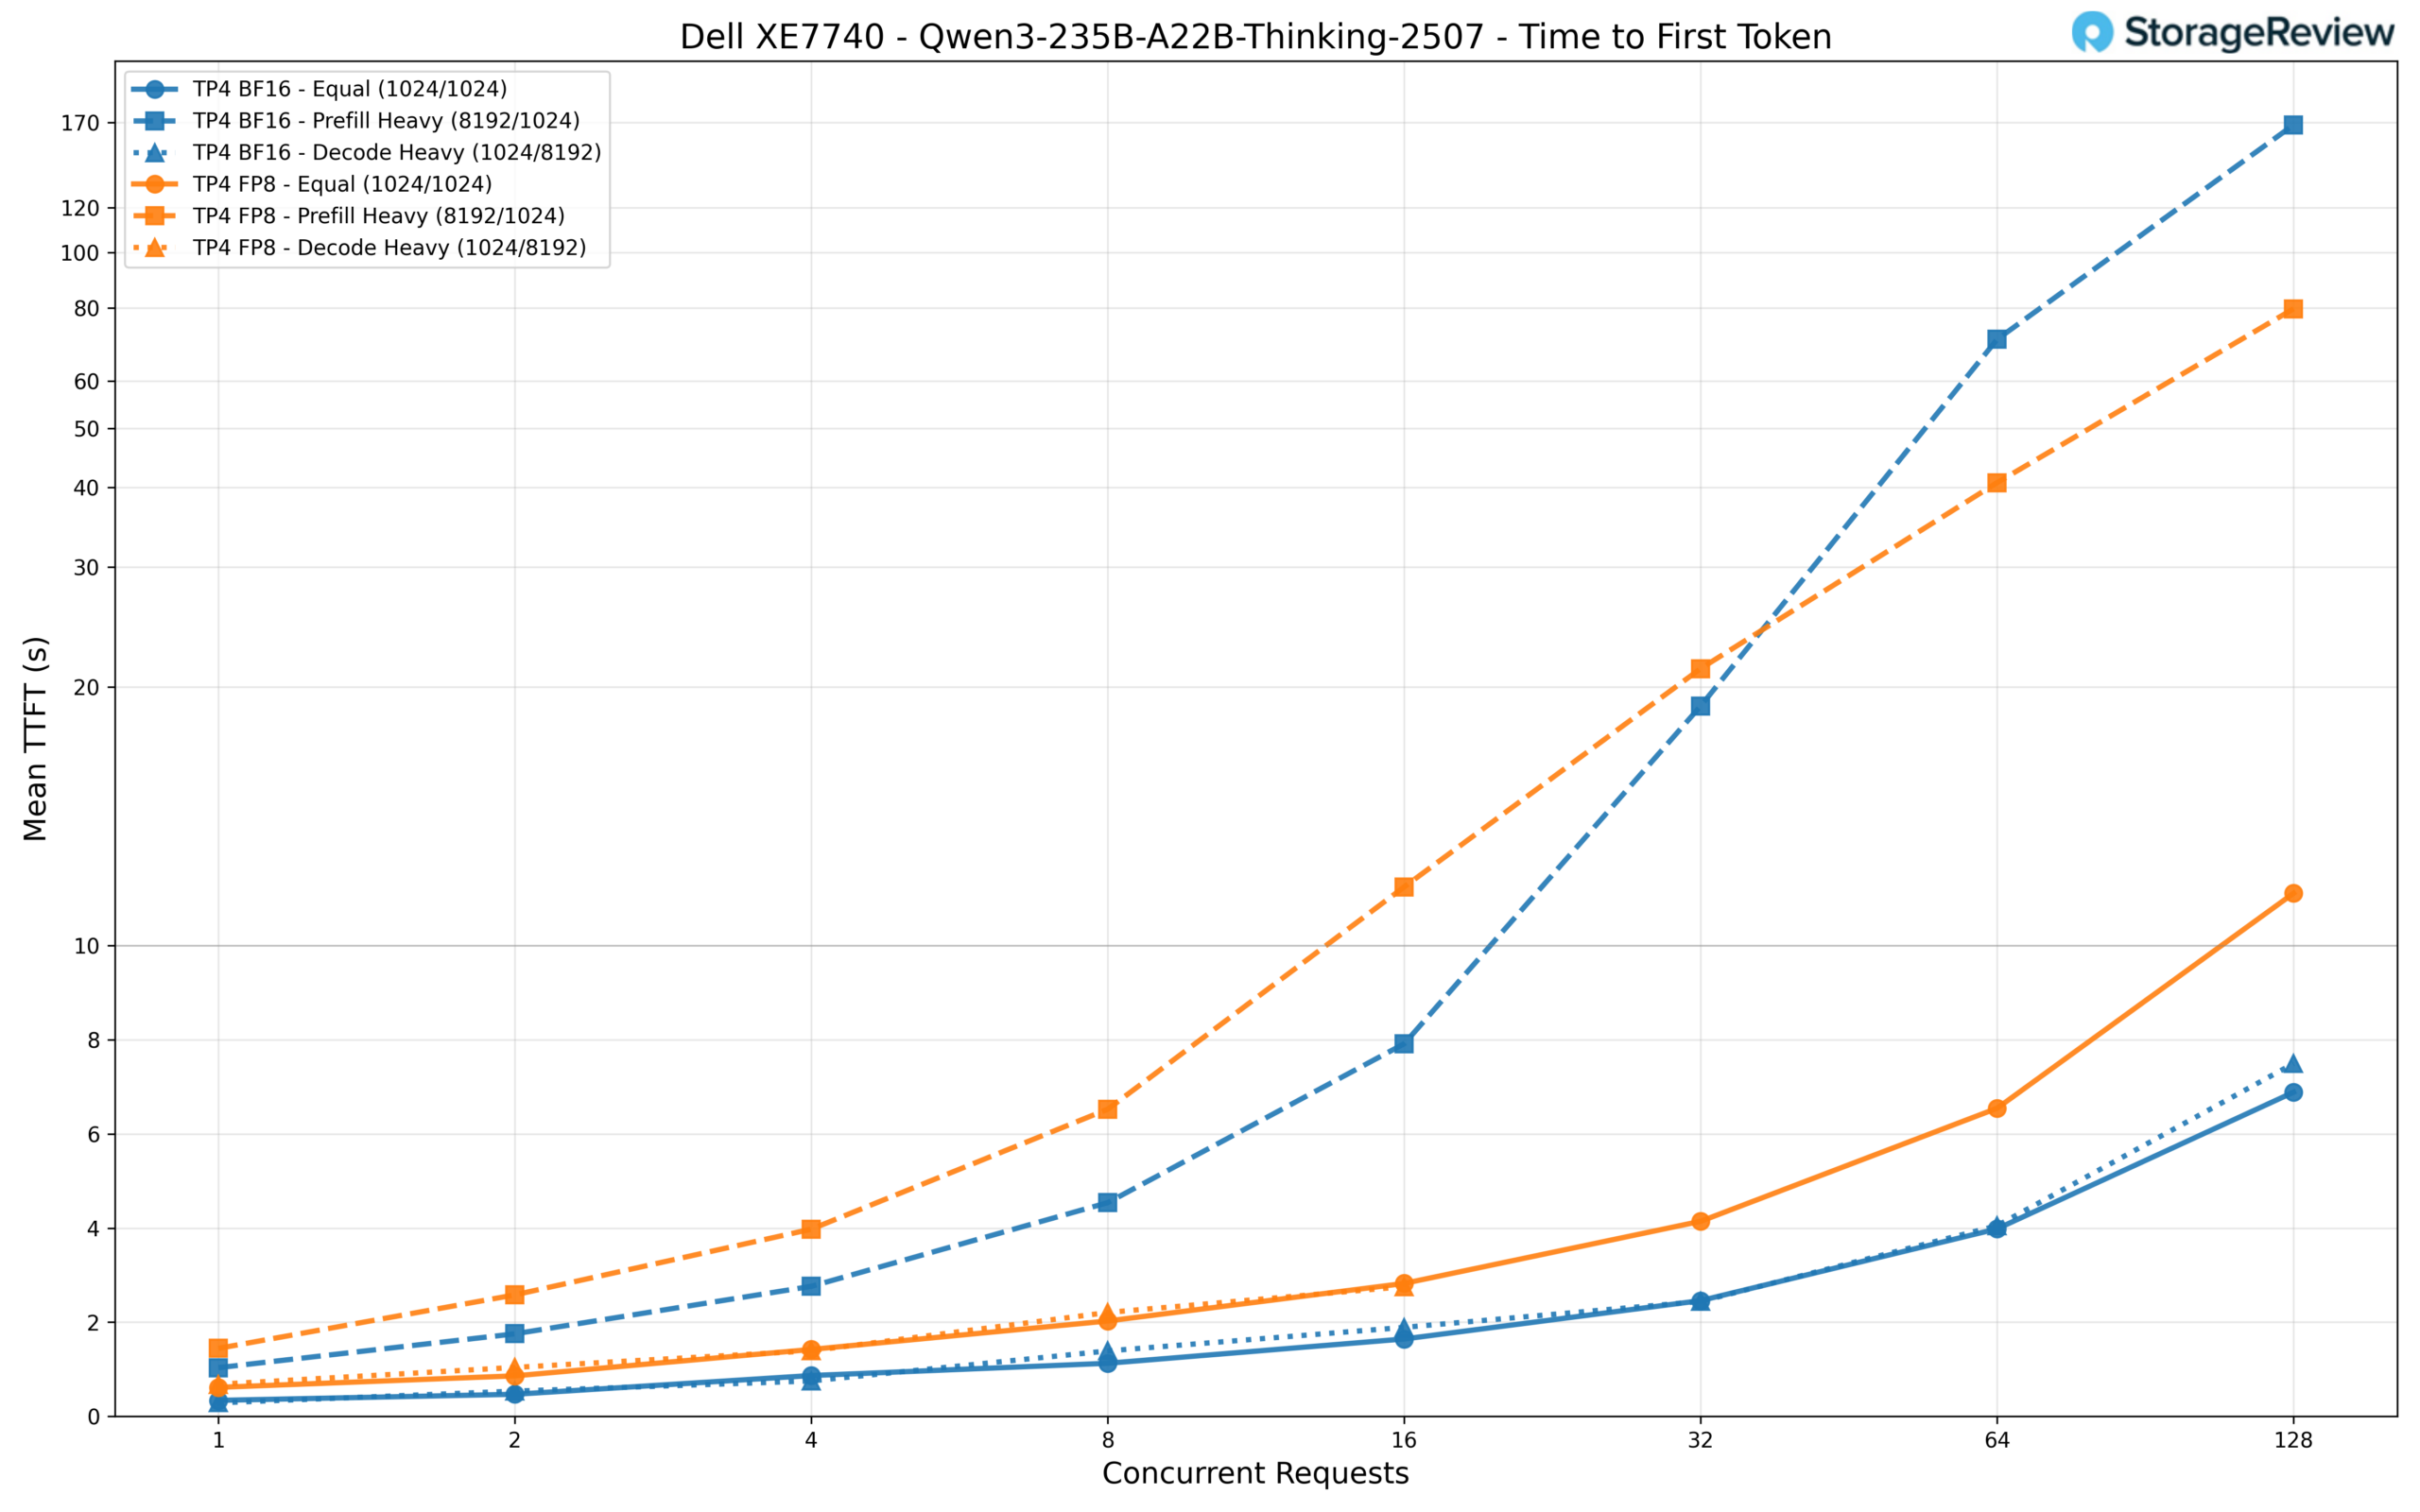
TTFTに関しては、BF16は単一の等長リクエストで約340msから始まり、同時リクエストが128件の場合、約6.9秒までスケールします。この規模のモデルとしては非常に応答性が高いと言えます。FP8は全体的に約2倍遅く、615msから始まり、フルロードで約11.2秒に達します。プリフィル負荷の高いワークロードが最も負荷の高いシナリオで、リクエストが128件の場合、BF16は168秒、FP8は80秒まで上昇します。
これは誰ですか?
推論需要は衰える気配を見せていません。組織が開発チームのスピードアップのために社内でモデルを導入したり、顧客向け製品にAIを組み込んだり、24時間稼働する自動化パイプラインを構築したりと、コンピューティング要件は増え続けています。そして、こうした需要の高まりに伴い、おなじみのボトルネック、つまり調達の問題が生じています。人気のアクセラレーターのリードタイムは数ヶ月に及ぶこともあり、既に資金と人員が確保されているプロジェクトが停滞してしまうケースも少なくありません。
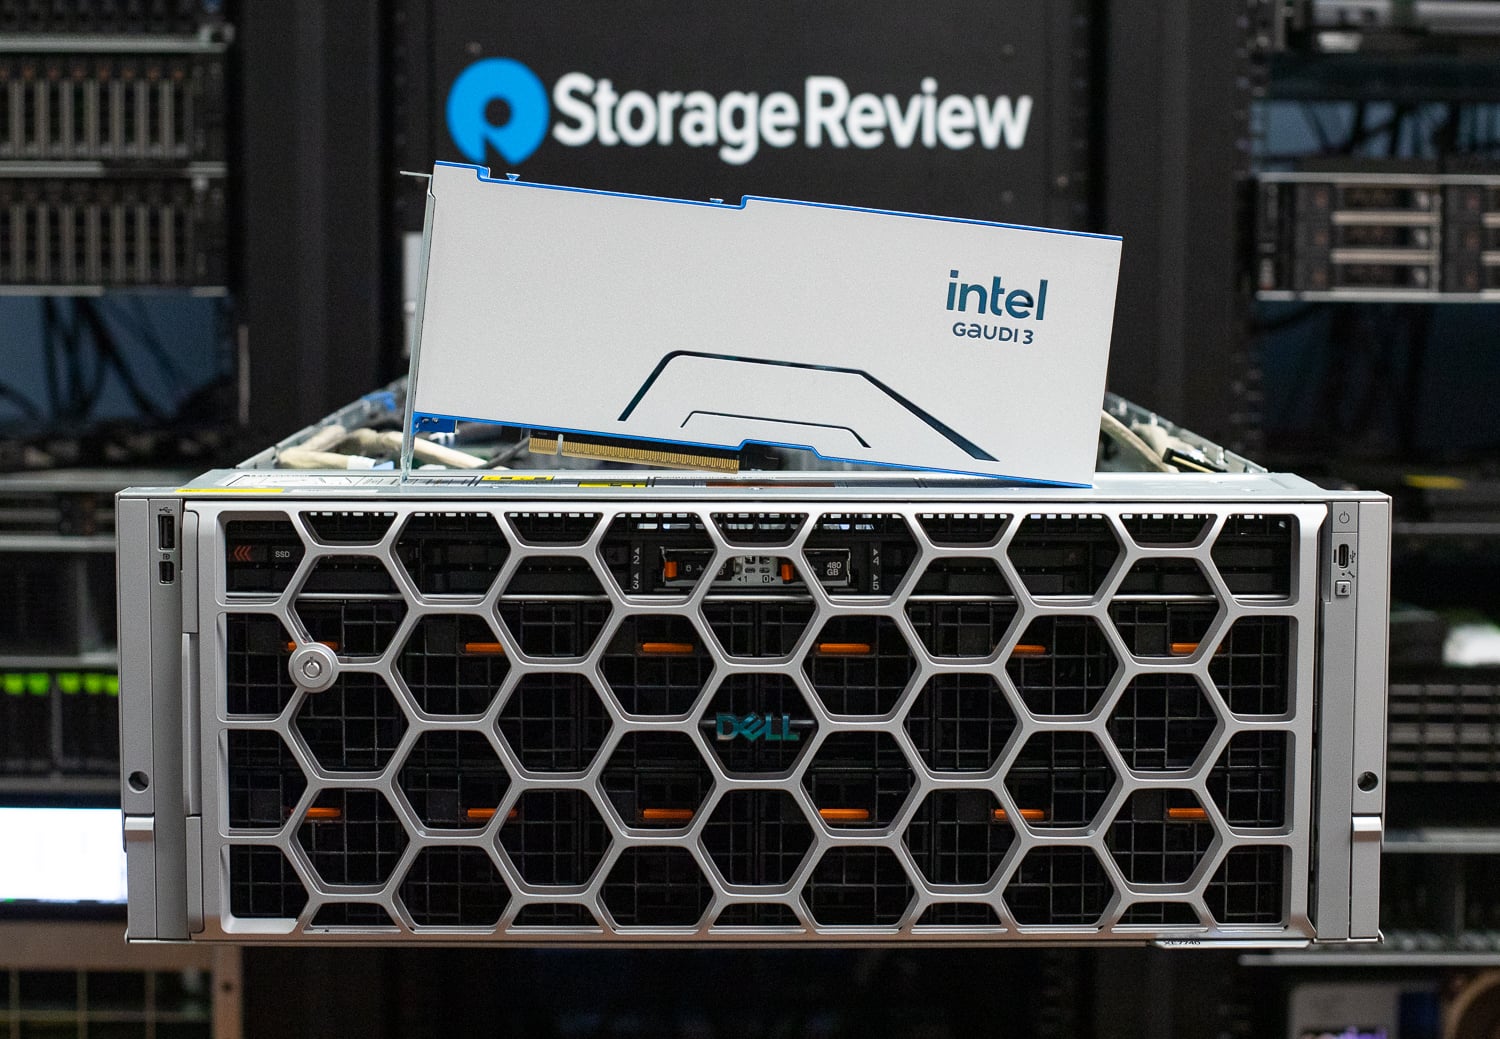
Intel Gaudi 3を搭載したXE7740は、この制約に直接対応します。Gaudi 3アクセラレータは現在入手可能で、Intelは検証済みの導入テンプレートを提供しているため、チームは開梱から推論処理の開始までを数時間で完了できます。Dellはさらに、XE7740システムをお客様の環境に直接導入できる試用プログラムを提供することで、導入のハードルを下げています。これにより、本格的な展開に踏み切る前に、実際のワークロード、データ、インフラストラクチャに対してパフォーマンスを検証できます。即時利用可能、迅速な価値実現、低リスク評価というこの組み合わせにより、Gaudi 3構成は、推論処理能力を今すぐ必要とし、割り当て待ちの列に並ぶ余裕のない組織にとって特に魅力的な選択肢となります。
とはいえ、XE7740は単一のアクセラレータのみを搭載したプラットフォームではありません。デルはシリコンの多様性を重視しており、同じプラットフォームでもさまざまなオプションや市場で人気の高いアクセラレータを選択できるため、最適な選択はワークロードによって決まります。たとえば、ビデオ処理パイプラインはNVIDIA L4に最適で、XE7740には16個のL4 GPUと8個のPCIe Gen5 x16 NICスロットを搭載でき、妥協のないストリーミングおよびトランスコーディングシステムを実現できます。複数の部門で異なるAIワークロードを実行している組織は、XE7740シャーシを標準化し、各導入環境に合わせてアクセラレータ構成を変更するだけで、フリート管理を簡素化しながら、タスクに合わせてコンピューティングを最適化できます。
結論
Dell PowerEdge XE7740は、エンタープライズ推論の実情に合わせて設計されています。デュアルゾーン熱設計、構造化PCIeトポロジー、高帯域幅メモリアーキテクチャ、スケールアウトネットワーク機能により、持続的な本番ワークロードに対応するシステムを構築しています。これらは偶然の選択ではなく、推論が継続的に実行され、予測可能なスケーリングを実現し、既存のデータセンター運用にスムーズに統合されるインフラストラクチャモデルを反映しています。この評価では、Intel Gaudi 3により、XE7740が高密度アーキテクチャとMoEアーキテクチャの両方で、予測可能なスケーリング動作と強力なメモリバウンドスループットを実現し、今日の推論処理能力を発揮することが実証されています。ソフトウェアの最適化は今後も改善されていきますが、プラットフォームのアーキテクチャ基盤は既に強固です。
さらに重要なのは、XE7740がエンタープライズAIインフラストラクチャの堅牢な設計図を確立することです。組織は、一貫したシャーシ、管理スタック、および展開モデルを標準化しながら、アクセラレータ戦略を時間とともに進化させることができます。モデルが成長し、ワークロードが多様化し、推論がビジネスオペレーションに深く組み込まれるにつれて、安定性と適応性に優れたインフラストラクチャの必要性は高まる一方です。PowerEdge XE7740は、こうしたニーズに応えるべく設計されています。エンタープライズAIが急速な導入から長期的な統合へと移行する際に必要となる、アーキテクチャのバランス、運用上の成熟度、および拡張性を提供します。
このレポートは、Dell Technologies の提供により提供されています。このレポートで表明されているすべての見解や意見は、検討中の製品に対する当社の公平な見解に基づいています。


 Amazon