

エッジサーバーは、データセンターやクラウドから離れた場所でコンピューティングリソースを提供することで、リアルタイムの意思決定を容易にします。この記事では、汎用性の高いマルチノードエッジサーバーであるSuperMicro IoT SuperServer SYS-210SE-31A上で、いくつかのエッジベンチマークを実行します。このサーバーは推論のために開発されたものであり、設計段階からエッジ推論を念頭に置いていたことは明らかです。
SuperMicro IoT スーパーサーバー SYS-210SE-31A 概要
SuperMicro IoT SuperServer SYS-210SE-31Aの詳細なレビューによると、この製品は5GやIoTだけでなく、小売業や、PCIeストレージカードと高速NICを組み合わせればストレージ用途にも大きな可能性を秘めていることが明らかになりました。
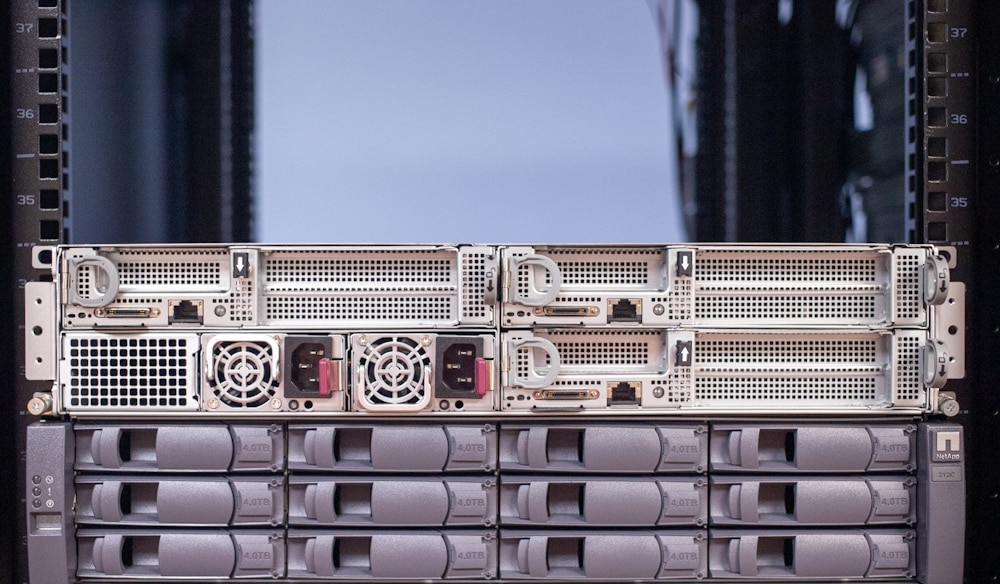
このサーバーはマルチノードであるため、多用途性が高くなります。 3 つの CPU ノードに適合し、それぞれ次の機能を備えています。
- 最大 32C/64T および 205W の第 270 世代 Intel Xeon スケーラブル プロセッサ (「Ice Lake」) XNUMX 基 (特別構成の XNUMXW チップのオプションあり)。
- 4 つのファン モジュール。
- 2 つの DIMM スロット。メモリの上限は 256GB 3DS DIMM を使用して XNUMXTB です。
- 2 つの M.2280 22110/4 PCIe GenXNUMX スロット。
- 4 つの PCIe Gen16 x4 フルハイト/ハーフレングスと 16 つの PCIe GenXNUMX xXNUMX ハーフハイト/ハーフレングス。
- IMPI 2.0 用の XNUMX つの GbE と KVM ドングル。
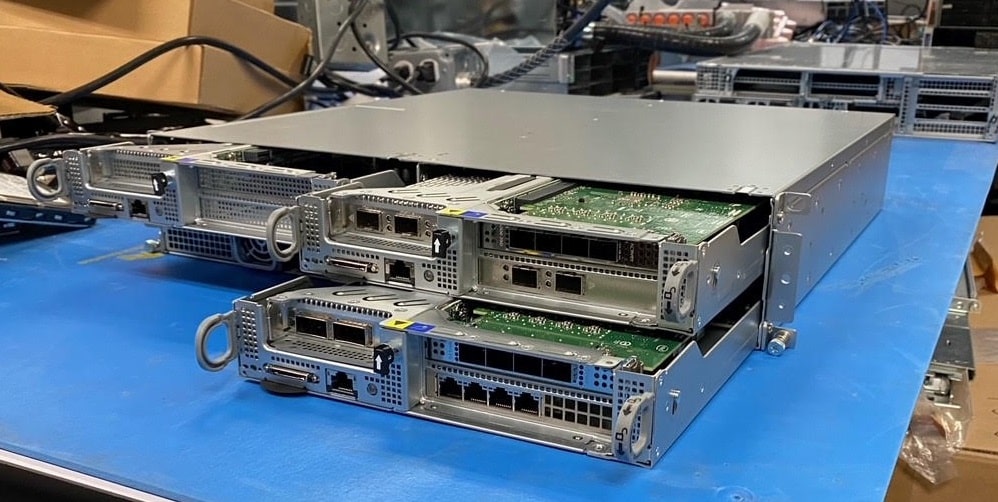
ここでは、独自のミニ ラックマウント サーバーのように、引き出されたノードが表示されます。
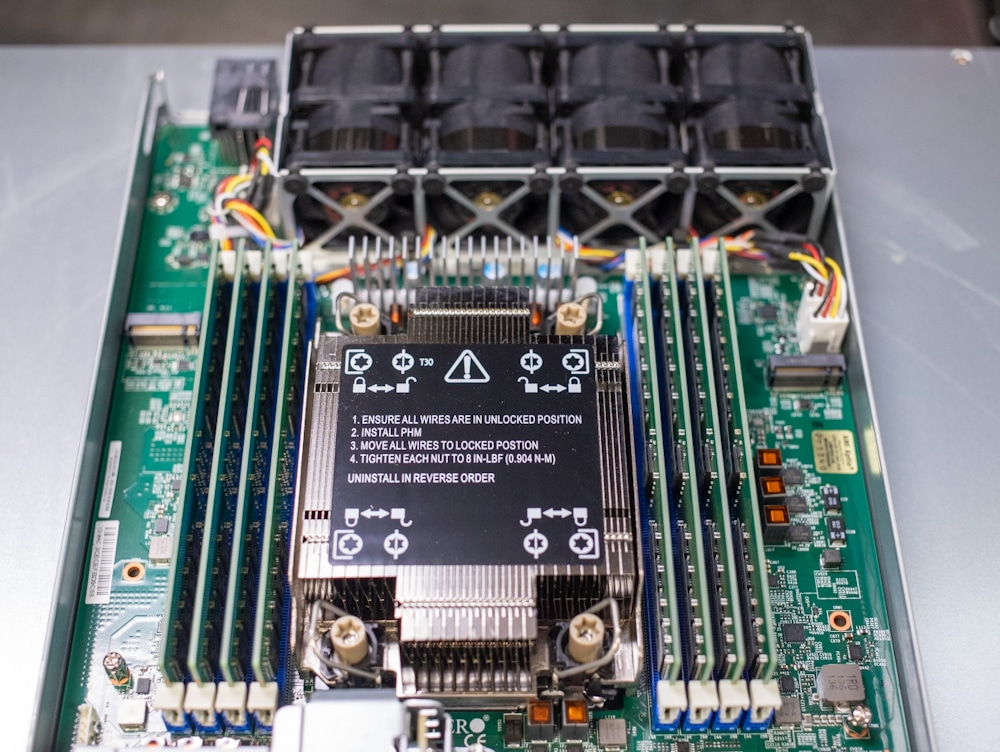
これはノードの内部です。すべてがどれほど緊密に組み合わされているかに注目してください。
このサーバーの主な弱点はストレージであり、ノード内ストレージは 2 つの M.2.5 ブート ドライブ スロットに制限されており、ネイティブ 3.5 インチまたは 1 インチ ベイはありません。前述したように、PCIe ストレージは非常に簡単に追加できます。ネットワーク ストレージもオプションです。 XNUMXGbE を超える接続は拡張カードに依存します。
このサーバーのエッジ フォーカスを強調しているのは、最高 45 ℃ の環境で動作する能力 (55 ℃ での短時間のスティント) と、利用可能なダスト フィルターです。
エッジ推論: エッジサーバーの場合
特集記事「新しいハードウェアのおかげでエッジ推論が本格化」では、エッジコンピューティングの現状について解説しています。かつては階層型の「ハブアンドスポーク」方式でデータを中央拠点に集約していた時代において、今日のエッジへの移行は後退のように思えたでしょう。しかし、リアルタイムの意思決定が今日のエッジへの移行を推進しており、より迅速な洞察と応答時間、そしてネットワーク接続への依存度の低減を実現しています。
エッジ推論はクラウドでも実行できますが、通常は時間に敏感でない、クリティカルではないアプリケーションに対してのみ実行できます。もちろん、ネットワーク接続が不足しているということは、クラウドは利用できないことを意味します。
SuperMicro IoT SuperServer SYS-210SE-31A でのエッジのテスト
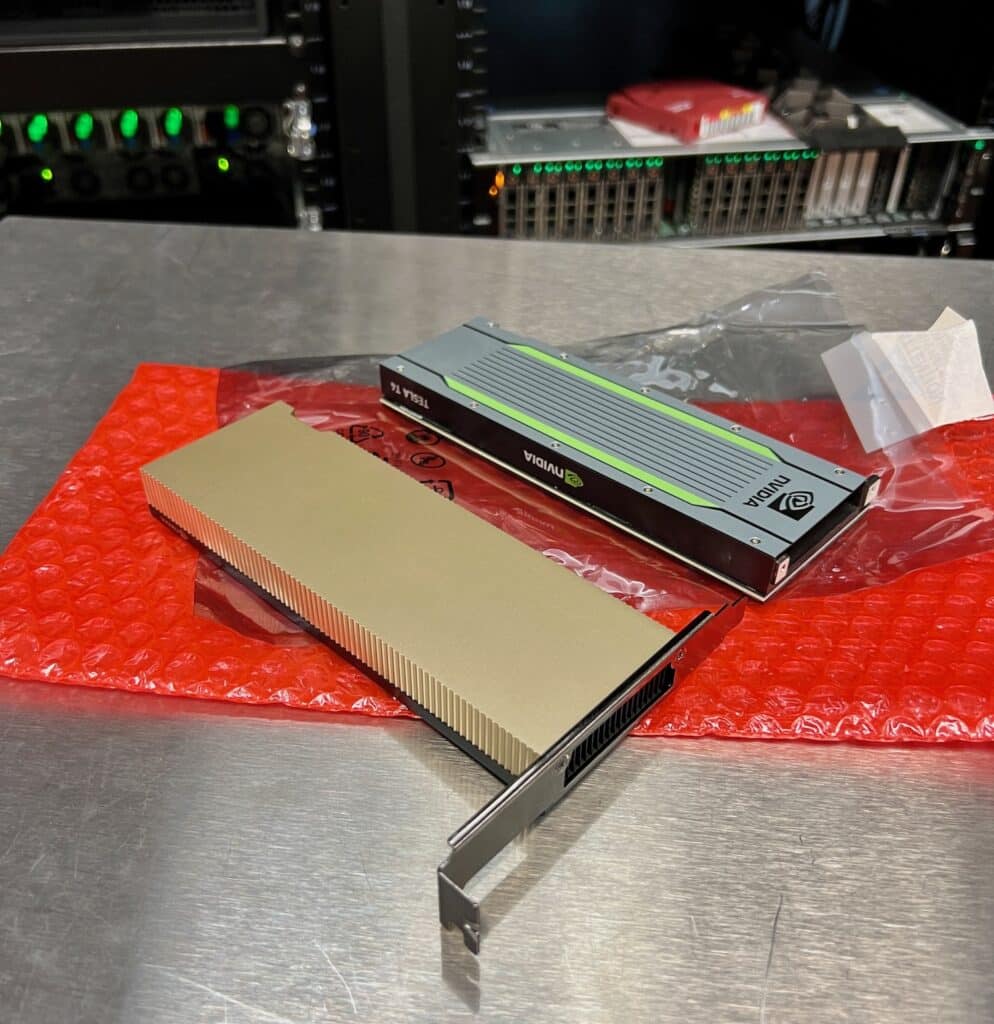
そしていよいよテストです。 GPU のデータ処理能力によりエッジ推論が促進され、エッジ サーバーは通常、NVIDIA A2 や古いながらも人気のある T4 などのシングル スロットのロープロファイル カードを使用します。私たちが評価している SuperMicro IoT SuperServer SYS-210SE-31A には T4 が搭載されています。以下は 4 枚のカードで、右側が T2、左側が A6330 です。各ノードのハードウェア構成には、Intel Xeon Gold 128 CPU と 4 GB の DDRXNUMX RAM が含まれていました。
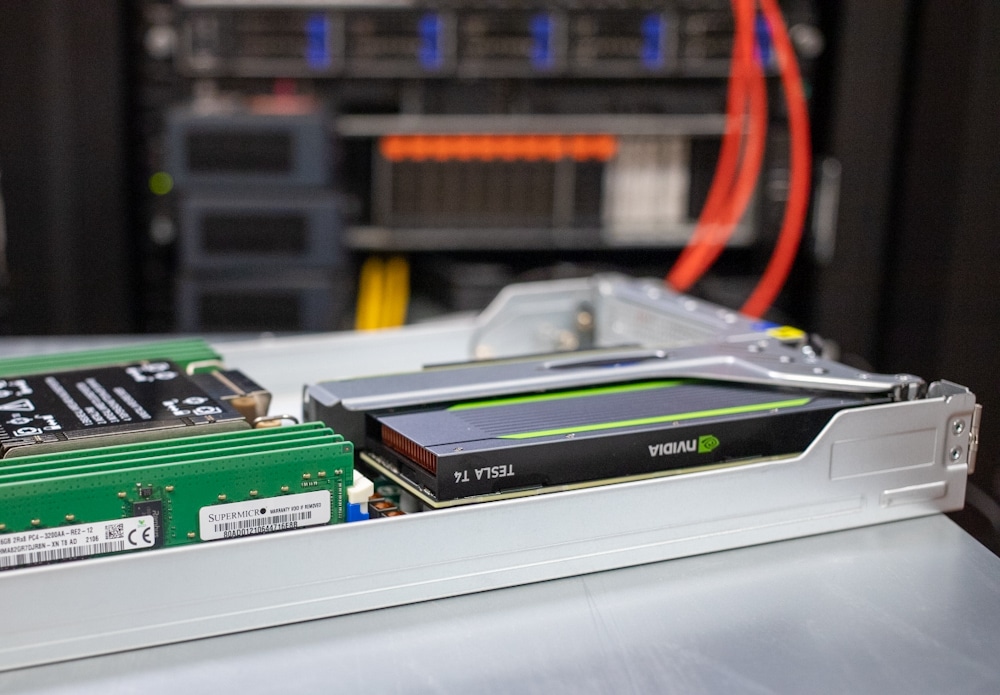
そして、こちらが SuperMicro ノードの 4 つにインストールされている TXNUMX です。
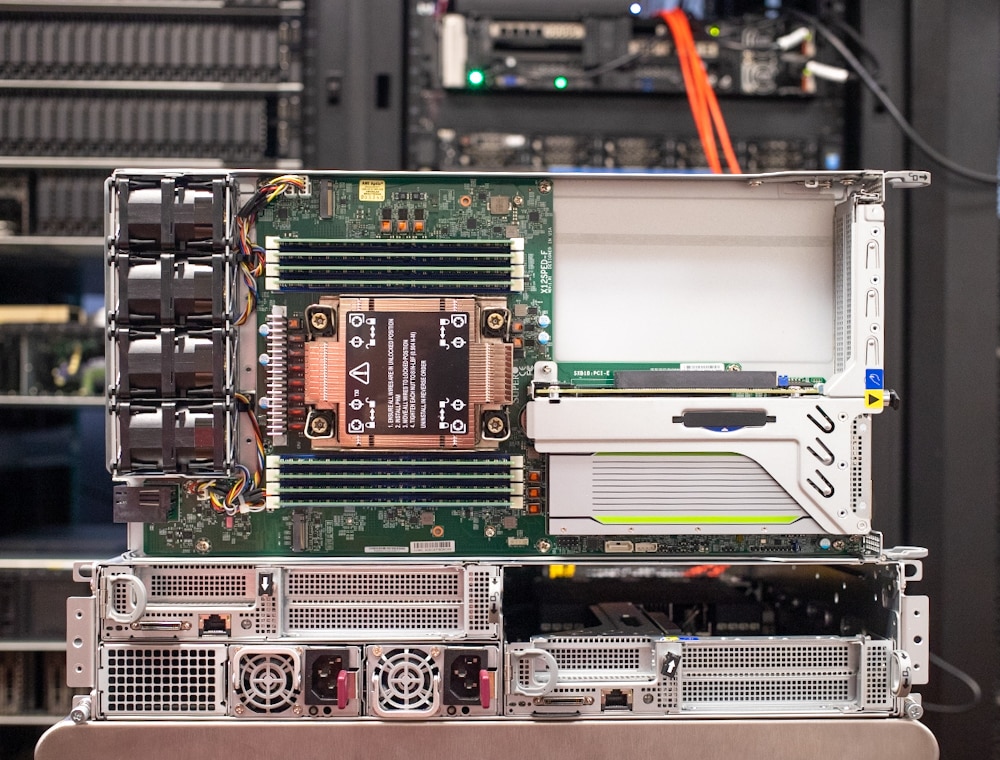
T4の70ワットプロファイルは、すべての電力をPCIeスロットから供給することを意味します。Turingアーキテクチャは、CPUでは実現できないFP32、FP16、INT8、INT4の精度性能を大幅に向上させるテンソルコアを搭載しています。NVIDIA A2は、40Wから60Wとやや低いプロファイルですが、より新しく効率的なアーキテクチャを採用しています。両カードの比較については、Lenovo ThinkEdge SE450でテストしたエッジ推論に関する記事をご覧ください。
私たちは MLPerf Inference: Edge ベンチマーク スイートを使用して作業しています。これは、現実世界のさまざまなエッジ シナリオで人気のある DL モデルの推論パフォーマンスを比較します。私たちのテストでは、質問応答タスク用の ResNet50 画像分類モデルと BERT-Large NLP モデルの数値が得られました。どちらもオフラインおよびシングルストリーム構成で実行されます。
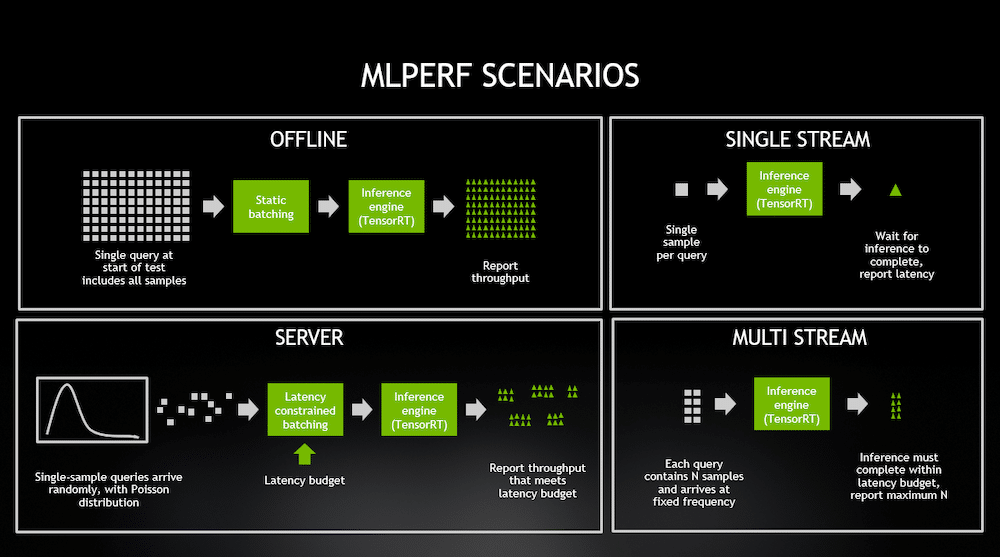
オフライン シナリオでは、すべてのテスト データがすぐに利用可能であり、待ち時間は考慮されない「バッチ モード」で推論パフォーマンスを評価します。このタスクでは、推論スクリプトはテスト データを任意の順序で処理でき、目標は 1 秒あたりのクエリ数 (QPS=スループット) を最大化することです。 QPS 数値が高いほど優れています。
対照的に、シングル ストリーム構成では、一度に 50 つのテスト サンプルが処理されます。単一の入力 (ResNet90 の場合、入力は単一の画像) で推論が実行されると、レイテンシが測定され、次のサンプルが推論ツールで使用できるようになります。目標は、各クエリを処理する待ち時間を最小限に抑えることです。遅延が短いほど良いです。クエリ ストリームの XNUMX パーセンタイル レイテンシーは、簡潔にするためのターゲット メトリックとしてキャプチャされます。
下の画像は、NVIDIAのブログ記事「MLPerf推論0.5」からのもので、様々なシナリオを非常に分かりやすく視覚化しています。様々なシナリオの詳細については、こちらのMLPerf推論に関する原文をご覧ください。
SuperMicro IoT SuperServer SYS-210SE-31A 内の XNUMX つのノードで動作するワークロードをテストしました。 XNUMX 番目のノードはスペアとして設定されました。
| ベンチマーク | ノード 1 (NVIDIA T4) | ノード 3 (NVIDIA T4) |
| RestNet50 オフライン | 5,587 サンプル/秒 | 5,492 サンプル/秒 |
| BERT シングルストリーム | 6.8ミリ秒(90ミリ秒)th パーセント) | 7.0ミリ秒(90ミリ秒)th パーセント) |
| BERT オフライン | 397 サンプル/秒 | 396 サンプル/秒 |
NVIDIA T4 は全体的に印象的でした。ノード 1 はわずかに優れたパフォーマンスを示しました。とはいえ、T4 は新しい A2 よりも高い電力プロファイルを備えた古いカードです。 ThinkEdge SE2 で A450 をテストしたところ、消費電力がはるかに少なく、特定の箇所では T4 よりも遅延が低いことがわかりました。アプリケーションと電力を考慮して、どちらを選択するかを決定する必要があります。ただし今のところ、Supermicro シャーシがこの種のワークロードに対応できる密度には満足しています。
最終的な考え
エッジへの競争は、エッジ コンピューティングに急速な進歩をもたらします。 GPU、特に NVIDIA T4 や新しい A2 などのロープロファイル、低電力オプションほどそれが顕著に表れるところはありません。私たちは、汎用性の高い 4 ノード エッジ サーバーである SuperMicro IoT SuperServer SYS-210SE-31A で TXNUMX をテストしました。
T4 は優れたパフォーマンスを示しましたが、その年齢を考慮するとさらに印象的です。ただし、A2 よりも少し多くの電力を消費するため、エッジ推論のニーズに応じて賢明に選択してください。エッジ主導の企業が GPU 使用率の最適化を続ける中、この由緒ある GPU にはまだその寿命の多くが残されていると予想されます。
さらに、Supermicro IoT サーバーは、これらのカードを処理するための十分な装備を備えており、エッジで非常に高密度の推論パフォーマンスを実現します。


 Amazon