

Lenovo ThinkSystem SR650 V4は、クラウドサービス、通信、ハイパフォーマンスコンピューティング(HPC)などの業界のニーズを満たすように設計された、柔軟でパワフルな2ソケット2Uラックサーバーです。スケールアウト型ワークロードの最適化や、高密度コンピューティングによるデータセンターの将来性確保など、SR650 V4は前モデルSR650 V3から大幅なアップグレードを実現しています。

Lenovo SR650 V4 と SR650 V3 の違い
プロセッサ
SR650 V4における最も大きなアップグレードの一つは、プロセッサ性能です。SR650 V3は第4世代インテル Xeon スケーラブル・プロセッサーを採用していましたが、SR650 V4ではインテル Xeon 6 プラットフォーム(旧コードネーム「Granite Rapids」)を採用しています。今回のレビューでは、特に計算負荷の高いワークロード向けに設計されたPコア(パフォーマンス・コア)アーキテクチャに焦点を当てています。V4は、1基または2基のプロセッサをサポートし、ソケットあたり最大86基のPコア(最大172スレッド)を搭載することで、より高いコア速度(最大4GHz)と最大350WのTDPを実現しています。
この移行により、組織はサーバー1台あたりの処理能力がより高まるため、物理的な設置面積を削減できます。このアーキテクチャは、仮想化と高負荷のデータベース処理のための堅牢な基盤を構築します。さらに、V4のアーキテクチャは、プロセッサあたり最大88レーンのPCIe 5.0レーンという広大なPCIe帯域幅をサポートし、最新の高速ネットワークアダプターやNVMeストレージアレイにボトルネックなくデータを供給する上で不可欠です。
| CPUモデル | コア/スレッド | 基本周波数 | マックスターボ | L3キャッシュ | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6781P | 80 / 160 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6767P | 64 / 128 | 2.4 GHz | 3.9 GHz | 336 MB | 350 W |
| 6761P | 64 / 128 | 2.5 GHz | 3.9 GHz | 336 MB | 350 W |
| 6760P | 64 / 128 | 2.2 GHz | 3.8 GHz | 320 MB | 330 W |
| 6747P | 48 / 96 | 2.7 GHz | 3.9 GHz | 288 MB | 330 W |
| 6745P | 32 / 64 | 3.1 GHz | 4.3 GHz | 336 MB | 300 W |
| 6741P | 48 / 96 | 2.5 GHz | 3.8 GHz | 288 MB | 300 W |
| 6740P | 48 / 96 | 2.1 GHz | 3.8 GHz | 288 MB | 270 W |
| 6737P | 32 / 64 | 2.9 GHz | 4.0 GHz | 144 MB | 270 W |
| 6736P | 36 / 72 | 2.0 GHz | 4.1 GHz | 144 MB | 205 W |
| 6732P | 32 / 64 | 3.8 GHz | 4.3 GHz | 144 MB | 350 W |
| 6731P | 32 / 64 | 2.5 GHz | 4.1 GHz | 144 MB | 245 W |
| 6730P | 32 / 64 | 2.5 GHz | 3.8 GHz | 288 MB | 250 W |
| 6724P | 16 / 32 | 3.6 GHz | 4.3 GHz | 72 MB | 210 W |
| 6714P | 8 / 16 | 4.0 GHz | 4.3 GHz | 48 MB | 165 W |
| 6530P | 32 / 64 | 2.3 GHz | 4.1 GHz | 144 MB | 225 W |
| 6527P | 24 / 48 | 3.0 GHz | 4.2 GHz | 144 MB | 255 W |
| 6521P | 24 / 48 | 2.6 GHz | 4.1 GHz | 144 MB | 225 W |
| 6520P | 24 / 48 | 2.4 GHz | 4.0 GHz | 144 MB | 210 W |
| 6517P | 16 / 32 | 3.2 GHz | 4.2 GHz | 72 MB | 190 W |
| 6515P | 16 / 32 | 2.3 GHz | 3.8 GHz | 72 MB | 150 W |
| 6511P | 16 / 32 | 2.3 GHz | 4.2 GHz | 72 MB | 150 W |
| 6507P | 8 / 16 | 3.5 GHz | 4.3 GHz | 48 MB | 150 W |
| 6505P | 12 / 24 | 2.2 GHz | 4.1 GHz | 48 MB | 150 W |
メモリ
メモリに関しては、SR650 V4はV3の機能を大幅に向上させ、サブシステムのパフォーマンスを最大限に引き出しています。最大6400MHz(チャネルあたり1枚のDIMM)のDDR5メモリ速度をサポートし、前世代の4800MHzという制限から大幅に向上しています。システムは32個のDIMMスロット(プロセッサあたり16個)を備え、プロセッサあたり8つのメモリチャネルに配置されています。標準RDIMM、3DS RDIMM、そして帯域幅を大量に消費するアプリケーション向けに最大8000MHzで動作可能な新しいMultiplexed Rank DIMM(MRDIMM)をサポートしています。256GBの3DS RDIMMを使用することで、このサーバーは合計8TBという大容量のシステムメモリをサポートします。

さらに、V4ではCXL 2.0(Compute Express Link)メモリ拡張のサポートが導入されました。管理者は、E3.Sドライブベイ(特にE3.S 2Tフォームファクタ)に最大12個のCXLメモリモジュールを搭載できます。これにより、システムは従来のプロセッサ接続の限界を超えてメモリ容量と帯域幅を拡張でき、次世代ワークロードの計算レイテンシを削減し、メモリの無駄を減らすことで総所有コスト(TCO)を削減できます。
Storage
Lenovo SR650 V4のストレージ機能は、高性能NVMe密度と柔軟なフォームファクターへの移行を体現しています。従来の3.5インチおよび2.5インチドライブをサポートする一方で、V4はE3.S NVMeフォームファクターを強力にサポートします。システムは最大32台のE3.S 1Tドライブまたは12台のE3.S 2Tドライブを搭載でき、従来のU.2 SSDと比較して高密度化と優れた熱管理を実現します。

重要なのは、V4がオーバーサブスクリプションなし(1:1)の直接NVMe接続をサポートしていることです。これにより、PCIeレーン共有による高速ストレージのボトルネックが回避されます。M.2ホットスワップ対応ブートドライブオプションも搭載されているため、保守性はさらに向上します。
Networking
ネットワークに関しては、SR650 V4は2つの専用OCP 3.0スロットを搭載し、どちらもPCIe Gen 5 x16をサポートしています。これは重要なアップグレードであり、標準のPCIeライザースロットを消費することなく、冗長化された高速ネットワーク(例:デュアルポート200GbEまたはシングルポート400GbE)を実現します。PCIe 5.0への移行により、理論上の帯域幅が2倍になり(32GT/s vs. 16GT/s)、V4は最も要求の厳しいクラウドおよびAIネットワークトラフィックを処理できるようになります。

電源と冷却
SR650 V4は、800Wから3200Wまでの電源オプションを拡充し、TitaniumおよびPlatinumの効率レベルからお選びいただけます。また、-48V DCおよびHVAC/HVDCオプションもサポートしており、データセンターの特定の要件にも対応します。

高TDPプロセッサとメモリからの熱を管理するため、LenovoはNeptune液冷オプションを導入しました。「Compute Complex Neptune Core Module」は、オープンループ液冷方式を採用し、プロセッサ、メモリ、電圧レギュレータから熱を除去します。これにより、サーバーの熱の80%以上を回収し、データセンターの冷却コストを大幅に削減できます。
全体として、SR650 V4 は、現代のエンタープライズ環境において、パフォーマンス、密度、熱効率の面で大きな飛躍をもたらします。
Lenovo ThinkSystem SR650 V4 仕様
| 製品仕様 | Details |
|---|---|
| システム仕様 | |
| フォームファクター | 2Uラック |
| プロセッサ | 最大 2 基の Intel Xeon 6700/6400 シリーズ (P コア)、CPU あたり最大 86 コア、最大 350W TDP |
| メモリ | 32個のDIMMスロット(プロセッサあたり16個); 最大6400MHzのTruDDR5 RDIMMと最大8000MHzのMRDIMMをサポート |
| メモリ拡張 | E3.S 2T フォーム ファクタで CXL 2.0 メモリ モジュールをサポート (最大 12 個の DIMM) |
| メモリ最大 | 最大 8TB のシステム メモリ (256GB 3DS RDIMM を使用) |
| ディスクドライブベイ | フロント: 最大24x 2.5インチNVMe/SAS/SATA、16x 3.5インチSAS/SATA、または32x E3.S NVMe 中: 最大8個の2.5インチシンプルスワップ リア: 最大8x 2.5インチまたは4x 3.5インチのホットスワップ |
| ストレージコントローラー | 最大36個のオンボードNVMeポート(1:1接続); RAID/HBAサポート |
| ネットワークインターフェイス | PCIe 5.0 x16 ホスト インターフェースを備えた 2 つの OCP 3.0 SFF スロット |
| PCI拡張スロット | 最大 10 個の PCIe 5.0 スロット (背面)、オプションの前面 PCIe スロット |
| GPUのサポート | 最大 10 個のシングル幅 GPU または 2 個のダブル幅 GPU |
| ポート | フロント: 外部診断ポート、オプションのUSB、およびMini-DP リア: USB 3.0 x 2、VGA x 1、RJ-45管理 x 1、シリアル(オプション) |
| 冷却 | 最大6個のホットスワップファン(N+1冗長性); オプションのNeptune液体冷却モジュール |
| 電源 | 最大2台のホットスワップ冗長AC/DC電源(800W~3200W) |
| システム管理 | XClarity コントローラ 3 (XCC3); オプションの XCC3 Premier |
| セキュリティ機能 | TPM 2.0、PFR Root of Trust(NIST SP800-193)、シャーシ侵入、ロック可能なベゼル |
| オペレーティングシステム | Microsoft Windows Server、RHEL、SLES、Ubuntu Server |
| 保証 | 3年間の基本保証(構成可能) |
| 寸法 | 高さ87mm(3.4インチ)×幅440mm(17.3インチ)×奥行き800mm(31.5インチ) |
| 重量 | 最大重量: 38.8 kg (85.5 ポンド) |
Lenovo ThinkSystem SR650 V4 の設計と構築
Lenovo ThinkSystem SR650 V4は、標準的な2Uプラットフォームで、物理的な筐体を効率的に活用し、コンポーネント密度とエアフロー、そして保守性のバランスをとっています。シャーシの寸法は高さ3.4インチ(約8.3cm)、幅17.3インチ(約48cm)、奥行き31.5インチ(約88cm)で、最大構成時の重量は85.5ポンド(約38kg)です。これらの寸法は、他の2Uエンタープライズサーバーとほぼ同等でありながら、高性能CPU、高密度メモリ構成、そして柔軟なストレージバックプレーンを搭載するのに十分な奥行きを確保しています。
Lenovoの定評あるThinkSystemのインダストリアルデザインは、堅牢なスチール製シャーシと明確で機能的なラベルによって、一目でそれと分かります。内部レイアウトはすっきりとしており、ストレートスルーエアフロー、モジュール式コンポーネントゾーン、そして日常的なメンテナンスのための工具不要のアクセスを重視しています。全体的な構造は堅牢で精巧に設計されており、見た目の美しさよりもデータセンター環境での継続的な運用を念頭に設計されたプラットフォームを反映しています。
フロントパネル
フロントパネルは柔軟に構成可能です。テストシステムには8ベイの2.5インチドライブバックプレーンが搭載されていますが、シャーシは最小限の労力で16ベイ、さらには24ベイまで容易に拡張できます。お客様は、より高い物理容量を求める3.5インチベイや、高性能NVMe密度を求める新しいE3.Sバックプレーンオプションを選択することもできます。AnyBayサポートにより、SAS、SATA、NVMeドライブを同じドライブケージ内に共存させることができ、混在ストレージ環境において高い柔軟性を実現します。

フロントパネルには、電源ボタン、IDボタン、そしてシステムの健全性とネットワークアクティビティを示すステータスLEDといった、オペレータにとって必須の操作ボタンが搭載されています。引き出し式の情報タブからは、XCCネットワークアクセスラベルとシリアル番号に簡単にアクセスできます。オプションのローカル接続機能として、Mini DisplayPortとUSBポートが用意されており、クラッシュカートアクセスが可能です。これは、「無人運転」データセンターにおけるトラブルシューティングに非常に役立ちます。
後面パネル
シャーシ背面は最大限のI/O密度を実現するよう設計されています。ライザー構成に応じて、最大10個のPCIe Gen 5スロットを搭載できます。OCP 3.0スロットを2つ搭載することで、標準PCIeライザーをGPUやストレージコントローラーなどのアドインカードに使用できます。
拡張性に加え、背面パネルにはオンボードBMC管理ネットワークポート、2つのUSB-Aポート、そしてローカルコンソールアクセス用のVGA出力が搭載されています。背面にはホットスワップ対応のデュアル電源が搭載されており、エアフローや拡張レイアウトに影響を与えることなく、保守性を維持します。
インナー
内部レイアウトはすっきりとしており、エアフローが最適化されています。32個のDIMMスロットはデュアルCPUソケットの両側に配置され、シャーシ前面に搭載された6基の高性能ホットスワップファンからの冷却を妨げずに前面から背面までスムーズに送風します。ファンは工具不要で簡単に交換でき、ファントレイ全体も工具なしで取り外し可能です。トレイを取り外すことで、AnyBayストレージエリアに直接アクセスできるため、メンテナンス、アップグレード、バックプレーンの変更が容易になります。

ストレージケーブルは、CPUとメモリへのエアフローを妨げないよう、シャーシ側面に沿ってすっきりと配線されています。Neptune水冷モジュールを使用した構成では、冷却ループに対応するため内部レイアウトが若干変更されますが、コア部分の保守性は高いままです。M.2ブートドライブモジュールはエアバッフルまたはドライブケージに搭載されているため、他のコンポーネントを取り外すことなく簡単にアクセスできます。
XClarity コントローラー 3
SR650 V4は、新しいXClarity Controller 3(XCC3)を搭載しています。この管理エンジンは、前世代と比べて大幅なパフォーマンス向上を実現し、起動時間の短縮とHTML5インターフェースの応答性向上を実現しています。プラットフォーム・リソース・マネージャーは、電力と温度に関する詳細なテレメトリを提供し、管理者がデータセンターの効率を最適化するのに役立ちます。
XCC3は、リモートコントロール(KVM)、仮想メディアのマウント、ファームウェアアップデートなど、幅広いリモート管理機能をサポートしています。直感的なインターフェースで、システムの健全性、アクティブなイベント、ハードウェアインベントリをダッシュボードで確認できます。自動化のために、XCC3はRedfish REST APIを完全にサポートしています。
レノボ ThinkSystem SR650 V4 のパフォーマンス
このセクションでは、Blender、y-cruncher、vLLM、Phoronixのベンチマーク結果を検証します。初期テストは、Intel Xeon 6740Pプロセッサーを搭載したLenovo ThinkSystem SR650 V4で実施し、プラットフォームのパフォーマンス重視のPコアアーキテクチャと、CPU依存のワークロードにおける全体的なスループットを評価しました。レビューの途中で、システム構成を調整し、GPUアクセラレーションテストを可能にしました。LenovoのGPU有効化アップグレードキット(高性能ファン、アップグレードされたヒートシンク、改良されたエアフローシュラウド、高出力アクセラレータをサポートするように設計されたGPU対応ライザーを含む)のおかげで、移行はスムーズに進みました。インストールにはシャーシの大幅な変更は必要なく、既存のシステムレイアウトにスムーズに統合されました。
アップグレードされた冷却およびエアフローコンポーネントを搭載し、プラットフォームにNVIDIA L40S GPUを1基追加しました。これにより、安定した熱管理と一貫したシステム動作を維持しながら、Blender GPUレンダリングや推論重視のベンチマークといったGPUアクセラレーションワークロードを含むテスト範囲を拡大することができました。モジュール式のアップグレードはSR650 V4の柔軟性を際立たせ、効率重視のCPU構成から、混合コンピューティングワークロードに適したバランスの取れたCPU+GPUプラットフォームへと容易に移行できます。
Lenovo ThinkSystem SR650 V4 構成:
- CPU: インテル Xeon 6740P 2基
- メモリ: 1TB RAM
- ストレージ: 4 x 960GB SSD
- GPU: NVIDIA L40S
ブレンダー4.5
Blenderはオープンソースの3Dモデリングアプリケーションです。このベンチマークはBlenderベンチマークユーティリティを使用して実行されました。スコアはXNUMX分あたりのサンプル数で測定され、値が高いほどパフォーマンスが優れていることを示します。
Blender CPUベンチマークにおいて、Lenovo ThinkSystem SR650 V4は、すべてのシーンで安定したレンダリング性能を発揮し、Monsterで1分あたり1136.99サンプル、Junkshopで707.60、Classroomで562.53というスコアを記録しました。この結果は、デュアルIntel Xeon 6740Pプロセッサーによる強力なマルチスレッドスケーリングを反映しており、シーンの複雑さが増しても安定したパフォーマンスを発揮します。
| Blender CPU (1 分あたりのサンプル数。高いほど良い) | Lenovo ThinkSystem SR650 V4 (Intel Xeon 6740P 2基、1TB RAM) |
|---|---|
| モンスター | 1136.99 |
| ジャンクショップ | 707.60 |
| 教室 | 562.53 |
Blender CPU no SMTベンチマークにおいて、SR650 V4はレンダリングスループットが大幅に向上し、Monsterでは毎分4686.40サンプル、Junkshopでは毎分2223.96サンプル、Classroomでは毎分2385.98サンプルを記録しました。GPUの結果は、複雑なレンダリングワークロードを高速化するシステムの能力を浮き彫りにし、CPUのみのレンダリングと比較して大幅に高いスループットを実現しています。
| Blender CPU (SMT なし) (1 分あたりのサンプル数。高いほど良い) | Lenovo ThinkSystem SR650 V4 (Intel Xeon 6740P 2基、1TB RAM) |
|---|---|
| モンスター | 4686.40 |
| ジャンクショップ | 2223.96 |
| 教室 | 2385.98 |
yクランチャー
y-cruncherは、円周率をはじめとする数学定数を数兆桁まで計算する、マルチスレッド対応のスケーラブルなプログラムです。2009年のリリース以来、オーバークロッカーやハードウェア愛好家の間で人気のベンチマークおよびストレステストアプリケーションとなっています。
y-cruncherでは、Lenovoは問題サイズの増加に応じてスムーズにスケーリングし、プラットフォームの強力なマルチスレッド演算性能とメモリ帯域幅を際立たせています。デュアルIntel Xeon 6740Pプロセッサーと1TBのRAMを搭載したシステムは、1億桁の円周率計算をわずか20秒強で完了し、25億桁まで安定した効率を維持し、362秒かかりました。結果は、CPUとメモリへの負荷が持続する状況下でも予測可能なスケーリングを示しており、SR650 V4は高負荷の数学ワークロードやストレステストのシナリオに最適です。
| Y-Cruncher (総計算時間) | Lenovo ThinkSystem SR650 V4 (Intel Xeon 6740P 2基、1TB RAM) |
|---|---|
| 1億 | 20.715秒 |
| 2.5億 | 44.412秒 |
| 5億 | 81.937秒 |
| 10億 | 152.743 |
| 25億 | 362.566 |
vLLMオンラインサービングLLM推論パフォーマンス
vLLMは、LLM向けの最も普及している高スループット推論およびサービス提供エンジンです。vLLMオンラインサービス提供ベンチマークは、同時リクエスト下におけるこの推論エンジンの実世界におけるサービス提供能力を測定するパフォーマンス評価ツールです。このベンチマークは、リクエストレート、入出力長、同時クライアント数などの設定可能なパラメータを使用して、実行中のvLLMサーバーにリクエストを送信することで、実稼働ワークロードをシミュレートします。このベンチマークは、スループット(1秒あたりのトークン数)、最初のトークンまでの時間、出力トークンあたりの時間(TPOT)などの主要な指標を測定することで、ユーザーがさまざまな負荷条件下でのvLLMのパフォーマンスを理解するのに役立ちます。
さまざまなアーキテクチャ、パラメータスケール、量子化戦略にわたる包括的なモデルスイート全体で推論パフォーマンスをテストし、さまざまな同時実行プロファイルでのスループットを評価しました。
高密度モデルのパフォーマンス
密モデルは従来のLLMアーキテクチャに準拠しており、推論中にすべてのパラメータと活性化関数が使用されるため、スパースモデルよりも計算負荷が高くなります。モデルスケールと量子化戦略にわたるパフォーマンス特性を包括的に評価するため、Llama 3.1 8Bファミリーの複数の密モデル構成をベンチマークしました。
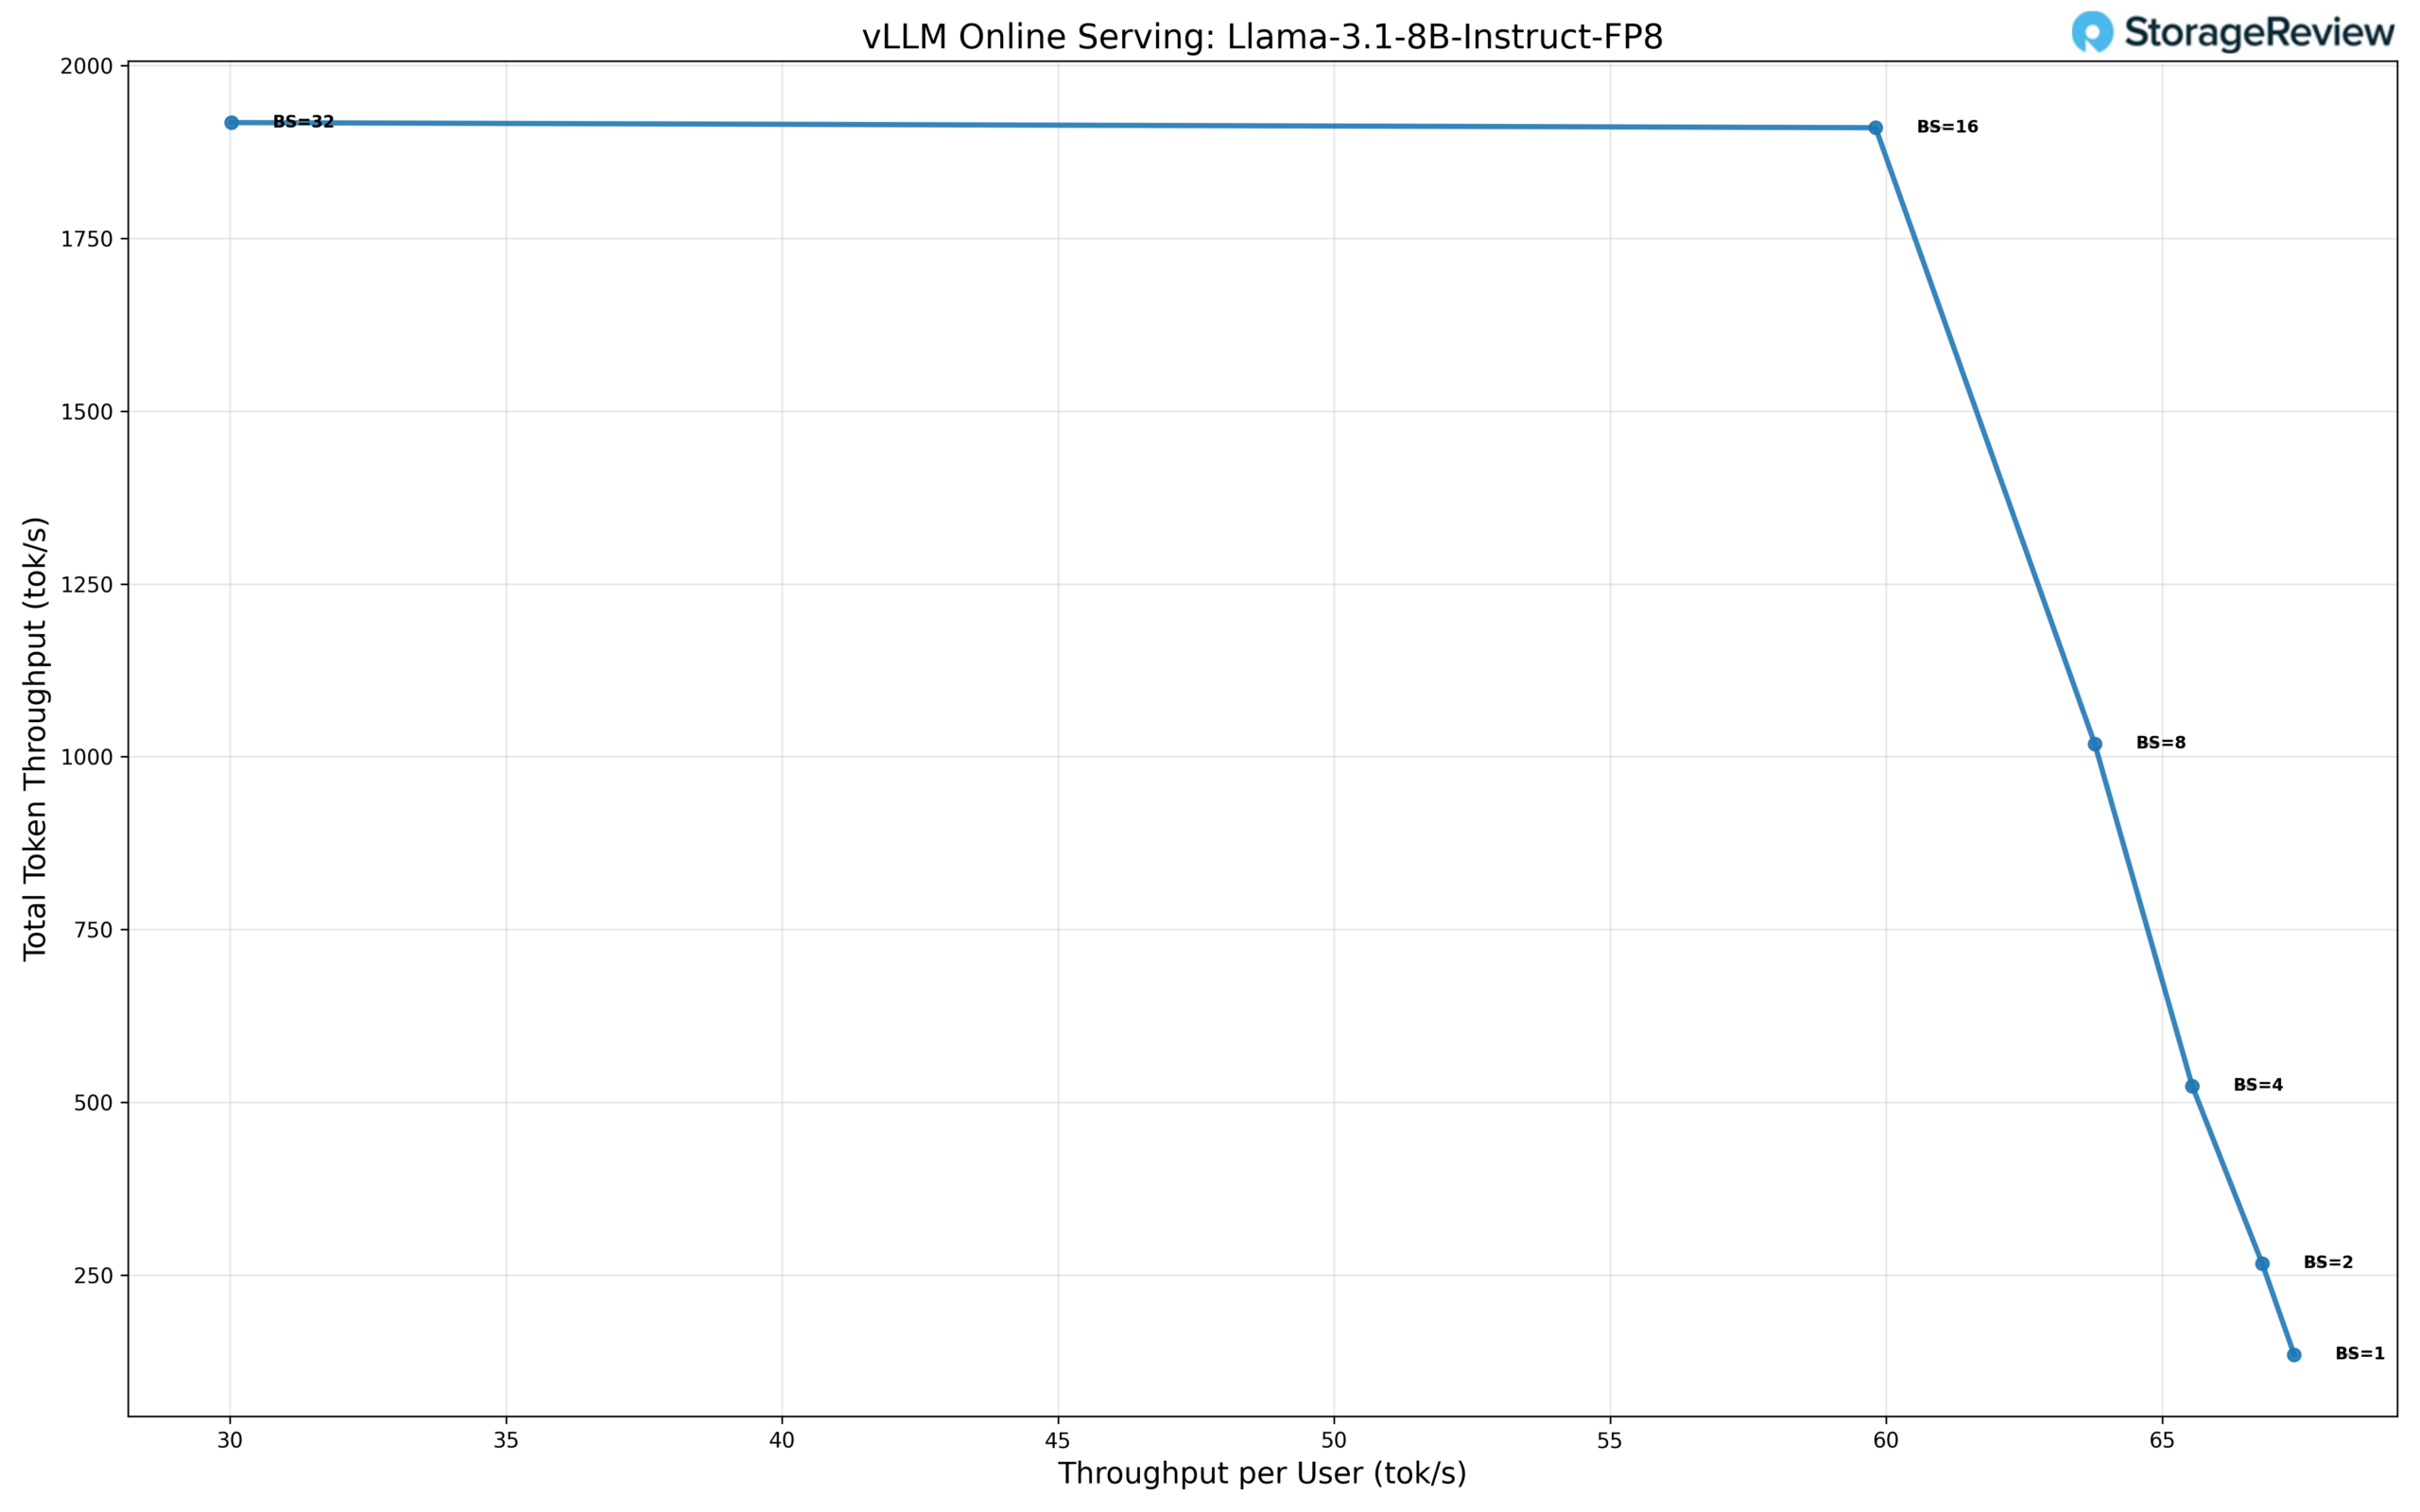
ラマ 3.1 8B プレシジョン FP8
FP8精度で動作するLlama 3.1 8Bモデルは、標準精度構成とは異なるスケーリングプロファイルを示し、中程度の同時実行レベルでの効率性を優先し、バッチサイズが大きい場合のピークスループットを犠牲にしています。シングルユーザー同時実行(BS=1)では、モデルはユーザーあたり67.8 tok/s、総スループットは135.6 tok/s、TPOTは約3.1ミリ秒を実現し、フル精度と比較してシングルストリームのベースラインが低くなっています。
バッチサイズが大きくなるにつれて、総スループットは急速に増大しますが、ユーザーあたりのスループットは制御された形で低下します。BS=2では、スループットは合計271 tok/sに増加し、ユーザーあたり66.8 tok/sとなります。BS=4では総スループットは523 tok/sに達し、BS=8では1,017 tok/s、ユーザーあたり63.6 tok/sを実現します。これらの低い同時実行レベルでもレイテンシは安定しており、FP8は軽量なマルチユーザー推論シナリオに適しています。
BS=16までスケーリングは継続し、モデルは総スループット1,918 tok/sを維持し、ユーザーあたりスループットは60.0 tok/sとなります。BS=32では、総スループットは約1,920 tok/sで横ばいとなり、ユーザーあたりスループットは30.0 tok/sまで低下します。この横ばい状態は、FP8構成が標準精度よりも早く飽和点に達し、最大総スループットよりも効率性と予測可能性を優先していることを示しています。
全体的に見ると、FP8はBS=1からBS=16-32のピークまで、総スループットを約14倍向上させます。レイテンシはBS=16までは一定ですが、その後は同時実行性が高まるにつれてスループットとともに平坦化します。これは、極端なバッチスケーリングではなく、バランスの取れたレイテンシに敏感な推論ワークロードにとって、FP8が実用的な選択肢であることを示しています。
ラマ 3.1 8B 標準精度
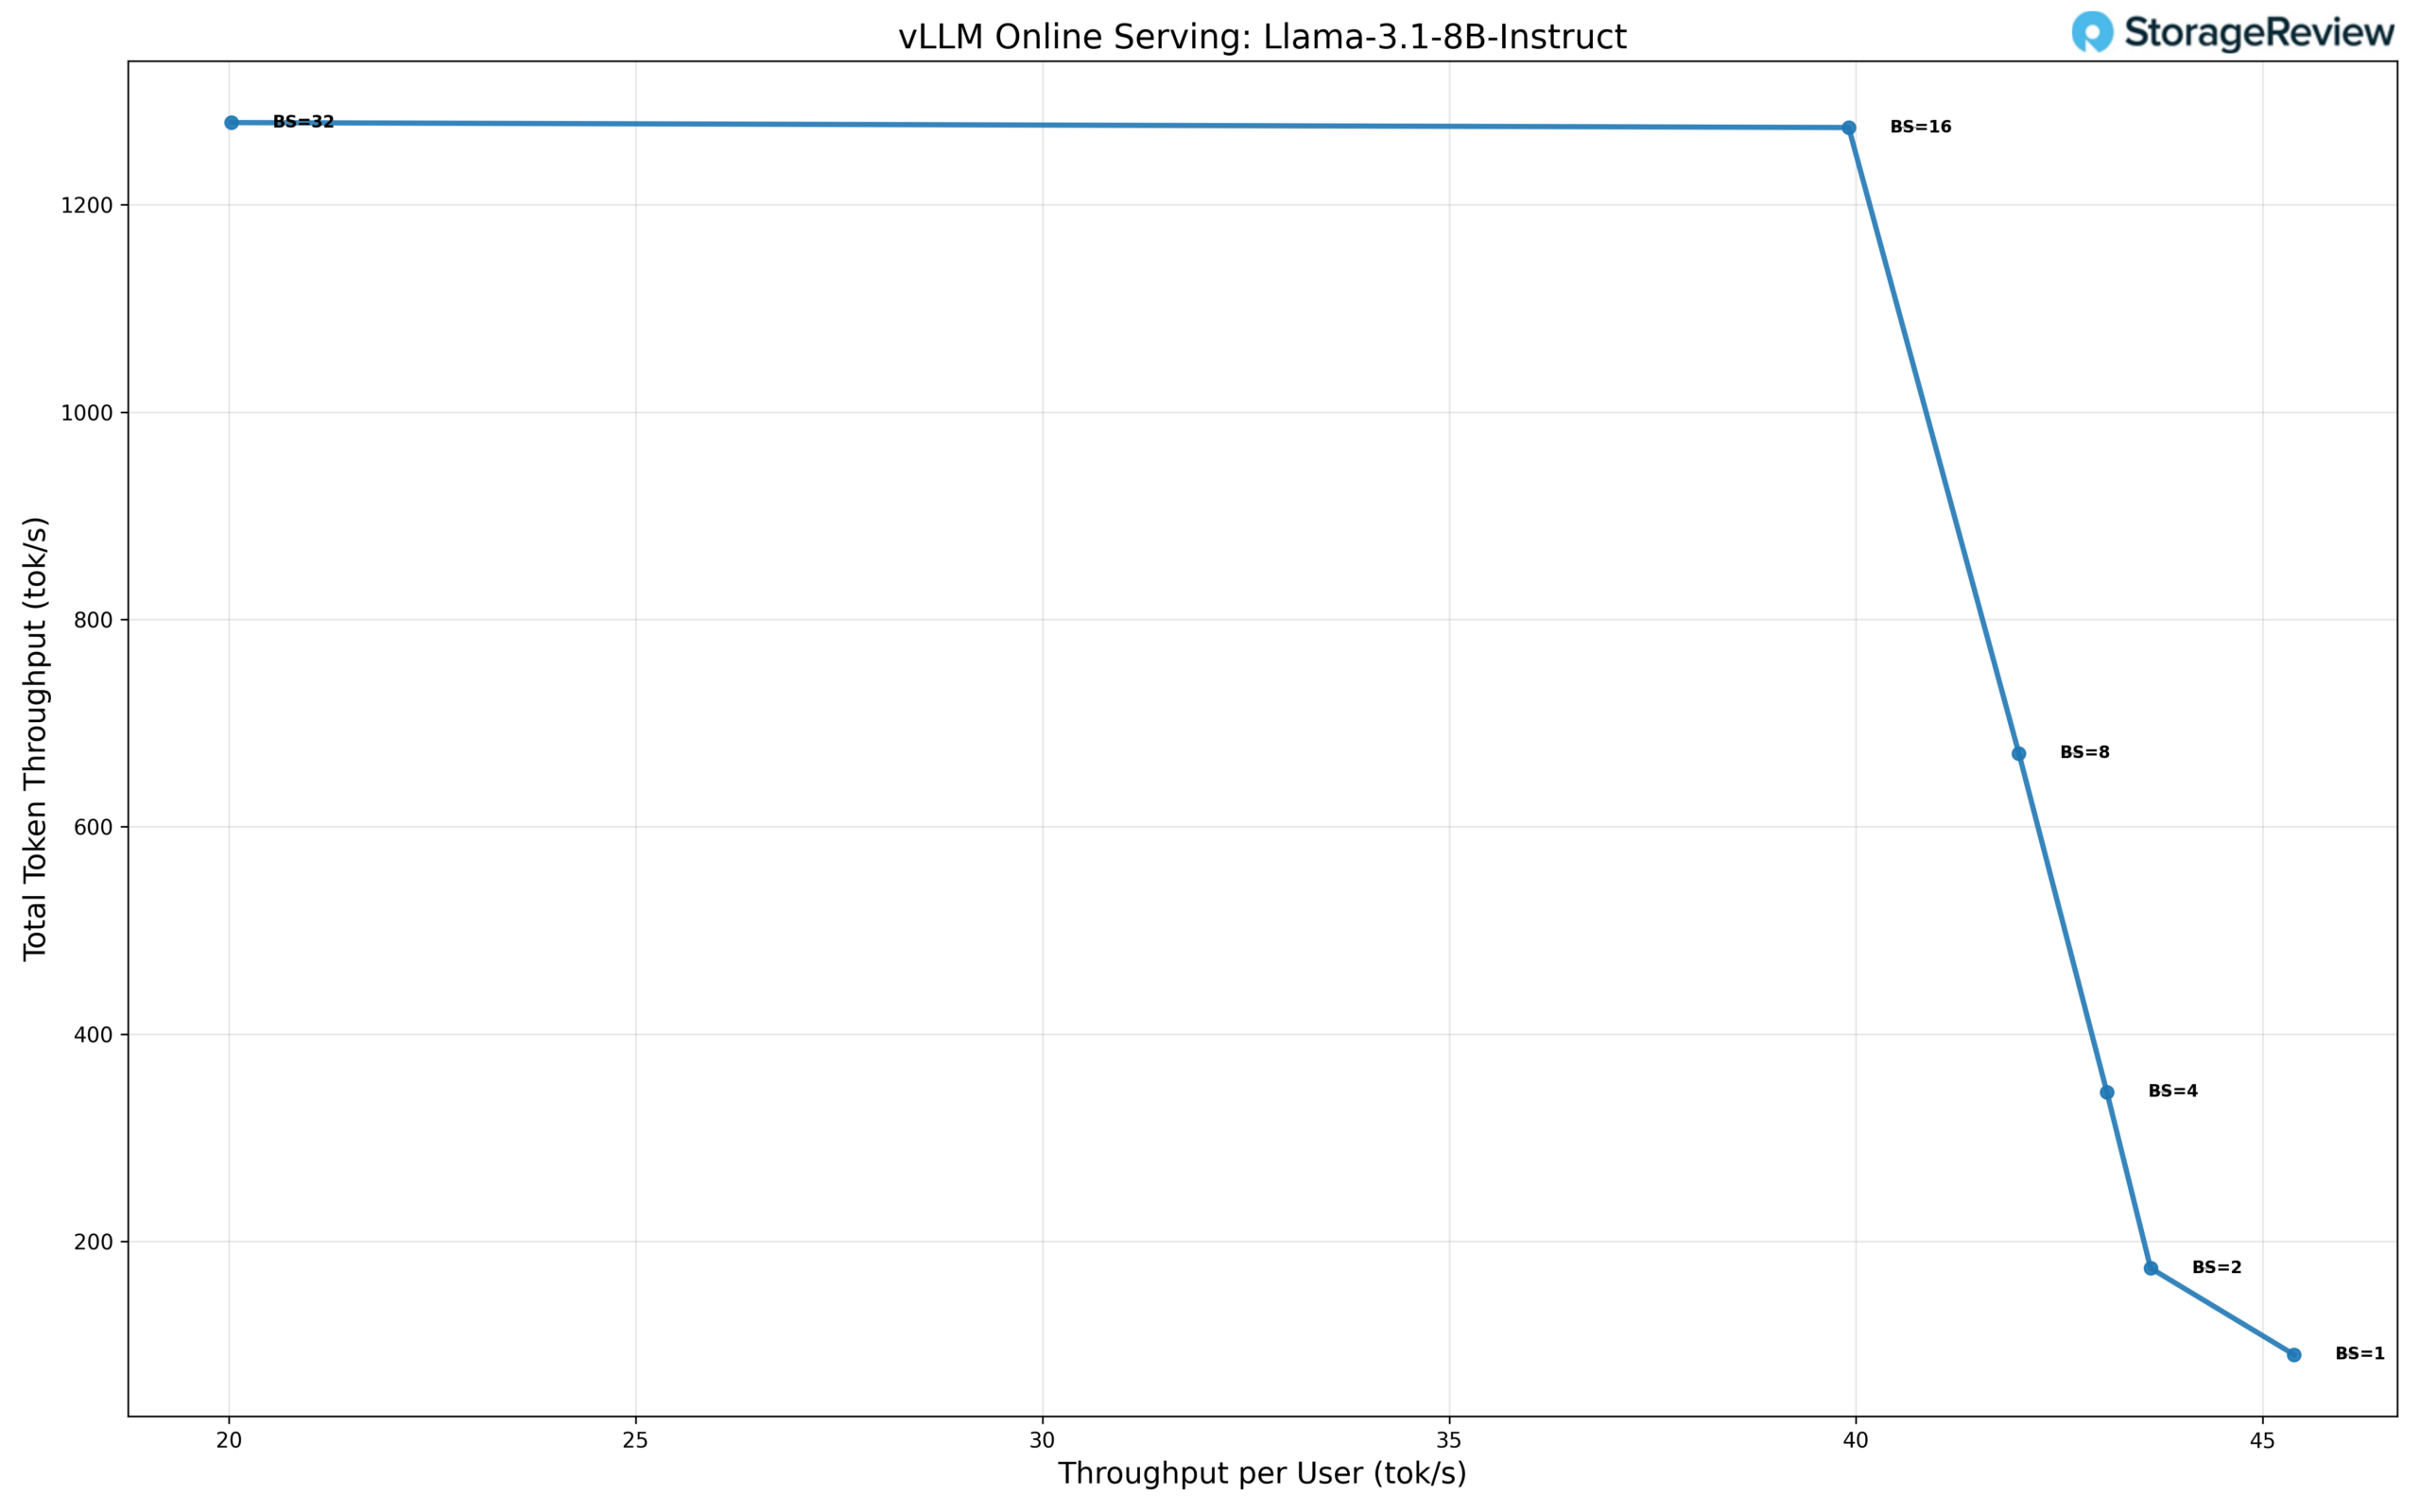
標準精度において、Llama 3.1 8Bモデルは、低い同時実行レベルにおいて予測可能なスケーリング挙動を示し、小さなバッチサイズではユーザーあたりのパフォーマンスが優れており、同時実行レベルが上昇するにつれて総スループットが着実に増加します。シングルユーザー動作(BS=1)では、このモデルはユーザーあたり約45.8 tok/sを実現し、総スループットは91.6 tok/sとなり、レイテンシに敏感なワークロードに対する確固たるベースラインを確立しています。
同時実行数が増加すると、総スループットは効率的に増加しますが、ユーザーあたりのスループットは徐々に低下します。BS=2では、総スループットは176 tok/sに増加し、ユーザーあたりのスループットは44.0 tok/sです。BS=4では、スループットは344 tok/sに達し、ユーザーあたりのスループットは43.0 tok/sです。この動作はBS=8まで続き、モデルは総スループット672 tok/s、ユーザーあたりのスループットは42.0 tok/sを維持します。これは、ユーザーあたりのスループットに大きな低下がなく、良好な利用率を示していることを示しています。
BS=16までスケーリングは継続し、総スループットは約1,280 tok/sでピークに達し、ユーザーあたりのスループットは40.0 tok/sとなります。BS=32では、総スループットは約1,280 tok/sで実質的に横ばいとなりますが、ユーザーあたりのスループットは20.0 tok/sまで低下し、実行パイプラインが飽和状態にあることを示しています。このプラトーは、標準精度では、モデルがBS=16付近で最適な動作点に達し、スループットと応答性のバランスが取れていることを示唆しています。
全体として、標準精度はBS=1からピーク時にかけて総スループットを約14倍向上させ、中程度の同時実行レベルにおいてユーザーあたりのパフォーマンスを安定させます。このプロファイルにより、標準精度は、積極的なバッチ拡張よりも一貫したレイテンシと予測可能なスケーリングを優先するデプロイメントに最適です。
スパースモデルのパフォーマンス
スパースモデル、特にMixture of Experts(MoE)アーキテクチャは、言語モデルを効率的にスケーリングするための新たなアプローチです。これらのアーキテクチャは、トークンごとにパラメータのサブセットのみをアクティブ化しながら、総パラメータ数を多く維持するため、アクティブパラメータあたりのパフォーマンスが向上する可能性があります。
Qwen3-Coder-30B-A3B FP8 パフォーマンス
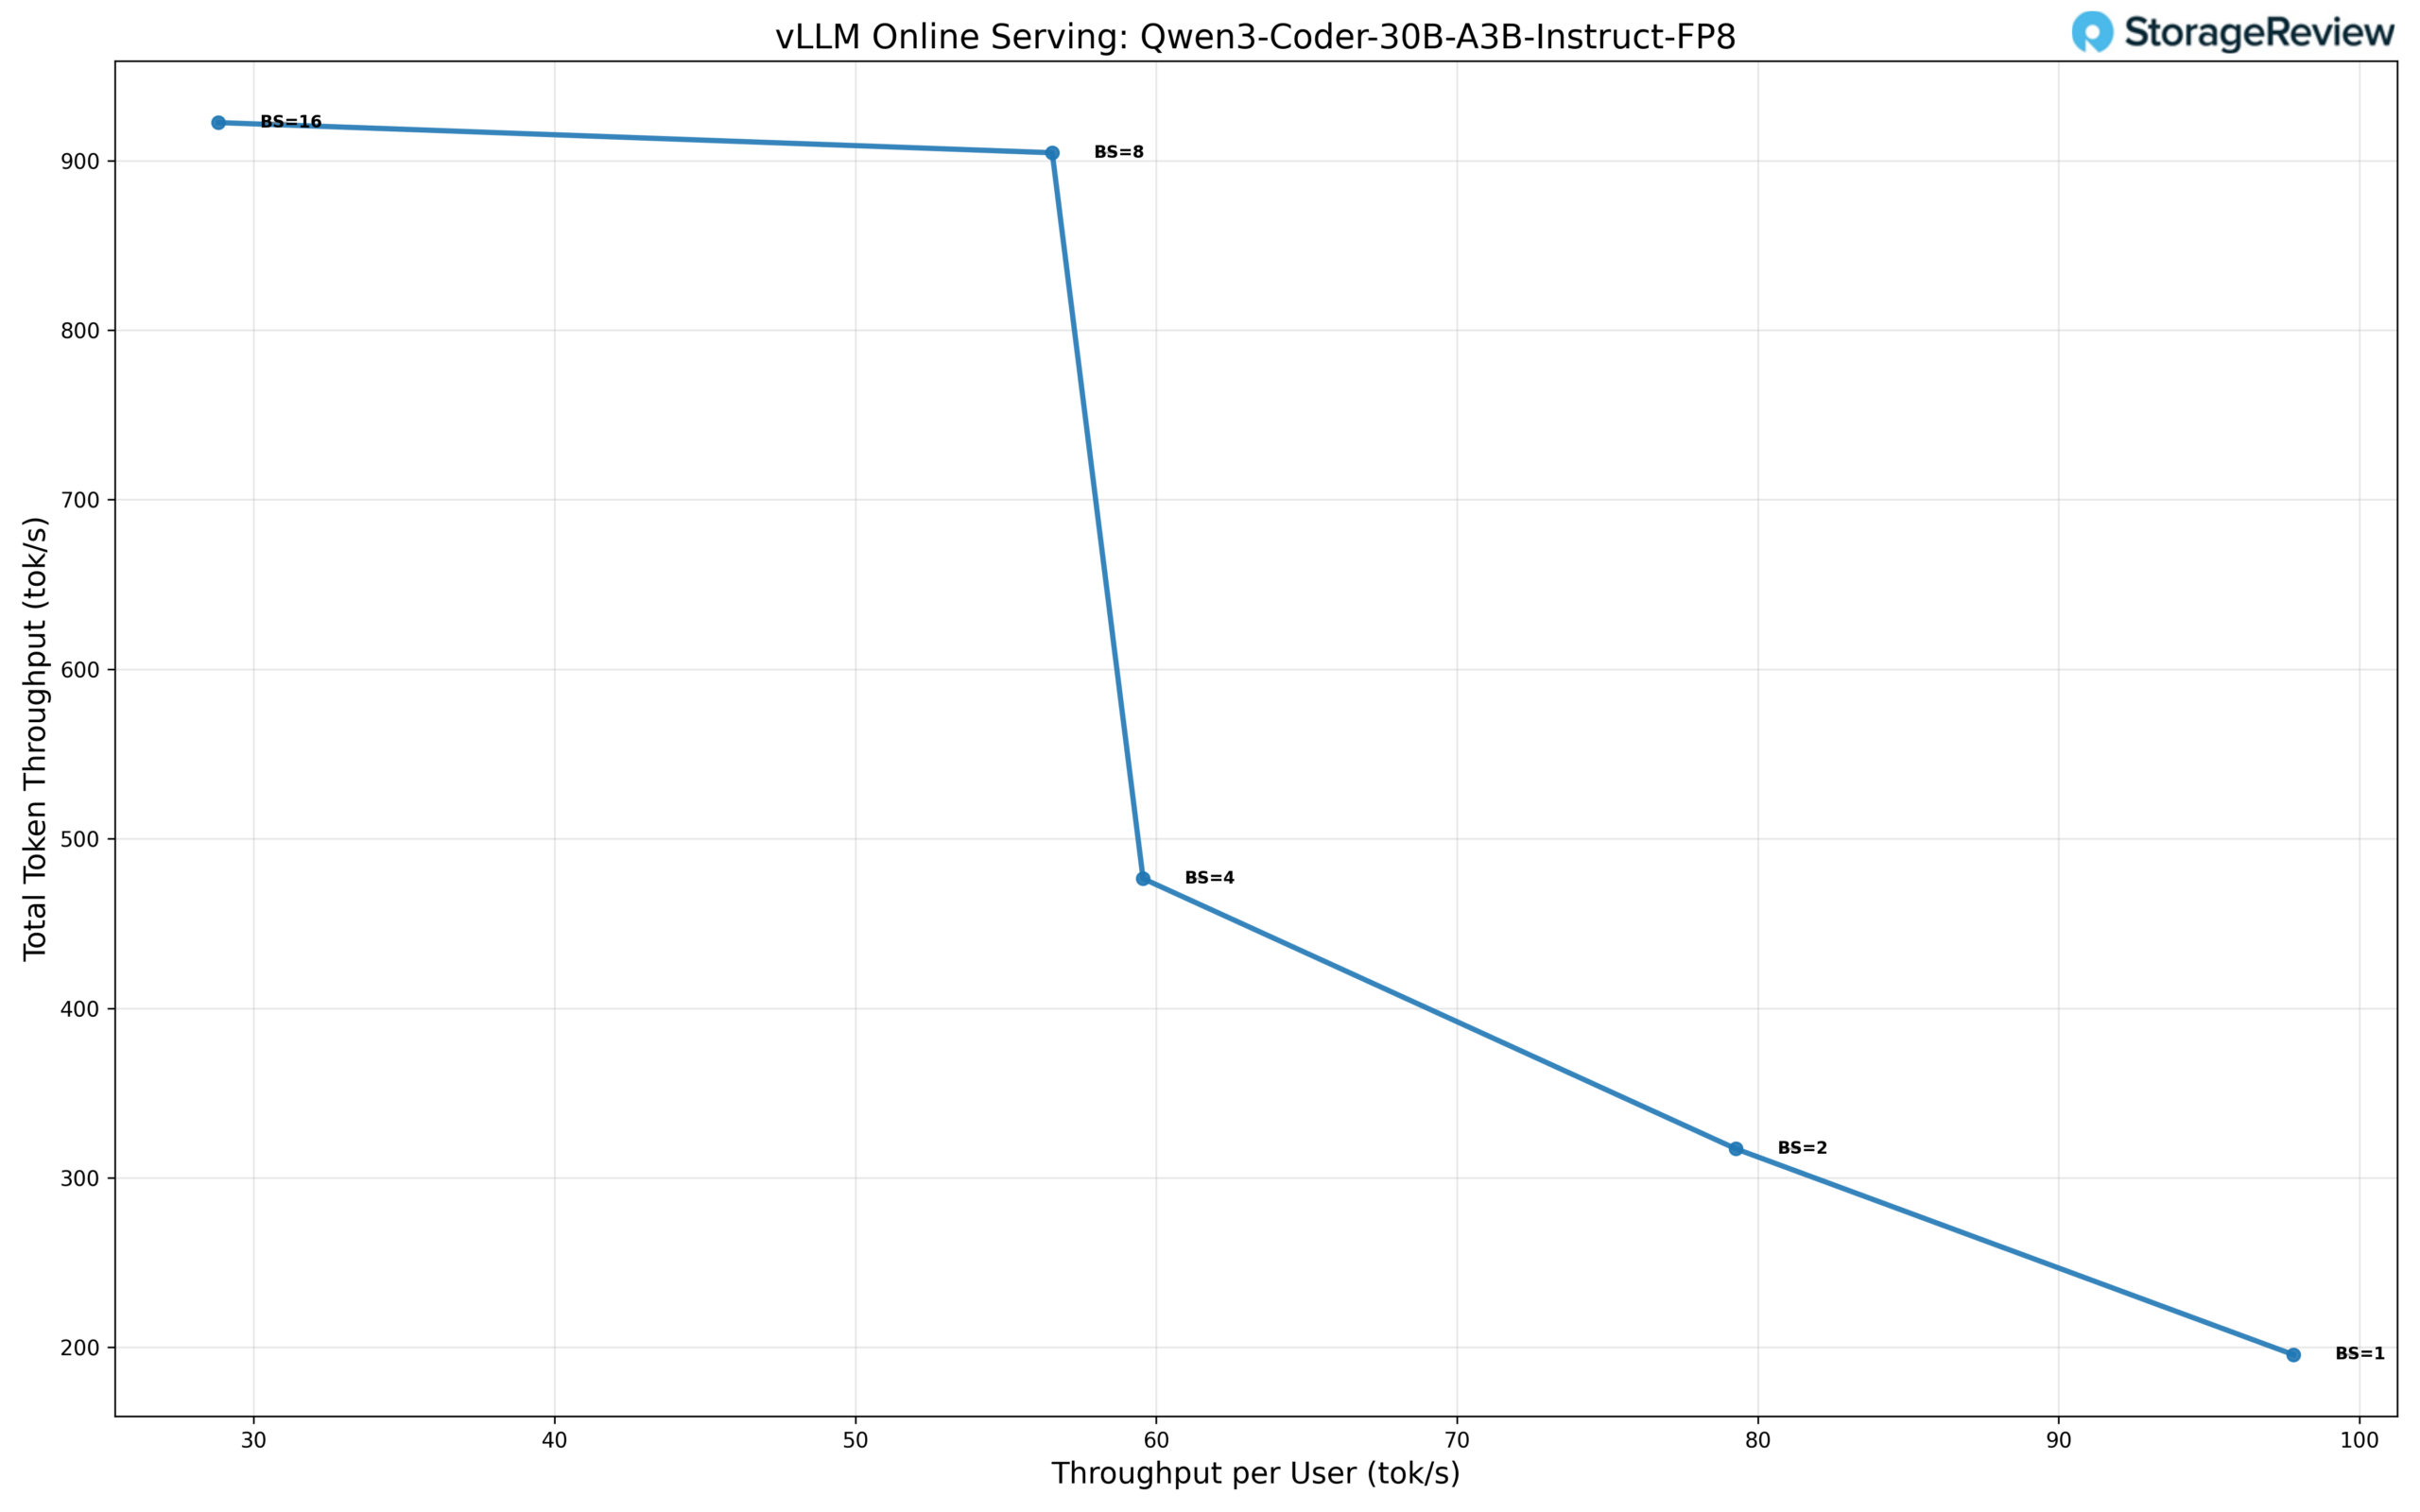
FP8精度で動作するQwen3-Coder-30B-A3Bモデルは、中程度の同時実行性に最適化されたスケーリングプロファイルを示し、ユーザーあたりの高いパフォーマンスを実現しながら、小規模なモデルよりも早く飽和に達します。シングルユーザー動作(BS=1)では、モデルはユーザーあたり約98 tok/s、総スループット196 tok/sを達成し、コード生成ワークロードへのモデルの最適化を反映した高いシングルストリームベースラインを確立しました。
同時実行性が高まるにつれて、総スループットは効率的にスケールする一方で、ユーザーあたりのスループットは制御された形で低下します。BS=2では、総スループットは317 tok/sに上昇し、ユーザーあたりのスループットは79 tok/sです。BS=4では、モデルは総スループット477 tok/s、ユーザーあたりのスループットは59 tok/sです。これらの結果は、低~中程度のバッチ処理によって、ユーザーあたりの応答性が急激に低下することなく、利用可能なコンピューティングリソースを効果的に活用していることを示しています。
モデルはBS=8で総スループットのピークに達し、約905 tok/sのスループット(ユーザーあたり56 tok/s)を維持します。BS=16までわずかにスケーリングが続き、ここで総スループットはわずかに増加して920 tok/sになりますが、ユーザーあたりのスループットは29 tok/sに低下し、推論パイプラインが飽和状態にあることを示します。この時点を超えると、同時実行性を追加しても総スループットの向上は最小限にとどまりますが、ユーザーあたりのパフォーマンスには大きな影響を及ぼします。
全体として、Qwen3-Coder-30B-A3B FP8は、BS=1からBS=16のピークまで、総スループットを約4.7倍向上させます。レイテンシとスループット特性から、この構成は、リクエストごとの高いパフォーマンスが求められる中程度のマルチユーザーコーディングワークロードに最適です。ただし、極端なバッチスケーリングは主な目的ではありません。
マイクロスケーリングデータ型パフォーマンス
マイクロスケーリングは、大規模なパラメータグループ全体にわたる均一な量子化ではなく、小さな重みブロックにきめ細かなスケーリング係数を適用する高度な量子化手法です。NVIDIAのNVFP4フォーマットは、この手法をブロック化浮動小数点表現によって実装します。8~32個の値からなるマイクロスケールブロックごとに、スケーリング係数として典型的な指数を共有します。このきめ細かなアプローチは、数値精度を維持しながら4ビット表現を実現し、Transformerアーキテクチャに不可欠なダイナミックレンジを維持します。このフォーマットはNVIDIAのTensor Coreアーキテクチャと統合されており、行列演算中にオンザフライで展開することで、効率的な混合精度計算を可能にします。
GPT-OSS-20b のパフォーマンス
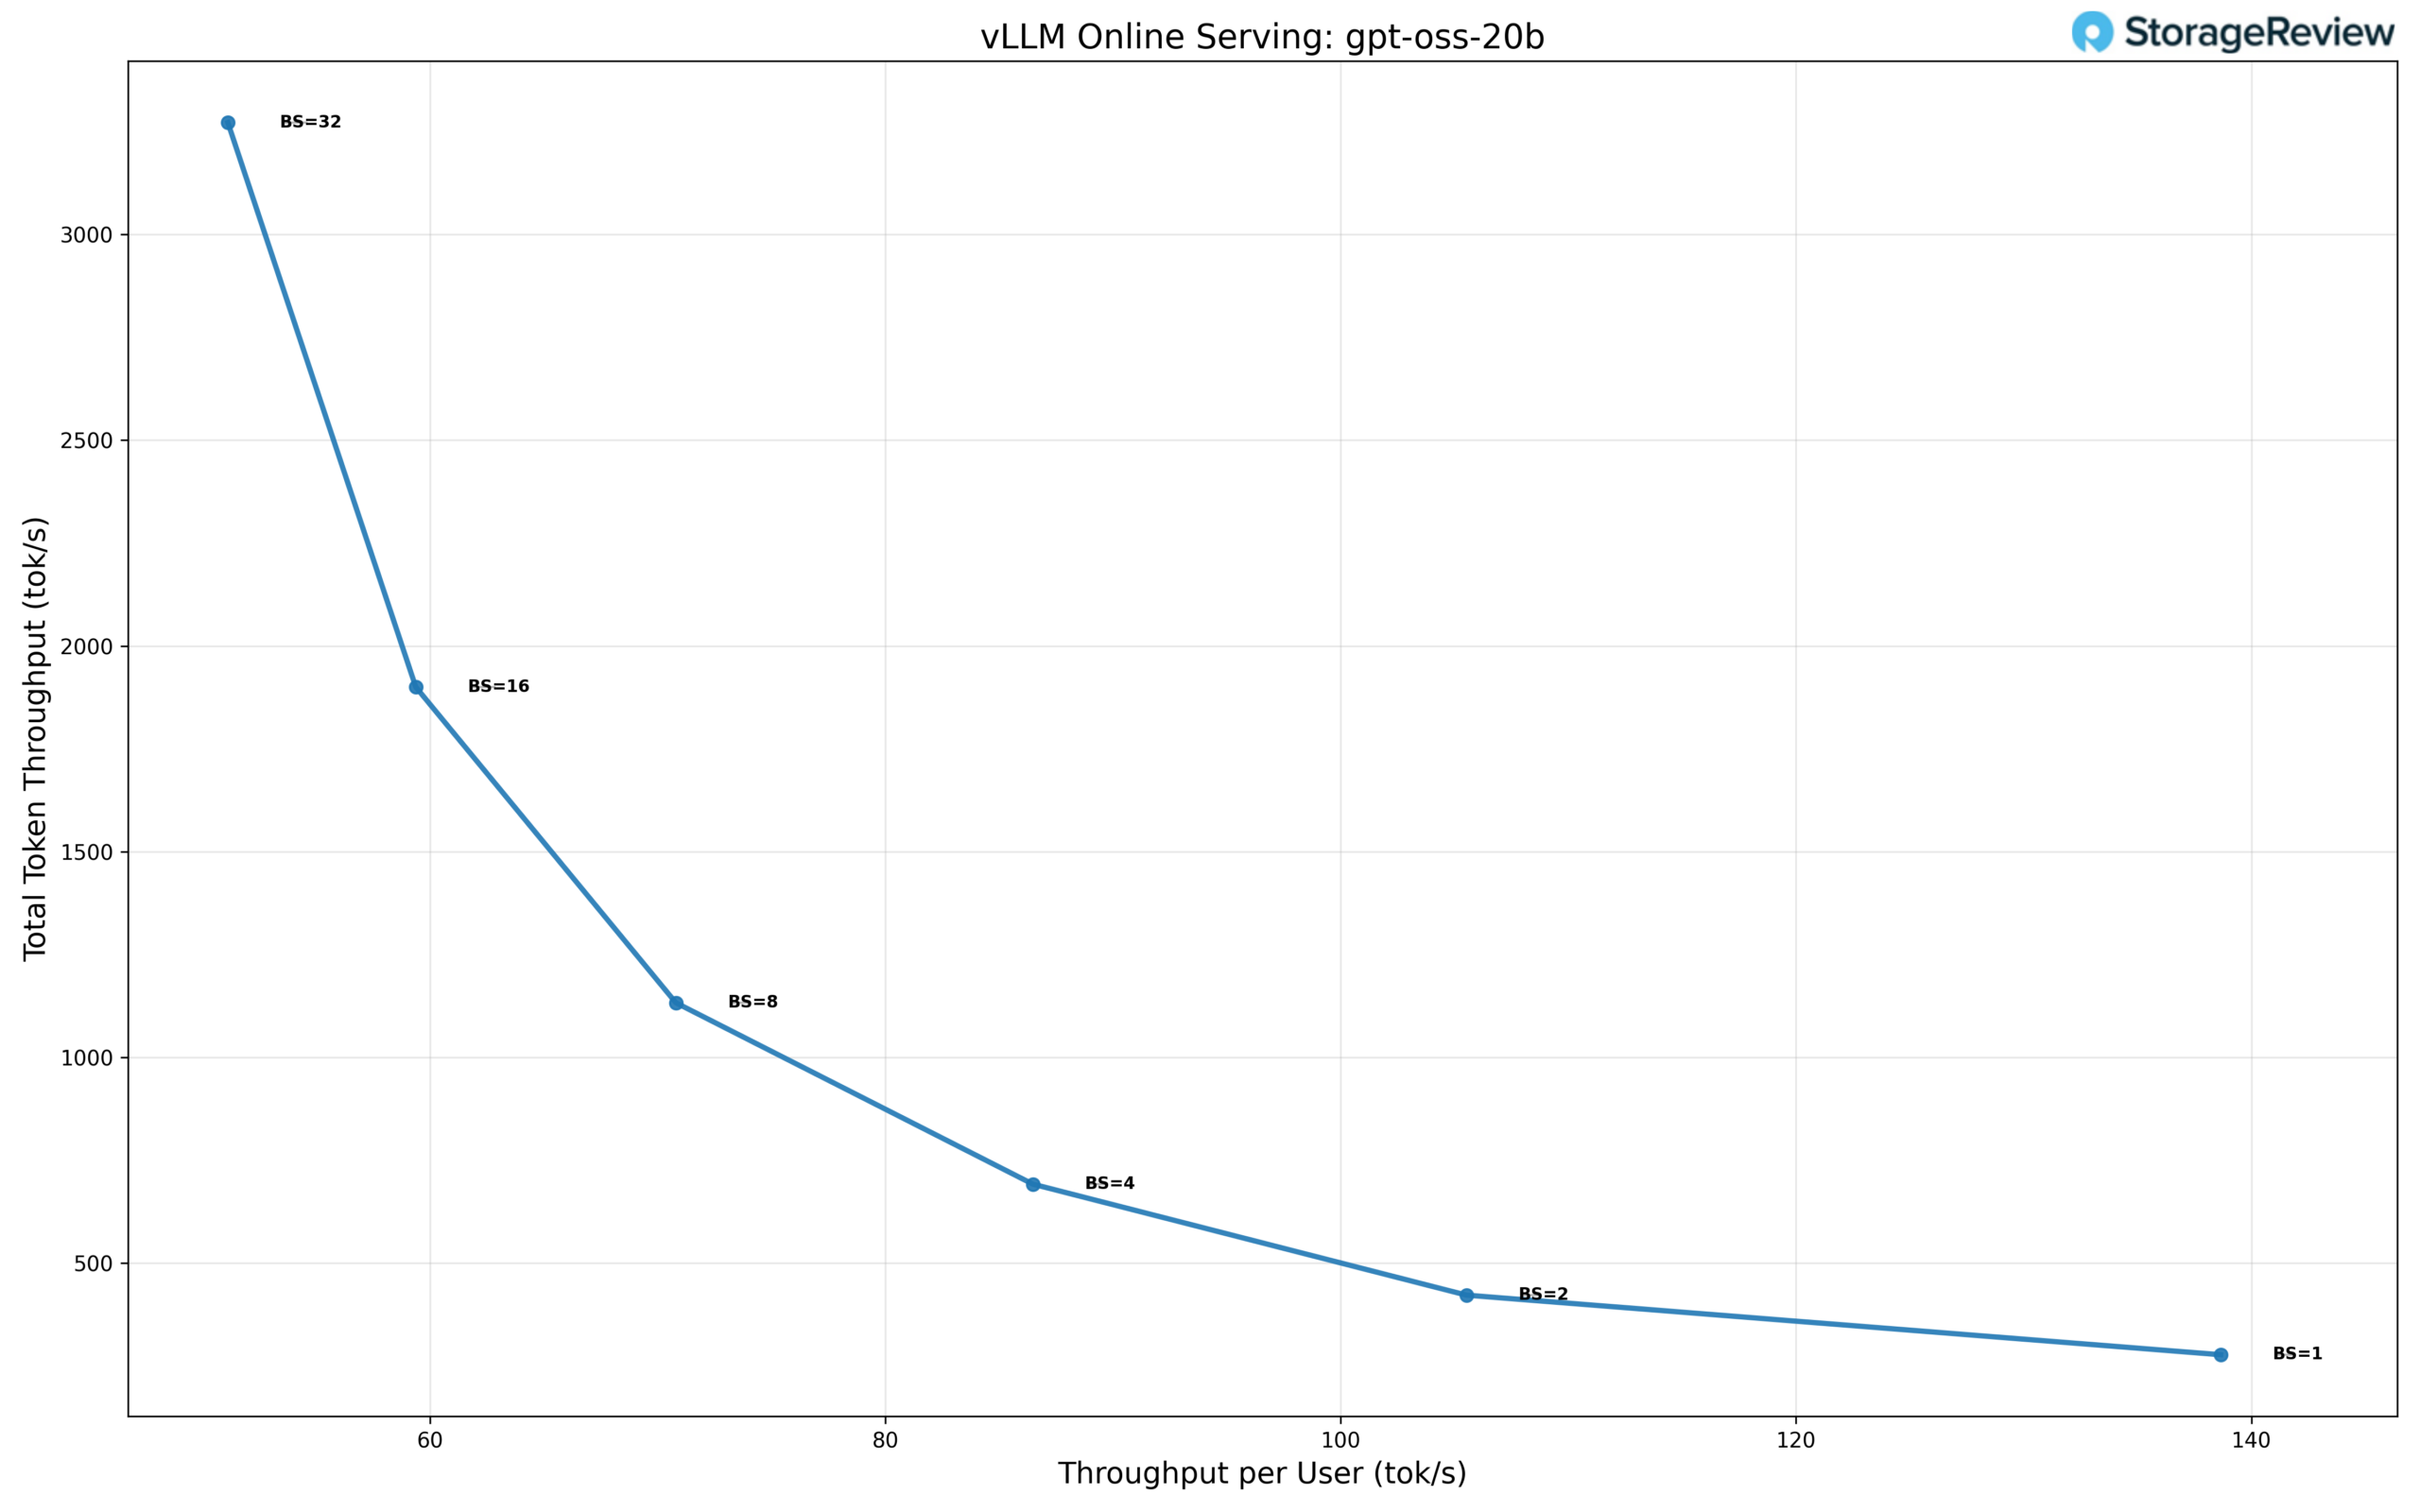
gpt-oss-20bモデルは、同時実行レベルの増加に伴って強力なスケーリング特性を示し、特にバッチサイズが大きい場合、高い総スループットを実現します。シングルユーザー同時実行(BS=1)では、このモデルはユーザーあたり約138 tok/sを実現し、総スループットは276 tok/sとなり、シングルストリーム推論の強力なベースラインを確立しました。
同時実行数が増加すると、総スループットは大幅に増加する一方で、ユーザーあたりのスループットは予想通り低下します。BS=2では、総スループットは420 tok/sに上昇し、ユーザーあたりのスループットは105 tok/sです。BS=4では、総スループットは690 tok/sに達し、ユーザーあたりのスループットは86 tok/sです。この着実な増加は、低~中程度のバッチ処理によって利用可能なコンピューティングリソースが効率的に利用されていることを示しています。
BS=8までスケーリングは継続し、モデルはユーザーあたり70 tok/sで約1,120 tok/sの総スループットを達成します。BS=16では、ユーザーあたり60 tok/sで総スループットが1,900 tok/sに増加します。これらの結果は、gpt-oss-20bが同時実行性が増加してもユーザーあたりのパフォーマンスが比較的高いことを示しており、マルチユーザーサービングシナリオに適しています。
このモデルはBS=32で総スループットのピークに達し、約3,250 tok/sの総スループットを実現します。一方、ユーザーあたりのスループットは50 tok/sに低下します。これは、単一ユーザーの場合と比較して、総スループットが11.8倍向上したことを意味します。ユーザーあたりのスループットはバッチサイズが大きいほど低下し続けますが、全体的なスケーリング効率は依然として高く、このモデルは早期の飽和点に遭遇することなく、より高い同時実行性によるメリットを享受していることを示しています。
全体的に見て、gpt-oss-20b は、高いシングルユーザーパフォーマンスと強力なバッチスケーリングを組み合わせた、バランスの取れたスケーリングプロファイルを示しています。そのため、応答性の高い個別推論と、より重いマルチユーザー負荷下における高い集約スループットの両方を必要とするデプロイメントにとって、gpt-oss-20b は魅力的な選択肢となります。
Phoronixベンチマーク
Phoronix Test Suiteは、OpenBenchmarking.org経由で450以上のテストプロファイルと100以上のテストスイートをサポートするオープンソースの自動ベンチマークプラットフォームです。依存関係のインストールからテストの実行、結果の収集まで、あらゆる処理を自動化するため、パフォーマンス比較、ハードウェア検証、継続的インテグレーションに最適です。
ストリームメモリ帯域幅
SR650 V4 は 369.6GB/秒のメモリ帯域幅を実現し、データ集約型のワークロードに対する強力なスループットを実証し、健全なマルチチャネル メモリ パフォーマンスを確認しました。
7-Zip圧縮
システムは 584,499 MIPS で優れた圧縮および解凍パフォーマンスを示し、安定したマルチコア効率と強力な整数計算能力を反映しています。
カーネルコンパイル
サーバーは allmod カーネル ビルドを 256.175 秒で完了しました。これは、並列コンパイルと開発者ワークフローを効率的に処理する能力を強調する立派な結果です。
Apache Webサーバー
SR650 V4 は 61,654 R/s で強力な Web サービス パフォーマンスを示し、フロントエンド ホスティングや軽量仮想化スタックに適した高い要求スループットを維持しました。
OpenSSL検証
このプラットフォームは、1 秒あたり 712.6 億バイトを達成し、堅牢な暗号検証パフォーマンスを実証し、安全で証明書を多用する操作に対する CPU の能力を確認しました。
| Phoronixベンチマーク | レノボ ThinkSystem SR650 V4 |
|---|---|
| Stream | 369,58.3 MB /秒 |
| 7-zip | 584,499MIPS |
| カーネルコンパイル (allmod) | 256.175秒数 |
| Apache(1秒あたりのリクエスト数) | 61,654.47 R/s |
| オープンSSL | 712,633,776,990 バイト/秒 |
結論
ThinkSystem SR650 V4は、単なるCPUの交換ではないという点で、プラットフォームの刷新と言えるでしょう。Lenovoはこの世代において、実環境での導入を制約する領域、すなわちメモリ帯域幅、PCIeレーンの可用性、ストレージ密度、そしてニーズの変化に合わせた構成の適応性といった点において、意義ある改善を推進しました。Intel Xeon 6への移行により、コアオプションとソケットあたりのI/Oヘッドルームが拡大し、MRDIMMサポートを備えた高速DDR5やオプションのCXL拡張といったプラットフォームの周辺機能により、SR650 V4は、ワークロードのメモリ消費量が増加しても、その価値を維持できる道筋を示しています。
ストレージに関しては、U.2構成での限定的なレビューにもかかわらず、LenovoはE3.Sへの取り組みを進めており、1:1接続による高いNVMe密度とよりクリーンな熱特性を実現しています。これは、特にローカルフラッシュを多く必要とする仮想化スタックや、GPUへのデータ供給が演算処理能力と同じくらい重要となるAI隣接パイプラインにおいて、現代のインフラストラクチャ構築方法と一致しています。デュアルOCP 3.0 Gen5 x16スロットも実用的なアップグレードとして採用されており、アクセラレータ、ストレージ、または特殊アダプター用に確保しておきたいPCIeスロットを犠牲にすることなく、本格的なネットワークを構築できます。
SR650 V3をご使用で、メモリ速度、PCIeヘッドルーム、NVMe密度の制約を感じているなら、SR650 V4は魅力的な一歩です。SR650シリーズの人気を支えてきた保守性と構成柔軟性はそのままに、ITチームが窮地に陥るのを防ぐプラットフォームの柔軟性も備えています。仮想化クラスターの構築、スケールアウトサービスのモダナイゼーション、バランスの取れたCPU/GPUノードの構築など、SR650 V4は重要な要件を満たし、さらにその先へと進むための余裕も提供します。
ランキング:今回テストしたL40Sは、当社の「ベストエンタープライズGPU」ランキングにおいて、現在も出荷されているメインストリーム推論GPUの中で最高の評価を獲得しています。


 Amazon