

MSI EdgeMesa N AI+ は、NVIDIA の RTX Spark N1X をベースにした 1.18 リットルのアルミニウム製ミニ PC です。RTX Spark N1X は、6,144 コアの Blackwell RTX GPU を搭載した 20 コアの Arm プロセッサで、これまではノートパソコンでのみテストされていました。レビュー用のユニットには、128GB の統合メモリ、4TB PCIe Gen5 SSD、10GbE、Windows 11 Pro が搭載されています。このミニ PC を、ラボにあるもう 1 つの RTX Spark ミニ PC である ASUS の 64GB ProArt GR1Xや、テストした中で最速の 128GB および 64GB RTX Spark ノートパソコンと比較し、デスクトップシャーシと 240W 電源アダプタが同じシリコンにどのような影響を与えるかを測定しました。
主要なポイント(要点)
- デスクトップシャーシは、持続的なCPU処理において4~11パーセントの性能向上に貢献する。 EdgeMesaは、30分間のCinebench 2026ループの定常状態において7,276ポイントを記録しました。これは、128GBのHP OmniBook Ultra 16の6,970ポイント、64GBのDell XPS 16 Creator Editionの6,550ポイントと比較して高い数値です。ASUS ProArt GR1X mini PCは7,306ポイントでした。
- デスクトップ型筐体は、平均的にノートパソコンよりも発熱が少なかった。 CPU はループ全体で平均 88.4℃ でしたが、両方のノート PC は 97℃ でした。Blender では、平均 76.0℃ で、96.7℃ と 94.2℃ でした。ピーク値は MSI の方が高く、ループで 107.3℃ に達し、GR1X は同じループで平均 83.3℃、ピーク 88.7℃ でした。
- 同時受講型のLLM(法学修士)プログラムでは、ノートパソコンとの比較において最も大きな差が見られた。 Qwen3.8 27Bで8つのリクエストを行った場合、EdgeMesaは毎秒39.8トークン、GR1Xは毎秒40.0トークンを生成したが、ノートパソコンではそれぞれ33.8と31.9だった。一方、単一リクエストの結果は、どのモデルでも6%以内の誤差に収まった。
- 128GBモデルは、64GBモデルよりも上位のモデル群で展開された。 Qwen-Image 20B (Q8) と 35B のコーディングエージェントモデルは、いずれもデフォルトのメモリ割り当てで実行され、EdgeMesa は 3 回すべてでエージェントタスクを 145 秒で完了しました。当社のテストスイートは、64GB の GR1X と XPS 16 ではどちらも実行されませんでした。
- 4TBの第5世代SSDは、プラットフォームの性能に十分対応できる。 25GiBの容量で、読み込み速度は13,315MB/s、書き込み速度は12,910MB/sで、GR1Xに搭載されている1TB Gen4ドライブの少なくとも2倍の速度であり、最高温度は62℃だった。
MSIのEdge AI PCシリーズにWindowsシステムが登場
MSIは、NVIDIAのDGX Sparkプラットフォームをベースにした1.2リットルのデスクトップPCであるEdgeXpertの他に、Edge AI PCカテゴリーでEdgeMesa N AI+を販売しています。EdgeXpertには、DGX OS、クラスタリング用の200GbE ConnectX-7ポート、64GBまたは128GBのメモリが搭載されています。EdgeMesaは、RTX Spark N1X、Windows 11、最大4台のディスプレイを接続できるデスクを中心としたポートセットを備えた、Windows版の製品です。MSIは2026年6月のComputexで初めてこの製品を発表し、AI開発者、ソフトウェアエンジニア、システムインテグレーター、そしてエージェント、RAG、コーディングアシスタントをローカルで実行したいクリエイター向けのコンパクトなデスクトップPCだと説明しています。
MSIの製品ページでは、このシステムは最大1ペタフロップのFP4 AI性能、最大1Mトークンのコンテキストを持つ120BパラメータのLLMのサポート、100fpsを超える1440pゲームに対応していると謳われています。ただし、これらの数値の背後にあるモデル、量子化、設定については記載されていません。以下のテストでは、3Bから27Bパラメータのモデルでトークンレートを測定し、35Bのコーディングエージェントモデルを実行しました。当社のWindowsクライアントスイートは35Bエージェントモデルが上限であり、120BクラスのモデルはLinuxスイートでのみ実行されるため、このシステムではモデルサイズの主張はテストされていません。
EdgeMesa N AI+は、LPDDR5XがCPUとGPUで共有される統合メモリであり、後からアップグレードできないため、固定構成で購入する必要があります。MSIは、最大128GBのメモリと最大4TBのシングルNVMe SSDを搭載可能としており、これは今回テストした構成です。また、MSIの米国ストアでは、X-005USとX-006USという部品番号で2つのバージョンを取り扱っています。NVIDIAによると、今回テストした128GBユニットの希望小売価格は7,499ドルで、RTX Sparkデスクトップの価格は4,399ドルからで、地域、メーカー、構成によって価格が異なります。
ビルドとデザイン
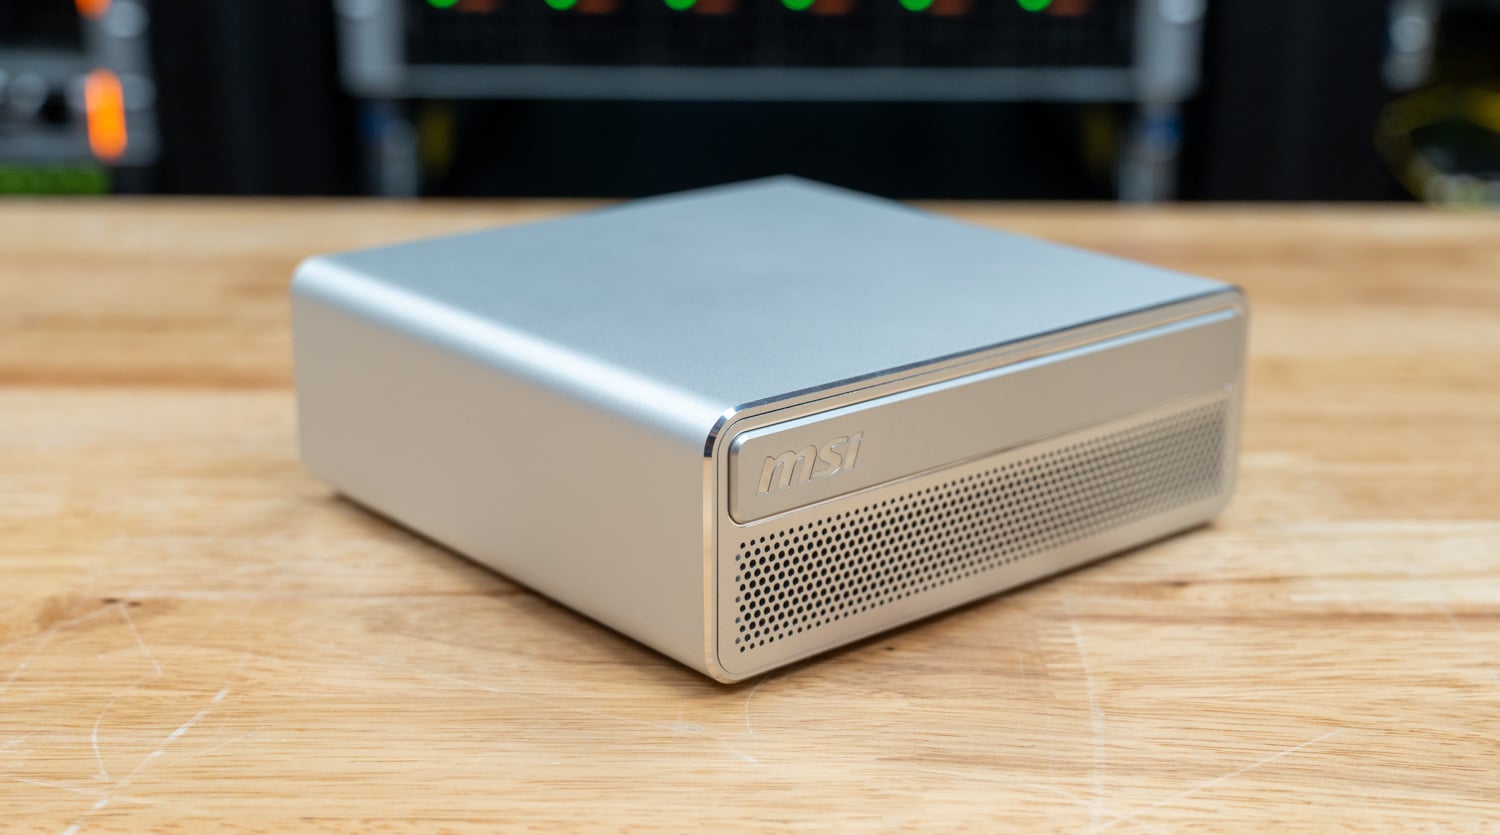
EdgeMesa N AI+ は、指紋防止加工を施したアルミニウム製シャーシを採用しています。サイズは 152 x 147 x 53mm、重量は 1.32kg で、容量は 1.18 リットルです。これは、MSI が宣伝している 1.3 リットルよりわずかに小さく、同社の 1.2 リットルの EdgeXpert に近い値です。ASUS ProArt GR1X は 150 x 150 x 51mm で容量は 1.15 リットルなので、この 2 つの RTX Spark ミニ PC はデスク上でほぼ同じスペースを占めます。前面は MSI バッジの下に穴あきグリルがあり、ポートやコントロールはありません。ベースの大部分は穴あきで、電源は 240W アダプターから供給されます。
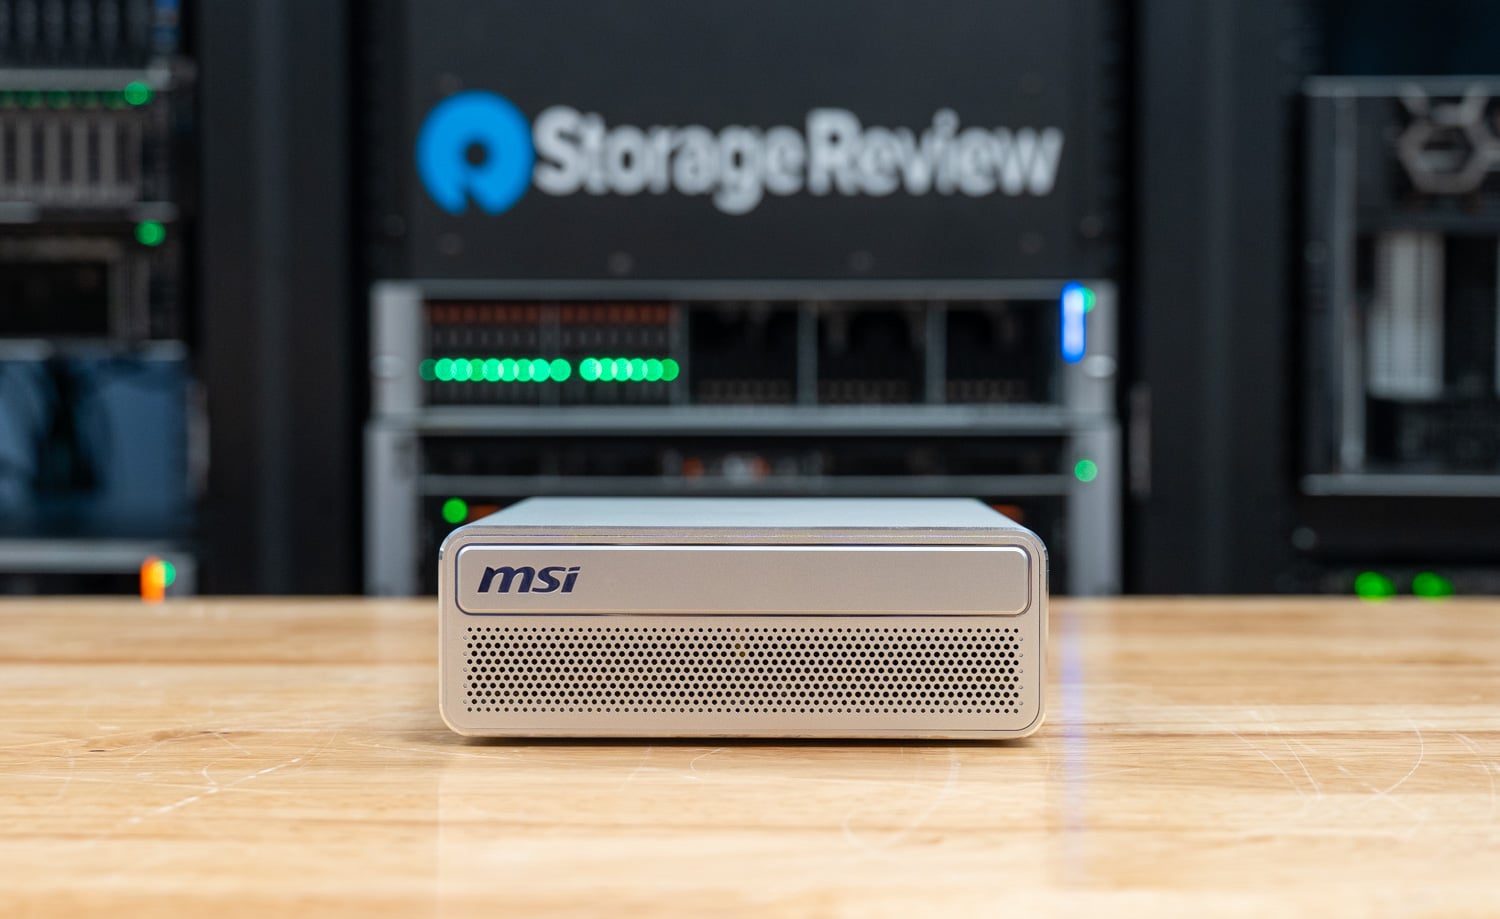
すべての接続は背面で行われ、本機には電源ボタン、20Gbps対応のUSB Type-Cポートが4つ、HDMI 2.1b出力ポートが1つ、10GbE RJ45ポートが1つ、そして幅広の通気口の下にケンジントンロック用スロットが配置されています。Type-Cポートのうち3つはDisplayPort 1.4 Alt Modeに対応しており、4つ目は電源入力なので、HDMIを使用すれば最大4台のディスプレイを駆動できます。MSIはワイヤレス接続としてWi-Fi 7とBluetooth 5.4を挙げています。USB Type-Aポートとオーディオジャックは搭載されていないため、ほとんどのデスクではハブまたはドックが必要になります。

MSIは、この熱設計をAI Pulse Cooling Systemと呼んでおり、同社が140Wの持続力を持つと評価する2つのファンを備えたベイパーチャンバーです。外側のシェルを取り外すと、背面通気口の後ろ、ポート列の上に、シャーシの幅全体にわたってフィンスタックが配置されています。XPS 16 Creator Editionは同じチップを17.8mmのシャーシに収めているため、ミニPCの差別化ポイントはクーラーであり、このレビューの後半で持続負荷と熱の結果がそれを検証します。

ストレージはシャーシ内部の単一の M.2 NVMe スロットに搭載されています。内部のスレッドが外側のケースからスライドして出てくるため、SSD やその他の内部部品にアクセスするには多少の手間がかかります。そこから、ドライブは内部フレームの切り欠きにあるサーマルパッドの下に配置され、私たちのユニットの 4TB Samsung モジュールは短い M.2 2242 フォーマットです。そのため、交換オプションは 2242 ドライブに限定され、一般的な 2280 長さよりも小売向けの選択肢が少なくなり、工場出荷時の容量選択がより重要になります。ProArt GR1X は、1.15 リットルのシャーシに 2 つの M.2 2280 スロットを搭載するという別のアプローチを採用しています。

MSI EdgeMesa N AI+ の仕様
| 製品仕様 | MSI EdgeMesa N AI+ |
|---|---|
| Platform | |
| モデル | EdgeMesa N1x N AI+ (MS-B215) のテスト結果 |
| プロセッサ | NVIDIA RTX Spark N1X 20コアのArm CPU(10コア×2クラス) |
| グラフィック | 6,144コアのNVIDIA Blackwell RTX GPU、統合型 最大1ペタフロップFP4(MSI) |
| メモリ | 最大128GBのLPDDR5X統合メモリ テスト対象は128GB LPDDR5X-9400です。 |
| テストされたGPUメモリ | 専用メモリ62.5GB、共有メモリ47.9GB(デフォルト割り当て) |
| Storage | M.2 NVMeスロット×1、最大4TB PCIe Gen5 x4リンク上の4TB Samsung MZALC4T0HBL1 (M.2 2242) をテストしました。 |
| オペレーティングシステム | Windows 11 Windows 11 Pro 26H1でテスト済み |
| 接続性 | |
| リアポート | USB Type-C 20Gbpsポート×4(DisplayPort 1.4 Alt Mode対応ポート×3、電源入力ポート×1) 1x HDMI 2.1b 1x 10GbE RJ45 電源ボタン |
| 出力を表示する | HDMI経由で最大4台のディスプレイ、USB Type-Cポート3つに対応 |
| Networking | 10GbE Wi-Fi 7、ブルートゥース5.4 |
| セキュリティ | ケンジントンロックスロット |
| 冷却、電源、シャーシ | |
| 冷却 | AIパルス冷却システム:ベイパーチャンバー、デュアルファン 定格出力140W(MSI) |
| 出力 | 240Wアダプター |
| 寸法 | 152 x 147 x 53mm (5.98 x 5.79 x 2.09インチ)、1.18L |
| 重量 | 1.32kg(2.91 lb) |
| シャーシ | 指紋防止加工を施したアルミニウム |
| 価格 | 希望小売価格:7,499ドル(NVIDIA調べ、テスト時:128GB、4TB) |
テストのセットアップと方法論
今回レビューしたユニットは、RTX Spark N1X、128GBのLPDDR5X-9400、4TBのSamsung SSDを搭載したMS-B215で、Windows 11 Pro 26H1 on Armを最高のパフォーマンス電源モードで実行しています。テスト実行時には4K外部ディスプレイに接続しました。出荷時の状態では、Windowsは統合メモリのうち62.5GBをGPU専用メモリとして認識し、残りの47.9GBは共有メモリとして認識していました。
そのメモリは1つの物理プールであり、WindowsはGPU割り当てを専用GPUメモリとして扱い、残りをシステムメモリとして扱います。GPUは必要に応じてシステムメモリにメモリを拡張できます。NVIDIAアプリのスライダーで割り当てを設定できます。デフォルトは、ここで紹介する64GBと128GBのシステムでほぼ均等に分割されています。アプリは、最小設定と最大設定では問題が発生する可能性があると警告しています。NVIDIAは、ワークロードでより多くのメモリが必要でない限り、デフォルト設定を維持することを推奨しています。GPUのメモリシェアを大きくすると、Windowsや他のアプリケーションに割り当てられるメモリが少なくなるためです。また、CPU用に少なくとも16GBを残しておくことを推奨しています。
NVIDIAによると、エージェントとLLMはシステムメモリにメモリが拡張されてもパフォーマンスの低下はほとんど見られないとのことです。また、デフォルトのメモリ容量では足りない画像および動画生成モデルについては、メモリ割り当てを増やすことを推奨しています。弊社ではすべてのシステムをデフォルト設定でテストしており、テストスイートはモデル階層を専用メモリ容量に合わせて設定するため、64GBシステムでテスト対象から外れたモデルでも、メモリの拡張やより大きなメモリ割り当てによって動作する可能性があります。
結果は、ローカルAI、コンテンツ作成、CPU、グラフィックス、ストレージをカバーするWindowsクライアントスイートであるsr-client 1.13によるものです。AIテストでは、LLMサービングとMLPerfクライアントにCUDA上のllama.cpp、モデルロード、コーディングエージェント、RAGにCUDA上のOllama、画像生成にVulkan上のstable-diffusion.cppを使用しています。各図は繰り返し実行した際のメディアン値であり、テストが複数回実行された場合は、最新の有効な結果を報告します。スイートが実行ごとのばらつきまたは失敗したパスとしてフラグを立てた結果にはアスタリスクが付いています。2台のラップトップは、以前にsr-client 1.11でテスト済みです。
比較対象は、当ラボにあるもう1台のRTX Spark搭載ミニPC、ASUS ProArt GR1Xから始まります。これは、64GBのメモリと1TBのMicron Gen4 SSDを搭載した1.15リットルのデスクトップPCで、同じsr-client 1.13リリースを実行しました。その隣には、各メモリ容量でテストした中で最も高速なRTX Spark搭載ノートPCが2台あります。HP OmniBook Ultra 16は128GBシステムで、2TBのSandisk Gen5 SSDを搭載しています。Dell XPS 16 Creator Editionは64GBシステムで、1TBのSK hynixドライブを搭載しています。
4台のマシンはすべて同じ20コアのN1Xプロセッサを搭載しており、デスクトップ2台はより大きなクーラーでより高い電力制限で動作させているため、違いは電力、冷却、メモリ容量、ストレージ容量に集約されます。GR1Xは、同じチップを使用した2つ目のデスクトップ設計がどのような性能を発揮するかを示しており、ノートPCは筐体の価値を示しています。エミュレーションで実行したCinebenchのx64ビルドは4台すべてでクラッシュしたため、エミュレーションの結果は報告できません。
| CPU | メモリ | GPUメモリ | ブートドライブ | オペレーティングシステム | |
|---|---|---|---|---|---|
| MSI EdgeMesa N AI+ | NVIDIA RTX Spark N1X、20コア | 128GB LPDDR5X-9400 | 62.5GB専用メモリ | 4TB Samsung MZALC4T0HBL1、PCIe Gen5 | ウィンドウズ 11 Pro 26H1 |
| ASUS ProArt GR1X | NVIDIA RTX Spark N1X、20コア | 64GB LPDDR5X-9400 | 30.5GB専用メモリ | 1TB Micron MTFDKBA1T0QGN、PCIe Gen4 | ウィンドウズ 11 Pro 26H1 |
| HP オムニブック ウルトラ 16 | NVIDIA RTX Spark N1X、20コア | 128GB LPDDR5X-9400 | 62.5GB専用メモリ | 2TB Sandisk SN8050S、PCIe Gen5 | ウィンドウズ 11 Pro 26H1 |
| Dell XPS 16 Creator Edition | NVIDIA RTX Spark N1X、20コア | 64GB LPDDR5X-9400 | 30.5GB専用メモリ | 1TB SK hynix PVC10 | ウィンドウズ 11 Pro 26H1 |
ローカルAIパフォーマンス
LLM サービング
| LLMサービング、llama.cpp CUDA、Q4_K_M(特に記載がない限り、数値が大きいほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| 省庁 3 3B、リクエスト 1、出力 (トークン/秒) | 58.1 | 58.4 | 57.5 | 57.8 |
| 省庁レベル3 3B、リクエスト数4、出力(トークン/秒) | 152.0 | 154.9 | 148.8 | 146.4 |
| ミニストラル3 3B、リクエスト1件、最初のトークン取得までの時間(ミリ秒、数値が低いほど良い) | 566 | 557 | 607 | 669 |
| 省庁 3 8B、リクエスト 1、出力 (トークン/秒) | 42.5 | 42.7 | 41.5 | 40.6 |
| 省庁レベル3 8B、リクエスト数4、出力(トークン/秒) | 107.5 | 109.3 | 104.1 | 96.3 |
| ミニストラル3 8B、リクエスト1件、最初のトークン取得までの時間(ミリ秒、数値が低いほど良い) | 1,343 | 1,331 | 1,554 | 1,794 |
| Qwen3.8 27B、1リクエスト、出力(トークン/秒) | 13.0 | 13.1 | 12.6 | 12.4 |
| Qwen3.8 27B、4リクエスト、出力(トークン/秒) | 31.1 | 31.4 | 28.1 | 27.5 |
| Qwen3.8 27B、8リクエスト、出力(トークン/秒) | 39.8 | 40.0 | 33.8 | 31.9 |
| Qwen3.8 27B、リクエスト数1、最初のトークン取得までの時間(ミリ秒、数値が小さいほど良い) | 8,721 | 8,604 | 10,818 | 10,935 |
LLM のサービスでは、各モデルを llama.cpp で実行し、同時に 1 つ、4 つ、8 つのリクエストを送信します。これは、1 つのマシンを共有する小規模チームがマシンをロードする方法です。単一のリクエストの場合、4 つのシステムはすべてのモデルで 6 パーセント以内の差となり、Ministral 3 3B では毎秒 58.1 トークン、8B モデルでは 42.5 トークン、EdgeMesa 上の Qwen3.8 27B では毎秒 13.0 トークンとなります。1 つのリクエストではチップの大部分がアイドル状態になるため、冷却の役割は最小限に抑えられます。

リクエストが増えるにつれて差が広がります。Qwen3.8 27B で 4 つのリクエストの場合、EdgeMesa は毎秒 31.1 トークンを生成し、HP は 28.1、XPS 16 は 27.5 でした。8 つのリクエストでは、39.8 に達し、33.8 と 31.9 を上回り、それぞれ 18 % と 25 % のリードとなりました。このモデルでの最初のトークンまでの時間は、MSI では 8.7 秒、ラップトップでは 10.8 秒から 10.9 秒でした。Ministral 3 8B では、4 つのリクエストで同じパターンの小規模版が見られ、毎秒 107.5 トークンに対し、104.1 と 96.3 でした。

ProArt GR1Xは、EdgeMesaをあらゆる段階で追跡し、Qwen3.8 27Bでは4リクエストで毎秒31.4トークン、8リクエストで毎秒40.0トークン、Ministral 3 8Bでは4リクエストで毎秒109.3トークン、27Bモデルでは最初のトークン取得に8.6秒を要しました。GR1Xのメモリ容量は半分ですが、この表のすべてのモデルが64GBシステムに適合するため、2台のデスクトップはサービングテーブル全体で2%以内の差で終了しました。
サービングテーブルは、設計上、27Bクラスで停止します。ここにあるすべてのRTX Sparkシステムで動作させたWindowsクライアントスイートには、gpt-oss 120Bや同サイズの他のモデルは含まれていません。これらのモデルは、より大規模な統合メモリデスクトップおよびGPUワークステーション上のLinuxスイートでテストしています。MSIはこのシステムで120BパラメータのLLMをサポートしていると宣伝していますが、これは私たちがテストしていない主張です。
MLPerfクライアントv2.0
| MLPerfクライアントv2.0、llama.cpp CUDA(特に記載がない限り、数値が高いほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| ラマ3.1 8B、最初のトークン獲得までの時間(秒、数値が小さいほど良い) | 0.25 | 0.24 | 0.28 | 0.31 |
| Llama 3.1 8B、トークンレート(トークン/秒) | 56.3 | 56.8 | 56.5 | 55.7 |
| Phi-4-mini、最初のトークン取得までの時間(秒、数値が小さいほど良い) | 0.11 | 0.11 | 0.13 | 0.14 |
| Phi-4-mini、トークンレート(トークン/秒) | 96.8 | 96.3 | 97.0 | 96.2 |

MLPerf Client は一度に 1 つのプロンプトを送信し、4 つのシステムで同点となりました。EdgeMesa は Llama 3.1 8B で毎秒 56.3 トークン、Phi-4-mini で毎秒 96.8 トークンを生成しました。GR1X では毎秒 56.8 トークンと毎秒 96.3 トークン、HP では毎秒 56.5 トークンと毎秒 97.0 トークン、XPS 16 では毎秒 55.7 トークンと毎秒 96.2 トークンでした。最初のトークンまでの時間は、デスクトップ (Llama 3.1 8B で 0.25 秒と 0.24 秒) の方がラップトップ (0.28 秒と 0.31 秒) よりわずかに短くなりました。小型モデルとチャットする 1 人のユーザーの場合、ミニ PC とラップトップは同じ体験を提供します。
モデルの読み込みとコーディングエージェント
| モデル読み込みおよびコーディングエージェント、Ollama CUDA | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| gpt-oss:20b 最初のトークンへのコールドロード(s、数値が小さいほど良い) | 7.00 | 10.94 | 6.70 | 7.73 |
| gpt-oss:20b 最初のトークンをウォームロードします(s、数値が小さいほど良い) | 3.96 | 3.68 | 3.68 | 3.69 |
| qwen3.6:35b 最初のトークンへのコールドロード(s、数値が小さいほど良い) | 8.32 | 実行しない | 9.33 | 実行しない |
| エージェント、gpt-oss:20b 64K コンテキスト、実行成功 (3 回中) | 2* | 1* | 2* | 3 |
| エージェント、gpt-oss:20b 64K コンテキスト、実行時間 (秒、数値が小さいほど良い) | 294 * | 154 * | 216 * | 360 |
| エージェント、qwen3.6:35b 64Kコンテキスト、実行成功(3件中) | 3 | 実行しない | 1* | 実行しない |
| エージェント、qwen3.6:35b 64K コンテキスト、実時間 (秒、数値が小さいほど良い) | 145 | 実行しない | 1783 * | 実行しない |
| エージェント、qwen3.6:35b 64K コンテキスト、生成レート (トークン/秒) | 86.8 | 実行しない | 72.7 | 実行しない |
| エージェント横のスピードメーターの減速(x、数値が低いほど良い) | 1.78 | 1.79 | 2.35 | 2.79 |
*スイートによってフラグが立てられました:3つのエージェント実行のうち、少なくとも1つがすべてのテストに合格しませんでした。
コールドロードは、シャーシよりもSSDとメモリパスを追跡します。EdgeMesaは、コールドスタートから最初のトークンまで7.00秒でgpt-oss:20bをロードし、HPの6.70秒とXPS 16の7.73秒の中間でした。また、21GBのqwen3.6:35bモデルを8.32秒でロードし、HPの9.33秒と比較しました。GR1Xは、Gen4ドライブからgpt-oss:20bモデルをロードするのに10.94秒かかりました。このスイートは、64GBのGR1XとXPS 16で35Bモデルを実行しません。
コーディングエージェントは、モデルにコードを複数ラウンドにわたって記述およびテストするように指示し、構成ごとに 3 回実行します。qwen3.6:35b では、EdgeMesa は 1 秒あたり 86.8 トークンで 145 秒で 3 回すべての試行に合格しましたが、128GB HP は 3 回のうち 1 回に合格し、1,783 秒かかりました。gpt-oss:20b では、MSI は 3 回のうち 2 回、GR1X は 1 回、XPS 16 は 3 回すべてに合格したため、このモデルの合格回数は実行ごとに異なります。エージェントの横で Speedometer を実行すると、ブラウザの速度は MSI で 1.78 倍、GR1X で 1.79 倍遅くなりましたが、ラップトップでは 2.35 倍と 2.79 倍でした。
RAG
| RAGパイプライン(特に明記されていない限り、数値が高いほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| 摂取量、1秒あたりの通過回数 | 114.7 | 115.6 | 111.5 | 104.4 |
| 取り込み、埋め込みレート(トークン/秒) | 18,566 | 18,720 | 18,049 | 16,901 |
| 回答、生成レート(トークン/秒) | 103.4 | 104.2 | 103.4 | 95.0 |
| 回答:最初のトークンp50に到達するまでの時間(秒、数値が小さいほど良い) | 0.15 | 0.15 | 0.15 | 0.17 |
| 質問と回答 p50 (s、数値が低いほど良い) | 0.23 | 0.22 | 0.23 | 0.25 |
RAG テストでは、パッセージ セットを埋め込み、それに対して検索を行い、phi4-mini を使用して質問に答えます。EdgeMesa での取り込みは 114.7 パッセージ/秒で実行され、HP の 111.5 を 3%、XPS 16 の 104.4 を 10% 上回りました。回答生成は HP と同の 103.4 トークン/秒、XPS 16 は 95.0 トークン/秒で、中央値の質問は両方の 128GB システムで 0.23 秒で回答されました。GR1X は EdgeMesa と同の 115.6 パッセージ/秒、104.2 トークン/秒でした。この規模の検索ベースのアシスタントは、4 台のいずれでも快適に動作します。
画像生成
| 画像生成解像度1024×1024、stable-diffusion.cpp Vulkan(特に明記されていない限り、数値が高いほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| FLUX.2 klein 4B Q4_0、1 分あたりの画像数 | 9.95 | 10.07 | 11.01 | 11.17 |
| FLUX.2 klein 4B Q4_0、画像あたりの処理時間(秒、数値が小さいほど良い) | 6.03 | 5.96 | 5.45 | 5.37 |
| Z-Image Turbo 6B BF16、1分あたりの画像数 | 4.03 | 4.17 | 4.19 | 3.89 |
| Qwen-Image 20B Q4_0、1分あたりの画像数 | 0.53 | 0.53 | 0.50 | 0.49 |
| Qwen-Image 20B Q8_0、1分あたりの画像数 | 0.51 | 実行しない | 0.47 | 実行しない |

画像生成は、EdgeMesaがノートPCに劣った唯一のAIテストです。Q4のFLUX.2 klein 4Bは、このテストで1分あたり9.95枚の画像を生成しましたが、HPでは11.01枚、XPS 16では11.17枚でした。一方、BF16のZ-Image Turbo 6Bは、2台のノートPCの中間の4.03枚でした。これらのテストはVulkanで実行され、ノートPCは以前のバージョンのテストスイートを実行しました。GR1Xは最新バージョンを実行し、FLUX.2で1分あたり10.07枚の画像を生成し、EdgeMesaと同等の性能を示しました。このことから、テストスイートのバージョンが差の原因であると考えられます。
Qwen-Image 20B は、4 つのシステムすべてで Q4 で実行され、1 分あたり約 0.5 枚の画像が処理されました。より大規模な Q8 バージョンは、2 台の 128GB マシンで実行され、EdgeMesa では 1 分あたり 0.51 枚、HP では 1 分あたり 0.47 枚の画像が処理されました。BF16 バージョンはスイートのワークステーション ティア用に予約されており、いずれのシステムでも実行されませんでした。FLUX.2 klein Q8 および BF16 は EdgeMesa で 1 回の実行を完了しましたが、スイートではそれ以上の実行が想定されているため、表から除外しました。
CPUパフォーマンス
Cinebench 2026と30分ループ
| Cinebench 2026(ポイント、特に記載がない限り数値が高いほど優れている) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| シングルコア | 548 | 553 | 561 | 565 |
| マルチコア | 7,284 | 7,304 | 7,001 | 6,631 |
| 30分間の周回コース、初回通過 | 7,219 | 7,256 | 7,014 | 6,539 |
| 30分間のループ、定常状態 | 7,276 | 7,306 | 6,970 | 6,550 |
| 定常状態/初回通過 | 1.008 | 1.007 | 0.994 | 1.002 |
| ループCPU温度、平均値(℃) | 88.4 | 83.3 | 97.4 | 97.3 |
| ループCPU温度、最大(℃) | 107.3 | 88.7 | 98.2 | 98.3 |
| 定常状態のCPUクロック周波数(平均値)(MHz) | 3,372 | 3,385 | 3,239 | 3,083 |

Cinebenchは、このテストスイートの中でシャーシの性能を最もよく評価しており、Cinebench 2026のマルチコアテストを1回実行したところ、EdgeMesaは7,284ポイントを獲得し、HPの7,001ポイントを4%、XPS 16の6,631ポイントを10%上回り、GR1Xは7,304ポイントでした。シングルコアテストのスコアは、EdgeMesaが548、GR1Xが553と、HPの561と565に対してわずかに逆の結果となりました。これは、1つのコアに負荷をかけ、クーラーに負荷をかけないテストの結果と一致しています。
持続テストでは、マルチコアレンダリングを30分間ループさせ、定常状態を最初のパスと比較します。4つのシステムすべてが最初のパスのスコアを維持したため、スロットリングは発生せず、デスクトップがノートPCを上回りました。EdgeMesaは平均クロック3,372MHzで7,276ポイント、GR1Xは3,385MHzで7,306ポイント、HPは3,239MHzで6,970ポイント、XPS 16は3,083MHzで6,550ポイントでした。
ループ内の温度は、3種類のシャーシタイプすべてで異なりました。ノートPCは平均97℃で動作し、上限の98℃に固定されていましたが、MSIは平均88.4℃で、ピークは107.3℃でした。GR1Xは同じループをわずかに高いクロックで実行し、平均83.3℃で、EdgeMesaより5℃低く、ピークは88.7℃でした。両方のデスクトップは同じ持続スコアを達成し、ASUSクーラーはチップの制限よりも余裕を持ってそれを達成しました。
7-Zip、Blender、HandBrake、およびLLVM
| コンテンツ作成と構築(特に記載がない限り、数値が高いほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| 7-Zip、全スレッド、合計(GIPS) | 152.6 | 153.8 | 150.6 | 147.0 |
| 7-Zip、1スレッド、合計(GIPS) | 8.92 | 8.92 | 9.10 | 9.13 |
| Blender 4.5 モンスター (サンプル/分) | 215.1 | 215.6 | 211.4 | 198.9 |
| Blender 4.5 Junkshop (サンプル/分) | 129.7 | 127.2 | 127.7 | 119.1 |
| Blender 4.5 Classroom(サンプル/分) | 95.7 | 95.7 | 92.8 | 86.7 |
| HandBrake x265 (fps) | 43.7 | 44.1 | 40.6 | 38.8 |
| HandBrake SVT-AV1 (fps) | 16.3 | 16.4 | 15.4 | 14.0 |
| LLVMビルド(数値が小さいほど良い) | 217 | 225 | 218 | 232 |

全コアアプリケーションテストでは、Cinebench のパターンをさまざまなサイズで繰り返します。クロック速度と同じくらいメモリに依存する 7-Zip は、150.6 と 147.0 と比較して、152.6 GIPS で最もばらつきが小さくなりました。Blender の Monster シーンは EdgeMesa で 215.1 サンプル/分でレンダリングされ、HP より 2%、XPS 16 より 8% 上回り、Classroom シーンではその差が 3% と 10% に広がりました。GR1X は 7-Zip、Monster および Classroom シーンで EdgeMesa と 1% 以内の差でしたが、Junkshop では 2% 下回りました。

ビデオエンコードでは、ミニ PC がアプリケーションで最大のリードを獲得しました。HandBrake の x265 エンコードは、HP の 40.6 fps および XPS 16 の 38.8 fps に対して 43.7 fps で実行され、それぞれ 8% および 13% のリードとなりました。SVT-AV1 は、15.4 fps および 14.0 fps に対して 16.3 fps で実行されました。GR1X は、EdgeMesa と同じ 44.1 fps および 16.4 fps でエンコードしました。LLVM ビルドは、MSI で 217 秒で完了し、HP の 218 秒と同時間で、GR1X より 8 秒早く、XPS 16 より 15 秒早く完了しました。シングルスレッドの 7-Zip は、デスクトップの 8.92 GIPS に対して、ノート PC が 9.10 GIPS および 9.13 GIPS でわずかに優位でした。

Stockfish、Primesieve、Python、そしてブラウザ
| 計算能力とウェブ関連能力(特に記載がない限り、数値が高いほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| ストックフィッシュ、1スレッド(Mnps) | 1.70 | 1.70 | 1.73 | 1.74 |
| Stockfish、全スレッド(Mnps) | 14.42 | 15.13 | 15.19 | 13.87 |
| 素篩を10^12まで、すべてのスレッド(s、数値が小さいほど良い) | 9.40 | 9.39 | 9.53 | 10.39 |
| 素篩を10^11まで、1スレッド(s、数値が小さいほど良い) | 12.33 | 12.35 | 12.02 | 12.03 |
| PyPerformance 実行時間 (ミリ秒、数値が低いほど良い) | 113.8 | 113.8 | 111.2 | 111.6 |
| PyPerformance nbody (ミリ秒、数値が低いほど良い) | 82.5 | 82.5 | 80.4 | 80.8 |
| スピードメーター 3.1(スコア) | 34.7 | 34.3 | 34.8 | 36.5 |
短時間でスレッド負荷の軽いテストでは、シャーシの影響は見られませんでした。Stockfish は、すべてのスレッドで EdgeMesa 上で 14.42 Mnps で実行され、HP の 15.19 と XPS 16 の 13.87 の間になりました。また、primesieve から 10^12 までは 9.40 秒で完了し、9.53 と 10.39 と比較しました。GR1X では Stockfish が 15.13 Mnps、primesieve が 9.39 秒で実行されました。シングルスレッドの Python テストと Speedometer 3.1 は 4 台で数パーセント以内の差でしたが、ブラウザでは XPS 16 が 36.5 対 34.7 でわずかにリードしました。日常的な応答性は、デスクトップとノート PC で同じです。
GROMACS、OpenBLAS、およびメモリ
| HPCカーネルとメモリ(特に明記されていない限り、数値が大きいほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| GROMACS benchMEM (ns/日) | 17.43 | 17.48 | 17.48 | 17.41 |
| OpenBLAS DGEMM、全コア(GFLOPS) | 361.0 | 356.8 | 374.0 | 354.6 |
| OpenBLAS LU 解決 N=20000、すべてのコア (GFLOPS) | 318.5 | 320.6 | 321.9 | 314.9 |
| ストリームトライアド(MB/秒) | 122,423 | 124,529 | 120,783 | 122,872 |
| メモリレイテンシ、4KiBページ(ナノ秒、数値が小さいほど良い) | 143.0 | 141.0 | 143.6 | 140.5 |
メモリサブシステムは4台のマシンすべてで同一であり、数値にもそれが反映されています。STREAM TriadはEdgeMesaで122,423MB/s、GR1Xで124,529MB/sを記録しましたが、ラップトップではそれぞれ120,783MB/sと122,872MB/sでした。4KiBページのメモリレイテンシは140.5nsから143.6nsの範囲でした。GROMACS benchMEMは4台すべてで0.4%以内の約17.4ns/日となり、OpenBLAS DGEMMとLUの結果は6%以内で、HPがわずかに先行していました。帯域幅がボトルネックとなる作業では、大型クーラーによるメリットはありません。
グラフィックスとGPUエンコーディング
| グラフィックスとGPUエンコード(数値が高いほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| SuperTuxKart 1080p、平均FPS | 269.8 | 274.0 | 269.7 | 248.6 |
| SuperTuxKart 1080p、標準的なFPS | 270 | 275 | 271 | 250 |
| SuperTuxKart 1080p、ほぼ安定したFPS | 232 | 238 | 236 | 214 |
| SuperTuxKart 1080p、安定したFPS | 134 | 136 | 141 | 131 |
| SuperTuxKart 4K、平均FPS | 111.8 | 114.1 | 実行しない | 実行しない |
| FFmpeg HEVC Media Foundation (fps) | 54 | 65 | 53 | 61 |
SuperTuxKart の ultra プリセットでは、EdgeMesa で 1080p で平均 269.8 fps を記録し、HP の 269.7 fps と同等、XPS 16 の 248.6 fps を上回りました。また、外部ディスプレイで 4K では平均 111.8 fps を記録しましたが、この解像度はノートパソコンでは動作しませんでした。GR1X では、1080p で平均 274.0 fps、4K で平均 114.1 fps を記録しました。Media Foundation を介した FFmpeg のハードウェア HEVC エンコードは 54 fps で動作し、HP の 53 fps と同等、XPS 16 は 61 fps、GR1X は 65 fps でした。hevc_nvenc エンコーダーは、このスイートが Arm 上で使用する FFmpeg ビルドでは利用できませんでした。
負荷時の熱
| CPU温度、平均値/最大値(℃、値が低いほど良好) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| Cinebench 2026 | 69.0 / 93.4 | 65.3 / 103.8 | 83.3 / 98.2 | 90.5 / 98.3 |
| シネベンチ 30分ループ | 88.4 / 107.3 | 83.3 / 88.7 | 97.4 / 98.2 | 97.3 / 98.3 |
| 7-Zip | 62.2 / 81.2 | 55.4 / 74.4 | 78.2 / 97.7 | 81.2 / 98.0 |
| ブレンダー4.5 | 76.0 / 87.7 | 70.0 / 81.9 | 96.7 / 98.3 | 94.2 / 98.3 |
| LLVMビルド | 70.5 / 85.9 | 67.2 / 79.2 | 91.6 / 98.1 | 92.9 / 98.2 |
| ハンドブレーキ | 74.1 / 90.9 | 66.5 / 87.9 | 87.5 / 97.9 | 90.3 / 98.4 |
| 干し魚 | 84.5 / 105.3 | 80.8 / 88.6 | 97.4 / 98.4 | 97.6 / 98.3 |
| LLM(法学修士)として勤務 | 85.0 / 95.0 | 73.4 / 88.4 | 81.0 / 92.9 | 94.0 / 97.8 |
| 画像生成 | 82.3 / 89.3 | 63.9 / 72.7 | 81.9 / 94.3 | 91.8 / 97.1 |
| RAG | 76.2 / 89.7 | 65.3 / 72.5 | 88.9 / 93.4 | 93.2 / 96.8 |

デスクトップ用クーラーの性能は平均温度に最も顕著に表れており、両方のノートPCは全コアCPUテストを98℃の上限まで実行し、Blender、LLVMビルド、30分ループの平均温度は92℃から97℃でした。一方、EdgeMesaはBlenderで平均76.0℃、LLVMビルドで70.5℃、Cinebenchの単回実行で69.0℃となり、ノートPCよりも14℃から22℃低い温度で同じ作業をより早く完了しました。この余裕こそが、より高いクロック周波数を維持できる理由です。
ProArt GR1X は、同じスループットでも再び低温で動作しました。表の 7 つの CPU テストでは、平均 CPU 温度は EdgeMesa より 3℃ ~ 8℃ 低く、Blender では 70.0℃、LLVM ビルドでは 67.2℃、LLM サービング、RAG、画像生成では 11℃ ~ 18℃ 低くなりました。ピーク温度は、10 回のテストのうち 9 回で 90℃ 未満に抑えられました。負荷時の平均温度は、今回のデータで 2 つのデスクトップ間の最大の差です。
EdgeMesaは、Stockfishで105.3℃、30分ループで107.3℃、MLPerf Clientで124.7℃のサンプルを1つ記録したため、ピーク値はそれほど整然としていません。MLPerf Clientの平均は70.4℃で、これはセンサーのスパイクとして読み取れます。GPU負荷の高いLLMサービングでは、平均85.0℃で、HPの81.0℃とXPS 16の94.0℃の間に位置しました。ストレージテスト中、SSDは62℃以下に保たれました。
貯蔵性能
| fio、25GiBのフットプリント(数値が大きいほど良い) | MSI EdgeMesa N AI+ (N1X、128GB) | ASUS ProArt GR1X (N1X、64GB) | HP OmniBook Ultra 16 (N1X、128GB) | Dell XPS 16 Creator Edition (N1X、64GB) |
|---|---|---|---|---|
| シーケンシャル読み取り速度 128K (MB/秒) | 13,315 | 6,511 | 13,598 | 6,502 |
| シーケンシャル書き込み速度 128K (MB/秒) | 12,910 | 5,235 | 11,899 | 5,670 |
| ランダム読み取り4K、QD32 x 4ジョブ(IOPS) | 331,187 | 552,652 | 449,043 | 300,063 |
| ランダム書き込み4K、QD32 x 4ジョブ(IOPS) | 386,814 | 143,165 | 234,888 | 256,856 |

今回テストしたユニットに搭載されている4TBのSamsung製ドライブは、PCIe Gen5 x4で接続され、25GiBの容量で読み取り13,315MB/s、書き込み12,910MB/sというGen5シーケンシャル速度を実現しています。これは、HPに搭載されている2TBのSandisk Gen5ドライブの13,598MB/sと11,899MB/sに匹敵し、GR1XのGen4ドライブの6,511MB/sと5,235MB/s、XPS 16の6,502MB/sと5,670MB/sの2倍の速度です。複数のマルチギガバイトのモデルファイルを格納するシステムでは、容量と読み取り速度の両方が重要であり、上記のモデルロードの結果はそれを反映しています。

4 つのジョブにわたるキュー深度 32 でのランダム パフォーマンスはまちまちでした。EdgeMesa は書き込みで 386,814 IOPS を記録し、HP の 234,888 と XPS 16 の 256,856 を大きく上回り、読み取りでは 331,187 IOPS を記録し、HP の 449,043 に劣り、XPS 16 の 300,063 を上回りました。現在のスイートでは、キュー深度全体でピークも記録されており、Samsung ドライブは読み取りで 674,013 IOPS、書き込みで 608,063 IOPS に達しました。GR1X の Micron ドライブは、ランダム読み取りで 552,652 IOPS でグループをリードし、書き込みでは 143,165 でグループに劣りました。Samsung ドライブは、テスト中に 62C でピークに達しました。
結論
MSI EdgeMesa N AI+は、デスクトップ版RTX Sparkシステムで、ノートPCの筐体からデスクトップ版にすることで何かメリットがあるのかという疑問に答えてくれます。テストでは、負荷が持続するとメリットがあることが分かりました。最速のN1XノートPCと比較して、マルチコア処理能力が4~11%向上し、x265エンコードでは8~13%向上、27Bモデルに8つのリクエストが集中した場合の出力は18~25%向上し、いずれも平均温度は低くなっています。単一リクエストのAI作業や短時間のタスクは、4機種すべてでほぼ同じように動作します。

より多くの KV キャッシュでより大きなモデルを実行できる能力が、より小さなモデルよりも 128GB モデルを選択する理由であり、これはこれらのローカル AI システムすべてに共通するテーマです。Qwen-Image を Q8 で実行し、64GB RTX Spark システムでは実行できなかった 35B のコーディング エージェント モデルを実行しました。4TB Gen5 SSD により、これらのモデルに十分な容量と高速なロード時間を提供します。メモリのフットプリントが大きいため、より大きなモデルもロードできますが、モデル サイズが大きくなるにつれてトークン レートは低下します。制限は、いくつかのテストで CPU のピーク値が 100℃ を超えることと、M.2 2242 スロットが 1 つしかないことです。
テストしたもう1つのRTX SparkミニPCであるASUS ProArt GR1Xとの比較では、パフォーマンスは互角で、Cinebenchループ、Blender、x265エンコード、LLMサービングのいずれにおいても両者の差は2%以内でした。主な違いは冷却とストレージ拡張です。GR1XはCPU負荷時において平均で3℃から8℃低く動作し、M.2 2280スロットを2つ備えているのに対し、EdgeMesaにはM.2 2242スロットが1つしかありません。EdgeMesaはメモリが2倍で4TB Gen5 SSDを搭載しており、これらの2つのパーツによってモデルの読み込み速度や、各ユニットでスイートを実行したモデルティアが決まりました。
7,499ドルの希望小売価格の128GB EdgeMesaは、6,999.99ドルの128GB XPS 16 Creator Editionより約500ドル高く、6,229.99ドルの128GB OmniBook Ultra 16より約1,270ドル高い(これらのノートパソコンのレビュー価格を使用)。どちらのノートパソコンも出荷時には2TBのドライブが搭載されていたのに対し、こちらは4TB SSDを搭載している。購入者はデスクトップ版に高い金額を支払うことで、より大容量のドライブ、10GbE、および持続的な負荷によるパフォーマンス向上を得られる。また、4,499ドルの64GB ProArt GR1Xは、デスクトップ版で同じチップをより低価格で入手できる選択肢である。
MSIの製品ラインナップの中で、EdgeMesaはWindows環境で作業する開発者やクリエイターにとって、10GbEリンクと4台のディスプレイを備えたデスクでRTX Sparkプラットフォームを利用したい場合に最適な選択肢です。一方、EdgeXpertはクラスタリングとLinuxファーストの展開のためのDGX OSシステムとして引き続き提供されます。ノートPCと比較すると、EdgeMesaは持続的なパフォーマンスが向上し、平均温度も低くなりますが、携帯性は犠牲になります。いずれにせよ、顧客はローカルでのAI作業においてこれまで以上に多くの選択肢を持つようになり、Windowsエコシステムが成長し、これらのプラットフォームがより多くのユーザーにとって利用しやすくなっているのは素晴らしいことです。


 Amazon